Этот протокол описывает исследование обучения и памяти Drosophila, называемое обучением ухаживания. Этот классический анализ основан на сокращении мужского поведения ухаживания после сексуального отторжения невосприимчивой женщиной. Эта естественная форма поведенческой пластичности может быть использована для тестирования обучения, краткосрочной памяти и долговременной памяти.
Методическая статья
Дрозофила в качестве меры обучения и памяти
В этой статье
Краткое содержание
Аннотация
Многие идеи о молекулярных механизмах, лежащих в основе обучения и памяти, были выяснены с помощью простых поведенческих анализов в модельных организмах, таких как фруктовая муха, Drosophila melanogaster . Drosophila полезен для понимания основной нейробиологии, лежащей в основе когнитивных дефицитов, вызванных мутациями в генах, связанных с человеческими когнитивными расстройствами, такими как интеллектуальная инвалидность (ID) и аутизм. В этой работе описывается методология тестирования обучения и памяти с использованием классической парадигмы в Drosophila , известной как обустройство ухаживания. Самцы мух судака, используя четкую картину легко узнаваемых поведений. Препаренные самки не восприимчивы к спариванию и отказываются от попыток копуляции мужчин. В ответ на это отклонение мужские мухи уменьшают свое поведение по ухаживанию. Это научное сокращение поведения ухаживания измеряется с течением времени, выступая в качестве индикатора обучения и памяти. Основное числоРезультатом этого анализа является индекс ухаживания (CI), который определяется как процент времени, в течение которого мужчина проводит ухаживание в течение 10-минутного интервала. Индекс обучения (LI) является относительным уменьшением CI у мух, которые были подвержены домашней женщине по сравнению с наивными мухами без предыдущих социальных контактов. Для статистического сравнения LI между генотипами используется тест рандомизации с начальной загрузкой. Чтобы проиллюстрировать, как анализ может быть использован для решения роли гена, связанного с обучением и памятью, здесь характеризовался пан-нейронный нокдаун дигидроксиацетонфосфат-ацилтрансферазы ( Dhap-at ). Человеческий ортолог Dhap-at , глицерофосфатная O-ацилтрансфераза ( GNPT ) участвует в ризомелиновой хондродиплазии punctata типа 2, аутосомно-рецессивный синдром, характеризующийся тяжелым ID. Используя анализ кондиционирования ухаживания, было установлено, что Dhap-at требуется для долговременной памяти, но не длякраткосрочная память. Этот результат служит основой для дальнейшего изучения лежащих в основе молекулярных механизмов.
Введение
Молекулярные механизмы, лежащие в основе обучения и памяти, сохраняются во многих видах. Пионерская работа по скринингу мутанта Drosophila melanogaster для дефектов обонятельного обучения и памяти обеспечила ключевую молекулярную информацию о процессах, лежащих в основе обучения и памяти 1 . В этих исследованиях были обнаружены некоторые из первых генов, участвующих в обучении и памяти, таких как рутабага 2 , амнезия 3 и dunce 4 , выявляющие критическую роль для сигнализации 5 циклического аденозинмонофосфата (цАМФ).
Ранние генетические экраны для мутантов памяти были в основном проведены с использованием обонятельной кондиции. Однако с течением времени появилось несколько методов измерения других форм обучения и памяти. Одна из наиболее широко используемых парадигм обучения и памяти и описанный здесь анализ известен как cКоторый впервые был описан Зигелем и Холл 6, а позже был усовершенствован несколькими другими исследовательскими группами 7 , 8 , 9 . Кондиционирование суставов зависит от присутствия специфического феромона, цис- ваккенилацетата (cVA) на женском животе, который осаждается самцом во время спаривания. Наблюдение cVA на женском животе естественно снижает ухаживающее поведение, и в сочетании с актом отклонения женского пола эффект cVA на сокращение ухаживания мужчин значительно увеличивается. Реакция мужских мух в этом анализе может быть легко определена количественно, наблюдая их четкое поведение ухаживания, которое характеризуется ориентацией на женщину и ее последующим выступом, растяжением и вибрацией крыла, лизанием и попыткой совокупления 10 ( рисунок 1A ). Мужские мухи учатся различать Ч между восприимчивой девственницей и невосприимчивыми матерями-женщинами 11 , а после полового отторжения они демонстрируют снижение поведения ухаживания по отношению к невосприимчивым женщинам на срок до 9 дней 8 . Это естественное поведение может быть использовано для выяснения механизмов обучения, краткосрочной памяти (STM) и долговременной памяти (LTM) 8 , 9 , 12 . Обучение определяется как немедленное снижение поведения ухаживания, которое происходит в течение периода обучения, и часто упоминается как память немедленного восстановления, измеренная через 0-30 мин после контакта с женщиной 6 , 8 . STM измеряется между 30 и 1 часами после тренировки, а LTM чаще всего измеряется через 24 часа после тренировки 8 ( рисунок 1B ). STM может быть вызван с использованием 1-часового периода обучения, но он длится только 2-3 часаS = "xref"> 6 , 8 . В большинстве обучающих парадигм, LTM может быть вызван только разнесенными приступами повторного обучения. Mcbride et al . (1999) 8 показали, что трех интервальных тренингов продолжительностью 1 час было достаточно, чтобы вызвать ухаживание, продолжающееся до 9 дней, в отличие от 2-3 часов, вызванных одной тренировкой в течение 1 часа. McBride et al . 8 также продемонстрировал, что в одном 5-часовом учебном сеансе был получен аналогичный ответ LTM на срок до 9 дней. Мухи не судят постоянно в течение этого 5-часового периода, фактически производя свое собственное разнесенное обучение, чтобы побудить ЛТМ на одной тренировке. Это очень важно с практической точки зрения, значительно увеличивая легкость, с которой этот анализ может быть использован для исследования LTM. Существующие протоколы преимущественно используют единую тренировочную сессию 7 часов для LTM 11 , 12 . В нескольких исследованияхМутантные условия, которые имеют определенные недостатки в разных аспектах обучения ухаживанию. Например, абсорбция тела грибов влияет на STM и LTM, но не на обучение 8 . Мутации в амнезиакном гене, который впервые был определен как специфический регулятор памяти с использованием обонятельного кондиционирования 3 , влияют на STM, но не на обучение 6 . Нарушение регулятора трансляции orb2 (oo18 РНК-связывание (orb) подсемейства CPEB2) и сигнализация ecdysone исключительно влияют на LTM 9 , 13 . Таким образом, обустройство ухаживания является полезной парадигмой для анализа механизмов, лежащих в основе различных этапов обучения и памяти.
Эта работа демонстрирует оптимизированную экспериментальную установку, которая позволяет относительно высокопроизводительное тестирование кондиционирования ухаживания. Кроме того, он описывает сценарий статистического анализа и обсуждает критические факторы анализа. Это shЧто ген Drosophila Dihydroxyacetone phosphate acyltransferase ( Dhap-at ) Требуется для нейронов для LTM, но не для STM. Человеческий ортолог этого гена, глицерофосфатная O-ацилтрансфераза ( GNPAT ), мутируется в ризомелиновой хондродисплазии punctata типа 2 14 , аутосомно-рецессивное расстройство, характеризующееся тяжелой умственной недееспособностью, судорогами и рядом других клинических характеристик 15 . В этом контексте обустройство ухаживания может быть использовано для функциональной проверки роли генов человеческой болезни в обучении и памяти, что является основой для механистических исследований.
Протокол
ПРИМЕЧАНИЕ. В протоколе, описанном ниже, описывается один повтор сбора, обучения и тестирования. Чтобы проверить воспроизводимость результатов, эти шаги следует повторять параллельно, в течение нескольких дней и с отдельными группами мух ( таблица 1) . Протокол основан на 10-дневном жизненном цикле от яйца до взрослого, что является нормальным при выращивании мух в постоянных условиях 25 ° C, влажности 70% и 12-часовом световом / темном цикле. Все аспекты этого протокола предполагают, что условия сохраняются постоянными на протяжении всего анализа. Времена обозначаются как часы до включения ламп (BLO) или после включения ламп (ALO) в инкубаторе, так как это удобно устанавливать в зависимости от предпочтительного времени суток исследователя. Используйте газ CO 2 только для первоначального сбора наивных мужских мух и для сбора вышедших женщин. Этот протокол для обустройства ухаживания состоит из следующих шагов:
- ЕСоздание культивируемых культур женской коллекции
- Создание культур для сбора мужских испытуемых
- Подготовка корпусных блоков
- Создание спаривающих флаконов для производства стандартизированных самок
- Коллекция мужских испытуемых
- Обучение
- тестирование
- Анализ видеоданных и статистика
1. Учреждение высших женских коллекционных культур
- Подготовьте питательную пищу 16 . Вареный 0,8% (мас. / Об.) Агар, 8% (мас. / Об.) Дрожжей, 2% (мас. / Об.) Дрожжевого экстракта, 2% (мас. / Об.) Пептона, 3% (мас. / Об.) Сахарозы, 6% Мас. / Об.) Глюкозы, 0,05% (мас. / Об.) MgSO 4 и 0,05% (мас. / Об.) CaCl 2 в воде в течение 15 мин. Дайте раствору остыть до 70 ° C перед добавлением 0,05% (мас. / Об.) Метилпарабена (ПРЕДОСТЕРЕЖЕНИЕ: токсичное) и 0,5% (об. / Об.) Пропионовой кислоты (ПРЕДОСТЕРЕЖЕНИЕ: токсичное). Хорошо перемешать при перемешивании при охлаждении до 50 ° С с получением гомогенного раствора.
- До еды такПри комнатной температуре, добавьте ~ 50 мл питательной пищи на каждый флакон объемом 175 мл. Дайте пищу охладиться дальше. Закройте флакон с помощью вилки.
ПРИМЕЧАНИЕ. Powerfood - это специальная пищевая смесь, разработанная специально для производства большого количества мух, возможно, путем индукции укладки яиц. Powerfood не используется для производства мужских мух, которые будут использоваться для анализа поведения (шаг 2), потому что атипичная диета и потенциальная скученность могут влиять на развитие. - В день -11 ( таблица 1 ) запустите 5-20 культур дикого типа с примерно 60-100 мухами (смесью самцов и самок) в флаконах с питанием; Они будут использоваться на этапе 4 для производства стандартизованных самок 17 . Добавьте фильтровальную бумагу в каждый флакон, чтобы увеличить площадь, на которой личинки могут окукливаться; Это увеличит количество мух, которые могут разрастись.
- Периодически повторяйте шаги 1.1-1.3 на протяжении всего эксперимента, чтобы получить достаточное количество вновь исчезающих мух в качестве входных данных для«Создание спаривающих флаконов для производства стандартизированных самок» (шаг 4).
2. Создание культур для сбора мужских испытуемых
- Подготовьте нормальное питание 16 , приготовленное с 0,5% (мас. / Об.) Агаром, 2,75% (мас. / Об.) Дрожжей, 5,2% (мас. / Об.) Кукурузной муки, 11% (мас. / Об.) Сахара, 0,05% ) Метилпарабена и 0,5% (об. / Об.) Пропионовой кислоты в воде, как описано в шагах 1.1 и 1.2. Закройте пластиковые флаконы емкостью 175 мл с пробкой для флаконов.
- В день -10 ( таблица 1 ) поместите около 10-20 мужчин с приблизительно 30-75 девственными самками ( Таблица материалов / оборудования ) в каждый флакон объемом 175 мл, содержащий нормальную пищу. Добавьте фильтровальную бумагу, чтобы увеличить площадь поверхности для окукливания и увеличить производительность.
- Установите три-шесть флаконов по 175 мл на каждый генотип, чтобы получить необходимое количество мужчин-испытуемых.
ПРИМЕЧАНИЕ. Может потребоваться больше флаконов, в зависимости от производительности желаемого генаotype.
3. Подготовка блоков корпуса ( рис. 2А )
- Растопите приблизительно 50 мл питательной пищи на корпус в микроволновой печи или подготовьте его свежим.
- Добавьте 500 мкл питательной пищи в каждую лунку 96-луночного плоского нижнего блока, используя пипетку мультидисперсера.
- Дайте пищевку застыть при комнатной температуре.
- Накройте блоки ПЦР-клейкой пленкой и используйте иглу, чтобы сделать по меньшей мере 4 отверстия на лунку, чтобы обеспечить свежий воздух мухам.
- Чтобы иметь возможность открывать каждую лунку, используйте лезвие бритвы, чтобы разрезать клейкую пленку вдоль каждого ряда. Оставьте пленку неповрежденной на одном конце блока.
- Блоки можно хранить при температуре 4 ° C в течение 2 дней.
ПРИМЕЧАНИЕ. Разрешите блокам переустановить до комнатной температуры до использования.
4. Создание спаривающих флаконов для производства стандартизированных пернатых женщин
- В день -1 удалите иОтбросить все взрослые виды диких видов из готовых женских коллекционных культур в 2-5 ч BLO.
- Собирайте мухи с помощью аспиратора ( рис. 2B ) из этих флаконов с интервалом 2-3 часа ( например, через 30 минут, 2,5 часа и 5 часов ALO) и размещайте их в новой флаконе с питанием, дополненной небольшим количеством дрожжей Пасты и фильтровальной бумаги.
- Чтобы избежать толпы и способствовать оптимальной спаривающей атмосфере, не переносите более 150-200 мух в каждый новый флакон. Обеспечьте спаривание всех самок, обеспечив не менее 25% мужчин. Убедитесь, что достаточное количество самок присутствует в спаренных флаконах, чтобы соответствовать размеру эксперимента.
ПРИМЕЧАНИЕ. Поскольку это важный шаг в протоколе, убедитесь, что только свежезакрытые мухи и никакие старые мухи, личинки или куколки не переносятся в новый спаривающий флакон. - Инкубируйте эти «спаривающиеся флаконы» в течение четырех дней, чтобы дать достаточное время для того, чтобы все женщины спаривались.
5. Кол.Лекция мужских испытуемых
- На 1-й день ( таблица 1 ) в 2-3 часа BLO используйте CO 2 для удаления всех взрослых мух из мужских коллекционных флаконов (этап 2), Но пусть больше летит мух в течение следующих нескольких часов.
- В течение следующих 5-6 часов удалите вновь закрытых мух каждые 20-30 минут, используя CO 2, и поместите каждого самеца в отдельную лунку блока корпуса (шаг 3) с помощью аспиратора ( рисунок 2B ).
- Повторно запечатать колодец с помощью клейкой ПЦР-пленки.
ПРИМЕЧАНИЕ. Это важный шаг в протоколе. Собаки должны собираться часто. Собранные самцы должны быть изолированы в жилищном блоке близко к времени эклезии, когда они демонстрируют бледную пигментацию и присутствие мекония в полупрозрачном животе.
ПРИМЕЧАНИЕ. Нежное использование аспиратора позволяет переносить мух; Однако ненадлежащее использование будет подчеркивать мух, вызывая отклонение в анализе (см. Обсуждение). - Цель сотрудничестваДо 48 мужчин на генотип. Это обеспечивает небольшой избыток максимального количества мужчин, необходимых для анализа как наивных, так и обученных условий, что позволяет получить некоторую потерю во время последующих шагов передачи.
6. Обучение
- Удалите мух из спаривающего флакона (шаг 4.2) с использованием CO 2 и отделите вышеперечисленных самок от самцов.
- Используя аспиратор, добавьте одну обезжиренную, помещенную женщину в каждую лунку в одном ряду нового блока корпуса.
- Используя аспиратор и без анестезии, перенесите отдельного наивного мужчину из блока корпуса, установленного на этапе 5.2, в лунку, содержащую самок. После того, как самец помещают в лунку, немедленно запечатывайте его с помощью клейкой пленки; Не позволяйте мужчине скрыться.
ПРИМЕЧАНИЕ. Передача самец летит от аспиратора к блоку корпуса, пользуясь их естественным поведением «отрицательного геотаксиса» (см. Обсуждение). - Повторите шаги6.2-6.3 до тех пор, пока не будут установлены достаточно пары мужчин и женщин. В идеале, установите 24 пары, два полных ряда жилого блока, по генотипу. Оставьте оставшихся наивных мужчин в исходном корпусе, установленном на шаге 5.2.
- Оставьте пары мужчин и женщин ненарушенными в течение периода обучения ( Таблица 2 , Рисунок 1B ).
ПРИМЕЧАНИЕ. В течение этого времени мужчина будет судить и быть отвергнутым женщиной, вышедшей на родину. Для обучения и STM период обучения составляет 1 час, а для LTM период обучения составляет 7-9 часов. - Завершите тренировку ( таблица 2 , рис. 1B ) с помощью аспиратора, чтобы осторожно отделить самца от вышедшей женщины; Не используйте анестезию. Поместите отдельный самец в новый корпус.
- Используйте аспиратор для переноса всех наивных мужчин мягко и без анестезии из блока корпуса, установленного на шаге 5.2, в новый блок корпуса.
ПРИМЕЧАНИЕ. Этот шаг является необязательным для STM и leaНо это очень важно для LTM, потому что мухи помещаются на дополнительные 24 часа для тестирования LTM. - Для STM и LTM разрешите самцам отдыхать в течение 1 ч и ~ 24 ч, соответственно ( таблица 2 , рис. 1В ) перед тестированием (шаг 7).
- Для обучения немедленно испытайте обученных и наивных мужчин (шаг 7).
7. Тестирование
- Собирайте мухи из спаривающих флаконов (этап 4.2) с использованием CO 2 и отделяйте вышеперечисленных самок от самцов.
- Позвольте самкам оправиться от анестезии в течение по крайней мере 1 часа во флаконе, содержащем нормальную пищу.
- Установите видеомагнитофоны заранее ( рисунок 2C ), чтобы все оборудование было готово до начала тестирования.
- Начните тестирование в соответствии с различными сроками обучения, STM и LTM ( таблица 2 , рисунок 1B ). Выполните тестирование сразу после обученияДля обучения, через 1 час после тренировки для STM и через 24 часа после тренировки для LTM.
- Используя аспиратор, осторожно перенесите отдельного самец из блока жилого корпуса или из блока корпуса для тренировки, если обучение тестируется (шаг 6.7, подготовленный, шаг 6.8, наивно) до половины арены ухаживания с закрытым разделителем ( рис. 2D , См. Файл S1 для плана здания).
ПРИМЕЧАНИЕ. Использование естественного поведения «отрицательного геотаксиса» должно быть достаточным для перевода мужских мух от аспиратора на арену ухаживания (обсуждение). - Быстро, но аккуратно переместите отверстие для входа на следующую арену и повторите шаг 7.5, пока все 18 аренов не содержат одного самеца.
- Используя аспиратор и без CO 2 , добавьте одну здоровую женщину (собранную на шаге 7.2) к другой половине всех 18 арен.
- Осторожно поместите камеру ухаживания под камеру, с открытием колодцев вниз ( рис. 2C ).
- Удалите разделитель арены, чтобы обеспечить прямое взаимодействие между самцами и вышедшими самками.
- Немедленно начните записывать поведение не менее 10 мин.
ПРИМЕЧАНИЕ. При использовании настройки с двумя камерами параллельная запись двух плат ухаживания может быть выполнена в перекрывающиеся таймфреймы для максимальной эффективности. - Опорожните арены для ухаживания с помощью ручного пылесоса и позвольте кабине для ухаживания проветриваться перед повторным использованием.
- Повторите шаг 7.4-7.11 до тех пор, пока не будет завершено тестирование всех генотипов и условий ( т.е. наивных и подготовленных).
8. Анализ и статистика видеоданных
- Вычислите индекс ухаживания (CI), определяемый как процент времени, в течение которого суды мужчин в течение первых 10 минут испытательного периода, для каждого отдельного мужчины летят.
ПРИМЕЧАНИЕ. Это можно сделать вручную, наблюдая стереотипное поведение ухаживания ( рис. 1A ) или uПеть компьютерное программное обеспечение для автоматизированного количественного определения поведения ухаживания (обсуждение).
ПРИМЕЧАНИЕ. Рекомендуется анализировать 40-60 мужчин на состояние в течение трех дней, чтобы обеспечить достаточную статистическую мощность и судить о соответствии данных CI. - Вычислите индекс обучения (LI), определяемый как процентное снижение среднего CI обученных мужчин по сравнению с наивными мужчинами (LI = (CI наивный - CI обученный ) / CI наивный ). Оцените LI для каждого дня тестирования и сравните его с кумулятивным LI, рассчитанным по всем комбинированным дням тестирования.
- Создайте отдельный файл данных вкладки с двумя столбцами с заголовками «Genotype» и «CI».
ПРИМЕЧАНИЕ. Эти заголовки чувствительны к регистру. Название генотипа для каждого CI должно состоять из описания генотипа с последующим подчеркиванием и условием обучения ( например, genotype_N и genotype_LTM и т. Д., Где N = наивный и LTM = долгосрочныйПамять; См. Дополнительный файл S2 для примера). Эта аннотация важна, так как функция analearn будет идентифицировать обученных и наивных мух на основе символов, присутствующих после первого подчеркивания в столбце «генотип». - Используйте скрипт analearn R (дополнительный файл S3), чтобы выполнить тест рандомизации, чтобы судить о статистической значимости различий между значениями LI от разных генотипов.
- Отправьте скрипт (дополнительный файл S3) в R 18 , который определяет функцию, называемую «analearn».
ПРИМЕЧАНИЕ. Определение функции: analearn <- function (nboot = 10,000, naivelevel = 'N', refmutation = NA, datname = NA, header = TRUE, seed = NA, writeoutput = TRUE). - Запустите функцию, введя «analearn ()» в командной строке R и выбрав файл данных, подлежащий анализу (подготовленный на шаге 8.3), во всплывающем окне.
- Выберите ссылочную мутацию, котораяЯвляется контрольным генотипом, введя соответствующий номер и нажав enter.
ПРИМЕЧАНИЕ. После выбора эталонного генотипа сценарий занимает несколько секунд, чтобы выполнить 10 000 реплик bootstrap. - Наблюдайте таблицу выходных данных (таблица 3), которая содержит генотип, состояние обучения ( то есть обучение, STM или LTM), среднее значение CI наивно, среднее CI, LI, разница между LI контроля по сравнению с экспериментальным состоянием (LI dif), нижний предел (LL) и верхний предел (UL) 95% доверительного интервала LI dif и p- значение, указывающее вероятность отсутствия существенной разницы.
ПРИМЕЧАНИЕ. Analearn будет хранить выходной текстовый файл в каталоге, где находится файл данных. Однако выходная таблица также появляется в консоли R-Studio. Имя по умолчанию создается на основе имени предоставленного файла данных. - Существует несколько аргументов в функции аналога, которые могут быть использованы для изменения deНастройки ошибок функции для настройки параметров начальной загрузки.
ПРИМЕЧАНИЕ: «nboot» определяет количество реплик bootstrap и по умолчанию установлено 10 000. Это значение можно изменить на любое целое число, большее нуля. В таблице 5 приведены несколько аргументов, которые можно использовать для изменения настроек по умолчанию для этой функции. Тем не менее, не рекомендуется использовать данные, которые создаются с небольшим количеством реплик bootstrap.
- Отправьте скрипт (дополнительный файл S3) в R 18 , который определяет функцию, называемую «analearn».
Результаты
Анализ кондиционирования ухаживания может использоваться для измерения обучения и памяти в Drosophila . Чтобы продемонстрировать это, результаты, представленные здесь, анализируют STM и LTM у контрольных мух по сравнению с мухами с нейроно-специфическим нокдауном Dhap-at. Контрольные самцы экспрессируют интерференционную последовательность шпилек РНК, нацеленную на специфический ген Caenorhabditis elegans , предполагаемый белок цинкового пальца C02F5.12 19 . Этот контрольный штамм обеспечивает равное количество элементов активирующей последовательности восходящего потока (UAS) между нокдауном и контролем в том же генетическом фоне, а контрольная шпилька RNAi учитывает любые неспецифические эффекты системы RNAi. Контрольные самцы (генотип: UAS-dcr2 / +; P {KK108109} VIE-260B / +; elav-Gal4 / + ) показывают значительное снижение CI в тренированных и наивных для обоих STM ( рис. 3A , p = 1,2 × 10 - 4 , Манн-УитнY U-тест) и LTM ( рисунок 3B , p = 1,2 × 10 -4 , U-тест Манна-Уитни). Этот результат отражает нормальную способность к обучению и памяти у этих мух. Dhap - у нокдаун-мух (генотип: UAS-dcr2 / +; P {KK101437} VIE-260B / +; elav-Gal4 / + ) также демонстрируют значительное снижение CI у обученных против наивных мух для STM ( рис. 3A , p = 1,2 × 10 -4 , U-тест Манна-Уитни). Однако они не показывают значительного снижения CI после обучения LTM ( рисунок 3B , p = 0,33, U-тест Манна-Уитни). У-тест Mann-Whitney использовался для сравнения среднего CI наивных и обученных мух из-за непараметрического распределения данных CI для некоторых условий ( рис. 3A и 3B ). Различия, наблюдаемые в результате анализа CI, отражаются LI для каждого генотипа, который измеряет процентное соотношениеВ КИ в наивных и опытных мухах ( рис. 3C ). Нет существенной разницы в LI между контрольными элементами и Dhap-при нокдаун-мух для STM ( p = 0,155, 10000 бутстрапов, рис. 3C , таблица 3 ), тогда как LI для LTM значительно ниже в Dhap-у нокдаун-мух ( p = 0,0034, 10000 копий бутстрапа, Рисунок 3C , Таблица 3 ). Для сравнения LI между генотипами тест 20 рандомизации, адаптированный из метода, впервые рекомендованного Камышевым и др. 7 . Поскольку LI - это одно значение, полученное из данных о населении ( т. Е. Среднее CI-наивное и среднее CI-обучение), стандартные статистические методы, основанные на экспериментально полученных распределениях, не применяются. Тест рандомизации не распространяется на распределение и использует загрузку ( т. Е. Случайные sampliNg с заменой), чтобы генерировать гипотетические наборы данных, полученные из фактических данных. Сценарий analearn (файл S3) генерирует набор гипотетических LI для каждого генотипа и вычисляет разницу между контролем и тестовым генотипом (LIdiff). Этот процесс повторяется 10000 раз, и полученные значения используются для определения 95% доверительного интервала LIdiff ( таблица 3 ). Эти данные используются для генерации p- значения, указывающего вероятность того, что LI двух генотипов отличается. Результаты, показанные здесь, показывают, что Dhap-at требуется в нейронах для LTM, но не для STM.
Чтобы контролировать повседневную изменчивость, CI и LI сравниваются между повторяющимися днями ( Таблица 4 ). Хотя некоторые колебания LI наблюдаются изо дня в день, результаты, как правило, воспроизводимы. Важно отметить, что данные CI могут сильно варьироваться в зависимости от управляющей strAin и условия окружающей среды для тестирования. Данные CI, показанные здесь, типичны для этого контрольного генотипа, но другие генотипы могут иметь более высокий или более низкий средний CI и распределение.
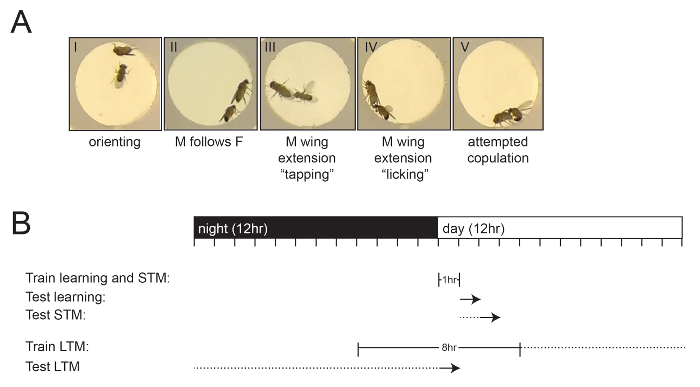
Рисунок 1: Определение индекса ухаживания и экспериментального обзора. ( A ) Изображения, показывающие стереотипное поведение супружеского ухаживания по отношению к женщине. Показаны различные этапы поведения ухаживания: ориентация (I), следующая (II), вибрация (растяжение) крыла и постукивание (III), лизание (IV) и попытка совокупления (V). ( B ) Схематический обзор времени обучения и тестирования относительно цикла освещения инкубатора, отмеченного в часах. Время обучения указано в барах, периоды отдыха для STM и LTM обозначены пунктирной линией, а начальная точка тестирования указана как стрелка. Обратите внимание, чтоВремя тестирования для LTM на следующий день после тренировки. Нажмите здесь, чтобы просмотреть увеличенную версию этого рисунка.
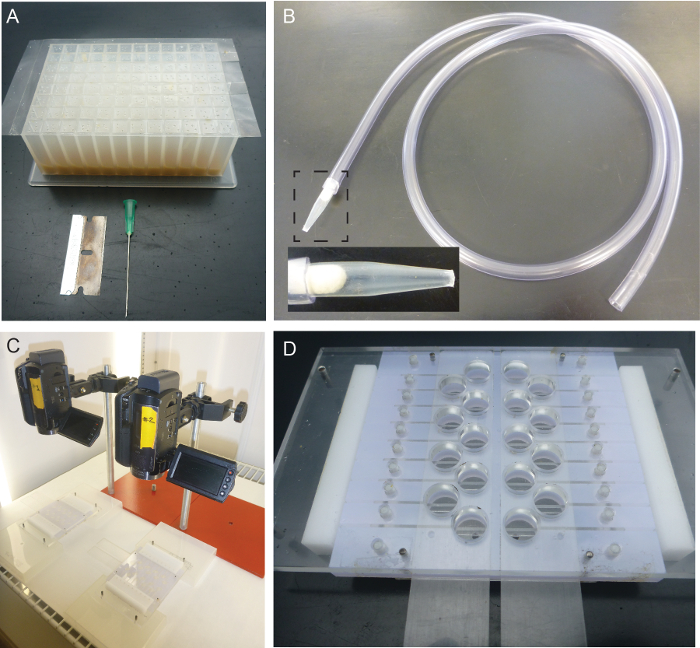
Рисунок 2: Оборудование, используемое для анализа кондиционирования суставов Drosophila. ( A ) Жилищный блок представляет собой плоский нижний блок с 500 мкл энергетической энергии на лунку. Он запечатывается клеящей пленкой qPCR с по меньшей мере 4 отверстиями на лунку, которые были созданы с помощью иглы шприца диаметром 0,8 мм. Отдельные ряды разрезаются продольно на полоски, используя лезвие бритвы, чтобы можно было открывать и закрывать. ( B ) Аспиратор необходим для нежной передачи мутантов и самцов без использования анестезии. На вставке показан кончик аспиратора, закрытый куском хлопка до кеEp мух внутри наконечника. ( C ) Настройка двухкамерной системы для одновременной записи двух ухаживающих камер. ( D ) Ухаживающая камера с 18 аренами. Раздвижные входные отверстия используются для размещения мух на аренах. Белые разделители можно одновременно открыть, чтобы инициировать взаимодействие между самцами и самками. Нажмите здесь, чтобы просмотреть увеличенную версию этого рисунка.
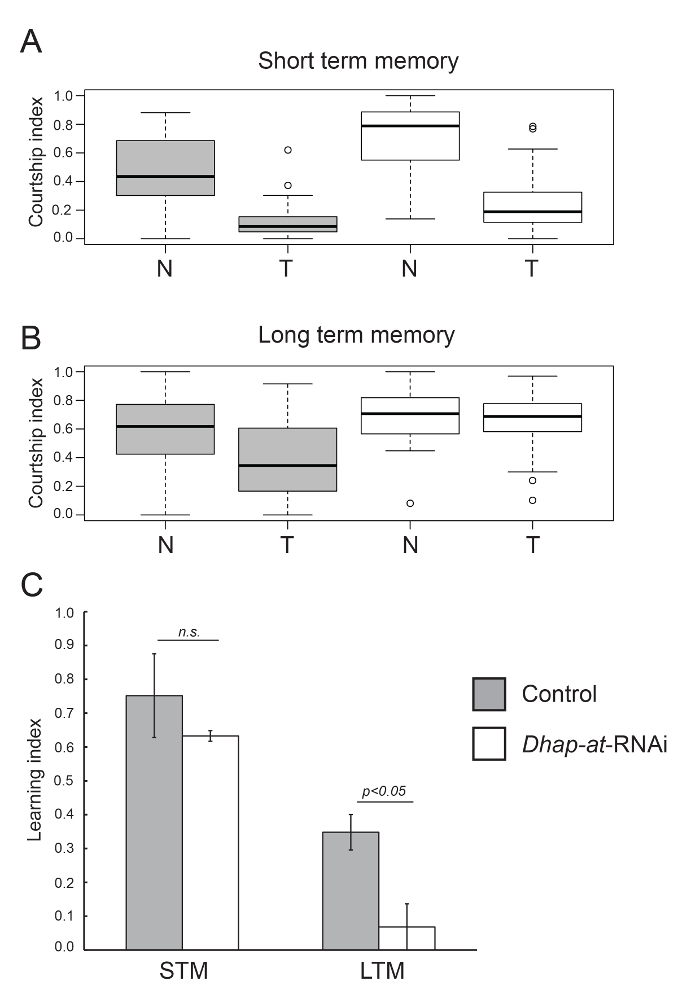
Рисунок 3: Анализ STM и LTM в контроле и Dhap-Knockdown Flies. ( AB ). Коробки, показывающие распределение значений CI для наивных (N) и обученных (T) мух контрольных (серых) и Dhap- нокаутированных (белых) генотипов, проверенных для STM (A) и LTM (B). ( C ) КорреспоЗначения LI для управления и Dhap-на нокдаун-мух, протестированных для STM и LTM. Различия в LI между генотипами контроля и нокдауна сравнивались с использованием теста рандомизации (10000 копий бутстрапа). Таблицы ошибок указывают на стандартную ошибку среднего, полученную из значений LI, рассчитанных в разные тестовые дни. Генотипы: w +, UAS-dcr2 / + ; P {KK108109} VIE-260B / + ; И elav-Gal4 / + (контроль) И w +, UAS-dcr2 / + ; P {KK101437} VIE-260B / +; И elav-Gal4 / + ( Dhap-at- RNAi). Нажмите здесь, чтобы просмотреть увеличенную версию этого рисунка.
| Генеральная | собирать | Поезд | Контрольная работа | |
| День -11 | Начать готовые женские коллекции культур (шаг 1.3) | |||
| День -10 | Начать культуру для сбора мужских испытуемых (шаг 2.2) | |||
| 1 день | по донесению 1 | |||
| день 2 | по донесению 2 | |||
| День 3 | по донесению 3 | |||
| День 4 | по донесению 4 | по донесению 1 | ||
| День 5 | по донесению 2 | по донесению 1 | ||
| День 6 | по донесению 3 | по донесению 2 | ||
| День 7 | по донесению 4 | по донесению 3 | ||
| День 8 | по донесению 4 | |||
| День 9 | Анализ и статистика видеоданных (шаг 8) | |||
| Rep = повторить | ||||
Таблица 1 : Пример временной шкалы для тестирования LTM над тремя репликами в отдельные дни.
| Обучение | STM | LTM | |
| Тренировочное время | 1 ч. | 1 ч. | 8 ч. |
| Время отдыха | 0 ч. | 1 ч. | ~ 24 ч. |
| Начать обучение | 0час ALO | 0 ч. ALO | 4 ч. BLO |
| Прекратить обучение | 1 ч. ALO | 1 ч. ALO | 4 ч. ALO |
| Начать тест | 1 ч. ALO | 2 ч. ALO | 0 ч. ALO (на следующий день) |
| ALO = после включения индикаторов, BLO = перед включением фары, STM = кратковременная память, LTM = долговременная память | |||
Таблица 2 : Продолжительность обучения, время обучения и время тестирования для обучения, STM и LTM.
| Генотип | Обучение состояние | CI наивный | CI обученный | LI | LI разница | Нижний предел (95% доверительный интервал) | Верхний предел (95% доверительный интервал) | р-значение |
| контроль | STM | 0,467 | 0,116 | 0,752 | Не Доступно | Не Доступно | Не Доступно | Не Доступно |
| DHAP-на-RNAi | STM | 0,699 | 0,257 | 0,633 | 0,119 | -0,030 | 0,265 | 0,116 |
| контроль | LTM | 0,590 | 0,384 | 0,348 | Не Доступно | Не Доступно | Не Доступно | Не Доступно |
| DHAP-на-RNAi | LTM | 0,697 | 0,650 | 0,068 | 0,280 | 0,103 | 0,446 | 0,003 |
Таблица 3: Статистические данные, подготовленные по аналоговому сценарию.
Статистические данные, полученные из сценария сравнения. Выходной файл загрузочного R-скрипта, содержащего генотип, условие обучения ( т. Е. Обучение, STM или LTM), означает CI наивный, средний CI, LI, разница между LI контроля по сравнению с экспериментальным условием (LI diff) , Нижний предел (LL) и верхний предел (UL) 95% доверительного интервала LI dif и p- значение, указывающее вероятность отсутствия существенной разницы.
| контроль | DHAP-на-RNAi | ||||||
| Средний CI наивный | Средний CI | LI | Средний CI наивный | Средний CI | LI | ||
| STM | 1 день | 0,300 | 0,125 | 0,584 | 0,679 | 0,239 | 0,648 |
| День 2 | 0,634 | 0,107 | 0,831 | 0,720 | 0,276 | 0,617 | |
| Все дни | 0,467 | 0,116 | 0,752 | 0,699 | 0,257 | 0,633 | |
| LTM | 1 день | 0,590 | 0,441 | 0,252 | 0,630 | 0,646 | -0,027 |
| День 2 | 0,640 | 0,363 | 0,432 | 0,709 | 0,710 | -0,002 | |
| День 3 | 0,547 | 0,349 | 0,363 | 0,738 | 0,598 | 0,190 | |
| Все дни | 0,590 | 0,384 | 0,348 | 0,697 | 0,650 | 0,068 |
Таблица 4 : Значения CI и LI, полученные в отдельные дни тестирования.
| «Naivelevel» определяет текст, который будет определять наивные значения для каждого генотипа. Значение по умолчанию - «N», но это может быть изменено на любой другой буквенно-цифровой текст. |
| «Refmutation» по умолчанию устанавливается «NA» (не применимо), но может быть изменено на имя элемента управления или генотипа для выполнения статистических сравнений. Это приведет кCript, чтобы автоматически выбрать контрольный генотип. |
| «Datname» относится к имени файла данных и может быть указано в этом аргументе вместо выбора файла по умолчанию. |
| «Header» может использоваться для указания, содержит ли файл данных заголовки столбцов. По умолчанию используется значение «TRUE», но файл, не содержащий заголовков, может использоваться, когда этот аргумент изменен на «FALSE». |
| «Seed» инициализирует генератор случайных чисел, который по умолчанию устанавливается «NA» и обеспечивает случайное число при каждом использовании сценария. По дизайну, анализ начальной загрузки будет давать несколько разные результаты при каждом запуске, даже при использовании одного и того же файла данных. Когда семя задается любым целочисленным числом, большим нуля, получается тот же набор выборок случайного бутстрапа. |
| "Написать Put "может быть установлен на" TRUE "или" FALSE ", чтобы определить, будет ли генерироваться выходной файл. По умолчанию используется значение «ИСТИНА». |
Таблица 5: Аргументы, используемые в функции Analearn, которые могут изменять настройки по умолчанию для функции «Настройка параметров начальной загрузки»
Дополнительный файл S1: План строительства камеры ухаживания. Файл можно открыть с помощью любого приложения, которое поддерживает расширения .stp (CAD-файлы) . Нажмите здесь, чтобы загрузить этот файл.
Дополнительный файл S2 : пример входного файла для скрипта Analearn .S2.zip "target =" _ blank "> Нажмите здесь, чтобы скачать этот файл.
Дополнительный файл S3 : The Analearn.R Acript. Файл можно открыть с помощью R-studio 18 . Нажмите здесь, чтобы загрузить этот файл.
Обсуждение
Анализ кондиционирования ухаживания является классической парадигмой для анализа обучения и памяти в Drosophila . Представленный здесь протокол следует общей методологии, описанной ранее 6 , 7 , 8 , 9, но включает в себя уникальные аспекты, такие как практические рекомендации, специализированное оборудование и сценарий анализа данных 9 , 12 для тестов рандомизации. Используя этот протокол, можно анализировать большое количество мух параллельно с использованием 96-луночных плоских блоков ( рис. 2А ) для сбора и обучения самцов. Блоки запечатываются ПЦР-клейкой пленкой, благодаря чему мухи легко доступны по мере необходимости. Кроме того, уникальные ухаживающие камеры, описанные здесь, допускают одновременное сопряжение 18 пар мужчина-женщина в почти двумерном пространстве, что iОптимальный для видеоанализа. Специально разработанные ухаживающие камеры просты в использовании, и предусмотрен план здания ( файл S1 , рисунок 2D ). Этот протокол, начиная с создания культур, используемых для сбора испытуемых на получение видеоданных, занимает приблизительно 20 дней ( таблица 1 ). Для анализа видеоданных требуется дополнительное время. По нашему опыту, анализ STM является чрезвычайно надежным. Анализ LTM также довольно устойчив, но он более чувствителен к смешиванию переменных окружения и поэтому может быть сложнее освоить.
Поведение животных может быть довольно переменным. Поэтому критические шаги в протоколе должны выполняться с осторожностью, чтобы уменьшить эту дисперсию. Во-первых, нежное использование аспиратора ( рис. 2B ) уменьшит напряжение, которое может быть наложено грубой обработкой или слишком сильно выдувается. Предлагаемый способ передачи отдельныхВылетает из аспиратора, используя отрицательную геотаксис. Поскольку мухи склонны подниматься, можно просто указать кончик аспиратора; Как раз перед тем, как муха достигнет кончика, нежного удара достаточно, чтобы вылететь. Кроме того, чтобы позволить мужчинам в кабины ухаживания перед тестированием, удар часто не нужен.
Другим важным шагом является сбор и генерация мужских испытуемых. Все мужчины должны собираться, когда они очень молоды и социально наивны. Это может быть достигнуто путем частых сборов во время пиковых периодов экклюзии (шаг 5.2). Если самцы не собираются в этот ограниченный промежуток времени, они могут иметь ранние социальные взаимодействия, что может привести к плохому обучению или высокой вариативности в КИ. Другим фактором мужских испытуемых, которые должны быть оценены, является генетический фон. Различные генетические основы будут демонстрировать различные уровни наивного ухаживания и могут также отличаться в общей активности или локомоторной способности. Когда compaКольцу несколько генотипов, следует соблюдать осторожность в отношении генетического фона, чтобы избежать этих смешающих факторов, которые могут повлиять на оценки LI. Кроме того, следует тщательно оценивать распределение данных CI. Данные CI могут быть как параметрическими, так и непараметрическими, в зависимости от генотипа или других факторов окружающей среды. В некоторых случаях, если распределение CI резко искажается от нормального распределения, может быть лучше использовать медианный CI, а не среднее значение для вычисления LI. Однако, по нашему опыту, использование среднего или среднего CI не влияет на статистическую интерпретацию данных, а использование среднего CI является распространенной практикой в литературе.
Для успешного лечения ухаживания активное участие в отборе мужских попыток ухаживания у самок для женщин является решающим в течение периода обучения. Важно обеспечить, чтобы домашние женщины, используемые в этом анализе, эффективно спаривались иТаким образом, не позволяя совокупление. Это предположение устанавливается в спаренных сосудах, приготовленных на стадии 4, где мухи самцов и самцов помещаются вместе в течение 4 дней ( таблица 1 ). Впоследствии спаривание может контролироваться путем регулярного обследования тестовых видеороликов и наблюдения пар мужского и женского пола во время обучения. Если спаривание действительно происходит, есть несколько мер, которые могут быть приняты при подготовке вышедших женщин. Во-первых, беременные женщины должны выращиваться в оптимальных условиях размножения. Флаконы могут быть дополнены дрожжевой пастой и сложенной фильтровальной бумагой для увеличения потенциальных поверхностей сопряжения. Инкубация мух в условиях, описанных здесь, в прошлом производила надежных самок, но это может различаться в разных лабораториях и с использованием разных генетических штаммов. Следовательно, может потребоваться оптимизация генерации вышедших самок путем изменения времени и условий инкубации.
Количественная оценка поведения ухаживания являетсяЕще один важный шаг в этом протоколе. Это можно сделать вручную или автоматически с помощью специализированных программ 9 . Автоматическая количественная оценка является быстрой и, в принципе, беспристрастной. Было опубликовано несколько программ 21 , 22 , 23 ; Однако они не просто используются, часто требуются специализированные видеоформаты и передовые вычислительные навыки. Ручная количественная оценка проста и точная, но она очень трудоемка и зависит от индивидуальной изменчивости и предвзятости. Важно подчеркнуть, что в этом протоколе не рассматриваются требования к форматированию видео, которые потенциально необходимы для автоматизированной количественной оценки ИИ. Для ручной количественной оценки используйте любое простое устройство записи видео, которое имеет потенциал для создания видео достаточного качества, чтобы точно наблюдать поведение ухаживания. Для автоматизированной количественной оценки, вероятно, будут разныеВ зависимости от используемого программного обеспечения, и пользователи должны тщательно изучить это, если требуется автоматическая количественная оценка.
В сочетании с обширными инструментами, которые доступны для генетической манипуляции мухами, анализ кондиционирования ухаживания обеспечивает надежное считывание, которое может быть использовано для анализа молекулярных механизмов и нейронных сетей, участвующих в обучении и памяти.
Раскрытие информации
Авторам нечего раскрывать.
Благодарности
Мы признаем Венский ресурсный центр дрозофилы для обеспечения штаммов дрозофилы . Кроме того, в этом исследовании использовались запасы, полученные в Центре акций Bloomington Drosophila (NIH P40OD018537). Это исследование частично поддерживалось крупномасштабной интегрированной сетью FUC7 Европейского союза Gencodys для KK, HvB и AS, а также грантами проекта NSERC Discovery и CIHR для JMK
Материалы
| Имя | Компания | Каталожный номер | Комментарии |
|---|---|---|---|
| P{KK101437}VIE-260B | VDRC | 101437 | Dhat-at-RNAi в 60100 background |
| P{KK108109}VIE-260B | - | - | Control-RNAi in 60100 background (подарок от K. Keleman) |
| w+, UAS-dcr2/yhh;; elav-Gal4 (III) | - | - | panneuronal driver line Контейнеры |
| для культуры растительных тканей | VWR | 960177 | пластиковые флаконы 175 мл |
| Складные фильтры | Ватман | 10311643 | Фильтровальная бумага для увеличения площади мухи могут окукливаться на |
| Блоки с плоским дном (96 лунок) | Qiagen | 19579 | Используется для блоков |
| Прозрачная клейкая пленка MicroAmp | Применяемая биосистема | 4306311 | ПЦР клейкая пленка в качестве крышки на блоках с плоским дном |
| Лезвие бритвы | - | - | Любой острый подойдет |
| Игла | - | - | Аспиратор диаметром 0,8 мм |
| - | - | Отрежьте ножницами кончик пипетки объемом 1 мл, чтобы получилось две части. Узкий кончик наконечника пипетки расположен в качестве входа для мухи в гибкий шланг длиной ~80 см. Чтобы муха не попала внутрь шланга, между кончиком и шлангом помещают обычный кусок хлопка или мелкую сетку. Другая половина наконечника пипетки может быть использована в качестве мундштука на конце шланга. | |
| Брачные камеры | - | файл S1 может быть открыт с помощью указанного программного обеспечения CAD | |
| Характеристики видеокамеры | Sony | : >4 МБ пикселей, Full HD.< чел./> Для ручной количественной оценки любое простое устройство видеозаписи может создать видео достаточного качества для точного наблюдения за поведением ухаживания. Для автоматизированной количественной оценки, вероятно, будут предъявляться различные требования в зависимости от используемого программного обеспечения, и пользователям следует тщательно изучить этот вопрос, если требуется автоматизированная количественная оценка. | |
| Name< | strong>Company | Каталожный номер | >Комментарии |
| power food | |||
| Agar | Sigma | A7002 | |
| Дрожжевой | Брюггемана | ||
| MP биомедицинский | 0210330391 | ||
| Пептон | Sigma | P6838 | |
| сахароза | Sigma | S9378 | |
| глюкоза | Sigma | G7021 | |
| MgSO4 | Sigma | M2643 | |
| CaCl2 | Merck | 1023780500 | |
| метилпарабен (ОСТОРОЖНО) | Sigma | H5501 | |
| Пропионовая кислота (ВНИМАНИЕ) | Sigma | P1386 | |
| Деминерализованная | |||
| смесь и смесь воды в соотношении 1:1 | |||
| Название< | strong>Company | Номер в каталоге | Комментарии |
| нормальная пища | |||
| Агар | MP биомедицинские препараты | 215017890 | |
| Дрожжи | брюггеман-кукурузная | ||
| мука | de | Molen-Сахар | |
| де | Молен | ||
| метилпарабен (ОСТОРОЖНО) | Sigma | H5501 | |
| Пропионовая кислота (ОСТОРОЖНО) | Sigma | P1386 | |
| Деминерализованная вода | - |
Ссылки
- Quinn, W. G., Harris, W. A., Benzer, S. Conditioned behavior in Drosophila melanogaster. Proc. Natl. Acad. Sci. USA. 71, 708-712 (1974).
- Livingstone, M. S., Sziber, P. P., Quinn, W. G. Loss of calcium/calmodulin responsiveness in adenylate cyclase of rutabaga, a Drosophila learning mutant. Cell. 37, 205-215 (1984).
- Quinn, W. G., Sziber, P. P., Booker, R. The Drosophila memory mutant amnesiac. Nature. 277, 212-214 (1979).
- Dudai, Y., Jan, Y. N., Byers, D., Quinn, W. G., Benzer, S. dunce, a mutant of Drosophila deficient in learning. Proc. Natl. Acad. Sci. USA. 73, 1684-1688 (1976).
- Dubnau, J., Tully, T. Gene discovery in Drosophila: new insights for learning and memory. Annu. Rev. Neurosci. 21, 407-444 (1998).
- Siegel, R. W., Hall, J. C. Conditioned responses in courtship behavior of normal and mutant Drosophila. Proc. Natl. Acad. Sci. USA. 76, 3430-3434 (1979).
- Kamyshev, N. G., Iliadi, K. G., Bragina, J. V. Drosophila conditioned courtship: two ways of testing memory. Learning & memory. 6, 1-20 (1999).
- McBride, S. M., et al. Mushroom body ablation impairs short-term memory and long-term memory of courtship conditioning in Drosophila melanogaster. Neuron. 24, 967-977 (1999).
- Keleman, K., Kruttner, S., Alenius, M., Dickson, B. J. Function of the Drosophila CPEB protein Orb2 in long-term courtship memory. Nature Neurosci. 10, 1587-1593 (2007).
- Hall, J. C. The mating of a fly. Science. 264, 1702-1714 (1994).
- Keleman, K., et al. Dopamine neurons modulate pheromone responses in Drosophila courtship learning. Nature. 489, 145-149 (2012).
- Kramer, J. M., et al. Epigenetic regulation of learning and memory by Drosophila EHMT/G9a. PLoS Biol. 9. 9, e1000569(2011).
- Ishimoto, H., Sakai, T., Kitamoto, T. Ecdysone signaling regulates the formation of long-term courtship memory in adult Drosophila melanogaster. Proc. Natl. Acad. Sci. USA. 106, 6381-6386 (2009).
- Kochinke, K., et al. Systematic Phenomics Analysis Deconvolutes Genes Mutated in Intellectual Disability into Biologically Coherent Modules. Am. J. Hum. Genet. 98, 149-164 (2016).
- Buchert, R., et al. A peroxisomal disorder of severe intellectual disability, epilepsy, and cataracts due to fatty acyl-CoA reductase 1 deficiency. Am. J. Hum. Genet. 95, 602-610 (2014).
- JoVE Science Education Database. Essentials of Biology 1: yeast, Drosophila and C. elegans. Drosophila Maintenance. JoVE. , Cambridge, MA. (2017).
- JoVE Science Education Database. Essentials of Biology 1: yeast, Drosophila and C. elegans. An Introduction to Drosophila melanogaster. JoVE. , Cambridge, MA. (2017).
- R Core Team. R: A Language and Environment for Statistical Computing. R Foundation for Statistical Computing. , Vienna (Austria). (2016).
- Stepien, B. K., et al. RNA-binding profiles of Drosophila CPEB proteins Orb and Orb2). Proc. Natl. Acad. Sci. USA. 113, E7030-E7038 (2016).
- Basu, D. Randomization Analysis of Experimental Data: The Fisher Randomization Test. J Am Stat Assoc. 75, 575-582 (1980).
- Dankert, H., Wang, L., Hoopfer, E. D., Anderson, D. J., Perona, P. Automated monitoring and analysis of social behavior in Drosophila. Nat Methods. 6, 297-303 (2009).
- Reza, M. A., et al. Automated analysis of courtship suppression learning and memory in Drosophila melanogaster. Fly. 7, 105-111 (2013).
- Schneider, J., Levine, J. D. Automated identification of social interaction criteria in Drosophila melanogaster. Biol. Lett. 10, 20140749(2014).
Перепечатки и разрешения
