تقترح هذه الورقة طريقة لمراقبة السلامة في خطوط الإنتاج تدمج بين نموذج "أنت تنظر مرة واحدة" الإصدار 11 (YOLOv11) والشبكات العصبية الالتفافية. وقد حققت هذه الطريقة متوسط دقة متوسطة عند عتبة تقاطع فوق الاتحاد 0.5 (mAP@0.5) بلغت 0.91، و mAP@0.5:0.95 بلغت 0.82، وبمعدل 120 إطاراً في الثانية على وحدة معالجة الرسوميات، متفوقة بذلك على النماذج المرجعية التي تم تقييمها.
يتطلب اشتراك JoVE لعرض هذا المحتوى. تسجيل الدخول أو ابدأ نسخة تجريبية مجانية
مقالة منهجية
مراقبة سلامة خطوط الإنتاج في الوقت الفعلي باستخدام كشف الأجسام وتعزيز السمات القائم على التعلم العميق
في هذه المقالة
ملخص
الملخص
مع تعمق الثورة الصناعية 4.0، تحسنت مستويات الأتمتة والذكاء في خطوط الإنتاج بشكل ملحوظ، مما فرض متطلبات أعلى على الأداء في الوقت الفعلي والدقة والسلامة في عمليات المراقبة. وتعاني أنظمة المراقبة التقليدية، التي تعتمد على الفحوصات اليدوية أو القرارات البسيطة القائمة على العتبات، عمومًا من بطء أوقات الاستجابة، وارتفاع معدلات الإنذارات الكاذبة، ومحدودية الذكاء. لذلك، تقترح هذه الورقة نظامًا لمراقبة سلامة خطوط الإنتاج يدمج إصدار You Only Look Once 11 (YOLOv11) مع شبكة عصبونية تلافيفية (CNN). أولاً، تمت معالجة الصور المكتسبة مسبقًا. ثم استُخدم نموذج YOLOv11 لتحديد العمال والمعدات والمخاطر المحتملة في الوقت الفعلي. بعد ذلك، تم تقديم شبكة CNN محسنة مع دمج الميزات متعددة المقاييس وآليات الانتباه لتحسين قدرات استخراج الميزات للأهداف الصغيرة والمحجوبة. وأخيرًا، دُمجت نتائج الكشف مع الميزات المحسنة بواسطة CNN لتقييم حالة السلامة. أُجريت التجارب باستخدام مجموعة بيانات سلامة خطوط إنتاج تم بناؤها ذاتيًا، مع توظيف محسّن descent gradient stochastic (SGD) بزخم قدره 0.9، ومعدل تعلم أولي قدره 0.01، وتضاؤل للوزن قدره 0.0005، وتعديل معدل التعلم باستخدام cosine-annealed، وحجم دفعة قدره 32، والتدريب لمدة 200 epochs. استُخدمت mAP@0.5 وسرعة الكشف بالإطارات في الثانية (FPS) كمقاييس تقييم للمقارنة مع الخوارزميات المرجعية التي تم تقييمها. وتظهر النتائج أن النظام المقترح حقق mAP@0.5 قدره 0.91 وسرعة كشف بلغت 120 FPS. كما أظهر أداءً قويًا في الظروف المعقدة مثل التظليل والإضاءة المتغيرة، مما يدعم فعاليتة وإمكانية تطبيقه العملي في مراقبة سلامة خطوط الإنتاج.
المقدمة
في الإنتاج الصناعي الحديث، تُعد السلامة حجر الزاوية لضمان كفاءة الإنتاج وسلامة الأفراد. عادةً ما تتضمن بيئة خط الإنتاج معدات ميكانيكية عالية السرعة، وعمليات تكنولوجية معقدة، وعمليات تعاونية تشمل مهام متعددة. ويمكن لأي خطر بسيط محتمل على السلامة أن يؤدي إلى حوادث إنتاج خطيرة، مما يتسبب في خسائر اقتصادية جسيمة بل وحتى وفيات. لذلك، من الضروري إنشاء نظام مراقبة سلامة فعال وذكي وفي الوقت الفعلي لتعزيز السلامة في الإنتاج الصناعي1,2.
تعتمد طرق مراقبة السلامة التقليدية بشكل أساسي على المراقبة اليدوية بالفيديو ومختلف المستشعرات (مثل مستشعرات الأشعة تحت الحمراء والدخان والاهتزاز)3. ولا تقتصر المراقبة اليدوية على كونها غير فعالة فحسب، بل إنها عرضة لفقدان بعض الاكتشافات بسبب إجهاد أفراد المراقبة، كما أنها لا توفر تغطية مستمرة وشاملة. ورغم أن المستشعرات يمكن أن توفر وظيفة إنذار مبكر معينة، إلا أن نطاق اكتشافها محدود، وهي حساسة للتداخلات البيئية، مما يؤدي إلى ظهور مشكلات بارزة تتمثل في الإنذارات الكاذبة4. لذا، أصبحت أنظمة المراقبة الذكية محوراً متزايداً للبحث؛ حيث يمكن للتحليل الفوري لتدفق الفيديو باستخدام خوارزمية التعلم العميق أن يحدد تلقائياً الأحداث غير الطبيعية، والسلوكيات غير الآمنة، والمخاطر المحتملة، مما يؤدي إلى تحسين ذكاء نظام المراقبة بشكل كبير4,5.
يُعد اكتشاف الكائنات تقنية أساسية في المراقبة الذكية. وتُظهر سلسلة خوارزميات You Only Look Once (YOLO)، بصفتها نماذج لمكتشفات الكائنات أحادية المرحلة، مزايا كبيرة. ومنذ YOLOv1 وصولاً إلى YOLOv8، خضعت هذه المجموعة من الخوارزميات لتطوير مستمر، مع تحسينات في بنية الشبكة، ودالة الفقد، ومنهجية التدريب، من بين جوانب أخرى6,7. وقد حققت YOLOv1، على وجه الخصوص، دقة اكتشاف أعلى مع الحفاظ على معدل إطارات مرتفع، لاسيما عند مواجهة الخلفيات المعقدة والأهداف المتكدسة بكثافة8.
ومع ذلك، ورغم أدائه المتميز في مهام الكشف العام عن الكائنات، لا يزال YOLOv1 يواجه تحديات في سيناريوهات محددة لمراقبة السلامة في خطوط الإنتاج9. فعلى سبيل المثال، قد تنخفض دقة الكشف في YOLOv1 عندما يكون العمال محجوبين جزئياً بواسطة المعدات، أو عندما تكون علامات السلامة صغيرة وتشبه لون الخلفية بشكل كبير. وهذا يتطلب أن يمتلك النموذج قدرات أقوى في استخراج الميزات والفهم الدلالي10.
تتمتع الشبكات العصبية التفافية (CNNs) بقدرات قوية في استخراج سمات الصور1. ومن خلال تصميم بنيات شبكية أكثر عمقاً وتعقيداً، يمكن للشبكات العصبية التفافية تعلم سمات صور أغنى وأكثر تجريداً. ويؤدي دمج الشبكات العصبية التفافية مع YOLOv1 إلى الاستفادة من قدرات الكشف السريع لـ YOLOv1 والاستخراج العميق للسمات الخاص بالشبكات العصبية التفافية، مما يساهم في بناء نظام مراقبة سلامة أكثر قوة وذكاءً.
وبناءً على ذلك، تقترح هذه الورقة نظاماً لمراقبة السلامة في خطوط الإنتاج باستخدام YOLOv1 وشبكة عصبية تلافيفية (CNN). وتتضمن الجوانب الابتكارية لهذه الدراسة ما يلي: (1) اقتراح بنية دمج عميقة لـ YOLOv1 وشبكة CNN محسنة؛ (2) تقديم دمج للميزات متعددة المقاييس وآلية انتباه مركبة لتعزيز التعرف على ميزات السلامة الرئيسية؛ و(3) التحقق من المزايا الأدائية للنموذج باستخدام مجموعة بيانات لمشاهد معقدة تم بناؤها ذاتياً.
تطوير سلسلة خوارزميات YOLO
منذ تقديمها لأول مرة من قبل Redmon وآخرين في عام 201512، حظيت خوارزمية You Only Look Once (YOLO) باهتمام كبير. وبخلاف الكواشف ثنائية المرحلة التي تعتمد على مقترحات المناطق، تعامل YOLO عملية اكتشاف الكائنات كمهمة انحدار. ومن خلال التنبؤ المباشر بفئات الكائنات ومواقعها في الصورة، تزيد YOLO سرعة الاكتشاف بشكل ملحوظ، مما يجعلها مناسبة للاستخدام في الوقت الفعلي13.
باعتباره العمل الرائد في هذه السلسلة، حقق YOLOv1 الكشف عن الأهداف من الطرف إلى الطرف لأول مرة14. يتضمن YOLOv1 تقسيم الصورة المدخلة إلى هيكل شبكي، حيث تُكلف كل خلية شبكية، والتي يتم ترتيبها عادةً بتنسيق S × S، بالكشف عن الكائنات التي تقع ضمن حدودها.
تحديدًا، تكون مخرجات YOLOv1 عبارة عن تنسور (tensor). ومن بين الـ S × S × (B × 5 + ج)، يحتوي التنبؤ بكل صندوق إحاطة على 5 عناصر: إحداثيات نقطة المركز (س، ص)، العرض و، الارتفاع هـ، والثقة جتوضح المعادلة (1) عملية الحساب:
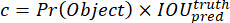 (1)
ومن بينها، Pr(كائن( ) تمثل احتمالية وجود هدف في الشبكة، و تقاطع الاتحاد (IOU) تمثل نسبة التقاطع على الاتحاد بين المربع المحيط المتوقع ومربع الحقيقة الأرضية. كما يتوقع كل مربع شبكي أيضاً مجموعة من احتمالات الفئة، بروتين (Pr) يمثل احتمالية انتماء الهدف إلى الـ i-الفئة في وجود هدف ما. تتكون دالة الخسارة في YOLOv1 من ثلاثة مكونات رئيسية: خسارة التنبؤ بالإحداثيات، وخسارة تقدير الثقة، وخسارة التنبؤ بالفئة.15.
يقدم YOLOv2 تقنية تطبيع الدفعات (Batch Normalization)، ومصنفاً عالي الدقة، واستراتيجية تدريب متعددة المقاييس، مما أدى إلى تحسين الاستقرار والدقة16. أما YOLOv3 فيستخدم Darknet-53 كشبكة أساسية، ويستلهم مفهوم شبكة الهرم الميزاتي (Feature Pyramid Network - FPN) لتعزيز عملية اكتشاف الأهداف17.
لقد أجرى YOLOv4 تحسينات عديدة بناءً على YOLOv3، حيث قدم تقنيات مثل الشبكة الجزئية عبر المراحل (CSPNet)18، وشبكة تجميع المسارات (PANet)19، وتعزيز البيانات بطريقة الموزاييك (Mosaic) لتحسين أداء النموذج بشكل أكبر. أما YOLOv5 فقد قدم مساهمات هندسية كبيرة، حيث وفر تطبيقاً أكثر كفاءة وأسهل في الاستخدام20.
في السنوات الأخيرة، استمرت سلسلة YOLO في التطور، حيث تم إصدار نسخ مثل YOLOv6 وYOLOv7 وYOLOv8 الواحد تلو الآخر. ومن خلال تقديم بنية شبكة تجميع الطبقات الفعالة الموسعة (E-ELAN) وتقنيات إعادة تمثيل معاملات النموذج، حقق YOLOv7 طفرات جديدة في كل من السرعة والدقة. ولا تساهم هذه التحسينات في رفع كفاءة تعلم الميزات فحسب، بل تعمل أيضاً على تحسين أداء الاستدلال للشبكة، مما مكن YOLOv7 من تجاوز الإصدارات السابقة والعديد من الكواشف الرئيسية في مختلف مهام اكتشاف الكائنات في الوقت الفعلي. كما قام YOLOv8 بتحسين بنية الشبكة بشكل أكبر، واعتماد تصميم خالٍ من المراسِي (anchor-free)، وتبسيط النموذج، وتحسين قدرته على التعميم21.
بناءً على مزايا الإصدارات السابقة، تم تحسين YOLOv1 المستخدم في هذه الدراسة للتعامل مع السيناريوهات الصناعية المعقدة. وتشمل تحسيناته الجوهرية شبكة لاستخراج الميزات، ووحدة دمج ميزات أكثر كفاءة، وتصميماً أكثر متانة لدالة الخسارة. تمكن هذه التحسينات YOLOv1 من تقديم أداء أفضل عند التعامل مع حالات الاحتجاب، والأهداف الصغيرة، والخلفيات المعقدة في بيئات الإنتاج. يُعد YOLOv1 إصداراً من سلسلة YOLO التي أصدرتها شركة Ultralytics. ومقارنةً بـ YOLOv8، فإنه يحسن وحدة C3K2 ومسار دمج الميزات، ويقدم استراتيجية صناديق الإرساء التكيفية، مما يوفر متانة أقوى في الكشف ضمن السيناريوهات الصناعية.
أساس وتطور الشبكة العصبية التلافيفية (CNN)
تُعد الشبكة العصبية التلافيفية (CNN) نموذجاً محورياً أثّر بشكل عميق في نجاح التعلم العميق ضمن مجال الرؤية الحاسوبية. وهي تعمل من خلال استخراج سمات الصور المحلية عبر عمليات التلافيف، ثم تقليل أبعاد هذه السمات لاحقاً عبر عمليات التجميع، وبذلك تحقق تجريداً هرمياً للصور2.
تكون الشبكة العصبية التلافيفية (CNN) النموذجية من طبقات تلافيفية، وطبقات تجميع، وطبقات متصلة بالكامل. تقوم الطبقة التلافيفية بمسح الصورة المدخلة باستخدام نواة تلافيفية، وتحسب الضرب النقطي عبر المناطق المحلية، وتنتج خريطة سمات. وتظهر عملية الحساب في المعادلة (2):
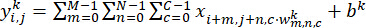 (2)
أين يرجى تزويدي بالنص المراد ترجمته. هي الصورة المدخلة، وك و bكـ يمثلان الوزن والانحياز لنواة التلافيف، على التوالي، و  هل قيم خريطة الميزات الناتجة عند الموضع (i,jتستخدم طبقة التجميع عادةً التجميع الأقصى (Max Pooling) أو التجميع المتوسط (Average Pooling). وتكون الطبقة كاملة الاتصال مسؤولة عن استخراج الميزات والتنبؤ باحتمالات التصنيف.
بناءً على ذلك، تصمم هذه الورقة وحدة تعزيز ميزات CNN لنموذج YOLOv1، والتي تتكون من فرعين متوازيين: فرع تلافيف متعدد المقاييس يستخدم نوى تلافيف 3 × 3 و 5 × 5 لاستخراج ميزات متعددة المقاييس؛ وفرع انتباه يربط بالتتابع وحدات انتباه القنوات (Squeeze-and-Excitation) وانتباه المكان لتعزيز الميزات التمييزية للأهداف الرئيسية. يتم دمج مخرجات الفرعين عن طريق الجمع العنصري، وتظهر دالة فقد تعزيز الميزات المقابلة في الصيغة (3):
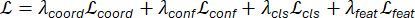 (3)
Lcoord هي خسارة انحدار إحداثيات الصندوق المحيط؛ وLconf هي خسارة الثقة المستهدفة؛ وLcls هي خسارة تصنيف الفئة؛ وLfeat هي خسارة تعزيز السمات، وتُستخدم لتقييد السمات التمييزية للأهداف الصغيرة والأهداف المحجوبة التي استخرجتها وحدة تعزيز CNN؛ بينما تمثل λcoord وλconf وλcls وλfeat معاملات الوزن لبنود الخسارة المقابلة. وبالنسبة لهذه المهمة، تم تعيين قيمة λfeat = 0.05، وتم موازنة الأوزان المتبقية وفقاً لمتطلبات مهمة الكشف.
حققت هياكل الشبكات العصبية الالتفافية (CNN) الكلاسيكية، مثل VGGNet23 وResNet24، نجاحاً كبيراً في مهام تصنيف الصور. ومن بين هذه البنيات، تعمل ResNet بفعالية على تخفيف مشكلة تلاشي التدرج (vanishing gradient problem) في تدريب الشبكات العميقة، مما يسهل بناء هياكل شبكية أكثر عمقاً وتعقيداً.
في مهام اكتشاف الكائنات، تُستخدم الشبكة العصبية التلافيفية (CNN) عادةً كمستخرج للميزات (backbone). على سبيل المثال، فإن Darknet وcross-stage partial Darknet (CSPDarknet)، وغيرها في سلسلة خوارزميات YOLO، مبنية جميعها على CNN25. ولتعزيز قدرات استخراج الميزات، اقترح الباحثون العديد من هياكل CNN المحسنة؛ حيث تقوم وحدة Inception مثلاً باستخراج الميزات بالتوازي من خلال نوى تلافيفية متعددة المقاييس، بينما تعز DenseNet إعادة استخدام الميزات عبر الاتصالات الكثيفة. كما تقوم شبكة Squeeze-and-Excitation بضبط أهمية قنوات الميزات تكيفياً من خلال آليات الانتباه26.
في هذه الدراسة، قمنا بتصميم وحدة CNN محسنة لتعزيز قدرات استخراج الميزات في YOLOv1. تدمج هذه الوحدة بين دمج الميزات متعددة المقاييس وآلية الانتباه لالتقاط معلومات السلامة الرئيسية في سيناريوهات خطوط الإنتاج بشكل أكثر فعالية.
حالة تطبيق التعلم العميق في مراقبة السلامة الصناعية
اكتسب التعلم العميق زخماً كبيراً في مراقبة السلامة الصناعية. وتُستخدم الخوارزميات القائمة على الشبكات العصبية التلافيفية (CNN) لتحديد ما إذا كان العمال يرتدون خوذات السلامة بشكل صحيح، والكشف عن الاقتحامات غير المصرح بها للمناطق الخطرة، ومراقبة حالة المعدات التي تعاني من أعطال27.
فيما يتعلق بالتعرف على السلوك، تُستخدم الشبكات العصبية التلافيفية ثلاثية الأبعاد (3D CNNs) والشبكات العصبية المتكررة لتحليل السلوك التشغيلي للعمال وتحديد الإجراءات التي قد تكون غير آمنة. فعلى سبيل المثال، يمكن تحديد ما إذا كان العمال ينتهكون إجراءات التشغيل الآمنة من خلال تحليل تسلسل وضعيات أجسامهم28.
يُستخدم كل من YOLO وFaster R-CNN على نطاق واسع للكشف عن الأفراد والمعدات في فيديوهات المراقبة في الوقت الفعلي. فعلى سبيل المثال، تم اقتراح نظام للكشف عن الخوذات في الوقت الفعلي بناءً على YOLOv5 في الأدبيات العلمية، مما ساهم بفعالية في تعزيز ذكاء إدارة السلامة في مواقع البناء29.
على الرغم من إحراز بعض التقدم في الأبحاث الحالية، لا تزال هناك عدة تحديات قائمة. أولاً، تتميز المشاهد الصناعية عادةً بإضاءة معقدة، وحجب للرؤية، وتداخلات في الخلفية، مما يفرض متطلبات صارمة على قوة الخوارزمية. ثانياً، يعد الأداء في الوقت الفعلي مطلباً أساسياً، حيث يجب أن تحقق الخوارزمية سرعة استدلال عالية مع الحفاظ على الدقة. وأخيراً، تركز الأبحاث الحالية بشكل أساسي على الكشف أحادي المهمة، وتفتقر إلى استكشاف دمج المعلومات متعددة المصادر والتحليل الشامل30.
تهدف دراسة هذا البحث، من خلال نموذج الدمج المقترح بين YOLOv11 وCNN، إلى معالجة التحديات المذكورة أعلاه وتحقيق مراقبة شاملة وفورية لمخاطر السلامة في خطوط الإنتاج، وذلك عن طريق تعزيز قدرات استخراج الميزات ودمجها.
الوصول مقيد. يرجى تسجيل الدخول أو بدء فترة تجريبية لعرض هذا المحتوى.
البروتوكول
خوارزمية YOLOv1 والشبكات العصبية التلافيفية (CNN)
البنية العامة للنظام
يعتمد نظام مراقبة سلامة خط الإنتاج المقترح في هذه الورقة بنية هجينة تجمع بين YOLOv1 وشبكة عصبية تلافيفية (CNN) محسنة لتحقيق مراقبة سلامة فورية عالية الدقة وعالية السرعة. وكما هو موضح في الشكل 1يتكون النظام بشكل أساسي من وحدة معالجة مسبقة للمدخلات، ووحدة YOLOv1 للكشف عن الأجسام، ووحدة CNN لتعزيز الميزات، ووحدة قرار دمج. أولاً، تقوم وحدة المعالجة المسبقة بتطبيع الصورة المدخلة وزيادتها لتحسين قدرة النموذج على التعميم. بعد ذلك، يتم استخراج الميزات بواسطة العمود الفقري CSPDarknet، ويتم توسيع المجال الاستقبالي بواسطة وحدة التجميع الهرمي المكاني السريع (SPPF). يتم دمج الميزات متعددة المقاييس بعد عملية زيادة العينة، ثم يتم تطبيق انتباه القنوات وانتباه المجال بالتتابع على الميزات المدمجة لتعزيز التمثيل التمييزي للأهداف الرئيسية بشكل أكبر. تم إدراج وحدة CNN لتعزيز الميزات بعد مخرجات الطبقات C3 وC4 وC5 من الشبكة العمودية YOLOv1، حيث تستقبل خرائط ميزات متعددة المقاييس بأحجام 80 × 80 × 256 و40 × 40 × 512 و20 × 20 × 1,024 على التوالي. وتعمل وحدة CNN لتعزيز الميزات على تحسين استخراج الميزات للأهداف الصغيرة والمحجوبة. وأخيراً، تقوم وحدة قرار الدمج بجمع نتائج الكشف الخاصة بـ YOLOv1 مع الميزات المعززة بواسطة CNN وتحسينهما معاً من خلال دالة خسارة مصممة لإخراج الموقع الدقيق، والفئة، ودرجة الثقة للهدف.
إطار عمل الكشف YOLOv1
قدم YOLOv11 عدة تحسينات جوهرية تستفيد من نقاط القوة في إطار عمل الكشف أحادي المرحلة الخاص بسلسلة YOLO. تنقسم بنيته إلى ثلاثة مكونات رئيسية: شبكة العمود الفقري (backbone network)، وشبكة دمج الميزات (feature fusion network)، ورأس الكشف (detection head). وتعتمد شبكة العمود الفقري على بنية CSPDarknet محسنة. أما شبكة دمج الميزات فتتضمن وصلات محلية عبر المراحل وتلافيف قابلة للفصل بعمق (depthwise separable convolutions)، مستمدة الإلهام من شبكات الهرم الميزاتي (feature pyramid networks) وشبكات تجميع المسارات (path aggregation networks) لدمج الميزات متعددة المقاييس بفعالية.
وحدة تعزيز الميزات
تهدف وحدة تحسين السمات إلى تحسين حساسية النموذج تجاه سمات السلامة الرئيسية. وتقوم هذه الوحدة بمعالجة خرائط السمات الناتجة عن كل طبقة من شبكة YOLOv1 الأساسية، مع دمج المعلومات عبر مقاييس مختلفة من خلال عمليات زيادة العينات (upsampling) وتقليل العينات (downsampling). وعلى وجه التحديد، يلتقط الفرع متعدد المقاييس تنوع المقاييس المكانية، بينما يقوم فرع الانتباه بتعزيز القنوات الرئيسية والاستجابات الموضعية ديناميكيًا. ولا يعمل هذان الفرعان بشكل مستقل، بل يكونان متكاملين ويتم دمجهما من خلال الوصلات المتبقية (residual connections) وإعادة معايرة السمات. ويتم تعديل خريطة السمات التي تمت معالجتها بواسطة وحدة التحسين عند كل مقياس لتتطابق مع عدد قنوات خريطة السمات الأصلية عبر عملية تلافيف (convolution) بمقاس 1 × 1، ثم تُدمج مع خريطة سمات YOLOv11 الأصلية عن طريق الجمع العنصري (element-wise addition). بعد ذلك، يتم تمرير خريطة السمات المدمجة إلى شبكة الهرم السماتي (FPN) اللاحقة لدمجها متعدد المقاييس، مما يشكل تمثيلاً هرمياً لسمات السلامة. ولضمان التكامل السلس بين الوحدات، تم اعتماد استراتيجية تدريب مشتركة من الطرف إلى الطرف (end-to-end)، حيث تتكون دالة الخسارة من خسارة الكشف في YOLOv1 وخسارة تحسين السمات في وحدة CNN.
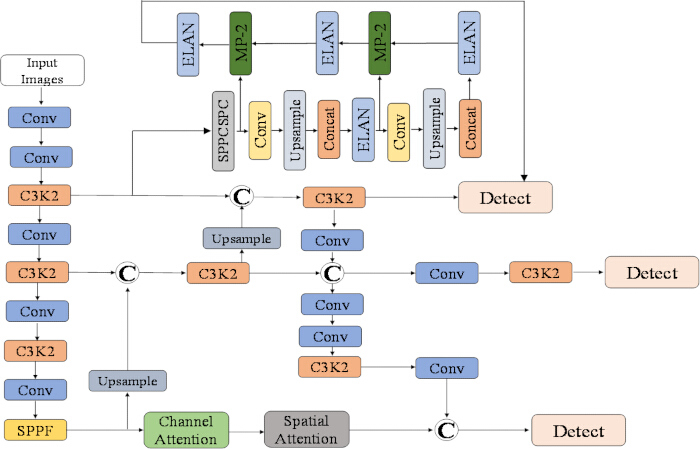
الشكل 1خوارزمية YOLOv1-CNN. تهدف وحدة تعزيز السمات إلى تضخيم حساسية النموذج تجاه سمات السلامة الحرجة. وتقوم هذه الوحدة بمعالجة خرائط السمات من طبقات مختلفة من العمود الفقري لنموذج YOLOv1، مع دمج سمات بمقاييس مختلفة من خلال عمليات زيادة العينات وتقليل العينات. بالإضافة إلى ذلك، تدمج الوحدة آليات انتباه القنوات والمكان. ولضمان التكامل السلس بين وحدات YOLOv11 والشبكات العصبونية الالتفافية (CNN)، تم استخدام استراتيجية تدريب مشتركة. وأثناء التدريب، يتم تحسين معلمات كلا الوحدتين من الطرف إلى الطرف. وتجمع دالة الخسارة بين خسارة الكشف في YOLOv11 وخسارة تعزيز السمات في وحدة CNN. يرجى النقر هنا لعرض نسخة أكبر من هذا الشكل.
الوصول مقيد. يرجى تسجيل الدخول أو بدء فترة تجريبية لعرض هذا المحتوى.
النتائج
للتحقق من فعالية نموذج دمج YOLOv11 وCNN المقترح في مراقبة السلامة في خطوط الإنتاج، تم إنشاء مجموعة بيانات تغطي سيناريوهات مختلفة لمخاطر السلامة. تحتوي مجموعة البيانات هذه على 12,000 صورة لمشاهد خطوط الإنتاج، مقسمة إلى مجموعات تدريب وتحقق واختبار بنسبة 7:1.5:1.5، مع تثبيت البذرة العشوائية عند 42. وتغطي المجموعة ظروف عمل متنوعة، بما في ذلك الإضاءة القياسية، والإضاءة المنخفضة، والانسداد الجزئي، والانسداد الشديد، والضبابية الحركية، والخلفيات المعقدة. تم ضبط حد الثقة للاستدلال عند 0.5، وحد كبت الحد الأقصى غير المرتبط (NMS) عن...
الوصول مقيد. يرجى تسجيل الدخول أو بدء فترة تجريبية لعرض هذا المحتوى.
المناقشة
تظهر النتائج التجريبية أن نموذج دمج YOLOv11–CNN المقترح يحسن دقة الكشف والأداء في الوقت الفعلي لمراقبة السلامة في خط الإنتاج. ومن خلال الاستفادة من الكشف الفعال أحادي المرحلة لـ YOLOv11 وتعزيز الميزات في وحدة CNN، تمكن النظام من تحديد العمال والمعدات والمناطق الخطرة في ظل ظروف إضاءة معقدة وحالات حجب الرؤية. كما ساهم دمج الميزات متعددة المقاييس وآليات الانتباه في تعزيز القدرة على التركيز على عناصر السلامة الرئيسية، مما وفر أدلة بصرية قابلة للتفسير للإنذار المبكر.
يتمتع النظام بقيمة عملية لخطوط ...
الوصول مقيد. يرجى تسجيل الدخول أو بدء فترة تجريبية لعرض هذا المحتوى.
الإفصاحات
ليس لدى المؤلفين أي تضارب في المصالح للإعلان عنه.
شكر وتقدير
تم تمويل هذا العمل جزئياً من قبل مؤسسة جامعة تايتشو للبحوث العلمية للمواهب المتقدمة ضمن مشروع "البحث في التقنيات الرئيسية للكشف الدقيق للتصنيع الذكي" (TZXY2020QDJJ006).
الوصول مقيد. يرجى تسجيل الدخول أو بدء فترة تجريبية لعرض هذا المحتوى.
المواد
| الاسم | الشركة | رقم فهرسي | التعليقات |
|---|---|---|---|
| COCO API | غير متاح | أداة تقييم مستخدمة لتحليل الإحصائيات وتقييم دقة اكتشاف الأهداف. | |
| CUDA 11.4 | NVIDIA | غير متاح | منصة حوسبة متوازية مستخدمة مع إطار عمل PyTorch 1.12. |
| Edge TPU | غير متاح | منصة نشر مستخدمة لاختبار استهلاك الطاقة وزمن الاستجابة؛ وكان زمن الاستجابة المسجل 18 ms واستهلاك الطاقة 15 W. | |
| جهاز Jetson Xavier للحوسبة الطرفية | NVIDIA | جهاز حوسبة طرفية مستخدم لاختبار إنتاجية البيانات؛ وكانت سرعة المعالجة المسجلة 70 FPS مع زمن استجابة للمئوية 99 ضمن 50 ms. | |
| وحدة معالجة الرسوميات NVIDIA Tesla V100 GPU | NVIDIA | وحدة معالجة الرسوميات المستخدمة في خادم التدريب والتقييم. | |
| PyTorch 1.12 | غير متاح | إطار عمل للتعلم العميق مستخدم لتدريب النموذج وتقييمه. | |
| scikit-learn | غير متاح | أداة تحليل إحصائي وتقييم مستخدمة لتقييم النموذج. | |
| مجموعة بيانات سلامة خط الإنتاج المُعدة ذاتياً | غير متاح | غير متاح | مجموعة بيانات تضم 12,000 صورة لمشاهد خط الإنتاج بتنسيق VOC، تغطي ظروف الإضاءة القياسية، والإضاءة المنخفضة، والانسداد الجزئي، والانسداد الشديد، وضبابية الحركة، والخلفيات المعقدة؛ وتتضمن ست فئات من التعليقات التوضيحية: العمال، وخوذات السلامة، والأذرع الروبوتية، والمناطق الخطرة، والأدوات، والمركبات. |
| خادم التدريب | خادم مجهز بوحدة معالجة الرسوميات NVIDIA Tesla V100 GPU ونظام تشغيل Ubuntu 20.04. | ||
| نظام التشغيل Ubuntu 20.04 | غير متاح | نظام التشغيل المستخدم في خادم التدريب والتقييم. | |
| تنسيق التعليقات التوضيحية VOC | غير متاح | غير متاح | تنسيق التعليقات التوضيحية المستخدم لمجموعة بيانات سلامة خط الإنتاج المُعدة ذاتياً. |
| نموذج YOLOv11 لاكتشاف الكائنات | Ultralytics | غير متاح | نموذج لاكتشاف الكائنات مستخدم للكشف عن العمال والمعدات والمخاطر المحتملة في الوقت الفعلي. |
المراجع
- Ramadan MNA, Ali MAH, Jaber H, Alkhedher M. Blockchain-secured IoT-federated learning for industrial air pollution monitoring: a mechanistic approach to exposure prediction and environmental safety. Ecotoxicol Environ Saf. 2025;300:118442.
- Ahn J, et al. SafeFac: video-based smart safety monitoring for preventing industrial work accidents. Expert Syst Appl. 2023;215:119397.
- Natha S, et al. A scalable and generalized deep ensemble model for road anomaly detection in surveillance videos. Comput Mater Contin. 2024;81(3):3707-3729.
- Diallo AR, Homri L, Dantan JY. Reducing false alarms in fault detection: a comparative analysis between conformal prediction and classical methods applied to PCA and autoencoders. J Process Control. 2025;152:103495.
- Cheng X, Han Y, Zhang W. Development of intelligent monitoring system for soil erosion in pipeline engineering based on deep learning. Comput Electr Eng. 2025;126:110432.
- Yan H, et al. A global feature fusion and adaptive optimization method to enhance detection accuracy and computational efficiency based on YOLOv8. Alexandria Eng J. 2025;129:538-552.
- Samma H, Al-Azani S, El-Ferik S. UAV-based real-time face detection using YOLOv7. Transp Res Procedia. 2025;84:331-338.
- Gong X, Yu J, Zhang H, Dong X. AED-YOLO11: a small object detection model based on YOLO11. Digit Signal Process. 2025;166:105411.
- Li R, Xiao K, Lin S, Wu Z. Enhancing aquatic ecosystem monitoring through fish jumping behavior analysis and YOLOv5: applications in freshwater fish identification. J Environ Manage. 2025;391:126413.
- Zhang D, Gao Q, Chen Z, Lin Z. Semantic feature refinement of YOLO for human mask detection in dense crowded. J Vis Commun Image Represent. 2025;107:104399.
- Choi MJ, Ku DG, Lee SJ. Integrated YOLO and CNN algorithms for evaluating degree of walkway breakage. KSCE J Civ Eng. 2022;26(8):3570-3577.
- Li Y, et al. Underwater acoustic intelligent spectrum sensing with multimodal data fusion: an Mul-YOLO approach. Future Gener Comput Syst. 2025;173:107880.
- Jiang D, et al. Real-time tracker of chicken for poultry based on attention mechanism-enhanced YOLO-Chicken algorithm. Comput Electron Agric. 2025;237:110640.
- Yang X, et al. Automated concrete bridge damage detection using an efficient Vision Transformer-enhanced anchor-free YOLO. Engineering. 2025;51:311-326.
- Fuertes D, et al. People detection with omnidirectional cameras using a spatial grid of deep learning foveatic classifiers. Digit Signal Process. 2022;126:103473.
- Deepak GD, Bhat SK. Maximizing YOLOv2 efficiency: a study on multiclass detection of indoor objects. Results Eng. 2025;26:105405.
- Zhang C, et al. Personnel target detection in infrared environment based on YOLOv3-tinier network and its FPGA implementation. Infrared Phys Technol. 2025;150:106015.
- Zhou Y. A YOLO-NL object detector for real-time detection. Expert Syst Appl. 2024;238:122256.
- Asadollahpour E, Rahmannejad R, Asghari A, Abdollahipour A. Back analysis of closure parameters of Panet equation and Burger's model of Babolak water tunnel conveyance. Int J Rock Mech Min Sci. 2014;68:159-166.
- Anguchamy KK, Palanisamy V. Real-time object detection using improvised YOLOv4 and feature mapping technique for autonomous driving. Expert Syst Appl. 2025;280:127452.
- Khan AT, Jensen SM, Khan AR. Advancing precision agriculture: a comparative analysis of YOLOv8 for multi-class weed detection in cotton cultivation. Artif Intell Agric. 2025;15(2):182-191.
- Raushan R, Singhal V, Jha RK. Damage detection in concrete structures with multi-feature backgrounds using the YOLO network family. Autom Constr. 2025;170:105887.
- Zarboubi M, Bellout A, Chabaa S, Dliou A. CustomBottleneck-VGGNet: advanced tomato leaf disease identification for sustainable agriculture. Comput Electron Agric. 2025;232:110066.
- Xie F, et al. Wine variety traceability by data fusion of near-infrared spectroscopy and mid-infrared spectroscopy combined with GAF and ResNet. Chemom Intell Lab Syst. 2025;264:105468.
- Huang J, et al. Estimation of the orientation of potatoes and detection bud eye position using potato orientation detection you only look once with fast and accurate features for the movement strategy of intelligent cutting robots. Eng Appl Artif Intell. 2025;142:109923.
- Huang Y, et al. Human intrusion detection with distributed fiber optic data based on Squeeze-Excitation and hierarchical connection enhancement network. Opt Fiber Technol. 2025;94:104297.
- Qi R, et al. Mechanical fault diagnosis of on-load tap changers using time-frequency vibration analysis and a lightweight YOLO model. Measurement. 2025;256:118441.
- Yan J, Wang Z. YOLO V3+VGG16-based automatic operations monitoring and analysis in a manufacturing workshop under Industry 4.0. J Manuf Syst. 2022;63:134-142.
- Nazli NANM, et al. A real-time system for detecting personal protective equipment compliance using deep learning model YOLOv5. Procedia Comput Sci. 2024;245:647-656.
- Xiao Y, et al. The prediction of kiwi quality attributes based on multi-source data fusion comprehensive analysis model using HSI and FHSI. J Food Compos Anal. 2025;144:107645.
الوصول مقيد. يرجى تسجيل الدخول أو بدء فترة تجريبية لعرض هذا المحتوى.