يصف هذا البروتوكول تطوير وتقييم روبوت دردشة قائم على الإرشادات ويعتمد على التوليد المعزز بالاسترجاع، والذي يسترجع ويلخص المحتوى من إرشادات الممارسة السريرية للسرطان عبر الإنترنت لتوليد ردود مبنية على المرجع على استفسارات المستخدمين.
يتطلب اشتراك JoVE لعرض هذا المحتوى. تسجيل الدخول أو ابدأ نسخة تجريبية مجانية
مقالة منهجية
تطوير روبوت دردشة من جيل الاسترجاع المعزز قائم على الإرشادات يستند إلى إرشادات ممارسة السرطان السريرية القائمة على الويب
في هذه المقالة
ملخص
الملخص
أدى توفر المعلومات الطبية على نطاق واسع على الإنترنت إلى تحسين وصول المرضى إلى المعرفة المتعلقة بالصحة؛ ومع ذلك، زادت أيضا من التعرض لمعلومات طبية غير دقيقة. تشمل رعاية السرطان معلومات معقدة، مما يصعب على المرضى تحديد مصادر دقيقة ومبنية على الأدلة. نماذج اللغة الكبيرة تتيح التفاعل مع اللغة الطبيعية لكنها غالبا ما تولد هلوسات، مما يحد من تطبيقها في نقل المعلومات الطبية. التوليد المعزز بالاسترجاع (RAG) لديه القدرة على التخفيف من هذه المخاطر من خلال تثبيت الاستجابات على مصادر مرجعية خارجية. تصف هذه الدراسة تطوير وتقييم روبوت دردشة RAG قائم على الإرشادات يستخدم إرشادات ممارسة السرطان السريرية المتاحة للجمهور عبر الإنترنت. يستخرج النظام عناوين URL من صفحات جدول المحتويات في الإرشاد، ويعالج نص الصفحة باستخدام التحليل الشكلي والتشابه بين جيب تمام بناء على تكرار المصطلحات–تكرار الوثائق العكسي، ويبني معلومات مرجعية من صفحات ذات صلة عالية. يستخدم نموذج لغوي كبير هذه المراجع لتوليد ردود مقيدة بالمحتوى الإرشادي. تم استخدام دليل JLCS لمرضى وعائلات سرطان الرئة كمرجع. شملت مجموعات الأسئلة كلا من أنواع السرطان داخل النطاق التي تغطيها الإرشادات وأنواع السرطان خارج النطاق لتقييم الاستجابة الضابطة. تم استخراج المعلومات الطبية بنجاح من صفحات جدول المحتويات، حيث احتوت 98٪ من عناوين URL المستخرجة على محتوى طبي قابل للمراجعة. بالنسبة للأسئلة داخل النطاق، كان روبوت الدردشة يولد إجابات من خلال تلخيص محتوى الإرشادات، ولم يتم تحديد أي هلوسات أثناء المراجعة اليدوية تحت ظروف الاختبار المحددة. بالنسبة للأسئلة خارج نطاق النطاق، رفض روبوت الدردشة الإجابة باستمرار وأشار إلى أن المعلومات المتاحة غير كافية. سهل هيكل الويب للإرشاد عمليات جمع وتنظيم فعال لمحتوى المراجع على مستوى الرابط. يوفر هذا البروتوكول إرشادات عملية لبناء أنظمة ذكاء اصطناعي تقدم المعلومات الطبية باستخدام إرشادات الممارسة السريرية عبر الإنترنت.
المقدمة
الاستخدام الواسع للإنترنت ووسائل التواصل الاجتماعي سهل على المرضى الوصول إلى المعلومات الطبية 1,2. معلومات رعاية السرطان غالبا ما تكون معقدة وشاملة، مما يجعل من الصعب بشكل خاص على المرضى تحديد مصادر دقيقة وذات صلة ومبنية على أدلة علمية3. بينما يمكن للموارد الإلكترونية دعم فهم المرضى، إلا أنها تحتوي أيضا على كميات كبيرة من المعلومات الطبية غير الصحيحة3، مما قد يؤثر سلبا على قرارات المرضى بشأن رعايتهم4. نظرا لأن المعلومات المضللة المتعلقة بالسرطان يمكن أن تؤثر على نتائج المرضى5، هناك حاجة متزايدة لأنظمة الذكاء الاصطناعي (AI) التي تساعد المستخدمين الأفراد في البحث والتلخيص وتفسير المعلومات الطبية6.
نماذج اللغة الكبيرة (LLMs) تتيح للمستخدمين الوصول إلى المعلومات من خلال المحادثة باللغة الطبيعية7؛ ومع ذلك، لا يزال توليد المعلومات المضللة (أي الهلوسات) مصدر قلق جاد في المجال الطبي 8,9,10,11. أحد المصادر الرئيسية للمعلومات المضللة هو جودة ودقة بيانات التدريب المستخدمة في تطوير الدردشة الروبوتية. بالإضافة إلى ذلك، تعني الطبيعة الثابتة لتدريب النماذج أن المعرفة قد تصبح قديمة مع مرور الوقت، مما يحد من قدرة نماذج اللغة الكبيرة على توفير معلومات حالية ومناسبة للسياق12،13. تسلط هذه القيود الضوء على أهمية استراتيجيات إدارة المعرفة الفعالة لضمان بقاء ردود الدردشة دقيقة وذات صلة ومحدثة. على وجه الخصوص، الأنظمة التي يمكنها الوصول بسهولة إلى الموارد الحالية المبنية على الأدلة، مثل إرشادات الممارسة السريرية، مرغوبة في البيئات الطبية، حيث تتطور التوصيات ومعايير الرعاية باستمرار. لمواجهة هذا التحدي، حظي التوليد المعزز بالاسترجاع (RAG)، الذي يولد استجابات من خلال دمج المعلومات من مصادر معرفة خارجية، باهتمام متزايد 10,13,14,15,16,17.
على الرغم من أن RAG تم تطبيقه بشكل متزايد على روبوتات الدردشة الطبية، إلا أن اهتماما محدودا تم إيلاء كيف يجب دمج إرشادات الممارسة السريرية بشكل منهجي كمصادر مرجعية للمعلومات18. العديد من إرشادات الممارسة السريرية متاحة للجمهور على الإنترنت؛ ومع ذلك، لا يزال من غير الواضح ما إذا كان هيكل الويب الحالي لديهم يمكن أن يكون إطار استرجاع مباشر لأنظمة RAG18. بالإضافة إلى ذلك، لم تثبت الطرق العملية لبناء معلومات مرجعية دون تطوير قاعدة معرفية يدوية بشكل جيد.
في هذه الدراسة، هدفنا إلى وضع مبادئ تصميم لأنظمة الذكاء الاصطناعي الموجهة للإرشادات في المجال الطبي من خلال تطوير وتقييم روبوت دردشة RAG قائم على الإرشادات يستخدم إرشادات ممارسة السرطان السريرية المتاحة للجمهور عبر الإنترنت، مما يتيح وصولا بسيطا وفي الوقت المناسب إلى المعلومات المبنية على الإرشادات. كدليل على المفهوم، قمنا بتقييم الجدوى الفنية لاسترجاع الإرشادات، وتوليد الاستجابة، وتقييد الاستجابة باستخدام الهيكل الحالي لإرشادات الممارسة السريرية المتاحة للجمهور، بهدف اقتراح بروتوكول تطوير قابل للتكرار لأنظمة RAG المشار إليها بالإرشادات.
الوصول مقيد. يرجى تسجيل الدخول أو بدء فترة تجريبية لعرض هذا المحتوى.
البروتوكول
هذه الدراسة لا تشمل الأشخاص الذين يحتاجون إلى الحماية من المخاطر المرتبطة بالبحث. لذلك، لا يتطلب مراجعة من قبل مجلس مراجعة مؤسسي وفقا للإرشادات الأخلاقية اليابانية للأبحاث الطبية التي تشمل البشر19. تم الإبلاغ عن هذه الدراسة وفقا لإرشادات التقارير الشفافة لنموذج متعدد المتغيرات للتشخيص أو التشخيص الفردي (TRIPOD)-LLM20.
راجع الشكل 1 للحصول على نظرة عامة تخطيطية لبروتوكول الدردشة الآلية RAG المعتمد على الإرشادات.
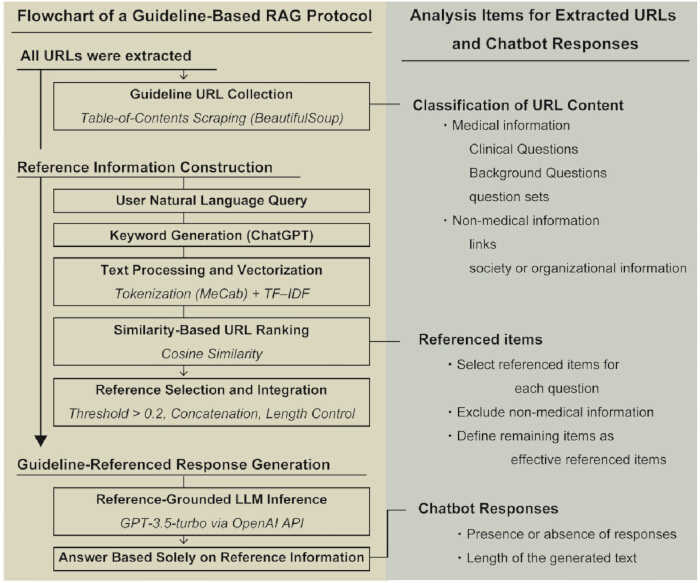
الشكل 1. سير عمل بروتوكول الدردشة الروبوت المعتمد على الإرشادات (RAG). نظرة عامة تخطيطية لسير عمل روبوتات الدردشة RAG المبنية على الإرشادات. يتم استخراج عناوين URL من صفحة جدول المحتويات في إرشادات الممارسة السريرية عبر الويب وتستخدم لبناء معلومات المرجع. يتم تحويل استعلامات المستخدمين إلى كلمات مفتاحية، ويتم معالجة محتوى صفحة الويب من خلال الترميز، وتكرار المصطلحات–تكرار الوثائق العكسي، وتحليل التشابه الجيب لتحديد صفحات الإرشادات ذات الصلة. يتم دمج معلومات المراجع المختارة وتقديمها لنموذج لغوي كبير لتوليد ردود بناء فقط على محتوى الإرشادات المشار إليه. تلخص اللوحة اليمنى عناصر التقييم المستخدمة لعناوين URL المستخرجة، ومعلومات المراجع، وردود روبوتات الدردشة. يرجى الضغط هنا لعرض نسخة أكبر من هذا الشكل.
1. إعداد معلومات مرجعية من الإرشادات المعتمدة على الويب
- استخراج جميع عناوين URL من صفحات جدول المحتويات في إرشادات الممارسة السريرية المستهدفة عبر الويب باستخدام BeautifulSoup 4 (مكتبة تحليل HTML) المطبقة بلغة البرمجة بايثون (الإصدار 3.12).
ملاحظة: تنفيذ سكريبت استخراج الرابط باستخدام لغة البرمجة مع الحزم التالية: مكتبة تحليل HTML (الإصدار 4.12.3) والطلبات (مكتبة استرجاع صفحات الويب؛ الإصدار 2.32.3). قم بتثبيت الحزم باستخدام pip. تم توفير الشيفرة المصدرية الكاملة لاستخراج الرابط في الملف التكميلي 1. راجع جدول المواد لتفاصيل البرمجيات. - راجع يدويا جميع عناوين URL المستخرجة لتأكيد الوصول الناجح والملاءمة لإرشادات الممارسة السريرية المستهدفة.
- صنف كل رابط على أنه يحتوي على معلومات طبية أو غير طبية. قم بتصنيف رابط URL بواسطة مؤلف واحد (S.N.).
ملاحظة: تم تعريف المعلومات الطبية كمحتوى إرشادي قابل للرجوع إليه، بما في ذلك الأسئلة السريرية (CQs)، والأسئلة الخلفية، ومجموعات الأسئلة. شملت المعلومات غير الطبية روابط، وصفحات جمعية أو منظمة، ومحتوى إضافي آخر غير مناسب للرجوع إليه. - قم بتجميع الروابط المعتمدة في كتاب عمل Microsoft Excel (بصيغة .xlsx)، مع تسجيل رابط واحد لكل صف. تخزين قائمة الروابط الناتجة كمجموعة بيانات مدخلة لاسترجاع النصوص، والمعالجة المسبقة، وتحليلات التشابه.
2. توليد الكلمات المفتاحية من استعلامات المستخدمين
- أدخل استعلام اللغة الطبيعية في ChatGPT (محول مولد مدرب مسبقا، الإصدار 4o؛ نموذج توليد الكلمات المفتاحية).
- اطلب من النموذج استخراج كلمتين مفتاحتين تقابلان استعلام المستخدم.
- استخدم التعليمات التالية، المكتوبة باليابانية، لتوليد الكلمات المفتاحية:
"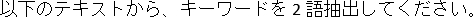 "
(الترجمة الإنجليزية: "استخرج كلمتين مفتاحتين من النص التالي.") - قم بإضافة استعلام اللغة الطبيعية للمستخدم إلى هذه التعليمة وتقديمه إلى نموذج توليد الكلمات المفتاحية لتوليد الكلمات المفتاحية.
- لا تعدل أي معلمات نموذج يدويا. قم بتوليد الكلمات المفتاحية باستخدام الإعدادات الافتراضية لنموذج توليد الكلمات المفتاحية.
- قم بتوليد كلمتيتين مفتاحتين لكل استعلام مستخدم. احتفظ بكلتا المفتاحتين دون تعديل إضافي أو تصفية أو اختيار يدوي، واستخدمهما لحسابات التشابه لاحقا.
- تخزين الكلمات المفتاحية المولدة في كتاب عمل Microsoft Excel (بصيغة .xlsx). لكل سجل، تخزن استعلام المستخدم الأصلي والكلمات المفتاحية المقابلة التي تم توليدها لاسترجاعها لاحقا بناء على التشابه.
3. معالجة النصوص وحساب التشابه
- استرجع محتوى النص الكامل من كل عنوان URL مستخرج باستخدام مكتبة استرجاع صفحات الويب ومكتبة تحليل HTML. استخرج محتوى النص من مصدر HTML باستخدام دالة BeautifulSoup get_text().
- قم بمعالجة نص صفحة الويب المستخرج والكلمات المفتاحية المولدة مسبقا عن طريق إزالة علامات HTML والأحرف غير اليابانية.
- قم بإجراء تحليل شكلي ياباني باستخدام MeCab (الإصدار 0.996؛ محلل صرفي ياباني) مع القاموس الافتراضي. احتفظ فقط بالأسماء وربطها في نص محدد بالفراغ.
- ادمج الكلمات المفتاحية المولدة في سلسلة نصية واحدة وطبق نفس إجراءات المعالجة المبدئية والترميز المستخدمة لنص صفحات الويب.
- توليد متجهات تردد المصطلحات–تردد المستند العكسي (TF–IDF) من نص صفحة الويب المعالجة ونص الكلمات المفتاحية باستخدام تنفيذ TfidfVectorizer في مكتبة scikit-learn (الإصدار 1.6.1) مع إعدادات المعلمات الافتراضية.
ملاحظة: جميع معلمات TfidfVectorizer تركت عند قيمها الافتراضية، ولم يتم تطبيق أي إعدادات معلمات مخصصة. - احسب تشابه جيب تمام بين كل متجه صفحة ويب ومتجه الكلمات المفتاحية باستخدام دالة تشابه جيب تمام.
- رتب عناوين URL بالترتيب التنازلي وفقا لدرجات التشابه في جيب تمام. لا تطبق معايير إضافية لكسر التعادل.
- اختر صفحات ذات درجة تشابه جيب تمام ≥0.2 كمعلومات مرجعية للمرشحين.
ملاحظة: تم اختيار عتبة تشابه الجيب التمامة (0.2) تجريبيا أثناء تطوير النظام لإعطاء الأولوية لاسترجاع الاسترجاع وتجنب استبعاد محتوى الإرشادات المحتملة ذات الصلة. - احتفظ بجميع صفحات المرشحين التي تحقق عتبة التشابه.
4. بناء معلومات المرجع
- استخرج محتوى النص للصفحات المختارة بشكل تسلسلي من أعلى القائمة المصنفة.
- قم بربط النصوص المستخرجة لتشكيل وثيقة مرجعية واحدة.
- قبل التقديم إلى النموذج اللغوي الكبير، استبدل الأحرف الجديدة والحروف المتتالية ذات المسافة البيضاء في النص المرجعي بمسافة واحدة.
- اقتصر النص المرجعي المتسلسل إلى أول 4,096 حرفا قبل تقديمه للنموذج اللغوي الكبير.
ملاحظة: كان حد الاقتطاع مبنيا على الأحرف وليس على الرموز. تم اختيار حد 4,096 حرفا تجريبيا لضمان بقاء المعلومات المجمعة للمطالبات والمرجع ضمن سعة إدخال نموذج توليد الاستجابة GPT-3.5-turbo-16k.
5. توليد الاستجابة المعتمد على الذكاء الاصطناعي
- يوفر معلومات المرجع المنشأة واستعلام المستخدم الأصلي لنموذج توليد الاستجابة عبر واجهة برمجة التطبيقات (API).
- وجه الذكاء الاصطناعي باستخدام التعليمات التالية (مكتوبة بالكامل باليابانية) لضمان أن الردود تولد فقط بناء على المعلومات المرجعية المقدمة:
"أنت مساعد معلومات طبية تقدم الإرشاد لمرضى السرطان. أنشئ ردودا بناء فقط على المعلومات المرجعية التالية، ولا تستخدم معرفتك العامة أو منطقك الشخصي. يجب أن تكون الردود مفصلة وسهلة الفهم، بطول يقارب 500 حرف. إذا لم تحتوي المعلومات المرجعية على معلومات كافية للإجابة على السؤال، رد بقول: 'لا توجد معلومات كافية في النص'، دون استخدام أي تكهنات أو معرفة عامة." - توفير معلومات المرجع واستعلام المستخدم معا داخل رسالة مستخدم واحدة. هيكل المدخل كالتالي: "معلومات مرجعية: [نص مرجعي]" متبوعا ب "سؤال: [استفسار المستخدم]".
- توليد الاستجابات باستخدام نموذج توليد الاستجابة مع الإعدادات التالية: درجة الحرارة = 0.1، الحد الأقصى لطول الإخراج = 1,024 رمزا، n = 1، والتوقف = لا شيء.
- احصل على الرد الذي يولده الذكاء الاصطناعي للتقييم لاحقا.
ملاحظة: قدم معلومات المرجع واستعلام المستخدم كرسالة مستخدم واحدة. قدم تعليمات توليد الاستجابة بشكل منفصل كرسالة نظام.
6. الإرشادات المرجعية وصياغة الأسئلة
- اختر دليل JLCS لمرضى وعائلات سرطان الرئة (دليل الرئة)21، المتوفر مجانا على الإنترنت، كمرجع لنظام الدردشة الآلية المبني على الإرشادات RAG.
- أنشئ فئتين من أسئلة التقييم بناء على نوع السرطان: أورام الغدة الزعترية، التي تقع ضمن نطاق الإرشادات، والورم الدبقي للأطفال، وهو خارج نطاق المعلومات المشار إليها.
- صيغ أربعة أسئلة تغطي التشخيص والعلاج لكل نوع من أنواع السرطان:
"ما هي طرق التشخيص المتاحة للأورام XX (مثل الغدة الدبقية أو الورم الدبقي لدى الأطفال)؟"
"ما هي الأساليب التشخيصية المرضية للأورام XX؟"
"ما هي خيارات العلاج المتاحة للأورام XX؟"
"ما هي خيارات العلاج الجراحي للأورمات XX؟" - قدم أسئلة متعلقة بأنواع السرطان المشمولة في الإرشادات الإلكترونية المشار إليها إلى روبوت الدردشة. على سبيل المثال، قدم سؤالا حول تشخيص ورم الغدة الدعترية مع استخدام دليل الرئة كمرجع.
- قدم أسئلة خارج نطاق الإرشادات المرجعية إلى روبوت الدردشة لتقييم قدرته على الامتناع عن استخدام معلومات خارجية أو غير ذات صلة. على سبيل المثال، قدم سؤالا حول الورم الدبقي للأطفال مع استخدام دليل الرئة كمرجع.
- قيم كل سؤال في جلسة دردشة مستقلة. لا تنقل تاريخ المحادثات بين الأسئلة.
- سجل الردود التي يولدها الذكاء الاصطناعي للتقييم لاحقا.
7. تقييم الاستجابة
- قم بمراجعة يدوية لجميع الردود المولدة.
- قيم ما إذا كان كل رد يحتوي على هلوسات.
- قيم ما إذا كان كل رد مدعوما بالمعلومات الواردة في الإرشادات المرجعية.
ملاحظة: تم تعريف الهلوسات بأنها استجابات تحتوي على أحداث أو أسماء أو مصطلحات غير موجودة قد تسبب ضررا طبيا14. تمت مراجعة جميع الردود المولدة من حيث الدقة وغياب الهلوسات من قبل مؤلف واحد لديه 8 سنوات من الخبرة في مستشفى جامعي، بما في ذلك دعم المرضى والتواصل الطبي مع مرضى السرطان. تم حل أي شك بشأن تصنيف الاستجابة من خلال مناقشة مع طبيب مشارك لديه أكثر من 20 عاما من الخبرة في خدمات معلومات السرطان في المركز الوطني للسرطان في اليابان. - اعتبر الرد مدعوما فقط عندما يمكن تأكيد جميع التصريحات ذات الصلة سريريا مباشرة من الإرشادات المرجعية المسترجعة دون الحاجة إلى معرفة إضافية أو استنتاج غير مدعوم.
- صنف كل استجابة باستخدام تسميات النتائج المحددة مسبقا. صنف الردود التي تحتوي فقط على معلومات مدعومة بدليل المرجع على أنها "غياب الهلوسة". صنف الردود التي تحتوي على معلومات غير مدعومة أو ملفقة على أنها "هلوسة موجودة".
الوصول مقيد. يرجى تسجيل الدخول أو بدء فترة تجريبية لعرض هذا المحتوى.
النتائج
قابلية استرجاع المحتوى الطبي عبر صفحات جدول المحتويات
كانت بنية جمع المواقع الإلكترونية روابط URL من صفحة جدول المحتويات في الإرشاد. من دليل الرئة، تم استخراج 106 روابط من صفحة جدول المحتويات، منها 104 (98٪) تحتوي على معلومات طبية (الجدول التكميلي 1). يتم تلخيص فعالية ردود الدردشة بناء على صفحات محتوى الإرشادات في الجدول 1. كان روبوت الدردشة يولد ردودا لجميع الكلمات المفتاحية السريرية الأربع عندما تقع الأسئلة ...
الوصول مقيد. يرجى تسجيل الدخول أو بدء فترة تجريبية لعرض هذا المحتوى.
المناقشة
في هذه الدراسة، درسنا فائدة روبوت دردشة RAG قائم على الإرشادات يستخدم إرشادات ممارسة سريرية عبر الويب—دليل JLCS لمرضى وعائلات سرطان الرئة—كمصدر مرجعي للمعلومات. كان روبوت الدردشة يولد ردودا تستند إلى محتوى الإرشادات من خلال استغلال هيكل الويب للإرشادات واسترجاع الصفحات بناء على تشابهها مع استفسارات المستخدمين. أظهر هذا النهج أن الاسترجاع القائم على التشابه مع توليد الاستجابة الموجهة إلى الإرشادات يمكن أن يدعم تقديم المعلومات الطبية بشكل موثوق وفعال. سلطت الدراسات الحديثة الضوء على إمكاني...
الوصول مقيد. يرجى تسجيل الدخول أو بدء فترة تجريبية لعرض هذا المحتوى.
الإفصاحات
يعلن المؤلفون عدم وجود مصالح متنافسة.
شكر وتقدير
يشكر المؤلفون كينيتشي إينووي، دكتور في الطب، دكتوراه في مركز ثدي مستشفى شونان التذكاري، على دعمه الفني المكثف في تطوير روبوت الدردشة المعتمد على الإرشادات والجيل المعزز بالاسترجاع. كما يشكر المؤلفون الدكتوراه شيكاكو ياماكي، وجميع أعضاء فريق البحث في معهد مكافحة السرطان، المركز الوطني للسرطان في اليابان (طوكيو، اليابان)، على تقديم نصائح قيمة حول الموضوع الذي تم تناوله في هذه الورقة. بالإضافة إلى ذلك، يشكر المؤلفون Editage على التحرير باللغة الإنجليزية. وقد تم دعم هذا العمل بمنحة بحثية من علوم الصحة والعمل (R6–Cancer Control–23EA1026).
الوصول مقيد. يرجى تسجيل الدخول أو بدء فترة تجريبية لعرض هذا المحتوى.
المواد
```html
```
| الاسم | الشركة | رقم فهرسي | التعليقات |
|---|---|---|---|
| Beautiful Soup 4 (الإصدار 4.12.3) | مشروع Beautiful Soup | N/A | مكتبة Python المستخدمة لاستخراج الروابط URL وتحليل HTML |
| إصدار ChatGPT 4o | OpenAI | N/A | يستخدم لتوليد الكلمات الرئيسية |
| GPT-3.5-turbo | OpenAI | N/A | يستخدم لتوليد الردود |
| دليل JLCS لمرضى سرطان الرئة وعائلاتهم | جمعية اليابان لسرطان الرئة | N/A | إرشادات الممارسة السريرية على شبكة الإنترنت المستخدمة كمرجع |
| MeCab (الإصدار 0.996) | مشروع MeCab | N/A | محلل شكلي ياباني |
| واجهة برمجة التطبيقات الخاصة بـOpenAI | OpenAI | N/A | يستخدم لتوليد الردود القائمة على الذكاء الاصطناعي |
| Python (الإصدار 3.12) | مؤسسة برمجيات Python | N/A | بيئة برمجة |
| Requests (الإصدار 2.32.3) | مشروع Requests | N/A | مكتبة Python المستخدمة للحصول على صفحات الويب |
| scikit-learn (الإصدار 1.6.1) | مطورو scikit-learn | N/A | يستخدم لتحوير TF–IDF والحسابات المتشابهة للجيوب |
| urllib.parse | مؤسسة برمجيات Python | N/A | مكتبة Python المستخدمة لتطبيع الروابط URL وربطها |
المراجع
- Helft PR, Hlubocky F, Daugherty CK. American oncologists' views of internet use by cancer patients: a mail survey of American Society of Clinical Oncology members. J Clin Oncol. 2003;21(5):942-947.
- Chen X, Siu LL. Impact of the media and the internet on oncology: survey of cancer patients and oncologists in Canada. J Clin Oncol. 2001;19(23):4291-4297.
- Goto Y, et al. Differences in the quality of information on the internet about lung cancer between the United States and Japan. J Thorac Oncol. 2009;4(7):829-833.
- Ogasawara R, et al. Reliability of cancer treatment information on the internet: observational study. JMIR Cancer. 2018;4(2):e10031.
- Johnson SB, Park HS, Gross CP, Yu JB. Complementary medicine, refusal of conventional cancer therapy, and survival among patients with curable cancers. JAMA Oncol. 2018;4(10):1375-1381.
- Rajpurkar P, Chen E, Banerjee O, Topol EJ. AI in health and medicine. Nat Med. 2022;28(1):31-38.
- The Lancet Digital Health. ChatGPT: friend or foe? Lancet Digit Health. 2023;5(3):e102.
- Huang L, et al. A survey on hallucination in large language models: principles, taxonomy, challenges, and open questions. arXiv. 2023;2311.05232.
- Ji Z, et al. Survey of hallucination in natural language generation. ACM Comput Surv. 2023;55(12):248.
- Yang R, et al. Retrieval-augmented generation for generative artificial intelligence in health care. npj Health Syst. 2025;2(2).
- Zakka C, et al. Almanac—retrieval-augmented language models for clinical medicine. NEJM AI. 2024;1(2):AIoa2300068.
- Chow JCL, Li K. Developing effective frameworks for large language model-based medical chatbots: insights from radiotherapy education with ChatGPT. JMIR Cancer. 2025;11:e66633.
- Chow JCL, Li K. Large language models in medical chatbots: opportunities, challenges, and the need to address AI risks. Information. 2025;16(7):549.
- Nishisako S, Higashi T, Wakao F. Reducing hallucinations and trade-offs in responses in generative AI chatbots for cancer information: development and evaluation study. JMIR Cancer. 2025;11:e70176.
- Lewis P, et al. Retrieval-augmented generation for knowledge-intensive NLP tasks. Adv Neural Inf Process Syst. 2020;33:9459-9474.
- Gao Y, et al. Retrieval-augmented generation for large language models: a survey. arXiv. 2023;2312.10997.
- Jeong M, Sohn J, Sung M, Kang JJB. Improving medical reasoning through retrieval and self-reflection with retrieval-augmented large language models. Bioinformatics. 2024;40:i119-i129.
- Lewis M, et al. Grounding large language models in clinical evidence: a retrieval-augmented generation system for querying UK NICE clinical guidelines. arXiv. 2025;2510.02967.
- Ministry of Education, Culture, Sports, Science and Technology; Ministry of Health, Labour and Welfare; Ministry of Economy, Trade and Industry. Ethical guidelines for medical and biological research involving human subjects [Article in Japanese]. Ministry of Health, Labour and Welfare.
- Gallifant J, et al. The TRIPOD-LLM reporting guideline for studies using large language models. Nat Med. 2025;31:60-69.
- The Japanese Lung Cancer Society. JLCS Guidebook for Lung Cancer Patients and Families. Available at: https://www.haigan.gr.jp/public/guidebook/2024/. Accessed January 21, 2026.
- Liu M, et al. Evaluating the effectiveness of advanced large language models in medical knowledge: a comparative study using Japanese national medical examination. Int J Med Inform. 2025;193:105673.
- Kudo T, Yamamoto K, Matsumoto Y. Applying conditional random fields to Japanese morphological analysis. In: Proceedings of the 2004 Conference on Empirical Methods in Natural Language Processing. 2004:230-237.
الوصول مقيد. يرجى تسجيل الدخول أو بدء فترة تجريبية لعرض هذا المحتوى.