يقترح هذا العمل إطار عمل لتحليل العواطف متعدد الوسائط من الطرف إلى الطرف، والذي يسخر المشفرات التحويلية (transformer encoders)، وتمثيلات العواطف المفككة، والانتباه عبر الوسائط القائم على الرسوم البيانية مع التعيين المرئي لتحسين دقة التعرف على العواطف عبر مجموعتي بيانات.
يتطلب اشتراك JoVE لعرض هذا المحتوى. تسجيل الدخول أو ابدأ نسخة تجريبية مجانية
مقالة بحثية
الرسم الخرائطي المرئي لسمات العواطف متعددة الوسائط لتصميم التفاعل الذكي
في هذه المقالة
ملخص
الملخص
يُعد التخطيط المرئي لسمات العواطف متعددة الوسائط أمراً بالغ الأهمية لتصميم الواجهات الذكية، وذلك من خلال تمكين الآلات من فهم الحالات العاطفية البشرية وتفسيرها والتفاعل معها. ومع ذلك، تركز خوارزميات اكتشاف العواطف متعددة الوسائط الحالية بشكل أساسي على أداء التنبؤ، مما يوفر رؤية محدودة فيما يتعلق بقابلية التفسير، أو الوعي بالتفاعل، أو التفاعلات عبر الوسائط على مستوى السمات. قدم هذا العمل إطار عمل للتخطيط المرئي لجوانب العواطف متعددة الوسائط يجمع بين التصور الموجه نحو التفاعل، وتعلم التمثيلات القابلة للتفسير، والتنبؤ العاطفي. تم استخدام مشفرات قائمة على نماذج transformer لاستخراج تضمينات عاطفية عالية المستوى من الوسائط النصية والصوتية والمرئية، دون الاعتماد على سمات تم إنشاؤها يدوياً. ولتعزيز المتانة، تم فصل المعلومات الخاصة بالعاطفة وتلك الخاصة بالوسائط باستخدام تقنية تعلم التمثيلات المفككة. بالإضافة إلى ذلك، تم إنشاء شبكة انتباه عبر الوسائط قائمة على الرسوم البيانية لاستخدام وزن انتباه تكيفي لمحاكاة العلاقات العاطفية الدقيقة بين الوسائط. كما تم تطوير وحدة تخطيط مرئي متعددة الرؤى لتصوير مسارات العواطف الزمنية، وتوزيعات الانتباه عبر الوسائط، وتضمينات العواطف الكامنة من أجل تعزيز الشفافية. تم تقييم إطار العمل المقترح باستخدام مجموعة بيانات Carnegie Mellon University Multimodal Opinion Sentiment and Emotion Intensity (CMU-MOSEI) ومجموعة بيانات تحليل المشاعر متعددة الوسائط الصينية (CH-SIMS). ووفقاً للنتائج التجريبية، وفر إطار العمل المقترح قابلية تفسير محسنة على مستوى السمات وتصوراً واعياً بالتفاعل، بينما تفوق باستمرار على التقنيات المرجعية التمثيلية من حيث الدقة، ومقياس F1-score، والارتباط، ومتوسط الخطأ المطلق. علاوة على ذلك، سهلت وحدة التخطيط المرئي التفسير النوعي لتمثيلات العواطف متعددة الوسائط، والتفاعلات عبر الوسائط، والديناميكيات العاطفية الزمنية، مما يدعم التحليل والتصور الواعي بالتفاعل.
المقدمة
لقد أصبحت القدرة على تحديد وفهم المشاعر البشرية بشكل صحيح أمراً بالغ الأهمية لتحسين التفاعل بين البشر والآلات. وبالإضافة إلى كونها ضرورية لتحسين التفاعل بين الإنسان والحاسوب، فإن لتحليل العواطف القدرة على إحداث ثورة في عدد من المجالات، بما في ذلك التشخيص الطبي السابق للتخيص1، وتحليل السلوك داخل الفصول الدراسية2، والمتابعة النفسية للمرضى3، وتحديد حالة الإجهاد في المركبات4، والإدارة الذكية في بيئات المنازل الذكية5. وقد أدت التطورات الأخيرة في الحوسبة العاطفية والتعلم العميق6 إلى زيادة الاهتمام بإنشاء أنظمة تعمل في الوقت الفعلي ويمكنها استيعاب تعقيد العواطف البشرية.
تعتمد العديد من الطرق الحالية بشكل أساسي على البيانات أحادية النمط، مثل الإشارات النصية أو الرسومية أو السمعية7,8,9. وتفشل هذه النهج بشكل متكرر في اكتشاف الإشارات الدقيقة مثل السخرية أو الفروق الدقيقة المرتبطة بالسياق. وقد انتقلت الأبحاث إلى تقييم العواطف متعدد الأنماط، والذي يدمج بيانات تكميلية من مصادر متعددة للتغلب على هذه القيود10,11,12. وقد أثبتت النماذج المرجعية مزايا دمج أنماط متعددة، مثل الذاكرة طويلة قصيرة المدى ذات الدمج المبكر (EF-LSTM)13، والشبكات العصبية العميقة خفيفة وFM (LF-DNN)14، وشبكات دمج الموتر (TFN)، ونهج الدمج متعدد الأنماط منخفض الرتبة. ومع ذلك، تعتمد معظم هذه النهج على توليد السمات في وضع عدم الاتصال، وهي غير مناسبة للمواقف الديناميكية في العالم الحقيقي.
من أجل استيعاب الحالات العاطفية، شهدت أبحاث وتطبيقات تحديد العواطف متعددة الوسائط نمواً ملحوظاً خلال السنوات العشر الماضية15. ويعد الرصد المستمر للحالات العاطفية باستخدام مصادر بيانات متنوعة واحداً من أكثر مجالات البحث تحدياً وأهمية في الوقت الحاضر16. وقد ظهر مفهوم تعدد الوسائط بشكل طبيعي مع ظهور هذا النظام المعرفي المتنوع، مما أدى إلى العديد من التطورات في تطبيق العواطف في مجالات مثل الحوسبة العاطفية، والتفاعل بين الإنسان والحاسوب (HCI)، والتعلم، وألعاب الفيديو، وخدمة العملاء، والرعاية الطبية، وتقييم تجربة المستخدم (UX)، وغيرها. ومع ذلك، لم يكن تطبيق تقنيات التعرف على العواطف في تقييم تجربة المستخدم أمراً بسيطاً دائماً.
إن أحد الأسباب الرئيسية للتركيز على التعرف متعدد الوسائط بدلاً من الطرق أحادية الوسائط هو العيوب المتأصلة في الاعتماد على مصدر معلومات واحد. فقد تعاني أنظمة اكتشاف العواطف أحادية الوسائط من انخفاض الدقة بسبب البيانات المفقودة أو غير الواضحة، بينما تعد مخططات التعرف على العواطف (MER) أكثر موثوقية وتقدم فهماً أكثر شمولاً وتعمقاً للحالات التعبيرية من خلال دمج مصادر بيانات متعددة17. فعلى سبيل المثال، قد لا تكون لغة الوجه وحدها كافية لتصنيف المشاعر بدقة، خاصة عندما تكون الإيماءات معقدة أو غير واضحة. وبالرغم من ذلك، فإن الجمع بين تعبيرات الوجه وأشكال أخرى من التواصل، مثل اللغة أو الإشارات الجسدية، قد يزيد من دقة التعرف على المشاعر.
أُجريت أبحاث مكثفة حول التعرف على العواطف عبر أنماط متعددة. ركزت الدراسات المبكرة على تحديد السمات المميزة من أنماط مختلفة، مثل المدخلات الرسومية أو الصوتية أو النصية. ومع ذلك، أصبح من الواضح بشكل متزايد أن دمج أنماط متنوعة يمكن أن يوفر معلومات عاطفية متوازنة، مما يؤدي إلى كشف أكثر موثوقية ودقة عن المشاعر. يستعرض هذا القسم التطورات الرئيسية في تحليل العواطف أحادي النمط ومتعدد الأنماط، مع التركيز على النهج الأساسية، وأوجه القصور فيها، والمنطق الذي استندنا إليه في منهجيتنا.
ركزت الدراسات الأولية حول التعرف على العواطف بشكل أساسي على نمط واحد. ففي المجال البصري، أدت الأبحاث الرائدة إلى تصنيف حركات الوجه النموذجية20. وشملت التطورات اللاحقة تقنيات لالتقاط الديناميكيات الزمنية، مثل الحركة البصرية21 ونماذج ماركوف المخفية22، بينما قُسمت استجابات الوجه إلى وحدات عمل باستخدام نظام ترميز تعبيرات الوجه (FACS)23. وقد استُخدمت شبكات الذاكرة طويلة قصيرة المدى (LSTMs) والشبكات العصبية الالتفافية (CNNs) بنجاح لاستخراج سمات ذات دلالة مباشرة من الإشارات الصوتية الخام؛ كما تطورت منهجيات تحديد العواطف القائمة على الصوت من معالجة الإشارات التقليدية إلى التعلم العميق24. كما تعزز استخراج إشارات المشاعر السياقية في تحليل العواطف القائم على النصوص بشكل كبير بواسطة الشبكات العصبية المتكررة (RNNs) التي تدمج آليات الانتباه، ومؤخراً بواسطة النماذج القائمة على المحولات (transformer-based models). ورغم إنجازاتها، فإن التقنيات أحادية النمط غير قادرة جوهرياً على تمثيل التعقيدات التي يمر بها البشر بدقة نظراً لافتقارها إلى المعلومات التكميلية الموجودة في الأنماط الأخرى.
تم اقتراح بعض النماذج القائمة على آلية الانتباه، مثل نموذج DialogXL25، في عام 2021 لجمع بيانات بيئية طويلة المدى في مجال تحديد المشاعر في المحادثات. وقد قدم Kim et al.26 نموذج EmoBERTa في عام 2021 لزيادة دقة التعرف على المشاعر في المحادثات (ERC). يستخدم هذا النموذج بيانات المتحدث لتحسين سمات المتحدثين في المحادثات وتفاعلاتهم مع بعضهم البعض. وفي عام 2022، عرض Li et al.27 طريقة CoG-BART. وتستخدم هذه البنية التعلم التبايني الخاضع للإشراف لتحسين قدرة النموذج على تفسير البيانات ذات الصلة. وتجدر الإشارة إلى أن التعلم الخاضع للإشراف يتطلب كمية كبيرة من البيانات المصنفة.
ومن الأمثلة النموذجية على هذا العمل إطار التمثيل المدرك للتفاعل متعدد الوسائط (MIAR)28، والذي يستخدم رموز تفاعل الميزات والمحاذاة التباينية لتحسين التعميم عبر الوسائط المختلفة. يعمل MIAR على تحسين محاذاة الوسائط ويحقق أداءً قوياً عبر عدة مجموعات بيانات؛ ومع ذلك، فإنه يركز بشكل أساسي على دقة التنبؤ دون معالجة التخطيط المرئي. وبالمثل، فإن نموذج الاندماج السمعي البصري عبر الانتباه (Cross-Attentional Audio-Visual Fusion)29 يلتقط بفعالية التفاعلات السمعية البصرية دقيقة التفاصيل للتنبؤ بالتكافؤ والاستثارة، ولكنه يقتصر على وسيطين فقط ويفتقر إلى قدرات التصوير المرئي. كما نجحت مناهج النمذجة الزمنية القائمة على شبكات LSTM واندماج المشفِّرات التلقائية في التقاط الديناميكيات الزمنية للعواطف، إلا أنها توفر رؤية محدودة فيما يتعلق بتفاعلات الوسائط والتمثيلات العاطفية المكتسبة. وفي الآونة الأخيرة، أظهرت الطرق القائمة على المحولات، مثل شبكة الاندماج متعدد الوسائط القائمة على المحول (TMFN)30، أداءً قوياً على مجموعات بيانات CMU-MOSI و CMU-MOSEI من خلال تعزيز الاندماج متعدد الوسائط والتعلم التبايني. ومع ذلك، تظل هذه المناهج مدفوعة بالأداء في المقام الأول، وتقدم دعماً محدوداً للقابلية للتفسير، والتأويل على مستوى الميزات، والتصوير المرئي الموجه نحو التفاعل.
بهدف تعزيز تكامل البيانات النصية والصوتية والبصرية، تم اقتراح العديد من تقنيات التعرف على العواطف متعددة الوسائط. وبالرغم من عدم قدرتها على التقاط التفاعلات المعقدة بين الوسائط المختلفة، فقد أظهرت تقنيات الدمج المبكر مثل EF-LSTM وLF-DNN مزايا استخدام المعلومات متعددة الوسائط لتحليل المشاعر والعواطف. ورغم أن TFN قد حسّن الأداء في مجموعات البيانات المرجعية مثل CMU-MOSI وCMU-MOSEI وقدم نمذجة صريحة للتفاعلات بين الوسائط، إلا أن محدودية قابليته للتفسير وتعقيده الحسابي العالي أعاقا فائدته. ولتحسين محاذاة الوسائط ودمج الميزات الديناميكية، استخدمت تقنيات أكثر حداثة مثل MIAR، ونماذج دمج الانتباه المتقاطع، وTMFN، ومحولات الوسائط المتعددة التكيفية، بنيات المحولات (transformer topologies) وآليات الانتباه. ركزت هذه الطرق بشكل أساسي على الأداء التنبؤي، وقدمت رؤى محدودة حول التمثيلات العاطفية على مستوى الميزات والتبعيات عبر الوسائط، رغم تحقيق نتائج تنافسية عبر مقاييس التقييم الشائعة مثل الدقة (accuracy)، وF1-score، ومتوسط الخطأ المطلق (mean absolute error). علاوة على ذلك، فإن الدراسات التي وضعت تقنيات تصور يمكنها الكشف عن تضمينات العواطف الكامنة وتوزيعات الانتباه وديناميكيات العواطف الزمنية، أو التي دمجت نمذجة قائمة على الرسوم البيانية (graph-based modeling) للتفاعلات بين الوسائط، تظل قليلة. يتضمن النهج المقترح رسم خرائط بصرية متعددة العروض، ودمج الانتباه المتقاطع القائم على الرسوم البيانية، وتعلم التمثيلات المفككة للتغلب على هذه العيوب وتعزيز أداء التعرف على العواطف متعدد الوسائط.
وبالمثل، يقترح محول الوسائط المتعددة التكيفي (Adaptive Multimodal Transformer)32 دمجاً قائماً على التبادل للتخفيف التكيفي من المعلومات النمطية المشوشة أو المفقودة، مما يعزز أداء تصنيف المشاعر. ورغم أن هذا النهج يمكن أن يعالج بشكل فعال التباينات في توزيع المعلومات النمطية، إلا أن تصميمه مخصص لمهام تحليل المشاعر ويوفر رؤية محدودة للتمثيلات العاطفية المكتسبة. وثمة مساهمة مهمة أخرى تتمثل في نموذج دمج الوسائط المتعددة (Multimodal Fusion Model)33، الذي يدمج الشبكات العصبونية التلافيفية (CNNs)، وذاكرات الوحدات القصيرة المدى (LSTMs) الضربية، وآلية الانتباه القائمة على المحولات للتعرف على العواطف متعددة الأنماط في الوقت الفعلي. ويقوم النموذج بدمج كامل لأنماط الفيديو والصوت والنص، ويظهر أداءً قوياً في التعرف. ومع ذلك، وكما هو الحال في النماذج الحالية الأخرى، فإنه يركز بشكل أساسي على دقة التنبؤ ويفتقر إلى ميزات صريحة للتصوير المرئي وقابلية التفسير الموجهة نحو التفاعل.
وفي الختام، بينما حققت مناهج التعرف على العواطف متعددة الوسائط الحديثة نجاحاً ملحوظاً في رصد التفاعلات عبر الوسائط وتعزيز دقة التنبؤ، فإن معظمها يركز على المهام القائمة على التعرف. وقد نالت مجالات قابلية التفسير على مستوى الميزات، وتصوير التمثيلات العاطفية في مساحة الصور، ودمج الإطار المقترح لتصميم التفاعل الذكي اهتماماً ضئيلاً. ومن هذا المنطلق، ومع مراعاة هذه التحديات، تم تقديم الإطار المقترح.
تركز غالبية الطرق الحالية بشكل أساسي على تحسين الأداء التنبئي مع تقديم القليل من القابلية للتفسير للتمثيلات العاطفية المكتسبة والتفاعلات عبر الوسائط، وذلك رغم التقدم الملحوظ في التعرف متعدد الوسائط على العواطف28,29. وغالباً ما يصعب على استراتيجيات الدمج الحالية نمذجة التفاعلات المعقدة بين الوسائط النصية والصوتية والبصرية، خاصة عند حدوث تباينات في الوسائط ونقص في المعلومات 28,31. وبينما أدت التصميمات القائمة على المحولات (transformers) وآليات الانتباه إلى تعزيز تعلم التمثيلات، فإن شفافيتها وقابليتها للتفسير غالباً ما تتضاءل بسبب الافتقار إلى الفصل الصريح بين المعلومات الخاصة بالعواطف والمعلومات الخاصة بالوسائط31,32,33. بالإضافة إلى ذلك، بحث عدد قليل فقط من الدراسات في النمذجة القائمة على الرسوم البيانية للتفاعلات بين الوسائط أو أنشأت أطر تصور يمكنها الكشف عن ديناميكيات العواطف الزمنية وتوزيعات الانتباه وتضمينات العواطف. وتوضح هذه العيوب الضرورة الملحة لإيجاد إطار عمل متعدد الوسائط وقابل للتفسير للتفاعل الذكي بين الإنسان والآلة يجمع بين الخرائط المرئية الموجهة نحو التفاعل والتعلم القوي عبر الوسائط.
يقدم هذا العمل إطار عمل قابل للتفسير لرسم الخرائط المرئية لجوانب العواطف متعددة الوسائط في تصميم الواجهات الذكية. يستخدم النظام التعلم العميق الشامل (end-to-end) لاستخراج تمثيلات عاطفية عالية المستوى من الوسائط النصية والصوتية والبصرية، دون الحاجة إلى ميزات مُعدة يدويًا. كما تم نمذجة التفاعلات العاطفية عبر الوسائط باستخدام آلية دمج قائمة على الانتباه الرسومي (graph-based attention fusion) تعمل على فصل المعلومات الخاصة بالعاطفة عن تلك الخاصة بالوسائط، مما يتيح تعلم التمثيلات المفككة ويحسن من القابلية للتفسير والمتانة. بالإضافة إلى ذلك، تم إنشاء وحدة تصور متعددة العروض لإظهار ديناميكيات العواطف الزمنية، وأنماط الانتباه عبر الوسائط، وتضمينات العواطف (emotion embeddings). وقد تم تقييم فعالية وملاءمة إطار العمل المقترح في أنظمة التفاعل الذكي بين الإنسان والآلة من خلال التحقق من صحته باستخدام مجموعات بيانات مرجعية للتعرف على العواطف متعددة الوسائط.
يقدم هذا العمل إطار عمل فريداً للرسم الخرائطي المرئي لجوانب العواطف متعددة الوسائط، والذي يتجاوز النهج التقليدية الموجهة نحو التنبؤ للتغلب على ضعف نمذجة التفاعلات عبر الوسائط ومحدودية القابلية للتفسير في أنظمة تحديد العواطف متعددة الوسائط الحالية. يدمج النهج المقترح، ضمن بنية واحدة، تعلّم التمثيلات متعددة الوسائط القائم على المحولات (transformer)، ونمذجة الميزات المفككة المدركة للعواطف، ودمج الانتباه عبر الوسائط القائم على الرسوم البيانية، والتصور الموجه نحو التفاعل. ويفصل إطار العمل بوضوح بين التمثيلات الخاصة بالعواطف وتلك الخاصة بالوسائط لتحسين القابلية للتفسير والمتانة والاتساق عبر الوسائط، وذلك على عكس النهج الحالية التي تركز بشكل أساسي على أداء التصنيف. بالإضافة إلى ذلك، تم تقديم آلية انتباه قائمة على الرسوم البيانية لتمكين النمذجة التكيفية للتفاعلات بين الوسائط من خلال التقاط الاعتماد المتبادل العاطفي دقيق التفاصيل بين الوسائط النصية والصوتية والمرئية. كما تم إنشاء وحدة رسم خرائطي مرئي متعدد الرؤى لزيادة الشفافية عن طريق الكشف عن مسارات العواطف الزمنية، وأنماط الانتباه عبر الوسائط، وتضمينات العواطف الكامنة، مما يوفر رؤى بديهية لعملية اتخاذ القرار في النموذج. وبالإضافة إلى توفير تصور وقابلية تفسير محسنة للديناميكيات العاطفية متعددة الوسائط، أظهر التقييم التجريبي على مجموعات بيانات CH-SIMS و CMU-MOSEI المرجعية أداءً تنافسياً من حيث الدقة، ومقياس F1-score، ومتوسط الخطأ المطلق، والارتباط.
الوصول مقيد. يرجى تسجيل الدخول أو بدء فترة تجريبية لعرض هذا المحتوى.
البروتوكول
يهدف العمل المقترح إلى تحسين تصميم التفاعل الذكي من خلال تقديم إطار عمل قابل للتفسير للرسم الخرائطي البصري لميزات المشاعر متعددة الوسائط. وقد استُخدمت في هذا العمل قاعدتا بيانات CH-SIMS و CMU-MOSEI المتاحتان للعامة. تم الحصول على كلتا المجموعتين من مصادرهما الرسمية واستُخدمتا وفقاً لإرشادات الاستخدام ومعايير البحث وشروط الترخيص التي وضعها منشؤوهما. قام مزودو مجموعات البيانات أولاً بجمع المحتوى متعدد الوسائط، بما في ذلك البيانات النصية والصوتية والمرئية، وتصنيفها وفقاً لأذونات المشاركين المعتمدة وبروتوكولات جمع البيانات الخاصة بهم. لم يتضمن هذا البحث أي تفاعل بشري مباشر، أو استقطاب لمشاركين جدد، أو جمع لمعلومات تحديد الهوية الشخصية. وقد أُجريت جميع التحليلات باستخدام مجموعات بيانات بحثية متاحة للعامة. وبناءً على ذلك، لم يتطلب تحليلنا الثانوي للبيانات أي موافقة أخلاقية إضافية أو مراجعة من مجلس المراجعة المؤسسية (IRB). نُفذت الدراسة وفقاً للمعايير المؤسسية المناسبة التي تحكم استخدام مجموعات البيانات المتاحة للعامة، وإجراءات البحث الأخلاقية، وسياسات استخدام البيانات المعمول بها.
تم استخدام آلية انتباه عبر وسائط تعتمد على الرسوم البيانية لتعلم توصيفات المشاعر عبر الوسائط المختلفة باستخدام خصائص محددة للمشاعر أو الوسائط لتحسين الفهم. ويُستخدم مكون رسم خرائط بصري متعدد الرؤى لتعزيز التصميم التفاعلي المدرك للمشاعر في الوقت الفعلي، كما تم تقدير كفاءته في التعرف على المشاعر. وتظهر النتائج أن الطريقة المقترحة تحسن كلاً من القابلية للتفسير والكفاءة لواجهات المستخدم الذكية المدركة للمشاعر في العالم الحقيقي. يوضح الشكل 1 سير العمل المعماري للعمل المقترح. كما يوضح الشكل 1 سير العمل الكامل لإطار رسم الخرائط البصري المقترح لتعلم سمات المشاعر متعددة الوسائط في سياق أنظمة التفاعل الذكية. يبدأ سير العمل بثلاث وسائط إدخال متزامنة، وهي النص والصوت والفيديو، والتي تلتقط معلومات عاطفية متكاملة من الوسائط اللغوية والعروضية وتعبيرات الوجه، على التوالي. يقوم مشفر محول (transformer encoder) محدد لكل وسيط بمعالجة كل وسيط للحصول على تمثيلات رفيعة المستوى لبيانات الإدخال الخام. ثم يتم تغذية هذه التمثيلات في وحدة تعلم التمثيلات المفككة، حيث يتم فك ارتباط تضمينات المشاعر المحددة عن السمات الخاصة بالوسائط لضمان الاتساق في المشاعر المتعلمة عبر مصادر البيانات غير المتجانسة. بعد ذلك، يتم تجميع التضمينات المحددة للمشاعر من كل وسيط بواسطة شبكة انتباه عبر وسائط تعتمد على الرسوم البيانية، والتي تقوم بنمذجة الاعتمادات العاطفية بين الوسائط وتعيين أوزان أهمية ديناميكية لكل وسيط بناءً على سياق التفاعل. وفي النهاية، يوفر الإطار كلاً من مخرجات تصنيف المشاعر ورؤى التفاعل، مما يسهل عملية اتخاذ القرار الشفافة المدركة للمشاعر وتصميم التفاعل الذكي التكيفي.
الحصول على البيانات متعددة الوسائط
تُعد مجموعتا بيانات CH-SIMS وCMU-MOSEI مجموعتين عامتين موجودتين من البيانات متعددة الوسائط التي جمعت معلومات متعددة الوسائط، مثل الفيديو والصوت والنص المتزامنة. وتضم مجموعة بيانات CH-SIMS فحوصات متعددة الوسائط لأشخاص صينيين، تشمل 2,281 مقطع فيديو، مستمدة من مقاطع فيديو متعددة من الأفلام والدراما التلفزيونية والبرامج الترفيهية. وقد أصبحت الدراسات المتعلقة بالتحليل متعدد الوسائط للعواطف باستخدام البيانات متعددة الوسائط أكثر جاذبية وجدوى من خلال إضافة الصوت والنص المقابلين إلى هذه المقاطع الفيديوية. ومع ذلك، فإن مجموعة بيانات CMU-MOSEI هي واحدة من أكبر مجموعات البيانات متعددة الوسائط لفحص الآراء والمشاعر والعواطف، حيث جُمعت من أكثر من 23,000 مقطع فيديو لعبارات نطق بها أكثر من 1,000 متحدث عبر مجموعة متنوعة من المواضيع. وقد تم تقسيم مجموعة البيانات عشوائياً إلى مجموعات فرعية للتدريب (70%)، والتحقق (15%)، والاختبار (15%) مع الحفاظ على توزيع الفئات.
يتم الحصول على التفريغات النصية، والإشارات الصوتية، وإطارات الفيديو ومزامنتها زمنياً لتتطابق على مستوى زمني دقيق. ويضمن التكامل على مستوى الإطار أن آليات تعلم التمثيل والدمج القائم على الرسوم البيانية المقترحة يمكنها نمذجة واستغلال المحتوى العاطفي الناشئ عن التعبيرات البصرية، ونبرات الصوت، والمحتوى اللغوي بشكل مشترك. وتسمح تقنية الاستحواذ متعدد الوسائط هذه بالاستخراج الفعال للديناميكيات العاطفية بين الوسائط، وهو أمر ضروري لتصميم التفاعل الذكي والرسم الخرائطي البصري المفهوم.
يعرض الجدول 1 الهياكل الأساسية لمجموعات بيانات العواطف متعددة الوسائط المستخدمة في الطريقة المقترحة. وللحصول على نطاق أوسع من المشاعر ذات الصلة، مثل الكلمات المنطوقة، وتنغيمات الصوت، وتعبيرات الوجه، تدمج مجموعتا بيانات CH-SIMS و CMU-MOSEI وسائط الفيديو والصوت والنص من هذه المجموعات. وعلاوة على ذلك، تتوفر مجموعة محدودة من عينات البيانات في CH-SIMS، مما يتيح إجراء فحص دقيق لتفاعلات الوسائط وتباين العواطف في الصين. من ناحية أخرى، تعد مجموعة بيانات CMU-MOSEI أكثر أهمية لتقييم متانة تعلم التمثيل وخوارزميات التصور ذات الصلة التي يتناولها هذا العمل، حيث أنها تحتوي على كمية كبيرة من البيانات عبر لغات وموضوعات ومستويات عواطف مشروحة متنوعة. بالإضافة إلى ذلك، فإنها تقلل من الصعوبات في اختيار المعلومات عند اختبار النماذج مقارنة بالأبحاث السابقة.
المعالجة المسبقة والمزامنة متعددة الأنماط
استُخدمت تعليقات الطوابع الزمنية من مجموعات بيانات CH-SIMS و CMU-MOSEI لمزامنة الأنماط النصية والسمعية والبصرية، مما ضمن تعلم تمثيلات متعددة الأنماط متسقة. عمل كل منطوق كوحدة تحليل أساسية وتم ربطه بمقاطع الصوت والفيديو المطابقة ضمن نفس الفترة الزمنية. أُجريت المحاذاة على مستوى المنطوق؛ حيث قُسّم النص المكتوب إلى مقاطع بناءً على طوابع زمن البداية والنهاية لكل منطوق. وتم إنشاء التوافق بين النص والصوت والبصر من خلال استخراج إطارات الفيديو وإشارات الصوت المقابلة التي وقعت ضمن نفس الفترة الزمنية. وبينما عولجت المقاطع الصوتية باستخدام Wav2Vec 2.0 لإنتاج تمثيلات صوتية، تم أخذ عينات من الإطارات البصرية من مقطع الفيديو بمعدل محدد مسبقاً وتشفيرها باستخدام Vision Transformer (ViT). كما استُخدم مشفر RoBERTa لإنشاء تضمينات نصية من نصوص المنطوقات. وتحققت المزامنة الزمنية من خلال محاذاة جميع سمات الأنماط مع حدود منطوق واحد، نظراً لأن الأنماط الثلاثة أنتجت تسلسلات سمات بأطوال متفاوتة. واستُخدم تنسيق ثابت الطول لتوحيد التسلسلات ذات الأطوال المختلفة؛ حيث قُصرت التسلسلات الأطول إلى أقصى طول تسلسل مسموح به، بينما عُززت التسلسلات الأقصر بحشو أصفار. وأثناء التدريب، استُخدمت أقنعة الانتباه لفصل العناصر المحشوة عن مواضع السمات الفعلية. كما تم إسقاط التضمينات الخاصة بكل نمط في فضاء كامن مشترك قبل الدمج للتغلب على اختلاف أطوال التسلسلات عبر الأنماط، مما ضمن الاتساق البعدي وأتاح لآلية الانتباه القائمة على الرسوم البيانية تسهيل تعلم التفاعل الناجح عبر الأنماط. وللحفاظ على جودة البيانات وسلامة المزامنة، تم استبعاد العينات ذات الملفات التالفة، أو التعليقات المفقودة، أو معلومات الأنماط غير المكتملة من الدراسات.
استخلاص الميزات القائم على المحولات (Transformer)
تُستخدم طريقة للتعلم العميق لتعلم تمثيلات ميزات عالية المستوى مدركة للعواطف من معلومات عبر وسائط متعددة، مثل الرؤية والصوت والنص، بطريقة شاملة (end-to-end) بعد محاذاة البيانات متعددة الوسائط وإجراء أي معالجة مسبقة مطلوبة. ومن خلال استخدام مشفر محول (transformer encoder) لتعلم تمثيلات ميزات تمييزية جوهرية من البيانات الخام متعددة الوسائط، تلغي الطريقة المقترحة الحاجة إلى هندسة الميزات. ولتسهيل الاتساق عبر مجموعات البيانات المستخدمة في النهج المقترح، يتم تعلم تضمين (embedding) ثابت الحجم لكل وسيط. على سبيل المثال، يتم تعلم تضمينات ميزات بأبعاد 768 عبر كل من الوسائط الفردية، بما في ذلك وسائط الصور والصوت والنص، مما يشكل مجتمعاً موحداً من الميزات يُستخدم عبر النهج بأكمله، وتحديداً نهج استخراج الميزات المستخدم عبر مجموعة بيانات CH-SIMS ومجموعة بيانات CMU-MOSEI لتعلم ميزات عالية المستوى عبر بيانات ذات أحجام مختلفة.
النمط البصري: محول الرؤية لتضمينات الإطارات المدركة للعواطف
تم استخدام نموذج Vision Transformer (ViT-Base) لاستخراج المعلومات المرئية من إطارات الفيديو من أجل الحصول على تمثيلات مكانية ذات صلة بالعواطف. وقبل استخراج الميزات، تم تغيير حجم إطارات كل مقطع فيديو إلى (224 × 224) بكسل وأخذ عينات منها على فترات زمنية منتظمة. وباعتماد حجم رقعة يبلغ 16 × 16 بكسل، تنتج بنية ViT-Base سلسلة من الرموز المرئية التي يتم معالجتها بواسطة 12 طبقة من مشفرات transformer. وقد تم إسقاط التمثيلات المستردة على مستوى الإطار في فضاء تضمين ذي 768 بُعدًا باستخدام نموذج ViT مُدرب مسبقًا كعمود فقري مرئي. ثم جُمعت تضمينات مستوى الإطار باستخدام التجميع المتوسط (mean pooling) لإنشاء التمثيل المرئي النهائي لكل مقطع. وخلال مرحلة التدريب، استُخدم تطبيع الصور وطرق تعزيز البيانات الشائعة، مثل الاقتصاص العشوائي والقلب الأفقي، لتحسين القدرة على التعميم. وبعد ذلك، استُخدم إطار دمج الوسائط المتعددة المقترح لدمج هذه التضمينات المرئية مع التمثيلات النصية والسمعية.
للحفاظ على الديناميكيات الزمنية في العاطفة، سيتم أخذ عينات منتظمة من عينات الفيديو من مجموعتي بيانات CH-SIMS و CMU-MOSEI للنمط البصري. يمكن تقسيم إطارات كل فيديو، 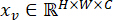 ، إلى N من الأقسام ثابتة الحجم، والتي يتم بعد ذلك تسطيحها ونقلها عكسيًا إلى فضاء تضمين كامن ببعد
 . ويتم إنشاء سلسلة عن طريق إضافة تضمينات موضعية ورمز تجميع قابل للتعلم:
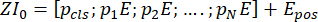 (1)
حيث تمثل  الترميز الموضعي، و
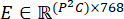 هي مصفوفة تضمين الرقعة.
تُستخدم طبقات مشفر المحولات المتراكمة، المكونة من شبكات التغذية الأمامية والاهتمام الذاتي متعدد الرؤوس، لمعالجة تسلسل الرقع المضمنة. ويتم وصف التحويل في الطبقة l كما يلي:
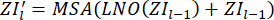 (2)
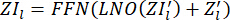 (3)
للحصول على متجه السمات المرئية المدرك للعواطف، يتم استخراج المخرج المكافئ لرمز الفئة (class token) كمتجه السمات  . ولمعالجة التمثيلات المرئية المتسقة للعواطف رغم الاختلافات في اللغة والمحتوى عبر مجموعات البيانات، يتم دمج تضمينات مستوى الإطار (frame-level embeddings) من كل مقطع فيديو لالتقاط تعبيرات الوجه وتطور العواطف.
النمط الصوتي باستخدام Wav2Vec 2.0 للتنغيم والتضمينات الصوتية الدلالية أُنتجت تضمينات كلامية سياقية باستخدام مشفر Wav2Vec 2.0 مُدرب مسبقاً كعمود فقري صوتي. وتم الحصول على متجه سمات صوتية ثابت الطول لكل عبارة عن طريق تجميع التمثيلات الخفية الناتجة باستخدام التجميع المتوسط (mean pooling). استُخدم نموذج Wav2Vec 2.0 لاستخراج التمثيلات الصوتية من الإشارات الصوتية لالتقاط خصائص الكلام السياقية وذات الصلة بالعواطف. وقبل استخراج السمات، جرى توحيد التسجيلات الصوتية وإعادة أخذ عيناتها بتردد 16 kHz. ولضمان المزامنة بين النمطين النصي والبصري، عُزلت كل قطعة صوتية على مستوى المنطوق باستخدام حدود الطوابع الزمنية المقدمة في تعليقات مجموعة البيانات. كما جرى ضبط المشفر الصوتي المُدرب مسبقاً أثناء تدريب النموذج لتعزيز التكيف مع المهمة المحددة، مما مكن التمثيلات المستمدة من تمثيل الجوانب العاطفية للإشارات الصوتية بدقة أكبر. ثم أُجري دمج الانتباه عبر الأنماط القائم على الرسوم البيانية وتعلم التمثيلات المفككة باستخدام التضمينات الصوتية النهائية.
في نمط الصوت، يُستخدم نموذج Wav2Vec-2.0 لنمذجة إشارات الكلام المستمدة من معلومات الكلام الأولية في مجموعتي بيانات CH-SIMS وCMU-MOSEI، وذلك لاستخراج السمات الصوتية المتعلقة بالعاطفة بشكل مباشر. ويوجد ترميز سمات تلافيفي لكل إشارة كلام مدخلة  :
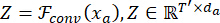 (4)
حيث يرمز Z إلى السمات العروضية منخفضة المستوى مثل اللحن والنغمة والطاقة. وتعتبر شبكة السياق القائمة على المحول (transformer) مفيدة للهياكل المذكورة سابقاً، حيث تمثل التبعيات الزمنية طويلة المدى:
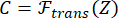 (5)
تتضمن هذه التمثيلات الصوتية السياقية بيانات صوتية عروضية ودلالية، وهي ضرورية للتعبير عن العاطفة. ويتم إنشاء تضمين صوتي بطول محدد من خلال إجراء عملية تجميع زمني:
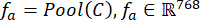 (6)
يتجنب هذا التصميم استخدام السمات الصوتية مثل MFCCs ويحقق المتانة باستخدام بيانات كلام باللغة الإنجليزية من CMU-MOSEI وبيانات كلام باللغة الصينية من CH-SIMS، وذلك ببساطة عن طريق استخراج التمثيلات من أشكال الموجات.
نمط النص باستخدام RoBERTa لاستخراج تضمينات المشاعر السياقية
بالنسبة للنمط النصي، تم تطبيق المحول ثنائي الاتجاه العميق، RoBERTa، على نصوص الكلام المستخرجة من مجموعتي البيانات لتوليد الدلالات السياقية والمعنى العاطفي. واستُخدمت مشفرات المحول القائمة على RoBERTa لاستخراج التمثيلات النصية من بيانات النصوص لالتقاط المعلومات الدلالية والسياقية والعاطفية. كما استُخدم نموذج RoBERTa مسبق التدريب لمجموعة بيانات CMU-MOSEI باللغة الإنجليزية، بينما استُخدم إصدار RoBERTa صيني لمجموعة بيانات CH-SIMS الصينية لمراعاة السمات اللغوية الخاصة بكل لغة بشكل أفضل. وشملت المعالجة المسبقة للنصوص عملية التجزئة (tokenization) باستخدام مجزئ RoBERTa المناسب لكل لغة، بالإضافة إلى تسوية النصوص. ولضمان اتساق معالجة الدفعات، تم تحويل تسلسلات الإدخال إلى تضمينات رمزية (token embeddings)، ثم تمت حشوها أو تقليمها لتصل إلى طول تسلسلي أقصى محدد مسبقاً. ووفقاً لتنسيق إدخال RoBERTa، تم إدراج رموز تصنيف وفاصل خاصة. وتم الحصول على تضمين نصي ثابت الطول عن طريق تجميع تمثيلات الرموز سياقياً التي أنتجها مشفر المحول باستخدام تمثيل الجملة النهائي المكافئ لـ [CLS]. ولتكييف التمثيلات المتعلمة مع مهمة التعرف على العواطف، تم تحسين مشفرات RoBERTa مسبقة التدريب من خلال التدريب متعدد الأنماط. ثم استُخدم إطار الدمج متعدد الأنماط المقترح لدمج التضمينات النصية مع الخصائص الصوتية والبصرية.
يمكن دمج تضمينات الرموز والترميزات الموضعية لكل مدخل تم تقسيم رموزه، 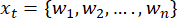 ، لإنشاء تمثيل المدخلات في تقنية التحويل ثنائية الاتجاه العميقة المعروفة باسم
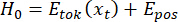 (7)
يتم تمثيل هذا النموذج من خلال طبقات محول L، الذي يستخدم آلية الانتباه الذاتي (self-attention) لاكتشاف الاعتمادات السياقية بين الكلمات:
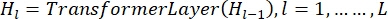 (8)
يتم الحصول على تضمين العاطفة السياقي باستخدام الحالة المخفية النهائية لرمز التصنيف:
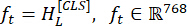 (9)
تُعد قطبية المشاعر، والعواطف القوية، والدلالات المرتبطة بها أمثلة على الخصائص اللغوية المتعلقة بالعواطف التي سيمثلها هذا التضمين. ويسهل نموذج RoBERTa عملية النمذجة المستقلة عن اللغة، مما يُمكّن النظام من استخدام نفس حجم التضمين لكل من النصوص الإنجليزية من مجموعة بيانات CMU-MOSEI والنصوص الصينية من مجموعة بيانات CH-SIMS.
يتم استخراج ثلاثة متجهات سمات خاصة بكل نمط بأبعاد 768، وهي الأنماط المرئية fv، والصوتية fa، والنصية ft ، وذلك من خلال خطوة تعلم تمثيل السمات العميقة المقترحة. وفي تصميم التفاعل الذكي، تُنشئ هذه التمثيلات المتعلمة فضاءً موحداً للسمات متعددة الأنماط، والذي يعمل كأساس لرسم الخرائط المرئية على مستوى السمات، والدمج عبر الأنماط القائم على الرسوم البيانية، وتعلم التمثيلات المفككة.
تعلم التمثيل المفكك
بعد تعلم تمثيل الميزات العميقة، يمكن أن تؤدي المعالجة الإضافية لمتجهات الميزات متعددة الوسائط من الوسائط المرئية والسمعية والنصية إلى وصف منفصل للعاطفة. إذا تم تمثيل تضمينات الميزات الخاصة بكل وسيط للوسائط السمعية والمرئية والنصية المستخدمة في الخطوة السابقة بواسطة fv، و fa و ft، على التوالي، بحيث تكون  و
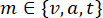 ، فإن الهدف من هذه الخطوة هو تحليل جميع ميزات الوسائط إلى وصفين كامنين متميزين، يتضمنان أوصاف العاطفة بعد أخذ الدلالات السابقة لكل من الوسائط المختلفة في الاعتبار.
يتم تحقيق ذلك عن طريق تغذية ميزة كل نمط، fm في شبكتي إسقاط متوازيتين: مشفر عواطف  ومشفر نمط
 ، حيث يتم إنتاج الترميزين.
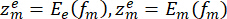 (10)
حيث أن  تمثل الميزة الكامنة المرتبطة بالعاطفة، بينما
 تمثل ميزة كامنة خاصة بنمط معين. وهذا يسمح للتضمينات الخاصة بالعاطفة بالتواصل مع فضاء بشكل متكرر عبر مدخلات متعددة، بما في ذلك الصوت والمرئيات والنصوص، مع الحفاظ على البيانات الهيكلية الفريدة المرتبطة بكل نمط.
يتم فرض فصل فعال من خلال إعادة البناء باستخدام قيود الاستقلال. وتتم عملية إعادة بناء ميزة النمط الأصلي وفقاً لما يلي:
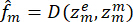 (11)
حيث أن  عبارة عن شبكة فك تشفير. وتعمل خسارة إعادة البناء على الحفاظ على البيانات التالية:
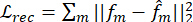 (12)
بالإضافة إلى ذلك، غالبًا ما تحد التعامدية، أو عدم الارتباط، بين العاطفة والتصويرات الخاصة بالنمط من تداخل المعلومات:
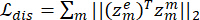 (13)
من خلال تحقيق هذه الأهداف، قد يتعلم النموذج تمثيلات عاطفية تكون موثوقة ومفهومة ومقاومة للتغيرات في الوسائط. وتعتمد عمليات دمج الوسائط المتقاطعة القائمة على الرسوم البيانية وميزات التخطيط البصري اللاحقة، خاصة في تصميم التفاعل الذكي، بشكل كبير على تمثيلات عاطفية مهيكلة وقابلة للتفسير.
اتساق العاطفة عبر الوسائط
من الواضح أن إضافة اتساق العاطفة تعزز من فعالية الدمج بين أنماط البيانات. ويرجع ذلك إلى أن استراتيجيات الدمج لا تحتاج إلى مراعاة الفجوات الكبيرة بين التمثيلين، بما أن تضمينات العاطفة الخاصة بكل نمط تشترك في فضاء كامن. ويوصف التوضيح المشترك للعاطفتين على النحو التالي  . سيكون الدمج الموزون أكثر استقراراً عندما تكون التمثيلات الخاصة بالعاطفة متسقة، لأن التباينات بين الإشارات القادمة من أنماط مختلفة لن يكون لها تأثير على النتيجة.
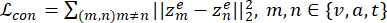 (14)
من خلال فرض المحاذاة الدلالية للمعلومات العاطفية، يعمل هذا الهدف على تقليل التباينات عبر الوسائط المختلفة ويضمن بقاء إدراك العاطفة متسقاً بغض النظر عن الوسيط المستخدم للتعبير عنها. وبناءً على ذلك، يتم إنشاء مساحة تمثيل وجدانية متماسكة من خلال إسقاط الإشارات العاطفية المستمدة من الإشارات الصوتية، وتعبيرات الوجه، والمحتوى اللغوي.
التأثير على الاندماج عبر الوسائط
يصبح الدمج عبر الوسائط أكثر فعالية عند إدخال اتساق عاطفي عبر هذه الوسائط. وبذلك، لا تعود آليات الدمج مضطرة لتعويض الفجوات الكبيرة في التمثيل بين الوسائط، لأن التضمينات الخاصة بالعواطف تكون متوافقة في فضاء كامن مشترك. ويُعرَّف تمثيل العاطفة المدمج على النحو التالي:
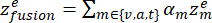 (15)
حيث يمثل αm وزن الاهتمام الممنوح للنمط m. يصبح الدمج الموزون أكثر استقراراً ووضوحاً عندما تكون التمثيلات الخاصة بالعاطفة متسقة، حيث تظهر نتيجة الدمج أدلة عاطفية تكميلية بدلاً من إشارات أنماط متناقضة.
من الناحية الرياضية، فإن خفض  التباين بين الأنواع المختلفة من التمثيلات الخاصة بانفعالات محددة فيما يتعلق بـ يعادل:
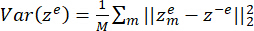 (16)
حيث  يمثل متوسط التعبير العاطفي. يؤدي تقليل التباين إلى وزن أنماط الإدخال وفقاً لأهميتها العاطفية الدقيقة بدلاً من ضجيج النمط، مما يضمن تحسناً في تقارب الشبكة وتقييماً أكثر دقة للانتباه.
يتمثل هدف التعلم النهائي للتصورات المرئية للعواطف المفككة في الجمع بين التجزئة، وإعادة البناء، وتجانس العواطف:
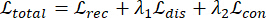 (17)
يتحكم المعلمان الفائقان، λ1 و λ2، في العلاقة بين موثوقية العاطفة عبر الوسائط والارتباط التفصيلي. ولتحقيق ذلك، يكتسب النموذج المقترح تمثيلات عاطفية قابلة للدمج وتفسيرية وغير متغيرة حسب الوسائط، مع التركيز على توفير أساس متين لعمليات الدمج القائمة على الرسوم البيانية والتمثيل على مستوى الميزات في تصميم الواجهات الذكية.
دمج الانتباه عبر الوسائط القائم على الرسم البياني
تم استخدام شبكة انتباه عبر-نمطية قائمة على الرسوم البيانية لمحاكاة العلاقات العاطفية دقيقة التفاصيل بين الأنماط. ولتسهيل تدفق المعلومات عبر الأنماط، تم بناء رسم بياني متعدد الأنماط متصل بالكامل، حيث يُمثَّل كل تضمين خاص بنمط معين (النص، والصوت، والمرئي) كعقدة في الرسم البياني. واستُخدمت العلاقات بين الأنماط لإنشاء مصفوفة التجاور الخاصة بالرسم البياني، والتي تم تحسينها لاحقاً عبر طريقة انتباه قابلة للتعلم. كما تم إنشاء فضاء كامن مشترك عن طريق دمج وإسقاط المخرجات من عدة رؤوس انتباه. بعد ذلك، تم إنتاج تمثيل موحد للعاطفة متعدد الأنماط من خلال تجميع تمثيلات العقد باستخدام تجميع مرجح بالانتباه. ومن ثم استلمت وحدات التنبؤ والتصور المخصصة للتحليل المدرك للتفاعل والتعرف على العواطف هذا التمثيل المدمج. تميزت وحدة دمج الرسم البياني ببعد تمثيل خفي قدره 256 وطبقتين من انتباه الرسم البياني، تحتوي كل منهما على ثمانية رؤوس انتباه. ولتحديد الأهمية النسبية للأنماط المجاورة، تم حساب معاملات الانتباه بين العقد المتصلة وتوحيدها باستخدام دالة softmax. وأعقب كل طبقة انتباه رسم بياني تسوية للطبقة (layer normalization)، ووصلات متبقية (residual connections)، ومعدل إسقاط (dropout rate) قدره 0.2 لزيادة استقرار التدريب وتقليل الإفراط في التخصيص (overfitting). وبعد دمج وإسقاط مخرجات عدة رؤوس انتباه على فضاء كامن مشترك، تم دمج تمثيلات العقد في تضمين عاطفي واحد متعدد الأنماط باستخدام تجميع مرجح بالانتباه. بعد ذلك، استُخدم التمثيل المدمج لرسم الخرائط المرئية متعددة العروض والتنبؤ بالعواطف.
تم التقاط التفاعلات المتنوعة عبر الأنماط باستخدام آلية الانتباه الرسومي متعدد الرؤوس. وقد استُخدمت دالة softmax لتقييس معاملات الانتباه بين العقد المتصلة لكل عقدة. ولتعزيز استقرار التدريب وتجنب الإفراط في الملاءمة، تلت طبقات الانتباه الرسومي المتراكمة في وحدة دمج الرسوم البيانية وصلات متبقية، وتقييس الطبقات، وتنظيم التسرب (dropout regularization).
لنعتبر أن المصطلحات تمثل بشكل فردي التمثيلات المقابلة لعواطف محددة تم جمعها عبر الوسائط المرئية والصوتية والنصية؛ حيث يقع كل مكون ضمن الفضاء الكامن المشترك  . تستخدم نماذج عُقد الوسائط تدوينًا للرسم البياني
 ، بحيث تتوافق عُقد المجموعة
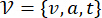 مع عُقد الوسائط الثلاثة ذاتها، وذلك لتعزيز الارتباطات العاطفية المشتركة بين مختلف تمثيلات الوسائط بشكل صريح.
بعد تعيين متجه سمات خاص بكل عاطفة لكل عقدة في الرسم البياني، يصبح لدينا:
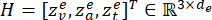 (18)
على عكس طرق الدمج التقليدية، التي تستخدم أوزان دمج محددة مسبقاً أو ثابتة، تتعلم الطريقة المقترحة أوزان حواف تكيفية بناءً على أهميتها والاعتمادات المتبادلة بينها، سواء عبر القنوات أو عبر الحالات العاطفية.
يُستخدم نموذج شبكة انتباه الرسوم البيانية (GAT) لدمج البيانات عبر الأنماط. ويتم حساب معامل الانتباه لكل عقدة i والعقد المجاورة لها، أي العقدة j:
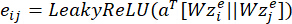 (19)
يتم قياس التأثير العاطفي للانتقال من النمط j إلى الوسيلة i بواسطة الأوزان المُطبعة αij.
بعد ذلك، يتم حساب المظهر المدمج لكل عقدة نمطية كمجموعة مرجحة من جيرانها:
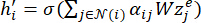 (20)
حيث تكون دالة التنشيط  غير خطية. وفي النهاية، يتم دمج الميزات المحدثة لكل عقدة للحصول على تمثيل مدمج وشامل للعاطفة:
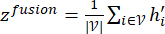 (21)
تعد هذه تقنية مفيدة لنمذجة العواطف القابلة للتفسير والمسح البصري اللاحق، لأنها تلتقط معلومات تكميلية من أنماط مختلفة مع الحفاظ على العلاقات المعقدة بين هذه الأنماط.
يوفر الخوارزمية 1 (الملف التكميلي 1) المخطط العام لتنفيذ الدمج عبر الوسائط القائم على الرسوم البيانية. في البداية، يتم إنشاء رسم بياني تتصل فيه الخصائص المحددة للعاطفة بكل من الوسائط المرئية والصوتية والنصية. بعد ذلك، يتم حساب درجات الانتباه لأزواج العقد في كل رسم بياني، والتي تمثل مزيج الاعتماد العاطفي. ثم يتم تطبيع درجات الانتباه للإشارة إلى المساهمة النسبية لكل وسيط في السياق العاطفي المحدد، مما يتيح تعلم أوزان الانتباه. وفي المرحلة الأخيرة، يتم إنتاج التضمين العاطفي العام عن طريق تجميع الميزات المرتبطة بعقد الرسم البياني. وبهذا المعنى، يظهر الدمج العام في الخوارزمية للميزات متعددة الوسائط المرتبطة بالعواطف المحددة إمكانات واعدة من حيث القابلية للتكيف والتفسير والذكاء السياقي.
يوضح الشكل 2 بنية وآلية عمل شبكة الانتباه عبر الوسائط المقترحة لدمج المشاعر متعدد الوسائط. يتم تمرير تضمينات المشاعر المحددة، والمشتقة بشكل مستقل لكل من وسائط النصوص والصوت والفيديو، أولاً عبر آليات انتباه على مستوى الوسائط تتعلم الأهمية النسبية للمعلومات اللغوية والصوتية وتعبيرات الوجه لسياق عاطفي معين. بعد ذلك، يتم دمج التمثيلات المرجحة بالانتباه للوسائط لتكوين تضمين عاطفي موحد، حيث تلتقط مصفوفة الانتباه التبعيات والتفاعلات البينية بين الوسائط. وتعمل مصفوفة الانتباه التي تعلمتها الشبكة على تعديل مساهمات الوسائط ديناميكياً، مما يمكنها من التركيز على أقوى وسيلة إرشادية مع تجاهل الوسائط المشوشة والأقل إفادة. يتيح تمثيل المشاعر المدمج التعرف الدقيق على العاطفة والتحليل التفصيلي للحالات العاطفية مثل الحياد، والعناق، والقلق.
وحدة الخرائط المرئية
بمساعدة قسم الخرائط المرئية، الذي تم إنشاؤه خصيصاً لهذا الغرض، يمكن لمصمم التفاعل الذكي تحويل التمثيل الموحد للحالة العاطفية إلى شكل مرئي مفهوم وسهل الاستيعاب بعد عملية الدمج عبر الوسائط، وذلك استناداً إلى الرسم البياني.
لتسهيل استيعاب التمثيلات العاطفية الكامنة، استُخدمت تقنيات تقليل الأبعاد لتصور تضمينات العواطف متعددة الوسائط المتعلمة. وبعد تقليل أبعاد الميزات مع الحفاظ على معظم التباين باستخدام تحليل المكونات الرئيسية (PCA)، تم إسقاط التضمينات في فضاء ثنائي الأبعاد للعرض باستخدام تقنية تضمين الجيران العشوائي الموزع t (t-SNE). وقد استُخدم في تقنية t-SNE رقم حيرة قدره 30، ومعدل تعلم 200، و1,000 تكرار لتحسين العملية. وتم تصور العناقيد الخاصة بكل عاطفة والعلاقات بين الوسائط باستخدام الإسقاطات التي تم الحصول عليها. كما استُخدمت أوزان الانتباه المتقاطعة بين الوسائط والمعيرة، والتي تم الحصول عليها من شبكة الانتباه القائمة على الرسم البياني، لإنشاء خرائط حرارية للانتباه. وتوضح هذه الخرائط الحرارية المساهمات النسبية للوسائط النصية والصوتية والبصرية أثناء التنبؤ بالعواطف. واستُخدمت معاملات الانتباه المتعلمة كأوزان للحواف لإنشاء رسوم بيانية للتفاعل المتقاطع بين الوسائط، مما سمح بالفحص البصري للعلاقات بين الوسائط وتدفق المعلومات داخل إطار الدمج. كما تم إنشاء مخططات مسار العاطفة من خلال مراقبة تطور تضمينات العواطف الكامنة عبر المنطوقات المتتالية لفحص الديناميات العاطفية الزمنية. وتسلط هذه المسارات الضوء على كيفية تطور الحالات العاطفية ومساهمات الوسائط بمرور الوقت. وقد استُخدمت حزمتان من لغة Python هما Matplotlib وScikit-learn لإنشاء جميع العناصر المرئية. ولتقييم القابلية للتفسير وتكوين العناقيد ومساهمات الوسائط والديناميكيات العاطفية الزمنية، أُجريت تحليلات نوعية لتصورات التضمين والرسوم البيانية للتفاعل والخرائط الحرارية للانتباه.
ليكن المتغير 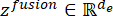 ممثلاً للتمثيل المدمج للحالة العاطفية بواسطة دالة شبكة الانتباه الرسومية. وبخلاف التصوير المرئي للحالة العاطفية على مستوى المخرجات، فإن الهدف الرئيسي لهذه الوحدة هو تحويل تمثيلات الحالة العاطفية وأوزان آلية الانتباه المقابلة لها إلى شكل بصري مفهوم.
باستخدام αji المكتسبة، يتم إنشاء خريطة حرارية للانتباه لفحص مساهمة كل نمط بصرياً. ثم تُجمع أوزان الانتباه الواردة لتحديد درجة أهمية مركبة لكل نمط:
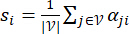 (22)
حيث تمثل si المساهمة العاطفية النسبية للنمط I. وللمساعدة في إنشاء خريطة حرارية للاهتمام، يتم تطبيع القيم التي تم الحصول عليها ورسمها على خريطة ألوان تسهل على المستخدم تحديد النمط البارز في خطوات زمنية أو حالات تفاعلية مختلفة. ومن خلال أنماط إدخال بصرية أو سمعية أو نصية متنوعة، تساعد هذه الواجهة المستخدم على فهم كيفية عمل آلية الانتباه في النظام.
يتم نمذجة الرسم البياني المكتسب تحديداً كـ "رسم بياني للتفاعل الموزون" لتمثيل الاعتمادية عابرة الوسائط للمشاعر البشرية. يتم تمثيل الوسيط نفسه بواسطة كل عقدة في الرسم البياني، ويتم تمثيل قوة التفاعلات المتعلقة بالمشاعر البشرية بواسطة أوزان على شكل αji على الحواف التي تربط بينها. يوضح الرسم البياني الموزون أعلاه كثافة التفاعلات العاطفية البشرية. تعريف i و j هو:
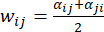 (23)
تظهر سماكة الخط أو درجة شفافيته في تمثيل الرسم البياني بشكل مناسب بفضل هذه الأوزان، مما يسهل فهم كيفية تفاعل الأنماط. ويمكن للمصمم، بمساعدة الرسوم البيانية للتفاعل عبر الأنماط، فهم كيفية تفاعل المؤشرات العاطفية بشكل أفضل أثناء عملية الدمج.
يتم تقليل تضمينات العواطف المدمجة  في خطوات زمنية مختلفة إلى فضاء أقل أبعاداً باستخدام خوارزمية لتقليل الأبعاد مثل PCA أو t-SNE، وذلك لعرض تطور العواطف الزمنية:
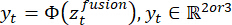 (24)
حيث يُمثَّل تابع الإسقاط بواسطة  . ويمكن تفسير ظهور مسارات العاطفة ثنائية وثلاثية الأبعاد (2D/3D)، والتي توضح انتقالات العاطفة وشدتها واستقرارها في التفاعلات، على أنها تصوير حدسي لتطور الحالات العاطفية بمرور الوقت. ويمكن استخدام هذه الجوانب في التفاعل الذكي، واتخاذ القرار، والمراقبة في الوقت الفعلي.
على عكس أنظمة العواطف التقليدية التي تكتفي بتقديم خرائط لفئات أو درجات محددة، يركز هذا النظام على توضيح كيفية تشكل العواطف البشرية بداخله. ويكشف النظام عن عملية اتخاذ القرار من خلال تقديم تصورات للميزات الوسيطة، بما في ذلك عوامل الترجيح، والتفاعلات بين النماذج، والمسارات المقابلة لها. وهذا يتيح للمستخدم استيعاب كيف يؤثر كل عامل —سواء كان بصرياً أو صوتياً أو لغوياً— في إنتاج استجاباته تجاه العاطفة البشرية.
وبذلك، يمكن لربط العواطف بأشكال مفهومة من خلال التمثيلات المرئية أن يسد الفجوة بين تحليل العواطف باستخدام طرق التعلم العميق ودمجها في تصميم الواجهات الذكية. ومن ثم يمكن استخدام البيانات التي تم جمعها من كلا النهجين لإنشاء واجهات مستخدم أكثر دقة. وبناءً عليه، يمكن للنهج المقترح أن يوفر لمصممي التفاعل معلومات حيوية لإنشاء واجهات مستخدم أكثر دقة. وبتعبير آخر، يصبح فهم العواطف جزءاً نشطاً للغاية في تصميم التفاعل. ولا يمكن أن تزداد الدقة إلا عندما يتم دمج فهم العواطف بشكل فعال في تصميم التفاعل.
تتيح وحدة الخرائط المرئية إمكانية التفسير عبر عدة طرق مترابطة ومختلفة: حيث يكشف التفسير على مستوى الميزات عن التمثيلات الكامنة للعاطفة التي أنشأتها الشبكة العصبية العميقة (DNN)، مما يمكننا من فهم الدلالات المستخدمة لوصف كل ميزة متعلقة بالعاطفة؛ ويستخدم التفسير على مستوى الوسائط بيانات من الرسوم البيانية للتفاعل وخرائط الحرارة للانتباه المرئي لوصف كيفية مساهمة كل وسيلة—سواء كانت مرئية أو صوتية أو نصية—في القرارات المتخذة للتعبير عن العواطف؛ وأخيراً، تتيح لنا المسارات الناتجة عن تضمين العواطف فهم كيفية تغير كل وسيلة مرئية ونصية بمرور الوقت من منظور التفاعل الديناميكي. يرجى الرجوع إلى الخوارزمية 2 (الملف التكميلي 1).
يتم تعيين السمات العاطفية متعددة الوسائط المدمجة إلى تمثيلات ذات دلالة بصرية لتصميم تفاعل ذكي باستخدام خوارزمية التعيين البصري المقترحة Algorithm 2. وتُستخدم أوزان الانتباه متعددة الوسائط القائمة على الرسم البياني لقياس الاختلافات بين العناصر البصرية والصوتية والنصية المدخلة عند كل خطوة زمنية. ثم يتم تعيين هذه الاختلافات إلى تمثيلات بصرية لإبراز المصادر الرئيسية المؤثرة في العواطف باستخدام عناصر مرئية متمثلة في الخرائط الحرارية. ولتقديم رؤية متعمقة للتفاعل بين العناصر المدخلة ونقل التطور العاطفي الناتج عن العناصر المدخلة متعددة الوسائط، يقوم النظام بعد ذلك بحساب قوة التفاعل الزوجي لإنشاء أوزان التفاعل متعدد الوسائط. وفي الوقت ذاته، يتم إنشاء عرض للتطور العاطفي من خلال تعيين العناصر العاطفية المدمجة التي تم جمعها بمرور الوقت في فضاء منخفض الأبعاد لإنتاج تطور مستمر للعناصر العاطفية.
التنبؤ بالعواطف والتغذية الراجعة للتفاعل
تُستخدم نتيجة تمثيل العاطفة المدمجة، والممثلة بـ ، كدالة لكل من تغذية الارتجاع التفاعلية والتنبؤ بالعاطفة. علاوة على ذلك، يوصف التنبؤ بالعاطفة بأنه نموذج متعدد المهام يتكون من مهمة انحدار للتعرف على شدة العاطفة المستمرة ومهمة تصنيف للتعرف على العاطفة المنفصلة. ويُستخدم نموذج التصنيف القائم على softmax التالي للتعرف على العاطفة المنفصلة:
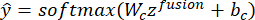 (25)
حيث تمثل  احتمالات فئة العاطفة المتوقعة، بينما Wc و bc هما قيود قابلة للتعلم. ويُستخدم فقدان الإنتروبيا المتقاطعة (cross-entropy loss) لتعزيز هدف التصنيف:
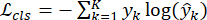 (26)
حيث يمثل yk علامة الحقيقة الأرضية (ground-truth tag)، و K هو عدد فئات العواطف. يُستخدم فرع الانحدار لتقدير شدة العاطفة بشكل متوازٍ، مما ينتج تنبؤًا بسمات وجدانية مستمرة متنوعة، بما في ذلك التكافؤ (valence) والاستثارة (arousal). يتم تعريفه على النحو التالي:
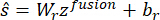 (27)
حيث يُشار إلى درجة شدة العاطفة المتوقعة بواسطة  . ويُستخدم فقد متوسط مربع الخطأ لتعزيز مهمة الانحدار:
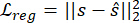 (28)
بشكل عام، يتم دمج المهمتين في هدف التنبؤ:
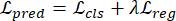 (29)
حيث يتم موازنة أهداف الانحدار والتصنيف بواسطة λ. ويقترح ذلك تعديلاً ديناميكياً لوحدة التصوير المرئي بناءً على الحالة العاطفية المحددة لتمكين هذا النوع من التغذية الراجعة المدركة للتفاعل. ويتم تمثيل سياق التفاعل في وقت معين t بواسطة ct. وتتم تقديم استجابة وحدة التصوير المرئي من خلال:
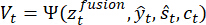 (30)
حيث يتم تمثيل دالة تكيف التصور بواسطة  . وهذا يجعل من الممكن ضبط الخرائط الحرارية للأنماط، ورسوم التفاعل البيانية، ومسارات العواطف في الوقت الفعلي بناءً على التغييرات والعواطف المتوقعة. وهذا يشير إلى أن النظام يوفر دعماً جوهرياً للتغذية الراجعة بالإضافة إلى أدائه الجيد في التنبؤ بحالة العاطفة.
الوصول مقيد. يرجى تسجيل الدخول أو بدء فترة تجريبية لعرض هذا المحتوى.
النتائج
يتحقق هذا العمل من صحة إطار عمل التخطيط المرئي المقترح لميزات العواطف متعددة الوسائط من حيث القابلية للتفسير المدركة للتفاعل والأداء التنبئي، وذلك باستخدام مجموعتي بيانات مرجعيتين هما CH-SIMS وCMU-MOSEI. ووفقاً للنتائج التجريبية، يتفوق النهج المقترح باستمرار على تقنيات التعرف على العواطف متعددة الوسائط الحالية عبر مجموعة متنوعة من المقاييس، بما في ذلك الارتباط، والدقة، ومقياس F1-score، ومتوسط الخطأ المطلق (MAE). وتساهم كل من تمثيلات العواطف المفككة، وآلية الاندماج عبر الوسائط القائمة على الرسوم البيانية، واستراتيجية تعلم...
الوصول مقيد. يرجى تسجيل الدخول أو بدء فترة تجريبية لعرض هذا المحتوى.
المناقشة
تظهر النتائج التجريبية أنه، عبر مجموعات بيانات CH-SIMS وCMU-MOSEI، يتفوق إطار الربط المرئي المقترح لخصائص العواطف متعددة الوسائط على تقنيات التعرف على العواطف متعددة الوسائط الحالية. ومقارنة بنماذج الدمج المبكر والمتأخر، مثل EF-LSTM وTFN، تحقق التقنية المقترحة دقة أعلى ودرجات F1 Score أعلى، مما يثبت متانتها في التعامل مع المعلومات العاطفية المتنوعة. ويمكن إرجاع التحسن في هذه الطريقة إلى تمثيل العواطف المفكك، والذي يعمل على كبح الضوضاء الخاصة بكل وسيط ويضمن اتساق العواطف عبر الوسائط المرئية والصوتية والنصية
الوصول مقيد. يرجى تسجيل الدخول أو بدء فترة تجريبية لعرض هذا المحتوى.
الإفصاحات
يصرح المؤلفون بعدم وجود أي تضارب في المصالح.
شكر وتقدير
يود المؤلفون الإعراب عن امتنانهم للدعم المقدم من كلية الإسكان والبناء والتخطيط بجامعة Sains Malaysia في بينانغ بماليزيا، وكلية فنون التصميم بجامعة Changsha للعلوم. &؛ التكنولوجيا، تشانغشا، الصين. كما يعرب المؤلفون عن تقديرهم لأكاديمية شيامن للفنون والتصميم بجامعة فوتشو، شيامن، الصين، لدعمهم الأكاديمي والبحثي طوال فترة هذا العمل.
الوصول مقيد. يرجى تسجيل الدخول أو بدء فترة تجريبية لعرض هذا المحتوى.
المواد
| الاسم | الشركة | رقم فهرسي | التعليقات |
|---|---|---|---|
| Adam | مكتبة مُحسِّنات PyTorch | https://pytorch-optimizers.readthedocs.io/en/latest/ (معدل التعلم = 1 × 10⁻⁴) | تحسين المعاملات أثناء تدريب النموذج |
| CH-SIMS | مستودع مجموعة البيانات الأصلية | أحدث إصدار عام | مجموعة بيانات مرجعية لتحليل المشاعر/العواطف متعدد الوسائط باللغة الصينية |
| CMU-MOSEI | مستودع CMU Multimodal SDK | https://github.com/CMU-MultiComp-Lab/CMU-MultimodalSDK (أحدث إصدار عام) | مجموعة بيانات مرجعية للتعرف على المشاعر والعواطف متعددة الوسائط |
| Disentangled Emotion Encoder | تنفيذ مخصص | https://pytorch-geometric.readthedocs.io/en/latest/(بنية المشفر المزدوج) | فصل التمثيلات الكامنة الخاصة بالعاطفة وتلك الخاصة بالوسائط |
| Graph Attention Network (GAT) | PyTorch Geometric | GAT متعدد الرؤوس (https://pytorch-geometric.readthedocs.io/en/latest/) | نمذجة العلاقات العاطفية عبر الوسائط ودمج الميزات التكيفي |
| Graph-Based Cross-Modal Attention Layer | تنفيذ مخصص | دمج الانتباه متعدد الرؤوس | تعلم الاعتمادات العاطفية دقيقة التفاصيل بين الوسائط |
| Matplotlib | مشروع Matplotlib | 3.7+ | إنشاء المخططات والتحليلات المرئية |
| NetworkX | مشروع NetworkX | 3.0+ | بناء وتصور رسوم التفاعل عبر الوسائط |
| NVIDIA GPU | شركة NVIDIA | وحدة معالجة رسومية تدعم CUDA | تسريع تدريب المحولات والشبكات العصبية الرسومية |
| Principal Component Analysis (PCA) | Scikit-learn | sklearn.decomposition.PCA | الاختزال الأولي لتضمينات العواطف عالية الأبعاد |
| Python | مؤسسة برمجيات Python | 3.8+ | لغة البرمجة الأساسية لتنفيذ إطار تحليل العواطف متعدد الوسائط |
| PyTorch | مؤسسة PyTorch | 2.0+ | تطوير وتدريب وتحسين الشبكات العصبية العميقة |
| RoBERTa | Hugging Face Transformers | https://huggingface.co/docs/transformers/index (roberta-base، تضمينات ببعد 768) | استخراج التمثيلات العاطفية اللغوية والدلالية السياقية |
| Seaborn | مشروع Seaborn | 0.12+ | إنشاء الخرائط الحرارية للانتباه والتصورات الإحصائية |
| t-distributed Stochastic Neighbor Embedding (t-SNE) | Scikit-learn | scikit-learn.org (الحيرة = 30، التكرارات = 1000) | تصور عناقيد العواطف الكامنة ومساراتها |
| Ubuntu Linux | Canonical Ubuntu | 20.04 LTS أو إصدار أحدث | بيئة تنفيذ التجارب |
| Vision Transformer (ViT-Base) | Google Research Vision Transformer | ViT-Base/16، تضمينات ببعد 768 | استخراج التمثيلات المرئية المدركة للعواطف من إطارات الفيديو |
| Wav2Vec 2.0 | Meta AI Research | النموذج الأساسي، تضمينات ببعد 768 | استخراج ميزات العواطف الصوتية والكلامية السياقية |
المراجع
- Zhu X, et al. EMVAS: End-to-end multimodal emotion visualization analysis system. Complex Intell Syst. 2025;11:1-15.
- Zhu X, et al. A client-server based recognition system: Non-contact single/multiple emotional and behavioral state assessment methods. Comput Methods Programs Biomed. 2025;260:108564.
- Lasri I, Riadsolh A, Elbelkacemi M. Facial emotion recognition of deaf and hard-of-hearing students for engagement detection using deep learning. Educ Inf Technol. 2023;28:4069-4092.
- Saibene A, Assale M, Giltri M. Expert systems: Definitions, advantages and issues in medical field applications. Expert Syst Appl. 2021;177:114900.
- Poria S, Cambria E, Bajpai R, Hussain A. A review of affective computing: From unimodal analysis to multimodal fusion. Inf Fusion. 2017;37:98-125.
- Chatterjee R, et al. Real-time speech emotion analysis for smart home assistants. IEEE Trans Consum Electron. 2021;67(1):68-76.
- Zhu X, Huang Y, Wang X, Wang R. Emotion recognition based on brain-like multimodal hierarchical perception. Multimed Tools Appl. 2024;83:56039-56057.
- Khan M, El Saddik A, Alotaibi FS, Pham NT. AAD-Net: Advanced end-to-end signal processing system for human emotion detection and recognition using attention-based deep echo state network. Knowl Based Syst. 2023;270:110525.
- Chaturvedi I, Chen Q, Cambria E, McConnell D. Landmark calibration for facial expressions and fish classification. Signal Image Video Process. 2022;16:377-384.
- Li D, Liu J, Yang Z, Sun L, Wang Z. Speech emotion recognition using recurrent neural networks with directional self-attention. Expert Syst Appl. 2021;173:114683.
- Zhu X, et al. A review of key technologies for emotion analysis using multimodal information. Cogn Comput. 2024;16:1504-1530.
- Wang R, et al. Multimodal emotion recognition using tensor decomposition fusion and self-supervised multitasking. Int J Multimed Inf Retr. 2024;13:39.
- Fan C, Lin J, Mao R, Cambria E. Fusing pairwise modalities for emotion recognition in conversations. Inf Fusion. 2024;106:102306.
- Williams J, Kleinegesse S, Comanescu R, Radu O. Recognizing emotions in video using multimodal DNN feature fusion. Proceedings of Grand Challenge and Workshop on Human Multimodal Language. Melbourne, Australia. 2018;10.18653/v1/W18-3302.
- Zhao Z, Wang Y, Wang Y. Multi-level fusion of Wav2Vec 2.0 and BERT for multimodal emotion recognition. arXiv. 2022;arXiv:2207.04697.
- Middya AI, Nag B, Roy S. Deep learning based multimodal emotion recognition using model-level fusion of audio-visual modalities. Knowl Based Syst. 2022;244:108580.
- Maithri M, et al. Automated emotion recognition: Current trends and future perspectives. Comput Methods Programs Biomed. 2022;215:106646.
- Wu Y, Mi Q, Gao T. A comprehensive review of multimodal emotion recognition: Techniques, challenges, and future directions. Biomimetics. 2025;10(4):418.
- Zheng S, Zhang X, Liu Y, Li Z. CMFF: A cross-modal multi-layer feature fusion network for multimodal sentiment analysis. Appl Soft Comput. 2025;184(Pt B):113868.
- Yan L, Shi Y, Wei M, Wu Y. Multi-feature fusing local directional ternary pattern for facial expressions signal recognition based on video communication system. Alex Eng J. 2023;63:307-320.
- Guo X, Zhang Y, Lu S, Lu Z. Facial expression recognition: A review. Multimed Tools Appl. 2024;83(8):23689-23735.
- Liu ZT, Han MT, Wu BH, Rehman A. Audio emotion recognition based on convolutional neural network with attention-based bidirectional long short-term memory network and multitask learning. Appl Acoust. 2023;202:109178.
- Mirsamadi S, Barsoum E, Zhang C. Automatic audio emotion recognition using recurrent neural networks with local attention. 2017 IEEE International Conference on Acoustics, Speech and Signal Processing (ICASSP), New Orleans, LA, USA. 2017; 10.1109/ICASSP.2017.7952552.
- Gu T, He Z, Zhao H, Li M, Ying D. Aspect-based sentiment analysis with multi-granularity information mining and sentiment hint. Expert Syst Appl. 2024;252:124104.
- Shen W, Chen J, Quan X, Xie Z. DialogXL: All-in-one XLNet for multi-party conversation emotion recognition. Proc AAAI Conf Artif Intell. 2021;35(15):13789-13797.
- Kim T, Vossen P. EmoBERTa: Speaker-aware emotion recognition in conversation with RoBERTa. arXiv. 2021;arXiv:2108.12009.
- Li S, Yan H, Qiu X. Contrast and generation make BART a good dialogue emotion recognizer. Proc AAAI Conf Artif Intell. 2022;36(10):11002-11010.
- Zhu J, Yu J. MIAR: Modality interaction and alignment representation fusion for multimodal emotion. arXiv. 2026;arXiv:2601.02414.
- Praveen RG, Granger E, Cardinal P. Cross attentional audio-visual fusion for dimensional emotion recognition. 2021 16th IEEE International Conference on Automatic Face and Gesture Recognition (FG 2021), Jodhpur, India. 2021;10.1109/FG52635.2021.9667055.
- Salas-Cáceres J, López M, Martínez A, Rodríguez P. Multimodal emotion recognition based on a fusion of audio-visual information with temporal dynamics. Multimed Tools Appl. 2025;84:27327-27343.
- Fu J, Zhang Y, Wang L, Chen H. TMFN: A text-based multimodal fusion network with multi-scale feature extraction and unsupervised contrastive learning for multimodal sentiment analysis. Complex Intell Syst. 2025;11:133.
- Tuerhong G, Fu F, Wushouer M. Adaptive multimodal transformer based on exchanging for multimodal sentiment analysis. Sci Rep. 2025;15:27265.
- Gupta C, Sharma R, Patel S, Verma A. A multimodal fusion model for real-time environment emotion recognition using audio-visual-textual features. J Big Data. 2025;12:256.
- Yu W, Li X, Zhang H, Wang Z, Liu Z. CH-SIMS: A Chinese multimodal sentiment analysis dataset with fine-grained annotation of modality. Proceedings of the 58th Annual Meeting of the Association for Computational Linguistics. 2020; 10.18653/v1/2020.acl-main.343.
- Zadeh A, et al. Multimodal language analysis in the wild: CMU-MOSEI dataset and interpretable dynamic fusion graph. Proceedings of the 56th Annual Meeting of the Association for Computational Linguistics, Melbourne, Australia. 2018; 10.18653/v1/P18-1208.
- Zadeh A, Chen M, Poria S, Cambria E, Morency LP. Tensor fusion network for multimodal sentiment analysis. arXiv. 2017;arXiv:1707.07250.
- Tsai YHH, Bai S, Yamada M, Morency LP, Salakhutdinov R. Multimodal transformer for unaligned multimodal language sequences. Proceedings of the 57th Annual Meeting of the Association for Computational Linguistics, Florence, Italy. 2019; 10.18653/v1/P19-1656.
- Moreno M, Rioseco P, Van Den Bosch H. Spectrum of the linearized Vlasov–Poisson equation around steady states from galactic dynamics. arXiv. 2023;arXiv:2305.05749.
الوصول مقيد. يرجى تسجيل الدخول أو بدء فترة تجريبية لعرض هذا المحتوى.