يدمج بروتوكول مصنف الشبكة العصبية الهجين الكمي-الكلاسيكي القائم على التعلم التجميعي (ML-HQNC) بين النمذجة المعرفية المستوحاة من الكم، والمعالجة المسبقة للبيانات، واختيار الميزات، والتعلم العصبي الهجين لتحديد اهتمامات طلاب الهندسة. يقدم هذا البروتوكول سير عمل قابل للتكرار لتعلم الآلة الهجين المستوحى من الكم مخصص للتحليلات التعليمية، وهو موضح من خلال تحديد اهتمامات طلاب الهندسة باستخدام بيانات تعليمية متعددة الأبعاد.
مقالة بحثية
تحديد اهتمامات الطلاب بناءً على البيانات لأنظمة إدارة التدريس الذكية في كليات الهندسة
في هذه المقالة
ملخص
الملخص
يقدم هذا البروتوكول إطاراً حوسبياً مستوحى من الكم لتحديد اهتمامات طلاب الهندسة باستخدام بيانات تعليمية وسلوكية متعددة الأبعاد. والهدف من ذلك هو توفير سير عمل منهجي وقابل للتكرار يدمج بين المعالجة المسبقة للبيانات، وتحليل الأنماط السلوكية، واختيار الميزات، والتعلم العصبي الهجين لدعم اتخاذ القرارات التعليمية والتعلم المخصص. يبدأ سير العمل باستخدام مقياس Box-Cox Robust IQR Scaling (BCRIS) لمعالجة البيانات التعليمية وتطبيعها من خلال تقليل الضوضاء الدلالية وتحسين جودة البيانات. بعد ذلك، يتم تحليل سلوكيات تعلم الطلاب باستخدام نموذج الحالة المعرفية الكمومية (QCSM)، الذي يمثل التحولات السلوكية وتفضيلات التعلم المتطورة في ظل ظروف غير مؤكدة. ثم يتم اختيار الميزات ذات الصلة باستخدام خوارزمية اختيار الميزات المعتمدة على تحسين سرب الحيتان المعزز كمومياً (QES-WOFS) لتقليل تكرار الميزات وتحديد الخصائص السلوكية المعلوماتية. وأخيراً، يقوم المصنف العصبي الهجين الكمومي-الكلاسيكي القائم على التعلم الفائق (ML-HQNC) بدمج التعلم المستوحى من الكم مع الشبكات العصبية العميقة لتصنيف اهتمامات الطلاب. تم التحقق من صحة البروتوكول باستخدام مجموعة بيانات تعليمية متاحة للعموم. وجرى تقييم أداء النموذج باستخدام مقاييس تقليدية، بما في ذلك الدقة (accuracy)، ودرجة F1-score، والمساحة تحت منحنى خصائص التشغيل للمستقبل (AUC)، جنباً إلى جنب مع دقة اكتشاف الاهتمامات (IDP)، ومؤشر استقرار النمط الكمومي (QPSI)، ومكسب التكيف عبر النطاقات (CDAG). حقق الإطار دقة تصنيف إجمالية بلغت 96.17% في مجموعة البيانات التي تم تقييمها. يوفر هذا البروتوكول سير عمل حوسبي قابل للتكرار لتحليل البيانات التعليمية متعددة الأبعاد لدعم الإدارة التعليمية الذكية وتطبيقات التعلم المخصص.
المقدمة
تُستخدم أنظمة الإدارة التعليمية بشكل متزايد في جميع أنحاء القطاع التعليمي، مدفوعة بالتطورات السريعة في تكنولوجيا المعلومات وشبكات الحاسوب. وقد رافق النمو المستمر في التعليم العالي زيادة في أعداد الطلاب المسجلين، لا سيما بين طلاب الهندسة، مما أدى إلى زيادة كبيرة في بيانات الإدارة التعليمية. ويدعم هذا النمو التنمية التعليمية المستدامة، ويسرع من عملية التحول الرقمي التعليمي، ويسهل إنشاء أنظمة إدارة تعليمية معيارية تعمل على تحسين اتساق وكفاءة الإدارة التدريسية. ويوفر تعلم الآلة (ML) تقنيات حسابية تمكن الأنظمة من تحليل البيانات، والتعلم من الأنماط، وتحسين أداء التنبؤ باستمرار دون الحاجة إلى برمجة صريحة1,2.
تُعد الجودة التعليمية مكوناً أساسياً من مكونات التعليم العالي. وفي السنوات الأخيرة، استُخدمت الاختبارات على نطاق واسع لتقييم مدى استيعاب طلاب الهندسة لمحتوى المساقات وقدرتهم على اكتساب معارف جديدة، مما يساهم في تعزيز التحسينات المستمرة في الجودة التعليمية. ويمكن إنشاء بيئات تعليمية محورها المتعلم من خلال الاستفادة من موارد التعلم المتنوعة المتاحة عبر المنصات التعليمية الإلكترونية وتطبيق نظريات تعليمية متعددة لتلبية احتياجات المتعلمين المختلفين. ويلعب التدريس الفعال دوراً رئيسياً في تحسين مخرجات التعلم لدى طلاب الهندسة في الجامعات والكليات3,4. علاوة على ذلك، يعزز التدريس الفعال بيئة تعليمية إيجابية، ويدعم فهم الطلاب لمحتوى المساق، ويحسن الأداء الأكاديمي. وتُقيم الجودة التعليمية باستخدام مؤشرات متعددة طوال عملية التعلم، بما في ذلك هيكل المنهج الدراسي، وبيئة الفصل الدراسي، ومحتوى التدريس.
يعزز التعليم العالي التطور الفكري والشخصي والاجتماعي للطلاب. وفي الوقت ذاته، أصبح اندماج الطلاب — بما في ذلك الأبعاد السلوكية والعاطفية والمعرفية — والاستمرار الأكاديمي محددات مهمة لمخرجات التعلم. وتساهم المستويات العالية من اندماج الطلاب بشكل كبير في النجاح الأكاديمي على المدى الطويل5,6. وقد خلقت التطورات في تكنولوجيا التعليم فرصاً جديدة للتحليلات التعليمية القائمة على البيانات من خلال نمذجة العلاقات غير الخطية المعقدة بين الخصائص المعرفية والسلوكية والأكاديمية للطلاب باستخدام تقنيات تعلم الآلة (ML) والتعلم العميق (DL).
لا يزال التحدي الرئيسي يتمثل في الملاحظة والتقييم الفعال لديناميكيات الفصل الدراسي مع مراعاة السلوكيات المتطورة للطلاب. غالبًا ما تكون النهج التقليدية لتقييم الجودة التعليمية وتحليل سلوك طلاب الهندسة مستهلكة للوقت وعرضة للتقدير البشري الذاتي. يؤثر تشتت انتباه الطلاب أثناء الأنشطة الصفية سلبًا على نواتج التعلم والأداء الأكاديمي7,8. ومع ذلك، يظل الحفاظ على الانتباه المستمر لدى طلاب الهندسة أمرًا صعبًا بسبب المشتتات الداخلية والخارجية والتقلبات في الدافعية.
لقد أصبح تقييم مشاركة الطلاب وتحسينها ذا أهمية متزايدة مع الاعتماد الواسع النطاق للتعلم عبر الإنترنت، والفصول الدراسية الذكية، وغيرها من التقنيات التعليمية التفاعلية. كما أن ضمان الشمولية عبر المجموعات المتنوعة من طلاب الهندسة يسلط الضوء بشكل أكبر على الحاجة إلى أطر شاملة تدمج المناهج القائمة على التكنولوجيا مع الممارسة التعليمية مع الحفاظ على معايير الخصوصية والأخلاقيات. بالإضافة إلى ذلك، فإن محدودية شفافية النماذج والتحديات المرتبطة بتكامل التكنولوجيا9,10، بما في ذلك التحيز المنهجي والعدالة التعليمية، لا تزال تعيق تطوير أنظمة تنبؤية قادرة على دعم المتعلمين من خلال المراقبة المستمرة.
استُخدمت نهج تعلم الآلة على نطاق واسع لمعالجة التحديات التعليمية، مثل التنبؤ بمستوى مخاطر الطلاب ومعدلات التسرب. وقد أثبتت هذه النهج قدرتها على تحديد الطلاب الأكثر عرضة للمخاطر، مما يدعم التدخلات التي تعمل على تحسين التحصيل الأكاديمي11. كما تم تطوير أنظمة إدارة تعليمية قائمة على الذكاء الاصطناعي (AI) لتعزيز العمليات الإدارية والأكاديمية داخل مؤسسات التعليم العالي. وعادةً ما تتضمن مجموعات البيانات التعليمية السجلات الأكاديمية مثل درجات المقررات، وسجلات الحضور، وتاريخ التسجيل12.
حللت الدراسات السابقة سلوك الطلاب من ثلاثة منظورات: بيانات التقييم، والمنهجيات، والنتائج13,14. وقد تم تطوير نماذج تنبؤ قائمة على الثقافة المعلوماتية لتحليل الخصائص السلوكية لطلاب الكليات. وتركز هذه الدراسات بشكل أساسي على تقييم سلوك المتعلم باستخدام طرق التعلم العميق (DL). ومع ذلك، لا يزال البحث في التقييم الذكي لسلوك المعلم في مراحله الأولى، مما يحد من التقدم في هذا المجال. وقد طُبقت الشبكات العصبية الالتفافية سريعة القائمة على المناطق (Fast R-CNNs) على مجموعات بيانات تعليمية لتحسين الكشف عن الأنشطة الصفية، مما أظهر تحسينات ملحوظة في الأداء مقارنة بالطرق التقليدية15.
ساهمت نماذج الذاكرة الطويلة قصيرة المدى ثنائية الاتجاه (Bi-LSTM) التي تدمج آليات المراقبة الذاتية في تحسين دقة التنبؤ بدرجات طلاب الكليات. وبالمثل، أظهرت نماذج التنبؤ التي تم تطويرها باستخدام مجموعات بيانات سلوك التعلم عبر الإنترنت أداءً تنبؤيًا محسنًا16,17,18. بالإضافة إلى ذلك، استُخدم تجميع الوسائل k-means (KMC) لتحديد خصائص مجموعات الطلاب المختلفة من خلال تحليل العنقوديات، مما وفر رؤى حول سلوك الطلاب تدعم التحسينات في التدريس والإدارة والتعلم. كما اقتُرحت استراتيجيات قائمة على التعلم العميق لتحسين الكشف عن سلوكيات التدريس داخل الفصول الدراسية وتقييمها. وفي هذه المنهجيات، تُستخدم سمات السلوك داخل الفصل لإنشاء علاقات بين تمثيلات السمات والمستويات الفائقة باستخدام قيم بداية قابلة للفصل خطيًا لآلة متجه الدعم (SVM)19,20. ومع ذلك، لا تزال هناك تحديات مثل الاحتجاب، والتفاصيل السلوكية الدقيقة، والتداخلات البيئية، والتي تحد من دقة التعرف على سلوك طلاب الهندسة في بيئات الفصول الدراسية.
كما طُبِّق التعلم العميق في التقييم القائم على المخرجات للمساقات الجامعية، بما في ذلك التقييم التربوي في التعليم السياسي والأيديولوجي.21,22وقد تم إثبات فعالية نماذج التنبؤ هذه باستخدام مجموعات بيانات تعليمية متاحة للعموم. كما استُخدمت الشبكات العصبية النبضية ذات التغذية الأمامية (FSNNs) للتنبؤ بالأداء الأكاديمي للطلاب باستخدام بيانات جُمعت من منصات التعلم عبر الإنترنت وأنظمة إدارة التعلم. وكما هو موضح في الشكل 1يتضمن سير العمل الحسابي المقترح مجموعة بيانات لتقييم تعليمي لتحديد اهتمامات طلاب الهندسة من خلال مراحل متسلسلة تشمل المعالجة المسبقة للبيانات، وتحليل الأنماط السلوكية، واختيار الميزات، والتصنيف. الجدول 123,24,25,26,27,28,29,30,31,32 يُلخص الأساليب التمثيلية الواردة في الدراسات السابقة، إلى جانب التقنيات المستخدمة والقيود المرتبطة بها لتحديد اهتمامات الطلاب ضمن أنظمة إدارة التعلم.
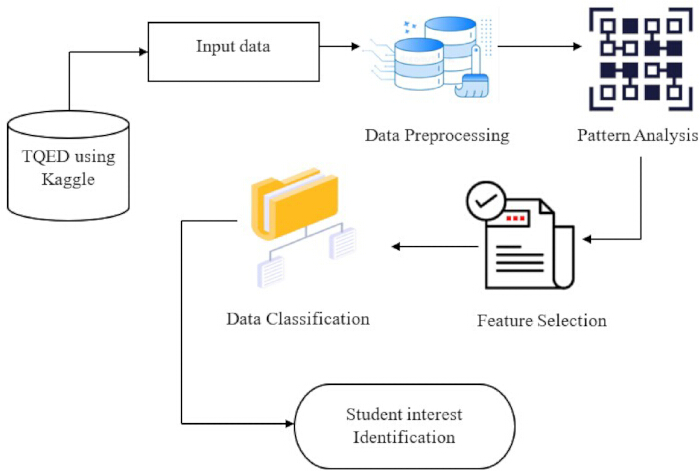
الشكل 1: إطار تحديد اهتمامات الطلاب. سير العمل العام لإطار تحديد اهتمامات طلاب الهندسة المقترح، والذي يتضمن الحصول على البيانات، والمعالجة المسبقة، وتحليل الأنماط السلوكية، واختيار الميزات، والتصنيف. يرجى النقر هنا لعرض نسخة أكبر من هذا الشكل.
الجدول 1: تحليل سلوك الطلاب في الإدارة التعليمية. ملخص للطرق والتقنيات ومجموعات البيانات ومقاييس التقييم والقيود المذكورة لتحليل سلوك الطلاب في الإدارة التعليمية. يرجى النقر هنا لتنزيل هذا الجدول.
تم تطبيق Swin Transformer وشبكة الهرم الميزاتي خفيفة الوزن (FPN) في الكشف عن سلوك الطلاب داخل الفصل الدراسي من خلال المعالجة الفعالة لخرائط الميزات متعددة المقاييس33. بالإضافة إلى ذلك، استُخدمت الشبكة العصبية المتكررة القابلة للتعديل والمحسنة بخوارزمية ذبابة الفاكهة (PFFO-ARNN) لتحليل سلوك التعلم عبر الإنترنت للطلاب والتنبؤ بالتحصيل الدراسي34. كما سلطت الدراسات القائمة على بيانات سلوك الطلاب التي تم جمعها من أنظمة إدارة التعلم الجامعية الضوء على عدم الكفاءة واستهلاك الوقت في مراقبة سلوك الفصل الدراسي باستخدام طرق التعلم العميق التقليدية35. يلخص الجدول 236,37,38,39,40,41,42,43,44,45,46,47 طرق التصنيف الممثلة، ومجموعات البيانات، ومقاييس التقييم، والقيود المسجلة لأنظمة إدارة التدريس الذكية في التعليم الهندسي.
الجدول 2: أنظمة إدارة التدريس الذكية القائمة على التعلم العميق للتعليم الهندسي. مقارنة بين أنظمة إدارة التدريس التمثيلية القائمة على التعلم العميق، ومجموعات البيانات، ومقاييس التقييم، والقيود المذكورة. يرجى النقر هنا لتنزيل هذا الجدول.
قامت دراسة سابقة48 بتطوير نموذج لتقييم جودة التدريس المدمج بناءً على شبكات الاعتقاد العميقة (DBNs)، واقترحت استراتيجية تقييم مختلطة لتقييم جودة التدريس في الجامعات. وقد تفوق النهج المقترح على الخوارزمية الجينية (GA) التقليدية من حيث دقة التصنيف ووقت التنفيذ، حيث حقق دقة تتجاوز 95% في زمن أقل من 5.4 ms. تم تدريب النموذج باستخدام مجموعات بيانات تعليمية مصنفة، وتم تقييمه باستخدام استراتيجية اختبار مستقلة49,50. وأظهرت النتائج المسجلة أداءً تنبؤياً قوياً، بمتوسط خطأ مطلق (MAE) قدره 0.593% وجذر متوسط مربع الخطأ (RMSE) قدره 0.785%.
تدمج البنى الحديثة المعززة بالانتباه، مثل KANFormer51، آلية الانتباه الذاتي متعدد الرؤوس مع شبكات Kolmogorov-Arnold لتحسين التنبؤ بأداء الطلاب من خلال رصد التفاعلات المعقدة بين الميزات. كما أظهرت نماذج تتبع المعرفة القائمة على Transformer تحسناً في دقة التنبؤ وقابلية التفسير عبر الاستفادة من آليات الانتباه لنمذجة مسارات تعلم الطلاب52. وعلى الرغم من أن البنى القائمة على Transformer والانتباه قد حسنت الأداء في مهام التنبؤ التعليمية من خلال نمذجة التبعيات السياقية والتفاعلات بعيدة المدى بين الميزات، إلا أن هذه المنهجيات تركز بشكل أساسي على التنبؤ بأداء الطلاب أو تتبع المعرفة، بدلاً من تحديد اهتمامات الطلاب مع مراعاة عدم اليقين من خلال النمذجة المعرفية المستوحاة من الكم، والاختيار الأمثل للميزات، والتعلم الفائق الهجين.
على الرغم من التطورات الأخيرة في تعلم الآلة والتعلم العميق في مجال التحليلات التعليمية، إلا أن الأساليب الحالية لتحديد اهتمامات طلاب الهندسة تعاني من عدة قيود. تركز العديد من النهج التقليدية بشكل أساسي على دقة التنبؤ مع إهمال الطبيعة متعددة الأوجه لسلوك الطالب، بما في ذلك تفضيلات التعلم المتطورة، وعدم اليقين السلوكي، والعلاقات السياقية، والتفاعلات الدلالية. علاوة على ذلك، تعتمد هذه الأساليب غالباً على هندسة الميزات التقليدية واستراتيجيات التعلم الحتمية، والتي قد لا تلتقط الأنماط السلوكية غير الخطية بشكل كافٍ أو تتكيف مع بيئات التعلم الديناميكية. وبناءً على ذلك، تبرز الحاجة إلى إطار عمل أكثر شمولاً يدمج المعالجة المسبقة القوية للبيانات، والنمذجة السلوكية الذكية، والاختيار التكيفي للميزات، وتقنيات التعلم الهجين لتحسين تحليل البيانات التعليمية المعقدة.
ولمعالجة هذه القصور، يدمج الإطار المقترح بين المعالجة المسبقة القوية للبيانات، والنمذجة السلوكية المستوحاة من الكم، واختيار الميزات الأمثل، والتعلم العصبي الهجين الكمي-الكلاسيكي في سير عمل حوسبي موحد لتحديد اهتمامات طلاب الهندسة. ومن خلال الجمع بين هذه المكونات المتكاملة، يوفر البروتوكول المقترح منهجاً منظماً وقابلاً للتكرار لتحليل البيانات التعليمية المعقدة لدعم التعلم المخصص واتخاذ القرارات التعليمية.
يتمثل الهدف من هذه الدراسة في تطوير والتحقق من صحة إطار عمل CQEI باستخدام بيانات تعليمية وسلوكية متعددة الأبعاد لتحديد اهتمامات طلاب الهندسة. يجمع إطار العمل بين المعالجة المسبقة القوية للبيانات، ونمذجة الحالة المعرفية المستوحاة من الكم، واختيار الميزات المحسّن، والمصنف العصبي الهجين الكمي-الكلاسيكي للتعلم الميتا (ML-HQNC) لتحليل سلوكيات التعلم لدى الطلاب وتسهيل التحديد الدقيق للاهتمامات. يتم تقييم الأداء باستخدام مقاييس قياسية، بما في ذلك الدقة، ومقياس F1-score، والمساحة تحت منحنى خصائص تشغيل المستقبل (AUC)، جنباً إلى جنب مع دقة اكتشاف الاهتمامات (IDP)، ومؤشر استقرار النمط الكمي (QPSI)، ومكسب التكيف عبر المجالات (CDAG). ومن خلال دمج هذه المكونات المتكاملة في سير عمل حوسبي واحد، يوفر إطار العمل المقترح منهجاً نظامياً للتحليلات التعليمية واتخاذ القرارات التعليمية الذكية.
البروتوكول
استخدمت هذه الدراسة مجموعة بيانات مجهولة المصدر ومتاحة للعموم تم الحصول عليها من مستودع Kaggle. لم يتم تجنيد أو إشراك أي مشاركين بشريين بشكل مباشر، ولم يتم جمع أي معلومات تحدد الهوية الشخصية. وبناءً على ذلك، لم تكن هناك حاجة لموافقة أخلاقية مؤسسية أو موافقة مستنيرة. وأدوات البحث المستخدمة في هذه الدراسة مدرجة في جدول المواد.
1. نظرة عامة على إطار عمل CQEI
دمج إطار عمل ذكاء التعليم المفاهيمي المستوحى من الكم (CQEI) المقترح عمليات المعالجة المسبقة للبيانات، وتحليل الأنماط السلوكية، واختيار الميزات، والتصنيف لتحديد اهتمامات طلاب الهندسة باستخدام مجموعة بيانات تقييم جودة التدريس التي تم الحصول عليها من مستودع Kaggle. أولاً، تمت المعالجة المسبقة لمجموعة البيانات باستخدام طريقة Box–Cox Robust IQR Scaling (BCRIS) لتقليل الضوضاء الدلالية وتطبيع ميزات الإدخال. بعد ذلك، تم تحليل الأنماط السلوكية للطلاب باستخدام نموذج الحالة المعرفية الكمومية (QCSM). ثم طُبقت خوارزمية اختيار الميزات المعتمدة على تحسين سرب الحيتان المعزز كمومياً (QES-WOFS) لتحديد الميزات المعلوماتية مع تقليل تكرار الميزات من خلال نمذجة الاختيار الكمومي الأمثل، وأهمية التغذية الراجعة، والتغيرات السلوكية العابرة. وأخيراً، دمج المصنف العصبي الهجين الكمومي-الكلاسيكي للتعلم الميتا (ML-HQNC) التعلم المستوحى من الكم مع طبقات دلالية متبقية عميقة لتحديد اهتمامات الطلاب.
يظهر سير العمل العام لإطار عمل ML-HQNC المقترح في الشكل 2. تضمن البروتوكول ست مراحل متتالية، بدأت بالحصول على مجموعة البيانات التعليمية من مستودع Kaggle، تلاها المعالجة المسبقة للبيانات باستخدام مقياس Box–Cox Robust IQR Scaling (BCRIS)، ثم تحويل الميزات والتمثيل السلوكي باستخدام نموذج الحالة المعرفية الكمومية (QCSM)، واختيار الميزات باستخدام خوارزمية اختيار الميزات المعتمدة على تحسين سرب الحيتان المعزز كمومياً (QES-WOFS). استُخدمت الميزات المختارة لاحقاً في تدريب النموذج والتحقق من صحته باستخدام المصنف العصبي الهجين الكمي-الكلاسيكي القائم على التعلم الفائق (ML-HQNC)، وفي النهاية تم تقييم إطار العمل باستخدام الدقة (accuracy)، ومقياس F1-score، والمساحة تحت منحنى خصائص تشغيل المستقبل (AUC)، ودقة الكشف عن الاهتمام (IDP)، ومؤشر استقرار النمط الكمومي (QPSI)، ومكسب التكيف عبر النطاقات (CDAG).
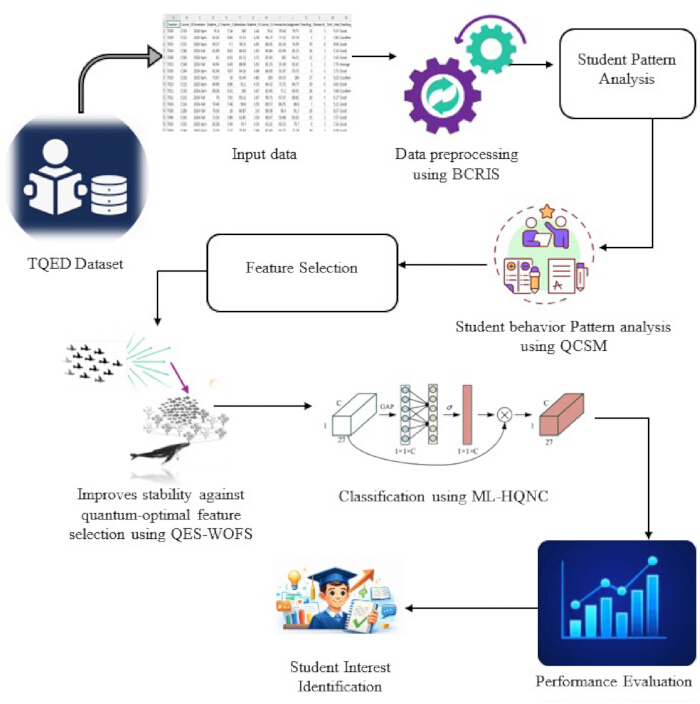
الشكل 2: إطار عمل المصنف العصبي الهجين الكمي-الكلاسيكي القائم على التعلم الفائق (ML-HQNC). البنية العامة لإطار عمل ML-HQNC المقترح والذي يدمج تقنية Box–Cox Robust IQR Scaling (BCRIS) للمعالجة المسبقة للبيانات، ونموذج الحالة المعرفية الكمية (QCSM) لتحليل الأنماط السلوكية، وخوارزمية اختيار السمات المعتمدة على تحسين سرب الحيتان المعزز كمياً (QES-WOFS) لاختيار السمات، والتعلم العصبي الهجين الكمي-الكلاسيكي لتصنيف اهتمامات الطلاب. يرجى النقر هنا لعرض نسخة أكبر من هذا الشكل.
2. مجموعة بيانات تقييم جودة التدريس
تم تطوير الإطار المقترح باستخدام مجموعة بيانات تقييم جودة التدريس المتاحة علناً والتي تم الحصول عليها من مستودع Kaggle. احتوت مجموعة البيانات على 1,014 سجلاً تعليمياً بـ 14 سمة متعددة الأبعاد تمثل الأداء الأكاديمي، ودرجات التقييم، والحضور، والخصائص التعليمية، والمؤشرات السلوكية للطلاب التي تم جمعها من خلال منصة إدارة التعليم الشاملة (CEMP). وفرت هذه السمات المعلومات التعليمية متعددة الأبعاد اللازمة لنمذجة العلاقات غير الخطية المرتبطة بتحديد اهتمامات طلاب الهندسة.
كما هو موضح في الشكل 3، تم تقسيم مجموعة البيانات إلى مجموعتين فرعيتين: مجموعة تدريب (80%) ومجموعة اختبار (20%). استُخدم ما مجموعه 800 سجل لتدريب النموذج المقترح، بينما تم تخصيص 200 سجل لتقييم الأداء. مجموعة البيانات متاحة للعموم على الرابط التالي: https://www.kaggle.com/datasets/ziya07/teaching-quality-evaluation-dataset. بعد ذلك، تمت معالجة مجموعتي بيانات التدريب والاختبار باستخدام الإطار المقترح لبناء نموذج التعلم وتحسين قدرته التنبؤية.
على الرغم من أن مجموعة البيانات الأساسية تحمل عنوان "مجموعة بيانات تقييم جودة التدريس"، إلا أن هذه الدراسة هدفت إلى تحديد اهتمامات طلاب الهندسة. وقد عملت السمات التعليمية والسلوكية والتعليمية الواردة في مجموعة البيانات كمتغيرات مدخلة لتدريب الإطار المقترح وتقييمه. وبناءً على ذلك، فإن جميع نتائج التنبؤ ومقاييس الأداء الواردة تصف مدى فعالية الإطار في تحديد اهتمامات طلاب الهندسة بدلاً من تقييم جودة التدريس. وقبل المعالجة المسبقة للبيانات، تم التحقق من مجموعة البيانات المستوردة لضمان تحميل كافة السجلات البالغ عددها 1,014 سجلاً بنجاح، ومطابقة مخطط مجموعة البيانات للتنسيق المتوقع، وتحديد ومعالجة أي سجلات مفقودة أو مكررة.
3. المعالجة المسبقة للبيانات باستخدام تحجيم المدى الربيعي المتين لبوكس-كوكس (BCRIS)
استُخدمت طريقة تحجيم المدى الربيعي المتين لبوكس-كوكس (BCRIS) لمعالجة وتطبيع مجموعة البيانات التعليمية مسبقاً، وذلك من خلال الدمج بين تحويل بوكس-كوكس والتحجيم المتين القائم على المدى الربيعي (IQR) للحد من تأثير القيم المتطرفة. وقد أدى تصحيح التماثل إلى جانب التطبيع الممركز حول الوسيط إلى إنشاء تمثيلات سمات مستقرة إحصائياً وقابلة للتوسع ومناسبة للتحليل اللاحق. وفي إطار الذكاء التعليمي المقترح، قامت طريقة BCRIS بتحويل المؤشرات التعليمية والإرشادية والسلوكية متعددة الأبعاد إلى تمثيلات سمات محكومة التباين. وتم تطبيع السمات التي تشمل attendance_rate وinteractive_sessions_percentage والمتغيرات التعليمية ذات الصلة لتحسين اتساق مجموعات بيانات التدريب والاختبار. تتوفر التفسيرات الرياضية المفصلة في الملف التكميلي 1 (القسم S1). وفرت طريقة BCRIS استراتيجية معالجة مسبقة متوافقة مع الحوسبة الكمومية، والتي قامت بتطبيع البيانات التعليمية غير المتجانسة قبل التحليل الإحصائي اللاحق، مع الحفاظ على الخصائص السلوكية الأساسية المطلوبة للنمذجة اللاحقة. وقبل إجراء التحليل السلوكي، تم التحقق من مسار المعالجة المسبقة لضمان خلو مجموعة البيانات المطببعة من أي قيم غير صالحة أو مفقودة، وتقليل الضوضاء الدلالية، والتأكد من أن السمات المعالجة مناسبة للنمذجة السلوكية اللاحقة.
4. تحويل السمات والتمثيل السلوكي باستخدام نموذج الحالة المعرفية الكمومية (QCSM)
تم تنفيذ نموذج الحالة المعرفية الكمومية (QCSM) لنمذجة ديناميكيات اهتمامات طلاب الهندسة باستخدام تمثيلات احتمالية مستوحاة من الكم. تم تمثيل اهتمام الطالب كتقاطع لحالات مفاهيمية متعددة تعكس التسلسل الهرمي للمفاهيم المعرفية، وعدم اليقين، والتداخل المفاهيمي، والمشاركة المتزامنة في مواضيع متعددة، وسلوكيات التعلم المترددة أو غير الحاسمة، واحتمالية التحولات في تفضيلات التعلم. وقد تم تمثيل المؤشرات متعددة الأبعاد من مجموعة بيانات تقييم جودة تدريس الهندسة، بما في ذلك Student_Avg_Score و Attendance_rate و Student_Feedback_Rating، كتحولات معرفية موزونة بالسعة ضمن فضاء حالة كمومية معياري. ودمج نموذج QCSM تحولات الحالة الكمومية مع المحاذاة المفاهيمية القائمة على التداخل لتوليد تمثيلات معرفية مستوحاة من الكم تعكس استقرار وتطور اهتمام الطلاب بمرور الوقت. تتوفر الصيغ الرياضية التفصيلية في الملف التكميلي 1 (القسم S2). وقام نموذج QCSM بنمذجة الحالات المعرفية الاحتمالية لتمثيل اكتساب المعرفة، والتغيير المفاهيمي، والمشاركة في التعلم، والاهتمام بالمادة من خلال تمثيلات الحالة الكمومية المعيارية. وتم التحقق من التمثيلات السلوكية عبر جميع سجلات الطلاب لضمان أن سمات الحالة المعرفية المستخلصة قد التقطت بدقة سلوكيات التعلم والتحولات في المواضيع.
5. اختيار الميزات باستخدام خوارزمية منتقي الميزات المعتمد على تحسين سرب الحيتان المعزز كمومياً (QES-WOFS)
استُخدمت خوارزمية اختيار الميزات المعتمدة على تحسين سرب الحيتان المعزز كمومياً (QES-WOFS) لتحديد المجموعة الفرعية المثلى من الميزات وتحديد الخصائص السلوكية ذات المعلومات العالية من البيانات التعليمية متعددة الأبعاد. وقد عززت آليات البحث المستوحاة من الكم تكامل استراتيجيات البحث العالمية والمحلية لتحسين الميزات. كما جرى تقييم المتغيرات التعليمية، بما في ذلك interactive_sessions_percentage وassignments_time_percentage وcourse_completion_rate، وفقاً لارتباطها بالنتيجة المستهدفة. وتمت نمذجة مجموعات الميزات المرشحة باستخدام تمثيلات الاحتمالية الكمومية، بينما مكنت آلية النفق الكمومي من إجراء انتقالات احتمالية تتجاوز القيم المثلى المحلية. كما قُدّرت أهمية الميزة باستخدام الاحتمالية الهامشية لتحديد مساهمة كل ميزة في أداء التصنيف وحالات السرب التكيفية. وقد اختارت خوارزمية QES-WOFS ميزات مستقرة وذات دلالة سلوكية، مما أدى إلى تحسين القدرة على مقاومة الضوضاء، والتباين من فصل دراسي لآخر، والتقلبات السلوكية الدورية.
للتغلب على القيود المرتبطة باستخدام خوارزمية تحسين الحوت (WOA) أو تحسين سرب الجسيمات (PSO) بشكل مستقل، قامت خوارزمية QES-WOFS بدمج الاستكشاف العالمي القائم على PSO مع الاستغلال المحلي القائم على WOA. كما أتاحت آلية النفق الكمومي إجراء انتقالات احتمالية تتجاوز القيم المثلى المحلية، مما أدى إلى زيادة تنوع المجتمع، وتقليل تكرار الميزات، وتحسين التقارب نحو مجموعة فرعية مثلى من الميزات لتحديد اهتمامات طلاب الهندسة.
تتوفر الصيغ الرياضية التفصيلية في الملف التكميلي 1 (القسم S3). دمجت خوارزمية QES-WOFS بين ترميز الميزات الاحتمالي الكمي، واستراتيجية سرعة مكيّفة بواسطة PSO، وآلية بحث لولبية مستوحاة من الحوت لتحديد الميزات التعليمية الأكثر إثراءً بالمعلومات. تم تحسين المعلمات الفائقة تجريبياً باستخدام مجموعة بيانات التدريب. كما تم تقييم القيم المرشحة من خلال تجارب منهجية، واختيار التركيبة التي حققت أعلى أداء في التحقق. وعلى وجه التحديد، تم اختيار معلمة تحويل Box–Cox (λ = 0.25)، وهامش الخسارة التباينية (m = 1.0)، ومعاملات النفق الكمي (α = 0.7 و β = 0.3) بناءً على دقة التحقق، ومقياس F1-score، وسلوك التقارب. وقبل تدريب المصنف، تم التحقق من نتائج اختيار الميزات لضمان أن خوارزمية QES-WOFS قد اختارت المجموعة الفرعية المثلى من الميزات واستبعدت الميزات الزائدة أو ذات الأهمية المنخفضة.
6. تدريب النموذج والتحقق من صحته باستخدام المصنف العصبي الهجين الكمي-الكلاسيكي القائم على التعلم الفائق (ML-HQNC)
تم تنفيذ المصنف العصبي الهجين الكمي-الكلاسيكي القائم على التعلم الفائق (ML-HQNC) من خلال دمج الشبكات العصبية العميقة مع الحسابات المستوحاة من الكم لتحديد اهتمامات طلاب الهندسة. وقد عملت آليات الانتباه الكمي متعددة الرؤوس وطبقات دلالية متبقية عميقة على رصد العلاقات غير الخطية المعقدة ضمن البيانات التعليمية متعددة الأبعاد الممثلة باستخدام الدوائر الكمية المتغيرة (VQCs). كما تم إسقاط السمات المستمدة سلوكياً، بما في ذلك student_average_grade وattendance_rate وstudent_feedback_rating، في فضاء حالة كمي، حيث تم تحويل المدخلات المعيرة إلى تمثيلات كمية قائمة على السعة لنمذجة أنماط التفاعل الاحتمالية والمتداخلة. وقد حُسبت متجهات السمات السلوكية المعيرة للطلاب وفقاً للمعادلات الواردة في الملف التكميلي 1 (القسم S4). وبناءً على ذلك، قام نظام ML-HQNC بتصنيف وتحديد اهتمامات طلاب الهندسة.
استخدم مصنف ML-HQNC استراتيجية تعلم ميتا عرضي (episodic meta-learning) أثناء التدريب، حيث تم تخصيص مهمة تعلم ميتا واحدة مختارة عشوائياً من مجموعة بيانات التدريب لكل حلقة. ومع الحفاظ على توزيع الفئات، قُسمت بيانات التدريب إلى مجموعة دعم (80%) ومجموعة استعلام (20%). استُخدمت مجموعة الدعم لتكييف المعلمات الخاصة بالمهمة من خلال حلقة التحسين الداخلية، بينما قامت مجموعة الاستعلام بتقييم النموذج المكيف وحساب خسارة الميتا (meta-loss) المستخدمة لتحديث المعلمات المشتركة. تم إنشاء ما مجموعه 100 مهمة تعلم ميتا خلال كل دورة تدريب. استُخدمت خمس خطوات تحديث للتدرج بمعدل تعلم داخلي قدره 0.001 للتكيف في الحلقة الداخلية، بينما قام محسن Adam بمعدل تعلم خارجي قدره 0.0005 بتحسين معلمات الميتا. تكررت عملية أخذ عينات المهام عشوائياً في كل حقبة تدريب لتعريض النموذج لأنماط سلوكية متنوعة وتحسين القدرة على التعميم على ملفات تعريف الطلاب التي لم يسبق رؤيتها. تم وصف تقدير الخسارة للمحاذاة التباينية الكمومية في الملف التكميلي 1 (المعادلات 41-45). تم التحقق من تدريب النموذج لضمان التقارب الناجح دون أخطاء حسابية، وللتأكد من استقرار منحنيات خسارة التدريب والتحقق عبر الحقبات المتتالية.
النتائج
تم تقييم إطار عمل ML-HQNC المقترح مقابل كل من Fast R-CNN وBi-LSTM وCNN وXGBoost باستخدام مقاييس التصنيف التقليدية، بما في ذلك الدقة (Accuracy)، والضبط (Precision)، والاستدعاء (Recall)، ومقياس F1-score، والمساحة تحت منحنى خصائص تشغيل المستقبل (AUC)، بالإضافة إلى مقاييس التقييم المقترحة وهي دقة اكتشاف الاهتمام (IDP)، ومؤشر استقرار النمط الكمي (QPSI)، ومكسب القابلية للتكيف عبر النطاقات (CDAG). تتوفر التعريفات الرياضية لهذه المقاييس في الملف التكميلي 1 (القسم S5).
لتقييم متانة الإطار المقترح، كُررت جميع التجارب خمس مرات باستخدام تهيئات أولية عشوائية مختلفة. وتُعرض قيم الأداء المُبلغ عنها في صورة المتوسط ± الانحراف المعياري عبر التشغيلات الخمس. كما تم تقييم الدلالة الإحصائية بين الإطار المقترح والنماذج المرجعية باستخدام اختبار t المقترن، مع اعتبار القيمة p < 0.05 ذات دلالة إحصائية.
كما هو موضح في الجدول التكميلي 1، أُجريت تجارب المحاكاة باستخدام مجموعة بيانات تقييم جودة التدريس التي تحتوي على 1,014 سجلاً. استُخدم ما مجموعه 800 سجل لتدريب النموذج، بينما خُصص 200 سجل للاختبار. تم تنفيذ إطار عمل ML-HQNC المقترح ونماذج المقارنة في بيئة Jupyter Notebook باستخدام لغة Python. كانت سمة Teaching_Quality بمثابة المتغير المستهدف الأصلي في مجموعة بيانات تقييم جودة التدريس المتاحة للجمهور، وتكونت من فئتين هما Good و Excellent. استُخدمت هذه التصنيفات كأهداف للتنبؤ لتدريب وتقييم إطار عمل ML-HQNC. وتلخص الجدول 3 فئات التنبؤ الناتجة. كما يلخص الجدول التكميلي 2 نتائج التحقق من مرحلة المعالجة المسبقة باستخدام Box–Cox Robust IQR Scaling (BCRIS). وقد عمل مسار المعالجة المسبقة على إزالة السجلات المفقودة والمكررة، وتقليل تأثير القيم المتطرفة، وتطبيع توزيعات السمات، وتحسين الاتساق الدلالي والسلوكي قبل تحويل السمات وتدريب النموذج.
الجدول 3: المتغير المستهدف لمجموعة بيانات تقييم جودة التدريس. وصف لمتغير Teaching_Quality المستهدف الأصلي وفئات تصنيفه (جيد وممتاز) المستخدمة في تدريب النموذج وتقييمه. يرجى النقر هنا لتنزيل هذا الجدول.
الجدول التكميلي 3 يعرض سمات ممثلة تم إنشاؤها بواسطة نموذج الحالة المعرفية الكمي (QCSM). تصف السمات المستخلصة سلوك تعلم الطلاب، بما في ذلك الحالة المعرفية، والمشاركة، وعدم اليقين، وانتقالات الموضوعات، والاتساق السلوكي، وقد استُخدمت كمدخلات لمرحلة اختيار السمات اللاحقة باستخدام QES-WOFS. يدرج الجدول التكميلي S4 السمات النهائية التي اختارتها خوارزمية QES-WOFS جنبًا إلى جنب مع فئات السمات، ومستويات التأثير النسبي، والأدوار الوظيفية ضمن الإطار المقترح. وتلخص خصائص السمات السلوكية متعددة الأبعاد المستخلصة في الجدول التكميلي 5. كما يعرض الجدول التكميلي 6 هياكل الحواف الممثلة التي تم إنشاؤها أثناء التمثيل السلوكي لفئتي التنبؤ (جيد وممتاز).
كما هو موضح في الشكل 4 والجدول 4، حقق إطار عمل ML-HQNC المقترح أعلى درجة F1-score بنسبة (87.9%) من بين الطرق التي تم تقييمها. وكانت درجات F1-score المقابلة لنماذج Fast R-CNN وBi-LSTM وCNN وXGBoost هي 77.9% و80.2% و82.8% و85.8% على التوالي. وقد تم تقييم الدلالة الإحصائية باستخدام اختبار t المستقل ثنائي الطرف (p < 0.05).
يلخص الشكل 5 والجدول 5 نتائج دقة اكتشاف الاهتمام (IDP). حيث حقق إطار عمل ML-HQNC المقترح دقة IDP بلغت 89.3%، مقارنة بـ 79.11% و82.12% و84.6% و87.10% لكل من Fast R-CNN وBi-LSTM وCNN وXGBoost على التوالي. ويقدم الشكل 6 والجدول 6 نتائج مؤشر استقرار النمط الكمي (QPSI). حيث حقق إطار العمل المقترح قيمة QPSI بلغت 92.7%، بينما حقق كل من Fast R-CNN وBi-LSTM وCNN وXGBoost قيم 81.1% و84.11% و87.4% و90.9% على التوالي. ويلخص الشكل 7 والجدول 7 نتائج كسب التكيف عبر النطاقات (CDAG). وقد حقق إطار عمل ML-HQNC المقترح أعلى قيمة CDAG (0.95)، مقارنة بـ Fast R-CNN (0.78) وBi-LSTM (0.83) وCNN (0.80) وXGBoost (0.86). وكما هو موضح في الشكل 8 والجدول 8، حقق إطار عمل ML-HQNC المقترح أعلى دقة تصنيف (96.17%). وكانت الدقة المقابلة لكل من Fast R-CNN وBi-LSTM وCNN وXGBoost هي 85.10% و87.21% و90.14% و93.19% على التوالي. ويعرض الشكل 9 والجدول 9 الوقت الحسابي الذي تطلبه كل منهج. حيث تطلب إطار عمل ML-HQNC المقترح 9.02 ms، بينما تطلب كل من Fast R-CNN وBi-LSTM وCNN وXGBoost زمن قدره 31.2 ms و27.5 ms و22.4 ms و17.6 ms على التوالي. ويقدم الشكل 10 تحليل خصائص تشغيل المستقبل (ROC). حيث حقق إطار عمل ML-HQNC المقترح قيمة AUC بلغت 0.944، مما يشير إلى معدل إيجابي حقيقي مرتفع ومعدل إيجابي كاذب منخفض عبر عتبة التصنيف التي تم تقييمها.
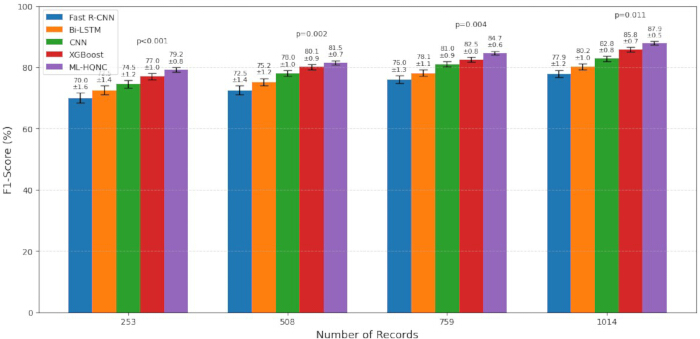
الشكل 4: مقارنة درجة F1 عبر أحجام مجموعات بيانات مختلفة. مقارنة لدرجة F1 التي حققها نموذج ML-HQNC والنماذج المنافسة عبر أحجام مختلفة من مجموعات البيانات. يتم عرض النتائج كمتوسط ± الانحراف المعياري عبر خمس تجارب مستقلة (n = 5). تمثل أشرطة الخطأ انحرافًا معياريًا واحدًا. تم تقييم الدلالة الإحصائية باستخدام اختبار t المستقل ذو الطرفين (p < 0.05). يرجى النقر هنا لعرض نسخة أكبر من هذا الشكل.
الجدول 4: مقارنة درجة F1 عبر أحجام مجموعات بيانات مختلفة. مقارنة لدرجة F1 التي حققها نموذج ML-HQNC والنماذج المنافسة. تم تسجيل النتائج كمتوسط ± انحراف معياري عبر خمس تجارب مستقلة (n = 5). يرجى النقر هنا لتنزيل هذا الجدول.
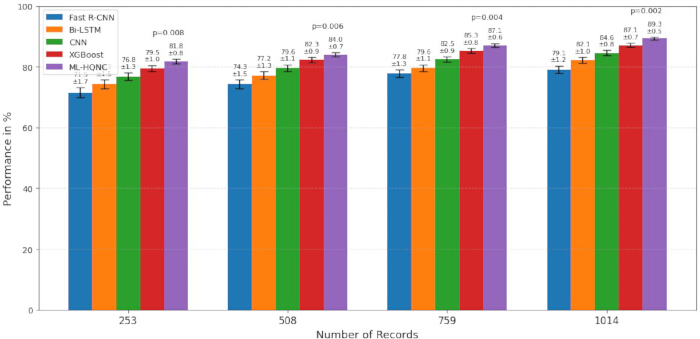
الشكل 5: مقارنة دقة كشف الاهتمام (IDP) عبر أحجام مختلفة من مجموعات البيانات. مقارنة لدقة كشف الاهتمام (IDP) التي حققها نموذج ML-HQNC والنماذج المنافسة عبر أحجام مختلفة من مجموعات البيانات. تم تسجيل النتائج كمتوسط ± الانحراف المعياري لخمس تجارب مستقلة (n = 5). تمثل أشرطة الخطأ انحرافاً معيارياً واحداً. وتم تقييم الدلالة الإحصائية باستخدام اختبار t المستقل ثنائي الجانب (p < 0.05). يرجى النقر هنا لعرض نسخة أكبر من هذا الشكل.
الجدول 5: مقارنة دقة كشف الاهتمام (IDP) عبر أحجام مجموعات بيانات مختلفة.مقارنة لدقة كشف الاهتمام (IDP) التي حققها نموذج ML-HQNC والنماذج المنافسة. يتم عرض النتائج كمتوسط ± الانحراف المعياري عبر خمس تجارب مستقلة (n = 5). يرجى النقر هنا لتحميل هذا الجدول.
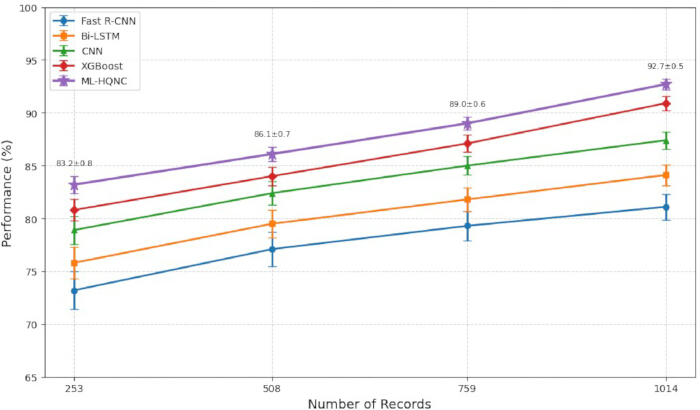
الشكل 6: مقارنة مؤشر استقرار النمط الكمي (QPSI) عبر أحجام مختلفة من مجموعات البيانات. مقارنة لمؤشر استقرار النمط الكمي (QPSI) الذي حققه نموذج ML-HQNC والنماذج المنافسة عبر أحجام مختلفة من مجموعات البيانات. تم تسجيل النتائج كمتوسط ± الانحراف المعياري عبر خمس تجارب مستقلة (n = 5). تمثل أشرطة الخطأ انحرافاً معياريًا واحدًا. تم تقييم الدلالة الإحصائية باستخدام اختبار t المستقل ثنائي الجانب (p < 0.05). يرجى النقر هنا لعرض نسخة أكبر من هذا الشكل.
الجدول 6: مقارنة مؤشر استقرار النمط الكمي (QPSI) عبر أحجام مختلفة من مجموعات البيانات. مقارنة لمؤشر استقرار النمط الكمي (QPSI) الذي حققه نموذج ML-HQNC والنماذج المنافسة. تم تسجيل النتائج كمتوسط ± الانحراف المعياري عبر خمس تجارب مستقلة (n = 5). يرجى النقر هنا لتحميل هذا الجدول.
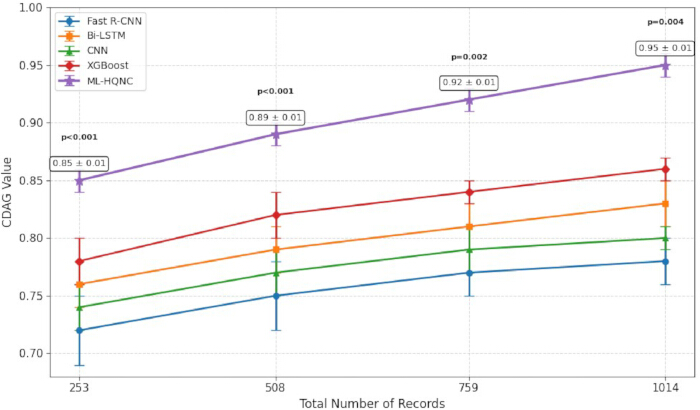
الشكل 7: مقارنة مكاسب التكيف عبر النطاقات (CDAG) عبر أحجام مجموعات بيانات مختلفة. مقارنة لمكاسب التكيف عبر النطاقات (CDAG) التي حققها نموذج ML-HQNC والنماذج المنافسة عبر أحجام مختلفة من مجموعات البيانات. تم تسجيل النتائج كمتوسط ± انحراف معياري عبر خمس تجارب مستقلة (n = 5). تمثل أشرطة الخطأ انحرافاً معيارياً واحداً. تم تقييم الدلالة الإحصائية باستخدام اختبار t المستقل ثنائي الجانب (p < 0.05). يرجى النقر هنا لعرض نسخة أكبر من هذا الشكل.
الجدول 7: مقارنة اكتساب القدرة على التكيف عبر النطاقات (CDAG) عبر أحجام مجموعات بيانات مختلفة. مقارنة لاكتساب القدرة على التكيف عبر النطاقات (CDAG) الذي حققه نموذج ML-HQNC والنماذج المنافسة. تم تسجيل النتائج كمتوسط ± الانحراف المعياري عبر خمس تجارب مستقلة (n = 5). يرجى النقر هنا لتنزيل هذا الجدول.
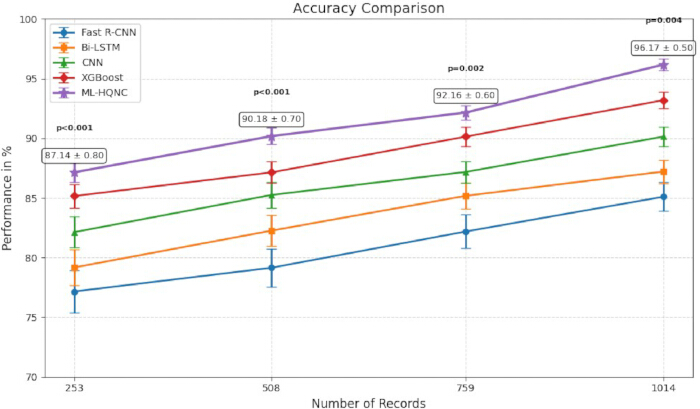
الشكل 8: مقارنة دقة التصنيف عبر أحجام مجموعات بيانات مختلفة. مقارنة لدقة التصنيف التي حققها نموذج ML-HQNC والنماذج المنافسة عبر أحجام مختلفة من مجموعات البيانات. تم تسجيل النتائج كمتوسط ± الانحراف المعياري عبر خمس تجارب مستقلة (n = 5). تمثل أشرطة الخطأ انحرافاً معيارياً واحداً. تم تقييم الدلالة الإحصائية باستخدام اختبار t المستقل ثنائي الجانب (p < 0.05). يرجى النقر هنا لعرض نسخة أكبر من هذا الشكل.
الجدول 8: مقارنة دقة التصنيف عبر أحجام مجموعات بيانات مختلفة. مقارنة لدقة التصنيف التي حققها نموذج ML-HQNC والنماذج المنافسة. تم إعداد النتائج كمتوسط ± الانحراف المعياري عبر خمس تجارب مستقلة (n = 5). يرجى النقر هنا لتنزيل هذا الجدول.
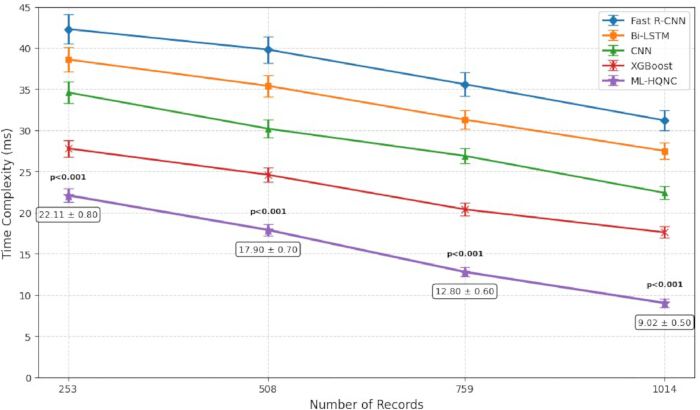
الشكل 9: مقارنة زمن الحوسبة عبر أحجام مختلفة من مجموعات البيانات. مقارنة لوقت التنفيذ الحوسبي لنموذج ML-HQNC والنماذج المنافسة عبر أحجام مختلفة من مجموعات البيانات. يتم تقديم النتائج كمتوسط ± الانحراف المعياري عبر خمس عمليات تجريبية مستقلة (n = 5). تمثل أشرطة الخطأ انحرافاً معيارياً واحداً. تشير القيم الأدنى إلى وقت تنفيذ حوسبي أقصر. تم تقييم الدلالة الإحصائية باستخدام اختبار t المستقل ثنائي الجانب (p < 0.05). يرجى النقر هنا لعرض نسخة أكبر من هذا الشكل.
الجدول 9: مقارنة زمن الحوسبة عبر أحجام مختلفة من مجموعات البيانات. مقارنة زمن التنفيذ الحوسبي لنموذج ML-HQNC والنماذج المنافسة. تم تسجيل النتائج كمتوسط ± الانحراف المعياري عبر خمس تجارب مستقلة (n = 5). تشير القيم الأقل إلى زمن تنفيذ حوسبي أقصر. يرجى النقر هنا لتحميل هذا الجدول.
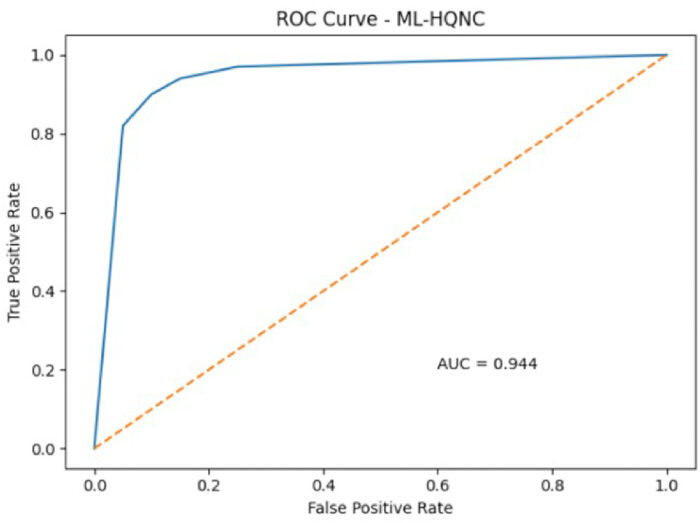
الشكل 10: مقارنة للمساحة تحت منحنى خصائص تشغيل المستقبل (AUC). مقارنة لقيم AUC التي حققها نموذج ML-HQNC والنماذج المنافسة لتحديد اهتمامات طلاب الهندسة. تتوافق قيم AUC المذكورة مع تشغيل تجريبي واحد؛ ولذلك، لم يتم عرض أشرطة الخطأ أو تحليلات الدلالة الإحصائية. يرجى النقر هنا لعرض نسخة أكبر من هذا الشكل.
الشكل التكميلي 1 يوضح مصفوفة الارتباط لمتغيرات سلوكية ممثلة. لوحظت ارتباطات إيجابية قوية بين Avg_Score و Course_Completion_Rate (0.81) وبين Attendance_Rate و Course_Completion_Rate (0.75). كما لوحظت ارتباطات متوسطة بين Avg_Score و Course_Completion (0.72) وبين Attendance_Rate و Time_Assignment_Percentage (0.74). وتلخص الشكلان التكميليان 2 و 3، إلى جانب الجدول 10، خرائط دقة التدريب والاختبار. حقق إطار عمل ML-HQNC المقترح دقة تدريب بلغت 96.1% ودقة اختبار بلغت 93.8%، متجاوزاً بذلك أداء طرق المقارنة. وتلخص الشكلان التكميليان 4 و 5، إلى جانب الجدول 11، تحليل التقارب. حقق إطار عمل ML-HQNC المقترح أدنى فقد في التدريب (0.21) وأدنى فقد في الاختبار (0.26)، مع تقارب مستقر طوال عملية التحسين.
يلخص الجدول 12 الأداء العام لإطار عمل ML-HQNC المقترح وطرق المقارنة عبر جميع مقاييس التقييم. وقد حقق إطار العمل المقترح أعلى أداء من حيث الدقة (Accuracy)، ودرجة F1 (F1-score)، والمساحة تحت المنحنى (AUC)، وIDP، وQPSI، وCDAG، بينما تطلب أقصر وقت حسابي بين الطرق التي تم تقييمها. ويعرض الجدول 13 تحليل الاستئصال لكل مكون من مكونات إطار العمل المقترح. وقد أدى الدمج التدريجي لمرحلة المعالجة المسبقة BCRIS، والتمثيل السلوكي QCSM، وخوارزمية اختيار الميزات QES-WOFS، ومصنف ML-HQNC الكامل إلى تحسينات تدريجية في أداء التصنيف، مما يثبت مساهمة كل مكون في إطار العمل العام.
الجدول 10: مقارنة دقة التدريب والاختبار. مقارنة بين دقة التدريب والاختبار التي حققها نموذج ML-HQNC والنماذج المنافسة. القيم المذكورة تتوافق مع تشغيل تجريبي واحد. يرجى النقر هنا لتحميل هذا الجدول.
الجدول 11: مقارنة فقدان التدريب والاختبار. مقارنة بين فقدان التدريب والاختبار الذي حققه نموذج ML-HQNC والنماذج المنافسة. تتوافق القيم المذكورة مع تشغيل تجريبي واحد. يرجى النقر هنا لتنزيل هذا الجدول.
الجدول 12: مقارنة الأداء العام.مقارنة بين نموذج ML-HQNC والنماذج المنافسة باستخدام مقاييس تقييم متعددة. يتم تقديم النتائج كمتوسط ± الانحراف المعياري عبر خمس تجارب مستقلة (n = 5). يرجى النقر هنا لتنزيل هذا الجدول.
توافر البيانات:
تتوفر مجموعة بيانات تقييم جودة التدريس الأصلية المستخدمة في هذه الدراسة بشكل عام من مستودع Kaggle عبر الرابط (https://www.kaggle.com/datasets/ziya07/teaching-quality-evaluation-dataset). قد يتطلب الوصول إلى مجموعة البيانات مصادقة المستخدم ويخضع لشروط استخدام Kaggle. ولدعم إمكانية إعادة الإنتاج مع الامتثال لشروط ترخيص مجموعة البيانات الأصلية، تم إيداع الموارد التي نتجت عن الدراسة—بما في ذلك مجموعة البيانات الاصطناعية، والشيفرة المصدرية، وملفات التنفيذ والتكوين، وأوصاف الميزات، وسير عمل المعالجة المسبقة، والوثائق الداعمة المطلوبة لإعادة إنتاج التجارب المذكورة—في مستودع Zenodo متاح للجميع: https://doi.org/10.5281/zenodo.21393413.
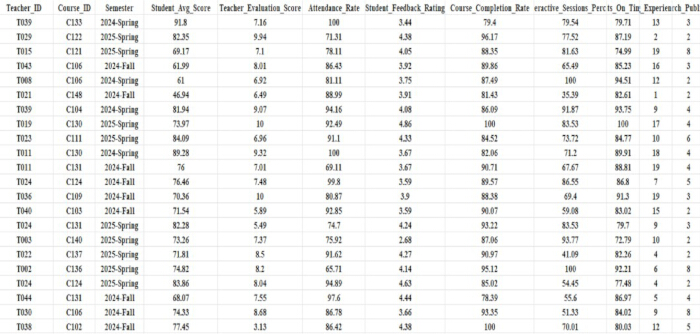
الشكل 3: مجموعة ميزات مجموعة بيانات تقييم جودة التدريس. هيكل وتكوين الميزات لمجموعة بيانات تقييم جودة التدريس المستخدمة لتحديد اهتمامات طلاب الهندسة. يرجى النقر هنا لعرض نسخة أكبر من هذا الشكل.
الشكل التكميلي 1: مصفوفة ارتباط الميزات. مصفوفة ارتباط توضح العلاقات الزوجية بين المتغيرات التعليمية والسلوكية التمثيلية المستخدمة في إطار عمل ML-HQNC المقترح. يرجى النقر هنا لتحميل هذا الملف.
الشكل التكميلي 2: مقارنة دقة التدريب. مقارنة لدقة التدريب التي حققها نموذج ML-HQNC والنماذج المنافسة خلال عملية التدريب. يرجى النقر هنا لتحميل هذا الملف.
الشكل التكميلي 3: مقارنة دقة الاختبار. مقارنة لدقة الاختبار التي حققها نموذج ML-HQNC والنماذج المنافسة خلال عملية الاختبار. يرجى النقر هنا لتنزيل هذا الملف.
الشكل التكميلي 4: تحليل فقدان التدريب. مقارنة بين فقدان التدريب الذي حققه نموذج ML-HQNC والنماذج المنافسة أثناء تحسين النموذج. يرجى النقر هنا لتنزيل هذا الملف.
الشكل التكميلي 5: تحليل خسارة الاختبار.مقارنة لخسارة الاختبار التي حققها نموذج ML-HQNC والنماذج المنافسة أثناء تقييم النموذج. يرجى النقر هنا لتحميل هذا الملف.
الجدول التكميلي 1: معاملات المحاكاة والإعدادات التجريبية. ملخص لمعاملات المحاكاة، وبيئة التنفيذ، وتقسيم مجموعة البيانات، والإعدادات التجريبية المستخدمة لتقييم إطار عمل ML-HQNC المقترح. يرجى النقر هنا لتنزيل هذا الملف.
الجدول التكميلي 2: نتائج التحقق من مرحلة المعالجة المسبقة باستخدام تحجيم المدى الربيعي القوي لـ Box–Cox (BCRIS). مقارنة لخصائص ممثلة لمجموعة البيانات قبل المعالجة المسبقة وبعدها، بما في ذلك القيم المفقودة، والسجلات المكررة، ومعالجة القيم المتطرفة، وتطبيع الميزات، واتساق البيانات. يرجى النقر هنا لتنزيل هذا الملف.
الجدول التكميلي 3: الميزات التمثيلية الناتجة عن نموذج الحالة المعرفية الكمي (QCSM). ميزات سلوكية تمثيلية ناتجة عن نموذج QCSM بعد المعالجة المسبقة للبيانات، بما في ذلك ميزات الحالة المعرفية، والمشاركة، وعدم اليقين، وانتقال الموضوع، واتساق السلوك. يرجى النقر هنا لتحميل هذا الملف.
الجدول التكميلي 4: الميزات التي تم اختيارها بواسطة خوارزمية اختيار الميزات القائمة على تحسين سرب الحيتان المعزز كمومياً (QES-WOFS). مجموعة الميزات النهائية التي تم اختيارها بواسطة خوارزمية QES-WOFS، إلى جانب فئات الميزات المقابلة، ومستويات التأثير النسبي، والأدوار الوظيفية ضمن الإطار المقترح. يرجى النقر هنا لتنزيل هذا الملف.
الجدول التكميلي 5: فئات التنبؤ بجودة التدريس. وصف لفئات التنبؤ والخصائص السلوكية التمثيلية المستخدمة في إطار عمل ML-HQNC المقترح. يرجى النقر هنا لتنزيل هذا الملف.
الجدول التكميلي 6: تحليل حساسية الهامش.ملخص لتحليل حساسية الهامش المستخدم أثناء تقييم النموذج. يرجى النقر هنا لتنزيل هذا الملف.
الملف التكميلي 1: الطرق التكميلية، والصياغات الرياضية، ومقاييس التقييم، والجداول التكميلية.يحتوي هذا الملف على صياغات رياضية مفصلة لكل من مقياس Box–Cox Robust IQR Scaling (BCRIS)، ونموذج الحالة المعرفية الكمومية Quantum Cognitive State Model (QCSM)، واختيار الميزات المعتمد على تحسين سرب الحيتان المعزز كمومياً Quantum-Enhanced Swarm–Whale Optimization Feature Selection (QES-WOFS)، والمصنف العصبي الهجين الكمومي-الكلاسيكي القائم على التعلم الميتا-تعلمي Meta-Learning Hybrid Quantum-Classical Neural Classifier (ML-HQNC) الموصوفة في البروتوكول الرئيسي. كما يتضمن تعريفات مقاييس التقييم، ومعلمات المحاكاة، والإعدادات التجريبية، والجداول التكميلية S1–S6 التي تدعم النتائج المعروضة في المخطوطة الرئيسية. يرجى النقر هنا لتنزيل هذا الملف.
المناقشة
أظهر إطار عمل ML-HQNC المقترح تحسناً في الأداء في تحديد اهتمامات طلاب الهندسة من خلال دمج النمذجة السلوكية المستوحاة من الكم، والاختيار التكيفي للميزات، والتعلم الفائق في سير عمل حوسبي موحد. وبالمقارنة مع Fast R-CNN وBi-LSTM وCNN وXGBoost، حقق إطار العمل باستمرار أداءً أعلى عبر مقاييس التصنيف التقليدية ومقاييس التقييم السلوكي المقترحة. وتشير هذه النتائج إلى أن الجمع بين تمثيل الحالة المعرفية المستوحى من الكم والتحسين التكيفي للميزات قد عزز قدرة إطار العمل على نمذجة السلوكيات التعليمية المعقدة مع الحفاظ على أداء تصنيف قوي. كما يشير وقت الحوسبة المنخفض والفرق الضئيل بين أداء التدريب والاختبار إلى استقرار في التحسين وقدرة جيدة على التعميم.
أكملت مقاييس التقييم المقترحة تدابير التصنيف التقليدية من خلال توفير معلومات إضافية حول النمذجة السلوكية. حيث قامت دقة كشف الاهتمام (IDP) بقياس دقة تحديد الاهتمام، وقام مؤشر استقرار النمط الكمي (QPSI) بتقييم استقرار التمثيلات السلوكية المستوحاة من الكم، بينما قام كسب القابلية للتكيف عبر المجالات (CDAG) بتقييم قدرة الإطار على التعميم عبر تقسيمات البيانات المختلفة. وقد وفرت هذه المقاييس مجتمعة تقييماً أوسع لأداء النموذج مما توفره مقاييس التنبؤ التقليدية وحدها.
أظهر تحليل الاستئصال لكل مكون على حدة (الجدول 13) بشكل أكبر مساهمة كل مرحلة من مراحل سير العمل المقترح. وقد أدى دمج مرحلة المعالجة المسبقة باستخدام قياس المدى الرباعي القوي لبوكس-كوكس (BCRIS) إلى تحسين اتساق البيانات من خلال تقليل تأثير القيم المتطرفة وتوليد تمثيلات ميزات معيارية. وقام نموذج الحالة المعرفية الكمومية (QCSM) بتحويل المتغيرات التعليمية متعددة الأبعاد إلى تمثيلات سلوكية تجسد حالة عدم اليقين، والمشاركة، وتفضيلات التعلم المتطورة. وبدورها، عملت عملية اختيار الميزات اللاحقة باستخدام خوارزمية اختيار الميزات المعتمدة على تحسين سرب الحيتان المعزز كموميًا (QES-WOFS) على تقليل تكرار الميزات مع الاحتفاظ بالخصائص السلوكية الغنية بالمعلومات. وأخيرًا، أدى دمج هذه المكونات ضمن مصنف الشبكة العصبية الكمومية والكلاسيكية الهجين للتعلم الميتافيزيقي (ML-HQNC) إلى تحسين أداء التصنيف والتعميم مقارنة بالنماذج المرجعية.
يهدف البروتوكول المقترح إلى تحديد اهتمامات الطلاب في الهندسة باستخدام بيانات تعليمية وسلوكية متعددة الأبعاد تم جمعها من بيئات التعلم الرقمية. يمكن لسير العمل الحسابي دعم التعلم المخصص، والإرشاد الأكاديمي، وتخطيط المناهج الدراسية، والإدارة التعليمية الذكية من خلال توفير نهج منهجي لتحليل سلوكيات تعلم الطلاب وتحديد الاهتمامات المتطورة. ويعد هذا الإطار مناسباً بشكل خاص لمجموعات البيانات التعليمية المهيكلة التي تحتوي على متغيرات سلوكية وأكاديمية وسياقية.
يعتمد التنفيذ الناجح على توفر بيانات تعليمية عالية الجودة وموارد حوسبية كافية. وقبل البدء في التحليل، يجب فحص مجموعات البيانات التعليمية للتأكد من خلوها من القيم المفقودة والسجلات المكررة والتناقضات، لأن جودة البيانات تؤثر بشكل مباشر على عمليات المعالجة المسبقة والنمذجة السلوكية اللاحقة. كما تعتمد التمثيلات المستقرة للميزات على المعالجة المسبقة المناسبة، وتحويل الميزات، وتحسين المعلمات الفائقة. وخلال تدريب النموذج، يجب مراقبة التقارب من خلال منحنيات فقدان التدريب والتحقق، كما ينبغي ضبط معاملات التحسين عند الضرورة للحفاظ على سلوك تعلم مستقر.
على الرغم من أن إطار العمل أظهر أداءً فعالاً باستخدام مجموعة البيانات التي تم تقييمها، إلا أنه يجب مراعاة عدة قيود. لقد تم التحقق من صحة البروتوكول باستخدام مجموعة بيانات تعليمية واحدة متاحة للعموم، وهناك حاجة إلى إجراء تقييم إضافي باستخدام مجموعات بيانات تعليمية أكبر وأكثر تنوعاً ومن مؤسسات متعددة لتقدير مدى إمكانية التعميم بشكل أكبر. بالإضافة إلى ذلك، يتطلب إطار التعلم الهجين المستوحى من الكم موارد حوسبية أكبر من مناهج التعلم الآلي التقليدية بسبب مكونات المعالجة المسبقة والتحسين والتعلم الهجين. كما يعتمد إطار العمل على بيانات تعليمية مشروحة جيداً، وقد يتأثر الأداء بمجموعات البيانات غير المكتملة أو المشوشة أو غير المتوازنة بشكل كبير.
سيركز العمل المستقبلي على توسيع نطاق الإطار ليشمل تحديداً أكثر دقة لاهتمامات الطلاب متعددة الفئات، ودمج أنماط إضافية من البيانات التعليمية مثل الملاحظات النصية، وسلوكيات التعلم الزمنية، وسجلات نشاط نظام إدارة التعلم في الوقت الفعلي، بالإضافة إلى تقييم البروتوكول عبر بيئات تعليمية هندسية متنوعة. كما قد يؤدي المزيد من التحسين في سير العمل الحسابي إلى تعزيز القابلية للتوسع وتسهيل النشر في أنظمة إدارة تعليمية واسعة النطاق.
باختصار، يوفر إطار عمل ML-HQNC المقترح سير عمل حوسبي قابل للتكرار لتحديد اهتمامات طلاب الهندسة باستخدام بيانات تعليمية متعددة الأبعاد. ومن خلال دمج المعالجة المسبقة القوية، والنمذجة السلوكية المستوحاة من الكم، والاختيار التكيفي للميزات، والتعلم العصبي الهجين الكمي-الكلاسيكي، حقق إطار العمل تحسناً في أداء التصنيف مع الحفاظ على استقرار التحسين وكفاءة الحوسبة. وتدعم هذه الخصائص إمكانية تطبيقه في التحليلات التعليمية الذكية وإدارة التعليم الهندسي.
الإفصاحات
يصرح المؤلف بعدم وجود تضارب في المصالح.
شكر وتقدير
يتوجه المؤلف بالشكر إلى جامعة Bengbu في Bengbu بالصين، لتوفير الدعم الأكاديمي والبيئة البحثية التي سهلت إجراء هذه الدراسة. تم دعم هذا العمل من خلال مشروع هندسة الجودة السنوي على مستوى المدرسة لعام 2025 بجامعة Bengbu (رقم 2025zhkc1).
المواد
| الاسم | الشركة | رقم فهرسي | التعليقات |
|---|---|---|---|
| النماذج المرجعية (Fast R-CNN, Bi-LSTM, CNN, XGBoost) | تنفيذات مفتوحة المصدر | Fast R-CNN (2015)؛ تنفيذ TensorFlow/Keras v2.16؛ XGBoost v2.1.1 | نماذج قياسية مستخدمة لتقييم الأداء المقارن. |
| وحدة معالجة BCRIS المسبقة | طُوّرت في هذه الدراسة | Version 1.0 | وحدة معالجة مسبقة مخصصة تطبق تحويل Box-Cox وتطبيع IQR القوي. |
| Jupyter Notebook | Project Jupyter | Version 7.2.2 | بيئة تطوير تفاعلية مستخدمة للتنفيذ والتدريب والاختبار. |
| مصنف ML-HQNC | طُوّر في هذه الدراسة | Version 1.0 | مصنف شبكة عصبية هجين كمومي-كلاسيكي مقترح مع إطار عمل للتعلم الميتا-معرفي. |
| Python | Python Software Foundation | Version 3.11.9 | لغة البرمجة المستخدمة لتطوير النماذج والتجريب. |
| PyTorch | PyTorch Foundation | Version 2.5.1 | إطار عمل للتعلم العميق مستخدم لتنفيذ النماذج وتدريبها. |
| نموذج QCSM | طُوّر في هذه الدراسة | Version 1.0 | نموذج الحالة المعرفية الكمومية المقترح لتمثيل الأنماط السلوكية. |
| خوارزمية QES-WOFS | طُوّرت في هذه الدراسة | Version 1.0 | خوارزمية اختيار الميزات المقترحة القائمة على تحسين سرب الحيتان المعزز كمومياً –. |
| Scikit-learn | Scikit-learn Developers | Version 1.6.1 | مكتبة تعلم آلي مستخدمة للمعالجة المسبقة واختيار الميزات والتقييم. |
المراجع
- Xu Q, Deng H. Research on education management system based on machine learning and multidimensional data modeling. Applied Mathematics and Nonlinear Sciences. 2024;9(1). https://dialnet.unirioja.es/servlet/articulo?codigo=9386765
- Li D. An interactive teaching evaluation system for preschool education in universities based on machine learning algorithm. Comput Hum Behav. 2024;157:108211. https://doi.org/10.1016/j.chb.2024.108211
- Chunhua H, Kaabar MKA, Qiuju X, Zhang G. Fuzzy comprehensive evaluation of students' classroom experience in online teaching. International Journal of Emerging Technologies in Learning. 2023;18(21):79-88.
- He Z, et al. Assessment of influencing factors of college and universities' teaching effects using fuzzy and deep learning techniques. Scientific Reports. 2026;16:5168. https://doi.org/10.1038/s41598-026-35940-5
- Liu J. Innovation and practice of educational management system in colleges and universities based on the concept of data analysis education. Applied Mathematics and Nonlinear Sciences. 2023;9(1). https://www.researchgate.net/publication/377568313
- Li C, Cao Z. Deep learning-based AI model for predicting academic success and engagement among physical higher education students. Scientific Reports. 2025;15:45471. https://doi.org/10.1038/s41598-025-29000-7
- Kong Y, Dong R, Zhang H. Classroom behavior analysis and digital teaching quality evaluation based on spatiotemporal graph neural network. Discover Artificial Intelligence. 2025;5:404. https://doi.org/10.1007/s44163-025-00623-z
- Zedan F, Jabali RR, Raiyn J. Detecting student inattention using deep learning and behavioral analysis. Journal of International Education Practice. 2026;9(1):1-17.
- Feng F. Deep learning-based model for analyzing student engagement in activities. Scientific Reports. 2025;16:2552. https://doi.org/10.1038/s41598-025-32521-w
- Turkmenbayev A, et al. The application of machine learning in predicting student performance in university engineering programs: A rapid review. Frontiers in Education. 2025;10:1562586. https://doi.org/10.3389/feduc.2025.1562586
- Albreiki B, Zaki N, Alashwal H. A systematic literature review of student performance prediction using machine learning techniques. Education Sciences. 2021;11(9):552. https://doi.org/10.3390/educsci11090552
- Lai Q. Research on the refinement of college student education management based on artificial intelligence. Discover Artificial Intelligence. 2026;6:31. https://doi.org/10.1007/s44163-025-00651-9
- Yuanyuan L, et al. Research on the application framework of intelligent technologies to promote teachers' classroom teaching behavior evaluation. Frontiers of Education in China. 2023;18(1):12–35. https://doi.org/10.3868/s110-008-023-0012-8
- Shi Y, Sun F, Zuo H, Peng F. Analysis of learning behavior characteristics and prediction of learning effect for improving college students' information literacy based on machine learning. IEEE Access. 2023;11:50447-50461.
- Liu S, Zhang J, Su W. An improved method of identifying learner's behaviors based on deep learning. Journal of Supercomputing. 2022;78(10):12861-12872.
- Yang J. Accurate prediction and analysis of college students' performance from online learning behavior data. IEIE Transactions on Smart Processing and Computing. 2023;12(3):404-411.
- Xie Y, Zhang S, Liu Y. Abnormal behavior recognition in classroom pose estimation of college students based on spatiotemporal representation learning. Traitement du Signal. 2021;38(6):1769-1778.
- Shen X, Yuan C. A college student behavior analysis and management method based on machine learning technology. Wireless Communications and Mobile Computing. 2021;2021:6611630. https://doi.org/10.1155/2021/6611630
- Li G, et al. A convolutional neural network-based approach for the recognition and evaluation of classroom teaching behavior. Scientific Programming. 2021;2021:5513886. https://doi.org/10.1155/2021/5513886
- Feng C, et al. IMRMB-Net: A lightweight student behavior recognition model for complex classroom scenarios. PLoS ONE. 2025;20(2):e0318817. https://doi.org/10.1371/journal.pone.0318817
- Zhang Y, Liu T, Ru B. Effect evaluation and student behavior design method of moral education in colleges and universities under the environment of deep learning. Scientific Programming. 2022;2022:6056117. https://doi.org/10.1155/2022/6056117
- Liu C, Wang H, Yuan Z. A method for predicting the academic performances of college students based on education system data. Mathematics. 2022;10(19):3737. https://doi.org/10.3390/math10193737
- Vora DR, Iyer KR. Deep learning in engineering education: performance prediction using cuckoo-based hybrid classification. In: Machine Learning and Deep Learning in Real-Time Applications. Studies in Computational Intelligence, Vol. 841, pp. 187-218. Springer; Singapore; 2020.
- Li H, Liu Z. An intelligent educational system: analyzing student behavior and academic performance using multi-source data. Electronics. 2024;14(16):3328. https://doi.org/10.3390/electronics14163328
- Zhang Y, Li J. Deep learning-based model for predicting student learning behavior: a pathway to early intervention and enhanced outcomes. Journal of Computational Methods in Sciences and Engineering. 2025;25(2):1169-1184.
- Jia Q, He J. Student behavior recognition in classroom based on deep learning. Applied Sciences. 2024;14(18):7981. https://doi.org/10.3390/app14187981
- Luo H. Prediction of student decision-making behaviour based on machine learning algorithms. Pakistan Journal of Life and Social Sciences. 2024;22(2):11045-11058.
- Abdi A, Sedrakyan G, Veldkamp B. Students' feedback analysis model using deep learning-based method and linguistic knowledge for intelligent educational systems. Soft Computing. 2023;27(38):14073-14094.
- Ning X. Behavior recognition of college students based on improved deep learning algorithm. International Journal of Web-Based Learning and Teaching Technologies. 2023;18(1):1-16.
- Sravya MN, Prashanth D, Saifa S, Reddy LS. A comprehensive analysis of learning behaviour characteristics and predictive modeling of learning outcomes to enhance college-level academic performance. International Journal of Pharmacy and Medical Sciences. 2025;5(2):94-100.
- Kalita E, et al. Predicting student academic performance using Bi-LSTM: a deep learning framework with SHAP-based interpretability and statistical validation. Frontiers in Education. 2025;10:1581247. https://doi.org/10.3389/feduc.2025.1581247
- Alias MAH, Hambali N, Aziz MAA. Feature selection techniques and classification algorithms for student performance classification: a review. International Journal of Electrical and Computer Engineering. 2024;14(3):3230-3242.
- Wang Z, et al. Students' classroom behavior detection system incorporating deformable DETR with Swin Transformer and lightweight feature pyramid network. Systems. 2023;11(7):372. https://doi.org/10.3390/systems11070372
- Zou X. Design of student behavior analysis and management system based on deep learning. International Journal of High Speed Electronics and Systems. 2024;33(1):2450005. https://doi.org/10.1142/S012915642450005X
- Zhang Q. The impact of machine learning-based student behaviour detection on teaching in classroom scenarios. Journal of Information and Knowledge Management. 2025;24(1):2450101. https://doi.org/10.1142/S021964922450101X
- Yu C, Wang Y. College student management system based on K-means clustering algorithm. Int J New Dev Educ. 2022;4(2):28-33.
- Chen J, Lu H. Evaluation method of classroom teaching effect under intelligent teaching mode. Mobile Networks and Applications. 2022;27(3):1262-1270.
- Han X, Chen X. The evaluation model of engineering practice teaching with complex network analytic hierarchy process based on deep learning. Scientific Reports. 2025;15:14733. https://doi.org/10.1038/s41598-025-14733-x
- Guo S, et al. The analysis of teaching quality evaluation for college sports dance by convolutional neural network model and deep learning. Heliyon. 2024;10(8):e36067. https://doi.org/10.1016/j.heliyon.2024.e36067
- Gao Y. Deep learning-based strategies for evaluating and enhancing university teaching quality. Computers and Education: Artificial Intelligence. 2025;8:100362. https://doi.org/10.1016/j.caeai.2025.100362
- Li Y, Lu B. Intelligent educational systems based on adaptive learning algorithms and multimodal behavior modeling. PeerJ Computer Science. 2025;11:e3157. https://doi.org/10.7717/peerj-cs.3157
- Geng F, John AD, Chinnappan CV. Analysis of the teaching quality using novel deep learning-based intelligent classroom teaching framework. Progress in Artificial Intelligence. 2023;12(2):147-162.
- Veluri RK, et al. Learning analytics using deep learning techniques for efficiently managing educational institutes. Materials Today: Proceedings. 2022;51(Part 8):2317-2320.
- Chen W, Min L. The evaluation model of physical education teaching performance based on deep learning algorithm. Scalable Computing: Practice and Experience. 2025;26(3):458-466.
- Zhang Y. A comprehensive evaluation system for physical education teaching effectiveness supported by multimodal machine learning. Discover Artificial Intelligence. 2026;6:75. https://doi.org/10.1007/s44163-026-00075-x
- Pei Y, Lu G. Design of an intelligent educational evaluation system using deep learning. IEEE Access. 2023;11:29790-29799.
- Ding J, Su Y. A teaching management system for physical education in colleges and universities using the theory of multiple intelligences and SVM. Soft Computing. 2024;28(2):685-701.
- Li Y, Zhang L, Tian Y, Qi W. Research on teaching practice of blended higher education based on deep learning route. Computational Intelligence and Neuroscience. 2022;2022:5751843. https://doi.org/10.1155/2022/5751843
- Jiang X, Du Y, Zheng Y. Evaluation of physical education teaching effect using Random Forest model under artificial intelligence. Heliyon. 2024;10(1):e23576. https://doi.org/10.1016/j.heliyon.2024.e23576
- Li S, Liu T. Performance prediction for higher education students using deep learning. Complexity. 2021;2021:6620684. https://doi.org/10.1155/2021/6620684
- Alnasyan B, Basheri M, Alassafi MO, Alnasyan K. Kanformer: An Attention-Enhanced Deep Learning Model for Predicting Student Performance in Virtual Learning Environments. Social Network Analysis and Mining. 2025;15:25. https://doi.org/10.1007/s13278-025-01446-7
- Lu Y, Tong L, Cheng Y. Advanced Knowledge Tracing: Incorporating Process Data and Curricula Information via an Attention-Based Framework for Accuracy and Interpretability. Journal of Educational Data Mining. 2024;16(2):58-84.