تنطوي اعتلال الكلية السكري (DN) على خلل في الوظائف الميتوكوندرية. وباستخدام علم النسخ، وعلم الصيدلة الشبكي، والتعلم الآلي، حددنا CAT و FABP1 و MAOA و MAOB كعلامات بيولوجية مرشحة مرتبطة بالميتوكوندريا لـ Ligustri Lucidi Fructus. وفي فئران db/db، عمل LLF على زيادة تنظيم CAT و MAOA، مما يدعم إجراء المزيد من الاستقصاءات الميكانيكية.
مقالة بحثية
تحديد المؤشرات الحيوية المرشحة المرتبطة بالميتوكوندريا لـ Ligustri Lucidi Fructus في اعتلال الكلية السكري
في هذه المقالة
ملخص
الملخص
يُعد خلل الوظائف الميتوكوندرية والإجهاد التأكسدي المفرط داخل الميتوكوندريا من العوامل المرضية الرئيسية التي تؤدي إلى إصابة الأنابيب الكلوية في اعتلال الكلية السكري (DN). ورغم أن ثمرة Ligustrum lucidum يُستخدم (LLF) تقليديًا لعلاج اعتلال الكلية السكري (DN)، إلا أن الآليات المعنية، وبخاصة تلك المتعلقة بالجينات والمسارات المرتبطة بالميتوكوندريا، لا تزال غير مفهومة بشكل كافٍ. استخدمت هذه الدراسة تحليل التعبير التفاضلي لمجموعة بيانات GSE142025 لتحديد الجينات ذات التعبير التفاضلي (DEGs) المرتبطة باعتلال الكلية السكري. تم اختيار الجينات المميزة من خلال المقارنة المرجعية لمخرجات أربعة نماذج من تعلم الآلة. ثم خضعت الجينات التي أظهرت تعبيراً تفاضلياً ملحوظاً وأنماط تعبير متسقة في كلتا مجموعتي البيانات لمزيد من التقييم باستخدام تحليل منحنى خصائص التشغيل للمستقبل (ROC). أما الجينات التي سجلت مساحة تحت المنحنى (AUC) > تم تحديد القيمة 0.7 في كلتا مجموعتي البيانات كعلامات بيولوجية مرشحة. وأُجريت تحليلات الإثراء الوظيفي، والارتشاح المناعي، وبناء الشبكات، والرسو الجزيئي. كما استُخدم نموذج فأر مصاب باعتلال الكلية السكري لتقييم غلوكوز الدم، والميكروألبومين البولي، وعلم الأمراض النسيجي، وتعبير العلامات البيولوجية المرشحة باستخدام تقنية RT-qPCR. تصوير مقطعي محوسب و MAOA ارتفعت مستويات تعبيرها بشكل ملحوظ في الجسم الحيوُجد إثراء للمؤشرات الحيوية المرشحة في المسارات المتعلقة بوظيفة الريبوسوم، وتحلل الفالين والليوسين والإيزوليوسين، والتفاعلات بين السيتوكينات ومستقبلات السيتوكينات، والبيروكسيسومات. وقد ارتبطت هذه المؤشرات ارتباطاً عكسياً مع الخلايا التائية CD8+ والخلايا الصارية المنشطة، وارتباطاً طردياً مع الخلايا القاتلة الطبيعية المنشطة والخلايا البائية الساذجة. وأظهر كل من التاكسيفولين، وبيتا-سيتوستيرول، والإريوديكتيول طاقات ارتباط أقل من -5 كيلوكالوري/مول مع المؤشرات الحيوية المرشحة. ويُعد CAT وMAOA من المرشحين الواعدين الذين يستحقون مزيداً من الاستقصاء الآلي.
المقدمة
يُعد اعتلال الكلية السكري (DN)، وهو السبب الرئيسي للفشل الكلوي في المرحلة النهائية في جميع أنحاء العالم، أحد أكثر مضاعفات داء السكري شيوعاً. ومن الناحية الباثولوجية، يتميز هذا المرض بتراكم مفرط للمادة الخلالية خارج الخلوية في كل من الحجيرات الكبيبية والأنبوبية، إلى جانب تسمك وتصلب الأوعية الدموية داخل الكلى2. وعادة ما يرتبط اعتلال الكلية السكري بالبيلة البروتينية وفرط ضغط الدم3. ويرتبط تطوره ارتباطاً وثيقاً بتلف الخلايا البطانية الوعائية، وتفاقم الاستجابة الالتهابية، وزيادة الإجهاد التأكسدي الناتج عن فرط سكر الدم لفترات طويلة4. كما ترتفع نسبة الإصابة باعتلال الكلية السكري عالمياً، خاصة بين مرضى السكري من متوسطي العمر وكبار السن. ومع تطور المرض، يمكن أن يؤدي ذلك إلى الفشل الكلوي في المرحلة النهائية وحتى إلى مضاعفات قلبية وعائية، مما يؤثر بشكل كبير على جودة حياة المرضى وإنذار حالتهم5. وعلى الرغم من التقدم في النهج التشخيصية والعلاجية لاعتلال الكلية السكري، لا تزال المؤشرات الحيوية المرشحة للتشخيص المبكر والدقيق بعيدة المنال، كما لا تزال استراتيجيات العلاج الفعالة لعكس العمليات الباثولوجية غائبة. ومن ثم، هناك حاجة ملحة لتطوير أدوية جديدة ومستهدفة مضادة لاعتلال الكلية السكري.
تعد المتقدرات (الميتوكوندريا) بالغة الأهمية في الطاقة الحيوية الخلوية، وتخليق السلائف الأيضية، والتوازن الكالسيومي، وإنتاج أنواع الأكسجين التفاعلية (ROS)، والإشارات المناعية، والموت الخلوي المبرمج، وهي جميعاً عمليات أساسية للحفاظ على استقرار الخلية والكائن الحي6. وباعتبارها مراكز الطاقة في الخلية، تلعب المتقدرات دوراً محورياً في عمليات أساسية مثل تحلل السكر، ودورة حمض التريكربوكسيليك، والفسفرة التأكسدية7. وتؤدي السمنة إلى اضطراب دورة كريبس وسلسلة التنفس المتقدرية، مما يؤدي إلى خلل وظيفي في المتقدرات وزيادة إنتاج ROS. ويمكن لمستويات ROS المرتفعة في سلسلة التنفس المتقدرية أن تحفز الإجهاد التأكسدي، مما يؤدي إلى تفاقم الاستجابة الالتهابية المرتبطة بالسمنة وتعزيز الموت الخلوي المبرمج8. وقد سلطت الأبحاث الحديثة الضوء على الدور الهام للخلل الوظيفي المتقدر في إمراض وتطور اعتلال الكلية السكري (DN)، بما في ذلك اضطرابات استقلاب الطاقة، والتوليد المفرط لـ ROS، وتزايد إشارات الموت الخلوي المبرمج9. كما يؤدي الخلل الوظيفي المتقدر المزمن إلى تسريع تطور أمراض الكلى10. وبالتالي، فإن تحسين وظائف المتقدرات قد يمثل استراتيجية وقائية حاسمة ضد اعتلال الكلية السكري.
Ligustri Lucidi Fructus (LLF) هي ثمار ناضجة ومجففة من فصيلة Luteaceae، وتشتهر بخصائصها المغذية للكبد والكلى، فضلاً عن قدرتها على تغميق لون الشعر وتحسين الرؤية. وقد تم تحديد نوع من عديد السكاريد غير المتجانس الموجود طبيعياً والمستخلص من LLF، مما كشف عن إمكاناته في حماية الكلى من التليف11. وفي السنوات الأخيرة، تزايد الاهتمام باستخدام LLF في علاج اعتلال الكلى السكري (DN)، حيث ظهرت تأثيرات ملحوظة في حماية الكلى11,12,13. علاوة على ذلك، تم بحث العلاقة المعقدة بين LLF والميتوكوندريا والتحقق منها على نطاق واسع. ومن الجدير بالذكر أن إحدى الدراسات أظهرت أن LLF يمارس تأثيراته المفيدة عن طريق تعديل وظيفة الميتوكوندريا من خلال تنشيط مسار إشارات AMPK14. وتحمي هذه الآلية الميتوكوندريا بفعالية من التلف الناتج عن الإجهاد التأكسدي. وتؤكد هذه النتائج بشكل أكبر على الدور الحيوي لـ LLF في الحفاظ على استقلاب الطاقة الخلوية وتحسين مرونة الخلايا تجاه الإجهاد التأكسدي. ومع ذلك، لا تزال الآلية العلاجية الدقيقة، خاصة فيما يتعلق باستعادة وظيفة الميتوكوندريا، غير مفهومة بشكل كافٍ.
كان الهدف من هذه الدراسة هو توضيح الآليات البيولوجية الكامنة وراء التأثير العلاجي لـ LLF على الوظيفة الميتوكندرية في حالة اعتلال الكلية السكري (DN). تم البحث في قواعد البيانات العامة باستخدام أدوات المعلوماتية الحيوية لتحديد المؤشرات الحيوية المرشحة المرتبطة بالتأثيرات الواقية للكلى لـ LLF، مع دمج بيانات النسخ المعلوماتي ومعلومات المكونات النشطة. وأشارت التحليلات الإضافية، بما في ذلك الارتشاح المناعي، والارتباط بالسمات السريرية، وتعديل m6A RNA، والإثراء الوظيفي، وبناء الشبكة التنظيمية، والرسو الجزيئي، إلى أن هذه المؤشرات الحيوية المرشحة تلعب دوراً محورياً في تنظيم الوظيفة الميتوكندرية أثناء علاج اعتلال الكلية السكري. وأكد التحقق In vivo أهميتها بشكل أكبر. يعمق هذا التحليل الشامل فهمنا للآليات التي يعالج بها LLF اعتلال الكلية السكري ويوفر أساساً متيناً لتطوير أهداف علاجية جديدة بناءً على الخلل الوظيفي الميتوكندري.
البروتوكول
جمع البيانات
تم استرجاع مصفوفة التعبير الجيني والبيانات السريرية المقابلة لها لمجموعات البيانات GSE142025 وGSE96804 المتعلقة بمرض اعتلال الكلية السكري (DN) من قاعدة بيانات Gene Expression Omnibus (GEO) عبر الرابط (https://www.ncbi.nlm.nih.gov/geo/)15. تضمنت مجموعة التدريب (GSE142025) عينات من أنسجة الكلى لـ 27 مريضاً مصاباً بـ DN وتسعة من مجموعة الضبط، والتي تم تسلسلها باستخدام منصة GPL20301. أما مجموعة التحقق (GSE96804) فاشتملت على بيانات تسلسل لـ 41 مريضاً بـ DN و20 من مجموعة الضبط، تمت معالجتها باستخدام منصة GPL17586. تركز كلتا المجموعتين على أنسجة الكلى؛ حيث تفحص مجموعة GSE96804 تحديداً الكبيبة الكلوية، وهي وحدة الترشيح الأساسية في الكلية (الشكل 1). وتتكون مجموعة GSE142025 (مجموعة التدريب) من عينات أنسجة الكلى الكاملة وتوفر نظرة عامة شاملة على المشهد الترانسكريبتومي لمرض DN. ومن ناحية أخرى، تركز مجموعة GSE96804 (مجموعة التحقق) تحديداً على أنسجة الكبيبات، والتي تعد الموقع الرئيسي لإصابة الترشيح الكبيبي. ونظراً لعدم دمج هاتين المجموعتين مباشرةً بسبب الاختلافات في المنصة والأنسجة، لم يتم تطبيق تصحيح تأثير الدفعة (batch effect correction)، وبدلاً من ذلك، تم إجراء التحقق المتقاطع بين مجموعات البيانات بشكل مستقل. وقد تم اختيار الجينات التي أظهرت تغيرات اتجاهية متسقة وكانت المساحة تحت المنحنى (AUC) لها أكبر من 0.7 في كلتا المجموعتين كمرشحات قوية، مما يدعم إمكانية التعميم عبر أقسام الكلى المختلفة.
تم استخراج ما مجموعه 1,136 من الجينات المرتبطة بالميتوكوندريا (MRGs) من قاعدة بيانات MitoCarta3.0 (https://www.broadinstitute.org/mitocarta). وتم التنبؤ بالمكونات النشطة لـ LLF باستخدام قاعدة بيانات فارماكولوجيا نظم الطب الصيني التقليدي (TCMSP) (http://sm.nwsuaf.edu.cn/lsp/tcmsp.php)، وذلك بناءً على عتبة توافر حيوي فموي (OB) تبلغ ≥30% وعتبة تشابه دوائي (DL) تبلغ ≥0.18. بعد ذلك، تم التنبؤ بالجينات المستهدفة المحتملة للمكونات النشطة باستخدام قاعدة بيانات Swiss Target Prediction (http://www.swisstargetprediction.ch/).
تحليل التعبير التفاضلي
أُجري تحليل التعبير التفاضلي لمجموعة البيانات GSE142025 (مرض الاعتلال العصبي السكري مقابل المجموعة الضابطة) باستخدام حزمة limma (الإصدار 3.54.1)، مع تحديد معايير الدلالة عند P.adj < 0.05 و |log2FoldChange| > 0.516. وتم تمثيل مخططات البركان والخرائط الحرارية بصرياً باستخدام حزمتي ggplot2 (الإصدار 3.3.6) و ComplexHeatmap (الإصدار 2.14.0) على التوالي17,18. ثم تم إجراء تقاطع بين الجينات ذات التعبير التفاضلي (DEGs)، والجينات المرتبطة بالتمثيل الغذائي (MRGs)، والجينات المستهدفة المحتملة للمكونات النشطة، وعُرِّفت الجينات المتداخلة بأنها الجينات المرشحة. وبُنيت الشبكة التي تربط بين المكونات النشطة والجينات المرشحة باستخدام برنامج Cytoscape (الإصدار 3.9.0)19.
تحليل الإثراء الوظيفي وبناء شبكة التفاعلات البروتينية-البروتينية (PPI)
أُجريت تحليلات إثراء الوجود الجيني (GO) وموسوعة كيوتو للجينات والجينومات (KEGG) للجينات المرشحة باستخدام حزمة clusterProfiler (الإصدار 4.6.2) لاستكشاف وظائفها البيولوجية ومسارات التأشير المرتبطة بها (P.adjust < 0.05). بعد ذلك، أُدخلت الجينات المرشحة في قاعدة بيانات STRING (https://cn.string-db.org/) لاسترجاع علاقات التفاعلات البروتينية-البروتينية (مستوى الثقة ≥ 0.4)، ثم تلا ذلك بناء شبكة PPI باستخدام برنامج Cytoscape (الإصدار 3.9.0)20.
تعلم الآلة
تم تنفيذ أربعة من خوارزميات تعلم الآلة، وهي الغابة العشوائية (RF)، والجيران الأقرب k (KNN)، والمربعات الصغرى الجزئية (PLS)، وآلة ناقلات الدعم ذات نواة الأساس الشعاعي (SVM)، باستخدام حزمة caret (الإصدار v6.0-93) بناءً على مجموعة بيانات GSE142025. استُخدمت الجينات المرشحة التي تم تحديدها في التحليل السابق كمتغيرات تنبؤية، واستُخدمت حالة المرض (DN أو المجموعة الضابطة) كمتغير نتيجة. بالنسبة لنموذج KNN، تم تنفيذ التحقق المتقاطع المكون من 10 طيات باستخدام دالة trainControl، مع ضبط tuneLength = 10. وتم ملاءمة نموذج RF باستخدام 20 شجرة (ntree = 20)؛ بينما تمت ملاءمة نموذجي PLS و SVM باستخدام الإعدادات المطبقة في سير عمل caret الأصلي.
تم تقييم توزيعات البواقي للنماذج باستخدام حزمة DALEX (v2.4.3). بعد ذلك، تم إجراء تقييم للمتغيرات استناداً إلى التبديل باستخدام دالة variable_importance في حزمة DALEX، مع تحديد جذر متوسط مربع الخطأ (RMSE) كدالة للخسارة. تمثل قيمة dropout_loss الناتجة قيمة RMSE التي تم الحصول عليها بعد تبديل المتغير المقابل21,22. وفي سير العمل التحليلي الأصلي، تم الاحتفاظ بالمتغيرات التي كانت قيمة dropout loss لها < 0.281 في جميع النماذج، وعُرِّفت الجينات المشتركة بين النماذج الأربعة جميعها على أنها جينات الميزات التوافقية (consensus feature genes) لغرض التحقق اللاحق.
استُخدمت نماذج تعلم الآلة الأربعة بشكل أساسي لتحديد أولويات الميزات بدلاً من بناء مصنف سريري نهائي. وبناءً على ذلك، تم تقييم التمييز التشخيصي لاحقاً على مستوى الجين الفردي باستخدام تحليل ROC في كل من مجموعتي بيانات الاكتشاف والتحقق.
تحديد المؤشرات الحيوية المرشحة
في مجموعتي البيانات GSE142025 وGSE96804، تم تقييم اختلافات التعبير في الجينات المميزة بين عينات اعتلال الكلية السكري (DN) والعينات الضابطة باستخدام اختبار ويلكوكسون. وقد تم اختيار الجينات التي أظهرت تعبيراً تفاضلياً معنوياً (P < 0.05) واتجاهات تعبير متوافقة عبر مجموعتي البيانات فقط لإجراء تحليل منحنى خصائص التشغيل للمستقبل (ROC). واستُخدمت حزمة pROC (الإصدار 1.18.0) لإنشاء منحنيات ROC وحساب المساحة تحت المنحنى (AUC)، حيث صُنفت الجينات التي أظهرت AUC > 0.7 في كلتا مجموعتي البيانات كمؤشرات حيوية مرشحة23.
تحليل إثراء مجموعة الجينات (GSEA)
تم استكشاف الوظائف البيولوجية ومسارات التأشير المرتبطة بالمؤشرات الحيوية المرشحة بشكل أكبر باستخدام تحليل إثراء مجموعة الجينات (GSEA) على مجموعة بيانات GSE142025. أولاً، أُجري تحليل ارتباط سبيرمان للمؤشرات الحيوية المرشحة مع جميع الجينات الأخرى باستخدام حزمة psych (الإصدار 2.2.9).24حُسبت معاملات الارتباط ورُتبت (من الأعلى إلى الأدنى). كانت مجموعة الجينات المرجعية هي c2.cp.kegg.v2023.1.Hs.symbols.gmt من قاعدة بيانات البصمات الجزيئية (MSigDB, https://www.gsea-msigdb.org/gsea/msigdb/). ثم أُجري تحليل إثراء مجموعة الجينات (GSEA) لتقييم إثراء الجينات المرتبة في مجموعة الجينات الخلفية باستخدام حزمة clusterProfiler (v4.6.2). كما طُبق تصحيح الاختبارات المتعددة. عن طريق طريقة معدل الاكتشاف الكاذب (FDR)، ومُعدلة P-القيم (يُرمز لها بـ P(adjust) واعتُبرت ذات دلالة إحصائية إذا كانت < 0.05.
تحليل تعديل M6A
للتحقيق في تعديلات مثيلة RNA للمؤشرات الحيوية المرشحة، تم استخدام قاعدة بيانات SRAMP (http://www.cuilab.cn/sramp/) للتنبؤ بمواقع تعديل m6A على المؤشرات الحيوية المرشحة، مع التركيز على المواقع ذات الموثوقية العالية ضمن هياكلها الثانوية. ثم استُخدمت قاعدة بيانات ENCORI (https://starbase.sysu.edu.cn/) لتحديد البروتينات المعدلة بـ m6A التي تتفاعل مع المؤشرات الحيوية المرشحة، باستخدام المعيار |HepG2 (shRNA)| > 1 لفحص البروتينات الرئيسية. بعد ذلك، استُخدمت قاعدة بيانات RPISeq (http://pridb.gdcb.iastate.edu/RPISeq/) للتنبؤ باحتمالية التفاعلات بين البروتينات الرئيسية والمؤشرات الحيوية المرشحة. تم رفع تسلسلات RNA لكليهما بتنسيق نصي بسيط لإنشاء درجات تنبؤ لمصنفات RF و SVM. واعتُبر التفاعل هاماً عندما تجاوزت الدرجة 0.525. أُجري تحليل SRAMP باستخدام عتبة "High" للتنبؤ بمواقع m6A، مع استخدام وضع "Transcript" والمعايير الافتراضية. واستخدم تحليل ENCORI وظيفة تفاعل "miRNA-mRNA" مع المعيار "HepG2 (shRNA)" > 1. أما تحليل RPISeq فقد استخدم مصنف RF بالمعايير الافتراضية؛ حيث أشارت الدرجات > 0.5 إلى وجود تفاعل إيجابي. هذه تنبؤات حاسوبية، وليست أدلة تجريبية على تعديل m6A أو تفاعلات RNA-protein في أنسجة الكلى. وقد اشتق معيار HepG2 shRNA من مجموعات البيانات المحسوبة مسبقاً في ENCORI وقد لا يعكس التنظيم الخاص بالكلى.
تحليل الارتشاح المناعي
طُبقت خوارزمية CIBERSORT لتقدير نسب 22 نوعاً من الخلايا المناعية في كل من عينات المجموعة الضابطة وعينات اعتلال الكلية السكري (DN) من مجموعة البيانات GSE142025، مع تمثيل النتائج بصرياً عبر خريطة حرارية تم إنشاؤها باستخدام حزمة ggplot2 (الإصدار 3.3.6).26تَمَّ تشغيل برنامج CIBERSORT باستخدام مصفوفة البصمة LM22، مع إجراء 1,000 تبديلة وتعطيل التسوية الكمية (كما هو موصى به لبيانات المصفوفات الدقيقة). أما العينات التي كانت قيمة p في برنامج CIBERSORT لها... < تم الاحتفاظ بـ 0.05 لإجراء مزيد من التحليل. يقدر برنامج CIBERSORT كسور الخلايا المناعية من تعبير أنسجة الكلى الكلية، وهو ما لا يمكنه تحليل الارتشاح الخاص بمقصورات معينة (على سبيل المثال، الكبيبي مقابل الأنبوبي الخلالي) ولا التمييز بين الكريات البيض المرتشحة والخلايا المناعية المقيمة. وبناءً على ذلك، فإن الارتباطات المسجلة هي على مستوى النسيج ويجب التحقق من صحتها باستخدام الطرق المكانية. كما أُجري تحليل ارتباط سبيرمان بين الخلايا المناعية ذات الوفرة المتباينة والمؤشرات الحيوية المرشحة باستخدام حزمة psych.
بناء الشبكات والالتحام الجزيئي
تم التنبؤ بجزيئات MicroRNAs (miRNAs) التي تتفاعل مع المؤشرات الحيوية المرشحة باستخدام قاعدة بيانات miRNet (https://www.mirnet.ca). بعد ذلك، تم التنبؤ بجزيئات RNAs غير المشفرة الطويلة (lncRNAs) التي تستهدف miRNAs المحددة من خلال قاعدتي بيانات TarBase (http://www.diana.pcbi.upenn.edu/tarbase) وstarbase (http://starbase.sysu.edu.cn/). وقد اختيرت جزيئات lncRNAs المشتركة بين قاعدتي البيانات لبناء الشبكة. ثم تم بناء شبكة تنظيمية من نوع lncRNA-miRNA-mRNA باستخدام برنامج Cytoscape. كما اختيرت المكونات النشطة المحتملة التي تستهدف المؤشرات الحيوية المرشحة لبناء شبكة مكون نشط-مؤشر حيوي. بالإضافة إلى ذلك، تم دمج المكونات النشطة والمؤشرات الحيوية المرشحة والمسارات المحددة في تحليل GSEA داخل برنامج Cytoscape لإنشاء شبكة مكون نشط-مؤشر حيوي-مسار.
أُجري تحليل الالتحام الجزيئي لتقييم ألفة الارتباط بين المكونات النشطة المحتملة والمؤشرات الحيوية المرشحة. تم الحصول على الهياكل ثلاثية الأبعاد لبروتينات المؤشرات الحيوية من بنك بيانات البروتينات التابع للمختبر التعاوني للأبحاث في المعلوماتية الحيوية الهيكلية (RCSB PDB, https://www.rscb.org/pdb) بصيغة ملفات PDB. كما استُرجعت الهياكل ثنائية الأبعاد للمكونات النشطة المحتملة بصيغة SDF من قاعدة بيانات PubChem (http://pubchem.ncbi.nlm.nih.gov). وقد نُفذ الالتحام الجزيئي باستخدام منصة CB-Dock (http://clab.labshare.cn/cb-dock/php/blinddock.php). وقد أشارت طاقة ارتباط أقل من -5 kcal/mol إلى وجود ألفة ارتباط قوية27.
تحضير وتوثيق Ligustri Lucidi Fructus
يشير مصطلح Ligustri Lucidi Fructus (LLF) هنا إلى الثمار الناضجة المجففة لنبات Ligustrum lucidum W. T. Aiton من فصيلة (Oleaceae). وقد تم توثيق المادة النباتية وفقاً لدستور الأدوية الصيني، وأودعت عينة توثيقية تحمل الأرقام 20240506، 20240911، 20241103 في جامعة شانشي للطب الصيني التقليدي.
لتحضير المغلي، نُقع 200 g من شرائح LLF المؤهلة في 1,000 mL من الماء المقطر لمدة 30 دقيقة في درجة حرارة الغرفة. غُلي الخليط بقوة ثم تُرِك يغلي بهدوء لمدة 60 دقيقة. جُمع الرشاحة، وأُعيد غلي المواد العشبية المتبقية مع 1,000 mL أخرى من الماء المقطر لمدة 60 دقيقة. جُمِعت الرشاحتان معاً، ثم رُشِحتا ووُضعتا في جهاز طرد مركزي، ورُكزتا تحت ضغط منخفض للحصول على تركيز نهائي للمخزون قدره 1 g من العقار الخام/mL (بحجم إجمالي 100 mL). حُفظ المغلي المُحضّر عند 4 °C للاستخدام قصير المدى أو عند −20 °C للحفظ طويل المدى. تُم تحديد جودة LLF ومغليه والتحقق منها بدقة وفقاً لمعايير دستور الأدوية الصيني لضمان موثوقية التجربة وقابلية تكرارها.
أُجري كروماتوغرافيا الطبقة الرقيقة للتحديد النوعي. وباختصار، تم طرد حجم مناسب من المغلي المُحضّر مركزياً، واستُخلص الراشح باستخدام الميثانول. وبعد الترشيح، وُضعت نقاط من محلول العينة ومحلول القياس المرجعي لمركب specnuezhenide على نفس لوح هلام السيليكا G. وبعد عملية الإظهار والتجفيف والفحص تحت الأشعة فوق البنفسجية، أظهرت بقعة محلول العينة لوناً وموقعاً متطابقين مع المركب المرجعي، مما أكد وجود المكون النشط بيولوجياً والمميز لـ LLF.
لأغراض مراقبة الجودة الكمية، تم إجراء الكشف باستخدام الكروماتوغرافيا السائلة عالية الأداء. أُجري التحليل باستخدام عمود C18 مع استخدام الميثانول والماء كطور متحرك. تم ضبط الطول الموجي للكشف عند 224 nm. كما تم تحديد محتوى specnuezhenide في المغلي بناءً على المنحنى القياسي. وأظهرت النتائج تركيباً كيميائياً مستقراً وموحداً للمغلي المُحضّر، مما يضمن اتساق جودة الدواء طوال فترة تجربة التدخل على الحيوانات.
التجارب على الحيوانات
تمت تربية اثني عشر فأراً ذكراً من سلالة db/db بدرجة SPF (بعمر 8-9 أسابيع) وستة فئران من سلالة db/m متطابقة في العمر في مرفق حيوانات SPF بجامعة شانشي للطب الصيني التقليدي. وقبل بدء التجارب، خضعت الحيوانات لفترة تأقلم لمدة 7 أيام تحت دورة إضاءة/ظلام مدتها 12 ساعة/12 ساعة، مع إتاحة الوصول إلى الغذاء والماء ad libitum. وقد تمت الموافقة على الدراسة من قبل لجنة الأخلاقيات بجامعة شانشي للطب الصيني التقليدي (رقم الموافقة 2022DW167). أما الحيوانات التي أظهرت فقداناً في وزن الجسم بنسبة >20%، أو حالة احتضار، أو عدم القدرة على الوصول إلى الغذاء أو الماء، فقد تم القتل الرحيم لها بطريقة إنسانية قبل نقطة النهاية المخطط لها للدراسة. وفي نهاية الدراسة، تم القتل الرحيم لجميع الفئران المتبقية عن طريق الحقن داخل الصفاق بـ pentobarbital sodium يليه خلع الرقبة وفقاً للبروتوكولات المؤسسية.
بعد فترة التأقلم، تم التأكد من إنشاء نموذج اعتلال الكلية السكري (DN) في فئران db/db من خلال قياس مستوى جلوكوز الدم في الوريد الذي وصل إلى ≥ 16 mmol/L ووجود بيلة ألبومينية دقيقة، وهو ما أشارت إليه نتيجة إيجابية لشريط اختبار الميكروألبومين في البول. وعقب نجاح إنشاء نموذج DN، تم تقسيم فئران db/db عشوائياً إلى مجموعتين (عدد = 6 لكل مجموعة): مجموعة نموذج DN (مجموعة DN) ومجموعة العلاج بـ LLF (مجموعة العلاج). بالإضافة إلى ذلك، تم استخدام فئران db/m (عدد = 6) كمجموعة ضابطة (مجموعة الضبط). تم اختيار الجرعة بناءً على دراسات ديناميكية دوائية سابقة لـ LLF في الجرذان المصابة بالسكري، وحُوِّلت إلى الجرعة المكافئة للبشر باستخدام تسوية مساحة سطح الجسم28. أُعطيت مجموعتا الضبط وDN ماءً مقطراً، بينما تلقت مجموعة العلاج 3.5 g/kg من LLF لمدة 8 أسابيع. وبعد 8 أسابيع من الإعطاء، تم القتل الرحيم لجميع الفئران لجمع المصل والبول وأنسجة الكلى لإجراء الاختبارات اللاحقة.
مؤشرات الدم والبول
تم تحليل مستويات جلوكوز المصل باستخدام محلل كيمياء حيوية الدم الأوتوماتيكي بالكامل. وقيس تركيز الميكروالبومين في البول وفقاً لتعليمات الطقم (الملف التكميلي 1).
الفحص الباثولوجي لأنسجة كلى الفئران
تمت معالجة أنسجة الكلى للفحص النسيجي المرضي. وبعد التثبيت في 4% paraformaldehyde، غُسلت الأنسجة، ثم جُففت، وطُمرت في البارافين، وقُطعت إلى شرائح. بعد ذلك، أُجري صبغ الهيماتوكسيلين والإيوسين (HE)، وفُحصت المقاطع المصبوغة تحت المجهر الضوئي لتقييم التغيرات الباثولوجية.
تفاعل البوليميراز المتسلسل الكمي بالنسخ العكسي (RT-qPCR)
استُخدم تقنية RT-qPCR لتحديد تعبير المؤشرات الحيوية المرشحة في أنسجة الكلى للفئران. تم استخلاص الحمض النووي الريبوزي (RNA) الكلي وفقاً لتعليمات الشركة المصنعة، وبعد ذلك تم تقييم تركيز وجودة RNA (الجدول 1). تم تخليق cDNA من RNA المستخلص باستخدام طقم تخليق cDNA. أجري التضخيم باستخدام أزواج البادئات المدرجة في الجدول 1، مع استخدام GAPDH كجين مرجعي. حُسبت مستويات التعبير النسبي باستخدام طريقة 2−ΔΔCt13,26.
التحليل الإحصائي
أجريت جميع التحاليل الإحصائية باستخدام برنامج R (الإصدار 4.2.2) إلى جانب البرامج المطلوبة للإجراءات التجريبية المقابلة. وما لم يُذكر خلاف ذلك، كانت جميع الاختبارات الإحصائية ثنائية الجانب، واعتُبرت الفروق ذات دلالة إحصائية عند P < 0.05. كما أُجري تحليل التعبير التفاضلي للترانسكريبتوم باستخدام حزمة limma. وعُرِّفت الجينات التي كانت قيمة P المعدلة لها < 0.05 وكان التغير اللوغاريتمي المطلق (log2fold change) أكبر من 0.5 على أنها جينات ذات تعبير تفاضلي.
لمقارنة تعبير الجينات المرشحة بين عينات مستقلة من مرض اعتلال الشبكية السكري (DN) والعينات الضابطة، استُخدمت اختبارات ويلكوكسون لمجموع الرتب غير المعلمية حيثما أشير إلى ذلك في سير العمل التحليلي الأصلي. كما تم تقييم الارتباطات بين المؤشرات الحيوية المرشحة وكسور الخلايا المناعية باستخدام ارتباط سبيرمان للرتب.
تُعرض البيانات التجريبية في صورة المتوسط الحسابي ± الانحراف المعياري (SD). أُجريت المقارنات بين المجموعات الحيوانية الثلاث المستقلة باستخدام تحليل التباين أحادي الاتجاه (one-way analysis of variance) عند استيفاء افتراضات التحليل المعلمي. وبالنسبة للمقارنات البعدية (post hoc comparisons)، استُخدم اختبار أقل فرق معنوي (least significant difference test) عندما كانت التباينات متجانسة، بينما استُخدم اختبار Dunnett's T3 عندما كانت التباينات غير متساوية. حُللت قياسات الديناميكا الدوائية عند الخط الأساسي وفي الأسبوع الثامن وعُرِضت بشكل منفصل؛ ولم يتم استخلاص أي استدلال بشأن التفاعل بين المجموعة والزمن. تتوفر نصوص R البرمجية والبيانات المصدرية المستخدمة في تحليلات المعلوماتية الحيوية والتعلم الآلي في الملف التكميلي 1.
النتائج
من أجل الاستقصاء المنهجي عن المؤشرات الحيوية المرشحة المحتملة المرتبطة بالميتوكوندريا لـ LLF في علاج DN، صممنا سير عمل تحليلي مكون من أربع مراحل (الشكل 1). في المرحلة الأولى، قمنا بدمج بيانات الترانسكريبتوم من مجموعة البيانات GSE142025 (مجموعة التدريب، الكلية بأكملها، n=36) وGSE96804 (مجموعة التحقق، الكبيبة، n = 61) مع 1,136 جيناً مرتبطاً بالميتوكوندريا من قاعدة بيانات MitoCarta 3.0 و517 هدفاً متوقعاً لـ 9 مكونات نشطة من قاعدة بيانات TCMSP. وقد أسفر تقاطع مجموعات الجينات الثلاث هذه عن 9 جينات مرشحة. في المرحلة الثانية، تم تطبيق أربعة نماذج للتعلم الآلي (RF وKNN وPLS وSVM) لتحديد أولويات الجينات الميزة باستخدام RMSE < 0.281 كحد فاصل. وأدى التحقق من صحة البيانات عبر المجموعات باستخدام تحليل ROC (حيث AUC > 0.7 في كلتا المجموعتين) إلى تحديد أربعة مؤشرات حيوية مرشحة هي: CAT وFABP1 وMAOB وMAOA. في المرحلة الثالثة، أجرينا تحليل GSEA لتحديد مسارات KEGG المخصبة، وتحليل الارتشاح المناعي باستخدام CIBERSORT، والتنبؤ بتعديلات m6A، وبنينا شبكات lncRNA-miRNA-mRNA، وشبكات المكون النشط-المؤشر الحيوي، وشبكات المكون النشط-المؤشر الحيوي-المسار، متبوعة بالالتحام الجزيئي. وفي المرحلة الرابعة، تم تقييم التأثيرات الديناميكية الدوائية لـ LLF والتغيرات في تعبير mRNA للمؤشرات الحيوية الأربعة المرشحة في نموذج فأر db/db المصاب بـ DN.
فحص الجينات المرشحة لـ LLF في علاج DN
في مجموعة بيانات GSE142025، تم تحديد 3,810 من الجينات المعبّر عنها تفاضلياً (DEGs) بين مجموعتي DN والمجموعة الضابطة، بما في ذلك 1,904 جين تم رفع تعبيرها و1,906 جين تم خفض تعبيرها (الشكل 2A,B). تم التنبؤ بثلاثة عشر مكوناً نشطاً من LLF باستخدام قاعدة بيانات TCMSP، وهي: beta-sitosterol، وkaempferol، وtaxifolin، وLucidumoside D، وLucidumoside D_qt، و(20S)-24-ene-3,20-diol-3-acetate، وeriodictyol، وsyringaresinol diglucoside_qt، وLucidusculine، وOlitoriside، وOlitoriside_qt، وluteolin، وquercetin (الجدول 2). لم يتنبأ أربعة مكونات نشطة—وهي Lucidumoside D_qt، و(20S)-24-ene-3,20-diol-3-acetate، وsyringaresinol diglucoside_qt، وOlitoriside_qt—بأي جينات مستهدفة محتملة، بينما تنبأت المكونات التسعة المتبقية بـ 517 جيناً مستهدفاً محتملاً. ومن خلال مطابقة 3,810 من الجينات المعبّر عنها تفاضلياً (DEGs)، و1,136 من الجينات ذات الصلة بالأمراض (MRGs)، و517 جيناً مستهدفاً محتملاً، تم تحديد تسعة جينات مرشحة وهي: GPX1، وBAX، وCASP8، وMAOA، وMAOB، وCAT، وAKR1B10، وALDH2، وFABP1 (الشكل 2C). وبناءً على ذلك، تم إنشاء شبكة تربط بين المكون النشط والجين المرشح (الشكل 2D). أظهرت هذه الجينات المرشحة التسعة إثراءً في 341 مصطلحاً من مصطلحات الوجود الجيني (GO)، بما في ذلك الاستجابة للمواد السامة، وعملية تقويض المركبات الهيدروكسيلية العضوية، وإزالة السموم الخلوية (الشكل 2E). بالإضافة إلى ذلك، ارتبطت هذه الجينات بـ 52 مساراً من مسارات KEGG، مثل استقلاب التربتوفان، ومسارات التحلل العصبي، واستقلاب الهيستيدين (الشكل 2F).
فحص المؤشرات الحيوية المرشحة لعلاج اعتلال الكلية السكري (DN) في فشل الرئة في المرحلة النهائية (LLF)
كشفت شبكة تفاعلات البروتين-بروتين (PPI) عن وجود سبع عُقد وثماني حواف، مع وجود تفاعلات بين MAOA و ALDH2 و MAOB و AKR1B10 (الشكل 3A). تم تحديد الجينات التي كانت قيم جذر متوسط مربع الخطأ (RMSE) لها أقل من 0.281 عبر أربعة نماذج لتعلم الآلة كجينات ميزة، وهي: CAT و MAOB و MAOA و BAX و FABP1 (الشكل 3B-E). وأظهر تحليل التعبير أن CAT و FABP1 و MAOB و MAOA كانت تختلف بشكل ملحوظ بين مجموعتي اعتلال الكلية السكري (DN) والمجموعة الضابطة، وكانت متسقة في كل من مجموعتي بيانات GSE142025 و GSE96804 (الشكل 3F,G). علاوة على ذلك، تجاوزت قيم المساحة تحت المنحنى (AUC) لهذه الجينات في تحليل منحنى خصائص تشغيل المستقبل (ROC) قيمة 0.7 في كلتا مجموعتي البيانات، مما يشير إلى أن هذه الجينات يمكنها التمييز بفعالية بين عينات اعتلال الكلية السكري والعينات الضابطة، وأنها يمكن أن تعمل كمؤشرات حيوية مرشحة لعلاج اعتلال الكلية السكري في فشل الرئة في المرحلة النهائية (الشكل 4A-H).
إثراء ملحوظ للمؤشرات الحيوية المرشحة في المسارات الالتهابية والمتعلقة بالمناعة
حدد تحليل GSEA أربعة مؤشرات حيوية مرشحة أظهرت إثراءً بارزاً في مسار إشارات الكيموكين وتفاعلات السيتوكين مع مستقبلات السيتوكين (الشكل 5A-D). ومن بين هذه المؤشرات، أظهر مسار إشارات البيروكسيداز ارتباطاً معنوياً بكل من CAT وMAOA وMAOB.
ارتباط المؤشرات الحيوية المرشحة بالخلايا المناعية
لوحظت فروق ملحوظة في تعبير تسعة أنواع من الخلايا المناعية-خلايا B الساذجة، والبلعميات M0، والبلعميات M1، والبلعميات M2، والخلايا الصارية المنشطة، وخلايا NK المنشطة، وخلايا T الذاكرة الراكنة CD4+، وخلايا T الساذجة CD4+، وخلايا T CD8+—بين عينات اعتلال الأعصاب السكري (DN) وعينات المجموعة الضابطة (P < 0.05) (الشكل 6A,B). وقد وجد ارتباط إيجابي معنوي (cor = 0.6) بين خلايا B الساذجة وخلايا NK المنشطة، بينما تم رصد ارتباط سلبي معنوي (cor = -0.69) بين خلايا B الساذجة والخلايا الصارية المنشطة (الشكل 6C). وأظهرت جميع المؤشرات الحيوية المرشحة ارتباطات سلبية قوية مع خلايا T CD8+ والخلايا الصارية المنشطة، وارتباطات إيجابية مع خلايا NK المنشطة وخلايا B الساذجة (الشكل 6D).
تفاعل بروتينات m6A المعدلة الرئيسية مع المؤشرات الحيوية المرشحة
يؤثر تعديل ميثيلة RNA من نوع m6A بشكل عميق على تخليق RNA واستقلابه، ويرتبط بنشوء العديد من الأمراض29. تظهر مواقع تعديل m6A في المؤشرات الحيوية المرشحة ومواقعها ذات الموثوقية العالية في البنى الثانوية في الشكل 7A-H. وكشف المزيد من التحليل أن بروتينات m6A المعدلة الرئيسية التي تتفاعل مع CAT تشمل AQR و RBM22، بينما تفاعل FABP1 مع كل من SF3A3 و AQR. ووجد أن MAOA يتفاعل مع IGF2BP3 و IGF2BP2، و MAOB مع TIA1 (الجدول 3).
تنبؤات ارتباط in silico إيجابية للتكسيفولين والبيتا-سيتوستيرول والإريوديكتيول في علاج LLF لمرض DN
في miRNet، تم التنبؤ بتفاعل CAT مع 24 من الـ miRNAs، بينما ارتبط FABP1 بخمسة من الـ miRNAs. بالإضافة إلى ذلك، ارتبط MAOB و MAOA بـ 29 و 26 من الـ miRNAs، على التوالي. ومن بين هذه، تم تحديد 23 من الـ lncRNAs في كل من قاعدتي بيانات TarBase و Starbase. بعد ذلك، تم بناء شبكة تنظيمية من lncRNA-miRNA-mRNA، تضمنت أربعة مؤشرات حيوية مرشحة، و 74 من الـ miRNAs، و 23 من الـ lncRNAs (الشكل 8A). وشملت المكونات النشطة المحتملة التي تستهدف المؤشرات الحيوية المرشحة كلاً من اللوتولين، والبيتا-سيتوستيرول، والإريوديكتيول، والكيمبفيرول، والكيرسيتين، والتكسيفولين (الشكل 8B). علاوة على ذلك، تم إنشاء شبكة من المكون النشط-المؤشر الحيوي-المسار بناءً على المكونات النشطة، والمؤشرات الحيوية المرشحة، وأبرز خمسة مسارات تم تحديدها في GSEA (الشكل 8C). على سبيل المثال، استهدف التكسيفولين CAT في مسار البيروكسيسوم. وكانت طاقات الارتباط بين CAT والتكسيفولين (-8.8 kcal/mol)، وبين FABP1 والبيتا-سيتوستيرول (-8.1 kcal/mol)، وبين MAOB والإريوديكتيول (-9.8 kcal/mol) جميعها أقل من -5 kcal/mol، مما يشير إلى وجود ألفة قوية بين هذه المؤشرات الحيوية المرشحة ومكوناتها النشطة المقابلة27. وقد تم تحديد التكسيفولين والبيتا-سيتوستيرول والإريوديكتيول كمكونات نشطة محتملة ذات تنبؤات ارتباط in silico إيجابية في علاج LLF لمرض DN (الشكل 8D-F). ومع ذلك، يتم تقديمها كمكونات متوقعة بناءً على قواعد البيانات وليس كوسائط نشطة بيولوجياً مؤكدة للتأثيرات الملحوظة in vivo.
التحقق من صحة المؤشرات الحيوية المرشحة في نموذج الفئران المصابة باعتلال الكلية السكري (DN)
التقييم الديناميكي الدوائي لـ LLF في علاج الفئران المصابة باعتلال الكلية السكري (DN)
خلال فترة الإعطاء، تمت مراقبة مستويات جلوكوز الدم والزلال البولي الدقيق في الفئران (الشكل 9A-D). وبالمقارنة مع مجموعة الضبط، ارتفعت مستويات جلوكوز الدم والزلال البولي الدقيق في مجموعة نموذج DN بشكل ملحوظ (P < 0.01)؛ وبالمقارنة مع مجموعة نموذج DN، انخفضت مستويات جلوكوز الدم لدى الفئران في مجموعة العلاج بشكل ملحوظ بعد 4 أسابيع من الإعطاء (P < 0.01)، كما انخفضت مستويات الزلال البولي الدقيق لدى الفئران في مجموعة العلاج بشكل ملحوظ بعد 8 أسابيع من الإعطاء (P < 0.05). وتشير هذه النتائج إلى أن LLF قد يكون مفيداً في علاج اعتلال الكلية السكري (DN).
التقييم الباثولوجي لـ LLF في علاج الفئران المصابة بـ DN
بعد صبغ HE، أظهرت مجموعة الضبط تراكيب كبيبية واضحة في أنسجة الكلى. وفي المقابل، أظهرت مجموعة نموذج DN تكثيفاً للنوى الكبيبية وفرطاً في التلون، بالإضافة إلى ارتشاح الخلايا الالتهابية حول الكبيبات، وذلك مقارنة بالمجموعة الطبيعية. وقد أدى العلاج بـ LLF إلى تحسين الضرر الباثولوجي في كلى فئران db/db (الشكل 9E).
تحليل RT-PCR للتعبير عن المؤشرات الحيوية المرشحة في فئران اعتلال الأعصاب السكري (DN)
بعد التأسيس الناجح لنموذج فئران اعتلال الأعصاب السكري وملاحظة تحسن ملحوظ في الأعراض مع العلاج بـ LLF، تم استخدام RT-qPCR لتحليل التغيرات في المؤشرات الحيوية المرشحة. وبالمقارنة مع مجموعة الضبط، أظهرت مجموعة DN انخفاضاً ملحوظاً في تعبير CAT وMAOA (P < 0.05 أو P < 0.001). وعلى العكس من ذلك، أظهرت مجموعة العلاج تعبيراً أعلى بشكل ملحوظ لـ CAT وMAOA مقارنة بمجموعة DN (P < 0.05). ومع ذلك، لم تُلاحظ فروق ذات دلالة إحصائية في تعبير MAOB وFABP1 بين المجموعات (الشكل 9F-I).
توفر البيانات
إن مجموعات بيانات التعبير الجيني التي تم تحليلها في هذه الدراسة متاحة للعموم عبر مستودع Gene Expression Omnibus (GEO) تحت أرقام الوصول GSE142025 وGSE96804. أما النصوص البرمجية لـ R المستخدمة في تحليلات المعلوماتية الحيوية، بالإضافة إلى البيانات المصدرية التجريبية (جلوكوز الدم، والميكروألبومين البولي، وبيانات RT-qPCR)، فهي متوفرة في الملف التكميلي 1. كما أن جميع قواعد البيانات والبرمجيات والموارد الإلكترونية الأخرى المستخدمة في هذه الدراسة مدرجة في جدول المواد.
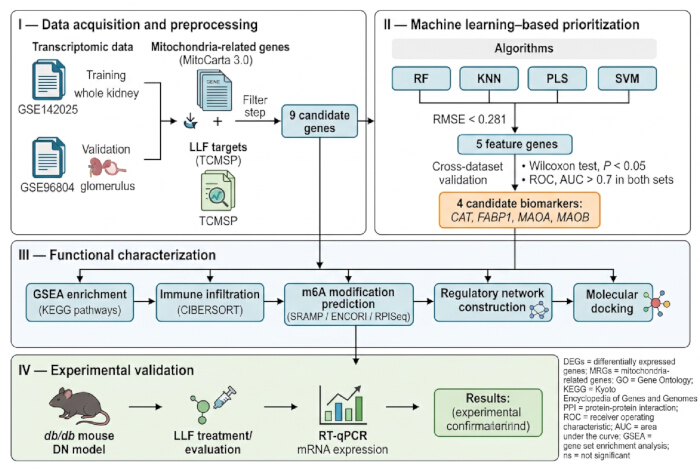
الشكل 1: سير عمل الدراسة. تم دمج مجموعات البيانات النسخية، والجينات المرتبطة بالميتوكوندريا، والأهداف المتوقعة لـ Ligustri Lucidi Fructus لتحديد الجينات المرشحة. ثم استُخدمت أربع خوارزميات للتعلم الآلي لإعطاء الأولوية للجينات الميزة، تلاها التحقق من صحة مجموعات البيانات المتقاطعة، والتوصيف الوظيفي، والتحقق التجريبي في فئران db/db. الاختصارات: DN = اعتلال الكلية السكري؛ DEGs = الجينات ذات التعبير التفاضلي؛ MRGs = الجينات المرتبطة بالميتوكوندريا؛ LLF = Ligustri Lucidi Fructus؛ RF = الغابة العشوائية؛ KNN = الجار الأقرب k؛ PLS = المربعات الصغرى الجزئية؛ SVM = آلة متجه الدعم؛ RMSE = جذر متوسط مربع الخطأ؛ GSEA = تحليل إثراء مجموعة الجينات؛ RT-qPCR = تفاعل البوليميراز المتسلسل الكمي في الوقت الحقيقي بعد النسخ العكسي. يرجى النقر هنا لعرض نسخة أكبر من هذا الشكل.
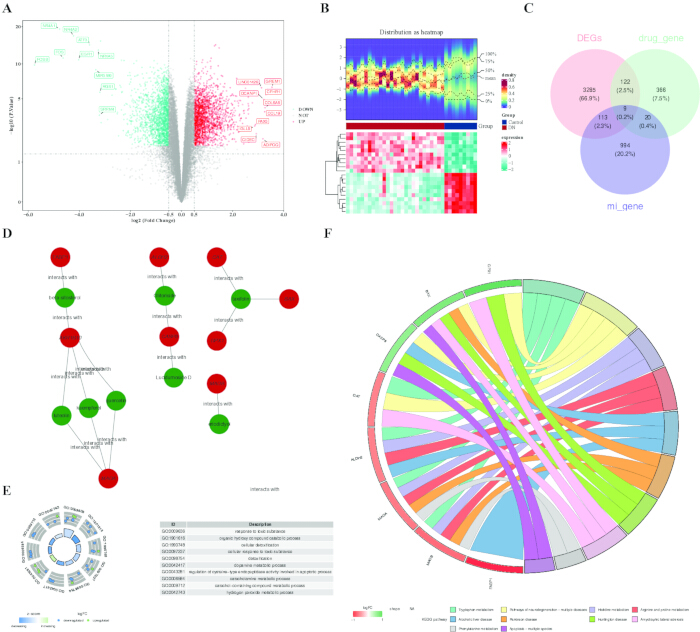
الشكل 2: فحص وتوصيف وظيفي للجينات المرشحة لعلاج DN باستخدام LLF. (A) مخطط بركاني يوضح الجينات ذات التعبير المتباين بين عينات DN والعينات الضابطة في GSE142025. (B) خريطة حرارية لأعلى 10 جينات ذات تعبير مرتفع وأعلى 10 جينات ذات تعبير منخفض مرتبة حسب |log2FC|. (C) مخطط فين يوضح التقاطع بين DEGs و MRGs والجينات المستهدفة المتوقعة لـ LLF. (D) شبكة المكون النشط والجينات المرشحة. (E) تحليل إثراء الوجود الجيني (Gene Ontology) للجينات المرشحة. يمثل ارتفاع العمود أهمية الإثراء، ويشير z-score إلى الاتجاه المتوقع للتنظيم الوظيفي. (F) تحليل إثراء مسارات موسوعة كيوتو للجينات والجينومات (KEGG) للجينات المرشحة. الاختصارات: DN = اعتلال الكلية السكري؛ LLF = Ligustri Lucidi Fructus؛ DEGs = الجينات ذات التعبير المتباين؛ MRGs = الجينات المرتبطة بالميتوكوندريا؛ GO = الوجود الجيني؛ KEGG = موسوعة كيوتو للجينات والجينومات. يرجى النقر هنا لعرض نسخة أكبر من هذا الشكل.
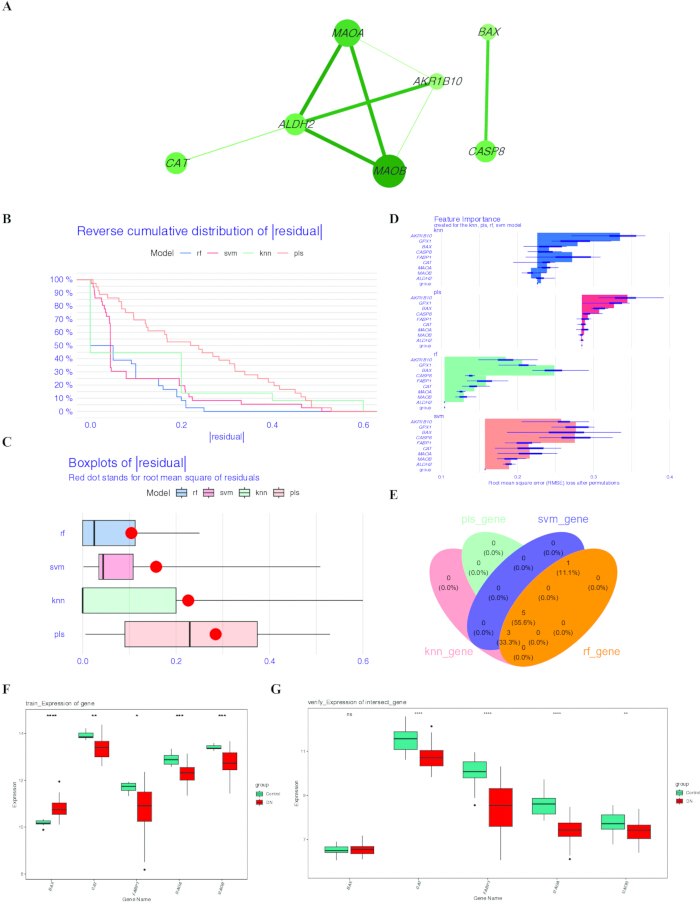
الشكل 3تحديد المؤشرات الحيوية المرشحة استناداً إلى تعلم الآلة. (Aشبكة تفاعل البروتين-بروتين للبروتينات التي تشفرها الجينات المرشحة.Bالتوزيع التراكمي العكسي للبواقي لنماذج RF وKNN وPLS وSVM.كربون) مخططات صندوقية توضح توزيعات البواقي للنماذج الأربعة؛ وتشير النقطة الحمراء إلى جذر متوسط مربع الخطأ. (د) أهمية الجينات المرشحة بناءً على جذر متوسط مربع الخطأ (RMSE) عبر نماذج تعلم الآلة الأربعة. (هـتقاطع الجينات الميزة التي تستوفي جذر متوسط مربع الخطأ (RMSE) < معيار قدره 0.281 عبر جميع النماذج الأربعة. (ف، ج) تعبير الجينات ذات السمات المختارة في GSE142025 وGSE96804، على التوالي. الاختصارات: RF = الغابة العشوائية؛ KNN = k-أقرب جار؛ PLS = المربعات الصغرى الجزئية؛ SVM = آلة المتجهات الداعمة؛ RMSE = جذر متوسط مربع الخطأ. يرجى النقر هنا لعرض نسخة أكبر من هذا الشكل.
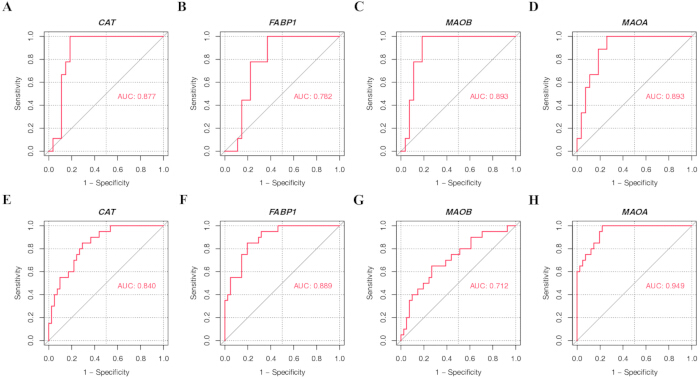
الشكل 4منحنيات خصائص تشغيل المستقبل للمؤشرات الحيوية المرشحة الأربعة. منحنيات خصائص تشغيل المستقبل (ROC) لكل من CAT وFABP1 وMAOB وMAOA في (أ-دمجموعة بيانات التدريب GSE142025 و(E-H) مجموعة بيانات التحقق GSE96804. تمثل AUC المساحة تحت منحنى خصائص تشغيل المستقبِل. الاختصارات: ROC = خصائص تشغيل المستقبِل؛ AUC = المساحة تحت المنحنى. يرجى النقر هنا لعرض نسخة أكبر من هذا الشكل.
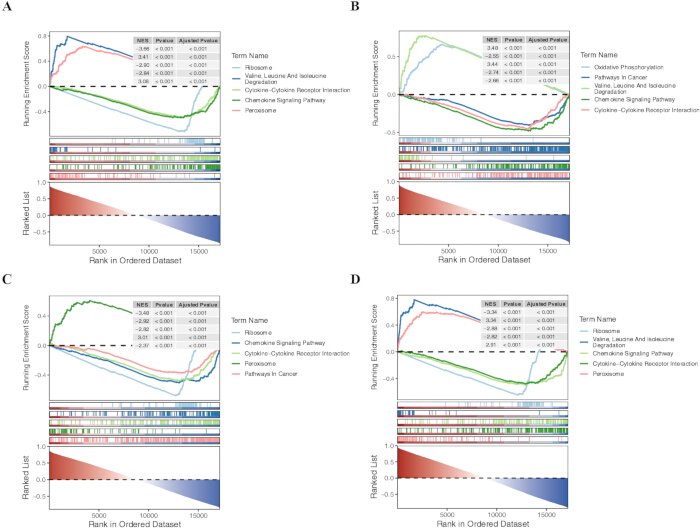
الشكل 5: تحليل إثراء مجموعة الجينات للمؤشرات الحيوية المرشحة. يوضح تحليل GSEA مسارات KEGG المثرية بشكل ملحوظ والمرتبطة بـ (A) CAT، و(B) FABP1، و(C) MAOA، و(D) MAOB في مجموعة بيانات GSE142025. الاختصارات: GSEA = تحليل إثراء مجموعة الجينات؛ KEGG = موسوعة كيوتو للجينات والأدوار الجينية. يرجى النقر هنا لعرض نسخة أكبر من هذا الشكل.
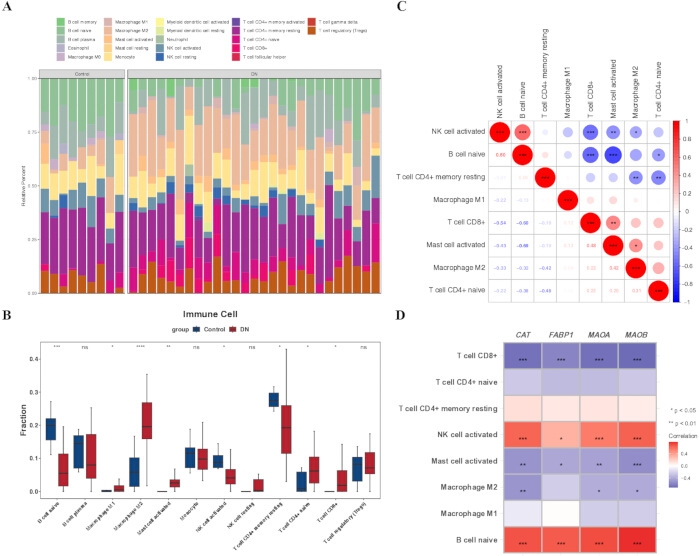
الشكل 6: ارتشاح الخلايا المناعية وعلاقته بالمؤشرات الحيوية المرشحة في مرض DN. (A) النسب النسبية لـ 22 نوعاً من الخلايا المناعية التي تم تقديرها بواسطة CIBERSORT في عينات DN وعينات المجموعة الضابطة. (B) مقارنة بين كسور الخلايا المناعية ذات الاختلاف المعنوي بين مجموعتي DN والمجموعة الضابطة. (C) مصفوفة الارتباط بين أنواع الخلايا المناعية ذات الوفرة المتباينة. (D) ارتباطات Spearman بين تعبير CAT و FABP1 و MAOA و MAOB وأنواع الخلايا المناعية ذات الوفرة المتباينة. الاختصارات: DN = اعتلال الكلية السكري. يرجى النقر هنا لعرض نسخة أكبر من هذا الشكل.
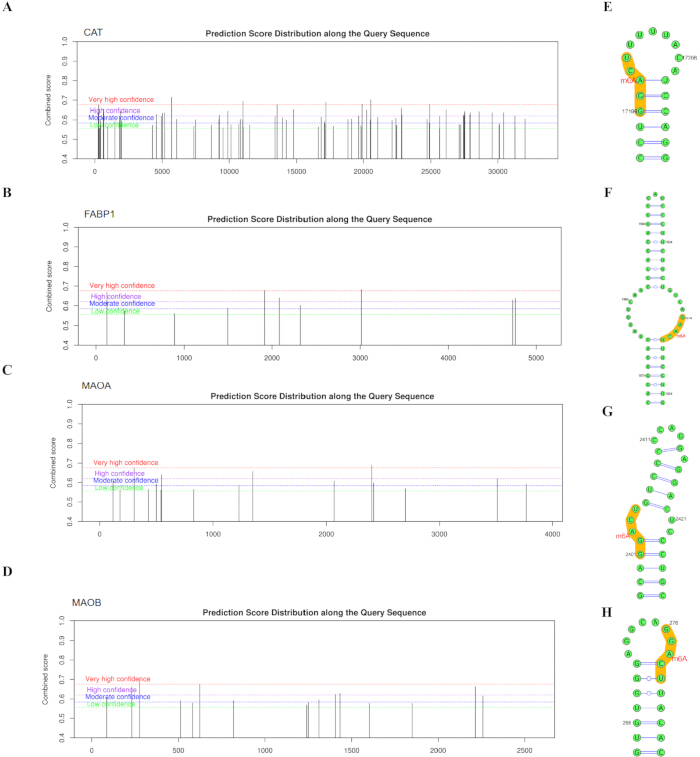
الشكل 7: مواقع تعديل m6A المتوقعة والبنى الثانوية لـ RNA لنسخ المؤشرات الحيوية المرشحة. مواقع تعديل m6A المتوقعة في (A) CAT، و(B) FABP1، و(C) MAOA، و(D) MAOB. البنى الثانوية المتوقعة لـ RNA والتي تظهر المناطق المرتبطة بـ m6A ذات الموثوقية العالية لـ (E) CAT، و(F) FABP1، و(G) MAOA، و(H) MAOB. تشير المناطق المظللة باللون الأصفر إلى مناطق التسلسل المتوقعة التي تحتوي على مواقع تعديل m6A. الاختصار: m6A = N6-methyladenosine. يرجى النقر هنا لعرض نسخة أكبر من هذا الشكل.
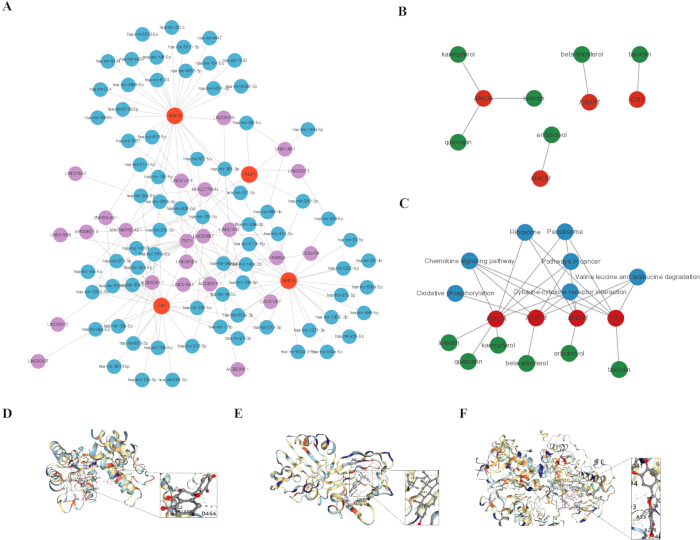
الشكل 8: الشبكات التنظيمية والرسو الجزيئي للمكونات النشطة المحتملة في LLF. (A) الشبكة التنظيمية المتوقعة لـ lncRNA–miRNA–mRNA التي تشمل المؤشرات الحيوية المرشحة. (B) شبكة المكونات النشطة المحتملة في LLF والمؤشرات الحيوية المرشحة. (C) شبكة المكون النشط–المؤشر الحيوي–المسار بناءً على نتائج GSEA. (D-F) هيئات الرسو الجزيئي المتوقعة لـ (D) CAT مع taxifolin، و (E) FABP1 مع beta-sitosterol، و (F) MAOB مع eriodictyol. الاختصارات: LLF = Ligustri Lucidi Fructus؛ lncRNA = الحمض النووي الريبوزي غير المشفر الطويل؛ miRNA = الحمض النووي الريبوزي الميكروي؛ GSEA = تحليل إثراء مجموعة الجينات. يرجى النقر هنا لعرض نسخة أكبر من هذا الشكل.
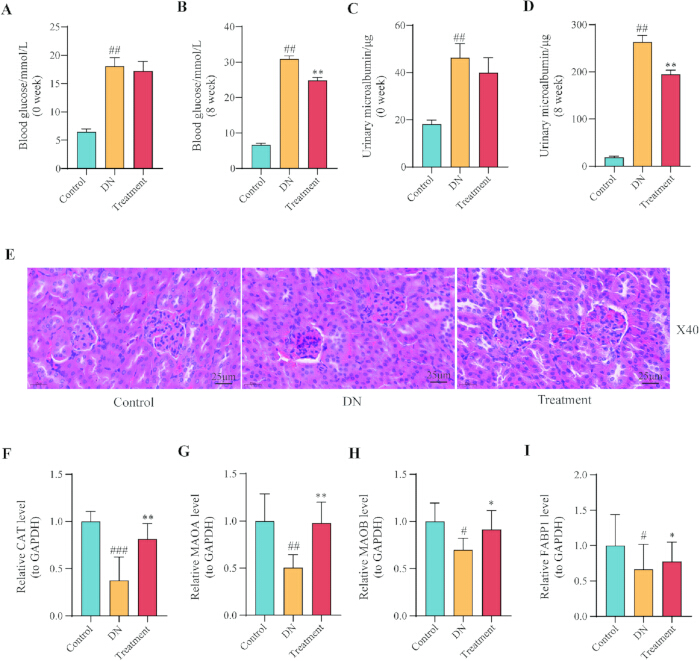
الشكل 9: تأثيرات العلاج بـ LLF على المؤشرات البيوكيميائية، والباثولوجيا النسيجية الكلوية، وتعبير المؤشرات الحيوية المرشحة في فئران db/db. (A,B) مستويات جلوكوز الدم عند خط الأساس وفي الأسبوع 8، على التوالي. (C,D) مستويات الميكروالبومين في البول عند خط الأساس وفي الأسبوع 8، على التوالي. (E) مقاطع ممثلة للكلى مصبوغة بالهيماتوكسيلين والإيوزين من مجموعات التحكم (Control)، واعتلال الكلية السكري (DN)، ومجموعات العلاج (Treatment) (التكبير، ×40؛ شريط المقياس = 25 µm). (F-I) مستويات تعبير mRNA الكلوية النسبية لكل من Cat و Maoa و Maob و Fabp1، على التوالي، مقاسة بواسطة RT-qPCR. #P < 0.05، و ##P < 0.01، و ###P < 0.001 مقارنة بمجموعة التحكم؛ *P < 0.05، و **P < 0.01، و ***P < 0.001 مقارنة بمجموعة DN. الاختصارات: LLF = Ligustri Lucidi Fructus؛ DN = اعتلال الكلية السكري؛ RT-qPCR = تفاعل البوليميراز المتسلسل الكمي بنسخ عكسي. يرجى النقر هنا لعرض نسخة أكبر من هذا الشكل.
| بادئ | التسلسلات |
| تصوير مقطعي محوسب ف | TCACTGACGAGATGGCACAC |
| تصوير مقطعي محوسب R | ATCGAACGGCAATAGGGGTC |
| FABP1 ف | CAATAGGTCTGCCCGAGGAC |
| بروتين ربط الأحماض الدهنية 1 (FABP1) R | GTCATGGTCTCCAGTTCGCA |
| مونوأمين أكسيديز ب (MAOB) ف | GCACTGAAACAGCCTCACAC |
| مونوأمين أكسيداز ب (MAOB) R | TCGTGCAGGGACATCCAAAG |
| أكسيداز أحادي الأمين أ (MAOA) ف | ACTTACCCATTCCGTGGTGC |
| أكسيداز أحادي الأمين أ (MAOA) R | ACCACAGGGCAGATACCTCA |
| M-GAPDH ف | CCTTCCGTGTTCCTACCCC |
| M-GAPDH R | GCCCAAGATGCCCTTCAGT |
الجدول 1: تسلسلات البادئات المستخدمة في تحليل RT-qPCR لأنسجة الكلى لدى الفئران. الاختصارات: F = بادئ أمامي؛ R = بادئ عكسي؛ RT-qPCR = تفاعل البوليميراز المتسلسل الكمي بالنسخ العكسي.
| معرف الجزيء | اسم الجزيء | OB (%) | تعلّم عميق | الرقم المستهدف |
| MOL000358 | بيتا-سيتوستيرول | 36.91 | 0.75 | 100 |
| MOL000422 | كامبفيرول | 41.88 | 0.24 | 103 |
| MOL004576 | تاكسيفولين | 57.84 | 0.27 | 92 |
| MOL005146 | لوسيدوموسيد دي (Lucidumoside D) | 48.87 | 0.71 | 104 |
| MOL005147 | لوسيدوموسايد D_qt | 54.41 | 0.47 | 0 |
| MOL005169 | (20S)-24-ene-3,20-diol-3-acetate | 40.23 | 0.82 | 0 |
| MOL005190 | إريوديكتيول | 71.79 | 0.24 | 101 |
| MOL005195 | سيرينجريسينول ديجلوكوزيد_qt | 83.12 | 0.8 | 0 |
| MOL005209 | لوسيدوسكولين | 30.11 | 0.75 | 105 |
| MOL005211 | أوليتوريسيد | 65.45 | 0.23 | 100 |
| MOL005212 | أوليتوريسيد_qt | 103.23 | 0.78 | 0 |
| MOL000006 | لوتيولين | 36.16 | 0.25 | 102 |
| MOL000098 | كيرسيتين | 46.43 | 0.28 | 103 |
الجدول 2: ثلاثة عشر مكوناً نشطاً من Ligustri Lucidi Fructus تم تحديدها باستخدام قاعدة بيانات TCMSP. الاختصارات: OB = التوافر الحيوي الفموي؛ DL = التشابه الدوائي.
| حمض رنا المرسال | بروتين | تردد راديوي | آلة المتجهات الداعمة |
| تصوير مقطعي محوسب | AQR | 0.7 | 0.98 |
| تصوير مقطعي محوسب | RBM22 | 0.8 | 0.97 |
| FABP1 | إيه كيو آر (AQR) | 0.65 | 0.94 |
| FABP1 | SF3A3 | 0.7 | 0.8 |
| MAOA | IGF2BP2 | 0.75 | 0.97 |
| MAOA | IGF2BP3 | 0.75 | 0.97 |
| مونوأمين أكسيداز ب (MAOB) | TIA1 | 0.85 | 0.89 |
الجدول 3: التفاعلات المتوقعة بين أربعة من mRNAs للمؤشرات الحيوية الميتوكوندرية والبروتينات الرابطة للحمض النووي الريبي (RNA) المرتبطة بـ m6A. تشير CAT وFABP1 وMAOA وMAOB إلى الحمض النووي الريبوزي المرسال (mRNA) للمؤشرات الحيوية البشرية؛ بينما تشير AQR وRBM22 وSF3A3 وIGF2BP2 وIGF2BP3 وTIA1 إلى البروتينات الرابطة للحمض النووي الريبوزي (RNA). درجات RF وSVM > يشير 0.5 إلى تفاعلات الحمض النووي الريبي والبروتين المتوقعة. الاختصارات: RF = الغابة العشوائية؛ SVM = آلة ناقلات الدعم.
الملف التكميلي 1. البرمجيات المعلوماتية الحيوية والبيانات المصدرية التجريبية. يحتوي هذا الأرشيف على برمجيات R المستخدمة في معالجة البيانات، وتحليل التعبير التفاضلي، والإثراء الوظيفي، والتعلم الآلي، وتحليل خصائص منحنى التشغيل للمستقبل، وتحليل إثراء مجموعة الجينات، وتحليل ارتباط سبيرمان، وتحليل CIBERSORT لارتشاح الخلايا المناعية، بالإضافة إلى البيانات المصدرية لتجارب جلوكوز الدم، والميكروألبومين في البول، وتجارب RT-qPCR. يرجى النقر هنا لتحميل هذا الملف.
المناقشة
يُعد LLF من الأدوية الصينية التقليدية شائعة الاستخدام، ويُوظف بشكل أساسي لتغذية الكبد والكلى وعلاج داء السكري ومضاعفاته. في الوقت الحالي، لا توجد أدوية أو علاجات محددة لاعتلال الكلية السكري (DN)، ويعتمد تدبيره بشكل أساسي على العلاجات الخافضة لسكر الدم، والخافضة للدهون، والخافضة لضغط الدم30,31,32. ومع ذلك، يمكن لهذه العلاجات أن تبطئ فقط من تطور التلف الكلوي لدى نسبة صغيرة من المرضى33. وقد ثبت أن LLF يمارس تأثيرات واقية للكلى في نماذج الجرذان المصابة باعتلال الكلية السكري عن طريق تصحيح اضطرابات استقلاب الجلوكوز والدهون وتخفيف الإجهاد التأكسدي34. والجدير بالذكر أنه نظرًا لأن الكلية عضو يحتوي على محتوى عالٍ جدًا من الميتوكوندريا واستهلاك أكسجين مرتفع، فإن ديناميكيات الميتوكوندريا غير الطبيعية في الكلية تلعب دورًا محوريًا في إمراضية اعتلال الكلية السكري35. تكشف هذه الدراسة عن آلية جديدة يمكن من خلالها لـ LLF أن يؤثر على وظيفة الميتوكوندريا عبر مؤشرات حيوية مرشحة محددة (CAT وFABP1 وMAOB وMAOA) في علاج اعتلال الكلية السكري.
أشارت الدراسات السابقة إلى أن الكاتالاز (CAT)، والبروتين الرابط للأحماض الدهنية 1 (FABP1)، وأكسيداز أحادي الأمين B (MAOB)، وأكسيداز أحادي الأمين A (MAOA) متورطة في اعتلال الكلية السكري (DN) بدرجات متفاوتة. يشارك CAT في نظام الدفاع المضاد للأكسدة، مما يحمي الكلية من التلف الناجم عن الإجهاد التأكسدي36. ويساهم CAT، وهو إنزيم مضاد للأكسدة أساسي في الجسم، في تنظيم حدوث وتطور اعتلال الكلية السكري عن طريق تعديل العمليات الفسيولوجية المرتبطة بالميتوكوندريا37. يقوم CAT على وجه التحديد بتحفيز تفكك بيروكسيد الهيدروجين (H₂O₂) إلى ماء وأكسجين، مما يعمل على إزالة أنواع الأكسجين التفاعلية (ROS) المنبعثة من الميتوكوندريا بشكل فعال. وهذا يقلل من التلف الناجم عن الإجهاد التأكسدي في بنية الميتوكوندريا ووظيفتها، ويحافظ على استقرار جهد غشاء الميتوكوندريا وكفاءة الفسفرة التأكسدية، مما يخفف من إصابة الخلايا الكلوية الناجمة عن ارتفاع الجلوكوز ويؤخر تطور اعتلال الكلية السكري38. علاوة على ذلك، يؤدي انخفاض تعبير CAT إلى عدم كفاية إزالة أنواع الأكسجين التفاعلية في الميتوكوندريا، مما يفاقم تفتت الميتوكوندريا وتمزق الأعراف. وهذا يثبط اندماج الميتوكوندريا بينما يعزز انشطارها، مما يزيد من زعزعة استقرار ديناميكيات الميتوكوندريا. ونتيجة لذلك، تصاب الخلايا الذاتية مثل الخلايا الميزانجية والخلايا القدمية باضطرابات أيضية، مما يسرع من تليف الأنسجة الكلوية39.
FABP1, باعتباره أحد أعضاء عائلة البروتينات الرابطة للأحماض الدهنية، يشارك بشكل أساسي في نقل واستقلاب ونقل الإشارات الخلوية للأحماض الدهنية طويلة السلسلة. وقد ثبت أن تعبيره غير الطبيعي يرتبط ارتباطاً وثيقاً بمختلف الأمراض الاستقلابية والإصابات الكلوية، حيث يلعب دوراً تنظيمياً حاسماً في تطور وتفاقم اعتلال الكلية السكري (DN)40. وتشير الأبحاث إلى أن FABP1 ينظم تطور اعتلال الكلية السكري عن طريق تعطيل استقلاب الدهون. ففي حالات السكري، يؤدي التعبير غير الطبيعي لـ FABP1 إلى اختلال نقل واستقلاب الأحماض الدهنية، مما يؤدي إلى تراكم الأحماض الدهنية الحرة ونواتج استقلابها في الأنسجة الكلوية، وهو ما يسبب ضرراً مباشراً للخلايا البطانية الكبيبية والخلايا الظهارية النبيبية، مما يفاقم الالتهابات والتليف الكلوي41. وبالتزامن مع ذلك، يزيد FABP1 من إصابة الأنسجة الكلوية عن طريق التوسط في الإجهاد التأكسدي والضرر الناجم عن نقص الأكسجة. وقد يزداد إفرازه في البول قبل ظهور مستويات غير طبيعية لألبومين البول، مما يوفر هدفاً جديداً للفحص والتشخيص المبكر لاعتلال الكلية السكري41,42. علاوة على ذلك، يلعب FABP1 دوراً تنظيمياً مركزياً في استقلاب الأحماض الدهنية داخل الميتوكوندريا43. وتشير الدراسات إلى أن زيادة تنظيم FABP1 تعزز بشكل كبير كفاءة نقل الأحماض الدهنية إلى الميتوكوندريا، وتزيد من نشاط أكسدة بيتا (β-oxidation) في الميتوكوندريا ونشاط إنزيمات دورة حمض ثلاثي الكربوكسيل، مما يحسن استقلاب الطاقة الخلوية44. ومع ذلك، لا تزال الآلية التي يؤثر بها FABP1 على نشوء اعتلال الكلية السكري من خلال مشاركته في العمليات المرتبطة بالميتوكوندريا غير واضحة. وفي حالات أخرى مرتبطة باعتلال الكلية السكري، ارتبط كل من MAOB و MAOA، بصفتهما إنزيمات تشارك في استقلاب الناقلات العصبية، بتطور اعتلال الكلية السكري، مما يساهم في اختلال حالة الأكسدة والاختزال في الأنسجة. وتؤكد هذه الدراسة بشكل أكبر الدور المحوري لهذه المؤشرات الحيوية المرشحة الأربعة في اعتلال الكلية السكري، حيث تنخفض مستويات تعبيرها في مجموعة اعتلال الكلية السكري. ويُفترض أن تعديل تعبير هذه المؤشرات الحيوية المرشحة قد يساعد في تقليل الالتهاب والإجهاد التأكسدي في اعتلال الكلية السكري.
بناءً على تحليل إثراء GSEA، تبين أن أربعة مؤشرات حيوية مرشحة—وهي CAT وFABP1 وMAOB وMAOA—كانت مُثراة في مسارات متعددة، بما في ذلك مسار إشارات الكيموكين، والتفاعل بين السيتوكين ومستقبل السيتوكين، ومسارات البيروكسيسوم. تُعد الكيموكينات مكونات رئيسية في الاستجابة المناعية التي تعزز الالتهاب. ويرتبط مسار البيروكسيداز (POD) بالإجهاد التأكسدي45. وقد أُفيد بأن مادة البايكالين تخفف من اعتلال الكلية السكري (DN) عن طريق تقليل الإجهاد التأكسدي والالتهاب، حيث قد تتضمن آليتها تنشيط مسار إشارات مضادات الأكسدة بوساطة NrF2 وتثبيط المسار الالتهابي بوساطة MAPK45. علاوة على ذلك، قد يساهم خلل تنظيم FABP1 في استقلاب الدهون في حدوث تصلب الكبيبات والتليف الخلالي في اعتلال الكلية السكري9. وتشير هذه النتائج إلى أن المؤشرات الحيوية المرشحة تلعب دوراً حاسماً في عمليات الالتهاب والإجهاد التأكسدي في اعتلال الكلية السكري. ومن شأن استهداف هذه المؤشرات الحيوية المرشحة لتعديل المسارات التي تؤثر عليها أن يقلل من الالتهاب والإجهاد التأكسدي المرتبطين باعتلال الكلية السكري، مما يؤدي بالتالي إلى تخفيف تطور المرض.
أظهر تحليل المعلوماتية الحيوية أن مستويات تسلل المجموعات الفرعية المناعية، مثل خلايا CD8+ T، في أنسجة الكلى المصابة باعتلال الكلية السكري (DN) قد تغيرت بشكل ملحوظ، وكان الارتفاع في خلايا CD8+ T مرتبطاً بشكل عكسي ومعنوي بالتعبير عن أربعة مؤشرات حيوية مرشحة مرتبطة بالميتوكوندريا (CAT, FABP1, MAOB, MAOA). وتتفق هذه التنبؤات الحاسوبية مع نتائج الملاحظات الباثولوجية للتجارب الحيوانية: حيث أظهرت مقاطع صبغة HE لكلى الفئران في مجموعة نموذج DN تسللاً واضحاً للخلايا الالتهابية حول الكبيبات؛ وبعد التدخل باستخدام LLF، انخفض تسلل الخلايا الالتهابية الكلوية في مجموعة العلاج بشكل ملحوظ، وتحسن الضرر الباثولوجي. يشير هذا إلى أن زيادة تسلل الخلايا الالتهابية هي سمة رئيسية لإصابة الكلى في اعتلال الكلية السكري، وقد يلعب LLF دوراً وقائياً من خلال تنظيم التسلل المناعي. وتتوافق هذه النتيجة مع الدراسات السابقة: حيث يرتبط تسلل خلايا CD8+ T بتطور اعتلال الكلية السكري، ويمكن أن يؤدي تثبيط استجابتها إلى تخفيف المرض46، وهو ما يفاقم أيضاً الإصابة الكلوية في اعتلال الكلية الناجم عن Adriamycin47. بالإضافة إلى ذلك، تتغير مجموعة متنوعة من الخلايا المناعية في باثولوجيا اعتلال الكلية السكري، مثل خلايا B، والبلاعم M1 / M2، وخلايا NK48. قد يؤثر المؤشر الحيوي CAT على وظيفة الخلايا المناعية في اعتلال الكلية السكري49، كما قد يؤثر MAOA أيضاً على البيئة المناعية الدقيقة من خلال تنظيم استقطاب البلاعم. تشير هذه النتائج إلى أن التأثير الوقائي الكلوي لـ LLF يرتبط ارتباطاً وثيقاً بتنظيمه للتسلل المناعي غير الطبيعي، بما في ذلك خلايا CD8+ T، مما يقلل من الضرر الالتهابي. وتشير الارتباطات السلبية بين المؤشرات الحيوية المرشحة الأربعة وخلايا CD8+ T والخلايا الصارية المنشطة إلى أن هذه الجينات قد تعدل البيئة المناعية الدقيقة في الكلى. وقد رُبط التعبير عن CAT باستقطاب البلاعم ونشاط خلايا T في الأنسجة الأيضية. ومع ذلك، فإن تقديرات CIBERSORT الخاصة بنا مشتقة من ترانسكريبتومات أنسجة الكلى الكلية، والتي لا يمكنها التمييز بين الأنواع الفرعية للخلايا المناعية التي تتسلل إلى المقصورات الكبيبية مقابل المقصورات الأنبوبية الخلالية. لذا يجب تفسير الارتباطات الملحوظة على أنها ارتباطات مولدة لفرضيات وليست كدليل على تنظيم مناعي سببي. وتتطلب الدراسات المستقبلية استخدام الكيمياء النسيجية المناعية المتعددة أو تسلسل RNA أحادي الخلية (single-cell RNA-seq) لتحديد موقع هذه التفاعلات بين الخلايا المناعية والمؤشرات الحيوية.
أفادت الدراسات السابقة بوجود مؤشرات حيوية مرتبطة بالميتوكوندريا في اعتلال الشبكية السكري (DN)، بما في ذلك OPA1 و MFN2 و DRP1 و PGC-1α و SOD2. وتأتي نتائجنا المتعلقة بـ CAT و MAOA لتكمل هذه الأدبيات الحالية من خلال تسليط الضوء على مسارات البيروكسيسوم ومؤكسيد أحادي الأمين التي نالت اهتماماً أقل في سياق ميتوكوندريا اعتلال الشبكية السكري. ومن الجدير بالذكر أنه بينما يُعد SOD2 و GPX1 من الإنزيمات التقليدية الكانسة لجذور الأكسجين الحرة (ROS)، فإن CAT يستهدف تحديداً H2O2 في البيروكسيسومات، مما يشير إلى وجود مقصورة خلوية فرعية متميزة لتنظيم الإجهاد التأكسدي.
لقد ثبت أن التاكسيفولين (TA)، وهو فلافونويد طبيعي، يقلل بشكل كبير من مستويات جلوكوز الدم وحمض اليوريك والكرياتينين ومستويات الأنسولين في مصل الجرذان المصابة بالسكري، بينما يحد أيضاً من التغيرات المرضية الكلوية في هذه الحيوانات50. وقد يعمل β-sitosterol على تحسين اعتلال الكلية السكري (DN) بشكل غير مباشر من خلال تنظيم توازن الدهون وإحداث تأثيرات مضادة للالتهابات. وتشارك مكونات β-sitosterol في مغلي Huangqi Gegen (HGD) في المسارات المرتبطة بـ DN، حيث تستهدف جزيئات مثل عامل نمو البطانة الوعائية أ (VEGFA) وإنترلوكين-6 (IL-6). وتشمل هذه التأثيرات عمليات مضادة للالتهابات، ومضادة لموت الخلايا المبرمج، ومضادة للأكسدة، وعمليات بلعمة ذاتية، مما يقلل من التليف الكلوي وتلف القشرة الكلوية ويحسن الوظائف الكلوية، مما يؤدي في النهاية إلى تأخير تطور DN51. كما ثبت أن الإريوديكتيول، وهو فلافونويد طبيعي آخر، يحمي من السكتة الدماغية الإقفارية (IS) من خلال موازنة الإجهاد التأكسدي والالتهاب52. ورغم محدودية الدراسات حول الإريوديكتيول في سياق DN، ونظراً لارتباط المرض بالالتهاب والإجهاد التأكسدي، يُفترض أنه قد يخفف من DN عبر آليات مماثلة. كما تشير تنبؤات الأدوية في هذه الدراسة إلى أن التاكسيفولين وβ-sitosterol والإريوديكتيول لها تأثيرات علاجية محتملة في DN. ويتنبأ الالتحام الجزيئي بتشكيلات وتقارب الارتباط المحتملة، ولكنه لا يثبت ارتباط الهدف in vivo، أو التوافر الحيوي، أو النشاط الدوائي. لذا يجب تفسير هذه النتائج على أنها تولد فرضيات وليست تأكيدية.
ركزت الدراسات السابقة في علم الصيدلة الشبكي حول اعتلال الكلية السكري (DN) بشكل كبير على مسارات تأشير فردية (مثل AGE-RAGE وPI3K-AKT وMAPK)، ولم تأخذ في الاعتبار الخلل الوظيفي في الميتوكوندريا أو تستخدم تعلم الآلة متعدد النماذج لتحديد أولويات المؤشرات الحيوية. تقدم دراستنا ثلاثة تطورات منهجية وبيولوجية: (1) دمج الجينات المعبّر عنها تفاضلياً (DEGs) على نطاق الترانسكريبتوم مع مجموعات جينات الميتوكوندريا وتنبؤات الأهداف الدوائية؛ (2) تطبيق أربعة نماذج متميزة لتعلم الآلة مع التحقق من صحتها عبر مجموعات بيانات مختلفة لتحديد المرشحين الأكثر قوة؛ (3) تحديد مسارات البيروكسيسوم (CAT) وأكسيداز أحادي الأمين (MAOA/MAOB) —وهي مسارات أقل دراسة في سياقات الميتوكوندريا لمرض DN— كمحاور علاجية مرشحة.
قد يعود عدم وجود تغيرات ذات دلالة إحصائية في تعبير MaoB و Fabp1 في كلية الفأر إلى عدة عوامل. أولاً، اشتُق مجموعتا بيانات Gene Expression Omnibus (GEO) المستخدمتان في تحديد أولويات المرشحين من عينات كلى بشرية (الكلية بأكملها والكبيبة، على التوالي)، بينما استخدمت تجربتنا الحيوانية أنسجة كلوية من الفئران. وقد تؤثر الاختلافات المحددة للأنواع في التنظيم الجيني على مستويات التعبير الأساسية والاستجابة للدواء. ثانياً، قد يكون حجم العينة الصغير نسبياً (n = 6 لكل مجموعة) قد حدّ من القدرة الإحصائية على اكتشاف أحجام التأثير المتوسطة. ثالثاً، جُمعت الأنسجة بعد 8 أسابيع من العلاج، وهو ما قد لا يكون قد رصد النافذة الزمنية المثلى للكشف عن التغيرات الترانسكريبتومية في MaoB و Fabp1، حيث قد يتم تنظيم هذه الجينات على مستوى البروتين أو النشاط بدلاً من مستوى mRNA. ورابعاً، قد تساهم عدم تجانس الأنسجة —بين الكلية بأكملها وأجزاء محددة منها— في وجود هذه التناقضات. مما يستدعي إجراء مزيد من الاستقصاء حول هذه الاحتمالات.
استخدمت هذه الدراسة نهجاً تكاملياً يجمع بين المعلوماتية الحيوية والتعلم الآلي لتحديد CAT وFABP1 وMAOA وMAOB كجينات ميتوكوندرية مرشحة محتملة لـ LLF في حالات DN. وأكدت التجارب In vivo أن LLF يزيد بشكل ملحوظ من تنظيم CAT وMAOA في أنسجة الكلى، مما يشير إلى أن هذه الجينات تمثل أهدافاً واعدة لمزيد من الاستقصاءات الميكانيكية والعلاجية. وفي المقابل، أظهر MAOB وFABP1 اتجاهات غير معنوية في الاتجاه ذاته، مما يؤكد على أهمية التحقق التجريبي عند تحديد أولويات التنبؤات الحسابية. توفر هذه النتائج مبرراً للدراسات المستقبلية لاستكشاف الاستراتيجيات العلاجية المرتبطة بالميتوكوندريا في حالات DN.
الإفصاحات
لا يوجد لدى المؤلفين أي تضارب في المصالح للإفصاح عنه.
شكر وتقدير
نود أن نعرب عن خالص امتناننا لجميع الأفراد والمؤسسات الذين قدموا لنا الدعم والمساعدة طوال فترة هذا البحث. تم دعم هذه الدراسة من قبل المؤسسة الوطنية للعلوم الطبيعية في الصين (رقم 81973486 و82173974)، ومشاريع البحث التابعة لإدارة الطب الصيني التقليدي في مقاطعة شانشي (رقم 2024ZYYA021)، ومشروع التخصص في جامعة شانشي للطب الصيني (رقم 2026XK24)، ومشروع صندوق البحث العلمي في جامعة شاندونغ للطب الصيني (رقم KYZK2024Q13). كما نشكر الأستاذ المشارك Qinqing Li من جامعة شانشي للطب الصيني، الذي قام بتوثيق المواد النباتية.
المواد
| الاسم | الشركة | رقم فهرسي | التعليقات |
|---|---|---|---|
| محلول مُثبت الأنسجة بارافورمالدهيد 4% | سايين للتكنولوجيا الحيوية المحدودة | 71033600 | |
| الإيثانول المطلق | شركة سينوفارم للكيماويات والمواد الكيميائية المحدودة | 10009218 | |
| جهاز قياس سكر الدم | سينوكير إنك. | GA-3 | |
| طقم تحليل النيتروجين اليوريا في الدم (BUN) | معهد نانجينغ للهندسة الحيوية | ج03-2-1 | |
| فأر سي57بيแอลكيه إس/ج دب-دب | تشانغتشو كافنز لتجربة الحيوانات المحدودة | SCXK (Su) 2021-0013 | |
| فأر سي57بي إل كيه إس/ج دبليو/م | تشانغتشو كافنز لتجربة الحيوانات المحدودة | SCXK (Su) 2021-0013 | |
| الطرد المركزي | شركة هونان شيانغي لتطوير أدوات المختبر المحدودة | HI650 | |
| كلورال هيدرات | شركة شنغهاي ألدرين للتقنية الكيميائية الحيوية المحدودة | 302-17-0 | |
| سايتوسكيب (v3.9.0) | <أ.href="https://cytoscape.org/">https://cytoscape.org | ||
| قاعدة بيانات لـ m6تنبؤ بتغيير ما | <أ.href="http://www.cuilab.cn/sramp/">http://www.cuilab.cn/sramp/ | ||
| قاعدة بيانات المكونات الفعالة في الطب الصيني التقليدي | <أ.href="http://sm.nwsuaf.edu.cn/lsp/tcmsp.php">http://sm.nwsuaf.edu.cn/lsp/tcmsp.php | ||
| ENCORI / Starbase | <أ.href="https://starbase.sysu.edu.cn/">https://starbase.sysu.edu.cn/ | ||
| جين إكسبريشن أونكوب (GEO) | <أ.href="https://www.ncbi.nlm.nih.gov/geo/">https://www.ncbi.nlm.nih.gov/geo/ | ||
| كِتَا بِصبغ الهيماتوكسيلين والإيوزين (HE) | سيرفيسبيو | C0105S | |
| الطرد المركزي عالي السرعة | لابنت، الولايات المتحدة الأمريكية | C2500-R-230V | |
| أداة تحليل الانتشار المناعي | <أ.href="https://cibersort.stanford.edu/">https://cibersort.stanford.edu/ | ||
| ثمار الليغوستروم اللامعة | شركة سيتشوان كوان يي رون للتكنولوجيا الحيوية المحدودة | 20240506 | |
| المحرك المغناطيسي | مصنع جينتان زهونغتيان للأدوات، جيانغسو | T8-1 | |
| المجهر | أوليمبوس | BX53 | |
| ميكروتوم | ليكا، ألمانيا | ر.م 2016 | |
| مقياس الطيف الضوئي ذي الحجم المجهري | هانغتشو أوسينغ للآلات الدقيقة المحدودة | نانو-300 | |
| miRNet | <أ.href="https://www.mirnet.ca/">https://www.mirnet.ca | ||
| ميتوكارتا 3.0 | <أ href="https://www.broadinstitute.org/mitocarta">https://www.broadinstitute.org/mitocarta | ||
| حزمة R لتفسير النماذج | <أ.href="https://cran.r-project.org/package=DALEX">https://cran.r-project.org/package=DALEX | ||
| منصة الارتباط الجزيئي | <أ.href="http://clab.labshare.cn/cb-dock/">http://clab.labshare.cn/cb-dock/ | ||
| طقم إيليسا للكشف عن البومين الدقيق في البول لدى الفأر | اختبار دقيق | EM0632 | |
| شريط اختبار البيلة المجهرية للفأر | قوانغتشو هوا دو غاو إر باو للتكنولوجيا الحيوية المحدودة | 20211203 | |
| كِت كشف الكرياتينين في مصل الفأر باستخدام تقنية إيليسا | أبمارت | AB5990A | |
| MSigDB | <أ.href="https://www.gsea-msigdb.org/gsea/msigdb/">https://www.gsea-msigdb.org/gsea/msigdb/ | ||
| جهاز تضخيم تفاعلي حراري | روش | روش لايت سايكلر 480 | |
| برنامج R (الإصدار 4.2.2) + حِزم R | <أ href="https://www.r-project.org/CRAN/Bioconductor">https://www.r-project.org / CRAN/Bioconductor | ||
| RCSB PDB | <أ.href="https://www.rcsb.org/">https://www.rcsb.org | ||
| كِتّ استخلاص الحمض النووي الريبي | بكين جومي للتقنية الحيوية المحدودة | MF-036-01 | |
| RPISeq | <أ.href="http://pridb.gdcb.iastate.edu/RPISeq/">http://pridb.gdcb.iastate.edu/RPISeq/ | ||
| طقم تفاعل البلمرة المتسلسل العكسي الكمي | بكين جومي للتكنولوجيا الحيوية المحدودة | MF949-T | |
| ساليدروسايد | سيتشوان كوان ييرون للتكنولوجيا الحيوية المحدودة | 20211009 | |
| مُجَرَّبُ كرياتينين المصل | معهد نانجينغ للهندسة الحيوية | C011-2-1 | |
| منشأة حيوانات معفاة من الجراثيم | جامعة شانشي للطب الصيني التقليدي | ||
| SRAMP | <أ.href="http://www.cuilab.cn/sramp/">http://www.cuilab.cn/sramp/ | ||
| سترينج | <أ.href="https://cn.string-db.org/">https://cn.string-db.org/ | ||
| سويس تارغيت بريدكشن | <أ.href="http://www.swisstargetprediction.ch/">http://www.swisstargetprediction.ch/ | ||
| TCMSP | <أ href="http://sm.nwsuaf.edu.cn/lsp/tcmsp.php">http://sm.nwsuaf.edu.cn/lsp/tcmsp.php | ||
| تزيه بيغان | شركة سيتشوان كوانيرون للتكنولوجيا الحيوية المحدودة | 20210602 | |
| حمام تعويم الأنسجة | ووهان جونجيي | JK-6 |
المراجع
- Thipsawat S. Early detection of diabetic nephropathy in patient with type 2 diabetes mellitus: a review of the literature. Diabetes Vasc Dis Res. 2021;18(6):14791641211058856.
- Kanwar YS, Sun L, Xie P, Liu FY, Chen S. A glimpse of various pathogenetic mechanisms of diabetic nephropathy. Annu Rev Pathol. 2011;6:395-423.
- Santulli G, et al. Prediabetes increases the risk of frailty in prefrail older adults with hypertension: beneficial effects of metformin. Hypertension. 2024;81(7):1637-43.
- Jin Q, et al. Oxidative stress and inflammation in diabetic nephropathy: role of polyphenols. Front Immunol. 2023;14:1185317.
- Alicic RZ, Rooney MT, Tuttle KR. Diabetic kidney disease: challenges, progress, and possibilities. Clin J Am Soc Nephrol. 2017;12(12):2032-45.
- Harrington JS, et al. Mitochondria in health, disease, and aging. Physiol Rev. 2023;103(4):2349-422.
- Peña FJ, et al. An integrated overview on the regulation of sperm metabolism (glycolysis-Krebs cycle-oxidative phosphorylation). Anim Reprod Sci. 2022;246:106805.
- de Mello AH, Costa AB, Engel JDG, Rezin GT. Mitochondrial dysfunction in obesity. Life Sci. 2018;192:26-32.
- Shen Y, et al. Notoginsenoside Fc, a novel renoprotective agent, ameliorates glomerular endothelial cells pyroptosis and mitochondrial dysfunction in diabetic nephropathy through regulating HMGCS2 pathway. Phytomedicine. 2024;126:155445.
- Zhang PN, et al. Mitochondrial dysfunction and diabetic nephropathy: nontraditional therapeutic opportunities. J Diabetes Res. 2021;2021:1010268.
- Zhang JL, et al. Structural characterization and protective effect against renal fibrosis of polysaccharide from Ligustrum lucidum Ait. J Ethnopharmacol. 2023;302(Pt A):115898.
- Luan R, et al. The protective effect of ethyl acetate and n-butanol fractions of wine-steamed Ligustri Lucidi Fructus on diabetic nephropathy in rats. Evid Based Complement Alternat Med. 2021;2021:6512242.
- Luan R, et al. Pharmacodynamics, pharmacokinetics, and kidney distribution of raw and wine-steamed Ligustri Lucidi Fructus extracts in diabetic nephropathy rats. Molecules. 2023;28(2):791.
- Seo HL, et al. Liqustri lucidi Fructus inhibits hepatic injury and functions as an antioxidant by activation of AMP-activated protein kinase in vivo and in vitro. Chem Biol Interact. 2017;262:57-68.
- Yan M, et al. Identification of pyroptosis-related genes and potential drugs in diabetic nephropathy. J Transl Med. 2023;21(1):490.
- Ritchie ME, et al. limma powers differential expression analyses for RNA-sequencing and microarray studies. Nucleic Acids Res. 2015;43(7):e47.
- Gustavsson EK, et al. ggtranscript: an R package for the visualization and interpretation of transcript isoforms using ggplot2. Bioinformatics. 2022;38(15):3844-6.
- Gu Z, Eils R, Schlesner M. Complex heatmaps reveal patterns and correlations in multidimensional genomic data. Bioinformatics. 2016;32(18):2847-9.
- Shannon P, et al. Cytoscape: a software environment for integrated models of biomolecular interaction networks. Genome Res. 2003;13(11):2498-504.
- Wu T, et al. clusterProfiler 4.0: a universal enrichment tool for interpreting omics data. Innovation (Camb). 2021;2(3):100141.
- Dong H, et al. Identification through machine learning of potential immune-related gene biomarkers associated with immune cell infiltration in myocardial infarction. BMC Cardiovasc Disord. 2023;23(1):163.
- Pei B, et al. The development of prediction model for cuffed tracheal tube size from the middle finger in pediatrics: a concise and feasible approach. Transl Pediatr. 2023;12(12):2222-31.
- Robin X, et al. pROC: an open-source package for R and S+ to analyze and compare ROC curves. BMC Bioinformatics. 2011;12:77.
- Robles-Jimenez LE, et al. Worldwide traceability of antibiotic residues from livestock in wastewater and soil: a systematic review. Animals (Basel). 2021;12(1):60.
- Wang Y, et al. Bioinformatics analysis combined with clinical sample screening reveals that leptin may be a biomarker of preeclampsia. Front Physiol. 2022;13:1031950.
- Livak KJ, Schmittgen TD. Analysis of relative gene expression data using real-time quantitative PCR and the 2^−ΔΔCT method. Methods. 2001;25(4):402-8.
- Klejborowska G, et al. Synthesis, anticancer activity and molecular docking studies of N-deacetylthiocolchicine and 4-iodo-N-deacetylthiocolchicine derivatives. Bioorg Med Chem. 2021;32:116014.
- Reagan-Shaw S, Nihal M, Ahmad N. Dose translation from animal to human studies revisited. FASEB J. 2008;22(3):659-61.
- An Y, Duan H. The role of m6A RNA methylation in cancer metabolism. Mol Cancer. 2022;21(1):14.
- Mazzieri A, Porcellati F, Timio F, Reboldi G. Molecular targets of novel therapeutics for diabetic kidney disease: a new era of nephroprotection. Int J Mol Sci. 2024;25(7):3969.
- Breyer MD, Susztak K. The next generation of therapeutics for chronic kidney disease. Nat Rev Drug Discov. 2016;15(8):568-88.
- Leoncini G, et al. Blood pressure reduction and RAAS inhibition in diabetic kidney disease: therapeutic potentials and limitations. J Nephrol. 2020;33(5):949-63.
- Pofi R, et al. Diabetic nephropathy: focus on current and future therapeutic strategies. Curr Drug Metab. 2016;17(5):497-502.
- Arellano Buendía AS, et al. Immunomodulatory effects of the nutraceutical garlic derivative allicin in the progression of diabetic nephropathy. Int J Mol Sci. 2018;19(10):3107.
- Zhang X, Agborbesong E, Li X. The role of mitochondria in acute kidney injury and chronic kidney disease and its therapeutic potential. Int J Mol Sci. 2021;22(20):11253.
- Liu Y, et al. DsbA-L interacting with catalase in peroxisome improves tubular oxidative damage in diabetic nephropathy. Redox Biol. 2023;66:102855.
- Zhong Y, et al. Jujuboside A ameliorates high fat diet and streptozotocin induced diabetic nephropathy via suppressing oxidative stress, apoptosis, and enhancing autophagy. Food Chem Toxicol. 2022;159:112697.
- Zhong Y, et al. Dioscin relieves diabetic nephropathy via suppressing oxidative stress and apoptosis, and improving mitochondrial quality and quantity control. Food Funct. 2022;13(6):3660-73.
- Issac PK, et al. Protective effect of morin by targeting mitochondrial reactive oxygen species induced by hydrogen peroxide demonstrated at a molecular level in MDCK epithelial cells. Mol Biol Rep. 2022;49(6):4269-79.
- Abo El-Asrar M, Ismail EAR, Elnhrawy AM, Thabet RA. Fatty acid binding protein 1 (FABP1) and fatty acid binding protein 2 (FABP2) as a link between diabetic nephropathy and subclinical atherosclerosis in children and adolescents with type 1 diabetes. J Diabetes Complications. 2023;37(3):108414.
- Gholaminejad A, Fathalipour M, Roointan A. Comprehensive analysis of diabetic nephropathy expression profile based on weighted gene co-expression network analysis algorithm. BMC Nephrol. 2021;22(1):245.
- Tanaka M, et al. Urinary fatty acid-binding protein 4 is a promising biomarker for glomerular damage in patients with diabetes mellitus. J Diabetes Investig. 2025;16(4):670-9.
- Liu Y, et al. Gastric cancer adapts high lipid microenvironment via suppressing PPARG-FABP1 axis after arriving in the lymph node. Redox Biol. 2025;85:103759.
- Borús DL, et al. Fatty acid binding protein 1 (FABP1) depletion promotes an oxidative metabolic shift in Caco-2 colorectal cancer cells. Biochim Biophys Acta Mol Cell Biol Lipids. 2025;1870(7):159661.
- Chu Y, et al. Glutathione peroxidase-1 overexpression reduces oxidative stress, and improves pathology and proteome remodeling in the kidneys of old mice. Aging Cell. 2020;19(6):e13154.
- Zhang F, et al. Mesenchymal stem cells alleviate rat diabetic nephropathy by suppressing CD103+ DCs-mediated CD8+ T cell responses. J Cell Mol Med. 2020;24(10):5817-31.
- Cao Q, et al. Renal F4/80+ CD11c+ mononuclear phagocytes display phenotypic and functional characteristics of macrophages in health and in adriamycin nephropathy. J Am Soc Nephrol. 2015;26(2):349-63.
- Zhou W, et al. The landscape of immune cell infiltration in the glomerulus of diabetic nephropathy: evidence based on bioinformatics. BMC Nephrol. 2022;23(1):303.
- Bloch K, Shichman E, Vorobeychik M, Bloch D, Vardi P. Catalase expression in pancreatic alpha cells of diabetic and non-diabetic mice. Histochem Cell Biol. 2007;127(2):227-32.
- Zhao Y, et al. Taxifolin attenuates diabetic nephropathy in streptozotocin-induced diabetic rats. Am J Transl Res. 2018;10(4):1205-10.
- Ding S, Wang W, Song X, Ma H. Based on network pharmacology and molecular docking to explore the underlying mechanism of Huangqi Gegen Decoction for treating diabetic nephropathy. Evid Based Complement Alternat Med. 2021;2021:9928282.
- Guo S, et al. Correction: Eriodictyol: a review of its pharmacological activities and molecular mechanisms related to ischemic stroke. Food Funct. 2023;14(10):4949.