يدمج إطار عمل MSCNN-LSTM المقترح استخراج الميزات المكانية متعددة المقاييس مع نمذجة التسلسل الزمني للتعرف على الأفعال في مقاطع الفيديو الرياضية، مما يتيح التقاط ميزات مكانية دقيقة وأنماط حركة زمنية مع تحقيق أداء تصنيف تنافسي في مجموعات بيانات الأفعال الرياضية المرجعية.
مقالة بحثية
التعرف على الأفعال في فيديوهات الرياضة باستخدام الشبكات التلافيفية متعددة المقاييس مع النمذجة الزمنية القائمة على الذاكرة الطويلة قصيرة المدى (LSTM)
في هذه المقالة
ملخص
الملخص
لا يزال التعرف على الأفعال في مقاطع الفيديو الرياضية يمثل تحدياً بسبب ديناميكيات الحركة المعقدة، والتداخل، والتباين العالي داخل الفئة الواحدة. ورغم أن نهج التعلم العميق الحالية، بما في ذلك نماذج CNN-BiLSTM والنماذج القائمة على التعلم بنقل المعرفة، قد أثبتت فعاليتها في التعرف على النشاط البشري، إلا أن أداءها قد يكون محدوداً في السيناريوهات الرياضية التي تتسم بحركات سريعة ومتنوعة. تعتمد العديد من الطرق الحالية على مرشحات تلافيفية أحادية المقياس، والتي قد لا تلتقط خصائص الحركة الدقيقة والخشنة بشكل فعال في آن واحد. ولمعالجة هذا القصور، تقترح هذه الدراسة شبكة عصبية تلافيفية متعددة المقاييس (MSCNN) مدمجة مع شبكة الذاكرة الطويلة قصيرة المدى (LSTM) للتعرف على الأفعال في مقاطع الفيديو الرياضية. تقوم MSCNN باستخراج تمثيلات مكانية عبر مجالات استقبال متعددة من خلال نوى تلافيفية متوازية، مما يسمح بتعلم سمات الحركة التفصيلية والسياقية معاً. تتم بعد ذلك معالجة هذه السمات بواسطة LSTM لالتقاط الاعتمادات الزمنية واستمرارية الحركة عبر الإطارات المتتالية. أُجري التقييم التجريبي على مجموعات البيانات المرجعية UCF11 وUCF Sports وJHMDB. وحقق نموذج MSCNN-LSTM المقترح دقة تصنيف بلغت 98.3% و95.4% و81.7% على التوالي، متفوقاً على النهج المقارنة التي تم تقييمها في هذه الدراسة. كما أظهرت دراسة استئصال مساهمة استخراج السمات متعددة المقاييس والنمذجة الزمنية في تحسين الأداء العام. وتثبت هذه النتائج قدرة الإطار المقترح على الجمع بين المعلومات المكانية والزمانية للتعرف على الأفعال في مقاطع الفيديو الرياضية.
المقدمة
تتمتع عملية التعرف على النشاط البشري بتطبيقات واسعة في مختلف المجالات الواقعية، بما في ذلك المراقبة الذكية، وكشف الشذوذ، والاسترجاع السمعي البصري القائم على الأفعال، ومراقبة المرضى في مجال الرعاية الصحية.1,2ينطوي التعرف على الأنشطة، لا سيما في تدفقات الفيديو الواردة من أنظمة المراقبة ومنصات التواصل الاجتماعي، على إمكانات كبيرة للكشف عن الشذوذ وفهم الأحداث.3يتم تحديد الأفعال البشرية في تحليل الفيديو من خلال ملاحظة أجزاء مختلفة من الجسم، مثل اليدين والساقين. وبخلاف الصور الثابتة، غالبًا ما يكون الإطار الواحد غير كافٍ لتمثيل الفعل.4على سبيل المثال، قد تبدو الوضعية الأولية لنشاطي لعب كرة القدم وقفز الحبل متشابهة في إطار واحد، إلا أن الاختلافات بين هذين الفعلين تصبح جلية عند ملاحظتهما عبر تسلسل من الإطارات التي ترصد أنماط الحركة وتفاعلات جسم الإنسان مع محيطه.5,6,7تتلخص الاختصارات المستخدمة في جميع أنحاء هذه المخطوطة في الجدول 1 لتحسين القراءة وضمان الاتساق في المصطلحات.
| اختصار | الصيغة الكاملة |
| الذكاء الاصطناعي | الذكاء الاصطناعي |
| المساحة تحت المنحنى | المساحة تحت المنحنى |
| الذاكرة طويلة قصيرة المدى ثنائية الاتجاه (BiLSTM) | الذاكرة قصيرة المدى طويلة المدى ثنائية الاتجاه |
| الشبكات العصبية التلافيفية | الشبكة العصبونية الالتفافية |
| CUDA | بنية الجهاز الموحدة الحسابية |
| مقياس F1 (F1-score) | المتوسط التوافقي للدقة والاسترجاع |
| وحدة معالجة الرسوميات | وحدة معالجة الرسوميات |
| مستقبلات الأنجيوتنسين من النوع الثاني (HAR) | التعرف على النشاط البشري |
| قاعدة بيانات JHMDB | قاعدة بيانات حركة الإنسان المشتركة |
| الذاكرة طويلة قصيرة المدى (LSTM) | الذاكرة قصيرة المدى المطولة |
| mAP-T | متوسط الدقة المتوسطة الزمنية |
| كربوكسي ميثيل السليلوز | معامل ارتباط ماثيوز |
| الشبكة العصبية التلافيفية متعددة المقاييس (MSCNN) | شبكة عصبية تلافيفية متعددة المقاييس |
| منحنى خصائص تشغيل المستقبل (ROC) | خصائص تشغيل المستقبل |
| اختبار السكر الثلاثي (TSI) | مؤشر الاستقرار الزمني |
| جامعة سنترال فلوريدا (UCF) | جامعة سنترال فلوريدا |
| ذاكرة الوصول العشوائي للفيديو | ذاكرة الوصول العشوائي للفيديو |
الجدول 1: قائمة بالاختصارات المستخدمة في المخطوطة.الاختصارات والمصطلحات الشائعة المستخدمة في جميع أنحاء الدراسة وأشكالها الكاملة المقابلة.
يعد التصنيف السريع والدقيق لمقاطع الفيديو الرياضية أمرًا بالغ الأهمية لمجموعة واسعة من التطبيقات8,9,10، بما في ذلك تحليلات الرياضة، والكشف عن الأحداث، والاسترجاع القائم على المحتوى، وأنظمة التوصية11,12,13. ومع النمو السريع لمحتوى الفيديو المتعلق بالرياضة، أصبحت قيود أطر التحليل السابقة واضحة بشكل متزايد14. وبناءً على ذلك، هناك طلب متزايد على مناهج قوية قادرة على معالجة التعقيد والطبيعة الديناميكية للأنشطة الرياضية. وقد اعتمدت الطرق التقليدية لتصنيف مقاطع الفيديو الرياضية بشكل كبير على الواصفات المصممة يدويًا، مثل التدفق البصري ومدرج التكرار للتدرجات الموجهة (HOG)، لتوصيف أنماط الحركة والأنشطة في مقاطع الفيديو الرياضية15.
لقد طُبقت الشبكات التلافيفية (ConvNets)، التي حققت نجاحاً ملحوظاً في تصنيف الصور الثابتة، في تحليل الفيديو أيضاً. ومع ذلك، لا يزال التعرف على الأفعال يمثل تحدياً أكبر لأن مقاطع الفيديو تحتوي على معلومات زمانية ومكانية ديناميكية. ويمكن تصنيف النهج الحالية القائمة على التعلم العميق عموماً إلى ثلاث مجموعات: شبكات التدفق المزدوج16، والشبكات التلافيفية ثلاثية الأبعاد (3D convolutional networks)، والبنى ذات الكفاءة الحسابية. ولتعلم المعلومات الزمانية من التدفق البصري، تستخدم شبكات التدفق المزدوج شبكة ConvNet إضافية17,18، على الرغم من أن هذا النهج مكلف حسابياً. وبينما تستطيع البنى التلافيفية ثلاثية الأبعاد مثل C3D وI3D وR3D نمذجة المعلومات الزمانية بشكل مباشر، فإنها تزيد بشكل كبير من عدد المعلمات، مما يجعل عملية التحسين أكثر صعوبة. وتحاول الطرق ذات الكفاءة الحسابية تقليل تعقيد النموذج من خلال استكشاف العمليات ثلاثية الأبعاد المفككة.
علاوة على ذلك، نظرًا لقدرة الشبكات العصبية التلافيفية (CNNs) على استخلاص الميزات المكانية المحلية وقدرة شبكات الذاكرة الطويلة قصيرة المدى (LSTMs) على التقاط معلومات السياق الزمني، يمكن للنماذج الهجينة تعلم أنماط الحركة المكانية والزمانية بفعالية من مدخلات المستشعرات. وقد أسفرت الدراسات الحديثة التي تدمج بين بنيات CNN والشبكات العصبية المتكررة عن نتائج مشجعة18,19,20. ومع ذلك، وبسبب قيام شبكات LSTMs بضغط المعلومات أثناء معالجة التسلسل، فقد تؤثر الضوضاء الناتجة أثناء استخلاص الميزات على أداء التعرف. ولمعالجة هذه المشكلة، دمجت عدة دراسات آليات الانتباه (attention mechanisms)21,22. تمكن آليات الانتباه النموذج من التركيز على الميزات الأكثر صلة بمهمة التعرف، مما يؤدي بالتالي إلى تحسين أداء التصنيف.
على الرغم من أن نماذج LSTM ثنائية الاتجاه والعميقة والمدمجة مع استخراج الميزات القائم على CNN قد حققت نتائج واعدة في التعرف على الأنشطة البشرية، إلا أن العديد من التحديات لا تزال قائمة عند توسيع هذه الأطر لتشمل التعرف على الحركات في مقاطع الفيديو الرياضية. أولاً، غالباً ما تعتمد بنيات CNN-LSTM الحالية على استخراج ميزات تلافيفية أحادية المقياس، مما قد يحد من قدرتها على التقاط الحركات التي تحدث بدقات مكانية وزمانية متعددة، مثل الحركة المتزامنة للاعب والأجسام في المشاهد الرياضية. وقد أثبتت الشبكات التلافيفية متعددة المقاييس، بما في ذلك 3D CNNs23 و CNNs ثنائية المسار، أهمية التقاط الإشارات المكانية والحركية بمقاييس مختلفة، رغم أن هذا المفهوم لا يزال أقل استكشافاً في الأنظمة الهجينة القائمة على LSTM. ثانياً، تركز معظم نماذج CNN-BiLSTM السابقة24 بشكل أساسي على الاعتمادات الزمانية قصيرة المدى، بينما قد لا يتم تمثيل استمرارية الحركة طويلة المدى والتفاعلات بين الأجسام الشائعة في الرياضات الجماعية بشكل كافٍ. تعتمد العديد من النهج القائمة على تعلم النقل، مثل MobileNetV2 و ResNet، على ميزات الإطارات الساكنة ولا تستغل بشكل كامل آليات الانتباه الزماني أو دمج الميزات التكيفي متعدد المقاييس25. علاوة على ذلك، تم تقييم معظم النماذج الحالية بشكل أساسي على مجموعات بيانات مرجعية مثل UCF11 و JHMDB، بينما تظل مجموعات البيانات الأحدث المتخصصة في الرياضات والتي تلتقط أنماط حركة الكاميرا والنشاط المعقدة، مثل SoccerNet و FineGym، غير مستكشفة بما يكفي. تسلط هذه القيود الضوء على الحاجة إلى إطار عمل لاستخراج الميزات التلافيفية متعددة المقاييس مدمج مع وحدات الذاكرة الزمانية، مثل شبكات LSTM أو BiLSTM، لالتقاط التمثيلات المكانية دقيقة التفاصيل والاعتمادات الزمانية طويلة المدى بشكل أفضل في التعرف على الحركات في مقاطع الفيديو الرياضية.
بالإضافة إلى ذلك، يمكن للشبكات العصبية التلافيفية (CNNs) استخراج الميزات المكانية المحلية، بينما يمكن لنماذج الذاكرة طويلة قصيرة المدى (LSTMs) نمذجة السياق الزمني. وبناءً على ذلك، أظهرت البنى الهجينة من نوع CNN-RNN أداءً واعدًا في التعرف على النشاط البشري26,27. وقد قامت دراسات حديثة بتوسيع أطر عمل CNN-LSTM التقليدية من خلال دمج استراتيجيات تعلم تكميلية لتحسين التعرف على النشاط البشري. على سبيل المثال، تم إدخال آليات الانتباه للتأكيد على الميزات ذات الصلة بالمهمة وتثبيط التمثيلات الأقل إفادة، مما أدى إلى تحسين أداء التعرف28. كما اعتمدت مقاربات أخرى التعلم متعدد المهام لتحسين مهام التعرف على الأفعال والتقسيم الزمني بشكل مشترك، مما عزز كفاءة التعلم وتمثيل الميزات29. ورغم هذه التطورات، قد تظل الطرق الحالية ذات قدرة محدودة على التمييز بين الأفعال المتشابهة بصريًا لأن الميزات المكانية والزمنية الدقيقة لا يتم التقاطها دائمًا بشكل فعال. يلخص الجدول 2 نقاط القوة والقيود في المقاربات الحالية30.
| المرجع / السنة | الطريقة المستخدمة | مجموعة (مجموعات) البيانات | مقاييس الأداء | نقاط القوة الرئيسية | القيود |
| Hassan et al. (2024)1 | KFDI (Key Frame Dynamic Image) | UCF11 | الدقة: 85.3% | اختيار فعال للإطارات الرئيسية وتحسين تمثيل الصور الديناميكية. | حساسية تجاه أخطاء اختيار الإطارات؛ نمذجة زمنية محدودة. |
| Zhou et al. (2023)24 | Dilated CNN + BiLSTM + Residual Block | UCF11, UCF Sports | الدقة: UCF11: 89 و UCF Sports: 92.2% | يدمج التعلم المكاني والزمني؛ يلتقط معلومات متعددة المقاييس. | كثيف حاسوبياً؛ خطر حدوث فرط التخصيص (overfitting) في مجموعات البيانات الصغيرة. |
| Ullah et al. (2025)34 | Local–Global Feature + QSVM | UCF11 | الدقة: 82.6% | يجمع بين الميزات المصممة يدوياً والميزات العميقة لتحقيق التعرف القوي. | يتطلب ضبطاً يدوياً؛ قابلية توسع محدودة. |
| Shin et al. (2025)25 | ViT-ReT (Vision Transformer + Recurrent Transformer) | UCF11, UCF50, UCF101, and JHMDB | الدقة: UCF11: 97.73%؛ UCF50: 98.81%؛ UCF101: 98.46%؛ JHMDB: 83.38% | يلتقط الاعتمادات المكانية والزمنية طويلة المدى. | تكلفة حاسوبية عالية ومتطلبات بيانات كبيرة. |
| Su et al. (2024)23 | 3D-CNN | UCF11 | الدقة: 85.1% | تعلم الميزات المكانية والزمنية من الطرف إلى الطرف. | متطلبات عالية للذاكرة ووحدات معالجة الرسوميات (GPU). |
| Karuppannan et al. (2024)35 | Deep Autoencoder + CNN | UCF11 | الدقة: 96.2% | يتعلم تمثيلات ميزات مدمجة. | نمذجة زمنية محدودة على المدى الطويل. |
| Sahoo et al. (2020)36 | HAR-Depth | KTH, UCF sports, JHMDB, UCF101, and HMDB51 | الدقة: KTH: 97.67%؛ UCF Sports: 95.00%؛ JHMDB: 73.13%؛ UCF101: 92.97%؛ HMDB51: 69.74% | تعلم زمني فعال قائم على العمق. | يتطلب تقديراً دقيقاً للعمق ومعالجة مسبقة مكثفة. |
الجدول 2: مقارنة بين طرق التعلم العميق الحالية للتعرف على الأفعال في مقاطع الفيديو الرياضية. ملخص لنهج التعلم العميق التمثيلية، بما في ذلك مجموعات البيانات، والخصائص المنهجية، والمزايا، والقيود، مع تسليط الضوء على الفجوات البحثية التي يعالجها إطار عمل MSCNN-LSTM المقترح.
تم اقتراح إطار عمل للتحريك الوجهي المدفوع بمزامنة الصوت، حيث يجمع بين نموذج إزالة الضجيج الوجهي (FDM) ونموذج انتشار كامن من المحلي إلى العالمي (LG-LDM) لتوليد تحريكات وجهية معبرة عاطفياً. وقد استُخدم مشفر تلقائي تبايني مكمم المتجهات متمحور حول العاطفة (EVQ-VAE) لإعادة بناء هندسة وجهية ثلاثية الأبعاد مفصلة وتغيرات دقيقة في التعبيرات31. كما تم تطوير إطار عمل للقبض الروبوتي المدرك للاحتجاب باستخدام الرؤية الستيريوية الثنائية لإجراء تجزئة الهدف، وتحديد الموقع، واستنتاج الاحتجاب، وتقدير وضعية القبض على أهداف متعددة في ظروف الاحتجاب32. بالإضافة إلى ذلك، تم تقديم إطار عمل من مرحلتين لاستخراج الأرض من السحب النقطية باستخدام الإسقاط الشبكي وتقسيم الصناديق التكيفي، حيث استُخدمت احتمالات الارتفاع والانحناء لتحسين حدود الأرض والعوائق بعد عملية الاستخراج الأولية من خلال تحليل الميزات القائم على الشبكة33.
على الرغم من التقدم الملحوظ في التعرف على الأفعال القائم على التعلم العميق، لا تزال الطرق الحالية تعاني في التعامل مع التباين العالي والتعقيد في مقاطع الفيديو الرياضية، بما في ذلك الحركة السريعة، وتحرك الكاميرا، والتفاعلات بين عدة لاعبين. وتعمل العديد من النماذج التقليدية القائمة على الشبكات العصبية التلافيفية (CNN) أو الذاكرة الطويلة قصيرة المدى (LSTM) بنطاق مكاني واحد، وبالتالي قد تواجه صعوبة في التقاط أنماط الحركة المحلية والعالمية بشكل فعال. علاوة على ذلك، لا يزال الحفاظ على التماسك الزمني في التسلسلات طويلة المدة أو الأفعال المتداخلة يمثل تحديًا. ورغم أن طرق التعلم الانتقالي قد حسنت من استخراج الميزات، إلا أن تكيفها مع مجموعات البيانات الخاصة بالرياضة لا يزال غير مستكشف بشكل كافٍ نسبياً.
تهدف هذه الدراسة إلى تطوير وتقييم إطار عمل يعتمد على الشبكة العصبية التلافيفية متعددة المقاييس والذاكرة الطويلة قصيرة المدى (MSCNN-LSTM) للتعرف على الحركات في مقاطع الفيديو الرياضية، وذلك من خلال دمج استخراج الميزات المكانية متعددة المقاييس مع النمذجة الزمنية القائمة على LSTM لالتقاط كل من الميزات المكانية دقيقة التفاصيل والتبعيات الزمنية طويلة المدى. يستخدم إطار العمل المقترح نوى تلافيفية تكميلية ودمجاً للميزات متعددة المستويات لتحسين تمثيل الحركات الرياضية المعقدة في ظل الظروف الصعبة. وقد تم تقييم أدائه على مجموعات البيانات المرجعية UCF11 وUCF Sports وJHMDB باستخدام الدقة (accuracy)، والضبط (precision)، والاستدعاء (recall)، ومقياس F1-score، ومتوسط الدقة المتوسطة بمرور الوقت (mAP-T)، ومؤشر الاستقرار الزمني (TSI)، ومعامل كوهين كابا (κ)، ومعامل ارتباط ماتيوس (MCC)، والمساحة تحت منحنى خصائص التشغيل المستقبلي (AUC). وأظهرت النتائج التجريبية أداءً تنافسياً مقارنة بالطرق التي تم تقييمها في هذه الدراسة، مما يسلط الضوء على إمكانات إطار العمل في التحليلات الرياضية، ومراقبة أداء الرياضيين، والكشف التلقائي عن الأحداث، وفهم مقاطع الفيديو الرياضية.
البروتوكول
وظفت هذه الدراسة إطار عمل للتعلم العميق يتكون من مرحلتين للتعرف على الأفعال في فيديوهات الرياضة، حيث يدمج بين شبكة عصبية تلافيفية متعددة المقاييس (MSCNN) وشبكة الذاكرة الطويلة قصيرة المدى (LSTM). وقد استُخدمت مجموعات بيانات مرجعية متاحة للعموم، وهي UCF1 وUCF Sports وJHMDB، لتطوير النموذج وتقييمه. لم يتم جمع أي بيانات جديدة من مشاركين بشريين، ولم يتم الوصول إلى أي معلومات تحديد هوية شخصية أو معالجتها. ونظراً لأن الدراسة تضمنت تحليلاً ثانوياً لمجموعات بيانات مجهولة المصدر ومتاحة للعموم، ولم تتضمن مشاركة بشرية مباشرة، فلم تكن هناك حاجة إلى موافقة أخلاقية مؤسسية أو موافقة مستنيرة.
تألف سير العمل من أخذ عينات الإطارات والتطبيع الزمني، يليه استخراج الميزات باستخدام وحدة MSCNN. تمت معالجة الميزات المستخرجة لاحقاً باستخدام شبكة LSTM للنمذجة الزمنية ثم تمريرها إلى طبقة تصنيف متعددة الفئات. وأخيراً، تم تدريب النموذج وتقييمه باستخدام مجموعات بيانات مرجعية مختارة. يوضح الشكل 1 البنية العامة للإطار المقترح.
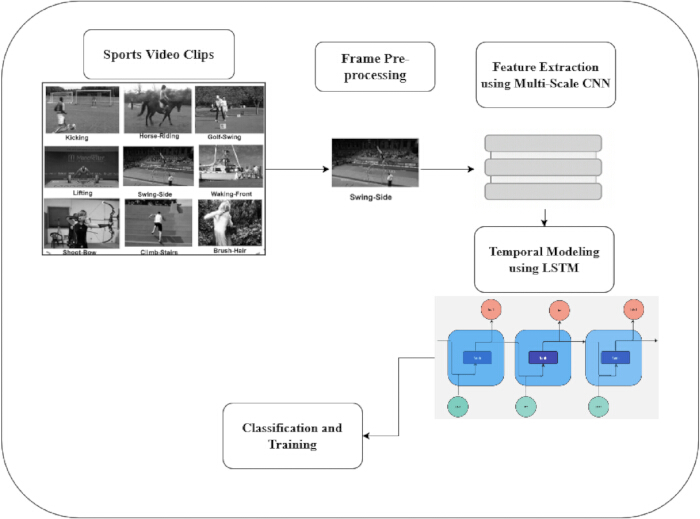
الشكل 1إطار عمل MSCNN-LSTM المقترح للتعرف على الأفعال في مقاطع الفيديو الرياضية. سير العمل العام الذي يوضح المعالجة المسبقة للفيديو، واستخراج الميزات المكانية متعددة المقاييس، وتعلم التسلسل الزمني، وتصنيف الأفعال. يرجى النقر هنا لعرض نسخة أكبر من هذا الشكل.
يوضح الشكل 1 سير العمل في إطار عمل التعرف على الأنشطة في الفيديوهات الرياضية المقترح، والذي يعتمد على بنية هجينة من MSCNN-LSTM. تبدأ العملية بمقاطع فيديو رياضية تحتوي على أنشطة رياضية متنوعة، بما في ذلك الركل، وركوب الخيل، وضرب كرة الغولف. تم تفكيك الفيديوهات الخام إلى إطارات فردية خلال مرحلة المعالجة المسبقة، حيث يتم قص الإطارات وتوحيد قياساتها وتجهيزها كمدخلات للنموذج. بعد ذلك، تم تغذية الإطارات التي تمت معالجتها مسبقاً في وحدة MSCNN لاستخراج الميزات. وتعمل البنية التلافيفية متعددة المقاييس على التقاط الميزات المكانية في مجالات استقبال مختلفة، مما يتيح استخراج المعلومات المحلية والسياقية من إطارات الفيديو الرياضي. ثم تمت معالجة متجهات الميزات المستخرجة بواسطة شبكة LSTM لنمذجة التبعيات الزمنية وتطور الحركة عبر الإطارات المتتالية. وأخيراً، استخدمت وحدة التصنيف والتدريب التمثيلات المكانية والزمانية المكتسبة للتنبؤ بفئة النشاط لكل مقطع فيديو. يتكون إطار العمل المقترح من أربع خطوات متسلسلة، تبدأ بجمع البيانات والمعالجة المسبقة باستخدام مجموعات البيانات المرجعية UCF1 (YouTube Actions) وUCF Sports وJHMDB. تم تحويل كل فيديو رياضي إلى تسلسل من الإطارات، والتي تمت إعادة تحجيمها وتطبيعها وتعزيزها من خلال التدوير والقلب والقص لتحسين القدرة على التكيف مع المتغيرات البيئية. ثم تمت معالجة الإطارات التي خضعت للمعالجة المسبقة بواسطة الشبكة العصبية التلافيفية متعددة المقاييس (MSCNN) المقترحة، حيث قامت فروع تلافيفية متوازية بنوى بحجم 3 × 3 و5 × 5 و7 × 7 باستخراج ميزات مكانية محلية وسياقية تكميلية. تم دمج هذه الميزات متعددة المقاييس وتنقيحها باستخدام تطبيع الدفعات (batch normalization) والتجميع الأقصى (max pooling) لتوليد تمثيلات ميزات مدمجة. تلت ذلك تزويد شبكة الذاكرة القصيرة المدى المطولة (LSTM) بميزات مستوى الإطار الناتجة لنمذجة التبعيات الزمنية عبر الإطارات المتتالية. تم تسطيح مخرجات LSTM النهائية وتمريرها عبر طبقات متصلة بالكامل مع تفعيل ReLU، يتبعها مصنف Softmax للتنبؤ بفئة النشاط. تم تدريب الشبكة باستخدام محسن Adam مع دالة خسارة الإنتروبيا المتقاطعة (cross-entropy loss) وتنظيم الإسقاط (dropout regularization) لتقليل الإفراط في التجهيز. وأخيراً، تم تقييم أداء النموذج على مجموعات البيانات المرجعية UCF1 وUCF Sports وJHMDB باستخدام الدقة (accuracy)، والضبط (precision)، والاستدعاء (recall)، ومقياس F1-score.
1. جمع البيانات ومعالجتها الأولية
استُخدمت في هذه الدراسة ثلاث مجموعات بيانات مرجعية متاحة للعامة للرياضات والحركات البشرية. تحتوي مجموعات البيانات هذه على لقطات رياضية من العالم الحقيقي مع تباين في حركة الكاميرا، ووجهات النظر، وتعقيد الخلفية. وبشكل محدد، استفادت الدراسة من مجموعة UCF1 (YouTube Actions) (https://www.crcv.ucf.edu/data/UCF_YouTube_Action.php)، والتي تتضمن 11 فئة من الحركات جُمعت من 1,168 مقطع فيديو من YouTube سُجلت لحوالي 25 شخصاً، مع عينات متعددة لكل حركة. وتضم قاعدة بيانات الحركة البشرية ذات التعليقات التوضيحية المشتركة (JHMDB)34,35 21 فئة من الحركات و928 مقطع فيديو مشروحاً. أما مجموعة بيانات UCF Sports فتتكون من 10 فئات من الحركات و150 تسلسلاً فيديو تم التقاطها من مصادر بث بدقة 720 × 480 pixels (https://www.crcv.ucf.edu/data/UCF_Sports_Action.php).
تغطي هذه المجموعات من البيانات مجتمعةً الرياضات الفردية والجماعية، وتوفر تنوعاً في المدة الزمنية والمقياس البصري لتقييم إطار عمل MSCNN-LSTM المقترح للتعرف على الأفعال. وكجزء من عملية فحص جودة البيانات، تم فحص مجموعات بيانات UCF1 وUCF Sports وJHMDB للبحث عن مقاطع فيديو تالفة، أو ملفات مكررة، أو مقاطع ذات تعليقات توضيحية غير مكتملة. ولم يتم تحديد أي عينات تستوفي معايير الاستبعاد هذه؛ وبناءً عليه، تم الاحتفاظ بجميع مقاطع الفيديو المتاحة للتحليل اللاحق. بعد ذلك، تم تقسيم مجموعات البيانات إلى مجموعات فرعية للتدريب (70%)، والتحقق (15%)، والاختبار (15%) باستخدام استراتيجية تقسيم عشوائية متسقة. ويعرض الشكل 2 صوراً نموذجية مستخدمة في التدريب والتقييم.
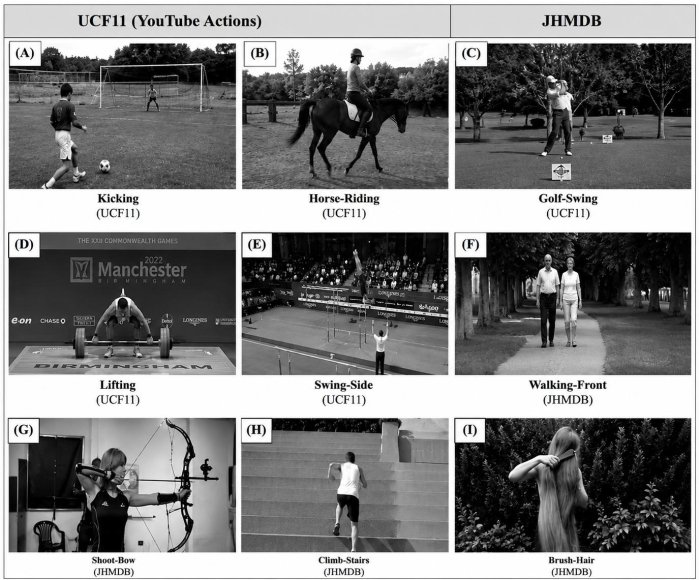
الشكل 2إطارات ممثلة من مجموعات بيانات معيارية للتعرف على الأفعال الرياضية. لوحات (أ-دتُظهر الرسوم التوضيحية أمثلة من مجموعة بيانات UCF1 (إجراءات YouTube)، اللوحات (هـ–ح) من مجموعة بيانات UCF Sports، واللوحات (١-١٢من مجموعة بيانات JHMDB. وتوضح الإطارات التباينات في فئات الأفعال، وزوايا الرؤية، والخلفيات، وظروف الإضاءة، وتعقيد الحركة. يرجى النقر هنا لعرض نسخة أكبر من هذا الشكل.
تم تقييم نموذج التعرف على الأفعال المقترح على مجموعات البيانات المرجعية UCF1 وUCF Sports وJHMDB، كما هو ملخص في الجدول 3. وتمثل مجموعات البيانات هذه أنماط حركة متنوعة وظروفاً بيئية صعبة. تحتوي مجموعة بيانات UCF1 (YouTube Actions) على أفعال رياضية من 1 فئة تم الحصول عليها في ظل ظروف إضاءة ووجهات نظر وخلفيات متنوعة. وتضم مجموعة بيانات UCF Sports ما مجموعه 150 مقطع فيديو لرياضات ميدانية من بث احترافي، وتتميز بتسلسلات حركية واقعية. أما مجموعة بيانات JHMDB فتوفر تعليقات توضيحية مفصلة لحركة الإنسان لـ 21 فئة من الأفعال دقيقة التفاصيل، وتعمل كمجموعة بيانات مرجعية للتعرف على الأفعال المكانية والزمانية. وقد استُخدمت هذه المجموعات معاً لتقييم أداء النموذج عبر سيناريوهات رياضية وأفعال بشرية. تم تدريب الشبكة باستخدام محسن Adam لمدة 10 epoch وبحجم دفعة (batch size) قدره 32، ومعدل تعلم أولي 0.001، ودالة فقدان الإنتروبيا المتقاطعة (cross-entropy loss function). وتم اختيار النموذج الذي حقق أدنى فقدان في التحقق للتقييم النهائي. استُخدمت جميع التجارب بذرة عشوائية ثابتة قدرها 42. كما طُبق التوقف المبكر وخفض معدل التعلم عند استقرار الأداء (plateau) لتحسين التقارب، واستُخدم قص التدرج (gradient clipping) بعتبة 5.0 أثناء تدريب LSTM لمنع تضخم التدرجات. احتوى نموذج MSCNN-LSTM المقترح على ما يقرب من 15 مليون معامل قابل للتدريب. وتلخص الجدول 4 تكوين الأجهزة والبرمجيات المستخدمة في التنفيذ. ونظراً لأن توزيعات الفئات كانت متوازنة بشكل كافٍ، لم يتم تطبيق أي إجراءات إضافية لوزن الفئات أو إعادة أخذ العينات. تم تنفيذ النماذج المقارنة باستخدام المعلمات الفائقة (hyperparameters) المذكورة في دراساتها الأصلية، مع مواءمة إعدادات التدريب حيثما كان ذلك ممكناً. وقد أُبلغت قيم الأداء كمتوسط ± الانحراف المعياري من خمس عمليات تشغيل مستقلة بتهيئات عشوائية مختلفة. وتم تقييم الاختلافات بين النموذج المقترح والنماذج المقارنة باستخدام اختبارات t المقترنة عند عتبة دلالة p < 0.05.
| مجموعة البيانات | عدد الفئات | عدد الفيديوهات | الدقة (بكسل) | يرجى تزويدي بالنص المصدر (Source text) المراد ترجمته، وسأقوم فوراً بتحويله إلى اللغة العربية وفقاً للمعايير الأكاديمية والعلمية الدقيقة التي حددتها. | الوصف |
| UCF1 (إجراءات يوتيوب) | 11 | 1168 | متغير (≈ 320×240) | جامعة سنترال فلوريدا | يتضمن 11 إجراءً بشرياً من الرياضات (على سبيل المثال: تصويب كرة السلة، والغطس، وأرجحة كرة الغولف، وتنطيط كرة القدم). جُمعت مقاطع الفيديو من YouTube مع تباين عالٍ في الإضاءة، وزاوية الرؤية، والخلفية. |
| رياضات جامعة سنترال فلوريدا (UCF) | 10 | 150 | 720×480 | مجموعة بيانات UCF للأفعال الرياضية | يحتوي على أنشطة رياضية مثل الغوص، وركوب الخيل، وأرجحة كرة الغولف، والجري، ورفع الأثقال، تم تسجيلها من لقطات بث تلفزيوني واقعية (BBC، ESPN). |
| قاعدة بيانات JHMDB | 21 | 928 | 320×240 | معهد ماكس بلانك للأنظمة الذكية | تضمن أنشطة يومية ورياضية مثل الإمساك، والقفز، وتمشيط الشعر، والتسديد، والجري، مع تعليقات توضيحية مشتركة للمفاصل لتحليل الحركة والوضعية. |
الجدول 3: خصائص مجموعات البيانات المرجعية المستخدمة في التدريب والتقييم. نظرة عامة على مجموعات بيانات UCF1 وUCF Sports وJHMDB، بما في ذلك عدد فئات الأفعال، وعينات الفيديو، وخصائص مجموعة البيانات، وأدوارها في تدريب النموذج والتحقق منه واختباره.
| المعلمات المستخدمة | الوصف |
| لغة البرمجة | Python 3.8.18 [4] |
| إطار عمل التعلم العميق | TensorFlow 2.15.0 [1] |
| مسرع وحدة معالجة الرسوميات | NVIDIA GeForce RTX 3090 (24 GB VRAM) [1] |
| وحدة المعالجة المركزية | Intel Core i9 @ 3.5 جيجاهرتز × 16 نواة |
| نظام التشغيل | ويندوز 1 |
| ذاكرة الوصول العشوائي (RAM) | 64 جيجابايت DDR4 |
| المُحسِّن | Adam (معدل التعلم = 0.001) |
| حجم الدفعة | 32 |
| عدد الدورات التدريبية | 100 |
| دوال التنشيط | وحدة التصحيح الخطي (طبقات الشبكة العصبية التلافيفية)، سوفت ماكس (طبقة المخرجات) |
| معدل التسرب | 0.5 |
الجدول 4: بيئة المحاكاة وتكوين المعلمات الفائقة لنموذج MSCNN-LSTM المقترح. مواصفات الأجهزة، وبيئة البرمجيات، وإعدادات المُحسِّن، ومعدل التعلم، وحجم الدفعة، وعدد العصور، وأبعاد الإدخال، والمعلمات الفائقة الأخرى المستخدمة أثناء تدريب النموذج وتقييمه.
2. المعالجة المسبقة
قبل التدريب، تم تحويل كل مقطع فيديو خام إلى تسلسل من الإطارات المرتبة زمنياً، ثم خضعت للتطبيع، وأخذ العينات زمنياً، والتعزيز. أولاً، تم تحويل كل فيديو إدخال V إلى تسلسل من الإطارات وتم تمثيله كموتّر رباعي الأبعاد V ∈ RT×H×W×C، حيث تمثل T عدد الإطارات، و H × W i تشير إلى مؤشر الإطار، وتمثل C عدد قنوات الألوان (3 لنظام RGB). تألف مسار المعالجة المسبقة من استخراج الإطارات، وتغيير الحجم المكاني يليه قص مركزي أو عشوائي إلى دقة ثابتة (H′, W′)، وتطبيع شدة كل بكسل، وتعزيز اختياري للبيانات، بما في ذلك القلب العشوائي، وتغيير المقياس، والاضطراب اللوني، وذلك قبل استخراج الميزات. وبشكل ملموس، تم تنفيذ تطبيع الشدة إما عن طريق تطبيع الدرجة المعيارية كما هو موضح في المعادلة (1).
 (1)
حيث تمثل μ و σ متوسطات القنوات والانحرافات المعيارية التي تم حسابها عبر مجموعة التدريب، أو باستخدام قياس الحد الأدنى-الأقصى (min–max scaling) كما هو موضح في المعادلة (2).
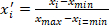 (2)
بعد التطبيع، تمثيل كل إطار كـ F̃t ∈ RH′×W′×C′، وتم تمثيل تنسور الفيديو الناتج كـ V′ ∈ RT×H′×W′×C. في الواجهة الأمامية الالتفافية متعددة المقاييس، يتم الحصول على خرائط سمات مكانية متعددة للمجال الاستقبالي من خلال تطبيق عدة عمليات التفاف ثنائية الأبعاد (أو ثلاثية الأبعاد لعمليات الالتفاف الزمكانية المبكرة) بأحجام نواة مختلفة؛ ومن ثم تم إنشاء تمثيل سمات زمنية لكل إطار أو مقطع فيديو قصير وإرساله إلى وحدة LSTM. تطبق الورقة البحثية الأصلية نموذج MobileNetV2 ثم نموذج Deep BiLSTM للنمذجة الزمنية؛ كما أن مسار المعالجة المسبقة المذكور أعلاه متوافق تماماً مع استبدالها بنموذج التفاف متعدد المقاييس + LSTM.
3. أخذ العينات والتطبيع الزمني
بما أن أطوال مقاطع الفيديو T تختلف بين مجموعات البيانات وداخل المجموعة الواحدة، فإننا نقوم بأخذ عينات منتظمة أو إعادة أخذ عينات زمنية للإطارات لتزويد عملية الالتفاف متعددة المقاييس + LSTM بطول إدخال ثابت N من حيث الإطارات أو المقاطع القصيرة. ويمكن حساب مؤشرات الإطارات المنتظمة كما هو موضح في المعادلة (3)،
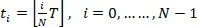 (3)
وبالتالي، يكون تسلسل الإطارات التي تم أخذ عينات منها هو Vs = {F̃t0, …, F̃tN−1}. وعندما تبرز الحاجة إلى دقة زمنية أعلى، نقوم بإجراء استكمال زمني خطي: لأي زمن كسري مُعاد أخذ عينات منه τ ∈ [0, T−1] يتم حسابه كما في المعادلة (4).
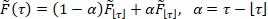 (4)
بحيث تحتوي التسلسلة المعاد أخذ عيناتها Vs على N من الإطارات بالضبط وتحافظ على سلاسة الحركة. وبدلاً من ذلك، فإن أخذ العينات عن طريق مقاطع قصيرة متصلة (طول النافذة الزمنية w وبخطوة s) ينتج مجموعة من موترات المقاطع حيث كل مقطع Cj ∈ RT×H′×W′×C و j = 0, …, ⌊(T − w)/s⌋. ولأغراض التطبيع الزمني داخل الشبكة، يكون التجميع الزمني البسيط على مقاييس متعددة فعالاً: فبالنظر إلى تسلسل سمات زمنية X = {x1, …, xN} ناتج عن عمليات التلافيف متعددة المقاييس، يتم تطبيق السمات المجمعة كما هو موضح في المعادلة (5).
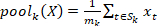 (5)
أين Sك هل الدعم الزمني مناسب للمقياس كـ (على سبيل المثال، Sك قد تكون كتلًا غير متداخلة أو مؤشرات موسعة) و مك = |Sكـ|.
قبل استخراج السمات، تم تغيير حجم جميع مقاطع الفيديو إلى 24 × 24 بكسل وأخذ عينات منها بمعدل 25 إطاراً في الثانية. وقد اعتمدت كل تجربة طول تسلسل ثابتاً قدره 32 إطاراً. تضمنت تقنيات تعزيز البيانات القص العشوائي (المقياس = 0.8–1.0)، والتدوير العشوائي (±15°)، والقلب الأفقي العشوائي (الاحتمالية = 0.5)، وتعديل السطوع (±20%). واستُخدمت قيم المتوسط الحسابي لـ ImageNet وهي [0.485, 0.456, 0.406] والانحرافات المعيارية [0.29, 0.24, 0.25] لتوحيد قيم البكسل. وبالنسبة لكل تسلسل فيديو، استُخدم اختيار الإطارات المنتظم لأخذ العينات الزمنية. كما تم تقليم أو أخذ عينات من المقاطع الأطول بشكل منتظم للحفاظ على طول تسلسل ثابت، بينما تمت إضافة أصفار (zero-padding) لمقاطع الفيديو التي تحتوي على أقل من 32 إطاراً. وقد طُبقت هذه الإعدادات باستمرار طوال مرحلتي التدريب والتقييم.
4. استخراج الميزات باستخدام MSCNN
تَمّ استخدام شبكة عصبية تلافيفية متعددة المقاييس (MSCNN) لتعزيز التمثيل المكاني للأفعال في مقاطع الفيديو الرياضية. قد تعاني الشبكات العصبية التلافيفية التقليدية التي تعتمد على حجم نواة واحد من قدرة محدودة في التقاط الميزات بمقاييس مكانية متعددة. ونظراً لأن بعض الأفعال الرياضية تُظهر خصائص بصرية متشابهة، فقد يكون من الصعب على البنية التلافيفية أحادية المقياس التقاط الميزات المحلية والعالمية في آن واحد. ولمعالجة هذا القصور، يستخدم الإطار المقترح نوى تلافيفية بأحجام مختلفة لإجراء استخراج ميزات متعدد المقاييس ودمج للميزات.
في بنية الشبكة المقترحة، تم استخدام نوى تلافيف بـمقاس 1 × 1 لتنظيم المعلومات عبر القنوات وتقليل أبعاد خرائط السمات المدخلة. بالإضافة إلى ذلك، تزيد هذه الطبقات من القدرة التعبيرية للشبكة من خلال إدخال تحويلات سمات إضافية وتمثيلات غير خطية. وتتيح نوى التلافيف ذات الأحجام المختلفة استخراج المعلومات المكانية بمقاييس متعددة. ويتم إجراء تسوية تسلسلية بعد دمج السمات متعدد المقاييس الموزونة لتحسين استقرار التدريب. وبغية التخفيف من مشكلات تلاشي التدرج وانفجار التدرج أثناء تدريب الشبكة العميقة، تستخدم البنية المقترحة اتصالات متبقية ونمذجة زمنية تعتمد على LSTM.
يعز التصميم متعدد المقاييس من قدرة الشبكة على التقاط السمات بدقات مكانية مختلفة ويحسن من قدرة تمثيل السمات. علاوة على ذلك، يتم تفكيك نواة الالتفاف التقليدية ذات الحجم N × N إلى عمليات التفاف بحجم N × 1 و 1 × N. وقد صُممت عمليات الالتفاف N × 1 و 1 × N المستخدمة في وحدة MSCNN لالتقاط سمات مكانية اتجاهية ومتعددة المقاييس ومتكاملة من إطارات الفيديو الفردية. وتعمل عمليات الالتفاف هذه على تعزيز تمثيل السمات المكانية من خلال استخراج الأنماط بمقاييس مختلفة من الحقول الاستقبالية. بعد ذلك، يتم نمذجة العلاقات الزمنية بين الإطارات المتتالية بواسطة وحدة LSTM، التي تعالج تسلسل السمات المستخرجة بواسطة MSCNN لتعلم التبعيات الزمنية طويلة المدى من أجل التعرف على الأفعال.
يتم تحليل كل فيديو رياضي V = {F1, F2, …, FT} إلى T من الإطارات. ولترميز التغيرات المكانية، على سبيل المثال، وضعية اللاعب، وضبابية الحركة، ومسار الكرة، تعمل فروع تلافيفية بثلاثة مقاييس مختلفة s ∈ {1, 2, 3}، بما يتوافق مع أحجام نوى تبلغ 3 × 3 و 5 × 5 و 7 × 7. ويستخلص كل فرع خرائط الميزات كما في المعادلة (6):
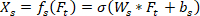 (6)
حيث يمثل Ws و bs أوزان وانحيازات التلافيف عند المقياس s، وتمثل σ دالة التنشيط ReLU. وتقوم طبقة الدمج متعددة المقاييس بتجميع الميزات كما هو موضح في المعادلة (7):
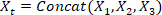 (7)
يضمن موتر السمات المدمج هذا تلميحات الحركة دقيقة التفاصيل والمعلومات السياقية للمساحات الواسعة، مثل الأنشطة الجماعية. يوضح الشكل 3 وحدة استخراج السمات الخاصة بـ MSCNN فقط. أما طبقة LSTM (بـ 256 وحدة مخفية)، والطبقة الكثيفة (بـ 128 عصبوناً)، وطبقة الإسقاط (0.5) المستخدمة في النمذجة الزمنية والتصنيف، فهي معروضة بشكل منفصل في الشكل 4.
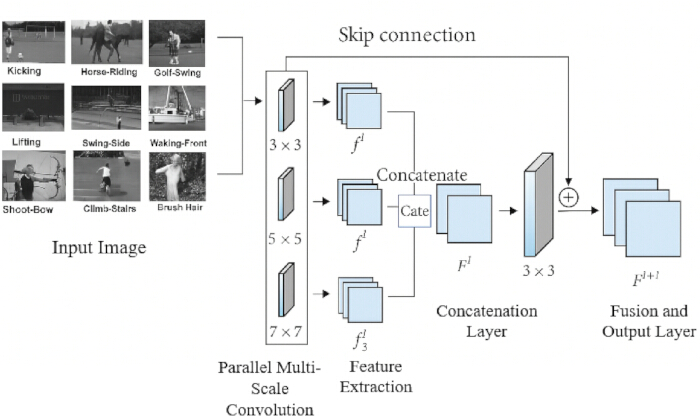
الشكل 3وحدة استخراج الميزات المقترحة للشبكة العصبية التلافيفية متعددة المقاييس (MSCNN). تستخلص ثلاثة فروع تلافيفية متوازية بأحجام نواة تبلغ 3 × 3 و 5 × 5 و 7 × 7 سمات مكانية متكاملة متعددة المقاييس، والتي يتم دمجها قبل النمذجة الزمنية بواسطة شبكة LSTM. يرجى النقر هنا لعرض نسخة أكبر من هذا الشكل.
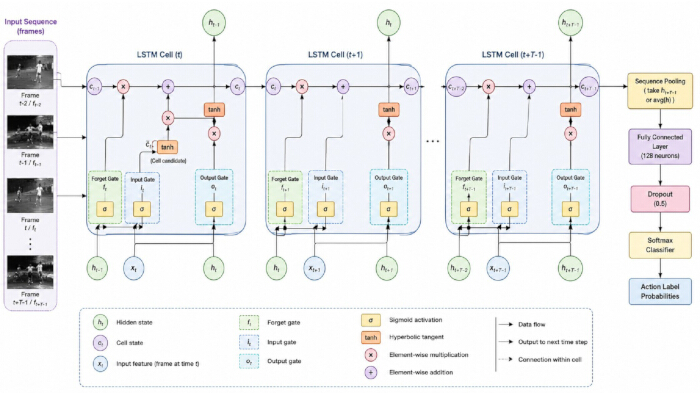
الشكل 4بنية LSTM المقترحة للتعرف على الأفعال في مقاطع الفيديو الرياضية. تقوم وحدة LSTM بنمذجة الاعتمادات الزمنية من خلال عمليات بوابات الإدخال، والنسيان، والإخراج عبر إطارات الفيديو المتتالية. يرجى النقر هنا لعرض نسخة أكبر من هذا الشكل.
الشكل 3 يوضح وحدة استخراج الميزات المقترحة باستخدام الشبكة العصبية التلافيفية متعددة المقاييس (MSCNN) للتعرف على الحركات في مقاطع الفيديو الرياضية. تمت معالجة إطارات الفيديو المدخلة بالتوازي من خلال ثلاثة فروع تلافيفية بأحجام نواة 3 × 3 و 5 × 5 و 7 × 7، حيث يحتوي كل منها على 64 مرشحاً لالتقاط ميزات مكانية مكملة دقيقة وخشنة الحبيبات. تم تحسين المخرجات باستخدام التسوية الدفعية (Batch Normalization)، وتنشيط ReLU، والتجميع الأقصى (max pooling) بحجم 2 × 2، ثم تم دمجها ودمجها بواسطة تلافيف 1 × 1 مع 128 مرشحاً. حافظ اتصال القفزة المتبقي (residual skip connection) على المعلومات المكانية منخفضة المستوى وحسن تدفق التدرج. تم تسطيح خرائط الميزات المدمجة وتمريرها إلى طبقة LSTM تحتوي على 256 وحدة خفية للنمذجة الزمنية، تلتها طبقة متصلة بالكامل تحتوي على 128 عصبوناً، وتنشيط ReLU، ومعدل إسقاط (dropout rate) قدره 0.5 قبل التصنيف النهائي باستخدام طبقة Softmax. تم دمج خرائط الميزات متعددة المقاييس (f1l، و f2l، و f3l) لتكوين التمثيل المدمج (Fl)، والذي تم تحسينه لاحقاً بواسطة تلافيف 3 × 3 لتوليد خريطة الميزات المخرجة للطبقة التالية. مكنت هذه البنية الهرمية من تعلم ميزات مكانية مكملة في مجالات استقبال متعددة، مما أدى إلى تحسين أداء التعرف على الحركات الرياضية.
5. النمذجة الزمنية باستخدام LSTM
من أجل نمذجة التطور الزمني عبر حواف الفيديو، تم تزويد نظام LSTM بتسلسل الميزات المجمعة لالتقاط التبعيات الديناميكية واستمرارية الحركة. بالنسبة لكل فيديو مدخل، قمنا أولاً باستخراج ميزات CNN متعددة المقاييس لكل إطار. لتكن إطارات الفيديو I1، ...، IT. لكل إطار t وكل مقياس s، ينتج المشفر الالتفافي متعدد المقاييس متجه ميزات ft(s) ∈ Rd. ثم يتم دمج المقاييس في واصف إطار واحد إما عن طريق الإسقاط + الدمج (projection + concat) أو المجموع المرجح كما في المعادلة (8):
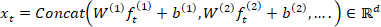 (8)
بعد ذلك، يتم إدخال التسلسل {xt}tT=1 في نموذج LSTM لنمذجة الديناميكيات الزمنية. وفي تدوين LSTM القياسي، تكون البوابات والحالات عند الزمن t كما هي موضح في المعادلات من (9) إلى (13):
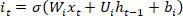 (9)
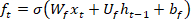 (10)
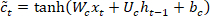 (11)
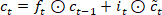 (12)
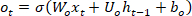 (13)
هنا تمثل σ تنشيط السجمويد (sigmoid activation)، وتمثل ⊙ الضرب العنصري (element-wise multiplication). وبالرغم من إمكانية استخدام بنيات LSTM ثنائية الاتجاه لالتقاط السياق الزمني الماضي والمستقبلي معاً، إلا أن الإطار المقترح يستخدم LSTM قياسياً لنمذجة التبعيات الزمنية عبر إطارات الفيديو المتسلسلة. ويتوافق خيار التصميم هذا مع بنية MSCNN-LSTM المعروضة في هذه الدراسة. وبعد معالجة المقطع، تم الحصول على تمثيل للمقطع (على سبيل المثال، الحالة الخفية الأخيرة أو التجميع الزمني): z = Poolt(vt).
الشكل 4 يوضح سير العمل لبنية LSTM المقترحة للتعرف على الأنشطة الرياضية. استقبلت الشبكة تسلسلاً من إطارات الفيديو أو الميزات المستخرجة بواسطة CNN وقامت بمعالجتها عبر خطوات زمنية متتالية (t−2 و t−1 و t). وتكونت كل خلية LSTM من بوابة إدخال، وبوابة نسيان، وبوابة إخراج، والتي عملت على تنظيم تدفق المعلومات عبر الشبكة. حيث قامت بوابة الإدخال بدمج المعلومات الجديدة في حالة الخلية، وتخلصت بوابة النسيان من المعلومات الزمنية غير ذات الصلة، بينما قامت بوابة الإخراج بتوليد الحالة المخفية التي يتم تمريرها إلى الخطوة الزمنية اللاحقة. حافظت حالة الخلية على الاعتمادات الزمنية طويلة المدى، بينما التقطت الحالة المخفية المعلومات الزمنية قصيرة المدى. وبعد المعالجة التسلسلية، تم تجميع مخرجات LSTM لتوليد تمثيل للميزات الزمنية، والذي تم تمريره إلى طبقة متصلة بالكامل ومصنف Softmax للتنبؤ بالنشاط الرياضي المقابل. تم تدريب الشبكة باستخدام محسن Adam لمدة 10 دورة (epochs) وبحجم دفعة (batch size) قدره 32، ومعدل تعلم أولي 0.001، ودالة خسارة الإنتروبيا المتقاطعة (cross-entropy loss function). تم اختيار النموذج الذي سجل أدنى خسارة في التحقق للتقييم النهائي. ولضمان إمكانية التكرار، أجريت جميع التجارب باستخدام بذرة عشوائية ثابتة بقيمة 42. كما تم استخدام التوقف المبكر وخفض معدل التعلم عند الثبات (learning-rate reduction on plateau) لتحسين التقارب، وطُبق قص التدرج (gradient clipping) بحد أقصى 5.0 أثناء تدريب LSTM لمنع تضخم التدرجات (exploding gradients). احتوى نموذج MSCNN-LSTM المقترح على ما يقرب من 15 مليون معلمة قابلة للتدريب.
تستخدم درجات الفئة النهائية والاحتمالية طبقة خطية + softmax كما هو موضح في المعادلة (14):
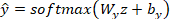 (14)
يتم التدريب عن طريق تقليل فقدان الإنتروبيا المتقاطعة (cross-entropy loss) عبر المقاطع المصنفة كما في المعادلة (15):
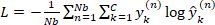 (15)
حيث تمثل Nb حجم الدفعة، و C عدد الفئات، و y(n) الحقيقة الأرضية بنظام الترميز أحادي الساخن (one-hot). يتم تطبيق التسوية (إسقاط عشوائي على xt/مخرجات LSTM، واضمحلال الوزن)، كما يتم تطبيق قص التدرج للمساعدة في استقرار التسلسلات الرياضية الطويلة.
النتائج
تَمَّ تدريب وتقييم نموذج MSCNN-LSTM المقترح على مجموعات بيانات UCF11 (YouTube Actions) وUCF Sports وJHMDB، والتي تضمنت حركات رياضية وزوايا رؤية وأنماط حركة متنوعة. ونظرًا لأن توزيعات الفئات كانت متوازنة بشكل كافٍ، لم يتم تطبيق أي إجراءات إضافية لوزن الفئات أو إعادة أخذ العينات. تَمَّ تنفيذ النماذج المقارنة باستخدام المعلمات الفائقة الواردة في دراساتها الأصلية، مع توحيد إعدادات التدريب حيثما كان ذلك ممكنًا. عُرضت النتائج في صورة المتوسط ± الانحراف المعياري لخمس عمليات تشغيل مستقلة بتهيئة عشوائية مختلفة. وكَمَا تَمَّ تقييم الفروق بين النموذج المقترح والنماذج المقارنة باستخدام اختبارات t المزدوجة عند عتبة دلالة p < 0.05.
تقارن الشكل 5 دقة التصنيف عبر مجموعات البيانات الثلاث. حقق نموذج MSCNN-LSTM أعلى دقة، حيث وصلت إلى 98.3% في مجموعة UCF1، و95.4% في مجموعة UCF Sports، و81.7% في مجموعة JHMDB. وقد تجاوزت هذه القيم تلك التي حققتها نماذج Dilated CNN–BiLSTM وTwo-Stream LSTM وViT-ReT. وتعكس الدقة المنخفضة في مجموعة JHMDB الصعوبة الأكبر في التعرف على الأفعال دقيقة التفاصيل في مقاطع الفيديو ذات الدقة المنخفضة.
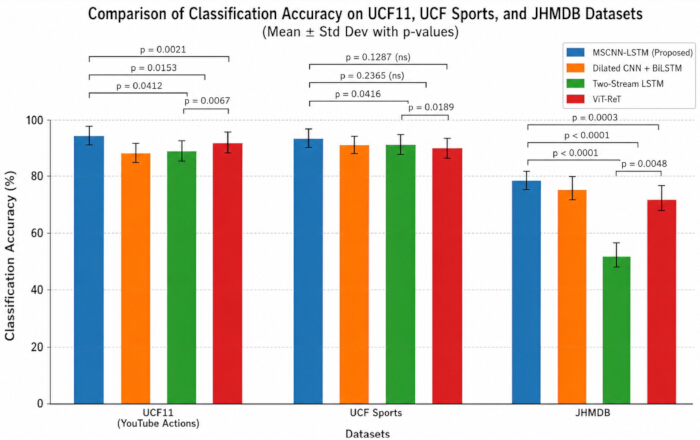
الشكل 5مقارنة لدقة التصنيف (%) لنماذج تعلم عميق مختلفة على مجموعات بيانات فيديوهات رياضية. دقة التصنيف لكل من MSCNN-LSTM وViT-ReT وTwo-Stream LSTM وDilated CNN + BiLSTM على مجموعات بيانات UCF1 وUCF Sports وJHMDB. تم تسجيل النتائج كمتوسط ± الانحراف المعياري من خمس عمليات تشغيل مستقلة (n = 5). تمثل أشرطة الخطأ انحرافاً معيارياً واحداً. تم تقييم الدلالة الإحصائية باستخدام اختبار تزاوجي ثنائي الذيل تـ-اختبارات (p < 0.05). يرجى النقر هنا لعرض نسخة أكبر من هذا الشكل.
حقق النموذج المقترح أيضًا أعلى دقة عبر جميع مجموعات البيانات، بقيم بلغت تقريبًا 96% في UCF1، و93% في UCF Sports، و78% في JHMDB (الشكل 6). وبلغت قيم الاستدعاء (Recall) تقريبًا 95% و94% و7% على التوالي (الشكل 7)، بينما بلغت درجات F1 المقابلة تقريبًا 95.5% و93.5% و7.5% (الشكل 8). وأشارت هذه النتائج إلى أن النموذج حافظ على توازن ملائم بين التحديد الصحيح لفئات الأفعال والحد من التنبؤات الإيجابية الكاذبة.
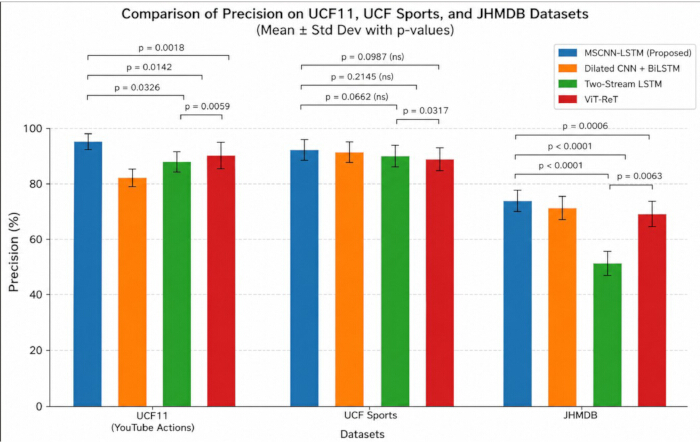
الشكل 6مقارنة الدقة (%) لنماذج التعلم العميق المختلفة على مجموعات بيانات مقاطع الفيديو الرياضية. تُسجل قيم الدقة كمتوسط ± الانحراف المعياري من خمس تجارب مستقلة (n = 5). وتمثل أشرطة الخطأ انحرافاً معياريًا واحدًا. كما تم تقييم الدلالة الإحصائية باستخدام اختبار t المزدوج ذي الذيلين. ت-اختبارات (p < 0.05). يرجى النقر هنا لعرض نسخة أكبر من هذا الشكل.
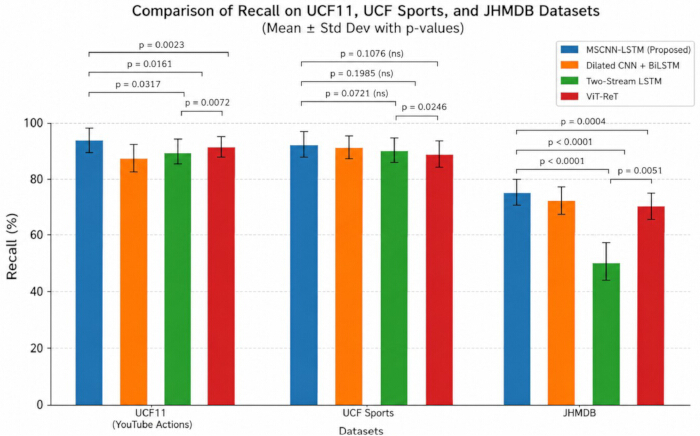
الشكل 7مقارنة لاستدعاء (%) نماذج التعلم العميق المختلفة على مجموعات بيانات فيديوهات رياضية. يتم الإبلاغ عن قيم الاستدعاء كمتوسط ± الانحراف المعياري من خمس تجارب مستقلة (n = 5). وتمثل أشرطة الخطأ انحرافاً معياريًا واحدًا. كما تم تقييم الدلالة الإحصائية باستخدام اختبار تزاوجي ثنائي الذيل تـ-اختبارات (p < 0.05). يرجى النقر هنا لعرض نسخة أكبر من هذا الشكل.
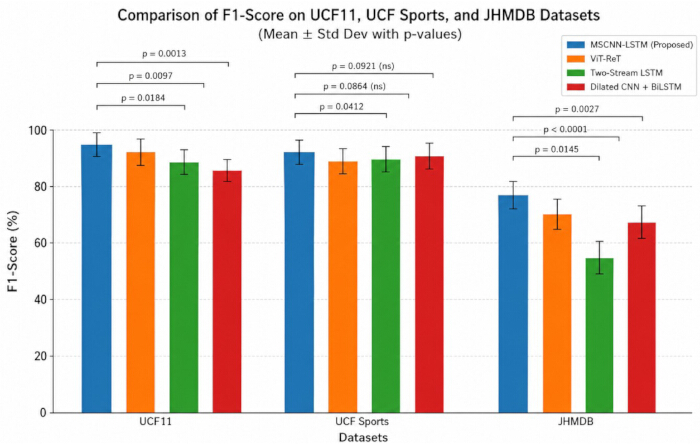
الشكل 8مقارنة لدرجة F1 (%) لنماذج تعلم عميق مختلفة على مجموعات بيانات فيديوهات رياضية. يتم تسجيل درجات F1 كمتوسط ± الانحراف المعياري من خمس عمليات تشغيل مستقلة (n = 5). وتمثل أشرطة الخطأ انحرافاً معيارياً واحداً. كما تم تقييم الدلالة الإحصائية باستخدام اختبار ثنائي الذيل مزدوج تـ-اختبارات (p < 0.05). يرجى النقر هنا لعرض نسخة أكبر من هذا الشكل.
يعرض الجدول 5 نتائج معامل كابا لكوهين (Cohen’s kappa) ومعامل ارتباط ماتيوس (Matthews correlation coefficient). في مجموعة بيانات UCF1، حقق النموذج المقترح قيمة κ = 0.96 وMCC = 0.96، مقارنة بقيم κ/MCC بلغت 0.92/0.92 لنموذج ViT-ReT، و0.90/0.90 لنموذج Two-Stream LSTM، و0.87/0.87 لنموذج Dilated CNN–BiLSTM. وفي مجموعة بيانات UCF Sports، حقق نموذج MSCNN-LSTM قيمة κ = 0.95 وMCC = 0.94، متجاوزاً القيم المقابلة التي حققها كل من ViT-ReT (0.90/0.90)، وTwo-Stream LSTM (0.8/0.89)، وDilated CNN–BiLSTM (0.84/0.85). أما في مجموعة بيانات JHMDB، فقد حقق النموذج المقترح κ = 0.83 وMCC = 0.84، مقارنة بـ 0.74/0.75 لنموذج ViT-ReT، و0.70/0.71 لنموذج Two-Stream LSTM، و0.71/0.72 لنموذج Dilated CNN–BiLSTM. وقد أظهرت هذه النتائج توافقاً أقوى بين التصنيفات المتوقعة والتصنيفات المرجعية (ground-truth labels) للنموذج المقترح.
| نموذج | مجموعة البيانات | معامل كوهين كابا (κ) | معامل ارتباط ماثيوز (MCC) |
| شبكة عصبونية تلافيفية متسعة + شبكة ذاكرة طويلة قصيرة المدى ثنائية الاتجاه [4] | UCF1 (إجراءات يوتيوب) | 0.87 ± 0.01 | 0.88 ± 0.01 |
| رياضات جامعة UCF | 0.84 ± 0.02 | 0.85 ± 0.02 | |
| قاعدة بيانات JHMDB | 0.71 ± 0.03 | 0.72 ± 0.03 | |
| شبكة الذاكرة الطويلة قصيرة المدى ذات المسارين (Two-Stream LSTM) [38] | UCF1 (إجراءات يوتيوب) | 0.90 ± 0.01 | 0.91 ± 0.01 |
| الرياضات في جامعة سنترال فلوريدا (UCF Sports) | 0.88 ± 0.02 | 0.89 ± 0.02 | |
| JHMDB | 0.70 ± 0.03 | 0.71 ± 0.03 | |
| ViT-ReT (محول الرؤية + المحول المتكرر) [6] | UCF1 (إجراءات YouTube) | 0.92 ± 0.01 | 0.92 ± 0.01 |
| الرياضات في جامعة سنترال فلوريدا (UCF) | 0.90 ± 0.01 | 0.90 ± 0.01 | |
| قاعدة بيانات جينوم ومورفولوجيا الجرذان (JHMDB) | 0.74 ± 0.02 | 0.75 ± 0.02 | |
| شبكة MSCNN–LSTM المقترحة | UCF1 (إجراءات YouTube) | 0.96 ± 0.01 | 0.96 ± 0.01 |
| الرياضات في جامعة سنترال فلوريدا (UCF) | 0.95 ± 0.01 | 0.94 ± 0.01 | |
| قاعدة بيانات JHMDB | 0.83 ± 0.02 | 0.84 ± 0.02 |
الجدول 5: مقارنة بين معامل كابا لكوهين (κ) ومعامل ارتباط ماتيوز (MCC) عبر نماذج التعلم العميق المختلفة. مقارنة الأداء لنماذج MSCNN-LSTM، وViT-ReT، وTwo-Stream LSTM، وDilated CNN + BiLSTM على مجموعات بيانات UCF1 وUCF Sports وJHMDB. تشير القيم الأعلى إلى توافق أقوى بين التسميات المتوقعة والحقيقية وموثوقية أكبر في التصنيف. تم تسجيل القيم كمتوسط ± الانحراف المعياري (SD) من خمس عمليات تشغيل مستقلة (n = 5).
الشكل 9 يوضح منحنيات خصائص تشغيل المستقبل. حقق نموذج MSCNN-LSTM المقترح قيم AUC بلغت 0.975 في مجموعة بيانات UCF1، و0.961 في UCF Sports، و0.937 في JHMDB. وقد أشارت قيم AUC المرتفعة باستمرار إلى قدرة تمييز قوية بين فئات الأنشطة عبر مجموعات البيانات ذات التعقيدات المختلفة.
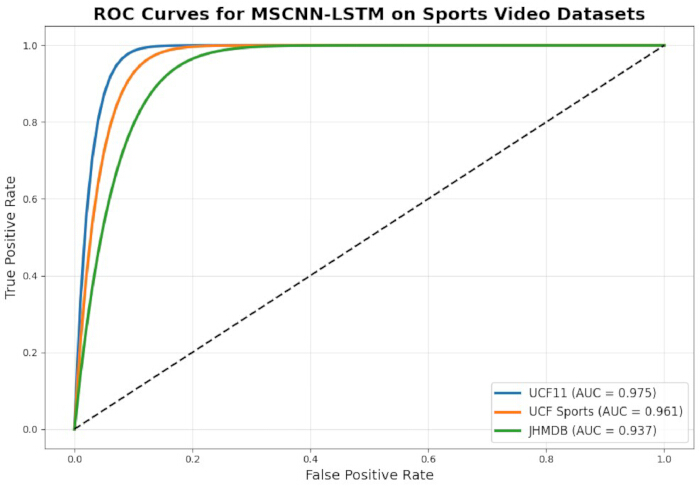
الشكل 9منحنيات خصائص تشغيل المستقبل (ROC) لنموذج MSCNN-LSTM المقترح. منحنيات خصائص تشغيل المستقبل (ROC) لمجموعات بيانات UCF1 وUCF Sports وJHMDB، والتي توضح المقايضة بين معدل الإيجابيات الصحيحة ومعدل الإيجابيات الكاذبة. وتلخص المساحة تحت المنحنى (AUC) أداء التمييز للنموذج عبر عتبات التصنيف المختلفة. يرجى النقر هنا لعرض نسخة أكبر من هذا الشكل.
تم تلخيص نتائج الأداء الزمني في الجدول 6. على مجموعة بيانات UCF1، حقق النموذج المقترح mAP-T بنسبة 98.3%، ودقة على مستوى الإطار بنسبة 96.5%، وTSI قدره 0.95. أما على مجموعة بيانات UCF Sports، فقد كانت القيم المقابلة 95.4% و94.0% و0.93 على التوالي. وعلى مجموعة بيانات JHMDB، حقق النموذج mAP-T بنسبة 81.7%، ودقة على مستوى الإطار بنسبة 78.9%، وTSI قدره 0.8 (الجدول 7). وكانت هذه القيم أعلى من تلك التي حصلت عليها النماذج المقارنة، مما يشير إلى تحسن في التماسك الزمني واستقرار التنبؤ عبر تتابعات الأنشطة قصيرة وطويلة المدى على حد سواء.
| الطريقة | مجموعة البيانات | متوسط الدقة المتوسطة (mAP-T) (%) | دقة مستوى الإطار (%) | مؤشر الاستقرار الزمني (TSI) |
| شبكة عصبية تلافيفية متسعة + شبكة ذاكرة طويلة قصيرة المدى ثنائية الاتجاه (Dilated CNN + BiLSTM)4 | UCF1 (إجراءات يوتيوب) | 93.6 ± 0.8 | 91.8 ± 0.9 | 0.87 ± 0.01 |
| الرياضات في جامعة سنترال فلوريدا (UCF Sports) | 90.2 ± 1.0 | 89.1 ± 1.1 | 0.83 ± 0.02 | |
| قاعدة بيانات JHMDB | 72.4 ± 1.5 | 70.3 ± 1.7 | 0.78 ± 0.03 | |
| الذاكرة طويلة قصيرة المدى ثنائية التدفق (Two-Stream LSTM)38 | UCF1 (إجراءات YouTube) | 94.8 ± 0.7 | 92.6 ± 0.8 | 0.89 ± 0.01 |
| الرياضات في جامعة UCF | 91.3 ± 0.9 | 90.0 ± 1.0 | 0.85 ± 0.02 | |
| قاعدة بيانات JHMDB | 73.8 ± 1.4 | 71.5 ± 1.6 | 0.79 ± 0.03 | |
| ViT-ReT (محول الرؤية + المحول المتكرر)6 | UCF1 (إجراءات يوتيوب) | 95.5 ± 0.6 | 93.4 ± 0.7 | 0.90 ± 0.01 |
| رياضات جامعة UCF | 92.4 ± 0.8 | 91.2 ± 0.9 | 0.87 ± 0.01 | |
| JHMDB | 74.6 ± 1.3 | 72.8 ± 1.4 | 0.81 ± 0.02 | |
| . | UCF1 (إجراءات يوتيوب) | 98.3 ± 0.5 | 96.5 ± 0.6 | 0.95 ± 0.01 |
| رياضات جامعة UCF | 95.4 ± 0.7 | 94.0 ± 0.8 | 0.93 ± 0.01 | |
| JHMDB | 81.7 ± 1.1 | 78.9 ± 1.3 | 0.88 ± 0.02 |
الجدول 6: مقارنة مقاييس الأداء الزمني للتعرف على الأفعال في مقاطع الفيديو الرياضية. النتائج التجريبية لمتوسط الدقة المتوسطة عبر المقاطع الزمنية (mAP-T)، والدقة على مستوى الإطار، ومؤشر الاستقرار الزمني (TSI) لمختلف نماذج التعلم العميق عبر مجموعات البيانات المرجعية. تم تسجيل القيم كمتوسط ± الانحراف المعياري (SD) من خمس تشغيلات مستقلة (n = 5).
| الإعدادات | الشبكة العصبونية التلافيفية متعددة المقاييس (MSCNN) | الذاكرة طويلة قصيرة المدى (LSTM) | الدقة (%) | مقياس F1 (%) | متوسط الدقة المتوسطة (mAP-T) (%) |
| الخط المرجعي المعتمد على الشبكة العصبونية الالتفافية فقط | ✗ | ✗ | 90.4 ± 1.2 | 89.8 ± 1.3 | 88.9 ± 1.4 |
| الشبكات العصبونية التلافيفية + الذاكرة الطويلة قصيرة المدى (CNN + LSTM) | ✗ | ✓ | 93.1 ± 0.9 | 92.4 ± 1.0 | 91.7 ± 1.1 |
| شبكة MSCNN فقط | ✓ | ✗ | 94.2 ± 0.8 | 93.6 ± 0.9 | 92.8 ± 1.0 |
| نموذج MSCNN-LSTM المقترح | ✓ | ✓ | 98.3 ± 0.5 | 97.8 ± 0.6 | 97.1 ± 0.6 |
الجدول 7: دراسة الاستئصال لإطار عمل MSCNN-LSTM المقترح. مساهمة الأداء لكل من مكونات MSCNN و LSTM تحت إعدادات تدريب وتقييم متطابقة. يتم عرض القيم كمتوسط ± الانحراف المعياري (SD) من خمس تجارب مستقلة (n = 5).
الشكل 10، الشكل 1، الشكل 12 تعرض مصفوفات الارتباك المعيرة لكل صف لـ UCF1 وUCF Sports وJHMDB على التوالي. أظهرت المصفوفات الثلاث هيمنة قطرية واضحة، مما يشير إلى أن معظم فئات الأفعال قد تم تحديدها بشكل صحيح. حدثت أخطاء محدودة خارج القطر بشكل أساسي بين الأفعال ذات الخصائص البصرية أو الحركية المتشابهة. وأظهرت مصفوفة JHMDB ارتباكاً أكبر نسبياً بين الفئات، وهو ما يتوافق مع الأداء الكمي الأدنى الملحوظ في مجموعة البيانات هذه الأكثر صعوبة.
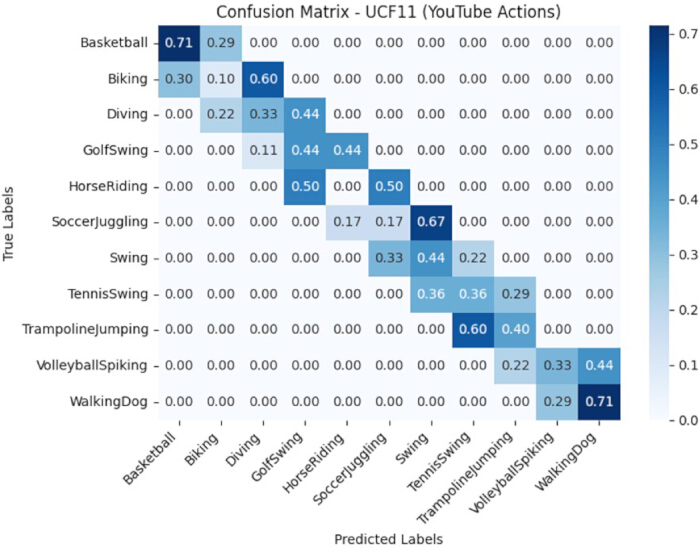
الشكل 10مصفوفة ارتباك مُطبعة صفياً لنموذج MSCNN-LSTM المقترح على مجموعة بيانات UCF1. يتم تطبيع كل صف ليصبح مقداره واحداً، وتمثل المدخلات القطرية الاستدعاء الخاص بكل فئة بدلاً من دقة التصنيف العامة، والتي يتم ذكرها بشكل منفصل. يرجى النقر هنا لعرض نسخة أكبر من هذا الشكل.
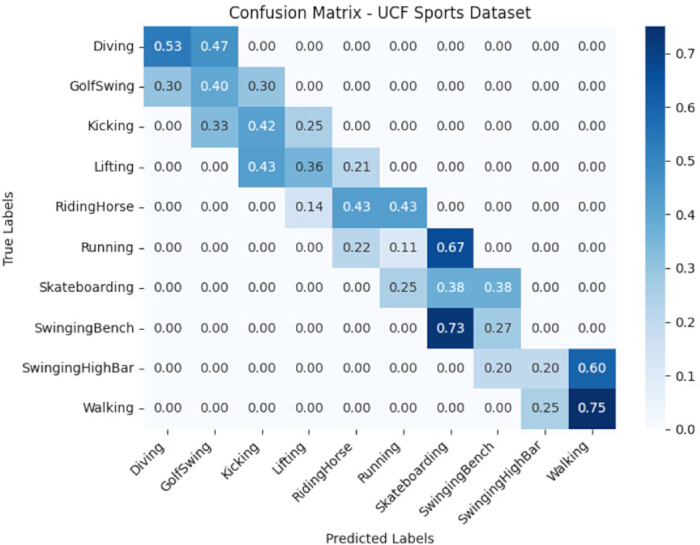
الشكل 1مصفوفة ارتباك مُطبعة صفياً لنموذج MSCNN-LSTM المقترح على مجموعة بيانات UCF Sports. يتم تطبيع كل صف ليصبح مجموع عناصره واحداً، وتمثل المدخلات القطرية استرجاع كل فئة على حدة بدلاً من دقة التصنيف الإجمالية، والتي يتم ذكرها بشكل منفصل. يرجى النقر هنا لعرض نسخة أكبر من هذا الشكل.
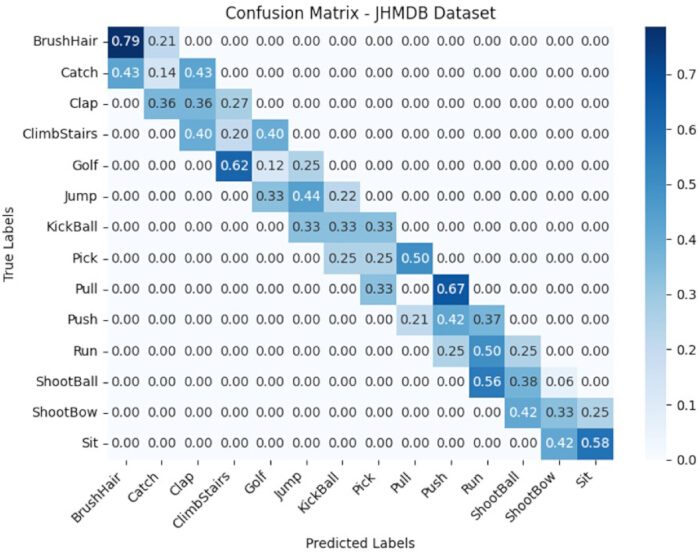
الشكل 12مصفوفة ارتباك مُطبعة صفياً لنموذج MSCNN-LSTM المقترح على مجموعة بيانات JHMDB. يتم تطبيع كل صف إلى الوحدة، وتمثل المدخلات القطرية الاستدعاء الخاص بكل فئة بدلاً من دقة التصنيف الإجمالية، والتي يتم ذكرها بشكل منفصل. يرجى النقر هنا لعرض نسخة أكبر من هذا الشكل.
بشكل عام، تفوق إطار عمل MSCNN-LSTM المقترح باستمرار على النماذج المقارنة التي تم تقييمها عبر مقاييس التصنيف، والاتفاق، والتمييز، والاستقرار الزمني. ودعمت هذه النتائج الفرضية القائلة بأن الجمع بين استخراج الميزات المكانية متعددة المقاييس والنمذجة الزمنية القائمة على LSTM أدى إلى تحسين التعرف على الأفعال الرياضية عبر مجموعات البيانات ذات التعقيد الحركي المتباين، وجودة الصور المختلفة، وظروف وجهات النظر المتغيرة.
توفّر البيانات:
تتوفر مجموعات البيانات التي تم تحليلها خلال الدراسة الحالية علنًا من المصادر التالية: مجموعة بيانات UCF11 (YouTube Actions) عبر الرابط (https://www.crcv.ucf.edu/data/UCF_YouTube_Action.php) ومجموعة بيانات UCF Sports عبر الرابط (https://www.crcv.ucf.edu/data/UCF_Sports_Action.php). ولدعم إمكانية إعادة إنتاج هذه الدراسة، تم إيداع خط معالجة البيانات المسبقة، وتقسيم مجموعة البيانات (توليد تقسيمات التدريب/التحقق/الاختبار)، وملفات التنفيذ، وملفات التكوين، والوثائق الداعمة المستخدمة في التجارب في مستودع Zenodo، وهي متاحة علنًا على الرابط https://doi.org/10.5281/zenodo.21020947.
المناقشة
تفوق إطار عمل MSCNN-LSTM المقترح باستمرار على الطرق التي تم تقييمها عبر مجموعات بيانات UCF11 وUCF Sports وJHMDB المرجعية. وقد أظهرت الطرق السابقة القائمة على Dilated CNN–BiLSTM، وبنيات Vision Transformer، و3D CNNs قدرة فعالة على تعلم الميزات المكانية والزمانية، ولكنها قد تكون محدودة بسبب التعقيد الحسابي العالي، أو متطلبات التدريب الكبيرة، أو التمثيل غير الكافي لأنماط الحركة دقيقة التفاصيل23,24,25. وفي المقابل، دمج إطار العمل المقترح استخراج الميزات المكانية متعددة المقاييس مع النمذجة الزمانية القائمة على LSTM، مما مكن من التقاط كل من تفاصيل الحركة المحلية والاعتمادات الزمانية طويلة المدى. وقد أدى هذا التكامل إلى تحسين التعرف على الأفعال الرياضية المعقدة، وتقليل الخلط بين الفئات، وتعزيز الاتساق الزماني، لا سيما في مجموعة بيانات JHMDB الأكثر تحديًا. وتشير هذه النتائج إلى أن إطار العمل المقترح قدم تمثيلاً متوازنًا للمعلومات المكانية والزمانية مقارنةً بالطرق القائمة على CNN والشبكات المتكررة والمحولات التي تم تقييمها.
من منظور نظري، وفّر إطار عمل MSCNN-LSTM نهجاً موحداً لدمج الميزات متعددة المقاييس والتعلم الزمني التسلسلي36,37. وقد مكن استخدام مجالات الاستقبال الهرمية من استخراج المعلومات المكانية بمقاييس مختلفة، بينما قامت شبكة LSTM بنمذجة التبعيات عبر إطارات الفيديو المتتالية. وقد وسّع هذا التصميم خط عمل CNN-LSTM التقليدي من خلال الحفاظ على المعلومات المكانية المحلية والسياقية قبل النمذجة الزمنية. كما عزز الأداء المتسق عبر مجموعات البيانات التي تحتوي على فئات حركية وأنماط حركة وزوايا رؤية مختلفة من الكاميرا مدى قوة البنية المقترحة.
من منظور عملي، أظهر الإطار إمكانات واعدة في التحليلات الرياضية المؤتمتة، وتقييم أداء الرياضيين، واكتشاف الأحداث، وفهم مقاطع الفيديو الرياضية. ومع ذلك، يلزم إجراء مزيد من التحقق تحت ظروف التشغيل في العالم الحقيقي قبل النشر. ورغم أن البنية حققت أداءً قويًا في التعرف، إلا أنه يجب تأكيد مدى ملاءمتها للأجهزة ذات الموارد المحدودة أو منصات التحليلات السحابية من خلال تقييم إضافي للتكلفة الحسابية، ووقت الاستدلال، ومتطلبات الذاكرة، واستهلاك الطاقة.
أظهرت دراسة الاستئصال المساهمات التكاملية لمكونات MSCNN و LSTM. حيث حسنت MSCNN استخراج الميزات المكانية من خلال تعلم التمثيلات بمقاييس متعددة للمجال الاستقبالي، بينما عززت LSTM النمذجة الزمنية عبر التقاط اعتمادات الحركة عبر الإطارات المتتالية. وقد حقق تكوين MSCNN-LSTM الكامل أفضل أداء، مما يشير إلى أن استخراج الميزات المكانية متعددة المقاييس ونمذجة التسلسلات الزمنية قد ساهمَا معاً في التحسن الملحوظ في التعرف على الأفعال.
بشكل عام، نجح إطار عمل MSCNN-LSTM المقترح في دمج تعلم التمثيلات المكانية والزمانية للتعرف على الحركات في مقاطع الفيديو الرياضية. وقد أظهر التقييم الذي أجري على مجموعات بيانات UCF11 وUCF Sports وJHMDB تحسناً في الأداء مقارنة بنهج التعلم العميق التي تم تقييمها. ودعمت هذه النتائج الفرضية القائلة بأن دمج الميزات التلافيفية متعددة المقاييس مع النمذجة الزمانية القائمة على LSTM يحسن من التعرف على الحركات الرياضية المعقدة. ومع ذلك، فإن التحقق من صحة النتائج باستخدام مجموعات بيانات أكبر وأكثر تنوعاً وعبر نطاقات مختلفة يعد أمراً ضرورياً لإثبات القابلية للتعميم والتطبيق في العالم الحقيقي.
يجب مراعاة عدة قيود. أولاً، اقتصر التقييم على مجموعات بيانات مرجعية متاحة للعموم، وقد لا تمثل بشكل كامل تنوع وتعقيد البيئات الرياضية في العالم الحقيقي. ثانياً، على الرغم من استخدام تقسيمات ثابتة للتدريب والتحقق والاختبار، إلا أنه لا يمكن استبعاد انحياز مجموعة البيانات وتسرب البيانات غير المقصود بشكل كامل. ثالثاً، قد يختلف الأداء المسجل وفقاً لتكوين مجموعة البيانات، وتهيئة النموذج، وإجراءات المعالجة المسبقة، وإعدادات التدريب. بالإضافة إلى ذلك، أدت مكونات النمذجة الزمنية والتلافيفية متعددة المقاييس إلى زيادة المتطلبات الحسابية، مما قد يؤثر على النشر في الأجهزة ذات الموارد المحدودة. كما لم يتم تقييم الإطار باستخدام مجموعات بيانات خارجية أو سيناريوهات إنتاج في الوقت الفعلي.
أظهرت نماذج الفيديو القائمة على المحولات (Transformers) أداءً قوياً في مجموعات بيانات التعرف على الأفعال واسعة النطاق، ولكنها غالباً ما تتطلب موارد حوسبية كبيرة وبيانات تدريب مكثفة. ويقدم إطار عمل MSCNN-LSTM المقترح نهجاً بديلاً من خلال الجمع بين استخراج الميزات المكانية متعددة المقاييس والنمذجة الزمنية المتكررة. وينبغي أن تبحث الأعمال المستقبلية في التحقق من الصحة عبر مجموعات بيانات مختلفة، والاستدلال في الوقت الفعلي، والتحسين الحوسبي، وتقدير عدم اليقين، والبنى الهجينة التي تدمج آليات الانتباه القائمة على المحولات مع إطار عمل CNN-LSTM متعدد المقاييس المقترح38.
الإفصاحات
يعلن المؤلفون عن عدم وجود تضارب في المصالح.
شكر وتقدير
أُجري هذا البحث في مركز تكنولوجيا الذكاء الاصطناعي (CAIT)، كلية علوم وتكنولوجيا المعلومات، بجامعة Kebangsaan Malaysia. ويعرب المؤلفون عن امتنانهم للدعم المؤسسي والمرافق البحثية المقدمة. لم يتلقَ هذا العمل أي تمويل محدد من أي وكالة تمويل عامة أو تجارية أو غير ربحية.
المواد
| الاسم | الشركة | رقم فهرسي | التعليقات |
|---|---|---|---|
| وحدة معالجة الرسوميات GeForce RTX 3090 | شركة NVIDIA | RTX 3090، ذاكرةات وصول عشوائي للفيديو (VRAM) بسعة 24 جيجابايت | تُستخدم لتدريب نماذج التعلم العميق والاستدلال بها |
| معالج Intel Core i9 | شركة إنتل (Intel Corporation) | 16 نواة، 3.5 جيجاهرتز | تُستخدم للمعالجة المسبقة للبيانات والحوسبة |
| ذاكرة النظام | عام | ذاكرة وصول عشوائي (RAM) بسعة 64 جيجابايت من نوع DDR4 | يدعم معالجة الفيديو على نطاق واسع |
| لغة برمجة بايثون (Python) | مؤسسة برمجيات بايثون (Python Software Foundation) | الإصدار 3.8.18 | لغة البرمجة الأساسية للتنفيذ |
| تنسور فلو (TensorFlow) | جوجل | الإصدار 2.15 | إطار عمل التعلم العميق المستخدم لتطوير النموذج |
| نظام التشغيل | شركة مايكروسوفت (Microsoft Corporation) | ويندوز 11 | تطوير النموذج والتجريب |
| مجموعة أدوات CUDA | NVIDIA Corporation | CUDA 11.8 | تسريع تدريب النماذج باستخدام وحدة معالجة الرسوميات (GPU) |
| cuDNN | شركة NVIDIA | cuDNN 8.9.7 | مكتبة تسريع الشبكات العصبية العميقة |
| OpenCV | مفتوح المصدر | الإصدار 4.8.1 | استخراج إطارات الفيديو ومعالجتها مسبقاً |
| NumPy | مفتوح المصدر | الإصدار 1.24.4 | الحساب العددي ومعالجة المصفوفات |
| Scikit-learn | مفتوح المصدر | الإصدار 1.3.2 | تقييم الأداء والتحليل الإحصائي |
| مات بلوت ليب (Matplotlib) | مفتوح المصدر | الإصدار 3.7.5 | تصوير النتائج التجريبية |
| مجموعة بيانات UCF11 | جامعة سنترال فلوريدا | مجموعة بيانات عامة | مجموعة بيانات مرجعية للتعرف على الأنشطة الرياضية |
| مجموعة بيانات UCF للرياضات | جامعة سنترال فلوريدا | مجموعة بيانات عامة | مجموعة بيانات مرجعية للتعرف على الأنشطة الرياضية |
| مجموعة بيانات JHMDB | معهد ماكس بلانك للمعلوماتية | مجموعة بيانات عامة | مجموعة بيانات مرجعية للتعرف على الحركة والعمل البشرية |
المراجع
- Hassan N, Miah ASM, Shin J. A deep bidirectional LSTM model enhanced by transfer-learning-based feature extraction for dynamic human activity recognition. Appl Sci. 2024;14:603. https://doi.org/10.3390/app14020603
- Egawa R, et al. Dynamic fall detection using graph-based spatial temporal convolution and attention network. Electronics. 2023;12:3234. https://doi.org/10.3390/electronics12153234
- Riahi M, Eslami M, Safavi SH, Torkamani Azar F. Human activity recognition using improved dynamic image. IET Image Process. 2020;14:3223–3231. https://doi.org/10.1049/iet-ipr.2020.0372
- Muhammad K, et al. Human action recognition using attention-based LSTM network with dilated CNN features. Future Gener Comput Syst. 2021;125:820–830. https://doi.org/10.1016/j.future.2021.06.017
- Al-Obaidi S, Al-Khafaji H, Abhayaratne C. Making sense of neuromorphic event data for human action recognition. IEEE Access. 2021;9:82686–82700. https://doi.org/10.1109/ACCESS.2021.3085769
- Wensel J, Ullah H, Munir A. ViT-ReT: Vision and recurrent transformer neural networks for human activity recognition in videos. IEEE Access. 2023;11:72227–72249. https://doi.org/10.1109/ACCESS.2023.3293445
- Vrskova R, Hudec R, Kamencay P, Sykora P. Human activity classification using the 3DCNN architecture. Appl Sci. 2022;12:931. https://doi.org/10.3390/app12020931
- Ullah A, et al. Action recognition using optimized deep autoencoder and CNN for surveillance data streams of non-stationary environments. Future Gener Comput Syst. 2019;96:386–397. https://doi.org/10.1016/j.future.2019.01.041
- Jaouedi N, Boujnah N, Bouhlel MS. A new hybrid deep learning model for human action recognition. J King Saud Univ Comput Inf Sci. 2020;32:447–453. https://doi.org/10.1016/j.jksuci.2018.08.001
- Zebhi S, Al-Modarresi SMT, Abootalebi V. Converting video classification problem to image classification with global descriptors and pre-trained network. IET Comput Vis. 2020;14:614–624. https://doi.org/10.1049/iet-cvi.2020.0023
- Cust E, Sweeting AJ, Ball K, Robertson S. Machine and deep learning for sport-specific movement recognition: A systematic review. J Sports Sci. 2019;37:568–600. https://doi.org/10.1080/02640414.2018.1504613
- Cao S, Wang B, Zhang W, Ma L. Visual consensus modeling for video-text retrieval. In Proc AAAI Conf Artif Intell. 2022:167–175. https://doi.org/10.1609/aaai.v36i1.19890
- Yu H, et al. Fine-grained video captioning for sports narrative. In Proc IEEE Conf Comput Vis Pattern Recognit (CVPR). 2018:6006–6015. https://doi.org/10.1109/CVPR.2018.00628
- Browne P, Sweeting AJ, Woods CT, Robertson S. Methodological considerations for furthering the understanding of constraints in applied sports. Sports Med Open. 2021;7:22. https://doi.org/10.1186/s40798-021-00307-9
- Gao T, et al. Sports video classification method based on improved deep learning. Appl Sci. 2024;14:948. https://doi.org/10.3390/app14020948
- Dong Z, Xie M, Li X. Multi-scale receptive fields convolutional network for action recognition. Appl Sci. 2023;13:3403. https://doi.org/10.3390/app13063403
- Liu S, et al. Human memory update strategy: A multi-layer template update mechanism for remote visual monitoring. IEEE Trans Multimed. 2021;23:2188–2198. https://doi.org/10.1109/TMM.2020.3009234
- Liu S, Liu D, Muhammad K, Ding W. Effective template update mechanism in visual tracking with background clutter. Neurocomputing. 2021;458:615–625. https://doi.org/10.1016/j.neucom.2021.05.032
- Haque MN, et al. GRU-based attention mechanism for human activity recognition. In Proc ICASERT. 2019:1–6. https://doi.org/10.1109/ICASERT.2019.8934521
- Al-qaness MA, Dahou A, AbdElaziz M, Helmi A. Multi-ResAtt: Multilevel residual network with attention for human activity recognition using wearable sensors. IEEE Trans Ind Inform. 2022;19:144–152. https://doi.org/10.1109/TII.2022.3147850
- Duan F, et al. A multi-task deep learning approach for sensor-based human activity recognition and segmentation. IEEE Trans Instrum Meas. 2023;72:2514012. https://doi.org/10.1109/TIM.2023.3264512
- Gomes E, et al. Machine learning algorithms for activity-intensity recognition using accelerometer data. Sensors. 2021;21:1214. https://doi.org/10.3390/s21041214
- Su C, et al. A novel model for fall detection and action recognition combining lightweight 3D-CNN and ConvLSTM networks. Pattern Anal Appl. 2024;27:3. https://doi.org/10.1007/s10044-023-01234-5
- Zhou T, et al. Behavior recognition based on improved density clustering and context-guided Bi-LSTM model. Multimed Tools Appl. 2023;82:45471–45488. https://doi.org/10.1007/s11042-023-14678-9
- Shin J, et al. Video-based human activity recognition using hybrid deep learning model. Comput Model Eng Sci. 2025;143:3615. https://doi.org/10.32604/cmes.2025.058341
- Vrskova R, Hudec R, Kamencay P, Sykora P. A new approach for abnormal human activities recognition based on ConvLSTM architecture. Sensors. 2022;22:2946. https://doi.org/10.3390/s22082946
- Vijeikis R, Raudonis V, Dervinis G. Efficient violence detection in surveillance. Sensors. 2022;22:2216. https://doi.org/10.3390/s22062216
- Rendón-Segador F, et al. ViolenceNet: Dense multi-head self-attention with bidirectional ConvLSTM for detecting violence. Electronics. 2021;10:1601. https://doi.org/10.3390/electronics10131601
- Kalfaoglu E, Kalkan S, Alatan A. Late temporal modeling in 3D CNN architectures with BERT for action recognition. In Proc ECCV Workshops. 2020. https://doi.org/10.1007/978-3-030-66823-5_43
- Moaaz M, Mohamed E. Violence detection in surveillance videos using deep learning. Inf Bull Fac Comput Artif Intell. 2020;2:6.
- Song W, et al. Expressive 3D facial animation generation based on local-to-global latent diffusion. IEEE Trans Vis Comput Graph. 2024;30:7397–7407. https://doi.org/10.1109/TVCG.2024.3456213
- Li L, Cherouat A, Snoussi H, Wang T. Grasping with occlusion-aware ally method in complex scenes. IEEE Trans Autom Sci Eng. 2025;22:5944–5954. https://doi.org/10.1109/TASE.2024.3434610
- Li R, et al. UE-Extractor: A grid-to-point ground extraction framework for unstructured environments. IEEE Robot Autom Lett. 2025;10:5991–5998. https://doi.org/10.1109/LRA.2025.3563127
- Jhuang, H., Gall, J., Zuffi, S., Schmid, C., Black, M. J. Towards understanding action recognition. Proceedings of the IEEE International Conference on Computer Vision. 3192–3199, doi:10.1109/ICCV.2013.396 (2013).
- OpenMMLab. MMAction2: JHMDB dataset preparation. GitHub. https://github.com/open-mmlab/mmaction2/tree/main/tools/data/jhmdb (2026).
- Ullah W, Khalid YN, Khan SH. A novel deep hybrid framework with ensemble-based feature optimization for HAR. arXiv preprint arXiv:2508.18695. 2025. https://arxiv.org/abs/2508.18695
- Karuppannan K, Darmanayagam SE, Cyril SR. Human action recognition using fusion-based discriminative features and LSTM classification. Concurr Comput Pract Exp. 2022;34:e7250. https://doi.org/10.1002/cpe.7250
- Sahoo SP, et al. HAR-depth: A novel framework for human action recognition using sequential learning and depth estimated history images. IEEE Trans Emerg Top Comput Intell. 2020;5:813–825. https://doi.org/10.1109/TETCI.2020.3006543