يصف هذا البروتوكول تنفيذ منصة ويب قابلة للتشغيل البيني تدمج البيانات السريرية القائمة على معيار FHIR مع تقنية التوليد المعزز بالاسترجاع (Retrieval-Augmented Generation) ونماذج لغوية كبيرة متعددة الوكلاء لدعم اتخاذ القرار السريري. يتيح سير العمل هذا نشراً قابلاً للتكرار، وتكاملاً معيارياً للبيانات، وتقييماً لتحليل البيانات الطبية المدعوم بالذكاء الاصطناعي (AI).
يتطلب اشتراك JoVE لعرض هذا المحتوى. تسجيل الدخول أو ابدأ نسخة تجريبية مجانية
مقالة بحثية
منصة ويب قابلة للتشغيل البيني تعتمد على النماذج اللغوية الكبيرة لتحليل البيانات الطبية: بروتوكول لدعم القرار السريري
في هذه المقالة
ملخص
الملخص
غالباً ما تعوق السجلات الصحية الإلكترونية المجزأة ومحدودية التشغيل البيني بين أنظمة معلومات الرعاية الصحية غير المتجانسة عملية اتخاذ القرار السريري. يقدم هذا المقال بروتوكولاً تفصيلياً خطوة بخطوة لتنفيذ منصة ويب قابلة للتشغيل البيني تدمج البيانات السريرية عبر معيار موارد التشغيل البيني السريع للرعاية الصحية (FHIR)، جنباً إلى جنب مع التوليد المعزز بالاسترداد (RAG)، والنماذج اللغوية الكبيرة (LLMs)، وإطار عمل للاستدلال السريري متعدد الوكلاء لدعم تحليل البيانات الطبية ودعم القرار السريري. يصف البروتوكول سير العمل كاملاً، بما في ذلك تهيئة البيئة الحسابية، والمعالجة المسبقة لمجموعة البيانات السريرية، وتكامل البيانات القائم على FHIR، وبناء قاعدة بيانات متجهية، وتهيئة الاسترداد، وهندسة التلقين، وتنسيق الوكلاء المتعددين، وتقييم النظام. تُظهر النتائج التمثيلية قدرة المنصة على توليد استجابات ذات صلة سريرياً ومتسقة سياقياً مع تحسين التشغيل البيني الدلالي عبر مصادر البيانات غير المتجانسة. تم تقييم أداء النظام باستخدام مقاييس كمية ودلالية تكميلية، بما في ذلك BLEU وROUGE وBERTScore والتشابه الجيبي. أُجري تقييم نوعي باستخدام مجموعات بيانات رعاية صحية مرجعية متاحة للعموم ومجهولة الهوية تماماً لتقييم إمكانية تكرار سير العمل المنهجي المقترح. تدمج البنية المقترحة التشغيل البيني المعياري للرعاية الصحية مع النماذج اللغوية المعززة بالاسترداد لتحسين الاستدلال السياقي، وتقليل الهلوسة، ودعم سير العمل السريري القابل للتكرار والمدعوم بالذكاء الاصطناعي. يوفر هذا البروتوكول إطاراً قابلاً للتطوير والتكرار للباحثين والمطورين الذين يسعون إلى تنفيذ أنظمة رعاية صحية ذكية، تراعي الخصوصية وقابلة للتشغيل البيني لدعم القرار السريري، وتحليل البيانات الطبية، والأبحاث الانتقالية المستقبلية.
المقدمة
يتم إنتاج المعلومات الصحية بشكل روتيني عبر المستشفيات، ومراكز التشخيص، والمختبرات، والعيادات الخارجية، وغالباً ما تظل موزعة بين أنظمة معلومات غير متجانسة. ويحد هذا التجزؤ من القدرة على التشغيل البيني ويقيد الوصول السريع إلى سجلات المرضى الشاملة، مما يخلق تحديات مستمرة في الرعاية السريرية، وتكامل البيانات، وإدارة الرعاية الصحية1,2,3,4.
تصبح عواقب هذا التجزؤ واضحة بشكل خاص في سير العمل السريري الذي يعتمد على الوصول السريع إلى معلومات المريض. فعندما لا يتمكن متخصصو الرعاية الصحية من استرجاع سجلات طبية كاملة ومتكاملة، يصبح التقييم السريري أكثر صعوبة، مما يزيد من خطر اتخاذ قرارات غير مكتملة ويقلل من كفاءة تقديم الرعاية، لا سيما في حالات الطوارئ5,6.
أدت التطورات الأخيرة في مجال الذكاء الاصطناعي (AI)، وخاصة النماذج اللغوية الكبيرة (LLMs)، إلى توسيع نطاق النهج الحسابية المتاحة لتطبيقات الرعاية الصحية. وقد تم استقصاء هذه النماذج في مهام مثل المساعدة التشخيصية، والفرز السريري، ودعم اتخاذ القرار. فعلى سبيل المثال، قام Jahan وآخرون5 بتقييم استخدام النماذج اللغوية الكبيرة في المهام الطبية الحيوية، بينما بحث Taylor وآخرون7 في النماذج الضبطية الدقيقة للفحص الرقمي للصحة النفسية، وأبلغوا عن نتائج مشجعة في البيئات السريرية المتخصصة.
وقد توسع تطبيق نماذج اللغات الكبيرة (LLMs) ليشمل مجالات سريرية أكثر تخصصاً. حيث استكشف Song وزملاؤه 49 استخدامها في تشخيص داء الغبار الرئوي، بينما طبق Chien وزملاؤه8 هذه النماذج لتحليل أنماط عبء العمل لدى مقدمي الرعاية غير الرسميين. وفي طب العيون، اقترح Xue وزملاؤه9 نظاماً للإجابة على الأسئلة لتشخيص الجلوكوما (المياه الزرقاء)، بينما أفاد Tan وزملاؤه3 وWu وزملاؤه10 باستخدام نماذج اللغات الكبيرة في أنظمة التشخيص الهجينة واستشارات الطب الصيني التقليدي.
لا يقتصر استخدام النماذج اللغوية الكبيرة (LLMs) على التطبيقات السريرية المباشرة؛ حيث بحث Zhang et al.11 في تطبيقها للتعرف على العواطف في سيناريوهات الصحة النفسية، بينما استكشف Sarzaeim et al.12 أنظمة الشرطة الذكية التي قد تساهم أيضًا في التحليلات المتعلقة بالصحة العامة. وتوضح هذه الدراسات القابلية الواسعة لتطبيق المنهجيات القائمة على النماذج اللغوية الكبيرة عبر مختلف المجالات المرتبطة بالرعاية الصحية.
على الرغم من أن النماذج اللغوية الكبيرة (LLMs) قد وسعت من إمكانيات تطبيقات الرعاية الصحية، إلا أن دمجها في البيئات السريرية لا يزال مرتبطاً بتحديات تقنية وتنظيمية وإدارية هامة. ويتطلب النشر العملي بنية تحتية حوسبية مناسبة، وحوكمة فعالة للبيانات، والامتثال للأطر التنظيمية مثل اللائحة العامة لحماية البيانات (GDPR) والقانون العام لحماية البيانات البرازيلي (LGPD). وتحدد هذه الأطر المتطلبات اللازمة للمعالجة الآمنة والأخلاقية للمعلومات الصحية الحساسة، مع معالجة القضايا المتعلقة بالخصوصية والموثوقية والتحيز الخوارزمي في أنظمة الرعاية الصحية المدعومة بالذكاء الاصطناعي13,14 .
لا تزال القابلية للتشغيل البيني عبر مصادر البيانات الصحية غير المتجانسة، بما في ذلك السجلات الصحية الإلكترونية (EHRs)، وأنظمة التصوير الطبي، وأجهزة إنترنت الأشياء (IoT)، تمثل تحدياً تقنياً رئيساً لنشر حلول الرعاية الصحية المدعومة بالذكاء الاصطناعي. وفي هذا السياق، توفر أطر القابلية للتشغيل البيني الموحدة مثل HL7 FHIR آلية منظمة لتبادل المعلومات السريرية عبر الأنظمة المختلفة مع الحفاظ على الاتساق الدلالي ودعم التكامل القابل للتوسع.
يقدم هذا العمل منصة ويب قابلة للتشغيل البيني تدمج النماذج اللغوية الكبيرة مع معايير التشغيل البيني للرعاية الصحية لدعم تحليل البيانات الطبية في البيئات السريرية غير المتجانسة. تجمع البنية المقترحة بين تكامل البيانات القائم على معيار HL7 FHIR والتوليد المعزز بالاسترجاع (RAG) وإطار عمل لمعالجة الوكلاء المتعددين لتوفير تحليل مدعوم بالذكاء الاصطناعي مدرك للسياق، مع الحفاظ على التوافق مع متطلبات حماية البيانات المعمول بها، بما في ذلك القانون العام لحماية البيانات البرازيلي (LGPD).
يصف هذا البروتوكول بنية تشغيلية مشتركة لدمج البيانات السريرية غير المتجانسة باستخدام معايير التشغيل البيني المعتمدة في الرعاية الصحية. كما يفصل تنفيذ خط معالجة متعدد الوكلاء يعتمد على نماذج لغوية كبيرة ونماذج لغوية صغيرة (LLMs و SLMs)، إلى جانب إطار تقييم يجمع بين المقاييس الكمية والتحليلات النوعية لتقييم سلوك المنصة المقترحة.
الوصول مقيد. يرجى تسجيل الدخول أو بدء فترة تجريبية لعرض هذا المحتوى.
البروتوكول
لم تتضمن هذه الدراسة استقطاب مشاركين بشريين، أو الوصول إلى سجلات مرضى يمكن تحديد هويتهم، أو إجراء تجارب تشمل الحيوانات. تم تطوير البروتوكول وتقييمه حصرياً باستخدام مجموعات بيانات متاحة للعموم ومجهولة الهوية تماماً لغرض التحقق المنهجي. لم يتم الوصول إلى أي معلومات صحية شخصية أو معالجتها. وبناءً على ذلك، لم تكن هناك حاجة للحصول على موافقة من مجلس مراجعة مؤسسي (IRB) أو لجنة أخلاقيات البحث. وقد تم تطوير البروتوكول وفقاً لمبادئ حماية البيانات المعمول بها، بما في ذلك القانون العام لحماية البيانات البرازيلي (LGPD)، لدعم التطبيقات المستقبلية التي تتضمن بيانات سريرية.
اختيار مجموعة البيانات ومعالجتها مسبقاً
تم تقييم البروتوكول المقترح باستخدام مجموعات بيانات سريرية مجهولة الهوية بالكامل ومتاحة للعامة، وتتكون من سجلات صحية إلكترونية (EHRs) مهيكلة، وبيانات الإجابة على الأسئلة السريرية، ومجموعات بيانات التصوير الطبي للتحقق من المنهجية. وقبل دمجها في المنصة، خضعت مجموعات البيانات لإجراءات معالجة مسبقة موحدة، شملت تطبيع البيانات، وإزالة السجلات غير المتسقة أو غير المكتملة، والربط بموارد HL7 FHIR، وتنظيف النصوص، والتقسيم إلى أجزاء استرداد (retrieval chunks)، وتوليد التضمينات (embeddings) للفهرسة المتجهة. وقد ضمنت خطوات المعالجة المسبقة هذه الاتساق الدلالي عبر مصادر البيانات غير المتجانسة، مما سهل التشغيل البيني ومكن من إعادة إنتاج سير العمل المقترح مع الحفاظ على الامتثال لمبادئ خصوصية البيانات المعمول بها.
تم الحصول على مجموعات البيانات من مستودعات مرجعية متاحة للعموم وتُستخدم بشكل شائع في أبحاث الذكاء الاصطناعي والصحة الرقمية. وقد اختيرت هذه المجموعات لتمثيل معلومات سريرية غير متجانسة، بما في ذلك السجلات الصحية الإلكترونية (EHRs) المهيكلة، والسرديات السريرية غير المهيكلة، ومهام الإجابة على الأسئلة السريرية، والبيانات الوصفية للتصوير الطبي. وبدلاً من تقييم مجموعة سريرية محددة، يركز البروتوكول على توضيح سير عمل تنفيذي قابل للتكرار يمكن تكييفه مع مجموعات بيانات الرعاية الصحية المختلفة. ويتيح تنوع هذه المجموعات المرجعية التحقق من صحة مسار التشغيل البيني، والجيل المعزز بالاسترداد (RAG)، وإطار الاستدلال متعدد الوكلاء عبر أنماط متعددة من البيانات السريرية.
تكوين البيئة التجريبية
تم تهيئة البيئة التجريبية لتقييم المنصة القابلة للتشغيل البيني في ظل ظروف مضبوطة وقابلة للتكرار. تتكون البنية من وحدات لاستيعاب البيانات، وطبقات التشغيل البيني، ونماذج لغوية كبيرة (LLMs)، ومكونات تقييم منظمة في مسار معالجة واحد لتحليل البيانات الطبية. يوضح الشكل 1 سير العمل الكامل، بدءاً من استيعاب البيانات السريرية وصولاً إلى إنتاج المخرجات التشخيصية.
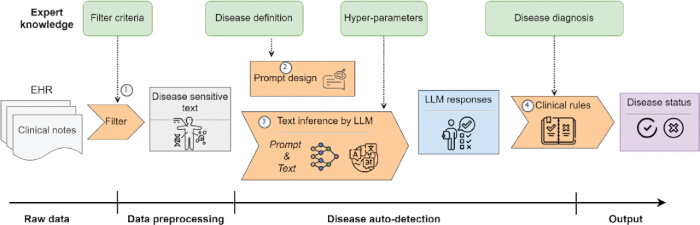
الشكل 1: سير عمل النظام العام الذي يوضح خط معالجة البيانات من البيانات السريرية الخام إلى مخرجات حالة المرض. تبدأ العملية باستيعاب السجلات الصحية الإلكترونية (EHR)، تليها تصفية البيانات ومعالجتها مسبقاً لاستخراج المعلومات الحساسة للمرض. تتضمن مرحلة تصميم المطالبات المهيكلة دمج معرفة الخبراء، وتعريفات الأمراض، والمعاملات الفائقة، مما يتيح تفاعلاً فعالاً مع النموذج اللغوي الكبير (LLM). يقوم النموذج اللغوي الكبير بإجراء استنتاج نصي لتوليد استجابات تراعي السياق، والتي يتم تقييمها لاحقاً من خلال قواعد سريرية لتحديد حالة المرض النهائية. يسلط سير العمل الضوء على تكامل المعالجة المسبقة للبيانات، والمطالبات الموجهة بالمعرفة، والاستنتاج القائم على الذكاء الاصطناعي لدعم اتخاذ القرار السريري. يرجى النقر هنا لعرض نسخة أكبر من هذا الشكل.
بنية 상호 التشغيل في الرعاية الصحية
تعتمد البنية التحتية للخلفية البرمجية بنية نمطية قائمة على واجهات برمجة التطبيقات RESTful APIs لدعم الاتصال بين مكونات المنصة (الشكل 2). وتستوعب هذه البنية معلومات سريرية غير متجانسة، بما في ذلك السجلات الصحية الإلكترونية (EHRs) المهيكلة، وملاحظات الأطباء، والبيانات الوصفية المستمدة من أنظمة التصوير الطبي. ونظراً لأن هذه البيانات تنشأ من مصادر وتنسيقات متعددة، فقد تم تحقيق 상호 التشغيل البيني من خلال نماذج بيانات موحدة، ولا سيما إطار موارد التشغيل البيني السريع للرعاية الصحية (FHIR)15,16,17.. ويدعم اعتماد FHIR تبادل المعلومات المهيكلة مع الحفاظ على القابلية للتوسع والمرونة في بيئات الرعاية الصحية الموزعة. كما تم دمج آليات اتصال قائمة على معيار HL7 لتسهيل التكامل مع الأنظمة السريرية القديمة التي لا تزال مستخدمة على نطاق واسع في مؤسسات الرعاية الصحية16,17.
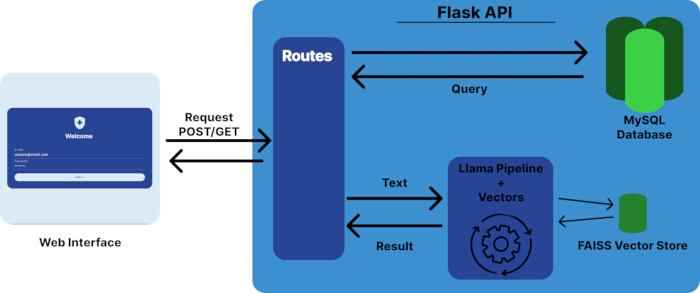
الشكل 2: بنية النظام للمنصة المقترحة القابلة للتشغيل البيني. تتواصل واجهة الويب مع الخلفية البرمجية من خلال Flask API باستخدام طلبات HTTP POST/GET. وتدير واجهة برمجة التطبيقات (API) عمليات التوجيه، ومعالجة الاستعلامات، والتفاعل مع مصادر البيانات المهيكلة وغير المهيكلة. تخزن قاعدة بيانات MySQL البيانات السريرية المهيكلة، بينما يدعم مخزن المتجهات القائم على FAISS البحث عن التشابه لعمليات الاسترجاع. وتقوم سلسلة معالجة تعتمد على LLaMA بمعالجة المدخلات النصية وتوليد الاستجابات باستخدام تمثيلات المتجهات، مما يتيح التوليد المعزز بالاسترجاع (RAG). وتسلط هذه البنية الضوء على تكامل خدمات الويب، وإدارة قواعد البيانات، واسترجاع المتجهات، واستدلال النماذج اللغوية الكبيرة في نظام موحد. يرجى النقر هنا لعرض نسخة أكبر من هذا الشكل.
تكوين سير عمل متعدد الوكلاء
تتكون بنية الوكلاء المتعددين من وكلاء وظيفيين متخصصين مسؤولين عن مراحل متميزة من سير العمل. حيث يقوم وكيل المعالجة المسبقة بإجراء تسوية البيانات ورسم خرائط FHIR، يليه وكيل استرجاع مسؤول عن البحث الدلالي داخل قاعدة البيانات المتجهية. ويقوم وكيل الاستدلال بدمج السياق المسترجع مع نموذج اللغة الكبير (LLM) لتوليد الاستجابات، بينما يتحقق وكيل التحقق من اتساق المخرجات وتنسيقها قبل تقديم الاستجابة النهائية. ويتبع تنسيق الوكلاء استراتيجية تنظيم تسلسلية يكون فيها مخرج كل وكيل بمثابة مدخل للمرحلة التالية، مما يضمن تنفيذاً نموذجياً وقابلاً لإعادة الإنتاج.
تكامل البيانات السريرية
تعمل طبقة تكامل البيانات على تجميع المعلومات من مصادر سريرية متعددة وتجهيزها للمعالجة اللاحقة. وتشمل المعالجة المسبقة تسوية البيانات، والتقسيم إلى وحدات رمزية (tokenization)، ومحاذاة الكيانات لتحسين الاتساق الدلالي عبر مجموعات البيانات غير المتجانسة. ونظرًا لأن المعلومات السريرية تختلف في بنيتها وجودتها، تساعد هذه العمليات في تقليل الضجيج وتسهيل التفاعل مع نماذج الذكاء الاصطناعي. كما تم تطبيق استراتيجيات رسم خرائط هيكلية لتوحيد تنسيقات البيانات المختلفة والحفاظ على التوافق مع مسار المعالجة، كما هو موضح في الشكل 315,16,17.
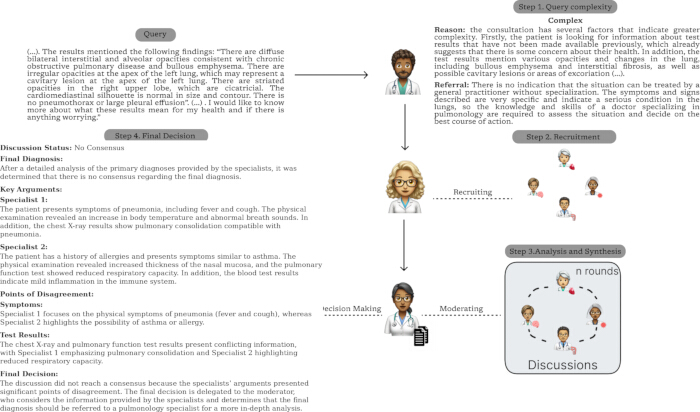
الشكل 3: مثال تفصيلي لعملية الاستدلال السريري متعددة الوكلاء. يوضح الشكل كيفية تحليل الاستعلام السريري عبر مراحل متعددة، بما في ذلك تقييم التعقيد، وتوظيف المتخصصين، والمناقشة التعاونية، واتخاذ القرار النهائي. وتبرز هذه العملية قدرة النظام على تكييف استراتيجيات الاستدلال ديناميكيًا بناءً على تعقيد الاستعلام، مما يحسن الكفاءة والدقة التشخيصية في سيناريوهات دعم القرار السريري. يرجى النقر هنا لعرض نسخة أكبر من هذا الشكل.
تكوين مسار التوليد المعزز بالاسترداد (Retrieval-Augmented Generation pipeline)
يتم دمج التوليد المعزز بالاسترداد (RAG) لتوفير تحليل واعٍ بالسياق من خلال الجمع بين استرداد المعلومات والقدرات التوليدية للنماذج اللغوية الكبيرة. يتم تحويل استعلامات المستخدم إلى تمثيلات متجهية باستخدام نماذج التضمين، ومطابقتها مع قاعدة البيانات المتجهية باستخدام البحث عن التشابه الدلالي لاسترداد المقاطع السياقية الأكثر صلة. ثم تُدمج المستندات المستردة مع الاستعلام الأصلي قبل عملية الاستدلال بواسطة النموذج اللغوي الكبير (LLM). وتساعد هذه الاستراتيجية في توفير معلومات سياقية أثناء توليد الاستجابة، وقد ارتبطت بتحسين الاتساق الواقعي وتقليل الهلوسة في التطبيقات كثيفة المعرفة، بما في ذلك الرعاية الصحية18,19. يوضح الشكل 1 والشكل 3 سير عمل الاسترداد العام وعملية الاستدلال المقابلة.
لكل طلب مستخدم، يتم بناء الأمر النهائي ديناميكيًا من خلال دمج الاستعلام الأصلي مع أكثر المقاطع السياقية صلة والتي تم استردادها من قاعدة البيانات المتجهية. يتم دمج المعلومات المستردة كأدلة سياقية قبل عملية الاستدلال، مما يسمح للنموذج اللغوي بتوليد استجابات مستندة إلى المعرفة الصحية المستردة مع الحفاظ على الاتساق الدلالي والحد من التوليدات غير المدعومة.
هندسة الأوامر والاستدلال متعدد الوكلاء
يتضمن البروتوكول استراتيجيات تحفيز مهيكلة لتحسين التفسير السياقي أثناء توليد الاستجابة. وتساعد تقنيات التحفيز هذه، إلى جانب آليات الاستنتاج المتقدمة، في توجيه عملية التفكير في السيناريوهات السريرية المعقدة، وهي تتوافق مع التطورات الأخيرة الواردة في الأدبيات العلمية20.
تتضمن البنية التحتية إطار عمل متعدد الوكلاء يتكون من وحدات متخصصة تؤدي وظائف متميزة ضمن مسار المعالجة، بما في ذلك التحقق من صحة البيانات، وتصفية السياق، ودعم الاستدلال السريري، والتحقق من المخرجات. ويسمح التنظيم النمطي بتنفيذ المهام بشكل متسلسل أو متوازٍ، مما يوفر المرونة اللازمة لمتطلبات المعالجة المختلفة (الشكل 4). ويؤدي توزيع هذه الأنشطة على وكلاء متعددين إلى تقليل الاعتماد على نموذج لغوي واحد ويدعم سير عمل أكثر قوة في المعالجة. وتتسق هذه الاستراتيجية المعمارية مع التطورات الأخيرة في مجال الذكاء الاصطناعي الموزع وتصميم الأنظمة الذكية21,22.
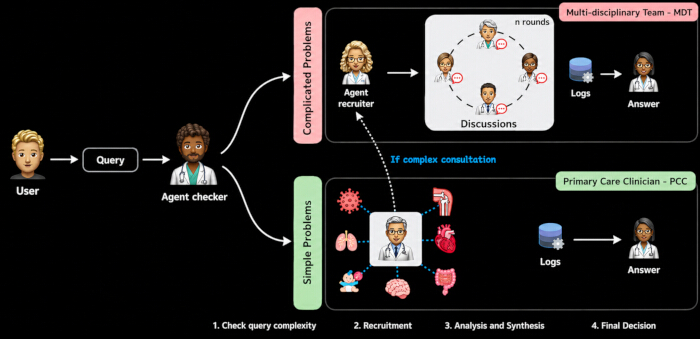
الشكل 4: إطار عمل اتخاذ القرار متعدد الوكلاء للاستدلال السريري. تبدأ العملية باستعلام من المستخدم، يقوم بتقييمه وكيل فحص مسؤول عن تقدير مدى تعقيد الاستعلام. وفي الحالات المعقدة، يقوم النظام باستدعاء فريق متعدد التخصصات (MDT) من الوكلاء المتخصصين الذين يشاركون في جولات نقاش تكرارية لتحليل المشكلة وتوليف المعرفة قبل اتخاذ القرار النهائي. أما في الحالات الأبسط، فيتولى وكيل ممارس الرعاية الأولية (PCC) التعامل مع الاستعلام، مما يتيح توليد استجابة أسرع. توازن هذه البنية التكيفية بين الكفاءة والعمق التحليلي، مما يحسن جودة القرار وقابلية توسع النظام في التطبيقات الرعاية الصحية. يرجى النقر هنا لعرض نسخة أكبر من هذا الشكل.
تقييم الأداء
تم تقييم أداء النظام باستخدام مقاييس تكميلية ترصد كلاً من الجودة اللغوية والاتساق الدلالي للمخرجات المولدة. طُبق مقياس BLEU لقياس التشابه النحوي بناءً على تداخل n-gram23، بينما قام مقياس ROUGE بتقييم الاستدعاء وتغطية المحتوى، لا سيما في مهام التلخيص واستخراج المعلومات24. كما تم تقييم التشابه الدلالي باستخدام BERTScore، الذي يعتمد على التضمينات السياقية المستمدة من النماذج القائمة على المحولات (transformer-based models) لمقارنة النصوص المولدة مع النصوص المرجعية25. وشملت التحليلات الإضافية قياس الحيرة (perplexity) وتشابه جيب التمام (cosine similarity) لفحص ثقة النموذج والتماسك الدلالي، على التوالي26,27.
توفر مقاييس التقييم المختارة رؤى متكاملة حول أداء النظام من خلال الجمع بين التحليلات المعجمية والدلالية. ويكتسب هذا الجمع أهمية خاصة في تطبيقات الرعاية الصحية، حيث لا يقل التفسير السياقي أهمية عن التشابه المعجمي. وقد جرى تقييم المنصة في بيئة حوسبة منضبطة تدعم النشر السحابي والمحلي على حد سواء. كما أُدرج التشغيل المحلي لنماذج اللغات الكبيرة (LLMs) كخيار لدعم متطلبات خصوصية البيانات وتقليل الاعتماد على الخدمات الخارجية عند معالجة المعلومات السريرية الحساسة. وتتوافق استراتيجية النشر هذه مع أطر حماية البيانات، ويمكن تكييفها مع بيئات تشغيلية مختلفة4.
الوصول مقيد. يرجى تسجيل الدخول أو بدء فترة تجريبية لعرض هذا المحتوى.
النتائج
تم تقييم أداء النظام باستخدام مقاييس كمية تكميلية إلى جانب التحليل النوعي لفحص كل من الدقة اللغوية والاتساق الدلالي للمخرجات التي تم إنشاؤها. وتجمع استراتيجية التقييم هذه بين المقاييس المعجمية والدلالية لتوفير توصيف أشمل لسلوك النموذج في مهام توليد اللغة المتعلقة بالرعاية الصحية.
يعرض الجدول 1 النتائج الكمية التي تم الحصول عليها باستخدام BLEU وROUGE وBERTScore. وقد تم اختيار هذه المقاييس لأنها تقيم جوانب متكاملة من النص المولد، بما في ذلك التشابه المعجمي، وتغطية المعلومات، وال...
الوصول مقيد. يرجى تسجيل الدخول أو بدء فترة تجريبية لعرض هذا المحتوى.
المناقشة
يمثل التقييم المقدم في هذه الدراسة تحققاً منهجياً تم إجراؤه باستخدام مجموعات بيانات رعاية صحية مرجعية متاحة للعموم ومجهولة الهوية تماماً. لم يتم إجراء أي تحقق سريري استباقي يشمل متخصصين في الرعاية الصحية أو استقطاباً للمرضى، حيث أن الهدف من هذا العمل هو عرض بروتوكول تنفيذ قابل للتكرار بدلاً من إثبات الفعالية السريرية.
تشير نتائج هذه الدراسة إلى أن الجمع بين معايير التشغيل البيني للرعاية الصحية والنماذج اللغوية الكبيرة يوفر إطاراً عملياً لدمج المعلومات السريرية غير المتجانسة. وتجمع البنية المقت...
الوصول مقيد. يرجى تسجيل الدخول أو بدء فترة تجريبية لعرض هذا المحتوى.
الإفصاحات
يصرح المؤلفون بعدم وجود أي تضارب في المصالح المالية أو علاقات شخصية من شأنها التأثير على العمل الوارد في هذه المخطوطة. تم استخدام أدوات الذكاء الاصطناعي التوليدي (AI) حصرياً للمساعدة في تحرير اللغة، وتصحيح القواعد النحوية، وتحسين مقروئية المخطوطة. وقد قام المؤلفون بتطوير والتحقق من واعتماد جميع المحتويات العلمية، وتصميم الدراسة، والمنهجية، وتحليل البيانات، وتفسير النتائج، والقرارات التحريرية، وهم يتحملون المسؤولية الكاملة عن محتوى هذه المخطوطة.
شكر وتقدير
يود المؤلفون تقديم الشكر لمختبر الأنظمة المدمجة والموزعة (LESC) بجامعة سيارا الاتحادية (UFC)، لتوفير بيئة البحث والمناقشات التقنية التي دعمت تطوير هذا العمل. كما يقر المؤلفون بجهود مطوري وصياني البرمجيات مفتوحة المصدر، ومعايير التشغيل البيني، ومجموعات البيانات المتاحة علناً والتي استُخدمت طوال هذه الدراسة.
الوصول مقيد. يرجى تسجيل الدخول أو بدء فترة تجريبية لعرض هذا المحتوى.
المواد
| الاسم | الشركة | رقم فهرسي | التعليقات |
|---|---|---|---|
| FAISS | شركة ميتا بلاتفورمز (Meta Platforms Inc.) | الإصدار 1.8.0 | قاعدة بيانات متجهية تُستخدم للبحث عن التشابه في مسار توليد النصوص المعزز بالاسترجاع (RAG). |
| معيار FHIR | منظمة HL7 الدولية | الإصدار 4 (R4) | معيار التشغيل البيني للرعاية الصحية المعتمد لتبادل البيانات السريرية المهيكلة. |
| دورق | مشاريع المنصات | الإصدار 3.0.3 | إطار عمل ويب بلغة Python استُخدم لتنفيذ واجهة برمجة تطبيقات RESTful للخلفية البرمجية. |
| معيار HL7 | HL7 International | الإصدار 2.x | بروتوكول مراسلة قديم يُستخدم لتحقيق التوافق التشغيلي مع نظم معلومات المستشفيات. |
| واجهة برمجة تطبيقات REST عبر البروتوكول HTTP | تنفيذ مخصص | نظرًا لعدم وجود نص مصدر، يرجى تزويدي بالنص الإنجليزي المراد ترجمته، وسأقوم بصياغته بدقة في السجل الأكاديمي العربي المتخصص لضمان الدقة العلمية والمنهجية وفقًا لمعايير JoVE. | طبقة اتصالات RESTful بين الواجهة الأمامية، والخلفية، وقاعدة البيانات، وخدمات الذكاء الاصطناعي. |
| لانج تشين (LangChain) | LangChain Inc. | الإصدار 0.3.x | إطار عمل مُستخدم لدمج النماذج اللغوية الكبيرة (LLMs)، وهندسة الأوامر (prompt engineering)، وسير عمل التوليد المعزز بالاسترجاع (Retrieval-Augmented Generation). |
| LangGraph | LangChain Inc. | الإصدار 0.2.x | إطار العمل المستخدم لتنظيم سير عمل الاستنتاج السريري متعدد الوكلاء. |
| LLaMA 3.1 8B Instruct | شركة ميتا بلاتفورمز (.Meta Platforms Inc) | الإصدار 3.1 | نموذج لغوي كبير مُستخدم في الاستدلال السريري وتوليد اللغة الطبيعية. |
| MySQL Community Server | شركة أوراكل (Oracle Corporation) | الإصدار 8.0 | قاعدة بيانات علاقتية تُستخدم لتخزين البيانات السريرية المهيكلة. |
| أولاما (Ollama) | Ollama Inc. | الإصدار 0.9.x | محرك استدلال محلي مُستخدم لتشغيل النماذج اللغوية الكبيرة مع الحفاظ على خصوصية المريض. |
| بايثون | مؤسسة برمجيات بايثون (Python Software Foundation) | الإصدار 3.11 | لغة البرمجة المستخدمة في تنفيذ المنصة الكاملة. |
| PyTorch | مؤسسة لينكس (Linux Foundation) | الإصدار 2.4 | إطار عمل التعلم العميق المستخدم لاستدلال النماذج اللغوية الكبيرة. |
| مسار التوليد المعزز بالاسترجاع (RAG) | تنفيذ مخصص | نظرًا لعدم توفر نص مصدر للترجمة، يرجى تزويدنا بالمحتوى العلمي المراد ترجمته إلى اللغة العربية. | إطار عمل للذكاء الاصطناعي يدمج الاسترجاع الدلالي مع استنتاج النماذج اللغوية الكبيرة (LLM) لتوليد استجابات مدركة للسياق. |
| محولات الجمل (Sentence Transformers) | Hugging Face Inc. | all-MiniLM-L6-v2 | نموذج التضمين المستخدم لتوليد تمثيلات متجهية كثيفة لاسترجاع المستندات دلالياً. |
| أوبونتو لينكس (Ubuntu Linux) | شركة كانونيكال المحدودة (Canonical Ltd.) | الإصدار 24.04 LTS | نظام التشغيل المستخدم للتطوير والتقييم التجريبي. |
| Visual Studio Code | شركة مايكروسوفت (Microsoft Corporation) | الإصدار 1.100 | بيئة تطوير متكاملة تُستخدم لتنفيذ البرمجيات وتصحيح الأخطاء. |
المراجع
- Chukwu E, Garg L. A systematic review of blockchain in healthcare: frameworks, prototypes, and implementations. IEEE Access. 2020;8:21196-21214. doi:10.1109/ACCESS.2020.2969881.
- Al-Nbhany WANA, Zahary AT, Al-Shargabi AA. Blockchain-IoT healthcare applications and trends: a review. IEEE Access. 2024;12:4178-4212. doi:10.1109/ACCESS.2023.3349187.
- Tan Y, et al. MedChatZH: a Chinese medical large language model. Comput Biol Med. 2024;172:108290.
- OLLAMA TEAM. Ollama: Run Large Language Models locally. Version 0.x. San Francisco: Ollama, 2024.
- Jahan I, Laskar MTR, Peng C, Huang JX. A comprehensive evaluation of large language models on benchmark biomedical text processing tasks. Comput Biol Med. 2024;171:108189. doi:10.1016/j.compbiomed.2024.108189.
- Liu X, Zhou Y, Wang Z, et al. Disease topic modeling of users' inquiry texts: a text mining-based PQDR-LDA model for analyzing the online medical records. IEEE Trans Eng Manag. 2023.
- Taylor N, Kormilitzin A, Lorge I, Nevado-Holgado A, Cipriani A, Joyce DW. Model development for bespoke large language models for digital triage assistance in mental health care. Artif Intell Med. 2024;157:102988.
- Song M, et al. PneumoLLM: a large language vision model for pneumonia diagnosis. Med Image Anal. 2024;97:103248.
- Chien SC, Yen CM, Chang YH, Chen YE, Liu CC, Hsiao YP, et al. Using large language model (LLM) to identify high-burden informal caregivers in long-term care. Comput Methods Programs Biomed. 2024;255:108329. doi:10.1016/j.cmpb.2024.108329.
- Xue X, Zhang D, Sun C, et al. Xiaoqing: a Q&A model for glaucoma based on LLMs. Comput Biol Med. 2024;174:108399.
- Wu D, Nie L, Mumtaz RA, Agarwal K. A LLM-based hybrid-transformer diagnosis system in healthcare. IEEE J Biomed Health Inform. 2024.
- Zhang Y, et al. LLM-enhanced multi-teacher knowledge distillation for modality-incomplete emotion recognition in daily healthcare. IEEE J Biomed Health Inform. 2024.
- Sarzaeim P, Mahmoud QH, Azim A. A framework for LLM-assisted smart policing system. IEEE Access. 2024;12:74915-74929. doi:10.1109/ACCESS.2024.3404862.
- Leme RS, Blank M. Lei Geral de Proteção de Dados e segurança da informação na área da saúde. Cad Ibero-Am Direito Sanit. 2020;9(3):210-224. doi:10.17566/ciads.v9i3.690.
- Zaganelli MV, Binda Filho DL. O sigilo médico e os dados sensíveis na telemedicina à luz da Lei Geral de Proteção de Dados. RECIIS. 2023;17(3):729-740. doi:10.29397/reciis.v17i3.3689.
- Tabari P, Costagliola G, De Rosa M, Boeker M. State-of-the-art Fast Healthcare Interoperability Resources (FHIR)-based data model and structure implementations: systematic scoping review. JMIR Med Inform. 2024.
- Martinez T, et al. HL7 systems and interoperability ecosystems in modern healthcare. IEEE Rev Biomed Eng. 2024.
- Chen L, et al. HL7 integration and semantic interoperability in distributed healthcare networks. IEEE J Biomed Health Inform. 2024.
- Liu W, Li W, Huang W, Gao Y. Security framework for medical data sharing. Telemed E-Health. 2024.
- Basile LJ, Carbonara N, Panniello U, Pellegrino R. How can technological resources improve the quality of healthcare service? IEEE Trans Eng Manag. 2024;71:5771-5781. doi:10.1109/TEM.2022.3192405.
- Singh A, et al. Prompt engineering in large language models: a survey using SWOT analysis [preprint]. arXiv. 2024
- Chen L, Chen Y, Liang W, Li X, Li KC, Wang J, Xiong N. MASS: a multiattribute sketch secure data sharing scheme for IoT wearable medical devices based on blockchain. IEEE Internet Things J. 2025;12(2):1990-2001. doi:10.1109/JIOT.2024.3468733.
- Autoridade Nacional de Proteção de Dados (BR). Diretrizes para agentes de tratamento de pequeno porte. Brasília (DF): ANPD; 2021.
- Patel R, Kim H. Interoperability in EHR. IEEE Transactions on Biomedical Engineering, v. 70, n. 8, p. 2341-2354, ago. 2023. DOI: 10.1109/TBME.2023.3241567.
- Zhang T, Kishore V, Wu F, Weinberger KQ, Artzi Y. BERTScore: evaluating text generation with BERT. In: International Conference on Learning Representations (ICLR); 2020.
- Chen X, Lu X, Li Q, Li D, Zhu F. Integration of LLM and Human-AI Coordination for Power Dispatching With Connected Electric Vehicles Under SAGVNs. IEEE Trans Veh Technol. 2025;74(2):1992-2002. doi:10.1109/TVT.2024.3434969
- Zhou S, Chen C, Gu HH. Testing and evaluating SNOMED CT web browsers' textual search feature. In: Proceedings of the IEEE International Conference on Bioinformatics and Biomedicine (BIBM); 2019.
- McPeak G, Sautmann A, George O, Hallal A, Simal EA, Schwartz AL, Abaluck J, Ravi N, Pless R. An LLM's medical testing recommendations in a Nigerian clinic: potential and limits of prompt engineering for clinical decision support. In: Proceedings of the 2024 IEEE 12th International Conference on Healthcare Informatics (ICHI); 2024.
- LLAMA TEAM, AI @ META. The Llama 3 Herd of Models. arXiv preprint arXiv:2407.21783, 2024. Disponível em: https://arxiv.org/abs/2407.21783.
- Conselho Nacional de Saúde (BR). Resolução nº 466, de 12 de dezembro de 2012. Aprova as diretrizes e normas regulamentadoras de pesquisas envolvendo seres humanos. Brasília (DF): Ministério da Saúde; 2012.
- Singhal K, Azizi S, Tu T, et al. Large language models encode clinical knowledge. Nature. 2023;620:172-180. doi:10.1038/s41586-023-06291-2.
- Sahoo P, et al. A systematic survey of prompt engineering in large language models [preprint]. arXiv. 2024. Available from: https://arxiv.org/abs/2402.07927
- Yan Y, Hou Y, Xiao Y, Zhang R, Wang Q. KNOWNET: guided health information seeking from LLMs via knowledge graph integration. IEEE Trans Vis Comput Graph. 2024.
الوصول مقيد. يرجى تسجيل الدخول أو بدء فترة تجريبية لعرض هذا المحتوى.