تقدم هذه الدراسة إطار عمل من مرحلتين لتصنيف الغطاء الأرضي باستخدام البيانات فائقة الطيف وLiDAR، وذلك عبر استخلاص الميزات باستخدام MetaFormer والمطابقة التدفقية ثنائية الاتجاه للمحاذاة عبر الوسائط قبل عملية الدمج. يظهر التقييم على ثلاث مجموعات بيانات مرجعية عامة أداءً تنافسياً في التصنيف وفقاً لبروتوكولات التقييم المحددة.
مقالة بحثية
تعلم حقل المتجهات عبر الوسائط المستمر لتصنيف الغطاء الأرضي باستخدام التصوير الفرط طيفي والرادار الليزري (LiDAR)
في هذه المقالة
ملخص
الملخص
يلعب تصنيف الاستشعار عن بعد متعدد الوسائط دورًا مهمًا في تطبيقات مثل الخرائط الحضرية والمراقبة البيئية. ومع ذلك، يمكن أن تؤدي توزيعات السمات غير المتجانسة عبر وسائط الاستشعار إلى عدم محاذاة السمات وعدم اتساق دلالي، مما يحد من فعالية الدمج متعدد الوسائط. ويمكن لنهج الدمج متعدد الوسائط الحالية، بما في ذلك الطرق التلافيفية، والقائمة على الرسوم البيانية، والقائمة على الانتباه، والتباينية، والموجهة للنقل، والقائمة على التسلسل، استغلال المعلومات التكميلية ولكنها قد لا تقوم بمحاذاة توزيعات السمات الخاصة بكل وسيط بشكل كافٍ. تقترح هذه الدراسة FlowErs، وهو إطار عمل للتصنيف متعدد الوسائط يتكون من مرحلتين ويعالج هذا التحدي من خلال مطابقة التدفق متعدد الوسائط. وتتمثل فرضية العمل في أن تقليل التباينات في توزيعات السمات المقترنة قبل دمج السمات يحسن تصنيف الغطاء الأرضي في ظل بروتوكولات معيارية ثابتة. في المرحلة الأولى، تقوم مشفرات MetaFormer الخاصة بكل وسيط باستخراج تمثيلات هرمية من بيانات التصوير الفرط طيفي (HSI) وبيانات الكشف عن الضوء وتحديد المدى (LiDAR). ثم يتعلم نموذج مطابقة التدفق متعدد الوسائط حقول سرعة مشروطة بالزمن لنقل توزيعات السمات المقترنة نحو تمثيل كامن مشترك باستخدام هدف متوسط مربع الخطأ ثنائي الاتجاه. وفي المرحلة الثانية، يتم إعادة استخدام وحدة المحاذاة المدربة مسبقًا لمحاذاة التمثيلات متعددة الوسائط قبل أن يقوم رأس دمج خفيف الوزن بإجراء تصنيف على مستوى البكسل. وأظهر التقييم على ثلاث مجموعات بيانات معيارية عامة دقة إجمالية (OA) قصوى بلغت 97.56% في ظل تقسيمات معيارية ثابتة. وقد تفاوت الأداء عبر فئات الغطاء الأرضي الفردية، وتناقش الدراسة القيود الخاصة بكل فئة وتأثير عدم توازن الفئات على المقاييس التجميعية. يقتصر التقييم الحالي على تجارب التقسيم الثابت دون تحليل إحصائي للتكرارات أو توصيف حاسوبي. وسوف تبحث الأعمال المستقبلية في المتانة الإحصائية والكفاءة الحاسوبية والتعميم عبر المناطق.
المقدمة
يعد التصنيف الدقيق لاستخدامات الأراضي والغطاء الأرضي (LULC) باستخدام الصور المستشعرة عن بُعد أمراً ضرورياً لمجموعة واسعة من التطبيقات الواقعية، بما في ذلك التنمية الحضرية، والرصد البيئي، وإدارة الكوارث، والتنمية المستدامة1. وقد أصبحت بيانات الاستشعار عن بُعد متعددة الأنماط، بما في ذلك الصور فائقة الطيف (HSI)، وكشف الضوء وتحديد المدى (LiDAR)، ورادار الفتحة الاصطناعية (SAR)، متاحة بشكل متزايد في السنوات الأخيرة. وقد أدى هذا التوفر المتزايد إلى توسيع قدرات الاستشعار عن بُعد بشكل كبير في تصنيف الغطاء الأرضي دقيق التفاصيل2. وتلتقط أنماط الاستشعار هذه خصائص متميزة ولكنها متكاملة لسطح الأرض؛ حيث توفر تقنية HSI معلومات طيفية غنية لتوصيف تركيب المواد، بينما يوفر نظام LiDAR معلومات دقيقة عن البنية والارتفاع3. ويمكن أن يؤدي دمج مصادر البيانات غير المتجانسة هذه إلى إنتاج تمثيلات ميزات أكثر تمييزاً، ومقاومة للضوضاء، وشاملة دلالياً مما يمكن أن يحققه أي نمط استشعار بمفرده4.
ومع ذلك، لا يزال الاستغلال الفعال للبيانات متعددة الوسائط يمثل تحديًا طويل الأمد5. وتنشأ الصعوبة الأساسية من عدم التجانس المتأصل في وسائط الاستشعار، والتي تختلف في الدقة المكانية، وخصائص الضوضاء، والتوزيعات الإحصائية، ودلالات الميزات6. على سبيل المثال، قد يتم تمثيل نفس كائن الغطاء الأرضي كبصمة طيفية عالية الأبعاد في HSI و كبنى هندسية متفرقة في LiDAR7. ونتيجة لذلك، غالبًا ما تقع الميزات الخاصة بكل وسيط في منوعات ميزات (feature manifolds) مختلفة، مما يجعل دمج الميزات المباشر غير فعال أو قد يؤدي إلى نتائج مضللة. علاوة على ذلك، فإن العديد من مناهج الدمج متعدد الوسائط الحالية، بما في ذلك الطرق القائمة على الالتفاف (convolution)، والانتباه (attention)، والمحولات (Transformer)، تفترض ضمنياً أن الميزات المستخرجة من مستشعرات مختلفة محاذات مكانياً ودلالياً بالفعل8. ومع ذلك، فإن هذا الافتراض غالباً ما يكون غير صالح في التطبيقات العملية. إن مجرد تسلسل الميزات (feature concatenation) أو الدمج على مستوى البكسل لا يمكنه استيعاب التناقضات عبر الوسائط بشكل كافٍ، مما قد يؤدي إلى تحسين غير مستقر وانخفاض في أداء التعميم. وفضلاً عن ذلك، على الرغم من أن طرق الدمج القائمة على الانتباه تحسن التفاعل بين الميزات، إلا أنها قد توفر نمذجة محدودة للاعتمادات طويلة المدى عبر الوسائط المطلوبة لتصنيف الغطاء الأرضي واسع النطاق أو عالي الدقة9. وبالتالي، يظل المحاذاة الفعالة لتمثيلات الميزات غير المتجانسة تحدياً رئيسياً في الاستشعار عن بُعد متعدد الوسائط، لأن التضمينات (embeddings) غير المتوافقة يمكن أن تحد من تكامل المعلومات التكميلية.
ولمواجهة هذا التحدي، تمت صياغة المحاذاة عبر الأنماط (cross-modal alignment) كمسألة نقل ميزات مشروطة. يوفر مطابقة التدفق (Flow matching) إطارًا مؤسسًا رياضيًا لتعلم تعيينات مستمرة وعكوسة بين توزيعات الميزات غير المتجانسة10. فهو ينقل توزيعًا واحدًا نحو توزيع آخر من خلال مجال سرعة يعتمد على الزمن ومعلم بـ معادلة تفاضلية عادية (ODE)، مما يعزز التحويلات المستمرة بين منوعات الميزات (feature manifolds)11. وبخلاف النماذج القائمة على الانتشار، التي تعتمد على اضطرابات الضوضاء العشوائية أو مطابقة التوزيع الضمنية من خلال التدريب التنافسي، يتعلم مطابقة التدفق تحويلات حتمية وتبادلية بين مساحات الميزات المهيكلة12. هذه الخصائص تجعل مطابقة التدفق مناسبًا تمامًا للاستشعار عن بعد متعدد الأنماط، حيث يمثل كل من HSI وLiDAR وSAR منوعات ميزات عالية الأبعاد تلتقط خصائص تكميلية لسطح الأرض13. وبناءً على ذلك، يوفر مطابقة التدفق نهجًا منهجيًا لإنشاء تقابل عبر الأنماط من خلال نقل الميزات المستمر مع تعزيز الاتساق الهندسي أثناء محاذاة الميزات. وفي ظل افتراضات الانتظام المناسبة، يمكن لتدفق ODE أن يوفر تعيينًا عكوسًا؛ ومع ذلك، لم يتم تقييم القابلية للعكس بدقة أو القابلية للتفسير الفيزيائي تجريبيًا في الدراسة الحالية. وتتمثل الفرضية التشغيلية في أن تقليل التباينات في توزيعات الميزات المقترنة قبل دمج الميزات يحسن التصنيف الإجمالي للغطاء الأرضي في ظل تقسيمات معيارية ثابتة.
وبناءً على هذه الاعتبارات، يتضمن الإطار المقترح، FlowErs، مرحلة محاذاة تعتمد على التدفق ضمن بنية مكونة من مرحلتين. في المرحلة الأولى، يتم تدريب شبكة تدفق ثنائية الاتجاه لمحاذاة منوعات الميزات لكل نمط. وبشكل محدد، تعمل هياكل MetaFormer الخاصة بكل نمط على استخراج تضمينات ميزات هرمية، ويتم تحسين هدف مطابقة التدفق لنقل العينات بين توزيعات الميزات الخاصة بكل نمط. توفر هذه العملية تحويلاً سلساً وقابلاً للعكس بين مساحات الميزات، مما يشجع التمثيلات التي تنتمي إلى نفس الفئة الدلالية على أن تصبح أكثر محاذاة داخل نطاق كامن مشترك. وفي المرحلة الثانية، يتم تجميد محاذي التدفق المدرب مسبقاً، وتحويل المدخلات متعددة الأنماط الجديدة قبل دمجها بواسطة مصنف خفيف الوزن. تفصل استراتيجية التدريب المنفصلة هذه بين المحاذاة الهندسية والتصنيف الدلالي، مما يسمح للمرحلتين بتحسين أهداف متكاملة. تهدف وحدة المحاذاة إلى تقليل التباينات في توزيع الميزات قبل دمج الميزات، ولا تدعي تقديم ضمان مثبت للحفاظ على الحجم. علاوة على ذلك، يوفر FlowErs صيغة صريحة لنقل الميزات من أجل الدمج متعدد الأنماط، على الرغم من أن المتانة تجاه أخطاء التسجيل لم يتم تقييمها بشكل منفصل في هذه الدراسة.
تتلخص المساهمات الرئيسية لهذه الدراسة فيما يلي. يتم تقديم FlowErs كإطار عمل من مرحلتين لتصنيف الغطاء الأرضي متعدد الوسائط. وفي إطار العمل المقترح، يتم أولاً استخراج الميزات الخاصة بكل وسيط باستخدام مشفرات MetaFormer، ثم يتم محاذاتها من خلال وحدة تعتمد على التدفق (flow-based module) قبل إجراء دمج ميزات خفيف الوزن. يدعم هذا التصميم المفكك التحسين الفعال مع الحفاظ على المرونة عبر وسائط الاستشعار المختلفة. بالإضافة إلى ذلك، تبحث هذه الدراسة في مطابقة التدفق الشرطي (conditional flow matching) كآلية لنقل الميزات من أجل المحاذاة المتقاطعة للميزات المزدوجة في الاستشعار عن بعد متعدد الوسائط. تتوقع وحدة التدفق ثنائية الاتجاه أهداف سرعة متقابلة لتمثيلات الميزات المزدوجة قبل دمج الميزات، مما يوفر استراتيجية محاذاة صريحة قبل التكامل متعدد الوسائط. علاوة على ذلك، تم تقييم إطار العمل المقترح على ثلاث مجموعات بيانات مرجعية عامة، حيث حقق دقة إجمالية (OA) قصوى بلغت 97.56% في ظل تقسيمات القياس المرجعية الثابتة المقدمة. كما تم توثيق القيود على مستوى الفئات ونطاق التقييم الحالي بشكل صريح.
أرست التطورات الأخيرة في مطابقة التدفق (flow matching) مكانتها كإطار عمل قوي للنمذجة التوليدية يوحد النماذج القائمة على الانتشار والطاقة والنقل. وبدلاً من محاكاة المسارات العشوائية، كما هو الحال في نماذج الانتشار، تعمل مطابقة التدفق على تعلم معادلة تفاضلية عادية (ODE) حتمية تنقل توزيعاً أولياً بسيطاً، مثل ضوضاء Gaussian، إلى توزيع البيانات المستهدف من خلال حقل سرعة قابل للتعلم15. تربط هذه الصيغة بشكل مباشر بين تقدير الدرجة وتطور الكثافة، مما يؤدي إلى مسارات احتمالية أكثر سلاسة وديناميكيات تدريب أكثر استقراراً. وتتمثل الميزة الرئيسية لمطابقة التدفق في صيغتها الحتمية والكفؤة حسابياً. وتقوم نماذج التدفق المصحح (Rectified flow models)16 بتبسيط مسارات النقل بشكل أكبر وتحويلها إلى مسارات مستقيمة تقريباً، مما يحسن الاستقرار العددي ويتيح توليد عينات عالية الجودة بخطوات تكامل قليلة نسبياً. وقد دمجت الدراسات اللاحقة، بما في ذلك نماذج الاتساق (consistency models)17، أهدافاً مستوحاة من الانتشار في أطر عمل مدمجة قائمة على التدفق لتحقيق جودة عينات مماثلة أو محسنة مع استدلال كفؤ. بالإضافة إلى ذلك، يمكن للتدريب القائم على التدفق الاستفادة من الهياكل الأساسية للانتشار المدربة مسبقاً، مما يسهل استخدام التوزيعات الأولية التوليدية واسعة النطاق مع تقليل تكاليف أخذ العينات. وقد وسعت الدراسات الحديثة نطاق مطابقة التدفق ليشمل مجموعة واسعة من التطبيقات؛ فعلى سبيل المثال، بحث Hu et al.18 في الهياكل الأساسية لمحولات transformer والتلاعب بالفضاء الكامن لتحرير الصور بشكل قابل للتحكم والتركيب باستخدام مطابقة التدفق. وتشمل التطبيقات الأخرى تركيب الصور19، وتشخيص أعطال المحامل20، واللحام الروبوتي متعدد الأهداف ومتعدد اللحامات21. وتوضح هذه الدراسات مجتمعة أن مطابقة التدفق قابلة للتطبيق بما يتجاوز تركيب الصور عالية الدقة والمشروطة، مع توفير أساس نظري راسخ وإمكانيات للتعميم عبر المجالات. ومن خلال تعلم خرائط نقل حتمية ومستمرة، توفر مطابقة التدفق توازناً بين الكفاءة وقابلية التحكم والدقة التوليدية. كما تقدم صيغتها القائمة على ODE منظوراً موحداً للنمذجة التوليدية الحديثة وتوفر أساساً نظرياً للتطبيقات التي تتضمن تمثيلاً للبيانات متعددة الوسائط ومحاذاة الميزات.
يهدف التصنيف بالاستشعار عن بعد متعدد الوسائط إلى التغلب على قيود كل وسيلة استشعار على حدة من خلال دمج معلومات تكميلية من التصوير فرط الطيفي (HSI)، والتصوير متعدد الأطياف، وLiDAR، وSAR. اعتمدت مناهج الدمج المبكر على ميزات مصممة يدويًا أو خوارزميات قائمة على النواة، مثل آلات ناقلات الدعم (SVMs)، ولكنها كانت محدودة بسبب الأبعاد العالية والتفاعل غير الكافي بين الوسائط22. وقد مكنت التطورات في التعلم العميق من استراتيجيات دمج مهيكلة، تشمل الدمج المبكر والمتوسط والمتأخر، حيث يوفر الدمج على مستوى الميزات توازنًا عمليًا بين تكامل المعلومات والتعقيد الحسابي23. تلتقط الشبكات العصبية التلافيفية (CNNs) المعلومات المكانية-الطيفية المحلية بفعالية، بينما تقوم البنى القائمة على Transformer بنمذجة الاعتمادات طويلة المدى بتكلفة حسابية أعلى24. وبناءً على ذلك، أصبحت بنى CNN–Transformer الهجينة شائعة بشكل متزايد لأنها تجمع بين نقاط القوة التكميلية لكلا النهجين. وتشمل الأمثلة النموذجية طرق دمج المقاييس المتجاورة التي تعزز المعلومات السياقية من خلال التفاعلات عبر المقاييس25 والأطر متعددة المستويات التي تجمع بين ميزات CNN الضحلة وتمثيلات Transformer العميقة باستخدام آليات الانتباه التكيفية26. وبشكل جماعي، تسلط هذه الدراسات الضوء على أهمية التفاعل الفعال عبر المقاييس وعبر الوسائط لتقليل تكرار الميزات وتحسين التمثيل الدلالي.
كما استكشفت التطورات الحديثة استراتيجيات تكميلية للتعلم متعدد الوسائط. فعلى سبيل المثال، تعمل طرق التمثيل منخفضة الرتبة، مثل الإطار الموجه بمنحنى إبينغهاوس، على تقليل الإفراط في التخصيص من خلال الحفاظ على بنية المتشعب مع كبح المعلومات الزائدة27. وبالتوازي مع ذلك، تم بحث التعلم الموزع متعدد الوسائط لمعالجة قيود الخصوصية والاتصالات في التطبيقات العملية؛ حيث يقوم FedFusion، على سبيل المثال، بإسقاط الميزات الضحلة في فضاءات جزئية منخفضة الرتبة لتمكين التعلم الاتحادي متعدد الوسائط28. وتوضح هذه الدراسات مجتمعة ثلاثة اتجاهات بحثية تكميلية: بنيات CNN–Transformer الهجينة لموازنة نمذجة الميزات المحلية والعالمية، والتعلم منخفض الرتبة لتقليل التكرار والضوضاء، والتعلم الموزع للنشر القابل للتوسع والحفاظ على الخصوصية. ومع ذلك، لا تزال هناك تحديات مهمة قائمة، بما في ذلك عدم توازن الوسائط، ومحدودية توفر البيانات المصنفة، والمفاضلة بين ضغط النموذج ودقة التصنيف. وقد حفزت هذه التحديات استمرار البحث في أطر دمج متعددة الوسائط تكون خفيفة الوزن وقابلة للتعميم. كما دمجت مناهج المحاذاة متعددة الوسائط الحديثة آليات الانتباه عبر الوسائط، والتعلم التبايني، والدمج القائم على الرسوم البيانية، وتكيف النطاق، واستراتيجيات مطابقة التوزيع. وفي المقابل، يصيغ FlowErs المحاذاة متعددة الوسائط كعملية نقل ميزات مزدوجة ومشروطة زمنياً، ويُقدم كاستراتيجية محاذاة تكميلية بدلاً من أن يكون بديلاً شاملاً للمناهج الحالية.
البروتوكول
استخدمت هذه الدراسة حصرياً مجموعات بيانات مرجعية متاحة للعموم (Houston2013 وAugsburg وMUUFL) لتصنيف غطاء الأرض عن طريق الاستشعار عن بعد. ولم تتضمن الدراسة أي مشاركين بشريين، أو تجارب على الحيوانات، أو عينات بيولوجية تم جمعها حديثاً. وبناءً على ذلك، لم تكن هناك حاجة للحصول على موافقة أخلاقية مؤسسية.
نظرة عامة على الدراسة
يعمل إطار عمل FlowErs المقترح على تصنيف الغطاء الأرضي متعدد الوسائط من خلال استراتيجية تعلم ثنائية المراحل. يوضح الشكل 1A–C سير العمل العام للإطار. يتكون إطار العمل من ثلاثة مكونات رئيسية: (i) مشفرات تعتمد على MetaFormer لاستخراج تمثيلات الميزات الهرمية من وسائط استشعار غير متجانسة، (ii) وحدة مطابقة التدفق متعدد الوسائط (MFM) التي تعمل على محاذاة توزيعات الميزات عبر الوسائط بشكل صريح، و(iii) رأس تصنيف خفيف الوزن يتنبأ بفئات الغطاء الأرضي من تمثيلات الميزات المدمجة. يقوم سير العمل العام أولاً باستخراج الميزات الخاصة بكل وسيط، ثم يحاذي هذه الميزات ضمن فضاء كامن مشترك من خلال مطابقة التدفق الشرطي، وفي النهاية يجري تصنيف الغطاء الأرضي على مستوى البكسل باستخدام التمثيلات متعددة الوسائط المحاذية.
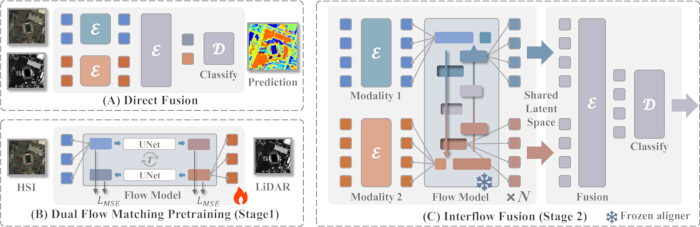
الشكل 1: نظرة عامة على إطار عمل FlowErs المقترح لتصنيف الغطاء الأرضي متعدد الوسائط. (A) دمج الميزات المباشر التقليدي، حيث يتم دمج الميزات الخاصة بكل وسيط والمستخرجة من الصور فائقة الطيف (HSI) وبيانات كشف المدى والضوء (LiDAR) مباشرة قبل عملية التصنيف. (B) المرحلة 1: التدريب المسبق لمطابقة التدفق متعدد الوسائط ثنائي الاتجاه. تتعلم شبكة U-Net مشروطة بالزمن نقلاً مستمراً للميزات ثنائي الاتجاه بين تمثيلات الميزات الخاصة بكل وسيط باستخدام فقدان متوسط مربع الخطأ لمحاذاة توزيعات الميزات غير المتجانسة. (C) المرحلة 2: دمج التدفق البيني. يتم تجميد وحدة مطابقة التدفق المدربة مسبقاً وإعادة استخدامها لمحاذاة تمثيلات الميزات الخاصة بكل وسيط قبل دمج الميزات خفيف الوزن وتصنيف الغطاء الأرضي على مستوى البكسل. E، المشفر؛ D، مفكك التشفير؛ T، تضمين الوقت؛ فقدان متوسط مربع الخطأ؛ S، التمثيل الكامن المشترك. يرجى النقر هنا لعرض نسخة أكبر من هذا الشكل.
يفصل الإطار المقترح بين محاذاة الميزات والتصنيف الدلالي من خلال استراتيجية تدريب مكونة من مرحلتين. في المرحلة الأولى، يتم تدريب وحدة MFM لتعلم نقل الميزات ثنائي الاتجاه بين مجمعات ميزات خاصة بكل نمط. وفي المرحلة الثانية، يتم تجميد وحدة محاذاة التدفق المدربة مسبقاً وإعادة استخدامها لمحاذاة تمثيلات الميزات متعددة الأنماط قبل إجراء عملية دمج الميزات والتصنيف خفيفة الوزن. يتيح هذا التصميم المنفصل لوحدة المحاذاة وشبكة التصنيف تحسين أهداف تكميلية مع تقليل التباينات في توزيع الميزات قبل الدمج متعدد الأنماط.
نظرة عامة نظرية
يعد مطابقة التدفق (Flow matching) نموذجاً توليدياً تم اقتراحه مؤخراً، حيث يتعلم تحويلاً حتمياً مستمراً بين توزيعين احتماليين. وعلى عكس النماذج القائمة على الانتشار، التي تدخل العشوائية من خلال اضطرابات الضوضاء، فإن مطابقة التدفق تحدد بشكل مباشر معلمات حقل سرعة قابل للتعلم ينقل توزيعاً احتمالياً واحداً باستمرار نحو توزيع آخر. وتسمح صيغة النقل المستمر هذه بمحاذاة الميزات من خلال معادلة تفاضلية عادية (ODE)، مما يسمح لتمثيلات الميزات المقترنة من أنماط استشعار مختلفة بالتطور على طول مسار مشترك قبل دمج الميزات. في الدراسة الحالية، تم اعتماد مطابقة التدفق الشرطية لتعلم نقل الميزات ثنائي الاتجاه بين التضمينات الخاصة بكل نمط والتي تم استخراجها بواسطة مشفرات MetaFormer. يتم تدريب النموذج باستخدام هدف مطابقة التدفق الشرطية الذي يقلل من التفاوت بين حقول السرعة المتوقعة والمستهدفة عبر تمثيلات الميزات المستحدثة بالاستكمال. تتوفر الصيغة الرياضية الكاملة، والاشتقاق النظري، والمعادلات الحاكمة، وهدف التدريب في الملحق 1.
صياغة المشكلة
يتضمن تصنيف غطاء الأرض من بيانات الاستشعار عن بعد متعددة الأنماط تعلم تمثيلات دلالية من أنماط استشعار غير متجانسة، مثل التصوير الطيفي الفائق (HSI) والرادار الليزري (LiDAR). وتظهر هذه الأنماط خصائص استشعار متميزة؛ حيث يكتسب HSI معلومات طيفية غنية بمئات القنوات ( )، بينما يوفر LiDAR معلومات هيكلية دقيقة بقنوات قليلة نسبياً (
 ). ويؤدي هذا التفاوت بين الثراء الطيفي والندرة الهيكلية إلى خلق فجوة نطاق كبيرة في توزيعات الميزات، مما يجعل الدمج المباشر للميزات غير مثالي وقد يكون غير مستقر.
من الناحية الشكلية، وبفرض وجود زوج من المدخلات متعددة الوسائط، 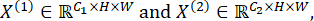 يتمثل الهدف في التنبؤ بخريطة دلالية على مستوى البكسل وفقاً لـ المعادلة 1:
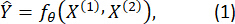
هنا، 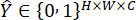 هو تنسور التصنيف المرمز بنظام (one-hot)، ويشير C إلى العدد الإجمالي لفئات الغطاء الأرضي، بينما تمثل θ جميع معاملات النموذج القابلة للتعلم. تبلغ أبعاد صور مجموعة بيانات Houston2013 مقدار 349 × 1905 بكسل مع 144 نطاقاً طيفياً فائقاً (HSI) ونطاق LiDAR واحد. أما مجموعة بيانات Augsburg فتبلغ أبعاد صورها 1152 × 480 بكسل مع 224 نطاق HSI ونطاق LiDAR واحد. وتبلغ أبعاد صور مجموعة بيانات MUUFL مقدار 325 × 220 بكسل مع 64 نطاق HSI ونطاقي LiDAR. وبالنسبة لجميع مجموعات البيانات، تم تغيير حجم رقع الصور المدخلة إلى 32 × 32 بكسل قبل عملية التدريب.
تقوم النهج التقليدية متعددة الوسائط بدمج الميزات الخاصة بكل وسيط من خلال الربط أو آليات الانتباه، بافتراض ضمني أن الوسائط المختلفة تقع في فضاء ميزات متوافق. ومع ذلك، فإن هذا الافتراض نادراً ما ينطبق على بيانات الاستشعار عن بعد لأن التوزيعات الإحصائية والخصائص المكانية-الطيفية الخاصة بكل وسيط تختلف اختلافاً جوهرياً.
ولسد هذه الفجوة بشكل صريح، تم تقديم وحدة مطابقة التدفق (flow matching module)،  . وتتم تحديد معلمات هذه الوحدة بواسطة
 وهي تعمل على تعلم تحويلات ثنائية الاتجاه ومستمرة بين منوعات الميزات الخاصة بكل نمط. وتحديداً (المعادلة 2)،
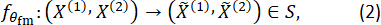
هنا، S تشير إلى الفضاء الكامن المشترك الذي يتم فيه محاذاة التمثيلات الميزية الخاصة بكل نمط هندسياً. وبالتبعية، يتم دمج التمثيلات الميزية المحاذات وتصنيفها وفقاً لـ المعادلة 3 على النحو التالي:
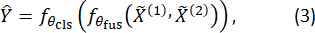
هنا، تشير  و
 إلى وحدتي دمج الميزات والتصنيف، على التوالي. وتحدد هذه الصيغة إطار عمل FlowErs العام. وبدلاً من الاعتماد فقط على دمج الميزات الإحصائي الضمني، يقدم إطار العمل المقترح آلية محاذاة صريحة تعتمد على التدفق تقوم بنقل تمثيلات الميزات الخاصة بكل نمط باستمرار إلى مساحة كامنة مشتركة قبل عملية دمج الميزات متعددة الأنماط والتنبؤ الدلالي.
مشفر MetaFormer
يقوم نظام FlowErs بإجراء محاذاة للميزات عبر الوسائط باستخدام مشفرات خفيفة الوزن خاصة بكل وسيط، والتي تتعلم تمثيلات ميزات غنية بالمعلومات ومتسقة هندسياً من كل وسيط استشعار. وكما هو موضح في الشكل 2، يتم معالجة كل وسيط بواسطة مشفر مستقل يعتمد على بنية MetaFormer. وتعمل MetaFormer على تعميم التصميم الأساسي لـ Transformer من خلال فصل خلط الرموز (token mixing) عن تحويل القنوات (channel transformation) دون حساب الانتباه الذاتي (self-attention) بشكل صريح. يتيح هذا التصميم معالجة فعالة لبيانات HSI عالية الأبعاد مع البقاء قابلاً للتكيف مع الوسائط ذات القنوات المنخفضة مثل LiDAR.
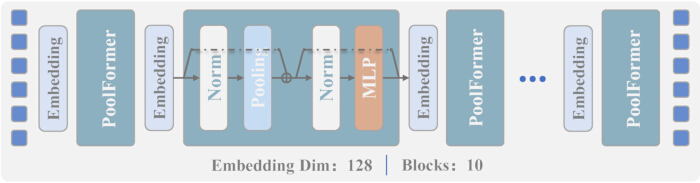
الشكل 2: بنية مشفر MetaFormer الخاص بالنمط المستخدم في إطار عمل FlowErs المقترح. يقوم المشفر بتحويل المدخلات الخاصة بكل نمط إلى تمثيلات ميزات هرمية من خلال كتل تضمين وPoolFormer متكررة. تتكون كل كتلة PoolFormer من عملية تسوية، ومزج الرموز القائم على التجميع، وإضافة متبقية، وتسوية، وبيرسيبترون متعدد الطبقات (MLP). تُمرر تمثيلات الميزات الهرمية الناتجة إلى وحدة مطابقة التدفق متعددة الأنماط لمحاذاة الميزات عبر الأنماط. Norm، التسوية؛ MLP، بيرسيبترون متعدد الطبقات. يرجى النقر هنا لعرض نسخة أكبر من هذا الشكل.
لكل نمط  ، يقوم مشفر MetaFormer
 ، بتحويل المدخل
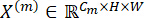 إلى تسلسل هرمي من تمثيلات الميزات الكامنة (المعادلة 4):
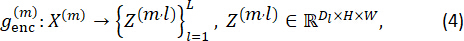
هنا، يشير L إلى العدد الإجمالي لمراحل المشفّر، ويشير Dl إلى بُعد التضمين في المرحلة l. يتكون مشفّر MetaFormer من ثلاث مراحل (N = 3) بأبعاد تضمين تبلغ 64 و128 و256 على التوالي. وتكون أعداد كتل PoolFormer المقابلة في كل مرحلة هي 2 و6 و2، وذلك اتباعاً للبنية الهرمية التصاعدية الموصوفة في المخطوطة.
يبدأ كل مشفر بعملية التفاف 1 × 1 تقوم بإسقاط قنوات الإدخال في فضاء تضمين مشترك (المعادلة 5):
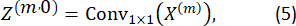
تلي هذه الطبقة الإسقاطية لـ كتل MetaFormer متراكمة. تتكون كل كتلة من عمليتين متبقيتين: (1) مزج الرموز (token mixing) من خلال التجميع المكاني لتجميع المعلومات السياقية، و(2) تحويل القنوات من خلال مدرك متعدد الطبقات (MLP) لتحسين تمثيلات الميزات الطيفية-المكانية. ويتم التعبير عن هذه العمليات باستخدام المعادلتان 6 و7 على النحو التالي:
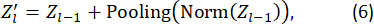

هنا، تشير Pooling(·) إلى تجميع السياق المكاني القائم على التجميع المتوسط (average-pooling)، بينما تشير MLP(·) إلى شبكة تغذية أمامية تلافيفية مكونة من طبقتين تتضمن تنشيط GELU وتنظيم الإسقاط (dropout regularization).
يتبع المشفّر بنية هرمية يزداد فيها بُعد التضمين تدريجياً عبر المراحل المتتالية (على سبيل المثال، 64  128 256). يتيح هذا التصميم التدريجي للطبقات الأكثر عمقاً تشفير معلومات مكانية-طيفية غنية بشكل متزايد مع تحسين القدرة التمثيلية للميزات المكتسبة. يستخدم التنفيذ نواة تجميع (pooling kernel) بحجم 3 × 3، وبُعداً خفياً لـ MLP قدره 128، ومعدل إسقاط (dropout rate) يبلغ 0.1. تستخدم جميع الطبقات الالتفافية داخل مشفّر MetaFormer نوى بحجم 1 × 1 مع خطوة (stride) قدرها 1 وبدون حشو (padding). يستخدم عامل التجميع تجميعاً متوسطاً (average pooling) بحجم 3 × 3 مع خطوة قدرها 1 وحشو قدره 1. يتم تطبيق تطبيع الدفعة (BatchNorm2d) في جميع أنحاء المشفّر. يتمتع MLP ببُعد خفي قدره 128، ويعتمد دالة التنشيط GELU، ويستخدم معدل إسقاط يبلغ 0.1. تحتوي مراحل المشفّر الثلاث على 2 و6 و2 من كتل PoolFormer على التوالي، وتُطبق هذه الإعدادات الهيكلية باستمرار عبر جميع المراحل.
بالمقارنة مع المشفرات القائمة على Transformer، يزيل مشفر MetaFormer التكلفة الحسابية التربيعية المرتبطة بالانتباه الذاتي (self-attention)، مع تقليل الانحياز الخاص بالنمط أثناء استخراج الميزات. يقوم مِزج الرموز القائم على التجميع (pooling-based token mixer) بتجميع السياق المكاني المحلي بكفاءة، بينما يتم تنفيذ المحاذاة عبر الأنماط لاحقاً بواسطة وحدة مطابقة التدفق (flow matching module). وبناءً على ذلك، توفر تمثيلات الميزات في أعلى مستوى التي ينتجها المشفر مدخلات غنية دلالياً ومتسقة هندسياً لمحاذاة الميزات متعددة الأنماط.
مطابقة التدفق متعددة الوسائط
يتمثل التحدي الرئيسي الذي يلي استخراج الميزات في محاذاة تمثيلات الميزات غير المتجانسة الناتجة عن أنماط استشعار مختلفة تقع على منوعات ميزات مختلفة. غالبًا ما يؤدي الربط المباشر بين  و
 إلى أداء ضعيف بسبب التوزيعات غير المتسقة للميزات والتحيزات الخاصة بكل نمط استشعار. ويعالج FlowErs هذا التحدي صراحةً من خلال تقديم وحدة MFM التي تتعلم تحويلات مستمرة وثنائية الاتجاه بين مساحتي الميزات، كما هو موضح مفاهيميًا في الشكل 1B.
دعنا 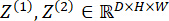 تُشير إلى تمثيلات السمات المستخلصة بواسطة مشفرات MetaFormer. حقل تدفق مستمر مُعلم بزمن الاستكمال
 يُعرَّف باستخدام المعادلة 8 على النحو التالي:
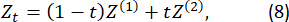
هنا، تمثل t = 0 النمط المصدري، بينما تمثل t = 1 النمط المستهدف.
يتم تنفيذ نموذج مطابقة التدفق، ، كشبكة U-Net مشروطة زمنياً تتنبأ بحقل السرعة اللحظي الذي يحكم التحويل على طول مسار الاستكمال هذا. يتكون كل متنبئ تدفق من ثلاث كتل لتقليل العينات (64 128 256 512) وثلاث كتل مقابلة لزيادة العينات (512 256 128 64) باستخدام عمليات تلافيف 3 × 3، وتطبيع الدفعات (batch normalization)، ووحدة خطية مُصححة (ReLU). تبلغ أبعاد تضمينات الوقت البينية 128، و256، و512، و256، و128، على التوالي. يستخدم تضمين الوقت ترميزاً موقعياً جيبياً ثابتاً. يتم إجراء تكامل المعادلات التفاضلية العادية (ODE) باستخدام طريقة أويلر الأمامية بحجم خطوة ثابت. خلال التدريب، تم ضبط عدد خطوات التكامل على 6، بينما استُخدمت 5 خطوات تكامل بشكل افتراضي أثناء الاستدلال. يتم حساب العدد الفعلي لتكرارات حلقة التكامل وفقاً لـ 
يتم تحديد مجال السرعة المتوقع بواسطة المعادلة 9 كما يلي:
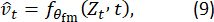
هنا،  تشير إلى السرعة اللحظية المتوقعة. يتعلم النموذج تقريب الإزاحة
 مما يشجع على التحولات المستمرة بين مساحات السمات الخاصة بكل نمط. وتتم صياغة هدف التدريب على شكل فقدان متوسط مربع الخطأ (MSE) ثنائي الاتجاه مشروط بالزمن كما يلي (المعادلة 10):
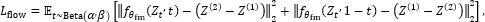 (10)
يؤدي أخذ العينات t من توزيع بيتا (Beta distribution) المحدد إلى تعريض النموذج لحالات استكمال داخلي (interpolation states) وسيطة، ولكن هذا لا يضمن اتساقاً دورياً دقيقاً. وبخلاف طرق المحاذاة القائمة على الانتشار (diffusion-based alignment)، فإن صيغة مطابقة التدفق (flow matching) المقترحة هي صيغة حتمية، ولا تتطلب أخذ عينات عشوائية أثناء الاستنتاج، ويمكن تدريبها باستخدام البيانات المصنفة وغير المصنفة على حد سواء.
يعمل نموذج التدفق المدرب لاحقاً كمشغل محاذاة حتمي يقوم بإسقاط تمثيلات الميزات الخاصة بكل نمط في فضاء كامن مشترك S. ويتم الحصول على التمثيلات المحذاة على النحو التالي (المعادلة 11):
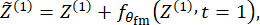
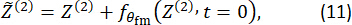
هنا،  و
 يشيران إلى تمثيلات الميزات المحاذية. يُطبق التراصف القائم على التدفق على تمثيلات الميزات المتوسطة من مرحلتي التشفير الأوليين (المرحلة 1 والمرحلة 2)، بأبعاد تضمين تبلغ 64 و 128 على التوالي. أما ميزات المشفر في المستوى الأعلى (المرحلة 3، بُعد التضمين 256) فلا يتم معالجتها بواسطة وحدة مطابقة التدفق؛ وبدلاً من ذلك، يتم دمج هذه الميزات مباشرةً وتمريرها إلى المصنف لإجراء التنبؤ متعدد الوسائط.
تقوم آلية المحاذاة ثنائية الاتجاه هذه بنقل تمثيلات الميزات الخاصة بكل نمط تدريجيًا نحو فضاء كامن مشترك من خلال مجال تدفق مستمر. وبناءً على ذلك، تصبح هذه التمثيلات أكثر محاذاة قبل عملية دمج الميزات متعددة الأنماط، مما يوفر تمثيلات ميزات متسقة دلاليًا ومتوافقة هندسيًا لعملية التصنيف اللاحقة.
مسار التدريب
يستغل نظام FlowErs كلاً من البيانات المصنفة وغير المصنفة مع الحفاظ على محاذاة مستقرة عبر الأنماط من خلال استراتيجية تدريب ثنائية المرحلة، كما هو موضح في الشكل 1(B,C). خلال المرحلة الأولى، يتم تعلم وحدة محاذاة غير متغيرة النمط من خلال مطابقة التدفق غير الخاضعة للإشراف. وخلال المرحلة الثانية، يتم إجراء تصنيف خاضع للإشراف باستخدام التمثيلات الكامنة المحاذات مع إعادة استخدام وحدة محاذاة التدفق المدربة مسبقاً.
المرحلة 1: التدريب المسبق للتدفق غير الخاضع للإشراف
بناءً على أزواج الصور متعددة الأنماط،  يتم استخراج تمثيلات الميزات الخاصة بكل نمط،
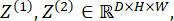 باستخدام مشفرات MetaFormer. كما يتم توليد تمثيلات الميزات المتوسطة باستخدام الاستكمال المحدد في المعادلة 8، حيث
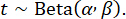 ويتم تحسين وحدة مطابقة التدفق،
 ، عن طريق تقليل الهدف ثنائي الاتجاه المشروط بالزمن والمحدد في المعادلة 10 دون استخدام تسميات الفئات. في هذه المرحلة، يتم تحديث معاملات مطابقة التدفق فقط،
 ، مما يسمح للنموذج بتعلم المراسلات المدركة للهندسة من العينات المصنفة وغير المصنفة قبل التصنيف الخاضع للإشراف. تم تنفيذ المرحلة 1 (التدريب المسبق على مطابقة التدفق) باستخدام محسن AdamW بمعدل تعلم قدره 1 × 10⁻4، واضمحلال في الوزن قدره 1 × 10⁻2، وجدول زمني لمعدل التعلم يعتمد على التخميد الجيبي (cosine annealing). تم استخدام أحجام دفعات قدرها 16 لمجموعات بيانات Houston2013 وTrento، بينما استُخدمت أحجام دفعات قدرها 32 لمجموعات بيانات Augsburg وMUUFL. تم تدريب وحدة مطابقة التدفق مسبقاً لمدة 2,000 دورة (epochs) باستخدام العينات المصنفة وغير المصنفة على حد سواء. تم تثبيت البذرة العشوائية عند 3407. وأُجريت جميع التجارب باستخدام PyTorch على وحدة معالجة رسوميات NVIDIA A100 واحدة (ذاكرة 80 GB).
المرحلة 2: التصنيف الخاضع للإشراف باستخدام محاذٍ مشترك
يتم إعادة استخدام وحدة مطابقة التدفق (flow matching) المدربة مسبقاً أثناء التدريب الخاضع للإشراف، وتُطبق على أول مرحلتين من مراحل المشفر بدلاً من تطبيقها على جميع مستويات الميزات. بعد ذلك، يتم دمج تمثيلات الميزات المحاذية باستخدام رأس التصنيف لإنشاء تنبؤات على مستوى البكسل. يعمل التحسين الخاضع للإشراف على تقليل خسارة الإنتروبيا المتقاطعة المقنعة (المعادلة 12):
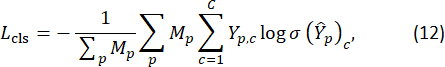
هنا، يشير M إلى قناع التسمية (label mask)، ويشير Y إلى تسميات الحقيقة الأرضية (ground-truth labels) المرمزة بنظام one-hot، و تشير σ(·) إلى دالة softmax. خلال المرحلة 2 (التدريب الخاضع للإشراف)، ظل نموذج مطابقة التدفق (flow-matching module) مسبق التدريب مجمداً تماماً وعمل كعامل محاذاة ثابت عبر الوسائط (cross-modal alignment operator). تم تحميل أوزانه مسبقة التدريب في بداية المرحلة 2 ولم يتم تحديثها أثناء التدريب الخاضع للإشراف. تم تحسين معاملات مشفر MetaFormer والمصنف فقط. أُجري التدريب الخاضع للإشراف باستخدام محسن AdamW بمعدلات تعلم خاصة بكل مجموعة بيانات وهي 1 × 10⁻4 (Houston2013)، و1 × 10⁻3 (Augsburg)، و1 × 10⁻2 (MUUFL)، و1 × 10⁻5 (Trento). تم ضبط تلاشي الوزن (Weight decay) عند 1 × 10⁻2 لجميع مجموعات البيانات باستثناء MUUFL، حيث استُخدمت قيمة 5 × 10⁻2. استُخدمت أحجام دفعات (Batch sizes) تبلغ 16 أو 32 اعتماداً على مجموعة البيانات. تم تدريب النماذج لمدة 100 حقبة (Houston2013 و MUUFL)، و200 حقبة (Augsburg)، و20 حقبة (Trento) باستخدام جدول زمني لمعدل التعلم يعتمد على تلدين جيب التمام (cosine annealing). استُخدمت دالة CrossEntropyLoss مع تقليل متوسط (mean reduction) كدالة للخسارة. لم يتم تطبيق التوقف المبكر؛ وبدلاً من ذلك، تم اختيار نقطة تفتيش النموذج (model checkpoint) التي حققت أعلى دقة إجمالية (OA) على مجموعة الاختبار كنموذج نهائي. تم تلخيص سير عمل التنفيذ الكامل لإجراء التدريب ثنائي المرحلة في الملف التكميلي S1 (الخوارزمية S1).
تفصل استراتيجية التدريب المنفصلة هذه بين المحاذاة الهندسية والتمييز الدلالي. فخلال المرحلة الأولى، يتعلم النموذج عمليات رسم خرائط للميزات ثنائية الاتجاه والمستمرة باستخدام هدف مطابقة التدفق. وخلال المرحلة الثانية، توفر وحدة المحاذاة المدربة مسبقاً عملية نقل ميزات مشتركة قبل دمج الميزات متعددة الوسائط، بينما تتعلم شبكة التصنيف تمثيلات تمييزية للفئات من الفضاء الكامن المحاذى. ويعزز إعادة استخدام أداة المحاذاة المدربة مسبقاً محاذاة الميزات بشكل متسق قبل الدمج، ولكن لا يتم تقديم ذلك كضمان مستقل لتحسين التعميم.
مجموعات البيانات التجريبية
تم تقييم الإطار المقترح باستخدام ثلاث مجموعات بيانات مرجعية تمثيلية للاستشعار عن بعد متعدد الوسائط: Houston201329، وAugsburg30، وMUUFL31.
تم إصدار مجموعة بيانات Houston2013 كجزء من مسابقة IEEE GRSS لدمج البيانات. وهي تمثل مشهداً حضرياً متنوعاً في مدينة هيوستن بالولايات المتحدة الأمريكية، وتحتوي على 15 فئة من غطاء الأرض، بما في ذلك المناطق السكنية، والطرق، والغطاء النباتي، والمسطحات المائية. وتتضمن مجموعة البيانات صوراً طيفية فائقة (HSI) مكونة من 144 نطاقاً طيفياً تمتد من الطيف المرئي إلى الأشعة تحت الحمراء القريبة، بالإضافة إلى نموذج سطح رقمي (DSM) مشتق من تقنية LiDAR بنطاق واحد وبدقة مكانية تبلغ 2.5 m. وتجعل الأنسجة الحضرية المعقدة والتباين الطيفي الكبير داخل الفئة الواحدة من مجموعة البيانات هذه تحدياً لتحقيق تصنيف دقيق لغطاء الأرض.
تم الحصول على مجموعة بيانات Augsburg من منطقة حضرية مكتظة بالمباني في ألمانيا. وهي تتكون من صور فرط طيفية تحتوي على 224 حزمة طيفية تغطي نطاق طول موجي يتراوح بين 400–1000 nm، إلى جانب بيانات ارتفاع LiDAR مسجلة بشكل مشترك. تحتوي مجموعة البيانات على 17 فئة مصنفة من غطاء الأرض، بما في ذلك المنشآت العمرانية، والتربة العارية، والأسفلت، والغطاء النباتي، والظلال، بدقة مكانية تبلغ 2 m. وبالمقارنة مع Houston2013، تظهر Augsburg ارتباطات طيفية أقوى بالإضافة إلى تنوع أكبر في الفئات، مما يوفر معياراً تحدياً لتقييم محاذاة الميزات عبر الأنماط والتعميم.
جُمِعت مجموعة بيانات MUUFL Gulfport عبر حرم جامعي، وهي تمثل بيئة شبه حضرية تحتوي على غطاء نباتي كثيف إلى جانب هياكل صغيرة من صنع الإنسان. تتضمن مجموعة البيانات صوراً فائقة الطيف مكونة من 64 نطاقاً تمت إزالة الضجيج منها، بالإضافة إلى قياسات LiDAR ثنائية النطاق تتكون من معلومات الارتفاع والشدة. تحتوي المجموعة على 11 فئة من غطاء الأرض وتُظهر تفاصيل مكانية دقيقة، وبكسلات مختلطة، وظروف إضاءة متفاوتة، مما يجعلها مناسبة تماماً لتقييم دمج الميزات متعدد الوسائط لتصنيف الأجسام الصغيرة.
تشتمل مجموعات البيانات المرجعية الثلاث هذه مجتمعة على تباين كبير في الدقة المكانية (1–2.5 m)، والأبعاد الطيفية (64–224 bands)، وتعقيد المشهد، وتكوين الغطاء الأرضي. وبناءً على ذلك، فإنها توفر معياراً متنوعاً لتقييم فعالية وقابلية تعميم طرق تصنيف الغطاء الأرضي متعدد الوسائط. تم تلخيص الخصائص الرئيسية لمجموعات البيانات في الجدول 1. تتوافق تقسيمات التدريب/الاختبار لجميع مجموعات البيانات الثلاث مع تقسيمات المعايير الرسمية المقدمة من مزودي البيانات الأصليين. وتحديداً، تستخدم مجموعة بيانات Houston2013 التقسيم الرسمي من مسابقة IEEE GRSS لدمج البيانات لعام 2013، والتي تضم 2,832 عينة تدريب و12,197 عينة اختبار. وتستخدم مجموعة بيانات Augsburg تعليقات mask_train وmask_test المقدمة رسمياً، مما ينتج عنه 4,538 عينة تدريب و47,896 عينة اختبار. أما مجموعة بيانات MUUFL فتستخدم تقسيم train_test_gt.mat الرسمي، والذي يحتوي على 28,645 عينة تدريب و24,283 عينة اختبار. وبالنسبة لكل مجموعة بيانات، تم استخراج رقعة صورة بحجم 32 × 32-pixel متمركزة حول كل بكسل مصنف كعينة تدريب أو اختبار فردية. ولم يتم إجراء أي تقسيم إضافي للبيانات أو إعادة أخذ عينات.
| الخاصية | Houston2013 | Augsburg | MUUFL |
| حجم صورة HSI (بكسل) | 349 × 1905 | 1152 × 480 | 325 × 220 |
| حجم صورة LiDAR (بكسل) | 349 × 1905 | 1152 × 480 | 325 × 220 |
| النطاقات الطيفية لـ HSI | 144 | 224 | 64 |
| نطاقات LiDAR | 1 | 1 | 2 |
| نطاق الطول الموجي لـ HSI | 0.38–1.05 µm | 0.40–1.00 µm | 375–1050 nm |
| نطاق الطول الموجي لـ LiDAR | غير قابل للتطبيق | غير قابل للتطبيق | غير قابل للتطبيق |
| الدقة المكانية (HSI) | 2.5 m | 2.0 m | 0.54 m × 1.00 m |
| الدقة المكانية (LiDAR) | 2.5 m | 2.0 m | 0.60 m × 0.78 m |
| عدد فئات الغطاء الأرضي | 15 | 17 | 11 |
الجدول 1: خصائص مجموعات البيانات المرجعية الثلاث للاستشعار عن بعد متعدد الأنماط المستخدمة في التقييم. يلخص الجدول أبعاد الصور، والخصائص الطيفية، والدقة المكانية، وأعداد فئات الغطاء الأرضي لمجموعات البيانات المرجعية Houston2013 وAugsburg وMUUFL المستخدمة لتقييم إطار عمل FlowErs المقترح.
تفاصيل التنفيذ
تم تنفيذ إطار عمل FlowErs باستخدام PyTorch، وجرى تدريبه وتقييمه باستخدام وحدة معالجة رسومات (GPU) بذاكرة سعتها 80 GB. أُجري التدريب لمدة 100 epochs وباستخدام حجم دفعة (batch size) قدره 16. استُخدم محسّن AdamW بمعدل تعلم أولي قدره 1 × 10⁻⁴ واضمحلال وزن (weight decay) قدره 1 × 10⁻². كما استُخدم مجدول معدل تعلم بتلدين جيبي (cosine annealing learning-rate scheduler) لتحديث معدل التعلم طوال فترة التدريب. طُبق معدل إسقاط (dropout rate) قدره 0.1 لتحسين تعميم النموذج والحد من فرط التخصيص (overfitting). واستُخدمت دالة خسارة الاعتلاج المتقاطع (cross-entropy loss function) للتحسين الخاضع للإشراف. ولضمان قابلية التكرار، بدأت جميع التجارب باستخدام بذرة عشوائية ثابتة قيمتها 3407. استُخدمت تقسيمات التدريب/الاختبار الموفرة دون إنشاء تقسيم إضافي للتحقق. تم تغيير حجم كل رقعة إدخال (input patch) إلى 32 × 32 بكسل قبل التدريب. لم يتم تطبيق أي زيادة في البيانات (data augmentation)، أو تصحيح صريح لتسجيل الصور، أو تسوية إضافية لمحمل البيانات (data-loader normalization). استُبعدت البكسلات المرتبطة بالتسميات السلبية من حساب الخسارة الخاضعة للإشراف، ولم يتم تقييم التعامل مع البكسلات المفقودة أو المشوشة بشكل منفصل.
مقاييس التقييم
استُخدمت ثلاثة مقاييس تقييم معتمدة على نطاق واسع لتقدير أداء التصنيف، وهي: الدقة الإجمالية (OA)، ومتوسط الدقة (AA)، ومعامل كابا (k). يقيس مقياس OA نسبة العينات المصنفة بشكل صحيح من بين جميع العينات، بينما يمثل AA متوسط دقة التصنيف عبر جميع فئات الغطاء الأرضي، ويحدد معامل كابا مدى الاتفاق بين التصنيفات المتوقعة والمرجعية بعد أخذ اتفاق الصدفة في الاعتبار. وتشير القيم الأعلى لهذه المقاييس الثلاثة إلى أداء تصنيف أفضل. جميع القيم الواردة في الجداول 2-6 هي تقديرات نقطية لتقسيم ثابت تم الحصول عليها باستخدام البذرة العشوائية 3407. ولم يتم ذكر أي فترات ثقة، أو اختبارات دلالة إحصائية، أو قيم p.
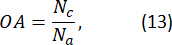
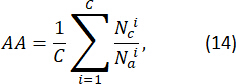
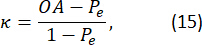
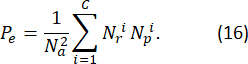
هنا، يشير Nc وNa إلى الأعداد الإجمالية للعينات المصنفة بشكل صحيح والعينات التي تم تقييمها، على التوالي.  و
 يشيران إلى أعداد العينات المصنفة بشكل صحيح وإجمالي العينات للفئة i، على التوالي. وفي حساب معامل Kappa، يشير Pe إلى احتمالية حدوث الاتفاق عن طريق الصدفة، بينما تشير
 و
 إلى تعدادات العينات المرجعية والمتوقعة للفئة i، على التوالي.
النتائج
يظهر سير عمل التقييم العام لإطار عمل FlowErs المقترح في الشكل 1، والذي يلخص استراتيجية التصنيف متعدد الوسائط ذات المرحلتين. وتوضح الشكل 2 عملية استخراج الميزات الخاصة بكل وسيط بناءً على مشفر MetaFormer، بينما تلخص الجدول 1 الخصائص الرئيسية لمجموعات البيانات المرجعية الثلاث المستخدمة في التقييم. تم تقييم أداء التصنيف لاحقاً على مجموعات البيانات المرجعية MUUFL وHouston2013 وAugsburg باستخدام الدقة الكلية (OA)، والدقة المتوسطة (AA)، ومعامل كابا (κ) المحددة في قسم البروتوكول.
المقارنة مع الطرق الأخرى
تم إدراج العديد من شبكات التصنيف متعددة الوسائط المرجعية لتوفير مقارنة شاملة للإطار المقترح. تقوم شبكة DFINet32 بدمج المعلومات فائقة الطيفية ومتعددة الأطياف باستخدام وحدة انتباه متقاطعة ذات عمق (depth-wise cross-attention module) لتحسين التفاعل بين الميزات من خلال أهداف خسارة متعددة. أما شبكة DSHFNet33 فتقدم استراتيجية دمج هرمية ديناميكية تجمع تدريجياً بين التمثيلات دقيقة النطاق وواسعة النطاق. وتعتمد MDL-Middle34 استراتيجية دمج ميزات الطبقة المتوسطة لموازنة المعلومات الواردة من أنماط استشعار متعددة. وتعامل شبكة CMCL35 بيانات HSI وLiDAR كوجهات نظر تكميلية للمشهد نفسه، وتطبق التعلم التبايني مع الضبط الدقيق المزدوج لتحسين محاذاة الميزات. وتستخدم Two-Branch36 بنية تلافيفية ثنائية المسار تعالج كل نمط بشكل مستقل قبل دمج الميزات. وتقوم ExViT37 بمعالجة الرقع متعددة الوسائط باستخدام فروع Transformer متوازية مع وحدات انتباه متقاطعة الوسائط. بينما تعمل DSymFuse38 على توسيع بنية Transformer ثنائية الفروع من خلال دمج الميزات المحلية والعالمية بشكل هرمي. وتجمع CTPMSN39 بين البنيات التلافيفية وبنيات Transformer مع محاذاة التلقين النصي والبصري لتحسين الاتساق الدلالي والتمييز بين الفئات. وقد تم الحصول على قيم المقارنة من المنشورات المستشهد بها أو بروتوكولات التقييم الواردة فيها، ولم يتم إنتاجها باستخدام تنفيذ موحد أو إطار تجريبي مشترك. وبناءً على ذلك، يجب تفسير هذه المقارنات على أنها مقارنات مرجعية وصفية وليس تقييمات مباشرة خاضعة للرقابة.
مجموعة بيانات MUUFL
تم تلخيص نتائج التصنيف التي تم الحصول عليها لمجموعة بيانات MUUFL Gulfport في الجدول 2، وتظهر خرائط التصنيف التمثيلية في الشكل 3A–J. وفي تقسيم المعيار الثابت المذكور، حقق الإطار المقترح دقة إجمالية (OA) بلغت 95.24% ومعامل Kappa بلغ 93.69%، مقارنة بـ 93.99% و 92.03% على التوالي لنموذج CTPMSN. تباين الأداء على مستوى الفئات عبر فئات الغطاء الأرضي المختلفة؛ فبالمقارنة مع CTPMSN، حقق الإطار المقترح دقة تصنيف أعلى لفئات الأشجار (Trees)، ومعظمها أعشاب (Mostly Grass)، والأسطح المختلطة (Mixed Surface) بنسب 2.73% و 3.16% و 1.86% على التوالي. وفي المقابل، ظلت فئة الرصيف الأصفر (Yellow Curb) تمثل تحدياً نظراً لمحدودية عدد العينات المتاحة، وكانت دقتها المسجلة أقل من دقة عدة طرق مقارنة. وبناءً على ذلك، لا ينبغي تفسير التحسن الملحوظ في الأداء الإجمالي على أنه يشير إلى أداء متفوق لكل فئة من فئات الغطاء الأرضي على حدة. وتوضح المقارنة النوعية في الشكل 3A–I خرائط التصنيف التي أنتجتها الطرق التي تم تقييمها، بينما يعرض الشكل 3J خريطة المرجع الأرضي (ground-truth) المقابلة، مما يوضح التوزيع المكاني لفئات الغطاء الأرضي عبر مجموعة بيانات MUUFL Gulfport.
| الفئة | DFINet | DSHFNet | الوسط المتوسط من MDL | الـ CMCL | ثنائي الفرع | ExVit | دي سيم فيوز (DSymFuse) | CTPMSN | FlowErs |
| الأشجار | 89.2 | 74.91 | 87.31 | 84.86 | 91.32 | 92.64 | 91.24 | 95.55 | 98.28 |
| أعشاب في الغالب | 72.98 | 84.63 | 76.38 | 86.54 | 80.65 | 77.48 | 79.57 | 88.92 | 92.08 |
| سطح مختلط | 69.22 | 34.77 | 68.33 | 54.75 | 67.92 | 82.07 | 82.23 | 87.92 | 89.78 |
| تربة/رمل | 76.68 | 87.06 | 78.74 | 84.45 | 78.32 | 93.74 | 89.17 | 97.27 | 93.55 |
| طريق | 86.68 | 81.09 | 83.76 | 86.25 | 84.34 | 90.35 | 85.6 | 94.52 | 95.94 |
| الماء | 100 | 99.25 | 88.52 | 98.53 | 100 | 99.38 | 100 | 100 | 97.56 |
| ظل | 83.29 | 90.65 | 92.12 | 97.72 | 84.89 | 91.47 | 91 | 95.98 | 90.54 |
| بناء | 93.26 | 90.22 | 89.69 | 97.54 | 93.76 | 89.27 | 96.29 | 96.29 | 98.26 |
| رصيف المشاة | 57.34 | 53.09 | 77.06 | 77.98 | 71.32 | 73.54 | 79.62 | 88.07 | 79.61 |
| رصيف أصفر | 84.28 | 1.03 | 96.75 | 80.62 | 81.41 | 93.72 | 91.57 | 97.37 | 48.91 |
| ألواح قماشية | 97.92 | 92.79 | 99.41 | 98.41 | 99.21 | 99.41 | 100 | 99.41 | 93.13 |
| الدقة الإجمالية (OA) | 83.87 | 74.29 | 83.54 | 82.45 | 85.61 | 89.94 | 88.78 | 93.99 | 95.24 |
| متوسط الدقة (AA) | 82.76 | 73.23 | 84.37 | 85.9 | 85.1 | 90.12 | 89.54 | 94.68 | 88.88 |
| معامل كابا (κ × 100) | 79.82 | 67.92 | 78.84 | 78.37 | 81.22 | 85.37 | 85.37 | 92.03 | 93.69 |
الجدول 2: أداء التصنيف (%) للطرق المختلفة على مجموعة بيانات MUUFL المرجعية. أداء التصنيف لكل فئة إلى جانب الدقة الإجمالية (OA)، ومتوسط الدقة (AA)، ومعامل كابا (κ) التي حققها إطار عمل FlowErs المقترح والطرق المنافسة على مجموعة بيانات MUUFL المرجعية.
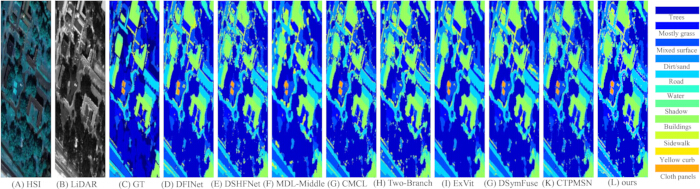
الشكل 3: نتائج نموذجية لتصنيف الغطاء الأرضي لمجموعة بيانات MUUFL المرجعية. (A) التصوير الفائق الطيف (HSI). (B) صورة الكشف عن الضوء وتحديد المدى (LiDAR). (C) خريطة مرجعية للحقيقة الأرضية (GT). (D-L) خرائط التصنيف التي تم إنشاؤها بواسطة DFINet، وDSHFNet، وMDL-Middle، وCMCL، وTwo-Branch، وExVit، وDSymFuse، وCTPMSN، وإطار عمل FlowErs المقترح، على التوالي. يحدد مفتاح الألوان فئات الغطاء الأرضي الممثلة في كل خريطة تصنيف.يرجى النقر هنا لعرض نسخة أكبر من هذا الشكل.
مجموعة بيانات Houston2013
تظهر نتائج التصنيف التي تم الحصول عليها لمجموعة بيانات Houston2013 في الجدول 3، وتُعرض خرائط تصنيف ممثلة في الشكل 4A–J. وفي تقسيم المعيار المرجعي الثابت المُبلغ عنه، حقق الإطار المقترح دقة إجمالية (OA) بلغت 97.56% ومعامل Kappa بنسبة 97.39%. وبالمقارنة مع نتائج CTPMSN المُبلغ عنها، أظهر الإطار المقترح دقة إجمالية أعلى بنحو 3.8 نقطة مئوية. كما لُوحظت تحسينات في فئتي السكن (Residential) والطرق السريعة (Highway)، بزيادات مُبلغ عنها تبلغ حوالي 2.4 و0.5 نقطة مئوية، على التوالي. ومع ذلك، ظلت الفئة التجارية (Commercial) صعبة نسبياً وأظهرت دقة تصنيف أقل من عدة طرق منافسة، وهو ما قد يعكس تشابهاً طيفياً ومكانياً مع فئات الغطاء الأرضي الحضري الأخرى. وبشكل عام، تشير النتائج الإجمالية إلى تحسن في أداء التصنيف على هذا المعيار المرجعي، مع تبيان تفاوت الأداء عبر الفئات الفردية. وتوضح المقارنة النوعية في الشكل 4A–I خرائط التصنيف التي أنتجتها الطرق التي تم تقييمها، بينما يعرض الشكل 4J خريطة المرجع الأرضي المقابلة، مما يوضح التوزيع المكاني لفئات الغطاء الأرضي عبر مجموعة بيانات Houston2013.
| الفئة | DFINet | DSHFNet | MDL-Middle | CMCL | Two-Branch | ExVit | DSymFuse | CTPMSN | FlowErs |
| عشب سليم | 82.39 | 85.58 | 83.1 | 82.91 | 80.31 | 81.67 | 80.06 | 96.96 | 100 |
| عشب مجهد | 100 | 94.65 | 85.06 | 95.68 | 92.44 | 100 | 78.67 | 94.27 | 96.94 |
| عشب اصطناعي | 100 | 98.12 | 99.6 | 94.93 | 99.23 | 99.01 | 99.41 | 99.41 | 99.84 |
| شجرة | 100 | 93.09 | 91.57 | 93.37 | 98.75 | 98.96 | 95.55 | 96.21 | 99.6 |
| تربة | 98.76 | 99.91 | 98.86 | 99.43 | 99.2 | 99.91 | 98.67 | 99.43 | 100 |
| ماء | 94.5 | 93.1 | 100 | 97.3 | 95.32 | 100 | 95.8 | 100 | 97.6 |
| سكني | 87.5 | 66.65 | 97.64 | 92.58 | 90.87 | 93.28 | 87.22 | 86.86 | 99.29 |
| تجاري | 91.53 | 76.29 | 88.13 | 87.96 | 95.31 | 89.27 | 85.85 | 94.61 | 84.07 |
| طريق | 84.19 | 36.29 | 85.93 | 80.76 | 82.63 | 89.42 | 93.29 | 88.07 | 92.73 |
| طريق سريع | 69.32 | 89 | 74.42 | 57.41 | 66.69 | 71.33 | 67.95 | 81.66 | 99.74 |
| سكة حديد | 96.76 | 94.78 | 84.54 | 79.57 | 93.44 | 92.88 | 79.13 | 97.7 | 99.72 |
| موقف سيارات 1 | 83.27 | 88.39 | 95.39 | 52.83 | 85.67 | 89.63 | 91.07 | 93.28 | 95.42 |
| موقف سيارات 2 | 85.36 | 96.46 | 87.37 | 92.42 | 86.17 | 89.47 | 84.21 | 95.09 | 99.18 |
| ملعب تنس | 100 | 97.3 | 95.14 | 83.04 | 98.72 | 97.89 | 100 | 100 | 99.72 |
| مضمار جري | 99.21 | 100 | 100 | 97.02 | 100 | 97.97 | 100 | 100 | 99.83 |
| الدقة الإجمالية (OA) | 91.21 | 85.02 | 89.55 | 83.87 | 90.01 | 91.57 | 87.57 | 93.74 | 97.56 |
| متوسط الدقة (AA) | 92.42 | 87.55 | 91.05 | 85.76 | 90.98 | 92.32 | 89.09 | 94.9 | 97.58 |
| معامل كابا (κ × 100) | 91.09 | 83.59 | 87.59 | 82.76 | 89.1 | 90.85 | 85.29 | 93.21 | 97.39 |
الجدول 3: أداء التصنيف (%) لطرق مختلفة على مجموعة بيانات Houston2013 المرجعية. أداء التصنيف لكل فئة إلى جانب الدقة الإجمالية (OA)، ومتوسط الدقة (AA)، ومعامل كابا (κ) التي حققها إطار عمل FlowErs المقترح والطرق المنافسة على مجموعة بيانات Houston2013 المرجعية.
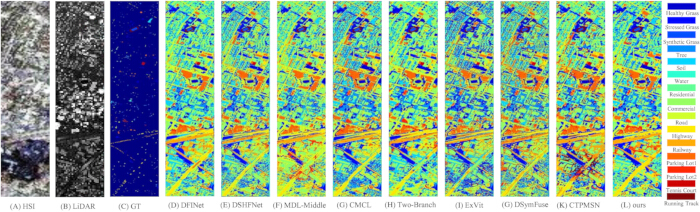
الشكل 4: نتائج نموذجية لتصنيف الغطاء الأرضي لمجموعة بيانات Houston2013 المرجعية. (A) التصوير فرط الطيفي (HSI). (B) صورة كشف الضوء وتحديد المدى (LiDAR). (C) خريطة مرجعية للحقيقة الأرضية (GT). (D–L) خرائط التصنيف التي تم إنشاؤها بواسطة DFINet وDSHFNet وMDL-Middle وCMCL وTwo-Branch وExVit وDSymFuse وCTPMSN وإطار عمل FlowErs المقترح، على التوالي. يحدد مفتاح الألوان فئات الغطاء الأرضي الممثلة في كل خريطة تصنيف. يرجى النقر هنا لعرض نسخة أكبر من هذا الشكل.
مجموعة بيانات أوغسبورغ
تلخص الجداول 4 نتائج التصنيف التي تم الحصول عليها لمجموعة بيانات Augsburg، بينما تُعرض خرائط التصنيف التمثيلية في الشكل 5A–J. وتتميز مجموعة البيانات هذه بتنوع كبير داخل الفئة الواحدة وبنية خلفية معقدة. وفي تقسيم المعيار الثابت المُبلغ عنه، حقق الإطار المقترح دقة إجمالية (OA) بلغت 97.56% ودقة متوسطة (AA) بلغت 89.21%. وبالمقارنة مع الطرق المرجعية المدرجة، سجل الإطار المقترح دقة تصنيف أعلى لفئتي المناطق الصناعية والتجارية بنسبة 14 و45 نقطة مئوية تقريباً، على التوالي. ويشير الفرق بين OA و AA إلى أن الأداء العام قد تأثر بتكرار الفئات، بينما تعكس AA متوسط الأداء عبر جميع الفئات. وبناءً على ذلك، يجب تفسير OA المُبلغ عنها جنباً إلى جنب مع النتائج الخاصة بكل فئة لأن أداء التصنيف تباين بين فئات الغطاء الأرضي الفردية. وتوضح المقارنة النوعية في الشكل 5A–I خرائط التصنيف التي أنتجتها الطرق التي تم تقييمها، بينما يعرض الشكل 5J خريطة المرجع الحقيقية المقابلة، والتي توضح التوزيع المكاني لفئات الغطاء الأرضي عبر مجموعة بيانات Augsburg.
| الفئة | DFINet | DSHFNet | MDL-Middle | CMCL | Two-Branch | ExVit | DSymFuse | CTPMSN | FlowErs |
| الأشجار | 96.41 | 98.21 | 91.72 | 94.27 | 95.85 | 93.64 | 90.58 | 93.36 | 99.57 |
| السكنية | 96.88 | 42.08 | 95.19 | 69.84 | 92.75 | 97.71 | 96.32 | 97.37 | 98.97 |
| الصناعية | 58.2 | 47.29 | 62.61 | 35.22 | 72.66 | 65.82 | 72.45 | 64.6 | 86.41 |
| النباتات المنخفضة | 92.22 | 51.75 | 87.76 | 80.27 | 88.9 | 84.88 | 89.65 | 96.72 | 99.58 |
| المخصصات الزراعية | 55.87 | 95.94 | 50.86 | 89.33 | 72.86 | 46.85 | 62.91 | 58.69 | 91.22 |
| التجارية | 10.98 | 50.91 | 24.24 | 45.59 | 20.32 | 24.49 | 17.22 | 29.73 | 74.3 |
| المياه | 22.87 | 67.78 | 29.04 | 54.87 | 36.82 | 24.49 | 13.27 | 15.53 | 74.39 |
| الدقة الإجمالية (OA) | 88.78 | 56.59 | 87.74 | 75.94 | 87.29 | 87.72 | 88.35 | 91.56 | 97.56 |
| متوسط الدقة (AA) | 62.29 | 65.47 | 63.06 | 67.61 | 67.78 | 62.56 | 63.2 | 65.14 | 89.21 |
| معامل كابا (κ × 100) | 84.32 | 46.78 | 82.69 | 67.83 | 82.58 | 82.49 | 83.36 | 87.88 | 96.48 |
الجدول 4: أداء التصنيف (%) لطرق مختلفة على مجموعة بيانات Augsburg المرجعية. أداء التصنيف لكل فئة جنبًا إلى جنب مع الدقة الكلية (OA)، ومتوسط الدقة (AA)، ومعامل كابا (κ) التي حققها إطار عمل FlowErs المقترح والطرق المنافسة على مجموعة بيانات Augsburg المرجعية.
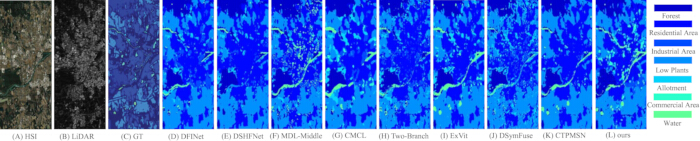
الشكل 5: نتائج نموذجية لتصنيف الغطاء الأرضي لمجموعة بيانات Augsburg المرجعية. (A) التصوير فرط الطيفي (HSI). (B) صورة الكشف عن الضوء وتحديد المدى (LiDAR). (C) خريطة المرجع الأرضي (GT). (D–L) خرائط التصنيف الناتجة عن DFINet، وDSHFNet، وMDL-Middle، وCMCL، وTwo-Branch، وExVit، وDSymFuse، وCTPMSN، وإطار عمل FlowErs المقترح، على التوالي. يحدد مفتاح الألوان فئات الغطاء الأرضي الممثلة في كل خريطة تصنيف. يرجى النقر هنا لعرض نسخة أكبر من هذا الشكل.
ولتسهيل المقارنة البصرية الدقيقة للمناطق الصعبة، يتم عرض مناظر مكبرة لمناطق اهتمام (ROIs) ممثلة من مجموعات بيانات MUUFL وHouston2013 وAugsburg في الشكل 6. وتبرز هذه المناظر المكبرة حدود الأجسام والبنى المكانية دقيقة المقياس التي تكون أقل وضوحاً في خرائط التصنيف للمشهد الكامل الموضحة في الأشكال 3-5، مما يوفر دليلاً نوعياً إضافياً على أداء التصنيف عبر مجموعات البيانات المرجعية الثلاث.
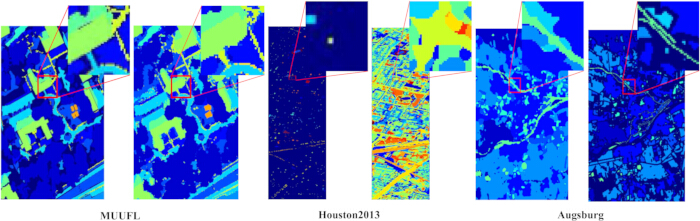
الشكل 6: مناظر مكبرة لمناطق اهتمام (ROIs) تمثيلية من مجموعات بيانات MUUFL وHouston2013 وAugsburg. تم تكبير مناطق اهتمام (ROIs) تمثيلية من مجموعات بيانات MUUFL وHouston2013 وAugsburg لتسهيل المقارنة البصرية لتفاصيل التصنيف دقيقة النطاق. تشير المربعات الحمراء إلى المناطق المختارة، وتبرز المناظر المكبرة المقابلة حدود الأجسام، والهياكل الصغيرة، وغيرها من المناطق الصعبة التي يصعب تقديرها في خرائط تصنيف المشهد الكامل الموضحة في الأشكال 3-5. توفر هذه المناظر المكبرة تقييماً نوعياً إضافياً لنتائج التصنيف. يرجى النقر هنا لعرض نسخة أكبر من هذا الشكل.
دراسة الاستئصال
تأثير وحدة مطابقة التدفق متعدد الوسائط:
لتقييم مساهمة وحدة MFM، أُجريت تجارب استئصال باستخدام ثلاثة تكوينات للنموذج: إطار عمل FlowErs الكامل (Baseline)، ونموذج بدون وحدة MFM (w/o MFM)، ونموذج مبسط يستخدم محاذاة تدفق أحادي الاتجاه (Single Flow). وتتلخص النتائج الكمية المقابلة في الجدول 5.
| الطريقة | MUUFL | Houston2013 | Augsburg | ||||||
| OA (%) | AA (%) | κ × 100 | OA (%) | AA (%) | κ × 100 | OA (%) | AA (%) | κ × 100 | |
| الخط الأساسي | 95.24 | 88.88 | 93.69 | 97.56 | 97.58 | 97.39 | 97.56 | 89.21 | 96.48 |
| بدون MFM | 92.87 | 86.02 | 91.05 | 95.31 | 95.28 | 94.97 | 95.12 | 87.06 | 93.98 |
| تدفق واحد | 94.38 | 87.43 | 92.72 | 96.58 | 96.47 | 96.22 | 96.47 | 88.36 | 95.47 |
الجدول 5: دراسة الاستئصال لإطار عمل FlowErs المقترح على مجموعات بيانات MUUFL وHouston2013 وAugsburg المرجعية. تم تسجيل أداء التصنيف للنموذج الكامل (Baseline) ومتغيرين من دراسة الاستئصال باستخدام الدقة الإجمالية (OA)، ومتوسط الدقة (AA)، ومعامل كابا (κ).
بالمقارنة مع النموذج المرجعي (Baseline model)، أدىت إزالة وحدة MFM إلى انخفاض قيم OA وAA وKappa عبر جميع مجموعات البيانات المرجعية الثلاث. وقد حقق تكوين التدفق الأحادي (Single Flow) أداءً متوسطاً بين النموذج الكامل والنموذج الخالي من وحدة MFM، مما يشير إلى أن محاذاة الميزات أحادية الاتجاه قد حافظت على جزء من تحسن الأداء الملحوظ، دون الوصول إلى الأداء التجميعي للتنفيذ ثنائي الاتجاه. وتشير هذه الملاحظات إلى أن وحدة محاذاة التدفق ثنائية الاتجاه قد ساهمت في الأداء المسجل في ظل إعدادات الاختبار المرجعية التي تم تقييمها. وتمثل الفروق المسجلة تقديرات نقطية لتقسيم ثابت تم الحصول عليها باستخدام بذرة عشوائية واحدة، وبالتالي يجب تفسيرها بشكل وصفي وليس كدليل على دلالة إحصائية.
عبر مجموعات البيانات المرجعية الثلاث، لوحظت أكبر فروق في الأداء الإجمالي بين النموذج المرجعي (Baseline) ونماذج الاستئصال (ablation models) في مجموعة بيانات MUUFL، بينما لوحظت فروق أصغر نسبياً في مجموعة بيانات Houston2013. وقد لوحظ تحسن في كل من الدقة الإجمالية (OA) ودقة المتوسط (AA) للنموذج الكامل مقارنة بتكوينات الاستئصال، مما يشير إلى أداء تصنيف إجمالي أعلى إلى جانب تحسن في متوسط أداء الفئات ضمن تقسيمات الاختبار المرجعية التي تم تقييمها. وتتسق هذه النتائج مع فرضية الدراسة القائلة بأن محاذاة الميزات قبل الدمج متعدد الوسائط قد يؤدي إلى تحسين أداء التصنيف؛ ومع ذلك، لم يتم إجراء تجارب متكررة أو تحليلات إحصائية في هذه الدراسة.
تأثير عدد خطوات تكامل التدفق:
لإجراء تقييم إضافي لتأثير عدد خطوات تكامل التدفق ضمن وحدة MFM، تم تغيير عدد خطوات التكامل من 2 إلى 10. والنتائج التصنيفية المقابلة ملخصة في الجدول 6. يتحكم بارامتر خطوة التكامل في تقسيم العملية المستمرة لنقل الميزات أثناء المحاذاة متعددة الوسائط، حيث تمثل القيم الأصغر تقسيماً أكثر خشونة والقيم الأكبر تقسيماً أكثر دقة. وكما هو موضح في الجدول 6، تم الحصول على أعلى تقديرات لنقطة التقسيم الثابتة عبر المقاييس التي تم تقييمها عندما كان عدد خطوات التكامل 6. وبشكل عام، تحسن الأداء مع زيادة عدد خطوات التكامل من 2 إلى 6، وبعد ذلك ظل الأداء المسجل مستقراً نسبياً أو انخفض قليلاً عبر مجموعات البيانات المرجعية الثلاث. وتشير هذه الملاحظات إلى أن الإعداد الاسمي المكون من ست خطوات تكامل قد وفر أعلى أداء إجمالي في ظل ظروف الاختبار المرجعي التي تم تقييمها. ونظراً لأن النتائج المسجلة تستند إلى بذرة عشوائية واحدة وتقسيمات مرجعية ثابتة، فيجب تفسير هذه الاختلافات بشكل وصفي بدلاً من اعتبارها دليلاً على وجود فروق ذات دلالة إحصائية في الأداء.
| خطوات تكامل التدفق | MUUFL | هيوستن 2013 | أوغسبورغ | ||||||
| النسبة المئوية لـ OA (%) | الأحماض الأمينية (%) | κ × 100 | النسبة المئوية للتحلل التأكسدي (OA (%)) | الأحماض الأمينية (%) | κ × 100 | نسبة الفتح (%) | الأحماض الأمينية (%) | κ × 100 | |
| 2 | 92.37 | 84.63 | 90.12 | 95.73 | 96.12 | 95.64 | 94.86 | 85.73 | 92.76 |
| 3 | 93.58 | 85.47 | 90.98 | 96.32 | 96.48 | 96.01 | 95.61 | 86.48 | 93.51 |
| 4 | 94.31 | 86.51 | 91.76 | 96.88 | 96.92 | 96.57 | 96.18 | 87.34 | 94.12 |
| 5 | 94.92 | 87.62 | 92.54 | 97.18 | 97.22 | 97.05 | 96.89 | 88.02 | 95.07 |
| 6 | 95.24 | 88.88 | 93.69 | 97.56 | 97.58 | 97.39 | 97.56 | 89.21 | 96.48 |
| 7 | 95.12 | 88.56 | 93.5 | 97.49 | 97.44 | 97.31 | 97.34 | 88.84 | 96.21 |
| 8 | 94.95 | 88.22 | 93.2 | 97.31 | 97.29 | 97.17 | 96.98 | 88.46 | 95.82 |
| 9 | 94.63 | 87.75 | 92.85 | 97.09 | 97.03 | 96.88 | 96.45 | 87.92 | 95.28 |
| 10 | 94.21 | 86.97 | 92.18 | 96.77 | 96.81 | 96.61 | 95.87 | 87.03 | 94.61 |
الجدول 6: تأثير عدد خطوات تكامل التدفق على أداء التصنيف لمجموعات بيانات MUUFL وHouston2013 وAugsburg المرجعية. يتم تقرير أداء التصنيف على شكل الدقة الإجمالية (OA)، ومتوسط الدقة (AA)، ومعامل كابا (κ) لأعداد مختلفة من خطوات تكامل التدفق. وتتوافق ست خطوات تكامل مع التكوين المستخدم في إطار عمل FlowErs النهائي.
من بين مجموعات البيانات التي تم تقييمها، أظهرت مجموعة بيانات MUUFL أكبر تباين في الأداء مع تغير عدد خطوات التكامل، بينما أظهرت مجموعة بيانات Houston2013 تغيرات أصغر نسبياً مع تحقيق أعلى أداء مسجل عند ست خطوات تكامل. وأظهرت مجموعة بيانات Augsburg اتجاهاً مماثلاً مع تباين متواضع نسبياً في الأداء عبر إعدادات الخطوات المختلفة. وتشير هذه الملاحظات مجتمعة إلى أن عدداً متوسطاً من خطوات تكامل التدفق قد وفر أعلى أداء تصنيف مسجل لمجموعات البيانات التي تم تقييمها. ولا يتضمن التحليل الحالي تجارب مكررة، أو تقديرات لعدم اليقين، أو توصيفاً حسابياً، أو دراسة للمتانة تجاه الأنماط المفقودة أو المدخلات المشوشة، أو تعميماً عبر المناطق، وبالتالي لم يتم استخلاص أي استنتاجات فيما يتعلق بهذه الجوانب.
أظهر التقييم عبر مجموعات البيانات المرجعية الثلاث أداءً تنافسياً في التصنيف الإجمالي بموجب تقسيمات الاختبار المحددة والمسجلة، حيث بلغت أقصى قيمة لـ OA نسبة 97.56%. وأوضحت تجارب الاستئصال (ablation experiments) أن تكوين مطابقة التدفق ثنائي الاتجاه الكامل حقق باستمرار أداءً إجمالياً أعلى من نماذج الاستئصال المقابلة عبر مجموعات البيانات التي تم تقييمها. وأشارت التحليلات على مستوى الفئات إلى أن أداء التصنيف تباين بين فئات الغطاء الأرضي، حيث ظلت الفئات الأقلية والفئات المتشابهة طيفياً صعبة نسبياً، مما ساهم في الفرق الملحوظ بين OA و AA في مجموعات البيانات غير المتوازنة. يستند التقييم الحالي إلى تقديرات نقطية لتقسيمات ثابتة تم الحصول عليها باستخدام بذرة عشوائية واحدة، ولا يشمل تقديرات عدم اليقين الناتجة عن التشغيل المتكرر، أو اختبارات الدلالة الإحصائية، أو التوصيف الحسابي، أو الحساسية تجاه عدم التسجيل المكاني، أو المتانة تجاه الوسائط المفقودة أو المشوشة، أو التعميم عبر المناطق. وتستحق هذه الجوانب مزيداً من الاستقصاء في الدراسات المستقبلية.
توافر البيانات:
تتوفر مجموعات بيانات القياس المرجعية العامة المستخدمة في هذه الدراسة من مزوديها الأصليين. كما تتوفر مواد التنفيذ، وخرائط التنبؤ، ومخرجات التقييم للعامة من خلال مستودع Zenodo على الرابط https://doi.org/10.5281/zenodo.21395701.
الملف التكميلي 1: الصياغة الرياضية وخوارزمية التدريب لإطار عمل FlowErs. يوفر هذا الملف التكميلي الصياغة الرياضية الكاملة التي يرتكز عليها إطار عمل FlowErs المقترح، بما في ذلك صياغة التدفق المستمر (المعادلتان S1–S2)، ومعادلة تدفق الاحتمالات (المعادلة S3)، ومسار التدفق الأمثل (المعادلتان S4–S5)، وهدف تدريب مطابقة التدفق الشرطي (المعادلة S6)، والخصائص النظرية المرتبطة بها. يتضمن الملف أيضاً الخوارزمية S1، التي تلخص سير عمل التدريب الكامل المكون من مرحلتين، واللتين تشملان التدريب المسبق على مطابقة التدفق غير الخاضع للإشراف، يليه التصنيف متعدد الوسائط الخاضع للإشراف.
المناقشة
تقدم هذه الدراسة FlowErs، وهو إطار عمل للاستشعار عن بُعد متعدد الوسائط يقوم بفصل محاذاة السمات عبر الوسائط عن التصنيف الدلالي من خلال استراتيجية تعلم ثنائية المرحلة. وبدلاً من دمج السمات غير المتجانسة الخاصة بكل وسيط بشكل مباشر، يقوم إطار العمل المقترح أولاً بمحاذاة تمثيلات السمات باستخدام مطابقة التدفق الشرطي قبل عملية الدمج والتصنيف متعدد الوسائط. ويعالج هذا التصميم التحدي القائم منذ فترة طويلة والمتمثل في التوزيعات غير المتجانسة للسمات بين HSI وLiDAR، حيث غالباً ما تحد الاختلافات في آليات الاستشعار من فعالية استراتيجيات الدمج التقليدية القائمة على التسلسل أو الانتباه23,26,35,36,37,38,39. ومن خلال صياغة المحاذاة متعددة الوسائط كنقل مستمر للسمات، يوسع FlowErs التطورات الأخيرة في مطابقة التدفق من النمذجة التوليدية نحو تعلم تمثيل الاستشعار عن بُعد متعدد الوسائط15,16,17,18,19,20,21. وفي ظل ظروف الاختبار المرجعية التي تم تقييمها، حقق إطار العمل المقترح أداء تصنيف إجمالي تنافسي على مجموعات بيانات Houston2013 وAugsburg وMUUFL، بينما دعمت دراسة الاستئصال المصاحبة بشكل أكبر مساهمة وحدة محاذاة التدفق ثنائية الاتجاه في الأداء المسجل للتقسيم الثابت.
تشير النتائج الواردة إلى أن المحاذاة الصريحة للميزات قبل الدمج متعدد الوسائط قد تعمل على تحسين التوافق بين تمثيلات الميزات غير المتجانسة المستخلصة من وسائط استشعار مختلفة. اعتمدت طرق الاستشعار عن بعد متعددة الوسائط السابقة بشكل أساسي على الشبكات الالتفافية، أو البنى القائمة على Transformer، أو آليات الانتباه، أو التعلم التبايني، أو الدمج الموجه بالمطالبات لتعزيز التفاعل بين الميزات23,26,35,36,37,38,39. وعلى الرغم من أن هذه النهج قد أظهرت أداءً قوياً في التصنيف، إلا أن معظمها يفترض إمكانية دمج التضمينات الخاصة بكل وسيط مباشرة بعد استخلاص الميزات. وفي المقابل، يقدم FlowErs مرحلة محاذاة هندسية وسيطة تقوم بنقل الميزات الخاصة بالوسائط باستمرار إلى فضاء كامن مشترك قبل عملية التصنيف. ويظهر التقييم لكل فئة أن التحسينات الإجمالية في الأداء لم تكن موزعة بشكل موحد عبر جميع فئات غطاء الأرض. فعلى سبيل المثال، ظلت العديد من الفئات الأقلية والفئات الحضرية المتشابهة طيفياً صعبة التصنيف نسبياً، كما أن الفرق الملحوظ بين OA وAA، خاصة في مجموعة بيانات Augsburg، يعكس تأثير عدم توازن الفئات إلى جانب التباين في الأداء على مستوى الفئة. وبناءً على ذلك، يجب تفسير المقاييس الإجمالية الواردة جنباً إلى جنب مع النتائج الخاصة بكل فئة بدلاً من اعتبارها دليلاً على تحسينات موحدة في كل فئة.
تدعم تجارب الاستئصال (ablation experiments) التصميم المقترح بشكل أكبر؛ حيث أدىت إزالة وحدة مطابقة التدفق متعدد الوسائط (multimodal flow matching module) إلى خفض أداء التصنيف الإجمالي عبر جميع مجموعات بيانات القياس المرجعية الثلاث، بينما كان أداء متغير التدفق أحادي الاتجاه ثابتًا بين النموذج الكامل والنموذج الخالي من محاذاة التدفق. وتتوافق هذه الملاحظات مع فرضية العمل القائلة بأن نقل السمات ثنائي الاتجاه قد يحسن التوافق عبر الوسائط قبل دمج السمات في ظل ظروف القياس المرجعية التي تم تقييمها. وبالمثل، أظهر تحليل تكامل التدفق أن التقطيع البيني لمسار النقل المكتسب قد حقق أعلى أداء إجمالي، حيث مثلت ست خطوات تكامل نقطة التشغيل الاسمية في التنفيذ الحالي. وأصبحت مكاسب الأداء هامشية أو انخفضت قليلاً مع إضافة خطوات تكامل إضافية، مما يشير إلى أن التقطيع الأكثر دقة قد يؤدي إلى عوائد متناقصة في ظل الظروف التجريبية التي تم تقييمها. ويبقى التحقق مما إذا كانت نقطة التشغيل هذه تعمم على مجموعات بيانات أخرى، أو وسائط استشعار، أو بنيات شبكية أخرى قيد البحث.
ينبغي مراعاة عدة قيود عند تفسير النتائج الحالية. أولاً، اقتصر التقييم على ثلاث مجموعات بيانات مرجعية متاحة للعامة باستخدام تقسيمات ثابتة للتدريب والاختبار وبذرة عشوائية واحدة؛ وبناءً على ذلك، لم يتم تقييم عدم اليقين الناتج عن تكرار التشغيل، وفواصل الثقة، واختبارات الدلالة الإحصائية، والتباين بين عمليات التشغيل. ثانياً، استُمدت طرق المقارنة من منشوراتها الخاصة بدلاً من إعادة تنفيذها ضمن إطار تجريبي مشترك؛ لذا، يجب تفسير المقارنات الواردة بشكل وصفي وليس كعمليات إعادة إنتاج منضبطة ومباشرة. ثالثاً، لم يتم استقصاء مدى المتانة في مواجهة الأنماط المفقودة، والملاحظات المشوشة، وسوء التسجيل المكاني، والتعميم عبر المناطق. بالإضافة إلى ذلك، وعلى الرغم من أن مطابقة التدفق توفر إطاراً نظرياً لنقل الميزات المستمر والقابل للعكس تقنياً15,16,17، إلا أن القابلية العكسية الدقيقة، والحفاظ على الطوبولوجيا، والقابلية للتفسير الفيزيائي للتحويلات المتعلمة لم يتم التحقق منها تجريبياً في هذه الدراسة. وبالمثل، لم يتم تحليل الخصائص الحسابية بشكل منفصل، بما في ذلك وقت الاستنتاج، واستهلاك الذاكرة، وتعقيد عمليات الفاصلة العائمة.
تستمر المناهج البديلة لدراسة المحاذاة متعددة الوسائط في التطور. وقد استكشفت الدراسات الحديثة التعلم التبايني، والدمج القائم على الرسوم البيانية، وتعلم التمثيلات منخفضة الرتبة، والتعلم متعدد الوسائط الموجه بالمطالبات، والتعلم الاتحادي، وبنيات Transformer-convolutional الهجينة لتحسين تكامل الميزات متعددة الوسائط23,26,27,28,35,36,37,38,39. وتظل هذه الاستراتيجيات تكميلية وليست متبادلة الاستبعاد، وقد تبحث الأعمال المستقبلية في الدمج بين نقل الميزات الصريح القائم على التدفق ونماذج المحاذاة الموجودة حالياً. وعلاوة على تصنيف الغطاء الأرضي، قد تكون المحاذاة المستمرة للميزات قابلة للتطبيق أيضاً في مهام الاستشعار عن بعد ذات الوسائط المتعددة ذات الصلة، بما في ذلك التقسيم الدلالي، وكشف التغيرات، والتعرف على الأشياء، والرصد البيئي، وتقييم الكوارث، والزراعة الدقيقة، ورسم الخرائط الحضرية، حيث تتوفر أنماط استشعار تكميلية بشكل متزايد2,3,4,5,6,7,8,9,23.
يجب أن تقيم الاستقصاءات المستقبلية الإطار المقترح تحت ظروف تجريبية أكثر تنوعاً من خلال دمج التحليلات الإحصائية للتشغيل المتكرر، والتوصيف الحسابي، ومدى المتانة تجاه الوسائط المفقودة أو المشوشة، والحساسية لأخطاء التسجيل المكاني، وتقييم النقل عبر المناطق. ومن شأن الدراسات الإضافية التي تفحص بارامترات التدفق البديلة، وبنى المشفرات المختلفة، ومجموعات بيانات معيارية متعددة الوسائط أكبر، أن توضح بشكل أكبر مدى قابلية تعميم المنهجية المقترحة وتطبيقها العملي. وتشير النتائج الحالية مجتمعة إلى أن محاذاة الميزات الصريحة من خلال مطابقة التدفق الشرطي تمثل استراتيجية تكميلية واعدة للتصنيف في الاستشعار عن بعد متعدد الوسائط، مع تسليط الضوء على العديد من الفرص لمزيد من التطوير المنهجي والتقييم الشامل.
الإفصاحات
تضارب المصالح:
يصرح المؤلفون بأنه لا يوجد لديهم أي تضارب في المصالح.
شكر وتقدير
تم دعم هذا العمل مالياً من خلال مشروع صندوق البحوث العلمية في مقاطعة Shaanxi A&جامعة #38;F (منحة رقم ZK25-38) وإدارة التعليم في مقاطعة شنشي (منحة رقم 24JK0734).
المواد
| الاسم | الشركة | رقم فهرسي | التعليقات |
|---|---|---|---|
| مُحسن AdamW | PyTorch Foundation | مدرج في PyTorch | يُستخدم لتحسين النموذج. تم استخدام PyTorch 2.5.0. |
| مجموعة بيانات Augsburg المرجعية | Hu J et al. (Earth System Science Data, 2022); Remote Sensing Technology, LMU Munich | https://doi.org/10.5281/zenodo.7185498 | مجموعة بيانات مرجعية عامة للاستشعار عن بعد متعدد الوسائط تُستخدم لتقييم النموذج. |
| CUDA Toolkit | NVIDIA | CUDA Toolkit 12.4; https://developer.nvidia.com/cuda-12-4-0-download-archive | تُستخدم لتسريع تدريب النموذج والاستنتاج عبر GPU. |
| وحدة معالجة الرسوميات (GPU) | NVIDIA Corporation | NVIDIA A100 80 GB PCIe | تُستخدم لتدريب النموذج وتقييمه. |
| مجموعة بيانات Houston2013 المرجعية | IEEE Geoscience and Remote Sensing Society Data Fusion Contest | http://www.grss-ieee.org/community/technical-resources/data-fusion/2013-grss-data-fusion-contest/ | مجموعة بيانات مرجعية عامة للصور فائقة الطيف وLiDAR تُستخدم لتقييم النموذج. |
| مجموعة بيانات MUUFL Gulfport المرجعية | University of Florida (Gader P et al., Technical Report REP-2013-570) | https://github.com/GatorSense/MUUFLGulfport | مجموعة بيانات مرجعية عامة للصور فائقة الطيف وLiDAR تُستخدم لتقييم النموذج. |
| نظام التشغيل | Canonical Ltd. | Ubuntu 22.04 LTS; https://ubuntu.com | البيئة الحسابية المستخدمة لتطوير النموذج وتدريبه وتقييمه. |
| PyTorch | PyTorch Foundation | PyTorch 2.5.0; https://pytorch.org/get-started/previous-versions/#v250 | إطار عمل للتعلم العميق يُستخدم لتنفيذ نموذج FlowErs وتدريبه وتقييمه. |
| Python | Python Software Foundation | Python 3.11; https://www.python.org/downloads/release/python-3110/ | لغة برمجة تُستخدم لتنفيذ وتشغيل سير العمل الحسابي. |
المراجع
- Geng X, et al. Fast and effective: Progressive hierarchical fusion classification for remote sensing images. IEEE Trans Multimed. 2024;26:9776–89.
- Tian F, et al. HireNet: Hierarchical-relation network for few-shot remote sensing image scene classification. IEEE Trans Geosci Remote Sens. 2024;62:1–10.
- Ye Z, et al. A multiscale incremental learning network for remote sensing scene classification. IEEE Trans Geosci Remote Sens. 2024;62:1–15.
- Li Q, Chen Y, He X, Huang L. Co-training transformer for remote sensing image classification, segmentation, and detection. IEEE Trans Geosci Remote Sens. 2024;62:1–18.
- Qin A, et al. Deep updated subspace networks for few-shot remote sensing scene classification. IEEE Trans Geosci Remote Sens. 2024;62:1–14.
- Wang S, et al. Personalized multiparty few-shot learning for remote sensing scene classification. IEEE Trans Geosci Remote Sens. 2024;62:1–15.
- Yang JY, et al. Multifrequency graph convolutional network with cross-modality mutual enhancement for multisource remote sensing data classification. IEEE Trans Geosci Remote Sens. 2024;62:1–14.
- Zhou G, Qian L, Gamba P. A novel iterative self-organizing pixel matrix entanglement classifier for remote sensing imagery. IEEE Trans Geosci Remote Sens. 2024;62:1–21.
- Zhu J, et al. MVP: Meta visual prompt tuning for few-shot remote sensing image scene classification. IEEE Trans Geosci Remote Sens. 2024;62:1–13.
- Gat I, et al. Discrete flow matching. Adv Neural Inf Process Syst. 2024;37:133345–85.
- Miller BK, Chen RT, Sriram A, Wood BM. FlowMM: Generating materials with Riemannian flow matching [Internet]. 2024 [cited 2026 Jul 6]. Available from: https://arxiv.org/abs/2406.04713
- Xin Y, et al. Confidence-weighted dual-teacher networks with biased contrastive learning for semi-supervised semantic segmentation in remote sensing images. IEEE Trans Geosci Remote Sens. 2024;62:1–16.
- He Y, et al. IGroupSS-Mamba: Interval group spatial-spectral Mamba for hyperspectral image classification. IEEE Trans Geosci Remote Sens. 2024;62:1–14.
- Liao D, Wang Q, Lai T, Huang H. Joint classification of hyperspectral and LiDAR data based on Mamba. IEEE Trans Geosci Remote Sens. 2026;19:11445–61.
- Lipman Y, et al. Flow matching for generative modeling [conference paper]. Presented at: 11th International Conference on Learning Representations (ICLR); 2023. Available from: https://openreview.net/forum id=PqvMRDCJT9t
- Liu X, et al. Flow straight and fast: Learning to generate and transfer data with rectified flow [conference paper]. Presented at: 11th International Conference on Learning Representations (ICLR); 2023. Available from: https://openreview.net/forum id=XVjTT1nw5z
- Geng Z, et al. Consistency models made easy [conference paper]. Presented at: 13th International Conference on Learning Representations (ICLR); 2025. Available from: https://openreview.net/forum id=1x7sJYh37d
- Hu VT, et al. Latent space editing in transformer-based flow matching [conference paper]. Presented at: AAAI Conference on Artificial Intelligence; 2024;38:2247–55. Available from: https://doi.org/10.1609/aaai.v38i3.28014
- Jeong J, Kim K, Kim W, Kim NJ. Real-time person image synthesis using a flow matching model [Internet]. 2025 [cited 2026 Jul 6]. Available from: https://arxiv.org/abs/2505.03562
- Kakesh MH, et al. An efficient data generation method based on flow matching for bearing fault diagnosis under imbalanced data conditions. IEEE Trans Energy Convers. 2026;1–11.
- Chu Z, et al. End-to-end seam tracking with flow matching-based diffusion policy [conference paper]. Presented at: International Conference on Machine Intelligence and Nature-Inspired Computing (MIND); Xiamen, China; 2025. p. 304–9. Available from: https://doi.org/10.1109/MIND67540.2025.11351867
- Melgani F, Bruzzone L. Classification of hyperspectral remote sensing images with support vector machines. IEEE Trans Geosci Remote Sens. 2004;42:1778–90.
- Li J, et al. Deep learning in multimodal remote sensing data fusion: A comprehensive review. Int J Appl Earth Obs Geoinf. 2022;112:102926.
- Vaswani A, et al. Attention is all you need [Internet]. 2017 [cited 2026 Jul 6]. Available from: https://arxiv.org/abs/1706.03762
- Zhuang Y, Chen M, Zhu D. UWASR-GAN: An attention-guided multi-scale residual framework for underwater image enhancement in underwater Internet of Things applications. IEEE Internet Things J. 2026;12:29452–71.
- Ma X, Zhang X, Pun MO, Liu M. A multilevel multimodal fusion transformer for remote sensing semantic segmentation. IEEE Trans Geosci Remote Sens. 2024;62:1–15.
- Xie W, Lu Y, Li D, Li Y. Ebbinghaus-curve guided low-rank component-induced attention for multisource remote sensing classification. IEEE Trans Geosci Remote Sens. 2024;62:1–12.
- Li D, Xie W, Li Y, Fang L. FedFusion: Manifold-driven federated learning for multi-satellite and multi-modality fusion. IEEE Trans Geosci Remote Sens. 2023;62:1–13.
- Debes C, et al. Hyperspectral and LiDAR data fusion: Outcome of the 2013 GRSS data fusion contest. IEEE J Sel Top Appl Earth Obs Remote Sens. 2014;7:2405–18.
- Hu J, et al. MDAS: A new multimodal benchmark dataset for remote sensing. Earth Syst Sci Data Discuss. 2022:1–26.
- Gader P, et al. MUUFL Gulfport hyperspectral and LiDAR airborne data set. University of Florida; Gainesville (FL); Technical Report REP-2013-570; 2013.
- Gao Y, et al. Hyperspectral and multispectral classification for coastal wetland using depthwise feature interaction network. IEEE Trans Geosci Remote Sens. 2021;60:1–15.
- Feng Y, Song L, Wang L, Wang X. DSHFNet: Dynamic scale hierarchical fusion network based on multiattention for hyperspectral image and LiDAR data classification. IEEE Trans Geosci Remote Sens. 2023;61:1–14.
- Hong D, et al. More diverse means better: Multimodal deep learning meets remote-sensing imagery classification. IEEE Trans Geosci Remote Sens. 2020;59:4340–54.
- Feng Z, et al. Cross-modal contrastive learning for remote sensing image classification. IEEE Trans Geosci Remote Sens. 2023;61:1–13.
- Xu X, et al. Multisource remote sensing data classification based on convolutional neural network. IEEE Trans Geosci Remote Sens. 2017;56:937–49.
- Yao J, et al. Extended vision transformer (ExViT) for land use and land cover classification: A multimodal deep learning framework. IEEE Trans Geosci Remote Sens. 2023;61:1–15.
- Chang H, et al. Deep symmetric fusion transformer for multimodal remote sensing data classification. IEEE Trans Geosci Remote Sens. 2024;63:1–15.
- Wang A, et al. CTPMSN: Enhancing multimodal remote sensing classification with composite text prompts. IEEE J Sel Top Appl Earth Obs Remote Sens. 2025;18:27960–27978.