تدرس هذه الورقة خوارزمية تحسين للجدولة الديناميكية تدمج بين نموذج Transformer والتعلم التعزيزي القائم على تحسين السياسة القريبة (PPO)، مع التركيز على تضاربات الموارد المتكررة وتأخيرات الاستجابة في جدولة الأنشطة النقابية.
يتطلب اشتراك JoVE لعرض هذا المحتوى. تسجيل الدخول أو ابدأ نسخة تجريبية مجانية
مقالة بحثية
خوارزمية الجدولة الديناميكية وتحسين الموارد لأنشطة الاتحادات من خلال دمج المحول والتعلم التعزيزي
في هذه المقالة
ملخص
الملخص
لمعالجة مشكلة انخفاض الكفاءة التنظيمية الناتجة عن تكرار تعارضات تخصيص الموارد وتأخر استجابات الجدولة في إدارة أنشطة النقابات العمالية، تقترح هذه الورقة خوارزمية جدولة ديناميكية تدمج بين نموذج Transformer وخوارزمية PPO (Proximal Policy Optimization). وفي التنفيذ المحدد، تم أولاً تصميم هيكل نمذجة موحد لسيناريو الجدولة لتحويل حالات الأنشطة والأفراد والموارد إلى مدخلات تنسورية (tensor inputs)، وبذلك يتم تحقيق تكامل للقيود متعددة الأبعاد. بعد ذلك، استُخدمت آلية الانتباه متعدد الرؤوس (multi-head attention mechanism) في نموذج Transformer لترميز السلاسل الزمنية لطلبات الأنشطة السابقة وحالة الموارد، واستخراج السمات الزمكانية متعددة الأبعاد، وتعزيز إدراك مخاطر التعارض. وبناءً على نتائج الترميز وشبكة استراتيجية PPO، يتم توليد إجراءات الجدولة من الحالة الراهنة لتعزيز قدرة الاستراتيجية على التكيف مع البيئات المعقدة. وأخيراً، ومن خلال تحديث التقليم (pruning update) وآلية تصحيح دالة الميزة (advantage function correction mechanism)، يتم ضمان استقرار الاستراتيجية أثناء التكرار وتحسين أداء الجدولة. وقد أظهرت التجارب أنه عندما تكون كثافة المهام 1000، بلغ متوسط وقت اتخاذ القرار في خوارزمية الجدولة 0.72s وكان متوسط تأخير الاستجابة 1.59s، مما يشير إلى سرعة استجابة وكفاءة عالية في اتخاذ القرار. وعبر سبعة أنواع من الأنشطة ومستويات تعقيد مختلفة، تراوح معدل تعارض الموارد بين 0.05–0.12؛ وبلغ متوسط معدل استهلاك الموارد 0.75–0.86؛ ومؤشر استقرار الجدولة 0.8–0.91، مما قلل بشكل فعال من تعارضات تخصيص الموارد المتكررة وحقق استقراراً عالياً في الجدولة. وفي ظل ظروف التزامن العالي، بلغ مؤشر توازن الموارد ومؤشر متانة نقل الاستراتيجية 0.88 و0.85 على التوالي، مما يشير إلى قدرة جيدة على التكيف مع أحمال تزامن المهام.
المقدمة
تتضمن أنشطة النقابة جدولة معقدة لمهام وموارد متعددة، مما يتطلب من النظام امتلاك قدرات استجابة ديناميكية فعالة1,2. وتتغير متطلبات الأنشطة بشكل متكرر، كما أن توزيع الموارد البشرية وموارد القاعات يتسم بالتعقيد، وهو ما قد يؤدي بسهولة إلى تضارب في الجدولة وهدر في الموارد3,4. ويعد الرصد الدقيق لسجل الأنشطة وحالة الموارد في الوقت الفعلي، فضلاً عن تحسين القدرة على تحديد التعارضات المحتملة والاستجابة لها، أمراً أساسياً لتعزيز الكفاءة التشغيلية التنظيمية5,6. ويمكن أن يحقق دمج تقنية نمذجة السلاسل الزمنية المتقدمة مع خوارزميات التعلم التعزيزي فهماً عميقاً وتحسيناً ذكياً في بيئات الجدولة المعقدة، مما يساعد في تحقيق أقصى استفادة من الموارد، وتسريع الاستجابة للجدولة، وتعزيز الترقية الذكية لإدارة أنشطة النقابة.
ومع ذلك، فإن نهج الجدولة الحالية المطبقة عملياً تعتمد بشكل كبير على القواعد وهي ثابتة، مما يجعلها تفشل في التكيف مع التغيرات المتكررة في المهام وتقلبات الموارد، وهو ما يؤدي غالباً إلى إطالة أوقات الاستجابة وحدوث تعارضات حادة في الموارد. وفي جدولة أنشطة النقابات، تتنوع أنواع المهام بشكل كبير؛ كما أن استخدام الموارد مقيد للغاية ويتغير باستمرار؛ كما أن التبعيات بين الأنشطة والتنافسية بين الموارد تشكل خارطة جدولة معقدة7,8. ومن الناحية العملية، لا يمكن مطابقة جدول الأنشطة بكفاءة مع النوافذ الزمنية المتاحة للموارد مثل الموظفين والمواقع9,10، وغالباً ما تحدث تعارضات تضعف التماسك العام للعمليات التنظيمية11,12. ولا يواجه نظام الجدولة هدفاً واحداً للتحسين، بل يتطلب توازناً بين مؤشرات متعددة الأبعاد، مثل تقليل تعارضات الموارد، وزيادة سرعة الاستجابة، واستقرار استراتيجية الجدولة، ومعدل إتمام المهام13,14، وهي مؤشرات تظهر خصائص نمطية للتحسين متعدد الأهداف. بالإضافة إلى ذلك، تظهر أنشطة النقابات العمالية مراحل ودورات متميزة، ويجب أن تتكيف استراتيجيات الجدولة ديناميكياً مع هياكل الطلب على الموارد المتغيرة عبر مراحل المهام المختلفة. ولا يمكن للخطط الثابتة التي يتم إنشاؤها لمرة واحدة أن تدعم بيئة تنفيذ تتسم بتغيرات عالية التردد15,16. كما تفتقر منطق الجدولة الحالي إلى الاستكشاف المتعمق لسلوك المهام التاريخية وأنماط تغيرات حالة الموارد، وهو غير قادر على تقديم تنبؤات واستنتاجات استراتيجية دقيقة للمستقبل17,18. وتستجيب استراتيجية الجدولة في النظام ببطء للمهام المفاجئة والتغيرات المؤقتة في الموارد، مما يؤثر على الاستدامة العامة للعملية19,20. لذا أصبح بناء نظام جدولة يتميز بالقدرة التنبؤية والمرونة والاستقرار مطلباً تقنياً أساسياً في التطبيقات العملية. ويتطلب ذلك أن يمتلك النموذج قدرات إدراك للمعلومات عالية الأبعاد، وذاكرة تسلسلية، وقدرات على نقل الاستراتيجيات، مع الحفاظ على اتخاذ قرارات قوية وتوازن الموارد في بيئة متعددة المهام، مما يتيح تنسيقاً ذكياً ومثاليًا لجدولة أنشطة النقابة.
اقترحت دراسات عديدة حلولاً متنوعة لمشكلة الجدولة الديناميكية. ومن بين هذه الحلول، أظهر الجمع بين التعلم العميق والتعلم التعزيزي قدرات قوية على التكيف والتحسين. حيث استخدم بعض الباحثين شبكات LSTM (الذاكرة قصيرة المدى المطولة)21,22 لنمذجة بيانات السلاسل الزمنية ودمج استراتيجيات التعلم التعزيزي لتحسين سلوك الجدولة، مما حقق نتائج معينة. وهناك نوع آخر من الأبحاث يستخدم طريقة 휴ريستية (heuristic) تعتمد على الخوارزمية الجشعة، مع التركيز على بساطة وكفاءة قرارات الجدولة، وهو ما يتناسب مع السيناريوهات ذات القواعد الواضحة23,24. كما استكشفت دراسات أخرى تطبيق شبكة Q العميقة (DQN) في الجدولة، محققة استراتيجيات محسنة من خلال تقريب دالة القيمة25,26. ومع ذلك، تعاني هذه الطرق من مشكلات مثل عدم كفاية التقاط الاعتمادات طويلة المدى، وعدم استقرار تحديثات الاستراتيجية، وتأخر الاستجابة الكبير عند مواجهة سيناريوهات أنشطة مشتركة معقدة ومتغيرة، مما يجعل من الصعب تلبية احتياجات الجدولة للمهام عالية الكثافة والمتنوعة. وبناءً على ذلك، أصبح كيفية بناء خوارزمية جدولة تتمتع بقدرات كفؤة في استخراج الميزات وتحديث مستقر للاستراتيجية بمثابة عنق زجاجة يتطلب التغلب عليه في الأبحاث الحالية.
في أبحاث جدولة المجالات المتعددة، تم تطبيق بنية Transformer على مهام متنوعة للتنبؤ بالسلاسل الزمنية وتحسين الجدولة بفضل آلية الانتباه الذاتي متعدد الرؤوس، والتي تلتقط بفعالية التبعيات الزمنية طويلة المدى27,28. وعند دمجها مع خوارزمية PPO في التعلم التعزيزي، يتم تحديث الاستراتيجية بشكل مستقر وفعال من خلال تقليم دالة الهدف، وقد أظهر هذا النهج أداءً جيدًا في مجالات مثل التحكم في الروبوتات والتصنيع الذكي29,30,31. وقد حاولت بعض الدراسات دمج Transformer مع التعلم التعزيزي لجدولة الموارد المعقدة32. ومع ذلك، في الجدولة الديناميكية لأنشطة النقابة، هناك دراسات قليلة تتناول الجمع بين أنواع الأنشطة المتنوعة وقيود الموارد المعقدة. واستخدمت بعض الدراسات الشبكات العصبية الرسومية لنمذجة العلاقة بين الموارد والمهام، مما أدى إلى تحسين دقة تحديد التعارضات33,34. كما قام بعض الباحثين بتحسين جدولة الموارد بناءً على الحوسبة الطرفية لتعزيز كفاءة وأداء النموذج35,36. بيد أن هذه الأساليب لا تزال ذات قدرات نمذجة محدودة للسياق الزمني. وبناءً على ذلك، تقترح هذه الورقة استخدام Transformer لترميز تسلسلات الأنشطة التاريخية وحالات الموارد، مدمجًا مع شبكة سياسة PPO، لتحقيق إدراك عالٍ لمخاطر التعارض وتحديث مستقر لاستراتيجيات الجدولة لمواجهة الاحتياجات المتغيرة والمعقدة لجدولة أنشطة النقابة.
بحثت دراسات أحدث في تحسين جدولة الموارد من منظورات مختلفة، مثل دمج الأجهزة الافتراضية (VM) لتحقيق كفاءة الطاقة في الحوسبة السحابية37، وخوارزميات المصادقة في الشبكات الخلوية38، وتعزيز دمج الأجهزة الافتراضية مع الهجرة المباشرة من أجل حوسبة سحابية مستدامة39، وتحسين حركة المرور باستخدام التنبؤ بفترات الانتظار والخوارزميات التطورية40، والتخزين السحابي القائم على سلسلة الكتل (blockchain) مع تحسين معزز والحفاظ على السلامة41. ورغم أن هذه الأعمال تقدم رؤى قيمة حول خوارزميات تخصيص الموارد وتحسينها، إلا أنها تستهدف بشكل أساسي البنية التحتية السحابية، أو الاتصالات، أو أنظمة التخزين، ولا تعالج تحديداً قيود الأنشطة متعددة الأنواع، وصراعات موارد الموظفين والمواقع الديناميكية، ومتطلبات الجدولة في الوقت الفعلي المتأصلة في إدارة أنشطة النقابات. ويؤكد هذا التمايز بشكل أكبر الحاجة إلى إطار جدولة مخصص ومصمم ليتناسب مع السياق التنظيمي لأنشطة النقابات.
غالبًا ما تفشل طرق الجدولة الحالية لأنشطة النقابات في استيعاب التبعيات المكانية والزمانية طويلة المدى والحفاظ على استقرار السياسات وسط التغييرات الديناميكية، مما يؤدي إلى بطء أوقات الاستجابة وزيادة تضارب الموارد. ولمعالجة هذه الفجوات البحثية، تقترح هذه الدراسة نموذجًا لتحسين الجدولة يقوم على مبدأ أن آلية الانتباه متعدد الرؤوس في نموذج Transformer يمكنها ترميز التسلسلات التاريخية بفعالية للتنبؤ بالتضاربات، وأن تحسين السياسة القريبة (PPO) مع هدف مقصوص يضمن تحديثات سياسة مستقرة وتكيفية. وبشكل محدد، يتم تطبيق Transformer لترميز تسلسلات حالات الأنشطة والموارد، واستخراج الميزات المكانية والزمانية الرئيسية لتعزيز الاستشراف المسبق للتضاربات، مع دمج PPO لتوليد إجراءات جدولة فعالة وتحديثات مستقرة. كما صُممت مصفوفة قيود موحدة لرسم خرائط الأنشطة والموظفين والقاعات، مما يحسن التعرف على التبعيات المعقدة. وتشمل الابتكارات الجوهرية لهذا العمل ما يلي: (1) دمج الترميز الزمني والتعلم التعزيزي خصيصًا لجدولة أنشطة النقابات؛ (2) آلية انتباه مدركة للتضاربات تعطي الأولوية لإدراك المخاطر؛ (3) تحديث تقليمي مع تصحيح دالة الميزة لضمان متانة الاستراتيجية في حالات التزامن العالي. وتؤكد التجارب المكثفة تحت كثافات وتعقيدات مهام متنوعة تفوق النموذج على الطرق الحالية من حيث سرعة الاستجابة، واستغلال الموارد، والاستقرار، مما يوفر حل جدولة ذكيًا وعمليًا وقابلًا للتوسع لإدارة أنشطة النقابات.
الوصول مقيد. يرجى تسجيل الدخول أو بدء فترة تجريبية لعرض هذا المحتوى.
البروتوكول
يوضح الشكل 1 بنية نظام جدولة أنشطة الاتحاد الذي يدمج بين نمذجة السلاسل الزمنية والتعلم التعزيزي. تقوم طبقة الإدخال بدمج جداول الأنشطة، وتوافر الموارد، ومعلومات النوافذ الزمنية للموظفين، وتنشئ مصفوفة علاقات تعارض متعددة الأبعاد بين المهام والموارد عبر وحدة الرسم البياني للقيود. يقوم المحول (transformer) بترميز انتباه متعدد الرؤوس عبر التسلسل التاريخي لحالات الأنشطة والموارد، مما ينتج حالات خفية ذات تبعيات زمنية. وتستخدم وحدة السياسة نتائج الترميز لتوليد توزيعات الإجراءات وتقدير الحالة، ثم تنفذ قرارات الجدولة بعد أخذ عينات من الإجراءات. يتم تغذية نتائج التنفيذ مرة أخرى إلى البيئة، مما يؤدي إلى تحديث حالة الموارد وتوليد مكافآت فورية. وبناءً على ذلك، تقوم وحدة التحسين بإنشاء دالة هدف للقص (clipping objective function)، وتقييم دالة الميزة، وتصحيح تقدير شبكة القيمة للحد من انحراف السياسة وضمان تحديثات مستقرة لسلوكيات الجدولة. وبذلك تتشكل حلقة بيانات مغلقة بين الوحدات لتحقيق إدراك عالي الحساسية لتعارضات الموارد وتحديثات استراتيجية تكيفية في البيئات الديناميكية، مما يعز قدرة الاستجابة الذكية وكفاءة تخصيص الموارد لنظام جدولة أنشطة الاتحاد في السيناريوهات متعددة المهام وعالية القيود.
نمذجة سيناريوهات جدولة أنشطة النقابات
تُنظم جميع طلبات الأنشطة في نظام الجدولة ضمن تسلسلات جدولة منفصلة بناءً على خطوات زمنية. ويتم تعريف كل نشاط بأوقات بدء وانتهاء محددة، وفئات الموارد، والمراحل، ومستويات الأولوية. كما يتم نمذجة حالة استخدام الموقع كمصفوفة زمنية ثنائية الأبعاد، حيث يمثل المحور الأفقي وحدة الزمن الموحدة، ويمثل المحور الرأسي رقم المورد المكاني. وتُحدد حالة المورد كـ "متاح" أو "مشغول"، مما يشكل خريطة توزيع أولية للموارد ذات بنية استاتيكية. كما يتم توسيع معلومات جدولة الموظفين في بُعد (الهوية-الزمن) لإنشاء متجه نافذة زمنية مستمر، يسجل كل منها حالة الموظف من حيث (تنفيذ المهمة أو الخمول) ورقم القسم. وتُدمج جميع معلومات المدخلات في بنية تنسور (Tensor) ثلاثية الأبعاد، حيث يرمز $t$ إلى الخطوة الزمنية المنفصلة، ويرمز $r$ إلى عدد كيانات الموارد، ويرمز $a$ إلى رمز سمة استخدام المورد المقابلة (مثل ما إذا كان مشغولاً، أو رقم النشاط، أو أولوية الاستخدام، وما إلى ذلك). وتسمح هذه البنية لنظام الجدولة بقراءة تكوين الموارد في أي وقت، مما يضمن تمثيلاً موحداً لأنواع حالات الموارد المختلفة.
بعد ربط معلومات المهمة بالنموذج، يتم تعيين متجه كثافة المهمة بناءً على أولوية النشاط وفترة استخدام الموارد. ويتم تحديد مجموعة المهام التي قد تسبب تعارضاً من خلال طريقة الكشف عن تداخل النافذة الزمنية. تُحوَّل مجموعات التعارض إلى مجموعات من العقد، وتُنشأ مجموعات الحواف بناءً على أنواع الموارد والفترات المشتركة لتمثيل التبعيات الضمنية بشكل صريح. يحتوي مخطط المهام النهائي المُنشأ على معلومات حدودية حول التسلسل الزمني، أو تداخل الموارد، أو تعارض القيود، مما يوفر أساساً هيكلياً لعمليات الكشف عن التعارض اللاحقة وتوليد استراتيجية الجدولة. ويحتفظ هذا الهيكل بالطبيعة الديناميكية لجدولة المهام والتغيرات المستمرة في حالة الموارد، كما يدعم الإدراك اللحظي للتغيرات في قيود الجدولة.
يستخدم اكتشاف التعارض المناطق المتداخلة المتناثرة لأبعاد الوقت والموارد في بنية التنسور كشروط أولية للحكم. ويقوم بتنفيذ معالجة ترميز العلاقات الساكنة لأزواج المهام ذات أهداف الجدولة المتداخلة. كما يبني بنية رسم بياني G=(V,E,C)، حيث تمثل V مجموعة العقد النشطة، وتمثل E الحواف الناتجة بناءً على تعارضات الموارد، و C هي مصفوفة ترميز وزن التعارض لهذه الحواف. وقد تم تعريف دالة وزن التعارض على النحو التالي:
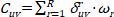 (1)
ومن بين هذه الرموز، يمثل Cuv وزن التعارض بين النشاطين u وv؛ ويمثل u وv مؤشري النشاط؛ بينما يمثل R العدد الإجمالي لأنواع الموارد؛ ويشير δuvr ∈ {0,1} إلى ما إذا كانت الفترات الزمنية للنشاطين u وv متداخلة على المورد r؛ ويمثل ωr وزن حساسية التعارض للمورد r. وتجري هذه الدالة مجموعاً موزوناً لكثافات التعارض، مع مراعاة الاختلافات في أهمية تعارضات الموارد بالنسبة لنتائج الجدولة، مع الاحتفاظ بتعبير كمي عن توزيع قوة التعارض.
يتم تحويل هيكل مخطط التعارض المذكور أعلاه إلى مصفوفة حدود القيود من خلال تمثيل المصفوفات المتناثرة. ويحتوي كل عنصر في المصفوفة على درجة تعارض الموارد. تدمج هذه المصفوفة في عملية اتخاذ قرار الجدولة لتحديد ما إذا كان يمكن جدولة المهام بالتوازي، بينما تكمن منطق حماية الإجراء في شبكة السياسات. وللتعامل مع تجميع الأنشطة الدورية وتدفقات المهام عالية الكثافة، تم تنفيذ آلية تحديث ديناميكية لمراقبة التغييرات في حالة المهام وتعديل محتوى المصفوفة في الوقت الفعلي عند تحرير الموارد أو إضافتها، مما يضمن استمرارية واتساق حدود الجدولة طوال تطور المهام.
يتيح تطبيق هيكل مخطط التضارب هذا لنظام الجدولة نمذجة الاختناقات المحتملة في الموارد وأنماط تداخل المهام بصرياً، مما يحسن كفاءة تحليل الفصل في شبكة القرار لسيناريوهات القيود المعقدة. ولم يعد سلوك الجدولة يعتمد على المطابقة المنطقية القائمة على القواعد، بل يسعى بدلاً من ذلك إلى إيجاد المسار الأمثل في حيز القيود، مما يعزز القدرة على الموازنة الديناميكية بين تضاربات الموارد المحلية وخريطة المهام الشاملة. ويمكن للنظام الحفاظ على استقرار الجدولة وترابط المهام في بيئة تتذبذب فيها الموارد، ويتم فيها إضافة المهام أو إزالتها بشكل متكرر.
الشكل 2 يوضح مخطط هيكل الشبكة بناءً على علاقة وزن تعارض المهام. تمثل كل عقدة في الشكل مهمة مطلوب جدولتها، وتشير الخطوط بين العقد إلى تعارضات استخدام الموارد. يعكس سمك الحافة وزن التعارض؛ فكلما كان التعارض أكثر حدة، زاد سمك الخط. يدمج حساب الوزن تداخل الموارد ويجمع بين حساسية التعارض لمختلف الموارد لتكوين كثافة تعارض مركبة بين المهام. ويكشف هيكل الرسم البياني أن بعض المهام تشكل مناطق ذات اتصال كثيف، مما يشير إلى منافسة كبيرة على استخدام الموارد. وتعد ظاهرة تجميع التعارضات المحلية هذه المصدر الرئيسي لاختناقات الموارد وتأخير المهام في عملية الجدولة، وبناءً عليه، يمكن لخوارزمية الجدولة تحديد أهداف وساطة الأولويات. يعتمد ترتيب العقد استراتيجية تخطيط موجهة بالقوة (force-directed layout) لتجميع المهام ذات التعارض العالي تلقائياً، مما يمكن نظام الجدولة من تحديد مجموعات المهام الرئيسية وتحسين توزيع الاستراتيجية، وبالتالي تعزيز تماسك الجدولة الشامل وتنسيق الموارد.
ترميز تسلسل الحالة التاريخي
بناءً على مخطط التعارض ومصفوفة القيود التي تم إنشاؤهما، تتمثل الخطوة التالية في ترميز التسلسلات التاريخية للأنشطة وحالات الموارد، بحيث يمكن استخراج الأنماط الزمنية الكامنة وراء هذه القيود لاتخاذ القرارات لاحقاً. تكون المعلومات الأساسية في سيناريو الجدولة من طلبات الأنشطة، وتغييرات حالة الموارد، وسجلات ملاحظات المهام. وتشكل هذه المعلومات سلاسل زمنية غير متجانسة متعددة، تقابل سمات مثل النقاط الزمنية للأحداث، ومعرفات استخدام الموارد، وحالة تنفيذ النشاط. ولتوحيد هيكل المعالجة، يتم ترميز كل نوع من المدخلات كتسلسل متجه متساوي الطول، ويتم إنشاء فهرس زمني موحد لضمان محاذاة الحالة تحت المزامنة الزمنية. يتم تمثيل وحدة الإدخال في كل لحظة من خلال دمج ثلاث مجموعات من متجهات السمات: يمثل متجه سمات النشاط نوع المهمة والأولوية ورقم المرحلة؛ ويسجل متجه سمات الموارد إشغال الموارد الحالي، والسعة المتبقية، وموضع النافذة المتاحة؛ بينما يصف متجه سمات الملاحظات ما إذا كانت المهمة قد نفذت بسلاسة في اللحظة السابقة، وما إذا كان قد حدث تعارض في الموارد أو واقعة تأخير.
يتم تحويل جميع السمات خطياً ورسمها في نفس الفضاء البعدي للحصول على مصفوفة تضمين معيارية X ∈ ℝT×d، حيث يمثل T عدد الخطوات الزمنية ويمثل d بُعد التضمين الموحد. وللحفاظ على البنية الزمنية، تُضاف مصفوفة الإدخال عنصراً بعنصر إلى مصفوفة ترميز الموضع P لتكوين إدخال مدرك للموضع:
Z = X + P (2)
Z هو تسلسل الإدخال النهائي، والذي يعمل كمدخل لآلية الانتباه اللاحقة. يستخدم تصميم ترميز الموضع قالب دالة جيب وجيب تمام ثابتة لمنع تسرب المعلومات المستقبلية وضمان الالتزام الصارم بالقيود السببية أثناء الترميز. وتتيح البنية المذكورة أعلاه للنموذج إدراك خصائص المهمة، وحالة الموارد، والموقع الزمني في آن واحد. كما أنها تمتلك أساساً كاملاً لذاكرة الحالة، مما يوفر بنية موحدة وعالية الدقة لآلية الانتباه اللاحقة.
تعمل وحدة الانتباه على معالجة التسلسل المدخل لالتقاط العلاقات المحتملة بين خطوات زمنية متعددة. وتُستخدم مجموعات متعددة من رؤوس الانتباه لمعالجة التسلسل بشكل منفصل، مما يعزز حساسية النموذج لأنواع مختلفة من مسارات تطور الحالة. يقوم كل رأس انتباه بإنشاء مصفوفة استعلام Q، ومصفوفة مفتاح K، ومصفوفة قيمة V من التسلسل المدخل، ثم يحسب مصفوفة توزيع الأوزان، وينتج تمثيلاً موزوناً. وتكون مخرجات الانتباه أحادي الرأس كما يلي:
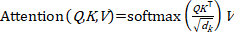 (3)
دك هو عدد أبعاد الميزات لكل رأس. وفي هذه المعادلة، سك⊤ يمثل التشابه بين العزوم، √يبدو أنك أرسلت حرفاً واحداً فقط ("d"). يرجى تزويدي بالنص الإنجليزي الكامل الذي ترغب في ترجمته، وسأقوم بتحويله إلى لغة عربية علمية دقيقة وفقاً للمعايير المهنية المحددة.ك تُستخدم لتحقيق الاستقرار العددي، وتضمن دالة softmax تطبيع الأوزان. وتركز رؤوس الانتباه المختلفة على تركيبات متنوعة من الخطوات الزمنية، كما أن التبعيات الديناميكية التي تلتقطها تكون متنوعة أيضًا، مما يساعد في الكشف عن قواعد ضمنية مثل بوادر صراعات المهام، وأنماط استهلاك الموارد، واتجاهات التغذية الراجعة غير الطبيعية.
يتم دمج جميع مخرجات رؤوس الانتباه وتمريرها عبر طبقة تحويل خطي لإنشاء تسلسل ترميز موحد، والذي يعمل كمدخل للحالة لشبكة توليد استراتيجية الجدولة. يدمج هذا التسلسل مسار سلوك المهمة، وخصائص تغيير الموارد، وتأثير انحرافات التنفيذ السابقة في نافذة الجدولة الحالية، مما يعالج بفعالية مشكلة الاعتماد التاريخي العالي في سلوك الجدولة والتعبير المحدود للميزات. كما تم دمج وحدات الاتصال المتبقي وتطبيع الطبقة في طبقة مخرجات الترميز لتعزيز استقرار التدريب وقدرات الاحتفاظ بالتعبير في الشبكة العميقة.
لا يحتفظ تسلسل حالة الحالة المخفية للمخرجات بمعلومات التطور الزمني فحسب، بل يستجيب أيضاً للتغييرات الناشئة عن المهام المفاجئة أو عدم تطابق الموارد المؤقت، مما يظهر قدرة عالية على التكيف. ويتجنب هذا التصميم الهيكلي التحديد الصريح للقواعد، مما يتيح نمذجة منظمة لبيئات الجدولة الديناميكية، ويدعم وحدات السياسة اللاحقة في توليد حلول جدولة تتميز باتساق عالمي وقدرة على التكيف محلياً في ظل ظروف متعددة الأهداف.
توليد استراتيجية الجدولة الديناميكية
تُغذى تسلسلات الحالة الخفية المرمزة، والتي تدمج كلاً من التبعيات الزمنية ومعلومات تضارب الموارد، في شبكة السياسات لتوليد إجراءات جدولة تتكيف مع البيئة الحالية. يُستخدم تسلسل الحالة الخفية الناتج عن وحدة الترميز كمدخل لشبكة استراتيجية الجدولة. وتشكل مجموعة متجهات الحالة في كل لحظة تعبير رصد البيئة الحالية، حيث تغطي تطور خصائص المهام، واتجاهات استخدام الموارد، ومسارات التغذية الراجعة التاريخية. يكون بُعد تمثيل الحالة وطول النافذة الزمنية ثابتين، ويتم التقاط استمرارية تغيرات الحالة عبر آلية تحديث انزلاقية. وقبل إرسال متجهة الحالة إلى شبكة السياسات، يتم تطبيعها وإعادة تنظيم ميزاتها لضمان احتفاظ المدخلات بتوزيع عددي مستقر في الفضاء عالي الأبعاد، مما يقلل من انفجار التدرج وتقلبات التقارب.
تعتمد بنية شبكة السياسة على وحدة مخرجات ذات فرعين، حيث يقوم أحد الفرعين بتوليد توزيع الإجراءات، بينما يقوم الآخر بإخراج تقدير دالة قيمة الحالة. وتتكون مساحة الإجراءات من جميع المهام القابلة للجدولة والموارد القابلة للتخصيص. وتقوم آلية فحص المرشحين بتصفية تركيبات العمليات غير القانونية أو الزائدة عن الحاجة لتشكيل مجموعة محدودة وقانونية من الإجراءات. ويقوم فرع السياسة بإخراج توزيع احتمالي π(at|st)، حيث يمثل at إجراء الجدولة عند الخطوة الزمنية، وst هو مدخل الحالة الحالية. وتُستخدم استراتيجية أخذ عينات غاوسية معيارية أو استراتيجية أخذ عينات softmax لاختيار الإجراءات من التوزيع لغرض الجدولة الفعلية. أما المخرج الآخر فهو تقدير دالة قيمة الحالة، والذي يمثل توقع المكافأة على المدى الطويل عند الحالة المعطاة، ويُستخدم لتقييم السياسة وتحديثها.
في شبكة السياسات، تطبق الطبقة الخفية دوال التنشيط والتطبيع الدفعي لتحسين القدرة التعبيرية غير الخطية وتسريع تقارب الشبكة. وفي عملية صنع القرار، تُعتبر أولوية التنفيذ، وتكلفة جدولة الموارد، والأداء التاريخي للمهام المختلفة عوامل انتباه، وتُطبق على آلية اختيار الإجراء عبر مصفوفة أوزان محددة لتشكيل إطار عمل مخرجات سياسة قابل للتعديل تكيُّفياً. يتجنب هذا التصميم الاعتماد على قواعد ثابتة، مما يعز مرونة الاستراتيجية في التعامل مع النزاعات المفاجئة والاختناقات الهيكلية.
تعتمد استراتيجية الجدولة على آلية أخذ عينات عشوائية لإنشاء تسلسل الإجراءات الفعلي. في كل دورة جدولة، يتم سحب إجراء قابل للتنفيذ من توزيع الإجراءات الحالي، ثم يتم تحديث حالة الموارد وعلامة عقدة المهمة. وبعد تنفيذ الإجراء، يحسب النظام مكافأة التغذية الراجعة الفورية بناءً على التغييرات في الموارد ونتائج تقدم المهمة لقياس تأثير جولة الجدولة هذه على الهدف العام. ويراعي تصميم المكافأة أبعاداً متعددة، بما في ذلك معدل إتمام المهام، وكفاءة استخدام الموارد، ودرجة كبح التعارضات؛ حيث توفر هذه المكافأة تغذية راجعة لوحدة تحديث الاستراتيجية من خلال مؤشرات شاملة.
تقوم عملية الجدولة بأكملها ببناء سلسلة قرار ماركوف وتستخدم طريقة أخذ عينات المسار التجريبية لتسجيل تسلسل الحالة-الإجراء-المكافأة، والذي يُرمز له بالرمز (st, at, rt, st+1). ويعتمد تحسين الاستراتيجية على بناء دالة الميزة، حيث يتم تعريف تقدير الميزة في الصيغة التالية:
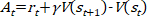 (4)
تمثل At قيمة الميزة، و rt هي المكافأة اللحظية الحالية، و γ هو عامل خصم المكافأة، بينما تمثل V(st) و V(st+1) مخرجات دالة قيمة الحالة في الحالتين الحالية والتالية، على التوالي. تعكس دالة الميزة درجة تفوق الإجراء الحالي بالنسبة للأداء المتوسط للاستراتيجية، وتُستخدم لتوجيه تحسين الاستراتيجية اللاحق. فإذا كانت At > 0، فهذا يعني أن الإجراء الحالي أفضل من التوقع المتوسط، وبالتالي يجب زيادة احتمالية حدوثه؛ وخلاف ذلك، يجب تقليل الميل إلى اختياره.
خلال عملية تحديث الاستراتيجية، ولتجنب تذبذبات الاستراتيجية الناتجة عن سعات التحديث المفرطة، يتم تطبيق آلية بتر لتوزيع الهدف للحد من نطاق التغيير بين الاستراتيجيتين الجديدة والقديمة، مما يحافظ على استمرارية واستقرار مخرجات الشبكة. ويتم إنشاء اقتران وثيق بين توزيع الإجراءات ومكافأة التغذية الراجعة، مما يسمح للاستراتيجية بالاستجابة الفورية للتغيرات في القيود المعقدة. وتحافظ هذه الآلية على استقرار اتخاذ القرار والجدولة العقلانية للموارد في الحالات التي تتغير فيها المهام بشكل متكرر أو يحدث عدم تطابق مفاجئ في الموارد، مما يتجنب بفعالية مشكلات مثل التخصيص المزدوج، أو ازدحام الموارد، أو تراكم طوابير المهام. ويمكن لنظام الجدولة الحفاظ على حالة تشغيل أفضل عبر كثافات المهام المتغيرة ونقص الموارد، مما يظهر قدرات تكيفية قوية.
تكرار الاستراتيجية وآلية التحديث المستقرة
لضمان بقاء استراتيجيات الجدولة التي تم إنشاؤها مستقرة وعدم تدهورها عبر جولات التدريب المتكررة، يتم تقديم آلية تحديث تكرارية مع تقليم وتصحيح الميزة في هذا القسم الفرعي. يتم تحديد فاصل تحديث القطع بين الاستراتيجيات القديمة والجديدة، وتُستخدم دالة هدف التقليم للحد من انحراف الاستراتيجية لمنع حدوث صدمات في الجدولة أثناء عملية تحديث الاستراتيجية. كما يتم تصحيح شبكة التقييم بالاشتراك مع دالة الميزة لتحسين دقة الجدولة طويلة المدى.
يكون توزيع احتمالية مخرجات الإجراء لشبكة السياسة عرضة لتقلبات حادة خلال تكرارات الجدولة المستمرة، مما قد يؤدي إلى سلوك غير مستقر أو تخصيص غير منظم للموارد. وللتخفيف من صدمة الجدولة الناتجة عن انحراف السياسة، تم تصميم فاصل تحديث مبتور للتحكم في نطاق التغيير بين السياسات الجديدة والقديمة، كما تم بناء حد تقييدي لتحسين دالة الهدف. يتم تسجيل احتمالية السياسة التاريخية في جولة أخذ العينات، ويتم بناء حد النسبة باستخدام احتمالية السياسة الحالية. وقد تم تحديد هدف تحديث السياسة على النحو التالي:
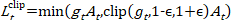 (5)
هنا، ترمز gt = πθ(at|st)/πθold(at|st) إلى نسبة الاحتمالية بين السياسات الجديدة والقديمة؛ وε هي عتبة القص التي تحدد نطاق تحديث السياسة. وعندما تتجاوز النسبة هذا الحد، تُستخدم قيمة القص بدلاً من ذلك لمنع الاستراتيجية من إنتاج تدرجات مفرطة ناتجة عن عينات متطرفة، مما يضمن بقاء تعديل معاملات الشبكة ضمن النطاق المحدد مسبقاً. يعمل هذا الهيكل على تقييد نطاق التغييرات في الاستراتيجية المخرجة ديناميكياً لكل جولة جدولة، مما يحافظ على سلاسة واتساق مخرجات الاستراتيجية في ظل توزيعات المهام الكثيفة، ويقلل بشكل كبير من معدل تذب سلوك الجدولة.
يتم تعزيز دالة هدف السياسة ببنود التنظيم ومكافأة الأنتروبيا أثناء عملية التحديث لتعزيز تنوع توزيع الإجراءات وكبح التقارب المبكر. وتستخدم كل جولة من تحديثات السياسة دفعات متعددة من عينات مسار الخبرة للتدريب المتدحرج، مما يحافظ على اتساع التغطية في فضاء الحالة. وعند مقارنة توزيع الاحتمالات لتسلسل الإجراءات المخرجة قبل التحديث وبعده، يتم حساب معدل انحراف التوزيع، ويقوم حد فاصل صارم بتصفية نطاق الاضطراب المقبول للسياسة. توفر هذه الآلية تحكماً في الحدود لنقل سياسات الجدولة عبر الدورات، مما يؤدي إلى كبح الإفراط في التخصيص الناتج عن التغيرات الجذرية في حالة الموارد.
تعتمد تحديثات الاستراتيجية على تقييم الحالة الذي توفره دالة القيمة. ويمكن أن تؤثر الانحرافات في تقدير قيمة الحالة بشكل مباشر على دقة دالة الميزة، مما يؤدي بالتالي إلى تغيير اتجاه تكرار الاستراتيجية. ولتحسين دقة التقييم، تم بناء آلية تراجع متعددة السلاسل الزمنية، واستُخدمت القيمة التراكمية المخصومة للمكافآت المستقبلية لتصحيح قيمة الحالة الحالية. وتعتمد مكافأة التراجع على هيكل تقدير الميزة المعمم (GAE)، والذي يُعرَّف على النحو التالي:
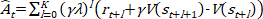 (6)
Ât هي قيمة الميزة المصححة؛ وλ هو معامل توازن التتبع الخلفي؛ وrt+l تمثل المكافأة الفورية للخطوة (t+l)؛ وV(st+l) هي قيمة الحالة التي تخرجها شبكة التقييم. يدمج هذا الهيكل بين التغذية الراجعة الفورية قصيرة المدى وتوقعات الحالة طويلة المدى لتصحيح الانحرافات في تنبؤات استجابة الاستراتيجية لتضاربات الموارد المستقبلية، وأحمال الذروة، وتراكم المهام. وتتحكم λ في عمق التتبع الخلفي وتتعدل تلقائيًا خلال فترات التقلبات الديناميكية الحادة في الموارد لتعزيز متانة استجابة شبكة التقييم للأحداث المفاجئة.
تتيح البنية المعتمدة على الزمن ومتعددة المقاييس والمدمجة في دالة الميزة لشبكة التقييم نمذجة اتجاهات الموارد على المدى الطويل. وفيما يخص الكشف عن انحراف مخرجات السياسة، يُستخدم مؤشر اتساق سلوك السياسة لتقييم ما إذا كانت الشبكة تظهر استجابة مفرطة لخطأ التقييم. وتعمل حدود المتبقي للفرق في التغذية الراجعة على مراقبة سلوك تحديث السياسة، كما يتم تصحيح هدف التدريب وسعة تحديث أوزان دالة القيمة ديناميكيًا. ويتم تحسين شبكة القيمة وشبكة السياسة بشكل مشترك لضمان عدم انحراف تقدير القيمة عن هدف إكمال المهمة، مع منع الجدولة عالية التردد من التقدير الخاطئ لحالة تعارض الموارد.
يمكن لآلية تحديث السياسة المستقرة هذه أن تحافظ بفعالية على إمكانية التحكم واتساق تحديثات سلوك السياسة في بيئة مهام ديناميكية عالية الأبعاد، مما يحسن كفاءة تغطية المهام ومرونة استخدام الموارد، ويشكل هيكل جدولة ذكيًا تكراريًا ومستمرًا. ويمنع سلوك الجدولة السقوط في المثالية المحلية أثناء التطور طويل الأمد، ويعز القدرة العامة على التكيف مع التغيرات في أنماط المهام والتقلبات في دورات الموارد.
يوضح الشكل 3A اتجاه قيمة الدالة الهدف كدالة في عدد تكرارات التدريب تحت ظروف عتبات بتر مختلفة. يمثل المحور الأفقي عدد تكرارات التدريب، بينما يمثل المحور الرأسي القيمة العددية للدالة الهدف المقصوصة. تم تعيين قيمة ε على 0.1 و0.2 و0.3، مما يمثل درجات مختلفة من قوة التحكم في انزياح السياسة. والمنحنى المقابل لقيمة ε الأصغر يتقلب بشكل أقل، وتظل الدالة الهدف مستقرة. فعندما تكون ε = 0.1، تتراوح قيمة الدالة الهدف الإجمالية بين 0.8 و1، مما يظهر تدرج واستقرار تحديث الاستراتيجية. ومع ذلك، تؤدي قيمة ε الأكبر إلى تقلبات ملحوظة؛ فعندما تكون ε = 0.3، تتراوح قيمة الدالة الهدف الإجمالية بين 0.65 و0.95، ويظهر منحنى الدالة الهدف سعة تذب أكبر، مما يعكس مخاطر الانحراف الشديد في عملية تحديث الاستراتيجية. وكلما كانت العتبة أصغر، كانت الاستراتيجية أكثر استقراراً، وهو ما يناسب بيئات الجدولة ذات القيود العالية. ويوضح الشكل 3B التغيرات في تقدير الميزة المعمم تحت معاملات توازن تراجع مختلفة. تم تعيين λ على 0.8 و0.9 و1.0 على التوالي للتحكم في عمق تراجع المكافآت المستقبلية. ويظهر المنحنى أنه كلما ارتفعت قيمة λ، قل تذب GAE، وأصبح الاتجاه طويل المدى أكثر سلاسة، وبدقة أكبر في التقاط التأثير المحتمل لسلوك الجدولة بعد خطوات متعددة. أما المنحنى الذي تبلغ فيه قيمة λ 0.8 فيظهر تقلبات دورية ملحوظة، مما يشير إلى أنه أكثر حساسية للمكافآت الفورية وأكثر ملاءمة للمهام القصيرة والمفاجئة. وفي المقابل، تركز قيمة λ التي تبلغ 1.0 بشكل أكبر على نمذجة الاتجاه طويل المدى وتكون مناسبة لسيناريوهات المهام الدورية.
تحليل التعقيد الحسابي والقابلية للتوسع
يتم تحديد التعقيد الحسابي لإطار عمل Transformer-PPO المقترح من خلال مكونين رئيسيين: مشفر Transformer وتحسين سياسة PPO.
بالنسبة لمشفر المحول (Transformer encoder) الذي يحتوي على L من الطبقات، و H من رؤوس الانتباه، وبُعد تضمين d، وطول تسلسل إدخال T (النافذة الزمنية التاريخية)، فإن التعقيد الزمني لكل تمريرة أمامية هو O(L·T2·d + L·T·d2)، حيث ينشأ الحد T2 من آلية الانتباه الذاتي. وفي التنفيذ، تم تحديد L = 3، و H = 4، و d = 128، و T عند 100 خطوة زمنية، مما أدى إلى عبء حسابي يمكن إدارته. وبالنسبة للنوافذ التاريخية الأطول، يصبح الحد التربيعي T2 هو العامل المهيمن؛ ومع ذلك، من الناحية العملية، تتضمن جدولة أنشطة النقابات عادةً آفاقاً تاريخية محدودة (على سبيل المثال، نوافذ متحركة لربع سنة أو سنة واحدة)، ويمكن تعديل دقة الخطوة الزمنية لتحقيق التوازن بين الدقة والكفاءة.
بالنسبة لمكون PPO، تعد شبكة السياسة وشبكة القيمة عبارة عن مدركات متعددة الطبقات (MLPs) خفيفة الوزن (256 و 128 عصبونًا لكل طبقة خفية)، وتبلغ تعقيد الاستدلال فيها O(d·m)، حيث تمثل m عدد الوحدات الخفية، وهو أمر ضئيل مقارنة بمشفر Transformer. يتضمن تحديث السياسة أثناء التدريب عدة دورات من تحديثات تدرج الدفعات الصغيرة، بتعقيد O(B·E·d2)، حيث تمثل B حجم الدفعة، و E عدد دورات التحديث.
من حيث القابلية للتوسع، يظهر إطار العمل ثلاث خصائص إيجابية. أولاً، يمكن موازاة آلية الانتباه عبر الخطوات الزمنية، مما يسمح بتسريع فعال باستخدام وحدات معالجة الرسوميات GPU. ثانياً، لا يعتمد حجم النموذج على عدد الأنشطة أو الموارد، حيث يتم بناء مصفوفة القيود ديناميكياً لكل خطوة جدولة بدلاً من تضمينها كبارامترات ثابتة، وهذا يتيح نشر النموذج المدرب نفسه عبر اتحادات بمقاييس مختلفة دون الحاجة إلى إعادة التدريب. ثالثاً، بالنسبة للسيناريوهات ذات النطاق الواسع للغاية، يمكن تقليل طول النافذة التاريخية T وبُعد التضمين d كحل وسط، أو يمكن اعتماد متغير الانتباه المتناثر لتقليل التعقيد من O(T2) إلى O(T log T) أو O(T).
الوصول مقيد. يرجى تسجيل الدخول أو بدء فترة تجريبية لعرض هذا المحتوى.
النتائج
البيانات التجريبية
لتقييم أداء خوارزمية الجدولة الديناميكية Transformer-PPO المعروضة في هذا البحث بشكل شامل، استخدمت التجربة بيانات إدارة الأنشطة من اتحاد مؤسسي كبير على مدى السنوات الثلاث الماضية كمجموعة بيانات مرجعية. تحتوي مجموعة البيانات هذه على أكثر من 5,0 سجل نشاط، تشمل أنواعاً مختلفة، بما في ذلك الاجتماعات والتدريب والترفيه، مع معلومات الجدولة لعدة موارد، مثل القاعات والمعدات والموظفين. يفصل كل سجل وقت البدء والانتهاء للنشاط، ومتطلبات الموارد، والأولوية، وحالة التنفيذ الفعلية (بما في ذلك أحداث...
الوصول مقيد. يرجى تسجيل الدخول أو بدء فترة تجريبية لعرض هذا المحتوى.
المناقشة
تُظهر النتائج التجريبية أن خوارزمية Transformer-PPO المقترحة تتفوق باستمرار على الطرق المرجعية (LSTM-PPO والبحث الجشع DQN) عبر جميع مقاييس التقييم. ويمكن إرجاع هذا الأداء المتفوق إلى عاملين رئيسيين؛ أولاً، تنجح آلية الانتباه الذاتي متعدد الرؤوس في Transformer في التقاط التبعيات الزمنية طويلة المدى في تسلسلات الأنشطة وحالات الموارد، مما يتيح التحديد الاستباقي للصراعات المحتملة. وهذا يفسر سبب بقاء معدل الصراع منخفضاً حتى في ظل التعقيد العالي (على سبيل المثال، التعاون بين الإدارات والإدراج المؤقت)، حيث يمكن للنموذج توقع الت...
الوصول مقيد. يرجى تسجيل الدخول أو بدء فترة تجريبية لعرض هذا المحتوى.
الإفصاحات
يصرح المؤلفون بأنه لا توجد لديهم تضاربات مصالح مالية.
المواد
| الاسم | الشركة | رقم فهرسي | التعليقات |
|---|---|---|---|
| Python 3.9 | مؤسسة برمجيات بايثون (Python Software Foundation) | https://www.python.org/downloads/release/python-390/ | لغة البرمجة الأساسية |
| PyTorch 1.12 | ميتا إيه آي (Meta AI) | https://pytorch.org/get-started/previous-versions/ | إطار عمل التعلم العميق (تنفيذ Transformer/PPO) |
| NumPy 1.23 | مُطوّرو NumPy | ملاحظات الإصدار 1.23.0 تم إصدار NumPy 1.23.0 في 13 يونيو 2022. أبرز التغييرات - تم تقديم نظام الـ DType الجديد كلياً، والذي يوفر مرونة أكبر في تعريف الأنواع المخصصة. - تحسينات كبيرة في الأداء لعمليات الفهرسة المتقدمة (Advanced Indexing). - دعم محسن لعمليات الـ SIMD لزيادة سرعة الحسابات العددية. - إضافة دوال جديدة للتعامل مع المصفوفات المتفرقة (Sparse Arrays) في إطار العمل التجريبي. الميزات الجديدة - تقديم `numpy.typing` المحدث لتقديم دعم أفضل للأنواع الثابتة (Static Typing). - إضافة `numpy.experimental` لتجربة الميزات الجديدة قبل اعتمادها بشكل نهائي. - دعم تحسينات في `numpy.linalg` لزيادة كفاءة العمليات الجبرية الخطية. التغييرات في سلوك الدوال (Behavioral Changes) - تحديث طريقة التعامل مع القيم المفقودة (NaN) في بعض دوال التجميع (Reduction Functions). - تعديل في سلوك البث (Broadcasting) ليتوافق مع المعايير الحديثة للغة Python. إصلاحات الأخطاء (Bug Fixes) - إصلاح مشكلة تسريب الذاكرة عند التعامل مع مصفوفات ضخمة في بيئات معينة. - تصحيح خطأ في حساب القيم المتوسطة لبعض أنواع البيانات ذات الدقة المحدودة. التحسينات (Improvements) - تقليل وقت تحميل المكتبة عند بدء التشغيل. - تحسين توثيق الدوال (Documentation) لتوفير أمثلة أكثر وضوحاً للمستخدمين. الكلمات المفتاحية: NumPy, مصفوفات، حسابات عددية, Python, برمجة علمية, إصدار 1.23.0 | مكتبة الحسابات العددية |
| Matplotlib 3.5 | فريق تطوير Matplotlib | تثبيت Matplotlib تثبيت Matplotlib يُعد تثبيت Matplotlib عملية بسيطة في معظم الحالات، ولكن قد تختلف التفاصيل بناءً على نظام التشغيل والبيئة المستخدمة. التثبيت باستخدام pip الطريقة الموصى بها لتثبيت Matplotlib هي استخدام pip، وهو مدير الحزم القياسي للغة Python. يمكنك تشغيل الأمر التالي في واجهة السطر البرمجي (terminal): python -m pip install matplotlib سيقوم هذا الأمر بتثبيت Matplotlib وأي تبعيات مطلوبة من مستودع Python Package Index (PyPI). التثبيت باستخدام conda إذا كنت تستخدم توزيعة Anaconda أو Miniconda، فيمكنك تثبيت Matplotlib باستخدام conda: conda install matplotlib يضمن هذا الخيار توافق الحزم مع بيئة conda الخاصة بك. التثبيت من المصدر (Source) للمستخدمين المتقدمين الذين يحتاجون إلى بناء Matplotlib من المصدر، يمكن اتباع التعليمات المتاحة في وثائق التطوير. تتطلب هذه العملية وجود مترجم C++ ومكتبات تطوير معينة مثبتة مسبقاً على النظام. التحقق من التثبيت بعد إتمام عملية التثبيت، يمكنك التحقق من أن Matplotlib يعمل بشكل صحيح عن طريق تشغيل الكود التالي في بيئة Python: import matplotlib print(matplotlib.__version__) إذا تم طباعة رقم الإصدار دون ظهور أي رسائل خطأ، فقد تمت عملية التثبيت بنجاح. التبعيات (Dependencies) تعتمد Matplotlib على عدة مكتبات أساسية لضمان عملها، وأبرزها: - NumPy: للعمليات الحسابية والمصفوفات. - Pillow: لمعالجة الصور. - Pycoast أو مكتبات أخرى اختيارية لدعم تنسيقات ملفات معينة. تحديث Matplotlib لتحديث Matplotlib إلى أحدث إصدار متاح، استخدم الأمر التالي: python -m pip install --upgrade matplotlib أو عبر conda: conda update matplotlib | تصوير النتائج بصرياً |
| مجموعة بيانات جدولة أنشطة الاتحاد | قاعدة بيانات داخلية لمؤسسة متعاونة (مجهولة الهوية) | غير متاح للعامة بسبب اتفاقية سرية؛ يمكن للباحثين التواصل مع المؤلف المسؤول لطلب الوصول إليه | أكثر من 5000 سجل نشاط (اجتماعات، تدريب، ترفيه) من نقابة مؤسسة كبيرة على مدى ثلاث سنوات |
| وحدة معالجة الرسوميات NVIDIA A100 | |||
| PyTorch |
المراجع
- Bosire RK, Muya J, Matula D. Employee recognition programs and employee output as moderated by workers’ union activities: evidence from Kenyatta National Hospital (KNH), Kenya. Saudi J Bus Manag Stud. 2021;6(3):61-70.
- Carneiro B, Costa HA. Digital unionism as a renewal strategy? Social media use by trade union confederations. J Ind Relat. 2022;64(1):26-51.
- Geelan T. Introduction to the special issue: the internet, social media and trade union revitalization—still behind the digital curve or catching up? New Technol Work Employ. 2021;36(2):123-39.
- Hennebert MA, Pasquier V, Lévesque C. What do unions do…with digital technologies? An affordance approach. New Technol Work Employ. 2021;36(2):177-200.
- Panagiotopoulos P. Digital audiences of union organising: a social media analysis. New Technol Work Employ. 2021;36(2):201-18.
- Wang W, Seifert R. Trade-union-engendered employee trust in senior management: a case study of digitalisation. Ind Relat J. 2024;55(6):472-91.
- Katsabian T. Collective action in the digital reality: the case of platform-based workers. Mod Law Rev. 2021;84(5):1005-40.
- Holgate J. Trade unions in the community: building broad spaces of solidarity. Econ Ind Democr. 2021;42(2):226-47.
- Ovi RP, Rana MS, Jodder PK, Sarkar B. Performance evaluation of e-service delivery of union digital centers at the local level using composite indexing method: a study of Batiaghata upazilla in Khulna district. Inf Dev. 2024;40(4):620-34.
- Crossan J, et al. Colours of democracy: trade union banners and the contested articulations of democratic spatial practices. Trans Inst Br Geogr. 2023;48(1):23-38.
- Victor C, Kavishe AM. The challenges faced by trade unions in improving employee welfare and strategies to address them: a case of the Tanzania Union of Government and Health Employees (TUGHE) at the National Health Insurance Fund (NHIF). Afr J Empir Res. 2025;6(1):189-200.
- Rogalewski A. Trade unions challenges in organising Polish workers: a comparative case study of British and Swiss trade union strategies. Eur J Ind Relat. 2022;28(4):385-404.
- Pacetti V, Rossi P, Romens AI. Remotizzare, o non remotizzare: questo è il dilemma. Imprese e sindacati di fronte alla remotizzazione ibrida del lavoro. Stato Merc. 2023;43(3):421-49.
- Hunt T, Connolly H. COVID-19 and the work of trade unions: adaptation, transition and renewal. Ind Relat J. 2023;54(2):150-66.
- Joyce S, Stuart M, Forde C. Theorising labour unrest and trade unionism in the platform economy. New Technol Work Employ. 2023;38(1):21-40.
- Dupuis M. Algorithmic management and control at work in a manufacturing sector: workplace regime, union power and shopfloor conflict over digitalisation. New Technol Work Employ. 2025;40(1):81-101.
- Suryadevara S. Real-time task scheduling optimization in WirelessHART networks: challenges and solutions. Int J Adv Eng Technol Innov. 2022;1(3):29-55.
- Roşu D, Cojanu F, Ştefănică V, et al. Experimental management of work collectives through social and socialization activities. J Phys Educ Sport. 2022;22(7):1742-47.
- Ahmed AAA, et al. Multi-project scheduling and material planning using Lagrangian relaxation algorithm. Ind Eng Manag Syst. 2021;20(4):580-87.
- Gao H, et al. TBDB: token bucket-based dynamic batching for resource scheduling supporting neural network inference in intelligent consumer electronics. IEEE Trans Consum Electron. 2024;70(1):1134-44.
- Ouhame S, Hadi Y, Ullah A. An efficient forecasting approach for resource utilization in cloud data centers using a CNN-LSTM model. Neural Comput Appl. 2021;33(16):10043-55.
- Valarmathi K, Kanaga Suba Raja S. Resource utilization prediction technique in the cloud using a knowledge-based ensemble random forest with an LSTM model. Concurr Eng. 2021;29(4):396-404.
- Yang Y, Shen H. Deep reinforcement learning enhanced greedy optimization for online scheduling of batched tasks in cloud HPC systems. IEEE Trans Parallel Distrib Syst. 2022;33(11):3003-14.
- Tang B, Luo J, Obaidat MS, Vijayakumar P. Container-based task scheduling in a cloud-edge collaborative environment using a priority-aware greedy strategy. Cluster Comput. 2023;26(6):3689-705.
- Zhang Y, Zou YH, Zhang XD. Manufacturing resource scheduling based on a deep Q-network. Wuhan Univ J Nat Sci. 2022;27(6):531-38.
- Mangalampalli S, et al. DRLBTSA: deep reinforcement learning-based task-scheduling algorithm in cloud computing. Multimed Tools Appl. 2024;83(3):8359-87.
- Wang Y, Wang Q, Chu X. Energy-efficient online scheduling of transformer inference services on GPU servers. IEEE Trans Green Commun Netw. 2022;6(3):1649-59.
- Liu L, et al. Dynamic sparse attention for scalable transformer acceleration. IEEE Trans Comput. 2022;71(12):3165-78.
- He X, et al. Channel assignment and power allocation for throughput improvement with PPO in B5G heterogeneous edge networks. Digit Commun Netw. 2024;10(1):109-16.
- Liu H, et al. A new multi-domain cooperative resource scheduling method using proximal policy optimization. Neural Comput Appl. 2024;36(9):4931-45.
- Jin J, Xu Y. Optimal policy characterization enhanced proximal policy optimization for multitask scheduling in cloud computing. IEEE Internet Things J. 2022;9(9):6418-33.
- Chavva M, Veera S. Dynamic cost-aware language models: a real-time framework for optimizing cloud resource recommendations. Int J Mach Learn Sustain Dev. 2023;5(2):1-15.
- Zhao Z, et al. Link scheduling using graph neural networks. IEEE Trans Wirel Commun. 2023;22(6):3997-4012.
- Zhang Z, et al. A resource optimization scheduling model and algorithm for heterogeneous computing clusters based on GNN and RL. J Supercomput. 2024;80(16):24138-72.
- Chai F, et al. Joint multi-task offloading and resource allocation for mobile edge computing systems in satellite IoT. IEEE Trans Veh Technol. 2023;72(6):7783-95.
- Luo Q, et al. Resource scheduling in edge computing: a survey. IEEE Commun Surv Tutor. 2021;23(4):2131-65.
- Gupta A, Namasudra S, Kumar P. An enhanced strategy for energy-efficient cloud computing environment through VM consolidation. In: Dagur A, Singh K, Mehra PS, Shukla DK, editors. Intelligent Computing and Communication Techniques. Boca Raton (FL): CRC Press; 2025. p. 330–34. https://doi.org/10.1201/9781003530176-46
- Sombo B, Apeh ST, Edeoghon IA. Review on authentication algorithms in cellular communication networks. Cloud Comput Data Sci. 2025;6(1):54-66.
- Gupta A, Kumar P, Namasudra S. Sustainable cloud computing: an enhanced energy-efficient VM consolidation approach using live migration. Iran J Comput Sci. 2026;9:27. doi:10.1007/s42044-025-00385-y.
- García F, et al. Traffic optimization through waiting prediction and evolutive algorithms. Int J Interact Multimed Artif Intell. 2025;9(3):96-103.
- Sharma P, Namasudra S, Lorenz P. Blockchain-based cloud storage system with enhanced optimization and integrity preservation. Presented at: IEEE International Conference on Communications (ICC); Rome, Italy; 2023. p. 3744-49.
- Ding F, et al. Transformer-enhanced DQN approach for energy- and cost-efficient large-scale dynamic workflow scheduling in a heterogeneous environment. IEEE Internet Things J. 2024;11(22):37351-67.
- Yu H, Tang N, Zhu Z, Guo Z. Flexible job-shop scheduling via gated recurrent unit and deep reinforcement learning. Knowl Based Syst. 2025;330:114734. doi:10.1016/j.knosys.2025.114734.
- Do KH, et al. Graph Neural PPO for joint user association and resource allocation in Open RAN [conference paper]. Presented at: 40th International Conference on Information Networking (ICOIN); Hanoi, Vietnam; 2026. p. 37-42.
الوصول مقيد. يرجى تسجيل الدخول أو بدء فترة تجريبية لعرض هذا المحتوى.