تتقصى هذه الدراسة المؤشرات الحيوية لتخطيط كهربائية الدماغ للتمييز بين مرض ألزهايمر، والخرف الجبهي الصدغي، والمجموعات الضابطة السليمة. وقد تم تفسير نماذج الغابة العشوائية (Random Forest) التي استخدمت ميزات جذر متوسط المربعات، وكثافة الطيف القدرية، والاعتلاج، وذلك باستخدام الذكاء الاصطناعي القابل للتفسير وتحليل حجم التأثير. وأدى استبعاد ميزات الاعتلاج ذات التأثير المنخفض إلى تحسين أداء التصنيف، حيث تم تحقيق دقة اختبار بلغت 94%.
مقالة بحثية
دمج المؤشرات الحيوية لتخطيط كهربية الدماغ متعدد المجالات للتصنيف القائم على التعلم الآلي للخرف
في هذه المقالة
ملخص
الملخص
تم استقصاء تخطيط كهربائية الدماغ (EEG) كنهج غير باضع لتوصيف نشاط الدماغ في الحالات التنكسية العصبية. قيمت هذه الدراسة ما إذا كانت المؤشرات الحيوية لتخطيط كهربائية الدماغ متعددة المجالات يمكن أن تميز بين مرض ألزهايمر (AD)، والخرف الجبهي الصدغي (FTD)، والمجموعات الضابطة السليمة (HC). احتوت مجموعة البيانات المتاحة للعموم على تسجيلات تخطيط كهربائية الدماغ في حالة الراحة مع إغلاق العينين لـ 88 مشاركاً، بما في ذلك 36 مصاباً بمرض AD، و23 مصاباً بـ FTD، و29 من الضوابط السليمة. تم استخراج المؤشرات الحيوية لتخطيط كهربائية الدماغ متعددة المجالات والسمات الديموغرافية من أجل التصنيف باستخدام التعلم الآلي. وشملت السمات المشتقة من تخطيط كهربائية الدماغ جذر متوسط المربعات (RMS)، وكثافة القدرة الطيفية (PSD)، ومقاييس الإنتروبيا. تم تدريب مصنف الغابة العشوائية (Random Forest) باستخدام مجموعة السمات المجمعة وتم تفسيره باستخدام الذكاء الاصطناعي القابل للتفسير. أُجريت تحليلات استقرار السمات وحجم تأثير Cohen’s d لتقييم مساهمات السمات، تلا ذلك تحليل الاستئصال. أظهرت السمات القائمة على الإنتروبيا أقل مساهمة في التصنيف. حقق النموذج متعدد المجالات الكامل دقة تدريب بلغت 96% ودقة اختبار بلغت 92%. وبعد إزالة سمات الإنتروبيا، ارتفعت دقة الاختبار إلى 94%. تصف هذه النتائج أداء التصنيف لسمات تخطيط كهربائية الدماغ متعددة المجالات والسمات الديموغرافية المختارة ضمن إطار الغابة العشوائية.
المقدمة
يُعد مرض ألزهايمر (AD) حالة عصبية تدريجية ترتبط بتدهور في الوظائف المعرفية والحركية. وتزداد نسبة انتشار هذا المرض بشكل كبير مع تقدم العمر، كما يُعتبر الخرف سبباً رئيسياً للمراضة والوفيات بين كبار السن1,2,3,4,5. ونظراً لأن التشخيص وتصنيف المرض لا يزالان يشكلان تحدياً، فقد تم بحث تحليل إشارات الدماغ كوسيلة لتوصيف التغيرات الفيزيولوجية العصبية المرتبطة بالخرف.
يُعد تخطيط كهربية الدماغ (EEG) طريقة غير بضعية لتسجيل النشاط الكهربائي للدماغ، وقد تم استقصاؤه في مرض ألزهايمر والاضطرابات العصبية الأخرى6,7,8,9,10,11. تعكس إشارات EEG الجهود الكهربائية الناتجة عن النشاط العصبي، ويتم تسجيلها بطريقة غير بضعية من مواقع متعددة في فروة الرأس12,13,14. وعادةً ما يتم توصيف نشاط الدماغ باستخدام نطاقات التردد دلتا (delta)، وثيتا (theta)، وألفا (alpha)، وبيتا (beta)، وجاما (gamma)15. وقد ارتبط مرض ألزهايمر بتباطؤ تخطيط كهربية الدماغ، وانخفاض تعقيد الإشارة، وتغير التزامن16. كما أشارت التحليلات الطيفية إلى زيادة نشاط دلتا وثيتا بالتزامن مع انخفاض نشاط ألفا وبيتا لدى المصابين بمرض AD مقارنة بالمجموعات الضابطة السليمة17,18,19. وأفادت دراسات تصنيف EEG السابقة بتحقيق أداء عالٍ في التمييز بين مرض AD والمجموعات الضابطة السليمة (HC)، وبين الخرف الجبهي الصدغي (FTD) والمجموعات الضابطة السليمة (HC). وفي المقابل، كان التمييز بين مرض AD وFTD بشكل عام أكثر صعوبة10,11.
تُستخدم طرق تعلم الآلة لتحديد الأنماط في إشارات تخطيط كهربائية الدماغ (EEG) المرتبطة بالأمراض العصبية20,21. ولذلك، يُعد استخراج الميزات مكوناً هاماً في التصنيف القائم على تخطيط كهربائية الدماغ. وقد بحثت دراسات سابقة في الميزات الطيفية، والزمنية، وميزات التعقيد، والاتصال الوظيفي، وذلك بالاقتران مع نماذج تعلم الآلة3,15,22,23. وتكتسب الميزات الطيفية أهمية خاصة لأنها تقيس التغيرات المعتمدة على التردد في نشاط الدماغ، بما في ذلك انخفاض نشاط ألفا وزيادة نشاط ثيتا التي تم رصدها في مرض ألزهايمر (AD)23,24,25,26.
قامت العديد من الدراسات القائمة على تخطيط كهربائية الدماغ (EEG) بتقييم تركيبات مختلفة من السمات والمصنفات واستراتيجيات التحقق. وقد استُخدم التحليل القائم على الاتصالية للتمييز بين مرض الزهايمر (AD)، والخرف الجبهي الصدغي (FTD)، والمجموعات الضابطة السليمة (HC)، حيث تباين أداء التصنيف المُبلغ عنه بناءً على المقارنة وإجراء اختيار السمات27. كما تم تقييم السمات القائمة على تحويل فوريه للتمييز بين مرض الزهايمر، والضعف المعرفي الخفيف (MCI)، والمجموعات الضابطة السليمة، على الرغم من وجود قيود شملت محدودية المعالجة المسبقة واحتمالية حدوث فرط التخصيص المرتبط باستراتيجية التحقق28. وأظهرت مقاييس تعقيد تخطيط كهربائية الدماغ غير الخطية إمكانات تمييزية لتصنيف مرض الزهايمر، حيث حقق بعضها دقة وحساسية وخصوصية عالية، على الرغم من أن قابليتها للتطبيق في التمييز بين الضعف المعرفي الخفيف ومراحل المرض لا تزال محدودة21.
لقد تم استقصاء طرق التعلم العميق القائمة على تمثيلات الوقت والتردد لتخطيط كهربية الدماغ (EEG) من أجل التصنيف متعدد الفئات لكل من مرض الزهايمر (AD)، والضعف المعرفي الخفيف (MCI)، والمجموعة الضابطة الصحية (HC)29. وعلى الرغم من تسجيل أداء تصنيف مرتفع، إلا أن القيود تشمل صغر حجم المجموعات أو انتقائيتها، وعدم توازن الفئات، وتباين شدة المرض، ونقص التحقق الخارجي، وانخفاض قابلية تفسير النماذج29. كما تعد استراتيجية التحقق اعتباراً منهجياً هاماً؛ حيث أظهرت النهج المستقلة عن المشاركين أن التحقق المتقاطع التقليدي على مستوى الحقبة (epoch-level cross-validation) قد يؤدي إلى تقدير مبالغ فيه للأداء عندما تظهر حقب من المشارك نفسه في مجموعتي التدريب والاختبار معاً30. ويكتسب هذا القيد أهمية خاصة عند مقارنة نتائج التصنيف عبر دراسات تستخدم مخططات تحقق مختلفة.
تم تقييم مقاييس التعقيد والاتصالية أيضاً باستخدام مصنفات آلة ناقلات الدعم، حيث أظهرت الاتصالية القائمة على الطور والاعتلاج متعدد المقاييس مستويات متفاوتة من أداء التمييز31,32. وأفادت أعمال أخرى استخدمت سمات مشتقة من تحويلات فورير والمويجات عن أداء متغير عبر المقارنات بين مرض الزهايمر (AD)، والضعف المعرفي الخفيف (MCI)، والمجموعة الضابطة السليمة (HC)، مع بقاء التصنيف متعدد الفئات بشكل عام أكثر صعوبة من التصنيف الثنائي14. بالإضافة إلى ذلك، أظهرت النهج القائمة على الاعتلاج والتزامن تمييزاً بين مجموعات مرض الزهايمر والمجموعات الضابطة، على الرغم من أن خصائص المجتمع الضابط قد تؤثر على حجم التأثير الملحوظ2.
تقيم الدراسة الحالية مجموعة ميزات متعددة المجالات تضم مقاييس جذر متوسط المربعات (RMS)، وكثافة الطيف القدرية (PSD)، والاعتلاج (entropy) المستخلصة من نطاقات ترددات تخطيط كهربية الدماغ (EEG)، بالإضافة إلى العمر كمتغير ديموغرافي. يمثل جذر متوسط المربعات (RMS) سعة الإشارة داخل كل نطاق ترددي، بينما تمثل كثافة الطيف القدرية (PSD) القدرة في النطاق الترددي. وقد أُدرج الاعتلاج كمقياس لتعقيد الإشارة. توفر هذه الميزات توصيفات متكاملة لنشاط تخطيط كهربية الدماغ ويتم تقييمها باستخدام مصنف الغابة العشوائية (Random Forest). كما تبحث الدراسة بشكل أكبر في أهمية الميزات، واستقرار الميزات، والذكاء الاصطناعي القابل للتفسير، وتحليل حجم التأثير لتقدير المساهمة النسبية للميزات المستخلصة. وتبحث الدراسة الحالية في فعالية ميزات تخطيط كهربية الدماغ متعددة المجالات، بما في ذلك المقاييس الطيفية والزمنية والقائمة على التعقيد، في التمييز بين مرض الزهايمر (AD)، والخرف الجبهي الصدغي (FTD)، والمجموعات الضابطة السليمة (HC) باستخدام التعلم الآلي. كما تبحث في ميزات نطاقات تردد تخطيط كهربية الدماغ التي تساهم بشكل أقوى في التصنيف عند استخدام مقاييس كثافة الطيف القدرية (PSD)، وجذر متوسط المربعات (RMS)، والاعتلاج. بالإضافة إلى ذلك، تقارن الدراسة مساهمات الميزات القائمة على القدرة، بما في ذلك PSD وRMS، مع تلك الخاصة بالميزات القائمة على الاعتلاج، وتقيم مساهمة العمر في نموذج التصنيف.
البروتوكول
يظهر مخطط عام لسير عمل المعالجة المسبقة لتخطيط كهربية الدماغ (EEG)، واستخراج الميزات، والتصنيف في الشكل 1. والمواد والبرمجيات المستخدمة في الدراسة مدرجة في جدول المواد.
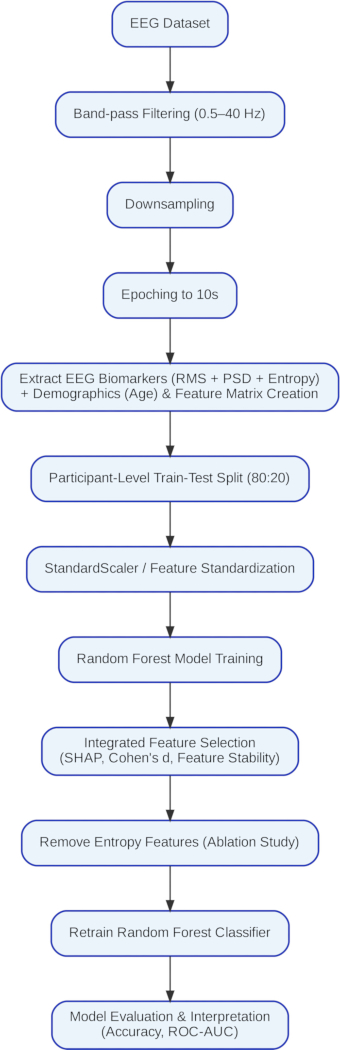
الشكل 1: سير عمل خط معالجة تخطيط كهربائية الدماغ (EEG) من حيث المعالجة الأولية، واستخراج الميزات، والتصنيف. نظرة عامة تخطيطية لسير عمل الدراسة، بما في ذلك التحقق من بيانات EEG، والترشيح بنطاق تمرير (band-pass filtering) وإعادة المرجعية، واستخراج ميزات جذر متوسط المربعات (RMS)، وكثافة القدرة الطيفية (PSD)، وميزات الإنتروبيا، وإضافة العمر، وتقسيم البيانات إلى مجموعات تدريب واختبار، وتطوير نموذج الغابة العشوائية (Random Forest)، وتحليل استقرار الميزات، وتحليل SHAP، وتحليل حجم التأثير باستخدام معامل Cohen’s d، والاختيار المتكامل للميزات، واستئصال ميزات الإنتروبيا، وإعادة تدريب النموذج، وتقييم الأداء. يرجى النقر هنا لعرض نسخة أكبر من هذا الشكل.
1. الحصول على البيانات
تم الحصول على مجموعة بيانات تخطيط كهربائية الدماغ (EEG) في حالة الراحة المتاحة للعموم من مستودع OpenNeuro (مجموعة البيانات ds004504، الإصدار 1.0.9)33. وتم التحقق من تسميات المشاركين والمعلومات الديموغرافية. تكونت مجموعة البيانات من 88 مشاركاً، من بينهم 36 مشاركاً مصاباً بمرض الزهايمر (AD)، و23 مصاباً بالخرف الجبهي الصدغي (FTD)، و29 من الضوابط الصحية (HC).
2. استيراد تسجيلات تخطيط كهربائية الدماغ (EEG)
بالنسبة لكل مشارك، تم تحميل تسجيل تخطيط كهربائية الدماغ باستخدام مكتبة MNE-Python. تم فحص كل ملف EEG للتأكد من إمكانية الوصول إليه، وإمكانية استيراده بنجاح، واحتوائه على معرف صالح للمشارك. وقد تم استبعاد التسجيلات التي كانت ملفاتها مفقودة أو تالفة. تم الإبقاء على تردد أخذ العينات الأصلي لـ EEG وهو 500 Hz في هذه المرحلة. ثم خُفض معدل أخذ العينات للإشارات لتقليل الحمل الحسابي مع الحفاظ على جميع معلومات EEG ذات الصلة سريريًا بهذه الدراسة.
3. الترشيح الممرر للنطاق
تم ترشيح تسجيلات EEG المستمرة باستخدام مرشح ممرر للنطاق من الدرجة الرابعة، مع تردد قطع منخفض قدره 0.5 Hz وتردد قطع مرتفع قدره 40 Hz.
4. المرجعية المتوسطة الشائعة وتقسيم الفترات الزمنية
تم تطبيق المرجعية المتوسطة الشائعة (CAR) على تسجيلات EEG المُرشحة. وعند كل عينة زمنية، تم حساب متوسط الإشارة عبر جميع قنوات EEG المتاحة وطرحه من كل قناة. وقد تم الاحتفاظ بإشارات EEG المرجعية للتحليلات اللاحقة. ثم قُسّم كل تسجيل EEG مرجعي إلى فترات زمنية (epochs) ثابتة الطول باستخدام دالة make_fixed_length_epochs() في مكتبة MNE-Python، حيث استُخدمت فترة زمنية مدتها 10 s مع تداخل قدره 0 s.
5. التحقق من صحة الحقبات الزمنية
بالنسبة لكل مشارك، تم الاحتفاظ بالحقبات الزمنية الكاملة التي تبلغ مدتها 10s فقط. وتم استبعاد أي جزء متبقٍ من تخطيط كهربائية الدماغ (EEG) تقل مدته عن 10s في نهاية التسجيل. واستُخدمت كل حقبة زمنية تم الاحتفاظ بها لاحقاً كعينة فردية لاستخراج الميزات.
6. تحضير الميزات
على الرغم من توفر بيانات فحص الحالة العقلية المصغر (MMSE) في مجموعة البيانات المصدر، إلا أنه تم استبعادها من التحليل الحالي. دُمجت ميزات تخطيط كهربائية الدماغ (EEG) المستخلصة مع المعلومات الديموغرافية للمشاركين، بما في ذلك العمر والتصنيفات التشخيصية، والتي تم الحصول عليها من ملف البيانات الوصفية participants.csv. استُخدم معرف المشارك كفتاح مشترك، وتم الاحتفاظ فقط بالمشاركين الذين لديهم سجلات ميزات تخطيط كهربائية الدماغ والمعلومات الديموغرافية المقابلة لها.
تضمنت مصفوفة سمات النطاقات المتعددة خمس سمات لجذر متوسط المربعات (RMS) وهي (delta_rms وtheta_rms وalpha_rms وbeta_rms وgamma_rms)، وخمس سمات لكثافة الطيف القدرية (PSD) وهي (delta_psd وtheta_psd وalpha_psd وbeta_psd وgamma_psd)، وخمس سمات للإنتروبيا وهي (delta_entropy وtheta_entropy وalpha_entropy وbeta_entropy وgamma_entropy). كما أُدرج العمر كمتغير ديموغرافي تكميلي. ونظراً لأن توزيعات الأعمار قد تختلف عبر المجموعات التشخيصية، فلم يكن من الممكن استبعاد التداخل الديموغرافي بشكل كامل. وقد تم تعيين المجموعة التشخيصية، التي عُرِّفت بأنها AD أو HC أو FTD، كملصق مستهدف.
7. المعالجة المسبقة للبيانات وتقسيم بيانات التدريب والاختبار
خلال مرحلة المعالجة المسبقة، تم خفض معدل أخذ العينات للتسجيلات من 500 Hz إلى 250 Hz لتقليل المتطلبات الحسابية مع الاحتفاظ بمعلومات تردد EEG ذات الأهمية.
تم تقسيم مجموعة البيانات إلى مجموعات فرعية للتدريب (80%) والاختبار (20%) على مستوى الشخص باستخدام استراتيجية تقسيم مجمعة. بعد ذلك، تم الحصول على التنبؤات على مستوى الشخص عن طريق التصويت بالأغلبية عبر العصور الزمنية المتوقعة التي تنتمي إلى كل مشارك. اعتمد التقييم الأساسي على تقسيم التدريب والاختبار المجمع على مستوى الشخص لمنع ظهور العصور الزمنية لنفس المشارك في كلتا المجموعتين الفرعيتين. تم الحصول على التنبؤات على مستوى الشخص عن طريق التصويت بالأغلبية عبر العصور الزمنية المتوقعة التي تنتمي إلى كل مشارك. كما تم فحص مجموعة البيانات بحثًا عن القيم المفقودة، وتمت إزالة الملاحظات المفقودة أو تعويضها حسب الاقتضاء. وتم ترميز التسميات التشخيصية. ثم تم ضبط StandardScaler على بيانات التدريب وتطبيقه بعد ذلك على كل من مجموعتي بيانات التدريب والاختبار.
8. تطوير نموذج الغابة العشوائية
تم تهيئة مصنف الغابة العشوائية (Random Forest) باستخدام 80 شجرة، وبحد أقصى لعمق الشجرة يبلغ 10، وبحد أقصى أربع سمات، وبحد أدنى خمس عينات لكل ورقة، وحالة عشوائية قدرها 42. وقد تم تدريب المصنف باستخدام مجموعة بيانات التدريب الموحدة.
9. تقييم النموذج
تَمّ التنبؤ بتصنيفات الفئات لكل من مجموعتي بيانات التدريب والاختبار. كما أُنشئت مصفوفة ارتباك (confusion matrix)، وحُسبت الدقة (accuracy)، والضبط (precision)، والاسترجاع (recall)، ومقياس F1-score، وذلك جنبًا إلى جنب مع تقرير التصنيف. وسُجلت دقة التدريب ودقة الاختبار.
بالنسبة للتقييم الخاص بكل مشارك، تأكد من تخصيص جميع الحقبات (epochs) الخاصة بمشارك معين حصرياً إما لمجموعة التدريب أو لمجموعة الاختبار. وقد تم تدريب مصنف الغابة العشوائية (Random Forest) باستخدام نفس المعلمات الفائقة (hyperparameters) المستخدمة في التحليل الأساسي.
10. التحقق المتبادل
كإجراء إضافي لتقييم النموذج، تم إجراء تحقق متبادل طبقي خماسي الطيات (five-fold stratified cross-validation) باستخدام shuffle = True و random_state = 30. وقد تم حساب متوسط الدقة والانحراف المعياري عبر الطيات الخمس. واعتُبر هذا التحليل منفصلاً عن تقييم الاحتجاز الأساسي على مستوى الأشخاص.
11. تحليل استقرار الميزات
تم تقييم استقرار الميزات عن طريق تكرار تدريب الغابة العشوائية (Random Forest) 10 مرات باستخدام بذور عشوائية من 0 إلى 9. وفي كل عملية تشغيل، تم تسجيل دقة الاختبار ودرجات أهمية الميزة. وحُسب المتوسط والانحراف المعياري لدرجة أهمية الميزة لكل متنبئ عبر عمليات التشغيل العشر، ثم رتبت المتنبئات وفقاً لاستقرارها. استُخدم هذا التحليل لتقييم اتساق تصنيفات الميزات بدلاً من استبدال التقييم الأساسي على مستوى العينة.
12. تحليل الذكاء الاصطناعي القابل للتفسير
طُبق SHAP TreeExplainer على نموذج Random Forest المدرب. حُسبت قيم SHAP لتقدير مساهمة كل ميزة في تنبؤات النموذج. كما حُسب متوسط القيمة المطلقة لـ SHAP لكل ميزة، ورُتبت الميزات وفقاً لمساهماتها في قيم SHAP. تم تحديد الميزات التي أظهرت قيم SHAP منخفضة باستمرار ومقارنتها بنتائج تحليلات استقرار الميزات وCohen’s d. واختيرت الميزات ذات المساهمات المنخفضة باستمرار لإجراء عملية الاستئصال (ablation) وإعادة تدريب النموذج لاحقاً.
13. تحليل حجم التأثير الإحصائي
تم حساب قيمة Cohen’s d لكل مؤشر حيوي من مؤشرات EEG للمقارنات التالية: AD مقابل HC، وAD مقابل FTD، وFTD مقابل HC. وقد تم تفسير مقادير حجم التأثير باستخدام عتبات قدرها 0.20 للتأثير الصغير، و0.50 للتأثير المتوسط، و0.80 للتأثير الكبير.
14. اختيار الميزات المتكامل
تمت مقارنة نتائج تحليل أهمية الميزات باستخدام الغابة العشوائية (Random Forest)، وتحليل SHAP، وتحليل معامل Cohen’s d. وقد تم تحديد المتنبئات التي أظهرت باستمرار أهمية منخفضة للميزات، ومساهمة منخفضة في قيم SHAP، وأحجام تأثير صغيرة كمرشحين للحذف.
15. استئصال السمات
تم تقييم سمات الإنتروبيا في تحليل استئصالي استكشافي، وتم إنشاء مصفوفة سمات مختزلة تحتوي على RMS و PSD والعمر. أُعيد تدريب مصنف الغابة العشوائية (Random Forest) باستخدام نفس المعلمات الفائقة. كما كُررت عمليات تدريب النموذج، والاختبار، والتحقق المتقاطع، وتحليل خصائص تشغيل المستقبل (ROC) باستخدام مجموعة السمات المختزلة.
16. تحليل منحنى خصائص تشغيل المستقبِل (ROC)
تم الحصول على احتمالات الفئة من مصنف الغابة العشوائية (Random Forest) المُحسَّن. كما تم إنشاء منحنيات خصائص تشغيل المستقبل (ROC) متعددة الفئات باستخدام نهج الـ one-مقابل- استراتيجية الراحة. تم حساب قيم المساحة تحت المنحنى (AUC) الخاصة بكل فئة، بالإضافة إلى متوسط المساحة تحت المنحنى.
17. مقارنة الأداء
تمت مقارنة أداء نموذج الميزات الكامل بأداء نموذج الميزات المختزل الذي تم الحصول عليه بعد استئصال ميزات الإنتروبيا.
النتائج
حقق نموذج الغابة العشوائية (Random Forest) دقة تدريب بلغت 96% ودقة اختبار بلغت 92%. وكان متوسط F1-score الكلي (macro-average) بنسبة 92%، بينما كان متوسط F1-score المرجح (weighted-average) أيضاً 92%، مما يشير إلى أداء متقارب عبر الفئات الثلاث. وكان أداء التصنيف الأعلى لفئة مرض الزهايمر (AD)، بينما أظهرت فئة الخرف الجبهي الصدغي (FTD) أداءً أقل نسبياً، كما هو موضح في الجدول 1.
استُخدم تحليل خصائص تشغيل المستقبل (ROC) لتقييم الفصل بين الفئات عبر عتبات التصنيف. وكما هو موضح في الشكل 2، تجاوزت المساحة تحت منحنى ROC (AUC) قيمة 0.98 لجميع الفئات الثلاث، مما يشير إلى قدرة فصل عالية بين مجموعات مرض الزهايمر (AD)، والخرف الجبهي الصدغي (FTD)، ومجموعة الضابطة السليمة (HC).
أُجري تحليل SHAP باستخدام TreeExplainer لتقييم مساهمات الميزات في نموذج تصنيف الغابة العشوائية (Random Forest). وأظهر مخطط الأعمدة الملخص في الشكل 3 المساهمة النسبية لكثافة الطيف القدرية (PSD)، وجذر متوسط المربعات (RMS)، والإنتروبيا، والميزات الديموغرافية. وقد ساهمت الميزات ذات قيم SHAP المطلقة الأعلى بشكل أقوى في تنبؤات النموذج، بينما أظهرت الميزات المتعلقة بالإنتروبيا مساهمات منخفضة نسبياً.
أُجري تحليل استقرار الميزات من خلال تكرار تدريب الغابة العشوائية (Random Forest) عبر بذور عشوائية محددة. سُجلت دقة الاختبار ودرجات أهمية الميزات لكل تشغيل، وحُسب المتوسط والانحراف المعياري لأهمية الميزات. حقق النموذج متوسط دقة تصنيف بلغت 95% في هذا التحليل، وبانحراف معياري قدره 0.17%. استُخدمت هذه التشغيلات المتكررة بشكل أساسي لتقييم اتساق ترتيب الميزات، واعتُبرت منفصلة عن تقييم الاستبعاد الأساسي على مستوى الأشخاص. وقد احتل العمر مرتبة عالية في تحليل استقرار الميزات، كما هو موضح في الجدول 2. كما احتلت ميزات theta_psd وtheta_rms مرتبة عالية، بينما أظهرت ميزات alpha_psd وalpha_rms وbeta_psd وbeta_rms أهمية متوسطة.
تم حساب قيمة Cohen’s d لتقييم حجم الفروق بين المجموعات، كما هو موضح في الجدول 3. أظهر تخامد نطاق ألفا (alpha_rms, d = 0.97; alpha_psd, d = 0.87) وزيادة نشاط ثيتا (theta_rms, d = 0.72) أكبر الفروق المسجلة بين المشاركين المصابين بـ AD والمجموعة الضابطة السليمة. وقد كانت هذه النتائج متوافقة مع التباطؤ القشري الذي تم رصده في دراسات تخطيط كهربائية الدماغ (EEG) الخاصة بالخرف34. أما الميزات القائمة على الإنتروبيا فقد أظهرت أحجام تأثير أصغر نسبياً. وأسفرت المقارنات بين AD و FTD في الغالب عن أحجام تأثير تتراوح بين الصغيرة والمتوسطة.
أظهرت سمات نطاق ألفا أحجام تأثير كبيرة لمجموعة مرضى الزهايمر (AD-مقابل-التحكم الصحي (HC) والخرف الجبهي الصدغي (FTD)-مقابل- مقارنات مع الضوابط الصحية (HC). بالنسبة لمرض الزهايمر (AD) مقابل وبالنسبة لمجموعة الضوابط الصحية (HC)، كانت أحجام التأثير المسجلة −0.87 لـ alpha_psd و−0.97 لـ alpha_rms. أما بالنسبة لمرضى الخرف الجبهي الصدغي (FTD) مقابل في مجموعة الضوابط الصحية (HC)، كان تخامد نطاق ألفا -0.73. وأظهرت سمة كثافة القدرة الطيفية لنطاق ثيتا (theta_psd) حجم تأثير قدره 0.61 لمرض الزهايمر (AD). مقابل المجموعة الضابطة السليمة (HC)، بينما أظهرت قيمة theta_rms حجم تأثير قدره 0.72. ولوحظت فروق أقل بالنسبة لمرض الزهايمر (AD). مقابل الخرف الجبهي الصدغي.
أظهرت سمات نطاق بيتا أحجام تأثيرات جماعية صغيرة إلى متوسطة في الغالب. وكانت أحجام تأثير beta_psd هي −0.35 لمرض AD مقابل HC و −0.41 لمرض AD مقابل FTD، بينما أظهر beta_rms تأثيرات صغيرة في الغالب. وأظهرت سمات نطاق غاما تأثيرات متوسطة لبعض المقارنات؛ حيث كان حجم تأثير gamma_psd هو 0.47 لمرض FTD مقابل HC و 0.20 لمرض AD مقابل HC، بينما أظهر gamma_rms حجم تأثير قدره 0.50 لمرض FTD مقابل HC.
أظهر كل من Delta PSD وRMS أحجام تأثير إيجابية صغيرة لمرض AD مقابل HC (0.29 و0.34، على التوالي) وFTD مقابل HC (0.25 و0.25، على التوالي). وكانت أحجام التأثير لمرض AD مقابل FTD قريبة من الصفر. كما أظهر Delta entropy أحجام تأثير صغيرة في جميع المقارنات الثلاث (0.08، و0.20، و−0.11).
أشارت تحليلات استقرار الميزات، وقيم SHAP، وحجم التأثير إلى مساهمات منخفضة نسبياً لميزات الإنتروبيا. وبناءً على ذلك، تم إجراء تحليل الاستئصال عن طريق استبعاد ميزات الإنتروبيا والاحتفاظ بـ RMS وPSD والعمر. وبعد استئصال الميزات، حقق نموذج الغابة العشوائية دقة تدريب بلغت 96% ودقة اختبار بلغت 94%. وقد فُسرت هذه النتيجة كمقارنة استكشافية ضمن إطار اختيار الميزات الذي تم تقييمه. تظهر قيم الدقة (Precision)، والاسترجاع (Recall)، ومقياس F1-score، والدعم لفئات AD وHC وFTD في الجدول 4.
تمت مقارنة الأداء قبل وبعد استئصال سمة الإنتروبيا (entropy-feature ablation) في الجدول 5. وقد ارتفعت دقة الاختبار من 92% إلى 94% بعد إزالة الإنتروبيا. وتوضح التغيرات حسب الفئة في الجدول 6. بالنسبة لمرض FTD، زادت الدقة (precision) بنسبة 4%، وزاد مقياس F1-score بنسبة 2%. أما بالنسبة لمجموعة HC، فقد زاد الاستدعاء (recall) بنسبة 4%، بينما انخفضت الدقة بنسبة 2%. كما ارتفعت مقاييس أداء المتوسط الكلي (macro-average) والمتوسط المرجح (weighted-average) بنسبة تتراوح تقريبًا بين 1%–2% عقب استئصال السمة.
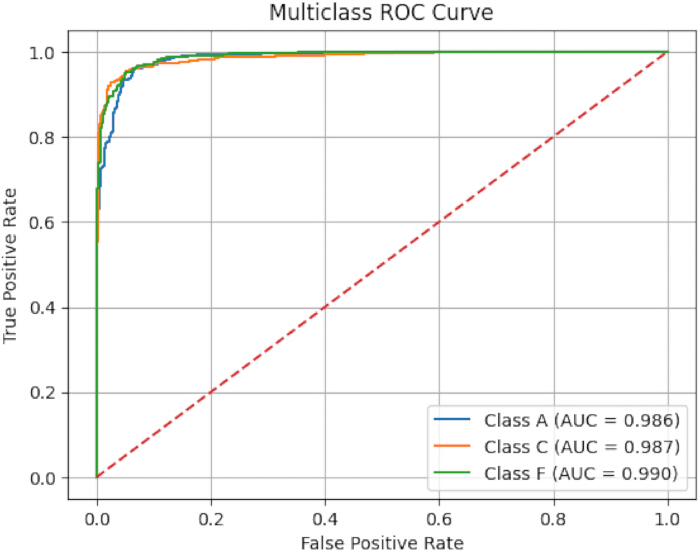
الشكل 2منحنيات خصائص تشغيل المستقبِل لمرض ألزهايمر، والخرف الجبهي الصدغي، والمجموعات الضابطة السليمة. منحنيات خصائص تشغيل المستقبل (ROC) متعددة الفئات التي تم إنشاؤها باستخدام طريقة الـ one-مقابل- استراتيجية الراحة لمرض ألزهايمر (الفئة A)، والخرف الجبهي الصدغي (الفئة F)، والمجموعات الضابطة السليمة (الفئة C). وتم حساب المساحة تحت المنحنى (AUC) لكل فئة. يرجى النقر هنا لعرض نسخة أكبر من هذا الشكل.
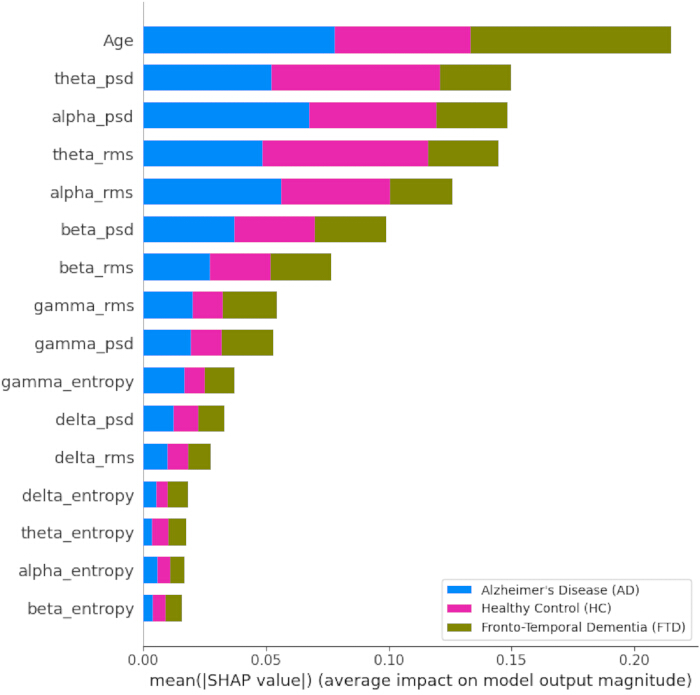
الشكل 3: تحليل ملخص SHAP لنموذج Random Forest المدرب. مخطط شريطي ملخص يوضح المساهمة النسبية للميزات المستمدة من تخطيط كهربائية الدماغ (EEG) والميزات الديموغرافية في نموذج تصنيف Random Forest. استُخدمت متوسطات قيم SHAP المطلقة لترتيب مساهمات ميزات جذر متوسط المربعات (RMS)، وكثافة الطيف القدرية (PSD)، والاعتلاج (entropy)، والعمر. يرجى النقر هنا لعرض نسخة أكبر من هذا الشكل.
| الدقة (Precision) | الاستدعاء (Recall) | مقياس F1 (F1-Score) | الدعم (Support) | |
| مرض ألزهايمر | 0.92 | 0.95 | 0.94 | 579 |
| المجموعة الضابطة | 0.93 | 0.92 | 0.93 | 480 |
| الخرف الجبهي الصدغي | 0.93 | 0.87 | 0.9 | 314 |
| المتوسط الكلي (Macro average) | 0.93 | 0.92 | 0.92 | 1373 |
| المتوسط المرجح (Weighted average) | 0.93 | 0.92 | 0.92 | 1373 |
الجدول 1: تقرير التصنيف لبيانات الاختبار. الدقة (Precision)، والاستدعاء (recall)، ومقياس F1-score، والدعم (support) لفئات مرض الزهايمر، والمجموعة الضابطة السليمة، والخرف الجبهي الصدغي في مجموعة بيانات الاختبار، إلى جانب مقاييس أداء المتوسط الكلي (macro-average) والمتوسط المرجح (weighted-average).
| ميزة | المتوسط الحسابي | الانحراف المعياري |
| العمر | 0.1966 | 0.0017 |
| كثافة القدرة الطيفية لثيتا | 0.0936 | 0.0027 |
| جذر متوسط مربع ثيتا (theta_rms) | 0.0911 | 0.0023 |
| كثافة القدرة الطيفية لألفا | 0.0824 | 0.0022 |
| جذر متوسط مربع ألفا (alpha_rms) | 0.0824 | 0.0024 |
| كثافة القدرة الطيفية لبيتا | 0.0638 | 0.0013 |
| الجذر التربيعي لمتوسط مربع بيتا (beta_rms) | 0.0629 | 0.0012 |
| كثافة القدرة الطيفية لجاما | 0.0534 | 0.001 |
| جذر متوسط مربع غاما | 0.0527 | 0.0014 |
| دلتا_psd | 0.0403 | 0.0007 |
| جذر متوسط مربع الفرق (delta_rms) | 0.0359 | 0.001 |
| إنتروبيا غاما | 0.0326 | 0.0008 |
| إنتروبيا ألفا | 0.0325 | 0.0006 |
| الإنتروبيا بيتا | 0.0283 | 0.0009 |
| إنتروبيا ثيتا | 0.0258 | 0.0004 |
| تغير الإنتروبيا | 0.0255 | 0.0005 |
الجدول 2: تصنيف استقرار الميزات لنموذج الغابات العشوائية (Random Forest). قيم متوسط أهمية الميزات والتباين المقابل لها، والتي تم الحصول عليها من تدريب متكرر لنموذج الغابات العشوائية باستخدام بذور عشوائية من 0 إلى 9. تم تصنيف الميزات وفقاً لاستقرارها عبر عمليات التشغيل المختلفة.
| ميزة | مرض ألزهايمر مقابل التحكم الصحي (HC) | مرض ألزهايمر مقابل الخرف الجبهي الصدغي | الخرف الجبهي الصدغي مقابل التحكم الصحي (Healthy Control) |
| دلتا PSD | 0.293 | -0.069 | 0.253 |
| كثافة القدرة الطيفية لموجات ثيتا (Theta PSD) | 0.612 | 0.23 | 0.355 |
| ألفا PSD | -0.869 | -0.219 | -0.64 |
| بيتا PSD | -0.352 | -0.408 | 0.201 |
| توزيع حجم الجسيمات غاما (Gamma PSD) | 0.201 | -0.326 | 0.468 |
| تغير الإنتروبيا | 0.081 | 0.199 | -0.111 |
| إنتروبيا ثيتا | 0.208 | 0.033 | 0.163 |
| إنتروبيا ألفا | -0.061 | 0.071 | -0.137 |
| الإنتروبيا بيتا | -0.37 | -0.042 | -0.332 |
| إنتروبيا جاما | -0.338 | 0.047 | -0.391 |
| جذر متوسط المربعات لـ دلتا (Delta RMS) | 0.342 | 0.041 | 0.251 |
| جذر متوسط مربعات ثيتا (Theta RMS) | 0.718 | 0.354 | 0.318 |
| ألفا RMS | -0.977 | -0.205 | -0.73 |
| جذر متوسط مربعات بيتا (Beta RMS) | -0.494 | -0.365 | 0.015 |
| جذر متوسط مربع غاما (Gamma RMS) | 0.187 | -0.33 | 0.5 |
الجدول 3: مقارنة حجم تأثير Cohen’s d عبر المجموعات التشخيصية. قيم Cohen’s d للمؤشرات الحيوية لتخطيط كهربائية الدماغ (EEG) عبر مقارنات مرض الزهايمر مقابل المجموعة الضابطة السليمة، ومرض الزهايمر مقابل الخرف الجبهي الصدغي، والخرف الجبهي الصدغي مقابل المجموعة الضابطة السليمة.
| الدقة | الاستدعاء | مقياس F1 (F1-Score) | الدعم | |
| مرض ألزهايمر | 0.94 | 0.95 | 0.94 | 579 |
| مجموعة ضابطة | 0.91 | 0.96 | 0.94 | 480 |
| الخرف الجبهي الصدغي | 0.97 | 0.89 | 0.92 | 314 |
| المتوسط الكلي (Macro avg) | 0.94 | 0.93 | 0.93 | 1373 |
| المتوسط المرجح | 0.94 | 0.94 | 0.94 | 1373 |
الجدول 4: تقرير التصنيف بعد استئصال الميزات. الدقة (Precision)، والاستدعاء (recall)، ومقياس F1-score، والدعم (support) لفئات مرض الزهايمر، ومجموعة الضبط الصحية، والخرف الجبهي الصدغي بعد إزالة ميزات الإنتروبيا وإعادة تدريب نموذج الغابة العشوائية (Random Forest).
| مقياس | قبل الاستئصال | ما بعد الاستئصال | تغيير |
| دقة التدريب | 0.96 | 0.96 | تغيير بنسبة 0% |
| دقة الاختبار | 0.92 | 0.94 | تحسن بنسبة +2% |
| الدقة الكلية | 0.93 | 0.94 | تحسن بنسبة 1%+ |
| الاسترجاع الكلي | 0.92 | 0.93 | تحسن بنسبة +1% |
| مقياس F1 الكلي (Macro F1-Score) | 0.92 | 0.93 | تحسن بنسبة +1% |
| الدقة المرجحة | 0.93 | 0.94 | تحسن بنسبة +1% |
| الاستدعاء الموزون | 0.92 | 0.94 | تحسن بنسبة +2% |
| مقياس F1 المرجح | 0.92 | 0.94 | تحسن بنسبة +2% |
الجدول 5: مقارنة الأداء قبل وبعد استئصال الميزات. مقارنة مقاييس أداء النموذج لمجموعة الميزات متعددة المجالات الكاملة ومجموعة الميزات المختصرة التي تم الحصول عليها بعد إزالة ميزات الإنتروبيا.
توافر البيانات:
تتوفر مجموعة بيانات CSV المعالجة المستخدمة في تطوير النموذج والتحليل كـ الملف التكميلي 1. يتوفر كود المعالجة المسبقة في دفتر Python عبر الرابط https://colab.research.google.com/drive/1PwidMZCbbIHdthDhat5OEZa7ya6f0-aC?usp=sharing، بينما يتوفر كود بناء النموذج والتحليل عبر الرابط https://colab.research.google.com/drive/1q8wYJjQpofAqZGYxz9xHKB0emGF4YGwM?usp=sharing. كما يمكن إعادة إنشاء مجموعة بيانات CSV المعالجة باستخدام كود المعالجة المسبقة المقدم
| الفئة | المقياس | قبل | بعد | التغيير |
| مرض ألزهايمر | الدقة (Precision) | 0.92 | 0.94 | 0.02 |
| الاستدعاء (Recall) | 0.95 | 0.95 | لا يوجد تغيير | |
| مقياس F1 (F1-score) | 0.94 | 0.94 | لا يوجد تغيير | |
| المجموعة الضابطة | الدقة (Precision) | 0.93 | 0.91 | −2% |
| الاستدعاء (Recall) | 0.92 | 0.96 | 0.04 | |
| مقياس F1 (F1-score) | 0.93 | 0.94 | 0.01 | |
| FTD | الدقة (Precision) | 0.93 | 0.97 | 0.04 |
| الاستدعاء (Recall) | 0.87 | 0.89 | 0.02 | |
| مقياس F1 (F1-score) | 0.9 | 0.92 | 0.02 |
الجدول 6: تغيرات الأداء حسب الفئة قبل وبعد استئصال الميزات. التغيرات في الدقة (precision)، والاستدعاء (recall)، ومقياس F1-score لفئات مرض ألزهايمر، والمجموعة الضابطة السليمة، والخرف الجبهي الصدغي بعد إزالة ميزات الإنتروبيا.
الملف التكميلي 1: مجموعة بيانات ميزات تخطيط كهربائية الدماغ (EEG) المعالجة على مستوى الحقبة والمستخدمة في تطوير النموذج والتحليل.يرجى النقر هنا لتحميل هذا الملف.
المناقشة
تم استخدام مصنف الغابة العشوائية (Random Forest) لتصنيف عينات تخطيط كهربائية الدماغ (EEG) إلى مجموعات مرض الزهايمر (AD)، والخرف الجبهي الصدغي (FTD)، ومجموعة الضوابط الصحية (HC) باستخدام سمات متعددة المجالات، بما في ذلك كثافة الطيف القدرية (PSD)، وجذر متوسط المربعات (RMS)، ومقاييس الإنتروبيا. تم إدراج العمر كمتغير ديموغرافي تكميلي. وبما أن توزيعات الأعمار قد تختلف عبر المجموعات التشخيصية، فلم يكن من الممكن استبعاد التداخل الديموغرافي تماماً، وبالتالي فإن الأداء المذكور عكس المساهمة المشتركة للمعلومات الديموغرافية والكهروفسيولوجية. وفحص التحليل قدرة سمات EEG متعددة المجالات على التمييز بين مجموعات AD وFTD وHC، وقيم مساهمة سمات نطاقات delta وtheta وalpha وbeta وgamma في التصنيف35. وأشارت تحليلات استقرار السمات وحجم التأثير إلى أن السمات القائمة على القدرة، بما في ذلك PSD وRMS، ساهمت بشكل أقوى من السمات القائمة على الإنتروبيا. كما عكسَت المؤشرات الحيوية المستخرجة من EEG أنماطاً مرتبطة بتباطؤ الإيقاعات وانخفاض نشاط alpha.
قامت دراسات سابقة بتقييم سمات تخطيط كهربائية الدماغ (EEG) القائمة على الإنتروبيا، وكثافة القدرة الطيفية (PSD)، وجذر متوسط المربعات (RMS) باستخدام مناهج مختلفة من تعلم الآلة2,14,27,28,36,37. وقد استُخدمت الإنتروبيا لتوصيف تعقيد وعدم انتظام تخطيط كهربائية الدماغ، بينما استُخدمت PSD لقياس الخصائص الطيفية2,14,27,28,36. كما تم تقييم RMS كسمة لنطاق التردد37. وباستخدام مجموعة البيانات الأساسية نفسها، طبقت أعمال سابقة تصنيفًا ثنائيًا قائمًا على PSD مع التحقق من صحة البيانات بطريقة استبعاد شخص واحد (leave-one-subject-out)33. أما التحليل الحالي فقد دمج RMS والإنتروبيا وPSD عبر نطاقات ألفا، وبيتا، وجاما، وثيتا، ودلتا ضمن إطار تصنيف متعدد الفئات. وتم تقييم محول (transformer) خفيف الوزن لتخطيط كهربائية الدماغ على مجموعة البيانات نفسها باستخدام استراتيجية تصنيف ثنائي بطريقة استبعاد شخص واحد. وسجل محول تخطيط كهربائية الدماغ خفيف الوزن الذي تم تقييمه على مجموعة البيانات نفسها باستخدام استراتيجية التصنيف الثنائي بطريقة استبعاد شخص واحد دقة بلغت 83.28%. وينبغي تفسير المقارنة الرقمية المباشرة مع النتائج الحالية بحذر نظرًا لاختلاف مهمة التصنيف وإجراءات التحقق38.
أظهرت سمات نطاق ألفا أكبر أحجام التأثير في التمييز بين مرض الزهايمر (AD) والمجموعة الضابطة الصحية (HC)، وبين الخرف الجبهي الصدغي (FTD) والمجموعة الضابطة الصحية (HC)، كما ساهم زيادة نشاط ثيتا في التمييز بين مرض الزهايمر (AD) والمجموعة الضابطة الصحية (HC). وأظهرت سمات نطاق بيتا تأثيرات أقل عبر المجموعات، بينما أظهرت السمات القائمة على الإنتروبيا فائدة تمييزية محدودة نسبياً. وأظهرت سمات نطاق غاما تأثيرات متوسطة في بعض المقارنات، بما في ذلك مقارنة الخرف الجبهي الصدغي (FTD) مقابل المجموعة الضابطة الصحية (HC). وقد ذكرت دراسات سابقة انخفاض قدرة ألفا وتغير نشاط ثيتا في مرض الزهايمر (AD) والمقارنات التشخيصية ذات الصلة23,25,39. كما وُصفت الإنتروبيا بأنها مؤشر حيوي قد يكون مفيداً في الأمراض التنكسية العصبية36، مما يشير إلى أن مساهمتها قد تختلف باختلاف مجموعة البيانات، وتعريف السمات، والنهج التحليلي المتبع.
استُخدمت آلات ناقلات الدعم (Support vector machines) بشكل متكرر في دراسات تصنيف تخطيط كهربائية الدماغ (EEG) السابقة3,21,24,37. وقد وفر مصنف الغابة العشوائية (Random Forest) المستخدم في التحليل الحالي تقديرات لأهمية الميزات، وكان قابلاً للتطبيق على مجموعة الميزات المهيكلة المستخدمة في هذه الدراسة40,41. وقد تم الحصول على دقة في التدريب والاختبار بلغت 96% و 94% على التوالي بعد استئصال ميزات الإنتروبيا. وارتبطت إزالة ميزات الإنتروبيا بتحسن أداء النموذج، مما يدعم المساهمة النسبية المنخفضة الملحوظة لهذه الميزات في تحليلات الاستقرار، وقيم SHAP، وحجم التأثير. كما طُبقت نهج التعلم العميق والنهج القائمة على المحولات (transformer-based approaches) في تصنيف تخطيط كهربائية الدماغ، رغم أن هذه النهج تتطلب عموماً مجموعات بيانات أكبر ومصممة لتمثيلات تسلسلية أو ذات أبعاد أعلى27,39,42,43,44,45.
تتسم إشارات تخطيط كهربائية الدماغ (EEG) بأنها مشوشة وغير مستقرة، ويمكن لنماذج الأشجار التجميعية أن توفر القوة اللازمة عند تحليل التمثيلات الميزات المهيكلة. في الدراسة الحالية، تم تقييم كل من جذر متوسط المربعات (RMS)، وكثافة القدرة الطيفية (PSD)، والإنتروبيا، والعمر كمدخلات تكميلية لنموذج الغابة العشوائية (Random Forest). مثل RMS سعة الإشارة ضمن نطاقات التردد، ومثل PSD القدرة الطيفية، بينما مثلت الإنتروبيا تعقيد الإشارة. وأشارت النتائج إلى أن PSD و RMS ساهموا بشكل أقوى من الإنتروبيا في التصنيف ضمن الإطار الذي تم تقييمه. كما ساهم العمر في النموذج، رغم أن إدراجه أدى إلى احتمال حدوث تداخل ديموغرافي. ويمكن للبحوث المستقبلية تقييم متغيرات ديموغرافية إضافية ونهج بديلة لتعلم الآلة أو التعلم العميق في مجموعات بيانات أكبر لتقييم القابلية للتعميم وأداء التصنيف بشكل أكبر.
الإفصاحات
لم يتم الإفصاح عن أي تضارب معروف في المصالح المالية، أو علاقات شخصية، أو علاقات مالية، أو أنشطة أخرى يمكن أن تكون قد أثرت على العمل الوارد في هذه الدراسة.
شكر وتقدير
يتم الإقرار بمجموعة بيانات EEG المتاحة علنًا والمستخدمة في هذه الدراسة، وكذلك إسهامات الباحثين الذين جعلوا مجموعة البيانات هذه متاحة لأغراض البحث. لم يتم تلقي أي تمويل محدد من وكالات تمويل عامة أو تجارية أو غير ربحية.
المواد
| الاسم | الشركة | رقم فهرسي | التعليقات |
|---|---|---|---|
| Google Colab | جوجل | [تأكيد البيئة] وقت تشغيل colab | بيئة حوسبة سحابية تُستخدم لتشغيل دفاتر التحليل الملاحظاتية |
| MNE-Python | مشروع MNE-Python | 1.12.1 | تُستخدم للمعالجة المسبقة لتخطيط كهربائية الدماغ (EEG)، وتحديد المرجع، والترشيح، وتقسيم الحقبات الزمنية |
| NumPy | مشروع NumPy | (2.0.2) | تُستخدم للحسابات العددية والقائمة على المصفوفات |
| مجموعة بيانات تخطيط كهربائية الدماغ (EEG) من OpenNeuro | OpenNeuro | ds004504, (1.0.9) | مجموعة بيانات تخطيط كهربائية الدماغ (EEG) في حالة الراحة متاحة للعموم، تحتوي على تسجيلات لمرضى داء ألزهايمر (AD)، ومرض الخرف الجبهي الصدغي (FTD)، ومجموعة ضابطة من الأصحاء (HC) |
| بايثون | مؤسسة برمجيات بايثون (Python Software Foundation) | [3.12.13 (رئيسي، مارس (4 2026، 09:23:07) [[GCC 11.4.0]] | بيئة البرمجة المستخدمة لمعالجة البيانات وتطوير النموذج |
| scikit-learn | مشروع scikit-learn | 1.6.1 | تُستخدم في المعالجة المسبقة، وتقسيم البيانات المجمعة، والتصنيف باستخدام الغابة العشوائية (Random Forest)، وتقييم الأداء |
| SciPy | مشروع SciPy | (1.16.3) | تُستخدم لمعالجة الإشارات والحسابات الإحصائية |
| قيم شابلي (SHAP) | مشروع SHAP | 0.52.0 | تُستخدم لتحليل الذكاء الاصطناعي القابل للتفسير باستخدام TreeExplainer |
المراجع
- Rodrigues PM, et al. Early prediction of Alzheimer's with the electroencephalogram. Procedia Comput Sci. 2016;100:865–71. https://doi.org/10.1016/j.procs.2016.09.236
- Houmani N, et al. Diagnosis of Alzheimer's disease with electroencephalography in a differential framework. PLoS One. 2018;13(3):e0193607. https://doi.org/10.1371/journal.pone.0193607
- Tripanpitak K, et al. Biomarkers for Alzheimer's disease and mild cognitive impairment: recent advances in task-based EEG. J Alzheimers Dis. 2025 [Epub ahead of print].
- Kung HC, Hoyert DL, Xu J, Murphy SL. Deaths: final data for 2005. Natl Vital Stat Rep. 2008;56(10):1-120.
- Falk TH, Fraga FJ, Trambaiolli L, Anghinah R. EEG amplitude modulation analysis for semi-automated diagnosis of Alzheimer's disease. EURASIP J Adv Signal Process. 2012;2012(1):192. https://doi.org/10.1186/1687-6180-2012-192
- Lehmann C, et al. Application and comparison of classification algorithms for recognition of Alzheimer's disease in electrical brain activity (EEG). J Neurosci Methods. 2007;161(2):342–50. https://doi.org/10.1016/j.jneumeth.2006.10.023
- Campanharo AS, Doescher E, Ramos FM. Automated EEG signals analysis using quantile graphs. In: Ferrández Vicente JM, Álvarez-Sánchez JR, de la Paz López F, Adeli H, editors. International Work-Conference on Artificial Neural Networks (IWANN 2017). Cham: Springer; 2017. p. 95–103. https://doi.org/10.1007/978-3-319-59147-6_9
- Adeli H, Ghosh-Dastidar S, Dadmehr N. Alzheimer's disease: models of computation and analysis of EEGs. Clin EEG Neurosci. 2005;36(3):131–40. https://doi.org/10.1177/155005940503600303
- Zheng H, Xiong X, Zhang X. Multi-threshold recurrence rate plot: a novel methodology for EEG analysis in Alzheimer's disease and frontotemporal dementia. Brain Sci. 2024;14(6):565. https://doi.org/10.3390/brainsci14060565
- Zheng X, et al. Diagnosis of Alzheimer's disease via resting-state EEG: integration of spectrum, complexity, and synchronisation signal features. Front Ageing Neurosci. 2023;15:1288295. https://doi.org/10.3389/fnagi.2023.1288295
- Abd Rahman F, Othman MF, Shaharuddin NA. Analysis methods of EEG signals: a review in EEG applications for brain disorders. J Teknol. 2015;72(2):41-6.
- Jackson AF, Bolger DJ. The neurophysiological bases of EEG and EEG measurement: a review for the rest of us. Psychophysiology. 2014;51(11):1061–71. https://doi.org/10.1111/psyp.12283
- Fouad IA, Labib FEZM. Identification of Alzheimer's disease from central lobe EEG signals utilising machine learning and a residual neural network. Biomed Signal Process Control. 2023;86:105266. https://doi.org/10.1016/j.bspc.2023.105266
- Fiscon G, et al. Combining EEG signal processing with supervised methods for Alzheimer's patients' classification. BMC Med Inform Decis Mak. 2018;18(1):35. https//doi.org/10.1186/s12911-018-0613-7
- Dauwels J, Vialatte F, Cichocki A. Diagnosis of Alzheimer's disease from EEG signals: where are we standing? Curr Alzheimer Res. 2010;7(6):487–505. https://doi.org/10.2174/156720510792231720
- Jelic V, Kowalski J. Evidence-based evaluation of diagnostic accuracy of resting EEG in dementia and mild cognitive impairment. Clin EEG Neurosci. 2009;40(2):129-42.
- Coben LA, Danziger WL, Berg L. Frequency analysis of the resting awake EEG in mild senile dementia of Alzheimer type. Electroencephalogr Clin Neurophysiol. 1983;55(4):372–80. https://doi.org/10.1016/0013-4694(83)90124-4
- Cibils D. Dementia and qEEG (Alzheimer's disease). Suppl Clin Neurophysiol. 2002;54:289-94.
- Ramírez-Arias FJ, et al. Evaluation of machine learning algorithms for the classification of EEG signals. Technologies. 2022;10(4):79. https://doi.org/10.3390/technologies10040079
- Hosseini MP, Hosseini A, Ahi K. A review on machine learning for EEG signal processing in bioengineering. IEEE Rev Biomed Eng. 2021;14:204–18. https://doi.org/10.1109/RBME.2020.2969915
- Vicchietti ML, Ramos FM, Betting LE, Campanharo AS. Computational methods of EEG signals analysis for Alzheimer's disease classification. Sci Rep. 2023;13(1):8184.
- Rahimi P, Noroozian M, Hatami J, Sadeghi M. Differential role of electroencephalography between mild cognitive impairment and Alzheimer disease during spatial working memory task. Iran J Neurodevelop Disord. 2025;4(1):101-10.
- Wang J, et al. Alzheimer's disease diagnosis using rhythmic power changes and phase differences: a low-density EEG study. Front Aging Neurosci. 2025;16:1485132. https://doi.org/10.3389/fnagi.2024.1485132
- Senkaya Y, Kurnaz C, Ozbilgin F. Enhancing Alzheimer's diagnosis with machine learning on EEG: a spectral feature-based comparative analysis. Diagnostics (Basel). 2025;15(17):2190. https://doi.org/10.3390/diagnostics15172190
- McBride JC, et al. Spectral and complexity analysis of scalp EEG characteristics for mild cognitive impairment and early Alzheimer's disease. Comput Methods Programs Biomed. 2014;114(2):153–63. https://doi.org/10.1016/j.cmpb.2014.01.019
- Al-Nuaimi AH, Jammeh E, Sun L, Ifeachor E. Changes in the EEG amplitude as a biomarker for early detection of Alzheimer's disease. In: 2016 38th Annual International Conference of the IEEE Engineering in Medicine and Biology Society (EMBC); 2016; Orlando, FL, USA. Piscataway: IEEE; 2016. p. 993–6. https://doi.org/10.1109/EMBC.2016.7590869
- Ma Y, Bland JKS, Fujinami T. Classification of Alzheimer's disease and frontotemporal dementia using electroencephalography to quantify communication between electrode pairs. Diagnostics (Basel). 2024;14(19):2189. https://doi.org/10.3390/diagnostics14192189
- Fiscon G, et al. Alzheimer's disease patients classification through EEG signals processing. In: 2014 IEEE Symposium on Computational Intelligence and Data Mining (CIDM); 2014; Orlando, FL, USA. IEEE; 2014. p. 105–12. https://doi.org/10.1109/CIDM.2014.7008655
- Fouladi S, et al. Efficient deep neural networks for classification of Alzheimer’s disease and mild cognitive impairment from scalp EEG recordings. Cogn Comput. 2022;14(4):1247–68. https://doi.org/10.1007/s12559-022-10022-y
- Miltiadous A, et al. Alzheimer’s disease and frontotemporal dementia: A robust classification method of EEG signals and a comparison of validation methods. Diagnostics. 2021;11(8):1437. https://doi.org/10.3390/diagnostics11081437
- Nobukawa S, et al. Classification methods based on complexity and synchronization of electroencephalography signals in Alzheimer’s disease. Front Psychiatry. 2020;11:255. https://doi.org/10.3389/fpsyt.2020.00255
- Huggins CJ, et al. Deep learning of resting-state electroencephalogram signals for three-class classification of Alzheimer’s disease, mild cognitive impairment and healthy ageing. J Neural Eng. 2021;18(4):046087. https://doi.org/10.1088/1741-2552/ac1a80
- Miltiadous A, et al. DICE-net: a novel convolution–transformer architecture for Alzheimer detection in EEG signals. IEEE Access. 2023;11:71840–58. https://doi.org/10.1109/ACCESS.2023a.3294618
- Miller R. Theory of the normal waking EEG: from single neurones to waveforms in the alpha, beta and gamma frequency ranges. Int J Psychophysiol. 2007;64(1):18–23. https://doi.org/10.1016/j.ijpsycho.2006.07.009
- Thomas JS, Thivakaran TK. Data mining algorithms and statistical techniques for identification of schizophrenia: A survey. In: 2020 International Conference on Smart Technologies in Computing, Electrical and Electronics (ICSTCEE); 2020; Bengaluru, India. IEEE; 2020. p. 246–51. https://doi.org/10.1109/ICSTCEE49637.2020.9276856
- Cacciotti A, et al. EEG entropy insights in the context of physiological aging and Alzheimer's and Parkinson's diseases: a comprehensive review. Geroscience. 2024;46(6):5537–57. https://doi.org/10.1007/s11357-024-01200-5
- Subhashree S, Eric PV. A unique EEG-Hyfusion fully automated stacked model for classification of Alzheimer's disease and frontotemporal dementia. J Vis Exp. 2026;(228):e69762.
- Miltiadous A, et al. A dataset of scalp EEG recordings of Alzheimer's disease, frontotemporal dementia and healthy subjects from routine EEG. Data (Basel). 2023;8(6):95. https://doi.org/10.3390/data8060095
- Malakouti SM, Menhaj MB, Suratgar AA. Enhanced epilepsy detection using discrete wavelet transform and bandpass filtering on EEG data: integration of ART-based and LVQ models. Clin eHealth. 2025. https://doi.org/10.1016/j.ceh.2025.02.001
- Durga P, et al. An ensemble model for detection of Parkinson's disease by comparing numerous machine learning models and XGBoost based on vocal features. Clin eHealth. 2025. https://doi.org/10.1016/j.ceh.2025.01.001
- Behnamian A, et al. A systematic approach for variable selection with random forests: achieving stable variable importance values. IEEE Geosci Remote Sens Lett. 2017;14(11):1988–92. https://doi.org/10.1109/LGRS.2017.2745049
- Macia G, Liddell A, Doyle V. Conversational AI with large language models to increase the uptake of clinical guidance. Clin eHealth. 2024;7:147–52. https://doi.org/10.1016/j.ceh.2024.07.001
- Zhao W. Research on the deep learning of small sample data based on transfer learning. AIP Conf Proc. 2017;1864(1):020018. https://doi.org/10.1063/1.4992835
- Hassan U, Singhal A. Convolutional neural network framework for EEG-based ADHD diagnosis in children. Health Inf Sci Syst. 2024;12(1):44. https://doi.org/10.1007/s13755-024-00303-x
- Jeong T, Park U, Kang SW. Novel quantitative electroencephalogram feature image adapted for deep learning: verification through classification of Alzheimer’s disease dementia. Front Neurosci. 2022;16:1033379. https://doi.org/10.3389/fnins.2022.1033379