تحدد هذه الدراسة ثمانية جينات تنبؤية مرتبطة بالكارثة الانقسامية (PDGFB, LDHA, ZEB2, H2AX, FKBP4, DMD, ANXA2, S100B) في سرطان الرئة الغدي، وتضع نموذجاً للمخاطر يتمتع بأداء تنبؤي مقبول، كما تكشف عن خصائص متميزة للبيئة المجهرية المناعية بين مجموعات المخاطر.
يتطلب اشتراك JoVE لعرض هذا المحتوى. تسجيل الدخول أو ابدأ نسخة تجريبية مجانية
مقالة بحثية
تحديد الجينات الإنذارية المرتبطة بالكارثة الانقسامية في سرطان الرئة الغدي عبر تحليل الترانسكريبتوم
في هذه المقالة
ملخص
الملخص
يتسم سرطان الرئة الغدي (LUAD)، وهو النوع الأكثر شيوعاً من سرطان الرئة، بإنذار سيئ. وعلى الرغم من إمكانية تحفيز الكارثة الانقسامية في LUAD، مما يؤدي إلى موت الخلايا، إلا أن الأهمية الإنذارية والبيولوجية للجينات المرتبطة بالكارثة الانقسامية (MCRGs) في هذا المرض لا تزال غير واضحة. تم فحص الجينات ذات التعبير المتباين (DEGs) المرتبطة بـ LUAD من مجموعة TCGA-LUAD، وتم تحديد الجينات المتداخلة عن طريق تقاطع DEGs مع MCRGs. اختيرت الجينات الإنذارية المرشحة عبر التعلم الآلي، وبعد ذلك تم بناء نموذج إنذاري متعدد الجينات. تم إنشاء بصمة إنذارية مكونة من ثمانية جينات مرشحة تشمل PDGFB، وLDHA، وZEB2، وH2AX، وFKBP4، وDMD، وANXA2، وS100B، والتي أظهرت موثوقية تنبؤية مقبولة في التدريب بمساحات تحت المنحنى (AUCs) لمدة سنتين و3 سنوات و5 سنوات بلغت 0.723 و0.715 و0.625 على التوالي في مجموعة التدريب (مؤشر C المصحح بطريقة bootstrap: 0.699، فاصل ثقة 95%: 0.657-0.742) وتحقق متسق في GSE31210 (AUCs: 0.812 و0.766 و0.814). وأظهر المرضى ذوو المخاطر المنخفضة نتائج بقاء أفضل بشكل ملحوظ، وتعزيزاً في الارتشاح المناعي، ودرجات مناعية وسدوية أعلى، وزيادة في درجات النمط الظاهري المناعي، ودورات مناعية سرطانية أكثر نشاطاً. كما لوحظت فروق ذات دلالة إحصائية في عبء الطفرات الورمية والحساسية الدوائية بين مجموعتي المخاطر العالية والمنخفضة. وقد أكد تفاعل البوليميراز المتسلسل الكمي (qPCR) الملفات النسخية لستة جينات مرشحة مرتبطة بالنتائج في العينات السريرية. وأظهر المخطط البياني (nomogram) الذي يدمج درجة المخاطر والمرحلة السريرية أداءً تنبؤياً جيداً. تثبت هذه النتائج أن الجينات الثمانية المرشحة المرتبطة بـ MCRG تمتلك إمكانية قوية للتنبؤ بنتائج المرضى وتصنيف المخاطر في LUAD، مع وجود خصائص متميزة للبيئة المجهرية المناعية بين مجموعات المخاطر.
المقدمة
ما يزال سرطان الرئة من بين أكثر أنواع السرطانات انتشاراً وفتكاً على مستوى العالم1,2. ويهيمن سرطان الرئة الغدي (LUAD) على سرطان الرئة غير صغير الخلايا (NSCLC)، حيث يمثل حوالي 40% من جميع حالات سرطان الرئة3,4. ورغم إحراز تقدم ملحوظ في الإجراءات الجراحية، والعلاجات الموجهة جزيئياً، ومثبطات نقاط التفتيش المناعية، والأنظمة العلاجية المركبة، إلا أن التوقعات السريرية لمرضى LUAD لا تزال غير مواتية5,6. ومع أن النهج التشخيصية المعتمدة على علم الأمراض والتصوير الطبي مستخدمة على نطاق واسع في LUAD، إلا أنها تعاني من قيود متأصلة في رصد عدم التجانس الورمي والخصائص الجزيئية. وفي المقابل، يمكن لتحليل أنسجة الورم القائم على المؤشرات الحيوية الجزيئية أن يوفر معلومات أكثر شمولاً عن بيولوجيا الورم، وقد يساهم في التقييم الإنذاري واستراتيجيات العلاج الفردية7. لذا، يظل تحديد مؤشرات حيوية جزيئية موثوقة أمراً هاماً لتحسين التنبؤ الإنذاري والفهم البيولوجي لسرطان LUAD.
يعتبر الانقسام الفتيلي (Mitosis) آلية أساسية للتكاثر الخلوي، تضمن التوزيع الدقيق للكروموسومات المتضاعفة بين خليتين بنتين8. ويمكن أن يؤدي خلل تنظيم عمليات الانقسام الفتيلي إلى تعزيز التكاثر الخلوي غير المنضبط، وعدم الاستقرار الجينومي، وتطور الأورام. وتُعرف الكارثة الفتيلية (Mitotic catastrophe - MC) بأنها مسار لموت الخلايا يتم تحفيزه عند الفشل في إكمال الانقسام الفتيلي، وينتج ذلك عادةً عن تلف جهاز المغزل أو خلل في نقاط تفتيش الدورة الخلوية9. وعلى المستوى المورفولوجي، تظهر الكارثة الفتيلية في شكل تشوهات خلوية تشمل تعدد النوى، والنوى الدقيقة، وتكوينات المغزل متعددة الأقطاب، وتعدد الصيغ الصبغية (polyploidization)10. وباعتبارها آلية للتخلص من الخلايا ذات العيوب الفتيلية الشديدة، قد تساهم الكارثة الفتيلية في كبح تطور الأورام9. ويمكن أن يؤدي حذف p53 في خلايا A549 LUAD إلى تحفيز الكارثة الفتيلية وفي النهاية موت الخلايا11، مما يشير إلى وجود صلة محتملة بين الكارثة الفتيلية والعمليات الخلوية المرتبطة بـ LUAD. ومع ذلك، لا تزال الأهمية الإنذارية والوظائف البيولوجية للجينات المرتبطة بالكارثة الفتيلية (MCRGs) في LUAD غير واضحة تماماً.
في هذا البحث، تم استقصاء الأهمية الإنذارية والأهمية البيولوجية المفترضة للجينات المرتبطة بالتحكم في الميتوكوندريا (MCRGs) في سرطان الرئة الغدي (LUAD) بشكل منهجي باستخدام بيانات من TCGA وGEO. تم أولاً تحديد الـ MCRGs المرشحة من خلال تحليلات التعبير التفاضلي والتقاطع. وقامت عدة مناهج للتعلم الآلي بفحص الجينات المرشحة وإنشاء توقيع مخاطر إنذاري، والذي تم التحقق من صحته خارجيًا لاحقًا. وعلاوة على ذلك، تم تطوير مخطط ترقيمي (nomogram) يدمج درجة المخاطر مع الخصائص السريرية لتحسين التنبؤ بالبقاء على قيد الحياة. بالإضافة إلى ذلك، تم استخدام توصيف البيئة المجهرية المناعية، وتقييم الطفرات الجسدية، وتقييم الحساسية الكيميائية لفحص الآثار البيولوجية والفائدة السريرية للجينات المحددة. وتظهر هذه النتائج مجتمعة الإمكانات الإنذارية للـ MCRGs في LUAD، وقد تساهم في تطوير المؤشرات الحيوية والإدارة العلاجية الفردية.
الوصول مقيد. يرجى تسجيل الدخول أو بدء فترة تجريبية لعرض هذا المحتوى.
البروتوكول
أُجريت هذه الدراسة وفقاً لإعلان هلسنكي، واعتمدت لجنة الأخلاقيات في مستشفى أنهوي للصدر البروتوكول الخاص بها (K2025-007) في 22 أبريل 2025. كما تم الحصول على موافقة مستنيرة من جميع الأشخاص المشاركين في الدراسة.
استخراج البيانات وتطبيعها
تَمَّ الحصول على ملفات النسخ الترانسكريبتومية ومجموعات البيانات السريرية المقابلة لها لسرطان الرئة الغدّي (LUAD) من مجموعات TCGA وGEO. وقد خُصصت مجموعة بيانات TCGA-LUAD لتكون مجموعة التدريب، بينما استُخدمت المجموعات GSE72094 وGSE31210 وGSE26939 كمجموعات للتحقق الخارجي (الجدول 1). بالإضافة إلى ذلك، تم جمع 900 مجموعة من الجينات المرجعية (MCRGs) من دراسة سابقة12(الجدول التكميلي 1تم تعليق بيانات النسخ (Transcriptome) باستخدام GENCODE v36 أو ملفات التعليق الخاصة بمنصة GPL المقابلة. حُوّلت معرفات المجسات (Probe IDs) إلى رموز جينية، ودُمجت الجينات المكررة باستخدام دالة avereps، واقتصر الاحتفاظ على الجينات المشفرة للبروتين فقط لإنشاء مصفوفات التعبير على مستوى الجين. وبالنسبة لمجموعة التدريب TCGA-LUAD، فإن الجينات التي بلغت قيم "القطع لكل كيلوباز من نموذج الإكسون لكل مليون قطعة مرسومة" (FPKM) < استُبعدت العينات التي تغلغل فيها التعبير الجيني في أقل من 1 من أكثر من 50% من العينات، وحُوِّلت قيم التعبير المتبقية باستخدام تحويل اللوغاريتم الثنائي (log2[FPKM+1]). وبالنسبة لمجموعات التحقق من قاعدة بيانات GEO، تم تنزيل بيانات التعبير الخام، ورُبطت معرفات المجسات برموز الجينات باستخدام ملفات التعليقات التوضيحية الخاصة بكل منصة، كما دُمجت المجسات المتعددة المقابلة للجين نفسه عن طريق حساب متوسط قيم التعبير الخاصة بها. وقد خضعت مجموعات البيانات هذه لتحويل اللوغاريتم الثنائي عند الضرورة. ولم يتم تطبيق أي تصحيح لتأثير الدفعة (batch effect) عبر المنصات المختلفة بين TCGA وGEO، حيث اعتمدنا استراتيجية تقييس لكل مجموعة على حدة لضمان القابلية للمقارنة النسبية. وتحديداً، بالنسبة لمجموعتي التدريب والتحقق، تم تمركز قيم التعبير الجيني ومقايستها (تحويل z-score) باستخدام المتوسط والانحراف المعياري لكل مجموعة بيانات بشكل فردي. ثم استُخدمت معاملات انحدار Cox نفسها المستمدة من مجموعة التدريب لحساب درجات المخاطر لجميع المجموعات. وللحفاظ على القابلية للتطبيق السريري وتجنب الإفراط في التخصيص (overfitting) لأي مجموعة تحقق، استُخدم متوسط درجة المخاطر في مجموعة التدريب كنقطة قطع ثابتة لتقسيم المرضى إلى مجموعات ذات مخاطر عالية ومنخفضة عبر جميع مجموعات التحقق الخارجية. كما استُخرجت المعلومات السريرية المتاحة، بما في ذلك العمر، والجنس، والمرحلة المرضية، ومرحلة الورم والعقد اللمفاوية والنقائل (TNM)، والنوع النسيجي، ووقت البقاء على قيد الحياة، وحالة البقاء، ونوع النسيج. وكانت نقطة النهاية هي البقاء الإجمالي (OS). أما العينات ذات المعلومات غير المكتملة عن البقاء أو وقت البقاء على قيد الحياة... < تم استبعاد 30 يوماً. وحُوِّل زمن البقاء إلى سنوات، بينما شُفِّر وضع البقاء بحيث يمثل الرقم 0 حالة "على قيد الحياة" والرقم 1 حالة "الوفاة".
تحديد وتحليلات وظيفية للجينات المرشحة
حددت حزمة Limma الجينات ذات التعبير التفاضلي (DEGs) بين عينات أورام سرطان الرئة الغدي (LUAD) والعينات الطبيعية في مجموعة التدريب.13حددت المعايير التالية الجينات المعبر عنها تفاضلياً (DEGs): |log2تحديد التدفق الخلوي (Flow Cytometry) > 0.5 ومعدلة pالقيمة الاحتمالية (p-value) < 0.05. وعقب ذلك، استُخدمت خوارزمية التجميع الضبابي mfuzz الموجودة في حزمة R المسماة ClusterGVis لتقسيم الجينات ذات التعبير التفاضلي (DEGs) إلى مجموعات تعبيرية متميزة. كما أُجري تحليل الوجود الجيني-العملية البيولوجية (GO-BP) على أهم خمسة جينات ممثلة في كل مجموعة بناءً على درجات العضوية الخاصة بها. واشتُقّت مجموعة من الجينات المشتركة عن طريق إيجاد التقاطع بين الجينات ذات التعبير التفاضلي (DEGs) والجينات ذات الصلة بالسرطان والتمثيل الغذائي (MCRGs). وقُيّمت الأهمية البيولوجية للجينات المتداخلة باستخدام تحليل الإثراء الوظيفي عبر الوجود الجيني وموسوعة كيوتو للجينات والجينومات (GO/KEGG). أما شبكات التفاعل البروتيني-البروتيني (PPI) فقد استُمدت من قاعدة بيانات STRING.14التفاعلات ذات درجات الثقة فقط > بقي 0.7 لتحسين موثوقية الشبكة.
فحص الجينات التنبؤية
استُخدمت حزمة Survival لإجراء تحليل انحدار Cox أحادي المتغير لتحديد الجينات المحتملة المرتبطة بالبقاء على قيد الحياة بشكل عام في LUAD15. واعتُبرت الجينات ذات قيمة p-value < 0.05 مؤشرات إنذارية محتملة. شملت مجموعة تدريب TCGA-LUAD عدد 500 مريض لديهم بيانات بقاء كاملة، من بينهم 216 مريضاً (43.2%) تعرضوا لحالات وفاة أثناء فترة المتابعة. وكانت نسبة الجينات المرشحة (n = 108) إلى الأحداث (n = 216) تقريباً 1:2، وهي نسبة مقبولة لتحليل انحدار Cox. لاحقاً، استُخدم تحليل انحدار LASSO (Least Absolute Shrinkage and Selection Operator) ونموذج XGBoost (Extreme Gradient Boosting) لمزيد من اختيار السمات. بُنيت نماذج مخاطر Cox النسبية باستخدام family = "cox" عبر دالة cv.glmnet من حزمة glmnet. وحُدد معامل التسوية الأمثل باستخدام التحقق المتقاطع العشري (10-fold cross-validation)، حيث مثلت قيمة λ.min الحد الأدنى من خطأ التحقق المتقاطع، والتي اختيرت كقيمة λ المثلى. استُخلصت الجينات ذات معاملات الانحدار غير الصفرية كسمات مرشحة. أما بالنسبة لنموذج XGBoost، فقد جُمِع وقت البقاء وحالة البقاء كمتغير نتيجة، مع تخصيص قيم موجبة لحالات الوفاة وقيم سالبة للحالات الخاضعة للرقابة (censored cases). وضُبطت المعلمات لتكون objective = "survival: cox" و eval_metric = "cox-nloglik"، مع 100 تكرار ومعدل تعلم قدره 0.1. وبعد تدريب النموذج، حُسبت درجات أهمية الجينات باستخدام قيم كسب السمات (feature gain values). وتم الاحتفاظ بأعلى 20 جيناً بعد فرز درجات الأهمية بترتيب تنازلي لتقليل أبعاد السمات وتعقيد النموذج. وحُددت الجينات المتداخلة بين نتائج LASSO و XGBoost كجينات إنذارية مرشحة.
بناء وتقييم نموذج إنذاري
تم تطوير نموذج إنذاري باستخدام تحليل انحدار كوكس متعدد المتغيرات للجينات المرشحة التي تم تحديدها. وقد تم حساب درجات المخاطرة بشكل فردي على النحو التالي:
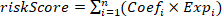 .
حيث يشير Coefi إلى معامل الجين i، بينما يشير Expi إلى قيمة التعبير الجيني المقابلة. بعد ذلك، تم تقسيم الأفراد إلى مجموعتين: مجموعة عالية الخطورة ومجموعة منخفضة الخطورة، باستخدام وسيط درجة الخطورة كحد فاصل. ثم تم إنشاء منحنيات خصائص تشغيل المستقبل (ROC) المعتمدة على الوقت. ولتقييم احتمالية وجود فرط في التخصيص (overfitting)، أُجري تحقق داخلي بطريقة bootstrap مع 1,000 تكرار لإعادة أخذ العينات لحساب مؤشر C المصحح للانحياز ومساحات تحت المنحنى (AUCs) المعتمدة على الوقت مع فواصل ثقة 95%. كما تم إنشاء منحنيات المعايرة لتقييم الاتفاق بين احتمالات البقاء المتوقعة والملاحظة عند سنتين و3 سنوات و5 سنوات. علاوة على ذلك، أُجري تحليل منحنى القرار (DCA) باستخدام حزمة ggDCA في لغة R لتقييم الفائدة السريرية الصافية للنموذج عند النقاط الزمنية 2 و3 و5 سنوات، وذلك لقياس القيمة المحتملة لدرجة الخطورة في اتخاذ القرارات السريرية عبر احتمالات عتبة مختلفة. وتمت مقارنة التفاوتات في البقاء بين المجموعات المصنفة حسب الخطورة وعبر الفئات السريرية الأخرى باستخدام منحنيات البقاء Kaplan–Meier (KM) مع اختبار log-rank. بالإضافة إلى ذلك، تم استخدام تحليل Shapley Additive exPlanations (SHAP) للتفسير التوضيحي اللاحق لتبيان مساهمات الجينات الفردية في أداء النموذج.
تطوير المخطط البياني (Nomogram) والتحقق الخارجي من صحته
تم فحص العلاقات بين درجات المخاطر المحسوبة ومختلف السمات السريرية (بما في ذلك الجنس، والعمر، ومرحلة TNM) باستخدام اختبارات Wilcoxon rank-sum أو Kruskal-Wallis لتقييم القابلية للتطبيق السريري للنموذج. ولتقييم ما إذا كانت درجة المخاطر تعمل كعامل إنذاري مستقل، تم إدراج المتغيرات السريرية، جنبًا إلى جنب مع درجة المخاطر، في نمذجة انحدار Cox متعدد المتغيرات. بعد ذلك، تم إنشاء مخطط إنذاري (nomogram) يجمع بين عوامل المخاطر السريرية المستقلة (مثل المرحلة Stage) ودرجة المخاطر الجينية باستخدام حزمة regplot في لغة R لتخصيص تنبؤات احتمالية البقاء على قيد الحياة. واستُخدمت منحنيات المعايرة لتقييم مدى توافق احتمالية البقاء التي توقعها المخطط الإنذاري مع نتائج البقاء الفعلية. وأخيرًا، تم التحقق بدقة من القدرة التنبؤية النهائية وقابلية التعميم لنظام المخطط الإنذاري المتكامل من خلال منحنيات ROC المعتمدة على الوقت وتحليلات KM الشاملة للمجموعات السريرية الفرعية عبر المجموعات المدروسة.
تحليلات الارتشاح المناعي والأنماط المناعية الفرعية
استُخدم برنامج CIBERSORT، بالاعتماد على مصفوفة بصمة جينات الكريات البيضاء (LM22)، لتقدير النسب النسبية لـ 22 نوعاً من الخلايا المناعية لتقييم ارتشاح الخلايا المناعية لدى مرضى LUAD. وتم تقييم العلاقات بين مستويات التعبير الجيني ذات القيمة الإنذارية والارتشاح المناعي عن طريق تحليل ارتباط سبيرمان (Spearman correlation analysis). كما استُخرجت درجات المناعة، واللحمة، ونقاء الورم، ودرجات ESTIMATE عبر خوارزمية ESTIMATE، واستُخدم اختبار ويلكوكسون (Wilcoxon test) لتقييم الفروق بين مجموعات المخاطر. وصُنِّف مرضى LUAD إلى ست مجموعات فرعية مناعية باستخدام حزمة ImmuneSubtypeClassifier16. كما استُخدم اختبار ويلكوكسون بشكل إضافي لمقارنة توزيعات المجموعات الفرعية المناعية عبر مجموعات المخاطر.
تحليلات نقاط التفتيش المناعية، ودرجة النمط الظاهري المناعي، ودورة المناعة السرطانية
في هذه الدراسة، استُخدم اختبار ويلكوكسون لمجموع الرتب (Wilcoxon rank-sum test) لتقييم 21 جينًا من جينات نقاط التفتيش المناعية17 عبر المجموعات المصنفة حسب المخاطر، بهدف توصيف المشهد المناعي لسرطان الرئة الغدي (LUAD). كما ربط ارتباط سبيرمان (Spearman correlation) بين الجينات الإنذارية المرشحة وجينات نقاط التفتيش المناعية. ولتقييم الاختلافات في الاستجابة لمثبطات نقاط التفتيش المناعية (ICIs) لدى مرضى LUAD في مستويات مخاطر مختلفة، تم الحصول على بيانات درجة النمط الظاهري المناعي (IPS) لعلاجات anti-PD-1 وanti-CTLA-4 من أطلس المناعة السرطانية (TCIA)18، واستُخدمت قاعدة بيانات تتبع النمط الظاهري المناعي للأورام (TIP)19 لتقييم نشاط دورة المناعة السرطانية، ومقارنة الدرجات المقابلة بين مجموعات المخاطر.
تحليل الطفرات الجسدية والحساسية للأدوية
استُخدمت أداة الطفرات الخاصة بـ TCGA لاسترجاع ملفات الطفرات الجسدية لحالات TCGA-LUAD للتحقق من التباين في أنماط الطفرات عبر مجموعات المخاطر. وقامت حزمة maftools بمعالجة بيانات الطفرات وتصورها. كما تم تحديد مستويات عبء الطفرات الورمية (TMB) لكل عينة ومقارنتها بين فئتي المخاطر. وأُجري تحليل الحساسية الدوائية الجينية باستخدام حزمة pRRophetic وفقاً لقاعدة بيانات علم جينوم الحساسية الدوائية في السرطان (GDSC)20. وتُنبئت قيم التركيز المثبط النصفي الأقصى (IC50) للأدوية المضادة للسرطان لكل مريض LUAD، وتم قياس الاختلافات بين مجموعات المخاطر باستخدام اختبار ويلكوكسون لمجموع الرتب (Wilcoxon rank-sum test).
تقييم مستويات التعبير للجينات التنبؤية
استُخدمت كل مجموعة بيانات لتقييم مستويات النسخ لجينات مرشحة مختارة ذات صلة بالنتائج. ولربط التعبير الجيني بتوقعات سير المرض لدى المرضى، تم اشتقاق نقاط القطع المثلى عبر دالة surv_cutpoint في حزمة survminer في لغة R. وبناءً على هذه العتبات، صُنفت حالات LUAD إلى مجموعات فرعية ذات تعبير مرتفع وتعبير منخفض لإجراء تحليل البقاء على قيد الحياة لاحقاً.
علاوة على ذلك، تم الحصول على خمس مجموعات متطابقة من أورام LUAD وأنسجة طبيعية مجاورة من مستشفى أنهوي للصدر، ومن ثم أُجري التحقق بواسطة qPCR. وقد قدم كل مشارك موافقة كتابية مستنيرة. تم اختيار ستة جينات تنبؤية مرشحة (PDGFB وLDHA وZEB2 وFKBP4 وDMD وS100B) للتحقق منها عبر qPCR. تم استخلاص RNA من عينات الأنسجة المتجانسة باستخدام كاشف استخلاص RNA، متبوعاً بالاستخلاص باستخدام الكلوروفورم والترسيب باستخدام الإيزوبروبانول. وقد أتاح جهاز spectrophotometer قياس تركيز RNA ونقاوته. أُجري التحقق من الجينات التنبؤية الستة المرشحة بواسطة qPCR باستخدام مزيج PCR رئيسي قائم على SYBR Green في نظام PCR في الوقت الحقيقي: تم البدء بمسخ أولي عند 95 °C لمدة 30 s، تلتها 40 دورة مكونة من 95 °C لمدة 20 s، و55 °C لمدة 20 s، و72 °C لمدة 20 s. تم حساب التعبير النسبي ومعايرته بالنسبة لـ Glyceraldehyde-3-Phosphate Dehydrogenase(GAPDH) باستخدام تقنية 2-ΔΔCt. تتوفر تفاصيل جميع الكواشف والأجهزة في جدول المواد.
التحليل الإحصائي
أُجريت التحليلات الإحصائية باستخدام برنامج للحوسبة والتمثيل البياني الإحصائي. كما تم تصور شبكة التفاعل بين البروتينات باستخدام برنامج لتحليل الشبكات. وبناءً على تقييم التوزيع الطبيعي، استُخدم اختبار t لـ Student للمتغيرات المستمرة ذات التوزيع الطبيعي، واختبار Mann-Whitney U للمتغيرات التي لا تتبع التوزيع الطبيعي.
الوصول مقيد. يرجى تسجيل الدخول أو بدء فترة تجريبية لعرض هذا المحتوى.
النتائج
تحديد الجين المرشح والتحليل الوظيفي
تم الكشف عن إجمالي 4,915 من الجينات ذات التعبير التفاضلي (DEGs)، بما في ذلك 2,485 جينًا منخفض التعبير و2,430 جينًا مرتفع التعبير (الشكل 1A). وصنف تحليل تجميع الوحدات الوظيفية هذه الجينات إلى ست وحدات تعبير (C1-C6)، حيث أظهرت الوحدات C1 وC2 وC3 وC5 تعبيرًا أعلى نسبيًا في عينات الورم (الشكل 1B). وأشار التوصيف الوظيفي إلى أن هذه الوحدات مرتبطة بعمليات بيولوجية، تشمل تنظيم الحلقة التقلص...
الوصول مقيد. يرجى تسجيل الدخول أو بدء فترة تجريبية لعرض هذا المحتوى.
المناقشة
يُعد سرطان الرئة الغدي (LUAD) من بين الأشكال الرائدة لسرطان الرئة، ولا يزال يمثل عبئاً كبيراً على الصحة العامة21. وتُعتبر الموت الخلوي الميتوزي (MC) عملية مرتبطة بموت الخلايا قد تساهم في التخلص من الخلايا التي تعاني من تشوهات انقسامية شديدة وكبح تطور الورم22. لذلك، فإن استكشاف الدور المحتمل للجينات المرتبطة بالموت الخلوي الميتوزي (MCRGs) في سرطان الرئة الغدي (LUAD) قد يساعد في تحديد المؤشرات الحيوية الإنذارية وتحسين فهم بيولوجيا هذا المرض. حللت الدراسة الصلة الإنذارية والأه...
الوصول مقيد. يرجى تسجيل الدخول أو بدء فترة تجريبية لعرض هذا المحتوى.
الإفصاحات
يقر المؤلفون بعدم وجود تضارب في المصالح.
المواد
| الاسم | الشركة | رقم فهرسي | التعليقات |
|---|---|---|---|
| ClusterGVis | CRAN | الإصدار 0.1.2 | تجميع وتصوير التعبير الجيني |
| Cytoscape | Cytoscape Consortium | الإصدار 3.9.1 | تصوير شبكات تفاعل البروتينات RRID:SCR_0030302 |
| CFX384 Real-Time Quantitative Fluorescent PCR System | Bio-Rad | CFX384 Touch | كاشف qPCR |
| DMD-primer | Tsingke | غير متاح | أمامي: 5’-GCTCAACCATCGATTTGCAGCC-3’ عكسي: 5’-TTCAGCCTCCAGTGGTTCAAGC-3’ |
| FKBP4-primer | Tsingke | غير متاح | أمامي: 5’-TGACTCCAGTCTGGATCGCAAG-3’ عكسي: 5’-CTGGTTTGCAGGTGATGTGGCA-3’ |
| GEO | NCBI | أداة عبر الإنترنت | الحصول على مجموعة بيانات التحقق الخارجية لـ LUAD RRID:SCR_005012 |
| GAPDH-primer | Tsingke | غير متاح | أمامي: 5’-GTCTCCTCTGACTTCAACAGCG-3’ عكسي: 5’-ACCACCCTGTTGCTGTAGCCAA-3’ |
| glmnet | CRAN | الإصدار 4.1-8 | اختيار الميزات في انحدار LASSO RRID:SCR_015505 |
| LDHA-primer | Tsingke | غير متاح | أمامي: 5’-GGATCTCCAACATGGCAGCCTT-3’ عكسي: 5’-AGACGGCTTTCTCCCTCTTGCT-3’ |
| limma | Bioconductor | الإصدار 3.60.6 | فحص DEG RRID:SCR_010943 |
| maftools | Bioconductor | الإصدار 2.20.0 | تصوير بيانات الطفرات الجسدية RRID:SCR_024519 |
| pRRophetic | CRAN | 0.5 | التنبؤ بقيم IC50 للعقاقير RRID:SCR_024417 |
| PDGFB-primer | Tsingke | غير متاح | أمامي: 5’-GAGATGCTGAGTGACCACTCGA-3’ عكسي: 5’-GTCATGTTCAGGTCCAACTCGG-3’ |
| qPCR SYBR Green Master Mix | Vazyme | Q111-02 | كاشف qPCR |
| R software | R Foundation | الإصدار 4.2.2 | التحليل المعلوماتي الحيوي |
| regplot | CRAN | الإصدار 1.1 | إنشاء المخططات الخطية |
| survival | CRAN | الإصدار 3.8-3 | تحليل البقاء وانحدار Cox RRID:SCR_021137 |
| STRING | STRING Consortium | أداة عبر الإنترنت | تحليل شبكة تفاعل البروتينات RRID:SCR_005223 |
| S100B-primer | Tsingke | غير متاح | أمامي: 5’-GAAGAAATCCGAACTGAAGGAGC-3’ عكسي: 5’-TCCTGGAAGTCACATTCGCCGT-3’ |
| survminer | CRAN | الإصدار 0.5.0 | رسم وتحسين منحنيات البقاء RRID:SCR_021094 |
| TRIzol | Tiangen | DP424 | كاشف qPCR |
| TCGA | NCI | أداة عبر الإنترنت | الحصول على بيانات النسخ والبيانات السريرية لـ LUAD RRID:SCR_003193 |
| ZEB2-primer | Tsingke | غير متاح | أمامي: 5’-AATGCACAGAGTGTGGCAAGGC-3’ عكسي: 5’-CTGCTGATGTGCGAACTGTAGG-3’ |
المراجع
- Asada K, et al. Multi-omics and clustering analyses reveal the mechanisms underlying unmet needs for patients with lung adenocarcinoma and identify potential therapeutic targets. Mol Cancer. 2024;23(1):182.
- Sun Q, et al. Prediction of lung adenocarcinoma prognosis and diagnosis with a novel model anchored in circadian clock-related genes. Sci Rep. 2024;14(1):18202.
- Ho KH, et al. Cancer Essential Genes Stratified Lung Adenocarcinoma Patients with Distinct Survival Outcomes and Identified a Subgroup from the Terminal Respiratory Unit Type with Different Proliferative Signatures in Multiple Cohorts. Cancers (Basel). 2021;13(9):2128.
- Zhang J, et al. Unraveling the Expression Patterns of Immune Checkpoints Identifies New Subtypes and Emerging Therapeutic Indicators in Lung Adenocarcinoma. Oxid Med Cell Longev. 2022;2022:3583985.
- Zheng T, et al. The pathological significance and potential mechanism of ARHGEF6 in lung adenocarcinoma. Comput Biol Med. 2023;158:106894.
- Yu Y, et al. Predicting potential therapeutic targets and small molecule drugs for early-stage lung adenocarcinoma. Biomed Pharmacother. 2024;174:116528.
- Guo Q, et al. Heterogeneous mutation pattern in tumor tissue and circulating tumor DNA warrants parallel NGS panel testing. Mol Cancer. 2018;17(1):131.
- Wang S, et al. Development and validation of a mitotic catastrophe-related genes prognostic model for breast cancer. PeerJ. 2024;12:e18075.
- Mao Z, et al. Mitotic catastrophe heterogeneity: implications for prognosis and immunotherapy in hepatocellular carcinoma. Front Immunol. 2024;15:1409448.
- Zhang QY, et al. Multiple Regulatory Mechanisms of Post-Translational Modifications and Therapeutic Potential of Mitotic Catastrophe. Int J Mol Sci. 2026;27(8):3370..
- Minemoto Y, et al. Loss of p53 induces M-phase retardation following G2 DNA damage checkpoint abrogation. Arch Biochem Biophys. 2003;412(1):13-9.
- Liu Y, et al. Developing a prognosis and chemotherapy evaluating model for colon adenocarcinoma based on mitotic catastrophe-related genes. Sci Rep. 2024;14(1):1655.
- Ritchie ME, et al. limma powers differential expression analyses for RNA-sequencing and microarray studies. Nucleic Acids Res. 2015;43(7):e47.
- Szklarczyk D, et al. The STRING database in 2023: protein-protein association networks and functional enrichment analyses for any sequenced genome of interest. Nucleic Acids Res. 2023;51(D1):D638-d46.
- Lei J, et al. Clinicopathological characteristics of pheochromocytoma/paraganglioma and screening of prognostic markers. J Surg Oncol. 2023;128(4):510-8.
- Thorsson V, et al. The Immune Landscape of Cancer. Immunity. 2018;48(4):812-30.e14.
- Guo Y, et al. Novel immune checkpoint-related gene model to predict prognosis and treatment responsiveness in low-grade gliomas. Heliyon. 2023;9(9):e20178.
- Sun X, et al. A transcriptomic-based model associated with PARP inhibitor sensitivity and immunogenic signatures in ovarian cancer. Discover Oncology. 2026;843.
- Wang L, et al. Identification of an ac4C modification related gene signature for predicting prognosis in laryngeal squamous cell carcinoma patients based on single-cell analysis and machine learning. 2026.
- Lin W, et al. Screening of Molecular Markers of Cisplatin Resistance in Lung Adenocarcinoma and Functional Verification Based on TCGA Database. Cancer Research on Prevention and Treatment. 2024;49(6):569-74.
- Gao W, et al. Promising therapeutic efficacy and safety of a novel integrin α6-targeting peptide-drug conjugate in lung adenocarcinoma. Molecular Cancer 2025;24(1):190.
- Vitale I, et al. Mitotic catastrophe: a mechanism for avoiding genomic instability. Nat Rev Mol Cell Biol. 2011;12(6):385-92.
- Liu M, et al. CDK1-mediated phosphorylation of LDHA fuels mitosis through LDHB-dependent lactate oxidation. EMBO Reports 2025;26(20):4923-4949.
- Zhang W, et al. Inhibition of LDHA suppresses cell proliferation and increases mitochondrial apoptosis via the JNK signaling pathway in cervical cancer cells. Oncology reports 2022;47(4).
- Mangé A, et al. FKBP4 connects mTORC2 and PI3K to activate the PDK1/Akt-dependent cell proliferation signaling in breast cancer. Theranostics. 2019;9(23):7003-7015.
- Meng W, et al. FKBP4 Accelerates Malignant Progression of Non-Small-Cell Lung Cancer by Activating the Akt/mTOR Signaling Pathway. Analytical cellular pathology (Amsterdam) 2020;2020:6021602.
- Xiu-Ying H, et al. PDGFBB facilitates tumorigenesis and malignancy of lung adenocarcinoma associated with PI3K-AKT/MAPK signaling. Sci Rep. 2024;14(1):4191.
- Sharma D, Singh M, Rani R. Role of LDH in tumor glycolysis: Regulation of LDHA by small molecules for cancer therapeutics. Semin Cancer Biol. 2022;87:184-95.
- Zhang P, et al. An Epithelial-Mesenchymal Transition-Based Prognostic Model for Survival Prediction in Lung Adenocarcinoma: COL5A2 and ZEB2. Current gene therapy 2026.
- Xu X, et al. Proteomic landscape of lung adenocarcinoma precancerous lesions reveals mitochondrial dsRNA-associated immune and stress responses. American journal of cancer research 2025;15(9):3888-3903.
- Li P, et al. Peripheral blood mononuclear cell DNA methylation biomarkers for prognostic stratification in Chinese lung adenocarcinoma: a genome-wide epigenetic profiling study. Clinical Epigenetics 2025;17(1):177.
- Chaudhary S, et al. Dissecting the MUC5AC/ANXA2 signaling axis: implications for brain metastasis in lung adenocarcinoma. Exp Mol Med. 2024;56(6):1450-60.
- Kondrup M, Nygaard AD, Madsen JS, Bechmann T. S100B as a biomarker for brain metastases in patients with non-small cell lung cancer. Biomed Rep. 2020;12(4):204-8.
- Jones L, Naidoo M, Machado LR, Anthony K. The Duchenne muscular dystrophy gene and cancer. Cell Oncol (Dordr). 2021;44(1):19-32.
- Peng G, Yan J, Shi P, Li H. LINC01140 Hinders the Development of Breast Cancer Through Targeting miR-200b-3p to Downregulate DMD. Cell Transplant. 2023;32:9636897231211202.
- Alnassar N, et al. Downregulation of Dystrophin Expression Occurs across Diverse Tumors, Correlates with the Age of Onset, Staging and Reduced Survival of Patients. Cancers (Basel). 2023;15(5):1378.
- Luce LN, Abbate M, Cotignola J, Giliberto F. Non-myogenic tumors display altered expression of dystrophin (DMD) and a high frequency of genetic alterations. Oncotarget. 2017;8(1):145-55.
- Hu Z, et al. IL6-STAT3-C/EBPβ-IL6 positive feedback loop in tumor-associated macrophages promotes the EMT and metastasis of lung adenocarcinoma. J Exp Clin Cancer Res. 2024;43(1):63.
- Ugel S, Canè S, De Sanctis F, Bronte V. Monocytes in the Tumor Microenvironment. Annu Rev Pathol. 2021;16:93-122.
الوصول مقيد. يرجى تسجيل الدخول أو بدء فترة تجريبية لعرض هذا المحتوى.
إعادة الطباعة والأذونات
تم نشر هذه المقالة
الفيديو قريباً