تقدم هذه الدراسة إطار عمل خفيف الوزن للحد من الهلوسات في النماذج اللغوية الكبيرة من خلال التحقق على مستوى الادعاء وعتبة إحصائية تكيفية. ومن خلال التصحيح الانتقائي للادعاءات غير المدعومة باستخدام استدلال اللغة الطبيعية، يعمل هذا النهج على تحسين الدقة الواقعية مع الحفاظ على زمن استجابة منخفض وكفاءة عملية في النشر.
يتطلب اشتراك JoVE لعرض هذا المحتوى. تسجيل الدخول أو ابدأ نسخة تجريبية مجانية
مقالة بحثية
التحقق التكيفي من الادعاءات الموجه بالاستدلال اللغوي الطبيعي مع نمذجة القرار الإحصائي للحد من الهلوسة ذات الكمون المنخفض في النماذج اللغوية الكبيرة
في هذه المقالة
ملخص
الملخص
تُظهر النماذج اللغوية الكبيرة (LLMs) ميلاً حرجاً لتوليد مخرجات غير صحيحة واقعياً ولكنها بليغة لغوياً - وهي ظاهرة تُعرف باسم الهلوسة (hallucination) - مما يشكل مخاطر جسيمة في التطبيقات التي تتطلب دقة عالية. إن استراتيجيات التخفيف الحالية، بما في ذلك التوليد المعزز بالاسترجاع (retrieval-augmented generation) وأخذ عينات الاتساق الذاتي (self-consistency sampling)، تؤدي إما إلى زيادة كبيرة في زمن استجابة الاستدلال أو تعتمد على بنية تحتية خارجية للمعرفة، مما يحد من قابليتها للتطبيق في عمليات النشر في الوقت الفعلي. تقترح هذه الورقة إطار عمل خفيف الوزن للتحقق من الادعاءات يتكون من خطوتين، حيث يقوم بتفكيك استجابات النماذج اللغوية الكبيرة إلى ادعاءات واقعية ذرية، ثم يتحقق بشكل مستقل من كل ادعاء مستخرج مقابل مرجع يتم توليده بشكل منفصل من خلال مطالبة استدعاء واقعية معزولة. وبالرغم من أن المولد والمحقق يتشاركان في نفس النموذج اللغوي الأساسي، إلا أن فصل توليد الاستجابة عن الاستدعاء الواقعي يقلل من التكييف المباشر للاستجابة ويخفف من انحياز التأكيد أثناء عملية التحقق، وذلك باستخدام الاستدلال اللغوي الطبيعي (Natural Language Inference)، مع تطبيق عتبة إحصائية تكيفية - مُعرفة بأنها τ = µ + kσ عبر توزيع درجات الثقة في الاستدلال اللغوي الطبيعي (NLI) - لتصحيح الادعاءات المتناقضة فقط بشكل انتقائي. وعلى عكس الطرق السابقة القائمة على الاستدلال اللغوي الطبيعي والتي تعتمد على حدود قرار ثابتة، فإن إطار العمل المقترح يكيف عتبة التحقق ديناميكياً وفقاً لتوزيع الثقة لكل استجابة، مما يظهر أداءً ثابتاً عبر المعايير المرجعية التي تم تقييمها دون الحاجة إلى إعادة تدريب النموذج. وبتقييمه على TruthfulQA و FEVER، خفّض إطار العمل معدل الهلوسة من 28% إلى 9% في TruthfulQA - وهو انخفاض نسبي قدره 67.9% - مع إضافة 160 ms فقط من زمن الاستجابة الإضافي مقارنة بالنموذج اللغوي الكبير الأساسي، متفوقاً بذلك على SelfCheckGPT و FActScore في دقة اكتشاف الهلوسة. وتشير هذه النتائج إلى أن إطار العمل يمكن أن يوفر توازناً ملائماً بين الموثوقية الواقعية وزمن استجابة الرد في المعايير المرجعية التي تم تقييمها، بينما لا تزال هناك حاجة إلى مزيد من التحقق عبر مجالات وإعدادات نشر مختلفة.
المقدمة
برزت النماذج اللغوية الكبيرة (LLMs) كمكونات أساسية في أنظمة الذكاء الاصطناعي الحديثة، حيث أظهرت قدرات ملحوظة عبر مجموعة واسعة من مهام اللغة الطبيعية، بما في ذلك توليد النصوص، والإجابة على الأسئلة، والتلخيص، والاستدلال المعقد1. وقد أدت قدرتها على إنتاج استجابات طليقة ومتماسكة سياقياً إلى تسريع اعتمادها في المجالات ذات التأثير العالي مثل دعم القرار السريري، والتحليل القانوني، وهندسة البرمجيات، والتكنولوجيا التعليمية2. ومع ذلك، ثمة قصور حاسم ومستمر يقوض موثوقيتها في هذه البيئات، وهو "الهلوسة" (hallucination)، حيث تولد النماذج استجابات طليقة لغوياً ولكنها غير صحيحة واقعياً، أو غير مدعومة بأدلة، أو مفبركة بالكامل 3. وتشير الدراسات التجريبية إلى أن معدلات الهلوسة تتراوح بين 15% وأكثر من 40% اعتماداً على المهمة والنموذج، مع ظهور تناقضات واقعية ملموسة حتى في الأنظمة الأكثر تطوراً مثل GPT-4 عند تقييمها في مجالات تخصصية2,3. ويفرض هذا القصور مخاطر جسيمة في التطبيقات التي تتطلب دقة فائقة، حيث يمكن أن تؤدي المخرجات الخاطئة إلى تضليل المعلومات، أو التشخيص الخاطئ، أو اتخاذ قرارات معيبة4. تنشأ الهلوسات بشكل أساسي من الطبيعة الاحتمالية لنمذجة اللغة؛ إذ تولد النماذج اللغوية الكبيرة الرموز (tokens) عن طريق التنبؤ بالتكملات المرجحة إحصائياً لتسلسلات المدخلات بدلاً من استرجاع المعرفة الواقعية الموثقة أو الاستدلال من خلالها5. ونتيجة لذلك، قد تتضمن المخرجات المولدة ادعاءات تبدو مقنعة ولكنها غير دقيقة، أو تدرج تأكيدات غير مدعومة، أو تخلط بين مفاهيم مرتبطة دلالياً ولكنها متميزة واقعياً6.
تعالج استراتيجيات التخفيف الحالية هذه المشكلة من خلال عدة نماذج، ولكل منها قيود ملحوظة. حيث يعمل التوليد المعزز بالاسترداد (RAG) على تقليل الهلوسة من خلال ربط الاستجابات بمستندات مستردة خارجيًا، ولكنه يتسبب في زيادة كبيرة في زمن الاستجابة، ويتطلب الوصول إلى قواعد معرفية يتم تحديثها باستمرار، ويظل عرضة لفشل الاسترداد في المجالات المتخصصة أو ذات الموارد المحدودة7,8,9.
على الرغم من أن مولد الاستجابة ومولد المراجع يتم إنشاؤهما باستخدام نموذج GPT-3.5 Turbo الأساسي نفسه، إلا أنهما يعملان وفق أهداف تحفيزية وسياقات تنفيذ مختلفة. حيث يقوم مولد الاستجابة بإنتاج إجابة غير مقيدة على استعلام المستخدم، بينما يقوم مولد المراجع بمهمة استرجاع حقائق معزولة دون الوصول إلى الاستجابة التي تم إنشاؤها مسبقاً. ويقلل هذا الفصل من تأثيرات تكييف الاستجابة المباشرة ويحد من انحياز التأكيد أثناء التحقق من الادعاءات. وبناءً على ذلك، يتعامل الإطار مع المرجع الذي تم إنشاؤه على أنه مستقل إجرائياً وليس مستقلاً إحصائياً.
استكشفت الأبحاث الحديثة أيضًا استراتيجيات فك تشفير خفيفة الوزن لتقليل الهلوسة في توليد النصوص دون الاعتماد على الاسترجاع الخارجي أو التحقق المتكرر. ومن النهج الممثلة في هذا الصدد "فك التشفير عن طريق تباين الطبقات" (DoLA)، والذي يحسن الواقعية من خلال مباينة التمثيلات من طبقات المحول (transformer) المتوسطة والنهائية أثناء عملية فك التشفير. وبخلاف أطر التحقق ما بعد التوليد، تتدخل هذه الأساليب مباشرة أثناء توليد الرموز (tokens)، وبالتالي فإنها تحسن مرحلة مختلفة من عملية توليد اللغة. وتظهر هذه الاستراتيجيات التكاملية أن التخفيف من الهلوسة يمكن تحقيقه إما أثناء فك التشفير أو من خلال التحقق ما بعد التوليد، حيث يقدم كل نهج مقايضات متميزة من حيث العبء الحسابي، وتعقيد التنفيذ، والموثوقية الواقعية.
تعمل طرق الاتساق الذاتي على تحسين الموثوقية الواقعية من خلال أخذ عينات من استجابات متعددة واختيار المخرج الأكثر تكراراً أو تماسكاً، ومع ذلك، فإن تكلفتها الحسابية تزداد خطياً مع عدد العينات، مما يجعلها غير مناسبة لعمليات النشر الحساسة لوقت الاستجابة8. أما نهج التحسين التكراري، الذي يقوم بمراجعة المخرجات بشكل متكرر من خلال حلقات التغذية الراجعة الذاتية، فيقلل معدلات الخطأ تدريجياً ولكنه يطيل وقت الاستنتاج بشكل كبير مع كل تمريرة إضافية9. وتقدم طرق التحقق القائمة على الاستلزام الطبيعي للغة (NLI) بديلاً أكثر استهدافاً من خلال تقييم الاستلزام الدلالي بين الادعاءات المولدة والنصوص المرجعية، إلا أن التنفيذات الحالية تعتمد على عتبات قرار ثابتة تفشل في التكيف عبر توزيعات الثقة المختلفة، أو المجالات، أو سلوكيات النماذج10,11. وبشكل جماعي، فإن هذه النهج إما تفرض عبئاً حسابياً غير مقبول، أو تعتمد على بنية تحتية خارجية، أو تفتقر إلى القدرة على التكيف المطلوبة للنشر العام. تتوفر مقارنة للخصائص الرئيسية لنهج التحقق من الهلوسة هذه في الجدول التكميلي 1.
تقترح هذه الورقة إطار عمل خفيف الوزن للتحقق من الادعاءات يتكون من خطوتين، صُمم لتقليل الهلوسة في مخرجات النماذج اللغوية الكبيرة (LLM) مع الحفاظ على زمن استجابة منخفض. في الخطوة الأولى، يقوم النموذج اللغوي الكبير بتوليد استجابة أولية، يتم بعد ذلك تفكيكها إلى ادعاءات واقعية ذرية. وفي الخطوة الثانية، يتم التحقق من كل ادعاء باستخدام الاستدلال اللغوي الطبيعي (NLI) مقابل مرجع واقعي تم توليده بشكل منفصل من خلال عملية استدلال معزولة لا تصل إلى الاستجابة المولدة الأصلية، ويتحكم عتبة ثقة مستمدة إحصائياً في قرار القبول أو التصحيح على مستوى الادعاء. وتتمثل المساهمات الرئيسية لهذا العمل فيما يلي: (1) خط معالجة للتحقق على مستوى الادعاء يتكون من خطوتين يفصل بين توليد الاستجابة والتحقق الواقعي، مما يتيح تقييماً مستقلاً ومستهدفاً لكل ادعاء ذري دون الحاجة إلى استرجاع خارجي أو إعادة توليد الاستجابة بالكامل؛ (2) آلية تكيفية لوضع العتبات الإحصائية تعتمد على توزيع درجات الثقة في الاستدلال اللغوي الطبيعي (τ = µ + kσ)، والتي تحدد ديناميكياً حدود القبول والتصحيح بدلاً من الاعتماد على قواعد قرار ثابتة، مما يحسن المتانة عبر توزيعات الثقة المتغيرة؛ (3) استراتيجية تصحيح انتقائية تقصر إعادة التوليد على الادعاءات المصنفة على أنها متناقضة فقط، مما يقلل بشكل كبير من الأعباء الحسابية مقارنةً بنهج إعادة أخذ العينات للاستجابة الكاملة أو طرق التحسين التكرارية؛ (4) تقييم تجريبي على معيار قياسي يركز على الهلوسة يوضح أن إطار العمل المقترح يقلل معدلات الهلوسة من 28% إلى 9% مع الحفاظ على زمن استجابة ضمن حدود النشر العملي.
الوصول مقيد. يرجى تسجيل الدخول أو بدء فترة تجريبية لعرض هذا المحتوى.
البروتوكول
لم تتضمن هذه الدراسة مشاركين بشريين، أو حيوانات، أو عينات بيولوجية، أو بيانات مرضى. وبناءً على ذلك، لم تكن هناك حاجة للحصول على موافقة أخلاقية مؤسسية أو موافقة مستنيرة.
نظرة عامة على تصميم الدراسة
تم تنفيذ إطار عمل للتحقق من مرحلتين لتحسين الموثوقية الواقعية لمخرجات النماذج اللغوية الكبيرة (LLM). تضمنت الإجراءات توليد الاستجابة، واستخراج الادعاءات، وبناء مراجع معزولة، والتحقق القائم على الاستدلال باللغة الطبيعية (NLI)، واتخاذ القرار الإحصائي التكيفي، والتصحيح الانتقائي، وتجميع الاستجابة النهائية. وتم تقييم إطار العمل باستخدام مجموعات بيانات TruthfulQA وFEVER المرجعية.
سير العمل العام
استعلام المستخدم ← توليد الاستجابة الأولية ← استخراج الادعاءات ← توليد مراجع مستقلة ← التحقق عبر الاستدلال الطبيعي للغة (NLI) ← حساب العتبة الإحصائية ← تصحيح الادعاءات ← الاستجابة النهائية المتحقق منها. يوضح الشكل 1 سير العمل العام لإطار التحقق التكيفي من الادعاءات.
تحضير مجموعة البيانات
تم تنزيل مجموعة بيانات TruthfulQA12، التي تحتوي على 817 سؤالاً موجهاً نحو الحقائق، وتجهيزها للتقييم. تتكون مجموعة بيانات FEVER13 من 185,445 ادعاءً مشروحاً ومصنفاً إلى "مدعوم" (Supported)، أو "مفند" (Refuted)، أو "معلومات غير كافية" (Not Enough Information)؛ وقد استخدم التقييم بيانات التطوير المصنفة مع حقول الادعاء، والأدلة، وتسمية الحقيقة الأرضية (ground-truth label). تم تقييم كل ادعاء بناءً على الأدلة المقدمة له، بينما تم الاحتفاظ بتسمية FEVER الأصلية كـنتيجة مرجعية للتحقق. تم الحصول على مجموعة بيانات FEVER، التي تحتوي على أزواج من الادعاءات والأدلة للتحقق من الحقائق، ومعالجتها أولياً. كما تم تحويل الأسئلة والادعاءات المدخلة إلى تنسيق نصي موحد، وحُذفت المدخلات المكررة والعينات غير المكتملة قبل إجراء التجارب. قُسمت مجموعة TruthfulQA إلى مجموعات فرعية للتحقق والاختبار؛ حيث استُخدم ما يقرب من 20% من عينات TruthfulQA (164 سؤالاً) لضبط العتبة (threshold tuning)، بينما خُصصت الأسئلة الـ 653 المتبقية لتقييم الأداء. وبالنسبة لـ FEVER، استُخدمت الادعاءات المقدمة في المقياس المرجعي مباشرة كوحدات تحقق، ولم تخضع لإجراءات توليد الاستجابة واستخراج الادعاءات المطبقة على TruthfulQA. وتلخص Table 1 خصائص مجموعات البيانات المرجعية المستخدمة في تطوير الإطار وتقييمه.
توليد الاستجابة الأولية
تم إرسال كل استعلام إلى نموذج اللغة الأساسي. وتم توليد الاستجابات باستخدام أخذ العينات النووي (nucleus sampling) بدرجة حرارة 0.7 وقيمة top-p تبلغ 0.9. كما تم تحديد الحد الأقصى لطول المخرج بـ 256 توكن. وخُزنت الاستجابات المولدة دون أي معالجة لاحقة أو تعديل يدوي، ثم حُوّل النص المولد مباشرة إلى مرحلة استخراج الادعاءات.
استخراج الادعاءات
تم تفكيك كل استجابة تم إنشاؤها إلى عبارات واقعية يمكن التحقق منها بشكل مستقل. واستُخدم موجه تفكيك مهيكل لتحديد الادعاءات الذرية. كما فُصلت العبارات المركبة إلى وحدات واقعية دنيا. وتمت إزالة الآراء الشخصية، والتعبيرات الأسلوبية، والحشوات الحوارية. وخُزّن كل ادعاء مستخلص كوحدة تحقق مستقلة.
مثال:
الاستجابة الأصلية:
"كانت ماري كوري عالمة فيزياء وكيمياء ولدت في بولندا، وأجرت أبحاثاً رائدة في مجال النشاط الإشعاعي."
الادعاءات المستخلصة: (1) ولدت ماري كوري في بولندا؛ (2) كانت ماري كوري عالمة في الفيزياء والكيمياء؛ (3) أجرت ماري كوري أبحاثاً حول النشاط الإشعاعي.
بناء المرجع المعزول:
تم إنشاء مرجع حقيقي مستقل لكل ادعاء مستخلص. وتلقى نموذج التحقق استعلام المستخدم الأصلي فقط، حيث تم تقييد الوصول إلى الاستجابة الأصلية التي تم إنشاؤها لتجنب انحياز التأكيد. كما استُخدم أمر استرجاع حقائقي لتشجيع تقديم استجابات موجزة ومستندة إلى الأدلة. وتم تخزين المراجع التي تم إنشاؤها لغرض التحقق اللاحق.
التحقق من الاستدلال باللغة الطبيعية
تم إرسال كل زوج من (الادعاء-المرجع) إلى نموذج استدلال لغوي طبيعي (NLI) مُدرب مسبقاً. قام نموذج NLI بتصنيف العلاقة إلى: استلزام (Entailment)، أو حياد (Neutral)، أو تناقض (Contradiction). وتم تسجيل احتمالات الثقة لجميع الفئات الثلاث. كما تم تعيين درجة تحقق موقعة: قيمة موجبة للاستلزام، وصفر للحياد، أو قيمة سالبة للتناقض. جُمعت كافة درجات التحقق لحساب العتبة.
حساب العتبة الإحصائية التكيفية
تختلف درجة الثقة في التحقق التي ينتجها نموذج NLI بشكل كبير عبر الاستجابات، وذلك لأن الاستعلامات المختلفة تولد أعداداً متفاوتة من الادعاءات، ومستويات متباينة من التعقيد الدلالي، وتوزيعات مختلفة للثقة. يفترض استخدام عتبة عالمية ثابتة أن جميع الاستجابات تتبع ملف ثقة مماثلاً، وهو أمر نادراً ما يُلاحظ في الممارسة العملية. وللتكيف مع هذا التباين، يقوم الإطار المقترح بتقدير حدود القرار بشكل فردي لكل استجابة باستخدام المتوسط والانحراف المعياري لدرجات التحقق الخاصة بها. يعكس المتوسط مستوى الثقة العام للاستجابة، بينما يحدد الانحراف المعياري تشتت قيم الثقة بين الادعاءات المستخرجة. وتسمح هذه الصيغة التكيفية لمعيار القبول بأن يتوافق مع حالة عدم اليقين الخاصة بكل استجابة بدلاً من الاعتماد على عتبة واحدة لجميع المدخلات.
تم حساب المتوسط (µ) والانحراف المعياري (σ) لجميع درجات التحقق الموقعة.
تم حساب عتبة القرار التكيفية كما يلي:

حيث تمثل τ العتبة التكيفية، ويرمز µ إلى متوسط درجة التحقق، بينما يرمز σ إلى الانحراف المعياري، وتمثل k معامل الحساسية.
تم تعيين القيمة الأولية لمعامل الحساسية عند 0.7. وقد تم قبول الادعاءات المصنفة على أنها استتباع (Entailment) والتي حصلت على درجات أكبر من أو تساوي +τ. أما الادعاءات المصنفة على أنها تناقض (Contradiction) والتي حصلت على درجات أقل من أو تساوي −τ فقد تم تحديدها للتصحيح. بينما تم الإبقاء على الادعاءات التي وقعت درجاتها ضمن الفاصل الزمني (−τ, +τ) كادعاءات محايدة.
تصحيح انتقائي للمطالبات
تم إرسال الادعاء للتصحيح فقط عندما صنف نموذج NLI الزوج المكون من (الادعاء-المرجع) على أنه تناقض (Contradiction)، وكان سجل التحقق الموقع المقابل له يستوفي معيار العتبة التكيفية si ≤ -τ. وبذلك، تم تحديد قرار التصحيح بشكل مشترك من خلال تسمية فئة NLI والعتبة الإحصائية الخاصة بالاستجابة. أما الادعاءات التي صُنفت على أنها استلزام (Entailment) وكان si ≥ τ فقد تم قبولها، بينما عُوملت الادعاءات التي وقعت ضمن الفاصل -τ < si < τ على أنها محايدة وتم الإبقاء عليها دون تصحيح. وقد ضمن هذا المعيار المشترك تطبيق التصحيح فقط على الادعاءات التي تظهر تناقضاً دلالياً وأدلة تحقق سلبية قوية بما يكفي.
إعادة بناء الاستجابة
تم ترتيب الادعاءات المقبولة والمصححة وفقاً لتسلسلها الأصلي. كما تمت استعادة حدود الجمل للحفاظ على سهولة القراءة. وطُبقت تعديلات نحوية طفيفة عند الضرورة. وخُزنت المخرجات المجمعة كاستجابة نهائية تم التحقق منها.
تقييم الأداء
تم تقييم إطار العمل باستخدام أربعة مقاييس: (1) الدقة: نسبة الاستجابات التي ظلت صحيحة واقعياً بعد التحقق؛ (2) مقياس F1: المتوسط التوافقي لدقة واستدعاء الكشف عن الهلوسة؛ (3) زمن استجابة النظام: إجمالي وقت المعالجة من تقديم الاستعلام حتى توليد الاستجابة التي تم التحقق منها؛ (4) معدل الهلوسة
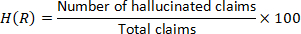
تم تسجيل زمن الاستجابة كمتوسط وقت التنفيذ عبر القياسات المكررة. ونظراً لعدم الاحتفاظ بقيم زمن الاستجابة الفردية لكل تشغيل، لم يتم حساب الانحرافات المعيارية وفترات الثقة.
تقييم الصحة الخاص بمرجع القياس
بالنسبة لـ TruthfulQA، تمت مقارنة الاستجابة النهائية المتحقق منها مع المراجع البشرية المعتمدة للإجابات في المقياس المرجعي وقوائم الإجابات غير الصحيحة. واعتُبرت الاستجابة صحيحة عندما كانت ادعاءاتها الواقعية متوافقة مع معلومات الإجابة المقبولة ولم تكن تحتوي على محتوى يتطابق مع أنماط الاستجابة غير الصحيحة المحددة. أما بالنسبة لـ FEVER، فقد تم تقييم كل ادعاء في المخرج النهائي مقابل الأدلة المرتبطة به وتوصيف FEVER الأصلي؛ حيث عُوملت الادعاءات المدعومة (Supported) على أنها متحقق منها واقعياً، بينما حُسبت الادعاءات المفندة (Refuted) على أنها غير صحيحة. أما الحالات التي تفتقر إلى معلومات كافية (Not Enough Information)، فقد تم الإبقاء عليها كحالات غير محددة بدلاً من معاملتها كأدلة واقعية إيجابية. ثم جُمعت القرارات الناتجة على مستوى الادعاءات عبر كل مقياس مرجعي لحساب الدقة (Accuracy) ومعدل الهلوسة (Hallucination Rate) المذكورين.
البيئة التجريبية
تم تنفيذ إطار العمل باستخدام لغة Python 3.9. وأُجريت عمليات معالجة البيانات باستخدام مكتبات التحليل العددي والجدولي. وعمل نموذج NLI في وضع الاستدلال دون إجراء أي ضبط دقيق إضافي. نُفذت التجارب على محطة عمل مجهزة بمعالج Intel Core i5، وذاكرة وصول عشوائي بسعة 16 GB، ونظام تشغيل 64-bit. وأُجريت جميع التقييمات باستخدام إعداد استدلال أحادي المرور لضمان التشغيل بـ زمن انتقال منخفض. كما نُفذت جميع التجارب باستخدام تكوينات مادية وبرمجية متطابقة لضمان اتساق التقييم عبر مجموعات البيانات وطرق الأساس.
النتيجة المتوقعة
صُمم هذا البروتوكول لإنشاء قرارات تحقق على مستوى الادعاء من خلال تحديد الادعاءات التي قد تكون غير مدعومة، وتوجيه الادعاءات المتناقضة بشدة بشكل انتقائي للتصحيح. والمخرجات المتوقعة هي استجابة مُحققة مع تقليل التناقضات الواقعية والحد من الأعباء الإضافية للمعالجة، وذلك رهناً بالأداء الملحوظ خلال التقييم التجريبي.
الوصول مقيد. يرجى تسجيل الدخول أو بدء فترة تجريبية لعرض هذا المحتوى.
النتائج
توليد الاستجابة الأولية
قام نموذج اللغة الأساسي بتوليد إجابات سلسة وذات صلة سياقية للأسئلة الواردة من كلتا مجموعتي بيانات القياس. ومع ذلك، كشف الفحص التفصيلي عن وجود تصريحات غير مدعومة وغير دقيقة واقعياً في العديد من الاستجابات. ففي مجموعة بيانات TruthfulQA، أظهر النظام الأساسي معدل هلوسة بلغ 28%، بينما لوحظ معدل هلوسة بنسبة 26% في مجموعة بيانات FEVER. وأكدت هذه النتائج أن توليد اللغة المباشر وحده لم يكن كافياً للتطبيقات التي تتطلب موثوقية واقعية عالية، كما حددت الحالة المرجعي...
الوصول مقيد. يرجى تسجيل الدخول أو بدء فترة تجريبية لعرض هذا المحتوى.
المناقشة
أدى الإطار المقترح إلى تحسين أداء التحقق من الحقائق مع تجنب أخذ العينات المتكرر والاسترجاع الخارجي. وفي اختبار TruthfulQA، انخفض معدل الهلوسة من 28% لنموذج LLM المرجعي إلى 9% باستخدام الإطار الكامل، بينما ارتفعت الدقة من 0.72 إلى 0.87. أما في اختبار FEVER، فقد انخفض معدل الهلوسة من 26% إلى 10%، مع زيادة الدقة من 0.74 إلى 0.89. ويجب تفسير هذه المقارنات ضمن الإعدادات التجريبية والتنفيذات المستخدمة في هذه الدراسة بدلاً من اعتبارها دليلاً على تفوق مطلق عبر جميع ظروف النشر. يقوم الإطار بإجراء عملية تحقق على مستوى الادعاء بعد ...
الوصول مقيد. يرجى تسجيل الدخول أو بدء فترة تجريبية لعرض هذا المحتوى.
الإفصاحات
ليس لدى المؤلفين أي تضارب في المصالح للإفصاح عنه.
شكر وتقدير
يود المؤلفون الإعراب عن خالص امتنانهم لمؤسستهم لتوفير البيئة الأكاديمية والموارد الحسابية اللازمة لإجراء هذا البحث. كما يقر المؤلفون بفضل مطوري ومسؤولي مجموعات بيانات القياس المرجعية المتاحة للعموم والمستخدمة في هذه الدراسة، والتي مكنت من إجراء تقييم شامل للإطار المقترح. ويمتد التقدير إلى الزملاء والمراجعين على ملاحظاتهم البناءة التي ساعدت في تحسين جودة ووضوح هذا العمل. كما يشكر المؤلفون مجتمع أبحاث المصادر المفتوحة لتوفير المكتبات البرمجية والأدوات التي سهلت إجراء التجارب وتحليل البيانات وتصور النتائج؛ حيث ساهمت جهودهم المستمرة بشكل كبير في دفع عجلة الأبحاث في مجال معالجة اللغات الطبيعية والذكاء الاصطناعي الموثوق. ويصرح المؤلفون بعدم تلقي أي دعم مالي خارجي أو تمويل لهذا البحث.
الوصول مقيد. يرجى تسجيل الدخول أو بدء فترة تجريبية لعرض هذا المحتوى.
المواد
| الاسم | الشركة | رقم فهرسي | التعليقات |
|---|---|---|---|
| مجموعة بيانات FEVER المرجعية | مهمة FEVER المشتركة (Thorne et al.) | https://fever.ai/dataset/fever.html | مجموعة بيانات للتحقق من الحقائق متاحة للعموم وتتكون من أزواج (ادعاء-دليل) مستخدمة لأغراض التقييم |
| GPT-3.5 Turbo (نموذج لغوي كبير B10+2:12:12 | OpenAI | معرف النموذج: gpt-3.5-turbo; https://developers.openai.com/api/docs/models/gpt-3.5-turbo | استُخدم كمولد للاستجابات ومولد مراجع مستقل، وتم الوصول إليه عبر واجهة برمجة تطبيقات OpenAI API |
| NumPy | مطورو NumPy (مفتوح المصدر) | https://numpy.org/ | مكتبة حسابات عددية استُخدمت لإجراء الحسابات الإحصائية، بما في ذلك المتوسط والانحراف المعياري لدرجات التحقق من الاستدلال اللغوي الطبيعي NLI |
| Openai (مكتبة عميل واجهة برمجة تطبيقات Python) | OpenAI | https://github.com/openai/openai-python | مكتبة عميل بلغة Python استُخدمت لإرسال المطالبات واسترداد الإكمالات من GPT-3.5 Turbo |
| pandas | فريق تطوير pandas (مفتوح المصدر) | https://pandas.pydata.org/ | مكتبة لتحليل البيانات الجدولية استُخدمت في المعالجة المسبقة لمجموعة البيانات ومعالجة النتائج |
| نموذج تصنيف الاستدلال اللغوي الطبيعي (NLI) مسبق التدريب | مركز نماذج Hugging Face (نموذج مبني على بنية DeBERTa-v3-large من Microsoft) | MoritzLaurer/DeBERTa-v3-large-mnli-fever-anli-ling-wanli | استُخدم في وضع الاستدلال، دون ضبط دقيق، لتصنيف كل زوج (ادعاء-مرجع) كاستلزام أو محايد أو تناقض |
| Python | مؤسسة برمجيات Python | الإصدار 3.9; https://www.python.org/downloads/release/python-390/ | لغة البرمجة الأساسية المستخدمة لتنفيذ إطار عمل التحقق |
| SciPy | مطورو SciPy (مفتوح المصدر) | https://scipy.org/ | مكتبة حوسبة علمية استُخدمت لدعم التحليل الإحصائي للنتائج التجريبية |
| Transformers (مكتبة Hugging Face Transformers) | Hugging Face | https://github.com/huggingface/transformers | مكتبة Python استُخدمت لتحميل وتشغيل نموذج NLI مسبق التدريب |
| مجموعة بيانات TruthfulQA المرجعية | أصدرها في الأصل Lin وHilton وEvans | https://github.com/sylinrl/TruthfulQA | مرجع متاح للعموم يضم 817 سؤالاً موجهاً نحو الحقائق استُخدم لضبط العتبة والتقييم |
| جهاز كمبيوتر محطة عمل | غير محدد في المخطوطة (يرجى تأكيد الشركة المصنعة/الطراز) | معالج Intel Core i5; ذاكرة وصول عشوائي 16 GB RAM; نظام تشغيل 64-bit | الأجهزة المستخدمة لتنفيذ جميع التجارب تحت تكوينات متطابقة |
| ملاحظة: تم فحص جميع الروابط المدرجة أعلاه والتأكد من أنها نشطة حتى تاريخ هذا الجدول. |
المراجع
- Dai Z, et al. Promptagator: Few-shot dense retrieval from 8 examples [conference presentation]. Presented at: The Eleventh International Conference on Learning Representations; 2022. [https://iclr.cc/virtual/2023/poster/10937]
- Achiam J, et al. GPT-4 technical report. arXiv. 2023;arXiv:2303.08774. [https://arxiv.org/abs/2303.08774]
- Ji Z, et al. Survey of hallucination in natural language generation. ACM Comput Surv. 2023;55(12):1-38.
- Bender EM, McMillan-Major A, Shmitchell S, Gebru T. On the dangers of stochastic parrots: Can language models be too big? [conference presentation]. Presented at: 2021 ACM Conference on Fairness, Accountability, and Transparency; 2021. [https://dl.acm.org/doi/10.1145/3442188.3445922]
- Devlin J, et al. BERT: Pre-training of deep bidirectional transformers for language understanding [conference presentation]. Presented at: 2019 Conference of the North American Chapter of the Association for Computational Linguistics: Human Language Technologies; 2019. [https://arxiv.org/abs/1810.04805]
- Maynez J, Narayan S, Bohnet B, McDonald R. On faithfulness and factuality in abstractive summarization [conference presentation]. Presented at: 58th Annual Meeting of the Association for Computational Linguistics; 2020. [https://arxiv.org/abs/2005.00661]
- Brown T, et al. Language models are few-shot learners. Adv Neural Inf Process Syst. 2020;33:1877-901.
- Guu K, et al. Retrieval augmented language model pre-training [conference presentation]. Presented at: International Conference on Machine Learning; 2020. [https://arxiv.org/abs/2002.08909]
- Izacard G, Grave E. Leveraging passage retrieval with generative models for open domain question answering [conference presentation]. Presented at: 16th Conference of the European Chapter of the Association for Computational Linguistics; 2021. [https://arxiv.org/abs/2007.01282]
- Bowman SR, Angeli G, Potts C, Manning CD. A large annotated corpus for learning natural language inference [conference presentation]. Presented at: 2015 Conference on Empirical Methods in Natural Language Processing; 2015. [https://arxiv.org/abs/1508.05326]
- Platt J. Probabilistic outputs for support vector machines and comparisons to regularized likelihood methods. Adv Large Margin Classif. 1999;10(3):61-74.
- Lin S, Hilton J, Evans O. Truthfulqa: Measuring how models mimic human falsehoods. InProceedings of the 60th annual meeting of the association for computational linguistics (volume 1: long papers) 2022 May (pp. 3214-3252).
- Thorne J, Vlachos A, Christodoulopoulos C, Mittal A. FEVER: A large-scale dataset for fact extraction and verification [conference presentation]. Presented at: 2018 Conference of the North American Chapter of the Association for Computational Linguistics: Human Language Technologies; 2018. [https://aclanthology.org/N18-1074/]
- Williams A, Nangia N, Bowman SR. A broad-coverage challenge corpus for sentence understanding through inference. arXiv. 2017;arXiv:1704.05426.
- Manakul P, Liusie A, Gales M. SelfCheckGPT: Zero-resource black-box hallucination detection for generative large language models [conference presentation]. Presented at: 2023 Conference on Empirical Methods in Natural Language Processing; 2023.
- Min S, et al. FActScore: Fine-grained atomic evaluation of factual precision in long-form text generation. arXiv. 2023;arXiv:2305.14251.
- Cohen J. Statistical power analysis for the behavioral sciences. Routledge; New York; 2013.
- Kadavath S, et al. Language models (mostly) know what they know. arXiv. 2022;arXiv:2207.05221.
- Hendrycks D, et al. Aligning AI with shared human values. arXiv. 2020;arXiv:2008.02275.
- Lewis P, et al. Retrieval-augmented generation for knowledge-intensive NLP tasks. Adv Neural Inf Process Syst. 2020;33:9459-74.
الوصول مقيد. يرجى تسجيل الدخول أو بدء فترة تجريبية لعرض هذا المحتوى.
إعادة الطباعة والأذونات
تم نشر هذه المقالة
الفيديو قريباً