تقدم هذه الورقة إطار عمل قائم على الشبكات العصبونية التلافيفية (CNN) القابلة للتفسير لتصنيف الآفات الجلدية، والذي يجمع بين الدقة التشخيصية العالية وقابلية تفسير النموذج. ويقوم هذا الإطار بتصنيف صور الآفات وتوليد تفسيرات مرئية لتنبؤاته. وتظهر النتائج أداءً قوياً وشفافية محسنة، مما يدعم عملية اتخاذ القرار السريري ويساعد أطباء الجلدية في الكشف المبكر عن الأمراض الجلدية.
مقالة بحثية
إطار عمل حاسوبي مساعد وقابل للتفسير لتصنيف آفات الجلد باستخدام التعلم العميق
في هذه المقالة
ملخص
الملخص
أثبت استخدام الشبكات العصبية التلافيفية العميقة لغرض تشخيص الأمراض الجلدية تحقيق مستويات دقة مماثلة لتلك التي حققها أطباء الجلد في دراسات مختلفة. ومع ذلك، لا تزال هناك العديد من التحديات القائمة، بما في ذلك ضعف الأداء وضعف التعميم في بعض الحالات، بالإضافة إلى انخفاض القابلية للتفسير المرتبط باستخدام نماذج الصندوق الأسود. ويخلق هذا عقبات رئيسية أمام التنفيذ العملي، حيث يتطلب الأمر قابلية للتفسير إلى جانب التشخيص الدقيق، مما يجعل من الضروري إيجاد حل. وللتغلب على الصعوبات المذكورة، تم تطوير إطار عمل للتعلم العميق القابل للتفسير لتصنيف الآفات الجلدية (EDLF-SLC) ضمن هذه الدراسة. يستخدم إطار العمل مناهج متنوعة في تعلم الآلة والذكاء الاصطناعي القابل للتفسير (XAI) لضمان تحسينات من حيث الدقة والقابلية للتفسير على ثلاث مراحل. في المرحلة الأولية، يتم دمج التمثيلات العميقة المستخرجة من بنى CNN متعددة ومسبقة التدريب للحفاظ على المعلومات التمييزية التكميلية التي تعلمتها بنى الشبكات المختلفة قبل التصنيف باستخدام SVM بنواة دالة الأساس الشعاعي. بعد ذلك، تُستخدم مصنفات آلة متجه الدعم (SVM) بنواة دالة الأساس الشعاعي لتصنيف الميزات التي تم الحصول عليها. وأخيرًا، يتم تفسير التنبؤات التي قدمها النموذج من خلال التفسيرات المحلية القابلة للتفسير والمستقلة عن النموذج (LIME). تظهر النتائج التجريبية أن EDLF-SLC حقق دقة بنسبة 88.0%، ودقة تحديد (precision) بنسبة 89.0%، واسترجاعاً (recall) بنسبة 87.0%، ومقياس F1 بنسبة 88.0%، مما يدل على أداء تنافسي مقارنة بالعديد من الطرق المبلغ عنها مؤخرًا في ظل الظروف التجريبية المأخوذة في الاعتبار في هذه الدراسة.
المقدمة
تعد الآفات الجلدية مصدر قلق كبير في مجالي الأمراض الجلدية وعلم الأورام لأنها تتراوح ما بين التشوهات الحميدة والسرطانات الخبيثة مثل الميلانوما، وهي الأخطر أنواع سرطان الجلد. في عام 2020، سجلت الميلانوما ما يقرب من 325,000 حالة جديدة وأكثر من 57,000 حالة وفاة في جميع أنحاء العالم1. ورغم أن التقدم في عمليات الفحص والعلاج قد أدى إلى تحسين نتائج المرضى، إلا أن التشخيص المتأخر ومحدودية الوصول إلى الرعاية الصحية لا يزالان يساهمان في ارتفاع معدلات الوفيات وسنوات العمر المفقودة، لا سيما بين الفئات العمرية الشابة2,3.
يعتمد التشخيص التقليدي بشكل أساسي على الفحص البصري والتنظير الجلدي، مما يجعل هذه العملية معتمدة على خبرة الأطباء وعرضة للذاتية، والتفاوت بين الفاحصين، وأخذ خزعات غير ضرورية، وإطالة أوقات الفحص4,5,6. ولمعالجة هذه المحدوديات، برز التعلم العميق، وخاصة الشبكات العصبية التلافيفية (CNNs)، كحل فعال للتصنيف الآلي للآفات الجلدية. وقد أظهرت النماذج القائمة على CNN، بما في ذلك DDCNN-F7 وYOLOv7-XAI8 وعدة بنيات أخرى9,10,11,12,13، دقة تشخيصية عالية من خلال التعلم التلقائي لميزات الصور التمييزية. وعلى الرغم من نجاحها، فإن معظم نماذج التعلم العميق تعمل كـ "صناديق سوداء"، مما يحد من ثقة الأطباء ويعيق اعتمادها في الممارسة الطبية الروتينية. ولذلك، تم تقديم تقنيات الذكاء الاصطناعي القابل للتفسير لتحسين شفافية النماذج من خلال توفير تفسيرات بصرية للتنبؤات. ومن بين هذه الطرق، تقوم طريقة التفسيرات المحلية القابلة للتفسير والمستقلة عن النموذج (LIME) بتوليد تفسيرات محلية قابلة للتفسير من خلال تحديد مناطق الصورة الأكثر تأثيراً على قرارات النموذج14.
تطورت عملية تصنيف الآفات الجلدية من التقييم السريري التقليدي إلى أنظمة تشخيصية متقدمة تعتمد على الذكاء الاصطناعي، مدفوعةً بالحاجة إلى الكشف الدقيق والموثوق والمبكر عن سرطان الجلد. وقد تقدم هذا التطور عبر خمس مراحل رئيسية هي: طرق التشخيص التقليدية، والتشخيص بمساعدة الحاسوب (CAD)، وتعلم الآلة (ML)، والتعلم العميق (DL)، ومؤخراً الذكاء الاصطناعي القابل للتفسير (XAI) والتعلم الاتحادي (FL)، مما يعكس الجهود المستمرة لتحسين دقة التشخيص واتساقه وقابليته للتوسع والموثوقية السريرية، مع التغلب على قيود الفحص التقليدي. حاولت الأساليب الحوسبية المبكرة محاكاة الاستدلال السريري من خلال واصفات صور مصممة يدوياً مشتقة من قاعدة ABCD، والتي تشمل عدم التماثل (asymmetry)، وعدم انتظام الحدود (border irregularity)، وتغير اللون (color variation)، وقطر الآفة (lesion diameter). وقد دُمجت هذه الميزات مع الشبكات البايزية (Bayesian networks)، وأشجار القرار، والأنظمة الخبيرة، ونماذج الاستدلال الضبابي لدعم تشخيص الميلانوما، حيث أشارت عدة دراسات إلى دقة تصنيف تجاوزت 90%15,16,17. وعلى الرغم من توفير أساس هام للتشخيص بمساعدة الحاسوب، إلا أن هذه الطرق كانت تعتمد كلياً على ميزات هندسية يدوية وقواعد تشخيصية محددة مسبقاً، وبالتالي، أظهرت متانة محدودة تجاه التغيرات في جودة الصورة، وشكل الآفة، والإضاءة، وظروف الحصول على الصور.
ولمعالجة هذه القصور، ظهرت أنظمة التشخيص بمساعدة الحاسوب (CAD) التقليدية كخطوة وسيطة بين تحليل الصور التقليدي وأطر العمل الحديثة القائمة على الذكاء الاصطناعي. وقد جمعت أنظمة CAD بين استخراج الميزات اليدوي والمصنفات التقليدية لتحسين اتساق التشخيص والمساعدة في اتخاذ القرارات السريرية. كما دمجت عدة مناهج هجينة التجميع الهرمي مع الشبكات العصبية المتكررة وبنى الذاكرة طويلة قصيرة المدى (LSTM)، مما أدى إلى تحقيق دقة تصنيف تقترب من 99.5%18. ودمجت أطر عمل أخرى قائمة على أنظمة CAD مصنفات تعزيز التدرج (gradient boosting classifiers) مع تفسيرات قائمة على قيم SHAP، مما أظهر دقة تشخيصية تنافسية مع تحسين شفافية النموذج19. وعلى الرغم من أن هذه الأنظمة مثلت تحسناً كبيراً مقارنة بالمناهج القائمة على القواعد البحتة، إلا أنها ظلت تعتمد بشكل كبير على استخراج الميزات يدوياً، والمعالجة المسبقة المكثفة، ومجموعات البيانات المشروحة بدقة، ومسارات المعالجة متعددة المراحل.
ساهمت تقنيات تعلم الآلة في تطوير التصنيف الآلي للآفات الجلدية من خلال تمكين التعلم القائم على البيانات بدلاً من التصميم الصريح للقواعد. وقد أظهرت الأطر الهجينة التي تجمع بين الشبكات العصبية التلافيفية ومصنفات تعلم الآلة التقليدية، بما في ذلك الانحدار اللوجستي وخوارزمية k-nearest neighbors، أداءً قوياً في التصنيف على مجموعات البيانات المرجعية، حيث حققت دقة تجاوزت 95%9. كما أدى التعلم متعدد الوسائط ذاتي الإشراف إلى تحسين تمثيل السمات من خلال الاستغلال المشترك للصور الجلدية والصور السريرية، مما قلل من الاعتماد على التعليقات التوضيحية اليدوية المكثفة مع تحسين أداء التصنيف20. ودمجت دراسات إضافية الشبكات العصبية التلافيفية مع تحليل التمييز العام، وواصفات SURF، وخوارزميات التحسين لتعزيز تمييز السمات ودقة التصنيف21. كما ساهمت تقنيات اختيار السمات التلقائية التي تستخدم DenseNet-201 وInceptionV3 وخوارزميات تحسين الشجرة الثنائية في تحسين تمثيل السمات مع الحفاظ على أداء تشخيصي تنافسي22. وأظهرت نهج تعلم النقل التي تستخدم بنيات مدربة مسبقاً مثل AlexNet وGoogLeNet قدرة واعدة على التصنيف على الرغم من محدودية بيانات التدريب23. ومع ذلك، استمرت معظم طرق تعلم الآلة في الاعتماد على إجراءات معالجة مسبقة مصممة بعناية، واستراتيجيات تحسين يدوية، ومجموعات بيانات متوازنة، وضبط دقيق للمعلمات الفائقة. كما أدى محدودية التحقق الخارجي والحساسية تجاه عدم توازن الفئات إلى تقييد قابليتها للتطبيق العملي في البيئات السريرية المتنوعة.
لقد أحدث إدخال التعلم العميق (DL) تحولاً جذرياً في التصنيف الآلي للآفات الجلدية من خلال تمكين التعلم الشامل (end-to-end learning) مباشرة من بيانات الصور الخام. وقد ألغت الشبكات العصبونية الالتفافية (CNNs) الحاجة إلى هندسة الميزات اليدوية، مع تحسين الأداء التشخيصي بشكل كبير عبر مجموعات بيانات مرجعية متعددة. وأظهرت معظم النهج القائمة على CNN تحسينات ملحوظة في تصنيف الآفات من خلال بنيات هندسية تزداد تعقيداً. استكشفت نماذج CNN المدركة للتناظر خصائص الآفات ذات الدلالة السريرية، ولكنها حققت دقة متوازنة متوسطة فقط24. ودمجت نماذج أخرى بنيات EfficientNet مع تفسيرات LIME وSHAP لتحسين القابلية للتفسير مع تقديم مقاييس كمية للموثوقية25. كما حققت أنظمة التعلم العميق الهجينة التي تجمع بين تقسيم الآفات (lesion segmentation) والتعلم التجميعي (ensemble learning) والشبكات العصبونية الالتفافية أداءً ممتازاً في مجموعات بيانات ISIC المتعددة، إلا أنها ظلت حساسة لجودة التقسيم وعدم توازن الفئات26.
وفي الآونة الأخيرة، أدت البنى الهجينة الأكثر تطوراً إلى تحسين دقة التصنيف بشكل أكبر من خلال دمج تقنيات التعلم العميق (DL) التكاملية. حيث حققت الشبكات التنافسية التوليدية الشرطية مدمجة مع YOLOv5 وتحليل المكونات المستقلة دقة تصنيف تجاوزت 99%، رغم أن تعقيدها الحسابي حدّ من إمكانية نشرها عملياً 27. وبالمثل، تعلمت بنى LSTM–ResNet الهجينة التمثيلات المكانية والزمانية بفعالية، ولكنها تطلبت موارد حسابية أكبر بكثير28. كما استغلت النماذج القائمة على Transformer، بما في ذلك Sap-Former، المعلومات السياقية العالمية لتعزيز تمثيل الميزات، ولكنها تطلبت معالجة مسبقة مكثفة، ومجموعات بيانات مشروحة واسعة النطاق، وقوة حسابية كبيرة29. وحاولت البدائل خفيفة الوزن مثل S-MobileNet الموازنة بين الكفاءة الحسابية ودقة التشخيص30، بينما حسنت طرق تكييف النطاق غير الخاضعة للإشراف من التعميم عبر النطاقات رغم انخفاض فعاليتها عند توفر عينات تدريب محدودة فقط31. كما أظهرت الشبكات الهجينة المعززة بآليات الانتباه، والتي تدمج وحدات انتباه تلافيفية معدلة وتعلم تجميع اللقطات، أداءً واعداً في تصنيف الآفات الجلدية لجدري القرود، رغم بقاء التحديات المرتبطة بعدم توازن الفئات، وتنوع الصور، ومحدودية القابلية للتفسير دون حل 32. وأدت البنى المتبقية المخصصة التي تستخدم تصميمات شبكية أعمق ودوال خسارة هجينة إلى تحسين دقة التصنيف لما بعد 99%، ولكنها تسببت في عبء حسابي ووقت تدريب أكبر بكثير33. وخلصت دراسات المراجعة الشاملة باستمرار إلى أن التعلم العميق يتفوق بشكل كبير على النهج التقليدية المصممة يدوياً من خلال التعلم التلقائي لتمثيلات الصور التمييزية، مع تحديد التحديات المستمرة المرتبطة بالشوائب التصويرية، وتغير الإضاءة، والتعقيد الحسابي، ومحدودية التعميم السريري34.
على الرغم من أن التعلم العميق (DL) قد أدى إلى تحسين دقة التشخيص بشكل كبير، إلا أن المخاوف المتعلقة بشفافية النماذج، وتقدير عدم اليقين، والنشر السريري الموثوق قد حفزت اهتماماً متزايداً بالذكاء الاصطناعي القابل للتفسير (XAI) والتعلم الاتحادي. وقد بحثت دراسات عدة في تقنيات كميّة عدم اليقين، بما في ذلك التنبؤ المتوافق، وإسقاط مونت كارلو، والتعلم العميق الاستدلالي، مما أثبت أن التقدير الموثوق للثقة يمكن أن يحسن دعم اتخاذ القرار بشكل كبير رغم فرض قيود إضافية متعلقة بالحوسبة والبيانات35. كما تم اقتراح أطر عمل للتعلم المتبادل القائمة على المحولات (Transformer) لمعالجة عدم توازن الفئات مع تحسين كفاءة تعلم الميزات36. ودمجت مقاربات أخرى الشبكات العصبونية التلافيفية (CNNs) كاملة الدقة مع تقنيات تحسين قائمة على الرسوم البيانية لتحسين تقسيم الآفات وتصنيفها37، بينما حققت أطر التعلم العميق الهجينة التي تدمج تمثيلات ميزات تكميلية متعددة دقة تصنيف تقترب من 99.5% رغم تطلبها لمعالجة مسبقة مكثفة38.
ركزت الأبحاث الحديثة بشكل متزايد على دمج القابلية للتفسير مباشرة في أطر التعلم العميق (DL) لتعزيز ثقة الأطباء وتسهيل الاعتماد السريري العملي. وقد نجحت الأنظمة القابلة للتفسير التي تستخدم بنيات متعددة من الشبكات العصبية التلافيفية (CNN) جنبًا إلى جنب مع تقنيات Grad-CAM وScore-CAM في تحديد مواقع مناطق الآفات ذات الصلة التشخيصية، مع الحفاظ على أداء تصنيفي تنافسي في كل من مجموعات البيانات الداخلية والخارجية39. كما أدت أطر عمل CNN–Transformer الهجينة التي تدمج الصور التنظيرية الجلدية مع البيانات السريرية الوصفية إلى تحسين الأداء التنبؤي بشكل أكبر، مع استخدام SHAP وGrad-CAM لإنشاء تفسيرات بصرية ذات معنى سريري40. وبالإضافة إلى ذلك، تمكنت البنيات الهجينة الإضافية القائمة على المحولات (Transformer) والتي تدمج EfficientNetV2S وSwin Transformers وشبكات Xception المعدلة وآليات انتباه الرسوم البيانية من التقاط خصائص الآفات العالمية والمحلية المتكاملة بفعالية، رغم أن أعداد المعاملات الكبيرة والأداء المحدود في الفئات الأقلية قد قيدت من إمكانية النشر العملي41. وبالمثل، أظهرت أطر عمل YOLOv8–Vision Transformer الهجينة تحسنًا في تحديد موقع الآفات، والتصنيف متعدد الفئات، والقابلية للتفسير البصري من خلال التعزيز التكيفي جنبًا إلى جنب مع تفسيرات SHAP وGrad-CAM؛ ومع ذلك، ظلت هذه الطرق تعتمد بشكل أساسي على مجموعات البيانات المرجعية وأظهرت متانة محدودة بالنسبة لفئات الآفات الأقلية42. وقد لخصت العديد من المقالات المرجعية هذه التطورات، مؤكدة على كل من التقدم الملحوظ الذي حققته تقنيات التعلم العميق الحديثة والتحديات المستمرة المرتبطة بالكفاءة الحسابية، والقابلية للتفسير، والاعتماد على مجموعات البيانات، والتحقق السريري43,44,45. ويلخص الجدول 1 بعض الأعمال المنشورة حديثًا التي تستخدم خوارزميات التعلم العميق لتصنيف الآفات الجلدية.
على الرغم من التقدم الملحوظ الذي حققته أساليب التعلم العميق (DL) الحديثة في تصنيف الآفات الجلدية، إلا أن معظم النهج الحالية لا تزال مقيدة بالتعقيد الحسابي العالي، والاعتماد على مجموعات بيانات ضخمة وموسومة، ومحدودية قابلية تفسير النماذج، وعدم كفاية التحقق من الصحة عبر مختلف الإعدادات السريرية الواقعية. وللتغلب على هذه القيود، يقترح هذا البحث إطار عمل EDLF-SLC الذي يدمج الميزات التكميلية المستخرجة من بنيات متعددة للشبكات العصبونية التلافيفية (CNN) مع مصنف آلات المتجهات الداعمة (SVM) لتحقيق تصنيف قوي ودقيق. علاوة على ذلك، يستخدم إطار العمل معالجة مسبقة محسنة لتحسين جودة الصور ومعالجة عدم توازن الفئات، مع دمج تقنية LIME لتقديم تفسيرات مرئية للتنبؤات الفردية، مما يعزز شفافية النموذج والموثوقية السريرية.
تتمثل مساهمات هذه الدراسة في ثلاثة جوانب. أولاً، يقترح المؤلفون إطار عمل قوياً، EDLF-SLC، يدمج الشبكات العصبية التلافيفية (CNNs) المتقدمة مع مصنف آلة متجه الدعم (SVM) لتحقيق تصنيف دقيق وموثوق للآفات الجلدية. ثانياً، ينفذ المؤلفون تقنيات معالجة مسبقة محسنة لمعالجة خلل توازن الفئات وتقليل ضوضاء الصور، مما يؤدي إلى تحسين جودة الصور المدخلة والأداء العام لنموذج التصنيف. ثالثاً، يدمج المؤلفون طريقة التفسيرات المحلية القابلة للتفسير والمستقلة عن النموذج (LIME) لتصور وتفسير تنبؤات النموذج الفردية من خلال تسليط الضوء على مناطق الصور التي تؤثر بشكل أقوى على قرارات التصنيف، مما يعزز شفافية وقابلية تفسير إطار العمل المقترح.
البروتوكول
لم تتضمن هذه الدراسة استقطاب مشاركين بشريين أو جمع بيانات مرضى يمكن تحديد هويتهم. وقد أُجريت جميع التجارب باستخدام مجموعة بيانات ISIC 2020 للآفات الجلدية المتاحة للعموم والمستمدة من مستودع Kaggle؛ وبناءً على ذلك، لم تكن هناك حاجة للحصول على موافقة لجنة أخلاقيات المؤسسة أو موافقة مستنيرة. إن جميع المواد المستخدمة في هذه الدراسة موجودة في الـ جدول المواد.
استخراج الميزات ودمجها
تمت معالجة صور الآفات الجلدية باستخدام نماذج متعددة من الشبكات العصبية التلافيفية (CNN) مسبقة التدريب. وتُدمج متجهات الميزات العميقة المستخلصة من بنيات CNN المختارة لتكوين تمثيل ميزات موحد لكل صورة من صور الآفات الجلدية. تحافظ استراتيجية الدمج المعتمدة على المعلومات المرئية التكميلية التي تعلمتها بنيات CNN المختلفة، مما يسمح لمصنف SVM اللاحق باستغلال كل من خصائص الملمس منخفضة المستوى والتمثيلات الدلالية ذات المستوى الأعلى. وعلى الرغم من أن تقنيات تقليل الأبعاد، مثل تحليل المكونات الرئيسية أو اختيار الميزات القائم على المعلومات المتبادلة، قد تقلل من أبعاد الميزات، فقد تم الاحتفاظ بالتمثيل المدمج الكامل عمدًا لأن فضاء الميزات المدمج يظل قابلاً للمعالجة حاسوبيًا بالنسبة لمصنف RBF-SVM المستخدم، مع الحفاظ في الوقت ذاته على المعلومات التشخيصية التكميلية المستخلصة من الهياكل الأساسية غير المتجانسة لشبكات CNN.
التصنيف
استُخدمت متجهات الميزات المدمجة لتدريب مصنف SVM بنواة RBF. كما طُبقت تقنيات تحسين المعاملات الفائقة لتحديد إعدادات التصنيف المثلى. بعد ذلك، قام المصنف بتصنيف الآفات الجلدية إلى فئاتها الخاصة.
القابلية للتفسير
لتحسين القابلية للتفسير، تم تطبيق LIME لإنشاء تفسيرات مرئية تسلط الضوء على مناطق الصور التي تساهم بشكل أكبر في نتائج التصنيف. من شأن هذه التفسيرات أن تساعد الأطباء في فهم قرارات النموذج والتحقق من صحتها.
خطة التقييم
تم تقييم الإطار المقترح باستخدام مجموعة بيانات مرجعية لآفات الجلد. وقُيِّم الأداء باستخدام الدقة (Accuracy)، والضبط (Precision)، والاستدعاء (Recall)، ومقياس F1-Score. كما أُجريت تجارب مقارنة مع مناهج تعلم الآلة والتعلم العميق الحالية لإثبات فعالية الإطار المقترح.
النتائج المتوقعة
كان من المتوقع أن تنتج الدراسة نظاماً دقيقاً وقابلاً للتفسير لتصنيف الآفات الجلدية. وتشير النتائج التجريبية الأولية إلى أن نظام EDLF-SLC حقق دقة بلغت 88.0%، ودقة تحديد (precision) بلغت 89.0%، ومعدل استدعاء (recall) بلغ 87.0%، ومقياس F1-score بلغ 88.0%، متفوقاً بذلك على العديد من الطرق المنافسة. وكان من المتوقع أن يؤدي دمج تفسيرات LIME إلى تعزيز الموثوقية وتسهيل اعتماد أنظمة التشخيص المدعومة بالذكاء الاصطناعي في الممارسة السريرية.
الأهمية
يساهم هذا البحث في المجال المتنامي للذكاء الاصطناعي القابل للتفسير في الرعاية الصحية من خلال معالجة تحديات الأداء والشفافية في تشخيص الآفات الجلدية. يمتلك الإطار المقترح القدرة على دعم أطباء الجلد في اتخاذ قرارات تشخيصية أكثر موثوقية وقابلية للتفسير، مما يؤدي في النهاية إلى تحسين رعاية المرضى. علاوة على ذلك، قدم المؤلفون في هذا القسم معلومات تتعلق بالمواد والمنهجية التي تم تطبيقها في هذه الدراسة البحثية. وتحديداً، بدأ المؤلفون بوصف مجموعة البيانات المستخدمة في التجارب، ثم انتقلوا إلى مناقشة تفصيلية لإطار التعلم العميق القابل للتفسير لتصنيف الآفات الجلدية.
مجموعة البيانات
يعتمد العمل المقدم على مجموعة بيانات ISIC 2020 (التعاون الدولي لتصوير الجلد) المتاحة للعموم، والتي يمكن الوصول إليها عبر موقع Kaggle الإلكتروني (https://www.kaggle.com/datasets/fanconic/skin-cancer-malignant-vs-benign). وقد تم الاعتراف بمستودع ISIC كأحد أفضل الموارد في مجال التصوير الجلدي، حيث يوفر مجموعة متنوعة وكبيرة من الصور التنظيرية الجلدية لأنواع مختلفة من الآفات الجلدية، كما هو موضح في الشكل 1. والأهم من ذلك أن مجموعة البيانات تتضمن صوراً لحالات حميدة وخبيثة على حد سواء، مما يجعلها مفيدة لإجراء مهام التصنيف الثنائي لسرطان الجلد 46. تحتوي مجموعة البيانات الحالية على 3,297 صورة، منها 1,800 صورة حميدة و 1,497 صورة خبيثة. ولإجراء تجارب أكثر كفاءة، توجب تقسيم البيانات إلى مجموعة تدريب ومجموعة اختبار. وبشكل أدق، هناك 2,637 صورة تدريب، تشمل 1,440 حميدة و 1,197 خبيثة، بينما تتكون مجموعة الاختبار من 660 صورة، منها 360 حميدة و 300 خبيثة. ويظهر ملخص لمجموعة البيانات في الجدول 2.
نموذج EDLF-SLC المقترح
تم في هذه الورقة اقتراح حل فعال ومفهوم لتصنيف الآفات الجلدية إلى فئتين: حميدة وخبيثة، وذلك باستخدام تقنية تعلم عميق قابلة للتفسير ومبتكرة تعتمد على نهج هجين يجمع بين مزايا عدة نماذج لشبكات عصبية تلافيفية مدربة مسبقاً. وقد أثبتت الشبكات العصبية التلافيفية فاعلية عالية في استخلاص سمات دلالية رفيعة المستوى من الصور الطبية. وبالاستفادة من هذه القدرة، يستغل إطار التعلم العميق القابل للتفسير المقترح لتصنيف الآفات الجلدية (EDLF-SLC) نماذج CNN متعددة ومدربة مسبقاً لتحقيق أداء فائق. ولضمان الشفافية اللازمة في عملية اتخاذ القرار الطبي، تم اعتماد تقنية LIME في النهج المقترح لتوليد تفسيرات محلية مقروءة بشرياً لنتائج المخرجات. يمكن تقسيم الإطار الكامل إلى ثلاث مراحل رئيسية، كما هو موضح في الشكل 2، وهي: (1) المعالجة المسبقة للبيانات، (2) استخلاص السمات والتصنيف، و(3) القابلية للتفسير.
بنية النموذج والتكامل
كخطوة أولية، تم اختيار سبعة من نماذج التعلم العميق الشائعة (MobileNetV2 وResNet50 وEfficientNetB0 وXception وInceptionResNetV2 وNASNetLarge وMobileNet) وتقييمها بشكل منفصل على مجموعة بيانات التحقق، وقد تم اختيار النماذج الأربعة الأكثر فعالية (ResNet50 وEfficientNetB0 وMobileNet وXception) لمرحلة استخراج الميزات. في الإطار المقترح، تم تمرير كل صورة إدخال x بشكل مستقل عبر النماذج المختارة والمدرّبة مسبقاً. وتمت إزالة الطبقة الأخيرة كاملة الاتصال من كل نموذج من هذه النماذج، والحصول على متجهات الميزات من الطبقات السابقة. تشير fResNet50(x) وfEfficientNetB0(x) وfMobileNet(x) وfXception(x) إلى متجهات الميزات الناتجة من كل نموذج من النماذج المذكورة أعلاه. ومن خلال دمج متجهات الميزات هذه، يتم الحصول على متجه ميزات مجمّع جديد F(xi):
F(xi) = [f(ResNet50)(xi);f(EfficientNetB0)(xi);f(MobileNet)(xi);f(Xception)(xi)] (1)
بعد ذلك، يتم تمرير F(xi) عبر مصنف SVM بنواة دالة الأساس الشعاعي (RBF) للحصول على نتيجة التصنيف. تظهر الخوارزمية الكاملة لإطار العمل المقترح في الملف التكميلي 1.
يعتمد الإطار المقترح دمج الميزات المباشر على مستوى الميزة لأن كل بنية CNN مسبقة التدريب تلتقط خصائص تمييزية مختلفة للآفات الجلدية من خلال بنيتها الشبكية المتميزة وتسلسل الميزات المكتسب. وبناءً على ذلك، فإن دمج هذه التمثيلات المتباينة للميزات يحافظ على المعلومات المتكاملة التي تساهم في توصيف أكثر شمولاً للآفة قبل عملية التصنيف. وعلى الرغم من أن تقنيات تقليل الأبعاد، مثل تحليل المكونات الرئيسية (PCA) أو اختيار الميزات القائم على المعلومات المتبادلة، يمكن أن تقلل من أبعاد التمثيل المدمج، فقد تم الإبقاء على متجه الميزات المدمج كاملاً عن قصد لأن أبعاده تظل قابلة للمعالجة حسابياً بواسطة مصنف RBF-SVM المعتمد، مع الحفاظ في الوقت ذاته على المعلومات التشخيصية المتكاملة التي استخرجتها الشبكات الخلفية المختلفة لـ CNN. لذا، فإن هذا التصميم يعطي الأولوية للاحتفاظ بالتمثيلات العميقة المتكاملة بدلاً من استبعاد الميزات التي قد تكون غنية بالمعلومات قبل التصنيف.
تحضير البيانات
تضمن تحضير البيانات إجراء المعالجة المسبقة وتقسيم مجموعة البيانات إلى مجموعات تدريب واختبار. تهدف المعالجة المسبقة إلى تحسين جودة البيانات من خلال إزالة التناقضات، وحذف العناصر المكررة، وتنسيق الصور المدخلة، وإجراء قياس الميزات لضمان تدريب مستقر لنموذج جيد. وقد تم تطبيع جميع الصور لتصبح ضمن النطاق [−1, 1] عن طريق تطبيع Z-score:
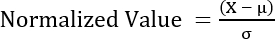 (2)
حيث يرمز µ و σ إلى القيمة المتوسطة والانحراف المعياري للصورة المقابلة، على التوالي. وقد تم تقسيم مجموعة البيانات إلى مجموعتين فرعيتين، وهما مجموعة تدريب (70.0%) ومجموعة اختبار (30.0%).
تعزيز البيانات
لتجنب الإفراط في التخصيص وزيادة قدرة النموذج على التعميم، تم استخدام بعض عمليات التعزيز لمجموعة التدريب. يتضمن تعزيز الصور تعديل الصور من أجل توسيع مجموعة البيانات اصطناعياً دون تغيير السمات الأساسية للحالات الطبية. وقد تم بناء مسار التعزيز باستخدام Keras Sequential API. تم استخدام تحويلات مثل القلْب الأفقي العشوائي، والتدوير ضمن زاوية صغيرة، وتغيير الحجم، وتغيير المقياس، وضبط السطوع/التباين، والتكبير، وبعض التحركات الطفيفة. وتظهر أمثلة تمثيلية للصور المعززة في الشكل 3.
النماذج مسبقة التدريب
تم اعتماد العديد من نماذج التعلم العميق مسبقة التدريب في الإطار المقترح لاستخراج الميزات من الصور المدخلة. وتشمل هذه النماذج MobileNet، وResNet50، وEfficientNetB0، وXception، وNASNetLarge، وInception-ResNet-v2، وMobileNetV2. يُعد MobileNet وMobileNetV2 نماذج تعلم عميق خفيفة الوزن لإجراء حسابات فعالة باستخدام الالتفافات القابلة للفصل بعمق (depth-wise separable convolutions). أما ResNet50 فيوظف آلية الاتصالات المتبقية (residual connections) لتدريب النموذج، وبذلك يتجنب مشكلة تلاشي التدرجات (vanishing gradients) أثناء التدريب. ويحقق EfficientNetB0 توازناً بين الكفاءة والدقة من خلال نهج القياس المركب (compound scaling). بينما يعمل Xception على توسيع شبكة Inception باستخدام الالتفافات القابلة للفصل بعمق. ويتضمن NASNetLarge استخدام البحث عن البنية العصبية (neural architecture search) لبناء هياكل مثالية للشبكات العصبية العميقة، في حين يدمج Inception-ResNet-v2 بين نموذج Inception وآلية الاتصالات المتبقية. يتم دمج متجهات الميزات المستخرجة من ResNet50 (1,024 ميزة)، وEfficientNetB0 (1,280 ميزة)، وMobileNet (1,024 ميزة)، وXception (2,048 ميزة) لإنتاج تمثيل موحد بأبعاد 5,376. وقد تم اختيار استراتيجية الدمج هذه للحفاظ على التمثيلات التكاملية التي تعلمتها بنيات CNN المختلفة بدلاً من تقليل التمثيل قبل عملية التصنيف. بعد ذلك، يتم تزويد متجه الميزات الناتج إلى مصنف RBF-SVM، الذي يحدد حدود القرار غير الخطية المثلى ضمن فضاء الميزات المدمج.
نموذج الذكاء الاصطناعي القابل للتفسير (LIME)
من أجل توفير قدر من القابلية للتفسير المحلي لتنبؤات النموذج، اعتمد المؤلفون طريقة لتوليد تفسيرات محلية مقروءة بشرياً لكل تنبؤ محدد للنموذج، وتُعرف باسم LIME47. بالنسبة لأي صورة مدخلة، يقوم LIME أولاً بتقسيمها إلى وحدات أصغر تسمى "البكسلات الفائقة" (superpixels). بعد ذلك، يتم توليد اضطرابات من الصورة الأصلية، وتُقدّر تنبؤات النموذج العصبي العميق لكل من هذه الاضطرابات. ثم يتم تطبيق نموذج خطي مرجح على الاضطرابات باستخدام أوزان تعتمد على مدى قربها من عينة المدخلات الأصلية. وبعد تطبيق النموذج الخطي، يتم تقدير درجات أهمية الميزات، مما يشير إلى دور كل بكسل فائق في التنبؤ بالتصنيف النهائي. وتظهر درجات الأهمية هذه بشكل بارز بصرياً في صورة التفسير النهائية. تظهر خوارزمية LIME في الملف التكميلي 2.
النتائج
يعتمد تقييم أداء إطار التصنيف المطور على مقاييس التقييم التقليدية المستمدة من مصفوفة الارتباك. تتيح مصفوفة الارتباك الحصول على فهم كامل لأداء المصنف من خلال تمثيل عدد التصنيفات الصحيحة والخاطئة التي تمت لكل فئة محددة. وبهذه الطريقة، يمكن تحليل جميع أنواع الأخطاء. على سبيل المثال، تكتسب كل من الإيجابيات الكاذبة والسلبيات الكاذبة أهمية خاصة في تشخيص الأمراض؛ فقد تشير القيم العالية للإيجابيات الكاذبة إلى حساسية عالية للمصنف، ولكن في الوقت ذاته، تشير الكميات الكبيرة من السلبيات الكاذبة إلى انخفاض حساسيته وتطرح مخاطر صحية محتملة. تم استخدام مقاييس الأداء التالية في هذا البحث، وهي: الدقة (Accuracy)، والضبط (Precision)، والاسترجاع (Recall)، ومقياس F1-score، والنوعية (Specificity)، ومعدل الإيجابيات الصحيحة (TPR)، ومعدل الإيجابيات الكاذبة (FPR). وترد صيغ هذه المقاييس أدناه:
الدقة=(TP+TN)/(TP+TN+FP+FN) (3)
الدقة = TP/(TP+FP) (4)
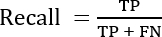 (5)
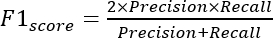 (6)
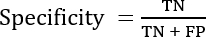 (7)
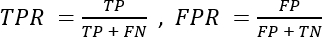 (8)
في هذه الحالة، تمثل TP عدد سرطانات الجلد الخبيثة التي اكتشفها إطار العمل، بينما تشير TN إلى عدد الآفات الحميدة. وفي المقابل، توضح FP عدد القرارات الخاطئة عندما يتم تصنيف الآفات على أنها خبيثة رغم كونها حميدة في الواقع. أما FN فتعكس عدد العينات الحميدة التي تم التعرف عليها بشكل خاطئ. وفيما يتعلق بتصنيف سرطان الجلد، فإن تقليل السلبيات الكاذبة (false negatives) أمر بالغ الأهمية نظرًا للآثار السلبية المحتملة الناتجة عن ذلك.
أداء النماذج المرجعية
أُجريت جميع التجارب الحسابية في بيئة Google Colab القائمة على السحابة. ومن الجدير بالذكر أن هذه المنصة تتيح تشغيل مثيلات من الأجهزة الافتراضية باستخدام نظام التشغيل Ubuntu 20.04 المحدد مسبقاً. ولتدريب النماذج المرجعية، استُخدم إصدار Python 3.9 وإطار عمل PyTorch إصدار 2.3.1. بالإضافة إلى ذلك، كانت جميع عقد الحوسبة ذات مواصفات متطابقة، وهي: وحدة معالجة مركزية Intel Xeon بتردد 2.2 GHz، ووحدة معالجة رسوميات NVIDIA Tesla T4، وذاكرة وصول عشوائي بسعة 16 GB، وسعة تخزين تبلغ 70 GB. وبذلك، سمح هذا الإعداد التجريبي بتقليل التباين الناتج عن اختلاف المنصات العتادية وزيادة موثوقية النتائج وقابلية تكرارها. ويمكن العثور على ملخص كامل للبيئة التجريبية في الجدول 3.
يوضح الشكل 4 منحنيات التعلم المقابلة لـ 100 حقبة تدريب لبنية ResNet-50. تم إجراء التدريب بناءً على مجموعة بيانات تحتوي على 2,110 صورة، بينما بلغ حجم مجموعة بيانات التحقق 660 صورة. وكما هو ملاحظ، فقد ارتفعت الدقة باستمرار أثناء التدريب لتصل إلى ما يقرب من 90.0%. وفي الوقت ذاته، لُوحظ تحسن في الدقة خلال أول 50 حقبة؛ وبعد هذه النقطة، أصبحت الدقة ثابتة تقريبًا، وهو ما يمكن اعتباره علامة على تقارب النموذج. وبالنسبة للتحقق، أظهر النموذج قيمة AUC تساوي 86.0%، مما يثبت امتلاكه خصائص تمييزية معقولة.
توضح مصفوفة الارتباك المعروضة في الشكل 5 أداء نموذج ResNet-50 من حيث دقة التصنيف في حالة مجموعة اختبار تحتوي على 660 صورة. وأثناء التقييم، تعرّف النموذج بشكل صحيح على 310 من أصل 360 عينة حميدة، و239 من أصل 300 عينة خبيثة. ومع ذلك، تم تصنيف عدد كبير نسبياً من العينات الخبيثة بشكل خاطئ، مما أدى إلى قيمة عالية نسبياً للسلبيات الكاذبة. ويجب النظر في هذه النتيجة بمزيد من التفصيل نظراً للتداعيات الخطيرة لهذا النوع من الأخطاء عند استخدام المصنف في الممارسة العملية. وبشكل إجمالي، حقق النموذج دقة بلغت 83.0%، مع دقة تحديد (precision) بنسبة 83.3%، ومعدل استدعاء (recall) بنسبة 83.3%، ودرجة F1-score بلغت 83.3%.
الجدول 4 يحتوي على وصف تفصيلي لخصائص أداء نموذج ResNet-50 بالنسبة لكلا الفئتين. أظهر المصنف سلوكاً متوازناً نسبياً من حيث الدقة (precision)، حيث بلغت قيمتها 83.0% للعينات الحميدة، بينما سجلت العينات الخبيثة دقة بلغت 84.0%. وبالمثل، وصلت قيم الاستدعاء (recall) إلى 88.0% للآفات الحميدة و78.0% للآفات الخبيثة. يمثل الدعم (Support) في الجدول عدد العينات المقابلة لكل فئة.
نموذج EDLF-SLC المقترح
توضح الشكل 6 المساحة تحت المنحنى (AUC) للتدريب والتحقق للنموذج المقترح على مدار 300 حقبة (epochs). يعكس مقياس AUC قدرة النموذج على التمييز بين الفئات الحميدة والخبيثة، حيث تشير القيم الأعلى إلى أداء تمييزي أفضل. وكما هو ملاحظ، تزداد قيمة AUC للتدريب بشكل مطرد طوال عملية التدريب، لتصل إلى قيمة قصوى تبلغ 1.00 عند الحقبة 200 تقريباً. كما تتحسن قيمة AUC للتحقق تدريجياً خلال مراحل التدريب الأولية؛ ومع ذلك، تبدأ في الثبات بعد حوالي 150 حقبة، مما يشير إلى تقارب النموذج. وتُظهر قيمة AUC النهائية للتحقق البالغة 0.95 قدرة قوية على التعميم وفصلاً فعالاً بين الفئات.
تُظهر مصفوفة الارتباك للنموذج المقترح، والموضحة في الشكل 7، أن النموذج قد صنف بشكل صحيح 299 عينة حميدة و272 عينة خبيثة، بينما أخطأ في تصنيف 28 حالة حميدة على أنها خبيثة و61 حالة خبيثة على أنها حميدة. وفي المجمل، حقق النموذج 571 تنبؤاً صحيحاً و89 تصنيفاً خاطئاً. والجدير بالذكر أن العدد المرتفع من السلبيات الكاذبة (الحالات الخبيثة التي صُنفت خطأً على أنها حميدة) يسلط الضوء على قصور حرج، حيث قد تترتب على مثل هذه الأخطاء تداعيات سريرية جسيمة. ومع ذلك، يظل أداء التصنيف العام قوياً. وبخلاف مناهج اختيار الميزات التي تعمل عمداً على إزالة الأبعاد قبل عملية التصنيف، يحافظ الإطار المقترح على التمثيل العميق المدمج الكامل الناتج عن بنيات CNN غير متجانسة ومتعددة. وقد تم اعتماد هذا التصميم لأن كل هيكل أساسي يستخلص خصائص تكميلية للآفة، كما أن الاحتفاظ بالتمثيل الكامل يتيح لمصنف SVM استغلال المعلومات التمييزية المدمجة دون استبعاد ميزات قد تكون غنية بالمعلومات. وبناءً على ذلك، تعطي استراتيجية دمج الميزات المعتمدة الأولوية لتعلم التمثيل التكميلي مع الحفاظ على الجدوى الحسابية.
يقدم الشكل 8 أمثلة نموذجية لنتائج التصنيف التي أنتجها النموذج المقترح. وتظهر النتائج أن النموذج يمنح درجات ثقة عالية للحالات المصنفة بشكل صحيح. وبالتحديد، تظهر الحالات الحميدة احتمالات تنبؤ عالية (على سبيل المثال، 99.84% و 99.85%)، بينما تظهر الحالات الخبيثة أيضًا مستويات ثقة قوية (على سبيل المثال، 99.98% و 99.96%). وتشير هذه النتائج إلى أن النموذج يمكنه التمييز بفعالية بين الآفات الحميدة والخبيثة، حتى في السيناريوهات الصعبة بصريًا. ولتعزيز القابلية للتفسير، تم استخدام إطار عمل LIME لتوليد تفسيرات موضعية لتنبؤات النموذج، كما هو موضح في الشكل 9A–D. يقوم LIME بتقريب حدود القرار المعقدة للنموذج باستخدام نموذج خطي قابل للتفسير محليًا. وبالنسبة لكل صورة مدخلة، تقوم هذه الطريقة بتوليد عينات مضطربة عن طريق حجب البكسلات الفائقة (superpixels) بشكل انتقائي وتقييم التنبؤات المقابلة. ثم يتم ملاءمة نموذج خطي مرجح لهذه العينات، حيث يتم تحديد الأوزان بناءً على القرب من المدخلات الأصلية باستخدام نواة دالة الأساس الشعاعي. وتمثل المعاملات الناتجة مساهمة كل بكسل فائق في التنبؤ النهائي وتُعرف على أنها:
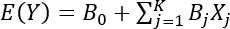 (9)
حيث يمثل Xj ∈ {0, 1} وجود أو غياب السوبر بكسل (superpixel) رقم j، ويمثل Bj وزن المساهمة المقابل، بينما يمثل B0 التنبؤ المرجعي. تشير المعاملات الموجبة (Bj > 0) إلى المناطق التي تساهم في تصنيف الحالة كخبيثة، بينما تقابل المعاملات السالبة (Bj < 0) السمات الحميدة. وتبرز التصورات القائمة على LIME، الموضحة في الشكل 9B, D، أكثر المناطق تأثيرًا والتي تساهم في كل قرار تصنيف. فبالنسبة للآفات الحميدة، يركز النموذج على المناطق التي تتميز بتصبغ موحد وحدود واضحة المعالم. وفي المقابل، بالنسبة للحالات الخبيثة، تقابل المناطق المظللة سمات ذات أهمية سريرية مثل الحدود غير المنتظمة، وعدم تجانس اللون، والأنسجة غير النمطية. وتعكس كثافة المناطق المظللة مقدار المعاملات Bj المقابلة لها.
توضح هذه النتائج أن نموذج EDLF-SLC يركز على سمات ذات دلالة سريرية تتماشى مع المعايير الجلدية المعتمدة، مثل قاعدة ABCD. ويعزز هذا التوافق من قابلية تفسير النموذج وموثوقيته، مما يجعله أكثر ملاءمة لدعم اتخاذ القرارات السريرية. علاوة على ذلك، يعرض الشكل 10 نتائج التصور المقارنة التي تم الحصول عليها باستخدام تقنيات إضافية للتفسير، بما في ذلك Grad-CAM وHiResCAM وGradCAM++ وXGradCAM وLayerCAM وEigenGradCAM وEigenCAM، مما يؤكد بشكل أكبر اتساق المناطق البارزة المحددة عبر الطرق المختلفة. وفيما يتعلق بأداء نموذج EDLF-SLC المقترح وسبعة نماذج أساسية بعد التدريب لمدة 100 epoch، يمكن الاطلاع على مقارنة في الجدول 5. حقق نموذج EDLF-SLC أداءً تنافسياً بلغ 0.88 في كل مقياس تم تقييمه مقارنة بالبنى الأساسية التي تم تقييمها بناءً على السياق التجريبي. كما حقق نموذجا EfficientNetB0 وResNet50 نتائج جيدة أيضاً، بدقة بلغت 0.85 و0.83 على التوالي. وفي المقابل، سجل نموذج Inception-ResNetV2 أسوأ أداء تصنيفي بين النماذج التي تم تقييمها. ومن ناحية أخرى، وبالرغم من انخفاض دقة التصنيف نسبياً، إلا أن كفاءته الحسابية ظلت قابلة للمقارنة مع النماذج الأساسية. وقد أظهر نموذج EDLF-SLC المقترح أداءً تنافسياً بالنسبة للنماذج الأساسية التي تم تقييمها في ظل الظروف التجريبية المعتمدة.
لتقييم أداء الإطار المقترح مقارنة بالنهج الحالية، يعرض الجدول 6 مقارنة مع طرق ممثلة لأحدث التقنيات في تصنيف الآفات الجلدية. على سبيل المثال، سجلت الدراسة47 دقة بلغت 0.86، بينما استخدمت الدراسة48 نموذجًا قائمًا على التعلم التجميعي حقق دقة مماثلة ولكن بدقة (precision) واستدعاء (recall) ومقياس F1-score أقل. وأفادت الدراسات الحديثة القائمة على التعلم التجميعي وبنيات CNN المتعددة25,49 عن دقة تصل إلى 0.87. وفي ظل الظروف التجريبية المعتمدة، حقق إطار EDLF-SLC المقترح دقة بلغت 0.88 باستخدام بنية موحدة قابلة للتفسير دون الحاجة إلى مكونات إضافية مثل نماذج تقسيم الآفات.
توفر البيانات
البيانات التي تدعم نتائج هذه الدراسة متاحة بشكل مفتوح في Kaggle على الرابط https://www.kaggle.com/datasets/fanconic/skin-cancer-malignant-vs-benign.
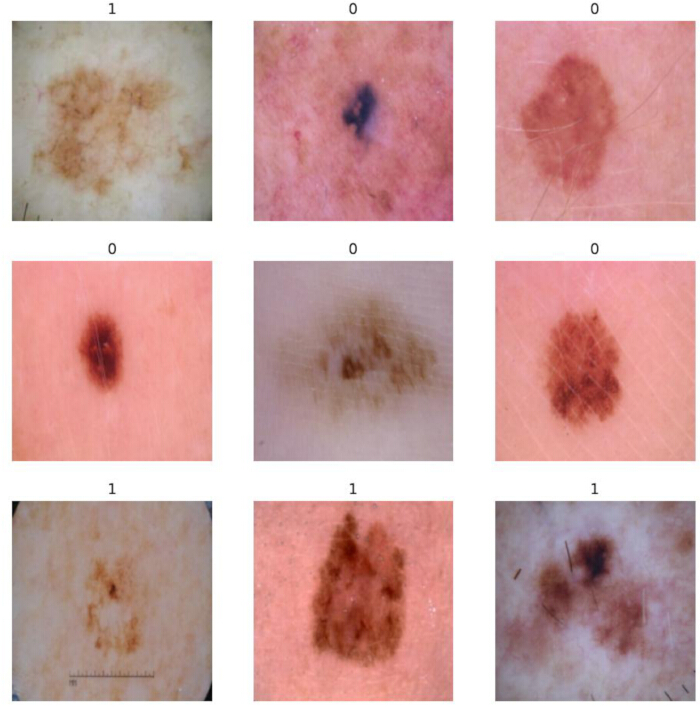
الشكل 1: صور تمثيلية بالتنظير الجلدي من مجموعة بيانات ISIC توضح الفئتين التشخيصيتين المستخدمتين في هذه الدراسة. تم تصنيف العينات إلى حميدة (0) وخبيثة (1)، مما يبرز التباين في شكل الآفة ولونها وملمسها عبر مجموعة البيانات. يرجى النقر هنا لعرض نسخة أكبر من هذا الشكل.
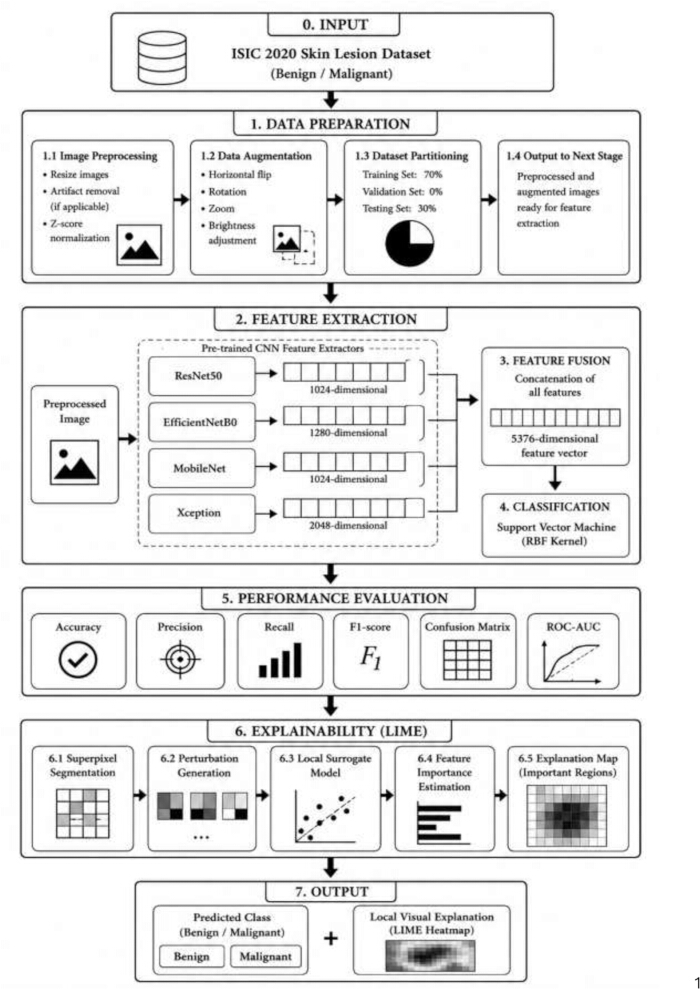
الشكل 2: سير العمل الكامل لإطار عمل EDLF-SLC المقترح. يبدأ البروتوكول بالحصول على صور ISIC 2020، يليه المعالجة المسبقة، وتعزيز البيانات، وتقسيم مجموعة البيانات، واستخراج الميزات العميقة باستخدام أربع بنيات CNN مُدربة مسبقاً، ودمج الميزات، وتصنيف SVM، وتقييم الأداء، وتوليد التفسيرات القائمة على LIME. يرجى النقر هنا لعرض نسخة أكبر من هذا الشكل.
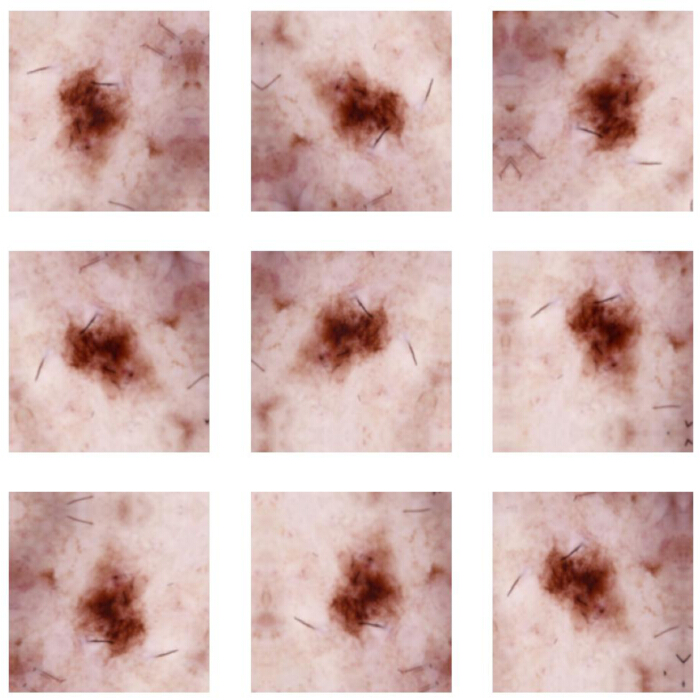
الشكل 3: أمثلة لصور آفات جلدية معززة تم توليدها باستخدام تقنيات تعزيز البيانات. ويشمل ذلك القلب الأفقي والرأسي، والتدوير، وتغيير المقياس، وتعديل السطوع. تعمل هذه التحويلات على زيادة تنوع مجموعة البيانات، وتحسين متانة النموذج، وتقليل مخاطر فرط التخصيص أثناء التدريب. يرجى النقر هنا لعرض نسخة أكبر من هذا الشكل.
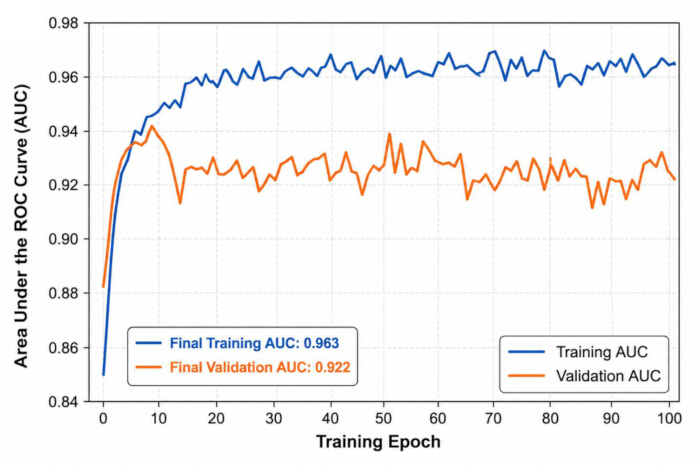
الشكل 4: المساحة تحت منحنى خصائص تشغيل المستقبل (ROC-AUC) للتدريب والتحقق لنموذج ResNet-50 على مدار 100 حقبة تدريبية. يمثل المنحنى الأزرق AUC التدريب، بينما يمثل المنحنى البرتقالي AUC التحقق. وتظهر المنحنيات تقارباً سريعاً خلال حقب التدريب الأولية، يليه تحسين مستقر مع أداء تحقق مرتفع باستمرار، مما يشير إلى تعلم فعال وتعميم مرضٍ على مجموعة بيانات التحقق. يرجى النقر هنا لعرض نسخة أكبر من هذا الشكل.
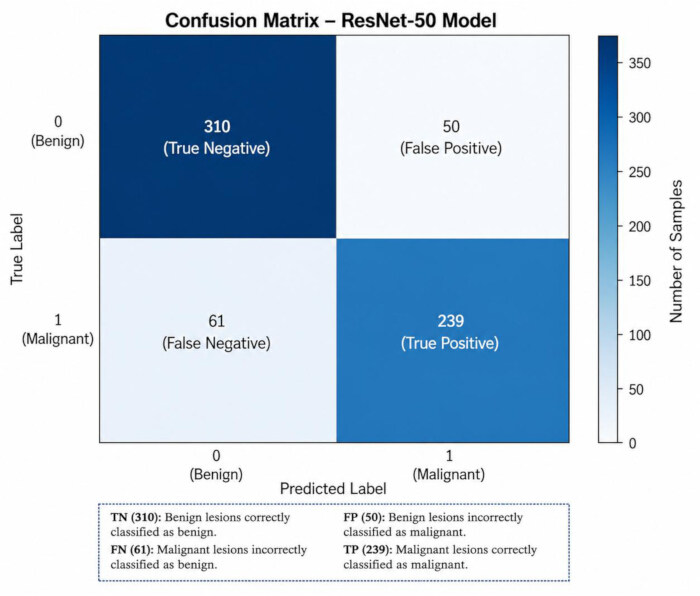
الشكل 5: مصفوفة الارتباك لنموذج ResNet-50 على مجموعة بيانات الاختبار. تمثل الصفوف تسميات الفئات الحقيقية (0 = حميدة، 1 = خبيثة)، بينما تمثل الأعمدة تسميات الفئات المتوقعة. تشير العناصر القطرية إلى العينات المصنفة بشكل صحيح (310 حميدة و239 خبيثة)، بينما تمثل العناصر خارج القطر العينات المصنفة بشكل خاطئ، بما في ذلك 50 حالة إيجابية كاذبة و61 حالة سلبية كاذبة. يرجى النقر هنا لعرض نسخة أكبر من هذا الشكل.
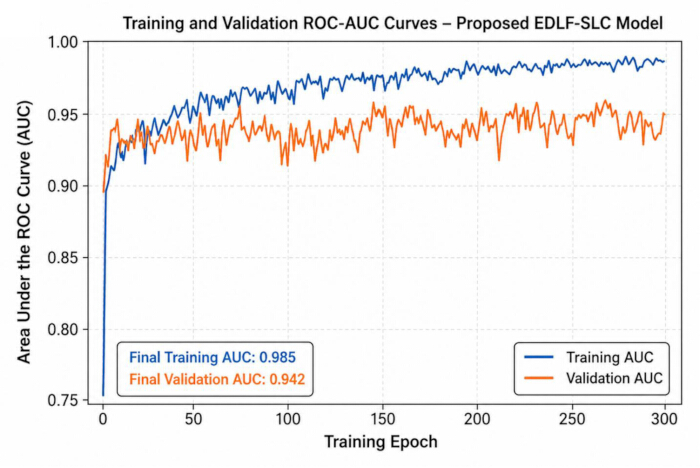
الشكل 6: المساحة تحت منحنى خصائص تشغيل المستقبل (ROC-AUC) للتدريب والتحقق لنموذج EDLF-SLC المقترح على مدار 300 حقبة تدريبية. يمثل المنحنى الأزرق قيمة AUC للتدريب، بينما يمثل المنحنى البرتقالي قيمة AUC للتحقق. يظهر النموذج تقارباً سريعاً خلال حقب التدريب الأولية، يليه تحسين مستقر مع قيم AUC عالية وثابتة للتدريب والتحقق طوال الحقب المتبقية. ويدل استقرار أداء التحقق على قدرة تعميم جيدة وسلوك تعلم مستقر لإطار عمل EDLF-SLC المقترح على مجموعة بيانات التحقق. يرجى النقر هنا لعرض نسخة أكبر من هذا الشكل.
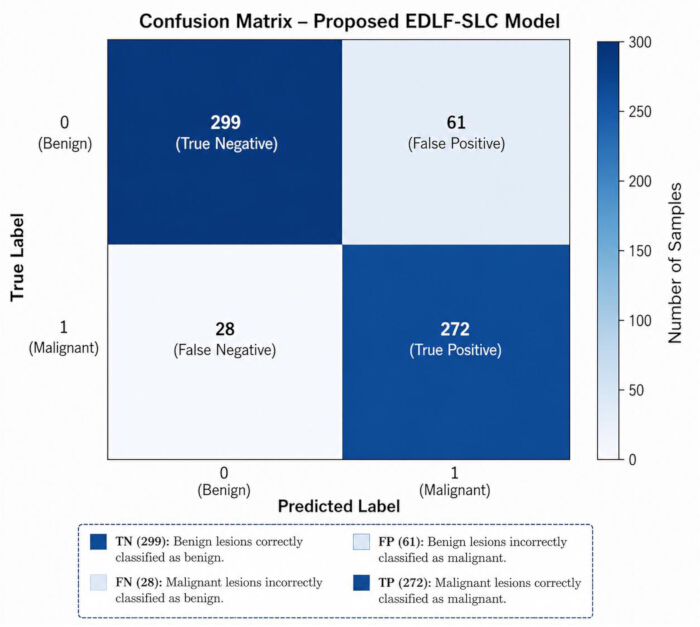
الشكل 7: مصفوفة الارتباك لنموذج EDLF-SLC المقترح على مجموعة بيانات الاختبار. تمثل الصفوف تسميات الفئات الحقيقية (0 = حميدة، 1 = خبيثة)، بينما تمثل الأعمدة تسميات الفئات المتوقعة. تشير العناصر القطرية إلى العينات التي تم تصنيفها بشكل صحيح (299 حميدة و 272 خبيثة)، بينما تشير العناصر خارج القطر إلى العينات المصنفة خطأً، بما في ذلك 61 حالة إيجابية كاذبة و 28 حالة سلبية كاذبة. يرجى النقر هنا لعرض نسخة أكبر من هذا الشكل.
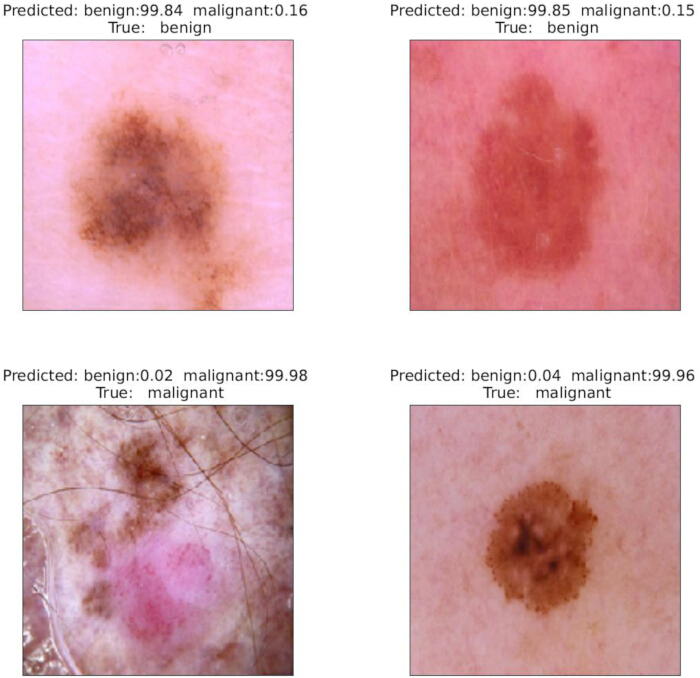
الشكل 8: عينات من التنبؤات التي أنتجها نموذج EDLF-SLC المقترح. يوضح هذا الشكل مستويات الثقة في تصنيف الآفات الحميدة والخبيثة، ويبرز القدرة التمييزية للنموذج. يرجى النقر هنا لعرض نسخة أكبر من هذا الشكل.
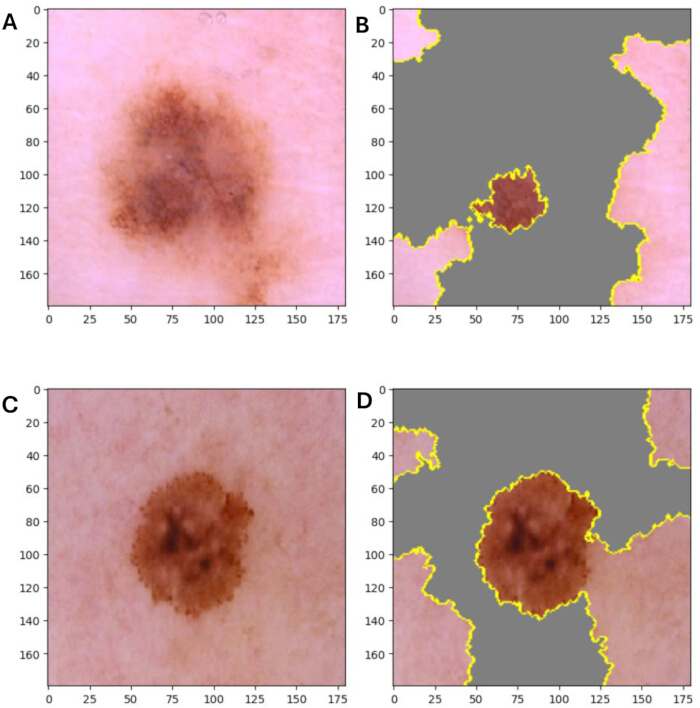
الشكل 9: تفسيرات محلية قائمة على LIME لنموذج EDLF-SLC المقترح. يسلط الشكل الضوء على مناطق البكسلات الفائقة (superpixel) الأكثر تأثيراً والتي ساهمت في قرارات التصنيف الخاصة بالنموذج. (A) صورة تنظيرية جلدية أصلية لآفة جلدية حميدة. (B) تفسير LIME للآفة الحميدة، حيث تشير البكسلات الفائقة المظللة إلى المناطق التي ساهمت بشكل أكبر في التنبؤ بأنها حميدة. (C) صورة تنظيرية جلدية أصلية لآفة جلدية خبيثة. (D) تفسير LIME للآفة الخبيثة، يوضح مناطق البكسلات الفائقة التمييزية التي أثرت بشكل غالب على التصنيف كخبيثة. تحدد الحدود الصفراء البكسلات الفائقة المؤثرة التي حددها LIME، بينما تمثل المناطق الرمادية المساحات ذات المساهمة الضئيلة في التنبؤ. يرجى النقر هنا لعرض نسخة أكبر من هذا الشكل.
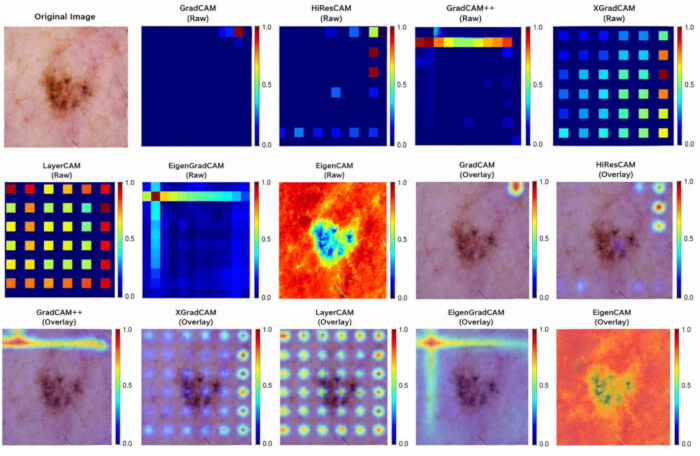
الشكل 10: مقارنة بين طرق القابلية للتفسير القائمة على تخطيط تنشيط الفئات (CAM) المطبقة على نموذج EDLF-SLC المقترح. يقارن الشكل خرائط التحديد الموضعي التي أنتجتها كل من GradCAM وHiResCAM وGradCAM++ وXGradCAM وLayerCAM وEigenGradCAM وEigenCAM لنفس الصورة الجلدية. يظهر اللوح الأول صورة الإدخال الأصلية، تليها خرائط التنشيط الخام المقابلة وتراكبات الخرائط الحرارية التي أنتجتها كل طريقة من طرق القابلية للتفسير. توضح هذه التصورات الاختلافات في التحديد الموضعي المكاني وتسلط الضوء على مناطق الصورة التي تساهم بقوة أكبر في قرار التصنيف الخاص بإطار عمل EDLF-SLC المقترح. يرجى النقر هنا لعرض نسخة أكبر من هذا الشكل.
| المرجع | السنة | مجموعة البيانات | حجم البيانات | استخلاص الميزات | الطريقة | الدقة |
| 9 | 2022 | HAM10000 dataset | 10015 صورة لآفات جلدية | ميزات اللون والشكل | خوارزميات ML ونماذج Convolutional NN | 95.1% |
| 19 | 2023 | PH2 dataset | 200 صورة مشروحة | ميزات عدم التماثل، والخطوط، والنقاط/الحبيبات، ومناطق التراجع | نماذج ML | 94.0% |
| 30 | 2024 | HAM10000 dataset | 10000 صورة | ميزات اللون والشكل | S-MobileNet | 97.7% |
| 28 | 2025 | مجموعات بيانات ISIC2020 وHAM10000 | ISIC2020 (12,670 صورة) وHAM10000 (10,015 صورة) | اللون والشكل | الشبكة المتبقية-الذاكرة طويلة قصيرة المدى (R-LSTM50) | 95.7% (ISIC2020)؛ 94.2% (HAM10000) |
| 32 | 2026 | Monkeypox Skin Lesion Dataset (MSLD) | 770 صورة | السياق والملمس | DenseNet121 وXception وInceptionV3 وCBAM | 88% (DenseNet121) |
| 39 | 2025 | HAM10000 | 38,569 صورة | السياق والملمس | MobileNet وResNet50 وInceptionV3 وEfficientNet | 93.6% (MobileNet) |
| 40 | 2025 | ISIC 2019 | 2357 صورة | السياق والميزات المكانية | DL متعدد الوسائط يعتمد على CNN-transformer | 98.71% |
| 41 | 2026 | ISIC 2019 | 25,000 صورة | السياق والملمس | TransXV2S | 95.26% |
| 42 | 2025 | HAM10000 | 10,015 صورة | اللون والشكل | ViT مع YOLOv8 | 93% |
الجدول 1: مقارنة أدبية. ملخص لبعض الأعمال المنشورة حديثًا التي تستخدم خوارزميات التعلم العميق لتصنيف الآفات الجلدية.
| مجموعة البيانات | حميد | خبيث | إجمالي |
| بيانات التدريب | 1440 | 1197 | 2637 |
| بيانات الاختبار | 360 | 300 | 660 |
| إجمالي البيانات | 1800 | 1497 | 3297 |
الجدول 2: توزيع مجموعة البيانات. توزيع العينات الحميدة والخبيثة في مجموعة بيانات ISIC 2020، بما في ذلك تقسيمات التدريب والاختبار.
| مكوّن | المواصفات |
| نظام التشغيل | Ubuntu 20.04 |
| لغة برمجة | Python 3.9 |
| إطار عمل التعلم العميق | PyTorch 2.3.1 |
| المُحسِّن | آدم |
| جدولة معدل التعلم | 1e−3 |
| عدد الدورات التدريبية | 100/300 |
| وحدة المعالجة المركزية | وحدتا معالجة مركزية افتراضيتان (2 vCPU) بتردد 2.2 جيجاهرتز |
| وحدة معالجة الرسومات | Tesla T4 (16 GB) × 1 |
| ذاكرة الوصول العشوائي | 16 جيجابايت |
| المعلمات القابلة للتدريب | ٢,٤٣٠,٣٥٣ (٩.٢٧ ميجابايت) |
| المعلمات غير القابلة للتدريب | 133,434,397 (509.01 ميجابايت) |
الجدول 3: مواصفات النظام. المواصفات التفصيلية للبيئة الحسابية، بما في ذلك أطر البرمجيات وموارد الأجهزة المستخدمة في تدريب النموذج وتقييمه.
| الفئة | الدقة (Precision) | الاستدعاء (Recall) | مقياس F1 | الدعم (Support) |
| الفئة الحميدة | 0.83 | 0.88 | 0.85 | 360 |
| الفئة الخبيثة | 0.84 | 0.78 | 0.81 | 300 |
| الدقة الإجمالية (Accuracy) | - | - | 0.832 | 660 |
| المتوسط الكلي (Macro avg) | 0.84 | 0.83 | 0.83 | 660 |
| المتوسط المرجح (Weighted avg) | 0.84 | 0.83 | 0.83 | 660 |
الجدول 4: تقرير التصنيف. أداء التصنيف لنموذج ResNet-50 على مجموعة بيانات الاختبار، بما في ذلك الدقة (precision)، والاستدعاء (recall)، ومقياس F1-score، والدعم (support) لكل فئة.
| النموذج | الدقة (Accuracy) | الضبط (Precision) | الاستدعاء (Recall) | مقياس F1 | الزمن (s) |
| NASNetLarge | 0.77 | 0.76 | 0.77 | 0.76 | 2002.47 |
| EfficientNetB0 | 0.85 | 0.85 | 0.85 | 0.85 | 734.8 |
| Xception | 0.8 | 0.81 | 0.8 | 0.8 | 732.23 |
| ResNetV2 | 0.63 | 0.64 | 0.63 | 0.611 | 1072.34 |
| MobileNet | 0.79 | 0.8 | 0.79 | 0.79 | 629.29 |
| MobileNetV2 | 0.77 | 0.79 | 0.77 | 0.77 | 660.5 |
| ResNet50 | 0.83 | 0.83 | 0.83 | 0.83 | 749.77 |
| EDLF-SLC | 0.88 | 0.89 | 0.87 | 0.88 | 3279.77 |
الجدول 5: مقارنة أداء النموذج. الأداء المقارن لنموذج EDLF-SLC المقترح ونماذج التعلم العميق المرجعية من حيث الدقة (accuracy)، والضبط (precision)، والاستدعاء (recall)، ومقياس F1-score، والوقت الحسابي.
| النموذج | الدقة (Accuracy) | الضبط (Precision) | الاسترجاع (Recall) | مقياس F1 (F1-Score) |
| ResNet-18 [25] | 0.85 | 0.85 | 0.85 | 0.85 |
| ResNet-50 مع SVM [50] | 0.87 | 0.88 | 0.98 | 0.93 |
| نماذج DL الهجينة + SVM [48] | 0.86 | 0.84 | 0.8 | 0.84 |
| نماذج DL الهجينة + SVM [49] | 0.86 | 0.8 | 0.6 | 0.68 |
| نموذج EDLF-SLC المقترح | 0.88 | 0.89 | 0.87 | 0.88 |
الجدول 6: مقاييس مقارنة النماذج. مقارنة الأداء بين إطار عمل EDLF-SLC المقترح والنهج الحديثة الأكثر تطوراً لتصنيف آفات الجلد.
الملف التكميلي 1: الخوارزمية 1. سير عمل إطار عمل EDLF-SLC المقترح، والذي يوضح المعالجة المسبقة للبيانات، واستخراج الميزات العميقة باستخدام بنيات CNN متعددة، والتصنيف القائم على SVM، والقابلية للتفسير القائمة على LIME للتنبؤ بالآفات الجلدية. يرجى النقر هنا لتحميل هذا الملف.
الملف التكميلي 2: الخوارزمية 2. سير عمل عملية التفسير المحلي القائمة على LIME، والتي توضح إنشاء البكسلات الفائقة (superpixels)، وأخذ عينات الاضطراب، وبناء النموذج البديل، وتصور مناطق الصورة الأكثر مساهمة في قرار التصنيف. يرجى النقر هنا لتنزيل هذا الملف.
المناقشة
يوضح إطار التعلم العميق القابل للتفسير المقترح لتصنيف الآفات الجلدية (EDLF-SLC) أن الجمع بين تمثيلات الميزات العميقة المتكاملة والذكاء الاصطناعي القابل للتفسير يمكن أن يحسن كلاً من أداء التصنيف وشفافية النموذج. ومن خلال دمج بنيات متعددة مسبقة التدريب من الشبكات العصبية التلافيفية (CNN) وهي (ResNet50، وEfficientNetB0، وMobileNet، وXception) لاستخراج الميزات، واستخدام آلة ناقلات الدعم (SVM) للتصنيف النهائي، يستفيد الإطار من نقاط القوة في مستخرجات الميزات المختلفة لإنشاء تمثيلات للآفات تكون أغنى وأكثر تمييزاً من تلك التي يتم الحصول عليها من شبكة أساسية واحدة. علاوة على ذلك، يوفر دمج التفسيرات المحلية القابلة للتفسير والمستقلة عن النموذج (LIME) تفسيرات مرئية موضعية، مما يمكن السريريين من فهم مناطق الصورة التي تساهم بشكل أكبر في كل تنبؤ، ويزيد من الثقة في القرارات التشخيصية للنموذج.
تظهر النتائج التجريبية أن نموذج EDLF-SLC يحقق أداءً تنافسياً مقارنة بنماذج CNN المرجعية، بما في ذلك MobileNet وXception وResNet50، مما يسلط الضوء على فعالية دمج الميزات التكميلية والتصنيف المعتمد على SVM. كما يؤكد المقارنة مع أحدث المنهجيات المتطورة مؤخراً مدى تنافسية الإطار المقترح. فعلى سبيل المثال، ذكرت دراستان48,49 تحقيق دقة تبلغ 0.86 تقريباً باستخدام طرق تعتمد على التجميع (ensemble-based methods)، بينما حققت أطر عمل هجينة أخرى من نوع CNN-SVM25,50,51,52,53 دقة تصل إلى 0.87 ولكنها اعتمدت على بنيات أكثر تعقيداً ووحدات إضافية للمعالجة المسبقة أو التجزئة. في المقابل، يحقق الإطار المقترح دقة تبلغ 0.88 باستخدام بنية مبسطة نسبياً دون الحاجة إلى تجزئة صريحة للآفات، وفي الوقت نفسه يوفر تنبؤات قابلة للتفسير من خلال LIME. وتشير هذه النتائج إلى أن الجمع بين مستخرجات ميزات CNN التكميلية قبل تصنيف SVM يمكن أن يعزز أداء التشخيص مع الحفاظ على بساطة البنية وشفافيتها.
على الرغم من أن الإطار المقترح يحسن دقة التصنيف وقابلية التفسير، إلا أن هذا التحسين يأتي على حساب زيادة التكلفة الحسابية. حيث يبلغ إجمالي وقت تدريب EDLF-SLC حوالي 3279.77 s، وهو أعلى بكثير من نماذج CNN الفردية مثل ResNet50 (749.77 s) و MobileNet (629.29 s). وينتج هذا العبء الحسابي الإضافي عن تدريب عدة نماذج CNN مسبقة التدريب وإجراء دمج للميزات قبل عملية التصنيف. ويُلاحظ مثل هذا المقايضة عادةً في نهج التعلم الهجين والتعلم التجميعي، حيث يتم تحقيق أداء تنبؤي محسن على حساب متطلبات حسابية أعلى. ومع ذلك، في أنظمة دعم القرار السريري، تُعتبر دقة التشخيص والمتانة والموثوقية بشكل عام أكثر أهمية من كفاءة التدريب لأنها تؤثر بشكل مباشر على نتائج المرضى.
تتمثل ميزة هامة أخرى للإطار المقترح في قابليته للتفسير؛ فخلافاً لنماذج التعلم العميق التقليدية التي غالباً ما تعمل كـ "صناديق سوداء"، يدمج نموذج EDLF-SLC تقنية LIME لتقديم تفسيرات مرئية مخصصة لكل حالة لعملية التنبؤ. وتساعد هذه التفسيرات السريريين في التحقق مما إذا كان النموذج يركز على مناطق الآفات ذات الصلة سريرياً، مما يعزز الشفافية، ويدعم التفسير السريري، ويسهل الثقة في التشخيص بمساعدة الذكاء الاصطناعي. وبناءً على ذلك، يوفر الإطار المقترح توازناً عملياً بين أداء التنبؤ وقابلية تفسير النموذج، مما يجعله أداة واعدة لدعم اتخاذ القرار بمساعدة الحاسوب في تصنيف الآفات الجلدية.
على الرغم من هذه النتائج المشجعة، يجب الإقرار بعدة قيود. أولاً، تم تقييم الإطار باستخدام مجموعة بيانات ISIC المتاحة للعموم فقط، ولا تزال قدرته على التعميم عبر الصور التي يتم الحصول عليها في ظروف سريرية مختلفة، وأجهزة تصوير متنوعة، ومجموعات مختلفة من المرضى بحاجة إلى التحقق من صحتها. ثانياً، يؤدي استخدام بنى CNN متعددة مسبقة التدريب حتماً إلى زيادة التعقيد الحسابي ووقت التدريب مقارنةً بالنماذج ذات العمود الفقري الواحد. ثالثاً، تم اعتماد إعدادات ثابتة للمعلمات الفائقة طوال التجارب، وقد يؤدي المزيد من التحسين إلى تعزيز الأداء والقابلية للتكيف عبر مجموعات بيانات مختلفة. وأخيراً، على الرغم من أن LIME يعزز شفافية النموذج، إلا أن تفسيراته محلية وتعتمد على الاضطراب، مما يعني أن اتساق التفسيرات قد يختلف بين عمليات التشغيل ويجب التحقق من صحتها بشكل أكبر مع خبراء الأمراض الجلدية قبل النشر السريري الروتيني.
ستركز الأبحاث المستقبلية على التحقق من صحة الإطار المقترح باستخدام مجموعات بيانات متعددة واسعة النطاق ومتعددة المراكز لآفات الجلد، وتحسين الكفاءة الحسابية من خلال دمج الميزات خفيفة الوزن وتقنيات ضغط النماذج، واستقصاء استراتيجيات متقدمة لتحسين المعلمات الفائقة، وتوسيع نطاق الإطار ليشمل تصنيف آفات الجلد متعدد الفئات. علاوة على ذلك، فإن دمج تقنيات إضافية للذكاء الاصطناعي القابل للتفسير وإجراء تقييمات سريرية استشرافية مع أطباء الجلد من شأنه أن يعزز الموثوقية والقابلية للتفسير والتطبيق العملي للإطار المقترح في البيئات السريرية الواقعية.
الإفصاحات
يصرح المؤلفون بعدم وجود تضارب في المصالح.
شكر وتقدير
يود المؤلفون أن يعربوا عن خالص تقديرهم لجامعة الطائف لتوفير البيئة البحثية والدعم المؤسسي الذي سهل إنجاز هذا العمل.
المواد
| الاسم | الشركة | رقم فهرسي | التعليقات |
|---|---|---|---|
| ISIC 2020 Skin Lesion Dataset | International Skin Imaging Collaboration (ISIC) | ISIC 2020 Challenge Dataset | مجموعة بيانات صور تنظير الجلد المستخدمة في تطوير النموذج وتقييمه. |
| Keras | Keras Team | متكامل مع TensorFlow | بناء وتدريب نماذج التعلم العميق. |
| LIME (Local Interpretable Model-Agnostic Explanations) | Ribeiro et al. | حزمة Python | توليد تفسيرات بصرية محلية لتنبؤات النموذج. |
| Matplotlib | Matplotlib Developers | أحدث إصدار متوافق | تصوير منحنيات التعلم، ومصفوفات الارتباك، ومخططات التقييم. |
| NumPy | NumPy Developers | أحدث إصدار متوافق | الحسابات العددية ومعالجة المصفوفات. |
| NVIDIA Tesla T4 GPU | NVIDIA Corporation | 16 GB VRAM | تسريع تدريب النموذج وعمليات الاستنتاج. |
| Pandas | Pandas Development Team | أحدث إصدار متوافق | معالجة البيانات وإدارة النتائج التجريبية. |
| Pretrained CNN Models | TensorFlow/Keras Applications | ResNet50, EfficientNetB0, MobileNet, Xception | استخراج الميزات العميقة من صور تنظير الجلد. |
| Python | Python Software Foundation | Version 3.9 | لغة البرمجة المستخدمة في التنفيذ. |
| PyTorch | PyTorch Foundation | Version 2.3.1 | إطار عمل للتعلم العميق مستخدم في استخراج الميزات وتنفيذ النموذج. |
| Scikit-learn | Scikit-learn Developers | أحدث إصدار متوافق | آلة متجه الدعم (SVM)، ومقاييس التقييم، والمعالجة المسبقة للبيانات. |
| Support Vector Machine (RBF Kernel) | Scikit-learn | SVC | تصنيف تمثيلات الميزات العميقة المدمجة. |
| TensorFlow | Google LLC | Version 2.x | إطار عمل للتعلم العميق لتدريب النموذج والاستنتاج. |
| Ubuntu Operating System | Canonical Ltd. | Ubuntu 20.04 | بيئة التشغيل التجريبية. |
المراجع
- Chan S, Reddy V, Myers B, Thibodeaux Q, Brown-Stone N, Liao W. Machine learning in dermatology: current applications, opportunities, and limitations. Dermatol Ther (Heidelb). 2020;10:365-386.
- Olsen CM. Global trends in melanoma mortality differ by sex and age. Br J Dermatol. 2020;183(6):985-986.
- Sun Y, Shen Y, Liu Q, Zhang H, Jia L, Chai Y, et al. Global trends in melanoma burden: a comprehensive analysis from the Global Burden of Disease Study, 1990-2021. J Am Acad Dermatol. 2025;92(1):100-107.
- Monika MK, Vignesh NA, Kumari CU, Kumar M, Lydia EL. Skin cancer detection and classification using machine learning. Mater Today Proc. 2020;33:4266-4270.
- Hosny KM, Elshora D, Mohamed ER, Vrochidou E, Papakostas GA. Deep learning and optimization-based methods for skin lesions segmentation: a review. IEEE Access. 2023.
- Baghdadi NA, Farghaly Abdelaliem SM, Malki A, Gad I, Ewis A, Atlam ES. Advanced machine learning techniques for cardiovascular disease early detection and diagnosis. J Big Data. 2023;10(1):144.
- Veeramani N, Jayaraman P, Krishankumar R, Ravichandran KS, Gandomi AH. DDCNN-F: double decker convolutional neural network feature fusion as a medical image classification framework. Sci Rep. 2024;14(1).
- Veeramani N, Jayaraman P. YOLOv7-XAI: multiclass skin lesion diagnosis using explainable artificial intelligence with fair decision making. Int J Imaging Syst Technol. 2024;34(6).
- Shetty B, Fernandes R, Rodrigues AP, Chengoden R, Bhattacharya S, Lakshmanna K. Skin lesion classification of dermoscopic images using machine learning and convolutional neural network. Sci Rep. 2022;12(1):18134.
- Ali AR, Li J, Yang G, O'Shea SJ. A machine learning approach to automatic detection of irregularity in skin lesion border using dermoscopic images. PeerJ Comput Sci. 2020;6:e268.
- Pham TTH, Luu TN, Nguyen TV, Huynh NT, Phan QH, Le TH. Polarimetric imaging combining optical parameters for classification of mice non-melanoma skin cancer tissue using machine learning. Heliyon. 2023;9(11).
- Liu N, Rejeesh M, Sundararaj V, Gunasundari B. ACO-KELM: anti coronavirus optimized kernel-based softplus extreme learning machine for classification of skin cancer. Expert Syst Appl. 2023;232:120719.
- Masud M, Almars AM, Rokaya MB, Meshref H, Gad I, Atlam ES. A novel lightweight convolutional neural network model to predict Alzheimer's disease applying weighted loss function. J Disabil Res. 2024;3(4):20240042.
- Kumar A, Veeraiah V, Gongada TN, Ahamad S, Khan H, Gupta A. Explainable machine learning models for clinical decision support systems. In: 2024 15th International Conference on Computing Communication and Networking Technologies (ICCCNT). Piscataway (NJ): IEEE; 2024. p. 1-6.
- Shahzad K, Wasim M, Pires IM, Garcia NM. Multi-classification of skin lesions using a deep learning-based convolutional neural network. Procedia Comput Sci. 2024;241:588-593.
- Celebi ME, Kingravi HA, Uddin B, Iyatomi H, Aslandogan YA, Stoecker WV, et al. A methodological approach to the classification of dermoscopy images. Comput Med Imaging Graph. 2007;31(6):362-373.
- Li CX, Shen CB, Xue K, Shen X, Jing Y, Wang ZY, et al. Artificial intelligence in dermatology: past, present, and future. Chin Med J (Engl). 2019;132(17):2017-2020.
- Ramprasad M, Nagesh S, Sahith V, Lankalapalli RK. Hierarchical agglomerative clustering based skin lesion detection with region-based neural networks classification. Meas Sens. 2023;29:100865.
- Khater T, Ansari S, Mahmoud S, Hussain A, Tawfik H. Skin cancer classification using explainable artificial intelligence on pre-extracted image features. Intell Syst Appl. 2023;20:200275.
- Wang H, Ahn E, Bi L, Kim J. Self-supervised multi-modality learning for multi-label skin lesion classification. Comput Methods Programs Biomed. 2025;265:108729.
- Thapar P, Rakhra M, Alsaadi M, Quraishi A, Deka A, Naga Ramesh JV. A hybrid grasshopper optimization algorithm for skin lesion segmentation and melanoma classification using deep learning. Healthc Anal. 2024;5:100326.
- Kumar S, Nath VK, Hazarika D. Blend of deep features and binary tree growth algorithm for skin lesion classification. Symmetry (Basel). 2023;15(12):2213.
- Chandrahaas BV, Mohanty SN, Panda SK, et al. An empirical study on classification of monkeypox skin lesion detection. EAI Endorsed Trans Pervasive Health Technol. 2023;9:e4.
- Talavera-Martínez L, Bibiloni P, Giacaman A, Taberner R, de Paz Hernando LJD, González-Hidalgo M. A novel approach for skin lesion symmetry classification with a deep learning model. Comput Biol Med. 2022;145:105450.
- Ieracitano C, Morabito FC, Hussain A, Suffian M, Mammone N. TIXAI: a trustworthiness index for explainable artificial intelligence in skin lesion classification. Neurocomputing. 2025;630:129701.
- Hasan MK, Elahi MTE, Alam MA, Jawad MT, Martí R. DermoExpert: skin lesion classification using a hybrid convolutional neural network through segmentation, transfer learning, and augmentation. Inform Med Unlocked. 2022;28:100819.
- Koparde S, Kotwal J, Deshmukh S, Adsure S, Chaudhari P, Kimbahune V. Conditional generative adversarial networks and YOLOv5 Darknet-based skin lesion localization and classification using an independent component analysis model. Inform Med Unlocked. 2024;47:101515.
- Padhy S, Dash S, Kumar N, Singh SP, Kumar G, Moral P. Temporal integration of ResNet features with LSTM for enhanced skin lesion classification. Results Eng. 2025;25:104201.
- Xin C, Liu Z, Ma Y, Wang D, Zhang J, Li L, et al. Transformer-guided self-adaptive network for multi-scale skin lesion image segmentation. Comput Biol Med. 2024;169:107846.
- Sulthana R, Chamola V, Hussain Z, Albalwy F, Hussain A. A novel end-to-end deep convolutional neural network-based skin lesion classification framework. Expert Syst Appl. 2024;246:123056.
- Chamarthi S, Fogelberg K, Brinker TJ, Niebling J. Mitigating the influence of domain shift in skin lesion classification: a benchmark study of unsupervised domain adaptation methods. Inform Med Unlocked. 2024;44:101430.
- Maity S, Paul S, Guha S, Dasgupta S, Ghosh M. Automated classification of monkeypox skin lesions using a hybrid deep learning model. Biomed Signal Process Control. 2026;126:110955.
- Nasir S, Bilal M, Khalidi H. Detection and classification of skin cancer by using CNN-enabled cloud storage data access control algorithm based on blockchain technology. Int J Theor Appl Comput Intell. 2025:145-169.
- Saba T. Computer vision for microscopic skin cancer diagnosis using handcrafted and non-handcrafted features. Microsc Res Tech. 2021;84(6):1272-1283.
- Fayyad J, Alijani S, Najjaran H. Empirical validation of conformal prediction for trustworthy skin lesion classification. Comput Methods Programs Biomed. 2024;253:108231.
- Liu P, Qian W, Li H, Cao J. A relationship-aware mutual learning method for lightweight skin lesion classification. Digit Commun Netw. 2025;11(3):603-612.
- Adla D, Reddy GVR, Nayak P, Karuna G. A full-resolution convolutional network with a dynamic graph cut algorithm for skin cancer classification and detection. Healthc Anal. 2023;3:100154.
- Thamizhamuthu R, Maniraj SP. Deep learning-based dermoscopic image classification system for robust skin lesion analysis. Trait Signal. 2023;40(3).
- Di Giammarco M, Santone A, Cesarelli M, Martinelli F, Mercaldo F. A method for skin lesion detection and localization by means of deep learning and reliable prediction explainability. Image Vis Comput. 2025;162:105675.
- Haq IU, Joarder HA, Khan AA, Shi X, Alsayaydeh JAJ, Yusof MFB, et al. XAAI-ledger: an explainable CNN-transformer-based multimodal deep learning framework for early detection of melanoma and non-melanoma skin cancers using dermoscopic and clinical data. Biomed Signal Process Control. 2026;123:110410.
- Saeed K, Shehzad M, Malik MGA, Ahmed S, Azar AT. TransXV2S-NET: a novel hybrid deep learning architecture with dual-contextual graph attention for multi-class skin lesion classification. Knowl Based Syst. 2026;337:115407.
- AbuAlkebash H, Saleh RAA, Ertunç HM. Automated explainable deep learning framework for multiclass skin cancer detection and classification using hybrid YOLOv8 and vision transformer (ViT). Biomed Signal Process Control. 2025;108:107934.
- Hasan MK, Ahamad MA, Yap CH, Yang G. A survey, review, and future trends of skin lesion segmentation and classification. Comput Biol Med. 2023;155:106624.
- Li H, Pan Y, Zhao J, Zhang L. Skin disease diagnosis with deep learning: a review. Neurocomputing. 2021;464:364-393.
- Wu Y, Chen B, Zeng A, Pan D, Wang R, Zhao S. Skin cancer classification with deep learning: a systematic review. Front Oncol. 2022;12:893972.
- Fanconic. Skin cancer: malignant vs benign dataset. Kaggle; 2023. Available from: https://www.kaggle.com/datasets/fanconic/skin-cancer-malignant-vs-benign
- Ribeiro MT, Singh S, Guestrin C. "Why should I trust you?": Explaining the predictions of any classifier. In: Proceedings of the 22nd ACM SIGKDD International Conference on Knowledge Discovery and Data Mining (KDD '16). New York (NY): ACM; 2016. p. 1135-1144.
- Bassel A, Abdulkareem AB, Alyasseri ZAA, Sani NS, Mohammed HJ. Automatic malignant and benign skin cancer classification using a hybrid deep learning approach. Diagnostics (Basel). 2022;12(10):2472.
- Bhardwaj A, Rege PP. Skin lesion classification using deep learning. In: Advances in Signal and Data Processing: Select Proceedings of ICSDP 2019. Singapore: Springer; 2021. p. 575-589.
- Keerthana D, Venugopal V, Nath MK, Mishra M. Hybrid convolutional neural networks with SVM classifier for classification of skin cancer. Biomed Eng Adv. 2023;5:100069.
- Ahmed A, Siam AI, Atwa MA, Atwa EM, Abdelrahim EM, Atlam ES. An explainable YOLO-based deep learning framework for pneumonia detection from chest X-ray images. Algorithms. 2025;18(11):703.
- Farsi M, ZainEldin H, Sayed RF, El-Agamy ES, Atlam SA, Alsaedi M, et al. Deep learning for pathology: YOLOv8 with EigenCAM for reliable colorectal cancer diagnostics. Bioengineering (Basel). 2025;12(11):1203.
- Atwa EA, Atlam ES, Ahmed A, Atwa MA, Abdelrahim EM, Siam AI. Interpretable deep learning models for arrhythmia classification based on ECG signals using the PTB-XL dataset. Diagnostics (Basel). 2025;15(15):1950.