تقترح هذه الورقة نموذجاً مبتكراً، وهو الشبكات العصبية الرسومية ذات الانتباه الخطي ذات الفتحات المبوّبة للتوصيات القائمة على الجلسات، والذي يعتمد على الانتباه الخطي ذي الفتحات المبوّبة بناءً على رسم بياني مزدوج البناء للجلسة. ويعمل هذا النموذج على تعزيز دقة وكفاءة التوصيات، كما يتفوق على أحدث التقنيات المتاحة (SOTA) في ثلاث مجموعات بيانات عامة.
مقالة بحثية
شبكات عصبية رسومية ذات انتباه خطي بفتحات مبوبة للتوصية القائمة على الجلسات
في هذه المقالة
ملخص
الملخص
تهدف أنظمة التوصية القائمة على الجلسة (SBR) إلى التنبؤ بالعنصر التالي الذي من المرجح أن يتفاعل معه المستخدم، وذلك بناءً على تسلسل السلوك ضمن الجلسة الحالية. وقد أظهرت النهج الحديثة التي تستفيد من آلية انتباه Transformer (مثل GC-SAN) أداءً فائقاً مقارنة بالطرق التقليدية؛ ومع ذلك، فإنها تعاني من عبء حسابي كبير وتعقيد في المساحة نظراً للتكلفة التربيعية للانتباه الذاتي. ولمعالجة هذه القيود، تم اقتراح نموذج جديد يسمى GSLA4Rec (الشبكات العصبية الرسومية ذات الانتباه الخطي ذي الفتحات الموجهة للتوصية القائمة على الجلسة)، والذي يدمج الانتباه الخطي مع آلية توجيه قابلة للتعلم واستراتيجية تحديث ذاكرة قائمة على الفتحات مستوحاة من انتباه الفتحات الموجهة. وتحديداً، يقوم GSLA4Rec أولاً ببناء رسمين بيانيين: الرسم البياني للجلسة لالتقاط انتقالات العناصر داخل الجلسة الواحدة، والرسم البياني العالمي للجيران لترميز إشارات التعاون عبر الجلسات، وبذلك يتم نمذجة معلومات السياق المحلي والعالمي معاً. يرتكز النهج المقترح على آلية الانتباه الخطي ذي الفتحات الموجهة، والتي (1) توظف وحدات توجيه لكبح الضوضاء الناتجة عن التفاعلات غير ذات الصلة أو الزائدة في الجلسات الطويلة، (2) تستخدم وحدات فتحات لتخزين وتحديث تمثيلات الجلسة المدمجة ديناميكياً — مما يقلل من استهلاك الذاكرة، (3) تستبدل الانتباه الذاتي بالانتباه الخطي لتحقيق تعقيد زمني خطي. وتعمل هذه المكونات مجتمعة على تعزيز دقة التنبؤ في النموذج وكفاءته في التقاط اهتمامات المستخدمين المتطورة بشكل كبير. وتثبت التجارب المكثفة على مجموعات بيانات مرجعية عامة متعددة، بما في ذلك Diginetica وTmall وNowPlaying، أن GSLA4Rec يتفوق باستمرار على أحدث طرق SBR من حيث أداء التوصية، مما يؤكد فعالية آلية GSLA.
المقدمة
مع التطور السريع للخدمات المتاحة عبر الإنترنت (مثل التجارة الإلكترونية، ومنصات الفيديوهات القصيرة، وخلاصات الأخبار)، أصبحت مشكلة التضخم المعلوماتي أكثر بروزاً وخطورة. وتوفر أنظمة التوصية1,2 خدمات دفع معلومات مخصصة ودقيقة من خلال التحليل العميق لبيانات سلوك المستخدمين. ومع ذلك، في العديد من التطبيقات العملية التي تتسم بالوصول المجهول، والمستخدمين غير المسجلين، وحماية الخصوصية، وفترات التفاعل القصيرة، تحد طرق التوصية التقليدية مثل التصفية التعاونية3 وتحليل المصفوفات4,5 بشكل كبير من إمكانية تطبيق خوارزميات التوصية. ولمواجهة هذه التحديات، ظهرت التوصية القائمة على الجلسات (SBR)6,7,8,9، حيث تركز SBR على بيانات تسلسل التفاعل ضمن الجلسة الحالية للمستخدم للتنبؤ بنقطة الاهتمام المحتملة التالية. لا يتجنب هذا النموذج الاعتماد على بيانات تاريخ المستخدمين طويلة المدى فحسب، بل يلتقط أيضاً بدقة التغيرات الديناميكية في الاهتمامات قصيرة المدى، مما يظهر قيمة تطبيقية فريدة في سيناريوهات مثل التجارة الإلكترونية، والفيديوهات القصيرة، وتوصيات الموسيقى، وغيرها.
اعتمدت الطرق المبكرة بشكل أساسي على سلاسل ماركوف (Markov Chains)5,10,11,12 لنمذجة احتمالات الانتقال بين العناصر في تسلسلات الجلسات. وعلى الرغم من قدرة هذه الطرق على رصد تبعيات التسلسل من الدرجة الأولى، إلا أن توصيف التبعيات المعقدة من الدرجات العليا والديناميكيات غير الخطية لاهتمامات المستخدمين ظل محدوداً، مما قيد فعالية النماذج في السيناريوهات المعقدة. ومع تطور تقنية التعلم العميق (Deep-Learning)13,14، طُبقت الطرق القائمة على الشبكات العصبية على نطاق واسع في التوصية القائمة على الجلسات (SBR). وكان نموذج GRU4REC15 هو الأول الذي طبق الشبكات العصبية المتكررة (RNNs)14 في التوصية القائمة على الجلسات، مما سمح برصد التبعيات الزمنية في التسلسلات بفعالية؛ كما عزز نموذج NARM16 القدرة على استخراج اهتمامات المستخدمين الأساسية من خلال دمج آليات الانتباه (attention mechanisms) مع الشبكات العصبية المتكررة؛ واستخدم نموذج STAMP17 المدركات المتعددة الطبقات (MLPs) مدمجة مع آليات الانتباه للتركيز على رصد اهتمامات المستخدمين قصيرة المدى. ورغم أن هذه الطرق حققت بعض التقدم في نمذجة التسلسلات، إلا أنها لا تزال تواجه تحديات مثل صعوبة التعامل مع التبعيات طويلة المدى والحساسية تجاه الضجيج.
في السنوات الأخيرة، قدمت الشبكات العصبية الرسومية (GNNs)18,19,20,21 منظوراً جديداً لمهمة توصيات الجلسات القائمة على التسلسل (SBR). حيث تعمل نماذج مثل SR-GNN22 على نمذجة علاقات الانتقال المعقدة بشكل صريح من خلال بناء رسم بياني للجلسة (SG)، مما أدى إلى تحقيق تحسينات جوهرية في دقة التوصيات. ومع ذلك، فإن معظم الطرق الحالية القائمة على الشبكات العصبية الرسومية تجري بناء الرسم البياني ونقل الرسائل داخل جلسات فردية، مما يفتقر إلى الاستخدام الفعال لمعلومات الارتباط العالمية للعناصر. ولمعالجة هذه المشكلة، يدمج نموذج GCE-GNN23 الدلالات العالمية والرسوم البيانية للجلسات باستخدام آلية الانتباه الذاتي لوزن أهمية العناصر تكيفياً من خلال بناء رسم بياني عالمي للجيران (NGG)، مما حقق تحسينات ملحوظة في الأداء. وبالرغم من ذلك، لا تزال الطرق القائمة على الشبكات العصبية الرسومية تواجه عقبتين رئيسيتين: الأولى هي أن تعقيد آلية الانتباه الذاتي يزداد تربيعياً مع طول الجلسة، مما يؤدي إلى أعباء حسابية كبيرة عند معالجة الجلسات الطويلة؛ والثانية هي أن الشبكات العصبية الرسومية التقليدية تفتقر إلى القدرة على تنظيم أهمية العناصر ديناميكياً أثناء تجميع المعلومات، مما يجعل من الصعب التمييز بين الضوضاء والسلوكيات الحرجة، وهو ما يؤثر بدوره على جودة التمثيل.
لمعالجة هذه التحديات، تقترح هذه الورقة شبكة عصبية رسومية ذات انتباه خطي بفتحات مبوبة للتوصية القائمة على الجلسات (GSLA4Rec): (1) تصميم آلية فتحات مبوبة تعمل على تصفية الضوضاء عبر البوابات وتخزين المعلومات الدلالية الرئيسية في فتحات الجلسة، مما يعزز متانة النموذج ويقلل من تكاليف التخزين؛ (2) تقديم آلية الانتباه الخطي التي تقلل التعقيد الحسابي من O(N2) إلى O(N) حيث تمثل N طول الجلسة)، مع الحفاظ على القدرة على نمذجة الاعتمادات بعيدة المدى؛ (3) إجراء تجارب مكثفة على ثلاث مجموعات بيانات مرجعية عامة (Diginetica وTmall وNowPlaying)، والتي أظهرت أن GSLA4Rec يتفوق بشكل ملحوظ على طرق SOTA الحالية، خاصة مع إظهار مزايا واضحة في سيناريوهات الجلسات الطويلة والبيانات الشحيحة.
البروتوكول
تجربة التوصية القائمة على الجلسة
يمكن فحص التوصية القائمة على الجلسة من ثلاثة منظورات: SBR، وتعلم السياق العالمي، و GSLA (راجع جدول المواد). لم يشارك أي من البشر أو الحيوانات في هذه الدراسة. جميع مجموعات البيانات التجريبية المستخدمة في هذا العمل متاحة للعامة وتم تقديمها كـ ملف تكميلي: GSLA4Rec. zip.
التوصية القائمة على الجلسات
كان نظام التوصية القائم على الجلسة (SBR) عبارة عن نظام ذكاء اصطناعي يتفاعل مع المستخدمين من خلال حوارات باللغة الطبيعية متعددة الأدوار لفهم تفضيلات المستخدمين ديناميكيًا وتقديم توصيات مخصصة. وقد تطور نظام SBR من الطرق التقليدية إلى النهج القائمة على التعلم العميق والنهج الهجينة، ثم تقدم نحو الحلول القائمة على النماذج اللغوية الكبيرة (LLM).
التوصية التقليدية القائمة على الجلسات
تم تمثيل نظام التوصية المتسلسلة (SBR) التقليدي عادةً بواسطة الطرق القائمة على سلاسل ماركوف والترشيح التعاوني. حيث قامت الطريقة الأولى بإنشاء التوصيات من خلال تحليل مصفوفات الانتقال الاحتمالية الخاصة بالمستخدم. على سبيل المثال، اقترح Guy Shani24 طريقة توصية تعتمد على عملية قرار ماركوف تقوم بإنتاج التوصيات عن طريق تحليل المصفوفات المقابلة؛ بينما عمل Wanrong Gu25 على تحسين أداء التوصية من خلال دمج سلاسل ماركوف مع الفترات الزمنية لعمليات الشراء. أما الطريقة الثانية فقد أنشأت التوصيات عن طريق استخراج العلاقات المتسلسلة الخفية بين العناصر التفاعلية المتجاورة من خلال تحليل المصفوفات. فعلى سبيل المثال، قام Sarwar B1 بحساب التشابه بين العناصر بناءً على السلوكيات التاريخية للمستخدمين (مثل التقييم والنقرات) للتوصية بعناصر تطابق تفضيلات المستخدمين السابقة؛ فإذا أعجب المستخدم A بالعنصر a، وكان العنصر c مشابهاً جداً للعنصر a، فإن النظام يوصي بالعنصر c للمستخدم A؛ كما اقترح Rendle S5 نموذج FPMC، وهو نموذج توصية متسلسلة يجمع بين تحليل المصفوفات وسلاسل ماركوف، لالتقاط العلاقات المتسلسلة الخفية بين العناصر التفاعلية المتجاورة. ومع ذلك، فإن نظام SBR التقليدي هذا ركز على العلاقات المتسلسلة بين العناصر المتجاورة، مما جعل من الصعب نمذجة علاقات الاعتماد المعقدة.
توصيات قائمة على الجلسات باستخدام التعلم العميق
تطورت أنظمة التوصية القائمة على الجلسات باستخدام التعلم العميق عبر مراحل شملت الشبكات العصبونية التلافيفية (CNNs)26,27,28,29، والشبكات العصبونية المتكررة (RNNs)، والشبكات العصبونية الرسومية (GNNs). وقد اعتمدت أنظمة التوصية القائمة على الجلسات (SBR) المعتمدة على CNNs على عمليات مثل التلافيف والتجميع لتعلم تمثيلات لسياق كل جلسة، والتي تُستخدم لاحقاً لتقديم التوصيات. وقام نموذج Caser30 بتحويل أحدث L من العناصر التي تفاعل معها المستخدم إلى متجهات ذات أبعاد d عبر طبقة تضمين، مما شكل مصفوفة تضمين يتم التعامل معها كـ "صورة" مُسقطة في الزمان والفضاء الكامن. ثم استخدم النموذج ثلاثة مرشحات تلافيفية لأنماط التسلسل — على مستوى النقطة، وعلى مستوى الاتحاد بدون تخطٍ، وعلى مستوى الاتحاد مع تخطٍ لمرة واحدة — لتعلم الأنماط التسلسلية من أجل تحسين أداء الـ SBR. بينما قام Tuan وزملاؤه31 بنمذجة تدفقات نقرات الجلسة وميزات المحتوى بشكل موحد عبر نوى تلافيفية ثلاثية الأبعاد لتكوين تمثيلات مشتركة مكانية-زمانية-محتوائية.
كانت الشبكات العصبية المتكررة (RNNs) فئة من بنيات الشبكات العصبية المصممة خصيصاً لمعالجة البيانات المتسلسلة. وكانت الفكرة الأساسية تكمن في التقاط التبعيات الزمنية من خلال هياكل متكررة مثل شبكات الذاكرة قصيرة المدى المطولة (LSTM)13 والوحدات المتكررة ذات البوابات (GRUs)32، وقد استُخدمت على نطاق واسع في مجالات مثل معالجة اللغات الطبيعية (NLP)33، والتعرف على الكلام34، وترجمة النصوص35، والسفر36,37، والجريمة38، والتنبؤ بالاتجاهات المستقبلية39 (على سبيل المثال، حركة المرور40، وبورصات الأسهم41,42، والأرصاد الجوية43). وقد شكل نموذج GRU4Rec، الذي اقترحه Hidasi وآخرون، علامة فارقة في أبحاث توصيات التسلسل (SBR)، حيث كان أول من أدخل الشبكات العصبية المتكررة (RNNs) إلى توصيات التسلسل، وعمل على التقاط أنماط السلوك المتسلسلة للمستخدمين عبر وحدة GRU لتحقيق توصيات مخصصة.
أظهرت الشبكات العصبية الرسومية (GNNs)44 قدرة تعبيرية قوية في نمذجة العلاقات المعقدة ضمن البيانات ذات البنية الرسومية، وقد قدم بعض الباحثين الشبكات العصبية الرسومية لنمذجة الانتقالات المعقدة داخل الجلسات أو بينها. وبناءً على بنيات نماذج GNNs المختلفة، صُنفت الطرق القائمة على GNNs في التوصية القائمة على الجلسات (SBR) بشكل عام إلى الشبكات العصبية الرسومية ذات البوابات (GGNNs)45، والشبكات العصبية التلافيفية الرسومية (GCNs)46، وشبكات الانتباه الرسومية (GATs)47. وكان نموذج SR-GNN هو الأول الذي طبق GNNs في SBR من خلال تمثيل تسلسلات الجلسات كرسوم بيانية موجهة واستخدام GGNNs لالتقاط علاقات انتقال العناصر المعقدة داخل الجلسات، مدمجة مع آليات الانتباه للحصول على التضمين النهائي للجلسة، مما أدى إلى تحسين أداء التوصية. واقترح Chen L48 إطار عمل GNNs متعدد الرؤى يجمع بين السمات المهيكلة والكلمات المفتاحية غير المهيكلة لنمذجة ارتباطات المنتجات متعددة الأبعاد، مما حسن دقة SBR. كما صمم Driss E49 نظام توصية جلسات مبتكر يعتمد على الشبكات العصبية الرسومية الكبسولية لالتقاط سمات العناصر المعقدة وتعزيز دقة التنبؤ في SBR.
لقد أغنت تقنيات التعلم العميق المذكورة سابقاً نطاق البحث في توصيات الجلسات المتسلسلة (SBR) وحسّنت الأداء بشكل فعال، ومع ذلك، لا تزال تعاني من قيود معينة، تظهر بشكل أساسي في: 1) بالنسبة للعناصر الناشئة حديثاً أو الجلسات شديدة الندرة، يصعب على النماذج تقديم تنبؤات دقيقة بسبب نقص السياق العالمي؛ 2) عدم قدرتها على الاستفادة من الأنماط العالمية المتضمنة في جميع الجلسات التاريخية.
توصية هجينة قائمة على الجلسات
دمج نظام التوصية الهجين القائم على الجلسات نقاط القوة في تقنيات مختلفة، مثل التصفية التعاونية (collaborative filtering)، والتعلم العميق (Deep-Learning)، وآليات الانتباه، لتحسين أداء توصيات الجلسات (SBR). وقد تضمن نظام GC-SAN50 آلية انتباه ذاتي تعتمد على SR-GNN لالتقاط معلومات التفاعل للعناصر المهمة داخل الجلسة بشكل أفضل. كما قام نظام FGNN51 بتجميع المعلومات من العناصر المجاورة عبر آلية انتباه متعددة الرؤوس لتعلم علاقات متعددة للعنصر المستهدف. وينتمي نظام SR-HetGNN52 إلى أنظمة SBR التي تعتمد على الرسوم البيانية غير المتجانسة؛ ومن خلال إدخال عناصر متعددة الأنواع (المستخدم، العنصر، الجلسة) وحواف متعددة العلاقات (النقر، الشراء، التزامن، ارتباط السمات)، قام ببناء شبكة معرفية عالمية، متجاوزاً بذلك قيود تسلسلات العناصر الفردية، وكان طريقة مهمة لنمذجة سلوك المستخدمين المجهولين وارتباطات الاهتمامات عبر الجلسات في السنوات الأخيرة. وبدوره، قام نظام KGSR-SAP53 ببناء رسم بياني معرفي من خلال ربط العناصر بحواف ذات علاقات متعددة لوصف تفاعلات المستخدم والعنصر المتنوعة، مما حل مشكلة فقدان المعلومات في الرسوم البيانية العالمية التي تحتوي فقط على نوع واحد من الحواف (تفاعل المستخدم والعنصر). واقترح Wang ZH54 نموذج DiffSBR، وهو نموذج توصية للجلسات يعتمد على الانتشار (diffusion-based)، حيث يقوم بتوليد تفضيلات موثوقة للعنصر التالي من خلال محاكاة إزالة الضوضاء، مما يحسن نمذجة تسلسلات نقرات المستخدم الديناميكية. كما قام Qiao ST55 ببناء إطار عمل لـ SBR يجمع بين تعلم النوايا متعدد الرؤى والمحاذاة مع النماذج اللغوية الكبيرة (LLM)، حيث استخرج نوايا المستخدم الضمنية من منظورات متنوعة واستخدم النماذج اللغوية لمحاذاة السمات الدلالية لتحسين أداء التوصية بشكل أفضل.
السياق العالمي
للتغلب على قصور "عرض الجلسات بشكل منعزل"، أدرك الباحثون إمكانية استخدام المعلومات العالمية لتعزيز قدرة التمثيل للجلسة الحالية، وذلك لحل مشكلات مثل تشتت البيانات، والبداية الباردة، والفجوة الدلالية في أنظمة التوصية القائمة على الجلسات (SBR) التقليدية. وفي الوقت ذاته، تطلب بناء السياق العالمي دمج المعلومات العالمية في جلسة واحدة مع تقليل تداخل الضجيج إلى أدنى حد. وقد عمل نموذج CSRM56 على تحسين التمثيل على مستوى الجلسة من خلال دمج المعلومات التعاونية بين الجلسة الحالية والجلسات المجاورة، باستخدام مشفر ذاكرة خارجي (OME) لاستخراج القصد التعاوني من المعلومات التعاونية. واقترح نموذج CA-TCN57 نموذج شبكة عصبية تلافيفية زمنية مدركة للجلسات المتقاطعة، حيث قام ببناء رسوم بيانية عالمية ورسوم بيانية لسياق الجلسة لمحاكاة تأثير التقاطع بين الجلسات على العناصر والجلسات، بينما تعمل الشبكة العصبية التلافيفية الزمنية (TCN) على توسيع المجال الاستقبالي من خلال التلافيف المتسعة، بحيث تغطي عدد الطبقات تسلسلات ذات طول أسي (المجال الاستقبالي = )، مما يحل مشكلة تلاشي التدرج في الشبكات العصبية المتكررة (RNNs). واقترح Chen58 طريقة SBR تعتمد على الشبكات العصبية للرسوم البيانية الفائقة (SR-HGNNs)، والتي تدمج آليات الانتشار والاهتمام مختلطة الرتب (رتب منخفضة وعالية) لحل مشكلة التنعيم المفرط في الشبكات العصبية الرسومية (GNNs) التقليدية في الجلسات القصيرة والتمييز بين أهمية رتب الانتشار المختلفة، مما يتيح التقاط الاعتمادات بدقة أكبر وتجنب تداخل الضجيج. واستخدم نموذج GCE-GNN أزواج العناصر المتزامنة متعددة الرتب لبناء رسم بياني موزون غير موجه، مع حساب ترددات تزامن العناصر لتعكس أهمية العناصر في الجلسة؛ بينما استخدم AGNN-GC59 علاقات انتقال العناصر عبر الجلسات لبناء رسم بياني تعاوني عالمي، مع حساب احتمالات انتقال العناصر في الرسم البياني العالمي لتعكس تغيرات الاهتمام في الجلسة؛ أما DA-GCN60 فقد استخدم أقصر مسار لتحديث مصفوفة الجوار لبناء رسم بياني موزون ديناميكي، مع حساب تردد التزامن في الرسم البياني العالمي ومسافة المسار بين العناصر. واستلهاماً من الأدبيات المذكورة أعلاه، اقترحت هذه الورقة بناء رسم بياني عالمي من خلال طريقة تعتمد على الجيران، أي استخدام معامل تشابه Jaccard لحساب الجلسات المتشابهة، وهو ما لم يقتصر على الاستفادة من المعلومات العالمية فحسب، بل عمل أيضاً على تصفية الضجيج (استبعاد العناصر غير ذات الصلة)، مما حقق الغرض من بناء السياق العالمي بدقة وأرسى أساساً متيناً لخوارزمية SBR اللاحقة.
الاهتمام الخطي ذو الفتحات المبوّبة
تسببت المحولات التقليدية61 في تعقيد مكاني وزماني عالٍ بسبب الحاجة إلى عمليات انتباه متصلة بالكامل عبر التسلسل بأكمله على النحو التالي:
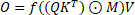 (1)
حيث تمثل Q و K و V ∈ RN×d تحويلات خطية للعناصر المدخلة، وكان M = {Mij = 1 if i ≥ j, o.w. −∞ } هو القناع السببي لمنع تسرب المعلومات المستقبلية، ورمز ⊙ يشير إلى الضرب العنصري، بينما مثلت f دالة التنشيط softmax.
لتحقيق الانتباه الخطي62، كانت الفكرة الأكثر مباشرة هي إزالة دالة التنشيط softmax. ومع ذلك، إذا تمت إزالة دالة التنشيط softmax بشكل مباشر، فإن الانتباه الخطي سيؤدي بالتأكيد إلى بعض المشكلات المحتملة: فقدان القدرة التعبيرية القوية للشبكات العصبية وعدم القدرة على حل المشكلات المعقدة في العالم الحقيقي.
الانتباه الخطي ذو الفتحات مع التحكم في الذاكرة المحدودة
بافتراض ضرورة الاحتفاظ بدالة التنشيط softmax، تم ضغط K و V بشكل منفصل إلى K̃ و Ṽ ∈ Rm×d. ومن منظور شبكة الذاكرة، كانت K̃ و Ṽ تحتويان على فتحات ذاكرة يزداد طولها مع التسلسل، أي أن عدد الفتحات m = N. أما إذا كانت m ثابتة، فإن الخطية تكون ممكنة بوضوح. واستلهاماً من التحكم في الذاكرة المحدودة (Bounded-memory Control)63، تطلب الأمر كتابة كل رمز (token) في العناصر المدخلة التي يبلغ طولها N بشكل تنافسي في m من الفتحات.
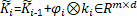 ,
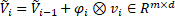 ,
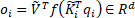 (2)
حيث كانت f دالة التنشيط softmax وكانت φi متجهاً للتحكم في المدخل الفعال للتحكم في قيمة المفتاح ki على النحو التالي.
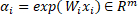 ,
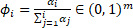 (3)
هنا، تمثل (φi)j كثافة الكتابة للرمز i في الفتحة j، وقد تم الحصول عليها باستخدام دالة softmax تراكمية.
لتحقيق حساب خطي فعال، تمت إعادة كتابة الصيغة (2) كصيغة (4)، والتي قامت بحساب οi من qi و ki و vi (المعادلة 4) بواسطة {οi|i=1T, qi, ki, vi)|i=1T} واعتمدت حساباً تسلسلياً ثنائي الممرات:
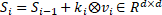 ,
 (4)
وبناءً على ذلك، يمكن اشتقاق عمليات SLA:
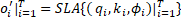 ,
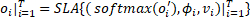 (5)
حيث oi′ ∈ ℝm، و οi ∈ ℝd. وبناءً على ذلك، يمكن لـ SLA اكتساب تدريب مجزأ خطي الزمن وفعال من حيث الأجهزة64.
الانتباه الخطي ذو الفتحات المبوّبة
يمكن لآلية الانتباه الخطي ذو الفتحات (Slot linear attention) مع التحكم في الذاكرة المحدودة أن تقلل من التعقيد الحسابي والمكاني. ومع ذلك، فإن تراكم المعلومات قد يؤدي أيضاً إلى إدخال معلومات ضوضائية في التفاعل ضمن الجلسة، لذا كان الاضمحلال المعتمد على البيانات مهماً جداً للاحتفاظ بالمعلومات ونسيانها بشكل انتقائي، وقد تمت إعادة دراسة هذه الآلية الانتقائية مؤخراً في نماذج حالة الفضاء الانتقائية 65. ويمكن التعبير عن آلية GSLA المعتمدة على البيانات كما يلي:
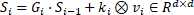 ,
 (6)
هنا تم تحديد معاملات بوابات الاضمحلال (decay gates) باستخدام صيغة الضرب الخارجي Gi = αi ⊗ βi، حيث αi، βi ∈ [0,1]d. وفيما يلي، يمكن كتابة GSLA أيضًا بالصيغة المكافئة التالية من خلال تعيين βt = 1 عادةً واستخدام ضرب المصفوفات كما هو موضح في64:
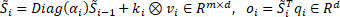 (7)
حيث يمثل αi و ki بشكل منفصل بوابة النسيان وبوابة الإدخال، ويمكن ربط البوابتين بحيث يكون ki = 1 − αi، استلهاماً من الدراسات المتعلقة بالشبكات العصبية المتكررة ذات البوابات (gated RNNs). وكان من الواضح أنه يمكن صياغة GSLA باستخدام حساب تسلسلي ثنائي المسار كما هو موضح في المعادلة (8). وقد دعم الهيكل من الدرجة الثانية التدريب المتوازي للكتل لتحسين كفاءة التدريب، كما أدى إدراج عملية softmax في منتصف الهيكل من الدرجة الثانية إلى تعزيز قدرة النمذجة لذاكرة الفتحات المحدودة.
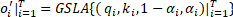 ,
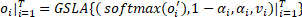 (8)
تحويل بيانات الجلسة
تحديد المشكلة
ليكن تسلسل الجلسة المعطى هو S = {v1s, v2s, ⋯, vns}، حيث يمثل vis العنصر الذي تم النقر عليه في الترتيب i. ومن خلال تحليل سلوك النقر للمستخدم ضمن هذا التسلسل، يتنبأ النظام بالعنصر التالي الذي قد يهتم به المستخدم vn+1s.
بناء الرسم البياني
بناء مخطط الجلسة
بالنسبة للجلسة S = {v1s, v2s, ⋯, vns}، تم بناء رسم بياني موجه Gs = (Vs, εs)، حيث كانت Vs مجموعة العناصر للجلسة المعطاة S، وكانت εs = {eijlocal|vi, vj, vi, vj ∈ Vs} مجموعة الحواف للجلسة المعطاة S. وقد مثلت ε(vi-1s, vis) العناصر التي تم النقر عليها بالتتابع في هذه الجلسة. ويمكن تقسيم الحافة eijlocal إلى أربعة أنواع: ein، و eout، و ein-out، و eself. ونظراً لأن العنصر نفسه قد يظهر بشكل متكرر في التسلسل، فقد تم حساب القيمة المرجحة لكل حافة.
تم تحويل الجلسة الحالية s = [v1, v2, v4, v2, v3] إلى رسم بياني للتسلسل (SG)، كما هو موضح في الشكل 1A.
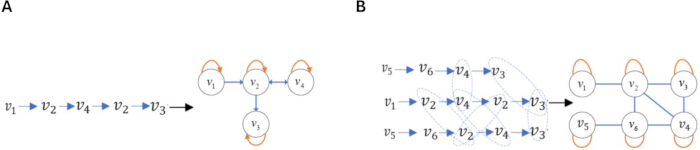
الشكل 1: تحويل العناصر التفاعلية إلى هياكل رسومية. (A) توضيح لبناء الرسم البياني للجلسة (SG) عن طريق تحويل الجلسة إلى رسم بياني. (B) توضيح لبناء الرسم البياني العالمي للجيران (NGG) عن طريق دمج العديد من الجلسات في رسم بياني واحد. تم رسم هذا الشكل ذاتيًا عبر برنامج Visio باستخدام عناصر مخصصة بالكامل. لم يتم استخدام أي موارد رسومية خارجية محمية بحقوق الطبع والنشر، وبالتالي لم تكن هناك حاجة إلى ترخيص حقوق طبع ونشر إضافي من طرف ثالث. حقوق الطبع والنشر للشكل مملوكة للمؤلفين وستمتثل لقواعد حقوق الطبع والنشر الخاصة بالمجلة عند القبول. يرجى النقر هنا لعرض نسخة أكبر من هذا الشكل.
بناء المخطط العالمي للجيران
بناءً على الجلسة الحالية S، تم إنشاء الرسم البياني المجاوز العام (NGG) المقابل Gg = (Vg, εg) لتعزيز تعلم تمثيل الجلسة الحالية بطريقة عابرة للجلسات. كانت Vg هي مجموعة العناصر التي تحتوي على جميع العناصر في Gg، وكانت εg = {eijglobal|vi, vj, vi, vj ∈ Vg} هي مجموعة الحواف لـ Gg. مثّلت ε(vi-1g, vig) العناصر المتفاعلة مباشرة vi-1g و vig في الـ NGG Gg. تألفت هذه العملية من خطوتين: الحصول على الجلسات المجاورة وإنشاء الـ NGG.
الحصول على جلسة الجوار
تم البحث في كامل مجموعة البيانات عن الجلسات التي تحتوي على أكبر عدد من العناصر المتزامنة مع الجلسة الحالية. وقد اختيرت أعلى N جلسة من حيث عدد التزامنات لتكوين مجموعة جلسات الجيران المرشحة S. لاحقاً، تم استخدام معامل تشابه جاكارد (Jaccard similarity coefficient) لحساب التشابه بين الجلسة الحالية cu والجلسة Sr ∈ S من مجموعة المرشحين S، كما هو موضح في المعادلة (9).
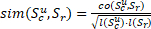 (9)
هنا، تشير co(Scu, Sr) إلى عدد العناصر التي تظهر معاً في كل من Scu و Sr، بينما يمثل l(Scu) و l(Sr) على التوالي أطوال Scu و Sr، وتشير Scu و Sr إلى الجلسة الحالية وجلسة مجاورة. تم استبعاد الجلسات التي تقل درجة تشابهها عن عتبة معينة (والتي يمكن تعيينها كمعامل فائق)، وشكلت الجلسات المتبقية مجموعة الجلسات المجاورة Ns للجلسة الحالية.
بناء المخطط العالمي للجيران
بناءً على مجموعة جلسات الجوار Ns، تم إنشاء الرسم البياني للمجالات المجاورة (NGG)، كما هو موضح في الشكل 1B. أثناء إنشاء مصفوفة التجاور، إذا حدث تفاعل بين عنصرين (vi, vj)، يتم تعيين الإدخال المقابل Aij إلى 1، وبخلاف ذلك، يتم تعيينه إلى 0. بالإضافة إلى ذلك، تمت معالجة التفاعلات بين العناصر كروابط غير موجهة ومزودة بحلقات ذاتية، متبوعة بعملية تطبيع (normalization)، كما هو موضح في الجدول 1.
| 1 | 2 | 3 | 4 | 5 | 6 | |
| 1 | 1/2 | 1/2 | 0 | 0 | 0 | 0 |
| 2 | 0 | 1/4 | 1/4 | 1/2 | 0 | 0 |
| 3 | 0 | 0 | 1 | 0 | 0 | 0 |
| 4 | 0 | 1/4 | 1/2 | 1/4 | 0 | 0 |
| 5 | 0 | 0 | 0 | 0 | 1/3 | 2/3 |
| 6 | 0 | 1/3 | 0 | 1/3 | 0 | 1/3 |
الجدول 1: مصفوفة التجاور المعيرة للرسم البياني العالمي للجيران. يعرض الجدول مصفوفة التجاور المعيرة التي تصف الاتصالات الموزونة بين العقد في الرسم البياني العالمي للجيران الذي تم إنشاؤه.
تصميم خوارزمية توصية قائمة على الجلسات
يتناول هذا القسم بالتفصيل النموذج المبتكر المقترح GSLA4Rec، والذي أدى إلى تحسين أداء SBR من خلال تقديم آلية GSLA على التمثيل المدمج لميزات SG وNGG.
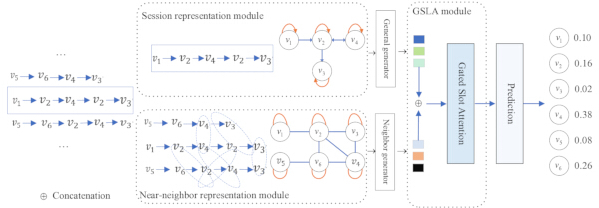
الشكل 2: إطار عمل GSLA4Rec. دمج إطار العمل هذا تعلّم بنية الرسم البياني للجلسة والرسم البياني العالمي للجيران، وقام بتصفية ضجيج التفاعل باستخدام آلية بوابية، ووازن بين التخزين والكفاءة من خلال آلية فتحات الذاكرة، والتقط صلة العناصر باستخدام آلية الانتباه الخطي للتنبؤ بتفضيلات النقر التالية للمستخدم. تم رسم هذا الشكل ذاتيًا عبر برنامج Visio باستخدام عناصر مخصصة بالكامل. لم يتم استخدام أي موارد رسومية خارجية محمية بحقوق الطبع والنشر، وبالتالي لم تكن هناك حاجة إلى تراخيص حقوق طبع ونشر إضافية من طرف ثالث. حقوق طبع ونشر الشكل مملوكة للمؤلفين وستمتثل لقواعد حقوق الطبع والنشر الخاصة بالمجلة عند القبول. يمثل GSLA4Rec الشبكات العصبية الرسومية ذات الانتباه الخطي والفتحات البوابية لنظام SBR. يرجى النقر هنا لعرض نسخة أكبر من هذا الشكل.
يوضح الشكل 2 إطار عمل GSLA4Rec، والذي يتكون من أربعة مكونات رئيسية: 1) تمثيل العناصر على مستوى الجلسة: حيث تم استخدام نموذج GNNs على SG لتعلم تضمينات العناصر على مستوى الجلسة ضمن الجلسة الحالية؛ 2) تمثيل العناصر على المستوى العالمي للجيران: حيث تم تعلم تضمينات العناصر على المستوى العالمي عبر جميع الجلسات من خلال استخدام GRU لدمج تضمينات الجيران لكل عنصر بشكل تكراري بناءً على NGG؛ 3) GSLA: حيث تم نمذجة تفضيلات المستخدمين في الجلسة الحالية عن طريق تجميع تمثيلات العناصر المتعلمة على كل من مستوى الجلسة والمستوى العالمي؛ 4) طبقة التنبؤ: والتي أخرجت احتمالات التنبؤ للعناصر المرشحة. وقد تم عرض المكونات الأربعة بالتفصيل في ما يلي.
تمثيل الجلسة
كان فهم سلوكيات تفاعل المستخدمين أمراً بالغ الأهمية في نظام توصية الجلسات (SBR). وتحقيقاً لهذه الغاية، تم بناء رسم بياني اجتماعي (SG) ورسم بياني غير متجانس للشبكة (NGG) لتعلم تمثيل الجلسات، وذلك بهدف الفهم الشامل لسلوكيات تفاعل المستخدمين وبالتالي التقاط نوايا المستخدمين الأكثر دقة.
تمثيل العناصر على مستوى الجلسة
استناداً إلى الرسم البياني الموجه (SG) في الشكل 1A، تم استخدام طريقة انتباه الرسم البياني ثنائي الاتجاه الموزون (WBGAT) لاستخراج ميزات الرسم البياني الموجه. وقد قدمت هذه الطريقة أوزان الحواف واتجاهية العناصر (الجار الداخل والجار الخارج) بناءً على آلية GAT القياسية، مما حقق تأثير تعزيز الحواف المهمة والتقاط التبعيات ثنائية الاتجاه، وبالتالي عالجت أوجه القصور في GAT التقليدية فيما يتعلق بعلاقات العناصر غير المتماثلة وقوة التفاعل. وكانت عملية الحساب كما يلي:
أولاً، حساب أوزان تسوية درجة الدخول للعنصر.
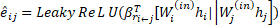 (10)
حيث تشير eij إلى وزن الجار الداخلي من الدرجة الأولى لميزات العنصر j بالنسبة للعنصر i، و تمثل العلاقة بين العنصر i والعنصر j، بينما كانت β* ∈ ℝd متجهات الوزن، وhi و hj يمثلان تمثيل العنصر i والعنصر j على التوالي، وكانت Wi(in) ∈ ℝd*d و Wj(in) ∈ ℝd*d معلمات قابلة للتدريب، بينما يمثل الرمز || عملية الدمج (concatenation). وللتمييز بين علاقات الدرجة الداخلة المختلفة، تم تدريب متجهي وزن، وهما rin و rin-self. كما تم اعتماد LeakyReLU كدالة تنشيط.
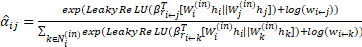 (11)
لجعل المعاملات قابلة للمقارنة عبر العناصر المختلفة، تم تطبيع أوزان الانتباه باستخدام دالة softmax. حيث كانت Ni(in) تمثل مجموعة الجيران الداخلين من الدرجة الأولى للعنصر i، و تمثل وزن الجار الداخل للحافة الموجهة (i←j) في SG، وقد مكنت هذه الطريقة النموذج من تعلم ارتباطات ميزات العناصر مع الاحتفاظ بمعلومات قوة الاتصال المتأصلة في بنية الرسم البياني من خلال أخذ اللوغاريتم لأوزان الحواف وإضافتها إلى درجة الانتباه الأصلية eij.
ثانيًا، حساب أوزان تطبيع درجة الخروج للعنصر.
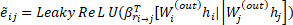 (12)
حيث يشير ẽij إلى وزن الجار الخارجي من الدرجة الأولى لسمات العنصر j بالنسبة للعنصر i،  كانت العلاقة بين العنصرين i و j، وتم تدريب متجهي وزن، وهما rout و rout-self.
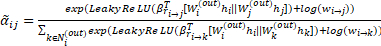 (13)
حيث تمثل Ni(out) مجموعة الجيران الخارجة من الدرجة الأولى للعنصر i، بينما تمثل  وزن الجار الخارج للحافة الموجهة (i→j) في SG.
ثالثاً، تجميع المعلومات. يمكن الحصول على التضمين المحدث للعنصر بعد ترجيح وجمع تضمينات الدرجة الداخلة والخارجة من الدرجة الأولى للعنصر i.
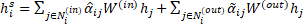 (14)
حيث تشير  و α̃ij على التوالي إلى أوزان الدرجة الداخلة والدرجة الخارجة للعنصر i، بينما تشير
 إلى التمثيل المحدّث للعنصر i.
تمثيل العناصر على المستوى العالمي للجيران
اتفقت الأبحاث الحديثة باستمرار على أن بناء رسم بياني عالمي يمكن أن يعزز تمثيل البيانات وبالتالي يحسن أداء SBR، وكان هذا الأمر لا يدع مجالاً للشك. ومع ذلك، فإن التعزيز العالمي للبيانات قد يؤدي أيضاً إلى إدخال معلومات غير ذات صلة مثل الضوضاء. وفي النموذج المقترح، ومن أجل تحقيق تعزيز عالمي للبيانات مع تقليل الضوضاء إلى أقصى حد ممكن، تم بناء رسم بياني عالمي للجيران القريبين.
بناءً على الرسم البياني الموجه غير المتجانس (NGG) في الشكل 1B ومصفوفة الجوار المعيرة في الجدول 1، تم تحويل الجلسة الحالية والجلسات المجاورة لها إلى NGG، وطُبقت طريقة الشبكات العصبية للرسوم البيانية الموجهة (GGNNs)45 لاستخراج سمات الـ NGG. وقد وُضحت عملية تعلم ناقلات العناصر في الـ NGG في المعادلة (15).
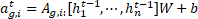
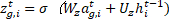
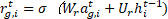
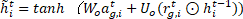
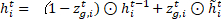 (15)
تشير W ∈ ℝd×2d إلى أوزان التحكم، بينما يمثل zg,i و rg,i بوابة التحديث وبوابة إعادة التعيين، على التوالي. وتمثل [h1t-1, ⋯, hnt-1] قائمة بجميع متجهات العناصر في الجلسة s. وكانت σ(x) = 1/(1 + e-x) هي دالة السجمويد اللوجستية، ويشير الرمز ⊙ إلى الضرب العنصري، بينما يمثل hi ∈ ℝd المتجه بعد التحديث المبوب. وأشارت مصفوفة الجوار As ∈ ℝn×n إلى الاتصال بين العناصر في الجلسات المجاورة، ومثل As,i: ∈ ℝ1×n كتلة عمودية من As المقابلة للعنصر vs,i في مصفوفة الجوار. وبالنسبة للجلسة الحالية s = [v1, v2, v4, v2, v3]، تم توضيح الـ NGG ومصفوفة الجوار المعيرة في الشكل 1B والجدول 1، على التوالي.
تمثيل العناصر
تم الحصول على تمثيل العنصر عن طريق جمع متجه العنصر على مستوى الجلسة ومتجه العنصر على المستوى العالمي للمجاور، كما هو موضح في المعادلة (16):
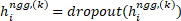
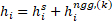 (16)
حيث استُخدم الإسقاط (dropout) على تمثيلات العناصر المجاورة على المستوى العام للتخفيف من فرط التخصيص (overfitting).
الانتباه الخطي ذو الفتحات المبوب
دمجت آلية الانتباه الخطي ذو الفتحات المبوبة (GSLA) في هذا البحث بين الانتباه الخطي والتحكم في الذاكرة المحدودة وآلية تبويب تعتمد على البيانات. فمن ناحية، ورثت هذه الآلية نظام فتحات الذاكرة المحدودة الخاص بنموذج المتحكم القائم على الانتباه (ABC)، حيث تم ضغط أزواج المفتاح والقيمة التي كانت تزداد أصلاً مع طول التسلسل إلى عدد ثابت من الفتحات، ويتم تحديث كل فتحة عبر الكتابة التنافسية، مما عالج مشكلة التعقيد الحسابي للانتباه العالمي في نماذج transformer. ومن ناحية أخرى، قدمت الآلية نظام تبويب دقيقاً مشابهاً لـ GLA، حيث تقوم بيانات الإدخال بتعديل نسبة الاحتفاظ بالمعلومات التاريخية ديناميكياً من خلال بوابة نسيان αi، مما حل مشكلة الضوضاء الناتجة عن غياب آلية النسيان في نموذج ABC.
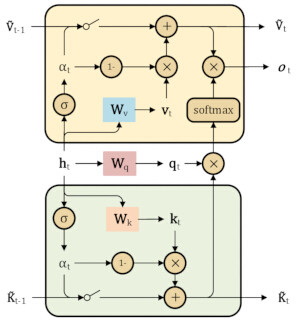
الشكل 3: مخطط تخطيطي لـ GSLA. تم تعيين متجه الإدخال إلى متجه الاستعلام، ومتجه الكلمة المفتاحية، ومتجه القيمة، على التوالي، ثم تمت معالجته بواسطة الانتباه الخطي مع تحكم في الذاكرة المحدودة وآلية بوابية تعتمد على البيانات للحصول على متجه الاستعلام المحدث، ومتجه الكلمة المفتاحية، ومتجه القيمة، ومتجه المخرجات. تم رسم هذا الشكل ذاتياً عبر Visio بعناصر مخصصة بالكامل. لم يتم استخدام أي موارد رسومية خارجية محمية بحقوق الطبع والنشر، وبالتالي لم تكن هناك حاجة إلى تراخيص حقوق طبع ونشر إضافية من طرف ثالث. تعود ملكية حقوق الطبع والنشر للشكل إلى المؤلفين وسوف تتوافق مع قواعد حقوق الطبع والنشر الخاصة بالمجلة عند القبول. يمثل GSLA الانتباه الخطي ذو الفتحات البوابية (gated-slot linear attention). يرجى النقر هنا لعرض نسخة أكبر من هذا الشكل.
كما هو موضح بالتحديد في الشكل 3، تم تعيين متجه الإدخال بشكل منفصل إلى متجه الاستعلام، ومتجه المفتاح، ومتجه القيمة64:
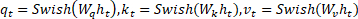 (17)
حيث تمثل Wq، وWk، وWv ∈ ℝd×d مصفوفات أوزان التحويل المقابلة للاستعلام (query)، والمفتاح (key)، والقيمة (value) على التوالي، بينما يشير ht إلى متجه التضمين عند الخطوة الزمنية t في تسلسل مدخلات الجلسة. عُرّفت دالة Swish على أنها Swish(x) = x · σ(x) وهي دالة تنشيط ذاتية البوابة، حيث تمثل σ دالة Sigmoid، وقد تفوقت هذه الدالة على دالة التنشيط التقليدية ReLU في مهام متعددة من مهام التعلم العميق (Deep-Learning).
استخدمت GSLA بوابة نسيان αi وبوابة إدخال 1 − αi، اعتماداً على بيانات الإدخال، لتحديث المعلومات ديناميكياً في فتحة الذاكرة رقم i. وكانت العملية على النحو التالي64:
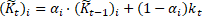 (18)
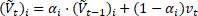 (19)
هنا، تمثل K̃t و Ṽt فتحات متجه المفتاح وفتحات متجه القيمة عند الخطوة الزمنية t، بينما تمثل K̃t-1 و Ṽt-1 فتحات متجه المفتاح وفتحات متجه القيمة عند الخطوة الزمنية t−1. وبوابة النسيان αi = σ(Wαht)1/τ، حيث كانت Wα ∈ ℝd مصفوفة وزن التحويل، و σ هي دالة Sigmoid، و τ هو معامل التخميد (الذي يتم ضبطه عادةً على 8)، والمستخدم للتحكم في مرونة بوابة النسيان. وقد سمح ذلك لـ GSLA بتعديل معدل نسيان المعلومات التاريخية بسلاسة: فكلما كانت αi أكبر، زاد اعتماد GSLA على المعلومات التاريخية، وكلما كانت αi أصغر، زاد تركيز GSLA على المدخلات الحالية.
كُتبت فتحات متجه المفتاح K̃t وفتحات متجه القيمة Ṽt للفتحات عند الخطوة t في شكل مصفوفة، كما هو موضح65 في المعادلتين (20) و(21):
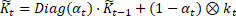 (20)
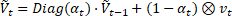 (21)
بعد ذلك، تم استخدام GSLA ذات الخصائص من الدرجة الثانية (راجع المعادلة (8)) لحساب المخرجات oi |i=1T لكل خطوة زمنية i ∈ [1, …, T]. وطُبق تحويل خطي على مخرجات كل خطوة زمنية للحصول على النتيجة h̃t. وأخيرًا، تم حساب القيمة المتوسطة لتمثيلات جميع العناصر في تسلسل الجلسة لإنشاء تضمين الجلسة S̃e مع تحديثات الذاكرة الديناميكية:
 (22)
 (23)
هنا، مثّل ot مخرجات Gated-Slot عند الخطوة الزمنية t، بينما رمز h̃t إلى نتيجة تطبيق التحويل الخطي على ot. ورمز S̃e إلى القيمة المتوسطة لـ h̃t عبر جميع الخطوات الزمنية.
طبقة التنبؤ
بناءً على تمثيل الجلسة الذي تم الحصول عليه S̃e والتضمين الأولي للعنصر i، أُجريت عملية الضرب النقطي لحساب درجة كل عنصر مرشح hi. بعد ذلك، استُخدمت دالة softmax للحصول على احتمالات التوصية للعنصر المرشح i:
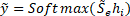 (24)
هنا، يمثل ỹ احتمالات التوصية للعنصر المرشح، بينما يشير hi إلى متجه العنصر المرشح، وقد تم استخدام دالة فقدان الإنتروبيا المتقاطعة (cross-entropy loss function) لتدريب النموذج.
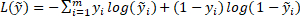 (25)
هنا، كان y هو التمثيل المشفر بترميز "one-hot" للحقيقة الأرضية (ground truth).
النتائج
مجموعات البيانات والمعالجة المسبقة
في هذه التجارب، تم اختيار ثلاث مجموعات بيانات عامة لأنظمة التوصية القائمة على الجلسات (SBR) مشتقة من بيانات معاملات حقيقية في سيناريوهات تطبيق عملية لتقييم أداء النموذج: مجموعة Diginetica التي تم استخراجها من مسابقة CIKM Cup 2016، والتي تحتوي على سجلات معاملات ونقرات المستخدمين، ومجموعة Tmall التي تتعلق بسجلات المستخدمين من منصة Tmall وتسجل سلوكيات التصفح والشراء للمستخدمين، ومجموعة Nowplaying التي تحتوي على سجلات موسيقية حول تاريخ تشغيل المستخدمين على المنصات الموسيقية. استُخدمت مجموعات البيانات هذه على نطاق واسع في أبحاث SBR، ويمكنها تقييم فعالية النموذج وقابليته للتطبيق بشكل شامل.
في مرحلة المعالجة المسبقة للبيانات، تم توحيد مجموعات البيانات لضمان الاتساق في جودة البيانات. وتحديداً، تم استبعاد جميع الجلسات التي يقل طولها عن 2، كما تم حذف العناصر التي ظهرت أقل من 5 مرات. علاوة على ذلك، تم توليد تسلسلات فرعية متعددة لكل جلسة S = {v1, v2, ..., vn} لغرض تدريب النموذج واختباره. وقد اتخذت هذه التسلسلات الفرعية الصيغة التالية: ([v1]|v2), ([v1, v2]|v3), ..., ([v1, v2, ..., vn-1]|vn). وبعد إتمام المعالجة المسبقة المذكورة أعلاه، أُجريت تحليلات إحصائية على مجموعات البيانات، وعُرضت المعلومات المفصلة في الجدول 2.
| مجموعة البيانات | ديجينيتيكا (Diginetica) | Tmall | يتم التشغيل الآن |
| انقر | 982961 | 818479 | 1367963 |
| تدريب | 719470 | 351268 | 825304 |
| اختبار | 60858 | 25898 | 60417 |
| العناصر | 43097 | 40728 | 60417 |
| متوسط الطول | 5.12 | 6.69 | 7.42 |
الجدول 2: وصف مجموعة البيانات. يلخص الجدول الإحصائيات الخاصة بمجموعات بيانات Diginetica وTmall وNowplaying، بما في ذلك أعداد النقرات، وعينات التدريب والاختبار، والعناصر، ومتوسط طول الجلسة.
الإعدادات التجريبية
إعداد المعايير
لضمان عدالة التجربة، تم اعتماد طرق معالجة مسبقة لمعالجة ثلاث مجموعات بيانات، مع ضبط مسبق لمعلمات نموذج GSLA4Rec. بالنسبة لمجموعتي بيانات Diginetica و Nowlaying، تم ضبط حجم الدفعة (batch size) على 150، و300 لمجموعة بيانات Tmall. تم تهيئة معلمات هذا النموذج باستخدام توزيع غاوسي بمتوسط 0 وانحراف معياري 0.1، وتم ضبط البعد على 100، واستُخدم المحسن Adam بمعدل تعلم أولي قدره 0.001، وكان معدل التعلم يُضرب في 0.1 كل 3 دورات (epochs). أُجري التدريب لمدة إجمالية بلغت 30 دورة على وحدة معالجة الرسوميات NVIDIA TITAN V وباستخدام PyTorch 1.11.0 مع cu113 (راجع جدول المواد) للحصول على أفضل قيمة، وتم ضبط عتبة تصفية الجلسات المجاورة على 0.5، كما طُبق تسوية L2 في التجربة. وبالنسبة لكل مجموعة بيانات، تم اختيار آخر 10% من البيانات المرتبة حسب وقت التداول كمجموعة اختبار، بينما تم اختيار الـ 10% والـ 80% المتبقية عشوائياً كمجموعتي التحقق والتدريب على التوالي. تم ضبط عدد فتحات الذاكرة في GSLA على قيمة من {0, 1, 2, 3, 4, 5}.
مقاييس التقييم
اعتمدت هذه الورقة البحثية مقياسي P@N (الدقة عند N، حيث N = 10/20) و MRR@N (متوسط الرتبة المقلوبة عند N، حيث N = 10/20). وقد استُخدم مقياس P@N لقياس نسبة التوصيات الصحيحة من بين أول N نتيجة توصية، بينما استُخدم مقياس MRR@N لحساب متوسط الرتبة المقلوبة للمشاريع الصحيحة، وكلما ارتفعت قيمة MRR، كان أداء الفرز أفضل.
تحليل الأداء
تم تقييم فعالية نموذج GSLA4Rec مقابل نماذج أساسية تمثل مراحل مختلفة من التطور التكنولوجي. في البداية، استُخدمت طرق تعلم الآلة في التوصية القائمة على الجلسات (SBR)، فعلى سبيل المثال، استُخدم FPMC5 للتنبؤ بالتأثير التسلسلي بناءً على سلسلة ماركوف. بعد ذلك، طُبق التعلم العميق على نطاق واسع في SBR مع تطور الذكاء الاصطناعي؛ فعلى سبيل المثال، اعتمد GRU4Rec10 على الشبكات العصبية المتكررة (RNNs) التي تقوم بنمذجة SBR عن طريق تكديس طبقات متعددة من وحدات GRU وتصميم دوال خسارة متخصصة لتحسين SBR، بينما قدم NARM16 آلية الانتباه (AM) لالتقاط الاهتمامات الرئيسية للمستخدمين، وتوليد تمثيل تضمين نهائي للعنصر التالي المحتمل للتوصية، واستخدم STAMP17 مدركات متعددة الطبقات (MLPs) معززة بآلية AM لالتقاط الاهتمام العام والاهتمام الفوري للمستخدمين في آن واحد. وفي السنوات الأخيرة، استُخدمت الشبكات العصبية الرسومية (GNNs) على نطاق واسع أيضًا في SBR نظرًا لقدرتها القوية على تعلم البيانات غير الإقليدية. على سبيل المثال، طبق SR-GNN22 الشبكات العصبية الرسومية على SBR لأول مرة، حيث استخلص علاقات انتقال العناصر المعقدة من خلال GGNNs وركز على الاهتمامات الفورية للمستخدمين بالاشتراك مع آلية AM، واستخدم GCE-GNN23 شبكات GATs للحصول على علاقات انتقال العناصر في السياقات المحلية والعالمية، وولّد تمثيلات للجلسات من خلال RPE و soft-AM، بينما قام S2-DHCN66 بتحويل بيانات الجلسة إلى رسم بياني فائق (hypergraph) ورسم بياني خطي (line-graph) واستفاد من التعلم الخاضع للإشراف الذاتي لتعزيز SBR.
تم مؤخراً اعتماد نهج شامل لتعزيز أداء توصيات الجلسات (SBR). فعلى سبيل المثال، دمج GC-SAN50 الشبكات العصبية الرسومية (GNNs) مع شبكات الانتباه الذاتي متعددة الطبقات لتحسين أداء التوصية من خلال نمذجة التبعيات قصيرة وطويلة المدى، بينما دمج TASRec67 المعلومات الزمنية عبر بناء تسلسل من لقطات الرسوم البيانية الديناميكية في طوابع زمنية مختلفة، واعتمد CT-GNN68 الشبكات العصبية الرسومية (GNNs) مع معلومات زمنية مدمجة لتعلم معلومات الارتباط الزمني الإضافية بين العناصر، وقام CORE69 بدمج معلومات التواجد المشترك والمعلومات الزمنية للعناصر للحصول على التمثيل النهائي للجلسة، واقترح RESTC70 أنماط تفاعل مكانية-زمانية مستوحاة من خصائص التوحيد والمحاذاة في التعلم التبايني، بينما اعتمد COTRec66,71 التعلم الخاضع للإشراف الذاتي على عرضين للرسوم البيانية للجلسات والتدريب المشترك لحل مشكلة ندرة البيانات في SBR، واستفاد RAIN71 من تقنيات قناع الحواف وإعادة البناء الهيكلي، وقام بتدريب مؤشر حواف بشكل مشترك لتحديد الحواف المشوشة وإزالتها صراحةً، مما أدى إلى تعزيز دقة وقوة SBR بشكل كبير.
| مجموعات البيانات | Diginetica | Tmall | Nowplaying | ||||||||||
| تصنيف الطريقة | المقاييس | P@10 | P@20 | MRR@10 | MRR@20 | P@10 | P@20 | MRR@10 | MRR@20 | P@10 | P@20 | MRR@10 | MRR@20 |
| تعلم الآلة | FPMC | 15.42 | 22.10 | 6.20 | 6.66 | 13.12 | 16.05 | 7.10 | 7.30 | 5.28 | 7.35 | 2.66 | 2.82 |
| التعلم العميق | GRU4REC | 17.92 | 30.80 | 7.73 | 8.20 | 9.47 | 10.93 | 5.78 | 5.89 | 6.74 | 7.92 | 4.40 | 4.48 |
| التعلم العميق | NARM | 35.44 | 48.32 | 15.12 | 16.00 | 19.16 | 23.30 | 10.40 | 10.70 | 13.60 | 18.59 | 6.62 | 6.92 |
| التعلم العميق | STAMP | 33.97 | 46.62 | 14.26 | 15.13 | 22.63 | 26.47 | 13.10 | 13.35 | 13.20 | 17.65 | 6.57 | 6.88 |
| شبكات GNNs | SR-GNN | 38.42 | 51.26 | 16.89 | 17.76 | 23.41 | 27.57 | 13.46 | 13.72 | 14.17 | 18.86 | 7.15 | 7.47 |
| شبكات GNNs | S2 -DHCN | 40.21 | 53.66 | 17.59 | 18.51 | 26.22 | 31.42 | 14.60 | 15.05 | 17.35 | 23.50 | 7.87 | 8.18 |
| شبكات GNNs | GCE-GNN | 41.16 | 54.22 | 18.15 | 19.04 | 28.01 | 33.42 | 15.08 | 15.42 | 16.94 | 22.37 | 8.03 | 8.40 |
| GNNs + Att | TASRec | 39.85 | 52.53 | 17.19 | 18.22 | 25.72 | 29.58 | 14.22 | 14.51 | 16.35 | 20.52 | 7.30 | 7.78 |
| GNNs + Att | GC-SAN | 38.40 | 51.30 | 16.80 | 17.80 | 23.50 | 27.60 | 13.50 | 13.80 | 14.20 | 18.90 | 7.20 | 7.50 |
| GNNs + Tem | CT-GNN | 39.40 | 52.71 | 17.50 | 18.56 | 25.95 | 31.42 | 14.52 | 15.00 | 16.55 | 22.28 | 7.75 | 8.06 |
| GNNs + Tem | CORE | 41.03 | 52.84 | 17.95 | 18.47 | 32.97 | 39.16 | 18.72 | 19.16 | 17.65 | 21.81 | 7.92 | 7.35 |
| GNNs + Tem | RESTC | 42.35 | 55.93 | 18.75 | 19.65 | 35.57 | 42.47 | 18.05 | 18.52 | 18.39 | 24.79 | 8.31 | 8.72 |
| GNNs + COT | COTRec | 39.87 | 54.18 | 17.53 | 19.07 | 30.62 | 36.35 | 17.65 | 18.04 | - | - | - | - |
| GNNs + ReStr | RAIN | - | 55.50 | - | 19.20 | - | 38.73 | - | 19.12 | - | 24.17 | - | 8.47 |
| GNNs + Gated-Slot | GSLA4Rec | 43.35 | 56.47 | 19.38 | 19.98 | 36.56 | 43.60 | 19.46 | 19.96 | 19.80 | 27.10 | 8.86 | 9.32 |
| الانحراف المعياري (SD) | ±0.0009 | ±0.0011 | ±0.0008 | ±0.0009 | ±0.0018 | ±0.0021 | ±0.0016 | ±0.0018 | ±0.0028 | ±0.0031 | ±0.0024 | ±0.0026 | |
| القيمة الاحتمالية (p-value) | <0.001 | <0.001 | <0.001 | <0.001 | <0.001 | <0.001 | <0.001 | <0.001 | <0.001 | <0.001 | <0.001 | <0.01 | |
| Tالاستدلال | 0.294 | 0.296 | 0.295 | 0.297 | 0.168 | 0.169 | 0.169 | 0.171 | 0.472 | 0.478 | 0.475 | 0.479 | |
الجدول 3: مقارنة الأداء على ثلاث مجموعات بيانات. يقارن الجدول بين GSLA4Rec وطرق التوصية القائمة على تعلم الآلة، والتعلم العميق، وشبكات GNN، والآليات القائمة على الانتباه، والطرق الزمنية، وطرق توصية أخرى، وذلك على مجموعات بيانات Diginetica و Tmall و Nowplaying باستخدام P@10 و P@20 و MRR@10 و MRR@20. كما تم ذكر قيم SD وقيم p لـ GSLA4Rec.
من أجل التحقق من أداء نموذج GSLA4Rec واستبعاد العشوائية في تحسن الأداء الناتجة عن عوامل عشوائية، تم إجراء تجارب تجميعية متعددة وتحليلات إحصائية على مجموعة الاختبار. وتحديداً، قُسمت مجموعة الاختبار إلى مجموعات تضم 150 جلسة لكل دفعة، وكُررت العملية 30 مرة باستخدام طريقة البذرة العشوائية (random seed). وحُسب متوسط النتائج واستهلاك الوقت لجميع التجارب المجمعة لتمثيلا أداء نموذج GSLA4Rec ووقت الاستنتاج الخاص به، على التوالي. كما حُسب الانحراف المعياري (SD) واختبار الدلالة الإحصائية t-test لنموذج GSLA4Rec لمزيد من التحقق من استقرار وموثوقية تحسن أداء نموذج GSLA4Rec. يوضح الجدول 3 الأداء، والانحراف المعياري (SD)، وقيمة p-value، وTinference لنموذج التوصية المقترح GSLA4Rec، مقارنة بالنماذج المرجعية (baselines) عبر مجموعات البيانات الثلاث. تشير الأرقام التي تحتها خط إلى أفضل طريقة مرجعية، بينما تم تمييز النموذج صاحب أفضل أداء لكل مقياس تقييم بالخط الأسود العريض.
طرق التوصية القائمة على تعلم الآلة: في مهام SBR، أظهرت طريقة FPMC التقليدية أسوأ أداء، ويرجع ذلك أساساً إلى فشل نماذج سلاسل ماركوف في التقاط أنماط الانتقال المعقدة بين العناصر. 2) طرق التوصية القائمة على التعلم العميق: استخدمت نماذج مثل GRU4REC وNARM وSTAMP مناهج نمذجة التسلسلات وحققت تحسينات معينة في الأداء. ومن بينها، أظهر نموذجا NARM وSTAMP نتائج توصية أفضل من GRU4REC، وذلك أساساً لأن NARM أدخل آلية الانتباه لالتقاط الاهتمامات الأساسية للمستخدمين. 3) طرق التوصية القائمة على شبكات GNNs: أدى اعتماد شبكات GNNs في SBR إلى تحسينات ملحوظة في الأداء. على سبيل المثال، تفوق نموذج SR-GNN، الذي كان سباقاً في تحويل تسلسلات الجلسات إلى هياكل رسومية لالتقاط المعلومات الهيكلية المكانية للعناصر، على طرق التعلم العميق المتمثلة في STAMP بتحسن يتراوح بين 0.36–4.64%، مما يثبت الميزة المكانية للهياكل الرسومية في معالجة البيانات التسلسلية. واعتمد نموذج S2-DHCN على التلافيف الرسومية الفائقة ثنائية القناة لالتقاط التبعيات عالية الرتبة بين العناصر، ودمج التعلم التبايني ذاتي الإشراف لتعزيز التمثيلات، مما عالج قصور شبكات GNNs التقليدية في نمذجة العلاقات الثنائية فقط ونقص المعلومات، حيث تجاوز أداؤه طرق التعلم العميق المتمثلة في STAMP بنسبة 1.30–7.04%. أما نموذج GCE-GNN، فمن خلال دمجه الفعال لمعلومات الجلسة الواحدة والمعلومات العالمية للجلسات، تفوق على طرق التعلم العميق المتمثلة في STAMP بنسبة 1.46–7.60% وتفوق على SR-GNN بنسبة 0.88–5.85%، مما يشير إلى أن طرق الهياكل الرسومية التي تدمج المعلومات السياقية العالمية يمكن أن تعزز أداء SBR بشكل كبير. 4) طرق التوصية القائمة على GNNs + آلية الانتباه: هدف نموذج TASRec إلى التقاط التفضيلات قصيرة وطويلة المدى في تسلسلات سلوك المستخدمين بدقة أكبر من خلال إدخال آلية مدركة للوقت، وقد تجاوز أداؤه طرق التعلم العميق بنسبة 0.73–5.91% ونموذج SR-GNN بنسبة 0.30–2.31%، ولكنه كان أقل من نموذج GCE-GNN بنسبة 0.59–3.84%. ودمج نموذج GC-SAN بين الهياكل الرسومية المحولة من تسلسلات الجلسات وآليات الانتباه الذاتي متعددة الرؤوس لالتقاط التبعيات المحلية وطويلة المدى داخل الجلسات بنجاح، وكان أداؤه مقارباً أو أقوى قليلاً من نموذج SR-GNN ولكنه كان أدنى من نموذجي TASRec وGCE-GNN. وهذا يشير إلى أن إدخال آليات الانتباه يمكن أن يحسن أداء SBR بفعالية، ومع ذلك كان التحسين أقل أهمية من ذلك الذي حققته المعلومات العالمية، مما يؤكد أهمية المعلومات السياقية العالمية. 5) طرق التوصية القائمة على GNNs + ترميز الوقت: كان CT-GNN أول من دمج الهياكل الرسومية مع الترميز الزمني لالتقاط "البنية المكانية" و"الديناميكيات الزمنية" في آن واحد، متفوقاً على نموذج GC-SAN بنسبة 0.55–3.82%. والتقط نموذج CORE التفضيلات طويلة المدى والنوايا قصيرة المدى من خلال التحليل الإحصائي لتكرارات التواجد المشترك للعناصر من الجلسات العالمية وتصميم وزن موضعي زمني للجلسات الحالية على التوالي، ودمج هذه المعلومات المشتركة والزمنية للحصول على التمثيل النهائي للجلسة، حيث تجاوز أداؤه نموذج TASRec بنسبة 0.25–9.58% ونموذج GC-SAN بنسبة 0.67–11.56%، مظهرًا تحسناً ملحوظاً بنسبة 3.64–5.74% عن نموذج GCE-GNN في مجموعة بيانات Tmall. وقدم RESTC نموذج تعلم تبايني يعتمد على شبكات GNNs المكانية-الزمانية لمعالجة المشكلات في شبكات GNNs التقليدية، مثل التركيز فقط على الهياكل الرسومية المكانية، وتجاهل المعلومات الزمنية، وعدم كفاية الدمج المكاني-الزماني، حيث تجاوز أداؤه نموذج CORE بنسبة 0.39–3.31% ونموذج GCE-GNN بنسبة 0.28–7.56%، مما يشير إلى أن كلاً من الترميز الزمني والتعلم التبايني يعززان أداء SBR بفعالية. واستخدم RAIN تقنيات قناع الحواف وإعادة البناء الهيكلي لتدريب مؤشر حواف بشكل مشترك لتحديد واستبعاد الحواف المشوشة صراحةً، محققاً أداءً قريباً من أداء نموذج RESTC.
دمج النموذج المقترح، GSLA4Rec، معلومات السياق العالمي مع آلية انتباه خطي ذات فتحات بوابية (gated-slot linear attention) لالتقاط المعلومات السياقية للمستخدمين بفعالية مع تصفية الضوضاء وتقليل التعقيد الحسابي. وقد أظهر النموذج تحسينات في الأداء عبر جميع مجموعات البيانات، متجاوزاً أفضل نموذجين مرجعيين؛ حيث تفوق على نموذج RESTC بنسبة 0.54–2.31% ونموذج GCE-GNN بنسبة 0.83–10.18%. وكان هذا التحسن بارزاً بشكل خاص في التعامل مع التبعيات التسلسلية في سيناريوهات الجلسات الطويلة في توصيات العناصر القائمة على الجلسات (SBR) (تحديداً، تحسينات بنسبة 10.18% و 4.73% مقارنة بنموذج GCE-GNN، وبنسبة 1.44% و 2.31% مقارنة بنموذج RESTC في مجموعتي بيانات Tmall و Nowplaying، على التوالي). وباختصار، تضمن نموذج GSLA4Rec المقترح بناءً فعالاً للرسوم البيانية لالتقاط سياقات المستخدم وتصفية الضوضاء؛ وقد تفوق أداؤه باستمرار على أحدث التقنيات المتاحة (SOTA) عبر جميع مجموعات البيانات.
تحليل الكفاءة
كما هو موضح في الشكل 4، أظهرت النتائج التجريبية على مجموعة بيانات Diginetica أن نموذج GSLA4Rec المقترح حقق سرعة تدريب أعلى من النماذج المرجعية من حيث زمن التدريب لكل دورة (epoch)، حيث أُجريت جميع التجارب باستخدام وحدة معالجة رسومات NVIDIA TITAN V واستهلكت حوالي 9300MB من الذاكرة. عملت النماذج القائمة على التعلم العميق، بما في ذلك STAMP وNARM وGRU4Rec، بكفاءة ولكنها قدمت أضعف أداء، بينما أدى نموذجَا TASRec وGC-SAN القائمان على شبكات GNNs وآلية الانتباه الذاتي (Self-Attention) إلى تحسين الأداء، إلا أنهما عانيا من استهلاك كبير للوقت. ورغم أن نموذجَي S2-DHCN وCORE القائمين على شبكات GNNs تسببا في زيادة طفيفة في زمن الحوسبة، إلا أن الأداء العام شهد تحسناً ملحوظاً، ولا سيما نموذج GSLA4Rec المقترح الذي أظهر تحسناً جوهرياً في الأداء. ويعود السبب الرئيسي في ذلك إلى أن نموذج GSLA4Rec استغرق وقتاً أقل في بناء الرسم البياني مقارنة بالنماذج المرجعية، وعلاوة على ذلك، فقد استخدم آلية انتباه خطي بوابي ثنائية المرور مع فتحات ذاكرة ثابتة m، مما أدى إلى تعقيد زمني خطي O(Ldm). وكان هذا التصميم أكثر كفاءة بكثير من الانتباه الذاتي القياسي O(L2d) مع الحفاظ على قدرة ذاكرة قوية من خلال قراءة الفتحات المعززة بـ softmax. وقد أظهر إجراء تجارب اختبار الأداء على مجموعة الاختبار لمزامنة زمن الاستنتاج الإحصائي، كما هو موضح في الصف الأخير من الجدول 3، الميزة الكبيرة في كفاءة نموذج GSLA4Rec، متجنباً حالة "الدقة العالية الوهمية مع عدم إمكانية التطبيق"، ومحققاً بالفعل توازناً بين الفعالية والكفاءة.
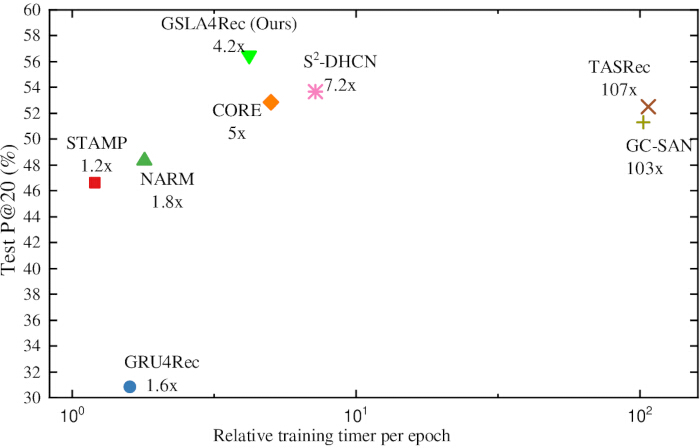
الشكل 4: الأداء مقابل وقت التشغيل لنموذج GSLA4Rec على مجموعة بيانات Diginetica. يوضح الشكل أن نموذج GSLA4Rec المقترح والنماذج المرجعية قد تم تشغيلها على وحدة معالجة الرسوميات NVIDIA TITAN V باستخدام Diginetica لقياس وقت التدريب النسبي لكل حقبة، وقد حقق GSLA4Rec سرعة تدريب أعلى من النماذج المرجعية. تم رسم هذا الشكل بواسطة OriginPro مع تخصيص كامل للعناصر. لم يتم استخدام أي موارد رسومية خارجية محمية بحقوق الطبع والنشر، وبالتالي لم تكن هناك حاجة إلى تراخيص حقوق طبع ونشر إضافية من طرف ثالث. تعود ملكية حقوق الطبع والنشر للشكل إلى المؤلفين وستمتثل لقواعد حقوق الطبع والنشر الخاصة بالمجلة عند القبول. يمثل GSLA4Rec الشبكات العصبية الرسومية ذات الانتباه الخطي ذو الفتحات المبوب لـ SBR. يرجى النقر هنا لعرض نسخة أكبر من هذا الشكل.
وخلاصة القول، فإن كفاءة نموذج GSLA4Rec المقترح، والمزود بآلية انتباه ذات فتحات بوابية ذات تعقيد خطي، قد تفوقت باستمرار على أفضل النماذج الحالية (SOTA) عبر جميع مجموعات البيانات. وبوجه خاص، حقق نموذج GSLA4Rec مكاسب ملحوظة في الأداء في سيناريوهات التوصية للجلسات الطويلة ضمن مجموعتي بيانات Tmall وNowplaying، وأظهر قدرة فائقة على نمذجة التبعية التسلسلية.
تحليل تجارب الاستئصال
تأثير SG وNGG وGSLA
لتقييم تأثير كل من SG وNGG وآلية البوابة (gating mechanism) وخانات الذاكرة (memory slots) والانتباه الخطي (linear attention) على نسبة إشارات السجل الحالية (SBR)، أُجريت دراسات استئصال (ablation studies) على مجموعات بيانات Diginetica وTmall وNowplaying. استبعد نموذج GSLA4Rec‑NotSG ترميز ميزة SG مع الحفاظ على ترميز NGG، بينما تخلى نموذج GSLA4Rec‑NotNGG عن ترميز NGG وأجرى استخراج الميزات بناءً على SG فقط، وقام نموذج GSLA4Rec‑NotGM بإزالة آلية البوابة داخل GSLA فقط، وألغى نموذج GSLA4Rec‑NotMS خانات الذاكرة في GSLA فحسب، أما نموذج GSLA4Rec‑NotLA فقد أغفل وحدة الانتباه الخطي في GSLA فقط.
| مجموعة البيانات | ديجينيتيكا (Diginetica) | تمول | يتم التشغيل الآن | |||
| المقاييس | P@20 | متوسط المرتبة المرتدة عند 20 (MRR@20) | P@20 | متوسط الرتبة المرتدة عند 20 (MRR@20) | P@20 | متوسط الرتبة المرتدة عند 20 (MRR@20) |
| GSLA4Recs-NotSG | 54.28 | 18.87 | 31.40 | 15.11 | 22.48 | 7.45 |
| GSLA4Recs-NotNGG | 52.65 | 17.67 | 28.90 | 14.61 | 20.17 | 7.74 |
| GSLA4Rec-NotGM | 53.82 | 18.21 | 39.26 | 16.52 | 23.14 | 7.62 |
| GSLA4Rec-NotMS | 53.40 | 17.60 | 38.05 | 15.65 | 22.55 | 7.40 |
| GSLA4Rec-NotLA | 51.86 | 16.92 | 29.12 | 13.96 | 20.82 | 7.28 |
الجدول 4: أداء تجارب الاستئصال لنموذج GSLA4Rec. يوضح الجدول أداء الاستئصال لنموذج GSLA4Rec بعد إزالة مكونات فردية من النموذج على مجموعات بيانات Diginetica وTmall وNowplaying، والتي تم تقييمها باستخدام P@20 وMRR@20.
الجدول 4 يوضح نتائج دراسة الاستئصال على مجموعات بيانات مختلفة، حيث انخفضت جميع مقاييس الأداء مقارنة بالنموذج الكامل. وكان الانخفاض في الأداء عند إزالة ترميز الرسم البياني للجلسة العالمي للجوار القريب (GSLA4Rec-NotNGG) أقوى منه عند إزالة ترميز ميزات الرسم البياني للجلسة (GSLA4Rec-NotSG). وأدى حذف أي وحدة فرعية في GSLA إلى تدهور في الأداء، وقد تم ترتيب هذا التدهور من الأعلى إلى الأقل كالتالي: الانتباه الخطي، ثم فتحات الذاكرة، ثم آلية البوابة. ويرجع السبب في ذلك إلى أن أهمية كل عنصر في SBR كانت مختلفة بالتأكيد، وكانت هناك حاجة إلى ذاكرة ترابطية بين العناصر. ويمكن ملاحظة أن GSLA كان جزءاً أساسياً من نموذج هذه الورقة البحثية.
تأثير طرق التجميع المختلفة
لتقييم تأثير طرق تجميع المعلومات المختلفة على أداء نموذج GSLA4Rec، تم استقصاء ثلاث طرق كلاسيكية لتجميع المعلومات وهي: 1) التجميع المتوسط (Average Pooling): إجراء عملية تجميع متوسط على المتجهات الناتجة عن SG و NGG؛ 2) تسلسل المتجهات (Vector Concatenation): دمج المتجهات الناتجة عن SG و NGG؛ 3) جمع المتجهات (Vector Summation): جمع المتجهات الناتجة عن SG و NGG. وقد ظهرت النتائج في الجدول 5. حقق نموذج GSLA4Rec باستخدام Vec-Sum أفضل أداء على مجموعات بيانات Diginetica و Tmall و Nowplaying. وفي المقابل، أدى التجميع المتوسط (Mean-pooling) إلى نتائج ضعيفة في جميع مجموعات البيانات. وقد يعود الأداء المتدني للتجميع المتوسط وتجميع التسلسل إلى فرط التخصيص (overfitting) الناتج عن كثرة المعلمات، مما أدى إلى تدهور الأداء العام للنموذج.
| مجموعة البيانات | ديجنيتيكا (Diginetica) | تي مول | يتم التشغيل الآن | |||
| المقاييس | P@20 | متوسط الرتبة المرتدة عند 20 (MRR@20) | P@20 | متوسط الرتبة المرتجعة عند 20 (MRR@20) | P@20 | متوسط الرتبة المرتدة عند 20 (MRR@20) |
| التجميع بالمتوسط (Mean-Pooling) | 45.26 | 15.63 | 38.84 | 16.3 | 23.56 | 7.55 |
| دمج المتجهات | 51.77 | 17.24 | 39.83 | 18.24 | 24.06 | 8.88 |
| مجموع المتجهات | 56.47 | 19.98 | 43.6 | 19.96 | 27.1 | 9.32 |
الجدول 5: تأثيرات طرق التجميع المختلفة. يقارن الجدول بين تأثيرات التجميع المتوسط (mean pooling)، وتسلسل المتجهات (vector concatenation)، وجمع المتجهات (vector summation) على أداء GSLA4Rec عبر مجموعات بيانات Diginetica وTmall وNowplaying باستخدام P@20 وMRR@20.
تحليل إعدادات المعلمات الفائقة
تأثيرات أحجام فتحات الذاكرة المختلفة
قامت فتحات الذاكرة بتخزين المعلومات من الخطوات الزمنية السابقة، وهو أمر كان بالغ الأهمية خاصة للمهام ذات التبعيات الزمنية. بحث هذا القسم في تأثير أحجام فتحات الذاكرة m = [0, 1, 2, 3, 4, 5] على أداء SBR. وأشارت النتائج التجريبية، الموضحة في الجدول 6، إلى أنه عندما تم ضبط أحجام فتحات الذاكرة m على 3، حققت المقاييس P@20 و MRR@20 أداءً مثالياً عبر مجموعات البيانات الثلاث. ويشير ذلك إلى أن أحجام فتحات الذاكرة المتوسطة حسنت بشكل فعال دقة توصيات النموذج وجودة التصنيف، بينما تعاني فتحات الذاكرة الأصغر من صعوبة في حفظ معلومات تاريخية كافية وتركز بشكل أكبر على اهتمامات المستخدمين قصيرة المدى، وفي حين أنه عندما زادت أحجام فتحات الذاكرة إلى 4 أو أكثر، يخزن النموذج معلومات تاريخية مفرطة، مما يجعله يعتمد بشكل زائد على الاهتمامات التاريخية مع إهمال معلومات الإدخال الحالية الأكثر أهمية، وبالتالي تدهور أداء التوصية.
| مجموعة البيانات | ديجينيتيكا (Diginetica) | Tmall | يتم التشغيل الآن | |||
| المقاييس | P@20 | متوسط الرتبة المرجعية عند 20 (MRR@20) | P@20 | متوسط الرتبة المرتدة عند 20 (MRR@20) | P@20 | معدل الاسترجاع المتوسط عند 20 (MRR@20) |
| GSLA4Rec-m0 | 53.40 | 17.60 | 38.05 | 15.65 | 22.55 | 7.40 |
| GSLA4Rec-m1 | 55.43 | 18.92 | 41.55 | 17.12 | 25.60 | 8.43 |
| GSLA4Rec-m2 | 56.02 | 19.35 | 42.90 | 18.25 | 26.62 | 8.95 |
| GSLA4Rec-m3 | 56.47 | 19.98 | 43.60 | 19.96 | 27.10 | 9.32 |
| GSLA4Rec-m4 | 53.96 | 19.25 | 43.06 | 19.09 | 26.34 | 8.35 |
| GSLA4Rec-m5 | 52.18 | 18.03 | 42.12 | 17.56 | 24.86 | 8.85 |
الجدول 6: تأثيرات أحجام فتحات الذاكرة المختلفة. يوضح الجدول أداء GSLA4Rec مع تكوينات مختلفة لفتحات الذاكرة (m0–m5) على مجموعات بيانات Diginetica وTmall وNowplaying باستخدام P@20 وMRR@20.
تأثيرات نسب الإسقاط (dropout) المختلفة
لمنع الإفراط في التخصيص (overfitting)، تم إدخال تنظيم الإسقاط (dropout regularization). وقبل جمع متجه العناصر على مستوى الجلسة ومتجه العناصر العالمي على مستوى الجيران، تم إسقاط مخرجات العصبونات عشوائياً في متجه العناصر العالمي على مستوى الجيران hingg,(k) لتعزيز المتانة وقدرة التعميم لنموذج GSLA4Rec.
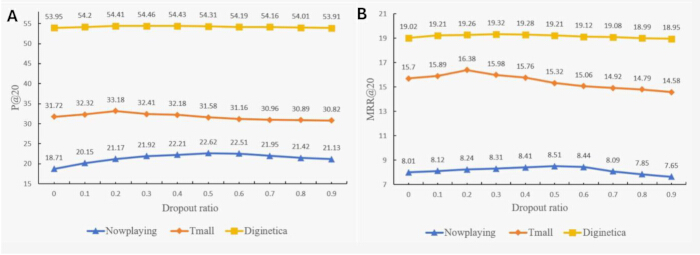
الشكل 5: أداء نموذج GSLA4Rec تحت نسب إسقاط (dropout ratios) مختلفة. (A) الدقة P@20 و (B) متوسط الرتبة المقلوبة MRR@20 لنموذج GSLA4Rec تحت نسب إسقاط مختلفة على مجموعات بيانات Nowplaying و Tmall و Diginetica. زاد الأداء في البداية ثم انخفض لاحقاً مع زيادة نسبة الإسقاط، مما يثبت متانة النموذج وقدرته على التعميم. يشير GSLA4Rec إلى الشبكات العصبية الرسومية ذات الانتباه الخطي ذات الفتحات المبوبّة للتوصية القائمة على الجلسات (SBR). تم رسم هذا الشكل ذاتياً باستخدام برنامج OriginPro مع عناصر مخصصة بالكامل. لم يتم استخدام أي موارد رسومية خارجية محمية بحقوق الطبع والنشر؛ وبناءً عليه، لم تكن هناك حاجة إلى تراخيص حقوق طبع ونشر إضافية من طرف ثالث. تعود ملكية حقوق الطبع والنشر للشكل إلى المؤلفين وسوف تلتزم بقواعد حقوق الطبع والنشر الخاصة بالمجلة عند القبول. يرجى النقر هنا لعرض نسخة أكبر من هذا الشكل.
الشكل 5A–B يوضح تأثير نسب الإسقاط (dropout ratio) المختلفة في المعادلة (16) على أداء النموذج. أشارت النتائج التجريبية إلى أن أداء النموذج كان ضعيفًا عندما كانت نسبة الإسقاط منخفضة، ومع ذلك، ومع زيادة نسبة الإسقاط، تحسن أداء النموذج تدريجيًا حتى وصل إلى المستوى الأمثل. وتحديدًا، كانت نسبة الإسقاط المثلى 0.3 في مجموعة بيانات Diginetica، و0.2 في مجموعة بيانات Tmall، و0.5 في مجموعة بيانات Nowplaying. وعندما تجاوزت نسبة الإسقاط هذه القيم المثلى، بدأ أداء النموذج في الانخفاض، ويرجع ذلك أساسًا إلى أن الإسقاط المفرط للخلايا العصبية منع النموذج من تعلم الميزات المهمة من بيانات الجلسة بفعالية.
تأثيرات أحجام التضمين المختلفة
لتقليل العبء الحسابي قدر الإمكان مع الحفاظ على الأداء الأمثل للنموذج، تم استقصاء تأثير أبعاد التضمين المختلفة d على أداء نموذج GSLA4Rec. وكما هو موضح في الشكل 6A–B، أظهر نموذج GSLA4Rec أداءً ضعيفاً في ثلاث مجموعات بيانات عامة وهي Diginetica وTmall وNowplaying عندما كان بُعد التضمين d يتراوح بين 10 و40، ومع ذلك، ارتفع أداء النموذج بسرعة مع زيادة قيمة d، ومالت مقاييس الأداء إلى الاستقرار عندما كانت قيمة d ضمن نطاق 80 إلى 120، ثم انخفض الأداء فعلياً مع استمرار زيادة d، وربما يرجع ذلك إلى الإفراط في التجهيز (overfitting) الناتج عن بُعد التضمين الكبير. وبناءً على ذلك، تم تحديد بُعد متجه تضمين العنصر نهائياً بقيمة 100.
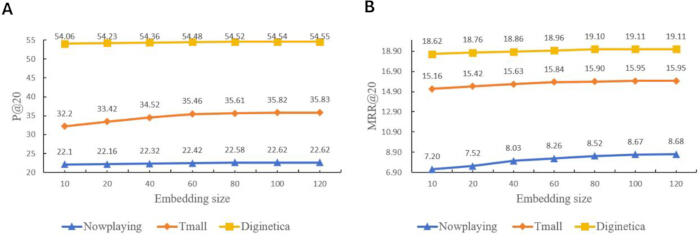
الشكل 6: أداء GSLA4Rec تحت أحجام تضمين مختلفة. (A) P@20 و (B) MRR@20 لنموذج GSLA4Rec تحت أحجام تضمين مختلفة في مجموعات بيانات Nowplaying و Tmall و Diginetica. تزايد أداء النموذج تدريجياً مع زيادة حجم التضمين ثم وصل في النهاية إلى مرحلة الثبات. يرمز GSLA4Rec إلى الشبكات العصبية الرسومية ذات الانتباه الخطي ذي الفتحات المبوب للتوصيات المستندة إلى الجلسة (SBR). تم رسم هذا الشكل ذاتياً باستخدام برنامج OriginPro مع عناصر مخصصة بالكامل. لم يتم استخدام أي موارد رسومية خارجية محمية بحقوق الطبع والنشر؛ وبالتالي، لم يتطلب الأمر أي تراخيص إضافية لحقوق الطبع والنشر من طرف ثالث. تعود ملكية حقوق الطبع والنشر للشكل إلى المؤلفين وستمتثل لقواعد حقوق الطبع والنشر الخاصة بالمجلة عند القبول. يرجى النقر هنا لعرض نسخة أكبر من هذا الشكل.
تأثيرات أطوال الجلسات المختلفة
من المعروف أن طول كل جلسة يتباين عبر مجموعات بيانات SBR الثلاث المستمدة من العالم الحقيقي (Diginetica وTmall وNowplaying). وللتحقق من متانة نموذج GSLA4Rec مقارنة بالنماذج المرجعية عند أطوال جلسات مختلفة، تم تقسيم جميع الجلسات في Diginetica وTmall إلى ثلاث مجموعات: المجموعة القصيرة (S)، والمجموعة المتوسطة (M)، والمجموعة الطويلة (L)، والتي تتراوح أطوالها من 1 إلى 6، ومن 7 إلى 12، وأكثر من 12 على التوالي. وقد اعتُمد مقياس MRR@20 للتحقق من أداء الطرق المستخدمة بدلاً من P@20، نظراً لأن MRR يمكن أن يعكس جودة ترتيب النتائج الصحيحة بشكل أفضل. وأشار الشكل 7A–B إلى أن نموذج GSLA4Rec تفوق على النموذج المرجعي القائم على التسلسل NARM، والنموذج المرجعي القائم على GNNs وهو SR-GNN، والنموذج المرجعي GNNs المعزز بالتعلم التبايني S2-DHCN، والنموذج المرجعي المكاني الزماني RESTC مع أطوال الجلسات المختلفة. وفي الوقت نفسه، لُحظ أيضاً أن أداء جميع الطرق انخفض مع زيادة طول التسلسل لأن الانتقالات طويلة المدى بين العناصر جعلت من الصعب التقاط تفضيلات المستخدمين، ولكن نموذج GSLA4Rec المقترح سجل أبطأ معدل انخفاض مقارنة بالنماذج المرجعية لأن آلية Gated-slot يمكنها تصفية العناصر غير ذات الصلة؛ حيث تفوق أداء GSLA4Rec على نموذج NARM بمقدار 6.3 و8.85 على التوالي في المجموعات الطويلة لبيانات Diginetica وTmall.
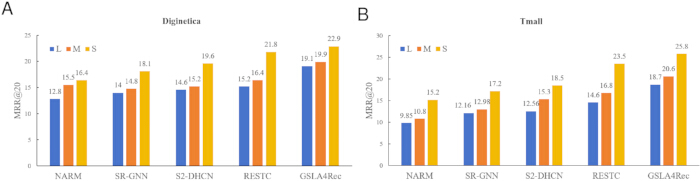
الشكل 7: أداء GSLA4Rec تحت أطوال جلسات مختلفة. أداء GSLA4Rec والنماذج المرجعية تحت مجموعات مختلفة من أطوال الجلسات في مجموعتي بيانات (A) Diginetica و (B) Tmall، والتي تم تقييمها باستخدام MRR@20. يُرمز لمجموعات طول الجلسة بالرموز L و M و S. GSLA4Rec هي شبكات عصبية رسومية ذات انتباه خطي بفتحات بوابية للتوصية القائمة على الجلسات (SBR). تم رسم هذا الشكل ذاتياً باستخدام OriginPro مع عناصر مخصصة بالكامل. لم يتم استخدام أي موارد رسومية خارجية محمية بحقوق الطبع والنشر؛ وبالتالي، لم تكن هناك حاجة إلى تراخيص حقوق طبع ونشر إضافية من طرف ثالث. تعود ملكية حقوق الطبع والنشر للشكل إلى المؤلفين وسوف تمتثل لقواعد حقوق الطبع والنشر الخاصة بالمجلة عند القبول. يرجى النقر هنا لعرض نسخة أكبر من هذا الشكل.
الخلاصة
تقترح هذه الورقة شبكة انتباه خطية ذات فتحات بوابية وسياق عالمي لأنظمة التوصية القائمة على الجلسات (SBR). ومن خلال الجمع بين SG و NGG، وإدخال آلية انتباه خطية ذات فتحات بوابية، تمكنت هذه الطريقة من التركيز على العناصر الرئيسية في تسلسل الجلسة، والتقاط التبعيات طويلة وقصيرة المدى، وتقليل الضوضاء بشكل فعال، وخفض التعقيد الحسابي. وتؤكد النتائج التجريبية أن هذه الطريقة تظهر دقة وكفاءة ممتازة في التوصية عبر ثلاث مجموعات بيانات عامة، مع تميز خاص في مهام نمذجة التبعيات طويلة المدى.
توفر البيانات:
تتوفر على شبكة الإنترنت بشكل مفتوح ثلاث مجموعات بيانات عامة شائعة (Diginetica وTmall وNowplaying، ويمكن العثور على روابط URL الخاصة بها في جدول المواد) تدعم نتائج هذه الدراسة. وفي الوقت ذاته، تم تقديم ثلاث مجموعات بيانات عامة واسعة الاستخدام والكود المصدري لهذا العمل ضمن المجلد التكميلي: GSLA4Rec.zip. يرجى النقر هنا لتنزيل هذا الملف.
المناقشة
بالمقارنة مع القيم الأساسية، يحقق نموذج GSLA4Rec تحسينات مزدوجة في الأداء والكفاءة لثلاثة أسباب رئيسية. أولاً، تطبيق آليات التحكم على NGG يخفف من ندرة البيانات ويُرشح الضوضاء بشكل فعال. ثانيًا، توازن آلية الفتحات الذاكرية بين سعة التخزين والكفاءة من خلال المعاملات الفائقة م التعديل. ثالثًا، تقوم آلية الانتباه الخطية بحساب الترابطات بين العناصر عند مستوى س(ن) تعقيد، أقل بكثير من O(ن2)61يعتمد نموذج GSLA4Rec بشكل مفرط على المستخدمين' تسلسلات التفاعل وتتجاهل الخصائص متعددة الوسائط للعناصر48في هذه الأثناء، تستخدم بنية NGG عتبة جاكارد الثابتة دون وظيفة التكيف الديناميكي، وفتحات الذاكرة م لا يمكن تحقيق القدرة التكيفية على التكيف65.
نموذج GSLA4Rec، الذي يُنشئ SG&NGG ويتبنى اهتمامًا خطيًا بشق مُدار، وهو مناسب بشكل خاص للتوصية في جلسات مجهولة الهوية39 عبر منصات التجارة الإلكترونية والبث عبر الإنترنت. في منصات التجارة الإلكترونية، يُوصَى بنماذج مناسبة للمنتجات للمستخدمين من خلال تسجيل سلوك التصفح أو النقر أو الإضافة إلى عربة التسوق، دون الاعتماد على سمات الخصائص الخاصة بالمستخدم. تعد مجموعتا البيانات Diginetica وTmall المستخدمتان في هذا البحث مجموعتي بيانات لتوصيات التجارة الإلكترونية. أما بالنسبة لمنصات مقاطع الفيديو القصيرة وتدفق الموسيقى، فإن هذه الطريقة تحلل المستخدمين' تُستخدم تسلسلات التشغيل لاستنتاج التفضيلات الضمنية، وتحديث ملخصات المحتوى للإبقاء على المستخدمين، وتمديد مدة المشاهدة. إن مجموعة البيانات Nowplaying المستخدمة في هذا البحث هي مجموعة بيانات توصية الموسيقى.
توجد حلول بديلة يمكنها أن تحل محل بنية الانتباه الخطي ذات الفتحة المُنظَّمة. المامبا الناشئة65 نموذج فضاء الحالة القائم على الحالة، كبديل، يتمتع بخصائص تخزين انتقائي لفضاء الحالة وتعقيد حسابي خطي، ما يُ log توازناً بين التعقيد الخطي وقدرة مطابقة التسلسلات الطويلة، ويُدمج مع النموذج اللغوي الكبير (LLM)55 إطار التحسين، يستخرج المستخدمين' النية الضمنية المستمدة من سجل التفاعل الأصلي، وبالتالي تحقيق أداء جيد في التوصية وكفاءة عالية. يمكن للعمل المستقبلي تحسين نموذج GSLA4Rec من جوانب متعددة: بناء شبكة جيران ديناميكية (NGG) لاستبدال التصفية الثابتة لمعيار جاكارد، وتنفيذ فتحات ذاكرة متغيرة لمطابقة الجلسات ذات الأطوال المختلفة تلقائيًا، وإدماج معلومات متعددة الوسائط عن المستخدم لتحسين دقة التوصيات. بالإضافة إلى ذلك، بمساعدة نماذج مدعومة باللغة الكبيرة (LLM)55، المستخدمون' يمكن استخلاص النوايا الضمنية من تسلسلات التفاعل، ويمكن تصفية بيانات المحادثات الضوضائية بدقة أكبر72.
الإفصاحات
يصرح المؤلفون بأنه لا توجد لديهم أي تضاربات مالية معروفة أو علاقات شخصية من شأنها أن تؤثر على العمل الوارد في هذه الورقة.
شكر وتقدير
يتوجه المؤلف بالشكر للمراجعين على ملاحظاتهم ومقترحاتهم القيمة خلال عملية المراجعة، وللبروفيسور Jiang Nan، المشرف على أطروحتي للدكتوراه، على توجيهاته الدقيقة. تم دعم هذه الدراسة جزئياً من قبل المؤسسة الوطنية للعلوم في الصين بموجب المنحة رقم 6217072713 والمنحة رقم 62061019، وبشكل جزئي من خلال موضوعات البحث المفتوحة في هندسة أبحاث أنظمة الاستشعار غير المأهولة وتكنولوجيا الذكاء الاصطناعي بمقاطعة Jiangxi لعام 2025، وجزئياً من قبل مختبر Jiangxi الإقليمي الرئيسي للمواد والأجهزة الإلكترونية المتقدمة (رقم 2024SSY03012).
المواد
| الاسم | الشركة | رقم فهرسي | التعليقات |
|---|---|---|---|
| CUDA 11.3 | NVIDIA | لا يوجد | CUDA 11.3 هو إصدار من منصة الحوسبة المتوازية ونموذج البرمجة الذي أصدرته NVIDIA في عام 2021، ويهدف إلى تعزيز الأداء ومرونة التطوير للتطبيقات المسرعة بواسطة وحدة معالجة الرسوميات GPU. |
| Diginetica | Diginetica | لا يوجد | Diginetica هي مجموعة بيانات المسابقة الرسمية لكأس CIKM (المؤتمر الدولي لاسترجاع المعلومات) لعام 2016، والتي استُخدمت في مسابقة خوارزميات CIKM لحل مشكلة استرجاع المنتجات المخصصة في التجارة الإلكترونية مع سياق البحث. وقد أصبحت الآن مجموعة بيانات مرجعية قياسية وأكثر شيوعاً في مجال التوصية القائمة على الجلسة (SBR). |
| Nowplaying | Zenodo | لا يوجد | هي مجموعة بيانات واسعة النطاق لسلوك الاستماع إلى الموسيقى، تم بناؤها بناءً على تنقيب تغريدات وسم "# nowplaying"، وتُستخدم بشكل أساسي في أبحاث توصية المحادثات الموسيقية، والتوصية المدركة للسياق، وتحليل ارتباط المشاعر. |
| OriginPro 2024 (64-bit) SR1 | OriginLab Corporation | لا يوجد | OriginPro هو برنامج تجاري متخصص للرسم العلمي وتحليل البيانات طورته شركة OriginLab Corporation، ويُستخدم عادةً لرسم المخططات بمستوى الأوراق البحثية، والإحصاءات البيانية، ومطابقة المنحنيات، ومعالجة الإشارات، وغيرها. يستخدم هذا المقال OriginPro لرسم مخططات المقارنة التجريبية، والمخططات الخطية، والمخططات الشريطية. |
| PyTorch 1.11.0 | PyTorch Foundation | لا يوجد | PyTorch هو إطار عمل مفتوح المصدر للتعلم العميق مخصص لتعلم الآلة والتعلم العميق، أصدرته شركة Facebook في عام 2016. يقوم بشكل أساسي بتنفيذ التفاضل التلقائي ويقدم رسوم بيانية حسابية ديناميكية لجعل بناء النماذج أكثر مرونة. |
| TITAN V GPU | NVIDIA | لا يوجد | NVIDIA TITAN V هي بطاقة رسوميات رائدة أطلقتها NVIDIA في نهاية عام 2017، تستهدف بشكل أساسي مجالات الحوسبة عالية الأداء والذكاء الاصطناعي. |
| Tmall | Tmall | لا يوجد | من مسابقة توصيات Alibaba Tmall في IJCAI 2015، أصدرت Alibaba Tianchi علناً سجلات Tmall الحقيقية عبر الإنترنت بعد إزالة البيانات الحساسة. وهي واحدة من ثلاث مجموعات بيانات قياسية في مجال SBR (Diginetica و Yoocoose و Tmall) ومجموعة التقييم المفضلة لسيناريوهات التجارة الإلكترونية الصينية. |
| visio 2021 | Microsoft | لا يوجد | Visio هو برنامج رسم شعاعي طورته شركة Microsoft، ويُستخدم لرسم مخططات بنية النماذج، والمخططات الانسيابية، ومخططات الإطار، ومخططات طوبولوجيا الشبكة في الأوراق البحثية العلمية، وإخراج رسوم شعاعية لتوضيحات الأوراق البحثية |
المراجع
- Sarwar B, Karypis G, Konstan J, Riedl J. Item-based collaborative filtering recommendation algorithms. In: Proceedings of the 10th International Conference on World Wide Web; 2001 May 1–5; Hong Kong, China. ACM; 2001.p.285-295.
- Zhao ZD, Shang MS. User-based collaborative-filtering recommendation algorithms on hadoop. In: 2010 Third International Conference on Knowledge Discovery and Data Mining; 2010 Jan 9–10; Washington, DC, USA. IEEE; 2010.p.478-481.
- Koren Y, Rendle S, Bell R. Recommender Systems Handbook. Berlin: Springer; 2022.
- Koren Y, Bell R, Volinsky C. Matrix factorization techniques for recommender systems. Computer. 2009;42(8):30-37.
- Rendle S, Freudenthaler C, Schmidt-Thieme L. Factorizing personalized markov chains for next-basket recommendation. In: Proceedings of the 19th International Conference on World Wide Web; 2010 Apr 26–30; Raleigh, North Carolina, USA. ACM; 2010.p.811-820.
- Wang S et al. A survey on session-based recommender systems. ACM Comput Surv. 2021; 54(7): 1-38.
- Ninichuk M, Namiot D. Survey On Methods For Building Session-Based Recommender Systems. Int J Open Inf Technol. 2023;11(5):22-32.
- Saxena A. A Survey of Session-Based Recommender Systems. In: 2023 5th International Conference on Advances in Computing, Communication Control and Networking. IEEE, 2023.
- Ravanmehr R, Mohamadrezaei R. Session-Based Recommender Systems Using Deep Learning. Berlin: Springer; 2023.
- He R, McAuley J. Fusing similarity models with markov chains for sparse sequential recommendation. In: 2016 IEEE 16th International Conference on Data Mining; 2016 Dec 12–15; Barcelona, Spain. IEEE; 2016.p.191-200.
- Chen R, Fan J, Wu M. MC-RGN: Residual graph neural networks based on Markov chain for sequential recommendation. Inf Process Manag. 2023;60(6):103519.
- Ni S, Hu S, Li L. An intention-aware markov chain based method for top-k recommendation. IEEE Trans Autom Sci Eng. 2022;21(1):581-592.
- Yu Y, Si X, Hu C, Zhang J. A review of recurrent neural networks: LSTM cells and network architectures. Neural Comput. 2019;31(7):1235-1270.
- Mienye ID, Swart TG, Obaido G. Recurrent neural networks: A comprehensive review of architectures, variants, and applications. Information. 2024;15(9):517.
- Hidasi B, Karatzoglou A, Baltrunas L, Tikk D. Session-based recommendations with recurrent neural networks. In: Bengio Y, LeCun Y, editors. Proceedings of International Conference on Learning Representations; 2016 May 2–4; San Juan, Puerto Rico.
- Li J et al. Neural attentive session-based recommendation. In: Proceedings of the 2017 ACM Conference on Information and Knowledge Management; 2017 Nov 6–10; Singapore. ACM; 2017. p.1419-1428.
- Liu Q, Zeng Y, Mokhosi R, Zhang H. STAMP: short-term attention/memory priority model for session-based recommendation. In: Proceedings of the 24th ACM SIGKDD International Conference on Knowledge Discovery & Data Mining; 2018 Aug 19–23; London, United Kingdom. ACM; 2018.p.1831-1839.
- Zhou J et al. Graph neural networks: A review of methods and applications. AI open. 2020;1:57-81.
- Scarselli F, Gori M, Tsoi AC, Hagenbuchner M, Monfardini G. The graph neural network model. IEEE Trans Neural Netw. 2009;20(1):61‑80.
- Corso G, Stark H, Jegelka S, Jaakkola T, Barzilay R. Graph neural networks. Nat Rev Methods Primers. 2024;4(1):17.
- Zheng Y, Yi L, Wei Z. A survey of dynamic graph neural networks. Front Comput Sci. 2025;19(6):196323.
- Wu S et al. Session-based recommendation with graph neural networks. In: Proceedings of the AAAI Conference on Artificial Intelligence; 2019 Jan 27‑Feb 1; Honolulu, USA. AAAI Press; 2019.p.346-353.
- Wang Z et al. Global context enhanced graph neural networks for session‑based recommendation. In: Proceedings of the 43rd International ACM SIGIR Conference on Research and Development in Information Retrieval; 2020 Jul 25‑30; Virtual conference. ACM; 2020.p.169‑178.
- Shani G, Heckerman D, Brafman RI. An MDP‑based recommender system. J Mach Learn Res. 2005;6:1265‑1295.
- Gu W, Dong S, Zeng Z. Increasing recommended effectiveness with Markov chains and purchase intervals. Neural Comput Appl. 2014;25(5):1153‑1162.
- O'shea K, Nash R. An introduction to convolutional neural networks. arXiv preprint arXiv:1511.08458, 2015.
- Wu J. Introduction to convolutional neural networks. Nanjing: National Key Lab for Novel Software Technology, Nanjing University; 2017.
- Li Z, Yang W, Peng S, Liu F. A survey of convolutional neural networks: analysis, applications, and prospects. IEEE Trans Neural Netw Learn Syst. 2021;33(12):6999‑7019.
- Krichen M. Convolutional neural networks: A survey. Computers. 2023;12(8):151.
- Tang J, Wang K. Personalized top-n sequential recommendation via convolutional sequence embedding. In: Proceedings of the 11th ACM International Conference on Web Search and Data Mining; 2018 Feb 5–9; Marina Del Rey, California, USA. ACM; 2018.p.565-573.
- Tuan T, Phuong T. 3D convolutional networks for session-based recommendation with content features. In: Proceedings of the 11th ACM Conference on Recommender Systems; 2017 Aug 27–31; Como, Italy. ACM; 2017.p.138-146.
- Graves A. Generating sequences with recurrent neural networks. arxiv preprint arxiv: 1308.0850, 2013.
- Tang D, Qin B, Liu T. Document modeling with gated recurrent neural network for sentiment classification. In: Proceedings of the 2015 Conference on Empirical Methods in Natural Language Processing; 2015 Sep 17‑21; Lisbon, Portugal. Association for Computational Linguistics; 2015.p.1422‑1432.
- Chan W, Jaitly N, Le Q, Vinyals O. Listen, attend and spell: a neural network for large vocabulary conversational speech recognition. In: 2016 IEEE International Conference on Acoustics, Speech and Signal Processing; 2016 Mar 20‑25; Shanghai, China. IEEE; 2016.p. 4960‑4964.
- Sutskever I, Vinyals O, Le QV. Sequence to sequence learning with neural networks. In: Advances in Neural Information Processing Systems 27; 2014 Dec 8‑13; Montreal, Canada.
- Xiao C, Li Z, Tang J, Lee J. United prediction of travel modes and purposes in travel chains based on multitask learning deep neural networks. Mathematics. 2025;13(9):1528.
- Chmielewski J, Wójcik M. The use of deep neural networks (DNN) in travel demand modelling. Appl Sci. 2025;15(20):11290.
- Shahmoradi N, Alesheikh AA, Jafari A, Lotfata A. Hybrid ST-ResNet and LSTM approach for precise crime hotspot prediction. Sci Rep. 2025;15:18672.
- Park J, Yi D, Ji SM. Analysis of recurrent neural network and predictions. Symmetry.2020;12(4): 615.
- Ramakrishnan N, Soni T. Network traffic prediction using recurrent neural networks. In: 2018 17th IEEE International Conference on Machine Learning and Applications; 2018 Dec 17‑20; Orlando, Florida, USA. IEEE; 2018.p.187‑193.
- Yu P, Yan X. Stock price prediction based on deep neural networks. Neural Comput Appl. 2020;32(6):1609‑1628.
- Zhao J, Zeng D, Liang S, Kang H, Liu Q. Prediction model for stock price trend based on recurrent neural network. J Ambient Intell Humaniz Comput. 2021;12:745‑753.
- Zaytar MA, Chaker EA. Sequence to sequence weather forecasting with long short-term memory recurrent neural networks. Int J Comput Appl. 2016;143(11):7-11.
- Xu L, Peng J, Jiang X, Chen E, Luo B. Graph neural network based on graph kernel: a survey. Pattern Recognit. 2025;161:111307.
- Li Y, Tarlow D, Brockschmidt M, Zemel R. Gated graph sequence neural networks. arxiv preprint arxiv: 1511.05493, 2015.
- Kipf TN, Welling M. Semi-supervised classification with graph convolutional networks. arXiv preprint arXiv:1609.02907;2016.
- Veličković P et al. Graph attention networks. arXiv preprint arXiv:1710.10903;2017.
- Chen L, Zhu X, Zhu G. Exploiting attributes and keywords for session-based recommendation with multi-view graph neural network. Expert Syst Appl. 2025;128990.
- Driss El Alaoui et al. A novel session-based recommendation system using capsule graph neural network. Neural Netw. 2025;185:107176.
- Xu C et al. Graph contextualized self‑attention network for session‑based recommendation. In: Proceedings of the 28th International Joint Conference on Artificial Intelligence; 2019 Aug 10‑16; Macao, China. 2019.p.3940‑3946.
- Qiu R, Huang Z, Li J, Chen H. Rethinking the item order in session‑based recommendation with graph neural networks. In: Proceedings of the 28th ACM International Conference on Information and Knowledge Management; 2019 Nov 3‑7; Beijing, China. ACM; 2019.p.579‑588.
- Chen J, Ji J, Li H, Zhang X. SR‑HetGNN: session‑based recommendation with heterogeneous graph neural network. Knowl Inf Syst. 2024;66(2):1111‑1134.
- Wang Y et al. Knowledge graph‑based session recommendation with session‑adaptive propagation. In: Companion Proceedings of the ACM Web Conference 2024; 2024 May 13‑17; Singapore. ACM; 2024.p.264‑273.
- Wang Z, Jin B. DiffSBR: a diffusion model for session-based recommendation. Inf. Process. Manag. 2026;63(1):104284.
- Qiao S et al. Multi-view intent learning and alignment with large language models for session-based recommendation. ACM Trans. Inf. Syst. 2025;43(4):91.
- Wang M et al. A collaborative session‑based recommendation approach with parallel memory modules. In: Proceedings of the 42nd International ACM SIGIR Conference on Research and Development in Information Retrieval; 2019 Jul 21‑25; Paris, France. ACM; 2019. p.345‑354.
- Ye R, Zhang Q, Luo H. Cross-session aware temporal convolutional network for session-based recommendation. In: 2020 International Conference on Data Mining Workshops; 2020 Nov 16–19; Sorrento, Italy. IEEE Computer Society; 2020.p.220-226.
- Chen Y, Huang L, Wang C, Lai J. Hybrid-order gated graph neural network for session-based recommendation. IEEE Trans Ind Inform. 2021;18(3):1458‑1467.
- Chen Y, Tang Y, Yuan Y. Attention-enhanced graph neural networks with global context for session-based recommendation. IEEE Access. 2023;11:26237-26246.
- Tang L, Wang X, Wang H, Shi C, Song L. DA‑GCN: a domain‑aware attentive graph convolution network for shared‑account cross‑domain sequential recommendation. In: Proceedings of the 30th International Joint Conference on Artificial Intelligence; 2021 Aug 19‑27; Montreal, Canada.
- Vaswani A et al. Attention is all you need. In: Advances in Neural Information Processing Systems 30; 2017 Dec 4‑9; Long Beach, USA.
- Lu Y, Letey M, Zavatone‑Veth JA, Maiti A, Pehlevan C. Asymptotic theory of in‑context learning by linear attention. Proc. Natl. Acad. Sci. U.S.A. 2025;122(28):e2502599122.
- Peng H, Pappas N, Yogatama D, Kong L. ABC: attention with bounded‑memory control. In: Proceedings of the 60th Annual Meeting of the Association for Computational Linguistics; 2022 May 22‑27; Dublin, Ireland. Association for Computational Linguistics; 2022.p.7469‑7483.
- Yang S et al. Gated linear attention transformers with hardware‑efficient training. In: Proceedings of the 41st International Conference on Machine Learning; 2024 Jul 21‑27; Vienna, Austria. PMLR; 2024.
- Yuan H et al. DG‑mamba: robust and efficient dynamic graph structure learning with selective state space models. In: Proceedings of the 39th AAAI Conference on Artificial Intelligence; 2025 Feb 25‑Mar 4; Philadelphia, Pennsylvania, USA. AAAI Press; 2025.p.22272‑22280.
- Xia X et al. Self‑supervised graph co‑training for session‑based recommendation. In: Proceedings of the 30th ACM International Conference on Information and Knowledge Management; 2021 Oct 25‑29; Virtual Event. ACM; 2021.p.2180‑2190.
- Zhou H, Zhang D, Song M, Han W. Temporal augmented graph neural networks for session‑based recommendations. In: Proceedings of the 44th International ACM SIGIR Conference on Research and Development in Information Retrieval; 2021 Jul 11‑15; Montreal, Canada. ACM; 2021. p. 1798‑1802.
- Chen Q, Jiang F, Wang Y, Li Y, Zhang Y. Combine temporal information in session‑based recommendation with graph neural networks. Expert Syst Appl. 2024;238:121969.
- Hou Y, Hu B, Zhang Z, Zhao W. Core: simple and effective session‑based recommendation within consistent representation space. In: Proceedings of the 45th International ACM SIGIR Conference on Research and Development in Information Retrieval; 2022 Jul 11‑15; Madrid, Spain. ACM; 2022.p.1796‑1801.
- Wan Z et al. Spatio‑temporal contrastive learning‑enhanced GNNs for session‑based recommendation. ACM Trans. Inf. Syst. 2023;42(2):1‑26.
- Zeng X et al. RAIN: reconstructed‑aware in‑context enhancement with graph denoising for session‑based recommendation. Neural Netw. 2025;184:107056.
- Zhan H et al. Capturing dynamic interests with deformable attention mechanism for session-based recommendation. Int J Mach Learn Cybern. 2026;17:375.