يصف هذا البروتوكول عملية إنشاء مجموعة بيانات تعتمد على أحوال الطقس والتقييم المنهجي لنماذج تعلم الآلة، والتعلم العميق، والنماذج الهجينة للتنبؤ بالتوهين الجوي في الاتصالات البصرية في الفضاء الحر تحت ظروف بيئية عراقية متنوعة، بما في ذلك العواصف الغبارية، والضباب، والمطر، والثلج.
مقالة بحثية
يتفوق تعلم الآلة على التعلم العميق في التنبؤ بالتوهين الجوي في الاتصالات البصرية في الفضاء الحر تحت الظروف الجوية العراقية
في هذه المقالة
ملخص
الملخص
توفر أنظمة الاتصالات البصرية في الفضاء الحر نطاقاً ترددياً عالياً وأمناً متزايداً وتشغيلاً خالياً من التراخيص، ولكنها تتأثر بشدة بتدهور الأداء الناتج عن التوهين الجوي الناجم عن التشتت والامتصاص. وتكتسب دقة التنبؤ بالتوهين أهمية أكبر في العراق، حيث تكون البيئة حارة ومغبرة وضبابية وممطرة بشكل عشوائي. تهدف هذه الدراسة إلى تقييم أداء تقنيات تعلم الآلة والتعلم العميق والنمذجة الهجينة للتنبؤ بالتوهين الجوي في أنظمة الاتصالات البصرية في الفضاء الحر تحت ظروف جوية عراقية مختلفة. تم إنشاء مجموعة بيانات اصطناعية مكونة من 1500 عينة باستخدام نماذج انتشار فيزيائية راسخة لخمسة أنظمة جوية: السماء الصافية، والضباب، والمطر، والعواصف الغبارية، والثلوج. تم تقييم خمسة عشر نموذجاً تنبؤياً بشكل منهجي، تتكون من ست تقنيات لتعلم الآلة (الغابة العشوائية [RF]، وتعزيز التدرج الأقصى، وآلة تعزيز التدرج الخفيفة، وانحدار متجه الدعم، والانحدار الخطي، وجيران K الأقرب)، وست بنيات للتعلم العميق (البرسيبترون متعدد الطبقات، والشبكة العصبية العميقة، والذاكرة قصيرة المدى الطويلة [LSTM]، والشبكة العصبية التلافيفية أحادية الأبعاد [CNN]، وCNN–LSTM، والشبكة القائمة على آلية الانتباه)، وثلاثة مناهج هجينة. أظهرت النتائج أن نموذج RF كان الأفضل أداءً (R2 = 0.9654، وجذر متوسط مربع الخطأ = 1.324 dB/km) مقارنة بمناهج التعلم العميق (أفضل R2 = 0.7766) والطرق الهجينة (أفضل R2 = 0.9571). تم تحليل أهمية الميزات باستخدام تفسيرات شابلي المضافة (Shapley Additive exPlanations)، ووجد أن تركيز الغبار (67.3%) والرؤية (21.2%) هما العاملان الأكثر تأثيراً. وبينما أدى RF إلى تدريب واستدلال أسرع بكثير، كشف الاختبار الإحصائي عن عدم وجود فرق جوهري بين RF وأفضل نهج هجين أداءً (p = 0.083). وقد ثبت أن أداء تقنيات تعلم الآلة التقليدية فعال للغاية في تقدير التوهين الجوي في أنظمة اتصالات FSO في الظروف البيئية القاسية، بما يتوافق مع نظريات الانتشار الفيزيائية المعروفة. ومع ذلك، فإننا نؤكد أن هذه الاستنتاجات تستند إلى بيانات اصطناعية، ويجب التحقق من صحتها من خلال قياسات جوية حقيقية قبل إمكانية استخدامها في أنظمة FSO التشغيلية.
المقدمة
توفر شبكات الاتصالات البصرية في الفضاء الحر (FSO) بشكل عام سعة أعلى وأماناً أفضل، إلا أن التوهين الجوي الناتج عن التشتت والامتصاص يمثل عاملاً محدداً رئيسياً لمسافة الاتصال1. نقدم في هذا العمل تحليلاً مفصلاً لنهج تعلم الآلة والتعلم العميق والنهج الهجينة2 لتقييم توهين إشارة FSO في البيئة الصعبة في العراق، التي تتسم بدرجات حرارة مرتفعة وعواصف ترابية وأمطار غير منتظمة.
برزت أنظمة اتصالات البصريات في الفضاء الحر (FSO) كواحدة من الحلول الواعدة للاتصال اللاسلكي عالي النطاق الترددي3 بمعدلات نقل بيانات تتجاوز 100 Gbps عبر مسافات تتراوح من مئات الأمتار إلى بضعة كيلومترات4. وتعمل وصلات FSO في الطيف المرئي وتحت الأحمر، على عكس أنظمة الترددات الراديوية التقليدية، مما يوفر مزايا مثل التشغيل بدون ترخيص، والحصانة ضد التداخل الكهرومغناطيسي، وأماناً محسناً من خلال تباعد الشعاع الضيق وسعة النطاق الترددي الكبيرة5. تجعل هذه الميزات من تقنية FSO خياراً جذاباً لتطبيقات الربط الخلفي (backhaul)، والوصلات بين المباني، وشبكات التعافي من الكوارث، واتصالات الميل الأخير حيث يكون نشر الألياف البصرية مكلفاً للغاية6. بيد أن الاتصال عبر التشتت وانحراف الشعاع والامتصاص7,8 يعتمد بشكل كبير على الظروف البيئية من حيث التوفر والأداء. ويعد هذا التحدي أحد القيود الرئيسية لأنظمة الاتصالات البصرية في الفضاء الحر. وتتسبب الظروف الجوية في تباينات واسعة في مستويات التوهين (dB/km)؛ ففي ظروف السماء الصافية، يمكن أن يكون التوهين أقل من 0.5 dB/km، بينما قد يتسبب الضباب الكثيف في وصول التوهين إلى ≥50 dB/km عند 1550 nm (باستخدام نموذج Kim للضباب، الذي يتنبأ بقيم توهين تصل إلى 50 dB/km عندما تكون الرؤية أقل من 50 m عند 1550 nm)9,10 كما يمكن أن تؤدي الأمطار الغزيرة إلى وصول التوهين إلى 20–30 dB/km اعتماداً على معدل هطول الأمطار (تنبؤ نموذج Carbonneau)11. وبناءً على ذلك، تبرز الحاجة إلى التنبؤ الدقيق بالتوهين من أجل تصميم وصلات موثوقة، وتخطيط الشبكات، واستراتيجيات الإرسال التكيفية. وتعتمد الطرق التقليدية على نماذج الانتشار الفيزيائية، مثل نموذج Kim للضباب12، ونموذج Carbonneau للأمطار13، ونظرية تشتت Mie لجزيئات الهباء الجوي14. ومع ذلك، ورغم أن هذه النماذج توفر أساساً نظرياً جيداً، إلا أنها غالباً ما تعتمد على معاملات جوية دقيقة لا تتوفر دائماً في الممارسة العملية، وكثيراً ما لا تأخذ في الاعتبار التفاعلات المعقدة بين الظواهر الجوية المتعددة والمتزامنة15.
يفرض التباين البيئي الشديد في العراق تحديات كبيرة أمام نشر أنظمة الاتصالات الضوئية في الفضاء الحر. وتزداد ظروف الإرسال تعقيداً بسبب ندرة هطول الأمطار ونوبات الضباب المتفرقة، بينما قد تنخفض درجات الحرارة في الشتاء إلى ما دون الصفر، وقد ترتفع في الصيف لتتجاوز 50 °C16. وفي الأطوال الموجية المعتادة، مثل الطيف المستخدم بانتظام عند 1550 nm، يمكن للعواصف الغبارية، التي تُعرف محلياً باسم "الهبوب"، أن تقلص الرؤية إلى أقل من 100 متر، مما يؤدي إلى قيم توهين تتجاوز 20dB/km17. ولكي يتم نشر أنظمة FSO بنجاح في العراق ودول الشرق الأوسط الأخرى، من الضروري إنشاء نماذج تنبؤ موثوقة يمكنها تقدير أداء النظام بدقة في ظل هذه الظروف البيئية المختلفة18.
تقدم التطورات الجديدة في تعلم الآلة بدائل قابلة للتطبيق لتقنيات النمذجة التقليدية القائمة على الفيزياء. إذ تتيح قدرة تقنيات تعلم الآلة على تعلم الارتباطات غير الخطية المعقدة بشكل مباشر بين التوهين والعوامل الجوية اكتشاف تفاعلات دقيقة قد تغفل عنها النماذج التحليلية التقليدية19. وقد أظهرت استراتيجيات الغابة العشوائية (Random Forest - RF) وتعزيز التدرج (gradient-boosting) أداءً قويًا في مجموعة متنوعة من مهام التنبؤ المناخي20. وبالمثل، حققت تقنيات التعلم العميق نجاحًا ملحوظًا في معالجة اللغات الطبيعية، والرؤية الحاسوبية، والتنبؤ بالسلاسل الزمنية21. ومع ذلك، فإن هذه النهج لم تنل قسطًا كافيًا من الدراسة في التنبؤ بتوهين الاتصالات البصرية في الفضاء الحر (FSO)، خاصة مع مجموعات البيانات المحدودة والظروف الجوية شديدة التباين22. ولسد هذه الفجوة، يقدم هذا العمل استقصاءً شاملاً لنهج تعلم الآلة، والتعلم العميق، والنهج الهجينة للتنبؤ بتوهين إشارة FSO في الظروف الجوية العراقية. وقد تم تحقيق ذلك من خلال بناء مجموعة بيانات اصطناعية مصممة جيدًا بناءً على نماذج الانتشار الفيزيائية المعروفة23. نحن نفترض أنه بالنسبة لمجموعات البيانات البيئية الجدولية متوسطة الحجم التي تحتوي على عدد قليل من المتغيرات التنبؤية المهيمنة، فإن الأداء التنبؤي لطرق التجميع القائمة على الأشجار سيتفوق على بنيات التعلم العميق المعقدة. وتتمثل الأهداف الرئيسية في: (1) وضع منهجية أساسية لمقارنة طرق التنبؤ في بيئة محاكاة مضبوطة، (2) تحديد أفضل الاستراتيجيات الخوارزمية للتنبؤ بالتوهين الجوي، و(3) تقييم أهمية الميزات وقابلية تفسير النموذج لاكتساب رؤى حول العوامل البيئية الأكثر تأثيرًا على التوهين. تم استخدام بيانات اصطناعية في هذا العمل، ولكن تم وضع الأساس للتحقق لاحقًا باستخدام قياسات تجريبية من العالم الحقيقي، وهو أمر متوقع في الأعمال المستقبلية. علاوة على ذلك، تم دمج تحليلات أهمية الميزات وقابلية التفسير لتحديد أهم العوامل البيئية التي تؤثر على التوهين.
البروتوكول
لم تتضمن هذه الدراسة مشاركين بشريين أو حيوانات فقارية، أو أخذ عينات من الأنسجة. تم توليد جميع البيانات المستخدمة في هذا البحث اصطناعياً باستخدام نماذج الانتشار الفيزيائي والمعايير الميتيورولوجية المتاحة علنياً. وبناءً على ذلك، لم تكن هناك حاجة للحصول على موافقة أخلاقية من مجلس مراجعة مؤسسي (IRB) أو لجنة مؤسسية لرعاية واستخدام الحيوانات (IACUC).
توليد مجموعة البيانات بناءً على نظرية الانتشار الفيزيائي. تم بناء مجموعة البيانات لمحاكاة الظروف الجوية الساعية لنظام اتصالات بصرية في الفضاء الحر على مدار عام تقويمي كامل (2024) للظروف الجوية العراقية. وقد أنشأنا قاعدة بيانات اصطناعية تحتوي على 1,500 عينة لكل ساعة.
أولاً، تم تعيين الظروف الجوية عشوائياً بناءً على الاتجاهات الإقليمية: سماء صافية (54.3%)، غبار (24.9%)، ضباب (10.5%)، مطر (7.4%)، وثلج (2.8%). ثانياً، طُبِّق نموذج التوهين الفيزيائي المقابل على كل عينة بناءً على الحالة الجوية، أي قانون Beer-Lambert للسماء الصافية، ونموذج Kim للضباب، ونظرية Carbonneau للمطر، ونظرية تشتت Mie للعواصف الغبارية. ثالثاً، تم ضبط معاملات نظام FSO كما يلي: قدرة إرسال 20 dBm، وطول موجي 1550 nm، ومسافة إرسال 3 km، وفتحة إرسال 2.5 cm، وفتحة استقبال 20 cm. رابعاً، تم حساب التوهين بوحدة dB/km لكل عينة. وأخيراً، قُسمت مجموعة البيانات الكاملة عشوائياً إلى 1,200 عينة تدريب (80%) و300 عينة اختبار (20%). تشمل الظروف المحاكاة تركيزات غبار عالية مرتبطة بالعواصف الرملية، والعواصف المطرية، وتغيرات في درجة الحرارة من −4.89°C إلى 47.99°C. وقد تم اختيار الظروف الجوية وتوزيعات المعاملات بناءً على السجلات المناخية العراقية للفترة 2020–2024. تم اختيار الأنظمة الجوية الخمسة (سماء صافية، ضباب، مطر، عواصف غبارية، وثلج) لأنها تغطي كامل نطاق الظروف الجوية التي تؤثر على توهين FSO في العراق، مع انتشار العواصف الغبارية بشكل خاص في الشرق الأوسط. واستُخدمت البيانات التاريخية للأرصاد الجوية التي جُمعت من مختلف المناطق العراقية لإنشاء توزيع احتمالي لكل حالة جوية. وكانت النتيجة كما يلي: 54.3% سماء صافية (الحالة السائدة)، 24.9% غبار (تمثل مشكلة العواصف الرملية في العراق)، 10.5% ضباب (متكرر في شتاء شمال العراق)، 7.4% مطر (كميات هطول منخفضة نموذجية للعراق)، و2.8% ثلج (يحدث أحياناً في المناطق الجبلية الشمالية). كما تمت نمذجة المعاملات الميتيورولوجية ذات الصلة باستخدام توزيعات احتمالية لكل حالة جوية على النحو التالي: نُمذِجت درجة الحرارة باستخدام توزيع طبيعي (متوسط 28.55±11.18°C) بين −4.89°C و 47.99°C بناءً على التطرفات الموسمية العراقية؛ ونُمذِجت الرطوبة باستخدام توزيع منتظم (متوسط 42.01±25.56%) من 0% إلى 100%؛ ونُمذِجت الرؤية باستخدام توزيع لوغاريتمي طبيعي بين 0.05 km و 29.99 km (متوسط 13.10±10.91 km) لمراعاة أحداث انخفاض الرؤية المتكررة أثناء العواصف الغبارية؛ ونُمذِج تركيز الغبار باستخدام توزيع أسي بين 0 و 4.96 mg/m3 (متوسط 0.74±1.30 mg/m3) مع احتمالات أعلى للتركيزات المنخفضة والذيول الطويلة لأحداث الغبار الشديدة.
صُمم نظام الاتصالات بقدرة إرسال تبلغ 20 dBm، وطول موجي قدره 1550 nm، ومسافة إرسال تصل إلى 3 km، وفتحة إرسال بقطر 2.5 cm، وفتحة استقبال بقطر 20 cm لتعويض فقدان التباعد. تم تقسيم معايير نظام الاتصالات الضوئية في الفضاء الحر (FSO) إلى مجموعتين: معايير ثابتة لم تتغير لجميع العينات، ومعايير متغيرة تم تعديلها أثناء إنشاء مجموعة البيانات. بالنسبة لجميع العينات البالغ عددها 1,500 عينة، تم تثبيت المعايير التالية: قدرة الإرسال (20 dBm)، وطول الموجة التشغيلي (1550 nm)، وفتحة الإرسال (القطر 2.5 cm، والكفاءة 0.7)، وفتحة الاستقبال (القطر 20 cm، والكفاءة 0.7). وقد ثبتت هذه المعايير لأنها تمثل المواصفات الفيزيائية للأجهزة الصلبة لنظام FSO ولا تتغير بتغير الظروف الجوية. أُنشئت مجموعة البيانات من 1,500 عينة مع تغيير المعايير التالية: درجة الحرارة (−4.89°C إلى 47.99°C)، والرطوبة (0% إلى 100%)، والرؤية (0.05 km إلى 29.99 km)، وتركيز الغبار (0 إلى 4.96 mg/m3)، والحالة الجوية (سماء صافية، ضباب، مطر، غبار، ثلج). تم تعديل هذه المعايير وفقاً لتوزيعات احتمالية مستمدة من سجلات المناخ العراقية للأعوام 2020–2024. ولكل عينة، تم حساب قيمة التوهين (dB/km) باستخدام نموذج التوهين الفيزيائي المقابل، وفقاً للمزيج المحدد من الظروف الجوية والمعايير المتغيرة.
تمت نمذجة التوهين الفيزيائي باستخدام نموذج Carbonneau للمطر، وقانون Beer–Lambert للسماء الصافية، ونظرية تشتت Mie للغبار، ونموذج Kim للضباب24. ينطبق قانون Beer-Lambert في ظروف السماء الصافية حيث يهيمن التشتت الجزيئي والامتصاص على التوهين، واللذان يتناقصان أسيًا مع المسافة25. يعود معامل الخمود α عند 1550 nm إلى تشتت Rayleigh بواسطة جزيئات الهواء والامتصاص بواسطة الغازات الجوية26. يُعد نموذج Kim نموذجًا خاصًا بالضباب يربط التوهين بالرؤية من خلال معاملات تجريبية مشتقة من توزيعات أحجام قطرات الضباب. ويأخذ الأس q المعتمد على الطول الموجي في الاعتبار تشتت Mie27. المعلمة الرئيسية لنموذج Carbonneau هي معدل هطول الأمطار R، حيث يعتمد توهين المطر على حجم وكثافة قطرات المطر، وقد تم اشتقاق المعاملات تجريبيًا عند 1550 nm ومعايرتها خصيصًا للأطوال الموجية البصرية28. وتعتبر نظرية تشتت Mie قابلة للتطبيق في ظروف الغبار، بما أن حجم جسيمات الغبار (نصف قطر 0.1–100 μm) يكون قابلاً للمقارنة مع الطول الموجي (1550 nm)، كما أن معامل الانكسار المركب m = 1.55–0.005i لغبار الشرق الأوسط يشمل كلًا من التشتت والامتصاص29. وقد تم تنفيذ نماذج التوهين الفيزيائي التالية بمعادلاتها وإعدادات معلماتها الخاصة.
بالنسبة لظروف السماء الصافية، استُخدم قانون بير-لامبرت:
Aclear = 10×log₁₀(e(α×d)) (1)
حيث تمثل α معامل الخمود (الذي تم تنويعه باستخدام توزيع طبيعي مركزه 0.02 dB/km مع تفاوت قدره ±0.005 dB/km عند 1550 nm في الظروف الصافية)، وتمثل d مسافة الإرسال (المثبتة عند 3 km). أما بالنسبة لظروف الضباب، فقد تم تطبيق نموذج Kim باستخدام المعادلة التالية:
Afog = 10×ln(10)/V×(λ/550)−q (2)
حيث تمثل V الرؤية بالكيلومتر (تراوحت من 0.05km إلى 10km)، وλ الطول الموجي بالنانومتر (ثابت عند 1550nm)، وq معامل توزيع حجم الجسيمات الذي يتم حسابه كالتالي: q=1.6 عندما تكون V>50 km، وq=1.3 عندما تكون 6<V<50 km، وq=0.585×V(1/3) عندما تكون 1 <V<6km، وq=0 عندما تكون 0.5<V<1km، وq=0.5 عندما تكون V<0.5km. وبالنسبة لظروف المطر، تم استخدام نموذج Carbonneau:
Arain=0.023×R0.93 (3)
حيث تمثل R معدلات هطول الأمطار بـ mm/h (والتي تراوحت بين 0.25 و 50mm/h وفقاً لسجلات الأمطار العراقية). وقد استُخدمت علاقة كفاءة الخمود لظروف العواصف الغبارية باستخدام تشتت Mie:
Adust=10×log₁₀(e(τ×L)) (4)
حيث τ=∫₀^∞ πr2Qext(r,λ,m)N(r)dr، و r هو نصف قطر الجسيم (0.1–100μm وفقاً لتكوين الغبار العراقي)، و Qext هي كفاءة الخمود المحسوبة باستخدام نظرية Mie، و λ=1550nm، و m=1.55–0.005i هو معامل الانكسار المركب للغبار في الشرق الأوسط، و N(r) هو توزيع حجم الجسيمات الذي تم نمذجته باستخدام توزيع لوغاريتمي طبيعي بمتوسط هندسي لنصف القطر يبلغ 2.5 μm وانحراف معياري قدره 2.0. وقد تم تطبيق نموذج التوهين لظروف الثلوج على النحو التالي:
Asnow = 0.1×S0.75 (5)
حيث يمثل S معدل تساقط الثلوج بوحدة mm/h (من 0.5 إلى 15 mm/h). وقد تم اختيار هذه المعادلة التجريبية بناءً على الدراسات المنشورة في الأدبيات العلمية30، حيث تم تطوير نماذج التوهين للانتشار البصري عبر الثلوج باستخدام نظرية تشتت Mie المطبقة على توزيعات أحجام رقاقات الثلج. هذه المعادلة صالحة لمعدلات تساقط الثلوج التي تتراوح بين 0.5 و15 mm/h، وتفترض ظروف الثلوج الجافة مع أقطار نموذجية لرقاقات الثلج تتراوح بين 1 و10 mm. وقد تم الحصول على المعامل 0.1 والأس 0.75 من خلال مطابقة المنحنى لحسابات تشتت Mie30 للثلوج عند طول موجي 1550 nm. ولا تأخذ هذه المعادلة في الاعتبار الثلوج الرطبة أو الهطول المشترك، والتي قد تمتلك خصائص توهين متغيرة، رغم أنها تقدم تقديراً مقبولاً للثلوج الجافة. وبسبب فعالية هذا النهج حاسوبياً، وكثيراً ما يتم الاستشهاد به في منشورات FSO، وملاءمته لظروف الثلوج المتوقعة في شمال العراق (إقليم كردستان في شهري يناير وفبراير)، فقد تم اختياره لهذا البحث. تم تنفيذ جميع النماذج باستخدام لغة Python 3.9، مع الاعتماد على مكتبة Numpy للحسابات العددية. واستُخدم النموذج المطابق مع حالة الطقس المختارة عشوائياً وبيانات المحيط التي تم أخذ عينات منها لحساب قيمة التوهين لكل عينة. وقد شمل توزيع الطقس الذي تم الحصول عليه 814 حالة سماء صافية (54.27%)، و375 حالة غبار (25.00%)، و157 حالة ضباب (10.47%)، و111 حالة مطر (7.40%)، و43 حالة ثلوج (2.87%).
استُخدم فحص المعلومات الأرصادية التاريخية التي جُمعت من محطات الأرصاد الجوية العراقية في عدة مناطق (بغداد، والبصرة، والموصل، والرمادي) بين عامي 2020 و2024 لتحديد نسب حالات الطقس. وقد وفرت وزارة النقل العراقية والهيئة العامة للأنواء الجوية والرصد الزلزالي العراقية (IMOS) البيانات الأصلية. تضمنت البيانات سجلات الطقس اليومية التي رصدت الظروف الجوية الحالية لكل يوم. ومن بين الخصائص المحددة المستخرجة من هذه السجلات: درجة الحرارة (الحد الأدنى والحد الأقصى والمتوسط اليومي)، والرطوبة النسبية، والمدى البصري، وكمية الأمطار، وحالات العواصف الغبارية. وتوفر بوابة البيانات المفتوحة للحكومة العراقية (https://www.motrans.gov.iq/) إمكانية الوصول إلى جزء من بيانات IMOS؛ ومع ذلك، فإن السجلات المحددة المستخدمة في هذه الدراسة ليست مخزنة علناً في مستودع مركزي. وتلخص الجدول 1 المعلومات المناخية المستخدمة لحساب النسب المئوية لظروف الطقس وقيم المعلمات. عُرّفت أيام السماء الصافية بأنها الأيام التي لا يوجد فيها هطول، ويكون المدى البصري فيها أكبر من 10 km، مع عدم وجود نشاط غباري، وشكلت 54.27% من إجمالي 1,825 يوماً مسجلاً. أما أيام العواصف الغبارية (بما في ذلك العواصف الغبارية الكاملة (مدى بصري < 1 km) والغبار العالق (مدى بصري 1–5 km)) فقد شكلت 25.00% من الأيام، مما يشير إلى التكرار العالي لحالات العواصف الرملية في المناخ القاحل وشبه القاحل في العراق. وصُنفت الأيام التي يكون فيها المدى البصري أقل من 1 km بسبب تعليق قطرات الماء (باستثناء انخفاض الرؤية الناتج عن الغبار) على أنها أيام ضباب. بلغت نسبة أيام الضباب 10.47%، وكانت هذه الأيام تتركز بشكل أساسي في فصل الشتاء في المناطق الشمالية من العراق. وكانت أيام المطر، وهي الأيام التي شهدت هطولاً قابلاً للقياس >0.1 mm، بنسبة 7.40%، وهو ما يتوافق مع المتوسط المنخفض لهطول الأمطار السنوي في العراق الذي يتراوح بين 150 و200 mm سنوياً. وشكلت أيام الثلوج (الأيام التي شهدت تراكم هطول متجمد) نسبة 2.87% من الأيام وكانت مقتصرة على المناطق الشمالية الجبلية (إقليم كردستان) في شهري يناير وفبراير. استُخدمت هذه النسب لاحقاً كأوزان احتمالية لأخذ عينات عشوائية في عملية توليد مجموعة البيانات. وبذلك، تعكس مجموعة البيانات الاصطناعية التكرار الواقعي لكل حالة طقس في البيئة العراقية.
اعتبارات الانحياز في توليد البيانات الاصطناعية
لتقليل الانحياز المحتمل، تم اتخاذ عدة خطوات:
(1) اختيار التوزيع: استُخدمت الخصائص الإحصائية لبيانات المناخ المصدر لاختيار توزيعات الاحتمالية. كانت درجة الحرارة موزعة توزيعاً طبيعياً بمتوسط وانحراف معياري وفقاً لما سجله IMOS. أما الرطوبة فقد كانت موزعة توزيعاً منتظماً على كامل النطاق المرصود (0-100%). واُفترض أن الرؤية تتبع توزيعاً لوغاريتمياً طبيعياً لتفسير التكرار العالي لحالات انخفاض الرؤية أثناء العواصف الغبارية. وتبع تركيز الغبار توزيعاً أسياً حيث كانت هناك احتمالات أعلى عند التركيزات المنخفضة وذيول طويلة عند أحداث الغبار الشديدة31، وهو ما يتوافق مع التكرار المرصود لأحداث الغبار في العراق32.
(2) نسب الظروف الجوية: أسفر تحليل سجلات IMOS للفترة 2020–2024، والتي شملت 1,825 ملاحظة يومية في جميع المناطق الأربع، عن النسب التالية: 54.3% سماء صافية، 24.9% غبار، 10.5% ضباب، 7.4% مطر و 2.8% ثلوج. عُرِّفت أيام السماء الصافية بأنها الأيام التي لا تسود فيها هطولات مطرية، وتكون فيها الرؤية >10 km مع عدم وجود نشاط غباري. وشملت أيام العواصف الغبارية كلاً من العواصف الغبارية الكاملة (الرؤية <1 km) والغبار العالق (الرؤية 1–5 km). وعُرِّف يوم الضباب بأنه اليوم الذي تكون فيه الرؤية أقل من 1 km ويكون السبب هو تعلق قطيرات الماء (وليس الغبار). أما أيام المطر فقد عُرِّفت بأنها الأيام التي شهدت هطولات مطرية قابلة للقياس >0.1 mm، وعُرِّفت أيام الثلوج بأنها الأيام التي شهدت تراكم هطولات متجمدة33.
(3) نطاقات المعاملات: استندت نطاقات المعاملات إلى القيم القصوى المرصودة في سجلات IMOS: حيث تراوحت درجة الحرارة من −4.89 °C (الموصل، شتاءً) إلى 47.99 °C (البصرة، صيفاً)، وتراوحت الرؤية من 0.05 km (العواصف الغبارية الشديدة) إلى 29.99 km (الأجواء الصحوة)، وتراوح تركيز الغبار من 0 إلى 4.96 mg/m3 (بناءً على أقصى تركيز غبار مرصود خلال أحداث الهبوب الشديدة)34.
(4) افتراضات الاستقلالية: افترضنا أن المعلمات البيئية قد تم أخذ عينات منها بشكل مستقل، وهو ما يعد تبسيطاً للظروف الواقعية حيث تكون المتغيرات الجوية مترابطة (على سبيل المثال، غالباً ما يرتبط تركيز الغبار العالي بانخفاض الرؤية). ومن أجل توفير بيئة محاكاة محكومة للمقارنة المنهجية بين النماذج، تم اعتماد افتراض الاستقلالية هذا 35. وقد تمت تغطية تداعيات هذه الافتراضات في قسم المناقشة.
(5) التقسيم الطبقي: تم إجراء تقسيم بيانات التدريب والاختبار بشكل طبقي بناءً على فئة الحالة الجوية (سماء صافية، ضباب، مطر، غبار، ثلج) لضمان أن تكون نسبة كل حالة جوية في مجموعتي التدريب والاختبار مطابقة لتوزيع مجموعة البيانات الأصلية. وبهذه الطريقة، لا تكون مجموعة الاختبار غير متوازنة فيما يتعلق بالحالات الجوية النادرة (خاصة الثلوج بنسبة 2.87%)36.
الإقرار بتوليد الهدف الحتمي
من المهم الإشارة إلى أن أداء التنبؤ الجيد الملحوظ هنا قد يعود جزئياً إلى تعلم النموذج أو تقريبه للمعادلات الفيزيائية الحتمية المستخدمة لتوليد قيم الهدف الاصطناعية37. وبخلاف القياسات التجريبية في العالم الحقيقي، التي تحتوي على ضوضاء القياس وأخطاء الأجهزة وظواهر فيزيائية غير منمذجة، توفر مجموعة البيانات الاصطناعية علاقة نظيفة وخالية من الضوضاء بين الميزات المدخلة وهدف التوهين. ويرجع ذلك إلى أن قيم التوهين تم حسابها مباشرة من نماذج الانتشار الفيزيائية (قانون Beer-Lambert، ونموذج Kim، ونموذج Carbonneau، ونظرية تشتت Mie) بناءً على المعلمات المدخلة. لذلك، فإن مقاييس الأداء الكمية (R2، وRMSE، وMAE) تمثل الأداء على بيانات اصطناعية مشتقة من معادلات، ولا ينبغي تفسيرها على أنها الأداء المتوقع للبيانات الرصدية أو التجريبية المشوبة بالضوضاء. ويجب النظر إلى النتائج في المقام الأول كتقييم مقارن لمنهجيات النمذجة في بيئة محاكاة مضبوطة38.
مجموعة الميزات الكاملة لتدريب النموذج
احتوت مجموعة بيانات التدريب على 10 ميزات إدخال لتدريب النموذج:
1. درجة الحرارة (°C)
2. الرطوبة (%)
3. الرؤية (km)
4. تركيز الغبار (mg/m3)
5. معدل هطول الأمطار (mm/h)
6. معدل تساقط الثلوج (mm/h)
7. سرعة الرياح (m/s)
8. الضغط الجوي (hPa)
9. الشهر (رقمي، 1–12)
10. الموسم (ترميز أحادي السخونة: الربيع، الصيف، الخريف، الشتاء)
توضيح هام: استُخدمت الظروف الجوية (سماء صافية، ضباب، مطر، غبار، ثلج) كمتغير فئوي للتقسيم الطبقي أثناء تقسيم مجموعة البيانات، ولم تُدرج كميزات إدخال لأي نموذج. يتضمن تحليل SHAP فقط الميزات العشر المذكورة أعلاه. تم ترميز متغير الموسم بنظام الترميز الأحادي الساخن (4 فئات: الربيع، الصيف، الخريف، الشتاء)، وبالنسبة لتحليل SHAP، جُمعت مساهمات متغيرات الموسم المرمزة أحاديًا عبر الفصول لإنتاج قيمة مساهمة موسمية واحدة. تمثل هذه القيمة المجمعة المساهمة الإجمالية لجميع المتغيرات المتعلقة بالموسم في التنبؤ بالتوهين. وقبل إنشاء الشكل الملخص، تم تحديد الأعمدة الأربعة للموسم المرمزة أحاديًا، وجمعت قيم SHAP الخاصة بها لكل عينة. تضمن هذه الطريقة أن استخدام النموذج للموسم كمتغير فئوي مركب يتوافق مع تحليل SHAP.
كانت العوامل البيئية الرئيسية التي أثرت بشكل مباشر على التوهين البصري عبر الآليات الفيزيائية هي السمات 1-6. وقد يكون لإضافة السمتين 7 و8 (سرعة الرياح والضغط) كعوامل أرصاد جوية تكميلية تأثير غير مباشر على التوهين من خلال التأثير على استقرار الهواء وتشتت الهباء الجوي. ومن أجل مراعاة التباينات الموسمية في الظروف الجوية، تم تضمين السمتين 9-10 (الشهر والفصل) كواصفات زمنية. واستُخدمت قيمة التوهين (dB/km) كمتغير مستهدف لجميع النماذج. وشملت الإحصائيات الرئيسية لمجموعة البيانات درجة الحرارة (28.55°C ± 11.18°C)، والرطوبة (42.01% ± 25.56%)، والرؤية (13.10 ± 10.91 km؛ المدى: 0.05–29.99 km)، وتركيز الغبار (0.74 ± 1.30 mg/m3؛ الحد الأقصى: 4.96 mg/m3)، والتوهين (4.80 ± 7.20 dB/km؛ المدى: 0.09–50.93 dB/km)، ونطاق التشغيل (5.74 ± 1.97 km)، ونسبة الإشارة إلى الضوضاء (64.88 ± 15.07 dB). وقد تم حساب نطاق التشغيل ونسبة الإشارة إلى الضوضاء (SNR) من قيم التوهين باستخدام معادلات ميزانية وصلة FSO القياسية.
حساب نطاق التشغيل
تم حساب نطاق التشغيل (بالكيلومتر km) باستخدام معادلة ميزانية الوصلة:
Prx=Ptx×Gt×Gr×(λ/(4πR))2×10(−A×R/10) (6)
حيث: Pوصفة طبية = القدرة المستقبلة (مُعدَّلة على أدنى حساسية تبلغ 30− ديسيبل مللي واط)؛ Pيرجى تزويد النص المراد ترجمته. = قدرة الإرسال (ثابتة عند 20 ديسيبل مللي واط (dBm)؛ Gيرجى تقديم النص المصدر المراد ترجمته. = كسب المرسل (يُحسب من أحجام الفتحة)؛ Gيرجى تزويدي بالنص المراد ترجمته. = كسب المستقبل (المحسوب من أحجام الفتحة)؛ λ = طول موجي (1550 نانومتر)؛ R = المدى بالكيلومتر؛ A = التوهين الجوي بوحدة ديسيبل/كم (محسوب بناءً على النماذج الفيزيائية).
كسب جهاز الإرسال والاستقبال: تم حساب كسب جهاز الإرسال (Gt) وفقاً للمعادلة التالية: Gt = 10×log₁₀[0.7×(π×0.025/1.55×10⁻6)2] ≈ 44.2 dBi. وتم حساب كسب جهاز الاستقبال (Gr) وفقاً للمعادلة التالية: Gr = 10×log₁₀[0.7×(π×0.20/1.55×10⁻6)2] ≈ 62.3 dBi. وبلغ قطر فتحة الإرسال 2.5 cm، بكفاءة قدرها 0.7. بينما بلغ قطر فتحة الاستقبال 20 cm، بكفاءة قدرها 0.7. تم حل المعادلة تكرارياً بالنسبة لـ R لتحديد أقصى مسافة وصل ممكن تحقيقها لكل قيمة من قيم التوهين.
حساب نسبة الإشارة إلى الضوضاء
تم حساب نسبة الإشارة إلى الضوضاء (SNR) بوحدة dB باستخدام المعادلة التالية:
نسبة الإشارة إلى الضوضاء (SNR)=Prx−10×log₁₀(kTB)−NF (7)
حيث: Pوصفة طبية = القدرة المستقبلة بوحدة dBm (محسوبة من ميزانية الوصلة)؛ k = 1.38×10⁻23 ج/ك (ثابت بولتزمان)؛ T = 290 K (درجة حرارة المستقبل)؛ B = 109 هرتز (عرض نطاق المستقبل، 1 جيجاهرتز)؛ NF = 3 ديسيبل (رقم ضوضاء المستقبل). وقد حُسبت أرضية الضوضاء على النحو التالي:
10 × log10(kTB) ≈ −84 dBm (8)
لكل عينة، وبعد حساب التوهين A باستخدام النموذج الفيزيائي المناسب، تم اشتقاق نطاق التشغيل (Operating Range) عن طريق حل ميزانية الوصلة (link budget) لإيجاد R، ثم تم حساب نسبة الإشارة إلى الضوضاء SNR من قدرة الاستقبال Prx الناتجة عند ذلك النطاق.
قيم نطاق التشغيل المحددة حسب حالة الطقس: تباين نطاق التشغيل وفقاً للظروف الجوية: السماء الصافية (7.12 ± 1.85 km)، والضباب (5.81 ± 1.92 km)، والثلج (5.42 ± 1.56 km)، والمطر (3.81 ± 0.98 km)، والغبار (3.72 ± 1.08 km). لم يتم تطبيق هامش قدره 3 dB في الحسابات الحالية؛ حيث يمثل نطاق التشغيل المدى الأقصى النظري دون هامش للنظام. ويمثل نطاق التشغيل المذكور (5.74 ± 1.97 km) المتوسط العام لجميع الظروف الجوية39.
مسافة الإرسال الثابتة: تم تعيين مسافة الإرسال في نماذج التوهين الفيزيائية لتكون 3 km. وهذه هي مسافة الوصلة التي أُجريت بناءً عليها حسابات التوهين. أما نطاق التشغيل المذكور فهو المسافة القصوى النظرية التي تم حسابها باستخدام معادلة ميزانية الوصلة، والتي قد تختلف عن مسافة الإرسال الثابتة البالغة 3 km. وقد سُجلت قيم التوهين الخاصة بكل حالة طقس للظروف الصافية (0.27±0.06 dB/km)، والضباب (1.88±1.92 dB/km)، والثلج (6.45±2.54 dB/km)، والمطر (13.58±6.32 dB/km)، والغبار (13.10±7.32 dB/km). جميع القيم الكمية الواردة في هذه المخطوطة معروضة كمتوسط ± الانحراف المعياري (SD) ما لم يُنص على خلاف ذلك40.
تم تسجيل قيمة R2 للتحقق المتقاطع لنموذج الغابة العشوائية (Random Forest) عند 0.960±0.007. وفي حالات معينة، مثل درجة الحرارة (−4.89 إلى 47.99°C)، والمدى الرؤي (0.05 إلى 29.99km)، وتركيز الغبار (0 إلى 4.96 mg/m3)، والتوهين (0.09 إلى 50.93dB/km)، تم ذكر النطاق (من الأدنى إلى الأعلى) نصياً. قُسمت مجموعة البيانات إلى مجموعات فرعية للاختبار (300 عينة؛ 20%) والتدريب (1,200 عينة؛ 80%). واستُخدم أخذ العينات العشوائية الطبقية لتنفيذ عملية تقسيم التدريب والاختبار. ولضمان تطابق نسبة كل حالة جوية في مجموعة التدريب (80%) ومجموعة الاختبار (20%) مع توزيع مجموعة البيانات الأصلية، استُخدمت الطبقية بناءً على فئة الحالة الجوية (السماء الصافية، والضباب، والمطر، والغبار، والثلج). وبشكل محدد، تم تخصيص 1,200 (80%) من أصل 1,500 عينة لمجموعة التعلم و 300 (20%) لمجموعة الاختبار. واختيرت العينات عشوائياً لكل فئة من الظروف الأرصادية مع الحفاظ على النسب الأصلية: فمن أصل 814 عينة للسماء الصافية (54.27%)، تم تخصيص 651 للتدريب و 163 للاختبار؛ ومن أصل 375 عينة للغبار (25.00%)، تم تخصيص 300 للتدريب و 75 للاختبار؛ ومن أصل 157 عينة للضباب (10.47%)، تم تخصيص 126 للتدريب و 31 للاختبار؛ ومن أصل 111 عينة للمطر (7.40%)، تم تخصيص 89 للتدريب و 22 للاختبار؛ ومن أصل 43 عينة للثلج (2.87%)، تم تخصيص 34 للتدريب و 9 للاختبار. وأُجري أخذ العينات العشوائية داخل كل طبقة باستخدام بذرة عشوائية (random seed) بقيمة 42 لضمان إمكانية تكرار النتائج. وقد اختير هذا النهج الطبقي لمنع التمثيل غير المتوازن للحالات الجوية النادرة (خاصة الثلج بنسبة 2.87%) في مجموعة الاختبار، وهو ما قد يؤدي بخلاف ذلك إلى تقييم غير موثوق للأداء في تلك الظروف.
تقييم نموذج تعلم الآلة
تم تقييم ست طرق للتعلم الآلي، بما في ذلك انحدار ناقل الدعم (SVR) مع نواة دالة القاعدة الشعاعية (C = 100)، والجيران الأقرب (KNN؛ k = 10، موزونة بالمسافة)، والغابات العشوائية (RF؛ 200 شجرة، الحد الأقصى للعمق = 20)، وتعزيز التدرج المتطرف (XGBoost؛ 200 مقدّر، الحد الأقصى للعمق = 10، معدل التعلم = 0.1)، وآلة تعزيز التدرج الخفيفة (LightGBM؛ 200 مقدّر، الحد الأقصى للعمق = 10، معدل التعلم = 0.1)، والانحدار الخطي المرجعي. وبالنسبة لجميع نماذج التعلم الآلي والتعلم العميق، تم إجراء ضبط للمعلمات الفائقة للمعلمات الأكثر أهمية، بينما تم الاحتفاظ بالقيم الافتراضية للمعلمات غير المحددة. وفيما يخص نماذج التعلم الآلي، تم ضبط المعلمات التالية صراحةً باستخدام البحث الشبكي مع التحقق المتقاطع خماسي الطيات على مجموعة التدريب: 1) الغابات العشوائية: عدد الأشجار (تم اختبار: 50، 100، 150، 200، 250) والحد الأقصى للعمق (تم اختبار: 10، 15، 20، 25، بلا حد)، مع اختيار القيم المثلى وهي 200 شجرة وعمق 20. 2) XGBoost: عدد المقدرات (تم اختبار: 100، 150، 200، 250)، والحد الأقصى للعمق (تم اختبار: 6، 8، 10، 12)، ومعدل التعلم (تم اختبار: 0.05، 0.1، 0.2)، مع قيم مثلى بلغت 200 مقدّر، وعمق 10، ومعدل تعلم 0.1. 3) LightGBM: تم استخدام نطاقات ضبط مماثلة، مما أدى إلى 200 مقدّر، وعمق 10، ومعدل تعلم 0.1. 4) SVR: تم ضبط معامل التنظيم C (تم اختبار: 1، 10، 50، 100) ومعامل النواة gamma (تم اختبار: ‘scale’، ‘auto’، 0.1، 0.01)، مع قيمة مثلى C = 100 ونواة RBF. 5) KNN: تم ضبط عدد الجيران k (تم اختبار: 3، 5، 7، 10، 15)، مع قيمة مثلى k = 10 مع تفعيل التصويت الموزون بالمسافة.
تُرِكت جميع المعلمات الأخرى لهذه النماذج عند قيمها الافتراضية كما هي محددة في scikit-learn (انظر جدول المواد بالنسبة للإصدار؛ على سبيل المثال، Random Forest: bootstrap=True, min_samples_split=2, min_samples_leaf=1؛ وXGBoost: subsample=1.0, colsample_bytree=1.0, gamma=0). أما بالنسبة لنماذج التعلم العميق، فقد تم ضبط البنية (عدد الطبقات والوحدات في كل طبقة) ومعدل الإسقاط (dropout rate) بنسبة (20%) يدويًا من خلال التجريب التكراري على مجموعة التحقق، بينما تم تحديد المُحسِّن (Adam)، ومعدل التعلم الأولي (0.001)، وصبر التوقف المبكر (20 حقبة/epoch)، ومعاملات خفض معدل التعلم (المعامل 0.5، والصبر 10) بناءً على الممارسات القياسية في الأدبيات العلمية وبقيت ثابتة في جميع تجارب التعلم العميق.
مصادر بيانات المناخ
استُخدمت المعلومات الأرصادية التاريخية التي جُمعت من محطات الرصد الجوي العراقية في عدة مواقع (بغداد، والبصرة، والموصل، والرمادي) بين عامي 2020 و2024 لحساب نسب حالات الطقس وتوزيعات المتغيرات. وقد وفرت وزارة النقل العراقية والهيئة العامة للأنواء الجوية والرصد الزلزالي (IMOS) البيانات الخام. تضمنت البيانات سجلات طقس يومية تفصل الحالة الجوية السائدة لكل يوم. وشملت المتغيرات المحددة المستخرجة من هذه السجلات درجة الحرارة (الدنيا، والعظمى، والمتوسط اليومي)، والرطوبة النسبية، ومدى الرؤية، وكمية الأمطار، وحالات حدوث العواصف الغبارية. تتوفر بيانات IMOS جزئياً من خلال بوابة البيانات المفتوحة للحكومة العراقية (https://www.motrans.gov.iq/)، رغم أن السجلات المحددة المستخدمة في هذه الدراسة ليست مؤرشفة علناً في مستودع مركزي. ويوجد ملخص لبيانات المناخ المستخدمة لتحديد نسب الظروف الجوية ونطاقات المعاملات في الجدول 1.
استُخدم التحقق المتقاطع خماسي الطيات (Fivefold cross-validation) على مجموعة التدريب (1,200 عينة) لضبط المعلمات التشعبية وتقدير الأداء لجميع نماذج تعلم الآلة. خضعت جميع متغيرات الإدخال (درجة الحرارة، الرطوبة، الرؤية، تركيز الغبار، معدل هطول الأمطار، معدل تساقط الثلوج، سرعة الرياح، الضغط) لتغيير مقياس السمات عن طريق التقييس (Standardization) (تطبيع درجة Z): x_scaled = (x − μ)/σ، حيث تمثل μ و σ المتوسط والانحراف المعياري لمجموعة التدريب. وقد أجرينا التقييس داخل كل طية من طيات التحقق المتقاطع باستخدام الإحصائيات المستمدة من طية التدريب فقط لتجنب تسرب البيانات. وتعد النماذج القائمة على الأشجار (Random Forest، XGBoost، LightGBM) غير متأثرة بمقياس البيانات (scale-invariant)، ولكن تم تطبيق التقييس نفسه لضمان الاتساق عبر جميع نماذج تعلم الآلة. أما بالنسبة لنماذج التعلم العميق، فقد استُخدم تطبيع الحد الأدنى والأقصى (Min-max normalization): x_scaled = (x−x_min)/(x_max−x_min)، والذي يقوم بضبط مقياس السمات لتصبح في النطاق [0, 1] بناءً على قيم الحد الأدنى والأقصى من مجموعة التدريب. وقد تم اختيار هذا الأسلوب لأن المدخلات المقيدة تؤدي إلى تقارب أسرع للشبكات العصبية. كما تم تغيير مقياس مجموعة الاختبار باستخدام المعلمات التي تم الحصول عليها من مجموعة التدريب، ولم تُستخدم هذه المجموعة في اختيار النموذج أو ضبط المعلمات التشعبية.
تم تسجيل مقاييس الأداء الكاملة، بما في ذلك معامل تحديد الاختبار (R2)، وجذر متوسط مربع الخطأ (RMSE)، ومتوسط الخطأ المطلق (MAE)، وR2 للتحقق المتقاطع، ووقت التدريب. وقد تم تسجيل أوقات التدريب لجميع نماذج تعلم الآلة والتعلم العميق بالثواني (s) للنماذج الأسرع (Linear Regression، وKNN، وSVR، وRandom Forest، وXGBoost، وLightGBM) وبالدقائق (min) للنماذج الأبطأ (بنى التعلم العميق). تم تدريب جميع النماذج في نفس البيئة الحسابية لضمان المقارنة العادلة41.
تم قياس وقت التدريب باستخدام وحدة time في لغة Python، أي الوقت الفعلي المنقضي من بداية دالة ملاءمة النموذج حتى نهايتها، باستثناء الوقت المطلوب لتحميل البيانات ومعالجتها مسبقاً. ويُعرف وقت التدريب لنموذج التعلم العميق بأنه الوقت المستغرق لإكمال جميع العصور (epochs) حتى حدوث التوقف المبكر، وهذا يشمل الانتشار الأمامي، والانتشار العكسي، وعمليات التحقق من الصحة. وقد أُجريت جميع التجارب بينما كان النظام يعمل دون أي عمليات أخرى كثيفة الحوسبة للحصول على قياسات زمنية متسقة. وتمثل الأوقات المذكورة متوسط 5 تشغيلات مستقلة (الانحرافات المعيارية)42.
تقييم نموذج التعلم العميق
تم تقييم ست بنيات للتعلم العميق باستخدام تسريع وحدة معالجة الرسوميات (GPU)، بما في ذلك البيرسيبترون متعدد الطبقات (MLP; 64-32-16)، وشبكة عصبية عميقة (DNN) مع تطبيع الدفعات (128-64-32-16)، وشبكة الذاكرة طويلة قصيرة المدى (LSTM; 64-32 وحدة، طول التسلسل = 10)، وشبكة عصبية تلافيفية أحادية الأبعاد (1D-CNN)، ونموذج هجين من CNN-LSTM، وشبكة قائمة على آلية الانتباه. تم تنفيذ جميع نماذج التعلم العميق باستخدام TensorFlow مع واجهة برمجة تطبيقات Keras وتم تشغيلها بتسريع GPU (راجع جدول المواد لمعرفة إصدارات الأجهزة والبرامج). تألفت بنية 1D-CNN من ثلاث طبقات تلافيفية (64 و128 و256 مرشحاً، وحجم النواة 3، وتنشيط ReLU، والحشوة 'same')، وطبقتين MaxPooling1D (حجم التجميع 2)، وطبقة GlobalAveragePooling1D، وطبقة Dense بـ 128 وحدة وتنشيط ReLU، وطبقة Dropout (0.2)، وطبقة Dense مخرجات (وحدة واحدة، تنشيط خطي)، بإجمالي حوالي 245,000 معلمة قابلة للتدريب. أما البنية الهجينة CNN-LSTM فقد قبلت تسلسلات مدخلات مكونة من 10 خطوات زمنية بـ 5 سمات، باستخدام طبقتين Conv1D (64 و128 مرشحاً، وحجم النواة 3، وReLU، والحشوة 'same')، وطبقة MaxPooling1D (حجم التجميع 2)، وطبقتين LSTM (64 و32 وحدة، return_sequences=False)، وطبقات Dropout (0.2)، وطبقة Dense (32 وحدة، ReLU)، وطبقة Dense مخرجات (وحدة واحدة، تنشيط خطي)، بإجمالي حوالي 198,000 معلمة قابلة للتدريب. واستخدمت الشبكة القائمة على الانتباه آلية انتباه متعددة الرؤوس بـ 4 رؤوس (أبعاد المفتاح والقيمة 64)، حيث تم إسقاط المدخلات إلى 64 بُعداً، متبوعة بانتباه حاصل الضرب النقطي المقاس (المعادلة: Attention(Q, K, V) = softmax(QKT/√d_k))، ووصلات متبقية، وتطبيع الطبقات، وشبكة تغذية أمامية (128→64 وحدة)، وتجميع متوسط عام، وDropout (0.2)، وطبقة Dense (32 وحدة، ReLU)، وطبقة Dense مخرجات (وحدة واحدة، تنشيط خطي)، بإجمالي حوالي 167,000 معلمة قابلة للتدريب43.
استخدمت جميع النماذج التوقف المبكر (patience = 20)، وخفض معدل التعلم (factor = 0.5، patience = 10)، والإسقاط (dropout) بنسبة (20%)، ومحسن Adam (learning rate = 0.001). وبالنسبة لجميع نماذج التعلم العميق، تم تعيين حجم الدفعة (batch size) على 32 عينة، وكان الحد الأقصى لعدد دورات التدريب (epochs) 200 مع تفعيل التوقف المبكر (patience = 20، مع استعادة أفضل الأوزان)، وكانت دالة الخسارة هي متوسط مربع الخطأ (MSE). وكان تقسيم بيانات التدريب والتحقق كما يلي: من أصل 1,200 عينة تدريب أصلية (بعد تقسيم بيانات التدريب والاختبار بنسبة 80/20)، تم استخدام 80% (960 عينة) للتدريب و 20% (240 عينة) للتحقق. وقد أجرينا تقسيم التدريب والتحقق بطريقة طبقية وفقاً للحالة الجوية للحفاظ على التوزيع. واستُخدمت مجموعة التحقق فقط للتوقف المبكر، وتناقص معدل التعلم، ومراقبة الإفراط في التخصيص (overfitting)؛ ولم تُستخدم أبداً لاختيار النموذج أو ضبط المعلمات الفائقة (hyperparameters) خارج هذه الإجراءات المؤتمتة. ولم نخصص مجموعة تحقق منفصلة لنماذج التعلم الآلي؛ وبدلاً من ذلك، استخدمنا التحقق المتقاطع خماسي الطيات (five-fold cross-validation) على 1,200 عينة تدريب لضبط المعلمات الفائقة وتقدير الأداء44.
تبرير تقييم بنية LSTM وبنية CNN–LSTM
تتكون مجموعة البيانات الرئيسية من عينات طقس تم توليدها بشكل مستقل، ولكننا قمنا أيضاً باختبار بنيات LSTM و CNN–LSTM للأسباب التالية: (1) الظروف الجوية في العالم الحقيقي مرتبطة ذاتياً زمنياً، واختبار النماذج القائمة على التسلسل يتيح لنا تحديد ما إذا كان التقاط هذه التبعيات يمكن أن يحسن دقة التنبؤ؛ (2) أظهرت الأبحاث الحديثة في التنبؤ الجوي القيمة المحتملة للبنيات التسلسلية في نمذجة التطور الزمني للمؤشرات الميتيورولوجية34؛ (3) يضمن اختبار مجموعة متنوعة من البنيات إجراء مقارنة شاملة للمناهج المنهجية، وهو ما يمثل مساهمة رئيسية لهذه الدراسة؛ و(4) تجمع البنية الهجينة CNN–LSTM بين استخراج الميزات المكانية والنمذجة الزمنية، وهو ما قد يكون مفيداً في التقاط التفاعلات المعقدة بين المتغيرات الجوية المتعددة45.
تنسيق البيانات لإدخال النموذج التسلسلي
بالنسبة للبنيات التسلسلية (LSTM وCNN–LSTM)، تمت إعادة هيكلة بيانات الإدخال من عينات مستقلة إلى تسلسلات وهمية باستخدام منهجية النافذة المنزلقة. وبشكل أدق، جُمعت عينات التدريب البالغ عددها 1,200 عينة أولاً في فئات حسب الظروف الجوية للحفاظ على الاتساق الفيزيائي. وضمن كل فئة جوية، رُتبت العينات وفقاً للطوابع الزمنية المُنشأة لها (ملاحظات ساعية محاكاة للسنة التقويمية 2024). بعد ذلك، طُبقت نافذة منزلقة بطول 10 لإنتاج تسلسلات إدخال مكونة من 10 خطوات زمنية متتالية (تتضمن كل خطوة 5 سمات: درجة الحرارة، والرطوبة، ومدى الرؤية، وتركيز الغبار، ومعدل هطول الأمطار) للتنبؤ بالوهن عند الخطوة 11.th خطوة زمنية. تحافظ هذه الطريقة على الترتيب الزمني للملاحظات التي تمت محاكاتها، بينما تسمح للنماذج التسلسلية بتعلم الاعتمادات الزمنية. كانت بنية مجموعة الاختبار هي نفسها، باستثناء استخدام نفس حجم النافذة ومجموعة الميزات. ونحن نقر بأن هذه البنية التسلسلية الزائفة هي تبسيط منهجي ولا تعكس الديناميكيات الزمنية في العالم الحقيقي، وقد أشرنا إلى ذلك كأحد القصور في قسم المناقشة.
تقييم النهج الهجينة
تم فحص ثلاثة نهج هجينة. كان النهج الأول عبارة عن "مجموعة تصويت" (Voting Ensemble) قامت بحساب متوسط التنبؤات من نماذج Random Forest وXGBoost وDeep Neural Network باستخدام أوزان متساوية (حيث تم تخصيص وزن 1/3 لكل نموذج)، مع حساب التنبؤ النهائي وفقاً لما يلي:
ŷensemble=(1/3)ŷRF+(1/3)ŷXGB+(1/3)ŷDNN (9)
تم اختيار التوزين المتساوي لتجنب إدخال معاملات فائقة إضافية ولتقييم أداء التجميع المرجعي دون انحياز لأي نموذج فردي. أما النهج الثاني فقد استخدم تكديس المتعلم الفائق من نوع Ridge. وكانت المتعلمات الأساسية هي Random Forest وXGBoost وشبكة عصبية عميقة (قائمة على Attention). تضمنت عملية التكديس مرحلتين: أولاً، تم تدريب كل متعلم أساسي على مجموعة التدريب الكاملة المكونة من 1,200 عينة باستخدام التحقق المتقاطع خماسي الطيات (5-fold cross-validation) لتوليد تنبؤات خارج الطي، مما أدى إلى إنشاء مصفوفة ميزات فائقة جديدة بحجم 1,200×3 (تنبؤ واحد لكل نموذج أساسي لكل عينة). ثانياً، تم تدريب متعلم فائق من نوع Ridge regression (معامل تنظيم L2 alpha=1.0) على هذه الميزات الفائقة، باستخدام قيم التوهين الأصلية كهدف، لتعلم أوزان الدمج المثلى للمتعلمات الأساسية. وكان التنبؤ النهائي للتكديس هو:
ŷstacking=wRF×ŷRF+wXGB×ŷXGB+wDNN×ŷDNN (10)
حيث تم تعلّم الأوزان w بواسطة متعلم Ridge الفائق. وكان النهج الثالث عبارة عن شبكة عصبية مستنيرة بالفيزياء (Physics-Informed Neural Network) دمجت 70% من تنبؤات الشبكة العصبية مع 30% من نموذج Kim لعينات ظروف الضباب. وقد تم الدمج عن طريق المتوسط المرجح الثابت باستخدام الصيغة التالية:
ŷhybrid=0.7×ŷneural+0.3×ŷKim (11)
حيث تمثل ŷneural مخرجات الشبكة العصبية القائمة على آلية الانتباه (Attention-based neural network)، وتمثل ŷKim التوهين المحسوب من نموذج Kim للضباب بناءً على مدخلات الرؤية. وبالنسبة للعينات غير الضبابية، تم ضبط الجزء الفيزيائي على 0، وتم تشغيل النموذج كشبكة عصبية بحتة. تم تثبيت الأوزان (70% للشبكة العصبية و30% للفيزياء) بناءً على تجارب أولية على مجموعة التحقق (وليس مجموعة الاختبار)، حيث اختبرنا تركيبات أوزان بنسب 90:10، و80:20، و70:30، و60:40، و50:50. وقد تم اختيار تقسيم 70/30 لأنه حقق أفضل قيمة R2 للتحقق، وظل يحافظ على قيود فيزيائية كافية من نموذج Kim لتنظيم التنبؤات وتجنب المخرجات غير المعقولة فيزيائياً، خاصة في حالات الضباب حيث يوفر نموذج Kim حدود توهين نظرية معتمدة.
تحليل أهمية الميزات وقابلية التفسير
تم استخدام نموذج الغابة العشوائية (Random Forest) مع أهمية الميزات القائمة على الشوائب (تقليل التباين) لاستخراج تصنيفات أهمية جميع الميزات العشر المدخلة. وأظهر التحليل أن تركيز الغبار (67.3%) والرؤية (21.2%) كانا أهم المتنبئات، حيث يفسران معاً 88.5% من إجمالي الأهمية التنبؤية. وكانت الميزة الثالثة من حيث الأهمية هي معدل هطول الأمطار (6.0%)، تليها سرعة الرياح (2.1%)، ودرجة الحرارة (1.5%)، والرطوبة (0.9%)، والشهر (0.5%)، والفصل (0.3%)، ومعدل تساقط الثلوج (0.1%)، والضغط الجوي (0.1%). وتشير درجات الأهمية المنخفضة للميزات الزمنية (الشهر والفصل) إلى أن التباين الموسمي في التوهين الجوي يتم استيعابه بشكل أساسي من خلال المعلمات البيئية الأساسية بدلاً من الأنماط القائمة على الوقت وحدها.
تم إجراء تحليل SHAP (تفسيرات شابلّي المضافة) لتقييم العلاقات بين العوامل البيئية والوهن. وقد استخدم تنفيذ SHAP وحدة TreeExplainer من مكتبة SHAP، وهي وحدة مُحسَّنة خصيصاً للنماذج القائمة على الأشجار، بما في ذلك Random Forest وXGBoost وLightGBM (راجع جدول المواد لمعرفة الإصدار). وكانت تهيئة تحليل SHAP كما يلي: تم تمرير نموذج Random Forest المدرب إلى TreeExplainer، الذي قام بحساب قيم SHAP باستخدام نهج إسناد الميزات التدخلي (الهامشي) بناءً على التوقع الشرطي لمخرجات النموذج. تم حساب قيم SHAP لجميع عينات مجموعة الاختبار البالغ عددها 300 عينة، مما أنتج مصفوفة بحجم 300 × 10 (قيمة SHAP واحدة لكل ميزة لكل عينة). وبالنسبة لكل ميزة، مثلت قيمة SHAP مساهمتها في التنبؤ بالنسبة إلى الخط المرجعي (متوسط تنبؤ النموذج). وأشارت قيم SHAP السالبة إلى إزاحة نحو الأسفل؛ بينما أظهرت قيم SHAP الموجبة أن الميزة عززت التنبؤ بالوهن. وقد دلت قيمة SHAP من حيث المقدار على قوة هذه المساهمة. وتم تصور توزيع أرقام SHAP لكل ميزة (باستخدام مخططات beeswarm)، واتجاه التأثير (الارتباط بين قيم الميزات وقيم SHAP)، وتصنيفات أهمية الميزات، وذلك باستخدام مخططات ملخصة. واستُخدمت وظائف الرسم المدمجة في مكتبة SHAP — وهي shap.summary_plot() لمخطط beeswarm وshap.bar_plot() لأهمية الميزات العالمية — لإنشاء جميع تصورات SHAP.
التعامل مع المتغيرات المرمزة بنظام الترميز الأحادي (One-Hot Encoding): استُخدمت في البداية أربعة أعمدة ثنائية (الربيع، والصيف، والخريف، والشتاء) لترميز متغير الفصل. ومن أجل إنشاء قيمة مساهمة واحدة لـ "الفصل" لكل عينة في تحليل SHAP، تم دمج مساهمات هذه المتغيرات الأربعة المرمزة بنظام الترميز الأحادي عن طريق جمع قيم SHAP لكل فئة من فئات الفصول. ولإتمام عملية التجميع هذه، تم تحديد جميع الأعمدة المقابلة لمجموعات الفصول المرمزة بنظام الترميز الأحادي، واستخراج قيم SHAP الخاصة بها لكل عينة، ثم جمعها عنصرًا تلو الآخر. وتمثل قيم SHAP المجمعة الناتجة المساهمة الإجمالية للفصل في التنبؤ بالوهن. تسمح هذه الطريقة بظهور صف واحد لـ "الفصل" في مخطط ملخص SHAP وتضمن الاتساق مع استخدام النموذج للفصل كمتغير فئوي مركب. ونظرًا لأن الرقم المجمع يقدم وصفًا أكثر وضوحًا للمساهمة الإجمالية للفصل، لم يتم عرض قيم SHAP الخاصة بالفصول بشكل منفصل لكل فئة فصل.
النتائج
تم تلخيص خصائص مجموعة البيانات الاصطناعية في الشكل 1A–F. تضمنت مجموعة البيانات ظروف السماء الصافية، والغبار، والضباب، والمطر، والثلج (الشكل 1A)، مع توزيع العينات عبر المواسم الحارة الجافة والباردة الرطبة (الشكل 1B) وفترات النهار والليل (الشكل 1C). وتظهر توزيعات درجة الحرارة، والرطوبة، والرؤية تحت ظروف جوية مختلفة في الشكل 1D–F.
أظهرت نماذج تعلم الآلة أداءً تنبؤياً قوياً في تقدير التوهين الجوي (الشكل 2A–D؛ الجدول 3). حقق نموذج RF أقوى أداء إجمالي بين النماذج التي تم تقييمها، حيث بلغت قيمة R2 للاختبار 0.9654، وبلغ جذر متوسط مربع الخطأ (RMSE) قيمة 1.324 dB/km (الشكل 2A؛ الجدول 3). وفسّر نموذج RF نسبة 96.54% من التباين الملحوظ مع الحفاظ على خطأ تنبؤ يقل عن 1.5 dB/km. كما أدى نموذج XGBoost بشكل جيد أيضاً (الشكل 2C)، يليه نموذج LightGBM (الشكل 2B). وقد تم دعم متانة النماذج من خلال التحقق المتقاطع خماسي الطيات، حيث حقق RF قيمة R2 للتحقق المتقاطع بلغت 0.960 ± 0.007 (الشكل 2D). وفي المقابل، أظهر نموذج K-Nearest Neighbors علامات على الإفراط في التخصيص (overfitting)، حيث بلغت قيمة R2 للتدريب 1.000 وقيمة R2 للاختبار 0.7341، بينما حقق نموذج Linear Regression أداءً تنبؤياً متوسطاً (الشكل 2A؛ الجدول 3).
يظهر تحليل أهمية الميزات للميزات العشر المدخلة المذكورة أعلاه في الشكل 3A. وقد رُتبت درجات الأهمية النسبية على النحو التالي: تركيز الغبار (67.3%)، والرؤية (21.2%)، ومعدل هطول الأمطار (6.0%)، وسرعة الرياح (2.1%)، ودرجة الحرارة (1.5%)، والرطوبة (0.9%)، والشهر (0.5%)، والموسم (0.3%)، ومعدل تساقط الثلوج (0.1%)، والضغط (0.1%). استُخدم متغير "الحالة الجوية" لتقسيم مجموعة البيانات طبقيًا، ولكنه لم يُدرج في تحليل أهمية الميزات لأنه متغير مركب فئوي يمثل عدة معلمات فيزيائية أساسية، كما أن تأثيره يتم استيعابه من خلال الميزات البيئية الفردية. حددت تحليلات أهمية الميزات والقابلية للتفسير المتغيرات البيئية الأكثر ارتباطًا بقوة بالتوهين (الشكل 3A،B). وقد شكل تركيز الغبار (67.3%)، والرؤية (21.2%)، ومعدل هطول الأمطار (6.0%) مجتمعين 94.4% من إجمالي الأهمية التنبؤية (الشكل 3A). كما أظهر تحليل SHAP أن زيادة تركيز الغبار وانخفاض الرؤية ارتبطا بزيادة تنبؤات التوهين (الشكل 3B).
أظهرت نماذج التعلم العميق أداءً تنبؤياً أقل مقارنة بنهج التعلم الآلي (الشكل 4A–D). وحقق نموذج التعلم العميق الأفضل أداءً، وهو الشبكة القائمة على آلية الانتباه (Attention-based network)، قيمة R2 بلغت 0.7766 وقيمة RMSE بلغت 3.362 dB/km (الشكل 4A). كما أظهرت البنى المتكررة (Recurrent architectures) أداءً ضعيفاً بشكل خاص، حيث أنتج كل من نموذجي LSTM و CNN–LSTM قيم R2 قريبة من الصفر وقيم RMSE تتجاوز 7.19 dB/km (الشكل 4B). ويمكن تفسير الأداء الضعيف نسبياً لبنى LSTM و CNN-LSTM (قيم R2 = 0.0110 و 0.0109 على التوالي؛ و RMSE = 7.193 dB/km و 7.196 dB/km) جزئياً بالطبيعة التسلسلية الزائفة لبيانات الإدخال، والتي لا تلتقط بشكل كامل الديناميكيات الزمنية الحقيقية للظروف الجوية.
على عكس تطبيقات السلاسل الزمنية الحقيقية، حيث تكون التبعيات التسلسلية قوية ومحددة جيدًا، تألفت مجموعة البيانات لدينا في الغالب من عينات مستقلة مع ترتيب زمني مفروض اصطناعيًا. ويشير ضعف أداء التنبؤ لهذه البنى الهيكلية إلى أن المعلومات الزمنية التي استخلصها نهج النافذة المنزلقة كانت إما غير كافية أو غير ممثلة للتطور الجوي الحقيقي (الشكل 4C). وهذا يدعم استنتاجنا بأنه بالنسبة لمجموعات البيانات من هذا النوع، تكون مناهج تعلم الآلة الأبسط أكثر ملاءمة من نماذج التعلم العميق المعقدة القائمة على التسلسل. وقد تم تلخيص أداء التحقق لجميع بنيات التعلم العميق في الشكل 4D.
تم تلخيص أداء تعلم الآلة، والتعلم العميق، والنهج الهجينة في الشكل 5A,B، والجدول 3. ومن بين الطرق الهجينة، حققت مجموعة التصويت (Voting Ensemble) قيمة R2 بلغت 0.9340 وقيمة RMSE بلغت 1.827 dB/km (الشكل 5A,B؛ الجدول 3). كما حقق تكديس المتعلم الميتاي (Ridge meta-learner stacking) قيمة R2 بلغت 0.9571 وقيمة RMSE بلغت 1.473 dB/km (الشكل 5A,B; الجدول 3)، وهو أداء يقترب من أداء RF ولكن يتطلب أوقات تدريب أطول بكثير. وحققت الشبكة العصبية المعتمدة على الفيزياء (Physics-Informed Neural Network) قيمة R2 = 0.8269 وقيمة RMSE = 2.960 dB/km (الشكل 5A,B؛ الجدول 3)، وكان أداؤها أفضل من نماذج التعلم العميق، ولكن ليس بجودة أفضل نهج في تعلم الآلة. وأشارت المقارنة الإحصائية بين نماذج RF وتكديس المجموعات (Stacking Ensemble) إلى عدم وجود فرق جوهري في الأداء التنبؤي (الجدول 3؛ اختبار t المقترن: t = −1.74, p = 0.083). وبناءً على ذلك، وعلى الرغم من تحقيق RF لأعلى قيمة عددية لـ R2، فإن الفرق عن أفضل نهج هجين لم يكن ذا دلالة إحصائية.
بشكل عام، تدعم النتائج الفرضية القائلة بأن مناهج تعلم الآلة يمكنها التنبؤ بدقة بالتوهين الجوي في ظل الظروف الجوية العراقية. حقق نموذج RF باستمرار أعلى أداء تنبؤي (الشكل 2A,B؛ الجدول 3)، بينما حددت تحليلات أهمية الميزات وتحليلات SHAP أن تركيز الغبار ومدى الرؤية هما العاملان البيئيان المهيمنان المؤثران على التوهين (الشكل 3A,B).
بيان بيانات التحقق: أُجريت جميع تقييمات النموذج على مجموعة البيانات الاصطناعية الموضحة في قسم الطرق. لم تُستخدم أي بيانات تجريبية أو رصدية حول التوهين الجوي في التحقق من صحة النموذج. وقد تم إنشاء مجموعة البيانات الاصطناعية باستخدام نماذج انتشار فيزيائية معروفة (قانون بير-لامبرت، ونموذج كيم، ونموذج كاربونيو، ونظرية تشتت مي) مع اختيار البارامترات الأرصادية من توزيعات احتمالية بناءً على سجلات المناخ العراقي. وكما ورد في قسم الطرق، فإن أداء التنبؤ القوي قد يعكس جزئيًا تعلم النموذج أو تقريبه للمعادلات الفيزيائية الحتمية المستخدمة لتوليد القيم المستهدفة. وبناءً عليه، فإن مقاييس الأداء الكمية (R2، وRMSE، وMAE) تمثل الأداء على بيانات اصطناعية مشتقة من معادلات، ويجب تفسيرها كمقارنات نسبية بين منهجيات النمذجة في بيئة محاكاة محكومة، وليس كضمانات أداء مطلقة لأنظمة الاتصالات البصرية في الفضاء الحر (FSO) التشغيلية. يوفر هذا النهج بيئة محكومة للتقييم المقارن لمنهجيات النمذجة التنبؤية (كما هو مدرج في الجدول 2)، ولكنه لا يحل محل التحقق باستخدام قياسات توهين FSO في العالم الحقيقي تحت ظروف الطقس العراقية الفعلية.
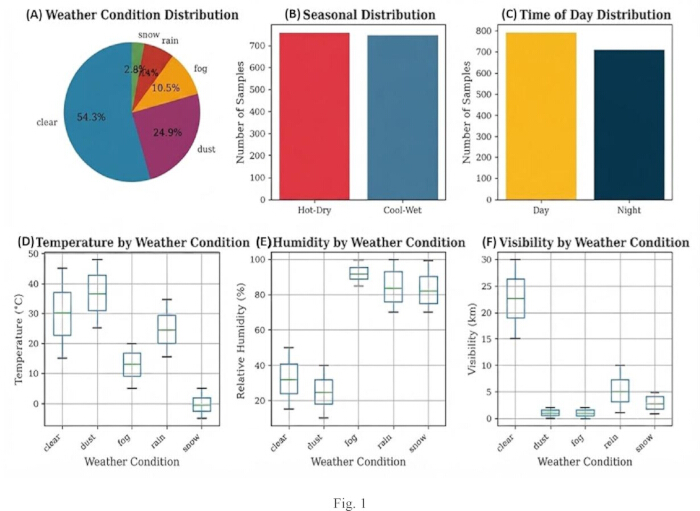
الشكل 1: خصائص مجموعة البيانات الاصطناعية والمتغيرات البيئية المستخدمة في نمذجة التوهين الجوي. (أ) توزيع الظروف الأرصادية الممثلة في مجموعة البيانات، بما في ذلك حالات السماء الصافية، والغبار، والضباب، والمطر، والثلج. (ب) التوزيع الموسمي للعينات عبر الفترات الحارة والجافة والباردة والرطبة. (ج) توزيع العينات التي تم جمعها خلال ظروف النهار والليل. (د) توزيعات درجة الحرارة لكل حالة طقس. (هـ) توزيعات الرطوبة لكل حالة طقس. (و) توزيعات الرؤية لكل حالة طقس. تظهر المخططات الصندوقية الوسيط (الخط المركزي)، والمدى الربيعي (الصندوق)، والقيم الدنيا والقصوى (الشعيرات). يتم تسجيل درجة الحرارة بـ °C، والرطوبة بـ %، والرؤية بـ km. يرجى النقر هنا لعرض نسخة أكبر من هذا الشكل.
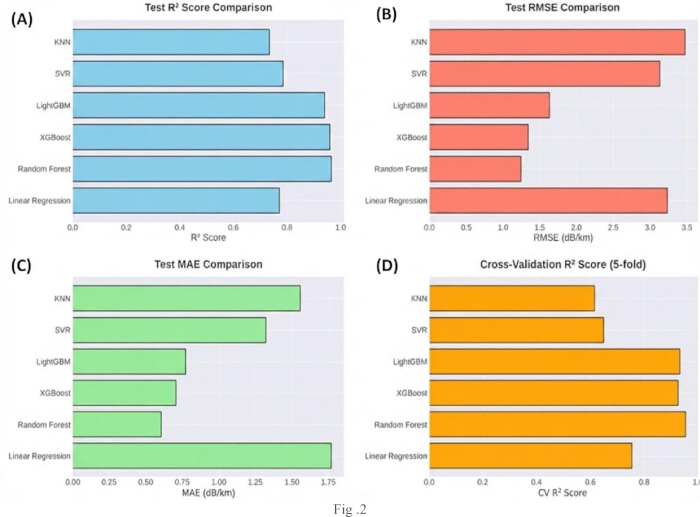
الشكل 2: مقارنة أداء نماذج تعلم الآلة للتنبؤ بالوهن الجوي. (A) درجات معامل التحديد (R2) للاختبار لنماذج تعلم الآلة التي تم تقييمها، بما في ذلك الانحدار الخطي (Linear Regression)، والغابة العشوائية (Random Forest)، وتعزيز التدرج الشديد (XGBoost)، وآلة تعزيز التدرج الخفيف (LightGBM)، وانحدار ناقل الدعم (SVR)، والجيران الأقرب K (KNN). (B) قيم جذر متوسط مربع الخطأ (RMSE) للاختبار لكل نموذج من نماذج تعلم الآلة. (C) قيم متوسط الخطأ المطلق (MAE) للاختبار لكل نموذج من نماذج تعلم الآلة. (D) درجات معامل التحديد (R2) للتحقق المتقاطع التي تم الحصول عليها باستخدام التحقق المتقاطع خماسي الطيات. تشير قيم R2 الأعلى وقيم RMSE وMAE الأقل إلى تحسن في أداء التنبؤ. تم تسجيل قيم RMSE وMAE بوحدة dB/km. يرجى النقر هنا لعرض نسخة أكبر من هذا الشكل.
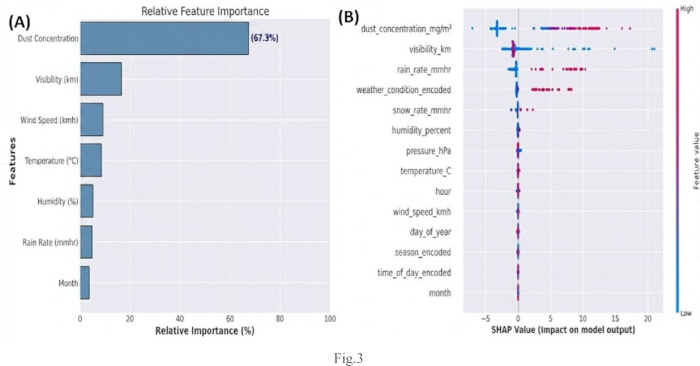
الشكل 3تحليل أهمية الميزات وقابلية تفسير النموذج للتنبؤ بالتوهين الجوي. (A) تصنيفات أهمية الميزات بناءً على الشوائب النسبية من نموذج الغابة العشوائية (Random Forest)، والتي توضح مساهمة جميع المتغيرات البيئية والزمنية العشرة في التنبؤ بالتوهين. كانت الميزة الأكثر تأثيراً هي تركيز الغبار (67.3%)، تلتها الرؤية (21.2%)، ومعدل هطول الأمطار (6.0%)، وسرعة الرياح (2.1%)، ودرجة الحرارة (1.5%)، والرطوبة (0.9%)، والشهر (0.5%)، والموسم (0.3%)، ومعدل تساقط الثلوج (0.1%)، والضغط الجوي (0.1%). وتمثل الأهمية النسبية نسبة مئوية من إجمالي أهمية النموذج. (Bمخطط ملخص SHapley Additive exPlanations (SHAP) يوضح تأثير الميزات الفردية على تنبؤات النموذج. تم حساب مصفوفة SHAP لـ 300 عينة من مجموعة الاختبار (300) × (10 ميزات). وبالنسبة لمتغير الفصل الذي تم ترميزه بأسلوب الترميز الأحادي (one-hot-encoded) (والذي كان في الأصل أربعة أعمدة ثنائية: الربيع، والصيف، والخريف، والشتاء)، فقد دُمجت قيم SHAP عن طريق الجمع عبر الفئات الأربع لإنتاج قيمة مساهمة واحدة لـ "الفصل" لكل عينة. تمثل كل نقطة عينة، ويشير مقياس الألوان إلى قيمة الميزة، والتي تتراوح من منخفضة (باللون الأزرق) إلى عالية (باللون الأحمر). وتشير قيم SHAP الموجبة إلى زيادة في التوهين المتوقع، بينما تشير قيم SHAP السالبة إلى انخفاض في التوهين المتوقع. يرجى النقر هنا لعرض نسخة أكبر من هذا الشكل.
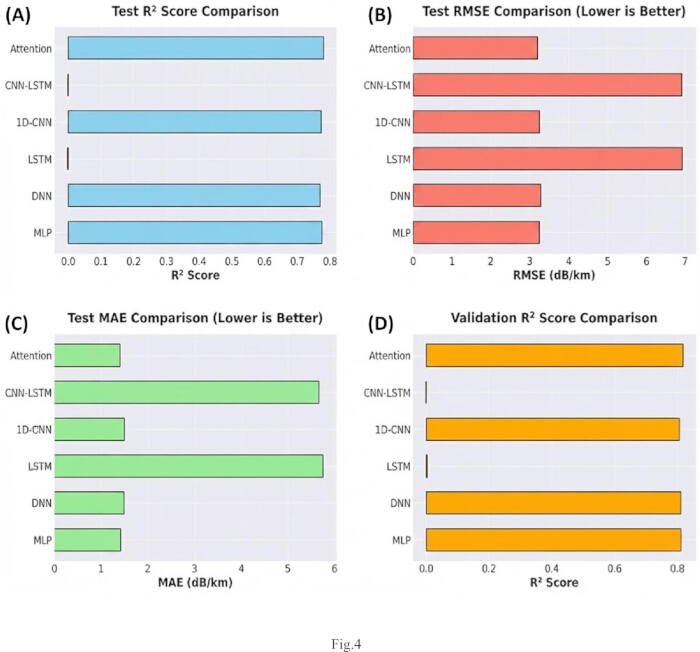
الشكل 4: مقارنة أداء نماذج التعلم العميق للتنبؤ بالتوهين الجوي. (A) درجات معامل التحديد (R2) للاختبار لمعماريات التعلم العميق التي تم تقييمها، بما في ذلك البيرسيبترون متعدد الطبقات (MLP)، والشبكة العصبية العميقة (DNN)، والذاكرة طويلة قصيرة المدى (LSTM)، والشبكة العصبية التلافيفية أحادية الأبعاد (1D-CNN)، والشبكة العصبية التلافيفية المدمجة مع الذاكرة طويلة قصيرة المدى (CNN–LSTM)، والنماذج القائمة على آلية الانتباه (Attention-based). (B) قيم جذر متوسط مربع الخطأ (RMSE) للاختبار لكل نموذج من نماذج التعلم العميق. (C) قيم متوسط الخطأ المطلق (MAE) للاختبار لكل نموذج من نماذج التعلم العميق. (D) درجات معامل التحديد (R2) للتحقق من صحة نماذج التعلم العميق التي تم تقييمها. تشير قيم R2 الأعلى وقيم RMSE وMAE الأقل إلى تحسن في أداء التنبؤ. تم تسجيل RMSE وMAE بوحدة dB/km. يرجى النقر هنا لعرض نسخة أكبر من هذا الشكل.
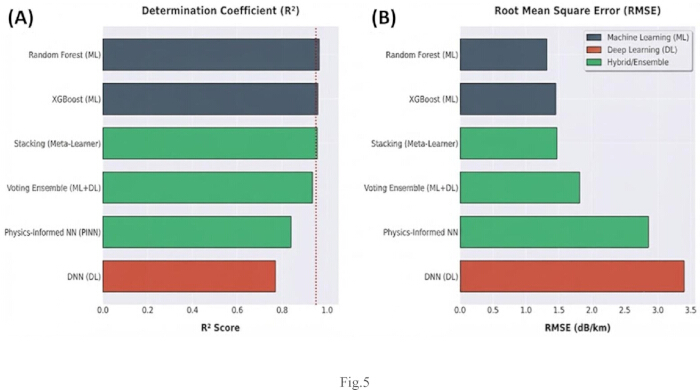
الشكل 5: مقارنة أداء نماذج تعلم الآلة، والتعلم العميق، والنماذج الهجينة للتنبؤ بالتوهين الجوي. (A) قيم معامل التحديد (R2) لنهج تمثيلية من تعلم الآلة، والتعلم العميق، والأساليب الهجينة، بما في ذلك نماذج الغابة العشوائية (Random Forest)، وتعزيز التدرج الشديد (XGBoost)، والشبكة العصبية العميقة (DNN)، وتجميع التصويت (Voting Ensemble)، والتكديس (Stacking)، والشبكات العصبية المستنيرة بالفيزياء (Physics-Informed Neural Network). (B) قيم جذر متوسط مربع الخطأ (RMSE) للنماذج ذاتها. تم ترميز النماذج بالألوان وفقاً لثلاث فئات هي: تعلم الآلة (ML)، والتعلم العميق (DL)، والتقنيات الهجينة/التجميعية. ويشير ارتفاع قيم R2 وانخفاض قيم RMSE إلى تحسن في أداء التنبؤ. يُعبر عن RMSE بوحدة dB/km. يرجى النقر هنا لعرض نسخة أكبر من هذا الشكل.
| الحالة الجوية | نسبة | النطاق الحراري | نطاق الرطوبة | مدى الرؤية | نطاق المعلمة الأساسية |
| سماء صافية | 54.27% (814 عينة) | من -4.89 إلى 47.99°C | 0–100% | >١٠ كم | — |
| غبار | 25.00% (375 عينة) | 10–45°C | 10–60% | ٠.٠٥-٥ كم | غبار: ٠-٤.٩٦ مجم/م³3 |
| ضباب | 10.47% (157 عينة) | من -5 إلى 20°C | 70–100% | 0.05–1 كم | — |
| مطر | 7.40% (111 عينة) | 5–30°C | 60–100% | 1-10 كم | هطول الأمطار: 0.25–50 ملم/ساعة |
| ثلج | 2.87% (43 عينة) | من 10- إلى 5°C | 50–100% | ٠.٥-٥ كم | ثلوج: 0.5–15 ملم/ساعة |
الجدول 1: مقاييس أداء نماذج التعلم الآلي للتنبؤ بالتوهين الجوي.
| النموذج | معامل التحديد للاختبار R2 | جذر متوسط مربع الخطأ (dB/km) | متوسط الخطأ المطلق (dB/km) | معامل التحديد للتحقق المتقاطع CV R2 | زمن التدريب (s) |
| Random Forest | 0.9654 | 1.324 | 0.815 | 0.960 ± 0.007 | 1.6 |
| XGBoost | 0.9582 | 1.455 | 0.892 | 0.953 ± 0.009 | 2.1 |
| LightGBM | 0.9507 | 1.581 | 0.971 | 0.946 ± 0.011 | 1.8 |
| انحدار متجه الدعم (SVR) | 0.8874 | 2.389 | 1.445 | 0.879 ± 0.015 | 3.2 |
| الانحدار الخطي | 0.8358 | 2.889 | 1.791 | 0.831 ± 0.018 | 0.2 |
| الجيران الأقرب (KNN) | 0.7341 | 3.671 | 2.296 | 0.721 ± 0.022 | 0.8 |
الجدول 2: تقييم مقارن لنماذج محددة من التعلم العميق، والنماذج الهجينة، والتعلم الآلي.
| نموذج | الفئة | اختبار R2 | جذر متوسط مربع الخطأ (ديسيبل/كم) | الترتيب |
| الغابة العشوائية | تعلم الآلة | 0.9654 | 1.324 | 1 |
| XGBoost | تعلم الآلة | 0.9582 | 1.455 | 2 |
| التجميع التراكمي | هجين | 0.9571 | 1.473 | 3 |
| LightGBM | تعلم الآلة | 0.9507 | 1.581 | 4 |
| مجموعة التصويت | هجين | 0.934 | 1.827 | 5 |
| الشبكة العصبية المرتكزة على الفيزياء | هجين | 0.8269 | 2.96 | 6 |
| تنبيه | تعلم عميق | 0.7766 | 3.362 | 7 |
| الذاكرة طويلة قصيرة المدى (LSTM) / الشبكة العصبية التلافيفية والذاكرة طويلة قصيرة المدى (CNN–LSTM) | التعلم العميق | −0.0006 | 7.195 | — |
الجدول 3: مقارنة كفاءة كل نموذج تم تقييمه في الحوسبة (التدريب والاستدلال).
توافر البيانات:
تتوفر مجموعة البيانات الاصطناعية الكاملة المكونة من 1,500 عينة مع جميع ميزات الإدخال (درجة الحرارة، والرطوبة، والرؤية، وتركيز الغبار، ومعدل هطول الأمطار، ومعدل تساقط الثلوج، وسرعة الرياح، والضغط الجوي، والشهر، والفصل، وحالة الطقس) والمتغير المستهدف (التوهين بوحدة dB/km) كملف تكميلي مرفق مع هذه المخطوطة على الرابط https://doi.org/10.5281/zenodo.21792999. وقد تم تنسيق مجموعة البيانات بحيث تخصص صف واحد لكل عينة، بما في ذلك جميع المتغيرات المحسوبة (نطاق التشغيل وSNR).
من المقرر أيضاً توفير رمز التنفيذ الكامل كملف تكميلي، بما في ذلك: برامج توليد البيانات (تنفيذات النماذج الفيزيائية)؛ ودوال المعالجة المسبقة وتغيير مقياس الميزات؛ وجميع تنفيذات نماذج تعلم الآلة؛ وجميع تنفيذات نماذج التعلم العميق؛ وبرامج التقييم والتصور؛ وإجراءات ضبط المعلمات الفائقة والتحقق المتقاطع.
بيانات المناخ المصدرية: تم الحصول على بيانات المناخ المستخدمة لتحديد توزيعات البيانات الاصطناعية من هيئة الأنواء الجوية والرصد الزلزالي العراقية (IMOS) ووزارة النقل العراقية، وهي تغطي الفترة من 2020 إلى 2024. يتوفر ملخص لبيانات المناخ المستخدمة لتحديد نسب الظروف الجوية ونطاقات المعلمات في الجدول التكميلي 1. إن سجلات IMOS المحددة المستخدمة في هذه الدراسة غير مؤرشفة علنًا في مستودع مركزي، ولكن يمكن طلبها مباشرة من IMOS. كما تتوفر الإحصائيات الملخصة وتوزيعات الاحتمالات المشتقة في المواد التكميلية لتمكين إمكانية إعادة إنتاج النتائج.
معلومات المستودع: تم إيداع الكود المصدري ومجموعة البيانات في مستودع عام (Zenodo) عبر الرابط https://doi.org/10.5281/zenodo.21792999.
المناقشة
من أجل التنبؤ بتوهين الهواء في أنظمة الاتصالات البصرية في الفضاء الحر (FSO) التي تعمل في ظل الظروف الجوية العراقية، قامت الدراسة الحالية بتقييم تقنيات التعلم الآلي والتعلم العميق والتقنيات الهجينة. ونظرًا لأن التأثيرات الجوية لا تزال تمثل إحدى القضايا الرئيسية التي تؤثر على أداء الرابط وتوافره، فقد أكدت التقييمات الحديثة على الأهمية المتزايدة للنمذجة التنبؤية لأنظمة FSO21. وأظهرت النتائج أن مناهج التعلم الآلي التقليدية، لا سيما RF وXGBoost، حققت دقة تنبؤية عالية، وتفوقت في بعض الحالات عدديًا على أساليب التعلم العميق والطرق الهجينة. ومع ذلك، لم تظهر الاختبارات الإحصائية فرقًا جوهريًا (p=0.083) بين RF وأفضل تجميع هجين (Stacking)، مما يعني أن كلا النهجين يمكن أن يصلا إلى نتائج مماثلة في هذه المجموعة من البيانات. وتشير نتائجنا إلى أن طرق التجميع القائمة على الأشجار لا تزال ذات أداء عالٍ بالنسبة للبيانات البيئية الجدولية ذات أحجام العينات المتوسطة والعدد المحدود من متغيرات التنبؤ المهيمنة. كما أظهر تحليل أهمية الميزات أن تركيز الغبار والرؤية كانا المحركين الرئيسيين للتوهين، حيث يفسران معًا معظم القوة التنبؤية. وتتفق هذه النتيجة مع الدراسات السابقة التي أظهرت التأثير الهام للضباب والغبار والهباء الجوي والتلوث الجوي على انتشار الإشارة البصرية22,23,24,25. وقد تم الإبلاغ عن نتائج مماثلة في تطبيقات الرصد البيئي، حيث تستفيد نماذج التعلم الآلي غالبًا من مجموعات البيانات التي تحتوي على عدد صغير من المتغيرات ذات القيمة المعلوماتية العالية26,27,28,29,30,31,32. كما عمل تحليل SHAP على تحسين قابلية تفسير النموذج من خلال قياس تأثير المعاملات البيئية الفردية على تنبؤات التوهين.
يمكن إرجاع الأداء المنخفض لنماذج التعلم العميق إلى عدة عوامل. فقد كان حجم مجموعة البيانات متواضعاً نسبياً لتدريب بنيات عصبية معقدة (في https://doi.org/10.5281/zenodo.21792999)، كما أظهرت المتغيرات البيئية أهمية ميزات مركزة للغاية. وقد أظهرت الدراسات السابقة أن طرق التعلم العميق تستفيد عموماً من مجموعات البيانات الضخمة، وبنيات الميزات الهرمية، والتمثيلات غير الخطية المعقدة33,34,35,36,37. وفي المقابل، احتوت مجموعة بيانات التوهين المستخدمة في هذه الدراسة على عدد محدود من المتنبئات المهيمنة، وافتقرت إلى التبعيات الزمنية المطلوبة للبنيات التكرارية. ويشير الأداء الضعيف لنماذج LSTM و CNN–LSTM إلى أن آليات التعلم التسلسلي قد لا توفر فوائد ملموسة لهذا التطبيق.
يمكن إرجاع هيمنة تركيز الغبار (67.3%) والرؤية (21.2%) كمتنبئات للتوهين الجوي إلى عدة عوامل. أولاً، يتضاءل أثر التشتت والامتصاص الجزيئي عند 1550 nm أمام تشتت ميه (Mie scattering) الناتج عن جزيئات الغبار. في نظرية ميه، تكون كفاءة الانقراض Q_ext حساسة للغاية لتركيز الجزيئات، ويتناسب التوهين بشكل خطي تقريباً مع تركيز الغبار في نطاق التركيز المتوسط إلى العالي. ثانياً، يتعرض العراق لعواصف ترابية متكررة (25.00% من الأيام في سجلاتنا المناخية)، والتي تؤدي إلى قيم توهين تتراوح بين 4–30 dB/km. وهذا يتناقض مع الضباب (10.47%، 0.5–10 dB/km) والمطر (7.40%، 2–25 dB/km). كما أن التباين الأكبر في توهين الغبار يوفر إشارات أقوى للنماذج لتتعلم منها. ثالثاً، ينتج التوزيع الأسي لتركيز الغبار (0.4–4.96 mg/m3) نطاقاً واسعاً من قيم التوهين. ويؤدي الذيل الطويل في حالات الغبار الشديدة إلى قيم توهين عالية، وهي ضرورية للتنبؤ الدقيق. رابعاً، يتميز نموذج تشتت ميه باعتماد أبسط (خطي تقريباً) على تركيز الغبار، وهو ما يسهل على النماذج القائمة على الأشجار (tree-based models) تقريبه مقارنة بالعلاقة الأكثر تعقيداً بين الرؤية وتوهين الضباب في نموذج Kim. خامساً، تكمن الأهمية العملية لهذه النتيجة في أن العواصف الترابية تعد واحدة من أكثر الظروف البيئية تحدياً للاتصالات البصرية في الفضاء الحر (FSO) في الشرق الأوسط؛ لذا فإن التنبؤ الدقيق أثناء أحداث الغبار أمر ضروري لضمان التشغيل الموثوق للنظام.
تعزز هذه النتائج أبحاث الاتصالات البصرية في الفضاء الحر (FSO) من خلال تقديم إرشادات عملية حول اختيار الخوارزميات المناسبة للتنبؤ بالتوهين الجوي. ويعد التنبؤ الدقيق بالتوهين أمراً ضرورياً لتخطيط الشبكات، والإدارة التكيفية للوصلات، والنشر الموثوق لأنظمة الاتصالات البصرية في البيئات الصعبة مثل منطقة الشرق الأوسط23,28,30,36. بالإضافة إلى ذلك، قد تكون هذه المنهجية قابلة للتطبيق في مشكلات التنبؤ البيئي الأخرى التي تتعلق بانتشار الموجات في الهواء، والرصد الجوي، وتقييم أداء الشبكات البصرية38,39,40. ومن بين الطرق الأخرى لبحث هذه الفكرة استخدام مجموعات بيانات واقعية أكبر، أو تقنيات تعلم تجميعية متطورة، أو أطر عمل التعلم بنقل المعرفة، أو بنيات أكثر تعقيداً مستنيرة بالفيزياء41,42,43,44,45.
نطاق الاستنتاجات وقضايا القابلية للتعميم
تعتمد استنتاجات هذا العمل بشكل أساسي على مجموعة بيانات اصطناعية تم إنشاؤها من نماذج انتشار فيزيائية راسخة (قانون Beer-Lambert، ونموذج Kim، ونموذج Carbonneau، ونظرية تشتت Mie). وينطوي هذا النهج المنهجي على بعض الآثار المترتبة على نطاق نتائجنا ومدى تعميمها:
الاستنتاجات من البيانات المحاكات: (1) ترتيب الأداء المقارن لتعلم الآلة، والتعلم العميق، والنهج الهجينة للتنبؤ بالتوهين الجوي. (2) تحديد تركيز الغبار والرؤية كأهم المتنبئات البيئية للتوهين البصري في ظل الظروف التي تمت نمذجتها. (3) ميزة الكفاءة الحسابية لطرق التجميع القائمة على الأشجار مقارنة ببنيات التعلم العميق. (4) قابلية تفسير أهمية الميزات وتحليلات SHAP لشرح تنبؤات النموذج.
استنتاجات تتطلب تأكيداً من الواقع العملي: (1) تعتمد القيم المطلقة لـ R2 و RMSE التي حصلت عليها النماذج المُقيمة على الخصائص المحددة لمجموعة البيانات الاصطناعية، وقد تعكس تعلم النماذج للمعادلات الفيزيائية الحتمية المستخدمة لتوليد الأهداف. (2) لم يثبت بعد ما إذا كان النموذج الأفضل، وهو Random Forest، يمكن تطبيقه على ظروف جوية واقعية غير معروفة. (3) يعد التحقق الميداني ضرورياً لتكون النتائج قابلة للتطبيق على وحدات FSO التشغيلية المثبتة في العراق. (4) من الضروري التأكد من أن ترتيبات أهمية الميزات المحددة تظل صامدة في ظل ظروف القياس الميداني.
من المهم التمييز بين الأداء على البيانات الاصطناعية المشتقة من معادلات والأداء على البيانات الرصدية أو التجريبية المشوبة بالضجيج. توفر مجموعة البيانات الاصطناعية علاقة نقية وخالية من الضجيج بين ميزات المدخلات وهدف التوهين، وهو ما قد يؤدي إلى مؤشرات أداء تنبؤي أعلى مما يمكن الحصول عليه باستخدام بيانات العالم الحقيقي التي تحتوي على ضجيج في القياس، وأخطاء في الأجهزة، وظواهر فيزيائية غير منمذجة. لذا، نوصي بتوجيه الأعمال المستقبلية نحو الحصول على قياسات توهين FSO من العالم الحقيقي تحت الظروف الجوية العراقية، وذلك للتحقق من صحة النتائج المعروضة في هذه الدراسة وتقييم القابلية الفعلية لتعميم المنهجيات المقترحة.
تداعيات البيانات الاصطناعية على قابلية تعميم النموذج
يجب النظر بعناية في تداعيات استخدام البيانات الاصطناعية في هذه الدراسة فيما يتعلق بقابلية تعميم النماذج:
مزايا النهج الاصطناعي: تتميز مجموعة البيانات بالاتساق الفيزيائي واستنادها إلى أطر نظرية راسخة من خلال استخدام نماذج انتشار فيزيائية معتمدة. وقد استُخلصت المعلمات الأرصادية من سجلات الأرصاد الجوية في العراق لجعل مجموعة البيانات تعكس الخصائص الإحصائية لظروف الطقس الحقيقية في العراق. وبالإضافة إلى تجنب المتغيرات المربكة للقياسات الميدانية (مثل أخطاء القياس، أو معايرة الأجهزة، أو عدم كفاية سجلات البيانات)، يتيح هذا الإعداد المنضبط إجراء فحص منهجي لمنهجيات النمذجة.
قيود القابلية للتعميم: تفرض مجموعة البيانات الاصطناعية قيوداً في محاكاة التعقيد الكامل للتوهين الجوي الحقيقي، بما في ذلك: (1) التفاعل بين عدة ظواهر جوية تحدث في آن واحد؛ (2) السلوك غير الخطي وغير المستقر للمعاملات الجوية؛ (3) التباين المناخي طويل الأمد الذي لم تشمله توزيعات العينات؛ (4) تأثيرات المناخ المحلي الموضعية التي قد تؤثر بشكل كبير على انتشار FSO؛ و(5) الضوضاء وعدم اليقين المتأصلين في عملية جمع البيانات من العالم الحقيقي.
اعتبارات التحيز في توليد البيانات الاصطناعية إن افتراض أخذ عينات مستقلة للمعاملات البيئية (انظر الطرق) يعد تبسيطاً مفرطاً لظروف العالم الحقيقي، حيث تميل المتغيرات الجوية إلى أن تكون مترابطة (على سبيل المثال، تميل تركيزات الغبار العالية إلى الارتباط بانخفاض الرؤية). وقد تم اعتماد افتراض الاستقلالية من أجل بيئة محاكاة محكومة لإجراء مقارنة منهجية للنماذج. ومع ذلك، قد لا تلتقط هذه الطريقة التعقيد الكامل للتفاعلات بين المعاملات الجوية. نحن نستخدم طريقة التقسيم الطبقي (مع الحفاظ على نسب الظروف الجوية في مجموعات التدريب والاختبار) لتقليل احتمالية التمثيل غير المتوازن للحالات النادرة في مجموعة الاختبار (لا سيما الثلوج بنسبة 2.87%).
توليد الأهداف الحتمية: قد يُعزى الأداء التنبؤي العالي الملاحظ في هذه الدراسة جزئياً إلى تعلم النماذج للمعادلات الفيزيائية الحتمية المستخدمة في توليد قيم الأهداف. وفي المقابل، تحتوي البيانات التجريبية الواقعية على ضوضاء في القياسات، وأخطاء في الأجهزة، وظواهر فيزيائية غير منمذجة تجعل التنبؤ أكثر صعوبة. لذا، يجب تفسير مقاييس الأداء الكمية (R2، RMSE، MAE) كـمقارنات نسبية بين المنهجيات في بيئة محاكاة محكومة، بدلاً من اعتبارها ضمانات أداء مطلقة لأنظمة الاتصالات البصرية في الفضاء الحر (FSO) التشغيلية.
وبناءً على ذلك، فبينما يُرجح أن تكون النتائج المقارنة لتصنيفات أداء النماذج قوية (بسبب الاتساق الفيزيائي للبيانات الاصطناعية)، فإن مقاييس الأداء المطلقة (R2 وRMSE وMAE) لا ينبغي اعتبارها مؤشرة على الأداء المتوقع في أنظمة الاتصالات البصرية في الفضاء الحر (FSO) التشغيلية. ومن الضروري اختبار مدى قدرة النموذج على التعميم في بيئات العالم الحقيقي باستخدام قياسات تجريبية لتوهين الهواء تم الحصول عليها تحت ظروف جوية متنوعة في العراق.
هناك بعض القيود التي يجب مراعاتها. أولاً، بدلاً من استخدام الملاحظات الميدانية، اعتمدت الدراسة على مجموعة بيانات اصطناعية تم إنتاجها باستخدام نماذج انتشار فيزيائية معروفة. وكما ذكر سابقاً، بدلاً من تقديم ضمانات أداء مطلقة لأنظمة FSO التشغيلية، يجب النظر إلى مقاييس الأداء الكمية (R2, RMSE, MAE) كمقارنات نسبية للنهج المتبعة في بيئة محاكاة محكومة. ثانياً، قد لا تكون النماذج القياسية مقابل نماذج التعلم العميق قادرة على تعلم تمثيلات ميزات قوية نظراً لحجم مجموعة البيانات. ثالثاً، لم يتم أخذ مؤشرات أداء FSO الأخرى مثل توفر الاتصال، وأخطاء التوجيه، والخبو الناجم عن الاضطرابات في الاعتبار لصالح التنبؤ بالتوهين. رابعاً، تم استخدام السجلات التاريخية من عام 2020 إلى 2024 لحساب نسب الظروف الجوية، والتي قد لا تعكس بدقة التباينات في الأنماط المناخية العراقية من سنة إلى أخرى. خامساً، إن بنية بيانات الإدخال شبه التسلسلية لنماذج CNN–LSTM وLSTM هي تبسيط منهجي قد لا يلتقط الديناميكيات الزمنية للتطبيقات الواقعية بشكل كافٍ. عند تقييم النتائج، يجب أخذ هذه القيود في الاعتبار لأنها قد تؤثر على قابلية تعميم النتائج.
الأولوية الموصى بها: التحقق في العالم الواقعي. إن جمع وتحليل قياسات توهين FSO الفعلية تحت الظروف الجوية العراقية هو أهم مسار للعمل المستقبلي. وينبغي أن يشمل ذلك: (1) إنشاء منصات اختبار FSO في مناطق مختلفة من العراق (على سبيل المثال، بغداد، البصرة، الموصل، الرمادي) لتسجيل التباينات المناخية الإقليمية؛ (2) استخدام أدوات معايرة في مواقع FSO لقياس المعلمات الجوية (درجة الحرارة، الرطوبة، الرؤية، تركيز الغبار) بشكل متزامن؛ (4) توثيق التوهين خلال الظواهر الجوية القاسية (العواصف الغبارية، الضباب الكثيف، الأمطار الغزيرة)؛ (5) إتاحة البيانات المجمعة للجمهور لتمكين إعادة الإنتاج والبحث المقارن؛ و(3) الاستمرار في المراقبة لدورة سنوية كاملة واحدة على الأقل لالتقاط التقلبات الموسمية. من شأن هذا التحقق العملي أن يتيح فرصة لتقييم قابلية تعميم النموذج وتعزيز تقنيات التنبؤ التي تم تطويرها في هذا البحث.
من أجل التحقق من صحة النماذج التي تم إنشاؤها وتحسينها، يجب أن تركز الأبحاث المستقبلية على دمج قياسات FSO فعلية تم الحصول عليها في الظروف الجوية العراقية. كما يمكن أن تبحث الدراسات الإضافية في استراتيجيات تعلم النقل التي تستفيد من مجموعات البيانات الجوية ذات الصلة، وبرامج التعلم عبر الإنترنت التي تتكيف مع الظروف البيئية المتغيرة، واستراتيجيات هجينة تجمع بين التجارب والمحاكاة لدمج البيانات المقاسة مع النماذج الفيزيائية. وقد يؤدي إجراء المزيد من الأبحاث في مجال الذكاء الاصطناعي القابل للتفسير ونهج التعلم المتقدمة القائمة على الفيزياء إلى تسليط مزيد من الضوء على الآليات الكامنة وراء تخميد الهواء وتعزيز مرونة أنظمة التنبؤ المستقبلية.
الإفصاحات
تضارب المصالح: يقر المؤلفون بعدم وجود أي تضارب في المصالح.
شكر وتقدير
يصرح المؤلفون بأنه لم يتم تلقي أي تمويل خارجي لهذا البحث. ونعرب عن شكرنا لمركز البحوث التطبيقية والنظرية الدولي (IATRC)، حي بغداد، العراق.
المواد
| الاسم | الشركة | رقم فهرسي | التعليقات |
|---|---|---|---|
| CUDA Toolkit | NVIDIA Corporation | 11.8 | مكتبة تسريع GPU لتدريب التعلم العميق |
| cuDNN | NVIDIA Corporation | 8.6.0 | مكتبة الشبكات العصبية العميقة المسرعة بواسطة GPU |
| GPU (وحدة معالجة الرسومات) | NVIDIA Corporation | GeForce RTX 4090, 24 GB VRAM | تُستخدم لتدريب التعلم العميق المسرع بواسطة GPU |
| CPU (وحدة المعالجة المركزية) | Intel Corporation | Core i9-13900K, 24 cores/32 threads | معالج محطة عمل لجميع عمليات تدريب وتقييم النماذج |
| ذاكرة النظام (RAM) | n/a | 64 GB DDR5, 5200 MHz | ذاكرة محطة العمل |
| Keras API | Open source (part of TensorFlow) | bundled with TensorFlow 2.11.0 | واجهة برمجة تطبيقات عالية المستوى للتعلم العميق تُستخدم لجميع بنيات DL |
| LightGBM | Open source (Microsoft) | 3.3.5 | إطار عمل لتعزيز التدرج (Gradient boosting) |
| NumPy | Open source (NumFOCUS) | 1.23.5 | مكتبة للحوسبة العددية |
| نظام التشغيل | Canonical Ltd. | Ubuntu 22.04 LTS | نظام تشغيل محطة العمل |
| Python | Python Software Foundation | 3.9 | لغة البرمجة المستخدمة في جميع عمليات توليد البيانات والنمذجة |
| scikit-learn | Open source | 1.2.2 | مكتبة تعلم الآلة (RF, SVR, KNN, Linear Regression, cross-validation, scaling) |
| SHAP (SHapley Additive exPlanations) | Open source | 0.41.0 | مكتبة لتفسير النماذج، وحدة TreeExplainer |
| TensorFlow | Open source (Google) | 2.11.0 | إطار عمل للتعلم العميق يُستخدم لجميع بنيات DL الست |
| XGBoost | Open source | 1.7.5 | مكتبة Extreme Gradient Boosting |
المراجع
- Kadhim MS, Hussein H, Elwi TA. Hybrid ANN-Z method for modeling carbon nanotube-based reconfigurable intelligent surfaces for terahertz beam steering. J Vis Exp. 2026;in press.
- Raham JK, Alshaibi M, Elwi TA. SMS optical fiber laser sensor for transformer oil temperature monitoring-based IoT of AI control. Prog Electromagn Res B. 2026;118:72–86.
- Abdulkareem ZJ, Hamad TK, Elwi TA. Reconfigurable metasurface based on graphene optical antennas for dynamic beam steering. Sustain Eng Innov. 2025;7:127–136.
- Abdulsattar RK, et al. Optical-microwave sensor for real-time measurement of water contamination in oil derivatives. AEU Int J Electron Commun. 2023;170:154798. doi:10.1016/j.aeue.2023.154798.
- Al-Khaylani HH, Elwi TA, Ibrahim AA. Optically remote control of miniaturized 3D reconfigurable CRLH printed self-powered MIMO antenna array for 5G applications. Micromachines. 2022;13(12):2061. doi:10.3390/mi13122061.
- Al-Khaylani HH, Elwi TA, Ibrahim AA. Optically remote-controlled miniaturized 3D reconfigurable CRLH-printed MIMO antenna array for 5G applications. Microw Opt Technol Lett. 2023;65(2):603–610.
- Jassim DA, Elwi TA. Optical nano monopoles for interconnection of electronic chip applications. Optik. 2022;249:168142. doi:10.1016/j.ijleo.2021.168142.
- Elwi TA. A novel approach for modeling the geometry and constitutive parameters of an armchair single-wall carbon nanotube antenna operating in the NIR regime. Al-Ma’mon Coll J. 2014;(24):261–285.
- Mohammed, AB.F.A., Al-hadeethi, S.T., Al-khaylani, H.H. et al. An investigation of success probability and fidelity of quantum repeater in asymmetry in midpoint placement in fiber-based quantum networks. J Opt (2025). https://doi.org/10.1007/s12596-025-02866-6.
- Kim II, McArthur B, Korevaar EJ. Comparison of laser beam propagation at 785 nm and 1550 nm in fog and haze for optical wireless communications [conference paper]. Presented at: Optical Wireless Communications III; Boston, MA, USA; 2000. Proc SPIE. 2001;4214:26–37. https://doi.org/10.1117/12.417512.
- Okbi ZA, Alak IK, Abdulla EN, Al-Khaylani HH. Design and security analysis of an image encryption based on a gigabit passive optical network employing fiber-FSO protection at the last mile. J Opt Commun. 2025. doi:10.1515/joc-2025-0466.
- Ojo JS, Olaitan JA, Ojo OL. Characterization of fog-induced attenuation for optimizing optical propagation links in Nigeria. Results Opt. 2022;9:100279. doi:10.1016/j.rio.2022.100279.
- Khidher SA. Dust storms in Iraq: Past and present. Theor Appl Climatol. 2024;155:4721–4735.
- Ali, Alaa Hussein, Abdulla, Essam N. and Al-Azawi, Razi J.. "Security and network performance analysis of coexistence TWDM – NG-PON2, GPON and 10G-EPON systems based on Hill Cipher" Journal of Optical Communications, 2025. https://doi.org/10.1515/joc-2025-0435.
- Lionis A, et al. Using machine learning algorithms for accurate received optical power prediction of an FSO link over a maritime environment. Photonics. 2021;8(6):212. doi:10.3390/photonics8060212.
- Chen T, Guestrin C. XGBoost: A scalable tree boosting system [conference paper]. Presented at: 22nd ACM SIGKDD International Conference on Knowledge Discovery and Data Mining; San Francisco, CA, USA; 2016. p. 785–794. https://doi.org/10.1145/2939672.2939785.
- Bai Y, et al. Air pollutants concentrations forecasting using back propagation neural network based on wavelet decomposition with meteorological conditions. Atmos Pollut Res. 2016;7(3):557–566.
- LeCun Y, Bengio Y, Hinton G. Deep learning. Nature. 2015;521:436–444.
- Mousa, Ekhlass, Abdulla, Essam N. and Adnan, Salah A.. "Enhancing network security based on 10G-EPON with the use of the Hill cipher algorithm" Journal of Optical Communications, 2025. https://doi.org/10.1515/joc-2025-0201.
- Lu G, et al. A survey of deep learning for time series forecasting: Theories, datasets, and state-of-the-art techniques. Comput Mater Contin. 2025;85(2):2403–2441.
- Liu J, Yang X, Wei Y, Zhao F. Integrated THz/FSO communications: A review of practical constraints, applications and challenges. Micromachines. 2025;16(11):1297. doi:10.3390/mi16111297.
- Bott A, Sievers U, Zdunkowski W. A radiation fog model with a detailed treatment of the interaction between radiative transfer and fog microphysics. J Atmos Sci. 1990;47:2153–2166.
- Fadhil HA, et al. Optimization of free space optics parameters: An optimum solution for bad weather conditions. Optik. 2013;124(19):3969–3973.
- Osipov S, et al. Severe atmospheric pollution in the Middle East is attributable to anthropogenic sources. Commun Earth Environ. 2022;3:203. doi:10.1038/s43247-022-00514-6.
- Castellanos P, et al. Mineral dust optical properties for remote sensing and global modeling: A review. Remote Sens Environ. 2024;303:113982. doi:10.1016/j.rse.2023.113982.
- Lolli S. Urban PM2.5 concentration monitoring: A review of recent advances in ground-based, satellite, model, and machine learning integration. Urban Clim. 2025;63:102566. doi:10.1016/j.uclim.2025.102566.
- Ridha, Fay F., Abdulla, Essam N. and Abdulhadi, Ali H.. "Machine learning based on raw ensemble predictions scheme for TWDM-PON" Journal of Optical Communications, 2025. https://doi.org/10.1515/joc-2025-0373.
- Khalid H, Sajid SM, Cheema MI, Leitgeb E. Optical signal attenuation through smog in controlled laboratory conditions. Photonics. 2024;11(2):172. doi:10.3390/photonics11020172.
- Ejike O, Ndị D, Shakir MZ. Comparative study of machine learning-based rainfall prediction in tropical and temperate climates. Climate. 2025;13(8):167. doi:10.3390/cli13080167.
- Esmail MA, Fathallah H, Alouini MS. An experimental study of FSO link performance in desert environment. IEEE Commun Lett. 2016;20(9):1888–1891.
- Kshirsagar MP, Khare KC. Support vector regression models of stormwater quality for a mixed urban land use. Hydrology. 2023;10(3):66. doi:10.3390/hydrology10030066.
- Mosso S, Lapo K, Stiperski I. Revealing the drivers of turbulence anisotropy over flat and complex terrain: An interpretable machine learning approach. Boundary Layer Meteorol. 2025;191:51. doi:10.1007/s10546-025-00946-5.
- Mohsen S, Ali AM, Emam A. Automatic modulation recognition using CNN deep learning models. Multimed Tools Appl. 2024;83:7035–7056.
- Mienye ID, Swart TG, Obaido G. Recurrent neural networks: A comprehensive review of architectures, variants, and applications. Information. 2024;15(9):517. doi:10.3390/info15090517.
- Castelli M, et al. Generative adversarial networks for generating synthetic features for Wi-Fi signal quality. PLoS One. 2021;16(11). doi:10.1371/journal.pone.0260308.
- Al-Imran, Chowdhury MZ, Mofidul RB, Jang YM. Machine learning and deep learning in FSO communication: A comprehensive survey. ICT Express. 2025;11(6):1026–1046.
- Grose MG, Watson EA. Forecasting atmospheric turbulence conditions from prior environmental parameters using artificial neural networks. Appl Opt. 2023;62:3370–3379.
- Radhi SS, et al. Design a secure TWDM-PON via the Hill cipher algorithm. Opt Contin. 2025;4:1051–1064.
- Mushatet, Adil Fadhil, Fadil, Elaf A. and Abdulla, Essam N.. "High bit rate secure FSO system utilizing Hill coding" Journal of Optical Communications, 2025. https://doi.org/10.1515/joc-2025-0147.
- Musadaq R, Abdulwahid SN, Abd Alwahed NN, Abdulla EN. Security analysis of an image encryption algorithm based on Blowfish in GPON. J Opt Commun. 2025. doi:10.1515/joc-2025-0109.
- Raissi M, Yazdani A, Karniadakis GE. Hidden fluid mechanics: Learning velocity and pressure fields from flow visualizations. Science. 2020;367(6481):1026–1030.
- Vasiliauskaite V, Antulov-Fantulin N. Generalization of neural network models for complex network dynamics. Commun Phys. 2024;7:348. doi:10.1038/s42005-024-01837-w.
- Oh S, Hong SK. Physics-informed neural modeling of 2D transient electromagnetic fields. Appl Sci. 2025;15(23):12612. doi:10.3390/app152312612.
- Pradhan S, Bhattarai JS, Murugavel M, Sharma OP. Machine learning approaches to surpass the limitations of the Beer–Lambert law. ACS Omega. 2025;10(16):16597–16601.
- Pavlyshenko B. Using stacking approaches for machine learning models [conference paper]. Presented at: 2018 IEEE Second International Conference on Data Stream Mining and Processing (DSMP); Lviv, Ukraine; 2018. p. 255–258. https://doi.org/10.1109/DSMP.2018.8478522.