يقترح هذا البروتوكول FedMediFormer-XAI، وهو إطار عمل ذكاء متعدد الوسائط لمرض السكري يحترم الخصوصية من خلال التعلم الاتحادي، والمحولات متعددة الوسائط، والتعزيز القائم على الانتشار، والتوصية الشخصية بالأدوية القائمة على الرسوم البيانية، والذكاء الاصطناعي القابل للتفسير، وذلك لتحقيق تنبؤ دقيق، واتخاذ قرارات شفافة، وإدارة شخصية لمرض السكري.
مقالة منهجية
FedMediFormer-XAI: محولات متعددة الوسائط اتحادية مع تعزيز بالانتشار وتوصية دوائية قائمة على الرسوم البيانية لمرض السكري
في هذه المقالة
ملخص
الملخص
تواجه إدارة مرض السكري عدداً من العقبات، مثل تشتت البيانات الرعاية الصحية، والمخاوف المتعلقة بالخصوصية، وضعف القابلية للتفسير، والافتقار إلى التوجيه العلاجي الشخصي. يقدم هذا العمل البحثي FedMediFormer-XAI، وهو إطار عمل موحد ومناسب يدمج التعلم الاتحادي (federated learning)، والمحولات متعددة الوسائط (multimodal transformers)، وتعزيز البيانات القائم على نماذج الانتشار (diffusion-based data augmentation)، والشبكات العصبية الرسومية (GNNs) للتوصية بالأدوية، والذكاء الاصطناعي القابل للتفسير (XAI) من أجل ذكاء مرض السكري. يستخدم النظام أنواعاً متنوعة من بيانات الرعاية الصحية، مثل السجلات السريرية، ومؤشرات صحة السكان، وبيانات المراقبة المستمرة للجلوكوز، وصور قاع الشبكية، وقياسات المستشعرات القابلة للارتداء، والمعلومات الدوائية. ولتوليد عينات اصطناعية ومعالجة عدم توازن الفئات، تُستخدم نماذج الانتشار، كما يتم توظيف بنيات المحولات متعددة الوسائط لتعلم العلاقات بين مصادر البيانات المختلفة تماماً. يتيح التعلم الاتحادي التدريب التعاوني للنماذج بطريقة تحافظ على الخصوصية دون مشاركة بيانات المرضى الخام. ويقوم مكون GNN برصد التفاعلات بين المريض والدواء وبين دواء وآخر لتقديم توصيات دوائية شخصية. وتوفر طرق القابلية للتفسير مثل SHapley Additive exPlanations (SHAP)، وتصور الانتباه (attention visualization)، والتدرجات المتكاملة (Integrated Gradients)، والاستدلال المضاد للواقع (counterfactual reasoning) تفسيرات شفافة لنتائج التنبؤ والتوصية. وفي التنفيذ التمثيلي، حقق إطار العمل المقترح دقة بلغت 94.2%، ودقة تحديد (precision) بلغت 93.1%، واستدعاء (recall) بلغ 92.8%، ومقياس F1-score بلغ 92.9%، ومعامل ارتباط ماتيوس (MCC) بلغ 0.88، ومساحة تحت منحنى خصائص تشغيل المستقبل (AUC-ROC) بلغت 0.96. وحققت وحدة التوصية القائمة على الرسوم البيانية دقة تحديد = 0.89، واستدعاء = 0.84، وكسب تراكمي مخصوم مُطبع (NDCG) = 0.91. يوفر هذا البروتوكول نهجاً منظماً لدمج بيانات الرعاية الصحية غير المتجانسة باستخدام المحولات متعددة الوسائط، والتعلم الاتحادي، والتعزيز القائم على الانتشار، والتوصية القائمة على الرسوم البيانية، والذكاء الاصطناعي القابل للتفسير. وتُظهر النتائج الحسابية المسجلة إمكانات إطار العمل في التنبؤ بمرض السكري والتوصية بالأدوية الشخصية، بينما يدعم التصميم الاتحادي التعامل اللامركزي مع البيانات. ويتطلب الأمر إجراء تقييم سريري مستقبلي متعدد المراكز لإثبات الفائدة السريرية، والقابلية للتعميم، وإمكانية التطبيق في العالم الحقيقي.
المقدمة
يُعد داء السكري من أبرز الأمراض الأيضية المزمنة التي تصيب البشرية، ويشكل قضية صحية عامة رئيسية نظرًا لاستمرار نموه، وما يترتب عليه من آثار طويلة المدى وتكاليف باهظة لعلاج المرضى1,2. ووفقًا لأحد التقارير، يوجد حاليًا أكثر من 537 مليون بالغ يعيشون مع داء السكري في جميع أنحاء العالم، ومن المتوقع أن يرتفع هذا الرقم بشكل ملحوظ خلال العقود القليلة القادمة3. وإذا لم يتم التحكم في مستويات السكر المرتفعة في الدم، فسيعاني الشخص من أسوأ المضاعفات، مثل مرض الشريان التاجي4، وتلف الكلى5، وتلف الأعصاب6، وفقدان البصر7، والسكتة الدماغية8. وبناءً على ذلك، فإن تشخيص المرض في أبكر مرحلة، والمراقبة المنتظمة لحالة المريض، وتدريبه من خلال مقاربات طبية متقدمة، هي خطوات ضرورية لمساعدة المرضى على عيش حياة أكثر صحة، وبذلك يتم تقليل نفقات نظام الرعاية الصحية في الدولة9,10.
في الوقت الحاضر، ينتشر استخدام السجلات الصحية الإلكترونية (EHRs)، والأجهزة القابلة للارتداء، وأنظمة المراقبة المستمرة للجلوكوز (CGM)، وتقنيات تصوير الشبكية، وتطبيقات الصحة المحمولة بشكل سريع، مما يؤدي إلى توليد أحجام كبيرة من البيانات الصحية غير المتجانسة التي يمكن تحليلها11. ويمكن لأدوات جمع البيانات المتنوعة هذه أن توفر معلومات متنوعة حول جسم الإنسان، وقدرته على العمل في مراحل مختلفة من المرض، وكيفية استجابة المريض لأنواع مختلفة من العلاج، وكيفية سلوكه في الحياة الواقعية12. وقد أثبت الذكاء الاصطناعي (AI) أنه الحل الأمثل لمعالجة البيانات شديدة التعقيد، والتنبؤ بمرض السكري، ومراقبة المرض، ومساعدة الأطباء في اتخاذ القرارات السريرية13. علاوة على ذلك، حققت خوارزميات تعلم الآلة، بما في ذلك الغابات العشوائية، وآلات متجه الدعم، وطرق تعزيز التدرج، نتائج ممتازة في تقييم مخاطر السكري14. وفي الآونة الأخيرة، مكنت بنيات التعلم العميق من استخراج الميزات تلقائيًا وتحسين أداء التنبؤ عبر تطبيقات الرعاية الصحية المتنوعة15.
باستخدام طرق التعلم متعدد الوسائط، تم تعزيز ذكاء مرض السكري بشكل كبير من خلال دمج السجلات السريرية المهيكلة، والقياسات الفسيولوجية، وصور الشبكية، والمؤشرات السلوكية في إطار تنبؤي واحد16. ومن خلال استخدام مصادر متعددة للمعلومات، تستطيع النماذج متعددة الوسائط تحديد أنماط لا تكون مرئية عند فحص كل وسيط بشكل منفصل17. وقد تعلمت النماذج القائمة على المحولات (Transformer-based models) مؤخراً التبعيات طويلة المدى والعلاقات السياقية من أنواع متنوعة من بيانات الرعاية الصحية بفعالية كبيرة18. ومع ذلك، لا تزال مشكلات مثل الفئات غير المتوازنة، والبيانات المفقودة، وعدم تجانس البيانات، ومحدودية القابلية للتعميم، تحول دون الاستخدام الواسع لأنظمة الذكاء الاصطناعي متعددة الوسائط في الإعدادات السريرية19.
على الرغم من هذه التطورات، لا تزال العديد من أنظمة ذكاء السكري الحالية تعتمد على أطر تعلم مركزية تتطلب بطبيعتها تجميع بيانات المرضى من مؤسسات مختلفة في مستودع واحد20. وتؤدي طرق كهذه بالفعل إلى نزاعات حول خصوصية المريض، وحيازة البيانات، والأمن السيبراني، والامتثال التنظيمي21. وفي الواقع، غالباً ما يواجه مقدمو الرعاية الصحية قيوداً في قدرتهم على مشاركة بيانات المرضى الحساسة بسبب اعتبارات قانونية وأخلاقية22. وفي هذا السياق، أصبح التعلم الاتحادي حلاً قابلاً للتطبيق، حيث يتيح تدريب نموذج تعاوني دون مشاركة بيانات المرضى الفعلية23. ومن خلال التحسين اللامركزي وتجميع المعاملات الآمن، يتيح التعلم الاتحادي إجراء تحليلات صحية محمية الخصوصية عبر الاستفادة من المعرفة المستمدة من مجموعات بيانات موزعة جغرافياً24. ومع ذلك، لا تزال الأعباء الإضافية للاتصالات، وتغاير العملاء، واستقرار التقارب تمثل مشكلات رئيسية في سيناريوهات الرعاية الصحية الاتحادية25.
ثمة عيب آخر في أنظمة ذكاء السكري المستخدمة حالياً وهو الافتقار إلى الشفافية ودعم العلاج الشخصي. إذ تعمل العديد من نماذج التعلم العميق كصناديق سوداء، وهو ما يشكل مشكلة للأطباء الذين يرغبون في فهم المنطق الكامن وراء التنبؤات والتوصيات26. وتثبت طرق الذكاء الاصطناعي القابل للتفسير (XAI)، مثل SHAP، وIntegrated Gradients، وتصور الانتباه (attention visualization)، والاستدلال المضاد للواقع (counterfactual reasoning)، أنها تمتلك إمكانات كبيرة لتعزيز شفافية النماذج وثقة الأطباء27. وعلاوة على ذلك، أصبحت الشبكات العصبية الرسومية (GNNs) الأدوات الأكثر تقدماً في رصد التفاعلات بين المريض والدواء والتفاعلات الدوائية-الدوائية، مما أدى إلى تقديم توصيات دوائية مخصصة وتقييم سلامة الأدوية28. كما قدمت نماذج الانتشار (diffusion models) الجديدة حلولاً لتوليد بيانات رعاية صحية اصطناعية واقعية ومعالجة مشكلة عدم توازن الفئات29.
لقد أظهرت كل من نماذج المحولات (Transformers)، والتعلم الاتحادي (federated learning)، وتوليد البيانات الاصطناعية القائمة على الانتشار (diffusion-based synthetic data generation)، والشبكات العصبية الرسومية (graph neural networks)، والذكاء الاصطناعي القابل للتفسير (explainable artificial intelligence) نتائج واعدة في تطبيقات الرعاية الصحية؛ ومع ذلك، لا يزال دمجها ضمن إطار عمل واحد قابل للتكرار لذكاء مرض السكري محدوداً. وعادة ما تتناول النهج الحالية هذه المكونات بشكل مستقل، حيث تركز على التعلم الذي يحافظ على الخصوصية دون تقديم توصيات علاجية مخصصة، أو التنبؤ متعدد الوسائط دون تدريب لامركزي، أو القابلية للتفسير دون دعم اتخاذ القرار السريري القائم على الرسوم البيانية. وعلى الرغم من أن نماذج الانتشار يمكن أن تدعم موازنة الفئات وأن بنيات المحولات يمكنها تعلم العلاقات عبر وسائط الرعاية الصحية غير المتجانسة، إلا أن البروتوكولات الموحدة لدمج هذه التقنيات المتكاملة لا تزال محدودة. وبناءً على ذلك، يقدم هذا العمل بروتوكولاً منهجياً موحداً يجمع بين التنبؤ متعدد الوسائط، والتعزيز القائم على الانتشار، والتحسين الاتحادي، والتوصية المخصصة بالأدوية القائمة على الرسوم البيانية، والذكاء الاصطناعي القابل للتفسير ضمن تدفق عمل قابل للتكرار، مع توفير أساس للتحقق السريري والترجمة المستقبلية.
على عكس الدراسات التي تفترض توفر مجموعات بيانات متعددة الوسائط على مستوى المريض، يدمج هذا البروتوكول مجموعات بيانات عامة غير متجانسة دون إجراء مطابقة مباشرة للمرضى. يتم تدريب نماذج مستقلة خاصة بكل وسيط لكل مصدر بيانات، ثم يتم دمج تضمينات السمات الكامنة من خلال آلية انتباه عبر الوسائط. يحافظ هذا التصميم على الصرامة المنهجية مع تمكين تكامل المعرفة متعددة الوسائط عبر مستودعات الرعاية الصحية المتنوعة.
يستهدف البروتوكول المقترح بشكل أساسي التطوير المنهجي وبيئات الذكاء الاصطناعي في الرعاية الصحية الموزعة، حيث تتوفر مصادر بيانات غير متجانسة عبر مستودعات أو مؤسسات منفصلة وتكون عملية مركزية البيانات المباشرة مقيدة. في التنفيذ الحالي، تكون مجموعات البيانات الخاصة بكل نمط مستقلة وغير مرتبطة بمرضى محددين؛ وبناءً على ذلك، يتم إجراء التكامل متعدد الأنماط على مستوى التمثيل المتعلم بدلاً من المراسلة المباشرة على مستوى المريض. سيتطلب التطبيق العملي توفر بيانات مرضى متعددة الأنماط مرتبطة بشكل مناسب، ومعالجة مسبقة وتعريفات نتائج متسقة عبر المواقع المشاركة، وبنية تحتية حوسبية ملائمة، والامتثال للمتطلبات الأخلاقية ومتطلبات الخصوصية والتنظيمية المعمول بها.
تقدم هذه الورقة FedMediFormer-XAI، وهو إطار عمل محول متعدد الوسائط اتحادي يتيح ذكاءً في مجال السكري مع الحفاظ على الخصوصية من خلال ميزات التنبؤ والتوصية والقابلية للتفسير في منصة واحدة. يدمج هذا الإطار تعزيز البيانات القائم على الانتشار لمعالجة عدم توازن الفئات، والتعلم باستخدام المحول متعدد الوسائط للتنبؤ بالسكري، والتعلم الاتحادي لتطوير النماذج بشكل تعاوني، وتوصيات الأدوية الشخصية القائمة على الشبكة العصبية الرسومية، وطرق الذكاء الاصطناعي القابل للتفسير لدعم القرارات السريرية بطريقة شفافة. تم توضيح البنية العامة وسير العمل لإطار عمل FedMediFormer-XAI المقترح في الشكل 1.
تتلخص المساهمات الرئيسية لإطار عمل FedMediFormer-XAI المقترح فيما يلي: (1) تقديم بروتوكول موحد يدمج التعلم الاتحادي، والمحولات متعددة الوسائط، وتعزيز البيانات القائم على الانتشار، والتوصية المخصصة بالأدوية القائمة على الشبكات العصبية الرسومية، والذكاء الاصطناعي القابل للتفسير ضمن سير عمل واحد قابل للتكرار لذكاء مرض السكري. (2) تطوير استراتيجية تعلم اتحادي تحافظ على الخصوصية لتمكين التدريب التعاوني للنماذج عبر عملاء رعاية صحية موزعين ومحاكات، دون مشاركة بيانات المرضى الخام. (3) تقديم بنية محول متعدد الوسائط لتعلم تمثيلات تكميلية بشكل مشترك من السجلات السريرية المهيكلة، وبيانات المراقبة المستمرة للجلوكوز، وصور قاع الشبكية، ومؤشرات صحة السكان. (4) دمج توليد البيانات الاصطناعية القائم على الانتشار لتقليل عدم توازن الفئات وتحسين متانة النموذج مع الحفاظ على الخصائص الإحصائية لبيانات التدريب الأصلية. (5) توظيف وحدة تعلم رسومية غير متجانسة قائمة على GraphSAGE لنمذجة العلاقات بين المريض والدواء وبين دواء وآخر من أجل توصية دوائية مخصصة وترتيب للعلاجات مع مراعاة التفاعلات الدوائية. (6) دمج تقنيات متعددة للذكاء الاصطناعي القابل للتفسير، بما في ذلك SHapley Additive exPlanations (SHAP)، والتدرجات المتكاملة (Integrated Gradients)، وتصور الانتباه (attention visualization)، والتفسيرات المضادة للواقع (counterfactual explanations)، لتحسين شفافية النموذج وتوفير مخرجات تنبؤ وتوصية قابلة للتفسير. (7) توفير بروتوكول تحقق شامل، يتضمن التقييم التنبؤي، وتقييم التعلم الاتحادي، وتقييم التوصيات، وتحليل القابلية للتفسير، والتقييم المتمحور حول الطبيب، والتحقق الخارجي، وتقييم القابلية للتكرار.
البروتوكول
تم الحصول على جميع مجموعات البيانات المستخدمة في هذه الدراسة من مستودعات متاحة للعموم، وكانت تحتوي على معلومات مرضى مجهولة الهوية. وشمل ذلك مجموعة بيانات Pima Indians Diabetes، ومجموعة بيانات CDC Diabetes Health Indicators، ومجموعة بيانات OhioT1DM، ومجموعة بيانات APTOS 2019 Blindness Detection، ومجموعة بيانات Drug Review، ومجموعة بيانات Drug-Drug Interaction. لم تتضمن الدراسة أي استقطاب مباشر للمرضى، أو تدخلات، أو جمع عينات، أو الوصول إلى معلومات صحية شخصية يمكن تحديد هوية أصحابها. اقتصرت الدراسة على تحليل ثانوي لمجموعات بيانات مجهولة المصدر ومتاحة للعموم لغرض التطوير المنهجي والتحقق من الصحة، وأُجريت وفقاً للمتطلبات المؤسسية لاستخدام مثل هذه البيانات. إن التقييم المتمحور حول الإنسان والموصوف في هذا البروتوكول مخصص للتنفيذ المستقبلي ولم يتم إجراؤه في الدراسة الحالية. يجب على الباحثين الذين يجرون هذا التقييم الحصول على الموافقة المناسبة من لجنة أخلاقيات المؤسسة، والحصول على موافقة كتابية مستنيرة من جميع المشاركين، والامتثال للمتطلبات المؤسسية المعمول بها، واتفاقيات استخدام البيانات، واللوائح الوطنية.
1. تهيئة البيئة الحسابية
- ثبّت Python 3.11 كبيئة برمجة أساسية. ثبّت PyTorch 2.3 وTensorFlow 2.15 لتطوير وتدريب نماذج التعلم العميق. ثبّت مكتبة Transformers (الإصدار v4.45) لتنفيذ البنى القائمة على المحولات (transformers).
- ثبّت PyTorch Geometric (الإصدار v2.5) لدعم بناء وتدريب الشبكات العصبية الرسومية. ثبّت SHAP (الإصدار v0.47) وCaptum (الإصدار v0.8) لإجراء تحليلات القابلية للتفسير وتحديد سمات الميزات.
- ثبّت NumPy وPandas وScikit-learn للحوسبة العددية، والمعالجة المسبقة للبيانات، وأدوات التعلم الآلي. ثبّت OpenCV وMatplotlib لمهام معالجة الصور والتصور البياني. ثبّت NetworkX لبناء وتحليل الرسوم البيانية للتفاعلات الدوائية.
- ثبّت CUDA Toolkit وبرامج تشغيل NVIDIA GPU المتوافقة لتمكين الحوسبة المسرعة بالأجهزة. جهّز وحدة معالجة رسومات NVIDIA RTX 4090 مع ذاكرة نظام لا تقل عن 32 GB. اضبط البذرة العشوائية (random seed) على 42 لعمليات التدريب والتحقق والاختبار لضمان إمكانية تكرار النتائج. تحقق من تثبيت وتوافق المكتبات البرمجية المستخدمة. سجّل إصدارات البرامج، ومواصفات الأجهزة، ومعلمات تكوين النموذج المستخدمة في التحليل.
2. تحضير مجموعات البيانات ومعالجتها مسبقًا
- قم بتنزيل وتنظيم مجموعات البيانات السريرية والفسيولوجية والتصويرية والدوائية المطلوبة في مستودعات خاصة بكل نمط، وتحقق من سلامتها. تأكد من خصائص مجموعة البيانات، وأهداف التنبؤ، ومستويات التكامل كما هو محدد في الجدولان 1 و2يتم توضيح سير العمل في الشكل 2.
- قم بإزالة السجلات المكررة أو غير الصالحة أو غير المتسقة، والسجلات التي تفتقر إلى المتغيرات الأساسية. قسّم كل مجموعة بيانات قابلة للتطبيق إلى مجموعات فرعية مستقلة للمرضى مخصصة للتدريب (70%)، والتحقق (15%)، والاختبار (15%). قم بضبط تعويض القيم المفقودة باستخدام الوسيط (median imputation)، ومقياس الحد الأدنى والأقصى (Min-Max scaling)، والترميز الفئوي (categorical encoding) باستخدام المجموعة الفرعية للتدريب فقط، ثم طبق التحويلات المضبوطة دون تغيير على المجموعتين الفرعيتين للتحقق والاختبار. قم بإجراء توليد البيانات الاصطناعية على المجموعة الفرعية للتدريب فقط. تحقق من عملية التقسيم ومنع تسرب البيانات وفقاً لـ الجدول التكميلي 1.
- استورد بيانات جلوكوز الدم، وتناول الغذاء، وجرعات الإنسولين، والنشاط البدني، والنوم. قم بتوحيد الطوابع الزمنية، ومحاذاة الأحداث وفق فواصل زمنية منتظمة، واستكمال قيم الجلوكوز غير المسجلة خطياً، وتقسيم السجلات المستمرة إلى نوافذ ثابتة الطول، وتطبيق تسوية Z-score لإنشاء مدخلات المحول الزمني (temporal transformer).
- حمّل صور قاع الشبكية، وقم بإزالة الملفات التالفة أو غير القابلة للقراءة، والصور المكررة، والصور التي تفتقر إلى التصنيفات، والصور التي تحتوي على تشوهات شديدة أو التي تكون فيها رؤية مجال الشبكية غير كافية.
- قم بتغيير حجم الصور المستبقاة إلى 224 × ٢٢٤ بكسل، وتطبيع كثافة البكسلات لتصبح في النطاق [٠، ١]، وتطبيق معادلة المدرج التكراري التكيفي المحدودة التباين (CLAHE).
- تعزيز صور التدريب باستخدام التدوير العشوائي ضمن ±15°، والقلب الأفقي باحتمالية 0.5، والتكبير العشوائي ضمن نطاق 0.9-1.1×، وضبط السطوع ضمن ±20%. لا تطبق التعزيز العشوائي على صور التحقق أو الاختبار. قم بتخزين الصور المعالجة لتدريب محول الرؤية (Vision Transformer).
- قم بدمج التمثيلات الخاصة بكل نمط وفقاً لاستراتيجية دمج مجموعة البيانات الملخصة في جدول 2لا تقم بإجراء مطابقة مباشرة على مستوى المريض عبر المستودعات المستقلة في حال عدم توفر معرفات مشتركة للمرضى.
- يتم تخزين كل مجموعة بيانات عامة كمجموعة بيانات مستقلة خاصة بنمط معين، نظراً لأن معرفات المرضى غير مشتركة عبر المستودعات.
- درب مستخرجات الميزات الخاصة بكل نمط بشكل مستقل باستخدام مجموعات البيانات المقابلة: (أ) السجلات السريرية → مشفر TabTransformer؛ (ب) مؤشرات صحة السكان → مشفر TabTransformer؛ (ج) المراقبة المستمرة للجلوكوز → محول زمني؛ (د) صور قاع الشبكية → محوّل الرؤية؛ (هـ) البيانات الدوائية → وحدة GraphSAGE
- استخلص تضمينات السمات الكامنة بشكل مستقل من كل نمط. ثم ادمج التضمينات الكامنة المتعلمة فقط عبر وحدة دمج الانتباه عبر الأنماط المقترحة، بدلاً من دمج سجلات المرضى الخام.
- تأكد من عدم إجراء أي مطابقة اصطناعية للمرضى بين مجموعات البيانات العامة المستقلة. وحافظ على تقسيمات مستقلة للتدريب والتحقق والاختبار لكل مجموعة بيانات طوال مراحل المعالجة المسبقة، والتعزيز، وتطوير النموذج.
- تخزين تمثيلات الميزات متعددة الوسائط المدمجة من أجل التنبؤ اللاحق، والتعلم الاتحادي، والقابلية للتفسير، والتوصية الشخصية بالأدوية (الشكل 2).
3. إجراء تعزيز البيانات القائم على الانتشار
- طَبِّق تعزيز البيانات القائم على الانتشار (diffusion-based augmentation) على مجموعات البيانات الجدولية المهيكلة الخاصة بالبيانات السريرية وصحة السكان باستخدام TabDDPM. وقُم بتوليد عينات اصطناعية حصرياً من قسم التدريب الذي تمت معالجته مسبقاً لمنع تسرب المعلومات. وقم بتكوين النموذج وفقاً لـ الجدول التكميلي 2.
- درب نموذج TabDDPM لمدة تصل إلى 500 حقبة (epoch) كحد أقصى باستخدام مُحسن Adam (معدل التعلم = 1 × 10⁻4(حجم الدفعة = 256). قم بتطبيق التوقف المبكر إذا لم يتحسن فقدان التحقق بمقدار 0.001 على الأقل لمدة 20 حقبة متتالية. قم بتوليد عينات اصطناعية للفئات ناقصة التمثيل.
- قم بتقييم جودة البيانات الاصطناعية باستخدام إحصائيات كولموغوروف-سميرنوف (KS)، وتباعد جينسن-شانون، ومسافة واسرستاين، وتحليل الارتباط لكل ميزة على حدة، وأداء التصنيف اللاحق. قارن توزيعات الميزات الأصلية والاصطناعية باستخدام تداخل المدرجات التكرارية، وتقدير كثافة النواة، ومعاملات الارتباط الزوجي.
- اقبل العينات الاصطناعية فقط عندما تظل توزيعات الميزات الخاصة بكل فئة متوافقة مع بيانات التدريب الأصلية (اختبار KS، p > 0.05؛ تباعد جينسن-شانون < 0.10) ولا تحتوي على قيم سريرية غير واقعية. ادمج العينات المقبولة مع مجموعة بيانات التدريب الأصلية لإنشاء مجموعة بيانات متوازنة الفئات. يظهر سير عمل التعزيز في الشكل 3.
- تحقق من صحة البيانات الاصطناعية من خلال إعادة تدريب نموذج التنبؤ بمرض السكري باستخدام مجموعات بيانات التدريب الأصلية والمعززة. قارن بين الدقة (Accuracy)، ومقياس F1 (F1-score)، ومعامل الارتباط ماتيوز (MCC)، والمساحة تحت منحنى خصائص تشغيل المستقبل (AUC-ROC) لتقييم التغييرات في قدرة النموذج على التعميم والانحياز التوزيعي.
4. تطوير نموذج المحول متعدد الوسائط
قم بتكوين المحول متعدد الوسائط باستخدام مشفرات خاصة بكل وسيط للبيانات السريرية المهيكلة، وتسلسلات CGM، وصور قاع الشبكية، كما هو موضح في الشكل 4. ثم ادمج التمثيلات الناتجة باستخدام الانتباه عبر الوسائط للتنبؤ بمرض السكري والتوصية بالأدوية المخصصة القائمة على الرسوم البيانية.
- تطوير المشفر السريري (Clinical Encoder)
- تهيئ بنية مشفر TabTransformer. يتم إدخال المتغيرات السريرية المُطبعة ومؤشرات الصحة السكانية. وتوليد تمثيلات الميزات السياقية باستخدام آليات الانتباه في المحول (transformer attention mechanisms).
- ضبط إعدادات مشفر TabTransformer بـ 32 متغيراً سريرياً مدخلاً، وبُعد تضمين (embedding dimension) قدره 128، وأربع طبقات محول، وثمانية رؤوس انتباه، وبُعد تغذية أمامية قدره 512، ومعدل تسرب (dropout rate) قدره 0.20، وتنشيط وحدة خطأ خطية غاوسية (GELU).
- تعلم تضمينات سريرية كامنة تلتقط العلاقات بين سمات المرضى. تخزين التضمينات السريرية الناتجة من أجل التكامل متعدد الوسائط.
- تطوير مشفر المراقبة المستمرة للجلوكوز (Continuous Glucose Monitoring Encoder)
- تهيئ مشفر المحول الزمني (temporal transformer encoder). يتم تغذيته بتسلسلات المراقبة المستمرة للجلوكوز والقياسات الفسيولوجية. استخدام آليات الانتباه الذاتي لتشفير التبعيات الزمنية.
- ضبط إعدادات المحول الزمني بطول تسلسل يبلغ 96 خطوة زمنية، وفاصل زمني لأخذ العينات قدره 15 min، وبُعد تضمين قدره 128، وأربع طبقات محول، وثمانية رؤوس انتباه، وتشفير موضعي جيبي (sinusoidal positional encoding)، ومعدل تسرب قدره 0.20.
- إنتاج تضمينات تسلسلية تعكس ديناميكيات الجلوكوز لدى المريض. الاحتفاظ بالتضمينات الزمنية جاهزة لعملية الدمج التالية.
- تطوير مشفر محول الرؤية (Vision Transformer Encoder)
- تهيئ بنية محول الرؤية (Vision Transformer). يتم إدخال صور قاع الشبكية التي تمت معالجتها مسبقاً. تقسيم الصور إلى رقع (patches) ثابتة الحجم.
- ضبط إعدادات محول الرؤية بدقة صورة مدخلة تبلغ 224 × 224 pixels، وحجم رقعة يبلغ 16 × 16 pixels، وبُعد تضمين قدره 768، و12 كتلة محول، و12 رأس انتباه، ومعدل تسرب قدره 0.10.
- توليد تمثيلات الميزات على مستوى الرقعة. الحصول على الميزات المرئية التي تدل على اعتلالات الشبكية والمؤشرات الحيوية المرتبطة بالمرض. الاحتفاظ بتضمينات الصور من أجل الدمج متعدد الوسائط.
- إجراء الدمج عبر الوسائط (Cross-Modal Fusion)
- استخراج التمثيلات الكامنة من مشفرات البيانات السريرية وCGM ومحول الرؤية، وإسقاط كل منها في فضاء كامن مشترك بأبعاد 256 باستخدام إسقاطات خطية مستقلة متبوعة بتطبيع الطبقة (Layer Normalization).
- دمج رموز الوسائط المُسقطة، وإضافة تضمينات قابلة للتعلم لنوع الوسائط، وتطبيق انتباه متعدد الرؤوس عبر الوسائط لتمكين تبادل المعلومات بين التمثيلات السريرية وCGM والشبكية. ضبط كتلة الانتباه بثمانية رؤوس، وفضاء نموذج بأبعاد 256، وطبقة تغذية أمامية بأبعاد 1,024، وتنشيط GELU، وتسرب بنسبة 0.10، واتصالات متبقية (residual connections)، وتطبيع الطبقة.
- إجراء تجميع متوسط (Mean-pool) لكل مجموعة رموز خاصة بوسائط معينة ودمج التمثيلات الناتجة. إسقاط المتجه المدمج ذو الأبعاد 768 إلى تمثيل موحد متعدد الوسائط بأبعاد 512، والاحتفاظ بأوزان الانتباه والتمثيلات المدمجة لتحليلات القابلية للتفسير والاستئصال (ablation analyses) اللاحقة.
- توجيه التمثيل الموحد إلى وحدات التنبؤ بالسكري وتوصية الأدوية القائمة على GraphSAGE. الحفاظ على تقسيمات التدريب والتحقق والاختبار الأصلية الخاصة بكل وسيط طوال عملية الدمج دون مطابقة اصطناعية على مستوى المريض عبر مجموعات البيانات المستقلة.
- ضبط إعدادات المحول متعدد الوسائط وفقاً لمعاملات النموذج الملخصة في الجدول التكميلي 3.
5. تهيئة التعلم الاتحادي
- قم بتكوين إطار عمل التعلم الاتحادي لتمكين التدريب التعاوني للنماذج عبر مؤسسات الرعاية الصحية الموزعة جغرافياً دون تبادل البيانات على مستوى المريض. قم بإجراء تحسين النموذج المحلي في كل مؤسسة مشاركة باستخدام البيانات المتاحة محلياً. شارك فقط معلمات النموذج المحمية مع خادم التجميع المركزي. حافظ على خصوصية المريض مع تمكين التطوير التعاوني للنماذج متعددة الوسائط.
- افصل مجموعات البيانات متعددة الوسائط ووزعها على عدة عملاء اتحاديين لمحاكاة سيناريو تعاون مؤسسات رعاية صحية مختلفة دون مشاركة بياناتها.
- قم بتكوين شبكة التعلم الاتحادي بحيث تضم 10 عملاء من المستشفيات المشاركة، وخادماً واحداً للتجميع المركزي، وخمسة عصور تدريبية (epochs) محلية لكل جولة اتصال، و100 جولة اتصال، ونسبة مشاركة للعملاء تبلغ 80%، واختيار عشوائي للعملاء في كل جولة اتصال، وبحد أدنى ثمانية عملاء مشاركين في كل جولة.
- امنح كل عميل مجموعة بيانات تنتمي إلى مؤسسة معينة بحيث تظل البيانات محلية وسرية. قم بتقسيم بيانات التدريب متعددة الوسائط بين 10 عملاء مستشفيات محاكات باستخدام استراتيجية توزيع غير مستقلة وغير متطابقة (non-IID) قائمة على توزيع Dirichlet لإنشاء توزيعات فئات وتكوينات ديموغرافية وأحجام مجموعات بيانات عملاء متباينة.
- استخدم بذرة عشوائية ثابتة لضمان إمكانية إعادة الإنتاج. تحقق من توزيعات مستوى العميل الناتجة واحتفظ بهذه التقسيمات طوال فترة التدريب الاتحادي. حافظ على استقلالية مجموعات بيانات التحقق والاختبار عن تقسيمات العملاء.
- قم بتهيئة كل عميل محلي بمعلمات النموذج العالمي المستلمة من خادم التجميع المركزي. قم بتدريب المحول (transformer) المحلي متعدد الوسائط لخمسة عصور تدريبية باستخدام بيانات التدريب المحلية الخاصة بالعميل. قم بتحسين النموذج المحلي باستخدام محسن AdamW بمعدل تعلم قدره 1 × 10⁻4.
- احسب تحديثات معلمات النموذج المحلي بعد اكتمال التدريب المحلي. قم بحماية معلمات النموذج المحلي قبل إرسالها إلى خادم التجميع المركزي. أرسل معلمات النموذج المحلي المحمية إلى خادم التجميع المركزي لإجراء التجميع العالمي.
- استقبل معلمات النموذج المحمية من جميع عملاء المستشفيات المشاركين. تحقق من سلامة تحديثات النموذج المستلمة قبل التجميع. قم بتجميع أوزان النموذج المحلية باستخدام خوارزمية المتوسط الاتحادي (FedAvg). قم بتحديث المحول العالمي متعدد الوسائط باستخدام معلمات النموذج المجمعة.
- أعد توزيع معلمات النموذج العالمي المحدثة على عملاء المستشفيات المشاركين. كرر إجراءات التدريب المحلي والتجميع العالمي حتى اكتمال 100 جولة اتصال أو استيفاء معيار التقارب المحدد مسبقاً.
- احمِ معلمات النموذج المرسلة باستخدام آلية التجميع الآمن المحددة وتشفير AES-256. قم بمصادقة العملاء المشاركين باستخدام الشهادات الرقمية.
- أنشئ قنوات اتصال مشفرة باستخدام بروتوكول أمان طبقة النقل (TLS) 1.3. احتفظ فقط بمعلمات النموذج العالمي المجمعة بعد اكتمال كل جولة اتصال.
- قيم الخصوصية والأمان باستخدام تقييمات الكشف عن البيانات الخام، والمشاركة غير المصرح بها، واستنتاج العضوية، وعكس النموذج. بالنسبة لاستنتاج العضوية، قارن AUC-ROC للهجوم مع الخط المرجعي العشوائي (0.50)؛ وقيم العكس باستخدام مقياس مؤشر التشابه الهيكلي (SSIM) ونسبة ذروة الإشارة إلى الضوضاء (PSNR) لصور الشبكية وخطأ إعادة البناء المعياري للميزات العددية.
- تحقق من التجميع الآمن من خلال التأكد من أن الخادم لا يمكنه الوصول إلى تحديثات العملاء الفردية غير المجمعة. تحقق من حماية AES-256/TLS 1.3 وتأكد من عدم حدوث أي عمليات إرسال لتحديثات النموذج غير مشفرة.
- قارن مقاييس الخصوصية بين التكوينات الاتحادية والمركزية حيثما كان ذلك ممكناً، وأبلغ عن المقاييس المحددة في الجدول التكميلي 4.
- قدر التعقيد الحسابي لتدريب المحول المحلي بـ O(N × L × d2)، حيث تمثل N عدد العينات، وتمثل L عدد طبقات المحول، وتمثل d بُعد التضمين.
- قدر التعقيد الحسابي للتجميع الاتحادي بـ O(K × P) لكل جولة اتصال، حيث تمثل K عدد العملاء المشاركين وتمثل P عدد معلمات النموذج القابلة للتدريب.
- تبادل فقط معلمات النموذج المحمية بين العملاء المشاركين وخادم التجميع المركزي خلال كل جولة اتصال. احسب العبء الإضافي للاتصالات بناءً على حجم النموذج، وعدد العملاء المشاركين، وعدد جولات الاتصال.
- قارن العبء الإضافي لتبادل المعلمات بالتكلفة التقديرية لنقل مجموعات بيانات الرعاية الصحية متعددة الوسائط المقابلة. قم بتكوين إطار عمل التعلم الاتحادي وفقاً للمعلمات الملخصة في الجدول التكميلي 4. يتم توضيح سير عمل التعلم الاتحادي وعملية تجميع المعلمات في الشكل 5.
6. إنشاء وحدة توصية الأدوية المخصصة
- استيراد البيانات الدوائية، والطبية، وعلاجات المرضى، وبيانات التفاعلات الدوائية إلى البيئة الحسابية. إنشاء رسم بياني غير متجانس للرعاية الصحية يحتوي على عُقد للمرضى، والأدوية، والأمراض، والاختبارات المختبرية، وعوامل الخطر السريرية.
- تحديد العلاقات بين المريض والمرض، والمريض والدواء، والمرض والدواء، والتفاعلات بين دواء ودواء، والعلاقات بين المريض والمختبر كحواف للرسم البياني. التحقق من بنية الرسم البياني وإزالة العلاقات المكررة أو غير الصالحة أو المنفصلة قبل تدريب النموذج.
- تمثيل عُقد المرضى باستخدام العمر، والجنس، ومؤشر كتلة الجسم (BMI)، وHbA1c، وجلوكوز الدم، وضغط الدم، ومدة الإصابة بالسكري. تمثيل عُقد الأدوية باستخدام الفئة الدوائية، وآلية العمل، والجرعة، وتكرار الإعطاء، والآثار الجانبية المعروفة.
- تمثيل عُقد الأمراض باستخدام شدة المرض، ومرحلة المرض، والمضاعفات المرتبطة به. ترميز السمات الفئوية وتطبيع ميزات العُقد المستمرة قبل تدريب GraphSAGE.
- تهيئة تضمينات العُقد (node embeddings) باستخدام ميزات العُقد التي تمت معالجتها مسبقاً. أخذ عينات تصل إلى 25 عقدة مجاورة لكل عقدة مستهدفة أثناء تجميع الجوار. تجميع تمثيلات العُقد المجاورة باستخدام التجميع المتوسط (mean aggregation). تحديث تضمينات العقدة المستهدفة باستخدام تمثيلات الجوار المجمعة.
- تطبيق دالة التنشيط الوحدة الخطية المصححة (ReLU) بعد كل طبقة من طبقات GraphSAGE. تطبيع تضمينات العُقد الناتجة. تكرار إجراء تجميع الجوار عبر ثلاث طبقات من GraphSAGE.
- تكوين نموذج GraphSAGE ببعد خفي قدره 256، وبُعد تضمين قدره 128، وثلاث طبقات GraphSAGE، وحجم عينات للجوار قدره 25، ومعدل إسقاط (dropout rate) قدره 0.30، ومعدل تعلم قدره 1 × 10⁻4، وحجم دفعة (batch size) قدره 512، وبحد أقصى 100 حقبة تدريبية. تحسين النموذج باستخدام محسن Adam.
- حساب التضمين الخاص بالمريض من نموذج GraphSAGE المدرب. حساب التضمينات للأدوية المرشحة. حساب درجات الملاءمة بين تمثيل المريض وتمثيلات الأدوية المرشحة. ترتيب الأدوية المرشحة وفقاً لدرجات الملاءمة المتوقعة.
- تحديد وإزالة الأدوية الممنوعة أو التي قد تكون غير آمنة باستخدام معلومات التفاعلات الدوائية المتاحة. استخراج الأدوية الخمسة الأعلى تصنيفاً والمؤهلة كأفضل 5 توصيات شخصية (Top-5 recommendations).
- تدريب نموذج التوصية باستخدام خسارة التصنيف الشخصي البايزي (BPR loss). تحسين هدف التصنيف لتعيين درجات أعلى للأدوية المناسبة سريرياً مقارنة بالأدوية المرشحة الأقل ملاءمة.
- تحديد العُقد المجاورة المؤثرة وعلاقات الرسم البياني ذات الصلة سريرياً والتي تساهم في كل توصية دوائية. حساب درجات إسناد الميزات (feature-attribution scores) للخصائص المتعلقة بالمريض، والمرض، والمختبر، والدواء والتي تساهم في التوصية.
- إنشاء تفسيرات مرئية قائمة على الرسم البياني توضح العلاقات التي تساهم في كل توصية دوائية شخصية. تكوين نموذج توصية GraphSAGE وفقاً للمعلمات الملخصة في الجدول التكميلي 5. يوضح سير عمل التوصية الشخصية بالأدوية القائمة على الرسم البياني في الشكل 6.
7. إجراء تقييم القابلية للتفسير
- إجراء تحليل SHAP
- تحميل المحول متعدد الوسائط (multimodal transformer) المدرب ومجموعة بيانات الاختبار المستبعدة في البيئة الحسابية.
- تهيئة مفسر SHAP باستخدام نموذج التنبؤ المدرب وعينة خلفية مكونة من 100 عينة تدريب، يتم اختيارها حصرياً من مجموعة بيانات التدريب باستخدام أخذ العينات العشوائية الطبقية وفقاً لفئة نتيجة مرض السكري. الحفاظ على التوزيع التقريبي للفئات لتقسيم التدريب الكامل في العينة الخلفية، واستخدام بذرة عشوائية ثابتة بقيمة 42 لضمان إمكانية إعادة إنتاج اختيار العينة. حساب قيم SHAP لعينات الاختبار المختارة.
- حساب أهمية الميزات العالمية من قيم SHAP المطلقة، وإنشاء تصورات SHAP العالمية والمحلية، والاحتفاظ بالقيم المحسوبة للتحليلات الكمية والإحصائية اللاحقة.
- إجراء تحليل التدرجات المتكاملة (integrated gradients)
- اختيار عينات ممثلة تم تصنيفها بشكل صحيح وعينات أخرى تم تصنيفها بشكل خاطئ من مجموعة بيانات الاختبار المستبعدة. تحديد المدخلات المرجعية (baseline) الخاصة بكل وسيطة قبل حساب التدرجات المتكاملة. استخدام مرجع صفري للميزات العددية السريرية وميزات CGM المعيرة، وهو ما يمثل مساهمة ميزة معيرة صفرية، واستخدام صورة مرجعية ذات قيمة صفرية لمدخلات صور الشبكية المعيرة.
- حساب درجات إسناد التدرجات المتكاملة باستخدام 100 خطوة استكمال (interpolation steps) بين المرجع والمدخل الأصلي. تعيير درجات الإسناد الناتجة لتمكين المقارنة عبر الميزات والوسائط. إنشاء تصورات للإسناد لتحديد الميزات السريرية والزمنية والتصويرية المؤثرة التي تساهم في تنبؤات النموذج الفردية.
- إجراء تصور الانتباه (attention visualization)
- استخراج مصفوفات الانتباه من طبقات المحول المدرب لعينات اختبار ممثلة. حساب متوسط أوزان الانتباه عبر رؤوس الانتباه المقابلة. إنشاء خرائط حرارية للانتباه لتصوير التفاعلات عبر الوسائط بين التمثيلات السريرية والزمنية وتصوير الشبكية. تحديد الميزات السريرية والزمنية وميزات الشبكية المهيمنة التي تتلقى أوزان انتباه عالية أثناء التنبؤ.
- استخراج أوزان الانتباه من المحول متعدد الوسائط المدرب لعينة اختبار مستبعدة مختارة عشوائياً، وتصوير توزيعات انتباه الميزات السريرية، والزمنية لـ CGM، والمكانية للشبكية، والانتباه عبر الوسائط.
- توليد تفسيرات مضادة للواقع (counterfactual explanations)
- اختيار سجلات مرضى ممثلة من مجموعة بيانات الاختبار المستبعدة. تحديد النطاقات والقيود المسموح بها سريرياً للميزات القابلة للتعديل للمرضى قبل توليد العينات المضادة للواقع. قصر الميزات المستمرة على نطاق بيانات التدريب الملحوظة، وقصر الميزات الفئوية على الفئات الصالحة الملحوظة في بيانات التدريب. عدم تعديل الخصائص الديموغرافية غير القابلة للتغيير، بما في ذلك العمر والجنس.
- توليد عينات مضادة للواقع عن طريق إجراء تعديلات طفيفة فقط على الميزات القابلة للتعديل المسموح بها مع الحفاظ على القيود السريرية وقيود نطاق الميزات المحددة مسبقاً. رفض التفسيرات المضادة للواقع التي تحتوي على قيم خارج نطاق بيانات التدريب الملحوظة، أو حالات فئوية غير صالحة، أو تعديلات في الميزات غير القابلة للتغيير. تحديد أصغر تعديلات ميزات معقولة سريرياً مطلوبة لتغيير النتيجة المتوقعة.
- ذكر الميزات المعدلة، والقيم الأصلية، والقيم المضادة للواقع، والتغييرات المقابلة في تنبؤات النموذج. يتم توضيح سير عمل تقييم القابلية للتفسير في الشكل 7، بينما يتم عرض مخرجات تصور الانتباه والتفسير المضاد للواقع الممثلة في الشكل التكميلي 1.
- تقييم جودة التفسير
- حساب الدقة (fidelity) لقياس مدى التوافق بين التفسيرات المولدة وسلوك نموذج التنبؤ. حساب الاستقرار (stability) عن طريق توليد التفسيرات بشكل متكرر تحت اضطرابات طفيفة في المدخلات ومقارنة أنماط الإسناد الناتجة. تقييم الاتساق (consistency) من خلال مقارنة التفسيرات المولدة لعينات اختبار متشابهة سريرياً.
- حساب التشتت (sparsity) من خلال تحديد عدد أو نسبة الميزات التي تساهم بشكل جوهري في كل تفسير. تقييم الاكتمال (completeness) لتحديد ما إذا كانت الميزات المسندة تفسر مخرجات النموذج المقابلة بشكل كافٍ. تقييم الحساسية (sensitivity) عن طريق قياس التغيرات في درجات الإسناد بعد إجراء اضطرابات محكومة لميزات المدخلات.
- حساب عدم الدقة (infidelity) لقياس عدم التوافق بين إسنادات الميزات والتغيرات الملحوظة في تنبؤات النموذج. تسجيل جميع مقاييس القابلية للتفسير الكمية للتحليل الإحصائي اللاحق.
- إجراء التحقق السريري المستقبلي
- من أجل التحقق السريري المستقبلي، يجب الحصول على موافقة لجنة أخلاقيات المؤسسة المختصة قبل استقطاب الخبراء السريريين. بعد الحصول على الموافقة الأخلاقية، يتم استقطاب 12 طبيباً سريرياً يضمون ستة أطباء غدد صماء، وثلاثة متخصصين في السكري، وثلاثة صيادلة سريريين، والحصول على موافقة مستنيرة من جميع المشاركين قبل بدء التقييم.
- اختيار تنبؤات نموذج ممثلة وتفسيراتها المقابلة عشوائياً لتقييم الأطباء السريريين. تقديم التفسيرات المختارة بشكل مستقل لكل طبيب مشارك باستخدام نموذج تقييم موحد.
- طلب من كل طبيب تقييم فائدة التفسير، وصلته السريرية، وقابليته للتفسير، وموثوقيته باستخدام مقياس ليكرت المكون من خمس نقاط. تسجيل تقييمات الأطباء مجهولة المصدر وحساب الاتفاق بين المقيمين والمقاييس الإحصائية المقابلة كما هو محدد في الخطوة 7.7.
- إجراء التحليل الإحصائي
- تقييم توزيع درجات التقييم الكمية قبل اختيار اختبار المقارنة الإحصائي. تطبيق اختبار t المزدوج (paired t-test) للقياسات المزدوجة ذات التوزيع الطبيعي أو اختبار ويلكوكسون للرتب الموقعة (Wilcoxon signed-rank test) للقياسات المزدوجة غير ذات التوزيع الطبيعي، حسب الاقتضاء.
- حساب معامل كابا لفليس (Fleiss' kappa) لقياس الاتفاق بين المقيمين من الأطباء السريريين المشاركين. حساب فترات الثقة 95% لمقاييس القابلية للتفسير الرئيسية ومقاييس تقييم الأطباء. تحديد عتبة الدلالة الإحصائية عند p < 0.05.
- ذكر إحصائيات الاختبار المحسوبة، وفترات الثقة، وقيم p مع نتائج التقييم المقابلة. تقييم وذكر مقاييس القابلية للتفسير وفقاً للمعايير الملخصة في الجدول التكميلي 6.
8. تقييم أداء النموذج
- قارن بين FedMediFormer-XAI وكل من Logistic Regression وRandom Forest وXGBoost وTabTransformer وVision Transformer وTemporal Transformer والمحول متعدد الوسائط المركزي (centralized multimodal transformer) باستخدام الدقة (accuracy)، والضبط (precision)، والاسترجاع (recall)، ومقياس F1-score، ومعامل ارتباط ماتيوس (MCC)، والمساحة تحت منحنى خصائص تشغيل المستقبل (AUC-ROC).
- أجرِ كل تقييم للنماذج المرجعية باستخدام نفس استراتيجية التدريب والتحقق والاختبار المحددة مسبقاً لضمان إجراء مقارنة متسقة مع الإطار المقترح.
- كرر تقييم النموذج عبر جولات تجريبية مستقلة وسجّل مقاييس الأداء التي تم الحصول عليها في كل جولة. احسب المتوسط، والانحراف المعياري (SD)، وفاصل الثقة 95% (CI) لكل من الدقة، والضبط، والاسترجاع، ومقياس F1-score، وMCC، وAUC-ROC. سجّل نتائج الأداء كقيمة المتوسط ± SD مع فاصل الثقة 95% المقابل.
- قيّم طبيعية توزيع فروق الأداء المقترنة بين FedMediFormer-XAI وكل نموذج مرجعي. طبق اختبار t المقترن (paired t-test) على القياسات المقترنة الموزعة طبيعياً، واختبار ويلكوكسون للرتب الموقعة (Wilcoxon signed-rank test) على القياسات المقترنة غير الموزعة طبيعياً. حدد عتبة الدلالة الإحصائية عند p < 0.05.
- سجّل إحصائيات الاختبار المقابلة، وقيم p، وفواصل الثقة 95% لتحديد الدلالة الإحصائية وعدم اليقين في فروق الأداء الملحوظة.
- احسب عدد جميع جولات الاتصال حتى تتقارب النماذج نهائياً. راقب أداء النموذج العالمي أثناء التدريب الاتحادي (federated training). ادرس كيف يتغير التقارب بمرور الوقت عبر جولات الاتصال.
- تحقق من مدى فعالية تجميع المعلمات (parameter aggregation). افحص كيف يؤثر التعلم اللامركزي على أداء التنبؤ. أجرِ مقارنة بين نتائج التعلم الاتحادي والتعلم المركزي.
- قيّم التقارب الاتحادي عبر جولات الاتصال وقارن بين أداء التنبؤ الاتحادي والمركزي. قيّم توصيات الأدوية باستخدام مقاييس Precision@5 وRecall@5 وNDCG@5.
- أنشئ عينات سلبية (عينات أدوية) من مجموعة الأدوية المرشحة المؤهلة عن طريق اختيار الأدوية التي لا تظهر كتفاعلات إيجابية بين المريض والدواء للمريض المقابل. استبعد جميع التفاعلات الإيجابية المعروفة وجميع الأدوية الموانعة (contraindicated medications) من مجموعة أخذ العينات السلبية. حافظ على نسبة ثابتة لأخذ العينات السلبية إلى الإيجابية تبلغ 1:1 لتدريب التوصيات، واستخدم بذرة عشوائية ثابتة (random seed) بقيمة 42 لضمان إمكانية تكرار اختيار العينات السلبية.
- حدد مجموعة العناصر ذات الصلة لكل مريض حصرياً من بيانات التقييم المستبعدة. عرّف مجموعة العناصر ذات الصلة Ru للمريض u بأنها مجموعة الأدوية التي تستوفي معايير التفاعل الإيجابي بين المريض والدواء في سجلات الحقيقة الأرضية (ground-truth) المستبعدة. لا تستخدم تنبؤات النموذج لبناء Ru. قم بإزالة الأدوية الموانعة من مجموعة توصيات المرشحين قبل إجراء الترتيب.
- أنشئ قائمة بالأدوية المؤهلة الخمسة الأعلى ترتيباً لكل مريض خاضع للتقييم. احسب Precision@5 كنسبة الأدوية الخمسة الموصى بها التي تنتمي إلى مجموعة العناصر ذات الصلة Ru الخاصة بالمريض. احسب Recall@5 كنسبة الأدوية ذات الصلة بالمريض التي تم استرجاعها من بين التوصيات الخمس. احسب NDCG@5 باستخدام الصلة المتدرجة للأدوية الموصى بها، مع تعيين صلّة أعلى للأدوية المناسبة سريرياً وصلّة صفرية للأدوية غير ذات الصلة. اجمع المقاييس عبر جميع المرضى الخاضعين للتقييم وسجّل متوسط Precision@5 وRecall@5 وNDCG@5.
- أنشئ الحقيقة الأرضية للتوصيات قبل تقييم النموذج، وحافظ على فصل تفاعلات المريض-الدواء المستبعدة عن بيانات تدريب التوصيات. لا تستخدم تفاعلات الأدوية في مجموعة الاختبار، أو تسميات مجموعة الاختبار، أو معلومات العلاج المستقبلية أثناء تدريب GraphSAGE، أو أخذ العينات السلبية، أو ترتيب المرشحين.
- قس درجة الدقة (Fidelity) للتحقق من مدى تطابق التفسيرات مع سلوك النموذج. قيّم استقرار التفسير من خلال فحوصات متعددة. احكم على قابلية الفهم (Comprehensibility) بناءً على معايير موجهة للأطباء.
- ابحث في مدى اتساق التفسيرات عبر أنواع مختلفة من البيانات. أكد القيمة السريرية للتفسيرات الناتجة. تم تلخيص مقاييس التقييم المستخدمة في جميع أنحاء الدراسة في الجدول التكميلي 7.
9. إجراء التحقق الاستباقي من قبل السريريين
- أجرِ عملية التحقق الاستباقي من قبل السريريين بعد الحصول على الموافقة الأخلاقية المناسبة والموافقة المستنيرة، وذلك باتباع إجراءات الاستقطاب، والتقييم، وجمع البيانات، والتحليل الإحصائي الموصوفة في الخطوات 7.6-7.8. ويتلخص تصميم التحقق الاستباقي من قبل السريريين، بما في ذلك تكوين المشاركين، ومعايير التقييم، وظروف المقارنة، والتحليلات الإحصائية المخطط لها، في الجدول التكميلي 8.
10. إجراء عملية التحقق وتقييم قابلية التكرار
- أجرِ دراسات الاستئصال من خلال إزالة المكونات الفردية بشكل منهجي من إطار عمل FedMediFormer-XAI الكامل، مع الحفاظ على نفس تقسيمات مجموعة البيانات، وإجراءات المعالجة المسبقة، وإعدادات التدريب، ومعايير التقييم. قم بتقييم النموذج الكامل والتكوينات التي تفتقر إلى تعزيز الانتشار، والتعلم الاتحادي، وتوصية الأدوية القائمة على GraphSAGE، والدمج متعدد الوسائط.
- قارن التكوينات المستأصلة مع إطار عمل FedMediFormer-XAI الكامل باستخدام الدقة (Accuracy)، والدقة التحديدية (Precision)، والاستدعاء (Recall)، ومقياس F1-score، ومعامل الارتباط ماتيوس (MCC)، والمساحة تحت منحنى خصائص تشغيل المستقبل (AUC-ROC). قم بقياس التغير في كل مقياس من مقاييس الأداء لتحديد مساهمة كل مكون من مكونات إطار العمل. قارن نتائج التحقق مع نتائج الاختبار الداخلي لتقييم القدرة على التعميم. أجرِ اختبارات الدلالة الإحصائية لتحديد مدى موثوقية الاختلافات الملحوظة في الأداء.
- قيّم قابلية تعميم الإطار العملي باستخدام مجموعة بيانات خارجية مستقلة في حال توفر مجموعة بيانات كهذه بمتغيرات مدخلة وتعريفات نتائج متوافقة. طبّق إجراءات المعالجة المسبقة والتقييم نفسها المستخدمة مع مجموعة بيانات الاختبار الداخلية، وقارن مقاييس الأداء الناتجة مع نتائج الاختبار الداخلي.
- أجرِ تحليل الدلالة الإحصائية عبر تجارب تكرارية. قيّم التوزيع الطبيعي لفروق الأداء المزدوجة قبل إجراء الاختبارات الإحصائية. طبق اختبار t للمجموعات المزدوجة (paired t-test) على القياسات المزدوجة ذات التوزيع الطبيعي، واختبار ويلكوكسون للرتب الموقعة (Wilcoxon signed-rank test) على القياسات المزدوجة غير ذات التوزيع الطبيعي. حدد عتبة الدلالة الإحصائية عند p < 0.05.
- احسب المتوسط وفترة الثقة 95% لكل من الدقة (Accuracy)، والضبط (Precision)، والاستدعاء (Recall)، ومقياس F1 (F1-score)، ومعامل ارتباط ماتيوس (MCC)، والمساحة تحت منحنى خصائص تشغيل المستقبل (AUC-ROC). قم بتدوين إحصائيات الاختبار المقابلة، والقيم الاحتمالية (p-values)، وفترات الثقة لمقارنات النماذج الرئيسية. وثّق جميع معاملات النماذج، وإجراءات المعالجة المسبقة، وتكوينات التدريب، وبروتوكولات التقييم اللازمة لإعادة إنتاج التجارب المذكورة.
- يجب الحفاظ على الكود المصدري، وملفات التكوين، ونصوص التقييم البرمجية، ومواصفات النماذج المدربة المستخدمة في التجارب المذكورة. كما يجب الاحتفاظ بسجلات مفصلة لتدريب النماذج، والإعدادات التجريبية، والبذور العشوائية، ونتائج التقييم.
- تحقق من اكتمال واتساق مواد إمكانية إعادة الإنتاج المتاحة. وتأكد من أن الطرق والمواد الموثقة توفر معلومات كافية لإعادة تنفيذ سير العمل التجريبي بشكل مستقل.
- لخّص موارد قابلية التكرار وإجراءات التحقق المستخدمة في الدراسة في الجدول التكميلي 9قم بتوثيق إجراء دراسة الاستئصال ومعايير التقييم لتقدير مساهمة المكونات الرئيسية لإطار العمل.
النتائج
تحليل أداء التنبؤ
أظهر نموذج FedMediFormer-XAI تحسناً في أداء التنبؤ مقارنة بالنماذج أحادية المنوال والنماذج المرجعية التقليدية التي تم تقييمها. وقد أدى التعزيز القائم على الانتشار (Diffusion-based augmentation) إلى تحسين تمثيل الفئات الأقلية، وتتلخص نتائج أداء التنبؤ الناتجة في الجدول 3. كما أظهر تقييم التشغيل المتكرر أداءً تنبؤياً مستقراً عبر النماذج التي تم تقييمها. وحقق نموذج FedMediFormer-XAI أعلى أداء إجمالي، بدقة بلغت 94.20 ± 0.34% (95% CI: 93.78–94.62)، ودقة تحديد (precision) بلغت 93.10 ± 0.30% (95% CI: 92.73–93.47)، واستدعاء (recall) بلغ 92.80 ± 0.28% (95% CI: 92.45–93.15)، ومقياس F1-score بلغ 92.90 ± 0.28% (95% CI: 92.55–93.25). كما حقق النموذج معامل ارتباط ماتيوس (MCC) قدره 0.88 ± 0.02 (95% CI: 0.86–0.90) ومساحة تحت منحنى خصائص التشغيل (AUC-ROC) بلغت 0.96 ± 0.01 (95% CI: 0.95–0.97). وقد قدم المحول متعدد المنوال المركزي (centralized multimodal transformer) ثاني أفضل أداء إجمالي، بينما أظهرت النماذج أحادية المنوال ونماذج التعلم الآلي التقليدية أداءً تنبؤياً أقل نسبياً. وتشير هذه النتائج إلى أن تعلم التمثيلات متعددة المنوال، مقترناً بالتحسين الاتحادي (federated optimization)، يؤدي إلى تحسين أداء تصنيف مرض السكري وزيادة استقراره.
دراسة الاستئصال
استُخدم الاستئصال على مستوى المكونات لتقييم مساهمة كل من تعزيز الانتشار، والتعلم الاتحادي، وتوصية الأدوية القائمة على GraphSAGE، والدمج متعدد الوسائط. حقق إطار عمل FedMediFormer-XAI الكامل دقة بلغت 94.20 ± 0.34%، ودقة تنبؤية (precision) بلغت 93.10 ± 0.30%، واستدعاءً (recall) بلغ 92.80 ± 0.28%، ومقياس F1-score بلغ 92.90 ± 0.28%، ومعامل ارتباط ماتيوس (MCC) بلغ 0.88 ± 0.02، ومساحة تحت منحنى خصائص تشغيل المستقبل (AUC-ROC) بلغت 0.96 ± 0.01 عبر خمس عمليات تشغيل مستقلة. أدىت إزالة تعزيز الانتشار إلى خفض الدقة إلى 91.80 ± 0.42%، وهو ما يمثل انخفاضاً قدره 2.40 نقطة مئوية، بينما انخفض مقياس F1-score وAUC-ROC إلى 90.30 ± 0.38% و0.94 ± 0.01 على التوالي. يشير هذا الانخفاض إلى مساهمة التعزيز القائم على الانتشار في تمثيل الفئات الأقلية وتعزيز المتانة التنبؤية.
أدى استبعاد التعلم الاتحادي إلى دقة بلغت 93.10 ± 0.37%، وهو ما يمثل انخفاضًا قدره 1.10 نقطة مئوية مقارنة بالإطار الكامل. كما انخفضت كل من الدقة (Precision)، والاستدعاء (Recall)، ومقياس F1-score، ومعامل ارتباط ماتيوس (MCC)، والمساحة تحت منحنى خصائص تشغيل المستقبل (AUC-ROC) إلى 92.20 ± 0.34%، و 91.80 ± 0.32%، و 92.00 ± 0.33%، و 0.86 ± 0.02، و 0.95 ± 0.01 على التوالي. وتوضح هذه المقارنة مدى مساهمة التكوين الاتحادي في تحسين أداء التنبؤ.
أدى إزالة مكون توصية الأدوية المخصصة القائم على GraphSAGE إلى تغيير صغير نسبياً في أداء التنبؤ بمرض السكري، حيث انخفضت الدقة إلى 93.80 ± 0.35% ومقياس F1-score إلى 92.60 ± 0.30%. وكانت قيم MCC وAUC-ROC المقابلة 0.87 ± 0.02 و0.96 ± 0.01، على التوالي. وتشير هذه النتيجة إلى أن GraphSAGE يساهم بشكل أساسي في توصية الأدوية المخصصة بدلاً من تحديد أداء تصنيف مرض السكري بشكل مباشر.
لُوحظ أكبر انخفاض عند إزالة الدمج متعدد الوسائط؛ حيث انخفضت الدقة إلى 87.60 ± 0.55%، وهو ما يمثل انخفاضاً قدره 6.60 نقطة مئوية، بينما انخفضت الدقة (precision)، والاستدعاء (recall)، ومقياس F1-score، ومعامل ارتباط ماتيو (MCC)، والمساحة تحت منحنى خصائص تشغيل المستقبل (AUC-ROC) إلى 86.80 ± 0.51%، و85.90 ± 0.54%، و86.30 ± 0.52%، و0.76 ± 0.03، و0.91 ± 0.01، على التوالي. وتبرهن هذه النتيجة على أهمية النمذجة المشتركة للمعلومات المتكاملة من الوسائط السريرية، ومراقبة الغلوكوز المستمرة (CGM)، ووسائط الشبكية.
تحليل التعلم الاتحادي
أتاح إطار التعلم الاتحادي تدريب النماذج بشكل تعاوني عبر عملاء موزعين مع الحفاظ على التعامل اللامركزي مع بيانات المرضى الخام. وخلال عملية التدريب، تم ضبط النموذج المحلي لكل عميل بشكل فردي ثم دمجها عبر طريقة المتوسط الاتحادي. وبعد 100 جولة اتصال، تقارب النموذج العالمي، وظل أداؤه التنبؤي متسقاً مع التعلم المركزي. وقد أظهر إطار التعلم الاتحادي تقارباً مستقراً عبر جولات الاتصال رغم تباين توزيعات بيانات العملاء. كما حافظ تبادل المعلمات المحمية على التعامل اللامركزي مع البيانات، بينما حافظ النموذج العالمي على أداء تنبؤي تنافسي مقارنة بالخط المرجعي المركزي. ويقارن الجدول 4 بين التنفيذ المركزي والاتحادي. وقد تطلب التعلم الاتحادي وقتاً إضافياً للتدريب بسبب عبء الاتصالات، مع الحفاظ على أداء تنبؤي مماثل للتعلم المركزي.
تحليل الأداء على مستوى مجموعة البيانات
لتقييم إمكانية التعميم عبر مختلف أنماط الرعاية الصحية، قمنا بتقييم الأداء في كل مجموعة بيانات على حدة. أظهر نموذج FedMediFormer-XAI متعدد الوسائط أداءً قوياً وتنافسياً بشكل عام عبر مجموعات البيانات التي تم تقييمها؛ حيث حقق دقة بلغت 91.8%، و93.1%، و92.4%، و94.2% في مجموعات بيانات Pima Indians Diabetes، وCDC Diabetes Health Indicators، وOhioT1DM، وAPTOS 2019، على التوالي. وعلى الرغم من أن مجموعة بيانات APTOS 2019 حققت دقة (94.7%) ودقة تنبؤ (precision) (93.9%) أعلى قليلاً من النموذج متعدد الوسائط، إلا أن النهج متعدد الوسائط المقترح حافظ على أداء تنافسي عبر جميع مجموعات البيانات وحقق قيمة AUC-ROC بلغت 0.96، وهي قيمة تضاهي أعلى قيمة AUC-ROC تم تسجيلها على مستوى مجموعة البيانات. وتظهر النتائج الإجمالية على مستوى مجموعة البيانات في الجدول 5. أما بالنسبة لمجموعات البيانات المنفردة، فقد حقق تحليل صور الشبكية أفضل أداء عند استخدامه بمفرده، بينما أدى الدمج متعدد الوسائط إلى تنبؤات أكثر استقراراً وتوازناً.
تحليل توصيات الأدوية المخصصة
تم تقييم مكون التوصيات القائم على الشبكة العصبية الرسومية باستخدام معلومات فعالية الأدوية وبيانات التفاعلات الدوائية، حيث تم ترتيب الأدوية المرشحة وفقاً لدرجات ملاءمة المريض للدواء التي تم تعلمها، مع استبعاد التركيبات الموانعة خلال عملية إنشاء التوصيات. وقد أتاح استخدام تنسيق الرسم البياني غير المتجانس ونمذجة التفاعلات بين المريض والدواء وبين دواء ودواء آخر إجراء ذلك بشكل شامل، مما دعم اختيارات الأدوية المخصصة وتقييم السلامة. كما نجح نموذج التوصيات GraphSAGE في استيعاب العلاقات المعقدة بين المرضى والأمراض والنتائج المختبرية والأدوية. وأظهرت التوصيات المخصصة أداءً عالياً في التصنيف مع الحفاظ على تفسيرات ذات دلالة سريرية من خلال تحليل جوار الرسم البياني وعزو الميزات.
وفقاً لـ الجدول 6، تم تقييم وحدة التوصية بالأدوية المخصصة باستخدام مقاييس Precision@5 وRecall@5 وNDCG@5. وتحدد هذه المقاييس مدى صلة وجودة ترتيب أفضل خمس توصيات دوائية مخصصة تم إنشاؤها بواسطة وحدة التوصية القائمة على GraphSAGE. وقد حقق نظام التوصية أداءً قوياً في التصنيف، حيث بلغت الدقة (precision) = 0.89، والاستدعاء (recall) = 0.84، ومقياس NDCG = 0.91.
تحليل القابلية للتفسير
يتضمن الإطار عمل SHAP، والتدرجات المتكاملة (Integrated Gradients)، وتصور الانتباه (attention visualization)، والتفسيرات المضادة للواقع (counterfactual explanations) لدعم تفسير التنبؤات متعددة الوسائط. استُخدم SHAP لقياس مساهمات مستوى الميزات، والتدرجات المتكاملة لنسب التنبؤات إلى ميزات الإدخال، وتصور الانتباه لفحص تركيز النموذج عبر الوسائط المختلفة، والتفسيرات المضادة للواقع لتحديد التغييرات في الميزات المرتبطة بتنبؤات بديلة. يعرض الشكل 8 مخطط ملخص SHAP ممثلاً مشتقاً من نموذج FedMediFormer-XAI المدرب، بينما يعرض الشكل 9 تصورات انتباه ممثلة مستخرجة من المحول (transformer) المدرب. تمثل هذه الأشكال مخرجات تم الحصول عليها من تقييم النموذج وليست رسوماً تخطيطية للبنية المقترحة.
في الشكل 8، يتم عرض تصنيفات أهمية الميزات على مستوى التجميع. وكان للميزات التي تمتلك قيم SHAP مطلقة أعلى تأثير أكبر على تنبؤات النموذج، كما أنها تماشَت بشكل جيد مع المعرفة السريرية الحالية.
يقدم الشكل 9 تصورات تمثيلية للانتباه تم استخراجها مباشرة من نموذج FedMediFormer-XAI المدرب لعينة اختبار عشوائية مستبعدة. وتتضمن هذه التصورات الانتباه للميزات السريرية، والانتباه الزمني لـ CGM، والانتباه المكاني للشبكية، والانتباه عبر الوسائط بين الوسائط الثلاثة. وقد أظهر تصور الانتباه بشكل أكبر توزيع الانتباه الذي تعلمه النموذج عبر وسائط متعددة. وأظهرت العينة المختارة انتباهاً أقرب نسبياً إلى HbA1c ومدة الإصابة بالسكري والعمر من بين الميزات السريرية، بينما سلطت خريطة انتباه CGM الضوء على عدة فترات اتسمت بتقلبات بارزة في مستوى الجلوكوز. كما حددت خريطة انتباه الشبكية مناطق محددة في الصورة تساهم في تمثيل النموذج، وأظهرت مصفوفة الانتباه عبر الوسائط أنماط الانتباه داخل الوسائط الواحدة وعبر الوسائط المختلفة. وكما هو موضح في الشكل 9، تبرز خرائط الانتباه التمثيلية المستمدة من النموذج أنماط جلوكوز زمنية مختارة، ومتغيرات سريرية مؤثرة، ومناطق في صور الشبكية ذات صلة تشخيصياً في عينة اختبار مستبعدة.
نتائج التقييم المرتكز على العنصر البشري
تم تصميم بروتوكول تقييم مستقبلي مرتكز على العنصر البشري لتقدير ثقة السريريين، وقابلية التفسير، وسهولة الاستخدام، والفائدة السريرية، ومدى ملاءمة التفسير تحت حالتي "التنبؤ فقط" و"التنبؤ مع التفسير". سيشمل التقييم المقترح أخصائيي الغدد الصماء، ومتخصصي السكري، وعلماء الصيدلة السريرية، مع الحصول على الموافقة المناسبة من لجنة أخلاقيات المؤسسة والموافقة المستنيرة. ونظرًا لأن هذا التقييم مخصص للتنفيذ المستقبلي، فإن درجات النتائج على مستوى السريريين لم تُذكر في البروتوكول الحالي.
يلخص الجدول 7 تصميم تقييم الأطباء الاستشرافي المقترح والمعايير المحددة مسبقاً لتقييم آثار التفسيرات على ثقة الأطباء، وقابلية التفسير، والمنفعة المدركة. سيقارن التقييم الاستشرافي بين تقييمات الأطباء لتنبؤات النموذج بوجود تفسيرات مصاحبة وبدونها، وذلك باستخدام معايير محددة مسبقاً وفق مقياس ليكرت. ويظهر إطار تقييم القابلية للتفسير الاستشرافي المقترح والمتمحور حول الإنسان في الشكل 10
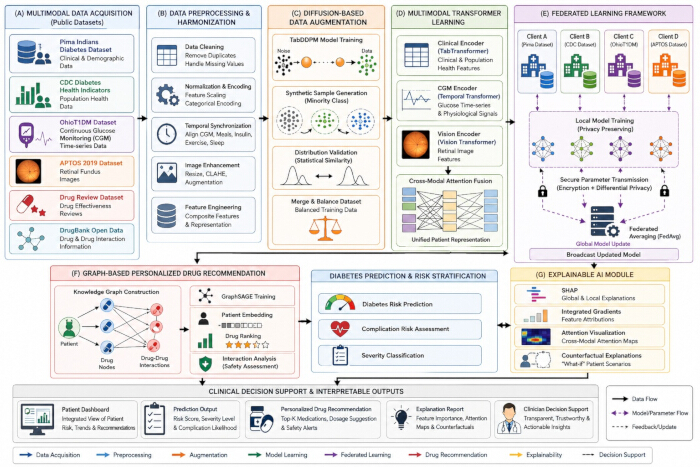
شكل 1: البنية العامة لإطار عمل FedMediFormer-XAI. نظرة عامة تخطيطية لإطار عمل FedMediFormer-XAI، توضح عملية الحصول على البيانات متعددة الوسائط ومعالجتها مسبقاً، والتعزيز القائم على الانتشار، والتعلم المعتمد على المحولات (transformer) لكل وسائط بيانات محددة، وتدريب النموذج الاتحادي، وتوصية الأدوية المخصصة القائمة على GraphSAGE، وتحليل القابلية للتفسير. يقوم إطار العمل بتوليد تنبؤات بمرض السكري، وتوصيات علاجية مخصصة، ومخرجات نموذج قابلة للتفسير. يرجى النقر هنا لعرض نسخة أكبر من هذا الشكل.
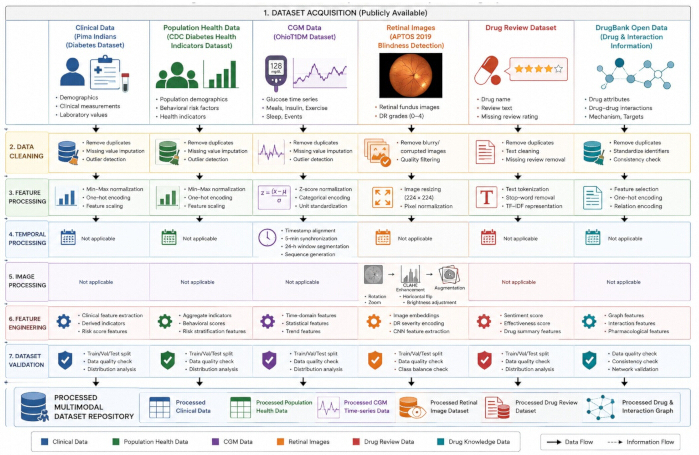
الشكل 2: مسار الحصول على مجموعة البيانات متعددة الوسائط ومعالجتها مسبقاً. مخطط سير العمل للحصول على مجموعات البيانات متعددة الوسائط المستخدمة في FedMediFormer-XAI ومعالجتها مسبقاً. تخضع البيانات السريرية وبيانات صحة السكان، وسجلات CGM، وصور الشبكية، والمعلومات الدوائية لعمليات مراقبة الجودة الخاصة بكل وسيط، والمعالجة المسبقة، والتقييس، والترميز، والتعزيز قبل تحويلها إلى تمثيلات جاهزة للنموذج لإجراء التحليلات اللاحقة. يرجى النقر هنا لعرض نسخة أكبر من هذا الشكل.
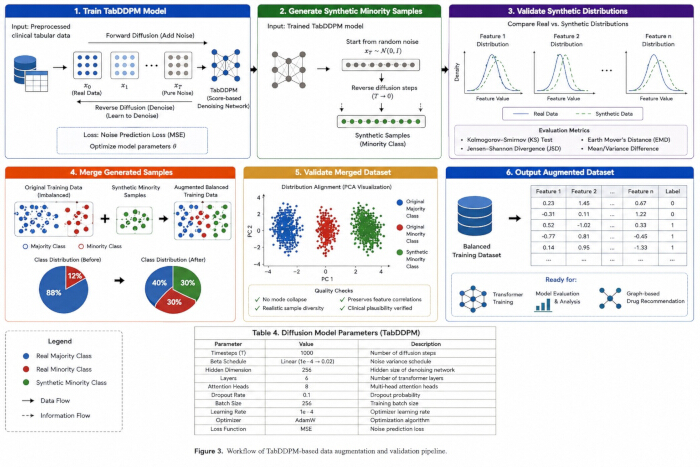
الشكل 3: سير عمل تعزيز البيانات القائم على الانتشار. مخطط لسير عمل تعزيز بيانات التدريب الجدولية المنظمة القائم على الانتشار باستخدام TabDDPM. تخضع العينات المولدة لتقييمات الجودة وتشابه التوزيع قبل دمجها مع بيانات التدريب الأصلية لتحسين توازن الفئات. يرجى النقر هنا لعرض نسخة أكبر من هذا الشكل.
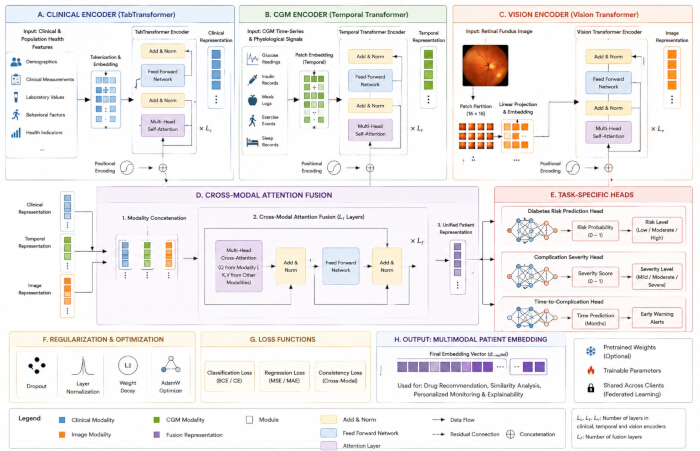
الشكل 4: بنية إطار عمل المحول متعدد الوسائط المقترح. مخطط البنية الذي يتكون من (A) مشفر TabTransformer للبيانات السريرية، (B) ومشفر محول زمني لبيانات CGM، و(C) مشفر Vision Transformer لصور الشبكية. (D) يتم دمج التمثيلات الخاصة بكل وسائط عبر الانتباه عابر الوسائط لتوليد تمثيل موحد متعدد الوسائط. (E) تقوم رؤوس تنبؤ خاصة بالمهام بتوليد مخرجات النموذج. (F) تدعم مكونات التنظيم والتحسين تدريب النموذج، و (G) توجه خسائر التصنيف والانحدار والاتساق عابر الوسائط عملية التحسين. يدعم التمثيل متعدد الوسائط الناتج مهام التنبؤ والتوصية وقابلية التفسير اللاحقة. يرجى النقر هنا لعرض نسخة أكبر من هذا الشكل.
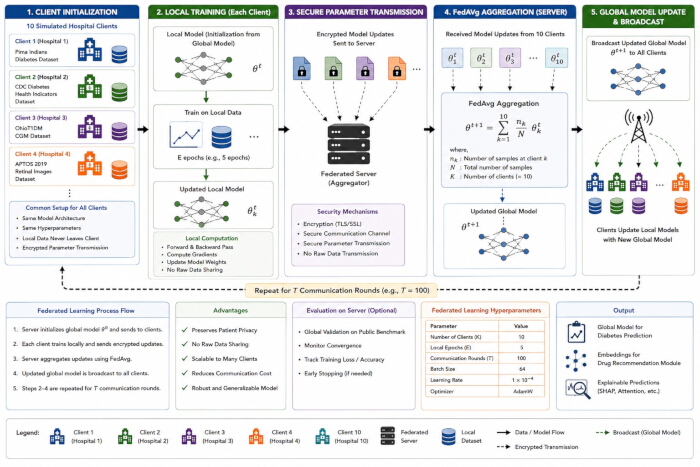
الشكل 5: إطار عمل اتصالات التعلم الاتحادي. مخطط سير العمل للتدريب الاتحادي عبر عملاء المستشفيات الموزعين. يتم تدريب النماذج المحلية متعددة الوسائط باستخدام بيانات خاصة بكل عميل، وتُنقل تحديثات النماذج المحمية إلى خادم مركزي لإجراء عملية المتوسط الاتحادي (Federated Averaging). يعاد توزيع النموذج العالمي المجمع على العملاء لجولات الاتصال اللاحقة. كما يوضح إطار العمل التبادل الآمن للمعلمات وتقييم متطلبات الخصوصية والاتصال والحوسبة. يرجى النقر هنا لعرض نسخة أكبر من هذا الشكل.
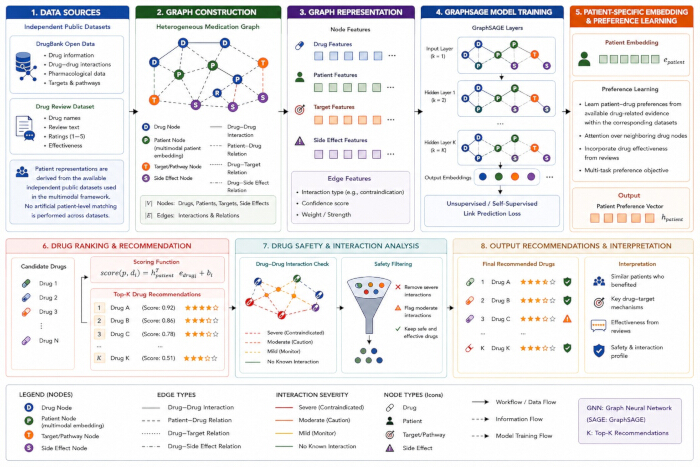
الشكل 6: سير عمل توصية الأدوية المخصصة القائم على الرسوم البيانية. مخطط لسير عمل توصية الأدوية المخصصة القائم على GraphSAGE. يتم تنظيم البيانات الدوائية وبيانات تمثيل المريض في رسم بياني غير متجانس يتضمن الكيانات والعلاقات الصحية ذات الصلة. يقوم GraphSAGE بتعلم تمثيلات المريض والدواء، والتي تُستخدم لحساب درجات ملاءمة المريض للدواء وترتيب الأدوية المرشحة. يتم تصفية تركيبات الأدوية الموانعة أو غير الآمنة قبل توليد التوصيات النهائية (Top-K)، مع دعم المعلومات القائمة على الرسم البياني لتفسير هذه التوصيات. يرجى النقر هنا لعرض نسخة أكبر من هذا الشكل.
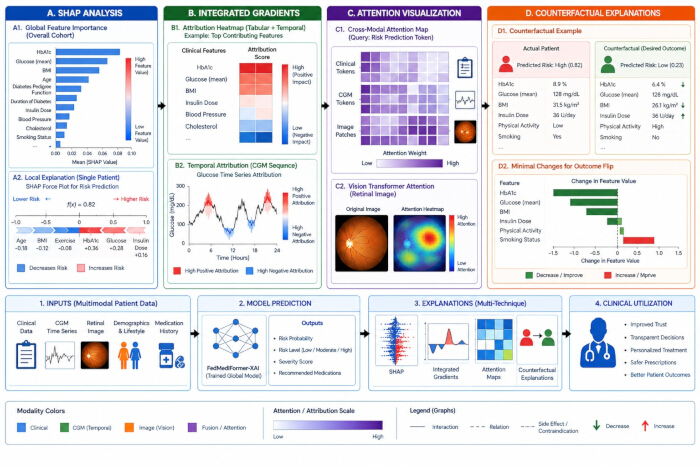
الشكل 7: إطار عمل تقييم القابلية للتفسير. نظرة عامة تخطيطية لسير عمل القابلية للتفسير. (A) يقوم تحليل SHAP بتقييم مساهمات الميزات العالمية والمحلية؛ (B) يوفر Integrated Gradients تفسيرات قائمة على الإسناد؛ (C) يحدد تصور الانتباه الميزات المؤثرة والتفاعلات بين الوسائط؛ و (D) يحدد التحليل المقابل للواقع التغييرات في الميزات المرتبطة بالتنبؤات المتغيرة. وتدعم مخرجات التفسير الناتجة تفسير تنبؤات النموذج والتوصيات الشخصية. يرجى النقر هنا لعرض نسخة أكبر من هذا الشكل.
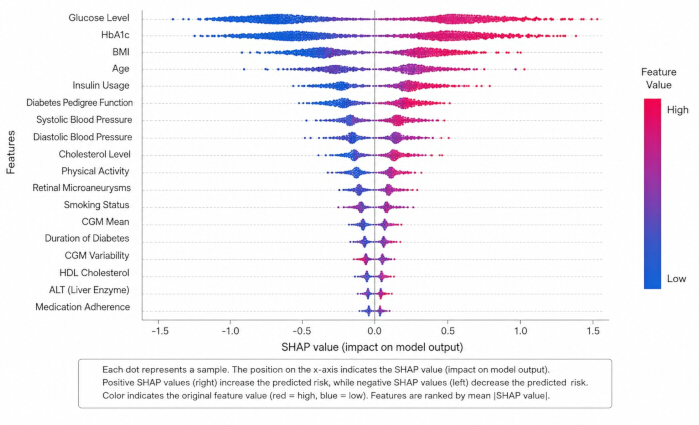
الشكل 8: تحليل نموذجي لأهمية الميزات باستخدام SHAP مستمد من النموذج، تم إنتاجه بواسطة نموذج FedMediFormer-XAI المدرب. يوضح مخطط ملخص SHAP توزيع قيم SHAP عبر العينات التي تم تقييمها، مع ترتيب الميزات وفقاً لمتوسط مساهمة SHAP المطلقة. تشير قيم SHAP الموجبة إلى مساهمات تزيد من خطر الإصابة بمرض السكري المتوقع، بينما تشير القيم السالبة إلى مساهمات تقلل من الخطر المتوقع. يمثل اللون قيمة الميزة المقابلة، حيث تظهر قيم الميزات الأعلى باللون الأحمر والقيم الأدنى باللون الأزرق. يمثل المخطط مخرجاً فعلياً للقابلية للتفسير مستمداً من النموذج وليس مجرد توضيح تخطيطي. يرجى النقر هنا لعرض نسخة أكبر من هذا الشكل.
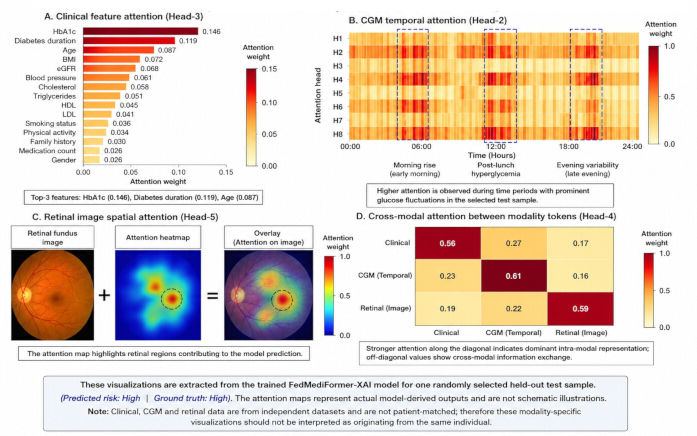
الشكل 9: مخرجات انتباه ممثلة أنتجها نموذج FedMediFormer-XAI المدرب لعينة اختبار واحدة تم اختيارها عشوائياً من مجموعة البيانات المستبعدة. (A) انتباه الميزات السريرية المستمد من رأس انتباه في المحول متعدد الوسائط، ويوضح أوزان الانتباه النسبية المخصصة للميزات السريرية. (B) الانتباه الزمني عبر تسلسل CGM، ويوضح الفترات الزمنية التي تلقت انتباهاً أعلى من النموذج. (C) الانتباه المكاني لصورة قاع الشبكية، بما في ذلك الصورة الأصلية، والخريطة الحرارية للانتباه، وتراكب الانتباه. (D) الانتباه عبر الوسائط بين رموز الوسائط السريرية وCGM والشبكية، ويوضح وزن المعلومات داخل الوسائط الواحدة وبين الوسائط المختلفة. التصورات المعروضة هي مخرجات مشتقة أنتجها النموذج المدرب. تظهر أوزان الانتباه للعينة المختبرة المحددة ويجب تفسيرها كأنماط انتباه للنموذج وليس كمقاييس مستقلة للسببية السريرية. يرجى النقر هنا لعرض نسخة أكبر من هذا الشكل.
| مجموعة البيانات | نوع البيانات | العينات/السجلات | المزايا/المحتوى | الغرض | التوافر العام |
| مجموعة بيانات مرض السكري لدى الهنود البيما | جدول سريري | ٧٦٨ مريضاً | 8 متغيرات سريرية | التنبؤ بمخاطر الإصابة بمرض السكري | عام |
| مؤشرات الصحة الخاصة بمرض السكري وفقاً لمراكز السيطرة على الأمراض والوقاية منها (CDC) | صحة السكان | ٢٥٣,٦٨٠ سجلاً | البيانات الديموغرافية، ونمط الحياة، والمؤشرات الصحية | تحليل مخاطر السكان | عام |
| مجموعة بيانات OhioT1DM | السلاسل الزمنية للمراقبة المستمرة للجلوكوز (CGM) | ١٢ شخصاً | الجلوكوز، الإنسولين، الوجبات، التمرين، النوم | نمذجة مرض السكري الزمانية | عام |
| كشف العمى APTOS 2019 | صور الشبكية | ٣,٦٦٢ صورة | صور لقاع العين مع تسميات توضح درجة الشدة | تحليل اعتلال الشبكية السكري | عام |
| مجموعة بيانات مراجعات الأدوية | دوائي | ٢١٥,٠٦٣ مراجعة | فعالية الدواء، والتقييمات، والمراجعات | توصية دوائية | عام |
| البيانات المفتوحة من DrugBank | مخطط معرفي للعقاقير | آلاف العقاقير | التفاعلات الدوائية-الدوائية، والأهداف، والمسارات | بناء الرسم البياني | الوصول العام/الأكاديمي |
الجدول 1: خصائص مجموعة البيانات. ملخص لمجموعات البيانات المتاحة علنًا والمستخدمة في هذه الدراسة، بما في ذلك نوع مجموعة البيانات، وحجم العينة، ونمط البيانات، ومحتوى الميزات، والغرض المنشود، ومدى التوافر.
| مجموعة البيانات | النمطية | هدف التنبؤ | مستوى الاندماج |
| مرض السكري لدى هنود البيما | سريري | تصنيف مرض السكري | تضمين الميزات |
| مؤشرات الصحة الخاصة بداء السكري من مراكز السيطرة على الأمراض والوقاية منها (CDC) | صحة السكان | التنبؤ بمخاطر الإصابة بداء السكري | تضمين السمات |
| OhioT1DM | المراقبة المستمرة للجلوكوز | التنبؤ باتجاهات الغلوكوز | تضمين الميزات |
| APTOS 2019 | صور قاع الشبكية | تحليل اعتلال الشبكية السكري | تضمين الميزات |
| مراجعة العقاقير + DrugBank | دوائي | توصية دوائية | تضمين الرسوم البيانية |
الجدول 2: استراتيجية دمج مجموعة البيانات متعددة الوسائط. ملخص لمجموعات البيانات المستخدمة في ذكاء مرض السكري متعدد الوسائط، بما في ذلك نمط البيانات، وهدف التنبؤ، والمستوى الذي يتم عنده دمج التمثيلات الخاصة بكل نمط. يتم تمثيل البيانات السريرية، وصحة السكان، والمراقبة المستمرة للجلوكوز، وصور الشبكية كتمثيلات ميزات (feature embeddings)، بينما يتم دمج المعلومات الدوائية عبر تمثيلات الرسوم البيانية (graph embeddings) للتوصية بالأدوية الشخصية.
| نموذج | الدقة، المتوسط الحسابي ± الانحراف المعياري (فاصل ثقة 95%) | الدقة، المتوسط الحسابي ± الانحراف المعياري (فاصل ثقة 95%) | الاستدعاء، المتوسط ± الانحراف المعياري (فاصل ثقة 95%) | مقياس F1، المتوسط ± الانحراف المعياري (فاصل ثقة 95%) | المعامل المتوسط، MCC ± الانحراف المعياري (فاصل ثقة 95%) | المساحة تحت منحنى خصائص تشغيل المستقبل (AUC-ROC)، المتوسط ± الانحراف المعياري (فاصل ثقة 95%) |
| الغابة العشوائية | 83.60 ± 0.74 (82.68–84.52) | 82.70 ± 0.60 (81.96–83.44) | 81.90 ± 0.56 (81.21–82.59) | 82.30 ± 0.56 (81.61–82.99) | 0.67 ± 0.03 (0.63–0.71) | 0.88 ± 0.01 (0.87–0.89) |
| XGBoost | 85.30 ± 0.71 (84.42–86.18) | 84.70 ± 0.60 (83.96–85.44) | 83.80 ± 0.56 (83.11–84.49) | 84.20 ± 0.56 (83.51–84.89) | 0.70 ± 0.03 (0.66–0.74) | 0.90 ± 0.01 (0.89–0.91) |
| TabTransformer | 87.50 ± 0.52 (86.85–88.15) | 87.00 ± 0.60 (86.26–87.74) | 86.20 ± 0.56 (85.51–86.89) | 86.60 ± 0.56 (85.91–87.29) | 0.75 ± 0.03 (0.71–0.79) | 0.92 ± 0.01 (0.91–0.93) |
| محول الرؤية (Vision Transformer) | 88.80 ± 0.50 (88.18–89.42) | 88.20 ± 0.60 (87.46–88.94) | 87.60 ± 0.56 (86.91–88.29) | 87.90 ± 0.56 (87.21–88.59) | 0.78 ± 0.03 (0.74–0.82) | 0.93 ± 0.01 (0.92–0.94) |
| محول زمني (Temporal Transformer) | 87.20 ± 0.51 (86.57–87.83) | 86.60 ± 0.60 (85.86–87.34) | 85.90 ± 0.56 (85.21–86.59) | 86.20 ± 0.56 (85.51–86.89) | 0.74 ± 0.03 (0.70–0.78) | 0.91 ± 0.01 (0.90–0.92) |
| الشبكات العصبية التلافيفية والذاكرة قصيرة المدى المطولة (CNN-LSTM) | 86.90 ± 0.58 (86.18–87.62) | 86.30 ± 0.60 (85.56–87.04) | 85.60 ± 0.55 (84.92–86.28) | 85.90 ± 0.56 (85.21–86.59) | 0.73 ± 0.03 (0.69–0.77) | 0.91 ± 0.01 (0.90–0.92) |
| محول متعدد الوسائط مركزي | 91.30 ± 0.12 (91.15–91.45) | 90.70 ± 0.60 (89.96–91.44) | 90.10 ± 0.56 (89.41–90.79) | 90.40 ± 0.56 (89.71–91.09) | 0.83 ± 0.03 (0.79–0.87) | 0.95 ± 0.01 (0.94–0.96) |
| FedMediFormer-XAI | 94.20 ± 0.34 (93.78–94.62) | 93.10 ± 0.30 (92.73–93.47) | 92.80 ± 0.28 (92.45–93.15) | 92.90 ± 0.28 (92.55–93.25) | 0.88 ± 0.02 (0.86–0.90) | 0.96 ± 0.01 (0.95–0.97) |
الجدول 3: أداء التنبؤ بمرض السكري. مقارنة لأداء التنبؤ لنموذج FedMediFormer-XAI ونماذج تعلم الآلة والتعلم العميق المرجعية باستخدام مقاييس الدقة (accuracy)، والدقة التحديدية (precision)، والاستدعاء (recall)، ودرجة F1-score، ومعامل ارتباط ماتيوس (MCC)، والمساحة تحت منحنى خصائص تشغيل المستقبل (AUC-ROC).
| مقياس | التعلم المركزي | التعلم الاتحادي |
| الدقة (%) | 94.7 | 94.2 |
| المساحة تحت منحنى خصائص تشغيل المستقبِل (AUC-ROC) | 0.97 | 0.96 |
| الحفاظ على الخصوصية | لا | نعم |
| مشاركة البيانات الخام مطلوبة | نعم | لا |
| جولات التواصل | غير متاح | 100 |
| وقت التدريب (ساعة) | 4.8 | 5.6 |
| الامتثال التنظيمي | متوسط | مرتفع |
الجدول 4: أداء التعلم الاتحادي مقابل التعلم المركزي. مقارنة بين تطبيقات التعلم المركزي والتعلم الاتحادي فيما يتعلق بأداء التنبؤ، ومتطلبات مشاركة البيانات الخام، وجولات الاتصال، ووقت التدريب.
| مجموعة البيانات | الدقة (%) | الدقة (%) | الاسترجاع (%) | المساحة تحت منحنى خصائص تشغيل المستقبِل (AUC-ROC) |
| مجموعة بيانات مرض السكري لدى هنود بيما | 91.8 | 90.5 | 89.8 | 0.93 |
| مؤشرات صحة السكري الخاصة بمراكز السيطرة على الأمراض والوقاية منها (CDC) | 93.1 | 92.2 | 91.6 | 0.95 |
| مجموعة بيانات OhioT1DM | 92.4 | 91.8 | 91.1 | 0.94 |
| كشف العمى APTOS 2019 | 94.7 | 93.9 | 93.5 | 0.96 |
| دمج متعدد الوسائط (FedMediFormer-XAI) | 94.2 | 93.1 | 92.8 | 0.96 |
الجدول 5: النتائج على مستوى مجموعة البيانات. تحليل الأداء عبر مجموعات البيانات الفردية وإعدادات الدمج متعدد الوسائط. توضح النتائج مساهمة الوسائط المختلفة للبيانات في الأداء التنبؤي العام.
| المقياس | القيمة |
| Precision@5 | 0.89 |
| Recall@5 | 0.84 |
| NDCG@5 | 0.91 |
| دقة كشف التفاعلات الدوائية | 0.95 |
| تغطية التوصيات | 0.88 |
| متوسط الرتبة العكسية (MRR) | 0.86 |
| درجة الامتثال للسلامة | 0.94 |
الجدول 6: أداء توصية الأدوية المخصصة. تقييم توصية الأدوية المخصصة القائمة على الرسوم البيانية باستخدام مقاييس الترتيب، ودقة اكتشاف التفاعلات، وتغطية التوصيات، وتقييم سلامة الأدوية.
| معيار التقييم | تصميم التقييم المقترح |
| ثقة السريري | تقييم بمقياس ليكرت خماسي النقاط |
| قابلية التفسير | تقييم بمقياس ليكرت خماسي النقاط |
| الأهمية السريرية | تقييم بمقياس ليكرت خماسي النقاط |
| فائدة التفسير | تقييم بمقياس ليكرت خماسي النقاط |
| المنفعة المدركة | تقييم بمقياس ليكرت خماسي النقاط |
| اتفاق المقيمين | معامل كابا لـ Fleiss، يتم حسابه بعد التقييم الاستشرافي |
| المقارنة الإحصائية | اختبار إحصائي مرتبط، حسبما يتناسب بعد جمع البيانات |
| المشاركون | 12 سريرياً، شريطة الحصول على الموافقة الأخلاقية والموافقة المستنيرة |
| حالة التقييم | تقييم استشرافي/مستقبلي |
الجدول 7: معايير التقييم المقترحة المتمحورة حول الإنسان. إطار تقييم مستقبلي مقترح متمحور حول السريريين لتقييم مدى فائدة تفسيرات FedMediFormer-XAI وصلتها السريرية وقابلية تفسيرها وموثوقيتها وسهولة استخدامها. يتضمن التقييم قياساً معيارياً باستخدام مقياس ليكرت الخماسي، واتفاق المقيمين باستخدام معامل كابا لفليس (Fleiss' kappa)، ومقارنة إحصائية بين حالتي "التنبؤ فقط" و"التنبؤ بالإضافة إلى التفسير"، وفواصل ثقة بنسبة 95%. يجب إجراء تقييم السريريين فقط بعد الحصول على موافقة لجنة أخلاقيات المؤسسة المختصة والموافقة المستنيرة.
الجدول التكميلي 1: استراتيجية التحقق من صحة مجموعة البيانات. تم تنفيذ تقسيم مجموعة البيانات، وإجراءات التحقق، واستراتيجيات موازنة الفئات، وتدابير مراقبة الجودة لضمان إمكانية التكرار والتقييم الموثوق للنموذج. يرجى النقر هنا لتنزيل هذا الملف.
الجدول التكميلي 2: معاملات نموذج الانتشار. إعدادات التكوين لنموذج الانتشار TabDDPM، بما في ذلك معاملات التدريب، وإعدادات التحسين، والأبعاد الكامنة، واستراتيجية جدولة الضوضاء، ومواصفات توليد العينات الاصطناعية. يرجى النقر هنا لتنزيل هذا الملف.
الجدول التكميلي 3: تكوين المحول متعدد الوسائط. تكوين بنية المحول متعدد الوسائط، بما في ذلك مشفرات البيانات السريرية والزمنية والصورية، وأبعاد التضمين والدمج، ورؤوس الانتباه، والمحسن، ومعدل التعلم، وحجم الدفعة، وعصور التدريب، ومعيار التوقف المبكر، وخسارة التدريب المجمعة. يرجى النقر هنا لتنزيل هذا الملف.
الجدول التكميلي 4: تكوين التعلم الاتحادي. المعلمات المستخدمة للتدريب الاتحادي الحافظ للخصوصية، بما في ذلك عدد المستشفيات المشاركة، وجولات الاتصال، وعصور التدريب المحلي، ومعدل مشاركة العملاء، وخوارزمية التجميع، والمحسن، ومعدل التعلم، وطريقة التشفير، وبروتوكول الاتصال، وسياسة مشاركة البيانات الخام. يرجى النقر هنا لتنزيل هذا الملف.
الجدول التكميلي 5: تهيئة GraphSAGE. تهيئة وحدة توصية الأدوية المخصصة القائمة على GraphSAGE غير المتجانسة، بما في ذلك نوع الرسم البياني، وأبعاد الطبقة الخفية والتضمين، وعدد طبقات الرسم البياني، وحجم أخذ عينات الجوار، والمحسن، ومعدل التعلم، وحجم الدفعة، وعصور التدريب، وخسارة التصنيف الشخصي البايزي (Bayesian Personalized Ranking loss)، وعدد توصيات الأدوية الأكثر أهمية. يرجى النقر هنا لتحميل هذا الملف.
الجدول التكميلي 6: مقاييس تقييم القابلية للتفسير. مقاييس كمية ومركزة على العنصر البشري تُستخدم لتقييم القابلية للتفسير في إطار عمل FedMediFormer-XAI. تقيم هذه المقاييس دقة التفسير، والاستقرار، والاتساق، والندرة، والاكتمال، والحساسية، وعدم الدقة، والاتفاق بين المقيمين، وجودة التفسير من وجهة نظر السريريين. يرجى النقر هنا لتحميل هذا الملف.
الجدول التكميلي 7: مقاييس التقييم. تُستخدم مقاييس التنبؤ، والتعلم الاتحادي، والتوصية، والقابلية للتفسير لتقييم أداء الإطار العملي، ومتانته، وجودة التصنيف، وقابلية التفسير. يرجى النقر هنا لتحميل هذا الملف.
الجدول التكميلي 8: تصميم التقييم المتمحور حول الإنسان. تصميم دراسة التقييم المتمحورة حول السريري، بما في ذلك مجموعات المشاركين، وظروف التقييم، ومعايير التقييم، وإجراءات التحليل الإحصائي. يرجى النقر هنا لتنزيل هذا الملف.
الجدول التكميلي 9: أصول قابلية التكرار. ملخص لمجموعات البيانات، ومواصفات التنفيذ، وملفات التكوين، وإجراءات التقييم، والوثائق، والسجلات التجريبية المطلوبة لدعم قابلية تكرار إطار عمل FedMediFormer-XAI المقترح. يرجى النقر هنا لتنزيل هذا الملف.
المناقشة
تفسير النتائج الرئيسية
تظهر النتائج التمثيلية أنه من الممكن دمج تعلم المحولات متعدد الوسائط، والتعلم الاتحادي، والتعزيز القائم على الانتشار، وتوصية الأدوية القائمة على الشبكة العصبية الرسومية، والذكاء الاصطناعي القابل للتفسير في إطار عمل موحد لذكاء مرض السكري. ومن خلال دمج السجلات السريرية، ومؤشرات صحة السكان، وبيانات المراقبة المستمرة للجلوكوز، وصور قاع الشبكية، والمعلومات الدوائية، أظهر إطار عمل FedMediFormer-XAI المقترح أداءً تنبؤياً قوياً مع دعم تطوير نموذج لامركزي وقابل للتفسير. وقد استخلصت طريقة التعلم متعدد الوسائط سمات غنية بالمعلومات من مختلف أنماط الرعاية الصحية، مما أدى إلى تحسين التنبؤ بمرض السكري وتوصيات العلاج الشخصية.
فوائد التعلم الاتحادي
تتمثل إحدى المساهمات الرئيسية لإطار العمل المقترح في دمج التعلم الاتحادي لتمكين بناء النماذج التعاونية اللامركزية. يختلف التعلم الاتحادي عن طرق التعلم المركزية التقليدية من خلال السماح لمؤسسات متعددة بالمشاركة في تدريب النموذج دون مشاركة بيانات المرضى الخام بشكل مباشر. وأظهرت النتائج الرئيسية أن التعلم الاتحادي حافظ على دقة تنبؤية تضاهي التعلم المركزي مع دعم التعامل اللامركزي مع البيانات. وتكتسب هذه الميزة أهمية خاصة في سيناريوهات الرعاية الصحية حيث تكون مشاركة البيانات محدودة بسبب السياسات المؤسسية ومتطلبات الخصوصية.
تحليل القابلية للتفسير
وجد تقييم القابلية للتفسير أن تحليل SHAP، والتدرجات المتكاملة (Integrated Gradients)، وتصوير الانتباه (attention visualization)، والتفسيرات المضادة للواقع (counterfactual explanations) يمكنها جميعاً تقديم رؤى ذات دلالة سريرية حول سلوك النموذج. وقد اتفقت التفسيرات العالمية والمحلية إلى حد كبير على أهم المتنبئات من منظور سريري (أي قياسات الجلوكوز، ومؤشر كتلة الجسم، والعمر، وأنماط إعطاء الإنسولين، وتشوهات الشبكية). كما أظهرت تصورات الانتباه أن بنية المحول (transformer architecture) ركزت على الميزات الزمنية والتصويرية ذات الصلة سريرياً. وتعزز هذه النهج من الشفافية من خلال توفير تفسيرات تكميلية لتنبؤات النموذج ومساهمات الميزات.
تحليل التوصية الشخصية بالأدوية
نقترح نموذج توصية قائم على الشبكات العصبية الرسومية (GNN)، يوفر توصيات شخصية بالأدوية إلى جانب نمذجة العلاقات بين المريض والدواء وبين الدواء والدواء. وفي الواقع، سهّلت بنية الرسم البياني غير المتجانسة كلاً من إتقان أنماط فعالية العلاج ومراعاة سلامة الأدوية. وتوضح نتائج توصية الأدوية الممتازة التي تم الحصول عليها في هذه الدراسة قدرات طرق التعلم القائمة على الرسوم البيانية في تطوير أنظمة ذكاء لمرض السكري تتجاوز مجرد التنبؤ بالمرض، وصولاً إلى إطار دعم علاجي شخصي.
التقييم المتمحور حول الإنسان
يتضمن الإطار بروتوكول تقييم مستقبلي متمحور حول الإنسان لتقدير آثار القابلية للتفسير على ثقة الطبيب، وقابلية التأويل، وسهولة الاستخدام، والفائدة السريرية المتصورة. سيقوم التقييم المقترح بمقارنة حالتي "التنبؤ فقط" و"التنبؤ بالإضافة إلى التفسير" باستخدام معايير تقييم موحدة. وسيوفر التنفيذ المستقبلي لهذا التقييم، بعد الحصول على الموافقة المناسبة من لجنة أخلاقيات المؤسسة والموافقة المستنيرة، أدلة تجريبية حول قبول الأطباء والجدوى العملية للتفسيرات الناتجة.
الخطوات الحاسمة للتنفيذ الناجح والقابل للتكرار
تتطلب عدة مراحل من البروتوكول المقترح اهتماماً خاصاً لضمان إمكانية التكرار. يجب أن يحافظت المعالجة المسبقة لمجموعة البيانات وتقسيمها على الفصل على مستوى المريض ومنع تسرب البيانات، بينما يجب الحفاظ على توزيعات العملاء غير المتماثلة (non-IID) المحددة أثناء التعلم الاتحادي. كما يجب أن يحافظ الدمج عبر الوسائط على الأبعاد الكامنة المحددة، وتكوين الانتباه، وتضمينات نوع الوسائط، والتطبيع، والإسقاط النهائي. ويجب أن يستخدم التعزيز القائم على الانتشار معلمات معالجة مسبقة وتدريب متسقة، بينما يجب أن يحافظ نظام التوصية القائم على GraphSAGE على تمثيلات متسقة للمريض والدواء، وفحص التفاعلات، وتعاريف العناصر ذات الصلة، ومعايير تصنيف Top-K. كما يجب أن يستخدم تحليل القابلية للتفسير عينات خلفية ثابتة لـ SHAP، وخطوط أساس للتدرجات المتكاملة (Integrated Gradients)، وإجراءات استخراج الانتباه، وقيود counterfactual المسموح بها سريرياً. كما يجب توثيق إصدارات البرامج، والبذور العشوائية، وتكوينات النماذج، وتقسيمات مجموعة البيانات، ومعلمات التقييم لتقليل التباين المعتمد على التنفيذ.
القيود
يجب مراعاة عدة قيود عند تفسير نتائج هذه الدراسة. أولاً، تم تطوير الإطار وتقييمه باستخدام مجموعات بيانات متاحة للعموم، والتي قد لا تمثل بشكل كامل تنوع مجموعات الرعاية الصحية والبيئات السريرية في العالم الحقيقي. ثانياً، على الرغم من تقييم التعلم الاتحادي باستخدام عملاء مستشفيات محاكات، إلا أنه لم يتم إجراء تحقق واسع النطاق يشمل مؤسسات رعاية صحية مستقلة. ثالثاً، يتسبب التعلم الاتحادي في زيادة الأعباء الاتصالية والحسابية التي قد تؤثر على قابلية التوسع في البيئات محدودة الموارد. وأخيراً، فإن تقنيات القابلية للتفسير المستخدمة في هذه الدراسة هي في الأساس طرق تفسير لاحقة، وقد لا تستوعب بشكل كامل سلوك النموذج المعقد.
يعتمد بروتوكول التحقق المقترح المتمحور حول الإنسان على لجنة أولية مكونة من 12 خبيراً إكلينيكياً، تضم أطباء غدد صماء، وأخصائيين في السكري، وأخصائيين في الصيدلة الإكلينيكية. ويهدف حجم العينة هذا إلى إجراء تقييم أولي لسهولة الاستخدام والقابلية للتفسير بدلاً من التحقق الإكلينيكي النهائي. وقد يحد حجم لجنة الخبراء الصغير نسبياً من القوة الإحصائية وإمكانية تعميم النتائج. لذا، يجب أن تشمل الدراسات الاستشرافية المستقبلية مجموعات أكبر من الإكلينيكيين من مراكز متعددة تمثل بيئات إكلينيكية وتخصصات متنوعة.
يتمثل أحد القيود الرئيسية للإطار المقترح في أن الأنماط السريرية، والأنماط الخاصة بمراقبة الجلوكوز المستمرة (CGM)، وتصوير الشبكية، والأنماط المتعلقة بالأدوية قد استُمدت من مجموعات بيانات عامة مستقلة بدلاً من سجلات متعددة الأنماط متطابقة للمرضى. وبناءً على ذلك، يجب تفسير مكون دمج الأنماط المتقاطعة كإطار منهجي لدمج تمثيلات الأنماط التكميلية بدلاً من اعتباره دليلاً مستمداً من قياسات متعددة الأنماط متزامنة على المرضى أنفسهم. وقد تؤدي الاختلافات في خصائص السكان، وبروتوكولات الحصول على البيانات، وتوزيعات الميزات، وتعريفات المرض عبر مجموعات البيانات المصدر إلى إحداث تباينات توزيعية، وقد تحد من المدى الذي تمثل به العلاقات المتقاطعة المكتسبة ارتباطات حقيقية على مستوى المريض. ورغم أن البروتوكول يتجنب صراحةً المطابقة الاصطناعية للمرضى عبر مجموعات البيانات المستقلة، إلا أن هذا التصميم يحد من التقييم المباشر للتفاعلات متعددة الأنماط الخاصة بكل مريض وقد يؤثر على القابلية للتطبيق السريري العام. لذا، لا ينبغي تفسير الأداء متعدد الأنماط المُبلغ عنه على أنه مكافئ للتحقق من الصحة باستخدام مجموعة بيانات متعددة الأنماط متطابقة للمرضى تم جمعها استباقياً. ويجب أن تعمل الدراسات المستقبلية على التحقق من صحة هذا الإطار باستخدام مجموعات بيانات أكبر تم جمعها بشكل مستقل وتحتوي على معلومات سريرية، وبيانات CGM، وبيانات الشبكية، ومعلومات العلاج متزامنة من المرضى أنفسهم.
استكشاف الأخطاء وإصلاحها وتعديلات البروتوكول
قد تؤثر عدة اعتبارات عملية على تنفيذ البروتوكول المقترح. فقد يؤدي عدم توازن الفئات إلى تقليل أداء التنبؤ عندما تكون الفئات الأقلية غير ممثلة بشكل كافٍ؛ ويمكن التخفيف من هذه المشكلة من خلال استراتيجيات إعادة أخذ العينات والتعزيز القائم على الانتشار. كما قد تؤثر القيم المفقودة وتنسيقات البيانات غير المتسقة على استقرار النموذج، ويجب معالجة ذلك من خلال إجراءات معالجة أولية صارمة. وقد يصبح تقارب التعلم الاتحادي غير مستقر عندما تظهر مجموعات بيانات العملاء تباينًا جوهريًا؛ وقد يؤدي ضبط دورات التدريب المحلية، ومعدلات التعلم، وتكرارات التجميع إلى تحسين الاستقرار. كما قد تؤثر قيود الأجهزة على كفاءة التدريب، خاصة عند معالجة مجموعات البيانات متعددة الوسائط الضخمة وبنى المحولات (transformer architectures). وفي مثل هذه الحالات، قد يؤدي تقليل حجم الدفعة أو تعقيد النموذج إلى تحسين الجدوى الحسابية مع الحفاظ على إمكانية إعادة الإنتاج.
التوجهات المستقبلية
قد تركز الأبحاث المستقبلية على دمج تقنيات التوأم الرقمي لمحاكاة الأمراض وتخطيط العلاج بشكل مخصص. وقد تؤدي النماذج التأسيسية المدربة على مجموعات بيانات رعاية صحية متعددة الوسائط واسعة النطاق إلى تحسين تعلم التمثيل وتعميم النماذج بشكل أكبر. كما يمكن لتقنيات القابلية للتفسير السببي أن توفر رؤية أعمق في آليات المرض وتأثيرات العلاج بما يتجاوز التفسيرات القائمة على الارتباط. بالإضافة إلى ذلك، قد تدعم مناهج التعلم التعزيزي تحسين العلاج التكيفي واستراتيجيات توصية الأدوية الديناميكية. ومن شأن هذه التطورات أن تعزز الفائدة السريرية وقدرات التخصيص لأنظمة ذكاء السكري. علاوة على ذلك، يجب اعتبار التنبؤات وتوصيات الأدوية الناتجة عن الذكاء الاصطناعي أدوات لدعم القرار وليس بدائل للحكم السريري المهني. وتظل الرقابة البشرية المناسبة أساسية للنشر المسؤول والأخلاقي لأنظمة الذكاء الاصطناعي في الرعاية الصحية.
الخلاصة
يوفر FedMediFormer-XAI إطار عمل قابل للتكرار يدمج التعلم متعدد الوسائط، والتدريب الاتحادي، والتوصية الشخصية بالأدوية، والقابلية للتفسير لذكاء مرض السكري. وتدعم النتائج التمثيلية جدوى سير العمل المقترح، بينما يتطلب الأمر مزيداً من التحقق باستخدام مجموعات بيانات متعددة الوسائط متطابقة للمرضى، وفي سياقات سريرية أوسع، وتقييم استشرافي من قبل السريريين قبل النشر السريري.
الإفصاحات
يقر المؤلفون بعدم وجود أي مصالح مالية متضاربة، أو تضارب في المصالح، أو علاقات شخصية كان من شأنها التأثير على العمل الوارد في هذه الدراسة. وقد استُخدمت أدوات الذكاء الاصطناعي فقط للمساعدة في تنقيح اللغة، وتنظيم المخطوطة، والتنسيق، والتحرير أثناء إعداد هذا المقال. كما قام المؤلفون بتطوير جميع المحتويات العلمية، وتصميم الدراسة، والمنهجية، وتحليل البيانات، وتفسير النتائج، والاستنتاجات، والتحقق منها والموافقة عليها. ويتحمل المؤلفون المسؤولية الكاملة عن دقة وسلامة وأصالة العمل المقدم في هذه المخطوطة.
شكر وتقدير
يقر المؤلفون بجهود مطوري ومسؤولي صيانة مجموعات البيانات المتاحة للعموم وموارد البرمجيات مفتوحة المصدر المستخدمة في هذه الدراسة.
المواد
| الاسم | الشركة | رقم فهرسي | التعليقات |
|---|---|---|---|
| AES Encryption | NIST | AES-256 | تشفير البيانات المخزنة / تشفير معاملات النموذج المحمية في التعلم الاتحادي |
| APTOS 2019 Blindness Detection Dataset | Kaggle/APTOS | 2019 Release | مجموعة بيانات صور قاع الشبكية؛ متاحة للعامة ومجهولة الهوية؛ https://www.kaggle.com/competitions/aptos2019-blindness-detection/data |
| Captum | Meta AI | Version 0.8 | قابلية تفسير النموذج وتحليل الإسناد |
| CUDA Toolkit | NVIDIA | Version 12.2 | الحوسبة المسرعة بواسطة GPU |
| Diabetes Health Indicators Dataset (CDC BRFSS 2015) | CDC/BRFSS; Kaggle | 2015 Release | مؤشرات صحة السكان؛ متاحة للعامة ومجهولة الهوية؛ https://www.kaggle.com/datasets/alexteboul/diabetes-health-indicators-dataset |
| Diabetic Retinopathy Detection Dataset | Kaggle | Public Release | مجموعة بيانات صور الشبكية؛ متاحة للعامة ومجهولة الهوية؛ https://www.kaggle.com/c/diabetic-retinopathy-detection/data |
| الشهادات الرقمية | - | - | مصادقة العميل في التعلم الاتحادي |
| Drug Interaction Dataset | Kaggle | Public Release | بيانات رسم بياني للتفاعلات الدوائية-الدوائية؛ متاحة للعامة ومجهولة الهوية؛ https://www.kaggle.com/datasets/rohanharode07/drug-drug-interaction |
| Drug Review Dataset | UCI Machine Learning Repository | Dataset 462 | مجموعة بيانات مراجعة وفعالية الأدوية؛ متاحة للعامة ومجهولة الهوية؛ https://archive.ics.uci.edu/dataset/462/drug+review+dataset+drugs+com |
| Matplotlib | Matplotlib Developers | Version 3.9 | التصور البياني |
| MTS Diabetes Dataset | Kaggle | Public Release | مجموعة بيانات المستشعرات القابلة للارتداء / التنبؤ بمرض السكري؛ متاحة للعامة ومجهولة الهوية؛ https://www.kaggle.com/datasets/marshalpatel3558/diabetespredictiondataset |
| NetworkX | NetworkX Developers | Version 3.3 | بناء وتحليل الرسم البياني للتفاعلات الدوائية |
| NumPy | NumPy Developers | Version 1.26 | الحوسبة العددية |
| NVIDIA RTX 4090 GPU | NVIDIA | RTX 4090 | تدريب النموذج والاستدلال؛ ذاكرة نظام لا تقل عن 32 GB |
| OhioT1DM Dataset | Ohio University | Public Release | مجموعة بيانات المراقبة المستمرة للجلوكوز؛ متاحة للعامة ومجهولة الهوية؛ https://webpages.charlotte.edu/rbunescu/data/ohiot1dm/OhioT1DM-dataset.html |
| OpenCV | OpenCV Foundation | Version 4.10 | معالجة الصور |
| Pandas | PyData | Version 2.2 | معالجة البيانات والمعالجة المسبقة |
| Pima Indians Diabetes Dataset | UCI Machine Learning Repository | Dataset 34 | مجموعة بيانات سريرية للتنبؤ بمرض السكري؛ متاحة للعامة ومجهولة الهوية؛ https://archive.ics.uci.edu/dataset/34/diabetes |
| Python | Python Software Foundation | Version 3.11 | بيئة البرمجة الأساسية |
| PyTorch | Meta AI | Version 2.3 | تطوير وتدريب نماذج التعلم العميق |
| PyTorch Geometric | PyG Team | Version 2.5 | بناء وتدريب الشبكات العصبية الرسومية |
| Scikit-learn | Scikit-learn Developers | Version 1.5 | أدوات وتقييم التعلم الآلي |
| آلية التجميع الآمن | - | - | التجميع المحمي لمعاملات النموذج المحلية في التعلم الاتحادي |
| SHAP | SHAP Developers | Version 0.47 | الذكاء الاصطناعي القابل للتفسير وتحليل إسناد الميزات |
| TensorFlow | Version 2.15 | تطوير وتدريب نماذج التعلم العميق | |
| Transformers | Hugging Face | Version 4.45 | تنفيذ البنية القائمة على المحولات |
| Transport Layer Security | IETF | TLS 1.3 | قناة اتصال مشفرة لتبادل المعاملات الاتحادية |
| محطة العمل | Generic | - | البيئة الحسابية؛ ذاكرة نظام لا تقل عن 32 GB |
المراجع
- Al-Hejri AM, et al. A hybrid explainable federated-based vision transformer framework for breast cancer prediction via risk factors. Sci Rep. 2025;15:18453.
- Dosovitskiy A, et al. An image is worth 16×16 words: transformers for image recognition at scale [conference presentation]. Presented at: International Conference on Learning Representations (ICLR); 2021. [https://arxiv.org/abs/2010.11929]
- Touvron H, et al. Training data-efficient image transformers & distillation through attention [conference presentation]. Presented at: 38th International Conference on Machine Learning; 2021. [https://arxiv.org/abs/2012.12877]
- Kotelnikov A, Baranchuk D, Rubachev I, Babenko A. TabDDPM: modelling tabular data with diffusion models [conference presentation]. Presented at: 40th International Conference on Machine Learning (ICML); 2023. [https://arxiv.org/abs/2209.15421]
- Pinaya WHL, et al. Brain imaging generation with latent diffusion models [conference presentation]. Presented at: International Conference on Medical Image Computing and Computer-Assisted Intervention (MICCAI); 2022. [https://arxiv.org/abs/2209.07162]
- Ho J, Jain A, Abbeel P. Denoising diffusion probabilistic models [conference presentation]. Presented at: Advances in Neural Information Processing Systems (NeurIPS); 2020. [https://arxiv.org/abs/2006.11239]
- Song Y, et al. Score-based generative modeling through stochastic differential equations [conference presentation]. Presented at: International Conference on Learning Representations (ICLR); 2021. [https://arxiv.org/abs/2011.13456]
- Li T, Sahu AK, Talwalkar A, Smith V. Federated learning: challenges, methods, and future directions. IEEE Signal Process Mag. 2020;37(3):50-60.
- Kairouz P, et al. Advances and open problems in federated learning. Found Trends Mach Learn. 2021;14(1-2):1-210.
- Rieke N, et al. The future of digital health with federated learning. NPJ Digit Med. 2020;3:119.
- Kaissis GA, Makowski MR, Rückert D, Braren RF. Secure, privacy-preserving and federated machine learning in medical imaging. Nat Mach Intell. 2020;2(6):305-11.
- Sheller MJ, et al. Federated learning in medicine: facilitating multi-institutional collaborations without sharing patient data. Sci Rep. 2020;10:12598.
- McMahan HB, et al. Communication-efficient learning of deep networks from decentralized data [conference presentation]. Presented at: International Conference on Artificial Intelligence and Statistics (AISTATS); 2017. [https://arxiv.org/abs/1602.05629]
- Lundberg SM, et al. From local explanations to global understanding with explainable AI for trees. Nat Mach Intell. 2020;2(1):56-67.
- Ribeiro MT, Singh S, Guestrin C. Why should I trust you? Explaining the predictions of any classifier [conference presentation]. Presented at: ACM SIGKDD International Conference on Knowledge Discovery and Data Mining (KDD); 2016. [https://arxiv.org/abs/1602.04938]
- Wachter S, Mittelstadt B, Russell C. Counterfactual explanations and algorithmic recourse in healthcare AI. AI Ethics. 2021;1(2):123-37.
- Chen J, Liao W, Yu W. Explainable AI for precision medicine: a systematic review. Brief Bioinform. 2024;25(2):bbae045.
- Zitnik M, Agrawal M, Leskovec J. Modeling polypharmacy side effects with graph neural networks. Bioinformatics. 2020;36(2):i457-i466.
- Wu Z, et al. A comprehensive survey on graph neural networks. IEEE Trans Neural Netw Learn Syst. 2021;32(1):4-24.
- Hamilton WL. Graph representation learning. Morgan & Claypool Publishers; San Rafael (CA); 2020.
- Shang J, Ma T, Xiao C, Sun J. Pre-training of graph augmented transformers for medication recommendation [conference presentation]. Presented at: International Joint Conference on Artificial Intelligence (IJCAI); 2021. [https://arxiv.org/abs/1906.00346]
- Wang X, et al. Neural graph collaborative filtering. IEEE Trans Knowl Data Eng. 2021;33(5):2136-49.
- Yu KH, Beam AL, Kohane IS. Artificial intelligence in healthcare. Nat Biomed Eng. 2021;5(8):719-31.
- Muhammad G, Hossain MS, Kumar N. EEG-based pathology detection for home health monitoring. IEEE J Sel Areas Commun. 2021;39(2):603-10.
- Alshehri F, Muhammad G. Internet of Things and edge computing in healthcare: a survey. IEEE Access. 2021;9:3660-78.
- Vaid A, et al. Federated learning of electronic health records to improve mortality prediction. JMIR Med Inform. 2021;9(1):e24207.
- Lim WYB, et al. Dynamic contract design for federated learning in smart healthcare applications. IEEE Internet Things J. 2021;8(23):16853-62.
- Chikumo OT, et al. Transformer-based models for disease prediction using electronic health records: a systematic review. J Appl Artif Intell Comput. 2026;10(1):1-18.
- Lai T. Interpretable medical imagery diagnosis with self-attentive transformers: a review of explainable AI for healthcare. Diagnostics (Basel). 2023;13(18):3021.