قدّم هذا العمل البحثي نهجاً يُسمى FusionNetX، من خلال تعزيز قدرة دمج الميزات لنموذجي DenseNet121 وEfficientNetB7 لتصنيف أورام الدماغ على خمس مجموعات بيانات متاحة علناً مع استخدام تعزيز البيانات، والمعالجة المسبقة، وتخصيص النموذج الهجين (الدمج الوسيط)، مما حقق نتائج تتراوح بين 98.77% و99.89%، متفوقاً بذلك عبر عدة معايير للتقييم.
يتطلب اشتراك JoVE لعرض هذا المحتوى. تسجيل الدخول أو ابدأ نسخة تجريبية مجانية
مقالة منهجية
FusionNetX: نموذج لدمج السمات العميقة يعتمد على التصوير بالرنين المغناطيسي والتعلم العميق لتحسين الكشف عن أورام الدماغ
في هذه المقالة
ملخص
الملخص
تُعد أورام الدماغ من أكثر الأمراض فتكاً في العالم، ويؤدي التشخيص الخاطئ لها إلى تعريض حياة المرضى للخطر وخفض معدلات البقاء على قيد الحياة. ويعد التصوير بالرنين المغناطيسي (MRI) باستخدام تقنيات التعلم العميق، وخاصة الشبكات العصبية التلافيفية، أمراً بالغ الأهمية للتغلب على هذه العقبة، حيث يتيح فحصاً أكثر تفصيلاً للبنية الداخلية للدماغ ويوفر قدرات تعلم وتنبؤ متميزة. ولا تزال الحاجة ملحة للتشخيص الدقيق للأورام في الدماغ. وبناءً على ذلك، تم اقتراح نموذج تعلم عميق مُحسّن يعتمد على دمج الميزات (FusionNetX)، والذي يستفيد من نقاط القوة في نموذجين مدربين مسبقاً هما DenseNet121 وEfficientNetB7، باستخدام معاملات ضبط دقيقة مخصصة، بما في ذلك الطبقات القابلة للتدريب وغير القابلة للتدريب. طُبق نموذج FusionNetX المقترح على خمس مجموعات بيانات متاحة للعموم لأورام الدماغ، وهي: Br35H وFigshare وSartaj وMasoud وBalanced Brain Tumor. وقد تم تطبيق بعض خطوات المعالجة المسبقة لتحسين جودة الصور ومعالجة مشكلة الإفراط في التخصيص من خلال تغيير الحجم وزيادة البيانات. وباستخدام مجموعة متنوعة من مقاييس تقييم الأداء، مثل الدقة، والخسارة، والقيمة التنبؤية الإيجابية، والقيمة التنبؤية السلبية، ومعدل الإيجابيات الحقيقية، ومعدل السلبيات الحقيقية، ومقياس F1-score، ومعدل السلبيات الكاذبة، ومعدل الإيجابيات الكاذبة، وُجد أن نموذج FusionNetX المقترح حقق دقة بلغت 99.33% لمجموعة Br35H، و99.13% لمجموعة Figshare، و99.89% لمجموعة Masoud، و99.19% لمجموعة BBT-Dataset، و98.77% لمجموعة Sartaj. بالإضافة إلى ذلك، تم تقييم مجموعات بيانات أورام الدماغ الخمس باستخدام الدمج المتأخر (late fusion) والدمج المعتمد على الانتباه (attention-based fusion) لإثبات أهمية نموذج FusionNetX المقترح، وكانت النتائج أفضل بشكل ملحوظ، بزيادات تراوحت بين 0.3% و1.9% في جميع مجموعات البيانات. علاوة على ذلك، تم حساب منحنى خصائص تشغيل المستقبل (receiver operating characteristic curve)، وتشير النتائج من مختلف مقاييس تقييم الأداء إلى أن نموذج FusionNetX المقترح يمكنه اكتشاف أورام الدماغ والتنبؤ بها بدقة، ومساعدة الممارسين الصحيين في اتخاذ قرارات في الوقت المناسب.
المقدمة
يُعد السرطان المرض الأكثر فتكاً بجسم الإنسان في الوقت الحاضر نظراً لشدته ومعدل نموه المتزايد، وفي حين توجد أمراض سرطانية متعددة في جسم الإنسان، مثل أورام الدماغ، وسرطان الثدي، وعقيدات الرئة، وسرطان الكلى، وغيرها، مما يتسبب في ارتفاع معدل الوفيات. ينشأ السرطان عندما تتكاثر الخلايا أو الأنسجة في جسم الشخص بشكل غير طبيعي. وعندما ينتقل السرطان عن طريق النقيلة، فإنه قد يتلف أعضاء بشرية أخرى ويصبح أكثر خطورة1. وبما أن الدماغ يتحكم في كل وظيفة من وظائف الجسم، فإن أي ضرر يلحق به يمكن أن يؤدي إلى عواقب بعيدة المدى على الجسم بأكمله. وهذا هو السبب في أن أورام الدماغ أو السرطان تكون قاتلة للغاية للبشر2. بالإضافة إلى ذلك، تنقسم أورام الدماغ إلى فئتين رئيسيتين هما الأورام الحميدة والأورام الخبيثة. وتعني كلمة "حميدة" أساساً أنها غير سرطانية؛ فهي مجرد مشكلة في الدماغ يمكن علاجها عن طريق تغيير الظروف المحيطة. أما في حالة الخباثة، فتعتبر خطيرة بسبب طبيعتها النقيلية، حيث تنتقل الخلايا أو الأنسجة غير الطبيعية إلى أجزاء أخرى من الجسم أو منها، مما يؤدي إلى اضطراب الأعضاء الأخرى أيضاً، وذلك عن طريق زيادة فرص انتشار السرطان في الجسم3.
علاوة على ذلك، ووفقاً للجمعية الأمريكية لأورام الدماغ ومنظمة الصحة العالمية (WHO)، تُعد أورام الغدة النخامية، والسحايا، والدبقيات الفئات الثلاث الرئيسية لسرطانات الدماغ4. تنشأ الدبقيات من الخلايا الدبقية التي تغذي العصبونات في الدماغ. أما أورام الغدة النخامية فتبدأ في الغدة النخامية الموجودة في قاعدة الدماغ والمسؤولة عن وظائف بدنية متنوعة؛ ومن ناحية أخرى، تبدأ أورام السحايا في السحايا، التي تحمي الأغشية المحيطة بالدماغ والنخاع الشوكي. بالإضافة إلى ذلك، تُستخدم عادةً أنماط متعددة من التصوير الطبي لفحص الأجزاء الداخلية من الجسم لأغراض تشخيصية، بما في ذلك الأشعة السينية (X-rays)، والتصوير المقطعي المحوسب (CT)، والتصوير بالرنين المغناطيسي (MRI)5,6. ولكل نمط تصوير مزاياه وعيوبه؛ حيث يُعد التصوير بالرنين المغناطيسي (MRI) نمط تصوير يوفر صوراً تفصيلية للأنسجة الرخوة والخلايا في الجسم، وخاصة في الدماغ. وبما أن السرطان يتضمن أنسجة أو خلايا غير طبيعية في الجسم، فإن التصوير بالرنين المغناطيسي يوفر صوراً تفصيلية لهذه التشوهات، مما يجعله نمط تصوير أكثر فائدة لتشخيص أورام الدماغ أو السرطان. كما أن التصوير بالرنين المغناطيسي أكثر أماناً من أنماط التصوير الأخرى لأنه لا ينتج إشعاعات ضارة أثناء فحوصات التشريح الداخلي للجسم.
بالإضافة إلى ذلك، يتم توظيف العديد من المنهجيات الحسابية لمعالجة التحديات التشخيصية المرتبطة بأورام الدماغ، بما في ذلك تعلم الآلة (ML)، ومعالجة الصور (IP)، والتعلم العميق (DL)، حيث يتم تطبيق كل نهج على الصور التي تلتقطها وسائط التصوير لتشخيص السرطان7. وتعمل هذه النهج على تعلم الأنماط والهياكل الخفية لمختلف الأجسام في الصور لتشخيص السرطان من خلال تحديد الأنماط في المنطقة المصابة. وله كل نهج حسابي مزاياه وعيوبه في عملية التشخيص؛ إذ تعتمد النهج القائمة على ML و IP على استخراج سمات يدوية الصنع (handcrafted features)، وهو ما يؤدي غالباً إلى تنبؤات غير دقيقة وتشخيص خاطئ للعملية، خاصة في مجموعات البيانات الكبيرة8. وللتغلب على المشكلات المتعلقة باستخراج السمات اليدوية، يتجه الباحثون نحو النماذج القائمة على التعلم العميق، والتي تسمى عادةً النماذج القائمة على الشبكات العصبية الالتفافية (CNN)، والتي تتعلم وتستخرج أفضل السمات من الصور تلقائياً لتشخيص الأورام بدقة. وتُستخدم النهج القائمة على DL حالياً بشكل شائع في التصوير الطبي لتشخيص الأمراض في جسم الإنسان، وخاصة للكشف المبكر والدقيق عن أورام الدماغ، وسرطان الثدي، وسرطان الرئة، وأمراض أخرى، وذلك لقدرتها على تعلم واستخراج أنماط معقدة في البيانات واسعة النطاق من خلال تقديم نتائج أكثر دقة9. وتتمثل المشكلة الرئيسية التي تواجه نموذج DL في استهلاك المزيد من الموارد وعينات البيانات، وهو ما يتم التغلب عليه من خلال نهج آخر قائم على التعلم العميق يسمى تعلم النقل10 (TL)، والذي تُستخدم فيه نماذج مُدربة مسبقاً لتشخيص المرض، مما يوفر الوقت والموارد. وتتيح النماذج المُدربة مسبقاً التشخيص المبكر والدقيق للمشكلات الصحية، حيث تكون قد تعلمت بالفعل السمات الأساسية المتعلقة بالملمس، واللون، والحواف، وغيرها من مجموعة بيانات كبيرة. ويمكن بعد ذلك نقل هذه النماذج إلى مجموعة بيانات جديدة لم يسبق رؤيتها من قبل من خلال الاستفادة من النموذج وإضافة المعلمات الفائقة (hyperparameters) وطبقات قابلة للتدريب وغير قابلة للتدريب11. وقد أُجري قدر كبير من الأبحاث حول تصنيف أورام الدماغ، ويوضح الجدول 112,13,14,15,16,17,18,19,20,21,22,23 تفاصيل هذه الأبحاث، بما في ذلك النهج ومجموعات البيانات والنتائج. ومع ذلك، لم توظف أي أعمال بحثية منهجية تجمع بين نموذجين لتعلم النقل من أجل استخراج قوي للسمات وتعديل تقنيات التسوية (regularization techniques) لضمان سلاسة التدريب والاختبار. ويوفر التقييم الشامل للمنهجية المقترحة رؤى حول أداء النموذج عبر سمات أورام الدماغ المختلفة.
| المرجع | المنهجية | عينات البيانات | النتائج | المحددات |
| 12 | شبكة CNN مخصصة | Br35H | الدقة = 97.45%، | لا تزال هناك حاجة لتحسين النتائج؛ وبدلاً من استخدام شبكة CNN مُصممة ذاتياً، يفضل استخدام نموذج CNN موجود مسبقاً مع إجراء تعديلات عليه. |
| الفقد = 0.1141%، | ||||
| الاستدعاء = 98.09%، | ||||
| مقياس F1-Score = 97.69%، | ||||
| الدقة التنبؤية = 97.29%، | ||||
| Br35H مُعززة | الدقة = 98.99%، | |||
| الدقة التنبؤية = 98.90%، | ||||
| الفقد = 0.0570%، | ||||
| الاستدعاء = 98.91%، | ||||
| مقياس F1-Score = 99.04% | ||||
| 13 | نموذج DNN لدمج الميزات | Br35H | الدقة = 98.22%، | لا تزال هناك حاجة لتحسين النتائج، وبدلاً من استخدام نموذج مخصص، تبرز الحاجة لاستخدام نموذج موجود مسبقاً لدمج الميزات. |
| FNR = 1.77%، | ||||
| الحساسية = 98.2%، | ||||
| مقياس F1-Score = 98%، | ||||
| الخصوصية = 98%، | ||||
| Figshare | الدقة = 98.01%، | |||
| الحساسية = 96.03%، | ||||
| مقياس F1-Score = 96%، | ||||
| الخصوصية = 98.67%، | ||||
| FNR = 3.96% | ||||
| 14 | AlexNet مع SGD | Br35H | الدقة = 98.79%، | لا تزال هناك حاجة لبعض التحسينات في النتائج، كما نحتاج إلى اختبار بعض نماذج CNN المتقدمة على عينات بيانات مختلفة. |
| MCR = 1.20%، | ||||
| الحساسية = 98.98%، | ||||
| الخصوصية = 98.58%، | ||||
| مقياس F1-Score = 98.82% | ||||
| 15 | InceptionV3 | Figshare | الدقة = 98.89%، | استخدم المؤلفون مجموعة بيانات Figshare التي تحتوي على ثلاث فئات من الأورام؛ وبدلاً من تصنيفها، قاموا بتصنيف وجود الورم من عدمه، ولا تزال هناك حاجة لتحسين النتائج وكذلك تصنيف فئات الأورام. |
| SensitivityB = 95.28%، | ||||
| SensitivityM = 94.47% | ||||
| 16 | ResNet50 مُحسَّنة | Figshare | الدقة = 99.03%، | هناك حاجة لحساب معايير أخرى لتقييم الأداء مع إجراء المزيد من التحسينات في النتائج. |
| الاستدعاء = 99%، | ||||
| مقياس F1-Score = 99% | ||||
| 17 | Res-BRNet | Br35H | الدقة = 98.22%، | لا تزال هناك حاجة لتحسين النتائج. |
| الحساسية = 98.11%، | ||||
| الدقة التنبؤية = 98.22%، | ||||
| Figshare | مقياس F1-Score = 98.41% | |||
| 18 | ResNet101 + DenseNet121 | Figshare | الدقة = 99.18%، | هناك تحسن طفيف في النتائج وهناك حاجة لفحص المزيد من مجموعات البيانات المتعلقة بأورام الدماغ. |
| الاستدعاء = 99.11%، | ||||
| مقياس F1-Score = 99.08، | ||||
| الدقة التنبؤية = 99.07%، | ||||
| Sartaj | الدقة = 97.24%، | |||
| الاستدعاء = 97.58%، | ||||
| مقياس F1-Score = 97.28%، | ||||
| الدقة التنبؤية = 97.06%، | ||||
| 19 | CNN-SVM | Brats | الدقة = 98.02%، | هناك حاجة لتطبيق بعض النماذج الموجودة مسبقاً مع SVM، ولا تزال هناك حاجة لتحسين النتائج. |
| مقياس F1-Score = 98.31%، | ||||
| الدقة التنبؤية = 98.09%، | ||||
| الحساسية = 98.53%، | ||||
| الخصوصية = 97.30%، | ||||
| Sartaj | الدقة = 96.83%، | |||
| الدقة التنبؤية = 95.36%، | ||||
| الحساسية = 94.73%، | ||||
| الخصوصية = 97.56%، | ||||
| مقياس F1-Score = 95% | ||||
| 20 | EfficientNetB3 مضبوط بدقة | Figshare | الدقة = 98.70% | هناك حاجة لاستخدام المتغيرات المذكورة آنفاً من EfficientNetB3 لتحسين النتائج. |
| Sartaj | الدقة = 97.50% | |||
| 21 | InceptionV4 | Masoud | الدقة = 98.7%، | مطلوب بعض التحسينات في النتائج مع استخدام المزيد من مجموعات البيانات. |
| الدقة التنبؤية = 99%، | ||||
| الحساسية = 98%، | ||||
| الخصوصية = 99%، | ||||
| مقياس F1-Score = 99.1% | ||||
| 22 | VGG16 | Masoud | الدقة = 98% | هناك حاجة لتحسين النتائج من خلال فحص المزيد من نماذج الشبكات العصبية العميقة. |
| 23 | MFR-CNN | Masoud | الدقة = 94%، | تعتبر بنية معقدة مستخدمة في هذا الحل المقترح. |
| الاستدعاء = 96%، | ||||
| مقياس F1-Score = 96%، | ||||
| الدقة التنبؤية = 96%، |
الجدول 1: دراسة مقارنة لأحدث الأعمال البحثية. يلخص الجدول الأبحاث الحالية، جنبًا إلى جنب مع منهجياتها، وعينات البيانات، والنتائج، وأوجه القصور. يرجى النقر هنا لتنزيل هذا الجدول.
يستعرض الجدول 1 المنهجيات الحالية، مع تسليط الضوء على قصورها في تحسين النتائج وضرورة استخدام نماذج التعلم العميق (DL) الموجودة مسبقاً مع تقييم أدائها مقابل معايير إحصائية مختلفة، كل ذلك ضمن إطار عمل فعال يقدم أداءً أفضل على مجموعات بيانات مختلفة من أورام الدماغ.
أهداف الدراسة وبيان المشكلة
تعتبر عملية التفسير اليدوي مستهلكة للوقت وتعاني من التباين بين الملاحظين؛ لذا فإن التصنيف السريع والدقيق لأنواع أورام الدماغ من خلال التصوير بالرنين المغناطيسي (MRI) أمر حيوي لاتخاذ القرارات السريرية. تعتمد معظم مناهج التعلم العميق (DL) المستخدمة حالياً للتصنيف الآلي لأورام الدماغ على شبكة عمود فقري واحدة أو دمج بسيط على مستوى القرار، وهو ما لا يستفيد بشكل كامل من تمثيلات الميزات المتكاملة من بنيات متعددة مسبقة التدريب، وغالباً ما يتم التحقق من صحتها على مجموعة بيانات واحدة فقط، مما يحد من الثقة في قابليتها للتعميم.
يهدف هذا المشروع البحثي إلى تطوير وتقديم طريقة كاملة ودقيقة لتشخيص سرطانات الدماغ في الأدمغة البشرية باستخدام إطار عمل للتعلم العميق (DL) ثنائي العمود الفقري (EfficientNetB7 وDenseNet121) يستفيد من تمثيلات الميزات المتكاملة لتمكين تصنيف قوي لأورام الدماغ من خلال التصوير بالرنين المغناطيسي (MRI). كما يقيم المشروع قوة إطار العمل عبر مجموعات بيانات عامة متعددة ومستقلة. ويمكن لهذا النهج أن يساعد أطباء الأشعة والمسعفين في تشخيص أورام الدماغ بسرعة وفعالية، مما يساهم في إنقاذ حياة المرضى من خلال تمكين التعرف على الأورام وتصنيفها.
لحل مشكلة بحثية معينة وتحقيق أهداف هذا المشروع البحثي، تم تحديد الأسئلة البحثية والمساهمات الرامية للإجابة عليها كما يلي: 1) هل دمج مستوى الميزات (الدمج المتوسط) لشبكتين عموديتين مسبقتي التدريب أفضل من تقنيات الدمج على مستوى القرار (الدمج المتأخر) والدمج القائم على الانتباه في تصنيف أورام الدماغ؟ 2) هل سيوفر النظام المقترح أداءً متسقاً في التصنيف عبر العديد من مجموعات بيانات التصوير بالرنين المغناطيسي لأورام الدماغ المكتسبة بشكل مستقل؟
يقتصر نطاق هذه الدراسة على التصنيف على مستوى الصورة (شريحة MRI ثنائية الأبعاد)، باستخدام خمس مجموعات بيانات متاحة للعموم لصور الرنين المغناطيسي لأورام الدماغ (Br35H وFigshare وSartaj وMasoud وBBT-Dataset)؛ حيث تم تقييمها بشكل مستقل وليس عبر مجموعات البيانات؛ وبالاعتماد على البنية المحددة، ومسار المعالجة المسبقة، والتكوين التجريبي الموضح في قسم المنهجية. ولا تشمل الدراسة التحقق على مستوى المريض أو الاختبار في بيئة تطبيق سريرية.
تتمثل المساهمات الرئيسية لهذا العمل البحثي فيما يلي: 1) المساهمة الأساسية لهذا العمل البحثي هي استخدام نموذجين مدربين مسبقاً لتحقيق استخلاص أفضل للميزات، بما في ذلك DenseNet121 وEfficientNetb7 مع تحسين المعلمات الفائقة. 2) بنية نموذج مبتكرة مع تقنية تسوية متقدمة مدمجة مع ميزات متسلسلة من نموذج مزدوج مدرب مسبقاً لضمان أداء قوي. 3) تطبيق استراتيجية فعالة لتعزيز البيانات لزيادة تنوع عينات التدريب من أجل تعلم ميزات أكثر شمولية وتحديداً، والتغلب على مشكلات الإفراط في التخصيص. 4) تقييم أداء النموذج المقترح على خمس مجموعات بيانات متميزة ومتاحة علناً لأورام الدماغ، مع التركيز على مختلف معاملات التقييم الإحصائية، بما في ذلك الدقة، ومعدل الخطأ في التصنيف، والضبط، والقيمة التنبؤية السالبة، والحساسية، والنوعية، وF1-Score، ومعدل السلبيات الكاذبة، ومعدل الإيجابيات الكاذبة.
الوصول مقيد. يرجى تسجيل الدخول أو بدء فترة تجريبية لعرض هذا المحتوى.
البروتوكول
المرض الأكثر تهديداً في العالم هو ورم الدماغ. يمكن أن يكون التشخيص الدقيق مفيداً لبقاء المرضى. ومع ذلك، لا يزال هناك حاجة إلى نظام تشخيصي دقيق يمكنه اكتشاف أورام الدماغ في مراحلها المبكرة. ولحل هذه المشكلة، تم اقتراح تقنية أكثر موثوقية لاكتشاف أورام الدماغ بدقة في مراحلها المبكرة، وذلك باستخدام آلية هجينة مزدوجة للتعلم العميق مع معاملات فائقة مُحسَّنة وطبقات مُهيأة بدقة تعتمد على نموذجي DenseNet121 وEfficientNetB7. يستخدم النهج المقترح صور الرنين المغناطيسي ثنائية الأبعاد كمدخلات، وينتج تنبؤاً إما بوجود ورم أو عدم وجود ورم لمجموعة البيانات ثنائية التصنيف Br35H، وتصنيف الأورام لأربع مجموعات بيانات أخرى متعددة التصنيف. وبالتالي، توضح هذه الفقرة الخطوات الرئيسية للنهج المقترح، بدءاً من جمع البيانات وحتى الناتج النهائي، بما في ذلك اقتناء البيانات، ومعالجة البيانات مسبقاً، وتقسيم البيانات، واختيار النموذج، واستخراج السمات، والتنبؤ بالورم، وتقييم النموذج المقترح، كما هو موضح في الشكل 1.
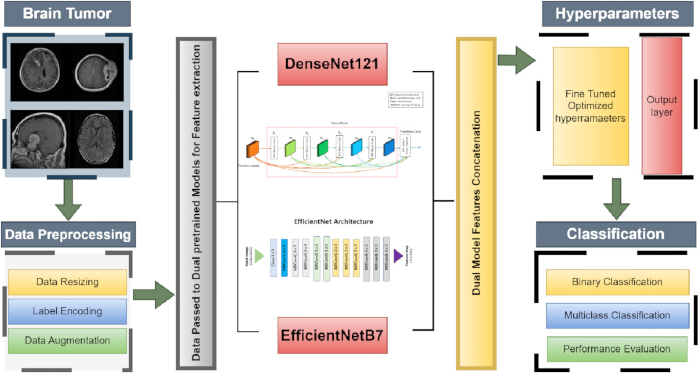
الشكل 1: تدفق منهجية العمل المقترحة. يُظهر هذا المخطط البنية الشاملة للنموذج المقترح، بما في ذلك الحصول على البيانات والمعالجة المسبقة؛ نموذجين مُدرّبين مسبقًا لاستخراج السمات؛ دمج السمات المستخرجة منهما؛ وضبط المعاملات الفائقة لتصنيف الورم ونوعه. يرجى النقر هنا لعرض نسخة أكبر من هذا الشكل.
استخلاص البيانات
في أي بحث تجريبي، تكون الخطوة الأولى هي اقتناء البيانات.为此، تم اختيار خمسة مجموعات بيانات مختلفة متاحة علنًا، بما في ذلك Br35H24، وFigshare25، وSartaj26، وMasoud27، ومجموعة بيانات صور الرنين المغناطيسي لأورام الدماغ من المكتبة مفتوحة المصدر Kaggle28، والتي استخدمها بالفعل العديد من الباحثين لتشخيص اكتشاف أورام الدماغ. وتضم مجموعة بيانات Br35H ما مجموعه 3000 صورة مقسمة إلى صنفين: صور دماغ سليم وصور دماغ غير سليم (ورم)، بواقع 1500 صورة لكل صنف. أما مجموعة بيانات Figshare فتضم 3064 صورة، موزعة على ثلاث مجموعات حسب نوع الورم: 1426 صورة لورم الدبلاستوما (glioma)، و708 صور لورم السحايا (meningioma)، و930 صورة لأورام الغدة النخامية (pituitary). وتضم مجموعة بيانات Sartaj ما مجموعه 3264 صورة مصنفة إلى أربع فئات من الأورام: الدبلاستوما (926 صورة)، وورم السحايا (937 صورة)، وأورام الغدة النخامية (901 صورة)، وحالة سليمة أو خالية من الورم (500 صورة). كما تضم مجموعة بيانات Masoud أربع فئات مختلفة من الأورام، وقد تم جمع صورها من المجموعات الثلاثة المذكورة سابقًا، بإجمالي 7023 صورة، مصنفة إلى ورم الدبلاستوما (1621 صورة)، وورم السحايا (1645 صورة)، وورم الغدة النخامية (1757 صورة)، وحالة سليمة أو خالية من الورم (2000 صورة). أما المجموعة الخامسة والأخيرة فهي مجموعة بيانات مبنية على صور الرنين المغناطيسي، وتشمل أيضًا أربع فئات بإجمالي 5248 صورة، موزعة بالتساوي إلى أنواع الأورام: 1312 صورة لورم الدبلاستوما، و1312 صورة لورم السحايا، و1312 صورة لأورام الغدة النخامية، و1312 صورة لحالة سليمة أو خالية من الورم، وتُعد هذه المجموعة متوازنة نظرًا لتوزيعها المتساوي بين الفئات.
المعالجة الأولية للبيانات
بعد اقتناء البيانات، تأتي الخطوة التالية وهي المعالجة المسبقة، وهي خطوة ضرورية للحصول على نتائج أفضل وأكثر فائدة للأساليب الحسابية لاستخلاص أفضل السمات من البيانات والتعلم منها، وبالتالي إنتاج نتائج أكثر دقة. أول خطوة تم تطبيقها كانت تغيير حجم الصور. تم اختيار خمس قواعد بيانات متاحة للعامة، تحتوي على فئات مختلفة وأحجام صور مختلفة، حتى داخل نفس قاعدة البيانات، وذلك حسب فئات الأورام المختلفة، ثم تم توحيد حجم جميع الصور إلى 224 × 224 لتحسين تفسير النموذج وتعلمه. علاوة على ذلك، تم تطبيق تضخيم البيانات على جميع قواعد البيانات من خلال إنشاء عينات إضافية من زوايا مختلفة، مما يحسّن استخلاص السمات والتعلم بواسطة نماذج التعلم العميق (DL). ولتحقيق ذلك، تم تطبيق مدى دوران بنسبة 7% على جميع الصور، بحيث تدور حتى 7 درجات. بالإضافة إلى ذلك، تم تطبيق إزاحة عشوائية بنسبة 5% على جميع الصور أفقياً ورأسياً، مع إزاحة بنسبة 5% في الارتفاع والعرض بالنسبة للصور الأصلية. بعد ذلك، تم تكبير الصور بنسبة 10% بالنسبة للصور الأصلية، وأخيراً تم قلب جميع الصور أفقياً ورأسياً. السبب الرئيسي لإجراء تضخيم البيانات29 هو التغلب على الإفراط في التخصيص (overfitting) وتحسين قدرة التعميم للنماذج من خلال تدريبها على إصدارات مختلفة ومُحوّلة من العينات الأصلية. قبل تقسيم قواعد البيانات إلى مجموعات تدريب وتحقق، تم تطبيق ترميز التسمية (label encoding)، وهو ما يُعد أكثر فائدة في حساب الخسارة (loss) أثناء التدريب والتحقق، كما يجعل عينات البيانات أكثر أهمية للنماذج لمعالجة التسميات بشكل صحيح. بالإضافة إلى ذلك، تم تقسيم قاعدة البيانات إلى مجموعتي تدريب وتحقق بنسبة 80% إلى 20%30 على التوالي، ويوضح الجدول 2 التوزيع الكلي لعينات البيانات ونِسب التدريب والتحقق الخاصة بها.
| مجموعة البيانات | فئات الأورام | إجمالي الصور | صور التدريب | صور التحقق |
| Br35H | سليمة | 1500 | 1200 | 300 |
| ورم | 1500 | 1200 | 300 | |
| إجمالي الصور | 3000 | 2400 | 600 | |
| Figshare | الورم الدبقي | 1426 | 1141 | 285 |
| الورم السحائي | 708 | 566 | 142 | |
| الورم النخامي | 930 | 744 | 186 | |
| إجمالي الصور | 3064 | 2451 | 613 | |
| Sartaj | الورم الدبقي | 926 | 741 | 185 |
| الورم السحائي | 937 | 749 | 188 | |
| لا يوجد ورم | 500 | 400 | 100 | |
| الورم النخامي | 901 | 721 | 180 | |
| إجمالي الصور | 3264 | 2611 | 653 | |
| Masoud | الورم الدبقي | 1621 | 1297 | 324 |
| الورم السحائي | 1645 | 1316 | 329 | |
| لا يوجد ورم | 2000 | 1600 | 400 | |
| الورم النخامي | 1757 | 1405 | 352 | |
| إجمالي الصور | 7023 | 5618 | 1405 | |
| Balanced brain tumor dataset (BBT-Dataset) | الورم الدبقي | 1312 | 1050 | 262 |
| الورم السحائي | 1312 | 1050 | 262 | |
| لا يوجد ورم | 1312 | 1050 | 262 | |
| الورم النخامي | 1312 | 1050 | 262 | |
| إجمالي الصور | 5248 | 4200 | 1048 |
الجدول 2: توزيع مجموعة البيانات. يعرض الجدول إحصائيات حسب الفئة حول إجمالي عدد الصور، وعدد الصور المستخدمة في التدريب، وعدد الصور المستخدمة في التحقق في مجموعات بيانات أورام الدماغ.
تتكون مجموعة بيانات Br35H من 3000 صورة، تم اختيار 2400 منها للتدريب و600 للتحقق. وتضم مجموعة بيانات Figshare 3064 صورة. من بين جميع الصور، تم اختيار 2451 للتدريب، والـ 613 المتبقية للتحقق. وتضم مجموعة بيانات Sartaj ما مجموعه 3264 صورة، استُخدم منها 2611 للتدريب، والـ 653 المتبقية للتحقق. وتضم مجموعة بيانات Masoud ما مجموعه 7023 صورة؛ استُخدم منها 5618 للتدريب، والـ 1405 المتبقية للتحقق. وتضم مجموعة بيانات BBT ما مجموعه 5248 صورة. من إجمالي الصور، اُعتبرت 4200 صورة لأغراض التدريب، في حين اُعتبرت الـ 1048 الصورة المتبقية لأغراض التحقق. بالإضافة إلى ذلك، الشكل 2 يوضح الشكل أدناه صورًا مختلفة للأورام الدماغية.
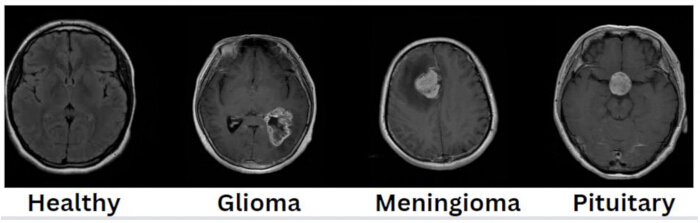
الشكل 2: صور أورام الدماغ، بما في ذلك أنواع الأورام. يحتوي المجموعة على أربع صور لأنسجة دماغية سليمة وثلاث صور لأورام: ورم دبقي، سرطان سحائي، وورم في الغدة النخامية. يرجى النقر هنا لعرض نسخة أكبر من هذا الشكل.
النموذج المقترح
بعد مرحلة المعالجة المسبقة، تتمثل الخطوة التالية في اقتراح نموذج تدريب فعّال يُستخدم فقط لتصنيف أورام الدماغ.为此، تم اقتراح نموذج فعّال للتدريب، مخصص خصيصًا لتصنيف أورام الدماغ. لهذا الغرض، يُقترح نموذج مُدرَّب مسبقًا قائم على دمج ميزات هجين جديد وفعال، يشمل DenseNet12131,32 وEfficientNetB733، والتي استُخدمت لاستخراج الميزات من الصور، وبعد ذلك تم دمج هذه الميزات المستخرجة وتمريرها إلى معلمات فائقة مختلفة تم ضبطها بدقة، بما في ذلك طبقات قابلة للتدريب وغير قابلة للتدريب، من أجل تشخيص أورام الدماغ بدقة، وتم تنفيذ هذا النموذج على خمسة مجموعات بيانات مختلفة متاحة للعامة، والتي نوقشت في الأقسام المرتبطة أعلاه. علاوةً على ذلك، تم تطوير نموذج DenseNet121 من قبل جاو هوانغ وزملائه في عام 2017 ويتكون من 121 طبقة. كان الهدف الرئيسي من هذا النموذج هو التركيز على تعظيم إعادة استخدام الميزات وتجنب مشكلة تلاشي التدرج34. يتم تنظيم الطبقات في هذا النموذج إلى كتل كثيفة، تحتوي كل منها على طبقات تلافيفية متعددة تقوم باستخراج الميزات وتعلُّمها. تستقبل كل طبقة خريطة الميزات من جميع الطبقات السابقة كمدخل، ويتم ربط مخرجها بمخرجات تلك الطبقات وتمريرها كمدخل للطبقات اللاحقة في نفس الكتلة بطريقة تغذية أمامية. علاوةً على ذلك، تُضاف طبقات انتقالية بين الكتل الكثيفة، تتكون كل منها من طبقة تلافيفية 1 × 1، وطبقة تسوية دُفعة (BatchNormalization)، وطبقات تجميع متوسطة 2 × 2، والتي تعمل على تقليل خريطة الميزات للتحكم في تعقيد النموذج. بالإضافة إلى ذلك، تُضاف طبقة نهائية بوظيفة تنشيط SoftMax (AF) قبل طبقة تجميع متوسطة عالمية للتصنيف. ويُظهر الشكل 334 أدناه التصميم الأساسي لنموذج DenseNet121.
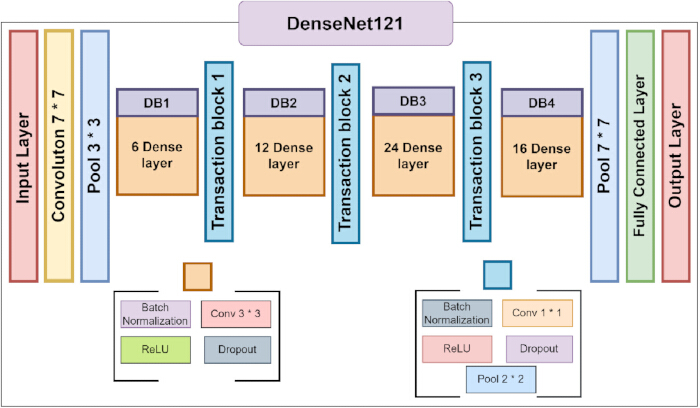
الشكل 3: تفاصيل بنية DenseNet12134. يوضح هذا الشكل التفاصيل البنائية لنموذج DenseNet121، بما في ذلك جميع الكتل الكثيفة وكتل الانتقال. يرجى النقر هنا لعرض نسخة أكبر من هذا الشكل.
علاوة على ذلك، تم اختراع نموذج EfficientNetB7 من قبل تان ولي في عام 2019. وينتمي هذا النموذج إلى عائلة EfficientNet، التي تتضمن نُسَخًا تتراوح من B0 إلى B7، وهدفه الأساسي هو التفوق على النماذج الأخرى مع استخدام عدد أقل من المعلمات وقدر أقل من القوة الحاسوبية. ويمكن ضبط عرض النموذج (عدد القنوات لكل طبقة) وعمقه (عدد الطبقات) ودقة المدخلات بدقة من خلال التدرج المركب، وهو الميزة الأساسية للنموذج. ويتكون هذا النموذج أيضًا من كتل MBConv (الالتواء العكسي المتنقل التلافيفي)، والتي تتضمن طبقة توسيع تلافيفية 1 × 1 مسؤولة عن توسيع القنوات، وطبقة تلافيف منفصلة حسب العمق (depthwise separable convolution) تقوم بتطبيق التلافيف على كل قناة على حدة، وطبقة إسقاط تلافيفية 1 × 1 تُقلل عدد القنوات إلى عددها الأصلي. وتحتوي كل كتلة MBConv أيضًا على كتل الضغط والتحفيز (Squeeze and Excitation (SE))35، التي تقوم بإعادة معايرة الخصائص الخاصة بكل قناة، مما يساعد الشبكة على التركيز على أهمها. وبدلًا من دالة السيجمويد أو أي دالة تنشيط أخرى، تُستخدم دالة Swish، التي تتفوق على دالة ReLU من خلال السماح بالقيم السالبة، مما يُحسّن تدفق التدرجات. علاوةً على ذلك، تُضاف طبقة مخرجات نهائية تستخدم دالة تنشيط SoftMax قبل طبقة التجميع المتوسطة الشاملة (global average pooling layer) لأغراض التصنيف. ويُظهر الشكل 435 التصميم الأساسي لنموذج EfficientNetB7، في حين يُظهر الشكل 5 البنية الموصى بها للنموذج.
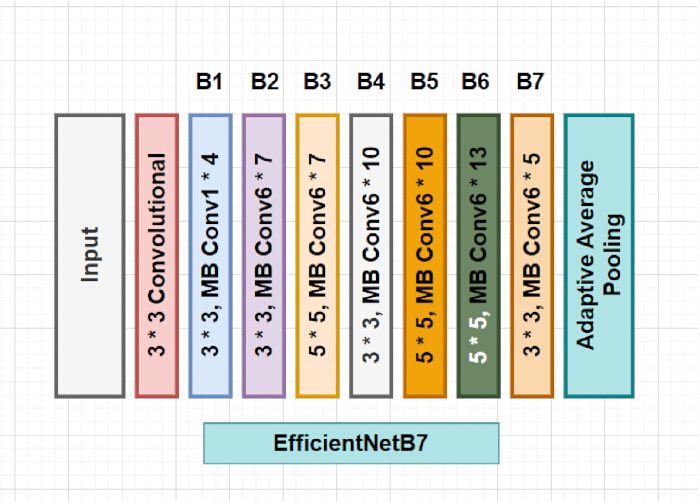
الشكل 4: تفاصيل بنية EfficientNetB735. يوضح هذا الشكل التفاصيل المعمارية لنموذج EfficientNetB7، بما في ذلك جميع كتل التلافيف المعكوسة المتنقلة ذات العُقدة الضيقة. يرجى النقر هنا لعرض نسخة أكبر من هذا الشكل.
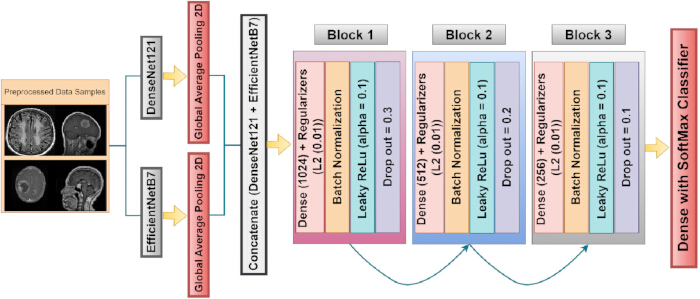
الشكل 5: هيكل النموذج المدمج الهجين المقترح. يوضح الهيكل المقترح كيفية تمرير الصور المعالجة مسبقًا إلى مستخرج السمات، والذي يتكون من ثلاثة كتل مخصصة ذات معلمات فائقة مختلفة، تليها طبقة مخرجات. يرجى النقر هنا لعرض نسخة أكبر من هذا الشكل.
بالإضافة إلى ذلك، تم استخراج الخصائص الأولى من نماذج DenseNet121 وEfficientNetB7 المُدرَّبة مسبقًا. تم تحميل الأوزان المُحدَّثة للنماذج المُدرَّبة مسبقًا على النماذج المُدرَّبة، وتجميد الطبقات الأساسية غير القابلة للتدريب لمنع إعادة تدريب النموذج مرة أخرى. وينبغي أن يساعد ذلك النموذج على الاحتفاظ بأفضل معرفة سابقة له، وتعديلها في ضوء عينات البيانات الجديدة لتحسين التقارب، والتركيز على الطبقات الإضافية من أجل التدريب واستخراج الخصائص المتقدمة. توضح المعادلتان 1 و2 أدناه طريقة عمل نموذجَي DenseNet120 وEfficientNetB7.
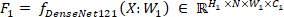 (1)
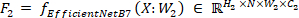 (2)
تُظهر المعادلتان 1 و 2 أعلاه طريقة عمل النموذج المدرب مسبقًا فيما يتعلق باستخراج الخصائص؛ حيث يدل F1 على خرائط الخصائص الناتجة عن النموذج المدرب مسبقًا DenseNet121، ويدل F2 على خرائط الخصائص الناتجة عن النموذج المدرب مسبقًا EfficientNetB7 من خلال تطبيق معالجة على الصور المدخلة، والتي يُرمز إليها بـ X. علاوة على ذلك، فإن W1 و W2 هي معلمات قابلة للتعلم أو أوزان مرتبطة بالكتل والطبقات الأولى لكل من نموذجي DenseNet121 و EfficientNetB7 على التوالي. كذلك، فإن ∈ RN ×H1×W1×C1 و ∈ RN ×H2×W2×C2 تمثل أبعاد خرائط الخصائص الناتجة من نموذجي DenseNet121 و EfficientNetB7 على التوالي، مع أبعاد H1 ×N×W1×C1 و H2 ×N×W2×C2، حيث يمثل N حجم الدفعة للصور، والذي اُعتبر 16. كما يمثل H1×W1 الارتفاع والعرض للصور على التوالي بالنسبة لنموذج DenseNet121، ويمثل H2×W2 الارتفاع والعرض للصور بالنسبة لنموذج EfficientNetB7، وقد تم اختيار مقاسات 224 × 224 للارتفاع والعرض. وتمثل C1 و C2 قناة اللون لكل من نموذجي DenseNet121 و EfficientNetB7 على التوالي. بعد الحصول على خرائط الخصائص الناتجة من النموذج، وهي 2560 قناة من EfficientNetB7 و 1024 من DenseNet121، تُطبَّق طبقة التجميع المتوسط العالمي ثنائي الأبعاد 2D36 على خرائط الخصائص الناتجة لتقليل البُعد المكاني من خلال أخذ المتوسط لجميع الأبعاد المكانية إلى متجه واحد، مما يجعل من الأسهل تمريرها إلى الطبقة التالية لتحسين استخراج الخصائص والتمييز بين الأنماط من حيث الخصائص القابلة للتفسير.
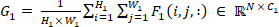 (3)
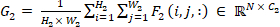 (4)
تُظهر المعادلتان 3 و4 أعلاه كيفية عمل طبقة التجميع المتوسطة العالمية ثنائية الأبعاد (Global Average Pooling 2D) المطبقة على نموذلي DenseNet121 وEfficientNetB7 على التوالي، حيث يُمثل  و
 إجراء تسوية المجموع من خلال قسمة المجموع الكلي على عدد المواقع المكانية لكل من النموذجين، لضمان أن يكون الناتج بعد التجميع هو متوسط وليس مجموعًا بسيطًا. وتمثل
 و
 عملية الجمع على الأبعاد المكانية لخرائط الميزات، في حين أن i وj يستخدمان فقط للتكرار على الارتفاع والعرض على التوالي، من أجل جمع خرائط الميزات لكلا النموذجين. علاوةً على ذلك، فإن F1(i, j, :) وF2(i, j, :) يمثلان قيم خرائط الميزات عند مواضع مكانية محددة (i, j) عبر جميع القنوات لكل من نموذلي DenseNet121 وEfficientNetB7 على التوالي. وتُجمع عملية التجميع هذه المعلومات المكانية في تمثيل أكثر إحكامًا ودقة مع الحفاظ على أهم الميزات عبر كل صورة. بالإضافة إلى ذلك، يتم دمج مخرجات طبقات التجميع المتوسطة العالمية لإنتاج متجه ميزة واحد لكل عينة، ويُستخدم هذا المتجه عادةً لدمج ميزات من نماذج مختلفة لتحسين الأداء من خلال الاستفادة من نقاط قوة كلا النموذجين؛ وتوضح المعادلة 5 كيفية عمل ذلك.
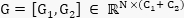 (5)
توضح المعادلة 5 أعلاه إجراء الدمج لاتّحاد متجهين مميزين من نموذجين مختلفين [G1، G2]، حيث يمثل G1 متجه الخصائص الخاص بنموذج DenseNet121، ويمثل G2 متجه الخصائص الخاص بنموذج EfficientNetB7، في حين يُعبّر عن شكل متجه الخصائص المدمج بالرمز RN ×(C1+ C2)، حيث يشير N إلى حجم الدفعة (batch size)، وهو ما يمثل عدد العينات التي تُعالج بشكل متوازٍ، و(C1+ C2) تمثل العدد الكلي للخصائص المستخلصة من النموذجين 1 و2 على التوالي، والذي يبلغ حوالي 3584 خاصية، وتُعالج هذه الخصائص بشكل متوازٍ، ويُعبّر عن متجه الخصائص الناتج من الدمج بالرمز G. علاوةً على ذلك، تم إضافة ثلاثة كتل مختلفة لتعديل النموذج المدمج بهدف استخلاص خصائص أكثر تعقيدًا، وتحسين التعميم، ومنع الإفراط في التخصيص (overfitting)، وذلك للحصول على نتائج أكثر دقة وكفاءة. تتكون كل كتلة من طبقة كثيفة (dense layer) تحتوي على عدد مختلف من الخلايا العصبية، حيث تحتوي الكتلة الأولى على 1024 خلية عصبية في طبقاتها الكثيفة، وتُركّز على التقاط طائفة واسعة من الخصائص وأنماط عامة في البيانات، في حين تحتوي الكتلة الثانية على 512 خلية عصبية في طبقتها الكثيفة، والتي تقوم بتنقيح الخصائص بشكل محدد من خلال تقليل البُعد (reducing dimensionality) والتركيز على أنماط أكثر تحديدًا. أما الكتلة الثالثة فتحتوي على 256 خلية عصبية في طبقتها الكثيفة، والتي تقوم بتركيز الخصائص بشكل أدق لضمان تمرير الخصائص والأنماط الأكثر صلةً فقط إلى الطبقة النهائية لأداء مهمة أكثر ملاءمة. علاوةً على ذلك، تم إضافة تقنيات تنظيم L237 إلى كل طبقة كثيفة ضمن كل كتلة لمنع الإفراط في التخصيص من خلال معاقبة الأوزان الكبيرة، مما يزيد أيضًا من تعقيد النموذج. كما تم إدخال طبقة إسقاط (dropout layer)38 بعد كل كتلة بهدف تجاهل 30% و20% و10% من الخلايا العصبية عشوائيًا في الكتل 1 و2 و3 على التوالي، مما يُجبر الشبكة على تطوير خصائص أكثر قوة وعدم الاعتماد على خلية عصبية واحدة فقط. بالإضافة إلى ذلك، ولتثبيت عملية التدريب، تم تطبيق طبقة تسوية الدُفعة (BatchNormalization)39 بعد كل طبقة كثيفة، مما يضمن بقاء التفعيلات ضمن نطاق مستقر، ويساعد النموذج على تجنب مشاكل مثل تلاشي التدرجات (vanishing gradients) أو انفجارها (exploding gradients) أثناء مرحلة التدريب. كما ساهمت طبقة التسوية هذه أيضًا في تسريع عملية التدريب، حيث مكّنت النموذج من التقارب بشكل أسرع من خلال تسوية سطح دالة الخسارة، مما سهّل الوصول إلى القيم الدنيا العالمية للمُحسّنات (optimizers). علاوةً على ذلك، تم استخدام دالة تفعيل Leaky ReLU40 في كل كتلة لإنتاج سلوك غير خطي، مما يسمح للنموذج بتعلّم أنماط معقدة، وتتميّز دالة Leaky ReLU هذه بميزات تفوق بها دوال التفعيل الأخرى، حيث تضمن ألا تصبح الخلية العصبية غير نشطة من خلال السماح بتدرّج صغير وغير صفري للمدخلات السالبة. وأخيرًا، توضح المعادلة 6 أدناه آلية عمل الكتل المختلفة المدمجة مع النموذج المهجّن المُدمج.
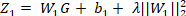 (6)
بعد الحصول على المتجه المدمج، يمر G عبر الطبقة الكثيفة (المتصلة بالكامل) في الكتلة 1 التي تحتوي على 1024 خلية عصبية، حيث تقوم مصفوفة الأوزان W1 بتحويل المتجه المدخل G إلى متجه خرج ذو بُعد 1024، ويكون كل عنصر في متجه الخرج عبارة عن تركيبة خطية من خصائص المدخلات. بعد ذلك، يُضاف متجه الانحياز b1 إلى كل عنصر من عناصر الخرج الـ1024، مما يسمح للنموذج بتحريك نتائج خصائص المدخلات بشكل مستقل. علاوةً على ذلك، فإن حد تنظيم L2: λ||W1||22 يُعاقب على الأوزان الكبيرة، ما يثني النموذج عن الاعتماد المفرط على خلية عصبية واحدة، وبالتالي يساعد ذلك في تجنب الإفراط في التخصيص. حيث تمثل مصفوفة الأوزان الخاصة بطبقة معينة W1 في الشبكة العصبية، بينما يدل الرمز ||W1||22 على المعيار التربيعي L2 لمصفوفة الأوزان W1، وλ هو معامل التنظيم الذي يتحكم في درجة التنظيم المطبقة، وقد تم ضبطه على 0.1 في جميع الكتل. ويصبح Z1 التمثيل الجديد للخصائص بعد تطبيق الطبقة الكثيفة وكذلك تنظيم L2 على المدخلات الواردة من المتجه المدمج G، كما هو موضح في المعادلة 6.
بعد الحصول على المخرجات من الطبقة الكثيفة للوحدة 1 على شكل Z1، تم تطبيق طبقة التسوية الدُفعة (BatchNormalization)، والتي تُستخدم لتسريع عملية التدريب، ويوضح المعادلة 7 أدناه كيف تعمل.
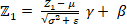 (7)
σ2 تمثل تباين مخرجات الطبقة الأخيرة Z1 عبر الدفعة، في حين أن μ هو متوسط المخرجات Z1 الذي يُحسب بشكل منفصل لكل عصبون، والذي كان 1024 في الطبقة الكثيفة الأولى. في المقابل، ε هو ثابت صغير يُدمج لضمان الاستقرار العددي ومنع القسمة على الصفر. يمكن تعديل المخرجات المعيارية بواسطة النموذج من خلال تعديل معلمة المقياس القابلة للتعلم γ، في حين يمكن إزاحة المخرجات المعيارية بواسطة معلمة الإزاحة القابلة للتعلم β. أخيرًا، بعد تطبيق طبقة التطبيع الدفعي (BatchNormalization) على مخرجات الطبقة الكثيفة، تضمن المخرجات المعيارية Z1 أن تكون التفعيلات ذات توزيع متسق عبر الطبقات المختلفة، مما يساعد على تثبيت وتسريع عملية التدريب. بعد التطبيع الدفعي، تمر المخرجات المعيارية Z1 عبر دالة التنشيط Leaky ReLU، التي تُنتج سلوكًا غير خطي في الشبكة، مما يساعد على تعلُّم الأنماط المعقدة في البيانات. بدلًا من اختيار دالة ReLU أو دالة تنشيط أخرى، تم اختيار دالة Leaky ReLU، وهي نسخة معدلة من دالة ReLU تأخذ القيم السالبة الصغيرة بعين الاعتبار بدل جعلها صفرًا كما تفعل دالة ReLU، وبالتالي تتفادى مشكلة "موت ReLU" (dying ReLU problem). توضح المعادلة 8 أدناه كيفية عملها.
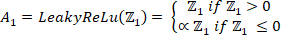 (8)
حيث ينتمي Z1 إلى مخرجات طبقة التسوية الدفعية (BatchNormalization)، والتي تُمرر إلى دالة ReLU التالفة كمدخل لأداء عدم الخطية، في حين أن ∝ هو ثابت صغير يُستخدم لتحديد ميل الجزء السالب من الدالة. علاوةً على ذلك، يُظهر A1 المخرجات التي تُحصل عليها بعد تطبيق عدم الخطية. وأخيرًا، تُطبَّق طبقة الإسقاط (dropout) على المخرجات A1 المستلمة كمدخل من دالة تنشيط Leaky ReLU، كما هو موضح في المعادلة 9.
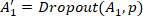 (9)
حيث إن A1 هو مخرج دالة التنشيط الأصلي المستلم من دالة التنشيط ReLu الأخيرة، وحيث إن p هو معدل الإسقاط (dropout rate)، والذي يتراوح بين 0 و1، وقد تم اختياره بقيم 0.3 و0.2 و0.1 على التوالي لثلاث طبقات كتلة، وذلك فقط لتجاهل جزء من الخلايا العصبية. علاوةً على ذلك، فإن A1′ يمثل المخرج المعدّل بعد تطبيق طبقة الإسقاط، والتي تم فيها تعيين بعض الخلايا العصبية بقيمة 0. والميزة الرئيسية لاستخدام هذه الطريقة هي منع مشكلة التخصّص الزائد (overfitting) وكذلك تقليل التكيّف المشترك (co-adaptation). بالإضافة إلى ذلك، يتم تمرير المخرج من الكتلة1 A1′ إلى الكتلة التالية مجددًا لاستخراج ميزات أكثر تجريدًا، ويتم تطبيق نفس المعاملات الموجودة في الكتلة 1، مع بعض الاختلافات وهي استخدام 512 خلية عصبية في الطبقة الكثيفة بدلاً من 1024، ومعدل إسقاط قدره 0.2 بدلاً من 0.3، وتبقى التسلسلات التشغيلية الأخرى نفسها، كما هو موضح في المعادلات من 10 إلى 13 أدناه.
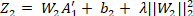 (10)
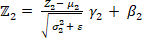 (11)
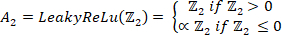 (12)
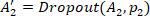 (13)
بعد الحصول على المخرجات من الكتلة 1 على شكل A1′، والتي تمر عبر الطبقة الكثيفة (المتصلة بالكامل) في الكتلة 2 التي تحتوي على 512 خلية عصبية، حيث تقوم مصفوفة الأوزان W2 بتحويل متجه الإدخال A1′ إلى متجه مخرجات ذو بُعد 512، وكل عنصر في متجه المخرجات يمثل تركيبة خطية من خصائص الإدخال. بعد ذلك، يتم إضافة متجه الانحياز b2 إلى كل عنصر من عناصر المخرجات الـ512، مما يسمح للنموذج بتحريك مخرجات خصائص الإدخال بشكل مستقل. علاوةً على ذلك، يتم تطبيق تنظيم L2 حيث: λ||W2||22 يُعاقب على الأوزان الكبيرة، وهو ما يُستخدم لتقليل الإفراط في التخصيص من خلال منع النموذج من الاعتماد المفرط على أي خلية عصبية معينة في هذه الكتلة المحددة. حيث إن W2 هي مصفوفة الأوزان لطبقة معينة في الشبكة العصبية، في حين أن λ هو معلمة التنظيم التي تتحكم في درجة التنظيم المطبقة، وقد تم تعيينها بقيمة 0.1. ويصبح Z2 التمثيل الجديد للخصائص بعد تطبيق الطبقة الكثيفة وكذلك تنظيم L2 على المدخلات الواردة من الكتلة 1، كما هو موضح في المعادلة 10.
علاوةً على ذلك، طُبق طبقة التطبيع الدُفعة (BatchNormalization) على الميزة الجديدة Z2، والتي استُخدمت لتسريع عملية التدريب، حيث يمثل σ22 التباين عبر الدُفعة، في حين أن μ2 هو متوسط المخرجات Z2. على الرغم من أن ε هو ثابت صغير يُدمج لضمان الاستقرار العددي، فإن γ هو معلمة قابلة للقياس يمكن للنموذج تعديلها لتغيير المخرجات المعيارية، وβ هي معلمة إزاحة قابلة للتعلم تسمح للنموذج بإزاحة المخرجات المعيارية. وأخيرًا، بعد تطبيق طبقة التطبيع الدُفعة، كما هو موضح في المعادلة 11، مرت المخرجات المعيارية Z2 عبر دالة التنشيط غير الخطية Leaky ReLU، التي أنتجت السلوك غير الخطي في الشبكة، كما هو موضح في المعادلة 12. حيث ينتمي Z2 إلى مخرجات طبقة التطبيع الدُفعة، والتي تُمرر إلى Leaky ReLU كمدخل لأداء السلوك غير الخطي. في المقابل، يُظهر A2 المخرجات التي تم الحصول عليها بعد تطبيق السلوك غير الخطي.
وأخيرًا، يتم تطبيق طبقة إسقاط على المخرجات A2 المستلمة كمدخلات من دالة التنشيط Leaky ReLU، كما هو موضح في المعادلة 13. حيث تمثل A2 المخرجات المستلمة من دالة التنشيط ReLU الأخيرة، وتمثل p2 معدل الإسقاط الذي تم اختياره بقيمة 0.2 لهذا الكتلة، وذلك فقط لإسقاط جزء من الخلايا العصبية. علاوةً على ذلك، فإن A2′ يمثل المخرجات المعدلة بعد تطبيق طبقة الإسقاط، والتي تم تعيين بعض الخلايا العصبية فيها إلى 0. بعد ذلك، تُمرر المخرجات من الكتلة الثانية A2′ إلى الكتلة الثالثة مجددًا لاستخلاص ميزات أكثر تجريدًا، وتُطبَّق نفس المعلمات الموجودة في الكتلة الثانية، مع بعض الاختلافات المتمثلة في استخدام 256 خلية عصبية في الطبقة الكثيفة بدلًا من 512 ومعدل إسقاط قدره 0.1 بدلًا من 0.2، وتبقى التسلسلات التشغيلية الأخرى كما هي، والتي تم وصفها في المعادلات التالية من 14 إلى 17.
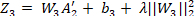 (14)
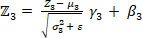 (15)
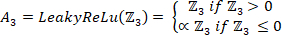 (16)
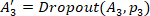 (17)
بعد الحصول على المخرجات من الكتلة 2 على شكل A2′، والتي تمر عبر الطبقة الكثيفة (المتصلة بالكامل) في الكتلة 3 المكونة من 256 خلية عصبية، حيث تقوم مصفوفة الأوزان W3 بتحويل متجه المدخلات A2′ إلى متجه مخرجات بُعده 256، وكل عنصر في متجه المخرجات يمثل تركيبًا خطيًا للميزات المدخلة. بعد ذلك، يتم إضافة متجه الانحياز b3 إلى كل عنصر من عناصر المخرجات الـ 256، مما يسمح للنموذج بتحريك مخرجات الميزات المدخلة بشكل مستقل. علاوةً على ذلك، يتم تطبيق تنظيم L2 حيث يُعاقب التعبير λ||W3||22 على الأوزان الكبيرة، ما يثني النموذج عن الاعتماد المفرط على خلية عصبية واحدة، ويساعد ذلك في تجنب التخصيص الزائد. حيث تمثل W3 مصفوفة الأوزان الخاصة بطبقة معينة في الشبكة العصبية، في حين يتم التحكم في درجة التنظيم المستخدم من خلال معلمة التنظيم λ، والتي تم ضبطها على القيمة 0.01. تصبح Z3 التمثيل الجديد للميزات بعد تطبيق الطبقة الكثيفة وكذلك تنظيم L2 على المدخلات الواردة من الكتلة 3، كما هو موضح في المعادلة 14.
علاوةً على ذلك، تم تطبيق طبقة التسوية الدُفعة (BatchNormalization) على الميزة الجديدة Z3، والتي استُخدمت لتسريع عملية التدريب، حيث يمثل σ32 التباين عبر الدُفعة، في حين أن μ3 هو متوسط المخرجات Z3. في المقابل، يُعد ε ثابتًا صغيرًا يُضاف لضمان الاستقرار العددي. يمكن تعديل المخرجات المُعدَّلة بواسطة النموذج باستخدام معلمة المقياس القابلة للتعلم γ3، وتحريكها باستخدام معلمة الإزاحة القابلة للتعلم β3. وأخيرًا، بعد تطبيق طبقة التسوية الدُفعة، كما هو موضح في المعادلة 15، تمر المخرجات المُعدَّلة Z3 عبر دالة التنشيط تسرب ReLU (leaky ReLU)، التي تُنتج سلوكًا غير خطي في الشبكة، كما هو موضح في المعادلة 16. حيث ينتمي Z3 إلى مخرجات طبقة التسوية الدُفعة، والتي تُدخل إلى دالة تسرب ReLU كمدخل لأداء السلوك غير الخطي. في المقابل، يُظهر A3 المخرجات التي تُحصل عليها بعد تطبيق السلوك غير الخطي.
وأخيرًا، يتم تطبيق طبقة الإسقاط على المخرجات A3 المستلمة كمدخلات من دالة التنشيط Leaky ReLU، كما هو موضح في المعادلة 17. حيث تمثل A3 المخرجات المستلمة من آخر دالة تنشيط ReLU، وتمثل p3 معدل الإسقاط الذي تم اختياره بقيمة 0.1 لهذا الكتلة، وذلك فقط لإسقاط جزء من الخلايا العصبية. علاوةً على ذلك، تُظهر A3′ المخرجات المعدلة بعد تطبيق طبقة الإسقاط، والتي تم فيها تعيين بعض الخلايا العصبية إلى الصفر.
علاوةً على ذلك، يمر المخرج من الكتلة 3 A3′ عبر الطبقة الكثيفة الأخيرة لأغراض التصنيف مع عدد K من الخلايا العصبية التي تمثل العدد الفعلي للفئات في مجموعة البيانات، كما هو موضح في المعادلة 18 أدناه.
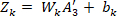 (18)
المصفوفة المرتبطة بالطبقة السميكة هي Wk، وهي المسؤولة عن تحويل المتجه ذي الأبعاد الـ 256 A3′ إلى متجه ذي أبعاد k، والذي يمثل السمات المُتعلمة من الكتلة السابقة ويظهر كمخرجات. علاوةً على ذلك، فإن bk يمثل متجه الانحياز الذي يُعدّل التنبؤ لضمان أن تكون دالة التنشيط ذات مخرجات غير صفرية عندما يكون المدخل صفرًا، وZk هو مخرج الطبقة النهائية قبل تطبيق دالة التنشيط، ويُنتج القيم اللوجستية مقابل كل فئة، وفي النهاية تم تطبيق مصنّف SoftMax41 الذي يحوّل القيمة اللوجستية Zk إلى احتمالات كل فئة، كما هو موضح في المعادلتين 19 و20.
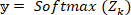 (19)
 (20)
حيث إن الاحتمال المتوقع للـ ith يُمثل الفصل بـ صi, ك هو عدد الفئات، بينما ضك, i هو اللوجيت للقيمة ith فئة، و هـضك, i هو الأس للدالة اللوجستية للقيمة ith فئة ي يُظهر التوزيع الاحتمالي لجميع الفئات الممكنة، ويضمن أن مجموع الاحتمالات يساوي 1. الجدول 3 يُقدِّم القسم أدناه تفاصيل المعلمات الفائقة المستخدمة لتدريب النموذج الهجين المقترح، بما في ذلك التفاصيل المعمارية المُعتمدة لتحسين إمكانية إعادة الإنتاج والأداء.
| المعاملات الفائقة | النموذج المقترح (FusionNetX) |
| حجم الصورة | 224 × 224 |
| معمارية العمود الفقري | تم استخدام EfficientNetB7 وDenseNet121 مُدرّبين مسبقًا كـ BBA1 وBBA2 |
| تكبير البيانات | مدى الدوران = 7، |
| مدى إزاحة العرض/الارتفاع حتى 0.05، | |
| مدى التكبير حتى 0.01، | |
| الانعكاس الأفقي/العمودي | |
| نسبة تقسيم البيانات | 80% للتدريب و20% للتحقق باستخدام أخذ عينات مصنفة مع قيمة عشوائية ثابتة randome_state = 42 |
| استخراج السمات والدمج | يتم تطبيق الاستخلاص المتوسط الكلي على مخرجات كل عمود فقري: 2560 لـ BBA1 و1024 لـ BBA2، ثم يتم دمجها للحصول على 3584 متجهًا مشتركًا للسمات. |
| تكوين كتلة الاتصال الكامل | 3 كتل متصلة بالكامل مع طبقة مخرجات واحدة. تحتوي كل كتلة على تنظيم L2 (λ=0.01)، التسوية الدُفعة (BatchNormalization)، دالة تنشيط LeakyReLU (α=0.01)، إسقاط (Dropout) بقيم (0.3، 0.2، و0.1) وأبعاد كامنة (1024، 512، 256) على التوالي. لم يتم إدخال اتصال تخطّي إضافي في رأس الدمج |
| دالة التنشيط | Leaky ReLU وSoftMax |
| خوارزمية التحسين ومعدل التعلم | Adam مع معدل تعلم ثابت قدره 0.00001 دون استخدام جدولة لمعدل التعلم. |
| دالة الخسارة | sparse_categorical_crossentropy |
| حجم الدفعة | 16 |
| عدد العصور | 100 عصر ثابت لكل مجموعة بيانات |
| المنصة المستخدمة | ملاحظات كاجل (Kaggle Notebook) مزودة بمعالج رسوميات P100 و16 غيغابايت ذاكرة وصول عشوائي فيديو (VRAM) مع منصتي TensorFlow وKeras. |
الجدول 3: المعلمات الفائقة المستخدمة لتدريب النموذج المقترح والتفاصيل المعمارية المقترحة. يقدِّم هذا الجدول التفاصيل الهيكلية والمعمارية للنموذج المقترح، إلى جانب المعلمات المُهيأة بدقة والبيئة التنفيذية.
الوصول مقيد. يرجى تسجيل الدخول أو بدء فترة تجريبية لعرض هذا المحتوى.
النتائج
يفصل هذا الجزء نتائج اختبار نموذج دمج الميزات المزدوج المقترح على خمس مجموعات بيانات مفتوحة المصدر عن سرطانات الدماغ، وهي: Br35H وFigshare وSartaj وMasoud وBalanced Brain tumor، كما يتم تقييم أدائها بناءً على معلمات مختلفة لتقييم الأداء الإحصائي، بما في ذلك الدقة42,43,4، ومعدل التصنيف الخاطئ (MCR)45، والدقة (precision) التي يشار إليها أيضاً بـ PPV46، والقيمة التنبؤية السلبية (NPV)،...
الوصول مقيد. يرجى تسجيل الدخول أو بدء فترة تجريبية لعرض هذا المحتوى.
المناقشة
وختاماً، عمل النموذج المقترح على النحو التالي: أولاً، تم اختيار حجم الصورة ليكون 224 × 224، وهو حجم متوسط لأي نموذج تعلم عميق لاستخراج وتعلم الميزات المناسبة من عينات البيانات مع الحفاظ على جميع المعلومات المهمة، كما تم إجراء تعزيز للبيانات (data augmentation)، وهو أمر أكثر فائدة لجعل عينات البيانات في اتجاهات أكثر تنوعاً، مما يلعب دوراً هاماً في تمكين النماذج من استخراج الميزات من مستويات أو زوايا مختلفة، وقد تم اختيار نطاق الدوران بنسبة 7% مع نطاق إزاحة للعرض والارتفاع بمقدار 0.05 ونطاق تكبير بمقدار 0.01. كما تم تطبيق ...
الوصول مقيد. يرجى تسجيل الدخول أو بدء فترة تجريبية لعرض هذا المحتوى.
الإفصاحات
ليس لدى المؤلفين ما يفصحون عنه ولا يوجد لديهم أي تضارب في المصالح. علاوة على ذلك، لم يتم استخدام أي أدوات ذكاء اصطناعي في إعداد المخطوطة أو الرسوم التوضيحية.
شكر وتقدير
يعرب المؤلفون عن امتنانهم للدعم المقدم من مشروع دعم الباحثين بجامعة الأميرة نورة بنت عبد الرحمن (PNURSP2026R192)، جامعة الأميرة نورة بنت عبد الرحمن، الرياض، المملكة العربية السعودية. كما يوجه المؤلفون الشكر للمشاركين في البحث والمؤسسات التي ساهمت في هذا البحث.
التمويل:
تم دعم هذا العمل من خلال منحة المؤسسة الوطنية للبحوث في كوريا (NRF) الممولة من قبل الحكومة الكورية (MSIT) (رقم RS-2023-00218176) وصندوق أبحاث جامعة سونتشونهيانغ. وكذلك مشروع دعم الباحثين بجامعة الأميرة نورة بنت عبد الرحمن رقم (PNURSP2026R192)، جامعة الأميرة نورة بنت عبد الرحمن، الرياض، المملكة العربية السعودية.
الوصول مقيد. يرجى تسجيل الدخول أو بدء فترة تجريبية لعرض هذا المحتوى.
المواد
| الاسم | الشركة | رقم فهرسي | التعليقات |
|---|---|---|---|
| مجموعة بيانات Br35H لأورام الدماغ | Kaggle (المساهم في مجموعة البيانات) | https://www.kaggle.com/datasets/ahmedhamada0/brain-tumor-detection | مجموعة بيانات عامة؛ تصنيف ثنائي (ورم / لا يوجد ورم) 300 صورة MRI |
| مجموعة بيانات Figshare لأورام الدماغ | Kaggle / Figshare | https://doi.org/10.6084/m9.figshare.1512427 | مجموعة بيانات عامة؛ تصنيف متعدد الفئات (ورم دبقي، ورم سحائي، ورم نخامي) 3064 صورة MRI |
| مجموعة بيانات Sartaj لتصنيف أورام الدماغ عبر MRI | Kaggle (مجموعة بيانات بواسطة Sartaj Bhuvaji) | https://doi.org/10.34740/kaggle/dsv/12745533 | مجموعة بيانات عامة؛ تصنيف متعدد الفئات (ورم دبقي، ورم سحائي، لا يوجد ورم، ورم نخامي) 3264 صورة MRI |
| مجموعة بيانات Masoud لأورام الدماغ عبر MRI | Kaggle (مجموعة بيانات بواسطة Masoud Nickparvar) | https://doi.org/10.34740/kaggle/dsv/14832123 | مجموعة بيانات عامة؛ تصنيف متعدد الفئات (ورم دبقي، ورم سحائي، لا يوجد ورم، ورم نخامي) 7023 صورة MRI |
| مجموعة بيانات BBT-Dataset (مجموعة بيانات أورام الدماغ) | Kaggle (المساهم في مجموعة البيانات) | https://doi.org/10.34740/kaggle/dsv/6758053 | مجموعة بيانات عامة؛ تصنيف متعدد الفئات متوازن لأورام الدماغ 5248 صورة MRI |
| Python | مؤسسة Python البرمجية | https://www.python.org | لغة برمجة، إصدار 3.10.13 |
| TensorFlow / Keras | Google / مطورو TensorFlow | https://www.tensorflow.org | إطار عمل للتعلم العميق؛ بناء النماذج وتدريبها وتقييمها، إصدار 2.15.0 |
| EfficientNetB7 (مُدرب مسبقاً) | Google / Keras Applications | https://keras.io/api/applications/efficientnet/ | هيكل أساسي مُدرب مسبقاً على ImageNet؛ استخراج الميزات |
| DenseNet121 (مُدرب مسبقاً) | Keras Applications | https://keras.io/api/applications/densenet/ | هيكل أساسي مُدرب مسبقاً على ImageNet؛ استخراج الميزات |
| scikit-learn | مطورو scikit-learn (NumFOCUS) | https://scikit-learn.org | ترميز التسميات، تقسيم بيانات التدريب والاختبار، مقاييس التقييم (تقرير التصنيف، مصفوفة الارتباك، ROC/AUC) |
| OpenCV (cv2) | فريق OpenCV | https://opencv.org | تحميل الصور وتغيير حجمها |
| NumPy | مطورو NumPy (NumFOCUS) | https://numpy.org | الحوسبة العددية وعمليات المصفوفات |
| pandas | فريق تطوير pandas (NumFOCUS) | https://pandas.pydata.org | تنظيم البيانات وجدولة المقاييس |
المراجع
- He Z, et al. A review on methods for diagnosis of breast cancer cells and tissues. Cell Prolif. 2020;53(7):e12822. doi:10.1111/cpr.12822.
- Siegel RL, Giaquinto AN, Jemal A. Cancer statistics, 2024. CA Cancer J Clin. 2024;74(1):12–49.
- Varuna Shree N, Kumar TNR. Identification and classification of brain tumor MRI images with feature extraction using DWT and probabilistic neural network. Brain Inform. 2018;5(1):23–30.
- Ghoreishi Mokri SM, Valadbeygi N, Grigoryeva V. Diagnosis of glioma, menigioma and pituitary brain tumor using MRI images recognition by deep learning in Python. EAI Endorsed Trans Intell Syst Mach Learn Appl. 2024;1:1–9.
- Sadeghi MH, et al. Deep learning in ovarian cancer diagnosis: a comprehensive review of various imaging modalities. Pol J Radiol. 2024;89:e30–e48.
- Anari S, Safarpour H, Cunneen M, Bendechache M. AR-EpiAid: an augmented reality decision support system for real-time interpretation of multimodal epilepsy data [conference paper]. Presented at: 3rd International Conference on Artificial Intelligence, Computer, Data Sciences, and Applications; Boracay Island, Philippines; 2026. https://doi.org/10.1109/ACDSA67686.2026.11468245.
- Iyortsuun NK, et al. A review of machine learning and deep learning approaches on mental health diagnosis. Healthcare (Basel). 2023;11(3):285. doi:10.3390/healthcare11030285.
- An Q, Rahman S, Zhou J, Kang JJ. A comprehensive review on machine learning in the healthcare industry: classification, restrictions, opportunities, and challenges. Sensors (Basel). 2023;23(9):4178. doi:10.3390/s23094178.
- Iqbal S, Qureshi AN, Li J, Mahmood T. On the analyses of medical images using traditional machine learning techniques and convolutional neural networks. Arch Comput Methods Eng. 2023;30:3173–3233.
- Chhimpa GR, et al. A transfer learning-driven fine-tuning of YOLOv10 for improved brain tumor detection in MRI images. Sci Rep. 2026;16:98. doi:10.1038/s41598-025-28813-w.
- Akbarian S, Seyyed-Kalantari L, Khalvati F, Dolatabadi E. Evaluating knowledge transfer in the neural network for medical images. IEEE Access. 2023;11. doi:10.1109/ACCESS.2023.3283216.
- Meena G, Mohbey KK, Acharya M, Lokesh K. An improved convolutional neural network-based model for detecting brain tumors from augmented MRI images. J Auton Intell. 2023;6:1–19.
- Ata MM, Yousef RN, Karim FK, Khafaga DS. An improved deep structure for accurately recognizing brain tumors. Comput Syst Sci Eng. 2023;46(2):1597–1616.
- Khushi HMT, et al. Performance analysis of state-of-the-art CNN architectures for brain tumour detection. Int J Imaging Syst Technol. 2024;34:e22949. doi:10.1002/ima.22949.
- Agarwal M, et al. Deep learning for enhanced brain tumor detection and classification. Results Eng. 2024;22:102117. doi:10.1016/j.rineng.2024.102117.
- Peddinti AS, Maloji S. Optimised ResNet50 for multiclass classification of brain tumors. Scalable Comput Pract Exp. 2024;25(3):1667–1680.
- Zahoor MM, et al. Brain tumor MRI classification using a novel deep residual and regional CNN. Biomedicines. 2024;12(7):1395. doi:10.3390/biomedicines12071395.
- Chen W, et al. A robust approach for multitype classification of brain tumors using deep feature fusion. Front Neurosci. 2024;18:1288274. doi:10.3389/fnins.2024.1288274.
- Suryawanshi S, Patil SB. Efficient brain tumor classification with a hybrid CNN-SVM approach in MRI. J Adv Inf Technol. 2024;15:340–354.
- Reyes D, Sánchez J. Performance of convolutional neural networks for the classification of brain tumors using magnetic resonance imaging. Heliyon. 2024;10:e25468. doi:10.1016/j.heliyon.2024.e25468.
- Bibi N, et al. A transfer learning-based approach for brain tumor classification. IEEE Access. 2024;12:111218–111238.
- Albalawi E, et al. Integrated approach of federated learning with transfer learning for classification and diagnosis of brain tumor. BMC Med Imaging. 2024;24:110. doi:10.1186/s12880-024-01261-0.
- Alkhatib AJ, et al. Diagnosing brain tumors from MRI images through a multi-fused CNN with auxiliary layers. Sustain Mach Intell J. 2024;6(1):4–13.
- Hamada A. Br35H: Brain Tumor Detection 2020 [dataset]. Kaggle; 2020. Available from: https://www.kaggle.com/datasets/ahmedhamada0/brain-tumor-detection.
- Cheng J. Brain tumor dataset [dataset]. Figshare; 2024. Available from: https://doi.org/10.6084/m9.figshare.1512427.
- Bhuvaji S. Brain Tumor Classification (MRI) [dataset]. Kaggle; cited 2026 Jul 30. Available from: https://doi.org/10.34740/kaggle/dsv/12745533.
- Nickparvar M. Brain Tumor MRI Dataset [dataset]. Kaggle; cited 2026 Jul 30. Available from: https://doi.org/10.34740/kaggle/dsv/14832123.
- Jayanti V. Brain Tumor MRIs [dataset]. Kaggle; cited 2026 Jul 30. Available from: https://doi.org/10.34740/kaggle/dsv/6758053.
- Tuteja P, et al. Augmented multimodal fusion for optimized brain tumor detection: evaluation and comparative analysis. J Vis Exp. 2025;(220):e67822. doi:10.3791/67822.
- Rasool N, et al. CNN-TumorNet: leveraging explainability in deep learning for precise brain tumor diagnosis on MRI images. Front Oncol. 2025;15:1554559. doi:10.3389/fonc.2025.1554559.
- Huang G, Liu Z, van der Maaten L, Weinberger KQ. Densely connected convolutional networks [conference paper]. Presented at: IEEE Conference on Computer Vision and Pattern Recognition; Honolulu, HI, USA; 2017. p. 4700–4708. Available from: https://openaccess.thecvf.com/content_cvpr_2017/html/Huang_Densely_Connected_Convolutional_CVPR_2017_paper.html.
- Tuteja P, Wani MA, Wani NA, Bedi J. EASE-Net: an explainable AI-based segmentation and ensemble network for interpretable brain tumor diagnosis and classification in MRI images. Arab J Sci Eng. 2026;in press. doi:10.1007/s13369-026-11350-7.
- Tan M, Le QV. EfficientNet: rethinking model scaling for convolutional neural networks [conference paper]. Presented at: 36th International Conference on Machine Learning; Long Beach, CA, USA; 2019. p. 6105–6114. Available from: https://proceedings.mlr.press/v97/tan19a.html.
- Vellaichamy AS, Swaminathan A, Varun C, Kalaivani S. Multiple plant leaf disease classification using DenseNet-121 architecture. Int J Electr Eng Technol. 2021;12(5):38–57.
- Naidji MR, Elberrichi Z. Automatic detection of COVID-19 from chest X-ray images using the EfficientNet-B7 CNN model with channel-wise attention. Int J Comput Digit Syst. 2024;15:1443–1456.
- Malla PP, Sahu S, Alutaibi AI. Classification of tumors in brain MR images using a deep convolutional neural network and global average pooling. Processes. 2023;11(3):679. doi:10.3390/pr11030679.
- Shi G, Zhang J, Li H, Wang C. Enhance the performance of deep neural networks via L2 regularization on the input of activations. Neural Process Lett. 2019;50:57–75.
- Srivastava N, et al. Dropout: a simple way to prevent neural networks from overfitting. J Mach Learn Res. 2014;15:1929–1958.
- Ioffe S, Szegedy C. Batch normalization: accelerating deep network training by reducing internal covariate shift [conference paper]. Presented at: 32nd International Conference on Machine Learning; Lille, France; 2015. p. 448–456. Available from: https://proceedings.mlr.press/v37/ioffe15.html.
- Varshney M, Singh P. Optimizing nonlinear activation functions for convolutional neural networks. Signal Image Video Process. 2021;15:1323–1330.
- Bera S, Shrivastava VK. Analysis of various optimizers on a deep convolutional neural network model in the application of hyperspectral remote-sensing image classification. Int J Remote Sens. 2020;41:2664–2683.
- Safarpour H, et al. A dual-phase segmentation framework utilizing Gumbel-Softmax and a cascaded Swin Transformer for multiclass brain tumor segmentation. Research Square. 2025:doi:10.21203/rs.3.rs-7093467/v1.
- Seyrek EC, Uysal M. A comparative analysis of various activation functions and optimizers in a convolutional neural network for hyperspectral image classification. Multimed Tools Appl. 2024;83:53785–53816.
- Maxwell AE, Warner TA, Guillén LA. Accuracy assessment in convolutional neural network-based deep-learning remote-sensing studies—part 1: literature review. Remote Sens (Basel). 2021;13(13):2450. doi:10.3390/rs13132450.
- Villon S, et al. A new method to control error rates in automated species identification with deep-learning algorithms. Sci Rep. 2020;10:10972. doi:10.1038/s41598-020-67573-7.
- Rasool N, et al. TransResUNet: revolutionizing glioma brain tumor segmentation through transformer-enhanced residual UNet. IEEE Access. 2024;12:72105–72116.
- Chen Y, et al. Evaluation efficiency of hybrid deep-learning algorithms with neural-network decision-tree and boosting methods for predicting groundwater potential. Geocarto Int. 2022;37:5564–5584.
- Alakus TB, Turkoglu I. Comparison of deep-learning approaches to predict COVID-19 infection. Chaos Solitons Fractals. 2020;140:110120. doi:10.1016/j.chaos.2020.110120.
- Ranjbarzadeh R, et al. Explainable attention-guided Swin Transformer networks for brain tumor segmentation from 3D MRI. Lect Notes Netw Syst. 2026;1730:110–128. Available from: https://lero.ie/bibliography/explainable-attention-guided-swin-transformer-networks-for-brain-tumor-segmentation-from-3d-mri/.
- Ranjbarzadeh R, et al. A global-local 3D brain tumor segmentation model using vision transformers and axial state-space modeling [conference paper]. Presented at: 3rd International Conference on Artificial Intelligence, Computer, Data Sciences, and Applications; Boracay Island, Philippines; 2026. https://doi.org/10.1109/ACDSA67686.2026.11468214.
- Hussain SS, et al. Next-generation automation in neuro-oncology: advanced neural networks for MRI-based brain tumor segmentation and classification. IEEE Access. 2025;13:41141–41158.
الوصول مقيد. يرجى تسجيل الدخول أو بدء فترة تجريبية لعرض هذا المحتوى.