يدمج VoiceNet-RAI سمات MFCC، وتضمينات wav2vec 2.0 متعددة اللغات، ونموذج EfficientNet-Lite لتصنيف النوع والعمر من البيانات الصوتية. ويحقق هذا الإطار دقة تصل إلى 97.87% في المجموعة الفرعية للغة الإنجليزية، كما يدعم التطبيقات المسؤولة في مجالات التعرف على الكلام، والمصادقة، والأدلة الجنائية الرقمية.
يتطلب اشتراك JoVE لعرض هذا المحتوى. تسجيل الدخول أو ابدأ نسخة تجريبية مجانية
مقالة بحثية
VoiceNet: إطار عمل للذكاء الاصطناعي المسؤول متعدد اللغات في التعرف على الكلام لتصنيف النوع الاجتماعي والعمر
127 مشاهدة
⸱
سبتمبر 11, 2026
في هذه المقالة
ملخص
الملخص
يعد التصنيف الدقيق للجنس والعمر من خلال بيانات الصوت أمرًا بالغ الأهمية لتحقيق تفاعل بشري-حاسوبي (HCI) مخصص وآمن وأخلاقي. ومع الاستخدام المتزايد لنماذج الكلام الضخمة مسبقة التدريب مثل wav2vec 2.0، برزت الحاجة إلى الاستفادة من هذه التمثيلات بشكل مسؤول للاستدلال الديموغرافي متعدد اللغات والمراعي للخصوصية. تقترح هذه الدراسة VoiceNet-RAI، وهو إطار عمل للتعلم العميق (DL) يدمج معاملات كبسترال التردد الميلي (MFCCs) مع تضمينات wav2vec 2.0 متعددة اللغات القائمة على المحولات (transformer) ضمن بنية EfficientNet-Lite لدعم تصنيف دقيق وعادل وشفاف عبر سياقات لغوية متنوعة. يجمع إطار العمل بين المعلومات السياقية والطيفية لتحسين المتانة في ظل ظروف تسجيل متغيرة. وقد أظهرت التجارب على بيانات كلام متعددة اللغات تغطي 28 لغة أداءً قويًا في التصنيف، حيث حققت المجموعة الفرعية للغة الإنجليزية دقة بلغت 97.87%، ودقة تحديد (precision) بنسبة 98.61%، واستدعاء (recall) بنسبة 98.70%، ودرجة F1 بلغت 98.65%. وأسفر التحقق الخارجي باستخدام مجموعة بيانات Mozilla Common Voice عن دقة بلغت 98.27% لتصنيف الجنس، مما يثبت إمكانية التعميم على مجموعة بيانات مستقلة. كما أظهر تحليل الاستئصال (Ablation analysis) أن دمج ميزات MFCC و wav2vec 2.0 قد حسن الأداء مقارنة بالتمثيلات الخام أو تلك المعتمدة على MFCC وحدها. وتبرهن هذه النتائج على إمكانات تمثيلات الكلام الهجينة الطيفية-السياقية في تحقيق تصنيف قوي ومسؤول للجنس والعمر.
المقدمة
يُعد التعرف على الصوت مكونًا أساسيًا في التواصل البشري، حيث يعبر الأفراد من خلاله عن مشاعرهم وأفكارهم وأهدافهم. وتنتج الأصوات البشرية عبر عملية بيولوجية يتم فيها زفير الهواء من الرئتين وتشكيله إلى صوت بواسطة أعضاء النطق مثل الشفتين واللسان والأسنان1. وتلعب الأذن دورًا جوهريًا في تحديد الصوت، حيث يمكنها التمييز بين أصوات الذكور والإناث بناءً على خصائص مثل مستوى الصوت وطبقة الصوت. ومن الخصائص التي تساهم في وجود فروق جوهرية في طبقة الصوت بين الذكور والإناث هي ثنائية الشكل الجنسي2. ويعد تصنيف العمر والجنس من خلال الصوت أمرًا ذا صلة بالعديد من التطبيقات، بما في ذلك التفاعل بين الإنسان والآلة، والتعرف الآلي على الجنس، والتحيات المخصصة، والتصنيف المسبق لعواطف الكلام، وتصنيف المكالمات بناءً على الجنس3.
يُعد الكلام جزءاً جوهرياً من التفاعل البشري. إذ يحتوي الصوت البشري على خصائص متعددة تختلف من فرد لآخر، ويمكن أن توفر معلومات عن الحالات العاطفية والنفسية، فضلاً عن العمر والجنس. ويمكن الاستفادة من هذه الخصائص متعددة الأبعاد في تطبيقات مثل أنظمة الأمان المعتمدة على الصوت والمساعدات الذكية القائمة على الذكاء الاصطناعي (AI) الموجهة للكلام. وتشمل المجالات الأخرى التي يبرز فيها تحليل الصوت أنظمة التحقق التلقائي من المتحدث (ASV) وأنظمة الذكاء الاصطناعي القائمة على العواطف. كما يمكن لأنظمة الإدخال المعتمدة على الصوت أن تقلل من نطاق البحث ضمن قواعد البيانات4,5. بالإضافة إلى ذلك، يمكن لأنظمة الأمان القائمة على الذكاء الاصطناعي استخدام بيانات الصوت في تطبيقات مثل التحقيقات الجنائية وحماية الضحايا. وتظهر أصوات الذكور والإناث خصائص مختلفة بسبب التباينات في الخصائص الرنينية للمسلك الصوتي. ويمكن استخلاص هذه الخصائص من إشارات الكلام في شكل مناسب للمعالجة الحسابية، مما يتيح تصنيف الجنس من بيانات الصوت6,7. وبناءً على ذلك، تبرز الحاجة إلى خوارزميات تعلم فعالة لتصنيف الجنس المعتمد على الصوت. وتعتبر خوارزميات التعلم العميق (DL) مناسبة بشكل خاص للتصنيفات المتعلقة بالكلام نظراً لقدرتها على تعلم أنماط معقدة من البيانات الصوتية. وقد تحتوي هذه النماذج على طبقات تلافيفية، أو متكررة، أو تلافيفية زمنية، أو طبقات متصلة بالكامل، وذلك حسب البنية المعمارية. ويمكن لهذه الطبقات تعلم الخصائص الصوتية ذات الصلة، بما في ذلك النبرة وطبقة الصوت. وبمجرد تدريب النموذج، يمكنه تصنيف الجنس من تسجيلات صوتية لم يسبق له رؤيتها8. ومن المجالات الهامة الأخرى في أبحاث تعلم الآلة (ML) تصنيف العمر من التسجيلات الصوتية؛ حيث يمكن لخوارزميات تعلم الآلة استخدام الخصائص الصوتية مثل طبقة الصوت، وجرس الصوت، والسعة لتحديد الأنماط المرتبطة بالعمر. كما يمكن تطبيق تقنيات مثل تحليل المكونات الرئيسية (PCA) لاستخلاص أنماط معلوماتية من بيانات الكلام، مما قد يؤدي إلى تحسين أداء التصنيف9.
لقد أظهر التعلم العميق (DL) أداءً قوياً في تطبيقات مثل التعرف على الصور والعواطف والكلام. وتُستخدم الشبكات العصبية العميقة (DNNs)، على وجه الخصوص، على نطاق واسع في المهام المتعلقة بالكلام. وفي هذه الدراسة، يتم تطبيق مناهج قائمة على التعلم العميق لتصنيف الصوت بالاقتران مع تقنيات استخلاص الميزات الراسخة. حيث تلتقط معاملات السبيكترال الترددية لـ ميل (MFCCs) الخصائص الطيفية ذات الصلة لإشارات الكلام وتوفر تمثيلاً فعالاً للمعالجة اللاحقة. ثم يتم دمج الميزات المستخلصة لاحقاً في إطار عمل للتعلم النقلي لتصنيف النوع والعمر بناءً على الصوت10,11.
اعتمدت الدراسات الحديثة بشكل متزايد على تمثيلات الكلام ذاتية الإشراف والقائمة على محولات Transformer لتصنيف سمات المتحدث. وقد بحث الباحثون في التحيزات الديموغرافية، بما في ذلك التحيزات المتعلقة بالنوع الاجتماعي والعمر، في نماذج الكلام ذاتية الإشراف مثل HuBERT و wav2vec 2.0، مما يسلط الضوء على أهمية التقييم الواعي بالعدالة12. وفي الآونة الأخيرة، أظهرت النهج المستقلة عن اللغة والقائمة على محولات Transformer فعالية تمثيلات الكلام السياقية المتعلمة للتعرف على النوع الاجتماعي في ظل ظروف متعددة اللغات وظروف صاخبة13. كما بحث Sinha وزملاؤه بشكل أعمق في تمثيلات wav2vec 2.0 على مستوى الطبقات لتصنيف العمر والنوع الاجتماعي، وأظهروا أن طبقات Transformer المختلفة تلتقط مستويات متفاوتة من المعلومات المتعلقة بالمتحدث14. وتحفز هذه التطورات إطار عمل VoiceNet-RAI المقترح، الذي يجمع بين المعلومات الطيفية التقليدية القائمة على MFCC وتمثيلات wav2vec 2.0 السياقية، مع دمج اعتبارات تعدد اللغات والذكاء الاصطناعي المسؤول.
أظهرت الدراسات الحديثة أنه يمكن توصيف عمر المتحدث وجنسه باستخدام كل من السمات الصوتية التقليدية والتمثيلات القائمة على التعلم العميق. وقد بينت المنهجيات التي تجمع بين المعلومات الصوتية والزمنية أن خصائص الكلام التكاملية يمكن أن تحسن من أداء تصنيف العمر والجنس15,16. كما أثبتت الأبحاث ذات الصلة أن سمات الكلام المحولة التي يتم إنتاجها باستخدام تمثيلات عنق الزجاجة العميقة (deep bottleneck representations) يمكن أن تحسن أداء تصنيف عمر المتحدث وجنسه17. وتدعم هذه النتائج التوسع في استخدام التمثيلات الطيفية والزمنية والمتعلمة لمهام التصنيف التي تتضمن الكلام والإشارات المشتقة منه.
بحثت دراسات عدة في التعرف على العمر والجنس من خلال الكلام باستخدام مناهج التعلم الآلي والتعلم العميق18,19,20,21,22,23,24,25,26,27,28,29,30. وقد استكشفت مناهج أكثر حداثة تمثيلات MFCC المحولة والشبكات العصبية العميقة لتصنيف عمر وجنس المتحدث31، بينما تظل التباينات متعددة اللغات والمعتمدة على اللغة اعتبارات مهمة عند تطوير أنظمة تصنيف ديموغرافية قوية تعتمد على الصوت. إذ يمكن أن تؤدي الاختلافات في النطق والبنية الصوتية وخصائص المتحدث وظروف التسجيل إلى تقليل قدرة النموذج على التعميم عبر اللغات والمجموعات السكانية المختلفة. وبناءً على ذلك، فإن استخدام تمثيلات كلام طيفية وسياقية تكميلية قد يعزز من قوة النظام في البيئات متعددة اللغات.
على الرغم من أن النهج الهجينة قد جمعت سابقاً بين سمات صوتية متعددة أو مصنفات تجميعية للتعرف على البيانات الديموغرافية بناءً على الصوت، إلا أن VoiceNet-RAI يختلف من خلال دمج مستويين متكاملين من تمثيل الكلام ضمن إطار عمل موحد. وتحديداً، تحافظ سمات MFCC التقليدية على الخصائص الطيفية والصوتية الموضعية، بينما يوفر wav2vec 2.0 تمثيلات سياقية يتم تعلمها من الكلام الخام باستخدام مشفر Transformer. وبدلاً من الاعتماد حصرياً على الواصفات الصوتية المصممة يدوياً أو تمثيل عميق واحد، يقوم VoiceNet-RAI بعملية دمج على مستوى السمات لتمثيلات MFCC وwav2vec 2.0 المجمعة زمنياً، ثم يقوم بتنقية التمثيل الهجين الناتج باستخدام EfficientNet-Lite. ومن ثم، تكمن الجدة العلمية في التكامل المنسق بين التمثيلات الطيفية، والسياقية ذاتية الإشراف، والتمثيلات العميقة خفيفة الوزن لتصنيف الجنس والعمر، جنباً إلى جنب مع التقييم متعدد اللغات، والتحقق من صحة البيانات باستخدام مجموعة بيانات مستقلة، وتحليل العدالة بين المجموعات الفرعية. ويعمل هذا المزيج على توسيع خطوط أنابيب تصنيف الكلام الهجينة التقليدية لتتجاوز دمج السمات الموجه نحو الدقة، وصولاً إلى إطار عمل يأخذ في الاعتبار في آن واحد تكامل التمثيلات، وتصميم النماذج خفيفة الوزن، وقابلية التعميم، والذكاء الاصطناعي المسؤول (Responsible AI).
تشمل المساهمات الرئيسية لهذا البحث تطوير نهج لتحديد الجنس والعمر من بيانات الصوت من خلال دمج سمات MFCC وwav2vec 2.0 مع EfficientNet-Lite. وقد أُجريت تجارب مكثفة على مجموعة بيانات من التسجيلات الصوتية بـ 28 لغة، حيث تم تقييم السمات الأصلية، وسمات MFCC، وسمات wav2vec 2.0، ومجموعاتها باستخدام نماذج التعلم الآلي (ML) والتعلم العميق (DL). كما تم تقييم أداء النموذج باستخدام كل من مجموعة البيانات متعددة اللغات الكاملة والمجموعة الفرعية للغة الإنجليزية. علاوة على ذلك، تم تقييم الإطار من منظور تعدد اللغات والذكاء الاصطناعي المسؤول من خلال تحليلات المجموعات الفرعية الخاصة بالجنس واللغة، والتقييم المستقل عن المتحدث، والتحقق باستخدام مجموعة بيانات Mozilla Common Voice. بالإضافة إلى ذلك، تمت مقارنة أداء الإطار المقترح مع أحدث النهج الواردة في الأدبيات الحالية، وتم تقديم نتائج التحقق المتقاطع. وقد أُجريت مجموعة كبيرة من الأبحاث ذات الصلة، ويلخص الجدول 1 هذه الدراسات، بما في ذلك النماذج ومجموعات البيانات والنتائج المسجلة19,20,21,22,23,24,25,26,27,28,29,30,31.
الوصول مقيد. يرجى تسجيل الدخول أو بدء فترة تجريبية لعرض هذا المحتوى.
البروتوكول
استخدمت هذه الدراسة مجموعات بيانات BVC Challenging Voice Set وMozilla Common Voice المتاحة للعموم دون مشاركة مباشرة من المشاركين. وبناءً على ذلك، لم تكن هناك حاجة للحصول على موافقة أخلاقية مؤسسية أو موافقة مستنيرة إضافية. تمت معالجة البيانات الضرورية فقط لتصنيف الجنس والعمر، ولم يتم إجراء أي محاولة لتحديد هوية المتحدثين الأفراد. وتظهر منهجية سير العمل الكاملة للإطار المقترح في الشكل 1.
جمع البيانات
تكونت مجموعة البيانات المستخدمة في النهج المقترح من ملفات صوتية بصيغة .wav تم الحصول عليها من مجموعة BVC Challenging Voice Set، وهي مجموعة بيانات صوتية متاحة للعامة طورتها مجموعة Biometrics Vision and Computing (BVC) ومستضافة على GitHub32. احتوت مجموعة البيانات على تسجيلات صوتية لـ 526 شخصاً، بما في ذلك 336 متحدثاً من الذكور و190 متحدثة من الإناث. وقد شملت ما يقرب من 3,964 تسجيلاً، تضمنت تسجيلات لجملة واحدة وجمل متعددة لكل متحدث. ويلخص الجدول 2 الخصائص الديموغرافية، والتغطية اللغوية، وخصائص التسجيل، واستراتيجية تقسيم البيانات، وإعدادات المعالجة المسبقة المستخدمة لمجموعات بيانات الكلام في إطار عمل VoiceNet-RAI المقترح.
استخلاص الميزات
تمت معالجة الملفات الصوتية لاستخراج الخصائص الأساسية، والتي تم تخزينها لاحقاً في ملف CSV. كما استُخرجت البيانات الوصفية، بما في ذلك العمر والجنس ونطق المتحدث، من ملفات README المقابلة. استُخدمت لغة Python، جنباً إلى جنب مع حزمة SciPy، لمعالجة ملفات WAV واستخراج الميزات ذات الصلة. ووظفت دوال تحويل فوريه السريع (FFT) والتردد في NumPy لتحويل الإشارات الصوتية من النطاق الزمني إلى النطاق الترددي. مثلت ملفات WAV السعة كدالة في الزمن؛ ومع ذلك، كانت الخصائص المرتبطة بالتردد، والتي يمكنها التمييز بين أصوات الذكور والإناث، ذات أهمية أكبر لمهمة التصنيف33.
لتحويل الإشارات الصوتية إلى تمثيلات في نطاق التردد، تم تطبيق تحويل فوريه المتقطع (DFT) باستخدام خوارزمية FFT. يقوم تحويل فوريه بتحويل الإشارة من النطاق الزمني إلى طيف ترددي. ونظراً لأن هذا الطيف لا يحافظ على المعلومات الزمنية، فقد تم تقسيم الإشارة الصوتية إلى مقاطع متداخلة، وطُبق تحويل فوريه على كل مقطع باستخدام منهج تحويل فوريه قصير المدى (STFT). قامت الدالة np.fft.fft بتوليد طيف التردد المركب، بينما وفرت الدالة np.fft.fftfreq ترددات العينات المقابلة. توفر في دليل العينات 10 ملفات صوتية لمتحدث واحد. تمت معالجة كل ملف WAV باستخدام نوافذ منزلقة بزمن 200 ms لاستخراج الترددات السائدة. على سبيل المثال، أنتج تسجيل صوتي مدته 4 ثوانٍ قائمة تضم 20 قيمة ترددية. وبالنسبة لدليل يحتوي على 10 تسجيلات، دُمجت القوائم العشر المقابلة، والتي تحتوي كل منها على 20 قيمة ترددية، في قائمة من القوائم. كما تم ترشيح الترددات للاحتفاظ بالقيم الواقعة بين 20 Hz و 280 Hz، مع استبعاد الضوضاء المحتملة حول 50 Hz.
تمثيل الميزات الهجين باستخدام MFCC و wav2vec 2.0
لالتقاط كلاً من تمثيلات الكلام السياقية عالية المستوى والخصائص الصوتية منخفضة المستوى، استخدمت هذه الدراسة استراتيجية هجينة لاستخراج الميزات تدمج ميزات MFCC مع تضمينات wav2vec 2.0 القائمة على نموذج Transformer.
استخراج ميزات MFCC
تُعد معاملات السيبسترال بتردد ميل (MFCCs) ميزات مستخدمة على نطاق واسع في معالجة الكلام وإشارات الصوت، لا سيما في تطبيقات مثل التعرف على الكلام وتحديد هوية المتحدث34,35. وفي هذه الدراسة، عمل استخراج MFCC على تحويل الإشارات الصوتية إلى متجهات ميزات تمثل الخصائص ذات الصلة بالإدراك الحسي للكلام. بدأت العملية بالتركيز المسبق (pre-emphasis) لتعزيز المكونات عالية التردد، يليه التأطير والتقطيع النافذي (framing and windowing) لتقسيم الإشارة إلى إطارات قصيرة ومتداخلة. أولاً، تمت إعادة أخذ عينات من كل عينة صوتية بتردد 16 kHz وتقسيمها إلى إطارات مدتها 25-ms مع تداخل قدره 10-ms. ثم طُبق تحويل فوريه السريع (Fast Fourier Transform) على كل إطار لتحويل الإشارة من المجال الزمني إلى المجال الترددي.
تم تمرير طيف التردد الناتج عبر سلسلة من بنوك مرشحات ميل (Mel filter banks) التي تحاكي الاستجابة الترددية غير الخطية للإدراك السمعي البشري. وقد ركزت بنوك المرشحات هذه على الترددات الأكثر أهمية من الناحية الإدراكية مع تقليل مساهمة الترددات الأقل إفادة. بعد ذلك، تم حساب اللوغاريتم لمخرجات كل بنك مرشحات لمحاكاة الحساسية اللوغاريتمية للسمع البشري تجاه الجهارة. ثم طُبِّق تحويل جيب التمام المتقطع (DCT) على طاقات بنوك المرشحات اللوغاريتمية لإزالة الارتباط بين المعاملات وإنتاج تمثيل مدمج للإشارة الصوتية. وقد التقطت المعاملات الناتجة، والمعروفة باسم MFCCs، الخصائص الطيفية الهامة للكلام. استُخدمت MFCCs لتصنيف الجنس والعمر لأنها التقطت الخصائص الصوتية التي تميز الأصوات وفقاً لهذه السمات.
استخراج التضمينات باستخدام wav2vec 2.0
تم تدريب نموذج wav2vec 2.0 Base مسبقاً على مجموعات بيانات كلامية ضخمة غير مصنفة. ويتكون النموذج من مشفر Transformer متعدد الطبقات يقوم بمعالجة مدخلات شكل الموجة الخام وتوليد تضمينات كلامية سياقية36.
بناءً على شكل موجي مدخل x ∈ RT، ينتج نموذج wav2vec 2.0 تسلسلاً من التمثيلات الكامنة:
Z = {z1,z1,....,zn},zi ∈ R768 (1)
حيث كانت أبعاد كل متجه تضمين 768. وللحصول على تمثيل ثابت الطول ومناسب للتصنيف، تم تطبيق عملية تجميع متوسط زمني (temporal mean pooling) عبر جميع الخطوات الزمنية.
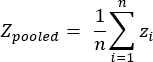 (2)
آلية دمج الميزات
تم دمج ميزات MFCC وwav2vec 2.0 عبر التسلسل على مستوى الميزات. وتحديداً، تم تجميع ميزات MFCC أولاً باستخدام المتوسط الزمني لإنتاج متجه ثابت الطول.
m ∈ R40 (3)
تم الحصول على متجه الميزات الهجين النهائي كما يلي:
h = [m || zpooled] ∈ R808 (4)
حيث يشير الرمز || إلى عملية التسلسل. وقد جمع هذا الدمج بين التضمينات السياقية العميقة والميزات الطيفية المصممة يدويًا، مما مكن النموذج من التقاط كل من المعلومات الدلالية رفيعة المستوى والأنماط الصوتية دقيقة التفاصيل.
أولاً، تمت إعادة أخذ عينات من جميع العينات الصوتية بتردد 16 kHz. حُسبت ميزات MFCC لكل إطار على حدة ثم أُجري لها متوسط زمني لإنتاج متجه ثابت بأبعاد 40، بينما تم تجميع تضمينات wav2vec 2.0 بالمتوسط عبر الزمن لإنتاج تمثيل بأبعاد 768. ونظراً لتحويل مجموعتي الميزات إلى متجهات ثابتة الطول قبل الدمج، لم تكن هناك حاجة للمحاذاة الزمنية على مستوى الإطار. بعد ذلك، تم دمج تمثيلات MFCC و wav2vec الناتجة في متجه ميزات هجين بأبعاد 808 قبل تمريره إلى نموذج التصنيف.
التكامل مع EfficientNet-Lite
تمت إعادة تشكيل متجه السمات المدمج، h، إلى تنسيق مناسب لتعلم السمات وتقديمه كمدخل لنموذج EfficientNet-Lite من أجل التدريب. قامت طبقة إسقاط متصلة بالكامل أولاً بخرائط المتجه ذو الـ 808 أبعاد إلى فضاء كامن أعلى أبعاداً، وبعد ذلك قامت كتل EfficientNet-Lite بتنقية السمات الهرمية. واستُخدمت طبقات تطبيع الدفعات (Batch normalization) وطبقات الإسقاط (dropout) لتقليل الإفراط في التخصيص وتحسين تعميم النموذج. كما استُخدمت دالة التنشيط SoftMax لتوليد الاحتمالات المتوقعة النهائية لفئات الجنس والعمر. عومل التمثيل المدمج، h ∈ R808، في البداية كمتجه سمات أحادي البعد ومُرِّر عبر طبقة إسقاط متصلة بالكامل قامت بخرائطه إلى 4,096 بُعداً. ثم أُعيد تشكيل التمثيل المُسقط إلى موتر (tensor) بأبعاد 1 × 64 × 64 قبل تزويده بمعمارية EfficientNet-Lite.
لمواءمة تمثيل سمات الكلام أحادي القناة، بدلاً من إدخال الصور التقليدي ثلاثي القنوات، تم تعديل طبقة التلافيف المدخلة في نموذج EfficientNet-Lite الأصلي من ثلاث قنوات إدخال إلى قناة واحدة. كما تم الاحتفاظ ببقية كتل استخراج السمات في EfficientNet-Lite دون تعديلات هيكلية رئيسية. وطُبقت طبقة تجميع متوسط عام تكيفية (adaptive global average pooling layer) على خرائط السمات النهائية لإنتاج تمثيل ثابت الطول. واستُبدل رأس التصنيف الأصلي بطبقة متصلة بالكامل مخصصة للمهمة، تحتوي على وحدتي إخراج لتصنيف النوع الاجتماعي، والعدد المقابل من وحدات الإخراج لمجموعات العمر المحددة مسبقاً. وأخيراً، طُبقت دالة التنشيط SoftMax لتوليد احتمالات الفئات. وقد دمج التمثيل الهجين المقترح بين تضمينات الكلام ذاتية الإشراف الحديثة وسمات معالجة الإشارات التقليدية؛ حيث التقطت تضمينات wav2vec 2.0 المعلومات السياقية والتبعيات طويلة المدى، بينما وفرت سمات MFCC معلومات صوتية تكميلية منخفضة المستوى. وقد أدى دمج هذه التمثيلات إلى تحسين أداء التصنيف، لا سيما في ظروف الكلام الضوضائية ومتعددة اللغات.
مصنف تعلم الآلة
في هذا البحث، تم تحليل أداء خوارزميات تعلم آلي (ML) متعددة لتصنيف النوع الاجتماعي والفئة العمرية استناداً إلى الصوت.
الغابة العشوائية (Random Forest)
استُخدمت الغابة العشوائية (Random Forest - RF) كـمُصنف قوي من مُصنفات تعلم الآلة (ML)، حيث تجمع بين عدة أشجار قرار (DTs) لتحسين دقة التنبؤ والحد من الإفراط في التخصيص (overfitting). تعمل الغابة العشوائية من خلال إجراء تعلّم تجميعي (ensemble-learning) يتم فيه تجميع التنبؤات من أشجار متعددة لإنتاج التنبؤ النهائي37,38. وقد مكن هذا النهج الغابة العشوائية من رصد أنماط متنوعة في البيانات مع تقليل الإفراط في التخصيص المرتبط عادةً بأشجار القرار الفردية. كما أدت العشوائية المُدخلة أثناء بناء الأشجار إلى تحسين قدرة النموذج على التعميم، مما جعل الغابة العشوائية مناسبة لمهام التصنيف مثل تصنيف الجنس والعمر من بيانات الصوت.
الانحدار اللوجستي
استُخدم الانحدار اللوجستي (LR) كنموذج إحصائي للتعلم الآلي (ML) لأغراض التصنيف39. وفي حالة التصنيف الثنائي، يقوم الانحدار اللوجستي بتقدير احتمالية حدوث نتيجة معينة بناءً على الميزات المدخلة باستخدام الدالة اللوجستية (sigmoid)، وتُستخدم الاحتمالات الناتجة لتوليد تنبؤات الفئات. كما كان الانحدار اللوجستي قابلاً للتطبيق على مشكلات التصنيف متعدد الفئات التي تتضمن أكثر من فئتين؛ حيث استخدم في التصنيف متعدد الفئات مناهج مثل "واحد مقابل البقية" (one-vs-rest) أو انحدار SoftMax، وذلك اعتماداً على إعدادات التصنيف.
مصنف الأشجار الإضافية
استُخدم مصنف الأشجار الإضافية (ETC) كخوارزمية تعلم تجميعي تجمع بين عدة أشجار قرار (DTs) لتوليد التنبؤات40,41. وبخلاف الغابات العشوائية (RF)، يقدم مصنف ETC عشوائية إضافية من خلال اختيار الميزات المرشحة وعتبات التقسيم بشكل عشوائي أثناء بناء الشجرة. وقد أنتج هذا الإجراء أشجاراً أقل ارتباطاً وقلل من حساسية النموذج للميزات الفردية، مما أدى إلى تحسين المتانة تجاه الضجيج. كما استُخدم مؤشر جيني (Gini index) كمعيار تقسيم لتقييم أهمية الميزات وتجزئة البيانات.
آلة متجه الدعم
تم استخدام آلة متجه الدعم (SVM) كمصنف تعلم آلي (ML) لتحديد حد قرار مثالي في فضاء ميزات عالي الأبعاد42. وكان الهدف هو تحديد مستوي فائق يحقق أقصى هامش بين الفئات. وبوجه عام، يدعم الهامش الأكبر بين حد القرار وأقرب نقاط البيانات فصلاً أفضل للفئات وقدرة أعلى على التعميم. وكانت آلة متجه الدعم قابلة للتطبيق في العديد من مهام التعلم الآلي، بما في ذلك التصنيف، والانحدار، وتحليل البيانات القائم على الميزات.
الشبكات العصبية التلافيفية
استُخدمت الشبكات العصبية الالتفافية (CNNs) كنماذج للتعلم العميق (DL) في مهام التصنيف التي تتضمن تمثيلات منظمة لبيانات الصور والصوت. كما طُبقت الشبكات العصبية الالتفافية أحادية الأبعاد (1D-CNNs) على نطاق واسع في البيانات التسلسلية والنصية. وتستخدم بنيات الشبكات العصبية الالتفافية المرشحات الالتفافية وعمليات التجميع لاستخلاص الميزات التمييزية من البيانات المدخلة43,44. ومن أجل تصنيف الجنس والعمر من بيانات الصوت، طُبقت الشبكات العصبية الالتفافية على التمثيلات المشتقة من الكلام لتعلم الأنماط المرتبطة بطبقة الصوت والتردد والنبرة والخصائص الصوتية الأخرى ذات الصلة بتمييز المجموعات العمرية والجنس.
VGG19
استُخدمت بنية VGG19 كبنية للتعلم العميق (DL) تتميز بهيكل هرمي عميق وموحد نسبيًا لاستخلاص الميزات45. وقد اعتمدت بنيتها على مرشحات تلافيفية صغيرة بحجم 3 × 3 عبر 19 طبقة، مما أتاح استخلاصًا تدريجيًا للميزات التمييزية. وعند تطبيقها على التمثيلات المشتقة من الكلام، تمكنت VGG19 من التقاط كل من الأنماط الصوتية منخفضة المستوى، مثل تغيرات طبقة الصوت والتردد، والميزات التمييزية عالية المستوى. كما أتاحت بنيتها العميقة تجريدًا تدريجيًا للميزات لنمذجة الخصائص الصوتية المرتبطة بالجنس والعمر.
EfficientNet-Lite
استُخدم EfficientNet-Lite كبنية للتعلم العميق (DL) تتسم بالكفاءة الحسابية46,47. وقد اعتمد النموذج استراتيجية قياس متوازنة لتحقيق أداء تصنيف قوي مع طلب موارد حسابية أقل مقارنة ببنيات التعلم العميق الأكثر تعقيداً. كما أخذ نهج القياس المركب الخاص به في الاعتبار عمق النموذج وعرضه ودقة المدخلات بشكل مشترك لتحقيق استخراج فعال للميزات.
تم اختيار EfficientNet-Lite لإطار عمل VoiceNet-RAI المقترح نظراً لبنيته خفيفة الوزن والتوازن الملحوظ بين أداء التصنيف وتعقيد النموذج. وبالمقارنة مع البنى الأكثر تعقيداً، فقد استخدم كتل تلافيفية فعالة وتحجيماً مركباً لتحقيق تعلم فعال للميزات بمعلمات أقل ومتطلبات حسابية منخفضة. جعلت هذه الخصائص EfficientNet-Lite مناسباً لإطار عمل تصنيف الكلام المقترح، ووفرت إمكانية نشره في البيئات محدودة الموارد.
MobileNet
استُخدم نموذج MobileNet كبنية خفيفة للتعلم العميق (DL) للتطبيقات ذات الموارد الحسابية المحدودة، بما في ذلك بيئات الحوسبة المتنقلة وحوسبة الحافة48. وقد تحققت كفاءته الحسابية بشكل أساسي من خلال الالتفافات القابلة للفصل بعمق (depthwise separable convolutions)، والتي قللت من عدد المعاملات والعمليات الحسابية مقارنة ببنيات الالتفاف التقليدية. جعلت هذه الخصائص MobileNet مناسباً لتقييم تصنيف الجنس والعمر من بيانات الصوت مع الحفاظ على متطلبات حسابية منخفضة نسبياً.
InceptionV3
استُخدم نموذج InceptionV3 كبنية عميقة لاستخراج السمات الهرمية من التمثيلات المشتقة من الكلام49. وتضمنت هذه البنية عمليات تلافيفية، وعمليات تجميع، وعمليات مختلطة لاستخراج السمات عند مستويات مختلفة من التجريد. ولغرض تصنيف النوع والعمر من بيانات الصوت، استُخدم InceptionV3 لتعلم الأنماط الصوتية المعقدة والتمثيلات الهرمية المرتبطة بالتباينات في الخصائص الصوتية.
معايير التقييم
كانت الدقة أحد أكثر مقاييس التقييم استخداماً لمهام التصنيف50. ورغم أن الدقة قدمت مقياساً مفيداً للأداء العام للتصنيف، إلا أنها لم توفر دائماً تقييماً شاملاً، لا سيما في حالات مجموعات البيانات غير المتوازنة. وبناءً على ذلك، تم استخدام مقاييس إضافية، بما في ذلك الدقة (precision)، والاستدعاء (recall)، ومقياس F1-score، لتقييم أداء النموذج. وقد وفرت هذه المقاييس تقييماً أكثر شمولاً من خلال مراعاة التنبؤات الصحيحة والخاطئة لكل فئة.
عُرِفت الدقة بأنها نسبة الملاحظات المصنفة بشكل صحيح إلى إجمالي عدد الملاحظات. ورغم أن الدقة كانت مفيدة بشكل خاص لمجموعات البيانات المتوازنة، إلا أن مجموعة البيانات المستخدمة في هذه الدراسة كانت غير متوازنة. وبناءً على ذلك، تم أخذ الإيجابيات الحقيقية (TP)، والإيجابيات الكاذبة (FP)، والسلبيات الحقيقية (TN)، والسلبيات الكاذبة (FN) في الاعتبار عند حساب وتفسير مقاييس التصنيف. وتمثل المعادلة أدناه التعريف القياسي للدقة:
الدقة = (TP+TN)/(TP+TN+FP+FN)×100 (5)
تقيس الدقة (Precision) قدرة المصنف على استرجاع الحالات ذات الصلة فقط:
الدقة= TP/(TP+FP) ×100 (6)
يقيس الاسترجاع، المعروف أيضاً بالحساسية، قدرة المصنف على تحديد جميع الحالات ذات الصلة:
الاستدعاء (Recall)= TP/(FN+TP) × 100 (7)
تجمع قيمة F1-score بين الدقة (precision) والاسترجاع (recall) في مقياس واحد، وهي مفيدة بشكل خاص لتقييم أداء التصنيف في مجموعات البيانات غير المتوازنة:
F1-Score =2 ×(PPV ×TPR)/(TPR+PPV) × 100 (8)
الوصول مقيد. يرجى تسجيل الدخول أو بدء فترة تجريبية لعرض هذا المحتوى.
النتائج
تم تقييم النتائج التجريبية لتصنيف العمر والجنس باستخدام تمثيلات ميزات تعتمد على MFCC وتمثيلات هجينة مع نماذج التعلم الآلي (ML) والتعلم العميق (DL). تم تقسيم مجموعة البيانات إلى مجموعات تدريب واختبار بنسبة 80:20، حيث استُخدمت 80% للتدريب و20% للاختبار. كما تم تطبيق التقسيم على مستوى المتحدث لمنع ظهور تسجيلات المتحدث نفسه في كلتا المجموعتين.
تم تلخيص المعاملات الفائقة وتفاصيل تنفيذ الإطار المقترح في الجدول 3. أُجريت التجارب على نظام مجهز بمعالج Intel i7-8265U CPU، وذاكرة وصول عش...
الوصول مقيد. يرجى تسجيل الدخول أو بدء فترة تجريبية لعرض هذا المحتوى.
المناقشة
طورت هذه الدراسة وأقامت تقييمًا لإطار عمل مؤتمت لتصنيف النوع الاجتماعي والعمر من بيانات الصوت من خلال دمج سمات MFCC وتضمينات wav2vec 2.0 مع نموذج EfficientNet-Lite. وفي التجارب الأولية، حقق EfficientNet-Lite دقة بلغت 83.48%، ودقة تحديد (precision) بنسبة 82.87%، وحساسية (recall) بنسبة 84.28%، ومقياس F1-score بنسبة 83.54% باستخدام السمات الأصلية. وبعد دمج سمات MFCC، تحسن الأداء بشكل ملحوظ، حيث بلغت الدقة 92.64%، ودقة التحديد 93.79%، والحساسية 94.92%، ومقياس F1-score بنسبة 94.84% على مجموعة البيانات التي تضم 28 لغة. وباستخد...
الوصول مقيد. يرجى تسجيل الدخول أو بدء فترة تجريبية لعرض هذا المحتوى.
الإفصاحات
ليس لدى المؤلفين أي تضاربات في المصالح للإفصاح عنها.
شكر وتقدير
يود المؤلفون تقديم الشكر لمشروع دعم الباحثين بجامعة الأميرة نورة بنت عبد الرحمن رقم (PNURSP2026R748)، وجامعة الأميرة نورة بنت عبد الرحمن، الرياض، المملكة العربية السعودية لتمويل هذا البحث.
الوصول مقيد. يرجى تسجيل الدخول أو بدء فترة تجريبية لعرض هذا المحتوى.
المواد
| الاسم | الشركة | رقم فهرسي | التعليقات |
|---|---|---|---|
| مجموعة الأصوات الصعبة من BVC | مجموعة رؤية وحوسبة القياسات الحيوية / OgeNI | مجموعة الأصوات الصعبة BVC | https://github.com/OgeNI/BVC_Challenging_Voice_Set |
| EfficientNet-Lite | جوجل | EfficientNet-Lite، والنسخة الدقيقة المستخدمة | https://github.com/tensorflow/tpu/tree/master/models/official/efficientnet/lite |
| وحدة معالجة الرسوميات | NVIDIA | Tesla K80 | https://www.nvidia.com/ |
| مجموعة بيانات موزيلا كومون فويس (Mozilla Common Voice) | مؤسسة موزيلا (Mozilla Foundation) | Common Voice، الإصدار المستخدم في التجارب | https://www.kaggle.com/datasets/mozillaorg/common-voice/data |
| NumPy | مطورو NumPy | الإصدار المحدد المستخدم في التجارب | https://numpy.org/ |
| المعالج | إنتل | Intel Core i7-8265U | https://www.intel.com/ |
| بايثون | مؤسسة برمجيات بايثون (Python Software Foundation) | الإصدار الدقيق المستخدم في التجارب | https://www.python.org/ |
| PyTorch | مؤسسة PyTorch | الإصدار الدقيق المستخدم في التجارب | https://pytorch.org/ |
| Scikit-learn | مطورو Scikit-learn | الإصدار الدقيق المستخدم في التجارب | https://scikit-learn.org/ |
| SciPy | مطورو SciPy | الإصدار الدقيق المستخدم في التجارب | https://scipy.org/ |
| wav2vec 2.0 Base | ميتا إيه آي (Meta AI) | facebook/wav2vec2-base | https://huggingface.co/facebook/wav2vec2-base |
| ويندوز 11 | مايكروسوفت | ويندوز 11، الإصدار/البناء المحدد في حال توفره | https://www.microsoft.com/windows/windows-11 |
المراجع
- Pahwa A, Aggarwal G. Speech feature extraction for gender recognition. Int J Image Graph Signal Process. 2016;8:17.
- Ericsdotter C, Ericsson AM. Gender differences in vowel duration in read Swedish: Preliminary results. Work Pap Lund Univ Dep Linguist Phon. 2001;49:34-37.
- Gamit MR, Dhameliya K, Bhatt NS. Classification techniques for speech recognition: A review. Int J Emerg Technol Adv Eng. 2015;5:58-63.
- Rabiner LR, Juang BH. Fundamentals of Speech Recognition. PTR Prentice Hall; Englewood Cliffs, NJ; 1993.
- Hansen JHL, Hasan T. Speaker recognition by machines and humans: A tutorial review. IEEE Signal Process Mag. 2015;32(6):74-99.
- Zhang Y, et al. Towards end-to-end speech recognition with deep convolutional neural networks [conference presentation]. Presented at: Interspeech 2016; San Francisco, CA; 2016. p. 410-414. Available from: https://www.isca-archive.org/interspeech_2016/zhang16b_interspeech.html
- Kabil SH, Muckenhirn H, Magimai-Doss M. On learning to identify genders from raw speech signal using CNNs [conference presentation]. Presented at: Interspeech 2018; Hyderabad, India; 2018. p. 287-291. Available from: https://www.isca-archive.org/interspeech_2018/kabil18_interspeech.html
- Albawi S, Mohammed TA, Al-Zawi S. Understanding of a convolutional neural network [conference presentation]. Presented at: 2017 International Conference on Engineering and Technology (ICET); Antalya, Türkiye; 2017. p. 1-6. Available from: https://ieeexplore.ieee.org/document/8308186
- Abdi H, Williams LJ. Principal component analysis. Wiley Interdiscip Rev Comput Stat. 2010;2(4):433-459.
- Mavaddati S. Voice-based age, gender, and language recognition based on ResNet deep model and transfer learning in spectro-temporal domain. Neurocomputing. 2024;580:127429.
- Jiang H, et al. 3WD-DRT: A three-way decision enhanced dynamic routing transformer for cost-sensitive multimodal sentiment analysis. Inf Sci. 2026;725:122704.
- Jameel HK, Al Ghrairi AHT, Neamah MM. Self-supervised learning for speech recognition: A review. Dijlah J Eng Sci. 2026;3(2).
- Anidjar OH, Yozevitch R. Transformer-based language-independent gender recognition in noisy audio environments. Sci Rep. 2025;15(1):14421.
- Sinha A, Kathania HK, Kurimo M. A study on the layer-wise transferability of self-supervised learning features for children's speech processing tasks. Speech Commun. 2026;180:103392.
- Li M, Han KJ, Narayanan SS. Automatic speaker age and gender recognition using acoustic and prosodic level information fusion. Comput Speech Lang. 2013;27(1):151-167.
- Sánchez-Hevia HA, Gil-Pita R, Utrilla-Manso M, Rosa-Zurera M. Age group classification and gender recognition from speech with temporal convolutional neural networks. Multimed Tools Appl. 2022;81:3535-3552.
- Abu Mallouh A, Qawaqneh Z, Barkana BD. New transformed features generated by deep bottleneck extractor and a GMM–UBM classifier for speaker age and gender classification. Neural Comput Appl. 2018;30:2581-2593.
- Almomani A, et al. Age and gender classification using backpropagation and bagging algorithms. Comput Mater Contin. 2023;74(2):3045-3062.
- Sahar RM, Rao TS, Anuradha S, Rao BS. Performance analysis of ML algorithms to detect gender based on voice. In: Recent Trends in Intensive Computing. 2021. p. 163-171. Available from: https://journals.sagepub.com/doi/abs/10.3233/APC210192
- Kone VS, et al. Voice-based gender and age recognition system [conference presentation]. Presented at: 2023 International Conference on Advancement in Computation & Computer Technologies (InCACCT); Gharuan, India; 2023. p. 74-80. Available from: https://ieeexplore.ieee.org/document/10141801
- Alhussein M, Muhammad G. Voice gender recognition under unconstrained environments using self-attention. Appl Acoust. 2021;175:107823.
- Yücesoy E. Automatic age and gender recognition using ensemble learning. Appl Sci. 2024;14(16):6868.
- Alnuaim AA, et al. Speaker gender recognition based on deep neural networks and ResNet50. Wirel Commun Mob Comput. 2022;2022:4444388.
- Ibrahim F, Nahar KMO, Al-Shannaq MA. Gender identification and age estimation of Arabic speaker using machine learning. J Theor Appl Inf Technol. 2020;98(19):3242-3256.
- Kannapiran P, Sindha MMR. Voice-based gender recognition model using FRT and LightGBM. Teh Vjesn. 2023;30:282-291.
- Alkhammash EH, Hadjouni M, Elshewey AM. A hybrid ensemble stacking model for gender voice recognition approach. Electronics. 2022;11:1750.
- Mutiany M, Herlistiono IO. Gender detection by voice using deep learning. Int J Innov Sci Res Technol. 2020;5(10):841-845.
- Raahul A, Sapthagiri R, Pankaj PK, Vijayarajan V. Voice based gender classification using machine learning. IOP Conf Ser Mater Sci Eng. 2017;263(4):042083. Available from: https://iopscience.iop.org/article/10.1088/1757-899X/263/4/042083
- Iloanusi O, et al. Voice recognition and gender classification in the context of native languages and lingua franca [conference presentation]. Presented at: 2019 6th International Conference on Soft Computing & Machine Intelligence (ISCMI); Johannesburg, South Africa; 2019. p. 175-179. Available from: https://ieeexplore.ieee.org/document/9004306
- Gupta Y, Gangwar K, Singhal M, Hemavathi D. Gender and age recognition using audio data-artificial neural networks. In: Soft Computing for Security Applications: Proceedings of ICSCS 2021. Springer; 2022. p. 449-470. Available from: https://link.springer.com/chapter/10.1007/978-981-16-5301-8_34
- Qawaqneh Z, Mallouh AA, Barkana BD. Deep neural network framework and transformed MFCCs for speaker’s age and gender classification. Knowl-Based Syst. 2017;115:5-14.
- OgeNI. BVC Challenging Voice Set [Internet]. GitHub; 2025 [cited 2026 Aug 16]. Available from: https://github.com/OgeNI/BVC_Challenging_Voice_Set
- Oppenheim AV, Schafer RW. Discrete-Time Signal Processing. 3rd ed. Pearson; Upper Saddle River, NJ; 2010.
- Logan B. Mel frequency cepstral coefficients for music modeling [conference presentation]. Presented at: International Society for Music Information Retrieval Conference (ISMIR); Plymouth, UK; 2000. Available from: https://ismir.net/conferences/ismir-2000/
- Davis SB, Mermelstein P. Comparison of parametric representations for monosyllabic word recognition in continuously spoken sentences. IEEE Trans Acoust Speech Signal Process. 1980;28(4):357-366.
- Baevski A, Zhou H, Mohamed A, Auli M. wav2vec 2.0: A framework for self-supervised learning of speech representations [conference presentation]. Presented at: Advances in Neural Information Processing Systems 33 (NeurIPS 2020); Virtual; 2020. p. 12449-12460. Available from: https://proceedings.neurips.cc/paper/2020/hash/92d1e1eb1cd6f9fba3227870bb6d7f07-Abstract.html
- Yıldırım Ş, Bingöl MS. Metaheuristic approaches to enhance voice-based gender identification using machine learning methods. Appl Sci. 2025;15(23):12815.
- Breiman L. Random forests. Mach Learn. 2001;45:5-32.
- Hosmer DW Jr, Lemeshow S, Sturdivant RX. Applied Logistic Regression. 3rd ed. Wiley; Hoboken, NJ; 2013.
- Geurts P, Ernst D, Wehenkel L. Extremely randomized trees. Mach Learn. 2006;63:3-42.
- Yücesoy E, Nabiyev VV. A new approach with score-level fusion for the classification of a speaker age and gender. Comput Electr Eng. 2016;53:29-39.
- Cortes C, Vapnik V. Support-vector networks. Mach Learn. 1995;20:273-297.
- Abdel-Hamid O, et al. Convolutional neural networks for speech recognition. IEEE/ACM Trans Audio Speech Lang Process. 2014;22(10):1533-1545.
- Nasaruddin N, Pratama Tresma MAP, Muchamad MK, Fuadi Z. Voice frequency-based gender classification using convolutional neural network for smart home. IEEE Access. 2024;12:104190-104203.
- Simonyan K, Zisserman A. Very deep convolutional networks for large-scale image recognition [conference presentation]. Presented at: International Conference on Learning Representations (ICLR); San Diego, CA; 2015. Available from: https://iclr.cc/archive/www/2015.html
- Tan M, Le QV. EfficientNet: Rethinking model scaling for convolutional neural networks [conference presentation]. Presented at: 36th International Conference on Machine Learning (ICML); Long Beach, CA; 2019. p. 6105-6114. Available from: https://proceedings.mlr.press/v97/tan19a.html
- Ertam F. An effective gender recognition approach using voice data via deeper LSTM networks. Appl Acoust. 2019;156:351-358.
- Zhao L, Wang L, Jia Y, Cui Y. A lightweight deep neural network with higher accuracy. PLoS One. 2022;17(8):e0271225.
- Szegedy C, et al. Rethinking the Inception architecture for computer vision [conference presentation]. Presented at: IEEE Conference on Computer Vision and Pattern Recognition (CVPR); Las Vegas, NV; 2016. p. 2818-2826. Available from: https://openaccess.thecvf.com/content_cvpr_2016/html/Szegedy_Rethinking_the_Inception_CVPR_2016_paper.html
- Sokolova M, Lapalme G. A systematic analysis of performance measures for classification tasks. Inf Process Manag. 2009;45(4):427-437.
- Mozilla Common Voice Project. Common Voice Dataset [Internet]. 2024 [cited 2024 Jun 18]. Available from: https://www.kaggle.com/datasets/mozillaorg/common-voice/data
الوصول مقيد. يرجى تسجيل الدخول أو بدء فترة تجريبية لعرض هذا المحتوى.