يقدم هذا البروتوكول سير عمل قابلاً للتكرار لتطوير نماذج الذكاء الاصطناعي القابلة للتفسير في الرعاية الصحية وتقييمها وتفسيرها. وهو يدمج عمليات تحضير البيانات الموحدة، وتطوير النماذج، وتقنيات القابلية للتفسير، والتقييم الكمي، وممارسات قابلية التكرار لتعزيز الشفافية والموثوقية والقابلية للتطبيق السريري.
مقالة منهجية
بروتوكول تجريبي قابل للتكرار لتطوير وتقييم نماذج الذكاء الاصطناعي القابلة للتفسير في أنظمة الرعاية الصحية
في هذه المقالة
ملخص
الملخص
يتم اعتماد الذكاء الاصطناعي (AI) بشكل متزايد كأداة قيمة لاتخاذ القرارات السريرية، والتنبؤ بالأمراض، والتشخيص الطبي، والرعاية الصحية الشخصية. ومع ذلك، لا يزال نقص الشفافية، والتطبيق غير المتسق لطرق الذكاء الاصطناعي القابل للتفسير (XAI)، ومحدودية القابلية للتكرار تشكل عوائق رئيسية أمام النشر الموثوق لنماذج الذكاء الاصطناعي في البيئات السريرية. تقترح هذه الورقة بروتوكولاً منهجياً وقابلاً للتكرار وشفافاً لتطوير وتقييم وتفسير نماذج الذكاء الاصطناعي القابلة للتفسير في تطبيقات الرعاية الصحية. يبدأ سير العمل بإعداد البيئة الحسابية، يليه الحصول على البيانات وتوصيفها، والمعالجة المسبقة، وهندسة الميزات، وتطوير النموذج، وتحسين المعلمات الفائقة، وتقييم الأداء التنبئي، وتحليل القابلية للتفسير، والتحقق الإحصائي، وتقييم القابلية للتكرار. يتضمن البروتوكول طرق XAI مثل SHapley Additive exPlanations (SHAP)، وLocal Interpretable Model-agnostic Explanations (LIME)، وGradient-weighted Class Activation Mapping (Grad-CAM)، وIntegrated Gradients، وتصور الانتباه (attention visualization)، والتفسيرات المضادة للواقع (counterfactual explanations) لإنشاء تفسيرات للنموذج على المستويين العالمي والمحلي. يركز البروتوكول على عدة مكونات رئيسية، بما في ذلك إعداد مجموعات بيانات رعاية صحية معيارية، وتطوير نماذج تعلم آلي مستقرة، وتقييم الأداء التنبئي، وتوليد تفسيرات ذات صلة سريرياً، والتقييم الإحصائي للقابلية للتكرار عبر التجارب المكررة. ومن خلال دمج تطوير النموذج، والقابلية للتفسير، والتقييم الكمي والنوعي، والتحقق الإحصائي، وتقييم القابلية للتكرار في سير عمل موحد، يوفر هذا البروتوكول إطاراً شاملاً لتطوير نماذج ذكاء اصطناعي شفافة وقابلة للتكرار لتطبيقات الرعاية الصحية.
المقدمة
أصبح الذكاء الاصطناعي مكوناً أساسياً في الرعاية الصحية الحديثة من خلال تمكين التحليل الذكي للبيانات السريرية المعقدة ودعم اتخاذ القرارات الطبية القائمة على الأدلة1. وقد أدت الرقمنة السريعة للرعاية الصحية من خلال السجلات الصحية الإلكترونية، ونظم التصوير الطبي، والأجهزة القابلة للارتداء، وتقنيات الجينوم إلى توليد أحجام كبيرة من البيانات غير المتجانسة التي تتطلب مناهج حوسبية متقدمة للتفسير الفعال2.
أظهرت خوارزميات تعلم الآلة (ML) والتعلم العميق (DL) قدرات ملحوظة في استخراج أنماط ذات دلالة من مجموعات بيانات الرعاية الصحية متعددة الأبعاد، مما أدى إلى تحسين دقة التشخيص، والتنبؤ بالأمراض، وتقييم نتائج المرضى3. وقد تم تطبيق النماذج القائمة على الذكاء الاصطناعي بنجاح في الأشعة، وعلم الأمراض، وأمراض القلب، والأورام، وطب العيون، وغيرها من التخصصات الطبية لمساعدة الأطباء في الكشف عن الأمراض في مراحل مبكرة والتوصية باستراتيجيات علاجية مخصصة4. كما ساهمت هذه التقنيات في تحسين سير العمل، وتقليل التباين التشخيصي، وتحسين استخدام موارد الرعاية الصحية5.
أدت التطورات الأخيرة في الأجهزة الحسابية، والحوسبة السحابية، وأطر الذكاء الاصطناعي مفتوحة المصدر إلى تسريع تطوير ونشر تطبيقات الرعاية الصحية الذكية6. وبناءً على ذلك، أصبح الذكاء الاصطناعي تقنية تمكينية أساسية للطب الدقيق وأنظمة دعم القرار السريري7. ورغم هذه التطورات، لا يزال الاعتماد الواسع للذكاء الاصطناعي في الممارسة السريرية الروتينية محدوداً لأن العديد من النماذج عالية الأداء لا تقدم سوى رؤى قليلة حول كيفية توليد تنبؤاتها8.
تعمل معظم خوارزميات التعلم العميق كنماذج "صندوق أسود" معقدة، حيث يصعب على السريريين والباحثين فهم عملية صنع القرار الداخلية فيها9. وعلى الرغم من أن هذه النماذج غالباً ما تحقق أداءً تنبؤياً ممتازاً، إلا أن افتقارها إلى الشفافية يضعف ثقة المستخدم ويفرض تحديات أمام التحقق السريري، والموافقة التنظيمية، وسلامة المرضى10. ويجب أن يكون المتخصصون في الرعاية الصحية قادرين على تبرير القرارات المدعومة بالذكاء الاصطناعي قبل دمجها في الممارسة السريرية الروتينية، خاصة في البيئات الطبية عالية المخاطر11.
لقد برز الذكاء الاصطناعي القابل للتفسير (XAI) كنهج فعال لتحسين شفافية نماذج تعلم الآلة وقابليتها للتفسير12. وبدلاً من التعامل مع نماذج التنبؤ كأنظمة معتمة، توفر تقنيات XAI معلومات حول الميزات، أو مناطق الصور، أو المتغيرات السريرية التي تساهم في التنبؤات الفردية13. وتمكن هذه التفسيرات الأطباء من فهم سلوك النموذج بشكل أفضل، وتحديد التحيزات المحتملة، وتحديد ما إذا كانت القرارات الناتجة عن الذكاء الاصطناعي تتوافق مع المعرفة الطبية الراسخة14.
تم تقديم العديد من تقنيات القابلية للتفسير لتطبيقات الرعاية الصحية. حيث تقيس تفسيرات SHapley الإضافية (SHAP) مساهمة كل ميزة في تنبؤ النموذج بناءً على نظرية الألعاب التعاونية15. بينما تقوم التفسيرات المحلية القابلة للتفسير والمستقلة عن النموذج (LIME) بإنشاء نموذج مبسط وشرح تنبؤات نموذج الصندوق الأسود16. وبالنسبة لمهام الصور الطبية التي تستخدم نماذج التعلم العميق، تقوم خرائط التنشيط الموزونة بالتدرج (Grad-CAM) بإنشاء خرائط حرارية تشير بصرياً إلى مناطق الصورة التي تساهم في قرارات التصنيف17. وقد أدى الجمع بين هذه الطرق إلى تعزيز شفافية أنظمة الذكاء الاصطناعي بشكل كبير عبر مختلف مجالات الرعاية الصحية18.
على الرغم من الاهتمام المتزايد بطرق التفسير في سياقات الرعاية الصحية، إلا أن استخدامها لا يزال متبايناً في الدراسات السابقة. ولا يختلف الباحثون في استخدام استراتيجيات المعالجة المسبقة فحسب، بل يختلفون أيضاً في تصميم بنية النموذج، ومقاييس التقييم، وحتى تقنيات التفسير19. كما أن العديد من الأوراق البحثية تشير إلى دقة تنبؤية عالية، ولكنها تخفق في تقديم تقييم شامل لجودة التفسيرات أو إمكانية تكرار نتائجها20.
تعد قابلية التكرار إحدى العقبات الرئيسية في علوم الذكاء الاصطناعي الحديثة؛ حيث غالبًا ما تغفل الأوراق البحثية الكشف عن إصدار البرمجيات، والبيئة الحسابية، ومسار المعالجة المسبقة، وإعدادات المعاملات الفائقة، وتهيئة البذور العشوائية، وتكوينات الأجهزة21. وبسبب ذلك، غالبًا ما يفشل الباحثون المستقلون في إعادة إنتاج النتائج المنشورة أو التحقق من الطرق المنشورة باستخدام مجموعات بيانات أو منصات برمجية أخرى22. ويعد نقص التوثيق المفصل أحد العوامل التي تعيق دراسات القياس المرجعي، والأبحاث التعاونية، والترجمة السريرية لأنظمة الذكاء الاصطناعي23.
وإدراكاً لهذه التحديات، شددت العديد من المنظمات والوكالات التنظيمية على أهمية توفير ذكاء اصطناعي شفاف وموثوق وقابل للتكرار في تطبيقات الرعاية الصحية24. وقد ساهمت إرشادات التقارير الحالية في تحسين التوثيق المنهجي، إلا أنها تصف بشكل أساسي ما يجب الإبلاغ عنه بدلاً من تقديم إجراءات تجريبية معيارية يمكن للباحثين تنفيذها مباشرة25. وبناءً على ذلك، لا تزال هناك حاجة إلى بروتوكول شامل يدمج تحضير مجموعات البيانات، وتطوير النماذج، وتحليل القابلية للتفسير، والتقييم الإحصائي، وممارسات إمكانية التكرار في سير عمل تجريبي واحد26.
يوفر البروتوكول التجريبي الموحد عدة مزايا لمجتمع الذكاء الاصطناعي في مجال الرعاية الصحية. علاوة على ذلك، فإنه يعزز الاتساق المنهجي، ويسهل مقارنة الدراسات المستقلة، ويزيد من شفافية التجارب الحسابية، ويتيح التحقق الموثوق من النتائج المنشورة27. كما تساعد سير العمل الموحدة في التعليم والتدريب، والبحث التعاوني، والتقييم التنظيمي من خلال إجراءات موثقة بوضوح وقابلة للتكرار عبر مختلف المختبرات ومؤسسات الرعاية الصحية28.
تم تطوير واختبار بروتوكول تجريبي قابل للتكرار لتدريب وتقييم نماذج الذكاء الاصطناعي في أنظمة الرعاية الصحية. يحدد البروتوكول معايير تهيئة البيئة الحسابية، والمعالجة المسبقة لمجموعات بيانات الرعاية الصحية، وتطوير نماذج تعلم الآلة، وتطبيق طرق الذكاء الاصطناعي القابل للتفسير (XAI)، وتقييم الأداء التنبؤي، وإجراء التحقق الإحصائي، وتقييم قابلية التكرار29. ومن المرجح أن يؤدي دمج هذه المكونات في سير عمل متماسك إلى تعزيز الشفافية والموثوقية وقابلية التكرار في أبحاث الذكاء الاصطناعي في مجال الرعاية الصحية، فضلاً عن المساعدة في تطوير أنظمة صحية ذكية وموثوقة30.
البروتوكول
استخدمت تجربة التحقق المُنفذة مجموعة بيانات سكري الهنود البيما (Pima Indians Diabetes Dataset) المتاحة علناً والمجهولة الهوية، ولم تتضمن سجلات مرضى يمكن تحديد هويتهم أو استقطاب مرضى جدد. وبناءً على ذلك، لم يكن هناك حاجة إلى موافقة مستنيرة أو موافقة من مجلس المراجعة المؤسسية (IRB)/لجنة الأخلاقيات، وأُجريت جميع التحليلات وفقاً لشروط مجموعة البيانات المطبقة وسياسات البحث المؤسسية.
يستخدم مثال التحقق العملي مجموعة بيانات سكري الهنود من قبيلة "بيما" (Pima Indians Diabetes Dataset) المتاحة للعموم، والتي تحتوي على 768 سجلاً للتنبؤ الثنائي بمرض السكري. وقد طُبق سير العمل الأساسي المكون من تسع مراحل على مجموعة البيانات هذه. شملت المراحل الأساسية التسع اختيار مجموعة البيانات والتحقق من صحتها، وتكوين البيئة الحوسبية، والمعالجة المسبقة للبيانات، وتقسيم مجموعة البيانات، وتطوير النموذج وتدريبه، وتقييم الأداء التنبئي والحوسبي، وتحليل القابلية للتفسير، والتحقق الإحصائي، وتقييم إمكانية التكرار. أما التحقق الخارجي وتقييم الخبراء السريريين فقد تم الإبقاء عليهما كـوحدات تحقق اختيارية ولم يتم تنفيذهما في هذا المثال العملي. يوضح الشكل 1 سير عمل البروتوكول الأساسي، ويلخص الجدول 1 المراحل الأساسية التسع التي تم تنفيذها فقط في عملية التحقق العملية الحالية؛ بينما تم وصف التحقق الخارجي وتقييم الخبراء السريريين الاختياريين بشكل منفصل ضمن البروتوكول ولم يتم إدراجهما ضمن المراحل التجريبية التسع.
1. اختيار مجموعة بيانات الرعاية الصحية والتحقق من صحتها
- اختر مجموعة بيانات السكري لدى الهنود البيما (Pima Indians Diabetes Dataset) كمجموعة بيانات أساسية لمثال التحقق العملي. تحقق من مصدر مجموعة البيانات، وحجم العينة، وهدف التنبؤ، وتوزيع الفئات، وبنية البيانات.
- طبق معايير الاشتمال والاستبعاد وجودة البيانات المحددة مسبقاً. قم بإزالة السجلات المكررة وغير الصالحة قبل تطوير النموذج.
- سجل مصدر مجموعة البيانات، وخصائصها، ومهمة التنبؤ، وتوزيع الفئات، ومعايير الاشتمال والاستبعاد، واستراتيجية التقسيم في الجدول 2.
- طبق معايير القرار لاختيار مجموعة البيانات والنموذج:
- حدد هدف التنبؤ قبل اختيار مجموعة البيانات، أو بنية النموذج، أو استراتيجية المعالجة المسبقة، أو طريقة القابلية للتفسير.
- طابق نمط مجموعة البيانات مع هدف التنبؤ. اختر البيانات الجدولية للمتغيرات السريرية المهيكلة، أو بيانات التصوير للصور الطبية، أو بيانات السلاسل الزمنية للإشارات الفسيولوجية، أو البيانات النصية للسرديات السريرية، أو البيانات متعددة الأنماط عند توفر أنماط تكميلية لنفس المريض أو وحدة الدراسة.
- قيم مجموعات البيانات المرشحة وفقاً لحجم العينة، وتوفر النتائج، وتوزيع الفئات، والبيانات المفقودة، وجودة التعليقات التوضيحية، والأهمية السريرية، واكتمال البيانات، وإمكانية الوصول إليها. اختر مجموعة البيانات التي تستوفي المتطلبات المحددة مسبقاً.
- اختر نماذج تعلم الآلة التقليدية للبيانات الجدولية المهيكلة عندما يحد حجم العينة أو الموارد الحسابية أو متطلبات القابلية للتفسير من استخدام البنى المعقدة. اختر بنيات التعلم العميق عندما تتوفر بيانات تدريب كافية ومدخلات عالية الأبعاد، مثل الصور الطبية أو الإشارات الفسيولوجية أو النصوص السريرية.
- اختر البنيات متعددة الأنماط فقط عندما تتوفر أنماط متعددة لنفس المريض أو وحدة الدراسة ويمكن محاذاتها بشكل موثوق دون التسبب في تسرب المعلومات. اختر عمليات المعالجة المسبقة وفقاً لخصائص نمط البيانات المختار.
- اختر طرق القابلية للتفسير وفقاً للنموذج ونمط البيانات. استخدم الطرق المستقلة عن النموذج مثل SHAP أو LIME لنماذج البيانات الجدولية المناسبة، والطرق الخاصة بالنمط مثل Grad-CAM للنماذج القائمة على الصور، عند الاقتضاء.
- وثق المبررات لاختيار مجموعة البيانات، واستراتيجية المعالجة المسبقة، والنموذج، وطريقة القابلية للتفسير. احتفظ بهذه القرارات كجزء من سجل إعادة الإنتاجية.
2. تهيئة البيئة الحسابية لتطوير نموذج الذكاء الاصطناعي القابل للتفسير (XAI)
- قم بتهيئة نظام التشغيل، ووحدة المعالجة المركزية (CPU)، وذاكرة الوصول العشوائي (RAM)، ووحدة التخزين، ووحدة معالجة الرسوميات (GPU) وفقاً لمتطلبات النموذج المختار. ثم أنشئ بيئة Python معزولة وقم بتثبيت المكتبات المطلوبة لتعلم الآلة، والتعلم العميق، والإحصاء، والتصور البياني، والذكاء الاصطناعي القابل للتفسير (XAI).
- سجّل بيئة الحوسبة الفعلية، وبنية النموذج، والمعلمات الفائقة المستخدمة في عملية التحقق التي تم إجراؤها في الجدول ٣حدد المُحسِّن (optimizer)، ومعدل التعلم، وحجم الدفعة، والعدد الأقصى للدورات (epochs)، ودالة الخسارة، ومعلمات التسوية (regularization parameters)، واستراتيجية التحقق، وتكوين التوقف المبكر، وتكوين البذرة العشوائية، وطرق القابلية للتفسير، والأجهزة المستخدمة، ونظام التشغيل، وإصدار لغة Python، وإصدارات المكتبات البرمجية ذات الصلة. ميّز هذه الإعدادات المستخدمة تجريبيًا عن الإعدادات العامة أو الموصى بها في البروتوكول.
- استخدم التكوين الوارد في الجدول 3 عند إعادة إنتاج عملية التحقق من مجموعة بيانات سكري هنود البيما (Pima Indians Diabetes Dataset)، والنتائج المقابلة المتعلقة بالتنبؤ، وقابلية التفسير، والإحصاءات، وقابلية إعادة الإنتاج.
- قم بتشغيل نص برمجي للتحقق (validation script) للتأكد من نجاح استيراد الحزم، وتحميل مجموعة البيانات، وتنفيذ النموذج، وتوليد المخرجات. حافظ على تكوين البيئة النهائي لضمان قابلية تكرار النتائج.
3. تحضير وتوصيف مجموعات البيانات الرعاية الصحية لتطوير نموذج الذكاء الاصطناعي القابل للتفسير (XAI)
- اختيار مجموعة بيانات الرعاية الصحية والحصول عليها
- اختر مجموعة بيانات رعاية صحية مناسبة لمهمة التنبؤ السريري المحددة. قم بتقييم مجموعات البيانات المرشحة وفقاً لهدف البحث، ونوع البيانات، وحجم العينة، وجودة التعليقات التوضيحية، وتوازن الفئات، والأهمية السريرية.
- يُفضل استخدام مجموعات البيانات المرجعية المتاحة للعموم عندما تعالج مهمة التنبؤ بشكل كافٍ وتسهل عملية التحقق المستقل.
- احصل على الموافقات الأخلاقية المطلوبة، والتصاريح المؤسسية، وتصريح الوصول إلى البيانات قبل الحصول على مجموعات البيانات المؤسسية أو الداخلية. احصل على مجموعة البيانات المختارة من مستودع موثق أو قاعدة بيانات مؤسسية معتمدة.
- احتفظ بملفات مجموعة البيانات الأصلية دون تعديل، وسجل مزود مجموعة البيانات، والإصدار، ومعلومات الاستحواذ، وشروط الترخيص، ومعايير الشمول، ومعايير الاستبعاد، والبيانات الوصفية المصاحبة. نظم مجموعة البيانات في أدلة منفصلة للبيانات الخام، والتوصيفات، والبيانات الوصفية، والمعلومات التكميلية.
- توصيف مجموعة بيانات الرعاية الصحية
- حدد المتغيرات التنبؤية، وتسميات النتائج، وأنواع السمات، وأنماط البيانات، وتوزيعات الفئات. حدد عدد الأشخاص، والعينات، وأبعاد السمات، والتوصيفات المتاحة.
- تأكد من أن خصائص مجموعة البيانات تتوافق مع طريقة الذكاء الاصطناعي المختارة.
- استخدم مجموعة بيانات مرض السكري لدى الهنود البيما (Pima Indians Diabetes Dataset) كـمجموعة البيانات التجريبية الوحيدة المُطبقة للتحقق من صحة البروتوكول الأساسي المكون من تسع مراحل. قم بتضمين مجموعات البيانات الإضافية المدرجة في جدول 2 فقط لإثبات مدى قابلية تطبيق البروتوكول العام عبر البيانات الجدولية السريرية، والسجلات الصحية الإلكترونية، وصور تنظير الجلد، وبيانات السلاسل الزمنية الفسيولوجية، والتصوير الطبي. ولا يجوز استخدام هذه المجموعات الإضافية من البيانات في تدريب النموذج، أو اختباره، أو التحقق الإحصائي، أو استخراج النتائج التجريبية الواردة في التقرير.
- تقييم جودة مجموعة البيانات
- افحص مجموعة البيانات بحثاً عن السجلات المكررة، والملفات التالفة، والقيم المفقودة، وأخطاء التعليقات التوضيحية، ومدخلات البيانات غير المنتظمة. قم بإزالة السجلات المكررة المؤكدة وتصحيح التجاوزات في التنسيق التي تم التحقق منها. وثق جميع إجراءات ضبط جودة مجموعة البيانات.
- تحقق من تطابق بيانات التصوير والبيانات السريرية والمخبرية والفيزيولوجية من خلال معرفات الأشخاص عند استخدام مجموعات البيانات متعددة الوسائط.
- قم بإزالة السجلات المكررة أو غير المتسقة، ومعالجة القيم المفقودة، وتوحيد الميزات العددية، وترميز المتغيرات الفئوية، وتطبيق المعالجة المسبقة الخاصة بكل نمط. قم بتقسيم مجموعة البيانات إلى مجموعات مستقلة للتدريب والتحقق والاختبار. ارجع إلى الشكل 2 لسير العمل الخاص بإعداد مجموعات بيانات الرعاية الصحية، ومعالجتها الأولية، وتقسيمها، وتقييم جودتها.
- ضمان خصوصية البيانات والامتثال الأخلاقي
- قم بإزالة المعرفات المباشرة من البيانات الصحية. وطبق إجراءات إخفاء الهوية أو إضفاء أسماء مستعارة عند الاقتضاء. وتعامل مع المعلومات الصحية الخاصة بالمرضى وفقاً للمتطلبات الأخلاقية، ومتطلبات حماية البيانات، والموافقة المستنيرة، والمتطلبات المؤسسية المعمول بها.
- سجّل الموافقة الأخلاقية المعمول بها، والتنازل، وإجراءات حوكمة البيانات، وطرق إخفاء الهوية، ومسار عمل إعداد مجموعة البيانات.
- قيّم التحيز الخوارزمي المحتمل من خلال مقارنة أداء النموذج عبر المجموعات الفرعية الديموغرافية أو السريرية ذات الصلة، وذلك عندما تكون هذه المعلومات متاحة ومسموحاً بها أخلاقياً.
- وثّق الغرض من الاستخدام، والمجتمع المستهدف، ومحدودية النموذج، وأنماط الفشل المحتملة، ومتطلبات الإشراف البشري، والمتطلبات الأخلاقية، ومتطلبات حماية البيانات، والمتطلبات التنظيمية للرعاية الصحية المعمول بها.
- سجّل قيود العدالة المحددة واعتبارات الذكاء الاصطناعي المسؤول كجزء من التوثيق النهائي للنموذج.
ملاحظة: احصل على مجموعة بيانات رعاية صحية معيارية وموثقة تكون مناسبة لتطوير نماذج الذكاء الاصطناعي، ومتوافقة أخلاقياً، وخالية من التناقضات الجوهرية المحددة.
4. المعالجة المسبقة لبيانات الرعاية الصحية وتقسيمها لتدريب نموذج الذكاء الاصطناعي
- إجراء مراقبة الجودة
- فحص مجموعة البيانات بحثاً عن السجلات المكررة، والقيم المفقودة، والقيم غير الصالحة، والتسميات غير المتسقة، والقيم المتطرفة، والملفات التالفة.
- إزالة أو تصحيح الملاحظات غير الصالحة وفقاً لمعايير محددة مسبقاً وتسجيل جميع الاستبعادات. والتحقق من اتساق المتغيرات التنبؤية وتسميات النتائج.
- معالجة البيانات المفقودة
- تحديد كمية الفقد لكل متغير. وتطبيق استراتيجية التعويض أو الاستبعاد المحددة مسبقاً.
- تقدير معالم التعويض باستخدام بيانات التدريب فقط وتطبيق التحويل الملائم على بيانات التحقق والاختبار.
- تطبيع وتحويل البيانات
- تطبيق قياس الميزات، أو التطبيع، أو الترميز، أو تقليل الأبعاد، أو أي تحويلات أخرى يتطلبها النموذج المختار. ويتم ملاءمة جميع التحويلات المعتمدة على البيانات باستخدام بيانات التدريب فقط.
- تطبيق التحويلات الملائمة دون تغيير على بيانات التحقق والاختبار.
- تحديد كمية عدم التوازن في الفئات في بيانات التدريب. وتطبيق أوزان الفئات، أو SMOTE، أو الإفراط في أخذ العينات، أو التكبير على مجموعة بيانات التدريب فقط. مع الحفاظ على التوزيع الأصلي لمجموعات بيانات التحقق والاختبار.
- التأكد من عدم مشاركة أي شخص خاضع للدراسة، أو ملاحظة مكررة، أو عينة مكبرة، أو إحصائية معالجة مسبقة، أو معيار اختيار ميزات، أو عينة اصطناعية بين أقسام التدريب والتقييم.
5. تطوير وتكوين نموذج الذكاء الاصطناعي القابل للتفسير (XAI)
- تحديد بنية النموذج من خلال تحديد أنماط بيانات الإدخال، وعمليات المعالجة المسبقة، وأجهزة تشفير الميزات الخاصة بكل نمط، وآلية دمج الميزات، وطبقة التنبؤ، ووحدة القابلية للتفسير.
- اختيار بنية تعلم الآلة أو التعلم العميق وفقاً لمهمة التنبؤ ونمط الإدخال. وتكوين طبقة الإدخال، ومكونات استخراج الميزات، والطبقات الخفية، وطبقة المخرجات، ودوال التنشيط. كما يتم تحديد المُحسّن، ومعدل التعلم، وحجم الدفعة، ودالة الخسارة، وعدد الدورات (epochs)، والمنتظمات، والإسقاط (dropout)، والتوقف المبكر، وجدول معدل التعلم.
- تحسين المعلمات الفائقة باستخدام بيانات التدريب والتحقق فقط.
- تسجيل البنية النهائية وتكوين المعلمات الفائقة في الجدول 3.
- التحقق من توافق أبعاد الإدخال والمخرجات قبل البدء في التدريب.
ملاحظة: إنشاء نموذج ذكاء اصطناعي قابل للتفسير (XAI) مهيأ بالكامل يتضمن بنية مناسبة، ومعلمات فائقة محددة، وتقنيات قابلية للتفسير مدمجة.
6. تدريب وتحسين وحفظ نموذج الذكاء الاصطناعي القابل للتفسير (XAI)
- قم بتحميل مجموعات بيانات التدريب والتحقق المحددة مسبقاً وتكوين النموذج النهائي. ابدأ تشغيل النموذج باستخدام البذرة العشوائية ومعايير التدريب المحددة مسبقاً.
- درب النموذج باستخدام المحسِّن، ودالة الخسارة، وحجم الدفعة، ومعايير التوقف المحددة.
- راقب أداء التحقق واحتفظ بنقطة الفحص المقابلة لمعيار اختيار النموذج المحدد مسبقاً. قم بتقييم نقطة الفحص المختارة على مجموعة بيانات الاختبار المستقلة دون إجراء مزيد من التحسين.
- احفظ النموذج المدرب، وتكوين المعالجة المسبقة، والمعلمات الفائقة، والبذرة العشوائية، وسجل التدريب.
ملاحظة: احصل على نموذج XAI محسَّن تم تدريبه والتحقق من صحته باستخدام مجموعة بيانات الرعاية الصحية المُعدة. احتفظ بالنموذج الأفضل أداءً، والمعلمات الفائقة، وسجلات التدريب، وتكوين المعالجة المسبقة، والبيئة الحوسبية لضمان إمكانية التكرار.
7. تقييم الأداء التنبؤي والحسابي
- تقييم الأداء التنبؤي
- قم بتحميل النموذج المُحسَّن ومجموعة بيانات الاختبار المستقلة بعد إتمام تدريب النموذج وتحسين المعلمات الفائقة. حافظ على ثبات معلمات النموذج المدرب ومسار المعالجة المسبقة دون تغيير أثناء الاختبار.
- قم بإنشاء تنبؤات لجميع العينات في مجموعة بيانات الاختبار. قارن المخرجات المتوقعة مع تسميات الحقيقة الأرضية المقابلة لها.
- حساب مقاييس الأداء
- اختر مقاييس التقييم وفقاً لنوع مهمة التنبؤ.
- احسب الدقة (accuracy)، والضبط (precision)، والاستدعاء (recall)، والخصوصية (specificity)، ومقياس F1-score، والدقة المتوازنة (balanced accuracy)، ومعامل ارتباط ماتيوس (MCC)، والمساحة تحت منحنى خصائص تشغيل المستقبل (AUC-ROC) لمهام التصنيف، حسبما يتطلب الأمر. واحسب متوسط الخطأ المطلق (MAE)، وجذر متوسط مربع الخطأ (RMSE)، ومعامل التحديد (R2)، والمقاييس الأخرى ذات الصلة لمهام الانحدار، حسبما يتطلب الأمر.
- تقييم تعميم النموذج ومتانته
- قيّم النموذج باستخدام مجموعة بيانات خارجية تم جمعها بشكل مستقل عن مجموعة بيانات التطوير كلما توفرت هذه البيانات.
- يفضل استخدام مجموعات بيانات خارجية مصدرها مؤسسة رعاية صحية مختلفة، أو منطقة جغرافية مختلفة، أو مجموعة مرضى مختلفة لتقييم القابلية للنقل.
- أجرِ التحقق الزمني باستخدام بيانات جُمعت خلال فترة لاحقة عندما تتوفر مجموعات بيانات طولية.
- أجرِ التحقق متعدد المراكز من خلال تقييم النموذج النهائي بشكل منفصل عبر المؤسسات المشاركة عندما تتوفر بيانات متعددة المراكز.
- أجرِ التحقق الجغرافي باستخدام مجموعة سكانية مستقلة من منطقة جغرافية مختلفة عندما يكون ذلك ممكناً.
- سجّل فروق الأداء وفترات الثقة بين مجموعات بيانات التطوير والبيانات الخارجية.
- تقييم الأداء الحوسبي
- قس وقت تدريب النموذج في البيئة الحوسبية المحددة مسبقاً، ووقت الاستنتاج والاختبار في ظل ظروف حوسبية متطابقة، واستهلاك الذاكرة، وحجم النموذج، ومدى استغلال المكونات المادية.
- كرر القياسات الحوسبية عبر عمليات تشغيل مستقلة.
- احسب متوسط وقت التنفيذ للتقليل من تأثير التباين التجريبي.
- مقارنة أداء النموذج
- اختر طرق تعلم آلي تقليدية أو طرق تعلم عميق مناسبة لإجراء تقييم مقارن.
- قيّم نموذج XAI المقترح والنماذج المقارنة باستخدام مجموعة البيانات نفسها. طبق إجراءات المعالجة المسبقة ومقاييس التقييم المتطابقة على جميع النماذج المقارنة.
- أجرِ جميع التجارب المقارنة ضمن البيئة الحوسبية نفسها.
ملاحظة: احصل على أدلة تجريبية على الاستقرار التنبؤي وقابلية التكرار في ظل الظروف الحوسبية ومجموعة البيانات المختبرة.
8. توليد مخرجات الذكاء الاصطناعي القابل للتفسير (XAI) وتقييمها
- توليد تفسيرات النموذج
- تحميل نموذج XAI المُحسّن. اختيار عينات التقييم التي لم تُستخدم في تدريب النموذج. تطبيق طرق القابلية للتفسير المحددة مسبقاً دون تعديل النموذج المُدرّب أو مسار المعالجة المسبقة.
- توليد تفسيرات عامة ومحلية للنموذج
- توليد تفسيرات عامة لتوصيف السلوك الشامل للنموذج التنبئي.
- توليد تفسيرات محلية لتوصيف تنبؤات النموذج الفردية.
- تطبيق SHAP على مجموعة بيانات Pima Indians Diabetes لتوليد تفسيرات عامة ومحلية لتنبؤات النموذج الجدولي.
- توليد مخطط ملخص SHAP لتصور الاتجاه العام وحجم مساهمات الميزات.
- توليد مخطط أهمية الميزات SHAP باستخدام متوسط قيم SHAP المطلقة لترتيب الميزات وفقاً لمساهمتها الإجمالية في تنبؤات النموذج.
- توليد مخطط شلال SHAP لتنبؤ ممثل من مجموعة الاختبار لتوضيح مساهمات الميزات الخاصة بالمريض.
- توليد مخطط اعتماد الميزات SHAP لفحص العلاقة بين ميزة مختارة ومساهمتها في مخرجات النموذج.
- تطبيق LIME على تنبؤات ممثلة من مجموعة الاختبار لتوليد تفسيرات محلية لتنبؤات النموذج الفردية.
- توليد تفسير مضاد حقيقةي (counterfactual) خاص بالمريض لتوضيح التغييرات في الميزات المرتبطة بتغيير في النتيجة المتوقعة.
- اختيار تقنيات إضافية للقابلية للتفسير وفقاً لنمط البيانات وبنية النموذج.
- استخدام Grad-CAM أو خرائط البروز (saliency maps) للنماذج القائمة على الصور المتوافقة، وتصورات الانتباه (attention visualizations) للبنيات القائمة على المحولات (transformer)، وIntegrated Gradients للنماذج القابلة للتفاضل عند الاقتضاء.
- التعامل مع Grad-CAM، ورسم خرائط البروز، وتصور الانتباه، وIntegrated Gradients كخيارات بروتوكول عامة تعتمد على نمط البيانات، وعدم تفسيرها أو الإبلاغ عنها كنتائج تجريبية من التحقق من مجموعة بيانات Pima Indians Diabetes ما لم يتم إجراء التحليلات المقابلة فعلياً.
- تطبيق طرق القابلية للتفسير على عملية التحقق من Pima
- تطبيق SHAP وLIME على مجموعة بيانات Pima Indians Diabetes لتوليد تفسيرات عامة ومحلية لتنبؤات النموذج الجدولي.
- توليد تصورات ملخص SHAP، وأهمية الميزات، والشلال، واعتماد الميزات من نتائج التحقق من Pima.
- توليد تفسير محلي LIME لتنبؤات ممثلة من مجموعة الاختبار.
- توليد تفسير مضاد حقيقةي خاص بالمريض لتوضيح التغييرات في الميزات المرتبطة بتغيير في تنبؤ النموذج.
- التعامل مع Grad-CAM، وتصور الانتباه، ورسم خرائط البروز، وIntegrated Gradients كخيارات قابلية للتفسير تعتمد على النمط لأنواع بيانات الرعاية الصحية وبنيات النماذج الأخرى.
- عدم الإبلاغ عن Grad-CAM، أو تصور الانتباه، أو رسم خرائط البروز، أو Integrated Gradients كفائدة تجريبية من التحقق العملي لـ Pima ما لم يتم إجراء التحليلات المقابلة فعلياً.
- تقييم جودة التفسير
- تقييم ما إذا كانت التفسيرات الناتجة تعكس عملية تنبؤ النموذج. تقييم استقرار التفسيرات عبر التشغيلات التجريبية المتكررة، واتساق مخرجات التفسير تحت ظروف حسابية متطابقة.
- تقييم حساسية مخرجات التفسير للتغيرات في بيانات الإدخال عند الاقتضاء. مقارنة التفسيرات الناتجة مع المعرفة المتوفرة في المجال أو تفسيرات الخبراء.
- تحديد الميزات التنبؤية أو المناطق التشريحية التي تتوافق مع المعرفة الطبية الراسخة عندما تكون هذه المقارنات متاحة.
- تسجيل مستوى الاتفاق أو الاختلاف بين التفسيرات الناتجة والتفسير السريري المتاح.
- قياس عدم اليقين في التنبؤ
- توليد تقديرات الثقة في التنبؤ للعينات التي تم تقييمها باستخدام طريقة لتقدير عدم اليقين مناسبة لبنية النموذج المختارة وتطبيق الرعاية الصحية.
- تطبيق Monte Carlo dropout، أو التنبؤ القائم على المجموعات (ensemble-based prediction)، أو الاستدلال البايزي (Bayesian inference)، أو التنبؤ المتوافق (conformal prediction)، أو أي نهج آخر معتمد لتقدير عدم اليقين عند الاقتضاء.
- تكرار تمريرات التنبؤ العشوائية عند استخدام Monte Carlo dropout وحساب متوسط التنبؤ وتباين التنبؤ لكل عينة تقييم.
- الإبلاغ عن ثقة التنبؤ أو فترات عدم اليقين جنباً إلى جنب مع تنبؤات النموذج المقابلة.
- تقييم ما إذا كانت تقديرات عدم اليقين تحدد التنبؤات المرتبطة بموثوقية أقل أو زيادة في خطأ التنبؤ. الحفاظ على طريقة تقدير عدم اليقين، والمعاملات، والبذور العشوائية، ومخرجات عدم اليقين الناتجة لضمان إمكانية التكرار.
- توثيق وحفظ مخرجات القابلية للتفسير
- حفظ جميع درجات أهمية الميزات الناتجة، والخرائط الحرارية، وخرائط البروز، وتصورات الانتباه، والتفسيرات الخاصة بالمريض. تخزين مخرجات القابلية للتفسير باستخدام تنسيقات ملفات معيارية. أرشفة المخرجات مع النموذج المُدرّب وتكوين المعالجة المسبقة.
- تسجيل الإعدادات الحسابية، ومعاملات التفسير، ووقت التنفيذ، وإصدارات البرامج المستخدمة لتوليد التفسيرات. الحفاظ على وثائق القابلية للتفسير الكاملة لتسهيل المراجعة المستقلة وإمكانية التكرار.
- تقييم جودة التفسير كمياً
- تقييم إخلاص التفسير (explanation faithfulness) من خلال إحداث اضطراب منهجي أو حجب الميزات المحددة كأهمية وقياس التغيير المقابل في مخرجات النموذج. حساب درجة إخلاص التفسير عن طريق مقارنة حجم الإسناد بالتغيير الناتج في تنبؤ النموذج.
- تقييم استقرار التفسير من خلال توليد تفسيرات لتشغيلات متكررة، أو مدخلات مضطربة، أو عينات متشابهة سريرياً وحساب التشابه بين أنماط الإسناد الناتجة. حساب عدم الإخلاص (infidelity) عن طريق قياس التباين بين تغيير المخرجات المتوقع والتغيير المقدر من إسناد التفسير تحت اضطرابات الإدخال الموجهة.
- بالنسبة لتفسيرات الصور الطبية، يتم تقييم دقة التحديد الموضعي باستخدام منطقة اهتمام محددة من قبل خبير عندما تكون التعليقات المرجعية متاحة. تقييم الفائدة السريرية من خلال الحصول على تقييمات مستقلة من خبراء سريريين مؤهلين باستخدام معايير تفسير محددة مسبقاً.
- حساب Cohen's kappa أو Fleiss' kappa عندما يقوم عدة خبراء بتقييم صلة التفسير أو الاتفاق بشكل مستقل.
ملاحظة: توليد تفسيرات عامة ومحلية تصف السلوك التنبئي لنموذج الذكاء الاصطناعي المُدرّب. الحفاظ على مخرجات القابلية للتفسير والتكوينات المقابلة لضمان التفسير الشفاف والتقييم القابل للتكرار.
9. إجراء التحقق الإحصائي وتقييم إمكانية التكرار
- إجراء التحقق الإحصائي
- اختر الأساليب الإحصائية وفقاً لهدف الدراسة، والتصميم التجريبي، وتوزيع البيانات، وخصائص المتغيرات التي يتم تقييمها.
- سجّل المتغيرات المستمرة كمتوسط ± انحراف معياري أو كـوسيط ونطاق ربيعي، حسبما هو مناسب، والمتغيرات الفئوية كأعداد ونسب مئوية.
- أجرِ تحققاً تقاطعياً خماسياً (five-fold cross-validation) على مجموعة التدريب لتقييم استقرار أداء النموذج، وسجّل الدقة (accuracy)، وAUC-ROC، والدقة (precision)، والاستدعاء (recall)، وF1-score كمتوسط ± انحراف معياري عبر الطيات. قدّر فواصل ثقة 95% لمقاييس أداء مجموعة الاختبار المستقلة باستخدام 1,000 عينة إعادة سحب (bootstrap resamples).
- قارن النموذج المقترح مع النماذج المرجعية CNN وRandom Forest وSVM باستخدام اختبار McNemar لمقارنات الدقة المزدوجة، واختبار DeLong لمقارنات AUC-ROC المرتبطة، واختبار bootstrap المزدوج مع 1,000 عينة إعادة سحب لمقارنات F1-score.
- سجّل إحصائية الاختبار المقابلة والقيمة الاحتمالية (p-value) الدقيقة لكل مقارنة، واستخدم مستوى دلالة ثنائي الطرف α = 0.05.
- مقارنة أداء النموذج إحصائياً
- قارن نموذج الذكاء الاصطناعي القابل للتفسير المقترح مع النماذج المرجعية المختارة من أحدث تقنيات تعلم الآلة والتعلم العميق.
- طبق اختبار Student's t-test أو اختبار Mann-Whitney U عند مقارنة مجموعتين، حسبما هو مناسب. طبق تحليل التباين أحادي الاتجاه (one-way ANOVA) للمقارنات البارامترية القابلة للتطبيق التي تشمل أكثر من مجموعتين. طبق اختبار Kruskal-Wallis للمقارنات غير البارامترية القابلة للتطبيق التي تشمل أكثر من مجموعتين.
- اعتبر القيمة p < 0.05 ذات دلالة إحصائية، كما هو محدد في المخطوطة الأصلية.
- استخدم مستوى دلالة ثنائي الطرف α = 0.05 لجميع المقارنات الإحصائية المحددة مسبقاً وسجّل إحصائيات الاختبار والقيم الاحتمالية المقابلة.
- سجّل فواصل ثقة 95% لمقاييس أداء التنبؤ الرئيسية.
- استخدم إعادة سحب bootstrap لتقدير فواصل الثقة لمقاييس الأداء عند الاقتضاء. استخدم اختبار DeLong لمقارنة قيم ROC-AUC المرتبطة عندما يتم تقييم نفس الأشخاص بواسطة نموذجين. استخدم اختبار McNemar لمقارنة نتائج التصنيف الفئوية المزدوجة الناتجة عن نفس الأشخاص. استخدم إجراءات bootstrap المزدوجة لمقارنة F1-score أو مقاييس الأداء المشتقة الأخرى عند الاقتضاء.
- قيّم المعايرة باستخدام مخططات المعايرة، وميل/تقاطع المعايرة، ودرجة Brier عندما تتوفر التنبؤات الاحتمالية.
- بالنسبة للتحقق من مجموعة بيانات سكري الهنود البيما (Pima Indians Diabetes Dataset)، استخدم المقارنة الإحصائية المزدوجة المحددة مسبقاً للنموذج المقترح والنماذج المرجعية. طبق الاختبار المختار باستمرار على تنبؤات مجموعة الاختبار المزدوجة أو قياسات أداء التشغيل المتكرر، حسبما يتناسب مع المقارنة. استخدم مستوى دلالة ثنائي الطرف α = 0.05 وسجّل إحصائية الاختبار والقيمة الاحتمالية الدقيقة. لا تسجّل اختبارات إحصائية بديلة على أنها قد أجريت ما لم تُعرض نتائجها في قسم النتائج.
- طبق الاختبارات ثنائية الطرف وفسر الدلالة الإحصائية باستخدام عتبة محددة مسبقاً وهي p < 0.05.
- تقييم متانة النموذج
- كرر إجراء التدريب والتقييم الكامل 10 مرات باستخدام بذور عشوائية (random seeds) مختلفة مع الحفاظ على تقسيم مجموعة البيانات المحدد مسبقاً، وإجراءات المعالجة المسبقة، وبنية النموذج، والمعلمات الفائقة (hyperparameters)، وبيئة البرمجيات، وبروتوكول التقييم.
- سجّل AUC-ROC والدقة وF1-score لكل تشغيل مستقل وسجّل المتوسط ± الانحراف المعياري عبر التشغيلات العشرة.
- قارن قيم الأداء الناتجة عبر التشغيلات المتكررة لتقييم استقرار التنبؤ وقابلية التكرار تحت تهيئات عشوائية مختلفة.
- تقييم قابلية تكرار التفسير
- أنتج نسب السمات (feature attributions)، أو خرائط الانتباه (attention maps)، أو مخرجات تفسيرية أخرى عبر عمليات تجريبية متعددة عندما يتضمن التقييم قياس استقرار التفسير. قارن مخرجات التفسير كمياً عبر التشغيلات المتكررة باستخدام مقياس تشابه مناسب أو مقياس اتفاق قائم على الرتب.
- بالنسبة للتحقق الحالي من مجموعة بيانات سكري الهنود البيما، لا تسجّل مقاييس كمية لاستقرار التفسير ما لم تكن مخرجات التفسير والتحليلات المتكررة المقابلة قد أُجريت.
- قيّم الاتفاق بين التفسيرات الناتجة عن النموذج وتفسيرات السريريين عندما تتوفر التقييمات السريرية المناسبة. احسب معامل كابا لكوهين (Cohen's kappa) أو كابا لفليس (Fleiss' kappa)، حسبما هو مناسب، لتقييم الاتفاق بين المقيمين.
- توثيق قابلية التكرار
- احفظ البيانات الخام، وإجراءات المعالجة المسبقة، وكود المصدر، والنماذج المدربة، وتكوينات المعلمات الفائقة، ومخرجات القابلية للتفسير، ونصوص التحليل الإحصائي، والنتائج الناتجة.
- سجّل بيئة البرمجيات وتكوين الأجهزة المستخدم في سير العمل. أعد تنفيذ سير العمل الكامل بشكل مستقل باستخدام الملفات والتكوينات المؤرشفة.
- قارن أداء التنبؤ المكرر مع النتائج التجريبية الأصلية، وتفسيرات النموذج المكررة مع مخرجات القابلية للتفسير الأصلية.
- سجّل أي اختلافات لوحظت أثناء التكرار. حدث التوثيق التجريبي ليعكس ملاحظات قابلية التكرار المحددة أثناء التنفيذ المستقل.
ملاحظة: احصل على نتائج أداء تنبؤي وقابلية تفسير متحقق منها إحصائياً يمكن تقييمها عبر التجارب المتكررة. احفظ التوثيق الحسابي والتحليلي والمنهجي الكافي لتمكين التحقق المستقل من سير العمل الكامل.
- قائمة مراجعة قابلية التكرار
- سجّل اسم مجموعة البيانات، وإصدارها، وتاريخ الحصول عليها، ومصدرها، ومعايير الاشتمال، ومعايير الاستبعاد، والعدد النهائي للعينة. سجّل جميع عمليات المعالجة المسبقة، ومعلمات التحويل، وإعدادات التسوية (normalization)، وإجراءات اختيار السمات، وقواعد تقسيم البيانات.
- سجّل نظام التشغيل، ووحدة المعالجة المركزية (CPU)، ووحدة معالجة الرسوميات (GPU)، وذاكرة الوصول العشوائي (RAM)، وإصدار Python، وإصدارات أطر العمل (frameworks)، وإصدارات المكتبات. سجّل جميع مواصفات بنية النموذج والمعلمات الفائقة.
- سجّل المحسن (optimizer)، ومعدل التعلم، وحجم الدفعة (batch size)، وعدد الدورات (epochs)، ودالة الخسارة، والتنظيم (regularization)، ومعايير التوقف المبكر. سجّل جميع البذور العشوائية وإعدادات مولد الأرقام العشوائية.
- احفظ أوزان النموذج المدرب وتكوينات المعالجة المسبقة. احفظ سجلات التدريب، ونصوص التقييم، ونصوص التحليل الإحصائي، ومخرجات القابلية للتفسير. سجّل إصدارات النموذج والبرمجيات المستخدمة في التجارب النهائية.
- احفظ البيئة الحسابية الكاملة المطلوبة للتكرار المستقل.
- وثّق مدى توفر كود المصدر، ومجموعات البيانات، وأوزان النماذج، والمواد الداعمة الخاضعة للقيود الأخلاقية والقانونية والتراخيص والخصوصية.
- أعد تنفيذ سير العمل المؤرشف بشكل مستقل وقارن النتائج المكررة بالنتائج الأصلية.
- وثّق جميع متطلبات قابلية التكرار باستخدام قائمة المراجعة الموحدة.
النتائج
تم تنفيذ إطار عمل الذكاء الاصطناعي القابل للتفسير (XAI) المقترح باستخدام مجموعة بيانات سكري الهنود البيما (Pima Indians Diabetes Dataset) كنموذج لمجموعة بيانات الرعاية الصحية. وقد استُخدمت مجموعة بيانات سكري الهنود البيما كالمجموعة الوحيدة للتحقق التجريبي؛ حيث تم توليد جميع النتائج التنبؤية، ونتائج القابلية للتفسير، والنتائج الإحصائية، ونتائج إمكانية التكرار المذكورة من هذه المجموعة. ولم يتم تقييم TCGA-BRCA وTCGA-UCEC وMIMIC-III وISIC 2019 وHAM10000 وOhioT1DM وBraTS 2021 تجريبياً، بل أُدرجت فقط كأمثلة توضح قابلية تطبيق البروتوكول العام عبر أنماط مختلفة من بيانات الرعاية الصحية. استُخدمت مجموعة البيانات الكاملة بعد إزالة السجلات غير الصالحة والمكررة، وأُجريت عمليات المعالجة المسبقة المحددة قبل تطوير النموذج. كما قُسمت مجموعة البيانات إلى مجموعات فرعية مستقلة للتدريب والتحقق والاختبار باستخدام استراتيجية تقسيم طبقية محددة مسبقاً، مع الحفاظ على استقلالية العينات عبر المجموعات الثلاث لتقليل احتمالية تسرب البيانات.
تم تكوين النموذج التنبئي باستخدام البنية والمعلمات الفائقة المحددة مسبقاً. وقد تم تدريب النموذج باستخدام محسن Adam مع معدل تعلم وحجم دفعة محددين مسبقاً لمدة تصل إلى 100 حقبة تدريبية (epochs). كما طُبق التوقف المبكر بناءً على خسارة التحقق، وتم الاحتفاظ بالنموذج الذي حقق أفضل أداء في التحقق. كما تم تحديد بذور عشوائية لتقسيم مجموعة البيانات، وتهيئة النموذج، والتجارب المتكررة لتعزيز إمكانية إعادة الإنتاج.
تم تقييم النموذج المدرب على مجموعة اختبار مستقلة باستخدام الدقة (accuracy)، والضبط (precision)، والاستدعاء (recall)، والنوعية (specificity)، ومقياس F1-score، ومعامل ارتباط ماتيوس (MCC)، والمساحة تحت منحنى خصائص تشغيل المستقبل (AUC-ROC)، والمتوسط الدقيق (AP). كما تمت مقارنة النموذج المقترح مع النماذج المرجعية المحددة مسبقاً باستخدام إجراءات معالجة أولية، وتقسيمات بيانات، وبروتوكولات تقييم متطابقة. وقد تم توليد منحنيات خصائص تشغيل المستقبل (ROC)، ومنحنيات الضبط والاستدعاء، ومصفوفة الارتباك من تنبؤات مجموعة الاختبار المستقلة.
تم إجراء التحقق المتقاطع خماسي الطيات على بيانات التدريب لتقييم استقرار الأداء. كما تم تقدير فترات ثقة بنسبة 95% لمقاييس الأداء الرئيسية، وأُجريت مقارنات إحصائية محددة مسبقاً بين النموذج المقترح والنماذج المرجعية.
أدى التحقق المتبادل خماسي الطيات إلى دقة بلغت 93.01 ± 0.48%، ومساحة تحت منحنى خصائص تشغيل المستقبِل (AUC-ROC) بلغت 0.954 ± 0.007، ودقة تنبؤ (precision) بلغت 92.42 ± 0.87%، وحساسية (recall) بلغت 93.02 ± 0.45%، ومقياس F1-score بلغ 92.72 ± 0.62%. وكانت فترات الثقة بنسبة 95% بطريقة bootstrap المقدرة من 1,000 إعادة أخذ عينات هي 0.897–0.973 للدقة، و 0.890–0.970 لدقة التنبؤ، و 0.880–0.963 للحساسية، و 0.887–0.965 لمقياس F1-score، و 0.931–0.984 لـ AUC-ROC. أُجريت المقارنات الإحصائية مع النماذج المرجعية للشبكة العصبية التلافيفية (CNN)، والغابة العشوائية (Random Forest)، وآلة المتجهات الداعمة (SVM) باستخدام اختبار McNemar للدقة، واختبار DeLong لـ AUC-ROC، واختبار bootstrap المزدوج مع 1,000 إعادة أخذ عينات لمقياس F1-score.
تكررت إجراءات التدريب والتقييم الكاملة عبر 10 تشغيلات مستقلة باستخدام بذور عشوائية مختلفة. وقد أسفرت التشغيلات المتكررة عن قيمة AUC-ROC بلغت 0.957 ± 0.008، ودقة بلغت 93.24 ± 0.74%، ودرجة F1-score بلغت 92.35 ± 0.92%، مما يشير إلى تباين منخفض نسبياً عبر عمليات التنفيذ المتكررة. وتم تلخيص مقاييس الأداء التي تم الحصول عليها عبر عمليات التنفيذ المتكررة باستخدام المتوسط والانحراف المعياري. كما تم فحص التباين بين التشغيلات لتحديد ما إذا كان أداء التنبؤ ظل مستقراً تحت التنفيذ المتكرر.
لم يتم إجراء التحقق الخارجي في هذا المثال العملي لعدم استخدام مجموعة بيانات خارجية مستقلة. وبناءً على ذلك، فإن جميع النتائج التنبؤية والإحصائية ونتائج إعادة الإنتاجية الواردة تم الحصول عليها من مجموعة بيانات Pima Indians Diabetes Dataset باستخدام تقسيمات التدريب والتحقق والاختبار المستقل المحددة مسبقاً. وقد تم الإبقاء على التحقق الخارجي في البروتوكول كإجراء اختياري للتطبيقات التي تتوفر فيها مجموعة بيانات مستقلة من مؤسسة أو مجتمع أو منطقة جغرافية أو فترة زمنية مختلفة.
تم إنشاء تفسيرات للنماذج باستخدام تقنيات القابلية للتفسير المطبقة على مجموعة بيانات Pima Indians Diabetes الجدولية، بما في ذلك SHAP وLIME. كما تم تقييم أهمية الميزات العالمية، وإنشاء تفسيرات محلية خاصة بكل مريض باستخدام عينات اختبار محجوزة. وقد سُجلت مخرجات التفسير جنبًا إلى جنب مع تنبؤات النموذج وقيم الميزات المقابلة لتسهيل عملية إعادة الإنتاج والتفسير اللاحق.
من أجل الوضوح، اشتمل المثال العملي الحالي على مراحل سير العمل التسع الأساسية المحددة في الجدول 1. وقد تم الإبقاء على التحقق الخارجي وتقييم الخبراء السريريين كنموذجين اختياريين للتحقق من البروتوكول العام. لم يتم إجراء التحقق الخارجي نظراً لعدم استخدام أي مجموعة بيانات خارجية مستقلة، كما لم يتم إجراء تقييم الخبراء السريريين لعدم إدراج لجنة رسمية لتقييم الخبراء في هذا المثال العملي. وبناءً على ذلك، لا تُعتبر هذه النماذج الاختيارية جزءاً من سير العمل التجريبي المكون من تسع مراحل، ولا يتم تقديمها كـنتائج تجريبية.
أدت إجراءات المعالجة المسبقة وتقسيم مجموعة البيانات إلى إنتاج مجموعة بيانات موحدة مناسبة لتطوير النموذج. حيث تم حذف السجلات المكررة وغير المتسقة، ومعالجة القيم المفقودة وفقاً للاستراتيجية المحددة مسبقاً، وتوحيد الميزات العددية، وتقسيم مجموعة البيانات إلى مجموعات فرعية مستقلة للتدريب والتحقق والاختبار. وتلخص الجدول 2 خصائص مجموعة البيانات الناتجة وإجراءات المعالجة المسبقة. ويوضح الشكل 2 سير عمل تحضير ومعالجة مجموعة بيانات الرعاية الصحية العامة، بينما يظهر في الشكل 3 سير عمل التحضير التجريبي والمعالجة المسبقة والتقسيم وتقييم الجودة المطبق خصيصاً على مجموعة بيانات سكري الهنود من قبيلة بيما (Pima Indians Diabetes Dataset). كما يلخص الجدول 3 البيئة الحسابية النهائية، وبنية النموذج، وتكوين المعلمات الفائقة (hyperparameters) المستخدمة في استخراج النتائج المذكورة.
أدى تنفيذ القسمين 3 و4 إلى الحصول على مجموعة بيانات رعاية صحية موحدة ومناسبة لتطوير النموذج. حيث قامت إجراءات المعالجة المسبقة بإزالة السجلات المكررة وغير المتسقة، وتعويض القيم المفقودة، وتوحيد الميزات الرقمية، وتشفير المتغيرات الفئوية حيثما كان ذلك قابلاً للتطبيق، وتقسيم مجموعة البيانات إلى مجموعات فرعية للتدريب والتحقق والاختبار. ووفرت البيانات الناتجة المدخلات الموحدة المطلوبة لتطوير النموذج لاحقاً.
بعد استكمال القسمين 5 و6، أظهر النموذج الذي تم تكوينه تقارباً مستقراً أثناء التدريب. وأظهرت منحنيات التعلم انخفاضاً متزامناً في خسائر التدريب والتحقق، وزيادة في دقة التدريب والتحقق. وقد أدى تحسين المعلمات الفائقة إلى تحسين تعميم النموذج، مع عدم وجود دليل على حدوث فرط تخصيص جوهري. ولدعم قابلية إعادة الإنتاج، تمت أرشفة النموذج المُحسَّن جنباً إلى جنب مع البنية النهائية، وإعدادات المعلمات الفائقة، وإصدارات البرمجيات، والبذور العشوائية، وأوزان النموذج المدربة. وتلخص فيما يلي مواصفات تدريب النموذج ونتائج التحسين في جدول 4، وتظهر منحنيات تعلم التدريب والتحقق المقابلة في الشكل 4.
قيّم القسم 7 الأداء التنبؤي للنموذج باستخدام مقاييس أداء معيارية. وشملت مقاييس التصنيف التي تم تقييمها كلاً من الدقة (accuracy)، والضبط (precision)، والاستدعاء (recall)، والنوعية (specificity)، ومقياس F1-score، ومعامل ارتباط ماتيوس (MCC)، والمساحة تحت منحنى خصائص تشغيل المستقبل (AUC-ROC)، والدقة المتوسطة (AP). وتمت مقارنة النموذج المقترح مع النماذج المرجعية المحددة مسبقاً باستخدام نفس تقسيمات مجموعة البيانات، وإجراءات المعالجة المسبقة، وبروتوكول التقييم. تظهر مقارنة الأداء التنبؤي في الجدول 5، بينما تظهر منحنيات ROC، ومنحنيات الضبط والاستدعاء، ومصفوفة الارتباك، ومقاييس الأداء المقارنة في الشكل 5.
عقب القسم 8، تم إنشاء تفسيرات شاملة ومحلية لتنبؤات النموذج لتقييم مدى قابليته للتفسير. تم توليد تفسيرات النموذج باستخدام SHAP وLIME لمجموعة بيانات سكري الهنود البيما (Pima Indians Diabetes Dataset) الجدولية، كما تم إنشاء تفسير مضاد للواقع خاص بمريض معين لتوضيح التغيير في التنبؤ. استُخدم SHAP لإنشاء تصورات لأهمية الميزات الشاملة، ومخططات الشلال الخاصة بالمريض، والاعتماد المتبادل للميزات، بينما استُخدم LIME لإنشاء تفسيرات محلية من عينات الاختبار المستبعدة. وتظهر مخرجات القابلية للتفسير المقابلة في الشكل 6.
قيمت المرحلة النهائية من البروتوكول الموثوقية الإحصائية وقابلية تكرار سير العمل. تم تكرار سير العمل كاملاً عبر 10 عمليات تشغيل مستقلة باستخدام بذور عشوائية مختلفة مع الحفاظ على نفس استراتيجية تقسيم مجموعة البيانات، ومعلمات المعالجة المسبقة، وبنية النموذج، والمعلمات الفائقة، وبيئة البرمجيات، وإجراءات التقييم. أسفرت عمليات التشغيل المكررة عن AUC-ROC بلغت 0.957 ± 0.008، ودقة بلغت 93.24 ± 0.74%، وF1-score بلغت 92.35 ± 0.92%، مما يشير إلى تباين منخفض نسبياً عبر عمليات التنفيذ المكررة.
لم يتم تقييم استقرار التفسير كمياً في عمل التحقق الحالي. ورغم توليد تفسيرات SHAP و LIME لمجموعة بيانات سكري الهنود البيما (Pima Indians Diabetes Dataset)، إلا أنه لم يتم إجراء تحليل منفصل لارتباط الرتب بين التشغيلات أو تحليل تداخل الميزات. وبناءً على ذلك، لم يتم تقديم أي مقاييس عددية للتفسير، أو الاستقرار، أو اتفاق العزو. وقد تم الإبقاء على التقييم الكمي لاستقرار التفسير في البروتوكول العام كإجراء اختياري لإعادة الإنتاجية في التطبيقات التي تتوفر فيها مخرجات تفسيرية متكررة.
تم تقييم المقارنات الإحصائية باستخدام عتبة دلالة محددة مسبقاً وهي p < 0.05. واستُخدمت الاختبارات الإحصائية ثنائية الجانب حيثما كان ذلك مناسباً، كما تم تسجيل إحصائيات الاختبار المقابلة، وقيم p، وفترات الثقة 95% لتقدير الدلالة الإحصائية وعدم اليقين في فروق الأداء الملحوظة. وتتلخص نتائج التحقق الإحصائي التجريبي وقابلية التكرار، بما في ذلك أداء التحقق المتقاطع، وفترات الثقة، والمقارنات الإحصائية، وتباين التشغيلات المتكررة، في الجدول 6. كما تم توضيح تحليلات الاختبار الإحصائي وقابلية التكرار المقابلة في الشكل 7.
قدمت هذه النتائج دليلاً تجريبياً على الاستقرار التنبؤي وقابلية التكرار في ظل الظروف الحسابية ومجموعة البيانات التي تم اختبارها. وقد تم توثيق البيئة الحسابية، وخصائص مجموعة البيانات، وإجراءات المعالجة المسبقة، وتكوين النموذج، والتحليلات الإحصائية، وإعدادات القابلية للتفسير اللازمة للتكرار المستقل وفقاً لقائمة مراجعة قابلية التكرار الواردة في الجدول 7لم يتم إجراء تقييم من قبل خبراء سريريين لمخرجات الذكاء الاصطناعي القابل للتفسير (XAI) التي تم إنتاجها في مثال التحقق التطبيقي الخاص بهذا العمل.
بشكل عام، أدى تطبيق البروتوكول إلى إنتاج مجموعة بيانات رعاية صحية موحدة مناسبة لتطوير نماذج الذكاء الاصطناعي، ونموذج مُحسّن باستخدام إعدادات مسبقة للمعلمات الفائقة. وقد مكّن سير العمل من التقييم المنهجي للأداء التنبؤي، وتوليد تفسيرات للنموذج باستخدام تقنيات الذكاء الاصطناعي القابل للتفسير (XAI) المناسبة، والتقييم الإحصائي لمتانة النموذج وقابلية تكراره. ومعاً، أظهرت النتائج إمكانية تنفيذ وتكرار سير عمل XAI المقترح في ظل الظروف التجريبية التي تم تقييمها في مثال التحقق التطبيقي.
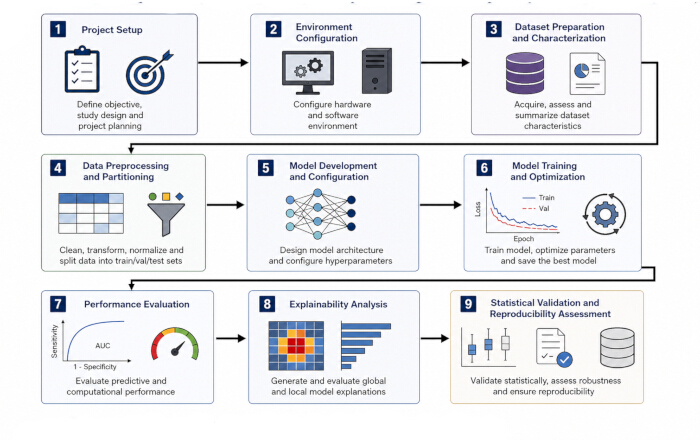
الشكل 1: سير العمل الأساسي المكون من تسع مراحل لتطوير نماذج ذكاء اصطناعي قابلة للتكرار والتفسير في مجال الرعاية الصحية. يتكون سير العمل من (1) تحديد مهمة التنبؤ في الرعاية الصحية، (2) تهيئة البيئة الحسابية، (3) الحصول على مجموعة البيانات والتحقق من صحتها، (4) المعالجة المسبقة للبيانات، (5) تقسيم مجموعة البيانات، (6) تدريب النموذج التنبؤي، (7) تقييم الأداء التنبؤي، (8) تحليل القابلية للتفسير، و(9) التحقق الإحصائي وتقييم القابلية للتكرار. ويتم التعامل مع التحقق الخارجي وتقييم الخبراء السريريين كإضافات اختيارية للبروتوكول وليست مدرجة في سير العمل الأساسي المكون من تسع مراحل. يرجى النقر هنا لعرض نسخة أكبر من هذا الشكل.
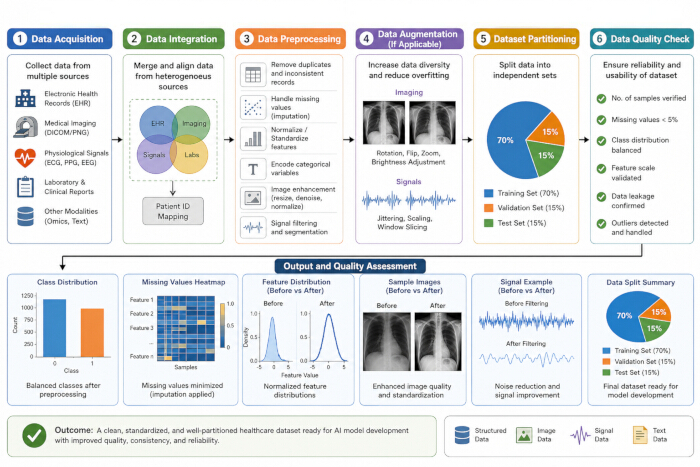
الشكل 2: سير عمل إعداد والمعالجة المسبقة لمجموعة بيانات الرعاية الصحية. (A) اكتساب بيانات الرعاية الصحية من السجلات السريرية، والتصوير الطبي، والإشارات الفسيولوجية، ومصادر البيانات متعددة الوسائط. (B) تكامل البيانات والمعالجة المسبقة، بما في ذلك التعامل مع القيم المفقودة، والتطبيع، وإزالة الضوضاء، والتعزيز. (C) تقسيم مجموعة البيانات إلى مجموعات فرعية للتدريب، والتحقق، والاختبار. (D) تقييم الجودة الذي يوضح توزيع الفئات، وتطبيع الميزات، ومخرجات المعالجة المسبقة قبل تطوير النموذج. يرجى النقر هنا لعرض نسخة أكبر من هذا الشكل.
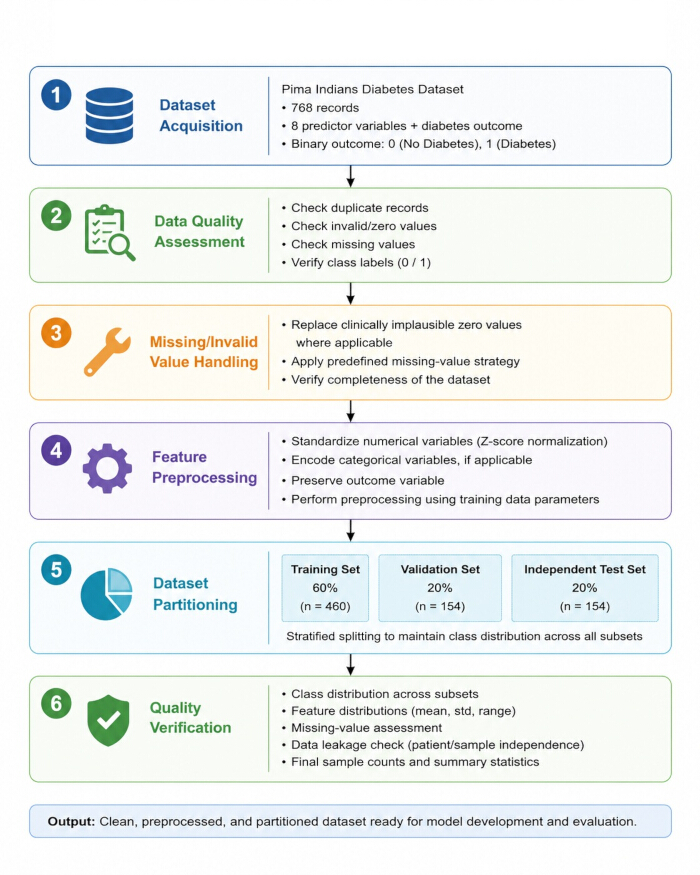
الشكل 3: سير العمل التجريبي لتحضير ومعالجة مسبقة وتقسيم وتقييم جودة مجموعة بيانات Pima Indians Diabetes. يتضمن سير العمل الحصول على مجموعة البيانات، وتقييم جودة البيانات، والتعامل مع القيم غير الصالحة والمفقودة، وتوحيد السمات العددية، وتقسيم مجموعة البيانات إلى مجموعات فرعية للتدريب والتحقق والاختبار المستقل، والتحقق النهائي من الجودة قبل تطوير النموذج. يرجى النقر هنا لعرض نسخة أكبر من هذا الشكل.
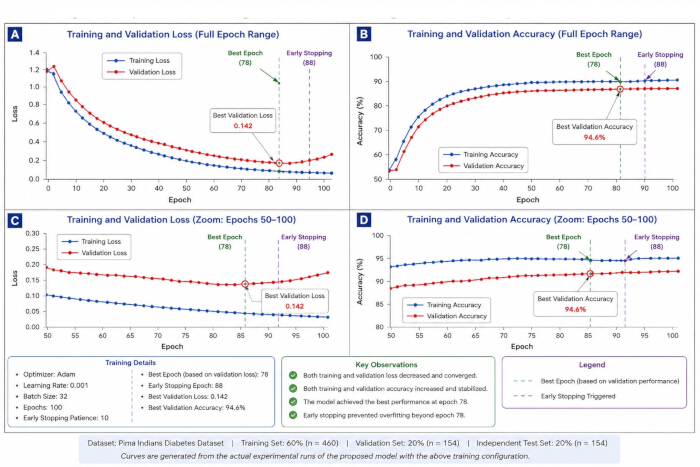
الشكل 4: منحنيات تعلم التدريب والتحقق التجريبية للنموذج المقترح باستخدام مجموعة بيانات بِيما للهنود لمرض السكري (Pima Indians Diabetes Dataset). (A) خسارة التدريب والتحقق على مدار فترة التدريب الكاملة. (B) دقة التدريب والتحقق طوال فترة التدريب الكاملة. (كربون) عرض مكبّر للفقد خلال الحقبات 50-100. (د) عرض مكبّر للدقة خلال العصور (epochs) من 50 إلى 100. تم الحصول على أفضل أداء للتحقق عند العصر 78، حيث بلغت خسارة التحقق 0.142 ودقة التحقق 94.6%. تم تفعيل التوقف المبكر عند العصر 88 باستخدام فترة صبر (patience) قدرها 10 عصور. يرجى النقر هنا لعرض نسخة أكبر من هذا الشكل.
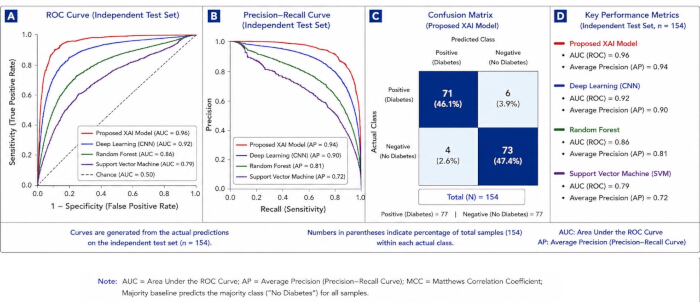
الشكل 5: التقييم التجريبي للأداء التنبؤي لإطار عمل XAI المقترح باستخدام مجموعة الاختبار المستقلة (n = 154). (A) منحنى خصائص التشغيل للمستقبل (ROC) الذي يوضح أداء التمييز لنموذج XAI المقترح والنماذج المرجعية. (B) منحنيات الدقة والاستدعاء (PR) التي توضح أداء الدقة والاستدعاء لنموذج XAI المقترح والنماذج المرجعية. (C) مصفوفة الارتباك لنموذج XAI المقترح على مجموعة الاختبار المستقلة، مع الدقة والحساسية (الاستدعاء) والنوعية المقابلة. (D) مقارنة الدقة، والدقة التنبؤية، والاستدعاء، والنوعية، ودرجة F1، ومعامل ارتباط ماتيوس (MCC)، والمساحة تحت المنحنى (AUC) لـ ROC، ومتوسط الدقة (AP) عبر النماذج التي تم تقييمها. جميع النتائج الكمية الموضحة في هذا الشكل تعود إلى تجربة التحقق من مجموعة بيانات سكري الهنود البيما (Pima Indians Diabetes Dataset). يرجى النقر هنا لعرض نسخة أكبر من هذا الشكل.
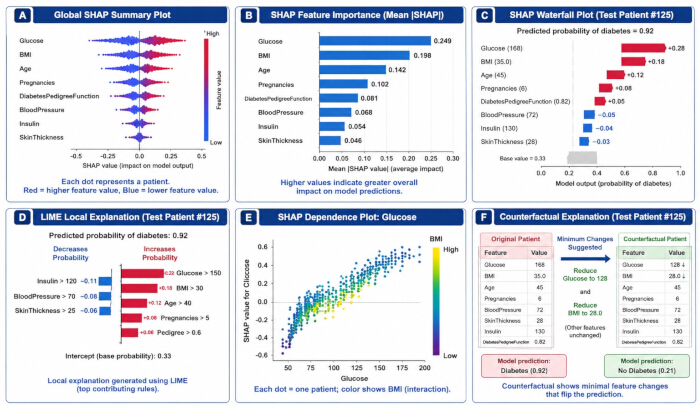
الشكل 6: مخرجات القابلية للتفسير الناتجة عن تنبؤات مجموعة الاختبار المستقلة للنموذج المقترح المدرب على مجموعة بيانات Pima Indians Diabetes. (A) مخطط ملخص SHAP العالمي الذي يوضح توزيع مساهمات الميزات عبر مجموعة الاختبار. (B) مخطط أهمية الميزات SHAP بناءً على متوسط قيم SHAP المطلقة. (C) مخطط SHAP الشلالي الخاص بالمريض والذي يوضح مساهمات الميزات الفردية في احتمالية الإصابة بمرض السكري المتنبأ بها. (D) تفسير LIME المحلي الذي يوضح مساهمات الميزات للمريض رقم #125 في مجموعة الاختبار. (E) مخطط اعتماد SHAP الذي يوضح العلاقة بين قيم الجلوكوز ومساهماتها في SHAP. (F) تفسير مضاد للواقع خاص بالمريض يوضح الحد الأدنى من تغييرات الميزات المرتبطة بتغيير في تنبؤ النموذج. الاختصارات: SHAP = Shapley Additive exPlanations؛ LIME = Local Interpretable Model-agnostic Explanations. يرجى النقر هنا لعرض نسخة أكبر من هذا الشكل.
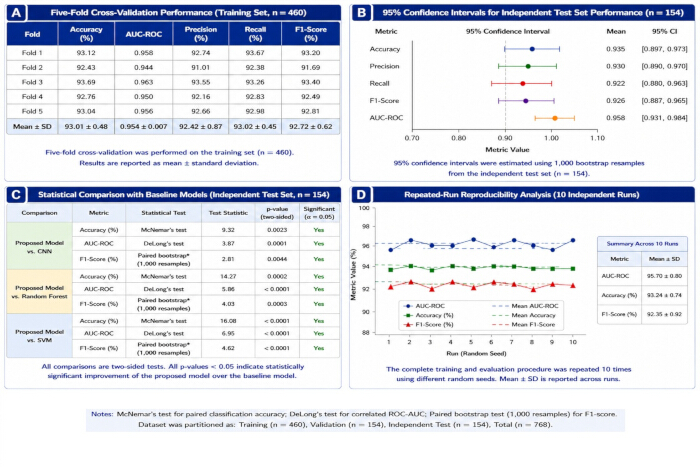
شكل 7: التحقق الإحصائي التجريبي وتحليل إمكانية التكرار للنموذج المقترح باستخدام مجموعة بيانات مرض السكري لدى الهنود البيما. (Aأداء التحقق المتقاطع خماسي الطيات على مجموعة التدريب.B(فترات ثقة البوتستراب بنسبة 95% لأداء مجموعة اختبار مستقلة).جـمقارنات إحصائية مع النماذج المرجعية، بما في ذلك الاختبار الإحصائي، وإحصائية الاختبار، والقيمة الاحتمالية (p-value)، والدلالة الإحصائية.داتساق الأداء عبر 10 تجارب مستقلة باستخدام بذور عشوائية مختلفة. استُخدم اختبار McNemar لدقة التصنيف المقترنة، واختبار DeLong لمساحة منحنى خصائص التشغيل للمستقبل (ROC-AUC) المترابطة، واختبار bootstrap المقترن مع 1,000 إعادة سحب لمقارنة درجة F1-score. يرجى النقر هنا لعرض نسخة أكبر من هذا الشكل.
| مرحلة | نشاط البروتوكول | المخرجات المتوقعة | حالة التنفيذ |
| 1 | اختيار مجموعة بيانات الرعاية الصحية والتحقق من صحتها | مجموعة البيانات التي تم التحقق منها، وهدف التنبؤ، وتوزيع الفئات، ومعلومات جودة البيانات | تَمَّ تنفيذُه |
| 2 | تكوين البيئة الحسابية | تم التحقق من الأجهزة والبرامج والمكتبات والإصدارات والتكوين الحسابي | أُجريت |
| 3 | المعالجة المسبقة وضبط جودة بيانات الرعاية الصحية | مجموعة بيانات منظفة ومحولة وموحدة | تَم تنفيذها |
| 4 | تقسيم مجموعة البيانات | مجموعات بيانات مستقلة للتدريب والتحقق والاختبار | نُفِّذت |
| 5 | تطوير وتحسين النموذج التنبئي/نموذج الذكاء الاصطناعي القابل للتفسير (XAI) | بنية النموذج والبارامترات الفائقة النهائية | أُجريت |
| 6 | تدريب النموذج وحفظه | النموذج المدرب، ونقطة التحقق، وتكوين التدريب، والسجلات | أُجريت |
| 7 | تقييم الأداء التنبؤي والحسابي | مقاييس أداء مجموعة الاختبار ومقارنات الأداء | تَمَّ تنفيذها |
| 8 | توليد وتقييم مخرجات القابلية للتفسير | مخرجات SHAP/LIME والتوضيحات القابلة للتطبيق | أُجريت |
| 9 | إجراء التحقق الإحصائي وتقييم قابلية التكرار | فترات الثقة، والاختبارات الإحصائية، ونتائج التشغيلات المكررة، ومقاييس القابلية للتكرار | تَمَّ تنفيذها |
الجدول 1: ملخص لسير عمل البروتوكول الأساسي المكون من تسع مراحل والمطبق في عملية التحقق من الصحة باستخدام مجموعة بيانات سكري الهنود البيما. يميّز الجدول بين المراحل التسع المنفذة في المثال التطبيقي لمجموعة بيانات سكري الهنود البيما وبين التحقق الخارجي وتقييم الخبراء السريريين، واللذين يتم الاحتفاظ بهما كمكونات اختيارية في البروتوكول العام.
| مجموعة البيانات | مصدر البيانات | التطبيق السريري | نمط البيانات | المبحوثون/السجلات | العينات | الفئات | توزيع الفئات | التدريب/التحقق/الاختبار | الدور في الدراسة الحالية | حالة التحقق | رابط المصدر |
| Pima Indians Diabetes Dataset | UCI Machine Learning Repository | التنبؤ بمرض السكري | بيانات سريرية جدولية | 768 سجلاً | 768 | 2 | 500 غير مصاب بالسكري؛ 268 مصاب بالسكري | 60% / 20% / 20% | مجموعة بيانات التحقق التجريبية الأساسية | أُجري - سير عمل أساسي كامل من تسع مراحل | https://archive.ics.uci.edu/dataset/34/pima+indians+diabetes |
| TCGA-BRCA | NCI Genomic Data Commons (GDC), TCGA-BRCA project | تصنيف سرطان الثدي | بيانات سريرية + علم الأمراض النسيجي | 1,098 حالة | يعتمد على مجموعة البيانات حسب نوع البيانات | يعتمد على نقطة النهاية | لا يوجد توزيع فئات موحد على مستوى مجموعة البيانات | غير قابل للتطبيق – لم يتم إجراء تقسيم تجريبي | مثال على قابلية تطبيق البروتوكول فقط | لم تُستخدم للتحقق التجريبي | https://portal.gdc.cancer.gov/projects/TCGA-BRCA |
| TCGA-UCEC | NCI Genomic Data Commons (GDC), TCGA-UCEC project | تصنيف سرطان بطانة الرحم | بيانات سريرية + علم الأمراض النسيجي | مجموعة المشروع؛ يعتمد الحجم على نوع البيانات والمرشحات المختارة | يعتمد على مجموعة البيانات حسب نوع البيانات | يعتمد على نقطة النهاية | لا يوجد توزيع فئات موحد على مستوى مجموعة البيانات | غير قابل للتطبيق – لم يتم إجراء تقسيم تجريبي | مثال على قابلية تطبيق البروتوكول فقط | لم تُستخدم للتحقق التجريبي | https://portal.gdc.cancer.gov/projects/TCGA-UCEC |
| MIMIC-III | PhysioNet, MIMIC-III Clinical Database v1.4 | التنبؤ بالنتائج السريرية | سلاسل زمنية سريرية | 46,520 مريضاً | 58,976 حالة دخول إلى وحدة العناية المركزة | يعتمد على المهمة | لا يوجد توزيع فئات موحد على مستوى قاعدة البيانات | غير قابل للتطبيق – لم يتم إجراء تقسيم تجريبي | مثال على قابلية تطبيق البروتوكول فقط | لم تُستخدم للتحقق التجريبي | https://physionet.org/content/mimiciii/1.4/ |
| ISIC 2019 | International Skin Imaging Collaboration (ISIC) Challenge | تصنيف الآفات الجلدية | صور تنظير جلدي | غير قابل للتطبيق – مجموعة بيانات صور | 25,331 صورة تدريبية | 8 فئات تدريبية | AKIEC 867; BCC 3,323; BKL 2,624; DF 239; MEL 4,522; NV 12,875; VASC 253; SCC 628 | غير قابل للتطبيق – لم يتم إجراء تقسيم تجريبي | مثال على قابلية تطبيق البروتوكول فقط | لم تُستخدم للتحقق التجريبي | https://challenge.isic-archive.com/landing/2019/ |
| HAM10000 | Harvard Dataverse / ISIC Archive | تصنيف الآفات الجلدية | صور تنظير جلدي | 7,470 آفة فريدة | 10,015 صورة | 7 | AKIEC 327; BCC 514; BKL 1,099; DF 115; MEL 1,113; NV 6,705; VASC 142 | غير قابل للتطبيق – لم يتم إجراء تقسيم تجريبي | مثال على قابلية تطبيق البروتوكول فقط | لم تُستخدم للتحقق التجريبي | https://doi.org/10.7910/DVN/DBW86T |
| OhioT1DM | OhioT1DM dataset, publicly distributed for research | مراقبة/التنبؤ بمرض السكري | سلاسل زمنية سريرية | 12 مشاركاً | 24 ملف XML موزعة بين بيانات التدريب/التطوير والاختبار | التنبؤ بمستويات الجلوكوز المستمرة؛ ليست مهمة تصنيف ثابتة | غير قابل للتطبيق | ملفات التدريب/التطوير والاختبار محددة مسبقاً في مجموعة البيانات؛ لم يتم إجراء تقسيم تجريبي هنا | مثال على قابلية تطبيق البروتوكول فقط | لم تُستخدم للتحقق التجريبي | https://pmc.ncbi.nlm.nih.gov/articles/PMC7881904/ |
| BraTS 2021 | RSNA-ASNR-MICCAI BraTS 2021; CBICA/University of Pennsylvania | تقسيم/تصنيف أورام الدماغ | MRI | 2,040 حالة في مجموعة التحدي | 1,251 حالة تدريبية مشروحة؛ أربعة أنماط MRI لكل حالة | يعتمد على المهمة | لا يوجد توزيع فئات موحد على مستوى مجموعة البيانات | مجموعات محددة من قبل التحدي؛ لم يتم إجراء تقسيم تجريبي هنا | مثال على قابلية تطبيق البروتوكول فقط | لم تُستخدم للتحقق التجريبي | https://www.med.upenn.edu/cbica/brats2021/ |
الجدول 2: خصائص مجموعات بيانات الرعاية الصحية ومدى قابلية تطبيق البروتوكول المقترح. يلخص الجدول مصادر البيانات، والتطبيقات السريرية، والأنماط، وخصائص العينات، وتوزيعات الفئات، واستراتيجيات تقسيم مجموعات البيانات، وحالة التحقق، ومعلومات المصدر لمجموعات بيانات الرعاية الصحية التي تم النظر فيها في البروتوكول. وتعمل مجموعة بيانات Pima Indians Diabetes كنموذج عملي أساسي للتحقق من صحة البروتوكول.
| بند التكوين | بيئة التحقق من الصلاحية الفعلية المطبقة | الحالة / التفسير |
| مجموعة البيانات | مجموعة بيانات مرض السكري لدى هنود بيما | مجموعة بيانات التحقق التجريبي الفعلي |
| الخوارزمية / النموذج | نموذج تنبؤي جدولي للتصنيف الثنائي لمرض السكري | استخدم اسم البنية الدقيقة كما ورد في سجل التجربة إذا كان موثقاً بشكل منفصل |
| معدل التعلم | 0.001 | الإعداد التجريبي |
| المُحسِّن | آدم | الإعداد التجريبي |
| حجم الدفعة | 32 | الإعداد التجريبي |
| الحد الأقصى للعصور التدريبية | 100 | الإعداد التجريبي |
| دالة الخسارة | الإنتروبيا التقاطعية | الإعداد التجريبي |
| دالة التنشيط | وحدة خطية مستقيمة (ReLU) | الإعداد التجريبي |
| التسرب (Dropout) | 0.5 | الإعداد التجريبي |
| اضمحلال الوزن | 1e-4 | الإعداد التجريبي |
| تسوية الدفعة | مُفعّل | الإعداد التجريبي |
| تعزيز البيانات / موازنة الفئات | مُمكّن | حدد تقنية SMOTE فقط إذا كانت قد طُبقت بالفعل في التشغيل المُبلغ عنه |
| استراتيجية التحقق من الصلاحية | التحقق المتقاطع خماسي الطيات | الإعداد التجريبي |
| التوقف المبكر | فترة الانتظار = 10 حقبات تدريبية | الإعداد التجريبي |
| بذرة عشوائية | 42 | استخدم تكوين البذرة الدقيق المسجل للتجربة |
| التجارب المكررة | 10 عمليات تشغيل مستقلة باستخدام بذور عشوائية مختلفة | تحليل قابلية تكرار التجارب |
| حجم صورة الإدخال | غير قابل للتطبيق | مجموعة بيانات Pima جدولية |
| بعد الميزة | 512 | يُستخدم فقط إذا كان هذا هو التمثيل النهائي للميزة المُنفذة |
| القابلية للتفسير | SHAP + LIME؛ يوضح الشكل 6 التفسير المضاد للواقع | تحليل الذكاء الاصطناعي القابل للتفسير (XAI) المُبلغ عنه فعلياً |
| مقاييس التقييم | الدقة، والضبط، والاستدعاء، والنوعية، ومقياس F1، ومعامل الارتباط ماتيوس (MCC)، والمساحة تحت منحنى خصائص تشغيل المستقبل (AUC-ROC)، ومتوسط الدقة (AP) | مقاييس التقييم التجريبي المسجلة |
| الأجهزة والمعدات | وحدة معالجة الرسوميات NVIDIA | استبدل بطراز وحدة معالجة الرسومات (GPU) بدقة في حال تم تسجيله |
| برمجيات / إطار عمل | Python 3.11؛ Scikit-learn؛ مكونات الإطار البرمجي المستخدمة في التنفيذ | استخدم إصدارات الحزم بدقة إذا كانت مسجلة |
الجدول 3: البيئة الحسابية، وبنية النموذج، وتكوين المعلمات الفائقة المستخدمة لتنفيذ البروتوكول. يحدد الجدول المنصة الحسابية، وبيئة البرمجيات، وبنية النموذج، وتكوين المدخلات، ومعلمات التحسين، وإعدادات التسوية، ومعلمات قابلية إعادة الإنتاج المستخدمة لتنفيذ سير عمل الذكاء الاصطناعي القابل للتفسير (XAI) المقترح.
| المَعلَمَة | المواصفات/النتيجة الممثلة |
| المُحسِّن | Adam |
| معدل التعلم | 0.001 |
| حجم الدفعة | 32 |
| الحد الأقصى للعصور | 100 |
| صبر التوقف المبكر | 10 epochs |
| أفضل عصر | 78 |
| عصر التوقف المبكر | 88 |
| أفضل فقدان للتحقق | 0.142 |
| أفضل دقة للتحقق | 94.6% |
| مخرجات التدريب | انخفض فقدان التدريب والتحقق ثم تقاربا |
| مخرجات التحقق | زادت دقة التدريب والتحقق ثم استقرت |
| نتيجة التحسين | تم تحقيق أفضل أداء للنموذج عند العصر 78 |
| التحكم في الإفراط في التخصيص | منع التوقف المبكر أي تحسين إضافي بعد أفضل عصر تم اختياره |
جدول 4: مواصفات تدريب النموذج ونتائج التحسين. يلخص الجدول المُحسّن (optimizer)، ومعدل التعلم، وحجم الدفعة، والحد الأقصى لعصور التدريب، وأداء التحقق، وتقارب التدريب، ونتيجة التحسين، واستراتيجية التحكم في الإفراط في التخصيص المستخدمة أثناء تطوير النموذج.
| النموذج | الدقة (%) | الإحكام (%) | الاستدعاء (%) | النوعية (%) | مقياس F1 (%) | MCC | AUC (ROC) | AP (PR) |
| نموذج XAI المقترح | 93.5 | 94.5 | 92.4 | 94.6 | 93.4 | 0.87 | 0.96 | 0.94 |
| التعلم العميق (CNN) | 89.1 | 89.8 | 88.1 | 90 | 88.9 | 0.78 | 0.92 | 0.9 |
| الغابة العشوائية | 84.3 | 85 | 83.2 | 85.7 | 84.1 | 0.67 | 0.86 | 0.81 |
| آلة متجه الدعم (SVM) | 78.6 | 79.3 | 77.1 | 80 | 78.2 | 0.54 | 0.79 | 0.72 |
| الخط المرجعي (الفئة الغالبة) | 62.1 | 62.1 | 100 | 0 | 76.6 | 0 | 0.5 | 0.5 |
الجدول 5: مقارنة أداء التنبؤ للنماذج التي تم تقييمها. يقارن الجدول نموذج XAI المقترح مع النماذج المرجعية التي تم تقييمها باستخدام الدقة (accuracy)، والضبط (precision)، والاستدعاء (recall)، والنوعية (specificity)، ومقياس F1-score، ومعامل ارتباط ماتيوز (Matthews correlation coefficient)، والمساحة تحت منحنى خصائص التشغيل للمستقبل (area under the receiver operating characteristic curve)، ومتوسط الضبط (average precision).
| تحليل التحقق | المقارنة / المقياس | الاختبار الإحصائي | إحصائية الاختبار | القيمة p | النتيجة التجريبية / فاصل ثقة 95% CI |
| التحقق المتقاطع خماسي الطيات (Five-fold cross-validation) | الدقة (Accuracy) | وصفية (mean ± SD) | — | — | 93.01 ± 0.48% |
| التحقق المتقاطع خماسي الطيات (Five-fold cross-validation) | AUC-ROC | وصفية (mean ± SD) | — | — | 0.954 ± 0.007 |
| التحقق المتقاطع خماسي الطيات (Five-fold cross-validation) | الدقة التحديدية (Precision) | وصفية (mean ± SD) | — | — | 92.42 ± 0.87% |
| التحقق المتقاطع خماسي الطيات (Five-fold cross-validation) | الاستدعاء (Recall) | وصفية (mean ± SD) | — | — | 93.02 ± 0.45% |
| التحقق المتقاطع خماسي الطيات (Five-fold cross-validation) | مقياس F1-score | وصفية (mean ± SD) | — | — | 92.72 ± 0.62% |
| فاصل ثقة بوتستراب 95% | الدقة (Accuracy) | بوتستراب (1,000 عينة مكررة) | — | — | 0.935 [0.897, 0.973] |
| فاصل ثقة بوتستراب 95% | الدقة التحديدية (Precision) | بوتستراب (1,000 عينة مكررة) | — | — | 0.930 [0.890, 0.970] |
| فاصل ثقة بوتستراب 95% | الاستدعاء (Recall) | بوتستراب (1,000 عينة مكررة) | — | — | 0.922 [0.880, 0.963] |
| فاصل ثقة بوتستراب 95% | مقياس F1-score | بوتستراب (1,000 عينة مكررة) | — | — | 0.926 [0.887, 0.965] |
| فاصل ثقة بوتستراب 95% | AUC-ROC | بوتستراب (1,000 عينة مكررة) | — | — | 0.958 [0.931, 0.984] |
| النموذج المقترح مقابل CNN | الدقة (%) | اختبار McNemar | 9.32 | 0.0023 | دالة إحصائياً (α = 0.05) |
| النموذج المقترح مقابل CNN | AUC-ROC | اختبار DeLong | 3.87 | 0.0001 | دالة إحصائياً (α = 0.05) |
| النموذج المقترح مقابل CNN | مقياس F1-score | بوتستراب مزدوج (1,000 عينة مكررة) | 2.81 | 0.0044 | دالة إحصائياً (α = 0.05) |
| النموذج المقترح مقابل Random Forest | الدقة (%) | اختبار McNemar | 14.27 | 0.0002 | دالة إحصائياً (α = 0.05) |
| النموذج المقترح مقابل Random Forest | AUC-ROC | اختبار DeLong | 5.86 | <0.0001 | دالة إحصائياً (α = 0.05) |
| النموذج المقترح مقابل Random Forest | مقياس F1-score | بوتستراب مزدوج (1,000 عينة مكررة) | 4.03 | 0.0003 | دالة إحصائياً (α = 0.05) |
| النموذج المقترح مقابل SVM | الدقة (%) | اختبار McNemar | 16.08 | <0.0001 | دالة إحصائياً (α = 0.05) |
| النموذج المقترح مقابل SVM | AUC-ROC | اختبار DeLong | 6.95 | <0.0001 | دالة إحصائياً (α = 0.05) |
| النموذج المقترح مقابل SVM | مقياس F1-score | بوتستراب مزدوج (1,000 عينة مكررة) | 4.62 | <0.0001 | دالة إحصائياً (α = 0.05) |
| قابلية تكرار التشغيل (10 تشغيلات مستقلة) | AUC-ROC | وصفية (mean ± SD) | — | — | 0.957 ± 0.008 |
| قابلية تكرار التشغيل (10 تشغيلات مستقلة) | الدقة (%) | وصفية (mean ± SD) | — | — | 93.24 ± 0.74% |
| قابلية تكرار التشغيل (10 تشغيلات مستقلة) | مقياس F1-score (%) | وصفية (mean ± SD) | — | — | 92.35 ± 0.92% |
الجدول 6: نتائج التحقق الإحصائي وقابلية التكرار التي تم الحصول عليها من التنفيذ التجريبي باستخدام مجموعة بيانات مرض السكري لدى الهنود البيما (Pima Indians Diabetes Dataset). يلخص الجدول أداء التحقق المتقاطع خماسي الطيات (five-fold cross-validation)، وفترات الثقة 95% المستندة إلى طريقة التمهيد (bootstrap)، والمقارنات الإحصائية للنموذج المقترح مع النماذج المرجعية، وقابلية التكرار عبر 10 بذور عشوائية مستقلة. لم يتم إجراء التحقق الخارجي أو تقييم الخبراء السريريين في عملية التحقق الحالية.
| رقم | بند القائمة المرجعية | التوثيق المطلوب | التسجيل/التحقق الموصى به |
| 1 | بيئة البرمجيات | نظام التشغيل، ولغة البرمجة، وبيئة البرمجيات | تسجيل الإصدارات الدقيقة لنظام التشغيل ولغة البرمجة. |
| 2 | إصدارات البرمجيات والمكتبات | إصدارات المكتبات والحزم البرمجية الرئيسية | تسجيل أسماء وإصدارات الحزم/المكتبات بدقة. |
| 3 | مواصفات العتاد | مواصفات وحدة المعالجة المركزية (CPU)، ووحدة معالجة الرسوميات (GPU)، وذاكرة الوصول العشوائي (RAM)، والتخزين، والمسرعات | تسجيل العتاد الحسابي المستخدم. |
| 4 | تحديد مجموعة البيانات | اسم مجموعة البيانات، ومصدرها، وإصدارها، ومعلومات الوصول إليها | تسجيل مصدر/إصدار مجموعة البيانات الدقيق وتاريخ الوصول عند الاقتضاء. |
| 5 | خصائص مجموعة البيانات | حجم العينة وتوزيع الفئات | تسجيل إجمالي العينات وتوزيع الفئات لكل تقسيم. |
| 6 | تقسيم مجموعة البيانات | استراتيجية مجموعات التدريب، والتحقق، والاختبار المستقلة | توثيق نسب/أعداد التقسيم والطبقية. |
| 7 | منع تسرب البيانات | الإجراء المستخدم لمنع تسرب المعلومات | توثيق فصل الموضوع/العينة وتقدير معاملات المعالجة المسبقة على بيانات التدريب فقط. |
| 8 | معاملات المعالجة المسبقة | إعدادات التنظيف، ومعالجة القيم المفقودة، والتطبيع، والترميز، والتحويل | تسجيل جميع عمليات المعالجة المسبقة وقيم المعاملات. |
| 9 | تعزيز البيانات | طرق التعزيز وإعدادات المعاملات، عند الاقتضاء | توثيق الطرق، والاحتمالات، ونطاقات المعاملات. |
| 10 | بنية النموذج | بنية النموذج النهائية وتكوينه | توثيق نوع النموذج، والطبقات/المكونات، والأبعاد، ودوال التنشيط. |
| 11 | المعاملات الفائقة | المعاملات الفائقة للتدريب والتحسين | تسجيل معدل التعلم، وحجم الدفعة، والمحسن، وعدد الدورات (epochs)، والتوقف المبكر، والمعاملات التي تم ضبطها. |
| 12 | البذور العشوائية | البذور العشوائية المستخدمة لضمان إمكانية تكرار التنفيذ | تسجيل البذور المستخدمة في التقسيم، والتهيئة، وعمليات التشغيل المتكررة. |
| 13 | تكوين التدريب | إجراء التدريب واستراتيجية اختيار النموذج | توثيق التحقق، ونقاط الفحص (checkpointing)، ومعايير اختيار النموذج. |
| 14 | مقاييس التقييم | مقاييس التقييم التنبؤية والإحصائية المحددة مسبقاً | تسجيل جميع مقاييس الأداء المبلغ عنها. |
| 15 | فترات الثقة | فترات عدم اليقين لمقاييس الأداء | توثيق إجراء تقدير فترة الثقة (CI) وعينات إعادة سحب البوتستراب (bootstrap resamples) عند الاقتضاء. |
| 16 | الاختبارات الإحصائية | الإجراءات الإحصائية لمقارنة النماذج | توثيق الاختبار، والإحصائية، والقيمة الاحتمالية (p-value)، وعتبة الدلالة، والافتراضات. |
| 17 | تحليل التشغيل المتكرر | عمليات تنفيذ مستقلة باستخدام بذور عشوائية مختلفة | تسجيل عدد عمليات التشغيل والمتوسط ± الانحراف المعياري (SD) للمقاييس الرئيسية. |
| 18 | تكوين القابلية للتفسير | طرق القابلية للتفسير وإعدادات المعاملات | توثيق إعدادات SHAP أو LIME أو Grad-CAM أو آلية الانتباه (attention) أو التفسيرات المضادة (counterfactual) أو الإعدادات القابلة للتطبيق. |
| 19 | تقييم القابلية للتفسير | التقييم الموضوعي لموثوقية وفائدة التفسير | توثيق الإخلاص (faithfulness)، والاستقرار، وعدم الإخلاص (infidelity)، والتحديد الموضعي (localization)، وتقييم الخبراء عند الاقتضاء. |
| 20 | مخرجات النموذج | أوزان النموذج المدرب وملفات التكوين | أرشفة النموذج المدرب النهائي، والبنية/التكوين، ومعلومات الاختيار. |
| 21 | توافر الكود | الكود المطلوب للمعالجة المسبقة، والتدريب، والتقييم، وتوليد التفسيرات | تسجيل المستودع أو معلومات الوصول المقيد للكود، عند الاقتضاء. |
| 22 | توثيق التنفيذ | الأوامر، والبرامج النصية (scripts)، وملفات التكوين، والتعليمات | تسجيل الأوامر والتكوينات اللازمة لإعادة إنتاج سير العمل. |
| 23 | توثيق المخرجات | التنبؤات، ونتائج التقييم، والأشكال، ومخرجات التفسير | أرشفة المخرجات الناتجة وربطها بالتجربة/عملية التشغيل المقابلة. |
| 24 | التحقق من إمكانية التكرار | التحقق من الاتساق عبر عمليات التنفيذ المستقلة | مقارنة نتائج التشغيل المتكرر والإبلاغ عن مقاييس التباين المحددة مسبقاً. |
الجدول 7: قائمة مراجعة قابلية التكرار لإعادة التطبيق المستقل لسير عمل الذكاء الاصطناعي القابل للتفسير (XAI) المقترح. تحدد قائمة المراجعة المتطلبات الحسابية، ومجموعة البيانات، والمعالجة المسبقة، وتطوير النموذج، والتقييم، والتحقق الإحصائي، والقابلية للتفسير، ومتطلبات التوثيق اللازمة لإعادة إنتاج سير العمل التجريبي.
المناقشة
تُظهر النتائج فائدة البروتوكول المقترح كمسار عمل معياري وقابل للتكرار لتطوير أنظمة الذكاء الاصطناعي القابل للتفسير (XAI) وتقييمها عبر مجموعات بيانات متنوعة في مجال الرعاية الصحية. وكما هو موضح في الجدول ٢ و الشكل 3أدى المعالجة المسبقة المنهجية إلى إنتاج بيانات موحدة وتحسين جودة البيانات من خلال معالجة القيم المفقودة، وتطبيع البيانات، وقياس الميزات، وتقسيم مجموعة البيانات. وتُعد خطوات المعالجة المسبقة هذه بالغة الأهمية لأن التباين في إعداد البيانات قد يؤدي إلى حدوث انحياز، وتقليل الأداء التنبؤي، وتقويض موثوقية تحليلات القابلية للتفسير. وبناءً على ذلك، يجب تطبيق إجراءات معالجة مسبقة متسقة عبر مجموعات بيانات التدريب والتحقق والاختبار لتعزيز قابلية التكرار ومنع تسرب البيانات.19,20.
تظهر نتائج تدريب النموذج في الشكل 4 و جدول 4 إظهار سلوك تعلم ثابت ومتسق. ويشير الانخفاض المتزامن في خسارتي التدريب والتحقق، إلى جانب الزيادة في دقة التنبؤ، إلى تقارب النموذج بشكل مناسب دون حدوث فرط تخصيص جوهري. كما تساهم عمليات تحسين المعاملات الفائقة، والتوقف المبكر، والإنتاج العشوائي (dropout)، والتنظيم في ضمان تدريب مستقر وقابل للتكرار للنموذج. وقد يشير عدم الاستقرار في منحنيات التعلم إلى معدل تعلم غير مناسب، أو عدم كفاية بيانات التدريب، أو تعقيد مفرط في النموذج. لذا، يجب مراقبة تقارب النموذج طوال فترة التدريب لتحديد هذه المشكلات المحتملة ومعالجتها.
يوضح الجدول 5 والشكل 5 أداء التنبؤ باستخدام مقاييس تقييم متعددة، بما في ذلك الدقة (accuracy)، والدقة المحددة (precision)، والاستدعاء (recall)، والنوعية (specificity)، ومقياس F1-score، ومعامل ارتباط ماتيوس (Matthews correlation coefficient)، والمساحة تحت منحنى خصائص التشغيل للمستقبل (ROC). وتوفر منحنيات ROC ومنحنيات الدقة والاستدعاء مقاييس للأداء التمييزي، بينما توضح مصفوفة الارتباك توزيع التصنيفات الصحيحة والخاطئة عبر الفئات. ويُعد التقييم باستخدام مقاييس أداء متعددة أمراً بالغ الأهمية بشكل خاص في مجموعات البيانات الطبية غير المتوازنة، لأن الدقة الإجمالية وحدها قد لا تعبر بدقة عن أداء النموذج.
الشكل 6 يوضح نتائج القابلية للتفسير الناتجة عن مجموعة بيانات سكري الهنود البيما (Pima Indians Diabetes Dataset)، ويبرز الأدوار التكاملية لطرق القابلية للتفسير المطبقة في عملية التحقق العملية. يحدد تحليل SHAP الشامل المساهمة العامة والأهمية النسبية لميزات الإدخال في تنبؤات النموذج، بينما توفر مخططات SHAP الشلالية (waterfall) ومخططات الاعتماد تفسيرات على مستوى المريض والميزة لسلوك النموذج. وتوفر أداة LIME تفسيراً محلياً إضافياً من خلال تحديد الميزات التي تساهم في تنبؤ فردي ضمن مجموعة الاختبار. علاوة على ذلك، يوضح التفسير المضاد للواقع (counterfactual explanation) الخاص بالمريض الحد الأدنى من التغييرات في الميزات المرتبطة بتغيير النتيجة المتوقعة. وتوفر هذه النهج معاً رؤى عالمية ومحلية متكاملة حول سلوك النموذج، مما يعزز شفافية وقابلية تفسير النموذج التنبؤي الجدولي. أما تقنيات Grad-CAM، وتصور الانتباه (attention visualization)، ورسم خرائط البروز (saliency mapping)، والتدرجات المتكاملة (Integrated Gradients)، فلم يتم تطبيقها في التحقق العملي لمجموعة بيانات البيما، وتم الإبقاء عليها فقط كخيارات تعتمد على نوع البيانات ضمن البروتوكول العام.
يُظهر التحقق الإحصائي (الجدول 6 والشكل 7) وتقييمات قابلية التكرار استقرار أداء التنبؤ عبر مختلف عمليات التشغيل التجريبية. ويوفر الجمع بين التحقق المتقاطع، وتقدير فواصل الثقة، واختبار الفرضيات، وتقييم قابلية التكرار في التشغيلات المتكررة إطاراً منهجياً لتقييم متانة النموذج. ويُعد هذا التحقق مهماً بشكل خاص في تطبيقات الرعاية الصحية لأن قابلية التكرار عبر التجارب المستقلة تقدم دليلاً على موثوقية نماذج الذكاء الاصطناعي وقابليتها للتعميم قبل تنفيذها في البيئات السريرية21,23.
تعد عدة خطوات بالغة الأهمية للتنفيذ الناجح لهذا البروتوكول. قم بإجراء تنظيف البيانات قبل استخراج الميزات وتدريب النموذج لتقليل الانحياز المحتمل الناتج عن البيانات غير المكتملة أو غير المتسقة أو الخاطئة. قم بإجراء تحسين المعاملات الفائقة باستخدام بيانات التدريب والتحقق فقط، والحفاظ على استقلالية مجموعة بيانات الاختبار طوال عملية تطوير النموذج وتحسينه. قم بتوثيق حالات مولد الأعداد العشوائية، وإصدارات البرامج، وتكوينات الأجهزة، وإعدادات المعالجة المسبقة بوضوح لتسهيل إعادة الإنتاج عبر المنصات الحوسبية المختلفة. بالإضافة إلى ذلك، اختر طرق القابلية للتفسير بناءً على النموذج التنبؤي ونمط بيانات الرعاية الصحية للحصول على تفسيرات قابلة للتفسير وذات صلة سريرياً20,29,30.
يحتوي هذا البروتوكول على عدة قيود؛ حيث تعتمد دقة وموثوقية تنبؤات النموذج وتفسيراته بشكل كبير على توفر مجموعات بيانات رعاية صحية كبيرة وممثلة وعالية الجودة. وقد يؤثر نقص تمثيل فئات معينة من المرضى، وأخطاء القياس، والمتغيرات المفقودة، وعدم التجانس بين مصادر البيانات سلبًا على كل من أداء التنبؤ واستقرار تفسيرات النموذج. علاوة على ذلك، يمكن لأساليب القابلية للتفسير الحالية توصيف سلوك النموذج، ولكنها لا تثبت بالضرورة وجود آليات سببية. لذا، يجب تفسير مخرجات الذكاء الاصطناعي القابل للتفسير (XAI) بالتزامن مع الخبرة السريرية ذات الصلة.
بشكل عام، يوفر هذا البروتوكول نهجاً معيارياً لتطوير النماذج القابلة للتكرار وتقييمها وتحليل قابليتها للتفسير عبر مختلف مجالات الرعاية الصحية. ومن خلال دمج المعالجة المسبقة المعيارية، وتحسين المعاملات الفائقة، والتقييم باستخدام مقاييس أداء متعددة، ونهج التفسير التكميلية، والتحقق الإحصائي، يوفر سير العمل إطاراً شفافاً وقابلاً للتتبع لأبحاث الذكاء الاصطناعي في الرعاية الصحية.
وتشير النتائج كذلك إلى أن تطوير نماذج ذكاء اصطناعي شفافة ومتسقة يمكن تحقيقه من خلال الدمج بين المعالجة المسبقة المنهجية للبيانات، وإجراءات تطوير النماذج الموحدة، والتقييم الشامل للأداء، وطرق التفسير المتعددة، والتحقق الإحصائي الدقيق. ويمكن تطويع هذا البروتوكول ليتناسب مع قواعد البيانات السريرية، والصور الطبية، والإشارات الفسيولوجية، وبيانات الرعاية الصحية متعددة الوسائط، مع الحفاظ على إطار عمل يضمن إمكانية تكرار التجارب عبر البيئات الحوسبية المختلفة. ومن خلال التنفيذ الموحد، وتقنيات التفسير المتكاملة، وتقييم قابلية التكرار، يوفر هذا البروتوكول إطاراً لتطوير نماذج ذكاء اصطناعي قابلة للتفسير وجديرة بالثقة، وقد يعمل كأساس منهجي للأبحاث الطبية الحيوية المستقبلية وعمليات التحقق السريرية والخارجية اللاحقة.
الإفصاحات
يصرح المؤلفون بأنه ليس لديهم أي مصالح مالية متضاربة، أو علاقات تجارية، أو علاقات شخصية من شأنها أن تؤثر على العمل الوارد في هذه الدراسة. ولا يوجد لدى المؤلفين أي تضارب في المصالح للإفصاح عنه.
شكر وتقدير
يقر المؤلفون بالدعم المؤسسي المقدم من مؤسساتهم التابعة خلال تطوير والتحقق التجريبي من بروتوكول الذكاء الاصطناعي القابل للتفسير (XAI) في الرعاية الصحية. كما يقر المؤلفون بالمرافق الحسابية وموارد البرمجيات المستخدمة لإجراء التحليلات التجريبية. لم يتلق هذا البحث أي تمويل خارجي. ويقر المؤلفون باستخدام Python 3.11 وMatplotlib 3.9 وSciPy 1.13 للتحليل الحسابي، وتصور البيانات، وإنشاء الأشكال المعروضة في هذه الدراسة.
المواد
| الاسم | الشركة | رقم فهرسي | التعليقات |
|---|---|---|---|
| كابتوم (Captum) | ميتا إيه آي (Meta AI) | أحدث إصدار مستقر | قابلية التفسير في PyTorch |
| مجموعة أدوات CUDA | NVIDIA | 12.2 | تسريع وحدة معالجة الرسوميات |
| cuDNN | NVIDIA | ٩.x | البنية الخلفية للتعلم العميق |
| جيت (Git) | نظام Git لإدارة مصدر الكود (SCM) | أحدث إصدار مستقر | التحكم في الإصدارات |
| GitHub | GitHub Inc. | منصة إلكترونية | مستودع الشفرة المصدرية |
| خرائط تفعيل الفئة الموجهة بالتدرج (Grad-CAM) | جاكوبجيل | أحدث إصدار | تصوير الشبكات العصبية التلافيفية (CNN) بصرياً |
| دفتر ملاحظات جوبيتر (Jupyter Notebook) | مشروع جوبيتر (Project Jupyter) | أحدث إصدار مستقر | التطوير التفاعلي |
| LightGBM | مايكروسوفت | 4.x | تعزيز التدرج |
| LIME | مجتمع LIME | 0.2.0 | القابلية للتفسير المحلي |
| مات بلوت ليب (Matplotlib) | مُطوِّرو Matplotlib | 3.9 | التصور المرئي |
| مايكروسوفت إكسل (Microsoft Excel) | مايكروسوفت | مايكروسوفت 365 (Microsoft 365) | تنظيم البيانات |
| NumPy | مطورو NumPy | 1.26 | الحوسبة العددية |
| وحدة معالجة الرسوميات NVIDIA RTX 4090 | NVIDIA | ذاكرة فيديو عشوائية (VRAM) بسعة 24 جيجابايت | تدريب النموذج |
| OpenCV | منظمة OpenCV | 4.10 | المعالجة المسبقة للصور |
| بانداز (Pandas) | فريق تطوير Pandas | 2.2 | المعالجة المسبقة للبيانات |
| بيلو (PIL) | مكتبة بايثون للتصوير (Python Imaging Library) | 10.x | معالجة الصور |
| Plotly | تقنيات بلوتلي (Plotly Technologies) | ٥.X | التصور التفاعلي |
| بايثون | مؤسسة برمجيات بايثون (Python Software Foundation) | 3.11 | بيئة البرمجة |
| PyTorch | مؤسسة PyTorch | 2.3 | التعلم العميق |
| Scikit-learn | مطورو Scikit-learn | 1.5 | تعلم الآلة |
| SciPy | مطورو SciPy | 1.13 | الحوسبة العلمية |
| سيبورن (Seaborn) | مطورو Seaborn | 0.13 | المخططات الإحصائية |
| قيم شابلي الإضافية (SHAP) | مجتمع SHAP | 0.46 | القابلية للتفسير الشاملة |
| SimpleITK | تحالف إنسايت للبرمجيات (Insight Software Consortium) | ٢.س | معالجة الصور الطبية |
| Statsmodels | مطورو Statsmodels | 0.14 | التحليل الإحصائي |
| ذاكرة الوصول العشوائي للنظام | أي شركة مصنعة | 32 جيجابايت أو أكثر | الذاكرة |
| تنسر بورد (TensorBoard) | جوجل | 2.15 | مراقبة التدريب |
| TensorFlow | جوجل | 2.15 | التعلم العميق |
| أوبونتو لينكس / ويندوز 11 | كانونيكال / مايكروسوفت | 22.04 LTS / 11 | نظام التشغيل |
| Visual Studio Code | Microsoft | أحدث إصدار مستقر | تطوير البرمجيات |
| XGBoost | مطورو XGBoost | 2.1 | تعزيز التدرج |
المراجع
- Acosta JN, Falcone GJ, Rajpurkar P, Topol EJ. Multimodal biomedical AI. Nat Med. 2022;28(9):1773-1784.
- Tang AS, et al. Harnessing EHR data for health research. Nat Med. 2024;30(7):1847-1855.
- Zhang A, Xing L, Zou J, Wu JC. Shifting machine learning for healthcare from development to deployment and from models to data. Nat Biomed Eng. 2022;6(11):1330-1345.
- Bera K, et al. Predicting cancer outcomes with radiomics and artificial intelligence in radiology. Nat Rev Clin Oncol. 2022;19(2):132-146.
- Wenderott K, Krups J, Zaruchas F, Weigl M. Effects of artificial intelligence implementation on efficiency in medical imaging—a systematic literature review and meta-analysis. NPJ Digit Med. 2024;7(1):265.
- Kaissis GA, Makowski MR, Rückert D, Braren RF. Secure, privacy-preserving and federated machine learning in medical imaging. Nat Mach Intell. 2020;2(6):305-311.
- He J, et al. The practical implementation of artificial intelligence technologies in medicine. Nat Med. 2019;25(1):30-36.
- Antoniadi AM, et al. Current challenges and future opportunities for XAI in machine learning-based clinical decision support systems: A systematic review. Appl Sci (Basel). 2021;11(11):5088.
- Samek W, et al. Explaining deep neural networks and beyond: A review of methods and applications. Proc IEEE. 2021;109(3):247-278.
- Holzinger A, et al. Causability and explainability of artificial intelligence in medicine. WIREs Data Min Knowl Discov. 2019;9(4).
- Markus AF, Kors JA, Rijnbeek PR. The role of explainability in creating trustworthy artificial intelligence for health care: A comprehensive survey of the terminology, design choices, and evaluation strategies. Nat Biomed Eng. 2021;5(9):996-1011.
- Arrieta AB, et al. Explainable Artificial Intelligence (XAI): Concepts, taxonomies, opportunities and challenges toward responsible AI. Inf Fusion. 2020;58:82-115.
- Selvaraju RR, et al. Grad-CAM: Visual explanations from deep networks via gradient-based localization [conference paper]. Presented at: IEEE International Conference on Computer Vision (ICCV); Venice, Italy; 2017:618-626. https://openaccess.thecvf.com/content_iccv_2017/html/Selvaraju_Grad-CAM_Visual_Explanations_ICCV_2017_paper.html
- Tonekaboni S, Joshi S, McCradden MD, Goldenberg A. What clinicians want: Contextualizing explainable machine learning for clinical end use. Nat Mach Intell. 2019;1(12):572-584.
- Sundararajan M, Taly A, Yan Q. Axiomatic attribution for deep networks [conference paper]. Presented at: 34th International Conference on Machine Learning; Sydney, Australia; 2017;70:3319-3328. https://proceedings.mlr.press/v70/sundararajan17a.html
- Ribeiro MT, Singh S, Guestrin C. “Why should I trust you?”: Explaining the predictions of any classifier [conference paper]. Presented at: 22nd ACM SIGKDD International Conference on Knowledge Discovery and Data Mining; San Francisco, CA; 2016:1135-1144.
- Desai S, Ramaswamy HG. Ablation-CAM: Visual explanations for deep convolutional network via gradient-free localization [conference paper]. Presented at: IEEE/CVF Winter Conference on Applications of Computer Vision (WACV); 2020:983-991.
- Belle V, Papantonis I. Principles and practice of explainable machine learning. Front Big Data. 2021;4:688969.
- Vilone G, Longo L. Notions of explainability and evaluation approaches for explainable artificial intelligence. Inf Fusion. 2021;76:89-106.
- Ali S, et al. Explainable artificial intelligence (XAI): What we know and what is left to attain trustworthy artificial intelligence. Inf Fusion. 2023;99:101805.
- Gundersen OE, Kjensmo S. State of the art: Reproducibility in artificial intelligence [conference paper]. Presented at: Thirty-Second AAAI Conference on Artificial Intelligence; New Orleans, LA; 2018:1644-1651. https://ojs.aaai.org/index.php/AAAI/article/view/11503
- Hutson M. Artificial intelligence faces reproducibility crisis. Science. 2018;359(6377):725-726.
- Pineau J, et al. Improving reproducibility in machine learning research: A report from the NeurIPS 2019 reproducibility program. J Mach Learn Res. 2021;22(164):1-20.
- U.S. Food and Drug Administration, Health Canada, Medicines and Healthcare products Regulatory Agency. Good Machine Learning Practice for Medical Device Development: Guiding Principles. 2021.
- Liu X, et al. Reporting guidelines for clinical trial reports for interventions involving artificial intelligence: The CONSORT-AI extension. Nat Med. 2020;26(9):1364-1374.
- Mongan J, Moy L, Kahn CE Jr. Checklist for Artificial Intelligence in Medical Imaging (CLAIM): A guide for authors and reviewers. Radiol Artif Intell. 2020;2(2).
- Peng RD. Reproducible research in computational science. Science. 2011;334(6060):1226-1227.
- Collins GS, et al. Protocol for development of the TRIPOD-AI and PROBAST-AI reporting and risk-of-bias tools for studies developing, validating, or updating prediction models based on artificial intelligence. BMJ Open. 2021;11.
- Kapoor S, Narayanan A. Leakage and the reproducibility crisis in machine-learning-based science. Patterns. 2023;4(9):100804.
- Wiens J, et al. Do no harm: A roadmap for responsible machine learning for health care. Nat Med. 2019;25(9):1337-1340.