Ce protocole décrit un test d' apprentissage et de mémoire de Drosophila appelé conditionnement de la cour. Cet essai classique est basé sur une réduction du comportement de la parade masculine après le rejet sexuel par une femme prématurée non réceptive. Cette forme naturelle de plasticité comportementale peut être utilisée pour tester l'apprentissage, la mémoire à court terme et la mémoire à long terme.
Article de méthode
Drosophila Courtship Conditionnement en tant que mesure de l'apprentissage et de la mémoire
Dans cet article
Résumé
Résumé
De nombreuses idées sur les mécanismes moléculaires sous-jacents à l'apprentissage et à la mémoire ont été élucidées grâce à l'utilisation de tests comportementaux simples dans des organismes modèles tels que la mouche des fruits, Drosophila melanogaster . Drosophila est utile pour comprendre la neurobiologie basique sous-jacente des déficits cognitifs résultant de mutations dans des gènes associés à des troubles cognitifs humains, tels que le handicap intellectuel (ID) et l'autisme. Ce travail décrit une méthodologie pour tester l'apprentissage et la mémoire en utilisant un paradigme classique dans Drosophila connu sous le nom de conditionnement de la cour. Les hommes voient des femmes de cour en utilisant un modèle distinct de comportements facilement reconnaissables. Les femmes prématurées ne sont pas réceptives à l'accouplement et rejettent les tentatives de copulation du mâle. En réponse à ce rejet, les mouches masculines réduisent leur comportement de parade. Cette réduction savante du comportement de la parade est mesurée au fil du temps, servant d'indicateur de l'apprentissage et de la mémoire. Le numéro de baseLa sortie rationnelle de ce dosage est l'indice de parade (CI), qui est défini comme le pourcentage de temps qu'un mâle passe courtisé pendant un intervalle de 10 minutes. L'indice d'apprentissage (LI) est la réduction relative de l'IC dans les mouches qui ont été exposées à une femelle prématurée par rapport aux mouches naïves sans rencontres sociales antérieures. Pour la comparaison statistique des LI entre les génotypes, on utilise un test de randomisation avec bootstrapping. Pour illustrer comment le dosage peut être utilisé pour aborder le rôle d'un gène relatif à l'apprentissage et à la mémoire, on a caractérisé ici le décapage pan-neuronal de Dihydroxyacetone phosphate acyltransferase ( Dhap-at ). L' orthologue humain de Dhap-at , l' O-acyltransférase de glycéronephosphate ( GNPT ), est impliqué dans la chondrodysplasie punctata de type 2 rhizomélique, un syndrome autosomique récessif caractérisé par une ID sévère. À l'aide du test de conditionnement de la cour, il a été déterminé que Dhap-at est requis pour la mémoire à long terme, mais pas pourmémoire à court terme. Ce résultat sert de base à une étude approfondie des mécanismes moléculaires sous-jacents.
Introduction
Les mécanismes moléculaires sous-jacents à l'apprentissage et à la mémoire sont conservés dans de nombreuses espèces. Le travail pionnier visant à trier les lignes mutantes de Drosophila melanogaster pour les défauts de l'apprentissage olfactif et de la mémoire a fourni des connaissances moléculaires clés sur les processus sous-jacents à l'apprentissage et à la mémoire 1 . Ces études ont identifié certains des premiers gènes impliqués dans l'apprentissage et la mémoire, tels que rutabaga 2 , amnésique 3 et dunce 4 , révélant un rôle critique pour la signalisation cyclique d'adénosine monophosphate (AMPc) 5 .
Les écrans génétiques précoce pour les mutants de mémoire ont été principalement conduits en utilisant un conditionnement olfactif. Cependant, plusieurs méthodes pour mesurer d'autres formes d'apprentissage et de mémoire ont émergé avec le temps. L'un des paradigmes d'apprentissage et de mémoire les plus utilisés, et l'analyse décrite ici, est connu sous le nom cLe conditionnement de la scène, décrit en premier par Siegel et Hall 6 et a ensuite été affiné par plusieurs autres groupes de recherche 7 , 8 , 9 . Le conditionnement de la courge dépend de la présence d'une phéromone spécifique, de l'acétate de cis- vaccenyl (cVA), sur l'abdomen féminin, qui est déposé par le mâle pendant la copulation. La détection de la cVA sur l'abdomen féminin réduit naturellement le comportement de la parade et, lorsqu'elle est associée à l'acte de rejet par la femme, l'effet de la cVA sur la réduction de la parade masculine est considérablement amélioré. La réponse des mouches mâles dans ce dosage peut être facilement quantifiée en observant leur comportement de courtisme distinct, qui se caractérise par l'orientation et la poursuite de la femelle, le taraudage, l'extension et la vibration de l'aile, la lèche et la tentative de copulation 10 ( figure 1A ). Les mouches masculines apprennent à se distinguer H entre les femmes accouchées réceptives et non accouplées 11 , et après le rejet sexuel, elles affichent un comportement réduit de parade envers des femelles non réceptives jusqu'à 9 jours 8 . Ce comportement naturel peut être utilisé pour élucider les mécanismes sous-jacents à l'apprentissage, la mémoire à court terme (STM) et la mémoire à long terme (LTM) 8 , 9 , 12 . L'apprentissage est défini comme la réduction immédiate du comportement de la parade qui se produit pendant la période de formation et est souvent appelée mémoire de rappel immédiate, mesurée de 0 à 30 minutes après l'exposition à une femme accouplée 6 , 8 . Le STM est mesuré entre 30 min et 1 h après l'entraînement, tandis que le LTM est le plus souvent mesuré 24 h après l'entraînement 8 ( figure 1B ). Le STM peut être induit en utilisant une période de formation de 1 h, mais il ne dure que 2-3 hS = "xref"> 6 , 8 . Dans la plupart des paradigmes d'apprentissage, LTM ne peut être induit que par des crises d'entraînement répétés. Mcbride et al . (1999) 8 ont montré que trois séances d'entraînement espacées de 1 h étaient suffisantes pour induire une mémoire de parade jusqu'à 9 jours, contrairement aux 2-3 h induites par une seule séance d'entraînement de 1 heure. McBride et al . 8 a également démontré qu'une seule séance d'entraînement de 5 h a produit une réponse LTM similaire pendant 9 jours. Les mouches ne courent pas constamment pendant cette période de 5 heures, produisant effectivement leur propre formation espacée pour induire LTM dans une seule séance d'entraînement. Ceci est très important d'un point de vue pratique, augmentant considérablement la facilité avec laquelle ce dosage peut être utilisé pour enquêter sur LTM. Les protocoles actuels utilisent principalement une séance de formation unique de 7 h pour LTM 11 , 12 . Plusieurs études ont étudié différentesConditions mutantes présentant des défauts spécifiques dans différents aspects de l'apprentissage de la parade. Par exemple, l'ablation du corps de champignon affecte STM et LTM, mais ne pas apprendre 8 . Les mutations du gène amnésique, qui a d'abord été définies comme un régulateur spécifique de la mémoire à l'aide du conditionnement olfactif 3 , affectent la MST mais pas l'apprentissage 6 . La perturbation du régulateur de traduction orb2 (sous-famille CPEB2 de liaison ARN oo18) et la signalisation ecdysone ont exclusivement effet LTM 9 , 13 . Ainsi, le conditionnement de la cour est un paradigme utile pour disséquer les mécanismes qui sous-tendent les différentes étapes de l'apprentissage et de la mémoire.
Ce travail démontre une configuration expérimentale optimisée qui permet de tester relativement à haut débit le conditionnement de la cour. En outre, il décrit un script d'analyse statistique et discute des facteurs critiques de l'analyse. C'est shPossède ici que le gène Drosophila Dihydroxyacetone phosphate acyltransferase ( Dhap-at ) Est nécessaire dans les neurones pour LTM, mais pas pour STM. L' orthologue humain de ce gène, l' O-acyltransférase de glycéronephosphate ( GNPAT ), est muté dans la chondrodysplasie pondeuse rhizomélique type 2 14 , un trouble autosomique récessif caractérisé par un handicap intellectuel sévère, des convulsions et plusieurs autres caractéristiques cliniques 15 . Dans ce contexte, le conditionnement de la parade peut être utilisé pour valider fonctionnellement le rôle des gènes de la maladie humaine dans l'apprentissage et la mémoire, en fournissant une base pour les études mécanistiques.
Protocole
REMARQUE: dans le protocole décrit ci-dessous, une réplique de collecte, de formation et de test est décrite. Afin de tester la reproductibilité des résultats, ces étapes doivent être répétées en parallèle, plusieurs jours et avec des groupes distincts de mouches ( tableau 1) . Le protocole est basé sur un cycle de vie de 10 jours d'œuf à adulte, ce qui est normal lorsque l'élevage flotte dans des conditions constantes de 25 ° C, 70% d'humidité et un cycle de lumière / obscurité de 12 h. Tous les aspects de ce protocole supposent que les conditions sont maintenues constantes pendant toute la durée de l'analyse. Les temps sont indiqués comme heures avant que les lumières ne s'allument (BLO) ou après les lumières allumées (ALO) dans l'incubateur, car cela peut être convenablement réglé en fonction de l'heure préférée du chercheur. Utiliser du gaz CO 2 uniquement pour la collecte initiale des mouches masculines naïves et pour la collecte des femelles prématurées. Ce protocole pour le conditionnement de la parade se compose des étapes suivantes:
- EÉtablissement de cultures de collections féminines prématurées
- Établissement de cultures pour la collecte de sujets de test masculins
- Préparation des blocs de logements
- Établissement de flacons d'accouplement pour la production de femelles prématurées normalisées
- Collection de sujets de test masculins
- Entraînement
- Essai
- Analyse et statistiques de données vidéo
1. Établissement de cultures de collections féminines prématurées
- Préparer la restauration 16 . Faire bouillir 0,8% (p / v) d'agar, 8% (p / v) de levure, 2% (p / v) d'extrait de levure, 2% (p / v) de peptone, 3% (p / v) de saccharose, 6% ( P / v) de glucose, 0,05% (p / v) de MgS04 et 0,05% (p / v) de CaCl2 dans de l'eau pendant 15 min. Laisser refroidir la solution à 70 ° C avant d'ajouter 0,05% (p / v) de méthylparabène (ATTENTION: toxique) et 0,5% (v / v) d'acide propionique (ATTENTION: toxique). Bien mélanger en remuant tout en refroidissant à 50 ° C pour obtenir une solution homogène.
- Avant la nourriture, alorsSe plie à température ambiante, ajoutez ~ 50 ml d'alimentations à chaque flacon en plastique de 175 ml. Laissez la nourriture refroidir davantage. Fermez le flacon avec une fiche.
NOTE: Powerfood est un mélange alimentaire spécialisé spécialement conçu pour la production d'un grand nombre de mouches, probablement en induisant la ponte. Powerfood n'est pas utilisé pour produire des mouches mâles qui seront utilisées pour l'analyse du comportement (étape 2), car le régime atypique et le surpeuplement potentiel pourraient influencer le développement. - Le jour -11 ( tableau 1 ), commencez 5-20 cultures de type sauvage avec environ 60-100 mouches (un mélange de mâles et de femelles) dans des flacons de courant; Ceux-ci seront utilisés à l'étape 4 pour produire des femelles prématurées normalisées 17 . Ajouter un papier filtre dans chaque flacon pour augmenter la surface sur laquelle les larves peuvent se gonfler; Cela augmentera le nombre de mouches qui peuvent se développer.
- Répétez périodiquement les étapes 1.1-1.3 tout au long de l'expérience afin d'obtenir suffisamment de mouches d'émergence comme entrée pour la"Établissement de flacons d'accouplement pour la production de femelles prématurées normalisées" (étape 4).
2. Établissement de cultures pour la collecte de sujets de test masculins
- Préparer des aliments normaux 16 , préparés avec 0,5% (p / v) d'agar, 2.75% (p / v) de levure, 5,2% (p / v) de farine de maïs, 11% (p / v) de sucre, 0,05% (p / v ) Méthylparabène et 0,5% (v / v) d'acide propionique dans l'eau, comme décrit aux étapes 1.1 et 1.2. Fermez les flacons en plastique de 175 ml avec un bouchon de flacon volant.
- Le jour 10 ( tableau 1 ), placez environ 10 à 20 mâles avec environ 30 à 75 femelles vierges ( Tableau Matériaux / Équipement ) dans chaque flacon de 175 mL contenant des aliments normaux. Ajouter un papier filtre pour augmenter la surface de la pupaison et maximiser la productivité.
- Établissez trois à six flacons de 175 mL par génotype pour obtenir le nombre requis d'hommes sujets testés.
REMARQUE: Plus de flacons peuvent être nécessaires, selon la productivité de la génération désiréeOtype.
3. Préparation des blocs de logement ( figure 2A )
- Faire fondre environ 50 ml d'alimentations par bloc de logement dans un four à micro-ondes ou le préparer à l'état frais.
- Ajouter 500 μL de puissance pour chaque puits d'un bloc à fond plat à 96 puits à l'aide d'une pipette multidisparateur.
- Laisser la nourriture se solidifier à température ambiante.
- Couvrez les blocs avec un film adhésif PCR et utilisez une aiguille pour faire au moins 4 trous par puits pour fournir de l'air frais aux mouches.
- Pour pouvoir ouvrir chaque puits, utilisez une lame de rasoir pour couper le film adhésif dans le sens de la longueur entre chaque rangée. Laissez le film intact sur une extrémité du bloc.
- Les blocs peuvent être conservés à 4 ° C pendant 2 jours maximum.
REMARQUE: Permettre aux blocs de rééquilibrer à température ambiante avant leur utilisation.
4. Établissement de flacons d'accouplement pour la production de femelles prématurées normalisées
- Le jour -1, supprimer etJeter toutes les mouches sauvages adultes des cultures prématurées de cultures féminines à 2-5 h BLO.
- Recueillir des mouches à l'aide de l'aspirateur ( Figure 2B ) de ces flacons dans des intervalles de 2 à 3 heures ( p. Ex. À 30 min, 2,5 h et 5 h d'ALO) et les placer dans un nouveau flacon d'alimentation enrichi avec une petite quantité de levure Coller et filtrer du papier.
- Pour éviter l'encombrement et pour favoriser une atmosphère d'accouplement optimale, ne transférez pas plus de 150-200 mouches à chaque nouveau flacon. Assurer l'accouplement de toutes les femelles en fournissant au moins 25% d'hommes. Assurez-vous que des femelles suffisantes sont présentes dans les flacons d'accouplement pour tenir compte de la taille de l'expérience.
REMARQUE: Étant donné qu'il s'agit d'une étape cruciale dans le protocole, assurez-vous que seules les mouches fraîchement fermées et les vieilles mouches, larves ou pupes sont transférées dans le nouveau flacon d'accouplement. - Incuber ces "flacons d'accouplement" pendant quatre jours pour laisser suffisamment de temps pour que toutes les femelles se soient accouplées.
5. ColLection de sujets de test masculins
- Le jour 1 ( tableau 1 ) à 2-3 h BLO, utilisez du CO 2 pour éliminer toutes les mouches adultes des flacons de collecte masculins (étape 2) Mais laissez plus de mouches éclipser au cours des prochaines heures.
- Au cours des 5 à 6 heures suivantes, retirez les mouches nouvellement fermées toutes les 20 à 30 minutes en utilisant du CO 2 et placez chaque mâle dans un puits individuel du bloc de logement (étape 3) à l'aide de l'aspirateur ( Figure 2B ).
- Re-sceller le puits avec le film PCR adhésif.
REMARQUE: Ceci est une étape cruciale dans le protocole. Les mâles doivent être collectés fréquemment. Les mâles collectés devraient être isolés dans le bloc de logement près du moment de l'éclosion, lorsqu'ils démontrent une pigmentation pâle et la présence du méconium dans l'abdomen translucide.
REMARQUE: Une utilisation douce de l'aspirateur permet le transfert de mouches; Cependant, une utilisation inappropriée mettra l'accent sur les mouches, provoquant une variance dans le dosage (voir la discussion). - Viser à coSélectionnez jusqu'à 48 mâles par génotype. Cela fournit un petit excès pour le nombre maximal d'hommes nécessaires à l'analyse des conditions naïves et formées, ce qui permet une perte lors des étapes de transfert ultérieures.
6. Formation
- Retirez les mouches du flacon d'accouplement (étape 4.2) en utilisant le CO 2 et séparez les femelles prématurées des mâles.
- À l'aide de l'aspirateur, ajoutez une seule femelle prématurée anesthésiée à chaque puits dans une rangée d'un nouveau bloc de logement.
- À l'aide de l'aspirateur et sans anesthésie, transférer un mâle naïf individuel du bloc de logement mis en place à l'étape 5.2 vers le puits contenant une femelle prématurée. Une fois que le mâle est placé dans le puits, ré-sceller immédiatement avec le film adhésif; Ne permettent pas aux hommes de s'échapper.
REMARQUE: Transférez les mouches masculines de l'aspirateur vers le bloc de logement en profitant de leur comportement naturel de «géotexie négative» (voir la discussion). - Répéter les étapes6.2-6.3 jusqu'à ce que suffisamment de couples mâle-femelle soient établis. Idéalement, établissez 24 paires, deux rangées entières d'un bloc de logement, par génotype. Laissez les mâles naïfs restants dans le bloc de logement d'origine mis en place à l'étape 5.2.
- Laissez les paires mâles et femelles sans être perturbées durant la période de formation ( tableau 2 , figure 1B ).
NOTE: Pendant ce temps, le mâle court et sera rejeté par la femme prématurée. Pour apprendre et STM, la durée de la formation est de 1 h et pour LTM, la période de formation est de 7 à 9 h. - Mettre fin à la formation ( tableau 2 , figure 1B ) en utilisant un aspirateur pour séparer doucement le mâle de la femelle prématurée; Ne pas utiliser l'anesthésie. Placez le mâle séparé dans un nouveau bloc de logement.
- Utilisez l'aspirateur pour transférer doucement tous les mâles naïfs et sans anesthésie à partir du bloc de logement mis en place à l'étape 5.2 vers un nouveau bloc de logement.
REMARQUE: cette étape est facultative pour STM et leaMais c'est très important pour LTM car les mouches sont hébergées pendant 24 h supplémentaires pour tester le LTM. - Pour STM et LTM, les mâles peuvent reposer pendant 1 h et ~ 24 h respectivement ( Tableau 2 , Figure 1B ) avant le test (étape 7).
- Pour apprendre, testez immédiatement les mâles formés et naïfs (étape 7).
7. Essais
- Collectez les mouches des flacons d'accouplement (étape 4.2) en utilisant du CO 2 et séparez les femelles prématurées des mâles.
- Laissez les femelles se remettre de l'anesthésie pendant au moins 1 h dans un flacon contenant des aliments normaux.
- Montez les magnétoscopes à l'avance ( Figure 2C ) afin d'avoir tous les équipements prêts avant le début du test.
- Commencez le test en fonction des différents délais d'apprentissage, STM et LTM ( Tableau 2 , Figure 1B ). Effectuer les tests immédiatement après l'entraînementPour l'apprentissage, 1 h après la formation pour la MST et 24 h après la formation pour le LTM.
- À l'aide de l'aspirateur, transférez doucement un mâle individuel du bloc de logement de repos ou du bloc de logement d'entraînement si l'apprentissage est en cours de test (étape 6.7, formé, étape 6.8, naïf) à la moitié d'une arène de cour avec le diviseur fermé ( Figure 2D , Voir le fichier S1 pour un plan de construction).
NOTE: L'utilisation du comportement naturel de "géotaxie négative" devrait être suffisante pour transférer les mouches mâles de l'aspirateur vers l'arène de la cour (discussion). - Déplacez rapidement mais doucement le trou d'entrée à l'arène suivante et répétez l'étape 7.5 jusqu'à ce que les 18 arènes contiennent un mâle.
- À l'aide de l'aspirateur et sans CO 2 , ajouter une femelle prématurée (collectée à l'étape 7.2) à l'autre moitié des 18 arènes.
- Placez soigneusement la chambre de parade sous la caméra, avec l'ouverture des puits vers le bas ( figure 2C ).
- Supprimez le diviseur des arènes pour permettre une interaction directe entre les mâles et les femelles prématurées.
- Commencez immédiatement à enregistrer le comportement pendant au moins 10 min.
REMARQUE: Lors de l'utilisation d'une installation à deux caméras, l'enregistrement parallèle de deux plaques de parade peut se faire en des temps de chevauchement pour maximiser l'efficacité. - Videz les arénas de la cour de récit à l'aide d'un aspirateur à main et permettez à la chambre de la cour de se ventiler avant de la réutiliser.
- Répétez l'étape 7.4-7.11 jusqu'à ce que le test de tous les génotypes et conditions ( c'est-à-dire naïf et formé) a été complété.
8. Analyse des données vidéo et statistiques
- Calculer l'indice de la parade (CI), défini comme le pourcentage de temps que les tribunaux masculins ont duré au cours des 10 premières minutes de la période d'essai, pour chaque mouche masculine.
REMARQUE: ceci peut être fait manuellement en observant le comportement de la parade stéréotypée ( Figure 1A ) ou par vousChanter des logiciels pour la quantification automatisée du comportement de la parade (Discussion).
NOTE: Il est recommandé d'analyser 40 à 60 mâles par condition sur trois jours afin d'obtenir une puissance statistique suffisante et de juger de la cohérence des données CI. - Calculer l'indice d'apprentissage (LI), défini comme la réduction en pourcentage dans l'IC moyen des mâles formés par rapport aux mâles naïfs (LI = (IC naïve - IC formé ) / CI naïf ). Évaluez le LI pour chaque jour de test et comparez-le à la LI cumulative calculée à partir de tous les jours de tests combinés.
- Créez un fichier de données d'onglet séparé à deux colonnes avec "Genotype" et "CI" comme en-têtes.
REMARQUE: ces rubriques sont sensibles à la casse. Le nom du génotype pour chaque IC doit consister en une description du génotype suivi d'un trait de soulignement et de la condition de formation ( p. Ex. Génotype_N et génotype_LTM, etc., où N = naïve et LTM = à long termeMémoire; Voir Fichier supplémentaire S2 pour un exemple). Cette annotation est essentielle, car la fonction analearn identifiera les mouches formées et naïves en fonction des caractères présents après le premier trait de soulignement dans la colonne "Genotype". - Utilisez le script analearn R (Supplemental File S3) pour effectuer un test de randomisation pour juger de la signification statistique des différences entre les valeurs LI de différents génotypes.
- Saisissez le script (Supplemental File S3) dans R 18 , qui définit une fonction appelée "analearn".
NOTE: La définition de la fonction est: analearn <- function (nboot = 10,000, naivelevel = 'N', refmutation = NA, datname = NA, header = TRUE, seed = NA, writeoutput = TRUE). - Commencez la fonction en entrant "analearn ()" dans la ligne de commande R et en sélectionnant le fichier de données à analyser (produit à l'étape 8.3) via la fenêtre contextuelle.
- Choisissez la mutation de référence, quiEst le génotype de contrôle, en entrant le numéro correspondant et en appuyant sur Entrée.
REMARQUE: après avoir sélectionné le génotype de référence, le script prend plusieurs secondes pour effectuer 10 000 réplicas bootstrap. - Observer le tableau de sortie (tableau 3), qui contient le génotype, la condition d'apprentissage ( c.-à-d. Apprentissage, STM ou LTM), CI moyen naïf, CI moyen formé, LI, la différence entre le LI du contrôle par rapport à la condition expérimentale (LI dif), la limite inférieure (LL) et la limite supérieure (UL) de l'intervalle de confiance de 95% du LI dif, et la valeur p indiquant la probabilité qu'il n'y ait pas de différence significative.
REMARQUE: analearn stockera un fichier texte de sortie dans le répertoire où se trouve le fichier de données. Toutefois, la table de sortie apparaît également dans la console R-Studio. Le nom par défaut est construit en fonction du nom du fichier de données fourni. - Il existe plusieurs arguments dans la fonction analearn qui peut être utilisé pour modifier leParamètres de défaut de la fonction pour ajuster les paramètres du démarrage.
REMARQUE: "nboot" définit le nombre de réplicas bootstrap et est défini à 10 000 par défaut. Cette valeur peut être changée en un nombre entier supérieur à zéro. Le tableau 5 renvoie plusieurs arguments qui peuvent être utilisés pour modifier les paramètres par défaut de la fonction. Toutefois, il n'est pas recommandé d'utiliser des données produites avec un faible nombre de réplicas bootstrap.
- Saisissez le script (Supplemental File S3) dans R 18 , qui définit une fonction appelée "analearn".
Résultats
Le test de conditionnement de la cour peut être utilisé pour mesurer l' apprentissage et la mémoire dans Drosophila . Pour démontrer cela, les résultats présentés ici analysent STM et LTM dans le contrôle des mouches par rapport aux mouches avec le knockdown spécifique du neurone de Dhap-at. Les mâles de contrôle expriment une séquence d'épingle à cheveux interférentielle d'ARN ciblant un gène spécifique de Caenorhabditis elegans, une protéine supposée de doigts de zinc C02F5.12 19 . Cette souche de contrôle assure un nombre égal d'éléments de séquence d'activation en amont (UAS) entre le knockdown et le contrôle dans le même fond génétique, et l'horloge RNAi de contrôle représente tous les effets non spécifiques du système RNAi. Les males de contrôle (génotype: UAS-dcr2 / +; P {KK108109} VIE-260B / +; elav-Gal4 / + ) montrent une réduction significative de l'IC dans la formation par rapport à la naïveté pour la STM ( Figure 3A , p = 1,2 x 10 - 4 , Mann-WhitneY U-test) et LTM ( Figure 3B , p = 1,2 x 10 -4 , test U de Mann-Whitney). Ce résultat reflète la capacité normale d'apprentissage et de mémoire dans ces mouches. Dhap-at knockdown flies (génotype: UAS-dcr2 / +; P {KK101437} VIE-260B / +; elav-Gal4 / + ) montrent également une réduction significative de l'IC dans les mouches formées contre naïvetées pour la MST ( Figure 3A , p = 1,2 x 10 -4 , test U de Mann-Whitney). Cependant, ils ne montrent pas une réduction significative de l'IC après la formation de LTM ( Figure 3B , p = 0,33, test U de Mann-Whitney). Le test U de Mann-Whitney a été utilisé pour comparer l'IC moyen des mouches naïves et entraînées en raison de la distribution non paramétrique des données CI pour certaines conditions ( figures 3A et 3B ). Les différences observées lors de l'analyse des IC se reflètent dans le LI pour chaque génotype, qui mesure le pourcentage réducteurDans CI dans des mouches naïves par rapport à celles formées ( Figure 3C ). Il n'y a pas de différence significative dans le LI entre les témoins et Dhap-at knockdown flies pour STM ( p = 0.115, 10 000 réplicats bootstrap, Figure 3C , Tableau 3 ), alors que le LI pour LTM est significativement plus bas dans Dhap-at knockdown flies ( p = 0,0034, 10 000 répétitions bootstrap, figure 3C , tableau 3 ). Pour la comparaison de LI entre les génotypes, un test de randomisation 20 adapté à partir d'un procédé initialement recommandé par Kamyshev et al. 7 a été utilisé. Étant donné que la LI est une valeur unique découlant des données démographiques ( c.-à-d., Une formation moyenne CI-naïve et moyenne), des méthodes statistiques standard qui reposent sur des distributions dérivées expérimentalement ne s'appliquent pas. Le test de randomisation est sans distribution et utilise bootstrapping ( c.-à-d. Sampli aléatoireNg avec remplacement) pour générer des ensembles de données hypothétiques dérivés des données réelles. Le script analearn (File S3) génère un ensemble de LI typiques pour chaque génotype et calcule la différence entre le contrôle et le génotype test (LIdiff). Ce processus est répété 10 000 fois et les valeurs résultantes sont utilisées pour déterminer l'intervalle de confiance à 95% de LIdiff ( tableau 3 ). Ces données sont utilisées pour générer une valeur p indiquant la probabilité que le LI des deux génotypes soit différent. Les résultats montrés ici démontrent que Dhap-at est requis dans les neurones pour LTM mais pas pour STM.
Afin de contrôler la variabilité quotidienne, les IC et les LI sont comparés entre les jours répliqués ( tableau 4 ). Bien que certaines fluctuations de LI soient observées au jour le jour, les résultats sont généralement reproductibles. Il est important de noter que les données CI peuvent varier considérablement en fonction du contrôle strUtilisé et les conditions environnementales des tests. Les données de CI présentées ici sont typiques de ce génotype de contrôle, mais d'autres génotypes peuvent présenter une CI et une distribution moyennes supérieures ou inférieures.
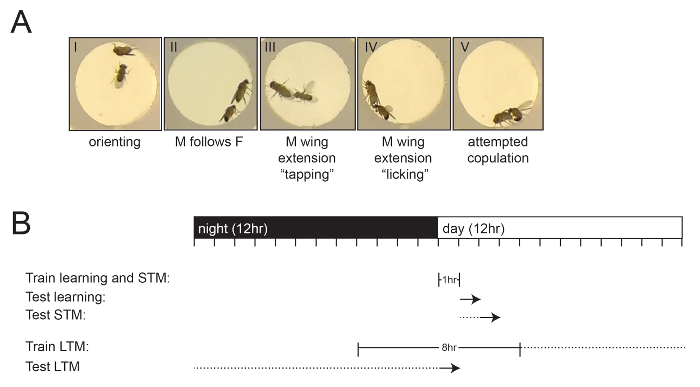
Figure 1: Détermination de l'indice de cour et aperçu expérimental. ( A ) Images montrant le comportement stéréotypé de la parade masculine à l'égard d'une mouche femelle. Les différents stades du comportement de la parade sont présentés: orientation (I), suivi (II), vibration des ailes (extension) et taraudage (III), léchage (IV) et tentative de copulation (V). ( B ) Aperçu schématique de la formation et des temps d'essai par rapport au cycle de l'éclairage de l'incubateur, marqué en heures. Les temps de formation sont indiqués par des barres, les périodes de repos pour STM et LTM sont indiquées par une ligne pointillée, et le point de départ du test est indiqué comme une flèche. Notez que leLe temps de test pour LTM est le lendemain de l'entraînement. Cliquez ici pour voir une version plus grande de ce chiffre.
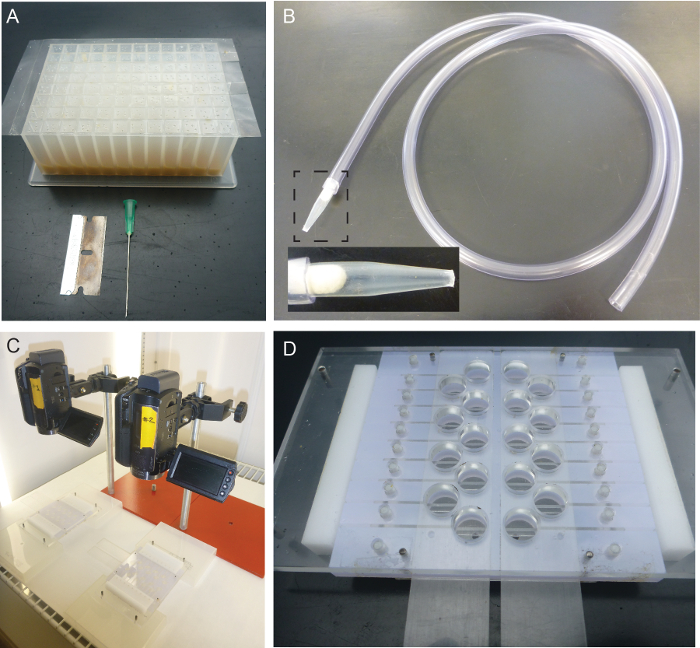
Figure 2: Équipement utilisé pour le test de conditionnement de la courge de Drosophila. ( A ) Le bloc de logement est un bloc plat et inférieur avec 500 μL de puissance par puits. Il est scellé avec un film adhésif qPCR avec au moins 4 trous par puits qui ont été créés à l'aide d'une aiguille de seringue avec un diamètre de 0,8 mm. Les rangées individuelles sont découpées longitudinalement en bandes à l'aide d'une lame de rasoir pour permettre l'ouverture et la fermeture. ( B ) L'aspirateur est nécessaire pour le transfert doux des mouches mâles et femelles sans anesthésie. L'encart montre le bout de l'aspirateur, fermé avec un coton à keEp les mouches dans la pointe. ( C ) Configuration d'un système à deux caméras pour l'enregistrement simultané de deux chambres de parade. ( D ) Une chambre de cour avec 18 arènes. Des trous d'entrée coulissants sont utilisés pour placer les mouches dans les arènes. Les diviseurs blancs peuvent être ouverts simultanément pour initier l'interaction entre les mâles et les femelles. Cliquez ici pour voir une version plus grande de ce chiffre.
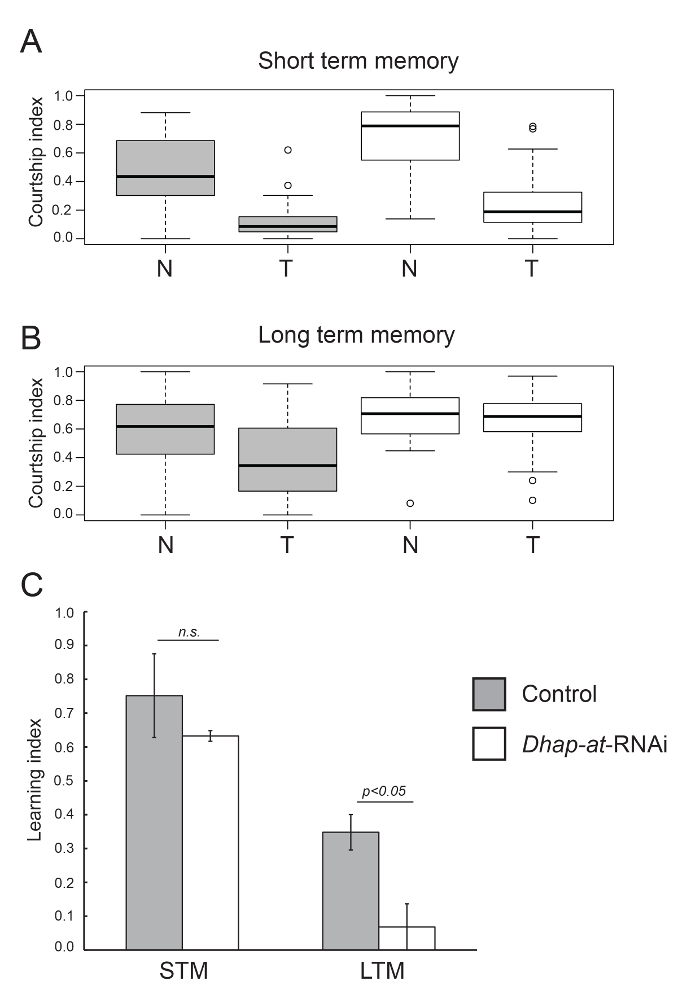
Figure 3: Analyse de STM et LTM dans Control and Dhap-at Knockdown Flies. ( AB ) Encadrés montrant la répartition des valeurs de CI pour les mouches naïves (N) et formées (T) des génotypes de contrôle (gris) et Dhap-at knockdown (blanc) testés pour STM (A) et LTM (B). ( C ) CorrespoNding LI pour le contrôle et Dhap-at knockdown mouches testées pour STM et LTM. Les différences de LI entre les génotypes de contrôle et de knockdown ont été comparées à l'aide d'un test de randomisation (10 000 répétitions bootstrap). Les barres d'erreur indiquent l'erreur standard de la moyenne dérivée des valeurs LI calculées sur différents jours de test. Les génotypes sont: w +, UAS-dcr2 / + ; P {KK108109} VIE-260B / + ; Et elav-Gal4 / + (Contrôle) Et w +, UAS-dcr2 / + ; P {KK101437} VIE-260B / +; Et elav-Gal4 / + ( Dhap-at- ARNi). Cliquez ici pour voir une version plus grande de ce chiffre.
| Général | Collecte | Train | Tester | |
| Jour -11 | Démarrer les cultures prématurées de la collection féminine (étape 1.3) | |||
| Jour -10 | Démarrer des cultures pour la collecte de sujets de test masculins (étape 2.2) | |||
| Jour 1 | représentant. 1 | |||
| jour 2 | représentant. 2 | |||
| Jour 3 | représentant. 3 | |||
| Jour 4 | représentant. 4 | représentant. 1 | ||
| Jour 5 | représentant. 2 | représentant. 1 | ||
| Jour 6 | représentant. 3 | représentant. 2 | ||
| Jour 7 | représentant. 4 | représentant. 3 | ||
| Jour 8 | représentant. 4 | |||
| Jour 9 | Analyse et statistiques de données vidéo (étape 8) | |||
| Rep = repeat | ||||
Tableau 1 : Exemple de chronologie pour tester LTM sur trois répliques sur les jours individuels.
| Apprentissage | STM | LTM | |
| Temps de formation | 1 h. | 1 h. | 8 h. |
| Temps de repos | 0 h. | 1 h. | ~ 24 h. |
| Commence l'entraînement | 0H. ALO | 0 h. ALO | 4 h. BLO |
| Arrête l'entraînement | 1 h. ALO | 1 h. ALO | 4 h. ALO |
| Test de départ | 1 h. ALO | 2 h. ALO | 0 h. ALO (jour suivant) |
| ALO = après les lumières allumées, BLO = avant que les lumières ne s'allument, STM = mémoire à court terme, LTM = mémoire à long terme | |||
Tableau 2 : Durée de la formation, temps de formation et temps de test pour l'apprentissage, STM et LTM.
| Génotype | Apprentissage condition | CI naïf | CI qualifié | LI | LI différence | Limite inférieure (Intervalle de concomitance de 95%) | Limite supérieure (Intervalle de concomitance de 95%) | Valeur p |
| Contrôle | STM | 0.467 | 0.116 | 0,752 | N / A | N / A | N / A | N / A |
| Dhap-at-RNAi | STM | 0,699 | 0,257 | 0.633 | 0.119 | -0,030 | 0,265 | 0.116 |
| Contrôle | LTM | 0,590 | 0,384 | 0,348 | N / A | N / A | N / A | N / A |
| Dhap-at-RNAi | LTM | 0,697 | 0,650 | 0,068 | 0,280 | 0,103 | 0,446 | 0,003 |
Tableau 3: Données statistiques produites à partir du script Analearn.
Données statistiques produites à partir du script analearn. Le fichier de sortie du script R d'amorçage contenant le génotype, la condition d'apprentissage ( c.-à-d. L' apprentissage, le STM ou le LTM), la CI moyenne naïve, la CI moyenne formée, LI, la différence entre LI du contrôle par rapport à la condition expérimentale (LI dif) , La limite inférieure (LL) et la limite supérieure (UL) de l'intervalle de confiance 95% de LI dif, et la valeur p indiquant la probabilité qu'il n'y ait pas de différence significative.
| Contrôle | Dhap-at-RNAi | ||||||
| NA moyen | Formation CI moyenne | LI | NA moyen | Formation CI moyenne | LI | ||
| STM | Jour 1 | 0.300 | 0,125 | 0,584 | 0,679 | 0,239 | 0,648 |
| Jour 2 | 0.634 | 0,107 | 0.831 | 0,720 | 0,276 | 0.617 | |
| Tous les jours | 0.467 | 0.116 | 0,752 | 0,699 | 0,257 | 0.633 | |
| LTM | Jour 1 | 0,590 | 0,441 | 0,252 | 0,630 | 0.646 | -0,027 |
| Jour 2 | 0,640 | 0,363 | 0,432 | 0,709 | 0,710 | -0.002 | |
| Jour 3 | 0,547 | 0,349 | 0,363 | 0,738 | 0,598 | 0.190 | |
| Tous les jours | 0,590 | 0,384 | 0,348 | 0,697 | 0,650 | 0,068 |
Tableau 4 : Valeurs CI et LI obtenues lors de jours de tests séparés.
| "Naivelevel" détermine le texte qui identifiera les valeurs naïves pour chaque génotype. La valeur par défaut est "N", mais cela peut être changé en n'importe quel autre texte alphanumérique. |
| "Refmutation" est réglé sur "NA" (non applicable) par défaut, mais peut être changé en nom du contrôle ou du génotype afin d'effectuer des comparaisons statistiques. Cela causera le sCript pour sélectionner automatiquement le génotype de contrôle. |
| "Datname" fait référence au nom du fichier de données et peut être spécifié dans cet argument au lieu de la sélection de fichier par défaut. |
| "En-tête" peut être utilisé pour indiquer si le fichier de données contient ou non des en-têtes de colonne. La valeur par défaut est "TRUE", mais un fichier sans en-têtes peut être utilisé lorsque cet argument est remplacé par "FALSE". |
| "Seed" initialise le générateur de nombres aléatoires. Ceci est défini par défaut sur "NA" et assure un nombre aléatoire chaque fois que le script est utilisé. Par conception, une analyse bootstrap donnera des résultats légèrement différents chaque fois qu'il est exécuté, même lorsque vous utilisez le même fichier de données. Lorsque la graine est spécifiée par n'importe quel nombre entier supérieur à zéro, on obtient le même ensemble d'échantillons aléatoires bootstrap. |
| "rédiger Mettre "peut être réglé sur" TRUE "ou" FALSE "afin de déterminer si un fichier de sortie sera généré. La valeur par défaut est "TRUE". |
Tableau 5: Arguments utilisés dans la fonction Analearn qui peut modifier les paramètres par défaut de la fonction pour ajuster les paramètres du Bootstrapping
Fichier supplémentaire S1: plan de construction d'une chambre de parade. Le fichier peut être ouvert avec n'importe quelle application qui permet des extensions .stp (fichiers CAD) . Cliquez ici pour télécharger ce fichier.
Fichier supplémentaire S2 : Exemple d'un fichier d'entrée pour le script Analearn .S2.zip "target =" _ blank "> Cliquez ici pour télécharger ce fichier.
Fichier supplémentaire S3 : The Analearn.R Acript. Le fichier peut être ouvert avec R-studio 18 . Cliquez ici pour télécharger ce fichier.
Discussion
Le test de conditionnement de la parade est un paradigme classique pour l'analyse de l' apprentissage et de la mémoire chez Drosophila . Le protocole présenté ici suit la méthodologie générale décrite précédemment 6 , 7 , 8 , 9 mais comprend des aspects uniques tels que des lignes directrices pratiques, un équipement spécialisé et un script d'analyse de données 9 , 12 pour les tests de randomisation. En utilisant ce protocole, il est possible d'analyser un grand nombre de mouches en parallèle en utilisant des blocs à fond plat de 96 puits ( Figure 2A ) pour collecter et former des mâles. Les blocs sont scellés avec un film adhésif PCR, ce qui rend les mouches facilement accessibles au besoin. En outre, les chambres de mariage uniques décrites ici permettent l'association simultanée de 18 paires mâle-femelle dans un espace quasi bidimensionnel que iS optimal pour l'analyse vidéo. Les chambres de parade conçues sur mesure sont faciles à utiliser, et un plan de construction est fourni ( Fichier S1 , Figure 2D ). Ce protocole, à partir de l'établissement des cultures utilisées pour collecter les sujets de test à l'acquisition de données vidéo, prend environ 20 jours ( tableau 1 ). Un temps supplémentaire est requis pour l'analyse des données vidéo. Dans notre expérience, l'analyse STM est extrêmement robuste. Le test LTM est également assez robuste, mais il est plus sensible aux variables environnementales qui confondent et peut donc être plus difficile à maîtriser.
Le comportement animal peut être assez variable. Par conséquent, les étapes critiques du protocole doivent être effectuées avec soin pour réduire cette variance. Tout d'abord, l'utilisation douce de l'aspirateur ( Figure 2B ) réduira le stress qui peut être imposé par une manipulation brutale ou par un souffle excessif. Une méthode suggérée de transfert d'individuSort de l'aspirateur en utilisant une géotaxis négative. Comme les mouches ont tendance à marcher vers le haut, on peut simplement pointer la pointe de l'aspirateur vers le haut; Juste avant que la mouche n'atteigne la pointe, un coup doux suffit à laisser tomber la mouche. En outre, pour laisser les hommes dans les chambres de la cour avant de tester, un coup n'est souvent pas nécessaire.
Une autre étape importante est la collecte et la génération de sujets de test masculins. Tous les mâles doivent être collectés lorsqu'ils sont très jeunes et socialement naïfs. Ceci peut être réalisé par une collecte fréquente pendant les périodes de pointe de l'eclosion (étape 5.2). Si les mâles ne sont pas collectés dans ce délai étroit, ils peuvent avoir des interactions sociales précoces, ce qui peut entraîner un faible apprentissage ou une grande variabilité dans l'IC. Un autre facteur de sujets de test masculin qui devrait être évalué est le fond génétique. Différents milieux génétiques présenteront différents niveaux de parade naïve et peuvent également différer dans l'activité générale ou la capacité locomotrice. Lorsque compaAssocient des génotypes multiples, il faut prendre soin de l'origine génétique afin d'éviter ces facteurs de confusion qui peuvent influencer les scores LI. En outre, la répartition des données CI doit être soigneusement évaluée. Les données CI peuvent être à la fois paramétriques et non paramétriques, selon le génotype ou d'autres facteurs environnementaux. Dans certains cas, si la répartition de l'IC est considérablement éloignée d'une distribution normale, il est préférable d'utiliser la CI médiane plutôt que la moyenne pour le calcul des LI. Cependant, selon notre expérience, l'utilisation d'IC médiane ou moyenne ne fait pas de différence dans l'interprétation statistique des données, et l'utilisation de la CI moyenne est la pratique courante dans la littérature.
Pour le conditionnement réussi de la parade, le rejet actif des tentatives de parade masculine par les femmes prématurées est crucial pendant la période de formation. Il est important de s'assurer que les femelles prématurées utilisées dans ce dosage ont été efficacement accouplées et sontNe permettant donc pas la copulation. Cette prémataison est établie dans les flacons d'accouplement préparés à l'étape 4, où les mouches mâles et femelles sont logées ensemble pendant 4 jours ( tableau 1 ). Par la suite, l'accouplement peut être surveillé par un examen régulier des vidéos de test et par l'observation de paires hommes-femmes lors de la formation. Si l'accouplement se produit, il existe plusieurs mesures qui peuvent être prises lors de la préparation des femelles prématurées. Premièrement, les femelles prématurées devraient être élevées dans des conditions de reproduction optimales. Les flacons peuvent être complétés avec une pâte de levure et un papier filtre plié pour augmenter les surfaces d'accouplement potentielles. L'incubation des mouches dans les conditions décrites ici a produit des femelles prématurées robustes dans le passé, mais cela peut varier selon les laboratoires différents et avec différentes souches génétiques. Par conséquent, il peut être nécessaire d'optimiser la génération de femelles prématurées en modifiant le temps et les conditions d'incubation.
La quantification du comportement de la parade estUne autre étape critique dans ce protocole. Cela peut se faire manuellement ou automatiquement à l'aide de logiciels spécialisés 9 . La quantification automatisée est rapide et, en principe, impartiale. Plusieurs programmes ont été publiés 21 , 22 , 23 ; Cependant, ils ne sont pas faciles à utiliser, nécessitant souvent des formats vidéo spécialisés et des compétences informatiques avancées. La quantification manuelle est simple et précise, mais elle nécessite beaucoup de travail et est soumise à une variabilité et à un biais particuliers. Il est important de souligner que ce protocole ne traite pas des exigences relatives au formatage vidéo qui sont potentiellement nécessaires à la quantification automatisée des IC. Pour la quantification manuelle, utilisez n'importe quel appareil d'enregistrement vidéo simple qui a le potentiel de produire une vidéo de qualité suffisante pour observer avec précision le comportement de la parade. Pour la quantification automatisée, il y aura probablement différentsExigences en fonction du logiciel utilisé, et les utilisateurs devraient procéder à une enquête approfondie si une quantification automatisée est souhaitée.
En combinaison avec les outils étendus disponibles pour la manipulation génétique des mouches, le test de conditionnement de la parade offre une lecture solide qui peut être utilisée pour disséquer les mécanismes moléculaires et les réseaux neuronaux impliqués dans l'apprentissage et la mémoire.
Déclarations de divulgation
Les auteurs n'ont rien à dévoiler.
Remerciements
Nous reconnaissons le Centre de ressources de Drosophila de Vienne pour fournir les souches de Drosophila . De plus, les stocks obtenus auprès du Bloomington Drosophila Stock Center (NIH P40OD018537) ont été utilisés dans cette étude. Cette recherche a été soutenue en partie par le réseau intégré à grande échelle FP7 à l'échelle européenne Gencodys à KK, HvB et AS et par le CRSNG Discovery et les Subventions de projet des IRSC à JMK
Matériaux
| Nom | Entreprise | Numéro de catalogue | Commentaires |
|---|---|---|---|
| P{KK101437}VIE-260B | VDRC | 101437 | Dhat-at-RNAi in 60100 background ; |
| P{KK108109}VIE-260B | - | - | Control-RNAi in 60100 background (don de K. Keleman) |
| w+, UAS-dcr2/yhh ;; elav-Gal4 (III) ; | - | -ligne | de commande panneuronale |
| Récipients pour la culture de tissus végétaux | VWR | 960177 | 175 mL |
| Filtres pliés | Whatman | 10311643 | Papier filtre pour agrandir la surface sur laquelle les mouches peuvent se nymphoser ; |
| Blocs à fond plat (96 puits) | Qiagen | 19579 | Utilisé pour les blocs d’habitation |
| Film adhésif transparent MicroAmp | adhésif 4306311 PCR appliqué comme couvercle sur les blocs à fond plat | ||
| Lame de rasoir | - | - | N’importe quel tranchant fera l’affaire |
| ; | - | - | 0,8 mm de diamètre |
| - | - | Coupez une pointe de pipette de 1 ml avec des ciseaux afin d’avoir deux morceaux. L’extrémité étroite de la pointe du pipette est placée comme entrée de mouche dans un tuyau flexible de ~80 cm. Pour éviter qu’une mouche ne pénètre dans le tuyau, un morceau normal de coton ou de petit filet est placé entre l’embout et le tuyau. L’autre moitié de la pointe du pipeton peut être utilisée comme embout buccal à l’extrémité du tuyau. | |
| Chambres de parade nuptiale | - | - | le fichier S1 peut être ouvert avec le logiciel de CAO indiqué ; |
| Caméscope | Caractéristiques | de l’appareil photo Sony : >4 millions de pixels, full HD. Pour la quantification manuelle, tout appareil d’enregistrement vidéo simple a le potentiel de produire une vidéo de qualité suffisante pour observer avec précision le comportement de la parade nuptiale. Pour la quantification automatisée, il y aura probablement des exigences différentes selon le logiciel à utiliser, et les utilisateurs doivent l’étudier de manière approfondie si une quantification automatisée est souhaitée. | |
| Name | Company | Numéro de catalogue | Comments |
| power food | |||
| Agar | Sigma | A7002 | |
| Yeast | Bruggeman-Yeast | ||
| MP biomedicals | 0210330391 ; | ||
| Peptone | Sigma | P6838 | |
| Saccharose | Sigma | S9378 | |
| Glucose | Sigma | G7021 | |
| MgSO4 | Sigma | M2643 | |
| CaCl2 | Merck | 1023780500 | |
| Méthylparabène (ATTENTION) | Sigma | H5501 | |
| Acide propionique (ATTENTION) | Sigma | P1386 | |
| Eau déminéralisée-Pâte | |||
| de | levure-grains de levure et mélange d’eau dans un rapport de 1:1 | ||
| Name | Company | Numéro de catalogue< | strong>Comments |
| alimentaire normal | |||
| Agar | MP biomedicals | 215017890 | |
| Levure | bruggeman-Farine | ||
| maïs | de | Molen-Sucre | |
| de | |||
| (ATTENTION) | Sigma | H5501 | |
| Acide propionique (ATTENTION) | Sigma | P1386 | |
| Eau déminéralisée | - |
Références
- Quinn, W. G., Harris, W. A., Benzer, S. Conditioned behavior in Drosophila melanogaster. Proc. Natl. Acad. Sci. USA. 71, 708-712 (1974).
- Livingstone, M. S., Sziber, P. P., Quinn, W. G. Loss of calcium/calmodulin responsiveness in adenylate cyclase of rutabaga, a Drosophila learning mutant. Cell. 37, 205-215 (1984).
- Quinn, W. G., Sziber, P. P., Booker, R. The Drosophila memory mutant amnesiac. Nature. 277, 212-214 (1979).
- Dudai, Y., Jan, Y. N., Byers, D., Quinn, W. G., Benzer, S. dunce, a mutant of Drosophila deficient in learning. Proc. Natl. Acad. Sci. USA. 73, 1684-1688 (1976).
- Dubnau, J., Tully, T. Gene discovery in Drosophila: new insights for learning and memory. Annu. Rev. Neurosci. 21, 407-444 (1998).
- Siegel, R. W., Hall, J. C. Conditioned responses in courtship behavior of normal and mutant Drosophila. Proc. Natl. Acad. Sci. USA. 76, 3430-3434 (1979).
- Kamyshev, N. G., Iliadi, K. G., Bragina, J. V. Drosophila conditioned courtship: two ways of testing memory. Learning & memory. 6, 1-20 (1999).
- McBride, S. M., et al. Mushroom body ablation impairs short-term memory and long-term memory of courtship conditioning in Drosophila melanogaster. Neuron. 24, 967-977 (1999).
- Keleman, K., Kruttner, S., Alenius, M., Dickson, B. J. Function of the Drosophila CPEB protein Orb2 in long-term courtship memory. Nature Neurosci. 10, 1587-1593 (2007).
- Hall, J. C. The mating of a fly. Science. 264, 1702-1714 (1994).
- Keleman, K., et al. Dopamine neurons modulate pheromone responses in Drosophila courtship learning. Nature. 489, 145-149 (2012).
- Kramer, J. M., et al. Epigenetic regulation of learning and memory by Drosophila EHMT/G9a. PLoS Biol. 9. 9, e1000569(2011).
- Ishimoto, H., Sakai, T., Kitamoto, T. Ecdysone signaling regulates the formation of long-term courtship memory in adult Drosophila melanogaster. Proc. Natl. Acad. Sci. USA. 106, 6381-6386 (2009).
- Kochinke, K., et al. Systematic Phenomics Analysis Deconvolutes Genes Mutated in Intellectual Disability into Biologically Coherent Modules. Am. J. Hum. Genet. 98, 149-164 (2016).
- Buchert, R., et al. A peroxisomal disorder of severe intellectual disability, epilepsy, and cataracts due to fatty acyl-CoA reductase 1 deficiency. Am. J. Hum. Genet. 95, 602-610 (2014).
- JoVE Science Education Database. Essentials of Biology 1: yeast, Drosophila and C. elegans. Drosophila Maintenance. JoVE. , Cambridge, MA. (2017).
- JoVE Science Education Database. Essentials of Biology 1: yeast, Drosophila and C. elegans. An Introduction to Drosophila melanogaster. JoVE. , Cambridge, MA. (2017).
- R Core Team. R: A Language and Environment for Statistical Computing. R Foundation for Statistical Computing. , Vienna (Austria). (2016).
- Stepien, B. K., et al. RNA-binding profiles of Drosophila CPEB proteins Orb and Orb2). Proc. Natl. Acad. Sci. USA. 113, E7030-E7038 (2016).
- Basu, D. Randomization Analysis of Experimental Data: The Fisher Randomization Test. J Am Stat Assoc. 75, 575-582 (1980).
- Dankert, H., Wang, L., Hoopfer, E. D., Anderson, D. J., Perona, P. Automated monitoring and analysis of social behavior in Drosophila. Nat Methods. 6, 297-303 (2009).
- Reza, M. A., et al. Automated analysis of courtship suppression learning and memory in Drosophila melanogaster. Fly. 7, 105-111 (2013).
- Schneider, J., Levine, J. D. Automated identification of social interaction criteria in Drosophila melanogaster. Biol. Lett. 10, 20140749(2014).
Réimpressions et autorisations
