Un test d’immunoprécipitation de la chromatine (X-ChIP) contre la marque d’histone H3K4me3 pour l’organisme modèle Exaiptasia diaphana est présenté. La spécificité et l’efficacité du test sont confirmées par la PCR quantitative et le séquençage de nouvelle génération. Ce protocole permet d’étudier davantage les interactions protéine-ADN chez l’anémone de mer E. diaphana.
Article de méthode
Immunoprécipitation de la chromatine dans le système modèle cnidaire Exaiptasia diaphana
* These authors contributed equally
Dans cet article
Résumé
Résumé
Les modifications post-traductionnelles des histones (PTM) et d’autres modifications épigénétiques régulent l’accessibilité de la chromatine des gènes à la machinerie transcriptionnelle, affectant ainsi la capacité d’un organisme à répondre aux stimuli environnementaux. L’immunoprécipitation de la chromatine couplée au séquençage à haut débit (ChIP-seq) a été largement utilisée pour identifier et cartographier les interactions protéine-ADN dans les domaines de l’épigénétique et de la régulation des gènes. Cependant, le domaine de l’épigénétique des cnidaires est entravé par un manque de protocoles applicables, en partie à cause des caractéristiques uniques d’organismes modèles tels que l’anémone de mer symbiotique Exaiptasia diaphana, dont la teneur élevée en eau et les quantités de mucus obstruent les méthodes moléculaires. Ici, une procédure ChIP spécialisée est présentée, qui facilite l’étude des interactions protéine-ADN dans la régulation du gène E. diaphana . Les étapes de réticulation et d’extraction de la chromatine ont été optimisées pour une immunoprécipitation efficace, puis validées par la réalisation de ChIP à l’aide d’un anticorps contre la marque d’histone H3K4me3. Par la suite, la spécificité et l’efficacité du test ChIP ont été confirmées en mesurant l’occupation relative de H3K4me3 autour de plusieurs loci génétiques activés constitutivement à l’aide de la PCR quantitative et par séquençage de nouvelle génération pour l’analyse à l’échelle du génome. Ce protocole ChIP optimisé pour l’anémone de mer symbiotique E. diaphana facilite l’étude des interactions protéine-ADN impliquées dans les réponses de l’organisme aux changements environnementaux qui affectent les cnidaires symbiotiques, tels que les coraux.
Introduction
Le rapport 2022 du Groupe d’experts intergouvernemental sur l’évolution du climat (GIEC) souligne que, malgré les efforts croissants de sensibilisation et d’atténuation, des vagues de chaleur marines de plus en plus intenses et fréquentes exposent les récifs coralliens à un risque élevé de blanchissement généralisé et de mortalité massive au cours des prochaines décennies1. Afin d’éclairer les efforts de conservation et de restauration des récifs coralliens, les effets actuels et prévus des conditions environnementales changeantes sur les cnidaires benthiques sont étudiés à plusieurs niveaux biologiques afin de comprendre les mécanismes sous-jacents de réponse et de résilience2.
La disponibilité d’outils d’investigation applicables aux cnidaires benthiques est cruciale pour relever ce défi, et le développement de ces outils nécessite un effort actif de transfert des connaissances et des technologies établies dans d’autres domaines aux organismes marins3. Les obstacles au travail avec de nombreuses espèces de coraux sont en partie atténués par l’utilisation de systèmes modèles, tels que l’anémone de mer Exaiptasia diaphana (communément appelée Aiptasia)4. Ces anémones de mer à croissance rapide, symbiotiques facultatives, sont relativement faciles à garder dans des conditions de laboratoire, se reproduisent à la fois sexuellement et asexuellement, et n’ont pas le squelette de carbonate de calcium5. Le génomede référence 5 en libre accès d’E. diaphana facilite l’utilisation de méthodes épigénétiques nécessitant un séquençage. Cependant, des caractéristiques telles qu’une teneur élevée en eau, une production de mucus et de faibles quantités de tissus par individu constituent des défis pour l’établissement de protocoles reproductibles, freinant ainsi la recherche épigénétique sur E. diaphana et d’autres cnidaires présentant des caractéristiques similaires.
Les modifications épigénétiques peuvent modifier le phénotype sans modifier la séquence nucléotidique génomique d’un organisme en régulant les processus associés à la chromatine6. La régulation épigénétique des cnidaires est principalement étudiée dans les contextes de l’histoire évolutive et du développement 7,8,9,10, de l’établissement et du maintien de la symbiose 11,12,13 et de la réponse aux changements environnementaux 14,15. Plus précisément, des variations dans les modèles de méthylation de l’ADN, qui, dans la plupart des cas, impliquent l’ajout d’un groupe méthyle à une base cytosine, ont été observées en réponse à des conditions environnementales changeantes telles que le réchauffement13 et l’acidification des océans16. Il a également été démontré que les modèles de méthylation de l’ADN sont héréditaires d’une génération à l’autre, ce qui met l’accent sur le rôle de l’épigénétique dans l’acclimatation des coraux aux facteurs de stressenvironnementaux17. Par rapport à la méthylation de l’ADN, il y a eu relativement peu d’études sur d’autres régulateurs épigénétiques importants, tels que les ARN non codants11,18,19, les facteurs de transcription 9,10 ou les modifications post-traductionnelles des histones (PTM) chez les cnidaires20. L’étude des protéines associées à l’ADN est particulièrement exigeante car les méthodes disponibles nécessitent l’accès à un génome de référence de l’organisme à l’étude et sont coûteuses en raison de la grande taille des échantillons et des anticorps à haute spécificiténécessaires3. Avec une grande variété de groupes chimiques qui forment des PTM au niveau de résidus d’histones spécifiques, la compréhension des paysages de modification de la chromatine chez les cnidaires, en particulier dans le contexte de stress environnementaux imminents, reste un grand défi.
L’objectif de ce travail est de faire progresser l’étude des PTM d’histones, des variants d’histones et d’autres protéines associées à la chromatine chez les cnidaires en présentant un protocole optimisé d’immunoprécipitation de la chromatine (ChIP) pour le modèle de corail E. diaphana (protocole original de Bodega et al.21). La ChIP peut être combinée à la PCR quantitative pour caractériser les interactions protéine-ADN spécifiques au locus ou au séquençage de nouvelle génération (NGS) pour cartographier ces interactions dans l’ensemble du génome. En général, les protéines et l’ADN sont réticulés de manière réversible, de sorte que la protéine d’intérêt (POI) reste liée au même locus qu’elle est associée in vivo. Alors que la méthode de réticulation couramment utilisée dans le système modèle de mammifère est généralement maintenue à 15 minutes ou moins à température ambiante, l’approche de réticulation a été optimisée pour permettre au formaldéhyde de pénétrer plus efficacement à travers le mucus produit par E. diaphana . Le tissu est ensuite congelé dans de l’azote liquide, homogénéisé et lysé pour extraire les noyaux des cellules. La perte de matière dans ces étapes est évitée en utilisant un seul tampon de lyse, puis en passant directement à la sonication, qui fragmente la chromatine en fragments de ~300 pb de long. Ces fragments sont incubés avec un anticorps spécifique au POI jusqu’à une précision de l’ordre du PTM. L’immunocomplexe anticorps-protéine-ADN est précipité à l’aide de billes magnétiques qui se lient aux anticorps primaires, ne sélectionnant ainsi que les segments d’ADN associés au POI. Après l’inversion de réticulation et le nettoyage du précipité, les segments d’ADN obtenus peuvent être utilisés pour la qPCR ou la construction d’une bibliothèque d’ADN pour le séquençage afin de cartographier les segments à un génome de référence et, ainsi, d’identifier les loci auxquels le POI est associé. Vous trouverez plus de détails sur les considérations relatives à chaque étape dans Jordán-Pla et Visa22.
Protocole
La figure 1 donne un aperçu de la procédure. Les données ChIP-Seq sont disponibles dans le NCBI Sequence Read Archive (SRA) sous le code BioProject PRJNA931730 (https://www.ncbi.nlm.nih.gov/bioproject/PRJNA931730).
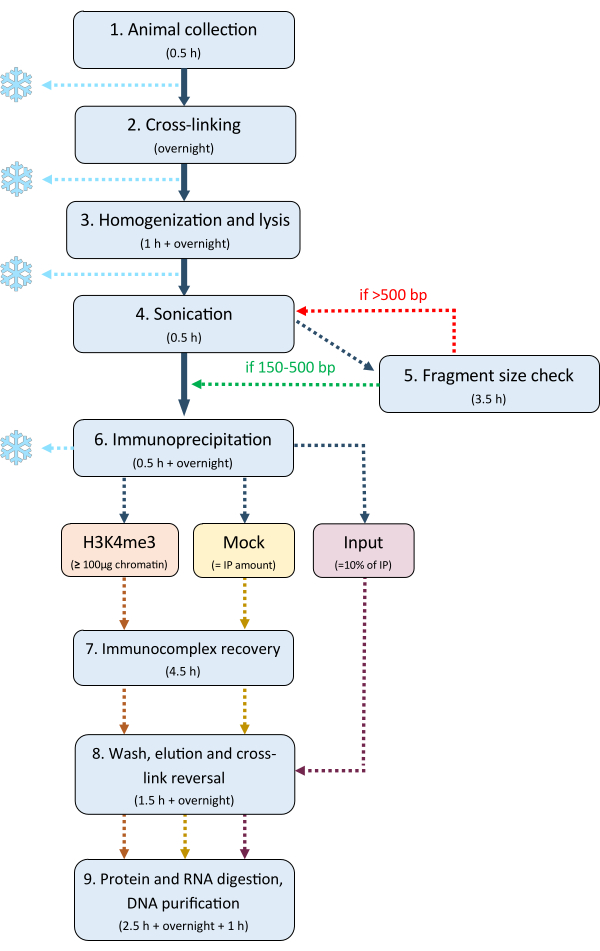
Figure 1 : flux de travail du protocole ChIP. Vue d’ensemble du flux de travail du protocole ChIP, y compris la durée estimée de chaque étape et les points d’arrêt facultatifs. Veuillez cliquer ici pour voir une version agrandie de cette figure.
1. Collection d’animaux
- À l’aide d’une spatule en plastique, détachez délicatement 20 E. diaphana symbiotiques (souche CC7) d’un diamètre de pédale de ~5 mm ou plus des parois de l’aquarium et pipetez-les dans un tube de 15 ml.
REMARQUE : Il est recommandé d’optimiser le nombre d’anémones en fonction de leur taille et du nombre d’adresses IP prévues. Les anémones peuvent être congelées dans de l’azote liquide (LN2) et stockées à −80 °C pendant au moins 1 mois avant de commencer le ChIP. Sinon, il est recommandé de procéder immédiatement pour éviter que les anémones ne se déposent sur les parois du tube de 15 ml.
2. Réticulation
- Préparez 10 mL de tampon de réticulation à 0,5 % (tableau 1).
- Laissez les anémones se déposer au fond du tube, ou faites-les tourner dans une centrifugeuse pendant quelques secondes, jusqu’à ~3 500 x g à température ambiante, puis éliminez l’excès d’eau de mer avec une pompe à vide. Lavez-les dans 1x DPBS en les suspendant, puis retirez les DPBS.
- Transférez les anémones dans le tampon de réticulation à 0,5 % à l’aide d’une pince à épiler ou d’une spatule en plastique pour éviter de transférer le tampon superflu. Incuber sur rotateur à 12 tr/min et 4 °C pendant 1 h.
- Entre-temps, préparer 10 mL de tampon de réticulation à 1 % (tableau 1).
- Comme à l’étape 2.2, retirez le tampon à 0,5 % et remplissez le tube avec le tampon de réticulation à 1 %. Incuber sur rotateur à 12 tr/min et 4 °C pendant la nuit.
REMARQUE : Assurez-vous que toutes les anémones sont suspendues et n’adhèrent pas les unes aux autres en inversant doucement le tube. - Le lendemain, préparer 10 mL de tampon de trempe à partir d’un stock de glycine de 2 M (tableau 1).
- Retirez la mémoire tampon de réticulation à 1 % comme à l’étape 2.2 et suspendez les anémones dans la mémoire tampon de trempe pour arrêter la réaction de réticulation. Incuber sur un rotateur à 12 tr/min et 4 °C pendant 20 min.
- Retirez le tampon de trempe comme à l’étape 2.2 et lavez les anémones deux fois dans DPBS. Si vous manipulez plusieurs échantillons, gardez les anémones en suspension dans le DPBS pendant que vous suivez les étapes 3.2 à 3.4, échantillon par échantillon.
REMARQUE : L’expérience peut être interrompue en congelant l’échantillon et en le stockant à -80 °C pendant au plus 1 mois à ce stade. Retirez tout excès de DPBS en vidant le tube sur un mouchoir en papier avant de le congeler et de le ranger.
Tableau 1 : Solutions et tampons utilisés dans le protocole ChIP. Les ingrédients et leurs concentrations respectives sont indiqués pour chaque tampon utilisé dans le protocole. Veuillez cliquer ici pour télécharger ce tableau.
3. Homogénéisation et lyse
- Préparez le tampon de lyse (tableau 1) frais le jour même (2 mL par échantillon) et ajoutez 100 fois le cocktail d’inhibiteurs de protéase (PIC, voir le tableau des matériaux) jusqu’à une concentration finale de 1 fois. Nettoyez un mortier et un pilon en porcelaine avec de l’éthanol et commencez à refroidir tous les outils avec du LN2.
- Décantez le DPBS et videz les anémones sur un mouchoir en papier pour éliminer le plus de liquide possible. Versez un peu de LN2 dans le mortier et transférez les anémones à l’aide d’une pince à épiler.
- À l’aide du pilon, commencez par briser soigneusement le tissu, puis broyez jusqu’à ce que l’échantillon soit une poudre fine. Continuez à faire l’appoint de LN2 au besoin pour éviter le dégivrage.
- Placez 2 ml de tampon de lyse dans un tube de 5 ml sur de la glace. Prélevez l’échantillon à l’aide d’une spatule et transférez-le dans le tampon de lyse, en veillant à ce que l’échantillon se dissolve dans le tampon. Laissez reposer l’échantillon sur de la glace pendant 1 min, puis mélangez par inversion. Répétez les étapes 3.2 à 3.4 pour tous les autres échantillons, en nettoyant soigneusement tout l’équipement avec de l’éthanol entre les échantillons.
REMARQUE : Minimisez autant que possible la perte d’échantillon dans cette étape. - Lavez un broyeur de mouchoirs Dounce (voir le tableau des matériaux) avec un tampon de lyse, transférez l’échantillon et dénoncez 20 à 30 fois avec un pilon bien serré.
- Transférez l’échantillon dans son tube, lavez le broyeur de tissus avec de l’éthanol et de l’eau distillée, puis répétez l’étape 3.5 pour tous les échantillons.
- Incuber les échantillons sur un rotateur à ~14 tr/min et 4 °C pendant la nuit.
- Utilisez le bleu de trypan pour vérifier la réussite de la lyse au microscope (grossissement de 20x) en le mélangeant avec 10 μL d’échantillon dans un rapport de 1:1. Si le colorant pénètre dans les noyaux, la lyse est réussie.
REMARQUE : L’expérience peut être interrompue à ce stade en stockant l’échantillon à −80 °C pendant une période pouvant aller jusqu’à 2 mois.
4. Sonication
- Faites tourner brièvement l’échantillon dans une centrifugeuse à ~2 000 x g pendant 3 à 5 s à température ambiante pour éliminer tout liquide du capuchon et des parois.
- Passez le lysat 10 fois à l’aide d’une aiguille de 25 g et d’une seringue de 1 ml pour briser les agrégats.
- Placez l’échantillon dans un bain de glace pour le garder aussi frais que possible pendant la sonication.
- Nettoyez l’aiguille de sonication avec de l’éthanol. Placez l’échantillon dans le sonicateur (voir tableau des matériaux) avec l’aiguille à 1 cm au-dessus du fond du tube et sans toucher les parois.
- Réglez le rapport cyclique sur 50 % et la sortie sur 0. Démarrez le sonicateur et assurez-vous qu’aucune mousse n’est produite dans l’échantillon (sinon, arrêtez-vous et réajustez la position de l’aiguille). Augmentez lentement la puissance de sortie jusqu’à 2, puis sonisez pendant 2 min.
- Éteignez le sonicateur, remettez la puissance de sortie à 0 et laissez l’échantillon reposer et refroidir pendant 2 min.
- Répétez les étapes 4.5-4.6 pour un total de quatre séries de sonication et de refroidissement par échantillon. Retirez l’échantillon, rangez-le sur de la glace, puis répétez l’opération avec d’autres échantillons. Nettoyez l’aiguille du sonicateur avec de l’éthanol entre les échantillons et à la fin.
REMARQUE : L’intensité de la sonication et le nombre de cycle peuvent avoir besoin d’être optimisés pour atteindre l’intensité de sonication la plus basse tout en produisant des fragments d’une taille de 150 à 500 pb.
5. Extraction de l’ADN et vérification de la taille des fragments
REMARQUE : Avant de passer à l’IP, la taille des fragments doit être vérifiée. Si les fragments sont trop gros (>500 pb), le nombre de cycles de sonication et/ou l’intensité de la sonication doivent être augmentés ; S’ils sont trop petits (<150 pb), le temps et/ou l’intensité de sonication doivent être réduits.
- Gardez l’échantillon sur la glace pendant que vous effectuez la vérification de la taille du fragment sur un sous-ensemble de l’échantillon. Transférez un sous-ensemble de 100 μL dans un tube frais de 1,5 mL.
- Ajouter 8 μL de cocktail de RNase (voir tableau des matériaux), et incuber à 42 °C pendant 30 min en agitant à 700 tr/min.
- Ajouter 2 μL de protéinase K (voir le tableau des matériaux). et incuber à 55 °C pendant 1 h en secouant à 700 tr/min.
- Réticuler l’échantillon en l’incubant à 95 °C pendant au moins 1 h tout en l’agitant à 700 tr/min.
- Préparez un gel d’agarose à 1 % avec 1 tampon TAE et du bromure d’éthidium à 0,01 % (voir le tableau des matériaux) ou un autre colorant de gel.
- Extrayez l’ADN de l’échantillon à l’aide d’un kit de purification en suivant les instructions du fabricant (voir le tableau des matériaux).
- Pour vérifier la taille de fragmentation de l’ADN extrait, chargez le gel d’agarose à l’aide d’une échelle et d’un échantillon. Mélangez 4 μL d’échelle de 1 kbp avec 1 μL de colorant de chargement violet 6x, et placez-le dans un puits de gel d’agarose. Mélangez 20 μL d’ADN avec 4 μL de colorant de chargement violet 6x pour une concentration finale de 1x, et pipetez dans un puits. Répétez l’opération pour tous les échantillons.
- Faites fonctionner le gel à 100 V pendant environ 30 minutes, puis imagez le gel en le chargeant sur un plateau, en le plaçant dans le système d’imagerie en gel et en suivant les instructions du logiciel du système respectif (voir le tableau des matériaux). Décidez de passer à autre chose en fonction de la taille de la fragmentation, qui doit être comprise entre 150 et 500 pb en moyenne (Figure 2).
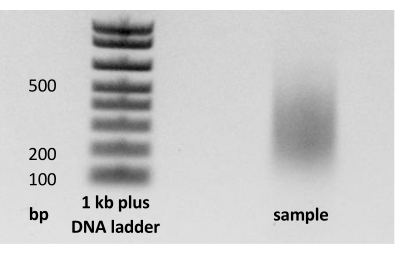
Figure 2 : vérification de la taille du fragment. Après la sonication, un sous-ensemble de l’échantillon est désréticulé, purifié et analysé sur un gel d’agarose pour s’assurer que la chromatine a été cisaillée à des tailles de fragments comprises entre 150 et 500 pb. Veuillez cliquer ici pour voir une version plus grande de cette figure.
6. Immunoprécipitation (IP)
- À l’aide d’une pipette, vérifiez le volume de l’échantillon principal qui a été conservé sur de la glace lors de l’extraction de l’ADN. Ajouter 10 % de Triton X-100 à une concentration finale de 1 %.
- Faites tourner l’échantillon à 20 000 x g à 4 °C pendant 10 min, puis transférez le surnageant dans un tube propre à l’aide d’une pipette.
REMARQUE : L’expérience peut être interrompue ici en congelant l’échantillon à −80 °C pendant une période pouvant aller jusqu’à 2 mois. Les détails des étapes IP suivantes devront être ajustés et optimisés pour chaque expérience. Il peut être nécessaire d’optimiser la quantité d’anticorps par IP. - À l’aide d’un tampon de lyse comme blanc, mesurez la concentration de chromatine en suivant les instructions d’un système de mesure de concentration d’ADN disponible (voir le tableau des matériaux).
- En fonction du volume de l’échantillon et du nombre de PI prévus, augmentez le volume total de l’échantillon en ajoutant 10 % de Triton X-100 et 100x PIC (voir le tableau des matériaux) à des concentrations finales de 1 % et 1x, respectivement. Il est recommandé d’utiliser 100 μg de chromatine dans un volume total de 1 000 μL.
- Répartissez le volume de chaque PI dans un tube séparé de 1,5 ml à faible rétention (voir le tableau des matériaux). Pour la ChIP-qPCR, placez le volume équivalent d’échantillon dans un autre tube de 1,5 mL comme témoin fictif. Prenez 10 % du volume des adresses IP comme contrôle d’entrée et stockez-le à -20 °C.
- Ajoutez 4 μg d’anticorps (ici, l’anticorps H3K4me3, voir le tableau des matériaux) à chaque IP respective. N’ajoutez rien à la simulation. Incuber les réactions IP et le simulacre sur le rotateur de tube à 12 tr/min et à 4 °C pendant la nuit.
7. Récupération des immunocomplexes avec des billes magnétiques
REMARQUE : Évitez toujours de dessécher les billes magnétiques ; Gardez-les recouverts de liquide ou remplissez les solutions le plus rapidement possible. Travaillez toujours sur un échantillon après l’autre.
- Retournez doucement les billes magnétiques (voir tableau des matériaux) pour mélanger.
- Préparez 10 mL de solution de blocage (tableau 1) fraîche le jour même et mélangez délicatement.
- Coupez l’extrémité d’une pointe de pipette pour augmenter le diamètre et transférez 50 μL de billes magnétiques dans des tubes séparés (un tube par IP et un pour le simulacre).
- Ajouter 1 mL de solution de blocage dans chaque tube et les incuber sur un rotateur à 12 tr/min et 4 °C pendant 30 min.
- Placez les billes dans la solution de blocage sur une grille magnétique et attendez la séparation. Pendant ce temps, faites tourner les réactions IP à 2 000 x g pendant 3 à 5 s à température ambiante pour éliminer tout résidu des parois.
- À l’aide d’une pipette, retirez et jetez le surnageant de solution de blocage, puis rincez les billes de la paroi avec l’un des échantillons ou le simulacre. Replacez le mixage dans le tube à faible rétention correspondant, puis passez à l’échantillon suivant.
- Incuber tous les tubes sur un rotateur à 12 tr/min et 4 °C pendant 3 h.
8. Lavage, élution et inversion de réticulation
- Préparez les tampons de lavage et le tampon de sel TE (tableau 1) pendant l’incubation de récupération des immunocomplexes.
- Après l’incubation, placez les IP et le simulacre sur le support magnétique, et attendez environ 10 à 20 s que les aimants se séparent.
- Jeter le surnageant et ajouter 1 mL de tampon de lavage à faible teneur en sel. Répétez l’opération avec toutes les réactions, puis retirez les tubes du support magnétique et mélangez jusqu’à ce que les billes soient suspendues.
- Incuber sur rotateur à 12 tr/min et 4 °C pendant 5 min.
- Placez les tubes sur la grille magnétique, retirez le tampon de lavage à faible teneur en sel, puis ajoutez 1 ml de tampon de lavage à haute teneur en sel et incubez comme à l’étape 8.4.
- Répétez les étapes 8.3-8.5 une fois de plus pour un total de quatre lavages en utilisant alternativement une teneur en sel faible et élevée.
REMARQUE : Le tampon de lavage à haute teneur en sel est très agressif et ne doit être utilisé que pendant précisément 5 minutes à chaque étape de lavage. - Retirer et jeter le surnageant à l’aide d’une pipette et laver avec 1 mL de tampon salin TE ; Répétez l’opération une fois de plus. Après le deuxième lavage, rincez toutes les perles du capuchon du tube.
- Fabriquer le tampon d’élution (tableau 1) pendant les lavages. Après avoir jeté le deuxième tampon de sel TE, ajoutez 210 μL de tampon d’élution à chaque réaction.
- Suspendre les billes magnétiques et les éluer à 65 °C en les secouant à 700 tr/min pendant 15 min.
- Placez les réactions sur la grille magnétique, recueillez l’éluat et placez-le dans un tube frais de 1,5 ml.
- Répétez le processus d’élution avec 210 μL supplémentaires de tampon d’élution et ajoutez l’éluat au premier lot pour un volume final de 420 μL d’élué par IP et mock.
- Retirez l’entrée du congélateur et ajoutez le tampon d’élution à un volume total de 420 μL.
- Inverser la réticulation de tous les éluats et de l’entrée en les incubant à 65 °C et 700 tr/min pendant la nuit.
9. Digestion des protéines et de l’ARN et purification de l’ADN
- Diluer la concentration de SDS (voir le tableau des matériaux) à 0,5 % en ajoutant 420 μL de tampon salin TE à l’éluat et à l’entrée.
- Pour la digestion de l’ARN, ajouter 10 μL de cocktail de RNase (voir Tableau des matériaux), et incuber à 42 °C à 700 tr/min pendant 30 min.
- Pour la digestion des protéines, ajouter 8 μL de protéinase K (voir tableau des matériaux) à tous, et incuber à 55 °C à 700 tr/min pendant 1 h.
- Pour la purification de l’ADN, suivez le « Ren Lab ENCODE Tissue Fixation and Sonication Protocol for MicroChIP »23 avec quelques ajustements :
- Préparez les tubes avec le gel Phase Lock (voir le tableau des matériaux) en faisant tourner le gel jusqu’au fond du tube à 20 000 x g pendant 1 min à température ambiante.
- Sous une hotte, ajoutez un échantillon et le même volume de phénol :chloroforme-alcool isoamylique (25:24:1) dans chaque tube. Secouez vigoureusement les tubes et agitez-les brièvement jusqu’à ce qu’ils forment une couche blanche mousseuse.
ATTENTION : Le mélange est toxique, corrosif et présente un danger pour la santé. - Essorage pendant 10 min à 4 °C et 20 000 x g. Vérifiez que la phase aqueuse est claire.
- Transférez la phase aqueuse dans un tube frais à l’aide d’une pipette. Deux nouveaux tubes par échantillon sont nécessaires en fonction du volume d’échantillon probable. Dans ce cas, transférez la moitié de l’échantillon du premier dans un deuxième tube.
- Ajouter 1/10 du volume d’acétate de sodium 3 M (NaAc, p. ex., 40 μL pour un échantillon de 400 μL) et 10 μL d’acrylamide linéaire à 5 mg/mL à chaque échantillon, et retourner pour mélanger.
- Ajouter 2 fois le volume de l’échantillon dans de l’éthanol à 100 % (p. ex., 800 μL pour un échantillon de 400 μL) et agiter vigoureusement. Ne vortex pas, car cela pourrait endommager l’ADN.
- Incuber à −20 °C pendant la nuit ou à −80 °C pendant 30 min.
- Refroidissez la centrifugeuse à 4 °C, puis faites tourner les échantillons pendant 30 min à 15 000 x g pour granuler l’ADN.
- Décantez soigneusement puis lavez les granulés avec 1 ml d’EtOH à 70 %. Essorez à vitesse maximale pendant 5 min à 4 °C.
- Décanter soigneusement, puis tourner à nouveau pendant quelques secondes. Utilisez une pipette pour retirer tout l’éthanol. S’il reste un petit morceau, il peut être utile de tourner à nouveau.
- Remettre les pastilles en suspension dans 30 μL d’eau exempte de nucléases (voir le tableau des matériaux).
REMARQUE : S’il y a plusieurs tubes par échantillon, remettre en suspension une pastille dans 30 μL, transférer dans le tube suivant et remettre en suspension la pastille suivante dans les mêmes 30 μL.
- Mesurez la concentration d’ADN, puis conservez l’échantillon à −20 °C.
Résultats
Selon le protocole ci-dessus, l’ADN associé à la triméthylation de l’histone 3 lysine 4 (H3K4me3) a été immunoprécipité. L’anticorps de grade ChIP-seq a déjà été utilisé sur l’anémone de mer Nematostella vectensis7 et a été validé ici par la coloration immunofluorescente de coupes de tissus d’E. diaphana (Figure 3). Bien que le rendement en ADN dépende de la quantité de matière d’entrée, il était régulièrement d’environ 100 ng/μL. Les fragments d’ADN obtenus ont été analysés par séquençage et qPCR (liste des amorces dans le fichier supplémentaire 1).
Une profondeur de séquençage de 40 millions de lectures a donné ~17,6 millions de lectures cartographiées de manière unique. Après des contrôles de qualité, les lectures brutes ont été coupées et cartographiées sur le génome d’E. diaphana à l’aide de Bowtie24 (voir le tableau des matériaux). L’analyse modélisée des données ChIP-Seq avec MACS (voir Tableau des matériaux) a permis d’identifier un total de 19 107 pics25. Comme prévu pour H3K4me3, la plupart des pics étaient situés près du site de début transcriptionnel (TSS), et la fréquence du comptage des pics a fortement diminué des deux côtés du TSS, mais surtout vers le corps du gène (Figure 4).
Trois gènes avec des pics élevés autour de leurs TSS ont été identifiés à partir des données de séquençage, et les amorces qPCR ont été conçues pour cibler plusieurs loci de pics élevés dans ces gènes. Les données qPCR ont été normalisées à l’aide de la méthode du pourcentage d’entrée (figure 5). Un enrichissement élevé en H3K4me3 par rapport aux témoins d’entrée et simulés a été observé. Le pourcentage d’entrée variait entre 2,7 % et 10,7 %, avec des différences d’enrichissement observées entre les gènes et entre les différents loci au sein d’un même gène.
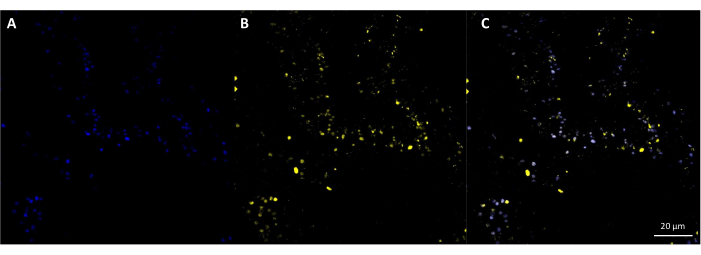
Figure 3 : Coloration immunofluorescente de H3K4me3. Une coupe de tissu d’E. diaphana a été colorée avec (A) une coloration bleue à l’acide nucléique Hoechst et (B) un anticorps secondaire jaune marqué au fluorophore contre l’anticorps primaire contre H3K4me3. (C) Un chevauchement de A et B montrant une co-localisation dans le noyau. Barre d’échelle = 20 μm. Veuillez cliquer ici pour voir une version agrandie de cette figure.
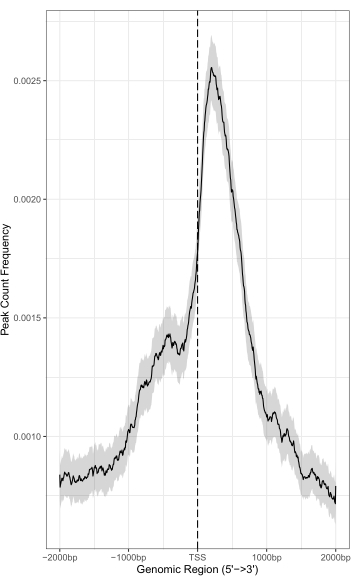
Figure 4 : Fréquence de comptage des pics élevée autour du site de départ transcriptionnel. La distribution de la fréquence de comptage des pics de modification de H3K4me3 s’étendant en amont (−) et en aval (+) 2 000 pb autour du site de début transcriptionnel (TSS). Veuillez cliquer ici pour voir une version agrandie de cette figure.
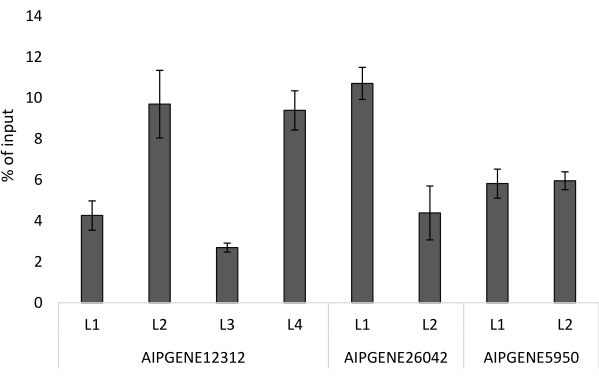
Figure 5 : H3K4me3 ChIP-qPCR chez Exaiptasia diaphana. Les résultats sont représentés en pourcentage (%) des entrées. Les locus situés près du site de départ transcriptionnel des gènes respectifs (AIPGENE12312, AIPGENE26042 et AIPGENE5950) ont été choisis pour la ChIP-qPCR. Les barres d’erreur indiquent l’écart-type entre les répétitions, n = 3. Veuillez cliquer ici pour voir une version agrandie de cette figure.
Fichier supplémentaire 1 : Liste des amorces utilisées pour la qPCR. Veuillez cliquer ici pour télécharger ce fichier.
Discussion
En suivant le protocole ci-dessus, l’ADN obtenu a été utilisé avec succès pour ChIP-qPCR et ChIP-Seq. Le même profil général de pic pour H3K4me3 précédemment signalé chez d’autres organismes 26,27,28 a été obtenu ici, avec le pic le plus élevé autour du MES et un enrichissement élevé aux sites attendus dans la ChIP-qPCR. Le nombre relativement élevé de lectures multiply mappées dans les données ChIP-Seq pourrait avoir été causé par des doublons de PCR. Le nombre de lectures cartographiées de manière unique pourrait être augmenté en modifiant le protocole de préparation de la banque d’ADN afin de réduire les doublons de PCR. Il existe plusieurs méthodes de normalisation pour les données ChIP-qPCR, le pourcentage de la méthode d’entrée présenté ici étant le plus couramment utilisé. Cette méthode normalise l’IP et les échantillons fictifs directement à l’entrée, avec l’inconvénient que l’entrée est traitée différemment de l’IP et des échantillons fictifs pendant le ChIP, ce qui peut introduire des erreurs. La méthode alternative d’enrichissement du pli normalise le signal de l’IP en fonction du signal du simulacre en utilisant les mêmes jeux d’amorces, donnant ainsi un rapport signal/arrière-plan. Cependant, l’intensité du signal de l’échantillon fictif peut varier fortement, ce qui, à son tour, a des effets importants sur les données. Une discussion détaillée de la ChIP-qPCR et de la normalisation des données peut être trouvée dans Haring et al.29.
Un ajustement majeur de la méthode présentée ci-dessus par rapport aux protocoles ChIP courants est le temps de réticulation beaucoup plus long, d’environ 15 minutes pour les protéines histones à une incubation d’une nuit. L’objectif principal de cet ajustement est de faciliter la pénétration du formaldéhyde fixateur à travers la couche de mucus dans les tissus plus profonds d’E. diaphana afin de préserver les interactions protéine-ADN à l’intérieur du noyau. L’optimisation de cette étape est essentielle pour assurer une réticulation suffisante pour préserver les interactions protéine-ADN sans réticulation au point que le cisaillement de la chromatine par sonication devienne inefficace. L’ajout de détergents tels que le SDS peut également augmenter l’efficacité de la sonication29. De plus, une longue incubation avec du formaldéhyde a facilité l’étape d’homogénéisation et a permis d’obtenir un échantillon plus finement et uniformément broyé par rapport aux anémones fraîches ou congelées qui ont été homogénéisées avant l’étape de réticulation. Les plages recommandées de longueurs de fragments varient entre 100 pb et 1 000 pb,29,30 et peuvent dépendre de la protéine cible. Il est essentiel que chaque utilisateur optimise les conditions de sonication pour atteindre la longueur de fragment souhaitée avec le moins de puissance de sonication possible, car une sonication excessive peut dénaturer les protéines et, par conséquent, avoir un impact sur l’IP31. Une autre limite de la ChIP est la quantité de matériau requise, qui affecte particulièrement les organismes relativement petits tels que les anémones ; Ce problème a été résolu en réduisant la perte d’échantillon entre les étapes. Après avoir homogénéisé l’échantillon, il a été lysé immédiatement, omettant ainsi plusieurs étapes courantes de préparation des noyaux. Le pool d’échantillons obtenu à partir de 20 anémones contenait généralement suffisamment de chromatine pour trois IP et des contrôles fictifs et d’entrée. La quantité de matériel de départ (c’est-à-dire le nombre d’anémones) pourrait être encore réduite à l’avenir, en particulier lors de l’exécution d’une ChIP avec une seule protéine cible. En fonction de la méthode en aval prévue, les contrôles doivent être ajustés ; pour ChIP-qPCR, il faut considérer qu’il inclut des contrôles supplémentaires29, tandis que pour ChIP-seq, le mock peut être omis en faveur d’un contrôle d’entrée.
Bien que la validation des anticorps ne relève pas du champ d’application de ce protocole et n’ait donc été que brièvement abordée ici, il s’agit d’une étape critique avant la réalisation de la ChIP. En particulier lors de l’utilisation d’anticorps commerciaux sur des espèces d’invertébrés, la disponibilité d’anticorps spécifiques pour les cibles souhaitées peut être une limitation. Dans un premier temps, la séquence N-terminale de la queue H3 d’E. diaphana et d’autres organismes modèles, y compris le poisson-zèbre et les souris, a été comparée et s’est avérée très conservée12. La spécificité de l’anticorps a ensuite été testée à l’aide de l’immunofluorescence, qui a co-localisé les signaux de l’acide nucléique et de l’anticorps. Le profil de pic de H3K4me3 autour du TSS obtenu à partir des données de séquençage donne une confiance supplémentaire quant à la spécificité de l’anticorps.
Une autre considération concernant la spécificité des anticorps est la possibilité de toute interaction avec les dinoflagellés symbiotiques que E. diaphana, ainsi que de nombreux autres anthozoaires, hébergent dans leurs cellules. L’analyse du transcriptome chez les dinoflagellés des genres Lingulodinium32 et Symbiodinium33 a révélé la présence de gènes codant pour les histones, y compris l’histone H3 centrale et plusieurs variantes H3 à de faibles niveaux d’expression, et l’étendue de la conservation fonctionnelle du code des histones n’est pas claire34. Marinov et Lynch34 ont comparé la conservation de la séquence des queues N-terminales de la variante H3 au sein et entre les espèces de dinoflagellés, et les espèces de Symbiodiniaceae ont montré une forte divergence autour de la lysine 4 dans la séquence de la queue, en particulier si l’on considère la congruence des acides aminés adjacents à la lysine 4 comme facteur. Il a également été démontré que cette région diverge d’autres espèces modèles telles que Arabidopsis thaliana, Drosophila melanogaster et Saccharomyces cerevisiae, qui correspondent à la séquence d’E . diaphana12. Par conséquent, le risque d’interaction involontaire de l’anticorps contre H3K4me3 avec le dinoflagellé H3 est faible. De plus, les séquences ne sont alignées que sur le génome d’E. diaphana , et les amorces qPCR doivent être spécifiques aux séquences d’E. diaphana , fournissant une couche supplémentaire de filtration de toute séquence précipitée involontairement.
Le protocole ChIP présenté produit suffisamment d’ADN pour la qPCR ainsi que pour le séquençage de prochaine génération, et bien qu’une optimisation individuelle par chaque utilisateur soit probablement nécessaire, il fournit un point de départ pour l’étude accrue des interactions protéine-ADN chez les cnidaires benthiques, peut-être dans le contexte de la symbiose et des changements environnementaux.
Matériaux
| Nom | Entreprise | Numéro de catalogue | Commentaires |
|---|---|---|---|
| 1 kb Plus DNA Ladder | Invitrogen | 10787018 | |
| 100 % éthanol | |||
| 15 mL Tubes | |||
| 16 % solution de formaldéhyde (w/v), sans méthanol | Thermo scientific | 28906 | |
| 5 mL | |||
| Tubes 5PRIME Phase Lock | Quantabio | 2302820 | lock gel - aiguille légère |
| AGANI 25 G | Terumo | AN*2516R1 | |
| Agarose | |||
| Bovine Serum Albumin | Sigma-Aldrich | A7030 | |
| Bowtie | open source, disponible à partir de https://bowtie-bio.sourceforge.net/index.shtml | ||
| Branson sonifier 250 | Branson | Sonicator ; | |
| Centrifugeuse ; | Eppendorf | 5430 R | Avec rotors pour tubes de 15 mL et 1,5 mL |
| Anticorps de qualité ChIP (ici anticorps polyclonal H3K4me3) | Diagenode | C15410003 | |
| Cocktail complet d’inhibiteur de protéase sans EDTA | Roche | 11873580001 | 2 comprimés/mL d’eau pour 100x stock |
| Verre de couverture | vwr | 48393 194 | |
| Spatule jetable | vwr | 80081-188 | |
| Kit de purification de l’ADN (ici QIAGEN QIAquick PCR purification kit) | QIAGEN | 28104 | |
| Broyeur de tissus Dounce | Pilon étanche | Wheaton | |
| Dulbecco’s Phosphate Buffered Saline (DPBS) 1x | gibco | 14190-094 | |
| Dynabeads Protein G | Thermo Fisher Scientific | 10004D | |
| EDTA | Sigma-Aldrich | 3609 | |
| EGTA | Sigma-Aldrich | 324626 | |
| d’électrophorèse | |||
| Bromure d’éthidium | |||
| FASTQC v0.11.9 | |||
| Logiciel Gel Doc EZ Système de documentation | Bio-Rad | 1708270 | Système d’imagerie Gel |
| Glycine | Sigma-Aldrich | 50046 | |
| Injekt-F Seringue à tuberculine 1 mL | B. Braun | 9166017V | |
| Acrylamide linéaire (5 mg/mL) | Invitrogen | AM9520 | |
| à faible rétention de 1,5 mL | |||
| Rack | pour tubes de 1,5 mL | ||
| Microscope | |||
| Lame | |||
| de microscopeModel-based Analysis of ChIP-Seq (MACS) | open source | ||
| Mortier et pilon, porcelaine | |||
| NanoDrop 2000c spectrophotomètre | Thermo scientific ; | ND-2000C | |
| N-lauroylsarcosine | Sigma-Aldrich | 61739 | |
| Pipette | |||
| Pasteur à eau | |||
| Phénol :Chloroforme :Alcool isoamylique Mélange (25:24:1) | Sigma-Aldrich | 77617 | |
| Protéinase K (20 mg/mL) | Ambion | AM2546 | |
| Purple Colorant de chargement 6x | New England BioLabs | B7024S | |
| Fluorimètre Qubit 2.0 | Invitrogen | ||
| RNase Cocktail Enzyme Mix | Invitrogen | AM2286 | RNase A = 500 U/mL, RNase T1 = 20000 U/mL |
| Acétate de sodium | Sigma-Aldrich | S2889 | |
| Chlorure de sodium | Sigma-Aldrich | S9888 | |
| Désoxycholate de sodium | Sigma-Aldrich | 30970 | |
| SYBR Safe DNA Gel Stain | Invitrogen | S33102 | |
| TAE buffer | |||
| Thermomixer | Eppendorf | 5384000012 | |
| Tris base | Sigma-Aldrich | 10708976001 | |
| Triton X-100 | solution Sigma-Aldrich | 93443 | |
| Trypan Blue Stain (0.4 %) | Gibco | 15250-061 | Danger : peut causer le cancer. Suspecté de nuire à la fertilité ou à l’enfant à naître |
| Rotateur de tube SB3 | Stuart | ||
| UltraPure SDS Solution, 10 % | Invitrogen | 15553027 | |
| Pompe à |
Références
- Pörtner, H. -O. 2022: Summary for Policymakers. Climate Change 2022: Impacts, Adaptation, and Vulnerability. Contribution of Working Group II to the Sixth Assessment Report of the Intergovernmental Panel on Climate Change. , Cambridge University Press. Cambridge, UK. (2022).
- Cziesielski, M. J., Schmidt-Roach, S., Aranda, M. The past, present, and future of coral heat stress studies. Ecology and Evolution. 9 (17), 10055-10066 (2019).
- Eirin-Lopez, J., Putnam, H. Marine environmental epigenetics. Annual Review of Marine Science. 11, 335-368 (2021).
- Rädecker, N. Using Aiptasia as a model to study metabolic interactions in cnidarian-Symbiodinium symbioses. Frontiers in Physiology. 9 (214), (2018).
- Baumgarten, S. The genome of Aiptasia, a sea anemone model for coral symbiosis. PNAS. 112 (38), 11893-11898 (2015).
- Strahl, B. D., Allis, C. D. The language of covalent histone modifications. Nature. 403 (6765), 41-45 (2000).
- Schwaiger, M. Evolutionary conservation of the eumetazoan gene regulatory landscape. Genome Research. 24 (4), 639-650 (2014).
- Zhang, X., Jacobs, D. A broad survey of gene body and repeat methylation in cnidaria reveals a complex evolutionary history. Genome Biology and Evolution. 14 (2), evab284(2022).
- Schwaiger, M. An ancestral Wnt-Brachyury feedback loop in axial patterning and recruitment of mesoderm-determining target genes. Nature Ecology & Evolution. 6 (12), 1921-1939 (2022).
- Ozment, E., et al. Cnidarian hair cell development illuminates an ancient role for the class IV POU transcription factor in defining mechanoreceptor identity. Elife. 10, e74336(2021).
- Baumgarten, S., et al. Evidence for miRNA-mediated modulation of the host transcriptome in cnidarian-dinoflagellate symbiosis. Molecular Ecology. 27 (2), 403-418 (2018).
- Li, Y. DNA methylation regulates transcriptional homeostasis of algal endosymbiosis in the coral model Aiptasia. Science Advances. 4 (8), eaat2142(2018).
- Rodriguez-Casariego, J. A., Cunning, R., Baker, A. C., Eirin-Lopez, J. M. Symbiont shuffling induces differential DNA methylation responses to thermal stress in the coral Montastraea cavernosa. Molecular Ecology. 31 (2), 588-602 (2021).
- Putnam, H. M., Davidson, J. M., Gates, R. D. Ocean acidification influences host DNA methylation and phenotypic plasticity in environmentally susceptible corals. Evolutionary Applications. 9 (9), 1165-1178 (2016).
- Weizman, E., Levy, O. The role of chromatin dynamics under global warming response in the symbiotic coral model Aiptasia. Communications Biology. 2, 282(2019).
- Liew, Y. J. Epigenome-associated phenotypic acclimatization to ocean acidification in a reef-building coral. Science Advances. 4 (6), eaar8028(2018).
- Liew, Y. J. Intergenerational epigenetic inheritance in reef-building corals. Nature Climate Change. 10 (3), 254-259 (2020).
- Liew, Y. J., et al. Identification of microRNAs in the coral Stylophora pistillata. PLoS One. 9 (3), e91101(2014).
- Huang, C., et al. Identification of long non-coding RNAs in two anthozoan species and their possible implications for coral bleaching. Scientific Reports. 7, 5333(2017).
- Rodriguez-Casariego, J. A., et al. Coral epigenetic responses to nutrient stress: Histone H2A.X phosphorylation dynamics and DNA methylation in the staghorn coral Acropora cervicornis. Ecology and Evolution. 8 (23), 12193-12207 (2018).
- Bodega, B., et al. A cytosolic Ezh1 isoform modulates a PRC2-Ezh1 epigenetic adaptive response in postmitotic cells. Nature Structural & Molecular Biology. 24 (5), 444-452 (2017).
- Jordán-Pla, A., Visa, N. Considerations on experimental design and data analysis of chromatin immunoprecipitation experiments. Chromatin Immunoprecipitation., edited by Visa, N., Jordán-Pla, A. Visa, N., Jordán-Pla, A. , Humana Press. Totowa, NJ. 9-28 (2017).
- ENCODE. Ren Lab ENCODE Tissue Fixation and Sonication Protocol for MicroChIP. , Stanford University. Available from: https://www.encodeproject.org/documents/ (2023).
- Langmead, B., Trapnell, C., Pop, M., Salzberg, S. L. Ultrafast and memory-efficient alignment of short DNA sequences to the human genome. Genome Biology. 10, R25(2009).
- Feng, J., Liu, T., Qin, B., Zhang, Y., Liu, X. S. Identifying ChIP-seq enrichment using MACS. Nature Protocols. 7, 1728-1740 (2012).
- Howe, F. S., Fischl, H., Murray, S. C., Mellor, J. Is H3K4me3 instructive for transcription activation. BioEssays. 39 (1), e201600095(2017).
- Zhang, Z., Shi, L., Dawany, N., Kelsen, J., Petri, M. A., Sullivan, K. E. H3K4 tri-methylation breadth at transcription start sites impacts the transcriptome of systemic lupus erythematosus. Clinical Epigenetics. 8, 14(2016).
- Li, X. High-resolution mapping of epigenetic modifications of the rice genome uncovers interplay between DNA methylation, histone methylation, and gene expression. The Plant Cell. 20, 2-276 (2008).
- Haring, M. Chromatin immunoprecipitation: optimization, quantitative analysis and data normalization. Plant Methods. 3, 11(2014).
- Landt, S. G. ChIP-seq guidelines and practices of the ENCODE and modENCODE consortia. Genome Research. 22 (9), 1813-1831 (2012).
- Raha, D., Hong, M., Snyder, M. ChIP-Seq: A method for global identification of regulatory elements in the genome. Current Protocols in Molecular Biology. Chapter 21, Unit 21.19.1-Unit 21.19.14 (2010).
- Roy, S., Morse, D. A full suite of histone and histone modifying genes are transcribed in the dinoflagellate Lingulodinium. PLoS One. 7 (4), e34340(2012).
- Bayer, T., et al. Symbiodinium transcriptomes: Genome insights into the dinoflagellate symbionts of reef-building corals. PLoS One. 7 (4), e35269(2012).
- Marinov, G. K., Lynch, M. Diversity and divergence of dinoflagellate histone proteins. G3 Genes, Genomes, Genetics. 6 (2), 397-422 (2016).
Réimpressions et autorisations
