Cette recherche visait à faire une comparaison entre L1-L2-anglais et L1-L2 portugais afin de vérifier dans quelle mesure l’effet d’un accent étranger compte à la fois pour les métriques et les paramètres prosodiques-acoustiques, ainsi que pour le choix de la voix cible dans une gamme de voix.
Un abonnement JoVE est requis pour visualiser ce contenu. Connectez-vous ou commencez votre période d'essai gratuite.
Article de méthode
Accent étranger et identification du locuteur médico-légal dans les alignements vocaux : l’influence des caractéristiques acoustiques basées sur la prosodie
Dans cet article
Résumé
Résumé
Cette recherche vise à examiner à la fois les caractéristiques prosodiques-acoustiques et les corrélats perceptifs de l'anglais avec un accent étranger et du portugais brésilien avec un accent étranger, et à vérifier comment les productions d'accents étrangers et natifs des locuteurs sont corrélées à la perception des auditeurs. Dans la méthodologie, nous avons mené une procédure de production de parole avec un groupe de locuteurs américains de portugais brésilien L2 et un groupe de locuteurs brésiliens de l’anglais L2, ainsi qu’une procédure de perception de la parole dans laquelle nous avons effectué des alignements vocaux pour les deux langues. Pour l’analyse statistique de la production de la parole, nous avons exécuté des modèles additifs généralisés pour évaluer l’effet des groupes de langues sur chaque classe (métrique ou prosodique-acoustique) des caractéristiques contrôlées pour l’effet de lissage de la ou des covariables de la classe opposée. Pour l'analyse statistique de la perception de la parole, nous avons effectué un test de Kruskal-Wallis et un test de Dunn post-hoc pour évaluer l'effet des voix des alignements sur les scores jugés par les auditeurs. Nous avons néanmoins effectué des tests de similarité acoustique (voix) basés sur les distances cosinus et euclidienne. Les résultats ont montré des différences acoustiques significatives entre les groupes linguistiques en termes de variabilité du f0, de durée et de qualité de la voix. Pour les alignements, les résultats ont indiqué que les caractéristiques prosodiques de f0, d'intensité et de qualité de la voix étaient corrélées aux jugements perçus par les auditeurs.
Introduction
L’accent est un aspect saillant et dynamique de la communication et de la fluidité, à la fois dans la langue maternelle (L1) et dans une langue étrangère (L2)1. L’accent étranger représente les caractéristiques phonétiques L2 d’une langue cible, et il peut changer (au fil du temps) en réponse à l’expérience L2 du locuteur, au style de parole, à la qualité de l’entrée, à l’exposition, entre autres variables. Un accent étranger peut être quantifié comme un degré (scalaire) de différence entre le discours L2 produit par un locuteur étranger et un accent local ou de référence de la langue cible2,3,4,5.
Cette recherche vise à examiner à la fois les caractéristiques prosodiques-acoustiques et les corrélats perceptifs de l'anglais avec un accent étranger et du portugais brésilien (BP) avec un accent étranger, ainsi qu'à vérifier dans quelle mesure les productions d'accents étrangers et natifs des locuteurs sont corrélées à la perception des auditeurs. Des recherches antérieures dans le domaine médico-légal ont démontré que la robustesse des voyelles et des consonnes dans l’identification des accents étrangers est soit stable pour une analyse à long terme d’un individu (The Lo Case6), soit se référant à la grande précision d’identification d’un locuteur (The Lindbergh Case7). Cependant, l’exploration des caractéristiques acoustiques prosodiques basées sur la durée, la fréquence fondamentale (f0, c’est-à-dire le corrélat acoustique de la hauteur), l’intensité et la qualité de la voix (VQ) a suscité de plus en plus d’attention 8,9. Ainsi, le choix des caractéristiques prosodiques-acoustiques dans cette étude représente une piste prometteuse dans le domaine de la phonétique médico-légale 8,10,11,12,13.
La présente recherche est soutenue par des études consacrées aux accents étrangers comme forme de déguisement de la voix dans les cas médico-légaux14,15, ainsi que dans la préparation des alignements vocaux pour la reconnaissance des locuteurs16,17. Par exemple, le débit de parole a joué un rôle important dans l’identification des locuteurs allemands, italiens, japonais et brésiliens de l’anglais18,19,20,21,22. Outre le débit de parole, les caractéristiques spectrales à long terme et f0 mettent au défi les locuteurs compétents en L2 avec la familiarité avec la langue cible, car le cerveau et les bases cognitives souffrent d'un déficit de mémoire, d'attention et d'émotion, ce qui se reflète dans les performances phonétiques du locuteur pendant les longs tours de parole23. Le point de vue sur les accents étrangers dans le domaine médico-légal est que la définition de ce qui ressemble vraiment à un accent étranger dépend beaucoup de la méconnaissance de l'auditeur plutôt que d'avoir un degré de discours avec accent étranger24.
Dans le domaine perceptuel, un outil médico-légal couramment utilisé depuis le milieu des années 1990 pour la reconnaissance des criminels est la Voice Lineup (reconnaissance auditive), qui est analogue à la reconnaissance visuelle utilisée pour identifier un auteur sur une scène de crime16,25. Dans une séance d'identification, la voix du suspect est présentée à côté de faire-valoir - des voix similaires sur le plan sociolinguistique tels que l'âge, le sexe, l'emplacement géographique, le dialecte et le statut culturel - pour être identifiée par un témoin auditif. Le succès ou l’échec d’une composition vocale dépend du nombre d’échantillons de voix et de la durée des échantillons25,26. De plus, pour les échantillons du monde réel, on considère que la qualité audio a un impact constant sur la précision de la reconnaissance vocale. Une mauvaise qualité audio peut déformer les caractéristiques uniques d’une voix27. Dans le cas d’une similitude vocale, des détails phonétiques fins basés sur f0 peuvent dérouter l’auditeur lors de la reconnaissance vocale 28,29. Ces caractéristiques acoustiques s’étendent au-delà de f0 et englobent des éléments de durée, ainsi que des caractéristiques spectrales d’intensité et de VQ30. Cette vue de plusieurs caractéristiques prosodiques est cruciale dans le contexte de la comparaison de voix médico-légales pour garantir une identification précise du locuteur 9,14,15,29,31.
En résumé, les études en phonétique médico-légale ont montré certaines variations concernant l’identification des accents étrangers au cours des dernières décennies. D’une part, un accent étranger ne semble pas affecter le processus d’identification d’un locuteur32,33 (surtout si le locuteur n’est pas familier avec l’accent étranger cible34). D’un autre côté, il y a des résultats dans la direction opposée 12,34,35.
Accès restreint. Veuillez vous connecter ou commencer un essai pour afficher ce contenu.
Protocole
Ce travail a reçu l'approbation d'un comité d'éthique de la recherche sur les êtres humains. En outre, un consentement éclairé a été obtenu de la part de tous les participants à cette étude pour l'utilisation et la publication de leurs données.
1. Production de la parole
REMARQUE : Nous avons recueilli des échantillons de parole lors d'une tâche de lecture portant à la fois sur le « L1 anglais - L2 PB » produits par Groupe 1: Le Amaméricain Efrançais (des États-Unis d'Amérique) Shaut-parleurs (AmE-S), et sur les deux productions de « L1 BP-L2 anglais » réalisées par Groupe 2: Le Brazilian Shaut-parleurs (Bra-S). Voir Figure 1 pour un organigramme de la production du langage.

Figure 1 : Organigramme schématique de la production du langage parlé. Veuillez cliquer ici pour visualiser une version agrandie de cette figure.
- Participants
- Déterminer le nombre de participants, le langue (L1 anglais, L2 BP ; L1 BP, L2 anglais), le sexe (femelle ou mâle), le âge (moyenne, écart type), le caractéristiques du groupe (professionnels ou étudiants universitaires), et le Niveau de compétence L2 (avancé ou très avancé) pour chaque groupe.
REMARQUE : Pour la présente recherche, l'anglais américain (AmE-S) et le portugais brésilien (Bra-S) étaient considérés comme des langues secondes maîtrisées (les deux groupes ont été classés au niveau B2-C1).36). L'AmE-S avait vécu deux ans au Brésil au moment de la réalisation des procédures. Le Bra-S avait vécu plus de deux ans aux États-Unis au moment de la réalisation des procédures. Pendant leur séjour à l'étranger, les deux groupes parlaient leur L2 au moins 6 jours par semaine pendant environ 4 à 5 heures par jour, dans un but d'étude ou de travail. - Répartir les participants dans une pièce confortable et calme et présenter le matériel de lecture pour chaque groupe.
- Déterminer le nombre de participants, le langue (L1 anglais, L2 BP ; L1 BP, L2 anglais), le sexe (femelle ou mâle), le âge (moyenne, écart type), le caractéristiques du groupe (professionnels ou étudiants universitaires), et le Niveau de compétence L2 (avancé ou très avancé) pour chaque groupe.
- Collecte des données
REMARQUE : Les données de parole doivent être collectées à partir d'une tâche de lecture dans les langues suivantes : L1-anglais et L2-BP ; L1-BP et L2-anglais. Permettez aux participants de lire les textes au préalable si nécessaire.- Procédures d'enregistrement
- Enregistrez les données de parole dans un endroit calme présentant des conditions acoustiques appropriées.
- Utilisez un magnétophone numérique (voir le Table des matériels)37 et un microphone cardioïde unidirectionnel à isolation électromagnétique (voir le Table des matériels)38.
- Enregistrer les données audio dans '.wavforme.
- Configurer la fréquence d'échantillonnage à 48 kHz et la quantification à 16 bits.
REMARQUE : Le format audio ainsi que la configuration des taux d'échantillonnage et de quantification décrits aux étapes 1.2.1.3 et 1.2.1.4 sont appliqués afin d'assurer une haute qualité et une réduction du bruit, préservant ainsi les caractéristiques spectrales utilisées lors de l'analyse acoustique ultérieure.
- Procédures d'enregistrement
- Analyse acoustique
REMARQUE : Diviser les procédures d'analyse acoustique en trois étapes : alignement forcé, réalignement et extraction des caractéristiques acoustiques.- Rédigez la transcription linguistique (dans un 'txt' fichier) pour chaque fichier audio.
- Étiqueter la paire de '.txt'/'.wavdes fichiers portant le même nom (c'est-à-dire « my_file.onde'/ 'mon_fichier.txt').
REMARQUE : Pour améliorer les performances de la procédure décrite à la section 1.3.7, il est fortement recommandé que les trois premiers caractères des balises de fichiers « .txt/.wav » représentent le Langue, Dialecte, ou Accent, tandis que les quatrième à sixième caractères indiquent le Sexe (par exemple, EL1FEM pour Eanglais L1 Femelleale). À partir du septième caractère, l'utilisateur doit indiquer le numéro du locuteur (par exemple, 001 pour le premier intervenant). Par conséquent, la première paire « .txt/.wav » est EL1FEM001. - Créez un dossier pour chaque langue L1-L2.
REMARQUE : Un dossier pour l'anglais L1-L2 et un dossier pour le BP L1-L2. - Vérifiez que toutes les paires de fichiers de la même langue se trouvent dans le même dossier.
- Effectuez l'alignement forcé.
- Accéder à l'interface web du système d'alignement forcé Munich Automatic Segmentation (MAUS)webMAUS39 à https://clarin.phonetik.uni-muenchen.de/BASWebServices/interface/Pipeline.
- Glissez et déposez chaque paire de .onde / .txt fichiers à partir du dossier au rectangle en pointillés dans Fichiers (ou cliquez à l'intérieur du rectangle, Figure 2A).
- Cliquez sur le bouton Téléverser bouton pour téléverser les fichiers dans l'aligneur (voir flèche rouge dans Figure 2A).
- Sélectionnez les options suivantes dans le Options de service menu (Figure 2B): G2P-MAUS-PHO2SYL pour Nom du pipeline ; anglais (États-Unis) (pour Langue) si Données L1-L2 en anglais; Italien (IT) (pour Langue) si Données de pression artérielle L1-L2.
REMARQUE : Nous avons choisi l'« italien » pour les données du portugais brésilien (BP) car webMAUS ne propose pas de modèles acoustiques préentraînés pour l'alignement forcé du BP. La littérature phonétique indique que la phonologie de l'italien possède un inventaire de sept voyelles relativement symétrique, comparable à celui du BP.40, ainsi que des similitudes acoustiques consonantiques41,42. - Conserver les options par défaut pour « Format de sortie » et « Conserver tout ».
- Vérifiez le Exécuter zone de sélection pour accepter les conditions d'utilisation (voir la flèche verte dans Figure 2C).
- Cliquez sur le bouton Service Web d'exécution bouton pour exécuter les fichiers téléchargés dans l'aligneur.
REMARQUE : Pour chaque fichier audio, l'aligneur MAUS renvoie un fichier Praat TextGrid objet (un fichier « .txt » préformaté pour Praat contenant l'annotation des mots, des syllabes phonologiques et des phonèmes, basée sur la transcription linguistique extraite du fichier « .txt » décrit à l'étape 1.3.1). - Cliquez sur le Télécharger en tant que fichier ZIP bouton pour télécharger les fichiers TextGrid sous forme de fichier compresséFigure 2C).
REMARQUE : Veillez à télécharger les fichiers TextGrid compressés dans le même dossier que les fichiers audio. - Extraire les fichiers TextGrid pour un réalignement ultérieur dans le logiciel d'analyse phonétique43.
- Effectuez la réalignement.
- Accéder au script et le télécharger pour Praat VVUnitAligner44 de https://github.com/leonidasjr/VVunitAlignerCode_webMAUS/blob/main/VVunitAligner.praat
- Certifiez que toutes les paires de fichiers de la même langue et le VVUnitAligner les scripts se trouvent dans le même dossier.
REMARQUE : Un dossier pour les fichiers anglais L1-L2 et le VVunitAligner, et un dossier pour les fichiers L1-L2 BP et le VVunitAligner. - Ouvrir le logiciel d'analyse phonétique.
- Cliquez Praat | Ouvrir le script Praat… appeler le script à partir du fenêtre de l'objet.
- Cliquez sur le bouton Exécuter appuyez une fois sur le bouton.
REMARQUE : Un formulaire appelé Alignement phonétique des syllabes contenant les paramètres pour utiliser le script apparaîtra à l'écran (Figure 3A). - Cliquez sur le bouton Langue bouton pour choisir parmi les langues « anglais (États-Unis) », « portugais (BR) », « français (FR) » ou « espagnol (ES) ».
- Cliquez sur le bouton Segmentation en morceaux bouton pour choisir entre les procédures de segmentation « Automatique », « Forcée (manuelle) » ou « Aucune ».
- Vérifiez le Enregistrer les fichiers TextGrid option d'enregistrer automatiquement les nouveaux fichiers TextGrid.
- Cliquez Ok | Exécuter boutons pour une réalignement des unités phonétiques de l'étape 1.3.5.7
REMARQUE : Pour chaque fichier audio, VVUnitAligner générera un nouveau fichier TextGrid pour la section 1.3.7Figure 3B).
- Effectuer l'extraction automatique des caractéristiques acoustiques.
- Accéder au script SpeechRhythmExtractor et le télécharger45 de https://github.com/leonidasjr/SpeechRhythmCode/blob/main/SpeechRhythmExtractor.praat pour l'extraction automatique des caractéristiques prosodiques-acoustiques.
- Créez un nouveau dossier et placez-y SpeechRhythmExtractor ainsi que toutes les paires de fichiers audio/TextGrid de toutes les langues.
- Ouvrez le logiciel d'analyse phonétique.
- Cliquez Praat | Ouvrir le script Praat… appeler le script à partir du fenêtre de l'objet.
- Cliquez sur le bouton Exécuter appuyer sur le bouton une seule fois
REMARQUE : Un formulaire contenant les paramètres du script apparaîtra à l'écran. Dans les champs correspondant aux noms de fichiers de sortie '.txt', renommez les fichiers en conséquence ou conservez les noms par défaut. - Vérifiez le paramètres de qualité vocale option d'enregistrer le Fichier de sortie VQ pour la qualité vocale (Figure 3C).
REMARQUE : Ce deuxième fichier de sortie (le Fichier de sortie VQ) contient les paramètres de la différence entre le 1st et le 2nd harmoniques (H1-H2) et le pic de prominente cepstrale (CPP)9. - Vérifiez le Cible linguistique option de choisir parmi les libellés « Langue », « Dialecte » ou « Accent » (Figure 3C).
- Vérifiez le Unité option de choisir les caractéristiques de f0 en Hz ou en demi-tons (Figure 3C).
- Configurer les valeurs pour seuil F0, les seuils minimum et maximum de f0Figure 3C).
REMARQUE : Sauf si la recherche a des objectifs spécifiques ou des caractéristiques audio prédéfinies, il est fortement recommandé de conserver les paramètres de l'étape 1.3.7.9 aux valeurs par défaut. - Cliquez Ok | Exécuter pour l'extraction automatique des caractéristiques acoustiques.
REMARQUE : Le script SpeechRhythmExtractor renvoie un fichier '.txt' délimité par des tabulations (Fichier de sortie / Fichier de sortie VQ) contenant les caractéristiques acoustiques extraites des locuteurs.
- Analyse statistique
- Téléversez le tableur contenant les caractéristiques acoustiques dans R46 environnement (ou tout autre logiciel/environnement statistique au choix).
- Effectuer des analyses statistiques non paramétriques à l'aide de modèles additifs généralisés (GAM).
- Effectuer des GAMs dans R.
- Saisissez les commandes suivantes et appuyez sur Entrer.
library(mgcv)
modèle = gam(le caractéristique métrique/prosodique-acoustique dans l'analyse ~ le Langue + s(le choix effectué caractéristique métrique, par = le Langue) + autres caractéristiques métriques/prosodiques-acoustiques, données = le trame de données)
REMARQUE : Nous avons choisi d'effectuer les analyses statistiques du protocole en langage de programmation R en raison de sa popularité croissante parmi les phonéticiens (et les linguistes) dans la communauté universitaire. R est largement utilisé dans la recherche en phonétique sur le terrain47. Garder à l'esprit que l'étape 1.4.2.2 contient un pseudo-code. Écrire le code en fonction des variables de recherche.

Figure 2 : Capture d'écran de l'alignement phonétique à l'aide de l'aligneur forcé MAUS. (A) Le rectangle en pointillés sert à glisser-déposer les fichiers 'my_file.wav'/'my_file.txt' ou à cliquer à l'intérieur pour rechercher ces fichiers dans le dossier ; le bouton de téléchargement est indiqué par la flèche rouge. (B) Les fichiers téléchargés depuis le panneau A (voir flèche bleue), le pipeline à utiliser, la langue des paires de fichiers, le format de fichier à renvoyer, et un bouton « vrai/faux » pour conserver tous les fichiers. (C) Les conditions d'utilisation sous forme de cases à cocher (voir flèche verte), le bouton Exécuter les services web, et les résultats (fichiers TextGrid à télécharger). Veuillez cliquer ici pour afficher une version agrandie de cette figure.
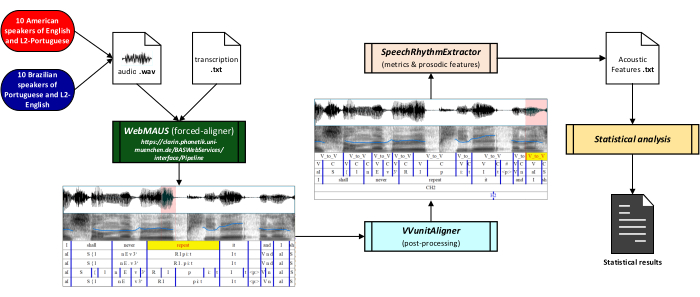
Figure 3 : Capture d'écran de la procédure de réalignement. (A) Formulaire des paramètres d'entrée pour la procédure de réalignement. (B) Forme d'onde partielle, spectrogramme large bande avec contour de f0 (en bleu) et six niveaux segmentés (et étiquetés) comme suit : tier 1 : unités allant du début d'une voyelle au début de la voyelle suivante (V_to_V) ; début de voyelle (V_to_V) ; tier 2 : unités de voyelle (V), de consonne (C) et de pause (#) ; tier 3 : représentations phoniques V_to_V ; tier 4 : certains mots extraits du texte ; tier 5 : certains groupes (CH) d'énoncés extraits du texte ; tier 6 : niveau tonal contenant le ton le plus élevé (H) et le ton le plus bas (L) de chaque groupe d'énoncé produit par une locutrice anglophone américaine. (C) Paramètres d'entrée pour l'extraction automatique des caractéristiques acoustiques. Veuillez cliquer ici pour visualiser une version agrandie de cette figure.
2. Perception de la parole
REMARQUE : Nous avons réalisé quatre séries d'identification vocale en anglais avec des auditeurs américains et quatre séries en portugais brésilien (BP) avec des auditeurs brésiliens. Voir Figure 4 pour un organigramme de la perception de la parole.
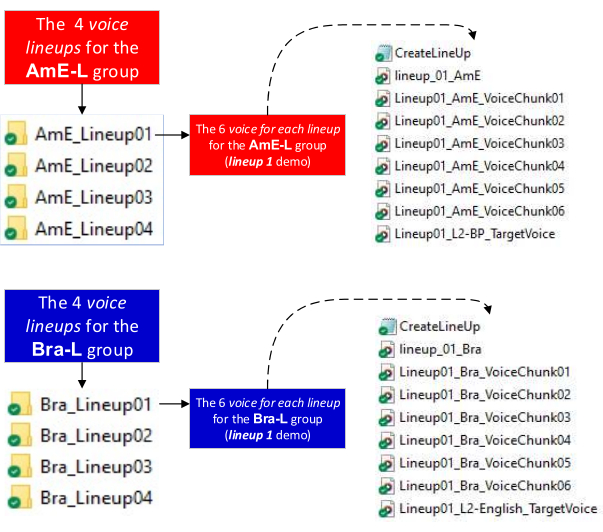
Figure 4 : Organigramme schématique de la perception de la parole. Veuillez cliquer ici pour visualiser une version agrandie de cette figure.
- Participants
- Choisir des participants différents pour chaque groupe par rapport à ceux qui ont participé au protocole de production de la parole.
REMARQUE : Deux groupes de participants ont été sélectionnés pour cette partie du protocole : Groupe 1: Le Amaméricain Eanglais (des États-Unis d'Amérique) Lécouteurs (AmE-L), et Groupe 2: Le Brazilian Lauditeurs (Bra-L). Pour la présente recherche, les AmE-L et les Bra-L ont tous deux été considérés comme des locuteurs compétents en L2 (les deux groupes ont été classés au niveau B2-C1)36 L'AmE-L avait vécu deux ans au Brésil au moment de la réalisation des procédures. Le Bra-L avait vécu plus de deux ans aux États-Unis au moment de la réalisation des procédures. Pendant leur séjour à l'étranger, les deux groupes utilisaient couramment leur L2 à des fins d'étude et de travail (au moins six jours par semaine, environ 4 à 5 heures par jour). - Déterminer le nombre de participants, le langue (L1 anglais, L2 BP ; L1 BP, L2 anglais), le sexe (femelle ou mâle), le âge (moyenne, écart type), le caractéristiques du groupe (professionnels ou étudiants de premier cycle) et les Niveau de compétence L2 pour chaque groupe.
- Choisir des participants différents pour chaque groupe par rapport à ceux qui ont participé au protocole de production de la parole.
- Les séries vocales
REMARQUE : Diviser les procédures des séries vocales en deux étapes distinctes : la préparation et la réalisation des séries vocales.- Préparez quatre séries vocales en anglais et quatre en BP.
- Obtenir les fichiers audio des locuteurs de la section 1 : Production de la parole.
- Vérifiez que les fichiers audio de chaque facteur linguistique se trouvent dans des dossiers séparés.
- Choisir au hasard six extraits vocaux en anglais langue maternelle ou en portugais brésilien langue maternelle.
REMARQUE : Six voix dans la séquence représentent une voix cible et cinq feuilles métalliques. - Sélectionnez un segment vocal en anglais L2 ou en portugais brésilien L2 parmi les locuteurs inclus à l'étape 2.2.1.3.
REMARQUE : Le fragment vocal de l'étape 2.2.1.4 est le voix de référence. Les fragments doivent avoir une durée d'environ 20 s. - Accéder et télécharger le script pour Praat CreateLineup48 de https://github.com/pabarbosa/prosody-scripts-CreateLineUp
- Vérifiez que la voix de référence L2, les voix distractrices L1 et la voix cible L1 se trouvent dans le même dossier avant d'exécuter le script CreateLineup (Figure 5).
- Ouvrir le logiciel d'analyse phonétique.
- À partir de fenêtre de l'objet, cliquer Praat | Ouvrir le script Praat… pour appeler le script.
- Cliquez Exécuter | Exécuter.
REMARQUE : Le script renvoie un fichier dans l'ordre suivant : (la voix de référence L2) + (la voix cible L1 et les voix distractrices réparties aléatoirement)Figure 5).
- Exécution des alignements vocaux
- Créer un espace en ligne pour héberger les listes sur la plateforme de son choix (par exemple, SurveyMonkey. Voir le Table des matériels) pour la réalisation à distance des confrontations auditives.
- Accédez au lien de l'espace en ligne.
- Téléversez les fichiers renvoyés par le script CreateLineup sur la plateforme.
- Exécuter la procédure devant les participants afin de tester chaque étape.
REMARQUE : Il est recommandé d'accéder préalablement au lien et d'exécuter les séquences pour vérifier que tout fonctionne normalement.
- Préparez quatre séries vocales en anglais et quatre en BP.
- Analyse statistique
- Téléversez le classeur contenant les scores des évaluations des auditeurs dans l'environnement R (ou tout autre logiciel/environnement statistique de votre choix).
- Effectuer le test de Kruskal-Wallis dans R.
- Saisissez les commandes suivantes et appuyez sur Entrer.
model = kruskal.test(jugements ~ chacun alignement vocal, données = le trame de données)
- Effectuer un test post-hoc de Dunn.
- Effectuer le test de Dunn dans R.
- Saisissez les commandes suivantes et appuyez sur Entrer.
library(FSA)
model = dunnTest(jugements ~ chacun alignement vocal, données = données, méthode = "bonferroni")
REMARQUE : Les codes aux étapes 2.3.1.2 et 2.3.2.2 sont des pseudo-codes (voir REMARQUE 1.4.2.2).
- Téléversez le classeur contenant les scores des évaluations des auditeurs dans l'environnement R (ou tout autre logiciel/environnement statistique de votre choix).
- Analyse de la similarité acoustique
- Sélectionner les alignements (cf. NOTE à l'étape 2.2.1.3) qui présentaient des différences non significatives entre la cible et l'un des témoins.
- Répéter les procédures des étapes 1.3.1 à 1.3.7.5, ainsi que des étapes 1.3.7.8 à 1.3.7.10.
- Accéder au script et le télécharger pour Python49, Similarité_acoustique_cosinus_euclidienne50 de https://github.com/leonidasjr/AcousticSimilarity/blob/main/AcousticSmilarity_cosine_euclidean.py
REMARQUE : Le script renvoie trois matrices (au format « .txt » et « .csv ») : une pour la similarité cosinus51,52, une pour la distance euclidienne52,53, et une pour les valeurs de distance euclidienne transformée, ainsi qu'une comparaison par paires entre la voix cible et chaque voix distrayante. - Vérifiez que le script est téléchargé dans le même dossier que le jeu de données d'alignement.
- Cliquez sur Ouvrir le fichier… bouton pour appeler le script.
- Cliquez Exécuter | Exécuter sans débogage boutons
REMARQUE : Le deuxième Exécuter le bouton peut être marqué comme Exécuter ou exécuter sans débogage ou Exécuter le script. Ils exécutent tous les mêmes commandes. Cela dépend simplement de l'environnement Python utilisé. - Effectuer des tests de similarité vocale fondés sur des caractéristiques acoustiques.
REMARQUE : La similarité cosinus (ou distance cosinus) est une technique appliquée en intelligence artificielle (IA), particulièrement dans l'apprentissage automatique des systèmes de reconnaissance automatique de la parole (ASR). Il s'agit d'une mesure de similarité comprise entre zéro et un. Une similarité cosinus proche de un indique que deux voix sont très probablement similaires. Une similarité cosinus proche de zéro indique que les voix sont très probablement dissemblables.52La distance euclidienne, souvent appelée similarité euclidienne, est également largement utilisée en intelligence artificielle, en apprentissage automatique et en reconnaissance automatique de la parole (ASR). Elle représente la distance en ligne droite entre deux points dans un espace euclidien.53, c'est-à-dire que plus les points sont proches (valeurs de distance plus faibles), plus les voix sont similaires. Pour une compréhension plus claire des résultats rapportés par les deux techniques, nous avons transformé les scores bruts de distance euclidienne en valeurs allant de zéro (moindre similarité des voix) à un (plus grande similarité des voix)54.

Figure 5 : Configuration du répertoire pour la perception de la parole. Dossiers des séries vocales. Chaque dossier contient six voix en langue maternelle (L1), la voix cible en langue seconde (L2), le script « CreateLineup », et le fichier audio de la série vocale (généré après l'exécution du script). Veuillez cliquer ici pour afficher une version agrandie de cette figure.
Accès restreint. Veuillez vous connecter ou commencer un essai pour afficher ce contenu.
Résultats
Résultats pour la production de la parole
Dans cette section, nous avons décrit la performance des caractéristiques prosodiques-acoustiques et des métriques rythmiques statistiquement significatives. Ces caractéristiques prosodiques comprenaient les débits de parole, d'articulation et de pauses, qui sont liés à la durée, ainsi que le scintillement (shimmer), qui est lié à la qualité vocale. Les métriques rythmiques étaient l'écart type (SD) de la durée des syllabes, l'écart type des consonnes, l'éc...
Accès restreint. Veuillez vous connecter ou commencer un essai pour afficher ce contenu.
Discussion
Le protocole actuel présente une nouveauté dans le domaine de la phonétique (médico-légale). Elle est divisée en deux phases : l’une basée sur la production (analyse acoustique) et l’autre basée sur la perception (analyse du jugement). La phase d’analyse de la production comprend la préparation des données et l’alignement forcé, le réalignement et l’extraction automatique des caractéristiques acoustiques prosodiques en plus des statistiques. Ce protocole relie l’étape de collecte des données à l’analyse des données de ma...
Accès restreint. Veuillez vous connecter ou commencer un essai pour afficher ce contenu.
Déclarations de divulgation
Les auteurs n’ont aucun conflit d’intérêts à déclarer.
Remerciements
Cette étude a été soutenue par le Conseil national pour le développement scientifique et technologique - CNPq, subvention n° 307010/2022-8 pour le premier auteur, et subvention n° 302194/2019-3 pour le deuxième auteur. Les auteurs tiennent à exprimer leur sincère gratitude aux participants à cette recherche pour leur généreuse collaboration et leurs contributions inestimables.
Accès restreint. Veuillez vous connecter ou commencer un essai pour afficher ce contenu.
Matériaux
| Nom | Entreprise | Numéro de catalogue | Commentaires |
|---|---|---|---|
| CreateLineup | Personal collection | # | Script for praat pour la préparation des alignements vocaux |
| Dell I3 (avec disque SSD - Solid State Drive) ; | Dell | # | Ordinateur portable |
| Praat Paul | Boersma & David Weenink | # | Logiciel d’analyse phonétique |
| Python 3 | Python Software Foundation | # | Langage de programmation interprété, de haut niveau et à usage général. |
| R | Le Projet R pour l’Informatique Statistique | # | Langage de programmation pour l’informatique statistique |
| Shure Beta SM7B | Shure | # | Microphone |
| SpeechRhythmExtractor | Collection personnelle | # | Script pour praat pour l’extraction automatique de caractéristiques acoustiques |
| SurveyMonkey | SurveyMonkey Inc. | # | Assemblez des enquêtes personnalisables gratuites, ainsi qu’une suite de programmes back-end qui incluent l’analyse des données, la sélection d’échantillons, la suppression des biais et la représentation des données. |
| Tascam DR-100 MKII | Tascam | # | Enregistreur vocal numérique |
| Système de segmentation automatique de Munich MAUS | Université de Munich | # | Alignement forcé de fichiers audio (.wav) et d’informations linguistiques (.txt) |
| VVUnitAligner | Personal collection | # | Script pour praat pour le réalignement automatique et le post-traitement des unités phonétiques |
Références
- Moyer, A. Foreign Accent: The Phenomenon of Non-native Speech. , Cambridge University Press. (2013).
- Munro, M., Derwing, T. Foreign accent, comprehensibility and intelligibility, redux. J Second Lang Pronunciation. 6 (3), 283-309 (2020).
- Levis, J. Intelligibility, Oral Communication, and the Teaching of Pronunciation. , Cambridge University Press. (2018).
- Munro, M. Applying Phonetics: Speech Science in Everyday Life. , Wiley-Blackwell. (2022).
- Gut, U. Speaker Classification. Muller, C. , Springer-Verlag. 75-87 (2007).
- Rogers, H. Foreign accent in voice discrimination: a case study. Forensic Linguistics. 5 (2), 203-208 (1998).
- Solan, L., Tiersma, P. Hearing Voices: Speaker Identification in Court. Hastings Law Journal. 54, 373-436 (2003).
- Alcaraz, J. The long-term average spectrum in forensic phonetics: From collation to discrimination of speakers. Estudios de Fonética Experimental / Journal o Experimental Phonetics. 32, 87-110 (2023).
- Silva, L. Jr, Barbosa, P. A. Voice disguise and foreign accent: Prosodic aspects of English produced by Brazilian Portuguese speakers. Estudios de Fonética Experimental / Journal o Experimental Phonetics. 32, 195-226 (2023).
- Munro, M., Derwing, T. Modeling perceptions of the accentedness and comprehensibility of L2 speech. Studies in Second Language Acquisition. 23 (4), 451-468 (2001).
- Keating, P., Esposito, C. Linguistic Voice Quality. Working Papers in Phonetics. , 85-91 (2007).
- Niebuhr, O., Skarnitzl, R., Tylečková, L. The acoustic fingerprint of a charismatic voice -Initial evidence from correlations between long-term spectral features and listener ratings. Proceedings of Speech Prosody. , 359-363 (2018).
- Segundo San, E. International survey on voice quality: Forensic practitioners versus voice therapists. Estudios de Fonética Experimental. 29, 8-34 (2021).
- Farrús, M. Fusing prosodic and acoustic information for speaker recognition. International Journal of Speech, Language and the Law. 16 (1), 169(2009).
- Farrús, M. Voice disguise in automatic speaker recognition. ACM Computing Surveys. 51 (4), 1-2 (2018).
- Nolan, F. A recent voice parade. The International Journal of Speech, Language and the Law. 10 (2), 277-291 (2003).
- McDougall, K. Ear-catching versus eye-catching? Some developments and current challenges in earwitness identification evidence. Speaker Individuality in Phonetics and Speech Sciences. Bernardasci, C., Dipino, D., Garassino, D., Negrinelli, S., Pellegrino, E., Schmid, S. , Officinaventuno. 33-56 (2021).
- Gut, U. Rhythm in L2 speech. Speech and Language Technology. 14 (15), 83-94 (2012).
- Urbani, M. Pitch Range in L1/L2 English. An Analysis of F0 using LTD and Linguistic Measures. Coop. , Libraria Editrice Università di Padova. (2012).
- Gonzales, A., Ishihara, S., Tsurutani, C. Perception modeling of native and foreign-accented Japanese speech based on prosodic features of pitch accent. J Acoust Soc Am. 133 (5), 3572(2013).
- Silva, L. Jr, Barbosa, P. A. Speech rhythm of English as L2: an investigation of prosodic variables on the production of Brazilian Portuguese speakers. J Speech Sci. 8 (2), 37-57 (2019).
- Foreign accent and L2 speech rhythm of English a pilot study based on metric and prosodic parameters. Silva, L. Jr, Barbosa, P. A. Proceedings of the II Brazilian Conference on Prosody (Anais II Congresso Brasileiro de Prosódia), 1, 41-50 (2023).
- Costa, A. El cerebro bilingüe: La neurociencia del lenguaje. , Penguin Randon House. (2017).
- Eriksson, A. Tutorial on forensic speech science: Part I. Forensic Phonetics. , (2005).
- Harvey, M., Giroux, M., Price, H. Lineup size influences voice identification accuracy. Applied Cognitive Psychology. 37 (5), 42-89 (2023).
- Pautz, N., et al. Identifying unfamiliar voices: Examining the system variables of sample duration and parade size. Q J Exp Psychol (Hove). 76 (12), 2804-2822 (2023).
- McDougall, K., Nolan, F., Hudson, T. Telephone transmission and earwitnesses: Performance on voice parades controlled for voice similarity. Phonetica. 72 (4), 257-272 (2015).
- Nolan, F., McDougall, K., Hudson, T. Some acoustic correlates of perceived (dis) similarity between same-accent voices. Proceedings of the International Congress of Phonetic Sciences (ICPhS 2011). , 1506-1509 (2011).
- Sheoran, S., Mahna, D. Voice identification and speech recognition: an arena of voice acoustics. Eur Chem Bull. 12 (5), 50-60 (2023).
- Hudson, T., McDougall, K., Hughes, V. Forensic phonetics. The Cambridge Handbook of Phonetics. Knight, R. -A., Setter, J. , Cambridge University Press. 631-656 (2021).
- Eriksson, A. The disguised voice: Imitating accents or speech styles and impersonating individuals. Language and identities. Llamas, C., Watt, D. , Edinburgh University Press. 86-96 (2010).
- Köster, O., Schiller, N. Different influences of the native language of a listener on speaker recognition. Forensic Linguistics. 4 (1), 18-27 (1997).
- The influence of native-language background on speaker recognition. Köster, O., Schiller, N., Künzel, H. Proceedings of the International Congress of Phonetic Sciences (ICPhS 1995), , 306-309 (1995).
- Thompson, C. P. A language effect in voice identification. Applied Cognitive Psychology. 1, 121-131 (1987).
- San Segundo, E., Univaso, P., Gurlekian, J. Sistema multiparamétrico para la comparación forense de hablantes. Estudios de Fonética Experimental. 28, 13-45 (2019).
- Council of Europe. Common European Framework of Reference for Languages: Learning, Teaching, Assessment. , Press Syndicate of the University of Cambridge. (2001).
- How to use Tascam DR-100 MKII: Getting started. , https://www.youtube.com/watch?v=O2E72uV9fWc (2018).
- Getting the most from your Shure SM58 microphone. , https://www.youtube.com/watch?v=wweNufW7EXA (2020).
- Kisler, T., Reichel, U. D., Schiel, F. Multilingual processing of speech via web services. Computer Speech & Language. 45, https://clarin.phonetik.uni-muenchen.de/BASWebServices/interface/WebMAUSBasic 326-347 (2017).
- Escudero, P., Boersma, P., Rauber, A., Bion, R. A cross-dialect acoustic description of vowels: Brazilian and European Portuguese. J Acoust Soc Am. 126 (3), 1379-1393 (2009).
- Post-aspiration in standard Italian: some first cross-regional acoustic evidence. Stevens, M., Hajek, J. Proceedings 11th Conference of the International Speech Communication Association (INTERSPEECH 2010), , 1557-1560 (2011).
- Barbosa, P., Madureira, S. Manual de Fonética Acústica Experimental: aplicações a dados do português. , Cortez. (2015).
- Boersma, P., Weenink, D. Praat: Doing phonetics by computer. (Version 6.1.38) [Computer program]. , https://www.praat.org/ (1992-2021).
- Silva, L. Jr VVUnitAligner. [Computer program]. , https://github.com/leonidasjr/VVunitAlignerCode_webMAUS (2022).
- Silva, L. Jr, Barbosa, P. A. SpeechRhythmExtractor [Computer program]. , https://github.com/leonidasjr/VowelCode (2019-2023).
- R Core Team. A language and environment for statistical computing. R Foundation for Statistical Computing. , https://www.R-project.org/ (2023).
- Pigoli, D., Hadjipantelis, P. Z., Coleman, J. Z., Aston, J. The statistical analysis of acoustic phonetic data. Journal of the Royal Statistical Society. 67 (5), 1103-1145 (2018).
- Barbosa, P. A. CreateLineup [Computer program]. , https://github.com/pabarbosa/prosody-scripts-CreateLineUp (2021).
- Van Rossum, G., Drake, F. L. Python 3 Reference Manual. , CreateSpace. (2009).
- Silva, L. Jr AcousticSimilarity_cosine_euclidean. [Computer program]. , https://github.com/leonidasjr/AcousticSimilarity/blob/main/AcousticSmilarity_cosine_euclidean.py (2024).
- Automatic assessment of voice similarity within and across speaker groups with different accents. Gerlach, L., McDougall, K., Kelly, F., Alexander, A. Proceedings of the International Congress of Phonetic Sciences (ICPhS 2023), , 3785-3789 (2023).
- Gahman, N., Elangovan, V. A comparison of document similarity algorithms. International Journal of Artificial Intelligence and Applications. 14 (2), 41-50 (2023).
- San Segundo, E., Tsanas, A., Gómez-Vilda, P. Euclidean distances as measures of speaker similarity including identical twin pairs: A forensic investigation using source and Filter voice characteristics. Forensic Science International. 270, 25-38 (2017).
- Speaker's voice characteristics and similarity measurement using Euclidean distances. Singh, M. K., Singh, N., Singh, A. K. Proceedings of the International Conference on Signal Processing and Communication (ICSC 2019), , 317-322 (2019).
- Darling-White, M., Banks, W. Speech rate varies with sentence length in typically developing children. J Speech Lang Hear Res. 64 (6), 2385-2391 (2021).
- Barbosa, P. A. Incursões em torno do ritmo da Fala. , Pontes Editores. (2006).
- Golestani, N., Pallier, C. Anatomical correlates of foreign speech sound production. Cereb Cortex. 17 (4), 929-934 (2007).
- Trouvain, J., Fauth, C., Möbius, B. Breath and non-breath pauses in fluent and disfluent phases of German and French L1 and L2 read speech. Proceedings of Speech Prosody. , 31-35 (2016).
- Waaning, J. The Lombard effect: the effects of noise exposure and being instructed to speak clearly on speech acoustic parameters. [Master's thesis]. , Radboud University. (2021).
- Villegas, J., Perkins, J., Wilson, I. Effects of task and language nativeness on the Lombard effect and on its onset and offset timing. J Acoust Soc Am. 149 (3), 1855(2021).
- Differences between native and non-native Lombard speech in terms of pitch range. Proceedings of the 23rd International Congress on Acoustics(ICA 2019). Marcoux, K., Ernestus, M. , 5713-5720 (2019).
- Marcoux, K., Ernestus, M. Pitch in native and non-native Lombard speech. Proceedings of the International Congress of Phonetic Sciences (ICPhS 2019). , 2605-2609 (2019).
- Marcoux, K., Ernestus, M. Acoustic characteristics of non-native Lombard speech in the DELNN corpus. Journal of Phonetics. 102, 1-25 (2024).
- Gil, J., San Segundo, E. La cualidad de voz en fonética judicial [Voice quality in judicial phonetics]. Lingüística Forense: la Lingüística en el ámbito legal y policial. Garayzábal, M., Jiménez, M., Reigosa, M. , Euphonía Ediciones. 154-199 (2014).
- Gil, J., San Segundo, E. El disimulo de la cualidad de voz en fonética judicial: Estudio perceptivo de la hiponasalidad [Voice quality disguise in judicial phonetics: A perceptual study of hyponasality. Panorama de la fonética española actual. Penas-báñez, M. A. , Arco Libros. 321-366 (2013).
- Passeti, R., Madureira, S., Barbosa, P. What can voice line-ups tell us about voice similarity. Proceedings of the International Congress of Phonetic Sciences (ICPhS 2023). , 3765-3769 (2023).
- Nolan, F. The DyViS database: Style-controlled recordings of 100 homogeneous speakers for forensic phonetic research. International Journal of Speech Language and the Law. 16 (1), 31-57 (2009).
- Caroll, D. Psychology of Language. , Wadsworth. (1994).
- Ortega-Llebaria, M., Silva, L. Jr, Nagao, J. Macro- and micro-rhythm in L2 English: Exploration and Refinement of Measures. Proceedings of the International Congress of Phonetic Sciences (ICPhS 2023). , 1582-1586 (2023).
- Fernández-Trinidad, M. Hacia la aplicabilidad de la cualidad de la voz en fonética judicial. Loquens. 9 (1-2), 1-11 (2022).
- Brouwer, S. The role of foreign accent and short-term exposure in speech-in-speech recognition. Atten Percep Psychophys. 81, 2053-2062 (2019).
- Love, R., Wright, D. Specifying challenges in transcribing covert recordings: Implications for forensic transcription. Front Commun. 6, 1-14 (2021).
- Meer, P. Automatic alignment for New Englishes: Applying state-of-the-art aligners to Trinidadian English. J Acoust Soc Am. 147 (4), 2283-2294 (2020).
- Montreal Forced Aligner: trainable text-speech alignment using Kaldi. McAuliffe, M., Socolof, M., Mihuc, S., Wagner, M., Sonderegger, M. Proceedings 18th Conference of the International Speech Communication Association (INTERSPEECH 2017), , 498-502 (2017).
- Chodroff, E. Montreal Forced Aligner: MFA Tutorial. , https://zenodo.org/records/7591607 (2023).
Accès restreint. Veuillez vous connecter ou commencer un essai pour afficher ce contenu.
Réimpressions et autorisations
