Ici, nous décrivons une adaptation à haut débit d’un test de stabilité colloïdale d’anticorps à grande échelle afin de générer de grands ensembles de données et de soutenir des prédictions de développement prêtes pour l’IA/ML.
Article de méthode
Mesures ultradiluées automatisées de l’auto-association pour l’identification d’anticorps aux propriétés favorables de solution à haute concentration
Dans cet article
Résumé
Résumé
L’un des principaux défis en ingénierie des anticorps est le développement de méthodes de dépistage analytiques pour évaluer la stabilité colloïdale, en garantissant que les biologiques sont adaptés à la formulation et à l’administration à haute concentration. La spectroscopie de nanoparticules auto-interaction stabilisée par charge (CS-SINS), une version modifiée de la spectroscopie conventionnelle d’auto-interaction par capture d’affinité (AC-SINS), a été adaptée comme une évaluation robuste de la stabilité colloïdale pour prédire le comportement de la solution à haute concentration. Cette méthode permet de prendre des décisions critiques de développement en début de phase en identifiant les problèmes de stabilité colloïdale avant que des ressources significatives ne soient investies, réduisant considérablement les taux d’attrition en aval et accélérant les délais de sélection des candidats. Cette étude démontre que le test s’intègre parfaitement aux flux de travail de découverte existants et peut être réalisé en parallèle avec les tests typiques en phase initiale grâce à ses besoins d’échantillonnage minimes, fournissant des données précieuses pour prédire un comportement à haute concentration sans compromettre d’autres efforts de caractérisation. Il a été démontré que les mesures courantes de diffusion dynamique de la lumière (DLS), en plus du décalage de la longueur d’onde de la résonance du plasmon, peuvent améliorer la fiabilité de la méthode HTP décrite ici. Pris ensemble, on prévoit que la validation croisée à l’aide de mesures DLS et de programmes d’analyse automatisée facilitera la sélection fiable des traitements anticorps candidats de diverses modalités.
Introduction
Dans le développement et la formulation d’anticorps thérapeutiques, l’opalescence et la viscosité sont des éléments clés dans le développement d’un produit commercial centré surle patient 1,2,3,4,5,6,7,8. Classiquement, de grandes quantités de protéines sont nécessaires pour observer directement ces propriétés à haute concentration, empêchant ainsi une identification optimale des plombs lors des premiers stades de la découverte des anticorps, où la disponibilité des protéines est limitée. L’identification fiable de ces phénomènes est essentielle pour les évaluations de la capacité de développement visant à atténuer un mauvais comportement de solution à haute concentration enaval 1,2,3,4,5,6,7,8. Ainsi, il existe un intérêt important pour les méthodes à haut débit et faible concentration, qui prédisent un mauvais comportement de solution àhaute concentration 9,10,11,12,13,14,15,16. Une de ces méthodes, kD-DLS, s’est avérée fiable pour prédire les propriétés à haute concentration mais ne répond pas aux exigences de faible consommation de protéines et de haut débit des flux de travail en phaseinitiale 12,13.
Récemment, un test à base de nanoparticules d’or à très faible consommation, connu sous le nom de CS-SINS, a montré une forte corrélation avec les résultats des expériences kD-DLS et est raisonnablement efficace pour prédire de mauvaises propriétés de solution à hauteconcentration 16. Ces caractéristiques font de CS-SINS un candidat idéal pour le développement en tant qu’outil de criblage à haut débit. Le test CS-SINS utilise un anticorps de capture immobilisé sur les surfaces de nanoparticules d’or pour ancrer les anticorps candidats via leurs régions Fc, laissant les bras Fab accessibles aux interactions de la solution. Cette configuration signifie que les interactions Fab-Fab dominent le signal d’auto-association mesuré, ce qui est avantageux puisque les études indiquent que les domaines Fab contribuent principalement aux caractéristiques d’auto-association mAb, probablement en raison des propriétés de surface de la région déterminant la complémentarité (CDR) 17,18,19,20,21,22,23 . Cette base mécanistique rend CS-SINS bien adapté à la prédiction des risques de stabilité colloïdale pertinents pour les formulations à haute concentration. Des méthodes HTP alternatives, notamment la chromatographie par adsorption monocouche debout (SMAC), une approche en colonne par exclusion de taille (SEC) qui imite l’auto-association avec une phase stationnaire générique, et la chromatographie à interaction croisée (CIC), impliquent la préparation de colonnes et des besoins en échantillonsimportants 17,24,25,26,27.
La méthode décrite ici détaille une mise en place validée par plaque du test CS-SINS et permet le dépistage HTP grâce à l’automatisation et à l’analyse en laboratoire, combinant les avantages des méthodes existantes tout en améliorant la fiabilité des résultats. Cette étude démontre également comment différents types d’échantillons donnent des résultats de haute qualité en raison de la nature de l’enrichissement de l’auto-interaction dans le test, établissant que la méthode est agnostique par rapport aux sources protéiques. De plus, nous considérons comment une communication plus précoce des propriétés colloïdales aux équipes de projet peut renforcer la conception stratégique de médicaments multicorpsmultispécifiques 28,29,30,31,32,33,34.
L’étude des propriétés de solution à haute concentration est généralement réalisée en aval dans des campagnes de sélection multispécifiques des candidats, après la sélection des pistes et l’achèvement de l’ingénierie (Figure 1A). La prédiction précoce de ces propriétés est devenue possible grâce à des méthodes telles que le CS-SINS qui nécessitent quelques microgrammes d’échantillon, prédisant ainsi les risques de stabilité colloïdale avec des mesuresultradiluées 16. L’introduction du dépistage précoce de la capacité de développement (Figure 1A), lorsque le pool de candidats est important, et des campagnes parallèles de génération de données pour des formats monospécifiques et multispécifiques pourraient mieux éclairer le processus de découvertede médicaments 31,32. HTP CS-SINS s’inscrit dans le paradigme existant de sélection moléculaire en parallèle de liaison et de détermination de fonction, ajoutant ainsi au package d’information sans perturber ni freiner les flux de travail existants. La sélection des candidats principaux, en mettant l’accent sur les propriétés colloïdales favorables, influencera la progression de la sélection telle que représentée à la Figure 1B.
Dans le flux de travail proposé de dépistage précoce de la capacité de développement, l’identification des prospects prend en compte la vision globale des propriétés favorables du médicament, y compris la fabrication et l’accès des patients, simplifiant ainsi le développement enaval 34. Les propriétés à haute concentration des biologiques peuvent déterminer leur voie d’administration : injections intraveineuses nécessitant des visites à l’hôpital ou injections sous-cutanées, qui peuvent être administrées à domicile par le patient, mais nécessitent souvent un produit à hauteconcentration 35,36. Les Mab développés avec une faible auto-association sont souvent formulés à >100 mg/mL 5,35. L’optimisation de la formulation à l’aide d’excipients, tels que des agents visco-réducteurs, peut surmonter les risques de stabilité colloïdale pour les candidats souhaitables ayant de mauvaises propriétés de solution aux stades de développementCMC 34,35. Cependant, cela introduit des défis en aval dans la fabrication biopharmaceutique et prolonge les délais pour l’approbation réussiedes médicaments 36. Les excipients connus pour réduire la viscosité (comme les sels et les acides aminés) peuvent également affecter la stabilité des protéines, modifiant les profils de développement précédemment caractérisés et compliquant davantage le processus36,37. De plus, un excès d’excipients peut limiter la population de patients en raison de considérations d’immunogénicité, de divers problèmes de sécurité ou affecter l’adhésion au traitement, et peut introduire de nouveaux défis dans le domaine de laproduction 38, 39, 40. Starr et al. ont publié pour la première fois la méthode CS-SINS, décrivant la fraction massique optimale de PLL et IgG à 0,03 et confirmant la stabilisation des nanoparticules par des mesures du potentiel zêta pour l’auto-association de mAb dans les formulationsd’histidine 16. Notamment, ajouter trop de PLL crée une surstabilisation dans le test et empêche l’observation de l’auto-interaction des mAb (l’amélioration de la stabilité des nanoparticules d’or par la PLL est illustrée dans la Figure supplémentaire 1). L’utilisation de formulations d’histidine sans sel minimise le criblage électrostatique (augmentant la longueur de Debye), ce qui étend la gamme des interactions intermoléculaires, amplifiant ainsi les signaux faibles d’auto-association et imitant un comportement à haute concentration lorsque les anticorps sont plus proches. En général, les formulations à faible force ionique sont préférées pour les formulations à haute concentration où l’auto-association n’est pas observée.
Les gros polymères PLL empêchent l’occupation de plus de mAbs de capture aux surfaces des nanoparticules d’or, ce qui réduit la fenêtre de décalage plasmonique et nécessite un programme d’ajustement des courbes plus sophistiqué et une analyse pour l’analyse ultérieure des données. Cette étude a utilisé un outil de portail web qui se synchronise avec les bases de données internes. Le principal avantage de ce coût initial réside dans le potentiel de construction de données d’un vaste pool de séquences pour maximiser la diversité des candidats en aval et atténuer les goulots d’étranglement aux étapes de développement pluscoûteuses 34, 35, 36. Le test CS-SINS que nous décrivons ici se distingue comme une méthode compatible HTP, qui a démontré une bonne corrélation avec les tests de stabilité colloïdale à un stadeavancé 16. Un profilage assisté par IA est en cours pour la conception réfléchie de multispécificités pour les programmes futurs et pour la compréhension des contributions individuelles de chaque domaine dans les formatscomplexes 41,42,43,44. Ces efforts influenceront collectivement les méta-analyses et une détermination plus détaillée des propriétés de stabilité colloïdale pour les traitements par anticorps, et permettront donc de gagner du temps aux premiers stades de la R&D.
Protocole
La figure 2 illustre la préparation de la conjugaison des nanoparticules, la figure 3 illustre l’ensemble du flux de travail, la figure 4 illustre le processus d’automatisation en laboratoire, et la figure 5 contient un schéma du pipeline d’analyse des données. Les réactifs et l’équipement utilisés sont listés dans le tableau des matériaux.
1. Préparation des tampons
REMARQUE : Semaine 1 (préparation d’échantillons)
- Préparez de l’histidine (10 mM), pH 6,0 (échantillon et tampon de test).
REMARQUE : Ces étapes sont effectuées le jour 1.- Dissoudre 5 mM de monochlorhydrate de L-histidine et 5 mM de L-histidine dans de l’eau ultrapure. Ajoutez de l’acide chlorhydrique goutte dans les gouttes en remuant jusqu’à ce que le pH atteigne 6,0, mesuré avec un pHömètre calibré.
- Filtrez la solution sous vide à travers un filtre de 0,22 μm de la taille d’un pore et collectez le filtrat dans une bouteille stérile.
- Mesurez la conductivité pour le contrôle qualité et assurez-vous d’une lecture d’environ 500 μS/cm.
- Préparez de l’acétate de potassium (20 mM), pH 4,3 (tampon de conjugaison capture de mAb).
- Dissoudre l’acétate de potassium dans de l’eau ultrapure et ajuster le pH à 4,3 avec de l’acide acétique glaciaire.
- Stériliser la solution par filtration sous vide à travers un filtre de 0,22 μm de taille de pore comme décrit à l’étape 1.1.2.
- Préparez la poly-L-lysine.
- Préparez une solution de fond de 5 mg/mL dans de l’eau ultrapure et conservez à −20 °C jusqu’à utilisation.
2. Dialyse de tous les échantillons (candidats mAbs)
REMARQUE : Effectuez ces étapes les jours 2 à 5.
- Pré-trempez 100 μL ou 300 μL de dialyseurs dans 10 mM d’histidine, pH 6,0, pendant 5 minutes.
- Transférez tous les échantillons (50–100 μL) sur des cassettes dialysiques. Immergez les cassettes dans un tampon d’histidine de 10 mM, pH 6,0 (700 mL par boîte), ajoutez des barres de mélange aux réservoirs, placez les réservoirs sur des plaques magnétiques d’agitation, puis incubez à 4 °C pendant 2 h 15 min.
- Effectuez sept échanges tampons avec 10 mM d’histidine, pH 6,0, toutes les 2 h 15 min, ou effectuez quatre échanges tampons nocturnes pour garantir un retrait complet du sel des échantillons.
- Récupérez les échantillons, transférez-les dans des fioles à matrice propre, et conservez-les à 4 °C jusqu’à la réalisation du test CS-SINS.
- Mesurez les concentrations de l’échantillon et enregistrez les informations de polydispersion après la dialyse. Calculez les concentrations corrigées en divisant les valeurs brutes d’absorption à 280 nm par l’absorbance à 280 nm pour une solution de 1 mg/mL.
- Préparez le fichier d’entrée du manipulateur de liquide avec les adresses et concentrations de puits (μg/mL), y compris les témoins.
3. Échange tampon de la capture mAb (Figure 2, étape 1)
REMARQUE : Effectuez ces étapes le premier jour de la semaine 2 (analyse).
- Retirez le tampon de stockage des colonnes de 2 mL de désalage en centrifugant pendant 2 minutes à 1 000 × g à température ambiante. Préparez deux colonnes de désalage pour chaque 700 μL de mAb de capture requis. Supprimez le flux à travers après chaque étape de centrifugation.
- Lavez les colonnes trois fois avec 1 mL de tampon d’acétate de potassium 20 mM, pH 4,3. Centrifugez les colonnes pendant 2 minutes à 1 000 × g à chaque lavage.
- Ajoutez 700 μL de capture mAb (anticorps spécifique à l’humain Fcγ) à chaque colonne et éluez dans un tube frais de 15 mL en centrifugant pendant 2 minutes à 1 000 × g.
- Collectez l’éluate désalé, appliquez-le sur une seconde colonne de désalage équilibrée, puis centrifugez pendant 2 minutes supplémentaires à 1 000 × g.
- Combinez tous les échantillons élués.
- Mesurez la concentration de la solution de mAb capturée après le désalage comme décrit aux jours 2–5, étape 2.5.
- Diluez la solution d’origine capture mAb à 0,8 mg/mL avec 20 mM de tampon d’acétate de potassium, pH 4,3, puis laissez de côté jusqu’à utilisation.
4. Préparation d’un stock de travail de poly-L-lysine
- Diluez une petite aliquote de la solution poly-L-lysine en 2,66 mg/mL avec de l’eau ultrapure.
5. Concentration des nanoparticules d’or (Figure 2, étape 2)
- Préparez 1,2 mL d’aliquotes de la suspension d’origine dans des tubes de 1 mL ou des aliquotes de 4,8 mL dans des tubes de 5 mL à l’aide de tubes microcentrifuges en polypropylène contenant des nanoparticules d’or de 20 nm. Centrifugeuse à 21 130 × g pendant 6 minutes.
- Retirez les surnatants (~1,1–1,15 mL) sans déranger les granulés et transférez-les dans un tube conique séparé.
- Combinez les granulés concentrés et les volumes résiduels dans un tube de microcentrifuge propre. Déterminez le volume des nanoparticules en pipettant et ajustez le volume à (nombre de tubes de 1 mL × 50 μL) ou (nombre de tubes de 5 mL × 200 μL) en utilisant le surnageant réservé. Par exemple, après centrifugation de 10 aliquotes de 1,2 mL dans des tubes de 1 mL, ajustez le volume final des nanoparticules concentrées à 500 μL.
6. Assemblage de nanoparticules
- Mélangez soigneusement 1,5 μL de la solution de travail poly-L-lysine avec 48,5 μL de mAb de capture échangé par tampon (Figure 2, étape 3).
- Préparez un mélange 1:1 de la solution concentrée de nanoparticules de l’étape 5 et de la solution poly-L-lysine/capture mAb de l’étape 6.1 (Figure 2, étape 4).
- Incubez le mélange toute la nuit à température ambiante (23 °C) (Figure 2, étape 5).
7. Installation de la plaque de manutention de liquides
REMARQUE : Effectuez ces étapes le jour 2.
- Compiler les matériaux nécessaires à l’analyse, y compris les anticorps dialysés, le fichier d’entrée du manipulateur de liquide contenant les concentrations post-dialyse, les nanoparticules d’or conjuguées, les embouts de manipulation robotique, les plaques et les réservoirs (Figure 3, Automatisation du laboratoire, étape 1). Préchargez les pointes, échantillons, plaques et réservoirs sur le tablier selon la disposition présentée à la Figure 3 (Automatisation du laboratoire, étape 1).
- Ajoutez les contrôles aux puits A12–D12 de la plaque d’échantillonnage (deux contrôles positifs et deux contrôles négatifs). Laissez le puits H12 vide pour l’échantillon tampon préparé par le manipulateur de liquides.
- Ouvrez la méthode du manutention de liquides CS-SINS et lancez le programme (Figure 3, Automatisation du laboratoire, étapes 2–3). Chargez le fichier d’entrée du manipulateur de liquides lorsqu’il est demandé et entrez le nombre d’échantillons (Figure 4A). Examinez les deux fenêtres suivantes de vérification de calcul (Figure 4B, C), confirmez les valeurs, puis poursuivez l’exécution.
- Normaliser les échantillons, y compris les témoins, à 55,5 μg/mL dans un tampon d’histidine de 10 mM, pH 6,0, en les transférant des tubes de matrice vers la plaque de réaction en chaîne de polymérases dans un volume final de 100 μL (Figure 4D, étape 1). Surveillez l’avancement, en notant que les zones de plaques complétées apparaissent grises et que les étapes actives sont mises en évidence en vert (Figure 4E).
- Préparez une dilution de plus grand volume de chaque échantillon à 11,1 μg/mL dans un tampon d’histidine de 10 mM, pH 6,0, en transférant du matériau de la plaque de réaction en chaîne polymérase vers un bloc de puits profond à un volume final de 200 μL (Figure 4D, étape 2).
- Laissez le système s’arrêter après l’étape 2. Lorsque vous le demandez, mélangez les nanoparticules d’or concentrées préparées à l’étape 6.3 en inversant le tube et en pipettant vers le haut et vers le bas environ 10 fois.
- Répartir les nanoparticules uniformément entre deux tubes microcentrifuges en polypropylène et placer les tubes, bouchons ouverts, à l’emplacement désigné pour le support à tubes sur le pont (Figure 4D, surlignée « AuNP »). Reprenez la course et laissez le manipulateur de liquides distribuer 20 μL de nanoparticules dans chaque puits du second bloc profond, deux puits à la fois (Figure 4D, étape 3).
- Laissez le manipulateur de liquide transférer 192 μL d’échantillon du bloc de puits profond contenant les échantillons de 11,1 μg/mL (Figure 4D, étape 2) vers le second bloc de puits profond et mélanger soigneusement. Générez un mastermix CS-SINS de 4× pour chaque échantillon, ce qui donne une concentration finale de 10 μg/mL après l’ajout de 48 μL de nanoparticules d’or pour un volume final de 240 μL (Figure 4D, étape 3). Commencez à ce stade le minuteur d’incubation de 4 heures.
- Laissez le manipulateur de liquide délivrer 30 μL dans le puits source, puis distribuer 60 μL dans trois des quatre puits de chaque quadrant d’une plaque à 384 puits pour générer des triplicates techniques pour chaque échantillon (Figure 4D, étape 4). Retournez les 30 μL restants sur la plaque source.
- Surveillez la disposition du pont des manutentionnaires de liquides au fur et à mesure de la progression. Observez en temps réel les extrémités utilisées et les puits d’échantillons remplis passant du gris clair au gris foncé, tandis que les mouvements actifs sont indiqués en vert (Figure 4E).
- Retirez la plaque après la fin de la course. Scellez la plaque avec un joint transparent minimalement adhésif et incubez à température ambiante pendant un total de 4 heures. Au point de 3,5 heures, commencez le programme de diffusion dynamique de la lumière pour équilibrer la chambre à 20 °C en utilisant les réglages présentés dans la Figure Supplémentaire 2.
- Mesurez le spectre d’absorbance de chaque puits de 510 à 570 nm par incréments de 1 nm (30 nm de chaque côté du pic) au point de temps de 4 heures.
- Mesurez immédiatement la plaque à l’aide du lecteur de plaques à diffusion dynamique de la lumière au point de 4,5 h selon les réglages présentés dans la Figure Supplémentaire 2.
REMARQUE : Utilisez un lecteur de plaques haute performance pour les mesures spectrales en raison de la plage dynamique limitée. N’utilisez pas la fonction de lecture rapide.
8. Analyse des données (Figure 5, Schéma de traitement des données)
- Exportez les fichiers bruts depuis la plateforme spectrophotomètre et enregistrez-les dans un dossier de lecteur accessible.
- Accédez au portail web de scripting lié au serveur interne. Entrez les paramètres d’entrée requis de CS-SINS, notamment : (1) longueur d’onde de départ ; (2) Emplacement du répertoire du fichier de résultats bruts ; (3) Ensemble de plaques et identifiants candidats ; (4) Adresses de puits témoins positifs et négatifs pour la normalisation ; (5) désignation de mise en place de la méthode (« Manuel » ou « Manipulateur de liquide ») ; (6) Instruments utilisés pour les mesures de balayage spectrale et de diffusion dynamique de la lumière ; (7) Identifiant de carnet de laboratoire électronique (ELN) ; (8) Date d’acquisition.
- Soumettez les paramètres au portail web et vérifiez que trois fichiers Excel sont générés dans un sous-dossier du répertoire des résultats bruts.
- Calculez les valeurs λmax à l’aide du script d’ajustement des courbes exécuté par le portail web.
- Examinez les deux fichiers de sortie contenant les valeurs répliquées, les résultats normalisés et les graphiques représentatifs pour les mesures de balayage spectrale et de diffusion dynamique de la lumière.
- Utilisez le troisième fichier de sortie, contenant les métadonnées de l’essai et les résultats normalisés, pour créer des résultats de laboratoire en masse dans l’interface utilisateur de la base de données. Définir les attributs de reporting selon les exigences spécifiques au groupe et téléverser les résultats dans la base de données pour permettre un accès à l’échelle de l’entreprise.
Résultats
La Figure 6 montre les résultats, la Figure Supplémentaire 3A montre un exemple de score CS-SINS à partir d’un échantillon représentatif de brut et purifié, la Figure Supplémentaire 3B montre la variabilité du signal du puits au puits selon les jours, la Figure Supplémentaire 4 contient les résultats du processus de validation des plaques, et la Figure Supplémentaire 5 décrit le calcul de normalisation pour les deux lectures CS-SINS.
Il est important de noter que des échantillons ont été prélevés avec des concentrations rapportées d’au moins 55 μg/mL après dialyse dans 10 mM d’histidine, pH 6,0, pour garantir la faisabilité du test, car il s’agit de la concentration minimale du stock (minimum de 6 μg par échantillon) et ont créé de nouveaux identifiants enfants. Au total, il y avait 70 échantillons purifiés et 20 échantillons d’expression brute, chacun représentant des types d’échantillons à différents points de contrôle de développement (purifiés à l’étape d’optimisation du plomb et matériau brut purifié en 1 ou 2 étapes à l’étape d’identification du plomb mis en évidence à la Figure 1A). Le matériau brut a été généré à partir d’un système d’expression mammifère entièrement automatisé, la Protein Expression and Purification Platform (PEPP ; GNF, San Diego, CA, États-Unis). Les témoins provenaient de matériaux commerciaux et avaient été précédemment validés comme ayant des valeurs de viscosité maximale ou minimale, kD-DLS et CS-SINS. Les aliquotes fraîches sont stockées à -80°C, et une nouvelle aliquote est utilisée pour chaque analyse.
Les figures 6A, B montrent les scores spectraux et DLS moyens par type d’échantillon, et les graphiques à barres affichent les barres d’erreur (écart-type) avec des codes couleur correspondants. La normalisation est calculée par le script en divisant la différence entre les valeurs témoins de l’échantillon et négatives (calculé lambda max par décalage spectral ou Z-moyenne, diamètre hydrodynamique en nm) par la différence entre les témoins (Figure supplémentaire 5). La figure 6C présente les scores spectraux par rapport aux scores DLS, illustrant une corrélation claire entre les approches analytiques. Le tableau 1 liste les identifiants, les adresses de puits, le type d’échantillon, les scores spectraux et les scores DLS ainsi que leurs écarts-types à titre de référence. Le seuil pour le risque de stabilité colloïdale (quelle que soit la lecture spectrale ou DLS) pour un IgG monospécifique est supérieur à une valeur normalisée de 0,35 (indiquée par une ligne pointillée verte dans la Figure 6A, B, 6/70 (hors témoins réplicatifs) les échantillons purifiés ont obtenu un score à haut risque, tandis que 64/70 ont obtenu un score faible pour le matériau purifié. Il est important de noter que nous attendons que le seuil soit plus élevé pour les formats multispécifiques. Pour les échantillons d’expression brute, 2 sur 20 ont obtenu un score élevé, tandis que 18 sur 20 ont obtenu un score faible. Parmi les matériaux purifiés testés ici, l’expression brute des lots parentaux d’un sous-ensemble a également été criblée et a donné des résultats similaires (illustrés dans la Figure Supplémentaire 3A), indiquant la nature représentative de l’essai lors de la mise à l’échelle (purification) des protéines candidates à partir de lots indépendants. Malgré la limitation des tailles d’échantillons, il est noté que l’erreur standard peut tendre à la hausse pour les échantillons PEPP bruts que pour les échantillons purifiés. L’avantage de réaliser CS-SINS aux étapes avancées permet de réaliser des évaluations orthogonales avec des tests nécessitant plus de protéines pour l’analyse, comme les mesures de viscosité et de kD-DLS, tandis que l’avantage de réaliser CS-SINS lors de criblages précoces de développement aborde de manière préventive les risques de stabilité colloïdale, pouvant influencer le pool final de candidats principaux (Figure 1B). Les candidats borderline avec une erreur élevée peuvent être confirmés comme à risque élevé ou faible par des tests en amont.
En raison de la faible nature des décalages plasmoniques détectés, une lecture alternative a été décrite pour instaurer confiance dans le test, ce qui élargit la plage dynamique, ce qui pourrait s’avérer particulièrement utile en l’absence d’un lecteur de plaque haut de gamme pour détecter les changements minimes. La lecture DLS distingue entre le regroupement de nanoparticules et la dépendance aux propriétés spectrales des nanoparticules ; cependant, les deux descripteurs ont des plages d’erreur standard similaires et sont faibles par rapport à leurs mesures. Il semble que les échantillons plus sujets aux lectures aberrantes auront une erreur plus élevée (ou seront « multimodaux » et ne rapporteront pas de résultat par DLS), mais les valeurs CS-SINS dans la plage de travail du test présentent de faibles distributions d’erreur. Lorsqu’on compare les valeurs DLS aux valeurs de scores spectraux, la distribution d’erreur est plus serrée pour les résultats DLS prélevés à partir d’échantillons bruts que pour les scores spectraux ; cependant, cela ne faisait une différence que pour un seul candidat qui se situait en dessous du seuil de score DLS mais pas spectral. Cela pourrait s’avérer utile si les laboratoires disposent d’instruments différents.
Pour traiter spécifiquement la fiabilité du traitement des données et de la méthode elle-même, les temps de balayage ont été modifiés d’un bout à l’autre pour les lectures des contrôles positifs et négatifs dans l’ensemble de données ci-dessus, en plus de multiples contrôles moyens et bas servant de points de référence intermédiaires au début et à la fin d’une plaque à 384 puits. La Figure 4 supplémentaire présente les résultats de la validation finale de la plaque, montrant des valeurs généralement insignifiantes entre les échantillons placés au début et la fin de la plaque (Figure supplémentaire 4A,B) et une forte corrélation entre les deux valeurs de lecture (Figure 4C supplémentaire). Enfin, le facteur Z et le pourcentage de CV ont été calculés pour les témoins à partir du balayage spectral et du jeu de données DLS de la Figure 6. À partir des données générées pour les témoins et présentées ici, la lecture spectrale du balayage a été déterminée avoir un facteur Z de 0,648, avec 0,019 % de CV pour le témoin positif et 0,012 % pour le témoin négatif. Pour la lecture DLS, un facteur Z de 0,998 a été calculé, avec 0,025 % de CV pour le témoin positif et 0,021 % pour le témoin négatif. Dans l’ensemble, le coefficient de corrélation de Spearman entre les valeurs de l’échantillon dans ce test (Figure 6C) a été calculé comme étant fortement positif à 0,829. Ces valeurs représentent une précision solide et une reproductibilité pour les deux types de mesures, et sans surprise, la nouvelle stratégie de détection DLS avantageuse optimise le facteur Z, mais le balayage spectral fournit une bande de séparation suffisante pour enregistrer des résultats fiables (Z > 0,5). Il est important de noter que le score DLS est une lecture orthogonale collectée simultanément dans le flux de travail CS-SINS, ne nécessitant aucune préparation supplémentaire de l’échantillon. La plus grande différence de valeurs pour les scores DLS bruts explique un facteur Z amélioré, mais les « scores » sont interprétés de la même manière car ils sont normalisés à partir des valeurs brutes. De plus, les relevés DLS capturent des tailles tridimensionnelles des amas de nanoparticules par rapport aux indications indirectes de proximité issues du décalage plasmonique et des informations spectrales, ce qui pourrait renforcer notre compréhension de la dynamique du test CS-SINS. Compte tenu de la nature basée sur les plaques et critique en temps d’un test HTP, nous avons cherché à augmenter la fiabilité du test avec ces méthodes.
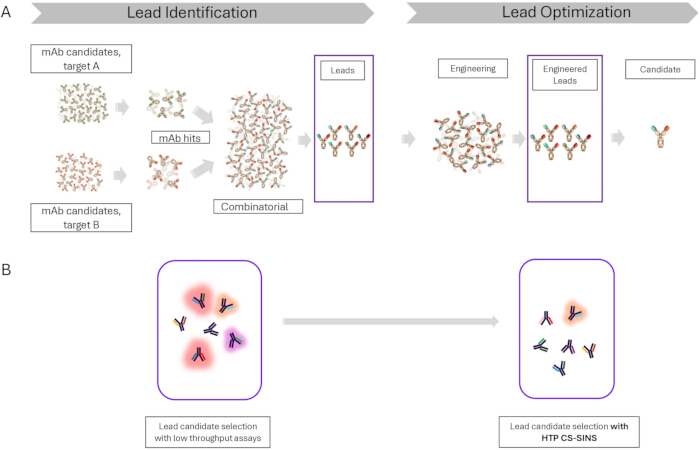
Figure 1 : Paradigme de développement et collecte de données CS-SINS. (A) Le flux de travail typique, allant d’une campagne de découverte à la sélection des candidats, est représenté pour les anticorps multispécifiques dans ce schéma. Le processus de découverte aboutit à des candidats monospécifiques à filtrer, suivis d’une sélection de divers paquets de données afin de cibler les monospécifiques d’intérêt avant de les combiner en formats multispécifiques. Les paquets de données sont répétés ou développés pour cibler les candidats principaux jusqu’à ce que le meilleur candidat soit choisi pour le développement. Des tests à faible débit sont réalisés dans le flux de travail actuel lorsqu’un petit panel de molécules est sélectionné (boîtes violettes). Les HTP CS-SINS peuvent être réalisés à chaque étape du parcours, ajoutant des données précieuses et améliorant le processus de sélection. (B) Le résultat hypothétique des propriétés colloïdales des 6 principaux candidats est montré pour 2 voies possibles : sélection des candidats principaux avec des essais à faible rendement, et sélection des candidats principaux avec HTP CS-SINS. Les candidats présentant un comportement défavorable de solution sont représentés par une lueur lumineuse. Dans le premier scénario, la moitié des candidats principaux selon les caractéristiques de liaison optimales issues des écrans de découverte présentent un comportement de concentration faible et médiocre. Dans le second scénario, un seul candidat avec une stabilité colloïdale modérément faible est inclus, car les données CS-SINS ont été considérées en parallèle avec les données de liaison dans les premiers écrans de découverte. Dans le second scénario, la diversité des candidats potentiellement viables est plus élevée que dans le premier scénario. Veuillez cliquer ici pour voir une version agrandie de cette figurine.
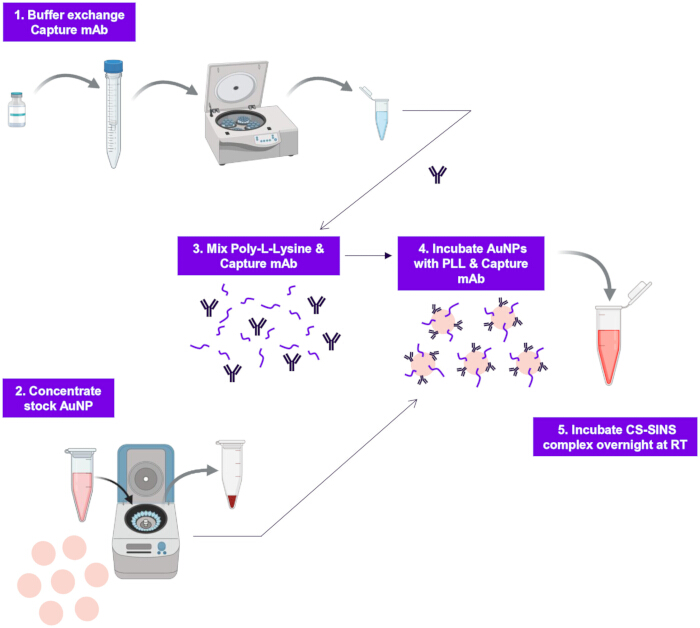
Figure 2 : Flux de travail du test SINS. Préparation et conjugaison des nanoparticules d’or : (1) Le mAb capturé est échangé par tampon en acétate de potassium de 20 mM, pH 4,3, puis dilué à 0,8 mg/mL. (2) Les nanoparticules d’or sont concentrées à partir de la crosse. (3) La poly-l-lysine est mélangée avec la capture mAb inversée par tampon échangée. (4) Les nanoparticules d’or sont incubées avec la poly-l-lysine et capturent le mAb, puis mélangées en profondeur. (5) Incubation du complexe CS-SINS pendant la nuit à température ambiante. Veuillez cliquer ici pour voir une version agrandie de cette figurine.
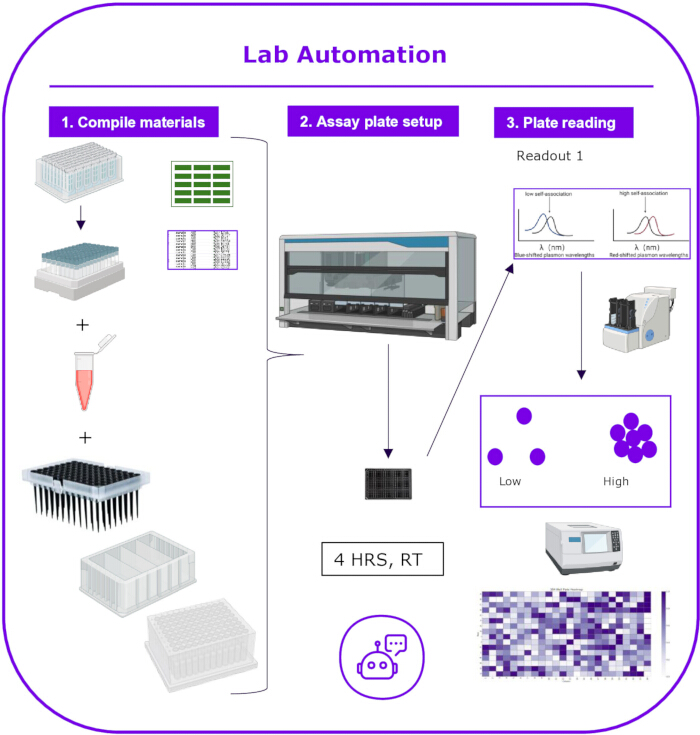
Figure 3 : Flux de travail d’automatisation en laboratoire. Workflow d’automatisation en laboratoire : (1) Les matériaux et échantillons sont compilés pour la méthode du manipulateur de liquides. Des échantillons dialysés dans de 10 mM d’histidine, pH 6, sont collectés dans des tubes matriciels ou des plaques à 96 puits. Les concentrations d’échantillons sont formatées dans un fichier d’entrée de manipulateur de liquides. Des nanoparticules d’or complexes CS-SINS conjuguées pour capturer le mAb, des embouts robotisés de manipulation de liquides et des objets plastiques sont collectés en préparation de l’installation du test de manipulation de liquides. (2) La plaque d’essai est préparée sur le manipulateur de liquide et incubée pendant 4 h à température ambiante. 3) À la marque des 4 heures, des scans spectraux (affichage 1) sont collectés dans des puits d’échantillonnage couvrant 25 minutes ; Après la marque des 4,5 h, la diffusion dynamique de la lumière (affichage 2) recueille des informations sur la taille de chaque population de puits plus uniforme. Veuillez cliquer ici pour voir une version agrandie de cette figurine.
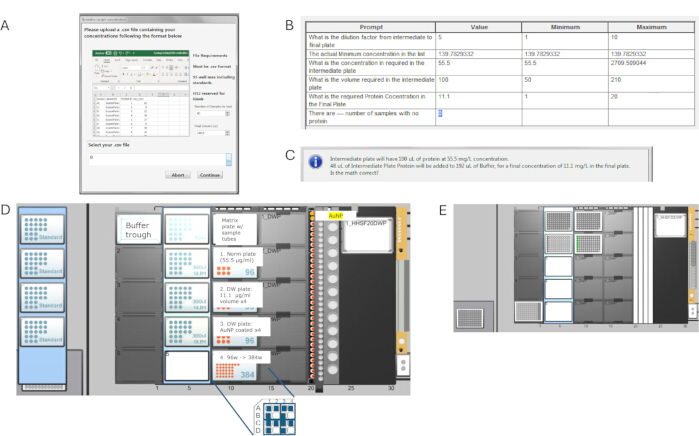
Figure 4 : Programme de manipulation de liquides et configuration de la plaque. (A) Au démarrage du programme et après l’initialisation du système, une fenêtre/invite séparée s’ouvre pour sélectionner le fichier d’entrée avec les adresses de puits désignées et les concentrations d’échantillons. Le nombre d’échantillons doit être spécifié à chaque fois, mais le volume de 200 μL (le volume final des réactifs mélangés avant l’emboutage de la plaque à 384 puits) reste le même. (B) Après avoir cliqué sur continuer depuis la fenêtre précédente dans (A), cette seconde fenêtre apparaîtra pour confirmer les interprétations du fichier d’entrée à gauche et des valeurs à droite. (C) Après confirmation des interprétations de (B), cette troisième fenêtre apparaît avec une boîte de dialogue vérifiant à nouveau les calculs de la concentration de l’échantillon pour la normalisation (le volume de 100 μL) vers la plaque finale de puits profond (le volume de 200 μL). (D) Cette disposition provient de la vue Method Editor du module logiciel de traitement de liquides. À gauche, des embouts standards de 300 μL sont chargés, et au centre de la scène, 1 boîte de 50 μL et 3 boîtes de pointes fines de 300 μL sont chargées, compatibles avec la robotique de manipulation de liquides. Un tampon est chargé à l’avant avec 10 mM d’Histidine, pH 6 (le tampon dans lequel les échantillons ont été dialysés). Les nanoparticules d’or sont réparties uniformément en 2 tubes microcentrifuges et chargées, sans bouchon, à l’arrière du rack de tubes à droite. La plaque matricielle avec les tubes d’échantillonnage est chargée à l’arrière du support dans la colonne 10. Après les échantillons, la plaque de normalisation (1), la plaque de puits profond avec un échantillon de 11,1 μg/mL (2), la plaque de puits de 200 μL de l’échantillon combiné et des nanoparticules (3), et la plaque formatée à 384 puits (4) sont indiquées. (E) La disposition du pont du manutention de liquides montre la récupération des pointes et la distribution des échantillons en temps réel, et marque les puits à chaque étape. Ici, tous les échantillons (image à 96 puits à l’arrière du support dans la3e colonne) sont grisés ainsi que la plaque de normalisation qui en résulte, ce qui indique que des échantillons ont été ajoutés à la plaque de normalisation à partir des plaques matricielles sources. En vert, nous montrons la tête à 8 canaux après avoir aspiré le tampon de la basse et l’avoir distribué dans la première colonne de la plaque de normalisation pendant le mélange. Veuillez cliquer ici pour voir une version agrandie de cette figurine.
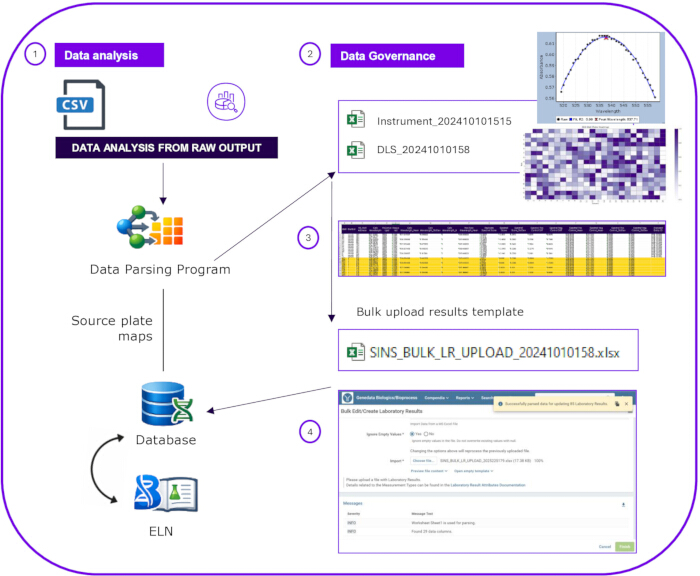
Figure 5 : Schéma de traitement des données. Le schéma de traitement des données : (1) Les fichiers bruts sont soumis à un serveur interne. (2) Les fichiers de données sont lus et traités par un script personnalisé pour affiner l’ajustement des courbes des balayages spectraux, calculer le lambda max pour les réplications CS-SINS, et vérifier les populations multimodales par DLS. (3) Les données sont regroupées par répliqués, puis ensuite moyennées et normalisées selon des contrôles spécifiés ; Les cartes correspondantes du portail de la base de données sont regroupées pour lier les résultats. (4) Toutes les données sont organisées dans un modèle prêt à être téléchargé dans la base de données, et des graphiques sont créés automatiquement pour le reporting ELN. Veuillez cliquer ici pour voir une version agrandie de cette figurine.
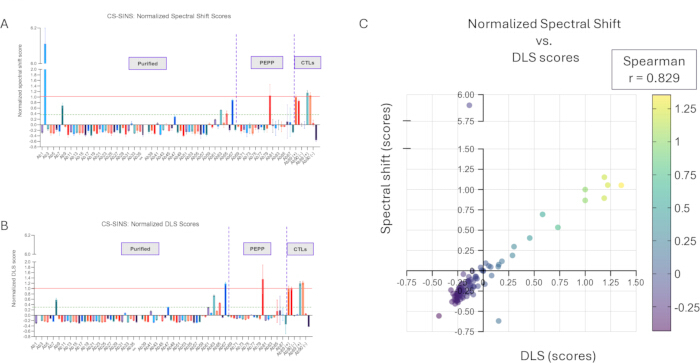
Figure 6 : Données représentatives des lectures 1 et 2. (A) Les scores de décalage spectral normalisés ont été tracés par l’ID PPB pour des échantillons purifiés, à expression brute, et les échantillons témoins où indiqués, séparés par une ligne pointillée verticale, dans un graphique à barres afin de déterminer la répartition des barres d’erreur entre types d’échantillons. La ligne rouge continue indique la limite supérieure du test, qui correspond au témoin positif, tandis que la ligne pointillée verte marque la valeur de coupure pour un profil moléculaire à faible risque pour le CS-SINS. (B) Les scores DLS normalisés ont été tracés par l’ID PPB pour les échantillons d’expression brute purifiés et les échantillons témoins, lorsque indiqués et séparés par une ligne pointillée, dans un graphique à barres afin de déterminer la répartition des barres d’erreur entre types d’échantillons. Certaines valeurs manquent (comme la2e valeur en bleu clair avec un score supérieur à la moyenne en (A)) dû à des scans multimodaux issus de la sortie DLS, que le portail web du logiciel de script a jugée invalide. La ligne rouge continue indique la limite supérieure du test, qui correspond au témoin positif, tandis que la ligne pointillée verte marque la valeur de coupure pour un profil moléculaire à faible risque pour le CS-SINS. (C) Les scores moyens et normalisés pour les valeurs de décalage spectral et DLS ont été comparés par un diagramme de points de corrélation, comme montré (les scores de décalage spectral correspondent à l’axe Y et les scores DLS correspondent à l’axe X). Le code couleur est coordonné uniquement avec les scores DLS. Veuillez cliquer ici pour voir une version agrandie de cette figurine.
Tableau 1. Les scores de stabilité colloïdale des échantillons d’anticorps sont déterminés par CS-SINS. Le tableau résume les identifiants d’échantillons, les adresses de puits, les classifications d’échantillons, les scores spectraux normalisés et les scores de diffusion dynamique de la lumière (DLS) obtenus à partir du test CS-SINS. Veuillez cliquer ici pour télécharger ce tableau.
Figure supplémentaire 1 : PLL a amélioré la stabilité de l’AuNP dans le tampon de 10 mM de His, pH 6, pour les CS-SINS. Cette figure illustre la superposition étroite du mAb de contrôle négatif lié au complexe CS-SINS recouvert de PLL et au contrôle uniquement en tampon, en contraste avec les nanoparticules d’or non recouvertes avec le seul mAb ou tampon de contrôle négatif, qui ont des pics dans des plages totalement différentes. Sont montrés en bleu les scans spectraux incrémentaux (effectués par incréments de 1 nm au point temporel de 4 heures) pour l’AuNP conjugué incubé avec 10 mM Son tampon recouvert de billes conjuguées incubées avec le témoin négatif (PPB-117487) en l’absence d’une pré-incubation de poly-l-lysine. Affichés en rouge sont les scans spectraux incrémentaux (réalisés par incréments de 1 nm au point temporel de 4 heures) pour l’AuNP conjugué incubé avec 10 mM. Son tampon recouvert de billes conjuguées incubées avec le témoin négatif (PPB-117487) après pré-incubation de poly-l-lysine. Le lambda max calculé pour les deux contrôles négatifs en présence de PLL est très proche. Veuillez cliquer ici pour télécharger ce fichier.
Figure 2 complémentaire : Réglages pour le DLS et la sélection de la plaque de puits pour le lecteur de plaques DLS. Veuillez cliquer ici pour télécharger ce fichier.
Figure complémentaire 3 : Scores CS-SINS issus des ABS exprimés en PEPP vs. purifiés en aval. (A) Les scores de décalage spectral normalisés ont été tracés par puits et par ID de plaque pour les échantillons PEPP (par exemple, A1PL1 = puits A1 à partir de la plaque 1) exprimant Ab64 et séparés par une ligne pointillée verticale du décalage spectral normalisé ou des scores DLS provenant de l’Ab64 purifié en aval, dans un graphique à barres afin de déterminer la répartition des barres d’erreur (écart-type) entre les types d’échantillons. La ligne pointillée verte marque la valeur de coupure pour un profil moléculaire à faible risque pour les CS-SINS. (B) L’AUC total et la répartition sur la plaque pour tous les échantillons des expériences réalisées dans (A) sont tracés ici (codés par couleur pour les expériences correspondantes). Veuillez cliquer ici pour télécharger ce fichier.
Figure 4 complémentaire : Validation de plaques de contrôle de bout en bout à 384 puits. (A) Les scores spectraux moyens et normalisés pour les échantillons des colonnes initiales de la plaque de 384 puits sont tracés et affichés en rouge, tandis que les valeurs dupliquées numérisées à la fin de la plaque de 384 puits sont affichées en vert chaux. Les valeurs de réplication sont côte à côte, allant du contrôle positif (indiqué par un signe plus à côté de l’ID PPB) au contrôle négatif (indiqué par un signe moins à côté de l’ID PPB). La valeur du contrôle tampon préparée par le programme de traitement de liquide (indépendante de l’invite d’entrée de l’échantillon) est affichée selon un motif à damier. (B) Les scores DLS moyens et normalisés pour les échantillons des premières colonnes de la plaque à 384 puits sont tracés et affichés en rouge, tandis que les valeurs dupliquées numérisées à la fin de la plaque à 384 puits sont indiquées en vert citron vert. Les valeurs de réplication sont côte à côte, allant du contrôle positif (indiqué par un signe plus à côté de l’ID PPB) au contrôle négatif (indiqué par un signe moins à côté de l’ID PPB). Il n’y a pas de valeur de contrôle de tampon pour la lecture DLS (en raison des lectures multimodales). (C) Les scores spectraux moyens et normalisés sont tracés par rapport aux scores DLS dans un diagramme de points de corrélation pour des échantillons allant des relevés dans les premières colonnes de la plaque à 384 puits jusqu’à la fin de la plaque à 384 puits. Le codage couleur des points correspond directement aux scores spectraux moyens et normalisés. Comme il n’y a pas de valeur de contrôle de tampon pour la lecture DLS (en raison des lectures multimodales), seuls les 6 contrôles en duplique sont comparés à partir des deux lectures dans ce graphique. Veuillez cliquer ici pour télécharger ce fichier.
Figure complémentaire 5 : Les calculs pour la normalisation des scores spectraux ou scores DLS afin de permettre un reporting et un référencement universels entre utilisateurs et jours. Les valeurs de contrôle positives sont fixées à 1, tandis que les témoins négatifs sont fixées à 0, et les scores élevés sont associés à un mauvais comportement colloïdal. Veuillez cliquer ici pour télécharger ce fichier.
Discussion
Ce protocole représente plusieurs modifications clés par rapport à la méthodeCS-SINS originale 16. Il est important de noter que le rapport PLL :IgG optimisé et le tampon d’histidine ont été maintenus à partir de l’étudeinitiale 16. Notamment, le test a été adapté à la plateforme robotique de manipulation de liquides afin de permettre le traitement HTP (jusqu’à 352 échantillons en 1 jour contre ~20), réduisant ainsi le temps d’intervention manuelle et améliorant la reproductibilité grâce à la manipulation automatisée des liquides. Le système robotique est compatible avec les formats à plaque, y compris l’estampage dans de nouveaux formats comme la plaque à 384 puits, ainsi que divers types de laboratoires. Les programmes peuvent s’exécuter indépendamment, et le flux de travail de bout en bout offre une lecture à grand volume avec une reproductibilité accrue dans un contexte limitant les échantillons. Les mesures DLS ont également été intégrées comme une lecture orthogonale du décalage spectral avec un facteur Z plus optimal que les interprétations du décalage spectral (0,998 contre 0,648), ce qui s’avère particulièrement précieux pour des échantillons avec des scores spectraux limites ou des écarts-types élevés, et décrit l’interprétation du décalage plasmonique pour améliorer la plage dynamique apparente uniquement à partir de la sortie du lecteur de plaques. Il est suggéré que les laboratoires disposant de lecteurs de plaques multimodes haut de gamme pourraient utiliser DLS pour effectuer de manière fiable des CS-SINS. Pour traiter la variabilité potentielle dépendante du temps sur une plaque à 384 puits, une validation approfondie de la plaque a été réalisée (Figure supplémentaire 4) en plaçant des contrôles au début et à la fin de la plaque, confirmant ainsi des effets minimaux sur le temps de balayage. De plus, il a été démontré que les échantillons bruts de PEPP donnent des résultats comparables à ceux du matériau purifié (Figure 6, Figure supplémentaire 3A), élargissant l’applicabilité de la méthode aux étapes de découverte antérieures où la protéine purifiée n’est pas disponible, ce qui n’avait pas été rapporté auparavant. Les données de la Figure Supplémentaire 3 indiquent la fiabilité des échantillons entre sources, mais indiquent aussi une variabilité minimale des essais d’un jour à l’autre, puisque les données ont été collectées et normalisées à partir de différents ensembles de données. Plus précisément, la Figure Supplémentaire 3B représente la surface totale sous la courbe pour tous les puits provenant des plaques expérimentales respectives (codées par couleur pour correspondre à la plaque de la même expérience dans la Figure Supplémentaire 3A) afin de démontrer la variabilité attendue, mais minimale, au sein d’une même expérience et selon des jours avec des préparations de billes distinctes. Au stade précoce de la découverte, des méthodes telles que kD-DLS et les approches basées sur des colonnes (SMAC, CIC) ne sont pas réalisables en raison de besoins accrus en consommation d’échantillons et de l’incapacité à traiter les matièresbrutes 12,13,24,25,26,27 ; CS-SINS permet de manière unique un dépistage de stabilité colloïdale à ce stade avec seulement 6 μg par échantillon, qui peut être purifié en une seule étape. Enfin, le script d’ajustement des courbes a été mis à jour pour permettre l’ajustement fin des décalages lambda max mineurs et pour permettre une meilleure gestion des fichiers et un automatisation des rapports de données vers les bases de données internes.
Les scénarios courants de dépannage incluent : (1) des écarts-types élevés dans les scores spectraux ou DLS, souvent indiquant un mélange incomplet des nanoparticules (étape 7.6) ou une agrégation d’échantillons – dans de tels cas, il est recommandé de réaliser une vérification QC par rapport aux échantillons dialysés par DLS afin d’assurer l’intégrité après la dialyse et de revenir par défaut à des scores spectraux comme lecture standard ; (2) distributions DLS multimodales ou défaillances de lectures DLS, généralement causées par une agrégation d’échantillons préexistante ou une contamination par la poussière – une filtration via des filtres à 0,22 μm avant la dialyse peut atténuer cela ; (3) des divergences entre les scores spectrales et DLS, généralement attribuables à des mesures DLS biaisées (probablement dues à une haute polydispersion, qui apparaîtrait dans la plage normale-élevée selon le score spectral) ; (4) valeurs de contrôle positives incohérentes, généralement résultant d’un stockage inapproprié des nanoparticules ou d’une dégradation de la capture de mAb ; Des aliquotes fraîches stockées à -80 °C doivent être utilisées pour chaque test (pas conservées à 4 °C plus de quelques jours).
Parmi les limites du test figurent la nécessité de disposer de temps pour dialyser les échantillons en profondeur et préparer les nanoparticules conjuguées semi-manuellement la veille du test ; cependant, le temps de dialyse est équivalent quel que soit la taille de l’ensemble d’échantillon. En ce qui concerne les risques de bouchon des embouts, les embouts de manipulation des liquides surveillent les variations de pression lors de l’aspiration, et des erreurs pertinentes apparaissent pendant le fonctionnement. Pendant la phase de développement de la méthode, nous avons vérifié les fichiers journaux (et continuons après le service) pour nous assurer que les volumes attendus sont calculés par le script. Les fonctions d’aliquotation ont été testées pour la préparation concentrée des billes et ne prévoient pas de problèmes. Nous reconnaissons la nature temporelle du test, la nature dominée par Fab de l’évaluation, et son rôle de test substitut sans mesurer directement les comportements colloïdaux tels que la viscosité et l’opalescence. Cependant, cette adaptation permet une caractérisation efficace de jeux de données plus vastes plus tôt dans le processus de découverte de médicaments, servant d’outil de dépistage puissant là où il n’y en avait pas auparavant.
Plusieurs étapes critiques de ce protocole nécessitent une attention particulière pour garantir des résultats reproductibles. Premièrement, un ajustement précis du pH lors de la préparation du tampon (étapes 1.1.1 et 1.2.1) est essentiel, car des écarts au-delà de ±0,1 unités de pH peuvent affecter la stabilité des nanoparticules et l’efficacité de la capture des anticorps. Le tampon à faible pH utilisé pour la préparation des anticorps de capture assure une conjugaison optimale, et les conditions tampon spécifiées étaient optimisées pour la stabilisation de la charge et une large compatibilité des anticorps (généralement dans un contexte de formulation). Le tampon d’histidine de 10 mM pH 6,0 assure des interactions électrostatiques optimales tout en maintenant la stabilité des protéines. Deuxièmement, une dialyse approfondie avec élimination complète du sel (étape 2.3) est cruciale ; une dialyse incomplète peut interférer avec les interactions électrostatiques lors de l’assemblage des nanoparticules. Troisièmement, l’étape de concentration des nanoparticules d’or (étapes du protocole 5.1–5.3) doit être effectuée avec soin pour éviter de perturber la pellete, car des concentrations incohérentes des nanoparticules impactent directement la sensibilité du test. Quatrièmement, le ratio PLL :capture mAb de 0,03 (étape 4.1) est optimisé pour une couverture de surface maximale tout en maintenant une fenêtre de décalage plasmonique suffisante, comme établiprécédemment 16. En ce qui concerne la dynamique de manipulation des liquides, des pointes de détection de liquides ont été utilisées pour effectuer des normalisations et le mélange des plaques jusqu’à l’introduction de nanoparticules d’or, qui ne sont pas mesurées de manière fiable en solution (et ont donc réglé les volumes de distribution à des quantités standard). La détection liquide en amont permet de signaler par l’opérateur des problèmes de désalignement de plaques ou d’échantillons manquants, tandis que l’étape de mise en marche de 384 puits permet d’identifier les problèmes d’alignement Z. Enfin, le respect strict du timing d’incubation de 4 heures (étapes du protocole 7.10–7.12) et la lecture cohérente de la plaque du début à la fin (indépendamment d’une plaque incomplète) sont essentiels, car le décalage plasmonique et le regroupement de nanoparticules sont des phénomènes dépendants du temps ; des retards ou des lectures précoces peuvent entraîner des scores CS-SINS inexacts, tandis que la lecture complète de la planche garantit la cohérence des scores sur plusieurs jours dans le format HTP.
À mesure que la stabilité colloïdale des anticorps multispécifiques est de plus en plus étudiée, les grands ensembles de données fournis par les tests biophysiques HTP comme CS-SINS ont le potentiel d’alimenter des modèles IA/ML permettant de mieux comprendre les effets combinatoires sur la stabilité moléculaire. Des études ont montré qu’à mesure que la diversité des séquences augmente, le besoin de jeux de données plus vastes s’accrut pour améliorer la précision des résultats IA/ML 41,42,43. Les propriétés et descripteurs moléculaires des monospécifiques peuvent changer lorsqu’ils sont reformatés en bispécifiques ou trispécifiques, en tenant compte de la distribution et de l’équilibre de charge moléculaire globale plutôt que de considérations spécifiques à la séquence ou au motif pour des attributs tels que les responsabilités de dégradationchimique 17,18,19,20,21,22 . Notamment, des caractéristiques structurelles telles que les taches électrostatiques prédites, l’hydrophobie et la surface accessible par solvant peuvent améliorer les prédictions d’agrégation et de stabilité indépendamment des caractéristiques spécifiques à la séquence, rendant plusieurs ensembles de données plus petits compatibles avec la préparationdes prédictions 17,18,19,20,21,22 . La simplicité du score CS-SINS en référence à la culmination représentative du profil biophysique d’une molécule rend le test adapté à l’entraînement des modèles IA/ML.
Déclarations de divulgation
Les auteurs déclarent qu’ils n’ont aucun conflit d’intérêts ni intérêts financiers concurrents.
Remerciements
Nous tenons à remercier les équipes et individus suivants pour leurs contributions et discussions réfléchies : Jonathan Kingsbury, responsable du groupe CMC Developability and Preformulation Science pour son expertise ; Peter Tessier, professeur de sciences pharmaceutiques et de génie chimique à l’Université du Michigan pour sa collaboration au développement de la méthode CS-SINS, d’autres membres au sein ou affiliés aux divisions LMR tout au long de l’évolution de ce projet (notamment Samantha Schultz, Xiaohua Liu, Megan Salemi, Tina Matin, Julie Jaworski, Sanjana Mandala, Kalie Mix, Maciej Majewski, Jinrong Ma, May Cindhuchao, David Reczek, Tristan Magnay, Drew Lynch, Ailin Wang, Dietmar Hoffmann, Eva Bric-Furlong, Karen Wong, Leighton Marcovici, Christian Lange, Christa Pescher, Ben Mittelstaedt et Melanie Fischer) ainsi que l’équipe de préparation tampon employée par Thermo Fisher Scientific (notamment Archer Killingsworth et Elisa Ferrara).
Matériaux
| Nom | Entreprise | Numéro de catalogue | Commentaires |
|---|---|---|---|
| CLEARSEAL FILM 100PKCLEARSEAL | Fisher Scientific | 500214 | |
| CO-RE II (50 μL Conductive Tips, 300 μL Conductive Tips, 300 µL Slim Conductive Tips) | Hamilton Company | 235966, 235902, 235806 | |
| Eppendorf Tubes Snap Cap (5.0 mL, Microtube) | Eppendorf | 30119401 | |
| Falcon Conical Centrifuge Tubes (15 mL) | Thermo Fisher Scientific | Falcon 352196 | |
| Goat antihuman Fcγ-specific antibody | Jackson ImmunoResearch Laboratories | 109-005-008 | |
| Gold nanoparticles (20 nm) | Ted Pella Inc. | 157051 | |
| Greiner Bio-One 384-well μClear Bottom Polystyrene Microplates – (SS & DLS assay plates) | Fisher Scientific | 07-000-057 | |
| Greiner Bio-One MASTERBLOCK 96 Deep Well Conical Bottom 2 mL Storage Plate – (mastermix and reagent mixing plates) | Fisher Scientific | 07-000-122 | |
| Hard-Shell PCR Plates normalization (96-Well, low profile, thin wall, skirted, white/clear HSP9601) | Bio-Rad | HSP9601 | URL: https://www.bio-rad.com/en-us/sku/HSP9601-hard-shell-96-well-pcr-plates-low-profile-thin-wall-skirted-white-clear?ID=HSP9601 |
| Histidine hydrochloride buffer sample (10 mM, pH = 6.0, sample and assay buffer) | Sigma | H8125; H6034 | Préparez une concentration finale de 5 mM par réactif dans de l'eau ultra-pure, ajustez le pH à 6,0, ajustez le volume final avec de l'eau ultra-pure et filtrez avec un filtre de 0,22 µm |
| Matrix ScrewTop Tubes sample (500 μL) | Thermo Fisher Scientific | 3744 | |
| MD100 or MD300 Xpress Mini Dialyzer (Xpress Micro Dialyzer, Scienova, 6-8 kDa, 96 pcs. in deep well plate (12 cartridges), sealing sheet) and dialysis reservoir/box (low volume dialysis cassettes) | Vivaproducts, Inc. | 40789, 40076 | |
| Microcentrifuge tubes pure polypropylene (1.5 mL) | USA Scientific | 1615-5500 | |
| Nalgene Disposable Polypropylene Robotic Reservoirs – (buffer trough) | Thermo Fisher Scientific | 1200-2300 | |
| Nalgene Rapid-Flow Sterile Disposable Filter Units with PES Membranes | Thermo Fisher Scientific | 567-0020 | |
| Poly-L-lysine, >70,000 MW | MP Biomedicals | 219454405 | Préparez une solution mère de 5 mg/mL dans de l'eau ultra-pure |
| Positive and negative Controls (1 mg/mL dialyzed into 10 mM Histidine, pH 6) | Internally-produced commercial antibodies | N/A | Décalage spectral d'environ 2 nm et taille DLS de 250 à 300 nm pour le contrôle positif; décalage spectral négligeable et taille DLS comparable au contrôle de tampon seulement |
| Potassium acetate buffer capture (20 mM, pH = 4.3, mAb conjugation buffer) | Fisher Scientific | P171-500 | Préparez une concentration finale de 10 mM de réactif dans de l'eau ultra-pure, ajustez le pH à 4,3 avec de l'acide acétique, ajustez le volume final avec de l'eau ultra-pure et filtrez avec un filtre de 0,22 µm |
| Zeba desalting columns (2 mL, 5 mL, or 10 mL) | Thermo Fisher Scientific | PI-89889; 89891; 89893 |
Réimpressions et autorisations
Étiquettes
BiochimieNuméro 232Numéro 232Valeur videNuméroautomatisation de laboratoireManipulateur de liquides automatisérobotique de laboratoireCriblage à haut débit (HTS)produits biologiquesprofilage de la développabilitéstabilité colloïdalecaractérisation biophysiquePropension à l'agrégationDiffusion dynamique de la lumière (DLS)modélisation IA/ML
Cet article a été publié
Vidéo bientôt disponible