Ce protocole de recherche décrit un flux de travail optimisé pour le séquençage métagénomique de nouvelle génération (mNGS) du liquide céphalorachidien. En relevant les défis propres aux échantillons à faible biomasse, la méthode permet une détection robuste des agents pathogènes dans divers contextes de ressources, offrant une base polyvalente pour les applications de recherche sur les maladies neuro-infectieuses.
Un abonnement JoVE est requis pour visualiser ce contenu. Connectez-vous ou commencez votre période d'essai gratuite.
Article de méthode
Séquençage métagénomique de nouvelle génération du liquide céphalorachidien pour la détection des agents pathogènes du système nerveux central
Dans cet article
Résumé
Résumé
Le séquençage de nouvelle génération métagénomique (mNGS) s’est imposé comme un outil puissant pour la détection impartiale des agents pathogènes et le profilage transcriptionnel de l’hôte en milieu clinique et de recherche. Bien que son utilité pour diagnostiquer les infections du système nerveux central (SNC) soit de plus en plus reconnue, les échantillons de liquide céphalo-rachidien (LCR) posent des défis uniques en raison d’une faible abondance d’acides nucléiques et d’une faible susceptibilité à la dégradation. Cette étude présente un protocole optimisé basé sur la recherche pour les plateformes de séquençage Illumina, adapté au mNGS du LCR, couvrant la manipulation des échantillons, l’extraction d’acides nucléiques, la préparation de bibliothèques, le séquençage et l’analyse bioinformatique. Des approches de contrôle qualité, adaptables à des environnements à haute ou faible ressources, sont également proposées, y compris des alternatives à l’électrophorèse capillaire. Cette étude démontre la robustesse du protocole à travers deux cohortes représentatives : un flux de travail à haute profondeur basé sur NovaSeq et un flux de travail basé sur NextSeq soucieux des coûts. Dans ces cohortes, des agents pathogènes ont été détectés dans plus de 50 % des cas, soulignant le potentiel diagnostique de la méthode même avec des adaptations limitées en ressources. Ce protocole facilite la reproduction du mNGS du LCR, fournissant une base pour diverses applications dans la recherche et le diagnostic des maladies neuro-infectieuses.
Introduction
Le séquençage métagénomique de nouvelle génération (mNGS) est une technique moléculaire de plus en plus utilisée qui permet la détection d’un large spectre d’acides nucléiques au sein d’un échantillon environnemental ou hôtedonné 1. En amplifiant et en séquençant la grande majorité du matériel génétique d’un échantillon, le mNGS ne nécessite pas d’hypothèse préconçue sur les micro-organismes spécifiques qui pourraient être présents. La mNGS s’est révélée utile comme outil diagnostique dans divers contextes cliniques, tels que la détection d’agents pathogènes rares ou de manifestations atypiques de maladies infectieuses 1,2,3. De plus, le profil transcriptionnel de l’hôte est également capturé par les données de séquençage de l’ARN générées par le test mNGS, permettant aux chercheurs de mieux comprendre la réponse immunitaire de l’hôte à divers étatspathologiques 4. L’applicabilité de la mNGS à un large éventail de contextes cliniques et de recherche, ainsi que la baisse spectaculaire du coût du séquençage générique ces dernières décennies, a conduit à une croissance considérable de l’utilisation de cettetechnologie 5.
En particulier, le mNGS a montré des promesses dans la détection des infections du système nerveux central (SNC), qui restent difficiles àdiagnostiquer 2,6,7. Avant l’avènement des tests cliniques de mNGS, le California Encephalitis Project a examiné les causes de l’encéphalite à travers l’État et a constaté que plus de la moitié des cas restaient non diagnostiqués, malgré l’utilisation d’un panel élargi de tests moléculaires et d’une évaluation cliniquedétaillée 8. Aujourd’hui, plus de vingt ans plus tard, un test mNGS du liquide cérébro-rachidien (LCR) validé cliniquement a détecté la présence d’organismes pathogènes dans le LCR chez près de 15 % des patients suspectés d’infections au SNC sur une période de septans. De plus, parmi les patients ayant un diagnostic infectieux confirmé, un sur cinq n’a été diagnostiqué que par ce test clinique de LCR mNGS, soulignant l’utilité de cette approchede test 7. De plus, des études ont également démontré le potentiel de prédire la probabilité de diverses infections du SNC à partir du transcriptome de l’hôte généré par le testmNGS 9,10,11.
Cependant, l’accessibilité de cette technique prometteuse est limitée par des défis propres à la manipulation et au traitement des échantillons de LCR. En particulier, la quantité d’ADN et d’ARN du LCR est souvent inférieure à la quantité minimale spécifiée par les kits de préparationde la bibliothèque 12,13. La qualité des acides nucléiques peut également être sous-optimale, étant donné que les échantillons de LCR prélevés à des fins cliniques sont souvent stockés à des températures auxquelles les ADNAses et ARNases peuvent resteractives 14. Cet article décrit un protocole CSF mNGS basé sur la recherche pour les plateformes de séquençage Illumina, optimisé pour maximiser la probabilité de générer des données utilisables pour la détection des agents pathogènes (Figure 1).
Accès restreint. Veuillez vous connecter ou commencer un essai pour afficher ce contenu.
Protocole
Ce protocole a été développé et testé à partir d’échantillons collectés dans le cadre d’études approuvées par le comité d’examen institutionnel de l’UCSF.
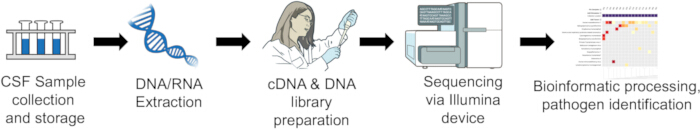
Figure 1 : Traitement des échantillons de séquençage de nouvelle génération métagénomique du liquide céphalorachidien (LCR) et flux de travail analytique pour la détection des agents pathogènes. Ce diagramme illustre les principales étapes des voies de laboratoire humide et bioinformatique du MFC mNGS. Veuillez cliquer ici pour voir une version agrandie de cette figurine.
1. Considérations sur la manipulation des échantillons de LCR
REMARQUE : les résultats du mNGS sont optimaux si la préparation de la bibliothèque de LCR a lieu au moment de la collecte, ou si les échantillons de LCR sont conservés par congélation instantanée dans de l’azote liquide, suivie d’un stockage à long terme à -80 °C 15. Alternativement, l’utilisation de solutions de conservation telles que la protection ADN/ARN au moment de la collecte de l’échantillon peut permettre un stockage à température ambiante pendant des périodes pluslongues 16,17. Cela peut être préférable dans des situations où il existe des inquiétudes quant à la fiabilité de la chaîne du froid. De plus, éviter des cycles de congélation-dégel inutiles peut également aider à préserver l’intégrité des acides nucléiques, et il peut être conseillé de pré-pré-aliquoter les échantillons au moment de la collecte si plusieurs flux de travail analytiques sont anticipés pour les échantillonsde LCR 18,19.
2. Extraction de l’acide nucléique LCR
ATTENTION : Agir dans une armoire de niveau de biosécurité appropriée, avec des gants et une blouse de laboratoire afin de réduire le risque de transmission d’organismes infectieux. Les réactifs sont nocifs s’ils sont avalés, inhalés ou entrent en contact avec la peau. Éliminer les matériaux usagés comme déchets chimiques dangereux conformément à la réglementation locale.
- Le kit Quick-DNA/ARN fonctionne généralement bien pour des échantillons à faible abondance d’acides nucléiques.
- Décongelez les échantillons de LCR sur glace, puis transférez 100 μL–1 mL de chaque échantillon dans un tube de 1,5 mL et centrifugez à 16 000 x g à 4 °C pendant 10 minutes.
- Faites soigneusement une pipette sur le surnageant, en laissant derrière elle la pellete (souvent invisible à l’œil nu) et 100 μL de surnageant.
- Ajoutez 100 μL de bouclier ADN/ARN aux 100 μL restants de surnageant et de pellets, et faites un mélange de pipettes soigneusement.
- Ensuite, ajoutez 600 μL de mélange tampon de lyse ADN/ARN et pipette jusqu’à ce que la solution soit homogène.
- Suivez le reste du protocole d’extraction ADN/ARN tel que décrit par le fabricant dans les annexes complémentaires A, avec les modifications importantes suivantes spécifiques au LCR :
- Effectuez toutes les étapes de centrifugation pendant 1 minute à vitesse maximale (~21 000 x g) sauf l’étape finale de lavage ADN/ARN, qui devrait durer 3 minutes à vitesse maximale.
- Éluez l’échantillon en ajoutant 22 μL (au lieu de 25 μL) d’eau sans nucléase directement sur la matrice colonne, puis incubez pendant 3 minutes à température ambiante. Le volume plus élevé entraîne généralement une plus grande quantité totale d’acide nucléique élue de la colonne.
- Après élution, pipettez le flux à travers la matrice de colonne et centrifugez à nouveau pendant une minute à vitesse maximale. Transférez l’échantillon dans un nouveau tube de stockage de 1,5 mL, puis passez immédiatement à la préparation de la bibliothèque ou stockez à -80 °C.
3. Préparation de la bibliothèque ARN du LCR
ATTENTION : Agir dans un cabinet de biosécurité approprié, en portant des gants et une blouse de laboratoire. Les réactifs sont nocifs s’ils sont avalés, inhalés ou entrent en contact avec la peau. Éliminer les matériaux usagés comme déchets chimiques dangereux conformément à la réglementation locale.
REMARQUE : Considérations importantes avant de commencer : l’épuisement de l’ARNr est préféré à l’enrichissement par polyadénylation pour l’isolement de l’ARNm, étant donné que la déplétion de l’ARNr ne nécessite pas d’étapes supplémentaires de nettoyage des billes (ce qui peut réduire le rendement d’ARNm utilisable), et que certains transcrits de virus à ARN neuroinvasifs ne présentent pas de polyadénylation. Le SPIKE-In de l’ARN (ERCC (External RNA controls consortium) peut être ajouté comme mesure de contrôle qualité, bien que ce ne soit pas strictement nécessaire. Si l’ARN a été stocké à -80 °C après l’extraction, dégelez sur la glace avant le début.
- Fragmentation et amorçage de l’ARN : Pipettez mélanger les éléments suivants dans un tube de réaction en chaîne polymérase (PCR) : échantillon d’ARN de 3,5 μL, spike-in dilué 1:2500 de 0,5 μL, tampon de réaction de première brin de 4 μL (5x), amorces aléatoires de 1 μL, et 1 μL d’ARNr dilué 1:100 (Table of Materials). Dans un thermocycleur, réglez le couvercle chauffé à 105 °C et faites couver les échantillons à 75 °C pendant 2 minutes, 70 °C pendant 2 minutes, 65 °C pendant 2 minutes, 60 °C pendant 2 minutes, 55 °C pendant 2 minutes, 37 °C pendant 5 minutes et 25 °C pendant 5 minutes.
- Synthèse d’ADNc de première brin : Pipette mélange l’ARN fragmenté et amorcé (10 μL) avec 8 μL d’eau sans nucléase et 2 μL de mélange enzymatique de synthèse de première brin. Dans un thermocycleur, réglez le couvercle chauffé à 105 °C et faites couver, les échantillons à 25 °C pendant 10 minutes, 42 °C pendant 15 minutes et 70 °C pendant 15 minutes.
- Synthèse d’ADNc de second brin : Pipette mélangez l’ADN synthétisé de première brin (20 μL) avec un tampon de réaction de synthèse de deuxième brin de 8 μL, un mélange enzymatique de synthèse de deuxième brin de 4 μL, et 48 μL d’eau sans nucléase. Dans un thermocycleur, incubez les échantillons pendant 1 heure à 16 °C, avec le couvercle chauffé éteint.
- Effectuer une purification des billes magnétiques (Annexes supplémentaires B) en utilisant un ratio de 1,8x des billes magnétiques SPRI (144 μL). Éluvez dans de l’eau sans nucléase de 53 μL et transférez 50 μL du surnageant final (contenant de l’ADNc double brin purifié) dans un tube PCR propre sans nucléase. À ce stade, les échantillons peuvent être congelés en toute sécurité à -20 °C toute la nuit si nécessaire.
- Fin de la préparation de la bibliothèque d’ADN : Si l’échantillon a été conservé à -20 °C toute la nuit, décongelez sur glace avant de recommencer. Pipette, mélangez le ds-cDNA purifié (50 μL) avec 7 μL de tampon de réaction de préparation finale et 3 μL de mélange enzymatique de préparation terminale.
- Dans un thermocycleur, incubez les échantillons à 20 °C pendant 30 minutes, et à 65 °C pendant 30 minutes, avec le couvercle chauffé éteint.
- Ligation de l’adaptateur (effectuer cette étape sur glace) : Créer une dilution 1:100 de l’adaptateur dans de l’eau sans nucléase. Pipeter le mélange de la réaction de préparation finale (60 μL) dans un tube contenant un mélange maître de ligation de 30 μL, un amplificateur de ligature de 1 μL et un adaptateur dilué 1:100 de 2,5 μL. Assurez-vous que l’adaptateur est ajouté séparément (par exemple, pas prémélangé avec le mélange maître de ligation ou l’amplificateur de ligatura) pour éviter la formation de dimers adaptateurs.
- Dans un thermocycleur, incubez les échantillons à 20 °C pendant 15 minutes, avec le couvercle chauffé éteint.
- Procéder immédiatement à la purification des billes magnétiques (Annexe supplémentaire 2) en utilisant un ratio 0,9x des billes magnétiques SPRI (87 μL).
- Éluez dans de l’eau sans nucléase de 17 μL, et transférez 15 μL du surnageant final dans un tube PCR propre sans nucléase
- PCR par code-barres : Pipeter l’ADNc purifié, ligué par un adaptateur (15 μL) dans un tube contenant l’enzyme USER de 3 μL, le Master Mix Q5 de 25 μL et des amorces uniques codées à barres de 10 μL. Dans un thermocycleur, réglez le couvercle chauffé à 105 °C, incubez les échantillons à 37 °C pendant 15 minutes, puis à 98 °C pendant 30 s, puis effectuez 19 cycles à 98 °C pendant 10 s et 65 °C pendant 75 s. Terminez la PCR en incubant à 65 °C pendant 5 minutes.
- Effectuer une purification finale des billes magnétiques en utilisant un ratio 0,8x des billes magnétiques (43 μL). Éluez dans de l’eau sans nucléase de 23 μL, puis après la dernière étape de séparation des billes, transférez 20 μL dans un tube PCR propre sans nucléase. À ce stade, les échantillons peuvent être congelés en toute sécurité à -20 °C toute la nuit si nécessaire.
4. Préparation de la bibliothèque d’ADN du LCR
ATTENTION : Intervenez dans un cabinet de niveau de biosécurité approprié, avec des gants et une blouse de laboratoire. Les réactifs sont nocifs s’ils sont avalés, inhalés ou entrent en contact avec la peau. Éliminer les matériaux usagés comme déchets chimiques dangereux conformément à la réglementation locale.
- Si l’ADN extrait a été stocké à -20 °C toute la nuit, dégelez sur de la glace avant de recommencer.
- Fragmentation de l’ADN et préparation finale : Mélangez soigneusement le tampon de réaction de première brin en faisant du vortex et en pipette, mélangeant la solution pour resuspendre tout précipité. Mélangez 3,5 μL de l’ADN extrait, 22,5 μL d’eau sans nucléase, 7 μL de tampon de réaction première brin, et 2 μL de mélange enzymatique de première brin.
- Dans un thermocycleur, réglez le couvercle chauffé à 105 °C et faites éclore les échantillons à 37 °C pendant 5 minutes, puis à 65 °C pendant 30 minutes.
- Le processus de ligation de l’adaptateur et de code-barres PCR est identique pour les bibliothèques d’ADN et d’ARN. Répétez les sections 7 à 10 de la « Préparation de la bibliothèque d’ARN du LCR » avec l’ADN fragmenté et préparé à l’extrémité pour compléter la préparation de la bibliothèque d’ADN.
5. Contrôle qualité des bibliothèques et mise en commun
- Quantifiez la concentration des bibliothèques d’échantillons via le kit de quantification ADN et le fluoromètre correspondant. Les contrôles de l’eau devraient avoir des concentrations nettement inférieures (ou non quantifiables) par rapport aux autres échantillons.
- Évaluez la taille de la bibliothèque d’échantillons en les utilisant sur une machine automatisée d’électrophorèse capillaire.
- Sinon, si une machine automatisée d’électrophorèse capillaire n’est pas disponible, amplifiez davantage 1 à 2 μL de l’échantillon en effectuant une réaction PCR avec des amorces universelles Illumina, puis effectuez une électrophorèse de 10 μL du produit final sur un gel d’agarose à 2 %. Éliminer les matériaux usagés comme déchets chimiques dangereux conformément à la réglementation locale.
REMARQUE : La longueur optimale de la bibliothèque est d’environ 400 à 500 paires de bases, donc les futures incubations de fragmentation doivent être ajustées en conséquence si les tailles de la bibliothèque sont plus grandes ou plus courtes que souhaitées. De plus, il est crucial d’évaluer la présence de dimers adaptateurs, qui font environ 150 paires de bases et se produisent lorsque deux molécules adaptatrices se liguent accidentellement sans séquence d’insertion. Même s’ils sont présents en faible quantité, les dimères adaptateurs ont tendance à se regrouper et à séquencer efficacement sur la cellule de flux, réduisant la proportion de lectures utilisables lors d’un séquençage. Ainsi, si des dimères adaptateurs sont présents, effectuer une purification supplémentaire des billes magnétiques avec un ratio 0,8x des billes magnétiques SPRI. (À noter, si >10 % de l’échantillon est un dimère adaptateur, il peut falloir 2 à 3 cycles de purification magnétique par billes magnétiques pour retirer la plupart des dimères adaptateurs). - Pour garantir une profondeur de séquençage similaire entre les échantillons au sein d’une même séquençage, il est nécessaire de regrouper les quantités équimolaires de chaque échantillon. Si les tailles des bibliothèques sont comparables sur tous les échantillons, il suffit de regrouper les masses équivalentes de chaque bibliothèque d’ARN et de répéter séparément pour chaque bibliothèque d’ADN.
6. Considérations de séquençage
- Les échantillons regroupés sont désormais prêts pour le séquençage sur les dispositifs de séquençage Illumina. Si le séquençage est effectué en interne (plutôt que via une installation spécialisée de séquençage), dénaturez et diluez soigneusement les bibliothèques mises en pool selon les instructions du dispositif de séquençage avant de charger le pool sur la cartouche de réactif (la concentration typique est de 4 nM pour la plupart des plateformes de séquençage Illumina).
- Calculez la profondeur de séquençage estimée en divisant le rendement attendu pour la cellule de flux Illumina par le nombre d’échantillons multiplexés dans la course.
REMARQUE : La détermination de la profondeur de séquençage souhaitée dépend de plusieurs facteurs, notamment le coût, le dispositif de séquençage utilisé et les objectifs de l’expérience. Deux exemples de profondeurs de séquençage différentes sont présentés ci-dessous dans la section Résultats représentatifs.
7. Analyse des données pour la détection des pathogènes
- Utilisez la plateforme web open source Chan Zuckerberg ID (CZID, https://www.czid.org, Illumina mNGS Pipeline v8.3) pour effectuer l’analyse métagénomique de détection des pathogènes. CZID inclut également des options pour télécharger des échantillons via une interface en ligne de commande et transférer directement d’un compte Illumina BaseSpace vers CZID. Un aperçu détaillé de l’analyse des données CZID mNGS est disponible sur https://chanzuckerberg.zendesk.com/hc/en-us/articles/13770737266196-Guide-to-mNGS-Data-Analysis
- Connectez-vous à CZID, cliquez sur « télécharger », sélectionnez « métagénomique » pour type d’analyse, puis sélectionnez les fichiers fastq d’entrée depuis la séquençage. Saisissez les informations nécessaires pour chaque échantillon, y compris le nom de l’échantillon, le type d’échantillon (LCR) et le nucléotide (ARN ou ADN).
REMARQUE : Les fichiers téléchargés sont traités automatisés via le pipeline CZID, qui intègre plusieurs outils de calcul tels que STAR, Bowtie2, Trimmomatic, PriceSeq et GSNAP, entre autres, afin de supprimer les lectures de faible qualité et les séquences de lecture humaines. Le pipeline aligne ensuite et assemble les séquences filtrées en utilisant les bases de données nucléotides (NT) et protéines (NR) du National Center for Biotechnology Information (NCBI) via les logiciels Minimap2 et DIAMOND, respectivement. La sortie finale du CZID inclut les décomptes de taxons NT/NR et les comptes contigus (segments contigus et superposés générés lors de l’assemblage) pour chaque échantillon. - Une fois traité, cliquez sur le dossier projet contenant les échantillons et naviguez vers le tableau de bord résumé.
- Faites défiler vers le bas pour examiner le nombre de lectures par échantillon (et comparez au nombre attendu de lectures en fonction de la cellule de flux Illumina utilisée et du nombre d’échantillons multiplexés lors de la séquence), le pourcentage de lectures passant le filtrage de contrôle qualité, et le taux de compression en double afin d’évaluer une suramplification PCR biaisée.
- La présence de contamination par des fragments d’acides nucléiques environnementaux – soit acquis lors du processus de collecte d’échantillons de LCR, soit lors de l’extraction/préparation de la bibliothèque – est un phénomènecourant 20. Pour déterminer si les lectures bactériennes, fongiques et parasites sont de véritables positives, des méthodes potentielles utilisant les décomptes de lectures normalisées (lectures par million, ou rPM) peuvent être envisagées :
- Créer un modèle de fond (par exemple, en utilisant des échantillons d’eau extraits, préparés et séquencés) directement dans CZID pour filtrer tout taxon avec des rPM qui sont similaires ou inférieurs en abondance par rapport au modèle de fond (et donc susceptibles de représenter une contamination). Dans le dossier du projet, vérifiez chacun des échantillons de contrôle de l’eau puis cliquez sur « modèle d’arrière-plan » pour créer. Lors de l’analyse de chaque échantillon, sélectionnez le modèle de fond et cliquez sur « filtres de seuil » pour appliquer un score « NTZ » > 1 (ou supérieur) afin de filtrer les contaminants probables.
- Utilisez des seuils rPM prédéfinis, tels quel’échantillon rpM > 10* (contrôles rpm moyens), ou log10 (échantillon rPM) d’au moins 1 logarthum supérieur au log 10 (rPMmoyen de la cohorte entière). Tout d’abord, téléchargez le rPM spécifique au taxon pour chaque échantillon en vérifiant chaque échantillon sur la page du projet, en cliquant sur Télécharger et en sélectionnant « Résultats combinés des taxons d’échantillon ». Le fichier .csv résultant peut être analysé à l’aide de logiciels statistiques tels que R ou Stata selon le souhait.
REMARQUE : Compte tenu de la faible abondance relative des agents pathogènes viraux, tout virus ayant un potentiel neuroinvasif connu et au moins une lecture correspondant au génome viral doit être considéré comme un résultat positif (et idéalement, confirmé par des tests répétés de mNGS ou des tests cliniques spécifiques à chaque pathogène). De plus, le pipeline analytique exige que chaque lecture dans le fichier fastq soit alignée de manière computationnelle sur le génome de référence le plus probable dans la base de données NCBI. En conséquence, certaines lectures peuvent être relativement non spécifiques à un pathogène particulier et pourraient théoriquement s’aligner sur un large éventail d’organismes plutôt qu’avec le taxon spécifique assigné dans la CZID. Compte tenu de ce risque, la confirmation manuelle des appels positifs doit être effectuée en confirmant l’alignement via l’outil NCBI BLAST basé sur le web (les lectures spécifiques d’un taxon peuvent être envoyées directement du CZID au NCBI BLAST en cliquant sur l’icône blast à côté du taxon concerné).
Accès restreint. Veuillez vous connecter ou commencer un essai pour afficher ce contenu.
Résultats
Contrôle qualité des bibliothèques
Après extraction de l’ADN/ARN, la concentration mesurée de l’ADN extrait est généralement de 1 à 10 ng/μL. Cependant, la concentration de l’ARN extrait est souvent de l’ordre de pg/μL, et il est donc fréquemment indétectable par les spectrophotomètres. Après la préparation de la bibliothèque, les bibliothèques d’ADN et de cDNA purifiées et amplifiées sont généralement à une concentration de 0,5–10 ng/μL et 10–30 ng/μL, respectivement...
Accès restreint. Veuillez vous connecter ou commencer un essai pour afficher ce contenu.
Discussion
Il existe des considérations importantes qui peuvent nécessiter des modifications de ce protocole, selon la profondeur de séquençage souhaitée, la plateforme de séquençage utilisée et la disponibilité d’équipements pour le contrôle qualité. Néanmoins, les deux cohortes représentatives présentées ici démontrent qu’une détection robuste des agents pathogènes est possible dans un large éventail de conditions expérimentales. Plus précisément, la cohorte B a démontré que, malgré plusieurs mes...
Accès restreint. Veuillez vous connecter ou commencer un essai pour afficher ce contenu.
Déclarations de divulgation
M.R.W. reçoit des financements de recherche non liés de Roche/Genentech, Novartis et Kyverna Therapeutics et est fondateur et membre du conseil d’administration de Delve Bio Inc. Il a assuré des services de conseil auprès de Pfizer, Vertex Pharmaceuticals, Ouro Medicines et Indapta Therapeutics.
Remerciements
Cette étude a été financée par le Fogarty International Center des National Institutes of Health sous le numéro de D43TW009343. Nous tenons à remercier les nombreux chercheurs du Wilson Lab, de l’UCSF et du CZI qui ont contribué au développement et à l’optimisation des protocoles mNGS pour diverses applications de recherche au cours des dernières années.
Accès restreint. Veuillez vous connecter ou commencer un essai pour afficher ce contenu.
Matériaux
| Nom | Entreprise | Numéro de catalogue | Commentaires |
|---|---|---|---|
| Bande de tube PCR 0,2 mL | Eppendorf | 30124359 | |
| Tubes de liaison ADN de 1,5 mL | Eppendorf | 30108051 | |
| Tubes de verrouillage sécurisé de 1,5 mL | Eppendorf | 30120191 | |
| Mélange d’ARN Spike-In de l’ERCC | Thermo Fisher | 4456740 | |
| Réactifs D1000 à haute sensibilité | Agilent | 5067-5585 | |
| Invitrogen Collibri Library Amplification Master Mix | Thermo Fisher | A38539050 | |
| Mastercycler x50 | Thermo Fisher | 6311000010 | |
| NEBNext Multiplex Oligos pour Illumina | New England Biolabs | 7335S/L | |
| Kit de préparation de la bibliothèque ADN NEBNext Ultra II | New England Biolabs | E7645 | |
| NEBNext Ultra II Kit de préparation de la bibliothèque ARN pour Illumina | New England Biolabs | E7770 | |
| NextSeq 500/550 Kit haute sortie v2.5 (150 cycles) | Illumina | 20024907 | |
| NextSeq 550 | Illumina | N/d | |
| QIAseq FastSelect -rRNA HMR Kit | Quiagen | 334386 | |
| Qubit 1X dsDNA kit de test à haute sensibilité | Qubit | Q33230 | |
| Fluoromètre Qubit 4 | Thermo Fisher | N/D | |
| Quick-DNA/ARN Microprep Plus Kit & nbsp ; | Zymo | D7005 | |
| TapeStation 4150 | Agilent | G2992AA |
Références
- Chiu, C. Y., Miller, S. A. Clinical metagenomics. Nat Rev Genet. 20 (6), 341-355 (2019).
- Wilson, M. R., et al. Clinical metagenomic sequencing for diagnosis of meningitis and encephalitis. N Engl J Med. 380 (24), 2327-2340 (2019).
- Forbes, J. D., Knox, N. C., Ronholm, J., Pagotto, F., Reimer, A. Metagenomics: the next culture-independent game changer. Front. Microbiol. 8, (2017).
- Wang, Z., Gerstein, M., Snyder, M. RNA-Seq: a revolutionary tool for transcriptomics. Nat Rev Genet. 10 (1), 57-63 (2009).
- DNA Sequencing Costs: Data. , National Human Genome Research Institute (US). https://www.genome.gov/about-genomics/fact-sheets/DNA-Sequencing-Costs-Data (2026).
- Wilson, M. R., et al. Chronic meningitis investigated via metagenomic next-generation sequencing. JAMA Neurology. 75 (8), 947-955 (2018).
- Benoit, P., et al. Seven-year performance of a clinical metagenomic next-generation sequencing test for diagnosis of central nervous system infections. Nat Med. 30 (12), 3522-3533 (2024).
- Glaser, C. A., et al. In search of encephalitis etiologies: diagnostic challenges in the California encephalitis project, 1998-2000. Clinical Infectious Diseases. 36 (6), 731-742 (2003).
- Ramachandran, P. S., et al. Integrating central nervous system metagenomics and host response for diagnosis of tuberculosis meningitis and its mimics. Nat Commun. 13, 1675(2022).
- Xing, Z., et al. Integrating DNA/RNA microbe detection and host response for accurate diagnosis, treatment, and prognosis of childhood infectious meningitis and encephalitis. J Transl Med. 22, 583(2024).
- Omura, C., et al. 298. Host response profiling from clinical metagenomic sequencing data for diagnosis of central nervous system infections. Open Forum Infect Dis. 12 (1), (2025).
- Andriuk, L. V., Skochiĭ, P. G. Nucleic acids of the cerebrospinal fluid in acute disorders of cerebral circulation. Zh Nevropatol Psikhiatr Im S S Korsakova. 88 (7), 32-34 (1988).
- Olausson, J., et al. Optimization of cerebrospinal fluid microbial DNA metagenomic sequencing diagnostics. Sci Rep. 12 (1), 3378(2022).
- Becskei, A., Rahaman, S. The life and death of RNA across temperatures. Comput Struct Biotechnol J. 20, 4325-4336 (2022).
- Wang, C., Liu, H. Factors influencing degradation kinetics of mRNAs and half-lives of microRNAs, circRNAs, lncRNAs in blood in vitro using quantitative PCR. Sci Rep. 12 (1), 7259(2022).
- Cb, T., et al. DNA/RNA preservation in glacial snow and ice samples. Frontiers in microbiology. 13, (2022).
- Kazantseva, J., et al. Optimisation of sample storage and DNA extraction for human gut microbiota studies. BMC microbiology. 21 (1), (2021).
- Xiaoli, J., et al. The impact of repeated freeze-thaw cycles on the quality of biomolecules in four different tissues. Biopreservation and biobanking. 15 (5), (2017).
- Kellman, B. P., et al. Multiple freeze-thaw cycles lead to a loss of consistency in poly(A)-enriched RNA sequencing. BMC genomics. 22 (1), (2021).
- Zinter, M. S., Mayday, M. Y., Ryckman, K. K., Jelliffe-Pawlowski, L. L., DeRisi, J. L. Towards precision quantification of contamination in metagenomic sequencing experiments. Microbiome. 7 (1), 62(2019).
- Mayday, M. Y., Khan, L. M., Chow, E. D., Zinter, M. S., DeRisi, J. L. Miniaturization and optimization of 384-well compatible RNA sequencing library preparation. PLoS One. 14 (1), e0206194(2019).
- Sakiyama, Y., et al. Brain biopsy and metagenomic sequencing enhance aetiological diagnosis of encephalitis. Brain Commun. 7 (3), fcaf1650(2025).
- Sakiyama, Y., Yuan, J., Yoshimura, A., Takei, J., Ando, M., Takashima, H. Etiological insights of encephalitis and encephalitis-like central nervous system diseases: brain tissue metagenomic next-generation sequencing. Neurology. 102 (7-1), 3782(2024).
- Sun, J., et al. Correcting PCR amplification errors in unique molecular identifiers to generate accurate numbers of sequencing molecules. Nat Methods. 21 (3), 401-405 (2024).
- Tan, J. K., et al. Laboratory validation of a clinical metagenomic next-generation sequencing assay for respiratory virus detection and discovery. Nat Commun. 15 (1), 9016(2024).
- Prasanna, A. kshatha Clin-mNGS: Automated pipeline for pathogen detection from clinical metagenomic data. , https://github.com/AkshathaPrasanna/Clin-mNGS (2025).
- Marra, P. S., et al. Metagenomic next-generation sequencing in patients with infectious meningoencephalitis: a comprehensive systematic literature review and meta-analysis. Open Forum Infect Dis. 12 (5), ofaf274(2025).
- Ramachandran, P. S., Wilson, M. R. Metagenomics for neurological infections - expanding our imagination. Nat Rev Neurol. 16 (10), 547-556 (2020).
- Salter, S. J., et al. Reagent and laboratory contamination can critically impact sequence-based microbiome analyses. BMC Biol. 12, 87(2014).
- Simner, P. J., Miller, S., Carroll, K. C. Understanding the promises and hurdles of metagenomic next-generation sequencing as a diagnostic tool for infectious diseases. Clin Infect Dis. 66 (5), 778-788 (2018).
Accès restreint. Veuillez vous connecter ou commencer un essai pour afficher ce contenu.
Réimpressions et autorisations
