L’étude actuelle décrit un flux de travail pour le séquençage nanopore des plasmides lorsque la séquence chromosomique est déjà connue ou sans intérêt. Une étape initiale d’enrichissement de l’ADN plasmidique assure une profondeur optimale de séquence plasmidique et maximise le nombre d’échantillons pouvant être séquencés par cellule de flux.
Article de méthode
Séquençage et assemblage de plasmides à longue lecture utilisant des flux de travail basés sur le séquençage nanopore
* These authors contributed equally
Dans cet article
Résumé
Résumé
La présente étude décrit un flux de travail pour le séquençage des nanopores conçu pour maximiser le rendement de l’ADN plasmidique et la précision du séquençage. Les chercheurs couvrent chaque étape du processus, qui inclut l’extraction d’ADN plasmidique, la préparation de la bibliothèque avec codage à barres rapide et ligature d’adaptateur, le chargement de la bibliothèque sur une cellule de flux pour le séquençage, l’appel de base (en temps réel ou post-hoc), et l’assemblage de séquences à l’aide d’Autocycler. Les auteurs spécifient également les exigences informatiques, qui dépendent en grande partie de l’exécution en temps réel de l’appel de base. Les auteurs ont séquencé des plasmides purifiés à partir de dix souches cliniques en utilisant ce flux de travail. Pour éliminer les différences entre souches hôtes et cellules en tant que variable, les auteurs ont également conjugué ces souches cliniques avec une souche commune de receveur et séquencé les transconjugants. Ces expériences ont produit des assemblages de plasmides correspondant à la taille des plasmides déduits de la mobilité du gel et qui, dans les deux tiers des cas, correspondent également à des assemblages polis en lecture courte ou se situent dans une identité de séquence par paires de 0,05 %. L’enrichissement des séquences d’ADN plasmidique maximise également l’efficacité du séquençage plasmidique, permettant le séquençage parallèle de jusqu’à 24 échantillons avec une couverture optimale. Ce protocole est adéquat pour des plasmides allant de 4 à 174 kb et tolère jusqu’à 72 % de contamination chromosomique sans altuer la précision. Ce protocole est idéal pour les situations où la séquence chromosomique est déjà connue ou sans intérêt, comme pour la vérification de la séquence plasmidique, l’amélioration de la précision des séquences plasmidiques déjà obtenues par WGS, ou le séquençage des plasmides capturés par conjugaison. L’organisme utilisé pour illustrer ce travail est Escherichia coli, qui représente les hôtes utilisés pour l’expression génique recombinante et la capture des plasmides par conjugaison.
Introduction
Les plasmides sont des morceaux d’ADN auto-réplicatifs que l’on trouve partout dans les bactéries. Ils sont très variables en taille, allant de <800 pb à 2,5 Mbp, et suivent généralement une distribution bimodale, avec un pic plus petit correspondant aux plasmides multicopies non conjugatives et un pic plus grand correspondant aux plasmides à faible copie,souvent conjugatifs 1,2. Les plasmides jouent un rôle clé dans l’écologie microbienne, portant des gènes qui aident leurs hôtes à s’adapter aux défis environnementaux ou à accéder à de nouvelles niches écologiques. Les plasmides servent également de plateformes pour une évolution accélérée, offrant une plasticité génétique accrue et médiant le transfert horizontal de gènes entre souches, espèces, genres, et mêmefamilles 3,4. Des analyses génomiques en réseau et comparatives ont confirmé le rôle du résistome environnemental comme réservoir persistant pour les gènes de résistance aux antibiotiques (ARG) cliniquement pertinents, facilitant ainsi leur maintien et leur diffusion dans les environnementsécologiques 5. Le suivi des plasmides et de leur charge de gènes de résistance aux antibiotiques et de virulence aide à identifier les voiesde transmission 6. Par conséquent, l’identification et la caractérisation des plasmides suscitent un grand intérêt pour diverses applications en santé publique, microbiologie clinique et biotechnologie.
L’introduction des technologies de séquençage de nouvelle génération (NGS), qui permettent le séquençage à haut débit de modèles d’ADN inconnus, a ouvert la porte à la caractérisation génomique des isolats microbiens. Le séquençage du génome entier (WGS) permet de suivre l’émergence, la propagation et la transmission de nouveaux agents pathogènes, souches résistantes aux médicaments et variants évitant les vaccins. Elle est également de plus en plus utilisée pour aider à identifier les voies de transmission lors des épidémies cliniques, pouvant potentiellement orienter les interventions pour la prévention futuredes épidémies 7. Enfin, le WGS permet le profilage des ARG, ce qui peut orienter les décisions thérapeutiques8, bien que le lien entre les ARG et des phénotypes qualitatifs et quantitatifs de résistance aux antibiotiques soit encore en cours9.
Cependant, les données de séquençage en lecture courte (SR) généralement produites par WGS à grande échelle se situent généralement dans la plage de 400 à 500 pb. Cette taille est plus courte que celle de la plupart des Éléments Génétiques Mobiles (MGE) et ne peut donc pas les résoudreà 10. L’identification in silico des séquences plasmidiques dans les données WGS est encore compliquée par une couverture incomplète, et par le partage des séquences entre plasmides et entre chromosomes bactériens et autresplasmides 10. En conséquence, les assemblages sont souvent très fragmentés et incomplets, ce qui rend impossible d’attribuer leur emplacement sous-génomique (chromosomique ou plasmide) 10.
La technologie de séquençage à longue lecture (LR) génère des assemblages très contigus s’étendant sur plusieurs répétitions, facilitant grandement la production d’ensembles plasmidiques complets. Il existe essentiellement deux types de technologies à longue lecture et à molécule uniquedisponibles 11,12. L’une de ces approches, le séquençage par nanopore, devient populaire en génomique microbienne en raison de son faible coût, de ses délais de traitement rapides et de son adaptation aux environnements aux ressourceslimitées 13,14.
Les dispositifs de séquençage nanopore utilisent des cellules de flux contenant des réseaux de milliers de nanopores. L’ADN est chargé dans la cellule de flux, ouvert par une protéine motrice à activité hélicase, et il traverse le nanopore entraîné par un différentiel de courant. Lorsque les nucléotides d’un brin unique donné traversent des nanopores individuels, le courant est perturbé pour produire un signal caractéristique mesuré par un capteur électronique relié à chaque pore. Ce signal est décodé à l’aide d’algorithmes de basecall, et les données résultantes sont assemblées et analysées plus en aval à l’aide de divers outils bioinformatiques.
Comparé aux approches de séquençage SR, le séquençage nanopore tend à produire une qualité de lecture inférieure (Q-scores plus faibles) et à générer des insertions/délétions dans des séquences homopolymères lors de l’analyse des données des signaux électriques (basecalling)15. Il a également été observé que la méthylation proche dans l’ADN natif peut provoquer des erreurs systématiques d’appelde base 16. Une solution couramment adoptée a été d’inclure des données à lecture courte pour la correction d’erreurs post-assemblage. Cependant, ce procédé (appelé « polissage ») augmente le coût et la complexité17. Augmenter la couverture de séquençage peut également améliorer la précision, mais ce n’est pas toujours techniquement réalisable.
En 2024, il a été démontré que les cellules de flux Oxford Nanopore Sequencing (ONT) R10.4.1 et la chimie V14 produisent des assemblages de haute qualité et contigus pour les bactéries G-, tandis que des analyses à plus grande échelle sur des niveaux mononucléotidiques bénéficient encore des données de séquençageSR 18. Cependant, l’écart entre la précision du séquençage LR et SR se réduit progressivement. Diverses améliorations récentes incluent un processus d’échantillonnage de données plus précis à une vitesse de séquençage accrue, l’introduction d’un nouveau basecaller adapté à l’ADN bactérien natif et à la méthylation, offrant une précision accrue des appels de base19, ainsi que des outils d’analyse mis à jour tels que de nouveaux algorithmes pour le phasage, l’appel variant et l’appel étoile-allèle. Notez également que le dernier algorithme Dorado V.0.9.0 ONT (2025) peut être utilisé pour appeler la base des données brutes de gribouillis. En effet, certaines études WGS rapportent déjà la génération de génomes microbiens par séquençage nanopore d’une qualité pour laquelle le polissage en lecture courte n’est pas censé améliorer significativement la séquenceconsensuelle 20,21.
Les plasmides contiennent souvent la majeure partie des gènes de résistance acquis, en particulier dans les isolats22 d’Enterobacteriaceae. Ainsi, la résolution des séquences plasmidiques permet la contextualisation des gènes AR, ce qui est essentiel pour suivre la transmission del’AMR 23,24. Le séquençage nanopore a déjà été utilisé pour examiner la microévolution de blaKPC contenant desplasmides 25. Les dispositifs MinION ont également été utilisés pour le séquençage en temps réel de plasmides sur le laboratoire et la détection de gènes de résistance dans des isolats cliniques en milieuhospitalier 26. Cela dit, l’interrogatoire des plasmides ne fait pas encore partie des pratiques courantes de contrôle des infections.
Malgré l’amélioration substantielle du séquençage LR par rapport au séquençage SR dans la capacité à sauver des plasmides de la séquencegénomique 27, certains problèmes subsistent. Les assembleurs à longue lecture comme Flye28, Canu29 et Raven30 produisent des assemblages chromosomiques de haute qualité mais ont du mal à assembler des séquences plasmidiques. Cela est en partie dû à une profondeur de couverture insuffisante, car l’ADN plasmidique est sous-représenté dans les données de séquençageWGS 31. Notez qu’en raison de leur structure modulaire, de leur abondance de structures secondaires et de la présence fréquente de répétitions, l’assemblage de haute qualité pour la séquence d’ADN plasmidique nécessite une couverture plus élevée que l’ADN chromosomique (profondeurde lecture 50x 32).
Enrichir les échantillons d’ADN avec des séquences plasmidiques est une approche efficace pour augmenter la profondeur de couverture, mais l’isolement ou l’enrichissement de l’ADN plasmidique avant le séquençage de l’ADN est trop coûteux ou laborieux pour des applications diagnostiques cliniques et pourrait introduire un biais en enrichissant certaines séquences d’ADN. En 2017, de l’ADN enrichi en plasmide a été utilisé pour tenter l’assemblage complet de l’ADN plasmidique dans des échantillons cliniques pour la détection desARGs 24. Huit isolats de six espèces différentes d’Enterobacteriaceae ont été séquencés pour maximiser la diversité structurale des populations et des plasmides. Après avoir essayé plusieurs assembleurs, il a été démontré que Canu/Canu+Pilon surpassait clairement les autres ; Ce groupe de recherche a également essayé une approche de méta-assemblage qui a permis la résolution de structures plasmidiques supplémentaires, aboutissant à l’assemblage complet de 78 % de tous les plasmides connus dans les échantillons séquencés. Cependant, la présence de structures à grandes répétitions et (dans une moindre mesure) des problèmes d’extraction d’ADN posaient encore des problèmes importants pour la détection de tous les assemblages de plasmides à un seulcontig 24.
Plus récemment, l’échantillonnage adaptatif comme approche complémentaire pour l’enrichissement de séquences plasmidiques à faible abondance a été examiné en rejetant des séquences chromosomiques dans des échantillons d’isolats bactériens, bien que cette méthode nécessite les séquences de référenceconnues 33.
Ici, les auteurs décrivent des protocoles de séquençage ONT personnalisés pour des échantillons enrichis en ADN plasmidique. Combinant une représentation accrue de l’ADN plasmidique avec des protocoles de préparation de bibliothèques à jour, la technologie des cellules de flux et des outils d’assemblage de séquences, le flux de travail a produit des assemblages correspondant à des tailles déduites par la mobilité du gel et, dans les deux tiers des cas, correspondant soit au polissage par séquençage SR, soit étant à une limite de 0,05 % d’identité par séquence. L’enrichissement des séquences d’ADN plasmidique maximise également l’efficacité du séquençage plasmidique, permettant le séquençage parallèle de jusqu’à 24 échantillons avec une couverture optimale. Les protocoles ne sont pas destinés à remplacer les approches WGS par nanopore standard, mais à maximiser la précision et l’efficacité du séquençage plasmidique dans des situations où la séquence chromosomique est déjà connue ou non d’intérêt.
Le flux de travail comprend l’extraction d’ADN plasmidique, la préparation de la bibliothèque avec code-barres, la ligation d’adaptateur à une protéine motrice, la vérification de la cellule de flux, le chargement de la bibliothèque sur une cellule de flux pour le séquençage, l’analyse des données des signaux électriques (en temps réel ou post hoc), l’assemblage de séquences à l’aide de l’Autocycler34, ainsi que diverses analyses en aval (Figure 1).
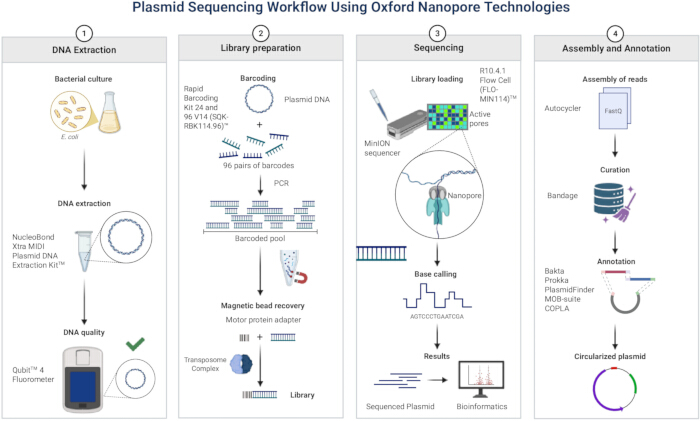
Figure 1 : Flux de travail de séquençage des plasmides utilisant Oxford Nanopore Technologies. Étape 1 : extraction d’ADN ; Étape 2 : Préparation à la bibliothèque ; Étape 3 : Séquençage ; Étape 4 : Assemblage et annotation. Créé dans BioRender. Cortés, G. (2026) https://BioRender.com/u3b15st. Veuillez cliquer ici pour voir une version agrandie de cette figurine.
Protocole
1. Extraction d’ADN plasmidique
REMARQUE : Ce protocole a été utilisé pour extraire l’ADN plasmidique d’une souche clinique d’Escherichia coli et de ses transconjugants correspondants à l’aide d’un kit commercial d’extraction d’ADNplasmidique 35. Des protocoles détaillés pour la conjugaison se trouvent dansle 36. Le protocole convient aussi bien aux plasmides à haute copie qu’à faible copie, allant de ~3 kb à ~200 kb. Les gros plasmides nécessitent une attention particulière car ils ont tendance à avoir un faible nombre de copies (aussi peu que 1 à 2 copies par cellule), limitant la production d’ADN. Pour compenser, le protocole recommande d’augmenter la masse cellulaire ainsi que les volumes de tampons de lyse et de neutralisation afin d’assurer un ADN plasmidique suffisant pour la liaison en colonne. Des plasmides jusqu’à 200 kb peuvent encore être récupérés grâce à ce protocole ; Cependant, son applicabilité aux mégaplasmides (>200 kb) est limitée.
- Extraction de plasmides
- Jour 1 : Échantillons de stries sur les plaques d’agar Luria–Bertani (LB) complétées par l’antibiotique approprié pour sélectionner le marqueur de résistance transmis par plasmides respectif, puis incuber à 37 °C pendant 24 heures.
REMARQUE : Ajoutez la carbénicilline (ou l’antibiotique approprié) à LB à une concentration finale de 100 μg/mL en ajoutant 1 μL d’une solution de 100 mg/mL par mL de milieu. - Jour 2 : Inoculez 3 à 5 mL de LB avec le milieu antibiotique approprié avec une colonie isolée unique dès le premier jour. Incubez en secouant à 37 °C pendant ~8 heures, ou jusqu’à ce que la culture atteigne un OD₆₀₀ de 1–2.
REMARQUE : Mesure de l’OD600 : Blanchir le spectrophotomètre avec un milieu LB frais contenant l’antibiotique approprié, puis transférer 1 mL de culture dans une cuvette propre et mesurer le OD à 600 nm. Si la lecture dépasse la plage linéaire, diluez l’échantillon et remesurez. - Inoculez 400 mL de LB complétés avec le milieu antibiotique approprié avec 400 μL de culture de démarrage du jour 2. Incubez avec des secousses à 37 °C pendant 8 à 12 heures, ou jusqu’à ce que leDO 600 atteigne 1–2 (comme décrit précédemment).
REMARQUE : Augmentez le volume de culture au-delà de 400 mL si leDO 600 n’atteint pas 1–2 dans les 12 heures. Pour réduire le risque de perte ou de réarrangement plasmidique, limitez autant que possible le passage en culture et maintenez la sélection des antibiotiques à toutes les étapes de croissance. N’augmentez le volume de culture que lorsqu’un rendement d’ADN plus élevé est souhaité. - Jour 3 : Transférez la culture dans des bouteilles centrifugeuses adaptées au volume de culture. Centrifugez à 4200 x g pendant 10 minutes, puis resuspendez le pellet en utilisant les volumes de réactifs recommandés par le fabricant selon la formule suivante :
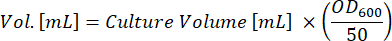
REMARQUE : Exemple : Pour lyser 400 mL d’une culture bactérienne à faible copie (OD600 = 2), les volumes appropriés de tampons de lyse RES, LYS et NEU sont de 16 mL chacun.
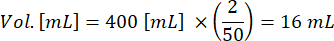
REMARQUE : si les volumes de réactifs pour la resuspension, la lyse ou la neutralisation ne sont pas correctement adaptés à la biomasse totale de la culture (OD600 × volume, ou ODV), la lyse peut être incomplète, la neutralisation inefficace et la formation de précipitations excessive. Cela peut entraîner un rendement plasmidique réduit, une pureté réduite et un risque d’obstruction des colonnes de purification. L’échelle proportionnelle des volumes de tampons, en utilisant la formule du fabricant (étape 1.1.4), garantit une lyse efficace, une neutralisation complète et une récupération constante d’ADN plasmidique de haute qualité. - Effectuer la lyse cellulaire, filtrer le mouillage en utilisant le tampon approprié, et neutraliser selon les instructions du kit.
REMARQUE : Empilez deux filtres si le volume de précipité est important, en ajustant le tampon proportionnellement. Effectuer des étapes supplémentaires de centrifugation si le surnageant reste opaque. Après neutralisation, le volume élevé de précipité peut nécessiter des étapes supplémentaires de centrifugation. C’est le cas pour la plupart des échantillons cliniques d’E. coli, probablement parce qu’ils ont tendance à former un biofilm dans la culture37, qui implique la sécrétion d’une matrice épaisse38. Un précipité excessif dans le lysat peut boucher la colonne, prolonger le temps de drainage et potentiellement contaminer l’échantillon avec des protéines. Si le surnageant est clair, ces étapes supplémentaires peuvent ne pas être nécessaires. - Centrifugez le lysat à 4200 x g pendant 30 minutes. Transférez le surnageant dans un nouveau tube et centrifugez à nouveau pendant 30 minutes. Si le surnageant reste opaque après ces spins (Figure 2), effectuez une centrifugation supplémentaire à 4200 x g.
REMARQUE : Le transfert du lysat dans un tube de culture de 50 mL lors de la centrifugation peut faciliter l’élimination du surnageant, car le précipité peut parfois ne pas se former correctement et se retrouver piégé près du sommet du tube. En raison des volumes importants traités, une seule colonne peut devenir saturée et ne pas pouvoir accueillir d’échantillons supplémentaires. Pour augmenter la vitesse de filtration ou maximiser le rendement d’ADN, le lysat peut être divisé entre deux colonnes. - Effectuez les étapes EQU, WASH et ELU selon les instructions du kit.
- Précipité l’ADN à l’aide d’isopropanol.
REMARQUE : Incubez à -20 °C pendant ~10 minutes si le granule n’est pas visible. Cependant, il est généralement préférable d’enlever soigneusement le surnageant, en faisant confiance au fait que la pastille reste collée aux parois du tube, même si elle n’est pas visible. - Lavez l’ADN avec de l’éthanol comme indiqué. Effectuez un lavage supplémentaire si le précipité protéique persiste.
- Sécher l’ADN à température ambiante (~20 °C) pendant 15 à 30 minutes.
- Resuspendre l’ADN dans 100 μL d’eau sans nucléase ; ce petit volume aide à maximiser la concentration pour la préparation de la bibliothèque Nanopore.
REMARQUE : C’est un point d’arrêt pratique. L’ADN plasmidique peut être stocké pendant plusieurs mois à –20 °C. Le kit d’extraction utilisé dans ce protocole est conçu pour minimiser la contamination de l’ADN chromosomique (génomique) grâce à une chimie tampon optimisée, une lyse douce et des étapes de clarification du lysat, bien qu’une contamination substantielle par l’ADN chromosomique ne puisse être exclue, et les auteurs l’ont trouvée dans les préparations (voir résultats).
- Jour 1 : Échantillons de stries sur les plaques d’agar Luria–Bertani (LB) complétées par l’antibiotique approprié pour sélectionner le marqueur de résistance transmis par plasmides respectif, puis incuber à 37 °C pendant 24 heures.
- Rendement ADN et contrôle qualité
Quantifiez l’ADN et évaluez sa qualité à l’aide de colorants fluorescents, qui offrent une plus grande spécificité et sensibilité aux faibles concentrations d’ADN comparées aux méthodes d’absorption UV. Dans ce protocole, utilisez un appareil à fluoromètre pour quantifier avec précision et commodité des échantillons d’ADN, d’ARN oude protéines 39.- Flux de travail du fluoromètre
- Apportez les échantillons d’ADN à température ambiante. Préparez les tubes pour les standards et les échantillons.
REMARQUE : Calculez les volumes appropriés de colorant et de tampon à inclure dans la solution de travail en fonction du nombre d’échantillons. Pour chaque étalon et échantillon, 200 μL de solution de travail doivent être préparés en diluant le colorant dans le tampon dans un rapport de 1:200. L’appareil dispose d’un calculateur de réactifs intégré qui peut également être utilisé pour ces calculs. - Préparez les tubes de test selon le tableau 1.
- Faites passer chaque tube en vortex quelques secondes avant d’incuber pendant 2 minutes à température ambiante.
- Calibrez le fluoromètre à l’aide des étalons. Insérez des tubes d’échantillon et enregistrez les lectures. Pour des instructions détaillées, consultez le manueldu fluoromètre 39.
REMARQUE : Pour les préparations typiques de plasmides Midi, les rendements d’ADN devraient varier de ~50 à 150 μg par culture de 100 à 400 mL, selon la taille du plasmide, le nombre de copies et les conditions de croissance. Les longueurs typiques de lecture des nanopores varient de ~2 kb à 20 kb, avec des lectures médianes souvent autour de 5 à 10 kb pour les plasmides standards. Les kits basés sur la ligature peuvent produire des lectures plus longues (médiane >20 kb) pour des plasmides plus grands, mais le kit rapide offre une préparation plus rapide au prix de lectures légèrement plus courtes.
- Apportez les échantillons d’ADN à température ambiante. Préparez les tubes pour les standards et les échantillons.
- Flux de travail du fluoromètre
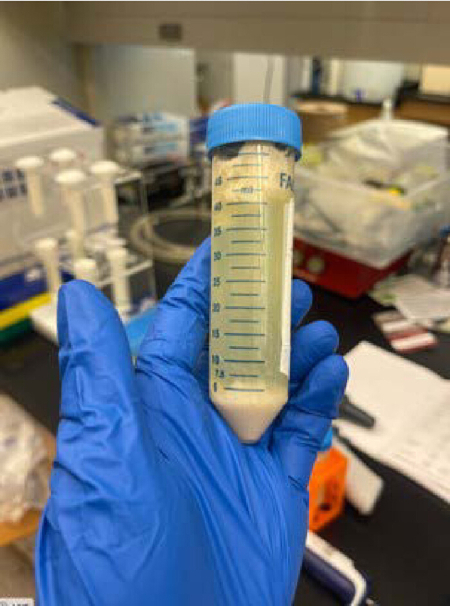
Figure 2 : Supranageant trouble du lysat après une étape de centrifugation. Une centrifugation en série est nécessaire jusqu’à ce que le surnageant soit clair afin d’éviter l’obstruction de la colonne de filtration. Veuillez cliquer ici pour voir une version agrandie de cette figurine.
| Tubes de test standards | Tubes d’essai d’échantillons utilisateurs | |
| Solution de travail (colorant et tampon, 1:200) | 190 μL | 180–199 μL |
| Standard (à partir du kit) | 10 μL | – |
| Exemple utilisateur | – | 1–20 μL |
| Volume total dans chaque tube de test | 200 μL | 200 μL |
Tableau 1 : Volumes et quantités de réactifs pour le fluoromètre. Les quantités sont indiquées pour un seul échantillon ; Un pool peut être préparé en fonction du nombre d’échantillons à analyser.
2. Méthode 2 : Préparation à la bibliothèque
NOTE : Considérations. La préparation à la bibliothèque pour le séquençage des plasmides extraits a été réalisée selon les instructions fournies avec le kit decode-barres 40. Ce protocole utilise un kit qui utilise une approche basée sur la transposase pour fragmenter simultanément et fragmenter l’ADN par code-barres, offrant un flux de travail rapide et fluide qui réduit le temps de travail pratique et simplifie la préparation de la bibliothèque.
- Préparation de l’ADN
- Jour 1 : Programmez un thermocycleur : 30 °C pendant 2 minutes, puis 80 °C pendant 2 minutes.
- Décongelez les composants du kit à température ambiante, réduisez-les et mélangez-les selon le Tableau 2.
REMARQUE : Si vous utilisez une centrifugeuse, tournez vers le bas à une vitesse ne dépassant pas 330 x g. - Préparation de l’ADN dans de l’eau sans nucléase : Transférer 200 ng d’ADN dans des tubes PCR de 0,2 mL et ajouter un volume approprié d’eau sans nucléase à chaque échantillon afin d’atteindre le volume final à 10 μL. Mélanger en pipettant doucement 10 à 15 fois. Faites brièvement tourner dans une microfuge ou centrifugeuse à 330 x g pour faciliter le pipetage dans les étapes suivantes.
- Préparez les mélanges dans des tubes PCR comme indiqué dans le tableau 3.
- Mélangez en pipettant, puis réduisez brièvement.
- Incubez les tubes PCR en utilisant le programme de cycle thermique de l’étape 1. Placez les tubes sur de la glace pour refroidir.
- Tourne brièvement vers le bas.
- Ligation du code-barres natif
- Échantillons codés par la piscine dans un tube Eppendorf propre de 1,5 mL. Assurez-vous que le volume total ne dépasse pas 1000 μL.
- Résuspendez les perles en faisant des vortex. Ajoutez un volume égal de perles aux échantillons codés à barres regroupés et mélangez en faisant des petits mouvements.
- Incubez les tubes pendant 10 minutes à température ambiante sur un batteur Hula.
- Préparez 2 mL d’éthanol à 80 % dans de l’eau sans nucléase.
- Faites descendre l’échantillon et la pellete en tenant le tube contre un aimant. Garder le tube sur l’aimant, faire sortir le surnageant comme déchet.
REMARQUE : Tout aimant de bonne force et taille, y compris les aimants en néodyme, peut servir d’alternative efficace à l’utilisation d’un rack à aimants coûteux. Les aimants d’une force de maintien d’environ 5 à 12 lb et d’un diamètre de 0,3 à 1 pouce conviennent généralement aux tubes standards de 0,2 à 1,5 mL, permettant un retrait net du surnageant lors des étapes de nettoyage à base de billes. - Lavez les billes avec 1 mL d’éthanol à 80 % pendant que vous êtes sur l’aimant. Retirez l’éthanol. Répétez le lavage.
REMARQUE : Modifier la position du tube par rapport à l’aimant peut améliorer la facilité d’extraction de l’éthanol. Utilisez une rotation supplémentaire à basse vitesse pour garantir un pelletage complet de billes si la pellete est accidentellement dérangée. - Faites un petit tour vers le bas et remettez le tube sur l’aimant. Pipette tout éthanol résiduel. Séchez pendant 30 secondes, mais ne séchez pas le pellet au point de le fissurer.
- Retirez l’aimant et resuspendez les billes dans le tampon d’élution. Voir le tableau 4 pour les volumes appropriés d’EB à utiliser selon le nombre de codes-barres utilisés.
- Faites couver le tube pendant 10 minutes à température ambiante.
- Retournez le tube à l’aimant jusqu’à ce que l’éluat soit dégagé.
- Quantifiez la concentration d’ADN en utilisant 1 μL de l’échantillon élué sur le fluoromètre afin de garantir que la préparation de la bibliothèque a été exécutée avec succès et d’éviter de gaspiller une cellule de flux sur une bibliothèque défaillante.
- Ligature de l’adaptateur
- Transférez 11 μL de la bibliothèque d’ADN dans un nouveau tube et marquez.
REMARQUE : Stockez l’ADN supplémentaire à -20 °C pour de futures séances de séquençage si nécessaire. - Diluez l’adaptateur rapide décongelé dans un nouveau tube selon le Tableau 5 et pipettez de haut en bas pour mélanger.
- Ajouter 1 μL d’AR dilué à la bibliothèque d’ADN de 11 μL.
- Faites un coup de fouet sur le tube pour mélanger, puis descendez brièvement pour que le volume complet s’accumule au fond du tube.
- Incubez pendant 5 minutes sur le banc.
- Transférez 11 μL de la bibliothèque d’ADN dans un nouveau tube et marquez.
| Réactif | Dégel à température ambiante | Descends en vrille | Mélanger par pipette |
| Codes barres rapides | Pas Frozen | ✓ | ✓ |
| Adaptateur rapide | Pas Frozen | ✓ | ✓ |
| Billons XP AMPure | ✓ | ✓ | Mélangez par pipetage ou vortex immédiatement avant utilisation |
| Tampon d’élution | ✓ | ✓ | ✓ |
| Tampon adaptateur | ✓ | ✓ | Mélange par vortex |
Tableau 2 : Volumes et quantités de réactifs pour la préparation de la bibliothèque de nanopores. Les actions à effectuer avec chaque réactif sont marquées (✓).
| Réactif | Volume/échantillon |
| ADN modèle de 10 μL (200 ng depuis l’étape précédente) | 10 μL |
| 1,5 μL de codes-barres rapides, un pour chaque échantillon | 1,5 μL |
| Volume total | 11,5 μL |
Tableau 3 : Réactifs et volumes pour le codage rapide. Les volumes sont indiqués par échantillon d’ADN ; un mélange en pool peut être préparé, et l’ADN ajouté séparément.
| Codes-barres 1-24 | 48 codes-barres | 72 codes-barres | 96 codes-barres | |
| Volume du tampon d’élution | 15 μL | 30 μL | 45 μL | 60 μL |
Tableau 4 : Volumes tampons d’élution utilisés pour chaque 24 codes-barres. Les volumes sont indiqués selon le nombre de codes-barres.
| Réactif | Volume |
| Adaptateur rapide (RA) | 1,5 μL |
| Tampon adaptateur (ADB) | 3,5 μL |
| Total Volume | 5μL |
Tableau 5 : Réactifs et quantités pour l’adaptateur. Les volumes peuvent être ajustés en fonction du nombre d’échantillons.
3. Fonctionnement de la cellule de flux
REMARQUE : Choisissez une cellule à flux à sortie standard lors du séquençage d’un petit nombre de plasmides avec des besoins de couverture modérés. Nanopore recommande de réaliser une vérification des cellules de flux pour déterminer le nombre de pores actifs ; Les cellules de flux des appareils nanopore doivent comporter au moins 800 pores actifs selon les critères de garantie. Une seule cellule de flux MinION fournit une production suffisante pour le séquençage de plusieurs échantillons d’ADN enrichis en ADN plasmidique (voir plus de détails sur le multiplexage dans la section discussion) tout en offrant un coût moindre et une plus grande flexibilité qu’une cellule de flux GRIDion ou Prométhéenne.
- Amorçage et chargement de la cellule de flux
REMARQUE : Les cellules à flux R10.4.1 (publiées en 2022) ont été utilisées pour développer ce protocole. Ces cellules à flux ont des pores plus longs avec une double tête lectrice, ce qui améliore le séquençage des homopolymères20,21. Ce protocole de séquençage et le kit de codage à barres ne sont pas compatibles avec d’autres cellules de flux. Optez pour une cellule de flux à haute sortie lors de multiplexage à grande échelle, de viser une couverture élevée ou de travailler avec des plasmides ou génomes plus volumineux. Considérez le nombre d’échantillons et la profondeur de la cible pour équilibrer le coût, le débit et la qualité du séquençage.- Retirez les réactifs du stockage froid, y compris le tampon de séquençage (SB), les billes bibliothèque (LIB) ou la solution bibliothèque (LIS), l’albumine sérique bovine (BSA), le câble à cellules de flux (FCT) et le rinçage des cellules à flux (FCF). Dégel sur la glace à température ambiante. Une fois les réactifs décongelés, le vortex est à mélanger, faire tourner rapidement et stocker sur glace.
- Préparez l’amorçage des cellules de flux en mélangeant un tube d’ADN frais à l’aide des réactifs listés dans le tableau 6. Mélangez par inversion et pipetage.
- Soulevez le couvercle de l’appareil et insérez la cellule de flux. Appliquez une pression douce pour assurer un bon positionnement.
- Exposez le port d’amorçage en poussant légèrement le couvercle sur le côté.
- Vérifiez s’il y a des bulles d’air à l’intérieur ou à côté de la prise d’amorçage. Retirez 20 à 30 μL de liquide pour éliminer les bulles.
REMARQUE : Ne retirez pas plus de 20 à 30 μL de tampon. Les pores doivent rester immergés dans le tampon en permanence. Les pores exposés à l’air peuvent devenir inutilisables. Assurez-vous que le tampon est continu sur tout le canal visible. - Préparez 800 μL de mélange d’amorçage et injectez dans la prise d’amorçage. Évitez d’introduire des bulles d’air. Laissez l’appareil reposer 5 minutes.
- Resuspendez le libérateur en pipettant de haut en bas.
REMARQUE : Suspendez immédiatement avant utilisation, car la libération se stabilise rapidement. - Mélangez la bibliothèque d’ADN avec le volume approprié de billes bibliothèque dans un nouveau tube, comme indiqué dans le tableau 7.
REMARQUE : Le kit de codage à barres rapide utilisé par les auteurs utilise une approche basée sur la transposase pour fragmenter l’ADN et attacher des codes-barres sans sélection intentionnelle de la taille, donc les longueurs de lecture reflètent principalement l’ADN d’entrée original. Contrairement aux kits basés sur ligature comme les kits de codage à barres natifs, le kit de codage à barres rapide ne comprend pas de tampons séparés pour fragments courts ou longs. Bien que l’ADN plus long puisse encore générer de longues lectures, la distribution est plus variable et généralement plus courte que dans les bibliothèques basées sur la ligation qui utilisent le Long Fragment Buffer pour enrichir les fragments longs. L’absence de tampons simplifie le flux de travail et réduit le temps de travail manuel, mais offre moins de contrôle sur la répartition de la taille des bibliothèques, ce qui peut impacter la qualité de l’assemblage. Les kits basés sur la ligatura, en enrichissant sélectivement de gros fragments et en retirant les courts, offrent généralement des longueurs médianes de lecture plus élevées et une meilleure continuité d’assemblage, notamment pour les assemblages de novo et les génomes complexes. - Ajustez le couvercle du port de l’échantillon pour révéler le port. Chargez 200 μL de mélange d’amorçage dans le port d’amorçage de la cellule de flux.
- Mélangez doucement la bibliothèque d’ADN préparée avant de charger.
- Distribuez 75 μL de la bibliothèque d’ADN avec des billes dans le port d’échantillon, une goutte à la fois, permettant à chaque goutte d’être absorbée avant d’ajouter la suivante.
- Remettez le couvercle du port d’échantillon et fermez le port d’amorçage.
- Ajoutez le protège-lumière à la cellule de flux en alignant le bord d’attaque du bouclier lumineux avec le clip, puis en abaissant le reste pour recouvrir la cellule de flux. N’essayez pas de placer la protection lumineuse sous le clip. Le paramètre lumineux doit rester autour du couvercle, protégeant toute la partie supérieure de la cellule de flux de l’exposition à la lumière.
REMARQUE : Installez le pare-lumière sur la cellule de flux dès que la bibliothèque a été chargée pour une sortie de séquence optimale. Laissez-le allumé lors des étapes suivantes jusqu’à ce que la bibliothèque soit retirée de la cellule de flux. Le paramètre lumineux n’est pas fixé solidement à l’appareil ; Manipulez avec précaution pour ne pas le déplacer. - Fermez le couvercle de l’appareil et commencez la séquence.
- Démarrer les exigences de calcul d’exécution du séquençage :
Minimum : processeur 8 threads, 16 Go de RAM, GPU NVIDIA 1070, SSD 500 Go
Recommandé : CPU 16 threads, 32 Go de RAM, GPU NVIDIA 2070, SSD de 1 To
REMARQUE : Assurez-vous que le logiciel et l’ordinateur sont à jour et disposent d’au moins 500 Go de stockage libre pour accueillir de nouveaux fichiers. Les mises à jour logicielles et autres programmes peuvent interférer avec l’exécution du séquençage. Assurez-vous d’exécuter le logiciel sur un système d’exploitation Windows ou Ubuntu.- Fixez la limite de temps d’exécution : selon le nombre de plasmides multiplexés, fixez la limite de diffusion. Par défaut est 48 heures, un temps maximum de 72 heures peut être couru. Pour des instructions détaillées, consultez le manuel.
REMARQUE : le temps d’exécution dépend du multiplexage et de la taille des plasmides plutôt que du nombre de plasmides. Le nombre d’échantillons ou de plasmides pouvant être multiplexés dépend de la profondeur de séquençage souhaitée et de la sortie de la cellule de flux. Pour le séquençage typique des plasmides, le multiplexage de 20 à 24 échantillons par cellule de flux nanopore standard offre généralement une couverture suffisante pour un assemblage précis et une détection de variantes, en supposant des tailles plasmidiques inférieures à ~200 kb. Des plasmides plus grands ou des exigences de couverture plus élevées peuvent nécessiter moins d’échantillons par cellule de flux. Les cellules de débit à plus haute puissance peuvent supporter beaucoup plus d’échantillons (jusqu’à 96 ou plus) par exécution, ce qui les rend adaptées au séquençage à plasmique à haut débit ou aux projets nécessitant une couverture très profonde. Les utilisateurs doivent équilibrer le nombre de codes-barres, la taille du plasmide et la profondeur de la cible afin de s’assurer que chaque plasmide reçoit des lectures adéquates pour un assemblage complet. - Activez le découpage du code-barres si vous effectuez un démultiplexage pendant le séquençage.
REMARQUE : Surveillez les lectures par code-barres et arrêtez la diffusion lorsque la couverture est suffisante pour préserver la durée de vie des cellules de flux. - Sélectionnez le mode d’appel de base super précis.
REMARQUE : Ne sélectionnez pas l’échantillonnage adaptatif / l’équilibrage par code-barres. Cette option réduit fortement la lecture-sortie et dégrade les pores plus rapidement. Si vous n’avez pas de carte graphique, il vaut mieux attendre avant de faire des appels de base après la fin de la séquence. - Sélectionnez le kit de code-barres rapide approprié (24 ou 96).
- Assurez-vous que l’appareil est à niveau et lancez la séquence avec les paramètres par défaut (score Q minimum 10)
REMARQUE : C’est un point d’arrêt pratique. L’appareil peut être utilisé toute la nuit. - Basecalling post-hoc (au cas où l’ordinateur ne disposerait pas de capacité suffisante pour un basecalling en temps réel ou pour améliorer la précision du basecall, réanalyse des données brutes avec des outils analytiques améliorés) : ouvrez la séquence terminée dans le logiciel
REMARQUE : Les étapes suivantes ne s’appliquent que si vous n’avez pas sélectionné l’appel en direct sur la base. - Sélectionnez Basecalling et choisissez le modèle de super-précision (SUP).
- Sélectionnez les données brutes FAST5/POD5 et définissez un répertoire de sortie.
- Commencez à appeler la base.
- Fixez la limite de temps d’exécution : selon le nombre de plasmides multiplexés, fixez la limite de diffusion. Par défaut est 48 heures, un temps maximum de 72 heures peut être couru. Pour des instructions détaillées, consultez le manuel.
| Réactifs | Volume par cellule de flux |
| Rinçage par cellule de flux (FCF) | 1 170 μL |
| Albumine sérique bovine (BSA) à 50 mg/mL | 5 μL |
| Câble de cellule de flux (FCT) | 30 μL |
| Volume total final dans le tube | 1 205 μL |
Tableau 6 : Réactifs et volumes pour amorcer et charger la cellule de flux. Les volumes de réactifs sont indiqués par cellule de flux.
| Réactifs | Volume par cellule de flux |
| Tampon de séquençage (SB) | 37,5 μL |
| Bibliothèque de perles (LIB) ou solution de bibliothèque (LIS), si utilisées | 25,5 μL |
| Bibliothèque ADN | 12 μL |
| Total | 75 μL |
Tableau 7 : Réactifs et volumes pour charger la bibliothèque. Les volumes sont présentés pour la bibliothèque ADN ; Les perles de bibliothèque (BID) doivent être mélangées immédiatement avant utilisation.
4. Méthode 4 : assemblage à l’aide d’un autocycleur
REMARQUE : Il existe de nombreuses options pour assembler les lectures dans les contigs. Chaque assembleur a ses points positifs et ses biais. Ce protocole recommande d’utiliser Autocycler, qui utilise de nombreux assemblages différents et les combine en un seul assemblage. C’est plus laborieux, et vous pouvez utiliser un seul assembleur pour gagner du temps. Veuillez installer Conda dans le terminal pour télécharger le logiciel approprié. Le document de commandes supplémentaires contient un lien vers un fichier environnemental pour configurer le système.
- Évaluer la qualité des runs : Vérifiez la qualité de la run via le logiciel Minknow ou depuis le fichier de rapport de run .html pour noter les métriques de qualité (rendement, Q-scores, longueur, distribution). En option, évaluez les fichiers FASTQ à l’aide de NanoPlot pour confirmer la distribution des longueurs de lecture, le N50 et les profils de score qualité pour chaque code-barres. Ne procéder que si les distributions de rendement et de longueur de lecture du séquençage sont cohérentes avec les tailles attendues des plasmides.
- Supprimer les codes-barres : Déterminez si le découpage des codes-barres a été activé pendant la séquence. Si les codes-barres n’ont pas été retirés, coupez les fichiers FASTQ avec Porechop (v0.2.4) et vérifiez la suppression réussie des séquences d’adaptateurs de codes-barres avant l’analyse en aval.
- Lectures de trim : Couper les lectures longues avec Filtlong (v0.3.1), en supprimant environ 5 à 10 % des lectures de moindre qualité tout en conservant ~90 % du rendement total. Générez un fichier FASTQ filtré pour l’assemblage. Si les assemblages suivants produisent des contenus chimériques, augmentez la stringence de filtrage en imposant un seuil de longueur de lecture minimale de ≥3 000 pb et régénérez les lectures filtrées.
- Sous-échantillonnages et assemblages de sous-ensembles de lecture : Les lectures de sous-échantillons utilisent Autocycler selon les réglages recommandés et assemblent chaque sous-ensemble de lecture avec Raven (v1.8.3), Flye (v2.9.6), Canu (v2.3.0), miniasm (v0.3.0), Myloasm (v0.2.0), NECAT (v0.0.1), Plassembler (v1.8.1) et tout autre assemblage de votre choix. Notez les longueurs contig et l’état de circularisation pour chaque assemblage. Les assembleurs qui signalent une circularisation (Raven, Flye, miniasm, Myloasm et Plassembler) doivent être priorisés pour la reconstruction des plasmides. Pour les assemblages Canu et NECAT, identifier les contigs plasmidiques candidats en fonction de la taille attendue du plasmide à partir des contigs circulaires des assemblages précédents.
- Inspecter et sélectionner les assemblages : visualisez chaque fichier graphe d’assemblage (.gfa) à l’aide de Bandage (v0.9.0) et évaluez les contigs pour la circularité, la cohérence de taille entre assembleurs et les preuves de jonctions chimériques. Supprimez les contigs linéaires manquant de support entre plusieurs assembleurs et conservez les contigs circulaires avec des estimations de taille cohérentes. Si de nombreux assemblages contiennent des jointures chimériques, revenez à l’étape 4.3 et augmentez le seuil de longueur de lecture minimale (recommandé ≥3 000 pb). Dans les cas où les principaux plasmides sont circularisés mais que de petits contigs non soutenus subsistent, on supprime les contigs mineurs avant la génération consensuelle. Passer à la génération de consensus et les étapes de polissage peuvent être exécutées par lots, après une curation manuelle.
- Générer un consensus et assemblage final : Après la curation manuelle, procéder à la génération de consensus Autocycler en utilisant les assemblages sélectionnés. Exécutez les commandes Autocycler restantes pour produire la séquence finale de plasmides consensuels. Des instructions détaillées en ligne de commande et des paramètres sont fournies dans le Matériel Supplémentaire.
- Polissage : Une fois qu’un assemblage complet a été généré, polissez l’assemblage en utilisant les lectures longues découpées avec Medaka (v2.1.1) pour améliorer significativement la précision du consensus.
REMARQUE : Bien que des balles de polissage supplémentaires puissent aider à la précision consensuelle, elles peuvent aussi introduire des erreurs. Il est recommandé d’utiliser un programme comme DNAapler pour faire pivoter le nouveau contenu avant le polissage ; Les commandes sont disponibles dans la section Commandes supplémentaires.
5. Méthode 5 : Annotation
REMARQUE : Il existe de nombreux outils d’annotation efficaces pour les bactéries. Les programmes suivants sont recommandés pour une annotation approfondie.
- Bakta est excellent pour les analyses protéomiques car il est actuellement activement maintenu et sert de successeur spirituel à Prokka41,42.
- Pour le typage des répliques, la mobilité des plasmides et le type de conjugaison, MOB-suite est fiable6. La suite MOB peut déduire la phylogénie plasmidique en utilisant la distanciation par mash et peut identifier les éléments43 de la séquence d’insertion (IS).
- COPLA est également un outil utile pour la taxonomie des plasmides. L’approche unique de Copla, qui classe les plasmides en unités taxonomiques plasmidéiques, est recommandée dans le domaine44.
REMARQUE : La phylogénie des plasmides a historiquement posé des défis importants car la structure modulaire des plasmides et la fréquence élevée de recombinaison rendent l’alignement des séquences difficile. COPLA répond à ces défis en calculant les identités moyennes des nucléotidiques (ANI).
Résultats
Souches cliniques d’E. coli
Pour illustrer l’utilisation de l’ONT pour le séquençage des plasmides issus de souches cliniques, les auteurs ont séquencé 10 souches, qui ont été un généreux don du Dr Stephen Salipante de l’Université de Washington. Ces souches faisaient partie d’une collection de 312 isolats d’E. coli pathogène extra-intestinal (ExPEC), obtenus lors des soins cliniques de routine au Centre médical del’Université de Washington 45.
Conjugaison et caractérisation des plasmides par test de mobilité sur gel
Les chercheurs ont également réalisé un test de conjugaison en utilisant la souche d’E. coli LMB100 comme receveur. La conjugaison est un processus qui conduit au transfert d’un plasmide présent dans une cellule (le donneur) vers une autre cellule (appelée receveur)46. Le transfert nécessite un contact physique entre les deux cellules et est généralement détecté à l’aide de marqueurs indiquant la présence du plasmide conjugatif dans les cellules réceptrices. Cela a permis aux auteurs d’éliminer les différences de souche de l’hôte en tant que variable et d’illustrer l’utilisation du protocole pour le séquençage des plasmides obtenus par capture de plasmides (une méthode utilisée pour profiler les plasmides d’une niche écologique donnée). Tous les tests de conjugaison ont produit des transconjugants, confirmant la présence d’un plasmide conjugatif chez les donneurs. Le protocole suivi par les auteurs est décrit dansla section 36. Le groupe a identifié les plasmides présents dans les souches donneuse et receveuse et a estimé leur mobilité par électrophorèse en gel à champ pulsé (PFGE). Une liste de dix souches donneuses représentatives est présentée dans le Tableau 8, et les tailles estimées des plasmides présents dans la troisième colonne. Les plasmides hors de la plage de résolution du gel de PFGE sont exclus de ce tableau, mais les chercheurs ont pu assembler plusieurs plasmides plus petits autour de ~4 kb (non montrés).
| Souche donneuse | Plasmide | Taille estimée du PFGE | Longueur d’assemblage | Profondeur moyenne | pb Profondeur zéro | Pourcentage de couverture | Changements de positions | Pourcentage de précision avant SR |
| blood_08 _0081 | pblood_08_ 0081_1 | 170000 | 171829 | 100 | 99.941803 | 54 | 0.0314 | 99.9686 |
| blood_08 _0081 | pBlood_08_ 0081_2 | 82000 | 85576 | 46.9 | 0 | 100 | 2 | 99.9977 |
| blood_d-08 _0094 | pBlood_d-08 _0094 | 179000 | 173334 | 382.6 | 3121 | 98.19943 | 2,347 | 98.646 |
| blood_08 _1447 | pBlood_08 _1447 | 97000 | 99624 | 36.2 | 0 | 100 | 0 | 100 |
| blood_10 _0913 | pBlood_10 _0913_1 | 70000 | 71788 | 49 | 4 | 99.994428 | 188 | 99.7381 |
| blood_10 _0913 | pBlood_10 _0913_2 | 112000 | 118727 | 41.2 | 126 | 99.893874 | 276 | 99.7675 |
| blood_1 1_184 | pBlood_11 _184_1 | 150000 | 146583 | 65.1 | 287 | 99.804206 | 134 | 99.9086 |
| blood_11_184 | pBlood_11 _184_2 | 75000 | 74263 | 82.1 | 0 | 100 | 32 | 99.9569 |
| blood_2011 _0238 | pBlood_ 2011_0238 | 170000 | 167286 | 110.9 | 0 | 100 | 0 | 100 |
| upec_108 | pUPEC_108 | 130500 | 131039 | 103.9 | 0 | 100 | 0 | 100 |
| upec_134 | pUPEC_134 | 160500 | 157829 | 169 | 0 | 100 | 0 | 100 |
| upec_271 | pUPEC_271 | 145500 | 144519 | 86 | 33311 | 76.950436 | 1,557 | 98.9226 |
| upec_90 | pUPEC_90 | 70000 | 74624 | 139.8 | 0 | 100 | 6 | 99.992 |
Tableau 8 : Estimations de la taille des plasmides et mesures de précision du séquençage pour un panel de 10 souches donneuses. Des estimations de la taille des plasmides basées sur le PFGE ou les séquences de plasmides donneurs d’ONT assemblées sont listées. Les comparaisons par paires des assemblages de plasmidiques polis uniquement en ONT et en séquence SR sont également montrées comme un indicateur de précision. Les indicateurs incluent : longueur d’assemblage, profondeur moyenne, régions à profondeur nulle, pourcentage de couverture, positions modifiées et pourcentage de précision avant SR.
Métriques de sortie du séquençage plasmidique basé sur ONT
La séquence était fixée à 24 heures. Un total de 24 échantillons ont été multiplexés. Les données techniques pour chaque échantillon, incluant le score de qualité (Q), la durée et la couverture, sont listées dans le Tableau 9. Le séquençage nanopore a produit une qualité de lecture suffisante pour tous les échantillons analysés. Dans toutes les bibliothèques, le séquençage générait en moyenne 134 115 lectures par échantillon, correspondant à un rendement moyen de 576,2 Mo. Les lectures avaient une longueur moyenne de 8 797 pb avec une moyenne N50 de 3 693 pb, assurant une continuité suffisante pour l’assemblage des plasmides. Le score moyen de qualité de lecture était de Q16,0 avec une médiane de Q16,6, et les runs individuels variaient de Q13,7 à Q18,0.
| Déformation séquencée | Lectures (kb) | Bases (Mb) | Longueur moyenne | Longueur maximale | Longueur minimale | N50 | Longueur médiane | Moyenne Q | Médiane Q | |
| Blood_08_0081 donneur | 109.8 | 261 | 5713 | 508418 | 78 | 2377 | 1351 | 14.5 | 15 | |
| Blood_08_0094 donneur | 89.3 | 229 | 4177 | 114948 | 81 | 2565 | 1065 | 13.7 | 14 | |
| Blood_08_1447 donneur | 87.5 | 246 | 5041 | 135147 | 75 | 2816 | 1609 | 15.1 | 15.7 | |
| Bblood_10_0913 donneur | 247.7 | 1026 | 9260 | 174231 | 70 | 4143 | 1661 | 15.5 | 16.1 | |
| Blood_11_154 donneur | 51.5 | 110 | 4172 | 91148 | 73 | 2127 | 1387 | 16.1 | 16.5 | |
| Blood_2011_0238 donneur | 16.8 | 42 | 6707 | 104848 | 62 | 2534 | 845 | 15.3 | 15.2 | |
| UPEC_108 donneur | 50.6 | 77 | 1915 | 90234 | 67 | 1525 | 1103 | 15.8 | 16.2 | |
| UPEC_134 donneur | 50 | 143 | 7110 | 158393 | 72 | 2865 | 1133 | 16 | 16.2 | |
| UPEC_217 donneur | 64 | 236 | 7512 | 144275 | 78 | 3678 | 1895 | 17.4 | 17.9 | |
| UPEC_90 donneur | 52.9 | 157 | 5666 | 95944 | 72 | 2969 | 1593 | 16.8 | 17.2 | |
| Blood_08_0081 transconjugant LMB100 | 53.5 | 119 | 5162 | 225856 | 1 | 2232 | 1009 | 16 | 16.8 | |
| Blood_08_0094 transconjugant LMB100 | 160 | 442 | 7257 | 252176 | 1 | 2761 | 1083 | 17.3 | 18.2 | |
| Blood_08_1447 transconjugant LMB100 | 238 | 1029 | 10249 | 209221 | 1 | 4320 | 1857 | 17.7 | 18.7 | |
| Blood_10_0913 transconjugant LMB100 | 792.3 | 4341 | 11508 | 474325 | 1 | 5479 | 2731 | 17.7 | 18.8 | |
| Blood_11_184 transconjugant LMB100 | 42.5 | 281 | 17931 | 146626 | 87 | 6615 | 2448 | 16 | 16.7 | |
| Blood_2011_0238 transconjugant LMB100 | 147.7 | 585 | 9000 | 344203 | 1 | 3962 | 1781 | 18 | 18.9 | |
| UPEC_108 transconjugant LMB100 | 173.4 | 778 | 10127 | 168756 | 80 | 4485 | 2079 | 15.3 | 16.1 | |
| UPEC_134 transconjugant LMB100 | 105.4 | 667 | 17568 | 349230 | 71 | 6323 | 2232 | 15.5 | 16.3 | |
| UPEC_271 transconjugant LMB100 | 74.2 | 336 | 14521 | 342195 | 83 | 4520 | 1306 | 14.6 | 14.8 | |
| UPEC_90 transconjugant LMB100 | 75.2 | 418 | 15348 | 225661 | 83 | 5561 | 2016 | 15.7 | 16.4 | |
Tableau 9 : Rapport NanoQ des métriques de sortie du séquençage pour un panel de 10 souches donneuses. Les métriques de sortie de séquençage sont listées. Cela inclut les lectures, les bases, la longueur (moyenne, médiane, max et min), les longueurs, N50, et les valeurs Q (moyenne et médiane) des donneurs et des transconjugants.
Assemblage des plasmides et précision
Les séquences plasmidiques ont été assemblées à l’aide de l’Autocycler34. Les tailles des séquences plasmidiques assemblées pour 10 échantillons sont listées dans le tableau 8, quatrième colonne, et elles étaient dans tous les cas conformes aux estimations basées sur la mobilité des PFGE (listées dans la troisième colonne). La précision a été évaluée en comparant les assemblages de lecture longue polissés Medaka avec les assemblages Medaka (v2.2.0) plus polypolonais (v0.6.1). L’identité de la séquence a été calculée à l’aide de dnadiff à partir de MUMmer (v3.2.4) (Tableau 8). Pour tous les plasmides analysés (n = 12), les assemblages avaient une longueur moyenne de 120,4 kb et étaient soutenus par une profondeur de séquençage moyenne de 109x, avec une couverture moyenne de 97,9 % sur les séquences plasmidiques. Avant le polissage, les assemblages présentaient une identité séquence moyenne de 99,74 % par rapport à l’assemblage poli de la séquence SR.
Estimation de la contamination chromosomique
Pour estimer la couverture plasmidique et la contamination chromosomique, les lectures ont été mappées sur les séquences plasmidiques assemblées ainsi que sur la séquence chromosomique E. coli LMB100. Les lectures Basecalled Nanopore étaient alignées à l’aide de minimap2 (v2.2.6). Les alignements résultants étaient traités à l’aide de SAMtools (v1.1.7) pour générer des fichiers BAM triés et calculer des statistiques de cartographie. La couverture plasmidique et la profondeur moyenne ont été estimées à l’aide de la couverture des outils SAMtools. La profondeur de séquençage des plasmides variait entre les échantillons mais restait bien au-dessus de la couverture minimale requise pour un assemblage précis (50–70 x). Une fraction des lectures mappées au chromosome, indiquant la transmission de l’ADN de l’hôte lors de l’extraction du plasmide (Tableau 10).
| Plasmides | Total des lectures | Lectures chromosomiques | % de lectures chromosomiques | Couverture chromosomique moyenne | Couverture moyenne des plasmides | P:C Ratio |
| pBlood_08_0081_2 | 53491 | 20116 | 37.61% | 5 | 1068 | 236 |
| pBlood_d-08_0094 | 160024 | 74827 | 46.76% | 37 | 1618 | 44 |
| pBlood_08_1447 | 238031 | 127967 | 53.76% | 62 | 7842 | 127 |
| pBlood_10_0913_1 | 792263 | 221610 | 27.97% | 87 | 7801 | 90 |
| pBlood_10_0913_2 | 792263 | 221610 | 27.97% | 87 | 7772 | 89 |
| pBlood_11_184_1 | 42494 | 15919 | 37.46% | 7 | 1637 | 250 |
| pBlood_11_184_2 | 42494 | 15919 | 37.46% | 7 | 2188 | 335 |
| pBlood_2011_0238 | 147680 | 80526 | 54.53% | 56 | 2965 | 53 |
| pUPEC_108 | 173409 | 107884 | 62.21% | 61 | 4008 | 65 |
| pUPEC_134 | 105418 | 68645 | 65.12% | 29 | 3640 | 127 |
| pUPEC_271 | 74232 | 53554 | 72.14% | 34 | 1202 | 35 |
| pUPEC_90 | 75193 | 30052 | 39.97% | 16 | 4488 | 278 |
Tableau 10 : Estimations de la contamination par l’ADN chromosomique. La contamination chromosomique dans les plasmides purifiés à partir de souches réceptrices a été quantifiée comme la proportion de lectures correspondant à la séquence chromosomique LMB100 par rapport aux lectures plasmodiques. Pour chaque plasmide, les lectures plasmidiques, totales, chromosomiques, couverture chromosomique moyenne, couverture plasmidique moyenne et rapport P :C sont listées. Notez que pBlood_08_0081_1 est absent car il n’a pas pu être récupéré chez le receveur, et ces estimations ont été réalisées sur les receveurs en raison de leur fond chromosomique uniforme.
La contamination chromosomique a été quantifiée comme la proportion de lectures correspondant à la séquence chromosomique assemblée de LMB100 par rapport aux lectures plasmidiques. Les taux de contamination chromosomique variaient entre 72,1 % et 28,0 %, avec une moyenne de 46,9 % (Tableau 10). La méthode est susceptible de surestimer la contamination chromosomique car les lectures correspondant au plasmide et au chromosome sont comptées comme chromosomiques uniquement, mais cela indique néanmoins un transfert chromosomique important. Malgré ce transfert chromosomique, le flux de travail d’assemblage a réussi à reconstituer des séquences plasmidiques complètes, qui restaient cohérentes avec la taille prédite par la mobilité des PFGE sur tous les échantillons (Tableau 8, troisième et quatrième colonnes).
Paires représentatives donneur-receveur de plasmides conjugatifs
La souche upec271 a été isolée à partir d’un échantillon urinaire entre 2011 et 2013 et a été assignée au phylogroupe B2 et au type de séquence ST131. L’analyse du PFGE a révélé la présence d’une bande correspondant à un plasmide d’environ 145 kb [Figure 3A, (Doneur)]. L’analyse de séquence en lecture courte a identifié la présence d’un réplicon IncF.
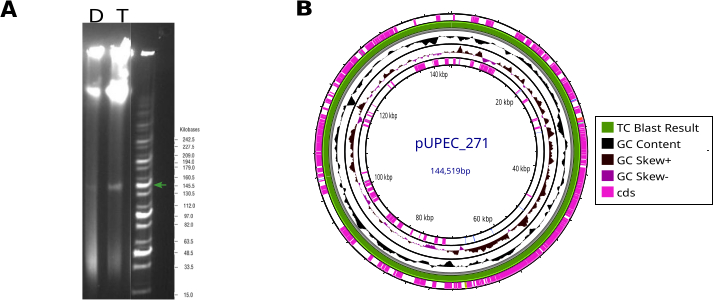
Figure 3 : Caractérisation de pUPEC271. (A) PFGE du donneur et du transconjugant. Les bandes PFGE pour le donneur (D) et le transconjugant (T) sont indiquées ; les flèches vertes indiquent la bande plasmidique correspondant à pUPEC271. Le protocole utilisé pour la PFGE est décrit dans une étude36. (B) Carte de pUPEC271. Le transconjugant a été projeté contre le donneur, et le consensus (qui est 100 % identique) est affiché comme l’anneau vert. Cette représentation a été générée à l’aide de Proksee48. L’anneau le plus externe indique l’emplacement du CDS, deux anneaux internes le contenu et l’asireté en GC, et l’anneau le plus interne indique la localisation des gènes d’ARNt. Veuillez cliquer ici pour voir une version agrandie de cette figurine.
Le transfert de ce plasmide, que les auteurs ont appelé pUPEC271, a été confirmé par une analyse PFGE utilisant le protocole précédemment décrit dans36 [Figure 3A, T(transconjugant)]. L’ADN plasmidique purifié à partir de la souche upec271 (pUPEC271_donor) du donneur a été séquencé à l’aide de nanopore. Conformément à la taille de sa bande sur le gel de PFGE, la séquence pUPEC271_donor a révélé un plasmide de 144 519 pb (Figure 3B). Ce plasmide possédait un réplicon de type IncF et possédait des gènes de résistance à six classes distinctes d’antibiotiques (voir Tableau supplémentaire 1). Les auteurs ont également purifié l’ADN d’un des transconjugants (pUPEC271_TC) et obtenu une séquence identique à celle du donneur. L’assemblage final, comparé à pUPEC271_donor, est représenté dans la figure 3B. Cela a confirmé que le plasmide conjugatif présent chez le donneur avait été transféré à la souche transconjugante. Les données techniques sont présentées dans le tableau 9.
La souche Blood_10_0913 est un exemple de souche comportant plus d’un plasmide. Cet échantillon a été prélevé dans le sang entre 2008 et 2013, et le séquençage en lecture courte a indiqué la présence de deux réplicons, un réplicon IncF et un réplicon IncY. L’analyse par la PFGE de cette souche a identifié deux plasmides d’environ 70 et 110 kb respectivement (Figure 4A). Cela a été confirmé par le séquençage par nanopore, qui a produit deux assemblages, respectivement de 71 182 pb et 111 226 pb. Les auteurs ont nommé ces deux plasmides pBlood_10_0913_1 et pBlood_10_0913_2 (Figure 4B). Cependant, les assemblages ne se sont initialement pas circulisés en raison de l’homologie de séquence étendue dans la section des plasmides portant la machinerie de conjugaison (la section d’homologie extensive est mise en évidence à la Figure 4B). Le diagramme d’assemblage défaillant, généré à l’aide du Bandage47 , est montré à la Figure 4C. L’assemblage complet des deux plasmides n’a été possible qu’après un éliminatoire agressif de séquences de lecture plus courte (< 3000 pb).
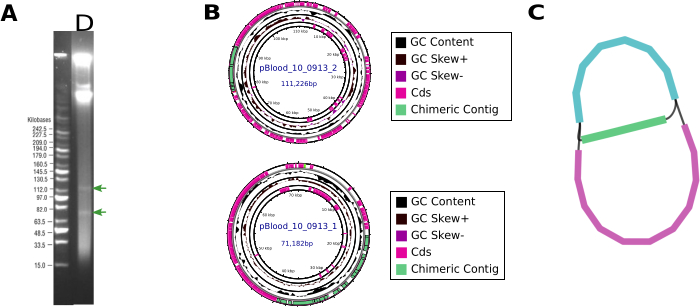
Figure 4 : Identification et assemblage des plasmides de Blood_10_0913 souche. (A) PFGE. Les flèches vertes indiquent des bandes plasmidiques. Le protocole utilisé pour le PFGE est décrit dansl’assemblage de séquence 36 (B). Assemblage des deux plasmides plus petits présents dans l’échantillon pBlood_10_0913, pBlood_10_0913_2 et pBlood_10_0913_2. (C) Montage raté. Représentation de la défaillance de l’assemblage due à la présence d’une suite partagée entre deux assemblages distincts. Cette représentation a été générée à l’aide du bandage47. Veuillez cliquer ici pour voir une version agrandie de cette figurine.
Tableau supplémentaire 1 : Gènes de résistance portés par pUPEC271. La taille du plasmide, les réplicons et les gènes de résistance associés à pUPEC271 sont montrés. Veuillez cliquer ici pour télécharger ce fichier.
Commandements Supplémentaires. Veuillez cliquer ici pour télécharger ce fichier.
Discussion
L’identification et la caractérisation des plasmides suscitent un grand intérêt pour la santé publique, la microbiologie clinique et l’écologie microbienne, car ils facilitent le maintien et la diffusion des gènes adaptatifs dans des contextes écologiques 1,5 et servent de plateformes pour une évolutionaccélérée 4. L’introduction des technologies NGS a permis le séquençage à haut débit des génomes d’isolats microbiens et de populations, bien que l’identification post-assemblage de plasmides complets ou de contigs dérivés des plasmides nécessite généralement des séquences à longue lecture, car les données de séquençage en lecture courte ne permettent pas de résoudre des régions répétées supérieures à la taille des lectures. L’ONT est devenue une approche très populaire de séquençage à longue lecture, avec des applications allant au-delà du séquençage du génome complet et de la métagénomique, incluant la vérification des séquences plasmidiques, la détection et la caractérisation des modifications épigénétiques, le séquençage de l’ARN, ainsi que l’évaluation de l’instabilité intrinsèque des réseaux de gènes en tandem (révisé dans12,49).
Ici, les chercheurs présentent un flux de travail pour le séquençage ONT des plasmides conçu pour des situations où la séquence chromosomique est déjà connue ou sans intérêt. La raison en est que l’extraction des plasmides est laborieuse et coûteuse en temps (car la population hôte doit être cultivée en culture et traitée), et le séquençage de l’ensemble du génome à l’aide de la technologie nanopore suffit souvent à obtenir des assemblages complets de plasmides tout en fournissant leur contexte génomique. Parmi les exemples où le protocole est utile, on trouve la vérification d’une séquence plasmidique dans le contexte de l’ingénierie génétiqueplasmidique 50,51, l’amélioration de la précision des séquences plasmidiques déjà obtenues par WGS24, ou la caractérisation de plasmides capturés à partir d’échantillons cliniques ou environnementaux par conjugaison.
L’extraction d’ADN à partir d’échantillons cliniques et environnementaux peut nécessiter une certaine adaptation. Ici, les auteurs rapportent que certaines souches cliniques qu’ils ont utilisées ont produit une matrice de biofilm qui obstruait les filtres, nécessitant plusieurs étapes de pelletage et parfois l’ajout de deux filtres. De plus, pour séquencer les plasmides conjugatifs, un volume de culture plus important est nécessaire par rapport au séquençage des plasmides multi-copies, car les plasmides de taille moyenne et grande naturellement présents ont tendance à avoir un faible nombre de copiesplasmidiques 2.
Le protocole a permis le séquençage de plasmides de taille comprise entre 4 kb et 173 kb. Cette plage correspond parfaitement aux spécifications du constructeur (entre 2 et 200 kb). Récemment, une étude a examiné 23 000 séquences plasmidiques déposées dans le NCBI et a trouvé des différences de taille significatives selon la source, les plasmides d’origine humaine ayant la plus petite taille médiane (76 kb), et les plasmides du sol et des plantes les plus importants (215 et 427 kb, respectivement) ; Les plasmides provenant de toutes les autres sources avaient une taille médiane comprise entre 79 et 147 kB, donc ce protocole devrait couvrir la plupart des plasmides, à l’exception possible des mégaplasmides52 et des plasmides d’origine solienneou végétale 3.
Les auteurs incluent une étape d’enrichissement de l’ADN plasmidique pour améliorer la précision des assemblages d’ADN plasmidique. La présence de grandes quantités d’ADN chromosomique inonde les pores cellulaires de la cellule de flux séquençant avec des lectures non ciblées, réduisant considérablement la profondeur de l’ADN plasmidique. Une étape d’enrichissement de l’ADN plasmidique a déjà été mise en œuvre pour tenter l’assemblage complet de l’ADN plasmidique dans des échantillons cliniques pour la détection des ARG24. Cela a montré des améliorations substantielles dans l’efficacité de l’assemblage des plasmides avec une séquence nanopore uniquement (78 % d’assemblages complets par rapport à la référence). D’autres exemples ont suivi50, 53, 54.
Pour améliorer la précision des lectures, deux de ces études ont utilisé une technique développée par nanopore appelée « appel de base par paires sur des lectures pseudo-appariées »50,53. Cette approche consiste à aligner les signaux électriques bruts provenant des brins sensibles et antisens d’une même molécule d’ADN, ce qui améliore la précision d’environ un ordre de grandeur. Le « pairing basecalling » sur des lectures pseudoappariées est compatible avec le multiplexage, tant que la stratégie permet d’identifier les brins avant et arrière d’une même molécule. Ainsi, il ne peut pas être utilisé dans des plasmides purifiés à partir d’échantillons de complément plasmidique inconnu ou contenant un mélange de plasmides. Notez que le nombre de plasmides dans un génome varie généralement entre 0 et 7 plasmides (notamment dans les isolats cliniques)2,55.
Les chercheurs ont constaté un niveau élevé de contamination chromosomique dans les échantillons (Tableau 10). Le niveau de contamination de 10 échantillons analysés variait entre 28 et 72 % selon la cartographie de lecture. Cependant, lorsque les chercheurs ont normalisé cette séquence à la taille du chromosome par rapport à celle du ou des plasmides présents, il a été constaté que les séquences plasmidiques étaient en moyenne 144 fois plus abondantes que les séquences chromosomiques. Traduire ce nombre au niveau d’enrichissement de l’ADN plasmidique nécessiterait de connaître le nombre de copies plasmidiques des plasmides dans chaque échantillon.
Les cellules de flux MinION produisent généralement une sortie de séquençage de ~30 Go, permettant théoriquement le séquençage de bien plus de 96 plasmides par exécution. En pratique, le multiplexage est également contraint par la limite de 96 codes-barres, ce qui fait de 96 plasmides la limite supérieure pratique par cellule de flux. Cependant, la contamination de l’ADN chromosomique et le déséquilibre naturel des codes-barres réduisent la profondeur de lecture effective par échantillon. Pour garantir une profondeur de lecture suffisante pour chaque échantillon, une approche plus conservatrice consiste à multiplexer environ 24 plasmides par cellule de flux. La profondeur recommandée pour l’assemblage précis de la séquence plasmidique est comprise entre 50 et70x32,56. Dans les exemples illustratifs présentés dans cet article, les auteurs ont analysé 21 échantillons multiplexés dans une cellule de flux et obtenu une profondeur moyenne (109x), ce qui correspond bien à l’optimum recommandé pour chaque cellule de flux.
Notez qu’avec une profondeur de lecture excédentaire, les partitions de lecture réussi/échec sont moins informatives pour évaluer la qualité globale de lecture. Au contraire, les métriques dérivées de la distribution de longueur offrent une représentation plus claire de la qualité des ensembles de données. Un de ces indicateurs est le N50, défini comme la longueur de lecture à laquelle les lectures de cette longueur ou plus représentent 50 % du total des bases. Cette valeur est très sensible aux étapes de contrôle qualité. Par exemple, filtrer les lectures de faible qualité ou courtes avec des outils comme Filtlong enlève une fraction substantielle de la queue plus courte de la distribution, gonflant ainsi le N50. Cet effet est évident dans le tableau 9.
Les auteurs ont utilisé le kit Rapid Barcode d’ONT, qui utilise un transposome pour fragmenter l’ADN plasmidique, et ne nécessite donc pas de connaissance préalable du schéma de restriction du plasmide. Une étude antérieure a montré que pour les petits plasmides (<20 kb), la fragmentation enzymatique est nécessaire car les petits plasmides restent circularisés lors de la plupart des extractions d’ADN, et ne contiennent donc pas d’extrémités libres pour la ligationadaptateur 54. Cette étude n’a pas utilisé de codes-barres, qui génèrent des extrémités libres supplémentaires par amplification PCR, donc dans ce cas, cela est probablement sans objet. OnRamp, l’une des procédures avancées pour la validation de plasmides de routine, évite l’utilisation de codes-barres en utilisant des lectures de plasmides pleine longueur pour l’assemblage, simplifiant ainsi la préparationde l’échantillon 54. Dans ce cas, les auteurs ont préféré les codes-barres pour trois raisons. La première consiste à construire un assemblage quelle que soit la longueur du plasmide. La seconde consiste à tolérer la contamination par l’ADN chromosomique. Le troisième est que cela ouvre la possibilité de multiplexer plusieurs échantillons, comme indiqué ci-dessus.
Une étude antérieure a noté que l’agrégation de différents assembleurs améliorait le résultat final en annulant les biais intégrés aux plateformesd’assemblage individuelles 24. Cette méta-analyse est une fonctionnalité qui a été intégrée dans le programme d’assemblage utilisé par les auteurs, Autocycler34. Par rapport à sa version précédente, nommée Trycycler57, Autocycler est un peu plus automatisé ; Il utilise plusieurs sous-ensembles des lectures et (comme mentionné précédemment) il effectue des assemblages avec plusieurs assembleurs pour créer un assemblage consensus plus précis. Cependant, la plupart des assembleurs, même les meilleurs, comme Flye28, Canu29 et Raven30, ont du mal à gérer la présence de plasmides présentant une homologie de séquence étendue, à fusionner par erreur des séquences plasmidiques ou à générer plusieurs copies d’un même plasmide, et sont sujets à manquer de petits plasmides58,59 (voir aussi Figure 4C). Lorsque cela se produit, supprimer les lectures de moindre qualité et supprimer les lectures courtes peut conduire à résoudre des contenus chimériques.
Pour établir la précision globale des protocoles de séquençage, les auteurs ont comparé les assemblages uniquement ONT avec des assemblages polis en combinant des lectures longues et courtes, ce qui (en dehors des données PacBio) est la référence actuelle. Les auteurs disposaient également de données sur gel montrant le nombre de plasmides présents et leur taille estimée (Tableau 8, troisième colonne). Les chercheurs ont réussi à assembler les 13 plasmides trouvés dans les 10 échantillons et à obtenir des tailles compatibles avec les séquences assemblées. C’est un certain succès, car les assembleurs de séquences LR échouent souvent à assembler des plasmides avec des séquences structurellement complexes. À un niveau plus précis, les comparaisons par paires entre les deux ensembles de séquences indiquaient un niveau de précision variable (Tableau 8). Cinq des assemblages plasmidiques avaient des zones sans couverture dans les assemblages ONT, vraisemblablement le résultat d’une séquence ajoutée artificiellement lors de l’assemblage de séquence uniquement ONT. Parmi les sept autres, trois présentaient des polymorphismes mononucléotidiques, avec des différences par paires allant de 0,0023 à 0,05 %, et quatre montraient une concordance parfaite. Le niveau de précision ne semble pas correspondre au niveau d’enrichissement ou de profondeur de séquençage de l’ADN plasmidique, mais la présence de plus d’un plasmide dans un échantillon donné, oui, possiblement parce que la présence de plus d’un plasmide tend à amplifier le niveau de complexité de séquence (Tableau 8). En résumé, le flux de travail est conçu pour optimiser le rendement et la précision des séquences plasmidiques. Bien qu’il soit capable d’assembler des séquences plasmidiques, il produit un niveau de précision variable au niveau des nucléotides. Le protocole peut être utilisé pour séquencer des plasmides de différentes tailles, tolère au moins 72 % de contamination par l’ADN chromosomique, et peut accueillir (selon la taille du plasmide et l’état de la cellule de flux) au moins 24 plasmides dans une seule cellule de flux.
Déclarations de divulgation
Les auteurs n’ont rien à divulguer.
Remerciements
Nous sommes très reconnaissants envers Steve Salipante (Université de Washington) pour avoir généreusement partagé un ensemble de souches cliniques d’E. coli publiées dans45. Ce travail a été partiellement soutenu par des fonds de soutien à la recherche pour une nomination de direction en innovation et développement entrepreneurial de l’UCSC à MC, ainsi que par la subvention Alianza MX de l’Université de Californie intitulée « Profilage génomique des isolats de tuberculose chez les populations à forte charge et vulnérables au Mexique : perspectives sur la transmission et la résistance aux médicaments » à la MC.
Matériaux
| Nom | Entreprise | Numéro de catalogue | Commentaires |
|---|---|---|---|
| 1.5 mL Eppendorf DNA LoBind tube | Sigma Aldrich | EP022431081 | Il peut être remplacé par une autre marque |
| 1.5 mL tube racks | Thermo Fisher Scientific | 22-313630 | Il peut être remplacé par une autre marque |
| 15 mL conical tubes | FALCON | 352096 | Il peut être remplacé par une autre marque |
| 15 mL tube racks | Thermo Fisher Scientific | 8850 | Il peut être remplacé par une autre marque |
| 2.0 mL microcentrifuge tubes | Fisherbrand | 05-408-138 | Il peut être remplacé par une autre marque |
| 250 mL sterile flasks | PYREX | 5320 | Il peut être remplacé par une autre marque |
| Carbenicillin | GOLD BIOTECHNOLOGY | C-103-50 | Il peut être remplacé par une autre marque |
| Centrifuge | Eppendorf | 5424R-PR-R | Il peut être remplacé par une autre marque |
| Centrifuge | Eppendorf | 5810R-P-R | Il peut être remplacé par une autre marque |
| Centrifuge bottles | Sigma Aldrich | B1283-4EA | Il peut être remplacé par une autre marque |
| Disposable Inoculating Loops: 1 µL | Fisherbrand | 22-363-595 | Il peut être remplacé par une autre marque |
| Electronic Digital Scale | Denver Instrument | APX-2001 | Il peut être remplacé par une autre marque |
| Ethanol | Fisher Scientific | 04-355-720 | Il peut être remplacé par une autre marque |
| Ethanol-resistant markers | Sharpie | 37001; 37002; 37003 | Il peut être remplacé par une autre marque |
| Flow cell (R10.4.1) | Oxford Nanopore Technologies | FLO-MIN114 | |
| Flow Cell Wash Kit | Oxford Nanopore Technologies | EXP-WSH004 | |
| Gloves | X-GEN | 44-100M | Toute marque de gants en nitrile fonctionne |
| Ice bucket | Thermo Fisher Scientific | 432128 | Il peut être remplacé par une autre marque |
| Isopropanol | Fisher Scientific | BP26184 | Il peut être remplacé par une autre marque |
| MinION Sequencing Device | Oxford Nanopore Technologies | MIN-101B | |
| Native Barcoding Kit 96 V14 | Oxford Nanopore Technologies | SQK-NBD114.96 | |
| NucleoBond Xtra MIDI Plasmid DNA Extraction Kit | Takara | 740410.5 | |
| PCR tube racks | AXYGEN | R96PCRFSP | Il peut être remplacé par une autre marque |
| PCR tubes: (0.2 mL) | AXYGEN | PCR-02-C | Il peut être remplacé par une autre marque |
| Program autocycler v0.5.2 | Ryan Wick / University of Melbourne | ||
| Program bcftools v1.22 | Wellcome Sanger Institute (HTSlib / Samtools team) | ||
| Program bwa v0.7.19 | Heng Li, originally at the Broad Institute | ||
| Program canu v2.3 | University of California, Davis & Pacific Biosciences collaborators | ||
| Program flye v2.9.6 | University of California, San Diego (Pavel Pevzner lab) | ||
| Program medaka v2.1.1 | Oxford Nanopore Technologies | ||
| Program metamdbg v1.2 | INRIA | ||
| Program miniasm v0.3 | Heng Li | ||
| Program minimap2 v2.28 | Heng Li | ||
| Program minipolish v0.2.0 | Ryan Wick / University of Melbourne | ||
| Program porechop v0.2.4 | Ryan Wick / University of Melbourne | ||
| Program racon v1.5.0 | Genome Institute of Singapore | ||
| Program samtools v1.22.1 | Wellcome Sanger Institute (HTSlib / Samtools project) | ||
| Qubit® 4 Fluorometer | Invitrogen | Q33226 | |
| Qubit® Assay Tubes | Invitrogen | Q32856 | |
| Rapid Barcoding Kit 24 and 96 V14 | Oxford Nanopore Technologies | SQK-RBK114.96 | |
| Set of micropipettes that dispense between 1 – 10 µL (P10), 2 – 20 µL (P20), 20 – 200 µL (P200) and 200 – 1000 µL (P1000) | RAININ | 17008648; 17008650; 17008652; 17008653 | Les micropipettes doivent être calibrées |
| Spectrophotometer | Thermo Scientific | 335905P | Il peut être remplacé par une autre marque |
| Sterilized tips for 10 µL, 200 µL and 1000 µL | Eclipse | 1011-260-000-9; 1018-260-000; 1019-260-000-9 | |
| Thermal cycler C1000 Touch | Bio-Rad | 1851196 | Il peut être remplacé par une autre marque |
| Water bath | Thermo Scientific | 51221052 | Il peut être remplacé par une autre marque |
Références
- Finks, S. S., Martiny, J. B. H. Plasmid-encoded traits vary across environments. mBio. 14 (1), e0319122(2023).
- Ramiro-Martinez, P., de Quinto, I., Lanza, V. F., Gama, J. A., Rodriguez-Beltran, J. Universal rules govern plasmid copy number. Nat Commun. 16 (1), 6022(2025).
- Redondo-Salvo, S., et al. Pathways for horizontal gene transfer in bacteria revealed by a global map of their plasmids. Nat Commun. 11 (1), 3602(2020).
- Rodriguez-Beltran, J., DelaFuente, J., Leon-Sampedro, R., MacLean, R. C., San Millan, A. Beyond horizontal gene transfer: the role of plasmids in bacterial evolution. Nat Rev Microbiol. 19 (6), 347-359 (2021).
- Castaneda-Barba, S., Top, E. M., Stalder, T. Plasmids, a molecular cornerstone of antimicrobial resistance in the one health era. Nat Rev Microbiol. 22 (1), 18-32 (2024).
- Robertson, J., Bessonov, K., Schonfeld, J., Nash, J. H. E. Universal whole-sequence-based plasmid typing and its utility to prediction of host range and epidemiological surveillance. Microb Genom. 6 (10), (2020).
- Conlan, S., et al. Single-molecule sequencing to track plasmid diversity of hospital-associated carbapenemase-producing Enterobacteriaceae. Sci Transl Med. 6 (254), 254ra126(2014).
- Zankari, E., et al. Identification of acquired antimicrobial resistance genes. J Antimicrob Chemother. 67 (11), 2640-2644 (2012).
- Eyre, D. W., et al. WGS to predict antibiotic MICs for Neisseria gonorrhoeae. J Antimicrob Chemother. 72 (7), 1937-1947 (2017).
- Arredondo-Alonso, S., Willems, R. J., van Schaik, W., Schurch, A. C. On the (im)possibility of reconstructing plasmids from whole-genome short-read sequencing data. Microb Genom. 3 (10), e000128(2017).
- Rhoads, A., Au, K. F. PacBio sequencing and its applications. Genomics Proteomics Bioinformatics. 13 (5), 278-289 (2015).
- Zhang, T., et al. Nanopore sequencing: flourishing in its teenage years. J Genet Genomics. 51 (12), 1361-1374 (2024).
- González, A., Fullaondo, A., Odriozola, A. Why are long-read sequencing methods revolutionizing microbiome analysis? Microorganisms. 13 (8), (2025).
- Wick, R. R., Holt, K. E. Polypolish: Short-read polishing of long-read bacterial genome assemblies. PLoS Comput Biol. 18 (1), e1009802(2022).
- Delahaye, C., Nicolas, J. Sequencing DNA with nanopores: Troubles and biases. PLoS One. 16 (10), e0257521(2021).
- Watson, M., Warr, A. Errors in long-read assemblies can critically affect protein prediction. Nat Biotechnol. 37 (2), 124-126 (2019).
- De Maio, N., et al. Comparison of long-read sequencing technologies in the hybrid assembly of complex bacterial genomes. Microb Genom. 5 (9), (2019).
- Lerminiaux, N., Fakharuddin, K., Mulvey, M. R., Mataseje, L. Do we still need Illumina sequencing data? Evaluating Oxford Nanopore Technologies R10.4.1 flow cells and the Rapid v14 library prep kit for Gram-negative bacteria whole genome assemblies. Can J Microbiol. 70 (5), 178-189 (2024).
- Dabernig-Heinz, J., et al. A multicenter study on accuracy and reproducibility of nanopore sequencing-based genotyping of bacterial pathogens. J Clin Microbiol. 62 (9), e0062824(2024).
- Sereika, M., et al. Oxford Nanopore R10.4 long-read sequencing enables the generation of near-finished bacterial genomes from pure cultures and metagenomes without short-read or reference polishing. Nat Methods. 19 (7), 823-826 (2022).
- Wick, R. R., Judd, L. M., Holt, K. E. Assembling the perfect bacterial genome using Oxford Nanopore and Illumina sequencing. PLoS Comput Biol. 19 (3), e1010905(2023).
- Paterson, D. L. Resistance in gram-negative bacteria: enterobacteriaceae. Am J Med. 119 (1), discussion S62-70 S20-S28 (2006).
- Peter, S., et al. Tracking of antibiotic resistance transfer and rapid plasmid evolution in a hospital setting by nanopore sequencing. mSphere. 5 (4), (2020).
- George, S., et al. Resolving plasmid structures in Enterobacteriaceae using the MinION nanopore sequencer: assessment of MinION and MinION/Illumina hybrid data assembly approaches. Microb Genom. 3 (8), e000118(2017).
- Dong, N., Yang, X., Zhang, R., Chan, E. W., Chen, S. Tracking microevolution events among ST11 carbapenemase-producing hypervirulent Klebsiella pneumoniae outbreak strains. Emerg Microbes Infect. 7 (1), 146(2018).
- Lemon, J. K., Khil, P. P., Frank, K. M., Dekker, J. P. Rapid nanopore sequencing of plasmids and resistance gene detection in clinical isolates. J Clin Microbiol. 55 (12), 3530-3543 (2017).
- Linde, J., et al. Comparison of Illumina and Oxford Nanopore Technology for genome analysis of Francisella tularensis, Bacillus anthracis, and Brucella suis. BMC Genomics. 24 (1), 258(2023).
- Bickhart, D. M., et al. Generating lineage-resolved, complete metagenome-assembled genomes from complex microbial communities. Nat Biotechnol. 40 (5), 711-719 (2022).
- Koren, S., et al. Canu: scalable and accurate long-read assembly via adaptive k-mer weighting and repeat separation. Genome Res. 27 (5), 722-736 (2017).
- Vaser, R., Sikic, M. Time-and memory-efficient genome assembly with Raven. Nat Comput Sci. 1 (5), 332-336 (2021).
- Lynch, M. D., Neufeld, J. D. Ecology and exploration of the rare biosphere. Nat Rev Microbiol. 13 (4), 217-229 (2015).
- Kruasuwan, W., et al. Comparative evaluation of commercial DNA isolation approaches for nanopore-only bacterial genome assembly and plasmid recovery. Sci Rep. 14 (1), 27672(2024).
- Ulrich, J. U., et al. Nanopore adaptive sampling effectively enriches bacterial plasmids. mSystems. 9 (3), e0094523(2024).
- Wick, R. R., Howden, B. P., Stinear, T. P. Autocycler: long-read consensus assembly for bacterial genomes. Bioinformatics. 41 (9), (2025).
- NucleoBond Xtra Plasmid DNA Purification User Manual. , Takara Bio USA. Available from: https://www.takarabio.com/documents/User%20Manual/NucleoBond%20Xtra%20Plasmid%20DNA%20Purification%20User%20Manual_Rev_15.pdf?srsltid=AfmBOorkdYVlr34yclNUgmBCn4imrn-gbvTafmkD2Yrnnch6fH-K_VwZ (2019).
- Mota-Bravo, L., et al. Detection of horizontal gene transfer mediated by natural conjugative plasmids in E. coli. J Vis Exp. (193), (2023).
- Hancock, V., Witso, I. L., Klemm, P. Biofilm formation as a function of adhesin, growth medium, substratum, and strain type. Int J Med Microbiol. 301 (7), 570-576 (2011).
- Hung, C., et al. Escherichia coli biofilms have an organized and complex extracellular matrix structure. mBio. 4 (5), e00645-e00713 (2013).
- Qubit 4 assays quick reference (Pub. No. MAN0017210 C.0). , Thermo Fisher Scientific. (2025).
- Rapid barcoding sequencing kit 96 v14. , Oxford Nanopore Technologies. Available from: https://store.nanoporetech.com/us/rapid-barcoding-sequencing-kit-96-v14.html (2026).
- Schwengers, O., et al. Bakta: rapid and standardized annotation of bacterial genomes via alignment-free sequence identification. Microb Genom. 7 (11), (2021).
- Seemann, T. Prokka: rapid prokaryotic genome annotation. Bioinformatics. 30 (14), 2068-2069 (2014).
- Singh, H., et al. Integrons: the hidden architects of bacterial adaptation, evolution, and the challenges of antimicrobial resistance. Antonie Van Leeuwenhoek. 118 (7), 90(2025).
- Redondo-Salvo, S., et al. COPLA, a taxonomic classifier of plasmids. BMC Bioinformatics. 22 (1), 390(2021).
- Salipante, S. J., et al. Large-scale genomic sequencing of extraintestinal pathogenic Escherichia coli strains. Genome Res. 25 (1), 119-128 (2015).
- Couturier, A., et al. Real-time visualisation of the intracellular dynamics of conjugative plasmid transfer. Nat Commun. 14 (1), 294(2023).
- Wick, R. R., Schultz, M. B., Zobel, J., Holt, K. E. Bandage: interactive visualization of de novo genome assemblies. Bioinformatics. 31 (20), 3350-3352 (2015).
- Grant, J. R., et al. Proksee: in-depth characterization and visualization of bacterial genomes. Nucleic Acids Res. 51 (W1), W484-W492 (2023).
- MacKenzie, M., Argyropoulos, C. An Introduction to nanopore sequencing: past, present, and future considerations. Micromachines (Basel). 14 (2), (2023).
- Emiliani, F. E., Hsu, I., McKenna, A. Multiplexed assembly and annotation of synthetic biology constructs using long-read nanopore sequencing. ACS Synth Biol. 11 (7), 2238-2246 (2022).
- Brown, S. D., Dreolini, L., Wilson, J. F., Balasundaram, M., Holt, R. A. Complete sequence verification of plasmid DNA using the Oxford Nanopore Technologies' MinION device. BMC Bioinformatics. 24 (1), 116(2023).
- Hall, J. P. J., Botelho, J., Cazares, A., Baltrus, D. A. What makes a megaplasmid? Philos Trans R Soc Lond B Biol Sci. 377 (1842), 20200472(2022).
- Brown Kav, A., Benhar, I., Mizrahi, I. A method for purifying high-quality and high-yield plasmid DNA for metagenomic and deep sequencing approaches. J Microbiol Methods. 95 (2), 272-279 (2013).
- Mumm, C., et al. Multiplexed long-read plasmid validation and analysis using OnRamp. Genome Res. 33 (5), 741-749 (2023).
- Balbuena-Alonso, M. G., et al. Genomic analysis of plasmid content in food isolates of E. coli strongly supports its role as a reservoir for the horizontal transfer of virulence and antibiotic resistance genes. Plasmid. 123-124, 102650(2022).
- Zhao, W., et al. Oxford nanopore long-read sequencing enables the generation of complete bacterial and plasmid genomes without short-read sequencing. Front Microbiol. 14, 1179966(2023).
- Wick, R. R., et al. Trycycler: consensus long-read assemblies for bacterial genomes. Genome Biol. 22 (1), 266(2021).
- Johnson, J., Soehnlen, M., Blankenship, H. M. Long read genome assemblers struggle with small plasmids. Microb Genom. 9 (5), (2023).
- Boostrom, I., Portal, E. A. R., Spiller, O. B., Walsh, T. R., Sands, K. Comparing long-read assemblers to explore the potential of a sustainable low-cost, low-infrastructure approach to sequence antimicrobial resistant bacteria with Oxford Nanopore sequencing. Front Microbiol. 13, 796465(2022).
Réimpressions et autorisations
