Ce protocole décrit un flux de travail reproductible permettant d'intégrer PIVKA-II, AFP et des variables cliniques de routine dans un modèle diagnostique de régression logistique pour le carcinome hépatocellulaire, avec une validation dans les stades précoces et les cas négatifs pour l'AFP.
Article de recherche
Intégration de la prothrombine anormale (PIVKA-II), de l'alpha-fœtoprotéine et de variables cliniques de routine pour la détection précoce du carcinome hépatocellulaire
Dans cet article
Résumé
Résumé
La détection précoce du carcinome hépatocellulaire (CHC) reste limitée par la sensibilité incomplète de l'alpha-foetoprotéine (AFP), en particulier pour les tumeurs au stade précoce et les tumeurs négatives pour l'AFP. Cette étude a évalué si la prothrombine anormale/protéine induite par l'absence de vitamine K-II (PIVKA-II), l'AFP et les variables cliniques habituelles pouvaient être intégrées dans un modèle diagnostique reproductible pour le CHC. Une cohorte d'apprentissage rétrospective de 205 participants, comprenant 112 cas de CHC confirmés par imagerie et 93 témoins sans CHC, a été utilisée pour le développement du modèle. Une cohorte indépendante de validation prospective de 184 participants, incluant 58 cas de CHC et 126 témoins sans CHC, a été utilisée pour des tests hors échantillon sans réajustement du modèle. Des échantillons sanguins prélevés avant l'imagerie ont été utilisés pour la mesure de l'AFP et de la PIVKA-II, et les variables cliniques ont été extraites de la même fenêtre diagnostique. Le modèle final de régression logistique multivariée combinait ln(AFP), ln(PIVKA-II), l'âge, le sexe, l'albumine, le ratio normalisé international et le nombre de plaquettes. Le modèle combiné a atteint une AUC de 0,93 dans la cohorte d'apprentissage et de 0,89 dans la cohorte de validation. Lors de la validation, la sensibilité était de 84,5 % et la spécificité de 90,5 %. La sensibilité restait de 72,7 % pour le CHC au stade précoce et de 73,1 % pour le CHC négatif à l'AFP, dépassant l'AFP seule dans les deux sous-groupes. La calibration et la validation par rééchantillonnage avec remise ont confirmé une stabilité acceptable du modèle. Ces résultats montrent comment la PIVKA-II, l'AFP et les variables cliniques habituellement disponibles peuvent être combinées en un outil diagnostique de tri pratique pour les populations à haut risque de maladie hépatique.
Introduction
Le carcinome hépatocellulaire (CHC) est l'une des principales causes de mortalité liée au cancer et survient généralement chez des patients atteints d'une maladie hépatique chronique, notamment une infection par le virus de l'hépatite B, une infection par le virus de l'hépatite C, une maladie hépatique liée à l'alcool ou une stéatose hépatique associée à une dysfonction métabolique1. La détection précoce revêt une importance clinique majeure, car le traitement curatif est le plus efficace lorsque les tumeurs sont découvertes avant l'invasion vasculaire, la dissémination extra-hépatique ou une détérioration marquée de la réserve hépatique. Les stratégies actuelles de surveillance s'appuient généralement sur l'échographie hépatique, avec ou sans dosage sérique de l'alpha-foetoprotéine (AFP)2. Toutefois, dans la pratique courante, la performance de la surveillance est compromise par la dépendance à l'opérateur, la petite taille des tumeurs, la présence de nodules cirrhotiques hétérogènes, les difficultés d'imagerie liées à l'obésité et les tumeurs produisant peu ou pas d'AFP3,4.
L'AFP reste largement utilisé car il est peu coûteux, accessible et familier aux cliniciens. Sa valeur diagnostique est limitée par une sensibilité incomplète et une spécificité imparfaite. Au seuil conventionnel de 20 ng/mL, l'AFP peut manquer une proportion importante de cas de carcinome hépatocellulaire (CHC) aux stades précoces ou négatifs pour l'AFP. Des seuils plus bas pourraient améliorer la sensibilité, mais augmenteraient le nombre de résultats faussement positifs chez les patients atteints d'hépatite active, de cirrhose ou d'autres affections hépatiques inflammatoires5,6. Ces limites rendent l'interprétation fondée sur un seul marqueur insuffisante pour le tri diagnostique dans les populations à haut risque de maladie hépatique.
La protéthrombine anormale, également connue sous le nom de protéine induite par l'absence de vitamine K-II (PIVKA-II) ou protéthrombine dés-γ-carboxylée, est libérée lorsque les hépatocytes malins produisent une protéthrombine incomplètement carboxylée. La PIVKA-II reflète la biologie tumorale liée à la coagulation plutôt que la sécrétion d'AFP et peut rester informative lorsque les taux d'AFP sont faibles7. Des études antérieures et des méta-analyses ont montré que la PIVKA-II améliore la détection du carcinome hépatocellulaire (CHC), en particulier lorsqu'elle est combinée à l'AFP, et pourrait apporter une valeur ajoutée dans les cas de maladie à un stade précoce ou négative pour l'AFP8,9. Toutefois, les stratégies fondées uniquement sur les marqueurs ne tiennent pas pleinement compte du terrain hôte, de la réserve hépatique, du chiffre plaquettaire, de l'état de la coagulation ou de la maladie hépatique sous-jacente.
Les modèles diagnostiques composites offrent un moyen pratique d'interpréter conjointement les résultats des marqueurs tumoraux et le contexte clinique. Les modèles GALAD, GAAD et apparentés ont montré que les variables démographiques et les biomarqueurs peuvent être combinés pour améliorer la détection du carcinome hépatocellulaire (HCC) dans différentes étiologies et populations10,11. Leurs performances appuient l'utilisation d'une estimation du risque multivariée plutôt que de seuils isolés pour les biomarqueurs. Par ailleurs, certains modèles incluent des dosages non disponibles dans tous les laboratoires, et le comportement des seuils peut varier selon les régions, les profils étiologiques, les stades de la maladie et l'usage clinique visé12. Un modèle construit à partir de biomarqueurs largement disponibles et de variables de laboratoire courantes pourrait être plus facile à intégrer dans les flux de travail diagnostiques habituels. Contrairement aux modèles publiés précédemment, qui peuvent s'appuyer sur des biomarqueurs spécialisés ou des stratégies de seuil spécifiques à une population, la présente étude a évalué un modèle diagnostique multivarié fondé sur des biomarqueurs largement accessibles et des variables cliniques de routine, et a validé ses performances dans une cohorte prospective indépendante.
Le PIVKA-II convient à ce cadre car il complète l'AFP et peut être mesuré sur des plateformes d'immunodosage automatisées déjà utilisées dans les laboratoires cliniques. Des variables courantes telles que l'âge, le sexe, l'albumine, la bilirubine, le nombre de plaquettes, le ratio normalisé international et les antécédents de maladie hépatique sont disponibles lors de la même consultation clinique et peuvent refléter des informations relatives à la réserve hépatique ou à la coagulation pertinentes pour le risque de carcinome hépatocellulaire13. La combinaison de ces variables avec l'AFP et le PIVKA-II pourrait améliorer la discrimination tout en évitant de dépendre d'un seuil unique.
PIVKA-II, AFP et variables cliniques de routine ont donc été évalués à l'aide d'un dispositif diagnostique à double cohorte. Un modèle de régression logistique multivariée a été développé dans une cohorte d'apprentissage rétrospective et testé dans une cohorte de validation prospective indépendante, sans réajustement. La performance diagnostique a été comparée à celle de l'AFP, du PIVKA-II et des variables cliniques prises isolément, en portant une attention prédéfinie aux cas de CHC à un stade précoce, aux CHC négatifs pour l'AFP, à l'interprétation des seuils, à la calibration et à la validation interne par rééchantillonnage bootstrap.
Protocole
Cette étude a été examinée et approuvée par le Comité d'éthique de l'Hôpital populaire n°1 affilié, École de médecine de l'Université Westlake. Le numéro d'approbation était IIT-20230528-0108-01. Un consentement éclairé écrit a été obtenu auprès des participants recrutés de manière prospective avant le prélèvement sanguin. Pour les dossiers cliniques inclus de manière rétrospective et les échantillons résiduaires archivés collectés lors de soins de routine, le consentement éclairé a été dispensé par le comité d'éthique, car des données anonymisées ont été utilisées et aucune intervention supplémentaire n'a été réalisée.
Reproductibilité, contrôle des biais et intégrité des données
Les critères d'éligibilité, les moments de prélèvement sanguin, les règles d'adjudication des images, les définitions des sous-groupes, les prédicteurs candidats, les définitions des seuils, les règles de gestion des données manquantes et les procédures de validation ont été prédéfinis avant l'analyse statistique. Les échantillons sanguins ont été recueillis avant la confirmation par imagerie avec produit de contraste et avant tout traitement anti-tumoral. Les analyses de laboratoire ont utilisé des identifiants d'étude anonymisés, et les échantillons des cohortes d'apprentissage et de validation ont été analysés selon un ordre aléatoire. Le personnel de laboratoire était en insu du diagnostic final, de l'affectation à la cohorte, du stade selon la classification du Barcelona Clinic Liver Cancer (BCLC) et du statut négatif en alphafœtoprotéine (AFP). Le diagnostic et le stadification par imagerie ont été réalisés indépendamment des analyses de laboratoire. La saisie des données, la conversion des unités, l'affectation aux cohortes, le codage des exclusions, le codage des valeurs manquantes et les jeux de données statistiques ont été vérifiés par deux investigateurs avant l'ajustement du modèle. Les cohortes d'apprentissage et de validation ont été maintenues distinctes tout au long du criblage des variables, de l'ajustement du modèle, de la détermination des seuils et de la validation.
Population et conception de l'étude
Cette étude diagnostique à double cohorte a développé et validé un modèle multivarié pour la détection du carcinome hépatocellulaire utilisant la prothrombine anormale/protéine induite par PIVKA-II, l'AFP et des variables cliniques de routine. La cohorte d'apprentissage constituée de manière rétrospective comprenait des participants évalués entre le 1er janvier 2021 et le 31 décembre 2023. Cette cohorte a été utilisée pour le criblage des variables, l'ajustement du modèle, la dérivation des seuils de décision et la validation interne par rééchantillonnage bootstrap. La cohorte de validation recrutée de manière prospective comprenait des participants évalués entre le 1er janvier 2024 et le 31 décembre 2025. Cette cohorte a été utilisée uniquement pour des tests sur échantillons externes. Aucune nouvelle sélection de variables, aucun réajustement du modèle, mise à jour des coefficients, ré-optimisation des seuils ni recalibration fondée sur des sous-groupes n’a été effectuée dans la cohorte de validation. Le flux des participants, l'attribution aux cohortes, le prélèvement sanguin, le traitement du plasma, les tests de biomarqueurs, l'interprétation des images et le déroulement statistique sont présentés dans Figure 1.
Les participants ont été recrutés dans le cadre d'un parcours de surveillance ou de diagnostic de maladie hépatique à haut risque à l'Hôpital populaire affilié n°1 de Hangzhou, École de médecine de l'Université Westlake. Le statut à haut risque était défini par une infection chronique par l'hépatite B, une infection chronique par l'hépatite C, une cirrhose d'étiologie quelconque, ou une stéatose hépatique avec fibrose documentée, basée sur une évaluation clinique, des dossiers de laboratoire ou des examens d'imagerie antérieurs. Les participants éligibles étaient des adultes âgés de 18 ans ou plus ayant réalisé un prélèvement sanguin préalable à l'imagerie ainsi qu'une tomodensitométrie multiphasique avec produit de contraste et/ou une imagerie par résonance magnétique dynamique avec produit de contraste, dans un délai de 14 jours suivant le prélèvement sanguin. Les critères d'exclusion étaient un traitement antérieur du carcinome hépatocellulaire (CHC), incluant une résection, une ablation, une thérapie artérielle transcatéter ou une thérapie systémique ; l'administration de vitamine K dans les 7 jours précédant le prélèvement ; un traitement par antagoniste de la vitamine K ou tout autre traitement anticoagulant susceptible d'affecter l'interprétation de la coagulation ; une cholangite aiguë ou une obstruction biliaire au moment du prélèvement ; une grossesse ; l'absence de dosage de l'AFP, du PIVKA-II ou du diagnostic final par imagerie ; ainsi que la mauvaise qualité de l'échantillon sans possibilité de prélèvement de remplacement valide.
La population finale de l'étude comprenait 389 participants. La cohorte d'apprentissage comprenait 205 participants, dont 112 cas de CHC confirmés par imagerie et 93 témoins sans CHC. La cohorte de validation comprenait 184 participants, dont 58 cas de CHC confirmés par imagerie et 126 témoins sans CHC. Dans la cohorte d'apprentissage, les 93 témoins sans CHC comprenaient 30 témoins sains et 63 témoins atteints de maladie hépatique chronique. Dans la cohorte de validation, les 126 témoins sans CHC comprenaient 0 témoin sain et 126 témoins atteints de maladie hépatique chronique.
Le statut symptomatique n'a pas été attribué uniquement sur la base des antécédents d'hépatite ou d'une cirrhose compensée. Un participant était classé comme symptomatique uniquement lorsque le dossier préalable à l'imagerie mentionnait une douleur nouvelle ou aggravée au quadrant supérieur droit, une perte de poids inexpliquée, une distension abdominale, une jaunisse, des urines foncées ou une décompensation cliniquement documentée non expliquée par une autre cause confirmée. Les participants sans ces signes étaient classés comme asymptomatiques ou détectés par surveillance.
Adjudication diagnostique et stadification
Le statut final de CCH a été établi à l'aide d'une tomodensitométrie multiphasique avec produit de contraste et/ou d'une IRM dynamique avec produit de contraste réalisée dans le cadre des soins courants. L'imagerie devait inclure au moins une phase artérielle et une phase porto-veineuse ; les résultats de la phase de retard ont été pris en compte lorsqu'ils étaient disponibles. Une lésion a été classée comme CCH lorsque l'imagerie, réalisée sur un foie à risque, montrait un hypersignalement en phase artérielle avec un phénomène de washout en phase porto-veineuse et/ou en phase de retard, avec ou sans capsule rehaussée. Les participants dont les caractéristiques d'imagerie n'étaient pas compatibles avec un CCH et qui n'avaient pas non plus de diagnostic de malignité autre ont été classés comme non-CCH.
Les informations d'imagerie ont été extraites à l'aide d'un formulaire prédéfini enregistrant la modalité d'imagerie, les phases obtenues, l'hyperfixation en phase artérielle, le phénomène de washout, l'aspect de la capsule, le nombre de lésions, le diamètre maximal des lésions, l'invasion macrovasculaire et la dissémination extra-hépatique. Deux lecteurs formés ont extrait indépendamment les caractéristiques d'imagerie des comptes rendus radiologiques finals. Les désaccords ont été résolus par consensus en utilisant les mêmes critères prédéfinis. Lorsque les examens tomodensitométrique (TDM) et par résonance magnétique (IRM) étaient disponibles, la modalité présentant la caractérisation multiphasique la plus complète était retenue. Si les deux modalités étaient complètes, celle indiquée comme base de la décision clinique finale était utilisée.
Le stade BCLC a été attribué une fois le statut du carcinome hépatocellulaire (HCC) définitivement établi. Le stade précoce de l'HCC a été défini comme un stade BCLC 0–A. L'HCC négatif pour l'AFP a été défini par une AFP <20 ng/mL au prélèvement sanguin préalable à l'imagerie. Ces étiquettes de sous-groupes ont été utilisées pour l'évaluation des performances par sous-groupe, et non pour l'apprentissage du modèle ou l'éligibilité des participants.
Prélèvement des échantillons et traitement du plasma
Du sang veineux périphérique a été prélevé le matin après un jeûne nocturne d'au moins 8 h, avant la confirmation par tomodensitométrie ou IRM avec produit de contraste et avant tout traitement anti-tumoral. Un volume total de 10 mL de sang veineux a été prélevé dans des tubes de prélèvement sanguin anticoagulés au K2-EDTA. Les tubes ont été retournés 8 à 10 fois immédiatement après le prélèvement, puis transportés au laboratoire à 4 °C. L'intervalle entre le prélèvement veineux et la centrifugation a été maintenu inférieur à 2 h et consigné dans le registre d'échantillonnage.
Le plasma a été séparé par centrifugation à 1 600 × g pendant 10 min à 4 °C à l’aide d’une centrifugeuse réfrigérée. Le surnageant plasmatique a été transféré dans des tubes microcentrifuge de 1,5 mL sans nucléase et aliquoté en portions de 0,5 à 1,0 mL. Les aliquots ont été stockés à -80 °C jusqu’au moment des analyses. Avant la mesure des biomarqueurs, un aliquot a été décongelé une seule fois à température ambiante, entre 20 et 25 °C, pendant 20 à 30 min, puis mélangé doucement par retournement, et analysé dans les 2 heures suivant la décongélation complète. Les échantillons présentant une coagulation visible, une hémolyse modérée à sévère ou une lipémie marquée ont été rejetés conformément aux critères prédéfinis d’acceptation en laboratoire. Pour la cohorte de validation prospective, un prélèvement sanguin répété a été effectué avant la confirmation par imagerie, lorsque cela était cliniquement réalisable.
Mesure de l'AFP et de la PIVKA-II
L'AFP et la PIVKA-II ont été mesurées à l'aide d'immunodosages par chimiluminescence électrochimique sur un analyseur d'immunodosage automatisé. L'AFP a été enregistrée en ng/mL et la PIVKA-II en mAU/mL. Les résultats ont été exportés directement à partir du système d'information du laboratoire.
Chaque lot analytique comprenait des étalons spécifiques au test et au moins deux niveaux de contrôle interne de la qualité. L'acceptation du lot exigeait que tous les résultats du contrôle de qualité se situent dans la plage de contrôle prédéfinie par le laboratoire. Les objectifs de précision analytique étaient un coefficient de variation intra-série ≤10 % et un coefficient de variation inter-série ≤15 % pour l'AFP et la PIVKA-II. Si le contrôle de qualité échouait ou si une dérive du lot était détectée, le lot était rejeté, l'analyseur était recalibré, et le lot était répété si un volume d'échantillon suffisant restait disponible. En cas de résultat unique invraisemblable ou hors plage, deux mesures de répétition étaient effectuées à partir de la même aliquote décongelée, lorsque cela était possible, et la moyenne des deux valeurs de répétition acceptées était utilisée. Si la répétition des tests échouait ou si le volume d'échantillon était insuffisant, le résultat était marqué comme invalide et traité conformément à la règle de gestion des données manquantes.
Extraction systématique des variables cliniques
Les variables cliniques de routine ont été extraites du même rendez-vous clinique que le prélèvement sanguin pré-imagerie d'AFP/PIVKA-II. Les variables candidates comprenaient l'âge, le sexe, l'alanine aminotransférase, l'aspartate aminotransférase, l'albumine, la bilirubine totale, le ratio normalisé international (INR), le temps de prothrombine et le nombre de plaquettes. Lorsque plusieurs valeurs étaient disponibles dans la fenêtre pré-imagerie, la valeur la plus proche du moment du prélèvement d'AFP/PIVKA-II a été sélectionnée. Les unités ont été standardisées avant l'analyse. L'âge a été enregistré en années ; le sexe a été codé comme suit : femme = 0 et homme = 1 ; le nombre de plaquettes a été enregistré en ×10⁹/L ; l'albumine en g/L ; la bilirubine totale en μmol/L ; l'AFP en ng/mL ; et le PIVKA-II en mAU/mL.
Des vérifications d'intervalle, des vérifications d'unités et des vérifications de valeurs invraisemblables ont été effectuées après l'extraction. Les valeurs signalées ont été vérifiées par rapport aux documents sources. Une valeur n'était exclue que lorsque le document source confirmait un problème de qualité de l'échantillon, une erreur de conversion d'unité ou un écart de traitement. Les valeurs extrêmes vérifiées ont été conservées. Le dictionnaire de variables définissait la structure du jeu de données, les noms des variables, les unités, les règles de codage, les règles de transformation et les codes des valeurs manquantes.
Définition du prédicteur et sélection des variables
Les prédicteurs candidats ont été définis avant le développement du modèle. Les biomarqueurs principaux étaient l'AFP et la PIVKA-II. Les candidats cliniques de routine étaient l'âge, le sexe, l'alanine aminotransférase, l'aspartate aminotransférase, l'albumine, la bilirubine totale, l'INR ou le temps de prothrombine, et le nombre de plaquettes. L'AFP et la PIVKA-II ont été transformées selon le logarithme naturel. Les valeurs inférieures à la limite de déclaration du test ont été remplacées par la moitié de la limite inférieure de déclaration avant transformation.
Les comparaisons univariées entre les participants atteints de CHC et ceux sans CHC dans la cohorte d'entraînement ont utilisé des tests t pour échantillons indépendants pour les variables approximativement distribuées de façon normale, des tests de Mann-Whitney U pour les variables continues asymétriques, et des tests χ2 ou des tests exacts de Fisher pour les variables catégorielles. Les variables ayant une valeur P < 0,10 lors du dépistage univarié ont été prises en compte pour la modélisation multivariée. La multicolinéarité a été évaluée à l'aide du facteur d'inflation de la variance (VIF), et un VIF >5 a été considéré comme indiquant une colinéarité préoccupante. Lorsque deux variables étaient fortement colinéaires, la variable offrant une interprétabilité clinique plus claire et une meilleure performance incrémentielle du modèle était conservée.
Le modèle final de régression logistique multivariée a été élaboré uniquement à partir de la cohorte d'apprentissage. Les variables ln(AFP) et ln(PIVKA-II) ont été intégrées de force dans le modèle. Les prédicteurs supplémentaires ont été sélectionnés par élimination descendante guidée par le critère d'information d'Akaike. Après sélection descendante, les variables retenues étaient ln(AFP), ln(PIVKA-II), l'âge, le sexe, l'albumine, l'INR et le compte des plaquettes.
Développement du modèle et calcul du score de risque
Le modèle diagnostique a été ajusté à l'aide d'une régression logistique multivariée avec le statut de CCH comme variable binaire de sortie. La probabilité prédite de CCH a été calculée à partir du prédicteur linéaire η en utilisant l'équation suivante :
p(HCC)=1/[1+exp(-η)]
η = -4,862 + 0,247×ln(AFP) + 0,712×ln(PIVKA-II) + 0,018×âge + 0,331×sexe - 0,062×albumine + 0,554×INR - 0,004×numération plaquettaire
L'AFP a été mesurée en ng/mL, la PIVKA-II en mAU/mL, l'âge en années, le sexe a été codé comme suit : femme = 0 et homme = 1, l'albumine a été mesurée en g/L, l'INR était sans unité, et le compte des plaquettes a été mesuré en ×109/L. Des logarithmes naturels ont été utilisés pour l'AFP et la PIVKA-II. Un nomogramme a été généré à partir des mêmes coefficients ajustés. La probabilité prédite, et non l'échelle de points du nomogramme, a été utilisée pour l'analyse de la caractéristique de fonctionnement du récepteur (ROC), l'analyse de calibration, l'analyse de la courbe de décision et la validation.
Définitions des seuils et gestion des limites
Les seuils de la PIVKA-II ont été indiqués en fonction de l'objectif analytique. Le seuil clinique établi pour la PIVKA-II était de 40,0 mAU/mL. Le seuil de Youden pour la cohorte d'apprentissage était de 45,0 mAU/mL. Le seuil à spécificité fixe a été déterminé en choisissant le seuil le plus proche d'une spécificité de 90 % dans la cohorte d'apprentissage ; cela a donné une valeur de 38,0 mAU/mL pour la PIVKA-II. Un seuil apparent de 37,5 mAU/mL, utilisé uniquement pour la validation, a été considéré comme exploratoire et n'a pas été retenu comme seuil principal de validation.
Pour le modèle combiné, le seuil binaire principal a été dérivé à partir de la cohorte d'entraînement en utilisant l'indice de Youden et appliqué sans modification à la cohorte de validation. L'AFP a utilisé le seuil clinique établi de 20,0 ng/mL pour la définition du sous-groupe AFP-négatif et la comparaison avec la pratique courante. Les seuils optimaux d'AFP utilisés dans l'analyse ROC ont été indiqués séparément du seuil clinique. Les seuils ont donc été rapportés selon leur objectif analytique plutôt que d'être considérés comme des seuils interchangeables.
Performance, étalonnage et validation du modèle
La discrimination a été évaluée à l'aide de courbes caractéristiques de fonctionnement du récepteur et de la surface sous la courbe. Les AUC ont été indiquées avec des intervalles de confiance à 95 %. Les comparaisons des AUC ont utilisé le test de DeLong. Les performances de classification ont été exprimées en termes de sensibilité, spécificité, valeur prédictive positive, valeur prédictive négative et exactitude aux seuils prédéfinis.
La calibration a été évaluée à l'aide de l'ordonnée à l'origine de calibration, de la pente de calibration, du score de Brier et du test d'ajustement de Hosmer–Lemeshow. Les graphiques de calibration ont comparé les probabilités prédites et observées de carcinome hépatocellulaire (CHC) dans les groupes de risque. La validation interne a utilisé 1 000 rééchantillonnages bootstrap dans la cohorte d'entraînement afin d'estimer la AUC corrigée pour l'optimisme et la pente de calibration corrigée pour l'optimisme. La cohorte de validation a été utilisée uniquement pour l'évaluation externe des performances. Aucune mise à jour des coefficients, aucun réajustement du modèle, aucune ré-optimisation du seuil ni aucune recalibration fondée sur des sous-groupes n'a été effectuée dans la cohorte de validation.
L'utilité clinique a été évaluée à l'aide d'une analyse de courbe décisionnelle sur des probabilités seuils allant de 0,05 à 0,50. Le bénéfice net a été comparé pour l'AFP seule, la PIVKA-II seule, le modèle basé sur les variables cliniques et le modèle combiné.
Traitement des données manquantes et analyse de sensibilité
L'analyse principale a utilisé une modélisation sur cas complets pour les participants dont toutes les variables étaient conservées dans le modèle final. Les valeurs manquantes ont été résumées pour chaque prédicteur candidat. Si la proportion de données manquantes dépassait 5 % pour l'un des prédicteurs retenus, une imputation multiple par équations enchaînées a été réalisée comme analyse de sensibilité, en incluant dans le modèle d'imputation l'issue, tous les prédicteurs retenus et l'indicateur de cohorte. Les variables présentant plus de 20 % de données manquantes n'étaient pas éligibles à la modélisation multivariée. Les coefficients du modèle, la surface sous la courbe (AUC), la pente de calibration et les métriques de classification obtenus à partir de l'analyse sur données imputées ont été comparés aux résultats obtenus sur cas complets.
Logiciels et reporting reproductible
Toutes les analyses ont été effectuées à l'aide de R version 4.3.2 et de RStudio version 2023.12.1. La régression logistique a été réalisée à l'aide du package stats de base. L'analyse ROC et les comparaisons selon la méthode de DeLong ont été effectuées à l'aide de pROC version 1.18.5. L'analyse de calibration a été réalisée à l'aide des packages rms version 6.7-1 et ResourceSelection version 0.3-6. La validation par bootstrap a utilisé 1 000 rééchantillonnages avec une graine aléatoire fixe de 70558. L'analyse de la courbe de décision a été effectuée à l'aide de rmda version 1.6. L'imputation multiple, si nécessaire, a été réalisée à l'aide de mice version 3.16.0. Le script d'analyse a reproduit le flux des participants, les coefficients du modèle, les courbes ROC, les métriques de calibration, la validation par bootstrap, l'analyse de la courbe de décision, les analyses basées sur des seuils de coupure et les tableaux statistiques.
Résultats
Caractéristiques de base
L'analyse finale a inclus 389 participants. Le groupe d'apprentissage comprenait 205 participants, dont 112 cas de carcinome hépatocellulaire (CHC) confirmés par imagerie et 93 témoins sans CHC. Le groupe de validation comprenait 184 participants, dont 58 cas de CHC confirmés par imagerie et 126 témoins sans CHC. Les caractéristiques de base sont résumées dans le Tableau 1.
Dans le groupe d'entraînement, les 93 contrôles sans HCC comprenaient 30 contrôles sains et 63 contrôles atteints de maladie hépatique chronique. Dans le groupe de validation, les 126 contrôles sans HCC comprenaient 0 contrôle sain et 126 contrôles atteints de maladie hépatique chronique. L'infection par le virus de l'hépatite B constituait la maladie hépatique sous-jacente prédominante. Les cas de stade BCLC 0–A représentaient 57 des 112 cas de HCC dans le groupe d'entraînement et 30 des 58 cas de HCC dans le groupe de validation. L'âge, le sexe, les antécédents de maladie hépatique, les antécédents familiaux de HCC, la présence de cirrhose, la classe Child-Pugh, l'alanine aminotransférase, l'aspartate aminotransférase, l'albumine, la bilirubine totale, le nombre de plaquettes, le temps de prothrombine, le ratio normalisé international, le diabète et l'hypertension étaient équilibrés entre les strates de cohortes rapportées dans le Tableau 1.
La médiane de l'AFP était de 57,3 ng/mL dans les cas de CHC du groupe d'entraînement et de 22,4 ng/mL dans les témoins non CHC du groupe d'entraînement. La médiane de la PIVKA-II était respectivement de 197,6 mAU/mL et de 86,3 mAU/mL. Dans le groupe de validation, la médiane de l'AFP était de 60,2 ng/mL dans les cas de CHC et de 21,5 ng/mL dans les témoins non CHC. La médiane de la PIVKA-II était respectivement de 191,5 mAU/mL et de 84,1 mAU/mL.
Performance diagnostique de la cohorte d'entraînement
La discrimination dans le groupe d'entraînement est illustrée dans la Figure 2(A), et la comparaison correspondante de la sensibilité et de la spécificité est présentée dans la Figure 2(B). Les caractéristiques de fonctionnement sont résumées dans le Tableau 2. L'AFP présentait une AUC de 0,78, une sensibilité de 62,50 % et une spécificité de 78,49 % au seuil clinique établi de 20,0 ng/mL. La PIVKA-II présentait une AUC de 0,85, une sensibilité de 78,57 % et une spécificité de 82,80 % au seuil de Youden du groupe d'entraînement de 45,0 mAU/mL. Le modèle basé sur les variables cliniques avait une AUC de 0,81, une sensibilité de 69,64 % et une spécificité de 80,65 % à un seuil de probabilité prédite de 0,40. Le modèle combiné présentait la meilleure discrimination dans le groupe d'entraînement, avec une AUC de 0,93, une sensibilité de 88,39 % et une spécificité de 89,25 % à un seuil de probabilité prédite de 0,50.
Performance stratifiée par stade
Les distributions des biomarqueurs stratifiés par stade sont présentées dans la Figure 3(A), les taux de détection dans la Figure 3(B), et les AUC spécifiques au stade dans la Figure 3(C). L'AFP, la PIVKA-II et le score du modèle combiné augmentaient progressivement selon les stades BCLC 0–A, B et C de la maladie. L'AFP présentait un recouvrement entre les cas de CHC à un stade précoce et les témoins sans CHC. La PIVKA-II montrait une meilleure séparation entre les strates de stade. Le modèle combiné offrait la discrimination la plus élevée selon les stades stratifiés, y compris pour le CHC BCLC 0–A.
Complémentarité entre l'AFP et la PIVKA-II
Les corrélations entre les marqueurs et les scores sont indiquées dans Figure 4(A)-(C), et la classification croisée des marqueurs est présentée dans Figure 4(D). L'AFP et la PIVKA-II présentaient un chevauchement partiel. Des cas de CHC AFP-positif/PIVKA-II-négatif ainsi que des cas AFP-négatif/PIVKA-II-positif ont été observés. Le modèle combiné a classé comme à haut risque des cas supplémentaires de CHC négatifs pour un seul marqueur, ce qui soutient l'utilisation du score intégré plutôt que d'un biomarqueur isolé.
Validation externe
Les courbes ROC de la cohorte de validation sont présentées dans la Figure 5(A), la courbe de calibration est montrée dans la Figure 5(B), et les profils de sensibilité-spécificité par sous-groupe sont illustrés dans la Figure 5(C). Les métriques de validation correspondantes sont résumées dans le Tableau 3. Pour tous les cas validés de CHC, l'AFP présentait une AUC de 0,75, une sensibilité de 62,1 % et une spécificité de 88,9 % à 18,5 ng/mL. La PIVKA-II avait une AUC de 0,78, une sensibilité de 72,4 % et une spécificité de 91,3 % à 38,0 mAU/mL. Le modèle combiné affichait une AUC de 0,89, une sensibilité de 84,5 %, une spécificité de 90,5 %, une valeur prédictive positive de 78,8 % et une valeur prédictive négative de 94,1 % pour un seuil de probabilité prédit de 0,56.
Dans le CHC à un stade précoce, l'AFP présentait une sensibilité de 45,5 % et une spécificité de 88,9 %, la PIVKA-II avait une sensibilité de 59,1 % et une spécificité de 91,3 %, et le modèle combiné affichait une sensibilité de 72,7 % et une spécificité de 90,5 %. Dans le CHC négatif pour l'AFP, la sensibilité de l'AFP était de 23,1 %, celle de la PIVKA-II de 61,5 %, et la sensibilité du modèle combiné de 73,1 %. Dans le CHC viral, le modèle combiné avait une sensibilité de 85,3 % et une spécificité de 91,3 %. Dans le CHC non viral, le modèle combiné présentait une sensibilité de 83,3 % et une spécificité de 89,7 %. L'ordonnée à l'origine de calibration de la cohorte de validation était de -0,08, la pente de calibration de 0,91, le score de Brier de 0,118, et la valeur P de Hosmer-Lemeshow de 0,64.
Régression multivariée et validation interne
Les résultats de la régression multivariable sont présentés dans le Tableau 4. Dans le modèle ajusté, la PIVKA-II transformée en logarithme restait le prédicteur indépendant le plus fort, avec un rapport de cotes ajusté de 2,05, intervalle de confiance à 95 % : 1,48-2,89, et une valeur P < 0,001. L'AFP transformée en logarithme était également associée indépendamment au carcinome hépatocellulaire (CHC), avec un rapport de cotes ajusté de 1,28, intervalle de confiance à 95 % : 1,05-1,62, et une valeur P = 0,021. Le ratio normalisé international conservait une valeur prédictive indépendante, avec un rapport de cotes ajusté de 1,74, intervalle de confiance à 95 % : 1,12-2,78, et une valeur P = 0,015. Le modèle final obtenu par sélection rétrograde retenait ln(AFP), ln(PIVKA-II), l'âge, le sexe, l'albumine, le ratio normalisé international et le nombre de plaquettes.
Les métriques de validation interne Bootstrap sont également indiquées dans le Tableau 4. La valeur apparente de la CUA sur l'échantillon d'apprentissage était de 0,93, l'optimisme moyen était de 0,018 et la CUA corrigée de l'optimisme était de 0,91. La pente de calibration apparente était de 1,00, la pente de calibration corrigée de l'optimisme était de 0,94, le score de Brier de l'échantillon d'apprentissage était de 0,104 et la valeur P de Hosmer-Lemeshow était de 0,72.
Audit des seuils et performances spécifiques à chaque seuil
Étant donné que les seuils de PIVKA-II variaient selon l'objectif analytique, les résultats fondés sur des seuils ont été rapportés séparément plutôt que considérés comme interchangeables. Les performances du seuil optimisé post hoc selon Youden sont indiquées dans le tableau 5. L'AFP présentait un seuil optimisé selon Youden de 19,0 ng/mL, avec une sensibilité de 67,9 %, une spécificité de 89,1 %, une valeur prédictive positive de 71,3 %, une valeur prédictive négative de 87,3 %, une exactitude de 81,2 % et une AUC de 0,78. Le PIVKA-II présentait un seuil optimisé selon Youden de 37,5 mAU/mL, avec une sensibilité de 75,4 %, une spécificité de 92,0 %, une valeur prédictive positive de 79,8 %, une valeur prédictive négative de 89,7 %, une exactitude de 85,9 % et une AUC de 0,82. Le modèle combiné avait un seuil de probabilité prédite optimisé selon Youden de 0,57, avec une sensibilité de 86,2 %, une spécificité de 90,6 %, une valeur prédictive positive de 82,7 %, une valeur prédictive négative de 92,4 %, une exactitude de 89,8 % et une AUC de 0,90.
Les performances obtenues à l'aide des seuils cliniques établis sont présentées dans le Tableau 6. Au seuil établi d'AFP de 20,0 ng/mL, l'AFP présentait une sensibilité de 65,2 %, une spécificité de 88,5 %, une valeur prédictive positive de 70,1 %, une valeur prédictive négative de 86,0 %, une exactitude de 80,3 % et une AUC de 0,77. Au seuil établi de PIVKA-II de 40,0 mAU/mL, PIVKA-II présentait une sensibilité de 73,0 %, une spécificité de 93,1 %, une valeur prédictive positive de 81,8 %, une valeur prédictive négative de 89,0 %, une exactitude de 85,6 % et une AUC de 0,82. À un seuil de probabilité prédite de 0,60, le modèle combiné présentait une sensibilité de 83,5 %, une spécificité de 92,0 %, une valeur prédictive positive de 84,7 %, une valeur prédictive négative de 91,2 %, une exactitude de 88,9 % et une AUC de 0,89.
Les performances au seuil le plus proche d'une spécificité de 90 % sont indiquées dans le Tableau 7. L'AFP a utilisé un seuil de 19,0 ng/mL, avec une sensibilité de 67,9 % et une spécificité de 89,1 %. La PIVKA-II a utilisé un seuil de 37,5 mAU/mL, avec une sensibilité de 75,4 % et une spécificité de 92,0 %. Le modèle combiné a utilisé un seuil de probabilité prédite de 0,57, avec une sensibilité de 86,2 % et une spécificité de 90,6 %. Ces résultats de l'analyse des seuils expliquent les différences numériques entre les seuils de PIVKA-II de 37,5, 38,0, 40,0 et 45,0 mAU/mL : 45,0 mAU/mL correspondait au seuil de Youden du lot d'entraînement utilisé pour la comparaison principale d'entraînement, 38,0 mAU/mL a été utilisé pour le rapport de spécificité fixe lors de la validation, 40,0 mAU/mL était le seuil clinique établi, et 37,5 mAU/mL était le seuil optimisé post hoc selon Youden dans le tableau d'analyse des seuils.
Répartition par sous-groupe de maladie
Les répartitions par sous-groupe de maladie de l'AFP, de la PIVKA-II et du score du modèle combiné sont présentées dans la Figure 6(A)-(C). L'AFP, la PIVKA-II et le score du modèle combiné étaient les plus faibles chez les témoins atteints de maladie hépatique chronique et plus élevés dans les groupes avec carcinome hépatocellulaire (CHC). L'AFP montrait un chevauchement entre les témoins atteints de maladie hépatique chronique et le CHC à un stade précoce. La PIVKA-II et le score du modèle combiné permettaient une meilleure distinction entre les témoins atteints de maladie hépatique chronique, le CHC à un stade précoce et le CHC à tous les stades.
DISPONIBILITÉ DES DONNÉES :
L'ensemble de données soutenant les résultats de cette étude est accessible publiquement sur Figshare à l'adresse https://doi.org/10.6084/m9.figshare.33048095.v1.
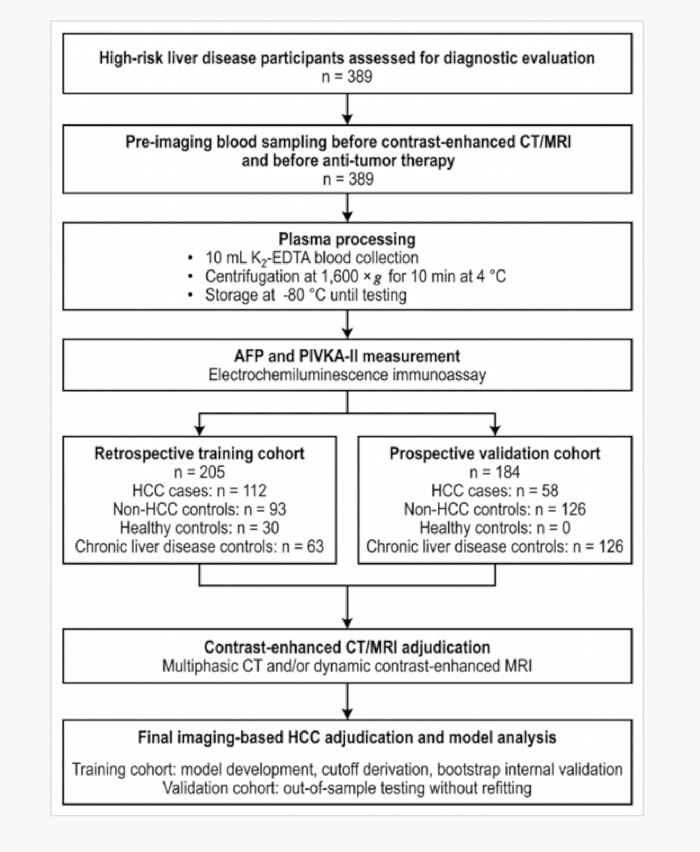
Figure 1 : Flux des participants, attribution des cohortes, traitement des échantillons et arbitrage diagnostique. Organigramme montrant le dépistage des participants, l'attribution aux cohortes, le prélèvement sanguin avant l'imagerie, le traitement du plasma, la mesure de l'AFP et de la PIVKA-II, l'évaluation par tomodensitométrie/IRM avec produit de contraste, et l'arbitrage final du carcinome hépatocellulaire basé sur l'imagerie, dans les cohortes d'apprentissage et de validation. Veuillez cliquer ici pour visualiser une version agrandie de cette figure.
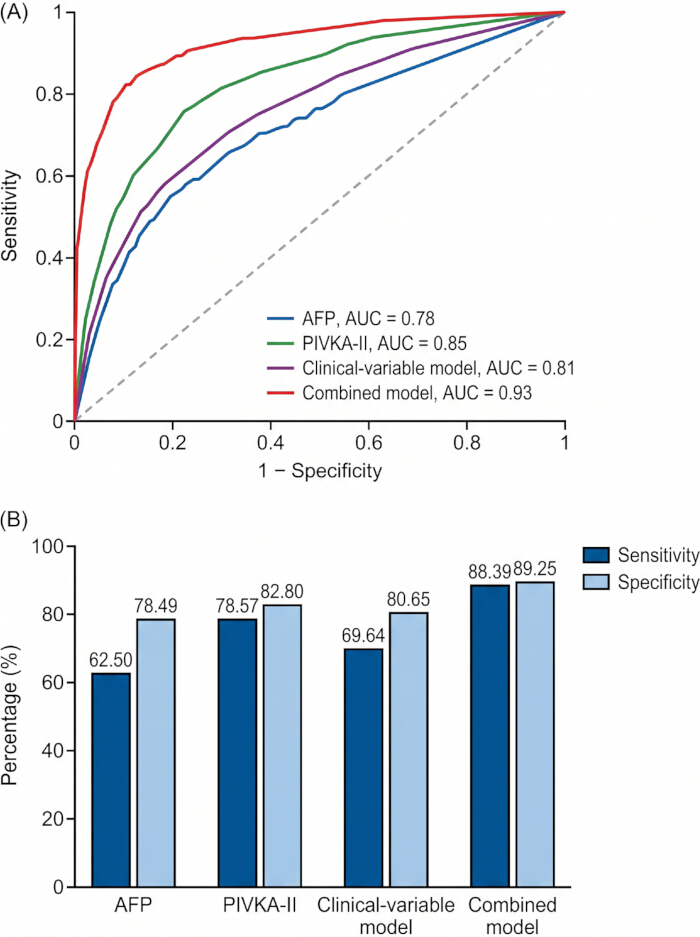
Figure 2 : Performances diagnostiques dans la cohorte d'apprentissage pour l'AFP, la PIVKA-II, le modèle basé sur les variables cliniques et le modèle combiné. (A) Courbes caractéristiques de fonctionnement du récepteur comparant l'AFP, la PIVKA-II, le modèle basé sur les variables cliniques et le modèle multivarié combiné dans la cohorte d'apprentissage. (B) Sensibilité et spécificité de chaque méthode diagnostique au seuil rapporté pour la cohorte d'apprentissage. Veuillez cliquer ici pour visualiser une version agrandie de cette figure.
Les caractéristiques de fonctionnement correspondantes sont résumées dans Tableau 2.
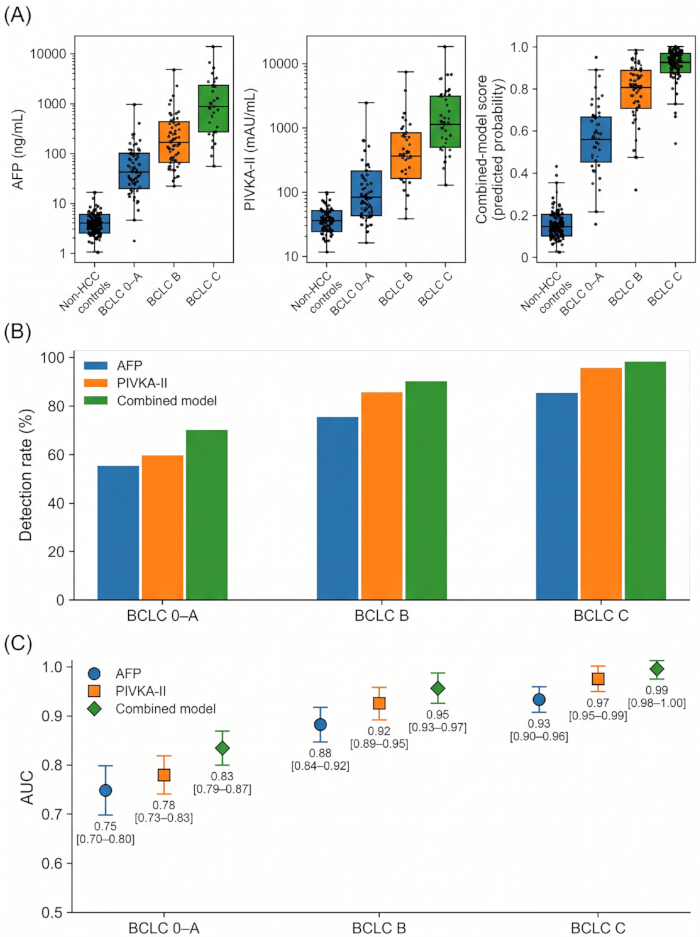
Figure 3 : Performances diagnostiques stratifiées par stade selon les stades BCLC. (A) Répartitions des valeurs de l’AFP, de la PIVKA-II et du score du modèle combiné chez les témoins sans CHC et selon les groupes de stades BCLC. (B) Taux de détection de l’AFP, de la PIVKA-II et du modèle combiné selon les stades BCLC. (C) AUC spécifiques à chaque stade pour l’AFP, la PIVKA-II et le modèle combiné, incluant le CHC aux stades BCLC 0–A. Veuillez cliquer ici pour visualiser une version agrandie de cette figure.
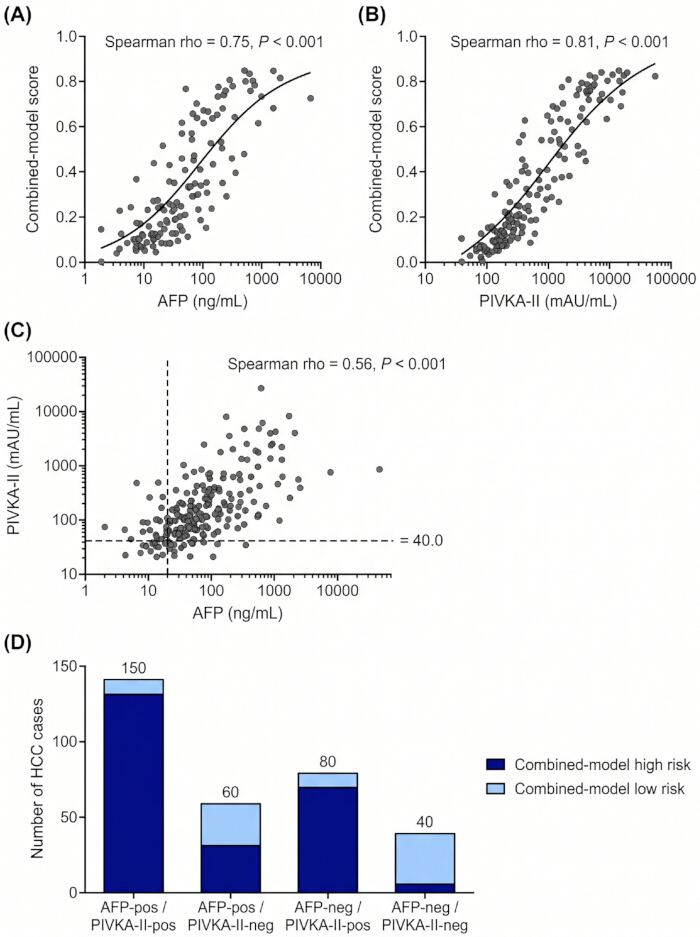
Figure 4 : Corrélation et complémentarité entre l'AFP, le PIVKA-II et le score du modèle combiné. (A) Corrélation entre l'AFP et le score du modèle combiné. (B) Corrélation entre le PIVKA-II et le score du modèle combiné. (C) Corrélation entre l'AFP et le PIVKA-II. (D) Classification croisée des cas de CHC selon le statut de l'AFP, le statut du PIVKA-II et la classification du risque selon le modèle combiné. Veuillez cliquer ici pour visualiser une version agrandie de cette figure.
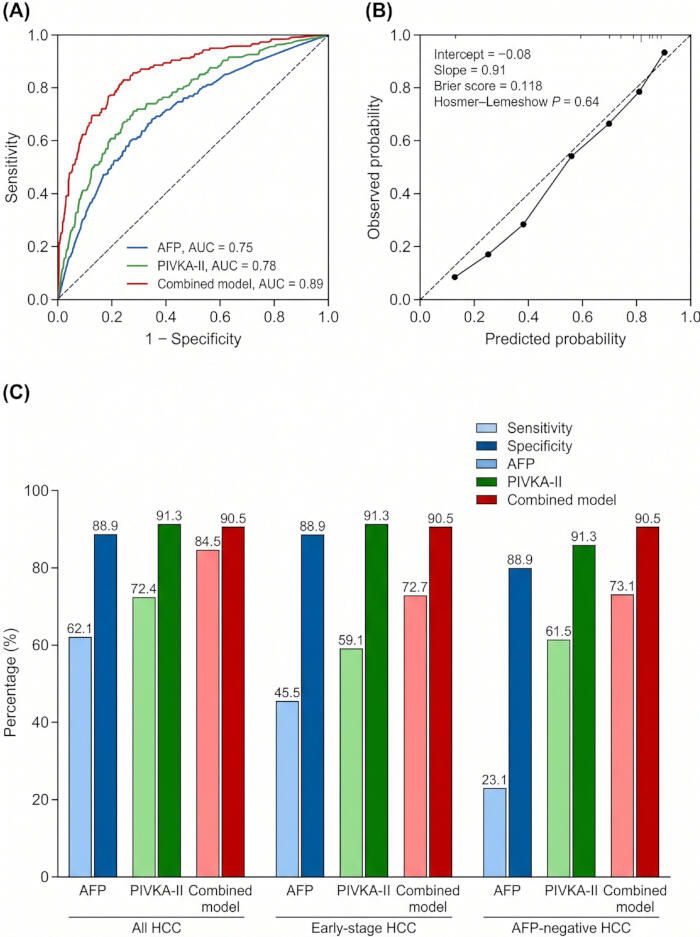
Figure 5 : Validation externe des performances diagnostiques dans la cohorte de validation indépendante. (A) Courbes caractéristiques de fonctionnement du récepteur (ROC) de la cohorte de validation pour l'AFP, la PIVKA-II et le modèle combiné. (B) Graphique de calibration du modèle combiné dans la cohorte de validation. (C) Sensibilité et spécificité comparées de l'AFP, de la PIVKA-II et du modèle combiné pour tous les cas de CHC, les CHC de stade précoce et les CHC avec AFP négative. Les métriques de validation correspondantes sont résumées dans le Tableau 3. Veuillez cliquer ici pour visualiser une version agrandie de cette figure.
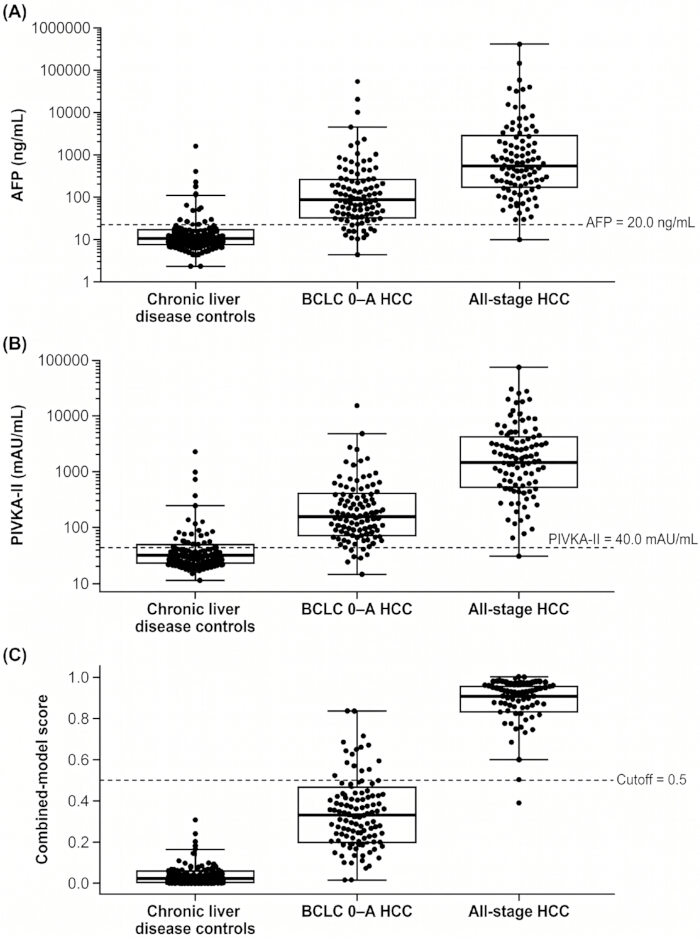
Figure 6 : Répartition par sous-groupe de maladie des taux d'AFP, de PIVKA-II et du score du modèle combiné. (A) Répartition de l'AFP parmi les témoins atteints de maladie hépatique chronique, les cas de carcinome hépatocellulaire aux stades BCLC 0–A et les cas de carcinome hépatocellulaire à tous les stades. (B) Répartition de la PIVKA-II parmi les témoins atteints de maladie hépatique chronique, les cas de carcinome hépatocellulaire aux stades BCLC 0–A et les cas de carcinome hépatocellulaire à tous les stades. (C) Répartition du score du modèle combiné parmi les témoins atteints de maladie hépatique chronique, les cas de carcinome hépatocellulaire aux stades BCLC 0–A et les cas de carcinome hépatocellulaire à tous les stades. Veuillez cliquer ici pour visualiser une version agrandie de cette figure.
| Facteur | Catégorie / Résumé | Formation à HCC n = 112 | Entraînement des témoins non-CHC n = 93 | Validation HCC n = 58 | Contrôles de validation non-HCC n = 126 | P valeur |
| Sexe, n (%) | Mâle | 76 (67.9%) | 59 (63.4%) | 39 (67.2%) | 76 (60.3%) | 0.374 |
| Femelle | 36 (32.1%) | 34 (36.6%) | 19 (32.8%) | 50 (39.7%) | — | |
| Âge, années | Moyenne ± ÉT | 58.9 ± 9.3 | 58.1 ± 10.4 | 59.4 ± 8.8 | 57.6 ± 9.7 | 0.281 |
| Antécédents de maladie hépatique, n (%) | VHB | 84 (75.0%) | 64 (68.8%) | 42 (72.4%) | 83 (65.9%) | 0.332 |
| VHC | 6 (5.4%) | 5 (5.4%) | 3 (5.2%) | 7 (5.6%) | 0.914 | |
| Maladie hépatique alcoolique | 13 (11.6%) | 10 (10.8%) | 6 (10.3%) | 12 (9.5%) | 0.825 | |
| Antécédents familiaux de CHC, n (%) | Oui | 9 (8.0%) | 7 (7.5%) | 4 (6.9%) | 8 (6.3%) | 0.887 |
| Cirrhose hépatique, n (%) | Oui | 80 (71.4%) | 61 (65.6%) | 42 (72.4%) | 88 (69.8%) | 0.468 |
| Stade du CHC (BCLC), n (%) | 0–A | 57 (50.9%) | — | 30 (51.7%) | — | — |
| B | 33 (29.5%) | — | 17 (29.3%) | — | — | |
| C | 22 (19.6%) | — | 11 (19.0%) | — | — | |
| Classe de Child–Pugh, n (%) | A | 85 (75.9%) | 77 (82.8%) | 43 (74.1%) | 101 (80.2%) | 0.341 |
| B | 27 (24.1%) | 16 (17.2%) | 15 (25.9%) | 25 (19.8%) | — | |
| ALT, U/L | Moyenne ± ÉT | 48.6 ± 22.1 | 47.1 ± 20.6 | 47.9 ± 22.4 | 45.2 ± 20.1 | 0.517 |
| AST, U/L | Moyenne ± ÉT | 60.3 ± 28.5 | 58.0 ± 27.8 | 58.7 ± 29.4 | 56.2 ± 26.9 | 0.488 |
| Albumine, g/L | Moyenne ± ÉT | 39.0 ± 4.7 | 39.5 ± 4.6 | 38.7 ± 5.1 | 39.6 ± 4.5 | 0.554 |
| bilirubine totale, μmol/L | Moyenne ± ÉT | 20.1 ± 11.3 | 18.6 ± 10.8 | 20.4 ± 11.6 | 18.1 ± 10.9 | 0.321 |
| Numération des plaquettes, ×10⁹/L | Moyenne ± ÉT | 137 ± 61 | 146 ± 59 | 134 ± 60 | 149 ± 57 | 0.437 |
| Temps de prothrombine, s | Moyenne ± ÉT | 13.7 ± 1.4 | 13.5 ± 1.3 | 13.8 ± 1.5 | 13.5 ± 1.2 | 0.411 |
| INR | Moyenne ± ÉT | 1.18 ± 0.12 | 1.16 ± 0.11 | 1.19 ± 0.13 | 1.15 ± 0.10 | 0.334 |
| AFP, ng/mL | Médiane (Q1 - Q3) | 57.3 (19.8–135.1) | 22.4 (10.4–46.0) | 60.2 (20.6–131.7) | 21.5 (9.8–48.1) | 0.071 |
| PIVKA-II, mU/mL | Médiane (Q1 - Q3) | 197.6 (83.1–438.2) | 86.3 (38.6–131.2) | 191.5 (81.4–422.5) | 84.1 (37.1–129.4) | 0.064 |
| TP prolongé, n (%) | Oui | 30 (26.8%) | 20 (21.5%) | 15 (25.9%) | 24 (19.0%) | 0.372 |
| Diabète, n (%) | Oui | 19 (17.0%) | 14 (15.1%) | 10 (17.2%) | 19 (15.1%) | 0.764 |
| Hypertension, n (%) | Oui | 33 (29.5%) | 26 (28.0%) | 18 (31.0%) | 36 (28.6%) | 0.824 |
| Type de contrôle parmi les non-HCC, n (%) | Témoins sains | — | 30 (32.3%) | — | 0 (0.0%) | — |
| Contrôles de la maladie hépatique chronique | — | 63 (67.7%) | — | 126 (100.0%) | — | |
| Remarque : HCC, carcinome hépatocellulaire ; BCLC, classification de la clinique de Barcelone pour le cancer du foie ; ALT, alanine aminotransférase ; AST, aspartate aminotransférase ; INR, rapport normalisé international ; AFP, alphafétoprotéine ; PIVKA-II, protéine induite par l'absence de vitamine K-II ; TP, temps de prothrombine ; IQR, écart interquartile. Les valeurs de p sont indiquées pour les comparaisons de base entre les cohortes ou strates de statut rapportées, lorsque cela s'applique. Le stade du HCC a été rapporté uniquement pour les cas de HCC. Le type de témoin a été rapporté uniquement pour les témoins sans HCC. | ||||||
Tableau 1 : Caractéristiques de base des cohortes d'apprentissage et de validation. Les caractéristiques démographiques, les antécédents de maladie hépatique, le stade du CHC, la classe Child-Pugh, les indices de laboratoire de routine, l'AFP et la PIVKA-II sont présentés selon la cohorte et le statut du CHC.
| Méthode | Sensibilité (IC à 95 %) | Spécificité (IC à 95 %) | AUC (IC à 95 %) | Seuil |
| AFP | 62,50 (53,41–71,06) | 78,49 (69,07–86,04) | 0,78 (0,72–0,84) | 20,0 ng/mL |
| PIVKA-II | 78,57 (70,29–85,37) | 82,80 (73,95–89,61) | 0,85 (0,80–0,90) | 45,0 mAU/mL |
| Modèle basé sur les variables cliniques | 69,64 (60,28–77,87) | 80,65 (71,13–88,04) | 0,81 (0,75–0,87) | Probabilité prédite = 0,40 |
| Modèle combiné | 88,39 (81,35–93,36) | 89,25 (81,26–94,65) | 0,93 (0,89–0,96) | Probabilité prédite = 0,50 |
| Remarque : L’AFP a été évaluée au seuil clinique établi de 20,0 ng/mL. Le seuil de 45,0 mAU/mL pour le PIVKA-II correspondait au seuil de Youden obtenu sur la cohorte d’entraînement, utilisé pour la comparaison principale lors de l’entraînement. Les modèles basés sur les variables cliniques et le modèle combiné ont été évalués à l’aide de seuils de probabilité prédite dérivés de la cohorte d’entraînement. | ||||
Tableau 2 : Performances diagnostiques dans la cohorte d'entraînement. Les valeurs d'AUC, de sensibilité, de spécificité et les seuils rapportés sont indiqués pour l'AFP, la PIVKA-II, le modèle basé sur les variables cliniques et le modèle multivariable combiné dans la cohorte d'entraînement.
| Sous-groupe | Élément | AFP | PIVKA-II | Modèle combiné |
| Tout HCC | AUC | 0.75 | 0.78 | 0.89 |
| Tout HCC | Seuil de validation principal | 18,5 ng/mL | 38,0 mAU/mL | Probabilité prédite = 0,56 |
| Tout HCC | Sensibilité, % (IC 95 %) | 62,1 (48,7–74,2) | 72,4 (59,1–83,5) | 84,5 (72,6–92,6) |
| Tout HCC | Spécificité, % (IC 95 %) | 88,9 (82,0–93,4) | 91,3 (85,1–95,3) | 90,5 (84,2–94,8) |
| Tout HCC | VP+, % | 63,8 | 72,7 | 78,8 |
| Tout HCC | VPN, % | 88,1 | 91 | 94,1 |
| HCC de stade précoce | Seuil exploratoire du sous-groupe | 15,2 ng/mL | 33,5 mAU/mL | Probabilité prédite = 0,51 |
| HCC de stade précoce | Sensibilité, % (IC 95 %) | 45,5 (25,1–67,3) | 59,1 (38,5–77,7) | 72,7 (52,0–87,6) |
| HCC de stade précoce | Spécificité, % | 88,9 | 91,3 | 90,5 |
| HCC de stade précoce | VP+, % | 40 | 54,5 | 66,7 |
| HCC de stade précoce | VPN, % | 90,1 | 87,5 | 92,3 |
| HCC AFP-négatif | Seuil exploratoire du sous-groupe | 7,5 ng/mL | 31,2 mAU/mL | Probabilité prédite = 0,48 |
| HCC AFP-négatif | Sensibilité, % (IC 95 %) | 23,1 (9,7–42,6) | 61,5 (40,6–79,8) | 73,1 (52,2–88,4) |
| HCC AFP-négatif | Spécificité, % | 88,9 | 91,3 | 90,5 |
| HCC AFP-négatif | VP+, % | 22 | 52 | 64,5 |
| HCC AFP-négatif | VPN, % | 90,2 | 88,3 | 92,7 |
| HCC viral | Seuil exploratoire du sous-groupe | 19,3 ng/mL | 40,7 mAU/mL | Probabilité prédite = 0,59 |
| HCC viral | Sensibilité, % (IC 95 %) | 64,7 (46,9–79,9) | 73,5 (56,4–86,4) | 85,3 (69,9–94,7) |
| HCC viral | Spécificité, % | 88,1 | 90,5 | 91,3 |
| HCC viral | VP+, % | 67,3 | 73 | 81,3 |
| HCC viral | VPN, % | 87,5 | 90,8 | 94,7 |
| HCC non viral | Seuil exploratoire du sous-groupe | 20,1 ng/mL | 34,5 mAU/mL | Probabilité prédite = 0,53 |
| HCC non viral | Sensibilité, % (IC 95 %) | 58,3 (36,6–77,9) | 70,8 (48,9–87,4) | 83,3 (62,6–95,3) |
| HCC non viral | Spécificité, % | 89,2 | 92,1 | 89,7 |
| HCC non viral | VP+, % | 59,2 | 69,7 | 75 |
| HCC non viral | VPN, % | 89 | 92 | 93,8 |
| Calibration du modèle combiné | Ordonnée à l'origine | — | — | −0,08 |
| Calibration du modèle combiné | Pente | — | — | 0,91 |
| Calibration du modèle combiné | Score de Brier | — | — | 0,118 |
| Calibration du modèle combiné | Valeur P de Hosmer–Lemeshow | — | — | 0,64 |
| Remarque : La ligne « tout HCC » indique l'analyse de validation principale. Les lignes HCC de stade précoce, HCC AFP-négatif, HCC viral et HCC non viral indiquent les performances exploratoires des sous-groupes. Les seuils des sous-groupes ont été indiqués pour décrire les points de fonctionnement apparents au sein de chaque sous-groupe et n'ont pas été utilisés pour la réajustement ou la recalibration du modèle. Le HCC AFP-négatif était défini comme AFP <20,0 ng/mL. VP+, valeur prédictive positive ; VPN, valeur prédictive négative. | ||||
Tableau 3 : Performances diagnostiques dans la cohorte de validation et analyse par sous-groupes. L'AUC, les seuils rapportés, la sensibilité, la spécificité, la valeur prédictive positive et la valeur prédictive négative sont indiqués pour l'AFP, la PIVKA-II et le modèle combiné dans tous les cas de CHC, les CHC de stade précoce, les CHC négatifs pour l'AFP, les CHC viraux et les CHC non viraux. Les métriques de calibration pour le modèle combiné sont également incluses.
| Facteur / métrique | Valeur P univariée | Coefficient β | OR ajusté / métrique de validation | IC à 95 % | P valeur |
| Intercepter | — | −4.862 | — | — | — |
| Âge | 0.112 | 0.018 | 1.02 | 0.99–1.05 | 0.186 |
| Sexe, mâle | 0.087 | 0.331 | 1.41 | 0.83–2.37 | 0.204 |
| AFP, transformé par logarithme naturel | 0.004 | 0.247 | 1.28 | 1.05–1.62 | 0.021 |
| PIVKA-II, transformé par logarithme naturel | <0.001 | 0.712 | 2.05 | 1.48–2.89 | <0.001 |
| Albumine, g/L | 0.008 | −0.062 | 0.94 | 0.89–0.99 | 0.032 |
| INR | 0.012 | 0.554 | 1.74 | 1.12–2.78 | 0.015 |
| Numération plaquettaire, ×109/ | 0.052 | −0.004 | 0.99 | 0.98–1.00 | 0.044 |
| AUC apparente d'entraînement | — | — | 0.93 | 0.89–0.96 | — |
| Optimisme moyen | — | — | 0.018 | — | — |
| AUC corrigée pour l'optimisme | — | — | 0.91 | 0.87–0.95 | — |
| Pente apparente de l'étalonnage | — | — | 1 | — | — |
| Pente de calibration corrigée par optimisme | — | — | 0.94 | — | — |
| Score de Brier d'entraînement | — | — | 0.104 | — | — |
| Valeur P de Hosmer-Lemeshow | — | — | 0.72 | — | — |
| Remarque : Le prédicteur linéaire final était η = −4,862 + 0,247 × ln(AFP) + 0,712 × ln(PIVKA-II) + 0,018 × âge + 0,331 × sexe − 0,062 × albumine + 0,554 × INR − 0,004 × numération plaquettaire. La probabilité prédite était calculée selon la formule p(HCC) = 1 / [1 + exp(−η)]. L'AFP était mesurée en ng/mL ; le PIVKA-II en mU/mL ; l'âge en années ; le sexe codé comme femme = 0 et homme = 1 ; l'albumine en g/L ; l'INR comme une valeur sans unité ; et la numération plaquettaire en ×10⁹/L. | |||||
Tableau 4 : Régression logistique multivariée et validation interne par bootstrap. Les valeurs P univariées, les coefficients du modèle ajusté, les rapports de cotes ajustés, les intervalles de confiance à 95 % et les valeurs P multivariées sont indiqués pour les variables évaluées dans le modèle de la cohorte d'apprentissage. Les résultats incluent l'optimisme du bootstrap, la surface sous la courbe (AUC) corrigée pour l'optimisme, la pente de calibration corrigée pour l'optimisme, le score de Brier et les résultats du test de Hosmer–Lemeshow.
Tableau 5 : Performance diagnostique à l'aide de seuils optimisés selon Youden. La sensibilité, la spécificité, la valeur prédictive positive, la valeur prédictive négative, l'exactitude et l'AUC sont indiquées pour l'AFP, la PIVKA-II et le modèle combiné utilisant les seuils déterminés par l'indice de Youden.
| Méthode | Seuil établi | Sensibilité, % (IC 95 %) | Spécificité, % (IC 95 %) | VPN, % (IC 95 %) | VPP, % (IC 95 %) | Exactitude, % (IC 95 %) | AUC (IC 95 %) |
| AFP | 20,0 ng/mL | 65,2 (57,0–72,7) | 88,5 (83,4–92,3) | 70,1 (61,8–77,4) | 86,0 (80,7–90,3) | 80,3 (75,0–84,8) | 0,77 (0,72–0,82) |
| PIVKA-II | 40,0 mAU/mL | 73,0 (65,2–79,8) | 93,1 (88,8–96,0) | 81,8 (74,2–87,7) | 89,0 (83,9–92,8) | 85,6 (80,9–89,5) | 0,82 (0,78–0,86) |
| Modèle combiné | Probabilité prédite = 0,60 | 83,5 (76,6–89,0) | 92,0 (87,4–95,3) | 84,7 (77,9–90,0) | 91,2 (86,3–94,6) | 88,9 (84,6–92,2) | 0,89 (0,86–0,93) |
| Remarque : Les seuils cliniques établis étaient de 20,0 ng/mL pour l'AFP et de 40,0 mAU/mL pour le PIVKA-II. Le modèle combiné a été rapporté au seuil de probabilité prédéfini correspondant utilisé pour cette comparaison avec les seuils cliniques. | |||||||
Tableau 6 : Performance diagnostique à l’aide de seuils cliniques établis. La sensibilité, la spécificité, la valeur prédictive positive, la valeur prédictive négative, l’exactitude et l’AUC sont indiquées en utilisant le seuil établi d’AFP de 20,0 ng/mL et le seuil établi de PIVKA-II de 40,0 mAU/mL. Le modèle combiné est rapporté au seuil de probabilité correspondant utilisé pour cette comparaison des seuils.
| Méthode | Seuil le plus proche d'une spécificité de 90 % | Sensibilité, % (IC à 95 %) | Spécificité, % (IC à 95 %) | VPN, % (IC à 95 %) | VPP, % (IC à 95 %) |
| AFP | 19,0 ng/mL | 67,9 (59,1–75,7) | 89,1 (84,2–92,8) | 71,3 (62,4–79,0) | 87,3 (82,1–91,2) |
| PIVKA-II | 37,5 mAU/mL | 75,4 (67,3–82,2) | 92,0 (87,7–95,1) | 79,8 (71,6–86,3) | 89,7 (84,7–93,3) |
| Modèle combiné | Probabilité prédite = 0,57 | 86,2 (79,3–91,3) | 90,6 (85,8–94,0) | 82,7 (74,8–88,7) | 92,4 (87,9–95,4) |
| Remarque : Ces seuils ont été choisis pour atteindre une spécificité aussi proche que possible de 90 % dans l'analyse de vérification des seuils. Pour le PIVKA-II, 37,5 mAU/mL correspond au seuil de Youden et à celui proche d'une spécificité de 90 % dans cette vérification, 38,0 mAU/mL est le seuil principal de validation indiqué dans le tableau 3, 40,0 mAU/mL est le seuil clinique établi, et 45,0 mAU/mL est le seuil de Youden du cohort d'apprentissage utilisé dans le tableau 2. | |||||
Tableau 7 : Performance diagnostique au seuil le plus proche d'une spécificité de 90 %. La sensibilité, la spécificité, la valeur prédictive positive et la valeur prédictive négative sont indiquées pour l'AFP, la PIVKA-II et le modèle combiné à des seuils choisis pour atteindre une spécificité aussi proche que possible de 90 %.
Discussion
Cette étude a évalué une stratégie diagnostique intégrée pour le carcinome hépatocellulaire utilisant la PIVKA-II, l'AFP et des variables cliniques de routine, en portant une attention particulière aux stades précoces et aux formes négatives pour l'AFP14. Dans les cohortes d'apprentissage et de validation, le modèle combiné a surpassé les tests basés sur un seul marqueur. Dans la cohorte d'apprentissage, le modèle combiné a atteint une AUC de 0,93, contre 0,78 pour l'AFP et 0,85 pour la PIVKA-II. Dans la cohorte de validation indépendante, le modèle a conservé une bonne capacité de discrimination, avec une AUC de 0,89, une sensibilité de 84,5 % et une spécificité de 90,5 %. Ces résultats appuient une approche fondée sur un modèle dans laquelle les signaux complémentaires des biomarqueurs et les données cliniques sont interprétés conjointement, plutôt que de fonder les décisions diagnostiques sur un seuil sérique unique.
Les résultats de validation clarifient la valeur ajoutée de la PIVKA-II, en particulier lorsque l'AFP est peu fiable. La sensibilité de l'AFP était de 62,1 % dans tous les cas de CHC validés et est tombée à 23,1 % dans les cas de CHC négatifs pour l'AFP. La PIVKA-II a montré une sensibilité globale plus élevée et a conservé une sensibilité de 61,5 % dans les formes de maladie négatives pour l'AFP. Le modèle combiné a encore amélioré la sensibilité à 73,1 % dans le CHC négatif pour l'AFP et à 72,7 % dans le CHC à un stade précoce, tout en maintenant une spécificité élevée. Ce profil est conforme aux données antérieures indiquant que la PIVKA-II capte des informations diagnostiques partiellement distinctes de celles de l'AFP, notamment dans les tumeurs à faible taux d'AFP et dans les stades précoces de la charge tumorale15,16,17. Les analyses de corrélation et de reclassement croisé ont également soutenu cette interprétation, montrant que l'AFP et la PIVKA-II ne sont pas des marqueurs interchangeables et que le score intégré permet de détecter des cas supplémentaires non identifiés par le classement fondé sur un seul marqueur.
Les résultats multivariés suggèrent que le gain obtenu avec le modèle combiné n'était pas uniquement dû à l'ajout conjoint de l'AFP et de la PIVKA-II. Les variables cliniques ont apporté un contexte supplémentaire lié à l'âge, au sexe, à la réserve hépatique, au statut de coagulation et au taux de plaquettes. Cette conception est conforme aux modèles multivariés établis de risque de carcinome hépatocellulaire (CHC), notamment les scores GALAD, GAAD et d'autres scores basés sur des biomarqueurs, qui combinent des variables démographiques et des paramètres de laboratoire afin d'améliorer les performances diagnostiques au sein de populations hétérogènes de maladies hépatiques18,19,20. Dans le modèle ajusté, la PIVKA-II transformée en logarithme est restée le prédicteur indépendant le plus puissant, l'AFP transformée en logarithme a conservé une association indépendante, et l'INR a apporté un signal diagnostique supplémentaire. Les aminotransférases se sont révélées moins informatives après ajustement, suggérant qu'une inflammation hépatique non spécifique n'était pas le principal facteur discriminant une fois pris en compte les marqueurs associés à la tumeur et ceux liés à la coagulation.
Les analyses de seuil abordent un point important soulevé lors de l'évaluation. Les différents seuils de PIVKA-II ne doivent pas être interprétés comme des seuils primaires contradictoires. La valeur de 45,0 mAU/mL a été utilisée pour la comparaison ROC dans la cohorte d'apprentissage, 40,0 mAU/mL représentait le seuil clinique établi, et la plage de 37,5 à 38,0 mAU/mL reflétait des stratégies alternatives de seuil basées sur l'optimisation de Youden ou une analyse à spécificité fixe. Ces seuils répondent à différentes questions cliniques : un seuil orienté vers la sensibilité peut s'avérer utile pour la surveillance des patients à haut risque, tandis qu'un seuil orienté vers la spécificité peut être préféré lorsque la priorité est de réduire les faux positifs. Quelle que soit la stratégie adoptée, le modèle combiné s'est révélé plus stable que l'AFP ou le PIVKA-II seuls, ce qui soutient son utilisation comme outil de stratification du risque plutôt que comme remplacement du diagnostic basé sur l'imagerie21.
Plusieurs limites persistent. La cohorte d'apprentissage provenait d'un seul centre, et la cohorte de validation prospective était d'une taille modérée. Une validation multicentrique est encore nécessaire, en particulier dans des populations aux antécédents étiologiques différents, notamment les HCC liés à la stéatohépatite non alcoolique, à l'alcool et au VHC. Le statut des HCC a été évalué à l'aide d'examens TDM ou IRM avec produit de contraste, ce qui reflète la pratique diagnostique courante mais pourrait sous-estimer les lésions extrêmement précoces ou atypiques. Certaines analyses de sous-groupes, en particulier les HCC de stade précoce et les HCC négatifs pour l'AFP, comprenaient moins de cas que la cohorte globale. Les analyses de calibration et de rééchantillonnage par bootstrap ont permis d'évaluer la stabilité du modèle, mais elles ne peuvent pas remplacer des études d'implémentation prospective qui testent si une surveillance guidée par le modèle améliore l'efficacité des références, le rendement de détection précoce et les résultats cliniques ultérieurs22.
En conclusion, l'intégration de PIVKA-II, de l'AFP et de variables cliniques de routine a amélioré la détection du carcinome hépatocellulaire par rapport aux stratégies fondées sur un seul biomarqueur, avec une performance constante dans les cohortes d'apprentissage et de validation indépendante. Le modèle conserve une sensibilité cliniquement utile pour le carcinome hépatocellulaire à un stade précoce et négatif pour l'AFP, tout en maintenant une spécificité élevée, comblant ainsi deux lacunes fréquentes de la surveillance basée sur l'AFP. Étant donné que les paramètres requis sont couramment disponibles, cette approche est praticable pour des évaluations ultérieures dans les populations présentant un risque élevé de maladie hépatique. De futures études multicentriques devraient comparer directement ce modèle à l'échographie associée à l'AFP, évaluer des seuils opérationnels prédéfinis et déterminer si l'intégration avec des biomarqueurs émergents ou des caractéristiques issues de l'imagerie améliore encore la détection précoce du carcinome hépatocellulaire23,24.
Déclarations de divulgation
Les auteurs déclarent n'avoir aucun intérêt financier ou non financier en conflit. Aucun financeur commercial, fabricant de réactifs, fournisseur de logiciels ou entreprise de plateforme diagnostique n'a joué de rôle dans la conception de l'étude, la collecte des données, l'analyse statistique, l'interprétation des résultats, la rédaction du manuscrit ou la décision de soumettre les travaux pour publication.
Remerciements
Les auteurs remercient les participants à l'étude ainsi que le personnel clinique qui a soutenu le prélèvement sanguin, la coordination clinique, l'analyse des images et la vérification des données pour cette étude.
Matériaux
| Nom | Entreprise | Numéro de catalogue | Commentaires |
|---|---|---|---|
| Tube microcentrifuge de 1,5 mL sans nucléase | Eppendorf | 30123328 | Aliquotation et stockage du plasma |
| Étalonneur AFP | Roche Diagnostics | AFP CalSet II, 09227261190 | Étalonnage AFP |
| Matériau de contrôle qualité AFP | Roche Diagnostics | PreciControl Tumor Marker, 11776452160 | Contrôle qualité AFP |
| Matériau de contrôle qualité AFP | Roche Diagnostics | PreciControl Universal, 11731416160 | Contrôle qualité AFP |
| Kit de réactif AFP | Roche Diagnostics | Elecsys AFP, 09015124190 | Mesure AFP |
| Analyseur automatisé d'immunodosage par électrochimiluminescence | Roche Diagnostics | cobas e 801 | Mesure AFP et PIVKA-II |
| Pack d'étalonnage | R package | rms 6.7–1 | Analyse d'étalonnage |
| Pack d'analyse de courbe décisionnelle | R package | rmda 1.6 | Analyse de courbe décisionnelle |
| Pack du test de Hosmer–Lemeshow | R package | ResourceSelection 0.3–6 | Test de Hosmer–Lemeshow |
| Tube de prélèvement sanguin K2-EDTA, 10 mL | BD | 367525 | Prélèvement de sang veineux périphérique |
| Pack d'imputation multiple | R package | mice 3.16.0 | Imputation multiple |
| Kit de réactif PIVKA-II | Roche Diagnostics | Elecsys PIVKA-II, 08333629190/08333629500 | Mesure PIVKA-II |
| Centrifugeuse réfrigérée | Eppendorf | Centrifuge 5425 R | Séparation du plasma |
| Pack d'analyse ROC | R package | pROC 1.18.5 | Analyse ROC et test de DeLong |
| Logiciel statistique | R Foundation | R 4.3.2 | Analyse statistique |
| Interface de logiciel statistique | Posit Software | RStudio 2023.12.1 | Analyse statistique |
Références
- Oh JH, Jun DW. The latest global burden of liver cancer: A past and present threat. Clin Mol Hepatol. 2023;29(2):355-357.
- Heimbach JK et al. AASLD guidelines for the treatment of hepatocellular carcinoma. Hepatology. 2018;67(1):358-380.
- Singal AG et al. Meta-analysis: Surveillance with ultrasound for early-stage hepatocellular carcinoma in patients with cirrhosis. Aliment Pharmacol Ther. 2009;30(1):37-47.
- Tzartzeva K et al. Surveillance imaging and alpha fetoprotein for early detection of hepatocellular carcinoma in patients with cirrhosis: A meta-analysis. Gastroenterology. 2018;154(6):1706-1718.e1.
- Parikh ND et al. Biomarkers for the early detection of hepatocellular carcinoma. Cancer Epidemiol Biomarkers Prev. 2020;29(12):2495-2503.
- Gopal P et al. Factors that affect accuracy of alpha-fetoprotein test in detection of hepatocellular carcinoma in patients with cirrhosis. Clin Gastroenterol Hepatol. 2014;12(5):870-877.
- Hanif H et al. Update on the applications and limitations of alpha-fetoprotein for hepatocellular carcinoma. World J Gastroenterol. 2022;28(2):216-229.
- Norman JS, Mehta N. The role of AFP-L3 and DCP biomarkers in the diagnosis and management of hepatocellular carcinoma. Curr Hepatol Rep. 2025;24(1):16.
- Suttichaimongkol T et al. PIVKA-II or AFP has better diagnostic properties for hepatocellular carcinoma diagnosis in high-risk patients. J Circ Biomark. 2023;12:12-16.
- Piratvisuth T et al. Development and clinical validation of a novel algorithmic score (GAAD) for detecting HCC in prospective cohort studies. Hepatol Commun. 2023;7(11):e0317.
- Jarrah M et al. Performance of GALAD, GAAD, and ASAP for early HCC detection in chronic liver disease: A systematic review and meta-analysis. Liver Cancer. 2026;15(2):285-299.
- Zhou JM, Wang T, Zhang KH. AFP-L3 for the diagnosis of early hepatocellular carcinoma: A meta-analysis. Medicine (Baltimore). 2021;100(43):e27673.
- Singal AG et al. AASLD practice guidance on prevention, diagnosis, and treatment of hepatocellular carcinoma. Hepatology. 2023;78(6):1922-1965.
- Best J et al. The GALAD scoring algorithm based on AFP, AFP-L3, and DCP significantly improves detection of BCLC early-stage hepatocellular carcinoma. Z Gastroenterol. 2016;54(12):1296-1305.
- Poté N et al. Performance of PIVKA-II for early hepatocellular carcinoma diagnosis and prediction of microvascular invasion. J Hepatol. 2015;62(4):848-854.
- Xu F et al. The diagnostic value of serum PIVKA-II alone or in combination with AFP in Chinese hepatocellular carcinoma patients. Dis Markers. 2021;2021:8868370.
- Liu M et al. Validation of the GALAD model and establishment of GAAP model for diagnosis of hepatocellular carcinoma in Chinese patients. J Hepatocell Carcinoma. 2020;7:219-232.
- Aralica M et al. GALAD, or des-gamma-carboxy prothrombin compared with alpha-foetoprotein for the diagnosis of hepatocellular carcinoma in people with chronic liver disease. Cochrane Database Syst Rev. 2024;12(12):CD015826.
- Zhang S et al. Evaluating the combined diagnostic power of alpha-fetoprotein and protein induced by vitamin K absence or antagonist-II for hepatocellular carcinoma. J Gastrointest Oncol. 2025;16(3):1157-1175.
- Pham TTT, Ho DT, Nguyen TB, Phan HT. Clinical performance of GAAD score, alpha-fetoprotein, and PIVKA-II in diagnosing hepatocellular carcinoma in the Vietnamese cohort. Discov Oncol. 2025;16:1813.
- Youden WJ. Index for rating diagnostic tests. Cancer. 1950;3(1):32-35.
- Tarao K et al. Real impact of tumor marker AFP and PIVKA-II in detecting very small hepatocellular carcinoma (≤2 cm, Barcelona stage 0): Assessment with a large number of cases. World J Hepatol. 2020;12(11):1046-1054.
- Kim DY et al. Utility of combining PIVKA-II and AFP in the surveillance and monitoring of hepatocellular carcinoma in the Asia-Pacific region. Clin Mol Hepatol. 2023;29(2):277-292.
- Kao SYZ et al. Cost-effectiveness of a precision hepatocellular carcinoma surveillance strategy in patients with cirrhosis. EClinicalMedicine. 2024;75:102755.