Cet article présente un protocole progressif pour la collecte de données de suivi oculaire à haute précision dans des expériences de lecture humaine, couvrant le choix du matériel et de l'affichage, l'installation du laboratoire, la gestion des participants, l'étalonnage et la validation, le contrôle de qualité en ligne, ainsi que le prétraitement (détection des événements et correction de la dérive), afin d'obtenir des données précises et reproductibles.
Article de méthode
Protocole méthodologique pour la collecte de données de haute qualité lors de l'oculométrie appliquée à la lecture humaine
Dans cet article
Résumé
Résumé
Le suivi oculaire est une approche méthodologique centrale pour l'étude de l'attention et du traitement du langage pendant la lecture. La validité et la reproductibilité des résultats dépendent de la qualité des données, d'une méthodologie claire et d'un prétraitement cohérent. Cet article présente un protocole complet et étape par étape pour la collecte de données de suivi oculaire de haute qualité dans les études de lecture. Le protocole commence par la préparation de l'environnement de laboratoire et la mise en place du matériel, puis se poursuit par la sélection et la configuration du matériel et des logiciels de suivi oculaire, ainsi que par la préparation des stimuli et la conception expérimentale. La gestion des participants, le consentement éclairé et la documentation des caractéristiques linguistiques et psychométriques sont réalisées. Des procédures d'étalonnage et de validation sont ensuite effectuées, le confort du participant et la qualité des données étant surveillés en continu en ligne pendant la collecte des données. Le pipeline de prétraitement comprend l'exportation des données brutes dans des formats standard, le nettoyage des données, la détection des fixations et des saccades (en utilisant des algorithmes fondés sur la vitesse et la dispersion) avec des paramètres clairement définis, l'inspection visuelle des pertes de signal et le contrôle du bruit, la correction de la dérive verticale pour les textes multilignes, et l'extraction des mesures standard de lecture (durée de fixation, métriques des saccades, omission de mots et taux de régression). Tout au long du protocole, l'alignement entre les questions de recherche et les spécifications du matériel, la gestion de la dérive par des vérifications régulières, ainsi que la description détaillée de tous les paramètres et décisions critiques sont particulièrement soulignés. Une collecte de données réussie donne généralement une précision de validation stable dans les limites fixées, des taux faibles de perte de données, et des distributions interprétables des durées de fixation et du comportement des saccades, reproduisant des effets bien connus liés à la longueur, à la fréquence et à la prévisibilité des mots. Le protocole est compatible avec les dispositifs de suivi oculaire de bureau, les environnements logiciels courants, et les configurations avec ou sans stabilisation de la tête, en tenant compte de problèmes pratiques tels que les conditions d'éclairage, les reflets sur les lunettes et les changements de posture du participant. Cette étude présente un protocole clair et pratique qui regroupe les recommandations méthodologiques en un flux de travail unifié. Il vise à soutenir la collecte fiable de données de suivi oculaire en recherche sur la lecture, à favoriser la reproductibilité et les méta-analyses, à améliorer la cohérence entre laboratoires et groupes, et à renforcer finalement la crédibilité scientifique de la recherche sur la lecture.
Introduction
Le suivi oculaire est une méthode centrale pour l'étude de l'attention et du traitement du langage pendant la lecture, car les fixations et les saccades indiquent l'allocation, instant après instant, des ressources visuelles et cognitives aux stimuli. Des revues classiques et contemporaines font état de liens solides entre les mouvements oculaires et des concepts théoriques tels que la portée perceptive, l'avantage du pré-affichage, et les modèles de contrôle des mouvements oculaires1,2. Pour mener des études fiables examinant ces liens, une rigueur méthodologique dans le choix du matériel, la conception expérimentale, l'étalonnage et la validation, ainsi que le prétraitement, est essentielle ; faute de quoi, une dégradation de la qualité des données fausse les estimations et compromet la reproductibilité3.
Au cours de la dernière décennie, plusieurs articles introductifs et des publications sur les meilleures pratiques ont consolidé les connaissances méthodologiques du domaine. Une série récente de fondamentaux relie la théorie aux mesures, aborde l'opérationnalisation et la variabilité algorithmique, et fournit des recommandations pour choisir des oculomètres adaptés à des questions de recherche spécifiques4,5,6,7,8. Des lignes directrices complémentaires présentent les meilleures pratiques pour sélectionner le matériel, assurer la précision et l'exactitude, définir les mesures et les rapports, avec des recommandations visant à réduire les menaces à la validité9. Des ressources pédagogiques destinées à la recherche sur la lecture offrent également des aperçus accessibles sur la conception des expériences, les mesures courantes et les pipelines d'analyse10,11. En linguistique appliquée et en lecture, des revues spécifiques au domaine résument le choix des mesures et des oculomètres et soulignent les contraintes dépendant des tâches12,13,14,15,16,17.
Cet article traduit ces recommandations en un protocole étape par étape pour la collecte de données de suivi oculaire à haute précision dans les études de lecture. Contrairement aux ressources existantes qui offrent principalement des lignes directrices théoriques générales ou se concentrent étroitement sur des techniques analytiques spécifiques, ce protocole opérationnalise ces concepts en un flux de travail complet et exécutable. Il vise à faciliter la pratique quotidienne en laboratoire en fournissant des instructions concrètes et séquentielles. En ce qui concerne son applicabilité, ce protocole est spécifiquement optimisé pour des expériences de lecture en laboratoire très contrôlées, utilisant des dispositifs de suivi oculaire de bureau à haute fréquence (par exemple, 500-2000 Hz) avec des dispositifs de stabilisation de la tête (repos-menton ou appui-front). Il convient particulièrement aux recherches exigeant des contraintes strictes sur la qualité des données, une grande précision spatiale et une exactitude élevée, telles que les études analysant des fixations au niveau du mot ou des métriques fines des saccades.
L'utilisation de dispositifs sans casque ou de configurations naturalistes gagne également en popularité, y compris dans la recherche sur la lecture, bien que nous restreignions le champ de cet article aux études en laboratoire. Nous abordons la sélection du matériel et des logiciels, l'aménagement du laboratoire, la préparation des stimuli, la gestion des participants, l'étalonnage et la validation, le contrôle qualité en ligne, ainsi que le prétraitement (y compris la détection des événements et la correction de la dérive). En suivant ce protocole, les chercheurs peuvent documenter et obtenir une qualité de données conforme aux normes actuelles, améliorant ainsi la transparence, la crédibilité et la reproductibilité des résultats liés à la lecture.
Protocole
L'autorisation éthique pour la collecte de données COST CA21131 a été accordée par le comité d'éthique de la recherche de la Faculté de philosophie de l'Université Jagellonne en Pologne, sous le numéro de protocole 221.0042.18_2024. Le consentement éclairé a été obtenu de la part de tous les participants.
1. Préparer l'environnement de laboratoire et installer l'équipement
- Préparation de l'environnement de laboratoire
- Vérifiez les conditions d'éclairage et de bruit ambiant. Les fenêtres dans l’environnement de laboratoire peuvent provoquer des changements soudains de la dilatation pupillaire ainsi que des reflets lumineux sur la caméra du dispositif de suivi oculaire et sur l’écran. Si possible, recueillez les données dans une pièce sans fenêtres ou utilisez des rideaux occultants pour bloquer la lumière du jour. Utilisez un éclairage artificiel et éliminez les sources lumineuses réfléchissantes. Vérifiez qu’aucun reflet n’apparaisse sur l’écran ; ajustez les stores ou les angles jusqu’à ce qu’aucun reflet ne subsiste. Assurez-vous que la pièce est silencieuse et évitez les interruptions (par exemple, en affichant un panneau ou en verrouillant la porte). Utilisez des signaux extérieurs pour éviter les interruptions (par exemple, placez un signal à l’extérieur indiquant : « Expérience en cours. Veuillez ne pas frapper à la porte ni entrer dans la pièce. »)
- Vérifiez l’ergonomie physique. Utilisez une chaise stable, non pivotante ; ajustez la hauteur de la table (si un réglage est possible) afin de maintenir une posture adéquate et d’éviter la perte de calibration due à la rotation de la chaise.
- Évitez la présence sociale. La présence d’un expérimentateur dans la même pièce pourrait distraire le participant. Séparez la pièce de contrôle de celle du participant, ou maintenez-la hors de vue, afin de minimiser les effets liés à la présence sociale.
- Vérifiez la ventilation de l’air. Aérez la pièce avant et après chaque session expérimentale. Contrôlez la température ambiante, car les participants devront rester immobiles pendant un certain temps.
- Sélection du matériel de suivi oculaire
- Vérifiez la compatibilité entre les objectifs de recherche et les mesures. Les objectifs d’une étude spécifique, et donc les mesures cibles (variables dépendantes), doivent correspondre aux capacités du dispositif de suivi oculaire. La disponibilité institutionnelle du matériel peut imposer des limites à l’étendue de l’étude prévue. Examinez les trois caractéristiques principales du système de suivi oculaire (fréquence d’échantillonnage, précision et exactitude) et leur potentiel pour répondre aux besoins de recherche. L’essentiel est de s’assurer que les performances du dispositif de suivi oculaire sont compatibles avec les objectifs de l’étude.
REMARQUE : Fréquence d’échantillonnage = La fréquence d’échantillonnage s’exprime en Hz et reflète la taille des échantillons collectés par le dispositif de suivi oculaire pendant une période donnée : un dispositif de 60 Hz collecte des échantillons toutes les 16 ms, tandis qu’un dispositif de 500 Hz collecte des échantillons toutes les 1 ms. Ceci influence les différents types de mesures, car un dispositif à faible fréquence pourrait classer comme fixations des saccades ayant commencé pendant une période de 16 ms, ou inversement. L’échantillonnage est parfois confondu avec la précision des données, mais il s’agit de propriétés distinctes.
Précision = Cohérence avec laquelle le dispositif de suivi oculaire parvient à collecter les données au fil du temps.
Exactitude = Amplitude de l’erreur entre le point de regard détecté par le dispositif de suivi oculaire et le point de regard réel.
Par exemple, l’étude des positions d’atterrissage des fixations sur les mots, décrites en fonction de la position du regard sur les lettres d’un mot, exige une fréquence d’échantillonnage (≥500-2000 Hz), une précision et une exactitude bien plus élevées qu’une étude portant uniquement sur le pourcentage de saccades régressives (par rapport aux saccades progressives) pendant la lecture. - Déterminez la méthodologie d’enregistrement des mouvements oculaires. Utilisez un dispositif de suivi oculaire fixe doté d’une fréquence d’échantillonnage, d’une précision et d’une exactitude élevées. Utilisez un système de stabilisation de la tête avec un appui-menton ou un appui-frontal. En cas d’utilisation d’un suivi oculaire sans fixation de la tête (suivi oculaire à distance), utilisez des autocollants, si disponibles, sur le front du participant pour améliorer le suivi du visage ; évitez également les autocollants réfléchissants, sauf recommandation contraire du fabricant du dispositif.
REMARQUE : L’utilisation d’équipements portables de suivi oculaire a été rare dans les études de lecture en raison de leur fréquence d’échantillonnage, de leur précision et de leur exactitude relativement faibles par rapport aux dispositifs de suivi oculaire fixes, ainsi que des difficultés liées à l’analyse des données de mouvements oculaires. Toutefois, les configurations sans fixation de la tête ou naturalistes gagnent en popularité depuis une dizaine d’années, accompagnées d’une amélioration de la qualité des données et de pipelines d’analyse automatisés, élargissant ainsi le champ des études sur les mouvements oculaires pendant la lecture vers des contextes naturalistes et la lecture en environnement de réalité virtuelle (VR).
- Vérifiez la compatibilité entre les objectifs de recherche et les mesures. Les objectifs d’une étude spécifique, et donc les mesures cibles (variables dépendantes), doivent correspondre aux capacités du dispositif de suivi oculaire. La disponibilité institutionnelle du matériel peut imposer des limites à l’étendue de l’étude prévue. Examinez les trois caractéristiques principales du système de suivi oculaire (fréquence d’échantillonnage, précision et exactitude) et leur potentiel pour répondre aux besoins de recherche. L’essentiel est de s’assurer que les performances du dispositif de suivi oculaire sont compatibles avec les objectifs de l’étude.
- Configuration du matériel et des logiciels
- Configurer le matériel. Mesurez les distances entre le visage du participant, l’écran et le dispositif de suivi oculaire. Réglez la distance de visionnage selon les recommandations du fabricant (par exemple, ~60–70 cm) et la géométrie de configuration requise, de préférence en utilisant un écran LCD plat de 21 à 27 pouces (par exemple, 24 pouces à 60 cm, champ visuel d’environ 48° x 28°), de sorte que tout le texte reste dans le champ visuel central et dans la plage efficace du dispositif de suivi. Vérifiez l’inclinaison et la rotation de l’écran, ainsi que l’alignement entre le vecteur de regard et l’emplacement correspondant sur l’écran. Réglez la taille de l’écran et sa fréquence de rafraîchissement aux valeurs cibles. Réglez la résolution de l’écran à la valeur spécifiée. Mesurez la luminance de l’écran sur fond blanc à la distance spécifiée. Enregistrez la valeur de luminance dans le rapport de la session.
- Lorsque nécessaire, privilégiez les écrans LCD dotés de fréquences de rafraîchissement élevées (120 Hz ou plus, par exemple 144–240 Hz), particulièrement pour les tâches dépendantes du regard et pour une synchronisation temporelle vérifiée. Désactivez les technologies de rafraîchissement variable (G-Sync/FreeSync). Si le dispositif de suivi oculaire est utilisé par différents chercheurs pour différentes expériences, il est important de noter tous les changements effectués lors de chaque session de collecte de données. À la fin de chaque session de collecte, la configuration doit être rétablie à son état initial au début de la session, ou selon les consignes du protocole de laboratoire.
- Configurer les logiciels. La plupart des fabricants de dispositifs de suivi oculaire fournissent des logiciels appropriés, des kits de développement logiciel (SDK) et/ou des bibliothèques pour assurer la compatibilité et l’intégration avec des logiciels open source.
REMARQUE : Récemment, certaines configurations spécifiques sont restées un défi technique nécessitant des solutions personnalisées. Par exemple, la synchronisation temporelle d’un dispositif de suivi oculaire avec des méthodes complémentaires de mesure, telles que l’EEG et la fNIRS, exige des solutions matérielles et/ou logicielles spécifiques afin d’assurer un niveau adéquat de verrouillage temporel entre l’horloge du dispositif de suivi oculaire et celle de la présentation des stimuli, et/ou de désynchronisation du rafraîchissement de l’écran. Par conséquent, la plupart des outils fournis par les fabricants offrent un environnement permettant de concevoir des expériences répondant aux besoins fondamentaux des chercheurs, tels que la présentation des stimuli et l’enregistrement des mouvements oculaires. Une liste des logiciels actuellement disponibles est présentée dans le Tableau des matériaux.
- Configurer le matériel. Mesurez les distances entre le visage du participant, l’écran et le dispositif de suivi oculaire. Réglez la distance de visionnage selon les recommandations du fabricant (par exemple, ~60–70 cm) et la géométrie de configuration requise, de préférence en utilisant un écran LCD plat de 21 à 27 pouces (par exemple, 24 pouces à 60 cm, champ visuel d’environ 48° x 28°), de sorte que tout le texte reste dans le champ visuel central et dans la plage efficace du dispositif de suivi. Vérifiez l’inclinaison et la rotation de l’écran, ainsi que l’alignement entre le vecteur de regard et l’emplacement correspondant sur l’écran. Réglez la taille de l’écran et sa fréquence de rafraîchissement aux valeurs cibles. Réglez la résolution de l’écran à la valeur spécifiée. Mesurez la luminance de l’écran sur fond blanc à la distance spécifiée. Enregistrez la valeur de luminance dans le rapport de la session.
2. Concevoir et piloter l'expérience
- Préparation des stimuli
- Préparer les documents de lecture. Les documents de lecture sont généralement présentés sous forme de phrases ou de paragraphes, selon les objectifs de l'étude. Préférer l'extraction de documents de lecture à partir de sources disponibles plutôt que la création manuelle de textes, tant que cette méthode est compatible avec l'objectif de l'étude.
- Vérifier les conditions de licence pour la réutilisation du texte. Vérifier les conditions de licence pour tous les textes. Si les matériaux provenant d'expériences publiées sont disponibles en source ouverte et donc accessibles au public pour toute personne souhaitant les utiliser, aucune autorisation n'est nécessaire. Dans le cas contraire, obtenir les autorisations requises avant utilisation. Il est important de vérifier si les stimuli peuvent être utilisés pour l'expérience et s'ils peuvent être partagés en tant que matériaux supplémentaires.
- Préparer les stimuli formatés. La mise en forme des stimuli textuels nécessite l'utilisation de propriétés adéquates de police (type, taille, espacement des lettres, des mots et des lignes). Utiliser une police à chasse fixe avec une taille et un espacement appropriés, en tenant compte des paramètres utilisés dans la littérature.
REMARQUE : Les polices à chasse fixe, telles que Courier New, sont recommandées pour les expériences de lecture utilisant des zones d’intérêt (AOI) basées sur les mots, car elles assurent une taille en pixels identique pour tous les caractères et symboles alphanumériques de l’alphabet latin. Le chercheur doit vérifier la compatibilité entre la police, l’interface et les propriétés spécifiques des stimuli, notamment la présentation de stimuli en caractères non latins ou dans un sens de lecture de droite à gauche, ainsi que la disponibilité, dans les outils logiciels expérimentaux, d’une méthodologie permettant la définition automatique des IA (zones d’intérêt) ou AOI (zones d’intérêt).
- Procédure de conception de l'expérience
- Préparation des instructions
REMARQUE : Les consignes sont importantes car elles ont un impact significatif sur les mouvements oculaires pendant la lecture. L'utilisation de consignes de tâche, même sous une forme minimale, est essentielle. L'absence de consignes explicites peut entraîner des conséquences involontaires qui affectent le comportement oculaire des participants. Par exemple, un participant pourrait avoir une hypothèse implicite de lecture attentive, tandis qu'un autre pourrait effectuer une lecture en diagonale plutôt qu'une lecture naturelle visant la compréhension.- Présenter des instructions normalisées à l'écran et enregistrer l'heure de début et la durée des instructions ; éviter les consignes verbales pendant l'enregistrement. Une pratique courante consiste à demander au participant de lire pour comprendre. Si l'on s'attend à ce que les participants lisent comme ils le font dans leur vie quotidienne, il convient de leur indiquer qu'ils doivent lire de manière naturelle, c'est-à-dire qu'ils n'ont pas à éviter de cligner des yeux ou de relire. Informer également les participants de toute tâche supplémentaire, telle que des questions de compréhension (ce qui est important pour garantir qu'ils lisent en vue de comprendre). Les instructions peuvent varier non seulement selon la tâche, mais aussi selon la phase de l'expérience (par exemple, entraînement par rapport à la tâche principale). Pour illustrer ce point, un exemple d'instructions utilisé lors d'une phase d'entraînement est fourni ci-dessous.18.
Nous allons maintenant commencer une séance d'entraînement. Pour cela, vous aurez besoin des quatre touches marquées (A, B, C, D). Des instructions supplémentaires vous seront affichées sous peu. À l'issue de l'entraînement, votre performance sera évaluée, ce qui prendra une à deux minutes. Si votre performance lors de l'entraînement n'est pas suffisante, la dernière partie de l'entraînement sera répétée. Si elle est suffisante, je reviendrai dans la pièce. Lorsque vous serez prêt, appuyez simplement sur la barre d'espace. - Il incombe au chercheur d'utiliser de telles instructions lors des séances d'entraînement d'expériences conçues pour l'étude de la lecture. Toutefois, utilisez les instructions pour la séance expérimentale. Un exemple d'instructions utilisées lors de la phase expérimentale dans une condition d'instruction de pertinence générale (avec et sans question dans le texte) peut être le suivant :19.
Vous allez lire un ensemble de courts textes explicatifs. Nous souhaitons que vous lisiez attentivement ces textes, en essayant de comprendre au maximum leur contenu. Ultérieurement, après la lecture, on vous demandera de faire un résumé oral des idées principales du texte afin d'évaluer dans quelle mesure vous avez compris ce que vous avez lu.
Un autre exemple d'instruction est donné ci-dessous pour une expérience utilisant des tâches de lecture de phrases.20.
Bienvenue dans notre étude de lecture. Au cours de cette étude, vous allez lire environ cent phrases, sélectionnées aléatoirement à partir de diverses sources et présentées dans un ordre aléatoire. Lisez-les silencieusement, en cherchant à en comprendre le sens, à votre rythme naturel de lecture, de la même manière que vous liriez des phrases dans un livre. Après certaines phrases, des questions de compréhension pourront vous être posées. Veuillez répondre à ces questions. Si vous ne connaissez pas la réponse, passez la question. Une pause sera prévue au milieu de la séance. Vous pouvez demander une pause ou quitter la séance à tout moment si vous vous sentez mal à l'aise. Si vous avez des questions, veuillez en informer l'expérimentateur. Sinon, appuyez sur un bouton pour commencer la procédure.
- Présenter des instructions normalisées à l'écran et enregistrer l'heure de début et la durée des instructions ; éviter les consignes verbales pendant l'enregistrement. Une pratique courante consiste à demander au participant de lire pour comprendre. Si l'on s'attend à ce que les participants lisent comme ils le font dans leur vie quotidienne, il convient de leur indiquer qu'ils doivent lire de manière naturelle, c'est-à-dire qu'ils n'ont pas à éviter de cligner des yeux ou de relire. Informer également les participants de toute tâche supplémentaire, telle que des questions de compréhension (ce qui est important pour garantir qu'ils lisent en vue de comprendre). Les instructions peuvent varier non seulement selon la tâche, mais aussi selon la phase de l'expérience (par exemple, entraînement par rapport à la tâche principale). Pour illustrer ce point, un exemple d'instructions utilisé lors d'une phase d'entraînement est fourni ci-dessous.18.
- Concevoir les essais et les blocs. Organiser le déroulement de l'expérience en prévoyant la présentation des essais par blocs et en randomisant l'ordre des essais à l'intérieur et entre les blocs. Utiliser une croix de fixation avant chaque essai (500-800 ms) afin de s'assurer que les fixations initiales des participants se situent au même endroit sur l'écran et à distance de toute partie du texte.
La conception d'une expérience de suivi oculaire dans laquelle la taille de la pupille constitue une variable dépendante exige d'ajuster en conséquence le déroulement de l'expérience, car la taille de la pupille n'est pas une réponse ponctuelle comme une séquence fixation-saccade. Plus précisément, lorsqu'on utilise la taille de la pupille comme variable dépendante, il est nécessaire d'introduire une fenêtre de référence préalable au stimulus et des intervalles d'écran noir de durées appropriées afin d'assurer la stabilisation de la taille de la pupille avant la présentation des stimuli et le début de chaque essai. Le chercheur doit consulter les études récentes sur les recommandations en pupillométrie afin de s'assurer que les données enregistrées sur la pupille peuvent être interprétées de façon appropriée comme une variable dépendante.21,22. - Prévoir des pauses entre les blocs. Introduire des écrans de correction de la dérive et des pauses courtes facultatives entre les blocs de l'expérience afin de garantir la qualité des données et de réduire la fatigue. Insérer des vérifications de la dérive après un nombre prédéfini d'essais, ou lorsque la précision diminue visiblement (vérifier s'il existe des touches raccourcies permettant de forcer l'étalonnage ou la validation pendant l'expérience) ; réétalonner si la dérive >1° d'angle visuel (moyenne des coordonnées x et y).
- Identifier les variables indépendantes cibles. Dans les études sur la lecture, certaines propriétés spécifiques du texte, telles que la fréquence des mots et la prévisibilité sententielle des mots, constituent les principales variables indépendantes cibles. Énumérer les variables indépendantes de l'expérience en fonction des objectifs de l'étude. Dans les analyses statistiques, les métriques des variables indépendantes peuvent nécessiter une normalisation des valeurs. Évaluer la pertinence de chaque variable en fonction des propriétés des stimuli.
- Excluez les mots situés au début de la ligne de texte de l'analyse, car les fixations sur ces mots ne sont généralement pas précises : elles peuvent refléter la première fixation provisoire dans le texte ou la phrase, ou la première fixation après un saut de ligne (ce qu'on appelle un « retour balayage »), qui, en tout état de cause, sont imprécises et sont habituellement suivies de fixations correctrices. Excluez également le dernier mot de chaque ligne, car ces mots sont soumis à une moindre surcharge visuelle (du fait des mots suivants) et parce que les fixations sur les mots en fin de ligne reflètent souvent la fin d'un essai ou la programmation d'un retour balayage vers la ligne de texte suivante.
REMARQUE : La durée de la première fixation pourrait être moins significative dans les langues comportant de nombreux mots fonctionnels, tels que les articles placés avant les noms (la région d'analyse doit inclure l'article et le nom, mais la première fixation aura moins d'importance, car elle peut ne refléter que le traitement de l'article).
- Excluez les mots situés au début de la ligne de texte de l'analyse, car les fixations sur ces mots ne sont généralement pas précises : elles peuvent refléter la première fixation provisoire dans le texte ou la phrase, ou la première fixation après un saut de ligne (ce qu'on appelle un « retour balayage »), qui, en tout état de cause, sont imprécises et sont habituellement suivies de fixations correctrices. Excluez également le dernier mot de chaque ligne, car ces mots sont soumis à une moindre surcharge visuelle (du fait des mots suivants) et parce que les fixations sur les mots en fin de ligne reflètent souvent la fin d'un essai ou la programmation d'un retour balayage vers la ligne de texte suivante.
- Identifier les variables dépendantes cibles. Dans les études sur la lecture, un ensemble de métriques oculomotrices, telles que la durée de la première fixation, la durée de la fixation unique, la durée du regard, le pourcentage de régressions et la probabilité de saut de mot, constitue les principales variables dépendantes cibles en lien avec les objectifs de l'étude. Préciser les métriques oculomotrices à analyser. Utiliser ces métriques comme base de l'analyse statistique.
REMARQUE : Éviter toute tâche nécessitant que le participant tape sur le clavier, car cela pourrait obliger à quitter le support-menton, entraînant ainsi une perte de calibration. Les participants peuvent plutôt utiliser la souris pour sélectionner leur réponse. Dans les cas où un retour oral du participant est nécessaire pendant l'enregistrement des mouvements oculaires, utiliser un appui-front au lieu d'un support-menton, et demander au participant de répondre verbalement ou autoriser des réponses à une seule touche tout en restant sur l'appui-front.
- Préparation des instructions
- Mise en œuvre de la procédure expérimentale
- Sélectionner un logiciel de présentation des stimulis. Configurer l'expérience à l’aide d’un logiciel de présentation des stimulis approprié. Des outils fournis par le fabricant ainsi que des logiciels généraux de conception d’expériences peuvent être utilisés pour présenter des textes et enregistrer les mouvements oculaires. Lors du choix du logiciel, prendre en compte les intégrations matérielles disponibles (par exemple, prise en charge native de leur dispositif de suivi oculaire), le degré de précision temporelle requis, ainsi que leur préférence quant au niveau de script ou de conception assistée par interface graphique. Quel que soit le plateau, le logiciel doit permettre une synchronisation fiable entre les événements de stimulus (par exemple, début d’un mot, début d’une phrase) et le flux de données de suivi oculaire, afin que les fixations et les saccades puissent être alignées avec les éléments textuels correspondants lors de l’analyse. En cas d’utilisation d’un logiciel externe, vérifier la compatibilité entre le logiciel de suivi oculaire et le logiciel externe, notamment en ce qui concerne la visualisation des données et l’exportation des données.
REMARQUE : Exemples de logiciels : Experiment Builder (SR Research, pour systèmes EyeLink) fournit une interface graphique avec un support intégré pour les vérifications de dérive, les procédures d'étalonnage et les messages d'événements envoyés à l'ordinateur d'enregistrement. Des plateformes open source telles que PsychoPy et OpenSesame offrent des fonctionnalités similaires et sont indépendantes du matériel, car elles permettent de concevoir des essais via une interface graphique ou par script (par exemple, en Python dans le cas de PsychoPy), de contrôler le chronométrage des stimuli et de définir des zones d'intérêt, appelées aussi zones d'intérêt (IAs) ou AOI (« Areas of Interest »), autour des mots ou des lignes de texte. Parfois, la visualisation des données et la liaison à l'exportation des données ne sont pas immédiatement accessibles pour les chercheurs débutants, et il peut donc être plus simple d'utiliser le logiciel du fabricant. Par conséquent, un critère important dans le choix d'un eye tracker est le niveau de soutien offert par les différents fabricants ou par la communauté de développeurs. - Pilotez l'expérience. Testez le protocole expérimental mis en œuvre et vérifiez les données enregistrées afin de vous assurer que l'expérience fonctionne comme prévu. Réalisez des études pilotes dans l'environnement du laboratoire pour confirmer que l'expérience se déroule comme attendu, en surveillant des critères de succès prédéfinis. Vérifiez les données enregistrées afin de confirmer que toutes les informations nécessaires à l'étude sont bien prises en compte.
- Sélectionner un logiciel de présentation des stimulis. Configurer l'expérience à l’aide d’un logiciel de présentation des stimulis approprié. Des outils fournis par le fabricant ainsi que des logiciels généraux de conception d’expériences peuvent être utilisés pour présenter des textes et enregistrer les mouvements oculaires. Lors du choix du logiciel, prendre en compte les intégrations matérielles disponibles (par exemple, prise en charge native de leur dispositif de suivi oculaire), le degré de précision temporelle requis, ainsi que leur préférence quant au niveau de script ou de conception assistée par interface graphique. Quel que soit le plateau, le logiciel doit permettre une synchronisation fiable entre les événements de stimulus (par exemple, début d’un mot, début d’une phrase) et le flux de données de suivi oculaire, afin que les fixations et les saccades puissent être alignées avec les éléments textuels correspondants lors de l’analyse. En cas d’utilisation d’un logiciel externe, vérifier la compatibilité entre le logiciel de suivi oculaire et le logiciel externe, notamment en ce qui concerne la visualisation des données et l’exportation des données.
3. Recrutement et information des participants
- Sélection des participants
- Déterminer les critères relatifs à la vision. Recruter des participants ayant une vision normale ou corrigée à la normale. Il est possible d’adapter les lunettes et les lentilles de contact, à condition qu’elles produisent des réflexions minimales (anti-reflets, angle du moniteur), conformément aux recommandations du fabricant. Documenter le type de correction (lunettes, lentilles de contact) pour les vérifications en tant que covariable.
REMARQUE : Généralement, les lentilles rigides (désormais peu courantes) sont très difficiles à suivre. Bien que les lentilles de contact ne posent pas de problème en soi, une bulle d’air peut parfois se former entre la lentille et la cornée, provoquant des réflexions qui perturbent le suivi. Les lunettes à monture brillante peuvent également interférer avec le suivi. Pour les montures brillantes, réduire la détection du champ de vision dans le logiciel du suivi oculaire. - Sélectionner les participants selon des caractéristiques individuelles spécifiques, telles que l’âge, le niveau de lecture, le milieu linguistique, la latéralité, ainsi que des critères d’exclusion et d’inclusion courants, comme la dyslexie, le bilinguisme ou les troubles de la lecture, qui peuvent influencer les données de mouvements oculaires. Par conséquent, en fonction des objectifs de la recherche, préciser les conditions dans lesquelles un lecteur constitue un participant approprié pour l’expérience, définissant ainsi les critères d’inclusion et d’exclusion (voir la Discussion).
- Vérifier les troubles visuels. S’assurer que le participant ne présente aucun trouble visuel non corrigible, tel qu’une cataracte (même après chirurgie), un glaucome ou une dégénérescence maculaire.
- Vérifier les troubles neurologiques. S’assurer que le participant ne souffre d’aucune affection le rendant mal à l’aise lors des enregistrements de mouvements oculaires. La plupart des dispositifs de suivi oculaire utilisent des LED/lasers proches de l’infrarouge ou une illumination certifiée LED/NIR ou VCSEL, considérées comme sans danger pour les yeux. Confirmer la certification de sécurité oculaire de l’appareil (par exemple, Classe 1 IEC 60825-1, IEC/EN 62471 ou équivalent). Informer le participant des réglementations de sécurité du matériel (comme la disponibilité d’un certificat CE délivré par le fabricant, communément appelé Déclaration de conformité UE, document par lequel le fabricant atteste qu’un produit respecte toutes les réglementations européennes nécessaires en matière de santé, de sécurité et d’environnement).
- Déterminer les critères relatifs à la vision. Recruter des participants ayant une vision normale ou corrigée à la normale. Il est possible d’adapter les lunettes et les lentilles de contact, à condition qu’elles produisent des réflexions minimales (anti-reflets, angle du moniteur), conformément aux recommandations du fabricant. Documenter le type de correction (lunettes, lentilles de contact) pour les vérifications en tant que covariable.
- Mise en place des mesures d’hygiène
- Prendre des précautions liées à la distance personnelle. Si nécessaire, porter des gants jetables et un masque, car la mise en œuvre des protocoles expérimentaux peut exiger une réduction de la distance personnelle.
- Désinfecter le matériel. Désinfecter le reposoir à menton et les autres accessoires à l’aide de lingettes alcoolisées, conformément aux directives institutionnelles en vigueur. Veiller à ne pas utiliser de produits chimiques susceptibles d’endommager le matériel. Consulter les spécifications du fabricant. Les participants peuvent se sentir plus à l’aise si la désinfection est effectuée en leur présence, notamment pour le reposoir à menton et le repose-tête, la souris ou toute autre partie du matériel avec laquelle ils seront en contact.
- Information du participant
- Informer le participant sur l’environnement du laboratoire. Concevoir une séance d’instructions orales durant laquelle l’expérimentateur présente l’environnement du laboratoire et le dispositif de suivi oculaire au participant.
- Informer le participant sur l’expérience. Fournir une explication claire du contexte de l’expérience (l’objectif et la durée approximative de l’étude ; cela doit être vérifié lors des tests pilotes), la procédure d’incitation ou de rémunération, la contribution du participant à l’expérience, ainsi que ses droits quant au suivi des résultats de l’étude à long terme. Informer le participant des consignes à respecter pendant une session d’enregistrement. Demander au participant de s’efforcer de ne pas trop bouger la tête durant l’enregistrement (en l’absence de stabilisateur de tête) ou de ne pas quitter le reposoir à menton, en précisant que ces précautions visent à garantir un enregistrement de haute qualité (dans le cas contraire, les participants peuvent toujours interrompre l’expérience et quitter la session sans avoir à fournir de justification).
- Obtenir le consentement éclairé. Remettre aux participants les documents d’approbation éthique et de consentement et les leur expliquer avant le début de la session. Pour les adultes, obtenir un consentement éclairé écrit après s’être assuré qu’ils comprennent l’objectif de l’étude, ce qui va se passer, ainsi que leurs droits, y compris le caractère volontaire de leur participation, la confidentialité des données et le droit de se retirer. Pour les mineurs participants, obtenir le consentement écrit d’un parent ou d’un tuteur ainsi que l’accord du mineur. Poursuivre avec l’étalonnage et l’enregistrement uniquement après que tous les formulaires de consentement et d’assentiment requis ont été complétés. Les procédures de consentement éclairé varient considérablement selon que les participants sont des adultes ou des mineurs. Par conséquent, le chercheur doit suivre les directives institutionnelles locales.
REMARQUE : Si une pause ou une interruption survient pendant l’expérience, une nouvelle validation de l’étalonnage est nécessaire ; si cette validation échoue, un nouvel étalonnage est requis.
4. Réalisation de l'étalonnage et de la validation
- Positionnement du participant et réglage du matériel
- Positionner le participant. Demander au participant de s'asseoir confortablement. Ajuster la chaise/la table et/ou le support pour menton afin de maintenir une position stable de la tête. Informer le participant qu’il s’agit de la position attendue de la tête pendant les phases d’étalonnage, de validation et d’enregistrement.
- Régler le matériel. Ajuster le dispositif de suivi oculaire en alignant la caméra du suivi oculaire de manière à ce que les pupilles du participant soient clairement visibles et détectables. Certains systèmes de suivi oculaire effectuent cet alignement automatiquement, tandis que d'autres peuvent nécessiter un réglage manuel de la mise au point de la caméra.
REMARQUE : L'expérimentateur devrait s'entraîner au réglage du matériel et à l'étalonnage avant de commencer la collecte réelle des données afin d'éviter d'importuner le participant avec ces étapes.
- Exécution de l’étalonnage
- Informer le participant. Informer le participant de la procédure d’étalonnage (par exemple, indiquer qu'une série de marqueurs cibles sera affichée, et que le participant devra les suivre pendant environ une minute).
REMARQUE : Il est recommandé de faire attention au choix des mots lors des ajustements. Par exemple, l'expérimentateur insiste sur le fait que la procédure vise à étalonner le dispositif de suivi oculaire pour le participant, et non à étalonner le participant pour le dispositif de suivi oculaire. En outre, il est important de s'assurer qu'aucune vidéo ou image n'est enregistrée avec le dispositif de suivi oculaire. Bien que l'œil du participant soit visible, seule la position de l'œil, convertie en coordonnées, sera enregistrée. - Exécuter la procédure d’étalonnage. Demander au participant de suivre les marqueurs cibles et de maintenir une position constante de la tête ; par exemple, de ne pas pencher la tête vers l’arrière à la fin de la procédure d’étalonnage. Demander aux participants de fixer le centre du symbole d’étalonnage et de ne pas bouger les yeux tant que le symbole n’a pas changé de position. Les participants ont tendance à anticiper le déplacement du symbole, particulièrement lors de la validation, ce qui peut augmenter les erreurs et entraîner des étapes d’étalonnage inutiles. Inclure cette explication dans les instructions ou dans la description du processus d’étalonnage/de validation.
REMARQUE : Les fabricants proposent différents types de symboles pour la procédure d’étalonnage (points, symboles adaptés aux enfants, symboles fixes ou rétrécissants, etc.) ainsi que différentes configurations d’étalonnage (c’est-à-dire le nombre de points d’étalonnage). Il est important de vérifier les différences d’étalonnage selon ces différentes configurations et de choisir celle qui convient le mieux aux besoins d’une étude spécifique. Par exemple, si les stimuli utilisent tout l’écran (par exemple, un texte comportant de nombreux paragraphes), il est important d’avoir une configuration d’étalonnage garantissant un bon étalonnage de haut en bas, y compris dans les coins. En revanche, si les stimuli sont des phrases présentées au centre de l’écran, une configuration avec moins de points peut suffire. De plus, la précision de l’étalonnage dans la direction horizontale, ou coordonnée x, est plus importante dans ce dernier cas que dans le premier, qui exige une bonne précision à la fois dans les coordonnées verticales et horizontales. - Terminer la procédure d’étalonnage. Informer le participant de la procédure de validation immédiatement après l’achèvement de la procédure d’étalonnage.
REMARQUE : En cas d’échec répété de l’étalonnage, vérifier l’alignement de la caméra du dispositif de suivi oculaire, les conditions d’éclairage et le positionnement du participant. Chez les adultes, le maquillage réfléchissant, les lunettes ou les lentilles de contact peuvent interférer avec le suivi. Rassurer le participant, prévoir de courtes pauses ou répéter l’étalonnage selon les besoins. Si les problèmes persistent, envisager de redémarrer le système de suivi oculaire. Si les problèmes persistent après redémarrage du système et qu’aucune cause n’a été identifiée après vérification des paramètres de configuration, informer le participant que la technologie de suivi oculaire n’est pas encore suffisamment développée, et que le problème est lié à l’état actuel de la technologie, et non au participant.
- Informer le participant. Informer le participant de la procédure d’étalonnage (par exemple, indiquer qu'une série de marqueurs cibles sera affichée, et que le participant devra les suivre pendant environ une minute).
- Réalisation de la validation
- Exécuter la procédure de validation. Lancer la procédure de validation immédiatement après l’étalonnage.
- Vérifier les erreurs. Vérifier l’erreur moyenne de position du regard et s’assurer qu’elle se situe dans des limites acceptables. En général, un angle visuel inférieur à 1 degré (<1°) est souhaitable, ce qui correspond à environ 4 caractères (ainsi, 0,5 correspond à environ 2 caractères). Procéder à un réétalonnage si les erreurs dépassent ces limites. Par exemple, accepter l’étalonnage si l’erreur moyenne est ≤0,5–1,0° et l’erreur maximale/par point est ≤1,5–2,0° ; sinon, effectuer un réétalonnage. Préciser la fréquence de la revalidation (par exemple, après chaque bloc ou interruption). À titre d’exemple des critères de notation de la qualité d’un étalonnage selon le fabricant SR Research, les erreurs sont considérées comme acceptables pour la plupart des tâches si l’erreur moyenne est <1° et l’erreur maximale <1,5° ; satisfaisantes si l’erreur moyenne est <1°-1,5° et l’erreur maximale <1,5°-2° ; et médiocres si elles dépassent ces valeurs.
- Informer le participant. Demander au participant de maintenir sa position aussi similaire que possible et l’informer du début de la session d’enregistrement.
5. Collecte des données
- Procédure de collecte des données
- Démarrer la session d’enregistrement. Lancez la session d’enregistrement et évitez d’interrompre le participant pendant qu’il effectue la tâche, par exemple en donnant des instructions verbales.
- Surveiller le participant. Surveillez le confort du participant pendant l’enregistrement des données. Assurez-vous que le participant maintient une posture stable, sans effort ni fatigue. Portez attention aux signes de distraction, de sécheresse oculaire ou d’inconfort liés au support de menton ou d’appui-frontal.
- Surveiller l’enregistrement des données. Contrôlez la qualité des données pendant l’enregistrement. Recalibrez si l’erreur moyenne de validation ou la précision en ligne dépasse 1° (ou un seuil de précision prédéfini), ou si le participant change de posture.
- Tenir un journal. Tenez un journal de la session d’enregistrement en notant toute anomalie observée pendant l’expérience (par exemple, une procédure de calibration anormalement longue ou une interruption involontaire pendant l’enregistrement), afin d’effectuer un examen post-expérimental. Utilisez un schéma de journal de session pour suivre l’heure des événements, les interruptions, le nombre de recalibrations effectuées et leurs erreurs, les vérifications de dérive et les changements d’éclairage.
- Fin de la session
- Enregistrer les données. Enregistrez les données brutes de regard à la fin de la session expérimentale, de préférence en utilisant une méthode systématique pour étiqueter la session (par exemple, la date de l’expérience et le numéro du participant, comme 25071801 ou 250718-P01 pour le participant 01 du 18 juillet 2025 ; évitez d’utiliser des informations personnelles identifiables concernant le participant).
- Saluer le participant. Remerciez le participant et répondez à toute question qu’il pourrait avoir concernant l’expérience ; désinfectez l’équipement (voir étape 3.2.2).
- Vérifier les données. Vérifiez les données et les journaux pour vous assurer que la session a été correctement réalisée.
6. Prétraitement des données et contrôle de qualité
- Exportation, organisation et nettoyage des données brutes
- Exporter les données. Exportez les données de regard brutes dans un format standard (par exemple, .csv, .tsv, .edf) et normalisez votre identifiant de session (par exemple, 25071801 ou 250718-P01, voir 5.2.1).
- Nettoyer les données. Nettoyez les données brutes en appliquant des algorithmes de détection des clignements et de détection des données manquantes, en utilisant les outils intégrés fournis par le logiciel du fabricant ou des scripts personnalisés, ajustés en fonction de l'appareil ou de la fréquence d'échantillonnage.
REMARQUE : Créez des sauvegardes des données brutes pendant l'exécution des routines de nettoyage.
- Détection des événements oculomoteurs
- Sélectionner l'algorithme de détection des mouvements oculaires. Sélectionnez et exécutez les procédures de détection des fixations, en ajustant les paramètres des algorithmes selon les besoins. Les algorithmes représentatifs d'identification des fixations impliquent principalement des algorithmes basés sur la vitesse (par exemple, identification par seuil de vitesse I-VT) et des algorithmes basés sur la dispersion (par exemple, identification par seuil de dispersion I-DT), parmi d'autres23. Chaque algorithme possède ses propres paramètres.
REMARQUE : Par défaut, les logiciels des fabricants supposent généralement un algorithme spécifique et un ensemble spécifique de paramètres couramment utilisés. Il incombe au chercheur de choisir un algorithme approprié ainsi que ses paramètres, et de les indiquer dans la description de la méthodologie de l'étude, tels que les seuils de dispersion/vitesse, un seuil minimal de durée de fixation (par exemple, 60 ms ou 100 ms) pour éliminer les fixations plus courtes que cette valeur, un seuil maximal de durée de fixation (par exemple, 1000 ms) pour éliminer les fixations plus longues que cette valeur, la fenêtre de lissage utilisée, et les règles de fusion des fixations adjacentes23. - Identifier les fixations illégitimes. Supprimez ou étiquetez les fixations situées en dehors de la zone d'affichage. Supprimez ou étiquetez les fixations plus courtes qu'un seuil prédéfini minimal et plus longues qu'un seuil prédéfini maximal.
- Examiner visuellement les données. Examinez visuellement les données à l'aide des outils de visualisation disponibles afin de garantir leur validité. Vérifiez la perte de signal, le bruit excessif, les échantillons manquants ou les fixations mal alignées. Après chaque session d'enregistrement, inspectez visuellement les données à l'aide des outils de visualisation fournis avec le logiciel de suivi oculaire (par exemple, tracés du regard, scanpaths, courbes temporelles). Cette étape permet de s'assurer que les données sont de qualité suffisante avant de passer au prétraitement et à l'analyse.
- En particulier, recherchez la perte de signal et les problèmes de suivi en identifiant de longues interruptions dans les motifs de regard ou des zones sur les stimuli où aucun échantillon de regard n'est enregistré. Une perte fréquente ou prolongée du suivi peut indiquer que la session doit être exclue ou répétée.
- Pour détecter le bruit excessif, examinez les tracés bruts des positions x/y à la recherche de sauts soudains ou d'échantillons erronés ne correspondant pas à la disposition du stimulus. Un bruit excessif peut indiquer une mauvaise calibration, une position instable de la tête ou des problèmes matériels.
- Pour repérer les échantillons manquants ou irréguliers, vérifiez si la fréquence d'échantillonnage est approximativement celle attendue (par exemple, 500 Hz) et s'il existe des groupes inattendus d'échantillons manquants au-delà des clignements normaux.
- Pour identifier les fixations mal alignées, superposez les fixations sur les stimuli présentés et vérifiez qu'elles se situent sur les lignes et les mots prévus. Des décalages systématiques (par exemple, des fixations constamment en dehors du texte) peuvent indiquer une dérive de calibration ou un mauvais mappage entre les coordonnées du regard et les coordonnées de l'écran. Les motifs de regard enregistrés doivent globalement suivre la structure du texte (par exemple, progression de gauche à droite, ligne par ligne), avec des fixations regroupées sur les mots et des saccades relativement fluides entre eux. Un écart systématique par rapport à ce motif, ou une perte fréquente de données exploitables, peut nécessiter l'exclusion des données concernées de toute analyse ultérieure.
- Effectuer la correction de la dérive. Effectuez la correction de l'erreur de dérive verticale si nécessaire. Appliquez une correction de dérive verticale par ligne pour les textes à plusieurs lignes. Vérifiez l'applicabilité des méthodes validées21.
REMARQUE : Figure 1 présente une illustration des étapes impliquées dans la conception d'un dispositif expérimental de suivi oculaire et d'un pipeline d'analyse des données, tel que décrit dans la section du protocole. La section suivante présente des résultats représentatifs issus de sessions enregistrées.
- Sélectionner l'algorithme de détection des mouvements oculaires. Sélectionnez et exécutez les procédures de détection des fixations, en ajustant les paramètres des algorithmes selon les besoins. Les algorithmes représentatifs d'identification des fixations impliquent principalement des algorithmes basés sur la vitesse (par exemple, identification par seuil de vitesse I-VT) et des algorithmes basés sur la dispersion (par exemple, identification par seuil de dispersion I-DT), parmi d'autres23. Chaque algorithme possède ses propres paramètres.
Résultats
Qualité et validation des données
Les séances réussies donnent généralement une exactitude de validation avec une erreur moyenne ≤0,5–1,0° et une erreur maximale ou par point <1,0–1,5° sur l'ensemble des cibles ; indiquez à la fois les valeurs moyennes et celles par point. Fournissez un histogramme de l'erreur par point et un tableau résumant la moyenne ± ÉT et l'erreur maximale par séance. Ces critères sont conformes aux pratiques courantes et aux recommandations des fabricants ; les séances dépassant ces seuils doivent être partiellement ou totalement exclues, selon les règles de l'étude. Figure 2 présente un exemple d'histogramme d'erreur par point pour l'exactitude de calibration lors d'une calibration à 9 points, comprenant trois tentatives de calibration.
Précision et perte de données
Signaler la précision (par exemple, dispersion échantillon à échantillon, exprimée par l'erreur quadratique moyenne – RMS – pendant la fixation) et la perte de données (% d'échantillons manquants par essai/séance). De bons essais montrent généralement une faible dispersion durant la fixation et une faible perte de données (par exemple, <5–10 %, selon l'équipement et le montage de suivi oculaire). Fournir les distributions des pourcentages de perte de données ainsi qu'une dispersion par essai de la précision en fonction de la perte, afin de révéler les valeurs aberrantes. Consulter la littérature actuelle concernant les définitions et les éléments minimaux à rapporter3,4,5,6,7,8,9,10,11.
Comportement de la dérive (avant/après correction)
Les essais corrects présentent de faibles écarts verticaux quasi constants, qui sont sensiblement réduits par la correction ligne par ligne, qu'elle soit effectuée par des algorithmes automatisés de correction de dérive21 ou manuellement. En revanche, les essais problématiques montrent une dérive résiduelle importante ou non monotone. Inclure l'erreur médiane absolue verticale avant et après correction. Vérifier l'applicabilité des méthodes automatisées de correction de dérive.
Répartition des mesures courantes de la lecture
Présenter les répartitions sommaires de la durée de la première fixation (FFD), de la durée de fixation unique (SFD), de la durée du premier passage (FP), de la durée totale ou de fixation oculaire (GD), du temps de dépassement, de la probabilité de saut et de la probabilité de régression vers l'arrière. Chez des adultes lecteurs expérimentés lisant un texte alphabétique, les durées de fixation se situent généralement autour de 200 à 250 ms (avec une asymétrie importante), et les saccades couvrent en moyenne environ 7 à 9 caractères. Les valeurs très éloignées de ces intervalles ou des répartitions de saccades fortement bimodales doivent être examinées afin de déterminer si elles reflètent des saccades progressives et régressives attendues dues à des contraintes de tâche ou à des difficultés de traitement, plutôt que des erreurs de chronométrage. Le choix et l'intervalle des mesures peuvent varier en fonction des populations, des langues spécifiques et des orthographies. Figure 3 montre un protocole d'exemple de répartition des durées de fixation provenant d'une session représentative.
Vérifications de cohérence
Une augmentation de la longueur des mots (mots longs) conduit généralement à une réduction du taux de sauts et à des durées de fixation plus longues sur ces mots. En revanche, les mots grammaticaux (par exemple, les articles ou les prépositions) sont généralement sautés. Les mots très fréquents et les mots hautement prévisibles selon le contexte linguistique (dans le texte ou la phrase) entraînent typiquement des durées de première fixation et de fixation plus courtes, ainsi qu'un taux de sauts plus élevé (l'inverse étant attendu pour les mots de faible fréquence et de faible prévisibilité). Vérifiez si les données reproduisent certaines de ces tendances, au moins dans un sens. De fortes inversions pourraient indiquer des erreurs de dérive, un mauvais alignement entre les mots et les fixations, ou des erreurs de traitement des données.
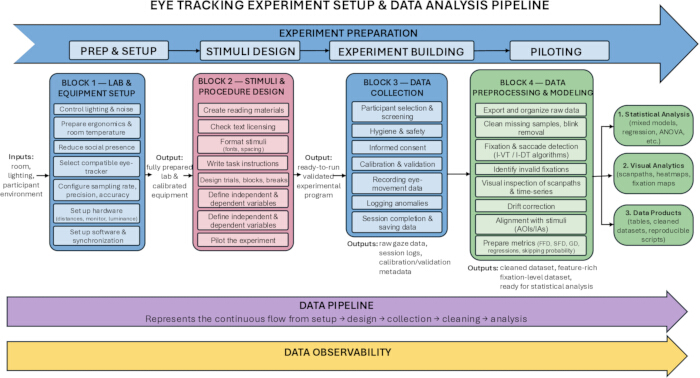
Figure 1. Représentation des étapes impliquées dans la conception d'un dispositif expérimental de suivi oculaire et d'un pipeline d'analyse des données. Veuillez cliquer ici pour visualiser une version agrandie de cette figure.
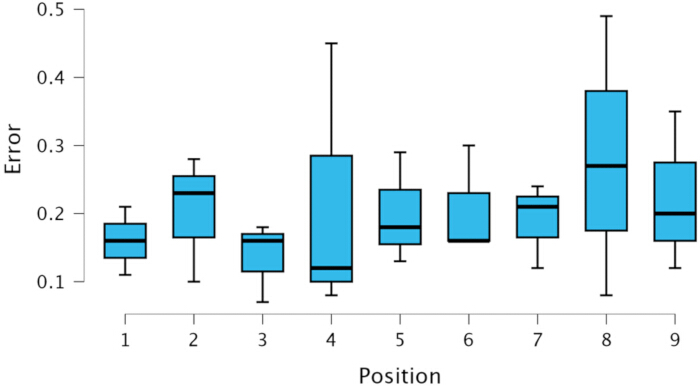
Figure 2. Histogramme des erreurs par point pour l'exactitude de l'étalonnage dans un étalonnage à neuf points, comprenant trois tentatives d'étalonnage. Veuillez cliquer ici pour visualiser une version agrandie de cette figure.
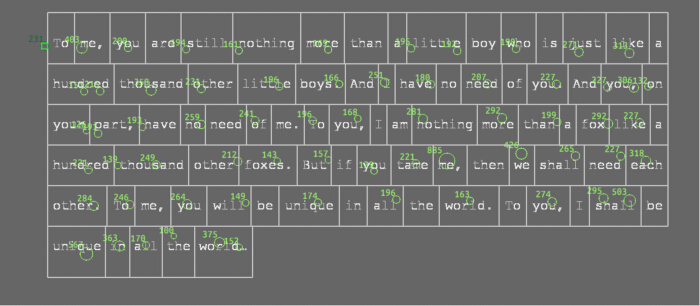
Figure 3. Protocole de distribution de la durée des fixations lors d'une session représentative ; un participant lisant un extrait du roman Le Petit Prince. La position et la taille des cercles indiquent respectivement les emplacements et les durées des fixations. Les nombres situés à côté des cercles indiquent les durées de fixation en ms. Veuillez cliquer ici pour visualiser une version agrandie de cette figure.
Discussion
Le protocole présenté ici résume les principales étapes nécessaires pour obtenir des données fiables de suivi oculaire dans la recherche sur la lecture. Bien que bon nombre de ces étapes soient probablement bien connues des chercheurs expérimentés, elles sont souvent dispersées dans différents articles méthodologiques, documents fournis par les fabricants et pratiques informelles de laboratoire. En les regroupant au sein d'un flux de travail unique, allant de la préparation du laboratoire au prétraitement des données, nous visons à fournir un guide pratique aux chercheurs novices dans les études de suivi oculaire appliquées à la lecture. Contrairement aux lignes directrices générales sur le suivi oculaire ou aux ressources axées principalement sur les algorithmes de détection des mouvements oculaires, ce protocole propose un cadre complet, conçu pour répondre aux exigences de la recherche en lecture en matière d'enregistrement de données à haute résolution spatiale et à fréquence d'échantillonnage élevée.
Un thème central à toutes les étapes du flux de travail est l'importance d'une gestion proactive de la qualité des données, en commençant par le contrôle de l'environnement et la configuration du matériel. De petits problèmes tels que des reflets sur l'écran, une instabilité de la chaise ou des distances de visionnage inconstantes peuvent produire des biais systématiques dans la localisation ou la précision du point de fixation. Régler ces facteurs précocement réduit le besoin de corrections post hoc importantes et favorise une précision de validation plus constante (erreur moyenne ≤ 0,5–1°).
Le protocole souligne également l'importance de l'alignement entre les questions de recherche et les caractéristiques du matériel. De nombreuses études en lecture s'appuient sur des mesures spatiales et temporelles précises des fixations, des positions d'atterrissage des saccades et des régressions1,2. Le choix d'un eye-tracker doté d'une fréquence d'échantillonnage, d'une précision et d'une exactitude adaptées est donc essentiel, en particulier pour des mesures telles que la position d'atterrissage ou l'aperçu parafovéal, sensibles aux petites erreurs spatiales. En fonction des contraintes spécifiques de l'étude, ces méthodes peuvent être modifiées. Par exemple, lorsqu'on travaille avec des populations neurodivergentes qui ne tolèrent pas un appui-menton, les chercheurs peuvent opter pour des dispositifs distants sans immobilisation de la tête, et compenser la perte de précision spatiale en utilisant des polices plus grandes, un interlignage plus espacé et des zones d'intérêt plus larges. Lorsque des systèmes sans immobilisation de la tête sont utilisés, les chercheurs doivent tenir compte des mouvements accrus et des pertes de données potentielles. Bien que les eye-trackers distants permettent des dispositifs expérimentaux plus naturalistes, l'immobilisation de la tête reste toutefois préférable pour la plupart des tâches de lecture actuelles.
La conception de l'expérience est un autre facteur clé qui influence à la fois la qualité des données et leur interprétabilité. Des consignes standardisées affichées à l'écran, une randomisation des essais et une structure par blocs appropriée permettent de maintenir un comportement stable des participants tout au long de la session. L'inclusion de vérifications de dérive à intervalles réguliers est particulièrement importante dans les expériences de lecture, car même de légers décalages progressifs peuvent s'accumuler d'une ligne de texte à l'autre. Le protocole permet également l'utilisation de normes lexicales dépendantes de la langue et un reporting transparent des variables indépendantes et dépendantes, ce qui facilite la réplication et la comparaison entre études.
Pendant la collecte des données, la surveillance continue de la précision, de la posture et du confort du participant permet d'éviter une perte importante de données. Un dépannage actif est souvent nécessaire pour résoudre les problèmes courants. Par exemple, l'étalonnage peut échouer aux coins de l'écran ; dans ce cas, ajuster la hauteur de l'écran ou du siège peut corriger la perte de suivi périphérique. Les problèmes causés par des lunettes réfléchissantes ou des lentilles de contact peuvent parfois être résolus en modifiant l'éclairage ambiant ou l'angle du moniteur. La tenue d'un journal détaillé de la session facilite le dépannage ultérieur et renforce la transparence en documentant les interruptions, les réétalonnages et les événements inattendus. Cette pratique gagne en importance car de nombreuses études publiées exigent désormais une description explicite des indicateurs de qualité, notamment la précision et le pourcentage de perte de données.
La section de prétraitement met l'accent sur des choix cohérents et bien documentés en matière de détection des événements, de correction des dérives et de procédures de nettoyage. Étant donné que les algorithmes et seuils de classification des fixations peuvent fortement influencer les mesures obtenues, les chercheurs doivent préciser tous les paramètres utilisés et justifier leurs choix lorsqu'ils s'écartent des valeurs par défaut courantes. L'inspection visuelle reste une étape essentielle, même lorsque des outils automatisés sont utilisés. Le protocole encourage également la présentation d'indicateurs standard de qualité, tels que la précision de validation, l'exactitude, la perte de données et le comportement de la dérive, afin que les études puissent être comparées de manière plus fiable.
En outre, le protocole recommande des vérifications simples du comportement de lecture, telles que les effets de la longueur des mots, de leur fréquence ou de leur prévisibilité. La reproduction de ces schémas canoniques constitue une garantie supplémentaire contre d'éventuels problèmes d'alignement, dérives indésirables ou erreurs de prétraitement. Ces vérifications ne remplacent pas une analyse statistique complète, mais offrent un retour rapide sur le caractère attendu du comportement des données lors d'une lecture compétente.
Outre les détails du protocole expérimental déjà mentionnés, il est important de décrire les caractéristiques linguistiques et psychométriques des participants. La principale justification à cela est le défi auquel sont confrontés les chercheurs expérimentaux en matière de comparabilité entre différentes études. Ceci est particulièrement important à l'ère de la science ouverte, où des ensembles de données accessibles publiquement peuvent être utilisés par des chercheurs qui ne les ont pas initialement collectés et qui pourraient donc ignorer les particularités potentielles découlant des variations des antécédents (socio)linguistiques des participants.
En ce qui concerne le contexte linguistique, il convient de noter la langue maternelle des participants et de recueillir des informations sur les dialectes qu’ils utilisent afin de tenir compte des éventuelles différences dialectales pouvant influencer les résultats. Si les participants parlent plus d’une langue — une situation fréquente dans le monde actuel —, il faut enregistrer leur niveau de compétence en langue seconde. Dans les études portant sur le bilinguisme ou le traitement d’une langue seconde, la compétence en langue seconde doit être évaluée à l’aide de tests normalisés de positionnement en langue seconde. Par ailleurs, certains aspects pertinents du statut socio-économique peuvent être notés (par exemple, les habitudes de lecture des participants).
Des tests doivent être réalisés pour évaluer les caractéristiques psychométriques des participants, comme la capacité de mémoire de travail et la flexibilité cognitive (en particulier dans les études sur les personnes bilingues). Du point de vue méthodologique, il convient de déterminer quels tests choisir, leurs exigences cognitives et temporelles, ainsi que le moment auquel administrer ces mesures dans le protocole expérimental — avant ou après la session de suivi oculaire, ou lors d'une session distincte.
Il est essentiel de garder à l’esprit que, dans les études de lecture, le comportement linguistique est mesuré et expliqué à l’aide des caractéristiques linguistiques du stimulus et des caractéristiques psychométriques des lecteurs (ou de toute autre caractéristique pertinente au comportement linguistique des participants)11,12,17,20. Afin de permettre la comparaison entre les études, tous les facteurs susceptibles d’être pertinents pour l’interprétation des données doivent être inclus. Le choix des caractéristiques à inclure dépendra de l’objectif de l’étude. Les données doivent être comparables. En résumé, les données doivent être collectées et décrites avec suffisamment de détails pour offrir à tout utilisateur potentiel la plus grande flexibilité possible dans leur utilisation. Ces considérations peuvent ne pas faire partie du protocole lui-même, mais elles sont pertinentes pour chaque étude individuelle. Dans l’environnement scientifique mondial actuel, de tels détails augmentent les possibilités futures d’utilisation des données collectées.
Ce protocole présente des limites, notamment le compromis entre la qualité des données et la validité écologique, car la lecture sur un écran fixe avec la tête immobilisée ne reflète pas pleinement le comportement de lecture en conditions naturelles, et des critères d'inclusion visuels stricts peuvent restreindre la représentativité de l'échantillon. De plus, les eye-trackers diffèrent sensiblement par leur échelle de coordonnées, la précision des horodatages et la classification des événements. Une limitation du protocole actuel est qu'il ne précise pas comment cette variabilité affecte la reproductibilité entre laboratoires ou marques de matériel. Élaborer des recommandations pour la validation inter-appareils, ainsi que pour des applications futures réalistes, telles que l'adaptation de paradigmes de laboratoire à des environnements de lecture en réalité virtuelle ou réalité augmentée immersifs, ou encore le développement de biomarqueurs numériques pour les troubles cognitifs ou de l'attention, comblerait un manque important.
Dans l'ensemble, le protocole regroupe les recommandations méthodologiques existantes en un flux de travail clair et transparent pour la collecte de données de suivi oculaire de haute qualité en lecture. En suivant les étapes et en rapportant les métriques de qualité associées, les chercheurs peuvent améliorer la reproductibilité et la crédibilité des études sur la lecture et contribuer à établir une cohérence méthodologique plus solide dans le domaine.
Remerciements
Financement : Ce projet a été soutenu par COST – Coopération européenne en matière de science et de technologie (CA21131 – Faciliter la collecte de données de suivi oculaire multilingue pour la recherche sur le traitement du langage humain et artificiel (MultiplEYE), https://www.cost.eu/actions/CA21131)24, la Fondation pour la science et la technologie, Portugal (subventions : UID/214/2025, UI/BD/154500/2022), et le programme stratégique de l'Université Jagellonne, Initiative d'excellence, domaine de recherche prioritaire DigiWorld (ID.UJ), projet « Aspects cognitifs de l'interaction et de la communication chez les agents naturels et artificiels ». Nous remercions Anna Maria Wilkosz pour leur aimable soutien technique.
Matériaux
| Nom | Entreprise | Numéro de catalogue | Commentaires |
|---|---|---|---|
| Compresses alcoolisés (isopropanol à 70 %) | Matériel de nettoyage | Fournisseur local de laboratoire | |
| Repose-menton à hauteur réglable | Dispositif de stabilisation de la tête | Divers fournisseurs de laboratoire | |
| Formulaire de consentement et documents de débriefing | Documentation | Modèles approuvés par l'institution | |
| Œillette (par exemple, SR Research EyeLink 1000 Plus, Tobii Pro Fusion) | Matériel de suivi oculaire | SR Research Ltd., Tobii AB | |
| Logiciel d'analyse des données de suivi oculaire (Data Viewer, Tobii Pro Lab) | Logiciel d'analyse des mouvements oculaires | SR Research Ltd., Tobii AB | |
| Logiciels de suivi oculaire (par exemple, Experiment Builder, Tobii Pro Lab, PsychoPy) et leurs kits de développement logiciel (SDK) | Logiciels de présentation de stimuli et kits de développement logiciel | SR Research Ltd., Tobii AB, Open source | |
| Logiciels génériques d'analyse de données (R avec lme4, ggplot2, JASP, Python avec Pandas, NumPy, Matplotlib) | Prétraitement et analyse des données | Open source, https://www.python.org, https://www.r-project.org, https://www.jasp.org | |
| Logiciels génériques pour la conception d'expériences (PsychoPy) | Logiciel de présentation de stimuli | Open source, https://www.psychopy.org | |
| Autres logiciels tiers (par exemple, E-Prime) | Logiciel de présentation de stimuli | Psychology Software Tools, Inc. | |
| Salle insonorisée | Contrôle environnemental | Installation institutionnelle | |
| Écran LCD standard de 24 pouces (ou plus petit) | Dispositif d'affichage | Tout fabricant conforme à la norme ISO |
Références
- Rayner, K. Eye movements in reading and information processing: 20 years of research. Psychol Bull. 124, 372-422 (1998).
- Rayner, K. Eye movements and attention in reading, scene perception, and visual search. Q J Exp Psychol. 62, 1457-1506 (2009).
- Carter, B. T., Luke, S. G. Best practices in eye tracking research. Behav Res Methods. 52, 278-295 (2020).
- Hessels, R. S., et al. The fundamentals of eye tracking part 1: The link between theory and research question. Behav Res Methods. 56, 16(2024).
- Hooge, I. T. C., et al. The fundamentals of eye tracking part 2: From research question to operationalization. Behav Res Methods. 57, 73(2025).
- Nyström, M., et al. The fundamentals of eye tracking part 3: How to choose an eye tracker. Behav Res Methods. 57, 67(2025).
- Niehorster, D. C., et al. The fundamentals of eye tracking part 4: Tools for conducting an eye tracking study. Behav Res Methods. 57, 46(2025).
- Hessels, R. S., et al. The fundamentals of eye tracking part 5: The importance of piloting. Behav Res Methods. 57, 216(2025).
- Dunn, M. J., et al. Minimal reporting guideline for research involving eye tracking (2023 edition). Behav Res Methods. 56, 4351-4357 (2024).
- Eskenazi, M. A. Best practices for cleaning eye movement data in reading research. Behav Res Methods. 56, 2083-2093 (2024).
- Schotter, E. R., Dillon, B. A beginner’s guide to eye tracking for psycholinguistic studies of reading. Behav Res Methods. 57, 68(2025).
- Conklin, K., Pellicer-Sánchez, A. Using eye tracking in applied linguistics and second language research. Second Lang Res. 32 (3), 453-468 (2016).
- Pellicer-Sánchez, A. Eye-tracking in vocabulary research: Introduction to the special issue. Res Methods Appl Linguist. 3 (1), 100095(2024).
- Hutton, S. B. Eye-tracking methodology. Eye movement research: An introduction to its scientific foundations and applications. , Springer International Publishing. 277-308 (2019).
- Pokhoday, M. Y., et al. Eye tracking methods in psycholinguistics and parallel EEG recording. Neurosci Behav Physi. 53, 220-229 (2023).
- Azman, H., Mihat, W., Soh, O. K. Analyzing stimuli presentations and exit-interview protocols to improve wearable eye-tracking data collection guidelines for reading research. IJCALLT. 11 (2), 51-65 (2021).
- Papadopoulos, T. C., et al. Eye-tracking in reading research: A systematic review of studies with children of varying reading ability. Eur Psychol. , (2026).
- Garlichs, A., Lustig, M., Gamer, M., Blank, H. Protocol to study how expectations guide predictive eye movements and information sampling in humans. STAR Protoc. 6 (2), 103737(2025).
- Moreno, J., León, J., Kaakinen, J. K., Hyönä, Relevance instructions combined with elaborative interrogation facilitate strategic reading: Evidence from eye movements. J Psicol Educ. 27 (1), 51-65 (2020).
- Acartürk, C. Eyes on Text: Eye movements in reading and language processing. , John Benjamins. (2025).
- Steinhauer, S. R., Bradley, M. M., Siegle, G. J., Roecklein, K. A., Dix, A. Publication guidelines and recommendations for pupillary measurement in psychophysiological studies. Psychophysiology. 59 (4), e14035(2022).
- Papesh, M. H., Goldinger, S. D. Modern pupillometry: Cognition, neuroscience, and practical applications. , Springer. (2024).
- Salvucci, D. D., Goldberg, J. H. Identifying fixations and saccades in eye-tracking protocols. Proc Symposium Eye Tracking Res Appl, , 71-78 (2000).
- Jakobi, D. N., et al. MultiplEYE: creating a multilingual eye-tracking-while-reading corpus. Proc Symposium Eye Tracking Res Appl, , ACM. 111(2025).