Cette étude a évalué si des interventions infirmières en oncologie gynécologique et des modifications du mode de vie améliorent la qualité de vie des femmes atteintes de cancers gynécologiques. Une amélioration significative a été observée uniquement dans le sous-groupe atteint de cancer ovarien à 6 mois, tandis que les preuves globales sont restées très incertaines en raison d'une hétérogénéité importante, de la petite taille des sous-groupes et de limitations méthodologiques.
Article de recherche
Une méta-analyse de l'impact des interventions sur le mode de vie et des soins infirmiers en oncologie gynécologique sur l'amélioration de la qualité de vie
* These authors contributed equally
Dans cet article
Résumé
Résumé
Cette méta-analyse a évalué l'impact des interventions infirmières en oncologie gynécologique et des modifications du mode de vie sur la qualité de vie (QoL). Une recherche systématique menée jusqu’en juin 2026 a permis d’identifier 1 123 références. Treize essais contrôlés randomisés portant sur 915 femmes atteintes d’un cancer gynécologique ont été inclus. L’impact des interventions infirmières en oncologie gynécologique et des modifications du mode de vie sur la qualité de vie a été évalué à l’aide de différences moyennes regroupées (MD) avec des intervalles de confiance à 95 %, en utilisant des modèles à effets aléatoires pour les analyses générales et des modèles à effets fixes pour les analyses de sous-groupes spécifiques au cancer. Par rapport aux témoins, les interventions ont significativement amélioré la qualité de vie chez les femmes atteintes d’un cancer de l’ovaire (MD 4,28, IC 95 % : 0,45–8,10, p = 0,03 ; I2 = 0 %). Aucune différence significative n’a été observée pour la qualité de vie à 6 mois dans les cancers mixtes (MD 2,11, IC 95 % : -0,90–5,12, p = 0,17 ; I2 = 71 %), le cancer de l’endomètre à 6 mois (MD 2,00, IC 95 % : –1,49–5,49, p = 0,26 ; I2 = 0 %) ou les cancers mixtes à 3 mois (MD 6,43, IC 95 % : –0,16–13,01, p = 0,06 ; I2 = 74 %). Toutefois, l’hétérogénéité marquée, la diversité des protocoles et des interventions, les faibles tailles d’échantillons et les risques variables de biais limitent la certitude des résultats, qui nécessitent une interprétation prudente et une confirmation par des essais rigoureux et standardisés. Les interventions infirmières en oncologie gynécologique et les modifications du mode de vie ont significativement amélioré la qualité de vie uniquement chez les femmes atteintes d’un cancer de l’ovaire à 6 mois. Cependant, une hétérogénéité importante, des limites méthodologiques et des preuves de très faible certitude justifient une interprétation prudente, et des essais plus larges et standardisés sont nécessaires.
Introduction
Le cancer qui prend naissance dans les organes reproducteurs féminins est appelé cancer gynécologique. Les cancers gynécologiques, qui englobent les tumeurs malignes du col de l'utérus, de l'ovaire, de l'utérus, du vagin et de la vulve, restent une préoccupation majeure de santé publique, touchant des millions de femmes dans le monde entier1. Ces tumeurs sont non seulement physiquement dévastatrices, mais provoquent également un détresse émotionnel et psychologique important. Malgré les progrès réalisés dans le traitement, la fréquence mondiale de ces tumeurs est en augmentation, et le pronostic global reste défavorable dans plusieurs régions, particulièrement là où l'accès aux soins de santé est limité. Les études sur les soins infirmiers en oncologie gynécologique soulignent la nécessité de stratégies complètes et pluridisciplinaires dans la prise en charge des patientes, compte tenu de l'impact significatif de ces tumeurs malignes sur la qualité de vie des femmes2. En revanche, les interventions infirmières efficaces vont au-delà de la gestion des symptômes physiques tels que la douleur et les nausées ; elles incluent également un soutien émotionnel, un accompagnement psychologique, une éducation des patientes et une prise en charge globale des symptômes. Ces interventions sont essentielles pour améliorer les résultats chez les patientes, aider les femmes à surmonter la complexité des protocoles de traitement et assurer des soins holistiques.
Le rôle des interventions infirmières sur la qualité de vie mérite des recherches supplémentaires, notamment quant à la manière dont différents aspects des soins infirmiers influencent le bien-être physique, émotionnel et psychologique au sein de diverses populations de patients3. Des soins infirmiers efficaces pour les patients atteints de cancer peuvent améliorer leur bien-être général. Les soins infirmiers en oncologie gynécologique constituent une discipline infirmière spécialisée axée sur l'apport d'un soutien complet aux femmes diagnostiquées avec un cancer gynécologique. Le cancer gynécologique englobe les tumeurs à cellules granuleuses, le mélanome du tractus génital, le cancer du col de l'utérus pouvant bénéficier d'une chirurgie préservant la fertilité, ainsi que le cancer de l'endomètre4. La prévalence du cancer du col de l'utérus a diminué à travers l'Europe ; toutefois, il continue de représenter un défi important de santé publique. Cette situation est soulignée par les statistiques de 2018, indiquant 61 000 nouveaux cas et 25 800 décès. Les résultats de survie montrent des inégalités régionales, avec un taux de survie relative à cinq ans de 62 % entre 2000 et 2007, variant de 57 % en Europe de l'Est à 67 % en Europe du Nord.
Le cancer du col de l'utérus demeure un problème majeur de santé publique mondiale, malgré les progrès réalisés en matière de prévention et de traitement. Ces inégalités soulignent la nécessité d'interventions infirmières ciblées afin d'améliorer les résultats pour les patientes et de corriger les disparités dans les soins selon les contextes. D'autres tumeurs gynécologiques, telles que les cancers de l'ovaire, de l'utérus et de la vulve, posent également des difficultés importantes pour la santé. Le cancer de l'ovaire est la principale cause de décès liés aux cancers gynécologiques dans le monde, avec plus de 300 000 nouveaux cas et 185 000 décès par an. Les taux de survie pour les tumeurs ovariennes et utérines dépassent généralement ceux du cancer du col de l'utérus ; néanmoins, des écarts importants persistent entre les pays et les régions. Comme pour le cancer du col de l'utérus, ces disparités sont influencées par l'accès aux soins de santé, les méthodes de détection précoce et les options thérapeutiques. Des interventions infirmières ciblées sont essentielles pour ces cancers afin d'améliorer les résultats et renforcer la qualité de vie des femmes à travers le monde5.
Les infirmières en oncologie gynécologique dispensent des soins holistiques centrés sur la patiente, allant au-delà du soutien émotionnel. En plus d'offrir un soutien psychologique, elles facilitent la planification du traitement, défendent les besoins des patientes et les accompagnent tout au long du processus thérapeutique. Les traitements efficaces comprennent la prise en charge des symptômes, notamment la réduction de la douleur, de la fatigue et des nausées, la thérapie psychologique et des programmes éducatifs destinés aux patientes, améliorant ainsi les résultats tant physiques qu'émotionnels6. Les stratégies thérapeutiques pluridisciplinaires intégrant un soutien psychologique associé à une rééducation physique se sont révélées particulièrement bénéfiques pour améliorer la qualité de vie. En conséquence, les infirmières en oncologie gynécologique jouent un rôle essentiel dans la gestion des symptômes, l'éducation des patientes et les traitements complets, améliorant ainsi les résultats pour les patientes6. Ces soins infirmiers spécialisés incluent l'administration de chimiothérapie, la surveillance et l'interprétation des signes vitaux, l'analyse des réponses au traitement et un accompagnement global, tout cela nécessitant une formation et des compétences spécifiques en soins infirmiers en oncologie7.
Les soins infirmiers améliorent considérablement le bien-être des individus dans divers environnements de soins. Les hôpitaux dispensent des traitements, surveillent l'état des patients et collaborent avec l'équipe médicale. Les infirmiers des centres de soins à domicile offrent un soutien continu, gèrent les maladies chroniques et aident les patients à préserver leur autonomie8. La qualité de vie englobe le bien-être physique, mental, émotionnel et social. Les soins infirmiers jouent un rôle essentiel dans l'amélioration de ces aspects grâce à des interventions ciblées. Les soins continus dispensés aux patients atteints de maladies chroniques incluent la surveillance des signes vitaux, l'administration de médicaments et l'enseignement de techniques d'autogestion8. Ces interventions infirmières permettent une gestion efficace des maladies chroniques, réduisent les symptômes et améliorent la santé physique, contribuant ainsi à une meilleure qualité de vie globale.
Les cancers gynécologiques constituent un problème de santé publique important pour les femmes dans le monde entier, avec plus d'un million de diagnostics par an, entraînant des troubles physiques considérables et des troubles psychosociaux, réduisant ainsi la qualité de vie9. Des recherches indiquent que jusqu'à 40 % des femmes diagnostiquées avec un cancer gynécologique souffrent d'une détresse mentale importante, tandis que 60 % signalent une détérioration de la qualité de vie liée à la santé pendant le traitement (Statistiques mondiales et rapports sur le cancer)10. Smits et al. n'ont observé aucun effet significatif provenant de traitements similaires, soulignant l'importance de l'engagement des participantes et de la qualité de la mise en œuvre pour déterminer les résultats11. L'étude met en évidence le rôle essentiel des infirmières dans la prévention des maladies, la promotion de modes de vie sains et la prise en charge des besoins physiques et émotionnels des patientes.
La présente étude vise à évaluer les effets des interventions sur le mode de vie et des soins infirmiers en oncologie gynécologique sur l'amélioration de la qualité de vie des femmes diagnostiquées avec des tumeurs malignes gynécologiques, au moyen d'une revue systématique et d'une méta-analyse. L'étude a pour objectif d'évaluer l'impact de certaines interventions sur le mode de vie et des soins infirmiers en oncologie gynécologique sur des aspects essentiels de la qualité de vie, notamment le bien-être physique, émotionnel et social. Le fait de se concentrer sur des mesures standardisées de la qualité de vie et sur des stratégies d'intervention clairement définies fournit des données pratiques sur l'efficacité de ces méthodes. Cette étude examine spécifiquement les effets à court terme (dans les six mois) de soins infirmiers psychologiques intensifs sur le bien-être émotionnel et social. Cette méthodologie ciblée permet une analyse complète de l'impact de certaines interventions sur les résultats relatifs à la qualité de vie et fournit des éléments probants pour orienter les stratégies de soins personnalisés.
Les revues systématiques antérieures, notamment celle de Smits et al.11, ont principalement évalué les interventions sur le mode de vie chez les femmes atteintes de cancer de l'endomètre et de cancer ovarien, et ont inclus relativement peu d'études. Depuis, de nouvelles données probantes sont devenues disponibles, et aucune revue systématique n'a évalué de manière exhaustive à la fois les interventions sur le mode de vie et les soins infirmiers en oncologie gynécologique dans un éventail plus large de tumeurs gynécologiques. Cette revue systématique et méta-analyse visait donc à synthétiser les données probantes actuelles concernant les effets de ces interventions sur la qualité de vie.
Protocole
critères d'éligibilité
Les études étaient éligibles si elles répondaient à tous les critères suivants : (1) incluaient des femmes atteintes d'une tumeur maligne gynécologique quelconque ; (2) évaluaient une intervention définie en matière de mode de vie ou une intervention menée par des infirmières ; (3) rapportaient des données quantitatives sur la qualité de vie ; et (4) étaient soit des études comparatives (intervention versus contrôle), soit des études observationnelles de trajectoire fournissant des données descriptives pertinentes sur la qualité de vie ; (5) étaient publiées en anglais. . Pour la méta-analyse quantitative intervention versus contrôle, la présence d'un groupe témoin simultané était requise12. Deux études sans groupe comparateur ont été conservées uniquement pour la synthèse narrative13. Aucune restriction géographique n'a été appliquée.
Sources d'information
Le processus complet de sélection des études est illustré à la figure 1 sous la forme d'un diagramme de flux PRISMA. La recherche a été effectuée dans les bases Cochrane Library, Embase, Google Scholar, OVID et PubMed, depuis la création de chaque base jusqu'en juin 2026. Les références récupérées ont été importées dans EndNote 20 et les doublons ont été supprimés. Deux évaluateurs ont examiné indépendamment les titres et résumés, puis procédé à l'évaluation en texte intégral des études potentiellement éligibles. Les désaccords ont été résolus par discussion. Seules les publications en anglais ont été prises en compte pour l'inclusion, conformément aux critères d'éligibilité préétablis.
Stratégie de recherche
La stratégie de recherche a été élaborée à l’aide du cadre PICOS : Population — femmes atteintes de cancers gynécologiques ; Intervention — interventions liées au mode de vie ou aux soins infirmiers ; Comparaison — soins habituels ou interventions alternatives ; Résultat — qualité de vie ; Conception de l’étude — aucune restriction14. Un ensemble complet de mots-clés et de descripteurs normalisés a été utilisé dans toutes les bases de données ; les chaînes de recherche détaillées pour chaque base sont indiquées dans Tableau 113.
Processus de sélection
Après la récupération du texte intégral, deux évaluateurs ont vérifié indépendamment que chaque rapport satisfaisait à tous les critères d'éligibilité. Ils ont en outre comparé les listes d'auteurs, les noms des essais (par exemple SUCCEED, WALC, BENITA, TOPCAT‑G), les périodes de recrutement et les centres d'étude afin d'identifier d'éventuelles cohortes de patients chevauchantes. Les cohortes de patients potentiellement chevauchantes ont été identifiées et documentées. Lorsque des rapports chevauchants ont contribué à l'analyse principale, leur influence a été évaluée dans une analyse de sensibilité préspécifiée excluant le jeu de données chevauchant.
Extraction des données et mesures des résultats
Deux évaluateurs ont extrait indépendamment les données des 15 rapports inclus à l'aide d'un formulaire d'extraction de données normalisé et testé. Les désaccords ont été résolus par consensus avec l'auteur correspondant. Pour chaque étude, les informations suivantes ont été enregistrées : premier auteur, année de publication, pays, conception de l'étude, type de cancer, description de l'intervention, description du comparateur, taille de l'échantillon par groupe, âge des participants et stade de la maladie, instrument d'évaluation de la qualité de vie (QV), points temporels évalués, et toutes les données numériques sur la qualité de vie (moyennes, mesures de dispersion et tailles d'échantillon par bras)15.
Regroupement quantitatif (13 études comparatives)
Pour la méta-analyse de l'intervention par rapport au groupe témoin, les scores finaux après l'intervention (moyennes et écarts-types) ont été extraits aux points temporels prédéfinis (3 et 6 mois) pour les deux groupes. Lorsqu'une étude rapportait à la fois les scores finaux et les scores de variation, seuls les scores finaux ont été extraits16. L'approche méthodologique de la méta-analyse et l'évaluation de la qualité des études ont suivi les recommandations établies de Cochrane17. Le choix du modèle de méta-analyse a pris en compte l'hétérogénéité clinique et méthodologique attendue entre les études18, et l'hétérogénéité statistique a été quantifiée à l'aide de la statistique I2, selon la méthode décrite par Higgins et al.19. Les 13 études comparatives incluses dans la synthèse quantitative sont résumées dans le tableau 220,21,22,23,24,25,26,27,28,29,30,31,32.
Mesures des résultats sur la qualité de vie, alignement et métrique d'effet
L'instrument spécifique de qualité de vie utilisé dans chaque étude a été enregistré. Les échelles identifiées comprenaient l'évaluation fonctionnelle du cancer – général (FACT‑G), le FACT‑ovarien (FACT‑O), le FACT‑endomètre (FACT‑En), le questionnaire sur la qualité de vie de l'Organisation européenne pour la recherche et le traitement du cancer, version standard 30 (EORTC QLQ‑C30), la formule abrégée‑36 (SF‑36), ainsi que des échelles spécifiques à la pathologie. Pour tous les instruments, des scores plus élevés indiquaient une meilleure qualité de vie, et aucun instrument nécessitant une inversion de notation n'a été inclus. Toutes les données sur la qualité de vie extraites ont donc été harmonisées selon la même métrique, une différence moyenne (DM) positive favorisant systématiquement le groupe d'intervention.
Pour la méta-analyse principale, les scores finaux post-intervention ont été extraits plutôt que les scores de variation par rapport à la ligne de base. Cette décision s'appuie sur les raisons suivantes : (i) toutes les études ne rapportaient pas les scores de variation ni leurs écarts-types ; (ii) les scores finals reflètent l'état absolu de qualité de vie (QdV) après le traitement, ce qui revêt une signification clinique ; et (iii) l'utilisation des scores finaux a permis de maximiser le nombre d'études pouvant être regroupées. Lorsqu'une étude rapportait plusieurs sous-échelles de QdV, le score global de QdV ou le score total FACT-G était privilégié comme critère principal ; en cas d'indisponibilité, le sous-score relatif à la fonction physique était utilisé, cette dérogation étant explicitement notée en bas de page dans Tableau 2.
La différence moyenne brute (MD) a été utilisée comme mesure d'effet plutôt que la différence moyenne standardisée (DMS), car tous les instruments inclus sont validés pour mesurer le même construit sous-jacent.—qualité de vie liée à la santé—sur des échelles conceptuellement similaires (les scores totaux varient de 0–100 ou 0–148). La MD est directement interprétable dans les unités d'origine de ces échelles et revêt une signification clinique plus grande qu'une DMS exprimée en unités d'écart-type. Les estimations ajustées (par exemple, moyennes ajustées par ANCOVA) n'ont pas été utilisées car les covariables d'ajustement variaient largement d'une étude à l'autre, compromettant la comparabilité.
Conversions d'écart type
Lorsque les études rapportaient des erreurs standard (ES) ou des intervalles de confiance à 95 % au lieu des écarts-types, ceux-ci étaient convertis en écarts-types à l’aide de formules standard : ET = ES × √n pour les ES, et ET = √n × (IC supérieur – IC inférieur) / (2 × 1,96) pour les IC à 95 %. Pour les études présentant des médianes avec des étendues interquartiles (EI), les moyennes ou les écarts-types n’ont pas été imputés ; ces données ont été extraites sous forme narrative et n’ont pas été incluses dans les calculs du MD global. Aucune imputation de ce type n’a été nécessaire pour les 13 études ayant contribué à la synthèse quantitative.
Traitement des données manquantes
Des estimations en intention de traiter (ITT) ont été extraites de préférence lorsqu'elles étaient explicitement indiquées, car elles fournissent l'estimation la plus conservatrice et la moins biaisée de l'effet du traitement. Lorsque les données ITT n'étaient pas disponibles, les données selon le protocole ou les données des cas complets ont été extraites telles que rapportées par les auteurs originaux. Les moyennes, écarts-types (ET) ou valeurs de résultat manquants n'ont pas été imputés ; le caractère manquant a été noté pour chaque étude et pris en compte dans l'analyse de sensibilité. Les études avec des ET non rapportés pour des points temporels clés ont été signalées, et les auteurs correspondants ont été contactés par courrier électronique afin de demander les statistiques manquantes. En l'absence de réponse dans un délai de deux semaines, les données disponibles les plus conservatrices ont été utilisées (par exemple, l'ET de base groupée si l'ET post-intervention était manquant) ou le point temporel concerné a été exclu de l'analyse regroupée.
Plusieurs bras d'intervention et témoins partagés
Aucune étude incluse ne présentait plus d'un bras d'intervention axé sur un mode de vie actif ou des soins infirmiers comparé à un groupe témoin unique partagé, ce qui aurait nécessité de diviser l'échantillon témoin pour l'analyse. Dans l'unique étude de conception factorielle (McCloy et al.30), les données ont été extraites du bras combiné exercice-et-conscience pleine et du bras témoin de soins habituels afin de simplifier le regroupement et d'éviter tout comptage double. Pour les cohortes chevauchantes de l'essai SUCCEED (Von Gruenigen et al.21 et McCarroll et al.23), les deux rapports ont été conservés dans le tableau d'extraction. Pour la méta-analyse principale, les deux jeux de données ont été inclus (car ils rapportaient la qualité de vie au même point temporel). Dans une analyse de sensibilité préspecifiée, le dernier rapport a été exclu afin d'évaluer l'impact de la duplication des cohortes sur l'estimation regroupée ; les résultats sont indiqués dans le texte.
Études observationnelles non comparatives
Pour deux rapports (Budisan et al.33 et Betea et al.34), qui ne comportait pas de groupe témoin concurrent, les données comparatives entre intervention et contrôle n'ont pas été extraites (c'est-à-dire qu'aucune différence moyenne ne pouvait être calculée). En revanche, les données descriptives sur l'évolution de la qualité de vie ont été extraites. (les changements intra-groupe dans le temps) et présentés de manière narrative dans le texte et dans Tableau 2Ils n'ont pas été inclus dans aucune représentation graphique en forêt ni dans aucune synthèse quantitative regroupée.
Évaluation du risque de biais
Les biais de publication potentiels et autres effets liés aux petites études ont été évalués à l’aide de l’inspection visuelle des graphiques en entonnoir et du test de régression linéaire d’Egger (qui effectue une régression de l’effet standardisé de l’intervention sur sa précision). Étant donné que le test d’Egger présente une puissance statistique limitée lorsque le nombre d’études est faible (généralement <10), les graphiques en entonnoir et les tests d’Egger ont été prédéfinis et n’ont été réalisés que pour les méta-analyses comprenant 10 études ou plus. Pour les résultats provenant de moins de 10 études contributrices, les graphiques en entonnoir et les valeurs-p d’Egger ne sont pas rapportés, car ces tests manquent de puissance et pourraient produire des résultats trompeurs17.
Deux évaluateurs ont indépendamment évalué la qualité méthodologique des 15 rapports inclus, et les désaccords ont été résolus par discussion avec les auteurs correspondants. Comme les études incluses comprenaient à la fois des essais contrôlés randomisés (ECR ; n = 13) et des études de cohortes observationnelles non randomisées (n = 2 ; Budisan et al.33 ; Betea et al.34), des outils spécifiques à la conception ont été appliqués.
Pour les ECR (13 études), l'outil Cochrane RoB 2.0 a été utilisé (version révisée), évaluant chaque étude selon cinq domaines17 : (1) Processus de randomisation — génération de la séquence et masquage de l'allocation ; (2) Écarts par rapport aux interventions prévues — aveugle des participants et du personnel, et analyse en intention-de-traiter ; (3) Données manquantes sur les résultats — exhaustivité du suivi et prise en compte des abandons ; (4) Mesure du résultat — masquage des évaluateurs des résultats (particulièrement pertinent pour la qualité de vie autodéclarée, où le masquage est moins réalisable mais tout de même pris en compte) ; (5) Sélection des résultats rapportés — risque de publication sélective des résultats (vérifié à partir des registres d'essais ou des protocoles publiés, lorsque disponibles).
Chaque domaine a été évalué comme présentant un risque faible, des préoccupations ou un risque élevé. Un jugement global sur le risque de biais a ensuite été attribué à chaque étude : faible (tous les domaines à risque faible), des préoccupations (un ou plusieurs domaines avec des préoccupations), ou élevé (un domaine quelconque évalué à risque élevé ou plusieurs domaines avec des préoccupations). Pour les résultats autodéclarés, tels que la qualité de vie, l'aveugle des participants est souvent irréalisable ; un jugement de risque élevé n'a donc pas été automatiquement attribué en l'absence d'aveugle des participants. En revanche, l'absence d'aveugle a été explicitement notée comme une source potentielle de biais de performance dans l'évaluation du domaine 2.
Pour les études de cohortes observationnelles non randomisées (2 études), Budisan et al.33 et Betea et al.34 n'ont pas inclus de groupe comparateur simultané et n'ont pas été regroupés dans l'analyse méta-quantitative. Pour celles-ci, l'échelle Newcastle-Ottawa (NOS), adaptée aux études de cohortes, a été utilisée pour évaluer la sélection, la comparabilité (non applicable en raison de l'absence de groupe comparateur) et la vérification des résultats. Toutefois, en raison de l'absence de bras témoin, elles ont été jugées présenter un risque élevé de confusion et de biais de sélection dans toute inférence causale. Elles ont été conservées uniquement à des fins descriptives ; leurs profils de risque de biais n'affectent pas les estimations d'effet regroupées, mais sont documentés dans Table 2.
Résumé du risque de biais
Une figure récapitulative du risque de biais (graphique en feux de circulation) a été créée, affichant les évaluations par domaine pour chaque ECR. En bref, les problèmes les plus fréquents observés dans les ECR étaient : (i) l'absence d'aveuglage des participants et du personnel concernant les interventions sur le mode de vie (domaine 2 – certains risques/risque élevé dans 9 des 13 études), et (ii) des données de résultat incomplètes dues à l'abandon (domaine 3 – certains risques dans 4 études). Aucune étude n'a été jugée à faible risque dans tous les domaines ; la majorité (8/13) présentait certains risques, et 5/13 ont été classées à risque élevé globalement, principalement en raison de l'absence d'aveuglage et de tailles d'échantillons réduites entraînant une imprécision.
Degré de certitude des preuves (GRADE)
La certitude globale de l'ensemble des données probantes a été évaluée pour chaque résultat regroupé en utilisant le Cadre Grading of Recommendations Assessment, Development and Evaluation (GRADE), conformément au manuel GRADE et en utilisant le logiciel GRADEpro GDT. Le degré de certitude a été évalué comme élevé, modéré, faible, ou très faible dans cinq domaines : risque de biais, incohérence, absence de spécificité, imprécision et biais de publication. Les résultats évalués comprennent (1) la qualité de vie à 6 mois – gynécologie oncologique générale (MD regroupée provenant de 9 études comparatives) ; (2) qualité de vie à 6 mois – cancer de l'ovaire (différence moyenne regroupée issue de 2 études comparatives) ; (3) qualité de vie à 6 mois – cancer de l'endomètre (DM regroupée issue de 4 études comparatives, incluant des cohortes SUCCEED chevauchantes) ; (4) qualité de vie à 3 mois – gynécologie oncologique générale (MD groupée provenant de 6 études comparatives).
Mesure d'effet et modèle de méta-analyse
Des modèles aléatoires à variance inverse ont été utilisés pour les analyses générales à 6 mois et à 3 mois, car une hétérogénéité clinique et méthodologique importante était attendue entre les études, notamment en ce qui concerne les types de cancer, les composantes des interventions, l'intensité, la durée et les conditions de contrôle18. Des modèles à effet fixe à variance inverse ont été utilisés pour les analyses de sous-groupes concernant le cancer de l'ovaire et le cancer de l'endomètre, pour lesquels aucune hétérogénéité statistique n'a été observée (I2 = 0 %). L'hétérogénéité a été évaluée à l'aide de la statistique I219.
L'hétérogénéité a été quantifiée à l'aide de la statistique I2, les seuils de 25 %, 50 % et 75 % représentant respectivement une faible, modérée et forte hétérogénéité. En complément de I2, τ2 a été indiqué pour les analyses à effets aléatoires afin de quantifier l'ampleur absolue de la variance entre les études. Toutes les analyses ont été réalisées à l'aide des packages meta et metafor dans R (version 4.3.1).
Justification du regroupement malgré une hétérogénéité importante et prise en charge de l'hétérogénéité
Pour l'analyse primaire à 6 mois, je2 = 71 % indiquait une hétérogénéité importante. Le regroupement a été jugé approprié selon le modèle à effets aléatoires pour les raisons suivantes : (i) l'estimation regroupée représente la moyenne effet à travers une gamme d'interventions et de populations, ce qui constitue une question de synthèse légitime ; (ii) le modèle à effets aléatoires intègre explicitement la variance entre les études (τ2) dans l'erreur type, réduisant ainsi le risque d'intervalles de confiance faussement étroits ; (iii) des analyses préspécifiées par sous-groupe ont été réalisées selon le type de cancer (ovarien, endométrial) afin d'expliquer les sources cliniques d'hétérogénéité ; (iv) des analyses d'influence et de sensibilité ont été effectuées pour évaluer la robustesse de l'estimation regroupée.
La décision de regrouper les études malgré une hétérogénéité statistique importante s'est fondée sur les principes suivants : interprétation de l'I2 — des valeurs d'I2 de 25 %, 50 % et 75 % ont été prédéfinies pour représenter respectivement une faible, modérée et forte hétérogénéité. Un I2 dépassant 75 % indique une hétérogénéité considérable, ce qui pourrait rendre inapproprié le regroupement si cette hétérogénéité ne peut être expliquée de manière significative par des facteurs cliniques ou méthodologiques. Pour l'analyse générale principale à 6 mois (I2 = 71 %), des analyses de sous-groupes selon le type de cancer (ovarien, endométrial) ont été prédéfinies afin d'explorer les sources cliniques d'hétérogénéité. Le regroupement en sous-groupes a réduit de manière importante l'I2 à 0 % dans les deux sous-groupes (ovarien et endométrial), suggérant qu'une grande partie de l'hétérogénéité globale est attribuable aux différences de type de cancer et aux cibles thérapeutiques associées. Toutefois, étant donné que ces sous-groupes comprennent très peu d'études, on ne peut pas conclure de manière fiable que l'hétérogénéité est entièrement expliquée.
La réalisation d'un regroupement a été considérée comme justifiée pour l'analyse générale à 6 mois, car : (i) elle fournit un effet moyen résumé à travers un large éventail d'interventions, ce qui constitue une question méta-analytique légitime ; (ii) la valeur de τ2 est explicitement indiquée afin de quantifier la variance entre les études ; (iii) des analyses d'influence ont été effectuées pour vérifier la présence de résultats influencés par des valeurs aberrantes ; et (iv) l'estimation regroupée n'est pas considérée comme définitive ou applicable sur le plan clinique — elle est interprétée comme génératrice d'hypothèses et fortement nuancée dans la discussion.
Conformément au Guide Cochrane, lorsque l’I2 dépasse 75 % et que les analyses de sous-groupes n’expliquent pas de manière convaincante l’hétérogénéité, les estimations regroupées doivent être interprétées avec une extrême prudence. Étant donné le faible nombre d’études dans les sous-groupes, on ne peut affirmer avec certitude que l’hétérogénéité est entièrement expliquée. Par conséquent, l’estimation regroupée principale est présentée principalement à des fins descriptives et exploratoires et ne sert pas de base à des recommandations cliniques. Toutes les statistiques d’hétérogénéité (I2, τ2) et les analyses de sensibilité sont rapportées de manière transparente, permettant aux lecteurs d’évaluer eux-mêmes la stabilité des estimations.
Analyses de sous-groupes, de sensibilité et d'influence
Afin d'explorer les sources d'hétérogénéité, les analyses préspécifiées suivantes ont été réalisées, sans effectuer de méta-régression : 1) Pour les analyses de sous-groupes, le résultat général à 6 mois a été stratifié selon le type de cancer (ovarien, endométrial) afin d'examiner si l'effet différait selon le site tumoral ; 2) Analyse de sensibilité (cohorts chevauchantes) : afin d'évaluer l'impact des cohortes chevauchantes de l'essai SUCCEED (Von Gruenigen et al.21 et McCarroll et al.23), l'analyse de sous-groupe endométrial a été répétée en excluant l'étude de McCarroll et al.23 ; 3) Analyse d'influence par suppression d'une étude (leave-one-out) : chaque étude a été supprimée successivement, et la MD globale et l'I2 ont été recalculées pour le résultat général à 6 mois afin d'identifier si une étude unique influençait de manière disproportionnée les résultats ou l'hétérogénéité ; 4) Comparaison avec un modèle à effets fixes : par souci d'exhaustivité, les estimations regroupées ont également été calculées selon un modèle à effets fixes (pondération par la variance inverse) afin d'être comparées aux résultats du modèle à effets aléatoires ; toute différence notable indiquerait que l'hétérogénéité entre les études influence de façon significative l'estimation.
La méta-régression n’a pas été réalisée pour explorer les covariables continues (par exemple, l’âge, la qualité de vie à l’état initial, la durée de l’intervention) en raison du nombre insuffisant d’études par sous-groupe (≤9 pour l'issue générale à 6 mois) est insuffisant pour produire des coefficients de régression fiables. Avec <10 études par covariable, la métarégression est fortement sous-alimentée et sujette aux erreurs de type I, et les données disponibles sur les covariables ont été inconstamment rapportées entre les études.
Biais de publication
Aucun des résultats regroupés n'incluait 10 études ou plus. Par conséquent, les graphiques en entonnoir et les tests de régression d'Egger n'ont pas été réalisés, car ces évaluations seraient peu puissantes et potentiellement trompeuses compte tenu du nombre d'études disponibles.
Résultats
Sélection des études
Une recherche systématique de la littérature dans PubMed, Embase, la Bibliothèque Cochrane, Ovid et Google Scholar jusqu’en juin 2026 a identifié 1 123 références. Après suppression de 897 doublons, 226 références ont fait l’objet d’un examen des titres et résumés. Parmi celles-ci, 124 ont été exclues selon les critères d’éligibilité. Une évaluation en texte intégral a été réalisée pour 102 rapports, dont 89 ont été exclus pour des raisons documentées dans le diagramme de flux PRISMA (Figure 1 ; Fichier supplémentaire 1). Au total, 15 rapports ont satisfait aux critères d’inclusion et ont été inclus dans la revue systématique, comprenant 13 essais contrôlés randomisés comparatifs et 2 études observationnelles non comparatives. Treize essais contrôlés randomisés ont fourni des données exploitables intervention-contre-témoins pour une méta-analyse quantitative, tandis que deux études observationnelles ont été conservées uniquement pour une synthèse narrative20,21,22,23,24,25,26,27,28,29,30,31,32.
Figure 1 présente le diagramme de flux PRISMA 2020 détaillant le processus de dépistage et de sélection. Les 13 essais contrôlés randomisés ont fourni des données extractibles intervention-contre-témoin pour une méta-analyse quantitative20,21,22,23,24,25,26,27,28,29,30,31,32.
Caractéristiques de l'étude
Les caractéristiques des 15 rapports inclus sont résumées dans le Tableau 2. Treize ECR comparatifs ont fourni des données pour la synthèse quantitative, tandis que deux études observationnelles ont été conservées uniquement pour la synthèse narrative. Parmi les 13 ECR comparatifs, 915 femmes ont été incluses, dont 468 participantes réparties dans des groupes d'intervention lifestyle ou infirmière et 447 dans des groupes témoins, tel qu'initialement rapporté.
Pour les méta-analyses quantitatives, les 13 ESS comparatifs ont inclus 915 participants (468 en intervention, 447 en contrôle). Les ESS inclus ont été publiés entre 2009 et 2025 et ont été réalisés dans plusieurs pays, notamment les États-Unis, le Danemark, le Royaume-Uni, la Chine, l'Égypte et la Roumanie. Les types de cancer étudiés comprenaient le cancer de l'ovaire (2 études), le cancer de l'endomètre (4 études) et des cancers gynécologiques mixtes (7 études). Les interventions variaient largement et comprenaient des programmes d'exercices structurés, des modifications alimentaires, des consultations sur la perte de poids, des séances psychoéducatives, un suivi dirigé par une infirmière, des soins initiés par le patient, une pleine conscience basée sur une application et des interventions combinées sur le mode de vie. Les durées de suivi allaient de 3 à 6 mois.
Les instruments d'évaluation de la qualité de vie comprenaient : le Functional Assessment of Cancer Therapy–General (FACT-G), le FACT-Ovarian (FACT-O), le FACT-Endometrial (FACT-En), le questionnaire sur la qualité de vie de l'Organisation européenne pour la recherche et le traitement du cancer, module principal 30 (EORTC QLQ-C30), le Short Form-36 (SF-36) et des échelles spécifiques à la condition. Tous les instruments ont été notés de manière à ce que des valeurs plus élevées indiquent une meilleure qualité de vie.
Évaluation du risque de biais
Le risque de biais a été évalué à l'aide de l'outil Cochrane RoB 2.0 pour les 13 ECR et de l'échelle Newcastle-Ottawa pour les 2 études de cohorte observationnelles. Un résumé des jugements par domaine est présenté dans le graphique en feux tricolores du risque de biais. Pour les ECR, les problèmes méthodologiques les plus fréquents étaient les suivants : (1) Domaine 2 (Écarts par rapport aux interventions prévues) : l'aveugle des participants et du personnel concernant les interventions sur le mode de vie n'était pas réalisable dans aucune des études ; 9 des 13 études (69 %) ont été jugées présentant «des préoccupations » ou un «risque élevé» dans ce domaine ; (2) Domaine 3 (Données manquantes pour le résultat) : quatre études (31 %) présentaient des données de résultat incomplètes en raison de taux de désistement supérieurs à 20 %, classées comme «des préoccupations» ; (3) Domaine 1 (Processus de randomisation) : sept études (54 %) ont décrit adéquatement la génération de la séquence et la dissimulation de l'allocation ; les autres présentaient un rapport peu clair ou inadéquat ; (4) Domaine 4 (Mesure du résultat) : toutes les études ont utilisé des instruments validés d'auto-évaluation de la qualité de vie (QoL) ; toutefois, l'aveugle des évaluateurs des résultats n'était pas systématiquement indiqué ; (5) Domaine 5 (Sélection du résultat rapporté) : six études (46 %) avaient enregistré leur protocole de manière prospective ; les études restantes ne disposaient pas de protocoles disponibles, ce qui suscite des inquiétudes quant à un rapport sélectif des résultats.
Évaluations globales du risque de biais : Aucune étude n’a été classée comme présentant un risque faible dans tous les domaines. Huit études (62 %) ont été jugées ayant "certaines préoccupations" globalement, et cinq études (38 %) ont été classées comme "risque élevé" globalement, principalement en raison d'un manque d'aveuglage et de faibles effectifs, ce qui a entraîné une imprécision.
Pour les deux études de cohorte observationnelles (Budisan et al.33; Betea et al.34), l'absence d'un groupe témoin simultané a entraîné un risque élevé de confusion et de biais de sélection pour toute inférence causale. Ces études ont été conservées uniquement pour une synthèse narrative et n'ont pas contribué aux estimations d'effet regroupées.
Résultats principaux
Qualité de vie à 6 mois – oncologie gynécologique générale
Neuf ECR comparatifs ont fourni des données au point temporel de 6 mois, comprenant 693 participants (358 dans le groupe d'intervention et 335 dans le groupe témoin). La différence moyenne regroupée (DM) calculée à l’aide d’un modèle à effets aléatoires n’a montré aucune amélioration statistiquement significative de la qualité de vie à 6 mois par rapport au groupe témoin (DM = 2,11 ; IC à 95 % : –0,90 à 5,12 ; p = 0,17).
Figure 2 présente le graphique en forêt pour cette analyse. L'hétérogénéité était importante : I2 = 71 %, τ2 = 10,60.
Qualité de vie à 6 mois – sous-groupe atteint de cancer de l'ovaire
Deux études (Zhou et al.25 ; Maurer et al.29) ont fourni des données spécifiquement pour le cancer de l'ovaire, incluant 124 participantes (66 dans le groupe d'intervention, 58 dans le groupe témoin). La différence moyenne regroupée indiquait une amélioration statistiquement significative de la qualité de vie en faveur du groupe d'intervention (DM 4,28 ; IC 95 % 0,45–8,10 ; p = 0,03). Figure 3 présente le graphique en forêt pour cette analyse. L'hétérogénéité était faible : I2 = 0 %, τ2 = 0.
Qualité de vie à 6 mois – sous-groupe de cancer de l'endomètre
Quatre études (Von Gruenigen et al.21 ; McCarroll et al.23 ; Rossi et al.24 ; Jeppesen et al.26) ont fourni des données sur le cancer de l'endomètre, portant sur 172 participantes (92 dans le groupe d'intervention, 80 dans le groupe témoin). Afin d'évaluer l'impact des cohortes chevauchantes de l'essai SUCCEED, l'analyse du sous-groupe endométrial a été répétée en excluant l'étude de McCarroll et al.23. La différence moyenne combinée a légèrement varié, passant de 2,00 (IC à 95 % : –1,49–5,49) à 1,87 (IC à 95 % : –1,62–5,36), et l'hétérogénéité I2 est restée nulle (0 %). L'exclusion de McCarroll et al. n'a pas modifié de manière significative l'estimation combinée ; l'effet est resté statistiquement non significatif, et l'hétérogénéité est demeurée absente (I2 = 0 %). Figure 4 présente le graphique en forêt de cette analyse. L'hétérogénéité était faible : I2 = 0 %, τ2 = 0.
Qualité de vie à 3 mois – oncologie gynécologique générale
Six études comparatives (Von Gruenigen et al.21; Donnelly et al.22; McCarroll et al.23; Maurer et al.29; Elzeblawy Hassan et al.32; McCloy et al.30) ont rapporté des résultats à 3 mois, incluant 275 participantes (140 dans le groupe d'intervention et 135 dans le groupe témoin). La différence moyenne regroupée n'a montré aucune différence statistiquement significative entre les groupes d'intervention et témoin (MD 6,43, IC à 95 % : −0,16 à 13,01, p = 0,06). Figure 5 présente le graphique en forêt pour cette analyse. L'hétérogénéité était importante (I2 = 74 %, τ2 = 42,53).
Analyses de sous-groupes
Des analyses préspécifiées de sous-groupes selon le type de cancer ont été réalisées afin d'explorer les sources d'hétérogénéité. Pour le résultat global en oncologie gynécologique à 6 mois : (1) sous-groupe cancer de l'ovaire (2 études) : I2 = 0 %, τ2 = 0 ; MD 4,28 (IC 95 % 0,45–8,10) ; (2) sous-groupe cancer de l'endomètre (4 études) : I2 = 0 %, τ2 = 0 ; MD 2,00 (IC 95 % : –1,49–5,49)
Le sous-groupage par type de cancer a réduit considérablement l'hétérogénéité, passant de I2 = 71 % dans l'analyse globale à 0 % dans chaque sous-groupe. Toutefois, le faible nombre d'études dans chaque sous-groupe (2 et 4, respectivement) limite la précision de ces estimations par sous-groupe.
Aucun test formel d'interaction entre les sous-groupes n'a été effectué, car le nombre d'études par sous-groupe (<10) était insuffisant pour produire des estimations d'interaction fiables. Les différences apparentes en termes de signification statistique entre les sous-groupes ovariens et endométriaux ne doivent pas être interprétées comme une preuve d'effets thérapeutiques différents selon le type de cancer.
De même, aucun test formel d'interaction temporelle n'a été effectué entre les résultats à 3 mois et à 6 mois.
Analyses de sensibilité
Exclusion des cohortes chevauchantes
Afin d'évaluer l'impact du chevauchement des cohortes de l'essai SUCCEED (Von Gruenigen et al.21 et McCarroll et al.23), l'analyse de sous-groupe endométrial a été répétée en excluant McCarroll et al.23.
La MD groupée est passée légèrement de 2,00 (IC à 95 % : –1,49–5,49) à 1,87 (IC à 95 % : –1,62–5,36), et l’I2 est restée à 0 %. Cela indique que la cohorte en double n’a pas affecté de manière significative l’estimation ponctuelle ni la conclusion selon laquelle il n’existe aucun effet significatif.
Pour le résultat général à 6 mois, l'exclusion de McCarroll et al. a modifié la DMO groupée de 2,11 (IC à 95 % : −0,90–5,12) à 2,33 (IC à 95 % : −1,16–5,82), avec un I2 passant de 71 % à environ 72 %. L'effet est resté statistiquement non significatif, indiquant que l'exclusion de la cohorte chevauchante n'a pas modifié de façon notable la conclusion générale.
Analyse d'influence leave-one-out
La suppression séquentielle des études individuelles a donné des MD regroupés variant approximativement de 1,29 à 4,33. L'hétérogénéité est généralement restée importante après l'exclusion de la plupart des études ; toutefois, l'exclusion de McCorkle et al.20 a réduit l'I2 à 0 %, indiquant que cette étude a contribué de manière substantielle à l'hétérogénéité observée entre les études. Les conclusions générales doivent donc être interprétées avec prudence.
Comparaison de modèles à effets fixes
Dans un modèle à effets fixes, la différence moyenne (DM) regroupée pour le résultat général à 6 mois était de 3,80 (IC à 95 % : 2,97–4,62), tandis que le modèle à effets aléatoires donnait une DM de 2,11 (IC à 95 % : −0,90–5,12). La différence de significativité statistique entre les deux modèles indique que l'hétérogénéité entre les études affecte sensiblement l'inférence regroupée. Étant donné l'hétérogénéité importante (I2 = 71 %), l'estimation selon le modèle à effets aléatoires a été considérée comme plus appropriée pour l'interprétation.
Biais de publication
Aucun des résultats regroupés n'incluait 10 études ou plus. Par conséquent, les graphiques en entonnoir et les tests de régression d'Egger n'ont pas été réalisés, car ces évaluations seraient peu puissantes et potentiellement trompeuses compte tenu du nombre d'études disponibles.
Bien qu'une évaluation formelle n'ait pas été réalisée en raison du faible nombre d'études, un biais de publication et des rapports sélectifs ne peuvent être exclus. La possibilité que des résultats négatifs ou non significatifs restent non publiés doit donc être prise en compte lors de l'interprétation des données probantes.
Disponibilité des données
L'ensemble de données analysé au cours de la présente étude est disponible à l'adresse 10.5281/zenodo.21777130 (https://doi.org/10.5281/zenodo.21777130).
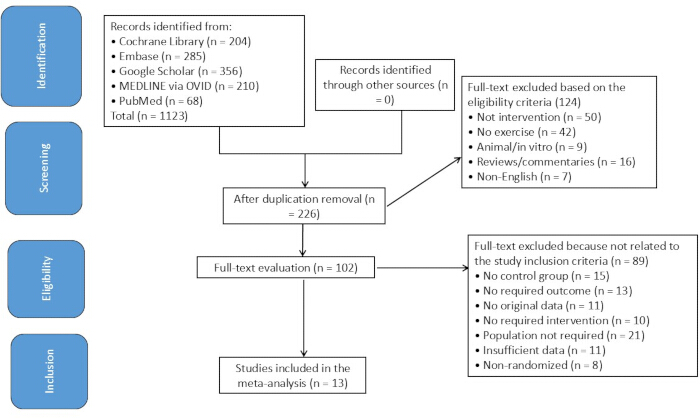
Figure 1 : Diagramme de flux PRISMA 2020 de la sélection des études. Schéma de flux illustrant l'identification, le tri, l'évaluation de l'éligibilité et l'inclusion des études évaluant les interventions infirmières en oncologie gynécologique et en mode de vie sur la qualité de vie des femmes atteintes de cancers gynécologiques. Veuillez cliquer ici pour visualiser une version agrandie de cette figure.
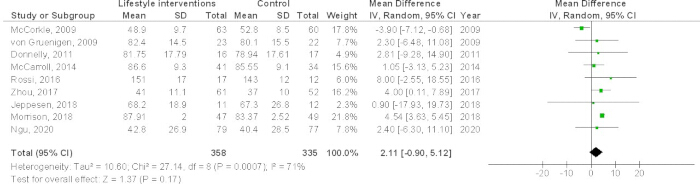
Figure 2 : Tracé en forêt de la qualité de vie à 6 mois chez les femmes atteintes de cancers gynécologiques. Tracé en forêt comparant les interventions sur le mode de vie et les soins infirmiers en oncologie gynécologique à des groupes témoins en ce qui concerne la qualité de vie lors du suivi à 6 mois. Les résultats sont présentés sous forme de différences moyennes (DM) avec des intervalles de confiance à 95 % (IC) à l’aide d’un modèle à effets aléatoires. Des valeurs positives de la DM favorisent le groupe bénéficiant de l’intervention. L’hétérogénéité est indiquée à l’aide de la statistique I2. Veuillez cliquer ici pour visualiser une version agrandie de cette figure.
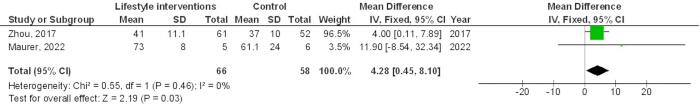
Figure 3 : Graphique en forêt de la qualité de vie à 6 mois chez les femmes atteintes d'un cancer de l'ovaire. Graphique en forêt illustrant l'effet des interventions sur le mode de vie et les soins infirmiers en oncologie gynécologique sur la qualité de vie lors du suivi à 6 mois chez les femmes atteintes d'un cancer de l'ovaire. Les résultats sont présentés sous forme de différences moyennes (DM) avec des intervalles de confiance à 95 % (IC). Des valeurs positives de DM favorisent le groupe d'intervention, et l'hétérogénéité est résumée à l'aide de la statistique I2. Veuillez cliquer ici pour visualiser une version agrandie de cette figure.
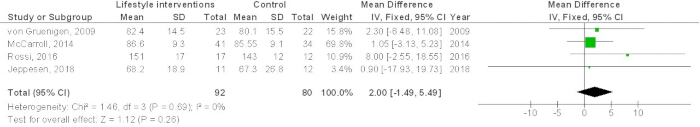
Figure 4 : Tracé en forêt de la qualité de vie à 6 mois chez les femmes atteintes d'un cancer de l'endomètre. Tracé en forêt comparant les interventions sur le mode de vie et les soins infirmiers en oncologie gynécologique aux groupes témoins en ce qui concerne la qualité de vie lors du suivi à 6 mois chez les femmes atteintes d'un cancer de l'endomètre. Les résultats sont exprimés en différences moyennes (DM) avec des intervalles de confiance à 95 % (IC). Des valeurs positives de la DM favorisent le groupe d'intervention, et l'hétérogénéité est indiquée à l'aide de la statistique I2. Veuillez cliquer ici pour visualiser une version agrandie de cette figure.
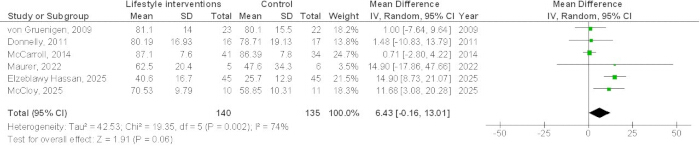
Figure 5 : Diagramme en forêt de la qualité de vie à 3 mois chez les femmes atteintes de cancers gynécologiques. Veuillez cliquer ici pour visualiser une version agrandie de cette figure.
Graphique en forêt comparant les interventions infirmières en oncologie gynécologique et les changements de mode de vie aux groupes témoins en matière de qualité de vie au suivi à 3 mois. Les résultats sont présentés sous forme de différences moyennes (DM) avec des intervalles de confiance à 95 % (IC) à l’aide d’un modèle à effets aléatoires. Des valeurs de DM positives favorisent le groupe d’intervention. L’hétérogénéité est indiquée à l’aide de la statistique I2.
Tableau 1 : Stratégies de recherche dans les bases de données utilisées pour l'analyse bibliographique. Des stratégies de recherche exhaustives ont été utilisées afin d'identifier les études admissibles dans PubMed, Embase, la Bibliothèque Cochrane, Ovid et Google Scholar. Les termes de recherche combinaient un vocabulaire contrôlé et des mots-clés en texte libre relatifs aux cancers gynécologiques, aux interventions sur le mode de vie, aux soins infirmiers en oncologie et à la qualité de vie. Veuillez cliquer ici pour télécharger ce tableau.
Tableau 2 : Caractéristiques des ECR incluses. Résumé des caractéristiques des études incluses, comprenant le plan d'étude, le type de cancer, l'intervention et le comparateur, la taille de l'échantillon, l'instrument d'évaluation de la qualité de vie, la durée de suivi et l'éligibilité à l'analyse méta-quantitative. Les études n'ayant pas de groupe comparateur adéquat ont été incluses uniquement dans la synthèse qualitative. Veuillez cliquer ici pour télécharger ce tableau.
Fichier supplémentaire 1 : Liste de contrôle PRISMA 2020. Liste de contrôle PRISMA 2020 complétée indiquant les numéros de pages du manuscrit correspondant à chaque élément de rapport, conformément à la déclaration PRISMA 2020 relative à la présentation des revues systématiques et des méta-analyses.Veuillez cliquer ici pour télécharger ce fichier.
Discussion
L'analyse principale à 6 mois n'a montré aucune amélioration statistiquement significative de la qualité de vie (DV 2,11, IC 95 % : −0,90 à 5,12, p = 0,17) pour les cancers gynécologiques mixtes, alors qu'une amélioration significative a été observée dans le sous-groupe des cancers de l'ovaire (DV 4,28, IC 95 % : 0,45–8,10, p = 0,03). Aucun effet significatif n'a été observé pour le cancer de l'endomètre à 6 mois (DV 2,00, IC 95 % : −1,49 à 5,49, p = 0,26) ni pour les cancers mixtes à 3 mois (DV 6,43, IC 95 % : −0,16 à 13,01, p = 0,06).
Ces résultats ne démontrent pas de bénéfice global significatif sur la qualité de vie à 6 mois, bien qu'une amélioration significative ait été observée dans le sous-groupe atteint de cancer de l'ovaire. L'analyse primaire à 6 mois a révélé une hétérogénéité importante (I2 = 71 %), et la certitude des preuves selon la méthode GRADE pour tous les résultats regroupés a été évaluée comme très faible. Par conséquent, ces résultats doivent être considérés comme générant des hypothèses plutôt que comme devant modifier la pratique clinique.
Il est crucial de noter que les différences apparentes de significativité entre les types de cancer et les points temporels n'ont pas été testées formellement pour interaction et ne doivent pas être interprétées comme une preuve d'une efficacité différentielle. Les profils observés peuvent refléter des différences entre les populations étudiées, les composantes des interventions, les tailles d'échantillon ou des fluctuations aléatoires, plutôt que des différences biologiques ou temporelles réelles. Toute conclusion concernant un effet lié au moment ou spécifique à un type de tumeur reste spéculative et devra être confirmée par de futurs essais comparatifs directs.
Comparaison avec les études précédentes
Les présents résultats concordent partiellement avec la revue systématique antérieure de Smits et al.10, qui avait évalué des interventions sur le mode de vie chez des femmes atteintes de cancer de l'endomètre ou de l'ovaire et avait trouvé des preuves limitées d'améliorations significatives de la qualité de vie (QoL). Toutefois, l'inclusion plus large d'interventions infirmières et d'études supplémentaires publiées depuis 2015 offre une image plus récente, bien que toujours incertaine. Le niveau de certitude très faible selon la méthode GRADE dans cette revue est nettement plus prudent que les conclusions de certaines études primaires, reflétant une évaluation méthodologique plus rigoureuse appliquée dans la présente revue et une reconnaissance explicite des limites inhérentes à la base de données probantes11.
Le bénéfice observé dans le sous-groupe atteint de cancer de l'ovaire est conforme aux recherches antérieures de Zhou et al.25 et de Maurer et al.29, qui ont signalé que des interventions structurées par l'exercice amélioraient le fonctionnement physique et le bien-être général chez les survivantes du cancer de l'ovaire. Ceci pourrait s'expliquer par le déconditionnement physique important, la neuropathie induite par la chimiothérapie et les complications abdominales qui affectent la mobilité dans cette population, rendant ainsi les interventions par l'exercice particulièrement bénéfiques. Toutefois, le faible nombre d'études (n = 2) ne permet pas de tirer des conclusions solides.
En revanche, l'absence de résultat pour le cancer de l'endomètre à 6 mois contredit certains rapports positifs antérieurs provenant d'essais individuels (par exemple, Von Gruenigen et al.21 ; Rossi et al.24). La combinaison de ces études, incluant des cohortes chevauchantes de l'essai SUCCEED, n'a révélé aucun effet significatif, suggérant que les résultats positifs antérieurs auraient pu être surestimés en raison de faibles tailles d'échantillon ou d'un biais de publication. L'absence d'effet significatif pourrait également refléter la nature hétérogène des survivantes du cancer de l'endomètre, qui présentent souvent une obésité et un syndrome métabolique, nécessitant des interventions plus intensives ou adaptées afin d'obtenir des améliorations mesurables de la qualité de vie (QoL).
Les résultats actuels confirment également ceux de Mokhtari-Hessari et Montazeri35, qui ont signalé des améliorations substantielles de la qualité de vie (QoL) grâce à des interventions infirmières chez des patientes atteintes d'un cancer du sein. De même, Aktas et Terzioglu36 ont constaté qu’un accompagnement infirmier à domicile améliorait nettement la qualité de vie chez des femmes sous traitement pour une oncologie gynécologique, et Ma et al.37 ont démontré qu’un accompagnement infirmier psychologique intensif atténuait les humeurs négatives et améliorait la qualité de vie chez des patientes atteintes d’un cancer du col de l’utérus. Ces résultats concordants, observés dans différents types de cancer et contextes, soulignent la valeur potentielle d’un accompagnement infirmier complet, bien que la qualité méthodologique des preuves disponibles reste préoccupante.
Mécanismes plausibles
Bien que les estimations regroupées ne puissent établir de lien de causalité, plusieurs voies peuvent expliquer les signaux observés concernant la qualité de vie. L'exercice structuré et la modification du régime alimentaire réduisent les facteurs pro‑cytokines inflammatoires (p. ex., IL‑6, TNF‑α) et C‑protéine réactive, associée au cancer‑fatigue, douleur et dépression associées. Chez les survivantes du cancer de l'endomètre et du cancer du sein, la perte de poids et l'exercice physique réduisent également les taux d'œstrogènes et d'IGF‑1 niveaux, pouvant influencer le métabolisme tumoral et l'équilibre énergétique systémique. Sur le plan psychosocial, infirmière‑éducation psychologique dirigée, counseling et suivi régulier‑peut améliorer le soi‑efficacité, réduire la peur de la récidive et améliorer l'adhésion au traitement. La plus grande cohérence 6‑mois (contre 3‑des effets à long terme (bien que non testés formellement) pourraient refléter le temps nécessaire pour que les changements comportementaux deviennent habituels et pour que les adaptations biologiques s'accumulent. Toutefois, aucun de ces mécanismes n'a été directement mesuré dans les études incluses ; cette discussion est spéculative et vise à orienter les futures recherches mécanistiques.
Limites méthodologiques
Absence d'enregistrement prospectif du protocole : Une limitation majeure est le manque d'enregistrement dans un registre prospectif (par exemple, PROSPERO, INPLASY ou OSF Registries). En l'absence d'un protocole prédéfini et publiquement accessible, un biais de déclaration ou de sélection des résultats est possible, car les décisions concernant la sélection des études, l'extraction des données et les analyses ne peuvent être vérifiées indépendamment par rapport à un plan préétabli. Les lecteurs doivent interpréter les estimations regroupées en tenant compte de ce point.
Hétérogénéité élevée : L'analyse primaire à 6 mois a présenté un I2 = 71 %, ce qui, selon les recommandations de Cochrane, est considéré comme "considérable" et souvent un critère justifiant de ne pas regrouper les données. Bien que le regroupement par type de cancer ait réduit I2 à 0 % pour les deux sous-groupes, ovarien et endométrial, chaque sous-groupe ne comprenant qu'un petit nombre d'études (2 et 4, respectivement), ce qui rend ces estimations imprécises. L'hétérogénéité ne peut être attribuée avec certitude uniquement au type de cancer. D'autres sources plausibles—différences en intensité de l'intervention, durée, mode de mise en œuvre, conditions de contrôle, caractéristiques initiales des participants et mesure des résultats—n'ont pas été formellement étudiés en raison d'un manque de données sur les covariables. Compte tenu de ces considérations, la différence moyenne regroupée (MD) pour l'analyse principale doit être considérée comme un résumé généré mathématiquement plutôt qu'une estimation cliniquement significative.
Risque de biais : Aucun ECR n'a été évalué comme présentant un risque faible dans tous les domaines de l'outil Cochrane RoB 2.0. La majorité ont été évalués comme présentant un risque "certaines préoccupations" ou "risque élevé," principalement en raison de l'absence d'aveuglage des participants (inévitable pour les interventions sur le mode de vie) et de données incomplètes sur les résultats. L'inclusion de cohortes chevauchantes issues de l'essai SUCCEED surestime artificiellement l'importance de cette intervention spécifique dans le sous-groupe endométrial ; une analyse de sensibilité excluant les données en double n'a pas modifié de façon significative l'estimation ponctuelle, mais cela reste une limitation structurelle.
Inclusion d'études observationnelles : deux des 15 rapports inclus ne comportaient tout à fait aucun groupe témoin (Budisan et al.33 ; Betea et al.34). Bien que ces études aient été conservées pour une synthèse narrative afin d'éviter un biais de sélection, elles n'ont pas pu être incluses dans les effets d'intervention regroupés et ont été jugées présenter un risque élevé de confusion et de biais de sélection.
Diversité des interventions et des résultats : Les études comparatives englobaient un large éventail d'interventions—des programmes d'exercices structurés, des modifications alimentaires, des consultations sur la perte de poids, des séances psychoéducatives, un suivi dirigé par une infirmière, des soins initiés par le patient et une pleine conscience basée sur une application. Le regroupement de telles interventions diverses sous le terme générique "intervention de style de vie/infirmière" fournit une estimation de l'effet moyen, mais cette moyenne pourrait ne pas s'appliquer à un type d'intervention spécifique. De même, bien que toutes les études aient mesuré la qualité de vie liée à la santé, elles ont utilisé différents instruments (FACT-G, FACT-O, FACT-En, EORTC QLQ-C30, SF-36), ce qui pourrait introduire une hétérogénéité indirecte.
Le biais de publication n'a pas pu être évalué de manière fiable, car aucun des résultats regroupés n'incluait 10 études ou plus. Les graphiques en entonnoir et les tests de régression d'Egger n'ont donc pas été réalisés. La taille réduite des échantillons et la prédominance d'études positives dans la littérature laissent supposer que des résultats négatifs ou non significatifs restent non publiés.
Suivi court et absence d'analyses par sous-groupes : La plupart des études comprenaient des périodes de suivi brèves (3–6 mois), ce qui limite la compréhension de la durabilité à long terme des améliorations de la qualité de vie. L'absence d'analyses détaillées par sous-groupes (par exemple, selon l'âge, le stade de la maladie ou le statut socio-économique) a entravé l'identification des catégories de patients qui pourraient tirer le plus grand bénéfice.
Qualité des données probantes selon GRADE
L'évaluation formelle selon la méthode GRADE a classé la certitude globale des preuves pour les quatre résultats regroupés comme TRÈS FAIBLE. Ce jugement reflète : (i) un risque de biais sérieux à très sérieux dans l'ensemble des ECR inclus ; (ii) une incohérence très sérieuse pour le résultat principal à 6 mois (I2 = 71 %) ; (iii) une imprécision liée au sous-groupe endométrial, qui comprenait principalement des survivantes en surpoids ou obèses, limitant ainsi la généralisabilité ; et (iv) une imprécision sérieuse à très sérieuse due à des tailles d'échantillon totales faibles par sous-groupe et à des intervalles de confiance larges qui franchissent souvent la valeur nulle. Par conséquent, la confiance dans les estimations des effets est très limitée ; les effets réels sont susceptibles d'être sensiblement différents des estimations ponctuelles rapportées.
Implications cliniques
Étant donné la certitude très faible des données et l'hétérogénéité importante, ces résultats sont hypothétiques‑génération plutôt que pratique‑change. Les cliniciens ne devraient pas modifier les soins de support habituels en fonction de ces estimations regroupées. Toutefois, quelques observations prudentes peuvent éclairer les discussions avec les patients : (i) les décisions relatives aux soins de support doivent être individualisées selon les préférences du patient et le contexte clinique ; (ii) le sous-groupe de cancer de l'ovaire a montré le seul signal statistiquement cohérent (DM 4,28, IC 95 % : 0,45–8,10), ce qui suggère que cette population pourrait particulièrement bénéficier d'interventions par l'exercice, bien que ces conclusions reposent uniquement sur deux petites études. La constance des résultats positifs observés dans les différentes études souligne l'importance de soins infirmiers complets, incluant la gestion de la douleur, le soutien émotionnel, l'éducation du patient et la coordination des soins, en tant que composante fondamentale des soins oncologiques multidisciplinaires. Il est essentiel de noter que les différences apparentes entre les types de cancer et les moments d'évaluation n'ont pas été formellement testées en termes d'interaction et ne doivent pas être surestimées.
Recherches futures
Cette revue met en évidence des lacunes critiques en matière de données probantes que les recherches futures devront combler. Élevé‑des ECR de haute qualité, multicentriques, sont urgentement nécessaires, avec des interventions standardisées et formalisées par un manuel, protocoles publiés, intention‑à‑analyses de traitement, suivi plus long‑vers le haut≥12 mois), et des analyses préspécifiées de sous-groupes avec des tests formels d'interaction. Les études mécanistiques devraient intégrer des évaluations de biomarqueurs (cytokines inflammatoires, profils hormonaux) et des médiateurs psychosociaux validés (soi‑efficacité, soutien social) afin d'identifier les composantes des interventions les plus efficaces et les sous-groupes de patients qui en bénéficient le plus. Des évaluations économiques sont également nécessaires pour analyser les coûts‑efficacité et orienter la répartition des ressources. De futures revues systématiques s'appuyant sur une base de données plus étendue devraient examiner si une méta-analyse‑l'analyse demeure-t-elle appropriée pour de telles interventions diverses, ou une synthèse narrative serait-elle plus informative ? Enfin, le patient‑résultats centrés sur le patient—y compris le domaine‑mesures spécifiques de la QV et patient‑mesures de l'expérience déclarée—doit être priorisée, avec la participation des patientes et du public dans la conception des études afin de garantir que la recherche traite des questions les plus importantes pour les femmes atteintes de tumeurs gynécologiques.
Cette méta-analyse n'a révélé aucune amélioration statistiquement significative de la qualité de vie globale à 3 ou 6 mois chez les femmes atteintes de cancers gynécologiques. Une amélioration significative a été observée dans le sous-groupe de cancer de l'ovaire à 6 mois, tandis qu'aucun effet significatif n'a été observé dans le sous-groupe de cancer de l'endomètre. Toutefois, une hétérogénéité importante, des limites méthodologiques, des tailles réduites des sous-groupes et des preuves de très faible certitude justifient une interprétation prudente. Des essais plus larges et mieux conçus, avec des interventions standardisées et un suivi plus long, sont nécessaires pour clarifier les effets des interventions liées au mode de vie et aux soins infirmiers sur la qualité de vie des femmes atteintes de tumeurs malignes gynécologiques.
Déclarations de divulgation
Les auteurs n'ont aucun conflit d'intérêts à divulguer.
Matériaux
| Nom | Entreprise | Numéro de catalogue | Commentaires |
|---|---|---|---|
| EndNote | Clarivate Analytics | https://endnote.com | Gestion des références, suppression des doublons, mise en forme des citations |
| GRADEpro GDT | Université McMaster et Evidence Prime | Université McMaster / Evidence Prime ; https://gradepro.org | Évaluation de la certitude selon la méthode GRADE (version en ligne) |
| Liste de contrôle PRISMA 2020 | Énoncé PRISMA | Énoncé PRISMA ; https://www.prisma-statement.org | Conformité au rapport |
| R | Fondation R pour l'informatique statistique | Fondation R ; https://cran.r-project.org | Analyse statistique, analyses de sensibilité, analyses d'influence, figures (version 4.3.1 ou supérieure) |
| Package R : meta | CRAN | CRAN ; https://cran.r-project.org/package=meta | Fonctions de méta-analyse (regroupement, hétérogénéité, forêts de méta-analyse, graphiques en entonnoir), version 6.0.0 ou supérieure |
| Package R : metafor | CRAN | CRAN ; https://cran.r-project.org/package=metafor | Estimation par maximum de vraisemblance restreinte (REML), diagnostics d'influence, fonctions supplémentaires de méta-analyse (version 4.0.0 ou supérieure) |
| Review Manager | RevMan | Cochrane Collaboration ; https://training.cochrane.org/online-learning/core-software-cochrane-reviews/revman[reference:14] | Méta-analyse (regroupement, forêts de méta-analyse, hétérogénéité, évaluation du risque de biais), version 5.4 |
Références
- Ackroyd SA, Shih YCT, Kim B, Lee NK, Halpern MT. A look at the gynecologic oncologist workforce – are we meeting patient demand Gynecol Oncol. 2021;163(2):229-36.
- Williams N, et al. The supportive care needs of women experiencing gynaecological cancer: a Western Australian cross-sectional study. BMC Cancer. 2018;18(1):912.
- Bizzarri N, et al. Building a personalized medicine infrastructure for gynecological oncology patients in a high-volume hospital. J Pers Med. 2022;12(1):3.
- Buckley L, Robertson S, Wilson T, Sharpless J, Bolton S. The role of the specialist nurse in gynaecological cancer. Curr Oncol Rep. 2018;20(10):83.
- Parkinson N, Pratt H. Clinical nurse specialists and the psychosexual needs of patients with gynaecological cancer. Br Menopause Soc J. 2005;11(1):33-5.
- Kobleder A, Mayer H, Gehrig L, Senn B. “Promoting continuity of care”—specialist nurses’ role experiences in gynaecological oncology: a qualitative study. J Clin Nurs. 2017;26(23-24):4890-8.
- Cook O, McIntyre M, Recoche K, Lee S. “Our nurse is the glue for our team”—multidisciplinary team members' experiences and perceptions of the gynaecological oncology specialist nurse role. Eur J Oncol Nurs. 2019;41:7-15.
- Lavdaniti M, et al. Factors influencing quality of life in breast cancer patients six months after the completion of chemotherapy. Diseases. 2019;7(1):26.
- Perry S, Kowalski TL, Chang CH. Quality of life assessment in women with breast cancer: benefits, acceptability and utilization. Health Qual Life Outcomes. 2007;5(1):24.
- Chhikara BS, Parang K. Global cancer statistics 2022: the trends projection analysis. Chem Biol Lett. 2023;10(1):451.
- Smits A, et al. The effect of lifestyle interventions on the quality of life of gynaecological cancer survivors: a systematic review and meta-analysis. Gynecol Oncol. 2015;139(3):546-52.
- Stroup DF, et al. Meta-analysis of observational studies in epidemiology: a proposal for reporting. JAMA. 2000;283(15):2008-12.
- Page MJ, et al. The PRISMA 2020 statement: an updated guideline for reporting systematic reviews. BMJ. 2021;372:n71.
- Liberati A, et al. The PRISMA statement for reporting systematic reviews and meta-analyses of studies that evaluate health care interventions: explanation and elaboration. J Clin Epidemiol. 2009;62(10):e1-34.
- Gupta S, et al. Efficacy of generic oral directly acting agents in patients with hepatitis C virus infection. J Viral Hepat. 2018;25(7):771-8.
- Adeiza SS, Aminul I. Meta-meta-analysis of the mortality risk associated with MRSA compared to MSSA bacteraemia. Infez Med. 2024;32(2):131-7.
- Higgins J, et al., editors. Cochrane handbook for systematic reviews of interventions. 2nd ed. Wiley & Sons; Chichester, UK; 2019.
- Sheikhbahaei S, et al. FDG-PET/CT and MRI for evaluation of pathologic response to neoadjuvant chemotherapy in patients with breast cancer: a meta-analysis of diagnostic accuracy studies. Oncologist. 2016;21(8):931-9.
- Higgins JP, Thompson SG, Deeks JJ, Altman DG. Measuring inconsistency in meta-analyses. BMJ. 2003;327(7414):557-60.
- McCorkle R, et al. Effects of a nursing intervention on quality of life outcomes in post-surgical women with gynecological cancers. Psychooncology. 2009;18(1):62-70.
- Von Gruenigen VE, et al. A randomized trial of a lifestyle intervention in obese endometrial cancer survivors: quality of life outcomes and mediators of behavior change. Health Qual Life Outcomes. 2009;7(1):17.
- Donnelly CM, et al. A randomised controlled trial testing the feasibility and efficacy of a physical activity behavioural change intervention in managing fatigue with gynaecological cancer survivors. Gynecol Oncol. 2011;122(3):618-24.
- McCarroll ML, et al. Self-efficacy, quality of life, and weight loss in overweight/obese endometrial cancer survivors (SUCCEED): a randomized controlled trial. Gynecol Oncol. 2014;132(2):397-402.
- Rossi A, et al. Feasibility of a physical activity intervention for obese, socioculturally diverse endometrial cancer survivors. Gynecol Oncol. 2016;142(2):304-10.
- Zhou Y, et al. Randomized trial of exercise on quality of life in women with ovarian cancer: Women’s Activity and Lifestyle Study in Connecticut (WALC). J Natl Cancer Inst. 2017;109(12).
- Jeppesen M, Jensen P, Hansen D, Christensen R, Mogensen O. Patient-initiated follow up affects fear of recurrence and healthcare use: a randomised trial in early-stage endometrial cancer. BJOG. 2018;125(13):1705-14.
- Morrison V, et al. Trial of optimal personalised care after treatment—gynaecological cancer (TOPCAT-G): a randomized feasibility trial. Int J Gynecol Cancer. 2018;28(2):401-11.
- Ngu SF, et al. Nurse-led follow-up in survivorship care of gynaecological malignancies—a randomised controlled trial. Eur J Cancer Care (Engl). 2020;29(6):e13325.
- Maurer T, et al. Randomised controlled trial testing the feasibility of an exercise and nutrition intervention for patients with ovarian cancer during and after first-line chemotherapy (BENITA-study). BMJ Open. 2022;12(2):e054091.
- McCloy K, et al. Management of fatigue in gynaecological cancer: a feasibility study of an app-based exercise and mindfulness intervention. Gynecol Oncol Rep. 2025;60:101807.
- Darwish EAF, Tayel SEA, Meleis MEH, Abou Elwafa HE, Shaaban Marouf FSA. A randomized controlled trial of the effect of a psychoeducational intervention program on quality of life of patients with gynecological cancers. Alex J Med. 2025;61(1):6-14.
- Elzeblawy Hassan H, Khalaf Gooda W, Ragabahmed T, Shehta Said Farag D. Marital, sexual satisfaction and quality of life among post-hysterectomy women: impact of nursing counseling guided by BETTER model. Egypt J Health Care. 2025;16(1):99-116.
- Budisan C, et al. Physical, emotional, and stress-related dynamics over six months in newly diagnosed epithelial ovarian cancer survivors. J Clin Med. 2025;14(14):5087.
- Betea R, et al. Quality-of-life trajectories and perceived stress in women treated for uterine cancer: a six-month prospective study. Healthcare (Basel). 2025;13(15):1787.
- Mokhtari-Hessari P, Montazeri A. Health-related quality of life in breast cancer patients: review of reviews from 2008 to 2018. Health Qual Life Outcomes. 2020;18(1):338.
- Aktas D, Terzioglu F. Effect of home care service on the quality of life in patients with gynecological cancer. Asian Pac J Cancer Prev. 2015;16(9):4089-94.
- Ma Y, Kamalibaike M, Xin C, Li L. Effect of the intensive psychological nursing on adverse mood and quality of life in patients with cervical cancer. Am J Transl Res. 2021;13(8):9633-8.