Ce protocole décrit le développement et l’évaluation d’un chatbot de génération augmentée par la recherche basé sur des lignes directrices, qui récupère et résume le contenu des lignes directrices cliniques de pratique du cancer en ligne afin de générer des réponses fondées sur des références aux questions des utilisateurs.
Un abonnement JoVE est requis pour visualiser ce contenu. Connectez-vous ou commencez votre période d'essai gratuite.
Article de méthode
Développement d’un chatbot de génération améliorée basée sur des lignes directrices, référant des directives de pratique clinique du cancer en ligne
Dans cet article
Résumé
Résumé
La large disponibilité des informations médicales sur Internet a amélioré l’accès aux connaissances liées à la santé pour les patients ; Cependant, cela a également augmenté l’exposition à des informations médicales inexactes. Les soins contre le cancer impliquent des informations complexes, ce qui rend difficile pour les patients d’identifier des sources précises et fondées sur des preuves. Les grands modèles de langage permettent l’interaction avec le langage naturel mais génèrent fréquemment des hallucinations, limitant leur application dans la transmission d’informations médicales. La génération augmentée par récupération (RAG) a le potentiel d’atténuer ces risques en ancrant les réponses dans des sources de référence externes. Cette étude décrit le développement et l’évaluation d’un chatbot RAG basé sur des lignes directrices qui utilise des directives cliniques du cancer accessibles publiquement et en ligne. Le système extrait les URL des pages de table des matières d’une ligne directrice, traite le texte des pages à l’aide d’analyses morphologiques et de similarité cosinus basées sur la fréquence des termes – fréquence inverse des documents, et construit des informations de référence à partir de pages très pertinentes. Un grand modèle de langage utilise ces références pour générer des réponses limitées au contenu des lignes directrices. Le Guide JLCS pour les patients et familles atteintes de cancer du poumon a été utilisé comme référence directrice. Les questions comprenaient à la fois des types de cancer inclus dans le champ couvert par la ligne directrice et des types de cancer hors champ pour évaluer le contrôle de la réponse. Les informations médicales ont été extraites avec succès des pages de table des matières, 98 % des URL extraites contenant du contenu médical référentable. Pour les questions dans le champ de l’application, le chatbot a généré des réponses en résumant le contenu des directives, et aucune hallucination n’a été identifiée lors de la revue manuelle dans les conditions de test définies. Pour les questions hors champ de vision, le chatbot a constamment refusé de répondre et a indiqué que les informations disponibles étaient insuffisantes. La structure web de la directive a facilité un extraction efficace et l’organisation du contenu de référence au niveau de l’URL. Ce protocole fournit des conseils pratiques pour la construction de systèmes d’intelligence artificielle qui fournissent des informations médicales en utilisant des lignes directrices de pratique clinique basées sur le web.
Introduction
L’utilisation généralisée d’Internet et des réseaux sociaux a facilité l’accès aux informations médicalesdes patients 1,2. Les informations sur les soins du cancer sont souvent complexes et étendues, ce qui rend particulièrement difficile pour les patients d’identifier des sources précises, pertinentes et fondées sur des preuvesscientifiques 3. Bien que les ressources en ligne puissent aider à comprendre les patients, elles contiennent également une quantité importante d’informations médicalesincorrectes 3, ce qui peut affecter négativement les décisions des patients concernant leurs soins4. Parce que la désinformation liée au cancer peut affecter les résultats des patients5, le besoin de systèmes d’intelligence artificielle (IA) peuvent aider les utilisateurs individuels à rechercher, résumer et interpréter les informationsmédicales 6 augmente.
Les grands modèles de langage (LLM) permettent aux utilisateurs d’accéder à l’information via une conversation en langagenaturel 7 ; Cependant, la génération de désinformation (c’est-à-dire des hallucinations) reste une préoccupation sérieuse dans le domainemédical 8,9,10,11. Une source clé de désinformation est la qualité et la précision des données d’entraînement utilisées pour développer le chatbot. De plus, la nature statique de l’entraînement des modèles signifie que les connaissances peuvent devenir obsolètes avec le temps, limitant la capacité des LLM à fournir des informations actuelles et contextuelles12,13. Ces limites soulignent l’importance de stratégies efficaces de gestion des connaissances afin de garantir que les réponses des chatbots restent précises, pertinentes et à jour. En particulier, les systèmes capables d’accéder facilement à des ressources actuelles fondées sur des preuves, telles que les lignes directrices de pratique clinique, sont souhaitables dans les milieux médicaux, où les recommandations et les normes de soins évoluent continuellement. Pour relever ce défi, la génération augmentée par la récupération (RAG), qui génère des réponses en incorporant des informations provenant de sources de connaissances externes, a suscité une attentioncroissante 10, 13, 14, 15, 16, 17.
Bien que le RAG ait été de plus en plus appliqué aux chatbots médicaux, une attention limitée a été portée à la manière dont les lignes directrices de pratique clinique devraient être systématiquement intégrées comme sources d’informationde référence 18. De nombreux guides de pratique clinique sont accessibles publiquement sur le web ; cependant, il reste incertain si leur structure web existante peut servir directement de cadre de récupération pour les systèmesRAG 18. De plus, les méthodes pratiques pour construire des informations de référence sans développement manuel de bases de connaissances n’ont pas été bien établies.
Dans cette étude, nous avons visé à établir des principes de conception pour les systèmes d’IA référentiels dans le domaine médical en développant et en évaluant un chatbot RAG basé sur des lignes directrices utilisant des lignes directrices cliniques du cancer accessibles publiquement et en ligne, permettant ainsi un accès simple et rapide aux informations basées sur des lignes directrices. À titre de preuve de concept, nous avons évalué la faisabilité technique de la récupération des directives, de la génération de réponses et de la restriction de la réponse en utilisant la structure web existante des lignes directrices cliniques publiques, dans le but de proposer un protocole de développement reproductible pour les systèmes RAG référencés aux lignes directrices.
Accès restreint. Veuillez vous connecter ou commencer un essai pour afficher ce contenu.
Protocole
Cette étude ne concerne pas des sujets humains nécessitant une protection contre les risques liés à la recherche. Par conséquent, elle ne nécessite pas d’examen par un comité d’éthique institutionnel selon les directives éthiques japonaises pour la recherche médicale impliquant des sujetshumains 19. Cette étude est rapportée conformément aux directives TRIPOD-LLM (Transparent Reporting of a Multivariable Model for Individual Prognosis and Diagnosis) (TRIPOD) 20.
Voir la Figure 1 pour un aperçu schématique du protocole de chatbot RAG basé sur des lignes directrices.
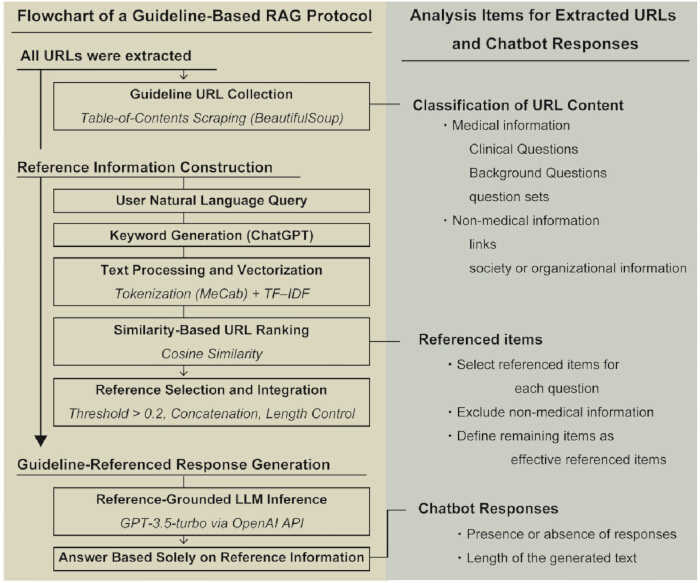
Figure 1. Workflow du protocole de chatbot Guideline Based Retrieval-Augmented Generation (RAG). Aperçu schématique du flux de travail du chatbot RAG basé sur des directives. Les URL sont extraites de la table des matières d’un guide de pratique clinique en ligne et utilisées pour construire des informations de référence. Les requêtes des utilisateurs sont converties en mots-clés, et le contenu de la page web est traité par tokenisation, vectorisation fréquence des termes–fréquence inverse des documents, et analyse de similarité cosinus pour identifier les pages directives pertinentes. Des informations de référence sélectionnées sont intégrées et fournies à un grand modèle de langage afin de générer des réponses basées uniquement sur le contenu des lignes directrices référencées. Le panneau de droite résume les éléments d’évaluation utilisés pour les URL extraites, les informations de référence et les réponses des chatbots. Veuillez cliquer ici pour voir une version agrandie de cette figurine.
1. Préparation des informations de référence issues des lignes directrices basées sur le web
- Extraire toutes les URL des pages de table des matières des directives de pratique clinique ciblées en ligne à l’aide de BeautifulSoup 4 (bibliothèque d’analyse HTML) implémentée dans le langage Python (version 3.12).
REMARQUE : Implémentez le script d’extraction d’URL en utilisant le langage de programmation avec les paquets suivants : bibliothèque d’analyse HTML (version 4.12.3) et requêtes (bibliothèque de récupération de pages web ; version 2.32.3). Installez des paquets en utilisant pip. Le code source complet pour l’extraction des URL est fourni dans le Fichier Supplémentaire 1. Voir le tableau des matériaux pour les détails du logiciel. - Examinez manuellement toutes les URL extraites pour confirmer leur accès réussi et leur pertinence par rapport à la directive clinique ciblée.
- Classez chaque URL comme contenant des informations médicales ou non médicales. Effectuer la classification des URL par un seul auteur (S.N.).
REMARQUE : Les informations médicales étaient définies comme un contenu référentiel des lignes directrices, incluant les questions cliniques (CQ), les questions de contexte et les ensembles de questions. Les informations non médicales comprenaient des liens, des pages de sociétés ou d’organisations, et d’autres contenus accessoires inadaptés à la référence. - Compilez les URL validées dans un classeur Microsoft Excel (format .xlsx), avec une URL enregistrée par ligne. Stockez la liste d’URL résultante comme jeu de données d’entrée pour la récupération de texte ultérieure, le prétraitement et les analyses de similarité.
2. Génération de mots-clés à partir des requêtes des utilisateurs
- Saisissez la requête en langage naturel dans ChatGPT (Transformer Génératif pré-entraîné, version 4o ; modèle de génération de mots-clés).
- Demandez au modèle d’extraire deux mots-clés correspondant à la requête utilisateur.
- Utilisez la consigne suivante, écrite en japonais, pour générer des mots-clés :
«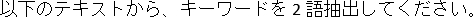 »
(Traduction anglaise : « Extraire deux mots-clés du texte suivant. ») - Ajoutez la requête en langage naturel de l’utilisateur à cette instruction et soumettez-la au modèle de génération de mots-clés pour la génération de mots-clés.
- Ne modifiez manuellement aucun paramètre du modèle. Effectuez la génération de mots-clés en utilisant les paramètres par défaut du modèle de génération de mots-clés.
- Générez deux mots-clés pour chaque requête utilisateur. Conservez les deux mots-clés sans modification supplémentaire, filtrage ou sélection manuelle, et utilisez-les pour les calculs de similarité ultérieurs.
- Stockez les mots-clés générés dans un classeur Microsoft Excel (format .xlsx). Pour chaque enregistrement, stockez la requête utilisateur originale et ses mots-clés générés correspondants pour une récupération ultérieure basée sur la similarité.
3. Traitement du texte et calcul de similarité
- Récupérez le texte intégral de chaque URL extraite en utilisant la bibliothèque de récupération de pages web et la bibliothèque d’analyse HTML. Extraire le contenu textuel du code source HTML en utilisant la fonction BeautifulSoup get_text().
- Pré-traiter le texte extrait de la page web et les mots-clés générés en supprimant les balises HTML et les caractères non japonais.
- Effectuer une analyse morphologique japonaise à l’aide de MeCab (version 0.996 ; analyseur morphologique japonais) avec le dictionnaire par défaut. Conservez uniquement les noms et concatènatez-les en une chaîne de texte délimitée par l’espace.
- Combinez les mots-clés générés en une seule chaîne de texte et appliquez les mêmes procédures de prétraitement et de tokenisation que celles utilisées pour le texte des pages web.
- Générez des vecteurs fréquence–fréquence inverse des documents (TF–IDF) à partir du texte de la page web traitée et du texte mot-clé à l’aide de l’implémentation TfidfVectorizer dans la bibliothèque scikit-learn (version 1.6.1) avec les paramètres par défaut.
REMARQUE : Tous les paramètres du TfidfVectorizer sont restés à leurs valeurs par défaut, et aucun paramètre personnalisé n’a été appliqué. - Calculez la similarité cosinus entre chaque vecteur de page web et le vecteur mot-clé à l’aide de la fonction de similarité cosinus.
- Classez les URL par ordre décroissant selon les scores de similarité cosinus. N’appliquez pas de critères de départage supplémentaires.
- Sélectionnez des pages avec un score de similarité cosinus de ≥0,2 comme références candidates.
REMARQUE : Le seuil de similarité cosinus (0,2) a été sélectionné empiriquement lors du développement du système afin de prioriser le rappel de récupération et d’éviter d’exclure des contenus potentiellement pertinents de lignes directrices. - Conservez toutes les pages candidates atteignant le seuil de similarité.
4. Construction des informations de référence
- Extraire séquentiellement le contenu textuel des pages sélectionnées depuis le haut de la liste classée.
- Concaténater les textes extraits pour former un document de référence unique.
- Avant de soumettre au LLM, remplacez les caractères de nouvelle ligne et les caractères d’espaces blancs consécutifs dans le texte de référence par un seul espace.
- Tronquez le texte de référence concaténé aux 4 096 premiers caractères avant de le fournir au LLM.
REMARQUE : La limite de troncature était basée sur les caractères plutôt que sur les jetons. Une limite de 4 096 caractères a été choisie empiriquement afin de garantir que les informations combinées de prompt et de référence restent dans la capacité d’entrée du modèle de génération de réponse GPT-3,5-turbo-16k.
5. Génération de réponses basée sur l’IA
- Fournir les informations de référence construites et la requête utilisateur originale au modèle de génération de réponses via l’interface de programmation d’applications (API).
- Instruisez l’IA à l’aide de l’invite suivante (entièrement écrite en japonais) afin de garantir que les réponses sont générées uniquement à partir des informations de référence fournies :
« Vous êtes un assistant à l’information médicale qui guide les patients atteints de cancer. Générez des réponses uniquement sur la base des informations de référence suivantes, et n’utilisez pas vos propres connaissances générales ou raisonnements. Les réponses doivent être détaillées et faciles à comprendre, d’environ 500 caractères de long. Si les informations de référence ne contiennent pas suffisamment pour répondre à la question, répondez : 'Il n’y a pas assez d’informations dans le texte', sans utiliser de spéculations ni de connaissances générales. » - Fournissez les informations de référence et la requête utilisateur ensemble dans un seul message utilisateur. Structurez l’entrée comme suit : « Informations de référence : [texte de référence] » suivi de « Question : [requête utilisateur] ».
- Générez des réponses en utilisant le modèle de génération de réponses avec les réglages suivants : température = 0,1, longueur maximale de sortie = 1 024 jetons, n = 1, et stop = Aucun.
- Obtenez la réponse générée par l’IA pour une évaluation ultérieure.
REMARQUE : Soumettez les informations de référence et la requête utilisateur sous forme d’un seul message utilisateur. Fournir séparément les instructions de génération de réponse sous forme de message système.
6. Ligne directrice de référence et formulation des questions
- Sélectionnez le Guide JLCS pour les patients et familles atteintes de cancer du poumon (Guide du poumon)21, qui est disponible gratuitement en ligne, comme information de référence pour le système de chatbot RAG basé sur des lignes directrices.
- Créez deux catégories de questions d’évaluation basées sur le type de cancer : les tumeurs thymiques, qui relèvent du champ d’application des directives, et le gliome pédiatrique, qui est en dehors du champ d’application des informations référencées.
- Formulez quatre questions couvrant le diagnostic et le traitement pour chaque type de cancer :
« Quelles méthodes diagnostiques sont disponibles pour les tumeurs XX (par exemple, le gliome thymique ou pédiatrique) ? »
« Quelles sont les approches diagnostiques pathologiques pour les tumeurs XX ? »
« Quelles options de traitement sont disponibles pour les tumeurs XX ? »
« Quelles sont les options de traitement chirurgical pour les tumeurs XX ? » - Soumettez des questions concernant les types de cancer couverts par la directive web référencée au chatbot. Par exemple, soumettez une question concernant le diagnostic de tumeur thymique en utilisant le Guide pulmonaire comme référence d’information.
- Soumettez des questions en dehors du cadre des directives de référence au chatbot afin d’évaluer sa capacité à s’abstenir d’utiliser des informations externes ou non liées. Par exemple, posez une question concernant le gliome pédiatrique en utilisant le Guide pulmonaire comme référence d’information.
- Évaluez chaque question lors d’une session de discussion indépendante. Ne reportez pas l’historique des conversations entre les questions.
- Enregistrez les réponses générées par l’IA pour une évaluation ultérieure.
7. Évaluation de la réponse
- Effectuez une révision manuelle de toutes les réponses générées.
- Évaluez si chaque réponse contient des hallucinations.
- Évaluez si chaque réponse est étayée par les informations contenues dans la ligne directrice de référence.
REMARQUE : Les hallucinations étaient définies comme des réponses contenant des événements, des noms ou des termes inexistants pouvant potentiellement causer des dommagesmédicaux 14. Toutes les réponses générées ont été examinées pour leur exactitude et l’absence d’hallucinations par un auteur ayant 8 ans d’expérience dans un hôpital universitaire, incluant le soutien aux patients et la communication médicale pour les patients atteints de cancer. Toute incertitude concernant la classification des réponses a été résolue par une discussion avec un médecin coauteur ayant plus de 20 ans d’expérience dans les services d’information sur le cancer au National Cancer Center Japan. - Considérez une réponse comme soutenue uniquement lorsque toutes les affirmations cliniquement pertinentes peuvent être directement confirmées à partir de la référence retrouvée, sans nécessiter de connaissances supplémentaires ou d’inférences non étayées.
- Classifiez chaque réponse à l’aide d’étiquettes de résultats prédéfinies. Classifiez les réponses contenant uniquement des informations étayées par la directive de référence comme « hallucination absente ». Classez les réponses contenant des informations non étayées ou fabriquées comme des « hallucinations présentes ».
Accès restreint. Veuillez vous connecter ou commencer un essai pour afficher ce contenu.
Résultats
Récupérabilité du contenu médical via les pages de table des matières
L’architecture de web-scraping collectait les URL de la table des matières de la ligne directrice. Du Guide pulmonaire, 106 URL ont été extraites de la table des matières, dont 104 (98 %) contenaient des informations médicales (Tableau supplémentaire 1). L’efficacité des réponses du chatbot basées sur les pages de contenu des lignes directrices est résumée d...
Accès restreint. Veuillez vous connecter ou commencer un essai pour afficher ce contenu.
Discussion
Dans cette étude, nous avons examiné l’utilité d’un chatbot RAG basé sur des lignes directrices utilisant une directive de pratique clinique en ligne — le Guide JLCS pour les patients et familles atteintes de cancer du poumon — comme source d’information de référence. Le chatbot générait des réponses ancrées dans le contenu des directives en exploitant la structure web de la directive et en récupérant les pages en fonction de leur similarité avec les requêtes des utilisateurs. Cette appr...
Accès restreint. Veuillez vous connecter ou commencer un essai pour afficher ce contenu.
Déclarations de divulgation
Les auteurs ne déclarent aucun intérêt concurrent.
Remerciements
Les auteurs remercient Kenichi Inoue, MD, PhD (Shonan Memorial Hospital Breast Center), pour son soutien technique étendu dans le développement du chatbot de génération augmentée par la récupération basé sur des lignes directrices. Les auteurs remercient également Chikako Yamaki, PhD, ainsi que tous les membres de l’équipe de recherche de l’Institute for Cancer Control, National Cancer Center Japan (Tokyo, Japon), pour leurs conseils précieux sur le sujet abordé dans cet article. De plus, les auteurs remercient Editage pour la révision en anglais. Ce travail a été soutenu par une subvention de recherche en sciences de la santé et du travail (R6–Cancer Control–23EA1026).
Accès restreint. Veuillez vous connecter ou commencer un essai pour afficher ce contenu.
Matériaux
```html
```
| Nom | Entreprise | Numéro de catalogue | Commentaires |
|---|---|---|---|
| Beautiful Soup 4 (version 4.12.3) | Projet Beautiful Soup | N/A | Bibliothèque Python utilisée pour l'extraction d'URL et l'analyse HTML |
| ChatGPT version 4o | OpenAI | N/A | Utilisé pour la génération de mots-clés |
| GPT-3.5-turbo | OpenAI | N/A | Utilisé pour la génération de réponses |
| Guidebook JLCS pour les patients atteints de cancer du poumon et leurs familles | Japan Lung Cancer Society | N/A | Ligne directrice de pratique clinique basée sur le web utilisée comme information de référence |
| MeCab (version 0.996) | Projet MeCab | N/A | Analyseur morphologique japonais |
| OpenAI API | OpenAI | N/A | Utilisé pour la génération de réponses basée sur l'IA |
| Python (version 3.12) | Python Software Foundation | N/A | Environnement de programmation |
| Requests (version 2.32.3) | Projet Requests | N/A | Bibliothèque Python utilisée pour la récupération de pages web |
| scikit-learn (version 1.6.1) | Développeurs scikit-learn | N/A | Utilisé pour la vectorisation TF–IDF et le calcul de similarité cosinus. |
| urllib.parse | Python Software Foundation | N/A | Bibliothèque Python utilisée pour la normalisation et l'assemblage d'URL |
Références
- Helft PR, Hlubocky F, Daugherty CK. American oncologists' views of internet use by cancer patients: a mail survey of American Society of Clinical Oncology members. J Clin Oncol. 2003;21(5):942-947.
- Chen X, Siu LL. Impact of the media and the internet on oncology: survey of cancer patients and oncologists in Canada. J Clin Oncol. 2001;19(23):4291-4297.
- Goto Y, et al. Differences in the quality of information on the internet about lung cancer between the United States and Japan. J Thorac Oncol. 2009;4(7):829-833.
- Ogasawara R, et al. Reliability of cancer treatment information on the internet: observational study. JMIR Cancer. 2018;4(2):e10031.
- Johnson SB, Park HS, Gross CP, Yu JB. Complementary medicine, refusal of conventional cancer therapy, and survival among patients with curable cancers. JAMA Oncol. 2018;4(10):1375-1381.
- Rajpurkar P, Chen E, Banerjee O, Topol EJ. AI in health and medicine. Nat Med. 2022;28(1):31-38.
- The Lancet Digital Health. ChatGPT: friend or foe? Lancet Digit Health. 2023;5(3):e102.
- Huang L, et al. A survey on hallucination in large language models: principles, taxonomy, challenges, and open questions. arXiv. 2023;2311.05232.
- Ji Z, et al. Survey of hallucination in natural language generation. ACM Comput Surv. 2023;55(12):248.
- Yang R, et al. Retrieval-augmented generation for generative artificial intelligence in health care. npj Health Syst. 2025;2(2).
- Zakka C, et al. Almanac—retrieval-augmented language models for clinical medicine. NEJM AI. 2024;1(2):AIoa2300068.
- Chow JCL, Li K. Developing effective frameworks for large language model-based medical chatbots: insights from radiotherapy education with ChatGPT. JMIR Cancer. 2025;11:e66633.
- Chow JCL, Li K. Large language models in medical chatbots: opportunities, challenges, and the need to address AI risks. Information. 2025;16(7):549.
- Nishisako S, Higashi T, Wakao F. Reducing hallucinations and trade-offs in responses in generative AI chatbots for cancer information: development and evaluation study. JMIR Cancer. 2025;11:e70176.
- Lewis P, et al. Retrieval-augmented generation for knowledge-intensive NLP tasks. Adv Neural Inf Process Syst. 2020;33:9459-9474.
- Gao Y, et al. Retrieval-augmented generation for large language models: a survey. arXiv. 2023;2312.10997.
- Jeong M, Sohn J, Sung M, Kang JJB. Improving medical reasoning through retrieval and self-reflection with retrieval-augmented large language models. Bioinformatics. 2024;40:i119-i129.
- Lewis M, et al. Grounding large language models in clinical evidence: a retrieval-augmented generation system for querying UK NICE clinical guidelines. arXiv. 2025;2510.02967.
- Ministry of Education, Culture, Sports, Science and Technology; Ministry of Health, Labour and Welfare; Ministry of Economy, Trade and Industry. Ethical guidelines for medical and biological research involving human subjects [Article in Japanese]. Ministry of Health, Labour and Welfare.
- Gallifant J, et al. The TRIPOD-LLM reporting guideline for studies using large language models. Nat Med. 2025;31:60-69.
- The Japanese Lung Cancer Society. JLCS Guidebook for Lung Cancer Patients and Families. Available at: https://www.haigan.gr.jp/public/guidebook/2024/. Accessed January 21, 2026.
- Liu M, et al. Evaluating the effectiveness of advanced large language models in medical knowledge: a comparative study using Japanese national medical examination. Int J Med Inform. 2025;193:105673.
- Kudo T, Yamamoto K, Matsumoto Y. Applying conditional random fields to Japanese morphological analysis. In: Proceedings of the 2004 Conference on Empirical Methods in Natural Language Processing. 2004:230-237.
Accès restreint. Veuillez vous connecter ou commencer un essai pour afficher ce contenu.