Cette étude observationnelle prospective décrit le développement et la validation interne d'un modèle prédictif utilisant des paramètres échographiques transabdominaux et transpérinéaux du premier stade, combinés à des caractéristiques cliniques maternelles, afin de faciliter l'identification précoce des femmes à risque de deuxième stade du travail prolongé.
Article de recherche
Développement et validation interne d'un modèle prédictif de la prolongation de la deuxième phase du travail à partir des données de la première phase : une étude observationnelle prospective
22 vues
⸱
11 septembre 2026
* These authors contributed equally
Dans cet article
Résumé
Résumé
L’allongement de la deuxième phase du travail est associé à des issues défavorables pour la mère et le nouveau-né, ce qui rend l’identification précoce des risques cliniquement importante. Cette étude a évalué si la combinaison de paramètres échographiques transabdominaux et transpérinéaux obtenus durant la première phase du travail pouvait prédire une deuxième phase prolongée. Cette étude observationnelle prospective a inclus des primipares ayant bénéficié d’une échographie transabdominale et transpérinéale durant la phase active de la première phase du travail. La position fœtale, l’angle de progression (AOP), la distance tête-symphyse pubienne, la distance tête-périnée ainsi que les caractéristiques cliniques maternelles ont été enregistrées. Les participantes ont été réparties en deux groupes selon la durée de la deuxième phase : normale (≤120 min) ou prolongée (>120 minutes). Une régression par sélection et contraction absolue minimale (LASSO) a été utilisée pour identifier les prédicteurs clés, et une régression logistique multivariée a permis de déterminer les prédicteurs indépendants afin d’élaborer un modèle prédictif. La performance prédictive a été évaluée par analyse de la courbe caractéristique de fonctionnement du récepteur (ROC), analyse de calibration et analyse de courbe décisionnelle (DCA) lors de la validation interne. L’analyse a inclus 159 primipares (95 avec une deuxième phase normale et 64 avec une deuxième phase prolongée). Par rapport au groupe à deuxième phase normale, le groupe à deuxième phase prolongée présentait des taux plus élevés de détresse fœtale (31,2 % contre 15,8 %, p = 0,035) et de scores bas au test d’Apgar (Apparence, Pouls, Grimace, Activité, Respiration) (70,3 % contre 36,8 %, p < 0,001). La régression LASSO a identifié quatre prédicteurs principaux — âge maternel, augmentation de l’indice de masse corporelle durant la grossesse, poids de naissance du nouveau-né et AOP — dont chacun est resté un prédicteur indépendant (p < 0,05). Le modèle prédictif a atteint une aire sous la courbe ROC de 0,927 et a montré une bonne discrimination, calibration et utilité clinique lors de la validation interne. Les paramètres échographiques de la première phase, combinés aux caractéristiques cliniques maternelles, pourraient faciliter l’identification précoce des primipares à haut risque et améliorer la prise en charge intrapartum.
Introduction
Le travail prolongé a longtemps été une préoccupation majeure en pratique obstétricale. En particulier, la prolongation du deuxième stade augmente non seulement la douleur maternelle, mais contribue également à des résultats néonatals défavorables1. Selon les dernières recommandations publiées par l'Organisation mondiale de la Santé (OMS), la durée normale du deuxième stade du travail est de ≤120 min. Autrement dit, un deuxième stade durant >120 min est considéré comme prolongé. L'incidence mondiale du deuxième stade prolongé est estimée entre 3 % et 8 %1,2. Cette prolongation accroît les risques d'infection maternelle, de césarienne, d'hémorragie post-partum, de détresse fœtale, de faibles scores d'Aspect, pouls, grimace, activité et respiration (Apgar) et de mortalité périnatale1. Des études antérieures ont montré que l'âge maternel, l'augmentation de l'indice de masse corporelle (IMC) pendant la grossesse et le poids de naissance du nouveau-né sont associés à un deuxième stade prolongé du travail ; toutefois, leur valeur prédictive reste limitée3. Par conséquent, l'identification de prédicteurs plus efficaces revêt une importance considérable pour faciliter des interventions cliniques rapides, optimiser la progression du travail, réduire la survenue du travail prolongé et améliorer les résultats maternels et néonatals.
Ces dernières années, l'imagerie par ultrasons s'est de plus en plus intégrée aux soins obstétricaux, en particulier à la prise en charge intrapartum, car elle permet une évaluation en temps réel et objective de la position, de l'orientation et de la descente du fœtus3,4. Des preuves indiquent que l'échographie intrapartum joue un rôle important dans la prédiction de l'évolution du travail, l'évaluation de l'état fœtal et l'orientation de la prise de décision clinique concernant le mode d'accouchement5. Néanmoins, des lacunes importantes persistent dans la littérature actuelle. Premièrement, relativement peu d'études ont spécifiquement examiné l'utilisation de paramètres échographiques pour prédire une deuxième phase prolongée du travail. Deuxièmement, bien que la position de la tête fœtale, la position fœtale et leur relation spatiale par rapport au bassin maternel au cours de la première phase du travail puissent influencer directement la durée de la deuxième phase6, les études évaluant ces paramètres échographiques de la première phase en lien avec un allongement de la deuxième phase restent limitées.
Dans ce contexte, la présente étude observationnelle prospective a recueilli des données d'accouchement provenant d'un seul centre pendant le premier stade du travail. Des paramètres échographiques ont été obtenus par échographie transabdominale et transpariétale, notamment la distance tête-symphysaire (HSD), l'angle de progression (AOP) et la distance tête-périnée (HPD). Contrairement aux études antérieures basées sur l'échographie, qui se concentraient principalement sur la prédiction des résultats immédiats de l'accouchement ou sur la nécessité d'une intervention opératoire pendant le deuxième stade du travail, la présente étude a spécifiquement examiné la prédiction précoce d'un deuxième stade prolongé du travail à l'aide de paramètres échographiques du premier stade. Ces paramètres ont été combinés aux caractéristiques démographiques et cliniques maternelles afin d'évaluer leur valeur prédictive pour un deuxième stade prolongé du travail. Cette approche comble une lacune importante dans les connaissances, car aucune étude antérieure n'avait intégré des résultats échographiques multidimensionnels du premier stade avec les caractéristiques cliniques maternelles dans un modèle prédictif de prolongation du deuxième stade. En conséquence, un modèle prédictif a été élaboré et validé en interne. On s'attend à ce que cette étude fournisse aux cliniciens un outil objectif permettant d'identifier précocement les primipares à risque de deuxième stade prolongé du travail durant le premier stade du travail, soutenant ainsi une prise en charge intrapartum plus individualisée et de meilleurs résultats maternels et néonatals.
Protocole
Cette étude a été menée conformément à la Déclaration d'Helsinki et approuvée par le comité d'éthique de l'hôpital de santé maternelle et infantile de Yuyao (hôpital populaire n°2 de Yuyao) (numéro d'approbation : YMCH-EC-2023KT-0012). Tous les participants ont donné leur consentement éclairé par écrit.
Participants à l'étude
Ont été incluses des femmes primipares ayant un déclenchement spontané du travail et ayant réussi un accouchement vaginal. Cela a permis d'enregistrer précisément la durée du deuxième stade nécessaire au modèle prédictif. Les critères d'éligibilité étaient les suivants : (1) grossesse singleton avec une âge gestationnel ≥37 semaines ; (2) présentation céphalique ; et (3) consentement éclairé obtenu auprès de la participante et de sa famille. Les critères d'exclusion comprenaient : (1) contre-indications absolues au travail identifiées pendant la phase active (par exemple, placenta praevia, vasa praevia, prolapsus du cordon) ; et/ou (2) inertie utérine secondaire (définie comme l'absence de progression de la dilatation cervicale ou de la descente fœtale pendant ≥4 heures malgré une augmentation par ocytocine ou une amniotomie). Les femmes subissant une induction du travail ont également été exclues.
Notamment, les femmes ayant nécessité une intervention chirurgicale d'urgence (césarienne ou accouchement instrumenté) en raison d'une détresse fœtale aiguë pendant le deuxième stade du travail ont été prises en charge conformément aux recommandations cliniques, mais n'ont pas été incluses dans cette analyse afin de préserver l'intégralité des données sur la durée du travail.
La taille de l'échantillon a été calculée à partir des résultats d'un essai préliminaire (n = 30, dans lequel l'incidence du prolongement du deuxième stade était de 20 %). Avec α fixé à 0,05 et β à 0,20, en supposant une incidence estimée du prolongement du deuxième stade d'environ 20 %, un minimum de 150 participants était nécessaire pour détecter un prédicteur significatif avec un rapport de cotes (OR) ≥ 2,5. Un total de 159 femmes a été inclus dans l'analyse finale.
Acquisition de données cliniques
Les variables maternelles comprenaient l'âge, l'augmentation de l'indice de masse corporelle (IMC) pendant la grossesse (définie comme la différence entre l'IMC pré-gestationnel et l'IMC pré-accouchement), le diabète gestationnel, l'hypertension gestationnelle, l'état mental (évalué à l'aide de l'échelle d'auto-évaluation de l'anxiété, un score ≥50 indiquant une anxiété), l'inertie utérine (faisant spécifiquement référence à un schéma de contraction hypotonique évalué cliniquement, défini comme des contractions utérines survenant à des intervalles >5 min ou durant <30 s, distinct de la définition du blocage du travail par le Collège américain des obstétriciens et gynécologues [ACOG]), et la parité. Les variables néonatales comprenaient le poids à la naissance (kg), le malaise fœtal (défini comme des décélérations tardives ou variables répétées en cardiotocographie ou une fréquence cardiaque fœtale de base <110 battements/min ou >160 battements/min) et le score d'Apgar (un score à 1 min <7 étant classé comme faible).
Le diabète gestationnel a été diagnostiqué selon les critères du groupe international d'étude sur le diabète et la grossesse (glycémie à jeun comprise entre 5,1 et 6,9 mmol/L, ou à 1 heure ≥10,0 mmol/L, ou à 2 heures comprise entre 8,5 et 11,0 mmol/L lors du test de tolérance orale au glucose de 75 g entre 24 et 28 semaines d'aménorrhée). L'hypertension gestationnelle a été définie selon les recommandations de l'ACOG (pression artérielle systolique ≥140 mmHg ou pression artérielle diastolique ≥90 mmHg mesurée deux fois à au moins 4 heures d'intervalle après 20 semaines d'aménorrhée, en l'absence de protéinurie). Un détresse fœtale sur cardiotocographie a été défini par des décélérations tardives répétées (≥50 % des contractions), des décélérations variables répétées de durée >60 s, une décélération prolongée de 2 à 10 minutes, ou une fréquence cardiaque fœtale de base <110 ou >160 battements/min pendant ≥10 minutes (critères du National Institute for Health and Care Excellence [NICE]). L'inertie utérine (contractions hypotoniques) a été définie par des intervalles entre contractions >5 min ou une durée de contraction <30 s sur une période de 30 min, évaluée par palpation ou tocodynamométrie. L'état psychique (anxiété) a été évalué à l'aide de l'échelle d'auto-évaluation de l'anxiété à l'admission (dilatation cervicale < 4 cm), un score brut ≥50 (indice standardisé) étant considéré comme anormal. Un score d'Apgar bas a été défini par un score à 1 minute <7 (OMS).
Étant donné qu'il s'agissait d'une étude observationnelle, la prise en charge du travail a suivi la pratique clinique habituelle sans protocole standardisé. Toutefois, l'analgésie péridurale (oui/non, moment d'administration, durée), l'augmentation par ocytocine (oui/non, dose totale, durée), la rupture artificielle des membranes (oui/non, dilatation cervicale au moment de l'intervention) et le mode d'accouchement (accouchement vaginal spontané uniquement, conformément aux critères d'inclusion) ont été systématiquement enregistrés. Aucune interaction significative entre ces variables et les prédicteurs principaux du modèle n'a été observée.
Examen échographique transabdominal et transpérinéal au début du premier stade du travail
L'échographie a été réalisée au début de la phase active du travail (dilatation cervicale ≥4 cm). La parturiente était placée en position allongée sur le dos avec une inclinaison latérale gauche de 15° après vidange de la vessie. Pour l'échographie transpérinéale, les cuisses étaient légèrement écartées et fléchies. Toutes les images ont été acquises au pic d'une contraction utérine, identifié par palpation clinique associée à une tocodynamométrie externe (cardiotocographie) afin de confirmer le sommet de chaque contraction. Chaque mesure a été répétée pendant trois contractions distinctes, la valeur moyenne étant utilisée pour l'analyse. Les examens échographiques ont été réalisés à l'aide d'un système échographique diagnostique portable (voir Tableau des matériaux). Pour l'imagerie transabdominale, une sonde convexe (2–5 MHz) a été utilisée ; pour l'imagerie transpérinéale, une sonde linéaire à haute fréquence ou une sonde convexe de petite empreinte (5–8 MHz) a été utilisée. Les paramètres d'imagerie ont été standardisés (profondeur de 6 à 10 cm, gain optimisé, et une zone de focalisation unique positionnée au niveau du symphysis pubienne).
Pour l'évaluation de la position fœtale, une coupe transversale transabdominale a permis d'identifier l'orbite fœtale, le cervelet et la ligne médiane des thalamus par rapport au pelvis maternel afin de déterminer la position occiput antérieur (OA), transverse ou postérieure. Pour les mesures transpérinéales, la sonde a été recouverte d'une gaine stérile et placée sur le périnée dans le plan médiansagittal, sans pression excessive. Les repères anatomiques comprenaient l'intégralité de la symphyse pubienne, le contour du crâne fœtal et la jonction anorectale.
Les paramètres suivants ont été mesurés (Figure 1A–D) : l'angle de progression (AOP), défini comme l'angle entre l'axe longitudinal de la symphyse pubienne et une ligne s'étendant depuis son bord inférieur jusqu'au point le plus profond du crâne fœtal ; l'angle médian (MLA), défini comme l'angle entre la ligne médiane du crâne fœtal (faux du cerveau) et l'axe antéropostérieur du pelvis maternel ; la distance tête-symphysis (HSD), définie comme la distance entre le bord inférieur de la symphyse pubienne et le point le plus proche du crâne fœtal ; et la distance tête-périnée (HPD), définie comme la plus courte distance entre le crâne fœtal externe et la peau du périnée7.
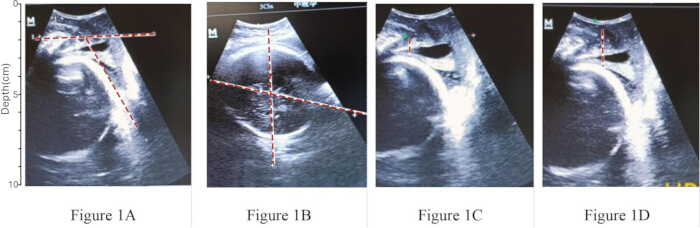
Figure 1. Mesures échographiques obtenues durant le premier stade du travail. (A) Mesure de l'angle de progression (AOP), défini comme l'angle entre l'axe longitudinal du pubis et une ligne partant de son bord inférieur jusqu'au point le plus profond du crâne fœtal. (B) Mesure de l'angle médian (MLA), défini comme l'angle entre la ligne médiane du crâne fœtal (faux du cerveau) et l'axe antéropostérieur du pelvis maternel. (C) Mesure de la distance tête-symphysaire (HSD), définie comme la distance entre le bord inférieur de la symphyse pubienne et le point le plus proche du crâne fœtal. (D) Mesure de la distance tête-périnée (HPD), définie comme la distance la plus courte entre la surface externe du crâne fœtal et la peau périnéale maternelle. Veuillez cliquer ici pour visualiser une version agrandie de cette figure.
Chaque mesure a été effectuée trois fois lors de trois pics de contraction distincts, et la valeur moyenne a été utilisée pour l'analyse. Tous les examens ont été réalisés par trois échographistes expérimentés (chacun ayant une expérience d'au moins 10 ans en échographie obstétricale), qui avaient suivi une formation normalisée aux mesures échographiques transpérinéales intrapartum avant l'étude. La compétence a été confirmée par l'obtention d'un coefficient de corrélation intraclasse (CCI) d'au moins 0,90 par rapport à un évaluateur de référence (auteur senior). La reproductibilité inter-observateurs et intra-observateurs a été évaluée lors d'une phase pilote incluant 10 patientes (non incluses dans l'étude principale), donnant des CCI compris entre 0,89 et 0,96 pour tous les paramètres (AOP, HSD, HPD et MLA).
L'acceptation des images nécessitait une visualisation claire de la symphyse pubienne, du contour du crâne fœtal et de la jonction anorectale. Les images présentant une pression excessive du transducteur ou des repères anatomiques mal visualisés ont été rejetées et recueillies à nouveau. Les échographistes étaient aveugles quant à l'affectation au groupe (deuxième stade normal versus prolongé) et aux données cliniques pendant l'acquisition et la mesure des images. Les données ont été saisies en double avec des vérifications de plage, et les valeurs hors plage ont déclenché un nouvel examen des images. Les données manquantes (<5 %) ont été traitées par une analyse sur cas complets après avoir confirmé que les données étaient manquantes de façon aléatoire (test de Little de données manquantes complètement au hasard, p > 0,05).
Enregistrement et regroupement de la durée du travail
Tout au long du travail, le déroulement du travail pour chaque participante a été soigneusement documenté. Le premier stade du travail a été défini comme la période allant du début des contractions utérines régulières jusqu'à la dilatation complète du col (10 cm). La phase active du travail a été définie comme une dilatation cervicale ≥4 cm accompagnée de contractions utérines régulières et intenses. Le deuxième stade du travail a été défini comme la période allant de la dilatation cervicale complète (10 cm) à l'expulsion complète du fœtus. Des examens échographiques ont été réalisés pendant la phase active du premier stade du travail afin d'évaluer la position de la tête fœtale, la présentation fœtale et les paramètres échographiques associés. Selon les recommandations de l'Organisation mondiale de la Santé (OMS), un deuxième stade du travail normal ne devrait pas dépasser 120 min2. Afin de maintenir un seuil de recherche standardisé pour toutes les primipares dans cette étude, les participantes ont été réparties selon ce critère de 120 minutes en deux groupes : un groupe avec un deuxième stade normal (≤120 min) et un groupe avec un deuxième stade prolongé (>120 min).
Analyse statistique
Toutes les analyses statistiques ont été réalisées à l'aide de SPSS version 26.0 (RRID:SCR_002865) et de R version 4.1.0 (RRID:SCR_001905) (voir tableau des matériaux). Les packages R suivants ont été utilisés : glmnet (version 4.1-2) pour la régression par l'opérateur de réduction et de sélection absolue (LASSO), rms (version 6.2-0) pour la construction et la calibration du nomogramme, pROC (version 1.18.0) pour l'analyse des caractéristiques de fonctionnement du récepteur (ROC), et rmda (version 1.6) pour l'analyse de courbe décisionnelle (DCA). La normalité des variables continues a été évaluée à l'aide du test de Shapiro–Wilk afin de guider le choix des statistiques descriptives et des méthodes de comparaison. Les données normalement distribuées ont été exprimées en moyenne ± écart-type (x̄ ± s) et comparées à l'aide du test t de Student pour échantillons indépendants, qui est robuste à de légères déviations par rapport à la normalité lorsque les tailles d'échantillon sont suffisantes. Les données non normalement distribuées ont été présentées sous forme de médiane avec intervalle interquartile (M [P25, P75]) et comparées à l'aide du test U de Mann–Whitney, qui évalue si une distribution a tendance à présenter des valeurs plus élevées que l'autre, plutôt que de tester strictement les différences entre médianes. Les variables catégorielles ont été exprimées en effectifs et pourcentages (n [%]) et comparées à l'aide du test du chi-deux (χ2) ou du test exact de Fisher lorsque la fréquence attendue était <5. Tous les tests étaient bilatéraux, et une valeur p <0,05 a été considérée comme statistiquement significative. Les variables présentant une valeur p <0,1 lors de l'analyse univariée ont été intégrées à la régression LASSO pour la sélection des variables. La régression LASSO a été effectuée à l'aide du package glmnet avec une validation croisée en 10 parties afin de déterminer le paramètre optimal de régularisation (λ). Le critère de l'écart-type unique (la valeur la plus élevée de λ située dans un écart-type de l'erreur minimale de validation croisée) a été appliqué pour sélectionner le jeu de prédicteurs le plus parcimonieux possédant des coefficients non nuls. Avant l'ajustement LASSO, tous les prédicteurs continus (âge maternel, augmentation de l'IMC pendant la grossesse, AOP, HSD, HPD et poids à la naissance du nouveau-né) ont été centrés et standardisés en scores z selon le paramètre par défaut de glmnet (standardize = TRUE), afin que les coefficients soient pénalisés de manière équivalente indépendamment des unités de mesure. Les variables sélectionnées ont ensuite été intégrées à un modèle de régression logistique multivariée (méthode d'entrée) afin de calculer les rapports de cotes ajustés (aOR) et les intervalles de confiance à 95 % (IC). La significativité du modèle a été évaluée à l'aide du test du rapport de vraisemblance.
Sur la base des coefficients de régression logistique, un modèle prédictif a été construit selon l'équation Logit(P) = β0 + Σ(βiXi). Ce modèle a été visualisé sous forme de nomogramme à l'aide du package rms, dans lequel chaque prédicteur s'est vu attribuer une valeur en points proportionnelle à son coefficient de régression, et les points totaux ont été convertis en probabilités prédites. La discrimination a été évaluée en traçant la courbe ROC et en calculant l'aire sous la courbe (AUC) avec son intervalle de confiance à 95 % à l'aide du package pROC (méthode de bootstrap avec 1 000 rééchantillonnages). La probabilité seuil optimale a été déterminée en maximisant l'indice de Youden (sensibilité + spécificité − 1), les valeurs correspondantes de sensibilité et de spécificité étant indiquées. La calibration a été évaluée à l'aide d'une courbe de calibration générée à partir de 1 000 rééchantillonnages bootstrap (package rms), complétée par le test d'ajustement de Hosmer–Lemeshow (une valeur p non significative indique une bonne calibration). L'utilité clinique a été évaluée par l'analyse de décision par courbe (DCA) à l'aide du package rmda, qui calcule le bénéfice net sur une gamme de probabilités seuil (0 % à 100 %). Le bénéfice net a été défini comme suit : (véritables positifs / n) − (faux positifs / n) × (probabilité seuil / [1 − probabilité seuil]). Le flux de travail global de l'étude est décrit ci-dessus et illustré dans la figure supplémentaire 1. Ce modèle est exploratoire ; le prédicteur « poids de naissance néonatal » fait référence au poids réel mesuré après l'accouchement, et une prédiction clinique nécessiterait un nouveau calibrage du modèle utilisant le poids estimé du fœtus (EFW) obtenu avant l'accouchement.
Résultats
Population étudiée et répartition en groupes
Au total, 159 parturientes ont été incluses dans l'analyse finale. Parmi celles-ci, 95 présentaient une durée normale du deuxième stade, tandis que 64 ont connu un deuxième stade prolongé (Tableau 1). Par rapport au groupe normal, le groupe prolongé présentait des incidences significativement plus élevées de détresse fœtale et de scores d'Apgar bas (les deux p < 0,05). Aucune différence significative concernant la mortalité périnatale n'a été observée entre les groupes (p > 0,05).
| Variable | Ensemble (N = 159) | Deuxième stade normal (N = 95) | Deuxième stade prolongé (N = 64) | Valeur de p |
| Durée du deuxième stade (min) | 109 [40,5; 172] | 88,4 [40,5; 125] | 139 [100; 172] | <0,0001 |
| Détresse fœtale | 0,0347 | |||
| Absente | 124 (78,0 %) | 80 (84,2 %) | 44 (68,8 %) | |
| Présente | 35 (22,0 %) | 15 (15,8 %) | 20 (31,2 %) | |
| Score d'Apgar bas | 0,0001 | |||
| Non | 79 (49,7 %) | 60 (63,2 %) | 19 (29,7 %) | |
| Oui | 80 (50,3 %) | 35 (36,8 %) | 45 (70,3 %) | |
| Mortalité périnatale | 0,5653 | |||
| Absente | 156 (98,1 %) | 94 (98,9 %) | 62 (96,9 %) | |
| Présente | 3 (1,89 %) | 1 (1,05 %) | 2 (3,12 %) |
Tableau 1 : Effet d’un travail prolongé au deuxième stade sur les résultats cliniques néonatals. Les variables continues sont présentées sous forme de médiane [intervalle interquartile (IIQ)], et les variables catégorielles sont présentées sous forme de nombre (%). Le groupe de travail normal au deuxième stade comprenait les participantes dont la durée du deuxième stade était ≤120 min, tandis que le groupe de travail prolongé au deuxième stade comprenait les participantes dont la durée du deuxième stade était >120 min. Un faible score de type Apparence, Pouls, Grimace, Activité et Respiration (Apgar) était défini par un score Apgar à 1 min <7. Les valeurs P représentent les comparaisons entre les groupes de travail normal et prolongé au deuxième stade.
Une comparaison des caractéristiques démographiques et cliniques entre les deux groupes est présentée dans le Tableau 2. Les parturientes ayant un deuxième stade prolongé présentaient une médiane d'âge maternel plus élevée et une augmentation plus importante de l'IMC gestationnel que celles ayant un deuxième stade normal. Les fréquences du diabète gestationnel, de l'inertie utérine et de l'état mental altéré étaient également significativement plus élevées dans le groupe à deuxième stade prolongé (toutes les valeurs de p < 0,05). Aucune différence significative entre les groupes n'a été observée pour l'hypertension gestationnelle ou l'âge gestationnel au moment de l'accouchement (les deux avec p > 0,05).
| Variable | Total (N = 159) | Deuxième stade normal (N = 95) | Deuxième stade prolongé (N = 64) | Valeur p |
| Âge (années) | 28,8 [19,4; 44,9] | 26,3 [19,4; 33,2] | 32,4 [22,3; 44,9] | <0,0001 |
| Augmentation du BMI gestationnel (kg/m²) | 11,4 ± 3,62 | 10,1 ± 3,33 | 13,3 ± 3,17 | <0,0001 |
| Diabète gestationnel | 0,0002 | |||
| Absent | 141 (88,7 %) | 92 (96,8 %) | 49 (76,6 %) | |
| Présent | 18 (11,3 %) | 3 (3,16 %) | 15 (23,4 %) | |
| Hypertension gestationnelle | 0,8723 | |||
| Absent | 124 (78,0 %) | 75 (78,9 %) | 49 (76,6 %) | |
| Présent | 35 (22,0 %) | 20 (21,1 %) | 15 (23,4 %) | |
| Poids à la naissance du nouveau-né (kg) | 2,61 [1,68; 4,60] | 2,46 [1,68; 2,85] | 3,39 [1,71; 4,60] | <0,0001 |
| État mental | 0,0017 | |||
| Modifié | 139 (87,4 %) | 90 (94,7 %) | 49 (76,6 %) | |
| Sain | 20 (12,6 %) | 5 (5,26 %) | 15 (23,4 %) | |
| Inertie utérine | <0,0001 | |||
| Absent | 123 (77,4 %) | 85 (89,5 %) | 38 (59,4 %) | |
| Présent | 36 (22,6 %) | 10 (10,5 %) | 26 (40,6 %) | |
| Âge gestationnel (semaines) | 38,1 ± 2,02 | 38,1 ± 1,99 | 37,9 ± 2,06 | 0,5156 |
Tableau 2 : Comparaison des caractéristiques démographiques et cliniques entre les groupes. Les variables continues sont présentées soit comme moyenne ± écart-type (ET), soit comme médiane [intervalle interquartile (IIQ)], selon le cas. Les variables catégorielles sont présentées sous forme de nombre (%). L'augmentation de l'indice de masse corporelle (IMC) a été définie comme la différence entre l'IMC pré-gestationnel et l'IMC avant l'accouchement. Le groupe présentant un travail de deuxième stade normal comprenait les participantes dont la durée du deuxième stade était ≤120 min, tandis que le groupe présentant un travail de deuxième stade prolongé comprenait les participantes dont la durée du deuxième stade était >120 min. Les valeurs P représentent les comparaisons entre les deux groupes.
Paramètres cliniques et échographiques au stade actif initial
Les paramètres échographiques transabdominaux et transpérinéaux du premier stade ont été comparés entre les groupes présentant un deuxième stade normal et prolongé (Tableau 3). La proportion de position fœtale en OA était significativement plus faible dans le groupe prolongé que dans le groupe normal. En outre, les valeurs d’AOP, de HSD et de HPD étaient significativement plus élevées chez les parturientes ayant présenté un deuxième stade prolongé (toutes les valeurs de p < 0,05).
| Variable | Ensemble (N = 159) | Deuxième stade normal (N = 95) | Deuxième stade prolongé (N = 64) | Valeur de p |
| Position fœtale | <0.0001 | |||
| OA | 74 (46,5 %) | 60 (63,2 %) | 14 (21,9 %) | |
| Non-OA | 85 (53,5 %) | 35 (36,8 %) | 50 (78,1 %) | |
| AOP (°) | 124 [64,3 ; 158] | 111 [64,3 ; 142] | 138 [123 ; 158] | <0.0001 |
| HSD (cm) | 1,97 ± 0,39 | 1,81 ± 0,33 | 2,21 ± 0,34 | <0.0001 |
| HPD (cm) | 4,61 ± 0,71 | 4,23 ± 0,56 | 5,17 ± 0,51 | <0.0001 |
Tableau 3 : Comparaison des paramètres échographiques transabdominaux et transpérinéaux au cours du premier stade du travail. Les variables continues sont présentées sous forme de moyenne ± écart type (ET) ou de médiane [intervalle interquartile (IIQ)], selon le cas. Les variables catégorielles sont présentées sous forme de nombre (%). OA, occiput antérieur ; non-OA, non-occiput antérieur ; AOP, angle de progression ; HSD, distance tête-symphysaire ; HPD, distance tête-périnée. L’AOP a été mesurée en degrés (°), tandis que la HSD et la HPD ont été mesurées en centimètres (cm). Le groupe du deuxième stade du travail normal comprenait les participantes dont la durée du deuxième stade était ≤120 min, tandis que le groupe du deuxième stade prolongé comprenait les participantes dont la durée du deuxième stade était >120 min. Les valeurs P représentent les comparaisons entre les deux groupes.
Analyse univariée des prédicteurs potentiels
Des analyses univariées ont été réalisées afin d'identifier les variables associées à un accouchement prolongé au deuxième stade (Tableau 4). Dix variables différaient de manière significative entre les groupes normal et prolongé (p < 0,10) : l'âge maternel, l'augmentation de l'IMC pendant la grossesse, le diabète gestationnel, le poids de naissance du nouveau-né, l'état mental, l'inertie utérine, la position fœtale, l'AOP, l'HSD et l'HPD. Aucune différence significative entre les groupes n'a été observée pour l'hypertension gestationnelle ou l'âge gestationnel (les deux avec p > 0,10). Les variables ayant un p < 0,10 ont ensuite été intégrées au modèle de régression LASSO pour la sélection des variables.
| Variable | Ensemble (N = 159) | Deuxième stade normal (N = 95) | Deuxième stade prolongé (N = 64) | Statistique | Valeur P |
| Caractéristiques démographiques et cliniques | |||||
| Âge (années) | 28,8 [19,4; 44,9] | 26,3 [19,4; 33,2] | 32,4 [22,3; 44,9] | Z = −5,891 | <0,001 |
| Augmentation du BMI pendant la grossesse (kg/m²) | 11,4 ± 3,62 | 10,1 ± 3,33 | 13,3 ± 3,17 | t = −5,912 | <0,001 |
| Diabète gestationnel, n (%) | 18 (11,3) | 3 (3,2) | 15 (23,4) | χ² = 15,207 | <0,001 |
| Hypertension gestationnelle, n (%) | 35 (22,0) | 20 (21,1) | 15 (23,4) | χ² = 0,135 | 0,872 |
| Poids à la naissance du nouveau-né (kg) | 2,61 [1,68; 4,60] | 2,46 [1,68; 2,85] | 3,39 [1,71; 4,60] | Z = −6,234 | <0,001 |
| Altération de l'état mental, n (%) | 139 (87,4) | 90 (94,7) | 49 (76,6) | χ² = 10,912 | 0,001 |
| Inertie utérine, n (%) | 36 (22,6) | 10 (10,5) | 26 (40,6) | χ² = 20,156 | <0,001 |
| Âge gestationnel (semaines) | 38,1 ± 2,02 | 38,1 ± 1,99 | 37,9 ± 2,06 | t = 0,654 | 0,516 |
| Paramètres échographiques durant le premier stade du travail | |||||
| Position fœtale (non-OA), n (%) | 85 (53,5) | 35 (36,8) | 50 (78,1) | χ² = 26,543 | <0,001 |
| AOP (°) | 124 [64,3; 158] | 111 [64,3; 142] | 138 [123; 158] | Z = −6,781 | <0,001 |
| HSD (cm) | 1,97 ± 0,39 | 1,81 ± 0,33 | 2,21 ± 0,34 | t = −7,445 | <0,001 |
| HPD (cm) | 4,61 ± 0,71 | 4,23 ± 0,56 | 5,17 ± 0,51 | t = −9,332 | <0,001 |
Tableau 4 : Analyse univariée des facteurs associés à un accouchement prolongé au deuxième stade du travail. Les variables continues sont présentées soit comme moyenne ± écart-type (ET), soit comme médiane [intervalle interquartile (IIQ)], selon le cas. Les variables catégorielles sont présentées en nombre (%). IMC, indice de masse corporelle ; OA, occiput antérieur ; non-OA, non-occiput antérieur ; AOP, angle de progression ; DSC, distance tête-symphysaire ; DPC, distance tête-périnée. Les variables continues normalement distribuées ont été comparées à l’aide du test t de Student pour échantillons indépendants, les variables continues non normalement distribuées ont été comparées à l’aide du test de Mann-Whitney U (rapporté comme statistique Z), et les variables catégorielles ont été comparées à l’aide du test du chi-deux (χ2). Les variables ayant une valeur P < 0,10 ont été considérées comme éligibles pour être incluses dans l’analyse de régression par l’opérateur de réduction et de sélection par valeur absolue minimale (LASSO).
Sélection de variables par régression avec l'opérateur de sélection et de réduction absolue minimale (LASSO)
Afin d'élaborer un modèle prédictif parcimonieux tout en réduisant le risque de surajustement et l'influence de la multicolinéarité, les 10 prédicteurs candidats identifiés par l'analyse univariée (p < 0,10 ; Tableau 4) ont été intégrés au modèle de régression LASSO pour la sélection de variables. Le paramètre optimal de régularisation (λ) a été déterminé à l'aide d'une validation croisée en 10 parties. Le tracé du chemin des coefficients (Figure 2A) illustre la réduction progressive des coefficients de régression vers zéro à mesure que λ augmente. La courbe correspondante de validation croisée (Figure 2B) montre la relation entre l'erreur de validation croisée et différentes valeurs de λ. La ligne verticale pointillée de gauche indique la valeur de λ qui minimise l'erreur de validation croisée, tandis que la ligne verticale pointillée de droite indique la valeur maximale de λ située à une erreur-type du minimum (critère de l'erreur-type unique). Cette dernière a été retenue afin d'obtenir un modèle plus parcimonieux. En utilisant le critère de l'erreur-type unique, quatre prédicteurs présentant des coefficients non nuls ont été conservés : le poids à la naissance (coefficient = 0,50), l'augmentation de l'IMC pendant la grossesse (coefficient = 0,12), l'âge maternel (coefficient = 0,05) et l'AOP (coefficient = 0,03). Ces coefficients représentent les coefficients pénalisés standardisés du modèle LASSO final pour la valeur de λ sélectionnée. Les variables candidates restantes — HSD, HPD, diabète gestationnel, état mental, inertie utérine et position fœtale — présentaient des coefficients réduits à zéro et ont donc été exclues de l'ensemble final des prédicteurs. Les variables retenues ont ensuite été intégrées à un modèle de régression logistique multivariée afin d'estimer les OR ajustés avec leurs intervalles de confiance à 95 % correspondants.
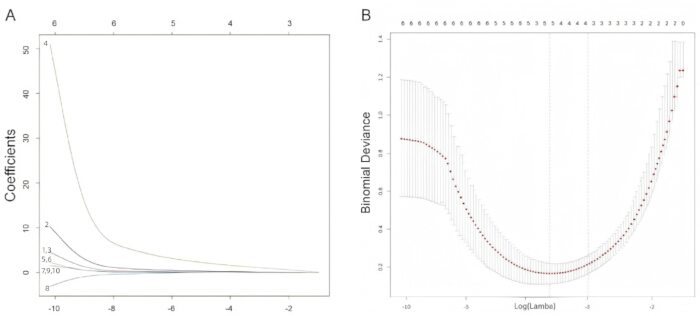
Figure 2. Analyse de régression par l'opérateur de sélection et de réduction absolue minimale (LASSO) pour la sélection des prédicteurs. (A) Chemins des coefficients générés lors de la régression par l'opérateur de sélection et de réduction absolue minimale (LASSO). L'axe des abscisses représente le logarithme du paramètre de régularisation (log λ), et l'axe des ordonnées représente les coefficients de régression standardisés. Chaque courbe illustre le rétrécissement progressif du coefficient d'un prédicteur individuel vers zéro à mesure que la pénalité de régularisation augmente. Les nombres indiqués en haut indiquent le nombre de variables conservées pour chaque valeur de λ. Les chemins de coefficients numérotés correspondent aux prédicteurs candidats suivants : (1) âge maternel, (2) augmentation de l'indice de masse corporelle (IMC) pendant la grossesse, (3) diabète gestationnel, (4) poids à la naissance du nouveau-né, (5) état mental, (6) inertie utérine, (7) position fœtale, (8) angle de progression (AOP), (9) distance tête-symphysaire (HSD), et (10) distance tête-périnée (HPD). (B) Graphique de validation croisée en dix parties utilisé pour déterminer le paramètre de régularisation optimal. L'axe des abscisses représente log(λ), et l'axe des ordonnées représente la déviance binomiale. Les points indiquent l'erreur moyenne de validation croisée, et les barres d'erreur représentent ±1 erreur standard. La ligne pointillée verticale de gauche indique la valeur de λ qui minimise l'erreur de validation croisée, tandis que la ligne pointillée verticale de droite indique la valeur maximale de λ située à une erreur standard du minimum (critère de l'erreur standard unique). Veuillez cliquer ici pour visualiser une version agrandie de cette figure.
Régression logistique multivariée et prédicteurs indépendants
Les quatre prédicteurs retenus par le modèle de régression LASSO — âge maternel, augmentation de l'IMC pendant la grossesse, poids de naissance du nouveau-né et AOP — ont été intégrés à un modèle de régression logistique multivariée (Tableau 5). Les quatre variables sont restées indépendamment associées à un travail prolongé du deuxième stade après ajustement mutuel (toutes les valeurs de p < 0,05). Dans le modèle de régression logistique multivariée recalibré, le poids de naissance du nouveau-né présentait l'odds ratio ajusté (aOR) le plus élevé (aOR = 8,45, IC à 95 % : 3,21–22,24). L'augmentation de l'IMC pendant la grossesse était également indépendamment associée à un travail prolongé du deuxième stade (aOR = 1,38, IC à 95 % : 1,15–1,66). L'âge maternel (aOR = 1,18, IC à 95 % : 1,05–1,32) et l'AOP (aOR = 1,07, IC à 95 % : 1,02–1,12) étaient de même indépendamment associés à un travail prolongé du deuxième stade. Le modèle de régression logistique multivariée était statistiquement significatif selon le test du rapport de vraisemblance (p < 0,001). Étant donné que le poids de naissance du nouveau-né est mesuré après l'accouchement, le modèle actuel est exploratoire et devrait être recalibré à l'aide du poids fœtal estimé avant toute application clinique.
| Variable | β | SE | Wald χ² | Valeur p | aOR | IC à 95 % |
| Constante | −15.92 | 3.01 | 27.98 | <0.001 | — | — |
| Âge maternel (années) | 0.16 | 0.06 | 7.11 | 0.008 | 1.18 | 1.05–1.32 |
| Augmentation du BMI pendant la grossesse (kg/m²) | 0.32 | 0.09 | 12.65 | <0.001 | 1.38 | 1.15–1.66 |
| Poids à la naissance du nouveau-né (kg) | 4.26 | 0.9 | 22.41 | <0.001 | 8.45 | 3.21–22.24 |
| AOP (°) | 0.07 | 0.02 | 10.76 | 0.001 | 1.07 | 1.02–1.12 |
Tableau 5 : Analyse de régression logistique multivariée identifiant les prédicteurs indépendants d’un travail prolongé au deuxième stade. Le tableau présente les résultats du modèle de régression logistique multivariée construit à l’aide des variables sélectionnées par la régression par l’opérateur de réduction et de sélection absolue minimale (LASSO). β, coefficient de régression ; SE, erreur type ; Wald χ2, statistique du khi-deux de Wald ; aOR, odds ratio ajusté ; CI, intervalle de confiance ; BMI, indice de masse corporelle ; AOP, angle de progression. L’ordonnée à l’origine représente la constante du modèle. La significativité globale du modèle a été évaluée à l’aide du test du rapport de vraisemblance (χ2 = 85,34, P <0,001).
Construction du modèle prédictif et nomogramme
À partir des prédicteurs indépendants et de leurs coefficients de régression identifiés par l'analyse de régression logistique multivariée (Tableau 5), un modèle prédictif personnalisé a été élaboré afin d'estimer la probabilité d'un accouchement prolongé au deuxième stade chez les primipares. Le modèle s'exprime comme suit :
Logit(P) = —15,92 + 0,16 (âge maternel) + 0,32 (augmentation du BMI gestationnel) + 4,26 (poids à la naissance du nouveau-né) + 0,07(AOP)
Ici, P représente la probabilité prédite d'un travail prolongé au deuxième stade.
Pour faciliter la visualisation du modèle, l'équation de régression a été présentée sous forme de nomogramme (Figure 3). Chaque prédicteur correspond à une échelle de points individuelle. Par exemple, une parturiente ayant un âge maternel de 28 ans, une augmentation du BMI gestationnel de 12 kg/m2, un poids de naissance néonatal (poids de naissance réel mesuré après l'accouchement) de 3,6 kg et un AOP de 115° peut être évaluée en localisant chaque valeur sur son axe correspondant, en projetant verticalement vers l'axe des Points, en additionnant les valeurs de points individuelles pour obtenir les Points totaux, puis en projetant le score total vers le bas jusqu'à l'axe du Risque de deuxième stade prolongé afin d'estimer la probabilité prédite. Ce nomogramme est fourni à titre illustratif uniquement, car il intègre le poids de naissance néonatal réel. Une application clinique nécessiterait un nouvel ajustement du modèle en utilisant le poids fœtal estimé.
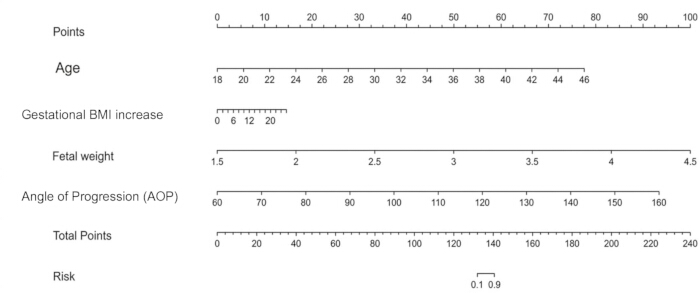
Figure 3. Nomogramme pour prédire la probabilité d’un accouchement prolongé au deuxième stade. Le nomogramme a été construit à partir d’un modèle de régression logistique multivariée utilisant quatre prédicteurs : l’âge maternel, l’augmentation de l’IMC gestationnel, le poids à la naissance du nouveau-né (poids réel mesuré après l’accouchement) et l’AOP. Pour estimer la probabilité prédite d’un accouchement prolongé au deuxième stade, repérez la valeur de chaque prédicteur sur son axe correspondant et projetez verticalement vers l’axe « Points » afin de déterminer le score attribué. Additionnez les scores individuels pour obtenir le total des points, puis projetez ce score total vers l’axe « Risque » pour estimer la probabilité prédite d’un accouchement prolongé au deuxième stade. Le nomogramme est présenté à titre illustratif uniquement, car il intègre le poids réel à la naissance du nouveau-né, qui n’est pas disponible avant l’accouchement. Une application clinique nécessiterait de recalibrer le modèle en utilisant le poids fœtal estimé (EFW). Veuillez cliquer ici pour visualiser une version agrandie de cette figure.
Validation du modèle : discrimination, calibration et utilité clinique
La performance prédictive du modèle a été évaluée en interne en ce qui concerne la discrimination, la calibration et l'utilité clinique. La discrimination du modèle a été évaluée à l'aide de la courbe ROC (Figure 4). Le modèle a atteint une AUC de 0,927 (IC à 95 % : 0,879–0,961), indiquant une excellente discrimination. En utilisant l'indice de Youden maximal, le seuil de probabilité optimal était de 0,48. À ce seuil, le modèle a démontré une sensibilité de 85,9 % et une spécificité de 84,2 % (Tableau 6).
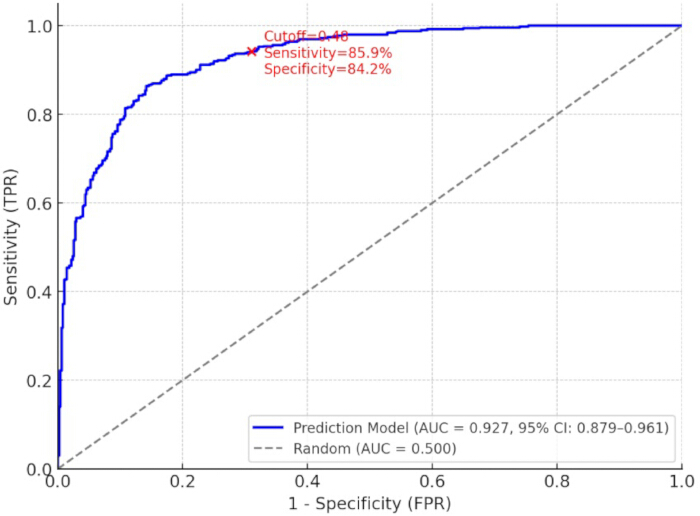
Figure 4. Courbe caractéristique de fonctionnement du récepteur (ROC) évaluant les performances du modèle prédictif. La courbe caractéristique de fonctionnement du récepteur (ROC) illustre la capacité du modèle prédictif à distinguer un travail de deuxième stade normal d’un travail prolongé. La courbe bleue représente le modèle prédictif, avec une aire sous la courbe (AUC) de 0,927 (intervalle de confiance à 95 % [IC] : 0,879–0,961). Le seuil de probabilité optimal était de 0,48, correspondant à une sensibilité de 85,9 % et à une spécificité de 84,2 %. La ligne en pointillés grise représente une classification aléatoire (AUC = 0,500). L’axe des abscisses représente 1 − la spécificité (taux de faux positifs [FPR]), et l’axe des ordonnées représente la sensibilité (taux de vrais positifs [TPR]). Veuillez cliquer ici pour visualiser une version agrandie de cette figure.
| Paramètre | Valeur | IC à 95 % |
| AUC | 0.927 | 0.879–0.961 |
| Seuil optimal | 0.480 | — |
| Sensibilité | 85,90 % | 75,0 %–93,4 % |
| Spécificité | 84,20 % | 75,3 %–90,9 % |
| VPN | 78,60 % | 67,5 %–87,3 % |
| VPP | 89,80 % | 81,9 %–95,0 % |
| Exactitude | 84,90 % | 78,3 %–90,1 % |
Tableau 6 : Performance du modèle prédictif au seuil de probabilité optimal. La performance prédictive du modèle de régression logistique multivariée a été évaluée à l’aide de l’aire sous la courbe caractéristique de fonctionnement du récepteur (ROC) (AUC). Le seuil de probabilité optimal de 0,48 a été déterminé en maximisant l’indice de Youden. La sensibilité représente la proportion de cas vrais positifs correctement identifiés, la spécificité représente la proportion de cas vrais négatifs correctement identifiés, la valeur prédictive positive (VPP) représente la probabilité que les participants classés positifs aient effectivement un travail prolongé du deuxième stade, et la valeur prédictive négative (VPN) représente la probabilité que les participants classés négatifs n’aient effectivement pas un travail prolongé du deuxième stade. IC, intervalle de confiance.
L'étalonnage du modèle a été évalué à l'aide d'une courbe d'étalonnage par rééchantillonnage bootstrap générée à partir de 1 000 répétitions, ainsi que par le test d'ajustement de Hosmer-Lemeshow (Figure 5A). La courbe d'étalonnage suivait étroitement la ligne de référence idéale, indiquant un bon accord entre les probabilités prédites et observées. Le test d'ajustement de Hosmer-Lemeshow n'était pas statistiquement significatif (χ2 = 6,15, p = 0,630), ce qui est compatible avec un étalonnage adéquat dans ce modèle validé en interne. L'utilité clinique a été évaluée à l'aide de l'analyse de décision fondée sur la courbe de bénéfice net (DCA) (Figure 5B). Dans la plage de probabilité seuil d'environ 10 % à 70 %, le modèle prédictif offrait un bénéfice net supérieur à celui des stratégies « traiter tous » ou « ne traiter aucun ». Pour des probabilités seuil inférieures à environ 10 %, la stratégie « ne traiter aucun » offrait un bénéfice net plus élevé, tandis que pour des probabilités seuil supérieures à environ 70 %, la stratégie « traiter tous » était similaire ou meilleure. Ces résultats indiquent que le modèle pourrait apporter un bénéfice clinique dans une plage intermédiaire de probabilités seuil. Dans l'ensemble, le modèle prédictif a démontré une excellente capacité de discrimination, un étalonnage adéquat et une utilité clinique favorable lors de la validation interne. Toutefois, comme la validation s'est limitée au jeu de données de l'étude et que le modèle intègre le poids réel à la naissance du nouveau-né, une validation externe et un réajustement à l'aide du poids fœtal estimé sont nécessaires avant toute mise en œuvre clinique.
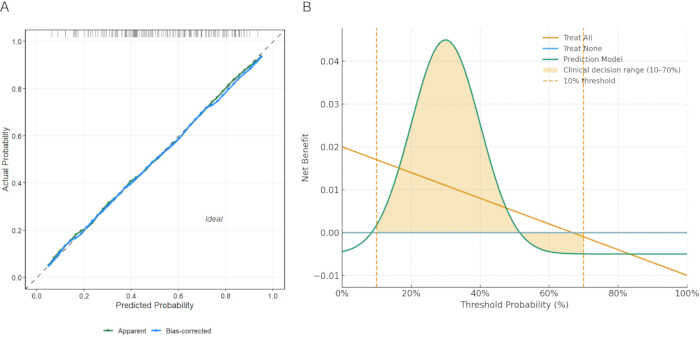
Figure 5. Analyses de calibration et de courbe de décision du modèle prédictif. (A) Courbe de calibration du modèle prédictif générée à l'aide de 1 000 rééchantillonnages bootstrap. La courbe apparente représente la performance du modèle dans le jeu de données de l'étude, la courbe corrigée du biais représente l'étalonnage ajusté par bootstrap, et la ligne pointillée diagonale indique un accord idéal entre les probabilités prédites et observées. Le test d'ajustement de Hosmer–Lemeshow a donné une valeur de χ2 = 6,15 et une valeur p = 0,630. (B) Analyse de courbe de décision (DCA) évaluant l'utilité clinique du modèle prédictif sur une gamme de probabilités seuils. La courbe verte représente le modèle prédictif, la ligne orange représente la stratégie de traitement de tous les patients, et la ligne bleue représente la stratégie de non-traitement. La zone ombrée indique la plage de probabilité seuil de 10 % à 70 % évaluée dans cette étude, les lignes pointillées verticales marquant les seuils inférieur (10 %) et supérieur (70 %). L'axe des abscisses représente la probabilité seuil, et l'axe des ordonnées représente le bénéfice net. Veuillez cliquer ici pour visualiser une version agrandie de cette figure.
Disponibilité des données :
Le jeu de données au niveau des participants, dé-identifié, qui soutient les résultats de cette étude est fourni dans le Tableau supplémentaire 1. Ce jeu de données contient les données brutes utilisées pour toutes les analyses statistiques, le développement des modèles, la validation interne, ainsi que la préparation des tableaux et figures rapportés.
Figure supplémentaire 1. Flux général de l'étude pour le développement et la validation interne du modèle prédictif. Le flux illustre le recrutement des participantes et l'évaluation des critères d'éligibilité, l'acquisition des caractéristiques cliniques maternelles et des mesures échographiques intrapartum durant la phase active du premier stade du travail, la classification en groupes de deuxième stade du travail normal ou prolongé selon le critère de 120 minutes de l'Organisation mondiale de la Santé (OMS), la sélection des prédicteurs à l'aide d'une régression par l'opérateur de réduction et de sélection des moindres valeurs absolues (LASSO), la construction du modèle de régression logistique multivariée et du nomogramme, ainsi que l'évaluation interne du modèle à l'aide d'une analyse de la courbe ROC (caractéristique de fonctionnement du récepteur), d'une analyse de calibration et d'une analyse de courbe décisionnelle (DCA). Veuillez cliquer ici pour télécharger ce fichier.
Tableau supplémentaire 1. Jeu de données au niveau des participantes utilisé pour le développement et la validation interne du modèle. Ce tableau contient les données anonymisées au niveau des participantes utilisées pour toutes les analyses statistiques, y compris le développement et la validation interne du modèle prédictif. Les variables comprennent le résultat du deuxième stade du travail, la durée du deuxième stade, les résultats néonatals, les caractéristiques démographiques et cliniques maternelles, ainsi que les mesures échographiques transabdominales et transpérinéales obtenues durant le premier stade du travail. Indice de masse corporelle (IMC) = indice de masse corporelle ; occiput antérieur (OA) = position fœtale avec l'occiput en avant ; angle de progression (AOP) = angle de progression ; distance tête-symphysaire (HSD) = distance tête-symphysaire ; et distance tête-périnée (HPD) = distance tête-périnée. Veuillez cliquer ici pour télécharger ce fichier.
Discussion
Grâce à des améliorations continues de la prise en charge obstétricale, la phase prolongée du deuxième stade du travail est devenue un facteur de plus en plus important influant sur les résultats maternels et néonatals. Des études antérieures ont montré que la phase prolongée du deuxième stade du travail est associée à une complexité accrue du travail, à des taux plus élevés de césariennes et à des scores d’Apgar néonatals plus bas1,2. Ces résultats soulignent l’importance clinique d’optimiser la prise en charge périnatale et de mettre en œuvre des stratégies permettant d’identifier précocement les femmes présentant un risque accru de phase prolongée du deuxième stade du travail. En utilisant des caractéristiques démographiques, des paramètres cliniques et des données échographiques, cette étude a développé et validé internement un modèle prédictif de phase prolongée du deuxième stade du travail, puis a évalué son utilité clinique potentielle. Les résultats ont montré que l’âge maternel, l’augmentation de l’IMC pendant la grossesse, le poids de naissance du nouveau-né et l’AOP étaient indépendamment associés à une phase prolongée du deuxième stade du travail dans le modèle multivarié final, tandis que le diabète gestationnel, l’inertie utérine et l’état mental altéré étaient associés à une phase prolongée du deuxième stade du travail dans l’analyse univariée, mais n’ont pas été conservés dans le modèle prédictif final. En intégrant des données démographiques, cliniques et échographiques dans un modèle prédictif multidimensionnel, cette étude fournit un cadre objectif pour identifier les femmes présentant un risque accru de phase prolongée du deuxième stade du travail durant le premier stade du travail. Une telle stratification précoce du risque pourrait faciliter une prise en charge individualisée pendant le travail, incluant une surveillance plus étroite de la progression du travail et une prise de décision clinique opportune, dans le but d’améliorer les résultats maternels et néonatals.
Nos résultats ont indiqué qu’un deuxième stade du travail prolongé était fortement associé à des issues fœtales défavorables. Conformément aux rapports antérieurs, un deuxième stade du travail prolongé augmentait significativement les risques de scores d’Apgar bas et de détresse fœtale3,8. Sur le plan mécanistique, cette association pourrait être attribuable à une hypoxie fœtale et à un stress intra-utérin accru pendant un travail prolongé. Lorsque la tête fœtale reste comprimée dans le pelvis maternel pendant une période prolongée, la perfusion placentaire peut devenir insuffisante, entraînant une privation d’oxygène et des anomalies du rythme cardiaque fœtal susceptibles de compromettre l’état néonatal immédiat9. D’un point de vue démographique, cette étude a montré que l’âge maternel avancé, l’augmentation plus marquée de l’IMC pendant la grossesse et le diabète gestationnel étaient associés à un deuxième stade du travail prolongé. En particulier, les mères âgées présentaient un risque plus élevé de travail prolongé, ce qui est conforme aux recherches antérieures10. Sur le plan physiologique, l’âge maternel avancé pourrait altérer la maturation cervicale et la contractilité utérine, retardant ainsi la progression du travail. Une augmentation plus importante de l’IMC pendant la grossesse et le diabète gestationnel pourraient également influencer la progression du travail en augmentant la taille fœtale et en modifiant les schémas de contraction utérine. En outre, l’inertie utérine et un état mental altéré étaient significativement associés à un deuxième stade du travail prolongé dans l’analyse univariée. Ces résultats soulignent l’importance d’un suivi attentif de la contractilité utérine et du bien-être psychologique maternel pendant le travail, car ces deux facteurs pourraient contribuer indirectement à un travail prolongé en influençant le rythme et l’intensité des contractions utérines. Les paramètres échographiques jouent également un rôle important dans la prédiction d’un deuxième stade du travail prolongé11,12,13,14. Dans la présente étude, l’analyse de régression logistique multivariée a identifié l’AOP comme prédicteur indépendant d’un deuxième stade du travail prolongé (p < 0,05). La HSD et la HPD étaient significativement associées à un deuxième stade du travail prolongé dans l’analyse univariée, mais n’ont pas été conservées dans le modèle prédictif final après sélection des variables par la méthode LASSO. Une HSD accrue indique que la tête fœtale reste à une station plus élevée au niveau de l’entrée pelvienne, suggérant une descente altérée et une probabilité accrue d’un deuxième stade du travail prolongé15,16,17. L’AOP reflète à la fois la descente et la rotation de la tête fœtale, et possède donc une relation directe avec la progression du travail6,18. Bien que la position fœtale déterminée par échographie transabdominale n’ait pas été conservée dans le modèle prédictif final, l’échographie transabdominale reste cliniquement utile pour identifier des malpositions fœtales (par exemple, positions occiput postérieur ou transverse) pouvant nécessiter une évaluation intrapartum plus approfondie. Collectivement, ces résultats suggèrent que l’échographie intrapartum fournit des informations objectives sur la position fœtale et la descente de la tête, pouvant aider à l’évaluation précoce des femmes présentant un risque accru de deuxième stade du travail prolongé. En intégrant les caractéristiques démographiques aux paramètres échographiques, cette étude a élaboré un modèle prédictif validé en interne. La régression LASSO a identifié quatre variables présentant des coefficients non nuls — l’âge maternel, l’augmentation de l’IMC pendant la grossesse, le poids de naissance du nouveau-né et l’AOP — qui ont ensuite été intégrées au modèle de régression logistique multivariée pour l’estimation de l’ampleur des effets ajustés. En utilisant le critère d’un écart-type pour la sélection du modèle, ce dernier a atteint une AUC de 0,927 lors de la validation interne, indiquant une excellente performance discriminatoire. Toutefois, comme le modèle incluait le poids de naissance réel du nouveau-né mesuré après l’accouchement, il doit être considéré comme exploratoire et illustratif, plutôt que directement applicable en pratique clinique. Une mise en œuvre clinique future nécessiterait un réajustement du modèle utilisant le poids fœtal estimé, ainsi qu’une validation externe indépendante. Dans le cadre de ces limites, l’intégration des caractéristiques démographiques et des paramètres échographiques pourrait faciliter une stratification précoce du risque et soutenir une prise en charge intrapartum individualisée19,20,21,22.
Par rapport aux études précédentes, la présente recherche présente plusieurs forces importantes. Premièrement, l'intégration des caractéristiques démographiques, des variables cliniques et des paramètres échographiques a permis une évaluation multidimensionnelle des facteurs associés à un travail prolongé au cours du deuxième stade. Deuxièmement, une régression LASSO a été utilisée pour la sélection des variables et la réduction des coefficients, ce qui permet de gérer la multicolinéarité et d'améliorer la stabilité du modèle en présence de prédicteurs corrélés. Troisièmement, la taille de l'échantillon a fourni une puissance statistique suffisante pour le développement du modèle et sa validation interne. Malgré ces atouts, plusieurs limites doivent être reconnues. Premièrement, il s'agissait d'une étude prospective monocentrique, et seules les femmes ayant finalement accouché par voie vaginale ont été incluses. Par conséquent, les femmes ayant eu recours à un accouchement vaginal instrumental ou à une césarienne durant le deuxième stade ont été exclues, ce qui introduit un biais de sélection et limite la généralisabilité des résultats. De plus, la définition de l'issue n'a pas pris en compte l'accouchement instrumental comme issue concurrente chez les femmes présentant un travail prolongé. Par conséquent, une validation externe dans des cohortes prospectives multicentriques indépendantes est nécessaire avant toute application clinique. Deuxièmement, toutes les évaluations des performances du modèle, y compris l'analyse ROC, la calibration et l'analyse de décision clinique (DCA), étaient basées sur une validation interne utilisant la même population d'étude, et aucune cohorte externe indépendante n'était disponible pour la validation externe. Troisièmement, bien que l'analgésie péridurale, l'augmentation par ocytocine et la rupture artificielle des membranes aient été enregistrées, ces variables n'ont pas été intégrées au modèle prédictif final. D'autres facteurs potentiellement importants, tels que les caractéristiques des contractions utérines, les stratégies de prise en charge du travail et les scores de douleur maternelle, pourraient également influencer la progression du travail et devraient être évalués dans des études futures. Quatrièmement, certaines mesures échographiques restent dépendantes de l'opérateur malgré une formation standardisée et une excellente reproductibilité inter-observateurs, et une seule évaluation, réalisée durant le stade actif du premier stade du travail, a été analysée. Étant donné que le travail est un processus dynamique, la moyenne de trois mesures effectuées lors de contractions distinctes pourrait réduire les erreurs aléatoires de mesure, mais pourrait également masquer des changements rapides de la descente fœtale. Des études futures intégrant des évaluations échographiques répétées et horodatées, telles que l'évolution de l'AOP au fil du temps, pourraient améliorer la performance prédictive23,24. Enfin, le modèle prédictif a été élaboré à l'aide du poids réel du nouveau-né mesuré après l'accouchement, afin d'établir l'association physiologique avec un deuxième stade prolongé. En conséquence, ce modèle doit être considéré comme exploratoire et n'est pas directement applicable à la prédiction clinique intrapartum. Une mise en œuvre clinique nécessiterait la refonte et la validation externe du modèle en utilisant le poids fœtal estimé avant l'accouchement, plutôt qu'une simple substitution dans l'équation actuelle. Étant donné que le poids fœtal estimé est soumis à une erreur de mesure inhérente (généralement ±10 % à 15 %), les coefficients du modèle et ses performances devraient être réévalués dans une cohorte indépendante avant toute utilisation clinique. En outre, l'inertie utérine a été définie dans cette étude selon la fréquence et la durée observées des contractions, et non selon les critères diagnostiques d'arrêt du travail recommandés par l'ACOG ou le NICE, ce qui pourrait limiter la comparaison directe avec d'autres études. Enfin, l'utilisation d'un seuil fixe de 120 minutes pour définir un deuxième stade prolongé, sans tenir compte des durées plus longues qui peuvent être acceptables chez les femmes recevant une analgésie péridurale, pourrait encore limiter la généralisabilité du modèle.
Les recherches futures devraient explorer des approches alternatives pour étudier l'hypothèse examinée dans cette étude. Premièrement, alors que cette étude a utilisé une seule évaluation par échographie au début de la phase active du travail, des mesures sérielles (par exemple, les variations de l'AOP ou de la distance de progression de la tête au fil du temps) pourraient mieux rendre compte du processus dynamique de la descente fœtale et améliorer la performance prédictive, comme le suggèrent des études récentes23,24. Deuxièmement, bien que la combinaison d'une régression LASSO et d'une régression logistique multivariée ait produit un modèle sobre et interprétable, d'autres approches d'apprentissage automatique, telles que les forêts aléatoires, les machines à vecteurs de support et le boosting par gradient, pourraient mieux capturer les relations non linéaires et les interactions complexes entre les prédicteurs, même si cela se fait potentiellement au détriment de l'interprétabilité. Troisièmement, comme les définitions du travail prolongé de la deuxième phase varient selon les recommandations cliniques, notamment par l'inclusion de seuils plus élevés pour les femmes recevant une analgésie péridurale, une recalibration du modèle pour d'autres définitions des critères de jugement devrait être étudiée. Quatrièmement, les modèles futurs devraient être élaborés à partir du poids fœtal estimé plutôt que du poids réel de naissance du nouveau-né, et des méthodes échographiques alternatives d'estimation du poids fœtal, notamment les techniques d'échographie tridimensionnelle, pourraient contribuer à réduire les erreurs de mesure. Enfin, l'intégration de données continues de surveillance intrapartum, telles que l'intensité des contractions utérines ou l'analyse automatisée de la cardiotocographie, pourrait améliorer davantage la stratification du risque. Une évaluation comparative de ces approches pourrait aider à identifier la stratégie optimale pour prédire un travail prolongé de la deuxième phase.
Une autre limitation de cette étude est qu'elle n'a inclus que les femmes ayant réussi un accouchement vaginal afin de garantir une mesure précise de la durée du deuxième stade. Par conséquent, les femmes ayant subi un accouchement vaginal instrumenté ou une césarienne après un deuxième stade prolongé ont été exclues, bien qu'elles auraient satisfait à la définition d'un travail prolongé retenue dans l'étude. Ce critère de sélection risque d'avoir sous-estimé l'incidence réelle du deuxième stade prolongé et d'avoir introduit un biais dans la détermination du résultat. En outre, l'accouchement instrumenté avant l'achèvement du deuxième stade constitue un résultat concurrent plutôt qu'un simple événement négatif, et n'a donc pas été intégré au modèle prédictif. Ainsi, le modèle actuel estime uniquement la probabilité d'un deuxième stade prolongé chez les femmes qui parviennent finalement à un accouchement vaginal, et ne doit pas être utilisé pour prédire la nécessité d'un accouchement instrumenté. Une validation externe auprès de populations obstétricales plus larges et non sélectionnées, incluant des accouchements instrumentés, sera nécessaire pour évaluer la généralisabilité et l'applicabilité clinique du modèle. L'association observée entre un deuxième stade prolongé et des complications, notamment un stress fœtal et des scores d'Apgar bas, même au sein d'une cohorte limitée aux femmes ayant accouché par voie vaginale, souligne l'importance d'une évaluation précoce des risques. Le taux élevé d'accouchements vaginaux dans cette cohorte reflète les critères d'inclusion de l'étude et ne doit pas être interprété comme une indication que les interventions instrumentées seraient inutiles dans la pratique clinique courante.
Le modèle prédictif présente plusieurs applications potentielles. Après une nouvelle élaboration utilisant le poids fœtal estimé et une validation externe indépendante, il pourrait être intégré aux systèmes de dossiers de santé électroniques afin d'estimer le risque individuel de deuxième stade du travail prolongé pendant le premier stade actif, facilitant ainsi l'identification en temps réel des femmes présentant un risque accru. En utilisant le seuil de probabilité optimal identifié dans cette étude (0,48), le modèle pourrait aider à soutenir une prise en charge intrapartum individualisée, incluant une surveillance maternelle et fœtale plus étroite ainsi qu'une prise de décision clinique opportune. De plus, le modèle pourrait faciliter la stratification du risque dans de futures études interventionnelles évaluant les stratégies de gestion du travail, les protocoles d'anesthésie péridurale ou la stimulation utérine, en permettant une répartition plus équilibrée du risque de base. Étant donné que les variables d'entrée requises sont couramment recueillies lors des soins cliniques, le modèle pourrait également fournir un cadre pratique pour une future validation externe et son adaptation à d'autres populations obstétricales, notamment les femmes multipares et celles subissant une induction du travail. En résumé, l'intégration de paramètres échographiques transabdominaux et transpérinéaux du premier stade aux caractéristiques démographiques et cliniques maternelles a permis de développer un modèle prédictif validé en interne pour le deuxième stade du travail prolongé. L'évaluation multidimensionnelle a montré que l'âge maternel, l'augmentation de l'IMC en cours de grossesse, le poids de naissance néonatal et l'AOP étaient indépendamment associés au deuxième stade du travail prolongé, et a révélé que le modèle offrait une excellente discrimination avec une bonne calibration lors de la validation interne. Bien que ces résultats soutiennent la valeur potentielle de cette approche pour l'évaluation précoce du risque intrapartum, le modèle doit être considéré comme exploratoire, car il intègre le poids de naissance néonatal réel et n'a fait l'objet que d'une validation interne. Avant toute mise en œuvre clinique, le modèle devrait être réélaboré à l'aide du poids fœtal estimé et validé externement dans des cohortes indépendantes et multicentriques. De futures études devraient également examiner l'intégration de prédicteurs supplémentaires, notamment les caractéristiques des contractions utérines, les variables de gestion de la douleur et les interventions intrapartum, afin de développer un modèle prédictif plus complet et généralisable pour une prise en charge individualisée du travail.
Déclarations de divulgation
Conflit d'intérêts :
Les auteurs déclarent ne pas avoir d'intérêts financiers ou non financiers concurrents liés à ce travail.
Remerciements
Les auteurs remercient le personnel infirmier et médical du service d'obstétrique de l'hôpital de santé maternelle et infantile de Yuyao (deuxième hôpital populaire de Yuyao) pour leur aide à la recrutement des participantes et à la collecte des données. Ce travail a été soutenu par le programme municipal des sciences et technologies de la santé de Yuyao 2024 (subvention no 2024YYB03).
Matériaux
| Nom | Entreprise | Numéro de catalogue | Commentaires |
|---|---|---|---|
| Système d'échographie diagnostique portable | Mindray | CAU-01040644 | Système d'échographie diagnostique portable utilisé pour l'imagerie transabdominale et transpérinéale ; voir le protocole pour les paramètres d'imagerie |
| Sonde échographique convexe (2–5 MHz) | Mindray | C5-2 | Utilisée pour l'imagerie échographique transabdominale |
| Sonde échographique linéaire à haute fréquence ou sonde convexe de petite empreinte (5–8 MHz) | Mindray | 75L38EA | Utilisée pour l'imagerie échographique transpérinéale |
| Logiciel R | Fondation R pour l'informatique statistique | Version 4.1.0 | Logiciel de calcul statistique (RRID : SCR_001905) |
| Logiciel SPSS | IBM Corp. | Version 26.0 | Logiciel d'analyse statistique (RRID : SCR_002865) |
| Échelle d'auto-évaluation de l'anxiété | Questionnaire publié (Échelle d'auto-évaluation de l'anxiété de Zung) | Non applicable | Questionnaire d'évaluation de l'anxiété utilisé à l'admission |
Références
- American College of Obstetricians and Gynecologists, Society for Maternal-Fetal Medicine. Obstetric Care Consensus No. 1: Safe prevention of the primary cesarean delivery. Obstet Gynecol. 2014;123(3):693-711. doi:10.1097/01.AOG.0000444441.04111.1d.
- World Health Organization. WHO Guidelines Approved by the Guidelines Review Committee. World Health Organization; Geneva; 2015.
- Miyamoto K, et al. Prolonged second stage of labor in delivery using epidural analgesia is a risk factor for postpartum urinary retention. J Obstet Gynaecol Res. 2024;50(3):424-429. doi:10.1111/jog.15867.
- Kahrs BH. Ultrasound before operative vaginal delivery: Why and how. Minerva Obstet Gynecol. 2021;73(1):67-73. doi:10.23736/S2724-606X.20.04667-5.
- Yano E, et al. Anatomical identification of ischial spines applicable to intrapartum transperineal ultrasound based on magnetic resonance imaging of pregnant women. J Matern Fetal Neonatal Med. 2022;35(25):9736-9741. doi:10.1080/14767058.2022.2051007.
- Kahrs BH, Eggebø TM. Intrapartum ultrasound in women with prolonged first stage of labor. Am J Obstet Gynecol MFM. 2021;3(6):100427. doi:10.1016/j.ajogmf.2021.100427.
- Lee NMW, et al. Implementation of sonopartogram: Multicenter feasibility study. Ultrasound Obstet Gynecol. 2024;64(2):214-221. doi:10.1002/uog.27634.
- Saucedo AM, et al. First and second stage risk factors associated with perineal lacerations. Matern Child Health J. 2024;28(7):1228-1233. doi:10.1007/s10995-024-03919-1.
- Zhang M, et al. Risk factors for episiotomy during vaginal childbirth: A retrospective cohort study in Western China. J Evid Based Med. 2018;11(4):233-241. doi:10.1111/jebm.12316.
- Friedman EA, Cohen WR. The active phase of labor. Am J Obstet Gynecol. 2023;228(5 Suppl):S1037-S1049. doi:10.1016/j.ajog.2021.12.269.
- Kalache KD, et al. Transperineal ultrasound imaging in prolonged second stage of labor with occipitoanterior presenting fetuses: How well does the angle of progression predict the mode of delivery? Ultrasound Obstet Gynecol. 2009;33(3):326-330. doi:10.1002/uog.6294.
- Chan YT, et al. Relationship between intrapartum transperineal ultrasound measurement of angle of progression and head-perineum distance with correlation to conventional clinical parameters of labor progress and time to delivery. J Matern Fetal Neonatal Med. 2015;28(12):1476-1481. doi:10.3109/14767058.2014.958459.
- Chor CM, et al. Prediction of labor outcome using serial transperineal ultrasound in the first stage of labor. J Matern Fetal Neonatal Med. 2019;32(1):31-37. doi:10.1080/14767058.2017.1369946.
- Maged AM, et al. Measurement of the fetal occiput-spine angle during the first stage of labor as predictor of the progress and outcome of labor. J Matern Fetal Neonatal Med. 2019;32(14):2332-2337. doi:10.1080/14767058.2018.1432589.
- Gimovsky AC, Berghella V. Evidence-based labor management: Second stage of labor (part 4). Am J Obstet Gynecol MFM. 2022;4(3):100548. doi:10.1016/j.ajogmf.2021.100548.
- Barak O, et al. The routine use of intrapartum ultrasound in clinical decision-making during the second stage of labor: Does it have any impact on delivery outcomes? Gynecol Obstet Invest. 2018;83(1):9-14. doi:10.1159/000455847.
- Beck R, et al. Intrapartum sonography of fetal head in second stage of labor with neuraxial analgesia: A literature review and possible medicolegal aftermath. Eur Rev Med Pharmacol Sci. 2019;23(8):3159-3166. doi:10.26355/eurrev_201904_17673.
- Li N, et al. Risk factors and clinical prediction of shoulder dystocia in non-macrosomia. Zhonghua Fu Chan Ke Za Zhi. 2015;50(1):17-21. doi:10.3760/cma.j.issn.0529-567X.2015.01.005.
- Carvalho Neto RH, et al. Assessment of the angle of progression and distance perineum-head in the prediction of type of delivery and duration of labor using intrapartum ultrasonography. J Matern Fetal Neonatal Med. 2021;34(14):2340-2348. doi:10.1080/14767058.2019.1666818.
- Haberman S, et al. A novel partogram for stages 1 and 2 of labor based on fetal head station measured by ultrasound: A prospective multicenter cohort study. Am J Perinatol. 2021;38(S01):e14-e20. doi:10.1055/s-0040-1702989.
- Pan WL, et al. Accuracy of non-invasive methods for assessing the progress of labor in the first stage: A systematic review and meta-analysis. BMC Pregnancy Childbirth. 2022;22(1):608. doi:10.1186/s12884-022-04938-y.
- Ghi T, Dall'Asta A. Sonographic evaluation of the fetal head position and attitude during labor. Am J Obstet Gynecol. 2024;230(3 Suppl):S890-S900. doi:10.1016/j.ajog.2022.06.003.
- Nassr AA, et al. Intrapartum ultrasound measurement of angle of progression at the onset of the second stage of labor for prediction of spontaneous vaginal delivery in term singleton pregnancies: A systematic review and meta-analysis. Am J Obstet Gynecol. 2022;226(2):205-214. https://doi.org/10.1016/j.ajog.2021.07.031.
- Hans R, Reddy D, Shetty J. Serial intrapartum ultrasound to predict vaginal delivery using angle of progression and head-progression distance in term nulliparous women. Eur J Obstet Gynecol Reprod Biol. 2025;293:18-23.