Ce protocole implémente un réseau d’apprentissage profond en forme de U intégrant convolution en moulin à vent, double attention et fusion multi-échelle pour segmenter les polypes colorectals.
Un abonnement JoVE est requis pour visualiser ce contenu. Connectez-vous ou commencez votre période d'essai gratuite.
Article de méthode
Réseau de segmentation des polypes basé sur la convolution en moulin et une double attention pour le diagnostic des lésions précancéreuses colorectales
* These authors contributed equally
Dans cet article
Résumé
Résumé
Une segmentation précise des polypes colorectaux est cruciale pour la prévention précoce et le diagnostic du cancer colorectal. Cependant, en raison de la forte hétérogénéité des polypes en termes de forme, de taille et de texture, ainsi que de la complexité de l’environnement intestinal (tels que les plis, les réflexions spéculaires et les résidus fécals), les méthodes existantes rencontrent encore des défis importants dans la localisation des limites et la détection des petits polypes. Pour répondre à ces problèmes, cet article propose un réseau de segmentation des polypes basé sur la convolution en moulin à épingle et la double attention (PWD-Net). Le réseau proposé adopte une architecture encodeur-décodeur en U, où un ResNet pré-entraîné est employé comme encodeur pour extraire des fonctionnalités locales multi-niveaux. Plus précisément, un module de convolution Pinwheel (PCM) est introduit à la couche goulot d’étranglement pour capturer la structure géométrique globale et l’information contextuelle multidirectionnelle des polypes via des noyaux de convolution rotés à plusieurs angles. Un mécanisme à double attention (DAM) qui intègre l’attention du canal et l’attention spatiale est conçu pour supprimer de manière adaptative le bruit de fond et renforcer les caractéristiques de la région des polypes. De plus, une stratégie de fusion multi-échelle (MSF) est employée pour combiner des informations sémantiques profondes avec des détails de frontières peu profonds, garantissant à la fois l’exhaustivité et la précision des résultats de segmentation. Des expériences menées sur les ensembles de données Kvasir-SEG et CVC-ClinicDB démontrent que PWD-Net atteint des coefficients Dice moyens de 0,865 et 0,944, et des scores IoU de 0,765 et 0,892 respectivement, surpassant nettement les méthodes de pointe existantes. Les études d’ablation vérifient l’efficacité de chaque module, et les évaluations croisées confirment la forte capacité de généralisation du modèle. Cette étude propose une solution robuste et de haute précision pour la segmentation clinique des polypes, offrant une valeur significative pour le diagnostic précoce des lésions précancéreuses colorectales et soutenant l’intervention assistée par ordinateur.
Introduction
Le cancer colorectal est l’une des tumeurs malignes les plus courantes dans le monde, avec des taux d’incidence et de mortalité constamment élevés. Des études ont montré que la plupart des cancers colorectaux se développent à partir de polypes adénomateux, un processus qui dure généralement 10 à 15 ans, offrant une fenêtre temporelle précieuse pour la détection précoce et l’intervention. Une augmentation de 1 % du taux de détection des adénomes (ADR) peut réduire le risque de cancer colorectal d’environ 3 %, diminuant significativement la mortalité despatients 1. La coloscopie, considérée comme la référence en matière de dépistage du cancer colorectal, permet l’élimination directe des polypes lors de l’examen, réduisant ainsi efficacement l’incidence et la mortalité du cancer.
Cependant, la coloscopie conventionnelle dépend fortement de l’expérience et du niveau de compétence des endoscopistes. Des facteurs tels que le jugement subjectif, la fatigue visuelle et la distraction peuvent entraîner un taux d’échec de 20 % à 30 %, ce qui affecte directement l’efficacité du dépistage2. Par conséquent, développer des systèmes de détection assistée par ordinateur (CAO) pour la segmentation automatique des polypes colorrectaux revêt une importance considérable pour améliorer la RAM et réduire les diagnostics manqués. Des enquêtes cliniques récentes ont également mis en lumière l’intérêt pour l’intégration de l’intelligence artificielle dans les flux de travail d’évaluation endoscopique des lésions, renforçant ainsi la nécessité de méthodes de segmentation robusteset reproductibles 3.
Ces dernières années, l’apprentissage profond a réalisé des progrès remarquables dans l’analyse d’images médicales, en particulier les réseaux neuronaux convolutionnels (CNN), qui démontrent une forte capacité d’extraction et de représentation de caractéristiques pour les tâches de segmentationd’images 4. En tant que modèle classique de segmentation d’image médicale, U-Net utilise une architecture encodeur-décodeur symétrique et des connexions à saut pour obtenir une segmentation précise au niveau des pixels, devenant une référence dans cedomaine 5. S’appuyant sur U-Net, de nombreuses architectures améliorées ont été proposées pour répondre à des tâches complexes de segmentation d’images médicales. UNet++ réduit l’écart sémantique entre les cartes de caractéristiques de l’encodeur et du décodeur en introduisant des connexions de saut imbriquées etdenses 6. ResUNet++ intègre des blocs résiduels, des modules de compression et d’excitation, des convolutions dilatées et des mécanismes d’attention, atteignant de fortes performances en segmentation depolypes 7. U2-Net adopte une structure imbriquée en forme de U à deux niveaux pour capturer des informations de caractéristiquesmulti-échelle 8. Plus récemment, un réseau de segmentation profonde de polypes basé sur un double encodeur-décodeur a été proposé, exploitant les chemins d’encodage et de décodage parallèles pour améliorer encore la précision desegmentation 9.
Par contre, l’introduction de mécanismes d’attention apporte de nouvelles solutions pour l’amélioration des caractéristiques et la suppression du bruit. Attention U-Net utilise des portails d’attention pour se concentrer sur les régions cibles tout en supprimant les informations de fond nonpertinentes 10. Le Double Attention Network (DANet) pondère adaptativement les caractéristiques à partir des dimensions du canal etspatiales 11, améliorant ainsi la perception des caractéristiques critiques. Les réseaux à triple attention (TANet) améliorent encore la performance de segmentation grâce à la sélection adaptative de fonctionnalitésmulti-échelle 12.
Avec le succès des architectures Transformer dans le traitement du langage naturel et la vision parordinateur 13, les chercheurs ont commencé à explorer leur application dans la segmentation d’images médicales. TransUNet a été le premier à utiliser un Transformer comme encodeur pour modéliser efficacement les dépendances à longueportée 14. Swin-UNet adopte une architecture purement Transformer et réalise une agrégation globale efficace de l’information grâce à un mécanisme à fenêtredécalée 15. UTNet propose une architecture hybride qui combine la capacité d’extraction locale des caractéristiques des CNN avec la modélisation globale de Transformers16.
Dans le domaine de la segmentation des polypes, Polyp-PVT utilise un Transformer à vision pyramidale pour capturer l’information sémantique globalemulti-échelle 17, tandis que l’UNet imbriqué multi-échelle améliore la compréhension contextuelle en intégrant Transformers18. Des études récentes ont également exploré des stratégies d’apprentissage par corrélation négative pour la segmentation inter-domainedes polypes 19, l’amélioration de la segmentation augmentée parGompertz 20, ainsi que des architectures basées sur l’attention incorporant un guidage de frontière21. Bien que ces approches améliorent dans une certaine mesure la performance de la segmentation, la segmentation des polypes rencontre encore plusieurs défis. Premièrement, les polypes présentent une forte hétérogénéité morphologie, taille et texture, allant de micro-polypes de plus de 5 mm à de gros polypes dépassant 30 mm, avec des formes allant de circulaires et elliptiques à des formes très irrégulières. Deuxièmement, l’environnement intestinal est complexe et variable, où les plis muqueuss, les réflexions spéculaires, les résidus fécaux et les débris alimentaires introduisent une interférence de fond sévère. Troisièmement, de nombreux polypes présentent des frontières floues, peuvent être partiellement obstrués par des plis ou submergés dans des liquides intestinaux, rendant la localisation précise des limites extrêmementdifficile 22.
Les méthodes existantes présentent encore des limites claires pour relever ces défis. Les CNN traditionnels sont efficaces pour extraire les textures locales et les contours ; cependant, les noyaux de convolution carrés fixes ne sont pas bien adaptés à la capture de formes géométriques diverses23, en particulier pour les polypes très irréguliers, et ne peuvent pas modéliser efficacement des caractéristiques géométriques multidirectionnelles. Les méthodes basées sur des transformateurs peuvent modéliser les dépendances globales mais sont moins efficaces pour capturer des détails locaux fins et des informations de frontière. De plus, leur grande complexité de calcul les rend moins adaptés aux applications cliniques en tempsréel 24. Les approches récentes de segmentation des polypes telles que PraNet, qui utilise des modules d’attention inversée pour affiner les régionsclés 25, les réseaux d’attention en cascade guidés par les frontières qui améliorent l’extraction des caractéristiquesdes limites 26, et CAFE-Net, qui fusionne les caractéristiques encodeur et décodeur via des mécanismes d’attentioncroisée 27, rencontrent encore une représentation des caractéristiques insuffisante et une localisation des limites imprécise lors de la gestion de petitspolypes 28, des frontières floues et des arrière-plans complexes. De plus, la plupart des méthodes négligent la morphologie géométrique et ne parviennent pas à exploiter pleinement les informations contextuelles multidirectionnelles, ce qui entraîne une segmentation sous-optimale des polypes de forme irrégulière.
En résumé, les méthodes actuelles basées sur CNN ne permettent pas de capturer des caractéristiques géométriques multidirectionnelles en raison de leur dépendance aux noyaux de convolution carrés fixes. Les approches basées sur les transformateurs offrent une modélisation globale mais sacrifient la précision des frontières locales et imposent des coûts de calcul élevés. Par ailleurs, les stratégies existantes de fusion à attention améliorée et à plusieurs échelles n’ont pas été optimisées conjointement dans un cadre unifié spécifiquement adapté à la segmentationdes polypes 29. Ces lacunes motivent le développement d’une méthode qui aborde simultanément la modélisation géométrique des caractéristiques, la suppression adaptative du bruit et l’intégration des caractéristiques à l’échelle croisée.
Pour résoudre ces problèmes, ce protocole présente un réseau de segmentation de polypes basé sur la convolution en moulin à éponge et la double attention (PWD-Net). Le réseau proposé intègre la modélisation géométrique des caractéristiques, l’amélioration de l’attention multidimensionnelle et la fusion de caractéristiques à plusieurs échelles, permettant une segmentation précise des polypes complexes. Les principales contributions de ce travail sont résumées ainsi : le module de convolution en moulin à pile (PCM), inspiré de la structure d’un moulin à vent, propose un nouveau noyau de convolution tourné qui capture les caractéristiques géométriques multidirectionnelles des polypes par des opérations de convolution à plusieurs angles (0°, 45°, 90°, 135°, 180°, 225°, 270° et 315°). Ce module remplace la couche de convolution conventionnelle à l’étape du goulot d’étranglement, permettant une perception efficace des orientations diverses des arêtes et améliorant significativement la représentation des polypes de forme irrégulière. Le mécanisme de double attention (DAM) traite les bruits de fond tels que les plis, les réflexions et les résidus fécaux dans les images de coloscopie. Un module à double attention intégrant l’attention canalisée et l’attention spatiale est conçu. Intégré dans les connexions à saut, ce module supprime de manière adaptative les interférences de fond et améliore les réponses des caractéristiques dans les régions polypes en identifiant conjointement « ce qui » est important (dimension du canal) et « où » la cible se trouve (dimension spatiale), garantissant que seules les caractéristiques affinées sont impliquées dans la fusion ultérieure. La stratégie de fusion de caractéristiques multi-échelles (MSF) préserve à la fois des informations sémantiques profondes et des détails superficiels des frontières grâce à un mécanisme hiérarchique introduit dans le décodeur. En intégrant progressivement les caractéristiques de l’encodeur amélioré par DAM avec des caractéristiques de décodeur suréchantillonné, cette stratégie compense efficacement la perte de détails spatiale causée par le downsampling, permettant une détection précise de petits polypes et une délimitation précise des frontières.
Accès restreint. Veuillez vous connecter ou commencer un essai pour afficher ce contenu.
Protocole
Cette étude utilise uniquement des ensembles de données d’images anonymisées et anonymisées publiques (Kvasir-SEG). Aucune nouvelle donnée sur les sujets humains n’a été collectée. L’approbation éthique institutionnelle et le consentement éclairé des patients n’étaient pas requis, comme le confirment les politiques d’examen institutionnel pour les analyses rétrospectives de jeux de données publics désidentifiés.
1. Préparation des données
- Téléchargez le jeu de données Kvasir-SEG depuis le dépôt officiel33 (https://datasets.simula.no/kvasir-seg/). Le jeu de données contient 1 000 images de polypes avec des masques de vérité au niveau des pixels correspondants.
- Divisez aléatoirement le jeu de données en ensembles d’entraînement (800 images), de validation (100 images) et de test (100 images) avec un ratio de 8:1:1 en utilisant une graine aléatoire fixe (graine = 42). Vérifiez qu’aucune image ne se chevauche entre les trois sous-ensembles afin d’éviter toute fuite de données.
- Redimensionner toutes les images et masques correspondants à 352 x 352 pixels en utilisant l’interpolation bilinéaire pour les images et l’interpolation du voisin le plus proche pour les masques.
- Normaliser les valeurs des pixels à [0, 1] en divisant par 255, puis appliquer la soustraction moyenne par canal par canal (0,485, 0,456, 0,406) et la normalisation par écart-type (0,229, 0,224, 0,225).
- Appliquez les transformations d’augmentation suivantes uniquement à l’ensemble d’entraînement (pas aux ensembles de validation ou de test) : retournement horizontal aléatoire (probabilité = 0,5) ; retournement vertical aléatoire (probabilité = 0,5) ; rotation aléatoire (plage : −30° à +30°, probabilité = 0,5) ; Redimensionnement aléatoire multi-échelle (facteur d’échelle : 0,75 à 1,25, probabilité = 0,5)
REMARQUE : Appliquer des transformations spatiales identiques à l’image et à son masque correspondant afin de maintenir l’alignement. Vérifiez la correction des augmentations en inspectant visuellement plusieurs paires image-masque augmentées avant d’initier l’entraînement.
2. Architecture générale
REMARQUE : Voir la Figure 1 pour la colonne vertébrale encodeur-décodeur au niveau macro de PWD-Net, et la Figure 2 pour l’intégration et l’interaction des modules de base dans le flux de fonctionnalités. L’architecture globale suit un design encodeur-décodeur en forme de U pour gérer les variations d’échelle des polypes et les interférences de fond dans les images de coloscopie.
- Réseau dorsale et chemin d’encodage (Figure 1)
- Utilisez un ResNet-50 pré-entraîné sur ImageNet (provenant du zoo officiel PyTorch) comme encodeur dorsale 30. Ajustez toutes les couches d’encodeurs pendant l’entraînement.
- Faites passer l’image de coloscopie d’entrée (redimensionnée à 352 x 352 pixels) à travers cinq étapes de blocs convolutionnels résiduels pour extraire des caractéristiques hiérarchiques. La résolution spatiale des cartes de caractéristiques est progressivement réduite de vers les cinq étapes, tandis que les dimensions du canal augmentent en conséquence (64 → 128 → 256 → 512 → 1024).
- Au goulot d’étranglement (la couche d’encodeur la plus profonde), remplacer la couche convolutionnelle standard par le Module de Convolution Pinwheel (PCM, décrit dans la Section 3) afin de capturer la morphologie géométrique globale et les informations contextuelles multidirectionnelles à faible résolution.
REMARQUE : Les cinq étapes de l’encodeur correspondent aux groupes de couches standard de ResNet-50 : conv1, couche 1, couche 2, couche 3 et couche 4. Les poids préentraînés offrent une initialisation robuste des caractéristiques de bas et moyen niveau, réduisant ainsi le temps de convergence sur de petits ensembles de données médicales.
- Composants clés et interaction des caractéristiques (Figure 2 et Figure 3)
- Appliquez le mécanisme de double attention (DAM, décrit dans la section 4) à la sortie de chaque étage de l’encodeur avant de le transmettre au décodeur via des connexions à saut. Cette étape supprime de manière adaptative le bruit de fond généré par les plis intestinaux et les réflexions spéculaires, tout en augmentant la réponse des caractéristiques dans les régions polypiques. Seules les caractéristiques filtrées sont transmises à la couche décodeuse correspondante.
- Dans le décodeur, restaurez progressivement la résolution spatiale par un échantillonnage bilinéaire. À chaque couche de décodeur, concaténer les caractéristiques suréchantillonnées de l’étape précédente avec les caractéristiques de l’encodeur amélioré DAM de la même résolution spatiale.
- Appliquez deux couches convolutionnelles convolutionnelles consécutives (chacune suivie d’une normalisation par lots et d’une activation ReLU) pour fusionner l’information multi-échelle. Cela constitue la stratégie Multi-scale Feature Fusion (MSF) décrite à la Section 5.
REMARQUE : Le décodeur passe des couches profondes aux couches peu profondes (étape 5 → étape 1), garantissant que les informations de localisation sémantique profonde et les informations de détail des limites superficielles sont efficacement intégrées à chaque niveau.
- Génération de production
- Appliquez une couche convolutionnelle suivie d’une fonction d’activation sigmoïde à la sortie finale du décodeur pour générer le masque de prédiction.
- Binariser le masque de prédiction en utilisant un seuil de 0,5 pour obtenir le résultat final de segmentation, où les pixels avec une probabilité prédite ≥ 0,5 sont classés comme polypes et les pixels restants en arrière-plan.
3. Module de convolution des moulins à piquet (Figure 3)
- Le Module de Convolution à Moulin (PCM) remplace la convolution standard du goulot d’étranglement pour capturer les caractéristiques géométriques multidirectionnelles des polypes. Mettez en œuvre ce module comme suit :
- Définissons un noyau de convolution de base W de taille 3 x 3 avec Cdans les canaux d’entrée et C dans les canauxde sortie .
- Définissons l’ensemble des angles de rotation Θ = {0°, 45°, 90°, ..., 315°}. Pour chaque angle θ ∈ Θ, générez le noyau rotationnelW θ en appliquant une rotation basée sur l’interpolation bilinéaire à W. Les huit noyaux tournés partagent les mêmes paramètres de base ; seule la disposition spatiale des poids diffère.
- Pour chaque angle θ, calculer la carte de caractéristiques spécifique à la direction :

où X est la carte des caractéristiques d’entrée. - Agréger les huit attributs directionnels par concaténation canal par canal le long de l’axe du canal, produisant un tenseur de dimension (8 x Cen sortie) x H x W. Ensuite, appliquez une convolution 1 x 1 pour réduire la dimension du canal à Cout, suivie d’une normalisation batch et de l’activationReLU 31 :

REMARQUE : La rotation et l’interpolation sont effectuées sur les poids du noyau, et non sur la carte de caractéristiques d’entrée. Cette conception permet une extraction multidirectionnelle efficace en termes de paramètres sans augmenter la résolution d’entrée. Dans l’implémentation actuelle, Cin = 1024 et Cout = 1024 au stade du goulot d’étranglement, correspondant à la dimension du canal de sortie de la couche ResNet-50 4. Consultez le paquet de code complémentaire pour l’implémentation complète.
4. Mécanisme de double attention (Figure 4)
REMARQUE : Le mécanisme de double attention (DAM) est intégré à chaque connexion de saut pour supprimer le bruit de fond et renforcer les caractéristiques de la région polyp, tant dans les dimensions du canal que spatiales.
- Attention sur la chaîne
La branche attention des canaux identifie quels canaux de fonctionnalités sont les plus informatifs. Avec une fonction d’entrée F ∈ RC×H×W :- Compressez les dimensions spatiales via un regroupement global de la moyenne pour obtenir un descripteur de canal z ∈ RC×1×1.
- Passer z à travers une MLP (couches entièrement connectées) à deux couches avec un rapport de réduction r = 16. La première couche réduit la dimension de C à C/16 avec l’activation ReLU ; la seconde couche le ramène de C/16 à C grâce à une activation sigmoïde pour produire le vecteur de poids du canalA c :
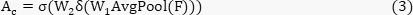
où δ désigne ReLU et σ désigne Sigmoïde.
- Attention spatiale
La branche de l’attention spatiale localise les régions cibles :- Appliquez à la fois le pooling max et le pooling moyen le long de la dimension du canal pour générer deux cartes de caractéristiques 2D de taille 1 x H x W.
- Concaténine les deux applications le long de l’axe du canal pour former un tenseur 2 x H x W. Appliquez une couche convolutionnelle de 7 x 7 suivie d’une activation sigmoïde pour produire la carte de poids spatiale As ∈ R1×H×W :
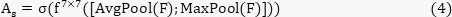
- Fusion des caractéristiques
- Fusionner les sorties du canal et de l’attention spatiale avec la fonction d’entrée par multiplication élément par élément :

où α et β sont des coefficients d’équilibrage apprisables, tous deux initialisés à 0,5 et mis à jour conjointement avec les paramètres réseau via une optimisation basée sur le gradient pendant l’entraînement.
REMARQUE : Référez-vous au paquet de code supplémentaire (dam_module.py) pour l’implémentation complète.
- Fusionner les sorties du canal et de l’attention spatiale avec la fonction d’entrée par multiplication élément par élément :
5. Fusion multi-échelle des caractéristiques
- Appliquer la stratégie de fusion multi-échelle des caractéristiques (MSF) dans le décodeur pour traiter la perte de détails spatiale dans les caractéristiques profondes. À chaque étape du décodeur, effectuez ce qui suit :
- Upéchantillonnez la carte de caractéristiques de l’étape précédente du décodeur par un facteur de 2 en utilisant une interpolation bilinéaire.
- Concaténer les caractéristiques suréchantillonnées avec les caractéristiques de l’encodeur amélioré DAM de la résolution spatiale correspondante le long de l’axe du canal.
- Appliquez deux couches convolutionnelles convolutionnelles consécutives de 3 x 3 (chacune suivie d’une normalisation par lots et d’une activationReLU 32) pour fusionner les caractéristiques concaténées.
REMARQUE : Cette fusion inter-niveaux garantit que les détails de la frontière des polypes (fournis par les caractéristiques peu profondes de l’encodeur) et la localisation sémantique (fournie par les caractéristiques profondes) sont simultanément préservés, générant des résultats de segmentation fines.
6. Fonction de perte et configuration d’entraînement
- Fonction de perte
- Une fonction de perte hybride L_total est adoptée pour optimiser conjointement le réseau, en corrigeant le déséquilibre omniprésent entre le premier plan et la classe arrière-plan dans la segmentation des polypes.
La perte binaire d’entropie croisée (LBCE) mesure la précision de classification au niveau des pixels :
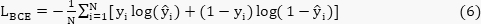
où N est le nombre total de pixels,y i ∈ {0,1} est l’étiquette de la vérité fondamentale, et ŷi ∈ [0,1] est la probabilité prédite. - La perte de dés (LDice) quantifie la similarité d’ensemble entre les régions prédite et la région de la vérité de terrain :


où ε est un facteur de lissage (réglé à 1 x 10⁻5) pour éviter la division par zéro.
Fixer λ = 0,5 pour équilibrer les contributions des deux termes de perte.
- Une fonction de perte hybride L_total est adoptée pour optimiser conjointement le réseau, en corrigeant le déséquilibre omniprésent entre le premier plan et la classe arrière-plan dans la segmentation des polypes.
- Configuration d’entraînement
- Initialisez l’encodeur avec des poids ResNet-50 pré-entraînés par ImageNet. Initialiser toutes les couches décodeur, PCM et paramètres DAM en utilisant une initialisation uniforme de Kaiming.
- Configurez l’optimiseur et le planning d’entraînement comme suit. Utilisez l’optimiseur Adam avec β₁ = 0,9 et β₂ = 0,999. Fixez le taux d’apprentissage initial à 1 x 10⁻⁴. Appliquer un schéma de taux d’apprentissage par recuit cosinus avec Tmax = 50 et ηmin = 1 x 10⁻⁶. Utilisez une taille de 16 lots et entraînez le modèle pour 50 époques.
- Entraînez le modèle pendant 50 époques sur l’ensemble d’entraînement (800 images). À la fin de chaque époque, évaluez le modèle sur l’ensemble de validation (100 images) en utilisant le coefficient de Dice comme métrique principale de surveillance.
- Sauvegardez le point de contrôle du modèle qui atteint le coefficient de dé le plus élevé sur l’ensemble de validation. Utilisez ce point de contrôle comme modèle final pour toutes les évaluations ultérieures sur l’ensemble de test.
REMARQUE : L’arrêt précoce n’est pas explicitement appliqué. La stratégie de sélection des meilleurs points de contrôle de dés sert de critère de sélection du modèle. Toutes les expériences sont menées à l’aide de l’environnement matériel et logiciel spécifié dans le tableau des matériaux. L’entraînement à 50 époques sur 800 images prend environ 2 heures sous la configuration décrite. Tous les résultats rapportés sont obtenus à partir d’une seule séance d’entraînement utilisant la graine aléatoire spécifiée (seed = 42). Référez-vous au package de code supplémentaire pour le script d’entraînement complet.
7. Pseudocode
- Utilisez l’algorithme 1 comme carte complète du workflow pour PWD Net. Associez les blocs PCM, DAM, architecture principale et pipeline d’entraînement dans l’algorithme avec les fichiers correspondants du package de code supplémentaire.
- Implémentez le bloc PCM montré aux lignes 4 à 12. Définissez un noyau de convolution en base 3 x 3 et générez huit noyaux rotationnés à 0°, 45°, 90°, 135°, 180°, 225°, 270° et 315° en utilisant une interpolation bilinéaire.
- Gardez les mêmes paramètres de base apprenables pour tous les noyaux PCM tournés. Pour chaque angle de rotation, calculez une carte de caractéristiques spécifique à une direction.
- Concaténez les huit cartes de caractéristiques PCM le long de la dimension du canal. Appliquez une convolution 1 x 1, une normalisation batch et une activation ReLU pour restaurer la dimension du canal d’origine.
- Implémentez le bloc DAM montré aux lignes 14 à 19. Appliquez le Global Average Pooling pour générer le descripteur de canal, puis passez-le à travers un MLP à deux couches avec un ratio de réduction de 16 pour obtenir les poids des canaux.
- Générez la carte d’attention spatiale en appliquant le pooling moyen canal par canal et le pool max à la fonction d’entrée. Concatéter les deux applications et les traiter avec une convolution 7 x 7 suivie d’une activation sigmoïde.
- Fusionner le canal DAM et les sorties d’attention spatiale avec la fonction d’entrée en utilisant la multiplication élément par élément. Pondérez les deux applications d’attention avec les coefficients apprenables α et β, toutes deux initialisées à 0,5.
- Construisez l’architecture principale PWD Net montrée dans les lignes 21 à 32. Faites passer l’image d’entrée à travers cinq étapes d’un encodeur ResNet 50 préentraîné pour obtenir de e1 à e5, avec une résolution spatiale décroissante de H x W à H/32 x W/32.
- Appliquez du PCM sur e5 au niveau du goulot d’étranglement. Appliquez DAM à e1 à e4 avant d’envoyer ces fonctionnalités au décodeur via des connexions de saut.
- Décodez la carte de caractéristiques des couches profondes à peu profondes. À chaque niveau de décodeur, suréchantillonnez la caractéristique précédente, concatènatez-la avec la fonction ENCODER améliorée DAM correspondante, et appliquez DoubleConv pour la fusion des caractéristiques.
- Générez la sortie de segmentation avec une convolution 1 x 1 suivie d’une activation sigmoïde. Utilisez la carte de probabilité pixel par pixel résultante comme masque prédit.
- Mettez en œuvre la boucle d’entraînement indiquée aux lignes 34 à 39. À chaque époque, exécutez la propagation vers l’avant via PWD Net et calculez le masque prédit.
- Calculez la perte d’entraînement comme 0,5 x perte BCE plus 0,5 x perte de dés. Mettez à jour tous les paramètres apprenables avec l’optimiseur Adam par rétropropagation.
Algorithme 1 : Segmentation des polypes PWD-Net
1 : Entrée : Image de coloscopie I ∈ RH×W×3
2 : Sortie : Masque de segmentation M ∈ {0,1}(H×W)
3:
4 : fonction Module de convolution PCM(X) ▷ Moulin à vent
5 : Définissons le noyau de base W (3 x 3), angles Θ = {0°, 45°, ..., 315°}
6 : pour chaque θ ∈ Θ faire
7 : Wθ ← BilinearRotate(W, θ) ▷ Rotate kernel
8 : Yθ ← Conv2d(X, Wθ) ▷ Caractéristiques spécifiques à la direction
9 : fin pour
10 : Yout ← ReLU(BN(Conv1 x 1(Concat({Yθ})))) ▷ Aggregate
11 : retour de Ydehors
12 : fin de fonction
13:
14 : fonction DAM(F) ▷ Mécanisme à double attention
15 : Ac ← Sigmoid(MLP(AvgPool(F))) ▷ Attention de canal (r=16)
16 : As ← Sigmoid (Conv7 x 7([AvgPool(F) ; MaxPool(F)])) ▷ Attention spatiale
17 : F' ← F ⊗ (α · Ac + β · As) ▷ Fusionner avec α apprenable, β (init=0,5)
18 : retour F'
19 : fonction finale
20:
21 : fonction PWD-Net(I)
22 : Encodeur : e1,e 2,e 3,e 4,e 5 ← ResNet50_Stages(I) ▷ Encodeur préentraîné à 5 étapes
23 : Goulot d’étranglement : b ← PCM(e5) ▷ Appliquer PCM au goulot d’étranglement
24 : Ignorer les connexions : si ← DAM(e i) pour i = 1, 2, 3, 4 ▷ Fonctionnalités de l’encodeur du filtre
25 : Décodeur :
26 : d 4 ← DoubleConv(Concat(Up(b), s4))
27 : d 3 ← DoubleConv(Concat(Up(d4), s3))
28 : d 2 ← DoubleConv(Concat(Up(d3), s2))
29 : d 1 ← DoubleConv(Concat(Up(d 2), s1))
30 : M ← Sigmoïde (Conv1 x 1(d1))
31 : retour M
32 : fonction finale
33:
34 : Entraînement :
35 : pour chaque époque, faire
36 : M̂ ← PWD-Net(I)
37 : L ← 0,5 · av. J.-C. (M̂,M gt) + 0,5 · DésPerte (M̂,M gt) ▷ λ = 0,5
38 : Mettre à jour les paramètres via rétropropagation (Adamoptimiser r)
39 : fin pour
Accès restreint. Veuillez vous connecter ou commencer un essai pour afficher ce contenu.
Résultats
Installation expérimentale
Jeu de données
Le jeu de données Kvasir SEG a été utilisé pour évaluer le comportement de segmentation de PWD Net sur des images de coloscopie présentant des apparences de polypes hétérogènes. Le jeu de données contient des images annotées de 1 000 pixels de polypes et comprend des variations de taille, de forme, de texture, d’illumination et de complexité de fond des polypes, ce qui le rend adapté à l’évaluation ...
Accès restreint. Veuillez vous connecter ou commencer un essai pour afficher ce contenu.
Discussion
Plusieurs choix de conception dans le protocole PWD-Net sont essentiels pour obtenir des résultats de segmentation fiables et méritent une attention particulière lors de la mise en œuvre. Premièrement, la sélection et l’initialisation de la dorsale de l’encodeur influencent directement le comportement de convergence et la performance finale. Le protocole utilise un encodeur ResNet-50 pré-entraîné sur ImageNet, qui offre une initialisation robuste des fonctionnalités bas et moyen niveau. ...
Accès restreint. Veuillez vous connecter ou commencer un essai pour afficher ce contenu.
Déclarations de divulgation
Les auteurs n’ont rien à divulguer.
Remerciements
Cette étude a été financée par le Programme national de recherche et développement clé de Chine (programmes n° 2022YFC3500200 et 2022YFC3500204).
Accès restreint. Veuillez vous connecter ou commencer un essai pour afficher ce contenu.
Matériaux
| Nom | Entreprise | Numéro de catalogue | Commentaires |
|---|---|---|---|
| Adam Optimizer | — | — | Inclus dans PyTorch |
| Albumentations | Albumentations Team | v1.0+ | Bibliothèque d'augmentation de données |
| CUDA Toolkit | NVIDIA | v11.3+ | Accélération GPU |
| Kvasir-SEG dataset | SimulaMet | — | https://datasets.simula.no/kvasir-seg/ |
| Matplotlib | Matplotlib Community | v3.4+ | Visualisation des courbes d'apprentissage |
| NumPy | NumPy Community | v1.21+ | Calcul numérique |
| NVIDIA Tesla P100 | NVIDIA | P100-PCIE-16GB | GPU pour l'entraînement et l'inférence |
| OpenCV | OpenCV Community | v4.5+ | Prétraitement d'image |
| Python | Python Software Foundation | v3.8+ | Langage de programmation |
| PyTorch | Meta Platforms | v1.12+ | Cadre de deep learning |
| ResNet-50 pretrained weights | PyTorch Model Zoo | — | Préentraîné sur ImageNet-1K |
| Ubuntu | Canonical | 18.04+ | Système d'exploitation |