Ici, nous présentons un protocole d'assemblage d'une cohorte, d'harmonisation en laboratoire, de développement d'un modèle pénalisé, de validation et de construction d'un score au chevet du patient pour la stratification précoce du risque de syndrome de dysfonction multiviscérale dans la pancréatite aiguë.
Article de recherche
Un protocole reproductible de score biochimique et de coagulation à l'admission pour le syndrome de dysfonctionnement multiviscéral dans la pancréatite aiguë
Dans cet article
Résumé
Résumé
La reconnaissance précoce du syndrome de dysfonction multiviscérale dans la pancréatite aiguë reste difficile, car une détérioration organique peut survenir avant l'achèvement des évaluations conventionnelles de gravité. Cet article décrit un protocole reproductible permettant d'élaborer, de valider et d'appliquer un score composite d'admission combinant des paramètres biochimiques et de coagulation, fondé sur des examens de laboratoire de routine réalisés dans les 24 heures suivant l'admission à l'hôpital. Le syndrome de dysfonction multiviscérale a été retenu comme critère principal de jugement, car il reflète un dysfonctionnement cliniquement significatif affectant plus d'un système organique, et oriente directement l'intensité de la surveillance précoce, la planification de l'escalade thérapeutique et l'affectation des ressources de soins intensifs. Le protocole couvre la constitution d'une cohorte multicentrique, le dépistage des critères d'éligibilité, l'attribution des critères de jugement, l'harmonisation des unités de laboratoire, le traitement des données manquantes, la normalisation des prédicteurs, le développement d'un modèle de régression pénalisée, une validation sur échantillon réservé, la construction du score, la comparaison avec des scores de gravité établis et des analyses de sensibilité. Les variables de laboratoire continues sont conservées durant l'élaboration du modèle afin de réduire la perte d'information, tandis que des catégories interprétables sur le plan clinique ne sont utilisées que lors de la traduction du modèle final en un score pratique utilisable au chevet du patient. Les points de contrôle du protocole incluent la confirmation de la constitution de la cohorte, les seuils de données manquantes, les règles figées de prétraitement, les résultats de sélection du modèle, les résultats de validation et l'interprétation finale du score. Grâce à ce flux de travail, des marqueurs biochimiques et de coagulation couramment mesurés peuvent être intégrés dans un outil structuré de stratification du risque à l'admission pour le syndrome de dysfonction multiviscérale associé à la pancréatite aiguë. Ce score vise à soutenir une observation plus rapprochée, des réévaluations biologiques répétées et la préparation à des voies de prise en charge organique, mais il doit compléter, et non remplacer, le jugement clinique ou les cadres établis d'évaluation de la gravité.
Introduction
La pancréatite aiguë est une urgence digestive fréquente dont l'évolution clinique varie d'une inflammation bénigne et autolimitée à une maladie rapidement progressive associée à un dysfonctionnement organique. L'évaluation actuelle de la gravité repose généralement sur la classification révisée de l'Atlanta, qui définit la sévérité de la maladie en fonction des complications locales, des complications systémiques, ainsi que de la présence et de la durée d'une insuffisance organique1. Des systèmes de score cliniques sont également utilisés en début d'hospitalisation pour aider à l'évaluation du risque et aux décisions de prise en charge. L'indice clinique de gravité de la pancréatite aiguë repose sur cinq variables disponibles dans les 24 premières heures et a été conçu pour estimer le risque de mortalité intra-hospitalière2. Les recommandations cliniques récentes continuent d'insister sur la reconnaissance précoce des formes graves, la réévaluation répétée, la réanimation hydroélectrolytique appropriée, la planification d'un soutien organique et une intensification opportune des soins3.
L'évaluation précoce du risque reste difficile dans la pratique courante. La réponse inflammatoire dans la pancréatite aiguë évolue rapidement, et certains systèmes d'évaluation traditionnels nécessitent des mesures répétées, des variables physiologiques qui changent après l'admission, ou des résultats d'imagerie qui peuvent ne pas être disponibles lors de la première consultation clinique4. Par conséquent, la classification du risque peut varier selon le moment de l'échantillonnage, le flux de travail local et le parcours thérapeutique. Ces incertitudes peuvent entraîner une surveillance ou une intervention intensive inutiles chez les patients à faible risque, tandis que les patients dont l'état se dégrade rapidement peuvent subir un report de l'escalade des soins. Une récente revue sur la prédiction de la gravité de la pancréatite aiguë a souligné que la performance des scores cliniques et des biomarqueurs individuels varie selon les populations de patients, la distribution de la gravité de la maladie et les fenêtres d'évaluation5.
La plupart des études récentes de prédiction ont tenté d'utiliser des variables recueillies dans les 24 heures suivant l'admission, souvent avec comme critère de jugement l'insuffisance organique persistante ou une pancréatite aiguë sévère. Cette approche est cliniquement utile, mais de nombreux modèles publiés restent limités par une conception monocentrique, une validation incomplète et un signalement insuffisant des méthodes de prétraitement et de gestion des données manquantes6. Un signalement transparent est particulièrement important pour les modèles prédictifs, car les critères d'éligibilité, les définitions des prédicteurs, la taille de l'échantillon, la gestion des données manquantes, les décisions relatives à l'élaboration du modèle et les procédures de validation influent directement sur la reproductibilité et l'interprétation clinique7. Pour qu'une méthode fondée sur l'admission puisse être utilisée dans différentes institutions, elle devrait s'appuyer sur des tests couramment disponibles, définir les procédures de conversion d'unités, expliquer comment les valeurs de laboratoire sont harmonisées et préciser la manière dont les valeurs manquantes des prédicteurs sont traitées avant l'ajustement du modèle.
Les anomalies biochimiques et de la coagulation sont toutes deux associées à la détérioration précoce dans la pancréatite aiguë. Une activation inflammatoire, une lésion endothéliale, une hémoconcentration, une hypoperfusion rénale et une perturbation de la microcirculation peuvent survenir précocement et contribuer au dysfonctionnement organique. L'activation de la coagulation est étroitement liée à l'inflammation, et la coagulopathie associée à la pancréatite aiguë a été décrite comme faisant partie de la progression vers une insuffisance organique persistante et des résultats défavorables8. Le D-dimère a également été signalé comme un marqueur d'admission associé à l'insuffisance organique, aux complications locales, à l'admission en soins intensifs et à la mortalité dans la pancréatite aiguë9. Toutefois, les paramètres de coagulation sont souvent interprétés séparément, plutôt que combinés aux variables biochimiques de routine dans un flux structuré d'admission.
Le syndrome de dysfonction multiviscérale a été choisi comme critère de jugement principal dans ce protocole, car il reflète un dysfonctionnement cliniquement significatif affectant plus d'un système organique. L'insuffisance organique persistante reste centrale dans la classification de la gravité de la pancréatite aiguë, mais le syndrome de dysfonction multiviscérale se rapproche davantage de la question pratique posée à l'admission : savoir si un patient risque d'avoir besoin d'une surveillance rapprochée, d'une réévaluation biologique répétée, d'une préparation au soutien organique ou de ressources de soins intensifs. Ce critère de jugement permet également d'évaluer les signaux biochimiques et de coagulation dans le contexte d'une détérioration systémique plus étendue, plutôt que par rapport à un résultat limité à un seul organe.
L'article de cette méthode décrit un protocole reproductible de score biochimique et de coagulation à l'admission pour la stratification précoce du risque de syndrome de dysfonction multiviscérale dans la pancréatite aiguë. Le protocole utilise des variables de laboratoire courantes obtenues dans les 24 heures suivant l'admission, normalise les unités et la gestion des données manquantes, applique un développement de modèle pénalisé et traduit le modèle final en un score composite cliniquement interprétable. L'objectif n'est pas de remplacer le jugement clinique ou les cadres de gravité établis, mais de fournir un flux de travail transparent et reproductible qui aide les établissements à organiser les données de laboratoire à l'admission en informations de risque exploitables.
Protocole
Le protocole de l'étude a été approuvé par le Comité d'éthique de la recherche biomédicale impliquant des êtres humains du Premier hôpital populaire de Jiashan, Hôpital affilié à l'Université de Jiaxing (numéro d'approbation : 2026 Research Approval No. 005 ; numéro d'acceptation : LW2026004 ; date d'approbation : 13 janvier 2026). L'exigence de consentement éclairé individuel a été levée car cette étude rétrospective utilisait des données cliniques anonymisées. Avant l'analyse, les identifiants directs, notamment le nom, le numéro d'identification hospitalier, le numéro de téléphone, l'adresse et le numéro d'identification nationale, ont été supprimés. Le traitement des données s'est conformé aux exigences institutionnelles en matière de protection des données et à la Déclaration d'Helsinki10.
Conception de l'étude et constitution d'une cohorte multicentrique
Cette étude de cohorte rétrospective multicentrique a utilisé les données biochimiques et de coagulation au moment de l'admission pour élaborer un flux de travail de scoring reproductible permettant une stratification précoce du risque de syndrome de dysfonction multiviscérale (MODS) dans la pancréatite aiguë (AP). L'AP était définie par au moins deux des critères suivants : douleur abdominale typique, taux sérique d'amylase ou de lipase au moins trois fois supérieur à la limite supérieure de la normale, ou résultats d'imagerie compatibles avec une AP. La fenêtre initiale était définie comme les 24 premières heures suivant l'admission à l'hôpital. Pour chaque prédicteur de laboratoire, la première valeur éligible obtenue dans cette fenêtre était utilisée. Les valeurs obtenues après le premier épisode documenté de MODS n'ont pas été prises en compte pour la construction des prédicteurs.
Des hospitalisations consécutives pour pancréatite aiguë (AP) provenant des centres participants, survenues entre le 1er janvier 2023 et le 20 décembre 2025, ont été examinées à l’aide d’un registre de dépistage harmonisé, d’une liste de critères d’éligibilité, d’un dictionnaire de données et d’un formulaire de validation des critères de jugement. Le registre de dépistage a recensé le nombre total d’admissions dépistées, les admissions en double, les exclusions dues à une AP non confirmée, à un âge inférieur à 18 ans, à une pancréatite chronique, à une pancréatite associée à une malignité pancréatique, à une heure d’admission non fiable, à l’absence de données biologiques sur 24 heures, à des dossiers de critères de jugement incomplets, ainsi que la cohorte analytique finale. Le registre de dépistage verrouillé a été utilisé pour produire Figure 1. Les effectifs de patients présentés dans Figure 1 ont été comparés au jeu de données analytique final avant l’analyse.
Une fois la cohorte analytique figée, les patients ont été répartis en une cohorte de développement et une cohorte de validation réservée selon un ratio de 7:3. La répartition a été effectuée avec la version 4.3.2 de R à l’aide du package caret version 6.0-94, la graine aléatoire étant fixée à 20260420. Un échantillonnage stratifié a été réalisé selon le statut MODS et le centre. Si la distribution par centre différait de plus de 5 points de pourcentage entre les cohortes, des strates combinées centre-MODS ont été utilisées. L’attribution aux cohortes a été enregistrée avant l’ajustement du modèle et n’a pas été modifiée par la suite. Les règles de prétraitement, les paramètres d’imputation, l’ajustement du modèle, l’estimation des coefficients, la construction du score et le choix du seuil ont été établis uniquement à partir de la cohorte de développement. La cohorte de validation réservée a été utilisée uniquement pour l’évaluation du modèle figé.
Critères d'éligibilité et procédures d'inscription
Les patients éligibles étaient des adultes âgés de 18 ans ou plus présentant une pancréatite aiguë (AP) confirmée, une heure d'admission à l'hôpital traçable, au moins un bilan biochimique ou de coagulation effectué dans les 24 heures suivant l'admission, et des dossiers complets pendant toute la durée de l'hospitalisation pour l'évaluation des critères de jugement. Les patients étaient exclus si la pancréatite aiguë ne pouvait être confirmée, s'ils présentaient une pancréatite chronique ou une pancréatite associée à un cancer du pancréas, ou si l'heure de la première admission à l'hôpital ne pouvait être reconstituée de façon fiable. Les cas transférés étaient exclus lorsque l'heure de la première admission, l'heure du premier prélèvement biologique ou l'état de dysfonctionnement organique précoce ne pouvaient être retracés entre les établissements. Pour les réadmissions multiples du même patient pendant la période d'étude, seule la première hospitalisation éligible était conservée. Un motif principal d'exclusion était enregistré pour chaque cas exclu.
Résultats et évaluation des critères de jugement
Le critère de jugement principal était le SDMO survenant à l'hôpital, défini comme un dysfonctionnement de deux systèmes organiques ou plus durant l'hospitalisation. Le dysfonctionnement organique a été évalué à partir des dossiers électroniques médicaux, en tenant compte des données respiratoires, cardiovasculaires, rénales, hépatiques, de la coagulation et des données neurologiques. Les mêmes critères prédéfinis par système organique ont été appliqués uniformément dans tous les centres avant l'élaboration du modèle, et les critères opérationnels utilisés pour l'évaluation des critères de jugement sont résumés dans le Tableau supplémentaire 1.
Deux évaluateurs formés ont évalué indépendamment chaque dossier anonymisé en utilisant les notes d'admission, les notes d'évolution, les dossiers de soins intensifs, les dossiers de procédures, les rapports de laboratoire, les dossiers des signes vitaux et les résumés de sortie. Le formulaire d'arbitrage enregistrait le code d'étude du patient, le système organique impliqué, le dossier source, la date et l'heure de début, la valeur de laboratoire ou physiologique justificative, la décision de l'évaluateur et le statut final d'arbitrage. L'accord entre les évaluateurs était considéré comme définitif. Les désaccords étaient résolus par un troisième évaluateur senior. Les critères de jugement secondaires comprenaient l'admission en soins intensifs, la ventilation mécanique invasive ou non invasive, la thérapie de remplacement rénal, la mortalité en cours d'hospitalisation, la nécrose infectée ou une procédure de drainage, ainsi que la durée du séjour hospitalier. La durée du séjour était calculée comme la date de sortie moins la date d'admission, plus un jour.
Prédicteurs candidats à l'admission
Les prédicteurs candidats étaient limités aux variables de routine disponibles dans les 24 heures suivant l'admission. Pour les tests répétés dans cette fenêtre de 24 heures, la première valeur éligible était conservée. Les variables biochimiques comprenaient le nombre de globules blancs, la protéine C-réactive, la procalcitonine lorsque disponible, le lactate, le glucose, le calcium total, l'azote uréique sanguin, la créatinine, l'alanine aminotransférase, la bilirubine totale, l'albumine et la lactate déshydrogénase. Les variables de coagulation comprenaient le nombre de plaquettes, le temps de prothrombine, le ratio normalisé international du temps de prothrombine, le temps de thromboplastine partielle activée, le fibrinogène et le D-dimère.
Les variables cliniques de base ont été recueillies afin de décrire le mélange de cas et de calculer les scores de référence. Ces variables comprenaient l'âge, le sexe, l'indice de masse corporelle, le délai entre le début des symptômes et l'admission, l'étiologie de la pancréatite aiguë, le statut tabagique, les antécédents de pancréatite, les comorbidités, la fréquence cardiaque à l'admission, la pression artérielle moyenne, le statut de syndrome inflammatoire systémique, le score Bedside Index for Severity in Acute Pancreatitis, le score Acute Physiology and Chronic Health Evaluation II et le score Sequential Organ Failure Assessment. Lorsque le temps de prothrombine et le rapport normalisé international du temps de prothrombine étaient tous deux disponibles, le rapport normalisé international du temps de prothrombine a été utilisé pour la modélisation, tandis que le temps de prothrombine a été conservé à des fins de description. Le fichier d'extraction contenait une ligne par hospitalisation et conservait le code du centre, le code d'étude du patient, l'heure d'admission, l'heure de prélèvement, la valeur brute, l'unité brute, la valeur harmonisée, l'unité harmonisée, la table source et un indicateur de données manquantes.
Harmonisation des laboratoires entre les centres
Toutes les variables de laboratoire ont été converties en unités cibles prédéfinies avant l'analyse : numération des globules blancs et numération des plaquettes, 109/L ; protéine C-réactive, mg/L ; procalcitonine, ng/mL ; lactate, glucose, calcium total et azote uréique sanguin, mmol/L ; créatinine et bilirubine totale, µmol/L ; alanine aminotransférase et lactate déshydrogénase, U/L ; albumine et fibrinogène, g/L ; temps de prothrombine et temps de thromboplastine partielle activée, secondes ; rapport international normalisé du temps de prothrombine, rapport sans unité ; et D-dimères, mg/L d'unités équivalentes fibrinogène. Les valeurs de D-dimères exprimées en µg/mL d'unités équivalentes fibrinogène ont été converties en mg/L d'unités équivalentes fibrinogène à l'aide d'une conversion numérique 1:1. Les valeurs de D-dimères exprimées en unités D-dimères ont été converties uniquement lorsque le laboratoire local fournissait un facteur de conversion validé. Les valeurs sans facteur de conversion validé ont été considérées comme manquantes pour la modélisation.
Les unités de déclaration, les plages de référence, les registres d'analyses et les notes des appareils de chaque centre ont été examinés avant regroupement. Le fichier d'harmonisation conservait l'unité d'origine, l'unité cible, la règle de conversion et le réviseur chargé de vérifier la conversion. Les valeurs de laboratoire n'ont pas été normalisées selon les plages de référence spécifiques à chaque centre dans l'analyse principale, car le score devait utiliser des valeurs cliniques absolues. Le code du centre a été conservé lors de l'imputation et de l'analyse de sensibilité. Les valeurs négatives pour des tests nécessairement positifs, les unités incompatibles, les horodatages hors de la fenêtre de 24 h et les valeurs non corroborées par les documents sources ont été signalées. Une valeur n'était corrigée que si le document source confirmait une erreur de transcription ou de conversion d'unité ; sinon, elle était considérée comme manquante.
Prétraitement des données et gestion des données manquantes
La présence de données manquantes a été résumée par variable, par centre et par statut MODS avant l'ajustement du modèle. Les prédicteurs candidats ont été exclus du développement du modèle si la proportion de données manquantes dépassait 30 % globalement ou si elle dépassait 50 % dans un centre particulier. Les patients ont été exclus de l'ensemble de données de modélisation si plus de 40 % des prédicteurs candidats étaient manquants ou si l'issue principale ne pouvait pas être évaluée.
Les prédicteurs continus ont été winsorisés aux 1er et 99e percentiles estimés dans la cohorte de développement. Les mêmes seuils ont été appliqués à la cohorte de validation réservée. Les seuils n'ont pas été réestimés dans les données de validation. Les variables présentant une asymétrie supérieure à 2 après winsorisation ont été transformées à l'aide du logarithme naturel ; log(x + 0,01) a été utilisé pour les variables pouvant contenir des valeurs nulles. Les prédicteurs continus ont été standardisés à l'aide de la moyenne et de l'écart-type de la cohorte de développement, et les mêmes paramètres ont été appliqués aux données de validation.
L'imputation multiple a été réalisée à l'aide d'équations enchaînées dans R avec le package mice version 3.16.0. Vingt jeux de données imputés ont été générés avec 20 itérations par jeu de données. L'appariement prédictif des moyennes a été utilisé pour les variables continues, la régression logistique pour les variables binaires et la régression logistique polytomique pour les variables catégorielles nominales. Le modèle d'imputation incluait les prédicteurs candidats, le code du centre, l'indicateur de cohorte et le statut MODS pour l'élaboration du modèle. Les résultats de validation n'ont pas été utilisés pour modifier les règles de prétraitement, l'éligibilité des variables ou les seuils. Les estimations de régression ont été combinées selon les règles de Rubin lorsqu'elles ont été rapportées. Les métriques de prédiction ont été calculées au sein de chaque jeu de données imputé et résumées sous forme d'estimations combinées ou médianes avec leurs intervalles. Deux analyses de sensibilité ont été prédéfinies : une analyse sur cas complets utilisant les patients sans prédicteurs manquants dans le modèle final, et une analyse basée sur les valeurs initiales utilisant la pire valeur de laboratoire éligible dans les 24 heures au lieu de la valeur la plus précoce.
Analyse statistique et élaboration du modèle
Les caractéristiques de base ont été résumées séparément pour les cohortes de développement et de validation réservée. Les variables continues ont été exprimées par la moyenne ± l’écart-type ou la médiane avec l’intervalle interquartile, et les variables catégorielles par n (%). Les paramètres biochimiques et de coagulation à l’admission ont été comparés entre les patients avec et sans SDMO. Le test t de Student ou le test de Wilcoxon (somme des rangs) a été utilisé pour les variables continues, et le test du chi-deux ou le test exact de Fisher pour les variables catégorielles. Ces valeurs P étaient descriptives et n’ont pas été utilisées seules pour la sélection des prédicteurs.
Le développement du modèle a été limité à la cohorte de développement. Une régression logistique pénalisée a été utilisée comme modèle principal afin de réduire le surajustement en présence d'un nombre limité d'événements et de prédicteurs de laboratoire corrélés. Le modèle a été ajusté dans R version 4.3.2 à l'aide du paquet glmnet version 4.1-8 avec une famille binomiale, des prédicteurs standardisés et une pénalisation de type opérateur de sélection et de réduction absolue minimale (LASSO), spécifiée par alpha = 1. Une validation croisée à dix plis répétée 10 fois a été utilisée pour le réglage de la pénalité, la graine aléatoire étant fixée à 20260420. Le paramètre de pénalité a été sélectionné selon la règle de l'écart-type unique. Le chemin des coefficients, les valeurs d'erreur de validation croisée, le paramètre de pénalité sélectionné et les prédicteurs conservés ont été enregistrés. Le flux de travail d'analyse est présenté dans Figure 2. Les logiciels, les paquets statistiques, les systèmes de bases de données et les plateformes de laboratoire utilisés dans le protocole sont répertoriés dans le Tableau des Matériaux.
Une régression logistique non pénalisée n’a pas été utilisée comme modèle principal d’inférence après la sélection pénalisée. Si des rapports de cotes ont été indiqués à des fins d’interprétation clinique, ils ont été précisés comme des estimations descriptives post-sélection. La discrimination a été évaluée à l’aide de l’aire sous la courbe ROC (caractéristique de fonctionnement du récepteur), avec des intervalles de confiance à 95 % calculés selon la méthode de DeLong dans le package pROC version 1.18.5. La calibration a été évaluée à l’aide de l’ordonnée à l’origine de calibration, de la pente de calibration, du score de Brier et de graphiques de calibration. Un rééchantillonnage bootstrap avec 1 000 répétitions a été utilisé dans la cohorte de développement pour estimer la performance corrigée de l’optimisme. L’analyse de courbe de décision n’a pas été conservée dans le jeu d’analyse révisé ; par conséquent, les affirmations relatives au bénéfice clinique net ont été supprimées du manuscrit.
Dérivation et interprétation du score
Le score composite biochimique et de coagulation fondé sur des points attribués a été dérivé des coefficients verrouillés du modèle pénalisé. Des variables continues ont été utilisées lors de l'ajustement du modèle. Des seuils catégorisés ont été introduits uniquement après la finalisation du modèle afin de faciliter le calcul au chevet du patient. Les seuils ont été choisis selon des plages de référence cliniques établies, des seuils d'anomalie couramment utilisés en laboratoire ou des points de coupure basés sur les coefficients définis dans la cohorte de développement avant la validation. Les seuils n'ont pas été optimisés dans la cohorte de validation.
Des points entiers ont été attribués en fonction de la direction et de l'ampleur relative des coefficients verrouillés. Des points plus élevés indiquaient des profils biologiques plus défavorables. Le score total était calculé en additionant les points attribués aux composantes conservées. Des catégories de risque prédéfinies ont été utilisées uniquement pour la stratification du risque ; elles n'ont pas été utilisées pour définir le SDMO. Le score avait pour but d'identifier les patients qui pourraient nécessiter une surveillance plus étroite, des évaluations biologiques répétées ou une préparation aux voies de prise en charge d'organes. Il n'a pas été utilisé comme règle diagnostique autonome, déclencheur d'anticoagulation ou substitut à la réévaluation clinique.
Validation par échantillon de retenue et évaluation comparative
Les règles figées de prétraitement, la structure d'imputation, les seuils de winsorisation, les paramètres de standardisation, les coefficients du modèle, les règles de calcul des scores et les seuils prédéfinis ont été appliqués à la cohorte de validation par échantillon de retenue. Aucun nouveau criblage de prédicteurs, aucun réajustement du modèle, aucune recalibration des coefficients ni aucune optimisation des seuils n’a été effectué. La performance de validation a été résumée à l’aide des mesures de discrimination, de calibration, du score de Brier, de la sensibilité, de la spécificité, de la valeur prédictive positive et de la valeur prédictive négative.
Les outils d'évaluation de la gravité établis ont été calculés à partir de la même fenêtre d'admission lorsque les données étaient disponibles, notamment l'indice clinique de gravité dans la pancréatite aiguë, le score d'évaluation de la physiologie aiguë et des antécédents chroniques de santé II, le score d'évaluation de l'insuffisance organique séquentielle, le score de Ranson, le score de pancréatite aiguë bénigne et les critères du syndrome de réponse inflammatoire systémique. Les comparaisons ont utilisé le même critère de jugement, la même population analysée et le même cadre de validation. Des comparaisons appariées des aires sous la courbe ont été réalisées à l'aide de tests de DeLong.
Tous les graphiques de validation et les graphiques stratifiés par score ont été générés à partir du jeu de données analytiques verrouillé. La taille de l'échantillon de chaque panneau de figure a été vérifiée par rapport au groupe analytique final, au groupe de développement, au groupe de validation réservé ou au strate de score prédéfini avant la préparation des figures. Les méthodes visuelles conçues pour les données omiques en haute dimension, les données de comptage écologiques ou l'analyse de l'abondance différentielle n'ont pas été utilisées pour les données de laboratoire clinique courantes.
Résultats
Caractéristiques de la cohorte et comparabilité au départ
Un total de 300 patients présentant une pancréatite aiguë ont été inclus dans la cohorte analytique finale. Selon la répartition stratifiée préspecifiée 7:3 avec jeu de validation réservé, 210 patients ont été répartis dans la cohorte de développement et 90 patients dans la cohorte de validation réservée. Tous les patients inclus disposaient de mesures biochimiques et de coagulation admissibles réalisées dans les 24 heures suivant l'admission à l'hôpital.
Les caractéristiques de base sont présentées dans le Tableau 1. Les cohortes de développement et de validation réservée étaient similaires en âge (54,0 ans ± 16,4 ans contre 55,3 ans ± 15,2 ans, P = 0,486), en répartition selon le sexe (hommes : 61,9 % contre 61,1 %, P = 0,898), en indice de masse corporelle (25,0 [22,6–27,9] kg/m2 contre 24,7 [22,2–27,5] kg/m2, P = 0,293), en délai entre le début des symptômes et l'admission (13,2 [7,1–22,6] h contre 12,8 [6,8–21,7] h, P = 0,612) et en étiologie de la pancréatite aiguë (P = 0,931). Les comorbidités, les signes vitaux à l'admission, le statut de syndrome de réponse inflammatoire systémique, le score Bedside Index for Severity in Acute Pancreatitis, le score Sequential Organ Failure Assessment, ainsi que les paramètres biochimiques et de coagulation indiqués à l'admission étaient également équilibrés entre les deux cohortes. Ces comparaisons ont confirmé que la séparation réservée n'avait pas introduit de déséquilibre cliniquement significatif au départ.
Profils biochimiques et de coagulation à l'admission selon le statut MODS
Parmi les 300 patients, 50 ont développé un syndrome de dysfonction multiviscérale (MODS) durant leur hospitalisation, et 250 n'en ont pas développé. Les profils biochimiques et de coagulation à l'admission selon le statut MODS sont résumés dans le Tableau 2. Par rapport aux patients sans MODS, les patients ayant développé un MODS présentaient une numération leucocytaire plus élevée (14,4 × 10⁹/L ± 5,2 × 10⁹/L contre 12,3 × 10⁹/L ± 4,6 ×10⁹/L, P = 0,008), un rapport neutrophiles-lymphocytes plus élevé (13,4 [9,1–21,3] contre 9,0 [5,9–14,2], P < 0,001), une protéine C-réactive plus élevée (138,6 [86,9–226,7] mg/L contre 61,4 [29,2–123,8] mg/L, P < 0,001), une procalcitonine plus élevée (1,25 [0,56–3,28] ng/mL contre 0,43 [0,18–1,02] ng/mL, P < 0,001), une lactatémie plus élevée (2,7 [2,0–4,0] mmol/L contre 1,7 [1,2–2,4] mmol/L, P = 0,004) et une glycémie plus élevée (11,2 [8,9–15,1] mmol/L contre 8,9 [7,3–11,4] mmol/L, P = 0,010).
Le groupe MODS présentait également des taux plus faibles de calcium (1,96 mmol/L ± 0,21 mmol/L contre 2,06 mmol/L ± 0,17 mmol/L, P = 0,013) et d'albumine (32,5 g/L ± 5,6 g/L contre 35,9 g/L ± 4,8 g/L, P < 0,001), ainsi qu'une urée sanguine plus élevée (9,4 [7,4–13,2] mmol/L contre 6,6 [5,1–8,9] mmol/L, P < 0,001), une créatinine (108,9 [84,7–163,4] µmol/L contre 77,1 [62,4–97,6] µmol/L, P < 0,001), une bilirubine totale (22,1 [14,2–38,9] µmol/L contre 18,6 [12,3–31,7] µmol/L, P = 0,038) et une lactate déshydrogénase (372,4 [289,8–512,3] U/L contre 254,6 [203,2–329,1] U/L, P < 0,001) plus élevées. Le temps de prothrombine, le ratio normalisé international du temps de prothrombine, le temps de thromboplastine partielle activée et les D-dimères étaient également plus élevés dans le groupe MODS. Le nombre de plaquettes (P = 0,096) et le taux de fibrinogène (P = 0,268) ne différaient pas de manière significative entre les groupes. Ces comparaisons étaient descriptives et n'ont pas été utilisées seules pour la sélection des prédicteurs.
Profils précoces des résultats et tendances liées aux scores
Les résultats cliniques bruts selon le statut du syndrome de dysfonction multiviscérale sont présentés dans la Figure 3. Les patients ayant développé un syndrome de dysfonction multiviscérale ont présenté une durée d'hospitalisation plus longue que ceux qui n'ont pas développé ce syndrome (Figure 3A). Ils ont également eu des taux plus élevés d'admission en unité de soins intensifs (Figure 3B), de ventilation mécanique (Figure 3C), de thérapie de remplacement rénal (Figure 3D), de nécrose infectée ou de procédures de drainage (Figure 3E), ainsi qu'une mortalité intra-hospitalière plus élevée (Figure 3F). Tous les graphiques ont été générés à partir de la cohorte analytique figée de 300 patients.
Les résultats cliniques observés selon les strates prédéfinies basées sur le score composite sont présentés dans la Figure 4. L'incidence du syndrome de dysfonction multiviscérale a augmenté progressivement entre les groupes à faible, intermédiaire, élevé et très élevé risque (Figure 4A). Des augmentations ordonnées similaires ont été observées pour les admissions en unité de soins intensifs (Figure 4B), la mortalité intra-hospitalière (Figure 4C) et les procédures liées à une nécrose infectée ou à un drainage (Figure 4D). La durée d'hospitalisation a également augmenté à travers les quatre strates de score (Figure 4E). Les gradients étaient particulièrement marqués pour l'incidence du syndrome de dysfonction multiviscérale et les admissions en unité de soins intensifs. Tous les graphiques ont été générés à partir du jeu de données analytiques figé, en utilisant les catégories de score prédéfinies.
La répartition du score composite basé sur des points selon les catégories de gravité d'Atlanta révisées est présentée dans la Figure 5. Les scores composites médians ont augmenté progressivement entre les formes légères, modérément sévères et sévères de pancréatite aiguë, indiquant une concordance entre le score biochimique–coagulatoire au moment de l'admission et les catégories cliniques de gravité établies. La Figure 5 a été générée à partir du même lot analytique figé de 300 patients. Aucune visualisation par ordination, par abondance différentielle, par diagramme en volcan, par valeur q, par distance de Bray–Curtis ou par analyse en coordonnées principales n'a été utilisée.
Développement du modèle pénalisé et prédicteurs conservés
Le développement du modèle pénalisé a été réalisé exclusivement sur le groupe de développement. Les trajectoires des coefficients des prédicteurs candidats à l'admission sont présentées dans la Figure 6A, et la courbe de validation croisée répétée en 10 parties utilisée pour sélectionner le paramètre de pénalité est illustrée dans la Figure 6B. Pour le paramètre de pénalité sélectionné selon la règle de l'écart-type unique, la pénalisation par l'opérateur de sélection et de réduction absolue minimale (least absolute shrinkage and selection operator) a conservé neuf prédicteurs mesurés à l'admission : l'albumine, l'azote uréique sanguin, la créatinine, le calcium, la lactate déshydrogénase, le temps de prothrombine–rapport normalisé international, le D-dimère, le nombre de plaquettes et le glucose.
Les prédicteurs retenus et les estimations descriptives après sélection sont présentés dans le Tableau 3. Ces estimations ont été rapportées afin d'aider à l'interprétation clinique et n'ont pas été considérées comme une inférence confirmatoire après sélection pénalisée. Le sens des associations était cliniquement cohérent : une albuminémie plus faible, une urée sanguine plus élevée, une créatininémie plus élevée, une calcémie plus basse, une lactate déshydrogénase plus élevée, un temps de prothrombine-ration internationale normalisée plus élevé, un taux de D-dimères plus élevé, un compte de plaquettes plus bas et une glycémie plus élevée étaient associés à un risque accru de MODS. Les estimations descriptives après sélection étaient les suivantes : pour une diminution de l'albumine de 5 g/L, rapport de cotes 1,29 (intervalle de confiance à 95 % : 1,13–1,47) ; pour une augmentation de l'urée sanguine de 1 mmol/L, rapport de cotes 1,12 (1,06–1,18) ; pour une augmentation de la créatinine de 10 µmol/L, rapport de cotes 1,05 (1,02–1,09) ; pour une diminution du calcium de 0,1 mmol/L, rapport de cotes 1,18 (1,07–1,30) ; pour une augmentation de la lactate déshydrogénase de 100 U/L, rapport de cotes 1,21 (1,07–1,37) ; pour une augmentation du temps de prothrombine-ration internationale normalisée de 0,1, rapport de cotes 1,14 (1,05–1,25) ; pour une augmentation des D-dimères de 1,0 mg/L en unités fibrinogène-équivalentes, rapport de cotes 1,09 (1,02–1,17) ; pour une diminution du compte de plaquettes de 50 × 109/L, rapport de cotes 1,16 (1,01–1,34) ; et pour une augmentation de la glycémie de 1 mmol/L, rapport de cotes 1,05 (1,00–1,10).
Construction du score composite basé sur des points
Les règles utilisées pour construire le score composite biochimique et de coagulation d'admission basé sur des points sont présentées dans le Tableau 4. Ce score a été dérivé des coefficients du modèle pénalisé verrouillé et traduit en catégories cliniquement interprétables permettant un calcul au chevet du patient. Huit variables — albumine, azote uréique sanguin, créatinine, calcium, lactate déshydrogénase, temps de prothrombine, rapport normalisé international, D-dimères et numération plaquettaire — ont été incluses comme composantes fondamentales du score. Le glucose a été conservé comme modificateur facultatif, car sa contribution était moindre par rapport à celle des variables biochimiques et de coagulation fondamentales, bien que le sens de son association avec le syndrome de dysfonction multiviscérale reste cohérent avec celui du modèle verrouillé.
Un nomogramme intégrant les neuf prédicteurs conservés par le modèle pénalisé verrouillé est présenté dans la Figure 7. Ce nomogramme fournit une estimation individualisée de la probabilité d'un syndrome de dysfonction multiviscérale fondée sur les taux d'albumine, d'urée sanguine, de créatinine, de calcium, de lactate déshydrogénase, du temps de prothrombine rapport normalisé international, du D-dimère, du nombre de plaquettes et de la glycémie au moment de l'admission. Il a été inclus comme aide à l'interprétation, tandis que le score composite basé sur un système de points restait l'outil pratique principal au chevet du patient, car il peut être calculé directement à partir des examens de laboratoire de routine effectués à l'admission.
Performance du modèle et validation interne
La performance du modèle dans les cohortes de développement et de validation réservée est présentée dans le Tableau 5. Le modèle logistique pénalisé avec un terme de pénalité a obtenu une aire sous la courbe caractéristique de fonctionnement du récepteur de 0,873 (intervalle de confiance à 95 % : 0,820–0,926) dans la cohorte de développement et de 0,836 (0,751–0,921) dans la cohorte de validation réservée. Le score de Brier était de 0,117 dans la cohorte de développement et de 0,139 dans la cohorte de validation réservée. L'ordonnée à l'origine et la pente de calibration étaient respectivement de 0,04 (−0,08–0,16) et 0,97 (0,79–1,18) dans la cohorte de développement, et de 0,08 (−0,14–0,30) et 0,91 (0,68–1,15) dans la cohorte de validation réservée.
Au seuil prédéfini de risque prédit de 0,18, le modèle a montré une sensibilité et une spécificité de 0,82 et 0,77 dans la cohorte de développement, et de 0,75 et 0,74 dans la cohorte de validation réservée. Les valeurs prédictives positives et négatives étaient de 0,39 et 0,96 dans la cohorte de développement, et de 0,39 et 0,93 dans la cohorte de validation réservée. Le score composite basé sur un système de points présentait une discrimination inférieure à celle du modèle pénalisé figé, mais conservait une performance de dépistage utile, avec des valeurs de la surface sous la courbe caractéristique de fonctionnement du récepteur de 0,823 dans la cohorte de développement et de 0,783 dans la cohorte de validation réservée. Au seuil prédéfini de ≥8 points, le score a montré des valeurs prédictives négatives de 0,93 et 0,91 dans les cohortes de développement et de validation réservée, respectivement.
Comparaison avec des scores de gravité établis
Les comparaisons de référence avec des outils de gravité établis sont présentées dans le Tableau 6. Le modèle biochimique-coagulatoire au moment de l'admission verrouillé présentait une meilleure discrimination que le score de Ranson, le score de pancréatite aiguë bénigne et les critères du syndrome de réponse inflammatoire systémique dans les deux cohortes. Dans la cohorte de développement, le modèle ne différait pas de manière significative du score d’évaluation séquentielle des insuffisances organiques selon le test de DeLong (P = 0,12), mais il montrait une discrimination supérieure au score d’évaluation de la physiologie aiguë et des antécédents de santé chronique II (P = 0,03), au score d’indice au chevet du patient pour la gravité de la pancréatite aiguë (P = 0,01), au score de Ranson (P < 0,001), au score de pancréatite aiguë bénigne (P < 0,001) et aux critères du syndrome de réponse inflammatoire systémique (P < 0,001). Dans la cohorte de validation externe, les différences n’étaient pas significatives par rapport au score d’évaluation séquentielle des insuffisances organiques (P = 0,34), au score d’évaluation de la physiologie aiguë et des antécédents de santé chronique II (P = 0,08) ou au score d’indice au chevet du patient pour la gravité de la pancréatite aiguë (P = 0,05), mais restaient significatives par rapport au score de Ranson (P = 0,02), au score de pancréatite aiguë bénigne (P = 0,01) et aux critères du syndrome de réponse inflammatoire systémique (P = 0,02).
Stratification du risque par score pondéré
Les résultats de la stratification du risque sont présentés dans le Tableau 7. Les patients ont été répartis en groupes de score faible (0–4 points), intermédiaire (5–8 points), élevé (9–12 points) et très élevé (≥13 points). L'incidence du SDMO a augmenté de 3,5 % (4/115) dans le groupe à faible risque à 8,9 % (9/101), 33,3 % (20/60) et 70,8 % (17/24) respectivement dans les groupes à risque intermédiaire, élevé et très élevé. L'admission en unité de soins intensifs a augmenté de 8,7 % à 23,8 %, 60,0 % et 83,3 % à travers les quatre groupes. La mortalité hospitalière a augmenté de 0,9 % à 2,0 %, 10,0 % et 25,0 %, et la nécrose infectée ou le drainage ont augmenté de 2,6 % à 8,9 %, 23,3 % et 33,3 %. La durée médiane d'hospitalisation est passée de 7,6 (5,2–10,4) jours dans le groupe à faible risque à 11,4 (8,0–16,5), 18,6 (13,0–26,8) et 24,9 (17,5–37,2) jours dans les groupes à risque plus élevé.
Analyses de sensibilité
Les analyses de sensibilité sont résumées dans le Tableau supplémentaire 2. Ces analyses ont évalué si les résultats principaux dépendaient de la gestion des données manquantes ou de l'attribution des valeurs initiales. Dans l'analyse sur cas complets, les prédicteurs conservés et le sens de l'association étaient cohérents avec ceux de l'analyse principale avec imputation. La discrimination n'a changé que légèrement, avec des aires sous les courbes caractéristiques de fonctionnement du récepteur de 0,861 dans la cohorte de développement et de 0,821 dans la cohorte de validation réservée. Dans l'analyse de sensibilité sur la valeur initiale utilisant la pire valeur de laboratoire éligible dans les 24 premières heures au lieu de la valeur la plus précoce, le modèle a montré des valeurs de l'aire sous la courbe caractéristique de fonctionnement du récepteur de 0,879 dans la cohorte de développement et de 0,829 dans la cohorte de validation réservée. L'incidence du MODS stratifiée par score est restée ordonnée à travers les groupes à faible, intermédiaire, élevé et très élevé risque dans les deux analyses de sensibilité. Ces résultats indiquent que le flux de travail biochimique-coagulatoire à l'admission n'a pas été sensiblement modifié par les alternatives préspécifiées de prétraitement.
DISPONIBILITÉ DES DONNÉES :
L'ensemble de données anonymisées utilisé pour reproduire les principales analyses, accompagné du dictionnaire de données, du tableau de conversion des unités et des scripts d'analyse, a été déposé sur Figshare avec l'identifiant unique https://doi.org/10.6084/m9.figshare.32565768.v1. Les identifiants directs des patients ont été supprimés avant le dépôt des données, et les identifiants des centres ont été codés conformément aux exigences institutionnelles de protection des données. Le dépôt contient les fichiers nécessaires pour reproduire la description de la cohorte, le prétraitement des prédicteurs, le développement du modèle, la construction du score, la validation sur échantillon réservé, les analyses de référence, les analyses de sensibilité et les résultats détaillés par figure rapportés dans cet article.
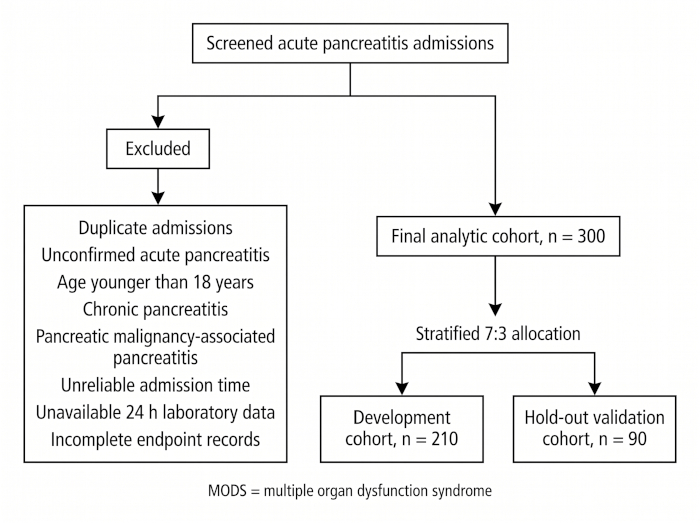
Figure 1 : Dépistage des patients et répartition en cohortes. L'organigramme illustre les admissions consécutives pour pancréatite aiguë soumises au dépistage dans les centres participants, les raisons d'exclusion, la cohorte analytique finale, ainsi que la répartition stratifiée selon un ratio 7:3 entre la cohorte de développement et la cohorte de validation réservée. La cohorte de développement comprenait 210 patients, et la cohorte de validation réservée comprenait 90 patients. MODS désigne le syndrome de dysfonction multiviscérale. Veuillez cliquer ici pour visualiser une version agrandie de cette figure.
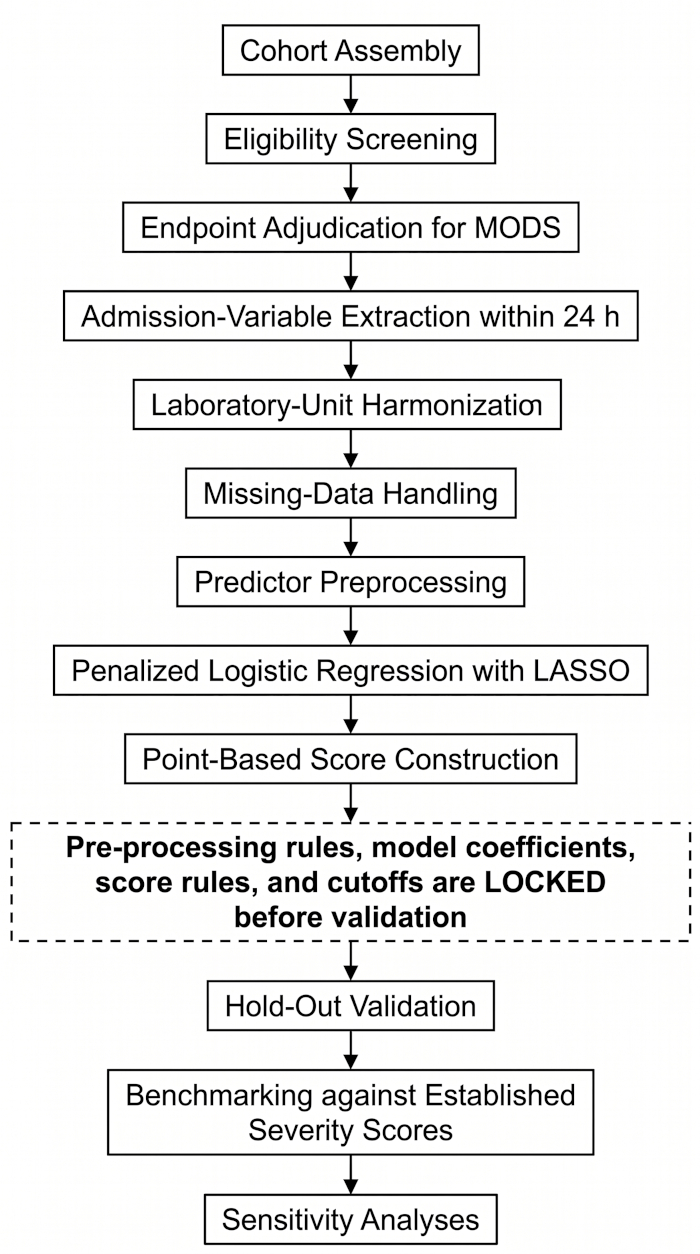
Figure 2 : Flux analytique reproductible pour le développement d'un score biochimique–de coagulation à l'admission. Le schéma résume l'assemblage de la cohorte, le dépistage des critères d'éligibilité, l'attribution des événements terminaux, l'extraction des variables à l'admission, l'harmonisation des unités de laboratoire, la gestion des données manquantes, le prétraitement des prédicteurs, le développement du modèle pénalisé, la construction du score basé sur des points, et la validation finale sur un échantillon réservé. Toutes les règles de prétraitement, les coefficients du modèle, les procédures de construction du score et les définitions des seuils ont été établies dans la cohorte de développement avant toute évaluation dans la cohorte de validation réservée. Veuillez cliquer ici pour visualiser une version agrandie de cette figure.
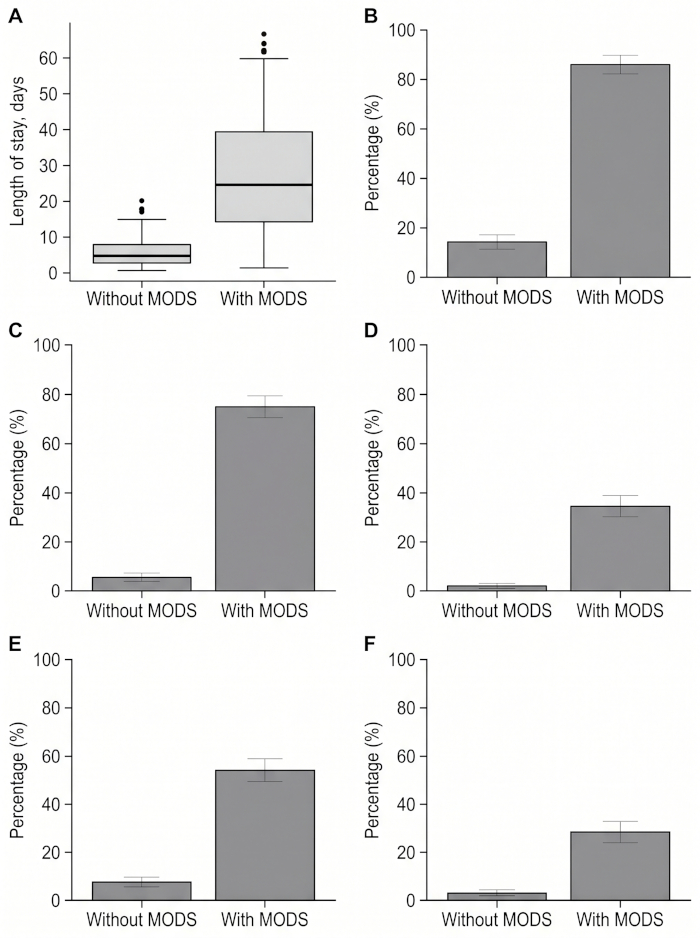
Figure 3 : Résultats cliniques bruts selon le statut du syndrome de dysfonction multiviscérale. (A) Durée du séjour à l'hôpital chez les patients sans et avec un syndrome de dysfonction multiviscérale. (B) Taux d'admission en unité de soins intensifs selon le statut du syndrome de dysfonction multiviscérale. (C) Taux de ventilation mécanique selon le statut du syndrome de dysfonction multiviscérale. (D) Taux de thérapie de remplacement rénal selon le statut du syndrome de dysfonction multiviscérale. (E) Taux de nécrose infectée ou de procédures de drainage selon le statut du syndrome de dysfonction multiviscérale. (F) Taux de mortalité intra-hospitalière selon le statut du syndrome de dysfonction multiviscérale. Tous les graphiques ont été générés à partir de la cohorte analytique figée de 300 patients. MODS désigne le syndrome de dysfonction multiviscérale ; ICU, unité de soins intensifs. Veuillez cliquer ici pour visualiser une version agrandie de cette figure.
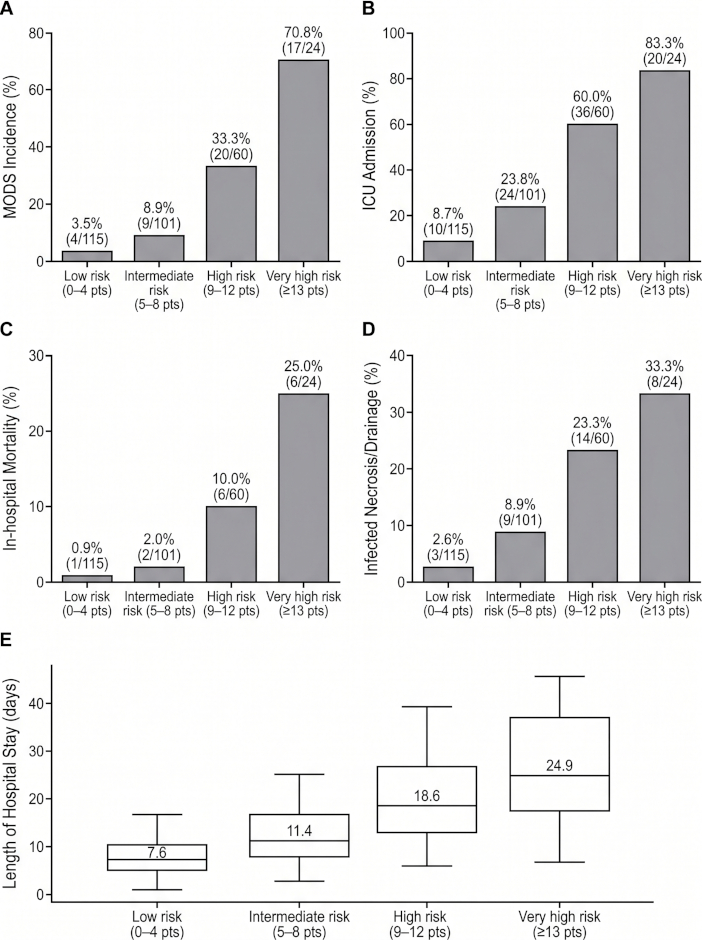
Figure 4 : Taux d'issues observés selon les strates du score composite basé sur les points. (A) Incidence du syndrome de dysfonction multiviscérale dans les groupes à faible, intermédiaire, élevé et très élevé risque. (B) Taux d'admission en unité de soins intensifs selon les quatre strates de score. (C) Taux de mortalité intra-hospitalière selon les quatre strates de score. (D) Taux de nécrose infectée ou d'interventions de drainage selon les quatre strates de score. (E) Durée de séjour hospitalier selon les quatre strates de score. Tous les graphiques ont été générés à partir du jeu de données analytiques figé, en utilisant les catégories de score prédéfinies suivantes : faible risque (0–4 points), risque intermédiaire (5–8 points), risque élevé (9–12 points) et risque très élevé (≥13 points). MODS désigne le syndrome de dysfonction multiviscérale ; ICU, unité de soins intensifs. Veuillez cliquer ici pour visualiser une version agrandie de cette figure.
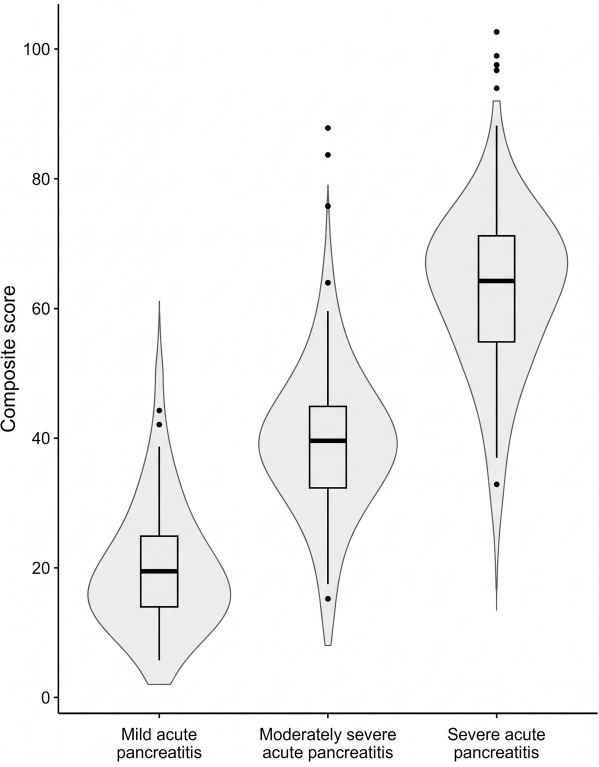
Figure 5 : Répartition du score composite basé sur les points selon les catégories de gravité selon la classification révisée d'Atlanta. La répartition des scores composites est présentée pour les patients présentant une pancréatite aiguë légère, modérément sévère et sévère. Les scores composites augmentent progressivement à travers les trois catégories de gravité, indiquant une concordance entre le score biochimique–coagulatoire au moment de l'admission et la classification de gravité révisée d'Atlanta. Cette figure a été générée à partir de la cohorte analytique verrouillée de 300 patients. AP désigne la pancréatite aiguë. Veuillez cliquer ici pour visualiser une version agrandie de cette figure.
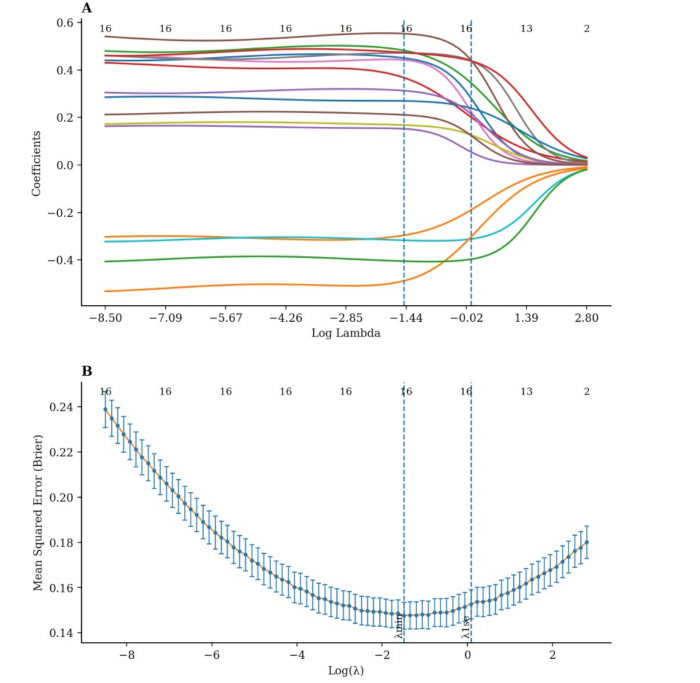
Figure 6 : Élaboration du modèle pénalisé dans la cohorte de développement. (A) Trajectoires des coefficients du sélecteur et réducteur par contraction absolue minimale pour les prédicteurs biochimiques et de coagulation candidats à l'admission. (B) Les résultats de la validation croisée répétée en 10 parties ont été utilisés pour sélectionner le paramètre de pénalité. La règle d'une erreur-type a été appliquée afin d'obtenir un modèle verrouillé parcimonieux pour la construction du score et la validation sur échantillon réservé. LASSO désigne le sélecteur et réducteur par contraction absolue minimale ; PT-INR, rapport normalisé international du temps de prothrombine. Veuillez cliquer ici pour visualiser une version agrandie de cette figure.
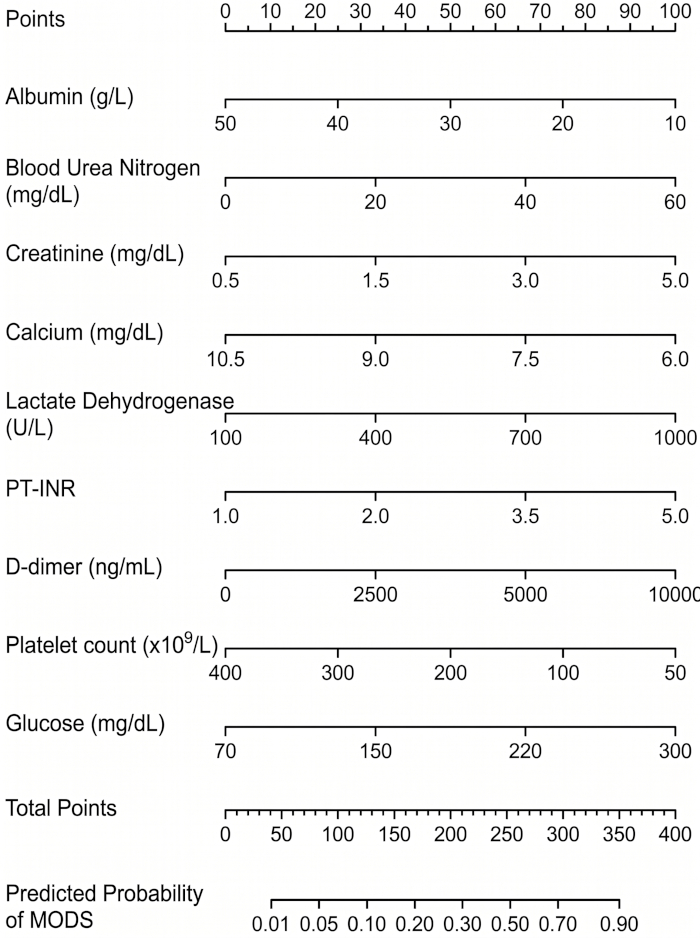
Figure 7 : Nomogramme basé sur le modèle de prédiction figé pour l'estimation du risque individualisé. Le nomogramme intègre les neuf prédicteurs au moment de l'admission conservés par le modèle pénalisé figé : albumine, azote uréique sanguin, créatinine, calcium, lactate déshydrogénase, temps de prothrombine–rapport normalisé international, D-dimère, numération des plaquettes et glucose. Chaque prédicteur contribue à un score total qui correspond à la probabilité estimée de syndrome de dysfonction multiviscérale. Le nomogramme a été inclus comme aide à l'interprétation, tandis que le score composite basé sur les points restait l'outil pratique principal au chevet du patient. SDMO désigne le syndrome de dysfonction multiviscérale ; TPI-RNI, temps de prothrombine–rapport normalisé international ; UEF, unités fibrinogène-équivalent. Veuillez cliquer ici pour visualiser une version agrandie de cette figure.
| Variable | Cohorte de développement n=210 | Cohorte de validation indépendante n=90 | Valeur P |
| Âge, années | 54,0 ± 16,4 | 55,3 ± 15,2 | 0,486 |
| Sexe masculin, n (%) | 130 (61,9) | 55 (61,1) | 0,898 |
| Indice de masse corporelle, kg/m² | 25,0 (22,6–27,9) | 24,7 (22,2–27,5) | 0,293 |
| Temps entre l'apparition des symptômes et l'admission, h | 13,2 (7,1–22,6) | 12,8 (6,8–21,7) | 0,612 |
| Étiologie, n (%) | 0,931 | ||
| Biliaire | 89 (42,4) | 38 (42,2) | |
| Hypertriglycéridémie | 65 (31,0) | 29 (32,2) | |
| Liée à l'alcool | 19 (9,0) | 8 (8,9) | |
| Idiopathique | 25 (11,9) | 11 (12,2) | |
| Autre | 12 (5,7) | 4 (4,4) | |
| Antécédent de pancréatite, n (%) | 31 (14,8) | 12 (13,3) | 0,742 |
| Antécédent de tabagisme, n (%) | 58 (27,6) | 24 (26,7) | 0,868 |
| Diabète sucré, n (%) | 37 (17,6) | 17 (18,9) | 0,795 |
| Hypertension artérielle, n (%) | 62 (29,5) | 28 (31,1) | 0,784 |
| Insuffisance rénale chronique, n (%) | 8 (3,8) | 4 (4,4) | 0,797 |
| Fréquence cardiaque à l'admission, battements/min | 92,4 ± 15,8 | 93,1 ± 16,2 | 0,726 |
| Pression artérielle moyenne, mmHg | 88,6 ± 12,4 | 87,9 ± 11,8 | 0,65 |
| Syndrome de réponse inflammatoire systémique, n (%) | 72 (34,3) | 30 (33,3) | 0,871 |
| Score du Bedside Index for Severity in Acute Pancreatitis | 1,0 (0,0–2,0) | 1,0 (0,0–2,0) | 0,842 |
| Score du Sequential Organ Failure Assessment | 1,0 (0,0–2,0) | 1,0 (0,0–2,0) | 0,796 |
| Score du Acute Physiology and Chronic Health Evaluation II | 7,0 (5,0–10,0) | 7,0 (5,0–10,0) | 0,884 |
| Syndrome de dysfonction multiviscérale, n (%) | 35 (16,7) | 15 (16,7) | 1 |
| Numération des globules blancs, ×10⁹/L | 12,8 ± 4,7 | 12,9 ± 4,9 | 0,865 |
| Protéine C-réactive, mg/L | 70,6 (32,8–141,5) | 72,4 (35,1–145,9) | 0,778 |
| Glucose, mmol/L | 9,1 (7,4–11,8) | 9,0 (7,2–11,6) | 0,691 |
| Calcium total, mmol/L | 2,05 ± 0,18 | 2,04 ± 0,19 | 0,672 |
| Urée sanguine, mmol/L | 6,9 (5,2–9,4) | 7,1 (5,3–9,6) | 0,584 |
| Créatinine, μmol/L | 80,2 (64,5–104,8) | 81,1 (65,1–106,2) | 0,731 |
| Albumine, g/L | 35,2 ± 5,1 | 35,0 ± 5,0 | 0,754 |
| Déshydrogénase lactique, U/L | 270,8 (212,5–356,7) | 275,6 (216,2–361,4) | 0,637 |
| Temps de prothrombine - rapport normalisé international | 1,09 (1,02–1,18) | 1,10 (1,03–1,19) | 0,694 |
| D-dimère, mg/L en unités fibrinogène-équivalent | 1,84 (0,92–3,82) | 1,91 (0,95–3,96) | 0,744 |
| Numération des plaquettes, ×10⁹/L | 203,6 ± 68,4 | 201,8 ± 66,9 | 0,836 |
Tableau 1 : Caractéristiques de base des patients dans les cohortes de développement et de validation réservée. Les variables démographiques, cliniques, de score de gravité, biochimiques et de coagulation de base sont comparées entre les cohortes de développement et de validation réservée. Les variables continues sont exprimées comme moyenne ± écart-type ou médiane (intervalle interquartile), et les variables catégorielles comme n (%). Les valeurs P sont utilisées pour des comparaisons descriptives entre les cohortes.
| Variable | Groupe sans MODS n = 250 | Groupe MODS n = 50 | Valeur de p |
| Numération des globules blancs, ×10⁹/L | 12,3 ± 4,6 | 14,4 ± 5,2 | 0,008 |
| Rapport neutrophiles-lymphocytes | 9,0 (5,9–14,2) | 13,4 (9,1–21,3) | <0,001 |
| Protéine C-réactive, mg/L | 61,4 (29,2–123,8) | 138,6 (86,9–226,7) | <0,001 |
| Procalcitonine, ng/mL | 0,43 (0,18–1,02) | 1,25 (0,56–3,28) | <0,001 |
| Lactate, mmol/L | 1,7 (1,2–2,4) | 2,7 (2,0–4,0) | 0,004 |
| Glucose, mmol/L | 8,9 (7,3–11,4) | 11,2 (8,9–15,1) | 0,01 |
| Calcium total, mmol/L | 2,06 ± 0,17 | 1,96 ± 0,21 | 0,013 |
| Urée sanguine, mmol/L | 6,6 (5,1–8,9) | 9,4 (7,4–13,2) | <0,001 |
| Créatinine, μmol/L | 77,1 (62,4–97,6) | 108,9 (84,7–163,4) | <0,001 |
| Alanine aminotransférase, U/L | 46,2 (25,6–93,8) | 58,7 (31,5–119,4) | 0,084 |
| Bilirubine totale, μmol/L | 18,6 (12,3–31,7) | 22,1 (14,2–38,9) | 0,038 |
| Albumine, g/L | 35,9 ± 4,8 | 32,5 ± 5,6 | <0,001 |
| Déshydrogénase lactique, U/L | 254,6 (203,2–329,1) | 372,4 (289,8–512,3) | <0,001 |
| Numération des plaquettes, ×10⁹/L | 207,4 ± 67,2 | 190,3 ± 72,5 | 0,096 |
| Temps de prothrombine, s | 12,7 (11,8–13,9) | 14,1 (12,9–15,7) | 0,002 |
| Ratio normalisé international du temps de prothrombine | 1,08 (1,02–1,16) | 1,22 (1,10–1,38) | 0,002 |
| Temps de thromboplastine partielle activée, s | 31,8 (28,4–36,5) | 36,9 (31,7–42,8) | 0,006 |
| Fibrinogène, g/L | 4,12 ± 1,18 | 4,31 ± 1,29 | 0,268 |
| D-dimère, mg/L en unités équivalentes fibrinogène | 1,48 (0,78–3,16) | 4,62 (2,10–8,95) | <0,001 |
Tableau 2 : Profils biochimiques et de coagulation à l'admission selon le statut de syndrome de dysfonctionnement multiviscéral. Les indices de laboratoire représentent la première mesure éligible obtenue dans les 24 heures suivant l'admission à l'hôpital. Les variables continues sont exprimées en moyenne ± écart-type ou médiane (intervalle interquartile). Les valeurs P correspondent à des comparaisons descriptives entre les patients ayant développé un syndrome de dysfonctionnement multiviscéral et ceux qui ne l'ont pas développé. Ces comparaisons ont été utilisées pour caractériser les différences à l'admission et n'ont pas été utilisées seules pour la sélection de prédicteurs.
| Prédicteur conservé dans le modèle verrouillé | Sens associé à un risque plus élevé de MODS | Unité normalisée pour l'interprétation | Odds ratio descriptive | Intervalle de confiance à 95 % | Rôle dans le modèle |
| Albumine | Valeur plus faible | Par diminution de 5 g/L | 1,29 | 1,13–1,47 | Composant principal du score |
| Urée sanguine | Valeur plus élevée | Par augmentation de 1 mmol/L | 1,12 | 1,06–1,18 | Composant principal du score |
| Créatinine | Valeur plus élevée | Par augmentation de 10 μmol/L | 1,05 | 1,02–1,09 | Composant principal du score |
| Calcium total | Valeur plus faible | Par diminution de 0,1 mmol/L | 1,18 | 1,07–1,30 | Composant principal du score |
| Déshydrogénase lactique | Valeur plus élevée | Par augmentation de 100 U/L | 1,21 | 1,07–1,37 | Composant principal du score |
| Temps de prothrombine - rapport normalisé international | Valeur plus élevée | Par augmentation de 0,1 | 1,14 | 1,05–1,25 | Composant principal du score |
| D-dimère | Valeur plus élevée | Par augmentation de 1,0 mg/L en unités équivalentes fibrinogène | 1,09 | 1,02–1,17 | Composant principal du score |
| Numération des plaquettes | Valeur plus faible | Par diminution de 50 × 10⁹/L | 1,16 | 1,01–1,34 | Composant principal du score |
| Glucose | Valeur plus élevée | Par augmentation de 1 mmol/L | 1,05 | 1,00–1,10 | Modificateur facultatif |
Tableau 3 : Prédicteurs retenus par le modèle pénalisé verrouillé et estimations descriptives post-sélection. Le tableau présente les prédicteurs conservés par le modèle logistique pénalisé selon l'opérateur de réduction et de sélection par contraction absolue verrouillé, ainsi que les estimations descriptives post-sélection destinées à l'interprétation clinique. Les rapports de cotes sont indiqués pour les unités normalisées spécifiées. Ces estimations ne sont pas considérées comme une inférence confirmatoire après sélection pénalisée.
| Composante du score | Category | Points attribués |
| Albumine, g/L | ≥38 | 0 |
| 34–37,9 | 1 | |
| 30–33,9 | 2 | |
| <30 | 3 | |
| Azote uréique sanguin, mmol/L | <6,5 | 0 |
| 6,5–8,9 | 1 | |
| 9,0–12,9 | 2 | |
| ≥13,0 | 3 | |
| Créatinine, μmol/L | <80 | 0 |
| 80–109 | 1 | |
| 110–169 | 2 | |
| ≥170 | 3 | |
| Calcium total, mmol/L | ≥2,10 | 0 |
| 2,00–2,09 | 1 | |
| 1,90–1,99 | 2 | |
| <1,90 | 3 | |
| Lactate déshydrogénase, U/L | <250 | 0 |
| 250–349 | 1 | |
| 350–499 | 2 | |
| ≥500 | 3 | |
| Temps de prothrombine - rapport normalisé international | <1,10 | 0 |
| 1,10–1,19 | 1 | |
| 1,20–1,39 | 2 | |
| ≥1,40 | 3 | |
| D-dimère, mg/L unités équivalentes fibrinogène | <1,0 | 0 |
| 1,0–2,9 | 1 | |
| 3,0–5,9 | 2 | |
| ≥6,0 | 3 | |
| Numération des plaquettes, ×10⁹/L | ≥200 | 0 |
| 150–199 | 1 | |
| 100–149 | 2 | |
| <100 | 3 | |
| Glucose, mmol/L | <10,0 | 0 |
| ≥10,0 | 1 |
Tableau 4 : Construction du score composite biochimique–coagulatif à l'admission.
Le score composite basé sur des points a été dérivé du modèle pénalisé verrouillé et traduit en catégories cliniques interprétables au chevet du patient. Des points ont été attribués selon la direction et la contribution relative des prédicteurs retenus. Le nombre total de points est calculé en additionnant tous les composants du score retenus. Le glucose a été conservé comme modificateur facultatif car son association était plus faible que celle des composants biochimiques–coagulatoires principaux, mais restait cohérente en termes de direction avec un risque accru.
| Outil | Cohorte | AUC | Score de Brier | Intercept de calibration | Pente de calibration | Seuil | Sensibilité | Spécificité | VPN | VPP |
| (IC à 95 %) | (IC à 95 %) | (IC à 95 %) | ||||||||
| Modèle pénalisé verrouillé | Cohorte de développement | 0.873 (0.820–0.926) | 0.117 | 0.04 (−0.08 à 0.16) | 0.97 (0.79–1.18) | Risque prédit ≥0,18 | 0,82 | 0,77 | 0,39 | 0,96 |
| Modèle pénalisé verrouillé | Cohorte de validation réservée | 0.836 (0.751–0.921) | 0.139 | 0.08 (−0.14 à 0.30) | 0.91 (0.68–1.15) | Risque prédit ≥0,18 | 0,75 | 0,74 | 0,39 | 0,93 |
| Score composite basé sur des points | Cohorte de développement | 0.823 (0.758–0.888) | 0.132 | Non applicable | Non applicable | ≥8 points | 0,76 | 0,72 | 0,35 | 0,93 |
| Score composite basé sur des points | Cohorte de validation réservée | 0.783 (0.684–0.882) | 0.151 | Non applicable | Non applicable | ≥8 points | 0,7 | 0,69 | 0,31 | 0,91 |
Tableau 5 : Performances du modèle pénalisé verrouillé et du score composite basé sur des points. La discrimination, la calibration et les performances basées sur le seuil sont indiquées pour les cohortes de développement et de validation réservée. La discrimination est exprimée par l'aire sous la courbe caractéristique de fonctionnement du récepteur, avec un intervalle de confiance à 95 %. La calibration est résumée par le score de Brier, l'intercept de calibration et la pente de calibration. Les métriques de seuil sont indiquées pour des seuils prédéfinis : risque prédit ≥0,18 pour le modèle pénalisé verrouillé et score ≥8 points pour le score composite basé sur des points.
| Outil de prédiction | AUC de développement | Valeur P de DeLong par rapport au modèle verrouillé | AUC de validation par échantillon de retenue | Valeur P de DeLong par rapport au modèle verrouillé |
| (95 % IC) | (Développement) | (95 % IC) | (Validation) | |
| Modèle biochimique–coagulatif verrouillé | 0.873 (0.820–0.926) | Référence | 0.836 (0.751–0.921) | Référence |
| Score d'évaluation de l'insuffisance organique séquentielle | 0.842 (0.780–0.904) | 0.12 | 0.810 (0.712–0.908) | 0.34 |
| Score d'évaluation de la physiologie aiguë et de l'état de santé chronique II | 0.812 (0.744–0.880) | 0.03 | 0.790 (0.682–0.898) | 0.08 |
| Score Bedside Index for Severity in Acute Pancreatitis | 0.795 (0.724–0.866) | 0.01 | 0.765 (0.648–0.882) | 0.05 |
| Score de Ranson | 0.742 (0.661–0.823) | <0.001 | 0.701 (0.577–0.825) | 0.02 |
| Score d'aponévrite aiguë bénigne | 0.701 (0.618–0.784) | <0.001 | 0.688 (0.560–0.816) | 0.01 |
| Critères du syndrome de réponse inflammatoire systémique | 0.684 (0.598–0.770) | <0.001 | 0.672 (0.541–0.803) | 0.02 |
Tableau 6 : Comparaison comparative avec des outils d'évaluation de la gravité établis. Le modèle biochimique–coagulatoire figé à l'admission est comparé à des outils établis d'évaluation de la gravité de la pancréatite aiguë ou du dysfonctionnement organique, calculés à partir de la même fenêtre d'admission lorsque les données étaient disponibles. Les valeurs de la surface sous la courbe caractéristique de fonctionnement du récepteur avec des intervalles de confiance à 95 % sont indiquées pour les cohortes de développement et de validation réservée. Des tests de DeLong appariés comparent chaque outil de référence au modèle biochimique–coagulatoire figé au sein de chaque cohorte.
| Catégorie de risque | Plage de score | Patients, n | Incidence de SDMO, n (%) | Admission en USI, n | Ventilation mécanique, n (%) | Thérapie de remplacement rénal, n (%) | Mortalité intra-hospitalière, n (%) | Nécrose infectée ou drainage, n (%) | Durée du séjour, jours |
| (%) | |||||||||
| Bas risque | 0–4 | 115 | 4 (3,5) | 10 (8,7) | 3 (2,6) | 1 (0,9) | 1 (0,9) | 3 (2,6) | 7,6 (5,2–10,4) |
| Risque intermédiaire | 5–8 | 101 | 9 (8,9) | 24 (23,8) | 9 (8,9) | 4 (4,0) | 2 (2,0) | 9 (8,9) | 11,4 (8,0–16,5) |
| Haut risque | 9–12 | 60 | 20 (33,3) | 36 (60,0) | 18 (30,0) | 10 (16,7) | 6 (10,0) | 14 (23,3) | 18,6 (13,0–26,8) |
| Très haut risque | ≥13 | 24 | 17 (70,8) | 20 (83,3) | 13 (54,2) | 7 (29,2) | 6 (25,0) | 8 (33,3) | 24,9 (17,5–37,2) |
Tableau 7 : Stratification du risque selon un score composite basé sur des points. Les patients sont classés en groupes à faible, intermédiaire, élevé et très élevé risque en fonction du nombre total de points obtenus. L'incidence observée du syndrome de dysfonction multiviscérale et les principaux résultats cliniques sont indiqués selon les strates de score. Les résultats catégoriels sont présentés sous forme de n (%), et la durée d'hospitalisation est exprimée en médiane (intervalle interquartile).
Tableau supplémentaire 1 : Critères opérationnels d'adjudication des critères d'arrêt pour le syndrome de dysfonction multiviscérale. Ce tableau définit les critères prédéfinis par système d'organes utilisés pour évaluer les dysfonctionnements respiratoire, cardiovasculaire, rénal, hépatique, de la coagulation et neurologique. Le critère d'arrêt final était attribué lorsqu'un dysfonctionnement de deux systèmes d'organes ou plus survenait pendant l'hospitalisation. Deux évaluateurs formés ont évalué indépendamment chaque cas, et les désaccords ont été résolus par un troisième évaluateur senior.Veuillez cliquer ici pour télécharger ce fichier.
Tableau supplémentaire 2 : Analyses de sensibilité pour la gestion des données manquantes et l'attribution des valeurs initiales. Ce tableau résume l'analyse principale avec données imputées et les analyses de sensibilité prédéfinies, incluant l'analyse des cas complets, l'attribution de la pire valeur initiale dans les 24 premières heures, et la vérification des performances ajustée par centre. Ces analyses évaluent si la discrimination du modèle, le score de Brier, le profil des prédicteurs retenus et les gradients de risque stratifiés par score ont été sensiblement modifiés par les différentes alternatives de prétraitement.Veuillez cliquer ici pour télécharger ce fichier.
Discussion
Le syndrome de dysfonction multiviscérale (SDMV) associé à la pancréatite aiguë peut évoluer rapidement après l'admission à l'hôpital, en particulier chez les patients présentant une inflammation systémique précoce, une lésion endothéliale, une perfusion tissulaire altérée et une instabilité métabolique. Le présent protocole a été conçu autour de cette période d'admission, car les premières 24 heures déterminent souvent si le patient doit rester sous observation courante en service ou nécessite une réévaluation plus étroite, une surveillance accrue ou une préparation aux voies de prise en charge des organes. Les résultats ont montré que des paramètres biochimiques et de coagulation couramment disponibles, lorsqu'ils sont traités selon un flux de modélisation figé et reproductible, peuvent être organisés en un score interprétable permettant la stratification précoce du risque de SDMV dans la pancréatite aiguë11. Cette approche est conforme à la réalité clinique selon laquelle un seul biomarqueur ou des classifications tardives de gravité peuvent ne pas refléter complètement le schéma de détérioration systémique précoce observé dans les cas de pancréatite aiguë à haut risque12.
La justification biologique de la combinaison de variables biochimiques et de coagulation est cliniquement plausible. La pancréatite aiguë sévère n'est pas provoquée par une voie isolée unique ; l'inflammation systémique, l'activation endothéliale, les fuites capillaires, l'hypoperfusion rénale, l'activation de la coagulation et les troubles microcirculatoires peuvent s'amplifier mutuellement lors de la détérioration précoce. Les prédicteurs biochimiques retenus reflètent ce processus multi-axial. Une albuminémie plus basse peut indiquer une fuite vasculaire liée à l'inflammation et une réserve physiologique réduite, tandis qu'une urée sanguine et une créatininémie plus élevées sont compatibles avec une hypovolémie, une hypoperfusion rénale ou une lésion rénale précoce. Une calcémie plus basse, une lactate déshydrogénase plus élevée et une glycémie plus élevée peuvent refléter un stress métabolique, une atteinte tissulaire et une perturbation inflammatoire systémique plus sévère13. Les prédicteurs de coagulation ajoutent un signal complémentaire : un temps de prothrombine-rapport normalisé international allongé, un taux élevé de D-dimères et une numération plaquettaire plus basse peuvent indiquer une activation de la coagulation, un renouvellement du fibrine, une consommation plaquettaire et une altération microcirculatoire avant qu'une dysfonction organique manifeste ne soit pleinement établie14. L'augmentation progressive de l'incidence des SDMO et des critères de jugement secondaires selon les strates du score suggère donc que celui-ci capte un schéma cliniquement cohérent de détérioration systémique précoce, plutôt que des anomalies de laboratoire isolées.
Une contribution méthodologique clé de cette étude réside dans l'accent mis sur la reproductibilité. Le protocole révisé fixe la fenêtre d'admission, utilise la première valeur de laboratoire éligible dans les 24 heures, applique des règles explicites d'harmonisation des unités, définit des seuils de valeurs manquantes, normalise le prétraitement et limite l'ajustement du modèle à la cohorte de développement. Ces étapes influencent directement la possibilité de reproduire le score dans différents établissements. Par exemple, la communication des résultats du D-dimère varie selon les laboratoires, et les unités équivalentes en fibrinogène ne peuvent être supposées lorsque les rapports locaux utilisent des unités de D-dimère sans facteur de conversion validé. De même, les valeurs de laboratoire manquantes peuvent refléter les parcours locaux de tests plutôt qu'une absence aléatoire de données15. Plusieurs étapes du protocole sont donc essentielles : la règle de la fenêtre de 24 heures doit être appliquée de manière cohérente, les valeurs de laboratoire post-MODS ne doivent pas être utilisées pour construire les prédicteurs, l'attribution des événements terminaux doit suivre des critères prédéfinis par système organique, les valeurs de laboratoire doivent être converties en unités cibles communes avant regroupement, et la cohorte de validation réservée ne doit pas être utilisée pour la sélection des caractéristiques, le recalibrage des coefficients ou l'ajustement des seuils16.
Le flux de travail peut être modifié selon différents contextes institutionnels, mais ces modifications doivent rester prédéfinies. Si une variable candidate présente une proportion excessive de données manquantes parce qu'elle n'est pas mesurée systématiquement à l'admission, elle doit être exclue du développement du modèle plutôt que d'être imputée au-delà d'un seuil justifiable. Si les unités du D-dimère ne peuvent pas être harmonisées en unités équivalentes en fibrinogène, la valeur doit être considérée comme non harmonisable plutôt que d'être convertie à l'aide d'une hypothèse non étayée. Si les laboratoires locaux utilisent des plateformes d'analyse différentes, l'analyse principale peut conserver les valeurs cliniques absolues, tandis que les analyses de sensibilité incluent le code du centre ou la plateforme d'analyse comme facteurs d'ajustement. Si le nombre d'événements de MODS est inférieur au nombre attendu, la stratégie de modélisation doit privilégier un rétrécissement plus marqué, un nombre réduit de prédicteurs retenus ou une structure de score plus simple, plutôt qu'une expansion du modèle pour s'ajuster à des signaux instables17. Le dépannage pratique devrait également inclure la vérification de si les tests de coagulation sont systématiquement prescrits à l'admission, de si les distributions des prédicteurs diffèrent de manière inattendue entre les centres, de si les seuils de validation ont été modifiés involontairement, et de si chaque panneau de figure correspond bien au jeu de données analytique figé18.
Les résultats doivent être interprétés en tenant compte de plusieurs limites. La cohorte de validation réservée a été extraite du même jeu de données rétrospectif multicentrique et représente donc une validation interne réservée plutôt qu'une validation externe indépendante. Le nombre d'événements était limité, augmentant ainsi le risque d'une rétention instable des prédicteurs, même dans le cadre de modélisation pénalisée. Les rapports de cotes descriptifs après sélection ont été inclus uniquement pour faciliter l'interprétation clinique et ne doivent pas être considérés comme une inférence confirmatoire. Certains composants du critère de jugement dépendaient de la qualité de la documentation dans les dossiers médicaux électroniques, et d'éventuelles différences non mesurées entre centres au niveau des pratiques cliniques ont pu influencer les décisions concernant le soutien d'organes. L'analyse de courbe de décision n'a pas été conservée dans le jeu de données révisé ; par conséquent, l'article ne revendique pas de bénéfice net clinique à travers les probabilités seuils19. Le score ne doit pas non plus remplacer l'évaluation établie de la gravité, l'examen clinique répété, les examens d'imagerie si indiqués, ou le jugement clinique. Des scores faibles peuvent soutenir une surveillance de routine et une réévaluation standard, mais ils n'excluent pas une détérioration ultérieure ; des scores plus élevés doivent être interprétés comme des signaux incitant à une surveillance plus étroite, à une réévaluation biologique répétée et à une préparation précoce aux voies de soutien d'organes, plutôt que comme des prescriptions thérapeutiques fixes20.
Dans l'ensemble, cette étude présente un flux de travail reproductible de score biochimique–coagulation à l'admission pour la stratification précoce du risque de SDMO dans la pancréatite aiguë. Le modèle pénalisé verrouillé et le score fondé sur des points ont montré une discrimination cohérente et des gradients de risque ordonnés dans les cohortes de développement et de validation réservée, tandis que les analyses de sensibilité ont indiqué que les principaux résultats n'étaient pas sensiblement modifiés par les alternatives prescrites concernant les données manquantes ou les valeurs de base. L'intérêt principal de cette approche réside dans l'organisation de données de laboratoire courantes disponibles à l'admission en un signal de risque précoce interprétable, pouvant aider au triage, ajuster l'intensité de la surveillance et préparer les voies de prise en charge des organes21. Les travaux futurs devraient prioriser une validation externe prospective dans différents hôpitaux utilisant des plateformes de laboratoire variées, l'évaluation du calibrage en temps réel, la comparaison avec des calculateurs électroniques de risque dérivés du même modèle verrouillé, ainsi que l'analyse de l'impact des voies de surveillance guidées par le score sur la réduction des escalades tardives, sans augmenter l'utilisation inutile des soins intensifs22.
Déclarations de divulgation
Les auteurs déclarent qu'ils n'ont aucun conflit d'intérêts pertinent à cette étude.
Remerciements
Les auteurs tiennent à remercier tous les cliniciens et le personnel de laboratoire ayant participé au diagnostic, au traitement et à la collecte des données chez les patients atteints de pancréatite aiguë. Nous sommes également reconnaissants envers les patients dont les données cliniques ont permis cette étude. Leur contribution est sincèrement appréciée.
Matériaux
| Nom | Entreprise | Numéro de catalogue | Commentaires |
|---|---|---|---|
| Nom | Nom de la société | Numéro de catalogue / URL | Commentaires |
| Logiciel statistique R | Fondation R pour l'informatique statistique | Version 4.3.2 https://www.r-project.org/ | Environnement de calcul statistique utilisé pour le prétraitement des données, le développement de modèles, la validation et la génération de figures. |
| Package R caret | CRAN / Max Kuhn | Version 6.0-94 https://cran.r-project.org/package=caret | Utilisé pour la division stratifiée 7:3 entre ensemble de développement et ensemble de validation retenu, à l’aide de la fonction createDataPartition. |
| Package R glmnet | CRAN / auteurs de glmnet | Version 4.1-8 https://cran.r-project.org/package=glmnet | Utilisé pour la régression logistique pénalisée LASSO avec famille binomiale et alpha = 1. |
| Package R mice | CRAN / projet amices | Version 3.16.0 https://cran.r-project.org/package=mice | Utilisé pour l’imputation multiple par équations enchaînées, avec 20 jeux de données imputées et 20 itérations. |
| Package R pROC | CRAN / auteurs de pROC | Version 1.18.5 https://cran.r-project.org/package=pROC | Utilisé pour l’analyse ROC, l’estimation de l’AUC, les intervalles de confiance et les comparaisons selon DeLong. |
| Série d'analyseurs modulaires cobas 8000 | Roche Diagnostics | 05641446001 / SYS_128 https://diagnostics.roche.com/global/en/products/systems/cobas-8000-analyzer-series-sys-128.html | Tests biochimiques et immunochimiques. Vérifier le modèle de l'analyseur et les informations du catalogue par rapport aux dossiers du laboratoire participant avant soumission. |
| Analyseur d’hématologie automatisé XN-1000 | Sysmex Corporation | Modèle XN-1000 https://www.sysmex.com/en-us/lab-solutions/hematology/xn-series/xn-1000 | Variables de numération sanguine complète, y compris les numérations des globules blancs et des plaquettes. À vérifier par rapport aux dossiers du laboratoire participant avant soumission. |
| Analyseur automatisé de coagulation sanguine CS-5100 | Sysmex Corporation | Modèle CS-5100 https://www.sysmex.com/en-us/lab-solutions/hemostasis/sysmex-cs-5100 | Variables de coagulation, y compris TP, TCA, fibrinogène et D-dimère. À vérifier par rapport aux dossiers du laboratoire participant avant soumission. |
| Analyseur de gaz du sang ABL90 FLEX PLUS | Radiometer Medical ApS | Modèle ABL90 FLEX PLUS https://www.radiometer.com/en/products/blood-gas-testing/abl90-flex-plus-blood-gas-analyzer | Mesure du lactate, si cette plateforme a été utilisée. À vérifier par rapport aux dossiers du laboratoire participant avant soumission. |
| Système de dossier médical électronique | Hôpitaux participants | Spécifique à l'établissement ; non applicable | Utilisé pour extraire les notes d'admission, les notes de suivi, les dossiers de soins intensifs, les procédures, les signes vitaux et les dossiers de sortie. Remplacer par le nom réel du fournisseur et du système lorsque disponible. |
| Système d'information de laboratoire | Hôpitaux participants | Spécifique à l'établissement ; non applicable | Utilisé pour extraire les horodatages des analyses, les valeurs brutes, les unités et les données harmonisées. Remplacer par le nom réel du fournisseur et du système lorsque disponible. |
| Formulaire d'adjudication des événements | Équipe de l'étude | Document personnalisé de l'étude ; non applicable | Formulaire standardisé utilisé par deux évaluateurs et un troisième évaluateur senior pour l'adjudication du statut et de l'apparition du SDOM. |
| Dictionnaire de données et tableau de conversion d'unités | Équipe de l'étude | Document personnalisé de l'étude ; non applicable | Définit les noms des variables, les unités cibles, les règles de conversion, les indicateurs de données manquantes, les codes des centres et les formats prêts à l'analyse. |
Références
- Banks PA, et al. Classification of acute pancreatitis-2012: revision of the Atlanta classification and definitions by international consensus. Gut. 2013;62(1):102-111.
- Wu BU, et al. The early prediction of mortality in acute pancreatitis: a large population-based study. Gut. 2008;57(12):1698-1703.
- Tenner S, et al. American College of Gastroenterology Guidelines: Management of Acute Pancreatitis. Am J Gastroenterol. 2024;119(3):419-437.
- Lee DW, Cho CM. Predicting severity of acute pancreatitis. Medicina (Kaunas). 2022;58(6):787.
- Metri A, Bush N, Singh VK. Predicting the severity of acute pancreatitis: current approaches and future directions. Surg Open Sci. 2024;19:109-117.
- Efthimiou O, et al. Developing clinical prediction models: a step-by-step guide. BMJ. 2024;386.
- Collins GS, Reitsma JB, Altman DG, Moons KGM. Transparent reporting of a multivariable prediction model for individual prognosis or diagnosis: the TRIPOD statement. Ann Intern Med. 2015;162(1):55-63.
- Li L, et al. Coagulopathy and acute pancreatitis: pathophysiology and clinical treatment. Front Immunol. 2024;15:1477160.
- Wan J, et al. Serum D-dimer levels at admission for prediction of outcomes in acute pancreatitis. BMC Gastroenterol. 2019;19:67.
- World Medical Association. World Medical Association Declaration of Helsinki: ethical principles for medical research involving human subjects. JAMA. 2013;310(20):2191-2194.
- Garg PK, Singh VP. Organ failure due to systemic injury in acute pancreatitis. Gastroenterology. 2019;156(7):2008-2023.
- Wu BU. Prognosis in acute pancreatitis. CMAJ. 2011;183(6):673-677.
- Wang H, et al. Early predictive value of different indicators for persistent organ failure in acute pancreatitis: a systematic review and network meta-analysis. J Clin Gastroenterol. 2024;58(3):307-314.
- Dumnicka P, et al. The interplay between inflammation, coagulation and endothelial injury in the early phase of acute pancreatitis: clinical implications. Int J Mol Sci. 2017;18(2):354.
- Favaloro EJ, Dean E. Variability in D-dimer reporting revisited. Pathology. 2021;53(4):538-540.
- Wolff RF, et al. PROBAST: A tool to assess the risk of bias and applicability of prediction model studies. Ann Intern Med. 2019;170(1):51-58.
- Riley RD, et al. Calculating the sample size required for developing a clinical prediction model. BMJ. 2020;368.
- Collins GS, et al. Evaluation of clinical prediction models (part 1): from development to external validation. BMJ. 2024;384.
- Vickers AJ, Elkin EB. Decision curve analysis: a novel method for evaluating prediction models. Med Decis Making. 2006;26(6):565-574.
- Riley RD, van der Windt D, Croft P, Moons KGM, editors. Prognosis Research in Healthcare: Concepts, Methods, and Impact. Oxford University Press; Oxford; 2019.
- Wu H, Li J, Zhao J, Li S. A new scoring system can be applied to predict the organ failure related events in acute pancreatitis accurately and rapidly. Pancreatology. 2020;20(4):622-628.
- Riley RD, et al. Evaluation of clinical prediction models (part 2): how to undertake an external validation study. BMJ. 2024;384.