La néphropathie diabétique (ND) implique un dysfonctionnement mitochondrial. À l'aide de la transcriptomique, de la pharmacologie par réseaux et de l'apprentissage automatique, nous avons identifié CAT, FABP1, MAOA et MAOB comme biomarqueurs mitochondriaux candidats pour la Ligustri Lucidi Fructus. Chez les souris db/db, le LLF a augmenté l'expression de CAT et MAOA, soutenant des investigations mécanistiques supplémentaires.
Article de recherche
Identification de biomarqueurs candidats liés aux mitochondries du Ligustri Lucidi Fructus dans la néphropathie diabétique
Dans cet article
Résumé
Résumé
Le dysfonctionnement mitochondrial et le stress oxydatif excessif au sein des mitochondries sont des facteurs pathologiques clés responsables des lésions tubulaires rénales dans la néphropathie diabétique (ND). Bien que Ligustri Lucidi Fructus (LLF) est traditionnellement utilisée pour traiter la néphropathie diabétique (DN), mais les mécanismes impliqués, en particulier ceux relatifs aux gènes et voies mitochondriales, restent mal compris. Cette étude a utilisé une analyse d'expression différentielle du jeu de données GSE142025 afin d'identifier les gènes différentiellement exprimés (DEG) associés à la DN. Les gènes caractéristiques ont été sélectionnés par recoupement des résultats provenant de quatre modèles d'apprentissage automatique. Les gènes présentant une expression différentielle significative et des profils d'expression cohérents dans les deux jeux de données ont été évalués ultérieurement par analyse de la courbe ROC (courbe caractéristique de fonctionnement du récepteur). Ceux dont l'aire sous la courbe (AUC) > 0,7 dans les deux jeux de données ont été définis comme des biomarqueurs candidats. Des analyses d'enrichissement fonctionnel, d'infiltration immunitaire, de construction de réseaux et de docking moléculaire ont été réalisées. Un modèle murin de DN a été utilisé pour évaluer la glycémie, la microalbuminurie urinaire, l'histopathologie et l'expression par RT-qPCR des biomarqueurs candidats. CAT et MAOA étaient significativement surexprimés in vivoLes biomarqueurs candidats étaient enrichis dans des voies liées à la fonction des ribosomes, à la dégradation de la valine, de la leucine et de l'isoleucine, aux interactions cytokines-récepteurs de cytokines et aux peroxysomes. Ils étaient négativement corrélés aux cellules T CD8+ et aux mastocytes activés, et positivement corrélés aux cellules NK activées et aux lymphocytes B naïfs. La taxifoline, le bêta-sitostérol et l'ériodictyol présentaient des énergies de liaison inférieures à -5 kcal/mol avec les biomarqueurs candidats. CAT et MAOA constituent des candidats prometteurs qui justifient des investigations mécanistiques supplémentaires.
Introduction
La néphropathie diabétique (ND), la principale cause d'insuffisance rénale terminale dans le monde, est l'une des complications les plus fréquentes du diabète sucré. Sur le plan histopathologique, elle se caractérise par une accumulation excessive de matrice extracellulaire dans les compartiments glomérulaires et tubulaires, ainsi que par un épaississement et une sclérose des vaisseaux sanguins intrarénaux2. La ND est couramment associée à une protéinurie et à une hypertension artérielle3. Son développement est étroitement lié à des lésions des cellules endothéliales vasculaires, à une réponse inflammatoire exacerbée et à un stress oxydatif accru résultant d'une hyperglycémie prolongée4. L'incidence de la ND augmente dans le monde entier, en particulier chez les personnes diabétiques d'âge moyen et âgées. À mesure que la maladie progresse, elle peut entraîner une insuffisance rénale terminale et même des complications cardiovasculaires, altérant considérablement la qualité de vie et le pronostic des patients5. Malgré les progrès réalisés dans les approches diagnostiques et thérapeutiques de la ND, des biomarqueurs candidats précoces et précis pour le diagnostic restent à identifier, et des stratégies thérapeutiques efficaces permettant d'inverser les processus pathologiques font encore défaut. Par conséquent, il existe un besoin urgent de développer de nouveaux médicaments ciblés contre la ND.
Les mitochondries sont essentielles pour la bioénergétique cellulaire, la synthèse des précurseurs métaboliques, l'homéostasie du calcium, la production d'espèces réactives de l'oxygène (ROS), la signalisation immunitaire et l'apoptose, tous des processus indispensables au maintien de la stabilité cellulaire et de l'organisme6. En tant que centrales énergétiques de la cellule, les mitochondries jouent un rôle central dans des processus fondamentaux tels que la glycolyse, le cycle de l'acide tricarboxylique et la phosphorylation oxydative7. L'obésité perturbe le cycle de Krebs et la chaîne respiratoire mitochondriale, entraînant un dysfonctionnement mitochondrial et une augmentation de la production de ROS. Des niveaux élevés de ROS dans la chaîne respiratoire mitochondriale peuvent induire un stress oxydatif, ce qui aggrave la réponse inflammatoire associée à l'obésité et favorise l'apoptose8. Des recherches récentes ont mis en évidence le rôle important du dysfonctionnement mitochondrial dans la pathogenèse et la progression de la néphropathie diabétique (DN), notamment par des troubles du métabolisme énergétique, une production excessive de ROS et une activation accrue de la signalisation apoptotique9. Un dysfonctionnement mitochondrial chronique accélère la progression de la maladie rénale10. Ainsi, l'amélioration de la fonction mitochondriale pourrait représenter une stratégie protectrice cruciale contre la DN.
Ligustri Lucidi Fructus (LLF) est un fruit séché et mûr appartenant à la famille des Luteaceae, réputé pour ses propriétés nutritives pour le foie et les reins, ainsi que pour sa capacité à assombrir les cheveux et améliorer la vision. Un hétéropolysaccharide naturel extrait du LLF a été identifié, révélant son potentiel à protéger les reins contre la fibrose11. Ces dernières années, l'utilisation du LLF dans le traitement de la néphropathie diabétique (DN) a suscité un intérêt croissant, avec des effets reno-protecteurs notables démontrés11,12,13. En outre, la relation complexe entre le LLF et les mitochondries a fait l'objet de recherches approfondies et a été validée. Notamment, une étude a montré que le LLF exerce ses effets bénéfiques en modulant la fonction mitochondriale par l'activation de la voie de signalisation AMPK14. Ce mécanisme protège efficacement les mitochondries des dommages causés par le stress oxydatif. Ces découvertes soulignent davantage le rôle essentiel du LLF dans le maintien du métabolisme énergétique cellulaire et dans l'amélioration de la résilience des cellules face au stress oxydatif. Toutefois, le mécanisme thérapeutique précis, notamment en ce qui concerne la récupération de la fonction mitochondriale, reste mal compris.
L'objectif de cette étude était d'élucider les mécanismes biologiques sous-jacents à l'effet thérapeutique de LLF sur la fonction mitochondriale dans le DN. Des bases de données publiques ont été explorées à l'aide d'outils de bio-informatique afin d'identifier des biomarqueurs candidats associés aux effets réno-protecteurs de LLF, en intégrant des données transcriptomiques et des informations sur les principes actifs. Des analyses supplémentaires, incluant l'infiltration immunitaire, l'association avec les caractéristiques cliniques, la modification de l'ARN par m6A, l'enrichissement fonctionnel, la construction de réseaux régulateurs et le dockage moléculaire, ont suggéré que ces biomarqueurs candidats jouent un rôle clé dans la régulation de la fonction mitochondriale au cours du traitement du DN. Une validation in vivo a de plus confirmé leur importance. Cette analyse complète approfondit notre compréhension des mécanismes par lesquels LLF traite le DN et fournit une base solide pour le développement de nouvelles cibles thérapeutiques fondées sur la dysfonction mitochondriale.
Protocole
Collecte des données
La matrice d'expression génique et les données cliniques correspondantes pour les jeux de données GSE142025 et GSE96804, associés à la néphropathie diabétique (DN), ont été extraites de la base de données Gene Expression Omnibus (GEO) (https://www.ncbi.nlm.nih.gov/geo/)15. Le jeu d'apprentissage (GSE142025) comprenait des échantillons de tissu rénal provenant de 27 patients atteints de DN et de neuf témoins, séquencés à l'aide de la plateforme GPL20301. Le jeu de validation (GSE96804) comprenait des données de séquençage de 41 patients atteints de DN et de 20 témoins, traitées à l'aide de la plateforme GPL17586. Les deux jeux de données portent sur le tissu rénal ; le jeu de données GSE96804 examine spécifiquement le glomérule, unité principale de filtration du rein (Figure 1). Le jeu de données GSE142025 (jeu d'apprentissage) comprend des échantillons de tissu rénal entier et fournit un aperçu complet du paysage transcriptomique de la DN. Le jeu de données GSE96804 (jeu de validation), en revanche, se concentre spécifiquement sur le tissu glomérulaire, qui est le site principal des lésions de filtration glomérulaire. Étant donné que ces deux jeux de données n'ont pas été directement fusionnés en raison de différences de plateforme et de tissu, aucune correction des effets de lot n'a été appliquée. À la place, une validation croisée entre jeux de données a été effectuée indépendamment. Les gènes présentant des variations directionnelles cohérentes et une aire sous la courbe (AUC) supérieure à 0,7 dans les deux jeux de données ont été sélectionnés comme candidats robustes, soutenant ainsi leur généralisabilité à travers les différents compartiments rénaux.
Un total de 1 136 gènes liés aux mitochondries (MRG) a été extrait de la base de données MitoCarta3.0 (https://www.broadinstitute.org/mitocarta). Les principes actifs du LLF ont été prédits à l'aide de la base de données de pharmacologie systémique de la médecine traditionnelle chinoise (TCMSP) (http://sm.nwsuaf.edu.cn/lsp/tcmsp.php), selon un seuil de biodisponibilité orale (OB) ≥30 % et un seuil de similitude aux médicaments (DL) ≥0,18. Par la suite, les gènes cibles potentiels des constituants actifs ont été prédits à l'aide de la base de données Swiss Target Prediction (http://www.swisstargetprediction.ch/).
Analyse de l'expression différentielle
L'analyse de l'expression différentielle de GSE142025 (DN par rapport au témoin) a été réalisée à l'aide du package limma (v3.54.1), avec des critères de significativité fixés à P.adj < 0,05 et |log2FoldChange| > 0,516. Les diagrammes en volcan et les cartes thermiques ont été visualisés à l'aide des packages ggplot2 (v 3.3.6) et ComplexHeatmap (v 2.14.0)17,18, respectivement. Les gènes à expression différentielle (DEGs), les gènes liés aux métaux (MRGs) et les gènes cibles potentiels des principes actifs ont été croisés, et les gènes communs ont été définis comme des gènes candidats. Le réseau reliant les principes actifs aux gènes candidats a été construit à l'aide du logiciel Cytoscape (v 3.9.0)19.
Analyse d'enrichissement fonctionnel et construction du réseau d'interactions protéine-protéine (PPI)
Des analyses d'enrichissement de l'ontologie génique (GO) et de l'Encyclopédie de Kyoto des gènes et des génomes (KEGG) ont été réalisées sur les gènes candidats à l'aide du package clusterProfiler (v 4.6.2) afin d'explorer leurs fonctions biologiques et les voies de signalisation associées (P.adjust < 0,05). Les gènes candidats ont ensuite été saisis dans la base de données STRING (https://cn.string-db.org/) pour récupérer les interactions PPI (niveau de confiance ≥ 0,4), puis un réseau PPI a été construit à l'aide de Cytoscape (v 3.9.0)20.
Apprentissage automatique
Quatre algorithmes d'apprentissage automatique, notamment la forêt aléatoire (RF), les k-plus proches voisins (KNN), les moindres carrés partiels (PLS) et la machine à vecteurs de support avec un noyau radial (SVM), ont été mis en œuvre à l'aide du package caret (v6.0-93) en se basant sur le jeu de données GSE142025. Les gènes candidats identifiés dans l'analyse précédente ont été utilisés comme variables prédictives, et l'état de la maladie (DN ou témoin) a été utilisé comme critère de jugement. Pour le modèle KNN, une validation croisée à 10 plis a été mise en œuvre à l'aide de la fonction trainControl, avec tuneLength = 10. Le modèle RF a été ajusté avec 20 arbres (ntree = 20) ; les modèles PLS et SVM ont été ajustés en utilisant les paramètres définis dans le flux de travail caret d'origine.
Les distributions des résidus du modèle ont été évaluées à l'aide du package DALEX (v2.4.3). Une évaluation des variables basée sur la permutation a ensuite été réalisée à l'aide de la fonction variable_importance de DALEX, la racine de l'erreur quadratique moyenne (RMSE) étant spécifiée comme fonction de perte. Le dropout_loss résultant représente le RMSE obtenu après permutation de la variable correspondante21,22. Dans le flux analytique initial, les variables présentant un dropout loss < 0,281 dans tous les modèles ont été conservées, et les gènes communs aux quatre modèles ont été définis comme gènes caractéristiques de consensus pour la validation ultérieure.
Les quatre modèles d'apprentissage automatique ont été utilisés principalement pour la priorisation des caractéristiques plutôt que pour la construction d'un classificateur clinique final. En conséquence, la discrimination diagnostique a ensuite été évaluée au niveau du gène individuel à l'aide d'une analyse ROC sur les jeux de données de découverte et de validation.
Identification de biomarqueurs candidats
Dans les jeux de données GSE142025 et GSE96804, les différences d'expression des gènes caractéristiques entre les échantillons DN et les témoins ont été évaluées à l'aide du test de Wilcoxon. Seuls les gènes présentant une expression différentielle significative (P < 0,05) et des tendances d'expression concordantes dans les deux jeux de données ont été sélectionnés pour une analyse des courbes ROC (caractéristique de fonctionnement du récepteur). Le package pROC (v1.18.0) a été utilisé pour générer les courbes ROC et calculer l'aire sous la courbe (AUC), les gènes présentant une AUC > 0,7 dans les deux jeux de données étant classés comme biomarqueurs candidats23.
Analyse d'enrichissement de l'ensemble de gènes (GSEA)
Les fonctions biologiques et les voies de signalisation associées aux biomarqueurs candidats ont été davantage explorées à l'aide de l'analyse d'enrichissement génique (GSEA) sur le jeu de données GSE142025. Premièrement, une analyse de corrélation de Spearman entre les biomarqueurs candidats et tous les autres gènes a été réalisée à l'aide du package psych (v2.2.9).24. Les coefficients de corrélation ont été calculés et classés par ordre décroissant. L'ensemble de gènes de référence utilisé était c2.cp.kegg.v2023.1.Hs.symbols.gmt, provenant de la base de données Molecular Signatures Database (MSigDB, https://www.gsea-msigdb.org/gsea/msigdb/). Une analyse GSEA (Gene Set Enrichment Analysis) a ensuite été réalisée afin d'évaluer l'enrichissement des gènes classés dans l'ensemble de gènes de référence, à l'aide du package clusterProfiler (v4.6.2). Une correction pour tests multiples a été appliquée. via la méthode FDR et ajusté P-valeurs (désignées par) P.ajust.) ont été considérés comme significatifs si < 0.05.
Analyse des modifications m6A
Pour étudier les modifications de méthylation de l'ARN des biomarqueurs candidats, la base de données SRAMP (http://www.cuilab.cn/sramp/) a été utilisée afin de prédire les sites de modification m6A sur les biomarqueurs candidats, en se concentrant sur les positions à haute confiance au sein de leurs structures secondaires. La base de données ENCORI (https://starbase.sysu.edu.cn/) a ensuite été utilisée pour identifier les protéines modifiées par m6A interagissant avec les biomarqueurs candidats, en appliquant le paramètre |HepG2 (shRNA)| > 1 pour sélectionner les protéines clés. La base de données RPISeq (http://pridb.gdcb.iastate.edu/RPISeq/) a ensuite été utilisée pour prédire la probabilité d'interactions entre les protéines clés et les biomarqueurs candidats. Les séquences d'ARN des deux ont été téléchargées en format texte brut afin de générer des scores de prédiction à partir des classificateurs RF et SVM. Une interaction était considérée comme significative lorsque le score dépassait 0,525. L'analyse SRAMP a été réalisée avec le seuil défini sur « Élevé » pour la prédiction des sites m6A, en mode « Transcrit » et avec les paramètres par défaut. L'analyse ENCORI a utilisé la fonction d'interaction « miRNA-mRNA » avec le paramètre « HepG2 (shRNA) » > 1. L'analyse RPISeq a utilisé le classificateur RF avec les paramètres par défaut ; des scores > 0,5 indiquaient une interaction positive. Il s'agit de prédictions informatiques, et non de preuves expérimentales de modifications m6A ou d'interactions ARN-protéine dans le tissu rénal. Le critère HepG2 shRNA provient des jeux de données précalculés d'ENCORI et pourrait ne pas refléter une régulation spécifique au rein.
Analyse de l'infiltration immunitaire
L'algorithme CIBERSORT a été appliqué pour estimer les proportions de 22 types de cellules immunitaires dans les échantillons témoins et DN issus de GSE142025, avec une visualisation sous forme de carte thermique générée à l'aide du package ggplot2 (v3.3.6).26. CIBERSORT a été exécuté en utilisant la matrice de signature LM22, avec 1 000 permutations et la normalisation par quantiles désactivée (comme recommandé pour les données de puces à ADN). Les échantillons dont la valeur p de CIBERSORT était inférieure à 0,05 ont été conservés pour les analyses ultérieures. < 0,05 ont été conservées pour une analyse ultérieure. Les estimations obtenues par CIBERSORT fournissent les fractions des cellules immunitaires à partir de l'expression tissulaire rénale globale, ce qui ne permet pas de distinguer une infiltration spécifique à un compartiment donné (par exemple, glomérulaire par rapport à tubulo-interstitielle) ni de différencier les leucocytes infiltrants des cellules immunitaires résidentes. Ainsi, les corrélations rapportées sont établies au niveau tissulaire et doivent être validées par des méthodes spatiales. Une analyse de corrélation de Spearman entre les cellules immunitaires différemment abondantes et les biomarqueurs candidats a été réalisée à l'aide du package psych.
Construction de réseaux et docking moléculaire
Les microARN (miARN) interagissant avec les biomarqueurs candidats ont été prédits à l'aide de la base de données miRNet (https://www.mirnet.ca). Par la suite, les ARN non codants longs (lncARN) ciblant les miARN identifiés ont été prédits à partir des bases de données TarBase (http://www.diana.pcbi.upenn.edu/tarbase) et starbase (http://starbase.sysu.edu.cn/). Les lncARN communs aux deux bases de données ont été sélectionnés pour la construction du réseau. Un réseau régulateur lncARN-miARN-mARN a ensuite été établi à l'aide du logiciel Cytoscape. Des ingrédients actifs potentiels ciblant les biomarqueurs candidats ont été choisis afin de construire un réseau ingrédient actif-biomarqueur. De plus, les ingrédients actifs, les biomarqueurs candidats et les voies identifiées dans l'analyse d'enrichissement des ensembles de gènes (GSEA) ont été intégrés dans Cytoscape pour créer un réseau ingrédient actif-biomarqueur-voie métabolique.
Une analyse de docking moléculaire a été réalisée afin d'évaluer l'affinité de liaison entre les ingrédients actifs potentiels et les biomarqueurs candidats. Les structures 3D des protéines biomarqueurs ont été obtenues à partir de la base de données du Research Collaboratory for Structural Bioinformatics Protein Data Bank (RCSB PDB, https://www.rscb.org/pdb) au format de fichier PDB. Les structures 2D des ingrédients actifs potentiels ont été récupérées au format SDF à partir de la base de données PubChem (http://pubchem.ncbi.nlm.nih.gov). Le docking moléculaire a été effectué à l'aide de la plateforme CB-Dock (http://clab.labshare.cn/cb-dock/php/blinddock.php). Une énergie de liaison inférieure à -5 kcal/mol indiquait une forte affinité de liaison27.
Préparation et authentification du Ligustri Lucidi Fructus
Ici, le Ligustri Lucidi Fructus (LLF) désigne le fruit séché et mûr de Ligustrum lucidum W. T. Aiton (Oleaceae). Le matériel botanique a été authentifié conformément à la Pharmacopée chinoise, et un spécimen-témoin n° 20240506,20240911,20241103 a été déposé à l'Université du Shanxi de médecine traditionnelle chinoise.
Pour la préparation de la décoction, 200 g de tranches de LLF sélectionnées ont été macérées dans 1 000 mL d'eau distillée pendant 30 min à température ambiante. Le mélange a été porté à ébullition puis maintenu à feu doux pendant 60 min. Le filtrat a été recueilli, et les résidus végétaux ont été soumis à une seconde décoction avec 1 000 mL d'eau distillée supplémentaire pendant 60 min. Les deux filtrats ont été combinés, filtrés, centrifugés, puis concentrés sous pression réduite afin d'obtenir une solution mère finale à 1 g de médicament brut/mL (volume total de 100 mL). La décoction préparée a été conservée à 4 °C pour une utilisation à court terme ou à −20 °C pour une conservation à long terme. La qualité du LLF et de sa décoction a été rigoureusement identifiée et vérifiée conformément aux normes de la Pharmacopée chinoise afin d'assurer la fiabilité et la reproductibilité des expériences.
Pour l'identification qualitative, une chromatographie sur couche mince a été réalisée. Brièvement, un volume approprié de décoction préparée a été centrifugé, et le surnageant a été extrait au méthanol. Après filtration, la solution échantillon et la solution standard de référence de specnuezhenide ont été déposées sur la même plaque de gel de silice G. Après élution, séchage et observation sous lumière ultraviolette, la tache de la solution échantillon présentait une couleur et une position identiques à celles du composé de référence, confirmant ainsi la présence du composant bioactif caractéristique du LLF.
Pour le contrôle qualité quantitatif, une détection par chromatographie liquide à haute performance a été réalisée. L'analyse a été effectuée à l'aide d'une colonne C18 utilisant un mélange méthanol-eau comme phase mobile. La longueur d'onde de détection a été fixée à 224 nm. La teneur en specnuezhenide dans la décoction a été déterminée à partir de la courbe standard. Les résultats ont démontré une composition chimique stable et homogène de la décoction préparée, garantissant une qualité constante du médicament tout au long de l'expérience d'intervention animale.
Expériences animales
Douze souris mâles db/db de qualité SPF (8 à 9 semaines d'âge) et six souris db/m témoins de même âge ont été maintenues dans l'installation animale SPF de l'Université de médecine traditionnelle chinoise du Shanxi. Avant les expériences, les animaux ont été acclimatés pendant 7 jours dans un cycle lumière/obscurité de 12 heures/12 heures avec à discrétion accès à la nourriture et à l'eau. L'étude a été approuvée par le comité d'éthique de l'Université de médecine traditionnelle chinoise du Shanxi (n° d'approbation : 2022DW167). Les animaux présentant >Une perte de poids corporel de 20 %, un état moribond ou l'incapacité d'accéder à la nourriture ou à l'eau entraînait une euthanasie précoce avant la fin prévue de l'étude. À la fin de l'étude, tous les souris restants ont été euthanasiés par injection intrapéritonéale de pentobarbital sodique suivie d'une dislocation cervicale, conformément aux protocoles institutionnels.
Après la période d'acclimatation, l'établissement d'un modèle de DN chez les souris db/db a été confirmé par un taux de glucose sanguin au niveau de la veine caudale ≥ 16 mmol/L et une microalbuminurie, indiquée par un test urinaire positif à la bandelette pour la microalbumine. Une fois le modèle de DN correctement établi, les souris db/db ont été réparties aléatoirement en deux groupes (n = 6 par groupe) : le groupe modèle de DN (DN) et le groupe traité au LLF (Traitement). Par ailleurs, des souris db/m (n = 6) ont été utilisées comme groupe témoin (Témoin). La dose a été choisie en se basant sur des études pharmacodynamiques antérieures du LLF chez des rats diabétiques et a été convertie en dose équivalente pour l'homme à l'aide d'une normalisation par surface corporelle28. Les groupes Témoin et DN ont reçu de l'eau distillée, tandis que le groupe traité a reçu 3,5 g/kg de LLF pendant 8 semaines. Après 8 semaines de traitement, toutes les souris ont été sacrifiées afin de prélever du sérum, des urines et du tissu rénal pour des analyses ultérieures.
Indicateurs sanguins et urinaires
Les taux de glucose sérique ont été analysés à l'aide d'un analyseur de biochimie sanguine entièrement automatique. La concentration urinaire en microalbumine a été mesurée conformément aux instructions du kit (Fichier supplémentaire 1).
Observation pathologique des tissus rénaux de souris
Les tissus rénaux ont été préparés pour un examen histopathologique. Après fixation dans du paraformaldéhyde à 4 %, les tissus ont été lavés, déshydratés, inclus en paraffine et coupés en sections. Une coloration à l'hématoxyline et à l'éosine (HE) a ensuite été réalisée, et les coupes colorées ont été examinées au microscope optique afin d'évaluer les modifications pathologiques.
PCR quantitatif en temps réel après transcription inverse (RT-qPCR)
Le RT-qPCR a été utilisé pour déterminer l'expression des biomarqueurs candidats dans le tissu rénal de souris. L'ARN total a été extrait conformément aux instructions du fabricant, puis la concentration et la qualité de l'ARN ont été évaluées (Tableau 1). La synthèse de l'ADN complémentaire (ADNc) a été réalisée à partir de l'ARN extrait à l'aide d'un kit de synthèse d'ADNc. L'amplification a été effectuée avec les paires d'amorces indiquées dans le Tableau 1, en utilisant GAPDH comme gène de référence. Les niveaux d'expression relatifs ont été calculés selon la méthode 2−ΔΔCt13,26.
Analyse statistique
Toutes les analyses statistiques ont été effectuées à l'aide du logiciel R (version 4.2.2) ainsi que des logiciels requis pour les procédures expérimentales correspondantes. Sauf indication contraire, tous les tests statistiques étaient bilatéraux, et les différences ont été considérées comme statistiquement significatives pour une valeur P < 0,05. L'analyse différentielle de l'expression transcriptomique a été réalisée à l'aide du package limma. Les gènes présentant une valeur P ajustée < 0,05 et une variation absolue du log2 supérieur à 0,5 ont été définis comme étant différentiellement exprimés.
Pour les comparaisons de l'expression des gènes candidats entre les échantillons DN indépendants et les échantillons témoins, des tests non paramétriques de Wilcoxon ont été utilisés là où cela était indiqué dans le protocole analytique initial. Les corrélations entre les biomarqueurs candidats et les fractions de cellules immunitaires ont été évaluées à l'aide du coefficient de corrélation de Spearman.
Les données expérimentales sont présentées comme moyenne ± écart-type (ET). Les comparaisons entre les trois groupes indépendants d'animaux ont été effectuées à l'aide d'une analyse de variance à un facteur lorsque les hypothèses d'une analyse paramétrique étaient satisfaites. Pour les comparaisons a posteriori, le test de la différence minimale significative a été utilisé lorsque les variances étaient homogènes, tandis que le test de Dunnett T3 a été utilisé lorsque les variances étaient inégales. Les mesures pharmacodynamiques de la ligne de base et de la semaine 8 ont été analysées et présentées séparément ; aucune inférence concernant une interaction groupe-par-temps n'a été faite. Les scripts R et les données brutes utilisés pour les analyses bioinformatiques et d'apprentissage automatique sont fournis dans le Fichier supplémentaire 1.
Résultats
Afin d'étudier de manière systématique d'éventuels biomarqueurs mitochondriaux candidats associés au LLF dans le traitement de la DN, nous avons conçu un flux de travail analytique en quatre phases (Figure 1). Dans la phase I, nous avons intégré des données transcriptomiques provenant des jeux de données GSE142025 (ensemble d'apprentissage, rein entier, n=36) et GSE96804 (ensemble de validation, glomérule, n = 61) avec 1 136 gènes mitochondriaux provenant de la base de données MitoCarta 3.0 et 517 cibles prédites de 9 ingrédients actifs provenant de la base de données TCMSP. L'intersection de ces trois ensembles de gènes a permis d'identifier 9 gènes candidats. Dans la phase II, quatre modèles d'apprentissage automatique (RF, KNN, PLS et SVM) ont été appliqués pour hiérarchiser les gènes caractéristiques, en utilisant un RMSE < 0,281 comme seuil. Une validation croisée entre jeux de données, réalisée par analyse ROC (AUC > 0,7 dans les deux jeux de données), a identifié quatre biomarqueurs candidats : CAT, FABP1, MAOB et MAOA. Dans la phase III, nous avons effectué une analyse GSEA afin d'identifier les voies KEGG enrichies, une analyse d'infiltration immunitaire à l'aide de CIBERSORT, une prédiction des modifications m6A, et construit des réseaux lncRNA-miRNA-mRNA, ingrédient actif–biomarqueur, ainsi que ingrédient actif–biomarqueur–voie, suivie d'un dockage moléculaire. Dans la phase IV, les effets pharmacodynamiques du LLF et les variations de l'expression des ARNm des quatre biomarqueurs candidats ont été évalués chez un modèle murin db/db de DN.
Évaluation de gènes candidats pour le traitement de la DN par le LLF
Dans le jeu de données GSE142025, 3 810 gènes différentiellement exprimés (DEG) ont été identifiés entre les groupes DN et témoin, incluant 1 904 DEG surexprimés et 1 906 DEG sous-exprimés (Figure 2A,B). Treize principes actifs provenant du LLF ont été prédits à l’aide de la base de données TCMSP, à savoir le bêta-sitostérol, le kaempférol, la taxifoline, la lucidumoside D, la lucidumoside D_qt, le (20S)-24-ène-3,20-diol-3-acétate, l’ériodictyol, la syringarésine diglucoside_qt, la lucidusculine, l’olitoriside, l’olitoriside_qt, la lutéoline et la quercétine (Tableau 2). Quatre principes actifs — la lucidumoside D_qt, le (20S)-24-ène-3,20-diol-3-acétate, la syringarésine diglucoside_qt et l’olitoriside_qt — n’ont prédit aucun gène cible potentiel, tandis que les neuf autres principes actifs ont permis de prédire 517 gènes cibles potentiels. En croisant les 3 810 DEG, les 1 136 gènes liés au métabolisme redox (MRG) et les 517 gènes cibles potentiels, neuf gènes candidats ont été identifiés : GPX1, BAX, CASP8, MAOA, MAOB, CAT, AKR1B10, ALDH2 et FABP1 (Figure 2C). Un réseau reliant les principes actifs aux gènes candidats a ensuite été construit (Figure 2D). Ces neuf gènes candidats étaient enrichis dans 341 termes GO, incluant la réponse aux substances toxiques, le processus catabolique des composés organiques hydroxylés et la détoxification cellulaire (Figure 2E). De plus, ils étaient associés à 52 voies KEGG, telles que le métabolisme du tryptophane, les voies de neurodégénérescence et le métabolisme de l’histidine (Figure 2F).
Recherche de biomarqueurs candidats pour le traitement de la DN dans le LLF
Le réseau PPI a révélé sept nœuds et huit interactions, avec MAOA, ALDH2, MAOB et AKR1B10 interagissant (Figure 3A). Les gènes présentant des valeurs de RMSE inférieures à 0,281 dans quatre modèles d'apprentissage automatique ont été identifiés comme gènes caractéristiques : CAT, MAOB, MAOA, BAX et FABP1 (Figure 3B-E). L'analyse d'expression a montré que CAT, FABP1, MAOB et MAOA présentaient des différences significatives entre les groupes DN et témoins, et étaient cohérents dans les deux jeux de données GSE142025 et GSE96804 (Figure 3F,G). De plus, leurs valeurs d'AUC dans l'analyse des courbes ROC dépassaient 0,7 dans les deux jeux de données, indiquant que ces gènes pourraient efficacement distinguer les échantillons DN des échantillons témoins et servir de biomarqueurs candidats pour le traitement de la DN dans le LLF (Figure 4A-H).
Enrichissement significatif de biomarqueurs candidats dans les voies inflammatoires et liées au système immunitaire
L'analyse GSEA a identifié quatre biomarqueurs candidats fortement enrichis dans la voie de signalisation des chimioquines et dans les interactions cytokines-récepteurs de cytokines (Figure 5A-D). Parmi eux, la voie de signalisation de la peroxydase présentait une association significative avec CAT, MAOA et MAOB.
Corrélation de biomarqueurs candidats avec les cellules immunitaires
Des différences notables dans l'expression de neuf types de cellules immunitaires — lymphocytes B naïfs, macrophages M0, macrophages M1, macrophages M2, mastocytes activés, cellules NK activées, lymphocytes T CD4 mémoire au repos+ lymphocyte T, CD4 naïf+ lymphocyte T, et CD8+ des lymphocytes T—ont été observés entre les échantillons DN et les échantillons témoins (P < 0.05) (Figure 6A,B). Une corrélation positive significative (cor = 0,6) a été observée entre les cellules B naïves et les cellules NK activées, tandis qu'une corrélation négative significative (cor = -0,69) a été détectée entre les cellules B naïves et les mastocytes activés. (Figure 6C). Tous les biomarqueurs candidats ont présenté de fortes corrélations négatives avec les CD8+ Lymphocytes T et mastocytes activés, et corrélations positives avec les lymphocytes NK activés et les lymphocytes B naïfs (Figure 6D).
Interaction de protéines m6A modifiées clés avec des biomarqueurs candidats
La modification de la méthylation de l'ARN m6A affecte profondément la synthèse et le métabolisme de l'ARN et est impliquée dans la pathogenèse de diverses maladies29. Les emplacements des sites de modification m6A sur les biomarqueurs candidats ainsi que leurs positions à forte confiance dans les structures secondaires sont illustrés dans la Figure 7A-H. Une analyse approfondie a révélé que les protéines clés modifiées par m6A interagissant avec CAT incluaient AQR et RBM22, tandis que FABP1 interagissait à la fois avec SF3A3 et AQR. MAOA interagissait avec IGF2BP3 et IGF2BP2, et MAOB avec TIA1 (Tableau 3).
Prédictions de liaison in silico favorables pour la taxifoline, le bêta-sitostérol et l'ériodictyol dans le traitement de la DN par LLF
Dans miRNet, CAT a été prédit interagir avec 24 miARN, tandis que FABP1 était associé à cinq miARN. De plus, MAOB et MAOA étaient liés respectivement à 29 et 26 miARN. Parmi ceux-ci, 23 ARNlnc ont été identifiés dans les deux bases de données TarBase et Starbase. Un réseau régulateur ARNlnc-miARN-mARN a ensuite été construit, intégrant quatre biomarqueurs candidats, 74 miARN et 23 ARNlnc (Figure 8A). Les ingrédients actifs potentiels ciblant les biomarqueurs candidats comprenaient la lutéoline, le bêta-sitostérol, l'ériodictyol, la kaempférol, la quercétine et la taxifoline (Figure 8B). En outre, un réseau ingrédient actif-biomarqueur-voie métabolique a été établi à partir des ingrédients actifs, des biomarqueurs candidats et des cinq voies principales identifiées par l'analyse d'enrichissement des ensembles de gènes (GSEA) (Figure 8C). Par exemple, la taxifoline ciblait CAT dans la voie des peroxysomes. Les énergies de liaison entre CAT et la taxifoline (-8,8 kcal/mol), FABP1 et le bêta-sitostérol (-8,1 kcal/mol), et MAOB et l'ériodictyol (-9,8 kcal/mol) étaient toutes inférieures à -5 kcal/mol, suggérant des affinités élevées entre ces biomarqueurs candidats et leurs ingrédients actifs respectifs27. La taxifoline, le bêta-sitostérol et l'ériodictyol ont été identifiés comme des ingrédients actifs potentiels présentant des prédictions de liaison in silico favorables dans le traitement de la DN par LLF (Figure 8D-F). Toutefois, ils sont indiqués comme des constituants prédits par base de données et non comme des intermédiaires bioactifs confirmés responsables des effets observés in vivo.
Valider les biomarqueurs candidats dans le modèle murin de DN
Évaluation pharmacodynamique du LLF dans le traitement des souris atteintes de DN
Pendant la période d'administration, les taux de glucose sanguin et d'albumine microscopique urinaire chez les souris ont été surveillés (Figure 9A-D). Par rapport au groupe témoin, les taux de glucose sanguin et d'albumine microscopique urinaire dans le groupe modèle de DN étaient significativement augmentés (P < 0,01) ; par rapport au groupe modèle de DN, le glucose sanguin des souris du groupe traité a diminué de manière significative après 4 semaines d'administration (P < 0,01) et l'albumine microscopique urinaire des souris du groupe traité a diminué de manière significative après 8 semaines d'administration (P < 0,05). Ces résultats suggèrent que le LLF pourrait être bénéfique dans le traitement de la DN.
Évaluation histopathologique de l'LLF dans le traitement des souris atteintes de DN
Après coloration à l'HE, le groupe témoin présentait des structures glomérulaires nettes dans le tissu rénal. En revanche, le groupe modèle de DN montrait une pyknose nucléaire glomérulaire et une hyperchromasie, ainsi qu'une infiltration de cellules inflammatoires autour des glomérules, par rapport au groupe normal. Le traitement par LLF a atténué les lésions pathologiques rénales chez les souris db/db (Figure 9E).
Analyse par RT-PCR de l'expression de biomarqueurs candidats chez les souris atteintes de DN
Après la mise en place réussie d'un modèle murin de DN et l'observation d'une amélioration significative des symptômes suite au traitement par LLF, la RT-qPCR a été utilisée pour analyser les variations des biomarqueurs candidats. Par rapport au groupe témoin, le groupe DN présentait une expression significativement réduite de CAT et MAOA (P < 0,05 ou P < 0,001). En revanche, le groupe traité montrait une expression de CAT et MAOA significativement plus élevée que celle du groupe DN (P < 0,05). Toutefois, aucune différence statistiquement significative n'a été observée dans l'expression de MAOB et FABP1 entre les groupes (Figure 9F-I).
Disponibilité des données
Les jeux de données d'expression génique analysés dans cette étude sont accessibles publiquement à partir du Gene Expression Omnibus (GEO) sous les numéros d'accès GSE142025 et GSE96804. Les scripts R utilisés pour les analyses bioinformatiques, ainsi que les données brutes expérimentales (glycémie, microalbuminurie et données de RT-qPCR), sont fournis dans le Fichier supplémentaire 1. Toutes les autres bases de données, logiciels et ressources web utilisés dans cette étude sont répertoriés dans le Tableau des matériaux.
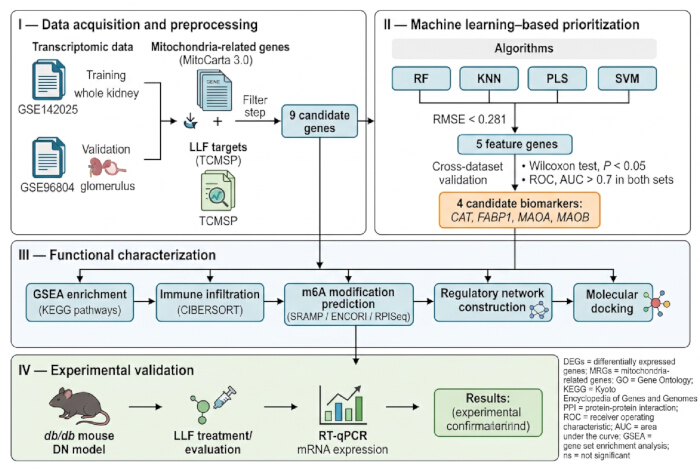
Figure 1: Déroulement de l'étude. ensembles de données transcriptomiques, gènes liés aux mitochondries et cibles prédits de Fructus Ligustri Lucidi ont été intégrés pour identifier les gènes candidats. Quatre algorithmes d'apprentissage automatique ont ensuite été utilisés pour hiérarchiser les gènes caractéristiques, suivis d'une validation croisée entre jeux de données, d'une caractérisation fonctionnelle et d'une validation expérimentale chez des souris db/db. Abréviations : DN = néphropathie diabétique ; DEGs = gènes différentiellement exprimés ; MRGs = gènes liés aux mitochondries ; LLF = Ligustri Lucidi Fructus ; RF = forêt aléatoire ; KNN = plus proches voisins ; PLS = moindres carrés partiels ; SVM = machine à vecteurs de support ; RMSE = erreur quadratique moyenne ; GSEA = analyse d'enrichissement des ensembles de gènes ; RT-qPCR = réaction de transcription inverse suivie d'une amplification en chaîne par polymérase en temps réel. Veuillez cliquer ici pour visualiser une version agrandie de cette figure.
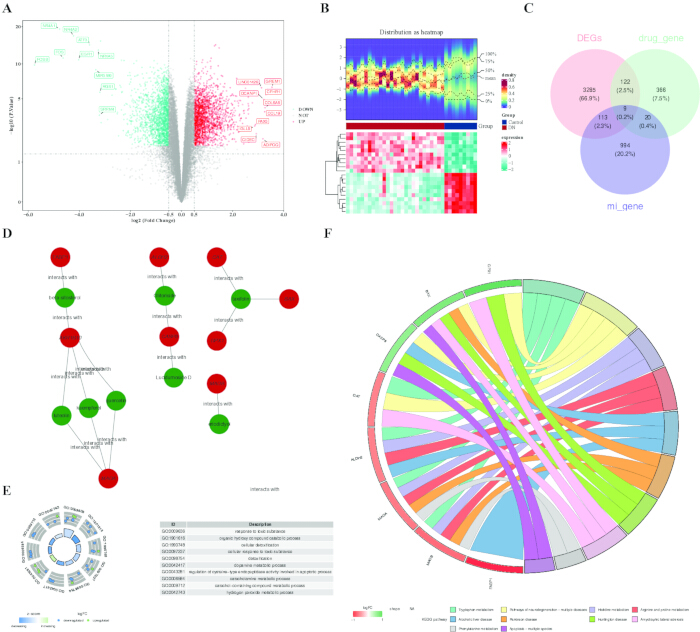
Figure 2 : Analyse de criblage et caractérisation fonctionnelle des gènes candidats pour le traitement de la DN par le LLF. (A) Diagramme volcanaire montrant les gènes différentiellement exprimés entre les échantillons de DN et les témoins dans GSE142025. (B) Carte thermique des 10 gènes les plus surexprimés et des 10 gènes les plus sous-exprimés, classés selon la valeur absolue du |log2FC|. (C) Diagramme de Venn montrant l'intersection des gènes différentiellement exprimés (DEG), des gènes mitochondriaux (MRG) et des gènes cibles du LLF prédits. (D) Réseau entre ingrédients actifs et gènes candidats. (E) Analyse d'enrichissement de l'ontologie génique (Gene Ontology) des gènes candidats. La hauteur des barres représente la significativité de l'enrichissement, et le score z indique la direction prédite de la régulation fonctionnelle. (F) Analyse d'enrichissement des voies de Kyoto Encyclopedia of Genes and Genomes (KEGG) pour les gènes candidats. Abréviations : DN = néphropathie diabétique ; LLF = Ligustri Lucidi Fructus ; DEGs = gènes différentiellement exprimés ; MRGs = gènes liés aux mitochondries ; GO = ontologie génique (Gene Ontology) ; KEGG = Kyoto Encyclopedia of Genes and Genomes. Veuillez cliquer ici pour afficher une version agrandie de cette figure.
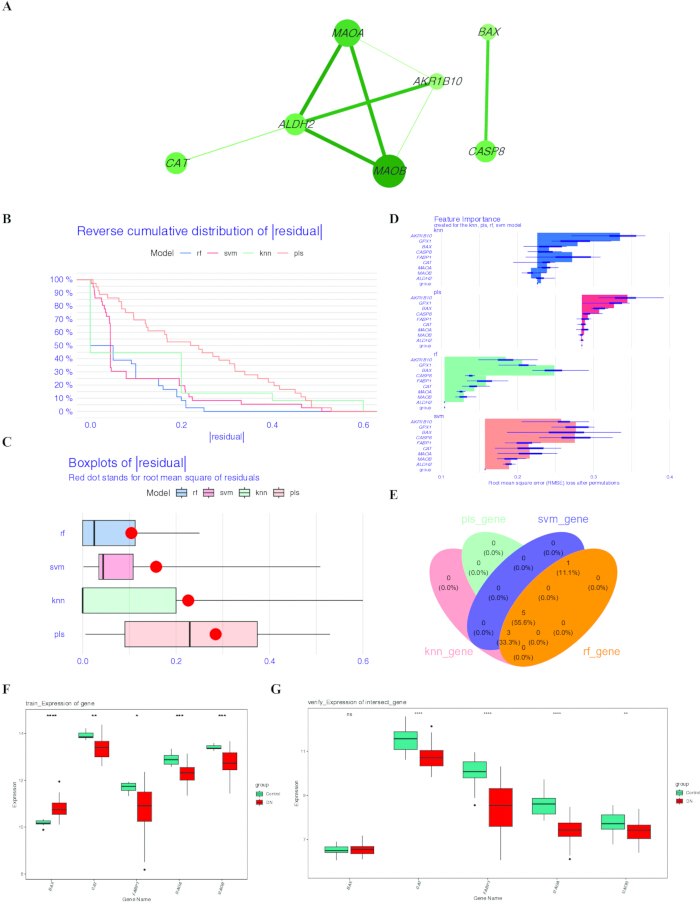
Figure 3 : Identification par apprentissage automatique de biomarqueurs candidats. (A) Réseau d'interactions protéine-protéine des protéines codées par les gènes candidats. (B) Distribution cumulative inverse des résidus pour les modèles RF, KNN, PLS et SVM. (C) Boîtes à moustaches montrant les distributions des résidus des quatre modèles ; le point rouge indique l'erreur quadratique moyenne. (D) Importance fondée sur le RMSE des gènes candidats dans les quatre modèles d'apprentissage automatique. (E) Intersection des gènes descripteurs satisfaisant au critère RMSE < 0,281 dans les quatre modèles. (F,G) Expression des gènes descripteurs sélectionnés dans GSE142025 et GSE96804, respectivement. Abréviations : RF = forêt aléatoire ; KNN = plus proches voisins ; PLS = moindres carrés partiels ; SVM = machine à vecteurs de support ; RMSE = erreur quadratique moyenne. Veuillez cliquer ici pour visualiser une version agrandie de cette figure.
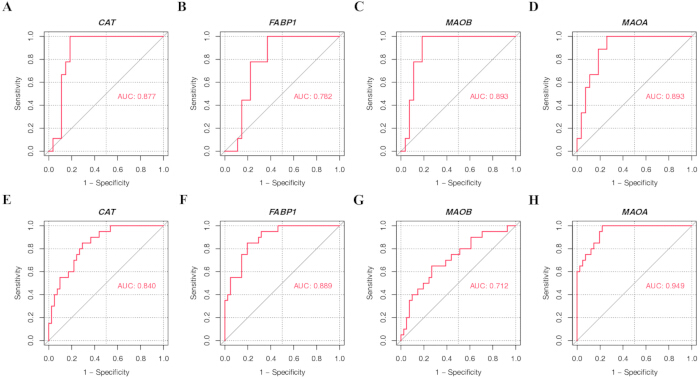
Figure 4 : Courbes caractéristiques de la performance (ROC) des quatre biomarqueurs candidats. Courbes ROC pour CAT, FABP1, MAOB et MAOA respectivement dans le jeu de données d'entraînement (A-D) GSE142025 et dans le jeu de données de validation (E-H) GSE96804. L'AUC représente la surface sous la courbe caractéristique de la performance. Abréviations : ROC = courbe caractéristique de la performance ; AUC = aire sous la courbe. Veuillez cliquer ici pour visualiser une version agrandie de cette figure.
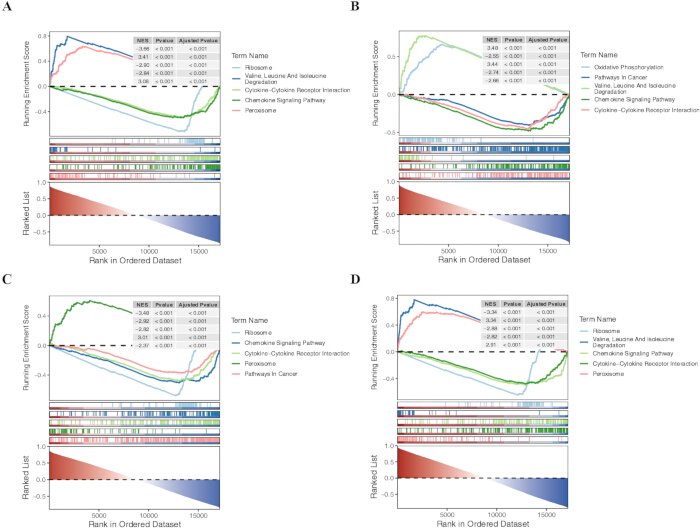
Figure 5 : Analyse d'enrichissement des ensembles de gènes des biomarqueurs candidats. Analyse d'enrichissement des ensembles de gènes (GSEA) montrant les voies KEGG significativement enrichies associées à (A) CAT, (B) FABP1, (C) MAOA et (D) MAOB dans le jeu de données GSE142025. Abréviations : GSEA = analyse d'enrichissement des ensembles de gènes ; KEGG = Kyoto Encyclopedia of Genes and Genomes. Veuillez cliquer ici pour visualiser une version agrandie de cette figure.
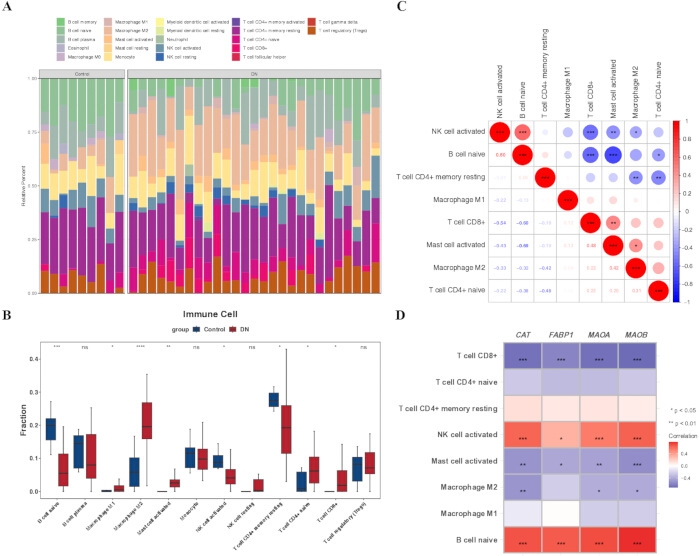
Figure 6 : Infiltration des cellules immunitaires et son association avec des biomarqueurs candidats dans la DN. (A) Proportions relatives des 22 types de cellules immunitaires estimées par CIBERSORT dans les échantillons de DN et témoins. (B) Comparaison des fractions de cellules immunitaires significativement différentes entre les groupes DN et témoins. (C) Matrice de corrélation entre les types de cellules immunitaires différemment abondants. (D) Corrélations de Spearman entre l'expression de CAT, FABP1, MAOA et MAOB et les types de cellules immunitaires différemment abondants. Abréviations : DN = néphropathie diabétique. Veuillez cliquer ici pour visualiser une version agrandie de cette figure.
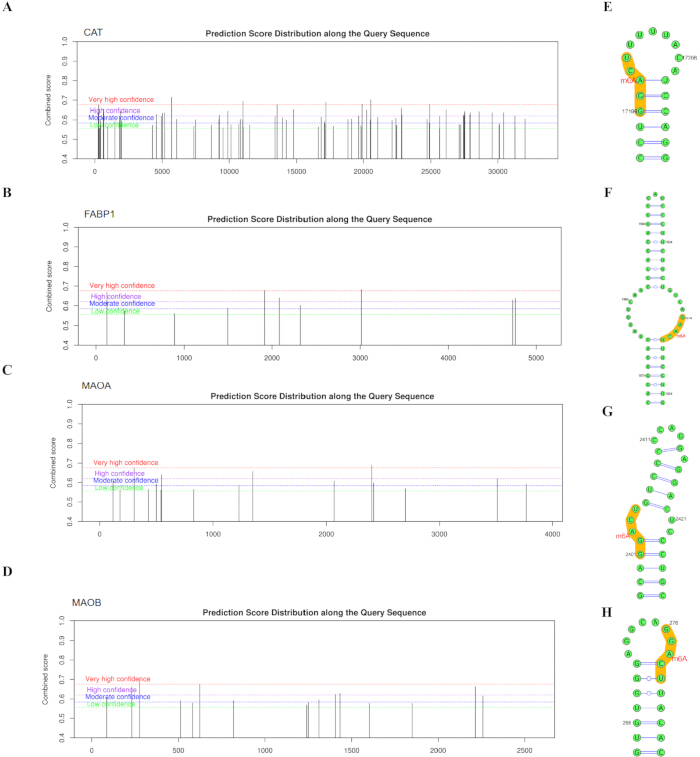
Figure 7 : Sites de modification m6A prédits et structures secondaires de l'ARN des transcrits biomarqueurs candidats. Sites de modification m6A prédits dans (A) CAT, (B) FABP1, (C) MAOA et (D) MAOB. Structures secondaires de l'ARN prédites, montrant les régions associées au m6A avec une forte confiance pour (E) CAT, (F) FABP1, (G) MAOA et (H) MAOB. Les régions surlignées en jaune indiquent les régions de séquence prédites contenant des sites de modification m6A. Abréviation : m6A = N6-méthyladénosine. Veuillez cliquer ici pour visualiser une version agrandie de cette figure.
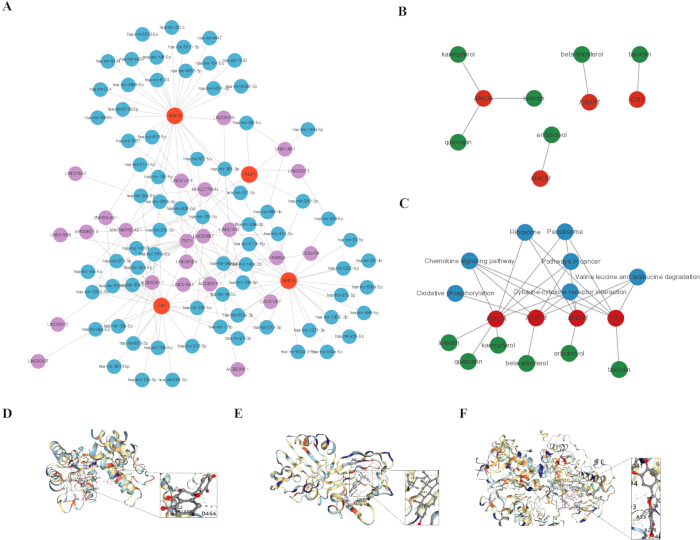
Figure 8 : Réseaux régulateurs et dockage moléculaire des ingrédients actifs potentiels du LLF. (A) Réseau régulateur prédictif lncRNA–miRNA–mRNA impliquant les biomarqueurs candidats. (B) Réseau des ingrédients actifs potentiels du LLF et des biomarqueurs candidats. (C) Réseau ingrédient actif–biomarqueur–voie métabolique basé sur les résultats de l'analyse d'enrichissement des ensembles de gènes (GSEA). (D–F) Conformations de dockage moléculaire prédictives de (D) CAT avec la taxifoline, (E) FABP1 avec le bêta-sitostérol, et (F) MAOB avec l'ériodictyol. Abréviations : LLF = Ligustri Lucidi Fructus ; lncRNA = ARN non codant long ; miRNA = microARN ; GSEA = analyse d'enrichissement des ensembles de gènes. Veuillez cliquer ici pour visualiser une version agrandie de cette figure.
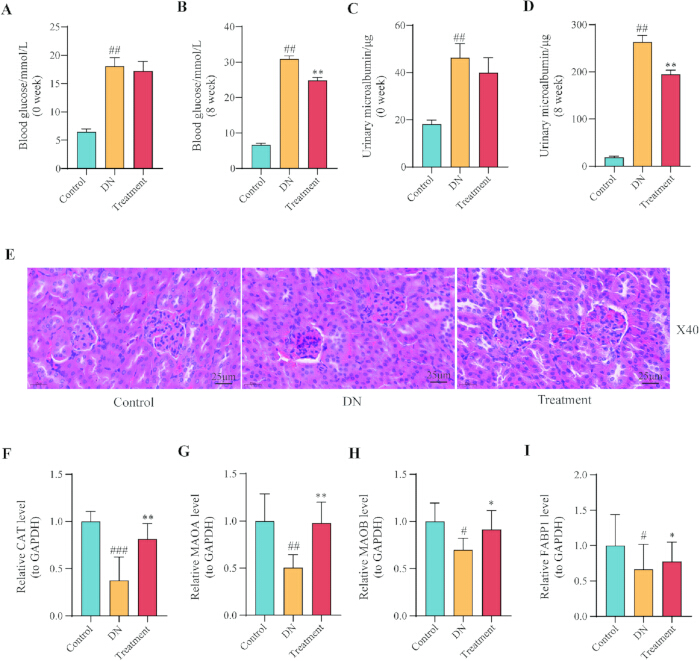
Figure 9 : Effets du traitement par LLF sur les indicateurs biochimiques, l'histopathologie rénale et l'expression des biomarqueurs candidats chez les souris db/db. (A,B) Niveaux de glucose sanguin au départ et à la semaine 8, respectivement. (C,D) Niveaux d'albumine microscopique urinaire au départ et à la semaine 8, respectivement. (E) Exemples de coupes rénales colorées à l'hématoxyline-éosine provenant des groupes Témoin, DN et Traitement (grossissement, ×40 ; barre d'échelle = 25 µm). (F-I) Niveaux relatifs d'expression rénale d'ARNm de Cat, Maoa, Maob et Fabp1, respectivement, mesurés par RT-qPCR. #P < 0,05, ##P < 0,01 et ###P < 0,001 par rapport au groupe Témoin ; *P < 0,05, **P < 0,01 et ***P < 0,001 par rapport au groupe DN. Abréviations : LLF = Ligustri Lucidi Fructus ; DN = néphropathie diabétique ; RT-qPCR = réaction de transcription inverse suivie d'une amplification quantitative par polymérase en chaîne. Veuillez cliquer ici pour consulter une version agrandie de cette figure.
| amorce | séquences |
| CAT F | TCACTGACGAGATGGCACAC |
| CAT R | ATCGAACGGCAATAGGGGTC |
| FABP1 F | CAATAGGTCTGCCCGAGGAC |
| FABP1 R | GTCATGGTCTCCAGTTCGCA |
| MAOB F | GCACTGAAACAGCCTCACAC |
| MAOB R | TCGTGCAGGGACATCCAAAG |
| MAOA F | ACTTACCCATTCCGTGGTGC |
| MAOA R | ACCACAGGGCAGATACCTCA |
| M-GAPDH F | CCTTCCGTGTTCCTACCCC |
| M-GAPDH R | GCCCAAGATGCCCTTCAGT |
Tableau 1 : Séquences des amorces utilisées pour l'analyse RT-qPCR des tissus rénaux de souris. Abréviations : F = amorce sens ; R = amorce antisens ; RT-qPCR = réaction de polymérase quantitative par transcription inverse.
| ID MOL | Nom de la molécule | OB (%) | DL | Nombre cible |
| MOL000358 | beta-sitosterol | 36,91 | 0,75 | 100 |
| MOL000422 | kaempferol | 41,88 | 0,24 | 103 |
| MOL004576 | taxifolin | 57,84 | 0,27 | 92 |
| MOL005146 | Lucidumoside D | 48,87 | 0,71 | 104 |
| MOL005147 | Lucidumoside D_qt | 54,41 | 0,47 | 0 |
| MOL005169 | (20S)-24-ène-3,20-diol-3-acétate | 40,23 | 0,82 | 0 |
| MOL005190 | érodichtyol | 71,79 | 0,24 | 101 |
| MOL005195 | syringarésinol diglucoside_qt | 83,12 | 0,8 | 0 |
| MOL005209 | Lucidusculine | 30,11 | 0,75 | 105 |
| MOL005211 | Olitoriside | 65,45 | 0,23 | 100 |
| MOL005212 | Olitoriside_qt | 103,23 | 0,78 | 0 |
| MOL000006 | lutéoline | 36,16 | 0,25 | 102 |
| MOL000098 | quercétine | 46,43 | 0,28 | 103 |
Tableau 2 : Treize principes actifs du Ligustri Lucidi Fructus identifiés à l'aide de la base de données TCMSP. Abréviations : OB = biodisponibilité orale ; DL = caractère proche d'un médicament.
| ARNm | Protéine | RF | SVM |
| CAT | AQR | 0.7 | 0.98 |
| CAT | RBM22 | 0.8 | 0.97 |
| FABP1 | AQR | 0.65 | 0.94 |
| FABP1 | SF3A3 | 0.7 | 0.8 |
| MAOA | IGF2BP2 | 0.75 | 0.97 |
| MAOA | IGF2BP3 | 0.75 | 0.97 |
| MAOB | TIA1 | 0.85 | 0.89 |
Tableau 3 : Interactions prédites entre quatre ARNm de biomarqueurs mitochondriaux et des protéines liant les ARN associées à la m6A. CAT, FABP1, MAOA et MAOB désignent des ARNm de biomarqueurs humains ; AQR, RBM22, SF3A3, IGF2BP2, IGF2BP3 et TIA1 désignent des protéines liant les ARN. Des scores RF et SVM > 0,5 indiquent des interactions ARN–protéine prédites. Abréviations : RF = forêt aléatoire ; SVM = machine à vecteurs de support.
Fichier supplémentaire 1. Scripts de bioinformatique et données brutes expérimentales. Cette archive contient les scripts R utilisés pour le traitement des données, l'analyse des expressions différentielles, l'enrichissement fonctionnel, l'apprentissage automatique, l'analyse des caractéristiques de fonctionnement du récepteur, l'analyse d'enrichissement des ensembles de gènes, l'analyse de corrélation de Spearman et l'analyse d'infiltration des cellules immunitaires par CIBERSORT, ainsi que les données brutes relatives à la glycémie, à la microalbuminurie et aux expériences de RT-qPCR. Veuillez cliquer ici pour télécharger ce fichier.
Discussion
Le LLF est un médicament traditionnel chinois couramment utilisé, principalement destiné à nourrir le foie et les reins, ainsi qu'à traiter le diabète et ses complications. À l'heure actuelle, aucun médicament ni traitement spécifique n'existe pour la néphropathie diabétique (DN), et sa prise en charge repose principalement sur des traitements hypoglycémiants, hypolipémiants et antihypertenseurs30,31,32. Toutefois, ces traitements ne permettent qu'un ralentissement de la progression des lésions rénales que chez une petite proportion de patients33. On a démontré que le LLF exerce des effets protecteurs rénaux dans des modèles de rats atteints de DN en corrigeant les troubles du métabolisme glucidique et lipidique et en atténuant le stress oxydatif34. Notamment, en tant qu'organe possédant une teneur exceptionnellement élevée en mitochondries et une forte consommation d'oxygène, des dynamiques mitochondriales anormales dans le rein jouent un rôle central dans la pathogenèse de la DN35. Cette étude met en évidence un mécanisme nouveau par lequel le LLF pourrait influencer la fonction mitochondriale via des biomarqueurs candidats spécifiques (CAT, FABP1, MAOB et MAOA) dans le traitement de la DN.
Des études antérieures ont indiqué que la catalase (CAT), la protéine de liaison aux acides gras 1 (FABP1), la monoamine oxydase B (MAOB) et la monoamine oxydase A (MAOA) sont impliquées dans la néphropathie diabétique (DN) à des degrés divers. CAT participe au système de défense antioxydant, protégeant le rein des lésions induites par le stress oxydatif36. La CAT, une enzyme antioxydante essentielle dans l'organisme, intervient dans la régulation de l'apparition et de la progression de la DN en modulant les processus physiologiques liés aux mitochondries37. La CAT catalyse spécifiquement la décomposition du peroxyde d'hydrogène (H₂O₂) en eau et en oxygène, éliminant efficacement les espèces réactives de l'oxygène (ROS) d'origine mitochondriale. Cela réduit les dommages induits par le stress oxydatif sur la structure et la fonction mitochondriales, maintient la stabilité du potentiel de membrane mitochondriale et l'efficacité de la phosphorylation oxydative, atténuant ainsi les lésions des cellules rénales induites par l'hyperglycémie et ralentissant la progression de la DN38. De plus, une diminution de l'expression de la CAT entraîne une élimination insuffisante des ROS mitochondriaux, aggravant la fragmentation mitochondriale et la rupture des crêtes. Ceci inhibe la fusion mitochondriale tout en favorisant la fission, ce qui perturbe davantage la dynamique mitochondriale. En conséquence, des cellules intrinsèques telles que les cellules mésangiales et les podocytes développent des troubles métaboliques, accélérant ainsi la fibrose du tissu rénal39.
FABP1, en tant que membre de la famille des protéines de liaison aux acides gras, participe principalement au transport, au métabolisme et à la signalisation intracellulaire des acides gras à longue chaîne. Une expression anormale de cette protéine a été associée de manière étroite à diverses maladies métaboliques et à des lésions rénales, jouant un rôle régulateur crucial dans le développement et la progression de la néphropathie diabétique (ND)40. Des recherches indiquent que FABP1 module la progression de la ND en perturbant le métabolisme lipidique. Dans le diabète, une expression anormale de FABP1 perturbe le transport et le métabolisme des acides gras. Des acides gras libres et leurs métabolites s'accumulent de manière excessive dans le tissu rénal, endommageant directement les cellules endothéliales glomérulaires et les cellules épithéliales tubulaires, ce qui aggrave l'inflammation et la fibrose rénales41. Parallèlement, FABP1 aggrave les lésions du tissu rénal en médiant le stress oxydatif et les dommages induits par l'hypoxie. Son excrétion urinaire pourrait augmenter avant l'apparition d'une albuminurie anormale, offrant ainsi une cible nouvelle pour le dépistage et le diagnostic précoce de la ND41,42. De plus, FABP1 joue un rôle régulateur central dans le métabolisme mitochondrial des acides gras43. Des études montrent qu'une surexpression de FABP1 améliore significativement l'efficacité du transport des acides gras vers les mitochondries, augmente l'activité de la β-oxydation mitochondriale et celle des enzymes du cycle de l'acide tricarboxylique, améliorant ainsi le métabolisme énergétique cellulaire44. Toutefois, le mécanisme par lequel FABP1 influence la pathogenèse de la ND par son implication dans les processus mitochondriaux reste mal compris. Dans d'autres affections liées à la ND, MAOB et MAOA, en tant qu'enzymes impliquées dans le métabolisme des neurotransmetteurs, ont été associées à la progression de la ND, contribuant à un déséquilibre de l'état redox tissulaire. Cette étude confirme davantage le rôle clé de ces quatre biomarqueurs candidats dans la ND, dont les niveaux d'expression sont réduits dans le groupe atteint de ND. On émet l'hypothèse qu'une modulation de l'expression de ces biomarqueurs candidats pourrait contribuer à réduire l'inflammation et le stress oxydatif dans la ND.
D'après l'analyse d'enrichissement GSEA, quatre biomarqueurs candidats — CAT, FABP1, MAOB et MAOA — étaient enrichis dans plusieurs voies, notamment la voie de signalisation des chimiotactiques, l'interaction cytokine-récepteur de cytokine et les voies des peroxysomes. Les chimiotactiques sont des composants clés de la réponse immunitaire, favorisant l'inflammation. La voie de la peroxydase (POD) est associée au stress oxydatif45. On a signalé que la baicaline atténue la néphropathie diabétique (DN) en réduisant le stress oxydatif et l'inflammation, son mécanisme impliquant potentiellement l'activation de la voie de signalisation antioxydante médiée par NrF2 et l'inhibition de la voie inflammatoire médiée par MAPK45. De plus, une régulation anormale de FABP1 dans le métabolisme des lipides pourrait contribuer à la sclérose glomérulaire et à la fibrose interstitielle dans la DN9. Ces résultats suggèrent que les biomarqueurs candidats jouent un rôle essentiel dans les processus inflammatoires et de stress oxydatif dans la DN. Cibler ces biomarqueurs candidats afin de moduler les voies qu'ils influencent pourrait atténuer l'inflammation et le stress oxydatif associés à la DN, freinant ainsi sa progression.
L'analyse bioinformatique a montré que les niveaux d'infiltration de sous-populations immunitaires, telles que les cellules T CD8+, dans le tissu rénal DN changeaient de manière significative, et que l'augmentation des cellules T CD8+ était significativement et négativement corrélée à l'expression de quatre biomarqueurs candidats liés aux mitochondries (CAT, FABP1, MAOB, MAOA). Ces prédictions computationnelles sont cohérentes avec les observations pathologiques issues des expériences animales : les coupes colorées à l'hématoxyline-éosine des reins de souris du groupe modèle DN montraient une infiltration évidente de cellules inflammatoires autour des glomérules ; après l'intervention par LLF, l'infiltration de cellules inflammatoires rénales dans le groupe traité était significativement réduite, et les lésions pathologiques étaient améliorées. Cela suggère qu'une infiltration accrue de cellules inflammatoires constitue une caractéristique clé des lésions rénales dans le DN, et que LLF pourrait jouer un rôle protecteur en régulant l'infiltration immunitaire. Cette découverte est conforme à des études antérieures : l'infiltration des cellules T CD8+ est associée au développement du DN, et l'inhibition de leur réponse peut atténuer la maladie46, ce qui aggrave également les lésions rénales dans la néphropathie à l'adriamycine47. En outre, diverses cellules immunitaires, telles que les cellules B, les macrophages M1/M2 et les cellules NK, sont modifiées dans la pathologie du DN48. Le biomarqueur CAT pourrait affecter la fonction des cellules immunitaires dans le DN49, et MAOA pourrait également influencer le microenvironnement immunitaire en régulant la polarisation des macrophages. Ces résultats indiquent que l'effet protecteur rénal de LLF est étroitement lié à sa régulation de l'infiltration immunitaire anormale, notamment des cellules T CD8+, réduisant ainsi les dommages inflammatoires. Les corrélations négatives entre les quatre biomarqueurs candidats et les cellules T CD8+ ainsi que les mastocytes activés suggèrent que ces gènes pourraient moduler le microenvironnement immunitaire rénal. L'expression de CAT a été associée à la polarisation des macrophages et à l'activité des cellules T dans les tissus métaboliques. Toutefois, nos estimations CIBERSORT proviennent de transcriptomes rénaux globaux, qui ne permettent pas de distinguer les sous-types de cellules immunitaires infiltrant les compartiments glomérulaires et tubulointerstitiels. Les corrélations observées doivent être interprétées comme des associations génératrices d'hypothèses, et non comme une preuve de régulation immunitaire causale. Des études futures utilisant l'immunohistochimie multiplex ou le séquençage ARN à la cellule unique seront nécessaires pour localiser ces interactions entre biomarqueurs et cellules immunitaires.
Des études antérieures ont signalé des biomarqueurs liés aux mitochondries dans la néphropathie diabétique (DN), notamment OPA1, MFN2, DRP1, PGC-1α et SOD2. Nos résultats concernant CAT et MAOA viennent compléter cette littérature existante en mettant en évidence des voies peroxy somales et des voies de la monoamine oxydase qui ont été moins étudiées dans le contexte mitochondrial de la DN. Notamment, alors que SOD2 et GPX1 sont des enzymes classiques de piégeage des ERO, CAT cible spécifiquement le H2O2 peroxyosomal, suggérant un compartiment subcellulaire distinct dans la régulation du stress oxydatif.
En tant que flavonoïde naturel, la taxifoline (TA) a démontré une réduction significative de la glycémie, de l'acide urique, de la créatinine et des niveaux sériques d'insuline chez des rats diabétiques, tout en atténuant les modifications rénales pathologiques chez ces animaux50. Le β-sitostérol pourrait améliorer indirectement la néphropathie diabétique (ND) en régulant l'équilibre lipidique et en exerçant des effets anti-inflammatoires. Les composants en β-sitostérol présents dans le décoction Huangqi Gegen (HGD) participent à des voies liées à la ND, ciblant des molécules telles que le facteur de croissance endothélial vasculaire A (VEGFA) et l'interleukine-6 (IL-6). Ces effets incluent des actions anti-inflammatoires, anti-apoptotiques, antioxydantes et d'autophagie, qui réduisent la fibrose rénale et les lésions du cortex rénal, tout en améliorant la fonction rénale, ralentissant ainsi la progression de la ND51. L'ériodictyol, un autre flavonoïde naturel, a montré une protection contre l'accident ischémique cérébral (AIC) en équilibrant le stress oxydatif et l'inflammation52. Bien que les études sur l'ériodictyol dans le contexte de la ND soient limitées, étant donné l'association de cette maladie avec l'inflammation et le stress oxydatif, on émet l'hypothèse qu'il pourrait atténuer la ND par des mécanismes similaires. Les prédictions thérapeutiques dans cette étude suggèrent également que la taxifoline, le β-sitostérol et l'ériodictyol pourraient avoir des effets bénéfiques potentiels dans la ND. La modélisation moléculaire permet de prédire des conformations de liaison possibles ainsi que des affinités, mais n'établit pas l'engagement du cible in vivo, la biodisponibilité ou l'activité pharmacologique. Ces résultats doivent être interprétés comme générant des hypothèses plutôt que confirmatoires.
Les études précédentes de pharmacologie en réseau sur la néphropathie diabétique (DN) se sont principalement concentrées sur des voies de signalisation individuelles (par exemple, AGE-RAGE, PI3K-AKT et MAPK) et n'ont pas pris en compte le dysfonctionnement mitochondrial ni utilisé d'apprentissage automatique multi-modèle pour hiérarchiser les biomarqueurs. Notre étude introduit trois avancées méthodologiques et biologiques : (1) l'intégration de gènes différentiellement exprimés (DEG) à l'échelle du transcriptome avec des jeux de gènes mitochondriaux et des prédictions cibles de médicaments ; (2) l'application de quatre modèles distincts d'apprentissage automatique avec une validation croisée entre jeux de données afin de hiérarchiser des candidats robustes ; et (3) l'identification de voies péroxysomales (CAT) et de l'oxydase de la monoamine (MAOA/MAOB) — peu étudiées dans les contextes mitochondriaux de la DN — comme axes thérapeutiques candidats.
L'absence de changements statistiquement significatifs dans l'expression de MaoB et de Fabp1 dans le rein de souris peut être attribuée à plusieurs facteurs. Premièrement, les deux jeux de données du Gene Expression Omnibus (GEO) utilisés pour la priorisation des candidats provenaient d'échantillons rénaux humains (rein entier et glomérule, respectivement), tandis que notre expérience animale a utilisé un tissu rénal de souris. Les différences propres aux espèces en matière de régulation génique peuvent influencer les niveaux d'expression de base ainsi que la réponse aux médicaments. Deuxièmement, la taille d'échantillon relativement faible (n = 6 par groupe) pourrait avoir limité la puissance statistique nécessaire pour détecter des effets modérés. Troisièmement, les prélèvements tissulaires ont été effectués 8 semaines après le traitement, ce qui ne correspond peut-être pas à la fenêtre optimale pour observer des modifications transcriptomiques de MaoB et de Fabp1, ces gènes pouvant être régulés au niveau protéique ou de l'activité enzymatique plutôt qu'au niveau de l'ARNm. Quatrièmement, l'hétérogénéité tissulaire — entre le rein entier et ses compartiments spécifiques — pourrait contribuer à ces écarts. Une investigation plus approfondie de ces hypothèses est justifiée.
Cette étude a utilisé une approche intégrative de bioinformatique et d'apprentissage automatique pour identifier CAT, FABP1, MAOA et MAOB comme gènes mitochondriaux candidats potentiels pour la LLF dans le DN. Des expériences in vivo ont confirmé que la LLF régule significativement à la hausse CAT et MAOA dans le tissu rénal, suggérant que ces gènes constituent des cibles prometteuses pour des investigations mécanistiques et thérapeutiques ultérieures. En revanche, MAOB et FABP1 ont montré des tendances non significatives dans le même sens, soulignant l'importance de la validation expérimentale lors de la priorisation des prédictions computationnelles. Ces résultats fournissent un fondement rationnel pour des études futures visant à explorer des stratégies thérapeutiques liées aux mitochondries dans le DN.
Déclarations de divulgation
Les auteurs n'ont aucun conflit d'intérêts à déclarer.
Remerciements
Nous tenons à exprimer notre profonde gratitude à toutes les personnes et organisations qui nous ont soutenus et aidés tout au long de cette recherche. Cette étude a été financée par le Fonds national des sciences naturelles de Chine (n° 81973486 et 82173974), les projets de recherche de l'Administration de la médecine traditionnelle chinoise de la province du Shanxi (n° 2024ZYYA021), le projet disciplinaire de l'Université de médecine traditionnelle chinoise du Shanxi (n° 2026XK24), ainsi que le projet de financement de la recherche scientifique de l'Université de médecine traditionnelle chinoise du Shandong (n° KYZK2024Q13). Nous remercions Qinqing Li, professeur adjoint à l'Université de médecine traditionnelle chinoise du Shanxi, qui a authentifié le matériel botanique.
Matériaux
| Nom | Entreprise | Numéro de catalogue | Commentaires |
|---|---|---|---|
| Solution fixative de paraformaldéhyde à 4 % | Saiyin Biotechnology Co., Ltd. | 71033600 | |
| Éthanol absolu | Sinopharm Chemical Reagent Co., Ltd. | 10009218 | |
| Glucomètre | Sinocare Inc. | GA-3 | |
| Kit de dosage de l'azote uréique sanguin (BUN) | Institut d'ingénierie biochimique de Nanjing Jianwei | C03-2-1 | |
| Souris C57BLKS/J db/db | Changzhou Cavens Experimental Animal Co., Ltd. | SCXK (Su) 2021-0013 | |
| Souris C57BLKS/J db/m | Changzhou Cavens Experimental Animal Co., Ltd. | SCXK (Su) 2021-0013 | |
| Centrifugeuse | Hunan Xiangyi Laboratory Instrument Development Co., Ltd. | HI650 | |
| Hydrate de chloral | Shanghai Aladdin Biochemical Technology Co., Ltd. | 302-17-0 | |
| Cytoscape (v3.9.0) | https://cytoscape.org | ||
| Base de données pour la prédiction de la modification m6A | http://www.cuilab.cn/sramp/ | ||
| Base de données des ingrédients actifs de la médecine traditionnelle chinoise | http://sm.nwsuaf.edu.cn/lsp/tcmsp.php | ||
| ENCORI / Starbase | https://starbase.sysu.edu.cn/ | ||
| Gene Expression Omnibus (GEO) | https://www.ncbi.nlm.nih.gov/geo/ | ||
| Kit de coloration à l'hématoxyline-éosine (HE) | Servicebio | C0105S | |
| Centrifugeuse haute vitesse | Labnet, USA | C2500-R-230V | |
| Outil d'analyse de l'infiltration immunitaire | https://cibersort.stanford.edu/ | ||
| Ligustri Lucidi Fructus | Sichuan Quanyirun Biotechnology Co., Ltd. | 20240506 | |
| Agitateur magnétique | Jintan Zhongtian Instrument Factory, Jiangsu | T8-1 | |
| Microscope | Olympus | BX53 | |
| Microtome | Leica, Germany | RM 2016 | |
| Spectrophotomètre microvolume | Hangzhou Aosheng Instrument Co., Ltd. | Nano-300 | |
| miRNet | https://www.mirnet.ca | ||
| MitoCarta 3.0 | https://www.broadinstitute.org/mitocarta | ||
| Paquet R pour l'interprétation de modèles | https://cran.r-project.org/package=DALEX | ||
| Plateforme de docking moléculaire | http://clab.labshare.cn/cb-dock/ | ||
| Kit ELISA de microalbuminurie murine | Fine Test | EM0632 | |
| Bandelette de test de microalbuminurie murine | Guangzhou Huadu Gaoerbao Biotechnology Co., Ltd. | 20211203 | |
| Kit ELISA de créatinine sérique murine | Abmart | AB5990A | |
| MSigDB | https://www.gsea-msigdb.org/gsea/msigdb/ | ||
| Cycleur thermique PCR | Roche | Roche LightCycler 480 | |
| Logiciel R (v4.2.2) + paquets R | https://www.r-project.org / CRAN/Bioconductor | ||
| RCSB PDB | https://www.rcsb.org | ||
| Kit d'extraction d'ARN | Beijing Jumei Biotech Co., Ltd. | MF-036-01 | |
| RPISeq | http://pridb.gdcb.iastate.edu/RPISeq/ | ||
| Kit RT-qPCR | Beijing Jumei Biotech Co., Ltd. | MF949-T | |
| Salidroside | Sichuan Quanyirun Biotechnology Co., Ltd. | 20211009 | |
| Kit de dosage de la créatinine sérique | Institut d'ingénierie biochimique de Nanjing Jianwei | C011-2-1 | |
| Installation animale SPF | Université de médecine traditionnelle chinoise du Shanxi | ||
| SRAMP | http://www.cuilab.cn/sramp/ | ||
| STRING | https://cn.string-db.org/ | ||
| SwissTargetPrediction | http://www.swisstargetprediction.ch/ | ||
| TCMSP | http://sm.nwsuaf.edu.cn/lsp/tcmsp.php | ||
| Tezhi Pigan | Sichuan Quanyirun Biotechnology Co., Ltd. | 20210602 | |
| Bain flottant pour tissus | Wuhan Junjie | JK-6 |
Références
- Thipsawat S. Early detection of diabetic nephropathy in patient with type 2 diabetes mellitus: a review of the literature. Diabetes Vasc Dis Res. 2021;18(6):14791641211058856.
- Kanwar YS, Sun L, Xie P, Liu FY, Chen S. A glimpse of various pathogenetic mechanisms of diabetic nephropathy. Annu Rev Pathol. 2011;6:395-423.
- Santulli G, et al. Prediabetes increases the risk of frailty in prefrail older adults with hypertension: beneficial effects of metformin. Hypertension. 2024;81(7):1637-43.
- Jin Q, et al. Oxidative stress and inflammation in diabetic nephropathy: role of polyphenols. Front Immunol. 2023;14:1185317.
- Alicic RZ, Rooney MT, Tuttle KR. Diabetic kidney disease: challenges, progress, and possibilities. Clin J Am Soc Nephrol. 2017;12(12):2032-45.
- Harrington JS, et al. Mitochondria in health, disease, and aging. Physiol Rev. 2023;103(4):2349-422.
- Peña FJ, et al. An integrated overview on the regulation of sperm metabolism (glycolysis-Krebs cycle-oxidative phosphorylation). Anim Reprod Sci. 2022;246:106805.
- de Mello AH, Costa AB, Engel JDG, Rezin GT. Mitochondrial dysfunction in obesity. Life Sci. 2018;192:26-32.
- Shen Y, et al. Notoginsenoside Fc, a novel renoprotective agent, ameliorates glomerular endothelial cells pyroptosis and mitochondrial dysfunction in diabetic nephropathy through regulating HMGCS2 pathway. Phytomedicine. 2024;126:155445.
- Zhang PN, et al. Mitochondrial dysfunction and diabetic nephropathy: nontraditional therapeutic opportunities. J Diabetes Res. 2021;2021:1010268.
- Zhang JL, et al. Structural characterization and protective effect against renal fibrosis of polysaccharide from Ligustrum lucidum Ait. J Ethnopharmacol. 2023;302(Pt A):115898.
- Luan R, et al. The protective effect of ethyl acetate and n-butanol fractions of wine-steamed Ligustri Lucidi Fructus on diabetic nephropathy in rats. Evid Based Complement Alternat Med. 2021;2021:6512242.
- Luan R, et al. Pharmacodynamics, pharmacokinetics, and kidney distribution of raw and wine-steamed Ligustri Lucidi Fructus extracts in diabetic nephropathy rats. Molecules. 2023;28(2):791.
- Seo HL, et al. Liqustri lucidi Fructus inhibits hepatic injury and functions as an antioxidant by activation of AMP-activated protein kinase in vivo and in vitro. Chem Biol Interact. 2017;262:57-68.
- Yan M, et al. Identification of pyroptosis-related genes and potential drugs in diabetic nephropathy. J Transl Med. 2023;21(1):490.
- Ritchie ME, et al. limma powers differential expression analyses for RNA-sequencing and microarray studies. Nucleic Acids Res. 2015;43(7):e47.
- Gustavsson EK, et al. ggtranscript: an R package for the visualization and interpretation of transcript isoforms using ggplot2. Bioinformatics. 2022;38(15):3844-6.
- Gu Z, Eils R, Schlesner M. Complex heatmaps reveal patterns and correlations in multidimensional genomic data. Bioinformatics. 2016;32(18):2847-9.
- Shannon P, et al. Cytoscape: a software environment for integrated models of biomolecular interaction networks. Genome Res. 2003;13(11):2498-504.
- Wu T, et al. clusterProfiler 4.0: a universal enrichment tool for interpreting omics data. Innovation (Camb). 2021;2(3):100141.
- Dong H, et al. Identification through machine learning of potential immune-related gene biomarkers associated with immune cell infiltration in myocardial infarction. BMC Cardiovasc Disord. 2023;23(1):163.
- Pei B, et al. The development of prediction model for cuffed tracheal tube size from the middle finger in pediatrics: a concise and feasible approach. Transl Pediatr. 2023;12(12):2222-31.
- Robin X, et al. pROC: an open-source package for R and S+ to analyze and compare ROC curves. BMC Bioinformatics. 2011;12:77.
- Robles-Jimenez LE, et al. Worldwide traceability of antibiotic residues from livestock in wastewater and soil: a systematic review. Animals (Basel). 2021;12(1):60.
- Wang Y, et al. Bioinformatics analysis combined with clinical sample screening reveals that leptin may be a biomarker of preeclampsia. Front Physiol. 2022;13:1031950.
- Livak KJ, Schmittgen TD. Analysis of relative gene expression data using real-time quantitative PCR and the 2^−ΔΔCT method. Methods. 2001;25(4):402-8.
- Klejborowska G, et al. Synthesis, anticancer activity and molecular docking studies of N-deacetylthiocolchicine and 4-iodo-N-deacetylthiocolchicine derivatives. Bioorg Med Chem. 2021;32:116014.
- Reagan-Shaw S, Nihal M, Ahmad N. Dose translation from animal to human studies revisited. FASEB J. 2008;22(3):659-61.
- An Y, Duan H. The role of m6A RNA methylation in cancer metabolism. Mol Cancer. 2022;21(1):14.
- Mazzieri A, Porcellati F, Timio F, Reboldi G. Molecular targets of novel therapeutics for diabetic kidney disease: a new era of nephroprotection. Int J Mol Sci. 2024;25(7):3969.
- Breyer MD, Susztak K. The next generation of therapeutics for chronic kidney disease. Nat Rev Drug Discov. 2016;15(8):568-88.
- Leoncini G, et al. Blood pressure reduction and RAAS inhibition in diabetic kidney disease: therapeutic potentials and limitations. J Nephrol. 2020;33(5):949-63.
- Pofi R, et al. Diabetic nephropathy: focus on current and future therapeutic strategies. Curr Drug Metab. 2016;17(5):497-502.
- Arellano Buendía AS, et al. Immunomodulatory effects of the nutraceutical garlic derivative allicin in the progression of diabetic nephropathy. Int J Mol Sci. 2018;19(10):3107.
- Zhang X, Agborbesong E, Li X. The role of mitochondria in acute kidney injury and chronic kidney disease and its therapeutic potential. Int J Mol Sci. 2021;22(20):11253.
- Liu Y, et al. DsbA-L interacting with catalase in peroxisome improves tubular oxidative damage in diabetic nephropathy. Redox Biol. 2023;66:102855.
- Zhong Y, et al. Jujuboside A ameliorates high fat diet and streptozotocin induced diabetic nephropathy via suppressing oxidative stress, apoptosis, and enhancing autophagy. Food Chem Toxicol. 2022;159:112697.
- Zhong Y, et al. Dioscin relieves diabetic nephropathy via suppressing oxidative stress and apoptosis, and improving mitochondrial quality and quantity control. Food Funct. 2022;13(6):3660-73.
- Issac PK, et al. Protective effect of morin by targeting mitochondrial reactive oxygen species induced by hydrogen peroxide demonstrated at a molecular level in MDCK epithelial cells. Mol Biol Rep. 2022;49(6):4269-79.
- Abo El-Asrar M, Ismail EAR, Elnhrawy AM, Thabet RA. Fatty acid binding protein 1 (FABP1) and fatty acid binding protein 2 (FABP2) as a link between diabetic nephropathy and subclinical atherosclerosis in children and adolescents with type 1 diabetes. J Diabetes Complications. 2023;37(3):108414.
- Gholaminejad A, Fathalipour M, Roointan A. Comprehensive analysis of diabetic nephropathy expression profile based on weighted gene co-expression network analysis algorithm. BMC Nephrol. 2021;22(1):245.
- Tanaka M, et al. Urinary fatty acid-binding protein 4 is a promising biomarker for glomerular damage in patients with diabetes mellitus. J Diabetes Investig. 2025;16(4):670-9.
- Liu Y, et al. Gastric cancer adapts high lipid microenvironment via suppressing PPARG-FABP1 axis after arriving in the lymph node. Redox Biol. 2025;85:103759.
- Borús DL, et al. Fatty acid binding protein 1 (FABP1) depletion promotes an oxidative metabolic shift in Caco-2 colorectal cancer cells. Biochim Biophys Acta Mol Cell Biol Lipids. 2025;1870(7):159661.
- Chu Y, et al. Glutathione peroxidase-1 overexpression reduces oxidative stress, and improves pathology and proteome remodeling in the kidneys of old mice. Aging Cell. 2020;19(6):e13154.
- Zhang F, et al. Mesenchymal stem cells alleviate rat diabetic nephropathy by suppressing CD103+ DCs-mediated CD8+ T cell responses. J Cell Mol Med. 2020;24(10):5817-31.
- Cao Q, et al. Renal F4/80+ CD11c+ mononuclear phagocytes display phenotypic and functional characteristics of macrophages in health and in adriamycin nephropathy. J Am Soc Nephrol. 2015;26(2):349-63.
- Zhou W, et al. The landscape of immune cell infiltration in the glomerulus of diabetic nephropathy: evidence based on bioinformatics. BMC Nephrol. 2022;23(1):303.
- Bloch K, Shichman E, Vorobeychik M, Bloch D, Vardi P. Catalase expression in pancreatic alpha cells of diabetic and non-diabetic mice. Histochem Cell Biol. 2007;127(2):227-32.
- Zhao Y, et al. Taxifolin attenuates diabetic nephropathy in streptozotocin-induced diabetic rats. Am J Transl Res. 2018;10(4):1205-10.
- Ding S, Wang W, Song X, Ma H. Based on network pharmacology and molecular docking to explore the underlying mechanism of Huangqi Gegen Decoction for treating diabetic nephropathy. Evid Based Complement Alternat Med. 2021;2021:9928282.
- Guo S, et al. Correction: Eriodictyol: a review of its pharmacological activities and molecular mechanisms related to ischemic stroke. Food Funct. 2023;14(10):4949.