Cette étude examine les comportements décisionnels et de révision de futurs spécialistes d'anglais traduisant des récits centrés sur la Chine, en intégrant des enregistrements de frappes au clavier et un corpus de danmu afin de révéler comment la saillance textuelle influence l'effort de traitement et la qualité de la traduction.
Article de recherche
Prise de décision et comportement de révision dans la traduction du chinois vers l'anglais : preuves issues d'étudiants en anglais traduisant des récits centrés sur la Chine
Dans cet article
Résumé
Résumé
Alors que les récits centrés sur la Chine pénètrent de plus en plus le circuit international, la traduction du chinois vers l'anglais est devenue un lieu de négociation de sens plutôt qu'un simple transfert linguistique. Pour les étudiants traducteurs, le défi principal va au-delà du choix lexical : il s'agit de décider comment restituer les références chargées de culture, les positions évaluatives et le positionnement narratif à destination de lecteurs extérieurs au contexte source. Cette étude examine la prise de décision en temps réel et les comportements de révision de 72 étudiants anglicistes traduisant des récits centrés sur la Chine. Selon une démarche processus-produit, la recherche intègre des données de frappe enregistrées à l’aide de Translog-II, l’évaluation des produits traductionnels et un corpus auxiliaire de « danmu » (commentaires synchronisés temporellement), considéré comme une couche de saillance pour le public plutôt que comme une mesure directe de la difficulté linguistique au niveau des segments. Les processus de traduction ont été analysés selon la durée des pauses, la fréquence et le lieu des révisions, ainsi que leur répartition par étape, tandis que la qualité du produit a été évaluée par notation d’experts et par un codage ciblé des segments liés à la culture. Un corpus de 18 642 commentaires « danmu » provenant de 24 vidéos Bilibili a permis d’identifier les thèmes narratifs saillants pour le public ainsi que les expressions sensibles sur le plan culturel. Les résultats montrent que les segments riches en contenu culturel et en charge évaluative provoquent des pauses plus longues, des révisions récursives plus fréquentes et des reformulations plus denses en cours de processus. Les traductions de meilleure qualité sont associées à des révisions sélectives et stratégiquement calibrées au niveau du discours et de l’adaptation culturelle, plutôt qu’à un nombre total de révisions plus élevé. Le recoupement entre les déclencheurs narratifs saillants dans les « danmu » et les segments de traduction exigeant un effort accru est interprété comme une preuve convergente de la saillance pour le public et de la pression cognitive subie par le traducteur, et non comme une preuve de causalité. Cette étude fait progresser la recherche sur le processus de traduction en reliant le comportement de révision à la traduction de récits ancrés dans la culture, et en ouvrant des perspectives pour la formation des traducteurs dans le domaine de la communication interculturelle.
Introduction
Ces dernières années, la traduction des discours liés à la Chine est passée d'une préoccupation relativement spécialisée à une question centrale dans la communication internationale1. Ce qui est en jeu dans une telle traduction n'est pas simplement le transfert d'un contenu propositionnel, mais la reformulation de récits publics porteurs de positionnements politiques, de cadres culturels et de stratégies d'adressage au public. Les travaux sur la traduction du discours politique chinois ont rendu ce point de plus en plus clair : lorsque des textes sont traduits pour des lecteurs extérieurs à la Chine, les choix relatifs à la formulation, à la modalité et à l'accent textuel deviennent aussi des choix quant à la manière dont la Chine est racontée et interprétée à l'étranger2. Dès lors que le problème est ainsi posé, une approche centrée uniquement sur le produit fini devient insuffisante. Une traduction achevée peut montrer ce qui a été retenu, mais elle ne peut pas révéler quand l'incertitude est apparue, à quel moment la reformulation a commencé, ni comment des solutions concurrentes ont été testées puis abandonnées3.
Ces limitations permettent de comprendre pourquoi la recherche empirique sur le processus de traduction est devenue un courant important au sein des études de traduction, utilisant des outils de traçage du processus pour enregistrer les pauses, les suppressions, les insertions et la structure temporelle de la prise de décision, plutôt que d’en inférer indirectement le déroulement à partir du texte final4. Ceci ne remplace pas les approches centrées sur le produit, sociologiques, culturelles ou fondées sur des corpus ; au contraire, cela ajoute des données sur la formation pas à pas des décisions de traduction. Les travaux récents sont passés de la simple description de pauses isolées à la modélisation de la traduction comme une activité structurée dans le temps. La taxonomie hésitation-orientation-fluence, par exemple, considère le comportement de traduction comme une alternance ordonnée entre incertitude, recherche et production fluente, expliquant pourquoi certaines parties d’une tâche deviennent instables et déclenchent une reformulation5. Ce changement est particulièrement pertinent dans le domaine de la traduction étudiante, où la maîtrise de la langue, les connaissances disciplinaires et le contrôle stratégique sont encore en cours de développement simultané6.
Des preuves issues de l'analyse combinée du suivi oculaire et de la frappe au clavier montrent que les traducteurs novices ne répartissent pas leur attention de manière uniforme, et que la production du texte cible devient souvent un point central de la charge cognitive lors de la traduction du chinois vers l'anglais7. Par conséquent, ce qui apparaît comme un problème local de formulation dans le produit peut en réalité refléter une réorganisation plus large de l'attention et des efforts durant le processus en temps réel8. Des travaux récents suggèrent en outre que les étudiants traducteurs peuvent produire des textes présentant une adéquation superficielle similaire tout en différant fortement quant à l'effort, à l'incertitude et à l'autosurveillance requis. Une version finale satisfaisante peut toutefois reposer sur un cheminement décisionnel fragile ou inefficace, que seules des mesures sensibles au processus permettent de capturer9. En outre, des études comparatives indiquent que l'expertise en traduction implique un contrôle métacognitif stable sur les moments où il convient de faire une pause, de rechercher de l'information, de poursuivre la rédaction ou de revenir en arrière pour réviser10.
La révision est précisément le moment où ce processus cognitif caché devient le plus visible. C'est là que les traducteurs reviennent sur les formulations antérieures, testent des alternatives et déterminent si un problème est lexical, syntaxique, discursif ou culturel. Par conséquent, la révision ne doit pas être considérée comme une simple étape de finition effectuée tardivement, mais comme un indicateur fondamental du développement du traducteur. De meilleurs résultats sont associés à la manière dont les alternatives sont consolidées pendant la production, ce qui montre que la révision efficace est sélective, stratégiquement synchronisée et adaptée aux exigences textuelles plus complexes, plutôt qu'une simple accumulation de modifications11,12,13.
La complexité de la prise de décision et de la révision s'accentue lorsque le texte source est un récit centré sur la Chine plutôt qu'un passage informatif neutre. De tels textes s'appuient fréquemment sur des présupposés fortement ancrés dans la culture, des expressions situées dans un contexte historique précis et des indices évaluatifs dont le sens dépend d'un bagage commun plutôt que d'une explication explicite14,15,16. La difficulté du texte modifie la granularité même du traitement ; les textes narratifs riches en contenu culturel ou évaluatif obligent les traducteurs à travailler par unités plus petites, à effectuer des opérations non linéaires et à procéder à des réorganisations locales répétées8. Pour les étudiants en traduction, le problème central consiste à déterminer dans quelle mesure il convient de déployer ou de réorganiser ce bagage implicite pour des lecteurs extérieurs à la communauté discursive d'origine, sans appauvrir la spécificité culturelle.
Trois lacunes spécifiques motivent la présente étude. Premièrement, les indicateurs du processus de traduction tels que la durée des pauses, la fréquence des longues pauses, les interruptions du curseur et la consultation du dictionnaire sont souvent examinés indépendamment des typologies de révision, ce qui rend difficile l’observation de la manière dont la pression décisionnelle se manifeste par une reformulation ultérieure. Deuxièmement, les catégories narratives spécifiques à une culture ont fait l’objet de moins d’analyses centrées sur le processus que les textes universitaires ou explicatifs généraux, bien que les récits centrés sur la Chine exigent souvent des traducteurs qu’ils gèrent simultanément la charge culturelle, la densité évaluative et l’implication implicite condensée14,15,16. Dans cette étude, la charge culturelle désigne la densité de références ancrées dans la culture et de présuppositions partagées ; la densité évaluative fait référence à l’expression explicite ou implicite d’un point de vue, à l’intensité affective et au cadre porteur de valeurs ; et la compression narrative indique dans quelle mesure les informations contextuelles, les relations causales ou le positionnement social sont condensés en de courts segments textuels. Troisièmement, les tâches de traduction sont généralement conçues uniquement à partir d’une analyse interne du texte, sans tenir suffisamment compte du fait que les segments identifiés comme difficiles coïncident ou non avec les points qui attirent l’attention du public lors de la diffusion numérique. Les danmu (commentaires vidéo synchronisés dans le temps) peuvent jouer le rôle de paratexte et de discours participatif, en mettant en évidence ce que les publics remarquent, contestent et réinterprètent17,18 ; toutefois, la saillance des danmu doit être considérée comme un indicateur, au niveau sémantique, de l’engagement du public, et non comme un substitut direct de la difficulté linguistique au niveau des segments.
Comblant ces lacunes, la présente étude examine comment les étudiants spécialisés en anglais prennent des décisions et procèdent à des révisions lorsqu’ils traduisent des récits centrés sur la Chine du chinois vers l’anglais. En intégrant les données sur le processus de traduction et le discours numérique des publics dans un même cadre analytique, l’étude vise à expliquer non seulement là où les étudiants traducteurs éprouvent des difficultés, mais aussi pourquoi ces difficultés se concentrent autour de certains types de sens narratif.
Plus précisément, cette étude aborde quatre questions de recherche : (1) Quels schémas de prise de décision caractérisent la traduction du chinois vers l'anglais, réalisée par des étudiants spécialisés en anglais, de récits centrés sur la Chine ? (2) Comment les comportements de révision varient-ils selon les segments présentant différents niveaux de charge culturelle et de densité narrative ? (3) Quelles dimensions du comportement de révision sont associées à une qualité de traduction plus élevée ? et (4) Les points culturellement saillants identifiés dans les échanges danmu coïncident-ils avec les segments qui exigent le plus d'effort cognitif pendant la traduction ?
En conséquence, l'étude teste quatre hypothèses liées dans une séquence analytique unique : l'hypothèse H1 postule que les segments présentant une charge culturelle plus élevée provoqueront des pauses plus longues, une incertitude décisionnelle accrue et des révisions plus fréquentes que les segments à charge culturelle plus faible ; l'hypothèse H2 distingue deux voies, prédisant qu'une densité évaluative plus élevée augmentera les révisions différées, tandis qu'une compression narrative favorisera la reformulation au niveau du discours ; l'hypothèse H3 prévoit que la qualité de la traduction sera davantage expliquée par la sélectivité et le moment des révisions que par le nombre total de révisions pris isolément ; et l'hypothèse H4 prévoit que les segments saillants pour les danmu coïncideront avec les segments de traduction à forte charge cognitive, révélant une convergence associative entre la saillance perçue par le public et la pression cognitive subie par le traducteur.
Protocole
Toutes les méthodes impliquant des sujets humains ont été menées conformément aux directives institutionnelles et ont été approuvées par le comité d'éthique institutionnel (IRB) ou le comité d'éthique de la recherche sur les êtres humains de l'Université Hanshan. Un consentement éclairé a été obtenu de la part de tous les participants avant le début de l'expérience.
Cadre conceptuel et conception de la recherche
Cette étude a utilisé un dispositif de recherche processus-produit avec une couche discursive auxiliaire afin d'examiner comment les commentaires danmu générés par le public influencent la traduction des sous-titres. Le cadre analytique intégrait les caractéristiques textuelles, les indicateurs du processus de traduction et les résultats en matière de qualité de la traduction. Plus précisément, elle a cherché à déterminer si l'attention du public, reflétée par la densité des danmu, orientait les ressources cognitives des traducteurs vers des caractéristiques textuelles particulières et si cette allocation de l'attention affectait par la suite la qualité de la traduction.
Pour mettre en œuvre ce cadre, l'étude a d'abord établi des caractéristiques textuelles au niveau des segments selon quatre dimensions : la charge culturelle, la densité évaluative, la compression narrative et la saillance des danmu. La charge culturelle faisait référence à la présence de références spécifiques à une culture, nécessitant adaptation ou explication. La densité évaluative mesurait la concentration de langage chargé d'émotions ou d'attitudes au sein d'un segment. La compression narrative traduisait le degré de condensation du contenu sémantique imposé par les contraintes des sous-titres. La saillance des danmu représentait l'importance de l'attention du public portée à chaque segment de sous-titre, quantifiée par le volume des commentaires danmu synchronisés. Contrairement aux mesures classiques de la difficulté de traduction, la saillance des danmu reflétait une attention socialement distribuée plutôt qu'une complexité textuelle intrinsèque. Un segment suscitant un fort engagement du public n'était pas nécessairement plus difficile à traduire ; il marquait plutôt un point de signification communicationnelle accrue dans l'expérience de visionnage.
Le cadre analytique comprenait trois jeux de données interconnectés. Le jeu de données au niveau des participants incluait les caractéristiques démographiques individuelles et le niveau d'expertise en traduction. Le jeu de données processus-produit associait chaque segment de sous-titre à des indicateurs comportementaux extraits de l'enregistrement des frappes au clavier, ainsi qu'à des évaluations expertes de la qualité de la traduction. Le jeu de données danmu contenait les commentaires synchronisés du public alignés sur le défilement des sous-titres, à partir desquels des valeurs de saillance des danmu ont été calculées. Ces jeux de données ont été associés grâce à des identifiants de participants et de segments, permettant une analyse simultanée de chaque segment de sous-titre traduit en lien avec les caractéristiques des traducteurs, leur comportement de traitement cognitif, l'attention du public et les résultats de traduction. La base de données intégrée finale comprenait 216 séances de traduction complètes et 3 168 observations participant-texte-segment, fournissant la base empirique pour les analyses subséquentes de type processus-produit.
Dépistage des participants et profilage de base
L'échantillon comprenait 72 étudiants anglicistes recrutés au sein d'une université publique du sud de la Chine, répartis équitablement entre la deuxième, la troisième et la quatrième année d'études de premier cycle (24 participants par groupe d'année). Tous les participants étaient des locuteurs natifs chinois suivant un enseignement formel en rédaction et traduction en anglais. Afin d'assurer la comparabilité au sein de la population d'apprentis traducteurs, les individus ayant résidé plus de 6 mois dans un pays anglophone ou détenant une certification professionnelle de traducteur ont été exclus. Les participants n'ont pas été répartis en groupes expérimentaux distincts selon leur expérience en traduction, leur familiarité culturelle ou leur niveau de compétence en langue seconde. Au lieu de cela, le niveau d'études, les résultats récents aux tests de compétence en anglais, les cours antérieurs en traduction, le degré d'auto-évaluation de la familiarité avec des sujets culturels liés à la Chine, ainsi que la pratique bilingue hebdomadaire moyenne ont été enregistrés et intégrés comme covariables au niveau des participants dans les modèles statistiques. Cette précision permet également de résoudre l'incohérence concernant le nombre de participants soulevée lors de l'évaluation par les pairs : le manuscrit et le jeu de données de réplication comprennent tous deux 72 participants, 216 séances de tâche et 3 168 observations au niveau des segments.
Sélection du texte source et élaboration de la tâche
Les matériaux de traduction étaient composés de trois textes narratifs contemporains centrés sur la Chine, élaborés spécifiquement pour cette étude afin de refléter un discours public authentique et d'éviter la reproduction de contenus protégés par le droit d'auteur. Chaque texte contenait entre 205 et 225 caractères chinois, mais différait systématiquement par ses caractéristiques internes. Le texte A présente un récit sur le retour au pays pour le Nouvel An chinois, avec une charge culturelle modérée et une syntaxe relativement simple. Le texte B relate un souvenir de la fête des bateaux-dragons et contient une densité plus élevée d'expressions spécifiques à la culture ainsi qu'une connaissance implicite du contexte. Le texte C décrit un récit sur la diffusion en direct et le commerce électronique en milieu rural, caractérisé par un langage évaluatif dense et une position narrative condensée.
Les textes ont été segmentés systématiquement en utilisant d'abord les limites des propositions, puis les limites des unités de sens, produisant 44 unités analysables réparties sur les trois tâches de traduction (Tableau 1). Avant le codage formel, un manuel de codage a défini la charge culturelle, la densité évaluative et la compression narrative à l'aide d'échelles ordinales allant de 1 à 5. Une étude pilote menée auprès de 12 étudiants n'ayant pas participé à l'expérience principale a confirmé le calibrage prévu de la difficulté, la clarté des instructions de la tâche et la stabilité des limites des segments pour l'alignement des frappes au clavier.
Construction d'un corpus auxiliaire et cartographie de la saillance
Afin d'identifier les indices narratifs saillants pour le grand public, un corpus auxiliaire de danmu a été compilé à partir de 24 vidéos Bilibili publiées entre janvier 2023 et décembre 2025. Les vidéos n'ont été incluses que si elles correspondaient à l'un des trois domaines sémantiques présents dans les textes sources, avaient accumulé plus de 50 000 vues, présentaient une interaction dense en danmu et permettaient l'exportation et la cartographie thématique des commentaires synchronisés temporellement. Après suppression des doublons et filtrage des émoticônes, des remplissages onomatopéiques et des fragments non pertinents, le corpus final comprenait 18 642 commentaires.
Les mots-clés ont été normalisés et regroupés à l’aide d’ancres de mots-clés liées au texte source. Chaque segment du texte source s’est ensuite vu attribuer un score de saillance danmu continu, fondé sur une combinaison pondérée de la fréquence normalisée des clusters de mots-clés, de la concentration des commentaires au sein du cluster thématique correspondant et de l’intensité évaluative moyenne. Cette procédure permet des comparaisons entre l’effort de traitement du traducteur et la saillance du public au niveau des clusters sémantiques, plutôt que par une simple correspondance lexicale directe. Étant donné que les danmu reflètent les réactions du public à des vidéos en ligne et non la tâche expérimentale de traduction elle-même, la saillance danmu est interprétée comme un indicateur externe de l’engagement du public, et non comme une preuve directe de la difficulté linguistique d’un segment source.
Procédure expérimentale et acquisition des données
Les sessions de traduction ont été menées individuellement dans un laboratoire informatique contrôlé, dans des conditions normalisées de matériel, de logiciel et d'accès à Internet (Figure 2). Après une période d'orientation de cinq minutes, mettant l'accent sur la production d'un anglais lisible destiné à un public international, les participants ont effectué un échauffement de trois minutes à la saisie en anglais afin de minimiser les effets de l'adaptation au clavier. Les trois tâches de traduction ont été administrées séquentiellement à l'aide de Translog-II, l'ordre des tâches étant contrebalancé selon un plan en carré latin afin de répartir uniformément les effets potentiels de fatigue et d'ordre entre les participants. Une durée maximale de 20 minutes par texte a été allouée aux participants, avec des intervalles de repos de cinq minutes entre chaque tâche.
Bien que le dictionnaire bilingue intégré ait été autorisé, les systèmes de traduction automatique et les moteurs de recherche externes étaient interdits. Toutes les frappes au clavier, les pauses et les déplacements du curseur ont été enregistrés automatiquement et complétés par des enregistrements synchrones de l'écran afin de vérifier les épisodes de révision non linéaires. Après avoir terminé chaque tâche, les participants ont rempli une évaluation subjective de la difficulté, utilisée uniquement pour aider à l'interprétation des cas limites lors du codage.
Mesure du processus et codage des variables
Les enregistrements des frappes au clavier ont été alignés avec la structure de segment prédéfinie. Un épisode d'alignement commençait par la première frappe en langue cible correspondant à un segment et se terminait lorsque le participant passait définitivement au segment suivant. Les révisions chevauchantes ont été réaffectées à l'aide des enregistrements chronométrés du suivi du curseur.
Le comportement de prise de décision a été quantifié à l'aide de cinq indicateurs : la durée de la première pause avant la traduction du segment initial, la durée moyenne des pauses intra-segment, la fréquence des pauses dépassant deux secondes, le nombre de consultations du dictionnaire et le nombre d'interruptions basées sur le curseur, indiquant des écarts par rapport à la rédaction linéaire (Tableau 2). Le comportement de révision a été classé selon deux dimensions : le moment et la fonction. Le moment différenciait les révisions locales immédiates des révisions différées, effectuées après que la rédaction avait progressé au-delà du segment en cours. Le codage fonctionnel classait les révisions en révisions de surface (corrections au niveau de la forme sans changement sémantique), révisions de sens (modifications lexicales ou syntaxiques), révisions au niveau du discours (ajustements des relations entre propositions ou de la cohérence) et révisions d'adaptation culturelle (reformulations orientées vers le public cible). Deux codeurs formés ont analysé indépendamment chaque épisode de révision, puis ont procédé à une arbitrage conjoint afin d'attribuer une catégorie fonctionnelle principale unique à chaque événement. La fiabilité inter-jugeurs était élevée pour toutes les mesures codées. L'indice ĸ de Cohen indiquait un accord substantiel pour le codage catégoriel des fonctions de révision (ĸ = 0,84, p < 0,001). Pour les variables ordinales au niveau du texte, les coefficients de corrélation intra-classes (CCI, modèle mixte à deux facteurs, accord absolu) ont montré une forte fiabilité pour la charge culturelle (CCI = 0,86), la densité évaluative (CCI = 0,78) et la compression narrative (CCI = 0,82). Toutes les divergences initiales de codage ont été par la suite résolues par arbitrage conjoint.
Évaluation de la qualité de la traduction
La qualité de la traduction a été évaluée indépendamment des données de processus par deux évaluateurs ayant une formation de niveau doctorat et une vaste expérience dans l'enseignement de la traduction. Aveugles aux identités des participants et aux mesures de processus, les évaluateurs ont appliqué une grille sur 100 points, répartie équitablement entre cinq dimensions : exactitude sémantique, fluidité linguistique, cohérence narrative, adaptation culturelle et adéquation du registre (Tableau 3). Les écarts de notes supérieurs à huit points ont déclenché un examen conjoint et une nouvelle notation par consensus, la moyenne retenue après arbitrage servant de score final de qualité de traduction. Les notes avant arbitrage ont été conservées afin de permettre une communication transparente de la fiabilité inter-évaluateurs dans les matériaux de réplication.
Modélisation statistique
Les analyses ont été menées en trois étapes séquentielles. Premièrement, des statistiques descriptives ont été calculées afin de résumer toutes les variables selon les groupes d'âge et les types de texte. Deuxièmement, l'effort de traitement au niveau des segments a été analysé à l'aide de modèles de régression à effets mixtes, afin de tenir compte de la structure imbriquée des segments dans les textes et des observations répétées provenant des participants individuels. Les variables dépendantes, notamment la durée de la première pause et la fréquence des révisions, ont été modélisées en fonction de la charge culturelle, de la densité évaluative, de la compression narrative et de la saillance des danmu, tout en contrôlant le niveau de compétence des participants. Les corrélations entre prédicteurs, les diagnostics d'inflation de la variance, les intervalles de confiance à 95 %, les estimations de la taille de l'effet et les indices d'ajustement du modèle ont été inclus afin d'améliorer la transparence statistique.
Enfin, la qualité de la traduction a été modélisée afin d'évaluer les contributions prédictives du moment des révisions et de la fonction des révisions par rapport à la fréquence globale des révisions. Le recouvrement entre les segments saillants de danmu et les segments de traduction à haut effort a été évalué à l'aide du quintile supérieur de chaque distribution, d'un indice composite normalisé d'effort et d'une analyse de recouvrement aléatoire. Aucune analyse factorielle exploratoire ni modélisation par équation structurelle n'a été réalisée. En conséquence, les figures accompagnant l'article sont présentées uniquement comme des résumés conceptuels, descriptifs ou fondés sur la régression.
Résultats
Profil général des séances de traduction
Les 72 participants ont tous terminé les trois tâches de traduction dans des conditions expérimentales standardisées, produisant 216 séances de traduction complètes. Après l'alignement des segments, le jeu de données analytique final comprenait 3 168 observations de segment-texte-participant. Le temps moyen d'achèvement de la tâche dans l'échantillon était de 998,4 s par texte, avec des différences nettes entre les groupes d'âge et les textes sources (Tableau 4 ; Figure 3). Ainsi, le manuscrit et les données associées soutiennent de manière cohérente une taille d'échantillon de n = 72 participants ; toutes les figures résumant des sous-ensembles doivent explicitement identifier ces sous-ensembles.
Les étudiants de quatrième année ont effectué les tâches de traduction plus rapidement et avec moins d'interruptions que les étudiants de deuxième année. Cette différence allait au-delà de la vitesse de traitement. La cohorte de quatrième année a également présenté des durées moyennes de première pause plus courtes, moins de longues pauses et un nombre total de révisions inférieur, tout en obtenant les scores de qualité de traduction les plus élevés. En revanche, les étudiants de deuxième année ont effectué le plus grand nombre de révisions, dont la plupart étaient des modifications superficielles et des corrections locales immédiates. Les étudiants avancés ont démontré une proportion plus élevée de révisions différées et de révisions liées à l'adaptation culturelle, indiquant que la performance supérieure en traduction était associée à des stratégies de révision sélectives plutôt qu'à un volume plus important de révisions.
Les différences entre les trois textes sources étaient tout aussi marquées. Le texte A a produit les temps de complétion les plus courts, le plus faible nombre de longues pauses et la densité de révision la plus basse. Les textes B et C ont tous deux imposé des exigences de traitement plus importantes, bien que par des mécanismes différents. Le texte B a provoqué le plus grand nombre d'événements de révision liés à la culture, tandis que le texte C a entraîné la fréquence la plus élevée de révisions au niveau du discours et la durée moyenne de pause intra-segment la plus longue. Ainsi, l'origine de la difficulté de traitement variait selon les textes. Dans le texte B, la difficulté se concentrait autour des références culturelles et des présupposés implicites, alors que dans le texte C, elle était principalement associée à la compression narrative et au positionnement évaluatif.
Une analyse de variance à un facteur a confirmé des différences significatives entre les groupes d'années en matière de qualité globale de la traduction, F (2, 69) = 31,84, p < 0,001, avec une taille d'effet importante (η2 ≈ 0,48 basée sur les scores moyens par participant). Des comparaisons a posteriori ont montré que les étudiants de quatrième année obtenaient des scores significativement plus élevés que ceux de troisième année, qui à leur tour surpassaient les étudiants de deuxième année. Le même schéma a été observé pour la durée du premier arrêt, la fréquence des longues pauses et le ratio de révision différée. Pris ensemble, ces résultats préliminaires établissent deux points importants pour les analyses ultérieures. Premièrement, les trois textes source différaient par leur difficulté de traitement plutôt que simplement par leur contenu thématique. Deuxièmement, une qualité de traduction plus élevée était associée à une réorganisation des processus de traduction plutôt qu'à une simple réduction de l'effort de traitement.
Effets de la saillance textuelle sur la prise de décision et les comportements de révision
Afin de déterminer si les propriétés textuelles au niveau du segment prédisaient l'effort de traitement, des modèles à effets mixtes ont été estimés pour la durée de la première pause, la fréquence des longues pauses, la densité totale de révisions et la densité des révisions différées. La charge culturelle, la densité évaluative, la compression narrative et la saillance des danmu ont été introduites comme effets fixes, les participants et les segments étant inclus comme intercepts aléatoires (Tableau 5 ; Figure 4). L'analyse préalable des prédicteurs a confirmé l'absence de multicolinéarité problématique, tous les facteurs d'inflation de la variance (VIF) étant nettement inférieurs au seuil conservateur de 2,5 (VIF maximal = 1,45). Pour évaluer l'ajustement du modèle et la proportion de variance expliquée, les valeurs de R2 marginales et conditionnelles ont été calculées pour tous les modèles à effets mixtes (R2 marginal variant de 0,08 à 0,19 ; R2 conditionnel variant de 0,46 à 0,64). Les composantes complètes de la variance pour les effets aléatoires (intercepts des participants et des segments) ainsi que les indices correspondants d'ajustement du modèle sont détaillés dans le Tableau 5. Les estimations des coefficients sont interprétées conjointement avec leurs intervalles de confiance à 95 %, plutôt qu'avec les seules valeurs p.
La charge culturelle a présenté l'effet le plus fort et le plus constant dans tous les modèles. Dans le modèle du premier arrêt, chaque augmentation d'une unité du score de charge culturelle était associée à une augmentation de 0,91 s de la durée du premier arrêt (b = 0,91, SE = 0,12, IC à 95 % [0,67, 1,15], p < 0,001). La charge culturelle augmentait également de manière significative la fréquence des longues pauses (b = 0,19, SE = 0,04, IC à 95 % [0,11, 0,27], p < 0,001) et la densité totale de révision (b = 0,27, SE = 0,06, IC à 95 % [0,15, 0,39], p < 0,001). Ainsi, les segments chargés culturellement retardaient non seulement le traitement initial, mais augmentaient aussi la probabilité de reformulation ultérieure.
La compression narrative a révélé un effet tout aussi robuste mais distinct. Elle constituait un prédicteur puissant de la révision au niveau du discours (b = 0,31, SE = 0,07, IC à 95 % [0,17, 0,45], p < ,001) et augmentait significativement la durée moyenne des pauses au sein des segments (b = 0,58, SE = 0,14, IC à 95 % [0,31, 0,85], p < ,001). En termes pratiques, les segments qui condensaient de nombreuses informations contextuelles en de courtes portions textuelles avaient moins tendance à provoquer un remplacement lexical immédiat et étaient plus susceptibles de nécessiter une réorganisation structurelle plus large.
La densité évaluative a également contribué de manière significative, bien que son effet principal se soit manifesté sur la révision différée plutôt que sur la latence de la décision initiale. Dans le modèle de révision différée, la densité évaluative a produit un coefficient positif (b = 0,23, SE = 0,05, IC à 95 % [0,13, 0,33], p < ,001). Son effet sur la durée de la première pause était relativement modeste (b = 0,34, SE = 0,13, IC à 95 % [0,09, 0,59], p = 0,010). Ces résultats suggèrent que les indices évaluatifs n'étaient pas toujours perçus comme des goulots d'étranglement lors du traitement initial. Au lieu de cela, ils devenaient fréquemment problématiques uniquement après la production d'un premier brouillon, incitant les traducteurs à revenir sur des questions de positionnement, de ton ou d'adéquation narrative.
La saillance des danmu est restée un prédicteur significatif après contrôle des variables internes au texte. Elle a prédit de manière significative à la fois la durée de la première pause (b = 0,36, SE = 0,14, IC à 95 % [0,09, 0,63], p = 0,011) et la densité totale de révision (b = 0,17, SE = 0,06, IC à 95 % [0,05, 0,29], p = 0,006). Bien que sa taille d'effet soit inférieure à celles de la charge culturelle et de la compression narrative, sa contribution constante suggère que les segments attirant une plus grande attention du public dans le corpus de danmu ont également tendance à nécessiter un effort de traitement plus important lors de la traduction. Ce résultat est interprété comme une preuve convergente de la saillance sémantique, plutôt que comme une preuve que la fréquence des danmu cause directement la difficulté de traduction.
Comportement lors de la révision et qualité de la traduction
Des analyses ultérieures ont examiné si la qualité de la traduction était mieux expliquée par la quantité globale de révisions ou par leurs caractéristiques temporelles et fonctionnelles. Le modèle de qualité (Tableau 5) a produit un schéma clair de résultats. Le nombre total de révisions ne prédisait pas de manière significative la qualité de la traduction (b = 0,04, IC 95 % [-0,06, 0,14], p = 0,412), tandis que le moment des révisions et la fonction des révisions étaient tous deux des prédicteurs significatifs. Plus précisément, le ratio de révisions différées (b = 1,12, IC 95 % [0,39, 1,85], p = 0,003), les révisions au niveau du discours (b = 1,76, IC 95 % [0,96, 2,56], p < 0,001) et les révisions d'adaptation culturelle (b = 2,04, IC 95 % [1,14, 2,94], p < 0,001) étaient tous positivement associés à la qualité de la traduction. En revanche, les révisions superficielles présentaient une faible association négative mais statistiquement significative (b = -0,63, IC 95 % [-1,18, -0,08], p = 0,028).
Ces résultats indiquent que la quantité de révisions seule ne permet pas de distinguer une reformulation productive d'une rédaction instable (Figure 5). L'analyse qualitative des scripts de traduction appuie cette interprétation. Dans les traductions moins bien notées, les révisions avaient tendance à se concentrer sur des substitutions lexicales locales et des corrections grammaticales, sans toutefois résoudre les divergences plus profondes entre les indices narratifs chinois et le cadre rhétorique anglais. Dans les traductions mieux notées, les révisions tardives impliquaient fréquemment une réorganisation de la structure de l'information, une explicitation sélective ou un ajustement du langage évaluatif afin d'améliorer l'accessibilité pour un lectorat international. Des commentaires traduits représentatifs de type danmu — tels que « cette expression est très chinoise », « le contexte doit être expliqué » et « le public étranger risque de ne pas comprendre cette référence » — illustrent les types de préoccupations culturellement marquées du public associées aux groupes de segments correspondants. Ces exemples sont présentés uniquement pour faciliter l'interprétation et ne doivent pas être interprétés comme une preuve des intentions des participants.
Recouvrement entre la saillance des danmu et les goulots d'étranglement de la traduction
L'analyse finale a examiné si les segments publiquement saillants dans le corpus de danmu coïncidaient avec ceux qui entraînaient le plus grand effort de traitement pendant la traduction. Un indice composite d'effort a été calculé pour chaque segment en standardisant et en additionnant la durée de la première pause, la fréquence des longues pauses et la densité de révision. Les 20 % de segments supérieurs selon cet indice composite d'effort ont ensuite été comparés aux 20 % supérieurs classés par saillance du danmu.
Le chevauchement était important : six des neuf segments les plus exigeants figuraient également parmi les neuf segments les plus saillants en termes de danmu, ce qui correspond à un taux de chevauchement de 66,7 %. Étant donné que la comparaison par quintile supérieur concernait uniquement neuf segments, l'intervalle de confiance de Wilson était relativement large (IC à 95 % d'environ 35,4 % à 87,9 %). Néanmoins, une analyse exacte du chevauchement aléatoire a indiqué qu'un chevauchement de six segments ou plus serait peu probable dans une répartition aléatoire (p ≈ ,001). Au niveau des segments, la saillance des danmu était positivement corrélée à l'indice composite d'effort (rho de Spearman = 0,41, p = 0,006). La plupart des segments en chevauchement se situaient dans les textes B et C et portaient sur des références ancrées dans la culture, l'entrepreneuriat numérique et des positions évaluatives. Ces résultats suggèrent que le discours public constitue un indicateur externe des moments où le sens narratif devient particulièrement saillant, bien que la relation demeure corrélative et non causale.
Pris ensemble, ces résultats démontrent que l'effort de traitement lors de la traduction de récits centrés sur la Chine est spécifique aux segments et principalement déterminé par la charge culturelle, la compression narrative et la densité évaluative. La qualité de la traduction dépend non pas du volume global de révision, mais de stratégies de révision différées, sensibles au discours et orientées culturellement. Enfin, l'alignement observé entre les segments de traduction à haut effort et les points narratifs saillants dans les danmu soutient une relation associative entre la saillance du public et l'effort de traitement du traducteur, sans impliquer que la saillance des danmu elle-même cause des difficultés de traduction.
DISPONIBILITÉ DES DONNÉES :
Toutes les données brutes, les fichiers de journalisation des frappes au clavier, les observations au niveau des segments traitées, les observations au niveau des sessions, les métadonnées des vidéos danmu et les 5 000 premiers commentaires danmu affichés sont fournis dans le classeur du jeu de données de réplication. Le fichier complet des commentaires danmu contient 18 642 commentaires et est déposé avec le lot de données. Le jeu de données est accessible via le dépôt Zenodo à l'adresse https://doi.org/10.5281/zenodo.19289665.
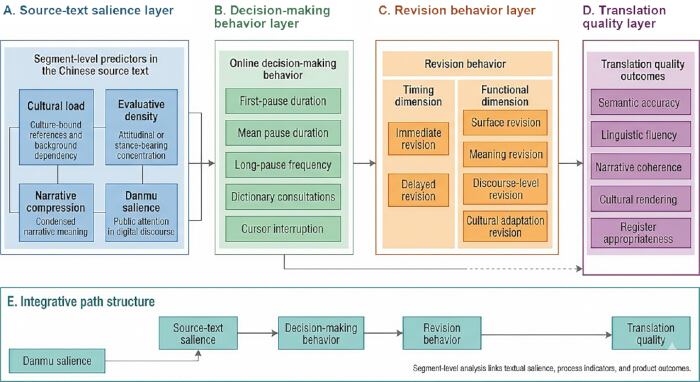
Figure 1: Cadre conceptuel de l'étude. (A) Prédicteurs textuels au niveau du segment, incluant la charge culturelle, la densité évaluative, la compression narrative et la saillance des danmu. (B) Indicateurs de processus utilisés pour opérationnaliser le comportement décisionnel en ligne, incluant la durée de la première pause, la durée moyenne des pauses, la fréquence des longues pauses, les consultations de dictionnaires et les interruptions du curseur. (C) Classification bidimensionnelle du comportement de révision selon le moment de la révision et sa fonction. (D) Cinq dimensions utilisées pour évaluer la qualité de la traduction : exactitude sémantique, fluidité linguistique, cohérence narrative, rendu culturel et adéquation du registre. (E) Cadre analytique global montrant les relations entre la saillance du texte source, le comportement décisionnel, le comportement de révision et la qualité de la traduction, la saillance des danmu servant d'indicateur externe de la prééminence sémantique auprès du public. Aucune analyse factorielle exploratoire (EFA) ni modélisation par équations structurelles (SEM) n’a été réalisée ni n’est présentée dans cette étude. Veuillez cliquer ici pour visualiser une version agrandie de cette figure.
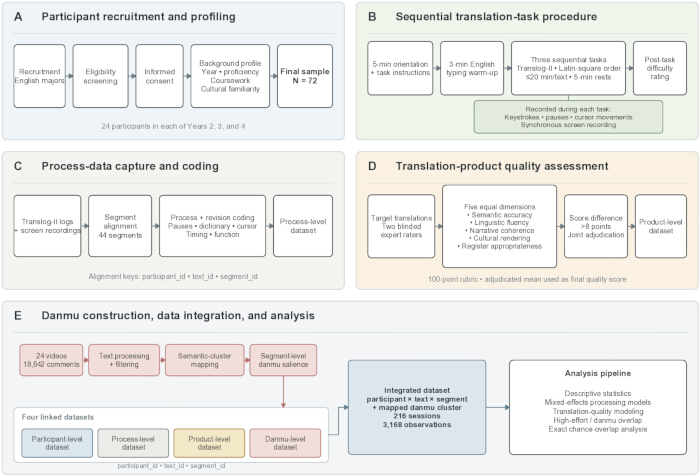
Figure 2: Flux de travail de la collecte des données et de l'alignement des données. (A) Recrutement des participants, dépistage de l'éligibilité, consentement éclairé et collecte des informations de base. (B) Administration des trois tâches de traduction dans Translog-II dans des conditions expérimentales standardisées. (C) Collecte des données de processus, incluant les frappes au clavier, les pauses, les mouvements du curseur, les épisodes de révision et les enregistrements synchronisés de l'écran. (D) Évaluation par des experts à l'aveugle des produits de traduction, suivie d'un arbitrage des divergences de notation. (E) Construction du corpus auxiliaire danmu et son alignement avec les jeux de données au niveau des participants, des textes, des segments, des processus et des produits afin de générer le jeu de données intégré final utilisé pour les analyses inférentielles. Veuillez cliquer ici pour visualiser une version agrandie de cette figure.
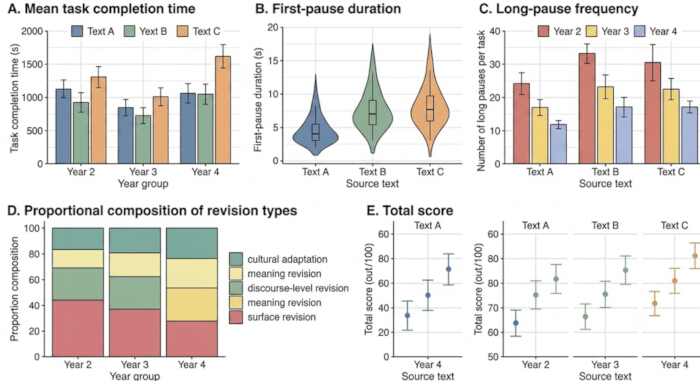
Figure 3: Répartition des mesures de processus et de produit selon les groupes d'année et les textes sources. (A) Temps moyen d'achèvement de la tâche selon le texte source et le groupe d'année. (B) Répartition de la durée de la première pause selon les trois textes sources. (C) Fréquence des longues pauses selon le texte source et le groupe d'année. (D) Répartition proportionnelle des catégories de révision selon les groupes d'année, incluant les révisions superficielles, les révisions de sens, les révisions au niveau du discours et les révisions d'adaptation culturelle. (E) Scores totaux de qualité de traduction par groupe d'année pour chaque texte source. Pris ensemble, les graphiques montrent que les niveaux d'année supérieurs sont associés à moins d'interruptions de traitement, à des stratégies de révision plus sélectives et à une qualité de traduction plus élevée, tandis que les textes B et C imposent des exigences de traitement plus importantes que le texte A. Veuillez cliquer ici pour visualiser une version agrandie de cette figure.
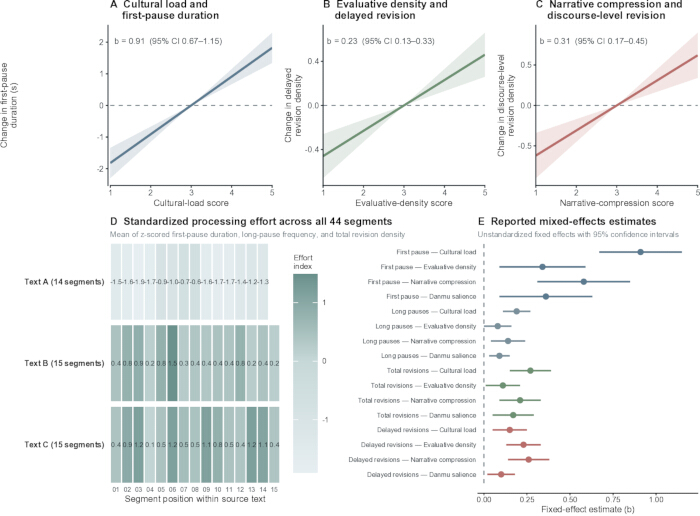
Figure 4: Effets de la saillance textuelle au niveau du segment sur le comportement du processus de traduction. (A) Effet marginal ajusté de la charge culturelle sur la durée de la première pause. (B) Effet marginal ajusté de la densité évaluative sur la densité des révisions différées. (C) Effet marginal ajusté de la compression narrative sur la densité des révisions au niveau du discours. (D) Carte thermique de l'indice normalisé d'effort de traitement pour tous les segments du texte source, regroupés par texte source. (E) Coefficients normalisés des effets fixes estimés à partir des modèles de régression à effets mixtes. La figure montre que différentes caractéristiques textuelles activent des voies de traitement distinctes, la charge culturelle, la densité évaluative et la compression narrative contribuant à l'hésitation et à la révision selon des mécanismes partiellement différents. Veuillez cliquer ici pour visualiser une version agrandie de cette figure.
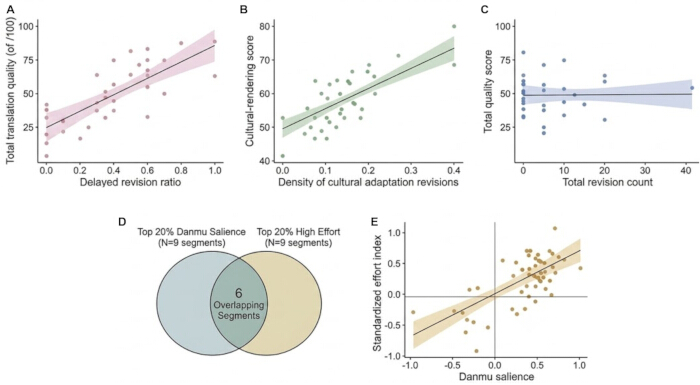
Figure 5 : Relations entre le processus de traduction, la qualité de la traduction et la saillance des danmu. (A) Association entre le ratio de révision différée et le score total de qualité de traduction. (B) Relation entre les révisions portant sur l'adaptation culturelle et le score d'interprétation culturelle. (C) Association entre le nombre total de révisions et la qualité globale de la traduction, démontrant la valeur prédictive limitée de la quantité de révisions prise isolément. (D) Chevauchement entre les 20 % de segments les plus saillants en termes de danmu et les 20 % de segments de traduction les plus exigeants en effort. (E) Association au niveau segment entre la saillance des danmu et l'indice normalisé d'effort de traitement. Pris ensemble, ces graphiques montrent que la performance réussie en traduction est associée à une révision ciblée fonctionnellement et stratégiquement temporelle, plutôt qu'au volume de révisions seul, et que les segments narratifs saillants pour le public coïncident également souvent avec des goulots d'étranglement en traduction. Veuillez cliquer ici pour visualiser une version agrandie de cette figure.
| ID du texte | Sujet narratif | Caractères chinois | Nombre de segments | Note de charge culturelle (1–5) | Note de densité évaluative (1–5) | Note de compression narrative (1–5) | Difficulté prévue | Note de validation |
| Texte A | Récit du retour au pays pour la Fête du Printemps | 212 | 14 | 3 | 2 | 3 | Moyenne | Testé en avant-première avec 12 étudiants non participants |
| Texte B | Récit de souvenir de la Fête des bateaux-dragons | 219 | 15 | 5 | 3 | 4 | Élevée | Testé en avant-première avec 12 étudiants non participants |
| Texte C | Récit sur la diffusion en direct en milieu rural et le développement du village natal | 223 | 15 | 4 | 5 | 4 | Élevée | Testé en avant-première avec 12 étudiants non participants |
Tableau 1 : Profil du texte source et structure des segments.
| Variable | Niveau | Définition opérationnelle | Unité de mesure |
| Durée de la première pause | Segment | Temps écoulé entre le début du segment et la première frappe pertinente dans la langue cible | Secondes |
| Durée moyenne des pauses intra-segment | Segment | Durée moyenne de toutes les pauses survenues au sein du segment | Secondes |
| Fréquence des longues pauses | Segment | Nombre de pauses supérieures à 2 secondes | Nombre |
| Consultations de dictionnaire | Segment | Nombre d'ouvertures de fenêtres de dictionnaire pendant le traitement du segment | Nombre |
| Interruptions du curseur | Segment | Nombre de déplacements du curseur hors du flux linéaire de rédaction avant l'achèvement stable du segment | Nombre |
| Révision immédiate | Segment | Révision effectuée avant que la rédaction ne progresse au-delà de la zone textuelle courante | Nombre / densité |
| Révision différée | Segment | Révision effectuée après que la rédaction a progressé vers une zone textuelle ultérieure | Nombre / densité |
| Révision de surface | Fonction de révision | Correction au niveau de la forme sans changement sémantique | Nombre / densité |
| Révision de sens | Fonction de révision | Modification lexicale ou syntaxique affectant l'expression du sens | Nombre / densité |
| Révision au niveau du discours | Fonction de révision | Ajustement des relations entre propositions, de la cohérence ou de l'ordre de l'information | Nombre / densité |
| Révision d'adaptation culturelle | Fonction de révision | Reformulation ou explicitation orientée vers le public cible, portant sur un sens lié à la culture | Nombre / densité |
| Indice composite d'effort | Segment | Composite standardisé de la durée de la première pause, de la fréquence des longues pauses et de la densité de révision | z-score |
| Pertinence des Danmu | Segment / regroupement sémantique | Indicateur pondéré de regroupement sémantique basé sur la fréquence normalisée des regroupements de mots-clés, la concentration des commentaires et l'intensité évaluative | Score continu |
Tableau 2 : Définitions opérationnelles des variables du processus.
| Exactitude sémantique | Échelle de notation | Objectif de la notation |
| Exactitude sémantique | 1-20 | Fidélité au sens source, précision du contenu transféré et absence de distorsion majeure |
| Fluidité linguistique | 1-20 | Grammaticalité, naturel, idiomaticité et lisibilité au niveau de la phrase |
| Cohérence narrative | 1-20 | Flux de l'information, liaison des propositions, progression et stabilité du texte |
| Rendu culturel | 1-20 | Traitement des références culturelles, explicitation, cadre et accessibilité interprétative |
| Adéquation au registre | 1-20 | Adaptation au lectorat visé, pertinence stylistique et maîtrise du ton |
Tableau 3 : Grille d'évaluation de la qualité de la traduction.
| Section | Variable | Année 2 (n = 24), moyenne ± ÉT | Année 3 (n = 24), moyenne ± ÉT | Année 4 (n = 24), moyenne ± ÉT |
| Profil de session au niveau des participants | Durée d'achèvement de la tâche (sec) | 1070.84 ± 18.22 | 996.59 ± 20.08 | 927.76 ± 19.91 |
| Profil de session au niveau des participants | Durée moyenne de la première pause (sec) | 7,09 ± 0,50 | 6,65 ± 0,40 | 6,38 ± 0,41 |
| Profil de session au niveau des participants | Fréquence des longues pauses par tâche | 21,04 ± 0,32 | 18,47 ± 0,30 | 16,31 ± 0,19 |
| Profil de session au niveau des participants | Nombre total de révisions par tâche | 28,65 ± 2,87 | 26,24 ± 2,63 | 24,59 ± 2,42 |
| Configuration des révisions | Proportion de révisions différées | 0,45 ± 0,01 | 0,54 ± 0,01 | 0,63 ± 0,01 |
| Configuration des révisions | Proportion de révisions au niveau du discours | 0,37 ± 0,01 | 0,40 ± 0,01 | 0,45 ± 0,01 |
| Configuration des révisions | Proportion de révisions d'adaptation culturelle | 0,38 ± 0,01 | 0,42 ± 0,00 | 0,48 ± 0,01 |
| Configuration des révisions | Proportion de révisions superficielles | 0,04 ± 0,00 | 0,02 ± 0,00 | 0,00 ± 0,00 |
| Qualité du produit | Note globale de qualité | 77,82 ± 4,65 | 84,03 ± 4,44 | 88,27 ± 4,56 |
| Qualité du produit | Note de restitution culturelle | 77,73 ± 4,49 | 83,95 ± 4,85 | 88,18 ± 4,86 |
Tableau 4 : Statistiques descriptives des variables de procédé et de produit.
| Variable dépendante | Prédicteur | b | ER | IC à 95 % | t/z | p |
| Durée de la première pause | Charge culturelle | 0.91 | 0.12 | [0.67, 1.15] | 7.58 | < 0.001 |
| Durée de la première pause | Densité évaluative | 0.34 | 0.13 | [0.09, 0.59] | 2.62 | 0.01 |
| Durée de la première pause | Compression narrative | 0.58 | 0.14 | [0.31, 0.85] | 4.14 | < 0.001 |
| Durée de la première pause | Prégnance des Danmu | 0.36 | 0.14 | [0.09, 0.63] | 2.55 | 0.011 |
| Fréquence des longues pauses | Charge culturelle | 0.19 | 0.04 | [0.11, 0.27] | 4.75 | < 0.001 |
| Fréquence des longues pauses | Densité évaluative | 0.08 | 0.04 | [0.00, 0.16] | 2 | 0.046 |
| Fréquence des longues pauses | Compression narrative | 0.14 | 0.05 | [0.04, 0.24] | 2.8 | 0.005 |
| Fréquence des longues pauses | Prégnance des Danmu | 0.09 | 0.03 | [0.03, 0.15] | 3 | 0.003 |
| Densité totale de révision | Charge culturelle | 0.27 | 0.06 | [0.15, 0.39] | 4.5 | < 0.001 |
| Densité totale de révision | Densité évaluative | 0.11 | 0.05 | [0.01, 0.21] | 2.2 | 0.028 |
| Densité totale de révision | Compression narrative | 0.21 | 0.06 | [0.09, 0.33] | 3.5 | < 0.001 |
| Densité totale de révision | Prégnance des Danmu | 0.17 | 0.06 | [0.05, 0.29] | 2.75 | 0.006 |
| Densité de révision différée | Charge culturelle | 0.15 | 0.05 | [0.05, 0.25] | 3 | 0.003 |
| Densité de révision différée | Densité évaluative | 0.23 | 0.05 | [0.13, 0.33] | 4.6 | < 0.001 |
| Densité de révision différée | Compression narrative | 0.26 | 0.06 | [0.14, 0.38] | 4.33 | < 0.001 |
| Densité de révision différée | Prégnance des Danmu | 0.1 | 0.04 | [0.02, 0.18] | 2.5 | 0.013 |
| Note de qualité totale | Révisions totales | 0.04 | 0.05 | [-0,06, 0,14] | 0,82 | 0,412 |
| Note de qualité totale | Rapport de révision différée | 1,12 | 0,37 | [0,39, 1,85] | 3,03 | 0,003 |
| Note de qualité totale | Révisions au niveau du discours | 1,76 | 0,41 | [0,96, 2,56] | 4,29 | < 0,001 |
| Note de qualité totale | Révisions d'adaptation culturelle | 2,04 | 0,46 | [1,14, 2,94] | 4,43 | < 0,001 |
| Note de qualité totale | Révisions superficielles | -0,63 | 0,28 | [-1,18, -0,08] | -2,25 | 0,028 |
| Note de qualité totale | Groupe d'année | 3,48 | 0,69 | [2,13, 4,83] | 5,04 | < 0,001 |
Tableau 5 : Modèles à effets mixtes prédisant le comportement du processus au niveau des segments et la qualité de la traduction.
Discussion
Les résultats actuels démontrent que la difficulté de la traduction du chinois vers l'anglais des récits centrés sur la Chine n'est pas uniformément répartie dans un texte. Elle se concentre plutôt dans les segments où convergent les références culturelles, les positions évaluatives et les significations narratives condensées. Cela soutient une conception fondée sur les processus, plutôt que sur un déficit lexical, de la difficulté de traduction. La recherche empirique sur les processus de traduction souligne que la traduction est une activité temporellement organisée, dans laquelle l'hésitation, l'orientation et la production sont inégalement réparties19. La concentration d'effort observée dans cette étude reflète la manière dont certains segments spécifiques exercent une pression interprétative plus forte, perturbant la rédaction linéaire plus profondément que d'autres. Les tests d'hypothèses peuvent être résumés comme suit : l'hypothèse H1 a été confirmée, car la charge culturelle augmentait l'hésitation initiale et la densité de révision ; l'hypothèse H2 a été affinée, car la densité évaluative et la compression narrative agissaient par des voies de révision différentes ; l'hypothèse H3 a été confirmée, car le moment et la fonction des révisions prédisaient la qualité plus fortement que le nombre total de révisions ; et l'hypothèse H4 a été confirmée comme un recoupement associatif entre la saillance des danmu et les segments à haut effort, et non comme une relation causale.
En ce qui concerne le comportement de révision, les données montrent que le nombre total de révisions ne permet pas de prédire la qualité de la traduction ; en revanche, les révisions différées, celles portant sur le niveau du discours et celles relatives à l'adaptation culturelle sont les principaux facteurs d'une meilleure performance. Cette distinction suggère que la révision n'est productive que lorsqu'elle est effectuée comme une réévaluation structurée, plutôt que comme une succession de corrections locales. Conformément aux recherches utilisant le suivi oculaire et l'enregistrement des frappes au clavier, qui indiquent que les traducteurs débutants répartissent leurs efforts différemment lorsque les tâches deviennent difficiles, les étudiants les plus performants dans cette étude n'étaient pas simplement plus actifs7. Ils interrompaient de manière sélective des solutions provisoires, les réévaluaient à des étapes ultérieures et orientaient leurs révisions vers la cohérence narrative ou culturelle. Par conséquent, les notes attribuées au produit final ne suffisent pas à expliquer la performance des traducteurs, puisque des notes finales comparables résultent souvent de trajectoires de traitement très différentes9.
Ce phénomène s'interprète mieux à la lumière de la conversion de l'effort. Dans les traductions moins bien notées, l'effort cognitif restait bloqué au niveau local : les étudiants s'arrêtaient, remplaçaient des éléments lexicaux ou ajustaient des articles, sans toutefois résoudre les divergences plus profondes entre les implications du texte source et la formulation du texte cible. En revanche, les scripts les mieux notés montraient un effort converti en décisions structurelles optimisant le texte pour le lecteur cible. En parallèle avec les recherches sur la performance des étudiants en post-édition, ces résultats confirment que l'effort de traitement n'est pas automatiquement bénéfique ; sa valeur dépend de sa conversion en améliorations textuelles compréhensibles20.
De plus, différentes propriétés textuelles activent des mécanismes de traitement distincts. La charge culturelle augmentait de manière fiable l'hésitation précoce et la densité de révision, tandis que la compression narrative prédisait fortement la révision au niveau du discours. Cette distinction permet de comprendre pourquoi les passages difficiles se manifestent différemment au cours du processus de traduction : certains perturbent l'accès cognitif dès le stade initial de formulation, tandis que d'autres ne deviennent problématiques qu'au moment de maintenir la cohérence sur de plus longs segments de discours. Conformément aux études montrant que les textes difficiles produisent des unités de traitement plus petites et des interruptions plus denses, ces résultats soulignent comment les significations culturelles et évaluatives compressées obligent les traducteurs à osciller entre l'expression locale et la structuration narrative globale8.
Une contribution méthodologique importante de cette étude est l'intégration de la saillance des danmu comme couche du discours du public. Le chevauchement important entre les segments de traduction exigeant un effort élevé et les segments saillants en matière de danmu indique que les goulots d'étranglement rencontrés par les étudiants coïncident souvent avec des points attirant une attention accrue du public dans la diffusion numérique. Ceci relie la difficulté de traduction au discours participatif sans confondre ces deux concepts. Les commentaires en danmu révèlent ce que les publics remarquent ou contestent dans la circulation médiatisée par vidéo, tandis que les enregistrements de frappes au clavier et de révisions montrent comment les traducteurs étudiants traitent les segments du texte source sémantiquement liés. L'interprétation la plus plausible est donc celle d'un facteur de signal commun : les références chargées culturellement, les présupposés implicites condensés et les positions évaluatives peuvent simultanément attirer l'attention du public et augmenter la pression de traitement pour le traducteur21.
Sur le plan pédagogique, ce recouvrement indique que les récits centrés sur la Chine circulent dans des contextes où le sens est négocié publiquement et rapidement, selon des priorités concurrentes telles que l'immédiateté, la compréhensibilité et l'adaptation au public cible22. Par conséquent, la formation des traducteurs doit évoluer : il ne s'agit plus de considérer la révision comme une simple étape de relecture générique, mais de privilégier des interventions fonctionnelles et stratégiques dans le temps. Les goulots d'étranglement observés n'étaient que rarement dus à la terminologie seule ; ils apparaissaient lorsque le sens du récit reposait sur des présupposés culturellement ancrés, des cadres relationnels et un accès sélectif du public. De façon analogue à la diffusion de la littérature narrative ethnique chinoise, la traduction de ces récits exige de dépasser la fidélité lexicale afin de déterminer comment le sens culturel local doit être restructuré pour une diffusion mondiale plus large23. Cette méthode peut être appliquée dans la formation des traducteurs en utilisant des journaux de frappe, des enregistrements d'écran et des exemples de discours destinés à un public donné, afin d'aider les étudiants à identifier les segments nécessitant une explicitation, un réarrangement, un encadrement culturel ou un ajustement de registre, plutôt qu'un simple remplacement lexical.
Plusieurs limites restreignent l'interprétation de ces résultats. Premièrement, la saillance des danmu est un indicateur sémantique regroupé servant de substitut à l'engagement du public, et non une mesure directe de la difficulté linguistique ; par ailleurs, la conception corrélative actuelle ne permet pas d'établir un lien de causalité entre la saillance publique et l'effort de traduction. De futures recherches pourraient manipuler expérimentalement la charge culturelle, la densité évaluative et la compression narrative afin de tester les voies causales. Deuxièmement, l'échantillon est restreint à des traducteurs en formation provenant d'une seule université, et l'expérience des participants, leur familiarité culturelle et leur niveau de compétence en langue seconde ont été contrôlées par des méthodes statistiques plutôt que par un échantillonnage pleinement stratifié. Une réplication impliquant des traducteurs professionnels, des étudiants provenant de plusieurs établissements et des groupes aux niveaux de compétence plus larges renforcerait la généralisabilité des résultats. Troisièmement, les textes sources ont été élaborés par les chercheurs et testés préalablement afin de calibrer la tâche, mais les études futures devraient inclure une validation supplémentaire à l'aide de textes publics authentiques et de comités indépendants chargés de la conception des supports. Quatrièmement, le codage de la charge culturelle, de la densité évaluative, de la compression narrative et des fonctions de révision repose sur des définitions opérationnelles transparentes, des enregistrements indépendants des codeurs et une fiabilité inter-juges vérifiable, en complément du fichier de codage validé. De futures recherches pourraient également combiner l'enregistrement des frappes au clavier avec le suivi oculaire, des entretiens rétrospectifs, des protocoles de verbalisation ou des tâches de post-édition afin de trianguler les mécanismes cognitifs sous-jacents aux décisions de révision.
En définitive, cette étude clarifie la base processuelle de la performance des étudiants dans la traduction du chinois vers l'anglais de récits centrés sur la Chine. En reliant les données issues de la frappe en continu, l'évaluation du produit final et le discours numérique du public, les résultats montrent que les goulots d'étranglement en traduction apparaissent aux points où le sens narratif revêt une charge publique. Le facteur déterminant dans la traduction interculturelle n'est pas le volume pur des révisions, mais la capacité du traducteur à identifier les segments nécessitant une restructuration interprétative et à retarder stratégiquement la finalisation jusqu'à ce qu'une solution stable et adaptée au public cible soit formulée.
Déclarations de divulgation
Les auteurs ont rien à divulguer.
Contributions des auteurs
Weijia Chen : Conception, méthodologie, analyse formelle, investigation, rédaction du projet original.
Chunming Wu : Conception de l'étude, encadrement concernant les analyses formelles et les procédures de traitement des données, ainsi qu'examen et commentaires sur les révisions en réponse aux observations des relecteurs.
Remerciements
Cette recherche a été financée par deux subventions de l'Université normale de Hanshan. Plus précisément, elle constitue un résultat intermédiaire du programme de 2023 relatif aux cours de premier cycle de niveau supérieur (cours en présentiel de niveau supérieur) intitulé « Théorie et pratique de la traduction chinois-anglais II » (n° d'approbation : YHS [2023] 172). En outre, cette étude a bénéficié du soutien du projet de qualité pédagogique et de réforme de l'enseignement 2025, désigné comme cours modèle pour l'éducation idéologique et politique intégrée au programme d'enseignement du cours « Traduction chinois-anglais » (n° d'approbation : YHSJ〔2025〕126). Les auteurs remercient sincèrement l'institution pour le soutien apporté à la réalisation de cette recherche.
Matériaux
| Nom | Entreprise | Numéro de catalogue | Commentaires |
|---|---|---|---|
| Corpus de commentaires danmu de Bilibili | Bilibili | 24 vidéos ; 18 642 commentaires ; https://www.bilibili.com | Construction du corpus auxiliaire de commentaires danmu et calcul de la saillance des segments au niveau des commentaires |
| Microsoft Excel | Microsoft Corporation | Excel 2021 ; https://www.microsoft.com/microsoft-365/excel | Nettoyage des données, organisation du codage et gestion préliminaire des données |
| R | Fondation R pour l'informatique statistique | R 4.3.1 ; https://www.r-project.org | Modélisation à effets mixtes, analyse de corrélation et génération de figures |
| Logiciel d'enregistrement d'écran | Poste de travail du laboratoire | Utilitaire local du poste de travail ; aucun numéro de catalogue | Vérification des épisodes de révision non linéaires et sauvegarde des données de processus |
| SPSS | IBM Corporation | SPSS Statistics 27.0 ; https://www.ibm.com/products/spss-statistics | Statistiques descriptives, ANOVA et analyses statistiques de base |
| Translog-II | École de gestion de Copenhague / CRITT | Translog-II ; https://sites.google.com/site/centretranslationinnovation/translog-ii | Enregistrement des frappes au clavier, des pauses, des déplacements du curseur et des épisodes de révision pendant les tâches de traduction |
Références
- Valdeón RA, Li S. Political discourse translation in contemporary Chinese and Western contexts. Translator. 2024;30(4):1-14.
- Du L, Afzaal M. Analyzing modality-mediated ideology in translated Chinese political discourses: An ideological square model approach. Humanit Soc Sci Commun. 2024;11:956.
- Carl M. Empirical translation process research: Past and possible future perspectives. Transl Cogn Behav. 2024;6(2):252-274.
- Qassem M, Al Thowaini BM. Cognitive processes and translation quality: Evidence from keystroke-logging software. J Psycholinguist Res. 2023;52(5):1589-1604.
- Carl M, et al. Hesitation, orientation, and flow: A taxonomy for deep temporal translation architectures. Ampersand. 2024;12:100164.
- Swar O, Mohsen M. Students' cognitive processes in L1 and L2 translation: Evidence from a keystroke logging program. Interact Learn Environ. 2023;31(10):6247-6263.
- Wang Y, Li S, Rasmussen YZ. Translators' allocation of cognitive resources in two translation directions: A study using eye-tracking and keystroke logging. Appl Sci. 2025;15(8):4401.
- Wang F, Xu Q. Processing of translation units by student and semi-professional translators in translating texts with different levels of translation difficulty. PLoS One. 2025;20(4):e0320809.
- Chen X, Yan JX. Examining student translators' writing and translation products: Quality, errors, and self-perceived mental workload. Interpret Transl Train. 2024;18(3):465-485.
- Dong D, Chen ML. Metacognitive strategies in translation: A comparative study of student and professional translators. Humanit Soc Sci Commun. 2025;12:890.
- Chen X, Yan JX. Investigating the processing effort in translation students' L2 writing and L2 translating: Evidence from keylogging. Humanit Soc Sci Commun. 2025;12:1810.
- Cao L, Doherty S, Lee JF. The process and product of translation revision: Empirical data from student translators using eye tracking and screen recording. Interpret Transl Train. 2023;17(4):548-565.
- Van Egdom GW, Schrijver I, Verplaetse H, Segers W. The impact of collaborative processes on target text quality in translator training. Interpret Transl Train. 2024;18(3):486-506.
- Riondel A. How to teach revision: Tips from an interview study. Interpret Transl Train. 2024;18(3):507-522.
- Lu S, Chen X. An experimental study on viewing perception and gratification of danmu subtitled online video streaming. J Spec Transl. 2024;42:217-238.
- Lei Y, Peng M, Han Y. Mistaken presuppositions and the translation of cultural texts: A study of two English translations of The Classic of Tea. Perspectives. 2025. doi:10.1080/0907676X.2025.2599854.
- Kim HR. Danmu as paratext: An exploratory study of paratextual functions in Chinese fan-subtitled videos. J Transl Stud. 2025;26(3):197-231.
- Wu X, Fitzgerald R. The danmu discourse of user engagement with cross-posted broadcast interviews in Chinese social media. Journalism. 2025;26(3):733-751.
- Yamada M, Carl M, Schaeffer MJ. Introduction to the special Ampersand issue on empirical translation process research. Ampersand. 2024;12:100179.
- Peng X, Wang X, Li X. When student translators meet with machine translation: The impacts of machine translation quality and perceived self-efficacy on post-editing performance. SAGE Open. 2024;14(4):21582440241291624.
- Yang Y. Making sense of the raw meat: A social semiotic interpretation of user translation on the danmu interface. Discourse Context Media. 2021;44:100550.
- Zeng D. Danmu subtitling as a self-regulative practice: A descriptive discourse analysis of Bilibili danmu subtitles from ethical perspectives. Front Psychol. 2025;16:1577260.
- Li Y, Cai X. The translation of ethnic literature: An analysis of the Chinese and English translations of the Yi folk narrative poem Ashima and their dissemination. Perspectives. 2025. doi:10.1080/0907676X.2025.2502935.