Un score d'apprentissage profond extrait de radiographies latérales thoracolombaires, combiné à des facteurs de risque cliniques, a permis une prédiction précise de fractures vertébrales incidentes dans un délai de deux ans. Le modèle validé en interne a montré une meilleure discrimination, calibration, reclassement et bénéfice décisionnel que le modèle clinique, soutenant ainsi des stratégies de stratification du risque individualisée et une prise en charge préventive précoce.
Article de recherche
Apprentissage profond des radiographies thoracolombaires de profil et facteurs de risque cliniques pour les fractures vertébrales incidentes : étude de cohorte rétrospective monocentrique
Dans cet article
Résumé
Résumé
L'identification précoce des patients à risque de fracture vertébrale incidente reste difficile, car l'évaluation clinique habituelle du risque ne reflète pas complètement la fragilité locale de la colonne vertébrale. Cette étude de cohorte rétrospective monocentrique a évalué si des caractéristiques issues de l'apprentissage profond (DL) extraites de radiographies latérales thoracolombaires initiales améliorent la prédiction de fracture vertébrale incidente dans les deux ans suivant l'examen, lorsqu'elles sont combinées à des facteurs de risque cliniques. Un total de 2 173 patients ont été inclus et répartis chronologiquement en une cohorte de développement (n = 1 449) et une cohorte de validation interne (n = 724). Les caractéristiques DL ont été extraites des radiographies initiales, et une régression de type LASSO-Cox a été utilisée pour sélectionner les prédicteurs et construire un modèle clinique, un modèle DL et un modèle combiné. Les performances ont été évaluées par correction de l'optimisme via bootstrap, validation interne temporelle, calibration, analyse de courbe décisionnelle, amélioration nette de reclassement dépendant du temps (NRI), amélioration intégrée de la discrimination (IDI) et analyses de sensibilité. Parmi 2 048 caractéristiques DL candidates, 5 ont été retenues pour générer un score DL, qui est resté un prédicteur indépendant dans le modèle combiné (HR 1,64, IC 95 % 1,34–2,01 ; P < 0,001). Dans la validation interne, le modèle combiné a atteint un indice C de 0,759, une AUC à 2 ans de 0,774 et un score de Brier à 2 ans de 0,077, tous supérieurs au modèle clinique, avec une bonne calibration (ordonnée à l'origine 0,012 ; pente 0,972). Par rapport au modèle clinique, le modèle combiné a également amélioré le reclassement (NRI à 2 ans de 0,316 dans la cohorte de développement et de 0,241 dans celle de validation) et la discrimination (IDI à 2 ans de 0,047 et 0,033, respectivement ; tous les P < 0,01), tout en offrant un bénéfice net supérieur selon l'analyse de courbe décisionnelle. Les analyses de sensibilité étaient concordantes avec les résultats principaux. La combinaison de caractéristiques DL extraites de radiographies latérales thoracolombaires avec des facteurs de risque cliniques pourrait permettre une prédiction individualisée plus précise de la fracture vertébrale incidente dans les deux ans suivant l'examen.
Introduction
La fracture vertébrale est l'un des types de fractures de fragilité ostéoporotique les plus fréquents, en particulier dans la région thoracolombaire. Elle peut entraîner des douleurs chroniques, une perte de taille, une déformation cyphotique, une mobilité réduite, et augmenter le risque de refraction ainsi que d’un pronostic défavorable1. En pratique clinique, une proportion importante de patients ne présente pas de symptômes typiques avant la survenue de la fracture, et de nombreux cas ne sont détectés que lors d’examens d’imagerie de suivi, ce qui suggère que le fait de s’appuyer uniquement sur les symptômes ou sur un diagnostic rétrospectif rend difficile la réalisation d’un dépistage opportun des populations à haut risque2,3. L’évaluation actuelle du risque repose principalement sur des informations telles que l’âge, le sexe, l’indice de masse corporelle, les fractures de fragilité antérieures, le diabète, l’exposition aux glucocorticoïdes et la densité minérale osseuse, qui permettent de refléter le contexte de fragilité osseuse systémique, mais il est difficile de caractériser pleinement la fragilité structurelle locale et les anomalies mécaniques de la colonne thoracolombaire, ce qui constitue également une difficulté majeure persistante dans la prédiction du risque de nouvelle fracture vertébrale4. La radiographie latérale thoracolombaire est l’un des examens d’imagerie rachidienne les plus couramment utilisés et accessibles en pratique clinique. Elle permet non seulement de visualiser la morphologie vertébrale, mais peut également révéler des phénotypes occultes associés à un risque futur de fracture, tels que des modifications des plateaux vertébraux, une trame osseuse clairsemée, un léger aplatissement en coin ou un déséquilibre de l’alignement5. Les études antérieures se sont principalement concentrées sur la détection des fractures vertébrales existantes, le diagnostic de l’ostéoporose ou l’évaluation du risque à l’aide d’indicateurs mesurés manuellement6,7. Des données récentes ont en outre montré que l’identification, par apprentissage profond, de fractures vertébrales prévalentes et d’ostéoporose sur des images latérales de la colonne vertébrale, combinée aux facteurs de risque cliniques, peut améliorer la prédiction des nouvelles fractures5 ; toutefois, les preuves restent limitées concernant la prédiction de nouvelles fractures vertébrales spécifiquement chez les patients sans fracture vertébrale cible au moment du diagnostic initial, à partir de radiographies latérales thoracolombaires de routine et de caractéristiques locales d’apprentissage profond (DL). Les méthodes d’intelligence artificielle ont été utilisées pour l’analyse d’imagerie rachidienne, mais les études directement axées sur ce scénario clinique spécifique restent rares, et l’évaluation systématique de la calibration, du bénéfice net issue de l’analyse décisionnelle et de la validation par division temporelle demeure insuffisante dans ce contexte8.
Par conséquent, il est difficile de répondre à une question cliniquement plus pertinente : les caractéristiques extraites par apprentissage profond à partir de radiographies latérales thoracolombaires de routine peuvent-elles fournir des informations supplémentaires indépendantes et significatives au-delà de l'évaluation clinique des risques9 ? Sur la base des éléments exposés ci-dessus, cette étude a adopté un dispositif de cohorte rétrospective monocentrique, extrait des caractéristiques issues de l'apprentissage profond à partir de radiographies latérales thoracolombaires, puis les a combinées aux facteurs de risque cliniques afin de construire un modèle de prédiction du risque de fracture vertébrale incidente dans les deux années suivantes. La discrimination, la calibration, la robustesse et la valeur clinique du modèle ont été évaluées par validation interne temporelle, correction de l'optimisme par rééchantillonnage bootstrap et analyse de sensibilité. Cette étude s'est concentrée sur l'alerte personnalisée au risque à partir de radiographies de routine, en intégrant des phénotypes d'images d'ostéoporose locale occulte et des informations cliniques systémiques de susceptibilité dans un outil de prédiction interprétable, afin de fournir une base pour l'identification des patients à haut risque, un suivi renforcé et des interventions préventives.
Protocole
Cette étude a été examinée et approuvée par le comité d'éthique médicale de l'hôpital populaire n°8 de Shanghai, Shanghai, Chine (numéro d'approbation 2026-102-03-02). Étant donné que cette étude était une étude rétrospective et que toutes les données avaient été désidentifiées avant l'analyse, le comité d'éthique a dispensé le consentement éclairé des patients.
Conception de l'étude :
Type d'étude
Cette étude était une étude de cohorte rétrospective monocentrique, et la base de données de l'étude a été établie à l'aide de données provenant du système de gestion et d'archivage d'images (PACS), du système d'information radiologique (RIS) et du système de dossier médical électronique de l'hôpital. La population étudiée comprenait des patients consécutifs ayant subi un examen radiographique numérique latéral du rachis thoracolombaire à l'hôpital. La période d'inclusion s'est étendue du 1er janvier 2018 au 31 décembre 2023, et la date limite de suivi était le 31 décembre 2025. Le rapport d'étude a suivi les recommandations TRIPOD+AI et STROBE afin d'assurer la standardisation des rapports d'études sur les modèles prédictifs impliquant l'intelligence artificielle et les études observationnelles.
Contexte de l'étude et source des cas
Les cas provenaient du processus habituel de diagnostic clinique et de traitement des patients externes, des patients aux urgences et des patients hospitalisés dans l'établissement. Les données d'imagerie provenaient toutes de fichiers DICOM originaux du système PACS, et les données cliniques provenaient des dossiers médicaux électroniques structurés, des systèmes de laboratoire et des dossiers de prescriptions. La date du premier examen radiographique latéral thoracolombaire répondant aux critères d'inclusion pendant la période d'étude a été définie comme la date de référence ; lorsqu'un même patient avait plusieurs examens satisfaisant aux critères, seul le plus ancien était conservé comme examen de référence afin d'éviter un double enrôlement. Toutes les données ont été désidentifiées avant l'analyse, et les informations d'imagerie et cliniques ont été appariées à l'aide d'un numéro d'identification d'étude unique.
Population étudiée :
Critères d'inclusion
Les critères d'inclusion étaient les suivants : âge de 50 ans ou plus ; réalisation d'un examen standard de radiographie numérique latérale thoracolombaire en position debout à l'hôpital pendant la période de l'étude ; imagerie de référence disponible en format DICOM traçable ; visualisation complète des vertèbres T10 à L4 sur l'imagerie de référence ; absence de fracture vertébrale préexistante entre T10 et L4 à l'analyse de l'imagerie de référence ; extraction possible des variables cliniques de base prédéfinies à partir des dossiers médicaux électroniques ; au moins un examen d'imagerie thoracolombaire de suivi par radiographie, tomodensitométrie (CT) ou imagerie par résonance magnétique (IRM) dans les 24 mois suivant l'examen de référence, ou survenue d'une fracture vertébrale nouvelle confirmée par imagerie dans les 24 mois.
Critères d'exclusion
Les critères d'exclusion étaient les suivants : fracture vertébrale de T10 à L4 au moment du début de l'étude ; antécédent certain de traumatisme violent à haute énergie au moment du début de l'étude ou pendant le suivi ; tumeur spinale primitive ou métastatique, infection spinale ou maladie osseuse destructive ; chirurgie antérieure de fixation interne thoracolombaire, vertébroplastie ou kyphoplastie ; scoliose avec un angle de Cobb supérieur à 30° ou déformation cyphosique évidente (y compris une cyphose de type Scheuermann, si présente), entraînant l'impossibilité d'identifier précisément les plateaux vertébraux de T10 à L4 ; artefact de mouvement marqué, exposition anormale, occultation métallique ou plage de visualisation insuffisante sur les images ; impossibilité de confirmer les variables clés au moment du début de l'étude ou les informations sur les résultats à partir des dossiers médicaux électroniques.
Processus de construction d'une cohorte rétrospective
Le dépistage de la population étudiée a été réalisé indépendamment par deux chercheurs selon des critères prédéfinis, et les désaccords ont été résolus par discussion afin d'aboutir à un consensus. Une fois le dépistage des cas terminé, un regroupement en séries chronologiques a été effectué selon la date de référence : les patients inclus du 1er janvier 2018 au 31 décembre 2021 ont constitué la cohorte de construction pour la sélection des caractéristiques et l'élaboration du modèle ; les patients inclus du 1er janvier 2022 au 31 décembre 2023 ont constitué la cohorte de validation interne pour l'évaluation des performances du modèle. La division temporelle, plutôt qu'une division aléatoire, permet de réduire le risque de fuite d'information et se rapproche davantage du scénario réel d'application du modèle chez des patients ultérieurs. Le processus de sélection de la population étudiée est présenté sous forme de diagramme de flux.
Résultat principal et sa détermination :
Définition du critère de jugement principal
Le critère de jugement principal de cette étude était la première fracture vertébrale de fragilité entre T10 et L4 survenant dans les 24 mois suivant le moment de référence. La fenêtre temporelle de prédiction de l'étude avait été prédéfinie à 2 ans, et le résultat du modèle était la probabilité individuelle de survenue d'une fracture vertébrale dans les 2 ans.
Critères pour la détermination d'une fracture vertébrale incidente
Une fracture vertébrale incidente était définie comme suit : par rapport aux images de référence, les images de suivi montraient une diminution de 20 % ou plus de la hauteur antérieure, moyenne ou postérieure de n'importe quel corps vertébral entre T10 et L4, avec une réduction absolue de hauteur d'au moins 4 mm, ou l'apparition d'un effondrement nouveau de la plaque terminale ou d'une interruption corticale10. La détermination du résultat a été effectuée de manière exhaustive à partir des radiographies de suivi du rachis thoracolombaire, de tomodensitométries (CT) et d'IRM. La lecture des images a été réalisée indépendamment par deux radiologues spécialisés en appareil locomoteur, ayant respectivement 8 ans et 12 ans d'expérience diagnostique pertinente, et aucun n'avait accès aux données cliniques ni aux résultats du modèle pendant la lecture des images ; en cas de désaccord, un troisième radiologue senior spécialisé en appareil locomoteur, disposant de 18 ans d'expérience, assurait l'arbitrage. Les fractures vertébrales causées par une tumeur, une infection ou un traumatisme à haute énergie n'étaient pas comptabilisées comme des événements d'issue.
Point de départ, point d'arrivée et fenêtre d'observation du suivi
Le point de départ du suivi était la date de l'examen radiographique latéral thoracolumbar de référence. Le point final du suivi était défini comme le plus précoce des événements suivants : la date du premier incident de fracture vertébrale, 24 mois après l'examen de référence, la date du dernier examen d'imagerie spinale confirmant l'absence de fracture vertébrale, ou la date du décès. Les fractures apparaissant pour la première fois après 24 mois n'ont pas été incluses dans le résultat principal. Les patients sans événement de résultat ont été considérés comme censurés.
Récolte des données cliniques et définition des variables cliniques candidates :
Données démographiques et cliniques générales
Les données cliniques de base ont été extraites du système de dossier médical électronique par deux chercheurs selon un formulaire de rapport de cas normalisé, sans examiner les résultats de la détermination des issues pendant l'extraction. Les données démographiques et cliniques générales recueillies comprenaient l'âge, le sexe, la taille, le poids et l'indice de masse corporelle. L'âge correspondait à l'âge réel à la date de référence ; le poids et la taille provenaient de l'enregistrement le plus proche de la date de référence, dans un intervalle de 30 jours avant ou après celle-ci ; l'indice de masse corporelle était calculé comme le poids divisé par le carré de la taille, en kilogrammes par mètre carré.
Antécédents médicaux, utilisation de médicaments et données relatives au métabolisme osseux
Sur la base de la disponibilité clinique et de la généralisabilité du modèle, les facteurs de risque cliniques candidats suivants ont été prédéfinis pour inclusion : antécédents de fracture de fragilité, diabète sucré de type 2, arthrite rhumatoïde, utilisation chronique de glucocorticoïdes par voie orale et traitement anti-ostéoporotique au moment de l'inclusion. Les mesures normalisées de la densité minérale osseuse au moment de l'inclusion et le score FRAX n'ont pas été prédéfinis comme prédicteurs candidats, car ils n'étaient pas systématiquement disponibles en tant que variables normalisées au moment de l'inclusion pour l'ensemble de la cohorte ; plusieurs facteurs cliniques liés au FRAX ont plutôt été considérés séparément comme variables candidates individuelles. Les antécédents de fracture de fragilité, le diagnostic de maladies sous-jacentes et les informations sur les médicaments ont tous été extraits des dossiers médicaux électroniques, des comptes rendus de sortie et des systèmes de prescription avant l'inclusion, et toutes les variables devaient exister avant l'inclusion afin de garantir que les prédicteurs précèdent temporellement l'événement cible.
Critères de définition des variables cliniques
Les antécédents de fracture fragilitaire ont été définis comme une fracture survenue après l'âge de 40 ans, provoquée par un traumatisme de faible énergie et clairement enregistrée dans le dossier médical ; les fractures du crâne, des os du visage, des doigts et des orteils n'étaient pas incluses dans cette définition. Le diabète de type 2 a été défini par un diagnostic clairement établi avant la période initiale, ou par une utilisation prolongée de médicaments hypoglycémiants. La polyarthrite rhumatoïde a été définie par un diagnostic précis établi par un spécialiste en rhumatologie dans le dossier médical. L'utilisation chronique de glucocorticoïdes par voie orale a été définie comme une dose équivalente de prednisone d'au moins 5 mg/j pendant au moins 3 mois au cours de l'année précédant la période initiale. Le traitement anti-ostéoporotique au moment initial a été défini comme l'utilisation continue de l'un des médicaments suivants — bisphosphonates, denosumab, téripapatide, raloxifène, calcitonine, alfacalcidol ou calcitriol — au cours des 3 mois précédant la période initiale, pendant une durée d'au moins 8 semaines. L'âge et l'indice de masse corporelle ont été considérés comme des variables continues dans les modèles statistiques et n'ont pas été artificiellement catégorisés.
Acquisition des données d'imagerie et prétraitement des images
Protocole d'acquisition de radiographies latérales thoracolombaires
Toutes les images de base étaient des radiographies latérales standard du rachis thoracolombaire réalisées en position debout, acquises par le système de radiographie numérique de l'hôpital. Lors de l'examen, les patients adoptaient une position naturelle debout, avec les deux membres supérieurs fléchis vers l'avant afin de réduire le recouvrement des épaules, et la zone d'imagerie couvrait T10 à L4. Un contrôle automatique de l'exposition a été utilisé pour l'examen, avec une tension du tube comprise entre 80 et 95 kV et une distance source-image de 110 cm. Chez le même patient, lorsqu'il existait plusieurs radiographies latérales admissibles à la date de référence, celle présentant une plage de visualisation complète et la meilleure qualité d'image était sélectionnée comme objet d'analyse.
Critères d'inclusion des images et contrôle de qualité
Les images de référence devaient satisfaire aux critères de qualité suivants : visualisation complète des vertèbres T10 à L4 et de leurs plateaux supérieur et inférieur ; contours antérieur et postérieur des vertèbres, plateaux et limites corticales bien définis ; absence d'artéfact de mouvement évident ; absence de surexposition ou sous-exposition sévère ; absence d'occlusion métallique sur une grande surface ; et absence de distorsion morphologique évidente due à une rotation de la position corporelle. Les images présentant des modifications dégénératives sévères ou des ostéophytes empêchant une identification fiable des contours vertébraux ou des plateaux étaient également exclues. Deux radiologues spécialisés en appareil musculosquelettique ont effectué l'évaluation de qualité de toutes les images de référence, et toute image ne satisfaisant pas à l'un des critères de qualité essentiels a été exclue.
Prétraitement et standardisation des images
Toutes les images DICOM ont été rendues anonymes avant l'analyse. Les étapes de prétraitement comprenaient l'unification de l'orientation des images, un rééchantillonnage à une résolution spatiale de 0,30 mm × 0,30 mm, la troncature des valeurs de niveaux de gris entre le 0,5e centile et le 99,5e centile, et la normalisation des valeurs des pixels à l'intervalle 0–1 à l'aide de la méthode de normalisation min-max. Le flux de travail de prétraitement ci-dessus a été maintenu identique pour la cohorte de développement et la cohorte de validation, et a été entièrement automatisé par des scripts prédéfinis afin de réduire les biais liés aux opérations manuelles.
Extraction de caractéristiques d'imagerie par apprentissage profond :
Détermination de la région d'intérêt
La région d'intérêt correspondait à la zone de projection latérale de la colonne vertébrale comprise entre la plaque supérieure de T10 et la plaque inférieure de L4. Un radiologue spécialisé en appareil locomoteur, possédant 8 ans d'expérience, a réalisé une annotation sous forme de boîte rectangulaire sur toutes les images de référence à l'aide du logiciel ITK-SNAP, en définissant la limite antérieure à 5 mm en avant de la marge antérieure du corps vertébral et la limite postérieure à 5 mm en arrière de la marge postérieure du corps vertébral11 ; un second radiologue spécialisé en appareil locomoteur, possédant 12 ans d'expérience, a ensuite examiné les images cas par cas. La région d'intérêt constituait une boîte rectangulaire au niveau régional, et non une segmentation stricte du contour vertébral ; par conséquent, les ostéophytes marginaux courants n'ont pas été retirés séparément et pouvaient être partiellement inclus s'ils se trouvaient à l'intérieur des limites prédéfinies, tandis que les cas présentant des modifications dégénératives suffisamment sévères pour masquer les marges vertébrales ou les plaques vertébrales avaient déjà été exclus lors de l'évaluation de la qualité des images. Afin d'évaluer la reproductibilité de l'annotation des régions, 50 images ont été sélectionnées aléatoirement et réannotées par le même radiologue après un délai de 4 semaines, puis réannotées indépendamment par le second radiologue, en vue d'une analyse ultérieure de la stabilité des caractéristiques. Après le recadrage de la région d'intérêt, toutes les images ont été redimensionnées uniformément à 224 × 224 pixels.
Architecture du modèle d'apprentissage profond et processus d'extraction de caractéristiques
Cette étude a utilisé le réseau neuronal convolutionnel ResNet50 comme extracteur de caractéristiques d'apprentissage profond. Les paramètres du réseau ont été initialisés avec des poids préentraînés sur ImageNet, et un processus d'adaptation de domaine auto-supervisé a été effectué sur toutes les images de ROI de base de la cohorte de dérivation, sans utiliser d'étiquettes de résultat pendant cette phase d'adaptation. Plus précisément, une tâche auto-supervisée contrastive a été mise en œuvre, dans laquelle deux vues augmentées indépendamment à partir d'une même image de ROI étaient considérées comme une paire positive, tandis que les vues provenant de patients différents au sein du même mini-lot étaient traitées comme des paires négatives, afin que l'encodeur puisse s'adapter à la distribution des images de l'étude. L'entraînement du modèle a utilisé l'optimiseur AdamW, avec un taux d'apprentissage initial fixé à 1 × 10^-4, une taille de lot de 64 et 200 époques d'entraînement ; durant l'entraînement, une augmentation des données a été réalisée avec une rotation de ±5°, un facteur de mise à l'échelle de 0,9 à 1,1, une translation de pas plus de 10 pixels et une perturbation du contraste de ±10%12. Ces augmentations ont été utilisées pour générer des paires de vues destinées à la tâche auto-supervisée, et seules les images non étiquetées de la cohorte de dérivation ont été utilisées à ce stade. Après l'adaptation de domaine, aucune réadaptation supervisée par les résultats n'a été effectuée, et l'encodeur principal adapté a été figé pour l'extraction de caractéristiques. Une fois l'adaptation de domaine terminée, le vecteur de 2 048 dimensions issu de la couche de moyennage global a été extrait comme caractéristiques candidates d'apprentissage profond pour chaque patient.
Préparation des caractéristiques d'imagerie et réduction de la dimensionnalité
Premièrement, le coefficient de corrélation intraclasse des caractéristiques a été calculé à partir des 50 images ayant fait l'objet d'annotations répétées, et les caractéristiques dont les coefficients ICC intra-observateur et inter-observateur étaient tous deux supérieurs ou égaux à 0,80 ont été conservées afin d'assurer la stabilité des caractéristiques face à de légères variations des régions d'intérêt. Ensuite, les caractéristiques retenues ont été standardisées selon le score Z dans la cohorte de modélisation, les caractéristiques de variance nulle ont été éliminées, et parmi les caractéristiques présentant un coefficient de corrélation par paires absolu supérieur à 0,90, une seule a été conservée. Enfin, une régression LASSO-Cox a été utilisée pour la sélection des caractéristiques, le paramètre de pénalité étant déterminé par une validation croisée en 10 parties selon le critère de 1-SE. Les caractéristiques dont les coefficients de régression étaient non nuls ont été pondérées puis additionnées selon leurs coefficients respectifs afin de construire le score d'apprentissage profond (score DL)13. Une fois cette formule de scoring établie dans la cohorte de modélisation, elle a été fixée sans modification et appliquée directement à la cohorte de validation interne.
Prétraitement et intégration des prédicteurs candidats :
Traitement des données manquantes et standardisation des données
Toutes les variables cliniques candidates ont été obtenues à partir de champs structurés du dossier médical. Les variables dont le taux de valeurs manquantes dépassait 20 % ont été exclues du processus de modélisation. Les valeurs manquantes restantes ont été traitées par imputation multiple par équations en chaîne, générant 10 jeux de données imputées ; le modèle d'imputation a intégré tous les prédicteurs candidats, la variable indicatrice de l'issue et l'estimation de la fonction de risque cumulée de Nelson-Aalen afin de préserver autant que possible l'information sur le délai jusqu'à l'événement. Les variables cliniques continues et le score DL ont été standardisés à l'aide de la moyenne et de l'écart-type de la cohorte de développement, et les mêmes paramètres de transformation ont été appliqués à la cohorte de validation ; les variables binaires ont été codées uniformément comme 0 ou 1.
Sélection des facteurs de risque cliniques
La prédéfinition des facteurs de risque cliniques candidats était fondée sur l'interprétabilité clinique, les preuves antérieures et la disponibilité des données, et aucun criblage basé sur la valeur P univariée n'a été utilisé. Les variables cliniques candidates introduites dans la sélection par régression LASSO-Cox étaient l'âge, le sexe, l'indice de masse corporelle, les antécédents de fracture de fragilité, le diabète de type 2, la polyarthrite rhumatoïde, l'utilisation chronique de glucocorticoïdes par voie orale et le traitement anti-ostéoporotique au moment de l'inclusion ; la taille et le poids ont été recueillis de manière descriptive et utilisés pour calculer l'indice de masse corporelle, mais n'ont pas été intégrés séparément dans la modélisation. La régression LASSO-Cox a été réalisée séparément sur les 10 jeux de données imputées de la cohorte de développement, et le paramètre de pénalité a été sélectionné par validation croisée en 10 parties ; les variables présentant des coefficients non nuls dans au moins 7 jeux de données imputées ont été retenues pour le modèle clinique final. L'âge et l'indice de masse corporelle ont tous deux été testés pour des relations non linéaires à l'aide de splines cubiques restreintes ; si le terme non linéaire n'était pas statistiquement significatif, la forme linéaire a été conservée. La multicolinéarité a été évaluée à l'aide du facteur d'inflation de la variance, et les variables présentant un facteur d'inflation de la variance supérieur à 5 n'ont pas été conservées simultanément.
Construction de l'ensemble de prédicteurs combiné
Pour éviter un surajustement dû à l'entrée directe de caractéristiques d'imagerie en haute dimension dans le modèle, les informations issues de l'apprentissage profond ont d'abord été compressées en une seule variable continue, le score DL, puis introduites conjointement dans un modèle combiné avec les facteurs de risque cliniques sélectionnés. Aucun terme d'interaction n'a été prédéfini dans le modèle combiné, afin de préserver la parcimonie et l'interprétabilité du modèle. L'ensemble final de prédicteurs combinés comprenait le score DL et les variables cliniques conservées.
Construction du modèle de prédiction des risques :
Stratégie de modélisation
Dans la cohorte de dérivation, le modèle clinique, le modèle d'apprentissage profond et le modèle combiné ont été établis séparément. Les modèles ont utilisé une régression de Cox aux risques proportionnels, la première fracture vertébrale de fragilité survenue dans les 24 mois suivant le moment de référence étant définie comme critère d'évaluation principal, et les règles de censure sont décrites dans la définition du suivi ci-dessus. Afin de limiter le surajustement, la complexité du modèle combiné a été restreinte avant la modélisation, et un ratio relativement élevé événements-par-paramètre a été maintenu autant que possible. Les coefficients de régression finaux et les erreurs standards de chaque modèle ont été estimés séparément dans les 10 jeux de données imputés, puis regroupés selon les règles de Rubin. La fonction de risque de base a été estimée selon la méthode de Breslow, et la probabilité individuelle de risque à 2 ans a été calculée.
Construction du modèle clinique
Le modèle clinique comprenait les facteurs de risque cliniques conservés après la sélection par régression LASSO-Cox. Toutes les variables continues ont été maintenues sous forme continue et n'ont pas été dichotomisées. Après l'ajustement du modèle, l'hypothèse de proportionalité des risques a été testée à l'aide des résidus de Schoenfeld ; pour les variables ne satisfaisant pas à cette hypothèse, un terme d'interaction avec ln(temps) a été ajouté afin de la corriger. Le modèle clinique a été utilisé pour caractériser la capacité prédictive des informations cliniques traditionnelles concernant la survenue de fractures vertébrales incidentes.
Construction du modèle d'imagerie par apprentissage profond
Le modèle d'apprentissage profond a été établi comme un modèle de risques proportionnels de Cox utilisant le score DL comme seul prédicteur, afin de quantifier la capacité prédictive des caractéristiques d'apprentissage profond issues de la radiographie latérale thoracolombaire de base pour le risque de fracture vertébrale incidente dans les 2 ans. Ce modèle n'a introduit aucune information clinique et a donc servi de modèle unimodal d'imagerie pour la comparaison avec les autres modèles.
Construction du modèle combiné
Le modèle combiné a en outre ajouté le score d'apprentissage profond (DL) à partir du modèle clinique, et a construit un modèle prédictif complet fondé sur des caractéristiques d'apprentissage profond issues de la radiographie latérale thoracolombaire combinées à des facteurs de risque cliniques. Une fois le modèle combiné établi, un nomogramme de risque sur 2 ans a été établi selon ses coefficients de régression, afin de permettre l'estimation individualisée du risque et de présenter son application clinique.
Validation interne et évaluation des performances du modèle :
Méthode de validation interne
La validation interne a adopté une stratégie de validation interne monocentrique séparée dans le temps. Tous les modèles établis dans la cohorte de dérivation ont été directement appliqués à la cohorte de validation recrutée du 1er janvier 2022 au 31 décembre 2023, une fois les paramètres fixés, sans réajustement. En outre, 1 000 rééchantillonnages par bootstrap ont été réalisés au sein de la cohorte de dérivation afin d'obtenir des estimations de performance corrigées de l'optimisme, dans le but d'évaluer la stabilité du modèle.
Évaluation de la discrimination
La discrimination du modèle a été évaluée à l'aide de l'indice de concordance de Harrell et de la superficie sous la courbe (AUC) dépendante du temps à 2 ans, calculée selon la méthode de pondération par la probabilité inverse de censure, les deux étant accompagnées d'intervalles de confiance à 95 %. Une discrimination plus élevée indique que le modèle est plus performant pour distinguer les individus qui développeront ou non des fractures vertébrales incidentes à l'avenir. Les différences de discrimination entre les modèles ont été calculées à l'aide de la méthode de bootstrap avec des intervalles de confiance à 95 %.
Évaluation de l'étalonnage
L'étalonnage du modèle a été évalué à l'aide de la courbe d'étalonnage du risque à 2 ans, de l'ordonnée à l'origine d'étalonnage, de la pente d'étalonnage et du score de Brier à 2 ans. La courbe d'étalonnage a été tracée en fonction des déciles du risque prédit et corrigée par rééchantillonnage avec remise. Une ordonnée à l'origine d'étalonnage proche de 0, une pente d'étalonnage proche de 1 et un score de Brier plus faible indiquent un bon accord entre le risque prédit et le risque effectivement observé.
Évaluation de la valeur d'application clinique
La valeur d'application clinique du modèle a été évaluée par une analyse de courbe de décision sur deux ans, comparant le bénéfice net selon différentes probabilités seuils. La plage de probabilité seuil a été prédéfinie entre 0,05 et 0,30 afin de couvrir l'intervalle de risque pouvant être utilisé en clinique pour un suivi intensifié, une évaluation osseuse complémentaire ou une prise en charge thérapeutique14. Un modèle présentant un bénéfice net plus élevé était considéré comme ayant une meilleure valeur d'aide à la décision clinique.
Comparaison des modèles et détermination du meilleur modèle
Le modèle clinique, le modèle d'apprentissage profond et le modèle combiné ont été comparés de manière exhaustive selon la discrimination, la calibration, le score de Brier et la courbe de décision. Le gain du modèle combiné par rapport au modèle clinique a été davantage quantifié à l'aide de l'amélioration nette de reclassement dépendante du temps à 2 ans et de l'amélioration intégrée de discrimination. Le meilleur modèle était prédéfini comme étant celui qui présentait simultanément une discrimination plus élevée, une bonne calibration, une erreur de prédiction plus faible et un bénéfice net plus grand.
Analyse statistique :
Les variables continues ont d'abord été évaluées quant à leur distribution à l'aide du test de Shapiro-Wilk ; celles qui suivaient une distribution normale ont été exprimées par la moyenne ± l'écart-type, tandis que celles présentant une distribution asymétrique ont été rapportées par la médiane et l'intervalle interquartile ; les variables catégorielles ont été présentées par le nombre de cas et le pourcentage. Les comparaisons des caractéristiques initiales entre le groupe de construction du modèle et le groupe de validation ont été effectuées à l'aide du test t pour échantillons indépendants, du test de Mann-Whitney U, du test χ2 ou du test exact de Fisher, respectivement. Les comparaisons initiales ont uniquement servi à décrire les caractéristiques des groupes et n'ont pas été utilisées comme critère de sélection des variables. Tous les tests statistiques étaient bilatéraux, et une valeur de P < 0,05 a été considérée comme statistiquement significative. Les analyses statistiques ont été réalisées avec le logiciel R, principalement à l'aide des packages survival, glmnet, mice, rms, timeROC et rmda ; le prétraitement des images et l'analyse par apprentissage profond ont été effectués dans l'environnement Python et PyTorch. Afin d'évaluer la robustesse des résultats, une analyse sur cas complets a été réalisée en complément comme analyse de sensibilité.
Résultats
Processus de construction de la cohorte rétrospective et caractéristiques de base des cohortes
Pendant la période d'étude, des radiographies latérales thoracolumbaires ont été récupérées, et 6 114 patients ont été inclus pour le dépistage après suppression des doublons. Après une exclusion progressive des patients âgés de < 50 ans, de ceux présentant des fractures préexistantes au moment de l'inclusion et de ceux ayant un suivi insuffisant, un total de 2 173 patients ont finalement été inclus, dont 1 449 dans la cohorte de modélisation et 724 dans la cohorte de validation interne (Figure 1). La répartition des caractéristiques de base dans la cohorte de modélisation et la cohorte de validation interne était globalement équilibrée, et aucune différence statistiquement significative n'a été observée concernant l'âge, le sexe, l'indice de masse corporelle ou les principaux facteurs de risque cliniques (tous les P > 0,05). La durée médiane de suivi dans les deux cohortes était respectivement de 23,4 mois et de 23,1 mois ; on a enregistré respectivement 131 et 63 cas de fractures vertébrales incidentes ; l'incidence cumulée à 2 ans était respectivement de 9,21 % et de 8,91 %, sans différence statistiquement significative (P = 0,812) (Table 1).
Sélection des facteurs de risque cliniques, dépistage des caractéristiques d'imagerie et construction du modèle de prédiction des risques
Après la sélection par LASSO-Cox, l’âge, le sexe féminin, l’indice de masse corporelle, les antécédents de fracture de fragilité, le diabète de type 2 et l’usage chronique de glucocorticoïdes par voie orale ont atteint le seuil préspecifié de fréquence d’inclusion ; après le criblage progressif de 2048 caractéristiques issues de l’apprentissage profond, 5 caractéristiques aux coefficients non nuls ont été conservées au seuil λ1se pour construire le score d’apprentissage profond (Figure 2A–C). À partir des variables cliniques sélectionnées et du score d’apprentissage profond, les modèles clinique, d’apprentissage profond et combiné ont été établis. Une régression de Cox multivariée a montré que les variables cliniques susmentionnées étaient toutes associées au risque de fracture vertébrale incidente dans les 2 ans (tous les P < 0,05) ; après l’ajout du score d’apprentissage profond au modèle clinique, celui-ci est resté un prédicteur indépendant dans le modèle combiné (HR = 1,64, IC 95 % 1,34–2,01, P < 0,001) (Tableau 2). En conséquence, un nomogramme du modèle combiné a été établi afin d’estimer de façon individualisée le risque de fracture vertébrale incidente à 2 ans ; plus le score total est élevé, plus le risque prédit est élevé (Figure 2D).
Validation interne et évaluation des performances du modèle
Après correction de l'optimisme par bootstrap dans la cohorte de développement, le modèle combiné conservait toujours la meilleure performance prédictive. La validation interne a montré que l'indice C et l'AUC₂y du modèle combiné étaient respectivement de 0,759 et 0,774, tous deux supérieurs à ceux du modèle clinique ; sa valeur de Brier₂y était la plus faible (0,077), et l'ordonnée à l'origine de la courbe de calibration était proche de 0, tandis que la pente de calibration était proche de 1, indiquant ainsi une bonne discrimination et une bonne calibration de ce modèle (Tableau 3). Dans la cohorte de développement, la courbe de calibration apparente et la courbe corrigée du biais par bootstrap étaient toutes deux proches de la droite idéale. Dans la cohorte de validation interne, le risque prédit à 2 ans était globalement conforme au risque observé selon Kaplan-Meier, et les points de calibration par décile étaient répartis près de la droite idéale, ce qui indique une bonne calibration du risque à 2 ans par le modèle combiné (Figure 3A, B).
Comparaison des modèles et évaluation de la valeur d'application clinique
Par rapport au modèle clinique, le modèle combiné a obtenu une amélioration significative de la reclassification nette et de la discrimination, tant dans la cohorte de développement que dans la cohorte de validation interne, avec des valeurs NRI₂y de 0,316 et 0,241 respectivement, et des valeurs IDI₂y de 0,047 et 0,033 respectivement (toutes les valeurs de P < 0,01) (Tableau 4). Dans la cohorte de développement et la cohorte de validation interne, le modèle combiné a généralement atteint le bénéfice net le plus élevé dans la plage de probabilité seuil préspecifiée de 0,05 à 0,30, et sa courbe de décision se situait principalement au-dessus des stratégies « Tout traiter » et « Ne rien traiter », indiquant ainsi une meilleure valeur d'application clinique (Figure 4A, B).
Résultats de l'analyse de sensibilité
L'analyse de sensibilité sur les cas complets a montré que les conclusions de l'analyse principale sont restées essentiellement stables. Dans la cohorte de développement et dans la cohorte de validation interne, l'indice C et l'AUC₂y du modèle combiné étaient supérieurs à ceux du modèle clinique, et le Brier₂y était inférieur ; son intercept de calibration et sa pente de calibration dans la cohorte de validation interne étaient respectivement de 0,019 et 0,964, suggérant que le modèle présentait une bonne robustesse (Table 5). Pendant le suivi, 27 décès dans la cohorte de développement et 13 décès dans la cohorte de validation interne ont été enregistrés. Dans l'analyse de sensibilité aux risques concurrents de Fine–Gray, où le décès était considéré comme un événement concurrent, le score DL est resté indépendamment associé à la survenue de fractures vertébrales dans le modèle combiné (risque relatif de sous-distribution = 1,58, IC 95 % 1,28–1,95, P < 0,001), et les conclusions générales n'ont pas changé.
En résumé, le modèle combiné intégrant le score d'apprentissage profond obtenu à partir des radiographies latérales thoracolombaires de base avec des facteurs de risque cliniques sélectionnés a montré la meilleure performance globale pour prédire une fracture vertébrale incidente dans les deux ans suivants. Par rapport au modèle clinique, il a démontré une discrimination plus élevée, une meilleure calibration, une erreur de prédiction plus faible, une reclassification améliorée et un bénéfice net supérieur, tant dans la cohorte de développement que dans celle de validation interne. La valeur prédictive indépendante du score d'apprentissage profond et la cohérence des résultats dans les analyses de sensibilité par cas complets et tenant compte des risques concurrents ont davantage renforcé la robustesse des résultats principaux.
DISPONIBILITÉ DES DONNÉES :
Les données brutes ont été téléchargées sous forme de fichier supplémentaire 1.
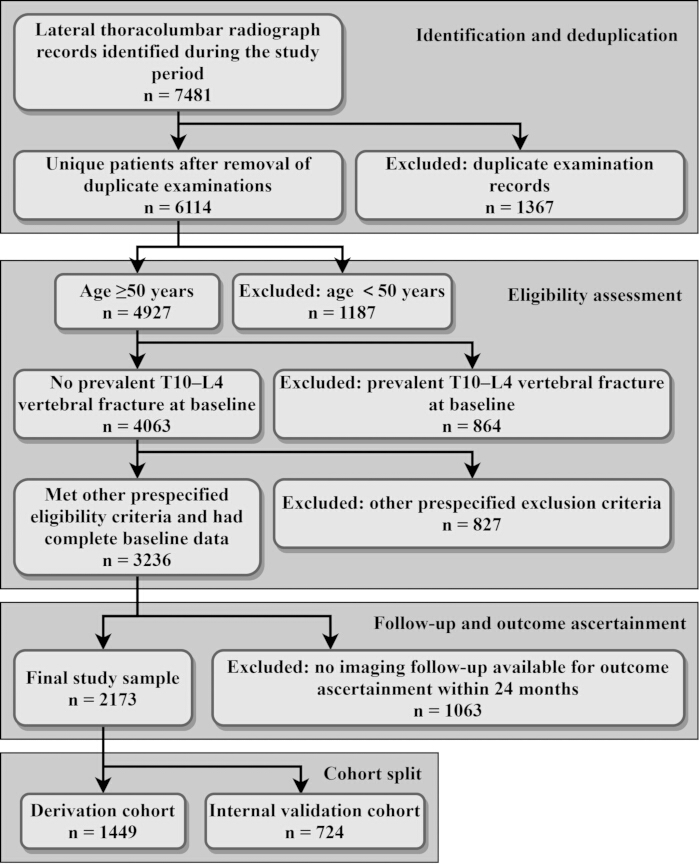
Figure 1. Schéma de l'identification de la population d'étude. Pour un même patient, lorsque plusieurs examens remplissaient les critères d'éligibilité, seul le plus ancien était conservé comme examen de référence. Chaque critère d'exclusion était appliqué séquentiellement selon l'ordre prédéfini, et chaque patient n'était comptabilisé qu'une seule fois pour l'exclusion. Veuillez cliquer ici pour visualiser une version agrandie de cette figure.
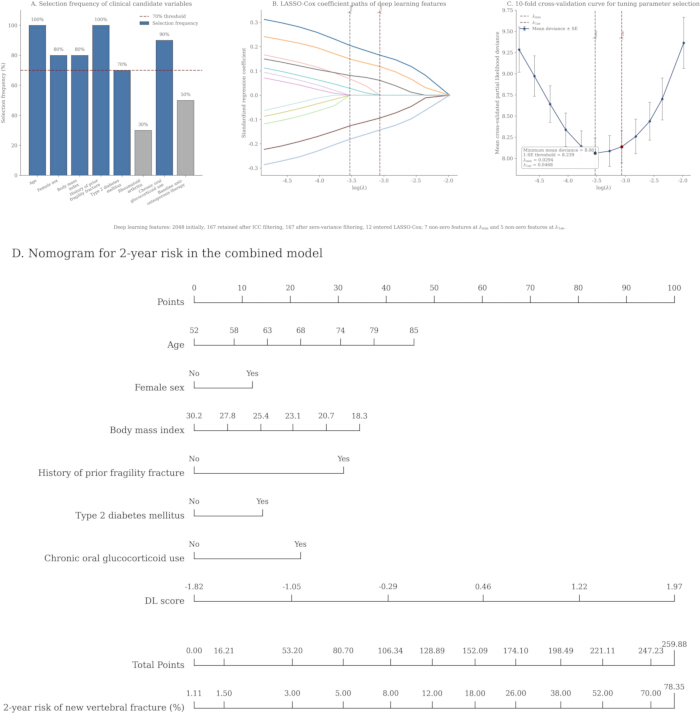
Figure 2. Sélection des facteurs de risque cliniques par LASSO-Cox, caractéristiques d'apprentissage profond et nomogramme du modèle combiné. (A) Fréquence d'inclusion des variables cliniques candidates dans 10 jeux de données imputés, la ligne pointillée indiquant le seuil de 70 %. (B) Courbes des coefficients LASSO-Cox des caractéristiques d'apprentissage profond. (C) Courbe de déviance de la vraisemblance partielle issue d'une validation croisée en 10 parties, les lignes verticales pointillées indiquant respectivement λmin et λ1se. (D) Nomogramme du risque à 2 ans dans le modèle combiné, chaque prédicteur correspondant à un certain nombre de points, les points étant additionnés pour obtenir le score total, qui est ensuite converti en risque individuel à 2 ans de fracture vertébrale incidente. Score DL, score d'apprentissage profond. Veuillez cliquer ici pour visualiser une version agrandie de cette figure.
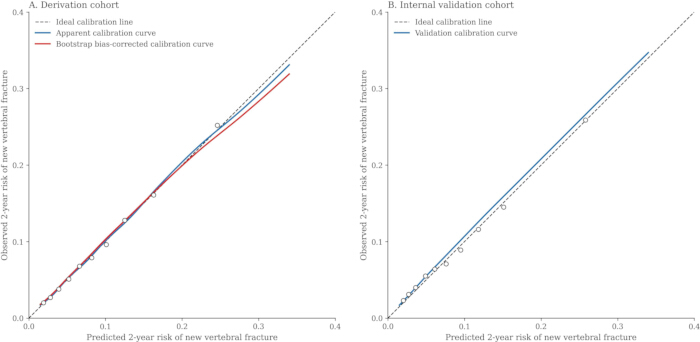
Figure 3. Courbes d'étalonnage du risque sur 2 ans du modèle combiné dans la cohorte de construction et la cohorte de validation interne. (A) Cohorte de construction. (B) Cohorte de validation interne. Les points d'étalonnage ont été générés selon les déciles du risque prédit, et le risque observé a été estimé à l'aide de la méthode de Kaplan-Meier. Veuillez cliquer ici pour visualiser une version agrandie de cette figure.
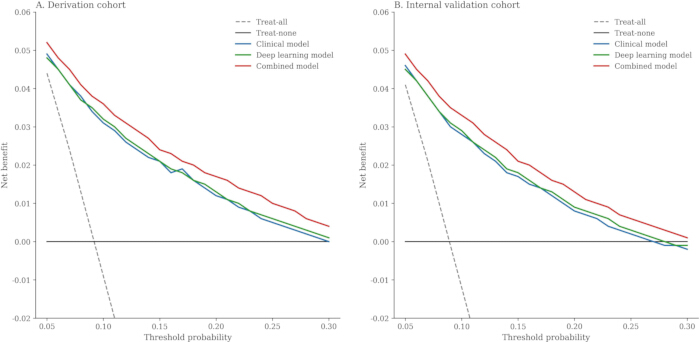
Figure 4. Analyse de la courbe de décision des trois modèles dans la cohorte de développement et la cohorte de validation interne. (A) Cohorte de développement. (B) Cohorte de validation interne. L'axe horizontal représente la probabilité seuil, et l'axe vertical représente le bénéfice net. « Tout traiter » indique une intervention pour tous les patients, et « Ne rien traiter » indique l'absence d'intervention pour tous. Veuillez cliquer ici pour visualiser une version agrandie de cette figure.
| Nom de la variable | Valeurs manquantes, n (%) | Cohorte de dérivation (n=1449) | Cohorte de validation interne (n=724) | P |
| Caractéristiques de base | ||||
| Taille de l'échantillon, n | — | 1449 | 724 | — |
| Âge, années | 0 (0,00) | 68,41 ± 8,37 | 68,96 ± 8,56 | 0,155 |
| Femmes, n (%) | 0 (0,00) | 962 (66,39 %) | 463 (63,95 %) | 0,259 |
| Taille, cm | 16 (0,74) | 158,42 ± 7,91 | 157,98 ± 8,16 | 0,232 |
| Poids, kg | 21 (0,97) | 59,76 ± 9,88 | 59,21 ± 10,14 | 0,23 |
| Indice de masse corporelle, kg/m² | 28 (1,29) | 23,77 ± 3,28 | 23,69 ± 3,34 | 0,597 |
| Antécédents de fracture de fragilité, n (%) | 0 (0,00) | 171 (11,80 %) | 96 (13,26 %) | 0,329 |
| Diabète de type 2, n (%) | 0 (0,00) | 303 (20,91 %) | 158 (21,82 %) | 0,624 |
| Arthrite rhumatoïde, n (%) | 0 (0,00) | 49 (3,38 %) | 29 (4,01 %) | 0,461 |
| Utilisation chronique de glucocorticoïdes par voie orale, n (%) | 0 (0,00) | 65 (4,49 %) | 38 (5,25 %) | 0,43 |
| Traitement anti-ostéoporotique de base, n (%) | 0 (0,00) | 131 (9,04 %) | 75 (10,36 %) | 0,323 |
| Suivi et description des résultats | ||||
| Durée de suivi, mois | 0 (0,00) | 23,4 [18,7, 24,0] | 23,1 [18,4, 24,0] | 0,341 |
| Nombre d'événements de fracture vertébrale incidente, n | 0 (0,00) | 131 | 63 | — |
| Incidence cumulée à 2 ans de fracture vertébrale incidente, % (IC à 95 %) | — | 9,21 (7,82, 10,60) | 8,91 (6,79, 11,03) | 0,812 |
Tableau 1 : Caractéristiques de base et résultats des deux cohortes. La colonne des valeurs manquantes s'appuie sur les données observées initiales, et l'imputation multiple n'a été utilisée que pour la modélisation. Les variables continues sont présentées sous la forme x̄ ± s ou M [IQR] selon la distribution, et les comparaisons entre groupes ont été effectuées à l'aide du test t pour échantillons indépendants ou du test de Mann-Whitney U ; les variables catégorielles sont présentées sous la forme n (%), et les comparaisons entre groupes ont été effectuées à l'aide du test χ2. L'incidence cumulative sur 2 ans des fractures vertébrales incidentes a été estimée par la méthode de Kaplan-Meier et est rapportée avec un intervalle de confiance à 95 % ; la comparaison entre groupes a été effectuée à l'aide du test du log-rank. Les valeurs de p ont uniquement été utilisées pour décrire les différences de composition des cohortes entre les deux groupes et n'ont pas été utilisées pour la sélection des prédicteurs.
| Prédicteur | β | HR | IC à 95 % | P |
| Modèle clinique | ||||
| Âge (par augmentation de 1 écart-type) | 0,28 | 1,33 | 1,10–1,60 | 0,003 |
| Sexe féminin (oui contre non) | 0,26 | 1,29 | 1,02–1,63 | 0,031 |
| Indice de masse corporelle (par augmentation de 1 écart-type) | −0,19 | 0,83 | 0,70–0,98 | 0,03 |
| Antécédents de fracture de fragilité (oui contre non) | 0,66 | 1,93 | 1,38–2,71 | <0,001 |
| Diabète sucré de type 2 (oui contre non) | 0,31 | 1,36 | 1,06–1,75 | 0,016 |
| Utilisation chronique de glucocorticoïdes par voie orale (oui contre non) | 0,49 | 1,63 | 1,14–2,33 | 0,008 |
| Modèle d'apprentissage profond | ||||
| Score d'apprentissage profond (par augmentation de 1 écart-type) | 0,58 | 1,78 | 1,46–2,17 | <0,001 |
| Modèle combiné | ||||
| Âge (par augmentation de 1 écart-type) | 0,22 | 1,25 | 1,07–1,46 | 0,004 |
| Sexe féminin (oui contre non) | 0,23 | 1,26 | 1,01–1,56 | 0,04 |
| Indice de masse corporelle (par augmentation de 1 écart-type) | −0,18 | 0,84 | 0,72–0,98 | 0,031 |
| Antécédents de fracture de fragilité (oui contre non) | 0,59 | 1,8 | 1,27–2,56 | 0,001 |
| Diabète sucré de type 2 (oui contre non) | 0,27 | 1,31 | 1,01–1,70 | 0,044 |
| Utilisation chronique de glucocorticoïdes par voie orale (oui contre non) | 0,42 | 1,53 | 1,05–2,21 | 0,026 |
| Score d'apprentissage profond (par augmentation de 1 écart-type) | 0,5 | 1,64 | 1,34–2,01 | <0,001 |
Tableau 2 : Prédicteurs et résultats de régression de Cox des trois modèles. Les estimations des paramètres du modèle clinique et du modèle combiné ont été regroupées à partir de 10 jeux de données imputées selon les règles de Rubin, et les valeurs de P ont été obtenues à l’aide du test de Wald. Les variables continues et le score DL ont été introduits dans les modèles sous forme de valeurs standardisées, et le rapport de risque (HR) correspondait à une augmentation par écart-type (SD) ; la catégorie de référence pour les variables binaires a été uniformément définie comme « non » ou « aucune ». Le score DL était un score composite obtenu en pondérant des caractéristiques d’apprentissage profond. Les taux de survie de base à 2 ans, notés S₀ (2 ans), des trois modèles étaient respectivement de 0,9387, 0,9194 et 0,9413. Le risque à 2 ans du modèle combiné a été calculé selon la formule suivante : 2 - yearrisk = 1 - [S0(2 ans)]exp(LP).
| Modèle | C apparent (IC à 95 %) | C corrigé | C de validation (IC à 95 %) | ΔC (IC à 95 %) | AUC₂y apparente (IC à 95 %) | AUC₂y corrigée | AUC₂y de validation (IC à 95 %) | ΔAUC₂y (IC à 95 %) | Brier₂y apparent | Brier₂y corrigé | Brier₂y de validation | Ordonnée à l'origine de validation | Pente de validation |
| Modèle clinique | 0.702 (0.657–0.747) | 0.691 | 0.687 (0.619–0.754) | Ref | 0.711 (0.665–0.757) | 0.7 | 0.694 (0.626–0.762) | Ref | 0.081 | 0.082 | 0.082 | 0.073 | 0.901 |
| Modèle d'apprentissage profond | 0.734 (0.691–0.777) | 0.722 | 0.713 (0.648–0.778) | 0.026 (−0.018–0.070) | 0.743 (0.698–0.789) | 0.731 | 0.722 (0.658–0.786) | 0.028 (−0.016–0.072) | 0.079 | 0.08 | 0.08 | 0.058 | 0.843 |
| Modèle combiné | 0.787 (0.748–0.826) | 0.773 | 0.759 (0.699–0.819) | 0.072 (0.030–0.114) | 0.799 (0.758–0.841) | 0.785 | 0.774 (0.715–0.833) | 0.080 (0.038–0.122) | 0.075 | 0.076 | 0.077 | 0.012 | 0.972 |
Tableau 3 : Performances prédictives, performances corrigées de l'optimisme et résultats de validation interne des trois modèles. Les résultats corrigés sont des estimations ponctuelles après 1 000 corrections de l'optimisme par rééchantillonnage bootstrap. ΔC et ΔAUC₂y représentent les différences par rapport au modèle clinique. Des valeurs plus élevées de C et d'AUC₂y, ainsi que des valeurs plus faibles de Brier₂y, indiquent une meilleure performance du modèle ; un intercept de calibration plus proche de 0 et une pente de calibration plus proche de 1 indiquent une meilleure calibration. C, indice de concordance de Harrell ; AUC₂y, aire sous la courbe ROC dépendante du temps à 2 ans ; Brier₂y, score de Brier à 2 ans.
| Cohorte | NRI₂y | IC à 95 % | P | IDI₂y | IC à 95 % | P |
| Cohorte de développement | 0.316 | 0.174–0.463 | <0.001 | 0.047 | 0.024–0.073 | <0.001 |
| Cohorte de validation interne | 0.241 | 0.058–0.389 | 0.009 | 0.033 | 0.009–0.058 | 0.007 |
Tableau 4 : NRI et IDI à 2 ans du modèle combiné par rapport au modèle clinique. Des valeurs positives de NRI₂y et d'IDI₂y indiquent que le modèle combiné possède une meilleure valeur prédictive incrémentielle que le modèle clinique. Le NRI₂y et l'IDI₂y ont tous deux été calculés selon la méthode dépendante du temps à 2 ans, et les données censurées ont été traitées à l'aide de la méthode de pondération par la probabilité inverse de censure ; l'intervalle de confiance à 95 % a été obtenu par 1 000 rééchantillonnages bootstrap, et les valeurs de P étaient bilatérales. NRI₂y, amélioration nette de la reclassification à 2 ans ; IDI₂y, amélioration intégrée de la discrimination à 2 ans.
| Modèle | Dérivation n | Événements de dérivation | Dérivation C (IC à 95 %) | Dérivation AUC₂y (IC à 95 %) | Dérivation Brier₂y | Validation n | Événements de validation | Validation C (IC à 95 %) | Validation AUC₂y (IC à 95 %) | Validation Brier₂y | Ordonnée à l'origine de validation | Pente de validation |
| Modèle clinique | 1431 | 129 | 0.699 (0.654–0.744) | 0.707 (0.661–0.752) | 0.082 | 714 | 62 | 0.681 (0.613–0.749) | 0.690 (0.622–0.759) | 0.083 | 0.084 | 0.892 |
| Modèle combiné | 1431 | 129 | 0.783 (0.744–0.822) | 0.795 (0.753–0.837) | 0.076 | 714 | 62 | 0.753 (0.692–0.814) | 0.769 (0.709–0.829) | 0.078 | 0.019 | 0.964 |
Tableau 5 : Analyse de sensibilité sur les cas complets. Les cas complets ont été définis comme les patients disposant de valeurs observées initiales pour toutes les variables requises par le modèle correspondant. L'analyse de sensibilité a utilisé une analyse sur les cas complets sans imputation multiple. L'intervalle de confiance à 95 % a été obtenu à partir de 1 000 rééchantillonnages bootstrap. C, indice de concordance de Harrell ; AUC₂y, aire sous la courbe caractéristique de fonctionnement du récepteur en fonction du temps à 2 ans ; Brier₂y, score de Brier à 2 ans.
Fichier supplémentaire 1 : Données brutes Veuillez cliquer ici pour télécharger ce fichier.
Discussion
Le modèle combiné a conservé une performance optimale après correction de l'optimisme et validation interne temporelle, ce qui suggère que les caractéristiques issues de l'apprentissage profond à partir de radiographies latérales thoracolombaires ne constituent pas une simple répétition des informations cliniques, mais qu'elles peuvent fournir des informations complémentaires indépendantes et vérifiables pour l'évaluation du risque de fracture vertébrale incidente dans les deux années suivantes. Son importance réside dans l'intégration du contexte de fragilité systémique et de la fragilité structurelle rachidienne locale au sein d'un même cadre prédictif. L'âge, le sexe féminin, un faible indice de masse corporelle, une fracture de fragilité antérieure, le diabète et l'exposition aux glucocorticoïdes reflètent une perte de masse osseuse, une altération de la qualité osseuse, un soutien musculaire insuffisant et une prédisposition aux refactures, et déterminent ainsi le risque basal global de fracture du patient15 ; les caractéristiques issues de l'apprentissage profond sont plus à même de capturer la morphologie des plateaux vertébraux, un léger aplatissement en coin, une trame osseuse clairsemée, des modifications des limites corticales et une distribution mécanique anormale dans la région thoracolombaire, éléments difficiles à quantifier de manière stable lors de l'analyse radiologique habituelle, complétant ainsi l'information de fragilité au niveau local de l'imagerie16. Ces deux types d'information correspondent à des niveaux physiopathologiques différents, et après combinaison, la discrimination, la calibration, l'erreur de prédiction, la capacité de reclassement et le bénéfice net clinique ont tous été améliorés, une cohérence qui confirme que l'amélioration du modèle n'est pas fortuite. Les modèles de risque traditionnels reposant uniquement sur des variables cliniques sont pratiques à utiliser, mais ils peinent à identifier l'hétérogénéité locale des vertèbres17. Les stratégies d'évaluation telles que la densité minérale osseuse ou le score FRAX sont davantage orientées vers la tendance systémique à la fracture et peuvent ne pas refléter pleinement la fragilité structurelle immédiate de la région thoracolombaire18. Les études antérieures utilisant l'intelligence artificielle se sont principalement concentrées sur la détection de fractures vertébrales existantes ou la classification de l'ostéoporose, restant ainsi encore éloignées d'une alerte précoce en pratique clinique19. Les résultats actuels se rapprochent davantage du scénario réel de prise de décision, indiquant que les phénotypes occultes présents dans les radiographies de routine, une fois extraits par apprentissage profond, peuvent renforcer significativement la stratification clinique du risque.
Dans l'évaluation du risque de fracture vertébrale, la tomodensitométrie (TDM), l'imagerie par résonance magnétique (IRM), l'évaluation basée sur la densité minérale osseuse et d'autres méthodes d'analyse d'images présentent chacune des scénarios d'application spécifiques. La TDM représente de manière plus directe la morphologie vertébrale, les modifications des plateaux vertébraux et la destruction du tissu osseux cortical, tandis que l'IRM offre des avantages plus marqués dans l'évaluation de l'œdème de la moelle osseuse, de l'atteinte des tissus mous et des fractures aiguës. Toutefois, ces deux méthodes sont moins avantageuses que les radiographies latérales thoracolombaires en termes de coût d'examen, d'accessibilité et de disponibilité pour un suivi de routine, ce qui rend difficile leur utilisation à grande échelle et avec un seuil bas comme outils de stratification précoce du risque. La mesure de la densité minérale osseuse et l'outil FRAX sont mieux adaptés pour refléter le contexte de fragilité osseuse systémique et possèdent une valeur informative importante quant à la tendance globale aux fractures, mais ils sont relativement limités pour évaluer la fragilité structurelle locale de la région thoracolombaire, les rétrécissements légers en coin, les anomalies subtiles des plateaux vertébraux et les déséquilibres mécaniques locaux. Les méthodes actuelles de radiomique permettent d'extraire des caractéristiques quantitatives prédéfinies à partir de radiographies, de TDM ou d'IRM et présentent un potentiel dans l'évaluation du risque, mais elles dépendent généralement d'espaces de caractéristiques définis manuellement et de procédures de segmentation relativement rigoureuses. Comparées à ces approches, la présente étude a choisi de construire un modèle fondé sur des radiographies latérales thoracolombaires de routine, non pas dans le but de remplacer la TDM, l'IRM ou l'évaluation de la densité minérale osseuse, mais pour compléter, à partir de la modalité d'imagerie la plus couramment disponible en pratique clinique quotidienne, les informations sur la fragilité locale occulte difficiles à détecter par les évaluations cliniques traditionnelles, offrant ainsi une voie de stratification du risque plus généralisable pour l'identification précoce des fractures vertébrales incidentes.
Les variables cliniques incluses dans le modèle final présentaient des implications physiopathologiques claires, suggérant que ce cadre prédictif n'était pas le résultat d'une sélection aléatoire. L'âge croissant, le sexe féminin et un faible indice de masse corporelle correspondent à une perte de masse osseuse, à un soutien musculaire affaibli et à une susceptibilité accrue aux chutes, constituant le fondement de la fragilité vertébrale. L'antécédent de fracture de fragilité indique une fragilité osseuse systémique persistante chez l'individu et constitue un marqueur important de refracture. Même lorsque la densité minérale osseuse n'est pas significativement réduite chez les patients atteints de diabète de type 2, le dépôt de produits avancés de glycation, un remodelage osseux anormal et une altération microstructurale peuvent néanmoins affaiblir la résistance mécanique vertébrale20. La prise prolongée de glucocorticoïdes par voie orale inhibe la formation osseuse, favorise la résorption osseuse, altère l'intégrité des travées osseuses et entraîne un risque accru de fracture21. Après sélection par stabilité, corrélation et régression pénalisée, un petit nombre de caractéristiques seulement ont été conservées parmi les caractéristiques issues de l'apprentissage profond pour construire le score DL, indiquant que le modèle a capté des informations d'imagerie stables et liées au résultat. Ces caractéristiques sont difficiles à associer individuellement à un indicateur manuel unique et reflètent probablement de manière globale des changements précliniques subtils des plateaux vertébraux, un léger déséquilibre de la morphologie vertébrale, une texture osseuse clairsemée, des modifications du contour cortical et une répartition anormale des contraintes locales dans la région thoracolombaire. Elles conservaient donc une valeur prédictive indépendante après ajustement sur les variables cliniques22. Des preuves épidémiologiques existantes ont confirmé que les facteurs cliniques susmentionnés sont étroitement associés aux fractures de fragilité, et les résultats de la présente étude sont globalement cohérents avec ces données. Contrairement aux mesures manuelles traditionnelles ou aux caractéristiques de radiomique prédéfinies, l'apprentissage profond ne nécessite pas de spécifier au préalable les caractéristiques et est mieux adapté à l'identification de phénotypes de fragilité occultes et complexes sur les radiographies23. La polyarthrite rhumatoïde et le traitement anti-ostéoporotique au moment du diagnostic n'ont pas été inclus dans le modèle final, ce qui pourrait être lié à la prévalence plus faible de la première et à un biais de prescription pour le second24. On peut donc conclure que ce modèle repose sur une intégration complémentaire du spectre des risques cliniques et des phénotypes de fragilité occultes visibles sur la radiographie, et non sur un simple empilement de variables.
Après correction de l'optimisme par rééchantillonnage, validation interne temporelle et analyse de sensibilité sur cas complets, l'avantage du modèle combiné est resté stable, indiquant que sa capacité prédictive ne provenait pas d'un ajustement excessif aux données d'apprentissage mais qu'il possédait une bonne validité interne. La validation par scission temporelle se rapproche davantage du scénario d'application réel que la scission aléatoire et permet de tester plus rigoureusement les performances du modèle chez des patients ultérieurs ; la correction de l'optimisme aide à identifier le risque de surajustement, et par conséquent, la persistance de la supériorité après correction soutient d'autant plus la robustesse des résultats. La courbe de calibration était proche de la droite idéale, l'ordonnée à l'origine de validation était proche de zéro et la pente proche de un, ce qui indique que la sortie du modèle n'était pas simplement un score de classement, mais une probabilité de risque absolu relativement cohérente avec le niveau réel d'occurrence des événements. Ceci revêt une importance clinique plus grande pour déterminer l'intensité du suivi, l'évaluation osseuse complémentaire et le moment des interventions préventives. Le bénéfice net plus élevé dans la plage de seuil prédéfinie indique qu'après l'ajout des caractéristiques issues de l'apprentissage profond à partir des radiographies, l'amélioration du modèle se reflète non seulement dans les indices statistiques, mais aussi dans un bénéfice potentiel au niveau de la prise de décision25. Le nomogramme a transformé le modèle combiné en un outil interprétable et individualisé, ce qui facilite la réalisation d'une stratification du risque à partir d'un examen radiographique latéral thoracolombaire de routine26. De nombreuses études antérieures sur la prédiction par intelligence artificielle rapportaient principalement la discrimination, accordaient une attention insuffisante à la calibration, au contrôle du surajustement et au bénéfice net clinique, et manquaient souvent de validation temporelle ou d'analyse de sensibilité, limitant ainsi leur transférabilité dans des scénarios réels27,28. La chaîne complète de preuves constituée autour de la discrimination, de la calibration, de l'erreur de prédiction, de la courbe de décision et de l'analyse de sensibilité peut mieux soutenir la traduction clinique de ce modèle combiné en tant qu'outil de stratification du risque de fracture vertébrale incidente.
Cette étude était une étude de cohorte rétrospective monocentrique, et tous les cas provenaient de patients hospitalisés ayant bénéficié d'un examen radiographique latéral thoracolombaire et ayant terminé un suivi d'imagerie. La composition de l'échantillon a été influencée par les modalités de référence, les indications des examens et l'adhésion au suivi, ce qui a introduit un biais de sélection ; par conséquent, il convient de faire preuve de prudence lors de la généralisation des résultats à d'autres centres, aux populations de dépistage communautaire ou à d'autres conditions d'équipement. Pendant la période d'étude, les radiographies de base ont été réalisées à l'aide du système de radiographie numérique de l'hôpital provenant d'un seul fournisseur, plutôt que de plusieurs systèmes ou fournisseurs de radiographie, ce qui a réduit l'hétérogénéité technique entre fournisseurs mais pourrait également limiter la généralisabilité à d'autres plateformes d'imagerie. En particulier, comme la confirmation des résultats nécessitait un suivi par imagerie, les patients n'ayant pas bénéficié d'un suivi d'imagerie dans les 24 mois ont été exclus, ce qui a pu privilégier le maintien de patients présentant davantage de symptômes, une utilisation accrue des soins de santé ou un risque de base plus élevé, et a pu augmenter le taux d'événements observé. De plus, comme les examens d'imagerie de suivi ont été réalisés dans la pratique clinique courante et non selon un protocole fixe, la censure n'a peut-être pas été totalement non informative, et les estimations de risque basées sur le modèle de Cox auraient pu être influencées par le processus de suivi en imagerie. Bien qu'une validation interne temporelle, une correction de l'optimisme par rééchantillonnage bootstrap et une analyse de sensibilité sur cas complets aient été effectuées, aucune validation externe indépendante n'a encore été réalisée, et la stabilité intercentres et la généralisabilité du modèle restent à confirmer. Cette étude s'est appuyée sur une radiographie latérale de routine, qui présente l'avantage d'une acquisition et d'une diffusion faciles, mais par rapport à la tomodensitométrie (CT), à l'imagerie par résonance magnétique (IRM) ou aux tests de densité minérale osseuse, sa représentation de la microstructure osseuse, de l'état de la masse osseuse et des informations sur les tissus adjacents reste limitée ; bien que les caractéristiques d'apprentissage profond puissent améliorer la performance prédictive, leurs significations spécifiques en imagerie et en biologie ne sont encore pas suffisamment intuitives. En outre, aucune analyse dédiée d'attribution de caractéristiques ou d'analyse de saillance n'a été réalisée ; par conséquent, les interprétations biologiques associées doivent être considérées comme génératrices d'hypothèses plutôt que directement validées. Les variables candidates provenaient principalement de dossiers médicaux structurés et de données cliniques de routine, et n'incluaient pas les antécédents de chutes, la fonction physique, l'état nutritionnel, les indices biologiques du métabolisme osseux ou les mesures normalisées de densité minérale osseuse ; par conséquent, un biais de confusion résiduel pourrait encore exister. De plus, les modèles basés sur la DMO ou sur FRAX n'ont pas été évalués dans la présente étude ; par conséquent, la valeur ajoutée du score d'apprentissage profond (DL score) a été établie uniquement par rapport au modèle clinique prédéfini. De futures études devraient réaliser une validation externe dans plusieurs centres, avec différents équipements et dans divers contextes cliniques, et explorer l'intégration avec la densité minérale osseuse, les indices biologiques et d'autres modalités d'imagerie, afin d'améliorer la généralisabilité, l'interprétabilité et la valeur d'application pratique du modèle.
Déclarations de divulgation
Les auteurs déclarent qu’ils n’ont aucun conflit d’intérêts.
Remerciements
Les auteurs remercient le personnel de l'hôpital étudié pour leur soutien dans la récupération des images, l'extraction des données et la gestion des données. Les auteurs remercient également tous les cliniciens et technologues en imagerie médicale ayant participé aux soins des patients et à l'acquisition des images. Cette étude a été financée par le projet de recherche médicale du district de Xuhui en 2024 (SHXH202405).
Matériaux
| Nom | Entreprise | Numéro de catalogue | Commentaires |
|---|---|---|---|
| paquet glmnet | CRAN | N/A | Utilisé pour l'analyse de régression LASSO-Cox. |
| ITK-SNAP | Université de Pennsylvanie / Projet ITK-SNAP | N/A | Utilisé pour l'annotation des régions d'intérêt (ROI) sur les images de base. |
| paquet mice | CRAN | N/A | Utilisé pour l'imputation multiple. |
| Python | Fondation Python Software Foundation | version 3.10 | Utilisé pour le prétraitement des images et l'analyse par apprentissage profond. |
| PyTorch | Fondation PyTorch / Linux Foundation | version 2.1 | Utilisé pour le développement du modèle d'apprentissage profond et l'extraction de caractéristiques. |
| version de R | Fondation R pour l'informatique statistique | version 4.3.2 | Utilisé pour l'analyse statistique. |
| paquet rmda | CRAN | N/A | Utilisé pour l'analyse de courbe de décision. |
| paquet rms | CRAN | N/A | Utilisé pour le développement du modèle et l'analyse de calibration. |
| paquet survival | CRAN | N/A | Utilisé pour l'analyse de régression des risques proportionnels de Cox. |
| paquet timeROC | CRAN | N/A | Utilisé pour l'analyse de la CUA dépendante du temps. |
Références
- Daskalakis II, Bastian JD, Mavrogenis AF, Tosounidis TH. Osteoporotic vertebral fractures: an update. SICOT J. 2025;11:40.
- Na D et al. Underdiagnosis and underreporting of vertebral fractures on chest radiographs in men aged over 50 years or postmenopausal women with and without type 2 diabetes mellitus: a retrospective cohort study. BMC Med Imaging. 2022;22(1):81.
- Urrutia J, Besa P, Piza C. Incidental identification of vertebral compression fractures in patients over 60 years old using computed tomography scans showing the entire thoraco-lumbar spine. Arch Orthop Trauma Surg. 2019;139(11):1497-1503.
- Zerikly R, Demetriou EW. Use of Fracture Risk Assessment Tool in clinical practice and Fracture Risk Assessment Tool future directions. Women's Health (Lond). 2024;20:17455057241231387.
- Hong N et al. Deep learning-based identification of vertebral fracture and osteoporosis in lateral spine radiographs and DXA vertebral fracture assessment to predict incident fracture. J Bone Miner Res. 2025;40(5):628-638.
- Hong N et al. Deep-Learning-Based Detection of Vertebral Fracture and Osteoporosis Using Lateral Spine X-Ray Radiography. J Bone Miner Res. 2023;38(6):887-895.
- Johansson L et al. Grade 1 Vertebral Fractures Identified by Densitometric Lateral Spine Imaging Predict Incident Major Osteoporotic Fracture Independently of Clinical Risk Factors and Bone Mineral Density in Older Women. J Bone Miner Res. 2020;35(10):1942-1951.
- Li Y et al. Machine learning value in the diagnosis of vertebral fractures: A systematic review and meta-analysis. Eur J Radiol. 2024;181:111714.
- Kong SH et al. Development of a Spine X-Ray-Based Fracture Prediction Model Using a Deep Learning Algorithm. Endocrinol Metab (Seoul). 2022;37(4):674-683.
- Lunt M et al. Defining incident vertebral deformities in population studies: a comparison of morphometric criteria. Osteoporos Int. 2002;13(10):809-815.
- Da Mutten R et al. Whole Spine Segmentation Using Object Detection and Semantic Segmentation. Neurospine. 2024;21(1):57-67.
- Xiao W, Chen R. A study on ACCC surface defect classification method using ResNet18 with integrated SE attention mechanism. Appl Sci. 2026;16(4):1899.
- Liu F, Zhang DB, Cheng SH, Gu GS. A radiomics and deep learning nomogram developed and validated for predicting no-collapse survival in patients with osteonecrosis after multiple drilling. BMC Med Inform Decis Mak. 2025;25(1):26.
- Yokota T et al. Internal validation of an 11-yr prediction model for new vertebral fractures using the vertebral bone quality score: a prospective cohort study. JBMR Plus. 2025;9(11):ziaf155.
- Chen W, Mao M, Fang J, Xie Y, Rui Y. Fracture risk assessment in diabetes mellitus. Front Endocrinol (Lausanne). 2022;13:961761.
- Kong SH. Incorporating Artificial Intelligence into Fracture Risk Assessment: Using Clinical Imaging to Predict the Unpredictable. Endocrinol Metab (Seoul). 2025;40(4):499-507.
- Schini M et al. An overview of the use of the fracture risk assessment tool (FRAX) in osteoporosis. J Endocrinol Invest. 2024;47(3):501-511.
- LeBoff MS et al. The clinician's guide to prevention and treatment of osteoporosis. Osteoporos Int. 2022;33(10):2049-2102.
- Gu Y, Wang Y, Li M, Wang R. Current applications of deep learning in vertebral fracture diagnosis. Osteoporos Int. 2025;36(11):2071-2082.
- Cavati G et al. Role of Advanced Glycation End-Products and Oxidative Stress in Type-2-Diabetes-Induced Bone Fragility and Implications on Fracture Risk Stratification. Antioxidants (Basel). 2023;12(4):928.
- Hofbauer LC, Compston JE, Saag KG, Rauner M, Tsourdi E. Glucocorticoid-induced osteoporosis: novel concepts and clinical implications. Lancet Diabetes Endocrinol. 2025;13(11):964-979.
- Saravi B et al. Integrating radiomics with clinical data for enhanced prediction of vertebral fracture risk. Front Bioeng Biotechnol. 2024;12:1485364.
- Zhang J et al. Differentiation of acute and chronic vertebral compression fractures using conventional CT based on deep transfer learning features and hand-crafted radiomics features. BMC Musculoskelet Disord. 2023;24(1):165.
- McGrath LJ et al. Using negative control outcomes to assess the comparability of treatment groups among women with osteoporosis in the United States. Pharmacoepidemiol Drug Saf. 2020;29(8):854-863.
- Piovani D, Sokou R, Tsantes AG, Vitello AS, Bonovas S. Optimizing Clinical Decision Making with Decision Curve Analysis: Insights for Clinical Investigators. Healthcare (Basel). 2023;11(16):2244.
- Nguyen HT et al. A predictive nomogram for selective screening of asymptomatic vertebral fractures: The Vietnam Osteoporosis Study. Osteoporos Sarcopenia. 2025;11(1):9-14.
- Hu Y et al. Beyond Comparing Machine Learning and Logistic Regression in Clinical Prediction Modelling: Shifting from Model Debate to Data Quality. J Med Internet Res. 2025;27:e77721.
- Groot OQ et al. Availability and reporting quality of external validations of machine-learning prediction models with orthopedic surgical outcomes: a systematic review. Acta Orthop. 2021;92(4):385-393.