Un cadre multistage ancré génétiquement, intégrant la randomisation mendélienne, la transcriptomique tumorale et des analyses unicellulaires, a permis de classer MAP1LC3A comme un gène associé à la ferroptose, lié à la susceptibilité au glioblastome, et candidat à une validation expérimentale ultérieure.
Article de recherche
Des preuves génétiques, transcriptomiques et à l'échelle de la cellule unique sur plusieurs étapes priorisent MAP1LC3A parmi les gènes liés à la ferroptose dans le glioblastome
34 vues
⸱
11 septembre 2026
* These authors contributed equally
Dans cet article
Résumé
Résumé
Le glioblastome (GBM) demeure une malignité hautement agressive, et la contribution des gènes liés à la ferroptose à la susceptibilité de la maladie n'est pas encore entièrement comprise. Un cadre multistage ancré sur la génétique a été appliqué afin de hiérarchiser les gènes liés à la ferroptose associés au GBM. Parmi les 483 gènes recensés dans FerrDb V2, 315 possédaient des locus quantitatifs d'expression candidats en position cis (cis-eQTL) dans eQTLGen, 250 conservaient au moins trois instruments indépendants après regroupement par déséquilibre de liaison, et 226 ont permis d'obtenir des estimations valides de randomisation mendélienne par pondération inverse de la variance (IVW) à l'aide d'une étude d'association génome entier sur le GBM comprenant 6 183 cas et 18 169 témoins. Trente-quatre gènes ont satisfait aux critères exploratoires de découverte, avec un P < 0,05 et un taux de faux positifs (BH-FDR) de Benjamini–Hochberg < 0,20, ainsi que des estimations concordantes en direction de la randomisation mendélienne pondérée bayésienne (BWMR). Une étape de réplication par randomisation mendélienne utilisant les cis-eQTLs de sang total de GTEx V10 a confirmé quatre gènes : ATG7, RPTOR, MAP1LC3A et CHMP6. L'évaluation menée sur trois cohortes indépendantes de profils transcriptomiques tumeur–témoin a démontré que MAP1LC3A était systématiquement sous-exprimé dans le tissu tumoral et présentait une estimation groupée pondérée par effets aléatoires significative (changement de l'expression, log₂ : −1,273 ; intervalle de confiance à 95 %, −1,625 à −0,920 ; taux de faux positifs = 0,016), tandis que les trois autres gènes ne présentaient pas un soutien statistique comparable entre les cohortes. Une analyse de coupure virtuelle au niveau cellulaire unique a ensuite été réalisée sur un sous-ensemble équilibré de patients composé de 2 400 cellules malignes sélectionnées parmi 4 916 cellules éligibles provenant de 20 tumeurs de GBM de type sauvage IDH chez des adultes. Au cours de cinq exécutions indépendantes, 3, 15, 4 et 7 gènes descendants robustes ont été identifiés respectivement pour ATG7, RPTOR, MAP1LC3A et CHMP6. Les ensembles consensus obtenus comprenaient 17 gènes uniques, RND3 étant partagé par les quatre cibles. Une analyse Gene Ontology a révélé un enrichissement des processus d'adhésion cellulaire et de surface cellulaire, tandis qu'aucun chemin biologique KEGG ou Reactome n'est resté significatif après correction pour tests multiples. Dans leur ensemble, ces résultats permettent de hiérarchiser MAP1LC3A pour des investigations expérimentales futures, tout en distinguant l'association génétique, la concordance d'expression dans la tumeur et la perturbation computationnelle de l'existence d'une preuve définitive de causalité ou de mécanisme.
Introduction
Le glioblastome (GBM) reste une malignité paradigmatique réfractaire au traitement. Malgré une classification moléculaire de plus en plus précise et une prise en charge pluridisciplinaire, les améliorations durables des résultats pour les patients ont été limitées1. Chez les patients aptes sur le plan médical, la prise en charge actuelle consiste en une résection maximale sûre, suivie d'une radiothérapie associée à une témozolomide concomitante et adjuvante, un régime établi dans un essai randomisé marquant et maintenu dans les lignes directrices cliniques actuelles1,2. Néanmoins, l'infiltration diffuse et l'hétérogénéité cellulaire et moléculaire importante limitent un contrôle durable de la maladie, et la plupart des patients finissent par présenter une progression ou une récidive, pour lesquelles aucun traitement standard universellement efficace n'existe1,3. Ce fossé persistant entre les progrès dans la caractérisation de la maladie et les résultats cliniques souligne la nécessité d'identifier des dépendances moléculaires biologiquement pertinentes pouvant guider de nouvelles stratégies thérapeutiques pour le GBM.
La ferroptose est une forme dépendante du fer de mort cellulaire régulée, caractérisée par une peroxydation incontrôlée des phospholipides et une défaillance des défenses antioxydantes cellulaires, ce qui la distingue mécanistiquement de l'apoptose et des autres programmes canoniques de mort cellulaire4,5. Ce processus revêt une importance particulière dans le cas du GBM, où des altérations génétiques et une plasticité métabolique modifient l'homéostasie du fer, l'équilibre redox et le métabolisme lipidique. Des profils génomiques et lipidomiques intégrés ont démontré que la délétion de CDKN2A redistribue les acides gras polyinsaturés oxydables, créant ainsi une sensibilité à la ferroptose dépendante du génotype dans les modèles de GBM6. De même, des analyses appariées de tumeurs primaires et récidivantes ont identifié des altérations associées à la rechute dans GPX4, ACSL4 et d'autres régulateurs de la ferroptose7. On a également montré que la modulation expérimentale des voies de défense contre la ferroptose influence la sensibilité au témozolomide dans les cellules de GBM et les modèles xénogreffés8. Dans leur ensemble, ces résultats identifient la ferroptose comme une vulnérabilité thérapeutique biologiquement plausible dans le GBM. Toutefois, ils reflètent principalement des associations liées à l'état tumoral ou des observations expérimentales dépendantes du contexte, et n'établissent pas si une variation constitutive de l'expression des gènes liés à la ferroptose contribue à une prédisposition héréditaire au GBM.
La plupart des études humaines portant sur la ferroptose dans le gliome se sont appuyées sur des analyses d'expression différentielle, de modélisation de la survie et de sous-typage moléculaire à l'aide des jeux de données TCGA, CGGA et GEO9,10. Bien que ces études aient établi la pertinence pronostique des programmes transcriptionnels liés à la ferroptose, leur conception observationnelle ne permet pas de déterminer si une expression génique altérée contribue à la prédisposition au GBM ou si elle constitue plutôt une conséquence du développement tumoral. Des analyses de randomisation mendélienne à l'échelle du transcriptome ont ensuite identifié des gènes régulés génétiquement et dépendants du tissu associés au risque de gliome, tandis que des études plus récentes basées sur des locus de caractères quantitatifs d'expression (eQTL) et de protéines (pQTL) ont commencé à hiérarchiser des cibles thérapeutiques potentielles pour le GBM11,12. Néanmoins, les recherches antérieures ont généralement adopté des approches orientées vers le transcriptome entier ou vers des cibles médicamenteuses, plutôt que d'évaluer un ensemble prédéfini et complet de gènes liés à la ferroptose. De plus, peu d'études ont intégré une vaste étude d'association génomique (GWAS) sur le GBM avec une randomisation mendélienne de réplication utilisant une ressource eQTL indépendante, suivie d'une évaluation à travers plusieurs cohortes transcriptomiques tumeur–contrôle. Cette distinction est importante car la régulation génétique de l'expression des gènes varie considérablement selon les tissus, et les associations eQTL dérivées du sang ne peuvent pas être supposées refléter les effets régulateurs au sein des tumeurs cérébrales11,13. Par conséquent, un cadre intégratif combinant association génétique, randomisation mendélienne en phase de réplication, transcriptomique tumorale trans-cohortes et prédiction fonctionnelle basée sur des cellules uniques provenant de patients est nécessaire pour identifier des gènes liés à la ferroptose soutenus par des preuves convergentes de leur implication dans le GBM.
Cette étude a examiné si l'expression génétiquement régulée des gènes liés à la ferroptose est associée à la susceptibilité au GBM. Une randomisation mendélienne en phase de découverte et en phase de réplication a été combinée à des analyses d'expression génique menées sur trois cohortes transcriptomiques indépendantes de tumeurs et de contrôles. Les gènes soutenus par les deux phases de la randomisation mendélienne ont ensuite été évalués à partir de données transcriptomiques unicellulaires provenant de patients, en utilisant une perturbation virtuelle afin de caractériser les réponses transcriptionnelles prédites dans les cellules malignes. Plutôt que de hiérarchiser les gènes uniquement selon leurs signatures d'expression tumorale, ce cadre analytique en plusieurs étapes exploite d'abord la variation génétique héréditaire, puis évalue les profils d'expression pertinents pour la maladie conjointement avec des profils de perturbation computationnelle résolus à l'échelle cellulaire. Les preuves convergentes ainsi obtenues ont permis de hiérarchiser les gènes liés à la ferroptose pour des investigations expérimentales futures dans le GBM.
Protocole
La présente étude a été dispensée de l'examen éthique par le comité d'éthique médicale du Premier hôpital populaire de Zhaoqing (numéro de référence B2026-08-03). L'étude a utilisé des données génétiques et transcriptomiques rétrospectivement collectées au niveau résumé et dé-identifiées, y compris des données à accès contrôlé approuvées par un comité d'accès aux données provenant d'EGAD00010001657 et des ensembles de données obtenus auprès de GEO, eQTLGen et GTEx, conformément à leurs conditions d'accès et d'utilisation applicables. Aucun nouveau participant n'a été recruté, aucun biospécimen n'a été collecté et aucune donnée identifiable au niveau des participants n'a été consultée. L'approbation éthique et le consentement éclairé pour les études initiales ont été obtenus par les producteurs respectifs des données, et les données à accès contrôlé ont été utilisées conformément à l'accord d'accès aux données applicable.
Conception de l'étude
Cette étude a utilisé un cadre multistage afin de hiérarchiser les gènes liés à la ferroptose associés à la susceptibilité du glioblastome (GBM) et d'évaluer leurs effets transcriptionnels pertinents pour la maladie (Figure 1). Premièrement, les gènes liés à la ferroptose, recensés à partir de FerrDb V2, ont été évalués à l'aide d'une randomisation mendélienne à deux échantillons (MR) combinée à des données de locus quantitatif d'expression en cis (cis-eQTL) et à une vaste étude d'association pangénomique sur le GBM (GWAS). La MR pondérée par la variance inverse (IVW) a servi de méthode de criblage principale, la randomisation mendélienne pondérée bayésienne (BWMR) a fourni une évaluation complémentaire de la robustesse, et un jeu de données eQTL indépendant a été utilisé pour la phase de réplication. Deuxièmement, les gènes soutenus par les analyses génétiques ont été évalués dans trois cohortes transcriptomiques indépendantes de tumeurs et de témoins, suivies d'une méta-analyse inter-cohorte. Troisièmement, des données transcriptomiques unicellulaires provenant de patients ont été utilisées pour réaliser une perturbation virtuelle des gènes dans les cellules malignes et identifier des réponses transcriptionnelles en aval reproductibles. Ces réponses ont ensuite été caractérisées par des analyses d'enrichissement fonctionnel et d'analyse de réseaux partagés. Dans l'ensemble, les analyses génétiques avaient pour objectif d'identifier les gènes associés à la susceptibilité au GBM, tandis que les analyses transcriptomiques et unicellulaires ont évalué la concordance biologique et généré des hypothèses destinées à une validation expérimentale ultérieure.
Sources de données
Les gènes liés à la ferroptose ont été obtenus à partir de FerrDb V2, fournissant 483 gènes uniques codant des protéines humaines après harmonisation des symboles géniques et élimination des entrées en double14. Les statistiques sommaires des locus quantitatifs d'expression en cis (cis-eQTL) sur l'ensemble du sang provenant du Consortium eQTLGen ont été utilisées comme jeu de données d'exposition pour la randomisation mendélienne (MR) au stade de découverte, tandis que les données cis-eQTL sur l'ensemble du sang de la version V10 de GTEx ont servi de jeu de données d'exposition indépendant pour la MR au stade de réplication11,15. Les associations avec le résultat du GBM ont été obtenues à partir de statistiques sommaires d'études d'association pangénomique (GWAS) sous accès contrôlé disponibles via l'European Genome-phenome Archive, comprenant 6 183 cas et 18 169 témoins d'ascendance européenne16. L'expression au niveau tissulaire des gènes génétiquement prioritaires a été évaluée dans trois cohortes indépendantes de Gene Expression Omnibus (GEO) : GSE196533, comprenant 61 échantillons de gliome de grade 4 annotés comme GBM dans les métadonnées déposées et neuf échantillons cérébraux non néoplasiques ; GSE4290, comprenant des échantillons de GBM et des échantillons cérébraux non tumoraux provenant d'épilepsie ; et GSE116520, contenant des spécimens appariés du centre tumoral et de la zone périvertumeuse ainsi que des témoins non néoplasiques17,18,19. Des données Smart-seq2 issues de patients provenant de GSE131928 ont été utilisées pour l'analyse de perturbation virtuelle des cellules malignes20. Les caractéristiques des jeux de données et leurs rôles analytiques respectifs sont résumés dans Tableau 1. Toutes les analyses ont été réalisées à l'aide de jeux de données préalablement collectés et anonymisés, pour lesquels une approbation éthique et un consentement éclairé avaient été obtenus dans les études initiales.
Sélection des instruments génétiques et harmonisation des données
Les instruments candidats ont été restreints aux locus de caractères quantitatifs d'expression en cis (cis-eQTLs) associés à l'expression génique à un seuil de signification au niveau du génome entierP < 5 × 10⁻8). Les variants ont été regroupés à l'aide du panel de référence européen du projet 1000 génomes avec un seuil de déséquilibre de liaison (LD) de r2 < 0,001 dans une fenêtre de 10 000 kb. Les gènes conservant moins de trois instruments indépendants après regroupement en fonction de la liaison déséquilibrée (clumping) ont été exclus de l'analyse principale de randomisation mendélienne (MR). Étant donné l'objectif de criblage exploratoire, un minimum de trois instruments avait été préspecifié afin de conserver les gènes bénéficiant d'un soutien faible mais solide par des eQTL cis, tout en permettant une estimation par la méthode IVW utilisant plusieurs instruments. Ce seuil était associé à un regroupement rigoureux selon la liaison déséquilibrée (LD clumping) et un filtrage strict basé sur la statistique F ; les estimations reposant uniquement sur trois ou quatre instruments ont été interprétées avec prudence, et des analyses de sensibilité n'ont été réalisées que lorsque les méthodes s'y prêtaient. La puissance des instruments a été évaluée pour chaque variant à l'aide de la statistique F (F = β2/SE2), où β et SE représentent respectivement l'estimation de l'effet cis-eQTL et son erreur standard. Les variants avec un F < 10 ont été exclus pour minimiser le biais dû à un instrument faible21,22Les jeux de données relatifs à l'exposition et au résultat ont été harmonisés en alignant les allèles d'effet et les directions d'effet. Les variants en double, les variants non disponibles dans le jeu de données GWAS du GBM et les variants présentant un codage allélique incompatible ont été exclus. Étant donné que les fréquences des allèles d'effet n'étaient pas disponibles pour le GWAS du GBM, les variants palindromiques à orientation de brin ambiguë ont été supprimés plutôt que déduits. Pour la même raison, un test formel de directionnalité de Steiger n'a pas été réalisé.
Analyses de randomisation mendélienne
L'association entre l'expression génique prédite génétiquement et la susceptibilité au GBM a été évaluée à l'aide d'une randomisation mendélienne à deux échantillons (MR). À l'étape de découverte, seuls les gènes possédant au moins trois instruments indépendants de locus quantitatif de caractères d'expression en cis (cis-eQTL) ont été inclus, et la méthode pondérée par l'inverse de la variance (IVW) a été utilisée comme approche analytique principale. Les estimations d'effet ont été exprimées sous forme de rapports de cotes (OR) avec des intervalles de confiance à 95 % (IC) par augmentation d'une unité de l'expression génique prédite génétiquement. Afin de tenir compte des tests multiples effectués sur l'ensemble des gènes évalués, les valeurs P obtenues par IVW ont été ajustées selon la procédure de Benjamini–Hochberg23. Les gènes présentant une valeur P < 0,05 et un taux de faux positifs (BH-FDR) de Benjamini–Hochberg < 0,20 ont été conservés comme candidats exploratoires. Ce seuil relativement permissif de FDR a été choisi afin de réduire l'exclusion prématurée de gènes potentiellement pertinents durant l'étape de découverte ; par conséquent, le statut de candidat a été interprété conjointement avec les analyses ultérieures, plutôt que comme une preuve confirmatoire. Une randomisation mendélienne pondérée par approche bayésienne (BWMR) a ensuite été appliquée aux candidats identifiés à l'étape de découverte, en utilisant les mêmes instruments harmonisés24. La concordance entre les résultats IVW et BWMR a été évaluée selon la significativité statistique et le sens de l'effet. Lorsque le nombre d'instruments disponibles le permettait, un test Q de Cochran, un test d'interception MR-Egger, une analyse MR-PRESSO et des analyses de type « laisser-un-de-hors » (leave-one-out) ont été réalisés afin d'évaluer l'hétérogénéité, la pléiotropie horizontale, la présence de variants aberrants influents, ainsi que l'effet de chaque polymorphisme nucléotidique unique (SNP) individuel22.
La réplication à l'étape MR a été réalisée à l'aide des données cis-eQTL de sang total de GTEx V10. La méthode du ratio de Wald a été appliquée lorsqu'un seul instrument était disponible, tandis que la méthode IVW a été utilisée pour les gènes possédant deux instruments ou plus. La réplication a été définie par un P < 0,05, un BH-FDR < 0,20 et une direction d'effet cohérente avec l'estimation correspondante à l'étape de découverte. Étant donné que plusieurs estimations de réplication GTEx reposaient sur un ou deux seuls instruments, elles ont été interprétées comme une preuve supplémentaire en faveur de la réplication plutôt que comme une preuve indépendante de causalité.
Évaluation transcriptomique transversale de cohortes
Les quatre gènes prioritaires identifiés par les analyses de randomisation mendélienne (MR) aux stades de découverte et de réplication ont été évalués dans trois cohortes transcriptomiques indépendantes. Pour GSE196533, les données brutes de comptage issues du séquençage ARN ont été analysées à l’aide de DESeq225. Les gènes dont les valeurs de comptage étaient inférieures à 10 dans tous les échantillons sauf deux ont été exclus, tandis que les quatre gènes cibles ont été conservés indépendamment du filtrage d’expression. L’expression différentielle a été évaluée entre 61 échantillons de gliome de grade 4 annotés comme GBM dans les métadonnées déposées et neuf échantillons de tissu cérébral non néoplasique.
Pour GSE4290, quatre échantillons dépourvus de diagnostic histopathologique explicite ont été exclus, laissant 77 échantillons de GBM et 23 échantillons de tissu cérébral non tumoral. Les intensités des puces à ADN traitées ont été transformées en log2, normalisées par quantiles et analysées à l'aide de modèles linéaires robustes de Bayes empirique mis en œuvre dans limma26. Lorsque plusieurs sondes étaient associées au même gène, la sonde présentant la plus forte expression moyenne parmi tous les échantillons inclus a été sélectionnée indépendamment de la significativité de l'expression différentielle.
GSE116520 comprenait des échantillons appariés de tumeur centrale et de tissu périvasculaire provenant de 17 patients, ainsi que huit témoins non néoplasiques. Les données d'expression normalisées par transformation logarithmique et normalisation quantile, déposées, ont été analysées à l'aide de limma. Les corrélations intra-patient entre les échantillons de tumeur centrale et périvasculaires ont été prises en compte à l'aide d'un blocage au niveau du patient et de la fonction duplicateCorrelation. La comparaison préspecifiée entre tumeur centrale et témoin a été utilisée pour la méta-analyse transversale de cohorte, tandis que les comparaisons périvasculaires et la tendance ordonnée témoin–périvascular–tumeur centrale ont été évaluées séparément.
Les changements différentiels log2 spécifiques à chaque étude et les erreurs standards ont été regroupés à l’aide d’un modèle à effets aléatoires par maximum de vraisemblance restreinte avec inférence de Hartung–Knapp, tel qu’implémenté dans metafor. L’hétérogénéité entre les études a été évaluée à l’aide de la statistique Q de Cochran et de l’indice I2. Les valeurs P regroupées pour les quatre gènes cibles ont été ajustées selon la procédure de Benjamini–Hochberg. Un soutien transcritomique fort a été défini par un taux de fausses découvertes (FDR) en méta-analyse < 0,05, une significativité du FDR au niveau des cohortes dans au moins deux jeux de données, et des directions d’effet concordantes dans les trois cohortes.
Analyse virtuelle de coupure unique à la cellule
Des données Smart-seq2 dérivées de patients provenant de GSE131928 ont été utilisées pour évaluer les quatre gènes confirmés par MR dans les cellules malignes. Les cellules malignes adultes ont été identifiées selon les annotations fournies dans l'étude initiale, et un nombre égal de cellules a été échantillonné aléatoirement pour chaque patient éligible afin de minimiser le déséquilibre dans la représentation des patients. Un faux knockout virtuel a été réalisé à l'aide de scTenifoldKnk et répété sur cinq itérations indépendantes. Les gènes présentant une valeur P ajustée selon Benjamini–Hochberg < 0,05 dans une itération individuelle ont été considérés comme significatifs. Les gènes en aval reproduits dans au moins trois des cinq itérations ont été définis comme l'ensemble de consensus principal, tandis qu'un critère plus strict de quatre sur cinq a été appliqué pour l'analyse de sensibilité. Ces résultats ont été interprétés comme des prédictions informatiques de perturbation transcriptionnelle, et non comme une preuve de régulation moléculaire directe.
Enrichissement fonctionnel et analyse de réseau partagé
Une analyse d'enrichissement fonctionnel a été réalisée à l'aide des gènes en aval spécifiques aux cibles identifiés de manière reproductible dans au moins trois des cinq simulations de coupure virtuel. L'enrichissement des voies de l'ontologie génique (GO), de l'Encyclopédie de Kyoto des gènes et des génomes (KEGG) et de Reactome a été évalué à l'aide de tests hypergéométriques unilatéraux, les 1 004 gènes inclus dans l'inférence du réseau servant de jeu génique de référence. Les valeurs P ont été ajustées séparément pour chaque base de données d'annotation selon la procédure de Benjamini–Hochberg, et une valeur P ajustée < 0,05 a été considérée comme statistiquement significative.
Un réseau bipartite a été construit pour représenter les relations entre les quatre cibles d'invalidation génique et leurs gènes en aval consensuels. Les gènes associés à plusieurs cibles ont été identifiés en fonction de leur degré partagé, et le recoupement entre les ensembles de gènes spécifiques à chaque cible a été quantifié à l'aide de décomptes d'intersections et d'indices de Jaccard. Les arêtes du réseau représentent des associations entre des perturbations computationnelles reproductibles et ne doivent pas être interprétées comme une preuve d'interactions moléculaires directes.
Analyse statistique et reproductibilité
Sauf indication contraire, les tests statistiques étaient bilatéraux, et les comparaisons multiples ont été corrigées à l’aide de la procédure de Benjamini–Hochberg. Les critères de significativité spécifiques à chaque analyse sont décrits dans les sous-sections correspondantes. Toutes les analyses ont été réalisées à l’aide de R ou de Python. Les procédures aléatoires ont utilisé des graines prédéfinies, et le code d’analyse, les versions des logiciels ainsi que les paramètres détaillés ont été archivés afin d’assurer la reproductibilité. Tous les jeux de données avaient été collectés et désidentifiés préalablement ; une approbation éthique et un consentement éclairé avaient été obtenus dans les études initiales.
Résultats
Sélection des gènes liés à la ferroptose et des instruments génétiques
Un total de 483 gènes liés à la ferroptose a été obtenu à partir de FerrDb V2 (Figure 1). Parmi ceux-ci, 315 gènes ont été appariés au jeu de données eQTLGen et présentaient au moins un locus quantitatif de caractères d'expression cis (cis-eQTL) candidat. Après regroupement par déséquilibre de liaison, 250 gènes conservaient au moins trois instruments candidats indépendants. Suite à la recherche des variants associés au critère de jugement, à l'harmonisation des allèles et au contrôle qualité, 226 gènes ont fourni des estimations valides par la méthode du poids inverse (IVW) et ont été inclus dans l'analyse de randomisation mendélienne (MR) de découverte (Fichier Supplémentaire 1). Tous les 3 578 instruments conservés dans l'analyse de découverte présentaient des valeurs de F-statistique >10 (minimum : 29,72 ; médiane : 70,76), indiquant l'absence de biais dû à des instruments faibles. Parmi les 34 gènes candidats identifiés à l'étape de découverte, la F-statistique médiane était de 67,22, avec un minimum de 29,72.
L'étape de découverte par RM identifie des gènes liés à la ferroptose associés à la susceptibilité au GBM
Parmi les 226 gènes produisant des estimations valides par IVW, 34 ont satisfait aux critères préétablis du stade de découverte : P IVW < 0,05 et taux de fausses découvertes de Benjamini–Hochberg (BH-FDR) < 0,20, comprenant 19 associations inverses et 15 associations positives avec la susceptibilité au GBM (Figure 2A). Les preuves statistiques les plus fortes ont été observées pour RPTOR (OR = 0,809, IC 95 % 0,737–0,887 ; P = 7,02 × 10⁻6 ; BH-FDR = 0,0012) et PLA2G6 (OR = 1,568, IC 95 % 1,281–1,920 ; P = 1,08 × 10⁻5 ; BH-FDR = 0,0012). Les estimations de la randomisation mendélienne pondérée bayésienne (BWMR) étaient significatives au seuil nominal et concordantes en direction avec les estimations IVW pour l'ensemble des 34 gènes candidats (Figure 2A). Les tests d'interception MR-Egger n'ont fourni aucune preuve de pléiotropie horizontale directionnelle. Le test de Cochran Q a détecté une hétérogénéité uniquement pour MAP1LC3A (P = 0,043), tandis que les tests globaux MR-PRESSO n'ont identifié aucune distorsion significative due à des valeurs aberrantes parmi les 33 gènes évaluables. L'analyse MR-PRESSO n'a pas pu être réalisée pour SLC7A11 car seuls trois instruments étaient disponibles (Supplementary File 1). Les analyses gène par gène de type « exclure un à la fois », les graphiques de comparaison des méthodes et les graphiques en embout de flèche pour les quatre gènes ultérieurement répliqués sont présentés dans la Supplementary Figure 1. Les 34 candidats du stade de découverte ont ensuite été évalués à l'aide d'un jeu de données eQTL indépendant. Parmi ceux-ci, 26 disposaient d'instruments suffisants pour la MR de réplication, et quatre ont satisfait aux critères préétablis de réplication.
La réplication MR indépendante soutient quatre candidats identifiés lors de la phase de découverte
Parmi les 34 candidats identifiés lors de la phase de découverte, 26 possédaient au moins un instrument cis-eQTL éligible dans les données de sang total de GTEx V10 et ont été inclus dans l'analyse MR de réplication. Treize gènes étaient représentés par un seul instrument et ont été analysés à l'aide du rapport de Wald, tandis que les 13 gènes restants comportaient deux instruments ou plus et ont été analysés selon la méthode IVW. Quatre gènes ont satisfait aux critères de réplication préétablis de P < 0,05, de FDR-BH < 0,20, et d'une direction d'effet concordante avec l'estimation obtenue lors de la phase de découverte (Figure 2B ; Fichier Supplémentaire 1).
Une expression génétiquement prédite plus élevée d'ATG7 (OR = 0,523, IC à 95 % = 0,330–0,831 ; P = 0,0061 ; BH-FDR = 0,0976), de RPTOR (OR = 0,718, IC à 95 % = 0,563–0,915 ; P = 0,0075 ; BH-FDR = 0,0976) et de MAP1LC3A (OR = 0,830, IC à 95 % = 0,717–0,959 ; P = 0,0117 ; BH-FDR = 0,1012) était associée à une susceptibilité réduite au GBM. En revanche, une expression génétiquement prédite plus élevée de CHMP6 était associée à une susceptibilité accrue (OR = 1,378, IC à 95 % = 1,032–1,838 ; P = 0,0295 ; BH-FDR = 0,1916). Le sens des effets pour les quatre gènes était cohérent avec celui observé dans l'analyse de découverte. Aucune hétérogénéité significative n’a été détectée parmi les gènes pour lesquels le Q de Cochran pouvait être calculé (Supplementary File 1). Étant donné que la plupart des estimations de réplication reposaient sur un ou deux seuls instruments, les tests formels de pléiotropie horizontale et de distorsion par valeurs aberrantes ne pouvaient s'appliquer qu'à un sous-ensemble limité de gènes (Supplementary File 1). Les graphiques diagnostiques correspondants pour MAP1LC3A, RPTOR et CHMP6 sont fournis dans la Supplementary Figure 2. ATG7 n’était pas éligible aux analyses diagnostiques multi-instruments, car son estimation de réplication était dérivée d’un ratio de Wald à instrument unique.
L'évaluation transcriptomique transversale de cohortes hiérarchise MAP1LC3A
Les quatre gènes soutenus par les analyses de MR aux stades de découverte et de réplication ont été évalués dans trois cohortes transcriptomiques indépendantes représentant différentes plates-formes d'expression (Figure 3 ; Tableau 2 ; Figure supplémentaire 3 ; Fichier supplémentaire 1). L'expression de MAP1LC3A était systématiquement réduite dans le tissu tumoral dans les trois cohortes : GSE196533 (log₂FC = −1.553, FDR au niveau du transcriptome = 3,21 × 10⁻8), GSE4290 (log₂FC = −1,243, FDR = 3,55 × 10⁻12) et GSE116520, noyau tumoral par rapport au témoin non néoplasique (log₂FC = −1,204, FDR = 9,78 × 10⁻8). Dans GSE116520, l'expression de MAP1LC3A était également plus faible dans le tissu périvulsaire que dans les témoins non néoplasiques (log₂FC = −1,056, FDR = 2,85 × 10⁻6), avec une tendance significative à la diminution allant du témoin au tissu périvulsaire puis au noyau tumoral (coefficient de tendance = −0,531, FDR = 8,59 × 10⁻6).
Une méta-analyse à effets aléatoires a confirmé une expression significativement plus faible de MAP1LC3A dans le tissu tumoral (log₂FC global = −1,273, IC 95 % de −1,625 à −0,920 ; P de Hartung–Knapp = 0,0041 ; BH-FDR = 0,016), sans preuve d'hétérogénéité entre les études (I2 = 0 % ; Fichier supplémentaire 1). L'expression de RPTOR était systématiquement plus faible dans les trois cohortes et atteignait une signification au niveau du transcriptome dans GSE4290, bien que son estimation globale ne soit pas statistiquement significative (log₂FC = −0,258, IC 95 % de −0,655 à 0,139 ; BH-FDR = 0,196 ; I2 = 42,3 %). L'expression de CHMP6 était constamment plus élevée dans le tissu tumoral et atteignait la signification dans GSE4290, tandis que l'estimation globale restait non significative (log₂FC = 0,150, IC 95 % de −0,130 à 0,431 ; BH-FDR = 0,196 ; I2 = 52,0 %). ATG7 présentait de faibles différences, directionnellement incohérentes, entre les cohortes, et aucune association globale significative (log₂FC = 0,036, IC 95 % de −0,073 à 0,146 ; BH-FDR = 0,291 ; I2 = 0 %). Ainsi, parmi les quatre gènes validés par MR, MAP1LC3A présentait les preuves les plus fortes et les plus cohérentes d'une expression différentielle associée à la tumeur.
La suppression virtuelle au niveau de la cellule unique révèle des perturbations transcriptionnelles spécifiques et reproductibles selon la cible
Les quatre gènes validés par MR ont été évalués dans 4 916 cellules malignes éligibles provenant de 20 tumeurs de GBM de type sauvage pour IDH chez des adultes issues de GSE131928. ATG7, RPTOR, MAP1LC3A et CHMP6 ont été détectés respectivement dans 42,78 %, 45,89 %, 46,89 % et 31,90 % des cellules malignes éligibles, ce qui soutient leur inclusion dans l'analyse de coupure virtuelle (Figure supplémentaire 4 ; Fichier supplémentaire 1). Afin de minimiser le déséquilibre dans la représentation des patients, 120 cellules ont été échantillonnées aléatoirement à partir de chaque tumeur, produisant un jeu de données équilibré par patient composé de 2 400 cellules malignes. Chaque gène cible a été évalué dans cinq analyses indépendantes, conduisant à 20 analyses de coupure virtuelle.
En utilisant le critère prédéfini de BH-FDR < 0,05 dans au moins trois des cinq exécutions, le coupure virtuelle a identifié trois gènes en aval robustes pour ATG7, 15 pour RPTOR, quatre pour MAP1LC3A et sept pour CHMP6 (Figure 4A ; Figure supplémentaire 5). L'ensemble consensus de RPTOR comprenait RND3, NKAIN4, CHI3L1, CDKN1A, BCAN, PDGFRA, OLIG1, LHFPL3, ENO2, HILPDA, LGALS3, ANXA1, CNTN1, NAMPT et SCRG1. L'ensemble consensus de MAP1LC3A incluait RND3, CD24, BCAN et S100B, tandis que les ensembles consensus d'ATG7 et de CHMP6 contenaient respectivement trois et sept gènes. L'application du critère de significativité plus strict dans au moins quatre des cinq exécutions a réduit les ensembles consensus à deux gènes associés à ATG7, neuf gènes associés à RPTOR, un gène associé à MAP1LC3A et quatre gènes associés à CHMP6. Collectivement, ces analyses ont identifié des perturbations transcriptionnelles reproductibles et spécifiques à la cible au sein du réseau régulateur des cellules malignes inféré.
Les analyses d'enrichissement fonctionnel et de réseau partagé identifient des réponses convergentes liées à l'adhésion
Les quatre ensembles consensus spécifiques aux cibles comprenaient 17 gènes uniques en aval. L'analyse du réseau a identifié RND3 comme le seul gène partagé par les quatre inactivations virtuelles, tandis que BCAN, CD24 et NKAIN4 étaient chacun partagés par trois des quatre inactivations virtuelles. CHI3L1, LHFPL3 et PDGFRA étaient partagés par deux cibles, tandis que les dix gènes restants étaient spécifiques à une cible (Figure 4B,C). Le plus grand chevauchement absolu par paire a été observé entre RPTOR et CHMP6, qui partageaient six gènes en aval. Selon la similarité de Jaccard, le chevauchement proportionnel le plus élevé a été observé entre ATG7 et CHMP6 (indice de Jaccard = 0,429), suivi de RPTOR–CHMP6 et MAP1LC3A–CHMP6 (les deux à 0,375).
L'analyse de l'ontologie génique du jeu de consensus combiné de 17 gènes a identifié dix termes significativement enrichis après correction de Benjamini–Hochberg (Figure 4D ; Figure supplémentaire 6). Les termes enrichis concernant les processus biologiques incluaient l'adhésion cellulaire (BH-FDR = 0,0028), la régulation positive de la prolifération de la population cellulaire (BH-FDR = 0,0028), la réponse inflammatoire (BH-FDR = 0,0139), la régulation positive de la cascade ERK1/ERK2 (BH-FDR = 0,0165) et l'adhésion cellule-cellule (BH-FDR = 0,0196). Les termes significatifs relatifs aux composants cellulaires comprenaient la surface cellulaire, la région extracellulaire, la membrane plasmique et la matrice extracellulaire, tandis que la liaison aux glucides constituait le seul terme de fonction moléculaire significativement enrichi. L'adhésion cellulaire est restée significativement enrichie lorsque l'analyse a été restreinte aux gènes partagés par au moins deux cibles, ainsi que lorsque le critère de consensus plus strict de quatre sur cinq séries a été appliqué. Aucun chemin métabolique KEGG ou Reactome n'est resté significatif après correction BH.
L'enrichissement spécifique à la cible était le plus important pour RPTOR, dont l'ensemble consensus de 15 gènes était enrichi pour quatre termes de processus biologique et quatre termes de composant cellulaire (Figure supplémentaire 7). L'ensemble consensus de MAP1LC3A était enrichi pour l'adhésion cellulaire (BH-FDR = 8,74 × 10⁻4) et le développement du système nerveux central (BH-FDR = 0,0364), tandis que l'ensemble consensus de CHMP6 était enrichi pour l'adhésion cellulaire (BH-FDR = 0,0075). Aucun terme de l'ontologie génique n'a atteint un BH-FDR < 0,05 pour l'ensemble consensus de trois gènes ATG7.
DISPONIBILITÉ DES DONNÉES :
Des jeux de données transcriptomiques publics sont disponibles dans GEO sous les numéros d'accession GSE196533, GSE4290, GSE116520 et GSE131928. Les statistiques sommaires sur les résultats du GBM sont déposées sous accès contrôlé dans l'Archive Européenne du Génome-phénotype (EGA), jeu de données EGAD00010001657 (https://ega-archive.org/datasets/EGAD00010001657). L'accès est géré par le comité responsable d'accès aux données et nécessite une demande approuvée ainsi qu'un accord d'accès aux données. Conformément à l'accord applicable, les auteurs ne sont pas autorisés à redistribuer les fichiers ni à les déposer dans un référentiel public. Les données sommaires d'eQTL sont disponibles auprès du Consortium eQTLGen et de GTEx, selon leurs conditions d'accès et d'utilisation respectives. Les scripts d'analyse soutenant cette étude sont fournis en tant que Fichier de code supplémentaire 1 et Fichier de code supplémentaire 2.
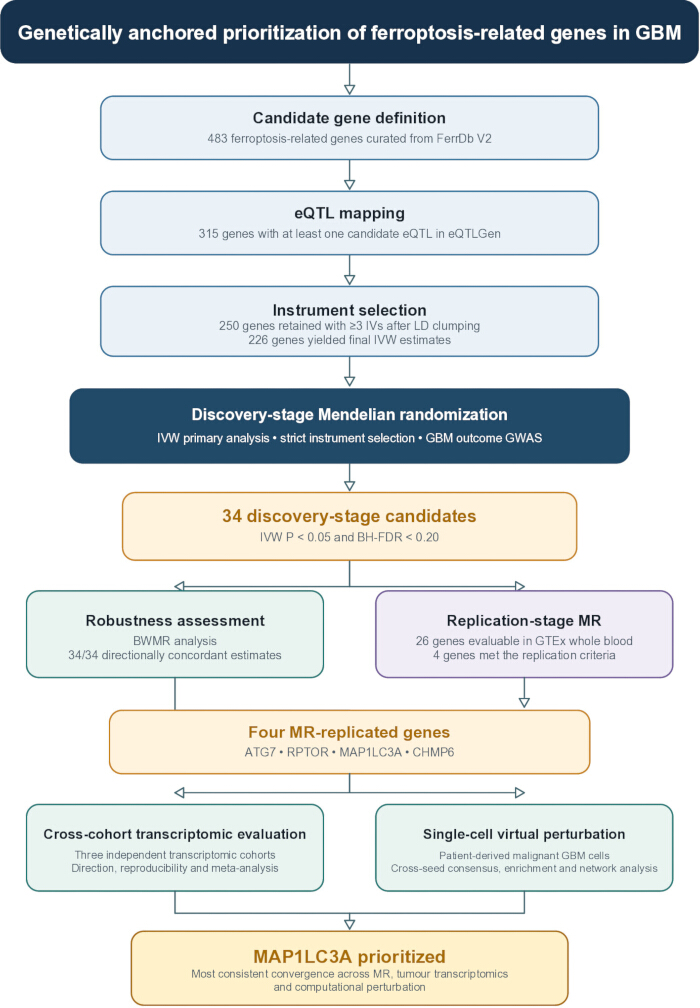
Figure 1: Conception de l'étude et cadre d'intégration des preuves pour la priorisation génétiquement ancrée des gènes liés à la ferroptose dans le glioblastome. Les gènes liés à la ferroptose, recensés à partir de FerrDb V2, ont été associés à eQTLGen, analysés pour identifier des instruments indépendants de locus quantitatif de caractères d'expression en cis (cis-eQTL), puis évalués par une randomisation mendélienne (MR) de stade de découverte. Parmi les 483 gènes recensés, 315 présentaient au moins un cis-eQTL candidat, 250 conservaient au moins trois instruments indépendants après regroupement par déséquilibre de liaison (LD), et 226 produisaient des estimations valides pondérées par la variance inverse (IVW) après recherche des variants associés au caractère d'intérêt et harmonisation des allèles. Trente-quatre gènes ont satisfait aux critères du stade de découverte, puis la randomisation mendélienne pondérée bayésienne (BWMR) a été utilisée pour évaluer la robustesse. Vingt-six gènes ont ensuite pu être évalués lors de la phase de réplication par MR en utilisant les cis-eQTLs de sang total de GTEx V10. Quatre gènes (ATG7, RPTOR, MAP1LC3A et CHMP6) ont satisfait aux critères de réplication et ont été davantage analysés à l’aide de trois cohortes transcriptomiques indépendantes et par perturbation virtuelle dans des cellules malignes dérivées de patients. L’intégration de ces analyses complémentaires a permis de prioriser MAP1LC3A pour des investigations ultérieures. BWMR = randomisation mendélienne pondérée bayésienne ; eQTL = locus quantitatif de caractères d'expression ; IVW = pondération par la variance inverse ; LD = déséquilibre de liaison ; MR = randomisation mendélienne. Veuillez cliquer ici pour visualiser une version agrandie de cette figure.
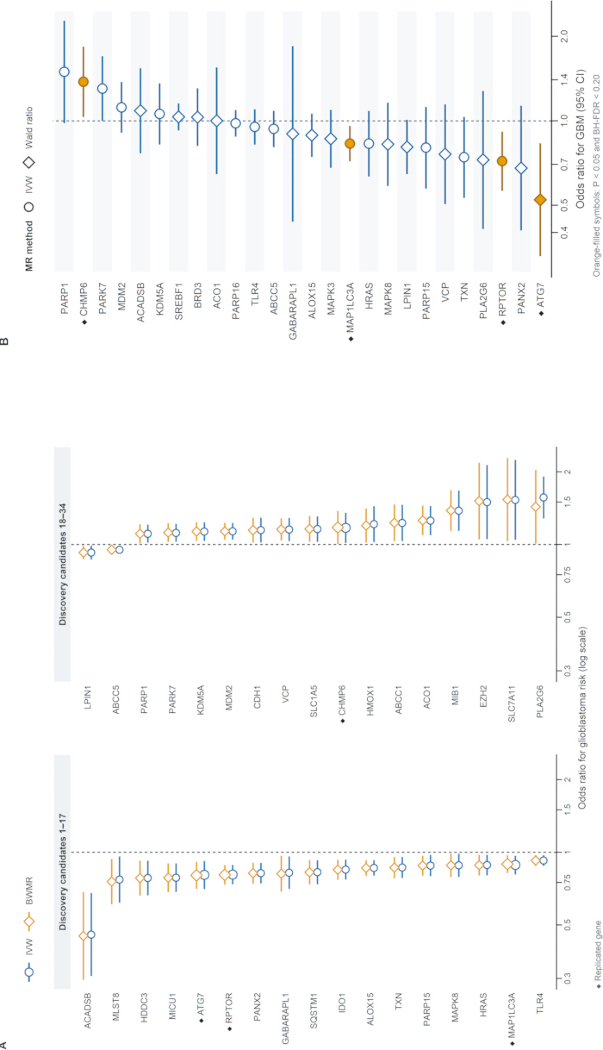
Figure 2: Robustesse au stade de découverte et réplication indépendante des effets des gènes liés à la ferroptose prédits génétiquement sur le risque de glioblastome. (A) Graphiques en forêt appariés comparant les estimations par randomisation mendélienne pondérée par la variance inverse (IVW) et par randomisation mendélienne bayésienne pondérée (BWMR) pour les 34 gènes remplissant les critères du stade de découverte (IVW P < 0,05 et taux de fausses découvertes de Benjamini–Hochberg (BH-FDR) < 0,20). Les carrés précédant les noms des gènes indiquent les gènes ultérieurement confirmés dans l'analyse de réplication indépendante. Le triangle identifie LPIN1, pour lequel les estimations IVW et BWMR présentaient des directions d'effet discordantes. (B) Graphique en forêt des 26 gènes évalués dans le jeu de données de réplication. Les estimations IVW sont indiquées pour les gènes possédant au moins deux instruments, tandis que les estimations par ratio de Wald sont indiquées pour les gènes possédant un seul instrument. Les symboles remplis en orange identifient ATG7, RPTOR, MAP1LC3A et CHMP6, qui ont satisfait aux critères de réplication (P < 0,05 et BH-FDR < 0,20). Les points et les lignes horizontales représentent respectivement les rapports de cotes (OR) et les intervalles de confiance à 95 % (IC) ; la ligne verticale en pointillés indique OR = 1. Les OR sont affichés sur une échelle logarithmique. GBM = glioblastome. Veuillez cliquer ici pour afficher une version agrandie de cette figure.
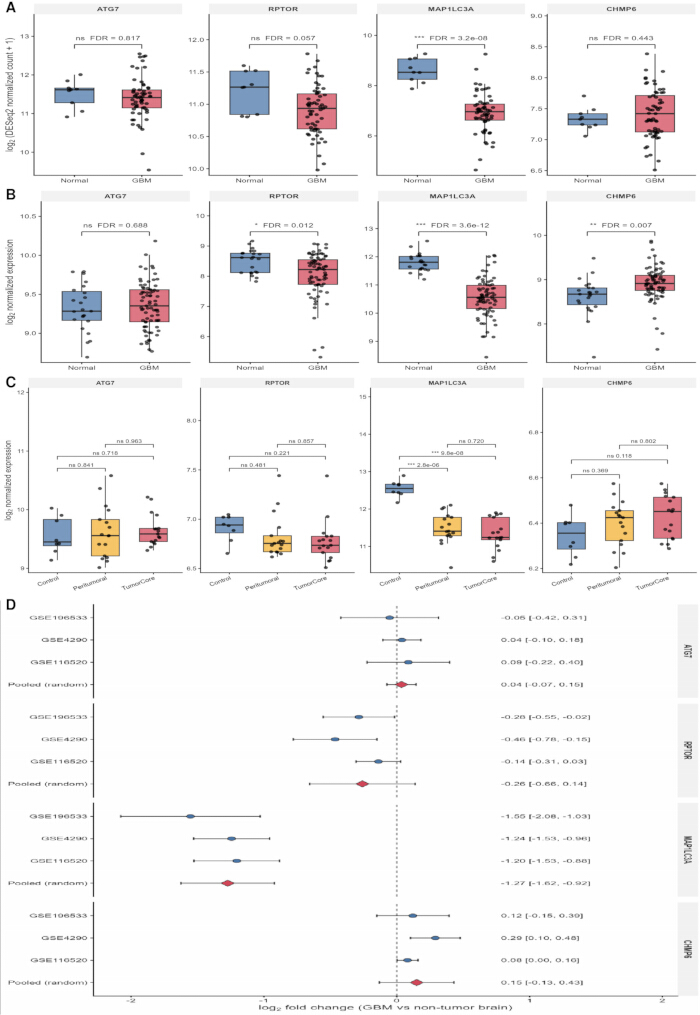
Figure 3 : Évaluation transcriptomique croisée entre cohortes des quatre gènes validés par la randomisation mendélienne. Expression des gènes ATG7, RPTOR, MAP1LC3A et CHMP6 dans GSE196533 (61 échantillons de gliome de grade 4 annotés comme GBM dans les métadonnées déposées et neuf échantillons de cerveau non néoplasique) ; (A) GSE4290 (77 échantillons de GBM et 23 échantillons de cerveau non tumoral) ; (B) et GSE116520 (17 échantillons du centre tumoral, 17 échantillons péri-tumoraux appariés au patient et huit échantillons contrôles non néoplasiques) ; (C) Les boîtes indiquent la médiane et l’intervalle interquartile (IIQ), les moustaches s’étendent jusqu’à 1,5 × IIQ, et les points représentent les échantillons individuels. (D) Changements moyens logarithmiques en base 2 spécifiques à chaque étude et méta-analyse à effets aléatoires comparant le tissu tumoral ou du centre tumoral au tissu cérébral non néoplasique. Les points et les lignes horizontales indiquent les estimations spécifiques à chaque étude et les intervalles de confiance à 95 %, tandis que les losanges représentent les estimations groupées par maximum de vraisemblance restreinte avec inférence de Hartung–Knapp. Des valeurs positives indiquent une expression plus élevée dans le tissu tumoral. FDR = taux de faux positifs ; GBM = glioblastome ; MR = randomisation mendélienne. Veuillez cliquer ici pour visualiser une version agrandie de cette figure.
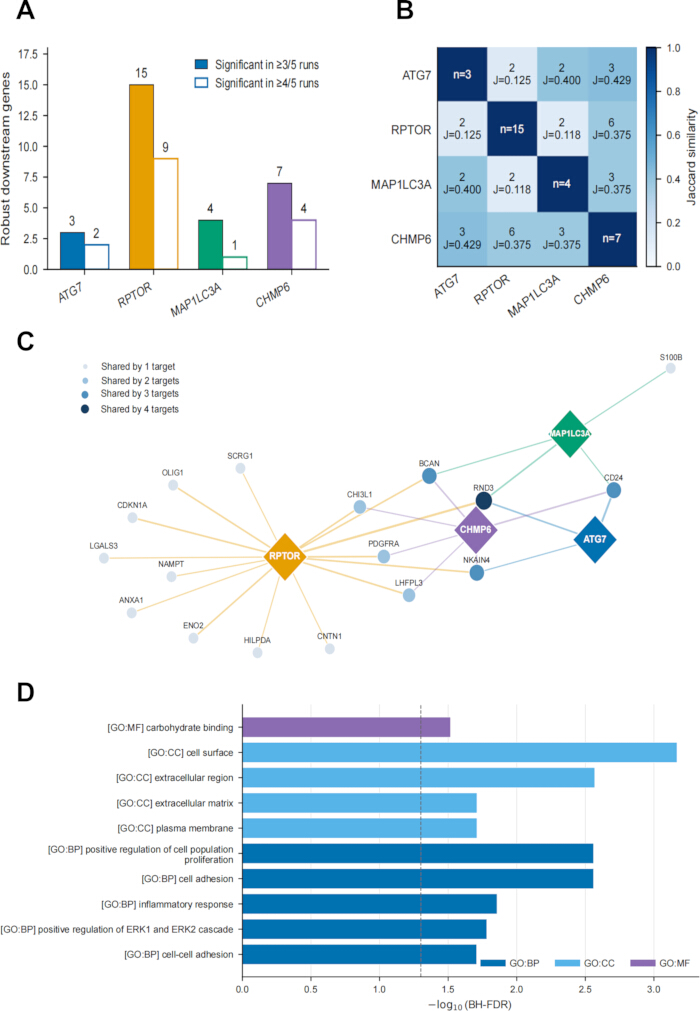
Figure 4 : Convergence croisée entre graines et convergence fonctionnelle de l'invalidation virtuelle unicellulaire dans les cellules de glioblastome malin. (A) Nombre de gènes descendants robustes identifiés pour chaque cible selon le critère préétabli de significativité dans au moins trois des cinq exécutions, ainsi que selon le critère plus strict de quatre exécutions sur cinq. (B) Chevauchement par paires des gènes descendants ; les cellules indiquent les effectifs de chevauchement et les coefficients de similarité de Jaccard. (C) Réseau bipartite reliant les quatre cibles d'invalidation virtuelle (losanges) aux gènes descendants robustes (cercles). Les couleurs des arêtes indiquent la cible perturbée, tandis que la taille des cercles et l'intensité de leur couleur reflètent le nombre de cibles partageant chaque réponse descendante. Les arêtes représentent des associations entre des perturbations computationnelles reproductibles, et non des interactions moléculaires directes. (D) Enrichissement significatif en ontologie génique (Gene Ontology) de l'ensemble consensus de 17 gènes regroupés. La longueur des barres représente −log10(BH-FDR), la ligne pointillée indique le seuil de significativité (BH-FDR = 0,05), et les couleurs distinguent le processus biologique (BP), le composant cellulaire (CC) et la fonction moléculaire (MF). L'analyse d'enrichissement fonctionnel a utilisé comme fond génomique le réseau régulateur équilibré entre patients comprenant 1 004 gènes. Aucun chemin biologique KEGG ou Reactome n'est resté significatif après correction de Benjamini–Hochberg. Abréviations : BH-FDR = taux de fausses découvertes selon Benjamini–Hochberg ; BP = processus biologique ; CC = composant cellulaire ; GO = ontologie génique (Gene Ontology) ; KEGG = Encyclopédie de Kyoto des gènes et des génomes (Kyoto Encyclopedia of Genes and Genomes) ; MF = fonction moléculaire. Veuillez cliquer ici pour visualiser une version agrandie de cette figure.
Tableau 1 : Aperçu des sources de données et de leurs rôles analytiques dans l'étude. Les effectifs d'échantillons représentent les observations incluses dans les analyses actuelles. BH-FDR = taux de fausses découvertes de Benjamini–Hochberg ; cis-eQTL = locus de caractères quantitatifs d'expression en cis ; EGA = European Genome-phenome Archive ; GBM = glioblastome ; GTEx = Genotype-Tissue Expression ; GWAS = étude d'association pangénomique ; IV = variable instrumentale ; MR = randomisation mendélienne ; RNA-seq = séquençage ARN. Veuillez cliquer ici pour télécharger ce tableau.
Tableau 2 : Preuves transcriptomiques transversales pour les quatre gènes validés par MR. Les valeurs représentent les variations d'expression exprimées en log₂ pour le GBM ou le tissu du centre tumoral par rapport au tissu cérébral non néoplasique. Les estimations regroupées ont été obtenues à l'aide de modèles à effets aléatoires par maximum de vraisemblance restreinte avec inférence de Hartung–Knapp. CI = intervalle de confiance ; FDR = taux de faux positifs. Veuillez cliquer ici pour télécharger ce tableau.
Figure supplémentaire 1 : Analyses de sensibilité de la randomisation mendélienne au stade de découverte pour les quatre gènes répliqués. Les gènes MAP1LC3A, ATG7, RPTOR et CHMP6 sont chacun présentés comme suit : (A) analyse d'exclusion un par un ; (B) graphique de dispersion comparant les méthodes ; et (C) graphique en entonnoir.Veuillez cliquer ici pour télécharger ce fichier.
Figure supplémentaire 2 : Graphiques diagnostiques de la randomisation mendélienne au stade de la réplication pour les trois gènes répliqués possédant plusieurs instruments. Les gènes MAP1LC3A, RPTOR et CHMP6 sont chacun présentés comme suit : (A) un graphique en nuage de points comparant les méthodes ; et (B) un graphique en entonnoir. ATG7 a été évalué à l’aide d’un ratio de Wald à instrument unique et n’était donc pas éligible aux graphiques diagnostiques à instruments multiples.Veuillez cliquer ici pour télécharger ce fichier.
Figure supplémentaire 3 : Analyse en composantes principales des trois cohortes transcriptomiques indépendantes. (A) Cohorte de séquençage ARN GSE196533. (B) Cohorte Affymetrix GPL570 GSE4290. (C) Cohorte Illumina GPL10558 GSE116520. L'analyse en composantes principales a été réalisée à l'aide des 500 gènes ou sondes présentant la plus grande variance intra-cohorte. Chaque point représente un échantillon biologique ; les couleurs indiquent les groupes de tissus ; les libellés des axes indiquent la variance expliquée par chaque composante principale.Veuillez cliquer ici pour télécharger ce fichier.
Figure supplémentaire 4 : Détection des quatre gènes validés par MR dans les cellules cancéreuses adultes atteintes de GBM. (A) Taux de détection globaux d’ATG7, RPTOR, MAP1LC3A et CHMP6 parmi 4 916 cellules malignes provenant de 20 tumeurs de GBM de type sauvage pour IDH chez l’adulte dans GSE131928/SCP393. (B) Taux de détection par patient pour les mêmes gènes. La couleur indique le pourcentage de cellules malignes avec un TPM > 0.Veuillez cliquer ici pour télécharger ce fichier.
Figure supplémentaire 5 : Répétabilité inter-séquences des signaux en aval du faux coupure virtuel. (A) Nombre de gènes en aval significatifs selon le test BH-FDR identifiés au cours de cinq exécutions indépendantes pour chaque cible. Les points représentent les séquences aléatoires, et les barres horizontales indiquent les médianes. (B) Gènes en aval significatifs dans au moins trois des cinq exécutions. L’axe des abscisses indique le nombre d’exécutions significatives, les couleurs identifient la cible perturbée, et la taille des points représente la statistique médiane Z de scTenifoldKnk. Le gène cible lui-même a été exclu.Veuillez cliquer ici pour télécharger ce fichier.
Figure supplémentaire 6 : Analyses de sensibilité pour l'enrichissement groupé, partagé et basé sur un seuil strict. Enrichissement fonctionnel de (A) le consensus groupé défini par la significativité dans au moins trois des cinq exécutions ; (B) les gènes partagés par au moins deux cibles selon le critère trois-sur-cinq ; (C) le consensus strict groupé défini par la significativité dans au moins quatre des cinq exécutions ; et (D) les gènes partagés par au moins deux cibles selon le critère quatre-sur-cinq. L'axe des abscisses indique −log₁₀(P nominal), la taille des points reflète le nombre de chevauchements, et les couleurs désignent la base de données d'annotations. Les points pleins atteignent un BH-FDR < 0,05, tandis que les points creux désignent des termes exploratoires avec un P nominal < 0,05. Un fond de réseau régulateur de 1 004 gènes a été utilisé dans toutes les analyses.Veuillez cliquer ici pour télécharger ce fichier.
Figure supplémentaire 7 : Enrichissement fonctionnel ciblé de réponses robustes de faux knockout virtuel. Enrichissement des gènes en aval robustes suite à l'invalidation virtuelle de (AATG7 (BRPTOR ; (C) MAP1LC3A ; et (D) CHMP6. L'axe des abscisses représente −log₁₀(nominal P), la taille des points reflète le nombre de chevauchements, et les couleurs indiquent GO : BP, GO : CC, GO : MF, KEGG ou Reactome. Les points pleins ont atteint le seuil BH-FDR < 0,05, tandis que les points ouverts indiquent des termes exploratoires avec une valeur nominale P < 0,05. Les 1 004 gènes composant le réseau régulatoire équilibré entre patients ont servi de fond pour l'enrichissement.Veuillez cliquer ici pour télécharger ce fichier.
Fichier supplémentaire 1 : Tableaux supplémentaires soutenant la priorisation en plusieurs étapes des gènes liés à la ferroptose associés à la susceptibilité au glioblastome. Ce fichier supplémentaire contient tous les tableaux supplémentaires appuyant les analyses génétiques, transcriptomiques et unicellulaires. Il inclut le criblage et la sélection des gènes liés à la ferroptose et des instruments génétiques ; les résultats complets de la randomisation mendélienne aux stades de découverte et de réplication, ainsi que les analyses de sensibilité, comprenant les évaluations de l'hétérogénéité, de la pléiotropie horizontale et de MR-PRESSO ; les caractéristiques des cohortes, les analyses de différentiel d'expression et la méta-analyse inter-cohortes des gènes priorisés génétiquement ; ainsi que les analyses de coupure virtuelle unicellulaire, les évaluations de reproductibilité, les analyses d'enrichissement fonctionnel et les résultats des réseaux partagés.Veuillez cliquer ici pour télécharger ce fichier.
Fichier de code supplémentaire 1 : Scripts R et Python utilisés pour les analyses de randomisation mendélienne, transcriptomiques, de coupure virtuelle au niveau cellulaire unique, d'enrichissement fonctionnel et de réseaux décrites dans cette étude.Veuillez cliquer ici pour télécharger ce fichier.
Fichier de code supplémentaire 2 : Scripts d'analyse complémentaires, routines de traçage et utilitaires de flux de travail utilisés pour générer les résultats de l'étude, les figures et les sorties supplémentaires.Veuillez cliquer ici pour télécharger ce fichier.
Discussion
Cette étude a intégré des analyses d'association génétique, une randomisation mendélienne (MR) de stade de réplication, de la transcriptomique tumorale et une modélisation à partir de cellules uniques issues de patients afin de hiérarchiser les gènes liés à la ferroptose associés à la susceptibilité au glioblastome (GBM). Le criblage de 483 gènes sélectionnés par rapport à une étude d'association génomique (GWAS) sur le GBM, comprenant 6 183 cas et 18 169 témoins, a identifié 34 candidats au stade de découverte, dont quatre—ATG7, RPTOR, MAP1LC3A et CHMP6—ont été confirmés lors de l'analyse de réplication utilisant une ressource indépendante de locus de caractères quantitatifs d'expression (eQTL). Les preuves sont devenues progressivement plus sélectives au-delà des analyses génétiques. MAP1LC3A était constamment sous-régulé dans trois cohortes tumorales indépendantes et est resté significatif dans la méta-analyse transversale des cohortes. Ce profil d'expression tumorale complétait l'association protectrice observée dans les analyses de MR, bien que les deux approches abordent des aspects distincts de la biologie de la maladie. RPTOR et CHMP6 ont montré des preuves transcriptomiques concordantes en termes de direction, mais moins concluantes, tandis qu'ATG7 ne présentait pas de soutien reproductible au niveau tissulaire. Un faux knockout virtuel a en outre révélé des réponses transcriptionnelles spécifiques à la cible, mais partiellement superposées, dans les cellules malignes. Collectivement, ces couches analytiques successives ont affiné les résultats initiaux de MR en distinguant les candidats selon leur degré de soutien pertinent pour la maladie, MAP1LC3A se démarquant comme le candidat le plus solide dans l'ensemble.
Une grande partie des données humaines existantes reliant la ferroptose au gliome provient d'études d'expression tumorale. Des analyses de cohortes publiques telles que TCGA, CGGA et d'autres ont répétitivement identifié des signatures liées à la ferroptose associées à la survie, au grade tumoral, aux caractéristiques moléculaires et aux caractéristiques immunitaires9,27. Bien que ces études aient établi la pertinence clinique des programmes transcriptionnels liés à la ferroptose, les profils d'expression obtenus à partir de tumeurs établies ne permettent pas de distinguer les gènes associés à la susceptibilité des modifications transcriptionnelles survenant au cours de la progression tumorale ou reflétant des différences de composition cellulaire. Les analyses génétiques offrent une perspective complémentaire. Robinson et ses collègues ont intégré des données GWAS sur le gliome avec des jeux de données d'eQTL cérébraux et sanguins totaux à l'aide de la randomisation mendélienne (MR) et de la colocalisation, en priorisant des gènes de susceptibilité putatifs présentant des effets dépendant des tissus, et en démontrant une concordance limitée entre les estimations issues du sang et du cerveau11. Plus récemment, une étude intégrative basée sur la MR à partir d'eQTL et de pQTL a combiné des preuves génétiques avec des analyses d'expression différentielle et de colocalisation afin de sélectionner GPX7 et CXCL10 pour une évaluation ultérieure dans le GBM12. En revanche, la présente étude est partie d'un ensemble prédéfini de gènes liés à la ferroptose et a évalué des candidats génétiquement priorisés par une MR de réplication, des transcriptomes tumoraux et une perturbation computationnelle à résolution cellulaire. L'affinement progressif passant de 34 associations identifiées à quatre gènes confirmés, puis finalement à MAP1LC3A comme seul gène présentant une expression différentielle statistiquement significative entre cohortes, illustre la valeur discriminante de l'intégration de plusieurs approches analytiques complémentaires. Il est important de noter que les analyses transcriptomiques n'avaient pas pour but de valider les instruments génétiques dérivés du sang, mais plutôt de déterminer si les gènes priorisés génétiquement présentaient également des profils d'expression reproductibles et pertinents pour la maladie.
MAP1LC3A suscite un intérêt particulier car les résultats actuels élargissent sa caractérisation antérieure en tant que marqueur associé aux tumeurs et pronostique. Une étude bioinformatique antérieure, basée sur plusieurs cohortes, a intégré MAP1LC3A dans une signature de six gènes associée à la survie et à la récidive du GBM, et a également signalé une altération de la méthylation de MAP1LC3A, bien que sa contribution à la prédisposition à la maladie soit restée non résolue28. Ici, une expression plus élevée de MAP1LC3A prédite génétiquement a été régulièrement associée à une moindre prédisposition au GBM lors des deux étapes de la randomisation mendélienne. En outre, MAP1LC3A a été de façon reproductible sous-régulé dans trois cohortes indépendantes de tumeurs, malgré des différences concernant les plateformes d'expression, la composition des échantillons et les méthodologies analytiques, et l'estimation regroupée de l'analyse méta-analytique n'a montré aucune hétérogénéité détectable entre les études. Bien que ces résultats n'établissent pas que la diminution de l'expression de MAP1LC3A initie le GBM, ils fournissent une preuve plus solide reliant ce gène à la prédisposition à la maladie que les seules analyses d'expression différentielle dans les tumeurs. MAP1LC3A code pour des isoformes LC3A appartenant à la famille des protéines ATG8 chez les mammifères. Bai et ses collègues ont démontré que la variante 1 de LC3A subit une conjugaison avec la phosphatidyléthanolamine pour former LC3A-II et se localise aux autophagosomes lors de l'autophagie induite29. On a également montré que le renouvellement autophagique de la ferritine influence la sensibilité à la ferroptose dans les cellules de GBM, notamment en cas de privation de cystine et dans des modèles dépendants de ALDH1A330,31. Toutefois, ces études ont principalement examiné la LC3-II totale ou LC3B, plutôt que MAP1LC3A spécifiquement. Dans les analyses unicellulaires actuelles, une perturbation virtuelle de MAP1LC3A a produit des réponses en aval reproductibles, enrichies pour des processus liés à l'adhésion cellulaire. Prises ensemble, ces observations identifient MAP1LC3A comme un candidat ciblé pour étudier la manière dont s'intersectent, dans le GBM, la régulation associée à l'autophagie, la sensibilité à la ferroptose et le comportement des cellules malignes.
Les gènes restants répliqués par MR ont reçu des niveaux de soutien variables lors des analyses ultérieures. Une expression de RPTOR génétiquement prédite plus élevée était associée à une susceptibilité plus faible au GBM lors des deux étapes de MR, et son expression était systématiquement plus basse dans les trois cohortes de tumeurs, bien que l'estimation groupée n'ait pas atteint la signification statistique. L'extinction virtuelle de RPTOR a produit le plus grand ensemble de modifications transcriptionnelles en aval reproductibles, avec un enrichissement impliquant la signalisation ERK, les réponses inflammatoires, la prolifération cellulaire et l'adhésion cellulaire. Bien que ces résultats soient compatibles avec le rôle établi de RPTOR en tant que protéine d'échafaudage de mTORC1, l'ampleur de la réponse transcriptionnelle ne doit pas être interprétée comme une preuve d'un effet causal plus fort32. CHMP6 a également montré des associations MR concordantes lors des deux étapes, une expression génétiquement prédite plus élevée étant associée à une susceptibilité accrue au GBM. Bien que l'expression de CHMP6 soit systématiquement augmentée dans les trois cohortes de tumeurs, l'intervalle de confiance groupé incluait la valeur nulle, et l'hétérogénéité entre les études était modérée. Des preuves expérimentales démontrant que la réparation membranaire dépendante de CHMP6 via ESCRT-III supprime la mort cellulaire ferroptotique fournit un contexte mécanistique plausible, bien que ces résultats aient été obtenus en dehors de modèles de GBM33. En revanche, ATG7 a montré une association génétique protectrice répliquée, mais aucun motif d'expression tumoral reproductible. L'extinction virtuelle n'a identifié que trois gènes en aval robustes, et aucune catégorie fonctionnelle n'est restée significative après correction pour tests multiples. Des études expérimentales antérieures ont impliqué l'autophagie dépendante de ATG7 dans l'adaptation au GBM et la réponse au traitement34,35, mais ces observations ne permettent pas de résoudre le soutien inter-plateformes relativement faible observé ici. Par conséquent, RPTOR, CHMP6 et ATG7 restent des candidats secondaires plausibles, tandis que MAP1LC3A a présenté la convergence la plus forte à travers les analyses génétiques, transcriptomiques et de perturbation computationnelle.
Les analyses de perturbation virtuelle n'ont pas identifié une voie en aval unique partagée par les quatre gènes prioritaires. Au lieu de cela, les réponses transcriptionnelles reproductibles présentaient seulement un chevauchement partiel, RND3 étant le seul gène en aval commun à l'ensemble des réseaux spécifiques aux cibles. La convergence fonctionnelle la plus nette concernait les processus d'adhésion cellulaire et les processus extracellulaires ou à la surface cellulaire, et l'enrichissement en adhésion cellulaire restait significatif selon le critère croisé de sélection plus strict. Aucune voie KEGG ou Reactome n'est restée significative après correction pour tests multiples. Cette observation est notable car, bien que les gènes candidats aient été sélectionnés parmi un ensemble curé de gènes liés à la ferroptose, leurs effets prédits en aval dans les cellules de GBM malignes n'étaient pas dominés par les voies canoniques de ferroptose. Plutôt, leur contribution à la susceptibilité au GBM pourrait impliquer des processus cellulaires plus larges au sein desquels fonctionne le mécanisme lié à la ferroptose. Les analyses actuelles n'établissent pas de mécanisme moléculaire partagé ni ne désignent RND3 comme médiateur causal. Elles mettent plutôt en évidence un ensemble restreint de programmes cellulaires malignes, en particulier ceux liés à l'adhésion cellulaire, qui méritent des investigations expérimentales futures.
Cette étude doit être interprétée comme un cadre de priorisation étagé plutôt que comme une attribution définitive de gènes causaux. Aucune couche analytique individuelle n’a été considérée comme concluante ; au lieu de cela, les associations identifiées au stade de découverte ont été évaluées successivement à l’aide de la méthode BWMR, d’une ressource indépendante d’eQTL, de trois cohortes transcriptomiques et d’une modélisation régulatoire à partir de cellules malignes issues de patients. Plusieurs limites doivent être reconnues. Premièrement, le seuil de découverte BH-FDR de < 0,20 visait le criblage de candidats plutôt qu’une inférence confirmatoire, et seulement 26 des 34 candidats identifiés au stade de découverte ont pu être évalués lors de la réplication. Deuxièmement, plusieurs gènes étaient représentés par un nombre relativement faible d’instruments génétiques, et aucune analyse formelle de puissance au niveau génique n’a été réalisée ; par conséquent, les associations faibles ou nulles doivent être interprétées avec prudence. Le seuil d’éligibilité de trois instruments a accru la couverture génique, mais a limité l’étendue et la stabilité des analyses de sensibilité pour les gènes représentés par seulement trois ou quatre variants. Bien que tous les instruments retenus au stade de découverte aient dépassé le seuil conventionnel F > 10, et que les candidats aient été davantage évalués par BWMR et par réplication indépendante, ces mesures de sécurité ne compensent pas entièrement le faible nombre d’instruments ; ces estimations doivent donc rester exploratoires. Troisièmement, les deux ressources d’eQTL provenaient de sang total et pourraient ne pas refléter fidèlement les effets régulateurs spécifiques au cerveau ou aux tumeurs. Quatrièmement, les statistiques sommaires GWAS disponibles pour le GBM ne contenaient pas les informations nécessaires pour effectuer des tests de directionnalité de Steiger ou des analyses formelles de colocalisation. Par conséquent, il reste incertain si les signaux d’association eQTL et GBM à chaque locus proviennent du même variant causal ou de variants distincts en déséquilibre de liaison. Bien que la méthode BWMR soit conçue pour tenir compte d’une pléiotropie horizontale répandue et d’instruments aberrants, la concordance entre IVW et BWMR ne peut exclure une pléiotropie résiduelle ni remplacer des analyses formelles de colocalisation. De plus, les cohortes transcriptomiques ont évalué des tumeurs déjà établies plutôt que la prédisposition à la maladie, et l’une des cohortes comprenait des échantillons de gliome de grade 4 et non exclusivement des GBM de type sauvage pour IDH. Enfin, les analyses en cellule unique ont été limitées aux cellules malignes d’un seul jeu de données et ont modélisé par calcul les perturbations régulatrices plutôt que de les tester expérimentalement ; elles n’ont pas évalué les cellules non malignes présentes dans le microenvironnement tumoral ni reproduit directement la perturbation génique in vitro ou in vivo. En conséquence, les variants causaux sous-jacents, les mécanismes spécifiques aux types cellulaires et les conséquences biologiques restent à établir.
Parmi les quatre gènes dupliqués, MAP1LC3A a montré le soutien le plus constant à travers les analyses génétiques, transcriptomiques et unicellulaires. RPTOR, CHMP6 et ATG7 conservaient des preuves issues des analyses MR en deux étapes, mais présentaient un soutien moins cohérent dans les analyses transcriptomiques et de perturbation ultérieures. En conséquence, MAP1LC3A devrait être considéré comme un candidat prioritaire pour des investigations supplémentaires, plutôt qu’un gène causal établi ou une cible thérapeutique. De futures études devraient d’abord déterminer si les signaux d’association entre les eQTL et le GBM sont colocalisés, en utilisant des jeux de données complets au niveau du locus ainsi que des ressources régulatrices spécifiques au cerveau ou aux tumeurs. Des études de perturbation bidirectionnelles ultérieures menées sur des modèles de GBM dérivés de patients pourraient ensuite examiner la sensibilité à la ferroptose, la peroxydation lipidique, la survie cellulaire et les programmes transcriptionnels liés à l’adhésion identifiés par les analyses computationnelles. De telles expériences seront nécessaires pour distinguer les effets sur la prédisposition héréditaire à la maladie de ceux influençant le comportement des cellules tumorales déjà établies, et pour tester directement les associations convergentes identifiées dans cette étude.
Déclarations de divulgation
Les auteurs déclarent qu’ils n’ont aucun intérêt concurrentiel.
Remerciements
Les auteurs remercient l'équipe de génomique du cancer de l'Institute of Cancer Research pour avoir fourni un accès aux statistiques sommaires de l'étude d'association pangénomique sur les gliomes via l'European Genome-phenome Archive (ensemble de données EGAD00010001657). La génération initiale de ces données a été financée par Cancer Research UK, y compris le Bobby Moore Fund, le Wellcome Trust et le DJ Fielding Medical Research Trust (C1298/A8362).
Matériaux
| Nom | Entreprise | Numéro de catalogue | Commentaires |
|---|---|---|---|
| BWMR | Paquet R | BWMR | Randomisation mendélienne pondérée bayésienne |
| DESeq2 | Bioconductor | Version 1.46.0 | Analyse différentielle d'expression à partir de données de séquençage ARN |
| FerrDb V2 | FerrDb | Version 2 | Source de 483 gènes liés à la ferroptose, soigneusement sélectionnés |
| Microarray massif du glioblastome | NCBI Gene Expression Omnibus | GSE4290 | Cohorte d'évaluation transcriptomique |
| Résumé des statistiques de GWAS du glioblastome | European Genome-phenome Archive | EGAD00010001657 | Données d'issue sous accès contrôlé ; 6 183 cas et 18 169 témoins |
| Séquençage ARN unicellulaire Smart-seq2 du glioblastome | NCBI Gene Expression Omnibus | GSE131928 | Analyse virtuelle de coupure d'expression dans les cellules malignes |
| Séquençage ARN massif du gliome de grade 4 | NCBI Gene Expression Omnibus | GSE196533 | Cohorte d'évaluation transcriptomique |
| Résumé des statistiques des eQTL cis du sang entier de GTEx | Projet Genotype-Tissue Expression | GTEx V10 | Données d'exposition en phase de réplication |
| limma | Bioconductor | Version 3.62.2 | Analyse différentielle d'expression sur microarray |
| metafor | Paquet R | Version 4.8-0 | Méta-analyse à effets aléatoires |
| R | Fondation R pour l'informatique statistique | Version 4.4.2 | Environnement de calcul statistique |
| scTenifoldKnk | Paquet R | Version 1.0.3 | Analyse unicellulaire de coupure d'expression virtuelle |
| Microarray massif du centre tumoral et de la zone périvertébrale | NCBI Gene Expression Omnibus | GSE116520 | Cohorte d'évaluation transcriptomique |
| TwoSampleMR | Paquet R | Version 0.6.29 | Randomisation mendélienne à deux échantillons |
| Résumé des statistiques des eQTL cis du sang entier | Consortium eQTLGen | eQTLGen | Données d'exposition en phase de découverte |
Références
- Weller M, et al. EANO guidelines on the diagnosis and treatment of diffuse gliomas of adulthood. Nat Rev Clin Oncol. 2021;18:170-186.
- Stupp R, et al. Radiotherapy plus concomitant and adjuvant temozolomide for glioblastoma. N Engl J Med. 2005;352:987-996.
- McBain C, et al. Treatment options for progression or recurrence of glioblastoma: a network meta-analysis. Cochrane Database Syst Rev. 2021;5:CD013579.
- Dixon SJ, et al. Ferroptosis: an iron-dependent form of nonapoptotic cell death. Cell. 2012;149:1060-1072.
- Stockwell BR, et al. Ferroptosis: A regulated cell death nexus linking metabolism, redox biology, and disease. Cell. 2017;171:273-285.
- Minami JK, et al. CDKN2A deletion remodels lipid metabolism, priming glioblastoma for ferroptosis. Cancer Cell. 2023;41:1048-1060.e1049.
- Kram H, et al. Glioblastoma relapses show increased markers of vulnerability to ferroptosis. Front Oncol. 2022;12:841418.
- Miao Z, et al. A targetable PRR11-DHODH axis drives ferroptosis- and temozolomide-resistance in glioblastoma. Redox Biol. 2024;73:103220.
- Liu HJ, et al. Ferroptosis-related gene signature predicts glioma cell death and glioma patient progression. Front Cell Dev Biol. 2020;8:538.
- Dong J, et al. Ferroptosis-related gene contributes to immunity, stemness, and predicts prognosis in glioblastoma multiforme. Front Neurol. 2022;13:829926.
- Robinson JW, et al. Transcriptome-wide Mendelian randomization study prioritizing novel tissue-dependent genes for glioma susceptibility. Sci Rep. 2021;11:2329.
- Zhang H, Wang Z, Qiao X, Wu J, Cheng C. Investigating potential drug targets for the treatment of glioblastoma: a Mendelian randomization study. BMC Cancer. 2025;25:654.
- GTEx Consortium. The GTEx Consortium atlas of genetic regulatory effects across human tissues. Science. 2020;369:1318-1330.
- Zhou N, et al. FerrDb V2: update of the manually curated database of ferroptosis regulators and ferroptosis-disease associations. Nucleic Acids Res. 2023;51:D571-D582.
- Võsa U, et al. Large-scale cis- and trans-eQTL analyses identify thousands of genetic loci and polygenic scores that regulate blood gene expression. Nat Genet. 2021;53:1300-1310.
- Melin BS, et al. Genome-wide association study of glioma subtypes identifies specific differences in genetic susceptibility to glioblastoma and non-glioblastoma tumors. Nat Genet. 2017;49:789-794.
- Zeng C, et al. Dissection of transcriptomic and epigenetic heterogeneity of grade 4 gliomas: implications for prognosis. Acta Neuropathol Commun. 2023;11:133.
- Sun L, et al. Neuronal and glioma-derived stem cell factor induces angiogenesis within the brain. Cancer Cell. 2006;9:287-300.
- Kruthika BS, et al. Transcriptome profiling reveals PDZ binding kinase as a novel biomarker in peritumoral brain zone of glioblastoma. J Neurooncol. 2019;141:315-325.
- Neftel C, et al. An integrative model of cellular states, plasticity, and genetics for glioblastoma. Cell. 2019;178:835-849.e821.
- Burgess S, Thompson SG. Avoiding bias from weak instruments in Mendelian randomization studies. Int J Epidemiol. 2011;40:755-764.
- Papadimitriou N, et al. Physical activity and risks of breast and colorectal cancer: a Mendelian randomisation analysis. Nat Commun. 2020;11:597.
- Song W, et al. Causal relationship between gut microbiota and lung squamous cell carcinoma: a bidirectional two-sample Mendelian randomization study. Postgrad Med J. 2025;101:526-534.
- Zhao J, et al. Bayesian weighted Mendelian randomization for causal inference based on summary statistics. Bioinformatics. 2020;36:1501-1508.
- Love MI, Huber W, Anders S. Moderated estimation of fold change and dispersion for RNA-seq data with DESeq2. Genome Biol. 2014;15:550.
- Ritchie ME, et al. limma powers differential expression analyses for RNA-sequencing and microarray studies. Nucleic Acids Res. 2015;43:e47.
- Yun D, et al. A novel prognostic signature based on glioma essential ferroptosis-related genes predicts clinical outcomes and indicates treatment in glioma. Front Oncol. 2022;12:897702.
- Li R, et al. Identification of candidate genes associated with prognosis in glioblastoma. Front Mol Neurosci. 2022;15:913328.
- Bai H, Inoue J, Kawano T, Inazawa J. A transcriptional variant of the LC3A gene is involved in autophagy and frequently inactivated in human cancers. Oncogene. 2012;31:4397-4408.
- Hayashima K, Kimura I, Katoh H. Role of ferritinophagy in cystine deprivation-induced cell death in glioblastoma cells. Biochem Biophys Res Commun. 2021;539:56-63.
- Wu Y, et al. ALDH1-mediated autophagy sensitizes glioblastoma cells to ferroptosis. Cells. 2022;11:4015.
- Carriere A, et al. ERK1/2 phosphorylate Raptor to promote Ras-dependent activation of mTOR complex 1 (mTORC1). J Biol Chem. 2011;286:567-577.
- Dai E, Meng L, Kang R, Wang X, Tang D. ESCRT-III-dependent membrane repair blocks ferroptosis. Biochem Biophys Res Commun. 2020;522:415-421.
- Comincini S, et al. microRNA-17 regulates the expression of ATG7 and modulates the autophagy process, improving the sensitivity to temozolomide and low-dose ionizing radiation treatments in human glioblastoma cells. Cancer Biol Ther. 2013;14:574-586.
- Wang L, et al. Autophagy mediates glucose starvation-induced glioblastoma cell quiescence and chemoresistance through coordinating cell metabolism, cell cycle, and survival. Cell Death Dis. 2018;9:213.