Cette étude développe un cadre d'optimisation de prompts en couches basé sur DeepSeek afin d'améliorer la compétence transférable en rédaction anglaise dans des contextes interculturels. Grâce à une chaîne de prompts en trois étapes et à une quasi-expérience menée auprès de 60 étudiants spécialisés en anglais, les résultats montrent une amélioration significative dans le groupe expérimental par rapport au groupe témoin.
Article de recherche
Optimisation des prompts DeepSeek pour l'enseignement de l'écriture en anglais interculturelle : une étude pratique sur la compétence de transfert
Dans cet article
Résumé
Résumé
Pour pallier la limitation selon laquelle l'enseignement traditionnel de la rédaction en anglais néglige le développement systématique du transfert linguistique et que les cadres de consignes existants ne s'adaptent pas à l'enseignement en classe, cette étude élabore un système hiérarchique d'entraînement au transfert fondé sur le modèle DeepSeek, couvrant quatre niveaux progressifs de tâches : phrase, paragraphe, discours et culture, toutes les tâches étant définies selon une structure en trois parties. Une bibliothèque de tâches en cinq dimensions — syntaxe, structure, culture, registre et logique — est établie, et des consignes ciblées sont automatiquement générées à partir des brouillons réels rédigés par les étudiants. Intégrée à l'architecture Mixture of Experts (MoE) du modèle, une chaîne imbriquée de consignes est développée afin de décomposer les tâches complexes en trois phases successives : réorganisation sémantique, révision linguistique et adaptation culturelle. En adoptant un dispositif quasi-expérimental, cette recherche recrute 60 étudiants de deuxième année spécialisés en anglais provenant d'une université, répartis en un groupe expérimental et un groupe témoin de 30 étudiants chacun, pour une intervention progressive étalée sur trois semaines et trois cycles d'entraînement. Les résultats post-expérimentation révèlent que le score de transfert culturel du groupe expérimental passe de 2,8 à 4,5, contre une augmentation de seulement 0,3 dans le groupe témoin ; le score moyen attribué par les enseignants progresse de 59,1 à 74,4 dans le groupe expérimental, contre une hausse de 60,1 à 64,9 dans le groupe témoin. La plupart des coefficients de corrélation entre l'évaluation par l'IA et celle des enseignants dépassent 0,8, et plus de 90 % des participants approuvent les fonctions de réécriture par l'IA et d'optimisation structurelle. En raison de la taille restreinte de l'échantillon dans cet essai, cette approche d'optimisation s'avère néanmoins réalisable pour une mise en œuvre en classes de rédaction en anglais universitaire.
Introduction
Dans l'enseignement de l'écriture en anglais dans un contexte interculturel, les apprenants non natifs font souvent face à une difficulté liée à une capacité insuffisante de transfert lorsqu'ils passent de la connaissance linguistique à l'application pratique1,2. Bien que les étudiants possèdent une certaine base grammaticale et词汇ulaire, ils éprouvent des difficultés à convertir efficacement les structures de phrases, les schémas syntaxiques et les expressions culturelles en écriture réelle, ce qui produit un langage figé et une pensée limitée, affectant ainsi la qualité globale de l'écriture3. De plus, les différences interculturelles en matière de structure linguistique, d'organisation logique et de normes pragmatiques aggravent encore la complexité du transfert en écriture4. Ces dernières années, les grands modèles linguistiques (LLMs) ont offert un nouveau soutien technique à l'enseignement de l'écriture5. Des outils d'écriture intelligents, tels que DeepSeek, ont démontré des capacités importantes en matière de génération et de restructuration linguistique. Toutefois, dans la pratique pédagogique, ils se limitent principalement à la correction superficielle de la langue et ne sont pas encore intégrés en profondeur dans un processus d'enseignement centré sur le développement de la compétence de transfert. Ils manquent d'orientation vers des objectifs pédagogiques et de maîtrise du comportement de génération6,7. Les applications courantes d'écriture assistée par IA restreignent généralement leurs fonctions à la correction d'erreurs grammaticales superficielles, plutôt que de viser le développement d'une compétence systématique de transfert, ce qui entraîne un contrôle insuffisant, du point de vue pédagogique, sur les sorties du modèle.
Les recherches existantes sur l'aide à la rédaction en anglais langue seconde (ESL) se répartissent en trois grandes catégories : les retours sur la rédaction basés sur des consignes traditionnelles, les interventions génériques de relecture par intelligence artificielle et la formation manuelle centrée sur le transfert. Premièrement, les recherches générales sur l'ingénierie des consignes privilégient l'optimisation technique des réponses aux questions et de la réécriture de textes, sans toutefois s'aligner sur les objectifs pédagogiques hiérarchisés du transfert8,9. Deuxièmement, l'enseignement type de l'ESL basé sur ChatGPT vise principalement à améliorer la précision globale de la rédaction, plutôt que le développement progressif du transfert syntaxique, structurel et interculturel10. Troisièmement, la pédagogie traditionnelle du transfert, fondée sur l'imitation et la rédaction contrastive, manque d'un retour d'information en boucle fermée appuyé par des outils intelligents11. Contrairement aux études précédentes, cette recherche personnalise des consignes hiérarchiques orientées vers le transfert, alignées sur des objectifs d'enseignement multiniveaux, et met en place un flux de travail d'auto-génération de consignes piloté par des exemples, formant ainsi un mécanisme d'entraînement unique en boucle fermée combinant génération par modèle, retour du professeur et révision par l'élève.
La littérature antérieure émet l'hypothèse d'un lien possible entre la divergence culturelle linguistique, les contraintes structurelles inhérentes aux modèles et des pratiques pédagogiques fragmentées, mais cette chaîne causale reste insuffisamment validée empiriquement dans les études existantes et constitue l'hypothèse centrale de recherche examinée dans cet article12,13. Concernant les caractéristiques intrinsèques de DeepSeek citées dans cet article, son interface d'instructions ouverte et sa conception de routage d'experts basée sur l'architecture MoE ont été documentées dans des rapports techniques existants sur les modèles ainsi que dans des recherches appliquées en linguistique. En s'appuyant sur ces caractéristiques documentées, la présente étude conçoit des chaînes de prompts imbriquées afin de décomposer des tâches complexes de transfert interculturel et développe des règles dynamiques de planification des sous-modèles pour des affectations de transfert différenciées. Axée sur le développement d'une capacité structurée de transfert, cette recherche explore une optimisation ciblée des prompts de DeepSeek, dans le but de transformer les grands modèles linguistiques d'outils universels d'édition textuelle en systèmes spécialisés d'entraînement au transfert pour l'enseignement de la rédaction en anglais au niveau universitaire.
Dans le domaine de la recherche sur l'écriture en langue seconde, le phénomène de transfert est depuis longtemps un sujet central14,15. La théorie traditionnelle du transfert linguistique se concentre principalement sur les effets de transfert positif et négatif de la langue maternelle dans le processus d'acquisition de la langue cible, en mettant particulièrement l'accent sur la phonétique, le vocabulaire et la syntaxe16. Mirzayev E a souligné que, dans l'enseignement de l'écriture en anglais langue seconde (ESL), le transfert négatif provenant de la langue maternelle reste un facteur clé limitant le développement des compétences rédactionnelles des étudiants17. À mesure que le champ de recherche s'élargit, la communauté académique a progressivement étendu son attention au transfert de structure rédactionnelle18. L'écriture interlangagière présente souvent des erreurs linguistiques et une fossilisation dues à de multiples facteurs19. Parallèlement, la théorie du transfert cognitif suscite également un intérêt croissant20. Cette théorie met l'accent sur les différences dans l'organisation cognitive et les schémas d'expression au cours du processus d'écriture. Par exemple, l'écriture occidentale privilégie un raisonnement linéaire et une logique explicite, tandis que la tradition chinoise préfère une approche en spirale et une ambiguïté sémantique. Il existe une tension marquée entre les deux. Ainsi, le transfert linguistique ne concerne pas seulement la conversion d'unités linguistiques, mais implique également l'adaptation et la transformation de structures de pensée et de normes culturelles d'expression à un niveau plus profond, ce qui constitue un défi important dans l'enseignement actuel de l'écriture en anglais21.
Dans la pratique du développement de la capacité de transfert, les études existantes utilisent souvent des stratégies telles que l'écriture imitative22, l'écriture contrastive23 et l'entraînement à la traduction24 afin d'améliorer la compréhension et l'application par les apprenants du mécanisme de transfert dans la langue cible. L'écriture imitative permet de développer des compétences discursives de base, mais elle peut facilement conduire à une rigidité structurelle ; l'écriture contrastive améliore le style linguistique et la sensibilité culturelle, mais elle manque d'une stratification systématique des tâches et de rétroaction personnalisée ; l'entraînement à la traduction favorise la reconnaissance des métaphores culturelles, mais, en l'absence d'encadrement, il peut facilement entraîner des déviations sémantiques ou des inadéquations pragmatiques. Ces stratégies s'appuient principalement sur une démonstration manuelle et un accompagnement empirique25, sans construire explicitement des stratégies de transfert ni mettre en place de mécanismes de rétroaction systématiques, ce qui rend difficile leur adaptation aux différences individuelles en compétence linguistique et en styles cognitifs. Bien que certaines études aient tenté d'élargir l'entraînement au transfert par des tâches d'écriture diversifiées26,27, le processus d'enseignement n'a pas encore constitué une boucle fermée du type « objectif de transfert – production langagière – rétroaction stratégique » ; l'effet d'internalisation des stratégies de transfert reste limité, et le développement de la capacité de transfert chez les étudiants dans des tâches d'écriture réelles demeure insuffisant28.
Avec le développement de la technologie des grands modèles linguistiques, leur potentiel d'assistance dans l'enseignement des langues suscite un intérêt croissant29. Les outils d'intelligence artificielle générative, représentés par ChatGPT (Chat Generative Pre-trained Transformer)30 et DeepSeek31, sont largement utilisés dans des scénarios tels que la correction de texte, la réécriture linguistique et l'ajustement du style. Diasamidze et al. ont constaté que les étudiants en anglais langue seconde utilisant ChatGPT surpassaient le groupe bénéficiant d'un enseignement traditionnel en ce qui concerne la précision grammaticale, la richesse du vocabulaire et la capacité d'organisation du texte32. Toutefois, les applications existantes se limitent majoritairement au traitement linguistique superficiel et manquent de guide systématique concernant les objectifs de transfert. Ranade a souligné que les projets basés sur des invites (« prompts ») dans les contextes éducatifs actuels reposent principalement sur des modèles généraux, et que le contenu généré manque d'adaptabilité contextuelle et de spécificité à la tâche33. De plus, l'entraînement des modèles dominants s'appuie sur un corpus ouvert, sans modélisation approfondie des différences entre les expressions culturelles chinoises et anglaises. Des inadéquations culturelles et des aspects pragmatiques peu naturels apparaissent fréquemment dans les textes générés34,35, ce qui limite leur application approfondie dans l'enseignement du transfert rédactionnel interculturel.
Protocole
Approbation éthique
Avant l'expérience, les auteurs ont obtenu une autorisation (Numéro d'approbation : NBCC-ETH-2026-037) de la part du collège et ont distribué des documents de consentement éclairé à tous les étudiants participants. Tous les étudiants ont été clairement informés des objectifs de la recherche, des procédures expérimentales et des règles relatives à l'utilisation des données. La participation était volontaire et les participants pouvaient se retirer de l'étude à tout moment. Toutes les données personnelles et les travaux écrits ont été anonymisés afin de protéger la vie privée, et n'ont été utilisés qu'à des fins d'analyse académique. L'ensemble des 60 participants a signé le formulaire de consentement avant de prendre part à la recherche. Les participants ont été sélectionnés parmi deux classes parallèles de deuxième année en anglais rédactionnel d'un même collège supérieur de formation professionnelle, recrutés selon un échantillonnage de convenance. Les critères d'inclusion comprenaient : avoir réussi le CET-6 avec une note > 425, aucune absence ce semestre, et scores moyens aux deux derniers tests de rédaction unitaires. Les critères d'exclusion comprenaient : l'utilisation à long terme d'un logiciel commercial d'écriture en anglais par intelligence artificielle en dehors des cours et une dyslexie sévère.
La variabilité de toutes les variables de résultat continues a été exprimée comme moyenne ± écart type (ET). Toutes les analyses ont été réalisées avec une taille d'échantillon de n = 30 participants par groupe (groupe expérimental contre groupe témoin), pour un total de N = 60. Pour les données longitudinales à mesures répétées, une analyse de variance à mesures répétées (ANOVA à mesures répétées) a été utilisée afin d'examiner les effets principaux du groupe et du temps, ainsi que l'interaction groupe-par-temps. Des tests t pour échantillons indépendants ont été utilisés pour des comparaisons par paires post-hoc à chaque point temporel. Le groupe témoin a reçu un enseignement traditionnel de la rédaction, complété par un outil d'écriture alimenté par une intelligence artificielle générique, gratuit et non personnalisé (sans consignes hiérarchisées, ni modèles orientés vers le transfert). Le nombre d'heures d'enseignement, les tâches d'écriture, la fréquence de la rétroaction et les textes d'entraînement étaient identiques à ceux du groupe expérimental, à l'exception de l'absence de la chaîne de consignes imbriquées personnalisées et de la bibliothèque de tâches à cinq niveaux utilisée dans cette étude. Le groupe expérimental a utilisé des instructions fondées sur le modèle DeepSeek afin d'optimiser l'enseignement de la rédaction, incluant un accompagnement par chaîne de consignes imbriquées, une production adaptée à l'interculturalité, et le mécanisme « génération-réflexion-régénération ». Le groupe témoin, en revanche, a utilisé des méthodes d'enseignement traditionnelles ou des outils d'assistance par IA non optimisés. En comparant les effets pédagogiques des deux groupes, l'efficacité de la méthode d'entraînement au transfert fondée sur un grand modèle de langage, dans l'amélioration de la capacité des étudiants à transférer leurs compétences en rédaction, a été vérifiée.
Idée générale de la recherche
Cette étude visait à améliorer la capacité des étudiants à transférer leurs compétences en rédaction anglaise et à développer des méthodes efficaces de conception pédagogique, en mettant particulièrement l'accent sur l'adaptation de DeepSeek à des fins éducatives. Premièrement, une stratégie d'optimisation des instructions a été proposée afin de redéfinir les invites du modèle. Cette stratégie a amélioré la conformité des sorties générées par rapport à plusieurs objectifs de transfert dans l'enseignement de la rédaction, notamment la structure syntaxique, la logique des paragraphes et l'expression culturelle. Deuxièmement, les tâches de rédaction des enseignants ont été converties en modèles d'invites structurés et orientés vers des objectifs précis. Une relation d'association a ensuite été établie entre les tâches pédagogiques et les comportements du modèle. Cela a accru la contrôlabilité du modèle et garanti que les contenus générés restent pertinents sur le plan pédagogique. Enfin, l'étude a mis au point un processus itératif de formation au transfert, « génération–réflexion–réécriture–régénération ». Ce processus encourage les étudiants à identifier des stratégies de transfert et à affiner activement leur expression linguistique à l'aide du modèle. Grâce à des itérations répétées, les compétences des étudiants en matière de transfert rédactionnel interlinguistique et interculturel se sont renforcées continuellement. Les étapes de transformation de la structure des phrases sont illustrées dans Figure 1A–D.
Afin de clarifier la logique complète de fonctionnement du système de formation à l'écriture assisté par l'intelligence artificielle et d'améliorer sa reproductibilité, le flux de mise en œuvre global est résumé dans le Tableau 1, couvrant les liens essentiels incluant l'entrée brute, les interventions de l'enseignant, l'application des invites, les activités des étudiants, les productions finales et les critères d'évaluation correspondants.
Stratégie de conception de tâche orientée vers le transfert
Cette étude s'est concentrée sur le développement de la capacité de transfert en écriture anglaise. Elle a conçu un parcours de tâches de transfert progressant du superficiel au profond, guidant systématiquement les étudiants dans l'acquisition et la pratique de stratégies de transfert linguistique à plusieurs niveaux. Pour décrire l'ensemble de la structure du parcours, celle-ci a été définie comme un ensemble de quatre niveaux de tâches :
T = {T1,T2,T3,T4} (1)
T1 représente la tâche de transfert au niveau de la phrase, qui met l'accent sur des opérations de base concernant la structure grammaticale, telles que l'expansion de phrases courtes, le changement de voix et le remplacement de propositions, afin d'aider les étudiants à maîtriser diverses méthodes de structuration des phrases. T2 est la tâche de transfert au niveau du paragraphe, qui guide les étudiants vers une attention accrue portée à l'organisation et à la liaison des informations au sein du paragraphe, et les entraîne à améliorer la clarté structurelle et la cohérence expressive du paragraphe par l'extraction de la phrase principale et l'ajustement de la logique entre les phrases. T3 représente la tâche de transfert au niveau du discours, qui s'étend davantage à l'agencement logique global et au rythme argumentatif du chapitre, et guide les étudiants à construire un article en anglais doté d'un système argumentatif complet en ajustant l'ordre des paragraphes et en optimisant les relations structurelles de juxtaposition. T4 est la tâche de transfert au niveau culturel, qui demande aux étudiants d'identifier les caractéristiques implicites d'expression culturelle présentes dans l'écriture en langue maternelle, telles que les formulations implicites et les indices sémantiques, et de les transformer en expressions directes ou en formes explicites et logiques conformes à la culture de la langue cible. Son processus d'évolution est illustré dans Figure 2. Afin d'améliorer l'opérabilité et l'évaluation de la conception des tâches, cette étude a défini plus précisément chaque niveau de tâche sous une forme triple :
Ti = (Si,Gi,Ei) (2)
Sj représente l'échantillon d'entrée de la tâche, Gi représente l'opération de transfert cible et Ei représente les critères d'évaluation associés. Grâce à cette expression structurée, on s'est assuré que chaque niveau de la tâche s'appuyait sur la maîtrise de la stratégie du niveau précédent et était doté d'échantillons correspondants, de descriptions cibles et de critères de performance, offrant ainsi un mécanisme permettant l'avancement progressif du parcours de transfert. Dans le processus de construction du système de formation au transfert, afin d'assurer une couverture systématique des types de tâches et une gestion efficace des sollicitations pédagogiques, cette étude a mis en place une bibliothèque de tâches structurée couvrant cinq types d'objectifs de transfert, basée sur les dimensions courantes de conversion linguistique dans le transfert écrit. La bibliothèque de tâches a été formellement exprimée comme suit :
M = {(Dj,TDj)∣j = 1,2,3,4,5} (3)
Dj correspond à cinq dimensions de transfert : transfert syntaxique, transfert structurel, transfert culturel, transfert de registre et transfert logique ; l'ensemble de tâches TDj associé à chaque dimension représente son sous-ensemble opérationnel. Lors de l'élaboration de la bibliothèque de tâches, les auteurs ont tout d'abord résumé et classé les difficultés courantes de transfert ainsi que les types d'erreurs linguistiques à partir d'un grand nombre d'échantillons réels de textes rédigés par des apprenants, puis, en tenant compte des besoins pédagogiques réels et des critères d'évaluation, ont réparti les différents types de transfert en domaines fonctionnels, et défini les objectifs fondamentaux de formation ainsi que les modes opératoires propres à chaque tâche. Chaque tâche a été représentée de manière abstraite par la structure en triple suivante :
Ti,j = (Si,j,Gi,j,Ci,j) (4)
Si,j représente l'échantillon d'entrée de la tâche, Gi,j est la description de la cible de transfert de la tâche, et Ci,j correspond à la dimension d'évaluation et de contrôle de la tâche. Dans la tâche de transfert syntaxique, cette étude a conçu une séquence de réorganisation de phrases progressant du simple au complexe, couvrant la liaison de phrases, l'imbrication de propositions, la transformation en voix passive et des concepts associés, dans le but d'améliorer les capacités des étudiants en expansion de phrases et en transformation grammaticale. La tâche de transfert structurel s'est concentrée sur l'optimisation de la logique des paragraphes, le renforcement de l'organisation de l'information et l'amélioration des compétences en construction logique, par le biais de la réécriture de la phrase principale, du tri des phrases de soutien et de la reconstruction des relations de cause à effet et des exemples. La tâche de transfert culturel s'appuie sur un corpus interculturel et vise les écarts pragmatiques, tels que les expressions implicites et les euphémismes. Elle propose des conversions d'expression proches du contexte réel afin de favoriser le développement de l'adaptabilité culturelle. La tâche de transfert de registre guide les étudiants dans la transformation d'expressions orales en langage académique et leur permet de maîtriser les stratégies de changement de registre. La tâche de transfert logique met l'accent sur la construction de chaînes de raisonnement et la clarté de l'expression, tout en proposant un entraînement à l'utilisation des conjonctions, à l'explicitation des relations logiques et aux transitions entre paragraphes.
Sur la base d'échantillons réels de textes rédigés par des élèves, cette étude a mis au point un processus de génération de consignes étroitement lié aux tâches pédagogiques, visant à renforcer la pertinence des instructions et l'utilité pratique du contenu généré. Ce processus a été piloté par des enseignants, qui ont sélectionné des extraits représentatifs des productions des élèves durant l'enseignement, en se concentrant sur des problèmes typiques de transfert tels que des phrases redondantes, des structures désordonnées ou des expressions culturelles inappropriées. Ils ont ensuite annoté ces échantillons selon les types de transfert via l'interface du système, afin de préciser les objectifs d'apprentissage. Après réception des annotations, le système activait automatiquement le module d'identification des tâches de transfert. Celui-ci comparait l'entrée avec une bibliothèque prédéfinie de tâches et de modèles de consignes. Ce processus d'appariement prenait en compte des facteurs tels que le type de transfert, les caractéristiques linguistiques et la structure du texte. En fonction de ces éléments, le système sélectionnait le modèle le plus adapté et générait une première version de la consigne. Le système permettait également un traitement structuré d'enrichissement. Les annotations des enseignants étaient converties dans un format normalisé facilement interprétable par le modèle. Des indices pédagogiques pertinents étaient intégrés à la consigne afin d'aider le modèle à comprendre précisément à la fois l'intention de l'enseignant et les difficultés de l'élève. Afin d'améliorer la souplesse et la maîtrise des instructions, le système incluait un module d'assistance pour les enseignants. Ce module permettait aux enseignants d'affiner les consignes en modifiant les indications pédagogiques, en ajustant les paramètres contextuels et en personnalisant le ton et le style. Ainsi, les enseignants disposaient d'un meilleur contrôle sur le processus de génération et pouvaient l'adapter plus efficacement à divers contextes d'enseignement.
Mécanisme d'optimisation des commandes Deepseek
En se basant sur les besoins pratiques de la formation au transfert de l'écriture en anglais, cette étude a conçu cinq types de modèles de consignes orientés vers le transfert. Ces modèles ont été élaborés afin de guider et encadrer le comportement de génération des grands modèles linguistiques. Le modèle de transfert structurel portait sur l'organisation des paragraphes et la structure du discours. Il aidait les étudiants à réorganiser leurs textes en adoptant des structures telles que introduction–développement–conclusion, et en améliorant la progression logique des idées. Le modèle de transfert syntaxique mettait l'accent sur la complexité au niveau de la phrase. Il encourageait l'utilisation de structures grammaticales variées, telles que la voix passive, les constructions parallèles et les propositions complexes, afin d'enrichir l'expression écrite. Le modèle de transfert culturel traitait de l'adaptation culturelle dans l'écriture. Il guidait les étudiants dans l'ajustement des expressions marquées par leur langue maternelle et leur culture vers des formulations plus naturelles et acceptables dans les contextes anglophones. Le modèle de transfert de registre visait l'adaptation stylistique et la maîtrise du registre. Il aidait les étudiants à adapter leur usage linguistique selon les objectifs d'écriture, les publics visés et les genres. Le modèle de transfert logique avait pour but de renforcer l'organisation logique. Il favorisait l'utilisation efficace de relations telles que la cause et l'effet, la comparaison et la contraste, ainsi que le développement parallèle, améliorant ainsi la cohérence et la rigueur argumentative. Ensemble, ces cinq modèles couvraient les principales dimensions du transfert en écriture. Ils offraient un soutien pédagogique structuré tant pour la conception de tâches d'enseignement que pour la génération de textes fondée sur un modèle.
Chaque type de modèle suivait un format unifié afin d'assurer son universalité et son adaptabilité à différentes situations d'enseignement. Le modèle comprenait quatre éléments fondamentaux : le premier était l'objectif d'instruction, qui indiquait clairement la tâche de transfert requise ; le second était l'exemple d'entrée, qui fournissait aux étudiants des extraits linguistiques réels servant de base de corpus à l'efficacité de l'instruction ; le troisième était la sortie cible, qui montrait le style standard d'une production linguistique idéale après transfert, permettant aux étudiants de comparer et d'utiliser ce modèle pour l'ajuster ; le quatrième était la suggestion d'utilisation, qui expliquait le niveau linguistique, le type de texte et les stratégies d'usage auxquels le modèle s'appliquait, et offrait des indications sur des paramètres ajustables afin d'améliorer le contrôle de la génération et l'efficacité du guidage pédagogique.
Afin d'illustrer davantage la logique de conception et l'application pratique des modèles de invites, des exemples représentatifs de cinq invites orientées vers le transfert sont présentés ci-dessous. Tous les modèles respectaient un cadre unifié, composé d'un objectif d'instruction, d'un exemple d'entrée, d'une sortie cible et d'une suggestion d'utilisation. Les étudiants étaient guidés pour développer des phrases simples, transformer la voix des phrases et intégrer des propositions subordonnées afin d'enrichir la diversité syntaxique. Par exemple, à partir du brouillon étudiant « I study English writing. It is very important for cross-cultural communication », la sortie optimisée est « Learning English writing plays a vital role in improving learners’ ability of cross-cultural communication ». Cette invite était adaptée à un entraînement au niveau de la phrase, destiné à des étudiants de deuxième année en anglais de niveau de difficulté modéré, en se concentrant sur la reconstruction syntaxique de base et la transformation de la voix. Un autre type d'invite visait le transfert culturel, dans le but d'identifier les expressions « Chinglish » influencées par la pensée culturelle maternelle et de réécrire les phrases en des expressions pragmatiques naturelles en anglais conformes aux normes culturelles occidentales. En prenant comme exemple la phrase étudiante « Many people think you must work hard if you want to succeed », la version révisée était « People generally believe that diligence is the key to success ». Cette invite était appliquée à un entraînement au transfert au niveau culturel, en ciblant l'élimination des schémas de pensée chinois implicites et favorisant une expression explicite dans le contexte anglais.
Cette étude a également mis au point une chaîne d'invites imbriquées en trois étapes qui prenait les brouillons de paragraphes des étudiants comme entrée unifiée et s'exécutait en phases séquentielles. La première phase était la réorganisation sémantique, l'invite demandant au participant de réorganiser les phrases du paragraphe donné, d'optimiser l'ordre logique des idées et de former un paragraphe complet doté de phrases-thèmes claires. La deuxième phase était la révision linguistique, qui consistait à réécrire le paragraphe révisé en anglais académique formel, à remplacer les termes familiers et à utiliser correctement des phrases complexes et des structures passives. La troisième phase était l'adaptation culturelle, dont l'invite guidait les utilisateurs afin qu'ils vérifient la présence d'expressions pragmatiques culturelles dans le texte, éliminent les interférences culturelles de la langue maternelle et polissent le contenu pour qu'il s'aligne aux conventions rédactionnelles interculturelles en anglais. Les exemples ci-dessus ont pleinement démontré les modes opératoires des modèles d'invites simples et des chaînes d'invites imbriquées. Sur cette base, l'étude a conçu une chaîne d'invites complète et progressive, combinée à l'architecture MoE de DeepSeek.
Pour pallier les limites des invites en un seul tour en matière de contrôle de la génération et de profondeur de réponse aux tâches, cette étude a conçu une structure en chaîne d'invites imbriquées aux caractéristiques progressives et continues, permettant une orientation hiérarchique et une génération progressive de tâches complexes de transfert. Ce mécanisme a décomposé une tâche complète de transfert en plusieurs sous-objectifs et a conçu des modèles d'invites correspondants pour chacun de ces sous-objectifs, reliés en série selon l'ordre logique de reconstruction sémantique, d'ajustement du style linguistique et d'adaptation pragmatique culturelle, formant ainsi une chaîne de génération dépendante du contexte. Cette étude a mis en œuvre une optimisation de chaîne d'invites imbriquées pour DeepSeek via son API ouverte standard. Le modèle DeepSeek adopte nativement une architecture de type Mixture of Experts (MoE) dotée d'un système automatique de routage d'experts en backend, qui fonctionne comme un module de raisonnement interne intrinsèque, indépendant des invites externes. Les invites personnalisées en plusieurs étapes modifiaient uniquement les caractéristiques de contenu des entrées du modèle. En réponse aux exigences sémantiques, stylistiques et culturelles intégrées dans les entrées optimisées, le mécanisme natif de routage MoE du modèle activait de manière autonome les modules d'experts les plus adaptés durant la génération du texte. La conception en trois étapes de l'invite, centrée sur la réorganisation sémantique, l'ajustement stylistique et l'adaptation culturelle, affinait simplement les textes d'entrée sans interférer avec la logique interne du modèle en matière de sélection et d'allocation des experts.
En ce qui concerne le processus opérationnel, le système recevait les textes des étudiants téléchargés par les enseignants, transférait les annotations cibles et déterminait automatiquement si la structure de chaîne imbriquée devait être activée. Si celle-ci était activée, le système exécutait trois étapes successivement : la première étape consistait en une réorganisation sémantique, appelant le modèle de transfert de structure afin d'optimiser l'organisation des paragraphes et les indices logiques ; la deuxième étape était un ajustement du style linguistique, utilisant le modèle linguistique pour transformer les expressions courantes en langage écrit académique ; la troisième étape était une adaptation culturelle, appelant le modèle de transfert culturel pour identifier et remplacer les expressions non conformes à la culture de la langue cible, et produisant ainsi un texte plus authentique.
Chaque cycle de génération prenait la sortie du cycle précédent comme entrée et conservait le cache du vecteur de contexte afin d'assurer la cohérence sémantique. Les enseignants personnalisent la structure de la chaîne de prompts dans l'interface du système, y compris la sélection de modèles, la modification des instructions et l'ajustement de la séquence. Le système prenait également en charge la fonction « package de combinaison de modèles », pratique pour que les enseignants réutilisent ou attribuent des tâches par lots. En outre, le système disposait d'un mécanisme intégré d'interruption dynamique et de rétroaction fournissant des résultats intermédiaires après chaque génération. Les enseignants annotaient ou ajustaient les instructions suivantes en temps réel, formant ainsi une boucle fermée pédagogique de « génération-ajustement-régénération ».
Génération et évaluation du modèle
Dans le processus de génération et d'évaluation de texte basé sur le modèle DeepSeek, cette étude a mis en place un mécanisme de notation automatique multidimensionnel afin d'analyser systématiquement et d'évaluer quantitativement le texte généré selon trois aspects : la complexité syntaxique, la normalisation structurelle et la cohérence du discours. Cette étude a utilisé l'analyseur syntaxique en dépendance spaCy et le module d'extension Coreferee de résolution de coréférence pour l'extraction et l'évaluation automatisée des caractéristiques du texte. L'analyseur syntaxique en dépendance spaCy a analysé la structure syntaxique du texte anglais, extrayant des indicateurs clés tels que la longueur moyenne des phrases et le nombre de propositions imbriquées, permettant ainsi une analyse quantitative de la complexité syntaxique. Le module d'extension de résolution de coréférence Coreferee, fonctionnant dans le cadre du logiciel spaCy, a principalement identifié les relations référentielles internes dans le texte et évalué la cohérence référentielle du discours, fournissant un soutien technique pour la notation automatisée de la qualité de l'écriture. En raison de limitations réseau, les sites open source étrangers susmentionnés étaient inaccessibles.
Premièrement, le système a évalué la complexité syntaxique. Il a extrait des caractéristiques telles que la longueur moyenne des phrases, la profondeur d’emboîtement des propositions et la variété des structures de phrases. Ces caractéristiques ont été obtenues par analyse dépendancielle et modélisation des arbres syntaxiques profonds. Sur la base des résultats, le système a évalué si les étudiants étaient passés avec succès de structures simples à des constructions syntaxiques plus complexes. Deuxièmement, le système a évalué l’organisation des paragraphes. Il a combiné des représentations textuelles basées sur BERT avec des modèles de classification afin d’identifier les éléments clés du paragraphe, notamment les phrases thématiques, d’appui et de conclusion. Une carte de structure de paragraphe a ensuite été construite pour déterminer si l’organisation respectait les conventions de l’écriture académique en anglais. Troisièmement, le système a évalué la cohérence du texte. Il a examiné l’usage des articulateurs logiques, la cohérence sémantique entre les phrases et la qualité des liens référentiels tout au long du texte. Ces indicateurs ont permis d’évaluer la clarté du développement logique et la progression fluide des idées. Pour mesurer la cohérence thématique, le système a calculé la similarité sémantique à l’aide de représentations vectorielles. La cohérence référentielle a été évaluée par des techniques de résolution de coréférence, qui ont permis de réduire les écarts sémantiques et les références ambiguës. Enfin, les scores provenant de toutes les dimensions ont été intégrés dans un vecteur de notation unifié. Les résultats ont été normalisés afin de constituer un système d’évaluation complet, permettant une comparaison fiable entre différents échantillons de textes rédigés.
Dans la phase d'évaluation manuelle, cette étude a mis au point un système tridimensionnel de notation pour la formation au transfert écrit, englobant l'évidence du comportement de transfert, la naturel de l'expression et l'adaptabilité culturelle, afin d'améliorer la pertinence de l'évaluation par les enseignants et l'efficacité de la rétroaction pédagogique. Le système a combiné ses fonctions auxiliaires pour parvenir à une association organique entre notation quantitative et commentaires qualitatifs. Dans la dimension du comportement de transfert, les enseignants évaluaient l'utilisation par les étudiants de stratégies de transfert lors de la réécriture de textes, selon des objectifs de tâche prédéfinis. Le système offrait une vue comparative côte à côte du texte original et de la version générée, afin d'aider les enseignants à déterminer si des opérations telles que l'ajustement des phrases et la reconstruction structurelle reflétaient effectivement le type de transfert requis.
L'évaluation de l'expression naturelle s'est concentrée sur la fluidité et l'authenticité de la production linguistique. Les enseignants ont utilisé les indicateurs linguistiques générés par le système pour évaluer si les phrases correspondaient aux habitudes d'expression des locuteurs natifs anglophones et pour juger si la structure grammaticale, la collocation des mots et le rythme de la phrase étaient naturels et appropriés. Ils ont également signalé les problèmes et suggéré des formulations alternatives par le biais d'annotations. La dimension de l'adaptabilité culturelle portait sur l'opportunité des aspects pragmatiques interculturels. Les enseignants devaient déterminer si le texte contenait des expressions inappropriées résultant d'une interférence de la culture de la langue source, telles qu'une ambiguïté sémantique, des conflits rhétoriques ou des jugements de valeur flous. Le système fournissait des exemples courants de termes présentant des écarts culturels et permettait aux enseignants d'expliquer dans les commentaires les raisons des modifications ainsi que les exigences liées au contexte culturel, guidant ainsi les étudiants vers une meilleure conscience du transfert culturel et une expression plus précise. Chaque dimension était notée sur une échelle de 5 points et comprenait des annotations libres ainsi que des modules suggérés à compléter. Les résultats finaux de l'évaluation étaient présentés sous forme de diagramme en radar.
Afin d'améliorer l'efficacité de l'évaluation et de soutenir une utilisation pratique en classe, cette étude a mis au point un mécanisme d'évaluation collaborative combinant un système de notation assisté par IA et l'évaluation par l'enseignant. Le système effectuait d'abord une évaluation multidimensionnelle du texte généré par DeepSeek. Il évaluait des aspects clés tels que la complexité syntaxique, l'organisation des paragraphes et la cohérence du texte à l'aide du module de notation automatique. Les résultats de notation étaient ensuite affichés en temps réel sur l'interface dédiée à l'enseignant. Les enseignants examinaient les notes détaillées pour chaque dimension et les ajustaient si nécessaire, selon leur jugement professionnel et leur compréhension des performances transférables des élèves. Ils ajoutaient également des commentaires ciblés directement sur le texte afin de fournir des retours et des suggestions pédagogiques que la notation automatique ne pouvait pas nécessairement capter. Chaque dimension d'évaluation utilisait une échelle de notation à cinq niveaux. L'interface comprenait également des modules d'annotation libre et de recommandations afin de faciliter un retour personnalisé. Les résultats de l'évaluation étaient visualisés à l'aide d'un graphique en radar, permettant aux enseignants d'identifier rapidement les forces et les faiblesses des élèves dans les différentes dimensions du transfert.
En outre, le système permettait aux enseignants d'ajuster l'importance accordée à certaines dimensions ou aux notes globales afin de les aligner sur les objectifs pédagogiques. Cette fonction garantissait que l'évaluation finale reflète plus précisément les performances réelles des élèves et leurs besoins d'apprentissage. Une fois la vérification manuelle terminée, le système intégrait automatiquement les données d'évaluation générées par la machine et celles produites par l'enseignant. Il produisait ensuite un rapport de rétroaction visuel comprenant un graphique radar des performances transférées et un graphique de suivi des versions. Ces visualisations illustraient clairement l'évolution des capacités de transfert des élèves au cours de plusieurs cycles de génération et de révision de textes, permettant ainsi un suivi continu des progrès d'apprentissage.
Processus d'entraînement par transfert
Cette étude a conçu un processus complet de formation au transfert. Tout d'abord, l'enseignant a attribué des tâches précises de rédaction en anglais en fonction des objectifs pédagogiques et du niveau réel des élèves, puis a précisé le type de transfert et l'accent de la formation. Ensuite, le système a généré automatiquement des instructions appropriées en fonction des tâches définies par l'enseignant et a appelé le modèle DeepSeek pour produire un premier brouillon de la rédaction, servant ainsi de matériel de base pour la réécriture des élèves et leur formation au transfert. Après avoir reçu ce premier brouillon, les élèves devaient activement identifier les caractéristiques de transfert présentes dans le texte et réécrire le contenu de manière ciblée, en utilisant les stratégies de transfert qu'ils avaient apprises afin d'améliorer l'adéquation de la structure syntaxique, de l'organisation des paragraphes et de l'expression culturelle. Une fois la réécriture terminée, l'enseignant effectuait une évaluation détaillée du texte soumis par l'élève, mettait en évidence l'efficacité de la stratégie de transfert utilisée et formulait des suggestions concrètes d'amélioration ainsi que des conseils d'écriture. Sur la base des commentaires de l'enseignant, le modèle DeepSeek était rappelé pour générer une version optimisée, soutenant ainsi davantage les élèves dans l'affinement de leurs textes et le renforcement de la pratique des stratégies de transfert. Enfin, l'élève finalisait la soumission de la version définitive, complétait le tableau de cognition du transfert, s'auto-évaluait et synthétisait les méthodes de transfert ainsi que leurs effets, favorisant ainsi l'amélioration des capacités métacognitives et l'internalisation des compétences de transfert en écriture. Le tableau de cognition du transfert conçu pour cette étude est présenté dans Tableau 2.
Tous les éléments utilisaient une échelle d'évaluation de 1 à 5, allant de 1 (aucune maîtrise) à 5 (maîtrise complète). Les données d'auto-évaluation ont été recueillies après trois séries de formation séquentielle ; les critères de notation se réfèrent aux normes prédéfinies de transfert opérationnel dans la bibliothèque de tâches à cinq dimensions.
Résultats
Enseigner la conception d'expériences
Cette étude a utilisé la version open-source de base de DeepSeek, s'appuyant sur l'interface API ouverte de la plateforme pour les appels de programme. L'ensemble complet des cinq textes modèles d'instructions, des quatre niveaux d'exemples de tâches, des balises de catégories d'annotations transférées et des règles de correspondance de mappage avec les modèles d'erreurs rédactionnelles a été compilé dans l'annexe complémentaire. Le système disposait de paramètres d'appel fixes : un coefficient de température de 0,7, et la longueur générée était limitée dynamiquement selon le type de question rédactionnelle. Il suivait strictement une séquence fixe de reconstruction sémantique > ajustement stylistique > adaptation culturelle, en exécutant des appels en chaîne imbriqués d'instructions. La sortie du modèle était sélectionnée manuellement par l'enseignant afin d'obtenir un texte pertinent pour l'enseignement en classe.
Cette étude a invité trois enseignants universitaires à temps plein, spécialisés en rédaction en anglais et ayant plus de cinq ans d'expérience, à participer à la notation manuelle. Tous les correcteurs ont reçu une formation normalisée avant la notation officielle, afin de se familiariser avec les dimensions d'évaluation, le système de notation sur 5 points, le transfert culturel, la syntaxe, le discours et d'autres détails de notation, et ont effectué une calibration préalable à la notation. Toutes les rédactions étudiantes ont été notées indépendamment par deux enseignants selon un mode de notation aveugle et doublement aveugle. Si l'écart entre les notes attribuées par les deux correcteurs dépassait 1 point (sur 5), un troisième enseignant expérimenté intervenait comme arbitre, et la moyenne des deux notes valides était retenue comme note manuelle finale pour cet échantillon. Deux groupes d'évaluateurs ont participé à la phase d'évaluation à des fins de recherche différentes. Trois enseignants universitaires à temps plein, spécialisés en rédaction en anglais et ayant plus de cinq ans d'expérience, ont réalisé une double notation aveugle de tous les échantillons de rédactions étudiantes lors de l'expérience formelle, et un troisième enseignant expérimenté a servi d'arbitre en cas d'écart supérieur à 1 point sur l'échelle de notation sur 5 points. En revanche, cinq évaluateurs ont participé à un test de fiabilité inter-juges fondé sur le coefficient de corrélation intraclasse (ICC), mené séparément afin de vérifier la cohérence des critères d'évaluation entre les évaluateurs. La différence dans le nombre d'évaluateurs s'explique par des exigences fonctionnelles distinctes : les trois enseignants principaux ont assuré la notation pratique des données expérimentales, tandis que le groupe élargi de cinq évaluateurs a fourni des preuves plus solides quant à la fiabilité de l'ensemble du système d'évaluation.
La complexité syntaxique, l'évaluation de la structure du texte par BERT et la similarité sémantique sont toutes notées sur une échelle de 0 à 5 points. Les poids attribués à chaque dimension ont été fixés selon les normes d'enseignement et de recherche en rédaction en langue étrangère : syntaxe 0,35, structure du texte 0,35, et logique et culture 0,3. Ces valeurs de poids reposent sur des systèmes d'évaluation quantitative éprouvés dans ce domaine. Le module de notation automatique par IA a été calibré à l'aide de seuils fondés sur 15 rédactions modèles préclassées. La notation humaine a suivi une échelle d'évaluation normalisée sur cinq points. La notation par machine et la calibration humaine ont été combinées pour une vérification préalable dans une expérimentation avant l'évaluation formelle.
La tâche d'enseignement a été réalisée selon les objectifs de transfert à trois niveaux « syntaxe-structure-culture », avec trois séries de formation, chacune durant une semaine. La première série comprenait une réécriture au niveau de la phrase afin d'améliorer la diversité syntaxique et la précision expressive ; la deuxième série impliquait une reconstruction structurelle au niveau du paragraphe pour renforcer l'organisation du paragraphe et la cohérence logique ; la troisième série portait sur le transfert au niveau culturel afin d'accroître la sensibilité pragmatique interculturelle et l'adaptabilité des expressions. Compte tenu des mesures répétées recueillies auprès des mêmes participants lors du pré-test, des trois séries successives de formation et du post-test, une analyse de variance à mesures répétées (RM-ANOVA) a été adoptée comme méthode statistique principale pour examiner les effets principaux du groupe (expérimental contre contrôle), les effets principaux du moment du test, ainsi que l'effet d'interaction groupe × temps, qui indiquait si les variations des scores au cours de la formation différaient entre les deux cohortes. L'hypothèse de sphéricité a été vérifiée à l'aide du test de Mauchly ; une correction de Greenhouse–Geisser a été appliquée en cas de violation de la sphéricité. Des tests t pour échantillons indépendants ont été utilisés uniquement pour des comparaisons post-hoc par paires entre groupes à des moments précis, tandis que la corrélation de Pearson et le d de Cohen ont été conservés respectivement pour évaluer la cohérence des notes et la taille de l'effet.
Toutes les analyses statistiques ont été prédéfinies avant la collecte des données. Des tests t pour échantillons indépendants ont été utilisés afin de comparer les indicateurs d'écriture avant et après entre deux groupes, l'hypothèse nulle principale supposant l'absence de différences intergroupes en matière de performance de transfert de l'écriture. Une analyse de corrélation de Pearson a été employée pour quantifier l'association linéaire entre la notation automatique par IA et les évaluations manuelles des enseignants, et le d de Cohen a été calculé comme taille d'effet standardisée pour les comparaisons entre groupes. Le seuil de significativité a été fixé à α = 0,05 pour tous les tests d'hypothèse, et des intervalles de confiance à 95 % ont été calculés conjointement avec toutes les statistiques de test. SPSS 26.0 a été utilisé pour effectuer tous les calculs statistiques. Aucune donnée manquante n'a été observée dans les résultats des tests des élèves ni dans les jeux de données des questionnaires, car tous les participants ont terminé l'ensemble de la formation en trois séances ainsi que les évaluations correspondantes ; par conséquent, aucune imputation ni suppression de cas pour valeurs manquantes n'a été nécessaire.
Construction du système d'indices d'évaluation
Afin d'évaluer de manière exhaustive les performances des étudiants dans la formation au transfert en écriture anglaise, cette étude a élaboré un système d'évaluation multidimensionnel couvrant les objectifs de transfert à trois niveaux « syntaxe-structure-culture », intégrant la capacité linguistique, la réponse du modèle, la rétroaction pédagogique et l'auto-perception, et a établi six indicateurs principaux. Premièrement, l'« indice de transfert en écriture » constituait un indicateur d'évaluation global englobant la diversité syntaxique, la clarté structurelle et l'adaptabilité culturelle, combinant la notation automatique du système et la notation manuelle par l'enseignant pour une analyse quantitative. Le « score de complexité syntaxique » utilisait la technologie du traitement automatique du langage naturel pour extraire des caractéristiques telles que la longueur moyenne des phrases, le nombre de niveaux d'imbrication des propositions et la fréquence d'utilisation des groupes verbaux, afin d'évaluer la richesse et la complexité des phrases des étudiants. L'analyse de « l'adéquation au style académique » examinait la proportion d'utilisation de la voix passive et la proportion de vocabulaire formel, à l'aide d'un modèle de traitement automatique du langage naturel (NLP), afin de déterminer si le texte respectait les normes stylistiques de l'écriture académique en anglais. En outre, l'étude a introduit une dimension d'évaluation subjective, recueillant, au moyen de questionnaires destinés aux enseignants, des retours sur l'acceptabilité et l'utilité pratique des suggestions générées par le modèle, afin d'évaluer l'impact réel de l'enseignement assisté par l'intelligence artificielle. Les « évolutions des notes attribuées par les enseignants » reflétaient l'effet de l'enseignement assisté par l'IA sur l'amélioration de la qualité de l'écriture, en comparant les notes attribuées par les enseignants aux rédactions des étudiants avant et après l'expérience. Enfin, l'« auto-évaluation par les étudiants de leur capacité de transfert » utilisait le tableau de cognition du transfert pour guider les étudiants dans l'auto-évaluation de leur maîtrise des dimensions structurelle, syntaxique, culturelle, et d'autres aspects, renforçant ainsi leur conscience métacognitive et leurs capacités de réflexion. Les descriptions détaillées et les sources de données pour chaque indicateur sont présentées dans Tableau 3.
Les indicateurs syntaxiques et stylistiques ont été calculés automatiquement à l'aide d'une analyse syntaxique en dépendances et d'une classification basée sur BERT, avec des scores normalisés allant de 0 à 5 ; l'évaluation manuelle utilise une échelle à 5 points. Les formules de calcul de la complexité syntaxique utilisaient le nombre total de mots divisé par le nombre de propositions comme dénominateur principal. Source des données brutes : compositions écrites du prétest et du posttest de l'ensemble des 60 étudiants inscrits.
Résultats expérimentaux et analyse
Afin de présenter de manière intuitive les différences globales de performance des étudiants selon les trois dimensions du transfert syntaxique, du transfert structurel et du transfert culturel, la figure 3 compare l'indice moyen de transfert écrit des étudiants du groupe expérimental et du groupe témoin avant et après l'expérience : la figure 3 montre la différence de scores moyens entre le groupe expérimental et le groupe témoin dans les trois dimensions du transfert syntaxique, du transfert structurel et du transfert culturel. Le groupe expérimental présente une amélioration significative des capacités de transfert dans chaque dimension après l'expérience, et le cercle extérieur du graphique en radar est nettement plus grand que le cercle intérieur, ce qui indique que la méthode d'optimisation de l'enseignement fondée sur le modèle DeepSeek exerce un effet positif sur le développement de la capacité des étudiants au transfert en écriture anglaise. En revanche, les différents indicateurs de capacité de transfert du groupe témoin sont restés relativement stables avant et après l'expérience. L'amélioration globale a été limitée, ce qui montre que les méthodes d'enseignement traditionnelles ou les outils d'assistance par IA n'ayant pas optimisé les instructions du système jouent un rôle restreint dans l'entraînement au transfert. Il était difficile de stimuler efficacement le potentiel d'apprentissage des étudiants dans le transfert linguistique multidimensionnel.
Les indices moyens de transfert écrits du groupe expérimental, dans les dimensions du transfert syntaxique, du transfert structurel et du transfert culturel avant l'expérience, étaient respectivement de 3,0, 2,9 et 2,8 ; ils ont augmenté après l'expérience à 4,3, 4,1 et 4,5, soit des augmentations respectives de 1,3, 1,2 et 1,7, ce qui indique que la méthode d'enseignement a eu un bon effet d'intervention à différents niveaux de transfert. Les scores du groupe témoin avant l'expérience étaient de 3,0, 3,0 et 2,9. Après l'expérience, ces valeurs ont augmenté respectivement à 3,4, 3,3 et 3,2, ce qui est nettement inférieur aux résultats du groupe expérimental. Il est particulièrement remarquable que, dans la dimension du transfert culturel, le groupe expérimental ait montré l'amélioration la plus significative, passant de 2,8 à 4,5, soit une augmentation de 1,7 point, bien supérieure à l'augmentation de 0,3 point observée dans le groupe témoin. Ce résultat suggère que la méthode d'enseignement proposée joue un rôle important dans l'aide aux étudiants pour identifier et s'adapter aux normes d'expression culturelle en anglais. Cela s'est manifesté non seulement par des ajustements de la forme linguistique, mais aussi par le renforcement de la conscience pragmatique interculturelle des étudiants et par la profondeur de leur compréhension des habitudes d'expression culturelle de la langue cible. Le transfert linguistique s'est principalement reflété dans la complexité syntaxique, l'adaptation du style linguistique et d'autres aspects. L'étude a utilisé une technologie NLP automatisée pour analyser en profondeur les textes écrits des étudiants, extraire des caractéristiques linguistiques clés, et combiné les évaluations des enseignants afin d'évaluer systématiquement les changements dans les capacités de transfert linguistique des étudiants au cours de trois séries de tâches.
Complexité syntaxique et style linguistique
En ce qui concerne la complexité syntaxique, l'étude a enregistré la longueur moyenne des phrases et le nombre de niveaux d'imbrication des propositions du texte produit par les étudiants après avoir accompli la tâche d'écriture désignée à chaque tour de tâches. Ces deux indicateurs étaient couramment utilisés pour mesurer la complexité de l'expression linguistique. Ils reflétaient efficacement le niveau de développement des étudiants en matière de diversité des phrases et de capacité d'organisation structurelle, comme illustré dans la Figure 4.
Dans l'évolution longitudinale de la complexité syntaxique, le groupe expérimental a présenté une tendance clairement ascendante au cours des trois séries de tâches, reflétant l'efficacité du transfert de formation sur la capacité des élèves à exprimer leur structure linguistique. En ce qui concerne la longueur moyenne des phrases, le groupe expérimental est passé de 12,5 mots dans la tâche 1 à 16,1 mots dans la tâche 3, soit une augmentation de 3,6 mots, nettement supérieure à l'augmentation du groupe témoin, qui n'a été que de 0,9 mot durant la même période (de 12,4 à 13,3). De même, en ce qui concerne la dimension de la complexité structurelle, mesurée par le nombre de niveaux d'emboîtement des propositions, le groupe expérimental est passé de 1,8 niveau à 2,7 niveaux, tandis que le groupe témoin est passé de 1,7 à 1,9 niveau, avec une augmentation relativement lente. Afin de vérifier davantage si la différence de complexité syntaxique entre les deux groupes d'élèves est statistiquement significative, l'étude a utilisé des tests t indépendants pour analyser la longueur moyenne des phrases et le nombre de niveaux d'emboîtement des propositions aux trois étapes de la tâche. Les résultats ont montré qu'il existe une différence significative entre le groupe expérimental et le groupe témoin en ce qui concerne la longueur moyenne des phrases, t(58) = 4,23, p < 0,001, d de Cohen = 0,98 ; il existait également une différence significative dans le nombre de niveaux d'emboîtement des propositions, t(58) = 3,15, p = 0,002, d de Cohen = 0,78. Cette comparaison a montré que la formation systématique au transfert améliore non seulement la capacité des élèves à construire des phrases complexes, mais renforce également leur maîtrise des stratégies d'organisation grammaticale. En particulier, lors de la troisième étape de la tâche, les élèves du groupe expérimental ont fait preuve d'une plus grande souplesse dans l'utilisation de propositions imbriquées et de structures de phrases complexes. Cela traduit un changement notable dans leur transfert linguistique, passant d'un niveau « fonctionnel » à un niveau plus « stratégique ». Le parcours de formation axé sur le transfert a continuellement renforcé les compétences syntaxiques des élèves en matière de transfert, permettant ainsi de surmonter efficacement les limites liées à l'écriture de phrases isolées et aux schémas d'expression figés souvent observés dans l'enseignement traditionnel. En ce qui concerne l'adaptation du style linguistique, l'étude a extrait les textes écrits par les élèves avant et après l'expérience. Elle a utilisé un modèle de traitement du langage naturel (NLP) pour déterminer la proportion de vocabulaire formel et la fréquence d'utilisation de la voix passive comme indicateurs principaux d'évaluation de l'adéquation au style académique. Ces indicateurs reflètent si les élèves possèdent la conscience linguistique et les capacités d'expression nécessaires pour s'adapter au style cible en écriture en anglais. Les résultats correspondants sont présentés dans Figure 5.
Figure 5 montre les changements dans l'adéquation au style académique du groupe expérimental et du groupe témoin avant et après la tâche, en se concentrant principalement sur deux indicateurs clés : la proportion de vocabulaire formel et la fréquence d'utilisation de la voix passive. Dans l'ensemble, après avoir suivi une formation au transfert basée sur le modèle DeepSeek, la capacité d'adaptation au style académique du groupe expérimental s'est nettement améliorée, démontrant ainsi l'efficacité de cette méthode pédagogique pour développer chez les étudiants la conscience des normes linguistiques et leur aptitude à s'adapter aux styles académiques. En ce qui concerne la proportion de vocabulaire formel, le groupe expérimental est passé de 0,42 avant la tâche à 0,56 après celle-ci, soit une augmentation relativement importante. En revanche, le groupe témoin n'a connu qu'une légère augmentation, passant de 0,43 à 0,48, ce qui suggère une amélioration limitée. Ce résultat indique qu'après avoir reçu une orientation systématique par le biais d'indications (prompts) et des retours du modèle, les étudiants du groupe expérimental ont eu davantage tendance à utiliser un vocabulaire formel conforme aux exigences du style académique lors de la rédaction, et que leur style linguistique s'est progressivement rapproché des normes de l'écriture académique en anglais. En ce qui concerne la fréquence d'utilisation de la voix passive, le groupe expérimental a augmenté de manière significative, passant de 0,18 avant la tâche à 0,27 après celle-ci, soit une hausse de 0,09 ; en revanche, le groupe témoin n'a augmenté que de 0,02.
Afin de vérifier davantage si les changements ci-dessus sont statistiquement significatifs, l'étude a réalisé un test t pour échantillons indépendants sur les données avant et après la tâche. Les résultats ont montré que le groupe expérimental présentait une amélioration significative de la proportion de vocabulaire formel, t(58) = 3,89, p < 0,001, d de Cohen = 0,92 ; l'augmentation de la fréquence d'utilisation de la voix passive était également significative, t(58) = 4,56, p < 0,001, d de Cohen = 1,05. Cela indique que les étudiants du groupe expérimental ont réalisé des progrès substantiels en matière d'adaptation du style linguistique, progrès qui n'étaient pas dus au hasard, mais résultant de l'effet combiné d'un guidage systématique par les consignes et des retours du modèle.
Vérification statistique
En outre, afin de vérifier davantage la fiabilité du contenu généré par l'IA dans la pratique enseignante, l'étude a également comparé les scores moyens du contenu généré par l'IA et de celui généré par les enseignants selon différents types de consignes. La cohérence entre les deux a été évaluée en calculant le coefficient de corrélation de Pearson. Les résultats comparatifs pertinents sont présentés dans le tableau 4. Le tableau 4 montre la cohérence entre les notes attribuées par l'IA et celles attribuées par les enseignants pour cinq types de consignes orientées vers le transfert. Du point de vue du score moyen, la note attribuée par l'IA était globalement légèrement inférieure à celle des enseignants. Toutefois, l'écart restait dans une fourchette raisonnable pour la plupart des types de tâches, ce qui indique que le modèle DeepSeek présente une grande stabilité et une valeur de référence élevée pour l'évaluation des tâches de transfert écrit. Dans le cas de la consigne de transfert syntaxique, la note moyenne attribuée par les enseignants était de 4,1, contre 4,0 pour l'IA, soit une différence de seulement 0,1. Pour les consignes de transfert structurel et logique, la note attribuée par l'IA était inférieure de seulement 0,1 point à celle des enseignants, ce qui indique que le modèle est capable de simuler correctement les critères d'évaluation des enseignants dans ces tâches, qui impliquent un haut degré de structure linguistique et des règles claires. En revanche, les écarts de notation sont plus marqués pour les consignes de transfert culturel et de transfert de registre, avec des notes attribuées par l'IA de 3,6 et 3,7 respectivement, soit 0,2 point de moins que les notes des enseignants, ce qui reflète que l'IA présente encore certaines limites lorsqu'elle traite des tâches fortement subjectives, telles que les implications sémantiques et les aspects pragmatiques culturels. La fiabilité inter-juges a été évaluée à l'aide du CCI (n = 5 évaluateurs). Le CCI global pour la notation manuelle était de 0,86, et les CCI pour chaque dimension variaient entre 0,82 et 0,89, indiquant un accord inter-juges satisfaisant.
Une analyse plus poussée du coefficient de corrélation de Pearson a révélé que la cohérence des scores selon diverses consignes était très élevée, indiquant que le score attribué par l'IA était non seulement proche du jugement de l'enseignant en valeur, mais présentait également une bonne relation linéaire dans sa tendance d'évaluation. Parmi eux, le coefficient de cohérence de la consigne de transfert syntaxique était le plus élevé, à 0,87, tandis que les consignes de transfert structurel et de transfert logique étaient respectivement de 0,83 et 0,85, ce qui indique que les résultats d'évaluation de l'IA en matière de complexité syntaxique, d'organisation des paragraphes et de cohérence logique sont très cohérents avec le jugement de l'enseignant. Cela pourrait s'expliquer par le fait que ces tâches ont des objectifs clairs et des caractéristiques linguistiques quantifiables, facilitant ainsi la reconnaissance par le modèle et un jugement stable. Le coefficient de corrélation de la consigne de transfert de domaine est de 0,81. Bien qu'il ait légèrement diminué, il démontre tout de même une capacité d'évaluation forte, indiquant que l'IA possède un certain niveau de jugement en matière d'adaptation stylistique. Toutefois, le coefficient de cohérence de la consigne de transfert culturel était de seulement 0,79, ce qui est inférieur à celui des autres types, mais reste tout de même dans une fourchette acceptable.
Afin d'examiner l'applicabilité de différents types de consignes dans la pratique enseignante et leur degré d'acceptation par les enseignants, un questionnaire évaluant la satisfaction quant à la réponse aux consignes a été conçu. Cinq enseignants d'anglais (numérotés T1 à T5) ont été invités à noter les suggestions générées par cinq types de consignes selon une échelle à cinq niveaux (de très insatisfait à très satisfait), comme indiqué dans Figure 6 : les notes attribuées par les cinq enseignants aux cinq types de consignes varient légèrement, mais la reconnaissance globale est élevée. Parmi eux, les consignes de « transfert syntaxique » et de « transfert culturel » obtiennent les scores les plus élevés, avec une moyenne de 4,0, reflétant une forte praticabilité et une bonne adaptabilité en contexte d'enseignement. En revanche, la consigne de « transfert de registre » obtient des notes relativement faibles, avec une moyenne de seulement 2,4, et certains enseignants, comme T4 et T5, ont attribué les notes les plus basses, indiquant que son orientation et son adaptabilité dans les applications pédagogiques doivent encore être améliorées.
Au niveau individuel, il existait des différences évidentes dans les tendances de notation des enseignants. Le score global de T1 était positif, indiquant un haut degré d'acceptation de la rédaction assistée par l'IA, tandis que les scores de T5 étaient faibles dans plusieurs dimensions de Prompt, notamment en ce qui concerne le « transfert de registre » et le « transfert logique ». Cette différence pourrait être liée à l'expérience pédagogique des enseignants, à leurs préférences linguistiques ou à leur familiarité avec les outils d'IA, suggérant que la conception future des Prompt devra prendre en compte des mécanismes d'adaptation personnalisés afin d'améliorer l'acceptation par différents groupes d'enseignants. Afin de vérifier davantage l'effet réel de l'enseignement assisté par l'IA sur l'amélioration de la qualité de la rédaction des étudiants, l'étude a comparé les changements des scores globaux du groupe expérimental et du groupe témoin, tels qu'évalués par les enseignants, avant et après l'expérience. Les résultats de cette comparaison sont présentés dans Figure 7.
Comme le montre la figure 7, les scores globaux du groupe expérimental et du groupe témoin, évalués par les enseignants avant et après l'expérience, présentaient des différences significatives. Dans l'ensemble, après l'intervention pédagogique d'optimisation de l'enseignement fondée sur le modèle DeepSeek, le score global du groupe expérimental a montré une tendance nettement croissante. En revanche, l'évolution des scores du groupe témoin a été relativement modérée. Le score moyen attribué par les enseignants au groupe expérimental avant l'expérience était de 59,1 points, et le score moyen après l'expérience a augmenté de manière significative pour atteindre 74,4 points, soit une hausse de 15,3 points. Cela indiquait que l'enseignement assisté par l'intelligence artificielle avait un impact positif sur la qualité de l'écriture des élèves. D'après le diagramme en boîte, on observe que la plage de distribution des scores du groupe expérimental s'est également élargie. En particulier, la boîte à moustaches des scores après l'expérience est nettement plus élevée qu'avant, et les valeurs maximale supérieure et minimale inférieure ont augmenté, ce qui indique une amélioration significative du niveau global des élèves. En revanche, les variations de scores dans le groupe témoin ont été relativement limitées. Avant l'expérience, le score moyen du groupe témoin était de 60,1 points, et après l'expérience, il s'élevait à 64,9 points, soit une augmentation de 4,8 points. Cette augmentation était bien inférieure à celle du groupe expérimental, et la boîte à moustaches du groupe témoin n'a guère changé avant et après l'expérience, ce qui indique que les méthodes d'enseignement traditionnelles ou les outils d'assistance par IA non optimisés ont un effet limité sur l'amélioration de la qualité de l'écriture.
En outre, cette étude a utilisé le tableau de la cognition transférée pour guider les étudiants à travers trois séries d'auto-évaluation de leur développement des compétences en ajustement structurel, transformation des phrases et expression culturelle, entre autres domaines, afin de refléter l'évolution de la conscience métacognitive des étudiants et de leur maîtrise des stratégies de transfert. Les résultats sont présentés dans Figure 8. D'après les données du graphique en radar concernant l'auto-évaluation par les étudiants de leurs capacités de transfert, illustrées dans Figure 8, l'auto-évaluation des étudiants dans les cinq dimensions — transfert structurel, transfert syntaxique, transfert culturel, transfert de registre et transfert logique — au cours des trois séries de tâches a montré une tendance croissante continue, indiquant qu'avec l'intervention pédagogique d'optimisation de l'enseignement fondée sur le modèle DeepSeek, la capacité des étudiants à utiliser les stratégies de transfert s'était nettement améliorée. Lors de la première série de tâches, les notes d'auto-évaluation des étudiants étaient généralement faibles. Parmi les cinq dimensions, le « transfert structurel » et le « transfert logique » ont obtenu respectivement 3,2 et 3,0, tandis que le « transfert culturel » et le « transfert de registre » ont obtenu 2,5 et 2,7, ce qui indique que les étudiants étaient encore peu expérimentés dans l'identification et l'utilisation des stratégies de transfert. Lors de la deuxième série de tâches, les notes de chaque item se sont améliorées, le « transfert structurel » passant à 3,8, le « transfert syntaxique » à 3,5 et le « transfert logique » à 3,7. Cela montre qu'avec l'accompagnement des enseignants et l'appui des retours du modèle, les étudiants ont progressivement maîtrisé les points clés des opérations de base de transfert et ont commencé à les appliquer à la rédaction effective. Lors de la troisième série de tâches, les notes d'auto-évaluation des étudiants ont augmenté de manière significative, le « transfert structurel » et le « transfert logique » atteignant respectivement 4,5 et 4,3, tandis que les autres dimensions se sont également stabilisées au-dessus de 4,0, démontrant l'effet durable de plusieurs séries d'entraînement au transfert pour améliorer le contrôle des formes linguistiques et les capacités de construction textuelle des étudiants. À ce stade, les étudiants avaient établi une boucle cognitive de base entre compréhension, exécution et réflexion des stratégies de transfert. Outre les retours des enseignants, l'étude a également distribué un questionnaire de satisfaction concernant la fonction d'écriture assistée par IA à tous les étudiants du groupe expérimental, et 30 questionnaires valides ont été recueillis. Le questionnaire évaluait la performance de l'IA dans trois modules fonctionnels — suggestions de réécriture, optimisation structurelle et indications culturelles — et demandait aux étudiants de choisir des options selon cinq niveaux de critères. Les résultats sont présentés dans Tableau 5.
D'après les résultats de l'enquête sur la satisfaction des étudiants concernant les fonctions d'écriture assistée par l'IA présentés dans le Tableau 5, les étudiants du groupe expérimental ont globalement formulé des commentaires positifs sur les performances de l'IA dans les trois modules fonctionnels que sont les suggestions de réécriture, l'optimisation de la structure et les indications culturelles, ce qui montre les bonnes perspectives d'application des systèmes d'écriture assistée par l'IA pour améliorer l'efficacité de l'entraînement à l'écriture et la qualité du soutien pédagogique. Dans l'ensemble, plus de 90 % des étudiants se sont déclarés « très satisfaits » ou « satisfaits » pour les deux fonctions « suggestions de réécriture » et « optimisation de la structure », la fonction « suggestions de réécriture » obtenant le taux de satisfaction le plus élevé, atteignant 91 %, ce qui indique que les étudiants reconnaissent fortement la capacité de l'IA en matière de restructuration syntaxique et de mise en forme linguistique. En comparaison, le taux de satisfaction concernant la fonction « indications culturelles » était relativement plus faible, bien qu'il atteigne tout de même 83 %, ce qui suggère que, malgré la complexité et la subjectivité inhérentes à l'accompagnement dans l'expression interculturelle, le rôle de l'IA pour aider les étudiants à identifier et corriger les interférences culturelles liées à leur langue maternelle est néanmoins reconnu par la majorité. En ce qui concerne l'insatisfaction, la proportion d'étudiants ayant choisi « insatisfait » ou « très insatisfait » pour les trois fonctions était inférieure à 5 %, indiquant que les fonctions assistées par l'IA présentent une bonne utilisabilité et un bon niveau d'acceptation dans la plupart des scénarios d'application. Il convient de noter que la proportion d'étudiants ayant attribué une évaluation « moyenne » à l'item « indications culturelles » était relativement élevée, ce qui suggère que l'IA actuelle pourrait ne pas pleinement répondre aux attentes des étudiants lorsqu'elle traite des questions d'adaptation culturelle, laissant ainsi une marge d'amélioration. Une analyse globale révèle que la méthode d'optimisation des instructions basée sur DeepSeek est largement reconnue par les étudiants, en particulier pour son soutien en matière de forme linguistique.
ANOVA-RM
Une analyse de variance à mesures répétées à deux facteurs (RM-ANOVA) a été réalisée pour examiner les effets du groupe (facteur inter-sujets : groupe expérimental contre groupe témoin) et du temps (facteur intra-sujets : pré-test, tâche 1, tâche 2, tâche 3, post-test), ainsi que leur interaction sur les performances des étudiants en transfert d'écriture en anglais. Le test de Mauchly a indiqué une violation de l'hypothèse de sphéricité (p < 0,05), de sorte que la correction de Greenhouse–Geisser a été appliquée pour ajuster les degrés de liberté des effets intra-sujets. Toutes les analyses étaient basées sur n = 30 participants par groupe. Les résultats sont présentés dans le Tableau 6 :
Les résultats de l'ANOVA à mesures répétées avec correction de Greenhouse–Geisser ont indiqué des effets principaux significatifs du groupe, du temps et de l'interaction groupe × temps sur toutes les dimensions mesurées (p < 0,001). Pour l'indice global de transfert, un effet de groupe significatif a été observé (F(1,58) = 76,32), ainsi qu'un effet de temps significatif (F(2,14,124,12) = 92,75) et une interaction groupe × temps significative (F(2,14,124,12) = 68,49), ce qui suggère que les changements dans la performance globale de transfert au fil du temps différaient significativement entre les groupes.
De même, le transfert syntaxique a révélé des effets significatifs du facteur Groupe (F(1,58) = 52,18), du Temps (F(2,11,122,38) = 71,26) et de l'interaction Groupe × Temps (F(2,11,122,38) = 45,73), indiquant des profils de développement différents dans la capacité de transfert syntaxique selon les groupes et les moments de mesure. Pour le transfert structurel, des effets significatifs du Groupe (F(1,58)=48,65), du Temps (F(2,09,121,22) = 67,81) et de l'interaction (F(2,09,121,22) = 41,36) ont également été identifiés, reflétant des améliorations régulières suivant des trajectoires dépendantes du groupe. Notamment, le transfert culturel a présenté les effets les plus marqués, avec un effet significatif du Groupe (F(1,58) = 81,44), un effet prononcé du Temps (F(2,07,119,96) = 98,52) et une interaction Groupe × Temps robuste (F(2,07,119,96) = 79,27), suggérant le profil de croissance le plus important et le plus différencié dans cette dimension. Dans l'ensemble, tous les indices montrent des effets statistiquement significatifs, confirmant que l'intervention a exercé un impact stable et différencié sur le développement du transfert au fil du temps.
DISPONIBILITÉ DES DONNÉES :
Toutes les données générées ou analysées au cours de cette étude sont incluses dans cet article. Les données brutes d'évaluation sont fournies dans le Tableau supplémentaire 1.
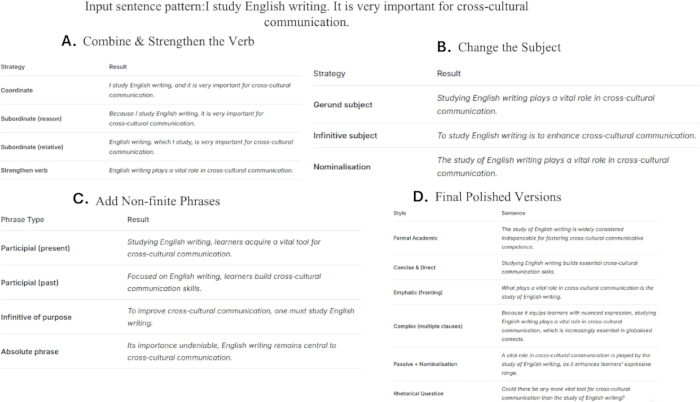
Figure 1 : Étapes de transformation de la structure des phrases. (A) Stratégies pour combiner et renforcer les verbes afin d'améliorer la structure des phrases. (B) Transformations alternatives du sujet, incluant les sujets en forme de gérondif, d'infinitif et de nominalisation. (C) Utilisation de phrases non finies pour accroître la variété et la concision des phrases. (D) Exemples de versions finales retravaillées illustrant un style académique amélioré et une expression anglaise adaptée au contexte interculturel. Veuillez cliquer ici pour visualiser une version agrandie de cette figure.
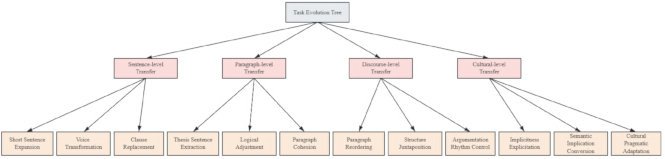
Figure 2 : Diagramme en arbre de l'évolution des tâches. Il présente la structure progressive de tâches de transfert à quatre niveaux, allant de la phrase, au paragraphe, au discours, jusqu'au niveau culturel. Veuillez cliquer ici pour visualiser une version agrandie de cette figure.
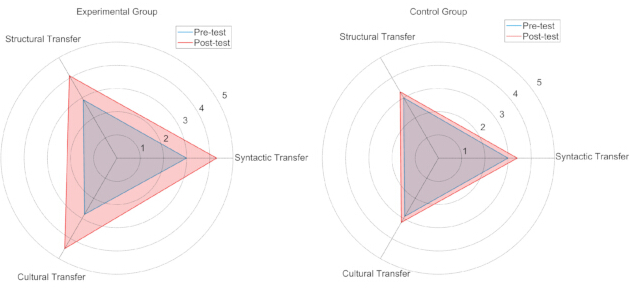
Figure 3 : Comparaison des capacités de transfert écrit avant et après l'expérience. Le graphique en radar présente les scores obtenus lors du pré-test et du post-test par le groupe expérimental et le groupe témoin selon les dimensions du transfert syntaxique, structurel et culturel. Veuillez cliquer ici pour visualiser une version agrandie de cette figure.
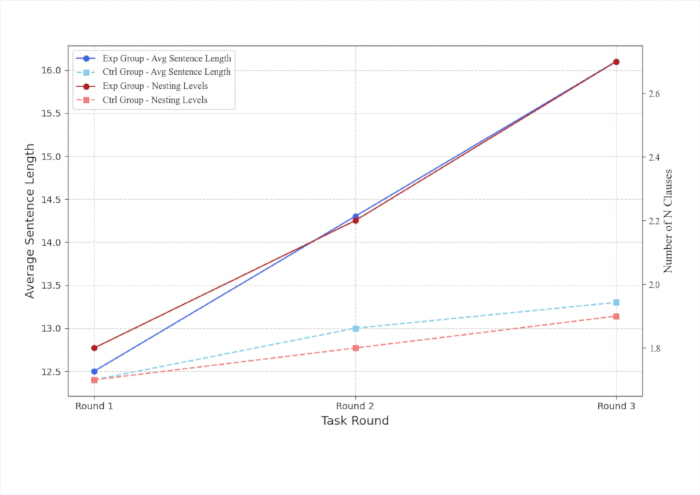
Figure 4 : Graphique des tendances de la complexité syntaxique. Les évolutions de la longueur moyenne des phrases et du nombre de niveaux d’imbrication des propositions au fil des trois tâches d’entraînement sont présentées. Veuillez cliquer ici pour afficher une version agrandie de cette figure.
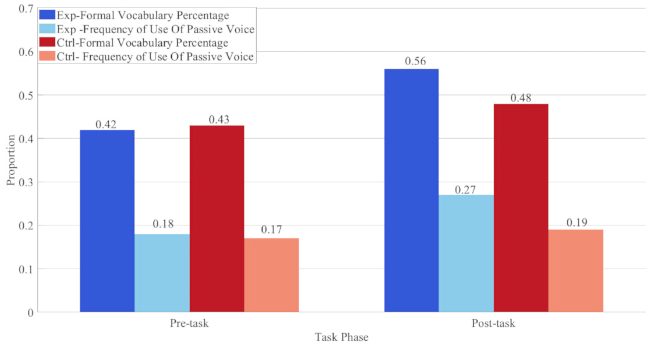
Figure 5 : Correspondance du vocabulaire académique. Cette figure montre les variations de la proportion de vocabulaire formel et de la fréquence de la voix passive avant et après l'intervention. Veuillez cliquer ici pour visualiser une version agrandie de cette figure.
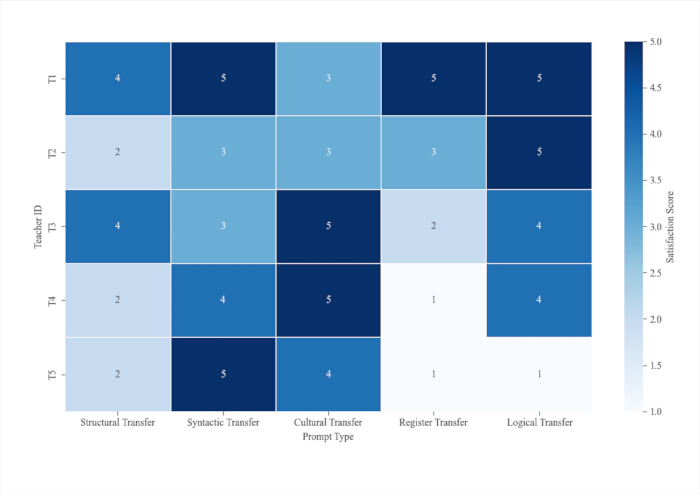
Figure 6 : Carte thermique de satisfaction des réponses aux consignes. Les évaluations de cinq types de modèles de consignes fournies par les enseignants participants sont résumées ici. Veuillez cliquer ici pour visualiser une version agrandie de cette figure.
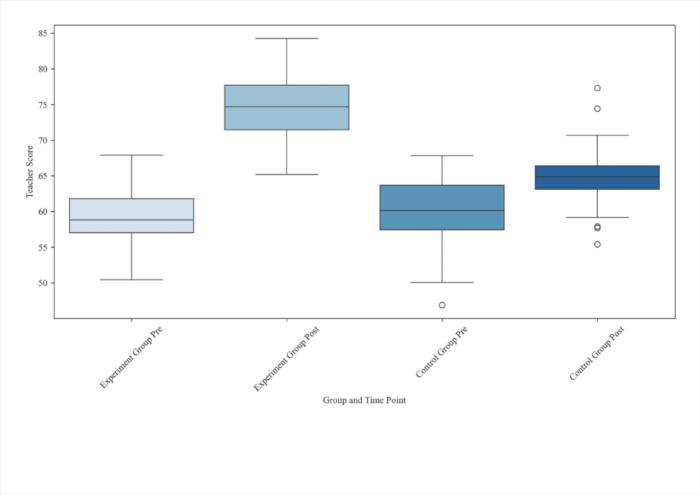
Figure 7 : Graphique en boîte des changements dans les évaluations par les enseignants. Le graphique en boîte illustre la répartition et les changements globaux des scores d'écriture évalués par les enseignants pour deux groupes avant et après l'expérience. Veuillez cliquer ici pour visualiser une version agrandie de cette figure.
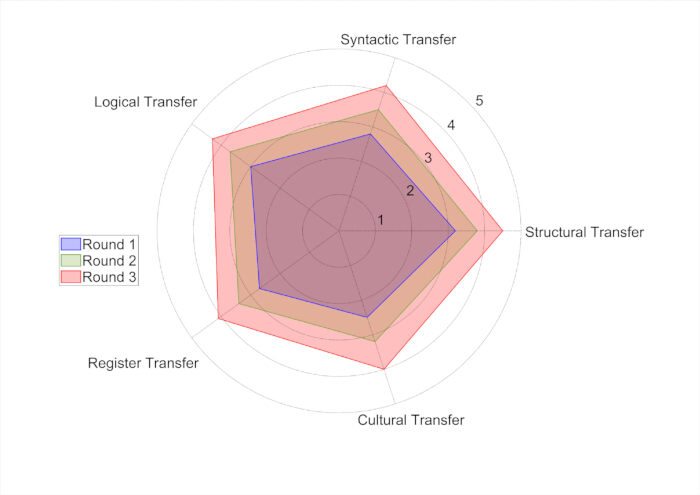
Figure 8 : Graphique radar des capacités d'auto-évaluation du transfert par les étudiants. Il présente les scores d'auto-évaluation des étudiants selon cinq dimensions du transfert, mesurés lors de trois tours de formation. Veuillez cliquer ici pour visualiser une version agrandie de cette figure.
| Entrée | Opération de l'enseignant | Type de consigne | Opération de l'élève | Résultat | Critères d'évaluation |
| Brouillons écrits initiaux des élèves (phrases/paragraphes/essais) | 1. Identifier les types de transfert et les niveaux de tâche 2. Ajuster les paramètres de la consigne si nécessaire | Consigne de transfert unique / Chaîne de consignes imbriquées en trois étapes | 1. Apprendre les stratégies de transfert 2. Réviser les brouillons selon les retours de l'IA 3. Réaliser une auto-évaluation | Texte révisé par l'IA + Brouillon final révisé par l'élève | Complexité syntaxique, rationalité structurelle, pertinence culturelle, cohérence logique, normalisation du registre (échelle de 0 à 5) |
Tableau 1 : Tableau récapitulatif du flux de travail. Ce tableau résume l'ensemble du flux de travail opérationnel de la formation au transfert d'écriture en anglais assistée par l'intelligence artificielle, en couvrant les matériaux d'entrée, les opérations des enseignants et des étudiants, les types de consignes, les produits finaux et les critères d'évaluation correspondants.
| Catégorie du projet | Contenu |
| Compréhension des objectifs de la mission | Veuillez décrire brièvement les objectifs de migration de ce cycle de tâches rédactionnelles, tels que l'ajustement structurel, l'adaptation culturelle et la conversion linguistique. |
| Stratégie de migration utilisée | Veuillez indiquer les stratégies de migration que vous avez adoptées (sélection multiple autorisée) : |
| Ajustement structurel | |
| Transformation de phrase | |
| Changement de langue | |
| Manifestation culturelle | |
| Renforcement de la liaison logique | |
| Autre : _______ | |
| Réécriture d'exemples et d'instructions | Sélectionnez 1 à 2 phrases réécrites, présentez les versions avant et après la réécriture, puis expliquez les raisons des modifications et les objectifs de transfert souhaités. |
| Difficultés et doutes rencontrés | Décrivez les difficultés que vous avez rencontrées pendant la migration ou les questions que vous vous êtes posées concernant une expression particulière. |
| Note d'auto-évaluation (sur 5 points) | Veuillez évaluer votre réécriture de texte selon les trois critères suivants : |
| • Précision de l'application des stratégies (/5) | |
| • Fluidité naturelle de l'expression (/5) | |
| • Adéquation culturelle (/5) | |
| Objectifs d'amélioration pour les prochaines rédactions | Décrivez brièvement les compétences transférables que vous souhaitez renforcer ou optimiser lors du prochain cycle de formation |
Tableau 2 : Tableau de la cognition transférée. Une échelle d'évaluation de 1 à 5 (1 = aucune maîtrise, 5 = maîtrise complète) est adoptée pour l'auto-évaluation par les étudiants des stratégies de transfert à l'écriture.
| Nom de l'indicateur | Description | Source des données |
| Indice de transfert écrit (0–5) | Un indicateur quantitatif mesurant de manière globale la capacité de transfert linguistique, couvrant trois niveaux : syntaxe, structure et culture. | Notation automatique par le système + notation manuelle par les enseignants |
| Score de complexité syntaxique | Y compris la longueur moyenne des phrases, le nombre d'emboîtements de propositions, la richesse des groupes verbaux, etc. | Analyse automatique par traitement du langage naturel (NLP) |
| Adéquation au style académique | Est-ce conforme aux normes de rédaction académique en anglais ? | Jugement par modèle de traitement du langage naturel |
| Satisfaction face aux réponses aux invites | Acceptation par les enseignants et évaluation pratique des suggestions générées par le modèle | Questionnaire destiné aux enseignants |
| Évolution des notes attribuées par les enseignants | Comparaison des notes données par les enseignants avant et après l'expérience, afin de refléter l'amélioration de la qualité de l'écriture | Registres de notation des enseignants |
| Capacité de transfert auto-évaluée par les étudiants | Les étudiants évaluent eux-mêmes leur maîtrise des différentes dimensions du transfert | Remplissage du formulaire de prise de conscience du transfert |
Tableau 3 : Résumé des indicateurs d'évaluation, de leurs descriptions et de leurs sources de données. Ce tableau précise les définitions, les méthodes de mesure et les sources de données d'origine pour chaque indicateur d'évaluation principal de cette étude.
| Type de prompt | Note moyenne des enseignants | Note moyenne de l'IA | Coefficient de corrélation de Pearson |
| Transfert structurel | 4 | 3.9 | 0.83 |
| Transfert syntaxique | 4.1 | 4 | 0.87 |
| Transfert culturel | 3.8 | 3.6 | 0.79 |
| Transfert de registre | 3.9 | 3.7 | 0.81 |
| Transfert logique | 4.2 | 4.1 | 0.85 |
Tableau 4 : Comparaison de la cohérence entre le contenu généré par l'IA et les évaluations des enseignants. Les résultats démontrent la cohérence entre le contenu généré par l'IA et les évaluations des enseignants selon différents types de consignes.
| Éléments fonctionnels | Très satisfait | Satisfait | Plutôt satisfait | Insatisfait | Très insatisfait |
| Suggestion de réécriture | 66% | 25% | 7% | 1,50% | 0,50% |
| Optimisation structurelle | 60% | 30% | 7% | 2% | 1% |
| Conseils culturels | 55% | 28% | 12% | 3,50% | 1,50% |
Tableau 5 : Statistiques des enquêtes sur la satisfaction des étudiants concernant les fonctions assistées par l'IA. Les statistiques montrent la répartition de la satisfaction des étudiants pour les fonctions de réécriture par l'IA, d'optimisation structurelle et de saisie culturelle.
| Mesure | Groupe F(dl) | Temps F(dl)GG | Groupe × Temps F(dl)GG | p |
| Indice global de transfert | 76.32 (1, 58) | 92.75 (2.14, 124.12) | 68.49 (2.14, 124.12) | <0.001 |
| Transfert syntaxique | 52.18 (1, 58) | 71.26 (2.11, 122.38) | 45.73 (2.11, 122.38) | <0.001 |
| Transfert structurel | 48.65 (1, 58) | 67.81 (2.09, 121.22) | 41.36 (2.09, 121.22) | <0.001 |
| Transfert culturel | 81.44 (1, 58) | 98.52 (2.07, 119.96) | 79.27 (2.07, 119.96) | <0.001 |
Tableau 6 : Résumé des résultats de l'ANOVA à mesures répétées. Il présente les résultats de l'ANOVA à deux facteurs avec mesures répétées concernant la performance globale en transfert d'écriture et ses trois sous-dimensions, incluant les effets principaux du groupe, du temps et de l'interaction groupe × temps. Abréviations : GG = correction de Greenhouse–Geisser.
Tableau supplémentaire 1 : Évaluation des données brutes. Comprend les données brutes utilisées dans toutes les analyses de cette étude.Veuillez cliquer ici pour télécharger ce fichier.
Discussion
Cette recherche construit un cadre d'optimisation des instructions à plusieurs niveaux, fondé sur l'architecture MoE de DeepSeek, pour l'enseignement du transfert rédactionnel en anglais dans un contexte interculturel. En s'appuyant sur quatre niveaux de tâches progressives, allant de la phrase à la dimension culturelle, ainsi que sur une bibliothèque normalisée de tâches en cinq catégories, l'étude parvient à générer automatiquement des instructions à partir d'échantillons réels de productions écrites d'apprenants, et met en place des chaînes d'instructions imbriquées en trois étapes afin de décomposer des tâches complexes d'adaptation interculturelle. Contrairement aux approches classiques d'élaboration d'instructions génériques, limitées au simple polissage du texte, la solution proposée associe étroitement la conception des instructions aux objectifs pédagogiques du transfert linguistique, et instaure un flux d'enseignement en boucle fermée comprenant la génération par le modèle, l'annotation par l'enseignant et la révision itérative par l'apprenant. Du point de vue de l'avancement disciplinaire, ce travail élargit le champ d'application pratique de l'ingénierie des instructions en acquisition d'une seconde langue, en proposant une voie quantifiable pour construire des modèles combinant les caractéristiques paramétriques des grands modèles linguistiques et une formation ciblée en classe de FLE. Il enrichit également les données empiriques disponibles sur le transfert pragmatique interculturel dans un environnement assisté par l'intelligence artificielle, en complétant les recherches existantes axées uniquement sur les erreurs de transfert négatif syntaxique36,37.
Des données empiriques issues d'une quasi-expérimentation confirment que le groupe expérimental a obtenu une amélioration nette sur les indicateurs de transfert syntaxique, structurel et culturel, mais plusieurs contraintes intrinsèques limitent la généralisation des résultats. En raison des conditions de recherche, l'étude a adopté un regroupement non randomisé des classes sans aveugle pour les évaluateurs, et tous les échantillons provenaient d'étudiants en anglais d'une seule université, ce qui rend difficile l'exclusion des interférences dues à la motivation autonome des apprenants et aux habitudes d'enseignement à long terme des enseignants lors des variations de notes. De plus, cette intervention n'a duré que trois semaines, correspondant ainsi à un programme de formation à court terme. Combiné à un plan d'échantillonnage monocentrique où tous les participants ont été recrutés dans un seul établissement professionnel, les effets positifs observés pourraient ne pas être pleinement stables dans une pratique pédagogique à long terme. Par conséquent, les résultats de cette recherche doivent être interprétés avec prudence, et il serait inapproprié de généraliser directement les conclusions à d'autres types d'établissements, à des cycles d'enseignement plus longs ou à des groupes d'étudiants ayant des niveaux de compétence linguistique différents.
Dans le cadre de l'enseignement pratique, le système actuel d'optimisation des prompts combiné au modèle DeepSeek présente des limites notables ainsi que des cas d'échec typiques. En ce qui concerne les tâches de transfert culturel et de registre, le modèle produit parfois des expressions pragmatiquement inappropriées ou des résultats de conversion stylistique rigides lors du traitement de textes aux connotations culturelles subtiles et aux exigences stylistiques dépendantes du contexte38,39 ; il échoue également à identifier avec précision la pensée culturelle implicite des locuteurs natifs dans des paragraphes longs et complexes, ce qui entraîne une correction incomplète des expressions en « chinglish ». En matière de notation automatique, la cohérence de l'évaluation par l'IA diminue fortement pour les items culturels et pragmatiques très subjectifs, et elle ne parvient pas à distinguer efficacement les différences nuancées dans l'expression rhétorique et l'implication interculturelle. Par ailleurs, la chaîne de prompts imbriquée en trois étapes est sujette à des déviations sémantiques lors de générations itératives multiples, les erreurs issues de la première étape de réorganisation sémantique étant transmises puis amplifiées lors des étapes suivantes de révision linguistique et d'adaptation culturelle40,41.
En ce qui concerne la tendance future du développement, des améliorations supplémentaires peuvent être entreprises selon trois axes pratiques. Premièrement, élargir l'échelle de la bibliothèque de tâches en recueillant un corpus d'écriture provenant d'étudiants non spécialistes en anglais et d'apprenants ayant différents niveaux de compétence linguistique, afin de renforcer la compatibilité des modèles pour des groupes d'apprenants diversifiés. Deuxièmement, combiner un ajustement fin continu de sous-modules légers DeepSeek afin de réduire l'écart existant dans la notation par IA du transfert culturel, qui s'est révélé moins cohérent par rapport à l'évaluation par les enseignants dans les statistiques actuelles. Troisièmement, intégrer l'ensemble du système d'optimisation des prompts dans des plateformes conventionnelles d'apprentissage en ligne des langues étrangères, afin de permettre une accumulation automatique et prolongée de données destinée à l'optimisation itérative continue des règles de prompts. Avec l'enrichissement continu des ressources de corpus culturels interlinguistiques, le cadre technique proposé devrait étendre son application à l'enseignement de la traduction bilingue et aux cours de communication interculturelle dans les recherches ultérieures.
Déclarations de divulgation
Les auteurs déclarent qu’ils n’ont aucun conflit d’intérêts financier.
Remerciements
Ce travail a été soutenu par le projet de planification de l'éducation de la province du Zhejiang 2026 : Recherche sur la reconstruction du cadre de compétences pédagogiques et les stratégies de promotion des enseignants du supérieur en formation professionnelle dans le contexte de l'accompagnement numérique et intelligent (numéro de projet : ZWT26024 ; numéro d'approbation : 2026SCG360).
Matériaux
| Nom | Entreprise | Numéro de catalogue | Commentaires |
|---|---|---|---|
| Modèle de langage pré-entraîné BERT | https://github.com/google-research/bert | La représentation du texte, la reconnaissance de la structure des paragraphes, le calcul de la similarité sémantique et la classification du texte permettent une évaluation automatisée du contenu écrit. | |
| Coreferee | Explosion AI | https://github.com/explosion/coreferee | Les relations référentielles dans le texte sont identifiées et la cohérence référentielle du discours est évaluée afin d'aider à l'évaluation automatique de la qualité de l'écriture. |
| Grand modèle de langage DeepSeek | DeepSeek AI | https://chat.deepseek.com/ | Basé sur l'architecture de modèle MoE, une optimisation des instructions et une conception de chaîne de mots-clés ont été effectuées. Le modèle utilise des paramètres fixes : un coefficient de température de 0,7, et la longueur générée est limitée dynamiquement selon le type de question. |
| spaCy | Explosion AI | https://github.com/explosion/spaCy | La structure syntaxique en dépendance du texte anglais est analysée, et des indicateurs tels que la longueur moyenne des phrases et le nombre de propositions imbriquées sont extraits afin de quantifier la complexité syntaxique. |
| SPSS 26.0 | IBM | https://www.ibm.com/products/spss-statistics | Des analyses statistiques telles que l'analyse de variance à mesures répétées (RM-ANOVA), le test t pour échantillons indépendants, l'analyse de corrélation de Pearson, le calcul de la taille de l'effet (d de Cohen’s) et le test de fiabilité (CCI) ont été réalisés. |
Références
- Maqsood M, Zahid A, Asghar T, et al. Issues in teaching English in a cultural context. Migr Lett. 2024; 21(4): 1020–1027.
- Tran NT, Nguyen TT, Pham HH. Exploring the challenges of L1 negative transfer among Vietnamese English language learners: a qualitative study. rEFLections. 2024; 31(2): 837–857.
- Zhu P. Cultural dimensions as guidelines in handling language problems for effective written communication across cultures. Int J Linguist Lit Transl. 2023; 6(12): 85–95.
- Zeng Z, Nair SM, Wider W. A comparative study of Chinese EFL undergraduates' pragmatic competence in English letter writing between urban and suburban universities. World J Engl Lang. 2022; 12(6): 377–388.
- Litvinova TA, Mikros GK, Dekhnich OV. Writing in the era of large language models: a bibliometric analysis of the research field. Nauchnyi Rezultat Voprosy Teoreticheskoi i Prikladnoi Lingvistiki. 2024; 10(4): 5–16.
- Long M. Cultivating interdisciplinary foreign language talents through interdisciplinary synergy of on-campus teaching and off-campus practices under the new liberal arts. Educ Rev USA. 2025; 9(5): 520–526.
- Voss E, Cushing ST, Ockey GJ, et al. The use of assistive technologies including generative AI by test takers in language assessment: a debate of theory and practice. Lang Assess Q. 2023; 20(4-5): 520-532.
- Manyasa J. When language transfer is negative: analysis of morpho-syntactic interference errors by learners of French in Tanzanian higher learning institutions. J Foreign Lang. 2021; 13(1): 165-190.
- Fikri N. The study of language transfer in EFL students' translation work. J Pendidik Nonformal. 2023; 1(1): 9.
- Ahmat A, Yang Y, Ma B, et al. Cross-lingual prompting method with semantic-based answer space clustering. Appl Intell. 2025; 55(2): 1-17.
- Maity S, Deroy A, Sarkar S. Investigating large language models for prompt-based open-ended question generation in the technical domain. SN Comput Sci. 2024; 5(8): 1-32.
- Wu W, Cao Y, Yi N, et al. Detecting and reducing the factual hallucinations of large language models with metamorphic testing. Proc ACM Softw Eng. 2025; 2(FSE): 1432-1453.
- Kaganovich P, Münz-Manor O, Ezra-Tsur E. Style transfer of modern Hebrew literature using text simplification and generative language modeling. CEUR Workshop Proc. 2023; 1613: 73-95.
- Yuan Y. Influence of native language transfer on senior high school English writing. Theory Pract Lang Stud. 2021; 11(2): 170-176.
- Jiamin M. The influence of cultural factors on language transfer in second language acquisition. Res J Engl Lang Lit. 2024; 12(1): 186-195.
- Zhang L. Native language transfer in vocabulary acquisition: an empirical study from connectionist perspective. J Lang Teach Res. 2023; 14(2): 446-458.
- Mirzayev E. The influence of first language interference on ESL writing skills. EuroGlob J Linguist Lang Educ. 2024; 1(1): 33-39.
- Fujiwara Y, Iwao T, Ito H, et al. Exploring the transfer of topic-comment structures called unagi-sentences in Asian L2 Englishes: cross-proficiency-level and cross-varietal studies. Asian Englishes. 2025; 27(1): 25-40.
- Guo Q. Interlanguage and its implications to second language teaching and learning. Pac Int J. 2022; 5(4): 8-14.
- Vereeck A, Janse M, De Herdt K, et al. Why Plato needs psychology: proposal for a theoretical framework underpinning research on the cognitive transfer effects of studying classical languages. Psiholoska Obzorja. 2023; 32: 121-130.
- Zhang W. Study on the negative transfer of mother tongue on college students. Int J Front Sociol. 2023; 5(16): 164-171.
- Li C. A review of theories, pedagogies and vocabulary learning tasks of English vocabulary learning apps for Chinese EFL learners. J China Comput Assist Lang Learn. 2024; 4(2): 346-375.
- Nsengimana I, Niyibizi E, Ngabonziza JDA. The impact of language transfers on learners' writing skills in English learning among students in Mahama Refugee Camp, Rwanda. Afr J Empir Res. 2024; 5(3): 605-613.
- Jovein S K, Sharifabad E D, Yazdani M. On the relationship between university translator training programs and the translation market requirements: The case of English translation graduates and postgraduates of Imam Reza International University. Journal of Critical Studies in Language and Literature. 2024; 5(6): 1-13.
- Qin X. Collaborative inquiry in action: a case study of lesson study for intercultural education. Asian Pac J Second Foreign Lang Educ. 2024; 9(1): 66-91.
- Sun L, Asmawi A. The effect of WeChat-based instruction on Chinese EFL undergraduates’ business English writing performance. International Journal of Instruction. 2023; 16(1): 43-60.
- Moro G, Piscaglia N, Ragazzi L, et al. Multi-language transfer learning for low-resource legal case summarization. Artificial Intelligence and Law. 2024; 32(4): 1111-1139.
- Sun Y. A study of college English writing teaching based on dynamic assessment. Pac Int J. 2023; 6(1): 83-88.
- Jeon J, Lee S. Large language models in education: a focus on the complementary relationship between human teachers and ChatGPT. Educ Inf Technol. 2023; 28(12): 15873-15892.
- Kostka I, Toncelli R. Exploring applications of ChatGPT to English language teaching: opportunities, challenges, and recommendations. TESL-EJ. 2023; 27(3): n3-n22.
- Antara IMAR, Anggreni NPY. Analyzing grammatical errors in EFL students' opinion essays using DeepSeek AI: patterns and pedagogical implications. Stilistika. 2025; 13(2): 210-218.
- Diasamidze L, Tedoradze T. Enhancing ESL students' writing skills through natural language processing model ChatGPT. Eurasia Proc Educ Soc Sci. 2024; 35: 230-238.
- Ranade N, Saravia M, Johri A. Using rhetorical strategies to design prompts: a human-in-the-loop approach to make AI useful. AI Soc. 2025; 40(2): 711-732.
- Zhou W, Gao B. Construction and application of English-Chinese multimodal emotional corpus based on artificial intelligence. Int J Hum Comput Interact. 2025; 41(3): 1782-1793.
- Chen B, Bao L, Zhang R, et al. A multi-strategy computer-assisted EFL writing learning system with deep learning incorporated and its effects on learning: a writing feedback perspective. J Educ Comput Res. 2024; 61(8): 60-102.
- Jeon H. Designing teaching for transfer in English for academic purposes. RELC Journal. 2024; 55(2): 567-577.
- Pei Y J. Construction of a" Feedback-Revision" Teaching Model for Senior High School English Continuation Writing Based on Generative AI. International Journal of Educational Development. 2026; 3(1): 16-25.
- Holubnycha L, Kuznetsova O, Shchokina T, et al. AI-Powered Teaching: Literature Review of ChatGPT's Impact on University Educators. International Journal of Interactive Mobile Technologies. 2025; 19(15): 41.
- Almuhanna M A. Teachers' perspectives of integrating AI-powered technologies in K-12 education for creating customized learning materials and resources. Education and Information Technologies. 2025; 30(8): 10343-10371.
- Hastomo T, Mandasari B, Widiati U. Scrutinizing Indonesian pre-service teachers’ technological knowledge in utilizing AI-powered tools. Journal of education and learning (EduLearn). 2024; 18(4): 1572-1581.
- Cai H, Lu L, Han B, et al. Exploring pre-service teachers’ reflection mediated by an AI-powered teacher dashboard in video-based professional learning: a pilot study. Educational technology research and development. 2025; 73(2): 1129-1154.