Cette étude a intégré la pharmacologie en réseau, le dockage moléculaire, la dynamique moléculaire et la méthode MM-PBSA afin de hiérarchiser les interactions protéiques potentielles des prodrogues piégeant les sites apuriniques en réponse au glutathion dans le CBNPC. Le composé 5 a été sélectionné pour des études complémentaires sur MMP9 et SRC ; toutefois, ces cibles restent des candidats informatiques. Les résultats obtenus permettent de formuler des hypothèses, mais nécessitent une validation biochimique et cellulaire.
Article de recherche
Priorisation in silico des interactions protéiques potentielles pour des prodrogues de piégeage de sites abasiques sensibles au glutathione dans le cancer du poumon non à petites cellules
Dans cet article
Résumé
Résumé
Le cancer du poumon non à petites cellules (NSCLC) reste une cause majeure de mortalité liée au cancer, et l'efficacité du traitement est fréquemment limitée par une résistance acquise et une toxicité systémique. Des prodrogues sensibles au glutathion et piégeant les sites apuriniques ont montré une activité anticancéreuse sélective dans des études expérimentales antérieures, mais on ignore encore si leurs métabolites libérés interagissent de manière significative avec des protéines pertinentes dans le cancer. Ici, un flux de travail intégré in silico, combinant pharmacologie des réseaux, docking moléculaire, dynamique moléculaire (DM) et analyse de l'aire de surface par la méthode de mécanique moléculaire de Poisson-Boltzmann (MM-PBSA), a été utilisé pour hiérarchiser des hypothèses testables d'interactions protéiques pour deux prodrogues sensibles au glutathion (Composé 1 et Composé 2), leurs produits contenant un groupe aminoxy (Composé 4 et Composé 5), ainsi qu'une paire témoin non piégeuse appariée (Composé 3 et Composé 6). Vingt et une cibles communes aux composés et à la maladie ont été identifiées, et AKT sérine/thréonine kinase 1 (AKT1), le récepteur du facteur de croissance épidermique (EGFR), le facteur de nécrose tumorale (TNF), la métalloprotéinase 9 de la matrice (MMP9) et la proto-oncogène SRC, tyrosine kinase non réceptrice (SRC) ont été priorisés selon la topologie des interactions protéine-protéine. Le Composé 5 a obtenu le score AutoDock Vina le plus favorable avec MMP9 (-8,418 kcal·mol⁻1) et a montré des poses dérivées du docking relativement stables au cours des trajectoires DM de MMP9 et SRC. Toutefois, la pose principale avec MMP9 n'a pas montré de coordination directe de l'ion Zn2⁺ catalytique ni d'interaction directe avec His401, Glu402, His405 ou His411, ce qui exclut un mode de liaison inhibiteur canonique de MMP9. Les analyses DM et MM-PBSA caractérisent uniquement le comportement des trajectoires et le classement énergétique relatif de ces complexes ; elles ne démontrent pas l'engagement intracellulaire de la cible, l'inhibition enzymatique ou la régulation de voies. L'activité établie de piégeage des sites apuriniques et les nouvelles interactions protéiques prédites sont donc considérées comme des hypothèses distinctes, potentiellement parallèles, et non comme une chaîne mécanistique démontrée. Dans l'ensemble, les résultats permettent de hiérarchiser des paires composé-cible spécifiques pour des tests futurs, mais n'établissent pas un mécanisme anticancéreux multi-cibles contre le NSCLC.
Introduction
Le cancer du poumon non à petites cellules (CPNPC) est le sous-type histologique le plus fréquent du cancer du poumon et demeure une cause majeure de mortalité liée au cancer dans le monde entier1. Bien que des progrès considérables aient été réalisés dans le domaine de la thérapie ciblée et de l'oncologie de précision, l'efficacité du traitement à long terme est encore fréquemment compromise par l'apparition de résistances acquises, la durée limitée de la réponse thérapeutique et la toxicité associée au traitement2. Les agents ciblant le récepteur du facteur de croissance épidermique (EGFR) ont amélioré les résultats chez les patients sélectionnés sur la base de critères moléculaires, mais une résistance apparaît presque inévitablement au cours du traitement, soulignant le besoin urgent de stratégies thérapeutiques agissant par des mécanismes alternatifs ou complémentaires3,4. La chimiothérapie conventionnelle à base de platine reste un composant important du traitement, mais son bénéfice clinique est limité par la toxicité cumulative et l'apparition de résistances lors d'une utilisation prolongée5,6. Ces limitations combinées mettent en évidence la nécessité d'identifier des agents antitumoraux à la fois mécanistiquement distincts et activés de manière sélective dans l'environnement tumoral.
Parmi les lésions de l'ADN endogènes, les sites apuriniques ou apyrimidiniques sont très abondants et ont des conséquences biologiques importantes, des milliers de lésions étant générées chaque jour dans chaque cellule7. Lorsqu'elles ne sont pas réparées efficacement, ces lésions peuvent se transformer en cassures de brin, pouvant entraîner une instabilité génomique et la mort cellulaire8,9. L'endonucléase 1 spécifique des sites apuriniques/apryimidiniques est une enzyme centrale dans la voie de réparation par excision de bases, car elle clive les sites apuriniques et permet le traitement réparateur en aval10,11. Cette dépendance à la réparation a fait des dommages associés aux sites apuriniques une cible intéressante pour le développement de médicaments anticancéreux12. Selon ce principe, des prodrogues sensibles au glutathion et capables de piéger les sites apuriniques ont été précédemment conçues afin d'exploiter l'environnement tumoral riche en glutathion. Leurs produits activés par le glutathion contiennent une fonction aminooxy capable de piéger les sites apuriniques de forme aldéhydique, et des travaux expérimentaux antérieurs ont montré une cytotoxicité sélective, un arrêt du cycle cellulaire et l'apoptose dans les cellules H129913. Ces données soutiennent la composante de piégeage des lésions de l'ADN dans la conception du composé. Elles ne montrent toutefois pas que MMP9, SRC, EGFR, AKT1 ou TNF soient régulés en aval du piégeage des sites apuriniques. Toute interaction protéine-ligand identifiée dans la présente analyse computationnelle doit donc être considérée comme une hypothèse distincte, à moins que les deux processus soient démontrés dans le même système biologique.
La présente étude a été conçue autour de cette distinction. Le premier niveau du raisonnement biologique repose sur la chimie déjà établie de libération sensible au glutathion et de piégeage des sites apuriniques/apirimidiniques14. Le second niveau, examiné ici, correspond à une question exploratoire : les prodrogues parentales ou leurs produits libérés sont-ils compatibles, d’un point de vue computationnel, avec certaines protéines associées au cancer ? La pharmacologie en réseau a été utilisée pour hiérarchiser les protéines candidates, suivie d’analyses de docking, de dynamique moléculaire (MD) et de MM-PBSA afin d’examiner les complexes protéine-ligand sélectionnés15,16. Ces calculs n’avaient pas pour but de démontrer que les protéines prédites médiatisent le phénotype de dommages à l’ADN connu, ni d’établir un lien de causalité entre le piégeage des sites apuriniques/apirimidiniques et la signalisation oncogénique. Au lieu de cela, cette approche a été utilisée pour générer un ensemble hiérarchisé d’hypothèses pouvant être testées expérimentalement, et qui pourront ultérieurement être évaluées par des tests de liaison directe, d’activité enzymatique, d’analyse des voies de signalisation, de dommages à l’ADN et de phénotypes.
Protocole
L'approbation du comité d'évaluation institutionnel n'était pas requise car cette étude était entièrement computationnelle et n'impliquait aucun participant humain, animal vertébré, échantillon biologique provenant de patients ou données personnelles identifiables. Le consentement éclairé n'était donc pas applicable. Toutes les bases de données, les logiciels, les champs de force et les ressources computationnelles utilisés dans ce protocole sont répertoriés dans le Tableau des matériaux.
Composés d'étude et flux de travail analytique
Des composés piégeurs de sites apuriniques réactifs au glutathion, précédemment décrits, ont été utilisés comme molécules d'étude17. Le composé 1 et le composé 2 ont été sélectionnés comme prodrogues parentales car leur clivage déclenché par le glutathion génère respectivement les produits contenant un groupe aminoxy, à savoir le composé 4 et le composé 5. Le composé 4 et le composé 5 ont été choisis pour l'analyse structurale car ils représentent les espèces libérées qui conservent le groupe aminoxy réactif envers les sites apuriniques. Le composé 3 a été inclus comme contrôle structural apparié sensible au glutathion ; son produit de clivage, le composé 6, ne possède pas la fonctionnalité aminoxy nécessaire au piégeage covalent des aldéhydes des sites apuriniques. Par conséquent, les composés 1 à 3 ont été inclus dans la prédiction cible inverse afin de comparer les squelettes parentaux, les composés 4 et 5 ont été évalués vis-à-vis des protéines prioritaires, et le composé 6 a été utilisé comme ligand témoin négatif dans la comparaison de dynamique moléculaire (MD) avec SRC. La trajectoire SRC–composé 6 a été incluse afin de fournir un comparateur structural apparié pour le système du composé 5 contenant le groupe aminoxy, et non comme preuve que le groupe aminoxy lui-même détermine la liaison à SRC. Les structures chimiques et les relations d'activation des composés 1 à 6 sont présentées dans Figure 1. Cette conception maintient intentionnellement la chimie établie de piégeage des lésions de l'ADN séparée de l'analyse générant des hypothèses sur d'éventuelles interactions protéiques.
Prédiction des cibles associées à un composé
Les structures bidimensionnelles du composé 1, du composé 2 et du composé 3 ont été enregistrées au format MDL MOL et converties en chaînes canoniques de notation simplifiée pour l'entrée de molécules (SMILES) à l'aide d'Open Babel version 3.1.1 avec le format de sortie SMILES canonique18. Chaque chaîne exportée a été réimportée, et la structure régénérée a été vérifiée visuellement par rapport à la structure bidimensionnelle correspondante avant soumission à SwissTargetPrediction, avec l'espèce restreinte à Homo sapiens19. Les cibles prédites ayant des valeurs de probabilité non nulles ont été conservées. Les listes de cibles obtenues pour les trois composés ont été fusionnées, les doublons supprimés, puis les cibles restantes ont été normalisées en symboles génétiques humains officiels avant toute analyse complémentaire. Les paires composé-cible normalisées ont été importées dans un logiciel de visualisation et d'analyse de réseaux sous forme de tableau de réseau, les composés et les cibles prédites étant représentés comme des nœuds, et les relations composé-cible comme des arêtes, afin de visualiser les relations prédites entre les cibles20.
Récupération des cibles associées à la maladie et identification des cibles communes
Les cibles associées à la maladie ont été extraites de la base de données GeneCards à l'aide du terme de recherche « lung cancer H1299 »21. Un seuil de score de pertinence supérieur à 0,27 a été appliqué afin de conserver les gènes présentant une corrélation plus forte avec cette requête. Les symboles génétiques ont été normalisés et les doublons ont été supprimés manuellement. L'intersection entre les cibles prédites par le composé et les cibles associées à la maladie a été identifiée à l'aide d'un outil en ligne d'analyse de diagramme de Venn/intersection22. Seules les cibles intersectées ont été conservées pour les analyses ultérieures d'interaction entre protéines (PPI), d'enrichissement et de priorisation des cibles.
Analyse des interactions protéine-protéine et criblage des cibles principales
Les cibles intersectées ont été soumises à l'outil de recherche pour la récupération des gènes/protéines en interaction (STRING) version 11.5, avec une restriction de l'espèce à Homo sapiens et le score d'interaction minimal requis fixé à 0,40023. Les données PPI résultantes ont été importées dans Cytoscape version 3.10.0 pour la visualisation et l'analyse de la topologie. Dans une analyse de topologie de réseau le degré, la centralité d'intermédiarité et la centralité de proximité ont été calculés pour chaque nœud du réseau PPI original de 21 nœuds ; les valeurs obtenues ont ensuite été utilisées pour le filtrage séquentiel fondé sur la médiane décrit ci-dessous24. Les métriques de centralité ont été calculées sur le réseau PPI original de 21 nœuds, puis utilisées pour un filtrage séquentiel. Le degré médian du réseau initial était de 12, et les nœuds dont le degré était ≥ 12 ont été conservés, donnant lieu à 13 candidats. Parmi ces 13 candidats, la centralité d'intermédiarité médiane était de 0,031293, et la centralité de proximité médiane était de 0,769231. Le second filtre a conservé les nœuds dont la centralité d'intermédiarité était ≥ 0,031293 et la centralité de proximité ≥ 0,769231. > 0,769231, identifiant cinq candidats hubs : AKT1, EGFR, TNF, MMP9 et SRC. Les valeurs de centralité indiquées ont été conservées telles quelles à partir du réseau initial de 21 nœuds, sans être recalculées après sous-ensemble. Les cinq candidats hubs finaux ont été utilisés pour l'analyse structurale ultérieure. Les métriques de topologie d'origine correspondent à un réseau d'interactions protéine-protéine non orienté composé de 21 nœuds et de 116 arêtes.
Analyse d'enrichissement de l'ontologie génique et de l'Encyclopédie de Kyoto des gènes et des génomes
Les cibles intersectées ont été soumises à une analyse d'enrichissement en Ontologie génique (GO) et dans l'Encyclopédie de Kyoto des gènes et des génomes (KEGG), à l'aide de la base de données DAVID (Database for Annotation, Visualization and Integrated Discovery), laquelle était limitée à l'espèce Homo sapiens25. L'enrichissement GO a été évalué selon les catégories processus biologique (BP), composant cellulaire (CC) et fonction moléculaire (MF), ainsi que pour les voies de signalisation KEGG. Pour cette analyse exploratoire, un seuil d'inclusion nominal de p < 0,10 a été appliqué pour conserver les entrées enrichies ; les valeurs de p ajustées selon Benjamini, les valeurs de Bonferroni, les taux de fausses découvertes et les valeurs du test exact de Fisher ont été indiquées dans les tableaux supplémentaires, mais n'ont pas été utilisées pour définir l'ensemble retenu. Les entrées conservées ont été classées selon la valeur p nominale. Pour la visualisation et l'interprétation ultérieures, les 20 premières voies KEGG et les 10 premiers termes de chaque catégorie GO ont été retenus. Des diagrammes en barres et des graphiques en bulles ont été générés à l'aide d'un outil en ligne de visualisation bioinformatique.
Préparation des récepteurs et des ligands pour le dockage moléculaire
Les structures cristallines des protéines prioritaires ont été récupérées dans la base de données RCSB Protein Data Bank (PDB) : AKT1, ID PDB 3O96 ; EGFR, ID PDB 5UWD ; TNF, ID PDB 2AZ5 ; MMP9, ID PDB 1GKC ; et SRC, ID PDB 2H8H. Les structures protéiques utilisées pour le docking ont été préparées à l’aide d’un logiciel de visualisation moléculaire en supprimant les ligands co-cristallisés et les molécules d’eau, puis traitées avec un logiciel de préparation au docking. Pour MMP9, une copie non modifiée du PDB 1GKC a été conservée séparément comme référence cristallographique pour l’environnement du Zn2⁺ catalytique et le mode de liaison du N2-[(2R)-2-{[formyl(hydroxy)amino]methyl}-4-methylpentanoyl]-N,3-dimethyl-L-valinamide (NFH). Dans la chaîne A du 1GKC, le Zn2⁺ catalytique est coordonné par His401, His405 et His411 à des distances de 2,21, 2,23 et 2,22 Å, respectivement, tandis que les deux atomes d’oxygène du NFH coordonnent le Zn2⁺ à 2,07 et 2,38 Å ; Glu402 est le résidu acide/base catalytique. Ces contacts cristallographiques ont été utilisés comme référence structurale positive pour évaluer la carte d’interaction du docking du composé 5. Pour SRC, le PDB 2H8H a été utilisé pour les calculs de dynamique moléculaire (MD) de SRC. Ces comparaisons structurales ont été utilisées uniquement à des fins d’interprétation et n’ont pas été considérées comme une preuve d’inhibition enzymatique ou d’engagement du cible intracellulaire.
Les structures tridimensionnelles du composé 4 et du composé 5 ont été obtenues à partir de PubChem et optimisées par minimisation de l'énergie à l'aide d'un logiciel de modélisation moléculaire26. Les ligands ont été protonés dans des conditions physiologiques et minimisés en utilisant le champ de force moléculaire Merck 94 (MMFF94) jusqu'à ce que le gradient d'énergie soit inférieur à 0,01 kcal·mol⁻1·Å⁻1. Des atomes d'hydrogène ont été ajoutés, des charges de Gasteiger ont été attribuées et les liaisons rotatables ont été définies à l'aide d'un logiciel de préparation au docking. Le composé 6, produit du clivage par la glutathion du composé témoin non piégeant 3, a été préparé selon le même protocole et docké à SRC uniquement afin de générer la pose initiale pour la trajectoire de dynamique moléculaire témoin appariée. Ainsi, le composé 6 n'a été ni introduit comme ligand thérapeutique prédit supplémentaire ni utilisé pour étayer un mécanisme à cibles multiples.
Procédure de docking moléculaire
Le dockage moléculaire a été effectué à l'aide d'un logiciel de dockage moléculaire selon un protocole de dockage semi-flexible, les récepteurs étant maintenus rigides et les ligands autorisés à rester flexibles27,28. Pour chaque récepteur, la boîte de dockage a été centrée sur la position du ligand co-cristallisé afin que la région de recherche corresponde au site de fixation défini expérimentalement. Les dimensions de la boîte de dockage ont été fixées à 24 Å × 24 Å × 24 Å pour AKT1, EGFR et SRC, à 26 Å × 26 Å × 26 Å pour MMP9, et à 28 Å × 28 Å × 28 Å pour TNF. L'exhaustivité a été réglée sur 32, le nombre de poses en sortie sur 20, et la plage d'énergie sur 4 kcal·mol⁻1. La conformation classée au premier rang à l'issue de chaque simulation de dockage a été conservée pour l'analyse des interactions.
Pour évaluer la fiabilité interne du protocole d'ancrage, chaque ligand co-cristallisé a été réancré dans son site récepteur correspondant en utilisant les mêmes paramètres, un écart quadratique moyen (RMSD) des atomes lourds inférieur à 2,0 Å servant de critère d'acceptation. Les poses finales ont été examinées à l'aide d'un logiciel de visualisation moléculaire. Pour le complexe MMP9–Composé 5, la carte d'interactions retenue a été analysée spécifiquement afin d'identifier une coordination directe annotée du ligand avec l'ion Zn2⁺ catalytique ainsi que les contacts avec His401, Glu402, His405 et His411, et la position du ligand a été comparée à celle du pose cristallographique NFH dans la base de données PDB 1GKC. Une distance quantitative de coordination métallique n'a été indiquée que lorsque la coordination directe entre le ligand et l'ion Zn2⁺ était clairement visible dans la pose retenue ; sinon, elle a été indiquée comme non applicable plutôt que d'être déduite. Ainsi, une pose d'ancrage MMP9 ne présentant pas ces caractéristiques canoniques du site catalytique a été classée comme non canonique et n'a pas été interprétée comme une preuve d'inhibition enzymatique de MMP9. De manière plus générale, les scores d'AutoDock Vina et les poses d'ancrage ont été utilisés pour une priorisation relative et la génération d'hypothèses, mais non comme preuve d'affinité de liaison ou d'engagement du cible intracellulaire.
Protocole de dynamique moléculaire
Les complexes protéine-ligand sélectionnés pour l'analyse de dynamique moléculaire (MD) ont été construits à partir des poses d'interaction obtenues par docking. Les calculs de MD ont été réalisés avec GROMACS29. Les protéines ont été paramétrées à l'aide du champ de force CHARMM36, tandis que les types d'atomes et les paramètres du ligand ont été attribués à l'aide du champ de force Amber généralisé de deuxième génération (GAFF2)30,31. Les charges partielles AM1-BCC (Austin Model 1-bond charge correction) ont été générées à l'aide d'outils de paramétrisation de petites molécules et de génération de topologie du ligand ; un logiciel de génération de topologie du ligand a ensuite produit les fichiers de topologie du ligand compatibles avec GROMACS32,33,34. Chaque complexe a été placé dans une boîte d'eau TIP3P sous conditions aux limites périodiques, avec une distance minimale entre le soluté et les parois de la boîte de 1,0 nm. Des ions sodium et chlorure ont été ajoutés afin de neutraliser la charge nette de chaque système, et du NaCl supplémentaire a été ajouté pour atteindre une force ionique finale de 0,15 M.
La minimisation d'énergie a été effectuée à l'aide de l'algorithme de descente de gradient jusqu'à ce que la force maximale tombe en dessous de 1000 kJ·mol⁻1·nm⁻1. Les systèmes minimisés ont ensuite été équilibrés en conditions de nombre de particules, pression et température constantes (NPT) à 310 K et 1 bar, avec des restrictions de position appliquées au squelette protéique. La température a été régulée à l'aide du thermostat V-rescale, et la pression à l'aide du barostat de Parrinello-Rahman. Les interactions électrostatiques à longue portée ont été calculées par la méthode particle mesh Ewald. Les seuils électrostatiques à courte portée et les seuils de van der Waals ont tous deux été fixés à 1,0 nm, et toutes les liaisons impliquant des atomes d'hydrogène ont été contraintes à l'aide de l'algorithme linear constraint solver (LINCS). Des trajectoires de production ont été générées pendant 150 ns avec un pas de temps d'intégration de 2 fs, et les coordonnées ont été enregistrées toutes les 10 ps pour une analyse ultérieure.
Analyse de trajectoire
Des analyses de trajectoire ont été effectuées sur les portions équilibrées des trajectoires de production. Les valeurs de RMSD de la charpente protéique et du ligand ont été calculées après un ajustement par moindres carrés à la conformation de référence initiale. Les valeurs de fluctuation quadratique moyenne (RMSF) ont été calculées pour chaque résidu en utilisant les atomes Cα. L'analyse des liaisons hydrogène entre chaque ligand et son récepteur a été réalisée en utilisant un seuil de distance donneur-accepteur de 3,5 Å et un seuil d'angle donneur-hydrogène-accepteur de 30°. L'occupation des liaisons hydrogène a été définie comme la proportion de cadres analysés dans lesquels une liaison hydrogène donnée était présente. Ces paramètres ont été utilisés pour caractériser la stabilité structurale, la flexibilité à l'échelle des résidus et la persistance des contacts intermoléculaires au cours des trois trajectoires de dynamique moléculaire.
Calcul de l'énergie libre de liaison par la méthode mécanique moléculaire avec surface accessible et équation de Poisson-Boltzmann (MM-PBSA)
L'énergie libre de liaison a été calculée à l'aide de la méthode MM-PBSA mise en œuvre avec le logiciel d'analyse MM-PBSA sur les segments équilibrés des trajectoires de dynamique moléculaire35. Pour chaque complexe protéine-ligand, les derniers 50 ns de la trajectoire de production de 150 ns ont été utilisés pour l'analyse de l'énergie libre. Un total de 500 images régulièrement espacées a été échantillonné à des intervalles de 100 ps, de 100,0 ns à 149,9 ns ; le point final à 150,0 ns a été exclu de l'ensemble échantillonné. L'énergie libre totale de liaison a été calculée comme la somme des termes d'énergie de van der Waals, d'énergie électrostatique, d'énergie de solvatation polaire et d'énergie de solvatation non polaire :
ΔG_bind = ΔE_vdW + ΔE_ele + ΔG_polar + ΔG_nonpolar (1)
Aucune correction d'entropie n'a été appliquée. Les énergies libres moyennes de liaison et les écarts types ont été calculés à partir de tous les cadres échantillonnés.
Contrôles de reproductibilité et de validation computationnelle
Tous les noms de gènes utilisés lors des étapes de prédiction des cibles, de récupération des cibles associées aux maladies et d'analyse des intersections ont été normalisés selon les symboles génétiques humains officiels avant l'analyse en aval. Les mêmes paramètres de docking ont été conservés pour toutes les paires récepteur-ligand. Le protocole de docking a été vérifié techniquement en redockinguant le ligand co-cristallisé correspondant dans chaque poche réceptrice à l'aide des mêmes paramètres de recherche et du seuil d'acceptation préspecifié de la RMSD des atomes lourds de <2,0 Å. Le complexe cristallographique MMP9–NFH a été conservé comme référence structurale positive pour l'environnement du Zn2⁺ catalytique, tandis que SRC–Compound 6 a servi de comparateur apparié non piégeant pour l'analyse de la trajectoire SRC. Les trajectoires de dynamique moléculaire ont été examinées afin de vérifier la stabilité de la température et de la pression, ainsi que l'absence de dérive anormale du volume de la boîte, avant leur inclusion dans les analyses ultérieures. Tous les fichiers d'entrée, structures réceptrices, fichiers de topologie des ligands, fichiers de configuration du docking, fichiers de paramètres de dynamique moléculaire et enregistrements de sélection des cadres MM-PBSA ont été archivés pour garantir la reproductibilité computationnelle.
Résultats
Prédiction des cibles associées aux composés et identification des cibles communes
La prédiction inverse des cibles des composés 1 à 3 a permis d'identifier 212 cibles humaines potentielles. Parallèlement, la récupération de cibles associées à la maladie à partir de GeneCards, à l’aide du mot-clé « lung cancer H1299 » et d’un seuil de score de pertinence supérieur à 0,27, a identifié 188 cibles associées au CBNPC. Une analyse d’intersection entre les cibles prédites pour les composés et le pool de cibles associées à la maladie a révélé 21 cibles communes, qui ont été conservées pour toutes les analyses ultérieures. Le recoupement entre les deux ensembles de cibles est illustré dans la Figure 2. Ces résultats indiquent que les composés étudiés ciblent un sous-ensemble restreint de cibles pertinentes pour la maladie, plutôt qu’un espace cible diffus et non spécifique.
Analyse des interactions entre protéines et criblage des cibles principales
Les 21 cibles intersectées ont été importées dans STRING afin de construire un réseau d'interactions protéine-protéine (PPI). Le réseau obtenu comprenait 21 nœuds et 116 arêtes. Les valeurs du degré des nœuds dans Tableau supplémentaire 1 s'élèvent à 232, ce qui correspond à 116 arêtes non orientées. Les valeurs de centralité ont été calculées pour ce réseau d'origine. Le degré médian était de 12 ; l'application d'un seuil de degré ≥ 12 a conservé 13 candidats. Parmi ces 13 candidats, la centralité d'intermédiarité médiane était de 0,031293 et la centralité de proximité médiane était de 0,769231. L'application d'une centralité d'intermédiarité ≥ 0,031293 combinée à une centralité de proximité > 0,769231 a priorisé cinq candidats parmi les nœuds centraux : AKT1, EGFR, TNF, MMP9 et SRC. Les valeurs indiquées pour les sous-ensembles retenus correspondent aux métriques de centralité du réseau initial à 21 nœuds, conservées lors du filtrage ; elles n'ont pas été recalculées pour les sous-réseaux à 13 ou à 5 nœuds. Leur centralité dans le réseau a uniquement servi à classer les candidats en vue d'une évaluation ultérieure basée sur la structure, et ne doit pas être interprétée comme une preuve qu'ils constituent des cibles biologiques des composés. Tableau supplémentaire 1, Tableau supplémentaire 2, et Tableau supplémentaire 3 rapporter les métriques pour le réseau initial de 21 nœuds, les 13 candidats conservés après la première étape de criblage, et les cinq candidats centraux finaux, respectivement. Le criblage séquentiel du réseau d'interactions protéine-protéine (PPI) et les cinq candidats centraux finaux sont présentés dans Figure 3A, Figure 3B, Figure 3C, et Figure 3D.
Analyse d'enrichissement de l'ontologie génique et de l'Encyclopédie de Kyoto des gènes et des génomes
L'analyse d'enrichissement fonctionnel des 21 cibles intersectantes a identifié 121 voies KEGG répondant aux critères d'inclusion nominaux de p < 0,10. Les 20 voies les mieux classées sont présentées dans la Figure 4A. Parmi celles-ci, la résistance aux traitements endocriniens, les voies du cancer, les protéoglycanes dans le cancer, la résistance aux inhibiteurs de la tyrosine kinase de l'EGFR et la voie de signalisation ErbB étaient particulièrement marquées. Ces voies sont étroitement associées à la prolifération tumorale, à la survie, à l'invasion et à la résistance au traitement dans le CBNPC. Les statistiques complètes d'enrichissement pour l'ensemble des 121 voies KEGG retenues répondant au seuil nominal de p < 0,10 sont fournies dans le Tableau supplémentaire 4.
L'analyse d'enrichissement en GO a en outre identifié 177 termes BP, 29 termes CC et 61 termes MF répondant au même critère d'inclusion nominal de p < 0,10. Les 10 termes les plus élevés de chaque catégorie sont présentés dans Figure 4B, Figure 4C, et Figure 4D. Les processus biologiques dominants comprenaient la régulation positive de la prolifération des cellules musculaires lisses associées aux vaisseaux sanguins, la transition G2/M du cycle cellulaire mitotique, la signalisation par le récepteur de l'insuline-like growth factor, la phosphorylation des protéines, la régulation négative de l'apoptose et la transduction du signal. Les principaux termes liés aux composants cellulaires étaient le noyau, les radeaux membranaires, les adhésions focales, la membrane plasmique et la région télomérique du chromosome. En revanche, les principaux termes liés aux fonctions moléculaires présentés dans Figure 4D incluaient l'activité de protéine kinase, l'activité de protéine sérine kinase, la liaison à l'ATP, l'activité de protéine sérine/thréonine kinase, l'activité de protéine tyrosine kinase, l'activité de kinase sur la répétition heptapeptidique CTD de l'ARN polymérase II, l'activité kinase, l'activité de kinase sur l'histone H2AXY142, l'activité de kinase sur l'histone H3Y41 et la liaison à une protéine identique. Les statistiques complètes d'enrichissement pour les termes BP, CC et MF sont fournies dans Supplementary Table 5, Supplementary Table 6 et Supplementary Table 7. Dans leur ensemble, ces résultats d'enrichissement indiquent que l'ensemble cible commun est concentré sur des processus de signalisation, de régulation de la survie et de réponse oncogénique pertinents pour la progression du CBNPC.
Priorisation basée sur le dockage moléculaire des complexes métabolite-cible
Un docking moléculaire a été réalisé entre le composé 4 et le composé 5 et les cinq protéines prioritaires selon la topologie du réseau. Les valeurs indiquées dans le Tableau 1 correspondent aux scores de docking AutoDock Vina et ne représentent pas des énergies libres de liaison mesurées expérimentalement. Le composé 5 a obtenu le score individuel le plus favorable avec MMP9 (-8,418 kcal·mol⁻1), suivi par le composé 4 avec MMP9 (-7,840 kcal·mol⁻1). Le composé 5 a également obtenu des scores plus favorables que le composé 4 pour AKT1 et EGFR, tandis que le composé 4 a obtenu des scores légèrement plus favorables pour SRC (-6,549 contre -6,204 kcal·mol⁻1) et TNF (-5,436 contre -5,299 kcal·mol⁻1). Ainsi, le composé 5 n'a pas montré d'avantage systématique en termes de scores sur l'ensemble des cinq protéines. Les résultats de docking ont uniquement été utilisés pour prioriser des complexes représentatifs en vue d'une analyse structurale approfondie.
Des conformations de docking représentatives sont présentées dans la Figure 5. Sur la carte d'interaction MMP9–Composé 5 classée en tête, les contacts affichés se situaient près d'Ala417 et de Pro421, avec des distances d'environ 3,0 Å et 2,4 Å, respectivement. Aucune coordination directe entre le Composé 5 et ZN2⁺ n'a été annotée sur la carte d'interaction de la pose principale retenue, et aucun contact direct avec His401, Glu402, His405 ou His411 n'a été observé. Ceci contraste avec la référence cristallographique 1GKC, dans laquelle His401, His405 et His411 coordonnent le ZN2⁺ catalytique à 2,21, 2,23 et 2,22 Å, et l'inhibiteur de type hydroxamate inverse NFH coordonne le même ZN2⁺ via deux atomes d'oxygène à 2,07 et 2,38 Å. Étant donné qu'aucune coordination directe Composé 5-ZN2⁺ n'a été annotée sur la carte d'interaction retenue, aucune distance de coordination Composé 5-ZN2⁺ n'a été attribuée ; cela est interprété comme l'absence d'une coordination directe démontrée dans la carte retenue, plutôt que comme une valeur mesurée de séparation métallique. Une comparaison tridimensionnelle avec la référence cristallographique MMP9–NFH est présentée dans la Figure supplémentaire 1. La géométrie diffère donc d'un mode de liaison inhibiteur canonique dépendant du zinc, et le résultat de docking actuel ne permet pas de classer le Composé 5 comme un inhibiteur de MMP9. MMP9 a été conservée pour l'analyse de dynamique moléculaire uniquement afin de déterminer si cette géométrie de docking non canonique spécifique persistait au cours de la trajectoire. Pour les autres complexes, le Composé 5 a montré des contacts prédits avec AKT1 et SRC, tandis que le Composé 4 a également formé des interactions de docking définies avec MMP9 et SRC. Conformément à la Figure 5F, ces observations décrivent des interactions prédites et des scores de docking relatifs, et non des affinités vérifiées expérimentalement.
Trois complexes ont été sélectionnés pour l'analyse de dynamique moléculaire (MD) à des fins comparatives, plutôt que confirmatoires. Le complexe MMP9–Composé 5 a été retenu car il présentait le score d'ancrage le plus favorable, mais une conformation non canonique de MMP9 nécessitant un suivi structural prudent. Le complexe SRC–Composé 5 a été choisi comme second complexe candidat, et le complexe SRC–Composé 6 a été inclus comme trajectoire témoin appariée sans piégeage. Les conformations initiales correspondantes sont présentées dans Figure 6A, Figure 6B, et Figure 6C. Cette conception permet de comparer la persistance des géométries d'ancrage sélectionnées, sans considérer la stabilité en dynamique moléculaire comme une preuve d'engagement de la cible ou de régulation fonctionnelle.
Analyse de la dynamique moléculaire
Afin de comparer la persistance de certaines géométries issues du docking sous des conditions aqueuses dynamiques, des trajectoires de dynamique moléculaire (DM) de 150 ns ont été générées pour les complexes MMP9–Composé 5 et SRC (PDB 2H8H)–Composé 5, le complexe SRC (PDB 2H8H)–Composé 6 étant inclus comme trajectoire témoin négative appariée. Les conformations initiales sont présentées dans Figure 6A, Figure 6B, et Figure 6C. Tout au long de ces trajectoires, le composé 5 a présenté un RMSD du ligand plus faible (Figure 6D) dans les systèmes MMP9 et SRC que le composé 6 dans SRC. La trajectoire MMP9–composé 5 a atteint un régime comparativement stable avec de faibles fluctuations, la trajectoire SRC–composé 5 s'est stabilisée après une période d'ajustement initiale, tandis que la trajectoire SRC–composé 6 a présenté des fluctuations plus importantes. Ces différences indiquent une persistance accrue des poses d'ancrage du composé 5 sélectionnées au cours de la dynamique moléculaire. Elles ne démontrent pas que le composé 5 se lie à MMP9 ou à SRC dans les cellules, et la trajectoire MMP9 ne compense pas l'absence du Zn catalytique canonique2⁺ interaction dans la position initiale.
Le RMSD du squelette protéique a révélé un profil comparatif similaire. La trajectoire MMP9–Compound 5 est entrée dans un régime relativement stable du squelette après environ 30 ns, tandis que la trajectoire SRC–Compound 5 a atteint un plateau plus tardivement, et la trajectoire SRC–Compound 6 a présenté des fluctuations plus importantes. Ces observations décrivent uniquement le comportement des trajectoires. Un squelette protéique stable ou une trajectoire de ligand ne permet pas d'établir l'occupation intracellulaire de la cible, l'inhibition enzymatique ou la modulation de la signalisation. Les profils de RMSD du squelette protéique pour les trois systèmes sont fournis dans la figure supplémentaire 2.
Analyse de trajectoire
Les analyses de la présence des liaisons hydrogène et des fluctuations des résidus ont été utilisées pour décrire la persistance des contacts au sein des trajectoires de dynamique moléculaire (Figure 7A). Le composé 5 établit une liaison hydrogène à forte présence avec Arg95 dans la trajectoire MMP9 (>85 %) et une interaction récurrente avec Leu325 dans la trajectoire SRC (>70 %), tandis que les contacts représentatifs dans le contrôle SRC–Composé 6 présentaient des présences plus faibles. Ces résidus ne sont pas présentés comme une preuve de modulation fonctionnelle de la cible ; les valeurs de présence indiquent uniquement la fréquence à laquelle les contacts spécifiés se sont produits au cours des trajectoires analysées.
L'analyse RMSF des résidus du site de fixation a révélé des différences spécifiques au système concernant la flexibilité locale (Figure 7B). La trajectoire SRC–Composé 6 présentait plusieurs fluctuations locales plus importantes que celle du SRC–Composé 5, tandis que la trajectoire MMP9–Composé 5 montrait un profil de fluctuation relativement restreint au sein de son propre ensemble de résidus du site de fixation. Étant donné que MMP9 et SRC sont des protéines différentes, leurs valeurs de RMSF au niveau des résidus n'ont pas été interprétées selon une comparaison directe résidu par résidu. Conjointement avec l'occupation des liaisons hydrogène, ces résultats caractérisent la persistance des contacts et la flexibilité locale, aidant ainsi à hiérarchiser les complexes pour des tests expérimentaux. Ils n'établissent ni MMP9 ni SRC comme cibles intracellulaires, ni ne démontrent que l'une ou l'autre protéine médie le phénotype anticancéreux des composés.
Calcul de l'énergie libre de liaison par la méthode mécanique moléculaire avec prise en compte de l'aire de surface via l'équation de Poisson-Boltzmann
Les estimations MM-PBSA calculées à partir des segments de trajectoire équilibrés sont présentées dans la Figure 8. Le complexe MMP9–Composé 5 a donné une estimation de ΔG_bind de -19,65 ± 6,43 kcal·mol⁻1, le complexe SRC–Composé 5 a donné -17,72 ± 6,84 kcal·mol⁻1, et le témoin SRC–Composé 6 a donné -10,37 ± 5,61 kcal·mol⁻1. Selon ce protocole de calcul, le classement énergétique relatif était donc MMP9–Composé 5, suivi de SRC–Composé 5 puis de SRC–Composé 6. Ces valeurs sont des estimations dépendantes de la méthode, dérivées d'un segment de trajectoire fini, et aucune correction d'entropie n'a été appliquée. Elles ont donc été utilisées uniquement pour des comparaisons internes à l'étude et ne doivent pas être interprétées comme des affinités de liaison mesurées expérimentalement ni comme une preuve de modulation fonctionnelle des protéines.
À travers les analyses de docking, de dynamique moléculaire, d'occupation des contacts, de fluctuation des résidus et de MM-PBSA, le composé 5 a été priorisé par calcul pour un suivi dans les complexes MMP9 et SRC. La convergence entre ces calculs renforce la justification du choix de ces paires pour des expériences ultérieures, mais elle ne valide pas MMP9 ou SRC comme cibles intracellulaires directes. En particulier, la conformation non canonique de MMP9 et l'absence de coordination démontrée du ZN2⁺ catalytique empêchent de déduire un mécanisme inhibiteur canonique de MMP9 à partir des données structurales actuelles.
Conclusions tirées des résultats
Le flux de travail computationnel a priorisé 21 cibles associées aux maladies et présentant des chevauchements, et identifié AKT1, EGFR, TNF, MMP9 et SRC comme candidats principaux en tant que nœuds topologiques. Des analyses basées sur la structure ont en outre priorisé le composé 5 pour un suivi expérimental dans les complexes MMP9 et SRC. Ces résultats ne démontrent pas un engagement direct des cibles, une inhibition de MMP9 ou de SRC, une régulation de voie métabolique, ni une relation mécanistique causale entre les interactions protéiques et l'effet piégeage de sites apuriniques précédemment établi. L'étude soutient donc un ensemble d'hypothèses computationnelles vérifiables, plutôt qu'un mécanisme anti-NSCLC à cibles multiples établi expérimentalement.
DISPONIBILITÉ DES DONNÉES :
L'ensemble de données soutenant les résultats de cette étude est accessible publiquement dans Wang X, Peng Z, Xing Y, Xue L. Priorisation in silico des interactions protéiques potentielles pour des prodrogues piégeant les sites apuriniques réactives au glutathion dans le cancer du poumon non à petites cellules [ensemble de données]. Figshare ; 2026. doi :10.6084/m9.figshare.33313620.v1.
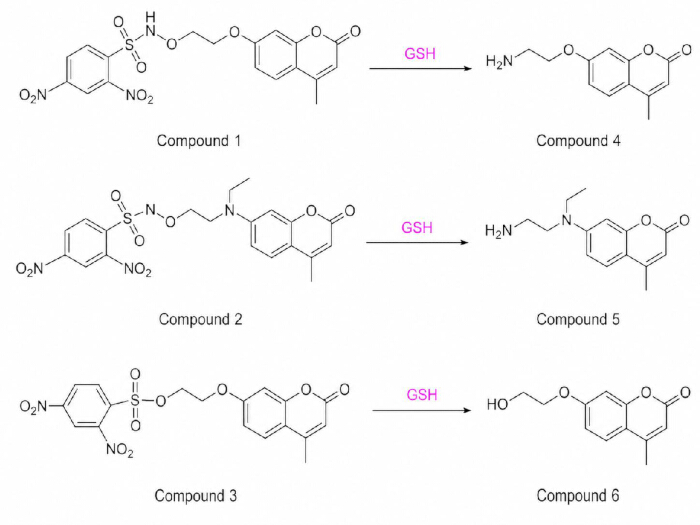
Figure 1 : Structures chimiques et relations de conversion déclenchées par la glutathion des composés étudiés. Le composé 1 et le composé 2 sont des prodrogues sensibles à la glutathion qui libèrent respectivement les métabolites contenant un groupe aminooxy, le composé 4 et le composé 5. Le composé 3 est un témoin structural apparié sensible à la glutathion, qui génère le composé 6, dépourvu de la fonctionnalité de piégeage d'un site apurinique/apyrimidinique par un groupe aminooxy. Les composés 1 à 3 ont été utilisés pour la prédiction inverse de cibles, les composés 4 et 5 pour le docking sur la cible centrale (hub-target), et le composé 6 comme ligand témoin négatif dans la comparaison de la dynamique moléculaire de SRC. Abréviations : SRC, proto-oncogène SRC, tyrosine kinase non réceptrice. Veuillez cliquer ici pour visualiser une version agrandie de cette figure.
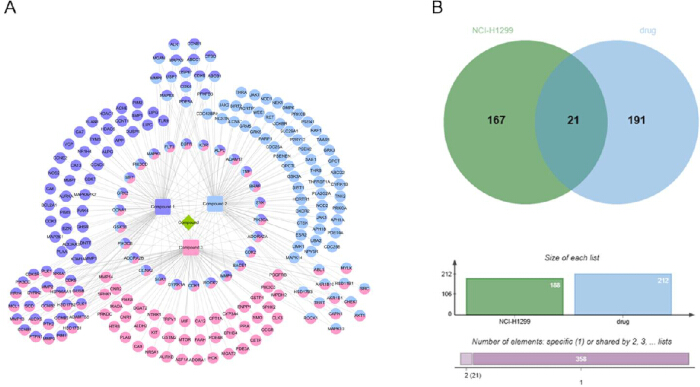
Figure 2 : Intersection entre les cibles prédites par les composés et les cibles associées au cancer du poumon non à petites cellules. (A) Réseau composé-cible généré à partir des résultats de la prédiction inverse des cibles pour les composés 1 à 3. (B) Diagramme de Venn montrant la superposition entre les cibles prédites par les composés et les cibles associées à la maladie, obtenues à l’aide de la requête sur le cancer du poumon H1299. Les 21 cibles communes ont été conservées pour l’analyse des interactions protéine-protéine, l’analyse d’enrichissement et la priorisation ultérieure basée sur la structure. Veuillez cliquer ici pour visualiser une version agrandie de cette figure.
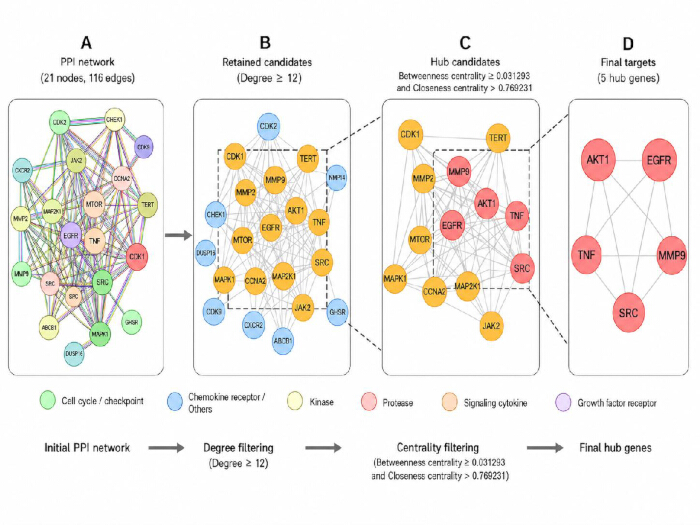
Figure 3 : Réseau d'interactions protéine-protéine et criblage des cibles principales. (A) Réseau d'interactions protéine-protéine des 21 cibles communes (116 liaisons). (B) Première étape de criblage utilisant un degré ≥ 12, conservant 13 candidats. (C) Deuxième criblage des 13 candidats retenus à l’aide de la centralité d’intermédiarité ≥ 0,031293 et de la centralité de proximité > 0,769231, conduisant à cinq candidats centraux. (D) Les cinq candidats centraux finaux : AKT1, EGFR, TNF, MMP9 et SRC. Les valeurs de centralité utilisées pour les filtres séquentiels ont été calculées sur le réseau initial composé de 21 nœuds et 116 liaisons, puis conservées sans être recalculées après la formation de chaque sous-ensemble. Abréviations : AKT1, kinase sérine/thréonine AKT 1 ; EGFR, récepteur du facteur de croissance épidermique ; TNF, facteur de nécrose tumorale ; MMP9, métalloprotéinase 9 de la matrice ; SRC, proto-oncogène SRC, tyrosine kinase non réceptrice. Veuillez cliquer ici pour visualiser une version agrandie de cette figure.
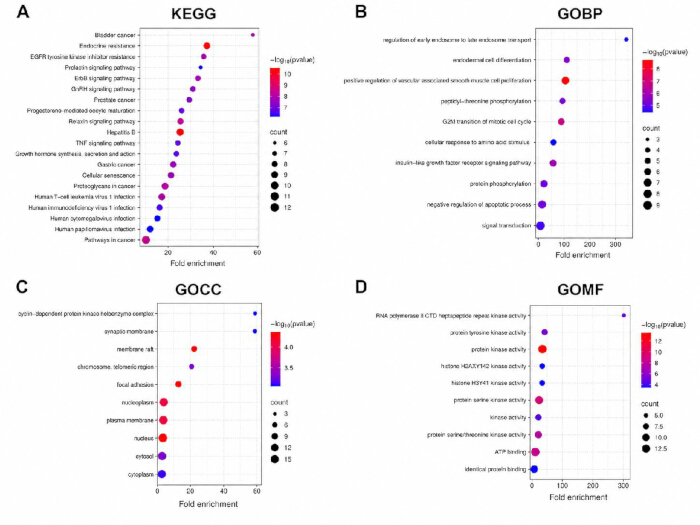
Figure 4 : Analyse d'enrichissement fonctionnel des cibles communes. (A) Graphique en bulles des 20 voies les plus enrichies de l'Encyclopédie de Kyoto des gènes et des génomes (KEGG). (B) Graphique en barres des 10 termes les plus enrichis du processus biologique de l'Ontologie des gènes (GO). (C) Graphique en barres des 10 termes les plus enrichis du composant cellulaire de l'Ontologie des gènes (GO). (D) Graphique en barres des 10 termes les plus enrichis de la fonction moléculaire de l'Ontologie des gènes (GO). Le degré d'enrichissement est indiqué sur l'axe des abscisses dans la visualisation finale ; la taille des bulles dans le panneau A reflète le nombre de gènes. Toutes les entrées KEGG et GO sous-jacentes incluses dans les tableaux supplémentaires 4 à 7 ont satisfait au critère d'inclusion nominal de p < 0,10 ; les voies/termes tracés étaient ceux ayant les valeurs de p nominales les plus élevées. Les valeurs ajustées pour les tests multiples sont indiquées dans les tableaux supplémentaires, mais n'ont pas été utilisées pour l'inclusion. Veuillez cliquer ici pour visualiser une version agrandie de cette figure.
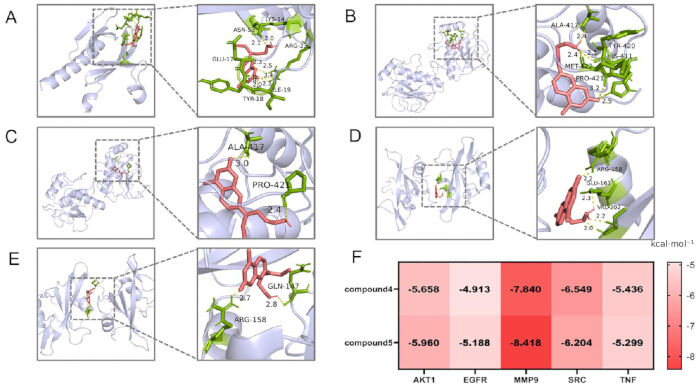
Figure 5 : Positions de dockage moléculaire et scores d'AutoDock Vina des composés 4 et 5 avec les protéines prioritaires. (A) Position de dockage prédite du composé 5 avec AKT1. (B) Position de dockage prédite du composé 4 avec MMP9. (C) Position prédite la mieux classée du composé 5 avec MMP9 ; les contacts affichés sont proches d'Ala417 et de Pro421, tandis qu'aucune coordination directe avec le ZN2⁺ catalytique ou contact direct avec His401, Glu402, His405 ou His411 n'est annoté. Cette position n'est donc pas présentée comme un mode canonique de liaison inhibitrice de MMP9. Une comparaison de carte d'interactions de référence avec la structure cristalline de MMP9 liée à NFH (PDB 1GKC), incluant les distances de coordination cristallographiques du ZN2⁺, est fournie dans la figure supplémentaire 3. (D) Position de dockage prédite du composé 4 avec SRC. (E) Position de dockage prédite du composé 5 avec SRC. (F) Carte thermique des scores de dockage d'AutoDock Vina (kcal·mol⁻1) pour les composés 4 et 5 vis-à-vis des cinq protéines prioritaires. Des valeurs plus négatives indiquent des scores Vina plus favorables dans ce protocole de dockage ; ils ne représentent pas des affinités de liaison mesurées expérimentalement. Abréviations : AKT1, kinase sérine/thréonine AKT 1 ; MMP9, métalloprotéinase 9 de la matrice ; NFH, N2-[(2R)-2-{[formyl(hydroxy)amino]methyl}-4-méthylpentanoyle]-N,3-diméthyl-L-valinamide ; SRC, proto-oncogène SRC, tyrosine kinase non réceptrice ; PDB, Protein Data Bank ; Ala, alanine ; Pro, proline ; His, histidine ; et Glu, glutamate. Veuillez cliquer ici pour visualiser une version agrandie de cette figure.
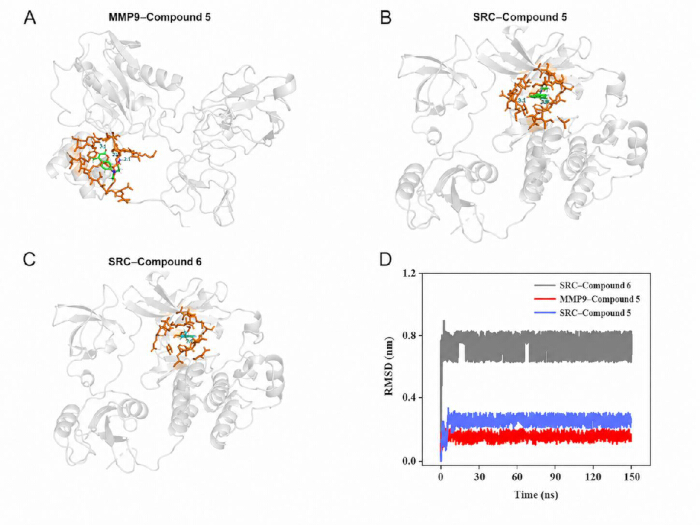
Figure 6 : Aperçu structural et analyse de la stabilité des ligands des complexes de dynamique moléculaire (MD). (A) Conformation initiale du dockage du composé 5 avec MMP9, utilisée comme structure de départ pour la dynamique moléculaire (MD). (B) Conformation initiale du dockage du composé 5 avec SRC (PDB 2H8H). (C) Conformation initiale du dockage du composé 6 avec SRC (PDB 2H8H) ; le composé 6 est le produit de clivage du glutathion du composé témoin 3 et ne possède pas la fonctionnalité de piégeage d'aminooxy au site apurinique/apirimidinique. (D) Écart quadratique moyen (RMSD) du ligand par rapport à la pose initiale de dockage au cours des trajectoires de 150 ns pour MMP9–composé 5, SRC–composé 5 et SRC–composé 6. Ce panneau compare la persistance de la pose durant la dynamique moléculaire (MD) et ne démontre pas l'engagement du ou des cibles intracellulaires. Abréviations : MD, dynamique moléculaire ; MMP9, métalloprotéinase 9 de la matrice ; SRC, proto-oncogène SRC, tyrosine kinase non réceptrice ; PDB, Protein Data Bank ; RMSD, écart quadratique moyen. Veuillez cliquer ici pour visualiser une version agrandie de cette figure.
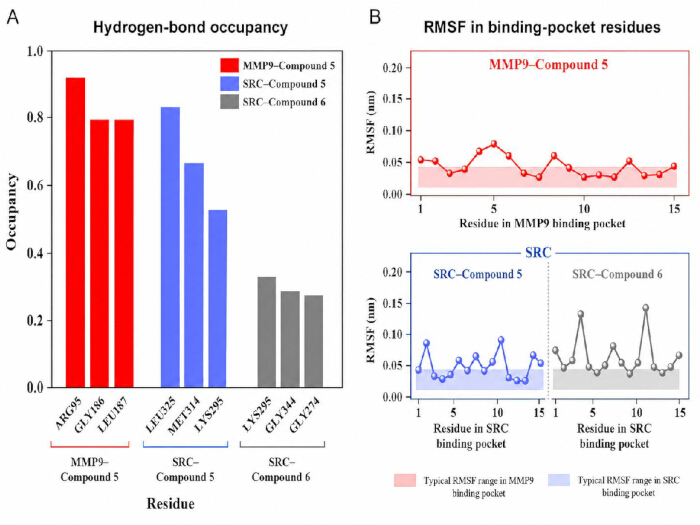
Figure 7 : Caractéristiques des interactions dynamiques lors de l'analyse de la dynamique moléculaire. (A) Occupation des liaisons hydrogène représentatives entre le ligand et la protéine au cours des trajectoires de 150 ns pour MMP9–Composé 5, SRC–Composé 5 et SRC–Composé 6. (B) Fluctuation quadratique moyenne des résidus du site de fixation. Le profil de MMP9 est interprété dans le cadre du système MMP9, tandis que les profils SRC–Composé 5 et SRC–Composé 6 permettent une comparaison directe appariée au sein de SRC. Ces analyses décrivent la persistance des contacts et la flexibilité locale durant la DM et ne démontrent pas l'engagement intracellulaire de la cible ni la modulation fonctionnelle de MMP9 ou de SRC. Abréviations : DM, dynamique moléculaire ; MMP9, métalloprotéinase 9 de la matrice ; SRC, proto-oncogène SRC, tyrosine kinase non réceptrice ; RMSF, fluctuation quadratique moyenne. Veuillez cliquer ici pour visualiser une version agrandie de cette figure.
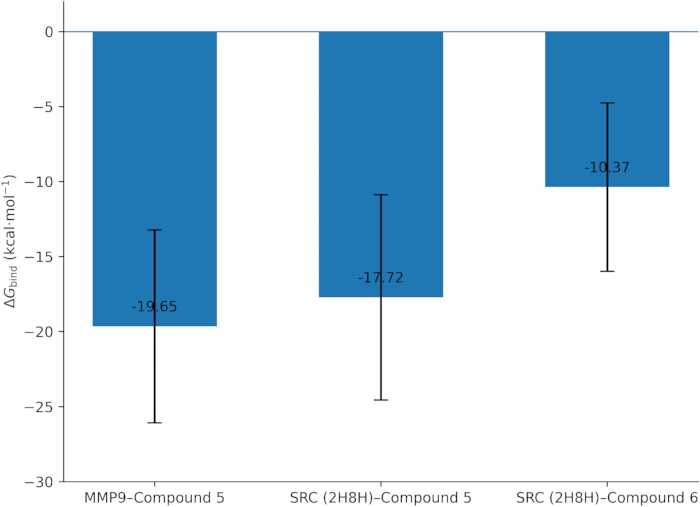
Figure 8 : Estimations énergétiques par la méthode de mécanique moléculaire de l'aire de surface Poisson-Boltzmann pour les complexes analysés. Valeurs de ΔG_bind estimées obtenues par la méthode de mécanique moléculaire de l'aire de surface Poisson-Boltzmann à partir des segments de trajectoire équilibrés des complexes MMP9–Composé 5, SRC (PDB 2H8H)–Composé 5 et SRC (PDB 2H8H)–Composé 6. Les valeurs sont présentées sous la forme moyenne ± écart type et sont utilisées pour des comparaisons relatives au sein de l'étude, plutôt que comme affinités de liaison mesurées expérimentalement. La figure 8 utilise l'étiquette de l'axe des ordonnées ΔG_bind (kcal·mol⁻1), conforme à l'équation et à la terminologie utilisées dans les Méthodes et les Résultats. Abréviations : MMP9, métalloprotéinase 9 de la matrice ; SRC, proto-oncogène SRC, tyrosine kinase non réceptrice ; PDB, Protein Data Bank ; ΔG_bind, énergie libre de liaison ; MM-PBSA, mécanique moléculaire de l'aire de surface Poisson-Boltzmann. Veuillez cliquer ici pour visualiser une version agrandie de cette figure.
| Composé | AKT1 (kcal·mol⁻¹) | EGFR (kcal·mol⁻¹) | MMP9 (kcal·mol⁻¹) | SRC (kcal·mol⁻¹) | TNF (kcal·mol⁻¹) |
| Composé 4 | -5.658 | -4.913 | -7.840 | -6.549 | -5.436 |
| Composé 5 | -5.960 | -5.188 | -8.418 | -6.204 | -5.299 |
Tableau 1 : Scores de docking AutoDock Vina des composés 4 et 5 contre les cinq protéines prioritaires. Scores de docking AutoDock Vina (kcal·mol⁻1) pour les composés 4 et 5 avec AKT1, EGFR, MMP9, SRC et TNF. Des valeurs plus négatives indiquent des scores plus favorables dans le protocole de docking spécifié. Ces valeurs sont des scores calculés et ne doivent pas être décrites comme des énergies libres de liaison ou des affinités mesurées expérimentalement. Abréviations : AKT1, kinase sérine/thréonine AKT1 ; EGFR, récepteur du facteur de croissance épidermique ; MMP9, métalloprotéinase matricielle 9 ; SRC, proto-oncogène non-récepteur à tyrosine kinase SRC ; TNF, facteur de nécrose tumorale.
Figure supplémentaire 1 : Comparaison structurale de la référence cristallographique MMP9–NFH et du meilleur pose d'ancrage MMP9–Composé 5. (A) Environnement du ZN2⁺ catalytique du complexe de référence MMP9–NFH (PDB 1GKC), montrant les His401, His405, His411, Glu402 et les distances de coordination du NFH indiquées. (B) Meilleur pose d'ancrage du Composé 5, montrant les contacts Ala417 et Pro421 indiqués. (C) Vue tridimensionnelle alternative du même pose d'ancrage du Composé 5. Cette comparaison est fournie à titre de référence structurale et n'établit pas une inhibition de la MMP9. Abréviations : MMP9, métalloprotéinase matricielle 9 ; NFH, N2-[(2R)-2-{[formyl(hydroxy)amino]methyl}-4-méthylpentanoyle]-N,3-diméthyl-L-valinamide ; PDB, Protein Data Bank ; Ala, alanine ; Pro, proline ; His, histidine ; Glu, glutamate.Veuillez cliquer ici pour télécharger ce fichier.
Figure supplémentaire 2 : Déviation quadratique moyenne du squelette protéique au cours de l'analyse de dynamique moléculaire. Profils de déviation quadratique moyenne du squelette protéique pour les systèmes MMP9–Composé 5, SRC (PDB 2H8H)–Composé 5 et SRC (PDB 2H8H)–Composé 6 au cours des trajectoires complètes de dynamique moléculaire. Le graphique final utilise les intitulés normalisés MMP9–Composé 5, SRC–Composé 5 et SRC–Composé 6, les axes étant indiqués en RMSD (nm) et Temps (ns). Les profils décrivent le comportement conformationnel dépendant du temps pendant la DM et ne doivent pas être interprétés comme une preuve de liaison cellulaire ou de régulation protéique. Abréviations : MMP9, métalloprotéinase 9 de la matrice ; SRC, proto-oncogène SRC, tyrosine kinase non réceptrice ; PDB, Protein Data Bank ; RMSD, déviation quadratique moyenne ; DM, dynamique moléculaire.Veuillez cliquer ici pour télécharger ce fichier.
Figure supplémentaire 3 : Comparaison de l'environnement du ZN2⁺ catalytique de la MMP9 dans le complexe de référence 1GKC-NFH et dans la pose d'ancrage du composé 5 classée en tête. Dans le complexe de référence cristallographique MMP9–NFH (PDB 1GKC), les His401, His405 et His411 coordonnent le ZN2⁺ catalytique à 2,21, 2,23 et 2,22 Å respectivement, et deux atomes d'oxygène du NFH coordonnent le ZN2⁺ à 2,07 et 2,38 Å ; Glu402 est le résidu acide/base catalytique. En revanche, la carte d'interaction conservée du composé 5 classé en tête montre des contacts avec Ala417 (3,0 Å) et Pro421 (2,4 Å), mais aucune coordination directe annotée du ZN2⁺ ni aucun contact direct avec His401, Glu402, His405 ou His411. Par conséquent, aucune distance de coordination entre le composé 5 et le ZN2⁺ n'a été attribuée. Cette comparaison soutient la classification de la pose du composé 5 comme une association prédite non canonique plutôt qu'un mode de liaison inhibiteur canonique dépendant du zinc. Abréviations : MMP9, métalloprotéinase matricielle 9 ; PDB, Protein Data Bank ; Ala, alanine ; Pro, proline ; His, histidine ; Glu, glutamate.Veuillez cliquer ici pour télécharger ce fichier.
Tableau supplémentaire 1 : Métriques topologiques du réseau initial d'interactions protéine-protéine composé de 21 nœuds et 116 arêtes. Paramètres topologiques pour les 21 nœuds cibles en intersection avant le criblage basé sur la centralité, incluant la longueur moyenne du plus court chemin, la centralité d'intermédiarité, la centralité de proximité, le coefficient de regroupement, le degré, l'excentricité, la connectivité du voisinage, la radialité, la contrainte et le coefficient topologique. La somme des degrés des nœuds est de 232, ce qui correspond à 116 arêtes non orientées.Veuillez cliquer ici pour télécharger ce fichier.
Tableau supplémentaire 2 : Métriques topologiques initiales du réseau pour les 13 candidats retenus après le criblage basé sur le degré. Paramètres topologiques des 13 nœuds conservés après application du critère de degré au réseau initial composé de 21 nœuds et 116 arêtes. Ces valeurs correspondent aux métriques du réseau initial à 21 nœuds et 116 arêtes, conservées pour l'étape suivante de filtrage selon la centralité d'intermédiarité et la centralité de proximité ; elles n'ont pas été recalculées sur un sous-réseau à 13 nœuds.Veuillez cliquer ici pour télécharger ce fichier.
Tableau supplémentaire 3 : Métriques topologiques initiales du réseau pour les cinq candidats hubs finaux retenus après filtrage séquentiel. Paramètres topologiques initiaux du réseau composé de 21 nœuds et 116 arêtes pour les cinq candidats hubs finaux, AKT1, EGFR, TNF, MMP9 et SRC, retenus après filtrage séquentiel. Ces valeurs conservées ne servent qu'à l'ordonnancement fondé sur le réseau et ne représentent pas des métriques recalculées sur un sous-réseau de cinq nœuds, ni n'établissent ces protéines comme des cibles thérapeutiques validées expérimentalement. Abréviations : AKT1, kinase sérine/thréonine AKT 1 ; EGFR, récepteur du facteur de croissance épidermique ; TNF, facteur de nécrose tumorale ; MMP9, métalloprotéinase 9 de la matrice ; SRC, proto-oncogène SRC, tyrosine kinase non réceptrice.Veuillez cliquer ici pour télécharger ce fichier.
Tableau supplémentaire 4 : Résultats complets de l'enrichissement selon l'Encyclopédie de Kyoto des gènes et des génomes pour 121 voies métaboliques répondant au seuil nominal p < Critère d'inclusion 0,10. Statistiques complètes d'enrichissement de la Kyoto Encyclopedia of Genes and Genomes pour les 121 voies conservées parmi les 21 cibles intersectantes (nominale p < 0,10), y compris le ratio des gènes, les nombres de gènes, les totaux des listes, les occurrences dans la population, les totaux de la population, pvaleurs, valeurs de Benjamini, enrichissement par facteur, valeurs de Bonferroni, taux de faux positifs et valeurs du test exact de Fisher. Les 20 voies métaboliques les mieux classées sont représentées dans la figure 4A. La valeur nominale ple critère de valeur définissait l'inclusion ; les valeurs de Benjamini, de Bonferroni et de taux de fausses découvertes sont indiquées par souci de transparence et n'ont pas été utilisées pour définir l'ensemble retenu.Veuillez cliquer ici pour télécharger ce fichier.
Tableau supplémentaire 5 : Résultats complets de l'enrichissement des processus biologiques de l'ontologie génique (177 termes répondant au critère nominal de p < 0,10). Statistiques complètes d'enrichissement pour les 177 termes de processus biologique de l'ontologie génique retenus (p nominal < 0,10), incluant le ratio des gènes, le nombre de gènes, le total de la liste, les occurrences dans la population, le total de la population, la valeur p, la valeur de Benjamini, l'enrichissement relatif, la valeur de Bonferroni, le taux de fausses découvertes et la valeur du test exact de Fisher. Les 10 termes les mieux classés sont illustrés dans la figure 4B. Le critère de la valeur p nominale a défini l'inclusion ; les valeurs ajustées sont indiquées par souci de transparence et n'ont pas été utilisées pour définir l'ensemble retenu.Veuillez cliquer ici pour télécharger ce fichier.
Tableau supplémentaire 6 : Résultats complets de l'enrichissement des composants cellulaires de l'ontologie génique (29 termes répondant au critère nominal de p < 0,10). Statistiques complètes d'enrichissement pour les 29 termes retenus de l'ontologie génique relatifs aux composants cellulaires (valeur p nominale < 0,10), incluant le ratio des gènes, le nombre de gènes, le total de la liste, les occurrences dans la population, le total de la population, la valeur p, la valeur de Benjamini, l'enrichissement relatif, la valeur de Bonferroni, le taux de fausses découvertes et la valeur du test exact de Fisher. Les 10 termes les mieux classés sont illustrés dans la Figure 4C. Le critère de la valeur p nominale a défini l'inclusion ; les valeurs ajustées sont indiquées par souci de transparence et n'ont pas été utilisées pour définir l'ensemble retenu.Veuillez cliquer ici pour télécharger ce fichier.
Tableau supplémentaire 7 : Résultats complets de l'enrichissement en fonctions moléculaires de l'ontologie génique (61 termes répondant au seuil nominal) p < 0.10). Statistiques complètes d'enrichissement pour les 61 termes fonctionnels moléculaires de Gene Ontology retenus (nominale p < 0,10), incluant le ratio des gènes, le nombre de gènes, le total de la liste, les occurrences dans la population, le total de la population, pvaleur, valeur de Benjamini, enrichissement par facteur, valeur de Bonferroni, taux de faux positifs et valeur du test exact de Fisher. Les 10 termes les mieux classés sont visualisés sur la figure 4D. La valeur nominale ple critère de valeur défini a déterminé l'inclusion ; les valeurs ajustées sont indiquées par souci de transparence et n'ont pas été utilisées pour définir l'ensemble retenu.Veuillez cliquer ici pour télécharger ce fichier.
Discussion
La présente étude doit être interprétée dans le cadre d'un modèle mécanistique à deux niveaux. Le premier niveau s'appuie sur des travaux expérimentaux antérieurs : l'activation sensible au glutathion libère une espèce contenant un groupe aminooxy capable de piéger les sites apuriniques/apyrimidiniques de type aldéhyde, et cette classe de composés a montré une cytotoxicité sélective, des effets sur le cycle cellulaire et une induction de l'apoptose dans les cellules H1299. Le second niveau est exploratoire et constitue le point central du présent travail : des prédictions computationnelles de cibles et des analyses basées sur la structure suggèrent que cette même série chimique pourrait également interagir avec certaines protéines associées au cancer. Aucune expérience de cette étude ne démontre que les interactions protéiques prédites se produisent dans les cellules ou qu'elles constituent des conséquences en aval du piégeage des sites apuriniques/apyrimidiniques. Les deux niveaux sont donc volontairement maintenus séparés, plutôt que combinés en un mécanisme multi-cibles validé.
Au niveau du réseau, les 21 cibles intersectantes étaient enrichies dans des voies liées au cancer et à la résistance, et les protéines AKT1, EGFR, TNF, MMP9 et SRC occupaient des positions centrales dans le réseau d'interactions protéine-protéine (PPI). Ces résultats sont utiles pour la priorisation des candidats, mais la centralité dans le réseau et l'enrichissement ne permettent pas de démontrer qu'un composé interagit physiquement avec une protéine ou modifie une voie métabolique. Les protéines centrales doivent donc être considérées comme des candidats pour une validation ciblée. L'établissement d'un rôle fonctionnel nécessiterait des expériences de perturbation directe ou de liaison à la cible, réalisées dans la même lignée cellulaire de CBNP utilisée pour mesurer le phénotype cellulaire.
MMP9 illustre pourquoi cette distinction est importante. Le composé 5 présentait le score d'ajustement (docking) le plus favorable avec MMP9, mais la carte d'interactions de la meilleure pose conservée n'indiquait pas une coordination directe de l'ion Zn2+ catalytique ni une interaction directe avec His401, Glu402, His405 ou His411. Dans la référence cristallographique 1GKC, His401, His405 et His411 coordonnent Zn2+ à des distances de 2,21, 2,23 et 2,22 Å respectivement, tandis que les deux atomes d'oxygène de NFH coordonnent Zn2+ à 2,07 et 2,38 Å ; Glu402 est le résidu acide/base catalytique. La carte du composé 5 montrait plutôt des contacts près d'Ala417 et de Pro421. Figure supplémentaire 3 présente la comparaison des cartes d'interactions de référence. Étant donné qu'aucune coordination directe entre le composé 5 et Zn2+ n'a été annotée, aucune distance de coordination composé 5–Zn2+ n'a été attribuée. Par conséquent, le résultat structural actuel doit être décrit comme une association prédite non canonique avec MMP9, et non comme une preuve d'inhibition du site catalytique. La trajectoire de dynamique moléculaire (MD) ultérieure ne teste que la persistance dans le temps de cette pose d'ajustement spécifique ; elle ne peut pas transformer une géométrie d'ajustement non canonique en preuve d'inhibition enzymatique36,37. MMP9 devrait donc rester un candidat pour des tests biochimiques, plutôt qu'une cible principale ou validée. MMP9 a été largement discutée en relation avec l'invasion cancéreuse, le remodelage de l'environnement tumoral et les stratégies thérapeutiques ciblant MMP938,39.
La même limite probante s'applique à la SRC. La trajectoire SRC–composé 5 présentait des contacts plus persistants que le témoin SRC–composé 6, mais la stabilité en dynamique moléculaire n'équivaut pas à l'occupation intracellulaire de la cible40,41. L'utilisation du composé 6 permet une comparaison appariée avec le produit de clivage non piégeant et renforce la comparaison structurelle interne, mais ne prouve pas que la fonctionnalité aminooxy soit responsable de la liaison à la SRC ou que la signalisation de la SRC soit modifiée dans les cellules. Une évaluation directe de la quantité totale de SRC, du rapport p-SRC/SRC, des marqueurs de signalisation en aval et des mesures orthogonales d'engagement de la cible serait nécessaire pour étayer une telle affirmation.
MM-PBSA fournit également une estimation énergétique relative pour les trajectoires échantillonnées, plutôt qu'une mesure expérimentale d'affinité. Les estimations plus favorables pour MMP9–Composé 5 et SRC–Composé 5 par rapport à SRC–Composé 6 sont cohérentes avec les observations comparatives des trajectoires, mais les calculs sont sensibles aux conformations échantillonnées et aux approximations méthodologiques, et l'analyse actuelle n'a pas inclus de correction entropique. L'accord entre le docking, la DM et MM-PBSA augmente donc uniquement la cohérence computationnelle interne ; il n'établit pas une modulation fonctionnelle de MMP9 ou de SRC.
La relation entre le piégeage des sites apuriniques et les interactions protéiques prédites reste non élucidée. Une possibilité est que l'échafaudage aminooxy libéré par la glutathion conserve son activité établie de piégeage des lésions de l'ADN tout en ayant des interactions indépendantes et parallèles avec des protéines sélectionnées. Une autre possibilité est que certaines interactions protéiques prédites n'aient pas lieu à des concentrations biologiquement pertinentes ou ne contribuent pas au phénotype. Les données actuelles ne permettent pas de distinguer ces hypothèses. La démonstration d'un lien mécanistique nécessiterait la mesure simultanée des réponses aux dommages de l'ADN et des modifications des voies protéiques après traitement par le composé, suivie d'expériences d'interférence démontrant qu'une modification de la cible candidate altère le phénotype anticancéreux.
Une validation expérimentale ultérieure devrait être réalisée dans les cellules H1299, le même modèle cellulaire utilisé lors de la caractérisation expérimentale précédente de cette série chimique. Une stratégie étagée comparerait d'abord le composé 5 au véhicule et au composé non piégeur apparié, le composé 6, en utilisant des tests de viabilité, d'apoptose, du cycle cellulaire, de migration/invasion et de γH2AX en fonction de la concentration, afin d'établir le contexte phénotypique et de dommage de l'ADN42. L'activité de la MMP9 devrait ensuite être examinée par zymographie au gélatine et par analyse de l'expression protéique, tandis que la signalisation SRC serait évaluée par la détection de la SRC totale et de la SRC phosphorylée sur la tyrosine 416, le rapport p-SRC/SRC étant utilisé comme indicateur principal de la signalisation. L'association directe entre le composé et la protéine devrait être évaluée indépendamment à l'aide d'une méthode d'engagement de cible orthogonale, telle que la résonance plasmonique de surface43. Une interaction candidate ne serait considérée comme étayée expérimentalement que si les preuves de liaison directe concordent avec l'indicateur fonctionnel cellulaire correspondant. Une perturbation génétique ou pharmacologique de la MMP9 ou de la SRC fournirait un test supplémentaire pour déterminer si l'un ou l'autre candidat contribue de manière causale au phénotype des cellules H1299. Ce cadre étagé préserve la distinction entre l'activité de piégeage des sites apuriniques déjà établie et les hypothèses d'interaction MMP9/SRC priorisées par calcul, tout en définissant une voie directe pour les tests expérimentaux ultérieurs.
Déclarations de divulgation
Les auteurs déclarent ne pas avoir d'intérêts financiers concurrents ni d'autres conflits d'intérêts liés à ce travail. Les bailleurs de fonds n'ont joué aucun rôle dans la conception de l'étude ; dans la collecte, l'analyse ou l'interprétation des données ; dans la rédaction du manuscrit ; ni dans la décision de publier les résultats.
Remerciements
Ce travail a été soutenu par le projet pour jeunes chercheurs du département de l'éducation de la province du Liaoning (JYTQN2023441), le projet de démarrage de recherche doctorale du fonds conjoint provincial du département des sciences et technologies du Liaoning (2023-BSBA-151), et le projet de soutien aux jeunes talents scientifiques et technologiques de l'Université médicale de Jinzhou (JYQT202305). ChatGPT (OpenAI) a été utilisé lors de la révision du manuscrit pour la correction linguistique, l'organisation et l'aide à la révision. Les auteurs ont examiné et vérifié le contenu scientifique, l'interprétation des données et la rédaction finale, et assument l'entière responsabilité du manuscrit.
Matériaux
| Nom | Entreprise | Numéro de catalogue | Commentaires |
|---|---|---|---|
| ACPYPE | Développeurs ACPYPE / Bio2Byte | Version 2023.11.14 | Génération et conversion de fichiers de topologie de ligands de petite molécule vers un format compatible avec GROMACS. |
| AmberTools (Antechamber) | Équipe de développement AMBER | AmberTools 23.3 | Attribution de charges partielles AM1-BCC et génération de paramètres de ligands selon GAFF2. |
| AutoDock Vina | Forli Lab, Scripps Research | Version 1.2.5 | Obtention de poses de docking moléculaire et classement des complexes protéine-ligand. |
| AutoDockTools (MGLTools) | Centre de biologie structurale computationnelle, Scripps Research | Version 1.5.7 | Préparation du récepteur et du ligand, attribution de charges de Gasteiger, définition des liaisons rotatables et conversion au format PDBQT. |
| BIOVIA Discovery Studio Visualizer | Dassault Systèmes BIOVIA | Version 2025 | Visualisation des poses de docking et analyse des interactions protéine-ligand. |
| Champ de forces CHARMM36 | MacKerell Laboratory / Développeurs du champ de forces CHARMM | CHARMM36 | Paramétrisation des protéines pour les calculs de dynamique moléculaire ; CHARMM36 a été utilisé de manière cohérente tout au long de l'étude (et non CHARMM36m). |
| Chem3D Ultra (ChemOffice Professional) | Revvity Signals Software | Version 22.2 | Minimisation de l'énergie du ligand à l'aide du champ de forces MMFF94. |
| Composés 1–6 | Synthétisés précédemment comme décrit dans Li et al., ACS Chemical Biology (2022) | N/A | Prodrogues parentales sensibles au glutathion, produits libérés et paire contrôle non piégeante appariée utilisés dans le flux de travail computationnel. |
| cytoHubba | Développeurs de cytoHubba / Cytoscape App Store | Version 0.1 | Analyse de degré, de centralité d'intermédiarité et de centralité de proximité pour la priorisation des cibles centrales. |
| Cytoscape | Consortium Cytoscape | Version 3.10.0 | Visualisation des réseaux composé-cible et d'interactions protéine-protéine, et analyse de leur topologie. |
| DAVID Bioinformatics Resources | Laboratoire de rétrovirologie humaine et d'immunoinformatique, Laboratoire national Frederick pour la recherche sur le cancer | Ressource web | Analyse d'enrichissement en ontologie génique et KEGG ; un seuil exploratoire de p nominal < 0,10 a été utilisé comme critère d'inclusion ; les valeurs ajustées ont été rapportées mais n'ont pas servi à définir l'ensemble retenu. |
| GAFF2 | Équipe de développement AMBER | GAFF2 | Paramétrisation du champ de forces pour les ligands. |
| Base de données géniques humaines GeneCards | Suite GeneCards / LifeMap Sciences, Inc. / Institut Weizmann des sciences | Ressource web | Récupération de cibles associées à la maladie à l'aide de la requête « lung cancer H1299 ». |
| gmx_MMPBSA | Équipe de développement de gmx_MMPBSA | Version 1.6.3 | Calculs d'énergie libre de liaison MM-PBSA à partir de trajectoires de dynamique moléculaire GROMACS ; 500 images ont été échantillonnées entre 100,0–149,9 ns par intervalles de 100 ps, l'instant final à 150,0 ns étant exclu ; aucune correction d'entropie n'a été appliquée. |
| GROMACS | Équipe de développement de GROMACS | Version 2024.4 | Génération et analyse de trajectoires de dynamique moléculaire. |
| Plateforme en ligne de visualisation Microbioinfo | Shanghai Newcore Biotechnology Co., Ltd. / Microbioinfo | Ressource web | Génération de diagrammes en barres d'enrichissement et de graphiques en bulles. |
| Open Babel | Équipe de développement Open Babel | Version 3.1.1 | Conversion des fichiers de structure en SMILES canoniques pour l'entrée dans SwissTargetPrediction. |
| PubChem | Centre national d'information sur la biotechnologie, Bibliothèque nationale de médecine des États-Unis, NIH | Ressource web | Récupération de structures tridimensionnelles de ligands. |
| Système graphique moléculaire PyMOL | Schrödinger, LLC | Version 2.5.4 | Préparation des protéines, visualisation structurale et inspection des poses de docking. |
| Banque de données des structures protéiques RCSB | Collaboratoire de recherche en bioinformatique structurale (RCSB) | Identifiants PDB : 3O96 ; 5UWD ; 2AZ5 ; 1GKC ; 2H8H | Récupération des structures protéiques respectivement pour AKT1, EGFR, TNF, MMP9 et SRC. |
| STRING | Consortium STRING | Version 11.5 | Construction du réseau d'interactions protéine-protéine ; Homo sapiens ; score d'interaction minimum requis de 0,400 ; les métriques de topologie initiales correspondent au réseau PPI non orienté composé de 21 nœuds et 116 arêtes. |
| SwissTargetPrediction | Groupe de modélisation moléculaire, Université de Lausanne / Institut suisse de bioinformatique SIB | Ressource web | Prédiction inverse des cibles pour les composés 1–3 ; espèce restreinte à Homo sapiens. |
| Modèle d'eau TIP3P | Implémenté dans GROMACS | TIP3P | Modèle d'eau explicite à trois sites utilisé pour solvater les complexes protéine-ligand. |
| Venny | BioinfoGP, Centre national de biotechnología (CNB-CSIC) | Version 2.1 | Intersection des listes de cibles prédites par composé et des cibles associées à la maladie. |
Références
- Sung H, et al. Global cancer statistics 2020: GLOBOCAN estimates of incidence and mortality worldwide for 36 cancers in 185 countries. CA Cancer J Clin. 2021;71:209-49.
- Herbst RS, Morgensztern D, Boshoff C. The biology and management of non-small cell lung cancer. Nature. 2018;553:446-54.
- Kim J, et al. Updates on the treatment of epidermal growth factor receptor-mutant non-small cell lung cancer. Cancer. 2025;131:e35778.
- Lin Y, Wang X, Jin H. EGFR-TKI resistance in NSCLC patients: mechanisms and strategies. Am J Cancer Res. 2014;4:411-35.
- Dasari S, et al. Pharmacological effects of cisplatin combination with natural products in cancer chemotherapy. Int J Mol Sci. 2022;23:1532.
- Ellie S, et al. Chemotherapy drugs cyclophosphamide, cisplatin and doxorubicin induce germ cell loss in an in vitro model of the prepubertal testis. Sci Rep. 2018;8:1773.
- De Bont R, van Larebeke N. Endogenous DNA damage in humans: a review of quantitative data. Mutagenesis. 2004;19:169-85.
- Ciccia A, Elledge SJ. The DNA damage response: making it safe to play with knives. Mol Cell. 2010;40:179-204.
- David SS, Williams SD. Chemistry of glycosylases and endonucleases involved in base-excision repair. Chem Rev. 1998;98:1221-62.
- Robson CN, Hickson ID. Isolation of cDNA clones encoding a human apurinic/apyrimidinic endonuclease that corrects DNA repair and mutagenesis defects in E. coli xth (exonuclease III) mutants. Nucleic Acids Res. 1991;19:5519-23.
- Sczepanski JT, et al. Rapid DNA-protein cross-linking and strand scission by an abasic site in a nucleosome core particle. Proc Natl Acad Sci U S A. 2010;107:22475-80.
- Krokan HE, Bjørås M. Base excision repair. Cold Spring Harb Perspect Biol. 2013;5:a012583.
- Li X, et al. Selective antitumor activity and photocytotoxicity of glutathione-activated abasic site trapping agents. ACS Chem Biol. 2022;17:797-803.
- Hopkins AL. Network pharmacology: the next paradigm in drug discovery. Nat Chem Biol. 2008;4:682-90.
- Meng XY, et al. Molecular docking: a powerful approach for structure-based drug discovery. Curr Comput Aided Drug Des. 2011;7:146-57.
- Hollingsworth SA, Dror RO. Molecular dynamics simulation for all. Neuron. 2018;99:1129-43.
- Genheden S, Ryde U. The MM/PBSA and MM/GBSA methods to estimate ligand-binding affinities. Expert Opin Drug Discov. 2015;10:449-61.
- O'Boyle NM, et al. Open Babel: an open chemical toolbox. J Cheminform. 2011;3:33.
- Daina A, Michielin O, Zoete V. SwissTargetPrediction: updated data and new features for efficient prediction of protein targets of small molecules. Nucleic Acids Res. 2019;47:W357-64.
- Shannon P, et al. Cytoscape: a software environment for integrated models of biomolecular interaction networks. Genome Res. 2003;13:2498-504.
- Stelzer G, et al. The GeneCards Suite: from gene data mining to disease genome sequence analyses. Curr Protoc Bioinformatics. 2016;54:1.30.1-1.30.33.
- Oliveros JC. Venny: an interactive tool for comparing lists with Venn's diagrams [Internet]. BioinfoGP, CNB-CSIC; 2007-2015.
- Szklarczyk D, et al. The STRING database in 2021: customizable protein-protein networks and functional characterization of user-uploaded gene/measurement sets. Nucleic Acids Res. 2021;49:D605-12.
- Chin CH, et al. cytoHubba: identifying hub objects and subnetworks from complex interactome. BMC Syst Biol. 2014;8:S11.
- Sherman BT, et al. DAVID: a web server for functional enrichment analysis and functional annotation of gene lists (2021 update). Nucleic Acids Res. 2022;50:W216-21.
- Kim S, et al. PubChem 2023 update. Nucleic Acids Res. 2023;51:D1373-80.
- Eberhardt J, et al. AutoDock Vina 1.2.0: new docking methods, expanded force field, and Python bindings. J Chem Inf Model. 2021;61:3891-8.
- Gerek ZN, Ozkan SB. A flexible docking scheme to explore the binding selectivity of PDZ domains. Protein Sci. 2010;19:914-28.
- Abraham MJ, et al. GROMACS: high-performance molecular simulations through multi-level parallelism from laptops to supercomputers. SoftwareX. 2015;1-2:19-25.
- Best RB, et al. Optimization of the additive CHARMM all-atom protein force field targeting improved sampling of backbone and side-chain dihedral angles. J Chem Theory Comput. 2012;8:3257-73.
- Vassetti D, Pagliai M, Procacci P. Assessment of GAFF2 and OPLS-AA general force fields in combination with the water models TIP3P, SPCE, and OPC3 for the solvation free energy of druglike organic molecules. J Chem Theory Comput. 2019;15:1983-95.
- Jakalian A, Jack DB, Bayly CI. Fast, efficient generation of high-quality atomic charges. AM1-BCC model: II. Parameterization and validation. J Comput Chem. 2002;23:1623-41.
- Sousa da Silva AW, Vranken WF. ACPYPE—AnteChamber PYthon Parser interfacE. BMC Res Notes. 2012;5:367.
- Case DA, et al. AmberTools. J Chem Inf Model. 2023;63:6183-91.
- Valdés-Tresanco MS, et al. gmx_MMPBSA: a new tool to perform end-state free-energy calculations with GROMACS. J Chem Theory Comput. 2021;17:6281-91.
- Islam MT, Jang NH, Lee HJ. Natural products as regulators against matrix metalloproteinases for the treatment of cancer. Biomedicines. 2024;12:794.
- Mondal S, et al. Matrix metalloproteinase-9 (MMP-9) and its inhibitors in cancer: a minireview. Eur J Med Chem. 2020;194:112260.
- Rashid ZA, Bardaweel SK. Novel matrix metalloproteinase-9 (MMP-9) inhibitors in cancer treatment. Int J Mol Sci. 2023;24:12133.
- Kessenbrock K, Plaks V, Werb Z. Matrix metalloproteinases: regulators of the tumor microenvironment. Cell. 2010;141:52-67.
- Vandooren J, Van den Steen PE, Opdenakker G. Biochemistry and molecular biology of gelatinase B or matrix metalloproteinase-9 (MMP-9): the next decade. Crit Rev Biochem Mol Biol. 2013;48:222-72.
- Merchant N, et al. Matrix metalloproteinases: their functional role in lung cancer. Carcinogenesis. 2017;38:766-80.
- Chabanon RM, et al. Targeting the DNA damage response in immuno-oncology: developments and opportunities. Nat Rev Cancer. 2021;21:701-17.
- Das S, et al. Surface plasmon resonance as a fascinating approach in target-based drug discovery and development. TrAC Trends Anal Chem. 2024;171:117501.