Ce protocole décrit un flux de travail basé sur une enquête visant à examiner comment les caractéristiques technologiques de l’IA agente se rapportent à l’excédent cognitif, à la sécurité psychologique et à la réaffectation des tâches IA-humain chez 331 employés. La modélisation structurelle partielle des moindres carrés avec analyse multi-groupes révèle des différences basées sur les rôles entre les dirigeants et le personnel.
Un abonnement JoVE est requis pour visualiser ce contenu. Connectez-vous ou commencez votre période d'essai gratuite.
Article de recherche
Comment l’IA agente remodele le travail : les rôles du surplus cognitif, de la sécurité psychologique et de la réallocation des tâches IA-humain
Dans cet article
Résumé
Résumé
Cette étude examine comment les caractéristiques technologiques de l’IA agente se rapportent aux états psychologiques des employés et aux réponses comportementales dans les organisations. En nous appuyant sur la théorie des Demandes d’Emploi-Ressources (JD-R) et la théorie de la Conservation des Ressources (COR), nous conceptualisons les caractéristiques technologiques de l’IA Agente (AITC) comme un construct d’ordre supérieur comprenant une planification autonome, l’orchestration multi-outils et le retour proactif, et proposons que ces caractéristiques fonctionnent comme des ressources d’emploi associées à un plus grand surplus cognitif et à une sécurité psychologique, ce qui est à son tour lié à la réallocation des tâches IA-humain. Nous étudions également si ces relations diffèrent entre les dirigeants et le personnel. Une enquête en ligne transversale et anonyme a été administrée via une plateforme d’enquête en ligne auprès des participants recrutés par un panel de recherche utilisant un échantillonnage non probabiliste intentionnel ; l’éligibilité était limitée aux adultes ayant déjà ou passé une expérience professionnelle liée à l’IA, et les réponses filtrées et suivies d’attention ont permis d’obtenir un échantillon final de 331 employés (171 leaders, 160 employés). Tous les constructs ont été mesurés avec des échelles validées adaptées au contexte de l’IA agente sur des échelles de Likert à 7 points. Les données ont été analysées en utilisant la modélisation structurelle des équations partielles des moindres carrés (PLS-SEM), en appliquant une approche en deux étapes pour la construction du second ordre, en bootstrapping avec 5 000 rééchantillonnages pour les effets directs et indirects, et en analyse multi-groupes (MGA) pour la comparaison leader-staff. Le modèle de mesure a démontré une fiabilité et une validité acceptables, et les résultats structurels étaient cohérents avec le modèle théorisé de gain de ressources : l’AITC était positivement associée à un surplus cognitif, à la sécurité psychologique et à la réallocation des tâches, avec des voies de médiation significatives et des associations AITC-ressources plus fortes entre les leaders. En se concentrant sur les mécanismes psychologiques plutôt que sur la performance technique, cette étude étend les recherches émergentes sur l’IA Agentique et offre des implications pratiques pour les stratégies d’adoption de l’IA différenciée selon les rôles.
Introduction
La prolifération de l’IA agente redéfinit le rôle de l’intelligence artificielle dans les industries et la vieorganisationnelle 1,2. L’IA agente peut être définie comme une forme avancée d’intelligence artificielle qui perçoit les environnements changeants, fixe des objectifs de manière indépendante grâce à des mécanismes de raisonnement, et orchestre des séquences d’actions avec un minimum de supervision humaine 3,4. Elle se distingue de l’IA traditionnelle, y compris des outils d’IA générative conventionnels, à trois égards : l’autonomie, car les systèmes agents poursuivent des objectifs avec une intervention humaine minimale plutôt que d’exécuter des règlespréprogrammées 5,6 ; fonction principale, car leur but est d’automatiser des flux de travail complexes plutôt que des tâchesuniques 7 ; et architecture, car elles coordonnent plusieurs grands modèles de langage, interfaces de programmation d’applications (API) et agents plutôt que de s’appuyer sur un seul modèle7. Ces capacités reposent sur les caractéristiques technologiques définissantes examinées dans cetteétude 8,9. La planification autonome (PA) signifie que, donné l’objectif de l’utilisateur, le système le décompose indépendamment en sous-tâches et révise son plan au fur et à mesure que les contrainteschangent 10 ; Par exemple, un employé peut fournir une instruction en une ligne et recevoir un plan de projet réalisable en plusieurs étapes. L’orchestration multi-outils (MTO) signifie que le système sélectionne, séquence et intègre les outils et APIexternes 1,11,12 ; par exemple, combiner la recherche web, les éditeurs de documents et les outils d’analyse de données pour produire un rapport cohérent unique. Le retour proactif (PF) signifie que le système signale les erreurs, les informations manquantes et les hypothèses risquées avant d’êtreinterrogé 10,13 ; Par exemple, rappeler à un employé les points de validation ou de conformité lors de l’exécution d’une tâche. Nous nous concentrons sur ces trois caractéristiques, collectivement appelées caractéristiques technologiques de l’IA Agentique (AITC), car ce sont les capacités fonctionnelles qui différencient l’IA agente de l’IA traditionnelle dans le travailquotidien 7,10 ; des attributs tels que la transparence, la contrôlabilité et l’explicabilité comptent pour la confiance de l’IA en général, mais ne sont pas spécifiques au paradigme agentique, et nous les considérons donc comme des conditions limites pour des recherches futures plutôt que comme des dimensions focales.
Malgré la diffusion rapide de l’IA agente sur les lieux de travail, la littérature existante s’est principalement concentrée sur son architecture technique, son efficacité opérationnelle et ses capacités d’automatisation des tâches, tout en accordant relativement peu d’attention à la manière dont ces caractéristiques reforment les états psychologiques et les réponses comportementales desemployés 14,15. Cette omission est importante car la réaffectation des tâches entre humains et IA n’est pas un ajustement purement technique, mais un processus psychologiquement et organisationnellement ancré : les employés doivent remettre en question les flux de travail existants, redéfinir les limites des rôles et accepter de nouvelles formes de collaboration avec des systèmesintelligents 16,17. De tels changements ne se produisent pas automatiquement simplement parce que des technologies avancées sont disponibles. En conséquence, l’objectif de cette étude est triple : examiner si l’AITC fonctionne comme des ressources d’emploi associées à un surplus cognitif, à la sécurité psychologique et à la réallocation des tâches IA-humain ; d’étudier les rôles médiateurs et séquentiels du surplus cognitif et de la sécurité psychologique ; et d’explorer si ces relations structurelles diffèrent entre les dirigeants et le personnel. La nouveauté de cette étude est triple. Premièrement, elle conceptualise et opérationnelle les caractéristiques technologiques de l’IA agente — planification autonome, orchestration multi-outils et retour proactif — comme une ressource d’emploi de niveau supérieur au sein du cadre JD-R, plutôt que de traiter l’adoption de l’IA comme un contexte indifférencié. Deuxièmement, elle introduit la réallocation des tâches IA-humain comme une forme spécifique à un domaine, mise en œuvre par la technologie, distincte à la fois de la création de tâches générique et des résultats de transformation numérique descendante. Troisièmement, elle fournit, à notre connaissance, la première preuve multigroupe que les associations génératrices de ressources de l’IA agente diffèrent systématiquement entre dirigeants et personnels.
La logique théorique intègre la théorie des Demandes d’Emploi-Ressources (JD-R) et la théorie de la Conservation des Ressources (COR). La théorie JD-R soutient que chaque emploi comprend les exigences du poste, les aspects physiques, émotionnels et cognitifs du travail qui nécessitent un effort soutenu, ainsi que les ressources du poste, les aspects qui réduisent les demandes, soutiennent l’atteinte des objectifs et stimulent le développement personnel ; Leur équilibre façonne l’engagement, le bien-être et la performance18,19. La théorie COR ajoute un mécanisme dynamique : les individus s’efforcent d’obtenir, de conserver et de protéger des ressources précieuses, et les ressources accumulées déclenchent des spirales de gains dans lesquelles les ressources existantes sont réinvesties pour acquérir d’autresressources 20,21,22. Dans cette perspective conjointe, l’AITC peut être conceptualisée non seulement comme des caractéristiques techniques, mais comme une nouvelle forme de ressource d’emploi : en absorbant des tâches répétitives et cognitivement exigeantes telles que la planification et l’analyse diagnostique, les systèmes agents réduisent les demandes et conservent l’énergie cognitive et le temps desemployés 15,23. Nous définissons le surplus cognitif (CS) comme le réservoir d’énergie cognitive et de temps discrétionnaire qui devient disponible lorsque ces tâches routinières sont déléguées à la technologie, et qui peut être réinvesti dans la participation collective, la collaboration et la création de nouvellevaleur 24. L’informatique est donc conceptuellement distincte de l’engagement au travail, qui est un état affectif-motivationnel, et de la simple disponibilité du temps, car elle désigne un stock convertible de ressources personnelles au sensCOR 20,24. L’informatique se distingue également du détachement et de la récupération psychologiques, qui concernent la restauration de l’énergie épuisée loin du travail, et de l’afluence temporelle, qui désigne la perception subjective d’avoir assez de temps ; L’informatique fait plutôt référence à la capacité cognitive libérée qui reste disponible pour être réinvestie pendant le travail lui-même. En termes de COR, l’accumulation de CS représente un gain de ressources qui devrait soutenir le bien-être professionnel en amortissant l’épuisement et l’épuisement, tandis que son absorption par des demandes routinières supplémentaires signaleraitune perte de ressources 20, 23, 24. La conversion effective du temps conservé en excédent peut dépendre de caractéristiques individuelles telles que la littératie en IA, des normes de charge de travail capables d’absorber le temps économisé avec des exigences supplémentaires, et de la culture organisationnelle ; Nous traitons donc la voie de gain de ressources comme une hypothèse à tester plutôt qu’une hypothèse.
H1 : L’AITC est positivement associé à l’informatique.
La sécurité psychologique (PS) est définie comme la croyance que son environnement de travail est sûr pour la prise de risques interpersonnels, comme admettre des erreurs, demander de l’aide et contester le statu quo25,26. Bien que la sécurité psychologique ait souvent été étudiée comme un climat d’équipe, cette étude la conceptualise et la mesure comme une perception au niveau individuel, conformément à notre conception d’enquêteau niveau individuel 27,28. Lorsque les systèmes agentiques fournissent un retour d’information orienté vers l’apprentissage et des outils de soutien, le coût interpersonnel de l’expérimentation et de l’exposition des erreurs peut diminuer, car les employés peuvent tester et corriger leur travail avant de le présenter auxautres 26,28. Nous reconnaissons cependant que la dynamique opposée est plausible : lorsque des systèmes agents sont déployés pour la surveillance ou la recherche de responsabilités, le risque et la méfiance perçus entre les relations interpersonnelles et la méfiance peuvent augmenterde 29 à 30. Parce que les caractéristiques examinées ici sont de nature assistative plutôt qu’évaluative, nous émettons l’hypothèse d’une association positive tout en traitant cette possibilité à double sens comme une condition aux limites importante.
H2 : L’AITC est positivement associé à la PS.
Nous définissons la réallocation des tâches IA-humain (AHTR) comme une redistribution auto-initiée des tâches par les employés entre eux-mêmes et les systèmes d’IA, en déléguant les tâches de routine à l’IA tout en élargissant leurs propres responsabilités stratégiques et créatives. Nous positionnons AHTR comme une forme spécifique à un domaine de création de tâches. Dans le modèle basé sur JD-R de Tims et Bakker, la création d’emplois comprend l’augmentation des ressources d’emploi, l’augmentation des demandes de défis et la diminution des demandes d’obstacles17,31 ; dans la typologie de Wrzesniewski et Dutton, elle comprend l’artisanat de tâches, relationnel etcognitif 32. L’AHTR correspond le plus étroitement à la création de tâches réalisée par la technologie : transférer simultanément les tâches routinières à l’IA réduit les contraintes et mobilise une nouvelle ressourced’emploi 17,23,32. Il est plus restreint qu’un résultat général de transformation numérique car il capture des changements discrétionnaires initiés par les employés dans les limites des tâches plutôt que la refonte organisationnelledescendante 33. Nous privilégions la réallocation des tâches plutôt que l’artisanat relationnel et cognitif car la redistribution des tâches constitue l’interface comportementale la plus immédiate entre les employés et les systèmes agentiques et est directement observable dans l’adoption précoce, tandis que la fabrication relationnelle et cognitive émerge généralement comme des adaptations en aval31,32. Contrairement aux études précédentes qui traitent l’adoption de l’IA comme un antécédent contextuel de la création généralede tâches 16,34, nous modélisons la réallocation elle-même comme le comportement central de fabrication. Parce que cette réaffectation perturbe les flux de travail établis, les employés sont plus enclins à la mettre en œuvre lorsqu’ils disposent de ressources cognitives suffisantes pour repenser leur travail et se sentent psychologiquement en sécurité pour prendre les risques interpersonnelsassociés 16,34. Dans la logique de la spirale de gain de la théorie COR, la sécurité psychologique fonctionne également comme une ressource contextuelle qui protège et amplifie l’accumulation de surpluscognitif 22.
H3 : L’informatique est positivement associée à l’AHTR.
H5 : La PS est positivement associée à l’AHTR.
H6 : La PS est positivement associée à l’informatique.
H9 : L’AITC est positivement associé à l’AHTR.
En intégrant ces arguments, l’AITC devrait se relier à l’AHTR non seulement directement mais aussi indirectement, à travers les voies de gain de ressources du surplus cognitif et de la sécurité psychologique.
H4 : CS médie la relation entre l’AITC et l’AHTR.
H7 : PS médie la relation entre l’AITC et l’AHTR.
H8 : PS et CS médient séquentiellement la relation entre AITC et AHTR.
Enfin, les employés n’interprètent pas et ne réagissent pas uniformément à l’IA agentique. Gibson, Cooper et Conger ont décrit la distance perceptuelle entre les dirigeants et leurs équipes comme une disparité cognitive par rapport aux mêmes objectifs organisationnels, enracinée dans des asymétries d’accès à l’information, de responsabilité, d’exposition au risque et d’expérienceprofessionnelle 35. S’appuyant sur cette vision, les dirigeants et le personnel occupent des positions structurellement différentes en ce qui concerne l’adoption de l’IA : les dirigeants ont une responsabilité stratégique et ont tendance à présenter l’IA comme une ressource orientée vers l’augmentation pour la productivité et la prise de décision basée sur les données, tandis que le personnel est relativement plus exposé à l’insécurité professionnelle liée à l’automatisation et à la surcharge d’apprentissage20,30. Nous traitons ces schémas comme des tendances à tester empiriquement plutôt que comme des dispositions fixes de l’un ou l’autre groupe. De telles divergences basées sur les rôles peuvent générer des schémas hétérogènes dans les relations entre AITC, CS, PS et AHTR, pourtant la recherche empirique qui capture explicitement ces différences de groupe reste limitée.
H10a : Les associations de l’AITC avec le CS et le PS diffèrent entre les dirigeants et le personnel.
H10b : Les associations entre PS et CS et AHTR diffèrent entre les dirigeants et le personnel.
Le protocole ci-dessous décrit le flux de travail complet, du recrutement et du dépistage des participants à l’administration des enquêtes, le nettoyage des données, la validation des mesures, l’estimation du modèle structurel, l’analyse de médiation et l’analyse multi-groupes (MGA) (Figure 1), afin que la procédure puisse être reproduite indépendamment. Le modèle de recherche est représenté à la Figure 2 : AITC, modélisé comme un construct de second ordre comprenant AP, MTO et PF, se rapporte directement ou indirectement à AHTR via CS et PS, PS étant également lié à CS ; la différence entre les rôles de direction et de personnel est examinée via la MGA.
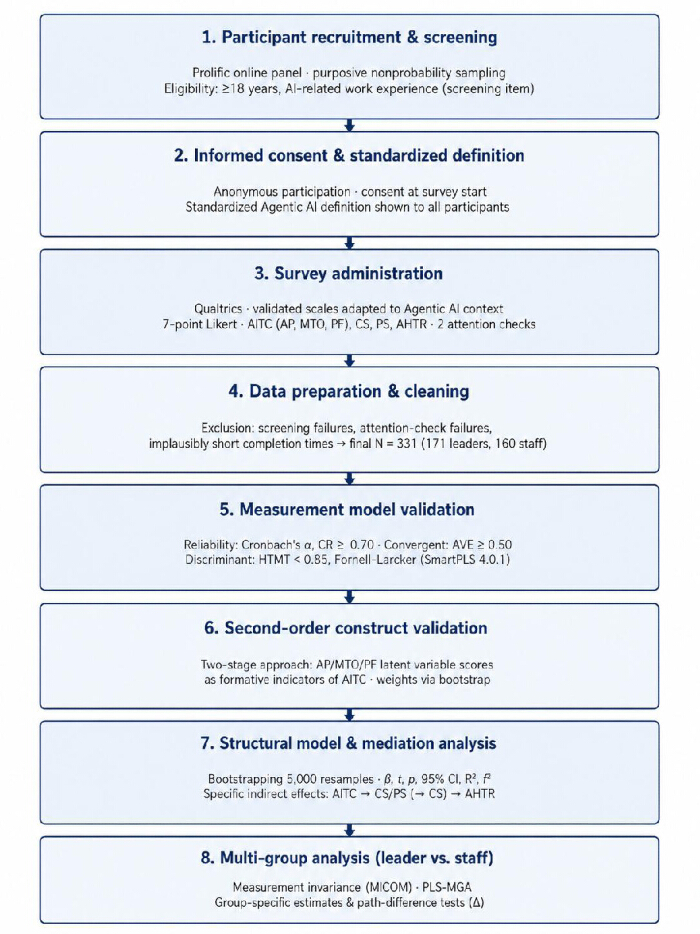
Figure 1. Flux de travail global de conception de l’étude. Schéma du protocole de recherche complet. Les participants ont été recrutés via le panel en ligne à l’aide d’échantillonnages non probabilistes intentionnels et dépistés pour leur expérience professionnelle liée à l’IA ; les répondants éligibles ont rempli une enquête anonyme mesurant tous les concepts sur des échelles de Likert à 7 points. Après nettoyage des données (échecs de dépistage, échecs de contrôle d’attention et temps de complétion incroyablement courts supprimés ; N final = 331), le modèle de mesure a été validé (fiabilité : α de Cronbach, fiabilité composite ; validité convergente : variance moyenne extraite ; validité discriminante : HTMT et Fornell-Larcker), le construct du second ordre a été validé via l’approche en deux étapes, et le modèle structurel, les voies de médiation et l’analyse multi-groupe leader-staff ont été estimés à 5 000 Des rééchantillonnages bootstrap. Veuillez cliquer ici pour voir une version agrandie de cette figurine.
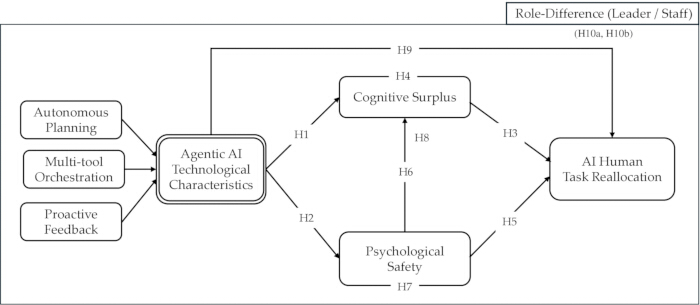
Figure 2. Modèle de recherche proposé. Modèle conceptuel des relations hypothétiques. Les caractéristiques technologiques de l’IA agente (AITC), un concept de second ordre comprenant la planification autonome (AP ; la capacité du système à décomposer des objectifs en sous-tâches et à réviser les plans), l’orchestration multi-outils (MTO ; la capacité à sélectionner, séquencer et intégrer plusieurs outils et API) et le retour proactif (PF ; la capacité à signaler erreurs et risques sans y être sollicité), est hypothétique comme étant positivement associée au surplus cognitif (CS ; le réservoir d’énergie cognitive et de temps discrétionnaire libéré lorsque les tâches routinières sont déléguées à l’IA), la sécurité psychologique (PS ; la perception que l’environnement de travail est sûr pour la prise de risques interpersonnelles), et la réallocation des tâches IA-humain (AHTR ; redistribution auto-initiée des tâches par les employés entre eux-mêmes et l’IA) (H1, H2, H9). On suppose que la CS et la PS sont positivement associées à AHTR (H3, H5), PS à CS (H6), et CS et PS pour médiatiser, individuellement et séquentiellement, la relation AITC-AHTR (H4, H7, H8). Les flèches représentent des chemins structurels hypothétisés ; H10a/H10b désignent des différences hypothétiques entre le leader et le personnel testées par analyse multigroupe. Veuillez cliquer ici pour voir une version agrandie de cette figurine.
Accès restreint. Veuillez vous connecter ou commencer un essai pour afficher ce contenu.
Protocole
Toutes les procédures ont été réalisées conformément aux normes éthiques pour la recherche impliquant des participants humains à l’Université aSSIST et à l’Université Dong-A. Puisque toutes les réponses étaient anonymisées lors de la collecte et qu’aucune information personnelle identifiable n’a été collectée à aucun moment, le comité d’examen institutionnel de l’université aSSIST a déterminé que l’étude était exemptée d’examen complet conformément à l’article 15 de la loi sur la bioéthique et la sécurité de la République de Corée et à l’article 13 de son règlement d’application. L’enquête s’ouvrait sur une page d’information et de consentement indiquant que la participation était limitée aux personnes actuellement employées et impliquées dans un projet d’IA, décrivant l’objectif de l’étude et expliquant la nature volontaire de la participation, l’anonymat des réponses et l’utilisation prévue des données ; seuls les répondants explicitement d’accord ont poursuivi le questionnaire. La page de consentement est fournie dans le Fichier Supplémentaire 1.
Détermination de la taille de l’échantillon
Une analyse de puissance a priori a été réalisée avant la collecte des données à l’aide de G*Power 3.1.9.7 (RRID : SCR_013726) pour la famille de régression multiple linéaire, spécifiant le plus grand nombre de prédicteurs dirigés vers une seule construction endogène dans le modèle ; dans cette étude, l’AHTR est prédit par trois concepts (AITC, CS et PS). Avec une taille d’effet moyenne (f2 = 0,15), α = 0,05 et une puissance statistique de 0,80, l’échantillon minimum requis était de 77 cas ; la sortie du protocole G*Power est fournie dans le Fichier Supplémentaire 2. La taille minimale de l’échantillon a été vérifiée à l’aide de la méthode de la racine carrée inverse pourPLS-SEM 36, selon laquelle environ 155 cas sont nécessaires pour détecter un coefficient de chemin standardisé minimal d’environ 0,20 au niveau de signification de 5 % avec 80 % de puissance. Enfin, l’objectif de recrutement a été fixé pour dépasser substantiellement les deux minimums, afin de soutenir le bootstrapping des effets indirects et l’analyse multi-groupes à échantillons fractionnés ; l’échantillon final (N = 331 ; leaders n = 171, personnel n = 160) satisfaisait l’exigence minimale d’échantillon au sein de chaque sous-groupe.
Recrutement et sélection des participants
Les participants ont été recrutés via le panel de recherche en ligne à l’aide d’un échantillonnage non probabiliste intentionnel ; c’est-à-dire que l’échantillon a été délibérément restreint aux répondants répondant à un critère substantiel a priori — expérience professionnelle actuelle ou antérieure impliquant l’IA — plutôt que tirés au hasard parmi la population générale. L’éligibilité était limitée aux répondants âgés de 18 ans ou plus. L’expérience professionnelle liée à l’IA a été mise en œuvre à travers l’élément de sélection « Lequel des éléments suivants décrit le mieux votre situation actuelle ? », présenté avant le questionnaire principal ; seuls les répondants qui indiquaient être actuellement employés et impliqués dans un travail lié à l’IA ont poursuivi, tandis que les autres options (employées mais non impliquées dans le travail en IA ; non employées mais déjà impliquées ; non employées et non impliquées) déclenchaient un retrait immédiat. La collecte des données a eu lieu lors d’une seule session le 8 février 2026 (10h28–13h30), et les participants ont été rémunérés à 6,98 GBP par heure conformément à la politique de rémunération équitable de la plateforme. La participation en double a été empêchée grâce aux identifiants uniques des participants de la plateforme et aux paramètres de prévention des réponses en double de la plateforme d’enquête. Le nombre de répondants à chaque étape a été enregistré pour documenter le flux de travail d’inclusion/exclusion : 537 réponses ont été enregistrées ; 151 ont été éliminés par les questions de sélection (386 restantes) ; 40 furent retirés pour avoir échoué aux contrôles d’attention, y compris la ligne droite (346 restants) ; et 15 ont été retirés pour des temps d’achèvement incroyablement courts (sous environ 180 s), donnant l’échantillon final de N = 331.
Définition standardisée et instructions d’enquête
Les participants ont été informés que l’enquête examinait comment l’IA agente pouvait affecter les organisations et leurs membres. Au début de l’enquête, tous les participants ont vu une brève définition standardisée de l’IA Agentique, conforme à la définition donnée dans l’Introduction — un système d’IA avancé caractérisé par une planification autonome, une orchestration multi-outils et un retour proactif qui réalise des actions orientées vers un objectif avec une supervision humaine limitée (Figure 1, étape 2). L’éligibilité était limitée aux répondants actuellement employés et impliqués dans un projet d’IA, ce qui fournissait une base professionnelle pertinente pour répondre au questionnaire. Aucun élément distinct de vérification de compréhension n’était inclus ; La définition standardisée servait donc d’orientation contextuelle plutôt que de vérification de la compréhension vérifiée. Les participants ont été invités à répondre à chaque question en se basant sur leur expérience réelle d’utilisation ou de travail avec de tels systèmes d’IA agentique dans des contextes organisationnels.
Développement et administration des instruments de topographie
Le questionnaire a été développé à partir d’échelles de mesure validées adaptées au contexte organisationnel de l’IA agentique. Le tableau 1 liste chaque élément, son échelle source et les statistiques descriptives : les items AP, MTO et PF ont été adaptés des conceptualisations récentes de l’IAAgentique 7,8 ; Items en informatique issus de la recherche sur les ressources cognitives en IAgénérative 37 ; PS éléments de Plomp et al.38 ; et les items AHTR issus des échelles de création de tâches basées surJD-R 17,39 adaptés à la réattribution des tâches. Tous les constructs ont été mesurés sur des échelles de Likert à 7 points allant de 1 (« fortement en désaccord ») à 7 (« fortement d’accord »). L’enquête était organisée en blocs couvrant la page de consentement, le filtrage, les items AITC (AP, MTO, PF), CS, PS, AHTR et les caractéristiques démographiques/témoins ; l’instrument contenait également des échelles supplémentaires (alphabétisation IA et auto-efficacité de l’étendue des rôles) qui dépassent le cadre du modèle actuel et qui ont été collectées mais non analysées ici, rapportées pour transparence. L’enquête était hébergée sur la plateforme d’enquête en ligne ; Le bouton retour était désactivé pour empêcher les répondants de réviser les réponses précédentes, et les items étaient présentés dans un ordre fixe dans des blocs. Le temps médian de complétion était de 7 min 44 s. Deux items de vérification d’attention à réponse instruite étaient intégrés comme branches de flux d’enquête qui clôturaient l’enquête en cas de réponse incorrecte : (i) une vérification factuelle, « L’IA est-elle une abréviation d’Informations sur les Artichauts ? » (réponse correcte : Non), et (ii) un contrôle de compréhension d’échelle confirmant que les réponses ont été enregistrées sur une échelle de Likert à 7 points, allant de « fortement en désaccord » à « fortement d’accord ». Avant l’administration principale, un test pilote a été mené avec 124 répondants pour évaluer la clarté des éléments de l’enquête, le flux global de l’enquête, la durée de l’achèvement et la faisabilité du questionnaire ; La durée de l’achèvement a été examinée afin d’identifier des réponses exceptionnellement courtes et de confirmer que la durée de l’enquête était appropriée pour les répondants cibles. Le test pilote n’a révélé aucun problème de formulation nécessitant une révision des items, et aucun changement de formulation n’a été effectué avant l’enquête principale. De plus, les données pilotes ont été analysées à l’aide de PLS-SEM comme procédure de validation préliminaire pour évaluer la performance des indicateurs, construire la fiabilité, la validité convergente, la validité discriminante, la colinéarité et la plausibilité des relations structurelles proposées ; Les résultats soutenaient l’adéquation de l’instrument pour l’enquête principale.
| Construction | Objet | Question | Méchant | STDEV | VIF | Source | |||
| AITC | AP | AP1 | Quand je propose un objectif, l’IA aide à créer un plan en plusieurs étapes pour l’atteindre. | 5.81 | 0.9 | 1.44 | Abou Ali, M., et al. (2025) ; Sapkota, R., et al. (2025) | ||
| AP2 | L’IA peut réviser son plan lorsque des contraintes ou des exigences changent. | 5.75 | 0.99 | 1.37 | |||||
| AP3 | L’IA divise les tâches complexes en sous-tâches gérables sans avoir besoin d’instructions étape par étape. | 5.33 | 1.37 | 1.33 | |||||
| MTO | MTO1 | L’IA peut combiner plusieurs outils ou applications (par exemple, recherche, documents, outils de données) pour accomplir une tâche. | 5.69 | 1.11 | 1.5 | ||||
| MTO2 | L’IA suggère le(s) bon outil(s) et les utilise dans la bonne séquence pour produire un livrable. | 5.36 | 1.04 | 1.64 | |||||
| MTO3 | L’IA aide à intégrer les résultats de différents outils en un résultat cohérent. | 5.61 | 1.01 | 1.63 | |||||
| PF | PF1 | L’IA signale de manière proactive les erreurs, les informations manquantes ou les hypothèses risquées dans mon travail. | 4.9 | 1.44 | 1.68 | ||||
| PF2 | L’IA suggère des améliorations avant que je ne demande explicitement un retour. | 5.07 | 1.38 | 1.85 | |||||
| PF3 | L’IA me rappelle les points de contrôle (par exemple, la validation, la conformité, la qualité) pour éviter les retravails. | 5.02 | 1.4 | 1.6 | |||||
| CS | CS1 | L’utilisation de l’IA a libéré mon énergie mentale pour me concentrer sur un travail plus complexe et significatif. | 5.59 | 1.28 | 2.07 | Liu, Y., Sheng, F., & Liu, R. (2025) | |||
| CS2 | J’ai plus de temps disponible pour la réflexion stratégique et la résolution de problèmes depuis que j’utilise l’IA. | 5.61 | 1.23 | 2.38 | |||||
| CS3 | La charge de travail liée aux tâches routinières a considérablement diminué, ce qui me donne de la marge d’esprit pour de nouvelles initiatives. | 5.42 | 1.28 | 2.23 | |||||
| CS4 | Je me sens moins épuisé mentalement à la fin de la journée de travail parce que l’IA gère les tâches répétitives. | 5.15 | 1.5 | 1.91 | |||||
| PS | PS1 | Dans mon entreprise, il est sûr de prendre un risque lié à l’utilisation de l’IA de nouvelles manières. | 4.74 | 1.37 | 1.52 | Plomp et al. (2019) | |||
| PS2 | Mon manager encourage l’expérimentation avec l’IA et tolère les erreurs. | 4.52 | 1.61 | 1.68 | |||||
| PS3 | Je me sens à l’aise de m’exprimer si j’ai des inquiétudes sur la façon dont l’IA est utilisée dans mon équipe. | 5.48 | 1.24 | 1.32 | |||||
| PS4 | Mes collègues me soutiennent si j’essaie de nouvelles façons de travailler avec l’IA. | 5.26 | 1.32 | 1.48 | |||||
| PS5 (exclu) | Je n’ai pas peur des conséquences négatives si je propose des usages innovants de l’IA dans mon travail. | 4.47 | 1.59 | 1.23 | |||||
| AHTR | AHTR1 | Je transfère délibérément les tâches routinières (par exemple, saisie de données, formatage de rapports) à l’IA afin de pouvoir me concentrer sur des tâches à plus grande valeur. | 5.12 | 1.35 | 1.68 | Tims, M., & Bakker, A. B. (2010) ; Li, W. et al. (2024) | |||
| AHTR2 | Je cherche activement des opportunités d’utiliser l’IA pour gérer des tâches que je faisais auparavant manuellement. | 5.58 | 1.28 | 1.84 | |||||
| AHTR3 | Depuis que j’utilise l’IA, j’ai pris de nouvelles responsabilités ou des responsabilités élargies, plus stratégiques ou créatives. | 5.18 | 1.3 | 1.58 | |||||
| AHTR4 (exclu) | Je négocie avec mon manager sur les tâches que l’IA doit gérer et lesquelles je dois faire. | 4.09 | 1.65 | 1.23 | |||||
| AHTR5 | J’ai repensé mon travail en réaffectant le travail routinier à l’IA, me libérant pour des tâches plus significatives. | 4.92 | 1.35 | 1.67 | |||||
Tableau 1 : Éléments de mesure, sources, statistiques descriptives et évaluation complète de la collinéarité. Instrument complet de l’arpentage. Chaque élément est listé avec sa construction (dimensions AITC AP, MTO, PF ; CS ; PS ; AHTR), code d’article, formulation, moyenne, écart-type (STDEV), facteur d’inflation de la variance de collinéarité (VIF ; les valeurs <3,3 indiquent l’absence de contamination courante par variance de la méthode), ainsi que l’échelle source à partir de laquelle il a été adapté. Tous les items ont été mesurés sur des échelles de Likert à 7 points (1 = fortement en désaccord, 7 = fortement d’accord). La PS5 et l’AHTR4 ont été retirées lors de l’évaluation du modèle de mesure en raison de faibles charges extérieures. AITC = Caractéristiques technologiques de l’IA agente ; AP = planification autonome ; MTO = orchestration multi-outils ; PF = retour proactif ; CS = surplus cognitif ; PS = sécurité psychologique ; AHTR = réallocation des tâches IA-humain. Veuillez cliquer ici pour télécharger ce tableau.
Préparation et nettoyage des données
Les réponses brutes étaient exportées au format CSV. Les cas ne remplissant pas le critère de dépistage ou l’un ou l’autre élément de contrôle d’attention ont été exclus, tout comme les réponses avec des données manquantes importantes (paramètres de réponse forcée minimisés l’absence au sein de l’enquête) ; Les décomptes d’exclusions résultants à chaque étape sont documentés dans la section 2 du protocole (537 enregistrés → 331 conservés). Les données conservées ont été inspectées pour leur cohérence et dépistées pour détecter les schémas de réponse inattentive : les réponses en ligne droite ont été supprimées via les contrôles d’attention, et les réponses avec des temps de complétion incroyablement courts (sous environ 180 s) ont été exclues. Les variables ont ensuite été codées pour l’analyse (par exemple, Rôle : Leader = 1, Personnel = 0 ; Genre : Homme = 1, Femme = 0) Comme documenté dans le Tableau 2, les contrôles catégoriels tels que l’industrie étaient codés par des indicateurs k-1, et le jeu de données finalisé a été importé dans le logiciel PLS-SEM. Un livre de codes associant chaque variable à son texte, son code et sa construction est fourni sous forme de fichier supplémentaire 2.
Évaluation du modèle de mesure
À l’aide du logiciel PLS-SEM, chaque élément observé était assigné à sa construction latente, et toutes les constructions du premier ordre (AP, MTO, PF, CS, PS, AHTR) étaient spécifiées comme réfléchissantes. AITC a été spécifié comme un construct de second ordre comprenant AP, MTO et PF et a été estimé avec l’approche en deux étapes40, 41, 42 : les scores de variables latentes ont d’abord été obtenus pour les constructs du premier ordre puis utilisés (AP_LVS, MTO_LVS, PF_LVS) comme indicateurs formatifs de l’AITC. L’algorithme PLS était exécuté avec le schéma de pondération des chemins, un maximum de 3 000 itérations, et un critère d’arrêt de 10−7. La fiabilité interne de la cohérence a été évaluée par rapport aux seuils de fiabilité α et composite (CR) de Cronbach de 0,7043, considérant α valeurs de 0,5 à 0,6 comme marginalement acceptables pour des échelles courtes dans des contextes de rechercheémergents 43 ; La validité convergente a été évaluée par rapport au seuil moyen de variance extraite (AVE) de 0,5044 ; et la validité discriminante a été évaluée à l’aide du ratio hétérotrait-monotrait (HTMT <0,85, seuil conservateur)45 et du critèreFornell-Larcker 44. Lorsque les critères de fiabilité ou de validité convergente n’étaient pas respectés, les charges externes étaient inspectées, et les indicateurs de mauvaise performance étaient supprimés tout en préservant la validité du contenu, chaque retrait et sa justification étant documentés ; dans cette étude, PS5 et AHTR4 ont été retirés en raison de faibles charges extérieures, ce qui a amélioré la validité convergente de PS et AHTR.
Modèle structurel et analyse de médiation
Les trajectoires structurelles ont été spécifiées conformément au modèle de recherche (Figure 2), et la colinéarité entre les constructions prédictives a été examinée à l’aide de facteurs d’inflation de variance internes (VIF < 5,0)36 et de VIFs de collinéarité totale (<3,3)46,47. La signification du chemin a été estimée par bootstrapping avec 5 000 rééchantillons à l’aide d’intervalles de confiance percentiles et de tests à deux queues, et des coefficients de chemin standardisés (β), moyennes d’échantillon (M), écarts-types (STDEV), valeurs t, valeurs p, intervalles de confiance à 95 %, R2 et tailles d’effet (f2) ont été rapportés. La puissance prédictive hors échantillon a été évaluée à l’aide de PLSpredict avec 10 fois et 10 répétitions ; pour chaque indicateur endogène, la prédiction Q2(>0 indique la pertinence prédicative) a été inspectée, et les erreurs de prédiction PLS-SEM (RMSE et MAE) ont été comparées au benchmark48 du modèle linéaire (LM). Pour l’analyse de médiation, les effets indirects de l’AITC sur l’AHTR via la CS, la PS et la voie séquentielle PS → CS ont été spécifiés, et chaque effet indirect spécifique a été évalué à l’aide de la distribution bootstrap (5 000 rééchantillons), avec un effet indirect jugé significatif lorsque son intervalle de confiance à 95 % excluait zéro.
Analyse multigroupe
Les répondants ont été classés en groupes de dirigeants et de personnel selon leur rôle organisationnel auto-déclaré (Rôle : Leader = 1, Personnel = 0 ; Tableau 2) ; Le groupe de leaders comprenait des chefs d’équipe/superviseurs, des managers/chefs de département, ainsi que des cadres/cadres supérieurs, et le groupe de personnel comprenait des employés au niveau du personnel. Avant la comparaison des coefficients de chemin, l’invariance de mesure entre groupes a été établie à l’aide de la procédure45 de l’invariance de mesure des modèles composites (MICOM). L’étape 1 (invariance configurale) a été satisfaite par une spécification de modèle identique entre les groupes, et l’étape 2 (invariance compositionnelle) a été prise en charge pour tous les constructs, avec des corrélations initiales égales ou supérieures à leurs quantiles de 5 % et des valeurs p de permutation non significatives (AHTR c = 0,999, p = 0,524 ; AITC c = 0,954, p = 0,205 ; CS c = 1,000, p = 0,800 ; PS c = 0,976, p = 0,073), établissant l’invariance partielle des mesures et justifiant la comparaison multi-groupe (résultats complets MICOM dans le Fichier Supplémentaire 3). Le modèle a ensuite été estimé séparément pour chaque groupe, et les différences de chemin ont été testées à l’aide de PLS-MGA basé sur le bootstrap, avec des valeurs p à une et à deux côtés rapportées pour la différence leader-bâton (Δ) de chaque chemin ; Des coefficients de chemin spécifiques au groupe, des valeurs t et des valeurs p ont été rapportés pour tous les chemins directs et indirects, ainsi que la magnitude de chaque différence entre groupes.
Signalement, vérification et dépannage
Tous les résultats de fiabilité, validité, structure, médiation et MGA ont été compilés ; les tableaux de résultats ont été exportés ; et chaque statistique rapportée était vérifiée par rapport à la sortie générée par logiciel afin d’assurer la cohérence entre tableaux, figures et textes. Pour le dépannage, les directives suivantes s’appliquent : si de nombreuses réponses échouent à un contrôle de sélection ou à des contrôles d’attention, affiner les critères d’éligibilité et clarifier les instructions de l’enquête ; si les critères de fiabilité (CR < 0,70) ou de validité convergente (AVE < 0,50) ne sont pas remplis, on examine les charges externes et on supprime les indicateurs faibles tout en préservant la couverture théorique ; si une collinéarité est identifiée (VIF au-dessus des seuils), réévaluer les spécifications de la construction et éliminer les indicateurs redondants ; si la médiation ou les effets de groupe ne sont pas significatifs, réexaminer l’adéquation de l’échantillon et construire l’opérationnalisation avant interprétation ; et utiliser un nombre suffisant de rééchantillonnages bootstrap (par exemple, 5 000) pour stabiliser les estimations.
Accès restreint. Veuillez vous connecter ou commencer un essai pour afficher ce contenu.
Résultats
Caractéristiques des participants
Le tableau 2 présente les caractéristiques démographiques de l’échantillon final (N = 331). L’échantillon comprenait 65,0 % d’hommes et 35,0 % de femmes, avec une répartition relativement équilibrée entre les dirigeants (51,7 %, n = 171) et le personnel (48,3 %, n = 160). Le plus grand groupe d’âge était de moins de 30 ans (46,5 %), suivi de 31 à 40 ans (32,0 %) ; 76,4 % détenaient des diplôme...
Accès restreint. Veuillez vous connecter ou commencer un essai pour afficher ce contenu.
Discussion
Cette étude a examiné comment les caractéristiques technologiques de l’IA agente se rapportent aux ressources psychologiques des employés et au comportement de réallocation des tâches, et si ces relations diffèrent selon les rôles organisationnels. En utilisant une enquête transversale auprès de 331 employés expérimentés en IA et PLS-SEM avec médiation et analyse multigroupe, les résultats étaient cohérents avec le modèle théorisé de gain de ressources : l’AITC était positivement associé...
Accès restreint. Veuillez vous connecter ou commencer un essai pour afficher ce contenu.
Déclarations de divulgation
Les auteurs déclarent ne pas exister de conflit d’intérêts.
Un outil d’IA générative (ChatGPT, OpenAI) a été utilisé pour l’édition de langage ; tout le contenu était examiné et vérifié par les auteurs, qui vérifiaient également que l’édition assistée par IA n’introduisait pas de changements de terminologie ou de ton entre les sections.
Remerciements
Ce travail a été financé par des financements de recherche de l’Université aSSIST.
Accès restreint. Veuillez vous connecter ou commencer un essai pour afficher ce contenu.
Matériaux
| Nom | Entreprise | Numéro de catalogue | Commentaires |
|---|---|---|---|
| Prolific | Prolific | https://www.prolific.com/ | Fournisseur de panneaux de sondage en ligne |
| Qualtrics | Qualtrics, LLC | https://www.qualtrics.com/ | Codage de sondage |
| SmartPLS | SmartPLS GmbH | version 4.0.1, https://www.smartpls.com/ | Analyse PLS-SEM |
Références
- Chawla C, Chatterjee S, Gadadinni SS, Verma P, Banerjee S. Agentic AI: The building blocks of sophisticated AI business applications. Journal of AI, Robotics & Workplace Automation. 2024;3(3):196–210.
- Lu C, et al. The AI scientist: Towards fully automated open-ended scientific discovery. arXiv [Preprint]. 2024. arXiv:2408.06292. Available from: https://arxiv.org/abs/2408.06292.
- Xie J, Chen Z, Zhang R, Wan X, Li G. Large multimodal agents: A survey. arXiv [Preprint]. 2024. arXiv:2402.15116. Available from: https://arxiv.org/abs/2402.15116.
- Du H, Thudumu S, Vasa R, Mouzakis K. A survey on context-aware multi-agent systems: Techniques, challenges and future directions. arXiv [Preprint]. 2024. arXiv:2402.01968. Available from: https://arxiv.org/abs/2402.01968.
- Acharya DB, Kuppan K, Divya B. Agentic AI: Autonomous intelligence for complex goals - a comprehensive survey. IEEE Access. 2025;13:18912–18936.
- Calegari R, Ciatto G, Mascardi V, Omicini A. Logic-based technologies for multi-agent systems: A systematic literature review. Auton Agent Multi Agent Syst. 2021;35(1):1.
- Sapkota R, Roumeliotis KI, Karkee M. AI agents vs. Agentic AI: A conceptual taxonomy, applications and challenges. Inf Fusion. 2026;126:103599.
- Abou Ali M, Dornaika F, Charafeddine J. Agentic AI: A comprehensive survey of architectures, applications, and future directions. Artif Intell Rev. 2025;59(1):11.
- Buyya R. Agentic artificial intelligence (AI): Architectures, taxonomies, and evaluation of large language model agents. arXiv [Preprint]. 2026. arXiv:2601.12560. Available from: https://arxiv.org/abs/2601.12560.
- Nisa U, Shirazi M, Saip MA, Pozi MSM. Agentic AI: The age of reasoning - a review. J Autom Intell. 2025. doi:10.1016/j.jai.2025.08.003.
- Singh A, Ehtesham A, Kumar S, Khoei TT. Enhancing AI systems with agentic workflows patterns in large language model. In: 2024 IEEE World AI IoT Congress (AIIoT); Seattle, WA; 2024:527–532.
- Zeng A, et al. AgentTuning: Enabling generalized agent abilities for LLMs. In: Findings of the Association for Computational Linguistics: ACL 2024; Bangkok, Thailand; 2024:3053–3077.
- Liu X, Zhang L, Wei X. Generative artificial intelligence literacy: Scale development and its effect on job performance. Behav Sci (Basel). 2025;15(6):811.
- Wooldridge M, Jennings NR. Intelligent agents: Theory and practice. Knowl Eng Rev. 1995;10(2):115–152.
- Masterman T, Besen S, Sawtell M, Chao A. The landscape of emerging AI agent architectures for reasoning, planning, and tool calling: A survey. arXiv [Preprint]. 2024. arXiv:2404.11584. Available from: https://arxiv.org/abs/2404.11584.
- Sha C, Chai T. When digital-AI transformation sparks adaptation: Job crafting and AI knowledge in job insecurity contexts. Front Psychol. 2025;16:1612245.
- Tims M, Bakker AB. Job crafting: Towards a new model of individual job redesign. SA J Ind Psychol. 2010;36(2):1–9.
- Bakker AB, Hakanen JJ, Demerouti E, Xanthopoulou D. Job resources boost work engagement, particularly when job demands are high. J Educ Psychol. 2007;99(2):274–284.
- Bakker AB, Demerouti E, Sanz-Vergel A. Job demands-resources theory: Ten years later. Annu Rev Organ Psychol Organ Behav. 2023;10(1):25–53.
- Hobfoll SE, Shirom A. Conservation of resources theory: Applications to stress and management in the workplace. In: Golembiewski RT, ed. Handbook of Organizational Behavior. 2nd ed. Marcel Dekker; New York; 2000:57–80.
- Hobfoll SE. Conservation of resources: A new attempt at conceptualizing stress. Am Psychol. 1989;44(3):513–524.
- Hobfoll SE, Halbesleben J, Neveu JP, Westman M. Conservation of resources in the organizational context: The reality of resources and their consequences. Annu Rev Organ Psychol Organ Behav. 2018;5(1):103–128.
- Bakker AB, Demerouti E. Job demands-resources theory: Taking stock and looking forward. J Occup Health Psychol. 2017;22(3):273–285.
- Shirky C. Cognitive Surplus: How Technology Makes Consumers into Collaborators. Penguin Press; New York; 2010.
- Edmondson A. Psychological safety and learning behavior in work teams. Adm Sci Q. 1999;44(2):350–383.
- Zhao G, Kumar N, Wang C, Liu Z. Bridging the AI gap: How AI-oriented leadership empowers non-technical employees in AI-based innovation engagement. Leadersh Organ Dev J. 2026;47(3):498–514.
- Edmondson AC, Lei Z. Psychological safety: The history, renaissance, and future of an interpersonal construct. Annu Rev Organ Psychol Organ Behav. 2014;1(1):23–43.
- Kim BJ, Kim MJ, Lee J. The dark side of artificial intelligence adoption: Linking artificial intelligence adoption to employee depression via psychological safety and ethical leadership. Humanit Soc Sci Commun. 2025;12(1):1–14.
- Cardon PW, Ma H, Fleischmann C. Recorded business meetings and AI algorithmic tools: Negotiating privacy concerns, psychological safety, and control. Int J Bus Commun. 2023;60(4):1095–1122.
- Raisch S, Krakowski S. Artificial intelligence and management: The automation-augmentation paradox. Acad Manage Rev. 2021;46(1):192–210.
- Tims M, Bakker AB, Derks D. Development and validation of the job crafting scale. J Vocat Behav. 2012;80(1):173–186.
- Wrzesniewski A, Dutton JE. Crafting a job: Revisioning employees as active crafters of their work. Acad Manage Rev. 2001;26(2):179–201.
- Grant AM, Parker SK. Redesigning work design theories: The rise of relational and proactive perspectives. Acad Manag Ann. 2009;3(1):317–375.
- Liu Q, Tian Q, Li X, Tan H. How does organizational AI adoption affect employees’ job crafting behaviors? An approach-avoidance perspective. Front Psychol. 2025;16:1690238.
- Gibson CB, Cooper CD, Conger JA. Do you see what we see? The complex effects of perceptual distance between leaders and teams. J Appl Psychol. 2009;94(1):62–76.
- Hair JF, et al. Partial Least Squares Structural Equation Modeling (PLS-SEM) Using R: A Workbook. Springer; Cham; 2021:1–56.
- Liu Y, Sheng F, Liu R. Generative AI adoption and employee outcomes: A conservation of resources perspective on job crafting, career commitment, and the moderating role of liking of AI. Humanit Soc Sci Commun. 2025;12:1376.
- Plomp J, Tims M, Khapova SN, Jansen PG, Bakker AB. Psychological safety, job crafting, and employability: A comparison between permanent and temporary workers. Front Psychol. 2019;10:974.
- Li W, et al. Embracing artificial intelligence (AI) with job crafting: Exploring trickle-down effect and employees’ outcomes. Tour Manag. 2024;104:104935.
- Gaskin J, Godfrey S, Vance A. Successful system use: It’s not just who you are, but what you do. AIS Trans Hum Comput Interact. 2018;10(2):57–81.
- Marakas G, Johnson R, Clay PF. The evolving nature of the computer self-efficacy construct: An empirical investigation of measurement construction, validity, reliability and stability over time. J Assoc Inf Syst. 2007;8(1):2.
- Loch KD, Straub DW, Kamel S. Diffusing the Internet in the Arab world: The role of social norms and technological culturation. Global Information Systems. 2008;143–175.
- Nunnally JC. Psychometric Theory. 2nd ed. McGraw-Hill; New York; 1978.
- Fornell C, Larcker DF. Evaluating structural equation models with unobservable variables and measurement error. J Mark Res. 1981;18(1):39–50.
- Henseler J, Ringle CM, Sarstedt M. A new criterion for assessing discriminant validity in variance-based structural equation modeling. J Acad Mark Sci. 2015;43(1):115–135.
- Kock N. Common method bias in PLS-SEM: A full collinearity assessment approach. Int J e-Collab. 2015;11(4):1–10.
- Kock N, Lynn GS. Lateral collinearity and misleading results in variance-based SEM: An illustration and recommendations. J Assoc Inf Syst. 2012;13(7):2.
- Shmueli G, et al. Predictive model assessment in PLS-SEM: Guidelines for using PLSpredict. Eur J Mark. 2019;53(11):2322–2347.
- Podsakoff PM, MacKenzie SB, Lee JY, Podsakoff NP. Common method biases in behavioral research: A critical review of the literature and recommended remedies. J Appl Psychol. 2003;88(5):879–903.
- Podsakoff PM, MacKenzie SB, Podsakoff NP. Sources of method bias in social science research and recommendations on how to control it. Annu Rev Psychol. 2012;63(1):539–569.
- Harman HH. Modern Factor Analysis. 3rd ed. University of Chicago Press; Chicago; 1976.
- Podsakoff PM, Organ DW. Self-reports in organizational research: Problems and prospects. J Manage. 1986;12(4):531–544.
Accès restreint. Veuillez vous connecter ou commencer un essai pour afficher ce contenu.