Ce protocole décrit la mise en œuvre d'une plateforme web interopérable qui intègre des données cliniques basées sur FHIR avec une génération augmentée par récupération et des grands modèles linguistiques multi-agents pour l'aide à la décision clinique. Le flux de travail permet un déploiement reproductible, une intégration standardisée des données et une évaluation de l'analyse médicale assistée par l'intelligence artificielle (IA).
Un abonnement JoVE est requis pour visualiser ce contenu. Connectez-vous ou commencez votre période d'essai gratuite.
Article de recherche
Plateforme Web interopérable basée sur des modèles de langage étendus pour l'analyse de données médicales : un protocole pour l'aide à la décision clinique
Dans cet article
Résumé
Résumé
La prise de décision clinique est fréquemment entravée par des dossiers de santé électroniques fragmentés et une interopérabilité limitée entre les systèmes hétérogènes d'information en santé. Cet article présente un protocole étape par étape pour la mise en œuvre d'une plateforme web interopérable qui intègre des données cliniques via la norme Fast Healthcare Interoperability Resources (FHIR), ainsi que la génération augmentée par recherche (Retrieval-Augmented Generation, RAG), les grands modèles linguistiques (Large Language Models, LLMs) et un cadre de raisonnement clinique multi-agents afin de soutenir l'analyse des données médicales et l'aide à la décision clinique. Le protocole décrit l'ensemble du flux de travail, y compris la configuration de l'environnement informatique, le prétraitement des jeux de données cliniques, l'intégration des données basée sur FHIR, la construction d'une base de données vectorielle, la configuration de la recherche, l'ingénierie des prompts, l'orchestration multi-agents et l'évaluation du système. Des résultats représentatifs démontrent la capacité de la plateforme à générer des réponses cliniquement pertinentes et contextuellement cohérentes, tout en améliorant l'interopérabilité sémantique entre des sources de données hétérogènes. Les performances du système ont été évaluées à l'aide de métriques quantitatives et sémantiques complémentaires, notamment BLEU, ROUGE, BERTScore et la similarité cosinus. Une évaluation qualitative a été réalisée à l'aide de jeux de données de référence en santé, entièrement anonymisés et accessibles au public, afin d'évaluer la reproductibilité du flux de travail méthodologique proposé. L'architecture proposée combine l'interopérabilité standardisée en santé avec des modèles linguistiques améliorés par la recherche afin d'améliorer le raisonnement contextuel, réduire les hallucinations et soutenir des flux de travail cliniques assistés par l'intelligence artificielle reproductibles. Ce protocole fournit un cadre évolutif et reproductible pour les chercheurs et les développeurs souhaitant mettre en œuvre des systèmes de santé interopérables, respectueux de la vie privée et intelligents, destinés à l'aide à la décision clinique, à l'analyse des données médicales et à la recherche translationnelle future.
Introduction
Des informations de santé sont générées de manière routinière dans les hôpitaux, les centres de diagnostic, les laboratoires et les cliniques externes, restant souvent réparties entre des systèmes d'information hétérogènes. Cette fragmentation limite l'interopérabilité et restreint l'accès en temps voulu à des dossiers patients complets, créant ainsi des difficultés persistantes pour les soins cliniques, l'intégration des données et la gestion des soins de santé1,2,3,4.
Les conséquences de cette fragmentation deviennent particulièrement évidentes dans les flux de travail cliniques qui dépendent d'un accès rapide aux informations du patient. Lorsque les professionnels de santé ne peuvent pas consulter des dossiers médicaux complets et intégrés, l'évaluation clinique devient plus difficile, augmentant ainsi le risque de prise de décision incomplète et réduisant l'efficacité de la prestation des soins, notamment en milieu d'urgence5,6.
Les récents développements de l'intelligence artificielle (IA), en particulier des grands modèles linguistiques (LLM), ont élargi l'éventail des approches computationnelles disponibles pour les applications en santé. Ces modèles ont été étudiés dans des tâches telles que l'aide au diagnostic, le tri clinique et le soutien à la prise de décision. Par exemple, Jahan et al.5 ont évalué l'utilisation des LLM dans des tâches biomédicales, tandis que Taylor et al.7 ont examiné des modèles affinés pour le dépistage numérique de la santé mentale, rapportant des résultats encourageants dans des contextes cliniques spécialisés.
L'application des modèles linguistiques de grande taille s'est également étendue à des domaines cliniques plus spécialisés. Song et al. 49ont exploré leur utilisation dans le diagnostic de la pneumoconiose, tandis que Chien et al.8 ont appliqué ces modèles à l'analyse des schémas de charge de travail parmi les aidants informels. En ophtalmologie, Xue et al.9 ont proposé un système de réponse à des questions pour le diagnostic du glaucome, alors que Tan et al.3 et Wu et al.10 ont rapporté l'utilisation de modèles linguistiques de grande taille dans des systèmes diagnostiques hybrides et des consultations en médecine traditionnelle chinoise.
L'utilisation des grands modèles linguistiques ne se limite pas aux applications cliniques directes. Zhang et al.11 ont étudié leur utilisation pour la reconnaissance des émotions dans des contextes de santé mentale, tandis que Sarzaeim et al.12 ont exploré des systèmes de police intelligents qui pourraient également contribuer à des analyses liées à la santé publique. Ces études illustrent l'applicabilité étendue des approches fondées sur les grands modèles linguistiques dans divers domaines liés aux soins de santé.
Bien que les modèles linguistiques de grande taille aient élargi les possibilités d'applications dans le domaine de la santé, leur intégration dans les environnements cliniques reste associée à d'importants défis techniques, organisationnels et réglementaires. Le déploiement pratique nécessite une infrastructure informatique adaptée, une gouvernance efficace des données et la conformité aux cadres réglementaires tels que le Règlement général sur la protection des données (RGPD) et la Loi brésilienne sur la protection des données personnelles (LGPD). Ces cadres établissent des exigences pour le traitement sécurisé et éthique des informations de santé sensibles, tout en abordant des questions liées à la confidentialité, à la fiabilité et aux biais algorithmiques dans les systèmes de santé assistés par l'intelligence artificielle13,14 .
L'interopérabilité entre des sources de données de santé hétérogènes, notamment les dossiers de santé électroniques (EHR), les systèmes d'imagerie médicale et les dispositifs de l'internet des objets (IoT), continue de représenter un défi technique majeur pour le déploiement de solutions de santé assistées par l'intelligence artificielle. Dans ce contexte, des cadres normalisés d'interopérabilité tels que HL7 FHIR offrent un mécanisme structuré pour échanger des informations cliniques entre différents systèmes, tout en préservant la cohérence sémantique et en permettant une intégration évolutive.
Ce travail présente une plateforme web interopérable qui intègre des modèles linguistiques volumineux avec des normes d'interopérabilité en santé afin de soutenir l'analyse de données médicales dans des environnements cliniques hétérogènes. L'architecture proposée combine une intégration des données fondée sur HL7 FHIR avec une génération améliorée par récupération (RAG) et un cadre de traitement multi-agents pour fournir une analyse assistée par l'intelligence artificielle adaptée au contexte, tout en restant conforme aux exigences applicables en matière de protection des données, notamment la loi brésilienne générale sur la protection des données (LGPD).
Ce protocole décrit une architecture interopérable pour intégrer des données cliniques hétérogènes à l'aide de normes établies en matière d'interopérabilité des soins de santé. Il détaille également la mise en œuvre d'un pipeline de traitement multi-agent basé sur des grands et petits modèles linguistiques (LLMs et SLMs), ainsi qu'un cadre d'évaluation combinant des métriques quantitatives et des analyses qualitatives afin d'évaluer le comportement de la plateforme proposée.
Accès restreint. Veuillez vous connecter ou commencer un essai pour afficher ce contenu.
Protocole
Cette étude n'a pas impliqué le recrutement de participants humains, l'accès à des dossiers de patients identifiables ou des expériences impliquant des animaux. Le protocole a été élaboré et évalué exclusivement à l'aide de jeux de données entièrement anonymisés et accessibles au public, dans le cadre d'une validation méthodologique. Aucune information personnelle relative à la santé n'a été consultée ou traitée. Par conséquent, aucune approbation par un comité d'éthique de la recherche ou un comité d'examen institutionnel (IRB) n'était requise. Le protocole a été conçu conformément aux principes applicables en matière de protection des données, notamment à la loi brésilienne générale sur la protection des données (LGPD), afin d'appuyer des applications futures impliquant des données cliniques.
Sélection et prétraitement des jeux de données
Le protocole proposé a été évalué à l'aide de jeux de données cliniques entièrement anonymisés et accessibles publiquement, comprenant des dossiers de santé électroniques (DSE) structurés, des données de réponse à des questions cliniques et des jeux de données d'imagerie médicale destinés à la validation méthodologique. Avant leur intégration dans la plateforme, les jeux de données ont subi des procédures standardisées de prétraitement, incluant la normalisation des données, la suppression des enregistrements incohérents ou incomplets, le mappage vers des ressources HL7 FHIR, le nettoyage du texte, la segmentation en fragments destinés à la récupération et la génération d'incorporations pour l'indexation vectorielle. Ces étapes de prétraitement ont assuré une cohérence sémantique entre les sources de données hétérogènes, facilitant l'interopérabilité et permettant la reproductibilité du flux de travail proposé, tout en respectant les principes applicables en matière de confidentialité des données.
Les ensembles de données ont été obtenus à partir de référentiels de référence accessibles au public, couramment utilisés dans la recherche en intelligence artificielle et en santé numérique. Ils ont été sélectionnés pour représenter des informations cliniques hétérogènes, notamment des dossiers de santé électroniques (EHR) structurés, des récits cliniques non structurés, des tâches de réponse à des questions cliniques et des métadonnées d'imagerie médicale. Plutôt que d'évaluer une cohorte clinique spécifique, le protocole se concentre sur la démonstration d'un flux de travail de mise en œuvre reproductible, adaptable à différents ensembles de données de soins de santé. La diversité de ces ensembles de données de référence permet de valider le pipeline d'interopérabilité, la génération assistée par récupération (RAG) et le cadre de raisonnement multi-agents à travers plusieurs modalités de données cliniques.
Configuration de l'environnement expérimental
L'environnement expérimental a été configuré afin d'évaluer la plateforme interopérable dans des conditions contrôlées et reproductibles. L'architecture comprend des modules d'ingestion de données, des couches d'interopérabilité, des modèles linguistiques de grande taille (LLMs) et des composants d'évaluation organisés en un pipeline de traitement unique dédié à l'analyse de données médicales. Figure 1 illustre l'ensemble du flux de travail, de l'ingestion des données cliniques jusqu'à la génération des résultats diagnostiques.
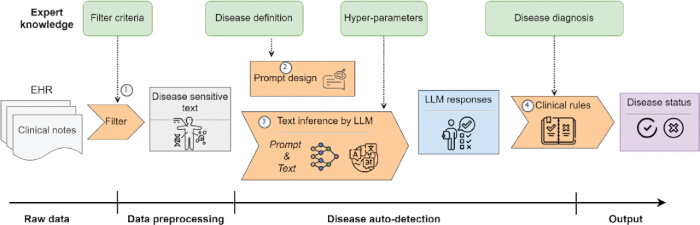
Figure 1 : Flux général du système illustrant le pipeline de traitement des données cliniques brutes jusqu'à la sortie du statut de la maladie. Le processus débute par l'ingestion des Dossiers de Santé Électroniques (DSE), suivie d'un filtrage et d'un prétraitement des données afin d'extraire les informations sensibles aux maladies. Une étape de conception de prompt structuré intègre les connaissances d'experts, les définitions de maladies et les hyperparamètres, permettant une interaction efficace avec le modèle de langage volumineux (LLM). Le LLM effectue une inférence textuelle pour produire des réponses adaptées au contexte, qui sont ensuite évaluées à l'aide de règles cliniques afin de déterminer le statut final de la maladie. Ce flux met en évidence l'intégration du prétraitement des données, de la formulation orientée par les connaissances et de l'inférence basée sur l'IA pour soutenir la prise de décision clinique. Veuillez cliquer ici pour visualiser une version agrandie de cette figure.
Architecture d'interopérabilité des soins de santé
L'infrastructure backend adopte une architecture modulaire basée sur des API RESTful afin de permettre la communication entre les composants de la plateforme (Figure 2). Cette architecture prend en charge des informations cliniques hétérogènes, notamment les dossiers de soins électroniques (DSE) structurés, les notes des médecins et les métadonnées issues des systèmes d'imagerie médicale. Étant donné que ces données proviennent de multiples sources et formats, l'interopérabilité est assurée par des modèles de données normalisés, en particulier le cadre Fast Healthcare Interoperability Resources (FHIR).15,16,17..L'adoption de FHIR permet un échange d'informations structuré tout en préservant l'évolutivité et la flexibilité dans les environnements de santé distribués. Des mécanismes de communication basés sur HL7 ont également été intégrés afin de faciliter l'interopérabilité avec les systèmes cliniques existants, encore largement utilisés dans les établissements de santé.16,17.
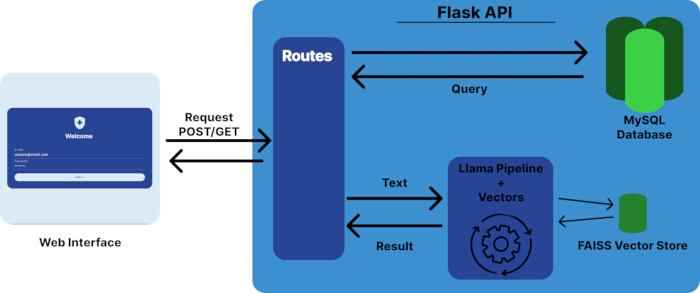
Figure 2 : Architecture système de la plateforme interopérable proposée. L'interface web communique avec le serveur principal via une API Flask en utilisant des requêtes HTTP POST/GET. L'API gère le routage, le traitement des requêtes et l'interaction avec des sources de données structurées et non structurées. Une base de données MySQL stocke les données cliniques structurées, tandis qu'un stockage vectoriel basé sur FAISS permet la recherche de similarité pour les opérations de récupération. Le pipeline basé sur LLaMA traite les entrées textuelles et génère des réponses à l'aide de représentations vectorielles, permettant ainsi une génération assistée par récupération (Retrieval-Augmented Generation, RAG). L'architecture illustre l'intégration des services web, de la gestion de bases de données, de la récupération vectorielle et de l'inférence de grands modèles linguistiques au sein d'un système unifié. Veuillez cliquer ici pour afficher une version agrandie de cette figure.
Configuration du flux de travail multi-agents
L'architecture multi-agents est organisée en agents fonctionnels spécialisés, chacun étant responsable d'une étape distincte du flux de travail. Un agent de prétraitement effectue la normalisation des données et le mappage FHIR, suivi par un agent de récupération chargé de la recherche sémantique dans la base de données vectorielle. Un agent de raisonnement intègre le contexte récupéré avec le LLM afin de générer des réponses, tandis qu'un agent de validation vérifie la cohérence et le formatage des sorties avant que la réponse finale ne soit retournée. La coordination des agents suit une stratégie d'orchestration séquentielle dans laquelle la sortie de chaque agent sert d'entrée pour l'étape suivante, garantissant ainsi une implémentation reproductible et modulaire.
Intégration des données cliniques
La couche d'intégration des données agrège les informations provenant de plusieurs sources cliniques et les prépare pour un traitement ultérieur. Le prétraitement comprend la normalisation des données, la tokenisation et l'alignement des entités afin d'améliorer la cohérence sémantique entre les ensembles de données hétérogènes. Étant donné que les informations cliniques varient en structure et en qualité, ces opérations permettent de réduire le bruit et de faciliter l'interaction avec les modèles d'intelligence artificielle. Des stratégies de mappage structuré ont également été appliquées pour harmoniser les différents formats de données et assurer la compatibilité avec le pipeline de traitement, comme illustré dans Figure 315,16,17.
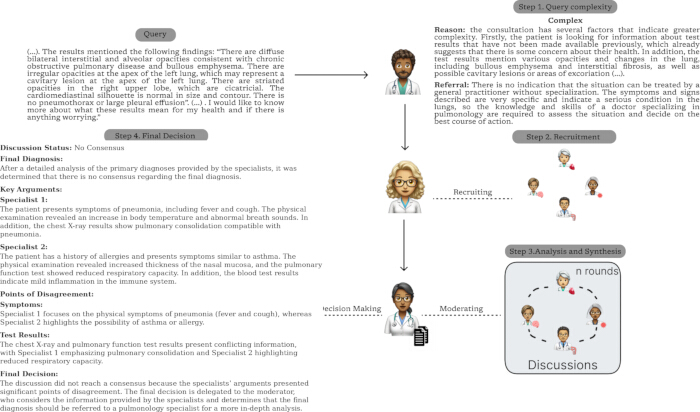
Figure 3 : Exemple détaillé du processus de raisonnement clinique multi-agents. Cette figure illustre comment une requête clinique est analysée à travers plusieurs étapes, notamment l'évaluation de la complexité, le recrutement de spécialistes, une discussion collaborative et la prise finale de décision. Ce processus démontre la capacité du système à adapter dynamiquement les stratégies de raisonnement en fonction de la complexité de la requête, améliorant ainsi l'efficacité et la précision diagnostique dans les scénarios d'aide à la décision clinique. Veuillez cliquer ici pour visualiser une version agrandie de cette figure.
Configurer le pipeline de génération augmentée par récupération
La génération augmentée par récupération (RAG) est intégrée afin de fournir une analyse tenant compte du contexte, en combinant la recherche d'information aux capacités génératives des grands modèles linguistiques. Les requêtes des utilisateurs sont converties en représentations vectorielles à l'aide de modèles d'incorporation et comparées à la base de données vectorielle par une recherche sémantique de similarité afin de récupérer les passages contextuels les plus pertinents. Les documents récupérés sont ensuite combinés à la requête initiale avant l'inférence par le modèle linguistique (LLM). Cette stratégie permet d'apporter des informations contextuelles durant la génération de la réponse et s'associe à une meilleure cohérence factuelle ainsi qu'à une réduction des hallucinations dans les applications intensives en connaissances, notamment dans le domaine de la santé18,19. Figure 1 et Figure 3 illustrent respectivement le flux de travail global de récupération et le processus de raisonnement correspondant.
Pour chaque demande d'utilisateur, l'invite finale est construite dynamiquement en combinant la requête initiale avec les passages contextuels les plus pertinents récupérés à partir de la base de données vectorielle. Les informations récupérées sont intégrées comme preuves contextuelles avant l'inférence, permettant ainsi au modèle linguistique de générer des réponses ancrées dans les connaissances médicales récupérées, tout en préservant la cohérence sémantique et en réduisant les réponses non étayées.
Ingénierie des prompts et raisonnement multi-agent
Le protocole intègre des stratégies de stimulation structurée afin d'améliorer l'interprétation contextuelle lors de la génération de réponses. Ces techniques de stimulation, combinées à des mécanismes d'inférence avancés, aident à orienter le processus de raisonnement dans des scénarios cliniques complexes et sont conformes aux récentes avancées rapportées dans la littérature20.
L'architecture comprend un cadre multi-agents composé de modules spécialisés qui exécutent des fonctions distinctes dans le pipeline de traitement, notamment la validation des données, le filtrage du contexte, l'aide au raisonnement clinique et la vérification des résultats. L'organisation modulaire permet d'exécuter les tâches de manière séquentielle ou en parallèle, offrant ainsi une flexibilité adaptée à diverses exigences de traitement (Figure 4). La répartition de ces activités entre plusieurs agents réduit la dépendance à un seul modèle de langage et favorise un flux de traitement plus robuste. Cette stratégie architecturale est conforme aux récents développements en intelligence artificielle distribuée et en conception de systèmes intelligents21,22.
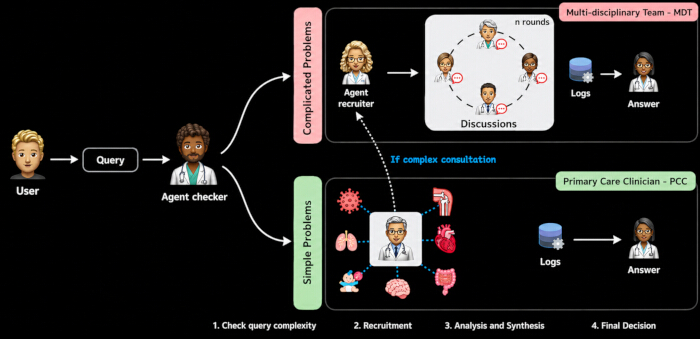
Figure 4 : Cadre décisionnel multi-agents pour le raisonnement clinique. Le processus débute par une requête utilisateur, évaluée par un agent vérificateur chargé d'analyser la complexité de la requête. Dans les cas complexes, le système recrute dynamiquement une équipe multidisciplinaire (MDT) d'agents spécialisés qui mènent des tours de discussion itératifs afin d'analyser le problème et de synthétiser les connaissances avant de produire une décision finale. Pour les cas plus simples, la requête est traitée par un agent de médecin généraliste (PCC), permettant une génération plus rapide de la réponse. Cette architecture adaptative équilibre efficacité et profondeur analytique, améliorant ainsi la qualité des décisions et la scalabilité du système dans les applications de santé. Veuillez cliquer ici pour visualiser une version agrandie de cette figure.
Évaluation des performances
Les performances du système ont été évaluées à l'aide de métriques complémentaires permettant de mesurer à la fois la qualité linguistique et la cohérence sémantique des sorties générées. Le score BLEU a été appliqué pour mesurer la similarité syntaxique fondée sur le recouvrement de n-grammes23, tandis que ROUGE a évalué le rappel et la couverture du contenu, notamment dans les tâches de résumé et d'extraction d'informations24. La similarité sémantique a été évaluée à l'aide de BERTScore, qui utilise des intégrations contextuelles issues de modèles basés sur des transformeurs afin de comparer les textes générés et les textes de référence25. Des analyses supplémentaires ont inclus la perplexité et la similarité cosinus pour examiner respectivement la confiance du modèle et la cohérence sémantique26,27.
Les métriques d'évaluation sélectionnées offrent des perspectives complémentaires sur les performances du système en combinant des analyses lexicales et sémantiques. Cette combinaison est particulièrement pertinente dans les applications de santé, où l'interprétation contextuelle est tout aussi importante que la similarité lexicale. La plateforme a été évaluée dans un environnement informatique contrôlé prenant en charge à la fois le déploiement dans le cloud et en local. L'exécution locale des modèles linguistiques de grande taille (LLM) a été incluse comme option afin de respecter les exigences de confidentialité des données et de réduire la dépendance aux services externes lors du traitement d'informations cliniques sensibles. Cette stratégie de déploiement est compatible avec les cadres de protection des données et peut être adaptée à différents environnements opérationnels4.
Accès restreint. Veuillez vous connecter ou commencer un essai pour afficher ce contenu.
Résultats
Les performances du système ont été évaluées à l'aide de métriques quantitatives complémentaires ainsi qu'une analyse qualitative afin d'examiner à la fois la précision linguistique et la cohérence sémantique des sorties générées. Cette stratégie d'évaluation combine des mesures lexicales et sémantiques pour fournir une caractérisation plus complète du comportement du modèle dans les tâches de génération de langage liées aux soins de santé.
Tableau 1 présente les résultats qua...
Accès restreint. Veuillez vous connecter ou commencer un essai pour afficher ce contenu.
Discussion
L'évaluation présentée dans cette étude représente une validation méthodologique réalisée à l'aide de jeux de données de référence en santé publiquement disponibles et entièrement anonymisés. Aucune validation clinique prospective impliquant des professionnels de santé ou un recrutement de patients n'a été menée, car l'objectif de ce travail est de démontrer un protocole de mise en œuvre reproductible plutôt que l'efficacité clinique.
Les résultats de cette étude suggèrent que la combinaison d...
Accès restreint. Veuillez vous connecter ou commencer un essai pour afficher ce contenu.
Déclarations de divulgation
Les auteurs déclarent qu'ils n'ont aucun intérêt financier concurrent ni aucune relation personnelle susceptible d'avoir influencé le travail rapporté dans ce manuscrit. Des outils d'intelligence artificielle générative (IA) ont été utilisés exclusivement pour aider à la révision linguistique, à la correction grammaticale et à l'amélioration de la lisibilité du manuscrit. L'ensemble du contenu scientifique, la conception de l'étude, la méthodologie, l'analyse des données, l'interprétation des résultats ainsi que les décisions éditoriales ont été élaborés, vérifiés et approuvés par les auteurs, qui assument l'entière responsabilité du contenu de ce manuscrit.
Remerciements
Les auteurs tiennent à remercier le Laboratoire des systèmes embarqués et distribués (LESC), de l'Université fédérale du Ceará (UFC), pour avoir fourni l'environnement de recherche et les discussions techniques qui ont soutenu le développement de ce travail. Les auteurs remercient également les développeurs et mainteneurs des logiciels open source, des normes d'interopérabilité et des ensembles de données publiques utilisés tout au long de cette étude.
Accès restreint. Veuillez vous connecter ou commencer un essai pour afficher ce contenu.
Matériaux
| Nom | Entreprise | Numéro de catalogue | Commentaires |
|---|---|---|---|
| FAISS | Meta Platforms Inc. | Version 1.8.0 | Base de données vectorielle utilisée pour la recherche de similarité dans le pipeline de génération augmentée par récupération (RAG). |
| Norme FHIR | HL7 International | Release 4 (R4) | Norme d'interopérabilité en santé adoptée pour l'échange structuré de données cliniques. |
| Flask | Pallets Projects | Version 3.0.3 | Framework web Python utilisé pour implémenter l'API backend RESTful. |
| Norme HL7 | HL7 International | Version 2.x | Protocole de messagerie hérité utilisé pour l'interopérabilité avec les systèmes d'information hospitaliers. |
| API REST HTTP | Implémentation personnalisée | N/A | Couche de communication RESTful entre l'interface utilisateur, le backend, la base de données et les services d'intelligence artificielle. |
| LangChain | LangChain Inc. | Version 0.3.x | Framework utilisé pour intégrer les grands modèles linguistiques (LLM), l'ingénierie des prompts et les flux de travail de génération augmentée par récupération. |
| LangGraph | LangChain Inc. | Version 0.2.x | Framework utilisé pour orchestrer le flux de travail de raisonnement clinique multi-agents. |
| LLaMA 3.1 8B Instruct | Meta Platforms Inc. | Version 3.1 | Grand modèle linguistique utilisé pour le raisonnement clinique et la génération de langage naturel. |
| MySQL Community Server | Oracle Corporation | Version 8.0 | Base de données relationnelle utilisée pour stocker des données cliniques structurées. |
| Ollama | Ollama Inc. | Version 0.9.x | Moteur d'inférence local utilisé pour exécuter des grands modèles linguistiques tout en préservant la confidentialité des patients. |
| Python | Python Software Foundation | Version 3.11 | Langage de programmation utilisé pour implémenter l'ensemble de la plateforme. |
| PyTorch | Linux Foundation | Version 2.4 | Framework d'apprentissage profond utilisé pour l'inférence des grands modèles linguistiques. |
| Pipeline de génération augmentée par récupération (RAG) | Implémentation personnalisée | N/A | Framework d'intelligence artificielle combinant la récupération sémantique et l'inférence de LLM pour la génération de réponses contextuelles. |
| Sentence Transformers | Hugging Face Inc. | all-MiniLM-L6-v2 | Modèle d'incorporation utilisé pour générer des représentations vectorielles denses destinées à la récupération sémantique de documents. |
| Ubuntu Linux | Canonical Ltd. | Version 24.04 LTS | Système d'exploitation utilisé pour le développement et l'évaluation expérimentale. |
| Visual Studio Code | Microsoft Corporation | Version 1.100 | Environnement de développement intégré utilisé pour l'implémentation et le débogage du logiciel. |
Références
- Chukwu E, Garg L. A systematic review of blockchain in healthcare: frameworks, prototypes, and implementations. IEEE Access. 2020;8:21196-21214. doi:10.1109/ACCESS.2020.2969881.
- Al-Nbhany WANA, Zahary AT, Al-Shargabi AA. Blockchain-IoT healthcare applications and trends: a review. IEEE Access. 2024;12:4178-4212. doi:10.1109/ACCESS.2023.3349187.
- Tan Y, et al. MedChatZH: a Chinese medical large language model. Comput Biol Med. 2024;172:108290.
- OLLAMA TEAM. Ollama: Run Large Language Models locally. Version 0.x. San Francisco: Ollama, 2024.
- Jahan I, Laskar MTR, Peng C, Huang JX. A comprehensive evaluation of large language models on benchmark biomedical text processing tasks. Comput Biol Med. 2024;171:108189. doi:10.1016/j.compbiomed.2024.108189.
- Liu X, Zhou Y, Wang Z, et al. Disease topic modeling of users' inquiry texts: a text mining-based PQDR-LDA model for analyzing the online medical records. IEEE Trans Eng Manag. 2023.
- Taylor N, Kormilitzin A, Lorge I, Nevado-Holgado A, Cipriani A, Joyce DW. Model development for bespoke large language models for digital triage assistance in mental health care. Artif Intell Med. 2024;157:102988.
- Song M, et al. PneumoLLM: a large language vision model for pneumonia diagnosis. Med Image Anal. 2024;97:103248.
- Chien SC, Yen CM, Chang YH, Chen YE, Liu CC, Hsiao YP, et al. Using large language model (LLM) to identify high-burden informal caregivers in long-term care. Comput Methods Programs Biomed. 2024;255:108329. doi:10.1016/j.cmpb.2024.108329.
- Xue X, Zhang D, Sun C, et al. Xiaoqing: a Q&A model for glaucoma based on LLMs. Comput Biol Med. 2024;174:108399.
- Wu D, Nie L, Mumtaz RA, Agarwal K. A LLM-based hybrid-transformer diagnosis system in healthcare. IEEE J Biomed Health Inform. 2024.
- Zhang Y, et al. LLM-enhanced multi-teacher knowledge distillation for modality-incomplete emotion recognition in daily healthcare. IEEE J Biomed Health Inform. 2024.
- Sarzaeim P, Mahmoud QH, Azim A. A framework for LLM-assisted smart policing system. IEEE Access. 2024;12:74915-74929. doi:10.1109/ACCESS.2024.3404862.
- Leme RS, Blank M. Lei Geral de Proteção de Dados e segurança da informação na área da saúde. Cad Ibero-Am Direito Sanit. 2020;9(3):210-224. doi:10.17566/ciads.v9i3.690.
- Zaganelli MV, Binda Filho DL. O sigilo médico e os dados sensíveis na telemedicina à luz da Lei Geral de Proteção de Dados. RECIIS. 2023;17(3):729-740. doi:10.29397/reciis.v17i3.3689.
- Tabari P, Costagliola G, De Rosa M, Boeker M. State-of-the-art Fast Healthcare Interoperability Resources (FHIR)-based data model and structure implementations: systematic scoping review. JMIR Med Inform. 2024.
- Martinez T, et al. HL7 systems and interoperability ecosystems in modern healthcare. IEEE Rev Biomed Eng. 2024.
- Chen L, et al. HL7 integration and semantic interoperability in distributed healthcare networks. IEEE J Biomed Health Inform. 2024.
- Liu W, Li W, Huang W, Gao Y. Security framework for medical data sharing. Telemed E-Health. 2024.
- Basile LJ, Carbonara N, Panniello U, Pellegrino R. How can technological resources improve the quality of healthcare service? IEEE Trans Eng Manag. 2024;71:5771-5781. doi:10.1109/TEM.2022.3192405.
- Singh A, et al. Prompt engineering in large language models: a survey using SWOT analysis [preprint]. arXiv. 2024
- Chen L, Chen Y, Liang W, Li X, Li KC, Wang J, Xiong N. MASS: a multiattribute sketch secure data sharing scheme for IoT wearable medical devices based on blockchain. IEEE Internet Things J. 2025;12(2):1990-2001. doi:10.1109/JIOT.2024.3468733.
- Autoridade Nacional de Proteção de Dados (BR). Diretrizes para agentes de tratamento de pequeno porte. Brasília (DF): ANPD; 2021.
- Patel R, Kim H. Interoperability in EHR. IEEE Transactions on Biomedical Engineering, v. 70, n. 8, p. 2341-2354, ago. 2023. DOI: 10.1109/TBME.2023.3241567.
- Zhang T, Kishore V, Wu F, Weinberger KQ, Artzi Y. BERTScore: evaluating text generation with BERT. In: International Conference on Learning Representations (ICLR); 2020.
- Chen X, Lu X, Li Q, Li D, Zhu F. Integration of LLM and Human-AI Coordination for Power Dispatching With Connected Electric Vehicles Under SAGVNs. IEEE Trans Veh Technol. 2025;74(2):1992-2002. doi:10.1109/TVT.2024.3434969
- Zhou S, Chen C, Gu HH. Testing and evaluating SNOMED CT web browsers' textual search feature. In: Proceedings of the IEEE International Conference on Bioinformatics and Biomedicine (BIBM); 2019.
- McPeak G, Sautmann A, George O, Hallal A, Simal EA, Schwartz AL, Abaluck J, Ravi N, Pless R. An LLM's medical testing recommendations in a Nigerian clinic: potential and limits of prompt engineering for clinical decision support. In: Proceedings of the 2024 IEEE 12th International Conference on Healthcare Informatics (ICHI); 2024.
- LLAMA TEAM, AI @ META. The Llama 3 Herd of Models. arXiv preprint arXiv:2407.21783, 2024. Disponível em: https://arxiv.org/abs/2407.21783.
- Conselho Nacional de Saúde (BR). Resolução nº 466, de 12 de dezembro de 2012. Aprova as diretrizes e normas regulamentadoras de pesquisas envolvendo seres humanos. Brasília (DF): Ministério da Saúde; 2012.
- Singhal K, Azizi S, Tu T, et al. Large language models encode clinical knowledge. Nature. 2023;620:172-180. doi:10.1038/s41586-023-06291-2.
- Sahoo P, et al. A systematic survey of prompt engineering in large language models [preprint]. arXiv. 2024. Available from: https://arxiv.org/abs/2402.07927
- Yan Y, Hou Y, Xiao Y, Zhang R, Wang Q. KNOWNET: guided health information seeking from LLMs via knowledge graph integration. IEEE Trans Vis Comput Graph. 2024.
Accès restreint. Veuillez vous connecter ou commencer un essai pour afficher ce contenu.