Ici, nous décrivons un flux de travail d'apprentissage automatique interprétable pour trois tâches spécifiques à des résultats dans la cholangite aiguë : la prédiction de la septicémie en service de médecine générale, la prédiction de la mortalité intra-hospitalière en service de médecine générale et la prédiction de la mortalité à 28 jours en unité de soins intensifs. Le flux de travail intègre la sélection de caractéristiques, la comparaison de modèles, l'interprétation par SHAP, des analyses de régression et la construction de nomogrammes.
Article de recherche
Modèle d'apprentissage automatique pour l'analyse des facteurs de risque et modèle de prédiction de la mortalité de la cholangite aiguë compliquée de sepsis
* These authors contributed equally
Dans cet article
Résumé
Résumé
Cette étude a examiné les facteurs associés au sepsis dans la cholangite aiguë et a élaboré des modèles spécifiques aux résultats pour le sepsis et la mortalité. Nous avons analysé rétrospectivement les données de 1 999 patients provenant de deux centres, dont 1 561 admis dans des services généraux et 438 en réanimation. Pour chaque tâche de prédiction, les données ont été divisées en cohortes d'apprentissage et de validation interne selon un ratio de 7:3. Des modèles de régression logistique (LR), de forêt aléatoire (RF), de machine à vecteurs de support (SVM) et de boosting extrême de gradient (XGBoost) ont été développés et comparés, et les explications additives de Shapley (SHAP) ont été utilisées pour l'interprétation. Un sepsis a été observé chez 544 patients des services généraux (34,85 %) et chez 299 patients de réanimation (68,3 %). La régression logistique a obtenu la plus haute AUC de validation interne pour la prédiction du sepsis en service général (0,826 ; AUC d'apprentissage, 0,893). Le sepsis était associé à une survie intra-hospitalière moindre dans la cohorte des services généraux et à une survie à 28 jours moindre dans la cohorte de réanimation. Le nomogramme de mortalité à 28 jours en réanimation intégrait le score de physiologie aiguë III (APS III), l'hémoglobine (Hb), l'alanine aminotransférase (ALT), le lactate (Lac), la bilirubine totale (TBil), l'albumine, le statut de sepsis et l'atteinte rénale, et a donné une AUC de 0,840. Le nomogramme de mortalité intra-hospitalière en service général intégrait l'albumine, l'atteinte rénale, le statut de sepsis, l'azote uréique sanguin (BUN), la TBil et l'aspartate aminotransférase (AST), donnant une AUC de 0,904. Les modèles validés en interne ont montré une capacité discriminatoire préliminaire pour la stratification du risque spécifique aux résultats. Une validation externe prospective multicentrique est nécessaire avant toute mise en œuvre clinique.
Introduction
La cholangite aiguë est une infection potentiellement mortelle du système biliaire provoquée par une obstruction biliaire et une prolifération bactérienne1. Décrite pour la première fois par Charcot en 1877 sous le nom de « fièvre hépatique », sa présentation classique correspond à la triade de Charcot : fièvre, douleur abdominale dans le quadrant supérieur droit et ictère. Une forme grave de la maladie peut se manifester par le pentade de Reynolds, qui ajoute à ces symptômes une hypotension et une altération de l'état de conscience2. Les causes fréquentes incluent la lithiase du cholédoque, les sténoses biliaires, les tumeurs biliaires et les obstructions parasitaires ; la lithiase du cholédoque représente environ la moitié des cas1. L'obstruction biliaire entraîne une stase biliaire et une augmentation de la pression intraductale, ce qui peut compromettre la barrière épithéliale biliaire, favoriser la translocation bactérienne et déclencher une inflammation3. La mortalité globale varie approximativement entre 2,7 % et 10 %, mais peut atteindre 50 % en cas de forme sévère4. Dans la cholangite aiguë sévère, des bactéries et des endotoxines peuvent pénétrer dans la circulation, provoquant une inflammation systémique et un état de sepsie.
Le sepsis est caractérisé par un dysfonctionnement organique menaçant le pronostic vital, causé par une réponse hôte désordonnée à une infection, et peut évoluer vers une défaillance multiviscérale5. Dans le monde, environ 48,9 millions de cas de sepsis sont recensés chaque année, et les décès liés au sepsis représentent environ 19,7 % de l'ensemble des décès6. Malgré les progrès réalisés en matière de soins d'urgence et de soins intensifs, la mortalité liée au sepsis reste importante7. Les Tokyo Guidelines 2018 (TG18) sont largement utilisés pour diagnostiquer et évaluer la gravité de la cholangite aiguë2. Toutefois, la détection d'un sepsis concomitant et la prédiction des issues défavorables restent difficiles14. Des approches améliorées de stratification du risque pourraient donc aider à identifier les patients nécessitant une évaluation plus approfondie.
Des études antérieures ont identifié les indices hématologiques ainsi que les paramètres de la fonction hépatique et rénale comme des marqueurs potentiels de la gravité et du pronostic de la cholangite aiguë8. Le score d'évaluation de l'insuffisance organique séquentielle (SOFA) est couramment utilisé pour quantifier le dysfonctionnement organique et possède une valeur pronostique dans le sepsis9. Le score de physiologie aiguë III (APS III), composante de la physiologie aiguë d'APACHE III, résume les anomalies physiologiques et contribue à l'évaluation du risque de mortalité chez les patients en soins intensifs10. Des comorbidités telles que les maladies cardiovasculaires, le diabète et les affections hépatiques chroniques peuvent augmenter davantage le risque de résultats indésirables11. Néanmoins, les données restent limitées concernant les modèles prédictifs spécifiques aux résultats pour le sepsis et la mortalité dans la cholangite aiguë.
L’apprentissage automatique est de plus en plus appliqué aux données cliniques structurées afin d’identifier des motifs complexes et d’aider à l’estimation des risques12,13. En conséquence, nous avons développé et validé en interne des modèles d’apprentissage automatique interprétables pour trois tâches distinctes : la prédiction de la septicémie en service de soins généraux, la prédiction du décès à l’hôpital en service de soins généraux, et la prédiction du décès à 28 jours en unité de soins intensifs. Nous avons comparé la régression logistique (LR), les forêts aléatoires (RF), les machines à vecteurs de support (SVM) et XGBoost, et utilisé la méthode SHAP pour quantifier l’importance des variables et expliquer les prédictions individuelles. L’objectif était d’évaluer les performances prédictives spécifiques à chaque issue ainsi que l’interprétabilité des modèles, et non d’établir un système d’aide à la décision clinique. Une validation externe prospective et multicentrique est nécessaire avant que ces modèles puissent être envisagés pour un usage clinique courant.
Protocole
La présente étude a été réalisée conformément aux principes de la Déclaration d'Helsinki. L'approbation a été accordée par le Comité d'éthique de l'Hôpital populaire du comté de Binhai (n° d'approbation : 2024-BHKYLL-055).
Méthodologie
Patients
Nous avons inclus rétrospectivement 1 999 adultes diagnostiqués avec une cholangite aiguë dans deux centres entre janvier 2020 et août 2024 : l'Hôpital populaire du comté de Binhai et le Deuxième hôpital populaire de Huai'an. Parmi ces patients, 1 561 ont été pris en charge dans des services généraux, et 438 ont été admis en unité de soins intensifs (USI). Le protocole de l'étude a été approuvé par le Comité d'éthique de l'Hôpital populaire du comté de Binhai (n° d'approbation 2024-BHKYLL-055). Un consentement éclairé écrit a été obtenu de chaque participant ou de son représentant légalement autorisé.
Les patients étaient éligibles s'ils (1) avaient un diagnostic de cholangite aiguë confirmé par un médecin, (2) étaient âgés de 18 ans ou plus, et (3) disposaient de dossiers médicaux complets et de données de suivi pour l'issue pertinente.
Les patients ont été exclus s'ils présentaient (1) une malignité concomitante susceptible d'affecter considérablement la survie, (2) une incapacité à donner leur consentement éclairé, ou (3) une perte de vue au cours du suivi.
Collecte de données cliniques et suivi
Les caractéristiques cliniques et les données de laboratoire ont été extraites rétrospectivement des dossiers médicaux de l'hôpital populaire du comté de Binhai et du deuxième hôpital populaire de Huai'an. Les variables démographiques et relatives aux antécédents médicaux comprenaient le sexe, l'âge, les maladies cardiovasculaires, le diabète, les hépatites, la cirrhose, l'hyperlipidémie et les accidents vasculaires cérébraux. Les premières mesures de laboratoire disponibles après l'admission en service ordinaire ou en réanimation comprenaient le nombre de globules blancs (WBC), le nombre de plaquettes (PLT), l'hémoglobine (Hb), l'albumine, le sodium, le potassium, le chlore, le lactate (Lac), la bilirubine totale (TBil), l'alanine aminotransférase (ALT), l'aspartate aminotransférase (AST), la créatinine (CR) et l'azote uréique sanguin (BUN). Les interventions enregistrées comprenaient la mise en place d'un stent biliaire, la cholangiopancréatographie rétrograde endoscopique (CPRE) et le drainage percutané. Les indicateurs de gravité de la maladie comprenaient le score SOFA, l'APS III et la nécessité d'une ventilation mécanique. Les prélèvements sanguins ont été traités selon des procédures automatisées standardisées en laboratoire. Les patients sortis vivants ont été suivis lors de consultations externes ou par contact téléphonique lorsque le suivi était nécessaire. Le statut de sepsie a été évalué tout au long de l'hospitalisation selon les critères de Sepsie-3 ; le groupe sepsie comprenait donc les patients présentant une sepsie à l'admission ainsi que ceux qui ont développé une sepsie ultérieurement. Étant donné que l'heure exacte de début de la sepsie n'était pas disponible et que la durée d'hospitalisation a été conservée dans le modèle final de sepsie en service ordinaire, un repère prospectif uniforme au moment de l'admission ne pouvait pas être établi pour ce modèle. Il doit donc être interprété comme un modèle rétrospectif de stratification du risque durant l'hospitalisation.
Résultat
L'étude a évalué trois tâches de prédiction connexes mais distinctes. Le critère principal était le statut de sepsie durant l'hospitalisation chez des patients de service général souffrant de cholangite aiguë, défini selon les critères de Sepsis-3. Les critères secondaires étaient la mortalité intra-hospitalière pour toutes causes dans la cohorte de service général, définie comme un décès avant la sortie, et la mortalité à 28 jours pour toutes causes dans la cohorte de réanimation, définie comme un décès survenant dans les 28 jours suivant l'admission en soins intensifs.
Analyse statistique
La distribution de chaque variable continue a été évaluée à l'aide du test de Shapiro-Wilk. Les variables normalement distribuées ont été présentées comme moyenne ± écart-type et comparées à l'aide du test t de Student pour échantillons indépendants ; le test t de Welch a été utilisé lorsque l'hypothèse d'homogénéité des variances n'était pas satisfaite. Les variables non normalement distribuées ont été présentées sous forme de médiane et d'intervalle interquartile (IIQ) et comparées à l'aide du test de Wilcoxon à somme de rangs. Les variables catégorielles ont été présentées en effectifs et pourcentages et comparées à l'aide du test du chi-deux ou du test exact de Fisher, selon le cas. Tous les tests étaient bilatéraux, et une valeur de P < 0,05 a été considérée comme statistiquement significative.
Les patients ont été stratifiés selon la présence ou l'absence de sepsie. Dans le groupe des patients hospitalisés en service général, une régression logistique multivariée a été utilisée pour identifier les facteurs associés à la sepsie ; les résultats sont exprimés sous forme de rapports de cotes (OR) avec des intervalles de confiance à 95 % (IC 95 %). Des courbes de Kaplan-Meier et des tests du log-rank ont été utilisés pour comparer la survie intra-hospitalière dans le groupe des patients en service général et la survie à 28 jours dans le groupe des patients en unité de soins intensifs (USI) entre les patients présentant ou non une sepsie. Des modèles de Cox de risques proportionnels ont été ajustés séparément pour les deux groupes, et les résultats sont exprimés sous forme de rapports de risques (HR) avec des intervalles de confiance à 95 % (IC 95 %).
Quatre modèles de Cox progressivement ajustés ont été construits. Le modèle 1 n’était pas ajusté. Le modèle 2 était ajusté sur l’âge et le sexe. Le modèle 3 était en outre ajusté sur l’hypertension, le diabète, l’insuffisance cardiaque, l’AVC et les lésions rénales. Dans la cohorte des patients hospitalisés en service général, le modèle 4 a été davantage ajusté sur les GB, l’Hb, les PLT, l’albumine, la CR, l’urée, l’AST, l’ALT, le sodium, le potassium, le chlore et le lactate. Dans la cohorte de soins intensifs, le modèle 4 incluait en outre les scores APS III et SOFA, car ces indices de gravité n’étaient disponibles que pour les patients en réanimation.
Pour chaque tâche de prédiction, une graine aléatoire fixe de 500 a été utilisée pour diviser le jeu de données complet correspondant en cohortes d'entraînement et de validation interne selon un ratio de 7:3. Toutes les procédures de sélection de caractéristiques ont été effectuées exclusivement dans la cohorte d'entraînement ; la cohorte de validation interne n'a pas été utilisée pour la sélection des prédicteurs. Au sein de la cohorte d'entraînement, une régression LASSO avec validation croisée en 10 parties et l'algorithme Boruta ont été utilisés pour identifier les prédicteurs candidats. Pour le LASSO, les prédicteurs ayant des coefficients non nuls à lambda.min ont été conservés. Boruta a été exécuté indépendamment jusqu'à 5 000 itérations. Les prédicteurs candidats obtenus ont été utilisés de manière cohérente pour développer quatre modèles pour chaque tâche : régression logistique (LR), forêts aléatoires (RF), machines à vecteurs de support (SVM) et XGBoost. Les variables cliniques binaires ont été codées comme 0 ou 1. Aucune normalisation ou transformation manuelle n'a été appliquée avant l'ajustement des modèles LR, RF ou XGBoost. La mise à l'échelle pour le LASSO et le SVM a suivi les paramètres par défaut des implémentations logicielles respectives, et les paramètres de prétraitement dérivés de la cohorte d'entraînement ont été appliqués sans modification à la cohorte de validation interne. Aucun suréchantillonnage, sous-échantillonnage, technique de suréchantillonnage synthétique pour les classes minoritaires (SMOTE) ou pondération manuelle des classes n'a été utilisée. Le modèle le plus performant a été défini comme celui présentant la meilleure performance globale sur la validation interne parmi les quatre implémentations prédéfinies, plutôt qu'une version entièrement optimisée de chaque algorithme. Les modèles ajustés sur la cohorte d'entraînement ont ensuite été évalués sur la cohorte de validation interne. Le flux de travail complet est illustré dans la Figure supplémentaire 1, et les détails d'implémentation sont fournis dans le Tableau supplémentaire 1.
Les performances du modèle ont été évaluées à l'aide de la surface sous la courbe caractéristique de fonctionnement du récepteur (AUC), de la sensibilité, de la spécificité, du rappel, du score F1 et de l'exactitude. L'AUC résume la discrimination à tous les seuils de classification possibles, où 0,5 indique une absence de discrimination et 1,0 une discrimination parfaite. Au seuil sélectionné, les vrais positifs (TP) et les vrais négatifs (TN) correspondaient aux cas correctement classés comme positifs et négatifs, tandis que les faux positifs (FP) et les faux négatifs (FN) correspondaient aux cas mal classés. La sensibilité, équivalente au rappel en classification binaire, a été calculée selon TP/(TP + FN) ; la spécificité selon TN/(TN + FP) ; la précision selon TP/(TP + FP) ; le score F1 selon 2 × précision × rappel/(précision + rappel) ; et l'exactitude selon (TP + TN)/(TP + TN + FP + FN). Les classes positives étaient le sepsis (codé comme 1) pour le modèle de prédiction du sepsis en service général, le décès à l'hôpital (codé comme 1) pour le modèle de mortalité intrahospitalière en service général, et le décès dans les 28 jours (codé comme 1) pour le modèle de mortalité à 28 jours en réanimation. Les classes négatives correspondantes étaient l'absence de sepsis, la sortie vivant de l'hôpital et la survie à 28 jours (toutes codées comme 0), respectivement.
Quatre algorithmes d'apprentissage automatique supervisés ont été sélectionnés pour représenter des stratégies complémentaires applicables aux données cliniques structurées. La régression logistique (LR) a servi de modèle de référence interprétable pour les associations linéaires additives. La forêt aléatoire (RF) représentait un modèle ensembliste fondé sur le bagging, capable de modéliser des relations non linéaires et des interactions tout en réduisant la variance. La machine à vecteurs de support (SVM) représentait un classificateur basé sur la marge, apte à prendre en compte des frontières de décision non linéaires dans des jeux de données de taille modérée. XGBoost représentait un algorithme de boosting régularisé, capable de capturer des interactions d'ordre supérieur et des motifs non linéaires. Tous les algorithmes ont utilisé le même ensemble de prédicteurs candidats et ont été évalués sur les mêmes cohortes d'apprentissage et de validation interne pour chaque tâche de prédiction.
Une analyse SHAP a été réalisée pour le modèle offrant les meilleures performances pour chaque résultat afin de quantifier l'importance globale des caractéristiques et d'expliquer les prédictions individuelles. Le développement du nomogramme a suivi des procédures spécifiques à chaque résultat. Pour le résultat concernant le sepsis en service général, les prédicteurs candidats ont été intégrés dans un modèle de régression logistique multivariée, et les variables qui sont restées statistiquement significatives avec une valeur P < 0,05 ont été incluses dans le nomogramme final. Pour les deux résultats relatifs à la mortalité, l'inclusion des prédicteurs s'est basée sur les résultats globaux de l'importance des caractéristiques selon SHAP pour les modèles correspondants les plus performants, sans élimination supplémentaire fondée sur la valeur P.
Lors de l'assemblage rétrospectif de la base de données, les dossiers manquants de données cliniques, de laboratoire ou relatives au pronostic, nécessaires à l'analyse en question, ont été exclus avant leur intégration dans le jeu de données analytique final. Un journal détaillé de criblage préalable n'a pas été conservé ; par conséquent, le nombre de dossiers exclus en raison de données manquantes et les profils initiaux de manquants par variable ne pouvaient pas être reconstitués. La cohorte finale de patients hospitalisés en service général (n = 1 561) et la cohorte de patients de réanimation (n = 438) ne présentaient aucune valeur manquante pour les variables utilisées dans les analyses correspondantes (0 % de valeurs manquantes), et aucune imputation statistique n'a été effectuée. Les 1 561 patients du service général ont tous été inclus dans les analyses concernant le sepsis et le décès en milieu hospitalier, et les 438 patients de réanimation ont tous été inclus dans l'analyse de la mortalité à 28 jours. Le taux de complétude par variable dans les jeux de données finalisés est indiqué dans le Tableau supplémentaire 2.
Les analyses par apprentissage automatique ont été réalisées à l'aide d'une plateforme d'analyse par apprentissage automatique. Les analyses statistiques classiques ont été effectuées à l'aide d'un environnement open source de calcul statistique et d'un logiciel statistique. Tous les tests statistiques étaient bilatéraux, et une valeur de P < 0,05 était considérée comme statistiquement significative.
Résultats
Caractéristiques de base des cohortes d'étude
L'étude comprenait 1 999 patients hospitalisés pour une cholangite aiguë : 1 561 dans le groupe de patients en unité de soins générale et 438 dans le groupe de patients en unité de soins intensifs (USI). Dans le groupe de soins générale, 544 patients ont développé une septicémie ou en présentaient déjà une, contre 1 017 qui n'en avaient pas ; dans le groupe USI, 299 patients présentaient une septicémie, contre 139 qui n'en présentaient pas. Les caractéristiques de base stratifiées selon le statut de septicémie sont présentées dans le Tableau 1. Dans le groupe de soins générale, les patients atteints de septicémie étaient plus âgés et présentaient des taux de potassium, d'AST, de CR et d'urée plus élevés que les patients sans septicémie (tous les P < 0,05), tandis que les taux d'Hb, de PLT et d'albumine étaient plus faibles (tous les P < 0,05). Le diabète, l'insuffisance cardiaque, l'hyperlipidémie, les lésions rénales et une durée d'hospitalisation plus longue étaient plus fréquents ou plus élevés chez les patients atteints de septicémie (tous les P < 0,05) ; les accidents vasculaires cérébraux, l'hypertension et les hépatites ne différaient pas de manière significative entre les groupes. Dans le groupe USI, les patients atteints de septicémie présentaient des taux de potassium, de bilirubine totale (TBil), d'AST, de CR et d'urée plus élevés, ainsi qu'un taux d'albumine plus bas que les patients sans septicémie (tous les P < 0,05). Les lésions rénales et une durée de séjour en USI plus longue étaient également associées au statut de septicémie (P < 0,05), tandis que les autres comorbidités évaluées ne différaient pas de manière significative. Les scores SOFA et APS III étaient plus élevés chez les patients en USI atteints de septicémie que chez ceux qui n'en étaient pas atteints (les deux P < 0,05).
Sélection de caractéristiques pour la prédiction de la septicémie en soins généraux
L'ensemble de données des services généraux a été divisé en une cohorte d'entraînement de 1 092 patients et une cohorte de validation interne de 469 patients. Pour le critère de jugement « sepsis », la cohorte d'entraînement comprenait 380 patients atteints de sepsis et 712 sans sepsis, et la cohorte de validation interne comprenait 164 patients atteints de sepsis et 305 sans sepsis. Pour la mortalité intra-hospitalière en service général, la cohorte d'entraînement comprenait 56 décès et 1 036 survivants, et la cohorte de validation interne comprenait 24 décès et 445 survivants. La cohorte d'entraînement en soins intensifs comprenait 306 patients (76 décès dans les 28 jours et 230 survivants), et la cohorte de validation interne comprenait 132 patients (33 décès et 99 survivants à 28 jours). Pour la prédiction de la sepsis en service général, 27 variables ont été initialement prises en compte. Boruta a classé les variables comme importantes confirmées, provisoires ou rejetées (Figure 1A). Onze variables ont été classées comme importantes : albumine, lésion rénale, durée d'hospitalisation, CR, GB, PLT, insuffisance cardiaque, âge et Hb. La régression LASSO avec validation croisée en 10 parties a conservé 19 caractéristiques candidates (Figures 1B,C). Les résultats de la sélection de caractéristiques et la pertinence clinique ont ensuite été examinés conjointement, conduisant à 11 prédicteurs candidats : urée sanguine azotée (BUN), CR, GB, PLT, âge, insuffisance cardiaque, albumine, lésion rénale, durée d'hospitalisation, Hb et cirrhose.
Comparaison des modèles et interprétation SHAP pour la prédiction du sepsis en service général
LR, RF, SVM et XGBoost ont été comparés pour la tâche de prédiction du sepsis en service général à l'aide des mêmes cohortes d'apprentissage et de validation interne (Figure 2). Les AUC de la cohorte d'apprentissage étaient de 0,893 pour LR, 0,853 pour RF, 0,718 pour SVM et 0,767 pour XGBoost ; les AUC correspondantes de validation interne étaient respectivement de 0,826, 0,787, 0,647 et 0,737 (Figure 2A,B). LR a obtenu l'AUC de validation interne la plus élevée et la meilleure performance globale parmi les quatre modèles évalués, et a donc été retenu pour une interprétation approfondie. Les mesures détaillées de performance sont fournies dans le Tableau Supplémentaire 3. Dans la plage de probabilités seuils évaluée, l'analyse de courbe décisionnelle a indiqué un bénéfice net supérieur pour LR (Figure 2D), et le graphique de calibration a montré un bon accord entre les probabilités prédites et observées de sepsis (Figure 2E). Ces résultats reposent sur une validation interne et n'établissent pas la prête-à-l'emploi pour une mise en œuvre clinique courante.
L'analyse SHAP a été utilisée pour interpréter le modèle de régression logistique sélectionné. Figure 2C,F montrent les contributions globales des prédicteurs, classés selon leur influence générale sur les estimations du modèle. Par ordre décroissant d'importance, les prédicteurs étaient l'urée sanguine azotée (BUN), la créatinine (CR), les globules blancs (WBC), les plaquettes (PLT), l'âge, l'insuffisance cardiaque, l'albumine, les lésions rénales, la durée d'hospitalisation, l'hémoglobine (Hb) et la cirrhose. Figure 2G présente un graphique de forces au niveau du patient. Les caractéristiques en rouge augmentaient la probabilité estimée de sepsis, tandis que celles en bleu la diminuaient. Le terme f(x) représente la sortie du modèle pour l'individu par rapport à l'espérance de base.
Construction du nomogramme de sepsie pour les services généraux
Les prédicteurs retenus après la sélection des caractéristiques ont été intégrés dans un modèle de régression logistique multivariée (Tableau 2). Les variables restant significatives avec un P < 0,05 ont été incluses dans le nomogramme final (Figure 3A) : lésion rénale, insuffisance cardiaque, GB, PLT, albumine et durée d'hospitalisation. Le nomogramme a donné une AUC de 0,791 (Figure 3B), et le graphique de calibration a montré un bon accord entre les probabilités de sepsis prédites et observées (Figure 3C).
Association entre la septicémie et les résultats de survie
Des courbes de Kaplan-Meier ont été utilisées pour comparer la survie selon le statut de sepsie (Figure 4). Dans le groupe de soins intensifs, les patients atteints de sepsie avaient une survie à 28 jours moins bonne que ceux sans sepsie (Figure 4A ; P du test de log-rank < 0,001). Dans le groupe des patients des services généraux, les patients atteints de sepsie avaient une survie pendant l'hospitalisation moins bonne que ceux sans sepsie (Figure 4B ; P du test de log-rank < 0,001).
Quatre modèles de risques proportionnels de Cox progressivement ajustés ont été utilisés pour évaluer l'association entre la septicémie et la mortalité (Tableau 3). Dans la cohorte des patients hospitalisés en service général, la septicémie était associée à la mortalité intra-hospitalière dans le modèle non ajusté (Modèle 1 : HR, 4,48 ; IC à 95 %, 2,53-7,95 ; P < 0,001). Cette association persistait après ajustement sur l'âge et le sexe (Modèle 2 : HR, 4,11 ; IC à 95 %, 2,31-7,32 ; P < 0,001), sur les comorbidités supplémentaires (Modèle 3 : HR, 3,51 ; IC à 95 %, 1,94-6,35 ; P < 0,001) et sur les variables biologiques (Modèle 4 : HR, 2,18 ; IC à 95 %, 1,15-4,15 ; P = 0,018). Dans la cohorte de patients en unité de soins intensifs (USI), la septicémie était associée à la mortalité à 28 jours dans le Modèle 1 (HR, 5,94 ; IC à 95 %, 3,00-11,76 ; P < 0,001), le Modèle 2 (HR, 5,89 ; IC à 95 %, 2,98-11,67 ; P < 0,001), le Modèle 3 (HR, 4,81 ; IC à 95 %, 2,41-9,61 ; P < 0,001) et le Modèle 4 (HR, 4,54 ; IC à 95 %, 2,22-9,29 ; P < 0,001). Ces résultats étaient cohérents avec les analyses de Kaplan-Meier.
Sélection des caractéristiques pour les modèles de mortalité
Boruta et LASSO ont été utilisés pour sélectionner les prédicteurs candidats de la mortalité à l'hôpital en service ordinaire et de la mortalité en USI à 28 jours (Figure 5). Pour la mortalité en USI à 28 jours, Boruta a identifié 10 variables importantes, incluant l'APS III, la bilirubine totale (TBil), les plaquettes (PLT), l'ALAT, le statut de sepsis et l'hémoglobine (Hb) (Figure 5A). LASSO avec une validation croisée en 10 parties a conservé 15 caractéristiques candidates (Figures 5B,C). En tenant compte des deux procédures de sélection de caractéristiques et de la pertinence clinique, huit prédicteurs ont été retenus : l'APS III, l'Hb, l'ALAT, le lactate (Lac), la TBil, le statut de sepsis, les lésions rénales et l'albumine. Pour la mortalité à l'hôpital en service ordinaire, six prédicteurs ont été retenus : l'albumine, les lésions rénales, le statut de sepsis, l'urée sanguine azotée (BUN), la TBil et l'ASAT (Figures 5D–F).
Comparaison des modèles et interprétation SHAP pour les résultats relatifs à la mortalité
LR, RF, SVM et XGBoost ont été comparés pour la mortalité en soins intensifs à 28 jours à l'aide des cohortes d'entraînement et de validation interne correspondantes (Figure 6). Les AUC de la cohorte d'entraînement étaient de 0,831 pour LR, 0,883 pour RF, 0,481 pour SVM et 0,862 pour XGBoost ; les AUC de validation interne correspondantes étaient respectivement de 0,773, 0,810, 0,322 et 0,805 (Figures 6A,B). RF a été sélectionné comme modèle offrant les meilleures performances sur la base de son AUC de validation et de l'ensemble des métriques de performance. Les résultats détaillés sont fournis dans le Tableau Supplémentaire 4. Dans la plage de probabilité seuil évaluée, l'analyse de courbe décisionnelle a indiqué un bénéfice net potentiel pour RF (Figure 6D), tandis que la courbe de calibration montrait un accord modéré seulement entre les probabilités prédites et observées de mortalité à 28 jours (Figure 6E). Les analyses SHAP globales ont classé les prédicteurs dans l'ordre suivant : APS III, Hb, ALT, Lac, TBil, albumine, statut de sepsie et lésion rénale (Figures 6C,F). La Figure 6G présente une explication représentative au niveau du patient.
Pour la mortalité à l'hôpital en service de soins généraux, les AUC de la cohorte d'apprentissage étaient de 0,951 pour la régression logistique (LR), de 0,873 pour les forêts aléatoires (RF), de 0,641 pour les machines à vecteurs de support (SVM) et de 0,902 pour XGBoost ; les AUC correspondantes de la validation interne étaient respectivement de 0,900, 0,829, 0,564 et 0,871 (Figures 7A,B). La régression logistique a obtenu l'AUC la plus élevée lors de la validation interne et a été choisie comme modèle offrant les meilleures performances. Les résultats détaillés sont fournis dans le Tableau supplémentaire 4. Dans la plage de probabilités seuil évaluée, l'analyse de courbe décisionnelle a indiqué un bénéfice net potentiel pour la régression logistique (Figure 7D), et la courbe de calibration a montré un accord modéré entre les probabilités prédites et observées de mortalité à l'hôpital (Figure 7E). Les analyses SHAP globales ont classé les prédicteurs dans l'ordre suivant : l'albumine, les lésions rénales, l'état de septicémie, l'urée sanguine azotée (BUN), la bilirubine totale (TBil) et l'AST (Figures 7C,F). La Figure 7G présente une explication représentative au niveau du patient.
Construction des nomogrammes de mortalité en soins intensifs à 28 jours et de mortalité intra-hospitalière en service de soins généraux
Des nomogrammes distincts ont été élaborés à l'aide de prédicteurs classés par ordre de priorité selon l'importance globale des caractéristiques SHAP dans les modèles de mortalité les plus performants (Figure 8). Le nomogramme de mortalité à 28 jours en soins intensifs incluait le score APS III, l'Hb, l'ALT, le lactate, la bilirubine totale (TBil), l'albumine, le statut de sepsis et une lésion rénale (Figure 8A). Il a donné une AUC de 0,840 (Figure 8B), et la courbe de calibration a montré un bon accord entre les probabilités de mortalité à 28 jours prédites et observées au sein de la cohorte étudiée (Figure 8C). Le nomogramme de mortalité intra-hospitalière pour les patients en unité de soins générale incluait l'albumine, la lésion rénale, le statut de sepsis, l'urée sanguine azotée (BUN), la bilirubine totale (TBil) et l'AST (Figure 8D). Il a donné une AUC de 0,904 (Figure 8E), et la courbe de calibration a montré un bon accord entre les probabilités de mortalité intra-hospitalière prédites et observées au sein de la cohorte étudiée (Figure 8F). Étant donné que ces estimations reposaient uniquement sur une validation interne, elles doivent être considérées comme préliminaires et nécessitent une confirmation dans des cohortes externes indépendantes.
Évaluation de la complexité du modèle par rapport aux événements observés
La complexité du modèle a été évaluée en comparant le nombre d'événements observés dans chaque cohorte d'apprentissage au nombre de prédicteurs dans le nomogramme final correspondant. Le modèle de prédiction du risque de sepsis en service général comprenait 380 cas de sepsis et six prédicteurs (63,3 événements par prédicteur). Le modèle de mortalité intra-hospitalière en service général comprenait 56 décès et six prédicteurs (9,3 événements par prédicteur), tandis que le modèle de mortalité à 28 jours en réanimation comprenait 76 décès et huit prédicteurs (9,5 événements par prédicteur). Ainsi, le nombre d'événements était largement suffisant pour le modèle de sepsis, mais plus limité pour les deux modèles de mortalité, dont les ratios se rapprochaient de la règle empirique couramment admise d'environ 10 événements par prédicteur.
DISPONIBILITÉ DES DONNÉES :
Toutes les données anonymisées au niveau des patients utilisées dans cette étude sont accessibles publiquement dans les fichiers supplémentaires joints à cet article. Tableau Supplémentaire 5 contient les données de la cohorte du service général, et Tableau Supplémentaire 6 contient les données de la cohorte de l'unité de soins intensifs. Avant soumission, toutes les informations d'identification personnelle directe ainsi que d'autres informations potentiellement identifiables ont été supprimées.
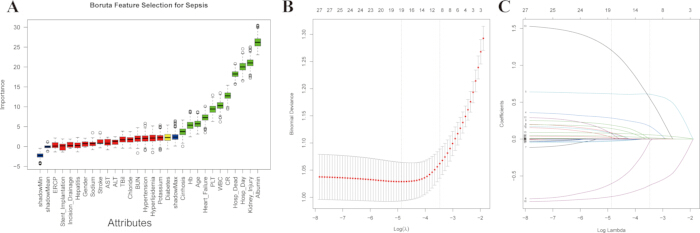
Figure 1 : Sélection de caractéristiques pour le modèle de prédiction de la sepsie en service général chez les patients atteints de cholangite aiguë. (A) Analyse de sélection de caractéristiques Boruta ; (B,C) Analyses du chemin des coefficients LASSO et de validation croisée à 10 plis. Veuillez cliquer ici pour visualiser une version agrandie de cette figure.
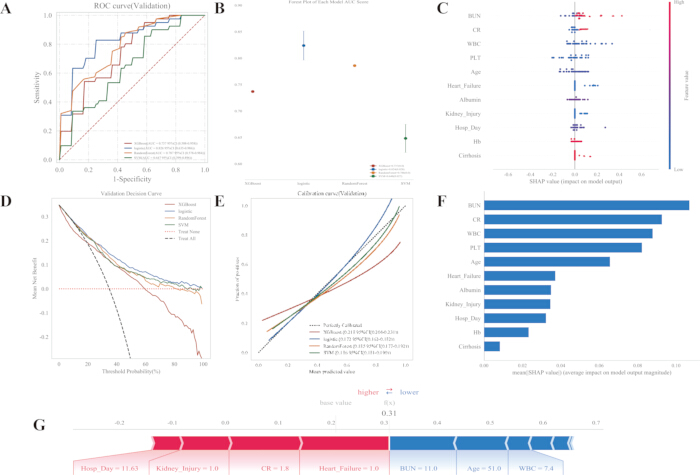
Figure 2 : Comparaison et interprétation des modèles d'apprentissage automatique pour la prédiction de la septicémie en service de soins généraux chez les patients atteints de cholangite aiguë. (A,B) Courbes ROC des modèles d'apprentissage automatique candidats dans les cohortes d'entraînement et de validation interne ; (C,F) analyses SHAP globales des contributions des prédicteurs ; (D) analyse de la courbe de décision ; (E) courbes de calibration ; (G) explication SHAP individuelle pour un patient représentatif. Veuillez cliquer ici pour afficher une version agrandie de cette figure.
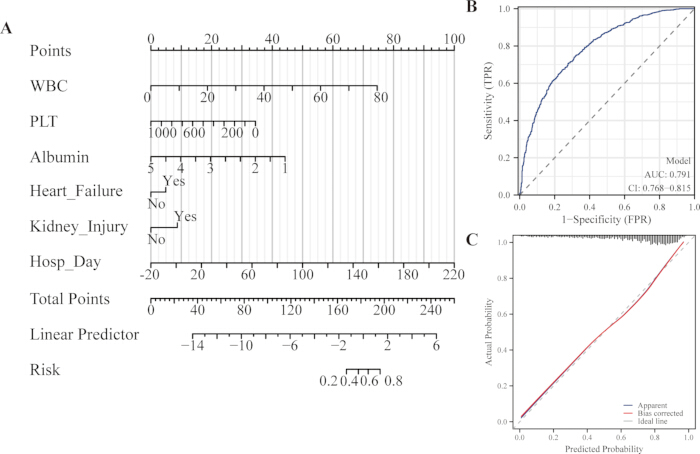
Figure 3 : Construction et évaluation du nomogramme de prédiction du risque de sepsis en service général. (A) Nomogramme ; (B) Courbe ROC ; (C) Courbe de calibration. Veuillez cliquer ici pour visualiser une version agrandie de cette figure.
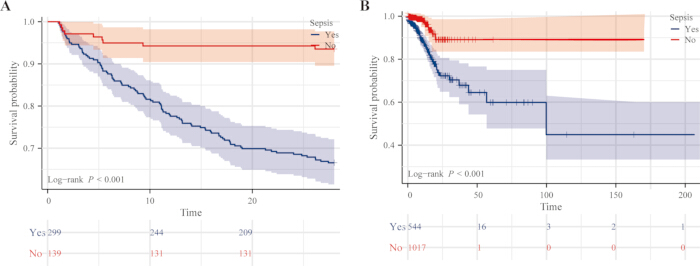
Figure 4 : Courbes de survie de Kaplan-Meier pour les patients atteints de cholangite aiguë stratifiés selon la présence ou l'absence de sepsis. (A) Comparaison de la survie à 28 jours entre les patients avec et sans sepsis dans le groupe de soins intensifs ; (B) comparaison de la survie en milieu hospitalier entre les patients avec et sans sepsis dans le groupe de service général. Veuillez cliquer ici pour visualiser une version agrandie de cette figure.
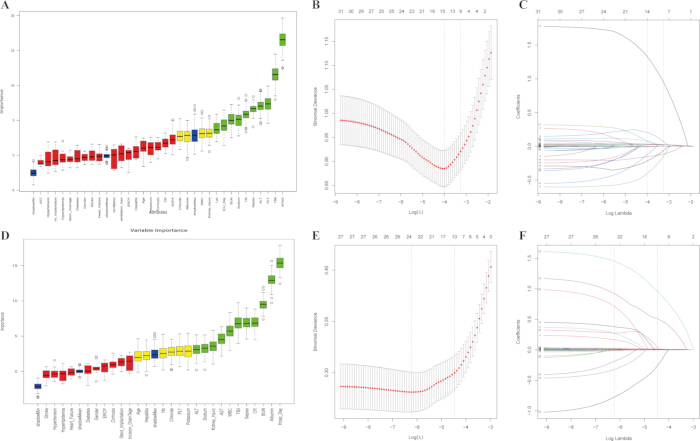
Figure 5 : Sélection des caractéristiques pour les modèles de mortalité à 28 jours en USI et de mortalité intra-hospitalière en service général. (A) Analyse de sélection des caractéristiques Boruta pour la mortalité à 28 jours en USI ; (B,C) Analyses du chemin des coefficients LASSO et de validation croisée en 10 parties pour la mortalité à 28 jours en USI ; (D) Analyse de sélection des caractéristiques Boruta pour la mortalité intra-hospitalière en service général ; (E,F) Analyses du chemin des coefficients LASSO et de validation croisée en 10 parties pour la mortalité intra-hospitalière en service général. Veuillez cliquer ici pour visualiser une version agrandie de cette figure.
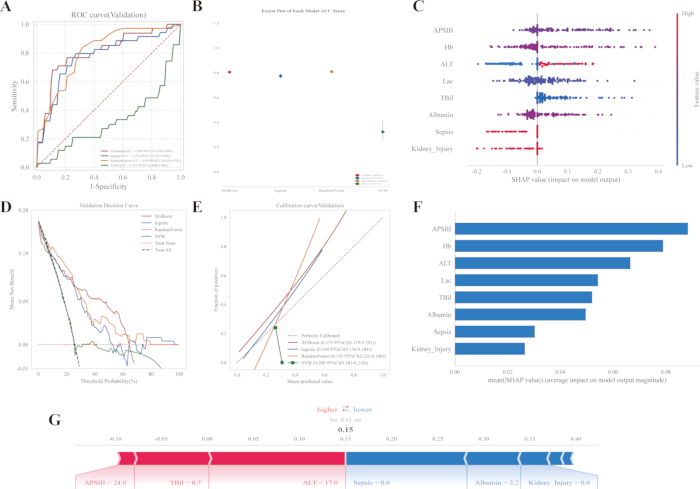
Figure 6 : Comparaison et interprétation de modèles d'apprentissage automatique pour la mortalité à 28 jours en soins intensifs chez les patients atteints de cholangite aiguë. (A,B) Courbes ROC des modèles candidats d'apprentissage automatique dans les cohortes d'apprentissage et de validation interne ; (C,F) analyses globales SHAP des contributions des prédicteurs ; (D) analyse de courbe de décision ; (E) courbes de calibration ; (G) explication individuelle SHAP pour un patient représentatif. Veuillez cliquer ici pour visualiser une version agrandie de cette figure.
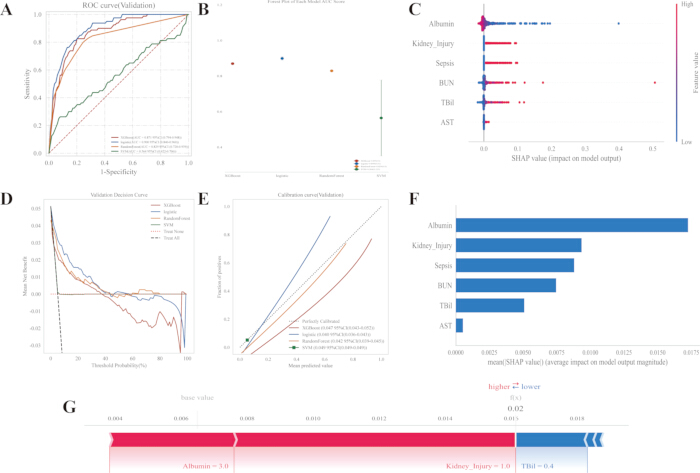
Figure 7 : Comparaison et interprétation des modèles d'apprentissage automatique pour la mortalité intra-hospitalière en service de soins généraux chez les patients atteints de cholangite aiguë. (A,B) Courbes ROC des modèles d'apprentissage automatique candidats dans les cohortes d'entraînement et de validation interne ; (C,F) analyses SHAP globales des contributions des prédicteurs ; (D) analyse de courbe de décision ; (E) courbes de calibration ; (G) explication SHAP individuelle pour un patient représentatif. Veuillez cliquer ici pour visualiser une version agrandie de cette figure.
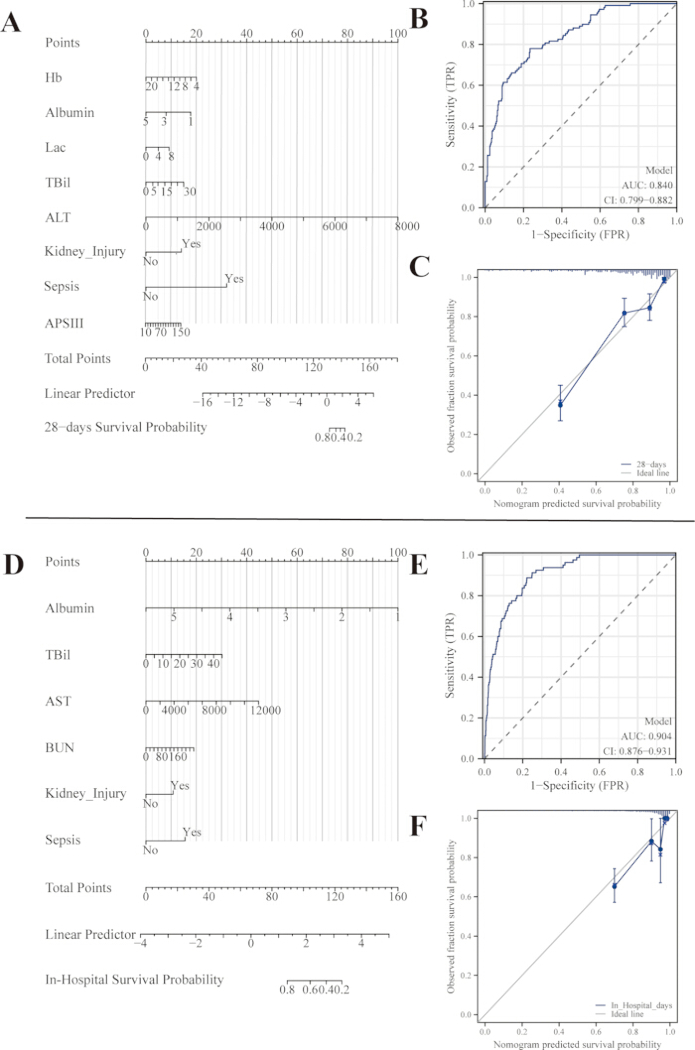
Figure 8 : Construction et évaluation des nomogrammes de mortalité en réanimation à 28 jours et de mortalité intra-hospitalière en service ordinaire. (A–C) Nomogramme, courbe ROC et courbe de calibration pour la mortalité en réanimation à 28 jours ; (D–F) nomogramme, courbe ROC et courbe de calibration pour la mortalité intra-hospitalière en service ordinaire. Veuillez cliquer ici pour visualiser une version agrandie de cette figure.
Tableau 1 : Caractéristiques de base des patients inclus. Les caractéristiques cliniques et de laboratoire sont présentées séparément pour les cohortes des services généraux et des soins intensifs, et comparées entre les patients avec et sans sepsie. Veuillez cliquer ici pour télécharger ce fichier.
Tableau 2 : Analyse multifactorielle de la septicémie chez les patients atteints de cholangite. Abréviations : WBC : globules blancs ; PLT : plaquettes. Les nombres indiquant des valeurs de p inférieures à 0,05 sont en gras. Veuillez cliquer ici pour télécharger ce fichier.
Tableau 3 : Relation entre la septicémie et le pronostic des patients atteints de cholangite. Le modèle 1 n’était pas ajusté. Le modèle 2 était ajusté pour l’âge et le sexe. Le modèle 3 était davantage ajusté pour l’hypertension, le diabète, l’insuffisance cardiaque, l’AVC et les lésions rénales. Pour la cohorte des patients hospitalisés en service général, le modèle 4 était en outre ajusté pour la numération des globules blancs (WBC), l’hémoglobine (Hb), la numération plaquettaire (PLT), l’albumine, la créatinine (CR), l’urée sanguine (BUN), l’aspartate aminotransférase (AST), l’alanine aminotransférase (ALT), le sodium, le potassium, le chlore et le lactate (Lac). Pour la cohorte des patients en réanimation (USI), le modèle 4 était en outre ajusté pour le score APS III, le score SOFA, la numération des globules blancs (WBC), l’hémoglobine (Hb), la numération plaquettaire (PLT), l’albumine, la créatinine (CR), l’urée sanguine (BUN), l’aspartate aminotransférase (AST), l’alanine aminotransférase (ALT), le sodium, le potassium, le chlore et le lactate (Lac). HR, rapport de risque ; CI, intervalle de confiance ; APS III, Évaluation de la physiologie aiguë et de la santé chronique III ; SOFA, Évaluation séquentielle des défaillances organiques ; WBC, numération des globules blancs ; Hb, hémoglobine ; PLT, numération plaquettaire ; CR, créatinine ; BUN, azote uréique sanguin ; AST, aspartate aminotransférase ; ALT, alanine aminotransférase ; Lac, lactate. Les valeurs en gras indiquent une signification statistique à P < 0,05. Veuillez cliquer ici pour télécharger ce fichier.
Figure supplémentaire 1 : Flux général de l'étude et du machine learning. Les patients atteints de cholangite aiguë ont été répartis en deux groupes, celui du service général et celui des soins intensifs (USI), et trois tâches de prédiction ont été définies : sepsis dans le service général, mortalité intra-hospitalière dans le service général et mortalité à 28 jours en USI. Pour chaque tâche, les données ont été divisées en cohortes d'apprentissage et de validation interne selon un ratio de 7:3, avant la sélection des caractéristiques. Les méthodes LASSO et Boruta ont été appliquées exclusivement sur la cohorte d'apprentissage, puis les modèles de régression logistique (LR), forêts aléatoires (RF), machines à vecteurs de support (SVM) et XGBoost ont été développés et comparés. Le modèle offrant les meilleures performances a été sélectionné selon les résultats de la validation interne et interprété à l'aide de SHAP. Le nomogramme de prédiction du sepsis en service général utilise les variables conservées dans la régression logistique multivariée, tandis que les nomogrammes de prédiction de la mortalité intègrent les prédicteurs prioritaires identifiés par l'importance globale des caractéristiques selon SHAP.Veuillez cliquer ici pour télécharger ce fichier.
Tableau supplémentaire 1 : Implémentation informatique détaillée, procédures de prétraitement, paramètres de sélection des caractéristiques et paramètres des modèles d'apprentissage automatique. Abréviations : AUC, aire sous la courbe caractéristique de fonctionnement du récepteur ; FN, faux négatif ; FP, faux positif ; ICU, unité de soins intensifs ; LASSO, opérateur de réduction et de sélection par valeur absolue minimale ; LR, régression logistique ; RF, forêt aléatoire ; SHAP, explications additives de Shapley ; SMOTE, technique de suréchantillonnage de la minorité synthétique ; SVM, machine à vecteurs de support ; TN, vrai négatif ; TP, vrai positif ; XGBoost, Boosting de gradient extrême. Remarque : les analyses d'apprentissage automatique ont été initialement réalisées à l'aide d'une plateforme basée sur le cloud. Étant donné que la plateforme a par la suite été mise à jour, les numéros exacts des anciennes versions des packages backend ne sont plus accessibles ; par conséquent, les versions actuelles des packages Python ne peuvent pas être indiquées rétroactivement comme celles utilisées lors des analyses initiales. Les valeurs d'algorithmes indiquées ci-dessus représentent les paramètres prédéfinis documentés, et non une optimisation hyperparamétrique spécifique aux résultats.Veuillez cliquer ici pour télécharger ce fichier.
Tableau supplémentaire 2 : Complétude des données au niveau des variables dans les jeux de données analytiques finaux pour les services généraux et les unités de soins intensifs (USI). Les jeux de données finaux ne contenaient aucune valeur manquante pour les variables incluses dans les analyses correspondantes, et aucune imputation statistique n’a été effectuée. Les enregistrements présentant des données requises manquantes ont été exclus lors de l’assemblage rétrospectif de la base de données ; le nombre exact d’exclusions préalables à l’entrée et les schémas initiaux de valeurs manquantes n’ont pas été conservés.Veuillez cliquer ici pour télécharger ce fichier.
Tableau supplémentaire 3 : Performances des modèles candidats d'apprentissage automatique pour la prédiction de la septicémie chez les patients en service général atteints de cholangite aiguë. Évaluation de l'efficacité des modèles d'apprentissage automatique dans la prédiction de la septicémie chez les patients atteints de cholangite aiguë.Veuillez cliquer ici pour télécharger ce fichier.
Tableau supplémentaire 4 : Performances des modèles candidats d'apprentissage automatique pour la mortalité en service général hospitalier et la mortalité en USI à 28 jours chez les patients atteints de cholangite aiguë. Les performances des modèles LR, RF, SVM et XGBoost sont résumées pour les cohortes d'apprentissage et de validation interne à l'aide de l'AUC, de la sensibilité, de la spécificité, du rappel, du score F1 et de la précision.Veuillez cliquer ici pour télécharger ce fichier.
Tableau supplémentaire 5 : Données anonymisées au niveau des patients pour la cohorte des patients hospitalisés en service général. Le jeu de données contient les variables cliniques et de laboratoire utilisées dans les analyses concernant la septicémie et le décès à l'hôpital.Veuillez cliquer ici pour télécharger ce fichier.
Tableau supplémentaire 6 : Données anonymisées au niveau des patients pour la cohorte de soins intensifs. Le jeu de données contient les variables cliniques et de laboratoire utilisées pour analyser la mortalité à 28 jours.Veuillez cliquer ici pour télécharger ce fichier.
Discussion
La cholangite aiguë est une infection du système biliaire potentiellement mortelle. Bien qu'une forme bénigne réponde souvent bien au traitement, la mortalité rapportée peut atteindre 50 % dans les cas graves1,5. La mortalité peut approcher 40 % en cas de développement d'un choc septique14. La septicémie indique que l'infection n'est plus limitée au système biliaire et peut évoluer rapidement vers une inflammation systémique et un dysfonctionnement multiviscéral. Il est donc important d'identifier les facteurs associés à la septicémie et aux résultats défavorables, en particulier chez les patients nécessitant des soins en unité de soins intensifs.
Parmi les 1 999 patients inclus dans cette étude, 843 (42,17 %) avaient ou ont développé une sepsie. La proportion était de 34,85 % dans le groupe des patients hospitalisés en service général et de 68,3 % dans le groupe de soins intensifs (USI) ; la proportion plus élevée en USI reflète probablement une gravité de maladie de base plus importante. Les patients présentant une sepsie avaient tendance à être plus âgés, ce qui est conforme aux observations antérieures et pourrait être lié à la détérioration physiologique liée à l’âge, à une fonction immunitaire altérée et à une charge plus importante de comorbidités.15 Liu et al.16 ont élaboré un nomogramme de régression logistique pour la sepsie dans la cholangite aiguë, utilisant l’âge, la durée de ventilation assistée, le diabète, une coagulopathie et la pression artérielle systolique ; les AUC rapportées étaient de 0,700 dans le groupe d’apprentissage et de 0,647 dans le groupe de validation. Dans cette étude, la régression logistique (RL) a atteint des AUC de 0,893 dans le groupe d’apprentissage et de 0,826 dans le groupe de validation interne. Un nomogramme de sepsie plus parcimonieux, destiné aux services généraux, a ensuite été construit à partir des critères suivants : atteinte rénale, insuffisance cardiaque, GB, PLT, albumine et durée d’hospitalisation, et a fourni une AUC de 0,791. Bien que l’AUC de validation interne de notre meilleur modèle d’apprentissage automatique soit numériquement supérieure à celle du nomogramme publié précédemment, la comparaison est indirecte, car les populations, prédicteurs, sources de données et procédures de validation diffèrent. Une validation externe indépendante est nécessaire avant de pouvoir établir une comparaison des performances et la généralisabilité.
La septicémie est restée associée à la mortalité après ajustement séquentiel, ce qui confirme son importance pronostique dans la cholangite aiguë. La septicémie est définie comme un dysfonctionnement organique mettant la vie en danger, provoqué par une réponse hôte désordonnée à une infection17. Des anomalies endothéliales, inflammatoires, oxydatives et de la coagulation peuvent contribuer au dysfonctionnement organique et à des résultats défavorables18,19. Le nomogramme de mortalité à 28 jours en USI intègre le score APS III, l'Hb, l'ALT, le Lac, la TBil, l'albumine, le statut de septicémie et les lésions rénales, donnant une AUC de 0,840. Le nomogramme de mortalité intra-hospitalière en service général inclut l'albumine, les lésions rénales, le statut de septicémie, l'urée sanguine azotée (BUN), la TBil et l'AST, produisant une AUC de 0,904. Schneider et al. ont rapporté une AUC moyenne validée par cross-validation de 0,915 pour le modèle de risque de mortalité dans la cholangite aiguë. Cette valeur est numériquement proche de celle du nomogramme du service général, mais une comparaison directe n'est pas appropriée, car les modèles ont été développés et évalués sur des cohortes différentes.
APS III est la composante physiologique aiguë de l'APACHE III et résume la gravité du déséquilibre physiologique chez les patients gravement malades10. L'APS III et le SOFA ont été évalués pour l'évaluation pronostique dans les affections critiques et la sepsie20,21,22. Les recommandations TG18 soutiennent le diagnostic et l'évaluation précoce de la gravité de la cholangite aiguë à partir de données cliniques et biologiques, notamment la fièvre, le taux de globules blancs, la bilirubine et l'albumine. Toutefois, les critères du syndrome de réponse inflammatoire systémique peuvent fournir des informations complémentaires lors du dépistage de la sepsie chez les patients atteints de cholangite aiguë14. Une concentration plus faible d'Hb a également été associée à une mortalité accrue chez les patients âgés souffrant de cholangite aiguë23. Le lactate est un marqueur cliniquement important d'hypoperfusion tissulaire et de dysfonctionnement organique ; durant la sepsie, des concentrations élevées peuvent refléter une altération de l'apport en oxygène, un métabolisme perturbé et une clairance réduite24,25.
Des concentrations élevées de bilirubine et d'aminotransférases ont précédemment été associées à une mortalité précoce dans la cholangite aiguë26. L'obstruction biliaire provoque une cholestase et une pression intraductale accrue. Le reflux de la bilirubine dans la circulation reflète une élimination biliaire altérée, tandis que l'élévation des aminotransférases peut indiquer une atteinte hépatocytaire due à la toxicité des acides biliaires, à une inflammation ou à une ischémie hépatique secondaire.
Les modèles de prédiction antérieurs du risque de sepsie ou de mortalité dans la cholangite aiguë se sont parfois appuyés sur des ensembles limités de prédicteurs ou de variables potentiellement indisponibles, comme les résultats des cultures microbiologiques16,27. Les modèles spécifiques à chaque issue utilisaient principalement des variables cliniques et biologiques couramment enregistrées ; toutefois, le moment et la disponibilité de ces variables variaient selon les contextes. Le score APS III n’était disponible que dans les unités de soins intensifs, et la durée d’hospitalisation n’était pas connue au moment de l’admission. Par conséquent, la valeur pratique de ces modèles doit être évaluée de façon prospective à des points temporels de prédiction clairement définis. L’atteinte rénale reste cliniquement pertinente car elle est indépendamment associée à la mortalité toutes causes confondues dans la cholangite aiguë28.
Nous avons utilisé un cadre de modélisation en étapes plutôt que de nous appuyer sur un seul algorithme. La régression LASSO et Boruta ont servi de méthodes complémentaires de sélection de caractéristiques : le LASSO réduit la dimensionnalité et la colinéarité par rétrécissement des coefficients, tandis que Boruta est conçu pour identifier tous les prédicteurs pertinents, y compris les variables impliquées dans des relations non linéaires ou des interactions. Les modèles de régression logistique (LR), forêts aléatoires (RF), machines à vecteurs de support (SVM) et XGBoost ont ensuite été développés en utilisant les mêmes prédicteurs candidats et la même répartition entre apprentissage et validation interne. La sélection des modèles a mis l'accent sur les performances en validation interne plutôt que sur les seules performances d'apprentissage, ce qui peut réduire mais non éliminer totalement le surajustement. Des analyses de calibration et de courbe de décision ont également été utilisées pour évaluer la concordance entre les risques prédits et observés, ainsi que pour apprécier le bénéfice net potentiel selon différentes probabilités seuils.
Pour la prédiction du sepsis en service de médecine générale, la régression logistique (LR) a obtenu la plus haute AUC lors de la validation interne, suggérant que des algorithmes non linéaires plus complexes n'ont pas apporté de valeur prédictive supplémentaire dans ce jeu de données. Cette observation n'exclut pas l'existence d'associations non linéaires, car la performance des algorithmes dépend de la taille de l'échantillon, des distributions des prédicteurs, des réglages des hyperparamètres et des caractéristiques de la cohorte. La méthode SHAP a été appliquée au modèle offrant les meilleures performances pour chaque tâche afin de quantifier l'importance globale des caractéristiques et d'expliquer les estimations au niveau individuel des patients. Le cadre comprenait trois modèles spécifiques selon l'issue et le contexte clinique : un modèle de prédiction du sepsis en service de médecine générale, un modèle de mortalité intra-hospitalière en service de médecine générale, et un modèle de mortalité en réanimation (USI) à 28 jours. Le nomogramme du sepsis a conservé les variables significatives dans la régression logistique multivariée, tandis que les nomogrammes de mortalité ont utilisé des prédicteurs sélectionnés selon l'importance globale des caractéristiques SHAP, sans élimination supplémentaire basée sur la valeur-P. Cette approche a permis aux ensembles de prédicteurs de refléter l'information disponible dans chaque contexte clinique et d'éviter l'application de mesures spécifiques aux unités de soins intensifs, telles que l'APS III, aux patients des services de médecine générale. Néanmoins, ces modèles validés en interne constituent des outils de recherche pour la stratification du risque et ne doivent pas être interprétés comme des modèles causaux ou comme un substitut au jugement clinique.
Les trois modèles abordent des contextes, des résultats et des points d'évaluation distincts. Le modèle de prédiction de la septicémie en service général intègre les lésions rénales, l'insuffisance cardiaque, les GB, les PLT, l'albumine et la durée d'hospitalisation. Étant donné que la durée d'hospitalisation n'est pas disponible à l'admission et que le moment exact du début de la septicémie n'a pas été enregistré, ce modèle doit être interprété comme un modèle rétrospectif de stratification du risque pendant l'hospitalisation, plutôt qu'un outil de prédiction au moment de l'admission. Le modèle de mortalité intrahospitalière en service général intègre l'albumine, les lésions rénales, le statut de septicémie, l'urée sanguine azotée, la bilirubine totale et l'ASAT, et ne peut être calculé qu'une fois que ces variables sont disponibles durant l'hospitalisation. Le modèle de mortalité à 28 jours en réanimation intègre le score APS III, l'Hb, l'ALAT, le lactate, la bilirubine totale, l'albumine, le statut de septicémie et les lésions rénales, et peut être évalué après l'admission en soins intensifs dès que les informations requises sont disponibles. Les nomogrammes transforment les valeurs des prédicteurs en probabilités estimées d'issue, tandis que l'analyse SHAP explique la contribution des variables individuelles. À l'heure actuelle, ces modèles validés en interne doivent être considérés comme des outils de recherche fournissant des estimations continues du risque, plutôt que des recommandations thérapeutiques fixes. Ils visent à compléter les critères Sepsis-3, l'évaluation fondée sur le TG18 et le jugement clinique, et nécessitent une validation externe prospective et multicentrique avant une mise en œuvre routinière.
Cette étude présente plusieurs limites. Premièrement, son design rétrospectif peut introduire un biais de sélection, un biais dû aux données manquantes, une variabilité des mesures et un facteur de confusion résiduel. La classification du sepsis s'appuyait sur les dossiers médicaux existants, et l'incertitude concernant le moment de début peut avoir entraîné une mauvaise classification. Les dossiers comportant des données incomplètes ont été exclus avant la construction de la base de données analytique, mais un journal détaillé du dépistage préalable n'a pas été conservé. Nous n'avons donc pas pu quantifier ces exclusions ni comparer les schémas initiaux de données manquantes entre les cohortes des services généraux et celles des unités de soins intensifs. Bien que les jeux de données finalisés ne contiennent aucune valeur manquante, la sélection par cas complets peut avoir introduit un biais si l'intégralité des données était associée à la gravité de la maladie ou aux résultats. Les mesures de laboratoire n'ont pas nécessairement été effectuées à un moment uniforme par rapport à l'admission, au début du sepsis ou au traitement, et des interventions telles que l'antibiothérapie, le drainage biliaire et le soutien d'organes ont pu influencer à la fois les valeurs de laboratoire et la mortalité. La mortalité intra-hospitalière a pu également être influencée par les pratiques de sortie ou de transfert, tandis que l'évaluation de la mortalité à 28 jours dépendait de l'exhaustivité du suivi. L'ajustement pour les covariables mesurées n'a pas permis d'éliminer les facteurs de confusion non mesurés ou variant dans le temps ; par conséquent, les associations rapportées ne doivent pas être interprétées comme causales.
Deuxièmement, bien que les patients aient été recrutés dans deux institutions, les performances du modèle ont été évaluées uniquement à l’aide d’une division aléatoire de validation interne. Les performances rapportées pourraient donc être optimistes, et la généralisabilité à d'autres institutions et populations reste incertaine. Une validation prospective multicentrique utilisant des cohortes indépendantes sur le plan temporel et géographique est nécessaire. En outre, l’heure exacte du début de la septicémie n’était pas disponible, ce qui empêche de distinguer la septicémie présente à l’admission de celle survenue durant l’hospitalisation, et rend impossible le calcul de la durée d’hospitalisation avant et après la septicémie. Étant donné que la durée d’hospitalisation a été incluse comme prédicteur, le modèle de prédiction de la septicémie en service de soins généraux doit être interprété comme un modèle rétrospectif de stratification du risque durant l’hospitalisation, et non comme un modèle prédictif au moment de l’admission ou un modèle prospectif de temps jusqu’à l’événement.
Troisièmement, les algorithmes LR, RF, SVM et XGBoost sont bien établis, et cette étude n'a pas introduit de nouvelle architecture ou de nouveau cadre d'optimisation. Ils ont été sélectionnés intentionnellement pour représenter des stratégies complémentaires linéaires, basées sur les marges, de type bagging et de type boosting, adaptées aux données cliniques structurées. Toutefois, limiter l'analyse à ces algorithmes a pu restreindre la détection d'autres motifs non linéaires ou d'interactions. De futures études pourraient évaluer des méthodes de boosting interprétables, des ensembles empilés (stacking) ou d'autres algorithmes, en jugeant les améliorations selon la discrimination externe, la calibration et le bénéfice net, plutôt que selon la seule AUC.
Quatrièmement, les algorithmes candidats ont utilisé des hyperparamètres par défaut prédéfinis, aucune optimisation systématique des hyperparamètres n'ayant été effectuée. Les différences observées reflètent donc des comparaisons entre ces implémentations prédéfinies et peuvent ne pas représenter la meilleure performance réalisable pour chaque algorithme. De futures études devraient combiner une validation croisée imbriquée avec une optimisation des hyperparamètres par grille, aléatoire ou bayésienne, et confirmer tout gain par une validation externe.
Cinquièmement, bien que la sélection de caractéristiques et la validation interne aient été utilisées pour réduire la complexité du modèle, les modèles de mortalité en service général et en réanimation comprenaient respectivement seulement 9,3 et 9,5 événements d'apprentissage par prédicteur. Ces ratios sont proches de la limite inférieure couramment citée pour la modélisation par régression ; par conséquent, un surajustement, des estimations instables et une performance de validation imprécise ne peuvent être exclus. Des cohortes indépendantes plus grandes, avec un plus grand nombre d'événements de mortalité, sont nécessaires.
Enfin, la méthode SHAP améliore l'interprétabilité des prédictions de modèles ajustés, mais ne permet pas d'établir de relations causales entre les prédicteurs et les résultats. Les modèles proposés doivent donc être considérés comme des outils de stratification du risque validés en interne, et non comme des systèmes d'aide à la décision clinique. Leur utilité clinique et leur généralisabilité nécessitent d'être évaluées dans des cohortes indépendantes prospectives.
En résumé, la septicémie était associée à une survie intra-hospitalière moins bonne dans le groupe de patients hospitalisés en service général et à une survie à 28 jours moins bonne dans le groupe de patients en unité de soins intensifs parmi les patients atteints de cholangite aiguë. Trois modèles spécifiques aux résultats et au contexte ont été développés : un modèle de prédiction de la septicémie en service général, un modèle de mortalité intra-hospitalière en service général et un modèle de mortalité à 28 jours en unité de soins intensifs. Ces modèles ont montré une performance discriminatoire lors de la validation interne, et la méthode SHAP a permis de caractériser la contribution des prédicteurs individuels aux estimations du modèle. Toutefois, en raison du nombre limité d'événements mortels, de la conception rétrospective et de l'absence de validation externe, les résultats restent préliminaires et potentiellement sujets à un surajustement. Une validation externe prospective multicentrique est nécessaire avant toute mise en œuvre clinique courante.
Déclarations de divulgation
Les auteurs déclarent qu’ils n’ont aucun conflit d’intérêts financiers ou non financiers. ChatGPT (OpenAI) a été utilisé lors de la révision du manuscrit pour aider à la correction linguistique, à la grammaire, à la clarté et à l’organisation. Il n’a pas été utilisé pour générer ou analyser les données de l’étude ni pour tirer des conclusions scientifiques de manière indépendante. Tout contenu assisté par l’intelligence artificielle a été soigneusement examiné et vérifié par les auteurs, qui assument l’entière responsabilité de l’exactitude, de l’intégrité et de l’originalité du manuscrit. Consentement à participer : un consentement éclairé écrit a été obtenu de tous les participants ou de leurs représentants légalement habilités.
Remerciements
Remerciements à tous les collaborateurs de cet article pour leur analyse des données et leur contribution à la rédaction. Financement : Ce travail a été soutenu par le projet de recherche collaborative d'innovation 2024 entre l'université et le gouvernement local du Jiangsu Medical College (202491011,202491007). Bureau de la science et de la technologie de Changzhou (CJ20239026, CJ20244028).
Matériaux
| Nom | Entreprise | Numéro de catalogue | Commentaires |
|---|---|---|---|
| Boruta (paquet R) | [version/CRAN] | Algorithme de sélection de variables exécuté au sein de la cohorte d'apprentissage | |
| glmnet / LASSO (paquet R) | [version/CRAN] | Régression LASSO avec validation croisée à 10 plis pour la sélection de variables | |
| R | Fondation R pour l'informatique statistique | version 4.3.2 | Environnement informatique statistique open source |
| Implémentation SHAP | [version] | Explications additives de Shapley pour l'interprétation du modèle | |
| Stata | StataCorp | version 17.0 | Logiciel statistique pour les analyses classiques |
| Implémentation XGBoost | [version] | Modèle d'amplification du gradient extrême | |
| Plateforme d'analyse Xsmart | [version] | Plateforme d'analyse d'apprentissage automatique |
Références
- An Z, Braseth AL, Sahar N. Acute cholangitis: causes, diagnosis, and management. Gastroenterol Clin North Am. 2021;50:403–14.
- Gravito-Soares E, et al. Clinical applicability of Tokyo Guidelines 2018/2013 in diagnosis and severity evaluation of acute cholangitis and determination of a new severity model. Scand J Gastroenterol. 2018;53:329–34.
- Cianci P, Restini E. Management of cholelithiasis with choledocholithiasis: endoscopic and surgical approaches. World J Gastroenterol. 2021;27:4536–54.
- Lan Cheong Wah D, Christophi C, Muralidharan V. Acute cholangitis: current concepts. ANZ J Surg. 2017;87:554–59.
- Cecconi M, Evans L, Levy M, Rhodes A. Sepsis and septic shock. Lancet. 2018;392:75–87.
- Rudd KE, et al. Global, regional, and national sepsis incidence and mortality, 1990–2017: analysis for the Global Burden of Disease Study. Lancet. 2020;395:200–11.
- Xie J, et al. The epidemiology of sepsis in Chinese ICUs: a national cross-sectional survey. Crit Care Med. 2020;48:e209–e218.
- Wilkins T, Agabin E, Varghese J, Talukder A. Gallbladder dysfunction: cholecystitis, choledocholithiasis, cholangitis, and biliary dyskinesia. Prim Care. 2017;44:575–97.
- Qiu X, Lei YP, Zhou RX. SIRS, SOFA, qSOFA, and NEWS in the diagnosis of sepsis and prediction of adverse outcomes: a systematic review and meta-analysis. Expert Rev Anti Infect Ther. 2023;21:891–900.
- Knaus WA, et al. The APACHE III prognostic system: risk prediction of hospital mortality for critically ill hospitalized adults. Chest. 1991;100:1619–36.
- Pötter-Lang S, et al. Modern imaging of cholangitis. Br J Radiol. 2021;94:20210417. doi:10.1259/bjr.20210417.
- Banerjee S. Generating complex explanations for artificial intelligence models: an application to clinical data on severe mental illness. Life (Basel). 2024;14:807. doi:10.3390/life14070807.
- Karako K, Tang W. Applications of and issues with machine learning in medicine: bridging the gap with explainable AI. Biosci Trends. 2024;18:497–504.
- Beliaev AM, Zyul'korneeva S, Rowbotham D, Bergin CJ. Screening acute cholangitis patients for sepsis. ANZ J Surg. 2019;89:1457–61.
- Fathi M, Markazi-Moghaddam N, Ramezankhani A. A systematic review on risk factors associated with sepsis in patients admitted to intensive care units. Aust Crit Care. 2019;32:155–64.
- Liu Q, et al. A nomogram for predicting the risk of sepsis in patients with acute cholangitis. J Int Med Res. 2020;48:300060519866100. doi:10.1177/0300060519866100.
- Singer M, et al. The third international consensus definitions for sepsis and septic shock (Sepsis-3). JAMA. 2016;315:801–10.
- Joffre J, Hellman J, Ince C, Ait-Oufella H. Endothelial responses in sepsis. Am J Respir Crit Care Med. 2020;202:361–70.
- Mitchell E, Pearce MS, Roberts A. Gram-negative bloodstream infections and sepsis: risk factors, screening tools and surveillance. Br Med Bull. 2019;132:5–15.
- Fan S, Ma J. The value of five scoring systems in predicting the prognosis of patients with sepsis-associated acute respiratory failure. Sci Rep. 2024;14:4760. doi:10.1038/s41598-024-55257-5.
- Pérez-Fernández X, et al. Clinical variables associated with poor outcome from sepsis-associated acute kidney injury and the relationship with timing of initiation of renal replacement therapy. J Crit Care. 2017;40:154–60.
- Lambden S, Laterre PF, Levy MM, François B. The SOFA score—development, utility and challenges of accurate assessment in clinical trials. Crit Care. 2019;23:374. doi:10.1186/s13054-019-2663-7.
- Inan O, Sahiner ES, Ates I. Factors associated with clinical outcome in geriatric acute cholangitis patients. Eur Rev Med Pharmacol Sci. 2023;27:3313–21.
- Bakker J, Postelnicu R, Mukherjee V. Lactate: where are we now? Crit Care Clin. 2020;36:115–24.
- Brooks GA. The science and translation of lactate shuttle theory. Cell Metab. 2018;27:757–85.
- Salek J, Livote E, Sideridis K, Bank S. Analysis of risk factors predictive of early mortality and urgent ERCP in acute cholangitis. J Clin Gastroenterol. 2009;43:171–75.
- Schneider J, et al. Mortality risk for acute cholangitis (MAC): a risk prediction model for in-hospital mortality in patients with acute cholangitis. BMC Gastroenterol. 2016;16:15. doi:10.1186/s12876-016-0428-1.
- Lee TW, et al. Incidence, risk factors, and prognosis of acute kidney injury in hospitalized patients with acute cholangitis. PLoS One. 2022;17:e0267023. doi:10.1371/journal.pone.0267023.