Cette étude intègre des données publiques de transcriptomique pédiatrique de la pneumonie, le séquençage ARN unicellulaire du poumon de souris, le criblage de composés dérivés de Paeonia, le dockage moléculaire et des simulations de dynamique moléculaire afin d'identifier des cibles inflammatoires associées aux neutrophiles et de prédire les interactions avec la catéchine pour une validation ultérieure.
Article de recherche
Effets de la catéchine dérivée de Paeonia sur l'inflammation associée aux neutrophiles dans la pneumonie
Dans cet article
Résumé
Résumé
La pneumonie chez l'enfant s'accompagne fréquemment de réponses inflammatoires excessives et d'une dysrégulation immunitaire, pouvant entraîner des conséquences cliniques graves. La catéchine a montré une activité anti-inflammatoire dans plusieurs contextes pathologiques, mais son rôle et ses mécanismes moléculaires dans la pneumonie restent peu clairs. Des données publiques de séquençage ARN en masse provenant de cas pédiatriques de pneumonie (GSE261482) et des données publiques de séquençage ARN unicellulaire de poumon de souris issues d'un modèle expérimental de pneumonie (GSE295484) ont été analysées à l'aide d'une analyse de réseau de co-expression génique pondérée, d'une analyse d'expression différentielle, d'une annotation des types cellulaires et d'une analyse d'enrichissement des ensembles de gènes. Les interactions entre la catéchine et les protéines sélectionnées ont été évaluées par docking moléculaire et simulations de dynamique moléculaire. Un module génique clé associé aux caractéristiques liées à la pneumonie a été identifié, et 18 gènes candidats, principalement enrichis dans des voies inflammatoires et immunitaires, ont été sélectionnés. L'analyse unicellulaire a montré que ces gènes étaient principalement enrichis dans les neutrophiles et les macrophages alvéolaires, avec une augmentation des proportions de neutrophiles en conditions inflammatoires. MMP9, PYGL et GADD45A ont été choisis comme gènes candidats. Les simulations de docking et de dynamique ont confirmé des interactions stables prédites entre la catéchine et ces protéines ciblées. La catéchine pourrait être associée aux voies inflammatoires liées à la pneumonie en modulant les voies associées aux neutrophiles et en interagissant avec des protéines immunitaires clés. Cette étude fournit une vision à l'échelle système de l'action de la catéchine dans la pneumonie et met en évidence des cibles potentielles pour une validation expérimentale ultérieure.
Introduction
La pneumonie est une maladie respiratoire fréquente et potentiellement grave chez l’enfant, principalement causée par des agents infectieux tels que Mycoplasma pneumoniae. Elle représente un élément majeur de la pneumonie acquise dans la communauté et est associée à une morbidité importante en raison de réponses inflammatoires excessives et d’un déséquilibre immunitaire1,2. Des données croissantes indiquent que des cytokines inflammatoires, notamment le facteur de nécrose tumorale-α (TNF-α) et l’interleukine-6 (IL-6), jouent un rôle essentiel dans la progression de la maladie en favorisant le recrutement des cellules immunitaires, les lésions tissulaires et le dysfonctionnement pulmonaire3. Malgré les progrès réalisés dans le traitement antimicrobien, les mécanismes moléculaires responsables de l’inflammation dans la pneumonie pédiatrique restent incomplètement compris4.
Les flavonoïdes ont suscité un intérêt considérable en raison de leurs propriétés anti-inflammatoires et antioxydantes5. La catéchine, un polyphénol naturellement présent largement dans le thé et les aliments d'origine végétale, a été signalée pour atténuer le stress oxydatif et les réponses inflammatoires dans divers modèles de maladies6. Des études antérieures ont démontré que la catéchine peut supprimer les cascades de signalisation pro-inflammatoires, notamment les voies MAPK et NF-κB, et réguler l'expression des cytokines, atténuant ainsi l'inflammation et les dysfonctionnements métaboliques7. Toutefois, la plupart des études existantes se concentrent sur les maladies métaboliques ou cardiovasculaires, tandis que le rôle de la catéchine dans les maladies inflammatoires respiratoires, en particulier la pneumonie, reste insuffisamment exploré. De plus, les cibles moléculaires et les mécanismes sous-jacents à la protection induite par la catéchine dans la pneumonie restent mal définis.
Cette étude visait à examiner les mécanismes moléculaires potentiels de la catéchine dans la pneumonie. On a émis l'hypothèse que la catéchine pourrait atténuer les réponses inflammatoires en interagissant avec des protéines clés et des voies de signalisation impliquées dans la régulation immunitaire. Pour tester cette hypothèse, une approche intégrée combinant la pharmacologie en réseau, le dockage moléculaire, la simulation de dynamique moléculaire et des analyses de séquençage ARN en cellule unique a été utilisée afin d'identifier systématiquement les gènes candidats et d'évaluer leurs interactions avec la catéchine. La distribution des cellules immunitaires et les profils d'expression génique ont été analysées plus en détail pour explorer le rôle des neutrophiles et des macrophages dans l'évolution de la maladie.
Les résultats ont montré une liaison prévue stable entre la catéchine et les protéines sélectionnées, notamment PYGL, MMP9 et GADD45A, ainsi qu'une stabilité structurelle maintenue tout au long des simulations de dynamique moléculaire. De plus, l'analyse en cellule unique a révélé des modifications significatives des proportions des cellules immunitaires, en particulier des neutrophiles, dans des conditions inflammatoires. Ces résultats suggèrent que la catéchine pourrait être associée à des mécanismes anti-inflammatoires impliquant la fonction des cellules immunitaires et des voies de signalisation clés. Cette étude fournit une vision à l'échelle du système des mécanismes potentiels associés à la catéchine dans la pneumonie et appuie la validation ultérieure de la catéchine comme composé candidat dans la recherche sur les maladies respiratoires inflammatoires.
Protocole
Cette étude a impliqué une analyse secondaire de jeux de données accessibles publiquement et anonymisés provenant de la base de données Gene Expression Omnibus. Aucun nouveau participant humain, aucune expérience animale ni aucun échantillon clinique n'ont été recrutés, collectés ou générés pour cette étude. L'approbation éthique et le consentement éclairé pour les jeux de données d'origine relevaient de la responsabilité des études initiales ayant produit les données. Par conséquent, une approbation supplémentaire par un comité d'éthique n'était pas requise pour la présente analyse secondaire.
Collecte et prétraitement des données
Les données de séquençage d'ARN en masse (ARN-séq) ont été obtenues à partir du jeu de données Gene Expression Omnibus (GEO) GSE2614828. La matrice d'expression utilisée dans cette étude contenait 177 échantillons de sang total, incluant 139 échantillons de pneumonie pédiatrique et 38 échantillons témoins sains. Les métadonnées disponibles comprenaient le sexe, la classification étiologique, le tube de prélèvement, le lot et l'état pathologique. Les échantillons de pneumonie ont été annotés comme bactériens définitifs (DB), viraux définitifs (DV), bactériens probables (PB), viraux probables (PV) ou inconnus (U), selon l'annotation du jeu de données d'origine.
Des données de séquençage de l'ARN à une cellule unique (scARN-séq) ont été obtenues à partir du jeu de données GEO GSE2954849, dérivé de tissus pulmonaires de souris C57BL/6 de type sauvage dans un modèle expérimental de pneumonie. Le jeu de données comprenait des souriceaux néonatals (JPN05) et des souriceaux juvéniles (JPN12) exposés à l'air ambiant, au PBS ou à E. coli, et prélevés à 48 h ou 96 h après l'aspiration.
Analyse de réseau de coexpression génique pondéré (WGCNA)
Pour la construction du réseau de coexpression, la matrice d'expression a d'abord été filtrée afin d'éliminer les gènes faiblement exprimés. Après suppression des gènes à faible expression, la variabilité a été évaluée à l'aide de l'écart absolu médian (MAD). Les 5 000 gènes présentant les valeurs MAD les plus élevées ont été retenus pour l'analyse de réseau de coexpression génique pondéré (WGCNA) sous R. Une puissance de seuil doux de 15 a été appliquée car elle satisfaisait au critère de topologie sans échelle avec un R2> 0,8. Ce seuil a été utilisé pour construire la matrice d'adjacence pondérée, qui a ensuite été transformée en une matrice de chevauchement topologique (TOM). Les modules géniques ont ensuite été identifiés à partir de l'arbre de regroupement hiérarchique basé sur la TOM. Afin de détecter les modules associés aux caractéristiques liées à la pneumonie, les eigengènes des modules ont été calculés et testés pour leur corrélation avec le statut de la maladie et son étiologie.
Analyse de l'expression différentielle
Les groupes pneumonie et témoins sains ont été comparés à l'aide du package R limma afin d'identifier les gènes différentiellement exprimés. La correction pour tests multiples a été effectuée selon la méthode de Benjamini-Hochberg. Les gènes n'ont été considérés comme différentiellement exprimés que si les deux seuils étaient atteints : |log2 du rapport d'expression| > 1 et valeur de p ajustée < 0,05.
Identification de Paeoniacomposés actifs dérivés et prédiction des cibles
Afin d'identifier de manière systématique les composés bioactifs présents dans le genre Paeonia et leurs cibles biologiques potentielles, une stratégie d'intégration multi-bases de données a été mise en œuvre afin d'assurer fiabilité et exhaustivité, conformément aux cadres établis de la pharmacologie en réseau. Premièrement, les composés actifs de Paeonia ont été récupérés à partir de la base de données Pharmacologie des Systèmes de Médecine Traditionnelle Chinoise (TCMSP, https://tcmsp-e.com) et d'autres bases de données publiques, notamment ETCM, ainsi que de sources de la littérature. Les composés ont été sélectionnés selon des paramètres pharmacocinétiques, notamment la biodisponibilité orale (BO ≥ 30 %) et le caractère « proche d’un médicament » (DL ≥ 0,18), afin d'identifier les ingrédients bioactifs candidats.
Les cibles protéiques potentielles ont été prédites à l'aide d'approches complémentaires basées sur les ligands. SwissTargetPrediction (http://www.swisstargetprediction.ch) a été utilisé pour identifier les cibles humaines probables en comparant les structures des composés avec celles de ligands dont l'activité est connue, et seules les prédictions ayant une probabilité ≥ 0,1 ont été conservées. Afin d'élargir la couverture des cibles, l'approche Similarity Ensemble Approach (SEA, http://sea.bkslab.org) a également été utilisée pour rechercher d'éventuelles interactions hors cible au sein des familles de protéines, y compris des interactions non détectées par les prédictions canoniques de cibles. Pour compléter davantage la prédiction basée sur les ligands, le serveur PharmMapper (http://lilab.ecust.edu.cn/pharmmapper/) a été utilisé afin d'effectuer un mappage pharmacophorique inverse contre une base de données complète de protéines humaines, et les cibles présentant des scores d'ajustement normalisés ≥ 0,7 ont été sélectionnées. De plus, les interactions expérimentalement validées entre composés et cibles ont été recueillies à partir de bases de données publiques, notamment DrugBank et BindingDB, afin d'améliorer la fiabilité de l'identification des cibles. Toutes les cibles prédites ont ensuite été normalisées en symboles génétiques officiels à l'aide de la base de données UniProt (https://www.uniprot.org), l'organisme étant restreint à « Homo sapiens ». Les doublons ont été supprimés afin d'assurer l'exactitude des données. L'ensemble intégré de cibles a été défini comme l'union de toutes les cibles prédites et validées pour Paeonia, représentant ainsi la base moléculaire potentielle de ses effets pharmacologiques. Étant donné que la catéchine a été identifiée comme l'un des composés actifs dérivés de Paeonia et qu'elle possède une activité anti-inflammatoire bien documentée, elle a été choisie comme composé représentatif pour les simulations ultérieures de docking moléculaire et de dynamique moléculaire.
Analyse d'enrichissement fonctionnel
L'enrichissement fonctionnel a été évalué pour les processus biologiques de l'Ontologie génétique (GO) et les voies de l'Encyclopédie de Kyoto des gènes et des génomes (KEGG) à l'aide du package R clusterProfiler. Les termes enrichis ont été conservés lorsque le taux de fausses découvertes (FDR) était < 0,05.
Analyse de séquençage de l'ARN au niveau cellulaire unique et analyses en aval
Les données de séquençage de l'ARN au niveau cellulaire unique ont été traitées avec Seurat. La matrice GSE295484 traitée a été utilisée pour les analyses en aval, aucune filtration complémentaire au niveau cellulaire n'ayant été appliquée après son importation. La matrice traitée comprenait 90 883 cellules et 26 511 gènes. Les graphiques de contrôle de qualité ont utilisé comme seuils de référence 200 et 8 000 gènes détectés par cellule, ainsi que 1,4 % de lectures mitochondriales. Les données ont été normalisées, mises à l'échelle, puis soumises à une analyse en composantes principales (ACP). Un regroupement cellulaire a ensuite été effectué, et l'approximation uniforme de variétés et la projection (UMAP) ont été utilisées pour visualiser les populations cellulaires dans un espace réduit dimensionnellement. Les identités cellulaires ont été attribuées selon les gènes marqueurs canoniques. Les gènes marqueurs ont été identifiés à l'aide de FindAllMarkers avec only.pos = TRUE, min.pct = 0,25 et logfc.threshold = 0,25.
Afin d'évaluer l'activité de jeux de gènes candidats au niveau de la cellule unique, une analyse AUCell a été réalisée à l'aide du package R AUCell. Les cellules ont été notées selon l'expression de signatures géniques prédéfinies, et les profils d'enrichissement ont été visualisés sur des graphiques UMAP. Pour GSE295484, les proportions des populations de cellules immunitaires, incluant les macrophages alvéolaires et les neutrophiles, ont été calculées dans les groupes air ambiant, PBS et E. coli aux temps 48 h et 96 h après l'aspiration. Les différences entre les groupes ont été évaluées à l'aide de tests statistiques non paramétriques. Les gènes marqueurs des neutrophiles ont été identifiés à partir du jeu de données de cellule unique et croisés avec les gènes candidats précédemment identifiés afin d'obtenir les gènes clés associés aux neutrophiles pour des analyses supplémentaires.
Docking moléculaire
Le docking moléculaire a été réalisé à l'aide d'AutoDock Vina, la préparation du récepteur et du ligand ayant été effectuée à l'aide d'AutoDock Tools. Les structures cristallines des protéines cibles ont été obtenues à partir de la Protein Data Bank (PDB), notamment GADD45A (ID PDB : 2KG4), MMP9 (ID PDB : 6ESM) et PYGL (ID PDB : 3DDS). Les structures protéiques ont été traitées avant le docking en supprimant les molécules d'eau et les ligands co-cristallisés. Des atomes d'hydrogène polaires ont ensuite été ajoutés, et les charges de Gasteiger ont été attribuées.
La structure tridimensionnelle de la catéchine a été obtenue à partir de PubChem et préparée à l'aide d'AutoDock Tools. AutoDock Vina a ensuite été utilisé pour effectuer le dockage de la catéchine avec chaque protéine cible et évaluer l'affinité de liaison prédite ainsi que le profil d'interaction. Les paramètres de la boîte de grille de dockage étaient les suivants : GADD45A-catéchine, center_x = 0,131, center_y = -0,002, center_z = -0,018, size_x = 47,25, size_y = 47,25, size_z = 47,25 ; MMP9-catéchine, center_x = -0,434, center_y = 43,036, center_z = 14,868, size_x = 47,25, size_y = 47,25, size_z = 47,25 ; PYGL-catéchine, center_x = 88,408, center_y = -80,795, center_z = 105,959, size_x = 100,45, size_y = 100,45, size_z = 100,45.
Simulation de dynamique moléculaire
Le champ de forces AMBER14SB a été utilisé pour les composants protéiques. Les paramètres du ligand ont été générés à l’aide du champ de forces GAFF2 à travers sobtop_1.0 (dev3.1), et les charges RESP ont été attribuées. L’eau TIP3P a été utilisée pour solvater chaque complexe protéine-ligand dans une boîte de simulation cubique. L’ajout d’ions Na⁺ et Cl⁻ a permis de neutraliser le système et d’atteindre une concentration ionique de 0,15 M. La méthode de Ewald en maille particulaire (PME) a été utilisée pour les interactions électrostatiques à longue portée, avec un seuil de coupure de 1 nm. Des contraintes sur les liaisons ont été appliquées à l’aide de l’algorithme LINCS. Afin d’éliminer les chevauchements stériques, une minimisation d’énergie a été effectuée à l’aide des méthodes de descente la plus abrupte et du gradient conjugué.
Après l'équilibration, des simulations de dynamique moléculaire en production ont été effectuées dans des conditions NPT à 310 K et 1 bar, régulées par le thermostat de Nosé–Hoover et le barostat de Parrinello–Rahman. Chaque simulation a été réalisée pendant 100 ns avec un pas de temps de 2 fs.
Analyse statistique
Toutes les analyses statistiques ont été effectuées à l'aide du logiciel R. Les analyses de corrélation ont été réalisées selon les méthodes de Pearson ou de Spearman, selon les cas. Les comparaisons entre groupes ont été effectuées à l'aide de tests non paramétriques, notamment le test de Kruskal–Wallis. Une valeur de p < 0,05 a été considérée comme statistiquement significative.
Résultats
Identification d'un module génique clé associé à la pneumonie pédiatrique par WGCNA
Afin d'identifier les modules géniques associés à la pneumonie pédiatrique, une analyse WGCNA a été réalisée à partir de données transcriptomiques provenant d'échantillons de sang total de patients atteints de pneumonie et de témoins sains. L'analyse de regroupement des échantillons n'a révélé aucun outlier évident, indiquant une bonne qualité des données pour les analyses ultérieures (Figure 1A). L'ACP a par ailleurs mis en évidence une séparation nette entre les groupes pneumonie et sains, suggérant des profils transcriptomiques distincts selon les conditions (Figure 1B). Pour construire un réseau sans échelle, les gènes ont été classés par déviation absolue médiane, les 5 000 gènes les plus variables ont été sélectionnés pour la construction du réseau, et la puissance de seuil doux a été fixée à 15 selon le critère d'ajustement à une topologie sans échelle (indice de corrélation R2 > 0,8), tout en maintenant une connectivité moyenne relativement faible (Figure 1C). À l'aide de ce seuil, le regroupement hiérarchique a identifié plusieurs modules géniques présentant des profils d'expression distincts (Figure 1D). L'analyse des relations entre modules et traits cliniques a révélé que plusieurs modules étaient significativement corrélés aux phénotypes cliniques. Notamment, le module bleu présentait une forte corrélation avec l'état pathologique (pneumonie contre sain) et la classification étiologique, suggérant son rôle potentiel dans la progression de la maladie et la réponse de l'hôte (Figure 1E).
De plus, l'analyse du nuage de points représentant l'appartenance au module par rapport à la signification des gènes au sein du module bleu a révélé une forte corrélation positive (cor = 0,6, p = 2,1e−35), indiquant que les gènes fortement connectés au sein du module étaient également fortement associés au caractère clinique (Figure 1F).
Association du module bleu avec l'étiologie de la pneumonie bactérienne
Afin d'approfondir l'analyse des différences d'expression génique selon les étiologies de la pneumonie, une analyse WGCNA a été réalisée en utilisant plusieurs classifications cliniques, incluant les groupes témoins (C), bactériens définitifs (BD), viraux définitifs (VD), bactériens probables (BP), viraux probables (VP) et d'étiologie inconnue (U). L'analyse des corrélations entre modules et traits a révélé que plusieurs modules présentaient des corrélations significatives avec des sous-types étiologiques spécifiques. Notamment, le module bleu a montré la plus forte corrélation positive avec le groupe BD, suggérant son implication potentielle dans les réponses de l'hôte spécifiques à l'infection bactérienne (Figure 2A).
Le dendrogramme de regroupement des gènes et l'attribution correspondante des modules ont davantage confirmé la robustesse de la construction des modules et la séparation nette des groupes de gènes (Figure 2B). Dans le module bleu, l'analyse de l'appartenance au module par rapport à la significativité des gènes a révélé une corrélation positive significative (cor = 0,41, p = 7,8e−14), suggérant que les gènes fortement connectés au sein de ce module étaient également fortement associés au caractère étiologique (Figure 2C).
De plus, la comparaison de l'expression des gènes-éigènes des modules entre différents groupes étiologiques a révélé des différences significatives dans le module bleu (test de Kruskal-Wallis, p = 1,5e−13). Plus précisément, le module bleu présentait une expression accrue dans les groupes atteints de pneumonie bactérienne, particulièrement dans le sous-groupe DB, par rapport aux autres catégories étiologiques (Figure 2D).
Dix-huit gènes candidats associés à des composés dérivés de Paeonia et identifiés par analyse intégrative dans la pneumonie pédiatrique
Afin d'identifier des gènes candidats associés à la pneumonie pédiatrique ainsi que des cibles potentielles liées au Paeonia, une analyse d'expression différentielle a d'abord été réalisée entre les patients atteints de pneumonie et les témoins sains. Selon ces critères, 1 110 gènes différentiellement exprimés (DEG) ont été identifiés entre les échantillons de pneumonie et les témoins sains, dont 524 gènes surexprimés et 586 gènes sous-exprimés. Les 524 DEG surexprimés sont fournis dans le Tableau supplémentaire S1 (voir également la Figure 3A). Afin d'affiner davantage les gènes clés, les DEG liés à la pneumonie ont été croisés avec les gènes associés au phénotype DB et les cibles prédites du Paeonia. Cette analyse intégrative a permis d'obtenir 18 gènes communs, suggérant leur rôle potentiel dans la progression de la maladie et dans les réponses associées au Paeonia (Figure 3B).
Un réseau d'interaction composé-cible a été construit afin de visualiser les relations entre les composants actifs de Paeonia et les gènes candidats identifiés, révélant une connectivité étendue entre les composés et les cibles (Tableau Supplémentaire S2 et Figure 3C). Afin d'explorer les fonctions biologiques de ces 18 gènes, des analyses d'enrichissement fonctionnel ont été réalisées. L'enrichissement des processus biologiques selon l'ontologie génétique (GO) a associé principalement les gènes candidats à des fonctions immunitaires et inflammatoires, notamment la régulation de la réponse inflammatoire, la réponse aux hormones peptidiques, la régulation positive du métabolisme des espèces réactives de l'oxygène, et la régulation de la signalisation médiée par l'interféron de type II (Figure 3D). L'analyse KEGG a en outre montré que les gènes étaient enrichis dans des voies liées à l'inflammation et à l'immunité, telles que les voies de signalisation IL-17 et NF-κB, ainsi que dans des voies métaboliques et endocriniennes, incluant la signalisation du glucagon et la biosynthèse des hormones stéroïdiennes (Figure 3D).
Enrichissement des gènes candidats dans les neutrophiles et les macrophages alvéolaires lors d'une analyse transcriptomique unicellulaire
Afin d'étudier la distribution cellulaire des gènes candidats dans un contexte expérimental de pneumonie, le jeu de données de séquençage transcriptomique unicellulaire (scARN-séq) pulmonaire de souris GSE295484 a été analysé. Une analyse de contrôle qualité a été réalisée afin d'évaluer la fiabilité des données. La distribution du nombre de gènes détectés, des comptages d'unités moléculaires uniques (UMI), ainsi que des pourcentages de gènes mitochondriaux et ribosomaux indiquait des données unicellulaires globalement de haute qualité dans la matrice traitée (Figure 4A). Des graphiques de dispersion ont montré les seuils de référence pour la détection des gènes et la teneur en mitochondries utilisés dans la visualisation du contrôle qualité (Figure 4B).
Après la normalisation et la réduction de la dimensionnalité, les cellules ont été regroupées et visualisées à l'aide de l'UMAP. Des populations cellulaires distinctes ont été identifiées, notamment des neutrophiles, des macrophages alvéolaires, des monocytes, des cellules épithéliales et d'autres types cellulaires immunitaires et stromales, démontrant l'hétérogénéité cellulaire du microenvironnement pulmonaire durant la pneumonie (Figure 4C). Afin d'évaluer l'activité des 18 gènes candidats au niveau monocellulaire, une analyse AUCell a été réalisée. Les résultats ont montré que la signature génique était principalement enrichie dans les neutrophiles et les macrophages alvéolaires, comme en témoignent des scores AUC plus élevés dans ces populations cellulaires (Figure 4D).
Gènes inflammatoires associés aux cibles de composés dérivés de Paeonia dans un modèle murin de pneumonie bactérienne
Afin d'approfondir l'étude de la dynamique des cellules immunitaires dans le modèle expérimental de pneumonie chez la souris, les proportions de macrophages alvéolaires et de neutrophiles ont été analysées dans les groupes air ambiant, PBS et E. coli aux temps 48 h et 96 h après l'aspiration. À 48 h, les macrophages alvéolaires présentaient une diminution marquée en cas d'infection par E. coli par rapport aux conditions air et PBS, tandis que les neutrophiles montraient une augmentation substantielle de leur proportion cellulaire (Figure 5A). Une tendance similaire a été observée à 96 h, la proportion de neutrophiles restant élevée en réponse à la stimulation par E. coli, alors que les macrophages alvéolaires présentaient des niveaux relativement plus faibles. Ces résultats indiquent une expansion marquée des neutrophiles durant l'infection bactérienne. Afin d'explorer les caractéristiques fonctionnelles des neutrophiles, les gènes marqueurs des neutrophiles ont été identifiés et une analyse d'enrichissement fonctionnel a été réalisée. L'enrichissement KEGG a associé les gènes marqueurs des neutrophiles à des voies de signalisation inflammatoire, notamment les voies du TNF, des MAPK et des récepteurs de type lectine C (Figure 5B). Les termes GO relatifs aux processus biologiques étaient également concentrés sur des fonctions liées à la réponse immunitaire, telles que la migration des leucocytes, l'adhésion cellule-cellule des leucocytes, la régulation positive de la réponse de défense et la réponse à des molécules d'origine bactérienne (Figure 5B). Afin d'identifier les gènes clés reliant l'activité des neutrophiles, la pneumonie et les cibles de Paeonia, les gènes marqueurs des neutrophiles ont été croisés avec les 18 gènes candidats identifiés précédemment. Cette analyse a révélé trois gènes communs : MMP9, PYGL et GADD45A (Tableau supplémentaire S3 et Figure 5C). Enfin, la visualisation de l'expression génique au niveau cellulaire unique a montré que ces trois gènes étaient principalement exprimés dans les populations de neutrophiles (Figure 5D), renforçant ainsi leur rôle potentiel dans les réponses inflammatoires médiées par les neutrophiles.
Affinité prévue de liaison de la catéchine avec des protéines sélectionnées lors du docking moléculaire
Afin d'évaluer davantage les interactions potentielles entre la catéchine et les protéines, une analyse de docking moléculaire a été réalisée entre les protéines sélectionnées (MMP9, PYGL et GADD45A) et la catéchine, un composé actif dérivé de Paeonia. Les structures cristallines de GADD45A, MMP9 et PYGL ont été obtenues à partir de la Protein Data Bank, et la structure tridimensionnelle de la catéchine a été extraite de la base de données PubChem. Les résultats du docking ont indiqué que la catéchine pourrait se lier à des sites des trois protéines sélectionnées, avec des énergies de liaison de −6,3 kcal/mol pour GADD45A, −7,6 kcal/mol pour MMP9 et −8,0 kcal/mol pour PYGL (Figure 6). Parmi ces protéines sélectionnées, la catéchine présentait l'affinité de liaison prévue la plus forte avec PYGL, suivie par MMP9 et GADD45A, suggérant une interaction potentielle privilégiée avec une protéine liée au métabolisme.
Au niveau moléculaire, la catéchine a formé plusieurs liaisons hydrogène et interactions hydrophobes avec des résidus d'acides aminés clés dans chaque protéine. Dans GADD45A, la catéchine a interagi avec des résidus tels que GLN33 et TRP135. Dans MMP9, une liaison hydrogène stable a été observée avec des résidus incluant GLN227, TYR248 et HIS236. De manière similaire, dans PYGL, la catéchine a formé plusieurs liaisons hydrogène avec des résidus tels que LYS554 et ASN631, contribuant à la stabilité de la liaison. En plus des liaisons hydrogène, l'analyse des interactions a révélé des forces de van der Waals et des interactions liées au π, indiquant un mode de liaison multiforme qui renforce la stabilité des complexes ligand–protéine prédits. Dans leur ensemble, ces résultats suggèrent que la catéchine peut former des complexes prédits stables avec MMP9, PYGL et GADD45A. Toutefois, la pertinence thérapeutique de ces interactions nécessite une validation expérimentale supplémentaire.
Interactions stables prédites entre la catéchine et les protéines sélectionnées
À partir des poses d'ancrage obtenues par la simulation d'ancrage moléculaire, des simulations de dynamique moléculaire de 100 ns ont été réalisées afin d'évaluer davantage la stabilité des complexes catéchine-protéine. L'analyse du RMSD a montré que les trois complexes protéine-ligand atteignaient un état d'équilibre pendant la durée de la simulation. Parmi eux, les complexes PYGL–catéchine et MMP9–catéchine présentaient des fluctuations de RMSD relativement stables, tandis que le complexe GADD45A–catéchine montrait des fluctuations légèrement plus élevées, mais restant dans une plage acceptable (Figure 7A). L'analyse du Rg indiquait que tous les complexes conservaient une compacité structurale stable tout au long de la simulation, avec des variations minimales dans le temps (Figure 7B). De même, l'analyse du SASA démontrait des niveaux d'exposition stables pour tous les complexes, confirmant ainsi leur stabilité structurale (Figure 7C). L'analyse des liaisons hydrogène révélait des interactions persistantes entre la catéchine et les protéines sélectionnées. Le complexe PYGL–catéchine maintenait un nombre plus élevé de liaisons hydrogène au cours du temps par rapport aux complexes MMP9 et GADD45A, suggérant des interactions de liaison plus fortes et plus stables (Figure 7D).
La flexibilité au niveau des résidus a été évaluée à l'aide de l'écart type quadratique moyen (RMSF). Les résultats ont montré que la plupart des résidus présentaient une faible fluctuation, seules quelques régions affichant une flexibilité plus élevée, ce qui indique que la liaison du ligand n'a pas induit d'instabilité structurale majeure dans les protéines (Figure 7E). Dans leur ensemble, ces résultats suggèrent que la catéchine forme des complexes prédits stables avec MMP9, PYGL et GADD45A, la stabilité la plus forte étant observée dans l'interaction entre PYGL et la catéchine. Ces résultats appuient l'existence d'interactions prédites stables entre la catéchine et les protéines sélectionnées, fournissant une preuve computationnelle justifiant une validation expérimentale ultérieure.
Disponibilité des données :
Des jeux de données accessibles au public ont été analysés dans cette étude. Le jeu de données de séquençage ARN en masse est disponible dans le Gene Expression Omnibus (GEO) sous le numéro d'accès GSE261482 (https://www.ncbi.nlm.nih.gov/geo/query/acc.cgi?acc=GSE261482), et le jeu de données de séquençage ARN monocellulaire du poumon de souris est disponible sous le numéro d'accès GSE295484 (https://www.ncbi.nlm.nih.gov/geo/query/acc.cgi?acc=GSE295484). Les résultats traités utilisés dans l'article sont fournis en tant que Tableau Supplémentaire S1, Tableau Supplémentaire S2 et Tableau Supplémentaire S3.
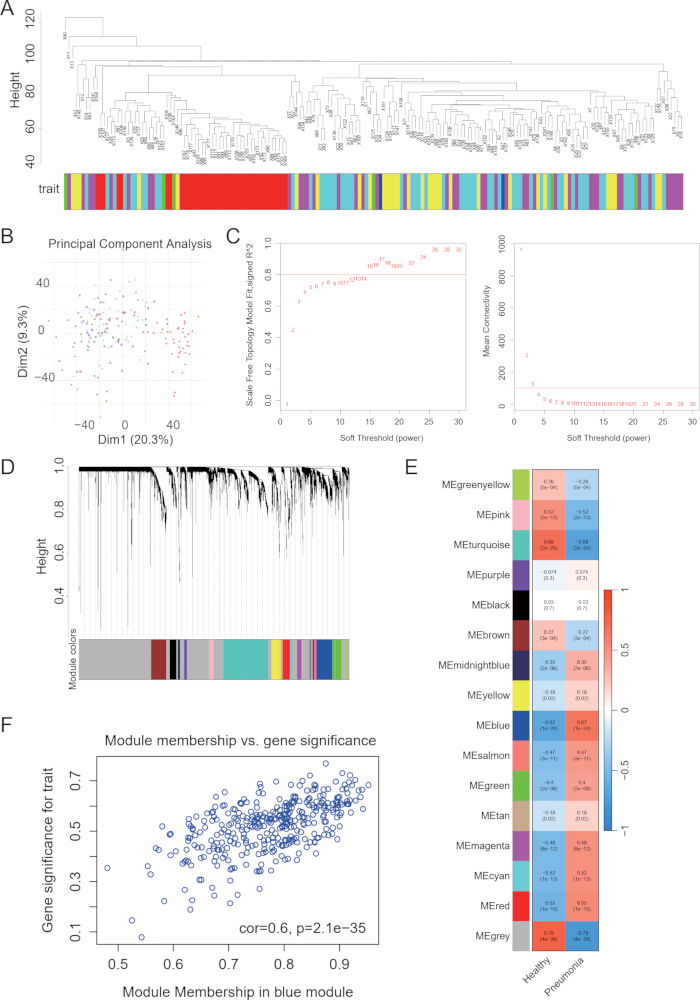
Figure 1. Construction de WGCNA et identification des modules associés à la maladie (A) Un regroupement des échantillons a été effectué à partir des profils d'expression génique, et les annotations des caractères correspondants sont affichées sous le dendrogramme. (B) L'analyse en composantes principales montre la répartition des échantillons selon les deux premières composantes principales. (C) La puissance de seuil doux a été évaluée à l'aide de l'indice d'ajustement à une topologie sans échelle et de la connectivité moyenne. (D) Les gènes ont été regroupés selon leur chevauchement topologique, et les affectations aux modules sont indiquées par des couleurs. (E) Les corrélations entre les eigengènes des modules et les caractères cliniques sont représentées sous forme de carte thermique. (F) La relation entre l'appartenance au module et la significativité du gène est illustrée pour les gènes du module bleu. Veuillez cliquer ici pour visualiser une version agrandie de cette figure.
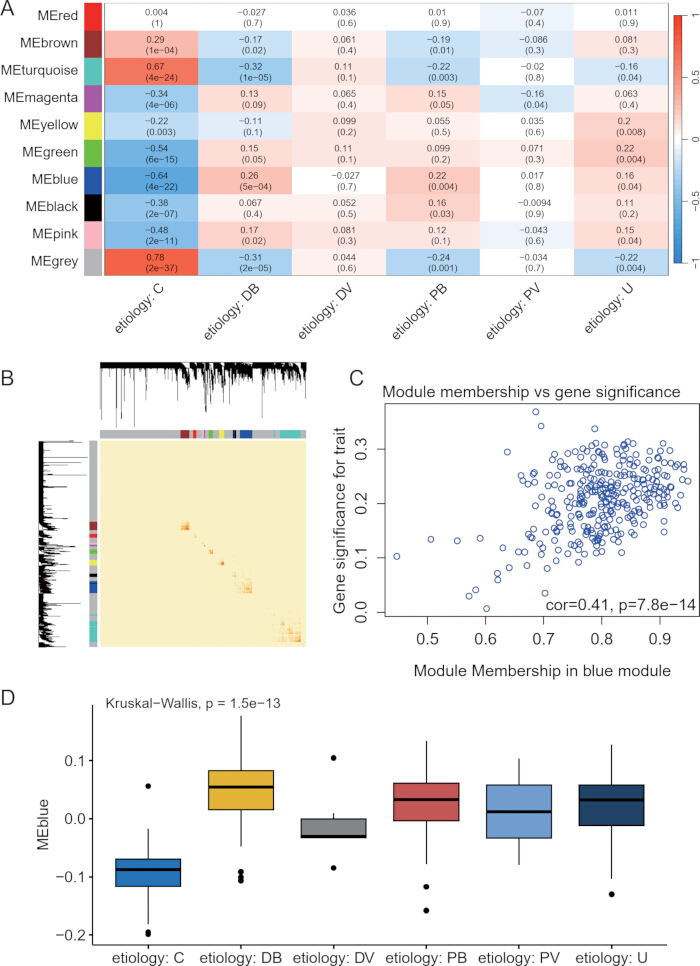
Figure 2. Analyse WGCNA selon l'étiologie de la pneumonie. (A) Les corrélations des eigengènes des modules sont présentées pour les groupes étiologiques, incluant le témoin, bactérien défini, viral défini, bactérien probable, viral probable et inconnu. (B) Les modules de gènes ont été attribués à partir du dendrogramme de regroupement basé sur la superposition topologique. (C) L'appartenance au module et la signification du gène sont représentées pour le module bleu. (D) L'expression de l'eigengène du module bleu est comparée entre les groupes étiologiques. Abréviations : WGCNA = analyse de réseau de co-expression génique pondérée ; C = témoin ; DB = bactérien défini ; DV = viral défini ; PB = bactérien probable ; PV = viral probable ; U = inconnu. Veuillez cliquer ici pour visualiser une version agrandie de cette figure.
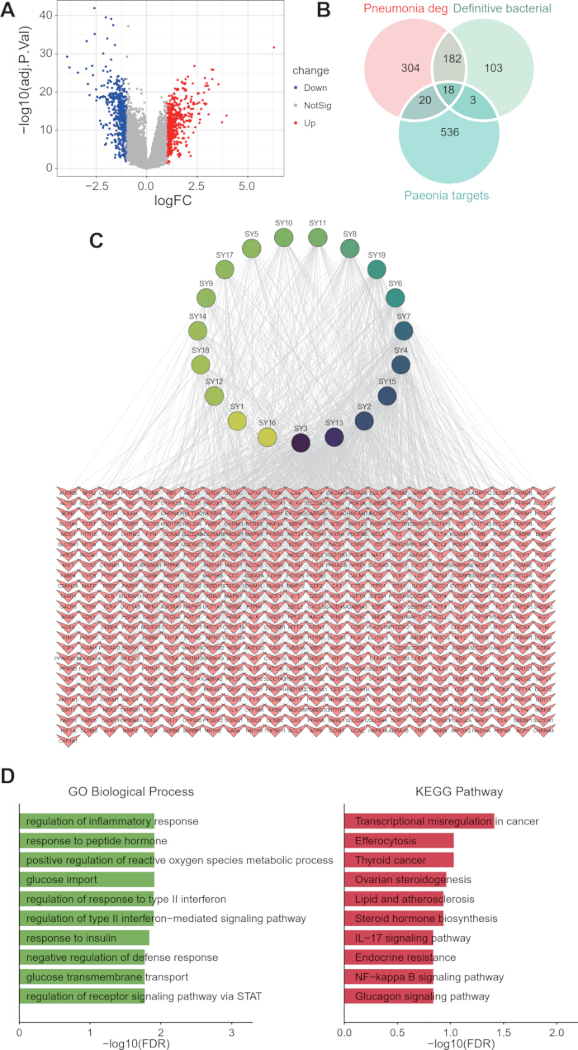
Figure 3. Identification et analyse fonctionnelle des gènes candidats. (A) Graphique en volcan illustrant les gènes différentiellement exprimés entre les échantillons de pneumonie et les témoins. (B) Diagramme de Venn montrant l'intersection entre les gènes différentiellement exprimés (DEGs) dans la pneumonie, les gènes associés aux bactéries définitives et les gènes cibles de Paeonia. (C) Réseau d'interactions composé-cible entre les composants actifs de Paeonia et les gènes candidats. (D) Diagrammes en barres montrant l'enrichissement fonctionnel en processus biologiques selon l'ontologie génétique (à gauche) et l'enrichissement en voies métaboliques selon KEGG (à droite) pour les gènes communs. Veuillez cliquer ici pour consulter une version agrandie de cette figure.
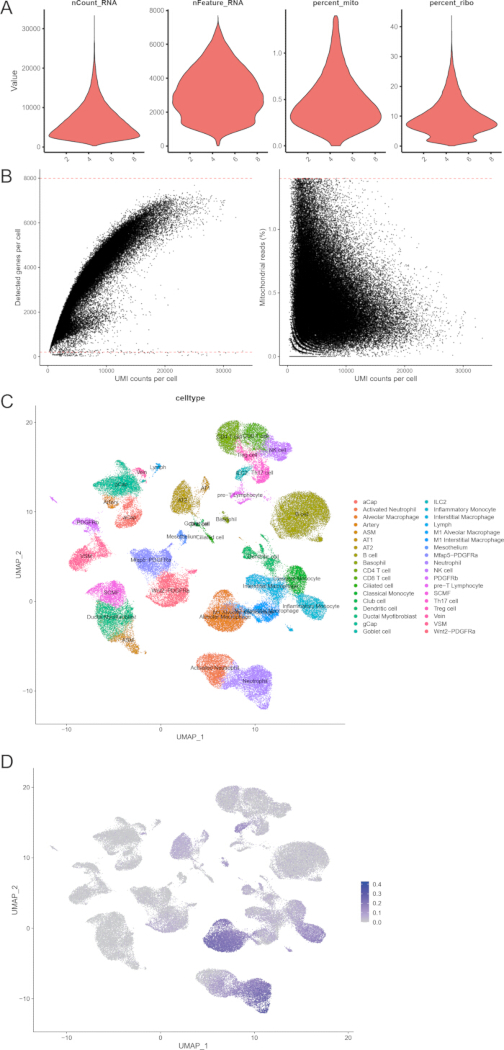
Figure 4. Analyse transcriptomique unicellulaire de la pneumonie. (A) Les diagrammes en violon résument les métriques de contrôle qualité, notamment le nCount_RNA, le nFeature_RNA, le pourcentage de gènes mitochondriaux et le pourcentage de gènes ribosomaux. (B) Diagrammes de dispersion montrant les relations entre le nombre d'UMI, le nombre de gènes détectés par cellule et le pourcentage de gènes mitochondriaux. (C) Visualisation UMAP des groupes cellulaires annotés par types cellulaires. (D) Graphique UMAP montrant les scores AUCell pour la signature génique candidate à travers les cellules uniques. Veuillez cliquer ici pour visualiser une version agrandie de cette figure.
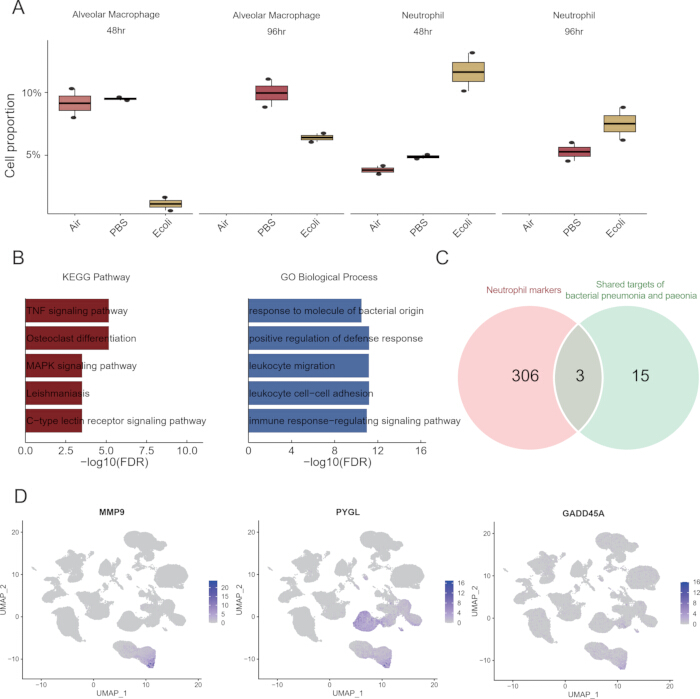
Figure 5. Dynamique des neutrophiles et identification des gènes clés. (A) Boîtes à moustaches montrant les proportions cellulaires des macrophages alvéolaires et des neutrophiles dans différentes conditions (air, PBS et E. coli) à 48 h et 96 h. (B) Histogrammes montrant l'enrichissement des voies KEGG (à gauche) et l'enrichissement des processus biologiques GO (à droite) pour les gènes marqueurs des neutrophiles. (C) Diagramme de Venn montrant les gènes communs entre les gènes marqueurs des neutrophiles et les cibles partagées de la pneumonie bactérienne et de Paeonia. (D) Graphiques UMAP montrant les profils d'expression de MMP9, PYGL et GADD45A au sein des populations cellulaires. Veuillez cliquer ici pour afficher une version agrandie de cette figure.
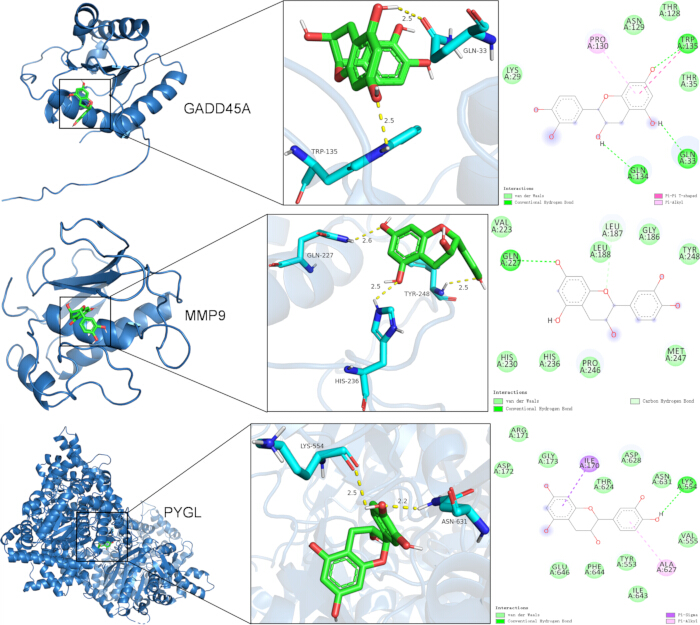
Figure 6. Docking moléculaire de la catéchine avec des protéines sélectionnées. Structures tridimensionnelles de complexes protéine-ligand illustrant la liaison de la catéchine à GADD45A (haut), MMP9 (milieu) et PYGL (bas). Les panneaux agrandis montrent les régions de liaison et les contacts avec des résidus d'acides aminés clés. Les diagrammes bidimensionnels présentent les liaisons hydrogène et autres interactions entre la catéchine et les protéines sélectionnées. Veuillez cliquer ici pour visualiser une version agrandie de cette figure.
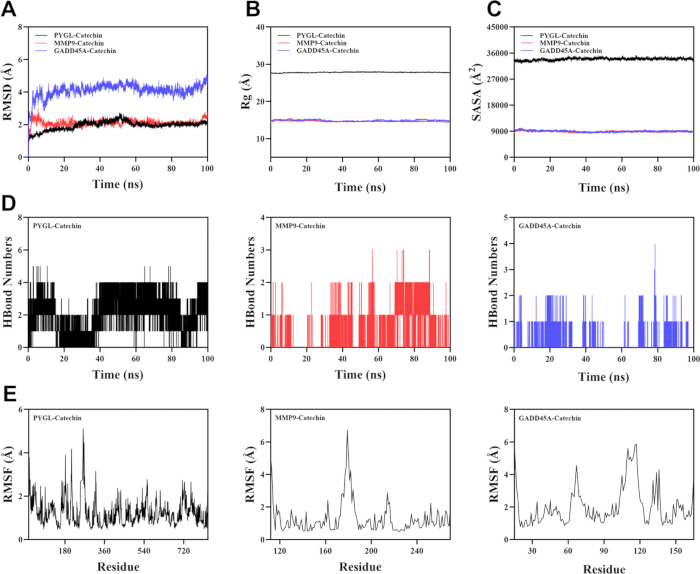
Figure 7. Simulations de dynamique moléculaire de complexes protéine-ligand. (A) Déviation quadratique moyenne des complexes au cours de la simulation. (B) Évolution du rayon de giration en fonction du temps. (C) Surface accessible au solvant au cours de la simulation. (D) Nombre de liaisons hydrogène entre la catéchine et les protéines cibles en fonction du temps. (E) Fluctuation quadratique moyenne des résidus protéiques dans chaque complexe. Abréviations : RMSD = déviation quadratique moyenne ; Rg = rayon de giration ; SASA = surface accessible au solvant ; RMSF = fluctuation quadratique moyenne. Veuillez cliquer ici pour visualiser une version agrandie de cette figure.
Tableau supplémentaire S1. Gènes différentiellement exprimés surexprimés chez les enfants atteints de pneumonie par rapport aux échantillons témoins sains, incluant les symboles des gènes, les variations d'expression logarithmiques en base 2, les valeurs P, les valeurs P ajustées et les statistiques limma associées. Veuillez cliquer ici pour télécharger ce fichier.
Tableau supplémentaire S2. Tableau des interactions composés-cibles pour Paeonia utilisé pour l'analyse de réseau, incluant les identifiants des composés, les noms des composés et les gènes cibles associés. Veuillez cliquer ici pour télécharger ce fichier.
Tableau supplémentaire S3. Tableau des gènes marqueurs en simple cellule provenant de GSE295484, incluant les valeurs P, les logarithmes moyens de rapport d'expression (log2 fold changes), les pourcentages d'expression, les valeurs P ajustées, les annotations des groupes cellulaires et les symboles des gènes. Veuillez cliquer ici pour télécharger ce fichier.
Discussion
La pneumonie est une cause majeure de morbidité et de mortalité chez les nourrissons et les jeunes enfants dans le monde entier, entraînant un fardeau important pour la santé publique1. La pathogenèse de la pneumonie pédiatrique est complexe et implique de nombreux processus interconnectés, notamment des réponses inflammatoires excessives, le stress oxydatif, ainsi que la dysrégulation des voies immunitaires et métaboliques2,10,11. Des études antérieures ont suggéré qu'une activation incontrôlée des cellules immunitaires innées, en particulier des neutrophiles et des macrophages, contribue à l'atteinte du tissu pulmonaire par la libération de cytokines pro-inflammatoires, d'enzymes protéolytiques et d'espèces réactives de l'oxygène (ROS)12. Malgré les progrès réalisés dans les thérapies antimicrobiennes et de soutien, les stratégies efficaces ciblant ces mécanismes moléculaires sous-jacents restent limitées. Il est donc très important d'identifier de nouveaux agents thérapeutiques capables de moduler l'inflammation et de rétablir l'homéostasie immunitaire.
Les phytochimiques, en particulier les catéchines, attirent une attention croissante en raison de leurs propriétés anti-inflammatoires, antioxydantes et immunomodulatrices bien documentées13,14,15. Toutefois, les mécanismes moléculaires précis par lesquels la catéchine exerce ses effets protecteurs dans la pneumonie restent largement obscurs. Cette étude a exploré de manière systématique les mécanismes potentiels associés aux catéchines dans la pneumonie pédiatrique en utilisant une approche intégrative combinant la transcriptomique, le séquençage de l'ARN en cellule unique, le dockage moléculaire et des simulations de dynamique moléculaire.
Conformément à l'hypothèse initiale, les résultats ont démontré que le module bleu identifié par l'analyse WGCNA était significativement associé à la fois au statut de la maladie et à la classification étiologique, suggérant que ce module représente un programme transcriptionnel fondamental impliqué dans la pneumonie pédiatrique. Une intégration supplémentaire de l'analyse d'expression différentielle et de la prédiction des cibles de Paeonia a révélé 18 gènes communs, enrichis dans des voies liées au système immunitaire, notamment la réponse inflammatoire, le métabolisme des espèces réactives de l'oxygène et la signalisation de l'interféron de type II16,17. Ces résultats renforcent davantage l'idée que des réponses immunitaires dysrégulées et le stress oxydatif sont des facteurs centraux dans la progression de la maladie.
L'analyse de séquençage de l'ARN au niveau cellulaire unique a révélé en outre que l'ensemble de gènes candidats était principalement enrichi dans les neutrophiles et les macrophages alvéolaires, soulignant le rôle central des cellules immunitaires innées dans la progression de la pneumonie. Les proportions de neutrophiles ont augmenté significativement sous stimulation par E. coli, en particulier à 48 h et 96 h, indiquant une activation prolongée durant l'inflammation aiguë, ce qui est cohérent avec leur double rôle dans l'élimination des agents pathogènes et les lésions tissulaires via les médiateurs inflammatoires et les ERO18. Une analyse approfondie a identifié trois gènes clés — MMP9, PYGL et GADD45A — comme des liens potentiels entre les réponses immunitaires, la régulation métabolique et le stress cellulaire. Alors que MMP9 est impliqué dans le remodelage de la matrice extracellulaire et l'infiltration inflammatoire19, et que GADD45A régule le stress et les réponses immunitaires, PYGL suggère un rôle du reprogrammation métabolique dans l'activation immunitaire20,21. Des simulations de docking moléculaire et de dynamique ont suggéré une liaison prédite stable entre la catéchine et ces protéines sélectionnées, appuyée par des énergies de liaison favorables et des profils stables de RMSD, Rg et SASA, ainsi que par des liaisons hydrogène persistantes et des valeurs faibles de RMSF. Ces résultats suggèrent que la catéchine pourrait être associée à ces cibles inflammatoires et métaboliques, mais des effets régulateurs directs restent à confirmer par une validation expérimentale ultérieure22.
Outre ses effets anti-inflammatoires, la catéchine pourrait également exercer des rôles protecteurs en modulant le stress oxydatif et l'équilibre métabolique. L'enrichissement des voies liées aux ERO suggère que la catéchine pourrait atténuer les dommages oxydatifs en renforçant la capacité antioxydante, ce qui est conforme aux rapports antérieurs sur les propriétés antioxydantes des catéchines. De plus, l'implication d'enzymes métaboliques telles que PYGL met en évidence un rôle potentiel de la catéchine dans la régulation de l'immunométabolisme, un concept émergent dans les maladies inflammatoires.
Plusieurs limites de cette étude doivent être reconnues. Premièrement, cette étude reposait principalement sur des jeux de données transcriptomiques accessibles publiquement et sur des analyses computationnelles, et les mécanismes prédits n'ont pas encore été validés expérimentalement. Bien que le dockage moléculaire et les simulations de dynamique moléculaire aient suggéré des interactions stables entre la catéchine et les protéines cibles candidates, ces résultats ne démontrent pas une inhibition fonctionnelle, une activation ou une efficacité thérapeutique. Des essais biochimiques supplémentaires, des expériences cellulaires et des études in vivo sont nécessaires pour valider les effets régulateurs de la catéchine sur MMP9, PYGL et GADD45A et pour déterminer son intérêt thérapeutique dans la pneumonie. Deuxièmement, les informations cliniques disponibles pour le jeu de données sur la pneumonie pédiatrique étaient limitées. Le jeu de données GSE261482 fournissait des données transcriptomiques de sang total provenant de patients pédiatriques atteints de pneumonie et de témoins sains, ainsi que des métadonnées incluant le sexe, la classification étiologique, le tube de prélèvement, le lot et l'état de la maladie.
Cependant, les variables cliniques détaillées, notamment l'âge individuel, la gravité de la pneumonie, le statut thérapeutique au moment de l'échantillonnage et d'autres informations sur l'évolution de la maladie, n'étaient pas entièrement disponibles dans les métadonnées GEO utilisées dans cette étude. Par conséquent, des analyses supplémentaires stratifiées selon la gravité clinique, le stade du traitement ou le sous-groupe d'âge n'ont pas pu être réalisées. Troisièmement, les jeux de données d'ARN-séquençage en masse et d'ARN-séquençage au niveau cellulaire unique provenaient de contextes biologiques différents. GSE261482 a été généré à partir d'échantillons de sang total de patients pédiatriques, tandis que GSE295484 a été obtenu à partir de tissus pulmonaires de souris C57BL/6 de type sauvage dans un modèle expérimental de pneumonie. Ainsi, les résultats obtenus par séquençage au niveau cellulaire unique doivent être interprétés comme des preuves contextuelles cellulaires appuyant la présence de populations de cellules inflammatoires et la distribution des gènes candidats, plutôt que comme une validation directe dans la pneumonie pédiatrique humaine. De plus, le modèle de pneumonie murin induit par E. coli ne reflète pas pleinement les étiologies hétérogènes de la pneumonie pédiatrique, incluant les causes bactériennes, virales, probablement bactériennes, probablement virales et inconnues.
Enfin, la sélection de MMP9, PYGL et GADD45A était fondée sur un criblage bioinformatique intégratif et leur pertinence biologique connue, mais leurs rôles précis dans l'inflammation associée aux neutrophiles et la régulation médiée par les catéchines restent à confirmer. Des études futures utilisant des cohortes cliniques pédiatriques, des jeux de données unicellulaires humains, des tests fonctionnels ciblant des gènes spécifiques et des modèles expérimentaux de pneumonie sont nécessaires pour valider ces résultats et préciser le potentiel translationnel des catéchines.
En résumé, cette étude suggère que la catéchine pourrait être associée à des réponses inflammatoires liées aux neutrophiles et à des gènes sélectionnés impliqués dans la régulation immunitaire, le stress oxydatif et les voies métaboliques dans la pneumonie. Grâce à une analyse intégrative de la séquençation ARN en masse, de la séquençation ARN à la cellule unique, du dockage moléculaire et de simulations de dynamique moléculaire, cette étude a identifié un module génique associé à la maladie et sélectionné MMP9, PYGL et GADD45A pour les analyses de dockage et de simulation avec la catéchine. L'enrichissement des gènes candidats dans les neutrophiles et les macrophages alvéolaires, conjugué aux interactions prévues stables observées entre la catéchine et les protéines sélectionnées, appuie un mécanisme potentiel nécessitant une validation expérimentale ultérieure. Dans l'ensemble, ces résultats offrent une perspective à l'échelle du système sur les mécanismes potentiels associés à la catéchine dans la pneumonie, mais des études expérimentales et cliniques supplémentaires sont nécessaires pour valider ces observations et préciser leur pertinence thérapeutique.
Déclarations de divulgation
Les auteurs déclarent ne pas avoir de conflits d'intérêts.
Matériaux
| Nom | Entreprise | Numéro de catalogue | Commentaires |
|---|---|---|---|
| Champ de forces AMBER14SB Type : Champ de forces | Champ de forces protéique pour les simulations de dynamique moléculaire | ||
| Paquet R AUCell Type : Paquet R | Évaluation de l'activité des ensembles de gènes au niveau cellulaire unique | ||
| AutoDock Tools Type : Logiciel | Préparation du récepteur et du ligand | ||
| AutoDock Vina Type : Logiciel | Accolement moléculaire | ||
| BindingDB Type : Base de données | BindingDB | Interactions expérimentalement validées entre composés et cibles ; URL/version non fournie dans le manuscrit | |
| Paquet R clusterProfiler Type : Paquet R | Analyse d'enrichissement GO et KEGG | ||
| DrugBank Type : Base de données | DrugBank | Interactions expérimentalement validées entre composés et cibles ; URL/version non fournie dans le manuscrit | |
| Base de données ETCM Type : Base de données | ETCM | Recherche de composés actifs de Paeonia ; URL/version non fournie dans le manuscrit | |
| Champ de forces GAFF2 Type : Champ de forces | Champ de forces du ligand pour les simulations de dynamique moléculaire | ||
| GROMACS 2022 Type : Logiciel | GROMACS | Simulation de dynamique moléculaire | |
| GSE261482 Type : Ensemble de données publiques de RNA-séquençage en masse | Gene Expression Omnibus (GEO) | https://www.ncbi.nlm.nih.gov/geo/query/acc.cgi?acc=GSE261482 | Données d'expression sanguines totales de patients pédiatriques atteints de pneumonie et de témoins sains |
| GSE295484 Type : Ensemble de données publiques de séquençage ARN unicellulaire | Gene Expression Omnibus (GEO) | https://www.ncbi.nlm.nih.gov/geo/query/acc.cgi?acc=GSE295484 | Données de séquençage ARN unicellulaire du poumon de souris issues d'un modèle expérimental de pneumonie |
| Paquet R limma Type : Paquet R | Analyse d'expression différentielle | ||
| PharmMapper Server Type : Base de données/outils | PharmMapper | http://lilab.ecust.edu.cn/pharmmapper/ | Cartographie pharmacophorique inverse |
| Protein Data Bank (PDB) Type : Base de données | Protein Data Bank | Structures protéiques pour GADD45A (2KG4), MMP9 (6ESM) et PYGL (3DDS) | |
| Base de données PubChem Type : Base de données | PubChem | Structure tridimensionnelle de la catéchine | |
| Logiciel R Type : Logiciel | R Project | Analyses statistiques | |
| Paquet R Seurat Type : Paquet R | Contrôle qualité, normalisation, regroupement, visualisation UMAP et annotation cellulaire pour le séquençage ARN unicellulaire | ||
| Similarity Ensemble Approach (SEA) Type : Base de données/outils | SEA | http://sea.bkslab.org | Prédiction d'interactions potentielles hors cible |
| sobtop_1.0 (dev3.1) Type : Logiciel | Génération de paramètres du ligand | ||
| SwissTargetPrediction Type : Base de données/outils | SwissTargetPrediction | http://www.swisstargetprediction.ch | Prédiction de cibles du composé |
| Modèle d'eau TIP3P Type : Modèle d'eau | Solvatation des complexes protéine-ligand | ||
| Base de données de pharmacologie systémique de la médecine traditionnelle chinoise (TCMSP) Type : Base de données | TCMSP | https://tcmsp-e.com | Recherche de composés actifs de Paeonia |
| Base de données UniProt Type : Base de données | UniProt | https://www.uniprot.org | Normalisation des symboles génétiques |
| Paquet R WGCNA Type : Paquet R | Analyse de réseau de co-expression génique pondéré |
Références
- Chen L, Chen Y, Huang J, Zhang J. LncRNA LINC00707 serves as a sponge of miR-382-5p to alleviate lipopolysaccharide (LPS)-induced WI-38 cell injury through upregulating NKAP in infantile pneumonia. Autoimmunity. 2022;55(5):328-38.
- Li S et al. miRNA-302e attenuates inflammation in infantile pneumonia through the RelA/BRD4/NF-κB signaling pathway. Int J Mol Med. 2019;44(1):47-56.
- Kennedy II DE et al. Contribution of Puma to inflammatory resolution during early pneumococcal pneumonia. Front Cell Infect Microbiol. 2022;12:886901.
- Wang C et al. Suppressing neutrophil itaconate production attenuates Mycoplasma pneumoniae pneumonia. PLoS Pathog. 2024;20(11):e1012614.
- Shen N et al. Plant flavonoids: classification, distribution, biosynthesis, and antioxidant activity. Food Chem. 2022;383:132531.
- Peng X, McClements DJ, Liu X, Liu F. EGCG-based nanoparticles: synthesis, properties, and applications. Crit Rev Food Sci Nutr. 2025;65(12):2177-98.
- Li T et al. Synergistic anti-inflammatory effects of quercetin and catechin via inhibiting activation of TLR4-MyD88-mediated NF-κB and MAPK signaling pathways. Phytother Res. 2019;33(3):756-67.
- Viz-Lasheras S et al. A diagnostic host-specific transcriptome response for Mycoplasma pneumoniae pneumonia to guide pediatric patient treatment. Nat Commun. 2025;16(1):673.
- Michki SN et al. Age-dependent immune responses and resident cell dynamics in young mice following pneumonia. iScience. 2026;29(1):114219.
- Jin M et al. Catechin-functionalized cationic lipopolymer based multicomponent nanomicelles for lung-targeting delivery. Adv Mater. 2024;36(17):e2302985.
- Shin-Ya M et al. Effects of tea, catechins and catechin derivatives on Omicron subvariants of SARS-CoV-2. Sci Rep. 2023;13(1):16577.
- Zheng Q, Li J, Yang L. Systematic investigation of catechin/cyclodextrin encapsulated polymeric nanospheres for the treatment and nursing care of pediatric pneumonia-causing human pathogens. Microb Pathog. 2025;205:107524.
- Zhang Y et al. Anti-inflammatory effect of chlorogenic acid in Klebsiella pneumoniae-induced pneumonia by inactivating the p38MAPK pathway. Int J Med Microbiol. 2023;313(2):151576.
- Gleeson K, Reynolds HY. Life-threatening pneumonia. Clin Chest Med. 1994;15(3):581-602.
- Ross SM. Resveratrol: the anti-inflammatory effects of a phytochemical compound on pneumonia, respiratory syncytial virus, and severe acute respiratory syndrome (SARS-CoV-2). Holist Nurs Pract. 2023;37(2):110-2.
- Hu H et al. Hybrid biomimetic membrane coated particles-mediated bacterial ferroptosis for acute MRSA pneumonia. ACS Nano. 2023;17(12):11692-712.
- Dong L et al. A ROS-responsive nanoprodrug-engineered phage biotherapy for precision treatment of multidrug-resistant Gram-negative bacterial pneumonia. J Control Release. 2025;382:113708.
- Wiegman CH et al. Oxidative stress in ozone-induced chronic lung inflammation and emphysema: a facet of chronic obstructive pulmonary disease. Front Immunol. 2020;11:1957.
- Jiang T et al. Dual role of Baimao-Longdan-Congrong-Fang in inhibiting Staphylococcus aureus virulence factors and regulating TNF-α/TNFR1/NF-κB/MMP9 axis. Phytomedicine. 2025;139:156477.
- Zhang H et al. The attenuated Mycoplasma bovis strain promotes apoptosis of bovine macrophages by upregulation of CHOP expression. Front Microbiol. 2022;13:925209.
- Borella R et al. Metabolic reprograming shapes neutrophil functions in severe COVID-19. Eur J Immunol. 2022;52(3):484-502.
- Xu Y et al. Exosomal miR-155-5p drives widespread macrophage M1 polarization in hypervirulent Klebsiella pneumoniae-induced acute lung injury via the MSK1/p38-MAPK axis. Cell Mol Biol Lett. 2023;28(1):92.