Ce protocole d'évaluation en sciences du comportement et en psychologie normalise la passation en ligne de questionnaires, le calcul des scores, le contrôle de qualité des données et l'analyse reproductible afin d'évaluer la dépendance à internet et les difficultés de régulation émotionnelle chez les étudiants universitaires.
Un abonnement JoVE est requis pour visualiser ce contenu. Connectez-vous ou commencez votre période d'essai gratuite.
Article de méthode
Un protocole de questionnaire standardisé pour l'évaluation de l'addiction à Internet et de la régulation émotionnelle chez les étudiants universitaires
Dans cet article
Résumé
Résumé
L'utilisation d'Internet est profondément intégrée à la vie universitaire, mais l'évaluation de l'utilisation problématique d'Internet ne peut pas reposer uniquement sur la durée d'exposition. Des données suggèrent que des schémas d'utilisation inadaptés ou compulsifs d'Internet sont associés à des difficultés dans la régulation des émotions, mais des incohérences dans l'ordre des questionnaires, les critères d'éligibilité, les seuils de dépistage, les procédures de cotation et la présentation des analyses continuent de limiter la comparabilité entre les études. Cet article méthodologique présente un protocole standardisé de questionnaire destiné aux études en sciences du comportement et en évaluation psychologique examinant la dépendance à Internet et les difficultés de régulation émotionnelle chez les étudiants universitaires. Le déroulement comprend une séquence fixe de questionnaires, des critères d'éligibilité prédéfinis, des paramètres de réponse obligatoire, des seuils de temps de complétion basés sur un essai préliminaire, un criblage séquentiel de la qualité des données, une cotation standardisée du test de dépendance à Internet et de l'échelle de difficultés de régulation émotionnelle en 16 items, ainsi que des analyses descriptives, corrélations et régressions multivariées reproductibles. Le protocole précise également l'archivage des réponses brutes, des journaux de criblage, des fichiers README ou codebook, et du jeu de données final prêt à l'analyse. Une mise en œuvre représentative est rapportée afin de démontrer l'exécution du protocole, sans toutefois valider les instruments ni établir la prévalence. Dans cette mise en œuvre, 520 étudiants ont été invités, et 480 questionnaires ont été retournés. Après exclusion séquentielle des soumissions en double, des réponses trop rapides, des échecs aux contrôles d'attention, des réponses systématiques, des incohérences logiques et des données essentielles manquantes, 452 questionnaires valides ont été conservés. La démonstration analytique prédéfinie a examiné l'association entre le score total au test de dépendance à Internet et le score total à l'échelle de difficultés de régulation émotionnelle. L'échantillon retenu présentait un score moyen de 51,94 au test de dépendance à Internet et un score moyen de 35,95 à l'échelle de difficultés de régulation émotionnelle. La difficulté à réguler les émotions augmentait selon les groupes de gravité de la dépendance à Internet, et cette association restait significative après ajustement sur des covariables démographiques et comportementales. Ce protocole fournit un déroulement transparent, reproductible, vérifiable et adaptable à de futures études transversales, répétées ou longitudinales dans les populations universitaires.
Introduction
L'utilisation d'Internet est devenue une partie ordinaire de la vie universitaire, incluant le travail académique, la communication sociale, les loisirs, la recherche d'information et la gestion émotionnelle. Pour cette raison, le comportement des étudiants sur Internet ne devrait pas être interprété simplement comme une exposition aux écrans ou un temps passé en ligne. Des études antérieures ont montré que l'utilisation problématique d'Internet était déjà observable chez les jeunes et les étudiants avant que l'environnement actuel basé sur les plateformes mobiles ne devienne largement répandu1. Des études plus récentes menées dans les universités indiquent en outre que l'utilisation problématique d'Internet est suffisamment fréquente pour nécessiter une évaluation systématique plutôt qu'une description informelle2.
Les étudiants universitaires constituent une population particulièrement pertinente pour l'évaluation normalisée, car la pression académique, la transition sociale, le mode de vie indépendant et l'autonomie accrue surviennent souvent au même stade du développement. Ces exigences sont fréquemment gérées à l’aide des mêmes appareils et plateformes numériques, qui peuvent également devenir difficiles à réguler. Une revue méta-analytique a montré que l’utilisation problématique d’Internet chez les étudiants est associée à plusieurs conséquences sur la santé mentale, ce qui appuie son interprétation comme un problème comportemental et psychologique plus large, plutôt que comme un simple problème d’utilisation technologique3. Le stress perçu a également été associé à des comportements d’addiction à Internet chez les étudiants universitaires, suggérant que les pressions émotionnelles et contextuelles doivent être prises en compte lors de la conception d’études fondées sur des questionnaires dans ce domaine4.
Le présent protocole utilise le terme « dépendance à internet » lorsqu'il fait spécifiquement référence au construit mesuré par le test de dépendance à internet et ses catégories de scores établies. L'appellation plus générale « usage problématique d'internet » est employée lorsqu'on aborde la littérature plus large portant sur des comportements liés à internet de manière maladaptée, excessive ou entraînant une altération fonctionnelle. Le terme « usage compulsif d'internet » n'est utilisé que lorsque la littérature citée met l'accent sur la perte de contrôle, les impulsions ou l'usage répétitif malgré des conséquences négatives. Ces termes sont donc apparentés, mais ne sont pas considérés comme pleinement interchangeables. Lorsque le protocole est mis en œuvre à l'aide du test de dépendance à internet, l'appellation « dépendance à internet » est conservée comme terminologie propre à l'instrument ; lorsqu'on utilise des instruments alternatifs ou modifiés, la terminologie doit être alignée sur les étiquettes de construit et les hypothèses diagnostiques de la mesure choisie.
La régulation des émotions constitue un point d'entrée psychologique plausible pour comprendre pourquoi certains étudiants passent d'une utilisation fréquente d'Internet à une utilisation maladaptée. Une étude prospective d'un an a montré que les difficultés de régulation émotionnelle étaient associées à la fois à l'apparition ultérieure et à la disparition de la dépendance à Internet chez les étudiants universitaires5. Cette découverte revêt une importance particulière pour la conception de protocoles, car la régulation des émotions ne constitue pas simplement un facteur corrélé supplémentaire ; elle pourrait influencer la manière dont les étudiants utilisent Internet pour éviter, réduire ou gérer la détresse. Parallèlement, le fonctionnement social demeure pertinent. L'utilisation problématique d'Internet a été associée aux compétences sociales chez les étudiants universitaires, ce qui indique que les facteurs interpersonnels et émotionnels doivent être évalués conjointement avec les variables liées à l'usage numérique6. Pendant la période de la COVID-19, l'utilisation problématique d'Internet s'est également accompagnée de troubles psychologiques plus larges chez les étudiants chinois, renforçant ainsi la nécessité d'une évaluation structurée dans les établissements universitaires7.
Un défi supplémentaire réside dans l'hétérogénéité du comportement numérique. Les étudiants peuvent utiliser les plateformes numériques pour leurs études, leurs contacts sociaux, leur divertissement, l'information sur la santé ou un soulagement émotionnel temporaire, et une utilisation fréquente n'est pas nécessairement nuisible. Une revue systématique portant sur l'utilisation numérique liée à la santé mentale chez les étudiants universitaires a montré que l'engagement numérique peut remplir plusieurs fonctions psychologiques8. Le domaine a donc besoin de procédures permettant de distinguer une utilisation fréquente ordinaire d'une utilisation problématique ou dysrégulée. Des preuves récentes concernant l'utilisation problématique du smartphone chez les étudiants universitaires suggèrent de la même manière que le risque dépend du schéma comportemental, de la fonction et du contexte, et non uniquement de la durée d'utilisation9. Pour cette raison, le présent protocole combine la durée d'utilisation d'Internet, l'utilisation tardive dans la nuit, l'activité en ligne principale et un score standardisé des symptômes, plutôt que de s'appuyer sur un seul indicateur d'exposition.
La mesure constitue une autre source importante d'incohérence. Le test d'addiction à Internet reste l'un des instruments les plus largement utilisés pour évaluer les symptômes d'addiction à Internet, mais sa dimensionnalité et son interprétation ont varié selon les contextes. Des données psychométriques systématiques indiquent que cet instrument a été intensivement utilisé tout en soulevant continuellement des questions concernant sa structure factorielle et l'interprétation des scores10. Des préoccupations similaires ont été signalées dans des échantillons d'étudiants universitaires, où l'utilisation répandue de cette échelle n'a pas totalement dissipé l'incertitude quant au construit mesuré11. Des études de validation menées auprès de populations universitaires espagnoles et péruviennes montrent également que l'instrument peut présenter des performances adéquates, mais que son comportement psychométrique doit être pris en compte en fonction de la population cible dans laquelle il est appliqué12,13.
Le protocole est donc conçu pour être stable en termes de flux de travail, tout en restant adaptable en ce qui concerne le choix de l'instrument. Le test de dépendance à Internet est utilisé ici en raison de son utilisation historique, des seuils disponibles et de sa comparabilité avec les recherches antérieures menées auprès d'étudiants universitaires. Toutefois, ce protocole n'exige pas que le test de dépendance à Internet demeure indéfiniment l'instrument privilégié. Si les cadres diagnostiques évoluent ou si de nouveaux instruments s'avèrent plus adaptés à une population spécifique, le même flux de travail peut être conservé, en remplaçant simplement le module propre à l'échelle, l'intervalle des scores, les seuils de gravité, les entrées du codebook et la documentation README. Tout remplacement de ce type doit être effectué avant le début officiel de la collecte de données et doit être signalé comme une modification du protocole, et non comme un changement analytique effectué de manière ponctuelle.
Le problème méthodologique abordé par cet article n'est pas simplement que les études sur la dépendance à Internet et la régulation des émotions parviennent à des conclusions différentes. Plutôt, de nombreuses études diffèrent quant à l'ordre des questionnaires, les critères d'éligibilité, les paramètres de la plateforme d'enquête, la gestion des réponses en double, les procédures de contrôle d'attention, les seuils de temps de complétion, les règles de traitement des données manquantes, la vérification des scores et la communication des fichiers prêts à l'analyse. Ces différences rendent difficile la comparaison, la reproduction et l'inclusion des résultats dans des synthèses ultérieures des preuves. Le présent protocole répond à cette lacune en fixant de manière reproductible, vérifiable et modifiable de façon transparente la séquence d'administration, la logique de dépistage, la structure de notation et le cheminement analytique. Sa contribution est donc orientée vers le protocole : il fournit un flux de travail reproductible pour les études observationnelles en sciences comportementales et en évaluation psychologique menées auprès de populations universitaires, sans pour autant proposer une nouvelle construction psychologique ni présenter une étude de prévalence comme résultat principal.
Accès restreint. Veuillez vous connecter ou commencer un essai pour afficher ce contenu.
Protocole
L'étude, intitulée « Un protocole de questionnaire standardisé pour l'évaluation de la dépendance à Internet et de la régulation des émotions chez les étudiants universitaires », a été examinée et approuvée par le Comité d'éthique et académique de l'Université de économie et de gestion de Zhengzhou sous le numéro d'approbation 20260113004 avant le début du recrutement des participants14. L'étude a utilisé un plan transversal anonyme basé sur un questionnaire en ligne, impliquant des étudiants universitaires à temps plein âgés de 18 à 24 ans, et a été menée conformément aux exigences éthiques institutionnelles et à la Déclaration d'Helsinki. Un consentement éclairé électronique a été obtenu avant l'accès au questionnaire. Les participants ont reçu une fiche d'information électronique détaillant l'objectif de l'étude, les procédures, le caractère volontaire de la participation et les mesures de protection des données, et ils ont pu se retirer à tout moment sans aucune pénalité. Aucune information personnelle directement identifiable, notamment nom, numéro d'identification étudiante, adresse exacte, numéro de téléphone, adresse e-mail personnelle ou compte de médias sociaux, n'a été collectée dans le fichier principal de l'enquête. Les identifiants générés par la plateforme ont été utilisés uniquement pour le dépistage des réponses en double et ont été supprimés avant l'analyse du jeu de données. Toutes les données ont été stockées de manière sécurisée et analysées sous forme désidentifiée. Ce protocole de questionnaire n'a pas été enregistré prospectivement avant le recrutement des participants. Toutefois, tous les composants essentiels du protocole, y compris la version figée du questionnaire, le fichier README/manuel de codage, le journal de dépistage, les règles de cotation, la syntaxe d'analyse et les fichiers de travail prêts à l'analyse, ont été archivés et sont fournis en tant que matériel complémentaire du flux de travail afin d'assurer la reproductibilité et la traçabilité.
Les identifiants de réponse générés par la plateforme ainsi que les identifiants techniques limités par appareil ou par compte ont été utilisés uniquement pour le dépistage des réponses en double et ont été supprimés du jeu de données analytiques final anonymisé. Les variables principales et les règles de cotation sont résumées dans le Tableau 1, et le dictionnaire complet des variables est fourni dans le Tableau supplémentaire 1. Les fichiers du questionnaire, le codebook, le journal de dépistage, le plan de sortie et les matériaux prêts à l'analyse sont fournis dans le Fichier supplémentaire 1.
| Domaine | Variable | Codage/Notation | Rôle dans le protocole |
| Éligibilité | Âge | Années ; plage éligible 18–24 | Variable d'éligibilité et covariable |
| Démographie | Sexe | 1 = homme ; 2 = femme ; 3 = préfère ne pas répondre | Variable descriptive et covariable de régression |
| Démographie | Année universitaire | 1 = première année ; 2 = deuxième année ; 3 = troisième année ; 4 = quatrième année ou plus ; 5 = cycle supérieur | Variable descriptive |
| Démographie | Domaine disciplinaire | 1 = lettres et sciences humaines ; 2 = sciences et ingénierie ; 3 = commerce et gestion ; 4 = arts et design ; 5 = autre | Variable descriptive |
| Démographie | Type de résidence | 1 = résidence universitaire ; 2 = logement loué hors campus ; 3 = domicile familial ; 4 = autre | Variable descriptive |
| Démographie | Dépenses mensuelles de subsistance | 1 = <1 000 CNY ; 2 = 1 000–1 999 CNY ; 3 = 2 000–2 999 CNY ; 4 = ≥3 000 CNY | Variable descriptive |
| Comportement d'utilisation d'Internet | Utilisation d'Internet en semaine | 1 = <2 h ; 2 = 2–3,9 h ; 3 = 4–5,9 h ; 4 = ≥6 h | Covariable comportementale |
| Comportement d'utilisation d'Internet | Utilisation d'Internet le week-end | 1 = <2 h ; 2 = 2–3,9 h ; 3 = 4–5,9 h ; 4 = ≥6 h | Covariable comportementale |
| Comportement d'utilisation d'Internet | Activité en ligne principale | 1 = étude ; 2 = réseaux sociaux ; 3 = jeux ; 4 = divertissement/vidéo ; 5 = achats ; 6 = usage mixte ; 7 = autre | Variable descriptive |
| Comportement d'utilisation d'Internet | Appareil principal d'accès | 1 = smartphone ; 2 = tablette ; 3 = ordinateur portable/de bureau ; 4 = appareils mixtes | Variable descriptive |
| Comportement d'utilisation d'Internet | Utilisation tardive après 23 h | 1 = jamais ; 2 = moins d'une fois par semaine ; 3 = 1–2 nuits/semaine ; 4 = 3–5 nuits/semaine ; 5 = presque chaque nuit | Covariable comportementale et variable de contrôle logique |
| Échelle principale | Note totale de l'IAT | Somme des 20 items ; chaque item noté de 1 à 5 ; plage totale 20–100 | Variable indépendante principale |
| Échelle principale | Groupe de gravité de l'IAT | 20–39 = usage normal ; 40–69 = usage problématique ; 70–100 = usage problématique sévère | Variable de regroupement |
| Échelle principale | Note totale du DERS-16 | Somme des 16 items après recodage inverse requis ; plage totale 16–80 | Variable dépendante principale |
| Échelle principale | Sous-échelles du DERS-16 | Calculées selon la clé de notation figée du DERS-16 | Résultats descriptifs relatifs à la régulation émotionnelle |
| Covariable | Durée de sommeil | 1 = <6 h ; 2 = 6–6,9 h ; 3 = 7–7,9 h ; 4 = ≥8 h | Variable d'ajustement |
| Covariable | Activité physique hebdomadaire | 0 = aucune ; 1 = 1–2 séances ; 2 = 3–4 séances ; 3 = ≥5 séances | Variable d'ajustement |
| Covariable | Stress académique | 1 = faible ; 2 = modéré ; 3 = élevé | Variable d'ajustement |
| Contrôle de qualité | Vérification d'attention | 1 = réussi ; 0 = échoué | Critère d'exclusion |
| Contrôle de qualité | Durée de complétion | Durée de complétion en secondes | Variable de contrôle basée sur le temps |
| Contrôle de qualité | Nombre de réponses en chaîne longue | Longueur maximale de réponses identiques consécutives parmi les 36 items notés des échelles | Variable de contrôle de réponse structurée |
| Contrôle de qualité | Écart-type intra-individuel | Écart-type intra-individuel sur les 36 items notés des échelles | Variable de contrôle de réponse invariante |
| Contrôle de qualité | Indicateur de cohérence logique | 0 = aucune incohérence ; 1 = incohérence détectée | Variable de contrôle de cohérence logique |
Tableau 1 : Variables fondamentales, structure de codage et règles de notation utilisées dans le protocole de questionnaire standardisé. Ce tableau résume les variables fondamentales d'éligibilité, démographiques, d'utilisation d'Internet, d'échelle, de covariables et de contrôle de qualité utilisées dans le flux de travail principal. Il inclut les valeurs de codage, les plages de scores, les règles de notation et les rôles des principales variables utilisées pour la passation du questionnaire, le dépistage, la notation et l'analyse. Abréviations : IAT = test de dépendance à Internet ; DERS-16 = échelle de difficultés de régulation émotionnelle en 16 items. Veuillez cliquer ici pour télécharger ce tableau.
1. Configurer la population d'étude, la structure du questionnaire et le déroulement de l'enquête
- Définir la population cible et l'échantillon valide
- Recruter des étudiants universitaires à temps plein, de niveau licence ou master, âgés de 18 à 24 ans, capables de remplir le questionnaire de manière autonome sur un téléphone mobile ou un ordinateur. Enregistrer la version linguistique du questionnaire et utiliser des versions d'échelles qui ont été validées ou correctement adaptées pour la population étudiante cible.
- Documenter toute adaptation liée à l'accessibilité ou à la langue avant la collecte des données, lorsque des étudiants internationaux, des étudiants en situation de handicap ou des groupes d'étudiants multilingues sont inclus.
- Limiter la participation à une seule réponse complète par participant. Utiliser, si disponible, la fonction de restriction par appareil, par compte, par cookie ou par lien authentifié offerte par la plateforme de sondage.
NOTE : Lorsqu'un même compte participant génère des réponses depuis plusieurs appareils, identifier et harmoniser ces enregistrements lors du tri des doublons, à l'aide de l'identifiant lié au compte, de l'horodatage, de l'état du questionnaire et de la similarité des profils de réponse. - Fixer l'échantillon valide final minimal à 450 questionnaires et poursuivre la recrutement jusqu'à ce que l'ensemble de données nettoyé reste au-dessus de ce seuil après dépistage.
NOTE : Lorsque l'usage problématique sévère d'Internet ou un autre petit sous-groupe constitue la cible principale de l'analyse, fixer un objectif de recrutement plus élevé avant le début de la collecte des données. - Enregistrer le nombre de personnes invitées, le nombre de réponses reçues, le nombre d'exclusions à chaque étape prédéfinie de dépistage, ainsi que le nombre final de participants retenus, afin de pouvoir résumer ultérieurement le flux des participants dans la Figure 1.
- Construire le questionnaire dans un ordre fixe
- Organiser le questionnaire selon la séquence suivante : consentement éclairé, informations démographiques, comportement d'utilisation d'Internet, Test d'addiction à Internet, Échelle abrégée des difficultés de régulation émotionnelle, durée de sommeil, activité physique hebdomadaire et stress académique perçu. Conserver cet ordre inchangé pour tous les participants. Ne pas randomiser l'ordre des échelles principales.
- Enregistrer l'âge, le sexe, l'année académique, la catégorie de discipline, le type de résidence et les dépenses mensuelles de subsistance à l'aide de catégories de réponse fermées. Indiquer que tous les items démographiques sont obligatoires.
NOTE : Pour le sexe, inclure les options homme, femme et préfère ne pas répondre. Conserver l'option « préfère ne pas répondre » dans les analyses descriptives. Dans les analyses de régression, coder le sexe à l'aide de variables indicatrices en prenant l'homme comme catégorie de référence, avec des indicateurs distincts pour femme et préfère ne pas répondre. Ne pas exclure les participants uniquement parce qu'ils choisissent « préfère ne pas répondre ». - Enregistrer la durée d'utilisation d'Internet en semaine, la durée d'utilisation d'Internet le week-end, l'activité en ligne principale, l'appareil principal d'accès et l'utilisation d'Internet tardive après 23h00. Coder l'usage nocturne comme suit : 1 = jamais, 2 = moins d'une fois par semaine, 3 = 1 à 2 nuits par semaine, 4 = 3 à 5 nuits par semaine, et 5 = presque chaque nuit.
- Enregistrer la période académique durant laquelle le questionnaire est administré. Dans la mise en œuvre représentative, l'enquête a été menée durant un semestre d'enseignement régulier, en dehors des semaines d'examens finaux, plus précisément aux semaines 6 à 7 du semestre.
- Administrer et noter les instruments principaux
- Administrer le test d'addiction à Internet à 20 items comme une échelle obligatoire et noter chaque item de 1 à 5. Additionner les 20 items pour obtenir un score total compris entre 20 et 100, puis classer les scores de 20 à 39 comme usage normal, de 40 à 69 comme usage problématique, et de 70 à 100 comme usage problématique sévère15.
- Utiliser l'expression « addiction à Internet » lors de la présentation des scores et des groupes de gravité basés sur le test IAT. Utiliser « usage problématique d'Internet » uniquement lorsqu'on fait référence à la littérature plus large ou à des concepts non fondés sur l'IAT.
- Administrer immédiatement après le test d'addiction à Internet l'échelle abrégée à 16 items des difficultés de régulation émotionnelle et noter chaque item de 1 à 5. Inverser les scores des items 1, 6 et 8 avant l'addition, puis calculer un score total compris entre 16 et 80, un score plus élevé indiquant une plus grande difficulté à réguler les émotions16.
- Générer cinq scores de sous-échelles pour la non-acceptation, les objectifs, les impulsions, les stratégies et la clarté, après vérification du recodage inversé.
- Revoir la direction du codage de tous les items inversés avant de calculer les scores totaux et les scores de sous-échelles. Utiliser la même clé de notation DERS-16 pour chaque participant et documenter cette clé dans le fichier README ou le codebook.
- Lorsqu'un instrument d'addiction à Internet révisé ou alternatif est utilisé, remplacer le module spécifique à l'échelle avant le début de la collecte des données et mettre à jour les noms des items, l'intervalle de scores, les seuils de gravité, la syntaxe de notation, le README/codebook, les captures d'écran du questionnaire, ainsi que le Tableau des matériaux.
- Ajouter des covariables et un item de contrôle d'attention
- Enregistrer la durée de sommeil comme <6 h, 6–6,9 h, 7–7,9 h et ≥8 h. Enregistrer la fréquence d'activité physique hebdomadaire comme 0, 1–2, 3–4 et ≥5 séances. Enregistrer le stress académique perçu comme faible, modéré ou élevé. Définir une séance d'activité physique comme une activité modérée ou intense d'au moins 20 minutes.
- Insérer un item de contrôle d'attention à réponse dirigée dans la section comportementale et exiger que le participant sélectionne une option de réponse spécifique. L'item utilisé dans la mise en œuvre représentative était le suivant : « Pour confirmer que vous lisez attentivement, veuillez sélectionner ‘3 = parfois’ pour cet item ». Marquer pour exclusion tout questionnaire qui échoue à cet item lors du nettoyage des données17.
ÉTAPE CRITIQUE : Ne pas modifier le libellé des items, les modalités de réponse, l'ordre des échelles, les seuils d'exclusion, les paramètres de la plateforme de sondage, les règles de codage ou les règles d'analyse statistique après le début officiel de la collecte des données.
NOTE : Résumer les variables principales, les valeurs de codage, les intervalles de scores et les règles de notation dans le Tableau 1. Fournir le dictionnaire complet des variables, les champs d'état des fichiers, les indicateurs de dépistage, les champs d'identifiants techniques, les variables de suivi des jeux de données, les noms de fichiers et les versions des logiciels dans le Tableau supplémentaire 1 ainsi que dans le README/codebook.
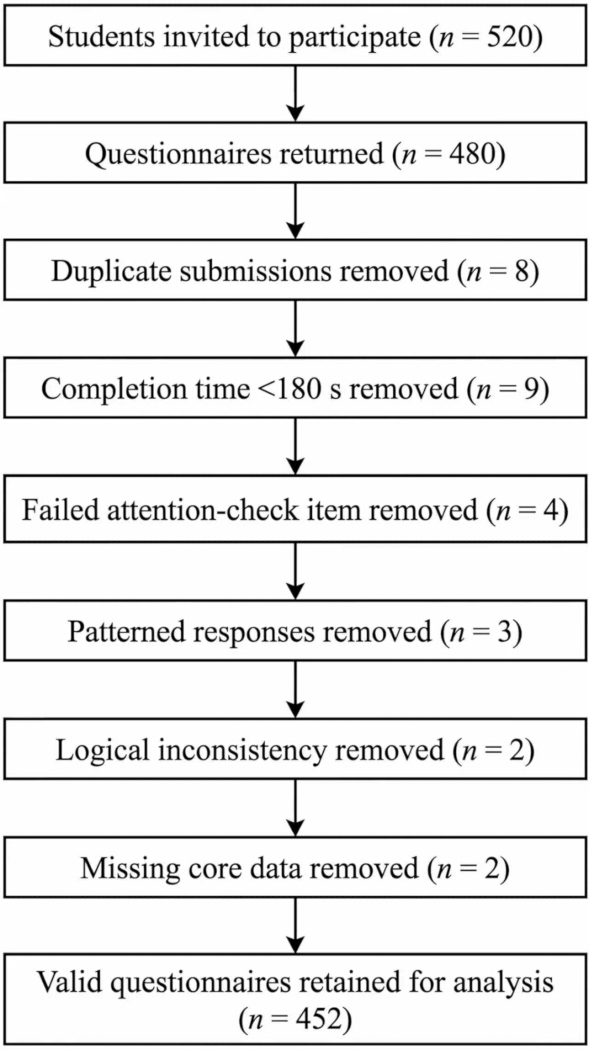
Figure 1 : Organigramme du questionnaire concernant le recrutement, le dépistage, l'exclusion et la rétention finale à des fins d'analyse. Ce schéma illustre la progression des étudiants invités aux questionnaires retournés, en passant par un dépistage séquentiel de la qualité des données et des exclusions selon des critères prédéfinis, jusqu'à la rétention finale des questionnaires valides pour l'analyse. La figure présente le nombre d'étudiants invités, de questionnaires retournés, d'enregistrements exclus à chaque étape de dépistage, ainsi que l'échantillon final destiné à l'analyse. Veuillez cliquer ici pour visualiser une version agrandie de cette figure.
2. Effectuer un test pilote du questionnaire et verrouiller la version finale sur le terrain
- Effectuer un pré-test du questionnaire complet
- Administrer le questionnaire complet à 20 à 30 étudiants répondant aux critères formels d'inclusion, mais qui ne seront pas inclus dans le jeu de données final.
- Enregistrer le temps de complétion ainsi que les commentaires écrits concernant la clarté, la charge de réponse, l'accès technique, l'ordre des questions, la compréhension des contrôles d'attention et toute ambiguïté dans les options de réponse démographiques ou comportementales.
- Noter la taille de l'échantillon pilote, le temps médian de complétion, l'intervalle interquartile, les temps minimum et maximum de complétion, ainsi que toutes les modifications apportées au libellé après le pré-test.
- Dans la mise en œuvre représentative, le pré-test comprenait 25 étudiants, le temps médian de complétion était de 540 s, et le temps de complétion attendu a été fixé à 6 à 8 min.
- Revoir les formulations ambiguës, les doublons de sens, les options de réponse peu claires ou les problèmes d'affichage logiciel identifiés lors du pré-test, puis figer la version finale du questionnaire avant sa diffusion officielle.
NOTE : Si l'étude inclut des étudiants multilingues, des adultes âgés, des adolescents ou des étudiants en situation de handicap, réaliser des tests cognitifs supplémentaires ou des pré-tests par sous-groupe avant la diffusion officielle.
- Fixer les paramètres opérationnels et les règles d'exportation
- Créer un nouveau projet d'enquête sur la plateforme en ligne choisie. Saisir la page de consentement comme première page et définir l'élément de consentement comme critère obligatoire de branchement.
- Configurer l'enquête de sorte que les participants n'ayant pas donné leur consentement quittent automatiquement l'enquête sans accéder au corps du questionnaire.
- Saisir tous les éléments relatifs aux données démographiques, à l'utilisation d'Internet, au test IAT, au DERS-16, aux covariables et aux contrôles d'attention en utilisant les formulations et les échelles de réponse figées. Définir tous les éléments principaux comme obligatoires.
- Activer l'enregistrement automatique de l'heure de début, de l'heure de fin, de la durée de complétion, du statut de réponse et de l'identifiant de réponse généré par la plateforme.
- Activer les contrôles limitant une réponse par participant, lorsque disponibles, notamment des liens d'enquête authentifiés, des restrictions par appareil, la prévention des doublons par cookie, la prévention par compte utilisateur ou les paramètres de vérification des réponses en double. Enregistrer les contrôles activés dans le fichier README ou codebook.
- Désactiver la collecte d'identifiants directs non nécessaires. Si la plateforme enregistre par défaut l'adresse IP, désactiver l'enregistrement des IP ou les remplacer par un champ de détection des doublons non identifiable, conformément à la politique institutionnelle.
NOTE : Lorsque les adresses IP ou les métadonnées des appareils sont temporairement conservées pour la détection des doublons, les stocker uniquement dans le fichier brut chiffré, restreindre l'accès à l'analyste de l'étude, et les supprimer avant la production du jeu de données analytique final. - Préciser si la pause et la reprise sont autorisées. Dans ce protocole, une fonction formelle de sauvegarde et de retour ultérieur entre différentes sessions n'est pas activée. Les participants peuvent uniquement interrompre le questionnaire au sein de la même session de navigation ouverte, et le temps de complétion enregistré inclut la durée totale écoulée.
- Exporter le fichier brut des réponses au format tableur et au format de valeurs séparées par des virgules (CSV) à la clôture de l'enquête18. Exporter également un fichier de documentation ou une copie PDF/A contenant le libellé final du questionnaire, l'ordre des items, les paramètres de branchement, les paramètres des items obligatoires et la structure de codage. Enregistrer ces fichiers avec des noms soumis à un contrôle de version.
- Calculer le temps médian de complétion du pré-test et fixer le seuil minimal de complétion valide à environ un tiers de cette valeur. Définir définitivement le seuil inférieur à 180 s et l'appliquer uniformément lors du triage officiel.
- Étant donné que ce seuil est basé sur l'échantillon pilote, le réévaluer lorsque le protocole est mis en œuvre auprès d'une population substantiellement différente, sur une plateforme différente, dans une version linguistique différente ou dans un contexte institutionnel distinct.
NOTE : Archiver les captures d'écran du questionnaire final, l'exportation finale du questionnaire, le README/codebook, le journal du pré-test, le libellé des contrôles d'attention, le modèle de journal de triage, les paramètres d'exportation et la syntaxe statistique comme fichiers supplémentaires ou documents d'audit.
3. Diffuser le questionnaire et préserver le jeu de données brut
- Recruter les participants par des canaux fixes
- Distribuer une invitation standardisée par l'intermédiaire de groupes de communication étudiants, de canaux de cours ou de listes de diffusion institutionnelles pendant une période de collecte fixe de 14 jours.
- Indiquer dans l'invitation et sur la page de consentement l'objectif de l'étude, la durée moyenne de complétion (6 à 8 minutes), le traitement anonyme des données, la participation volontaire, ainsi que l'absence de pénalité ou de récompense académique en cas de non-participation.
- Afficher la page de consentement avant l'apparition de toute question du questionnaire et exiger un accord actif avant l'accès. Ne pas autoriser l'accès au corps du questionnaire sans réponse affirmative au consentement.
- Indiquer sur la page de consentement que les participants peuvent interrompre le processus avant la soumission finale et que les réponses incomplètes ne seront pas utilisées dans l'analyse finale.
- Utiliser la même version verrouillée du questionnaire pour tous les canaux de recrutement. Si plusieurs canaux de recrutement sont utilisés, enregistrer le canal uniquement s'il a été préalablement défini comme une variable d'étude.
- Conserver le fichier brut de retour
- Conserver tous les enregistrements reçus, y compris les soumissions incomplètes ou ultérieurement exclues, dans le fichier d'exportation brut. Exporter l'ensemble du jeu de données immédiatement après la clôture de l'enquête et le stocker sous les noms raw_returns_YYYYMMDD.csv et raw_returns_YYYYMMDD.xlsx.
- Conserver dans le fichier brut l'heure initiale de soumission, la durée d'achèvement, le statut de réponse, l'identifiant de réponse généré par la plateforme et l'identifiant technique limité par appareil ou par compte. Ne pas écraser ces champs lors du nettoyage ultérieur.
- Enregistrer une copie en lecture seule du jeu de données brut avant le début du tri. Stocker le fichier brut, le journal de tri et le jeu de données analytique final dans des dossiers distincts. Restreindre l'accès au fichier brut contenant les identifiants techniques aux seuls membres autorisés de l'équipe d'étude.
ATTENTION : Ne pas recueillir d'informations directement identifiables, telles que le nom complet, le numéro d'identification étudiant, l'adresse exacte du dortoir, le numéro de téléphone personnel, l'adresse e-mail personnelle ou le compte de média social, dans le fichier principal de l'enquête.
NOTE : Interrompre le flux de travail après l'exportation brute, sauvegarder une copie en lecture seule du jeu de données brut, et ne reprendre le nettoyage qu'à partir de cette copie préservée.
4. Examiner les questionnaires retournés et générer le jeu de données analytique final
- Appliquer la séquence de triage dans un ordre fixe
- Trier tous les enregistrements retournés par identifiant lié à l'appareil, puis par identifiant lié au compte (si disponible), par horodatage, par statut du questionnaire et par similarité des réponses. Identifier d'abord les soumissions en double. Conserver l'enregistrement complet le plus ancien lorsque deux soumissions ou plus proviennent du même participant au cours du même cycle de collecte.
- Si plusieurs soumissions proviennent du même compte authentifié mais de différents appareils, les considérer comme des soumissions en double du même participant. Conserver l'enregistrement complet le plus ancien et exclure les enregistrements complets ultérieurs. Si l'enregistrement le plus ancien est incomplet et qu'un enregistrement ultérieur est complet, conserver l'enregistrement complet le plus ancien.
- Supprimer les enregistrements dont le temps de complétion est <180 s, examiner les enregistrements complétés en 180–240 s, et supprimer les enregistrements qui échouent à l'élément de contrôle d'attention par réponse dirigée en quatrième position. Documenter le nombre de suppressions à chaque étape dans screening_log_v1.xlsx19.
- Pour les enregistrements complétés en 180–240 s, effectuer un examen manuel à l’aide du résultat du contrôle d’attention, du drapeau de réponse en chaîne longue, de l’écart-type intra-individuel et du drapeau de cohérence logique.
- Ne conserver un enregistrement à vitesse limite que s’il n’affiche aucun autre indicateur de qualité de données. Enregistrer chaque décision concernant une vitesse limite dans le journal de triage.
- Supprimer les enregistrements présentant des motifs, des incohérences ou des données manquantes
- Supprimer tous les questionnaires présentant une réponse en chaîne longue, définie comme 18 réponses identiques consécutives ou plus parmi les 36 items cotés de l’échelle, ou un écart-type intra-individuel ≤0,25 pour ces items.
- Supprimer tout questionnaire présentant des combinaisons comportementales impossibles. Définir « la catégorie de réponse la plus élevée pour presque tous les items du test de dépendance à Internet » comme un score de 5 sur au moins 18 des 20 items du IAT.
NOTE : La règle d’incohérence logique est déclenchée lorsqu’un répondant déclare une utilisation d’Internet en semaine et le week-end dans la catégorie de durée la plus faible (<2 h par jour), une utilisation tardive de l’Internet codée comme « presque tous les soirs » et un score de 5 sur au moins 18 des 20 items du IAT. Appliquer cette règle uniquement après avoir terminé le triage des doublons, du temps de complétion, du contrôle d’attention et des réponses structurées. - Supprimer tous les questionnaires comportant des valeurs manquantes pour un item du IAT, un item du DERS-16 ou une covariable prédéfinie.
NOTE : Cette règle de cas complet est utilisée car l’enquête en ligne impose les items principaux et parce que le modèle de régression représentatif exige un ensemble fixe de covariables. Lorsque les données manquantes pour les covariables dépassent 5 %, utiliser une méthode prédéfinie alternative de traitement des données manquantes, telle que l’imputation multiple. - Attribuer un identifiant d’étude anonyme à chaque enregistrement conservé et sauvegarder le fichier restant sous les noms analytic_dataset_v1.csv et analytic_dataset_v1.xlsx.
- Supprimer du jeu de données analytique final les identifiants de réponse générés par la plateforme, les identifiants liés à l’appareil, les identifiants liés au compte, les adresses IP (si conservées durant le triage), les horodatages et les notes textuelles d’examen. Ne conserver que l’identifiant d’étude anonyme et les variables d’analyse.
ÉTAPE CRITIQUE : Appliquer la séquence de triage dans le même ordre à chaque enregistrement et ne pas réintroduire de cas précédemment exclus à des étapes ultérieures. Attribuer comme motif principal d’exclusion le premier critère d’exclusion déclenché et noter les drapeaux secondaires uniquement comme annotations dans le journal de triage.
NOTE : Résumer dans Tableau 2 les effectifs finaux d’exclusion par motif, et s’assurer que ces effectifs correspondent exactement au flux de participants indiqué ultérieurement dans Figure 1.
| Ordre de dépistage | Élément de dépistage | Règle opérationnelle | Action de dépistage | Règle de documentation |
| Étape 1 | Préservation de l'export brut | Exporter tous les enregistrements retournés immédiatement après la clôture de l'enquête et les enregistrer sous les noms raw_returns_YYYYMMDD.csv et raw_returns_YYYYMMDD.xlsx | Conserver une copie en lecture seule avant tout nettoyage | Archiver dans le dossier de données brutes |
| Étape 2 | Vérification du consentement et de l'accès | Identifier les enregistrements sans consentement éclairé électronique actif avant l'accès au questionnaire | Exclure les enregistrements sans consentement du flux analytique | Enregistrer les enregistrements exclus ou inaccessibles dans screening_log_v1.xlsx lorsqu'ils sont conservés dans l'export de la plateforme |
| Étape 3 | Dépistage des doublons | Identifier les enregistrements partageant le même identifiant limité par appareil ou identifiant limité par compte dans le même cycle de collecte, et correspondant en sexe, âge, année universitaire et au moins 80 % de réponses identiques au questionnaire | Conserver l'enregistrement complet le plus ancien et exclure tous les doublons ultérieurs | Enregistrer le nombre exclu et les valeurs raw_record_id concernées dans screening_log_v1.xlsx ; attribuer primary exclusion_reason = 1 |
| Étape 4 | Réconciliation des doublons sur plusieurs appareils | Identifier plusieurs soumissions complètes provenant du même compte participant authentifié sur différents appareils | Considérer ces enregistrements comme des soumissions en double ; conserver l'enregistrement complet le plus ancien | Enregistrer l'identifiant limité par compte et le raw_record_id conservé dans screening_log_v1.xlsx ; attribuer aux enregistrements ultérieurs primary exclusion_reason = 1 |
| Étape 5 | Dépistage selon le temps de complétion | Identifier tous les questionnaires dont le temps de complétion est <180 s | Exclure automatiquement tous ces enregistrements | Enregistrer le nombre exclu dans screening_log_v1.xlsx ; attribuer primary exclusion_reason = 2 |
| Étape 6 | Examen des vitesses limites | Identifier tous les questionnaires dont le temps de complétion est compris entre 180 et 240 s | Examiner manuellement chaque enregistrement à l'aide des indicateurs d'attention, des chaînes longues, de l'écart-type intra-individuel et des incohérences logiques ; ne conserver que ceux sans autre indicateur | Enregistrer chaque cas comme retained_after_manual_review = 1 ou excluded_after_manual_review = 1 dans screening_log_v1.xlsx |
| Étape 7 | Dépistage des vérifications d'attention | Identifier tous les enregistrements ayant échoué à l'élément de contrôle d'attention à réponse dirigée | Exclure tous les enregistrements ayant échoué qui n'ont pas déjà été exclus à une étape précédente | Enregistrer le nombre exclu dans screening_log_v1.xlsx ; attribuer primary exclusion_reason = 3 |
| Étape 8 | Dépistage des réponses structurées | Identifier les enregistrements présentant 18 réponses identiques consécutives ou plus parmi les 36 items évalués, ou un écart-type intra-individuel ≤0,25 sur ces items | Exclure tous ces enregistrements qui n'ont pas déjà été exclus à une étape précédente | Enregistrer le nombre exclu dans screening_log_v1.xlsx ; attribuer primary exclusion_reason = 4 |
| Étape 9 | Dépistage de la cohérence logique | Identifier les enregistrements présentant la combinaison comportementale impossible prédéfinie : weekday_internet_use et weekend_internet_use tous deux codés comme <2 h, late_night_use codé comme presque tous les soirs, et un score de 5 sur au moins 18 des 20 items IAT | Exclure tous ces enregistrements qui n'ont pas déjà été exclus à une étape précédente | Enregistrer le nombre exclu et la note d'examen dans screening_log_v1.xlsx ; attribuer primary exclusion_reason = 5 |
| Étape 10 | Dépistage des données manquantes essentielles | Identifier les enregistrements comportant une valeur manquante dans IAT_1–IAT_20, DERS_1–DERS_16, âge, sexe, weekday_internet_use, weekend_internet_use, sleep_duration, physical_activity ou academic_stress ; la réponse « préfère ne pas répondre » pour le sexe est considérée comme valide, et non comme une donnée manquante | Exclure tous ces enregistrements qui n'ont pas déjà été exclus à une étape précédente | Enregistrer le nombre exclu dans screening_log_v1.xlsx ; attribuer primary exclusion_reason = 6 |
| Étape 11 | Attribution de l'exclusion principale | Identifier les enregistrements répondant à plus d'un critère d'exclusion | Attribuer comme raison principale d'exclusion le premier critère déclenché dans la séquence de dépistage prédéfinie | Enregistrer les indicateurs secondaires uniquement dans les notes d'examen ; ne pas attribuer plusieurs raisons principales |
| Étape 12 | Suppression des identifiants techniques | Identifier les identifiants de réponse générés par la plateforme, les identifiants limités par appareil, les identifiants limités par compte, les horodatages et toutes les métadonnées techniques temporairement conservées dans le fichier nettoyé | Supprimer ces champs du jeu de données analytique final après la fin du dépistage | Documenter la suppression dans screening_log_v1.xlsx |
| Étape 13 | Conservation finale | Conserver tous les enregistrements ayant passé toutes les étapes de dépistage précédentes | Attribuer un identifiant d'étude anonyme à chaque enregistrement conservé | Enregistrer sous les noms analytic_dataset_v1.csv et analytic_dataset_v1.xlsx |
| Étape 14 | Résumé du dépistage | Compter le nombre d'exclusions à chaque étape et le nombre final conservé | Résumer les comptes finaux pour la rédaction de l'article | Veiller à ce que les chiffres du Tableau 2 correspondent exactement à ceux de la Figure 1 |
| Étape 15 | Préservation de la traçabilité | Conserver le fichier brut, le journal de dépistage et le jeu de données analytique final comme fichiers distincts | Ne pas écraser, fusionner ou modifier manuellement les fichiers sources archivés | Les stocker séparément dans les dossiers de données brutes, de dépistage et de données analytiques |
Tableau 2 : Séquence prédéfinie de dépistage, seuils d'exclusion, actions de dépistage et règles de documentation pour le nettoyage des questionnaires. Ce tableau résume l'ordre de dépistage fixe utilisé pour nettoyer les questionnaires retournés, y compris les vérifications de consentement et d'accès, le dépistage des doublons, la conciliation entre plusieurs appareils, le dépistage du temps de complétion, l'examen des réponses à vitesse limite, l'échec des vérifications d'attention, les réponses systématiques, les incohérences logiques, les données manquantes essentielles, la suppression des identifiants techniques, la rétention finale et la préservation de la traçabilité. Abréviations : IAT = internet addiction test ; DERS-16 = 16-item difficulties in emotion regulation scale. Veuillez cliquer ici pour télécharger ce tableau.
5. Noter les variables, vérifier la fiabilité et préparer le fichier prêt à l'analyse
- Générer les scores totaux, les scores des sous-échelles et les variables catégorielles dérivées
- Additionnez les scores des 20 items du TAI afin d'obtenir le score total d'addiction à Internet, puis enregistrez à la fois le score continu et la classe de gravité à trois niveaux dans le fichier prêt pour l'analyse.
- Inverser les items 1, 6 et 8 du DERS-16, calculer le score total et les cinq scores de sous-échelles, puis ajouter toutes les variables dérivées au même jeu de données au niveau des participants.
- Exécuter une vérification des plages avant le calcul des scores. Vérifier que toutes les valeurs des items du IAT et du DERS-16 se situent entre 1 et 5, que toutes les valeurs inversées se situent entre 1 et 5, que les scores totaux du IAT se situent entre 20 et 100, et que les scores totaux du DERS-16 se situent entre 16 et 80. Enregistrer les résultats de la vérification des plages dans le journal de codage.
- Recodifier les covariables en catégories analytiques fixes
- Recoder la durée d'utilisation d'internet en semaine et le week-end comme <2 h, 2–3,9 h, 4–5,9 h et ≥6 h. Recoder l'utilisation d'internet tard le soir comme jamais, <1 nuit/semaine, 1 à 2 nuits/semaine, 3 à 5 nuits/semaine et presque chaque nuit.
- Recoder la durée du sommeil, la fréquence de l'activité physique et le niveau perçu de stress académique à l'aide des règles de catégorisation prédéfinies dans la section 1.4, et stocker les valeurs recodées sous des noms de variables fixes dans le même jeu de données.
- Recoder le sexe pour la régression à l'aide de deux variables indicatrices : femme par rapport à homme, et préfère ne pas répondre par rapport à homme. Indiquer ce codage dans la note de bas de page du tableau ainsi que dans le fichier README ou le codebook.
- Vérifier l'intégrité du score et la cohérence interne
- Calculer l'alpha de Cronbach pour le score total du IAT et pour le score total du DERS-16 avant l'analyse inférentielle. Vérifier à nouveau le codage des items, le codage inversé et les plages de valeurs impossibles si l'une des deux valeurs d'alpha est inférieure à 0,7. <0.7020. Indiquer les valeurs de l'alpha de Cronbach dans la section Résultats représentatifs.
- Calculer les corrélations entre l'élément et le total ou les valeurs alpha-si-élément-supprimé si l'une des échelles présente une faible cohérence interne inattendue. Ne pas supprimer d'éléments des échelles dans l'analyse principale, sauf si la suppression d'éléments a été prédéfinie ou si l'étude est explicitement conçue comme une étude de validation psychométrique.
- Enregistrez le jeu de données final prêt pour l'analyse, accompagné d'un fichier LISEZ-MOI listant les noms des variables, les règles de codage, les seuils d'exclusion, les noms des fichiers, les versions des logiciels, la version du questionnaire, la syntaxe de calcul des scores, la spécification du modèle de régression, ainsi que les procédures nécessaires pour recréer le même jeu de données.
6. Analyser les données et préserver les résultats reproductibles
- Générer des statistiques descriptives et des comparaisons de groupes
- Présenter les variables continues sous la forme moyenne ± écart-type et les variables catégorielles sous la forme de fréquence et de pourcentage. Résumer les caractéristiques démographiques, les comportements d’utilisation d’internet et les scores d’échelle à l’aide de la structure de sortie prédéfinie.
- Indiquer la taille de l’échantillon utilisée pour chaque analyse. Utiliser l’échantillon analytique retenu comme dénominateur, sauf indication contraire clairement précisée dans un tableau.
- Comparer les scores totaux et les sous-échelles du DERS-16 entre les trois groupes de gravité du TAI et utiliser des tests bilatéraux avec α = 0,05 pour les analyses principales. Indiquer les tailles d’effet standardisées lorsque cela est approprié.
REMARQUE : Pour les comparaisons de groupes, indiquer η2 ou η2 partiel pour l’analyse de variance, ou une taille d’effet non paramétrique équivalente si un test non paramétrique est utilisé. Interpréter avec prudence les comparaisons de sous-groupes présentant un usage problématique sévère lorsque la taille de ce sous-groupe est faible. - Calculer la corrélation de Pearson entre le score total du TAI et le score total du DERS-16 lorsque les deux variables présentent un comportement distributionnel acceptable ; sinon, utiliser la corrélation de Spearman comme analyse de sensibilité. Indiquer n, r ou ρ, l’intervalle de confiance à 95 % si généré par le logiciel statistique, la valeur p et l’interprétation de l’ampleur.
- Estimer le modèle de régression ajusté et archiver les sorties
- Utiliser le score total du DERS-16 comme variable dépendante et le score total du TAI comme variable indépendante principale. Introduire l’âge, le sexe, l’utilisation d’internet en semaine, l’utilisation d’internet le week-end, la durée de sommeil, l’activité physique et le stress académique perçu comme covariables. Ce modèle constitue la démonstration analytique prédéfinie du flux de travail standardisé.
- Avant d’interpréter le modèle de régression ajusté, évaluer les hypothèses de régression et la stabilité du modèle. Examiner les graphiques des résidus en fonction des valeurs ajustées pour vérifier la linéarité et l’homoscédasticité, examiner un graphique Q-Q ou un test de normalité pour la distribution des résidus, et calculer les facteurs d’inflation de la variance pour évaluer la multicolinéarité.
- Présenter ces diagnostics dans la section Résultats représentatifs ou dans les sorties d’analyse complémentaires.
- Si une hétéroscédasticité des résidus est détectée, indiquer les erreurs-types robustes à l’hétéroscédasticité comme analyse de sensibilité.
- En présence d’observations influentes, indiquer si le coefficient principal du score total du TAI reste fondamentalement inchangé après les diagnostics d’influence. Ne pas supprimer les observations influentes sauf si une règle prédéfinie de qualité des données est respectée.
- Indiquer les coefficients non standardisés, les erreurs-types, les coefficients standardisés, les valeurs p, le R2 du modèle, le R2 ajusté, la statistique F du modèle et l’intervalle des VIF pour le modèle ajusté. Inclure la taille de l’échantillon dans le titre du tableau ou dans une note de bas de page.
- Si des interactions, des effets de sous-groupe ou des voies de médiation sont testées, spécifier ces analyses avant la collecte des données ou les indiquer comme exploratoires. Le protocole principal ne requiert pas de test d’interaction, sauf si les différences de sous-groupes constituent un objectif d’étude prédéfini.
- Enregistrer toutes les syntaxes statistiques, les tableaux de résultats, les graphiques des résidus, les sorties des VIF, les sorties de fiabilité et les figures générées sous des noms de fichiers soumis à un contrôle de version. Recréer toutes les sorties à publier directement à partir de analytic_dataset_v1 plutôt que de fichiers modifiés manuellement.
REMARQUE : Conserver le texte du protocole centré sur la reproductibilité du flux de travail. Présenter les statistiques représentatives détaillées, les figures par sous-groupe, les diagnostics de régression, l’évaluation de la multicolinéarité et les sorties du modèle dans la section Résultats représentatifs.
Accès restreint. Veuillez vous connecter ou commencer un essai pour afficher ce contenu.
Résultats
Déroulement de l'étude et rétention analytique finale
Les résultats démontrent la mise en œuvre du flux de travail du questionnaire standardisé, plutôt qu'une validation indépendante du test d'addiction à Internet ou du DERS-16. Pendant la période de 14 jours, 520 étudiants universitaires ont été invités à participer, et 480 questionnaires ont été retournés. Le tri a été effectué selon l'ordre prédéfini. Tout d'abord, 8 soumissions en double ont été éliminées, puis 9 questionn...
Accès restreint. Veuillez vous connecter ou commencer un essai pour afficher ce contenu.
Discussion
La contribution principale de cet article réside dans le flux de travail standardisé du questionnaire, plutôt que dans l'association représentative observée entre la dépendance à Internet et les difficultés de régulation émotionnelle. La mise en œuvre a montré qu'une séquence fixe composée du consentement électronique, des éléments démographiques, du comportement d'utilisation d'Internet, du calcul du score IAT, du calcul du score DERS-16, de la collecte des covariables, du contrôle séquentiel de la qualité des données e...
Accès restreint. Veuillez vous connecter ou commencer un essai pour afficher ce contenu.
Déclarations de divulgation
L'auteur n'a rien à divulguer.
Remerciements
Ce travail a été soutenu par le projet de science douce de la province du Henan 2025, « Recherche sur l'impact et la voie d'optimisation des changements de la population scolaire sur le développement de haute qualité de l'enseignement supérieur privé dans la province du Henan » (n° de projet 252400410490), et par le projet de fonds de recherche doctorale 2025 de l'Université de économie et de commerce de Zhengzhou, « Recherche sur le mécanisme de formation et le mécanisme d'orientation de l'opinion publique concernant le comportement en grappe en ligne des étudiants universitaires ». L'auteur remercie l'Université de économie et de commerce de Zhengzhou pour le soutien institutionnel fourni.
Accès restreint. Veuillez vous connecter ou commencer un essai pour afficher ce contenu.
Matériaux
| Nom | Entreprise | Numéro de catalogue | Commentaires |
|---|---|---|---|
| Jeu de données prêt à l'analyse | Document interne spécifique à l'étude | analytic_dataset_v1.csv et analytic_dataset_v1.xlsx | Jeu de données final anonymisé utilisé pour toutes les analyses descriptives, de fiabilité, de corrélation et de régression pouvant faire l'objet d'un rapport |
| Syntaxe d'analyse | Document interne spécifique à l'étude | analysis_syntax_v1.R ou fichier de script équivalent | Utilisé pour reproduire la vérification du calcul des scores, les contrôles de fiabilité, les statistiques descriptives, l'analyse de corrélation, la modélisation par régression, le calcul du facteur d'inflation de la variance (VIF) et les sorties diagnostiques |
| Formulation de l'élément de contrôle d'attention | Document interne spécifique à l'étude | attention_check_v1.txt | Formulation verrouillée de l'élément de contrôle d'attention à réponse dirigée utilisé lors de la passation du questionnaire |
| Questionnaire DERS-16 | Source originale de l'échelle ou version du questionnaire autorisée ou adaptée | Échelle courte à 16 items Difficulties in Emotion Regulation Scale | Utilisé pour évaluer les difficultés de régulation émotionnelle ; le calcul des scores suit la clé de codage verrouillée du DERS-16 documentée dans le codebook |
| Fiche d'information électronique et page de consentement | Document interne spécifique à l'étude | consent_form_v1.pdf ou page de consentement de la plateforme | Utilisé pour fournir les informations sur l'étude et obtenir le consentement éclairé électronique avant l'accès au questionnaire |
| Fiche des conventions de nommage de fichiers | Document interne spécifique à l'étude | file_naming_convention_v1.xlsx | Utilisé pour standardiser les noms des fichiers bruts, nettoyés, analytiques, des journaux de sélection, des codebooks et des sorties |
| Captures d'écran finales du questionnaire | Document interne spécifique à l'étude | questionnaire_screenshots_v1.pdf | Utilisé pour documenter l'affichage verrouillé du questionnaire, l'ordre des items, les échelles de réponse et les paramètres d'items obligatoires |
| Environnement de développement intégré | Posit | RStudio Desktop | Utilisé pour gérer les scripts, les journaux et les flux de travail d'analyse reproductibles |
| Questionnaire Internet Addiction Test | Source originale de l'échelle ou version du questionnaire autorisée ou adaptée | Test d'addiction à Internet à 20 items | Utilisé pour évaluer les symptômes d'addiction à Internet et classer l'usage normal, l'usage problématique et l'usage gravement problématique |
| Plateforme de sondage en ligne | Qualtrics | XM Platform ; compte institutionnel ou sous licence | Utilisé pour construire le questionnaire, imposer des items obligatoires, gérer l'accès basé sur le consentement, restreindre les soumissions répétées lorsque cela est possible, et exporter les données de réponse |
| Pack logiciel statistique optionnel à interface graphique | IBM | SPSS Statistics | Utilisé lorsqu'un flux de travail d'analyse basé sur une interface graphique est requis pour les statistiques descriptives, les contrôles de fiabilité ou l'analyse de régression |
| Fichier README/codebook | Document interne spécifique à l'étude | README_v1.txt ou codebook_v1.xlsx | Utilisé pour documenter les noms des variables, les règles de codage, les plages de scores, les règles de codage inversé, les seuils d'exclusion, les noms de fichiers et les versions de logiciels |
| Copie d'archivage en lecture seule | Format de document portable | PDF/A ou PDF d'archivage approuvé par l'institution | Utilisé pour préserver l'instrument de sondage verrouillé, la page de consentement et les documents de soutien au protocole |
| Classeur du journal de sélection | Document interne spécifique à l'étude | screening_log_v1.xlsx | Utilisé pour documenter les doublons lors du tri, le temps de complétion, les échecs aux contrôles d'attention, les réponses systématiques, les incohérences logiques, les données manquantes, les décisions de relecture manuelle et les effectifs finaux retenus |
| Logiciel de tableur | Microsoft | Format de classeur Microsoft Excel (.xlsx) | Utilisé pour les journaux de sélection, le dictionnaire de variables, les enregistrements de relecture manuelle et la préparation des classeurs supplémentaires |
| Environnement de calcul statistique | R Foundation / CRAN | R 4.5.3 | Utilisé pour la vérification du calcul des scores, les statistiques descriptives, les contrôles de fiabilité, l'analyse de corrélation, l'analyse de régression, le calcul du facteur d'inflation de la variance (VIF) et les sorties diagnostiques |
| Fichier supplémentaire 1 | Fichier supplémentaire spécifique à l'étude | Supplementary File 1.xlsx | Contient les documents relatifs au déroulement du questionnaire, le codebook, le journal de sélection, le plan de sortie et les documents relatifs au flux de travail prêt à l'analyse |
| Tableau supplémentaire S1 | Tableau supplémentaire spécifique à l'étude | Supplementary Table S1 | Fournit le dictionnaire complet des variables, la présence des fichiers, la structure de codage, les champs d'identifiants techniques, les variables de sélection et les champs de suivi du jeu de données |
| Document d'exportation du questionnaire | Qualtrics | Exportation du questionnaire vers Word ou exportation PDF | Utilisé pour archiver la formulation finale du questionnaire, l'ordre des items, les paramètres de branchement, les paramètres d'items obligatoires et le codage des réponses |
| Format d'exportation du questionnaire | Qualtrics | Exportation CSV | Utilisé pour la préservation des données brutes et l'exportation des données prêtes à l'analyse |
Références
- Moreno MA, et al. Problematic internet use among US youth: a systematic review. Arch Pediatr Adolesc Med. 2011;165:797-805.
- Ramón-Arbués E, et al. Prevalence and factors associated with problematic internet use in a population of Spanish university students. Int J Environ Res Public Health. 2021;18:7620.
- Cai Z, et al. Associations between problematic internet use and mental health outcomes of students: a meta-analytic review. Adolesc Res Rev. 2023;8:45-62.
- Gong Z, Wang L, Wang H. Perceived stress and internet addiction among Chinese college students: mediating effect of procrastination and moderating effect of flow. Front Psychol. 2021;12:632461.
- Tsai JK, et al. Relationship between difficulty in emotion regulation and internet addiction in college students: a one-year prospective study. Int J Environ Res Public Health. 2020;17:4766.
- Romero-López M, Pichardo C, De Hoces I, García-Berbén T. Problematic internet use among university students and its relationship with social skills. Brain Sci. 2021;11:1301.
- Xie X, et al. Problematic internet use was associated with psychological problems among university students during COVID-19 outbreak in China. Front Public Health. 2021;9:675380.
- Montagni I, et al. Mental health-related digital use by university students: a systematic review. Telemed J E Health. 2020;26:131-146.
- Candussi CJ, Kabir R, Sivasubramanian M. Problematic smartphone usage, prevalence and patterns among university students: a systematic review. J Affect Disord Rep. 2023;14:100643.
- Moon SJ, Hwang JS, Kim JY, Shin AL, Bae SM, Kim JW. Psychometric properties of the Internet Addiction Test: a systematic review and meta-analysis. Cyberpsychol Behav Soc Netw. 2018;21:473-484.
- Jelenchick LA, Becker T, Moreno MA. Assessing the psychometric properties of the Internet addiction test in US college students. Psychiatry Res. 2012;196:296-301.
- Tafur-Mendoza AA, Acosta-Prado JC, Zárate-Torres RA, Ramírez-Ospina DE. Assessing the psychometric properties of the Internet addiction test in Peruvian university students. Int J Environ Res Public Health. 2020;17:5782.
- Fernández-Villa T, Molina AJ, García-Martín M, Llorca J, Delgado-Rodríguez M, Martín V. Validation and psychometric analysis of the Internet addiction test in Spanish among college students. BMC Public Health. 2015;15:953.
- World Medical Association. World Medical Association Declaration of Helsinki: ethical principles for medical research involving human subjects. JAMA. 2013;310:2191-2194.
- Wei Z, Hassan NC, Hassan SA, Ismail N, Gu X, Dong J. Psychometric validation of Young’s Internet addiction test among Chinese undergraduate students. PLoS One. 2025;20:e0320641.
- Bjureberg J, et al. Development and validation of a brief version of the Difficulties in emotion regulation scale : the DERS-16. J Psychopathol Behav Assess. 2016;38:284-296.
- Muszyński M. Attention checks and how to use them: review and practical recommendations. ASK: Research and Methods. 2023;32:3-38.
- Broman KW, Woo KH. Data organization in spreadsheets. Am Stat. 2018;72:2-10.
- Leiner DJ. Too fast, too straight, too weird: non-reactive indicators for meaningless data in internet surveys. Surv Res Methods. 2019;13:229-248.
- Taber KS. The use of Cronbach’s alpha when developing and reporting research instruments in science education. Res Sci Educ. 2018;48:1273-1296.
- Gioia F, Rega V, Boursier V. Problematic Internet use and emotional dysregulation among young people: a literature review. Clin Neuropsychiatry. 2021;18:41-54.
- Chen M, Zhang X. Factors influencing internet addiction among university students: the mediating roles of self-control and anxiety. Acta Psychol (Amst). 2024;250:104535.
- Akbari M, Seydavi M, Sheikhi S, Spada MM. Problematic smartphone use and sleep disturbance: the roles of metacognitions, desire thinking, and emotion regulation. Front Psychiatry. 2023;14:1137533.
- Wang S, Cheng Y, Yang Y, Lu B. The impact of physical activity on internet addiction among college students: the chain mediation role of rumination and mindfulness. BMC Public Health. 2025;25:3643.
- Struminskaya B, Sakshaug JW. Ethical considerations for augmenting surveys with auxiliary data sources. Public Opin Q. 2023;87:619-633.
- Yin J, et al. Associations between both smartphone addiction and objectively measured smartphone use and sleep quality and duration among university students: a cross-sectional study. JMIR Ment Health. 2025;12:e77796.
- Hainagiu SM, Neagu SN. Caught in the Web—emotional regulation difficulties and internet addiction among Romanian medical and technical university students: a pilot cross-sectional study. Healthcare (Basel). 2025;13:2528.
- Guo C, Chen M, Ji X, Li J, Ma Y, Zang S. Association between internet addiction and sleep quality in medical students: a longitudinal study. Front Psychol. 2025;16:1517590.
- Barker M, Chue Hong NP, Katz DS, Lamprecht AL, Martinez-Ortiz C, Psomopoulos F, et al. Introducing the FAIR Principles for research software. Sci Data. 2022;9:622.
- Nosek BA, Alter G, Banks GC, Borsboom D, Bowman SD, Breckler SJ, et al. Promoting an open research culture. Science. 2015;348:1422-1425.
Accès restreint. Veuillez vous connecter ou commencer un essai pour afficher ce contenu.