Cette étude présente un flux de travail clinique rétrospectif permettant d'estimer le risque d'hypertension pulmonaire chez les patients âgés hospitalisés pour une exacerbation aiguë de la maladie pulmonaire obstructive chronique, en utilisant des variables cliniques couramment disponibles et un modèle prédictif basé sur un nomogramme.
Un abonnement JoVE est requis pour visualiser ce contenu. Connectez-vous ou commencez votre période d'essai gratuite.
Article de recherche
Nomogramme basé sur des données de routine pour estimer le risque d'hypertension pulmonaire chez les patients âgés présentant une exacerbation aiguë de la bronchopneumopathie chronique obstructive
Dans cet article
Résumé
Résumé
L'hypertension pulmonaire est une complication cliniquement importante chez les patients âgés hospitalisés pour une exacerbation aiguë de la maladie pulmonaire obstructive chronique, mais l'estimation précoce du risque reste difficile dans les établissements hospitaliers de première ligne et à ressources limitées. Cette étude de cohorte rétrospective a élaboré et évaluée en interne un nomogramme basé sur des données de routine pour estimer le risque d'hypertension pulmonaire. Un total de 230 patients âgés hospitalisés pour une exacerbation aiguë de la maladie pulmonaire obstructive chronique entre mai 2023 et mai 2025 ont été analysés. Les patients ont été classés en groupes sans hypertension pulmonaire et avec hypertension pulmonaire selon les résultats de l'échocardiographie transthoracique. Les caractéristiques démographiques, les comorbidités, les indices de la numération formule sanguine, les marqueurs de la coagulation, les marqueurs inflammatoires et les marqueurs de stress cardiaque ont été comparés entre les groupes. Les prédicteurs candidats ont été sélectionnés à l'aide d'une analyse univariée, d'une évaluation de la pertinence clinique, d'une évaluation de la redondance et d'une régression logistique multivariée. Quatre variables—le rapport neutrophiles-lymphocytes, le peptide natriurétique de type B, le D-dimère et les antécédents d'asthme—étaient indépendamment associées à l'hypertension pulmonaire et ont été intégrées au nomogramme principal. Le modèle a montré une bonne discrimination, avec une aire sous la courbe caractéristique de fonctionnement du récepteur de 0,82. L'analyse de la courbe décisionnelle a indiqué un bénéfice net potentiel pour des probabilités seuils d'environ 1 % à 70 %. Les résultats de calibration nécessitent une interprétation prudente en raison d'un écart résiduel de calibration. Ce flux de travail propose une approche pratique pour la stratification précoce du risque d'hypertension pulmonaire chez les patients âgés hospitalisés pour une exacerbation aiguë de la maladie pulmonaire obstructive chronique. Toutefois, une validation externe et un recalibrage du modèle sont nécessaires avant une application clinique plus large.
Introduction
La maladie pulmonaire obstructive chronique est une affection respiratoire chronique fréquente caractérisée par une limitation persistante du flux d'air, des symptômes respiratoires et des épisodes récurrents de détérioration clinique. Elle demeure une cause majeure de morbidité, de mortalité et de charge pour les systèmes de santé dans le monde entier1. L'exacerbation aiguë de la maladie pulmonaire obstructive chronique correspond à une aggravation aiguë des symptômes respiratoires, notamment la dyspnée, la toux et la production de crachats, et est fréquemment déclenchée par une infection, une exposition environnementale ou d'autres agressions aiguës2. Chez les patients âgés, les exacerbations aiguës surviennent souvent en présence d'une multimorbidité, d'une réserve cardiaque et pulmonaire altérée, d'une inflammation systémique et d'une tolérance physiologique réduite, ce qui augmente la difficulté d'une évaluation précoce du risque.
L'hypertension pulmonaire est une complication importante de la maladie pulmonaire obstructive chronique, en particulier lors des exacerbations aiguës. Son développement est associé à l'hypoxie chronique, au remodelage vasculaire pulmonaire, à un dysfonctionnement endothélial, à une activation inflammatoire et à une postcharge ventriculaire droite accrue3. Une pression élevée dans l'artère pulmonaire a été observée chez des patients présentant une exacerbation aiguë de la maladie pulmonaire obstructive chronique et peut aggraver l'insuffisance respiratoire, la surcharge du cœur droit, la durée d'hospitalisation et la survie4. Cet impact pronostique est particulièrement important chez les patients âgés et chez ceux souffrant d'une maladie cardioréspiratoire avancée5,6. L'identification précoce des patients présentant un risque accru d'hypertension pulmonaire pourrait donc permettre une surveillance plus étroite, une évaluation échocardiographique rapide et une orientation vers une évaluation cardioréspiratoire complémentaire.
La cathétérisation cardiaque droite reste la référence standard pour confirmer l'hypertension pulmonaire ; toutefois, son caractère invasif, son coût, ses exigences techniques et sa disponibilité limitée restreignent son utilisation comme procédure de dépistage initiale dans de nombreux hôpitaux de premier recours et de niveau départemental7. L'échocardiographie transthoracique est couramment utilisée comme méthode d'évaluation non invasive, mais sa fiabilité peut être compromise par une hyperinflation, des fenêtres acoustiques médiocres et des modifications emphysémateuses chez les patients atteints de maladie pulmonaire obstructive chronique8. Bien que ces limitations n'altèrent pas la valeur clinique de l'échocardiographie, elles soulignent la nécessité d'un flux de travail simple d'estimation du risque, pouvant être appliqué avant ou en parallèle avec une évaluation fondée sur l'imagerie.
Des variables cliniques et de laboratoire courantes peuvent aider à répondre à ce besoin. Le rapport neutrophiles-lymphocytes est calculé à partir des résultats de la numération formule sanguine complète et reflète l'équilibre entre l'inflammation induite par les neutrophiles et la régulation immunitaire liée aux lymphocytes9. Il a été associé à l'activité de la maladie et à des résultats défavorables dans les affections pulmonaires et cardiovasculaires10. Le peptide natriurétique de type B est un marqueur facilement disponible du stress pariétal myocardique, de la surcharge de pression du ventricule droit et de la souffrance cardiopulmonaire11. Le D-dimère reflète l'activation de la coagulation et la fibrinolyse secondaire, et peut augmenter pendant les exacerbations aiguës en raison de l'hypoxémie, des infections, des lésions endothéliales et de la mobilité réduite12. Toutefois, aucun biomarqueur unique ne semble capable de refléter intégralement le profil de risque de l'hypertension pulmonaire chez les patients âgés présentant une exacerbation aiguë de la maladie pulmonaire obstructive chronique.
Un nomogramme offre un moyen pratique de traduire un modèle de prédiction multivarié en une estimation de risque individualisée. Contrairement à la simple présentation des coefficients de régression, il permet d’intégrer plusieurs prédicteurs au niveau du patient dans un outil cliniquement interprétable13. Des études cliniques antérieures ont utilisé des modèles fondés sur des nomogrammes pour faciliter l’évaluation du risque au chevet du patient, mais leur utilité dépend d’une sélection transparente des prédicteurs, d’une calibration et d’une validation adéquates, ainsi que d’une interprétation prudente14. L’originalité de la présente étude réside dans l’élaboration d’un flux de travail basé sur des données de routine destiné aux patients âgés hospitalisés pour une exacerbation aiguë de la bronchopneumopathie chronique obstructive, en intégrant des informations inflammatoires, liées au stress cardiaque, à la coagulation et au phénotype des voies respiratoires dans un nomogramme pratique. L’étude visait à identifier des prédicteurs cliniques associés à une hypertension pulmonaire définie par échocardiographie et à construire un modèle validé en interne pour une stratification précoce du risque, plutôt que pour un diagnostic définitif.
Accès restreint. Veuillez vous connecter ou commencer un essai pour afficher ce contenu.
Protocole
Le protocole de l'étude a été examiné et approuvé par le Comité d'éthique de l'Hôpital de médecine traditionnelle chinoise du district de Santai, dans la province du Sichuan (n° d'approbation : 2025003). L'étude a été menée conformément aux principes de la Déclaration d'Helsinki. Un consentement éclairé écrit a été obtenu auprès de chaque patient ou d'un proche parent avant leur inclusion dans l'étude. Cette étude de cohorte rétrospective a passé en revue les dossiers cliniques de patients âgés hospitalisés pour une exacerbation aiguë de la maladie pulmonaire obstructive chronique (AECOPD) dans le service de pneumologie et de soins critiques de l'Hôpital de médecine traditionnelle chinoise du district de Santai entre mai 2023 et mai 2025. L'objectif de l'étude était d'identifier des prédicteurs cliniques couramment disponibles d'hypertension pulmonaire (PH) et de développer un nomogramme permettant une estimation personnalisée du risque de PH. Les instruments de laboratoire, le système d'échographie, les fournitures pour prélèvement sanguin, les outils d'extraction des données et les logiciels statistiques utilisés dans cette procédure sont indiqués dans le Tableau des matériaux.
1. Dépistage des patients et évaluation des critères d'éligibilité
Les patients hospitalisés ayant reçu un diagnostic de rechute aiguë de la BPCO (AECOPD) lors de la période d'étude ont été sélectionnés via le système informatisé des dossiers médicaux des patients hospitalisés. Chaque dossier a été examiné afin de confirmer que le patient avait au moins 60 ans et que le diagnostic de broncho-pneumopathie chronique obstructive était conforme aux critères diagnostiques de l'Initiative mondiale pour la maladie pulmonaire obstructive chronique (GOLD) de 202115. Une rechute aiguë de la BPCO était définie comme une aggravation aiguë des symptômes respiratoires nécessitant une hospitalisation et un traitement complémentaire. Pour les patients ayant plus d'une admission pour rechute aiguë de la BPCO durant la période d'étude, seule la première hospitalisation éligible a été incluse.
Les patients ont été inclus lorsqu'ils répondaient à tous les critères suivants : âge d'au moins 60 ans ; hospitalisation pour une exacerbation aiguë de la BPCO entre mai 2023 et mai 2025 ; échocardiographie transthoracique disponible durant l'hospitalisation initiale ; prélèvement sanguin veineux au premier jeûne disponible après l'admission ; et informations cliniques, biologiques et échocardiographiques complètes nécessaires à la construction du modèle. Les patients ont été exclus s'ils présentaient une insuffisance hépatique sévère, une maladie rénale au stade terminal, une malignité active, une hypertension pulmonaire attribuable à d'autres causes connues, une maladie cardiaque gauche primaire, une maladie du tissu conjonctif telle que la sclérodermie systémique, une tuberculose pulmonaire active, ou des variables essentielles manquantes requises pour la classification du résultat ou la construction du modèle.
Avant que les dossiers ne soient supprimés en raison d'informations incomplètes, l'âge, le sexe, les antécédents de tabagisme, les antécédents de consommation d'alcool, les antécédents d'allergie médicamenteuse, l'hypertension, le diabète sucré, la maladie coronarienne, l'asthme, la bronchiectasie, l'infection pulmonaire, l'emphysème, l'insuffisance respiratoire, l'insuffisance cardiaque, le statut échocardiographique de PH, les paramètres de la numération formule sanguine, l'albumine, la créatinine, la protéine C-réactive de haute sensibilité, le D-dimère, le fibrinogène, le peptide natriurétique de type B et le ratio neutrophiles-lymphocytes ont été vérifiés. Le nombre de dossiers dépistés et exclus, les raisons des exclusions ainsi que les cas finalement inclus ont été enregistrés afin d'établir le diagramme de flux de sélection des patients (Figure 1).
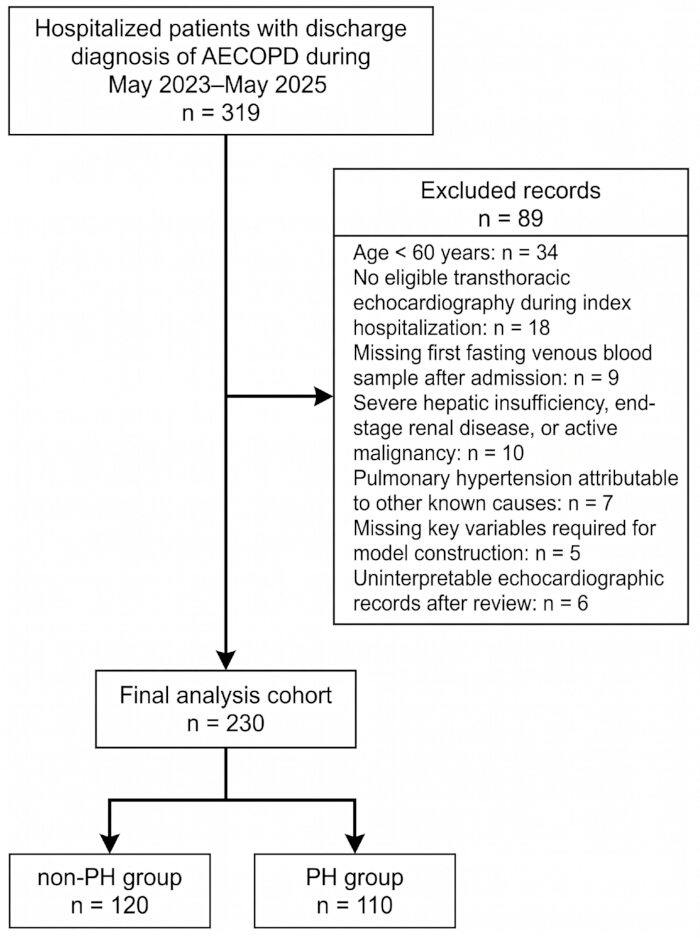
Figure 1 : Sélection des patients et constitution de la cohorte. Le diagramme de flux illustre l'identification des dossiers, l'évaluation des critères d'éligibilité, les exclusions et le regroupement final des patients âgés hospitalisés pour une BPCO-GEA. Les patients ont été classés dans le groupe sans HP ou dans le groupe HP selon les résultats de l'échocardiographie transthoracique. Abréviations : BPCO-GEA, exacerbation aiguë de la maladie pulmonaire obstructive chronique ; HP, hypertension pulmonaire. Veuillez cliquer ici pour afficher une version agrandie de cette figure.
2. Regroupement clinique et définition diagnostique de l'hypertension pulmonaire
Les patients inclus ont été classés dans un groupe sans HP ou dans un groupe HP selon les résultats de l'échocardiographie transthoracique réalisée pendant l'hospitalisation. Le cadre diagnostique était fondé sur les recommandations de 2015 de la Société européenne de cardiologie et de la Société européenne de pneumologie concernant l'hypertension pulmonaire16. L'échocardiographie transthoracique au repos a été utilisée comme base diagnostique dans ce jeu de données rétrospectif. Les examens ont été réalisés par des médecins échocardiographes formés, en utilisant des vues parasternales, apicales et sous-costales standard. L'interprétabilité échocardiographique a été revue avant l'affectation aux groupes, car des fenêtres acoustiques médiocres sont fréquentes chez les patients atteints de bronchopneumopathie chronique obstructive. Un dossier était considéré comme approprié pour la classification de l'HP lorsque le signal Doppler du reflux tricuspidien était mesurable ou lorsque la taille du ventricule droit, l'épaisseur de la paroi et la fonction systolique pouvaient être évaluées à partir de vues cardiaques interprétables.
La pression artérielle pulmonaire systolique a été estimée à l'aide de la vélocité maximale du reflux tricuspidien et de la pression auriculaire droite estimée. La pression auriculaire droite a été évaluée à partir du diamètre de la veine cave inférieure et de son collapsus inspiratoire lorsque les deux mesures étaient disponibles. Une hypertension pulmonaire (HP) a été définie par une pression artérielle pulmonaire systolique estimée d'au moins 40 mmHg. Lorsque la pression artérielle pulmonaire systolique ne pouvait pas être estimée de façon fiable, le diagnostic d'HP nécessitait la présence d'indices échocardiographiques indirects d'atteinte du ventricule droit, notamment un agrandissement du ventricule droit, une hypertrophie du ventricule droit, une dysfonction systolique du ventricule droit, un aplatissage du septum interventriculaire ou un élargissement de l'artère pulmonaire. Les dossiers échocardiographiques comportant des images floues, des signaux Doppler de reflux tricuspidien non traçables ou des anomalies incohérentes du cœur droit ont été revus par un deuxième médecin échocardiographe avant l'attribution définitive au groupe. Les dossiers restant ininterprétables après cette révision ont été exclus de l'analyse finale. Dans la cohorte finale, 230 patients âgés répondaient aux critères d'éligibilité ; 120 patients ont été affectés au groupe sans HP et 110 patients au groupe HP.
3. Extraction des variables démographiques et cliniques
Toutes les données cliniques ont été extraites du système informatisé des dossiers médicaux des patients hospitalisés à l'aide d'un formulaire standardisé de collecte des données. Ont été enregistrés : le sexe, l'âge, les antécédents de tabagisme, les antécédents de consommation d'alcool, les antécédents d'allergie médicamenteuse, l'hypertension artérielle, le diabète sucré, la maladie coronarienne, l'asthme, la bronchiectasie, l'infection pulmonaire, l'emphysème, l'insuffisance respiratoire et l'insuffisance cardiaque. Un antécédent de tabagisme était défini comme une consommation cumulée d'au moins 100 cigarettes au cours de la vie, et un antécédent de consommation d'alcool, comme une consommation régulière d'alcool au moins deux fois par semaine.
L'infection pulmonaire a été diagnostiquée en intégrant les symptômes respiratoires, les signes physiques, les résultats d'imagerie thoracique et, lorsque disponibles, les éléments microbiologiques. L'insuffisance cardiaque a été diagnostiquée selon les manifestations cliniques, les signes physiques, les taux de peptide natriurétique de type B et les résultats échocardiographiques. Les informations sur les comorbidités ont été vérifiées croisées avec les diagnostics de sortie, les notes d'évolution, les comptes rendus d'imagerie, les rapports de laboratoire et les dossiers de consultation, lorsque disponibles.
4. Collecte et traitement des variables de laboratoire
L'échantillon sanguin veineux à jeun prélevé le matin suivant l'admission à l'hôpital a été utilisé comme source de données de laboratoire. Ce moment correspondait au premier prélèvement sanguin matinal après l'admission et avant tout ajustement habituel du traitement diurne, lorsque ces informations étaient disponibles dans le dossier médical. Les paramètres de la numération formule sanguine, les paramètres biochimiques, les marqueurs de la coagulation, les marqueurs inflammatoires et les marqueurs de stress cardiaque ont été extraits du système d'information laboratoriale de l'hôpital.
Le nombre de neutrophiles, le nombre de lymphocytes, le nombre de plaquettes, le volume moyen des plaquettes et le coefficient de variation de la largeur de distribution des hématies ont été enregistrés à partir du compte rendu d'hémogramme. Le ratio neutrophiles/lymphocytes a été calculé comme suit :
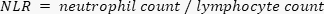
L'albumine, la créatinine, le D-dimère, le fibrinogène, la protéine C-réactive à haute sensibilité et le peptide natriurétique de type B ont été relevés à partir des rapports de laboratoire correspondants. Des unités de mesure cohérentes ont été utilisées pour l'ensemble du jeu de données : l'albumine en g/L, la créatinine en µmol/L, la protéine C-réactive à haute sensibilité en mg/L, le D-dimère en µg/mL, le fibrinogène en g/L, le nombre de neutrophiles, le nombre de lymphocytes et le nombre de plaquettes en ×109/L, le volume plaquettaire moyen en fL, et le peptide natriurétique de type B en pg/mL.
5. Nettoyage et préparation des données
Le jeu de données a été examiné avant l'analyse statistique. Chaque enregistrement inclus a été vérifié quant à l'éligibilité, l'affectation au groupe, l'exhaustivité du laboratoire, l'interprétabilité échocardiographique et la disponibilité des prédicteurs candidats. Les identifiants personnels directs ont été supprimés et chaque patient s'est vu attribuer un numéro d'identification d'étude. Les enregistrements en double, les hospitalisations répétées, les étiquettes de groupe incohérentes, les dates impossibles et les valeurs de laboratoire invraisemblables ont été vérifiées par rapport au dossier médical électronique d'origine et au rapport de laboratoire. Aucune imputation n'a été effectuée pour les variables clés d'issue ou de prédiction, car le modèle final était basé sur une analyse des cas complets.
Les variables continues ont été examinées pour leurs caractéristiques de distribution. Les variables normalement distribuées ont été résumées par la moyenne ± l'écart type ; les variables non normalement distribuées par la médiane avec l'intervalle interquartile ; et les variables catégorielles par les effectifs et les pourcentages. Avant la modélisation multivariée, les variables cliniquement apparentées ont été vérifiées pour détecter d'éventuelles redondances. Le nombre de neutrophiles et celui de lymphocytes ont été examinés conjointement avec le ratio neutrophiles/lymphocytes ; l'infection pulmonaire a été examinée conjointement avec le nombre de neutrophiles, la protéine C-réactive de haute sensibilité et le ratio neutrophiles/lymphocytes ; l'insuffisance cardiaque a été examinée conjointement avec le peptide natriurétique de type B et les résultats échocardiographiques cardiaques ; le D-dimère et le fibrinogène ont été examinés comme variables liées à la coagulation ; et le nombre de plaquettes, le volume moyen des plaquettes et le coefficient de variation de la largeur de distribution des globules rouges ont été examinés comme variables hématologiques.
6. Comparaison univariée entre les groupes
Les caractéristiques démographiques, les comorbidités, les indicateurs de laboratoire et les variables de regroupement échocardiographiques ont été comparés entre les groupes sans HP et avec HP. Un test t pour échantillons indépendants a été utilisé pour les variables continues normalement distribuées. Le test U de Mann-Whitney a été utilisé pour les variables continues non normalement distribuées. Le test χ2 ou le test exact de Fisher a été utilisé pour les variables catégorielles, selon les effectifs théoriques par cellule. Une valeur P bilatérale inférieure à 0,05 a été considérée comme statistiquement significative. Les variables présentant des différences significatives entre les groupes ont été prises en compte pour une évaluation multivariée, conjointement avec les prédicteurs cliniquement pertinents.
7. Analyse de régression logistique multivariée
Une régression logistique binaire a été utilisée pour identifier les prédicteurs indépendants associés à l'hypertension pulmonaire (PH) chez les patients âgés atteints d'une exacerbation aiguë de la BPCO (AECOPD). Le statut d'hypertension pulmonaire a été utilisé comme variable dépendante. Les prédicteurs continus ont été saisis dans leurs unités de mesure d'origine, et les prédicteurs catégoriels ont été codés sous forme de variables binaires. Les variables candidates ont été sélectionnées en fonction des résultats univariés et de leur pertinence clinique. Les variables présentant une valeur P < 0,05 dans la comparaison univariée ont d'abord été identifiées, puis examinées pour vérifier leur redondance, leur interprétabilité et leurs chevauchements cliniques.
Les variables candidates initiales comprenaient la protéine C-réactive de haute sensibilité, le D-dimère, le coefficient de variation de la largeur de distribution des globules rouges, le nombre de plaquettes, le volume plaquettaire moyen, le ratio neutrophiles-lymphocytes, le peptide natriurétique de type B, la maladie coronarienne et les antécédents d'asthme. Le nombre de neutrophiles et le nombre de lymphocytes n'ont pas été saisis conjointement avec le ratio neutrophiles-lymphocytes, car ils constituaient les composantes de ce ratio. L'infection pulmonaire et l'insuffisance cardiaque ont été évaluées lors de l'évaluation de la redondance. Afin d'examiner si leur exclusion influençait l'interprétation du modèle, une analyse de sensibilité a été réalisée en ajoutant l'infection pulmonaire et l'insuffisance cardiaque au jeu de prédicteurs principaux. Les estimations de régression, la discrimination, l'étalonnage et le bénéfice net clinique ont été comparés entre les modèles principal et de sensibilité.
La multicolinéarité entre les prédicteurs candidats a été évaluée à l'aide des facteurs d'inflation de la variance. Les variables catégorielles ont été codées avant le calcul, et les variables continues ont été saisies dans les mêmes unités que celles utilisées pour la modélisation par régression. Un facteur d'inflation de la variance inférieur à 5 a été considéré comme indiquant l'absence de multicolinéarité sévère. Les coefficients de régression, les erreurs types, les valeurs de χ2 de Wald, les rapports de cotes, les intervalles de confiance à 95 %, les valeurs P et les facteurs d'inflation de la variance ont été rapportés pour les variables incluses dans le modèle multivarié.
8. Construction du nomogramme
Le nomogramme a été construit à partir des prédicteurs indépendants retenus dans le modèle de régression logistique multivariée. Les prédicteurs finaux étaient le D-dimère, le ratio neutrophiles-lymphocytes, le peptide natriurétique de type B et les antécédents d'asthme. Le modèle de régression logistique a été converti en un nomogramme basé sur un système de points à l'aide du logiciel R et du package rms. Un objet de distribution des données a été généré pour l'ensemble de données de modélisation, le modèle de régression logistique a été ajusté, et les coefficients de régression ont été utilisés pour attribuer des points à chaque prédicteur. Pour chaque patient, les points correspondant au D-dimère, au ratio neutrophiles-lymphocytes, au peptide natriurétique de type B et aux antécédents d'asthme ont été additionnés afin d'obtenir un score total, qui a ensuite été associé à la probabilité estimée d'hypertension pulmonaire (PH).
Le nomogramme a été interprété à l'aide de procédures standard fondées sur des points, décrites dans des études antérieures sur les modèles de prédiction clinique17,18. La valeur de D-dimère du patient, le ratio neutrophiles/lymphocytes, la valeur du peptide natriurétique de type B et le statut asthmatique ont été repérés sur leurs axes respectifs. Une ligne verticale a été tracée depuis chaque valeur prédictive jusqu'à l'échelle de points. Les points ont été additionnés pour obtenir le score total, puis une ligne verticale a été tracée depuis l'échelle du score total jusqu'à l'axe de la probabilité prédite, afin d'obtenir la probabilité estimée individualisée de PH. Le patient à titre d'illustration utilisé dans le manuscrit a été choisi parmi des valeurs situées dans ou proches de la distribution clinique observée dans la cohorte.
9. Évaluation des performances du modèle
La discrimination du modèle a été évaluée à l'aide de l'analyse de la courbe ROC (caractéristique de fonctionnement du récepteur) et de l'aire sous la courbe. L'aire sous la courbe a été indiquée avec un intervalle de confiance à 95 %. Le nomogramme a été comparé aux prédicteurs individuels ainsi qu'à un modèle combinant des marqueurs de laboratoire quantitatifs. La calibration a été évaluée en comparant les probabilités prédites aux résultats observés de PH. Une courbe de calibration a été générée à l'aide d'un rééchantillonnage par bootstrap. L'intercept de calibration, la pente de calibration, l'erreur absolue moyenne, le score de Brier et le test de Hosmer-Lemeshow ont été rapportés. L'intercept de calibration corrigé par bootstrap et la pente de calibration corrigée par bootstrap ont également été calculés. Le test de Hosmer-Lemeshow a été interprété conjointement avec la courbe de calibration et les indices quantitatifs de calibration.
L'utilité clinique a été évaluée à l'aide d'une analyse de courbe décisionnelle. Le bénéfice net a été tracé en fonction des probabilités seuils et comparé aux stratégies de référence « traiter tous » et « ne traiter aucun ». La plage de probabilité seuil dans laquelle le modèle offrait un bénéfice net supérieur à celui des stratégies de référence a été identifiée.
10. Validation interne et reproductibilité
Une validation interne a été réalisée à l'aide d'un rééchantillonnage bootstrap avec 1 000 répétitions. Pour chaque répétition bootstrap, le modèle a été réajusté et testé afin d'estimer le biais optimiste de la performance du modèle. Les indices de discrimination et de calibration corrigés pour le biais optimiste ont été calculés et rapportés conjointement avec la performance apparente du modèle.
Les analyses statistiques ont été réalisées à l'aide de logiciels statistiques standards et de la version 4.5.2 de R. Des packages R ont été utilisés pour la modélisation par régression logistique, la construction de nomogrammes, l'analyse des courbes ROC (caractéristique de fonctionnement du récepteur), l'évaluation de la calibration, la validation interne et l'analyse des courbes de décision. Le nomogramme a été construit à l'aide du package rms dans R.
Accès restreint. Veuillez vous connecter ou commencer un essai pour afficher ce contenu.
Résultats
Dépistage des patients et caractéristiques de la cohorte
Au total, 230 patients âgés hospitalisés pour une exacerbation aiguë de la maladie pulmonaire obstructive chronique (AECOPD) ont satisfait aux critères d'éligibilité et ont été inclus dans l'analyse finale. Selon l'évaluation par échocardiographie transthoracique, 120 patients ont été affectés au groupe sans hypertension pulmonaire (non-HP), et 110 patients au groupe avec hypertension pulmonaire (HP) (
Accès restreint. Veuillez vous connecter ou commencer un essai pour afficher ce contenu.
Discussion
Cette étude a mis au point un nomogramme basé sur des données de routine afin d'estimer le risque d'hypertension pulmonaire (PH) chez les patients âgés hospitalisés pour une exacerbation aiguë de la maladie pulmonaire obstructive chronique (AECOPD). Quatre variables facilement disponibles, à savoir le rapport neutrophiles-lymphocytes (NLR), le peptide natriurétique de type B (BNP), le D-dimère et les antécédents d'asthme, ont été retenues dans le modèle principal. Le nomogramme présentait une meilleure discrimination que...
Accès restreint. Veuillez vous connecter ou commencer un essai pour afficher ce contenu.
Déclarations de divulgation
Les auteurs déclarent ne pas avoir d'intérêts financiers concurrents ni d'autres conflits d'intérêts liés à ce travail.
Contributions des auteurs
Mingfeng Wu : conception de l'étude, supervision et mise en œuvre, rédaction et révision du manuscrit, coordination des responsabilités de l'équipe ; Li Zhang : collecte et organisation des données, analyse statistique, rédaction du manuscrit ; Xiong Wang : collecte des données et rédaction du manuscrit ; Sshaohua Xu : analyse statistique et révision du manuscrit ; Li Xie : révision du manuscrit.
Remerciements
Cette étude a été soutenue par les projets de recherche scientifique de l'Administration provinciale de médecine traditionnelle chinoise du Sichuan, notamment Exploration pratique de la construction d'un modèle de prédiction de l'hypertension pulmonaire chez les patients âgés atteints de bronchopneumopathie chronique obstructive basé sur le ratio NLR (subvention n° 25MSZX321) et élaboration d'un modèle de service de laboratoire pour une communauté médicale de district et recherche sur les réponses politiques pilotées par la « livraison par drone + diagnostic assisté par intelligence artificielle » (Subvention n° 25MSZX322). Les auteurs remercient l'hôpital de médecine traditionnelle chinoise du comté de Santai pour son soutien à cette étude.
Accès restreint. Veuillez vous connecter ou commencer un essai pour afficher ce contenu.
Matériaux
| Nom | Entreprise | Numéro de catalogue | Commentaires |
|---|---|---|---|
| Analyseur automatisé de biochimie clinique | Mindray Bio-Medical Electronics Co., Ltd. | BS-480 | Utilisé pour mesurer l'albumine sérique, la créatinine et la protéine C-réactive de haute sensibilité lors d'analyses de laboratoire clinique de routine. |
| Analyseur automatisé de coagulation | Mindray Bio-Medical Electronics Co., Ltd. | C3510 | Utilisé pour mesurer le D-dimère et le fibrinogène lors d'analyses de coagulation de routine. |
| Analyseur automatisé d'hématologie | Mindray Bio-Medical Electronics Co., Ltd. | BC-5380 | Utilisé pour mesurer le nombre de neutrophiles, le nombre de lymphocytes, le nombre de plaquettes, le volume plaquettaire moyen et le coefficient de variation de la largeur de distribution des globules rouges. |
| Analyseur d'immunodosage par chimiluminescence | Mindray Bio-Medical Electronics Co., Ltd. | CL-1200i | Utilisé pour mesurer le peptide natriurétique de type B lors d'analyses de laboratoire clinique de routine. |
| Réactifs, calibrateurs et contrôles d'immunodosage par chimiluminescence | Mindray Bio-Medical Electronics Co., Ltd. | Système de réactifs série CL | Utilisés pour les tests d'immunodosage par chimiluminescence et le contrôle qualité. |
| Réactifs, calibrateurs et contrôles de biochimie clinique | Mindray Bio-Medical Electronics Co., Ltd. | Système de réactifs série BS | Utilisés pour les dosages de biochimie clinique de routine effectués sur l'analyseur série BS. |
| Calibrateurs et contrôles de coagulation | Mindray Bio-Medical Electronics Co., Ltd. | Produit-spécifique* | Utilisés pour le contrôle qualité et l'étalonnage des dosages de coagulation. |
| Package dcurves | CRAN | dcurves | Utilisé pour réaliser une analyse de courbe décisionnelle et calculer le bénéfice net clinique selon différentes probabilités seuils. |
| Tubes de prélèvement sanguin veineux avec EDTA | BD | Tube Vacutainer K2EDTA (REF 367856) | Utilisé pour les analyses de numération formule sanguine complète. |
| Système de dossier médical électronique | Hôpital de médecine traditionnelle chinoise du comté de Santai | Non applicable | Utilisé pour extraire les caractéristiques démographiques des patients hospitalisés, les dossiers d'admission, les diagnostics de sortie, les comorbidités, les notes d'évolution, les comptes rendus d'imagerie, les consultations et les résultats cliniques. |
| Réactifs, calibrateurs et contrôles d'hématologie | Mindray Bio-Medical Electronics Co., Ltd. | Système de réactifs série BC | Utilisés pour les analyses de numération formule sanguine complète de routine et le contrôle qualité de l'analyseur. |
| IBM SPSS Statistics | IBM Corp. | Version 26.0 | Utilisé pour les statistiques descriptives, les comparaisons entre groupes et les analyses préliminaires de régression logistique. |
| Système d'information de laboratoire | Hôpital de médecine traditionnelle chinoise du comté de Santai | Non applicable | Utilisé pour extraire les indices d'hémogramme, les indices biochimiques, les marqueurs de coagulation, les marqueurs inflammatoires et les marqueurs de stress cardiaque. |
| Package pROC | CRAN | pROC | Utilisé pour l'analyse des courbes ROC (caractéristique de fonctionnement du récepteur) et l'estimation de l'aire sous la courbe. |
| Logiciel statistique R | R Foundation for Statistical Computing | Version 4.5.2 | Utilisé pour la modélisation par régression logistique, la construction de nomogrammes, l'analyse des courbes ROC, l'évaluation de la calibration, la validation interne par bootstrap et l'analyse de courbe décisionnelle. |
| Package ResourceSelection | CRAN | ResourceSelection | Utilisé pour réaliser le test d'ajustement de Hosmer-Lemeshow. |
| Package rms | CRAN (Frank E. Harrell Jr.) | rms | Utilisé pour la modélisation de régression, la construction de nomogrammes, l'évaluation de la calibration et la validation interne. |
| Tubes de prélèvement sanguin veineux avec séparateur de sérum | BD | Tube Vacutainer SST (REF 367820) | Utilisé pour les tests biochimiques sériques et les marqueurs inflammatoires. |
| Tubes de prélèvement sanguin veineux avec citrate de sodium | BD | Tube Vacutainer au citrate (REF 363080) | Utilisé pour les tests de coagulation, notamment le D-dimère et le fibrinogène. |
| Formulaire normalisé d'extraction des données cliniques | Créé par l'équipe de l'étude | Non applicable | Utilisé pour extraire des variables prédéfinies concernant les données démographiques, cliniques, biologiques et échocardiographiques à partir de dossiers rétrospectifs. |
| Système d'échocardiographie transthoracique | GE HealthCare | Vivid E95 | Utilisé pour estimer la pression artérielle pulmonaire systolique et évaluer la taille du ventricule droit, l'épaisseur de sa paroi et sa fonction systolique. |
Références
- Adeloye D, et al. Global, regional, and national prevalence of, and risk factors for, chronic obstructive pulmonary disease (COPD) in 2019: a systematic review and modelling analysis. Lancet Respir Med. 2022;10:447-58.
- Chronic Obstructive Pulmonary Disease Group of Chinese Thoracic Society, Chronic Obstructive Pulmonary Disease Committee of Chinese Association of Chest Physician. Guidelines for the diagnosis and management of chronic obstructive pulmonary disease, revised version 2021. Chin J Tuberc Respir Dis. 2021;44:170-205.
- Johnson S, et al. Pulmonary hypertension: a contemporary review. Am J Respir Crit Care Med. 2023;208:528-48.
- Munshi RF, Pellegrini JR Jr, Patel P, Anjum F. Impact of pulmonary hypertension in patients with acute exacerbation of chronic obstructive pulmonary disease and its effect on healthcare utilization. Pulm Circ. 2021;11(3):20458940211046838.
- Prins KW, et al. Disproportionate right ventricular dysfunction and poor survival in group 3 pulmonary hypertension. Am J Respir Crit Care Med. 2018;197:1496-9.
- Andersen KH, et al. Prevalence, predictors, and survival in pulmonary hypertension related to end-stage chronic obstructive pulmonary disease. J Heart Lung Transplant. 2012;31:373-80.
- Chen Y, et al. Right heart catheterization-related complications: a review of the literature and best practices. Cardiol Rev. 2020;28:36-41.
- Younis M, et al. Echocardiography and pulmonary hypertension in patients with chronic obstructive pulmonary disease undergoing lung transplantation evaluation. Am J Med Sci. 2024;367:95-104.
- Pascual-González Y, López-Sánchez M, Dorca J, Santos S. Defining the role of neutrophil-to-lymphocyte ratio in COPD: a systematic literature review. Int J Chron Obstruct Pulmon Dis. 2018;13:3651-62.
- Lee SJ, et al. Usefulness of neutrophil to lymphocyte ratio in patients with chronic obstructive pulmonary disease: a prospective observational study. Korean J Intern Med. 2016;31:891-8.
- Leuchte HH, et al. Brain natriuretic peptide is a prognostic parameter in chronic lung disease. Am J Respir Crit Care Med. 2006;173:744-50.
- Husebø GR, et al. Coagulation markers as predictors for clinical events in COPD. Respirology. 2021;26:342-51.
- Iasonos A, Schrag D, Raj GV, Panageas KS. How to build and interpret a nomogram for cancer prognosis. J Clin Oncol. 2008;26:1364-70.
- Balachandran VP, Gonen M, Smith JJ, DeMatteo RP. Nomograms in oncology: more than meets the eye. Lancet Oncol. 2015;16(4):e173-e180.
- Global Initiative for Chronic Obstructive Lung Disease. Global Strategy for the Diagnosis, Management, and Prevention of Chronic Obstructive Pulmonary Disease: 2021 Report. Global Initiative for Chronic Obstructive Lung Disease; Fontana; 2021.
- Galiè N, et al. 2015 ESC/ERS Guidelines for the diagnosis and treatment of pulmonary hypertension. Eur Heart J. 2016;37:67-119.
- Wu Z, Zhan S, Wang D, Tang C. A novel nomogram for predicting the risk of acute heart failure in intensive care unit patients with COPD. Chronic Obstr Pulm Dis. 2025;12(2):117-126.
- Cheng H, et al. A risk nomogram for predicting prolonged intensive care unit stays in patients with chronic obstructive pulmonary disease. Front Med. 2023;10:1177786.
- Zinellu A, et al. Clinical significance of the neutrophil-to-lymphocyte ratio and platelet-to-lymphocyte ratio in acute exacerbations of COPD: present evidence and future perspectives. Eur Respir Rev. 2022;31(166):220095.
- Jiang T, et al. Value of the neutrophil-to-lymphocyte ratio in chronic obstructive pulmonary disease complicated with pulmonary hypertension. J Int Med Res. 2023;51(1):3000605231200266.
- Hawkins NM, et al. B-type natriuretic peptides in chronic obstructive pulmonary disease: a systematic review. BMC Pulm Med. 2017;17:11.
- Hu G, et al. Prognostic role of D-dimer for in-hospital and 1-year mortality in exacerbations of COPD. Int J Chron Obstruct Pulmon Dis. 2016;11:2729-36.
- Zuo H, et al. Predictive value of novel inflammation-based biomarkers for pulmonary hypertension in the acute exacerbation of chronic obstructive pulmonary disease. Anal Cell Pathol (Amst). 2019;2019:5189165.
- Hayiroglu MI, Cicek V, Kilic S, Cinar T. Mean serum D-dimer level to predict in-hospital mortality in COVID-19 patients. Rev Assoc Med Bras (1992). 2021;67:1108-13.
- Guney BC, et al. Evaluation of N/LP ratio as a predictor of disease progression and mortality in COVID-19 patients admitted to the intensive care unit. Medeni Med J. 2021;36:241-8.
- Hayiroglu MI, Cinar T, Tekkesin AI. Fibrinogen and D-dimer variances and anticoagulation recommendations in COVID-19: current literature review. Rev Assoc Med Bras (1992). 2020;66:842-8.
- Collins GS, Reitsma JB, Altman DG, Moons KGM. Transparent reporting of a multivariable prediction model for individual prognosis or diagnosis: the TRIPOD statement. Ann Intern Med. 2015;162:55-63.
- Moons KGM, et al. Transparent reporting of a multivariable prediction model for individual prognosis or diagnosis: explanation and elaboration. Ann Intern Med. 2015;162(1):W1-W73.
- Kalenderoglu K, et al. Heart rate variability nomogram predicts atrial fibrillation in patients with moderate to high burden of premature ventricular complexes. Medicina (Kaunas). 2026;62:243.
- Cicek V, et al. A new risk prediction model for the assessment of myocardial injury in elderly patients undergoing non-elective surgery. J Cardiovasc Dev Dis. 2025;12(1):6.
Accès restreint. Veuillez vous connecter ou commencer un essai pour afficher ce contenu.