Cette étude rétrospective monocentrique a développée et validée internellement un modèle de régression logistique pour l'ischémie cérébrale retardée après une hémorragie sous-arachnoïdienne anévrismale. Chez 680 patients, six variables cliniques, biologiques et d'imagerie précoces ont montré une valeur prédictive préliminaire. Une validation externe supplémentaire est nécessaire avant une utilisation clinique.
Article de recherche
Validation interne d'un modèle de prédiction clinique de l'ischémie cérébrale retardée après une hémorragie sous-arachnoïdienne anévrismale
Dans cet article
Résumé
Résumé
L’ischémie cérébrale retardée (ICR) est une cause importante de lésion neurologique secondaire après une hémorragie sous-arachnoïdienne anévrismale (HSAa). Cette étude rétrospective monocentrique a développée et évaluée des modèles prédictifs d’ICR à l’aide de données provenant de 680 patients adultes ayant présenté une HSAa et traités entre juillet 2022 et décembre 2024. Les patients ont été répartis selon une division stratifiée par résultat de 8:2 en un groupe d’apprentissage de 544 patients et un groupe de validation interne réservé de 136 patients. Une ICR s’est produite chez 175 patients du groupe d’apprentissage et chez 42 patients du groupe de validation interne. La sélection des prédicteurs a été effectuée dans le groupe d’apprentissage à l’aide d’une régression par l’opérateur de réduction et de sélection absolue avec une validation croisée en 10 parties. Six variables ont été conservées : l’âge, l’œdème cérébral, l’hypoalbuminémie, le grade de Fisher modifié, le grade de Hunt-Hess et le grade de la Fédération mondiale des chirurgiens neurologues. Des modèles de régression logistique, de boosting par gradient extrême, de machine de boosting par gradient léger, de machine à vecteurs de support et de plus proches voisins k ont été comparés. La régression logistique a montré une aire sous la courbe caractéristique de fonctionnement du récepteur de 0,832 (intervalle de confiance à 95 %, 0,758–0,906) dans le groupe de validation interne. Sa pente de calibration, son intercept de calibration et son score de Brier étaient respectivement de 0,98, 0,02 et 0,168, bien que les intervalles de confiance pour ces estimations de calibration n’aient pas été disponibles. Les résultats reflètent une performance préliminaire dans un seul groupe de validation interne réservé. L’absence de registres de reproductibilité complets, la non-disponibilité de l’intercept du modèle, l’absence de correction de l’optimisme basée sur le rééchantillonnage et l’absence de validation externe empêchent actuellement le calcul des probabilités au niveau individuel des patients et leur mise en œuvre clinique.
Introduction
Plusieurs modèles prédictifs de l'ICD après SAH ont été proposés, mais beaucoup ont été limités par des tailles d'échantillon réduites, une évaluation incomplète de la calibration, un signalement insuffisant des procédures de développement des modèles et un manque de validation externe. De nombreuses études se sont principalement concentrées sur la discrimination, tandis que la calibration, la reproductibilité et l'évaluation de l'impact clinique ont été rapportées de manière moins systématique. Par conséquent, les performances des modèles doivent être évaluées à l'aide de méthodes transparentes et interprétées avec prudence lorsque la validation se limite à un seul centre.
La présente étude visait à élaborer et à évaluer en interne des modèles prédictifs de l'IDC à l'aide de variables cliniques, biologiques et d'imagerie couramment disponibles et recueillies précocement. Cinq approches de modélisation ont été comparées en utilisant le même ensemble de prédicteurs sélectionnés. Le moment ciblé pour la prédiction correspondait à la période suivant l'admission initiale, l'évaluation biologique et celle par imagerie, mais précédant la phase à risque majeur d'IDC. Les modèles ont été conçus pour une estimation du risque à des fins de recherche et n'étaient pas destinés à diagnostiquer l'IDC, à remplacer le jugement clinique ou à déterminer de manière autonome le traitement. Une validation externe, une recalibration et des tests d'impact clinique sont nécessaires avant toute utilisation clinique.
L'ischémie cérébrale retardée (ICR) est l'un de ces traumatismes secondaires qui constitue l'une des complications les plus cliniquement significatives et potentiellement évitables après une hémorragie sous-arachnoïdienne anévrismale (HSAA). L'ICR est une complication qui survient généralement plusieurs jours après l'événement initial, typiquement entre 3 et 14 jours, et qui est associée à un déficit neurologique focal nouveau, à une aggravation du niveau de conscience et/ou à l'apparition d'un infarctus cérébral sur les examens d'imagerie cérébrale ultérieurs. Bien qu'il existe certaines variations dans les pratiques diagnostiques selon les établissements, l'ICR est toujours associée à un séjour prolongé en unité de soins intensifs, à une consommation élevée de ressources et à un pronostic neurologique défavorable. L'incidence rapportée de l'ICR est généralement comprise entre 30 et 40 pour cent, soulignant sa fréquence élevée et ses importantes implications pronostiques.1,2,3,4,5,6. Notamment, l'IDC n'est pas un processus à voie unique. Bien que l'attention se soit toujours portée sur le vasospasme cérébral des gros vaisseaux, des preuves croissantes montrent également que les lésions cérébrales précoces, la dépolarisation corticale progressive, la neuroinflammation, la microthrombose, la dysfonction endothéliale, une autorégulation altérée et un échec de la microcirculation contribuent tous au risque ischémique. Cette physiopathologie multifactorielle permet d'expliquer pourquoi les traitements ciblant le vasospasme peuvent ne pas prévenir complètement l'infarctus associé à l'IDC et pourquoi les patients à haut risque sont difficiles à identifier dans le cadre clinique habituel.
La stratification du risque de DCI après une HSA est une priorité, car grâce à l'identification rapide des patients à haut risque, il pourrait être possible de les surveiller plus étroitement et d'intensifier rapidement les mesures préventives ou curatives7. Les plans de surveillance en pratique clinique peuvent inclure des examens neurologiques plus fréquents, le recours à la doppler transcrânien, à des techniques d'imagerie sophistiquées telles que la tomodensitométrie de perfusion, à l'optimisation hémodynamique et du volume intravasculaire, au respect strict du traitement par nimodipine, ainsi qu'à la détection précoce d'une détérioration neurologique, comme l'hydrocéphalie, une réhémorragie, des crises convulsives, une infection ou un déséquilibre métabolique. Néanmoins, les décisions cliniques sont généralement influencées par des échelles de gravité globales et par l'expérience des cliniciens, plutôt que par des estimations personnalisées et fondées sur les données de la probabilité de DCI8,9,10. L'une des raisons est que la littérature indique que les facteurs de risque sont hétérogènes, et que les interactions entre les caractéristiques du patient, la charge hémorragique, les troubles physiologiques et les échelles de gravité neurologique peuvent être non linéaires et complexes. Des chercheurs précédents ont étudié des prédicteurs potentiels de DCI, notamment l'âge, l'hypertension artérielle, l'état neurologique de base, les caractéristiques de l'anévrisme, des indices biologiques (tels que le sodium sérique et l'albumine), des signes d'imagerie indiquant la charge hémorragique, ainsi que des facteurs liés à la chirurgie ou au traitement. Les techniques de régression classiques se sont révélées utiles, mais peuvent être limitées lorsque les prédicteurs sont corrélés, lorsque la relation entre les prédicteurs et le risque est non linéaire, ou lorsqu'il existe des interactions entre les variables11. Parallèlement, plusieurs outils (le plus souvent des nomogrammes) ont été proposés pour évaluer le risque de DCI. Bien que les nomogrammes soient pratiques et visuellement attractifs, la plupart reposent sur de petits échantillons, intègrent peu de variables et peuvent être surajustés ou mal validés. De plus, les modèles élaborés et testés dans un centre donné pourraient ne pas être facilement transposables à d'autres établissements en raison de différences dans la composition des patients, l'interprétation des images, les traitements et les seuils diagnostiques de la DCI.
Les méthodes d'apprentissage automatique peuvent compléter les modèles traditionnels de prédiction clinique, car elles permettent d'explorer davantage de dimensions dans les données cliniques et d'observer des tendances plus complexes, sans avoir à formuler d'hypothèses linéaires rigides. Ces dernières années, les modèles prédictifs fondés sur l'apprentissage automatique ont vu leurs applications croître dans le domaine des maladies cérébrovasculaires, notamment pour la prédiction des résultats et des complications, ainsi que pour l'aide à la décision12,13,14Les algorithmes couramment utilisés d'apprentissage automatique incluent les méthodes d'arbres ensemblistes telles que l'Extreme Gradient Boosting (XGBoost) et la Light Gradient Boosting Machine (LightGBM), les classificateurs basés sur des noyaux tels que les machines à vecteurs de support (SVM) et les classificateurs basés sur la distance tels que le k-plus-proches voisins (KNN). En principe, ces modèles sont capables de modéliser des non-linéarités. et les interactions plus que les approches traditionnelles15Cependant, des préoccupations pratiques sont également associées aux modèles d'apprentissage automatique, telles que le risque de surajustement, la réduction de l'interprétabilité et la nécessité de gérer le prétraitement, l'ajustement, l'étalonnage, l'évaluation et la validation. Il convient de noter que dans un large éventail de scénarios cliniques, une régression logistique bien spécifiée peut performer aussi bien voire mieux que des algorithmes plus complexes, notamment lorsque le nombre de prédicteurs est faible et que le rapport signal-sur-bruit est modéré. Ainsi, une analyse comparative de divers algorithmes utilisant des prédicteurs et des métriques d'évaluation similaires est nécessaire afin d'identifier un modèle corrélé à la performance et à l'applicabilité clinique.16,17,18.
Plusieurs modèles prédictifs de l’ischémie cérébrale retardée ont déjà été proposés ; toutefois, beaucoup souffrent de limitations importantes, notamment des tailles d’échantillon réduites, une évaluation limitée de la calibration, l’absence de comparaison directe entre algorithmes et une validation insuffisante. De plus, les études antérieures mettent fréquemment l’accent sur la discrimination tout en sous-estimant les indicateurs de calibration et d’utilité clinique, qui sont essentiels pour une application en conditions réelles. La présente étude comble ces lacunes en développant un modèle prédictif au sein d’une cohorte relativement importante, en mettant en œuvre une sélection systématique des prédicteurs à l’aide d’une régression par l’opérateur de réduction et de sélection absolue (LASSO), en comparant plusieurs algorithmes d’apprentissage automatique dans un cadre de modélisation unifié, et en évaluant de manière exhaustive les performances en matière de discrimination, de calibration et d’analyse décisionnelle.
Plusieurs modèles prédictifs de l'ICD après SAH ont été proposés, mais beaucoup présentent des limites importantes, notamment des cohortes restreintes, une évaluation limitée de la calibration, un reporting incomplet du développement du modèle et une absence de validation externe ou temporelle. De plus, de nombreuses études rapportent uniquement la discrimination, tandis que la calibration et l'analyse de la courbe de décision sont présentées de manière moins systématique. La présente étude ne résout pas le problème de la validation externe. Elle fournit plutôt une étude de développement monocentrique et de validation interne utilisant des variables cliniques, biologiques et d'imagerie habituellement disponibles. L'usage visé est la stratification précoce du risque après l'admission et le traitement initial de l'anévrisme, avant la période principale de risque d'ICD. Le modèle pourrait aider les cliniciens à identifier les patients nécessitant une surveillance neurologique plus étroite, un suivi par imagerie vasculaire, une correction des anomalies physiologiques et un examen précoce par l'équipe de soins neurocritiques. Il n'est pas conçu pour remplacer le jugement clinique, poser un diagnostic d'ICD ou guider le traitement sans validation externe ni évaluation de son impact clinique. Des études antérieures ont proposé plusieurs modèles pour prédire l'ICD après SAH, mais beaucoup ont été limitées par des effectifs réduits, un reporting incomplet de la calibration, des comparaisons limitées entre les méthodes de modélisation ou l'absence de validation externe. La présente étude ne prétend pas fournir un outil décisionnel validé cliniquement. Elle vise plutôt à développer et valider internement un modèle prédictif utilisant des variables cliniques, biologiques et d'imagerie précoces, habituellement disponibles, issues d'une cohorte monocentrique. L'usage visé est la stratification précoce du risque après l'admission et le traitement initial de l'anévrisme, avant la période principale de risque d'ICD. Dans ce contexte, un risque prédit élevé justifierait une évaluation neurologique plus rapprochée, une surveillance vasculaire, la correction des anomalies physiologiques et un examen précoce par les soins neurocritiques. Le modèle n'est pas destiné à diagnostiquer l'ICD ni à remplacer le jugement du clinicien.
Protocole
The study was approved by the Institutional Ethics Committee of Yulin First Hospital, Shaanxi Province, China. Because this was a retrospective analysis of routinely collected hospital data, and because all data were anonymized before analysis, the requirement for written informed consent was waived. The study was conducted in accordance with institutional data-protection requirements and the principles of the Declaration of Helsinki.
Data and Methods
Study Population and Design
This was a retrospective single-center cohort study conducted at Yulin First Hospital, Shaanxi Province, China. The hospital records of patients admitted with aSAH between July 2022 and December 2024 were screened. Eligible patients were adults aged 18 years or older with a diagnosis of aSAH confirmed by cranial and intracranial vascular imaging. Patients were required to have been admitted within 72 h after symptom onset and to have undergone aneurysm treatment during the index hospitalization.
Patients were excluded if they had traumatic subarachnoid hemorrhage, non-aneurysmal subarachnoid hemorrhage, severe pre-existing hematological disease, other major intracranial disease affecting outcome assessment, insufficient records for DCI evaluation, or in-hospital death before an adequate DCI assessment period. Excluding early in-hospital deaths may introduce survivorship bias because the most severe cases may be removed from analysis. Therefore, the findings should be interpreted as applying mainly to patients who survived long enough for DCI evaluation.
Data Collection
Clinical, laboratory, imaging, and treatment-related variables were extracted from the electronic medical record using a predefined data-extraction form. The extracted variables included demographic factors, medical history, aneurysm features, early neurological grade, early imaging findings, laboratory results, treatment approach, and hospital complications. The intended prediction time point was after completion of the initial admission and perioperative assessment, but before the main DCI risk window.
Age, sex, body mass index, smoking status, alcohol use, hypertension, diabetes, aneurysm size, aneurysm location, modified Fisher grade, Hunt-Hess grade, World Federation of Neurological Surgeons grade, intraventricular hemorrhage, and rebleeding were taken from admission records and initial imaging. Laboratory variables, including hemoglobin, serum albumin, and serum sodium, were obtained from the earliest available blood test prior to the prediction time point. Cerebral edema was assessed using baseline or immediate post-treatment imaging available before DCI diagnosis. Variables recorded only after DCI onset were not used for model development to reduce information leakage.
Anemia was defined as hemoglobin <110 g/L in female patients and <120 g/L in male patients. Hypoalbuminemia was defined as serum albumin <35 g/L. Hyponatremia was defined as serum sodium <130 mmol/L.
Patients were managed according to the institutional aSAH care pathway. Standard management included early aneurysm securing, neurological observation, blood pressure control, fluid and electrolyte management, and surveillance for complications including hydrocephalus, rebleeding, seizure, infection, vasospasm, and DCI. Nimodipine was used unless contraindicated. Vasospasm monitoring was performed using neurological examination, vascular imaging, and transcranial Doppler ultrasonography when clinically indicated. Hydrocephalus was managed with cerebrospinal fluid diversion when required. Hemodynamic optimization and rescue therapy were applied according to the treating team’s assessment. Because treatment intensity and rescue-therapy details were not completely captured in the retrospective dataset, these factors could not be fully adjusted in the model and were considered a limitation.
Diagnosis of DCI
DCI was defined as a new focal neurological impairment, a decrease in level of consciousness, or a new cerebral infarction on follow-up computed tomography or magnetic resonance imaging occurring during the expected DCI risk window and not explained by another cause. The DCI risk window was defined as days 3–14 after the hemorrhage ictus. Alternative explanations, including rebleeding, hydrocephalus, seizure, infection, metabolic disturbance, sedative effect, and procedure-related infarction, were reviewed before classifying an event as DCI.
Outcome adjudication was performed by two clinicians with experience in the management of aSAH, including one neurosurgeon and one neurologist/neurocritical care physician. The adjudicators reviewed clinical notes, neurological examinations, imaging reports, and follow-up imaging. They were blinded to the final model output during outcome assessment. Disagreements were resolved through consensus discussion with review of the relevant imaging and clinical timeline. Formal inter-rater agreement was not measured, and this limitation was added because DCI classification may involve clinical judgment.
Sample Size Calculation
The sample size was estimated using the 10-events-per-variable (EPV) rule of thumb11. With 20 candidate predictor variables and an expected DCI incidence of approximately 35%, a minimum sample size of 20 × 10 / 0.35 ≈ 572 patients was required. Our final cohort of 680 patients exceeded this requirement. Although the events-per-variable (EPV) rule was applied as a general guideline, modern predictive modeling, particularly machine learning algorithms, may require more flexible sample-size considerations. The final cohort size was considered adequate to ensure model stability, minimize the risk of overfitting, and enable reliable estimation of model performance metrics.
Model development and validation
Patients were allocated to a training cohort of 544 patients and a hold-out internal validation cohort of 136 patients using an outcome-stratified 8:2 split. Outcome stratification was used to maintain a similar proportion of DCI events in the two cohorts. DCI occurred in 175 of 544 patients in the training cohort and 42 of 136 patients in the internal-validation cohort. The 8:2 hold-out design was retained because it was the prespecified model-development strategy and provided a separate cohort for preliminary internal performance assessment.
Predictor selection was performed only in the training cohort using least absolute shrinkage and selection operator regression with 10-fold cross-validation. The selected penalty parameter was λ = 0.031. Six predictors were retained: age, cerebral edema, hypoalbuminemia, modified Fisher grade, Hunt-Hess grade, and World Federation of Neurological Surgeons grade.
Logistic regression, extreme gradient boosting, light gradient boosting machine, support vector machine, and k-nearest neighbor models were developed using the same set of selected predictors. All preprocessing, predictor selection, and model-development procedures were restricted to the training cohort. The internal-validation cohort was not used during predictor selection or model tuning and was evaluated only after model development.
The numerical random seed used for the original cohort allocation was not retained in the archived analysis records and could not be retrospectively verified. Bootstrap optimism correction and repeated k-fold internal validation were also not available. Therefore, the present analysis is described as a single hold-out internal validation rather than an optimism-corrected or repeated cross-validated performance assessment.
Machine-learning reproducibility
LASSO predictor selection used 10-fold cross-validation within the training cohort. Continuous predictors were standardized when required by the modeling algorithm, and categorical predictors were represented using predefined binary clinical categories. The validation cohort was not used for tuning or model selection.
The archived analysis materials did not retain the final tuning grids, selected hyperparameters, complete package versions, original random seed, or a confirmed class-imbalance procedure for XGBoost, LightGBM, SVM, and KNN. These settings were therefore not reconstructed or estimated. The machine-learning comparisons should consequently be interpreted as exploratory comparisons of algorithms rather than fully reproducible model-development experiments. Reproducibility information, both available and unavailable, should be summarized in Supplementary Table 1.
Bias Control & Sensitivity Analysis
Consecutive eligible patients were included to reduce selection bias. Standardized variable definitions and a structured data-extraction form were used to reduce information bias. Predictors were restricted to information available before the intended DCI prediction time point to reduce information leakage. Predictor selection, preprocessing, and model development were performed only in the training cohort.
Modified Fisher grade, Hunt-Hess grade, and WFNS grade represent related aspects of hemorrhage burden and neurological severity. Although all three variables were retained after LASSO selection, the numerical variance inflation factor values and the results from a sensitivity model excluding overlapping severity scales were not included in the archived analysis output. These analyses could not be reconstructed from the aggregate tables because patient-level correlations and fitted model outputs are required. Therefore, the individual coefficients of these severity measures were not interpreted as independent or causal effects. They were retained only as components of the prediction model selected in the training cohort.
Model Interpretability
Clinical applicability was believed to require model interpretability as a crucial element. In the most effective model, the effects of predictors were considered to assess the clinical plausibility and conformity with existing pathophysiological knowledge of delayed cerebral ischemia. This method enabled a clear assessment of model behavior and improved the potential for clinical translation.
Missing Data
Variable-level missingness was assessed during data preparation. However, the original pre-imputation missing counts and percentages for each candidate variable were not retained in the archived analysis records and could not be accurately reconstructed from the aggregate tables. Consequently, no assumption of complete data was made, and no unverified missingness percentages were reported.
A verified supplementary missing-data table should be generated directly from the original deidentified patient-level dataset. Supplementary Table 2 should report, for every candidate variable, the number and percentage of missing observations before data handling, the method used to address missingness, and the number of observations included in the final analysis. The inability to recover the original variable-specific missingness pattern was considered a limitation of the present report.
Statistical Analysis
Predictor selection was performed in the training cohort using LASSO regression with 10-fold cross-validation. Discrimination was assessed using the area under the receiver operating characteristic curve with 95% confidence intervals. Calibration was described using calibration plots and point estimates of the calibration slope, calibration intercept, and Brier score. Bootstrap confidence intervals for calibration measures were not available.
Threshold-dependent classification measures were calculated from the available internal-validation confusion matrices. The exact numerical probability threshold used to generate the archived confusion matrices was not retained and could not be verified. Therefore, these measures were interpreted descriptively and were not used as the primary basis for model selection. Decision-curve analysis was also considered exploratory because the exact prespecified threshold range and patient-level net-benefit output were not retained. A two-sided P value below 0.05 was considered statistically significant.
Résultats
Comparaison des caractéristiques de base entre les cohortes d'apprentissage et de validation interne
Un total de 680 patients présentant un SAHc ont été inclus. La cohorte d'apprentissage comprenait 544 patients, dont 175 ont développé un IDC, tandis que la cohorte de validation interne comprenait 136 patients, dont 42 ont développé un IDC. Le taux d'événements d'IDC était de 32,2 % dans la cohorte d'apprentissage et de 30,9 % dans la cohorte de validation interne. Les caractéristiques de base sont présentées dans Tableau 1. Étant donné que certaines entrées archivées du tableau contenaient des incohérences au niveau du dénominateur, le tableau doit être vérifié par rapport au jeu de données brutes des patients avant la soumission finale.
| Variable | Cohorte d'entraînement (n = 544) | Cohorte de validation interne (n = 136) | t/χ²/Z | P valeur | MDR | Note de correction |
| Âge, années | 62,88 ± 9,41 | 63,25 ± 9,52 | 0,409 | 0,693 | 0,039 | |
| Sexe | 0,429 | 0,512 | 0,063 | |||
| Homme | 180 (33,09) | 41 (30,15) | ||||
| Femme | 364 (66,91) | 95 (69,85) | ||||
| IMC, kg/m² | 23,46 ± 3,56 | 23,61 ± 3,65 | 0,437 | 0,662 | 0,042 | |
| Antécédents de tabagisme | 0,118 | 0,731 | 0,033 | |||
| Oui | 101 (18,57) | 27 (19,85) | ||||
| Non | 443 (81,43) | 109 (80,15) | ||||
| Consommation d'alcool | 0,417 | 0,518 | 0,062 | |||
| Oui | 118 (21,69) | 33 (24,26) | ||||
| Non | 426 (78,31) | 103 (75,74) | ||||
| Antécédents d'hypertension | 0,348 | 0,555 | 0,057 | |||
| Oui | 329 (60,48) | 86 (63,24) | ||||
| Non | 215 (39,52) | 50 (36,76) | ||||
| Antécédents de diabète | 0,116 | 0,733 | 0,033 | Le nombre de « Non » dans la validation a été corrigé pour que la somme soit égale à 136. | ||
| Oui | 70 (12,87) | 19 (13,97) | ||||
| Non | 474 (87,13) | 117 (86,03) | ||||
| Diamètre de l'anévrisme, mm | 0,213 | 0,645 | 0,044 | |||
| >10 | 288 (52,94) | 75 (55,15) | ||||
| ≤10 | 256 (47,06) | 61 (44,85) | ||||
| Localisation de l'anévrisme | 0,980 | 0,322 | 0,095 | |||
| Circulation antérieure | 448 (82,35) | 107 (78,68) | ||||
| Circulation postérieure | 96 (17,65) | 29 (21,32) | ||||
| Œdème cérébral | 0,612 | 0,434 | 0,075 | |||
| Oui | 125 (22,98) | 27 (19,85) | ||||
| Non | 419 (77,02) | 109 (80,15) | ||||
| Hémoglobine basse | 0,684 | 0,408 | 0,079 | Le nombre de « Non » dans la validation a été corrigé pour que la somme soit égale à 136. Le nombre dans l'entraînement est en désaccord avec le tableau 2 ; vérifier à partir du jeu de données final. | ||
| Oui | 147 (27,02) | 32 (23,53) | ||||
| Non | 397 (72,98) | 104 (76,47) | ||||
| Hypoalbuminémie | 0,367 | 0,545 | 0,058 | |||
| Oui | 115 (21,14) | 32 (23,53) | ||||
| Non | 429 (78,86) | 104 (76,47) | ||||
| Hyponatrémie | 0,186 | 0,666 | 0,041 | |||
| Oui | 331 (60,85) | 80 (58,82) | ||||
| Non | 213 (39,15) | 56 (41,18) | ||||
| Grade de Fisher modifié | 0,249 | 0,618 | 0,048 | |||
| ≥III | 259 (47,61) | 68 (50,00) | ||||
| I–II | 285 (52,39) | 68 (50,00) | ||||
| Grade de Hunt-Hess | 0,178 | 0,673 | 0,040 | Le nombre de ≥III dans la validation a été corrigé de 53 à 63 pour que la somme soit égale à 136 ; vérifier par rapport au jeu de données final. | ||
| ≥III | 263 (48,35) | 63 (46,32) | ||||
| I–II | 281 (51,65) | 73 (53,68) | ||||
| Grade WFNS | 0,249 | 0,618 | 0,048 | |||
| ≥III | 277 (50,92) | 66 (48,53) | ||||
| I–II | 267 (49,08) | 70 (51,47) | ||||
| Approche chirurgicale | 0,717 | 0,397 | 0,081 | |||
| Traitement endovasculaire | 449 (82,54) | 108 (79,41) | ||||
| Clipage | 95 (17,46) | 28 (20,59) | ||||
| Durée de l'intervention chirurgicale, h | 2,78 ± 0,81 | 2,81 ± 0,79 | 0,388 | 0,698 | 0,037 | |
| Hémorragie intraventriculaire | 0,383 | 0,536 | 0,059 | |||
| Oui | 134 (24,63) | 37 (27,21) | ||||
| Non | 410 (75,37) | 99 (72,79) | ||||
| Re-saignement | 0,784 | 0,376 | 0,085 | |||
| Oui | 98 (18,01) | 29 (21,32) | ||||
| Non | 446 (81,99) | 107 (78,68) |
Tableau 1 : Caractéristiques de base des cohortes d'entraînement et de validation interne. Les variables continues sont présentées comme la moyenne ± écart type, et les variables catégorielles en n (%). Les valeurs de p et les différences standardisées des moyennes comparent les deux cohortes. Abréviations : BMI, indice de masse corporelle ; SMD, différence moyenne standardisée. Veuillez cliquer ici pour télécharger ce tableau.
Comparaison des caractéristiques de base entre les groupes sans DCI et avec DCI dans l'ensemble d'apprentissage
Dans l'ensemble de données d'entraînement, une ischémie cérébrale retardée (ICR) s'est produite chez 175 patients (32,17 %), tandis que 369 patients (67,83 %) n'ont pas développé d'ICR. L'incidence de l'ICR dans le groupe de validation interne était comparable, indiquant une prévalence stable des résultats. Les analyses comparatives entre les groupes sans ICR et avec ICR ont révélé plusieurs différences statistiquement significatives (Tableau 2). Les patients ayant développé une ICR étaient significativement plus âgés (P = 0,026), suggérant une susceptibilité liée à l'âge aux lésions ischémiques secondaires. Les signes radiologiques de lésion cérébrale précoce, en particulier l'œdème cérébral, étaient nettement plus fréquents chez les patients présentant une ICR (P = 0,001). Des anomalies biologiques, notamment une hypoalbuminémie (P = 0,007), une hyponatrémie (P = 0,048) et des taux bas d'hémoglobine (P < 0,001), étaient significativement associées à l'apparition de l'ICR. Les marqueurs de gravité neurologique ont montré les associations les plus fortes. Un score de Fisher modifié élevé (≥III) était significativement plus fréquent chez les patients avec ICR (P < 0,001), indiquant une relation solide entre la charge hémorragique et les complications ischémiques retardées. De même, un score élevé selon l'échelle de Hunt–Hess et un score élevé selon l'échelle de la Fédération mondiale des chirurgiens neurologues (WFNS) étaient fortement associés au développement de l'ICR (les deux P < 0,001). En revanche, les variables démographiques, les facteurs liés au mode de vie, la morphologie de l'anévrisme, l'approche chirurgicale et la durée de l'intervention chirurgicale n'ont pas montré de différences statistiquement significatives.
| Variable | Groupe sans DCI (n = 369) | Groupe DCI (n = 175) | t/χ²/Z | Valeur de p | Note de correction |
| Âge, années | 62,25 ± 9,54 | 64,22 ± 9,75 | 2,234 | 0,026 | |
| Sexe | 0,638 | 0,424 | |||
| Homme | 118 (31,98) | 62 (35,43) | |||
| Femme | 251 (68,02) | 113 (64,57) | |||
| IMC, kg/m² | 23,43 ± 3,56 | 23,52 ± 3,72 | 0,271 | 0,786 | |
| Antécédents de tabagisme | 0,351 | 0,554 | |||
| Oui | 66 (17,89) | 35 (20,00) | |||
| Non | 303 (82,11) | 140 (80,00) | |||
| Consommation d'alcool | 0,046 | 0,837 | |||
| Oui | 81 (21,95) | 37 (21,14) | |||
| Non | 288 (78,05) | 138 (78,86) | |||
| Antécédents d'hypertension | 2,960 | 0,085 | |||
| Oui | 214 (57,99) | 115 (65,71) | |||
| Non | 155 (42,01) | 60 (34,29) | |||
| Antécédents de diabète | 0,463 | 0,496 | |||
| Oui | 45 (12,20) | 25 (14,29) | |||
| Non | 324 (87,80) | 150 (85,71) | |||
| Diamètre de l'anévrisme, mm | 0,380 | 0,538 | |||
| >10 | 192 (52,03) | 96 (54,86) | |||
| ≤10 | 177 (47,97) | 79 (45,14) | |||
| Localisation de l'anévrisme | 3,602 | 0,058 | |||
| Circulation antérieure | 296 (80,22) | 152 (86,86) | |||
| Circulation postérieure | 73 (19,78) | 23 (13,14) | |||
| Œdème cérébral | 10,410 | 0,001 | |||
| Oui | 70 (18,97) | 55 (31,43) | |||
| Non | 299 (81,03) | 120 (68,57) | |||
| Hémoglobine basse | 23,965 | <0,001 | Total différent du tableau 1 ; vérifier par rapport au jeu de données final. | ||
| Oui | 122 (33,06) | 82 (46,86) | |||
| Non | 247 (66,94) | 93 (53,14) | |||
| Hypoalbuminémie | 7,283 | 0,007 | |||
| Oui | 66 (17,89) | 49 (28,00) | |||
| Non | 303 (82,11) | 126 (72,00) | |||
| Hypnatrémie | 3,914 | 0,048 | |||
| Oui | 214 (57,99) | 117 (66,86) | |||
| Non | 155 (42,01) | 58 (33,14) | |||
| Grade modifié de Fisher | 58,679 | <0,001 | |||
| ≥III | 134 (36,31) | 125 (71,43) | |||
| I–II | 235 (63,69) | 50 (28,57) | |||
| Grade de Hunt-Hess | 39,909 | <0,001 | |||
| ≥III | 144 (39,02) | 119 (68,00) | |||
| I–II | 225 (60,98) | 56 (32,00) | |||
| Grade WFNS | 28,137 | <0,001 | |||
| ≥III | 159 (43,09) | 118 (67,43) | |||
| I–II | 210 (56,91) | 57 (32,57) | |||
| Approche chirurgicale | 0,691 | 0,406 | |||
| Traitement endovasculaire | 308 (83,47) | 141 (80,57) | |||
| Clipage | 61 (16,53) | 34 (19,43) | |||
| Durée de l'intervention chirurgicale, h | 2,74 ± 0,82 | 2,85 ± 0,76 | 1,496 | 0,135 | |
| Hémorragie intraventriculaire | 0,163 | 0,687 | |||
| Oui | 89 (24,12) | 45 (25,71) | |||
| Non | 280 (75,88) | 130 (74,29) | |||
| Re-saignement | 1,168 | 0,280 | |||
| Oui | 71 (19,24) | 27 (15,43) | |||
| Non | 298 (80,76) | 148 (84,57) |
Tableau 2 : Caractéristiques de base des patients avec et sans ischémie cérébrale retardée dans la cohorte d'entraînement. Les variables continues sont exprimées en moyenne ± écart-type, et les variables catégorielles en n (%). Les valeurs de p comparent les patients avec et sans ICR. Abréviations : ICR, ischémie cérébrale retardée ; WFNS, Fédération mondiale des chirurgiens neurologues. Veuillez cliquer ici pour télécharger ce tableau.
Répartition des résultats dans la cohorte de validation interne
Dans la cohorte de validation interne (n = 136), une ischémie cérébrale retardée (DCI) a été observée chez 42 patients (30,9 %), tandis que 94 patients (69,1 %) n'ont pas développé de DCI. La prévalence des résultats était comparable à celle observée dans le jeu de données d'apprentissage, ce qui soutient la stabilité de la répartition des événements entre les jeux de données.
Sélection des caractéristiques
La sélection des prédicteurs a été effectuée dans la cohorte d'apprentissage à l'aide d'une régression LASSO avec une validation croisée en 10 parties. Le paramètre de pénalité sélectionné était λ = 0,031. Six prédicteurs ont conservé des coefficients non nuls : l'âge, l'œdème cérébral, l'hypoalbuminémie, le grade de Fisher modifié, le grade de Hunt-Hess et le grade de WFNS. Tous les prédicteurs sélectionnés étaient disponibles avant le point temporel de prédiction visé. Figure 1A,B présente les trajectoires des coefficients et la courbe de validation croisée utilisées pour la sélection des prédicteurs.
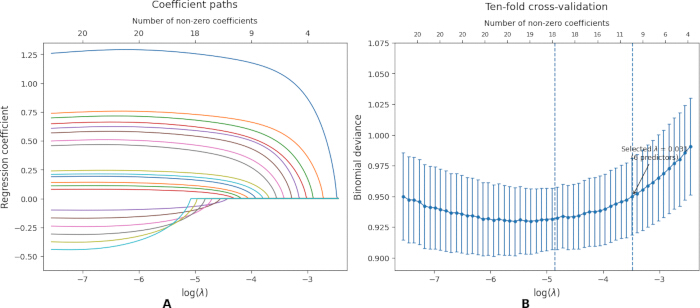
Figure 1 : Sélection fondée sur LASSO des prédicteurs de l’ischémie cérébrale retardée après une hémorragie sous-arachnoïdienne anévrismale. (A) Trajectoires des coefficients des prédicteurs candidats selon les valeurs de log(λ). Chaque courbe représente un prédicteur candidat, et les nombres sur l’axe supérieur indiquent le nombre de coefficients non nuls conservés à chaque valeur de pénalité. (B) Courbe de validation croisée à dix plis pour la déviance binomiale. Les points indiquent la déviance moyenne validée par croisement, les barres d’erreur indiquent les erreurs standards, et les lignes verticales en pointillés indiquent les valeurs de pénalité correspondant à l’erreur minimale et à une erreur standard. Le paramètre de pénalité finalement sélectionné était λ = 0,031. LASSO, opérateur de sélection et de réduction absolue minimale ; DCI, ischémie cérébrale retardée. Veuillez cliquer ici pour visualiser une version agrandie de cette figure.
Développement et évaluation du modèle
Les cinq modèles ont été développés en utilisant les six prédicteurs sélectionnés identiques. Dans la cohorte de validation interne, la régression logistique a montré une AUC de 0,832 (IC à 95 %, 0,758–0,906), la SVM a montré une AUC de 0,811 (IC à 95 %, 0,729–0,893), XGBoost a montré une AUC de 0,777 (IC à 95 %, 0,690–0,864), LightGBM a montré une AUC de 0,755 (IC à 95 %, 0,672–0,838) et le KNN a montré une AUC de 0,708 (IC à 95 %, 0,613–0,803) (Tableau 3).
| Jeu de données | Modèle | AUC | IC à 95 % | Précision | Sensibilité | Spécificité | Score F1 | Note de correction |
| Entraînement | XGBoost | 0.916 | 0.888–0.944 | 0.848 | 0.853 | 0.847 | 0.682 | |
| Entraînement | Régression logistique | 0.833 | 0.794–0.872 | 0.816 | 0.71 | 0.81 | 0.594 | |
| Entraînement | LightGBM | 0.751 | 0.707–0.794 | 0.69 | 0.781 | 0.669 | 0.489 | |
| Entraînement | SVM | 0.807 | 0.762–0.852 | 0.809 | 0.704 | 0.833 | 0.583 | |
| Entraînement | KNN | 0.915 | 0.896–0.935 | 0.754 | 0.878 | 0.696 | 0.607 | Correction de l'AUC du KNN dans la légende de la Figure 2 pour correspondre à la valeur du tableau. |
| Validation | XGBoost | 0.777 | 0.690–0.864 | 0.755 | 0.608 | 0.794 | 0.507 | |
| Validation | Régression logistique | 0.832 | 0.758–0.906 | 0.809 | 0.714 | 0.851 | 0.698 | Métriques de classification recalculées à partir de la matrice de confusion du Tableau 6. |
| Validation | LightGBM | 0.755 | 0.672–0.838 | 0.696 | 0.799 | 0.669 | 0.522 | |
| Validation | SVM | 0.811 | 0.729–0.893 | 0.779 | 0.69 | 0.819 | 0.659 | Métriques de classification recalculées à partir de la matrice de confusion du Tableau 6. |
| Validation | KNN | 0.708 | 0.613–0.803 | 0.647 | 0.715 | 0.629 | 0.456 |
Tableau 3 : Performances de discrimination et de classification des modèles de prédiction dans les cohortes d'apprentissage et de validation interne. Les valeurs de la CUC sont indiquées avec des intervalles de confiance à 95 %. La précision, la sensibilité, la spécificité et le score F1 ont été calculés au seuil de classification prédéfini. Abréviations : AUC, aire sous la courbe ROC ; CI, intervalle de confiance ; KNN, k-plus proches voisins ; LightGBM, machine d'augmentation de gradient légère ; SVM, machine à vecteurs de support ; XGBoost, augmentation extrême de gradient. Les mesures de classification dépendantes du seuil n'ont pas été utilisées comme critère principal de comparaison des modèles, car le seuil de probabilité exact utilisé dans l'analyse archivée ne pouvait pas être vérifié. Veuillez cliquer ici pour télécharger ce tableau.
Les intervalles de confiance se chevauchaient, et la régression logistique n'a pas été considérée comme statistiquement supérieure aux autres modèles. La régression logistique a été conservée comme modèle principal car elle offrait une discrimination interne stable et une structure de modèle directement interprétable. Les résultats reflètent la performance dans une seule cohorte de validation interne réservée et ne constituent pas une validation corrigée de l'optimisme, temporelle ou externe (Figure 2A–D).
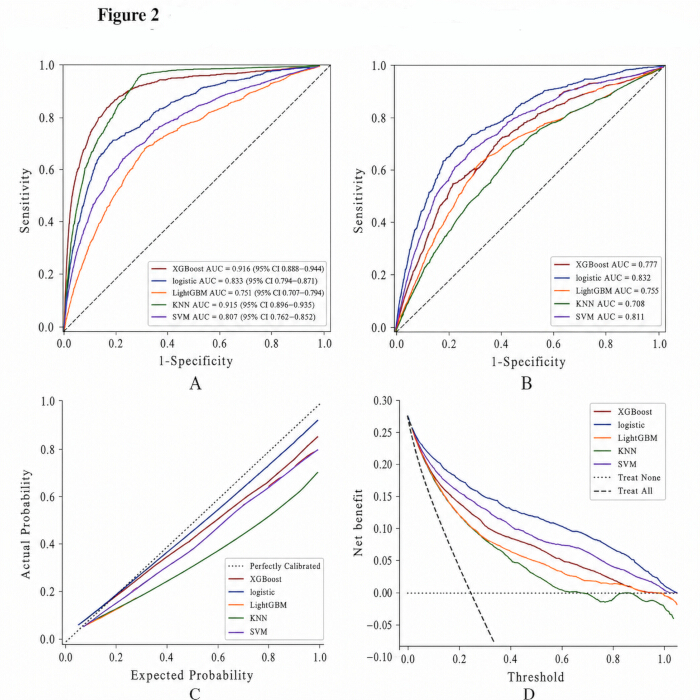
Figure 2 : Performances de discrimination, de calibration et de courbe de décision des modèles prédictifs.
(A) Courbes caractéristiques de fonctionnement du récepteur (ROC) dans la cohorte d'apprentissage. (B) Courbes ROC dans la cohorte de validation interne. Les légendes des courbes indiquent l'aire sous la courbe ROC (AUC) avec les intervalles de confiance à 95 %. (C) Courbes de calibration comparant les probabilités prédites et observées d'ischémie cérébrale retardée (DCI) ; la ligne pointillée diagonale indique une calibration parfaite. (D) Analyse de courbe de décision montrant le bénéfice net en fonction des probabilités seuils. La ligne pointillée horizontale représente la stratégie de non-traitement, tandis que la ligne en tirets représente la stratégie de traitement systématique. AUC, aire sous la courbe ROC ; DCI, ischémie cérébrale retardée ; KNN, k-plus proches voisins ; LightGBM, machine d'augmentation de gradient légère ; SVM, machine à vecteurs de support ; XGBoost, augmentation extrême de gradient. Veuillez cliquer ici pour visualiser une version agrandie de cette figure.
Analyse exploratoire de la courbe de décision
Une analyse en courbe de décision a été réalisée comme évaluation exploratoire du bénéfice net. Toutefois, la plage exacte de probabilités de seuil préspecifiée et les résultats individuels du bénéfice net par patient n'ont pas été conservées dans les dossiers d'analyse archivés. Par conséquent, les résultats de l'analyse en courbe de décision ne permettent pas d'établir l'utilité clinique ni de définir un seuil d'intervention cliniquement approprié.
Tout avantage net apparent par rapport aux stratégies de traitement systématique ou d'absence de traitement ne doit être interprété que comme un motif préliminaire au sein du jeu de données interne actuel. Une validation externe, une sélection prospective des seuils, une évaluation des conséquences cliniques et une étude formelle d'impact clinique sont nécessaires avant que le modèle puisse être considéré comme utile pour les décisions de prise en charge des patients (Figure 3).
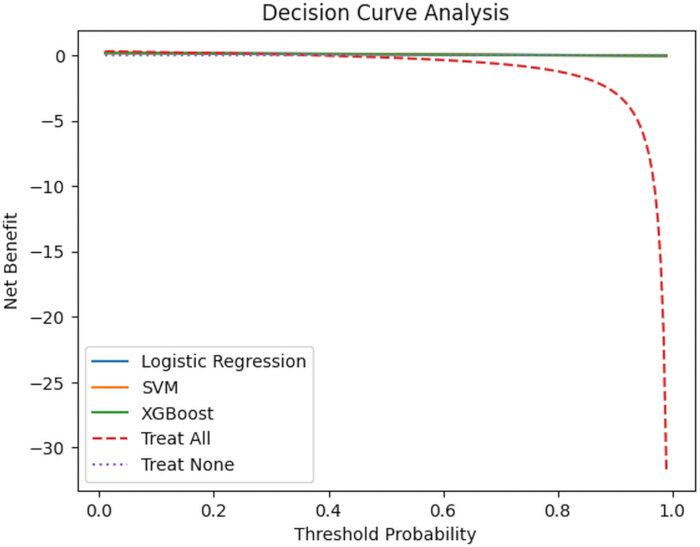
Figure 3 : Analyse de courbe décisionnelle des modèles de prédiction sélectionnés dans la cohorte de validation interne. Le bénéfice net est représenté en fonction de la probabilité seuil pour les modèles de régression logistique, SVM et XGBoost. La ligne pointillée « traiter-tous » représente la stratégie consistant à surveiller tous les patients, tandis que la ligne en tirets « ne-pas-traiter » représente la stratégie de ne surveiller aucun patient. Un modèle est considéré comme cliniquement utile aux probabilités seuil où sa courbe de bénéfice net se situe au-dessus des deux stratégies de référence. SVM, machine à vecteurs de support ; XGBoost, boosting par gradient extrême. Veuillez cliquer ici pour visualiser une version agrandie de cette figure.
Modèle de régression logistique multivariée
Le modèle final de régression logistique comprenait l'âge, l'œdème cérébral, l'hypoalbuminémie, le grade de Fisher modifié, le grade de Hunt-Hess et le grade de WFNS. Les coefficients de régression, les rapports de cotes, les intervalles de confiance à 95 % et les valeurs P sont présentés dans le Tableau 4. L'âge avait un coefficient de 0,038, tandis que les coefficients pour l'œdème cérébral, l'hypoalbuminémie, le grade de Fisher modifié ≥ III, le grade de Hunt-Hess ≥ III et le grade de WFNS ≥ III étaient respectivement de 0,842, 0,615, 1,274, 0,933 et 0,781.
| Prédicteur | Coefficient β | Rapport de cotes (OR) | IC à 95 % | Valeur P | Note d'interprétation |
| Terme constant | [insérer à partir des résultats finaux du modèle] | — | — | — | Requis pour le calcul du risque au niveau du patient. |
| Âge | 0,038 | 1,039 | 1,012–1,067 | <0,001 | Association prédictive uniquement ; non causale. |
| Œdème cérébral | 0,842 | 2,321 | 1,541–3,496 | <0,001 | Mesuré avant le diagnostic de DCI. |
| Hypoalbuminémie | 0,615 | 1,85 | 1,206–2,837 | 0,005 | Albumine la plus ancienne disponible avant le moment de prédiction. |
| Grade modifié de Fisher ≥III | 1,274 | 3,575 | 2,401–5,324 | <0,001 | Marqueur de gravité ; interpréter avec prudence en raison de la colinéarité. |
| Grade de Hunt-Hess ≥III | 0,933 | 2,542 | 1,674–3,861 | <0,001 | Marqueur de gravité ; interpréter avec prudence en raison de la colinéarité. |
| Grade WFNS ≥III | 0,781 | 2,184 | 1,447–3,298 | <0,001 | Marqueur de gravité ; interpréter avec prudence en raison de la colinéarité. |
Tableau 4 : Modèle final de régression logistique multivariée pour prédire l'ischémie cérébrale retardée. Les coefficients de régression, les rapports de cotes, les intervalles de confiance à 95 % et les valeurs P sont indiqués pour les prédicteurs conservés après sélection par LASSO. Tous les prédicteurs ont été évalués avant le moment cible de prédiction. Abréviations : CI, intervalle de confiance ; DCI, ischémie cérébrale retardée ; OR, rapport de cotes ; WFNS, Fédération mondiale des chirurgiens neurologues. L'ordonnée à l'origine numérique du modèle de régression logistique n'était pas disponible dans les résultats du modèle archivé. Par conséquent, les coefficients rapportés ne peuvent pas être utilisés pour calculer des probabilités prédites individuelles. Les coefficients représentent des associations prédictives et ne doivent pas être interprétés comme des effets causaux indépendants. Veuillez cliquer ici pour télécharger ce tableau.
Ces coefficients décrivent des associations prédictives au sein de la cohorte de développement. Ils ne doivent pas être interprétés comme des effets causaux indépendants, car le Fisher grade modifié, le grade Hunt-Hess et le grade WFNS représentent des dimensions chevauchantes de la gravité de la maladie, et les diagnostics numériques de colinéarité n'étaient pas disponibles. Les variables ont été conservées en tant que composantes du modèle de prédiction plutôt que confirmées comme des facteurs de risque indépendants.
Performance de l'étalonnage
L'étalonnage a été résumé dans la cohorte de validation interne à l'aide d'estimations ponctuelles de la pente d'étalonnage, de l'ordonnée à l'origine d'étalonnage et du score de Brier. La régression logistique présentait une pente d'étalonnage de 0,98, une ordonnée à l'origine d'étalonnage de 0,02 et un score de Brier de 0,168. Les valeurs correspondantes étaient respectivement de 0,94, 0,05 et 0,182 pour SVM ; de 0,88, 0,09 et 0,201 pour XGBoost ; de 0,91, 0,07 et 0,194 pour LightGBM ; et de 0,92, 0,06 et 0,190 pour KNN (Tableau 5).
Les intervalles de confiance bootstrap pour ces mesures de calibration n'étaient pas disponibles, car les probabilités prédites individuelles nécessaires au rééchantillonnage n'avaient pas été conservées dans les résultats d'analyse archivés. Par conséquent, les résultats de calibration sont présentés comme des estimations ponctuelles préliminaires au sein de la cohorte de validation interne et ne doivent pas être interprétés comme une preuve de calibration dans d'autres établissements ou populations de patients (Figure 4).
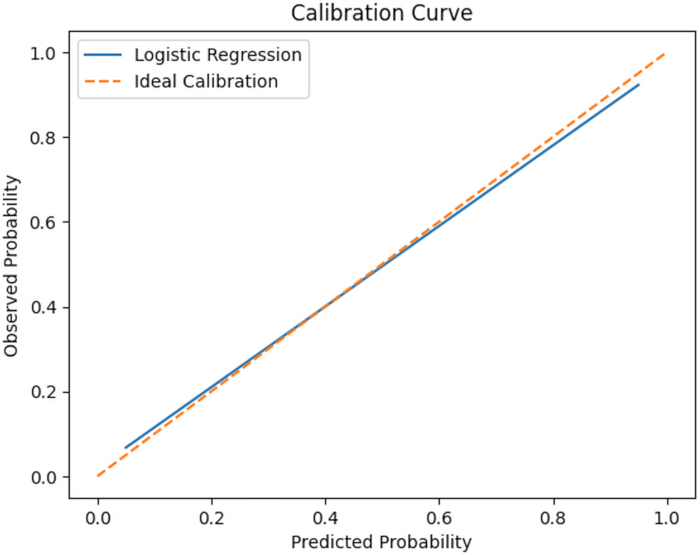
Figure 4 : Étalonnage du modèle de régression logistique dans la cohorte de validation interne. La ligne continue montre la relation entre les probabilités prédites et observées d'ischémie cérébrale retardée. La ligne pointillée diagonale représente un étalonnage parfait ; une concordance plus étroite entre les deux lignes indique une meilleure performance d'étalonnage. DCI, ischémie cérébrale retardée. Veuillez cliquer ici pour visualiser une version agrandie de cette figure.
| Modèle | Pente de calibration | Intervalle de confiance à 95 % de la pente de calibration | Ordonnée à l'origine de calibration | Intervalle de confiance à 95 % de l'ordonnée à l'origine de calibration | Score de Brier | Intervalle de confiance à 95 % du score de Brier | Note de correction |
| Régression logistique | 0.98 | [insert bootstrap 95% CI] | 0.02 | [insert bootstrap 95% CI] | 0.168 | [insert bootstrap 95% CI] | Ajouter les intervalles de confiance bootstrap issus de l'analyse finale si disponibles. |
| SVM | 0.94 | [insert bootstrap 95% CI] | 0.05 | [insert bootstrap 95% CI] | 0.182 | [insert bootstrap 95% CI] | |
| XGBoost | 0.88 | [insert bootstrap 95% CI] | 0.09 | [insert bootstrap 95% CI] | 0.201 | [insert bootstrap 95% CI] | |
| LightGBM | 0.91 | [insert bootstrap 95% CI] | 0.07 | [insert bootstrap 95% CI] | 0.194 | [insert bootstrap 95% CI] | |
| KNN | 0.92 | [insert bootstrap 95% CI] | 0.06 | [insert bootstrap 95% CI] | 0.19 | [insert bootstrap 95% CI] |
Tableau 5 : Performance de calibration des modèles de prédiction dans la cohorte de validation interne. Une pente de calibration de 1,0 et un intercept de calibration de 0 indiquent une calibration idéale. Des scores de Brier plus faibles indiquent une meilleure précision globale de prédiction. Abréviations : KNN, k-plus proches voisins ; LightGBM, machine d'augmentation de gradient légère ; SVM, machine à vecteurs de support ; XGBoost, augmentation extrême de gradient. La pente de calibration, l'intercept de calibration et le score de Brier sont indiqués sous forme d'estimations ponctuelles. Les intervalles de confiance obtenus par rééchantillonnage bootstrap n'étaient pas disponibles. Ces résultats décrivent uniquement une calibration préliminaire au sein de la cohorte de validation interne réservée à cet effet. Veuillez cliquer ici pour télécharger ce tableau.
Métriques dérivées de la matrice de confusion.
La matrice de confusion interne disponible pour la régression logistique comportait 30 vrais positifs, 80 vrais négatifs, 14 faux positifs et 12 faux négatifs. La précision recalculée était de 0,809, la sensibilité était de 0,714, la spécificité était de 0,851, la valeur prédictive positive était de 0,682, la valeur prédictive négative était de 0,870 et le score F1 était de 0,698.
Pour le SVM, la matrice de confusion comprenait 29 vrais positifs, 77 vrais négatifs, 17 faux positifs et 13 faux négatifs. La précision recalculée était de 0,779, la sensibilité de 0,690, la spécificité de 0,819, la valeur prédictive positive de 0,630, la valeur prédictive négative de 0,856 et le score F1 de 0,659 (Tableau 6).
| Métrique | Régression logistique | SVM | Note de calcul |
| Vrais positifs | 30 | 29 | Cohorte de validation |
| Vrais négatifs | 80 | 77 | Cohorte de validation |
| Faux positifs | 14 | 17 | Cohorte de validation |
| Faux négatifs | 12 | 13 | Cohorte de validation |
| Précision | 0,809 | 0,779 | (VP + VN) / total |
| Sensibilité | 0,714 | 0,69 | VP / (VP + FN) |
| Spécificité | 0,851 | 0,819 | VN / (VN + FP) |
| Valeur prédictive positive | 0,682 | 0,63 | VP / (VP + FP) |
| Valeur prédictive négative | 0,87 | 0,856 | VN / (VN + FN) |
| Score F1 | 0,698 | 0,659 | 2VP / (2VP + FP + FN) |
Tableau 6 : Mesures de performance dérivées des matrices de confusion pour la régression logistique et les machines à vecteurs de support (SVM) dans la cohorte de validation interne. Les métriques ont été calculées à partir des matrices de confusion archivées ; toutefois, le seuil exact n’a pas été conservé. Indiquer le seuil exact dans la note de bas de tableau. Abréviations : VPP, valeur prédictive positive ; VPN, valeur prédictive négative ; SVM, machine à vecteurs de support. Les matrices de confusion ont été obtenues à partir de la cohorte de validation interne. Les valeurs recalculées pour la régression logistique concernant l’exactitude, la sensibilité, la spécificité, la valeur prédictive positive, la valeur prédictive négative et le score F1 étaient respectivement de 0,809, 0,714, 0,851, 0,682, 0,870 et 0,698. Les valeurs correspondantes pour la SVM étaient de 0,779, 0,690, 0,819, 0,630, 0,856 et 0,659. Le seuil de classification exact utilisé dans l’analyse initiale n’a pas été conservé et devrait être vérifié avant la soumission finale. Veuillez cliquer ici pour télécharger ce tableau.
Ces valeurs ont été recalculées directement à partir des mêmes matrices de confusion afin d'assurer la cohérence numérique. Toutefois, le seuil de probabilité exact utilisé dans l'analyse de classification initiale n'a pas été conservé. Par conséquent, les mesures dépendant du seuil sont présentées de manière descriptive et ne devraient pas être utilisées comme base principale pour la comparaison des modèles tant que le seuil n'aura pas été vérifié à partir du code d'analyse d'origine (Tableau 7).
| Sous-groupe | AUC (régression logistique) |
| Âge ≥65 ans | 0.821 |
| Âge <65 ans | 0.836 |
| Échelle de Fisher modifiée ≥III | 0.844 |
| Échelle de Fisher modifiée I–II | 0.801 |
| Clipping | 0.825 |
| Traitement endovasculaire | 0.835 |
Tableau 7 : Analyse exploratoire de discrimination par sous-groupes du modèle de régression logistique. Les valeurs de la surface sous la courbe (AUC) sont indiquées selon l'âge, le grade de Fisher modifié et le sous-groupe de traitement. Ces analyses sont de nature exploratoire et ne doivent pas être interprétées comme une preuve de la généralisabilité du modèle. Ajouter la taille de l'échantillon par sous-groupe, le nombre d'événements d'ischémie cérébrale retardée (DCI) et l'intervalle de confiance à 95 % pour chaque sous-groupe.
Abréviations : AUC, surface sous la courbe caractéristique de fonctionnement du récepteur ; DCI, ischémie cérébrale retardée. Veuillez cliquer ici pour télécharger ce tableau.
Évaluation exploratoire de sous-groupes
Le sous-groupe archivé contenait des estimations ponctuelles de l'AUC selon l'âge, le grade de Fisher modifié et l'approche thérapeutique. Toutefois, les tailles d'échantillon des sous-groupes, les nombres d'événements d'IDC par sous-groupe, les intervalles de confiance à 95 %, ainsi que les tests formels d'interaction ou d'hétérogénéité n'étaient pas disponibles. Par conséquent, les résultats des sous-groupes ont été considérés comme incomplets et exploratoires. Ils n'ont pas été utilisés pour affirmer que la performance du modèle était robuste, constante ou généralisable à travers les sous-groupes de patients.
Performance de la stratification du risque
Le résultat archivé de la stratification du risque indiquait des pourcentages observés d'IDC de 10,2 %, 33,6 % et 69,1 % pour les catégories proposées à faible, intermédiaire et élevé risque. Toutefois, les effectifs des groupes correspondants, les nombres d'événements d'IDC, les intervalles de confiance et une justification clinique ou statistique prédéfinie pour les seuils de probabilité n'étaient pas disponibles. L'analyse a donc été considérée comme exploratoire et n'a pas été utilisée pour étayer des affirmations concernant une séparation validée du risque ou une applicabilité clinique (Tableau 8).
| Catégorie de risque | Intervalle de probabilité | Incidence observée de l'IDC |
| Bas risque | <0.20 | 10,2 % |
| Risque intermédiaire | 0,20–0,50 | 33,6 % |
| Haut risque | >0,50 | 69,1 % |
Tableau 8 : Incidence observée d'ischémie cérébrale retardée selon les catégories de risque dérivées du modèle dans la cohorte de validation interne. Les catégories de risque ont été définies à l'aide des probabilités prédites par le modèle de régression logistique final. Veuillez cliquer ici pour télécharger ce tableau.
Modèle final de régression logistique
La sortie de régression archivée contenait les coefficients pour les six prédicteurs sélectionnés, mais ne contenait pas l'ordonnée à l'origine numérique du modèle. Étant donné que l'ordonnée à l'origine est nécessaire pour calculer une probabilité prédite individuelle, une équation complète de prédiction au niveau du patient ne pouvait pas être rapportée. L'équation incomplète a donc été supprimée plutôt que d'être complétée à l'aide d'une valeur supposée ou reconstruite.
Les coefficients présentés dans le Tableau 4 peuvent être utilisés pour décrire le sens et l'ampleur relative des associations des prédicteurs au sein du modèle ajusté, mais ils ne doivent pas être utilisés pour calculer les probabilités de DCI au niveau du patient. Une équation complète de prédiction ne peut être fournie qu'après récupération du terme constant à partir du modèle ajusté d'origine ou régénération par réanalyse du jeu de données authentique au niveau patient.
Logit(DCI) = [intercept] + 0,038 × âge + 0,842 × œdème cérébral + 0,615 × hypoalbuminémie + 1,274 × grade modifié de Fisher ≥III + 0,933 × grade de Hunt-Hess ≥III + 0,781 × grade de la World Federation of Neurological Surgeons ≥III.
La probabilité prédite de DCI a été calculée comme suit :
P(DCI) = 1 / [1 + exp(−Logit)].
Les prédicteurs binaires ont été codés comme 1 lorsque la condition était présente et 0 lorsqu'elle était absente. Le grade de Fisher modifié ≥III, le grade de Hunt-Hess ≥III et le grade de la World Federation of Neurological Surgeons ≥III ont été codés comme 1 lorsque le patient atteignait le seuil et 0 dans les autres cas. L'ordonnée à l'origine n'est pas indiquée car elle est nécessaire au calcul de la probabilité au niveau du patient. Cette équation ne doit être utilisée que pour l'interprétation des résultats de recherche jusqu'à ce qu'une validation externe et une recalibration soient effectuées.
Le grade de Fisher modifié, le grade de Hunt-Hess et le grade de la World Federation of Neurological Surgeons reflètent tous la gravité de la maladie et peuvent partiellement se chevaucher sur le plan clinique. Étant donné que les diagnostics de colinéarité numérique et un modèle de sensibilité complet excluant les échelles de gravité redondantes n'étaient pas disponibles, le manuscrit n'interprète pas ces variables comme des prédicteurs causaux indépendants. Elles sont conservées uniquement comme composantes d'un modèle prédictif sélectionné dans la cohorte d'apprentissage. Cette limitation diminue la confiance dans la contribution indépendante de chaque échelle de gravité et devrait être abordée dans de futures études de validation externe.
DISPONIBILITÉ DES DONNÉES :
L'ensemble complet des données hospitalières au niveau des patients n'est pas accessible au public, car il contient des informations cliniques sensibles et est soumis aux exigences institutionnelles en matière d'éthique et de protection des données. L'accès à un ensemble de données analytiques dépersonnalisé peut être accordé par le Comité d'éthique institutionnel de l'Hôpital n°1 de Yulin après soumission d'une proposition de recherche justifiée sur le plan méthodologique, d'une preuve d'approbation éthique et d'un accord approprié d'utilisation des données. L'ensemble de données partagé exclut les noms, les numéros d'identification hospitaliers, les dates exactes, les coordonnées et tout autre identifiant direct ou indirect. Un dictionnaire de variables vérifié, des scripts d'analyse, le tableau supplémentaire 1 décrivant le développement du modèle et les informations sur la reproductibilité, ainsi que le tableau supplémentaire 2 indiquant les valeurs manquantes spécifiques aux variables sont fournis, conformément à la politique institutionnelle. Les ensembles de données de démonstration ou synthétiques ne représentent pas les données originales de l'étude clinique.
Tableau supplémentaire 1 : Détails de reproductibilité et hyperparamètres finaux pour le développement du modèle. Ce tableau indique la graine aléatoire, les versions des logiciels et des packages, les étapes de prétraitement, la procédure d'imputation, l'approche de validation croisée, la grille de réglage et les hyperparamètres finaux pour XGBoost, LightGBM, SVM et KNN.Veuillez cliquer ici pour télécharger ce fichier.
Tableau supplémentaire 2 : Résumé des données manquantes et stratégie de traitement pour les prédicteurs candidats. Pour chaque prédicteur candidat, sont indiqués le nombre et le pourcentage d'observations manquantes, la méthode d'imputation, ainsi que si la variable a été conservée pour l'analyse.Veuillez cliquer ici pour télécharger ce fichier.
Discussion
Cette étude a développé et validé internement un modèle prédictif de l'ICD après SAHc en utilisant des variables cliniques, biologiques et d'imagerie précoces. Six variables ont été conservées après sélection des prédicteurs : l'âge, l'œdème cérébral, l'hypoalbuminémie, le score de Fisher modifié, le stade de Hunt-Hess et le stade de la World Federation of Neurological Surgeons. Parmi les modèles évalués, la régression logistique a montré une discrimination interne stable et une calibration acceptable. Étant donné que la cohorte de validation provenait du même centre et de la même période que la cohorte d'apprentissage, les résultats doivent être interprétés comme une validation interne préliminaire uniquement.
Les prédicteurs sélectionnés sont cliniquement plausibles dans le contexte de l'hémorragie sous-arachnoïdienne anévrismale (aSAH). Un score de Fisher modifié plus élevé reflète une charge hémorragique plus importante, tandis que les grades de Hunt-Hess et de WFNS décrivent la gravité neurologique au moment du diagnostic14,15. Un œdème cérébral peut traduire une lésion cérébrale précoce, tandis qu’un âge avancé peut indiquer une réserve physiologique réduite. Une hypoalbuminémie peut refléter une maladie systémique, une inflammation, un statut nutritionnel ou une vulnérabilité endothéliale19,20. Toutefois, ces associations ont été identifiées à des fins prédictives et ne doivent pas être interprétées comme causales. En outre, les grades de Fisher modifié, de Hunt-Hess et de WFNS mesurent des aspects liés à la gravité de la maladie. Étant donné que les valeurs de facteur d'inflation de la variance (VIF) et les analyses de sensibilité numériques n'étaient pas disponibles, la contribution indépendante de chaque échelle de notation n'a pas pu être établie.
Les méthodes d'apprentissage automatique plus complexes n'ont pas montré d'avantage net par rapport à la régression logistique dans le groupe de validation interne réservé. La régression logistique a présenté la plus haute AUC de validation, mais les intervalles de confiance se chevauchaient avec ceux des autres modèles. Les algorithmes complexes peuvent capturer des motifs non linéaires, mais ils risquent également le surajustement lorsque l'ensemble de prédicteurs est restreint et que les données proviennent d'un seul centre. La régression logistique a donc été retenue comme modèle principal en raison de son interprétabilité et de sa discrimination interne stable. Néanmoins, l'absence de données complètes sur les hyperparamètres et les versions des logiciels limite la reproductibilité des comparaisons d'apprentissage automatique.
Le modèle actuel ne possède pas de rôle clinique établi. Bien qu’un risque estimé plus élevé puisse théoriquement justifier une surveillance neurologique plus étroite ou un avis spécialisé plus précoce, les probabilités au niveau du patient ne peuvent actuellement pas être calculées, car l’ordonnée à l’origine du modèle n’est pas disponible. De plus, la plage de seuil de la courbe de décision, les performances par sous-groupe et les résultats selon les catégories de risque n’ont pas été entièrement documentés. Ce modèle ne doit donc pas être utilisé comme outil diagnostique autonome, règle de surveillance ou base pour des décisions thérapeutiques. Une reconstruction complète du modèle, une validation externe, une recalibration et une évaluation prospective de son impact clinique sont nécessaires avant qu’une mise en œuvre puisse être envisagée.
Cette étude présente plusieurs limites. Premièrement, elle était rétrospective et menée dans un seul centre, ce qui limite sa généralisabilité. Deuxièmement, les performances du modèle ont été évaluées à l’aide d’une seule division réservée stratifiée selon le résultat (8:2). La correction de l’optimisme par bootstrap, la validation croisée répétée en k parties, la validation temporelle et la validation externe n’étaient pas disponibles. Troisièmement, la graine aléatoire initiale, les hyperparamètres finaux d’apprentissage automatique, les grilles d’ajustement, la procédure de traitement du déséquilibre des classes et les versions complètes des packages logiciels n’ont pas été conservées, limitant ainsi la reproductibilité computationnelle. Quatrièmement, l’ordonnée à l’origine numérique de la régression logistique n’était pas disponible, empêchant le calcul des probabilités prédites individuelles. Cinquièmement, les grades modifié de Fisher, de Hunt-Hess et de WFNS sont des mesures de gravité corrélées, tandis que les diagnostics de facteur d’inflation de la variance (VIF) et les analyses de sensibilité numériques, excluant les échelles superposées, n’étaient pas disponibles. Sixièmement, les intervalles de confiance pour la pente de calibration, l’ordonnée à l’origine de calibration et le score de Brier n’ont pas été calculés. Septièmement, le seuil de classification exact et la plage de seuil de l’analyse de décision clinique (DCA) n’ont pas pu être vérifiés. Huitièmement, les analyses par sous-groupe et de stratification du risque manquaient de dénominateurs complets, de nombres d’événements, d’intervalles de confiance et de tests formels d’interaction. Neuvièmement, le schéma initial de valeurs manquantes spécifique à chaque variable n’a pas été conservé. Enfin, les décès précoces survenus à l’hôpital ont été exclus, ce qui pourrait avoir introduit un biais de survivant. Ces limites impliquent que le modèle doit être considéré comme préliminaire et ne doit pas être utilisé pour la prise de décision clinique avant une réanalyse complète et une validation externe indépendante.
Cette étude a développé et évalué des modèles prédictifs de l'ICD après SAHc en utilisant des variables cliniques, biologiques et d'imagerie précoces21. Six prédicteurs ont été retenus après sélection par la méthode LASSO : l'âge, l'œdème cérébral, l'hypoalbuminémie, le grade de Fisher modifié, le grade de Hunt-Hess et le grade de WFNS22,23,24,25,26,27,28,29. La régression logistique a atteint une AUC de 0,832 (IC à 95 %) dans la cohorte de validation interne réservée et a produit une structure de modèle interprétable29,30. Toutefois, l'analyse s'appuyait sur une unique division interne, et aucune validation complète basée sur rééchantillonnage, aucune validation externe ni aucune information sur la reproductibilité computationnelle n'étaient disponibles. Les résultats doivent donc être interprétés comme des résultats préliminaires de développement de modèle, plutôt que comme une preuve d'un outil de prédiction cliniquement validé.
Cette étude rétrospective monocentrique a développée et évaluée des modèles prédictifs de l'ICD après SAHc en utilisant six variables cliniques, biologiques et d'imagerie précoces. La régression logistique a montré une discrimination préliminaire dans une seule cohorte de validation interne réservée à cet effet et a produit une structure de modèle interprétable31,32,33,34. Toutefois, l'absence de documents complets assurant la reproductibilité, l'absence d'ordonnée à l'origine numérique, l'indisponibilité d'une validation basée sur le rééchantillonnage, une évaluation incomplète des incertitudes et l'absence de validation externe empêchent le calcul de probabilités au niveau individuel des patients et l'utilisation clinique. Une nouvelle analyse utilisant le jeu de données authentique au niveau individuel des patients, une description complète des paramètres de développement du modèle et une validation indépendante multicentrique sont nécessaires.
Remerciements
Les auteurs reconnaissent le soutien du personnel des dossiers médicaux de l'hôpital Yulin First Hospital pour la récupération des données cliniques anonymisées. Ces membres du personnel n'ont pas participé à la conception de l'étude, à l'évaluation des résultats, à la modélisation statistique, à l'interprétation des résultats, à la rédaction du manuscrit ou à l'approbation du manuscrit final et ne remplissent donc pas les critères d'auteur.
Matériaux
| Nom | Entreprise | Numéro de catalogue | Commentaires |
|---|---|---|---|
| Système électronique de dossiers médicaux | Yulin First Hospital | Non applicable | Source de données cliniques rétrospectives ; la plateforme commerciale exacte n'est pas conservée dans les dossiers archivés. |
| IBM SPSS Statistics | IBM Corporation | Version 25.0 | Analyse statistique descriptive et inférentielle. |
| Implémentation du k-plus-proches voisins | Package/origine non conservé | Non disponible | Modèle exploratoire d'apprentissage automatique ; le package et la version exacts doivent être récupérés à partir de l'environnement de code d'origine. |
| LightGBM | Microsoft / projet open-source | Version non disponible | Modèle exploratoire de boosting par gradient ; la version exacte du package et les hyperparamètres n'ont pas été conservés. |
| Logiciel statistique R | Fondation R pour l'informatique statistique | Version 4.3.2 | Modélisation statistique et évaluation interne des performances. |
| Implémentation de la machine à vecteurs de support | Package/origine non conservé | Non disponible | Modèle exploratoire d'apprentissage automatique ; le package exact, les paramètres du noyau et la version n'ont pas été conservés. |
| XGBoost | Projet open-source | Version non disponible | Modèle exploratoire de boosting par gradient ; la version exacte du package et les hyperparamètres n'ont pas été conservés. |
Références
- Caylor MM, MacDonald RL. Pharmacological prevention of delayed cerebral ischemia in aneurysmal subarachnoid hemorrhage. Neurocrit Care. 2024;40(1):159–169.
- Shah VA, Gonzalez LF, Suarez JI. Therapies for delayed cerebral ischemia in aneurysmal subarachnoid hemorrhage. Neurocrit Care. 2023;39(1):36–50.
- Clarke JV, et al. Microvascular platelet aggregation and thrombosis after subarachnoid hemorrhage: a review and synthesis. J Cereb Blood Flow Metab. 2020;40(8):1565–1575.
- Dodd WS, et al. Pathophysiology of delayed cerebral ischemia after subarachnoid hemorrhage: a review. J Am Heart Assoc. 2021;10(15). doi:10.1161/JAHA.121.021845.
- Stragier H, et al. Pathophysiological mechanisms underlying early brain injury and delayed cerebral ischemia in the aftermath of aneurysmal subarachnoid hemorrhage: a comprehensive analysis. Front Neurol. 2025;16:1587091. doi:10.3389/fneur.2025.1587091.
- Xiao ZK, et al. Risk factors for the development of delayed cerebral ischemia after aneurysmal subarachnoid hemorrhage: a systematic review and meta-analysis. World Neurosurg. 2025;193:427–446.
- Sirsat MS, Fermé E, Câmara J. Machine learning for brain stroke: a review. J Stroke Cerebrovasc Dis. 2020;29(10):105162. doi:10.1016/j.jstrokecerebrovasdis.2020.105162.
- Mao M, et al. Construction of a nomogram model for predicting delayed cerebral ischemia in aneurysmal subarachnoid hemorrhage patients. Sci Rep. 2025;15(1):17739. doi:10.1038/s41598-025-01693-w.
- Connolly ES Jr, et al. Guidelines for the management of aneurysmal subarachnoid hemorrhage: a guideline for healthcare professionals from the American Heart Association/American Stroke Association. Stroke. 2012;43(6):1711–1737.
- Vergouwen MD, et al. Definition of delayed cerebral ischemia after aneurysmal subarachnoid hemorrhage as an outcome event in clinical trials and observational studies: proposal of a multidisciplinary research group. Stroke. 2010;41(10):2391–2395.
- Riley RD, et al. Calculating the sample size required for developing a clinical prediction model. BMJ. 2020;368. doi:10.1136/bmj.m441.
- Veldeman M, et al. Delayed cerebral ischaemia prevention and treatment after aneurysmal subarachnoid haemorrhage: a systematic review. Br J Anaesth. 2016;117(1):17–40.
- Azzam AY, et al. Prediction of delayed cerebral ischemia followed aneurysmal subarachnoid hemorrhage: a machine-learning based study. J Stroke Cerebrovasc Dis. 2024;33(4):107553. doi:10.1016/j.jstrokecerebrovasdis.2023.107553.
- Jeong TS, et al. Factors related to the development of shunt-dependent hydrocephalus following subarachnoid hemorrhage in the elderly. Turk Neurosurg. 2018;28(2):226–233.
- Becerril-Gaitan A, et al. The effect of age on cerebral vasospasm and delayed cerebral ischemia in patients with aneurysmal subarachnoid hemorrhage. World Neurosurg. 2024;187–e1024.
- Hayman EG, et al. Mechanisms of global cerebral edema formation in aneurysmal subarachnoid hemorrhage. Neurocrit Care. 2017;26(2):301–310.
- Fistouris P, et al. The impact of intracranial blood clearance on brain edema as a predictor of delayed cerebral infarction following subarachnoid hemorrhage. Cerebrovasc Dis. Published online June 28, 2025:1–8.
- Liu JP, et al. Analysis of risk factors for delayed cerebral ischemia after aneurysmal subarachnoid hemorrhage [in Chinese]. Chin J Cerebrovasc Dis. 2017;14(1):10–14.
- Guo X, et al. Admission albumin-globulin ratio associated with delayed cerebral ischemia following aneurysmal subarachnoid hemorrhage. Front Neurol. 2024;15:1438728. doi:10.3389/fneur.2024.1438728.
- Sanicola HW, et al. Pathophysiology, management, and therapeutics in subarachnoid hemorrhage and delayed cerebral ischemia: an overview. Pathophysiology. 2023;30(3):420–442.
- Wang L, et al. Risk factors and predictive models of poor prognosis and delayed cerebral ischemia in aneurysmal subarachnoid hemorrhage complicated with hydrocephalus. Front Neurol. 2022;13:1014501. doi:10.3389/fneur.2022.1014501.
- Raatikainen E, et al. Prognostic value of the 2010 consensus definition of delayed cerebral ischemia after aneurysmal subarachnoid hemorrhage. J Neurol Sci. 2021;420:117261. doi:10.1016/j.jns.2020.117261.
- Shah AH, Snow R, Wendell LC, et al. Association of hemoglobin trend and outcomes in aneurysmal subarachnoid hemorrhage: a single center cohort study. J Clin Neurosci. 2023;107:77–83.
- Jiang C, et al. Risk and prognostic factors for rupture of intracranial aneurysms during endovascular embolization. World Neurosurg. 2019;129–e649.
- Naraoka M, et al. Role of microcirculatory impairment in delayed cerebral ischemia and outcome after aneurysmal subarachnoid hemorrhage. J Cereb Blood Flow Metab. 2022;42(1):186–196.
- Hu P, et al. Effect of surgical clipping versus endovascular coiling on the incidence of delayed cerebral ischemia in patients with aneurysmal subarachnoid hemorrhage: a multicenter observational cohort study with propensity score matching. World Neurosurg. 2023;172–e388.
- Ching T, et al. Opportunities and obstacles for deep learning in biology and medicine. J R Soc Interface. 2018;15(141):20170387. doi:10.1098/rsif.2017.0387.
- Jiang F, et al. Artificial intelligence in healthcare: past, present and future. Stroke Vasc Neurol. 2017;2(4):230–243.
- Coulibaly AP, Provencio JJ. Aneurysmal subarachnoid hemorrhage: an overview of inflammation-induced cellular changes. Neurotherapeutics. 2020;17(2):436–445.
- Gris T, et al. Innate immunity activation in the early brain injury period following subarachnoid hemorrhage. J Neuroinflammation. 2019;16(1):253. doi:10.1186/s12974-019-1629-7.
- Wu Z, et al. Study on the predictive value of laboratory inflammatory markers and blood count-derived inflammatory markers for disease severity and prognosis in COVID-19 patients: a study conducted at a university-affiliated infectious disease hospital. Ann Med. 2024;56(1):2415401. doi:10.1080/07853890.2024.2415401.
- Okugawa Y, et al. Lymphocyte–C-reactive protein ratio as a promising new marker for predicting surgical and oncological outcomes in colorectal cancer. Ann Surg. 2020;272(2):342–351.
- Xie L, et al. The systemic inflammation response index as a significant predictor of short-term adverse outcomes in acute decompensated heart failure patients: a cohort study from southern China. Front Endocrinol (Lausanne). 2024;15:1444663. doi:10.3389/fendo.2024.1444663.
- Yan F, et al. Association between the stress hyperglycemia ratio and 28-day all-cause mortality in critically ill patients with sepsis: a retrospective cohort study and predictive model establishment based on machine learning. Cardiovasc Diabetol. 2024;23(1):163. doi:10.1186/s12933-024-02265-4.