Cette étude présente un pipeline bioinformatique reproductible intégrant la transcriptomique, l'apprentissage automatique et l'analyse de l'infiltration immunitaire afin d'identifier des biomarqueurs diagnostiques potentiels et des réseaux régulateurs dans la maladie pulmonaire obstructive chronique (COPD).
Article de recherche
UPP1 en tant que biomarqueur diagnostique : enseignements issus des analyses bioinformatiques intégratives et d'infiltration immunitaire dans la BPCO
* These authors contributed equally
Dans cet article
Résumé
Résumé
La MPOC est un trouble respiratoire progressif caractérisé par une limitation persistante du flux d'air et une inflammation chronique, mais le rôle de la modification de l'ARN par la N4-acétylcytidine (ac4C) dans sa pathogenèse reste largement inexploré. Cette étude visait à effectuer un criblage systématique de gènes liés à l'ac4C (ac4C-RG) à partir d'une base de données publiée et à examiner leurs réseaux régulateurs dans la MPOC, afin d'identifier des biomarqueurs potentiels pour des études mécanistiques ultérieures, sans supposer de relation régulatrice directe entre un gène spécifique et la modification par ac4C. Les gènes différentiellement exprimés (DEG) ont été identifiés à partir de profils transcriptomiques, et une analyse de réseau de co-expression génique pondérée (WGCNA) a été appliquée pour découvrir les modules de co-expression clés. Une analyse croisée entre les DEG, les modules significatifs et les ac4C-RG a été réalisée. Les gènes centraux ont été sélectionnés à l'aide des algorithmes de régression LASSO, XGBoost et forêt aléatoire, suivis de la construction d'un modèle diagnostique basé sur une régression logistique. Les performances du modèle ont été évaluées par analyse de la courbe ROC (caractéristique de fonctionnement du récepteur), de l'aire sous la courbe (AUC) avec intervalles de confiance à 95 %, de l'évaluation de la courbe de calibration et de l'analyse de la courbe de décision (DCA). Un total de 160 gènes communs a été identifié, et six gènes centraux (PTRF, PRKCDBP, UPP1, TOR3A, FAM168B et B4GALT2) ont été systématiquement sélectionnés par les trois algorithmes d'apprentissage automatique. Le modèle diagnostique a montré une bonne performance discriminante, avec des AUC de 0,766, 0,759 et 0,723 respectivement dans les ensembles d'entraînement, de test interne et de validation externe. L'analyse du réseau régulateur a suggéré des axes ceRNA potentiels et des interactions avec des facteurs de transcription, tandis que le profil d'infiltration immunitaire a révélé des corrélations significatives entre les gènes clés et plusieurs sous-ensembles de cellules immunitaires. L'analyse des interactions médicament-gène et le dockage moléculaire ont indiqué que le fluorouracile, la capécitabine et la 5-benzylacyclouridine pourraient présenter des affinités de liaison prédites favorables avec UPP1. En conclusion, PTRF, PRKCDBP, UPP1, TOR3A, FAM168B et B4GALT2 ont été identifiés comme des biomarqueurs potentiels liés à l'ac4C dans la MPOC, potentiellement impliqués dans la régulation immunitaire et métabolique, fournissant ainsi une base pour de futures investigations fonctionnelles et explorations thérapeutiques.
Introduction
La BPCO est un trouble respiratoire chronique et hétérogène caractérisé par une limitation progressive du flux aérien résultant d'anomalies des structures alvéolaires et des voies respiratoires1,2. Un déséquilibre protéase-antiprotéase, le stress oxydatif, l'inflammation chronique et la sénescence cellulaire constituent les mécanismes physiopathologiques fondamentaux de la BPCO, entraînant une destruction structurelle et une altération fonctionnelle du tissu pulmonaire3,4. Par ailleurs, la BPCO est influencée par de nombreux facteurs de risque, notamment le tabagisme prolongé, la pollution environnementale, l'exposition professionnelle, les infections respiratoires et la prédisposition génétique5,6. La BPCO pèse un fardeau considérable sur l'économie mondiale. Elle devrait représenter 0,111 % du PIB mondial chaque année entre 2020 et 20507. Bien que les stratégies thérapeutiques actuelles, telles que les bronchodilatateurs, les corticostéroïdes inhalés, la réadaptation pulmonaire et l'oxygénothérapie à long terme, permettent d'atténuer les symptômes, l'arrêt de la progression de la maladie demeure difficile. En raison d'une hétérogénéité clinique marquée, les résultats chez les patients varient considérablement8. Par conséquent, de nouveaux biomarqueurs diagnostiques et indicateurs pronostiques sont urgemment nécessaires afin d'améliorer la prise en charge de la BPCO et la survie des patients.
La modification de l'ARN fait référence à l'altération chimique des molécules d'ARN, pouvant modifier la structure et la fonction de l'ARN afin de réguler l'expression des gènes9,10. Les modifications courantes de l'ARN incluent la N6-méthyladénosine (m6A), la pseudouridine (Ψ), la 5-méthylcytosine (m5C) et l'ac4C11. La modification ac4C joue un rôle essentiel dans la préservation de la stabilité des ARNm et dans la promotion de leur traduction12,13. NAT10 est la seule enzyme eucaryote connue qui catalyse la modification ac4C, et son activité est indispensable à la formation de cette modification14. Des études ont mis en évidence une forte corrélation entre le stress oxydatif, la sénescence cellulaire, l'inflammation et la modification ac4C. Par exemple, les lymphocytes T CD4+ présents dans les tissus coliques de personnes atteintes de maladie inflammatoire de l'intestin (IBD) présentent des niveaux nettement élevés de NAT1015. NAT10 renforce l'acétylation ac4C des chimiokines CCL2 et CXCL1, favorisant ainsi l'infiltration des macrophages et des neutrophiles et aggravant les lésions inflammatoires16. La réponse cellulaire au stress oxydatif pourrait impliquer la modification ac4C, comme en témoigne l'augmentation marquée des niveaux d'ac4C sous stress oxydatif. De plus, NAT10 favorise la fibrose pulmonaire induite par les PM2.5 en stabilisant l'ARNm de TGFB1 par modification ac4C, déclenchant ainsi une transition épithélio-mésenchymateuse17. Toutefois, le rôle de la modification ac4C dans la BPCO reste largement inexploré, soulignant la nécessité de recherches supplémentaires dans ce domaine.
La base de données GEO a été utilisée dans cette étude afin d'identifier les gènes différentiellement exprimés (DEG) entre les patients atteints de BPCO et les témoins. Une liste publiée de gènes régulateurs de l'ac4C, compilée à partir de données multiomiques18, a ensuite été intégrée aux DEG afin d'identifier les candidats communs. Étant donné que la modification par ac4C est connue pour influencer l'inflammation et le stress oxydatif—des processus clés dans la BPCO—nous avons émis l'hypothèse que les gènes associés au réseau régulateur de l'ac4C pourraient être régulés de manière anormale dans la BPCO. Toutefois, les gènes communs n'ont pas été considérés comme des substrats directs de NAT10 ni comme des gènes directement régulés par l'ac4C ; ils ont plutôt été considérés comme des candidats associés au réseau lié à l'ac4C. Les gènes clés ont été sélectionnés à l'aide de plusieurs algorithmes d'apprentissage automatique, suivis de la construction et de la validation d'un modèle diagnostique. Par la suite, les voies pertinentes impliquées dans la pathogenèse de la BPCO ont été déterminées, et des médicaments ciblés potentiels ont été prédits. Enfin, des tests de RT-qPCR ont été réalisés afin de confirmer les niveaux d'expression des gènes clés, fournissant ainsi des indications préliminaires sur la physiopathologie de la BPCO et des pistes potentielles pour l'exploration thérapeutique.
Protocole
Déclaration du comité d'éthique institutionnel
Cette étude a été menée conformément à la Déclaration d'Helsinki. Le protocole a été approuvé par le Comité d'éthique de l'Hôpital Shenzhen Luohu de médecine traditionnelle chinoise (numéro d'approbation : 2024-LHQZYYYXLL-KY-039), et un consentement éclairé écrit a été obtenu de tous les participants avant leur inclusion. Les détails des outils et matériaux de recherche utilisés dans ce protocole sont fournis dans le Tableau des matériaux.
Source des données et traitement
Les jeux de données d'expression génique liés à la BPCO ont été obtenus à partir du Gene Expression Omnibus (GEO). Le jeu de données GSE54837 a été utilisé comme jeu de données de transcriptome, et le jeu de données GSE112811 a servi de jeu de validation (Tableau 1). Les gènes liés à l'ac4C (ac4C-RGs) ont été recueillis à partir de la littérature18. Les gènes différentiellement exprimés (DEG) entre les groupes BPCO et témoins ont été identifiés à l'aide du package R limma. Les DEG ont été considérés comme statistiquement significatifs si |log2FC| > 0 et p < 0,05. Des graphiques en volcan ont été générés pour visualiser la distribution globale des modifications d'expression génique.
Construction de WGCNA
L'analyse WGCNA a été réalisée sur le jeu de données GSE54837 à l'aide de R afin d'identifier les modules liés à la BPCO. Avant la construction du réseau, des échantillons aberrants ont été identifiés et éliminés par analyse de clustering hiérarchique utilisant la fonction hclust avec la méthode de liaison moyenne et une métrique de distance euclidienne. La puissance optimale de seuil doux (soft-thresholding) (β = 10) a été choisi pour obtenir un indice d'ajustement à une topologie sans échelle de R2 ≥ 0,85, équilibrant la topologie sans échelle et la connectivité moyenne. Une matrice d'adjacence a été construite puis transformée en une matrice de chevauchement topologique (TOM). Les modules de gènes ont été identifiés à l'aide de l'algorithme de découpage dynamique d'arbre hiérarchique (deepSplit = 2, minClusterSize = 50). Les modules présentant des corrélations d'expression des gènes caractéristiques > 0,75 ont ensuite été fusionnés à l'aide de la fonction mergeCloseModules. Les eigengènes des modules ont ensuite été corrélées aux caractéristiques cliniques (statut BPCO, âge, sexe et statut tabagique) à l'aide de coefficients de corrélation de Pearson afin d'identifier les modules associés au BPCO pour les analyses ultérieures.
Étude de criblage, analyse d'enrichissement et analyse du réseau PPI des gènes chevauchants
Un diagramme de Venn a été généré à l'aide du package R ggvenn afin d'identifier les gènes communs parmi les DEG, les gènes du module MEsaumon et les ac4C-RG. Une analyse d'enrichissement fonctionnel des gènes communs a été réalisée à l'aide des bases de données Gene Ontology (GO) et Kyoto Encyclopedia of Genes and Genomes (KEGG) avec le package R clusterProfiler. Les informations sur les interactions entre protéines (PPI) ont été obtenues à partir de la base de données STRING (https://string-db.org/) afin d'analyser les interactions au niveau protéique parmi les gènes communs. Le logiciel Cytoscape a été utilisé pour visualiser le réseau PPI obtenu.
Identification de gènes clés par apprentissage automatique
Trois techniques d'apprentissage automatique ont été appliquées : la régression par l'opérateur de réduction et de sélection des moindres valeurs absolues (LASSO), le boosting par gradient extrême (XGBoost) et la forêt aléatoire (RF). La régression LASSO a été mise en œuvre à l'aide du package glmnet avec une validation croisée à 10 folds pour déterminer le paramètre de pénalité optimal λ. Le paramètre type.measure a été fixé à « deviance », et le paramètre family a été fixé à « binomial ». Le λ optimal a été sélectionné selon le critère λmin, qui minimise la déviance validée par validation croisée, produisant 17 gènes. XGBoost a été réalisé à l'aide du package xgboost avec les hyperparamètres suivants : nrounds = 100, max_depth = 6, eta = 0,3, subsample = 0,8, colsample_bytree = 0,8, et eval_metric = « logloss ». L'importance des variables a été classée selon la métrique gain, et les 30 gènes les plus importants ont été sélectionnés. La forêt aléatoire a été mise en œuvre à l'aide du package randomForest avec ntree = 200. L'importance des variables a été classée selon la diminution moyenne de l'indice de Gini, et les 30 gènes les plus importants ont été sélectionnés. Les gènes sélectionnés par les trois méthodes d'apprentissage automatique ont été croisés afin d'identifier les gènes clés pour les analyses ultérieures.
Construction et évaluation du modèle de régression logistique pour la prédiction du risque
Le jeu de données GSE54837 a été divisé aléatoirement en un ensemble d'apprentissage (70 %) et un ensemble de test (30 %). Un modèle de régression logistique a été construit sur l'ensemble d'apprentissage à l'aide de la fonction glm du package MASS, en utilisant les niveaux d'expression des gènes clés comme variables prédictives. Les performances du modèle ont été évaluées à l'aide de courbes ROC générées avec le package pROC. Les intervalles de confiance à 95 % pour l'AUC ont été calculés par 2 000 répétitions de bootstrap. La calibration du modèle a été évaluée à l'aide de courbes de calibration générées avec 1 000 rééchantillonnages bootstrap (package rms). L'analyse de décision clinique (DCA) a été réalisée à l'aide du package dca pour évaluer le bénéfice clinique net sur une gamme de probabilités seuils. Un nomogramme a été construit à l'aide de la fonction nomogram du package rms afin de faciliter l'estimation personnalisée du risque.
L'équation de régression était la suivante :
logit(P) = 0,5823 + 0,6010 × UPP1 - 0,6563 × PTRF + 0,3853 × B4GALT2 - 0,3972 × FAM168B + 0,1848 × PRKCDBP - 0,4787 × TOR3A. (1)
Ici, P représente la probabilité prédite de BPCO, et chaque coefficient représente la contribution de la valeur d'expression génique correspondante aux cotes logarithmiques de la BPCO.
Analyse d'expression, réseau GeneMANIA et réseau régulatoire moléculaire
Les niveaux d'expression génique entre les groupes BPCO et témoins dans le jeu de données GSE54837 ont été comparés à l'aide du test de Wilcoxon-Mann-Whitney. Des boîtes à moustaches ont été générées à l'aide du package ggplot2 afin de visualiser la distribution des niveaux d'expression, avec la médiane, l'intervalle interquartile (IIQ) et les points de données individuels superposés. GeneMANIA a été utilisé pour construire les réseaux géniques et prédire les interactions fonctionnelles. La recherche a été effectuée avec les paramètres par défaut : espèce = Homo sapiens, nombre maximal de gènes associés = 20. Le réseau obtenu a été téléchargé et visualisé, les couleurs des arêtes indiquant les types d'interaction. Un réseau d'ARN endogènes compétitifs (ceRNA) a été construit afin d'étudier les mécanismes régulateurs post-transcriptionnels. Les miARN ciblant les six gènes clés ont été prédits à l'aide de deux bases de données indépendantes : DIANA-microT (score ≥ 0,8) et miRanda (score ≥ 140, énergie ≤ −20 kcal/mol). L'intersection des miARN identifiés par les deux bases de données a été utilisée pour construire des paires miARN-mARN. Par la suite, les lncARN ciblant ces miARN ont été prédits à l'aide de la base de données StarBase. Un réseau régulateur lncARN-miARN-mARN a été construit et visualisé à l'aide de Cytoscape. Les relations régulatrices transcriptionnelles ont été prédites à l'aide de l'analyse d'enrichissement ChIP-X version 3 (ChEA3). Pour chaque gène clé possédant des facteurs de transcription (FT) prédits, les 10 premiers facteurs de transcription présentant les scores d'enrichissement les plus élevés ont été sélectionnés. Un réseau régulateur FT-cible a été construit dans Cytoscape.
Analyse de l'enrichissement des ensembles de gènes et évaluation de l'infiltration des cellules immunitaires
Une analyse d'enrichissement de gènes (GSEA) a été réalisée à l'aide du package clusterProfiler afin d'étudier les fonctions biologiques de chaque gène clé. Pour chaque gène clé, les échantillons ont été divisés en deux groupes, à expression élevée et faible, selon la valeur médiane. Une analyse d'expression différentielle entre les deux groupes a été effectuée à l'aide de limma, et la liste de gènes obtenue a été classée selon le changement de rapport logarithmique en base 2 signé. L'analyse GSEA a été menée à l'aide de la fonction gseGO pour les termes du processus biologique de l'ontologie générique (GO) et de la fonction gseKEGG pour les voies KEGG, avec les paramètres suivants : minGSSize = 10, maxGSSize = 500, pvalueCutoff = 0,05, et nPerm = 1 000. L'abondance relative de 28 types de cellules immunitaires a été estimée à l'aide de l'analyse d'enrichissement de gènes par échantillon unique (ssGSEA) mise en œuvre dans le package GSVA. Une matrice de signature de gènes soigneusement sélectionnée, comprenant des gènes marqueurs pour 28 types de cellules immunitaires, a été obtenue à partir de travaux antérieurs19. Pour chaque échantillon, la fonction gsva a été appliquée avec method = "ssgsea", ssgsea.norm = TRUE, et kcdf = "Gaussian". Les coefficients de corrélation de Spearman entre les scores d'enrichissement ssGSEA et les niveaux d'expression des six gènes clés ont été calculés à l'aide de la fonction cor.test. Les valeurs de p ont été ajustées pour les tests multiples selon la méthode de Benjamini-Hochberg. La matrice de corrélation a été visualisée sous forme de carte thermique à l'aide du package pheatmap.
Prédiction de médicaments, docking moléculaire et analyse d'association avec les maladies
Des composés thérapeutiques potentiels ciblant des gènes clés ont été identifiés à l'aide de la base de données DrugBank. Un réseau d'interactions « médicament ciblant un gène clé » a été construit dans Cytoscape afin de visualiser les interactions prévues entre médicaments et gènes. Un dockage moléculaire a été réalisé à l'aide de la plateforme CB-Dock2 pour évaluer les affinités de liaison. La structure protéique tridimensionnelle de l'UPP1 humain a été obtenue à partir de la Protein Data Bank (PDB ID : 7B8T). Les structures moléculaires des médicaments (format SMILES) ont été récupérées depuis PubChem. Le dockage a été effectué en utilisant le moteur AutoDock Vina, et les résultats ont été classés selon l'énergie libre de liaison (ΔG, en kcal/mol). Les complexes de dockage ont été visualisés à l'aide de PyMOL. Les associations entre les gènes clés et les maladies humaines liées à des expositions environnementales ont été étudiées à l'aide de la base de données Comparative Toxicogenomics Database (CTD). Chaque gène a fait l'objet d'une requête individuelle, et les dix maladies les plus fortement associées ont été extraites et visualisées à l'aide de diagrammes en radar.
Protocole de RT-qPCR
Des échantillons de sang veineux périphérique ont été prélevés chez huit patients atteints de BPCO et huit témoins sains à l'hôpital Shenzhen Luohu de médecine traditionnelle chinoise. Le diagnostic de BPCO a été établi selon les critères de l'Initiative mondiale pour la maladie pulmonaire obstructive chronique (GOLD), définis par un rapport VEMS/CVF post-bronchodilatateur < 0,70. Le groupe témoin comprenait des volontaires sains appariés par âge et sexe, sans antécédent de maladies respiratoires et présentant des épreuves fonctionnelles respiratoires normales (VEMS % prédit ≥ 80 % et VEMS/CVF ≥ 0,70). Les informations de base concernant les patients sont indiquées dans le Tableau 2. L'ARN total a été extrait des échantillons sanguins de patients BPCO à l'aide d'un kit d'extraction d'ARN sanguin. Pour la synthèse d'ADN complémentaire, 500 ng d'ARN total ont été rétrotranscrits à l'aide d'un kit de synthèse d'ADN complémentaire avec élimination de l'ADN génomique, conformément au protocole fourni. L'ADN complémentaire obtenu a été dilué à 150 ng/μL.
La RT-qPCR a été réalisée à l'aide d'un mélange maître qPCR basé sur le SYBR Green sur un système de PCR en temps réel. Chaque réaction de 10 μL contenait 5 μL de mélange maître 2x SYBR Green, 0,5 μL de chacun des amorces avant et arrière (10 μM), 1 μL d'ADNc dilué (15 ng/μL) et 3 μL d'eau sans nucléase. Les conditions de cyclage comprenaient une dénaturation initiale à 95 °C pendant 5 min, suivie de 40 cycles de 95 °C pendant 10 s et de 60 °C pendant 30 s, avec une analyse finale de courbe de fusion allant de 60 °C à 95 °C afin de vérifier la spécificité de l'amplification. Toutes les réactions ont été effectuées en triplets techniques. L'actine β a été utilisée comme gène de référence interne. L'efficacité des amorces pour chaque gène cible a été validée à l'aide de séries de dilutions par courbe standard et variait entre 90 % et 110 %. Les niveaux d'expression génique ont été normalisés par rapport à l'actine β, et l'expression relative a été calculée selon la méthode 2-ΔΔCt. Les comparaisons statistiques entre les groupes BPCO et témoins ont été effectuées à l'aide du test de Mann-Whitney U.
Analyse statistique
Les visualisations de réseaux ont été créées à l'aide de Cytoscape, et les analyses statistiques ont été effectuées avec le logiciel R. Sauf indication contraire, le test de Mann-Whitney U a été utilisé pour les données non normalement distribuées, et le test t de Student a été utilisé pour les données normalement distribuées afin de comparer deux groupes. Une valeur de p < 0,05 a été considérée comme statistiquement significative.
Résultats
Identification de gènes chevauchants, analyse d'enrichissement et construction du réseau PPI
À partir du jeu de données GSE54837, 3 371 gènes différentiellement exprimés (DEG) ont été identifiés, dont 1 675 gènes surexprimés et 1 696 gènes sous-exprimés. Les 10 gènes présentant la surexpression et la sous-expression la plus significative sont indiqués dans Figure 1A. Une analyse de regroupement hiérarchique des données GSE54837 a été réalisée (Figure supplémentaire 1A), et une puissance de seuil doux de 10 a été appliquée afin d'assurer une topologie de réseau sans échelle (Figure 1B). Des modules de co-expression génique ont été construits à l'aide de la méthode de découpage dynamique en arbre avec une taille minimale de module fixée à 50 gènes, et chaque module s'est vu attribuer une couleur distincte (Figure supplémentaire 1B). Modules présentant des corrélations entre les gènes propres > 0,75 ont ensuite été fusionnés (Figure supplémentaire 1C, Figure 1C), ce qui donne 14 modules distincts. Sur la base de l'analyse de corrélation de Pearson entre les eigengènes des modules et les caractéristiques cliniques, le module MEsalmon (composé de 5 226 gènes) présentait la corrélation positive la plus significative avec la BPCO (r = 0,35, p = 7 x 10⁻8, Figure 1D). L'analyse de Venn a identifié 160 gènes communs parmi les 3 371 gènes différentiellement exprimés (DEG), les 5 226 gènes du module MEsalmon et les 2 118 gènes associés à l'ac4C (ac4C-RG)Figure 1E). L'analyse d'enrichissement fonctionnel de ces 160 gènes a révélé que les termes GO significatifs incluaient la liaison à l'ARN simple brin, la régulation du processus métabolique des ARNm et la voie de signalisation RIG-I (Figure 1F). De plus, l'analyse KEGG a montré que ces gènes étaient principalement enrichis dans la phagocytose médiée par les récepteurs Fc gamma R, la voie de surveillance de l'ARNm et l'adhésion focale (Figure 1G). Le réseau PPI des gènes chevauchants comprenait 118 nœuds et 196 arêtes (Figure 1H).
Identification de six gènes clés dans la BPCO
Afin d'identifier davantage les gènes clés potentiels parmi les 160 candidats communs, trois algorithmes d'apprentissage automatique ont été appliqués. Une régression LASSO a d'abord été utilisée, la validation croisée permettant de déterminer le paramètre de pénalité optimal (λ) ≈ 0,091 (Figure 2A). Le tracé du profil des coefficients a indiqué que 17 gènes ont été conservés à la valeur optimale de λ (Figure 2B). L'analyse XGBoost a identifié les 30 gènes ayant le gain le plus élevé, parmi lesquels PTRF, WBP11 et LDOC1L présentaient une forte valeur prédictive (Figure 2C). L'algorithme RF a classé de manière similaire les 30 gènes les plus importants selon leurs scores d'importance de Gini, PTRF, RFX5 et PRKCDBP figurant parmi les plus prédictifs (Figure 2D). Une analyse d'intersection des gènes sélectionnés par les trois méthodes a permis d'identifier six gènes clés communs : PTRF, PRKCDBP, UPP1, TOR3A, FAM168B et B4GALT2 (Figure 2E).
Construction du modèle diagnostique et analyse d'expression des gènes clés
En utilisant 70 % du jeu de données GSE54837 comme ensemble d'apprentissage, un modèle de régression logistique a été établi, intégrant les six gènes clés. L'analyse de la courbe ROC a indiqué une performance diagnostique modérée, avec des AUC de 0,766 (IC 95 % : 0,691–0,8417), 0,759 (IC 95 % : 0,6368–0,8817) et 0,723 (IC 95 % : 0,6085–0,8596) respectivement pour les ensembles d'apprentissage, de test interne et de validation externe (Figure 3A–C). L'analyse de calibration a confirmé une forte fiabilité, et l'analyse DCA a montré un bénéfice clinique net clair sur une large gamme de probabilités seuils, tant pour les ensembles d'apprentissage (Figure 3D–E) que de validation (Figure 3F–G). Un nomogramme a été construit afin de visualiser la contribution de chaque gène et de faciliter l'estimation personnalisée du risque (Figure 3H). L'analyse d'expression a révélé que B4GALT2, PRKCDBP et UPP1 étaient significativement surexprimés dans les échantillons de BPCO, tandis que FAM168B, PTRF et TOR3A étaient sous-exprimés (Figure 3I).
Réseau régulateur et analyse fonctionnelle des gènes clés dans la BPCO
Un réseau d'interaction fonctionnelle comprenant les 20 gènes les plus associés aux gènes centraux identifiés a été construit à l'aide de l'analyse GeneMANIA (Figure 4A). Les interactions physiques représentaient la majorité des connexions, suivies par les corrélations de co-expression et les domaines protéiques partagés. L'annotation fonctionnelle a révélé un enrichissement significatif dans des processus tels que le métabolisme des petites molécules contenant une base azotée, le catabolisme des nucléosides et les radeaux de la membrane plasmique. La régulation post-transcriptionnelle a été étudiée en croisant les prédictions de miARN provenant des bases de données DIANA-microT et miRanda, permettant d'identifier huit miARN communs (Figure 4B). Un axe régulateur lncARN-miARN-mARN a ensuite été construit. Selon le diagramme de Sankey, deux des miARN identifiés, tous deux associés à la régulation de FAM168B, étaient prédits comme ciblés par sept lncARN ; aucune interaction régulatrice de ce type n'a été identifiée pour les cinq autres gènes centraux (Figure 4C). La régulation transcriptionnelle a été approfondie à l'aide de la plateforme ChEA3, qui a prédit les facteurs de transcription (FT) en amont pour B4GALT2, UPP1, FAM168B et TOR3A. Les dix premiers FT pour chaque gène ont été sélectionnés afin de construire un réseau régulateur FT-cible (Figure 4D). Une analyse GSEA a été réalisée pour étudier les fonctions biologiques des six gènes clés. UPP1 était significativement enrichi dans des processus biologiques tels que le métabolisme du diacylglycérol et la biosynthèse des purine nucléosides triphosphate, ainsi que dans des voies incluant le protéasome et le métabolisme des xénobiotiques par le cytochrome P450 (Figure 4E–F). Les résultats d'enrichissement pour les cinq autres gènes clés sont fournis dans la Figure supplémentaire 2A–J.
Infiltration immunitaire de UPP1 et prédiction de cibles médicamenteuses dans la BPCO
Les niveaux d'infiltration immunitaire de 28 types de cellules immunitaires ont été évalués dans les groupes témoins et BPCO à l'aide de l'algorithme ssGSEA. Chez les patients atteints de BPCO, les lymphocytes B mémoire, les cellules myéloïdes suppressives et les cellules dendritiques activées présentaient des scores d'enrichissement significativement plus élevés. En revanche, les lymphocytes T helper de type 1, les lymphocytes B activés et les lymphocytes B immatures présentaient des scores d'enrichissement significativement plus faibles (Figure 5A). Il convient de noter que la ssGSEA fournit des estimations relatives de l'enrichissement en cellules immunitaires basées sur des données transcriptomiques, plutôt que des mesures directes des proportions de cellules immunitaires. Une analyse de corrélation a révélé que les six gènes clés présentaient des profils d'association différents avec les sous-ensembles de cellules immunitaires. Plus précisément, UPP1, PRKCDBP et B4GALT2 étaient positivement corrélés avec les niveaux d'infiltration des lymphocytes B mémoire, des cellules dendritiques activées et des cellules myéloïdes suppressives (ρ de Spearman > 0,4, p < 0,05), tandis que PTRF, TOR3A et FAM168B présentaient des corrélations négatives avec les lymphocytes T helper de type 1 et les lymphocytes B activés (ρ de Spearman < −0,3, p < 0,05). La matrice complète des corrélations est présentée dans la carte thermique (Figure 5B). Une analyse de prédiction de médicaments a identifié UPP1 comme le seul gène parmi les six candidats présentant des interactions prédites avec des petites molécules. Trois composés, notamment le fluorouracile, la capécitabine et la 5-benzylacyclouridine, ont été identifiés dans la base de données comme des composés pouvant interagir avec UPP1 (Figure 5C). Ces composés sont principalement utilisés en oncologie ou dans des contextes expérimentaux, et leur pertinence dans la BPCO nécessite des investigations supplémentaires. Les calculs d'énergie libre de liaison ont révélé que la 5-benzylacyclouridine présentait l'affinité de liaison la plus forte, suggérant une affinité de liaison prédite relativement plus élevée (Table 3). Les visualisations du dockage moléculaire pour les trois composés indiquaient des conformations de liaison prédites favorables avec UPP1, conformément à des prédictions de dockage computationnelles plutôt qu'à une validation expérimentale (Figure 5D–F). De plus, l'analyse CTD a indiqué que les six gènes clés étaient fortement associés à divers phénotypes de maladies, notamment des effets retardés d'une exposition prénatale, une perte de poids, une hépatomégalie et une inflammation (Figure 5G–L).
Validation par RT-qPCR de gènes diagnostiques clés dans des échantillons cliniques
Afin de valider les niveaux d'expression de gènes clés, des échantillons sanguins ont été recueillis auprès de huit patients atteints de BPCO et de huit sujets témoins, et cette analyse a été considérée comme une validation préliminaire en raison de la taille limitée de l'échantillon. Comme illustré dans la Figure 6A–F, PTRF, TOR3A et FAM168B étaient significativement sous-régulés, tandis que PRKCDBP et UPP1 étaient significativement sur-régulés dans les échantillons de BPCO, ce qui est conforme aux tendances observées dans l'analyse bioinformatique. En revanche, aucune différence significative n'a été observée pour l'expression de B4GALT2 entre les deux groupes. Cette divergence pourrait être attribuée à la taille limitée de l'échantillon ou à des différences entre les types d'échantillons utilisés dans les jeux de données et les prélèvements cliniques.
DÉCLARATION DE DISPONIBILITÉ DES DONNÉES :
Toutes les données de séquençage de l'ARN ont été obtenues à partir de la base de données Gene Expression Omnibus (GEO, https://www.ncbi.nlm.nih.gov), le jeu de données GSE54837 ayant été sélectionné comme ensemble d'apprentissage et le jeu de données GSE112811 comme ensemble de validation. Le code utilisé dans cette analyse peut être obtenu à partir de https://doi.org/10.5281/zenodo.21771476.
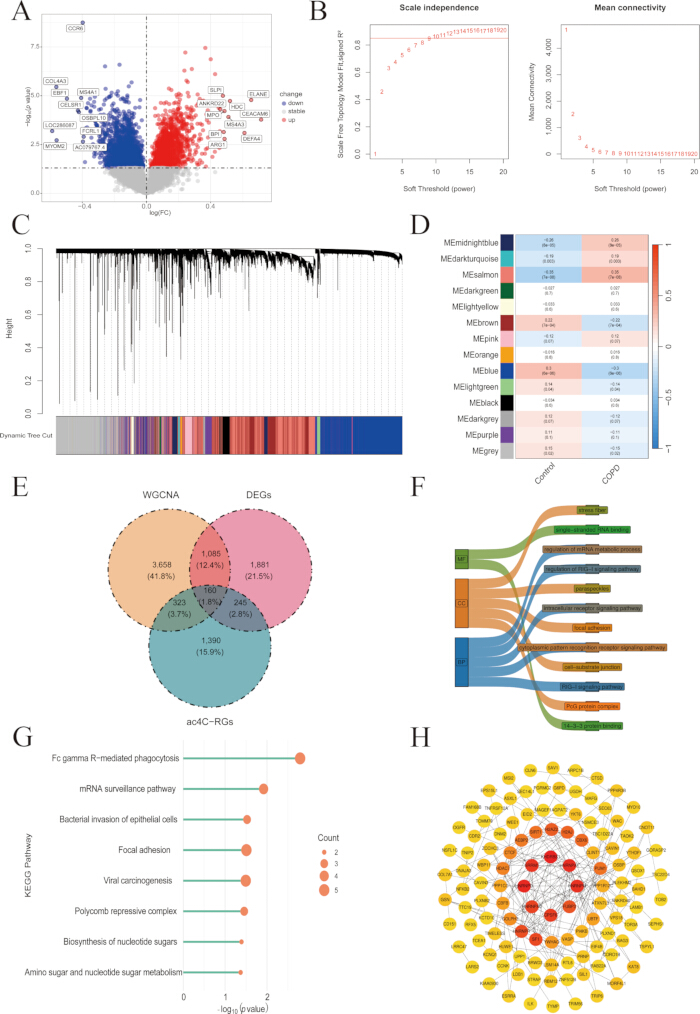
Figure 1 : Identification des gènes communs, analyse d'enrichissement et construction du réseau PPI. (A) Tracé volcanique des gènes différentiellement exprimés (DEGs) dans le jeu de données GSE54837. (B) Sélection du seuil doux. (C) Dendrogramme de regroupement des modules (après fusion). (D) Carte thermique de la corrélation entre les modules et les caractères. (E) Diagramme de Venn pour l'identification des gènes communs. (F) Diagramme en mûrier de l'analyse d'enrichissement GO, montrant les principaux résultats d'enrichissement des gènes d'intersection dans MF, CC et BP. (G) Diagramme en sucette de l'analyse d'enrichissement des voies de signalisation KEGG, la taille des bulles représentant le nombre de gènes enrichis. (H) Réseau PPI des gènes communs ; les nœuds représentent les protéines, et les arêtes représentent les interactions protéine-protéine. Abréviations : DEGs = gènes différentiellement exprimés ; PPI = interaction protéine-protéine ; GO = Ontologie génétique (Gene Ontology) ; MF = fonction moléculaire ; CC = composant cellulaire ; BP = processus biologique ; KEGG = Encyclopédie de Kyoto des gènes et des génomes (Kyoto Encyclopedia of Genes and Genomes) ; ac4C-RGs = gènes liés à la N4-acétylcytidine. Veuillez cliquer ici pour visualiser une version agrandie de cette figure.
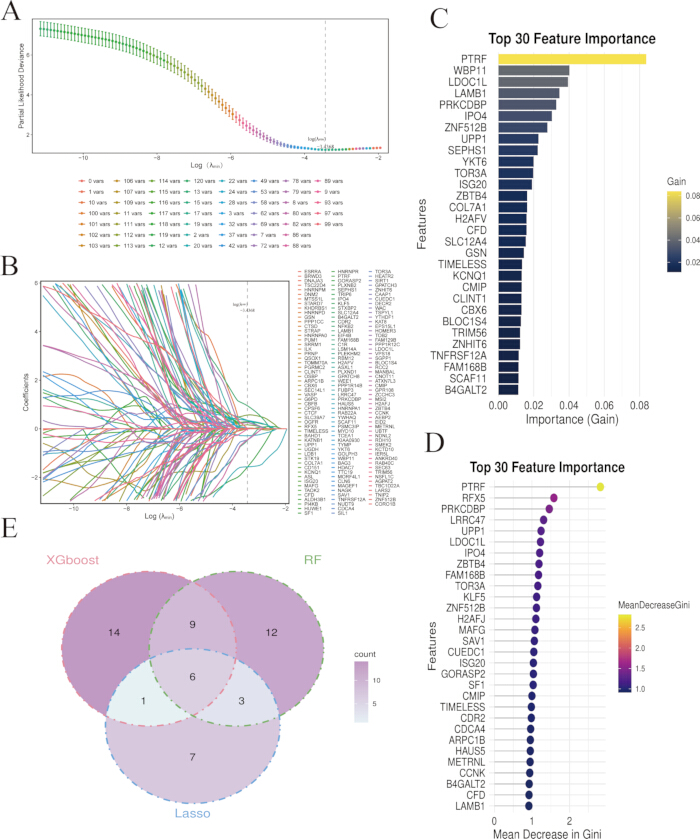
Figure 2 : Identification de six gènes clés dans la BPCO. (A) Courbe de validation croisée LASSO. (B) Diagramme du chemin des coefficients de régression LASSO. À mesure que λ augmente, les coefficients des gènes non importants convergent vers 0. (C) Classement de l'importance des caractéristiques selon XGBoost. L'axe des abscisses représente la valeur de gain, l'axe des ordonnées représente le nom du gène, et l'intensité de la couleur représente l'importance. (D) Classement de l'importance des caractéristiques selon RF. L'axe des abscisses représente la diminution moyenne de l'indice de Gini. (E) Diagramme de Venn des gènes communs obtenus par analyse croisée des trois algorithmes. Abréviations : LASSO = opérateur de réduction et de sélection par valeur absolue minimale ; XGBoost = boosting par gradient extrême ; RF = forêt aléatoire. Veuillez cliquer ici pour afficher une version agrandie de cette figure.
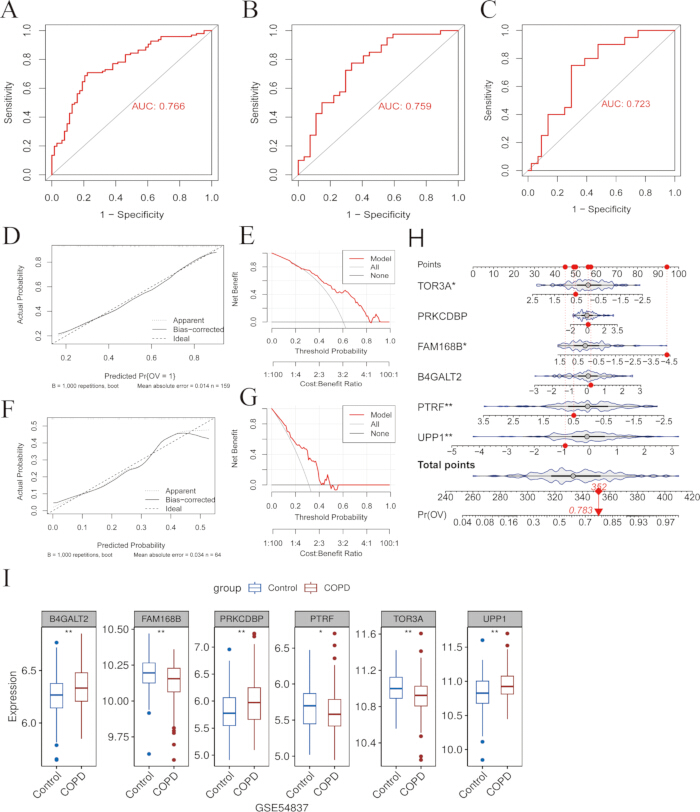
Figure 3 : Construction d'un modèle diagnostique et analyse d'expression des gènes clés. (A) Courbe ROC du jeu d'apprentissage. (B) Courbe ROC du jeu de test interne. (C) Courbe ROC du jeu de validation externe. (D) Courbe de calibration du jeu d'apprentissage. (E) Analyse de courbe de décision (DCA) du jeu d'apprentissage. (F) Courbe de calibration du jeu de validation externe. (G) Analyse de courbe de décision (DCA) du jeu de validation externe. (H) Nomogramme des six gènes clés. Pour la prédiction du risque individuel de BPCO, chaque gène se voit attribuer un score correspondant. (I) Analyse d'expression des six gènes clés dans les échantillons de BPCO et les échantillons témoins du jeu de données GSE54837. Abréviations : ROC = caractéristique de fonctionnement du récepteur ; AUC = aire sous la courbe ; DCA = analyse de courbe de décision ; BPCO = maladie pulmonaire obstructive chronique. Veuillez cliquer ici pour visualiser une version agrandie de cette figure.
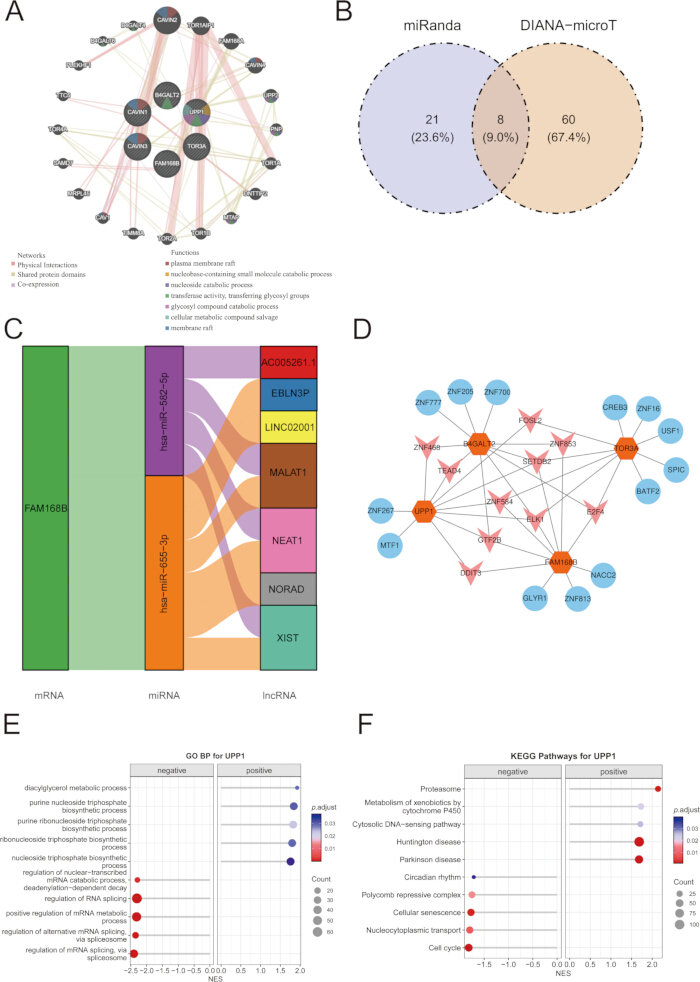
Figure 4 : Réseau régulateur et signification fonctionnelle des gènes clés dans la BPCO. (A) Résultats de l'analyse GeneMANIA pour 6 gènes clés. La couleur des lignes indique la corrélation entre les gènes, et la couleur des nœuds indique différentes catégories fonctionnelles. (B) Diagramme de Venn d'analyse croisée des bases de données DIANA-microT et miRanda. (C) Diagramme de mûrier du réseau régulateur ceRNA. (D) Réseau régulateur potentiel des facteurs de transcription. Les nœuds bleus représentent les facteurs de transcription, et les nœuds oranges représentent les gènes cibles. (E) Analyse d'enrichissement GSEA à gène unique pour UPP1, incluant GO. (F) Analyse d'enrichissement GSEA à gène unique pour UPP1, incluant KEGG. Abréviations : GO = Gene Ontology ; KEGG = Kyoto Encyclopedia of Genes and Genomes. Veuillez cliquer ici pour visualiser une version agrandie de cette figure.
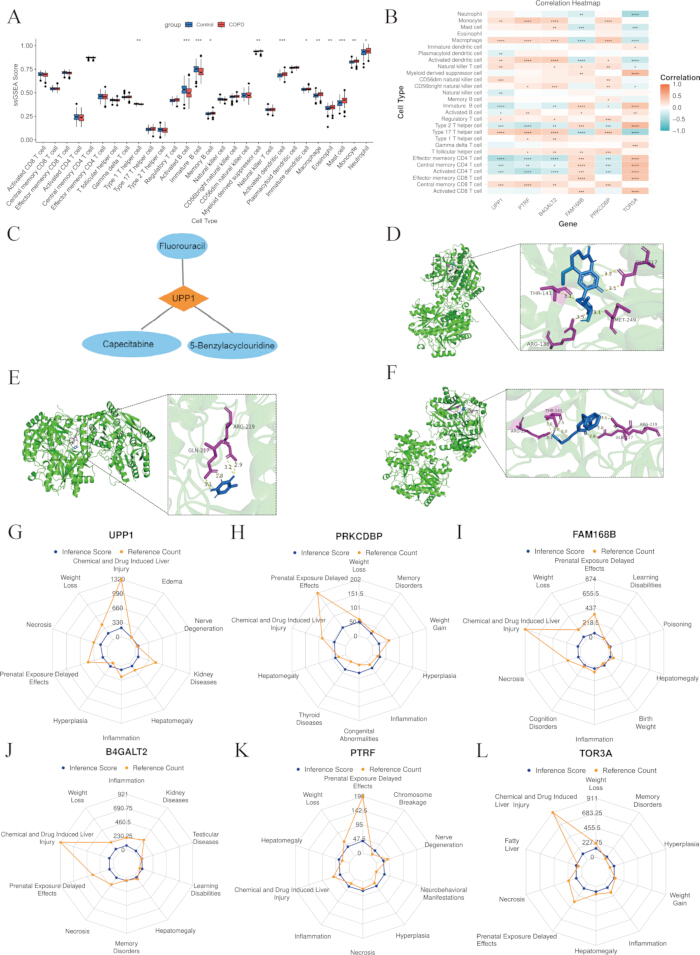
Figure 5 : Infiltration immunitaire des gènes clés et prédiction de cibles médicamenteuses dans la BPCO. (A) Différences d'abondance des cellules immunitaires entre les groupes. (B) Carte thermique de la corrélation entre les cellules immunitaires et les gènes clés. (C) Réseau d'interaction entre les gènes clés et les médicaments prédits. (D) Docking moléculaire de la fluorouracile avec UPP1. (E) Docking moléculaire de la capécitabine avec UPP1. (F) Docking moléculaire du 5-benzylacyclouridine avec UPP1. Pour chaque composé, l'image de gauche montre la conformation globale du docking, et l'image de droite montre les interactions locales de liaison. (G) Analyse CTD de B4GALT2. (H) Analyse CTD de FAM168B. (I) Analyse CTD de PRKCDBP. (J) Analyse CTD de PTRF. (K) Analyse CTD de TOR3A. (L) Analyse CTD de UPP1. Veuillez cliquer ici pour visualiser une version agrandie de cette figure.
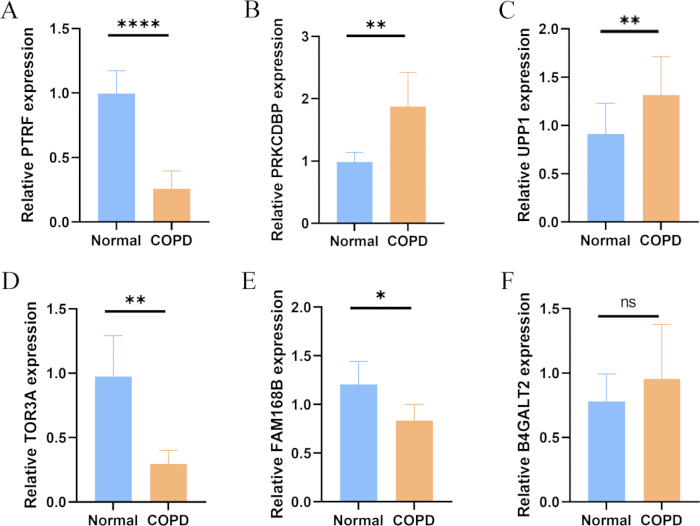
Figure 6 : Validation par RT-qPCR de l'expression de gènes clés dans des échantillons de MPOC et des échantillons témoins. (A) Expression relative de PTRF. (B) Expression relative de PRKCDBP. (C) Expression relative de UPP1. (D) Expression relative de TOR3A. (E) Expression relative de FAM168B. (F) Expression relative de B4GALT2. ns = non significatif, p > 0,05 ; * p < 0,05 ; ** p < 0,01 ; *** p < 0,001 ; **** p < 0,0001. Abréviation : RT-qPCR = réaction de transcription inverse suivie d'une amplification quantitative par polymérase en chaîne. Veuillez cliquer ici pour visualiser une version agrandie de cette figure.
Figure supplémentaire 1 : Échantillons du jeu de données GSE54837 et regroupement en modules géniques. (A) Diagramme de regroupement des échantillons du jeu de données GSE54837. (B) Dendrogramme de regroupement des modules avant fusion. Les gènes ont été regroupés à l'aide de la méthode de coupe dynamique de l'arbre afin d'identifier des modules distincts. (C) Dendrogramme de regroupement hiérarchique des eigengènes des modules. Les modules présentant des profils d'expression similaires ont été regroupés en fonction de la similarité de leurs eigengènes.Veuillez cliquer ici pour télécharger ce fichier.
Figure supplémentaire 2 : Analyse d'enrichissement GSEA. (A) Analyse GO de PRKCDBP. (B) Analyse KEGG de PRKCDBP. (C) Analyse GO de PTRF. (D) Analyse KEGG de PTRF. (E) Analyse GO de TOR3A. (F) Analyse KEGG de TOR3A. (G) Analyse GO de FAM168B. (H) Analyse KEGG de FAM168B. (I) Analyse GO de B4GALT2. (J) Analyse KEGG de B4GALT2. Abréviations : GO = ontologie génétique ; KEGG = Encyclopédie de Kyoto des gènes et des génomes.Veuillez cliquer ici pour télécharger ce fichier.
| Jeu de données | Témoins | Patients | Plateforme de séquençage |
| GSE54837 | 90 | 136 | GPL570 |
| GSE112811 | 44 | 20 | GPL570 |
Tableau 1 : Jeux de données d'expression génique utilisés dans l'étude. Caractéristiques des jeux de données GSE54837 et GSE112811 utilisés respectivement pour le développement du modèle/test interne et la validation externe.
| Patiente | 1 | 2 | 3 | 4 | 5 | 6 | 7 | 8 |
| Sexe (F/M) | M | M | M | F | M | M | M | M |
| Âge (années) | 69 | 72 | 75 | 73 | 68 | 70 | 69 | 71 |
| Statut tabagique | Oui | Oui | Arrêt du tabac (2 ans) | Non | Oui | Oui | Oui | Arrêt du tabac (5 ans) |
| Paquets-années | 20 par jour / 30 ans | 15 par jour / 35 ans | 20 par jour / 50 ans | 20 par jour / 40 ans | 30 par jour / 40 ans | 15 par jour / 40 ans | 20 par jour / 30 ans | |
| Groupe BPCO | 2 | 3 | 3 | 2 | 2 | 3 | 2 | 3 |
Tableau 2 : Caractéristiques de base des participants à l'étude. Caractéristiques démographiques et cliniques de base des patients BPCO et des témoins sains inclus dans la validation par RT-qPCR.
| Nom moléculaire | Gène | Score (kcal/mol) |
| 5-Benzylacyclouridine | UPP1 | -9.6 |
| Capecitabine | UPP1 | -6.1 |
| Fluorouracile | UPP1 | -5.5 |
Tableau 3 : Résultats de docking moléculaire pour UPP1 et les composés candidats.
Résultats prévus de docking moléculaire concernant l'interaction entre UPP1 et le fluorouracile, la capécitabine et la 5-benzylacyclouridine, incluant leurs affinités de liaison.
Discussion
La modification ARN conservée ac4C, qui se produit principalement dans l'ARN messager (ARNm) et l'ARN de transfert (ARNt), augmente la stabilité de l'ARNm et l'efficacité de traduction20. NAT10 est la seule acétyltransférase ARN connue qui médie la modification ac4C21. Des études ont montré que NAT10 est surexprimé dans les cellules épithéliales pulmonaires des patients atteints de BPCO. L'extinction partielle de NAT10 perturbe la fonction mitochondriale et les réponses transcriptomiques22. Sur la base d'une analyse intégrée multi-omique, cette étude a identifié six gènes clés étroitement associés à la BPCO et a élaboré un modèle diagnostique, qui a montré une performance diagnostique modérée et une valeur potentielle pour des recherches ultérieures. Une analyse supplémentaire a révélé les rôles essentiels de ces gènes dans la régulation transcriptionnelle, les réseaux ceARN et le microenvironnement immunitaire. En outre, des médicaments ciblés potentiels ont été prédits, offrant des perspectives sur la pathogenèse de la BPCO et facilitant le développement de stratégies de traitement personnalisées et précises. Nous avons identifié des gènes à la fois différentiellement exprimés dans la BPCO et présents dans une liste de gènes liés à l'ac4C publiée précédemment, à l'aide de l'analyse WGCNA et de l'analyse d'expression différentielle. Il est important de noter que ces gènes ont été sélectionnés en fonction de leur association avec le réseau régulateur de l'ac4C, et non sur la base de liens mécanistiques prouvés avec NAT10 ou l'acétylation ac4C, ce qui a permis d'obtenir un total de 160 gènes candidats. Six gènes clés (PTRF, PRKCDBP, UPP1, TOR3A, FAM168B et B4GALT2) ont été identifiés à l'aide d'algorithmes d'apprentissage automatique. Parmi eux, PTRF joue un rôle essentiel dans l'inflammation des voies respiratoires induite par les acariens de la poussière domestique (HDM) en régulant la nécroptose des macrophages médiée par IL-33-ZBP1, suggérant qu'il pourrait être impliqué dans des affections pulmonaires inflammatoires chroniques telles que la BPCO23. Lai et al.24 ont démontré qu'une administration exogène d'uridine inhibe la ferroptose des macrophages via la voie Nrf2/SLC7A11/GPX4, atténuant ainsi les lésions pulmonaires aiguës causées par la septicémie. Bien qu'une surexpression de UPP1, une enzyme clé du métabolisme de l'uridine, ait été observée dans le tissu pulmonaire de modèles de lésion pulmonaire aiguë, son rôle exact — et que cette surexpression représente une réponse protectrice ou une conséquence des lésions tissulaires — reste à élucider davantage. Toutefois, cette découverte suggère que UPP1 pourrait avoir une association potentielle avec les processus physiopathologiques des maladies pulmonaires inflammatoires telles que la BPCO, justifiant des recherches complémentaires. Les quatre autres gènes clés ont été moins étudiés dans les affections pulmonaires, mais en se basant sur leurs fonctions dans d'autres maladies et sur nos résultats actuels, nous émettons l'hypothèse de voies potentielles par lesquelles ils pourraient contribuer à la pathogenèse de la BPCO.
À partir des six gènes clés, nous avons construit un modèle diagnostique de la BPCO et validé sa bonne performance prédictive. L'analyse d'expression a montré que UPP1, B4GALT2 et PRKCDBP étaient significativement surexprimés, tandis que FAM168B, PTRF et TOR3A étaient fortement sous-exprimés dans la BPCO. Bien que B4GALT2 ait été identifié comme surexprimé lors de l'analyse des jeux de données, aucune différence significative n'a été observée lors de la validation par RT-qPCR. Ce désaccord pourrait être attribué à la taille limitée de l'échantillon, à l'hétérogénéité de la cohorte et aux différences de sources d'échantillons entre les jeux de données publics et les échantillons sanguins cliniques. L'analyse d'enrichissement des gènes a révélé que ces gènes clés étaient significativement enrichis dans l'épissage de l'ARN et le traitement des ARNm, ainsi que dans des voies telles que le cycle cellulaire et la dépendance à la nicotine. L'arrêt irréversible du cycle cellulaire est reconnu comme un mécanisme principal sous-jacent au vieillissement cellulaire, ce qui pourrait contribuer de façon importante à la physiopathologie de la BPCO25,26. Une analyse supplémentaire a indiqué que le phénotype sécrétoire associé au vieillissement (SASP) induit par des lésions de l'ADN pourrait favoriser la progression persistante de la BPCO en maintenant une inflammation chronique et en aggravant les lésions du tissu pulmonaire27. Une étude antérieure a également passé en revue les liens génétiques sous-jacents à la dépendance à la nicotine et à la BPCO28. Bien que le tabagisme soit le facteur de risque principal de la BPCO, seul un faible pourcentage de fumeurs développe cette maladie, suggérant que des facteurs génétiques jouent un rôle important à la fois dans la BPCO et la dépendance à la nicotine. Liu et al.29 ont résumé les rôles des protéines liant l'ARN (RBPs) dans la BPCO et l'hypertension pulmonaire (PH), soulignant leur implication dans le remodelage vasculaire pulmonaire et les réponses inflammatoires par la régulation de l'épissage de l'ARNm et de l'expression génique post-transcriptionnelle, mettant ainsi en évidence leur potentiel comme biomarqueurs et cibles thérapeutiques. En résumé, les gènes clés et les voies associées identifiés dans cette étude approfondissent non seulement notre compréhension de la pathogenèse de la BPCO, mais fournissent également une base solide pour le développement de biomarqueurs diagnostiques et de stratégies thérapeutiques ciblées à l'avenir.
Le réseau ARN compétitif (ceRNA) implique diverses espèces d'ARN, notamment des ARNlnc, des ARNcirc et des ARNm, qui se lient de manière compétitive à des ARNmi partagés, établissant ainsi des relations régulatrices mutuelles et influençant l'expression des gènes30. Ce réseau complexe participe à de nombreux processus physiologiques et pathologiques et contribue à l'élucidation des mécanismes régulateurs des gènes ainsi que de la pathogenèse de maladies telles que le cancer et les troubles inflammatoires chroniques. Par exemple, Wang et al. ont construit un réseau de coexpression ceRNA composé de 11 ARNlnc, cinq ARNmi et 16 ARNm, dont le sous-réseau central était associé à des modifications des proportions de cellules immunitaires et de la fonction pulmonaire dans la BPCO31. De même, Zhang et al.32 ont mis au point un réseau régulateur circRNA-miRNA-mRNA basé sur des cellules mononucléées du sang périphérique de fumeurs de sexe masculin, identifiant des ARNcirc dysrégulés et des voies clés liées à la BPCO. Notre analyse de réseau de coexpression a révélé que les gènes clés établissaient principalement des connexions fonctionnelles par des interactions physiques, une coexpression et des domaines protéiques partagés, et étaient significativement enrichis dans plusieurs voies liées au métabolisme. Sur la base de ces résultats, nous avons construit un réseau régulateur facteur de transcription (TF)-gène cible et un axe régulateur ARNmi-ARNlnc-ARNm. Ces résultats suggèrent que les gènes clés pourraient être régulés de manière coopérative par des mécanismes multinationaux impliquant des ARNlnc, des facteurs de transcription et des ARNmi dans la BPCO.
L'infiltration immunitaire reflète l'état immunitaire en indiquant la distribution et l'activité des cellules immunitaires au sein des tissus ou du sang. Sur cette base, des médicaments candidats potentiels ont été prédits à l'aide d'un criblage computationnel, suivi de simulations d'ancrage moléculaire afin d'évaluer l'affinité de liaison et la stabilité avec les protéines cibles. Ensemble, ces analyses facilitent l'identification de nouveaux agents thérapeutiques et fournissent des éclairages approfondis sur les mécanismes des maladies. Dans cette étude, six gènes clés étaient positivement corrélés à la majorité des infiltrations de cellules immunitaires. La prédiction de médicaments a révélé des interactions potentielles entre UPP1 et la fluorouracile, la capécitabine et la 5-benzylacyclouridine, cette dernière présentant l'affinité de liaison la plus élevée, comme confirmé ultérieurement par l'ancrage moléculaire. Notamment, la fluorouracile et la capécitabine sont principalement utilisées comme agents antitumoraux et ont été identifiées dans cette étude comme des composés interagissant avec UPP1 prédits par base de données, et non comme des options thérapeutiques validées pour la BPCO. Des études antérieures ont rapporté qu'une administration locale de fluorouracile pourrait améliorer la perméabilité des voies respiratoires en cas d'obstruction sévère33. Toutefois, d'autres données indiquent que la fluorouracile et la capécitabine pourraient induire une toxicité pulmonaire, particulièrement chez les patients présentant des affections pulmonaires préexistantes34. Par conséquent, leur pertinence potentielle dans la BPCO nécessite des vérifications expérimentales et toxicologiques supplémentaires. De plus, l'analyse CTD a indiqué que les six gènes clés étaient associés à de nombreux processus pathologiques. Dans leur ensemble, l'analyse intégrée de l'infiltration immunitaire, de la prédiction de médicaments et de l'ancrage moléculaire fournit de nouvelles cibles moléculaires et une base théorique pour le traitement précis de la BPCO, favorisant ainsi le développement et la traduction clinique de médicaments associés.
Néanmoins, plusieurs limites doivent être reconnues. L'étude s'est appuyée sur des jeux de données publics aux sources d'échantillons relativement restreintes, ce qui pourrait introduire des effets de lot et un surajustement potentiel du modèle. La validation par RT-qPCR a été réalisée sur un petit groupe, et l'incohérence observée dans l'expression de B4GALT2 suggère une possible hétérogénéité du groupe. De plus, les analyses de l'infiltration immunitaire et de la prédiction de médicaments étaient de nature computationnelle et nécessitent une validation expérimentale supplémentaire. En outre, en tant qu'enquête bioinformatique de phase de découverte, notre modèle diagnostique a été principalement évalué à l'aide de valeurs d'AUC avec des intervalles de confiance à 95 %. Des métriques de performance complètes, telles que la sensibilité, la spécificité, les valeurs prédictives et des statistiques de calibration détaillées, n'ont pas été entièrement évaluées en raison de la nature rétrospective des jeux de données publics et de la taille limitée des échantillons. Par conséquent, notre modèle doit être considéré comme un outil de preuve de concept, et son utilité clinique nécessite une validation supplémentaire dans des cohortes prospectives plus larges.
Grâce à des analyses intégratives de bioinformatique et d'apprentissage automatique, cette étude a identifié six gènes clés fortement associés à la BPCO. Un modèle diagnostique robuste a été établi, démontrant une performance prédictive fiable dans plusieurs cohortes. Des analyses fonctionnelles ont révélé que ces gènes participent à des réseaux régulateurs essentiels impliquant la régulation transcriptionnelle et post-transcriptionnelle, l'infiltration des cellules immunitaires, ainsi que des voies liées à la dépendance à la nicotine et au cycle cellulaire. Des analyses de prédiction thérapeutique et de docking moléculaire ont mis en évidence UPP1 comme cible thérapeutique prometteuse, plusieurs composés candidats présentant de fortes affinités de liaison. Dans l'ensemble, ces résultats approfondissent notre compréhension de la physiopathologie de la BPCO et offrent des cibles moléculaires précieuses pour le développement futur de traitements et de stratégies de médecine personnalisée.
Déclarations de divulgation
Les auteurs déclarent qu'ils n'ont aucun conflit d'intérêts. Le consentement éclairé a été obtenu de la part de tous les sujets ayant participé à l'étude.
Remerciements
Nous remercions l'hôpital de médecine traditionnelle chinoise de Luohu à Shenzhen de nous avoir fourni les installations cliniques et le soutien administratif essentiels à cette étude. Enfin, nous sommes reconnaissants envers tous les patients et les volontaires sains qui ont participé à cette recherche ; leur contribution a été indispensable à ce travail. Ce travail a été soutenu par le projet Sanming de médecine à Shenzhen (n° SZZYSM202401018), les fonds des spécialités prioritaires du district de Luohu (n° LX202402021) et les fonds des spécialités prioritaires du district de Luohu (n° LX202302064).
Matériaux
| Nom | Entreprise | Numéro de catalogue | Commentaires |
|---|---|---|---|
| β-actine amorces | Tsingke | N/A | Sens direct : 5’-CATGTACGTTGCTATCCAGGC-3’ Sens inverse : 5’-CTCCTTAATGTCACGCACGAT-3’ |
| Amorces B4GALT2 | Tsingke | N/A | Sens direct : 5’-GGGCAGACTGCTGATCGAG-3’ Sens inverse : 5’-CCGGTGTCTAAAGGGGATGAT-3’ |
| CB-Dock2 | LabShare | En ligne | Docking moléculaire |
| clusterProfiler | Bioconductor | v4.14.6 | Analyse d'enrichissement |
| Cytoscape | Cytoscape Consortium | v3.8.3 | Visualisation de réseaux |
| DrugBank | University of Alberta | En ligne | Prédiction de médicaments |
| Amorces FAM168B | Tsingke | N/A | Sens direct : 5’-TCTGGGGTTCCCTATGCAAAT-3’ Sens inverse : 5’-GTAGGATTCGCTCCAGGATACA-3’ |
| glmnet | CRAN | v4.1 | Régression LASSO |
| GSVA | Bioconductor | v1.52.3 | Analyse ssGSEA |
| Hifair III 1st Strand cDNA Synthesis Supermix | YEASEN | 11141ES | Synthèse d'ADN complémentaire |
| Hieff RTPCR SYBR Green Master Mix | YEASEN | 11201ES | Amplification qPCR |
| limma | Bioconductor | v3.54.0 | Expression différentielle |
| LightCycler 480 II System | Roche | LightCycler 480 II | PCR en temps réel |
| Amorces PTRF | Tsingke | N/A | Sens direct : 5’-GGGCCGTAGACCAGATCCA-3’ Sens inverse : 5’-CTTGCTCACCGTATTGCTCGT-3’ |
| Amorces PRKCDBP | Tsingke | N/A | Sens direct : 5’-CACGTTCTGCTCTTCAAGGAG-3’ Sens inverse : 5’-TGTACCTTCTGCAATCCGGTG-3’ |
| Logiciel R | R Foundation | v4.4.2 | Informatique statistique |
| randomForest | CRAN | v4.7 | Forêt aléatoire |
| Kit RNA isolater MolPure Blood RNA | YEASEN | 19241ES50 | Extraction d'ARN |
| Base de données STRING | EMBL | En ligne | Réseau PPI |
| Amorces TOR3A | Tsingke | N/A | Sens direct : 5’-CCCTTGCTCTGTCGTTCCAC-3’ Sens inverse : 5’-CCCGTCCCGATACAGGTTC-3’ |
| Amorces UPP1 | Tsingke | N/A | Sens direct : 5’-CTGTCAGTCATGGTATGGGCA-3’ Sens inverse : 5’-GAGCACCGGGCATAGTACA-3’ |
| WGCNA | CRAN | v1.72 | Réseau de co-expression |
| xgboost | CRAN | v1.7 | Algorithme XGBoost |
Références
- Hogg JC. Pathophysiology of airflow limitation in chronic obstructive pulmonary disease. Lancet. 2004;364(9435):709-21.
- Baraldo S, Turato G, Saetta M. Pathophysiology of the small airways in chronic obstructive pulmonary disease. Respiration. 2012;84(2):89-97.
- Fischer BM, Pavlisko E, Voynow JA. Pathogenic triad in COPD: oxidative stress, protease-antiprotease imbalance, and inflammation. Int J Chron Obstruct Pulmon Dis. 2011;6:413-21.
- Pandey KC, De S, Mishra PK. Role of proteases in chronic obstructive pulmonary disease. Front Pharmacol. 2017;8:512.
- Wang L, Xie J, Hu Y, Tian Y. Air pollution and risk of chronic obstructed pulmonary disease: the modifying effect of genetic susceptibility and lifestyle. EBioMedicine. 2022;79:103994.
- Elonheimo HM, et al. Environmental substances associated with chronic obstructive pulmonary disease-a scoping review. Int J Environ Res Public Health. 2022;19(7):3945.
- Chen S, et al. The global economic burden of chronic obstructive pulmonary disease for 204 countries and territories in 2020-50: a health-augmented macroeconomic modelling study. Lancet Glob Health. 2023;11(8):e1183-e93.
- Rutten-van Mölken MP, et al. Costs and effects of inhaled corticosteroids and bronchodilators in asthma and chronic obstructive pulmonary disease. Am J Respir Crit Care Med. 1995;151(4):975-82.
- Ontiveros RJ, Stoute J, Liu KF. The chemical diversity of RNA modifications. Biochem J. 2019;476(8):1227-45.
- Roundtree IA, Evans ME, Pan T, He C. Dynamic RNA modifications in gene expression regulation. Cell. 2017;169(7):1187-200.
- Wang C, et al. RNA modification in cardiovascular disease: implications for therapeutic interventions. Signal Transduct Target Ther. 2023;8(1):412.
- Zhang W, et al. ac4C acetylation regulates mRNA stability and translation efficiency in osteosarcoma. Heliyon. 2023;9(6):e17103.
- Qiu L, Jing Q, Li Y, Han J. RNA modification: mechanisms and therapeutic targets. Mol Biomed. 2023;4(1):25.
- Luo J, Cao J, Chen C, Xie H. Emerging role of RNA acetylation modification ac4C in diseases: current advances and future challenges. Biochem Pharmacol. 2023;213:115628.
- Li H, et al. RNA cytidine acetyltransferase NAT10 maintains T cell pathogenicity in inflammatory bowel disease. Cell Discov. 2025;11(1):19.
- Wang JN, et al. NAT10 exacerbates acute renal inflammation by enhancing N4-acetylcytidine modification of the CCL2/CXCL1 axis. Proc Natl Acad Sci U S A. 2025;122(17):e2418409122.
- Shenshen W, et al. NAT10 accelerates pulmonary fibrosis through N4-acetylated TGFB1-initiated epithelial-to-mesenchymal transition upon ambient fine particulate matter exposure. Environ Pollut. 2023;322:121149.
- Liu J, et al. Unveiling ac4C modification pattern: a prospective target for improving the response to immunotherapeutic strategies in melanoma. J Transl Med. 2025;23(1):287.
- Su F, et al. Multimodal single-cell analyses outline the immune microenvironment and therapeutic effectors of interstitial cystitis/bladder pain syndrome. Adv Sci (Weinh). 2022;9(18):e2106063.
- Schiffers S, Oberdoerffer S. ac4C: a fragile modification with stabilizing functions in RNA metabolism. RNA. 2024;30(5):583-94.
- Jiao L, et al. Emerging role of N-acetyltransferase 10 in diseases: RNA ac4C modification and beyond. Mol Biomed. 2025;6(1):46.
- Zheng N, et al. Regulatory roles of NAT10 in airway epithelial cell function and metabolism in pathological conditions. Cell Biol Toxicol. 2023;39(4):1237-56.
- Du J, et al. PTRF-IL33-ZBP1 signaling mediating macrophage necroptosis contributes to HDM-induced airway inflammation. Cell Death Dis. 2023;14(7):432.
- Lai K, et al. Uridine alleviates sepsis-induced acute lung injury by inhibiting ferroptosis of macrophage. Int J Mol Sci. 2023;24(6):5093.
- Kumari R, Jat P. Mechanisms of cellular senescence: cell cycle arrest and senescence associated secretory phenotype. Front Cell Dev Biol. 2021;9:645593.
- Ogrodnik M, Salmonowicz H, Jurk D, Passos JF. Expansion and cell-cycle arrest: common denominators of cellular senescence. Trends Biochem Sci. 2019;44(12):996-1008.
- Kumar M, Seeger W, Voswinckel R. Senescence-associated secretory phenotype and its possible role in chronic obstructive pulmonary disease. Am J Respir Cell Mol Biol. 2014;51(3):323-33.
- Pérez-Rubio G, et al. Role of genetic susceptibility in nicotine addiction and chronic obstructive pulmonary disease. Rev Invest Clin. 2019;71(1):36-54.
- Liu Y, Wang R, Jiang T. RNA-binding proteins as a molecular link between COPD and pulmonary hypertension. Int J Med Sci. 2025;22(8):1979-91.
- Marques TM, Gama-Carvalho M. Network approaches to study endogenous RNA competition and its impact on tissue-specific microRNA functions. Biomolecules. 2022;12(2):332.
- Wang J, Xia B, Ma R, Ye Q. Comprehensive analysis of a competing endogenous RNA co-expression network in chronic obstructive pulmonary disease. Int J Chron Obstruct Pulmon Dis. 2023;18:2417-29.
- Zhang J, et al. Construction of a ceRNA network and screening of potential biomarkers and molecular targets in male smokers with chronic obstructive pulmonary disease. Front Genet. 2024;15:1376721.
- Celikoğlu F, Celikoğlu SI. Intratumoural chemotherapy with 5-fluorouracil for palliation of bronchial cancer in patients with severe airway obstruction. J Pharm Pharmacol. 2003;55(10):1441-8.
- Chan AK, Choo BA, Glaholm J. Pulmonary toxicity with oxaliplatin and capecitabine/5-fluorouracil chemotherapy: a case report and review of the literature. Onkologie. 2011;34(8-9):443-6.