Ce protocole intègre des données transcriptomiques multidimensionnelles avec l'apprentissage automatique afin d'identifier des gènes liés au vieillissement et aux mitochondries dans la cardiomyopathie dilatée, pour la découverte de biomarqueurs et le sous-typage moléculaire.
Article de recherche
Identification des gènes pivots liés au vieillissement et aux mitochondries dans la cardiomyopathie dilatée
Dans cet article
Résumé
Résumé
La cardiomyopathie dilatée (DCM) se caractérise par une dilatation du ventricule gauche et une dysfonction systolique, et est associée à un dysfonctionnement mitochondrial ainsi qu'à une activation immuno-inflammatoire. Toutefois, les signatures moléculaires liées au vieillissement et les voies régulatrices mitochondriales dans la DCM restent incomplètement comprises. Cette étude a analysé six jeux de données transcriptomiques en masse et un jeu de données de séquençage ARN unicellulaire provenant de la base de données Gene Expression Omnibus. Après normalisation des données, correction par lot et annotation des types cellulaires, les gènes candidats liés au vieillissement et aux mitochondries ont été identifiés à l’aide d’une analyse d’expression différentielle, d’une analyse de réseau de co-expression génique pondéré et de la construction d’un réseau d’interactions protéine-protéine. Les gènes centraux ont été sélectionnés davantage à l’aide d’une régression par l’opérateur de réduction et de sélection absolue minimale (LASSO), d’une forêt aléatoire et d’une élimination récursive de caractéristiques par machine à vecteurs de support. Des analyses d’infiltration des cellules immunitaires, de communication intercellulaire et de sous-typage moléculaire ont été réalisées afin de caractériser le microenvironnement immunitaire cardiaque dans la DCM. Un total de 66 gènes liés au vieillissement et de 16 gènes liés aux mitochondries ont été associés à la DCM et étaient principalement enrichis dans les voies de signalisation du facteur inductible par l’hypoxie-1, la phosphorylation oxydative et les voies liées à la synthase de l’oxyde nitrique. Des analyses par apprentissage automatique et par séquençage ARN unicellulaire ont identifié SERPINE1, TGFB2, CYBB et TLR2 comme gènes centraux. CYBB et TLR2 étaient fortement exprimés dans les monocytes et les macrophages, tandis que SERPINE1 et TGFB2 étaient principalement exprimés dans les cellules stromales. L’analyse du paysage immunitaire a révélé une activation accrue des macrophages pro-inflammatoires et une communication intercellulaire altérée dans les échantillons de DCM. Sur la base de l’expression des gènes centraux, les échantillons de DCM ont été divisés en deux sous-types moléculaires associés respectivement à la signalisation du facteur de croissance endothélial vasculaire et à la biosynthèse des acides biliaires primaires. Ce protocole fournit un cadre intégré pour l’identification de biomarqueurs candidats et de sous-types moléculaires dans la DCM.
Introduction
La cardiomyopathie dilatée (DCM) est un trouble myocardique caractérisé par une dilatation du ventricule gauche et une altération de la fonction systolique. Elle est la troisième cause la plus fréquente d'insuffisance cardiaque et l'indication principale de transplantation cardiaque dans le monde entier1. Des études basées sur des populations estiment une prévalence d'environ 1 cas pour 250 adultes, avec une prévalence plus élevée chez les hommes et une proportion importante de cas attribuable à des variants monogéniques2. Ces résultats indiquent que la susceptibilité génétique et les facteurs environnementaux contribuent tous deux à l'apparition et à la progression de la DCM.
La pathogenèse de la MDC implique des processus interconnectés, notamment l'activation inflammatoire, le stress oxydatif, l'apoptose des cardiomyocytes et une signalisation profibrotique dysrégulée. Des polymorphismes génétiques inflammatoires, notamment des variants du promoteur du facteur de nécrose tumorale-α, ont été associés à la susceptibilité à la MDC d'origine virale3. Une augmentation du stress oxydatif a également été associée à la mort des cardiomyocytes et à un dysfonctionnement du ventricule gauche dans différents sous-types humains de MDC4. De plus, une activation anormale des voies de signalisation Wnt/β-caténine et calcineurine/facteur nucléaire des lymphocytes T activés favorise l'hypertrophie myocardique et la fibrose interstitielle, contribuant ainsi à la progression de la maladie5,6. Le dysfonctionnement mitochondrial constitue un autre élément important de la MDC, car les cardiomyocytes ont des besoins énergétiques élevés. L'altération de la biogenèse mitochondriale, de l'homéostasie calcique, de la mitophagie et de l'intégrité de l'ADN mitochondrial peut compromettre la phosphorylation oxydative et contribuer à un dysfonctionnement cardiaque progressif7,8,9,10.
Malgré ces découvertes mécanistiques, des lacunes importantes subsistent dans les connaissances. En particulier, les relations temporelles et causales entre le remodelage structural des mitochondries et le dysfonctionnement bioénergétique durant l'initiation et la progression de la cardiomyopathie dilatée (DCM) n'ont pas été entièrement définies11. Plusieurs stratégies thérapeutiques ont été étudiées. La thérapie par cellules souches a montré un potentiel régénératif grâce à des effets paracrines, cytoprotecteurs et immunomodulateurs, mais l'optimisation des sources cellulaires, des voies d'administration et de la survie post-greffe reste nécessaire12. Les approches de thérapie génique, notamment la livraison basée sur le virus adéno-associé et l'édition du génome basée sur les répétitions palindromiques courtes régulièrement espacées en palindromes (CRISPR), offrent également des stratégies de traitement ciblé prometteuses. Toutefois, des limites liées à la tropisme cardiaque, à l'immunogénicité des vecteurs et à la sécurité à long terme restent à résoudre13.
Les jeux de données transcriptomiques publics provenant de référentiels tels que le Gene Expression Omnibus (GEO) sont largement utilisés pour la découverte de biomarqueurs dans la MCD. Ces ressources offrent un accès à des cohortes cliniques multicentriques, permettent des investigations rentables et reproductibles, et peuvent améliorer la puissance statistique grâce à l'intégration croisée des jeux de données14. Le profilage transcriptomique permet également le criblage de gènes candidats à l'échelle du génome, le sous-typage moléculaire et l'analyse au niveau des voies biologiques15. Toutefois, les jeux de données publics présentent des limites inhérentes, notamment des effets techniques liés aux lots, une hétérogénéité clinique et étiologique, une capacité limitée à établir des inférences causales, ainsi qu'une information longitudinale ou pronostique incomplète16. Par conséquent, les résultats obtenus à partir de jeux de données transcriptomiques publics conviennent surtout à la génération d'hypothèses et à la priorisation de biomarqueurs candidats, et nécessitent une validation dans des cohortes indépendantes et des modèles expérimentaux.
De nombreuses études bioinformatiques sur la MDC reposent principalement sur l'analyse de l'expression différentielle, méthode qui peut produire des résultats faussement positifs et ne caractérise pas pleinement les réseaux de co-expression génique ni l'hétérogénéité cellulaire au sein du tissu cardiaque. Pour pallier ces limites, la présente étude a mis en œuvre une stratégie analytique intégrée combinant des méthodes complémentaires. L'analyse transcriptomique globale fournit des profils d'expression au niveau tissulaire, adaptés aux comparaisons cas-témoins. L'analyse par réseau pondéré de co-expression génique (WGCNA) permet d'identifier des modules de gènes associés à des caractéristiques phénotypiques et de hiérarchiser des ensembles de gènes fonctionnellement liés plutôt que des gènes individuellement différentiellement exprimés. L'analyse du réseau d'interactions protéine-protéine (PPI) permet d'identifier les gènes fortement connectés en se basant sur la topologie du réseau. Trois algorithmes d'apprentissage automatique — la régression par sélection et contraction absolue minimale (LASSO), la forêt aléatoire et la machine à vecteurs de support avec élimination récursive des caractéristiques — ont été utilisés pour identifier des biomarqueurs candidats parmi les jeux de données intégrés¹⁷. Le séquençage de l'ARN à l'échelle de la cellule unique (scRNA-seq) a ensuite été utilisé pour examiner les profils d'expression spécifiques aux types cellulaires ainsi que les réseaux de communication intercellulaire18.
Bien que les dysfonctionnements mitochondriaux et les modifications moléculaires liées au vieillissement aient chacun été étudiés dans la cardiomyopathie dilatée (DCM), leurs associations combinées avec les modifications transcriptionnelles liées à la maladie restent insuffisamment explorées. La présente étude a intégré plusieurs jeux de données transcriptomiques en masse et en scRNA-seq afin d'identifier des gènes centraux liés au vieillissement et aux mitochondries dans la DCM, de caractériser le microenvironnement immunitaire cardiaque et d'analyser des sous-types moléculaires basés sur les gènes identifiés. Cette approche intégrée a permis de hiérarchiser des biomarqueurs candidats et de fournir une base pour des études mécanistiques et de validation ultérieures.
Protocole
Toutes les procédures animales ont été examinées et approuvées par le Comité d'éthique des animaux de laboratoire du Deuxième Hôpital Affilié de l'Université de médecine chinoise du Henan (n° d'approbation : HNSZYYYJS2023011150). Toutes les procédures ont été réalisées conformément aux Lignes directrices pour l'évaluation éthique du bien-être des animaux de laboratoire (GB/T 35892-2018) et aux principes 3R de substitution, réduction et raffinement. Les réactifs, bases de données, logiciels et équipements utilisés dans cette étude sont répertoriés dans le Tableau des matériaux.
1. Ressources de données et matériaux expérimentaux
Des souris transgéniques mâles CTNTR141W de qualité SPF, présentant un phénotype de cardiomyopathie dilatée spontanée (DCM) et un poids corporel de 25 ± 2 g, ont été utilisées comme groupe modèle. Des souris mâles C57BL/6J de qualité SPF, appariées par âge, avec un poids corporel de 25 ± 2 g, ont été utilisées comme groupe témoin. Chaque groupe comprenait 12 souris. Tous les animaux provenaient d'institutions titulaires de licences valides de production d'animaux de laboratoire et étaient élevés dans un environnement à barrière de qualité SPF à 22 ± 2 °C et une humidité relative de 40 % à 60 %, sous un cycle lumière/obscurité de 12 h, avec un accès libre à de la nourriture et de l'eau stériles. Après une semaine d'acclimatation, toutes les souris ont été maintenues dans les mêmes conditions pendant 4 semaines supplémentaires avant l'évaluation de la fonction cardiaque et la collecte d'échantillons. Toutes les souris avaient entre 6 et 8 semaines au début de l'expérience. Les souris ont été profondément anesthésiées puis euthanasiées par dislocation cervicale.
Sept jeux de données transcriptomiques publics de tissu myocardique du ventricule gauche provenant de patients atteints de cardiomyopathie dilatée (DCM) ont été récupérés à partir de la base de données Gene Expression Omnibus (GEO)19. Ces jeux de données comprenaient six jeux de données transcriptomiques en masse et un jeu de données de séquençage de l'ARN monocellulaire (scRNA-seq), GSE145154. Les fractions positives et négatives pour CD45 ont été incluses dans l'analyse. Les fractions cellulaires positives et négatives pour CD45 ont été combinées avant le regroupement. L'identité des échantillons a été utilisée comme variable principale de lot pour l'intégration Harmony. Des échantillons normaux du ventricule gauche et des échantillons de ventricule gauche atteint de DCM provenant de GSE145154 ont été inclus, spécifiquement GSM4307515, GSM4307516, GSM4307520 et GSM4307521. Les jeux de données utilisés dans cette étude étaient GSE145154, GSE5406, GSE42955, GSE57338, GSE79962, GSE116250 et GSE141910. Tous les échantillons autres que ceux de DCM ont été exclus, et seuls les échantillons témoins (groupe Témoin) et les échantillons de DCM (groupe DCM) ont été conservés. Aucun échantillon n’a été éliminé après le contrôle de qualité. Les informations sur les échantillons des jeux de données GEO inclus sont résumées comme suit : GSE5406 contenait 102 échantillons (16 témoins et 86 échantillons de DCM) ; GSE42955 contenait 17 échantillons (5 témoins et 12 échantillons de DCM) ; GSE57338 contenait 231 échantillons (136 témoins et 95 échantillons de DCM) ; GSE79962 contenait 20 échantillons (11 témoins et 9 échantillons de DCM) ; GSE116250 contenait 51 échantillons (14 témoins et 37 échantillons de DCM) ; et GSE141910 contenait 322 échantillons (161 témoins et 161 échantillons de DCM).
2. Prétraitement des données de transcriptome en masse
Les matrices d'expression brutes et les fichiers d'annotation clinique pour les six jeux de données en masse ont été téléchargés à l'aide du package GEOquery20. Les fichiers CEL bruts ont été récupérés pour les jeux de données de puces Affymetrix, et les matrices de comptages bruts ont été récupérées pour les jeux de données d'ARN-séquençage. La correction du bruit de fond, la normalisation par quantiles et le calcul de l'expression pour les données de puces ont été effectués à l'aide de l'algorithme robuste de moyenne multi-puce (RMA) implémenté dans le package affy21.
Les données de décompte de RNA-seq ont été normalisées à l'aide de la méthode de la moyenne tronquée des valeurs M dans le package edgeR22 et converties en valeurs logarithmiques en base 2 des décomptes par million. Les identifiants de sondes ont été convertis en symboles génétiques officiels à l'aide de fichiers d'annotation spécifiques à la plateforme. Lorsque plusieurs sondes étaient associées au même gène, la valeur moyenne d'expression a été calculée.
Les effets techniques de lot entre les jeux de données ont été éliminés à l'aide de l'algorithme ComBat du package sva23. La source du jeu de données et la plateforme de détection ont été indiquées comme facteurs de lot. Une analyse en composantes principales a été réalisée avant et après la correction des lots afin d'évaluer l'efficacité de la suppression des effets de lot.
3. Prétraitement des données de transcriptome en cellule unique et annotation cellulaire
La matrice d'expression génique provenant de GSE145154 a été importée dans Seurat afin de construire un objet Seurat à l'aide de la version 5 de Seurat24. Les cellules de faible qualité ont été exclues selon les seuils suivants : 200 à 6 000 gènes détectés par cellule, nombre total de descripteurs moléculaires uniques supérieur à 500, et pourcentage de gènes mitochondriaux inférieur à 25 %. Les cellules situées en dehors de ces seuils de contrôle qualité ont été exclues car considérées de faible qualité ou rompues. L'exclusion des cellules de faible qualité a été effectuée uniquement selon les seuils de contrôle qualité décrits ci-dessus.
Une normalisation logarithmique a été effectuée à l'aide de la fonction NormalizeData avec un facteur d'échelle de 10 000. Les 3 000 gènes les plus variables ont été sélectionnés à l'aide de la fonction FindVariableFeatures avec la méthode vst. Les données ont été mises à l'échelle à l'aide de ScaleData, suivies d'une analyse en composantes principales pour la réduction de dimensionnalité linéaire.
Les effets de lot ont été corrigés à l'aide de l'algorithme Harmony25 via la fonction RunHarmony, l'identité de l'échantillon étant précisée comme variable de regroupement. Les 15 premières composantes principales ont été utilisées pour regrouper les cellules à l'aide des fonctions FindNeighbors et FindClusters. Le regroupement a été effectué à l'aide de l'algorithme de Leiden avec une résolution de 0,15. La réduction non linéaire de la dimensionnalité et la visualisation ont été réalisées à l'aide de l'approximation uniforme de variétés et de la projection.
Les types cellulaires ont été annotés à l'aide de gènes marqueurs canoniques ainsi que par une annotation automatisée utilisant le package SingleR26. Les gènes marqueurs étaient les suivants : cellules B, IGKC, MS4A1 et CD79A ; cardiomyocytes, TNNI3, MYL2 et ACTC1 ; cellules endothéliales, VWF, PECAM1 et EGFL7 ; macrophages, C1QC, C1QB et C1QA ; monocytes, S100A8, S100A9 et G0S2 ; cellules natural killer, NKG7, GNLY et CCL5 ; cellules musculaires lisses, MYL9, TAGLN et ACTA2 ; cellules stromales, FBLN1, LUM et DCN ; et cellules T, CD3E, CD3G et CD3D.
4. Analyse de l'expression différentielle et score d'enrichissement des ensembles de gènes
Un modèle linéaire a été construit à l'aide du package limma27 afin de comparer l'expression génique entre les groupes atteints de CMD et les groupes témoins sains. Les gènes présentant une valeur P < 0,05 et un changement d'expression absolue supérieur à 1,5, correspondant à un changement d'expression logarithmique en base 2 (log₂) absolu supérieur à 0,58, ont été considérés comme significativement différemment exprimés.
Une analyse d'enrichissement de gènes à échantillon unique a été réalisée afin de calculer les scores d'enrichissement pour les ensembles de gènes liés au vieillissement et aux mitochondries dans chaque échantillon28. Les différences de scores d'enrichissement entre les groupes DCM et témoins sains ont été évaluées à l'aide du test de somme des rangs de Wilcoxon, un seuil de significativité statistique étant fixé à une valeur de P < 0,05.
Au niveau de la cellule unique, les scores des modules liés au vieillissement et aux mitochondries ont été calculés à l'aide de la fonction AddModuleScore dans Seurat. Les différences de scores de module entre les groupes ont été évaluées à l'aide du test de somme des rangs de Wilcoxon.
Les signatures génétiques associées au vieillissement ont été extraites de la base de données CellAge (https://genomics.senescence.info/cells/), et les ensembles de gènes liés aux mitochondries ont été obtenus à partir de GeneCards (https://www.genecards.org/). Les listes complètes des gènes utilisées pour le calcul du score sont fournies dans le fichier supplémentaire 1.
5. Construction du réseau de co-expression génique pondéré
Les 5000 gènes codant pour des protéines présentant la plus forte variance d'expression dans les données transcriptomiques globales ont été conservés pour la construction du réseau. La fonction pickSoftThreshold a été appliquée pour calculer l'indice d'ajustement à la topologie sans échelle sous plusieurs puissances de seuil doux. Le seuil optimal a été déterminé comme étant la puissance minimale permettant d'obtenir un réseau sans échelle dont la valeur de R2 est supérieure à 0,9. En conséquence, une puissance de seuil doux de β = 5 a été adoptée pour les analyses ultérieures du réseau.
Un réseau de co-expression pondéré et signé a été construit à l'aide de la fonction blockwiseModules avec une taille de module minimale de 30. Les coefficients de corrélation de Pearson ont été calculés entre chaque eigengène de module et le score d'enrichissement lié au vieillissement ou mitochondrial. Les modules présentant un coefficient de corrélation absolu supérieur à 0,4 et une valeur P < 0,001 ont été considérés comme des modules significativement associés.
Les gènes appartenant aux modules significativement associés ont été croisés avec les gènes différentiellement exprimés afin d'identifier les gènes candidats liés au vieillissement associé à la DCM et les gènes candidats mitochondriaux associés à la DCM.
6. Analyse d'enrichissement fonctionnel
Des analyses d'enrichissement fonctionnel, incluant les analyses de l'Ontologie Génétique (GO) et des voies de la Kyoto Encyclopedia of Genes and Genomes (KEGG), ont été réalisées sur les gènes candidats à l'aide du package clusterProfiler29. L'enrichissement GO couvrait les trois catégories standard : processus biologique, composant cellulaire et fonction moléculaire.
Toutes les analyses ont été effectuées avec l'annotation de l'espèce humaine, un taux de faux positifs (FDR) pour la correction de la valeur P, et un seuil de q-valeur de 0,05. Les ensembles de gènes ont été restreints à une plage de taille de 10 à 500 gènes, et les termes présentant un FDR < 0,05 ont été considérés comme statistiquement significatifs. Enfin, les résultats d'enrichissement GO ont été visualisés via des diagrammes en barres groupées, tandis que les résultats d'enrichissement KEGG ont été affichés à l'aide de graphiques en bulles.
7. Construction du réseau PPI et sélection des gènes centraux
Les gènes candidats ont été soumis à la base de données STRING version 11.530, avec l'organisme défini comme Homo sapiens et le seuil de confiance des interactions fixé à un score combiné supérieur à 0,7. Les nœuds déconnectés ont été masqués, et les données d'interaction ont été exportées au format de valeurs séparées par des tabulations.
Les données d'interaction ont été importées dans Cytoscape version 3.9.1 pour visualisation31. Les scores topologiques des nœuds ont été calculés à l'aide du module complémentaire CytoHubba32 selon trois algorithmes : Degré, composante de voisinage maximale et centralité de la clique maximale.
Les modules fonctionnels principaux du réseau ont été identifiés à l'aide du plugiciel MCODE33 avec les paramètres par défaut suivants : seuil de degré, 2 ; k-core, 2 ; seuil de score des nœuds, 0,2 ; et profondeur maximale, 100. Les gènes classés parmi les 10 premiers par les trois algorithmes topologiques ont été croisés avec les gènes du sous-réseau principal MCODE afin d'identifier les gènes centraux finaux d'interaction protéine-protéine.
8. Sélection des gènes centraux et construction du modèle diagnostique basées sur l'apprentissage automatique
Afin d'assurer la reproductibilité et une représentation équilibrée, le jeu de données transcriptomiques intégré a été divisé aléatoirement en ensembles d'apprentissage et de validation selon un ratio de 7:3, en utilisant une graine aléatoire fixe (seed = 123456). Cette répartition a été stratifiée selon le groupe de maladie (CMID par rapport au témoin) afin de maintenir des proportions de classes cohérentes dans les deux ensembles. Avant la division, les effets de lot provenant de différentes sources de jeux de données ont été corrigés à l'aide du package sva, et les échantillons intégrés ont été traités comme une cohorte unique durant l'affectation aléatoire.
Trois algorithmes d'apprentissage automatique ont été appliqués pour sélectionner des gènes candidats. Premièrement, une régression logistique LASSO a été effectuée via la fonction cv.glmnet du package glmnet34. Un modèle de classification binaire par validation croisée en cinq parties a été construit, l'AUC étant adoptée comme métrique d'évaluation. Les gènes présentant des coefficients non nuls à lambda.min ont été retenus comme gènes candidats.
Deuxièmement, un modèle de classification par forêt aléatoire composé de 500 arbres décisionnels a été construit à l'aide du package randomForest35. Le nombre de variables échantillonnées pour chaque division a été fixé à la racine carrée du nombre total de caractéristiques. L'importance des gènes a été quantifiée selon le coefficient de Gini, et les 10 gènes présentant les scores d'importance les plus élevés ont été conservés.
Troisièmement, l'analyse SVM-RFE a été mise en œuvre à l'aide de la fonction rfe du package caret.36Les nombres de caractéristiques ont été fixés entre 1 et 10, et une validation croisée à 5 plis a été utilisée pour l'apprentissage du modèle. Le sous-ensemble de gènes présentant la précision optimale en validation croisée a été sélectionné en fin de compte.
Les gènes identifiés par les trois algorithmes ont été définis comme les gènes mitochondriaux et liés au vieillissement constituant le noyau final de la MCD. Des modèles diagnostiques ont ensuite été construits à l'aide de 10 algorithmes de classification : arbre de décision, machine à renforcement par gradient, modèle linéaire généralisé renforcé, k-plus proches voisins, régression logistique, réseau de neurones, moindres carrés partiels, forêt aléatoire, machine à vecteurs de support et boosting extrême du gradient.
Des courbes de caractéristique de fonctionnement du récepteur ont été générées à l'aide du package pROC37. La surface sous la courbe, la précision, la sensibilité et la spécificité ont été calculées afin d'évaluer la performance diagnostique dans les jeux d'apprentissage et de validation.
Une analyse SHapley Additive exPlanations a été réalisée pour calculer la contribution de chaque gène central aux prédictions du modèle38. Des graphiques récapitulatifs et des graphiques en cascade par échantillon ont été générés. Un modèle diagnostique final présentant une aire sous la courbe supérieure à 0,8 dans l'ensemble de validation a été considéré comme ayant une bonne performance diagnostique.
9. Inférence de la communication cellule-cellule
Les réseaux de communication cellule-cellule dans le microenvironnement cardiaque ont été inférés à l'aide du package CellChat39. Un objet CellChat a été construit en utilisant la base de données CellChatDB.human. Les ligands et récepteurs différentiellement exprimés ont été identifiés à l'aide de identifyOverExpressedGenes, et les paires d'interactions significatives ont été filtrées à l'aide de identifyOverExpressedInteractions.
Les probabilités de communication entre les types de cellules ont été calculées à l'aide de computeCommunProb. Le réseau global de communication au niveau des types de cellules a été agrégé à l'aide de aggregateNet. Le nombre d'interactions et la force de communication entre chaque paire de types de cellules ont été quantifiés et visualisés à l'aide de cartes thermiques et de diagrammes en barres.
10. Quantification de l'infiltration des cellules immunitaires
Des scores d'enrichissement pour 28 types de cellules immunitaires ont été calculés pour chaque échantillon global à l'aide d'une analyse d'enrichissement de gènes par ensemble de gènes spécifique à une cellule immunitaire28 et d'un ensemble de gènes signatures de cellules immunitaires40. Le test de Wilcoxon a été utilisé pour comparer les scores d'enrichissement des cellules immunitaires entre les groupes atteints de CMD et les groupes témoins sains. Une valeur de P < 0,05 a été considérée comme statistiquement significative.
Une analyse de corrélation de Pearson a été réalisée pour évaluer l'association entre les niveaux d'expression des gènes centraux et les scores d'enrichissement des cellules immunitaires. Toutes les corrélations ayant une valeur de P < 0,05 ont été considérées comme statistiquement significatives.
11. Clustering de consensus pour la sous-typage moléculaire
Un clustering de consensus non supervisé des échantillons de DCM a été réalisé à l'aide des profils d'expression génique principaux via le package ConsensusClusterPlus41. Les paramètres de clustering ont été définis avec un nombre maximal de clusters fixé à 6, 1000 itérations de rééchantillonnage et une proportion de rééchantillonnage de 0,8. Le partitionnement autour des médoides avec distance euclidienne a été utilisé pour le clustering, et une graine aléatoire fixe a été appliquée afin d'assurer la reproductibilité.
Le nombre optimal de sous-types a été déterminé à partir du tracé de la variation de la surface et des scores de stabilité du regroupement par consensus, avec une valeur finale de K = 2. Une analyse en composantes principales a ensuite été réalisée afin de confirmer la séparation nette des deux sous-types moléculaires.
Une analyse de la variation des ensembles de gènes42 a été appliquée pour calculer les scores d'enrichissement des voies KEGG spécifiques à chaque échantillon. Le package limma27 a été utilisé pour détecter l'activation différentielle des voies entre les sous-types, et une valeur P inférieure à 0,05 a été considérée comme statistiquement significative.
12. Évaluation échocardiographique de la fonction cardiaque
Les souris ont été anesthésiées via injection intrapéritonéale de pentobarbital sodique à 1 % (30 mg/kg) et fixé en position supine sur une table opératoire thermostatée. Après épilation thoracique, du gel de couplage échographique a été appliqué uniformément sur la région précordiale.
Une échographie en mode M guidée en deux dimensions a été réalisée au niveau des muscles papillaires du ventricule gauche à l'aide d'un système d'échographie pour petits animaux. Trois cycles cardiaques stables consécutifs ont été enregistrés afin de mesurer le diamètre diastolique final, le diamètre systolique final, la fraction d'éjection et le raccourcissement fractionné du ventricule gauche. Toutes les évaluations échocardiographiques ont été effectuées en aveugle par un ultrasonographe professionnel.
Trois souris ont été sélectionnées aléatoirement dans chaque groupe pour un examen échocardiographique, et ces 6 animaux au total ont ensuite été sacrifiés pour la collecte de tissu myocardique et la mesure par ELISA. Les animaux expérimentaux restants ont subi des tests de laboratoire parallèles supplémentaires, et leurs données n'ont pas été incluses dans la présente étude.
13. Prélèvement du tissu myocardique, extraction des protéines et dosage immunoenzymatique
Après l'évaluation échocardiographique, les souris ont été euthanasiées sous anesthésie profonde. Les tissus cardiaques ont été prélevés rapidement. via thoracotomie médiane, et le myocarde du ventricule gauche a été disséqué sur glace. Les tissus isolés ont été soigneusement rincés avec une solution saline tamponnée au phosphate glacée pour éliminer le sang intracardiaque résiduel. Après élimination du liquide excédentaire à l’aide de papier filtre stérile, les échantillons ont été immédiatement congelés par trempe dans l’azote liquide et stockés à −80 °C pour une extraction protéique ultérieure, en évitant strictement les cycles répétés de congélation-décongélation.
Les tissus myocardiques congelés ont été pesés et découpés en fragments d'environ 1 mm3 sur de la glace. Les tissus ont été lysés dans un tampon de lyse RIPA glacé contenant des inhibiteurs de protéase et de phosphatase, selon un rapport standardisé de 100 µL de tampon pour 10 mg de tissu. Les échantillons ont été homogénéisés complètement par voie mécanique sur de la glace, puis incubés pendant 30 min afin d'obtenir une lyse cellulaire complète.
Les lysats ont été centrifugés à 12 000 × g pendant 15 min à 4 °C. Les surnageants obtenus ont été recueillis dans des tubes exempts d'enzymes, et la concentration totale en protéines a été quantifiée à l'aide d'un kit de dosage des protéines par l'acide bicinchoninique, conformément aux protocoles du fabricant. Tous les échantillons ont été normalisés à une concentration identique en protéines à l'aide du tampon de lyse.
Les niveaux d'expression protéique des quatre gènes centraux dans les lysats myocardiques ont été mesurés à l'aide des kits correspondants de dosage immunoenzymatique (ELISA). Des étalons dilués en série et des lysats tissulaires normalisés ont été ajoutés en double (100 µL par puits) dans des microplaques prérecouvertes. Les plaques ont été incubées pendant 2 h à température ambiante, puis soigneusement lavées avec le tampon de lavage fourni avec le kit.
Chaque puits a reçu un anticorps conjugué à une enzyme et a été incubé pendant 1 h à température ambiante, suivi d'un lavage complet. Une solution de chromogène substrat a ensuite été ajoutée, et les plaques ont été incubées pendant 20 min à température ambiante à l'abri de la lumière. La réaction colorimétrique a été arrêtée à l'aide de la solution d'arrêt, et les valeurs d'absorbance ont été mesurées à 450 nm (longueur d'onde de référence : 570 nm) à l'aide d'un lecteur de microplaques à longueur d'onde complète.
14. Analyse statistique
Toutes les analyses statistiques et visualisations de données ont été réalisées à l'aide de R version 4.2.3. Pour les mesures de concentration par ELISA de chaque gène cible (TGFB2, SERPINE1, CYBB, TLR2), le test de Shapiro-Wilk a d'abord été appliqué afin d'évaluer la normalité des données dans les groupes Témoin et MCD séparément. Ensuite, un test F a été utilisé pour évaluer l'homogénéité des variances entre les deux groupes. La méthode de comparaison intergroupe a été déterminée selon les résultats du test d'homogénéité des variances : si les variances étaient homogènes (P ≥ 0,05), un test t de Student non apparié a été utilisé pour comparer les moyennes entre les groupes ; si les variances étaient hétérogènes (P < 0,05), le test t de Welch corrigé a été employé pour l'analyse. Tous les tests étaient bilatéraux, et le seuil de significativité statistique a été fixé à P < 0,05. Les données ont été représentées sous forme de boîtes à moustaches superposées avec des points individuels dispersés. Les valeurs P de tous les tests ainsi que le type de test t utilisé ont été indiqués en détail sur chaque graphique.
Résultats
Prétraitement des données et analyse d'expression différentielle
Les six jeux de données transcriptomiques en bloc ont subi un prétraitement normalisé et une correction des effets de lot avant l'analyse en aval. Les données de puces à ADN ont été normalisées à l'aide de l'algorithme de moyenne robuste multi-puce, tandis que les données de comptage issues de l'ARN-séquençage ont été normalisées selon la méthode de la moyenne tronquée des valeurs M. L'algorithme ComBat a été appliqué pour éliminer les effets techniques de lot associés à la source du jeu de données et à la plateforme de détection. Une analyse en composantes principales a montré que les échantillons s'agrégeaient selon la source du jeu de données avant correction, mais qu'ils étaient plus uniformément répartis après correction, sans séparation visible selon le lot.
Une analyse de l'expression différentielle entre les groupes atteints de cardiomyopathie dilatée (DCM) et les témoins sains (HC) a été réalisée à l'aide du package limma. La carte thermique des 20 gènes les plus significativement différentiellement exprimés a montré une séparation des profils d'expression entre les deux groupes (Figure 1A). Au total, 1 473 gènes différentiellement exprimés ont été identifiés en utilisant des seuils de valeur P < 0,05 et |log₂ du changement d'expression| > 0,58. Parmi ceux-ci, 819 gènes étaient surexprimés et 654 étaient sous-exprimés dans les échantillons myocardiques de DCM (Figure 1B).
Une analyse d'enrichissement de gènes à échantillon unique a ensuite été utilisée pour calculer les scores d'enrichissement des ensembles de gènes liés au vieillissement et aux mitochondries dans chaque échantillon. Les deux scores différaient de manière significative entre les groupes DCM et HC (Figure 1C).
Analyse du réseau de co-expression génique pondéré
Une analyse du réseau de co-expression génique pondéré a été réalisée afin d'identifier les modules géniques associés aux scores d'enrichissement liés au vieillissement et aux mitochondries. Les 5 000 gènes codant pour des protéines présentant la plus grande variance d'expression dans le jeu de données global ont été utilisés pour construire le réseau. Avec une puissance de seuil doux fixée à β = 5, l'indice d'ajustement à une topologie sans échelle a dépassé R2 = 0,9, satisfaisant ainsi au critère de réseau sans échelle (Figure 1D).
Le regroupement hiérarchique et la fusion de modules ont identifié trois modules de gènes. Les trois modules étaient significativement corrélés au score lié au vieillissement. Le module turquoise présentait la corrélation la plus forte avec le score lié au vieillissement (r = 0,69, P < 0,001). Pour le score mitochondrial, les modules bleu et gris étaient significativement corrélés, le module bleu montrant l'association la plus forte (r = 0,56, P < 0,001 ; Figure 1E). Le module turquoise a donc été sélectionné pour le criblage des gènes liés au vieillissement, et le module bleu a été sélectionné pour le criblage des gènes liés aux mitochondries.
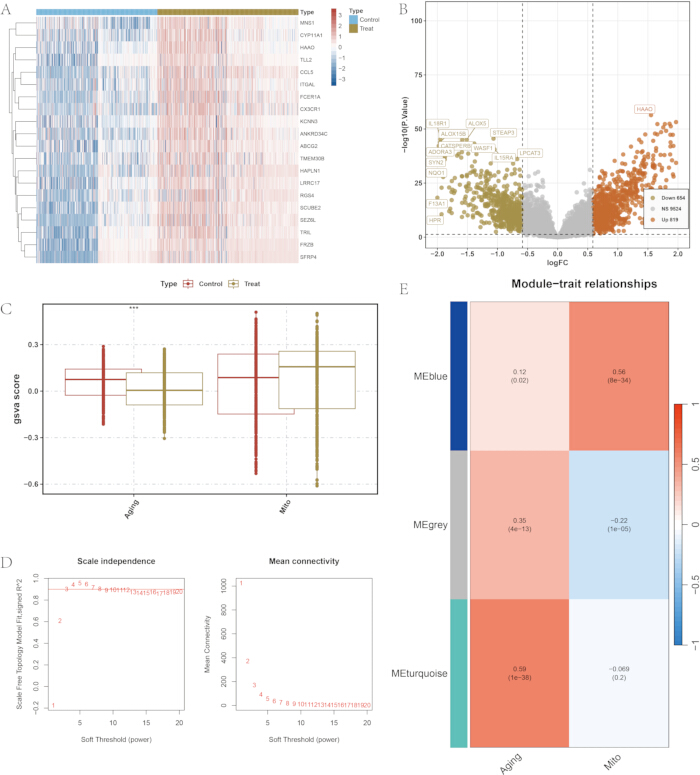
Figure 1Analyse de l'expression différentielle et construction d'un réseau de co-expression génique pondéré. (ACarte thermique des 20 gènes les plus significativement différemment exprimés entre les groupes atteints de cardiomyopathie dilatée (DCM) et les témoins sains (HC).B) Graphique en volcan des gènes différentiellement exprimés. Les gènes en rouge indiquent une surexpression, les gènes en vert une sous-expression, et les gènes en gris une absence de signification statistique. Les seuils étaient une valeur P < 0,05 et un changement d'expression d'au moins 1,5 fois. < 0,05 et |log₂ de variation| > 0.58. (C) Boîtes à moustaches des scores d'analyse d'enrichissement des ensembles de gènes pour les ensembles de gènes liés au vieillissement et aux mitochondries.D) Sélection du seuil doux pour l'analyse du réseau de co-expression génique pondéré, montrant l'indice d'ajustement à la topologie sans échelle et la connectivité moyenne selon différentes puissances de seuil doux.ECarte thermique des corrélations entre les eigengènes des modules et les scores liés au vieillissement et aux mitochondries. Veuillez cliquer ici pour afficher une version agrandie de cette figure.
Identification de gènes candidats liés au vieillissement et aux mitochondries
Les gènes candidats ont été identifiés en croisant les gènes différentiellement exprimés, les gènes appartenant aux modules sélectionnés de l'analyse de réseau de co-expression pondérée des gènes et les jeux de gènes de référence correspondants. Cette analyse a permis d'identifier 66 gènes candidats liés au vieillissement associés à la MCD (Figure 2A) et 16 gènes candidats mitochondriaux associés à la MCD (Figure 2B).
L'analyse d'enrichissement de l'ontologie génique a montré que les gènes candidats liés au vieillissement étaient enrichis dans des processus biologiques, notamment la biosynthèse de la synthase de l'oxyde nitrique et l'organisation de la matrice extracellulaire contenant du collagène (Figure 2C). Les gènes candidats liés aux mitochondries étaient enrichis dans des termes associés au métabolisme énergétique mitochondrial, notamment la membrane interne mitochondriale et le complexe de la chaîne respiratoire (Figure 2D).
L'analyse du Kyoto Encyclopedia of Genes and Genomes a montré que les gènes candidats liés au vieillissement étaient enrichis dans les voies de signalisation du facteur induit par l'hypoxie-1, de la phosphoinositide 3-kinase-protéine kinase B, et des produits finaux de glycation avancée-récepteur des produits finaux de glycation avancée (Figure 2E). Les gènes candidats liés aux mitochondries étaient enrichis dans des voies comprenant la phosphorylation oxydative (Figure 2F).
Les profils d'expression différentielle des 66 gènes candidats liés au vieillissement entre les groupes DCM et HC ont été visualisés à l'aide d'une carte thermique d'expression (Figure 2G). Les profils d'expression des 16 gènes candidats mitochondriaux ont été visualisés à l'aide de diagrammes en boîte (Figure 2H).
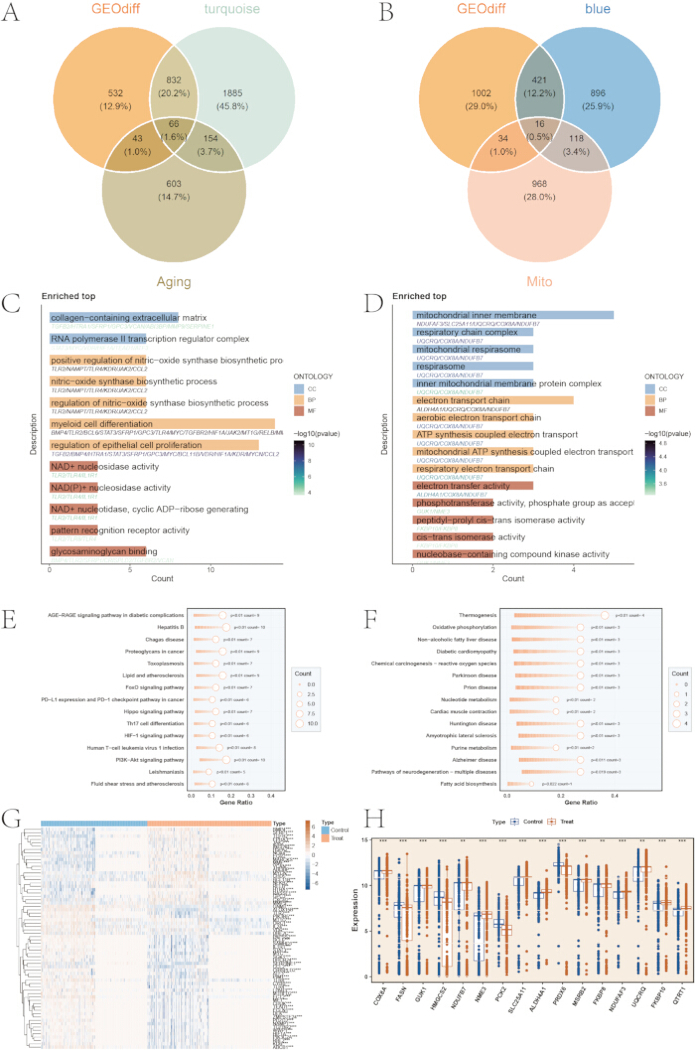
Figure 2 : Analyse de criblage et d'enrichissement fonctionnel des gènes candidats. (A) Diagramme de Venn montrant l'intersection des gènes différentiellement exprimés, des gènes du module de l'analyse de réseau de co-expression pondérée des gènes et de l'ensemble de référence des gènes liés au vieillissement. (B) Diagramme de Venn montrant l'intersection des gènes différentiellement exprimés, des gènes du module de l'analyse de réseau de co-expression pondérée des gènes et de l'ensemble de référence des gènes liés aux mitochondries. (C) Analyse d'enrichissement de l'ontologie génique des gènes candidats liés au vieillissement. (D) Analyse d'enrichissement de l'ontologie génique des gènes candidats liés aux mitochondries. (E) Analyse d'enrichissement des voies de l'Encyclopédie de Kyoto des gènes et des génomes (KEGG) pour les gènes candidats liés au vieillissement. (F) Analyse d'enrichissement des voies de l'Encyclopédie de Kyoto des gènes et des génomes (KEGG) pour les gènes candidats liés aux mitochondries. (G) Carte thermique d'expression des 66 gènes candidats liés au vieillissement dans les groupes DCM et HC. (H) Graphiques en boîte d'expression des 16 gènes candidats liés aux mitochondries dans les groupes DCM et HC. Veuillez cliquer ici pour afficher une version agrandie de cette figure.
Annotation des types cellulaires du jeu de données de séquençage ARN unicellulaire
Le jeu de données de séquençage ARN unicellulaire GSE145154 a été utilisé pour la validation à résolution unicellulaire. Après filtration de contrôle de qualité, normalisation logarithmique et correction de lot par Harmony, les cellules provenant d’échantillons différents se sont réparties dans l’espace de projection et d’approximation uniforme des variétés (UMAP) sans séparation visible spécifique à l’échantillon. À l’aide des 15 premières composantes principales et d’une résolution de regroupement de 0,15, les cellules ont été divisées en 9 groupes (Figure 3A).
Des gènes marqueurs canoniques et une annotation automatisée à l'aide de SingleR ont identifié 9 grands types cellulaires : les macrophages, les cellules tueuses naturelles, les cellules T, les cellules B, les cellules endothéliales, les cellules musculaires lisses, les monocytes, les cellules stromales et les cardiomyocytes (Figure 3B). Les profils d'expression des gènes marqueurs spécifiques à chaque type cellulaire appuient ces annotations (Figure 3C).
Les scores du module mitochondrial ont été calculés pour chaque cellule à l'aide de la fonction AddModuleScore et différaient de manière significative entre le groupe atteint de cardiomyopathie dilatée et le groupe témoin sain (P < 2,22 × 10⁻16 ; Figure 3D). Les scores du module lié au vieillissement différaient également de manière significative entre les deux groupes (P < 2,22 × 10⁻16 ; Figure 3E). La projection des scores mitochondriaux sur l'espace de projection et d'approximation de variété uniforme a montré que des scores élevés étaient principalement observés dans les cardiomyocytes (Figure 3F). En revanche, des scores élevés liés au vieillissement étaient principalement observés dans les macrophages (Figure 3G).
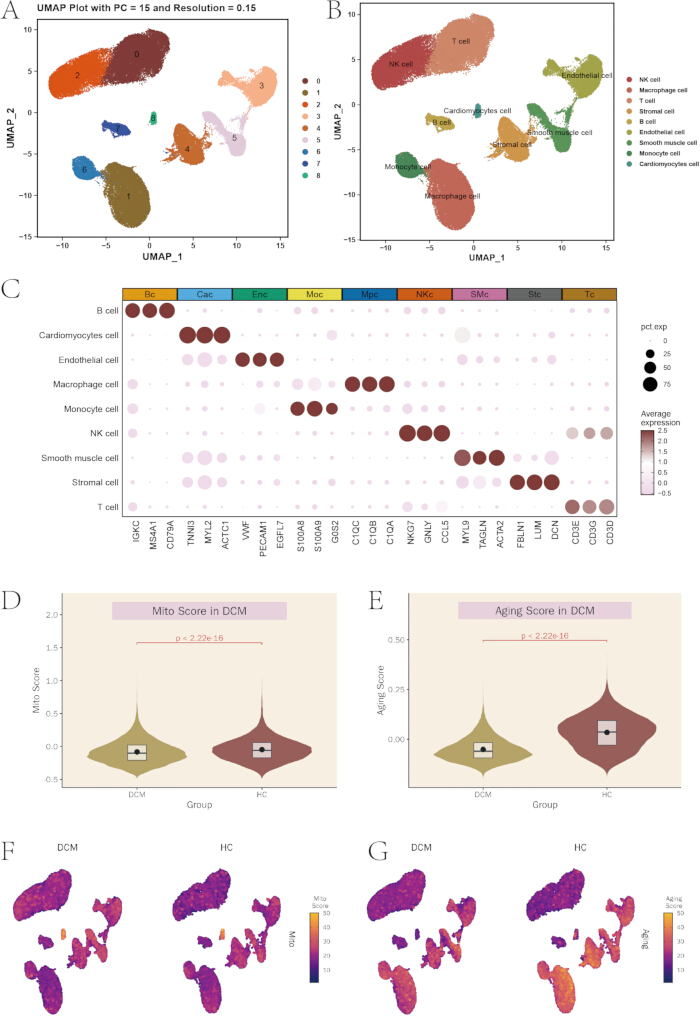
Figure 3 : Annotation du transcriptome unicellulaire et analyse des scores de modules. (A) Graphique de projection par approximation de variété uniforme (UMAP) des groupes cellulaires générés à l'aide des 15 premières composantes principales et d'une résolution de regroupement de 0,15. (B) Graphique UMAP des types cellulaires annotés. (C) Diagramme en bulles montrant l'expression des gènes marqueurs canoniques selon les types cellulaires. (D) Diagramme en violon des scores des modules mitochondriaux dans les groupes MCD et HC. (E) Diagramme en violon des scores des modules liés au vieillissement dans les groupes MCD et HC. (F) Graphique UMAP montrant la répartition des scores des modules mitochondriaux parmi les cellules. (G) Graphique UMAP montrant la répartition des scores des modules liés au vieillissement parmi les cellules. Veuillez cliquer ici pour visualiser une version agrandie de cette figure.
Construction du réseau d'interactions protéine-protéine
L'ensemble combiné de 66 gènes candidats liés au vieillissement et de 16 gènes candidats liés aux mitochondries a été soumis à la base de données STRING version 11.5 afin de construire un réseau d'interactions protéine-protéine en utilisant un seuil de confiance élevée correspondant à un score combiné > 0,7. Le réseau a été importé dans Cytoscape pour la visualisation et l'analyse topologique (Figure 4A).
Les analyses de degré, de centralité de la clique maximale, de composante de voisinage maximale et de MCODE ont été utilisées pour identifier les nœuds fortement connectés et les sous-réseaux centraux. Les sous-réseaux identifiés par ces méthodes sont présentés dans Figure 4B–E.
Les 10 premiers gènes classés par degré, par centralité de la clique maximale et par composante de voisinage maximale ont été croisés avec les gènes du sous-réseau central MCODE. Cette analyse a identifié 10 gènes candidats : TGFB2, TLR2, SERPINE1, CYBB, KDR, TLR4, HIF1A, CCL2, MMP9 et CXCR2.
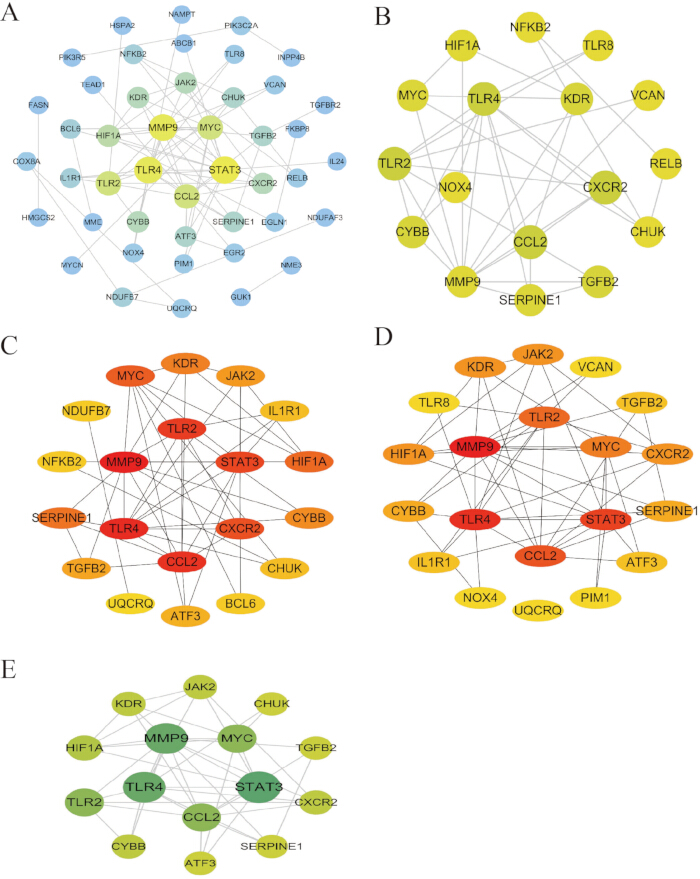
Figure 4 : Construction du réseau d'interactions protéine-protéine et criblage des gènes centraux.
(A) Réseau global d'interactions protéine-protéine des gènes candidats. (B) Sous-réseau central identifié à l'aide de MCODE. (C) Sous-réseau central identifié à l'aide de la centralité par clique maximale. (D) Sous-réseau central identifié à l'aide du composant voisin maximal. (E) Sous-réseau central identifié à l'aide du degré. Veuillez cliquer ici pour visualiser une version agrandie de cette figure.
Recherche de gènes centraux par apprentissage automatique
Trois algorithmes d’apprentissage automatique — la régression logistique avec l’opérateur de sélection et de réduction absolue (LASSO), la forêt aléatoire et la machine à vecteurs de support avec élimination récursive des caractéristiques — ont été appliqués pour identifier les gènes centraux parmi les 10 candidats d’interaction protéine-protéine. Toutes les analyses ont été réalisées en utilisant une graine aléatoire fixe (set.seed(12345)) et une validation croisée à 5 plis. Dans le modèle LASSO, les gènes présentant des coefficients non nuls à la valeur optimale de lambda (lambda.min) ont été conservés comme candidats (Figure 5A).
Dans le modèle de machine à vecteurs de support avec élimination récursive de caractéristiques, la précision maximale de validation croisée de 0,859 a été obtenue lorsqu'on incluait 10 caractéristiques (Figure 5B), avec un taux d'erreur minimal correspondant de 0,141 (Figure 5C). Le modèle de forêt aléatoire composé de 500 arbres de décision a montré une convergence stable du taux d'erreur « out-of-bag » (Figure 5D). Le classement d'importance des gènes basé sur le coefficient de Gini a placé TGFB2, TLR2, SERPINE1 et CYBB parmi les gènes les mieux classés (Figure 5E). L'intersection des gènes sélectionnés par les trois algorithmes a permis d'obtenir quatre gènes centraux finaux : CYBB, SERPINE1, TGFB2 et TLR2 (Figure 5F).
Une analyse SHapley Additive exPlanations a été réalisée afin d'évaluer la contribution de chaque gène central aux prédictions du modèle. TGFB2 présentait la valeur moyenne absolue SHapley Additive exPlanations la plus élevée, à 0,249, suivie par SERPINE1 à 0,103, CYBB à 0,083 et TLR2 à 0,078 (Figure 6A). Le graphique récapitulatif montrait la distribution et le sens des contributions génétiques à travers les échantillons (Figure 6B). Les graphiques de dépendance illustraient la relation entre les valeurs individuelles des gènes et les contributions au modèle (Figure 6C), tandis que les graphiques en cascade par échantillon montraient la contribution de chaque gène aux prédictions individuelles (Figure 6D).
Des modèles de classification diagnostique basés sur les quatre gènes centraux ont ensuite été construits à l'aide de 10 algorithmes de classification. Dans le jeu d'apprentissage, la plupart des algorithmes ont atteint des valeurs de la surface sous la courbe supérieures à 0,85 (Figure 6E). Dans le jeu de validation interne, la plupart des algorithmes ont atteint des valeurs de la surface sous la courbe supérieures à 0,78 (Figure 6F).
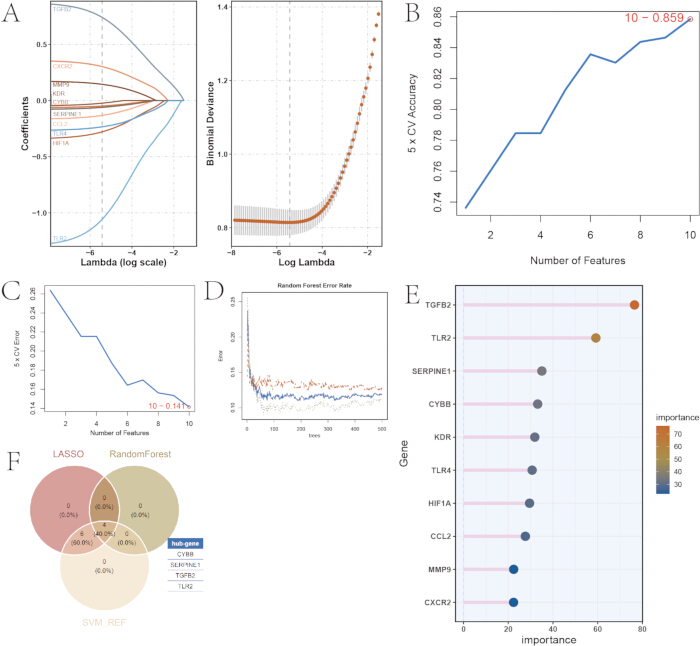
Figure 5 : Analyse par apprentissage automatique des gènes centraux. (A) Trajectoire des coefficients de la régression par l'opérateur de rétrécissement et de sélection par norme L1 (LASSO) et sélection du lambda optimal. (B) Courbe de précision de la validation croisée pour le modèle d'élimination récursive de caractéristiques par machine à vecteurs de support (SVM-RFE). (C) Courbe d'erreur de validation croisée pour le modèle d'élimination récursive de caractéristiques par machine à vecteurs de support (SVM-RFE). (D) Courbe du taux d'erreur « out-of-bag » pour le modèle de forêt aléatoire. (E) Classement d'importance des gènes basé sur le coefficient de Gini dans le modèle de forêt aléatoire. (F) Diagramme de Venn montrant les gènes centraux identifiés par les trois algorithmes d'apprentissage automatique. Veuillez cliquer ici pour visualiser une version agrandie de cette figure.
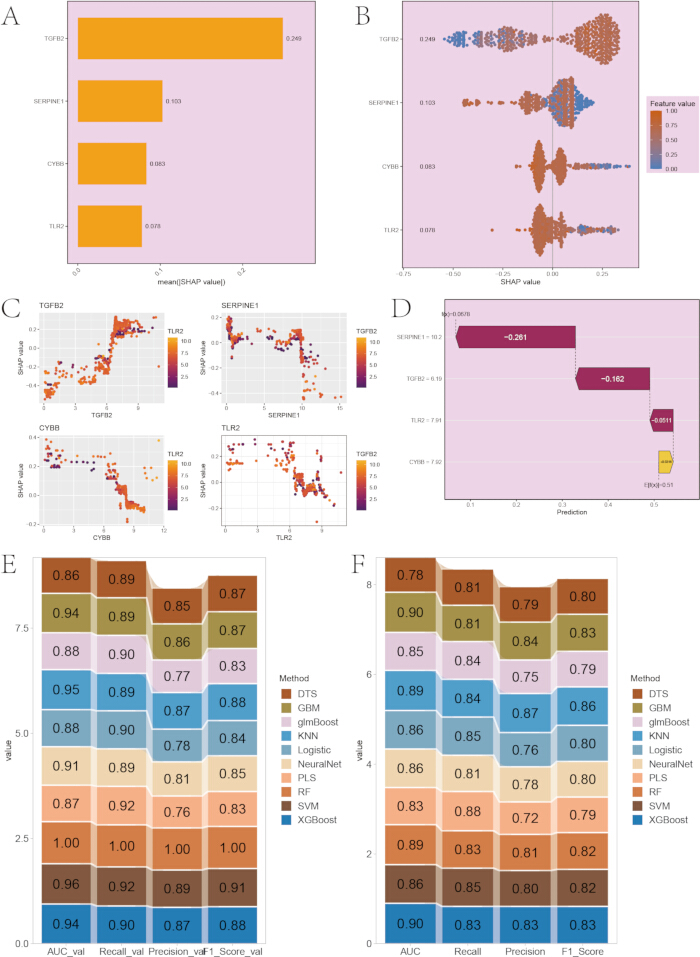
Figure 6 : Évaluation du modèle diagnostique et analyse par décomposition additive de Shapley (SHAP). (A) Valeurs moyennes absolues de la décomposition additive de Shapley (SHAP) pour les quatre gènes centraux. (B) Graphique récapitulatif SHAP montrant la distribution et le sens des contributions des gènes. (C) Graphiques de dépendance SHAP pour chaque gène central. (D) Graphique en cascade SHAP pour un échantillon représentatif. (E) Carte thermique des performances diagnostiques de 10 algorithmes de classification dans l'ensemble d'apprentissage. (F) Carte thermique des performances diagnostiques de 10 algorithmes de classification dans l'ensemble de validation. Veuillez cliquer ici pour visualiser une version agrandie de cette figure.
Validation au niveau de la cellule unique et analyse de la communication intercellulaire
Les profils d'expression des quatre gènes centraux ont été évalués au niveau de la cellule unique. L'analyse de la répartition par type cellulaire a montré que CYBB et TLR2 étaient fortement exprimés dans les monocytes et les macrophages, tandis que SERPINE1 et TGFB2 étaient principalement exprimés dans les cellules stromales (Figure 7A).
Les graphiques en violon ont montré que l'expression de CYBB différait significativement entre les groupes atteints de cardiomyopathie dilatée et les témoins sains (Figure 7B). SERPINE1 (Figure 7C), TGFB2 (Figure 7D) et TLR2 (Figure 7E) différaient également de manière significative entre les groupes. Les quatre gènes étaient tous significativement surexprimés dans le groupe atteint de cardiomyopathie dilatée par rapport aux témoins sains, avec une valeur P < 0,0001 pour chaque comparaison.
Les réseaux de communication entre cellules dans le microenvironnement cardiaque ont été inférés à l'aide de CellChat et d'une base de données ligand-récepteur. Le nombre et l'intensité globale des interactions entre cellules différaient entre les groupes atteints de cardiomyopathie dilatée et les groupes témoins (Figure 7F). Une intensité différentielle de communication entre les types cellulaires a également été observée (Figure 7G). Les monocytes, les macrophages, les cardiomyocytes et les cellules stromales étaient les principaux participants du réseau de communication.
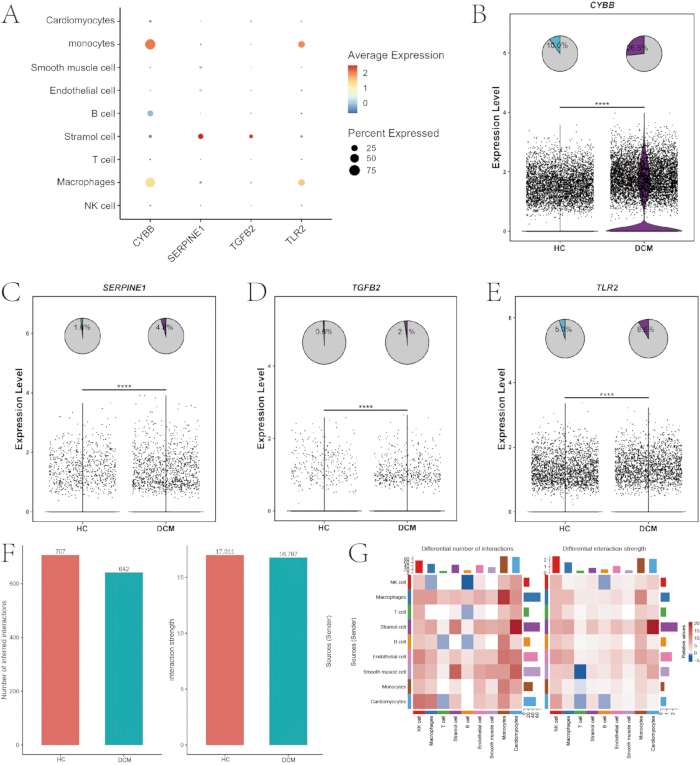
Figure 7 : Validation au niveau cellulaire unique des gènes centraux et analyse des communications entre cellules. (A) Diagramme en bulles montrant l'expression des quatre gènes centraux selon les types cellulaires. (B) Diagramme en violon de l'expression de CYBB dans les groupes DCM et HC. (C) Diagramme en violon de l'expression de SERPINE1 dans les groupes DCM et HC. (D) Diagramme en violon de l'expression de TGFB2 dans les groupes DCM et HC. (E) Diagramme en violon de l'expression de TLR2 dans les groupes DCM et HC. (F) Diagramme en barres montrant le nombre et l'intensité globale des interactions entre cellules. (G) Carte thermique montrant la différence d'intensité des communications entre cellules selon les groupes. Veuillez cliquer ici pour visualiser une version agrandie de cette figure.
Analyse de l'infiltration des cellules immunitaires
Les scores d'enrichissement pour 28 sous-ensembles de cellules immunitaires ont été calculés pour chaque échantillon global à l'aide d'une analyse d'enrichissement de gène à échantillon unique. L'abondance de la plupart des types de cellules immunitaires différait de manière significative entre les groupes atteints de cardiomyopathie dilatée et les témoins sains (Figure 8A).
Une analyse de corrélation de Pearson a ensuite été réalisée afin d'évaluer la relation entre l'expression des gènes centraux et les scores d'enrichissement des cellules immunitaires. L'expression de CYBB était significativement corrélée à l'abondance de plusieurs types de cellules immunitaires (Figure 8B). Des corrélations similaires ont été observées pour SERPINE1 (Figure 8C), TGFB2 (Figure 8D) et TLR2 (Figure 8E). CYBB, SERPINE1 et TLR2 présentaient des corrélations positives avec plusieurs populations de cellules immunitaires innées, notamment les monocytes et les macrophages.
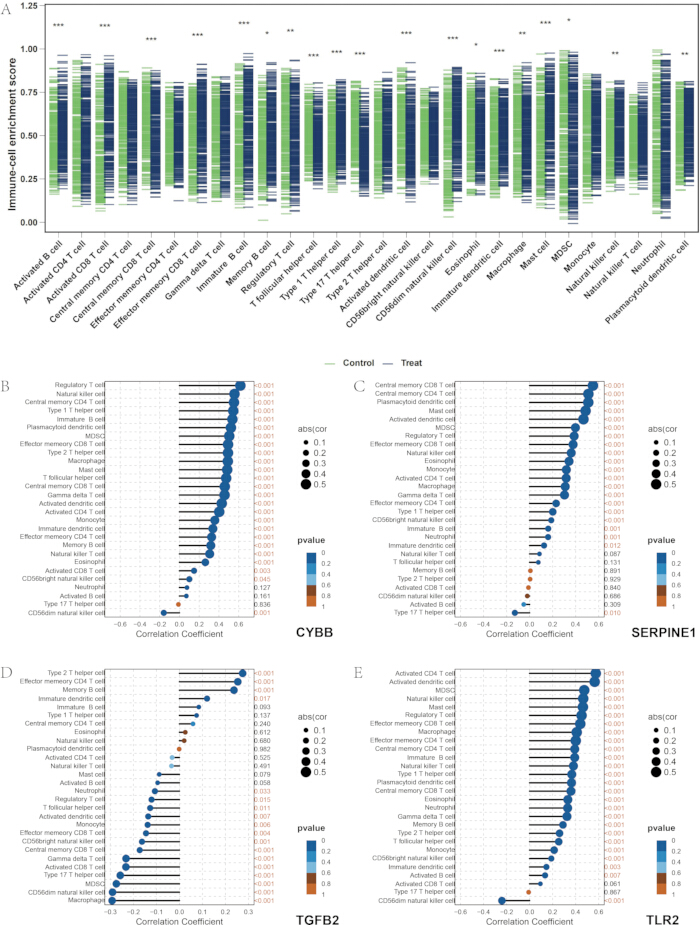
Figure 8 : Infiltration des cellules immunitaires et analyse de corrélation. (A) Diagrammes en boîte des scores d'enrichissement pour 28 types de cellules immunitaires dans les groupes DCM et HC. (B) Graphique en bâtonnets montrant les corrélations entre l'expression de CYBB et l'abondance des cellules immunitaires. (C) Graphique en bâtonnets montrant les corrélations entre l'expression de SERPINE1 et l'abondance des cellules immunitaires. (D) Graphique en bâtonnets montrant les corrélations entre l'expression de TGFB2 et l'abondance des cellules immunitaires. (E) Graphique en bâtonnets montrant les corrélations entre l'expression de TLR2 et l'abondance des cellules immunitaires. Veuillez cliquer ici pour visualiser une version agrandie de cette figure.
Sous-typage moléculaire de la cardiomyopathie dilatée
Un regroupement par clustering de consensus non supervisé a été effectué sur des échantillons de cardiomyopathie dilatée en se basant sur les profils d'expression des quatre gènes centraux. La matrice de clustering de consensus a soutenu une séparation à K = 2 (Figure 9A). Le tracé de la surface delta a en outre confirmé que K = 2 constituait le nombre optimal de groupes, divisant ainsi les échantillons en deux sous-types moléculaires, C1 et C2 (Figure 9B).
Les niveaux d'expression de CYBB, SERPINE1 et TLR2 différaient significativement entre les deux sous-types (Figure 9C). L'abondance de plusieurs sous-ensembles de cellules immunitaires différait également entre les sous-types (Figure 9D). Une analyse de variation des ensembles de gènes a révélé une activation relative de la voie de signalisation du facteur de croissance endothélial vasculaire dans le sous-type C1, tandis que la biosynthèse des acides biliaires primaires et la biosynthèse des glycosphingolipides étaient enrichies dans le sous-type C2 (Figure 9E). Une analyse en composantes principales a montré une séparation entre les échantillons attribués aux deux sous-types (Figure 9F).
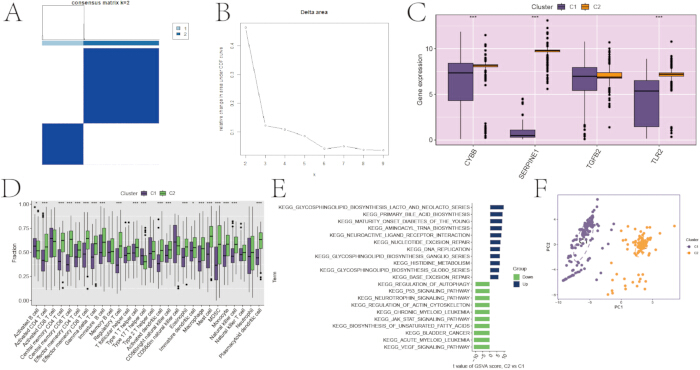
Figure 9 : Clustering de consensus pour la sous-typage moléculaire de la cardiomyopathie dilatée. (A) Matrice de clustering de consensus pour K = 2. (B) Graphique du delta de surface utilisé pour déterminer le nombre optimal de groupes. (C) Boîtes à moustaches de l'expression des gènes centraux dans les deux sous-types moléculaires. (D) Boîtes à moustaches de l'abondance des cellules immunitaires dans les deux sous-types moléculaires. (E) Carte thermique des voies de l'Encyclopédie des gènes et génomes de Kyoto (KEGG) différemment enrichies entre les deux sous-types moléculaires. (F) Graphique d'analyse en composantes principales montrant la séparation entre les deux sous-types moléculaires. Veuillez cliquer ici pour visualiser une version agrandie de cette figure.
In vivo validation dans le modèle murin de cardiomyopathie dilatée
Des souris transgéniques CTNTR141W présentant un phénotype de cardiomyopathie dilatée spontanée ont été utilisées pour in vivo validation. Par rapport à des souris contrôles C57BL/6J de type sauvage appariées par âge, les souris transgéniques présentaient un diamètre télédiastolique du ventricule gauche significativement augmenté et une fraction d'éjection du ventricule gauche diminuée, en accord avec une dilatation ventriculaire et une dysfonction systolique (Figure 10A).
Des protéines totales ont été extraites de tissu myocardique du ventricule gauche, et les concentrations des quatre protéines codées par les gènes centraux ont été mesurées par dosage immunoenzymatique (ELISA) après normalisation des protéines totales par la méthode de l'acide bichinconinique. Tous les dosages ont été réalisés en double. Les courbes standards présentaient des coefficients de corrélation (R2) ≥ 0,99, et les coefficients de variation entre les puits en double étaient inférieurs à 10 %. La significativité statistique entre les groupes Témoin et CMH a été évaluée à l'aide du test t de Student ou du test t de Welch, selon l'égalité des variances évaluée par le test F (la normalité ayant été confirmée par le test de Shapiro-Wilk). Les niveaux myocardiques des protéines correspondant aux quatre gènes centraux étaient significativement augmentés chez les souris atteintes de cardiomyopathie dilatée (CMH) par rapport aux témoins (Figure 10B). Pour la validation par ELISA, 3 réplicats biologiques (souris individuelles) ont été inclus dans chaque groupe. Pour la validation par ELISA, trois réplicats biologiques indépendants ont été inclus par groupe. Ces résultats doivent être considérés comme préliminaires et nécessitent une confirmation dans une cohorte plus large.
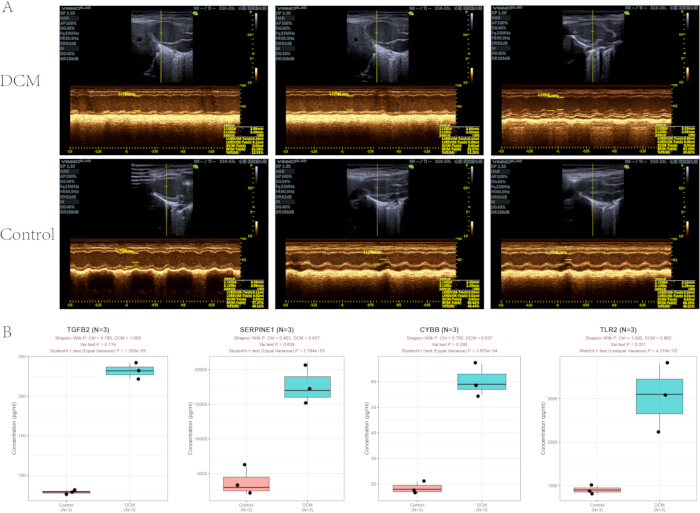
Figure 10 : Validation in vivo dans le modèle murin transgénique de cardiomyopathie dilatée CTNTR141W. (A) Images échocardiographiques représentatives en mode M de souris transgéniques DCM CTNTR141W et de souris contrôles de type sauvage. (B) Quantification par ELISA de quatre protéines dérivées de gènes centraux dans les tissus myocardiques du ventricule gauche de souris. Les boîtes à moustaches illustrent les concentrations protéiques pour les groupes Témoin et DCM (n = 3 réplicats biologiques par groupe). Pour chaque boîte à moustaches : la ligne horizontale pleine à l’intérieur de la boîte indique la valeur médiane ; les bords supérieur et inférieur de la boîte représentent les percentiles 75e et 25e (intervalle interquartile, IIQ) ; les moustaches supérieure et inférieure s’étendent jusqu’aux valeurs maximale et minimale non aberrantes situées dans un rayon de 1,5 × IIQ ; les points noirs pleins individuels correspondent à des réplicats biologiques indépendants provenant d’animaux uniques. L’axe des ordonnées indique la concentration protéique absolue : pg/mL pour TGFB2 et CYBB, ng/mL pour TLR2 et SERPINE1. Les comparaisons statistiques entre deux groupes ont été effectuées à l’aide du test t de Student (variance égale) ou du test t de Welch (variance inégale), la normalité étant vérifiée par le test de Shapiro-Wilk et l’homogénéité des variances évaluée par le test F. Déclaration de limitation : les résultats d’ELISA obtenus à partir de n = 3 réplicats constituent des découvertes exploratoires préliminaires, et une validation ultérieure avec un effectif d’échantillonnage accru est nécessaire. Veuillez cliquer ici pour visualiser une version agrandie de cette figure.
Disponibilité des données :
Les six jeux de données de transcriptomique en bloc et le jeu de données de séquençage de l'ARN monocellulaire analysés dans cette étude sont accessibles publiquement dans la base de données Gene Expression Omnibus sous les numéros d'accès GSE5406, GSE42955, GSE57338, GSE79962, GSE116250, GSE141910 et GSE145154. L'analyse monocellulaire inclut les échantillons GSM4307515, GSM4307516, GSM4307520 et GSM4307521 provenant de GSE145154. Toutes les autres données générées ou analysées au cours de cette étude, ainsi que le code informatique, sont inclus dans cet article publié et ses fichiers d'informations supplémentaires. Plus précisément, le fichier supplémentaire 1 contient les listes complètes des gènes liés au vieillissement et aux mitochondries, la signature immunitaire à 28 cellules, les scripts analytiques personnalisés, les matrices de données transcriptomiques normalisées, les données brutes des tests ELISA et les données sources brutes sous-jacentes à toutes les figures du manuscrit.
Fichier supplémentaire 1 : Ensembles de gènes liés au vieillissement et aux mitochondries, signatures immunitaires, scripts d'analyse, données transcriptomiques normalisées et données brutes des figures. Veuillez cliquer ici pour télécharger ce fichier.
Discussion
Le flux de travail intégré et multicouche combinait une méta-analyse de transcriptomique globale, la construction d'un réseau de co-expression génique pondéré, un apprentissage automatique ensembliste, une validation par transcriptomique unicellulaire et une vérification in vivo sur un modèle animal. Quatre gènes centraux liés au vieillissement et aux mitochondries — CYBB, SERPINE1, TGFB2 et TLR2 — ont été identifiés comme biomarqueurs diagnostiques candidats pour la cardiomyopathie dilatée (DCM). L'intégration de six jeux de données indépendants de transcriptomique du ventricule gauche provenant du référentiel Gene Expression Omnibus, incluant des plateformes de puces à ADN et de séquençage ARN, a réduit les biais propres à chaque jeu de données individuel et renforcé la base statistique de l'analyse43,44,45. L'analyse du réseau pondéré de co-expression génique, combinée à des ensembles de gènes prédéfinis liés au vieillissement et aux mitochondries, a permis d'identifier des modules fonctionnels associés au caractère étudié, plutôt que de se limiter uniquement à l'analyse de l'expression différentielle46. L'apprentissage automatique ensembliste a réduit les biais spécifiques aux algorithmes liés aux méthodes individuelles de sélection de caractéristiques47,48, tandis que l'analyse SHapley Additive exPlanations (SHAP) a quantifié la contribution de chaque gène central aux prédictions du modèle49. La validation effectuée sur des transcriptomes myocardiques globaux, des transcriptomes unicellulaires et un modèle murin transgénique a permis de caractériser davantage la distribution cellulaire et les niveaux protéiques myocardiques des gènes sélectionnés50.
La correction par lot a constitué une étape cruciale dans l'analyse intégrée, car des variations résiduelles spécifiques aux jeux de données pourraient affecter l'analyse d'expression différentielle et les associations entre modules et caractères. La source des jeux de données et la plateforme de détection ont donc été incluses comme facteurs de lot dans le modèle ComBat. Un regroupement résiduel dépendant du jeu de données observé sur les graphiques d'analyse en composantes principales indiquerait une correction incomplète et un biais systématique potentiel44. La puissance de seuil doux était également importante pour la construction du réseau de co-expression génique pondéré. La valeur minimale permettant d'obtenir un indice d'ajustement à une topologie sans échelle (R2 > 0,9) a été retenue, conduisant à β = 5. Une valeur plus faible pourrait produire des modules fragmentés ou fonctionnellement peu informatifs, tandis qu'une valeur plus élevée pourrait affaiblir la connectivité des gènes et réduire la puissance statistique de l'analyse de corrélation entre modules et caractères46. Les seuils de contrôle qualité pour les cellules uniques ont été adaptés au tissu cardiaque, car les cardiomyocytes présentent une activité métabolique élevée. Une stratégie de filtration stricte, avec un seuil de pourcentage de gènes mitochondriaux inférieur à 25 % et une plage de gènes détectés comprise entre 200 et 6 000, a été mise en œuvre afin d'éliminer les cellules rompues et de faible qualité tout en conservant les cardiomyocytes50. Une graine aléatoire fixe, set. seed(12345), a été utilisée pour la séparation des jeux de données, l'entraînement du modèle et la validation croisée afin de réduire les variations entre les analyses répétées d'apprentissage automatique47.
La confirmation du génotype, un hébergement standardisé et des mesures échocardiographiques cohérentes ont été essentielles pour maintenir la stabilité phénotypique dans les expériences animales. Les souris transgéniques CTNTR141W développent une dilatation du ventricule gauche et une dysfonction systolique après la période d'acclimatation et d'alimentation spécifiée51. La vérification du génotype avant le regroupement est nécessaire afin d'exclure les animaux non transgéniques et d'éviter une mauvaise classification du phénotype. Les mesures échocardiographiques doivent être réalisées de manière constante au niveau des muscles papillaires du ventricule gauche, en moyennant les valeurs obtenues sur trois cycles cardiaques stables consécutifs. Une variation de la position d'imagerie ou de la profondeur d'anesthésie peut augmenter la variabilité des mesures de la fraction d'éjection du ventricule gauche51. La qualité du dosage immunoenzymatique a été évaluée à l'aide des coefficients de corrélation des courbes standards, avec un R2 ≥ 0,99, et des coefficients de variation < 10 % entre les puits dupliqués. Une linéarité insuffisante de la courbe standard ou des mesures dupliquées incohérentes peuvent introduire une erreur systématique dans l'estimation des concentrations protéiques.
Plusieurs problèmes analytiques peuvent survenir lors de la mise en œuvre du flux de travail. Une séparation persistante par lot après correction par ComBat peut refléter une colinéarité entre les variables de lot et les facteurs cliniques, un filtrage insuffisant des gènes faiblement exprimés ou une variation technique non modélisée. Les covariables cliniques telles que l'âge et le sexe peuvent être incluses comme variables protégées si elles sont disponibles, et les gènes dont l'expression est nulle dans plus de 70 % des échantillons peuvent être supprimés afin de réduire le bruit44. Une correction supplémentaire à l’aide de removeBatchEffect peut être envisagée en cas de séparation résiduelle persistante. Un nombre inattendu de gènes différentiellement exprimés, trop élevé ou trop faible, peut nécessiter une évaluation de l'hétérogénéité des échantillons, de la normalisation, des valeurs aberrantes et du choix des seuils27. Des corrélations faibles entre modules et traits peuvent être corrigées en réévaluant le seuil de variance, la puissance de seuil doux (soft-thresholding) et les valeurs extrêmes des traits. L’élargissement du jeu de gènes aux 7 500 gènes les plus variables (au lieu de 5 000) ou le remplacement de l’analyse d’enrichissement de jeux de gènes sur échantillon unique par une analyse de variation de jeux de gènes peut améliorer la détection des modules46. Un nombre excessif de nœuds isolés dans le réseau d’interactions protéine-protéine peut nécessiter un ajustement du seuil de confiance de STRING ou un élargissement de l’ensemble des gènes candidats30. Des performances médiocres en apprentissage automatique peuvent refléter des différences de distribution entre les jeux d’apprentissage et de validation, une redondance des caractéristiques ou un déséquilibre entre les groupes. Un échantillonnage stratifié, la réduction des caractéristiques redondantes ou la sur-échantillonnage de la classe minoritaire peuvent atténuer ces effets47. Un regroupement ambigu en analyse de cellules uniques peut nécessiter une réévaluation de la correction par Harmony, du choix des composantes principales et de l’annotation des gènes marqueurs50.
Plusieurs limites doivent être prises en compte. Les jeux de données transcriptomiques ont été obtenus de manière rétrospective à partir de référentiels publics, et les plans d'étude initiaux ainsi que les facteurs de confusion cliniques n'ont pas pu être contrôlés. Les annotations cliniques étaient incomplètes dans l'ensemble des jeux de données, et la plupart d'entre eux ne contenaient pas d'informations détaillées sur l'étiologie, les antécédents médicamenteux, l'âge des patients ou les résultats à long terme. Ces limites ont empêché l'évaluation des associations entre les gènes sélectionnés et le pronostic, la réponse au traitement ou le vieillissement chronologique52. Une variation technique résiduelle pourrait également persister malgré la correction par lots. L'analyse était principalement fondée sur l'expression de l'ARN messager et n'incluait pas de données épigénomiques, protéomiques ou métabolomiques intégrées. Par conséquent, l'activité des protéines, la régulation post-traductionnelle et les mécanismes en amont n'ont pas pu être déterminées. Un seul jeu de données en cellule unique a été inclus, ce qui limite l'évaluation de l'hétérogénéité cellulaire selon les différentes étiologies de la MCD50. Le modèle transgénique CTNTR141W représente principalement une MCD héréditaire associée à une mutation de la troponine T cardiaque et pourrait ne pas reproduire les formes idiopathiques, virales ou ischémiques de la maladie51. Les différences entre espèces, entre la souris et l'humain, limitent également la traduction clinique directe. La validation au niveau protéique s'est limitée au tissu myocardique de souris, et aucune étude sur de grandes cohortes cliniques ni comparaison avec des biomarqueurs établis n'a été réalisée. Les quatre gènes centraux ne sont pas spécifiques à la MCD et pourraient également être modifiés dans d'autres affections cardiovasculaires ou inflammatoires. De plus, la sélection des candidats s'est appuyée sur des ensembles de gènes prédéfinis liés au vieillissement et aux mitochondries. Cette stratégie basée sur une hypothèse pourrait exclure des gènes situés en dehors des ensembles de référence sélectionnés, tandis que l'intersection entre trois algorithmes d'apprentissage automatique pourrait omettre des gènes identifiés par une seule méthode48.
Le cadre analytique pourrait soutenir des études futures de sous-typage moléculaire, de validation de biomarqueurs et de multi-omiques dans la MCD. Le panel de quatre gènes pourrait être évalué dans des cohortes indépendantes de sang périphérique ou de myocarde avant d'être utilisé comme outil diagnostique ou de sous-typage. Les sous-types C1 et C2 ont montré des profils différents des voies immunitaires et métaboliques, fournissant une base pour la validation ultérieure de caractéristiques biologiques spécifiques à chaque sous-type15. Les gènes sélectionnés pourraient également être examinés dans des études de docking moléculaire, cellulaires et fonctionnelles. TLR2 et CYBB sont associés à la signalisation inflammatoire et à la production d'espèces réactives de l'oxygène, tandis que TGFB2 et SERPINE1 sont associés à la fibrose et au remodelage cardiaque53. L'intégration avec des données protéomiques, métabolomiques, épigénomiques, d'association génomique à grande échelle et de randomisation mendélienne pourrait aider à évaluer les relations régulatrices et les associations causales potentielles54. Le flux de travail pourrait également être adapté à des études transcriptomiques de la cardiomyopathie hypertrophique, de la cardiomyopathie ischémique et de l'insuffisance cardiaque en remplaçant les jeux de données spécifiques à la maladie et les jeux de gènes de référence45. L'intégration future de tests unicellulaires pour le séquençage de la chromatine accessible à la transposase et de la transcriptomique spatiale pourrait fournir des informations supplémentaires sur la régulation cellulaire et l'expression spatiale. L'enrichissement observé des signatures liées au vieillissement dans les macrophages et des signatures mitochondriales dans les cardiomyocytes était conforme aux rapports précédents sur les processus inflammatoires et mitochondriaux dans les maladies cardiaques55,56,57.
Cette étude présente plusieurs limites qui doivent être reconnues. Notamment, les kits ELISA commerciaux utilisés pour la quantification des protéines ont été officiellement validés pour la détection des protéines cibles dans des échantillons de sérum. Dans la présente étude, des lysats de tissu myocardique ont été utilisés comme matrice de détection au lieu du sérum. Bien que des protocoles de prétraitement des échantillons et d'opérations expérimentales cohérents aient été strictement appliqués tout au long du dosage afin d'assurer la fiabilité et la comparabilité des données expérimentales, l'absence de validation officielle par le fabricant de ces kits ELISA pour des échantillons de lysat de tissu myocardique pourrait entraîner d'éventuelles petites déviations dans les résultats quantitatifs des protéines. Par conséquent, l'utilisation de kits ELISA spécifiques au sérum sur des lysats de tissu myocardique constitue une limite méthodologique de cette étude.
Déclarations de divulgation
L'auteur déclare ne pas avoir d'intérêts concurrents.
Remerciements
Nous remercions sincèrement pour les données accessibles au public fournies par la base de données Gene Expression Omnibus. Nous remercions également les relecteurs et les rédacteurs pour leurs commentaires constructifs sur le manuscrit. Ce travail a été soutenu par le projet provincial de recherche scientifique de niveau départemental (subvention n° 2021JDZX2026), « Mécanisme de la formule Yiqi Huoxue dans l'atténuation du remodelage vasculaire athéroscléreux via la régulation inflammatoire médiée par KLF2-Nrf2 ».
Matériaux
| Nom | Entreprise | Numéro de catalogue | Commentaires |
|---|---|---|---|
| Gel d'échographie Aquasonic Clear | Parker Laboratories, Inc. | Mar-34 | Utilisé pour l'imagerie échocardiographique chez les petits animaux. |
| Kit d'analyse des protéines BCA | Thermo Fisher Scientific | 23227 | Détection à 562 nm ; plage, 20–2 000 µg/mL ; utilisé pour la quantification totale des protéines dans les lysats cardiaques de souris. |
| Base de données CellAge | Ressources génomiques sur le vieillissement humain | https://genomics.senescence.info/cells/ | Source de signatures génétiques liées au vieillissement. |
| CytoHubba, greffon Cytoscape | Boutique d'applications Cytoscape | Version 0.1 | Utilisé pour le score de topologie des nœuds dans les réseaux d'interactions protéine-protéine. |
| Cytoscape | Consortium Cytoscape | Version 3.9.1 | Utilisé pour la visualisation des réseaux d'interactions protéine-protéine. |
| Lecteur de microplaque à spectre complet | Thermo Fisher Scientific | Multiskan FC | Utilisé pour mesurer l'absorbance dans les dosages ELISA. |
| Gene Expression Omnibus | Centre national pour les ressources en biotechnologie | https://www.ncbi.nlm.nih.gov/geo/ | Référentiel public utilisé pour obtenir des jeux de données transcriptomiques. |
| GeneCards | Institut Weizmann des sciences | https://www.genecards.org/ | Source de jeux de gènes liés aux mitochondries. |
| Cocktail inhibiteur de protéases et de phosphatases Halt, 100×, sans EDTA | Thermo Fisher Scientific | 78441 | Conservé à 4 °C ; ajouté au tampon RIPA à raison de 10 µL/mL juste avant utilisation. |
| Azote liquide | Fournisseur local de gaz pour laboratoire | Non applicable | Utilisé pour la congélation rapide du tissu myocardique. |
| Souris mâles C57BL/6J de qualité SPF, âgées de 6–8 semaines, pesant 25 ± 2 g | Beijing Vital River Laboratory Animal Technology Co., Ltd. | Non applicable | Numéro de licence de production animale SCXK (Jing) 2021-0006 ; utilisées comme témoins normaux. |
| Souris transgéniques mâles DCM CTNTR141W de qualité SPF, âgées de 6–8 semaines, pesant 25 ± 2 g | Institut des sciences des animaux de laboratoire, Académie chinoise des sciences médicales | Non applicable | Numéro de licence de production animale SCXK (Jing) 2021-0065 ; utilisées comme modèle spontané de DCM. |
| MCODE, greffon Cytoscape | Boutique d'applications Cytoscape | Version 2.0.2 | Utilisé pour identifier les sous-réseaux fonctionnels centraux dans les réseaux d'interactions protéine-protéine. |
| Kit ELISA souris CYBB | Biogradetech | A-QEK09250-96wells | Utilisé dans cette étude pour mesurer CYBB dans les lysats tissulaires myocardiques de souris. |
| Kit ELISA souris PAI-1 | EK-BIO | ML30970 | Utilisé dans cette étude pour mesurer PAI-1, la protéine codée par SERPINE1, dans les lysats tissulaires myocardiques de souris. |
| Kit ELISA souris TGF-β2 | ElaBoX | SEKM-0036 | Utilisé dans cette étude pour mesurer TGF-β2 dans les lysats tissulaires myocardiques de souris. |
| Kit ELISA souris TLR-2 | Solarbio | SEKM-0163 | Utilisé dans cette étude pour mesurer TLR-2 dans les lysats tissulaires myocardiques de souris. |
| Solution tamponnée au phosphate, pH 7,4, sans calcium ni magnésium | Biological Industries | 02-024-1ACS | Solution stérile 1× ; conservée à 4 °C ; utilisée pour le lavage et la dilution des tissus. |
| Package R : caret | CRAN | Version 6.0-94 | Utilisé pour l'élimination récursive de caractéristiques par machine à vecteurs de support. |
| Package R : CellChat | Développeurs de CellChat | Version 1.6.1 | Utilisé pour l'inférence des communications intercellulaires à partir de données de séquençage ARN unicellulaire. |
| Package R : clusterProfiler | Bioconductor | Version 4.8.3 | Utilisé pour l'analyse d'enrichissement fonctionnel. |
| Package R : ConsensusClusterPlus | Bioconductor | Version 1.64.0 | Utilisé pour le regroupement par consensus non supervisé. |
| Package R : edgeR | Bioconductor | Version 3.42.4 | Utilisé pour la normalisation des données de séquençage ARN par la méthode de la moyenne tronquée des valeurs M. |
| Package R : GEOquery | Bioconductor | Version 2.68.0 | Utilisé pour télécharger des données à partir du Gene Expression Omnibus. |
| Package R : glmnet | CRAN | Version 4.1-8 | Utilisé pour la régression logistique par l'opérateur de sélection et de réduction absolue minimale. |
| Package R : limma | Bioconductor | Version 3.56.2 | Utilisé pour l'analyse d'expression différentielle et la modélisation statistique. |
| Package R : pROC | CRAN | Version 1.18.5 | Utilisé pour l'analyse des courbes ROC (caractéristique de fonctionnement du récepteur). |
| Package R : randomForest | CRAN | Version 4.7-1.2 | Utilisé pour l'apprentissage automatique par forêts aléatoires. |
| Package R : Seurat | CRAN | Version 5.0.1 | Utilisé pour l'analyse des données de séquençage ARN unicellulaire. |
| Package R : SingleR | Bioconductor | Version 2.2.0 | Utilisé pour l'annotation automatisée des types cellulaires. |
| Package R : sva | Bioconductor | Version 3.48.0 | Utilisé pour la correction des effets de lot avec ComBat. |
| Centrifugeuse réfrigérée | Sigma-Aldrich | SIGMA 3-K | Utilisée pour la centrifugation des lysats tissulaires myocardiques. |
| Solution de lyse et d'extraction RIPA | Thermo Fisher Scientific | 89900 | Solution prête à l'emploi 1× ; conservée à 4 °C ; supplémentée avec des inhibiteurs de protéases et de phosphatases avant utilisation. |
| Système d'imagerie par ultrasons pour petits animaux | VINNO Technology Co., Ltd. | VINN06LAB | Utilisé pour l'évaluation échocardiographique de la fonction cardiaque. |
| Pentobarbital de sodium | Sinopharm Chemical Reagent Co. | 20040428 | Préparé sous forme de solution à 1 %, 10 mg/mL, dans du sérum physiologique stérile ; utilisé pour l'anesthésie intrapéritonéale à 30 mg/kg. |
| Base de données STRING | Consortium STRING | Version 11.5 | Utilisée pour la construction de réseaux d'interactions protéine-protéine. |
| Homogénéisateur de tissus TGrinder H24 | TIANGEN | OSE-TH-01 | Utilisé pour homogénéiser le tissu myocardique de souris dans du tampon RIPA à 6,0 m/s pendant 30–60 s, sur 2–3 cycles. |
| Plateforme animale thermostatée/table chauffante pour petits animaux | Shanghai Yuyan Scientific Instrument Co., Ltd. | T-30350 | Utilisée pour maintenir les souris à 37 °C pendant l'échocardiographie ; plage de fonctionnement, de la température ambiante à 50 °C. |
Références
- Pinto YM et al. Proposal for a revised definition of dilated cardiomyopathy, hypokinetic non-dilated cardiomyopathy, and its implications for clinical practice: a position statement of the ESC working group on myocardial and pericardial diseases. Eur Heart J. 2016;37(23):1850-1858. https://doi.org/10.1093/eurheartj/ehv727
- Newman NA, Burke MA. Dilated Cardiomyopathy: A Genetic Journey from Past to Future. Int J Mol Sci. 2024;25(21):11460. https://doi.org/10.3390/ijms252111460
- Mishra B et al. Tumour necrosis factor-alpha promoter polymorphism and its association with viral dilated cardiomyopathy in Indian population: a pilot study. Indian J Med Microbiol. 2015;33(1):16–20. https://doi.org/10.4103/0255-0857.148368
- Frustaci A et al. Oxidative myocardial damage in human cocaine-related cardiomyopathy. Eur J Heart Fail. 2015;17(3):283-290. https://doi.org/10.1002/ejhf.219
- Ni B et al. The role of β-catenin in cardiac diseases. Front Pharmacol. 2023;14:1157043. https://doi.org/10.3389/fphar.2023.1157043
- Kuwahara K et al. TRPC6 fulfills a calcineurin signaling circuit during pathologic cardiac remodeling. J Clin Invest. 2006;116(12):3114-3126. https://doi.org/10.1172/JCI27702
- He SL et al. Mitochondrial-related gene expression profiles suggest an important role of PGC-1alpha in the compensatory mechanism of endemic dilated cardiomyopathy. Exp Cell Res. 2013;319(17):2604–2616. https://doi.org/10.1016/j.yexcr.2013.07.017
- Luczak ED et al. Mitochondrial CaMKII causes adverse metabolic reprogramming and dilated cardiomyopathy. Nat Commun. 2020;11(1):4416. https://doi.org/10.1038/s41467-020-18165-6
- Li E et al. BMAL1 regulates mitochondrial fission and mitophagy through mitochondrial protein BNIP3 and is critical in the development of dilated cardiomyopathy. Protein Cell. 2020;11(9):661–679. https://doi.org/10.1007/s13238-020-00713-1
- Alila-Fersi O et al. First description of a novel mitochondrial mutation in the MT-TI gene associated with multiple mitochondrial DNA deletion and depletion in family with severe dilated mitochondrial cardiomyopathy. Biochem Biophys Res Commun. 2018;497(4):1049-1054. https://doi.org/10.1016/j.bbrc.2018.02.162
- Ramaccini D et al. Mitochondrial Function and Dysfunction in Dilated Cardiomyopathy. Front Cell Dev Biol. 2020;8:624216. https://doi.org/10.3389/fcell.2020.624216
- Yang J et al. Stem cells in the treatment of myocardial injury-induced cardiomyopathy: mechanisms and efficient utilization strategies. Front Pharmacol. 2025;16:1600604. https://doi.org/10.3389/fphar.2025.1600604
- Van Linthout S et al. State of the art and perspectives of gene therapy in heart failure. A scientific statement of the Heart Failure Association of the ESC, the ESC Council on Cardiovascular Genomics and the ESC Working Group on Myocardial & Pericardial Diseases. Eur J Heart Fail. 2025;27(1):5–25. https://doi.org/10.1002/ejhf.3516
- Alimadadi A, Munroe PB, Joe B, Cheng X. Meta-Analysis of Dilated Cardiomyopathy Using Cardiac RNA-Seq Transcriptomic Datasets. Genes (Basel). 2020;11(1):60. https://doi.org/10.3390/genes11010060
- Verdonschot J et al. Clustering of Cardiac Transcriptome Profiles Reveals Unique Subgroups of Dilated Cardiomyopathy Patients. JACC Basic Transl Sci. 2023;8(4):406–418. https://doi.org/10.1016/j.jacbts.2022.10.007
- Zhu T et al. Identification and Verification of Feature Biomarkers Associated With Immune Cells in Dilated Cardiomyopathy by Bioinformatics Analysis. Front Genet. 2022;13:874544. https://doi.org/10.3389/fgene.2022.874544
- Li H et al. Identification of Centrosome Duplication-Related Biomarkers in Hypertrophic Cardiomyopathy Through Integrative Multi-Omics, Single-Cell Transcriptomics, and Experimental Validation. J Am Heart Assoc. 2026;15(12):e047416. https://doi.org/10.1161/JAHA.125.047416
- Ni L et al. Dissecting and validation the biomarker of heart failure progression in patients with atherosclerosis by single-cell sequencing, bioinformatics, and machine learning. Front Genet. 2025;16:1587274. https://doi.org/10.3389/fgene.2025.1587274
- Barrett T et al. NCBI GEO: archive for functional genomics data sets--update. Nucleic Acids Res. 2013;41(Database issue):D991–D995. https://doi.org/10.1093/nar/gks1193
- Davis S, Meltzer PS. GEOquery: a bridge between the Gene Expression Omnibus (GEO) and BioConductor. Bioinformatics. 2007;23(14):1846-1847. https://doi.org/10.1093/bioinformatics/btm254
- Irizarry RA et al. Exploration, normalization, and summaries of high density oligonucleotide array probe level data. Biostatistics. 2003;4(2):249-264. https://doi.org/10.1093/biostatistics/4.2.249
- Robinson MD, McCarthy DJ, Smyth GK. edgeR: a Bioconductor package for differential expression analysis of digital gene expression data. Bioinformatics. 2010;26(1):139–140. https://doi.org/10.1093/bioinformatics/btp616
- Leek JT et al. The sva package for removing batch effects and other unwanted variation in high-throughput experiments. Bioinformatics. 2012;28(6):882–883. https://doi.org/10.1093/bioinformatics/bts034
- Butler A et al. Integrating single-cell transcriptomic data across different conditions, technologies, and species. Nat Biotechnol. 2018;36(5):411-420. https://doi.org/10.1038/nbt.4096
- Korsunsky I et al. Fast, sensitive and accurate integration of single-cell data with Harmony. Nat Methods. 2019;16(12):1289-1296. https://doi.org/10.1038/s51592-019-0619-0
- Aran D et al. Reference-based analysis of lung single-cell sequencing reveals a transitional profibrotic macrophage. Nat Immunol. 2019;20(2):163-172. https://doi.org/10.1038/s41590-018-0276-y
- Ritchie ME et al. limma powers differential expression analyses for RNA-sequencing and microarray studies. Nucleic Acids Res. 2015;43(7):e47. https://doi.org/10.1093/nar/gkv007
- Barbie DA et al. Systematic RNA interference reveals that oncogenic KRAS-driven cancers require TBK1. Nature. 2009;462(7269):108-112. https://doi.org/10.1038/nature08460
- Yu G et al. clusterProfiler: an R package for comparing biological themes among gene clusters. OMICS. 2012;16(5):284-287. https://doi.org/10.1089/omi.2011.0118
- Szklarczyk D et al. STRING v11: protein-protein association networks with increased coverage, supporting functional discovery in genome-wide experimental datasets. Nucleic Acids Res. 2019;47(D1):D607–D613. https://doi.org/10.1093/nar/gky1131
- Shannon P et al. Cytoscape: a software environment for integrated models of biomolecular interaction networks. Genome Res. 2003;13(11):2498-2504. https://doi.org/10.1101/gr.1239303
- Chin CH et al. cytoHubba: identifying hub objects and sub-networks from complex interactome. BMC Syst Biol. 2014;8(Suppl 4):S11. https://doi.org/10.1186/1752-0509-8-S4-S11
- Bader GD, Hogue CW. An automated method for finding molecular complexes in large protein interaction networks. BMC Bioinformatics. 2003;4:2. https://doi.org/10.1186/1471-2105-4-2
- Friedman J, Hastie T, Tibshirani R. Regularization Paths for Generalized Linear Models via Coordinate Descent. J Stat Softw. 2010;33(1):1-22. https://doi.org/10.18637/jss.v033.i01
- Touw WG et al. Data mining in the Life Sciences with Random Forest: a walk in the park or lost in the jungle. Brief Bioinform. 2013;14(3):315-326. https://doi.org/10.1093/bib/bbs034
- Chicco D. Ten quick tips for machine learning in computational biology. BioData Min. 2017;10:35. https://doi.org/10.1186/s13040-017-0155-3
- Robin X et al. pROC: an open-source package for R and S+ to analyze and compare ROC curves. BMC Bioinformatics. 2011;12:77. https://doi.org/10.1186/1471-2105-12-77
- Lundberg SM et al. From Local Explanations to Global Understanding with Explainable AI for Trees. Nat Mach Intell. 2020;2(1):56-67. https://doi.org/10.1038/s42256-019-0138-9
- Jin S et al. Inference and analysis of cell-cell communication using CellChat. Nat Commun. 2021;12(1):1088. https://doi.org/10.1038/s41467-021-21246-9
- Charoentong P et al. Pan-cancer Immunogenomic Analyses Reveal Genotype-Immunophenotype Relationships and Predictors of Response to Checkpoint Blockade. Cell Rep. 2017;18(1):248–262. https://doi.org/10.1016/j.celrep.2016.12.019
- Wilkerson MD, Hayes DN. ConsensusClusterPlus: a class discovery tool with confidence assessments and item tracking. Bioinformatics. 2010;26(12):1572–1573. https://doi.org/10.1093/bioinformatics/btq170
- Hänzelmann S, Castelo R, Guinney J. GSVA: gene set variation analysis for microarray and RNA-seq data. BMC Bioinformatics. 2013;14:7. https://doi.org/10.1186/1471-2105-14-7
- Zheng Y et al. Exploring Key Genes to Construct a Diagnosis Model of Dilated Cardiomyopathy. Front Cardiovasc Med. 2022;9:865096. https://doi.org/10.3389/fcvm.2022.865096
- Johnson WE, Li C, Rabinovic A. Adjusting batch effects in microarray expression data using empirical Bayes methods. Biostatistics. 2007;8(1):118-127. https://doi.org/10.1093/biostatistics/kxj037
- Koslow M, Mondaca-Ruff D, Xu X. Transcriptome studies of inherited dilated cardiomyopathies. Mamm Genome. 2023;34(2):312-322. https://doi.org/10.1007/s00335-023-09978-z
- Zhang B, Horvath S. A general framework for weighted gene co-expression network analysis. Stat Appl Genet Mol Biol. 2005;4:Article17. https://doi.org/10.2202/1544-6115.1128
- Lin M et al. Machine learning and multi-omics integration: advancing cardiovascular translational research and clinical practice. J Transl Med. 2025;23(1):388. https://doi.org/10.1186/s12967-025-06425-2
- Climente-González H et al. Interpretable machine learning leverages proteomics to improve cardiovascular disease risk prediction and biomarker identification. Commun Med (Lond). 2025;5(1):170. https://doi.org/10.1038/s43856-025-00872-0
- Shah P et al. Predicting cardiovascular risk with hybrid ensemble learning and explainable AI. Sci Rep. 2025;15(1):17927. https://doi.org/10.1038/s41598-025-01650-7
- Chaffin M et al. Single-nucleus profiling of human dilated and hypertrophic cardiomyopathy. Nature. 2022;608(7921):174-180. https://doi.org/10.1038/s41586-022-04817-8
- Juan F et al. The changes of the cardiac structure and function in cTnTR141W transgenic mice. Int J Cardiol. 2008;128(1):83-90. https://doi.org/10.1016/j.ijcard.2008.03.006
- Russell-Hallinan A et al. Single-Cell RNA Sequencing Reveals Cardiac Fibroblast-Specific Transcriptomic Changes in Dilated Cardiomyopathy. Cells. 2024;13(9):752. https://doi.org/10.3390/cells13090752
- Knowlton KU. Dilated Cardiomyopathy. Circulation. 2019;139(20):2339-2341. https://doi.org/10.1161/CIRCULATIONAHA.119.040037
- Smith GD, Ebrahim S. Mendelian randomization: prospects, potentials, and limitations. Int J Epidemiol. 2004;33(1):30-42. https://doi.org/10.1093/ije/dyh132
- Chen R et al. Macrophages in cardiovascular diseases: molecular mechanisms and therapeutic targets. Signal Transduct Target Ther. 2024;9(1):130. https://doi.org/10.1038/s41392-024-01840-1
- Liu R et al. Tead1 is essential for mitochondrial function in cardiomyocytes. Am J Physiol Heart Circ Physiol. 2020;319(1):H89-H99. https://doi.org/10.1152/ajpheart.00732.2019
- Sharma S et al. SOD2 deficiency in cardiomyocytes defines defective mitochondrial bioenergetics as a cause of lethal dilated cardiomyopathy. Redox Biol. 2020;37:101740. https://doi.org/10.1016/j.redox.2020.101740