Ce protocole décrit un flux de travail structuré et traçable pour le traitement de données anonymisées issues d'un questionnaire sur le bien-être des étudiants de premier cycle, allant de l'export brut et de l'examen des réponses au calcul des scores d'échelle, à la vérification de la fiabilité, aux diagnostics de régression, à la validation des sources des figures, et à la production de sorties analytiques prêtes à être visualisées.
Article de méthode
Un flux de travail structuré pour le criblage, la notation et la visualisation des données d'un questionnaire sur le bien-être des étudiants de premier cycle
Dans cet article
Résumé
Résumé
Les études fondées sur des questionnaires sont largement utilisées pour examiner le bien-être des étudiants, mais le processus méthodologique permettant de passer des réponses brutes à des variables analysables, des tableaux statistiques et des représentations visuelles est souvent insuffisamment documenté. Ce protocole décrit un flux de travail structuré et vérifiable pour le traitement de données anonymisées provenant d’un questionnaire sur le bien-être des étudiants de premier cycle, comprenant plusieurs sections utilisant des échelles de type Likert. Le flux de travail commence par l’obtention de l’approbation éthique, la documentation du consentement, la configuration du questionnaire et l’exportation des données brutes, puis se poursuit par l’examen des réponses, la vérification des doublons, la gestion des données manquantes, le codage des items, la transformation des scores inversés, l’évaluation de la fiabilité, l’analyse descriptive, l’analyse des corrélations, la comparaison entre groupes contrastés, la modélisation par régression, les vérifications diagnostiques et la préparation des fichiers sources pour la visualisation. Le questionnaire exemple utilise des sections d’échelles documentées à la source et adaptées à l’étude, inspirées des échelles Depression Anxiety Stress Scales-21, de l’échelle de Procrastination de Tuckman, de l’échelle Psychological Sense of School Membership, de la littérature sur la mesure de la pensée de niveau supérieur et de documents relatifs aux échelles de bien-être subjectif. Les émotions négatives, la procrastination académique, l’appartenance scolaire, la pensée de niveau supérieur et le bien-être subjectif sont utilisées comme variables exemple au niveau des échelles afin d’illustrer comment les réponses au niveau des items peuvent être converties en résultats analytiques traçables. Les résultats représentatifs incluent un tableau du flux de sélection, un résumé démographique, des statistiques descriptives et de vérification des plages de valeurs, des estimations de la cohérence interne, une matrice de corrélation, les résultats des comparaisons contrastives, les coefficients de régression, les diagnostics des résidus et des influences, ainsi que les fichiers sources des figures. Le protocole insiste sur l’importance de règles de décision préétablies, d’une carte des échelles interconnectée, d’un journal de criblage préalable à l’analyse, de la vérification du recodage des items inversés et de la vérification numérique des sources des figures. Plutôt que de proposer une nouvelle échelle psychométrique, de valider un modèle de mesure ou d’établir des relations causales, cette méthode fournit une procédure pratique et vérifiable destinée aux chercheurs devant cribler, coder, analyser et visualiser des données de questionnaires portant sur le bien-être des étudiants de premier cycle. Ce flux de travail peut être adapté à d’autres études fondées sur des questionnaires, à condition que la carte des échelles, l’approbation éthique, les règles de codage, les seuils de criblage des réponses et les fichiers sources pour la visualisation soient définis avant l’analyse.
Introduction
Le bien-être subjectif est un résultat important dans la recherche sur les étudiants, car il reflète la manière dont ceux-ci évaluent leur vie, leurs expériences émotionnelles, leurs relations sociales et leur fonctionnement quotidien dans les environnements d'apprentissage. Dans l'enseignement supérieur, le bien-être des étudiants est multidimensionnel et ne se limite pas à la satisfaction de vie ou à la détresse psychologique seule1. Les données issues de questionnaires restent donc utiles lorsque les chercheurs doivent examiner des expériences émotionnelles, comportementales, sociales, cognitives et liées au bien-être dans un même cadre analytique.
La valeur des données issues des questionnaires dépend non seulement des construits sélectionnés, mais aussi de la manière dont les réponses brutes sont converties en variables analytiques. De nombreuses études rapportent des scores d'échelle, des matrices de corrélation, des comparaisons de groupes ou des modèles de régression sans montrer les décisions intermédiaires qui relient les données brutes aux tableaux et figures finaux. Les réponses manquantes peuvent être traitées de façon incohérente, les items inversés peuvent être mal codés, les soumissions en double peuvent rester dans le jeu de données, et les réponses inattentives peuvent être considérées comme des observations valides. Les décisions relatives aux données manquantes doivent donc être planifiées, documentées et rapportées, plutôt que d'être traitées comme une étape post hoc invisible2. Les données de questionnaires en ligne exigent également des règles explicites de qualité des réponses, car la précipitation, les réponses linéaires constantes, les incohérences et d'autres schémas de faible effort peuvent fausser les statistiques descriptives, les estimations de fiabilité et les associations observées3.
La nouveauté de ce protocole réside dans sa traçabilité associée, allant de l'export brut du questionnaire aux résultats statistiques et visuels finaux. Plus précisément, le flux de travail inclut une carte des échelles complétées, un journal de contrôle préalable à l'analyse, un point de contrôle pour le recodage inverse, un journal de vérification des scores, une vérification de la source numérique des figures, ainsi qu'une traçabilité permettant d'associer chaque tableau ou figure à son fichier source. Cela distingue la méthode des pratiques courantes de nettoyage de questionnaires, de calcul des échelles, de test de fiabilité ou de visualisation. Plutôt que de simplement indiquer que les données du questionnaire ont été nettoyées et analysées, le protocole précise quel fichier est verrouillé, quel fichier est contrôlé, quelles règles sont appliquées, quels scores d'échelle sont générés, et quel tableau numérique validé est utilisé pour produire chaque sortie visuelle.
Le flux de travail est illustré à l'aide de données anonymisées provenant d'un questionnaire administré à des étudiants universitaires, contenant cinq variables de type échelle : émotion négative, procrastination académique, sentiment d'appartenance scolaire, pensée de niveau supérieur et bien-être subjectif. Ces construits ont été choisis afin de fournir des exemples d'ordre émotionnel, comportemental, contextuel scolaire, cognitif et orientés vers les résultats, le tout dans un flux de travail structuré et traçable. La procrastination académique a été associée à des difficultés ultérieures de santé mentale chez les étudiants universitaires, notamment la dépression, l'anxiété et les conséquences liées au stress4. Le sentiment d'appartenance scolaire et le bien-être subjectif sont également étroitement liés au sein des populations étudiantes, ce qui justifie l'inclusion de mesures relatives à l'appartenance et au bien-être dans un même cadre de traitement des questionnaires5. Toutefois, dans ce protocole, ces construits sont utilisés pour illustrer le flux de travail, et non pour établir un modèle psychologique causal.
Une caractéristique centrale du protocole réside dans la séparation des décisions relatives au traitement des données de l'interprétation scientifique. La carte d'échelle est établie avant l'analyse, les critères de qualité des réponses sont fixés avant le calcul des scores, la vérification du recodage inverse est effectuée avant les tests statistiques, et les figures ne sont générées qu'après vérification des tableaux numériques sources. Cette séquence est importante car les échelles de réponse de type Likert exigent un alignement rigoureux entre la formulation des items, les modalités de réponse, le sens du codage et le traitement statistique6. Le protocole privilégie également la transparence de la préparation et de la vérification du codage plutôt que la complexité du modèle. Bien que des modèles prédictifs ou multivariés puissent être utiles dans le cadre de recherches étudiantes7, et que des résumés graphiques puissent améliorer l'interprétation lorsqu'ils restent liés à des matrices numériques validées8, ces deux approches dépendent d'une préparation transparente des variables d'entrée. Pour cette raison, le flux de travail utilise l'analyse de corrélation, la comparaison contrastive entre groupes, la modélisation par régression, les vérifications diagnostiques et la visualisation comme modules d'exemple, et non comme des affirmations scientifiques obligatoires.
Ce protocole est destiné aux chercheurs qui ont besoin d'un flux de travail pratique pour le traitement de questionnaires portant sur des données anonymisées concernant le bien-être des étudiants. Il convient lorsque les réponses aux items du questionnaire sont exportées à partir d'une plateforme en ligne, que des variables au niveau des échelles doivent être calculées à partir d'items de type Likert, et que l'objectif est de produire des résultats descriptifs, corrélations, comparaisons de groupes, régressions, diagnostics et visualisations, prêts à être présentés. Il n'est pas conçu pour établir des relations causales, valider de nouvelles échelles, remplacer une analyse factorielle confirmatoire, remplacer les tests d'invariance de mesure, ni servir de substitut à la modélisation par théorie de réponse à l'item ou par variables latentes. Sa contribution est d'ordre procédural : il rend visible, reproductible et vérifiable le parcours allant des données recueillies par questionnaire aux tableaux et figures publiés. Cet accent mis sur la procédure s'inscrit dans les préoccupations actuelles relatives à la qualité des données issues de sondages en ligne9, à la vérification des régressions et des influences10, ainsi qu'aux flux d'analyse basés sur des questionnaires transparents et vérifiables11.
Protocole
Cette étude impliquant des participants humains a été examinée et approuvée par le comité d'éthique du Collège d'aéronautique de l'Université ouverte du Guizhou (numéro d'approbation : GZOU-EDU-2024-015). Le comité a jugé que l'étude pouvait bénéficier d'une exemption éthique car elle utilisait des questionnaires anonymes et volontaires, et présentait un risque minimal pour les participants. Tous les participants ont donné leur consentement éclairé par voie électronique avant de remplir le questionnaire, et pouvaient cesser de répondre à tout moment sans pénalité. Étant donné que plusieurs questions portaient sur des émotions négatives, le stress, la solitude, l'impuissance, l'insatisfaction ou d'autres expériences liées au bien-être, la page de consentement et la dernière page du questionnaire indiquaient les coordonnées du chercheur et de l'institution, à destination des participants éprouvant un malaise. Le jeu de données utilisé dans ce protocole a été anonymisé avant le tri, la notation, l'analyse et la visualisation. Le questionnaire complet est fourni en tant que fichier supplémentaire 1.
1. Préparer le questionnaire, les documents éthiques et les documents relatifs au flux de travail
- Définir la population éligible, le cadre de l'étude, les variables du questionnaire et les résultats analytiques prévus avant la programmation du questionnaire.
- Préparer une demande d'éthique couvrant la population cible, le canal de recrutement, le contenu du questionnaire, le temps de complétion estimé, la protection de l'anonymat, le stockage des données, la procédure de retrait, les informations de soutien aux participants et les analyses prévues.
- Archiver dans le dossier du projet l'approbation ou l'exemption d'éthique, le libellé du consentement, le texte de recrutement, la version du questionnaire, les informations de soutien aux participants et le flux de travail prévu avant le début de la collecte de données.
- Définir la population cible comme étant les étudiants universitaires à temps plein âgés d'au moins 18 ans, actuellement inscrits dans un établissement d'enseignement supérieur, capables de comprendre le questionnaire et de donner leur consentement éclairé.
- Définir les critères d'exclusion avant le recrutement. Exclure les répondants qui refusent le consentement, ne répondent pas à la définition de la population cible, soumettent des réponses en double, dépassent le seuil de données manquantes ou satisfont aux critères combinés de réponse non valide décrits à l'étape 1.4.
- Placer l'énoncé de consentement éclairé au début du questionnaire. Indiquer l'objectif de l'étude, le caractère volontaire de la participation, le temps de complétion approximatif de 12 min, la protection de l'anonymat, le droit de se retirer, le plan d'utilisation des données, les coordonnées du chercheur et les coordonnées pour l'assistance.
- Ne pas recueillir d'informations directement identifiables, notamment les numéros d'identification étudiante, les numéros d'identification nationaux, les numéros de téléphone mobile, les adresses e-mail personnelles, les adresses de résidence universitaire ou tout autre identifiant personnel.
- Organiser le questionnaire dans l'ordre suivant : consentement éclairé, informations démographiques, items sur les émotions négatives, items sur le procrastination académique, items sur le sentiment d'appartenance scolaire, items sur la pensée de niveau supérieur, et items sur le bien-être subjectif.
- Sélectionner les instruments sources avant la programmation du questionnaire. Dans ce protocole, les émotions négatives ont été évaluées à l'aide de l'échelle de dépression, anxiété et stress (DASS-21) à 21 items, la procrastination académique à l'aide de l'échelle de procrastination de Tuckman à 16 items, le sentiment psychologique d'appartenance à l'école à l'aide de l'échelle à 18 items, la pensée de niveau supérieur à l'aide d'un ensemble de 20 items adapté de la littérature sur la mesure de la pensée de niveau supérieur, et le bien-être subjectif à l'aide d'une échelle de 20 items destinée à la recherche sur les étudiants universitaires12,13,14,15,16.
- Préparer une matrice normalisée des échelles avant la programmation du questionnaire. Inclure le nom de la variable, le nom original de l'échelle, la citation originale, la version linguistique, le statut d'autorisation ou de permission, la procédure de traduction ou d'adaptation, le code de l'item, le libellé de l'item, l'intervalle de réponse, les points d'ancrage, le sens du score, le statut des items inversés, la variable finale au niveau de l'échelle et la règle de calcul du score.
- Ne décrire un ensemble d'items comme une échelle validée que si l'instrument source, la citation, les preuves de validation et le statut de traduction ou d'adaptation sont documentés. Identifier tout ensemble d'items développé par l'auteur ou spécifique à l'étude dans Tableau 1 et Fichier Supplémentaire 1.
- Verrouiller le cadre de mesure avant la collecte des données. Pour les instruments traduits ou adaptés, effectuer la traduction, la relecture, la réconciliation et un test préliminaire avant le début du recrutement.
- Préparer un dossier d'audit du flux de travail incluant le fichier verrouillé du questionnaire, la matrice des échelles, la liste de contrôle d'exportation des données brutes, le journal de dépistage, le journal de vérification du calcul des scores, le journal d'analyse, le modèle de tableau des sources des figures et le fichier de syntaxe ou de script d'analyse.
- Utiliser des noms de fichiers avec numérotation de version pour tous les artefacts du flux de travail.
- Définir les colonnes requises pour chaque fichier d'audit.
- Le journal de dépistage inclut l'identifiant du dossier, le critère de dépistage, le statut du drapeau, le statut d'exclusion, la raison de l'exclusion, la date de décision et les initiales du relecteur.
- La matrice des échelles inclut le nom de la variable, la source de l'échelle, le code de l'item, le libellé de l'item, l'intervalle de réponse, les points d'ancrage, le statut d'inversion du score, le nom final de la variable, la règle de calcul du score et le statut d'autorisation ou d'adaptation.
- Le journal de vérification du calcul des scores inclut le code de l'item, l'intervalle de valeurs d'origine, l'intervalle de valeurs recodées, la formule d'inversion du score, le résultat du contrôle d'intervalle, le statut des écarts, la correction effectuée et la date de correction.
- Le tableau des sources des figures inclut le numéro de la figure, le numéro du panneau, le tableau source, les variables représentées, la statistique affichée, la taille de l'échantillon et le statut de vérification.
- Définir le flux analytique avant la programmation du questionnaire : administration du sondage, exportation des données brutes, dépistage des réponses, calcul des scores des échelles, évaluation de la fiabilité, analyse descriptive, analyse de corrélation, comparaison entre groupes hauts et bas, modélisation par régression, vérifications diagnostiques et préparation des visualisations17.
- Structurer le protocole autour des décisions, des opérations et des résultats de vérification plutôt que des chemins de menus logiciels.
- Mettre à disposition les ressources du flux de travail lorsque les politiques institutionnelles et éditoriales le permettent, notamment le fichier du questionnaire, la matrice des échelles, le modèle de journal de dépistage, le modèle de journal de calcul des scores, le fichier de syntaxe ou de script d'analyse et les tableaux des sources des figures.
NOTE : Figure 1 montre le parcours allant de la préparation du questionnaire à l'exportation des données brutes, au dépistage des réponses, au calcul des scores des échelles, à l'analyse statistique, aux vérifications diagnostiques et à la production des visualisations. Tableau 1 indique l'instrument source, le nombre d'items, l'intervalle de réponse, le cadre de calcul des scores, la règle d'inversion des scores, le statut d'autorisation ou d'adaptation et la variable finale au niveau de l'échelle pour chaque variable.
2. Configurer et distribuer le questionnaire
- Vérifiez que la plateforme de questionnaire prend en charge la validation du consentement, les champs obligatoires, l'examen des soumissions en double, la capture des horodatages et l'enregistrement de la durée de réponse.
- Créez le questionnaire à l’aide de la plateforme de sondage en ligne indiquée dans le Tableau des matériaux. Programmez le questionnaire conformément à la grille d’échelle verrouillée.
- Comparez le questionnaire programmé à la grille d’échelle verrouillée, élément par élément, avant de diffuser le lien du questionnaire. Notez toutes les corrections dans le journal d’étude.
- Définissez le champ de consentement éclairé comme premier champ obligatoire. Interrompez automatiquement le questionnaire lorsqu’un participant sélectionne « Je ne consens pas à participer ».
- Programmez les sections relatives aux données démographiques et aux échelles psychologiques selon l’ordre fixé à l’étape 1.8. Utilisez des codes d’éléments correspondant à la grille d’échelle.
- Définissez les éléments des échelles psychologiques comme obligatoires uniquement si cela est autorisé par l’approbation ou la dispense du comité d’éthique et si les participants peuvent se retirer sans pénalité. Si les réponses obligatoires ne sont pas autorisées, enregistrez la règle de gestion des données manquantes avant le début de la collecte.
- Affichez les repères de réponse avant chaque section d’échelle et maintenez une cohérence des repères au sein de chaque échelle18.
- Désactivez les soumissions répétées lorsque la plateforme de sondage propose cette fonction. Conservez tout identifiant anonyme relatif au dispositif, au navigateur, à la plateforme ou à la soumission, nécessaire à l’examen des réponses en double.
- Activez l’enregistrement automatique de l’heure de soumission et de la durée d’achèvement.
- Définissez la période d’ouverture du questionnaire sur 7 jours civils, ou utilisez la fenêtre de collecte approuvée par le comité d’éthique.
- Envoyez le lien du questionnaire via le canal de recrutement institutionnel approuvé. Fournissez les mêmes instructions écrites à tous les participants.
- Fermez le questionnaire à l’issue de la période de collecte prédéfinie.
NOTE : Conservez dans le journal d’étude le libellé du recrutement, le lien du questionnaire, les dates d’ouverture et de fermeture, les paramètres de la plateforme, le libellé du consentement, la version finale du questionnaire et les paramètres d’exportation de la plateforme.
3. Exporter et sécuriser les données brutes
- Exporter les réponses au questionnaire complété sous forme de fichier tableur immédiatement après la fermeture de la période de collecte.
- Enregistrer le premier fichier exporté comme jeu de données brutes verrouillé. Ne pas modifier ce fichier.
- Créer une copie de travail pour le tri, le calcul des scores et l'analyse. Nommer le fichier avec la date, le numéro de version et l'identifiant du projet.
- Vérifier que le fichier exporté contient une ligne par répondant et une colonne par variable démographique, item du questionnaire, variable d'horodatage, variable de plateforme ou champ dérivé de plateforme.
- Stocker le jeu de données brutes verrouillé, la copie de travail, la carte des échelles, le fichier du questionnaire, le journal d'étude, le journal de tri, le journal de vérification des scores, le journal d'analyse, les tableaux sources des figures, ainsi que le fichier de syntaxe ou de script dans un dossier projet protégé par mot de passe.
- Vérifier que le jeu de données ne contient aucune information directement identifiable. Supprimer tout champ identifiant inattendu de la copie de travail avant l'analyse, et noter le nom du champ, la raison de la suppression, la date de suppression et les initiales du relecteur dans le journal d'étude.
- Vérifier l'identifiabilité indirecte avant de partager ou publier des données au niveau des participants. Examiner les petites cellules démographiques créées par des combinaisons de sexe, âge, niveau d'année, catégorie d'établissement et catégorie de spécialité académique. Si une cellule contient moins de cinq répondants, regrouper les catégories, supprimer la cellule ou fournir uniquement des données agrégées.
- Noter dans le journal d'étude le statut de disponibilité des données, en précisant si les données au niveau des participants sont disponibles, restreintes en raison d'exigences éthiques ou de confidentialité, ou remplacées par un jeu de données agrégé issu du flux de travail.
- Créer un journal de tri avant le nettoyage des données. Y noter la taille initiale de l'échantillon, le critère de tri, le nombre d'enregistrements signalés, le nombre d'enregistrements supprimés, le nombre d'enregistrements conservés, la raison de l'exclusion, la date de la décision et les initiales du relecteur.
- Créer un fichier de traçabilité analytique avant l'analyse statistique. Y noter le nom du logiciel, la version du logiciel, le système d'exploitation, les noms des fichiers, la version des données, la version du script ou de la syntaxe, et la date de chaque exécution d'analyse.
REMARQUE : Utiliser le jeu de données brutes verrouillé uniquement à des fins de vérification. Réaliser tout tri, calcul des scores et analyse à l'aide de la copie de travail.
4. Analyser les réponses et construire le jeu de données analytique
- Appliquer les règles prédéfinies d'exclusion et de contrôle de qualité avant de calculer un score au niveau de l'échelle.
- Appliquer les règles de dépistage à la copie de travail dans cet ordre : statut du consentement, admissibilité, soumissions en double, données manquantes, durée des réponses, réponses linéaires, valeurs hors plage et indicateurs combinés de qualité des réponses.
- Après chaque opération de tri, enregistrez le nombre d'enregistrements signalés, supprimés et conservés dans le journal de tri. Ne pas écraser les versions antérieures du fichier de travail.
- Supprimez tous les enregistrements pour lesquels l'élément du consentement éclairé est marqué « Non » ou laissé sans réponse.
- Supprimez tous les enregistrements qui ne répondent pas aux critères d'inclusion définis à l'étape 1.4.
- Détectez les soumissions en double à l'aide d'identifiants de réponse anonymes, de l'heure de soumission, des indicateurs de soumission en double du plateau-forme et de motifs de réponse répétés.
- Conserver la première soumission complète lorsqu'une entrée en double est détectée, sauf s'il existe une raison documentée justifiant la conservation d'une réponse complète ultérieure.
- Corrigez toutes les règles relatives à la qualité des réponses avant de calculer les scores d'échelle. Tableau 2 résume les seuils d'exclusion, les seuils de signalement, la justification, les appuis bibliographiques et le plan d'analyse de sensibilité utilisés dans le flux de travail.
- Vérifiez la présence de données manquantes. Supprimez un répondant lorsque plus de 20 % des items de l'échelle sont manquants. Remplacez un item manquant isolé par la moyenne du répondant pour la même échelle uniquement si au moins 80 % des items de cette échelle ont été complétés. Ne pas imputer les variables démographiques, sauf si la variable n'est utilisée dans aucune analyse.
- Enregistrer le nombre de répondants exclus en raison de plus de 20 % d'items manquants par échelle, ainsi que le nombre de répondants ayant bénéficié d'une imputation de la moyenne intra-échelle. Dans le jeu de données actuel, 4 répondants ont été exclus en raison de plus de 20 % d'items manquants par échelle, et 21 répondants ont reçu une imputation de la moyenne intra-échelle pour 37 items manquants isolés.
- Vérifier la durée de la réponse. Signaler les réponses complétées en moins de 180 s. Considérer cette valeur comme un indicateur de réponse trop rapide plutôt que comme une règle automatique d'exclusion.
- Relever les réponses en ligne droite. Signaler une réponse lorsque la même option est sélectionnée pour plus de 90 % de tous les items de l'échelle de Likert. Considérer cette valeur comme un indicateur de motif de réponse plutôt que comme une règle automatique d'exclusion.
- Rechercher d'autres indicateurs faciles à détecter, notamment des preuves de soumissions en double, des horodatages impossibles, des chaînes de réponses identiques dans des soumissions distinctes ou des incohérences entre les métadonnées de la plateforme et le contenu du questionnaire.
- Supprimez une réponse signalée uniquement lorsqu'au moins deux indicateurs de contrôle qualité suggèrent une réponse non valide, tels qu'un temps de complétion extrêmement court combiné à des réponses en ligne droite, des indices de soumission en double ou des métadonnées de plateforme impossibles.19.
- Enregistrez tous les enregistrements signalés, même lorsqu'ils sont conservés. Dans le jeu de données actuel, 19 réponses ont été signalées en raison de la durée de complétion. < 180 s, 8 réponses ont été signalées pour >90 % de réponses en ligne droite, et 13 dossiers ont été exclus car ils présentaient deux indicateurs de qualité de réponse ou plus.
- Vérifiez la présence de valeurs hors plage. Confirmez que les items relatifs aux émotions négatives se situent entre 1 et 4, que les items relatifs au procrastination scolaire, au sentiment d'appartenance à l'école et à la pensée de niveau supérieur se situent entre 1 et 5, et que les items relatifs au bien-être subjectif se situent entre 1 et 6.
- Ne corrigez une valeur que lorsque l'exportation d'origine montre clairement une erreur de format. Ne modifiez pas des scores psychologiques valides sous prétexte qu'ils semblent anormalement élevés ou faibles.
- Générer un tableau de flux de dépistage indiquant les questionnaires soumis, les exclusions liées au consentement et à l'éligibilité, les exclusions pour doublons, les exclusions pour données manquantes, les signalements de qualité des réponses, les exclusions combinées de contrôle de qualité, les imputations d'éléments isolés, les cas analytiques conservés et la taille finale de l'échantillon analytique.
- Complétez le tableau du flux de dépistage à l'aide du journal de dépistage verrouillé et conservez un enregistrement d'audit exporté des décisions de dépistage. Dans le jeu de données actuel, le flux de dépistage était le suivant : questionnaires soumis, n = 448 ; exclusions liées au consentement ou à l'éligibilité, n = 6 ; soumissions en double supprimées, n = 5 ; documents exclus pour >20 % d'éléments manquants à l'échelle n = 4 ; enregistrements exclus en raison de deux indicateurs ou plus de qualité de réponse, n = 13 ; jeu de données analytique final, n = 420.
- Enregistrez les données conservées sous forme de jeu de données analytique. Utilisez un nouveau nom de fichier comportant un numéro de version et conservez le journal de dépistage avec le jeu de données analytique.
REMARQUE: Conserver les scores extrêmes valides sauf s'il existe un problème documenté de qualité de réponse.
5. Évaluer les échelles psychologiques
- Convertir les réponses au niveau des items en variables au niveau des échelles uniquement après avoir terminé le contrôle des réponses et sauvegardé le jeu de données analytique.
- Coder tous les items de type Likert selon les modalités de réponse du questionnaire figé et selon les règles de cotation indiquées dans la matrice d'échelle.
- Conserver inchangées les variables initiales des items. Créer des variables dérivées distinctes pour les items recodés ou inversés.
- Calculer chaque échelle conformément à la matrice d'échelle figée et au dispositif source ou au manuel de cotation correspondant.
- Inverser la cotation des items de bien-être subjectif désignés avant de calculer le score de bien-être subjectif. Pour l'échelle de réponse allant de 1 à 6, calculer chaque item inversé comme étant 7 moins le score initial, et ajouter _R au nom de la variable dérivée.
- Utiliser les variables à cotation inversée, et non les variables initiales, lors du calcul du bien-être subjectif.
- Calculer chaque score au niveau de l'échelle comme la moyenne de ses items retenus : émotion négative, procrastination académique, sentiment d'appartenance scolaire, pensée de niveau supérieur et bien-être subjectif.
- Attribuer aux variables finales au niveau des échelles les noms suivants : Émotion négative, Procrastination académique, Sentiment d'appartenance scolaire, Pensée de niveau supérieur et Bien-être subjectif.
- Vérifier la valeur minimale et maximale de chaque variable au niveau de l'échelle par rapport à sa plage théorique de réponse. Revoir le codage, la cotation inversée et la gestion des valeurs manquantes si un score se situe en dehors de la plage attendue.
- Vérifier le sens de chaque échelle par rapport à la matrice d'échelle avant toute analyse inférentielle. Des scores plus élevés doivent refléter le sens attendu du construit.
- Effectuer un audit de la cotation inversée avant l'analyse. Recalculer les items à cotation inversée pour un sous-ensemble aléatoire d'enregistrements ou pour tous les items à cotation inversée lorsque cela est faisable, et consigner le résultat de l'audit dans le journal de vérification de la cotation.
- Si une erreur de cotation est détectée, corriger la variable dérivée, recréer le score d'échelle concerné, mettre à jour le journal de vérification de la cotation, puis refaire toutes les analyses en aval et les tableaux sources de figures basés sur le jeu de données analytique corrigé.
NOTE : Considérer la cotation inversée et la vérification des plages comme des points de contrôle obligatoires avant toute analyse de corrélation, comparaison de groupes, modélisation par régression ou visualisation.
6. Évaluer la cohérence interne et les propriétés descriptives
- Calculez la cohérence interne, les corrélations corrigées entre chaque item et le total, ainsi que les statistiques descriptives pour chaque échelle à l’aide des variables d’items définies dans la carte d’échelle verrouillée.
- Enregistrez la valeur alpha de Cronbach, le nombre d’items, la taille de l’échantillon valide, les corrélations corrigées entre chaque item et le total, ainsi que les valeurs d’alpha-si-l’item-était-supprimé pour chaque échelle.
- Utilisez une valeur alpha de Cronbach de 0,70 comme seuil minimal acceptable de fiabilité pour ce flux de travail. Avant de supprimer un item, vérifiez la formulation de l’item, le sens de la cotation, la cotation inversée, l’adéquation au construit et la documentation de l’instrument d’origine20.
- Calculez l’oméga de McDonald comme estimation complémentaire de la fiabilité lorsque l’environnement d’analyse le permet. Signalez l’oméga conjointement à l’alpha de Cronbach lorsque ces deux estimations conduisent à des interprétations différentes de la fiabilité.
- Examinez tout item présentant une corrélation corrigée entre l’item et le total négative ou très faible avant d’envisager sa suppression. Considérez d’abord ce cas comme un problème potentiel de codage, de cotation inversée ou d’adéquation au construit.
- Ne supprimez pas un item uniquement pour augmenter l’alpha de Cronbach. La suppression d’un item doit être justifiée par le manuel de cotation, la formulation de l’item, la corrélation corrigée entre l’item et le total, l’adéquation conceptuelle et la vérification documentée de la cotation.
- Calculez les statistiques descriptives pour l’ensemble des cinq variables au niveau des échelles, incluant la moyenne, l’écart-type, le minimum, le maximum, l’asymétrie (skewness) et l’aplatissement (kurtosis).
- Vérifiez la présence d’une concentration au plancher ou au plafond en notant la proportion de répondants ayant obtenu les scores minimum et maximum possibles pour chaque échelle.
- Enregistrez les estimations de fiabilité, les diagnostics relatifs aux corrélations item-total, les statistiques descriptives et toutes les décisions prises concernant la cotation dans le journal d’analyse.
REMARQUE : L’alpha de Cronbach est utilisé comme point de contrôle de la fiabilité, et non comme procédure complète de validation psychométrique. Lorsqu’une évaluation formelle de la mesure est requise, complétez ce flux de travail par l’oméga de McDonald, une analyse factorielle confirmatoire, des tests d’invariance de mesure, la modélisation des réponses aux items ou d’autres méthodes fondées sur des variables latentes.
7. Réaliser une analyse de corrélation
- Utilisez les cinq variables validées au niveau de l'échelle : émotion négative, procrastination académique, sentiment d'appartenance scolaire, pensée de niveau supérieur et bien-être subjectif.
- Avant de calculer les corrélations de Pearson, examiner les distributions et les nuages de points bivariés pour chaque paire de variables à échelle.
- Évaluer si les variables présentent une variation de scores approximativement continue, une asymétrie marquée, des relations non linéaires ou des schémas atypiques influents.
- Calculer les coefficients de corrélation de Pearson et les valeurs p bilatérales pour toutes les paires de variables à échelle lorsque les hypothèses sont satisfaisantes pour une analyse descriptive des associations.
- Enregistrez le coefficient de corrélation, p-valeur, taille de l'échantillon et sens de l'association pour chaque paire de variables.
- Indiquez les coefficients de corrélation avec trois décimales.
- Comparez le sens de chaque coefficient avec la carte des échelles. Vérifiez à nouveau le codage des items si un coefficient contredit le sens prévu de la construction.
- Enregistrer la matrice de corrélation validée comme tableau source numérique pour la carte thermique de corrélation dans la section Résultats représentatifs.
- Lorsque les distributions sont nettement asymétriques, qu'une échelle de sensibilité ordinale est requise, ou que les nuages de points suggèrent des associations monotones mais non linéaires, répétez l'analyse en utilisant la corrélation de Spearman et comparez le sens et l'ampleur relative des associations.
- Indiquer si les résultats de Pearson et de Spearman ont conduit à la même interprétation substantive.
REMARQUE : Utilisez l'analyse de corrélation à la fois comme vérification descriptive de l'association et comme contrôle du sens de la cotation.
8. Créer des groupes présentant un bien-être subjectif élevé et faible
- Utilisez le jeu de données analytique nettoyé et noté. Ne revenez pas à l'exportation brute pour la construction des groupes.
- Utilisez le score continu de bien-être subjectif comme critère principal dans la modélisation par régression. N'utilisez le regroupement haut-bas que pour la comparaison contrastive des profils.
- Classez les répondants par score de bien-être subjectif, du plus élevé au plus faible.
- Appliquez la règle préétablie des groupes extrêmes à 27 % pour définir les groupes de fort et faible bien-être subjectif. Documentez la justification de ce seuil dans Tableau 2 et dans le journal d'analyse.
- Affectez les répondants aux 27 % supérieurs au groupe de fort bien-être subjectif et ceux des 27 % inférieurs au groupe de faible bien-être subjectif.
- Conservez les 46 % centraux dans le jeu de données analytique complet pour les statistiques descriptives, l'analyse de corrélation, la comparaison par sexe et la modélisation par régression, mais excluez ces cas de la comparaison haut-bas.
- Créez une variable de regroupement nommée Groupe de bien-être subjectif. Codez le groupe supérieur comme Élevé, le groupe inférieur comme Faible, et les répondants restants comme Moyen.
- Vérifiez que les groupes élevé et faible contiennent le nombre prévu de cas. En cas d'égalité des scores à la limite des 27 %, appliquez la règle préétablie de traitement des ex-aequo et consignez la décision dans le journal d'analyse.
- Effectuez une analyse de sensibilité lorsque la limite à 27 % entraîne une instabilité de l'appartenance aux groupes en raison d'égalités de scores ou d'une taille d'échantillon réduite. Utilisez une règle alternative préétablie, comme le regroupement par tiers, et indiquez si l'interprétation reste inchangée.
REMARQUE : Le regroupement haut-bas est une procédure de comparaison descriptive. Il ne doit pas remplacer le score continu de bien-être subjectif dans le modèle de régression principal.
9. Comparer les groupes présentant un bien-être subjectif élevé et faible
- Filtrer le jeu de données analytique pour ne conserver que les répondants codés comme Élevé ou Faible dans la variable de regroupement du bien-être subjectif.
- Comparer les groupes élevé et faible en matière d'émotion négative, de procrastination académique, d'appartenance scolaire et de pensée de niveau supérieur.
- Avant la comparaison entre groupes, examiner les distributions spécifiques à chaque groupe, les tailles d'échantillon et l'égalité des variances pour chaque variable.
- Utiliser un échantillonnage indépendant t-test lorsque les hypothèses de distribution et de variance sont satisfaites. Utiliser le test de Welch t-test lorsque l'hypothèse d'égalité des variances n'est pas vérifiée.
- Enregistrer les moyennes des groupes, les écarts types, les différences de moyennes, t-valeurs, degrés de liberté, p-valeurs et intervalles de confiance à 95 %.
- Calculer le d de Cohen pour chaque différence entre groupes et interpréter la taille de l'effet à l'aide de la valeur p.
- Vérifiez si le sens de chaque différence de groupe est conforme aux définitions des construits et à la matrice de corrélation.
- Enregistrez le tableau de comparaison des groupes validé comme source numérique pour toute visualisation de la comparaison des groupes.
- Présentez cette analyse comme un contraste entre des profils extrêmes de bien-être subjectif.
REMARQUE : Ne pas interpréter la comparaison haut-bas comme une preuve de causalité.
10. Examiner les différences sexuelles
- Supprimez le filtre de groupe haut-bas et revenez au jeu de données analytiques complet.
- Utilisez le sexe comme variable de regroupement descriptive plutôt que comme exposition causale.
- Comparez les répondantes et les répondants en ce qui concerne les émotions négatives, le procrastination scolaire, le sentiment d'appartenance à l'école, la pensée de niveau supérieur et le bien-être subjectif.
- Avant la comparaison, examinez les tailles d'échantillon spécifiques à chaque groupe, les données manquantes, les distributions et l'égalité des variances.
- Utilisez un test t pour échantillons indépendants lorsque les hypothèses sont acceptables. Utilisez le test t de Welch lorsque l'hypothèse d'égalité des variances n'est pas vérifiée.
- Enregistrez les moyennes par groupe, les écarts-types, les différences de moyennes, les valeurs t, les degrés de liberté, les valeurs p, les intervalles de confiance à 95 % et les valeurs d de Cohen.
- Interprétez les différences selon le sexe de manière descriptive et signalez les tailles d'effet avec les valeurs p.
- Ne vous servez pas des résultats des comparaisons par sexe pour justifier une exclusion a posteriori, une modification d'échelle ou une interprétation causale.
NOTE : Les comparaisons selon le sexe sont incluses comme vérifications descriptives par sous-groupe dans ce flux de travail basé sur un questionnaire transversal.
11. Estimer le modèle de régression
- Utilisez le bien-être subjectif comme variable dépendante.
- Utilisez les émotions négatives, le procrastination académique, le sentiment d'appartenance à l'école et la pensée de niveau supérieur comme prédicteurs simultanés au niveau échelle21.
- Utilisez les variables continues au niveau échelle créées lors du calcul des scores d'échelle. Ne remplacez pas le score continu de bien-être subjectif par la variable groupée haute-basse.
- Ajustez le modèle principal à l’aide d’une régression linéaire multiple avec entrée simultanée.
- Enregistrez les coefficients non standardisés, les coefficients standardisés, les erreurs types, les valeurs t, les valeurs p, les intervalles de confiance à 95 %, R2, R2 ajusté, la tolérance et le facteur d’inflation de la variance.
- Utilisez des valeurs du facteur d’inflation de la variance inférieures à 5,00 comme seuil d’absence de multicolinéarité sévère.
- Examinez les nuages de points bivariés, les graphiques de régression partielle ou les graphiques de composante plus résidus afin d’évaluer si les associations entre les prédicteurs et le bien-être subjectif sont approximativement linéaires.
- Évaluez l’indépendance des résidus à l’aide de la statistique de Durbin-Watson.
- Évaluez la normalité des résidus à l’aide d’un graphique Q-Q des résidus et d’un test formel de normalité, lorsque cela est approprié en fonction de la taille de l’échantillon.
- Évaluez l’homoscédasticité à l’aide d’un graphique des résidus standardisés en fonction des valeurs prédites standardisées.
- Enregistrez les résidus standardisés, les valeurs prédites standardisées, les valeurs de levier et la distance de Cook pour les vérifications diagnostiques.
- Estimez un modèle supplémentaire ajusté incluant les quatre prédicteurs psychologiques et les variables démographiques indiquées dans la description de l’échantillon, notamment le sexe, l’âge, le niveau d’année, la catégorie d’établissement et la catégorie de spécialité académique, lorsque ces variables sont disponibles et adéquatement distribuées.
- Comparez le modèle principal avec le modèle supplémentaire ajusté. Notez si la direction, l’ampleur et l’interprétation statistique des quatre prédicteurs psychologiques restent stables après ajustement démographique.
- Enregistrez les coefficients standardisés vérifiés et les intervalles de confiance à 95 % provenant du modèle principal comme tableau numérique source pour le graphique des coefficients dans la section Résultats représentatifs22.
NOTE : Interprétez les coefficients de régression comme des associations conditionnelles, et non comme des effets causaux. Le modèle ajusté aux variables démographiques est utilisé dans une analyse de sensibilité afin d’évaluer si les conclusions du protocole restent stables après prise en compte des variables contextuelles disponibles.
12. Diagnostiquer le modèle de régression
- Examiner les résidus standardisés du modèle de régression ajusté. Signaler les cas dont les résidus standardisés en valeur absolue sont supérieurs à 3,00.
- Examiner les valeurs de levier et la distance de Cook pour détecter les observations influentes.
- Signaler les observations dont la distance de Cook est supérieure à 4/n comme potentiellement influentes, où n représente la taille de l'échantillon analytique. Considérer une distance de Cook supérieure à 1,00 comme un seuil de référence indiquant une influence sévère, et non comme la seule limite de dépistage.
- Examiner le graphique des résidus en fonction des valeurs prédites afin de détecter toute non-linéarité, une variance inégale ou un regroupement inhabituel.
- Examiner le graphique quantile-quantile (Q-Q) des résidus ainsi que le résultat du test de normalité des résidus. Noter si l'évaluation de la normalité soutient l'utilisation du modèle linéaire pour l'analyse descriptive des associations.
- Noter la statistique de Durbin-Watson et déterminer si l'indépendance des résidus est acceptable.
- Revoir tous les cas signalés à la lumière du journal de dépistage, du journal de vérification des cotes et des critères d'éligibilité.
- Conserver les cas signalés lorsqu'ils représentent des observations valides et qu'ils ne reflètent pas d'erreurs de saisie, d'erreurs de cotation, de soumissions en double, de violations des critères d'éligibilité ou de problèmes de qualité de réponse documentés.
- Ne corriger ou supprimer un cas signalé que si la traçabilité documentaire révèle une erreur procédurale, d'éligibilité, de codage, de cotation ou de saisie des données.
- Refaire tourner le modèle de régression après toute correction documentée et comparer les coefficients, les intervalles de confiance, R2, R2 ajusté et les résultats diagnostiques avec ceux du modèle initial.
- Effectuer un contrôle de sensibilité à l'influence en réajustant le modèle après exclusion des cas dont la distance de Cook est supérieure à 4/n. Indiquer si l'interprétation substantive change.
- Noter la décision diagnostique finale dans le journal d'analyse, incluant le nombre de cas signalés par les résidus standardisés, le nombre signalés par une distance de Cook supérieure à 4/n, la distance de Cook maximale, la statistique de Durbin-Watson, ainsi que la conclusion des vérifications de normalité et de linéarité des résidus.
NOTE : Ne pas supprimer des cas influents uniquement pour améliorer l'ajustement du modèle. La suppression ou la correction doit reposer sur une justification documentée dans la traçabilité.
Résultats
Jeu de données analytique généré après le tri des réponses
Le flux de travail de tri a produit un jeu de données analytique composé de 420 dossiers d'étudiants anonymisés, issus de 448 questionnaires soumis. Le journal de tri a enregistré chaque point de décision. Six dossiers ont été supprimés car les conditions de consentement ou d'éligibilité n'étaient pas remplies, cinq soumissions en double ont été éliminées, quatre dossiers ont été exclus car plus de 20 % des éléments des échelles étaient manquants, et 13 dossiers ont été exclus car ils présentaient deux critères ou plus d'indicateurs de qualité de réponse. Dix-neuf réponses ont été signalées en raison d'une durée de complétion <180 s, huit réponses ont été signalées en cas de réponse linéaire >90 %, et 21 répondants ont bénéficié d'une imputation de la moyenne intra-échelle pour 37 éléments manquants isolés. Le jeu de données analytique final ne contenait aucune information permettant d'identifier directement les participants, aucun cas conservé ne dépassait le seuil d'exclusion lié aux données manquantes, et toutes les réponses aux items conservées se situaient dans les plages de réponse prédéfinies. Le flux de tri est résumé dans le tableau 3.
L'échantillon retenu comprenait 275 répondantes et 145 répondants, représentant respectivement 65,5 % et 34,5 % de l'ensemble de données analytique. L'âge moyen était de 20,1 ± 1,2 ans. Les répondants étaient répartis entre quatre niveaux universitaires, les années 1 à 4 représentant respectivement 27,1 %, 27,4 %, 25,5 % et 20,0 % de l'échantillon. L'ensemble de données comprenait également trois catégories institutionnelles et cinq catégories de spécialisation académique. Aucune cellule démographique publiée ne comptait moins de cinq répondants après examen des catégories. Les caractéristiques démographiques de l'ensemble de données analytique sont résumées dans le tableau 4.
Construction de l'échelle, vérification des plages et exemples de flux de travail sous-optimaux
Après le codage des items et la correction inverse, cinq variables au niveau de l'échelle ont été calculées : émotion négative, procrastination académique, sentiment d'appartenance à l'école, pensée de niveau supérieur et bien-être subjectif. Chaque score est resté dans sa plage théorique de réponse. Les scores d'émotion négative variaient de 1,048 à 3,143 sur une échelle de 1 à 4. La procrastination académique, le sentiment d'appartenance à l'école et la pensée de niveau supérieur variaient respectivement de 1,312 à 4,250, de 2,333 à 4,444 et de 2,350 à 4,850 sur leurs échelles respectives de 1 à 5. Le bien-être subjectif variait de 2,000 à 5,300 sur une échelle de 1 à 6. La vérification de la correction inverse n'a révélé aucune divergence entre les variables corrigées inversées obtenues et la règle de correction figée dans le jeu de données analytique final. Ces vérifications ont confirmé que le codage des items, la correction inverse, la gestion des items manquants et l'agrégation des scores avaient été effectués sans erreur détectable de plage.
Le flux de travail a également produit des exemples d'audit sous-optimaux illustrant la manière dont les erreurs ou les résultats douteux sont détectés avant l'analyse finale. Lors d'un audit, une valeur inversée incorrecte de bien-être subjectif a été détectée, car le journal de vérification des scores comparait la valeur initiale, la formule attendue « score inversé = 7 - score initial », la valeur calculée et l'intervalle final de l'échelle. La variable dérivée a été corrigée, le score de bien-être subjectif a été régénéré, et tous les résultats ultérieurs — descriptifs, de corrélation, de comparaison, de régression, diagnostiques et servant de source aux figures — ont été recalculés. Dans un autre fichier de travail intermédiaire, une valeur d'élément hors plage a été identifiée lors de la vérification des plages et attribuée à une manipulation du tableur plutôt qu'à l'export brut verrouillé. La copie de travail a été corrigée et documentée sans modifier aucune réponse extrême valide. Un avertissement de fiabilité a également été examiné lorsqu'un élément présentait une corrélation corrigée élément-total inférieure à celle des autres éléments de la même échelle ; étant donné que la formulation de l'élément, le sens du score et l'alignement du construit étaient corrects, l'élément a été conservé. Un écart dans une visualisation préliminaire a été repéré lorsque la figure ne correspondait pas au tableau numérique vérifié ; la figure a donc été régénérée à partir du tableau vérifié, et l'enregistrement de la source de la figure a été mis à jour. Ces exemples montrent que le flux de travail ne produit pas seulement des résultats satisfaisants, mais détecte également des erreurs de codage, des problèmes de plage, des avertissements de fiabilité, des incohérences entre les figures et leurs sources, ainsi que des préoccupations relatives à la qualité des réponses, grâce à la traçabilité de l'audit.
Propriétés descriptives et cohérence interne
Les cinq variables de niveau échelle présentaient une variation exploitable. Le score moyen d'émotion négative était de 2,099 ± 0,391, et le score moyen de procrastination académique était de 2,639 ± 0,484. Le sentiment d'appartenance scolaire et la pensée de niveau supérieur présentaient des moyennes modérément élevées, respectivement de 3,343 ± 0,390 et de 3,627 ± 0,418. Le score moyen de bien-être subjectif était de 3,784 ± 0,543. Aucune échelle ne présentait de manière évidente un effet plancher ou plafond, et la proportion de répondants au minimum ou au maximum théorique était inférieure à 2,0 % pour chaque échelle.
La cohérence interne était satisfaisante pour les cinq échelles. Les valeurs de l'alpha de Cronbach variaient entre 0,834 et 0,899, dépassant le seuil prédéfini de 0,70. L'émotion négative présentait la plus forte cohérence interne, avec un alpha de Cronbach de 0,899, suivie par le bien-être subjectif avec une valeur de 0,895. Les valeurs d'oméga de McDonald s'étendaient de 0,842 à 0,906, et les estimations d'oméga n'ont pas modifié l'interprétation de la fiabilité. L'examen des corrélations corrigées entre chaque item et le total n'a identifié aucun item nécessitant une suppression. Les statistiques descriptives et les estimations de fiabilité sont indiquées dans Tableau 5.
Structure de corrélation parmi les variables au niveau échelle
La matrice de corrélation a été utilisée comme mesure descriptive d'association et pour vérifier le sens des cotes. Avant le calcul des corrélations de Pearson, les distributions des échelles et les nuages de points bivariés ont été examinés. Aucune variable ne présentait d'asymétrie ou d'aplatissement sévère, et aucun nuage de points bivarié ne montrait de motif fortement non linéaire qui pourrait invalider l'analyse descriptive de corrélation de Pearson. Le bien-être subjectif était corrélé négativement avec les émotions négatives (r = -0,496) et le procrastination académique (r = -0,294), et positivement avec le sentiment d'appartenance à l'école (r = 0,481) et la pensée de niveau supérieur (r = 0,386). Les autres associations suivaient la même logique de cotation : les émotions négatives étaient positivement associées à la procrastination académique (r = 0,270) et négativement associées au sentiment d'appartenance à l'école (r = -0,346) et à la pensée de niveau supérieur (r = -0,205) ; la procrastination académique était négativement associée au sentiment d'appartenance à l'école (r = -0,222) et à la pensée de niveau supérieur (r = -0,134) ; et le sentiment d'appartenance à l'école était positivement associé à la pensée de niveau supérieur (r = 0,310). La matrice complète des corrélations de Pearson est présentée dans Tableau 6.
Un contrôle de sensibilité de Spearman a produit la même interprétation directionnelle pour toutes les paires de variables. Les corrélations de Spearman entre le bien-être subjectif et les quatre prédicteurs étaient ρ = -0,502 pour les émotions négatives, ρ = -0,301 pour le procrastination académique, ρ = 0,477 pour le sentiment d'appartenance scolaire et ρ = 0,392 pour la pensée de niveau supérieur. La matrice de Pearson validée a été utilisée comme tableau source numérique pour la visualisation. Figure 2A présente la carte thermique complète des corrélations entre les cinq variables de niveau d'échelle. Figure 2B montre les quatre corrélations avec le bien-être subjectif.
Démonstration contrastée à l'aide de groupes présentant un bien-être subjectif élevé et faible
La règle de regroupement à 27 % a été utilisée comme démonstration méthodologique contrastée, et non comme une classification substantielle de profils réels de bien-être. Cette règle a produit deux groupes de taille égale : 113 répondants dans le groupe du haut niveau de bien-être subjectif et 113 dans le groupe du niveau bas. Les 194 répondants intermédiaires ont été conservés dans l'ensemble de données analytiques complet, mais exclus de cette comparaison contrastée. Aucune valeur limite n'a modifié l'attribution aux groupes.
Ce module a montré que le flux de travail permettait de générer une variable de regroupement prédéfinie, de filtrer le jeu de données analytique, de calculer des statistiques descriptives spécifiques à chaque groupe, d'effectuer des comparaisons entre groupes adaptées aux hypothèses, et d'exporter un tableau source vérifié destiné à la visualisation. Le groupe présentant un niveau élevé de bien-être subjectif a affiché une émotion négative inférieure à celle du groupe présentant un faible bien-être subjectif (1,864 ± 0,358 contre 2,335 ± 0,343 ; différence moyenne = -0,472) ainsi qu'une procrastination académique moindre (2,455 ± 0,476 contre 2,801 ± 0,483 ; différence moyenne = -0,346). Le sentiment d'appartenance scolaire et la pensée de niveau supérieur étaient plus élevés dans le groupe à fort bien-être subjectif, avec des différences moyennes respectives de 0,454 et 0,351. Les quatre comparaisons étaient significatives (p < 0,001), les valeurs de d de Cohen étant de -1,346 pour l'émotion négative, -0,722 pour la procrastination académique, 1,279 pour le sentiment d'appartenance scolaire et 0,860 pour la pensée de niveau supérieur. Le test t de Welch a été utilisé lorsque l'hypothèse d'égalité des variances n'était pas vérifiée ; sinon, le test t standard pour échantillons indépendants a été conservé. Ces résultats ne doivent pas être interprétés comme une preuve que les prédicteurs sélectionnés définissent des profils réels de bien-être chez les élèves, puisque les groupes ont été créés à partir de la variable d'issue, puis comparés sur des variables corrélées. La comparaison entre les groupes élevé et faible est résumée dans Tableau 7.
Comparaison descriptive par sexe
Le sexe a été examiné comme variable de regroupement descriptive. Les répondantes présentaient un score moyen d'émotion négative légèrement plus élevé que celui des répondants (2,129 ± 0,380 contre 2,042 ± 0,407). Cette différence était statistiquement significative, mais de faible ampleur (p = 0,033 ; d de Cohen = 0,224). La procrastination universitaire, le sentiment d'appartenance scolaire, la pensée critique et le bien-être subjectif ne présentaient pas de différences significatives selon le sexe. Les moyennes de bien-être subjectif étaient presque identiques entre les répondantes et les répondants (3,781 ± 0,521 contre 3,789 ± 0,583 ; p = 0,887 ; d de Cohen = -0,015). Des vérifications de sensibilité par le test t de Welch n'ont pas modifié l'interprétation des résultats de comparaison selon le sexe. Les résultats concernant les différences selon le sexe sont présentés dans le tableau 8.
Modèle de régression comme exemple de génération de modèle et de vérification diagnostique
Le modèle de régression linéaire multiple a été utilisé comme exemple de création, de diagnostic et de validation d'un modèle à partir de données issues d'un questionnaire coté. Le bien-être subjectif a été introduit comme variable dépendante, tandis que l'émotion négative, le procrastination académique, le sentiment d'appartenance à l'école et la pensée de niveau supérieur ont été introduits simultanément comme prédicteurs au niveau d'échelle. L'objectif de ce module était de démontrer l'extraction des coefficients, les vérifications de la multicolinéarité, les diagnostics des résidus, l'évaluation de l'influence, une analyse de sensibilité ajustée aux données démographiques, ainsi que la préparation des figures et des sources.
Le modèle explique une proportion modérée de la variance du bien-être subjectif, avec un R2 = 0,411 et un R2 ajusté de 0,406. L'émotion négative présente le coefficient standardisé négatif le plus élevé (B = -0,450, β standardisé = -0,324). La procrastination académique présente également un coefficient négatif (B = -0,130, β standardisé = -0,116). L'appartenance scolaire et la pensée de niveau supérieur montrent des coefficients standardisés positifs de β = 0,275 et β = 0,218, respectivement. Les quatre prédicteurs sont statistiquement significatifs dans le modèle ajusté : l'émotion négative, l'appartenance scolaire et la pensée de niveau supérieur avec p < 0,001, et la procrastination académique avec p = 0,004. Aucun indicateur de multicolinéarité n’a été observé, puisque toutes les valeurs du facteur d'inflation de la variance étaient inférieures à 1,24. Ces résultats de régression sont des sorties représentatives de vérification du modèle, et non une explication psychologique définitive du bien-être des élèves. Tableau 9 présente les résultats complets de la régression.
Un modèle supplémentaire ajusté sur les données démographiques a été estimé en ajoutant le sexe, l'âge, le niveau d'année, la catégorie d'établissement et la catégorie de spécialité universitaire aux quatre prédicteurs psychologiques. Le modèle ajusté explique une proportion similaire de la variance, avec un R2 = 0,427 et un R2 ajusté de 0,414. La direction et l'interprétation statistique des quatre prédicteurs psychologiques sont restées inchangées après l'ajustement démographique. Le modèle de sensibilité ajusté aux données démographiques est résumé dans le Tableau 10. Le Figure 3A présente les coefficients standardisés et les intervalles de confiance à 95 % pour les quatre prédicteurs. Le Figure 3B montre l'affichage diagnostique basé sur les valeurs prédites standardisées, les résidus standardisés et la distance de Cook.
Analyses de régression et conservation du modèle
Les analyses diagnostiques de régression n'ont pas indiqué que le modèle ajusté était influencé par une seule observation prépondérante. Les graphiques de régression bivariée et partielle ne montraient aucune non-linéarité marquée. Le graphique des résidus par rapport aux valeurs prédites ne révélait ni hétéroscédasticité sévère ni regroupement inhabituel. La statistique de Durbin-Watson s'élevait à 1,93, ce qui indique une indépendance acceptable des résidus. Le graphique quantile-quantile (Q-Q) des résidus ne présentait aucune forte déviation par rapport à la normalité. Un test formel de normalité des résidus était statistiquement significatif, W = 0,992, p = 0,031, mais le graphique Q-Q et la taille de l'échantillon justifiaient la conservation du modèle linéaire pour l'analyse descriptive des associations.
Deux enregistrements présentaient des résidus standardisés absolus supérieurs à 3,00. Aucun enregistrement n'avait une distance de Cook supérieure à 1,00. En utilisant le seuil plus sensible de la distance de Cook >4/n, où n = 420 et 4/n = 0,0095, 17 enregistrements ont été signalés comme potentiellement influents. La distance de Cook maximale était de 0,037. Les cas présentant des résidus et des influences signalés ont été examinés en comparaison avec le journal de dépistage, le journal de vérification des cotes et les critères d'éligibilité. Aucun ne présentait d'erreur de saisie de données, de cotation incorrecte, de réponses en double, d'échec d'éligibilité ou de problèmes de qualité de réponse documentés ; par conséquent, ces cas ont été conservés dans le modèle final. Une vérification de sensibilité à l'influence, excluant les cas ayant une distance de Cook >4/n, a donné la même interprétation du flux opérationnel que le modèle principal. La variation maximale absolue des coefficients standardisés était de 0,026, et le R² ajusté R2 passé de 0,406 à 0,405. Les résultats du diagnostic et de la sensibilité sont résumés dans Tableau 11.
Vérification interne du pipeline analytique
Le flux de travail a été répété à partir du jeu de données analytiques nettoyé et noté, en utilisant les mêmes règles de notation, seuils de décision et fichier d’analyse tracée. L’analyse de cohérence interne, les statistiques descriptives, l’analyse de corrélation, les comparaisons entre groupes haut-bas, les comparaisons selon le sexe, la modélisation par régression, les vérifications diagnostiques et la préparation des fichiers sources pour la visualisation ont été répétées. Les résultats répétés correspondaient aux statistiques descriptives initiales, à la matrice de corrélation, aux valeurs des comparaisons entre groupes, aux coefficients de régression, aux sorties diagnostiques et aux fichiers sources de visualisation. Ceci a confirmé la stabilité informatique du pipeline analytique lorsqu’il est appliqué au même jeu de données analytiques verrouillé. Ce contrôle ne constitue pas une reproductibilité procédurale indépendante, qui nécessiterait qu’un analyste indépendant applique l’ensemble du flux de travail à partir de l’export brut verrouillé et obtienne les mêmes résultats documentés.
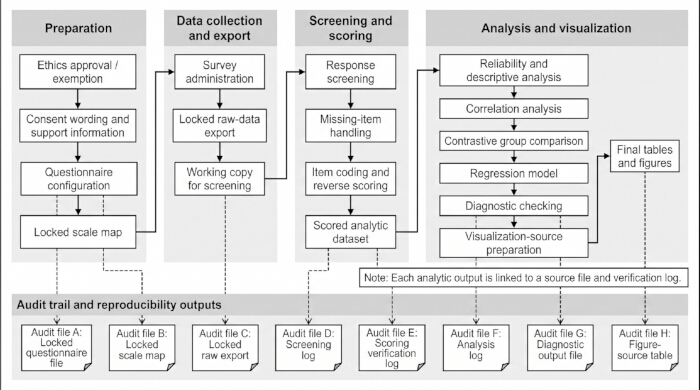
Figure 1 : Flux de travail pour le traitement des données subjectives sur le bien-être fondées sur des questionnaires. Le schéma illustre la séquence du protocole et les principaux résultats de vérification, notamment la préparation éthique, la configuration du questionnaire, la mise en œuvre de l'enquête, l'exportation des données brutes, la carte des échelles, le journal de dépistage, le jeu de données analytiques noté, les tableaux d'analyse vérifiés, les diagnostics de régression, les fichiers sources des figures et les sorties de visualisation. Veuillez cliquer ici pour afficher une version agrandie de cette figure.
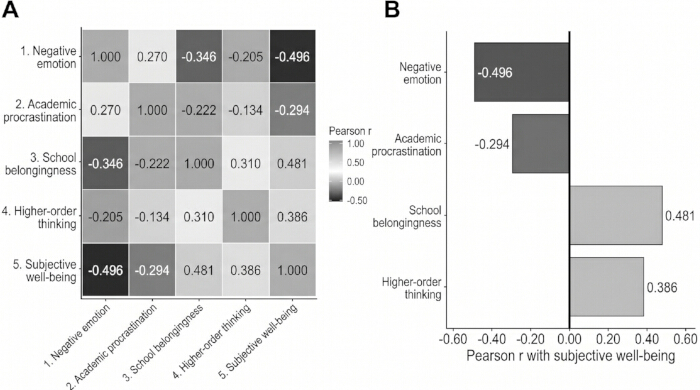
Figure 2 : Structure de corrélation parmi les variables au niveau des échelles. (A) Carte thermique de corrélation de Pearson générée à partir de la matrice de corrélation validée dans le Tableau 6. (B) Profil de corrélation centré sur le bien-être subjectif, généré à partir du même tableau source validé. Les cinq variables au niveau des échelles sont affichées : émotion négative, procrastination académique, sentiment d'appartenance à l'école, pensée de niveau supérieur et bien-être subjectif. Veuillez cliquer ici pour visualiser une version agrandie de cette figure.
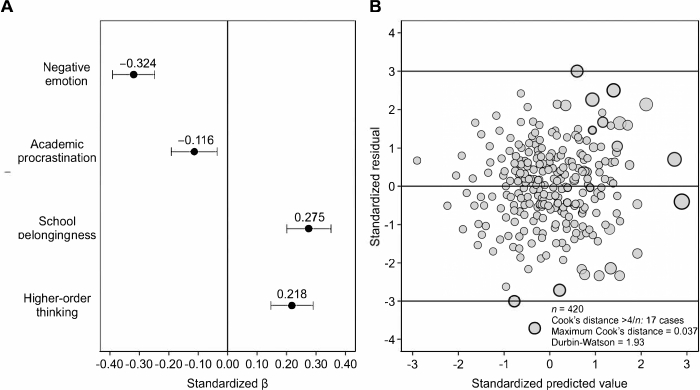
Figure 3 : Visualisation des coefficients de régression et des diagnostics. (A) Coefficients de régression standardisés et intervalles de confiance à 95 % obtenus à partir des résultats principaux de régression présentés dans le Tableau 9. (B) Représentation des diagnostics de régression générée à partir des valeurs prédites standardisées, des résidus standardisés et des valeurs de la distance de Cook résumées dans le Tableau 11. Des valeurs plus élevées de la distance de Cook indiquent des observations ayant une influence potentielle plus importante sur le modèle ajusté. Veuillez cliquer ici pour visualiser une version agrandie de cette figure.
Tableau 1 : Structure du questionnaire et cadre de notation des échelles. Ce tableau résume le cadre de mesure, incluant le nom de la construction, l'instrument source, la référence source, le statut d'adaptation ou de documentation, le nombre d'items, l'étendue des réponses, le sens de la notation, la nécessité d'une inversion des notes, la méthode de calcul des scores, la variable finale au niveau de l'échelle et le rôle dans le protocole. Veuillez cliquer ici pour télécharger ce tableau.
Tableau 2 : Critères de tri des réponses et critères analytiques de décision. Ce tableau énumère les critères prédéfinis pour le tri relatif au consentement, le tri d'éligibilité, l'examen des réponses en double, la gestion des données manquantes, la détection des durées de réponse anormales, l'identification des réponses linéaires continues, les plages de réponses valides, l'évaluation de la fiabilité, la classification en groupes haut et bas, les diagnostics de régression et les vérifications de sensibilité. Veuillez cliquer ici pour télécharger ce tableau.
Tableau 3 : Flux du dépistage depuis les questionnaires soumis jusqu'au jeu de données analytiques final. Ce tableau indique le nombre de questionnaires soumis, de dossiers signalés, de dossiers supprimés, de dossiers conservés et des sources de vérification à chaque étape du dépistage. La durée d'achèvement et les réponses linéaires systématiques ont été considérées comme des indicateurs de qualité de réponse plutôt que comme des critères d'exclusion automatique. Veuillez cliquer ici pour télécharger ce tableau.
Tableau 4 : Caractéristiques démographiques de l'ensemble de données analytique. Ce tableau résume les dossiers d'étudiants anonymisés conservés après le tri des réponses, y compris le sexe, l'âge, l'année d'études de premier cycle, la catégorie d'établissement et la catégorie de spécialité académique. Les cellules démographiques ont été examinées pour évaluer le risque d'identifiabilité indirecte avant publication. Veuillez cliquer ici pour télécharger ce tableau.
Tableau 5 : Statistiques descriptives, vérification des plages et cohérence interne des cinq variables au niveau échelle. Ce tableau indique le nombre d'items, la plage théorique, la plage observée, la moyenne, l'écart type, l'alpha de Cronbach, l'oméga de McDonald, ainsi que la concentration aux extrémités inférieure et supérieure pour les émotions négatives, le procrastination académique, le sentiment d'appartenance scolaire, la pensée de niveau supérieur et le bien-être subjectif. Veuillez cliquer ici pour télécharger ce tableau.
Tableau 6 : Matrice de corrélation de Pearson des variables au niveau échelle. Ce tableau présente les coefficients de corrélation de Pearson entre les émotions négatives, le procrastination académique, le sentiment d'appartenance scolaire, la pensée de haut niveau et le bien-être subjectif. La matrice a été utilisée comme sortie descriptive des associations et comme étape de vérification du sens des scores. Veuillez cliquer ici pour télécharger ce tableau.
Tableau 7 : Comparaison contrastive entre les groupes à forte et faible bien-être subjectif. Ce tableau compare les émotions négatives, le procrastination académique, le sentiment d'appartenance scolaire et la pensée de niveau supérieur entre les répondants situés dans les 27 % supérieurs et les 27 % inférieurs des scores de bien-être subjectif. La comparaison illustre le processus de regroupement et de comparaison, plutôt qu'une classification substantielle de profils de bien-être. Veuillez cliquer ici pour télécharger ce tableau.
Tableau 8 : Comparaison descriptive selon le sexe. Ce tableau présente des comparaisons descriptives des émotions négatives, du procrastination scolaire, du sentiment d'appartenance à l'école, de la pensée de haut niveau et du bien-être subjectif selon le sexe. Le sexe a été considéré comme une variable de regroupement descriptif. Veuillez cliquer ici pour télécharger ce tableau.
Tableau 9 : Modèle principal de régression linéaire multiple prédisant le bien-être subjectif. Ce tableau présente le modèle de régression principal dans lequel le bien-être subjectif constituait la variable dépendante, tandis que les émotions négatives, le procrastination académique, le sentiment d'appartenance scolaire et la pensée de niveau supérieur ont été introduits simultanément comme prédicteurs au niveau d'échelle. Les valeurs d'erreur standard, d'intervalle de confiance et du facteur d'inflation de la variance sont incluses. Veuillez cliquer ici pour télécharger ce tableau.
Tableau 10 : Modèle de sensibilité de régression ajusté sur les données démographiques prédisant le bien-être subjectif. Ce tableau présente les quatre prédicteurs psychologiques après ajustement selon le sexe, l'âge, l'année d'études de premier cycle, la catégorie d'établissement et la catégorie de spécialité académique. Les variables démographiques catégorielles ont été saisies à l'aide d'un codage fictif (dummy coding). Les valeurs d'erreur type, d'intervalle de confiance et de facteur d'inflation de la variance sont incluses. Veuillez cliquer ici pour télécharger ce tableau.
Tableau 11 : Analyses diagnostiques de régression et vérifications de la sensibilité aux influences. Ce tableau résume les résultats relatifs aux résidus, aux influences et aux diagnostics du modèle, notamment les résidus standardisés, la distance de Cook > 1,00, la distance de Cook > 4/n, la distance de Cook maximale, la statistique de Durbin-Watson, le graphique quantile-quantile (Q-Q) des résidus, le test de normalité des résidus, le graphique des résidus en fonction des valeurs prédites, la vérification de la linéarité et l'analyse de sensibilité aux influences. Veuillez cliquer ici pour télécharger ce tableau.
Fichier supplémentaire 1 : Structure du questionnaire, origine des échelles et documentation relative au calcul des scores. Ce fichier supplémentaire fournit l'ordre d'administration du questionnaire, le libellé du consentement éclairé, les variables démographiques, la documentation sur les instruments sources, les codes des items, les points d'ancrage des réponses, les informations sur l'adaptation et l'état de la documentation, le sens du calcul des scores, les règles de recodage inverse, la construction finale des variables au niveau des échelles, les règles de gestion des items manquants, les champs de liaison pour la qualité des réponses, les règles de vérification des plages et les références associées aux cinq constructions du questionnaire. Il sert de complément questionnaire/livre-code pour documenter la programmation, le calcul et la vérification des échelles dans le flux de travail. Veuillez cliquer ici pour télécharger ce fichier.
Discussion
Ce protocole normalise un processus courant mais souvent mal documenté dans les études sur le bien-être fondées sur des questionnaires : le passage des enregistrements bruts de réponses à des données filtrées, à des variables d’échelle cotées, à des sorties statistiques et à des fichiers prêts à être visualisés. Sa contribution ne réside pas dans l’élaboration d’une nouvelle théorie du bien-être subjectif ni dans la proposition d’un modèle causal. Au contraire, le flux de travail fournit un cheminement vérifiable pour la configuration du questionnaire, le tri des réponses, le calcul des scores d’échelle, la vérification de la fiabilité, l’analyse descriptive, l’analyse des associations, les diagnostics de régression et la validation des sources des figures. Cette distinction est importante car la vérifiabilité dans la recherche par questionnaire dépend de décisions procédurales souvent prises avant le début de l’interprétation statistique, notamment le choix des enregistrements conservés, la gestion des items manquants, le traitement des items inversés et la manière dont les tableaux numériques sources sont associés aux sorties visuelles. Rendre ces décisions explicites réduit les pratiques douteuses en matière de mesure dans la recherche fondée sur des échelles23 et favorise une culture de recherche plus transparente24.
Une caractéristique centrale du protocole est l'utilisation d'artefacts concrets d'audit plutôt que d'une simple description verbale. Le flux de travail révisé relie chaque construit à son instrument source, à l'étendue des items, aux modalités de réponse, au sens du score, à la règle de codage inversé, à la variable finale au niveau de l'échelle, ainsi qu'aux informations sur l'adaptation ou l'état de la documentation. La traçabilité comprend le fichier verrouillé du questionnaire, la carte verrouillée des échelles, l'export brut verrouillé, le journal de dépistage, le journal de vérification du codage, le journal d'analyse, le fichier de sortie diagnostique et le tableau des sources des figures. Ces fichiers précisent quelle version du questionnaire a été administrée, quels enregistrements ont été exclus ou conservés, comment les scores ont été calculés, et quel tableau validé a été utilisé pour créer chaque figure. Lorsque les données au niveau des participants ne peuvent pas être partagées publiquement, un jeu de données synthétique, ayant la même structure de variables et accompagné des journaux de dépistage et de codage complétés, peut permettre aux lecteurs de tester le flux de travail computationnel sans accéder à des données identifiables ou indirectement identifiables. Cette structure fondée sur des artefacts est conforme au principe FAIR selon lequel des résultats de recherche réutilisables exigent une provenance claire, une structure définie et des conditions d'accès explicites25.
Les résultats présentatifs doivent être interprétés comme des sorties de flux de travail, et non comme une preuve concrète concernant les déterminants psychologiques du bien-être des étudiants. La comparaison entre bien-être subjectif élevé et faible a été incluse afin de montrer comment une règle de regroupement prédéfinie peut être mise en œuvre, vérifiée et rapportée ; elle ne doit pas être interprétée comme une classification réelle de profils de bien-être dans le monde réel. De même, le modèle de régression illustre comment des données issues d'un questionnaire coté peuvent être modélisées, vérifiées pour détecter une éventuelle multicolinéarité, évaluées à l'aide de diagnostics sur les résidus et les influences, puis associées à un tableau source de figure validé. Ce modèle n'établit pas que l'émotion négative, le procrastinateur académique, le sentiment d'appartenance scolaire ou la pensée de niveau supérieur déterminent de façon causale le bien-être subjectif. Étant donné que toutes les variables principales ont été recueillies à l'aide d'un même questionnaire auto-administré à un seul moment, un biais de méthode commune, des effets de style de réponse et un contexte de mesure partagé ne peuvent être exclus26.
Ce flux de travail ne remplace pas non plus une validation psychométrique complète. L'alpha de Cronbach, l'oméga de McDonald, les vérifications de la plage observée, l'analyse des éléments par rapport au total et la vérification du codage inversé sont des étapes utiles de contrôle qualité pour un flux de notation vérifiable, mais elles n'établissent pas la validité factorielle, l'invariance de mesure, les propriétés de réponse aux items ou la comparabilité entre groupes. Les études qui utilisent le questionnaire pour tester une théorie substantielle devraient réaliser une analyse factorielle confirmatoire, des tests d'invariance de mesure entre les groupes démographiques ou institutionnels pertinents, ainsi que des vérifications supplémentaires de validité lorsque cela est approprié27. Par conséquent, le présent protocole doit être compris comme un cadre vérifiable de traitement et de rapport des données, et non comme une étude complète de validation des constructions incluses.
Le flux de travail a été démontré sur un échantillon composé d'un étudiant de premier cycle, à l'aide de données provenant d'un questionnaire auto-administré recueillies à un seul moment, sans validation externe. Sa transposition à d'autres populations, disciplines, institutions, langues et contextes culturels ne doit pas être supposée. Si le flux de travail est réutilisé dans un autre contexte, la carte des échelles doit être reconstruite plutôt que copiée mécaniquement. Les chercheurs doivent examiner l'origine des items, leur statut en matière de traduction ou d'adaptation, la dépendance culturelle et contextuelle des items relatifs au bien-être, les points d'ancrage des réponses, les règles de cotation inversée, l'interprétation des scores et les exigences éthiques locales. Les procédures de traduction et d'adaptation exigent une documentation explicite, plutôt que de simples modifications informelles du libellé28, et l'interprétation des scores de tests éducatifs et psychologiques doit rester liée aux preuves relatives à l'usage prévu et à la population cible29.
En pratique, le protocole s'avère particulièrement utile comme cadre vérifiable pour le traitement et la restitution des données dans les recherches sur le bien-être fondées sur des questionnaires. Il aide les chercheurs à rendre visibles les décisions relatives au nettoyage, au calcul des scores, aux diagnostics et à la visualisation avant même le début de l'interprétation. De futures applications devraient tester ce flux de travail sur des échantillons indépendants, dans différents contextes institutionnels, selon des plans longitudinaux et avec des équipes d'analystes indépendamment répliquées. Une validation externe, des règles de décision préenregistrées, des jeux de données synthétiques partagés, des journaux d'exemple complets de dépistage et de calcul des scores, ainsi que la réplication par des analystes indépendants renforceraient davantage la portabilité et la crédibilité du flux de travail.
Déclarations de divulgation
Les auteurs n'ont aucun conflit d'intérêts à déclarer.
Remerciements
Les auteurs remercient les étudiants du collège qui ont participé à l'enquête par questionnaire pour leur soutien durant la collecte des données. Les auteurs remercient également les enseignants concernés et les assistants de recherche pour leur aide à la distribution des questionnaires, à l'organisation des données, à la vérification des résultats, ainsi qu'à la préparation des tableaux et des figures. Ce travail n'a reçu aucun financement spécifique.
Matériaux
| Nom | Entreprise | Numéro de catalogue | Commentaires |
|---|---|---|---|
| paquet R broom | CRAN | paquet R | Utilisé pour convertir les sorties de régression en tableaux structurés de coefficients et de résumés de modèles. |
| paquet R car | CRAN | paquet R | Utilisé pour la vérification du facteur d'inflation de la variance et le soutien aux diagnostics de régression. |
| Documentation source des échelles Dépression, Anxiété, Stress-21 | Fondation de psychologie d'Australie | Lovibond et Lovibond, 1995 | Documentation source pour la section des émotions négatives. Le flux de travail a utilisé une formulation adaptée à l'étude, alignée sur l'évaluation récente des états émotionnels négatifs. |
| paquet R dplyr | CRAN | paquet R | Utilisé pour le filtrage des données, le recodage, le regroupement, les résumés du flux de contrôle et la préparation des tableaux analytiques. |
| paquet R ggplot2 | CRAN | paquet R | Utilisé pour générer la carte thermique de corrélation, le graphique de corrélation du bien-être subjectif, le graphique des coefficients de régression et l'affichage des diagnostics. |
| Documentation source pour la mesure de la pensée de niveau supérieur | Springer Nature | DOI : 10.1038/s41598-024-70908-3 | Documentation source pour la section de la pensée de niveau supérieur. Le flux de travail a utilisé un ensemble d'items adapté à l'étude, aligné sur la pensée analytique, évaluative, réflexive, intégrative et fondée sur des preuves. |
| IBM SPSS Statistics | IBM Corp. | Version 29.0.2.0 | Utilisé pour les statistiques descriptives, l'alpha de Cronbach’s, la corrélation de Pearson, les tests t pour échantillons indépendants et de Welch’s, la régression linéaire multiple, la statistique de Durbin-Watson, les résidus standardisés, les valeurs de levier, la distance de Cook’s et les facteurs d'inflation de la variance. |
| paquet R psych | CRAN | paquet R | Utilisé pour les résumés psychométriques, la vérification de l'alpha de Cronbach’s et l'omega de McDonald’s. |
| Documentation source de l'échelle de sentiment psychologique d'appartenance à l'école | Wiley | Psychol Sch. 1993;30(1):79-90 | Documentation source pour la section d'appartenance scolaire. Le flux de travail a utilisé une formulation adaptée à l'étude, alignée sur l'acceptation perçue, la connexion, le soutien et le sentiment d'appartenance dans l'environnement scolaire. |
| Environnement statistique R | Fondation R pour l'informatique statistique | Version 4.4.2 | Utilisé pour la vérification analytique secondaire, l'omega de McDonald’s, les vérifications de sensibilité de Spearman, la préparation des sorties de régression, la préparation des sorties de diagnostic et la préparation des sources de visualisation. |
| paquet R readxl | CRAN | paquet R | Utilisé pour importer les exports de questionnaires au format tableur dans le flux de vérification R. |
| Documentation source de l'échelle de bien-être subjectif pour les citoyens chinois | Scientific & Academic Publishing | DOI : 10.5923/j.ijap.20190905.01 | Documentation source pour la section du bien-être subjectif. Le flux de travail a utilisé une formulation adaptée à l'étude et des items inversés alignés sur la satisfaction de vie, le sens, le soutien, le progrès, l'insatisfaction, l'impuissance et les expériences de bien-être liées au stress. |
| Fichier supplémentaire 1 : Structure du questionnaire et documentation des échelles | Auteurs | Fichier supplémentaire 1 | Fournit la structure du questionnaire administré, l'ordre des construits, l'origine des échelles, les codes des items, les points d'ancrage des réponses, le sens de notation, les règles de notation inversée, la construction des scores au niveau des échelles et les informations sur l'état de la documentation. |
| Documentation source de l'échelle de procrastination de Tuckman | SAGE Publications | Educ Psychol Meas. 1991;51(2):473-480 | Documentation source pour la section de la procrastination académique. Le flux de travail a utilisé une formulation adaptée à l'étude, alignée sur le retard académique et le report des tâches. |
| Plateforme en ligne de questionnaire Wenjuanxing | Changsha Ranxing Information Technology Co., Ltd. | Plateforme web | Utilisée pour le consentement électronique, la programmation du questionnaire, la collecte des réponses aux items, la capture des horodatages, l'enregistrement de la durée d'achèvement, la vérification des soumissions en double et l'exportation des réponses brutes. |
Références
- 1. Khatri P et al. Student well-being in higher education: scale development and validation with implications for management education. Int J Manag Educ. 2024;22(1):100933.
- Mirzaei A, Carter SR, Patanwala AE, Schneider CR. Missing data in surveys: key concepts, approaches, and applications. Res Social Adm Pharm. 2022;18(2):2308-16.
- Gummer T, Roßmann J, Silber H. Using instructed response items as attention checks in web surveys: properties and implementation. Sociol Methods Res. 2021;50(1):238-64.
- Johansson F et al. Associations between procrastination and subsequent health outcomes among university students in Sweden. JAMA Netw Open. 2023;6(1):e2249346.
- Li X, Kuo YL, Huggins TJ. Perceived feedback and school belonging: the mediating role of subjective well-being. Front Psychol. 2024;15:1450788.
- Sönning L. Ordinal response scales: psychometric grounding for design and analysis. Res Methods Appl Linguist. 2024;3(3):100156.
- Song P et al. Predictive analysis of college students’ academic procrastination behavior based on a decision tree model. Humanit Soc Sci Commun. 2024;11:869.
- Dudáš A. Graphical representation of data prediction potential: correlation graphs and correlation chains. Vis Comput. 2024;40(10):6969-82.
- Niessen ASM, Meijer RR, Tendeiro JN. Detecting careless respondents in web-based questionnaires: which method to use? J Res Pers. 2016;63:1-11.
- Parsons J, Bao L. A unified approach for outliers and influential data detection: the value of information in retrospect. Stat. 2022;11(1):e442.
- Donche V et al. Careless responding in online student learning surveys: profiles and impact on data quality. Frontline Learn Res. 2026;13(3):1-14.
- Lovibond SH, Lovibond PF. Manual for the Depression Anxiety Stress Scales. 2nd ed. Psychology Foundation; Sydney; 1995.
- Tuckman BW. The development and concurrent validity of the Procrastination Scale. Educ Psychol Meas. 1991;51(2):473-80.
- Goodenow C. The psychological sense of school membership among adolescents: scale development and educational correlates. Psychol Sch. 1993;30(1):79-90.
- Li D, Fan X, Meng L. Development and validation of a higher-order thinking skills (HOTS) scale for major students in the interior design discipline for blended learning. Sci Rep. 2024;14:20287.
- Huang L, Xing Z. A nationwide study on Subjective Well-being Scale for Chinese Citizens (SWBS-cc). Int J Appl Psychol. 2019;9(5):117-27.
- DeSimone JA, Harms PD, DeSimone AJ. Best practice recommendations for data screening. J Organ Behav. 2015;36(2):171-81.
- Revilla MA, Saris WE, Krosnick JA. Choosing the number of categories in agree-disagree scales. Sociol Methods Res. 2014;43(1):73-97.
- Muszyński M. Attention checks and how to use them: review and practical recommendations. ASK Res Methods. 2023;32(1):3-38.
- McNeish D. Thanks coefficient alpha, we’ll take it from here. Psychol Methods. 2018;23(3):412-33.
- Romeo I, Stanislaw H, McCreary J, Hawley M. The importance of belonging for well-being in college students. PLOS Ment Health. 2024;1(1):e0000057.
- Kastellec JP, Leoni EL. Using graphs instead of tables in political science. Perspect Polit. 2007;5(4):755-71.
- Flake JK, Fried EI. Measurement schmeasurement: questionable measurement practices and how to avoid them. Adv Methods Pract Psychol Sci. 2020;3(4):456-65.
- Nosek BA et al. Promoting an open research culture. Science. 2015;348(6242):1422-5.
- Wilkinson MD et al. The FAIR Guiding Principles for scientific data management and stewardship. Sci Data. 2016;3:160018.
- Podsakoff PM, MacKenzie SB, Lee JY, Podsakoff NP. Common method biases in behavioral research: a critical review of the literature and recommended remedies. J Appl Psychol. 2003;88(5):879-903.
- Vandenberg RJ, Lance CE. A review and synthesis of the measurement invariance literature: suggestions, practices, and recommendations for organizational research. Organ Res Methods. 2000;3(1):4-70.
- van de Vijver FJR, Hambleton RK. Translating tests: some practical guidelines. Eur Psychol. 1996;1(2):89-99.
- American Educational Research Association, American Psychological Association, National Council on Measurement in Education. Standards for educational and psychological testing. American Educational Research Association; Washington, DC; 2014.