Ce protocole décrit un flux de travail hybride quantique–classique reproductible pour classifier la maladie de Parkinson à partir d’enregistrements vocaux humains, incluant le prétraitement des données, la mise en œuvre de circuits quantiques, l’entraînement de modèles et la validation croisée pour une réplication indépendante.
Un abonnement JoVE est requis pour visualiser ce contenu. Connectez-vous ou commencez votre période d'essai gratuite.
Article de recherche
Un protocole hybride quantique-classique reproductible pour classifier la maladie de Parkinson à partir d’enregistrements vocaux humains
Dans cet article
Résumé
Résumé
La maladie de Parkinson est un trouble neurodégénératif progressif pour lequel les méthodes de dépistage accessibles et peu coûteuses restent limitées. Les enregistrements vocaux à voyelles soutenues contiennent des biomarqueurs acoustiques mesurables associés à la dysphonie liée aux maladies, qui peuvent être acquis sans équipement spécialisé. Ce protocole décrit un réseau de neurones convolutionnel hybride quantique–classique de quatre qubits (QI-HCNN) qui combine un circuit quantique paramétré avec une couche de classification classique peu profonde pour classer la maladie de Parkinson à l’aide de caractéristiques vocales acoustiques réduites en dimension. Le protocole compare également l’approche proposée avec un réseau de neurones classique adapté en dimensionnalité et des classificateurs d’arbres à gradient boostés, entraînés à la fois sur les ensembles de fonctionnalités réduits et complets. En utilisant un ensemble de données public et désidentifié comprenant 195 enregistrements vocaux de 31 individus, le QI-HCNN a atteint une zone sous la courbe caractéristique de fonctionnement du récepteur de 0,78 grâce à une validation croisée stratifiée triple, contre 0,87 pour le réseau de neurones classique apparié et 0,94–0,95 pour les bases augmentées de gradient entraînées respectivement sur les ensembles de fonctionnalités réduit et complet. Une analyse d’ablation contrôlée a démontré qu’une des deux opérations d’intrication du circuit ne pouvait pas influencer la sortie mesurée par conception, tandis que l’opération d’intrication restante réduisait, plutôt qu’améliorait, la performance de classification par rapport à une variante non intriquée. La validation croisée groupée par patients a également montré que les estimations de performance variaient considérablement selon les individus assignés à l’ensemble testé, reflétant la taille limitée de la cohorte. Ce protocole fournit donc une base quantique–classique entièrement spécifiée et reproductible de manière indépendante, accompagnée d’une évaluation fondée sur les données des forces et des limites de la conception actuelle du circuit, fournissant une base méthodologique pour les futures recherches plutôt que de soutenir des affirmations de préparation diagnostique.
Introduction
La maladie de Parkinson est un trouble neurodégénératif chronique causé par la perte progressive des neurones dopaminergiques dans la substance noire, touchant plus de 10 millions de personnes dans le monde et représentant un fardeau important et croissant pour la santépublique 1. La maladie provoque à la fois des symptômes moteurs, notamment des tremblements, une rigidité et une bradykinésie, ainsi que des symptômes non moteurs tels que des troubles du sommeil et des anosmies. Le diagnostic clinique repose principalement sur un examen neurologique utilisant des échelles de notation motorie standardisées, complétées, lorsque possible, par l’imagerie par transporteur de dopamine ; cependant, les deux approches nécessitent une expertise spécialisée et une infrastructure qui ne sont pas uniformément accessibles, et l’évaluation clinique en phase précoce restesubjective 2. Comme aucune thérapie modifiante de la maladie n’est actuellement disponible, la détection précoce est précieuse principalement parce qu’elle permet une prise en charge plus précoce des symptômes et un suivi longitudinal. Ce besoin a motivé le développement d’approches de dépistage à faible coût, évolutives et non invasives, capables de compléter, plutôt que de remplacer, l’évaluation clinique.
L’altération vocale est l’un des premiers changements mesurables associés à la maladie de Parkinson et précède fréquemment les symptômes moteursmanifestes 3. La phonation soutenue d’une voyelle tenue fournit un signal contrôlé à partir duquel des caractéristiques acoustiques, telles que le jitter, le scintillement, le rapport harmonique/bruit, l’entropie de la densité de période de récurrence et l’analyse des fluctuations détendances, peuvent être extraites. Ces fonctionnalités ont été maintes fois démontrées comme contenant des informations diagnostiques pertinentes et peuvent être acquises à l’aide d’équipements d’enregistrement grandpublic 4,5. Un jeu de données de référence public dérivé de tels enregistrements est devenu un banc d’essai standard pour cette tâche, et les méthodes classiques d’apprentissage automatique appliquées à l’ensemble des caractéristiques, y compris les machines à vecteurs de support, les forêts aléatoires et les arbres à gradient boosté, ont rapporté des valeurs de surface sous la courbe caractéristique de fonctionnement du récepteur approchant 0,99 6,7,8, ce qui suggère que la tâche de classification est proche d’être résolue lorsque l’ensemble complet des caractéristiques et les stratégies appropriées pour gérer le déséquilibre de classe sont utilisés. L’apprentissage automatique quantique est apparu comme un paradigme computationnel alternatif pour les tâches de classification biomédicale, dans lequel les circuits quantiques paramétrés utilisent la superposition et l’intrication pour représenter des interactions de caractéristiques avec relativement peu de paramètres entraînables, et les gradients de circuit peuvent être calculés analytiquement en utilisant la règle du décalage paramétrique plutôt que des approximations aux différencesfinies 9. Cependant, de nombreuses études publiées décrivant des réseaux de neurones « quantiques » ou « inspirés par le quantique » pour des applications biomédicales mettent en œuvre des architectures entièrement classiques qui adoptent des formalismes mathématiques inspirés du quantique sans exécuter un véritable circuit quantique paramétré sur un simulateur ou sur le matérielquantique 10. Les développements récents dans la détection de la maladie de Parkinson ont également inclus des architectures hybrides de réseaux neuronaux convolutionnels-transformateurs11, des méthodes d’apprentissage profond basées sur l’attention pour l’imagerie par résonance magnétique (IRM)12, et des réseaux de neurones convolutionnels légers conçus pour un diagnosticcomputationnellement efficace 13, illustrant l’expansion rapide des approches d’intelligence artificielle à travers plusieurs modalités de données. Plus largement, le diagnostic assisté par ordinateur non invasif a été étendu avec succès à d’autres applications biomédicales, y compris les pipelines hybrides d’apprentissage automatique et d’apprentissage profond pour l’imageriemédicale 14. Les évaluations comparatives des architectures d’apprentissage profond sur le même ensemble de données de voix publiques démontrent également les performances élevées atteignables avec des modèles classiques conventionnels à fonctionnalitéscomplètes 15.
Ces développements mettent en lumière un besoin méthodologique spécifique d’un modèle de réseau de neurones convolutionnel hybride quantique–classique reproductible (QI-HCNN) qui (i) exécute un véritable circuit quantique paramétré entièrement spécifié ; (ii) est évalué en utilisant des caractéristiques d’entrée identiques à la fois par rapport à un réseau de neurones classique adapté architecturalement et à une base classique forte ; et (iii) est évalué à l’aide d’un protocole qui examine explicitement les principales sources de biais dans les petits ensembles de données biomédicales, notamment le déséquilibre de classe, la confusion démographique et la fuite de données au niveau du patient lors de la validation croisée.
L’objectif global de ce protocole est de fournir un flux de travail QI-HCNN entièrement reproductible pour la classification de la maladie de Parkinson à l’aide d’enregistrements vocaux humains. Le protocole décrit un circuit quantique paramétré à quatre qubits utilisant un codage angulaire, deux couches d’intrication contrôlées basées sur NOT, et une couche variationnelle entraînable optimisée avec la règle du décalage de paramètre, couplée à une tête de classification classique peu profonde et appliquée à une représentation principale à quatre composantes d’un jeu de données d’enregistrement vocal public disponible. Le flux de travail spécifie, à un niveau suffisant pour une réplication indépendante, toutes les procédures de prétraitement, la construction complète du circuit, la configuration classique d’entraînement et les procédures d’évaluation, y compris des comparaisons avec un réseau neuronal classique adapté en dimensionnalité, des bases d’arbre à répartition dimensionnelle et à gradient amplifié en toutes les caractéristiques, des ablations contrôlées par composants du circuit, une validation croisée groupée par les patients pour évaluer la sensibilité aux participants en retard, ainsi que des statistiques explicites Des tests de signification. Plutôt que de ne présenter que des résultats favorables, le protocole est conçu pour rapporter de manière transparente lorsque les composants individuels du circuit n’améliorent pas de manière mesurable les performances, fournissant ainsi un cadre méthodologique reproductible pouvant orienter le développement futur de l’architecture QI-HCNN pour les tâches de classification biomédicale de petite cohorte.
Accès restreint. Veuillez vous connecter ou commencer un essai pour afficher ce contenu.
Protocole
Ce protocole utilise un jeu de données d’enregistrement vocal tiers, dé-identifié et accessible publiquement. Aucune nouvelle donnée sur des sujets humains n’a été collectée par les auteurs, et aucune approbation supplémentaire du comité d’examen institutionnel (IRB) n’a été requise pour cette étude. L’ensemble de données décrit dans la sous-section Acquisition de données et Gestion des données au niveau des participants a été initialement collecté sous approbation éthique institutionnelle par Little et al.3, ne contient aucune information directement identifiante des participants (seulement des identifiants anonymisés d’enregistrement) et est accessible au public pour une utilisation en recherche. Confirmez, selon vos politiques institutionnelles, si une analyse secondaire de cet ensemble de données accessible au public nécessite un examen éthique. À l’institution des auteurs, une analyse secondaire rétrospective de ce jeu de données entièrement désidentifié et archivé publiquement a été jugée exemptée de toute revue complète par l’IRB.
Acquisition de jeux de données et gestion des données au niveau des participants
Le jeu de données de classification de la maladie de Parkinson (UCI Machine Learning Repository, Dataset ID 174), initialement décrit par Little et al.3, a été téléchargé. Le jeu de données contenait 195 enregistrements de phonation /a/ à voyelles soutenues provenant de 31 individus (23 diagnostiqués atteints de la maladie de Parkinson et 8 témoins en bonne santé ; tranche d’âge, 46–85 ans). Comme le dépôt ne fournit pas de DOI versionné, la date exacte de téléchargement a été enregistrée et rapportée dans le tableau des matériaux. Le jeu de données était fourni sous forme de fichier CSV (parkinsons.csv). Aucune décompression ni conversion de fichiers n’était requise, et le fichier était importé directement via la fonction read_csv depuis la bibliothèque Pandas (voir Table of Materials).
Le jeu de données téléchargé a été vérifié qu’il contenait 195 lignes et 24 colonnes comprenant une colonne d’identification d’enregistrement (format : phon_R01_S  sujet
 _ enregistrement), 22 colonnes de caractéristiques acoustiques continues (Tableau 1) et une colonne binaire d’étiquette de classe (statut : 1 = maladie de Parkinson ; 0 = contrôle en bonne santé). Le tableau 1 servait de référence pour toutes les caractéristiques acoustiques et catégories de caractéristiques tout au long du protocole.
| Catégorie | Caractéristiques représentatives | Importance clinique |
| Fréquence fondamentale | MDVP :Fo(Hz), MDVP :Fhi(Hz), MDVP :Flo(Hz) | Fréquence fondamentale moyenne, maximale et minimale de phonation ; reflète la stabilité de la vibration des cordes vocales. |
| Jitter (perturbation fréquentielle) | MDVP :Jitter( %), MDVP :Jitter(Abs), MDVP :RAP, MDVP :PPQ, Jitter :DDP | Variation de la période de hauteur d’un cycle à l’autre, reflétant un contrôle moteur laryngé altéré. |
| Shimmer (perturbation d’amplitude) | MDVP : Scintillement, MDVP : Scintillant (dB), Scintillant : APQ3, Scintillant : APQ5, MDVP : APQ, Scintillant : DDA | Variation d’amplitude du signal d’un cycle à l’autre, reflétant une phonation haletante ou instable. |
| Mesures de bruit | NHR, HNR | Rapport entre le bruit et les composantes harmoniques (tonales) du signal vocal. |
| Dynamique non linéaire / échelle fractale | RPDE, D2, DFA, spread1, spread2, EPI | Mesures de la dynamique vocale non linéaire, de la périodicité et des corrélations temporelles à longue portée associées à la vibration des cordes vocales. |
Tableau 1 : Catégories de caractéristiques acoustiques utilisées pour la classification de la maladie de Parkinson. Les 22 caractéristiques vocales acoustiques extraites de l’ensemble de données de la Classification de la maladie de Parkinson sont regroupées en cinq catégories : fréquence fondamentale, tremblement, scintillement, mesures de bruit et dynamique non linéaire. Les caractéristiques représentatives sont listées pour chaque catégorie avec leur signification clinique correspondante. MDVP, Programme de voix multidimensionnelle ; RAP, perturbation moyenne relative ; PPQ, quotient de perturbation de la période de hauteur ; APQ, quotient de perturbation d’amplitude ; DDP, différence de différences de règles ; DDA, différence absolue moyenne des amplitudes ; NHR, rapport bruit/harmoniques ; HNR, rapport harmoniques/bruit ; RPDE, entropie de densité de période de récurrence ; D2, dimension de corrélation ; DFA, analyse des fluctuations déclassées ; EPI, entropie de la période de hauteur.
Un identifiant participant était extrait pour chaque enregistrement en analysant la sous-chaîne précédant le dernier underline dans le nom de l’enregistrement. Par exemple, phon_R01_S01_1 et phon_R01_S01_2 ont été assignés au participant S01. Des identifiants de participant, plutôt que des identifiants d’enregistrement, ont ensuite été utilisés pour toutes les procédures de validation groupées ou sans participation décrites dans la sous-section du protocole d’évaluation , car les enregistrements obtenus auprès du même participant sont acoustiquement corrélés. Après extraction, une table de fréquences des identifiants a été générée et inspectée pour confirmer que les 195 enregistrements étaient assignés à exactement 31 participants uniques, qu’aucun enregistrement n’était resté non attribué, et que le nombre d’enregistrements par participant correspondait à la documentation du jeu de données source.
La répartition des classes a été calculée au niveau des enregistrements (147 enregistrements de la maladie de Parkinson, 75,4 % ; 48 enregistrements de témoins sains, 24,6 %) et au niveau des participants (23 sur 31 participants, 74,2 % diagnostiqués avec la maladie de Parkinson). Les deux distributions ont été rapportées car le déséquilibre au niveau de l’enregistrement et au niveau des classes des participants n’est pas identique et influence l’évaluation en aval.
L’absence de groupes de la maladie de Parkinson et de groupes témoins sains correspondant à l’âge ou au sexe dans l’ensemble de données source a été documentée comme une limitation de l’étude et reportée à la Discussion car cette caractéristique reflète la collecte de données originale et ne peut être corrigée par un prétraitement en aval.
Pipeline de prétraitement
Toutes les procédures de prétraitement ont été effectuées indépendamment dans chaque pli d’entraînement de la procédure de validation croisée décrite dans la sous-section Protocole d’évaluation . Les étapes de normalisation Min–Max ainsi que l’analyse des composantes principales (PCA) ont été ajustées uniquement en utilisant la partition d’entraînement de chaque pli. Les transformations ajustées étaient ensuite appliquées à la partition de test correspondante sans réajustement afin d’éviter la fuite d’information de la partition de test vers les paramètres de prétraitement.
Les 22 caractéristiques acoustiques brutes de chaque partition d’entraînement ont été normalisées à l’aide d’un scaler Min–Max avec une plage de sortie de [0, π]. L’ajusteur ajusté était ensuite appliqué à la fois aux partitions d’entraînement et de test du pliage correspondant (Équation 1). L’équation 1 suit la formulation standard de normalisation Min–Max et a été définie pour le protocole actuel. La normalisation Min–Max a été réalisée en utilisant la classe MinMaxScaler issue de scikit-learn (version 1.8.0) avec feature_range=(0, π), copy=True, et clip=False.
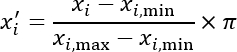 (1)
Un modèle PCA avec n_components = 4 a été ajusté uniquement en utilisant les données d’entraînement normalisées. La transformation PCA ajustée a ensuite été appliquée à la fois aux partitions d’entraînement et de test. La proportion de variance totale expliquée par les quatre composantes principales conservées a été enregistrée pour chaque fold. Dans les analyses présentées ici, les quatre composantes principales conservées expliquaient 81,5 % de la variance totale (respectivement 50,3 %, 16,3 %, 9,4 % et 5,5 %). L’ACP était réalisée en utilisant la classe PCA avec n_components=4, svd_solver="pleine », blanchit=Faux, et random_state=42.
Comme la PCA peut générer des scores de composants à valeurs négatives, un second scaler Min–Max avec une plage de sortie de [0, π] a été installé en utilisant la partition d’entraînement transformée en PCA. Le scaler ajusté a ensuite été appliqué à la fois sur les cloisons d’entraînement et d’essai. Toute valeur transformée de partition test qui se trouvait hors de l’intervalle [0, π] était découpée à la frontière la plus proche car l’échelle avait été ajustée uniquement en utilisant la partition d’entraînement. Aucune caractéristique à variance nulle n’était présente dans l’ensemble de données. La diversité de chaque long-métrage sur les 195 enregistrements était strictement positive ; par conséquent, aucune condition de division par zéro n’est apparue. Cela a été confirmé en vérifiant que la sortie à grande échelle ne contenait ni NaN ni valeurs infinies.
Les quatre composantes principales re-normalisées ont été attribuées séquentiellement comme angles de rotation pour les qubits 0, 1, 2 et 3 lors de la procédure d’encodage d’angle décrite dans la sous-section Construction de circuits quantiques . La première composante principale était assignée au qubit 0, la deuxième au qubit 1, la troisième au qubit 2, et la quatrième au qubit 3. Cela complétait la chaîne de prétraitement et transférait les caractéristiques classiques traitées au circuit quantique. Après la deuxième étape de mise à l’échelle Min–Max, toutes les valeurs de sortie ont été confirmées comme étant dans l’intervalle [0, π]. Les valeurs de partition de test qui sortaient légèrement de cette plage à cause de l’arrondi en virgule flottante étaient découpées à la frontière la plus proche grâce à la fonction de découpe de NumPy (version 2.4.4). Cette procédure garantissait que les quatre entrées de la couche d’encodage d’angle étaient des angles de rotation valides dans l’intervalle [0, π].
Construction de circuits quantiques
Le circuit à quatre qubits a été construit à l’aide du simulateur de vecteur d’état listé dans le tableau des matériaux et la séquence de portes décrite ci-dessous. Le fichier de codage supplémentaire 1 a été utilisé comme l’implémentation complète du circuit exécutable, incluant toutes les fonctions auxiliaires pour la construction de portes et le calcul du gradient de décalage de paramètres. La figure 1 montre le flux de travail complet, du prétraitement de l’enregistrement vocal à travers les quatre couches de circuits, la tête de post-traitement classique, et la classification finale.
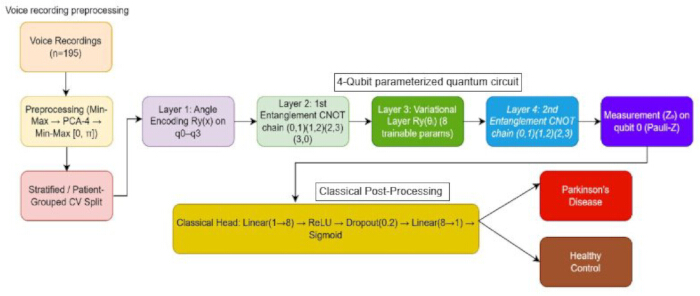
Figure 1. Architecture système et flux de travail des circuits quantiques. Flux de travail pour la classification de la maladie de Parkinson à partir d’enregistrements vocaux humains. Le diagramme montre le prétraitement de l’enregistrement vocal, la validation croisée stratifiée ou groupée par patients, l’exécution de circuits quantiques paramétrés à quatre qubits, la mesure Pauli-Z à un qubit sur le qubit 0, le post-traitement classique, et la classification binaire finale comme maladie de Parkinson ou contrôle sain. CNOT, porte contrôlée-NOT ; PCA, analyse des composantes principales ; ReLU, unité linéaire rectifiée. Veuillez cliquer ici pour voir une version agrandie de cette figurine.
Un registre à quatre qubits était initialisé dans l’état de base computationnel ∣0000.
Pour la couche d’encodage d’angles, une porte de rotation Ry (x i) a été appliquée au qubit i, où i = 0,1,2,3, en utilisant les quatre angles produits par le pipeline de prétraitement (Équation 2). L’équation 2 décrit la procédure standard d’encodage angulaire utilisée dans les circuits quantiques paramétrés, conforme au cadre d’apprentissage des circuits quantiques paramétrés de Mitarai et al.9, et a été appliquée ici dans la configuration spécifique à quatre qubits définie pour le protocole actuel.
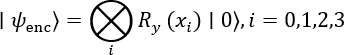 (2)
Pour la première couche d’intrication, une chaîne circulaire de portes contrôlées-NOT a été appliquée dans l’ordre suivant-cible de contrôle : (0,1), (1,2), (2,3) et (3,0).
Pour la couche variationnelle, les huit paramètres entraînables w0 à w 7 ont été initialisés par échantillonnage indépendant à partir d’une distribution normale avec une moyenne de 0 et un écart-type de 0,3. La graine aléatoire utilisée a été enregistrée dans la Table des Matériaux. Les huit paramètres quantiques variationnels ont été initialisés en utilisant numpy.random.default_rng(42 + fold_index).normal(0, 0,3, taille = 8), où fold_index est le nombre de pli basé sur zéro, fournissant ainsi des initialisations spécifiques au pliage mais reproductibles. Pour chaque qubit i = 0,1,2 et 3, une porte R z(w i) était appliquée, suivie d’une porte R y(w i+4) (Équation 3). L’équation 3 décrit une couche quantique variationnelle (entraînable) cohérente avec le cadre général paramétré d’apprentissage des circuits quantiques introduit par Mitarai et al.9 et a été instanciée ici en utilisant la séquence de portes spécifique et la paramétrisation définies pour le protocole actuel.
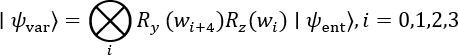 (3)
Pour la deuxième couche d’intrication, une chaîne ouverte de portes contrôlées-NOT a été appliquée dans l’ordre suivant-cible de contrôle : (0,1), (1,2) et (2,3). Cette chaîne n’a pas été refermée au qubit 0.
La valeur d’attente de l’opérateur de Pauli- sur le qubit 0 seulement,  , a été calculée à l’aide d’un produit scalaire vectoriel d’état. L’exécution sur circuit utilisait un simulateur de vecteur d’état personnalisé implémenté à l’aide d’opérations numériques standard sur tableau (Supplementary Coding File 1 ; qhcnn.py). La précision Complex128 (numpy.complex128) a été utilisée partout. Les valeurs d’espérance étaient calculées analytiquement à partir du produit scalaire du vecteur d’état ; par conséquent, aucun échantillonnage basé sur les injections n’a été réalisé. Aucun cadre de calcul quantique tiers n’était requis. Si un simulateur basé sur l’échantillonnage ou un dispositif quantique avait été utilisé à la place du simulateur de vecteur d’état, des mesures répétées en base computationnelle du qubit 0 auraient été effectuées, et les fréquences de bits résultantes auraient été converties en une valeur d’espérance (Équation 4). L’équation 4 est la formule standard de valeur espérée de la mécanique quantique et a été appliquée ici à l’observable Pauli- à un seul qubit défini pour le protocole actuel. Comme aucun échantillonnage basé sur le tir n’a été effectué, aucune atténuation des erreurs de mesure n’a été requise. Le simulateur utilisait une indexation de qubits big-endian, le qubit 0 correspondant au bit le plus significatif de l’indice du vecteur d’état. Cette convention a été explicitement prise en compte lors de la construction de l’observable de Pauli- pour s’assurer que la valeur d’attente correcte était mesurée.
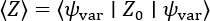 (4)
Le gradient de par rapport à chacun des huit paramètres variationnels a été calculé à l’aide de la règle du décalage de paramètre. Le circuit a été évalué deux fois pour chaque paramètre lors de chaque calcul de gradient, une fois à θ + π/2 et une fois à θ - π/2 (Équation 5). L’équation 5 est la règle standard du décalage des paramètres introduite par Mitarai et al.9 et a été appliquée ici sans modification.
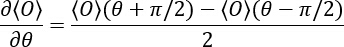 (5)
La deuxième couche d’intrication, comme spécifié ci-dessus, n’a jamais appliqué une porte contrôlée-NOT avec le qubit 0 comme cible. Parce qu’une porte contrôlée-NOT laisse l’état réduit de son qubit de contrôle inchangé, la seconde couche d’intrication ne pouvait pas modifier , indépendamment des valeurs des paramètres entraînables. Pour permettre à la seconde couche d’intrication d’influencer la sortie mesurée dans un protocole modifié, le qubit 0 devrait être inclus comme cible, par exemple en fermant la chaîne avec une porte contrôlée-NOT supplémentaire (3,0), ou un observable multiqubit devrait être mesuré plutôt qu’une valeur d’espérance d’un seul qubit. La deuxième couche d’intrication initialement spécifiée a été conservée dans ce protocole, et sa contribution mesurée a été explicitement rapportée dans la section Résultats plutôt que corrigée silencieusement, car ce comportement de circuit fait partie des présentes conclusions.
Couche classique de post-traitement
L’étape classique de post-traitement consistait en un réseau de neurones en avance implémenté à l’aide des opérations numériques standard basées sur des tableaux listées dans le Table des matériaux. La sortie du circuit scalaire unique,  , a été mappée à huit unités cachées à l’aide d’une couche entièrement connectée, suivie d’une activation d’unité linéaire rectifiée (ReLU). Pendant l’entraînement, une couche d’abandon avec une probabilité de rétention de 0,8 (taux d’abandon = 0,2) a été appliquée. Les huit unités cachées ont ensuite été mappées à une seule unité de sortie à l’aide d’une seconde couche entièrement connectée, et une fonction d’activation sigmoïde a été appliquée pour générer la probabilité finale de classe, ŷ (Équation 6). L’équation 6 définit l’architecture classique spécifique de post-traitement utilisée dans le protocole actuel et comprend des opérations linéaires standard, linéaires redressées (ReLU) et sigmoïdes.
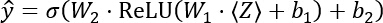 (6)
Les matrices de poids de première et deuxième couche ont été initialisées par échantillonnage indépendant à partir d’une distribution normale avec une moyenne de 0 et un écart-type de 0,5, tandis que tous les termes de polarisation ont été initialisés à 0. La même instance génératrice de nombres aléatoires et la même graine utilisées pour l’initialisation des paramètres variationnels quantiques ont également été utilisées pour la couche classique afin d’assurer la reproductibilité run-to-run. Plus précisément, les matrices de poids classiques ont été initialisées en utilisant numpy.random.default_rng(42 + fold_index).normal(0, 0,5, size=...), tandis que tous les termes de biais étaient initialisés à zéro. Une instance unique de générateur de nombres aléatoires ensemencés, initialisée avec 42 + fold_index, était créée au début de chaque pliage de validation croisée et réutilisée séquentiellement pour l’initialisation des paramètres quantiques, l’initialisation classique en poids, le mélange mini-batch et la génération de masques de dropout, plutôt que d’utiliser des flux de départ indépendants séparés pour chaque processus.
Pendant l’entraînement, le dropout était appliqué en générant un nouveau masque binaire échantillonné à chaque passage avant en utilisant la convention du rejet inversé, dans laquelle les unités survivantes étaient évaluées de 1/0,8. Lors de la validation et des tests, la coupure était complètement désactivée, et le réseau complet et non scalé était utilisé pour l’inférence.
Le modèle combiné QI-HCNN contenait 33 paramètres entraînables : huit paramètres variationnels quantiques issus du circuit quantique et 25 paramètres classiques. La composante classique comprenait huit poids et huit biais dans la première couche entièrement connexe, ainsi que huit poids et un biais dans la seconde couche entièrement connexe. Les dimensions du poids et du tenseur de biais étaient 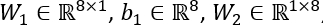 et
 . La couche classique de post-traitement a été entièrement implémentée en utilisant des opérations numériques standard sur tableaux sans cadre d’apprentissage automatique supplémentaire. Tous les calculs classiques étaient effectués à l’aide d’arithmétique float64 (double précision).
Entraînement par mannequins
Le circuit quantique décrit dans la sous-section Construction de circuits quantiques et la couche classique de post-traitement décrite dans la sous-section Couche de post-traitement classique ont été combinés en un seul modèle entraînable de bout en bout. Les 33 paramètres entraînables ont été optimisés conjointement à l’aide de l’optimiseur Adam avec un taux d’apprentissage initial de 0,01 et une décroissance de poids, implémentée comme une pénalité L2 de , appliquée uniquement aux matrices de poids classiques. L’optimiseur Adam a été implémenté manuellement en utilisant des opérations numériques standard sur tableaux avec les paramètres suivants : taux d’apprentissage = 0,01, β1 = 0,9, β2 = 0,999, ∈ = 1 × 10⁻⁸, et décroissance de poids = 1 × 10⁻⁴, appliqués uniquement aux matrices de poids classiques et non aux termes de biais ou aux paramètres variationnels quantiques.
L’entropie binaire croisée était utilisée comme fonction de perte. Pour la procédure d’équilibrage de classes post-division décrite dans la sous-section Protocole d’évaluation, la contribution à la perte de chaque échantillon d’entraînement était pondérée par l’inverse de la fréquence de sa classe dans la partition d’entraînement du pli courant. Pour le protocole déséquilibré, des poids d’échantillon uniformes étaient attribués. L’entropie binaire croisée était calculée comme la perte moyenne sur tous les échantillons de chaque mini-lot en utilisant la formulation standard de l’entropie binaire croisée.
Le modèle a été entraîné pendant 30 époques à l’aide de mini-lots de 16 échantillons. Les échantillons d’entraînement étaient aléatoirement mélangés au début de chaque époque en utilisant numpy.random.default_rng(42 + fold_index).permutation(n) pour générer un ordre d’échantillon aléatoire. Lorsque le nombre d’échantillons d’entraînement n’était pas divisible de manière égale par 16, le mini-lot final plus petit était conservé et traité à sa taille réelle plutôt que rejeté.
Un calendrier de taux d’apprentissage par étapes était appliqué pendant la formation. Le taux d’apprentissage était multiplié par 0,7 après chaque 10 époques complétées, spécifiquement au début des époques 11 et 21.
Les gradients pour les huit paramètres variationnels quantiques ont été calculés à l’aide de la règle de décalage des paramètres décrite dans la sous-section Construction de circuits quantiques . Les gradients pour les 25 paramètres classiques étaient calculés en utilisant la différentiation standard en mode inverse via la couche classique uniquement. La sortie du circuit quantique, , et ses gradients de décalage de paramètres servaient d’interface entre le circuit quantique et la couche classique. Les 33 paramètres ont été mis à jour en utilisant la même instance d’optimiseur Adam.
L’arrêt précoce basé sur la validation n’a pas été utilisé. Chaque modèle était entraîné pour un calendrier fixe de 30 époques, et la performance de la partition de test suspendue était rapportée après l’achèvement de la dernière époque. Tous les paramètres du modèle (paramètres variationnels quantiques, matrices de poids classiques et termes de biais) ont été réinitialisés indépendamment au début de chaque pli de validation croisée en utilisant la graine aléatoire spécifique au pli (42 + fold_index). Les paramètres n’étaient pas partagés entre les folds ou les exécutions de baseline.
L’environnement de calcul, incluant le processeur, la mémoire, les versions logicielles et le temps d’entraînement approximatif de l’horloge murale par pli, était enregistré dans la Table des Matériaux.
Protocole d’évaluation
La performance du modèle a été évaluée à l’aide de procédures de validation croisée au niveau de l’enregistrement et au niveau des participants, ainsi que des comparaisons de modèles de référence, des analyses d’équilibrage de classes, des expériences d’ablation sur circuit, des tests de signification statistique et des analyses d’importance des caractéristiques.
Pour l’évaluation primaire, les 195 enregistrements vocaux ont été divisés en trois plis stratifiés à l’aide d’une graine aléatoire fixe, tout en conservant le ratio maladie de Parkinson au niveau de l’enregistrement/contrôle sain de 75,4 %/24,6 % dans chaque pli. Le modèle décrit dans les sections précédentes a été entraîné à l’aide de deux plis et évalué sur le pli restant tendu, et cette procédure a été répétée jusqu’à ce que chaque pli ait servi une fois de partition de test. La précision, la précision, le rappel, le score F1 et la zone sous la courbe caractéristique de fonctionnement du récepteur (AUC–ROC) ont été calculés pour chaque pli et rapportés comme la moyenne ± l’écart-type sur les trois plis. La validation croisée primaire stratifiée à trois volets était implémentée en utilisant la classe StratifiedKFold avec n_splits=3, shuffle=True, et random_state=42.
Les prédictions de classes binaires étaient générées en appliquant un seuil de probabilité fixe de 0,50 à la probabilité de classe prédite, ŷ, produite par la couche classique de post-traitement. La précision, la récidion, le rappel et le score F1 étaient calculés à partir de ces prédictions à seuil, tandis que l’AUC–ROC était calculé directement à partir des valeurs de probabilité continues sans seuil. La précision, le rappel et le score F1 étaient calculés à l’aide des fonctions métriques avec zero_division=0, attribuant une valeur de 0,0 à toute métrique non définie. Aucune condition indéfinie de ce type ne s’est produite lors des expériences rapportées.
Les modèles de référence ont été évalués en utilisant les partitions de pliage identiques et la représentation identique des caractéristiques prétraitées à quatre composantes générée par le pipeline de prétraitement. Un perceptron multicouche classique contenant une couche cachée de huit unités activées par ReLU, architecturalement adaptées à la composante classique du modèle hybride mais sans le circuit quantique, a été entraîné à l’aide de l’optimiseur Adam avec une pénalité L2 de 1 × 10⁻⁴. Un classificateur d’arbre à gradient boosté a également été entraîné en utilisant la même représentation en quatre composantes avec 200 arbres, une profondeur maximale d’arbre de 3, un taux d’apprentissage de 0,1, et une pondération de classe égale à l’inverse de la fréquence de classe dans chaque fold d’entraînement. De plus, un second classificateur d’arbre boosté par gradient a été entraîné en utilisant la représentation complète des 22 caractéristiques générée après la normalisation initiale Min–Max, sans appliquer de PCA ni d’encodage quantique des caractéristiques. Ce modèle utilisait 300 arbres, une profondeur maximale d’arbre de 4, un taux d’apprentissage de 0,05, et la même stratégie inverse de pondération des classes par entraînement. La référence classique du perceptron multicouche a été implémentée en utilisant MLPClassifier avec hidden_layer_sizes=(8,), activation="relu », solver="adam », alpha=1 × 10⁻4, batch_size="auto », learning_rate_init=0,001, max_iter=500, early_stopping=Faux, aléatoire=Vrai, et random_state=42. L’initialisation uniforme par défaut de poids Glorot (Xavier) fournie par l’implémentation a été utilisée. Les bases arboricoles boostées par gradient ont été implémentées avec XGBoost 3.3.0 avec objectif = « binaire :logistique », eval_metric = « logloss », tree_method = « auto », sous-échantillon = 1,0, colsample_bytree = 1,0, reg_alpha = 0, reg_lambda = 1 et random_state = 42.
Pour évaluer l’effet de l’équilibrage des classes post-scindé, la procédure principale de validation croisée a été répétée pour le modèle QI-HCNN avec la pondération de l’échantillon activée. Les poids d’équilibrage étaient calculés exclusivement à partir de la partition d’entraînement de chaque pli après la séparation train/test et n’étaient pas calculés à partir de la partition de test correspondante en attente.
Les expériences d’ablation composante circuit ont été réalisées en répétant quatre fois le flux complet de prétraitement, d’entraînement et d’évaluation tout en modifiant uniquement les deux couches d’intrication du circuit quantique. Les quatre variantes de circuits comprenaient : (i) le circuit complet contenant les deux couches d’intrication ; (ii) le circuit avec la première couche d’intrication retirée et la seconde conservée ; (iii) le circuit avec la première couche d’intrication conservée et la seconde retirée ; et (iv) le circuit avec les deux couches d’intrication retirées. Des partitions de pli identiques, des graines aléatoires et des configurations d’entraînement ont été maintenues dans les quatre expériences afin que toute différence de performance observée puisse être attribuée uniquement à la configuration de couche d’intrication.
En tant qu’évaluation de la robustesse, une validation croisée par groupe de participants a été réalisée en partitionnant les 31 participants, au lieu des 195 enregistrements, en cinq groupes de six à sept participants chacun. À chaque itération, le modèle a été entraîné à partir d’enregistrements de participants de quatre groupes et évalué à partir d’enregistrements de participants du groupe restant, s’assurant qu’aucun participant ne contribuait d’enregistrements à la fois aux partitions d’entraînement et de test du même groupe. La précision, la précision, la rappel, le score F1 et l’AUC–ROC ont été rapportés comme la moyenne ± l’écart-type sur les cinq plis groupés par participants pour le modèle QI-HCNN, le perceptron multicouche classique, et la base de base à gradient amplifié en quatre caractéristiques. La validation croisée groupée par participants a été réalisée en utilisant la classe GroupKFold avec n_splits=5, où les identifiants des participants servaient de variable de groupement. Comme GroupKFold ne mélange pas les groupes, les participants ont été assignés selon l’ordre déterministe par défaut de l’implémentation, ce qui a donné des folds contenant chacun six ou sept participants.
La signification statistique a été évaluée en appliquant des tests de Wilcoxon par signe aux valeurs AUC–ROC par fold obtenues pour l’évaluation primaire et les modèles de référence. Les valeurs p exactes et le nombre correspondant d’observations appariées ont été rapportés car la puissance statistique de ce test est limitée lorsque seul un petit nombre de plis est disponible. Quatre comparaisons par paires AUC–ROC ont été définies a priori : (1) QI-HCNN versus perceptron multicouche classique ; (2) QI-HCNN versus la base de référence de l’arbre boosté par gradient apparié selon PCA ; (3) le perceptron multicouche classique versus la base de l’arbre amplifié par gradient adapté aux PCA ; et (4) le modèle QI-HCNN déséquilibré versus le modèle QI-HCNN post-scindé. Aucune correction par comparaison multiple n’a été appliquée car les analyses étaient exploratoires et le nombre limité de repliés réduisait considérablement la puissance statistique.
L’analyse de l’importance des caractéristiques a été réalisée à l’aide du classificateur d’arbre à gradient boosté, entraîné sur la représentation complète à 22 caractéristiques. Des scores d’importance des caractéristiques basés sur le gain ont été extraits et classés pour toutes les caractéristiques acoustiques originales. Par ailleurs, l’ACP a été ajustée à l’ensemble de données complète uniquement à des fins de rapport et n’a pas été utilisée lors de l’évaluation du modèle. Pour chaque caractéristique acoustique originale, les charges absolues sur les quatre composantes principales conservées étaient sommées, et les caractéristiques étaient classées selon ces valeurs. Les deux méthodes de classement et leur chevauchement ont été rapportées. Pour l’analyse d’importance des caractéristiques basée sur le gain, l’implémentation de l’arbre à gradient boosté a produit des valeurs uniques de gain en virgule flottante, sans qu’aucun égal ne soit survenu. Pour le classement de charge par composante principale, les égalités dans les valeurs de charge absolues sommées ont été résolues selon l’ordre original des colonnes de caractéristiques dans le jeu de données.
Accès restreint. Veuillez vous connecter ou commencer un essai pour afficher ce contenu.
Résultats
Toutes les valeurs numériques rapportées dans le texte sont réconciliées avec celles présentées dans les Figures 2–8 et les Tableaux 2–4. Chaque figure était générée directement à partir du code fourni dans le Fichier de Codage Supplémentaire 1 plutôt que préparée manuellement, assurant ainsi la cohérence entre les valeurs numériques rapportées et les données tracées.
Performance de validation croisée ...
Accès restreint. Veuillez vous connecter ou commencer un essai pour afficher ce contenu.
Discussion
Ce protocole spécifie une architecture QI-HCNN entièrement reproductible pour la classification de la maladie de Parkinson à partir d’enregistrements vocaux, dans laquelle chaque porte, choix d’initialisation de paramètre, étape de prétraitement et procédure d’évaluation est décrite à un niveau suffisant pour une mise en œuvre indépendante. Le circuit proposé est testé en utilisant des caractéristiques d’entrée identiques et des partitions de pli croisé identiques contre un perceptron cl...
Accès restreint. Veuillez vous connecter ou commencer un essai pour afficher ce contenu.
Déclarations de divulgation
Conflit d’intérêts :
Les auteurs déclarent qu’ils n’ont aucun intérêt financier ou non financier concurrent lié à cette œuvre.
Remerciements
Ce travail n’a été financé par aucune agence ou organisation, ni techniquement ni financièrement. Les auteurs remercient les responsables du dépôt UCI Machine Learning Repository pour leur accès public au jeu de données d’enregistrement vocal utilisé dans cette étude.
Accès restreint. Veuillez vous connecter ou commencer un essai pour afficher ce contenu.
Matériaux
| Nom | Entreprise | Numéro de catalogue | Commentaires |
|---|---|---|---|
| Adam optimizer | Implémentation standard d'optimisation numérique | Implémentation personnalisée ; NumPy 2.4.4 | Optimisation conjointe des paramètres quantiques et classiques ; Entraînement du modèle |
| Implémentation de la perte binaire par entropie croisée | Implémentation personnalisée utilisant NumPy | NumPy 2.4.4 ; perte moyenne (réduction moyenne) sur chaque mini-batch | Fonction de perte d'entraînement ; Entraînement du modèle |
| Classificateur d'arbre à gradient | Bibliothèque open-source de gradient boosting XGBoost | XGBoost 3.3.0 ; objective="binary:logistic" ; eval_metric="logloss" ; tree_method="auto" ; random_state=42 | Références classiques full-feature et assorties par PCA ; Protocole d'évaluation |
| Bibliothèque d'apprentissage automatique | Bibliothèque open-source d'apprentissage automatique scikit-learn | scikit-learn 1.8.0 | Mise à l'échelle Min–Max, analyse en composantes principales, validation croisée stratifiée, validation croisée groupée par participant, référence de perceptron multicouche et métriques d'évaluation |
| Bibliothèque de calcul numérique | Bibliothèque de calcul numérique open-source NumPy | NumPy 2.4.4 | Opérations matricielles de base, simulation de vecteur d'état, initialisation des paramètres et calcul manuel des gradients |
| Ensemble de données de classification de la maladie de Parkinson | Little, McSharry, Roberts, Costello et Moroz ; distribué par l'UCI Machine Learning Repository | ID du jeu de données UCI 174 ; 195 enregistrements de 31 participants ; consulté le 19 juin 2025 | Source du jeu de données d'enregistrements de voix avec voyelles soutenues ; https://archive.ics.uci.edu/dataset/174 |
| Bibliothèque de calcul scientifique | Bibliothèque open-source de calcul scientifique SciPy | SciPy 1.17.1 | Test statistique de signification signée de Wilcoxon ; Protocole d'évaluation |
| Simulateur de vecteur d'état | Simulateur de vecteur d'état personnalisé (Fichier de codage supplémentaire 1 ; qhcnn.py) | Implémentation pure NumPy ; précision complex128 (double) ; aucun backend externe requis | Exécution du circuit quantique à quatre qubits ; Construction du circuit quantique |
| Bibliothèque de données tabulaires | Bibliothèque d'analyse de données open-source Pandas | Pandas 3.0.2 | Chargement, inspection et manipulation des données tabulaires |
| Environnement informatique de la station de travail | Station de travail CPU locale (conteneur Linux hébergé dans le cloud) | CPU x86_64 ; Ubuntu Linux ; Python 3 ; aucun GPU ou matériel quantique utilisé ; temps d'entraînement approximatif au mur de 30–60 secondes par pli | Environnement informatique utilisé pour tous les entraînements et évaluations ; Simulation de vecteur d'état basée sur le CPU ; aucun GPU ou matériel quantique requis |
Références
- Rabie H, Akhloufi MA. A review of machine learning and deep learning for Parkinson's disease detection. Discov Artif Intell. 2025;5:24.
- Devi SVA, et al. Hybrid deep learning methods for enhancing Parkinson's disease early detection [conference presentation]. Presented at: 4th International Conference on Smart Applications, Data and Living (ICSADL); 2025; Bhimdatta, Nepal. IEEE. p. 1462-1469. Available from: https://doi.org/10.1109/ICSADL65848.2025.10933259.
- Little MA, et al. Exploiting nonlinear recurrence and fractal scaling properties for voice disorder detection. Biomed Eng Online. 2007;6:23.
- Costantini G, et al. Artificial intelligence-based voice assessment of patients with Parkinson's disease off and on treatment. Sensors (Basel). 2023;23(4):2293.
- Gunduz H. Deep learning-based Parkinson's disease classification using vocal feature sets. IEEE Access. 2019;7:115540-115551.
- Naeem I, et al. Voice biomarkers as prognostic indicators for Parkinson's disease using machine learning techniques. Sci Rep. 2025;15:12129.
- Ebrahimzadeh E, et al. Explainable machine learning for early detection of Parkinson's disease in aging populations using vocal biomarkers. Front Aging Neurosci. 2025;17:1672971.
- Alishah S. An explainable ensemble and deep learning framework for accurate and interpretable Parkinson's disease detection from voice biomarkers. Diagnostics (Basel). 2025;15(22):2892.
- Mitarai K, Negoro M, Kitagawa M, Fujii K. Quantum circuit learning. Phys Rev A. 2018;98(3):032309.
- Alissa M, et al. Parkinson's disease diagnosis using convolutional neural networks and figure-copying tasks. Neural Comput Appl. 2022;34(2):1433-1453.
- Kumari GRP, Ravi Kanth M, Kamal MV. Parkinson's disease early detection using hybrid attentive CNN-transformer model. Neural Comput Appl. 2025;37(32):26523-26543.
- Palakayala R, Kuppusamy P. AttentionLUNet: a hybrid model for Parkinson's disease detection using MRI brain. IEEE Access. 2024;12:91752-91769.
- Wang X, et al. A light-weight CNN model for efficient Parkinson's disease diagnostics [conference presentation]. Presented at: IEEE International Symposium on Computer-Based Medical Systems (CBMS); 2023; L'Aquila, Italy. IEEE. p. 616-621. Available from: https://doi.org/10.1109/CBMS58004.2023.00289.
- Haq I, et al. Lung nodules localization and report analysis from computerized tomography (CT) scan using a novel machine learning approach. Appl Sci. 2022;12(24):12614.
- Alzaidi A, et al. Comparative study of deep learning models for Parkinson's disease detection using the UCI vocal dataset. TBench. 2025;5(2):10021
Accès restreint. Veuillez vous connecter ou commencer un essai pour afficher ce contenu.